

في أكتوبر 2019 نشر فريق من قسم الكيمياء في جامعة Hawaii بحثاً في مجلة Organic Letters عن مركبات استخلصوها من بكتيريا زرقاء، وكانت المفاجأة في عنوان البحث نفسه كما في ملخصه في PubMed: سكربتات Python المعروفة باسم Willoughby-Hoye، التي يستخدمها كثير من الكيميائيين لحساب الإزاحة الكيميائية في الرنين المغناطيسي النووي NMR، تعطي نتائج مختلفة بحسب نظام التشغيل. والسبب كما شرحوه في النص الكامل أن السكربت يقرأ مجموعتين من الملفات ويقرن الأول بالأول والثاني بالثاني، وهذا صحيح على Windows الذي يرتب أسماء الملفات، أما Linux فلا يرتبها، فتقترن طاقة جزيء بإزاحات جزيء آخر وتخرج نتيجة خاطئة دون أي رسالة خطأ. وهذا المقال موجه للباحث وطالب الدراسات العليا الذي يحلل بياناته بالكود، وللمحكم والمحرر الذي يريد أن يتحقق من نتائج بحث، ولمن يشرف على مختبرات البيانات في الجامعة.
في هذا المقال سوف نتناول:
- الفرق بين إعادة الإنتاج Reproducibility وتكرار النتائج Replicability.
- لماذا لا يكفي أن تشارك الـ Notebook، وما الذي يجب أن تحتويه حزمة البحث Research Compendium.
- تجربة حقيقية: تحليل صغير بـ Jupyter، ثابت الإصدارات في Docker، ومحفوظ في Git، يعيد تشغيله أي أحد من الصفر فيحصل على البصمة نفسها للنتائج.
- أربعة أسباب تمنع تكرار النتائج جربناها فعلاً: البذرة العشوائية، والإصدارات غير المثبتة، وترتيب الملفات بين أنظمة التشغيل، ونهايات الأسطر في Git.
- أرشفة الكود بمعرف DOI إلى جانب معرف البيانات.
ما معنى أن يكون البحث قابلاً لإعادة الإنتاج Reproducible؟
التعريف الذي نعتمده هنا من دليل The Turing Way: النتيجة قابلة لإعادة الإنتاج Reproducible عندما تعطي خطوات التحليل نفسها على البيانات نفسها الإجابة نفسها في كل مرة، وقابلة للتكرار Replicable عندما يعطي التحليل نفسه على بيانات جديدة نتيجة مشابهة، وقوية Robust عندما يصل تحليل مختلف على البيانات نفسها إلى النتيجة نفسها. ولاحظ أن الدليل نفسه ينبه إلى أن جهات أخرى مثل ACM تستخدم المصطلحين بمعنيين معكوسين، لذلك عرف المصطلح في بحثك قبل أن تستخدمه.
وإعادة الإنتاج هي الحد الأدنى من بين الثلاثة، فهي لا تقول إن النتيجة صحيحة، وإنما تقول إن من يملك بياناتك وكودك يحصل على أرقامك نفسها، فإذا لم يحصل عليها فلا معنى لنقاش صحتها أصلاً. والمثال القريب وصفة الطبخ: إذا أعطيت صديقك الوصفة دون المقادير الدقيقة ودون نوع الفرن فلن تخرج الكعكة نفسها، والكود دون البيانات والإصدارات والبذرة العشوائية وصفة بلا مقادير.
لماذا لا يكفي أن تشارك الـ Notebook؟
الطريقة البسيطة أن يرفع الباحث ملف analysis.ipynb مع البحث، والمشكلة أن الملف يفترض أشياء غير مكتوبة فيه: مسار البيانات على جهاز الباحث، وإصدار pandas الذي كان مثبتاً يومها، وترتيب تشغيل الخلايا، والبذرة العشوائية إن وجدت. والحل الذي يليه أن يضيف ملف requirements.txt فيه أسماء المكتبات، وهذا أفضل، لكن السطر pandas بلا إصدار يثبت أحدث إصدار يوم التشغيل، والسطر pandas==3.0.6 يثبت pandas وحدها ويترك عشرات المكتبات التي تعتمد عليها تتغير. ثم يأتي من يضيف Dockerfile يبدأ بالسطر FROM python:3، فيحصل كل من يبنيه على Python مختلف بحسب يوم البناء.
لذلك فالحل الأنسب أن تجمع في مستودع واحد أربع طبقات، وهو ما يسمى حزمة البحث Research Compendium، كما في الصورة التالية:
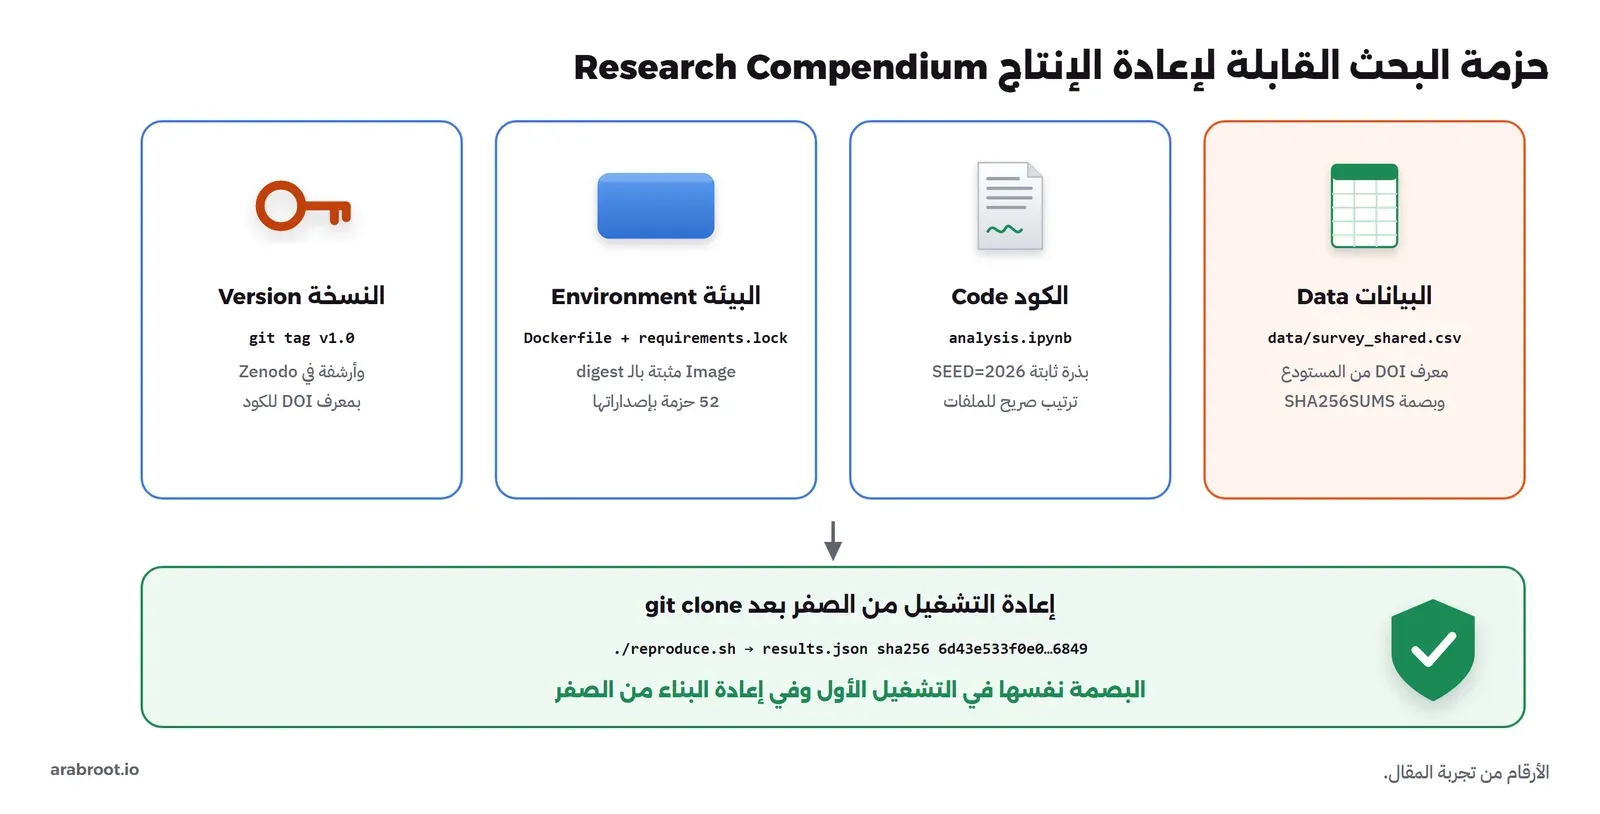
- البيانات Data: الملف نفسه أو معرفه الدائم DOI في مستودع بيانات، ومعه بصمة SHA-256 يتحقق منها التحليل قبل أن يبدأ، وقد شرحنا الإيداع في مقال مستودعات البيانات.
- الكود Code: الـ Notebook أو السكربت، يعمل من أوله إلى آخره دون تدخل، ويكتب النتائج في ملف.
- البيئة Environment: Dockerfile يبدأ من Image مثبتة بالإصدار والبصمة digest، وملف قفل Lock File فيه كل المكتبات بإصداراتها الدقيقة.
- النسخة Version: مستودع Git بوسم Tag للنسخة التي بنيت عليها نتائج البحث، وأرشيف لها بمعرف DOI.
 دليلإدارة بيانات البحث Research Data Management ومبادئ FAIRكيف تحفظ بيانات بحثك وتصفها وتشاركها وفق مبادئ FAIR وما يطلبه الممولون في خطة إدارة البيانات، مع قالب جاهز وتجربة لإخفاء الهوية.
 دليلمستودع البيانات Data Repository: Dataverse أم Zenodo؟الفرق بين مستودعات بيانات البحث وبوابات البيانات المفتوحة، مع تجربة كاملة لإيداع بيانات بوصف عربي ونشرها بمعرف DOI في Dataverse.
تجربة عملية: حزمة تحليل تعيد نفسها
لنأخذ مثالاً ملف الاستبانة الذي أخفينا هويته في مقال إدارة بيانات البحث وأودعناه في Dataverse بالمعرف doi:10.5072/FK2XSXQ3V، وهو معرف اختبار لأن التجربة كانت على مستودع محلي، والتحليل بسيط: متوسط الرضا بحسب الجنس، ومتوسط ساعات الاستخدام بحسب فئة العمر، وفترة ثقة 95% للفرق بين المتوسطين بطريقة Bootstrap التي تعتمد على السحب العشوائي، وهي التي سوف تكشف مشكلة البذرة.
شكل الحزمة Compendium Layout
.gitattributes
.gitignore
Dockerfile
README.md
analysis.ipynb
data/SHA256SUMS
data/survey_shared.csv
reproduce.sh
requirements.lock
requirements.txt
results/.gitkeep
وهذه قائمة الملفات كما يعرضها git ls-files، والمجلد results فارغ في المستودع لأن النتائج تنتج من التشغيل ولا تحفظ يدوياً.
بصمة البيانات Checksum
sha256sum data/survey_shared.csv | tee data/SHA256SUMSedb02e6272cc8d71159656378798e1f510e1b86a10b67514d48b680a63570b0d *data/survey_shared.csvوالسبب في البصمة أن اسم الملف لا يضمن محتواه، فإذا صحح أحد قيمة واحدة في البيانات أو حولها برنامج إلى ترميز آخر توقف التحليل قبل أن يحسب أي رقم.
الـ Notebook
الخلايا الأربع التالية هي كل التحليل، وأول ما تفعله أنها تطبع البصمة والإصدارات، فمن يقرأ الـ Notebook المنفذ يعرف على أي بيئة خرجت الأرقام:
import hashlib, json, os, platform, sys
import numpy as np
import pandas as pd

SEED = int(os.environ.get("SEED", "2026"))
DATA = "data/survey_shared.csv"
sha = hashlib.sha256(open(DATA, "rb").read()).hexdigest()
df = pd.read_csv(DATA)
print("rows:", len(df), "sha256:", sha[:16])
print("python", platform.python_version(), "pandas", pd.__version__, "numpy", np.__version__)
by_gender = df.groupby("gender")["q1_satisfaction"].mean().round(4)
by_age = df.groupby("age")["q2_hours_online"].mean().round(4)
by_gender, by_age# Bootstrap 95% CI for the difference in mean satisfaction (F - M)
rng = np.random.default_rng(SEED)
f = df.loc[df.gender == "F", "q1_satisfaction"].to_numpy()
m = df.loc[df.gender == "M", "q1_satisfaction"].to_numpy()
diffs = np.array([rng.choice(f, f.size).mean() - rng.choice(m, m.size).mean() for _ in range(5000)])
ci = np.percentile(diffs, [2.5, 97.5]).round(4)
print("difference:", round(f.mean() - m.mean(), 4), "95% CI:", ci)results = {
"data_sha256": sha,
"n": int(len(df)),
"mean_satisfaction_by_gender": by_gender.to_dict(),
"mean_hours_by_age": by_age.to_dict(),
"diff_F_minus_M": round(float(f.mean() - m.mean()), 4),
"bootstrap_ci95": [float(x) for x in ci],
"seed": SEED,
}
os.makedirs("results", exist_ok=True)
with open("results/results.json", "w", encoding="utf-8") as fh:
json.dump(results, fh, ensure_ascii=False, indent=1, sort_keys=True)
fh.write("\n")لاحظ أن النتائج تكتب بمفاتيح مرتبة sort_keys=True وأرقام مقربة إلى أربع خانات، والسبب أن ملف النتائج نفسه هو الذي سوف نقارن بصمته بين التشغيلات، فأي ترتيب عشوائي للمفاتيح يغير البصمة دون أن يتغير رقم.
البيئة: من requirements.txt إلى ملف القفل
نكتب المكتبات التي نستخدمها مباشرة بإصداراتها:
pandas==3.0.6
numpy==2.5.4
nbconvert==7.17.2
nbclient==0.11.0
ipykernel==7.4.0
ثم نثبتها مرة واحدة في Container من الـ Image نفسها التي سوف نبني عليها، ونحفظ كل ما ثبت فعلاً بالأمر pip freeze:
docker run --rm -v "$PWD":/w -w /w python:3.13.17-slim sh -c \
  "pip install -q --no-cache-dir --root-user-action=ignore -r requirements.txt; pip freeze > requirements.lock; wc -l requirements.lock"
52 requirements.lockأي أن خمس مكتبات كتبناها جلبت معها 52 حزمة، منها مثلاً python-dateutil==3.0.0 وpyzmq==27.2.0 وtornado==6.6، وكل واحدة منها يمكن أن يتغير سلوكها في إصدار قادم، لذلك فالـ Dockerfile يثبت من ملف القفل وليس من requirements.txt:
# Base image pinned by tag and digest: the same bytes on every machine
FROM python:3.13.17-slim@sha256:fe14fd57a4c0361110eaa0c284112b189750bcb43fb04bb5d1ee7b7744027ccf
ENV PYTHONHASHSEED=0 PIP_DISABLE_PIP_VERSION_CHECK=1
WORKDIR /work
COPY requirements.lock .
RUN pip install --no-cache-dir -r requirements.lock
COPY . .
CMD ["sh", "-c", "sha256sum -c data/SHA256SUMS && jupyter nbconvert --to notebook --execute analysis.ipynb --output results/analysis.executed.ipynb && cat results/results.json"]
في الإعداد أعلاه لاحظ التالي:
- السطر
FROMيحدد الوسم والبصمة@sha256:معاً، فالوسم3.13.17-slimيمكن أن يعاد بناؤه بتحديثات النظام، أما البصمة فتشير إلى Image واحدة لا تتغير، كما في مرجع Dockerfile. - الأمر الافتراضي يتحقق من بصمة البيانات أولاً، ثم ينفذ الـ Notebook كاملاً من أول خلية بأداة nbconvert، فلا مجال لخلية نفذت يدوياً بترتيب مختلف.
- المتغير
PYTHONHASHSEED=0يثبت ترتيب العناصر في الـ Sets التي تعتمد على الهاش، وهي مصدر آخر للاختلاف بين التشغيلات.
سكربت إعادة التشغيل reproduce.sh
#!/bin/sh
# Rebuild the environment and rerun the whole analysis from the raw data.
set -e
docker build -t survey-analysis:1.0 .
docker run --rm -v "$(pwd)/results:/work/results" survey-analysis:1.0
sha256sum results/results.json
واخترنا سكربت Shell بدلاً من Makefile لأن الأداة make غير موجودة افتراضياً على Windows، والفكرة واحدة: أمر واحد يعيد كل شيء.
الحفظ في Git مع ملف gitattributes
قبل الـ Commit الأول نضيف ملف .gitattributes، وسوف نرى بعد قليل لماذا هو ضروري:
data/** binary
*.sh text eol=lf
git init -b main .
git add -A
git commit -m "Survey analysis v1.0"
git tag v1.0التشغيل الأول
./reproduce.shdata/survey_shared.csv: OK
[NbConvertApp] Converting notebook analysis.ipynb to notebook
[NbConvertApp] Writing 4807 bytes to results/analysis.executed.ipynb
{
"bootstrap_ci95": [
-0.2238,
0.3197
],
"data_sha256": "edb02e6272cc8d71159656378798e1f510e1b86a10b67514d48b680a63570b0d",
"diff_F_minus_M": 0.0452,
"mean_hours_by_age": {
"10-19": 6.6,
"20-29": 4.962,
"30-39": 5.8873,
"40-49": 6.1386,
"50-59": 5.3699,
"60-69": 6.0714
},
"mean_satisfaction_by_gender": {
"F": 3.0452,
"M": 3.0
},
"n": 400,
"seed": 2026
}
6d43e533f0e076b3e1dd39e463642ec45bfbc89bae1f034d475b7166ba656849 *results/results.jsonوالنتيجة البحثية هنا أن الفرق في الرضا بين الإناث والذكور 0.0452 على مقياس من 5، وفترة الثقة من -0.2238 إلى 0.3197 تحتوي الصفر، أي لا يوجد فرق يعتد به، وهذا متوقع لأن البيانات مولدة عشوائياً. أما الذي يهمنا فهو السطر الأخير: بصمة ملف النتائج.
إعادة البناء من الصفر Rebuild
الآن نتصرف كمحكم لا يملك إلا رابط المستودع: ننسخ الوسم v1.0 إلى مجلد جديد، ونبني الـ Image دون أي Cache، ونشغلها:
git clone --branch v1.0 <repository-url> rerun
cd rerun
docker build --no-cache -q -t survey-analysis:rerun .
docker run --rm -v "$(pwd)/results:/work/results" survey-analysis:rerun > /dev/null
sha256sum results/results.json
sha256:2afb18a6d309068d9ca91097606386e0128e8134959e77acdf5494753cc3667d
6d43e533f0e076b3e1dd39e463642ec45bfbc89bae1f034d475b7166ba656849 *results/results.jsonالبصمة نفسها حرفاً بحرف 6d43e533…6849، أي أن كل رقم في النتائج تكرر. ولاحظ أن معرف الـ Image الجديدة sha256:2afb18a6… يختلف عن معرف الأولى الذي كان sha256:586e0dd3…، والسبب أن Docker يسجل وقت البناء داخل طبقات الـ Image، وهذا لا يهمنا، فالمطلوب أن تتكرر النتائج وليس أن تتطابق الـ Images بايتاً ببايت.
لماذا لا تتكرر النتائج؟ أربعة أسباب جربناها
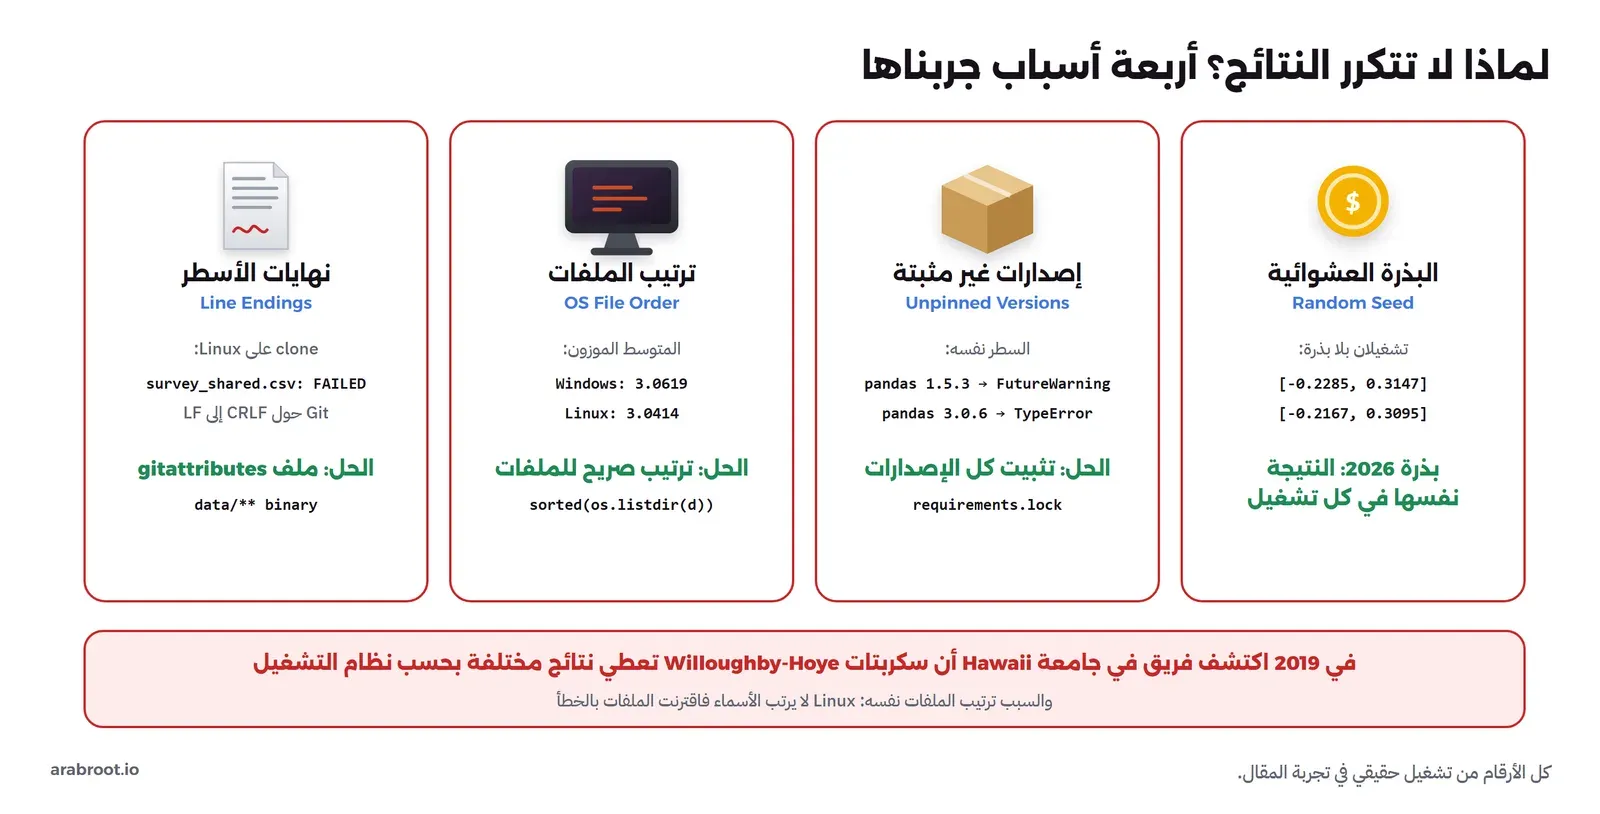
كل حل في الحزمة أعلاه جاء لسبب، والصورة التالية تجمع الأسباب الأربعة مع الأرقام الحقيقية التي ظهرت عندما أزلنا الحل:
1. البذرة العشوائية Random Seed
نأخذ خلية الـ Bootstrap نفسها في سكربت مستقل، يقبل البذرة اختيارياً:
"""Same bootstrap as the notebook, once without a seed and once with a fixed seed."""
import sys
import numpy as np
import pandas as pd

df = pd.read_csv("data/survey_shared.csv")
f = df.loc[df.gender == "F", "q1_satisfaction"].to_numpy()
m = df.loc[df.gender == "M", "q1_satisfaction"].to_numpy()
rng = np.random.default_rng(int(sys.argv[1])) if len(sys.argv) > 1 else np.random.default_rng()
diffs = np.array([rng.choice(f, f.size).mean() - rng.choice(m, m.size).mean() for _ in range(5000)])
print("95% CI:", np.percentile(diffs, [2.5, 97.5]).round(4))
ونشغله في الـ Image نفسها مرتين بلا بذرة ثم مرتين بالبذرة 2026:
docker run --rm -v "$PWD/bootstrap_noseed.py":/work/b.py survey-analysis:1.0 python b.py
docker run --rm -v "$PWD/bootstrap_noseed.py":/work/b.py survey-analysis:1.0 python b.py
docker run --rm -v "$PWD/bootstrap_noseed.py":/work/b.py survey-analysis:1.0 python b.py 2026
docker run --rm -v "$PWD/bootstrap_noseed.py":/work/b.py survey-analysis:1.0 python b.py 2026
95% CI: [-0.2285 0.3147]
95% CI: [-0.2167 0.3095]
95% CI: [-0.2238 0.3197]
95% CI: [-0.2238 0.3197]البيئة نفسها والبيانات نفسها، ومع ذلك تغيرت الخانة الثانية بعد الفاصلة بين التشغيلين الأولين، ومع البذرة تطابقت النتيجة مع ما في results.json. والسبب أن مولد الأرقام العشوائية في NumPy يأخذ بذرة جديدة من نظام التشغيل في كل مرة إذا لم تعطه بذرة. والقاعدة: كل تحليل فيه سحب عشوائي، كالـ Bootstrap والتقسيم إلى تدريب واختبار وتعلم الآلة، يأخذ بذرته من متغير واحد مكتوب في الكود ومذكور في البحث.
2. الإصدارات غير المثبتة Unpinned Versions
السطر التالي كان شائعاً في كثير من الأكواد البحثية: متوسط كل الأعمدة لكل فئة عمر:
"""The same line on two pandas versions: mean of every column per age band."""
import pandas as pd

df = pd.read_csv("survey_shared.csv")
print("pandas", pd.__version__)
print(df.groupby("age").mean().round(3).head(3))
نشغله على pandas 1.5.3 التي كانت حديثة في بداية 2023، في Image بـ Python 3.11 لأن pandas 1.5.3 لا توفر حزماً جاهزة Wheels لـ Python 3.13:
docker run --rm -v "$PWD":/w -w /w python:3.11.14-slim sh -c \
  "pip install -q --root-user-action=ignore pandas==1.5.3 numpy==1.26.4; python version_drift.py"
/w/version_drift.py:6: FutureWarning: The default value of numeric_only in DataFrameGroupBy.mean is deprecated. In a future version, numeric_only will default to False. Either specify numeric_only or select only columns which should be valid for the function.
print(df.groupby("age").mean().round(3).head(3))
pandas 1.5.3
q1_satisfaction q2_hours_online
age
10-19 3.050 6.600
20-29 3.076 4.962
30-39 2.901 5.887ثم نشغل الملف نفسه في الـ Image الحالية بـ pandas 3.0.6:
docker run --rm -v "$PWD":/w -w /w survey-analysis:1.0 python version_drift.pypandas 3.0.6
Traceback (most recent call last):
File "/w/version_drift.py", line 6, in <module>
...
TypeError: dtype 'str' does not support operation 'mean'في الإصدار القديم أسقطت pandas أعمدة النص مثل participant وcity بصمت وأعطت نتيجة مع تحذير لا يقرؤه أحد، وفي الإصدار الحالي يتوقف الكود، والسبب أن الإصدار 2.0 غير القيمة الافتراضية لـ numeric_only إلى False في كل الدوال. وهنا كان التغيير ظاهراً لأنه أوقف الكود، والأخطر منه التغيير الذي يغير الرقم دون أن يوقف شيئاً، لذلك ثبت كل الإصدارات بملف القفل، واكتب الأعمدة التي تريدها صراحة df.groupby("age")[["q1_satisfaction", "q2_hours_online"]].mean() بدلاً من الاعتماد على السلوك الافتراضي.
3. ترتيب الملفات بين أنظمة التشغيل OS File Order
لنعد إلى حالة Willoughby-Hoye ونصنعها بأنفسنا: نقسم الاستبانة إلى ملف إجابات لكل مدينة وملف وزن لكل مدينة، والأوزان هنا للتوضيح فقط، ثم نحسب المتوسط الموزون بسكربت يقرن الملفات بترتيب ظهورها في المجلد، كما يفعل السكربت الذي اكتشفت فيه المشكلة:
"""Weighted mean satisfaction: pairs each answers file with a weight file by listing order."""
import os, sys

d = "parts"
answers = [f for f in os.listdir(d) if f.startswith("answers_")]
weights = [f for f in os.listdir(d) if f.startswith("weight_")]
if "--sorted" in sys.argv:
    answers, weights = sorted(answers), sorted(weights)
total = 0.0
for a, w in zip(answers, weights):
    vals = [int(x) for x in open(os.path.join(d, a))]
    total += float(open(os.path.join(d, w)).read()) * sum(vals) / len(vals)
    print(f"  {a:<20} x {w}")
print("weighted mean:", round(total, 4))
على Windows بـ Python 3.13.3 مباشرة:
  answers_abha.txt     x weight_abha.txt
  answers_dammam.txt   x weight_dammam.txt
  answers_hail.txt     x weight_hail.txt
  answers_jeddah.txt   x weight_jeddah.txt
  answers_riyadh.txt   x weight_riyadh.txt
  answers_tabuk.txt    x weight_tabuk.txt
weighted mean: 3.0619
ثم ننسخ الملفات نفسها إلى Image من Linux بالأمر COPY ونشغل السكربت نفسه:
  answers_dammam.txt   x weight_riyadh.txt
  answers_riyadh.txt   x weight_hail.txt
  answers_hail.txt     x weight_dammam.txt
  answers_tabuk.txt    x weight_tabuk.txt
  answers_abha.txt     x weight_jeddah.txt
  answers_jeddah.txt   x weight_abha.txt
weighted mean: 3.0414
خمس مدن من ست أخذت وزن مدينة أخرى، فتغير المتوسط من 3.0619 إلى 3.0414 دون أي خطأ أو تحذير، وهي المشكلة نفسها التي وجدها فريق Hawaii. وعند التشغيل بالخيار --sorted على Linux:
  answers_abha.txt     x weight_abha.txt
  answers_dammam.txt   x weight_dammam.txt
  answers_hail.txt     x weight_hail.txt
  answers_jeddah.txt   x weight_jeddah.txt
  answers_riyadh.txt   x weight_riyadh.txt
  answers_tabuk.txt    x weight_tabuk.txt
weighted mean: 3.0619
والقاعدة: لا تعتمد أبداً على ترتيب os.listdir أو glob، فالترتيب ليس جزءاً من وعدهما، ورتب القائمة دائماً بـ sorted()، والأفضل من الترتيب أن تقرن الملفات بالاسم نفسه، أي أن تبني اسم ملف الوزن من اسم المدينة في ملف الإجابات بدلاً من الاعتماد على أن القائمتين متوازيتان.
4. نهايات الأسطر في Git Line Endings
ملف CSV الذي تكتبه وحدة csv في Python ينهي الأسطر بـ CRLF، وGit على Windows مضبوط غالباً على core.autocrlf=true، وهو ما وجدناه على جهاز التجربة، فيحول CRLF إلى LF عند الحفظ في المستودع ثم يعيدها عند النسخ على Windows. والنتيجة أن من ينسخ المستودع على Linux يحصل على ملف بايتاته مختلفة. جربنا ذلك بمستودع فيه البيانات وبصمتها دون ملف .gitattributes، ثم نسخناه في Container من Linux:
git ls-files --eol data/survey_shared.csv
docker run --rm -v "$PWD":/src:ro --entrypoint sh alpine/git:v2.54.0 -c \
  'git config --global --add safe.directory "*"; git clone -q /src /tmp/c && cd /tmp/c && sha256sum -c data/SHA256SUMS'
i/lf w/crlf attr/ data/survey_shared.csv
data/survey_shared.csv: FAILED
sha256sum: WARNING: 1 of 1 computed checksums did NOT matchالسطر الأول يوضح المشكلة: الملف في المستودع i/lf وفي مجلد العمل w/crlf. وبالأمر نفسه على حزمتنا التي فيها data/** binary:
i/crlf  w/crlf  attr/-text            	data/survey_shared.csv
data/survey_shared.csv: OK
والسبب أن ملف gitattributes يخبر Git أن ملفات البيانات ثنائية Binary فلا يغير فيها شيئاً، وهذا ما يجعل بصمة البيانات صالحة على أي نظام. ولاحظ أن التحقق من البصمة هو الذي كشف المشكلة، فلولاه لحلل المحكم ملفاً مختلفاً دون أن يعرف.
وماذا عن JupyterHub في الجامعة؟
إذا كانت جامعتك تشغل JupyterHub للطلاب كما شرحنا في دليل مختبرات البرمجة للطلاب مع JupyterHub، فالأفكار نفسها تنطبق: الـ Image التي يعمل عليها كل طالب يجب أن تكون مثبتة بالإصدار وليس latest، وإلا حصل طالبان في الشعبة نفسها على نتيجتين مختلفتين لأن أحدهما بدأ قبل تحديث الـ Image والآخر بعده. والـ JupyterHub مكان مريح للعمل والتجربة، لكنه ليس الحزمة التي تنشرها مع البحث، فالحزمة يجب أن تعمل خارج خادم الجامعة.
أرشفة الكود بمعرف DOI
مستودع Git على GitHub أو GitLab مكان للعمل، وليس أرشيفاً، فالحساب يمكن أن يحذف والمستودع يمكن أن ينقل أو يعدل تاريخه. لذلك أرشف النسخة v1.0 في مستودع يعطيها معرفاً دائماً، وZenodo يتيح ربطاً مع GitHub يؤرشف كل إصدار Release تنشره تلقائياً ويعطيه DOI. وفي البحث اذكر المعرفين معاً: معرف البيانات في قسم توفر البيانات Data Availability، ومعرف الكود في قسم توفر الكود Code Availability، ومعهما البذرة وأمر التشغيل.
قائمة تحقق Checklist قبل إرسال البحث
- هل يعمل التحليل من أوله إلى آخره بأمر واحد دون أي خطوة يدوية؟
- هل يتحقق التحليل من بصمة البيانات قبل أن يبدأ، وهل البيانات منشورة بمعرف دائم؟
- هل كل الإصدارات مثبتة بملف قفل، والـ Image الأساسية مثبتة بالبصمة digest؟
- هل كل سحب عشوائي يأخذ بذرة مكتوبة؟
- هل كل قائمة ملفات مرتبة صراحة، وهل الملفات تقرن بالاسم وليس بالترتيب؟
- هل يوجد
.gitattributesيحمي ملفات البيانات؟ - هل جربت أن تنسخ المستودع في مجلد جديد وتبنيه دون Cache وتقارن بصمة النتائج؟
- هل للنسخة المستخدمة في البحث وسم Tag وأرشيف بمعرف DOI؟
الخلاصة
- إعادة الإنتاج تعني أن البيانات نفسها والكود نفسه يعطيان الأرقام نفسها، وهي الحد الأدنى قبل أي نقاش في صحة النتائج.
- الـ Notebook وحده لا يكفي، والحزمة الكاملة بيانات ببصمة ومعرف، وكود يعمل بأمر واحد، وبيئة مثبتة بملف قفل وImage بالبصمة، ونسخة بوسم وأرشيف.
- في تجربتنا أعاد البناء من الصفر ملف النتائج بالبصمة نفسها، بينما غيرت البذرة الغائبة فترة الثقة، وأوقف إصدار pandas الأحدث الكود، وغير ترتيب الملفات على Linux المتوسط من 3.0619 إلى 3.0414، وأفشل Git بصمة البيانات.
- كل مشكلة من هذه لها حل صغير، لكنه يجب أن يكون في الحزمة قبل النشر وليس بعد أن يسألك المحكم.
تدريب عملي
- خذ آخر تحليل كتبته، وضعه في حزمة بالطبقات الأربع، ثم انسخه على جهاز زميل أو في Container جديد وقارن بصمة النتائج.
- ابحث في كودك عن
os.listdirوglobوأي دالة عشوائية، وتأكد أن كل واحدة منها مرتبة أو لها بذرة.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختبار الحزمة على python:3.13.17-slim مع pandas 3.0.6 وnumpy 2.5.4 وnbconvert 7.17.2، والمقارنة مع pandas 1.5.3 على Python 3.11.14.