

في مقال إدارة بيانات البحث ومبادئ FAIR وصلنا إلى أن البيانات يجب أن تنتهي في مستودع بيانات Data Repository يعطيها معرفاً دائماً ووصفاً وترخيصاً، فإذا جاء وقت الإيداع وجدت أمامك أسماء كثيرة: Dataverse وZenodo وFigshare وDryad، وCKAN الذي تراه خلف بوابات البيانات الحكومية، وDSpace الذي تستخدمه مكتبة جامعتك للرسائل والأبحاث. وهذا المقال موجه للباحث الذي يريد أن يعرف أين يودع بياناته، ولعمادة البحث العلمي أو المكتبة أو إدارة تقنية المعلومات في الجامعة التي تفكر في تشغيل مستودع بيانات خاص بها.
في هذا المقال سوف نتناول:
- الفرق بين مستودع بيانات البحث وبوابة البيانات المفتوحة الحكومية Open Data Portal والمستودع المؤسسي Institutional Repository.
- Dataverse وZenodo وCKAN، ونظرة سريعة على Figshare وDryad: لمن صمم كل واحد، ونقاط القوة ونقاط الضعف.
- كيف يصل الـ DOI إلى بياناتك عبر DataCite، وما بادئة الاختبار 10.5072.
- تجربة حقيقية: تشغيل Dataverse 6.12.1 في Docker، وإنشاء مجموعة Collection، وإيداع بيانات بوصف عربي، ونشرها بمعرف DOI تجريبي، والبحث فيها بالعربية.
- الإيداع في Zenodo عبر الـ API وبيئة الاختبار Sandbox.
ثلاثة أنواع من المستودعات Repositories لثلاث وظائف
الخطأ الشائع أن نعامل كل هذه الأنظمة كأنها نظام واحد بأسماء مختلفة، والواقع أن كل نوع صمم لوظيفة مختلفة، والصورة التالية تضعها جنباً إلى جنب:
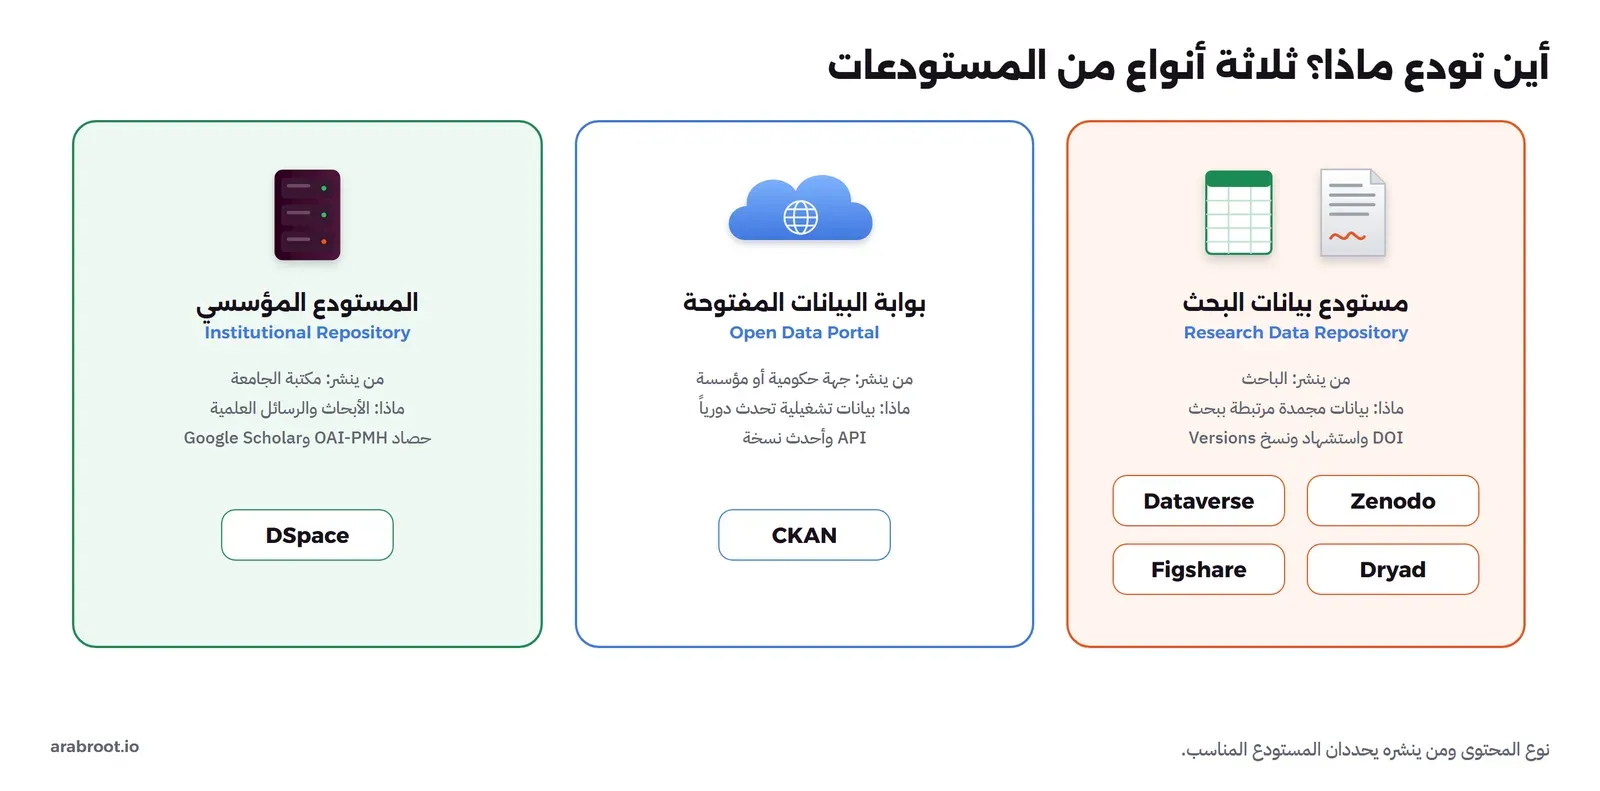
- مستودع بيانات البحث Research Data Repository: يودع فيه الباحث مجموعة بيانات مرتبطة ببحث، ويحصل على DOI واستشهاد جاهز ونسخ مرقمة Versions، ويتحكم في الترخيص والوصول. وهنا تقع Dataverse وZenodo وFigshare وDryad.
- بوابة البيانات المفتوحة Open Data Portal: تنشر فيها جهة حكومية أو مؤسسة بياناتها التشغيلية، مثل أعداد الطلاب أو الميزانيات أو بيانات النقل، وتحدثها دورياً وتتيحها عبر API، والمستخدم فيها مطور أو صحفي أو باحث يريد أحدث نسخة وليس نسخة مجمدة مرتبطة ببحث. وهنا يقع CKAN، وفي السعودية المنصة الوطنية للبيانات المفتوحة التي تنظمها سياسة البيانات المفتوحة من مكتب إدارة البيانات الوطنية في سدايا.
- المستودع المؤسسي Institutional Repository: مكتبة الجامعة الرقمية للأبحاث المنشورة والرسائل العلمية، يحصدها Google Scholar والفهارس عبر OAI-PMH، وقد شرحناه بالتفصيل في دليل مستودع الجامعة مع DSpace. يستطيع DSpace أن يحفظ ملفات بيانات، لكنه لا يفهم الجداول ولا يصف المتغيرات كما يفعل مستودع البيانات.
 دليلمستودع الجامعة Institutional Repository مع DSpaceكيف تشغل DSpace لأرشفة رسائل الطلاب وأبحاث الجامعة، من الإيداع ومراجعته حتى الحصاد عبر OAI-PMH، وما يحتاج تعريباً قبل الإطلاق.
 دليلإدارة بيانات البحث Research Data Management ومبادئ FAIRكيف تحفظ بيانات بحثك وتصفها وتشاركها وفق مبادئ FAIR وما يطلبه الممولون في خطة إدارة البيانات، مع قالب جاهز وتجربة لإخفاء الهوية.
المستودعات واحداً واحداً
Dataverse
Dataverse برنامج مفتوح المصدر بترخيص Apache 2.0 يطوره معهد العلوم الاجتماعية الكمية IQSS في جامعة Harvard مع مجتمع واسع، وتشغله الجامعة نفسها في مستودع Harvard Dataverse المفتوح للباحثين من كل التخصصات، وتشغله جامعات ومراكز بحث كثيرة على خوادمها، وآخر إصدار عند كتابة المقال 6.12.1 الصادر في 8 أكتوبر 2026. والفكرة فيه أن كل جهة أو مجموعة بحثية لها مجموعة Collection (كانت تسمى dataverse بحرف صغير) فيها مجموعات بيانات Datasets، ولكل مجموعة بيانات وصف ونسخ وملفات ومعرف دائم.
نقاط القوة:
- يفهم البيانات الجدولية، فعند رفع CSV أو SPSS أو Stata يحولها بعملية Tabular Data Ingest إلى صيغة نصية مستقلة عن البرامج، ويستخرج وصفاً لكل متغير وإحصاءات ملخصة، ويحسب بصمة رقمية UNF تثبت أن الأرقام لم تتغير.
- يصدر DOI عبر DataCite أو EZID، أو Handle، أو رابطاً دائماً PermaLink للاستخدام الداخلي.
- يسمح بتقييد ملفات بعينها مع طلب وصول Access Request، فالوصف منشور والبيانات الحساسة خلف موافقة صاحبها.
- كتل وصف Metadata Blocks جاهزة للعلوم الاجتماعية والجغرافيا والفلك وعلوم الحياة، وAPI كامل لكل ما تفعله من الواجهة.
نقاط الضعف:
- تشغيله على خادمك يحتاج إلى Payara وPostgreSQL وSolr، أي أنه نظام كامل يحتاج من يديره، وليس برنامجاً تثبته وتنساه.
- الواجهة من اليسار إلى اليمين، والبحث بالعربية يطابق الكلمة كما كتبت كما سوف نرى في التجربة.
- الـ DOI الحقيقي يحتاج عضوية في DataCite أو اتفاقاً مع جهة عضو، وهي تكلفة سنوية على الجامعة.
Zenodo
Zenodo مستودع عام يشغله مختبر CERN على برنامج InvenioRDM مفتوح المصدر، ويقبل البيانات والكود والأبحاث والعروض من أي باحث في أي تخصص، وقد عرضناه في مقال النشر المسبق Preprints كمكان للنسخ المسبقة. والأرقام التالية من صفحة سياساته:
- الحد الأعلى لحجم الملفات في السجل الواحد 50GB.
- الملفات محفوظة في مراكز بيانات CERN في جنيف مع نسخ في بودابست، ونسخ احتياطي ليلي على الأشرطة، ومدة الحفظ هي عمر المختبر نفسه الذي لديه برنامج تجارب محدد لعشرين سنة قادمة على الأقل.
- الوصول مفتوح أو مغلق أو مؤجل Embargo أو مقيد بموافقة المودع، والترخيص إلزامي لكل ملف مفتوح.
- السحب Withdrawal استثنائي، وإذا حدث يبقى الـ DOI وتظهر مكان السجل صفحة توضح سبب السحب.
نقاط القوة: لا تحتاج أن تشغل شيئاً، والـ DOI حقيقي من أول إيداع، والنسخ Versioning مدعومة بـ DOI لكل نسخة وDOI يجمعها، ومعه REST API وبيئة اختبار منفصلة.
نقاط الضعف: لا يفهم الجداول ولا يستخرج وصف المتغيرات، والجامعة لا تملك المستودع ولا تتحكم في سياساته، وبياناتك على خوادم خارج المملكة، وهذا يهم إذا كانت البيانات شخصية لأن نقلها خارج المملكة له أحكام في لائحة نظام حماية البيانات الشخصية، فالبيانات التي أخفيت هويتها فعلاً هي وحدها المناسبة لمستودع عام.
CKAN
CKAN نظام مفتوح المصدر بترخيص AGPL من Open Knowledge Foundation، يصف نفسه بأنه نظام لإدارة البيانات يشغل بوابات البيانات المفتوحة، ويستخدمه عدد من الحكومات الوطنية والمحلية في أوروبا والأمريكتين وآسيا، وآخر إصدار له 2.12.0 الصادر في 26 أغسطس 2026.
نقاط القوة: مصمم للنشر المستمر، فالجهة تنشر ملف الميزانية كل ربع سنة في المجموعة نفسها، وخاصية DataStore تحول الجداول إلى API يستعلم عنه المطور مباشرة، والإضافات Extensions كثيرة للتصنيف والخرائط والحصاد من بوابات أخرى.
نقاط الضعف: فكرته الأساسية فهرس للبيانات وواجهات للوصول إليها، وليس الاستشهاد العلمي، فالنسخة المجمدة المرتبطة ببحث منشور والمعرف الدائم والاستشهاد الجاهز ليست محور تصميمه كما في Dataverse وZenodo. لذلك فهو الخيار الصحيح لعمادة التخطيط التي تنشر إحصاءات الجامعة، وليس لباحث يودع بيانات رسالته.
Figshare وDryad باختصار
- Figshare: مستودع تجاري من شركة Digital Science، الحساب المجاني فيه بحسب صفحة حدود الحسابات مساحة 20GB وحد أقصى للملف الواحد 20GB، ولديه نسخة مؤسسية مدفوعة تشغلها بعض الجامعات مستودعاً لها.
- Dryad: مستودع غير ربحي يراجع فريقه كل إيداع قبل نشره Curation، ويشترط ترخيص CC0 لكل البيانات، ويطلب رسوم نشر بيانات Data Publishing Charge إذا لم تكن جامعتك أو مجلتك شريكاً له، وهي بحسب صفحة التكاليف السارية منذ 6 مايو 2025: 150 دولاراً حتى 5GB، و180 دولاراً حتى 10GB، و520 دولاراً حتى 50GB.
المقارنة في جدول
| Dataverse | Zenodo | CKAN | |
|---|---|---|---|
| صمم من أجل | بيانات البحث في جهة أو جامعة | أي مخرج بحثي من أي باحث | بيانات الجهات الحكومية المفتوحة |
| التشغيل | على خادمك، أو Harvard Dataverse | خدمة يشغلها CERN | على خادمك |
| الترخيص البرمجي | Apache 2.0 | InvenioRDM مفتوح المصدر | AGPL |
| المعرف الدائم | DOI أو Handle أو PermaLink | DOI لكل نسخة | ليس محور تصميمه |
| فهم الجداول والمتغيرات | نعم، Ingest وUNF | لا | DataStore وAPI للجداول |
| ملفات مقيدة بطلب وصول | نعم | نعم | مجموعات خاصة بحسب الصلاحيات |
| مكان البيانات | حيث تشغله | جنيف وبودابست | حيث تشغله |
وقد يتساءل البعض: إذا كان Zenodo يعطي DOI حقيقياً دون أن أشغل شيئاً، فلماذا تشغل جامعة Dataverse؟ والإجابة في ثلاث نقاط من الجدول: البيانات الشخصية التي لا يمكن إخفاء هويتها تحتاج أن تبقى داخل المملكة وتحت صلاحيات الجامعة، والجامعة تريد أن تجمع بيانات باحثيها في مكان واحد يحمل اسمها وتخرج منه تقاريرها، والبيانات الجدولية تستفيد من الـ Ingest ووصف المتغيرات. أما الباحث الفرد الذي لديه بيانات مخفية الهوية أو كود ولا يوجد في جامعته مستودع بيانات، فـ Zenodo هو الحل الأنسب له.
كيف يصل الـ DOI إلى بياناتك؟
شرحنا ما هو الـ DOI ومن يسجله في مقال معرف ORCID وDOI، والذي يهمنا هنا أن معرفات البيانات تسجل عادة عند DataCite وليس Crossref الذي تسجل عنده المجلات أبحاثها. والمستودع هو الذي يتحدث مع DataCite نيابة عنك، كما في الصورة التالية:
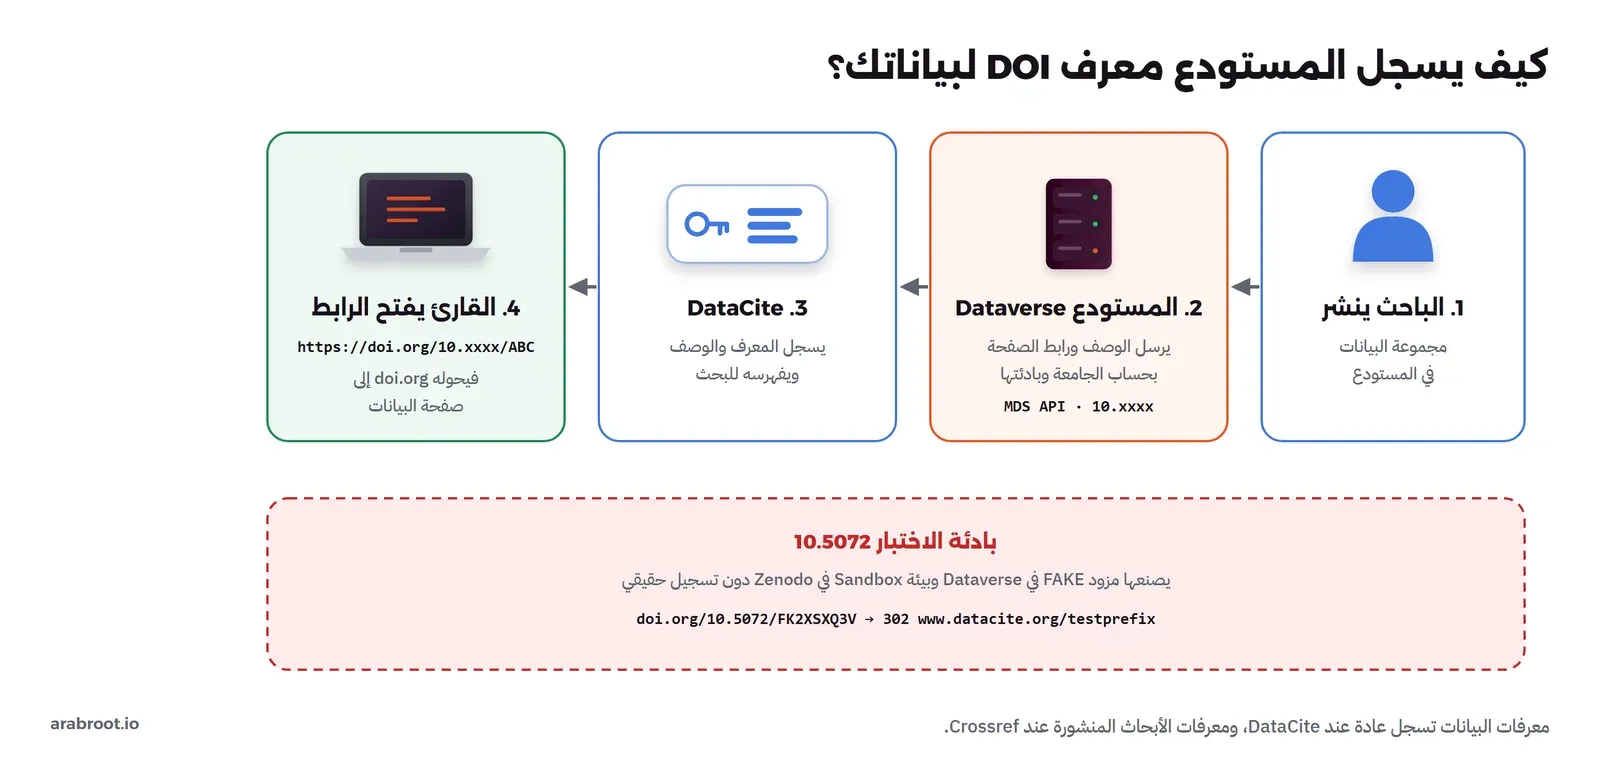
وللاختبار تستخدم Dataverse مزوداً وهمياً اسمه FAKE يصنع معرفات بالبادئة 10.5072 دون أن يتصل بأحد، وهي البادئة نفسها التي تستخدمها بيئة الاختبار في Zenodo وبيئة الاختبار في DataCite. ولاحظ أن الرابط https://doi.org/10.5072/... لا يفتح صفحة بياناتك، فـ doi.org يحول أي معرف بهذه البادئة إلى صفحة DataCite التي تشرح أنها بادئة اختبار، وهذا ما رأيناه في التجربة بالأمر التالي:
curl -s -o /dev/null -w '%{http_code} %{redirect_url}\n' https://doi.org/10.5072/FK2XSXQ3V302 http://www.datacite.org/testprefixتجربة عملية: Dataverse في Docker
سوف نشغل Dataverse بالإعداد الذي ينشره المشروع في دليل التشغيل التجريبي بالـ Containers، مع تعديلات قليلة: إصدارات مثبتة بدلاً من latest، ومزود DOI وهمي FAKE بدلاً من PermaLinks حتى نرى شكل الـ DOI، وبدون خدمة البريد وأداة المعاينة. وهذا الإعداد للتجربة والتعلم وليس للإنتاج Production، فكلمات المرور فيه مكتوبة في الملف، والـ Admin API مفتوح.
المتطلبات
- Docker مع Docker Compose، وذاكرة 4GB على الأقل متاحة للـ Containers، فخادم Payara وحده محدد بـ 2GB، ومعه PostgreSQL وSolr.
- مساحة قرص نحو 3GB للـ Images.
- المنفذ 8080 على جهازك.
ملف docker-compose.yml
name: dataverse-lab
services:
  dataverse:
    hostname: dataverse
    image: gdcc/dataverse:6.12.1-noble-r0
    restart: on-failure
    user: payara
    environment:
      DATAVERSE_SITEURL: "http://localhost:8080"
      DATAVERSE_DB_HOST: postgres
      DATAVERSE_DB_PASSWORD: secret
      DATAVERSE_DB_USER: dataverse
      DATAVERSE_FEATURE_API_BEARER_AUTH: "1"
      DATAVERSE_MAIL_SYSTEM_EMAIL: "Demo Dataverse <[email protected]>"
      JVM_ARGS: -Ddataverse.files.storage-driver-id=file1
        -Ddataverse.files.file1.type=file
        -Ddataverse.files.file1.label=Filesystem
        -Ddataverse.files.file1.directory=/dv/store
        -Ddataverse.pid.providers=fake1
        -Ddataverse.pid.default-provider=fake1
        -Ddataverse.pid.fake1.type=FAKE
        -Ddataverse.pid.fake1.label=FakeDOI
        -Ddataverse.pid.fake1.authority=10.5072
        -Ddataverse.pid.fake1.shoulder=FK2
    ports:
      - "8080:8080"
    depends_on: [postgres, solr, dv_initializer]
    volumes:
      - dv-app:/dv
      - dv-secrets:/secrets
      - ./persistence.xml:/opt/payara/deployments/dataverse/WEB-INF/classes/META-INF/persistence.xml:ro
      - ./platform-fix/classes/org/arabroot:/opt/payara/deployments/dataverse/WEB-INF/classes/org/arabroot:ro
    tmpfs:
      - /dumps:mode=1777,size=2052M
      - /tmp:mode=1777,size=2052M
    mem_limit: 2147483648
  bootstrap:
    image: gdcc/configbaker:6.12.1-noble-r0
    restart: "no"
    environment: [TIMEOUT=10m]
    command: [bootstrap.sh, dev]
  dv_initializer:
    image: gdcc/configbaker:6.12.1-noble-r0
    restart: "no"
    command: [sh, -c, "fix-fs-perms.sh dv"]
    volumes:
      - dv-app:/dv
  postgres:
    hostname: postgres
    image: postgres:17.6-alpine
    restart: on-failure
    environment: [POSTGRES_USER=dataverse, POSTGRES_PASSWORD=secret]
    volumes:
      - dv-db:/var/lib/postgresql/data
  solr_initializer:
    image: gdcc/configbaker:6.12.1-noble-r0
    restart: "no"
    command: [sh, -c, "fix-fs-perms.sh solr && cp -a /template/* /solr-template"]
    volumes:
      - dv-solr:/var/solr
      - dv-solrconf:/solr-template
  solr:
    hostname: solr
    image: solr:9.8.0
    depends_on: [solr_initializer]
    restart: on-failure
    environment: [SOLR_OPTS=-Dsolr.jetty.request.header.size=102400]
    command: [solr-precreate, collection1, /template]
    volumes:
      - dv-solr:/var/solr
      - dv-solrconf:/template
volumes:
  dv-app:
  dv-secrets:
  dv-db:
  dv-solr:
  dv-solrconf:
في الإعداد أعلاه لاحظ التالي:
- الخدمة
bootstrapتنتظر حتى يعمل Dataverse ثم تنشئ المستخدم المديرdataverseAdminوالمجموعة الرئيسية Root والتراخيص، والوضعdevيترك الـ Admin API مفتوحاً، لذلك لا تستخدمه على خادم متصل بالإنترنت، فللإنتاج يوجد الوضعdemoالذي يطلب مفتاحاً لفتح الـ Admin API. - الخدمتان
dv_initializerوsolr_initializerتضبطان صلاحيات الـ Volumes وتنسخان إعداد Solr الخاص بـ Dataverse ثم تنتهيان. - مزود الـ DOI اسمه
fake1ونوعهFAKEبالبادئة 10.5072، وفي الإنتاج تستبدله بمزود من نوعdataciteببادئة جامعتك وحسابها كما في دليل الإعداد. - السطران الأخيران في
volumesعلاج لعطل في الإصدار الحالي نشرحه الآن.
لماذا يفشل التشغيل الأول؟ عطل SERIAL
عند تشغيل الإعداد الرسمي كما هو على قاعدة بيانات جديدة لم يعمل Dataverse، وبقيت الصفحة ترجع 404، وفي سجلات Payara ظهرت مئات الأخطاء من هذا النوع:
PER01000: Got SQLException executing statement "CREATE TABLE EXTERNALTOOLTYPE (ID BIGINT SERIAL NOT NULL, TYPE VARCHAR(255) NOT NULL, EXTERNALTOOL_ID BIGINT NOT NULL, PRIMARY KEY (ID))": org.postgresql.util.PSQLException: ERROR: syntax error at or near "SERIAL"ثم فشلت ترحيلات Flyway Migrations لأن الجداول لم تنشأ:
Caused by: org.flywaydb.core.internal.exception.FlywayMigrateException: Failed to execute script V4.11__5513-database-variablemetadata.sql
Message    : ERROR: relation "datavariable" does not exist
والسبب أن الـ Image مبنية على Payara 7.2026.9، وفيها نسخة EclipseLink 5.0.0.payara-p1 التي تكتب BIGINT SERIAL للأعمدة التي تزيد تلقائياً، وهي صيغة لا يقبلها PostgreSQL، والعطل موثق في تقرير Payara رقم 8250 الذي ظهر منذ الإصدار 7.2026.6، وفي تقرير Dataverse رقم 12724. والترقية من إصدار سابق لا تتأثر لأن الجداول موجودة أصلاً، أما التثبيت الجديد فيتعطل. وقد جربنا أولاً أن نحدد المنصة PostgreSQLPlatform القديمة في persistence.xml فظهر الخطأ نفسه، لأنها تكتب SERIAL بالطريقة نفسها.
والعلاج الذي نجح كلاس صغير يرث منصة PostgreSQL 10 ويكتب الصيغة المعيارية GENERATED BY DEFAULT AS IDENTITY:
package org.arabroot.lab;

import java.io.IOException;
import java.io.Writer;
import org.eclipse.persistence.exceptions.ValidationException;
import org.eclipse.persistence.platform.database.PostgreSQL10Platform;

/** EclipseLink 5.0.0.payara-p1 prints "BIGINT SERIAL" for IDENTITY columns (eclipse-ee4j/eclipselink#2644);
 *  PostgreSQL 10+ needs "GENERATED BY DEFAULT AS IDENTITY". Used only to create a fresh Dataverse database. */
public class FixedPostgreSQLPlatform extends PostgreSQL10Platform {
    @Override
    public void printFieldIdentityClause(Writer writer) throws ValidationException {
        try {
            writer.write(" GENERATED BY DEFAULT AS IDENTITY");
        } catch (IOException e) {
            throw ValidationException.fileError(e);
        }
    }
}
نأخذ مكتبة EclipseLink من الـ Image نفسها حتى نترجم Compile الكلاس على النسخة نفسها، ثم نترجمه في Container فيه JDK 21، ثم ننسخ ملف persistence.xml من الـ Image ونضيف إليه سطراً واحداً:
docker create --name dv-tmp gdcc/dataverse:6.12.1-noble-r0
docker cp dv-tmp:/opt/payara/appserver/glassfish/modules/org.eclipse.persistence.core.jar platform-fix/
docker cp dv-tmp:/opt/payara/deployments/dataverse/WEB-INF/classes/META-INF/persistence.xml .
docker rm dv-tmp
docker run --rm -v "$PWD/platform-fix":/w -w /w eclipse-temurin:21.0.8_9-jdk-noble \
  javac --release 21 -cp org.eclipse.persistence.core.jar -d classes FixedPostgreSQLPlatform.java
<property name="eclipselink.weaving" value="false"/>
<property name="eclipselink.target-database" value="org.arabroot.lab.FixedPostgreSQLPlatform"/>والسطر الثاني هو الإضافة، تضعه بعد السطر الأول داخل <properties>. والـ Compose أعلاه يركب الملف والكلاس فوق الموجود في الـ Image للقراءة فقط. وبعد إصلاح العطل في إصدار قادم من Dataverse أو Payara احذف السطرين من volumes، ولا تضف هذا العلاج إلى خادم يعمل منذ إصدار سابق، فهو يحتاجه التثبيت الجديد فقط.
التشغيل
docker compose up -d
docker compose logs -f bootstrap
التشغيل الأول يأخذ عدة دقائق، فخادم Payara ينشئ الجداول ثم تعمل ترحيلات Flyway ثم يبدأ bootstrap عمله، وآخر ما يكتبه:
Setting DOI provider to "FAKE"...
{"status":"OK","data":{"message":"Setting :DoiProvider added."}}Publishing root dataverse...
Checking Dataverse version...
{"status":"OK","data":{"version":"6.12.1","build":null}}
Done, your instance has been configured for development. Have a nice day!
حساب الباحث والتوكن API Token
الوضع dev يضبط مفتاح إنشاء المستخدمين :BuiltinUsersKey على القيمة burrito، فننشئ حساباً لباحث عبر الـ API، والرد يحتوي على التوكن API Token الذي نستخدمه في باقي الخطوات، ونحفظه في متغير دون أن نطبعه:
B=http://localhost:8080
curl -s -X POST "$B/api/builtin-users?password=Lab-Passw0rd-2026&key=burrito" \
  -H "Content-Type: application/json" \
  -d '{"firstName":"Research","lastName":"Lab","userName":"researcher","affiliation":"ArabRoot","email":"[email protected]"}' > user.json
python3 -c "import json;d=json.load(open('user.json'));print(d['status'], d['data']['user']['userName'])"
TOKEN=$(python3 -c "import json;print(json.load(open('user.json'))['data']['apiToken'])")
OK researcherوفي الإنتاج لا يوجد هذا المفتاح، فالباحث يسجل من الواجهة أو بحساب الجامعة عبر SSO، ثم ينشئ التوكن من صفحة API Token في حسابه.
إنشاء مجموعة Collection
نحدد المجموعة في ملف dataverse.json:
{
  "alias": "arabroot-lab",
  "name": "مختبر بيانات البحث",
  "affiliation": "ArabRoot",
  "dataverseType": "LABORATORY",
  "description": "مجموعة تجريبية لإيداع بيانات البحث بوصف عربي",
  "dataverseContacts": [{ "contactEmail": "[email protected]" }]
}
curl -s -H "X-Dataverse-key: $TOKEN" -X POST "$B/api/dataverses/root" \
-H "Content-Type: application/json" --data-binary @dataverse.jsonوالرد يؤكد الإنشاء، والمجموعة غير منشورة بعد "isReleased":false حتى ننشرها بعد إضافة البيانات.
مجموعة بيانات بوصف عربي
ملف البيانات هو الاستبانة التي رمزنا هويتها وعممنا العمر فيها في مقال إدارة بيانات البحث، 400 صف بترميز UTF-8، ومعه ملف README.md فيه قاموس المتغيرات. والوصف في ملف dataset.json بكتلة الاستشهاد Citation الإلزامية:
{
  "datasetVersion": {
    "license": { "name": "CC0 1.0", "uri": "http://creativecommons.org/publicdomain/zero/1.0" },
    "metadataBlocks": {
      "citation": {
        "fields": [
          { "typeName": "title", "multiple": false, "typeClass": "primitive",
            "value": "استبانة استخدام الإنترنت لدى طلاب الجامعة" },
          { "typeName": "alternativeTitle", "multiple": true, "typeClass": "primitive",
            "value": ["University students internet use survey"] },
          { "typeName": "author", "multiple": true, "typeClass": "compound", "value": [
            { "authorName": { "typeName": "authorName", "multiple": false, "typeClass": "primitive", "value": "فريق عرب رووت" },
              "authorAffiliation": { "typeName": "authorAffiliation", "multiple": false, "typeClass": "primitive", "value": "ArabRoot" } } ] },
          { "typeName": "datasetContact", "multiple": true, "typeClass": "compound", "value": [
            { "datasetContactEmail": { "typeName": "datasetContactEmail", "multiple": false, "typeClass": "primitive", "value": "[email protected]" } } ] },
          { "typeName": "dsDescription", "multiple": true, "typeClass": "compound", "value": [
            { "dsDescriptionValue": { "typeName": "dsDescriptionValue", "multiple": false, "typeClass": "primitive",
              "value": "بيانات استبانة مولدة للتجربة من 400 مشارك بعد ترميز الهوية وتعميم العمر، مع قاموس المتغيرات في ملف README." } } ] },
          { "typeName": "subject", "multiple": true, "typeClass": "controlledVocabulary", "value": ["Social Sciences"] },
          { "typeName": "keyword", "multiple": true, "typeClass": "compound", "value": [
            { "keywordValue": { "typeName": "keywordValue", "multiple": false, "typeClass": "primitive", "value": "استبانة" } },
            { "keywordValue": { "typeName": "keywordValue", "multiple": false, "typeClass": "primitive", "value": "الإنترنت" } } ] },
          { "typeName": "language", "multiple": true, "typeClass": "controlledVocabulary", "value": ["Arabic"] }
        ]
      }
    }
  }
}
curl -s -H "X-Dataverse-key: $TOKEN" -X POST "$B/api/dataverses/arabroot-lab/datasets" \
-H "Content-Type: application/json" --data-binary @dataset.json{"status":"OK","data":{"id":3,"persistentId":"doi:10.5072/FK2XSXQ3V"}}لاحظ أن الـ DOI حجز من لحظة إنشاء المسودة Draft، قبل النشر، حتى يستطيع الباحث أن يكتبه في البحث قبل إرساله للمجلة.
رفع الملفات وتحويل الجدول Ingest
P=doi:10.5072/FK2XSXQ3V
curl -s -H "X-Dataverse-key: $TOKEN" -X POST "$B/api/datasets/:persistentId/add?persistentId=$P" \
  -F "file=@deposit/survey_shared.csv" -F 'jsonData={"description":"","restrict":"false"}'
ارفع الملف الثاني README.md بالأمر نفسه بعد أن ينتهي تحويل الملف الأول، فالمجموعة تكون مقفلة Locked أثناء الـ Ingest، وقد رفض Dataverse الملف الثاني عندما أرسلناه مباشرة بعد الأول. ثم نعرض قائمة الملفات:
curl -s -H "X-Dataverse-key: $TOKEN" "$B/api/datasets/:persistentId/versions/:draft/files?persistentId=$P" | python3 -c "
import json,sys
for f in json.load(sys.stdin)['data']:
    x=f['dataFile'];print(x['id'],x['filename'],x['contentType'],x['filesize'],x.get('tabularData'),x.get('originalFileFormat'),x.get('originalFileSize'))"
5 README.md text/markdown 1009 False None None
4 survey_shared.tab text/tab-separated-values 17320 True text/csv 14581في المخرج أعلاه لاحظ أن ملف CSV أصبح survey_shared.tab، أي أن Dataverse قرأ الجدول وحوله إلى صيغته المستقلة واحتفظ بالأصل بحجمه 14581 بايت لمن يريد تنزيله كما رفع. ووصف المتغيرات الذي استخرجه متاح بصيغة DDI، وفيه 6 متغيرات، ولعمود الرضا q1_satisfaction حسب المتوسط 3.0225 والوسيط 3.0 والانحراف المعياري 1.3845 من 400 قيمة صالحة، دون أن نكتب سطراً من التحليل.
النشر والاستشهاد Citation
ننشر المجموعة أولاً ثم مجموعة البيانات، فلا يمكن نشر بيانات داخل مجموعة غير منشورة:
curl -s -H "X-Dataverse-key: $TOKEN" -X POST "$B/api/dataverses/arabroot-lab/actions/:publish"
curl -s -H "X-Dataverse-key: $TOKEN" -X POST "$B/api/datasets/:persistentId/actions/:publish?persistentId=$P&type=major"{"status":"OK","data":{"id":3,"identifier":"FK2XSXQ3V","persistentUrl":"https://doi.org/10.5072/FK2XSXQ3V","protocol":"doi","authority":"10.5072","separator":"/","publisher":"Root","storageIdentifier":"local://10.5072/FK2XSXQ3V","datasetType":"dataset","locks":["finalizePublication"]}}ثم نطلب الاستشهاد الذي يولده Dataverse:
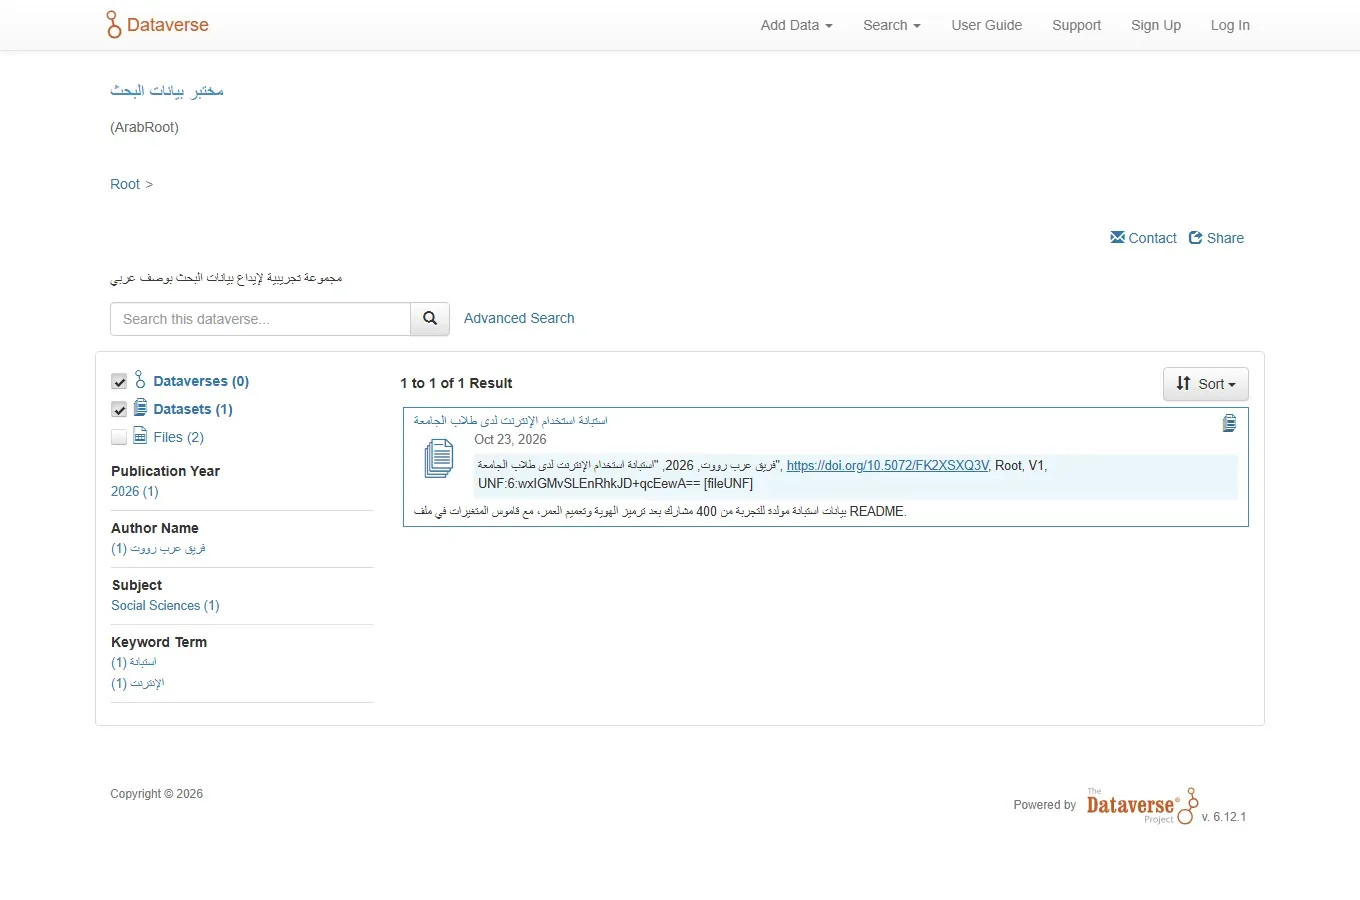
curl -s "$B/api/datasets/:persistentId/versions/:latest-published/citation?persistentId=$P"{"status":"OK","data":{"message":"فريق عرب رووت, 2026, \"استبانة استخدام الإنترنت لدى طلاب الجامعة\", <a href=\"https://doi.org/10.5072/FK2XSXQ3V\" target=\"_blank\">https://doi.org/10.5072/FK2XSXQ3V</a>, Root, V1, UNF:6:wxIGMvSLEnRhkJD+qcEewA== [fileUNF]"}}في المخرج أعلاه لاحظ التالي:
- الناشر Publisher في الاستشهاد هو
Root، أي اسم المجموعة الرئيسية، فعلى خادم الجامعة غير اسمها إلى اسم الجامعة قبل أول نشر، لأن هذا الاسم يذهب إلى DataCite ويظهر في كل استشهاد. - الاستشهاد ينتهي ببصمة UNF، فإذا أعاد أحد التحليل على ملف مختلف ولو برقم واحد اختلفت البصمة.
- النسخة V1، وأي تعديل لاحق ينشئ مسودة ثم V1.1 أو V2، والنسخة الأولى تبقى كما هي لمن استشهد بها.
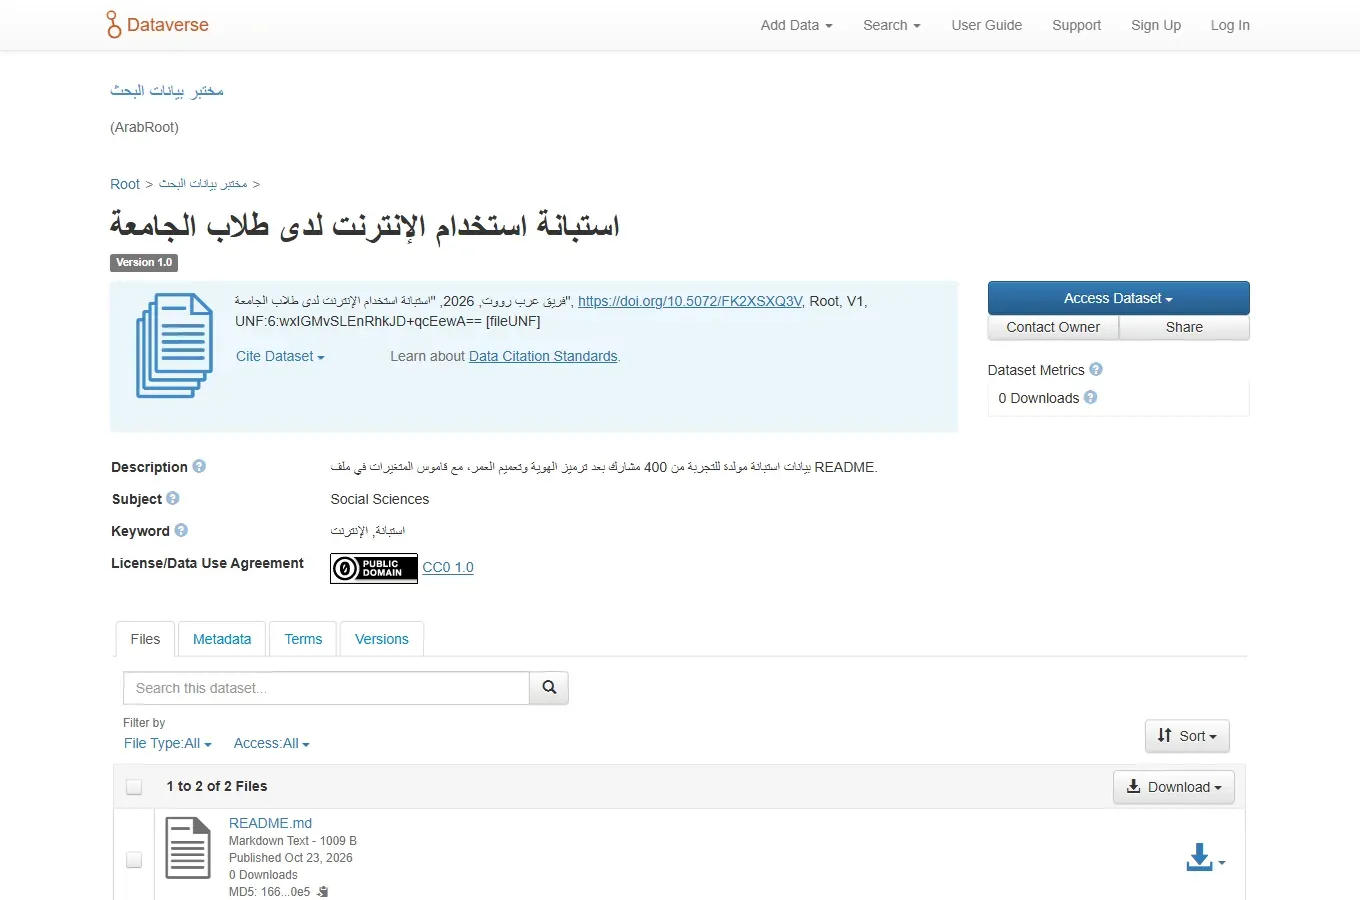
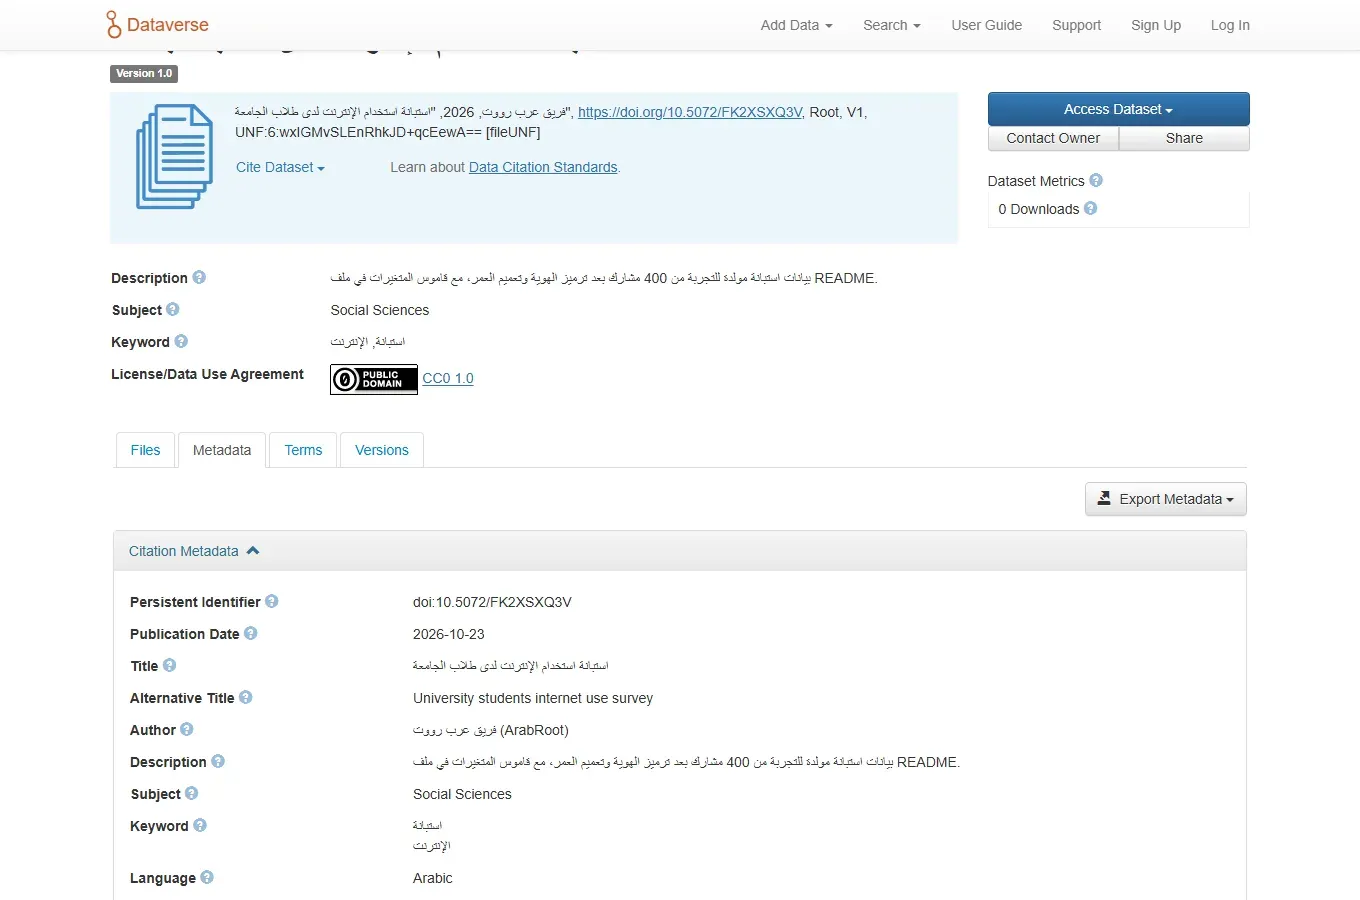
ولاحظ في الصورة أن الواجهة من اليسار إلى اليمين، فالفقرة العربية التي تنتهي بكلمة إنجليزية مثل README تظهر الكلمة في غير مكانها، والحل البسيط أن تختم الفقرة العربية بكلمة عربية، وأن تضع العنوان الإنجليزي في حقل العنوان البديل Alternative Title كما فعلنا. وتبويب Metadata يعرض كل الحقول، ومنه زر Export Metadata الذي يصدر الوصف بصيغ DataCite وDDI وDublin Core وSchema.org:
الوصف Metadata الذي يصل إلى DataCite
نصدر الوصف بصيغة DataCite لنرى ما سوف يرسله المستودع عند التسجيل الحقيقي:
curl -s "$B/api/datasets/export?exporter=Datacite&persistentId=$P"<resource xmlns="http://datacite.org/schema/kernel-4" xsi:schemaLocation="http://datacite.org/schema/kernel-4 http://schema.datacite.org/meta/kernel-4.7/metadata.xsd">
<identifier identifierType="DOI">10.5072/FK2XSXQ3V</identifier>
<creators>
<creator>
<creatorName nameType="Personal">فريق عرب رووت</creatorName>
<affiliation>ArabRoot</affiliation>
</creator>
</creators>
<titles>
<title>استبانة استخدام الإنترنت لدى طلاب الجامعة</title>
<title titleType="AlternativeTitle">University students internet use survey</title>
</titles>
<publisher>Root</publisher>
<publicationYear>2026</publicationYear>
<subjects>
<subject>Social Sciences</subject>
<subject>استبانة</subject>
<subject>الإنترنت</subject>
</subjects>
<language>ara</language>
<resourceType resourceTypeGeneral="Dataset"/>
<rightsList>
<rights rightsURI="info:eu-repo/semantics/openAccess"/>
<rights rightsURI="http://creativecommons.org/publicdomain/zero/1.0" rightsIdentifier="CC0-1.0" rightsIdentifierScheme="SPDX" schemeURI="https://spdx.org/licenses/" xml:lang="en">Creative Commons CC0 1.0 Universal Public Domain Dedication.</rights>
</rightsList>
</resource>اختصرنا من المخرج عناصر التاريخ والحجم والصيغ، والذي يهمنا فيه نقطتان: المخطط هو DataCite 4.7 والعناصر الإلزامية الستة موجودة، واسم الفريق صنفه Dataverse شخصاً nameType="Personal" لأنه لا يعرف أنه اسم جهة، فإذا كان المؤلف مؤسسة أو فريقاً فراجع هذا الحقل قبل التسجيل الحقيقي، واربط كل مؤلف شخص بمعرف ORCID في حقل معرف المؤلف.
البحث Search بالعربية
البحث في Dataverse يعمل عبر Solr، ونريد أن نعرف كيف يتعامل مع العربية. ولاحظ هنا تفصيلة صغيرة كلفتنا وقتاً: عند إرسال كلمة عربية من Git Bash على Windows بالأمر curl --data-urlencode وصلت إلى السيرفر علامات استفهام، وعلامة الاستفهام في Solr رمز يطابق أي حرف، فظهرت نتائج لكل كلمة لها عدد الحروف نفسه. لذلك كتبنا سكربتاً صغيراً بـ Python يرمز الكلمة بـ UTF-8 بشكل صحيح:
import json, sys, urllib.parse, urllib.request
base = "http://localhost:8080/api/search?"
for q in sys.argv[1:]:
    url = base + urllib.parse.urlencode({"q": q, "type": "dataset"})
    d = json.load(urllib.request.urlopen(url))["data"]
    print(f"{q:<12} total={d['total_count']}  {[i['name'] for i in d['items']]}")
python3 -X utf8 dvsearch.py "استبانة" "الاستبانة" "استبانات" "الإنترنت" "الانترنت" "طلاب" "الطلاب" "internet"استبانة total=1 ['استبانة استخدام الإنترنت لدى طلاب الجامعة']
الاستبانة total=0 []
استبانات total=0 []
الإنترنت total=1 ['استبانة استخدام الإنترنت لدى طلاب الجامعة']
الانترنت total=0 []
طلاب total=1 ['استبانة استخدام الإنترنت لدى طلاب الجامعة']
الطلاب total=0 []
internet total=1 ['استبانة استخدام الإنترنت لدى طلاب الجامعة']والنتيجة واضحة: البحث العربي يطابق الكلمة كما كتبت فقط، فإضافة «ال» أو الجمع أو كتابة الألف دون همزة تعطي صفراً، والسبب أن حقل العنوان في مخطط Solr الذي يأتي مع Dataverse نوعه text_en، أي أنه مضبوط للإنجليزية، وملف المخطط نفسه فيه نوع text_ar بفلاتر التطبيع Normalization والتجذيع Stemming العربية لكنه غير مستخدم في حقول Dataverse. والكلمة الإنجليزية internet وجدت البيانات لأننا وضعنا العنوان البديل بالإنجليزية.
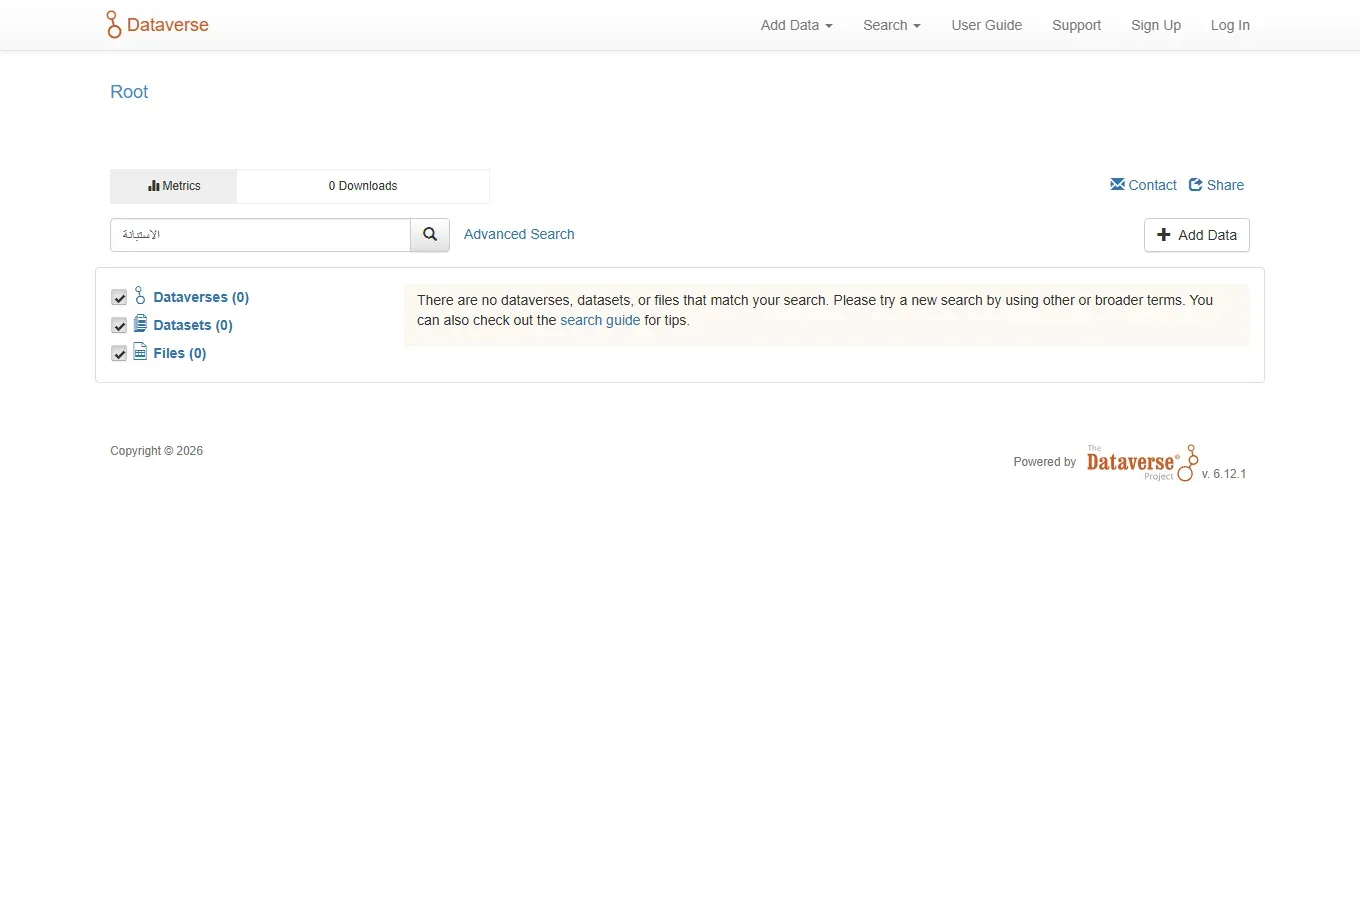
وإلى أن يدعم المشروع العربية في البحث فالحل العملي في الوصف نفسه: ضع الكلمات المفتاحية بصيغها الشائعة، مثل «استبانة» و«استبيان» و«الإنترنت» و«الانترنت»، واكتب العنوان البديل والكلمات المفتاحية بالإنجليزية، فمن يبحث في الفهارس العالمية غالباً يبحث بالإنجليزية أصلاً.
الإيداع في Zenodo عبر الـ API
لم نشغل هذا الجزء لأن الإيداع في Zenodo يحتاج حساباً وتوكناً شخصياً، والخطوات التالية من توثيق Zenodo للمطورين. وللتجربة توجد بيئة اختبار على https://sandbox.zenodo.org تحتاج تسجيلاً وتوكناً منفصلين عن الموقع الحقيقي، وتصدر معرفات بالبادئة 10.5072، ويمكن أن تمسح محتواها في أي وقت. والتوكن يحتاج الصلاحيتين deposit:write وdeposit:actions، والمسار كالتالي:
- إنشاء إيداع فارغ:
POST /api/deposit/depositions، والرد فيه رقم الإيداع ورابطbucket. - رفع الملف بطلب
PUTإلى رابط الـbucketمتبوعاً باسم الملف. - إضافة الوصف:
PUT /api/deposit/depositions/<id>بالعنوان والمؤلفين والوصف ونوع الرفعdatasetوالترخيص. - النشر:
POST /api/deposit/depositions/<id>/actions/publish، وبعده لا يمكن حذف الملفات، وإنما إنشاء نسخة جديدة.
التحقق من النجاح
curl -s http://localhost:8080/api/info/versionيرجع{"status":"OK","data":{"version":"6.12.1","build":null}}.- صفحة المجموعة
http://localhost:8080/dataverse/arabroot-labتعرض مجموعة البيانات المنشورة. - الاستشهاد ينتهي بـ
V1وبصمة UNF، وقائمة الملفات فيهاsurvey_shared.tabبقيمةtabularDataتساوي True. - البحث عن «استبانة» يجد مجموعة البيانات.
النسخ الاحتياطي والاستعادة
بيانات Dataverse في مكانين: قاعدة PostgreSQL للوصف والصلاحيات والنسخ، ومجلد الملفات /dv/store في الـ Volume. أما فهرس Solr فيمكن إعادة بنائه من القاعدة، لذلك لا تحتاج إلى نسخه.
docker compose exec -T postgres pg_dump -U dataverse -Fc dataverse > dataverse-$(date +%F).dump
docker run --rm -v dataverse-lab_dv-app:/dv -v "$PWD":/backup alpine:3.22 tar czf /backup/dv-store-$(date +%F).tar.gz -C /dv store
وبعد الاستعادة أعد بناء الفهرس بالأمر curl http://localhost:8080/api/admin/index من داخل الخادم، والسبب أن نتائج البحث تأتي من Solr وليس من القاعدة.
التحديث إلى إصدار أحدث
اقرأ ملاحظات الإصدار في صفحة إصدارات Dataverse قبل أي تحديث، فبعض الإصدارات تطلب تحديث مخطط Solr أو إعادة الفهرسة أو خطوات يدوية. خذ نسخة احتياطية، وغير الوسم في الأسطر الأربعة من gdcc/dataverse وgdcc/configbaker إلى الإصدار الجديد، ثم docker compose pull وdocker compose up -d، وراجع هل ما زال علاج SERIAL لازماً، فإذا أصلح الإصدار الجديد العطل فاحذف السطرين من volumes.
مشكلات شائعة وحلولها
- الصفحة ترجع 404 بعد عدة دقائق، وفي السجلات
syntax error at or near "SERIAL": هو عطل EclipseLink الذي شرحناه، وعلاجه الكلاس والسطر فيpersistence.xml، ثمdocker compose down -vوتشغيل جديد لأن القاعدة الأولى نصف منشأة. bootstrapينتهي قبل أن يعمل Dataverse: زد قيمةTIMEOUT، فالتشغيل الأول على جهاز بأربع أنوية قد يأخذ أكثر من خمس دقائق.- رفض رفع ملف بعد ملف جدولي مباشرة: انتظر حتى ينتهي الـ Ingest، وتأكد من عدم وجود أقفال بالأمر
/api/datasets/:persistentId/locks. - البحث العربي يرجع نتائج غريبة أو كل شيء: تأكد أن الكلمة وصلت بترميز UTF-8، وليس علامات استفهام.
- الاستشهاد يذكر Root ناشراً: غير اسم المجموعة الرئيسية إلى اسم جهتك.
الخلاصة
- مستودع بيانات البحث للبيانات المجمدة المرتبطة ببحث مع DOI واستشهاد، وبوابة البيانات المفتوحة مثل CKAN للبيانات الحكومية المتجددة، والمستودع المؤسسي مثل DSpace للأبحاث والرسائل.
- Zenodo هو الحل الأنسب للباحث الفرد ببيانات مخفية الهوية، وDataverse للجامعة التي تريد مستودعاً تملكه وتبقي فيه البيانات الحساسة داخل المملكة.
- Dataverse 6.12.1 يحول الجداول ويصف المتغيرات ويعطي استشهاداً ببصمة UNF، لكن التثبيت الجديد يحتاج علاجاً لعطل EclipseLink حتى يصلح في إصدار قادم.
- البحث العربي في Dataverse يطابق الكلمة كما كتبت، فاكتب الكلمات المفتاحية بصيغها الشائعة ومعها الإنجليزية.
وفي المقال التالي بإذن الله سوف نستخدم معرف البيانات في تحليل كامل يعيد أي أحد تشغيله ويحصل على الأرقام نفسها:
تدريب عملي
- عدل ملف
dataset.jsonوأضف كلمة «استبيان» و«الانترنت» إلى الكلمات المفتاحية، وأنشئ نسخة جديدة V2، ثم أعد تشغيل سكربت البحث ولاحظ ما تغير. - ارفع ملفاً ثالثاً مقيداً بالخيار
"restrict":"true"، ثم افتح صفحة البيانات دون تسجيل الدخول وانظر كيف يظهر الملف المقيد وزر طلب الوصول.
سجل التحديثات
- أكتوبر 2026: كتابة الدليل واختباره على Dataverse 6.12.1 (gdcc/dataverse:6.12.1-noble-r0) مع PostgreSQL 17.6 وSolr 9.8.0.


