

ينتهي طالب الماجستير من جمع استبانته، ثم يكتشف أن ترخيص SPSS في معمل الكلية مرتبط بأجهزة المعمل فقط، وأن الاشتراك الشخصي يبدأ من 99 دولاراً لكل مستخدم بحسب صفحة IBM، فيبحث عن نسخة «مجانية» من مصدر لا يعرفه، أو يؤجل التحليل حتى يتوفر جهاز في المعمل. والحقيقة أن الأدوات التي يستخدمها أغلب الإحصائيين اليوم مجانية ومفتوحة المصدر، وتعطي الأرقام نفسها التي يعطيها SPSS إذا استخدمت الاختبار نفسه بالإعدادات نفسها. وهذا المقال موجه لطالب الدراسات العليا الذي يحلل بيانات رسالته، وللباحث وعضو هيئة التدريس الذي يريد تحليلاً يستطيع أن يعيده بعد سنة، وللمحكم ومحرر المجلة الذي يطلب من الباحثين البيانات والكود ويريد أن يعرف ماذا يطلب بالضبط.
في هذا المقال سوف نتناول:
- العائلات الأربع لأدوات التحليل الإحصائي Statistical Analysis، وأين يقع SPSS بينها، وأسعاره من صفحة IBM الرسمية.
- لغة R مع RStudio أو Positron، ولغة Python مع pandas وSciPy وstatsmodels، وبرنامجي JASP وjamovi، مع نقاط القوة ونقاط الضعف لكل منها.
- مختبر عملي: نشغل التحليل نفسه، أي اختبار t ومعامل الارتباط Correlation والانحدار الخطي Linear Regression، في R وفي Python داخل Docker، ونقارن الأرقام حتى الخانة السادسة.
- البيانات العربية: ملفات CSV بترميز Windows-1256، وأسماء الأعمدة العربية، والرسوم البيانية بعناوين عربية.
- كيف تجعل تحليلك قابلاً لإعادة الإنتاج Reproducible عندما يطلب المحكم البيانات والكود.
وإذا كنت في بداية الطريق فابدأ بمقال كيف يصل البحث العلمي من الفكرة إلى النشر لترى أين يقع التحليل في دورة البحث، وإذا كانت بياناتك من مشاركين بشر فاقرأ أولاً مقال أخلاقيات البحث على البشر وحماية البيانات، لأن ما تفعله بالملف قبل التحليل يخضع لموافقة اللجنة ولنظام حماية البيانات الشخصية.
أربع عائلات من الأدوات
قبل أن نقارن البرامج، لاحظ أن الفرق الحقيقي بينها ليس في الاختبارات نفسها، فاختبار t هو اختبار t في كل برنامج، وإنما في طريقة العمل: هل تختار التحليل من القوائم بالفأرة، أم تكتبه في سكربت Script تحفظه وتعيد تشغيله؟ والصورة التالية تبين أين تقع كل أداة:
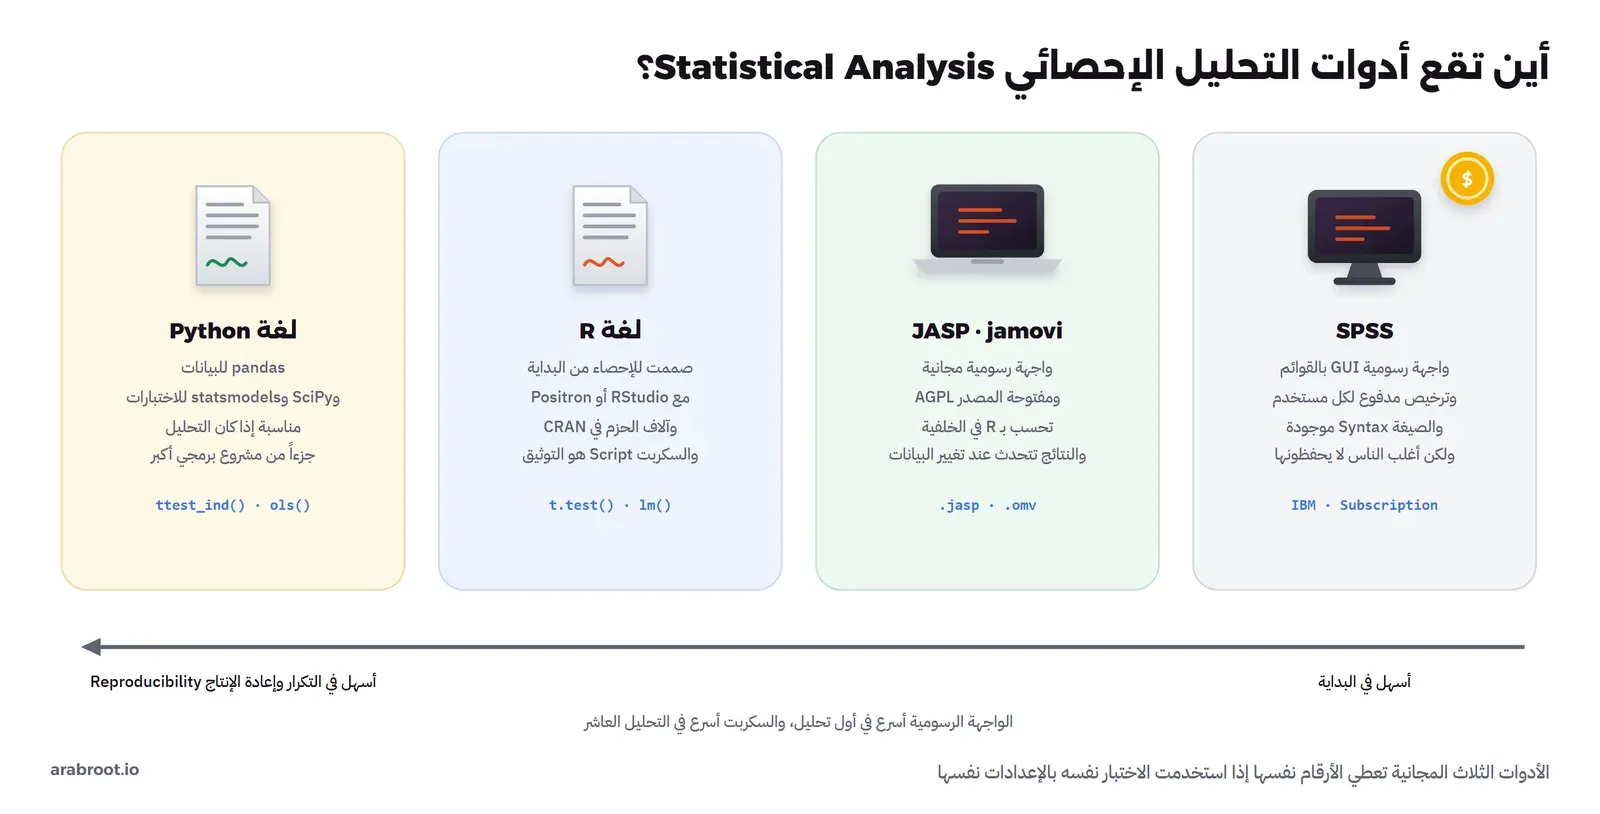
وقد يتساءل البعض: إذا كانت الأرقام واحدة فلماذا لا أبقى على SPSS إذا كانت جامعتي توفره؟ والإجابة أنك تستطيع ذلك بكل تأكيد، ولكن المشكلة تظهر في ثلاثة مواقف: عندما تنتهي علاقتك بالجامعة وتريد أن تعيد التحليل بعد التخرج، وعندما يطلب منك المحكم أن تعيد التحليل باستبعاد عشر حالات فلا تتذكر بالضبط أي القوائم اخترت قبل ستة أشهر، وعندما تنشر في مجلة تطلب مشاركة الكود Code Sharing مع البيانات. والمواقف الثلاثة تحلها أداة تعمل بالسكربت أو تحفظ خطوات التحليل في الملف نفسه.
SPSS: ماذا تدفع مقابله؟
IBM SPSS Statistics برنامج تجاري مغلق المصدر، وصفحة الأسعار الرسمية التي قرأناها يوم 23 أكتوبر 2026 تعرض الأسعار التالية للشراء المباشر من موقع IBM:
| الباقة | السعر المعلن | ماذا تضيف |
|---|---|---|
| الاشتراك الأساسي Base Subscription | يبدأ من 99 دولاراً لكل مستخدم مخول Authorized User | الإحصاء الأساسي وتجهيز البيانات وطريقة Bootstrapping |
| Custom Tables and Advanced Statistics | يبدأ من 79 دولاراً لكل مستخدم | الجداول المخصصة والنماذج الخطية المعممة GLM والنماذج المختلطة Mixed Models |
| Forecasting and Decision Trees | يبدأ من 79 دولاراً لكل مستخدم | التنبؤ بنماذج ARIMA وأشجار القرار والشبكات العصبية |
| Complex Sampling and Testing | يبدأ من 79 دولاراً لكل مستخدم | العينات المعقدة والقيم المفقودة Missing Values والاختبارات الدقيقة Exact Tests |
وفي الجدول أعلاه لاحظ التالي:
- الصفحة لا تكتب فترة الفوترة بجوار السعر، وتذكر في وصف الباقة أن الاشتراك يدفع شهرياً أو سنوياً لكل مستخدم، وأن سعر التجديد بعد السنة الأولى هو السعر المعتمد وقتها، وأن الأسعار لا تشمل الضرائب وتختلف بحسب الدولة، لذلك اعتبر الأرقام نقطة بداية وليست عرض سعر.
- الصفحة تعرض وقت قراءتها خصماً مؤقتاً على الشراء من موقع IBM، والتجديد مستثنى منه.
- ترخيص الطلاب Student License وترخيص الحرم الجامعي Campus Edition لا تذكر الصفحة سعرهما، وتقول إنهما متاحان بأسعار أكاديمية خاصة من خلال موزعين معتمدين، لذلك اسأل عمادة تقنية المعلومات في جامعتك أولاً قبل أن تشتري، فكثير من الجامعات تشتري ترخيصاً للحرم كاملاً.
وبالطبع فإن SPSS ليس أداة سيئة، فواجهته مألوفة لأجيال من الباحثين، وكثير من مقررات مناهج البحث في الجامعات العربية تدرس عليه، وله لغة أوامر اسمها SPSS Syntax تستطيع أن تحفظ بها خطوات التحليل، ولكن أغلب المستخدمين لا يحفظونها، ويبقى التحليل سلسلة نقرات لا يوجد لها أثر.
البدائل المجانية بالتفصيل
الأدوات التالية كلها مجانية، وقرأنا تراخيصها وإصداراتها من صفحاتها ومستودعاتها الرسمية يوم 23 أكتوبر 2026.
لغة R مع RStudio أو Positron
R لغة برمجة صممت للإحصاء من البداية، بترخيص GPL، وآخر إصدار عند كتابة المقال هو 4.6.1 الصادر في 24 يونيو 2026 بحسب أرشيف المصادر في CRAN. والاختبارات الأساسية مثل t.test() وcor.test() وlm() جزء من اللغة نفسها دون أي حزمة إضافية، وما زاد على ذلك تجده في آلاف الحزم Packages على CRAN. أما بيئة العمل فأشهرها RStudio من شركة Posit، ونسختها المفتوحة بترخيص AGPLv3 بحسب ملف الترخيص في المستودع، والبديل الأحدث من الشركة نفسها هو Positron الذي يدعم R وPython معاً في واجهة مبنية على VS Code، ولكن انتبه إلى أن ترخيصه هو Elastic License 2.0 بحسب ملف الترخيص في مستودعه، أي أن الكود منشور واستخدامه مجاني ولكنه ليس ترخيصاً مفتوح المصدر بالمعنى الدقيق.
نقاط القوة:
- كثير من الطرق الإحصائية الجديدة تنشر أولاً كحزمة R، وكثير من كتب الإحصاء وأوراقه المنهجية تأتي أمثلتها بلغة R.
- مخرجات الاختبارات الأساسية تشبه ما يكتب في البحث مباشرة: قيمة t ودرجات الحرية df وفترة الثقة Confidence Interval والمتوسطات.
- الرسوم البيانية بحزمة ggplot2 تخرج بجودة النشر، وتدعم العناوين العربية كما سوف نرى في المختبر.
نقاط الضعف:
- تحتاج إلى تعلم كتابة الأوامر، والأسبوع الأول صعب على من لم يبرمج من قبل.
- إصدارات الحزم تتغير، وإذا لم تثبتها فقد يعطي السكربت نفسه نتيجة مختلفة بعد سنتين، وسوف نعود إلى هذه النقطة في قسم إعادة الإنتاج.
لغة Python مع pandas وSciPy وstatsmodels
Python لغة عامة وليست إحصائية في الأصل، ولكن ثلاث مكتبات تجعلها مناسبة للتحليل: pandas لقراءة البيانات وتنظيفها في جداول DataFrame، وSciPy للاختبارات الإحصائية، وstatsmodels لنماذج الانحدار بمخرجات تشبه مخرجات SPSS وR. والإصدارات التي استخدمناها هي pandas 3.1.0 وSciPy 1.18.1 وstatsmodels 0.15.0 على Python 3.13.17، وكلها بتراخيص BSD المفتوحة.
نقاط القوة:
- مناسبة إذا كان التحليل جزءاً من مشروع أكبر: جمع البيانات من API، أو تعلم الآلة Machine Learning، أو تطبيق ويب يعرض النتائج.
- إذا كنت تعرف Python من عملك فلن تتعلم لغة جديدة من أجل الإحصاء.
نقاط الضعف:
- الإعدادات الافتراضية Defaults لبعض الاختبارات تختلف عن R وSPSS، وسوف نرى في المختبر مثالاً حقيقياً في اختبار t.
- الطرق الإحصائية المتخصصة، مثل بعض نماذج القياس النفسي Psychometrics، أقل توفراً منها في R.
JASP: واجهة رسومية مجانية بنتائج تتحدث مباشرة
JASP برنامج بواجهة رسومية تطوره جامعة أمستردام، ويحسب بلغة R في الخلفية، وآخر إصدار بحسب صفحة التحميل هو 0.99.0 الصادر في 21 أكتوبر 2026، لأنظمة Windows وmacOS وLinux (من خلال Flatpak)، بترخيص GNU AGPLv3، والصفحة تصفه بأنه مجاني بالكامل. وما يميزه أن الجدول يتحدث مباشرة عندما تغير خياراً أو تعدل البيانات، وأنه يعرض التحليل البايزي Bayesian بجانب التحليل التقليدي في كثير من الاختبارات.
نقاط القوة: لا يحتاج إلى برمجة، وواجهته قريبة من SPSS، والملف .jasp يحفظ البيانات والتحليلات وخياراتها معاً، فيعرف من يفتحه ماذا اخترت بالضبط.
نقاط الضعف: نسخة سطح المكتب فقط، ولا توجد له Docker Image رسمية لتشغيله على سيرفر، والتحليلات المتاحة هي ما في قوائمه وإضافاته Modules.
jamovi: واجهة رسومية مبنية على R ونسخة سحابية
jamovi برنامج آخر بواجهة رسومية يحسب بلغة R، وآخر إصدار بحسب صفحة الإصدارات هو 28.14 الصادر في 21 أكتوبر 2026، بعد أن غير المشروع ترقيم إصداراته من سلسلة 2.7 إلى 28. وبحسب ملف الترخيص في مستودعه فالبرنامج بترخيص AGPL3 وبعض مكوناته بترخيص GPL2 أو أحدث، والتحليلات نفسها في مشروع منفصل اسمه jmv بترخيص GPL2 أو أحدث. ونسخة سطح المكتب مجانية دائماً، وله نسخة سحابية jamovi Cloud فيها خطة Guest مجانية، وخطة Priority بسعر يختلف بحسب المنطقة، وخطة للمؤسسات بعرض سعر.
وقد يتساءل البعض: هل يمكن تشغيل jamovi على سيرفر الكلية في Docker بدلاً من تثبيته على كل جهاز؟ يوجد على Docker Hub مستودع jamovi/jamovi، ولكن آخر Image لمعالجات x86 فيه هي 2.7.4 من أغسطس 2025، أي قبل سلسلة 28 بأكثر من سنة، والوسم 28.0 مبني لمعالجات ARM فقط. وعندما شغلنا 2.7.4 فتحت الواجهة في المتصفح، ولكن السيرفر توقف تماماً عند فتح ملف CSV البيانات نفسه بالخطأ التالي:
ValueError: 4294967288 is not a valid ColumnType
Segmentation fault (core dumped)
لذلك لا ننصح بهذه الـ Image لتشغيل jamovi لطلابك، والطريق الرسمي هو نسخة سطح المكتب أو jamovi Cloud.
نقاط القوة: واجهة جدول بيانات مألوفة، ويعرض لكل تحليل كود R المقابل له إذا فعلت خيار Syntax Mode، فيصبح جسراً بين الواجهة الرسومية والسكربت.
نقاط الضعف: مثل JASP، ما لا يوجد في القوائم أو الإضافات يحتاج إلى R مباشرة، والنسخة السحابية المجانية تشغل جلسات محدودة المدة والموارد.
مختبر: التحليل نفسه في R وPython
الآن سوف نختبر الادعاء الأساسي في هذا المقال: أن الأدوات المجانية تعطي الأرقام نفسها. لنأخذ بيانات عامة معروفة هي Palmer Penguins، وهي قياسات 344 طائر بطريق من ثلاث جزر في القارة القطبية الجنوبية، منشورة بترخيص CC0 أي ملكية عامة، وفيها الكتلة بالغرام وطول الزعنفة بالمليمتر والجنس. وسوف نجيب عن ثلاثة أسئلة يعرفها كل من درس مناهج البحث:
- هل يختلف متوسط كتلة الذكور عن الإناث؟ اختبار t لعينتين مستقلتين Independent Samples t-test.
- هل يرتبط طول الزعنفة بالكتلة؟ معامل ارتباط بيرسون Pearson Correlation.
- كم تزيد الكتلة مع كل مليمتر في طول الزعنفة بعد ضبط أثر الجنس؟ الانحدار الخطي المتعدد Multiple Linear Regression.
التجهيز في Docker
نشغل كل لغة في Docker Image بإصدار مثبت، حتى لا يعتمد الناتج على ما هو مثبت في جهازك. وملف Python كما يلي:
FROM python:3.13.17-slim
RUN apt-get update && apt-get install -y --no-install-recommends fonts-hosny-amiri && rm -rf /var/lib/apt/lists/*
RUN pip install --no-cache-dir pandas==3.1.0 scipy==1.18.1 statsmodels==0.15.0 matplotlib==3.11.2
WORKDIR /work
وملف R يبدأ من Image مشروع Rocker الذي يثبت إصدار R نفسه، ونضيف إليه ggplot2 وragg للرسوم، والخط العربي Amiri، والمكتبات التي تحتاجها ragg في النظام:
FROM rocker/r-ver:4.6.1
RUN apt-get update && apt-get install -y --no-install-recommends fonts-hosny-amiri libwebpmux3 libharfbuzz0b libfribidi0 libfreetype6 libtiff6 libjpeg-turbo8 libpng16-16t64 libfontconfig1 && rm -rf /var/lib/apt/lists/*
RUN install2.r --error ggplot2 ragg
WORKDIR /work
ثم نبني الاثنين:
docker build -f Dockerfile.python -t stats-py .
docker build -f Dockerfile.r -t stats-r .
وفي الإعداد أعلاه لاحظ أن المكتبات libwebpmux3 وما بعدها ليست زيادة، ففي المحاولة الأولى بدونها توقف السكربت عند تحميل ragg بالخطأ التالي، لأن الحزمة تنزل جاهزة Binary وتفترض وجود مكتبات النظام:
Error in dyn.load(file, DLLpath = DLLpath, ...) :
  unable to load shared object '/usr/local/lib/R/site-library/ragg/libs/ragg.so':
  libwebpmux.so.3: cannot open shared object file: No such file or directory
سكربت R
السكربت التالي يقرأ الملف، ويحذف الصفوف التي ينقصها الجنس أو القياسات، ثم يشغل الاختبارات الثلاثة، ويكتب في النهاية الأرقام الأساسية بصيغة ثابتة في ملف لنقارنه بملف Python:
d <- read.csv("penguins.csv", na.strings = "NA")
d <- na.omit(d[, c("species", "flipper_length_mm", "body_mass_g", "sex")])
cat("rows used:", nrow(d), "\n")

# 1) body mass by sex: Welch t-test (R default) and Student t-test
welch   <- t.test(body_mass_g ~ sex, data = d)
student <- t.test(body_mass_g ~ sex, data = d, var.equal = TRUE)
print(welch)

# 2) flipper length vs body mass: Pearson correlation
pear <- cor.test(d$flipper_length_mm, d$body_mass_g, method = "pearson")
print(pear)

# 3) linear regression
m <- lm(body_mass_g ~ flipper_length_mm + sex, data = d)
print(summary(m))

# key numbers in a fixed format, to compare with Python
s <- summary(m)
k <- c(
  sprintf("welch_t      %.6f", welch$statistic),
  sprintf("welch_df     %.6f", welch$parameter),
  sprintf("welch_p      %.6e", welch$p.value),
  sprintf("student_t    %.6f", student$statistic),
  sprintf("student_p    %.6e", student$p.value),
  sprintf("pearson_r    %.6f", pear$estimate),
  sprintf("pearson_ci   %.6f %.6f", pear$conf.int[1], pear$conf.int[2]),
  sprintf("pearson_p    %.6e", pear$p.value),
  sprintf("b_intercept  %.6f", coef(m)[1]),
  sprintf("b_flipper    %.6f", coef(m)[2]),
  sprintf("b_male       %.6f", coef(m)[3]),
  sprintf("se_flipper   %.6f", s$coefficients[2, 2]),
  sprintf("r_squared    %.6f", s$r.squared),
  sprintf("adj_r2       %.6f", s$adj.r.squared)
)
writeLines(k, "out/key-r.txt")
ونشغله بالأمر التالي:
docker run --rm -v "$PWD:/work" stats-r Rscript analysis.Rوالمخرج سوف يكون كما يلي (اختصرنا منه سطر البواقي Residuals):
rows used: 333

	Welch Two Sample t-test

data:  body_mass_g by sex
t = -8.5545, df = 323.9, p-value = 4.794e-16
alternative hypothesis: true difference in means between group female and group male is not equal to 0
95 percent confidence interval:
 -840.5783 -526.2453
sample estimates:
mean in group female   mean in group male
            3862.273             4545.685

	Pearson's product-moment correlation

data:  d$flipper_length_mm and d$body_mass_g
t = 32.562, df = 331, p-value < 2.2e-16
alternative hypothesis: true correlation is not equal to 0
95 percent confidence interval:
 0.8447622 0.8963550
sample estimates:
      cor
0.8729789

Coefficients:
                   Estimate Std. Error t value Pr(>|t|)
(Intercept)       -5410.300    285.798 -18.931  < 2e-16 ***
flipper_length_mm    46.982      1.441  32.598  < 2e-16 ***
sexmale             347.850     40.342   8.623 2.78e-16 ***

Residual standard error: 355.9 on 330 degrees of freedom
Multiple R-squared:  0.8058,	Adjusted R-squared:  0.8047
F-statistic: 684.8 on 2 and 330 DF,  p-value: < 2.2e-16
وفي المخرج أعلاه لاحظ التالي:
- استخدم التحليل 333 صفاً من أصل 344، لأن 11 طائراً لم يسجل جنسها، واثنين منها لا توجد لهما قياسات أصلاً، وهذا الرقم يجب أن يظهر في قسم المنهجية في بحثك، فالمحكم يسأل دائماً: أين ذهبت بقية العينة؟
- متوسط الإناث 3862.273 غراماً ومتوسط الذكور 4545.685، والفرق دال إحصائياً، وفترة الثقة للفرق بين 526 و841 غراماً تقريباً.
- الارتباط قوي جداً، r = 0.873، وR تكتب قيمة p بالشكل
< 2.2e-16لأنها أصغر مما تعرضه افتراضياً، وليس لأنها تساوي هذا الرقم. - في الانحدار، كل مليمتر في طول الزعنفة يضيف قرابة 47 غراماً بعد ضبط الجنس، والذكر يزيد بقرابة 348 غراماً عند الطول نفسه، والنموذج يفسر 80.6% من التباين R².
سكربت Python
والسكربت نفسه في Python كما يلي:
import pandas as pd
import scipy.stats as st
import statsmodels.formula.api as smf

d = pd.read_csv("penguins.csv")
d = d.dropna(subset=["species", "flipper_length_mm", "body_mass_g", "sex"])
print("rows used:", len(d))

female = d.loc[d.sex == "female", "body_mass_g"]
male = d.loc[d.sex == "male", "body_mass_g"]

# 1) body mass by sex: Welch t-test and Student t-test (scipy default is Student)
welch = st.ttest_ind(female, male, equal_var=False)
student = st.ttest_ind(female, male)
print(welch, welch.confidence_interval())

# 2) flipper length vs body mass: Pearson correlation
pear = st.pearsonr(d.flipper_length_mm, d.body_mass_g)
ci = pear.confidence_interval()
print(pear, ci)

# 3) linear regression
m = smf.ols("body_mass_g ~ flipper_length_mm + sex", data=d).fit()
print(m.summary())
# ... the same key numbers written to out/key-py.txt
ونشغله بالأمر التالي:
docker run --rm -v "$PWD:/work" stats-py python -I analysis.pyوالجزء الأهم من المخرج هو جدول الانحدار من statsmodels:
rows used: 333
TtestResult(statistic=np.float64(-8.554537231165762), pvalue=np.float64(4.793891255051507e-16), df=np.float64(323.89588102864843)) ConfidenceInterval(low=np.float64(-840.5782615026451), high=np.float64(-526.2453315709477))
PearsonRResult(statistic=np.float64(0.8729788985653616), pvalue=np.float64(3.1328362509712445e-105)) ConfidenceInterval(low=np.float64(0.8447621646757955), high=np.float64(0.8963549843006371))
                            OLS Regression Results
==============================================================================
Dep. Variable:            body_mass_g   R-squared:                       0.806
Model:                            OLS   Adj. R-squared:                  0.805
Method:                 Least Squares   F-statistic:                     684.8
No. Observations:                 333   AIC:                             4860.
=====================================================================================
                        coef    std err          t      P>|t|      [0.025      0.975]
-------------------------------------------------------------------------------------
Intercept         -5410.3002    285.798    -18.931      0.000   -5972.515   -4848.085
sex[T.male]         347.8503     40.342      8.623      0.000     268.491     427.209
flipper_length_mm    46.9822      1.441     32.598      0.000      44.147      49.817
ولاحظ أن قيمة p للارتباط التي كتبتها R بالشكل < 2.2e-16 تظهر هنا كاملة: 3.13 × 10-105، فالرقم واحد والعرض مختلف، وstatsmodels تكتب 0.000 في جدول الانحدار لنفس السبب. ولا تكتب في بحثك «p = 0.000» أبداً، والسبب أن قيمة p لا تساوي صفراً، والصيغة المعتمدة في أغلب أدلة الكتابة هي p < .001.
المقارنة حتى الخانة السادسة
الآن نقارن الملفين اللذين كتبهما السكربتان بالأمر diff، والذي لا يطبع شيئاً إذا تطابق الملفان:
diff out/key-r.txt out/key-py.txt && echo IDENTICALوالمخرج سوف يكون كما يلي، ومعه محتوى الملف نفسه:
IDENTICAL

welch_t      -8.554537
welch_df     323.895881
welch_p      4.793891e-16
student_t    -8.541720
student_p    4.897247e-16
pearson_r    0.872979
pearson_ci   0.844762 0.896355
pearson_p    3.132836e-105
b_intercept  -5410.300224
b_flipper    46.982175
b_male       347.850254
se_flipper   1.441257
r_squared    0.805837
adj_r2       0.804661
أربعة عشر رقماً متطابقة حتى الخانة السادسة بين لغتين مختلفتين ومكتبات كتبتها فرق مختلفة، وهذا منطقي لأن الاختبارات معادلات معروفة منشورة، والبرنامج الجيد ينفذ المعادلة نفسها. ولكن هذا التطابق لم يحدث تلقائياً، وإنما لأننا طلبنا في Python الاختبار نفسه صراحة، والتفصيل في القسم التالي.
نجرب العطل: اختبار t بالإعداد الافتراضي Default
اختبار t لعينتين له صيغتان: صيغة Student التي تفترض تساوي التباين Equal Variances في المجموعتين، وصيغة Welch التي لا تفترضه. والإعداد الافتراضي في R هو Welch، أما في SciPy فالإعداد الافتراضي للدالة ttest_ind هو Student، أي equal_var=True بحسب توثيق الدالة. فإذا كتبت st.ttest_ind(female, male) دون أي خيار، وقارنت الناتج بـ t.test() في R، فسوف تجد قيمتين مختلفتين:
| الاستدعاء | الصيغة | t | p |
|---|---|---|---|
t.test(body_mass_g ~ sex) في R | Welch | -8.554537 | 4.793891e-16 |
ttest_ind(female, male) في SciPy | Student | -8.541720 | 4.897247e-16 |
والفرق هنا صغير لأن تباين المجموعتين متقارب والعينة كبيرة، ولكنه في عينة صغيرة بتباين مختلف قد ينقل النتيجة من دالة إلى غير دالة. وSPSS يعرض الصيغتين في جدول واحد بسطرين «Equal variances assumed» و«Equal variances not assumed» مع اختبار Levene، فينسخ الباحث أحياناً السطر الخطأ. لذلك اكتب الخيار صراحة في كل اختبار، ولا تعتمد على الإعداد الافتراضي لأي أداة، واذكر في البحث أي صيغة استخدمت.
البيانات العربية: الترميز Encoding والأسماء والرسوم
البيانات في بحوثنا عربية في الغالب: استبانة بأسماء أعمدة عربية، وإجابات مثل «ذكر» و«أنثى» و«موافق بشدة». ولكي نختبر ذلك أنشأنا نسخة من البيانات نفسها بأعمدة وقيم عربية، وحفظناها مرتين: بترميز UTF-8، وبترميز Windows-1256 الذي يستخدمه Excel عند الحفظ بصيغة «CSV (Comma delimited)» على Windows بلغة عربية.
ملف CSV لا يقرأ
عند قراءة ملف Windows-1256 في R بالإعداد الافتراضي:
read.csv("penguins-ar-1256.csv")يتوقف بالخطأ التالي:
invalid multibyte string at '<c7><e1><e4><e6><da>'وفي pandas يتوقف بخطأ آخر يقول الشيء نفسه:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xc7 in position 0: invalid continuation byteوالبايتات c7 e1 e4 e6 da هي كلمة «النوع» بترميز Windows-1256، أي أول عمود في الملف، والأداة تحاول قراءتها على أنها UTF-8 فتفشل. والحل أن تخبر الأداة بالترميز:
read.csv("penguins-ar-1256.csv", fileEncoding = "CP1256")pd.read_csv("penguins-ar-1256.csv", encoding="cp1256")والمخرج في الحالتين أسماء الأعمدة صحيحة:
"النوع" "الجزيرة" "طول_الزعنفة_مم" "الكتلة_غرام" "الجنس"والحل الأفضل من ذلك أن تحفظ الملف من Excel بصيغة «CSV UTF-8 (Comma delimited)» من البداية، وتجعل UTF-8 قاعدة لكل ملفات البحث.
التحليل بأسماء عربية
بعد قراءة الملف الصحيح يعمل التحليل بالأسماء العربية دون مشكلة، والمثال التالي في R يحدد ترتيب الفئات ثم يشغل اختبار t:
d <- read.csv("penguins-ar-utf8.csv")
d$الجنس <- factor(d$الجنس, levels = c("أنثى", "ذكر"))
print(table(d$الجنس, useNA = "ifany"))
print(t.test(الكتلة_غرام ~ الجنس, data = d))
والمخرج سوف يكون كما يلي، والأرقام هي نفسها التي رأيناها بالأسماء الإنجليزية:
أنثى  ذكر <NA>
 165  168   11

	Welch Two Sample t-test

data:  الكتلة_غرام by الجنس
t = -8.5545, df = 323.9, p-value = 4.794e-16
95 percent confidence interval:
 -840.5783 -526.2453
sample estimates:
mean in group أنثى  mean in group ذكر
          3862.273           4545.685
ولاحظ سطر <NA>: إحدى عشرة حالة بلا جنس، والأداة تخبرك بها إذا طلبت useNA، وتسقطها بصمت من الاختبار إذا لم تطلب.
الرسوم البيانية Charts بعناوين عربية
هنا كانت المشكلة القديمة: الحروف العربية تظهر منفصلة ومعكوسة في رسوم Python. وفي R مع ggplot2 وجهاز الرسم ragg تظهر العناوين صحيحة لأن ragg يستخدم مكتبة textshaping لتشكيل الحروف Text Shaping، والكود كما يلي:
library(ggplot2)
p <- ggplot(na.omit(d), aes(x = الجنس, y = الكتلة_غرام)) +
  geom_boxplot(fill = "#3F78E0", alpha = .35) +
  labs(title = "كتلة البطريق حسب الجنس", x = "الجنس", y = "الكتلة (غرام)") +
  theme_minimal(base_family = "Amiri", base_size = 16)
ragg::agg_png("out/r-arabic-plot.png", width = 900, height = 600, res = 120)
print(p)
invisible(dev.off())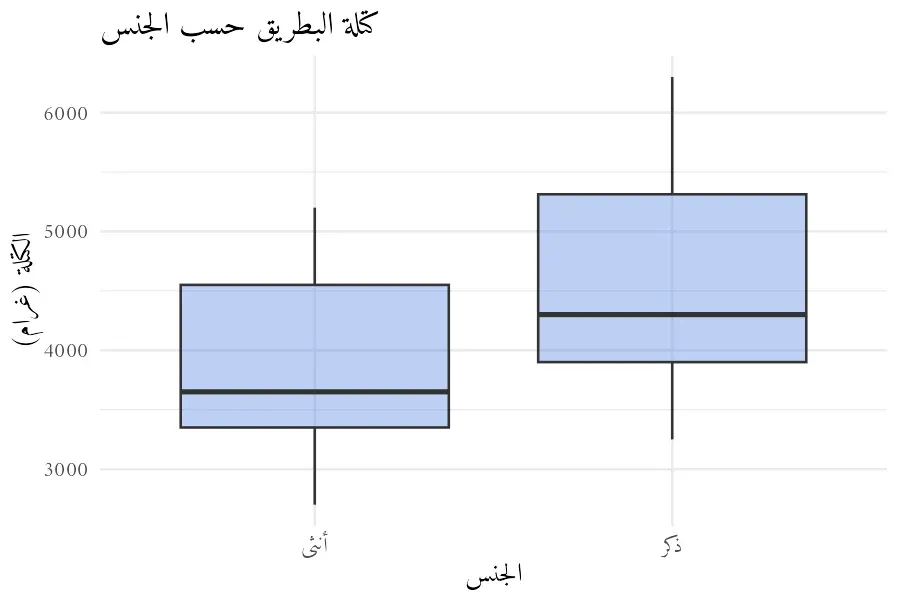
ولاحظ أن العنوان في يسار الرسم، فإذا أردته في اليمين أضف theme(plot.title = element_text(hjust = 1)).
أما في Python فقد تغير الوضع هذه السنة، فقد أضاف matplotlib في الإصدار 3.11 دعم التخطيط المعقد للنص Complex Text Layout من خلال مكتبة libraqm، وتذكر ملاحظات الإصدار صراحة اللغة العربية والنص المختلط بين الاتجاهين، وتطلب إزالة الحل القديم الذي كان يعتمد على مكتبتي arabic_reshaper وpython-bidi. ولكي نرى أثر ذلك رسمنا العنوان نفسه بالطريقتين على إصدارين:
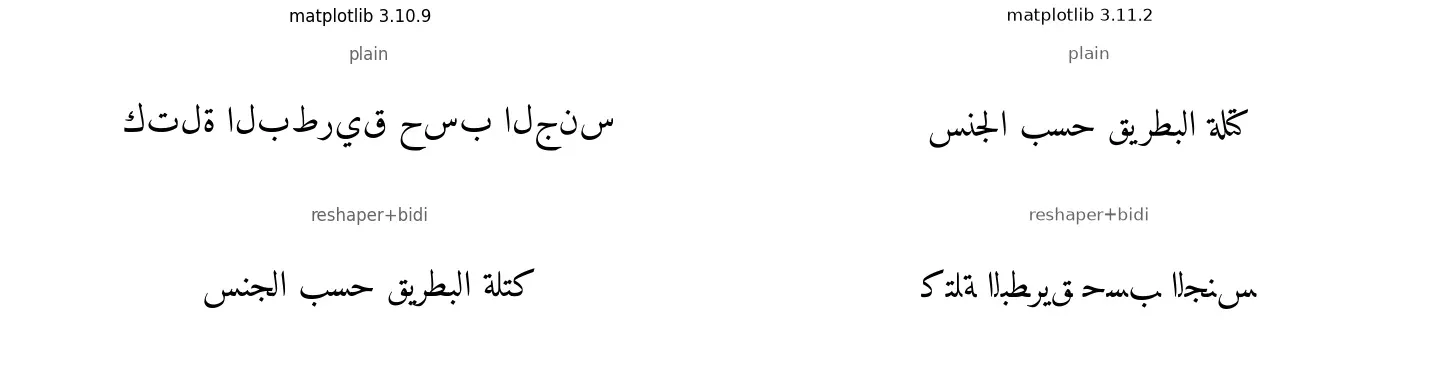
وفي الصورة أعلاه لاحظ التالي:
- في matplotlib 3.10.9 يظهر النص العادي بحروف منفصلة وترتيب معكوس، والحل القديم يصلحه.
- في matplotlib 3.11.2 يظهر النص العادي صحيحاً دون أي مكتبة إضافية، والحل القديم يعكسه لأن الإصدار الجديد يعيد ترتيب نص قد رتبته المكتبتان من قبل.
- لذلك إذا ورثت سكربتاً من زميل فيه
get_display(arabic_reshaper.reshape(...))ثم حدثت matplotlib، فسوف تخرج عناوينك مقلوبة، فاحذف السطر وثبت رقم الإصدار في ملف المتطلبات.
اجعل التحليل قابلاً لإعادة الإنتاج Reproducible
إعادة الإنتاج Reproducibility تعني أن يأخذ شخص آخر بياناتك وكودك فيصل إلى الأرقام نفسها في جداولك، والصورة التالية تبين ما تحتاج إليه:
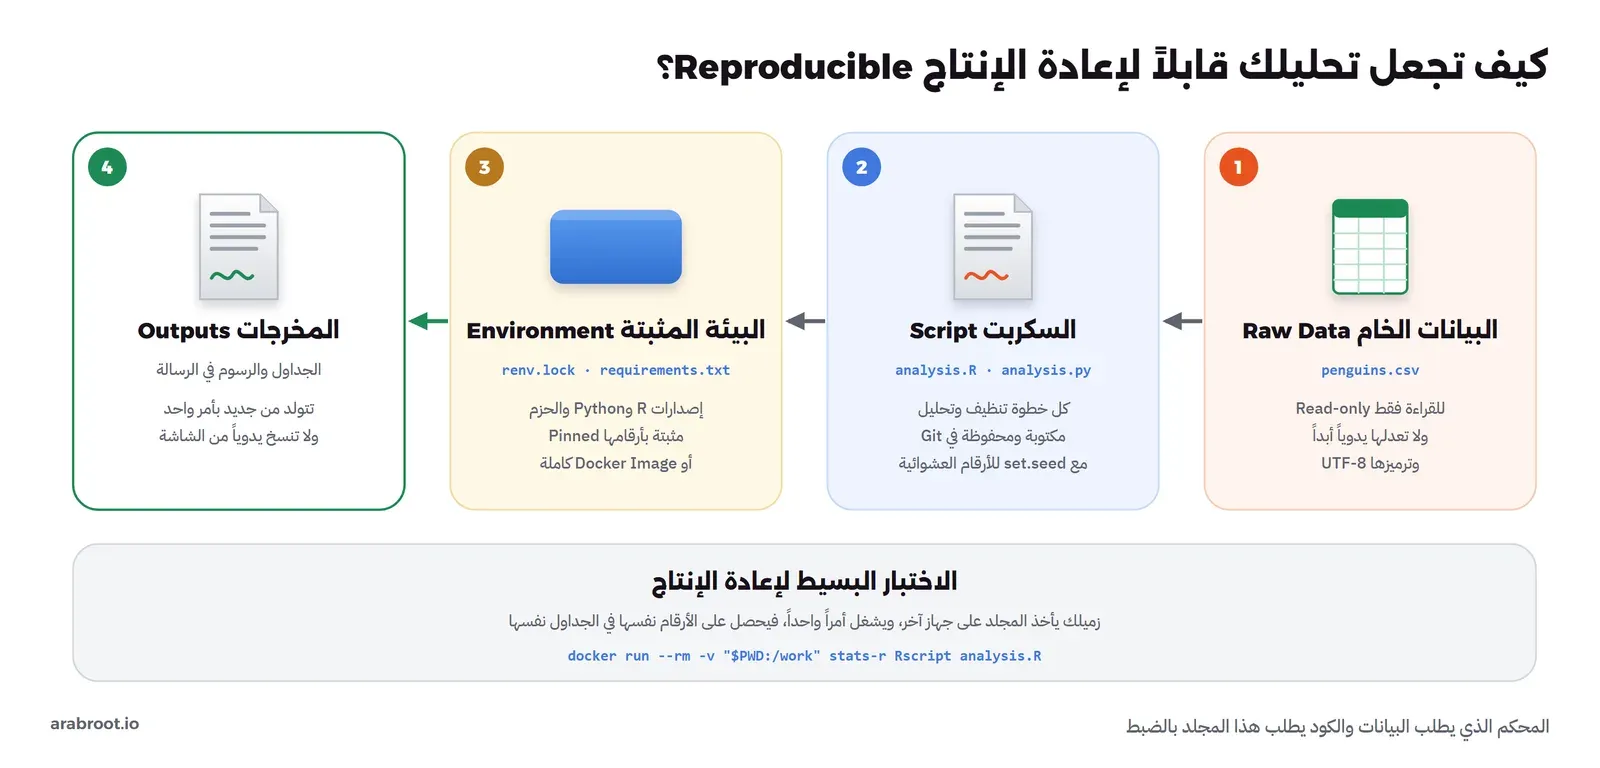
- البيانات الخام Raw Data للقراءة فقط: لا تعدل الملف الأصلي في Excel أبداً، وكل تنظيف أو استبعاد لحالات يكون سطراً في السكربت، لأن التعديل اليدوي لا يترك أثراً يراه المحكم أو تراه أنت بعد سنة.
- السكربت في Git: كل خطوة من القراءة إلى الجدول الأخير مكتوبة، ومحفوظة بتاريخها، وإذا استخدمت أرقاماً عشوائية في Bootstrapping أو المحاكاة فثبت البذرة
set.seed(2026)في R أوnumpy.random.default_rng(2026)في Python. - البيئة المثبتة: في Python ثبت الإصدارات في ملف
requirements.txtكما فعلنا في Dockerfile، وفي R استخدم حزمة renv التي تكتب إصدار كل حزمة في ملفrenv.lock. - المخرجات تتولد ولا تنسخ: الجدول الذي في الرسالة يأتي من ملف يكتبه السكربت، وليس من نسخ الأرقام يدوياً من الشاشة، فإذا تغير شيء أعدت تشغيل السكربت وتحدثت الجداول كلها.
وقد يتساءل البعض: ألا يكفي أن أكتب في الرسالة «R 4.6.1»؟ والإجابة لا، والسبب أن إصدار R لا يحدد إصدارات الحزم. وفي المختبر نفسه ثبتنا rocker/r-ver:4.6.1، ولكن عند فحص الإعداد داخل الـ Container وجدنا أن مستودع الحزم فيه هو https://p3m.dev/cran/__linux__/noble/latest، أي أحدث الحزم يوم البناء، فقد أعطانا ggplot2 4.0.3 وragg 1.5.2 اليوم، وسوف يعطي غيرها لو بنيت الـ Image بعد سنة. لذلك سجل إصدارات الحزم نفسها، بملف renv.lock أو بإخراج sessionInfo() في ملحق الرسالة، واحتفظ بالـ Docker Image نفسها إذا كان التحليل سيعاد بعد النشر.
ولمن يكتب الرسالة نفسها في LaTeX أو Quarto فإن الخطوة التالية الطبيعية أن تتولد الجداول والرسوم داخل الملف مباشرة، وهذا ما شرحناه في مقال Word أم LaTeX لكتابة الرسالة وأين يقف Quarto، أما حفظ البيانات نفسها ووصفها ومشاركتها فموضوع مقال إدارة بيانات البحث ومبادئ FAIR.
كيف تختار؟
| حالتك | الأنسب | والسبب |
|---|---|---|
| تحليل رسالة باختبارات معروفة، ولم تبرمج من قبل | JASP أو jamovi | مجانيان بواجهة قريبة من SPSS، والملف يحفظ خيارات التحليل |
| باحث سوف يحلل بيانات لسنوات، أو قسم يدرس الإحصاء | R مع RStudio | أوسع مكتبة إحصائية، والسكربت هو التوثيق |
| التحليل جزء من نظام أو مشروع بيانات أو تعلم آلة | Python | لغة واحدة من جمع البيانات إلى النتيجة |
| جامعتك توفر SPSS وقسمك يعتمد عليه | SPSS مع حفظ الـ Syntax | استخدمه، ولكن احفظ ملف الأوامر مع البيانات، وجرب jamovi على التحليل نفسه لتعرف أنك تستطيع الخروج |
وللمحكم ومحرر المجلة: عندما تطلب من الباحث «البيانات والكود» فاطلب أربعة أشياء محددة: البيانات الخام أو نسخة مجهلة منها، والسكربت الكامل من القراءة إلى الجداول، وإصدارات الأدوات والحزم، وعدد الحالات المستبعدة وسببها. وإذا كان التحليل بواجهة رسومية فاطلب ملف .jasp أو .omv أو ملف SPSS Syntax، لأن لقطات الشاشة لا تكفي لإعادة التحليل.
أخطاء شائعة
- الاعتماد على الإعداد الافتراضي: رأينا أن اختبار t في SciPy يفترض تساوي التباين وفي R لا يفترضه، فاكتب الخيار صراحة واذكره في البحث.
- كتابة p = 0.000: هذا ما تعرضه الأداة عندما تكون القيمة أصغر من خاناتها، والصحيح p < .001.
- ملفات CSV بترميز Windows-1256: احفظ بصيغة CSV UTF-8 من Excel، أو أخبر الأداة بالترميز صراحة.
- الحالات المفقودة الصامتة: الاختبار يسقط الصفوف الناقصة دون أن يخبرك، لذلك اطبع عدد الحالات المستخدمة في كل تحليل.
- حلول قديمة للعربية في الرسوم: arabic_reshaper مع matplotlib 3.11 يقلب النص، فاحذفه بعد الترقية.
- نسخة SPSS «مجانية» من مصدر مجهول: غير قانونية، وقد تحمل برمجيات خبيثة، والبدائل القانونية المجانية تعطي النتائج نفسها.
الخلاصة
- SPSS يبدأ من 99 دولاراً لكل مستخدم للاشتراك الأساسي و79 دولاراً لكل إضافة بحسب صفحة IBM يوم 23 أكتوبر 2026، والبدائل المجانية تعطي الأرقام نفسها إذا استخدمت الاختبار نفسه.
- شغلنا اختبار t والارتباط والانحدار في R 4.6.1 وفي Python بمكتبات SciPy وstatsmodels، فتطابقت أربعة عشر رقماً حتى الخانة السادسة.
- الإعدادات الافتراضية تختلف بين الأدوات، واختبار t مثال حقيقي على ذلك.
- JASP وjamovi مجانيان ومفتوحا المصدر بواجهة رسومية، وهما البداية الأنسب لمن لا يبرمج.
- البيانات العربية تعمل في R وPython إذا كان الترميز UTF-8، والرسوم العربية صحيحة في ggplot2 مع ragg وفي matplotlib 3.11 دون أي حل إضافي.
- إعادة الإنتاج تحتاج إلى بيانات خام لا تعدل، وسكربت في Git، وإصدارات مثبتة للأدوات والحزم.
وفي المقال التالي من هذه المرحلة بإذن الله سوف نتناول استخدام الذكاء الاصطناعي في الكتابة الأكاديمية: ما الذي تسمح به المجلات والجامعات، وما الذي يعد مخالفة.
تدريب عملي
- خذ بيانات استبانة سابقة لك، واحفظها بصيغة CSV UTF-8، ثم شغل عليها اختبار t واحداً في jamovi واختباراً مماثلاً في R، وقارن قيمة t ودرجات الحرية، وتأكد أنك اخترت الصيغة نفسها في الأداتين.
- اكتب ملف
requirements.txtأوrenv.lockلمشروع تحليل حالي، ثم اطلب من زميل أن يشغله على جهازه، وسجل كم خطوة احتاج إليها حتى وصل إلى أرقامك.
سجل التحديثات
أكتوبر 2026: كتابة المقال وتشغيل المختبر على R 4.6.1 وPython 3.13.17 مع pandas 3.1.0 وSciPy 1.18.1 وstatsmodels 0.15.0 وmatplotlib 3.11.2، وقراءة أسعار SPSS بتاريخ 23 أكتوبر 2026.


