

لنفرض أن لديك شركة ناشئة تبني محفظة إلكترونية للعمال المستقلين، يستلمون فيها أجورهم من الشركات ويحولون منها لعائلاتهم ويدفعون للمتاجر، والفريق أنهى شاشة التسجيل وربطها بالتحقق من الهوية، والتطبيق جاهز للإطلاق التجريبي. ثم جلست مسؤولة الالتزام Compliance Officer مع المهندسين وسألت سؤالاً واحداً: «عندما يسجل عميل اسمه محمد عبدالرحمن الشهري، كيف نعرف أنه ليس شخصاً مدرجاً في قوائم العقوبات Sanctions Lists؟». فقال أحد المهندسين إننا نبحث عن الاسم في القائمة، فسألته: بأي كتابة؟ فالاسم في الهوية بالعربية، والقائمة الدولية بالإنجليزية، وفي القائمة قد يكون مكتوباً Muhammad أو Mohamed، وقد تكون «عبدالرحمن» كلمة واحدة أو كلمتين. ثم أضافت أن مزود خدمة الفحص الذي جربوه الأسبوع الماضي نبه على أربعين عميلاً تجريبياً من أول مئة، فهل نوقف أربعين عميلاً من كل مئة حتى يراجعهم أحد؟
هذا السؤال هو قلب معرفة العميل Know Your Customer واختصاراً KYC، ومكافحة غسل الأموال Anti-Money Laundering واختصاراً AML، في أي منتج يحرك المال. والمهندس الذي يبني هذا الجزء يحتاج أن يفهم ثلاثة أشياء معاً: ما الذي يطلبه النظام في المملكة بالضبط ومن نصوصه الرسمية، وكيف تعمل مطابقة الأسماء Name Matching من الداخل، ولماذا تعطي العربية هذه المطابقة صعوبة خاصة. ولن نكتفي بالكلام، وإنما سوف نفحص في مختبر بلغة Python عشرين ألف عميل مولد مقابل قائمة مجلس الأمن الموحدة كما تنشرها OpenSanctions، ونقيس كم شخصاً مدرجاً نمسك، وكم عميلاً بريئاً نوقف، مع كل طريقة.
سوف نناقش في هذا المقال:
- ما الذي يطلبه نظام مكافحة غسل الأموال ودليل البنك المركزي السعودي من المنتج: العناية الواجبة، والتصنيف بحسب المخاطر، والمراقبة، والبلاغ، والحفظ.
- قواعد تطبيق العقوبات المالية المستهدفة الصادرة في ديسمبر 2025، ولماذا تذكر الكتابات المختلفة للاسم والأسماء المتشابهة نطقاً بالاسم.
- لماذا مطابقة الأسماء العربية صعبة، وقصة حقيقية لغرامة سببها خوارزمية مطابقة ضعيفة.
- مختبر على قائمة مجلس الأمن: المطابقة التامة، ثم التقريبية، ثم الهيكل الساكن للاسم العربي، ثم سنة الميلاد، وماذا يحدث مع كل عتبة.
- مشكلتان واجهناهما في المختبر وكيف حللناهما، وأربع تجارب «ماذا لو»، وماذا يحدث عندما تتحدث القائمة.
- ماذا يحدث بعد التنبيه، والسجلات، والأدوات مفتوحة المصدر، وأخطاء شائعة، وقائمة تحقق.
معرفة العميل ومكافحة غسل الأموال: ما الفرق؟
الكلمتان تظهران معاً دائماً، ولكنهما ليستا الشيء نفسه. فمعرفة العميل KYC هي ما تفعله عند بداية العلاقة وطوالها لتعرف من هو العميل فعلاً: اسمه الكامل من وثيقة رسمية، وتاريخ ميلاده، وجنسيته، وعنوانه، ومصدر دخله، ومن يملك الحساب فعلاً إذا كان شركة. أما مكافحة غسل الأموال AML فهي البرنامج كله الذي تكون معرفة العميل جزءاً منه: تقييم المخاطر، والفحص مقابل القوائم، ومراقبة العمليات، والبلاغ عن الاشتباه، وحفظ السجلات، والتدريب. ومعها دائماً مكافحة تمويل الإرهاب Counter-Terrorist Financing واختصاراً CTF، لأن الأدوات نفسها تخدم الهدفين.
وغسل الأموال Money Laundering باختصار هو إدخال مال جاء من جريمة في النظام المالي بحيث يبدو مشروعاً، ولذلك يحتاج الغاسل إلى منتج مالي يقبله دون أسئلة كثيرة، وهنا تقع المحفظة الناشئة في القصة: منتج جديد، وتسجيل سريع من الجوال، وتحويلات صغيرة كثيرة. وتمويل الإرهاب عكسه في الاتجاه، فقد يكون المال نظيفاً في مصدره، ولكنه يذهب لغرض محظور، وقد تكون المبالغ صغيرة جداً. والنتيجة للمهندس واحدة: النظام يجب أن يعرف من العميل، ومن الطرف الآخر في كل عملية، وهل أحدهما مدرج في قائمة.
ما الذي يطلبه النظام في المملكة؟
المرجع الأول هو نظام مكافحة غسل الأموال الصادر بالمرسوم الملكي م/20 بتاريخ 5/2/1439هـ الموافق 25 أكتوبر 2017، كما ينشره دليل قواعد البنك المركزي السعودي SAMA. ومنه مواد تمس تصميم المنتج مباشرة، وهذه أهمها كما وردت في النص:
| المادة | ما تطلبه | ما يعنيه للمهندس |
|---|---|---|
| 5 | تحديد مخاطر غسل الأموال وتقييمها وتوثيقها، ومنها مخاطر المنتجات والتقنيات الجديدة قبل استخدامها | إطلاق ميزة جديدة مثل التحويل الدولي يحتاج تقييماً موثقاً قبله |
| 6 | منع الحسابات المجهولة أو بأسماء وهمية أو الحسابات الرقمية | لا يفتح حساب في المحفظة قبل التحقق من الاسم |
| 7 | تطبيق العناية الواجبة، وتعزيزها عند ارتفاع المخاطر | مسار تسجيل يختلف بحسب تصنيف العميل |
| 8 | أنظمة مناسبة لمعرفة هل العميل شخص معرض سياسياً | فحص مقابل قوائم PEP وليس العقوبات فقط |
| 10 | بيانات المرسل والمستفيد تبقى مع الحوالة في كل السلسلة | لا تنفذ حوالة ناقصة البيانات |
| 12 | حفظ السجلات عشر سنوات على الأقل، بما فيها نتائج التحليل | نتيجة كل فحص تحفظ، لا آخر حالة فقط |
| 13 | مراقبة العمليات باستمرار، وفحص المعقد وغير المعتاد | نظام مراقبة للعمليات بعد التسجيل |
| 15 و16 | البلاغ فوراً للإدارة العامة للتحريات المالية، ومنع إبلاغ العميل بذلك | شاشات ورسائل لا تكشف للعميل وجود بلاغ |
والمادة 17 تجعل الإدارة العامة للتحريات المالية تحت إشراف رئيس أمن الدولة، وهي الجهة الوطنية التي تستقبل بلاغات الاشتباه Suspicious Transaction Report واختصاراً STR، ويسميها دليل البنك المركزي باختصار SAFIU. ولاحظ أن المادة 16 لها أثر مباشر على الكود: لا يجوز أن يظهر للعميل في التطبيق ما يدل على أن بلاغاً رفع عنه، وهذا يعني أن رسائل الخطأ وحالات الحساب يجب أن تصمم مع فريق الالتزام، لا أن يكتبها المطور كما تخطر له.
ثم يأتي دليل مكافحة غسل الأموال وتمويل الإرهاب الذي أصدره البنك المركزي بالتعميم المؤرخ 20/3/1441هـ الموافق 17 نوفمبر 2019، وهو يشرح كيف تطبق المؤسسة المالية هذه المواد. ففي الفقرة 3.3 من قسم العناية الواجبة يطلب للشخص الطبيعي الاسم الكامل بحسب الوثائق الرسمية، والعنوان الوطني أو مكان الإقامة، وتاريخ الميلاد ومكانه، والجنسية، ومصدر الدخل، وأن يكون التحقق من مصدر مستقل لا من المؤسسة ولا من العميل نفسه، ويعطي الوثائق الحكومية مثالاً على المصدر المستقل. وفي الفقرة 3.9 يقول إن العميل لا يحتاج أن يحضر عند تحديث بياناته ما دامت تستخدم خدمات التحقق الإلكتروني المعتمدة من مركز المعلومات الوطني، وهذا ما يسمح لمحفظة مثل التي في القصة أن تسجل عملاءها من الجوال. وفي الفقرة 3.12 يطلب فحص أسماء العملاء والمالكين المستفيدين والمديرين ومن يتصرف عنهم مقابل قوائم العقوبات المحلية وقوائم الأمم المتحدة، قبل العلاقة أو العملية أو أثناءها.
كيف تبدو هذه الطبقات في منتج واحد؟
إذا جمعنا المواد والفقرات السابقة في شكل يفهمه فريق هندسي، نحصل على خمس طبقات، كل منها نظام صغير له مدخلات ومخرجات، كما في الصورة التالية:
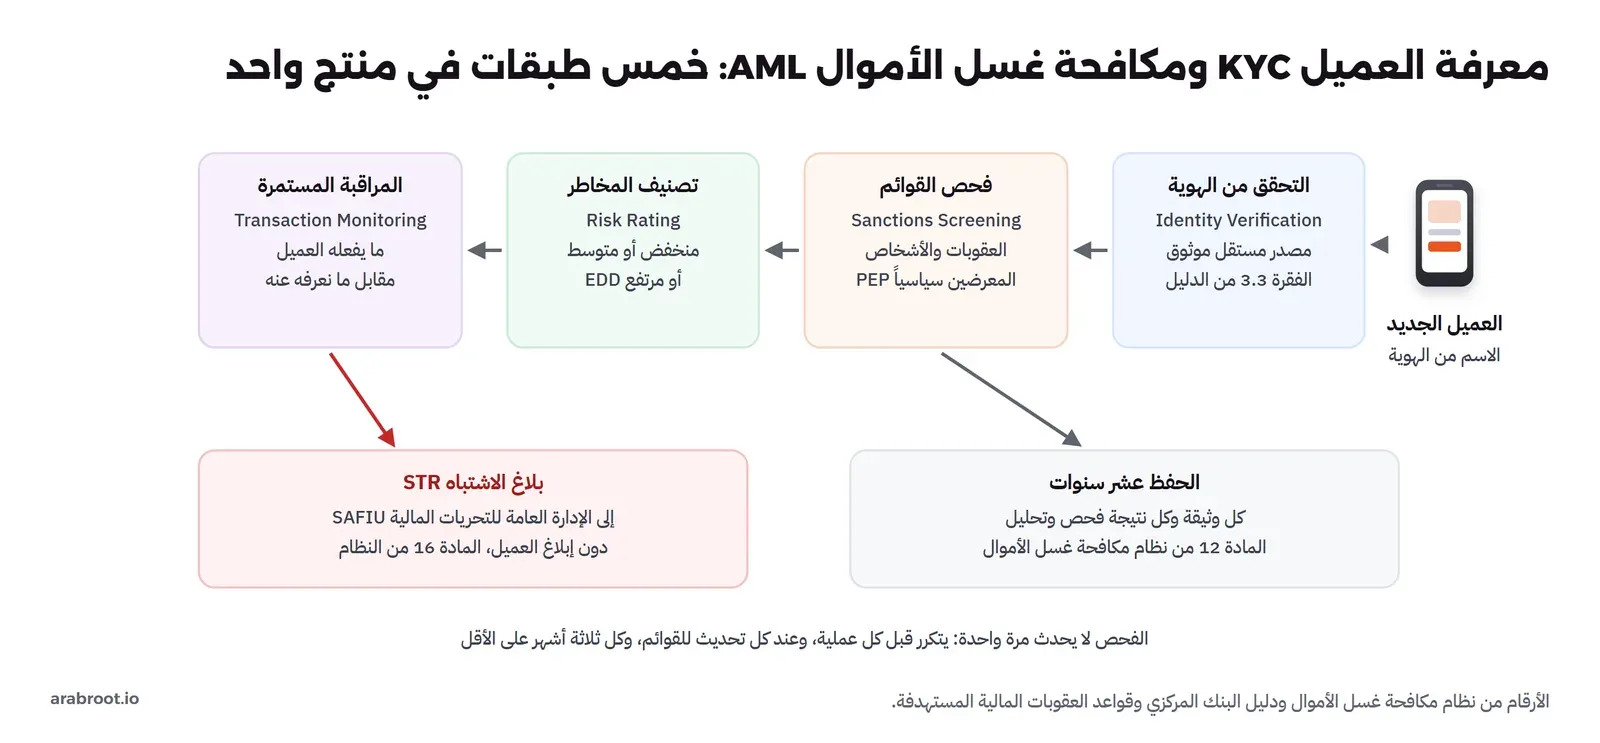
- التحقق من الهوية Identity Verification: هل الشخص الذي يسجل هو صاحب الهوية فعلاً؟ وهذا في المملكة يعتمد على خدمات التحقق الإلكتروني المعتمدة كما في الفقرة 3.9، والناتج المهم للطبقات التالية هو الاسم الرسمي بالعربية كما في الوثيقة، وتاريخ الميلاد، والجنسية.
- فحص القوائم Screening: هل هذا الاسم، أو اسم المالك المستفيد Beneficial Owner إذا كان العميل شركة، موجود في قائمة عقوبات أو قائمة أشخاص معرضين سياسياً Politically Exposed Persons واختصاراً PEP؟ وهذه الطبقة هي موضوع المختبر.
- تصنيف المخاطر Risk Rating: من نتائج الطبقتين السابقتين ومن طبيعة المنتج والدولة وقناة التسجيل، يعطى العميل درجة، فالمرتفع يحتاج العناية الواجبة المعززة Enhanced Due Diligence واختصاراً EDD، مثل سؤاله عن مصدر أمواله، والمنخفض قد تكفيه العناية المبسطة.
- المراقبة المستمرة Transaction Monitoring: العميل الذي سجل بأجر شهري متوسط ثم بدأ يستقبل عشرين حوالة يومياً من غرباء ويحولها فوراً لا يتسق سلوكه مع ما نعرفه عنه، وهذا ما تطلبه المادة 13.
- البلاغ والحفظ: الاشتباه المؤكد يرفع إلى SAFIU، وكل خطوة في كل الطبقات تحفظ عشر سنوات.
وقد يتساءل البعض: أليست هذه كلها مسؤولية فريق الالتزام، فلماذا يقرؤها المهندس؟ والإجابة أن كل طبقة منها كود: شاشة تسجيل، وخدمة فحص تستدعى قبل كل تحويل، وجدول تصنيف، وقواعد مراقبة، وسجل لا يحذف منه شيء. وفريق الالتزام يحدد السياسة، ولكن الفريق الهندسي هو الذي يقرر هل ينتظر التحويل نتيجة الفحص أم لا، وماذا يحدث إذا تعطلت خدمة الفحص، وكم تنبيهاً سوف يصل لمراجع واحد كل صباح.
قواعد العقوبات المالية المستهدفة: الفحص بالأرقام
أحدث وأدق نص لمن يبني الفحص هو قواعد تطبيق العقوبات المالية المستهدفة المؤرخة 7 ديسمبر 2025 الموافق 16/6/1447هـ، والنسخة الإنجليزية في دليل القواعد موصوفة بأنها مترجمة. وهي تخص قوائم العقوبات الصادرة تطبيقاً لقرارات مجلس الأمن في مكافحة الإرهاب وتمويله ومنع انتشار أسلحة الدمار الشامل، وتعرف «دون تأخير» بأنها خلال ساعات من إدراج الشخص في القائمة أو رفعه منها. وفيها فقرات تكاد تكون مواصفة هندسية:
- متى تفحص (3.5): قبل بدء العلاقة أو فتح الحساب أو المحفظة الإلكترونية، وقبل تنفيذ أي عملية محلية أو دولية، وفوراً عند أي تحديث للقوائم، وعند تحديث بيانات العميل، وفحصاً شاملاً كل ربع سنة، وعند أحداث خاصة.
- بأي سرعة (3.6): العمليات الصادرة تفحص قبل تنفيذها، والواردة فور استلامها دون انتظار نهاية اليوم، والفحص الشامل لقاعدة العملاء مرة كل ثلاثة أشهر على الأقل، وعند تحديث القائمة يعاد فحص كل البيانات مقابل القائمة المحدثة مع سجل يوثق ذلك.
- ماذا يكتشف (3.7): يجب أن تكون أنظمة الفحص قادرة على كشف التطابق في الأسماء والأسماء المستعارة واختلاف الكتابة Spelling Variations والأسماء المتشابهة في النطق والكتابة بحروف لغة أخرى Transliteration، وأن تتحقق المؤسسة من فاعليتها دورياً.
- توثيق المنهجية (3.10): منطق المطابقة وآليتها ومعاييرها مكتوبة في الإجراءات، وأي تعديل عليها يوثق ويعتمد ويسبقه اختبار بحسب 3.11.
- القائمة نفسها (4.1): تحديث القوائم الداخلية فور الإعلان عن أي إدراج، ومتابعة يومية من المصادر الرسمية، مع سجل لوقت استلام التحديث وتطبيقه.
وأهم ما في هذه الفقرات للمهندس هو 3.7، لأنها تقول بوضوح إن المطابقة التامة لا تكفي، فالنظام الذي يبحث عن الاسم كما هو حرفاً بحرف لا يحقق القاعدة. و3.10 تقول إن العتبة Threshold التي تختارها ليست تفصيلاً تقنياً تتركه في ملف إعدادات، وإنما قرار موثق يعتمد ويختبر قبل تغييره. ولهذا سوف نقيس في المختبر بالضبط ما يحدث عندما تتغير العتبة خمس درجات.
لماذا مطابقة الأسماء العربية صعبة؟
الاسم العربي يكتب في الهوية بالحروف العربية دون حركات، والقوائم الدولية تكتبه بالحروف اللاتينية بحسب من نقله، وبين الاثنين أربعة مصادر للاختلاف:
- الحركات لا تكتب: «محمد» تحمل حروفها الساكنة فقط، فتصبح في اللاتينية Mohammed أو Muhammad أو Mohamed أو Mohammad، وكلها صحيحة.
- حروف بلا مقابل لاتيني واحد: القاف تكتب Q أو K أو G، والجيم J أو G، والخاء KH أو H، والعين تحذف أو تكتب بفاصلة عليا، والذال DH أو Z.
- أداة التعريف والأسماء المركبة: «الشهري» قد تكون Al-Shehri أو Alshehri أو Shehri، و«عبدالرحمن» قد تكون Abdulrahman أو Abdul Rahman أو Abd al-Rahman، وكذلك في العربية نفسها «عبد الرحمن» بكلمتين.
- طول الاسم وترتيبه: الهوية فيها أربعة أجزاء عادة، والعميل يكتب جزأين، والقائمة قد تحمل ثلاثة أجزاء بترتيب آخر.
والطريقة البسيطة التي يبدأ بها أغلب الفرق هي البحث عن الاسم اللاتيني الذي كتبه العميل كما هو في القائمة، وسوف نرى في المختبر أنها تفوت أكثر من ثلث الأسماء المدرجة. والطريقة التالية هي المطابقة التقريبية Fuzzy Matching، أي مقياس تشابه بين نصين من 0 إلى 100 مع عتبة، وهي أفضل، ولكنها تقارن حروف الكتابة اللاتينية وتعامل اختلاف الحركات كأخطاء. والطريقة التي تعتمد عليها أنظمة الفحص الجادة هي أن تحول الاسمين إلى شكل مشترك أولاً ثم تقارن، وهذا ما سوف نبنيه.
قائمة مجلس الأمن كما تنشرها OpenSanctions
لكي نجرب على بيانات حقيقية، نحتاج قائمة رسمية بصيغة يقرؤها الكود. ومشروع OpenSanctions يجمع قوائم العقوبات من مصادرها ويعيد نشرها بصيغة موحدة، ومنها قائمة مجلس الأمن الموحدة التي يصفها بأنها أساس أغلب قوائم العقوبات الوطنية. والبيانات منشورة بترخيص Creative Commons 4.0 للاستخدام غير التجاري، فاستخدامها في مختبر تعليمي مثل هذا مسموح، أما استخدامها في منتج تجاري فيحتاج ترخيصاً تجارياً منهم، فانتبه لذلك قبل أن تبني عليها.
وفي المختبر لا نستخدم OpenSanctions كمصدر للقرار، وإنما كمصدر للبيانات بصيغة سهلة، فالمصدر الرسمي للالتزام في المملكة هو ما تحدده الجهات المختصة، والفقرة 4.1 تطلب التحديث من القنوات والمواقع الرسمية. وكل نسخة من البيانات لها رقم إصدار وتاريخ، فنزلنا نسختين: نسخة 27 أكتوبر 2026 للمختبر الأساسي، ونسخة 1 يوليو 2026 لتجربة التحديث لاحقاً:
mkdir -p kyc-lab/data kyc-lab/lab
cd kyc-lab/data
curl -sL -o entities.ftm.json \
  https://data.opensanctions.org/artifacts/un_sc_sanctions/20261027120104-iaa/entities.ftm.json
curl -sL -o entities-20260701.ftm.json \
  https://data.opensanctions.org/artifacts/un_sc_sanctions/20260701200101-msm/entities.ftm.json
الملف بصيغة FollowTheMoney، أي كيان JSON في كل سطر، ومنه أشخاص ومنظمات وعناوين وجوازات. وكل شخص له اسم رئيسي وأسماء مستعارة Aliases وتاريخ ميلاد قد يكون سنة فقط أو عدة سنوات، وفي حوالي نصف الأشخاص اسم بالحروف العربية كما ورد في القائمة الأصلية، وبعضها بالفارسية أو البشتو بحرف «ی» و«ک» بدل «ي» و«ك»، وهذا وحده سبب كاف لتوحيد الحروف قبل المقارنة. وقرأنا الأشخاص بدالة صغيرة:
# listdata.py: read the persons of the UN Security Council consolidated list from the OpenSanctions export
import json, re
from names import is_arabic

def load_people(path):
    people = []
    for line in open(path, encoding="utf-8"):
        e = json.loads(line)
        if e["schema"] != "Person":
            continue
        pr = e["properties"]
        names = pr.get("name", []) + pr.get("alias", []) + pr.get("weakAlias", [])
        years = sorted({int(m) for d in pr.get("birthDate", []) for m in re.findall(r"^(\d{4})", d)})
        unsc = sorted(r for r in e.get("referents", []) + [e["id"]] if r.startswith("unsc-"))
        people.append({"id": e["id"], "caption": e["caption"], "unsc": unsc[0] if unsc else None,
                       "latin": [n for n in names if not is_arabic(n)],
                       "arabic": [n for n in names if is_arabic(n)],
                       "years": years})
    return people
ولاحظ أننا نحفظ لكل شخص رقمه المرجعي في الأمم المتحدة إلى جانب معرف OpenSanctions، وسوف تعرف السبب في تجربة التحديث.
الفكرة: الهيكل الساكن للاسم
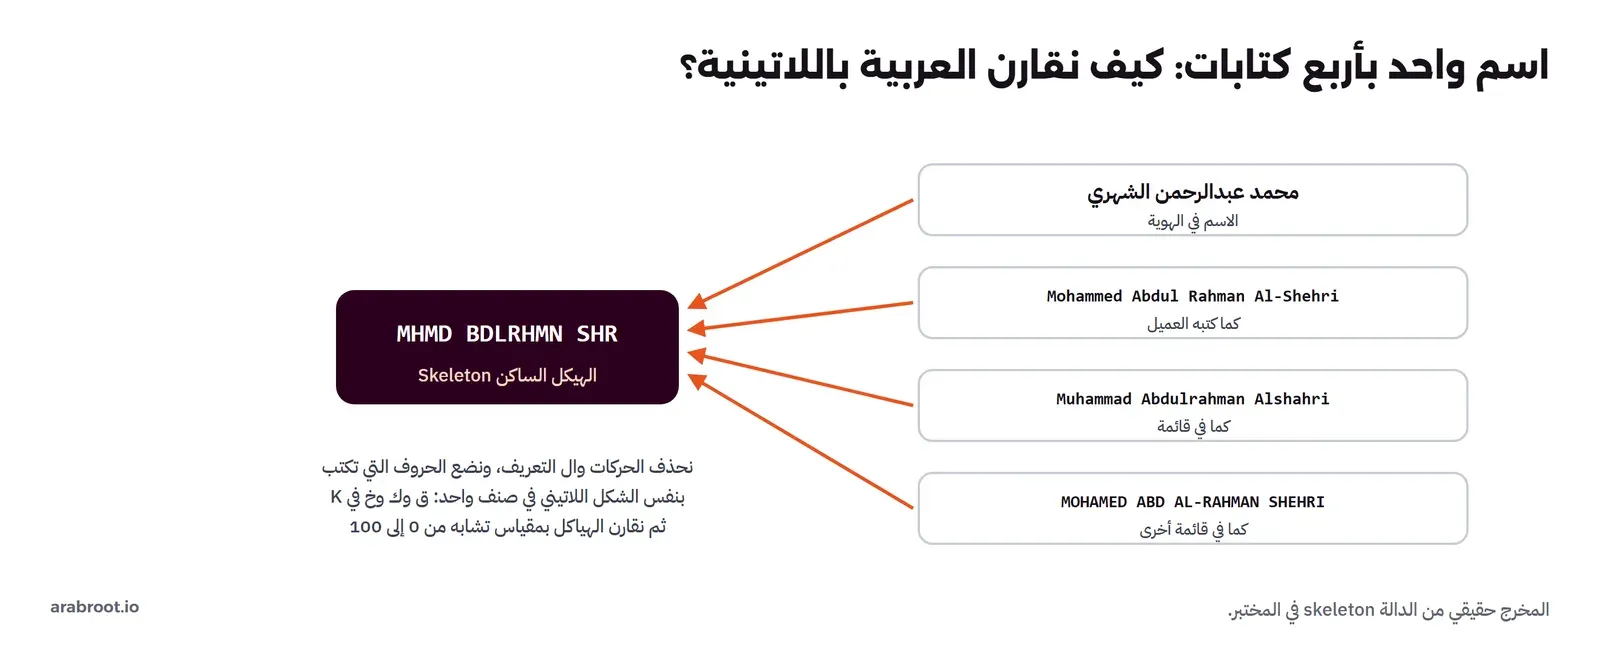
إذا نظرت إلى Mohammed وMuhammad وMohamed وجدت أن الاختلاف كله في الحركات، أي في الحروف التي لا تكتب في العربية أصلاً، وأن الحروف الساكنة M وH وM وD هي نفسها. فالفكرة أن نحول كل اسم، عربياً كان أو لاتينياً، إلى حروفه الساكنة فقط، ونضع الحروف التي تكتب بالشكل اللاتيني نفسه في صنف واحد، فالقاف والكاف والخاء كلها K، والسين والشين والصاد كلها S، ثم نقارن هذه الهياكل. ونسميه هنا الهيكل الساكن Skeleton، وهو نفس فكرة خوارزميات الصوت Phonetic Algorithms مثل Soundex، ولكن بأصناف تناسب الحروف العربية. والصورة التالية تبين أربع كتابات لاسم واحد تصل كلها إلى الهيكل نفسه:
والملف التالي هو قلب المختبر، وفيه التوحيد والأصناف والهيكل:
# names.py: normalising Arabic and Latin names into one comparable "skeleton".
# Arabic names are written without short vowels, and Latin spellings of the same name differ mostly in vowels
# (Mohammed, Muhammad, Mohamed). So both sides are reduced to their consonants, with letters that are often
# written the same way in Latin grouped into one class.
import re
AR_DIACRITICS = re.compile("[ً-ْٰـ]") # harakat, dagger alef, tatweel
AR_UNIFY = str.maketrans({"أ": "ا", "إ": "ا", "آ": "ا", "ٱ": "ا", "ى": "ي", "ی": "ي", "ئ": "ي",
"ؤ": "و", "ة": "ه", "ک": "ك", "گ": "ك", "پ": "ب", "چ": "ج", "ژ": "ز"})
# consonant classes shared by both scripts; letters missing from the map are dropped (vowels, ع, ء)
AR_CLASS = {"ب": "B", "ت": "T", "ث": "T", "ط": "T", "ج": "J", "ح": "H", "ه": "H", "خ": "K", "ق": "K", "ك": "K",
"د": "D", "ض": "D", "ذ": "Z", "ظ": "Z", "ز": "Z", "ر": "R", "س": "S", "ش": "S", "ص": "S",
"غ": "G", "ف": "F", "ل": "L", "م": "M", "ن": "N"}
LATIN_DIGRAPHS = [("kh", "K"), ("gh", "G"), ("sh", "S"), ("ch", "S"), ("th", "T"), ("dh", "Z"), ("dj", "J"), ("ph", "F")]
LATIN_CLASS = {"b": "B", "p": "B", "t": "T", "j": "J", "g": "J", "h": "H", "k": "K", "q": "K", "c": "K",
"d": "D", "z": "Z", "r": "R", "s": "S", "f": "F", "v": "F", "l": "L", "m": "M", "n": "N", "x": "KS"}
def norm_ar(s):
s = AR_DIACRITICS.sub("", s).translate(AR_UNIFY)
s = re.sub(r"[^ء-ي\s]", " ", s)
return " ".join(s.split())
def norm_latin(s):
s = s.lower().replace("'", "").replace("`", "")
s = re.sub(r"[^a-z\s-]", " ", s).replace("-", " ")
return " ".join(s.split())
def _collapse(k):
k = re.sub(r"(.)\1+", r"\1", k) # doubled letters: Mohammed -> MHMD, shadda is not written
return k[:-1] if len(k) > 2 and k.endswith("H") else k # final h/ة is written or not: Fatima, Fatimah
def skel_token_ar(t):
if t.startswith("ال") and len(t) > 4: # the article: الشهري -> شهري
t = t[2:]
return _collapse("".join(AR_CLASS.get(ch, "") for ch in t))
def skel_token_latin(t):
if t in ("al", "el", "ul"):
return ""
for a, b in (("al", ""), ("el", "")): # Alshehri, Elsayed (but keep Ali, Elias)
if t.startswith(a) and len(t) > 5:
t = b + t[2:]
break
for a, b in LATIN_DIGRAPHS:
t = t.replace(a, b)
return _collapse("".join(LATIN_CLASS.get(ch, ch if ch.isupper() else "") for ch in t))
COMPOUND_LATIN = {"abd", "abdul", "abdel", "abdal", "abdoul", "abu", "abou"}
def join_compounds(toks, heads):
"""'abdul rahman' -> 'abdulrahman', 'عبد الله' -> 'عبدالله': one name written as one or two words"""
out = []
for t in toks:
if out and out[-1] in heads:
out[-1] += t
else:
out.append(t)
return out
def is_arabic(s):
return bool(re.search("[-ۿ]", s))
def skeleton(name):
"""'محمد عبدالرحمن الشهري' and 'Mohammed Abdul Rahman Al-Shehri' -> comparable consonant keys"""
if is_arabic(name):
toks = [skel_token_ar(t) for t in join_compounds(norm_ar(name).split(), {"عبد", "ابو"})]
else:
toks = [skel_token_latin(t) for t in join_compounds(norm_latin(name).split(), COMPOUND_LATIN)]
return " ".join(t for t in toks if t)في الكود أعلاه لاحظ التالي:
- التوحيد قبل كل شيء: الهمزات على الألف كلها ألف، والتاء المربوطة هاء، والألف المقصورة ياء، والحروف الفارسية مثل «ی» و«ک» تتحول إلى مقابلها العربي. والسبب أن الهوية قد تكتب «أحمد» والقائمة «احمد»، والاسم في قائمة الأمم المتحدة قد يأتي من وثيقة أفغانية.
- الحروف المحذوفة: الألف والواو والياء والعين والهمزة لا تدخل الهيكل، لأنها في اللاتينية تصبح حركات تختلف من كاتب لآخر، والعين بالذات تكتب Abd أو 'Abd أو تختفي.
- الحروف المضاعفة: الشدة لا تكتب في العربية، وفي اللاتينية تكتب حرفين، فنجمع أي حرفين متتاليين متشابهين في حرف واحد، فتصبح Mohammed وMohamed كلاهما MHMD.
- الهاء الأخيرة: Fatima وFatimah كلاهما FTM، لأن التاء المربوطة تكتب هاء في كتابة وتحذف في أخرى. ولهذا القرار ثمن سوف تراه: «عبدالحي» و«عبدالله» يصبحان BDL معاً.
- الأسماء المركبة: «عبد» و«أبو» وما يقابلهما تلصق بالكلمة التي بعدها، فتصبح «عبد الرحمن» و«Abd al-Rahman» و«Abdul Rahman» كلها كلمة واحدة BDLRHMN. وهذا السطر لم يكن في النسخة الأولى، وقصته في فقرة المشكلات أدناه.
ثم نقارن الهيكلين بمقياس token_sort_ratio من مكتبة RapidFuzz، وهو كما في توثيق المكتبة يرتب كلمات كل نص أبجدياً ثم يحسب نسبة التشابه بينهما من 0 إلى 100، فلا يتأثر بترتيب الاسم الأول والعائلة. وRapidFuzz مكتوبة بلغة C++ وتقارن آلاف الأسماء بآلاف في أجزاء من الثانية، وهذا مهم لأن الفحص عند تحديث القائمة يجب أن يمر على كل العملاء.
المختبر: عشرون ألف عميل لا وجود لهم
لا يجوز أن نستخدم أسماء عملاء حقيقيين في مختبر، ولذلك ولدنا قاعدة عملاء من أسماء شائعة: 58 اسماً أول للذكور والإناث، و43 اسم عائلة، وكل عميل له اسم رباعي بالعربية كما في الهوية، واسم لاتيني يختار لكل جزء كتابة من الكتابات التي يستخدمها الناس فعلاً، وسنة ميلاد بين 1955 و2006. ولا أحد من هؤلاء العشرين ألفاً مدرج في أي قائمة، لأننا اخترعناهم، فأي تنبيه على أحدهم هو تنبيه خاطئ False Positive، أي عميل بريء سوف يوقف حتى يراجعه أحد.
ثم بنينا من القائمة نفسها 326 عميلاً اختبارياً، واحداً لكل شخص مدرج له اسم بالحروف العربية: اسمه العربي من القائمة مع تغيير صغير مثل همزة في أول كلمة أو «عبد الرحمن» بكلمتين، واسمه اللاتيني من القائمة بعد أربعة تغييرات في الكتابة مثل MOHAMMED إلى MUHAMMAD أو حذف الشرطة من AL-، ومع احتمال 30% أن يحذف اسماً من الوسط، وسنة ميلاده من سنوات القائمة. وهؤلاء هم من يجب أن نمسكهم، ونسبة من نمسكه منهم هي الاستدعاء Recall.
synthetic customers 20,000 | test customers built from listed persons 326
  C00000 | فهد حمد هشام باوزير | Fahad Hamad Hesham Ba Wazeer | 2003
  C00001 | مريم مازن ياسر الرشيدي | Maryam Mazen Yasser Al-Rashedi | 1961
C00002 | ياسر محمد عبدالملك الناصر | Yasir Muhammad Abdul Malik Al-Naser | 1977وشغلنا كل شيء في Container مؤقت من Image الرسمية لـ Python، والمجلد data مقروء فقط، لأنه بيانات من الإنترنت لا نريد لأي سكربت أن يغيرها:
cd kyc-lab
docker run --rm -v "$PWD/lab":/lab -v "$PWD/data":/data:ro -w /lab python:3.13.17-slim sh -c \
  "pip install -q rapidfuzz==3.14.1 numpy==2.3.4 anyascii==0.3.3 && python gen_customers.py && python screen.py --examples"
والفحص نفسه في screen.py يبني جدولاً بكل أسماء القائمة وهياكلها، ثم يستخدم process.cdist من RapidFuzz لحساب التشابه بين كل عميل وكل اسم مرة واحدة، ويعيد لكل عميل الأشخاص الذين تجاوز أحد أسمائهم العتبة:
def best_hits(queries, choices, scorer, threshold):
    """for each query: the set of person indexes whose best name scores >= threshold"""
    m = process.cdist(queries, choices, scorer=scorer, score_cutoff=threshold, workers=-1, dtype=np.uint8)
    return [set(owner[np.nonzero(row)[0]].tolist()) for row in m]
النتيجة: أربع طرق على نفس العملاء
والمخرج سوف يكون كما يلي:
list: 732 persons, 3259 names and aliases (326 persons with an Arabic-script name)
== 1. exact match on the Latin name the customer typed
exact Latin                                  caught 201/326 ( 61.7%)   innocent customers flagged     0 ( 0.00%)
== 2. fuzzy match on the Latin name (token_sort_ratio)
fuzzy Latin >= 90                            caught 263/326 ( 80.7%)   innocent customers flagged     2 ( 0.01%)
fuzzy Latin >= 85                            caught 283/326 ( 86.8%)   innocent customers flagged     6 ( 0.03%)
fuzzy Latin >= 80                            caught 301/326 ( 92.3%)   innocent customers flagged    83 ( 0.41%)
== 3. consonant skeleton of the Arabic name from the ID
skeleton(Arabic) >= 95                       caught 325/326 ( 99.7%)   innocent customers flagged     6 ( 0.03%)
skeleton(Arabic) or skeleton(Latin) >= 95    caught 326/326 (100.0%)   innocent customers flagged     6 ( 0.03%)
  ... and birth year within 1 (or missing)   caught 326/326 (100.0%)   innocent customers flagged     0 ( 0.00%)
skeleton(Arabic) >= 90                       caught 325/326 ( 99.7%)   innocent customers flagged    56 ( 0.28%)
skeleton(Arabic) or skeleton(Latin) >= 90    caught 326/326 (100.0%)   innocent customers flagged    58 ( 0.29%)
  ... and birth year within 1 (or missing)   caught 326/326 (100.0%)   innocent customers flagged     0 ( 0.00%)
skeleton(Arabic) >= 85                       caught 325/326 ( 99.7%)   innocent customers flagged   450 ( 2.25%)
skeleton(Arabic) or skeleton(Latin) >= 85    caught 326/326 (100.0%)   innocent customers flagged   460 ( 2.30%)
  ... and birth year within 1 (or missing)   caught 326/326 (100.0%)   innocent customers flagged    56 ( 0.28%)
skeleton(Arabic) >= 80                       caught 325/326 ( 99.7%)   innocent customers flagged  2677 (13.38%)
skeleton(Arabic) or skeleton(Latin) >= 80    caught 326/326 (100.0%)   innocent customers flagged  2732 (13.66%)
  ... and birth year within 1 (or missing)   caught 326/326 (100.0%)   innocent customers flagged   450 ( 2.25%)
time for all the runs above: 7.6 s
في المخرج أعلاه لاحظ التالي:
- القائمة: 732 شخصاً بـ 3,259 اسماً واسماً مستعاراً، أي أن الشخص الواحد له أكثر من أربعة أسماء في المتوسط، وهذا وحده يقول إن البحث عن «الاسم» بالمفرد غير كاف.
- المطابقة التامة فوتت 125 شخصاً من 326: أمسكت 61.7% فقط، رغم أن التغييرات في الكتابة صغيرة جداً، مثل حرف واحد أو شرطة. ولم تنبه على أي بريء، وهذا ما يجعلها مغرية: لوحة تنبيهات فارغة تبدو نجاحاً، وهي في الحقيقة ثلث المدرجين يمرون.
- المطابقة التقريبية على الاسم اللاتيني أفضل: 80.7% عند 90، ثم 92.3% عند 80 مع 83 بريئاً. ولكنها تعتمد على الاسم الذي كتبه العميل بيده، وهذا مدخل يتحكم فيه الشخص الذي نفحصه نفسه.
- الهيكل الساكن للاسم العربي من الهوية: 99.7% عند 95 مع ستة أبرياء فقط، والاسم هنا يأتي من الوثيقة الرسمية لا من العميل، وهذا هو الفرق الحقيقي. وعندما نضيف الهيكل من الاسم اللاتيني أيضاً، أي ننبه إذا تجاوز أي منهما العتبة، نمسك الـ 326 كلهم.
- الوقت: كل هذه التشغيلات، بأربع عتبات وطريقتين، استغرقت 7.6 ثانية على جهاز مكتبي، أي أن فحص قاعدة عملاء بهذا الحجم ليس مشكلة أداء.
العتبة: خمس درجات بثمن كبير
الأرقام في الطريقة الثالثة تستحق أن تنظر إليها مرة ثانية، والصورة التالية ترسمها:
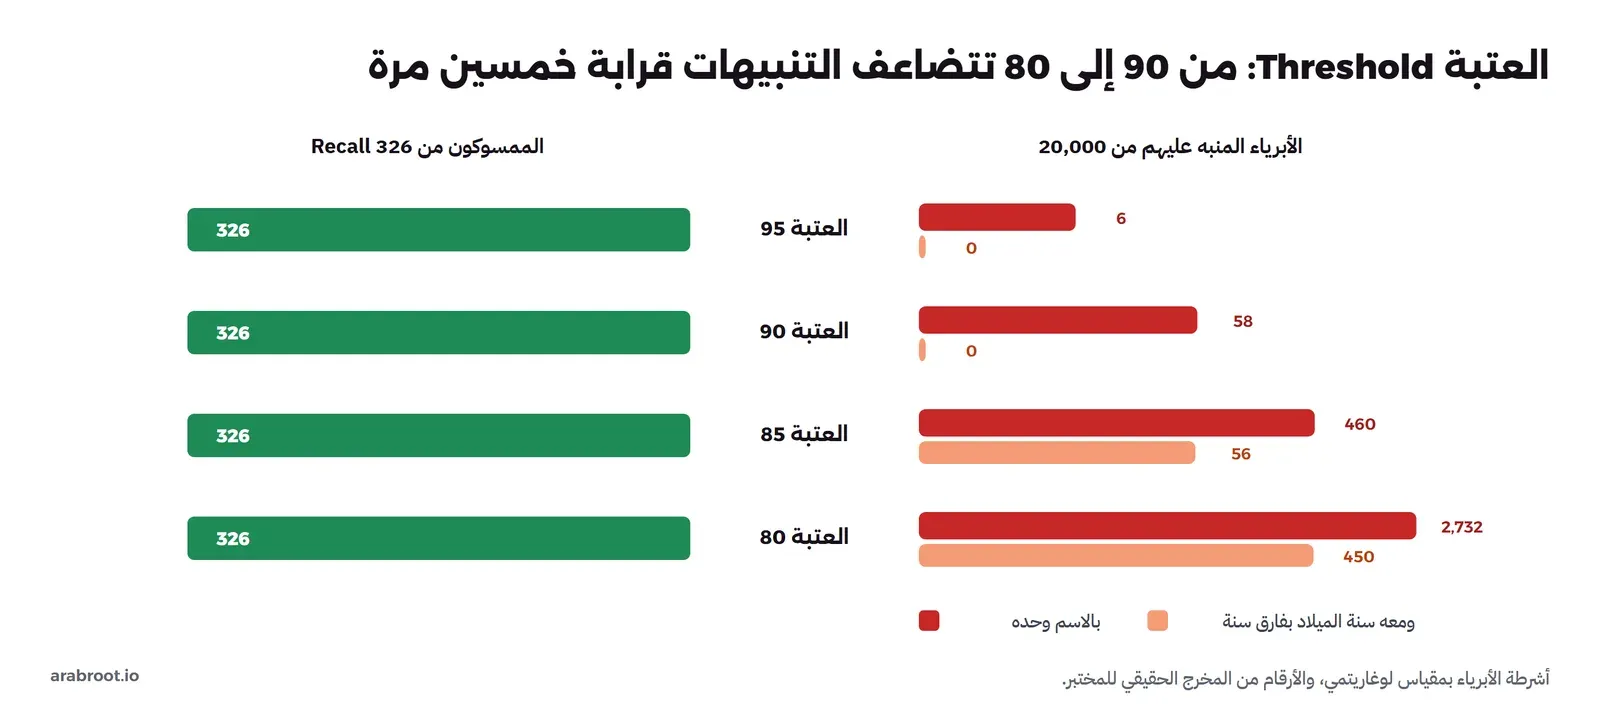
من 95 إلى 90 زادت التنبيهات الخاطئة من 6 إلى 58، ومن 90 إلى 80 إلى 2,732، أي قرابة خمسين ضعفاً، بينما الاستدعاء ثابت عند 326 من 326 في كل العتبات. وهذا يعني في القصة أن المحفظة التي تسجل عشرين ألف عميل في أشهرها الأولى سوف تحتاج مراجعة 58 حالة عند 90، أو 2,732 حالة عند 80، والفرق بين الرقمين هو الفرق بين مراجع واحد في أسبوع وفريق كامل لا يلحق. والسؤال الطبيعي: لماذا لا نختار 95 إذن؟ والإجابة أن هذه الأرقام من تغييرات كتابة صممناها نحن، والواقع فيه أخطاء لم نفكر فيها، فالعتبة الأعلى أخطر من حيث لا تراه. لذلك لا تختار العتبة من مختبر واحد، وإنما من اختبار دوري على أمثلة حقيقية متنوعة كما تطلب الفقرة 3.12 من قواعد العقوبات، وتكتب سبب اختيارها كما تطلب 3.10.
المعلومة الثانية: سنة الميلاد
السطر الذي يبدأ بـ and birth year يضيف شرطاً واحداً: لا ننبه إلا إذا كانت سنة ميلاد العميل على بعد سنة واحدة على الأكثر من إحدى سنوات الشخص في القائمة، أو إذا لم تكن للشخص سنة في القائمة أصلاً:
def year_ok(r, pi):
    ys = people[pi]["years"]
    return not ys or any(abs(y - r["birth_year"]) <= 1 for y in ys)
وهذا الشرط خفض الأبرياء عند 85 من 460 إلى 56، وعند 90 إلى صفر، دون أن يفوت شخصاً مدرجاً. والسبب أن الاسم وحده معلومة ضعيفة في مجتمع تتكرر فيه الأسماء، أما الاسم مع سنة الميلاد فمعلومة أقوى بكثير. ولكن انتبه إلى ثلاثة أشياء قبل أن تنقل هذا الشرط إلى الإنتاج: الأول أن سنوات الميلاد في القوائم تقريبية أحياناً، وبعض الأشخاص لهم سنتان أو ثلاث، ولهذا وضعنا هامش سنة. والثاني أن غياب السنة في القائمة يجب أن يعني «نبه»، لا «تجاهل»، وإلا صار أي شخص بلا تاريخ ميلاد في القائمة غير مرئي لنظامك. والثالث أن الأفضل استخدام السنة لترتيب التنبيهات ورفع أولويتها، لا لإسقاطها، فالمراجع يرى الاسم المتطابق مع سنة متطابقة أولاً، ثم البقية في وقتها، وهذا قريب مما تطلبه الفقرة 5.2 من مراجعة التنبيهات عالية الخطورة أولاً.
مشكلتان واجهناهما في المختبر
الأرقام أعلاه من النسخة الثالثة من names.py، والنسختان قبلها علمتانا أكثر من النتيجة النهائية.
الأولى: حمزة يساوي أحمد
في النسخة الأولى وضعنا الدال والذال والضاد والظاء والزاي كلها في صنف واحد D، لأن الكتابات اللاتينية تخلط بينها، فالذال تكتب dh أو z، والضاد تكتب d أو dh. وكانت النتيجة عند 90 بالاسمين 78 بريئاً، ولما طبعنا أمثلة منهم وجدنا هذا:
C00134 حمزة حسين زياد السبيعي | HMD HSN D SB -> ADNAN S. HASAN AHMED | years -«حمزة» أصبحت HMD، أي نفس هيكل «أحمد» و«حمد»، لأن الزاي صارت دالاً والتاء المربوطة حذفت. والدرس أن كل صنف تجمع فيه حروفاً يزيد الاستدعاء ويزيد التنبيهات الخاطئة معاً، وأن الطريقة الوحيدة لتعرف الثمن هي أن تطبع التنبيهات وتقرأها بعينك. ففصلنا الزاي والذال والظاء في صنف Z، وصارت dh في اللاتينية Z أيضاً، فنزل العدد عند 90 إلى 52 دون أن يتغير عدد الممسوكين.
الثانية: عبد الرحمن بكلمتين
ثم رسمنا الصورة الثانية في هذا المقال، وأردنا أن نتأكد أن الكتابات الأربع تعطي الهيكل نفسه، فشغلنا الدالة عليها، فلم تكن كذلك:
Mohammed Abdul Rahman Al-Shehri | MHMD BDL RHMN SHR | 72.7
Muhammad Abdulrahman Alshahri | MHMD BDLRHMN SHR | 100.0
MOHAMED ABD AL-RAHMAN SHEHRI | MHMD BD RHMN SHR | 68.8
الرقم الأخير في كل سطر هو التشابه مع هيكل الاسم العربي «محمد عبدالرحمن الشهري»، والاسم نفسه حصل على 72.7 و68.8، أي تحت أي عتبة معقولة. والسبب أن token_sort_ratio يرتب الكلمات أبجدياً قبل المقارنة، فإذا كانت «عبدالرحمن» كلمة في نص وكلمتين في الآخر، اختلف الترتيب واختلفت المقارنة كلها. فأضفنا الدالة join_compounds التي تلصق «عبد» و«Abdul» و«Abd al» بالكلمة التي بعدها، فأصبحت الكتابات الأربع 100. ولاحظ أن العملاء الاختباريين أمسكوا كلهم قبل هذا الإصلاح أيضاً، لأن الهيكل من الاسم الآخر غطاهم، وهذا بالضبط نوع الخطأ الذي لا تكشفه الأرقام الإجمالية، ويكشفه اختبار صغير على أمثلة تعرف إجابتها.
وبعد الإصلاحين بقيت حالات تستحق أن تعرفها، وهذه أمثلة حقيقية من آخر المخرج للأبرياء الذين نبه عليهم عند 90 قبل شرط السنة:
== examples of innocent customers flagged at 90 (both names, before the birth-year check)
  C00586 محمد عبدالعزيز أنس الزهراني | MHMD BDLZ NS ZHRN  ->  list name HMD BDL S ZHRN | years [1978]
  C00613 أحمد راشد محمد العمري | HMD RSD MHMD MR  ->  list name MHMD SDK MR MHMD | years [1934]
  C00872 حمد علي سعود اليمني | HMD L SD MN  ->  list name SK HMD MN L | years [1973, 1974]
  C01167 نايف طارق سعود الأحمدي | NF TRK SD HMD  ->  list name TRK NR SD HMD | years [1963]
  C01208 خالد أحمد أحمد الأحمدي | KLD HMD HMD HMD  ->  list name HMD HMD HMD L | years [1960]
  C01346 محمد راشد عبدالرحمن الجهني | MHMD RSD BDLRHMN JHN  ->  list name BDLRHMN MHMD TFR JHN | years [1971, 1977]
وفيها ملاحظتان. الأولى أن الأسماء القصيرة مثل «علي» تصبح حرفاً واحداً L، و«أحمد» و«حمد» و«الأحمدي» كلها HMD، فالهيكل يفقد معلومات في الأسماء القصيرة، وتحتاج لها أنظمة الإنتاج قواعد إضافية، مثل وزن أقل للكلمات القصيرة والشائعة. والثانية أن أغلب هذه الحالات اسمان أو ثلاثة متشابهة مع اسم عائلة شائع، وهذه هي طبيعة الأسماء في المنطقة، وليست عيباً في عميلك، ولهذا يجب أن تكون رسالة التطبيق للعميل الذي ينتظر المراجعة مهذبة ولا تتهمه بشيء.
ماذا لو غيرنا شيئاً واحداً؟
بعد أن عرفنا النتيجة عند العتبة 90، جربنا في whatif.py ثلاثة تغييرات يقع فيها كثير من الفرق، كل منها وحده:
== what if, at threshold 90, on the Arabic name
our skeleton (baseline)                              caught 325/326   innocent flagged    56 ( 0.28%)
   anyascii('محمد عبدالرحمن') = mhmd `bdlrhmn
generic transliteration (anyascii) then skeleton     caught 224/326   innocent flagged    21 ( 0.10%)
token_set_ratio instead of token_sort_ratio          caught 325/326   innocent flagged 19018 (95.09%)
customer gave two names only (first + family) caught 325/326 innocent flagged 2965 (14.82%)- مكتبة عامة لتحويل الحروف: مكتبة anyascii تحول أي نص إلى حروف لاتينية، فأعطت «محمد عبدالرحمن» الشكل
mhmd `bdlrhmn، وبدا ذلك قريباً مما نريده. ولكن الاستدعاء نزل من 325 إلى 224، والسبب أن المكتبة تكتب كل حرف بطريقة واحدة، فالقاف q والذال dh، ثم تمر هذه الحروف في قواعدنا اللاتينية بأصناف لم تصمم لها. والدرس أن تحويل الحروف للمقارنة يحتاج أن يعرف الطرفين معاً، لا أن يحول طرفاً واحداً ويتمنى. - token_set_ratio بدل token_sort_ratio: هذا المقياس يعطي 100 إذا كانت كلمات أحد النصين جزءاً من الآخر، ويبدو مناسباً للأسماء الناقصة، فنبه على 19,018 بريئاً من عشرين ألفاً، أي 95%. والسبب أن العميل «محمد ... » يكفي أن تكون كلمة MHMD في اسمه ليطابق أي شخص في القائمة اسمه محمد فقط. وهذا المقياس يصلح للبحث اليدوي، ولا يصلح للفحص الآلي.
- اسمان فقط: إذا طلبت من العميل اسمه الأول واسم عائلته فقط، كما تفعل نماذج تسجيل كثيرة، فإن عدد الأبرياء يقفز من 56 إلى 2,965. والسبب أن الاسم الرباعي في الهوية يحمل معلومات تفرق بين الناس، والاسم الثنائي يتكرر آلاف المرات. لذلك افحص الاسم الكامل من الوثيقة الرسمية دائماً، لا ما يكتبه العميل في حقل الاسم.
ماذا يحدث عندما تتحدث القائمة؟
الفقرة 4.1 تطلب تحديث القائمة الداخلية فور الإعلان عن أي إدراج، والفقرة 3.6 تطلب إعادة فحص كل العملاء مقابل القائمة المحدثة. فقارنا نسختي يوليو وأكتوبر 2026، وكانت المفاجأة في السطر الأول:
== the list changes: July 2026 -> October 2026
persons in July 729, in October 732; by OpenSanctions id: added 36, removed 33
by UN reference number: added 6, removed 3, persons without a UN reference 0
   added unsc-6909618  names 4  arabic script no  birth years [1969]
   added unsc-6909616  names 2  arabic script no  birth years [1975]
   added unsc-6909614  names 3  arabic script no  birth years [1968]
   added unsc-6909615  names 7  arabic script no  birth years -
   added unsc-6909617  names 1  arabic script no  birth years [1978]
   added unsc-6909613  names 3  arabic script no  birth years [1970]
full screening of 20,326 customers against 3,259 names: 0.53 s
delta screening against the 20 names of added persons only: 0.053 s, customers flagged 0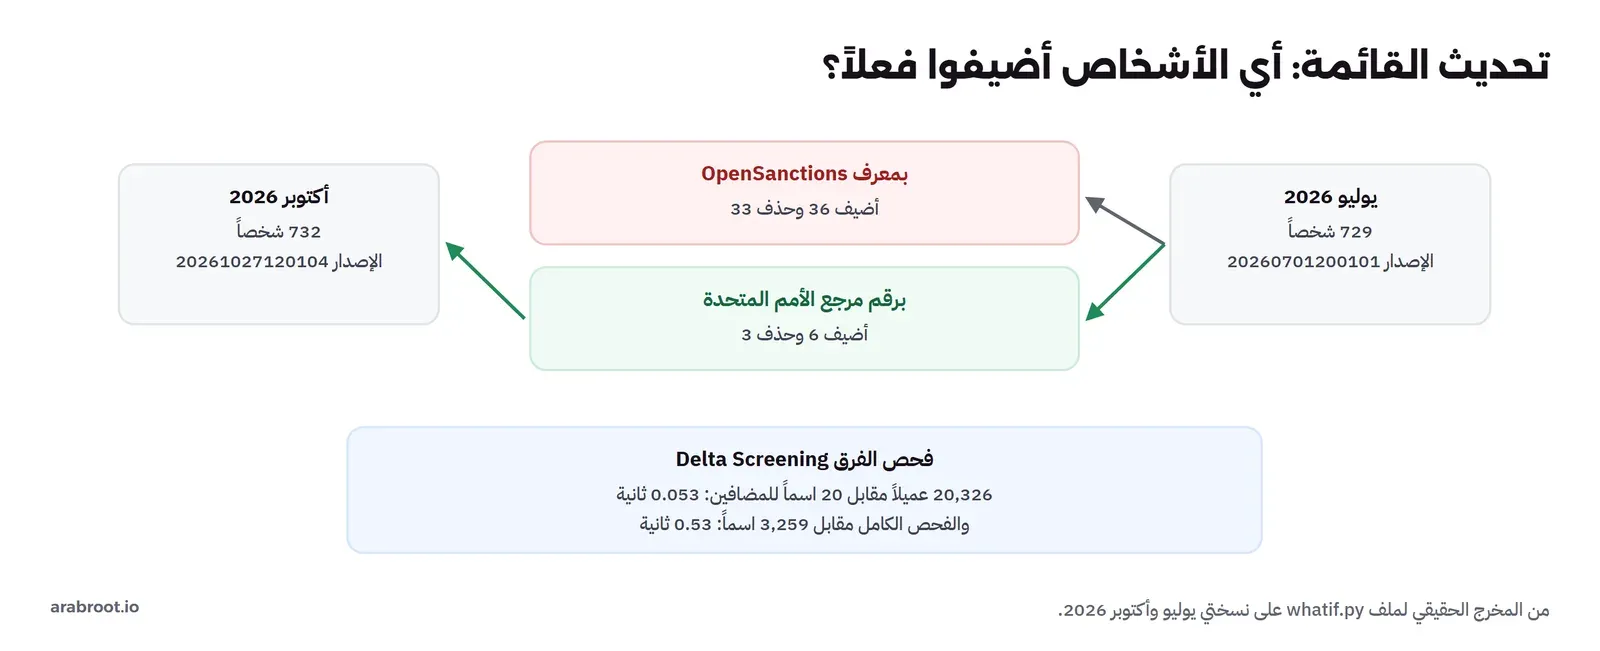
في المخرج أعلاه لاحظ التالي:
- معرف الناشر ليس معرف القائمة: بمعرفات OpenSanctions أضيف 36 شخصاً وحذف 33، وبرقم المرجع الذي تعطيه الأمم المتحدة أضيف 6 وحذف 3 فقط. والفرق أن الناشر غير معرفات بعض الكيانات بين النسختين دون أن يتغير الشخص. فلو بنيت فحص التحديث على المعرف الخاطئ، لأعدت فحص ثلاثين شخصاً لم يتغيروا، والأخطر أنك قد ترفع التجميد عن شخص «حذف» وهو موجود بمعرف آخر. لذلك اربط سجلاتك دائماً بمرجع القائمة الرسمية نفسها.
- فحص الفرق Delta Screening: فحص العشرين ألف عميل مقابل أسماء المضافين الستة فقط، وهي 20 اسماً، استغرق 0.053 ثانية، والفحص الكامل مقابل 3,259 اسماً 0.53 ثانية. والرقمان صغيران جداً في هذا الحجم، ولكن الفرق يكبر مع ملايين العملاء والقوائم الكثيرة، ولهذا تفحص الأنظمة الكبيرة الفرق فوراً عند التحديث، ثم الكل في الفحص الدوري.
- المضافون الستة بلا أسماء عربية: ولذلك لا يمسكهم إلا الهيكل من الاسم اللاتيني، وهذا سبب كاف لتفحص الاسمين دائماً.
وتذكر أن الفقرة 3.4 تطلب أيضاً مراجعة العمليات التي نفذت في الأشهر الاثني عشر السابقة لمعرفة هل تعامل أحد المدرجين الجدد مع المؤسسة، فالفحص عند التحديث لا يشمل قائمة العملاء الحاليين فقط، وإنما المستفيدين من الحوالات السابقة أيضاً، وهؤلاء أسماء في جدول العمليات لا في جدول العملاء.
ماذا يحدث بعد التنبيه؟
التنبيه ليس قراراً، وإنما بداية عمل بشري، والفصل الخامس من قواعد العقوبات يصف هذا العمل بتفاصيل يحتاج المهندس أن يبني لها شاشات وحالات، كما في الصورة التالية:
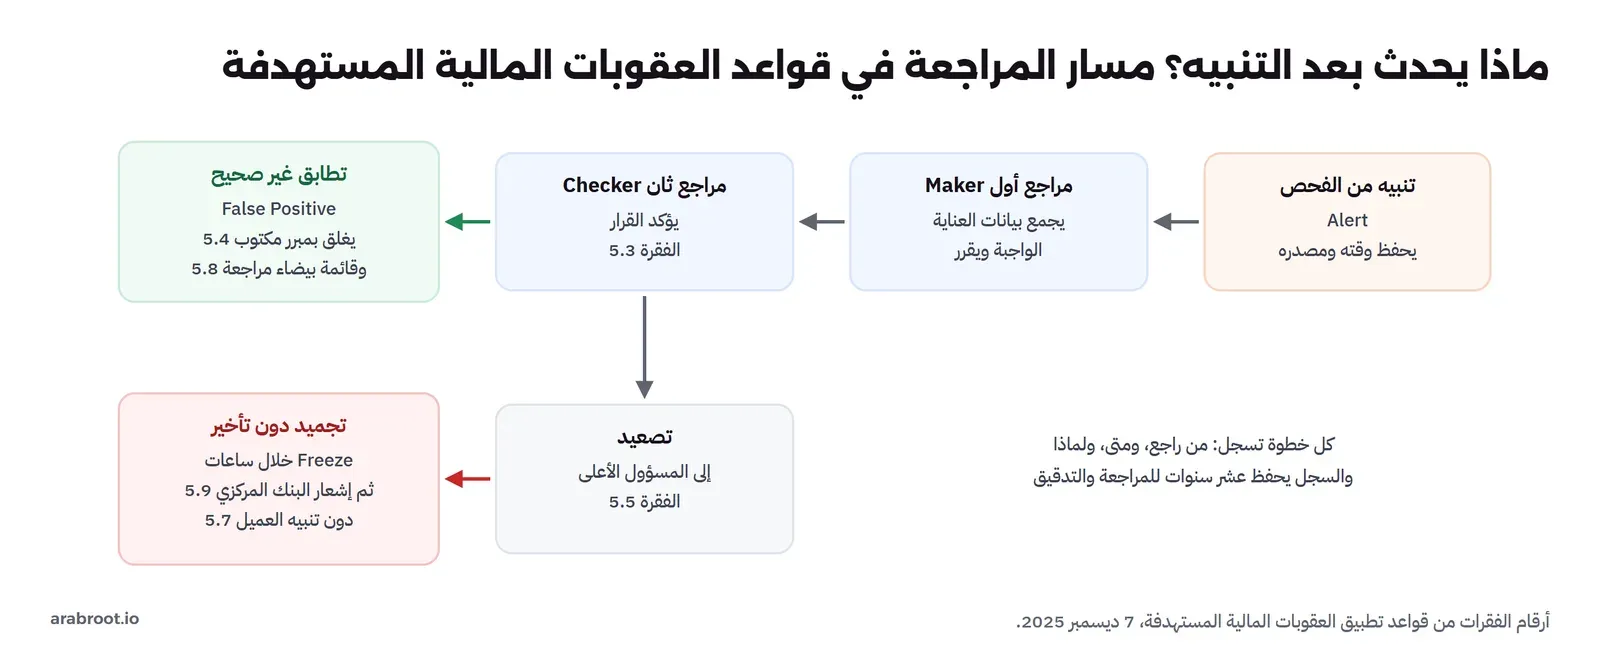
- مراجعان لا مراجع واحد (5.3): يراجع التنبيه متخصصان بنظام Maker-Checker، أي أن من يغلق التنبيه ليس من فتحه وحده، وهذا يعني في الكود أن حالة «مغلق» تحتاج موافقة مستخدم ثان مختلف عن الأول.
- الإغلاق بمبرر (5.4): التنبيه الخاطئ يغلق مع مبرر مكتوب يشرح لماذا ليس تطابقاً، مثل أن سنة الميلاد تختلف عشرين سنة والجنسية مختلفة. فحقل المبرر إلزامي، ولا يكفي زر «ليس هو».
- القائمة البيضاء (5.8): إذا تكرر التطابق الخاطئ مع اسم بعد التحقق، يجوز إضافته إلى قائمة بيضاء داخلية Whitelist تستثنيه من التنبيهات القادمة بمبرر، على أن تراجع القائمة دورياً وتعتمد. وهنا خطأ هندسي شائع: القائمة البيضاء يجب أن تربط العميل بالشخص المحدد في القائمة الذي ثبت أنه ليس هو، لا أن تستثني العميل من كل فحص، وإلا فلن يظهر إذا أدرج هو نفسه غداً.
- التجميد دون تأخير (5.5 و6.1): إذا وجد المسؤول الأعلى أسباباً كافية، تجمد الأموال دون تأخير ودون إشعار مسبق، ولا ينتظر التجميد لجنة أو مراجعة قانونية. وهذا يعني أن نظامك يحتاج زراً يجمد المحفظة كلها فوراً، بما فيها الحوالات المعلقة، وأن يعمل هذا الزر في منتصف الليل.
- الإشعار والسرية (5.9 و5.7): بعد التجميد يشعر البنك المركزي بالبيانات المطلوبة، ولا يعرف العميل ولا غيره بوجود التطابق أو نية التجميد. فرسالة التطبيق للعميل المجمد يكتبها فريق الالتزام، لا المطور.
وهنا تظهر قيمة رقم العتبة مرة أخرى: كل تنبيه خاطئ يحتاج شخصين، وبمبرر مكتوب، فالعتبة 80 في المختبر لا تعني 2,732 تنبيهاً فقط، وإنما 5,464 مراجعة. وفي قصة Payoneer كان تحرير المدفوعات المعلقة آلياً في فترات التراكم أحد أسباب الغرامة، أي أن الفريق لم يلحق بالتنبيهات، فاختار النظام أن يمررها.
قرارات هندسية حول الفحص
بعد المختبر جلس فريق المحفظة مع مسؤولة الالتزام، وكتبوا قرارات صغيرة لم يفكر فيها أحد قبل ذلك:
- الفحص في مسار التحويل نفسه: الفقرة 3.6 تطلب فحص الصادرة قبل التنفيذ، فخدمة الفحص صارت خطوة في مسار التحويل، والتحويل ينتظر نتيجتها. والمهم ماذا يحدث إذا تعطلت الخدمة: هل يمر التحويل أم ينتظر؟ والإجابة الوحيدة المقبولة أن ينتظر أو يرفض، لأن «يمر إذا تعطل الفحص» هو نفس خطأ التحرير الآلي.
- الطرف الآخر يفحص أيضاً: المحفظة لا تفحص عميلها فقط، وإنما المستفيد من كل تحويل، والفقرة 3.4 تذكر المستفيدين من الحوالات بالاسم. وفي التحويل بين محفظتين داخل المنصة، الطرفان عميلان مفحوصان، أما التحويل إلى حساب خارجي فاسم المستفيد يأتي من العميل، فيفحص في كل مرة.
- نسخة القائمة جزء من كل نتيجة: كل نتيجة فحص تحفظ مع رقم إصدار القائمة التي فحصت بها ووقت الفحص والعتبة ونسخة كود المطابقة، لأن الفقرة 3.5 تطلب توثيق طريقة الفحص ووقته ونتيجته، ولأنك بعد سنة لن تستطيع أن تشرح لماذا لم ينبه النظام على اسم ما إلا إذا عرفت بأي قائمة وبأي منطق فحصت.
- السجلات لا تعدل: المادة 12 تطلب الحفظ عشر سنوات بما فيه نتائج التحليل، فجدول نتائج الفحص وقرارات التنبيهات يضاف إليه فقط Append-Only، ولا يحدث سطر فيه، وكل تصحيح سطر جديد يشير للقديم. وهذه نفس فكرة دفتر القيود التي شرحناها في المحفظة الرقمية من الداخل.
- اختبار انحدار للمطابقة: ملف صغير بأسماء مدرجة وكتاباتها المختلفة، وأسماء بريئة معروفة بأنها تشبهها، يشغل مع كل تعديل في كود المطابقة أو العتبة، ويفشل البناء إذا تغير عدد الممسوكين أو الأبرياء. وهذا ما كان سيكشف مشكلة «عبد الرحمن» قبل أن نرسم الصورة، وهو التطبيق العملي للفقرة 3.11 التي تطلب أن يسبق اعتماد أي تعديل اختبار.
بعد التسجيل: مراقبة العمليات
الفحص يجيب «من هو العميل؟»، ولكن المادة 13 تسأل سؤالاً آخر: هل ما يفعله يتسق مع ما نعرفه عنه؟ والقسم السابع من دليل البنك المركزي يطلب أن تكون للمؤسسة أنظمة إلكترونية لمراقبة العمليات لأن المراقبة اليدوية وحدها لا تكفي بحسب الفقرة 7.5، وأن تختبر هذه الأدوات دورياً، وأن تطور مؤشرات وأنماطاً Typologies تناسب نشاطها وتحدثها. وهذا قريب جداً مما بنيناه في كشف الاحتيال: قواعد أم تعلم آلة؟، حيث رأينا أن القواعد تمسك الأنماط المعروفة، وأن النمط الجديد لا يراه أحد حتى يكتب له قاعدة أو يتعلمه نموذج من أمثلة موسومة. والفرق أن نمط غسل الأموال يتكرر عبر أيام وأسابيع لا في دقائق، مثل حساب يستقبل مبالغ صغيرة من كثيرين ثم يحولها مجمعة لشخص واحد، أو عميل مسجل بدخل متواضع يتحرك في حسابه أضعاف دخله.
وفي القصة اختار الفريق أن يبدأ بقواعد قليلة واضحة يكتبها فريق الالتزام، لكل منها مالك وسبب، ثم يرسل ما تطلقه إلى نفس شاشة المراجعة التي بناها للفحص، بحالات مختلفة. والمهم هندسياً أن المراقبة تحتاج ملف العميل من KYC، أي مهنته ودخله المتوقع وتصنيف مخاطره، فإذا لم تحفظ هذه البيانات بشكل منظم عند التسجيل فلن تستطيع أي قاعدة لاحقاً أن تقارن السلوك بالملف. وبلاغ الاشتباه نفسه قرار بشري يرفع للإدارة العامة للتحريات المالية بحسب المادة 15، والنظام يجهز له البيانات ولا يرفعه وحده.
وللحوالات قاعدة إضافية في المادة 10 والقسم الرابع عشر من الدليل: بيانات المرسل والمستفيد يجب أن تبقى مع الحوالة في كل السلسلة، والحوالة التي لا تكتمل بياناتها لا تنفذ. وفي رسائل ISO 20022 لهذه البيانات أماكن محددة، كما رأينا في رسائل البنوك: ISO 8583 وISO 20022، وهي نفسها الأسماء التي تفحصها البنوك في الطريق، فاسم المستفيد الذي يكتبه عميلك بلا تدقيق قد يوقف الحوالة في بنك آخر.
الأدوات مفتوحة المصدر: ماذا تستخدم وماذا تبني؟
ما بنيناه في المختبر مئة سطر توضح الفكرة، وليس نظام فحص للإنتاج. وفي المصادر المفتوحة أدوات أنضج يجب أن تعرفها قبل أن تقرر:
- yente: خدمة مطابقة من مشروع OpenSanctions نفسه، برخصة MIT، تعمل كـ API تبحث فيها عن شخص أو شركة بالاسم وتاريخ الميلاد والجنسية وتعيد المرشحين بدرجات، وتحدث بياناتها من ملفات OpenSanctions. والكود مفتوح، ولكن البيانات نفسها تحتاج ترخيصاً تجارياً للاستخدام التجاري كما ذكرنا، وهي تحتاج محرك بحث بجانبها، فتكلفة تشغيلها أكبر من سكربت.
- RapidFuzz: مكتبة المقارنة التي استخدمناها، وهي مناسبة لبناء طبقة مطابقة داخل خدمتك إذا كانت قوائمك صغيرة وتعرف بالضبط ما تفعله.
- مزودو الفحص التجاريون: يقدمون القوائم المحدثة من مصادرها، وقوائم الأشخاص المعرضين سياسياً، وواجهة مراجعة جاهزة. وإذا اخترت أحدهم، فاطلب منه ما تطلبه الفقرة 3.10: منطق المطابقة ومعاييرها موثقة، واختبرها بنفسك على أمثلة عربية تعرف إجابتها كما فعلنا، قبل أن توقع.
والقرار في القصة كان مزيجاً: مزود تجاري للقوائم وفحص الأشخاص المعرضين سياسياً، لأن جمع القوائم الرسمية وتحديثها يومياً عمل لا يناسب فريقاً من خمسة مهندسين، وطبقة صغيرة داخل المحفظة تحفظ القرار ونسخة القائمة وتنتظر النتيجة في مسار التحويل، وملف اختبار الانحدار من المختبر يشغل على المزود نفسه كل شهر، ليعرف الفريق إذا تغير سلوكه.
أخطاء شائعة
| الخطأ | لماذا يضر | البديل |
|---|---|---|
| المطابقة التامة للاسم اللاتيني | فاتها 38% من المدرجين في المختبر | مطابقة تقريبية على الاسم العربي واللاتيني معاً |
| فحص الاسم الذي كتبه العميل | مدخل يتحكم فيه المفحوص نفسه، والاسم الثنائي يضاعف الأبرياء | الاسم الكامل من الوثيقة الرسمية |
| عتبة في ملف إعدادات بلا سبب | خمس درجات تغير التنبيهات عشرات المرات | عتبة موثقة ومعتمدة ومختبرة قبل كل تغيير |
| token_set_ratio في الفحص الآلي | نبه على 95% من الأبرياء | token_sort_ratio مع معالجة الأسماء المركبة |
| تمرير التحويل إذا تعطل الفحص | هو نفسه التحرير الآلي الذي غرمت عليه Payoneer | التحويل ينتظر أو يرفض |
| القائمة البيضاء تستثني العميل كلياً | لن يظهر إذا أدرج هو نفسه لاحقاً | استثناء زوج عميل وشخص محدد بمبرر ومراجعة |
| ربط السجلات بمعرف الناشر | 36 «تغييراً» بدل 6 في المختبر | رقم المرجع في القائمة الرسمية |
| رسالة للعميل تكشف السبب | تخالف منع الإبلاغ في المادة 16 | نصوص يكتبها فريق الالتزام |
قائمة تحقق لطبقة الفحص
| البند | كيف تتحقق منه |
|---|---|
| الفحص قبل فتح المحفظة وقبل كل عملية | التحويل لا ينفذ دون نتيجة فحص للطرفين |
| الاسم الرسمي بالعربية والاسم اللاتيني يفحصان | كل نتيجة تحفظ الاسمين والدرجتين |
| العتبة موثقة ومعتمدة | قرار مكتوب بتاريخه وسبب اختياره |
| اختبار انحدار للمطابقة | أسماء معروفة الإجابة تشغل مع كل تعديل |
| تحديث القائمة يومياً وفحص الفرق فوراً | سجل بوقت استلام كل تحديث ووقت تطبيقه |
| فحص شامل كل ربع سنة | مهمة مجدولة ونتيجتها محفوظة |
| مراجعان لكل تنبيه | الإغلاق يحتاج مستخدماً ثانياً ومبرراً مكتوباً |
| التجميد يعمل في أي وقت | زر واحد يوقف المحفظة والحوالات المعلقة |
| السجلات عشر سنوات ولا تعدل | جدول إضافة فقط مع نسخة القائمة والكود |
| لا بيانات عملاء حقيقيين في الاختبار | أسماء مولدة وقوائم عامة فقط |
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- معرفة العميل جزء من برنامج مكافحة غسل الأموال، ونظام مكافحة غسل الأموال ودليل البنك المركزي يطلبان العناية الواجبة بحسب المخاطر، والفحص مقابل القوائم، والمراقبة، والبلاغ دون إبلاغ العميل، والحفظ عشر سنوات.
- قواعد العقوبات المالية المستهدفة (ديسمبر 2025) تطلب أن يكشف الفحص اختلاف الكتابة والتشابه في النطق والكتابة بحروف أخرى، وأن تكون منهجية المطابقة موثقة ومختبرة.
- في المختبر على قائمة مجلس الأمن، المطابقة التامة أمسكت 61.7% فقط، والهيكل الساكن للاسم العربي والاسم اللاتيني معاً أمسك 326 من 326 عند العتبة 90 مع 58 بريئاً من عشرين ألفاً.
- من العتبة 90 إلى 80 زاد الأبرياء من 58 إلى 2,732، وسنة الميلاد خفضتهم إلى صفر عند 90، والاسم الثنائي بدل الرباعي رفعهم إلى 2,965.
- مقارنة نسختي القائمة بمعرف الناشر أعطت 36 إضافة، وبرقم مرجع الأمم المتحدة 6 فقط، وفحص الفرق استغرق 0.053 ثانية.
- كل تنبيه يحتاج مراجعين ومبرراً مكتوباً، والتجميد دون تأخير، وكل ذلك حالات وسجلات في الكود.
والمقالات المرتبطة:
 دليلكشف الاحتيال Fraud Detection: قواعد أم تعلم آلة؟قارنا القواعد بنموذجين لتعلم الآلة على بيانات دفع مولدة بنفس سعة المراجعة، ورأينا من يمسك الأنماط المعروفة ومن يتأخر عن النمط الجديد.
 دليلالمحافظ الرقمية Digital Wallets: الأنواع والترخيص والبناءأنواع المحافظ الرقمية وتراخيص النقود الإلكترونية في المملكة وحدودها، وحماية أموال العملاء، مع مختبر للحدود والمطابقة اليومية.
 دليلرسائل البنوك: ISO 8583 للبطاقات وISO 20022 للتحويلاتنفكك رسالة تفويض بطاقة بايتاً بايتاً، ونبني أمر تحويل بأسماء عربية ونتحقق منه بالمخطط الرسمي، ونرى ما يتعطل في كل معيار.
 دليلالتحويلات الدولية: SWIFT والبنوك المراسلةنتبع حوالة دولية عبر سلسلة البنوك المراسلة في نموذج بافتراضات مكتوبة، ونقرأ رسائل MT103 وpacs.008 ومثال تتبع gpi من Swift.
 دليلالمحفظة الرقمية من الداخل: دفتر القيد المزدوج Ledgerكيف تبني محفظة رقمية لا يضيع فيها ريال ولا يخصم مرتين، بالقيد المزدوج والمعاملات والمطابقة مع مزود الدفع.
سجل التحديثات
- أكتوبر 2026: كتابة المقال وتشغيل المختبر على python:3.13.17-slim بمكتبات RapidFuzz 3.14.1 وNumPy 2.3.4 وanyascii 0.3.3، على قائمة مجلس الأمن من OpenSanctions بإصداري 20261027120104 و20260701200101، مع نظام مكافحة غسل الأموال ودليل البنك المركزي (نوفمبر 2019) وقواعد تطبيق العقوبات المالية المستهدفة (7 ديسمبر 2025) وإشعار OFAC عن Payoneer كما ظهرت في 27 أكتوبر 2026.