

كل مرة تفتح فيها معرض الصور في هاتفك وتجده قد جمع صور أطفالك في ألبوم واحد دون أن تسميهم، أو تكتب «قطة» في البحث فتظهر صور القطط وحدها، أو تدخل موقف سيارات فترتفع البوابة لأن الكاميرا قرأت لوحة سيارتك، فأنت ترى نتيجة مجال اسمه الرؤية الحاسوبية Computer Vision. وقد تبدو هذه الأشياء من الوهلة الأولى سحراً، أو تبدو في الاتجاه المعاكس شيئاً بسيطاً لا يحتاج شرحاً، فالإنسان يرى القطة في الصورة في جزء من الثانية دون أن يفكر، لكن الحاسب لا يرى قطة ولا كنبة، وإنما يرى جدولاً من الأرقام، والمسافة بين هذا الجدول وجملة «ثلاث قطط على كنبة» هي ما سوف نمشيه في هذا المقال خطوة خطوة.
والهدف ليس أن تصبح باحثاً في التعلم العميق، وإنما أن تفهم ما يحدث داخل هذه الأنظمة بما يكفي لتعرف متى تثق بها ومتى لا تثق، وكيف تقرأ أرقامها، ولماذا تخطئ عندما تخطئ، وهذا ما تحتاجه عندما تشغل كاميرات مراقبة ذكية، أو بوابة تقرأ اللوحات، أو تريد أن تضيف ميزة تتعرف على المنتجات في تطبيقك. وسوف نشغل نموذجين حقيقيين على حاسب عادي دون بطاقة رسومية، ونرى بأعيننا ما يقولانه عن صور حقيقية وأين يخطئان. وهذا المقال من مرحلة معالجة الصور والمستندات في خارطة الطريق، ويفترض أنك تعرف الفكرة العامة للتعلم الآلي من التعلم الآلي للمبتدئين.
وسوف نناقش في هذا المقال ما يلي:
- ما هي الصورة بالنسبة للحاسب، بالأرقام الحقيقية من صورة شارع.
- الطريقة القديمة: خصائص يكتبها المبرمج بيده مثل الحواف، ولماذا لم تكف.
- الطريقة الحديثة: الشبكات الالتفافية CNN التي تتعلم الخصائص وحدها، وقصة ImageNet التي غيرت المجال سنة 2012.
- المهام الرئيسية: التصنيف والكشف والتجزئة وغيرها، ومتى تحتاج كل واحدة.
- كيف يعمل كشف الأجسام Object Detection من الداخل: الصناديق والدرجات والعتبة وحذف المكرر NMS.
- تجربة عملية بمكتبة OpenCV ونموذجي MobileNetV2 وYOLOX على صور مفتوحة الرخصة، مع ما يحدث إذا غيرنا العتبة أو أظلمنا الصورة أو صغرنا النموذج.
- كيف تقيس النموذج، وأين يعمل في الإنتاج، وما الأخطاء التي تتكرر عند الفرق التي تبدأ في هذا المجال.
ماذا يرى الحاسب عندما ينظر إلى صورة؟
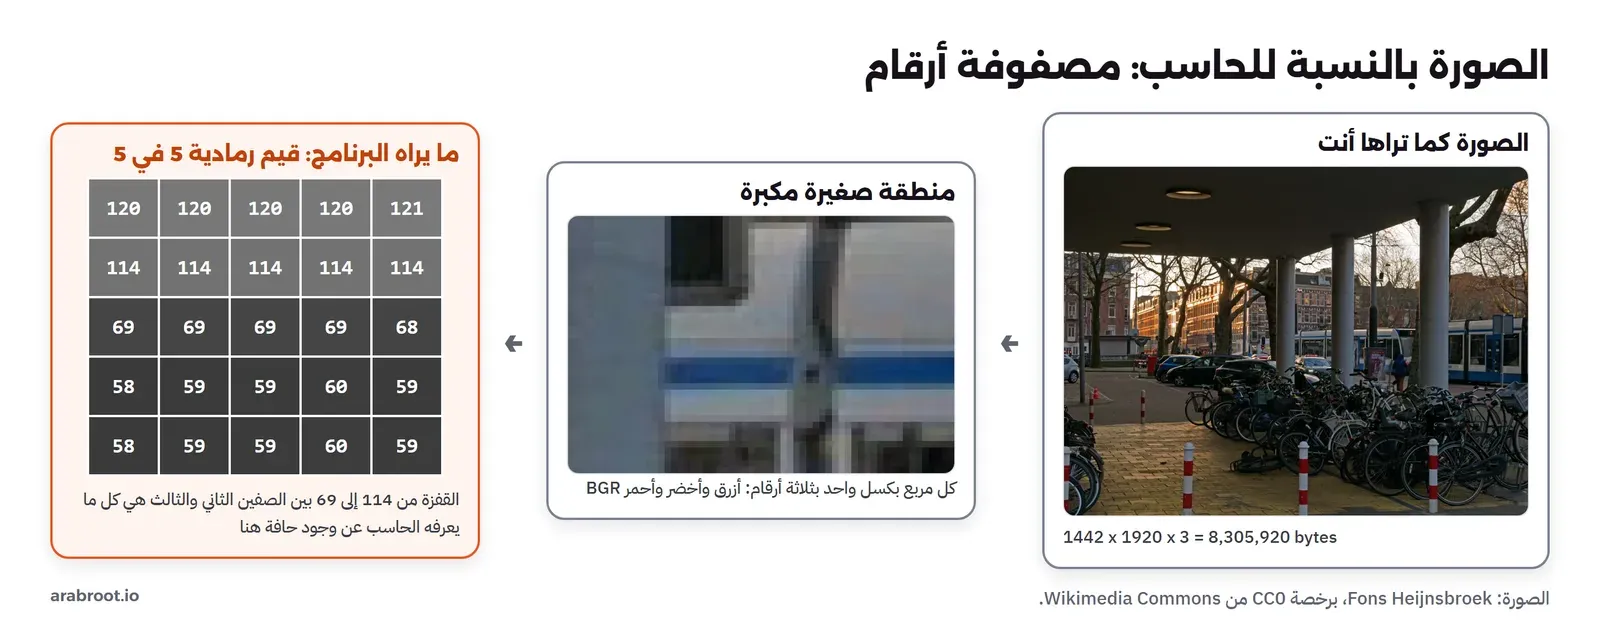
الصورة الرقمية شبكة من المربعات الصغيرة اسمها البكسلات Pixels، ولكل بكسل في الصورة الملونة ثلاثة أرقام من 0 إلى 255 لشدة الأحمر والأخضر والأزرق، وقد شرحنا كيف تحفظ الصيغ المختلفة هذه الأرقام في صيغ الصور. وفي التجربة العملية في آخر المقال فتحنا صورة شارع مقاسها 1920 في 1442 بكسلاً بمكتبة OpenCV وطبعنا ما يراه البرنامج فعلاً:
shape (1442, 1920, 3) dtype uint8 bytes 8305920
top-left 3x3 pixels (B,G,R):
[[[15, 23, 22], [17, 25, 24], [19, 27, 26]], [[13, 21, 20], [15, 23, 22], [16, 24, 23]], [[13, 21, 20], [14, 22, 21], [15, 23, 22]]]
gray 5x5 patch at (960, 700)
[[120 120 120 120 121]
 [114 114 114 114 114]
 [ 69  69  69  69  68]
 [ 58  59  59  60  59]
 [ 58  59  59  60  59]]
في المخرج أعلاه لاحظ التالي:
- الصورة كلها مصفوفة ثلاثية الأبعاد: 1442 صفاً في 1920 عموداً في 3 قنوات، أي أكثر من 8.3 مليون رقم، وكل رقم بايت واحد من النوع
uint8. - OpenCV يقرأ القنوات بالترتيب أزرق ثم أخضر ثم أحمر BGR، وليس RGB كما تتوقع، وهذا تفصيل تاريخي سوف يعود إلينا في التجربة، لأن نسيانه من أشهر الأخطاء.
- المربع الرمادي 5 في 5 في منتصف الصورة فيه انتقال واضح من قيم حول 120 إلى قيم حول 58 بين الصف الثاني والثالث، وهذا الانتقال هو كل ما يعرفه الحاسب عن وجود حافة شيء ما هنا، ربما سقف سيارة أو طرف رصيف.
والصورة التالية تبين نفس الفكرة: منطقة صغيرة من صورة الشارع مكبرة حتى ترى البكسلات، ومعها الأرقام التي يراها البرنامج:
والسؤال الذي يقوم عليه المجال كله: كيف تكتب برنامجاً يأخذ ثمانية ملايين رقم ويقول «هنا دراجة، وهنا شخص»؟ والصعوبة أن نفس الدراجة تعطي أرقاماً مختلفة تماماً إذا تغيرت الإضاءة، أو اقتربت الكاميرا، أو ظهرت الدراجة من جانبها بدل أمامها، أو غطى جزءاً منها عمود، بينما تبقى بالنسبة لك نفس الدراجة.
الطريقة القديمة: خصائص يكتبها المبرمج بيده
الحل الأول الذي يخطر على البال أن نصف الشيء بقواعد: الدراجة فيها دائرتان وخطوط مستقيمة بينهما، والوجه فيه منطقتان داكنتان للعينين فوق منطقة فاتحة. وأول خطوة في هذه القواعد هي إيجاد الحواف Edges، أي الأماكن التي تتغير فيها شدة الإضاءة فجأة، كما رأينا في المربع الرمادي. والطريقة الكلاسيكية لذلك هي الالتفاف Convolution بمرشح صغير، مثل مرشح Sobel التالي الذي يمر على كل بكسل في الصورة ويضرب جيرانه في هذه الأوزان ثم يجمعها:
-1  0  +1
-2  0  +2
-1  0  +1
فإذا كانت المنطقة متساوية الإضاءة كانت النتيجة قريبة من الصفر، لأن السالب يلغي الموجب، وإذا كان يسار البكسل داكناً ويمينه فاتحاً كانت النتيجة كبيرة، أي حافة عمودية. وفي التجربة طبقنا هذا المرشح وأخاه الأفقي على صورة الشارع، فكانت النتيجة:
edge strength: mean 64.4, 99th percentile 498.5, max 884.7
pixels that are strong edges (>100): 19.2%
والصورة التالية تبين الصورة الأصلية وخريطة الحواف التي خرجت منها:
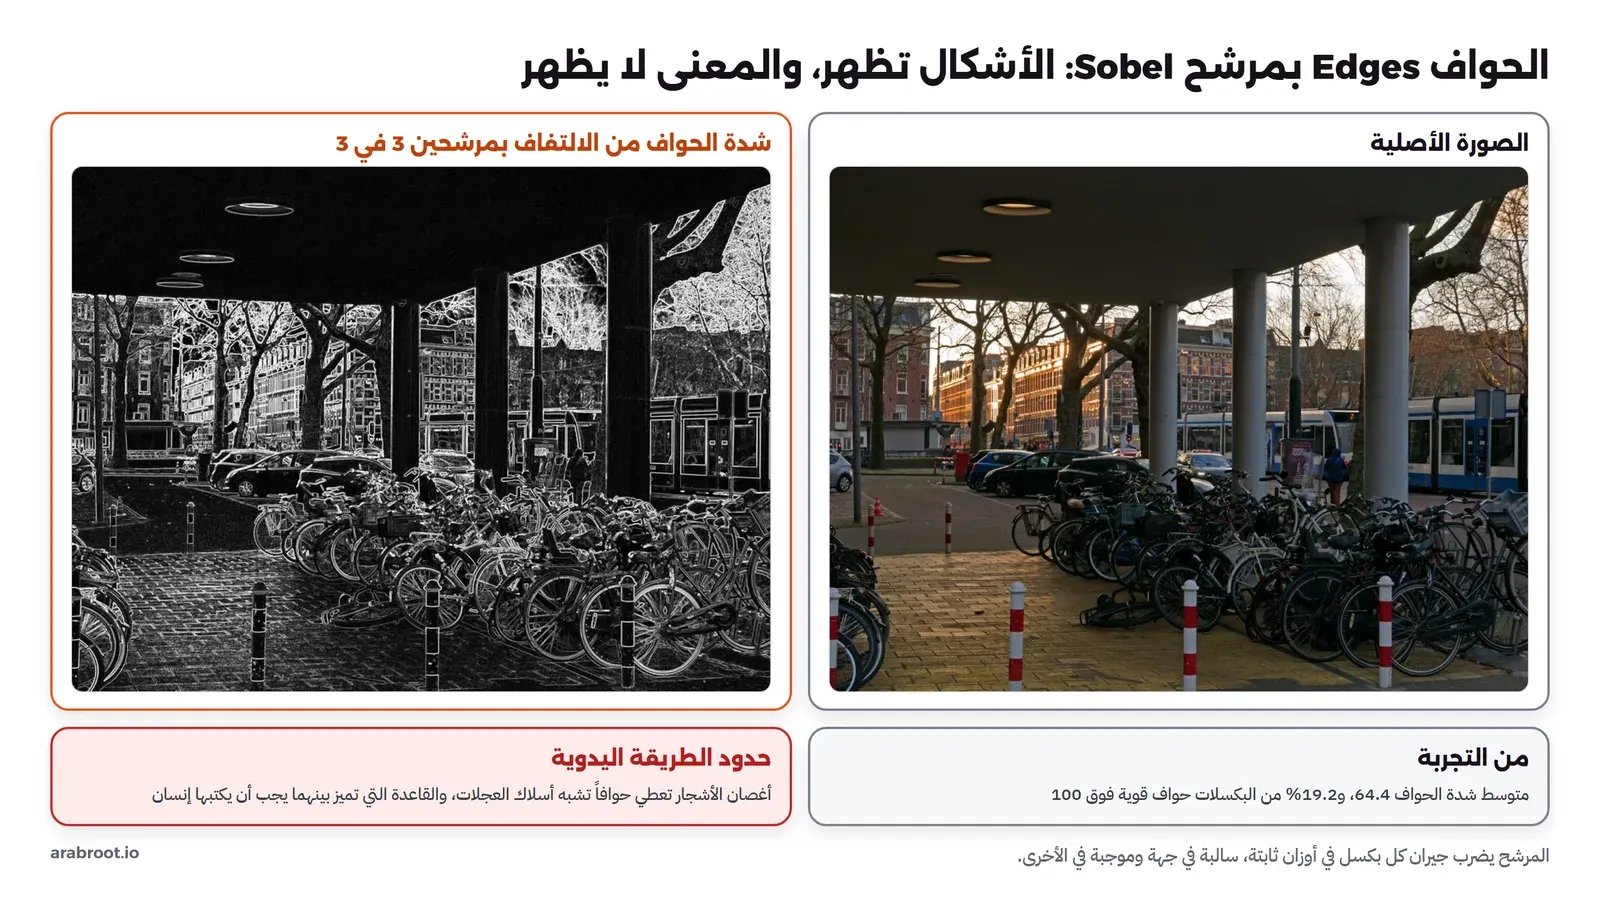
لاحظ أن 19% من بكسلات الصورة صارت حواف قوية، وأن أغصان الأشجار العارية تعطي حوافاً تشبه أسلاك عجلات الدراجات، وهنا بالضبط المشكلة: الحواف خطوة أولى ممتازة، لكن تحويلها إلى «دراجة» يحتاج آلاف القواعد، وكل قاعدة تفشل مع زاوية أو إضاءة لم يتوقعها كاتبها. وقد بنى الباحثون لعقود خصائص أذكى من الحواف، مثل اتجاهات التدرج في مناطق صغيرة، ونجحت في مهام محدودة مثل كشف الوجوه الأمامية، لكنها كانت تنهار عندما يكبر عدد الأشياء التي تريد التعرف عليها، لأن الإنسان لا يستطيع أن يكتب بيده وصفاً لألف نوع من الأشياء من كل الزوايا.
الطريقة الحديثة: الشبكة تتعلم المرشحات وحدها CNN
الفكرة التي غيرت المجال بسيطة في جوهرها: بدل أن يكتب الإنسان أوزان المرشح بيده، مثل -1 و0 و+1 في Sobel، نترك البرنامج يتعلمها من أمثلة. فنبني شبكة من طبقات كثيرة، كل طبقة فيها عشرات أو مئات المرشحات الصغيرة مثل Sobel لكن أوزانها مجهولة في البداية، ثم نعرض عليها ملايين الصور مع اسم ما فيها، ونعدل الأوزان قليلاً بعد كل خطأ بنفس طريقة التدريب التي شرحناها في التعلم الآلي للمبتدئين. وهذا النوع يسمى الشبكة العصبية الالتفافية Convolutional Neural Network، واختصاراً CNN، وأشهر مثال مبكر لها شبكة LeNet التي نشرها Yann LeCun وزملاؤه سنة 1998 في بحث قراءة الأرقام المكتوبة باليد لقراءة الشيكات البنكية.
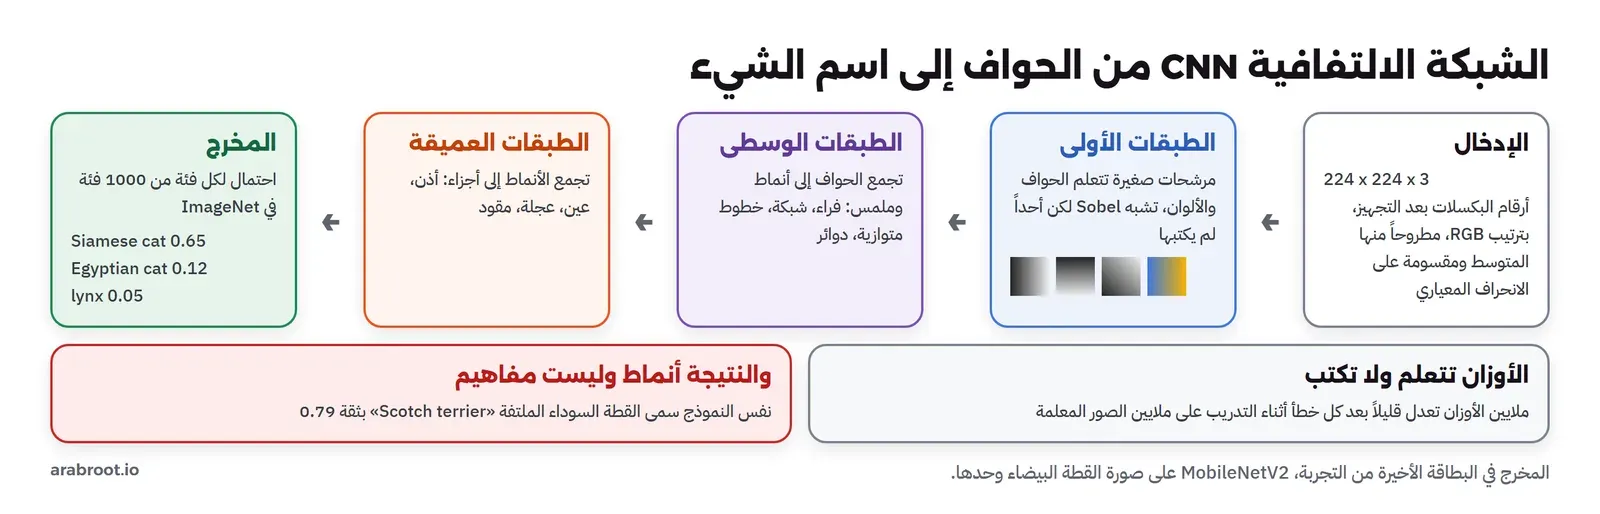
والشيء المدهش الذي يحدث بعد التدريب أن الطبقات الأولى تتعلم وحدها مرشحات تشبه الحواف التي كان المهندسون يكتبونها، ثم تجمع الطبقات التالية الحواف إلى أنماط وملمس، ثم إلى أجزاء مثل العجلة والعين والأذن، ثم تقول الطبقة الأخيرة «قطة» أو «دراجة». والصورة التالية تبين هذه الفكرة:
لكن الفكرة كانت معروفة قبل 2012 بسنوات، فلماذا انفجر المجال فجأة في تلك السنة؟ والإجابة أن ثلاثة أشياء اجتمعت: مجموعة بيانات ضخمة، وقوة حساب كافية، وتحسينات في طريقة التدريب. أما البيانات فكانت ImageNet، وهي مجموعة صور صنفها البشر إلى آلاف الفئات، واستخدمت منها مسابقة سنوية قرابة 1.3 مليون صورة تدريب في 1000 فئة. وأما الحساب فجاء من بطاقات الرسوميات GPU التي صممت للألعاب، وتبين أنها ممتازة في ضرب المصفوفات الذي تحتاجه الشبكات. وفي بحث ImageNet Classification with Deep Convolutional Neural Networks المنشور سنة 2012، والمعروف باسم AlexNet، درب Alex Krizhevsky وIlya Sutskever وGeoffrey Hinton شبكة فيها 60 مليون معامل وخمس طبقات التفافية على بطاقتي رسوميات، ويذكر ملخص البحث أنها وصلت إلى خطأ 18.9% في أفضل خمسة توقعات على بيانات اختبار 2010، وهو أفضل بكثير مما وصلت إليه الطرق السابقة. ومن يومها صارت الشبكات العميقة هي الطريقة الأساسية في الرؤية الحاسوبية، وقد حكينا هذه القصة ضمن تاريخ المجال في قصة الذكاء الاصطناعي.
وماذا بعد الشبكات الالتفافية؟
الشبكات الالتفافية ما زالت أساس أغلب النماذج الصغيرة والسريعة، مثل التي سنجربها، لكن المجال لم يتوقف عندها. ففي 2020 نشر باحثون من Google بحث An Image is Worth 16x16 Words الذي قسم الصورة إلى مربعات صغيرة وعاملها كأنها كلمات في جملة، ومررها في نفس معمارية Transformer التي تقوم عليها نماذج اللغة، وسميت هذه النماذج Vision Transformers. ومن هذا الخط جاءت النماذج متعددة الوسائط Multimodal التي تقرأ صورة وتجيب عن سؤال مكتوب عنها، وقد شرحنا معمارية Transformer في كيف تعمل نماذج اللغة الكبيرة. وهذه النماذج أقوى في الفهم العام للصورة، لكنها أكبر وأبطأ وأغلى بكثير، لذلك ما زالت الأنظمة التي تعالج فيديو من عشرات الكاميرات في كل ثانية تعتمد على نماذج كشف صغيرة متخصصة، وتترك النماذج الكبيرة للأسئلة التي تحتاج فهماً أعمق ولا تتكرر كثيراً.
كيف تتعلم الشبكة أوزانها؟
التدريب في جوهره حلقة تتكرر ملايين المرات: تأخذ صورة معروف ما فيها، وتمررها في الشبكة بأوزانها الحالية، فتخرج الشبكة احتمالاً لكل فئة، ثم تقيس دالة الخسارة Loss Function كم ابتعدت هذه الاحتمالات عن الإجابة الصحيحة، ثم تحسب خوارزمية الانتشار العكسي Backpropagation كيف يجب أن يتغير كل وزن من ملايين الأوزان ليقل هذا الخطأ قليلاً، ثم تعدل الأوزان خطوة صغيرة في ذلك الاتجاه. وبعد أن تمر الشبكة على كل صور التدريب عدة دورات Epochs تكون الأوزان قد استقرت على قيم تميز الفئات بعضها عن بعض. ولاحظ أن الشبكة لا تتعلم «ما هي القطة»، وإنما تتعلم أي أنماط في الأرقام ترتبط بكلمة «قطة» في صور التدريب، وهذا الفرق هو ما رأيناه في التجربة عندما صارت القطة السوداء الملتفة كلباً أسود.
وتدريب شبكة من الصفر يحتاج ملايين الصور وأياماً من بطاقات الرسوميات، لذلك لا تبدأ أي شركة تقريباً من الصفر، وإنما تأخذ نموذجاً مدرباً على ImageNet أو COCO، وتعيد تدريب طبقاته الأخيرة على صورها هي، وهذا ما يسمى نقل التعلم Transfer Learning. والسبب أن الطبقات الأولى تعلمت حوافاً وأنماطاً عامة تصلح لأي صور، فلا تحتاج أن تتعلمها من جديد، ويكفيك مئات الصور المعلمة لفئاتك بدل ملايين.
وهناك سبب آخر لوجود نماذج صغيرة مثل التي سنجربها: الشبكات الأولى مثل AlexNet كانت تحتاج بطاقات رسوميات قوية، والهواتف والكاميرات لا تحملها، فظهرت عائلات نماذج مصممة للأجهزة المحدودة، منها MobileNetV2 التي يصفها بحثها بأنها معمارية للأجهزة المحمولة تحسن الأداء عبر أحجام مختلفة من النماذج، وتستخدم نوعاً من الالتفاف يقسم العمل إلى خطوتين أرخص بكثير من الالتفاف العادي، فتعطي دقة قريبة بجزء صغير من الحساب.
ماذا تستطيع الرؤية الحاسوبية أن تفعل؟ المهام الرئيسية
عبارة «الحاسب يفهم الصورة» تخفي عدة مهام مختلفة جداً، ولكل منها نماذجها وبياناتها وطريقة قياسها، فأول سؤال يجب أن تسأله عندما يأتيك طلب في هذا المجال: أي مهمة نحتاج بالضبط؟
| المهمة | السؤال الذي تجيب عنه | شكل المخرج | مثال |
|---|---|---|---|
| التصنيف Classification | ما الشيء الرئيسي في هذه الصورة؟ | اسم فئة واحدة واحتمالها | فرز صور المنتجات المرفوعة إلى أحذية وحقائب وساعات |
| كشف الأجسام Object Detection | ما الأشياء في الصورة، وأين كل منها؟ | صناديق حول الأشياء، مع اسم ودرجة لكل صندوق | عد السيارات في موقف، أو تنبيه عند ظهور شخص في كاميرا مراقبة |
| التجزئة Segmentation | أي بكسل ينتمي لأي شيء؟ | قناع Mask بنفس مقاس الصورة | فصل الشخص عن الخلفية في مكالمة الفيديو، أو مساحة الأسطح في صورة جوية |
| التعرف على النص OCR | ما النص المكتوب في الصورة؟ | نص مع مواضع الكلمات | الفواتير والمستندات، وقد شرحناه في مقال Tesseract في نفس المرحلة |
| التتبع Tracking | هل هذا الشخص في الإطار الحالي هو نفسه في الإطار السابق؟ | معرف ثابت لكل شيء عبر الإطارات | عد الداخلين إلى متجر دون عد نفس الشخص مرتين |
| تقدير الوضعية Pose Estimation | أين مفاصل الجسم؟ | نقاط للرأس والكتفين والركبتين | تطبيقات التمارين الرياضية، وكشف السقوط |
| التشابه والبحث Embeddings | أي الصور تشبه هذه الصورة؟ | متجه أرقام لكل صورة يقارن بغيره | «ابحث بصورة» في متجر، وتجميع الوجوه في معرض الهاتف |
وفي عرب رووت مقالان يطبقان هذه المهام على أنظمة حقيقية: Frigate لتسجيل كاميرات المراقبة يستخدم كشف الأجسام ليسجل فقط عندما يظهر شخص أو سيارة، وبوابة تقرأ لوحة السيارة يجمع كشف اللوحة مع قراءة حروفها. وفي التجربة سوف نجرب أكثر مهمتين انتشاراً، التصنيف والكشف، لأن الفرق بينهما هو أول ما يربك من يبدأ.
كيف يعمل كشف الأجسام Object Detection من الداخل؟
التصنيف يعطي اسماً واحداً للصورة كلها، وهذا يكفي لصورة منتج على خلفية بيضاء، لكنه لا يفيد في صورة شارع فيها عشرون شيئاً. أما الكشف فيجب أن يجيب عن سؤالين معاً: ماذا وأين. والطريقة التي جعلت ذلك سريعاً بما يكفي للفيديو جاءت مع عائلة نماذج اسمها YOLO، أي You Only Look Once، التي نشرها Joseph Redmon وزملاؤه في بحث سنة 2015، والفكرة أن الشبكة تنظر إلى الصورة مرة واحدة وتخرج كل الصناديق في نفس الوقت، بدل أن تفحص آلاف المناطق كل منها وحدها. والنموذج الذي نستخدمه في التجربة اسمه YOLOX، من نفس العائلة، ونشره فريق Megvii في بحث سنة 2021 ومستودعه على GitHub برخصة Apache-2.0، وأصغر نسخه YOLOX-Nano فيها 0.91 مليون معامل فقط بحسب ملخص البحث.
والخطوات داخل النموذج كما يلي، وكل خطوة منها سوف تراها في كود التجربة:
- تجهيز الصورة: تصغر الصورة إلى المقاس الذي تدرب عليه النموذج، مثل 416 في 416 ل YOLOX-Nano، مع الحفاظ على النسبة بإضافة حواف رمادية Letterbox، لأن مط الصورة يغير أشكال الأشياء.
- الشبكة تقسم الصورة إلى شبكة من الخلايا بثلاثة مقاسات، خلايا صغيرة للأشياء الصغيرة وخلايا كبيرة للأشياء الكبيرة، وفي المقاس 416 يصبح العدد 3549 خلية، ولكل خلية تخرج الشبكة صندوقاً مقترحاً بموضعه ومقاسه، ودرجة لوجود شيء فيه، واحتمالاً لكل فئة من الفئات الثمانين.
- الدرجة النهائية لكل صندوق هي درجة وجود الشيء مضروبة في احتمال الفئة، ثم تحذف الصناديق التي درجتها أقل من عتبة الثقة Confidence Threshold، مثل 0.35.
- الشيء الواحد تكتشفه عادة عدة خلايا متجاورة، فيظهر عليه عدة صناديق متداخلة، لذلك تأتي خطوة حذف المكرر Non-Maximum Suppression، واختصاراً NMS: تأخذ الصندوق صاحب أعلى درجة، وتحذف كل صندوق من نفس الفئة يتداخل معه بأكثر من نسبة معينة، مثل 45%، ثم تكرر مع الصندوق التالي.
والفئات التي يعرفها النموذج ليست اختياره، وإنما فئات البيانات التي تدرب عليها، وأشهرها مجموعة COCO التي يصفها بحثها بأنها 328 ألف صورة فيها 2.5 مليون شيء معلم بأيدي البشر، وتستخدم مسابقات الكشف منها 80 فئة مثل الشخص والدراجة والسيارة والقطة والكنبة، كما في موقع المجموعة. وهذا يعني شيئاً مهماً جداً: النموذج المدرب على COCO لا يعرف الجمل ولا النخلة ولا الشماغ، وسوف يسمي ما لا يعرفه بأقرب فئة يعرفها، أو يتجاهله تماماً.
تجربة عملية: نموذجان حقيقيان على حاسب دون بطاقة رسومية
الآن سوف نشغل كل ما سبق بأدوات مفتوحة المصدر على المعالج فقط: مكتبة OpenCV بإصدارها 5.0.0، وفيها وحدة dnn التي تشغل النماذج بصيغة ONNX المفتوحة دون أي إطار تعلم عميق، ونموذج تصنيف MobileNetV2 من مستودع نماذج ONNX مدرب على 1000 فئة من ImageNet، ونموذج كشف YOLOX-Nano. والصور ثلاث صور من Wikimedia Commons برخصة CC0، أي دون أي قيد على الاستخدام: ثلاث قطط على كنبة، وقطة على دراجة نارية، وصورة شارع فيه دراجات وسيارات وترام من تصوير Fons Heijnsbroek.


تجهيز البيئة
نبني Image فيها Python وOpenCV وNumPy، ونضع فيها النموذجين وملف أسماء فئات ImageNet:
FROM python:3.13.17-slim
RUN pip install --no-cache-dir numpy==2.5.4 opencv-python-headless==5.0.0.93
ADD https://github.com/Megvii-BaseDetection/YOLOX/releases/download/0.1.1rc0/yolox_nano.onnx /models/yolox_nano.onnx
ADD https://github.com/onnx/models/raw/main/validated/vision/classification/mobilenet/model/mobilenetv2-12.onnx /models/mobilenetv2-12.onnx
ADD https://raw.githubusercontent.com/onnx/models/main/validated/vision/classification/synset.txt /models/synset.txt
WORKDIR /lab
docker build -t cv-lab:1 .
docker run --rm cv-lab:1 sh -c "python -c 'import cv2, numpy; print(cv2.__version__, numpy.__version__)'; ls -l /models"5.0.0 2.5.4
total 17248
-rw------- 1 root root 13964571 Oct 28 11:53 mobilenetv2-12.onnx
-rw------- 1 root root 31675 Jan 1 1970 synset.txt
-rw------- 1 root root 3659407 Dec 8 2021 yolox_nano.onnxلاحظ حجم النموذجين: نموذج كشف يعرف 80 فئة في 3.7 ميجابايت، ونموذج تصنيف يعرف 1000 فئة في 14 ميجابايت، أي أصغر من صورة واحدة من كاميرا احترافية، وهذا ما يجعل تشغيلها على أجهزة صغيرة ممكناً. ونسخة OpenCV بلا واجهة رسومية headless لأننا على سيرفر لا يعرض نوافذ.
التصنيف: اسم واحد لكل صورة
السكربت التالي يحمل MobileNetV2، ويجهز الصورة كما تدرب النموذج: يحولها من BGR إلى RGB، ويصغرها إلى 224 في 224، ويقسم كل قيمة على 255 ثم يطرح متوسط ImageNet ويقسم على انحرافه المعياري، ثم يعيد ترتيب الأبعاد إلى الشكل الذي تتوقعه الشبكة، ثم يحول المخرج إلى احتمالات بدالة Softmax ويطبع أعلى ثلاث فئات:
import cv2, numpy as np, time, sys
net = cv2.dnn.readNetFromONNX("/models/mobilenetv2-12.onnx")
labels = [l.strip().split(" ", 1)[1] for l in open("/models/synset.txt")]
mean, std = np.array([0.485, 0.456, 0.406]), np.array([0.229, 0.224, 0.225])
def prep(img):          # first version: squash the whole photo to 224x224
    rgb = cv2.cvtColor(cv2.resize(img, (224, 224)), cv2.COLOR_BGR2RGB).astype(np.float32) / 255
    return ((rgb - mean) / std).transpose(2, 0, 1)[None].astype(np.float32)   # NCHW
def top(img, p=prep, k=3):
    net.setInput(p(img)); out = net.forward()[0]
    pr = np.exp(out - out.max()); pr /= pr.sum()
    return [(labels[i].split(",")[0], float(pr[i])) for i in pr.argsort()[::-1][:k]]
if __name__ == "__main__":
    for name in sys.argv[1:]:
        img = cv2.imread(f"img/{name}")
        print(f"{name}: " + " | ".join(f"{l} {p:.2f}" for l, p in top(img)))
    img = cv2.imread("img/cat-moto.jpg"); top(img)
    t = time.perf_counter()
    for _ in range(20): top(img)
    print("mobilenetv2 224x224: %.1f ms per image (avg of 20)" % ((time.perf_counter() - t) / 20 * 1000))
docker run --rm -v "$PWD:/lab" cv-lab:1 python classify.py cat-moto.jpg three-cats.jpg street.jpgوالمخرج سوف يكون كما يلي:
cat-moto.jpg: snowmobile 0.49 | moped 0.21 | parachute 0.03
three-cats.jpg: soft-coated wheaten terrier 0.12 | French bulldog 0.09 | teddy 0.06
street.jpg: bicycle-built-for-two 0.12 | patio 0.09 | parking meter 0.05
mobilenetv2 224x224: 51.9 ms per image (avg of 20)
النتيجة مخيبة لمن يتوقع أن الذكاء الاصطناعي «يفهم» الصور: الدراجة النارية مع القطة صارت مركبة ثلج Snowmobile بثقة 49%، والقطط الثلاث صارت كلب Terrier بثقة 12%. وأول ما شككنا فيه هو تجهيز الصورة، لأن مط الصورة الأفقية إلى مربع يغير أشكال الأشياء، فجربنا الطريقة المعتادة في تدريب نماذج ImageNet، أي تصغير الضلع الأقصر إلى 256 ثم قص مربع 224 من المنتصف، وجربنا معها الخطأ الشائع، أي إعطاء الشبكة BGR على أنها RGB:
cat-moto.jpg [resize 256 + center crop 224]: snowmobile 0.38 | backpack 0.11 | moped 0.09
cat-moto.jpg [BGR fed as RGB]: snowmobile 0.35 | moped 0.18 | scuba diver 0.14
three-cats.jpg [resize 256 + center crop 224]: French bulldog 0.59 | Boston bull 0.09 | Chihuahua 0.05
three-cats.jpg [BGR fed as RGB]: Boston bull 0.16 | French bulldog 0.11 | West Highland white terrier 0.05
street.jpg [resize 256 + center crop 224]: library 0.20 | moped 0.09 | motor scooter 0.09
street.jpg [BGR fed as RGB]: altar 0.07 | library 0.05 | fountain 0.03
تغيرت الإجابات مع كل طريقة تجهيز، وهذا وحده درس مهم: النموذج حساس جداً لأي اختلاف بين ما تدرب عليه وما تعطيه، لكن النتائج بقيت خطأ. فهل النموذج معطل؟ لكي نعرف قصصنا من صورة القطط منطقتي القطتين اللتين وجدهما نموذج الكشف كما سيأتي، وأعطينا كل منطقة للمصنف وحدها:
cat box 0.70 squash: [('Siamese cat', 0.21), ('Egyptian cat', 0.16), ('tabby', 0.15)]  crop: [('Siamese cat', 0.65), ('Egyptian cat', 0.12), ('lynx', 0.05)]
cat box 0.48 squash: [('Scotch terrier', 0.79), ('schipperke', 0.04), ('Angora', 0.03)]  crop: [('schipperke', 0.16), ('pug', 0.07), ('Rottweiler', 0.06)]
cat on motorcycle box: [('triceratops', 0.26), ('Egyptian cat', 0.19), ('wallaby', 0.09)]
القطة البيضاء وحدها صارت «قطة سيامي» بثقة 65%، أي أن النموذج يعمل، والمشكلة كانت في السؤال نفسه. والقطة السوداء الملتفة صارت كلاباً سوداء من سلالات مختلفة، والقطة على الدراجة صارت ديناصوراً قبل أن تصير قطة. وفي المخرج كله لاحظ التالي:
- التصنيف يفترض أن في الصورة شيئاً رئيسياً واحداً يملأ أغلبها، كما في صور ImageNet، فإذا كان في الصورة ثلاث قطط وكنبة، أو دراجات وسيارات وترام، فلا توجد إجابة صحيحة واحدة، والنموذج يعطيك أقرب شيء رآه بهذا الشكل العام.
- الثقة ليست صحة: «snowmobile 0.49» رقم كبير لإجابة خطأ، و«Scotch terrier 0.79» أكبر منه لإجابة خطأ أيضاً، والنموذج لا يملك خيار «لا أعرف» ما لم تبنه أنت، وقد شرحنا هذه الظاهرة في نماذج اللغة في متى يكون الذكاء الاصطناعي واثقاً ومخطئاً.
- القطة السوداء الملتفة دون وجه ظاهر تشبه في الأرقام كلباً أسود صغيراً، فالنموذج لم يتعلم «مفهوم القطة»، وإنما أنماط البكسلات التي رآها في صور القطط أثناء التدريب، وأغلبها صور لقطط بوجوه واضحة.
- التصنيف بنموذج صغير يأخذ قرابة 50 مللي ثانية للصورة على المعالج، أي عشرين صورة في الثانية لكل نواة تقريباً.
الكشف: ماذا وأين
الآن نشغل YOLOX-Nano على نفس الصور. والكود أطول قليلاً لأننا نفك مخرج الشبكة بأنفسنا كما شرحنا في قسم الكشف، وهذا مقصود حتى ترى كل خطوة:
import cv2, numpy as np, time, sys
from coco import COCO
net = cv2.dnn.readNetFromONNX("/models/yolox_nano.onnx")
S = 416
def letterbox(img):
    r = min(S / img.shape[0], S / img.shape[1])
    pad = np.full((S, S, 3), 114, np.uint8)
    pad[:int(img.shape[0] * r), :int(img.shape[1] * r)] = cv2.resize(img, (int(img.shape[1] * r), int(img.shape[0] * r)))
    return pad.transpose(2, 0, 1)[None].astype(np.float32), r
def decode(out):
    grids, strides = [], []
    for s in (8, 16, 32):
        n = S // s; yv, xv = np.meshgrid(np.arange(n), np.arange(n), indexing="ij")
        grids.append(np.stack((xv, yv), 2).reshape(-1, 2)); strides.append(np.full((n * n, 1), s))
    g, st = np.concatenate(grids), np.concatenate(strides)
    out[:, :2] = (out[:, :2] + g) * st; out[:, 2:4] = np.exp(out[:, 2:4]) * st
    return out
def detect(img, conf=0.35, nms=0.45, use_nms=True):
    blob, r = letterbox(img); net.setInput(blob)
    t = time.perf_counter(); out = net.forward()[0]; ms = (time.perf_counter() - t) * 1000
    out = decode(out.copy())
    scores = out[:, 4:5] * out[:, 5:]; cls = scores.argmax(1); sc = scores.max(1)
    keep = sc > conf
    b = out[keep, :4] / r; b[:, :2] -= b[:, 2:] / 2          # cx,cy,w,h -> x,y,w,h in original pixels
    boxes, sc, cls = b.tolist(), sc[keep].tolist(), cls[keep]
    idx = cv2.dnn.NMSBoxes(boxes, sc, conf, nms) if use_nms and boxes else range(len(boxes))
    return [(COCO[cls[i]], sc[i], boxes[i]) for i in np.array(idx).flatten()], ms
في الكود أعلاه لاحظ التالي:
- الدالة
letterboxتصغر الصورة مع الحفاظ على نسبتها وتملأ الباقي باللون الرمادي 114، وهو نفس ما فعله فريق YOLOX عند التدريب، ثم تعيد معامل التصغيرrحتى نرجع الصناديق إلى مقاس الصورة الأصلية. - الدالة
decodeتحول مخرج كل خلية من أرقام نسبية إلى بكسلات: موضع الخلية في الشبكة مضروباً في خطوتها 8 أو 16 أو 32، والعرض والارتفاع بالدالة الأسية، وهذا هو الجزء الذي يختلف من نموذج إلى آخر، فإذا أخطأت فيه ظهرت الصناديق في أماكن غريبة. - الدرجة النهائية هي درجة وجود شيء مضروبة في احتمال الفئة، ثم العتبة، ثم
NMSBoxesمن OpenCV لحذف المكرر.
street.jpg: 7 objects in 61 ms -> bicycle x4, car x1, motorcycle x1, person x1
   car          0.73  box x=370 y=773 w=287 h=133
   motorcycle   0.65  box x=1 y=972 w=169 h=469
   person       0.58  box x=1353 y=768 w=73 h=162
   bicycle      0.53  box x=1534 y=922 w=381 h=470
   bicycle      0.50  box x=1103 y=894 w=228 h=407
   bicycle      0.46  box x=1234 y=921 w=233 h=398
cat-moto.jpg: 2 objects in 87 ms -> motorcycle x1, cat x1
   motorcycle   0.76  box x=-56 y=273 w=1987 h=1149
   cat          0.63  box x=589 y=566 w=295 h=199
three-cats.jpg: 3 objects in 60 ms -> cat x2, couch x1
   cat          0.70  box x=1197 y=736 w=449 h=342
   couch        0.68  box x=-4 y=89 w=1925 h=1322
   cat          0.48  box x=802 y=409 w=388 h=595
والفرق عن التصنيف واضح: الصورة التي قال عنها المصنف «مركبة ثلج» صارت «دراجة نارية وقطة»، كل منهما بصندوقه ودرجته، والصورة التي قال عنها «كلب» صارت «قطتان وكنبة». لكن انظر إلى الصورة التالية من التجربة، وعد القطط بنفسك:
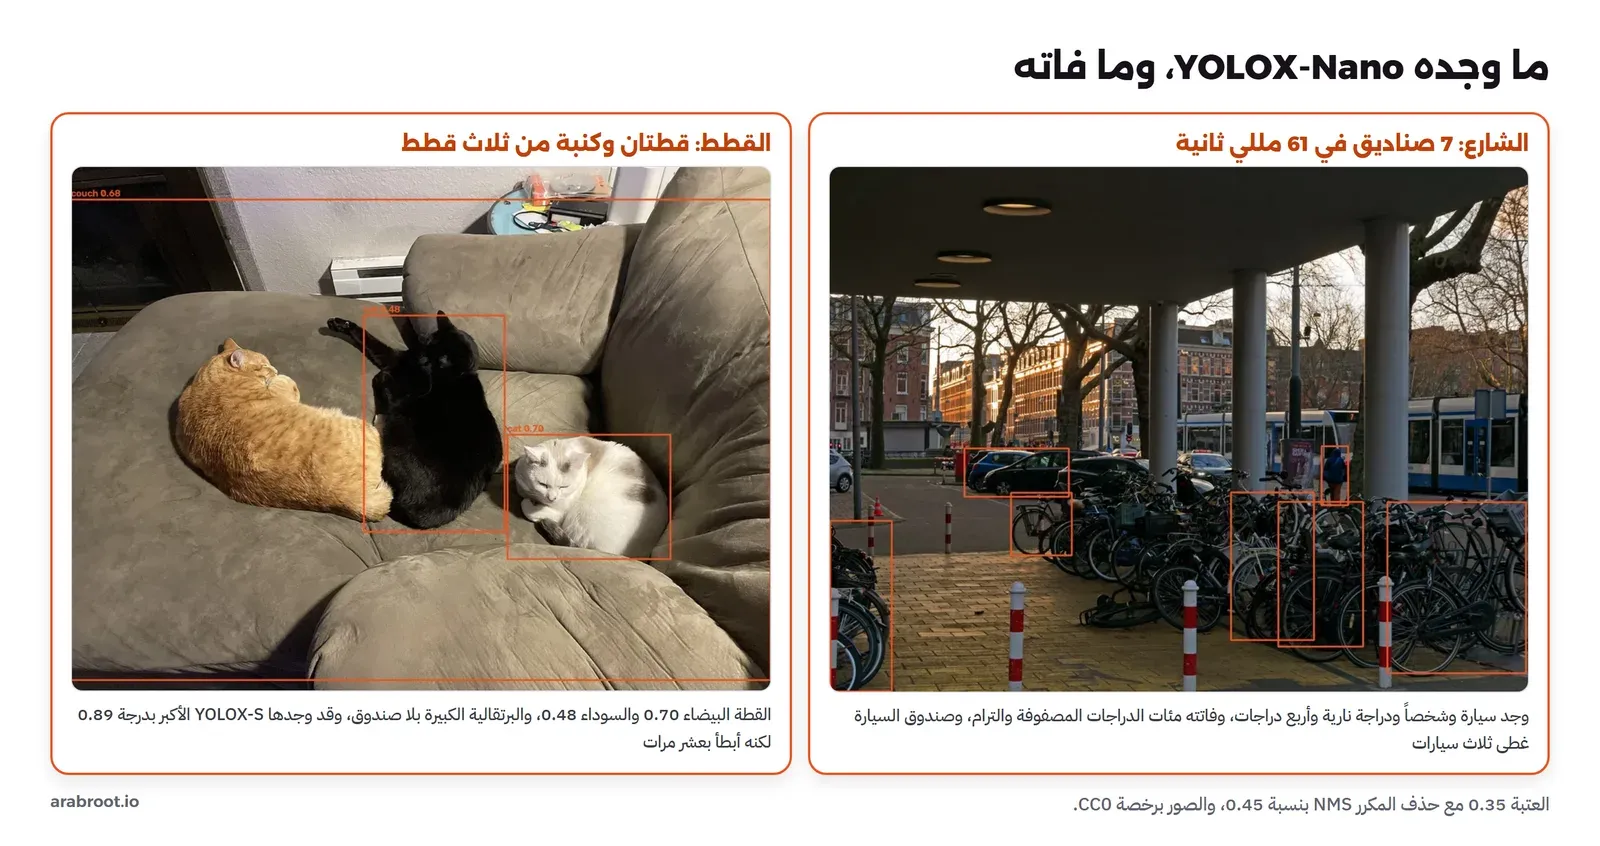
في النتائج أعلاه لاحظ التالي:
- القطة البرتقالية، وهي أكبر قطة في الصورة وأوضحها، لم يجدها النموذج بالعتبة 0.35، والسبب غالباً أنها ملتفة على نفسها بلون قريب من لون الكنبة، فلم تصل درجتها إلى العتبة.
- في صورة الشارع مئات الدراجات المصفوفة، والنموذج وجد أربعاً فقط، وصندوق «سيارة» واحد غطى ثلاث سيارات متلاصقة، والترام لم يظهر رغم أن COCO فيها فئة «قطار» Train. والأشياء المتداخلة بكثافة من أصعب الحالات على كل نماذج الكشف، لأن حذف المكرر نفسه قد يحذف شيئاً حقيقياً يتداخل مع جاره.
- الصندوق الأول للدراجة النارية يبدأ من x=-56، أي خارج الصورة قليلاً، لأن الشبكة تتوقع امتداد الشيء، فقص الصناديق إلى حدود الصورة قبل استخدامها.
- زمن الشبكة نفسها بين 60 و87 مللي ثانية لكل صورة في هذا التشغيل، وفي قياس لاحق من 20 مرة كان الوسيط 48.6 مللي ثانية، أي قرابة 20 صورة في الثانية على المعالج.
ماذا يحدث إذا غيرنا العتبة، أو ألغينا NMS، أو أظلمنا الصورة؟
السكربت التالي يعيد الكشف على صورة الشارع بإعدادات مختلفة، ويطبع عدد الصناديق ونوعها في كل حالة:
import cv2, time
from detect import detect, summary
img = cv2.imread("img/street.jpg")
for label, kw in [("conf 0.35 + NMS (default)", {}), ("conf 0.35, NMS off", {"use_nms": False}),
                  ("conf 0.10 + NMS", {"conf": 0.10}), ("conf 0.70 + NMS", {"conf": 0.70})]:
    d, _ = detect(img, **kw); print(f"{label:<28} {len(d):>3} boxes: {summary(d)}")
small = cv2.resize(img, (480, 360)); d, _ = detect(small); print(f"{'street at 480x360':<28} {len(d):>3} boxes: {summary(d)}")
dark = (255 * (img / 255.0) ** 3).astype("uint8"); d, _ = detect(dark); print(f"{'street dark (gamma 3)':<28} {len(d):>3} boxes: {summary(d)}")
ms = []
for _ in range(20): ms.append(detect(img)[1])
print("yolox-nano 416x416 forward: median %.1f ms" % sorted(ms)[10])
conf 0.35 + NMS (default) 7 boxes: bicycle x4, car x1, motorcycle x1, person x1
conf 0.35, NMS off 35 boxes: bicycle x17, car x7, motorcycle x6, person x5
conf 0.10 + NMS 25 boxes: bicycle x13, car x5, motorcycle x4, person x2, fire hydrant x1
conf 0.70 + NMS 1 boxes: car x1
street at 480x360 12 boxes: motorcycle x4, bicycle x4, car x3, person x1
street dark (gamma 3) 4 boxes: car x3, bicycle x1
yolox-nano 416x416 forward: median 48.6 msوالصورة التالية تبين أثر حذف المكرر على نفس الصورة:
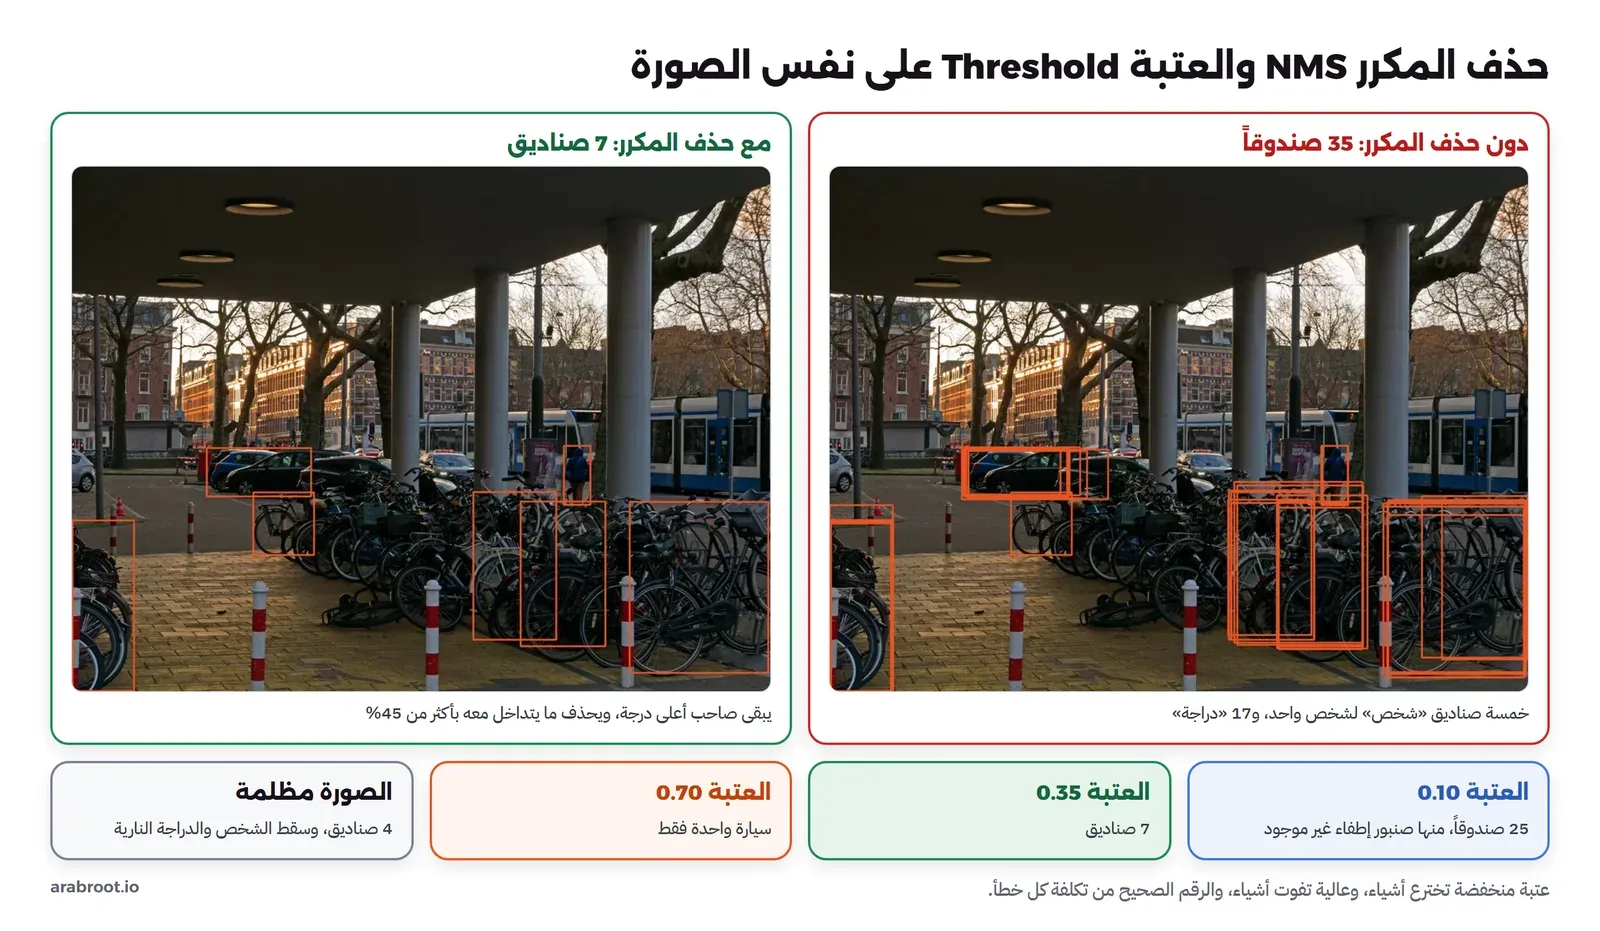
في النتائج أعلاه لاحظ التالي:
- دون حذف المكرر ظهر 35 صندوقاً، منها خمسة صناديق «شخص» والصورة فيها شخص واحد واضح، فإذا كان نظامك يعد الأشخاص لينبه عند الزحام فسوف يعد خمسة بدل واحد.
- خفض العتبة إلى 0.10 وجد دراجات أكثر بكثير، 13 بدل 4، لكنه اخترع «صنبور إطفاء» Fire Hydrant غير موجود، والأرجح أنه أحد الأعمدة الحمراء والبيضاء القصيرة. ورفعها إلى 0.70 ترك سيارة واحدة فقط. وهذه هي المبادلة الأساسية في كل نظام كشف: عتبة منخفضة تعني أشياء أقل تفوتك وإنذارات كاذبة أكثر، وعتبة عالية تعني العكس، ولا يوجد رقم صحيح إلا بالنسبة لتكلفة كل خطأ في منتجك.
- تصغير الصورة إلى 480 في 360 قبل الكشف أعطى 12 صندوقاً بدل 7، أي أن النتيجة تغيرت بشيء لا يغير معنى الصورة إطلاقاً، والسبب أن الصورة في الحالتين تصغر إلى 416 داخل النموذج، لكن بطريقتي تصغير مختلفتين، فتختلف تفاصيل صغيرة تغير درجات صناديق قريبة من العتبة.
- إظلام الصورة، كما يحدث في كاميرا ليلية دون إضاءة كافية، أسقط الأشخاص والدراجة النارية ونصف الدراجات، وهذا سبب أن أنظمة المراقبة الجادة تهتم بالإضاءة والكاميرا قبل النموذج، كما شرحنا في أنواع كاميرات المراقبة.
نموذج أكبر: هل يحل المشكلة؟
بعد أن فاتت القطة البرتقالية جربنا نموذجاً أكبر من نفس العائلة، YOLOX-S من مجموعة نماذج OpenCV، بحجم 35.9 ميجابايت ومقاس إدخال 640، على نفس الصورتين:
yolox_nano.onnx  three-cats.jpg  conf 0.35:  3 in  282 ms -> cat x2, couch x1
yolox_nano.onnx  street.jpg      conf 0.35:  7 in   20 ms -> bicycle x4, car x1, motorcycle x1, person x1
yolox_s.onnx     three-cats.jpg  conf 0.35:  4 in  429 ms -> cat x3, couch x1
yolox_s.onnx     street.jpg      conf 0.35: 18 in  481 ms -> bicycle x12, car x5, person x1
    [('cat', 0.89), ('couch', 0.77), ('cat', 0.76), ('cat', 0.52)]
النموذج الأكبر وجد القطط الثلاث بدرجات 0.89 و0.76 و0.52، ووجد 12 دراجة و5 سيارات بدل 4 وواحدة، لكنه أخذ قرابة 450 مللي ثانية للصورة بدل 20 إلى 60، أي أبطأ بعشر مرات تقريباً. ولاحظ أن أول تشغيل ل YOLOX-Nano أخذ 282 مللي ثانية لأنه أول استدعاء للشبكة، حيث تجهز OpenCV طبقاتها، ثم نزل إلى 20 في الصورة التالية، لذلك لا تقس الزمن من أول استدعاء أبداً. وهذه هي المبادلة الثانية في المجال: النموذج الأكبر أدق وأبطأ، والاختيار يعتمد على عدد الكاميرات أو الصور في الثانية، وعلى العتاد الذي سيشغله، وعلى تكلفة الخطأ.
حذف التجربة
docker image rm cv-lab:1
rm -rf out yolox_s.onnx
كيف تقيس النموذج؟ الدقة Precision والاستدعاء Recall
في التجربة حكمنا على النتائج بأعيننا، وهذا يكفي للفهم، لكن لا يكفي لاختيار نموذج لمنتج. والطريقة المعتادة أن تجمع مجموعة اختبار من صورك أنت، وتعلم فيها البشر كل شيء بصندوقه، ثم تقارن صناديق النموذج بها بمقياسين:
- الدقة Precision: من كل الصناديق التي أخرجها النموذج، كم منها صحيح؟ في حالة العتبة 0.10 كان صنبور الإطفاء صندوقاً خاطئاً يخفض الدقة.
- الاستدعاء Recall: من كل الأشياء الموجودة فعلاً، كم وجد النموذج؟ في حالة النموذج الصغير فاتته القطة البرتقالية ومئات الدراجات، فالاستدعاء منخفض جداً في صورة الشارع.
والصندوق يعتبر صحيحاً إذا تطابق مع صندوق البشر بنسبة تداخل كافية، تسمى التقاطع على الاتحاد Intersection over Union، واختصاراً IoU، أي مساحة الجزء المشترك مقسومة على مساحة الصندوقين معاً. ثم يجمع المقياس المشهور في الأبحاث، متوسط الدقة Average Precision واختصاراً AP، الدقة والاستدعاء عند كل العتبات وعدة نسب تداخل في رقم واحد، ويذكر بحث YOLOX مثلاً أن نسخة Nano تصل إلى 25.3% AP على بيانات COCO. وقد يبدو هذا الرقم منخفضاً، لكنه مقياس صارم جداً، والأهم أنه رقم على COCO وليس على صورك، فكاميرا مراقبة مثبتة فوق باب في إضاءة ليلية تختلف تماماً عن صور COCO الملتقطة بالهواتف، لذلك قس دائماً على عينتك، كما فعلنا مع النصوص في مقال OCR.
النماذج لها رخص أيضاً
عندما تختار نموذجاً جاهزاً فأنت تختار كوداً وأوزاناً لها رخصة، وهذا يغيب عن كثير من الفرق حتى تأتي مراجعة قانونية قبل الإطلاق. فنموذجا التجربة برخصة Apache-2.0، وهي رخصة متساهلة تسمح بالاستخدام التجاري، أما مكتبة Ultralytics الشهيرة التي تقدم نماذج YOLO الحديثة فرخصتها AGPL-3.0، وهي رخصة تلزمك بفتح كود الخدمة التي تستخدمها عبر الشبكة ما لم تشتر رخصة تجارية. ولا يعني ذلك أن تتجنبها، وإنما أن تقرأ رخصة النموذج ورخصة بيانات تدريبه قبل أن تبني عليه منتجاً، كما تفعل مع أي مكتبة أخرى.
من التجربة إلى الإنتاج
إذا أردت أن تضيف رؤية حاسوبية إلى نظام حقيقي فهذه هي الأسئلة التي تحدد شكل الحل، بالترتيب الذي يجب أن تسأله:
- هل يوجد نموذج جاهز يعرف فئاتك؟ إذا كنت تريد أشخاصاً وسيارات وحيوانات شائعة فنماذج COCO تكفي غالباً، أما إذا كانت فئاتك خاصة، مثل عيوب في منتج على خط مصنع أو أنواع تمور، فتحتاج أن تعيد تدريب نموذج جاهز على صورك، وهذا يعني مئات أو آلاف الصور المعلمة بأيدي بشر، وهو غالباً الجزء الأغلى والأطول في المشروع.
- أين يعمل النموذج؟ على السيرفر مع كاميرات كثيرة تحتاج غالباً بطاقة رسومية أو معالجاً مساعداً، أو على جهاز صغير عند الكاميرا نفسها Edge، كما يفعل Frigate مع معالجات الذكاء الاصطناعي الصغيرة. وصيغة ONNX التي استخدمناها تسمح بنقل نفس النموذج بين OpenCV ومحركات أسرع دون إعادة تدريب.
- كم صورة في الثانية؟ النموذج الصغير في التجربة عالج قرابة 20 صورة في الثانية على المعالج، فإذا كانت لديك 8 كاميرات وتحتاج 5 إطارات في الثانية من كل منها فأنت تحتاج 40 صورة في الثانية، أي ضعف ما يقدمه نموذج صغير على معالج واحد، قبل أي حساب للتسجيل والضغط.
- ما تكلفة كل خطأ؟ بوابة تفتح لسيارة خطأ تختلف عن تنبيه زائد على الهاتف، وهذا ما يحدد العتبة، وهل تحتاج إنساناً يراجع، وقد بنينا هذا القرار في بوابة اللوحات.
- الخصوصية والأنظمة: الكاميرات التي تتعرف على الأشخاص تجمع بيانات حساسة، فارجع إلى كاميرات المراقبة والخصوصية في الأنظمة السعودية قبل أن تشغل أي كشف على أشخاص.
- الانحياز Bias: النموذج يتعلم من صور تدريبه، فإذا كانت أغلبها من بيئات وإضاءات وملابس معينة، فسوف يكون أضعف مع غيرها، وهذا سبب إضافي لأن تقيس على صور من بيئتك أنت.
أخطاء شائعة عند البدء
- استخدام التصنيف لصورة فيها عدة أشياء: كما رأينا مع «مركبة الثلج»، فإذا كان السؤال «ما الأشياء وأين» فأنت تحتاج كشفاً.
- تجهيز الصورة بطريقة تختلف عن التدريب: ترتيب BGR وRGB، والمقاس، والقص أو المط، والمتوسط والانحراف المعياري، وكل اختلاف يغير النتيجة بصمت دون أي رسالة خطأ.
- اعتبار الثقة احتمالاً للصحة: 0.79 لكلب في صورة قطة، فالثقة رقم يقارن به بين إجابات النموذج نفسه، وليس ضماناً.
- نسيان حذف المكرر أو ضبطه: شخص واحد يعد خمس مرات.
- اختيار العتبة دون عينة من بياناتك: كل عتبة تبادل بين ما يفوت وما يخترع، والرقم الصحيح يأتي من تكلفة كل خطأ في منتجك.
- قياس الزمن من أول استدعاء، أو من صورة واحدة: الاستدعاء الأول أبطأ بكثير، والصور المزدحمة قد تكون أبطأ في مراحل ما بعد الشبكة.
- افتراض أن النموذج يعرف ما لم يدرب عليه: نماذج COCO لا تعرف إلا 80 فئة، وكل ما سواها إما يتجاهله وإما يسميه باسم فئة قريبة.
الخلاصة
- الصورة للحاسب مصفوفة أرقام، فصورة الشارع في التجربة أكثر من 8.3 مليون رقم، والرؤية الحاسوبية هي تحويل هذه الأرقام إلى معنى.
- الطريقة القديمة تكتب الخصائص باليد مثل الحواف، والحديثة تترك الشبكة الالتفافية CNN تتعلم مرشحاتها من ملايين الأمثلة، وقد جعلت ImageNet وبطاقات الرسوميات هذه الطريقة هي الأساس منذ 2012.
- التصنيف يعطي اسماً واحداً لصورة فيها شيء رئيسي، والكشف يعطي صناديق بأسماء ودرجات، والمهمة الخطأ تعطي إجابات خطأ بثقة عالية كما رأينا.
- الكشف يمر بتجهيز الصورة ثم الشبكة ثم العتبة ثم حذف المكرر، وكل خطوة منها غيرت النتيجة في التجربة: من 7 صناديق إلى 35 دون NMS، ومن 7 إلى 25 بعتبة أقل، ومن 7 إلى 4 في الظلام.
- النموذج الأكبر وجد ما فات الصغير، لكنه أبطأ بعشر مرات، فالاختيار مبادلة بين الدقة والسرعة والعتاد، ولا يحسم إلا بقياس على صورك أنت.
وفي المقال التالي من نفس المرحلة نجمع الكشف وقراءة النص في مشروع واحد، بوابة تفتح تلقائياً بقراءة لوحة السيارة، وهذه مقالات قريبة من الموضوع:
 دليلبوابة تفتح تلقائياً بقراءة لوحة السيارة: مشروع عمليكيف تبني بوابة لمجمع سكني أو شركة تقرأ لوحة السيارة وتفتح للمصرح لهم، مع شاشة للحارس وسجل لكل دخول.
 دليلFrigate: تسجيل كاميرات المراقبة على سيرفرك مع كشف الأجسامكيف تثبت Frigate على سيرفرك، وتسجل به كاميرات المراقبة محلياً، ويكشف لك الأشخاص والسيارات دون أن يخرج الفيديو من بيتك.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلصيغ الصور: كيف تختار الصيغة المناسبة لموقعككيف تحفظ كل صيغة صور البكسلات والألوان، ولماذا يصغر الملف نفسه إلى الثلث أو أقل عندما تختار الصيغة والمقاس المناسبين.
 دليلمتى يكون الذكاء الاصطناعي واثقاً ومخطئاً؟أنماط الأخطاء التي يكتبها مساعد البرمجة بثقة كاملة، ولماذا تحدث، وكيف تكشف كل واحد منها قبل أن يصل إلى الإنتاج.
 دليلأنواع كاميرات المراقبة وكيف تختار بينهاما الفرق بين أنواع كاميرات المراقبة، وما الذي تحتاجه في الكاميرا حتى تسجلها على جهازك، وكم قرصاً تحتاج للتسجيلات.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على OpenCV 5.0.0 وNumPy 2.5.4 مع نماذج MobileNetV2 وYOLOX-Nano وYOLOX-S بصيغة ONNX على المعالج في Docker Engine 29.8.0.