

عندما يتقدم باحث للترقية أو لمنحة أو لوظيفة، فأول ما يفعله من يقيمه أن يكتب اسمه في Google Scholar أو Scopus، وما يظهر أمامه في هذه الدقيقة هو صورته الأكاديمية، سواء كانت صحيحة أم لا: بحوث ناقصة لأن ملفه انقسم إلى ملفين، أو بحوث لغيره دخلت ملفه لأن اسمه شائع، أو رقم h-index أعلى أو أقل مما يستحق بحسب القاعدة التي فتحها المقيم. وفي المقال السابق شرحنا المعرف الثابت ORCID الذي يربط اسمك ببحوثك، وهنا سوف نرى الملفات التي يبنيها الآخرون من هذه البحوث، وكيف تراجعها وتصححها.
هذا المقال هو الثاني والأخير في مرحلة «هوية الباحث وظهوره» من مسار الباحثين والنشر العلمي، وهو للباحث وعضو هيئة التدريس الذي يريد ملفاً صحيحاً، ولطالب الدراسات العليا الذي يبدأ ملفه الآن، ولعضو لجنة الترقية أو التوظيف الذي يقرأ هذه الملفات ويحتاج أن يعرف ما الذي يخفيه كل رقم. وسوف نتناول:
- الملفات الأربعة الأشهر: Google Scholar وResearchGate وScopus Author ID وWeb of Science ResearcherID، ومن يبني كلاً منها.
- كيف ينقسم الملف وكيف يدمج خطأً، مع تجربة حقيقية على بيانات OpenAlex المفتوحة.
- كيف تصحح كل ملف وتدمج المكرر منه.
- كيف لا تخدع نفسك بالأرقام: الاستشهاد الذاتي، والاستشهادات المزيفة، وحالات موثقة.
- أرقام من الجامعات السعودية، وقائمة عملية للمراجعة الدورية.
أربعة ملفات، فمن يبني كل ملف؟
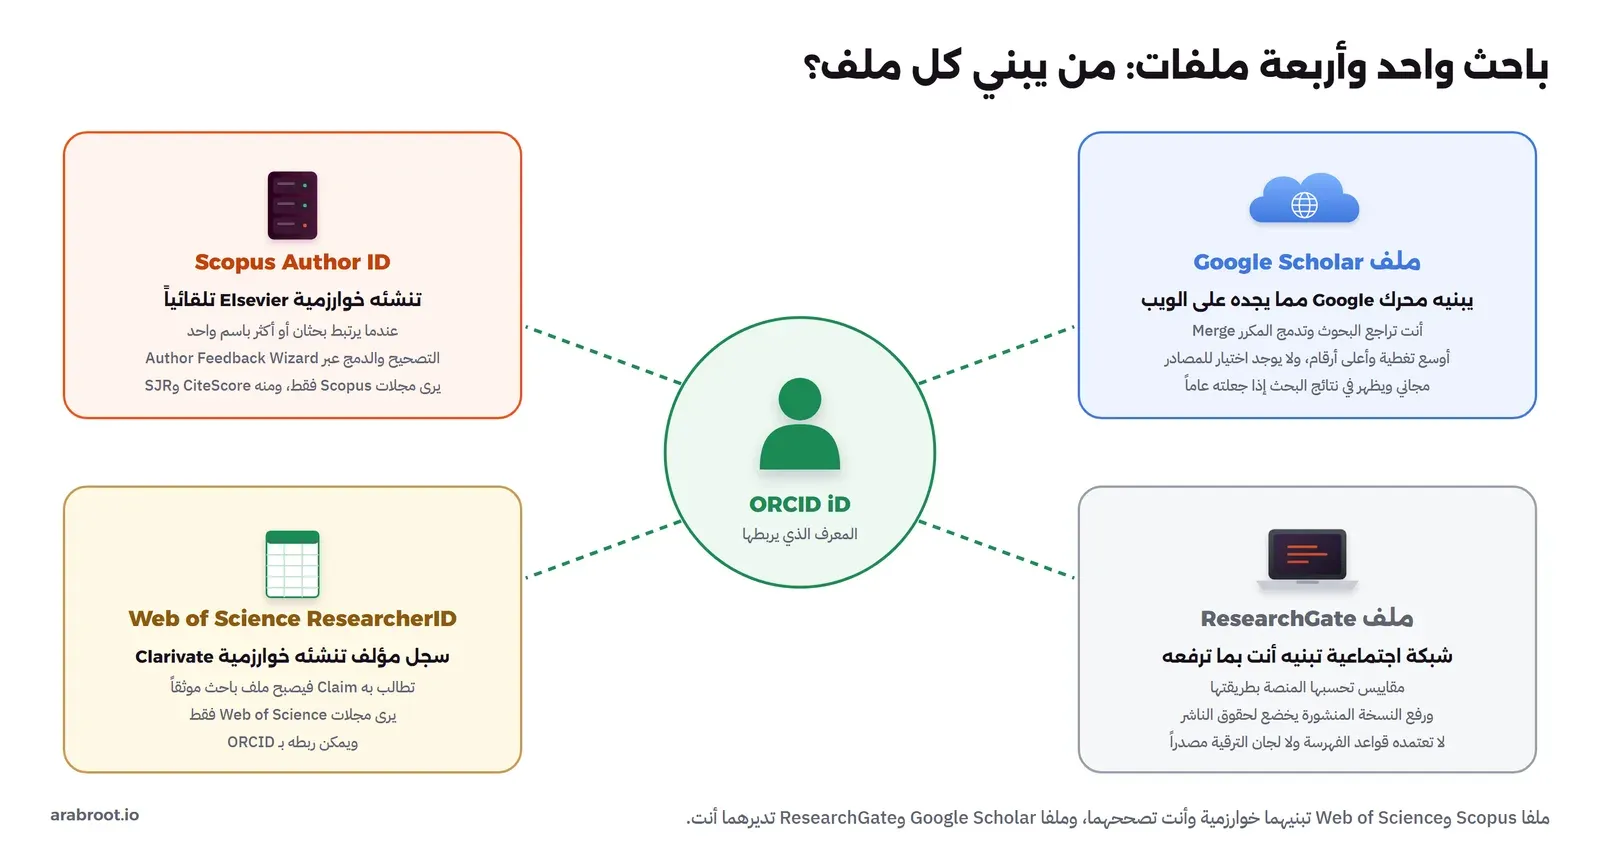
الفرق الأهم بين هذه الملفات ليس في الشكل، وإنما في من يبني الملف: خوارزمية تجمع البحوث وأنت تصحح أخطاءها، أم أنت تبني الملف بيدك. والصورة التالية تلخص ذلك:
ملف Google Scholar
بحسب صفحة المساعدة الرسمية، تنشئ الملف بنفسك من حساب Google، وتنصح Google باستخدام حساب شخصي وليس حساب الجامعة لكي يبقى الملف معك إذا انتقلت، ثم تختار بحوثك من نتائج Google Scholar، وبعد ذلك تختار ماذا يحدث عندما تجد Google بحوثاً جديدة باسمك: أن تضاف تلقائياً، أو أن ترسل إليك لتراجعها قبل إضافتها، ثم تتحقق من بريدك الجامعي وتجعل الملف عاماً لكي يظهر في نتائج البحث. وتحسب الأرقام فيه، ومنها عدد الاستشهادات وh-index، تلقائياً كلما وجد محرك Google استشهاداً جديداً على الويب.
وهنا نقطة القوة ونقطة الضعف معاً: Google Scholar يجمع كل ما يجده تقريباً، من المجلات والمؤتمرات والرسائل والمستودعات وحتى صفحات الجامعات، فتغطيته أوسع وأرقامه أعلى من أي قاعدة أخرى، ولكن لا يوجد فيه اختيار للمصادر، فيدخل فيه ما ينشر في مجلات ضعيفة، ويمكن رفع أرقامه بمستندات توضع على الويب كما سنرى في الحالات الموثقة.
ملف ResearchGate
ResearchGate شبكة اجتماعية للباحثين تبني فيها ملفك بنفسك، وترفع بحوثك وتتابع زملاءك وتجيب عن الأسئلة، وتحسب المنصة مقاييسها الخاصة بطريقتها، وهذه المقاييس لا تعتمدها قواعد الفهرسة. وفيها نقطتان يجب أن تعرفهما:
- حقوق النشر Copyright: رفع النسخة المنشورة من الناشر Version of Record للعامة قد يخالف اتفاقك مع الناشر. ففي 2017 رفعت ACS وElsevier دعوى على ResearchGate في ألمانيا والولايات المتحدة بسبب بحوث رفعها المستخدمون، وفي سبتمبر 2023 أعلنت الأطراف في بيان مشترك تسوية الدعويين، وأصبحت المنصة تتحقق من حقوق كل بحث من الناشرين عند رفعه، فتحفظ النسخة المنشورة بشكل خاص Private في ملف المؤلف ويشاركها عند الطلب، وتحدد البحوث التي يجوز نشرها للجميع. والحل الأنسب أن تعرف سياسة مجلتك في المشاركة، ونسخة المؤلف المقبولة Accepted Manuscript غالباً أوسع حقوقاً كما شرحنا في مقال أنواع النشر.
- معرفات DOI من ResearchGate: عندما ترفع عملاً غير منشور، كمسودة أو عرض أو تقرير، تستطيع أن تطلب له DOI، فالمنصة عميل مسجل في DataCite، وسوف ترى في التجربة كم معرفاً سجلت. ولاحظ أن DOI هنا يثبت أن العمل موجود، ولا يعني أنه محكم أو منشور في مجلة، فلا تضعه في سيرتك على أنه بحث منشور.
ملف Scopus Author ID
لا تنشئ هذا الملف بنفسك، فبحسب صفحة ملفات المؤلفين في Elsevier تنشئه خوارزمية Scopus تلقائياً عندما يرتبط بحثان أو أكثر باسم واحد، وتطابق البحوث مع الملفات بحسب الاسم والبريد والجهة والتخصص والاستشهادات والمؤلفين المشاركين، وتعترف الصفحة نفسها بأن الخوارزميات نادراً ما تطابق كل البحوث مع ملف واحد بدقة 100%، ولذلك توفر أداة مجانية اسمها Author Feedback Wizard تراجع فيها ملفك وتطلب تصحيحه: إضافة بحث ناقص، أو إزالة بحث ليس لك، أو دمج ملفين لك، أو تحديث الجهة. وتشرح صفحة المعرف في مركز الدعم كيف تبحث عن مؤلف بمعرفه في البحث المتقدم بالصيغة AU-ID()، وكيف تجمع الخوارزمية أشكال الاسم المختلفة تحت معرف واحد.
وملف Scopus هو الذي تحسب منه أرقام كثير من لجان الترقية، لأنه يعتمد على مجلات اختارتها لجنة Scopus، وشرحنا الفرق بين القواعد في مقال مقاييس المجلات.
ملف Web of Science ResearcherID
تشرح صفحة ResearcherID لدى Clarivate أن المعرف يعطى لكل سجل مؤلف تنشئه الخوارزمية في Web of Science Core Collection، وأن وجود المعرف لا يعني أن الباحث طالب بالسجل، فالباحث يطالب Claim بالسجل الذي لم يطالب به غيره، أو يضيف بحوثه منه إلى ملفه الموثق، ويمكنه ربطه بـ ORCID. وعندما تضيف بحثاً بيدك، فبحسب صفحة التحقق من التأليف يبحث النظام عن اسمك في قائمة مؤلفي البحث، فإذا وجده أصبح التأليف «موثقاً» Verified وظهر في ملفك العام، وإذا لم يجده بقي «غير موثق» ولا يظهر للعامة إلى أن تحدد موقعك بين المؤلفين بنفسك.
وفي السياق السعودي تذكر صفحة الناشرين في المكتبة الرقمية السعودية أن من قواعدها Web of Science من Clarivate، فمنسوبو الجامعات يصلون إليها عبر حساب جامعاتهم في المكتبة.
كيف ينقسم الملف؟ تجربة على OpenAlex
لا تتيح Google Scholar واجهة برمجية، وواجهتا Scopus وWeb of Science تحتاجان اشتراكاً، لذلك سوف نستخدم OpenAlex، وهي قاعدة مفتوحة تبني ملفات المؤلفين بخوارزمية من النوع نفسه، فنرى المشكلة نفسها التي تحدث في القواعد التجارية. والسكربت التالي يبحث عن اسم الباحث J. E. Hirsch الذي تتبعنا سجله في المقال السابق، ثم يحسب الاستشهاد الذاتي في ملفه الرئيسي، ثم يعد ملفات المؤلفين في ثلاث جامعات سعودية وكم منها مرتبط بـ ORCID، وأخيراً يقرأ من DataCite عدد المعرفات التي سجلتها ResearchGate:
# One researcher, several profiles: what an author profile hides, read from open data (OpenAlex, DataCite).
#   1) a name search returns several profiles, some of them pieces of the same person
#   2) self-citations: how much of a profile's citations come from the author himself, and the h-index without them
#   3) author profiles at three Saudi universities, and how many are linked to an ORCID iD
#   4) DOIs that ResearchGate registers for uploads
import json, sys, time, urllib.error, urllib.parse, urllib.request
sys.stdout.reconfigure(encoding="utf-8")

def get(base, path, **params):
    url = base + path + ("?" + urllib.parse.urlencode(params) if params else "")
    for wait in (5, 15, 45):
        try:
            req = urllib.request.Request(url, headers={"User-Agent": "arabroot-lab/1.0 (mailto:[email protected])"})
            with urllib.request.urlopen(req, timeout=90) as r:
                return json.load(r)
        except urllib.error.HTTPError as e:
            if e.code != 429: raise
            time.sleep(wait)                       # rate limited: wait and try again
    raise SystemExit("still rate limited")
oa = lambda path, **p: get("https://api.openalex.org/", path, **p)

print("== 1) searching OpenAlex authors for 'J. E. Hirsch' ==")
d = oa("authors", search="J. E. Hirsch", per_page=10,
       select="id,display_name,orcid,works_count,cited_by_count,last_known_institutions")
print(f"profiles found: {d['meta']['count']}")
for a in d["results"]:
    inst = (a["last_known_institutions"] or [{}])[0].get("display_name", "-")
    print(f"   {a['id'].split('/')[-1]:<12} {a['display_name']:<18} works {a['works_count']:>4}  cited {a['cited_by_count']:>6}"
          f"  ORCID {'yes' if a['orcid'] else 'no ':<3}  {inst}")

print("\n== 2) self-citations in the main profile ==")
AID = "A5036688434"
works, page = [], 1
while True:                                        # page paging, fine for a few hundred works
    r = oa("works", filter=f"author.id:{AID}", select="id,cited_by_count,referenced_works", per_page=200, page=page)
    works += r["results"]
    if len(works) >= r["meta"]["count"] or not r["results"]:
        break
    page += 1
own = {w["id"] for w in works}
self_cites = {w["id"]: 0 for w in works}
for w in works:                                    # every reference from one of his works to another of his works
    for ref in w["referenced_works"]:
        if ref in own:
            self_cites[ref] += 1
total = sum(w["cited_by_count"] for w in works)
selfc = sum(self_cites.values())
def h_index(counts):
    counts = sorted(counts, reverse=True)
    return sum(1 for i, c in enumerate(counts, 1) if c >= i)
print(f"works {len(works)} | citations {total:,} | self-citations {selfc:,} ({100*selfc/total:.1f}%)")
print(f"h-index {h_index(w['cited_by_count'] for w in works)} | without self-citations "
      f"{h_index(w['cited_by_count'] - self_cites[w['id']] for w in works)}")
top = sorted(works, key=lambda w: self_cites[w["id"]], reverse=True)[:3]
for w in top:
    print(f"   {w['id'].split('/')[-1]}: cited {w['cited_by_count']:,}, of which by himself {self_cites[w['id']]}")

print("\n== 3) author profiles whose last known institution is a Saudi university ==")
for name, iid in [("King Saud University", "I28022161"), ("King Abdulaziz University", "I185163786"),
                  ("KAUST", "I71920554")]:
    n = oa("authors", filter=f"last_known_institutions.id:{iid}", per_page=1, select="id")["meta"]["count"]
    o = oa("authors", filter=f"last_known_institutions.id:{iid},has_orcid:true", per_page=1, select="id")["meta"]["count"]
    print(f"   {name:<26} profiles {n:>6,}  linked to ORCID {o:>6,} ({100*o/n:.0f}%)")

print("\n== 4) DOIs registered by ResearchGate at DataCite ==")
c = get("https://api.datacite.org/", "clients/rg.rg")["data"]
n = get("https://api.datacite.org/", "dois", **{"client-id": "rg.rg", "page[size]": 0})["meta"]["total"]
print(f"{c['attributes']['name']} | DataCite client since {c['attributes']['year']} | prefix "
      f"{c['relationships']['prefixes']['data'][0]['id']} | DOIs {n:,}")
والمخرج عند تشغيله في 23 أكتوبر 2026 كان كما يلي:
== 1) searching OpenAlex authors for 'J. E. Hirsch' ==
profiles found: 8
   A5036688434  J. E. Hirsch       works  399  cited  32710  ORCID yes  University of California San Diego
   A5069423877  Judith E. Hirsch   works   11  cited    485  ORCID no   Western Illinois University
   A5108539371  J. E. Hirsch       works    2  cited     34  ORCID no   University of California San Diego
   A5109258699  Jerrold E. Hirsch  works    3  cited     77  ORCID no   National Jewish Health
   A5083018460  Lidia R. Bons      works   44  cited    609  ORCID yes  -
   A5037572057  Jane E. Hirsch     works    8  cited     42  ORCID no   University of California, San Francisco
   A5108597229  Hirsch Je          works    2  cited      2  ORCID no   -
   A5039441333  J. E. Hirsch       works    1  cited      0  ORCID no   -

== 2) self-citations in the main profile ==
works 387 | citations 32,716 | self-citations 2,322 (7.1%)
h-index 66 | without self-citations 61
   W2063324794: cited 259, of which by himself 75
   W1987478093: cited 234, of which by himself 60
   W4243169089: cited 182, of which by himself 57

== 3) author profiles whose last known institution is a Saudi university ==
   King Saud University       profiles 27,285  linked to ORCID  5,913 (22%)
   King Abdulaziz University  profiles 22,628  linked to ORCID  4,785 (21%)
   KAUST                      profiles  6,025  linked to ORCID  3,537 (59%)

== 4) DOIs registered by ResearchGate at DataCite ==
ResearchGate | DataCite client since 2016 | prefix 10.13140 | DOIs 1,560,754
والصورة التالية تلخص الجزأين الأولين من المخرج:
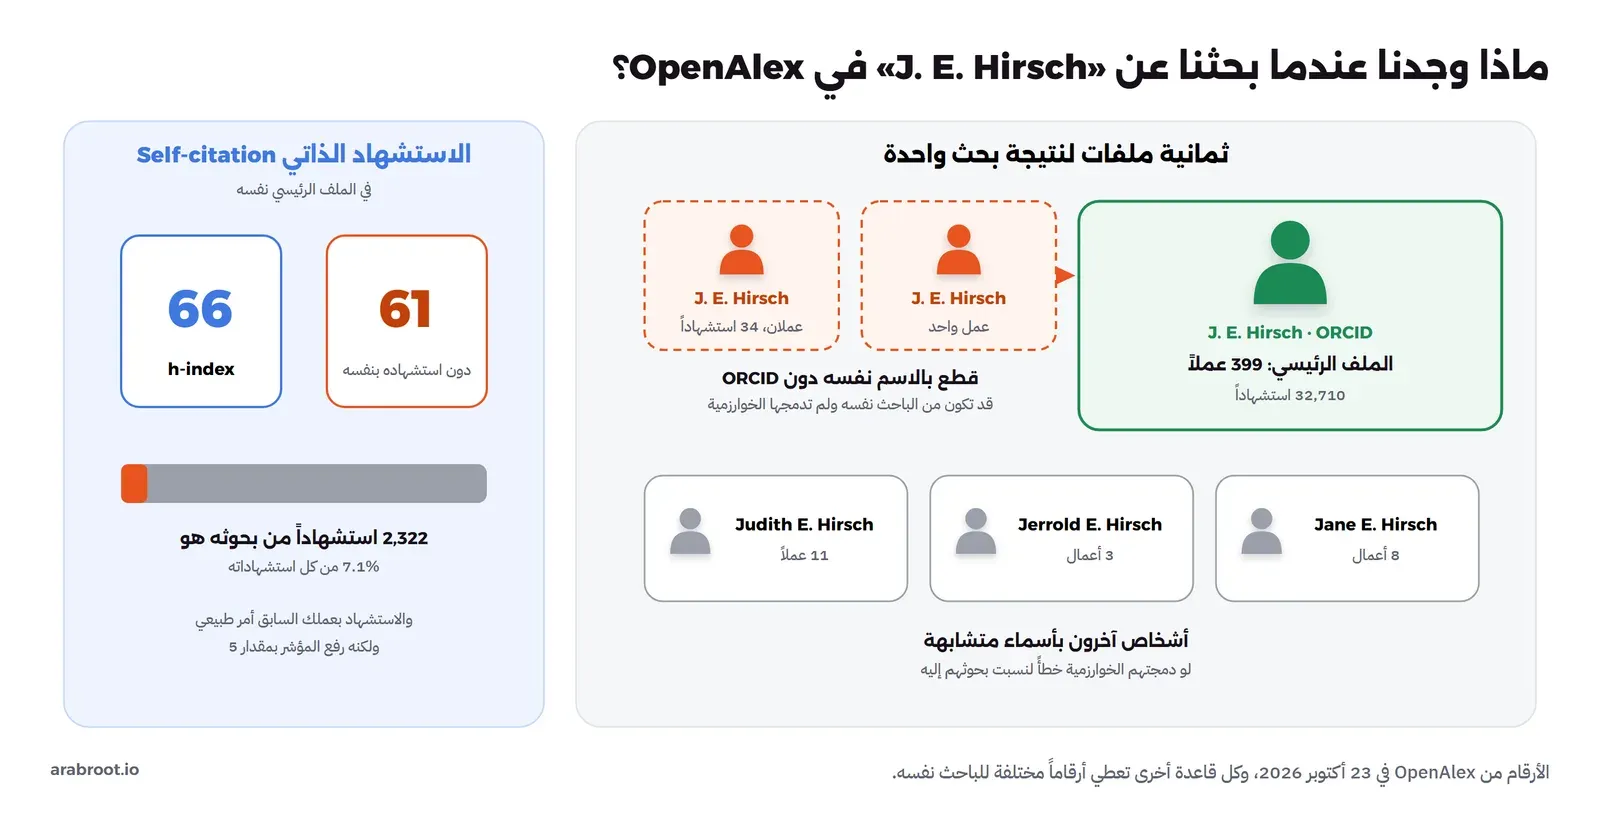
في الجزء الأول من المخرج لاحظ التالي:
- الملف الرئيسي مرتبط بـ ORCID: 399 عملاً، ولذلك جمعت الخوارزمية أغلب بحوثه في مكان واحد.
- قطع بالاسم نفسه: ملف فيه عملان و34 استشهاداً وآخر جهة معروفة له هي الجامعة نفسها University of California San Diego، وملف آخر فيه عمل واحد، وكلها دون ORCID، وهذه هي الصورة المعتادة للملف المنقسم: بحوث قديمة أو بيانات ناقصة لم تستطع الخوارزمية أن تربطها بالملف الرئيسي، فلا تحسب استشهاداتها في أرقامه.
- أشخاص آخرون: Judith وJerrold وJane يشتركون معه في الحرف الأول من الاسم الأوسط والعائلة، ولو دمجتهم الخوارزمية في ملفه لنسبت إليه بحوثهم، وهذا ما يحدث فعلاً مع الأسماء الشائعة.
- نتيجة غريبة: ظهر في النتائج ملف باسم مختلف تماماً هو Lidia R. Bons، وهذا يبين أن نتائج البحث بالاسم تحتاج مراجعة يدوية دائماً، ولا تصلح وحدها للحكم على باحث.
وفي الجزء الثاني لاحظ التالي:
- من 32,716 استشهاداً في البحوث التي قرأها السكربت، جاء 2,322 استشهاداً، أي 7.1%، من بحوث الباحث نفسه، وعدد البحوث المقروءة 387 وليس 399 لأن السكربت قرأ البحوث التي تسمح الواجهة بتصفحها بهذا المرشح Filter.
- المؤشر 66، ودون الاستشهاد الذاتي يصبح 61، أي أن خمس درجات من المؤشر جاءت من استشهاده بنفسه.
- أكثر البحوث استشهاداً بنفسه بحوث في تخصصه الدقيق استشهد بها 75 و60 و57 مرة، وهذا طبيعي لباحث يبني نظرية على مدى سنوات، فالاستشهاد الذاتي ليس خطأ في ذاته، ولكن يجب أن تعرف نسبته عندما تقرأ رقماً.
ونجرب ما يحدث لو اعتمدت على الاسم في Google Scholar أو في محرك بحث: سوف تجد نتائج لأكثر من شخص، ولن تعرف أي ملف هو الصحيح إلا من الجهة والتخصص والمؤلفين المشاركين، وهذا ما يفعله المقيم في لجنة الترقية عندما لا يجد ORCID في ملفك.
كيف تصحح ملفاتك وتدمج المكرر منها؟
| الملف | دمج ملفين لك | إزالة بحث ليس لك | إضافة بحث ناقص |
|---|---|---|---|
| Google Scholar | لا يوجد إلا ملف واحد لأنك أنشأته، والدمج يكون للبحث المكرر: حدد النسختين واختر Merge | حدد البحث واحذفه من ملفك | ابحث عنه في Google Scholar وأضفه، أو أضفه يدوياً |
| Scopus Author ID | عبر Author Feedback Wizard، وتراجع Elsevier الطلب | عبر الأداة نفسها | عبر الأداة نفسها إذا كان البحث مفهرساً في Scopus |
| Web of Science | بالمطالبة بالسجلات الأخرى وإضافتها إلى ملفك الموثق | من قائمة بحوثك في الملف | من Web of Science أو من ORCID، مع التحقق من موقعك بين المؤلفين |
| ResearchGate | عبر دعم المنصة | من ملفك | بالإضافة اليدوية أو الرفع |
وقد يتساءل البعض: هل يجب أن أصحح كل هذه الملفات واحداً واحداً؟ والإجابة أن أكثرها يقرأ من ORCID أو يربط به، فإذا كان سجل ORCID كاملاً، وكتبت معرفك عند كل إرسال، قل التصحيح المطلوب في الملفات الأخرى كثيراً، ويبقى عليك أن تراجعها مرة كل بضعة أشهر.
كيف لا تخدع نفسك بالأرقام؟
رقم الملف ليس حكماً على الباحث، وإنما نتيجة خوارزمية على بيانات قاعدة معينة، ولكل رقم طريقة ليرتفع دون أن ترتفع الجودة:
- الاستشهاد الذاتي Self-citation: كما رأيت في التجربة، رفع المؤشر خمس درجات لباحث معروف، وهو طبيعي بنسبة معقولة، ولكن النسب العالية جداً علامة تستحق السؤال.
- اختلاف القواعد: رقم Google Scholar أعلى دائماً تقريباً من رقم Scopus وWeb of Science لأنه يغطي مصادر أكثر، فلا تقارن رقمك في Google Scholar برقم زميلك في Scopus.
- البحوث غير المحكمة: المسودات والعروض التي لها DOI من ResearchGate أو المستودعات تظهر في بعض الملفات وتجمع استشهادات، وهي ليست بحوثاً منشورة.
- الاستشهادات المصنوعة: وهي أخطر نقطة، وفيها حالتان موثقتان.
ولهذا يوصي إعلان سان فرانسيسكو لتقييم البحث DORA بتقييم البحث نفسه بدل الأرقام المبنية على المجلة، وإذا كنت عضواً في لجنة تقييم فاطلب من المتقدم معرف ORCID ورابط ملف Scopus أو Web of Science، واقرأ أهم بحوثه، واستخدم الأرقام قرينة وليس حكماً.
في الجامعات السعودية
في الجزء الثالث من المخرج ترى أن OpenAlex فيها 27,285 ملف مؤلف آخر جهة معروفة له جامعة الملك سعود، منها 5,913 فقط، أي 22%، مرتبطة بمعرف ORCID، وفي جامعة الملك عبدالعزيز 21%، أما KAUST فالنسبة 59%، وهي الجامعة التي تطلب ORCID من طلابها عند تسليم الرسائل كما ذكرنا في المقال السابق. ولاحظ أن عدد الملفات أكبر من عدد الباحثين الفعلي، لأن جزءاً منها قطع منفصلة لباحث واحد كما رأيت في حالة Hirsch، والمعرف الثابت هو ما يجمع هذه القطع، لذلك فالنسبة المنخفضة تعني أن ملفات كثيرة من باحثي هذه الجامعات ما زالت عرضة للانقسام والدمج الخاطئ.
قائمة مراجعة كل ثلاثة أشهر
- افتح سجل ORCID وتأكد أن آخر بحوثك وصلت إليه، وأن جهة عملك الحالية مضافة.
- ابحث عن اسمك بكل أشكاله في Scopus، وإذا وجدت ملفين لك فاطلب الدمج من Author Feedback Wizard.
- راجع اقتراحات Google Scholar وارفض ما ليس لك، وادمج النسخ المكررة من البحث نفسه.
- طالب بسجلك في Web of Science واربطه بـ ORCID.
- في ResearchGate تأكد أن ما رفعته للعامة تسمح به سياسة المجلة.
- اكتب في سيرتك الذاتية كل رقم مع مصدره وتاريخه، مثلاً «h-index 12 في Scopus، أكتوبر 2026».
الخلاصة
- ملفا Scopus وWeb of Science تبنيهما خوارزمية وأنت تصححهما، وملفا Google Scholar وResearchGate تبنيهما أنت.
- الخوارزمية تقسم الباحث الواحد إلى ملفات وتدمج المتشابهين في الاسم، وفي التجربة وجدنا ملفاً رئيسياً وقطعاً بالاسم نفسه دون ORCID.
- Google Scholar أوسع وأرقامه أعلى ويمكن رفعها بمستندات مزيفة واستشهادات مشتراة، كما وثقت دراستان منشورتان.
- الاستشهاد الذاتي رفع h-index لباحث معروف من 61 إلى 66، فاعرف نسبته قبل أن تحكم برقم.
- 22% فقط من ملفات المؤلفين في جامعة الملك سعود في OpenAlex مرتبطة بـ ORCID، و59% في KAUST.
- راجع ملفاتك كل ثلاثة أشهر، واكتب كل رقم مع مصدره وتاريخه.
وبهذا نكون قد أنهينا مرحلة هوية الباحث، وفي المرحلة التالية بإذن الله سوف ننتقل إلى الجهة الأخرى من النشر: المحررون والناشرون، ونبدأ بتأسيس مجلة علمية.


