

لنفرض أن مدير الشركة دخل عليك صباحاً وسألك سؤالاً واحداً: «هل نحن آمنون؟»، وأنت تعرف أن الفريق يشغل فحص الأسرار وSAST في خط CI/CD منذ أشهر، وأن هناك اختبار اختراق Penetration Test تم قبل سنة، وأن أحد المطورين يهتم بالأمن أكثر من غيره. فماذا تقول له؟ إذا قلت «نعم» فأنت لا تملك ما يثبتها، وإذا قلت «لا» فهو سوف يسألك «إذن ماذا نشتري؟»، والحقيقة أن السؤال نفسه خطأ، لأن الأمن ليس مفتاحاً يكون مفتوحاً أو مغلقاً، وإنما مجموعة عادات في الفريق بعضها موجود وبعضها ناقص وبعضها نصف موجود، والسؤال الصحيح هو «أين نحن اليوم، وما الخطوة التالية؟».
وهذا هو بالضبط ما تفعله نماذج النضج Maturity Models، ففي مقال ما هي OWASP؟ ذكرنا نموذج SAMM في فقرة واحدة، وفي هذا المقال سوف نشرحه بالتفصيل، ونعبئ ملف التقييم الرسمي فعلاً لشركة تخيلية، ونرى كيف تحسب الدرجات، ثم نحولها إلى خطة. وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يجيب شراء الأدوات عن سؤال «هل نحن آمنون؟»، وما المشكلة التي يحلها نموذج النضج.
- ما هو نموذج النضج، والفرق بين SAMM الذي يقيس البرنامج وASVS الذي يقيس التطبيق، والبدائل BSIMM وDSOMM.
- هيكل OWASP SAMM v2: الوظائف الخمس والممارسات الخمس عشرة والمسارات الثلاثون والمستويات الثلاثة، وكل ممارسة في جملة مع مثال لكل مستوى.
- كيف تحسب الدرجة بالضبط من معادلات ملف التقييم الرسمي SAMM Toolbox.
- كيف تجري التقييم: النطاق، ومن يحضر، والمقابلات، والأدلة، والصدق في الإجابة.
- مثال عملي حقيقي: نعبئ ملف SAMM v2.2.0 الرسمي لشركة SaaS تخيلية من 15 شخصاً، ونقرأ الدرجات التي حسبها الملف نفسه.
- من الدرجة إلى خطة تحسين على مراحل، مربوطة بمقالات الموقع وبضوابط دليل ضوابط أمن التطبيقات، مع قالب جاهز للنسخ.
لماذا لا يجيب شراء الأدوات عن سؤال «هل نحن آمنون؟»
الحل البسيط الذي يخطر على البال أولاً هو أن نشتري أو نثبت أداة كلما سمعنا عن مشكلة، فإذا سمعنا عن تسريب مفاتيح أضفنا فحص الأسرار، وإذا سمعنا عن مكتبة فيها ثغرة أضفنا فحص الاعتماديات SCA، وإذا طلب عميل كبير تقريراً أجرينا اختبار اختراق. والصورة التالية تبين ما يحدث بعد سنة من هذه الطريقة:
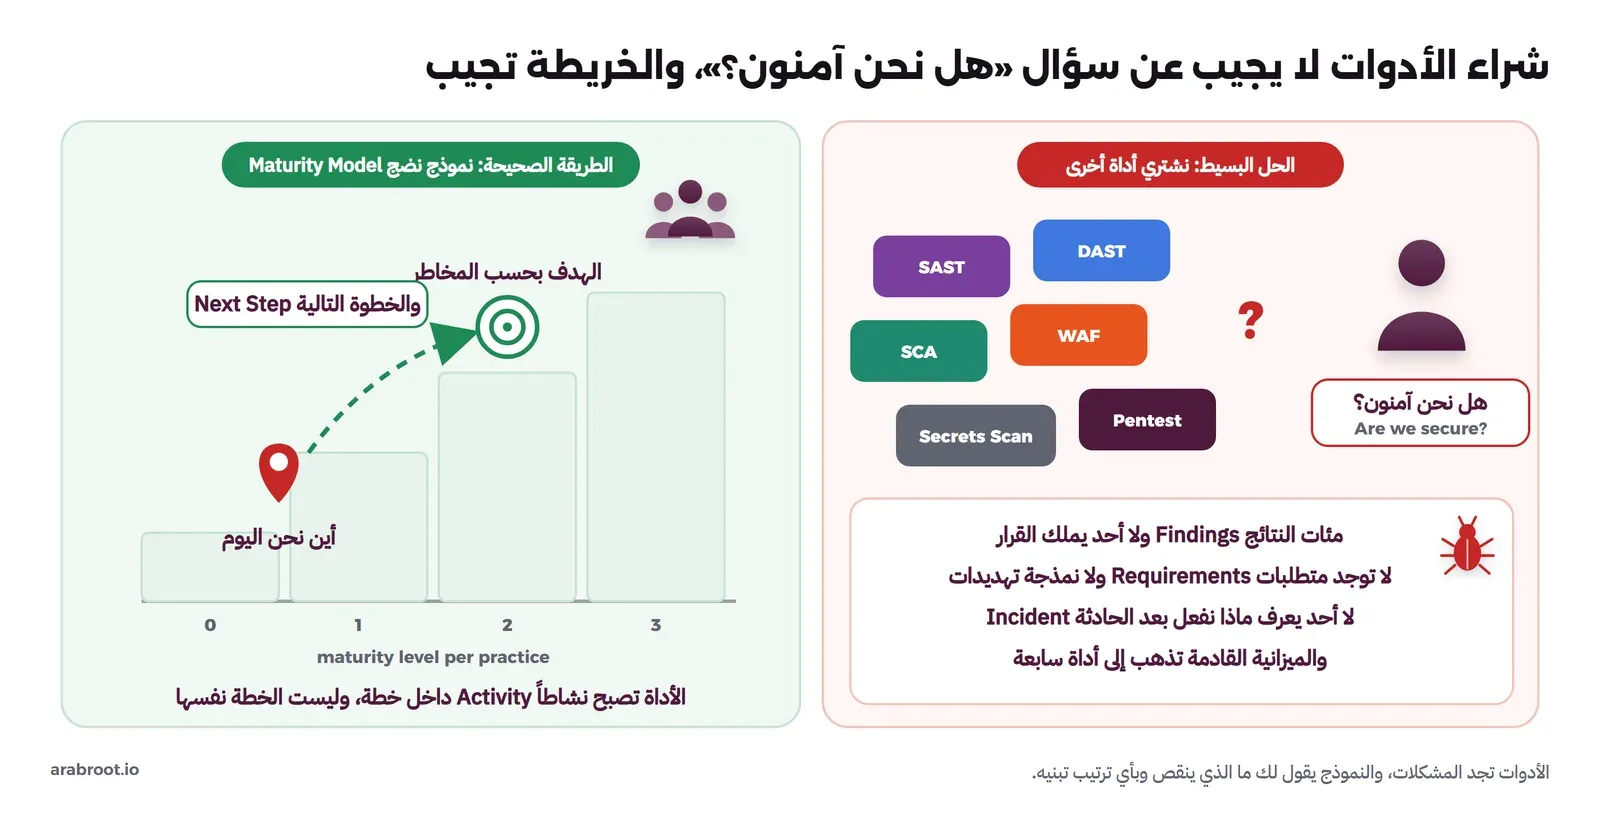
في الصورة أعلاه لاحظ التالي:
- كل أداة تحل جزءاً صغيراً: أداة SAST لا تكتب متطلبات أمان، وأداة DAST لا تعرف من يصلح النتيجة ومتى، وكما شرحنا في فرز النتائج Triage فإن القائمة الطويلة دون مالك ومواعيد تتحول إلى ضجيج.
- الأشياء التي لا تشترى لا تظهر في القائمة أصلاً: نمذجة التهديدات، وتدريب المطورين، وخطة الاستجابة للحوادث، وتصنيف التطبيقات بحسب المخاطر، وكلها عادات وليست منتجات.
- لا يوجد رقم تقارن به نفسك بعد سنة: عدد الأدوات ليس مقياساً، وعدد النتائج يرتفع كلما أضفت أداة، فلا تستطيع أن تقول للمدير «تحسنا» وأنت لا تملك نقطة بداية.
والحل الثاني الذي يجربه البعض هو أن يأخذ قائمة تحقق Checklist من معيار ما ويضع علامة صح أو خطأ على كل بند، وهذا أفضل من لا شيء، ولكنه يعطيك صورة «نجح أو فشل» عن كل بند دون أن يقول لك أي البنود أهم لك، ولا ما الذي يأتي أولاً، ولا كيف تنتقل من «نفعلها أحياناً» إلى «نفعلها دائماً». والحل الأنسب هو نموذج يقسم عمل الأمن إلى ممارسات واضحة، ويعطي كل ممارسة درجات متدرجة بدلاً من نعم ولا، ويقول لك ما النشاط التالي في كل منها، وهذا هو نموذج النضج.
ما هو نموذج النضج Maturity Model؟
نموذج النضج هو وصف مرتب لمستويات يمر بها الفريق في عمل معين، من «لا نفعله» إلى «نفعله بشكل ثابت ونحسنه بالأرقام»، مع وصف لما يجب أن يكون موجوداً في كل مستوى، فتستطيع أن تقيس أين أنت وتعرف ماذا ينقصك للمستوى التالي. والتشبيه الأقرب هو أحزمة الكاراتيه، فالمدرب لا يسألك «هل تعرف الكاراتيه؟» وإنما يرى ما تتقنه ويعطيك لوناً، ويقول لك ما الحركات المطلوبة للون التالي، ولاحظ أن الحزام الأسود ليس هدف كل من يتدرب.
وأشهر نماذج النضج في عالم البرمجيات هو CMMI، وفيه خمسة مستويات نضج Maturity Levels من المستوى 1 «Initial» إلى المستوى 5 «Optimizing»، ويعطي المؤسسة كلها رقماً واحداً. أما SAMM فيعمل بطريقة مختلفة: لا يوجد فيه رقم واحد للمؤسسة يحكم عليها، وإنما درجة لكل ممارسة من خمس عشرة ممارسة بين 0 و3، فقد تكون في المستوى 2 في البناء الآمن وفي المستوى 0 في نمذجة التهديدات في الوقت نفسه، وهذا أقرب للواقع، لأن الفرق الحقيقية لا تنضج في كل شيء بالسرعة نفسها.
وقد يتساءل البعض: لماذا لا أكتفي بقائمة ضوابط؟ والإجابة أن قائمة الضوابط Controls تقول لك «ما الذي يجب أن يكون صحيحاً»، ونموذج النضج يقول لك «هل لدى فريقك عادة ثابتة تجعله صحيحاً في كل مرة»، والفرق يظهر عندما يأتي تطبيق جديد أو موظف جديد، فالضابط الذي طبق مرة واحدة بجهد شخص واحد يختفي عندما يغادر هذا الشخص، أما الممارسة الناضجة فتبقى لأنها جزء من طريقة العمل.
SAMM يقيس المصنع، وASVS يقيس المنتج
في مقال متطلبات الأمان ومراجعة الكود مع OWASP ASVS رأينا أن ASVS يسأل عن تطبيق محدد: «هل هذا التطبيق يحقق المتطلب v5.0.0-8.2.2؟»، أما SAMM فيسأل عن الفريق أو المؤسسة: «هل لديكم عادة ثابتة لكتابة متطلبات أمان لكل تطبيق، وهل تختبرونها؟». والجدول التالي يلخص الفرق:
| السؤال | OWASP ASVS | OWASP SAMM |
|---|---|---|
| ماذا يقيس؟ | تطبيقاً واحداً (المنتج) | برنامج الأمن في فريق أو مؤسسة (المصنع) |
| شكل الإجابة | كل متطلب ينجح أو يفشل Pass/Fail | درجة بين 0 و3 لكل ممارسة، مع إجابات جزئية |
| من يستخدمه؟ | المطور والمختبر ومراجع الكود | قائد الفريق ومسؤول الأمن والإدارة |
| متى؟ | في كل ميزة وكل طلب دمج Pull Request | مرة كل 6 إلى 12 شهراً، ثم خطة |
| المخرج | قائمة متطلبات واختبارات للتطبيق | خريطة نضج وخطة تحسين Roadmap |
ولاحظ أن الاثنين يعملان معاً، فممارسة «متطلبات الأمان Security Requirements» في SAMM تسألك هل تكتب الفرق متطلبات أمان، وASVS هو أحد أفضل المصادر لكتابتها، فإذا رفعت درجتك في هذه الممارسة فغالب الظن أنك فعلت ذلك باستخدام ASVS.
البدائل: BSIMM يصف ما تفعله الشركات، وDSOMM يركز على DevSecOps
هناك نموذجان آخران سوف تقابلهما، والفرق الأهم بينهما وبين SAMM هو الفرق بين النموذج التوجيهي Prescriptive والنموذج الوصفي Descriptive:
- OWASP SAMM (توجيهي): كتبه مختصون ويقول لك ما الذي يجب أن تفعله في كل مستوى، وهو مفتوح بترخيص CC BY-SA 4.0 كما تقول الصفحة الرئيسية للمشروع ومستودعه على GitHub، وأصله نموذج OpenSAMM 1.0 الذي كتبه Pravir Chandra في 2009 بحسب ملاحظات إصدار SAMM v2.
- BSIMM (وصفي): نموذج تنشره شركة Black Duck، ويصف ما تفعله الشركات المشاركة فعلاً بدلاً من أن يقول لك ما يجب، والإصدار الحالي BSIMM16 نشر في يناير 2026 وبني على تحليل 111 مؤسسة، وفيه 128 نشاطاً في 12 ممارسة وأربعة مجالات Domains هي Governance وIntelligence وSSDL Touchpoints وDeployment، بحسب صفحة التقرير. ونقطة قوته المقارنة مع شركات حقيقية، ولكن «ما تفعله الشركات الكبيرة» ليس بالضرورة ما يناسب فريقاً من خمسة عشر شخصاً، والتقرير يحمل من موقع الشركة بعد تعبئة نموذج تسجيل، ولم نجد في الصفحة ترخيصاً مفتوحاً مثل ترخيص SAMM.
- OWASP DSOMM (توجيهي، لخط DevOps): نموذج نضج DevSecOps Maturity Model، وهو مشروع OWASP بتصنيف Lab بحسب صفحة المشروع، ويقسم الأنشطة إلى أبعاد Dimensions مثل البناء والنشر Build and Deployment والثقافة والتنظيم Culture and Organization والاختبار والتحقق Test and Verification، وفي خمسة مستويات، ولكل نشاط ربط بممارسات SAMM، وتطبيقه في dsomm.owasp.org، وآخر إصدار لبيانات النموذج v5.1.0 في مستودع البيانات. وهو مفيد عندما تريد تفاصيل أدق داخل خط CI/CD، ولكنه لا يغطي الحوكمة والتشغيل بعمق SAMM.
والخلاصة العملية أن تبدأ بـ SAMM لأنه مفتوح ومجاني ويغطي البرنامج كله من الحوكمة إلى التشغيل، ثم تستخدم DSOMM إذا أردت تفاصيل أكثر في جزء DevSecOps، وتقرأ تقرير BSIMM إذا أردت أن تعرف ما تفعله الشركات الأخرى، وكل ما يلي في هذا المقال عن SAMM.
هيكل النموذج: الوظائف Business Functions والممارسات Practices والمسارات Streams
الإصدار الحالي من النموذج هو SAMM v2، وقد صدر في 31 يناير 2020 بحسب الأسئلة الشائعة، وهو يحدث على دفعات صغيرة، فآخر إصدار في المستودع هو v2.2.0 المنشور في 6 يوليو 2026، وقبله v2.1.0 في سبتمبر 2024، والتغييرات في v2.2.0 صغيرة: تحسين صياغة النصوص، وتعديل بعض مجموعات الإجابات، وإضافة العلاقات بين الأنشطة، أما الهيكل فهو نفسه. والصورة التالية تبين الهيكل كما في ملفات YAML للنموذج:
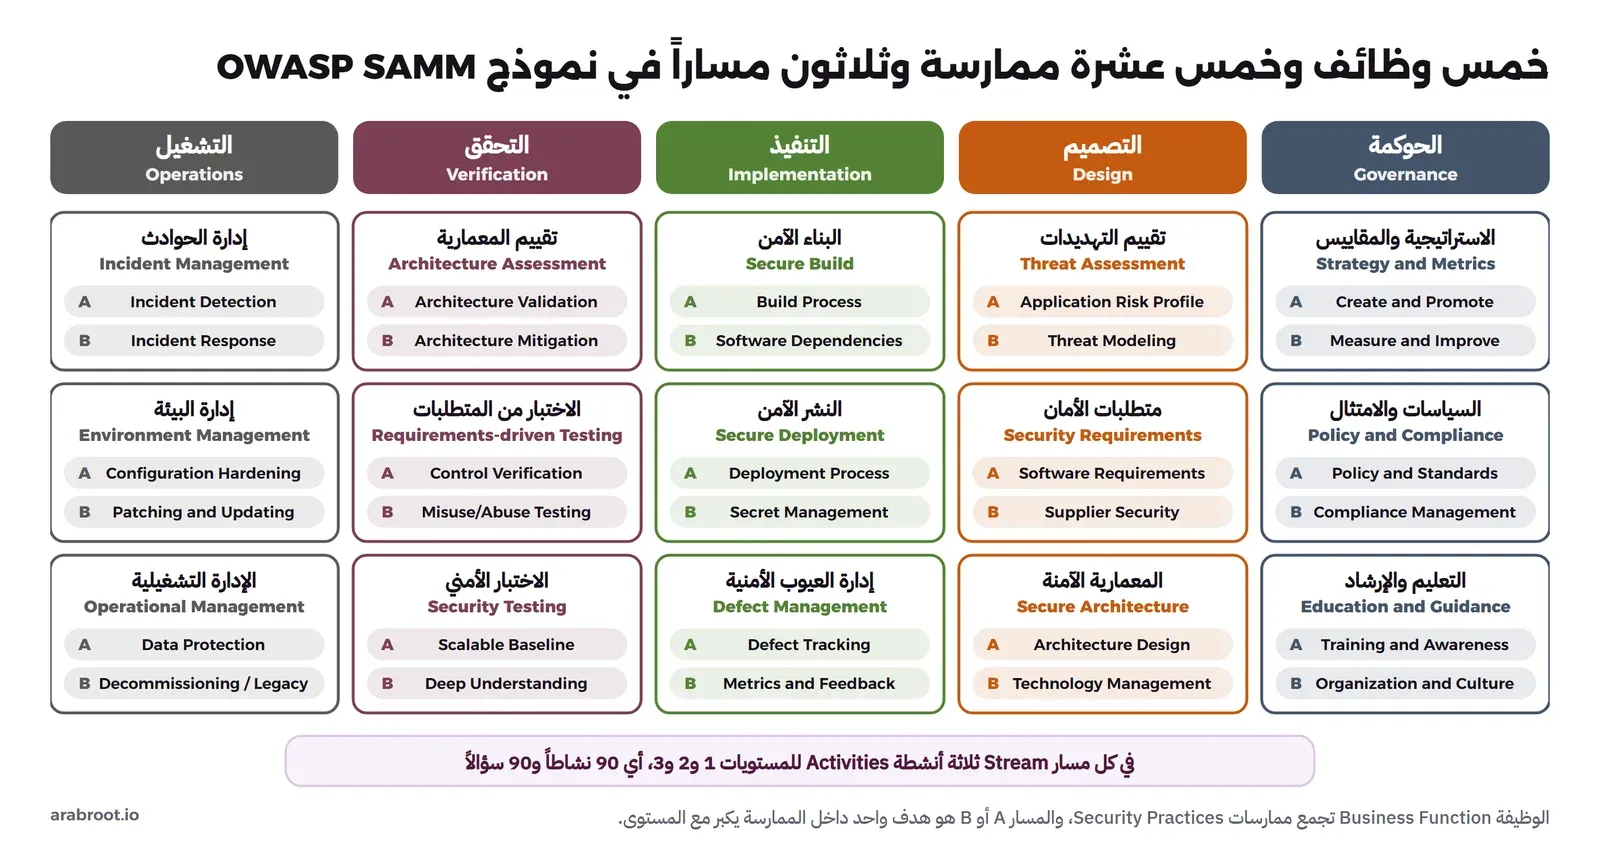
في الهيكل أعلاه لاحظ التالي:
- الوظيفة Business Function: مجموعة كبيرة من عمل تطوير البرمجيات، وهي خمس: الحوكمة Governance (كيف تدير المؤسسة برنامج الأمن)، والتصميم Design (المتطلبات والمعمارية قبل الكود)، والتنفيذ Implementation (البناء والنشر وإدارة العيوب)، والتحقق Verification (الاختبار والمراجعة)، والتشغيل Operations (ما بعد الإطلاق).
- الممارسة الأمنية Security Practice: ثلاث في كل وظيفة، أي خمس عشرة ممارسة، وهي الوحدة التي تأخذ درجة.
- المسار Stream: في كل ممارسة مساران A وB، وكل مسار هدف واحد يكبر مع المستوى، فممارسة تقييم التهديدات Threat Assessment فيها مسار «ملف مخاطر التطبيق Application Risk Profile» ومسار «نمذجة التهديدات Threat Modeling».
- النشاط Activity: في كل مسار نشاط لكل مستوى من الثلاثة، فيصبح المجموع 90 نشاطاً، ويقابل كل نشاط سؤال واحد في ملف التقييم، ويرمز للنشاط في ملفات النموذج برمز مثل
D-TA-1-B، أي الوظيفة Design والممارسة Threat Assessment والمستوى 1 والمسار B.
الممارسات الخمس عشرة Security Practices في جملة واحدة لكل منها
الجدول التالي يشرح كل ممارسة في جملة، ومثالاً من أنشطتها في المستويات الثلاثة (من المسار A غالباً، وأسماء الأنشطة الأصلية في صفحة النموذج)، والمقال الذي يشرح الجانب العملي منها في الموقع:
| الممارسة | ماذا تعني؟ | المستوى 1 | المستوى 2 | المستوى 3 | في الموقع |
|---|---|---|---|---|---|
| Strategy and Metrics الاستراتيجية والمقاييس | خطة أمن مكتوبة تعرف شهية المؤسسة للمخاطر Risk Appetite وتقاس بالأرقام | تحديد شهية المخاطر | استراتيجية أمن مع ميزانية ومحطات | مراجعة الاستراتيجية مع استراتيجية العمل | المخاطر Risk |
| Policy and Compliance السياسات والامتثال | سياسات ومعايير داخلية، ومعرفة الالتزامات الخارجية مثل ضوابط الهيئة | كتابة السياسات والمعايير | تحويلها إلى إجراءات اختبار يفهمها المطور | قياس الالتزام بها وتقريره | NCA ECC |
| Education and Guidance التعليم والإرشاد | تدريب كل من يلمس الكود، وثقافة أمن داخل الفرق | توعية للجميع، وسفير أمن لكل فريق | تدريب بحسب الدور، ومركز خبرة | نظام لتتبع التدريب، ومجتمع داخلي | سفير الأمن |
| Threat Assessment تقييم التهديدات | معرفة أي التطبيقات أخطر، وما الذي قد يسوء في تصميمها | تصنيف التطبيقات بحسب المخاطر، ونمذجة بسيطة بـ STRIDE | ملفات مخاطر مركزية، وطريقة نمذجة موحدة | مراجعة دورية وتحسين الطريقة | نمذجة التهديدات |
| Security Requirements متطلبات الأمان | متطلبات أمان مكتوبة للبرنامج، ومتطلبات للموردين Suppliers | الفرق تكتب متطلبات أمان | متطلبات موحدة ومرتبة بالأولوية | إطار متطلبات تستخدمه كل الفرق | ASVS |
| Secure Architecture المعمارية الآمنة | مبادئ تصميم آمن، وتقنيات معتمدة يعرف الجميع مخاطرها | قائمة مبادئ أمن في التصميم | خدمات أمن مشتركة مثل مزود الهوية | معماريات مرجعية Reference Architectures | النطاق 02 |
| Secure Build البناء الآمن | بناء متكرر ومؤتمت، ومعرفة الاعتماديات Dependencies التي تبني عليها | توثيق البناء، وقائمة الاعتماديات BOM | بناء مؤتمت بالكامل، ومراجعة الاعتماديات | البناء يفشل عند تجاوز خط الأمان | سلسلة التوريد |
| Secure Deployment النشر الآمن | نشر متكرر بصلاحيات محددة، وأسرار لا يراها المطورون | نشر موثق، وأسرار الإنتاج محمية | نشر مؤتمت بفحوص أمنية، وحقن الأسرار عند النشر | التحقق من توقيع ما ينشر، ودورة حياة للأسرار | فحص الأسرار |
| Defect Management إدارة العيوب الأمنية | كل ثغرة مسجلة في مكان واحد ولها خطورة وموعد إصلاح | تتبع مركزي للعيوب الأمنية | مقياس خطورة واحد ومواعيد SLA | فرض المواعيد آلياً وربطها بإدارة المخاطر | فرز النتائج |
| Architecture Assessment تقييم المعمارية | مراجعة المعمارية نفسها ضد الأهداف الأمنية والتهديدات المعروفة | مراجعة عند الحاجة | مراجعة منهجية لكل واجهة | قياس فعالية الضوابط الأمنية | المراجعة Validation |
| Requirements-driven Testing الاختبار من المتطلبات | اختبارات إيجابية تثبت الضوابط، واختبارات إساءة Abuse Cases وفحص بالعشوائية Fuzzing | اختبار ضوابط المصادقة والصلاحيات | اختبارات مكتوبة من المتطلبات | اختبارات انحدار Regression أمنية آلية | أنواع الاختبارات |
| Security Testing الاختبار الأمني | فحص آلي على كل تطبيق، واختبار يدوي للأجزاء عالية المخاطر | أدوات فحص آلية | ضبط الأدوات لتطبيقاتك، واختبار اختراق دوري | الفحص داخل خط التسليم ولوحة واحدة | SAST وDAST |
| Incident Management إدارة الحوادث | اكتشاف الحادثة من السجلات، والاستجابة لها بخطة | تحليل السجلات دورياً، وشخص مسؤول عن الحوادث | عملية موثقة للاكتشاف والاستجابة | فريق استجابة وتحليل السبب الأساسي Root Cause | DFIR وسجل التدقيق |
| Environment Management إدارة البيئة | تحصين Hardening الإعدادات، وتحديث المكونات في وقتها | تحصين المكونات الأساسية، وتحديث بأفضل جهد | خطوط أساس Baselines لكل مكون، وعملية تحديث | مراقبة مستمرة للالتزام، وتحديث بمواعيد | تأمين VPS |
| Operational Management الإدارة التشغيلية | حماية البيانات بحسب حساسيتها، وإيقاف الأنظمة القديمة بشكل منظم | معرفة البيانات في كل تطبيق، وإزالة ما لا يستخدم | فهرس للبيانات Data Catalog، وعملية إيقاف رسمية | مراجعة دورية لحالة كل نظام وبياناته | النطاق 06 |
مستويات النضج الثلاثة Maturity Levels: من البداية إلى التحسين المستمر
يصف النموذج في ملفات maturity_levels المستويات الثلاثة كما يلي: المستوى 1 تطبيق مؤقت بأفضل جهد ad-hoc، والمستوى 2 عملية ثابتة قابلة للتكرار يمكن الاعتماد عليها، والمستوى 3 تعظيم الفعالية بالتحسين المستمر بناء على تغذية راجعة فعالة وفي وقتها، والمستوى 0 يعني أن النشاط غير موجود. والصورة التالية تبين المستويات على مسار نمذجة التهديدات:
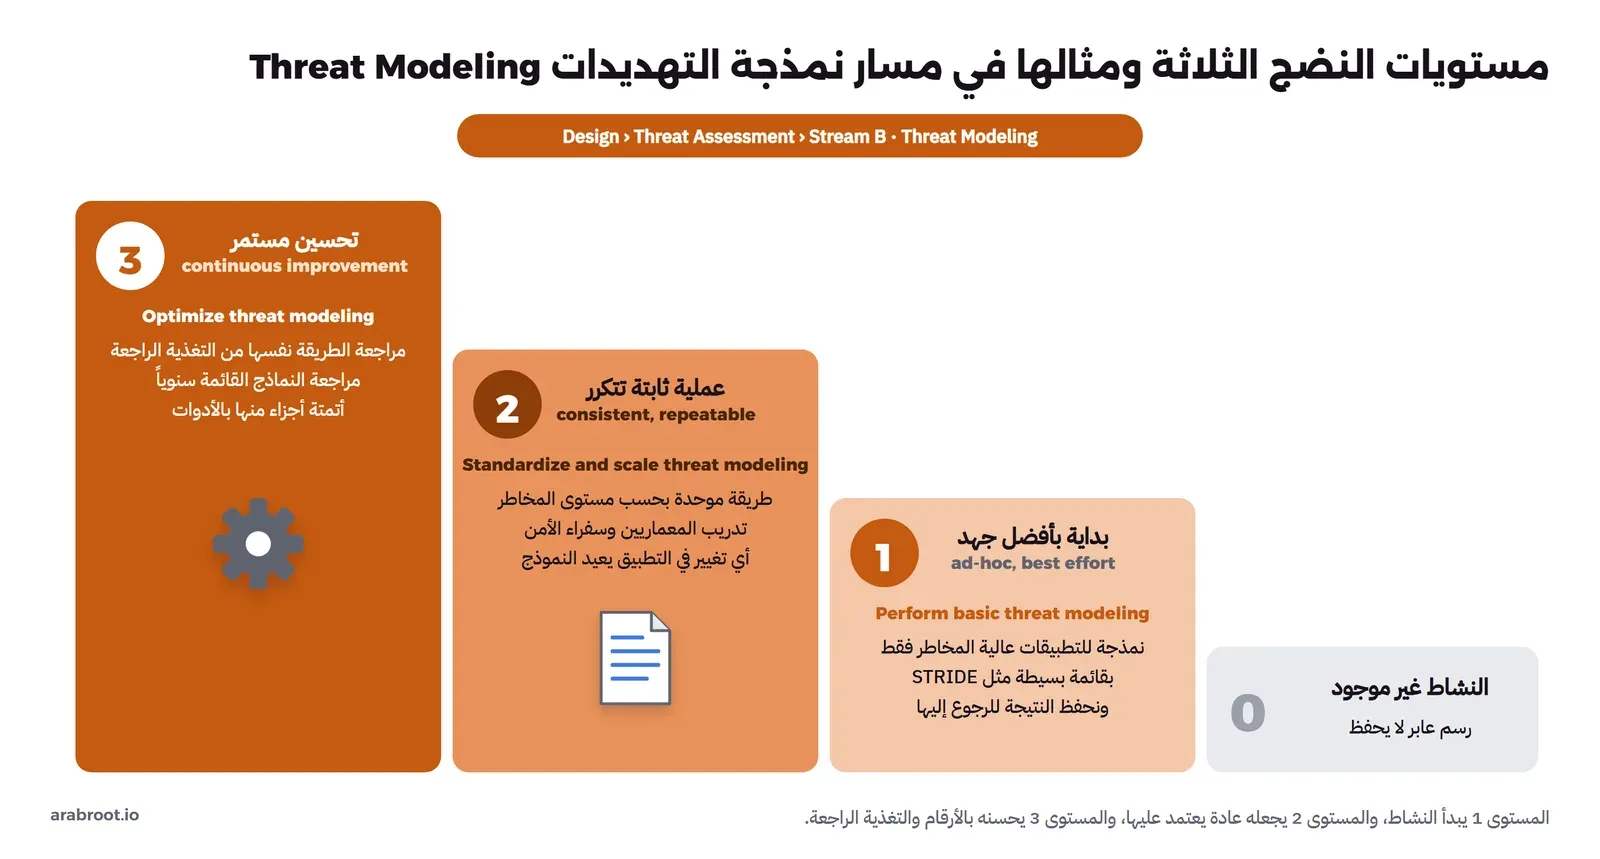
ويجدر الانتباه إلى أن النموذج لا يشترط أن تكمل المستوى 1 قبل أن تعمل على المستوى 2، فالأسئلة الشائعة تقول صراحة إن بعض أنشطة المستوى 1 قد لا تنطبق عليك فتتجاوزها، وإن الترتيب منطقي ولكنه ليس قيداً، وهذا ما سوف تراه في طريقة حساب الدرجة.
كيف تحسب الدرجة Score بالضبط؟
الإجابة في SAMM v2 ليست «نعم» أو «لا»، فلكل سؤال أربع إجابات لها قيم 0 و0.25 و0.5 و1، ونص الإجابة يختلف بحسب السؤال، فأغلب الأسئلة إجاباتها «No» و«Yes, for some applications» و«Yes, for at least half of the applications» و«Yes, for most or all of the applications»، وبعضها يسأل عن المكونات أو الحوادث أو الوقت أو المؤسسة. وتحت كل سؤال معايير جودة Quality Criteria، وتقول صفحة التقييم إن المعايير إذا لم تتحقق بالكامل فالإجابة «No»، وإذا تحققت تختار من الإجابات الأخرى بحسب التغطية. وقد قرأنا معادلات ملف التقييم الرسمي نفسه، والصورة التالية تبين الخطوات:
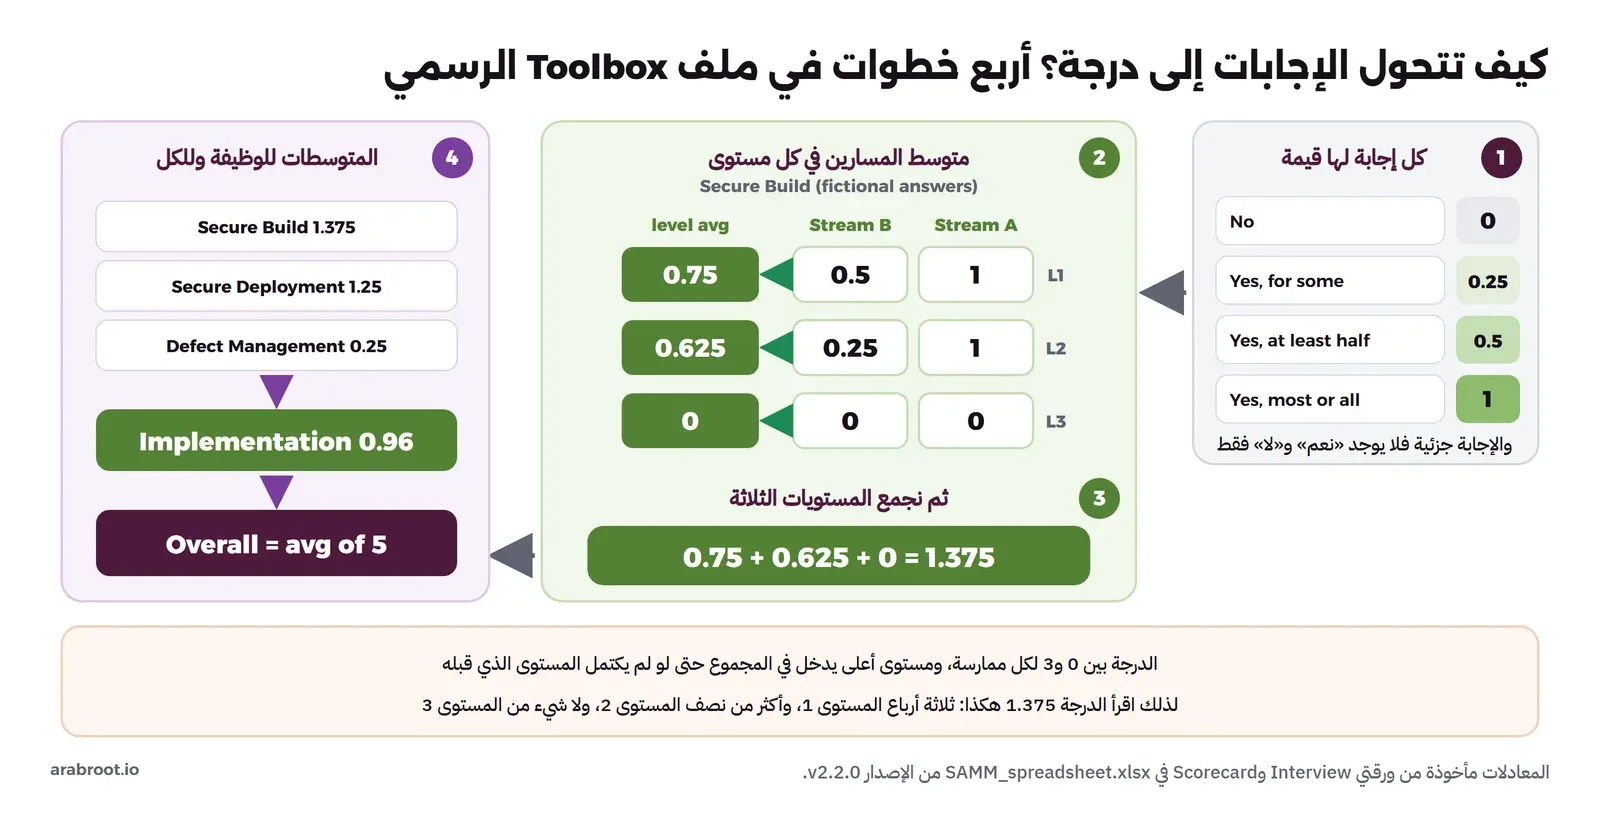
في الحساب أعلاه لاحظ التالي:
- درجة المستوى متوسط المسارين: في ورقة
Interviewتحسب الخلية لكل مستوى بالمعادلةAVERAGEلإجابة المسار A وإجابة المسار B في المستوى نفسه. - درجة الممارسة مجموع المستويات: عمود التقييم Rating هو
SUMللمستويات الثلاثة، فتكون الدرجة بين 0 و3، ولهذا يمكن أن تأخذ درجة من المستوى 2 دون أن تكمل المستوى 1. - درجة الوظيفة والدرجة الكلية متوسطات: في ورقة
Scorecardدرجة الوظيفةAVERAGEلممارساتها الثلاث، والدرجة الكلية Overall متوسط الوظائف الخمس.
وقد يتساءل البعض: هل الدرجة 1.375 تعني «المستوى 1»؟ والإجابة لا بالضبط، فهي تعني أن ثلاثة أرباع أنشطة المستوى 1 موجودة وأكثر من نصف المستوى 2، لذلك اقرأ الأعمدة L1 وL2 وL3 مع الدرجة دائماً ولا تكتف بالرقم وحده، والسبب أن الرقم 1.0 قد يأتي من مستوى 1 كامل، وقد يأتي من نصف المستوى 1 ونصف المستوى 2، والخطة في الحالتين مختلفة.
ملف التقييم الرسمي SAMM Toolbox والأدوات الأخرى
تقول صفحة التقييم إن هناك نسختين من ملف التقييم SAMM Toolbox: نسخة Microsoft Excel ونسخة Google Spreadsheet، وإن هناك أداتين على الويب: SAMMwise وهي أداة تستضيفها بنفسك (مستودعها owaspsamm/sammwise بترخيص Apache-2.0، وآخر تحديث لكودها في مارس 2023)، وSAMMY وهي أداة تجارية من طرف ثالث هو شركة Codific أحد رعاة المشروع. ونسخة Excel تنشر مع كل إصدار في المستودع، فملف SAMM_spreadsheet.xlsx مرفق بإصدار v2.2.0، وقد قمنا بتنزيله وفتحه داخل Container من python:3.12-slim مع openpyxl 3.1.5 لنرى أوراقه:
curl -sLO https://github.com/owaspsamm/core/releases/download/v2.2.0/SAMM_spreadsheet.xlsx
docker run -d --name lab-samm-lo -v "$PWD:/w" python:3.12-slim sleep infinity
docker exec lab-samm-lo sh -c "apt-get update -qq && apt-get install -y -qq --no-install-recommends libreoffice-calc-nogui fonts-dejavu-core poppler-utils && pip install -q openpyxl==3.1.5"
docker exec lab-samm-lo sh -c "cd /w && python sheets.py 2>/dev/null"
والملف sheets.py يطبع رقم الإصدار والترخيص من الورقة الأولى، ثم أسماء الأوراق وحالتها:
import openpyxl
wb = openpyxl.load_workbook('/w/SAMM_spreadsheet.xlsx')
print(wb['Attribution and License']['B3'].value, '|', wb['Attribution and License']['B7'].value)
for ws in wb.worksheets:
    print(f'{ws.title:24} {ws.sheet_state}')
والمخرج سوف يكون كما يلي:
'v2.2.0 | Creative Commons Attribution-ShareAlike 4.0 License
Attribution and License  visible
Getting Started          visible
Benchmark                visible
Interview                visible
Scorecard                visible
Roadmap                  visible
Roadmap Chart            hidden
Lookups                  hidden
imp-questions            hidden
DV-Lists                 hidden
imp-answers              hidden
Background Images        hidden
في المخرج أعلاه لاحظ التالي:
- Getting Started: ست خطوات: افهم النموذج، وحدد النطاق، وأجر المقابلة، وراجع النتيجة، وخطط، وشارك بياناتك في المقارنة Benchmark إذا أردت.
- Interview: الورقة التي تعبئها، وفيها الأسئلة التسعون مرتبة بالوظائف والممارسات، وتحت كل سؤال معايير الجودة، وعمود الإجابة من قائمة منسدلة، وعمود ملاحظات المقابلة Interview Notes، ومربع التقييم Rating لكل ممارسة.
- Scorecard: ورقة للقراءة فقط تحسب درجات الممارسات والوظائف تلقائياً، وفيها رسم بياني Radar.
- Roadmap: تكتب فيها الإجابات المستهدفة في أربع مراحل Phase 1 إلى Phase 4، فيحسب الملف درجة كل مرحلة.
- الأوراق المخفية: فيها الأسئلة ومجموعات الإجابات وقيمها، ولا تقم بتعديلها، لأن المعادلات تبحث فيها بالنص.
- الترخيص: حقل الترخيص يقول CC BY-SA 4.0 مثل الموقع والمستودع، ولاحظ أن في الورقة نفسها سطراً قديماً متبقياً يذكر نص ترخيص 3.0، والمرجع هو حقل الترخيص وموقع المشروع. ولأن الترخيص يسمح بالمشاركة مع ذكر المصدر، فالصور التالية من الملف منشورة مع نسبتها إلى OWASP SAMM.
كيف تجري التقييم Assessment خطوة بخطوة؟
الصورة التالية تبين دورة التقييم كما يصفها دليل البداية السريعة Quick Start Guide ودليل التقييم Assessment Guide:
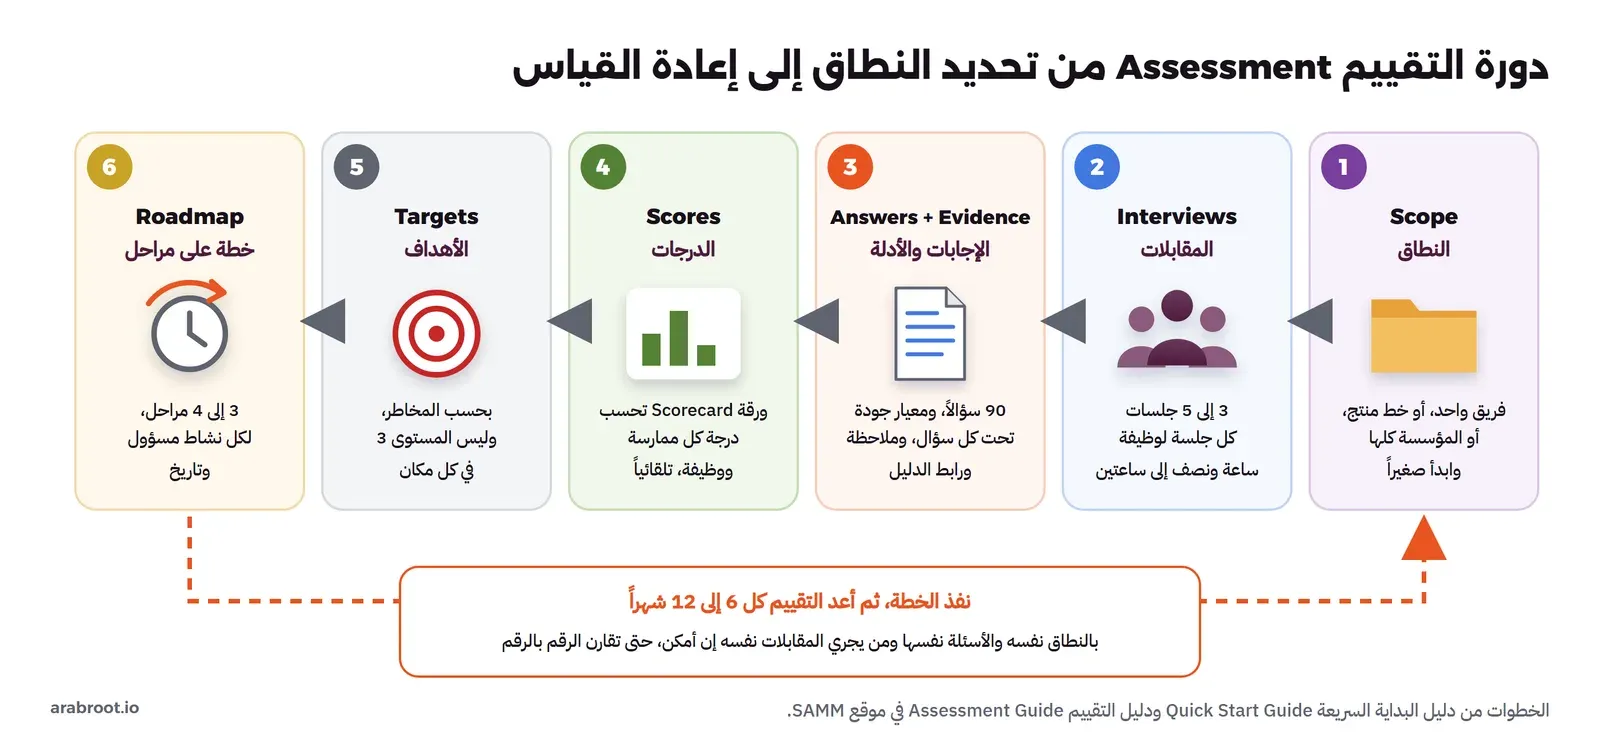
الخطوة الأولى: حدد النطاق Scope
النطاق قد يكون تطبيقاً واحداً أو فريقاً أو خط منتج أو المؤسسة كلها، وصفحة تحديد النطاق واضحة في نصيحتها للتقييم الأول: ابدأ صغيراً بفريق متعاون يمثل بقية الفرق، والسبب أن البدء بالمؤسسة كلها منحنى تعلم صعب على الجميع. والقاعدة المهمة هنا أن كل من في النطاق يجب أن يعمل بالطريقة نفسها والإجراءات نفسها، فإذا كان لديك فريق يستخدم CI/CD كاملاً وفريق ينشر يدوياً، فهذان تقييمان وليسا تقييماً واحداً، لأن الإجابة «Yes, for some applications» سوف تخفي الفرق بينهما. واكتب النطاق والافتراضات والأشخاص في رأس الملف، لأنك سوف تعيد التقييم بعد أشهر وتحتاج أن تقيس الشيء نفسه.
الخطوة الثانية: من يحضر المقابلات من أصحاب العلاقة Stakeholders؟
تذكر الخطوة الأولى في الدليل الأطراف التالية: الراعي التنفيذي Executive Sponsor، وفريق الأمن، والمطورين، والمعماريين، وأصحاب العمل Business Owners، والمختبرين QA، والمديرين. وفي الفريق الصغير هذا يعني عملياً قائد التطوير Dev Lead، ومن يدير السيرفرات والنشر Ops، ومن يهتم بالأمن أو سفير الأمن، وصاحب المنتج Product Owner لأنه يعرف الالتزامات تجاه العملاء. ولا تقم بتوزيع الأسئلة التسعين على الجميع، فدليل إجراء المقابلات يقترح من 3 إلى 5 مقابلات، كل منها ساعة ونصف إلى ساعتين، وكل مقابلة لوظيفة أو موضوع، مع مجموعة صغيرة من الناس، لأن الناس يتحدثون بصراحة أكثر في المجموعات الصغيرة.
الخطوة الثالثة: المقابلة Interview وليس الاستبيان
يفرق دليل التقييم بين التقييم الذاتي Self-assessment والتقييم بخبير مستقل Expert Assessment، وبين الاستبيان Questionnaire والمقابلة، ويقول إن الاستبيان بتسعين سؤالاً قد يكون مرهقاً وتفسيره يختلف من فريق لآخر، وإن المقابلة أفضل في المرة الأولى، والاستبيان مناسب لتحديث الدرجات بعد ذلك. وأهم نصائح المقابلة في الدليل:
- اسأل عما حدث وليس عما يجب: «متى حدثت وثيقة السياسات آخر مرة؟» بدلاً من «هل تحدث السياسات باستمرار؟».
- لا تقرأ سؤال SAMM كما هو: بدلاً من «هل تستخدمون قوائم تحقق في نمذجة التهديدات؟» قل «صف لي كيف تتم نمذجة التهديدات عندكم» واستمع هل تذكر القائمة أم لا.
- اطلب الأدلة Artifacts مبكراً: عندما يرى الناس أنك سوف تتحقق، تصبح الإجابات أدق.
- ليست امتحاناً: التقييم تعاون وليس تحقيقاً، والهدف أن تعرف الواقع لتحسنه.
- شخصان أفضل من شخص: واحد يسأل وواحد يكتب، ثم اعرض النتيجة الأولية على الفريق ليصححها قبل اعتمادها.
الخطوة الرابعة: الأدلة Evidence والصدق في الإجابة
هناك إغراء كبير في أن ترفع الإجابة قليلاً، فـ «نمذجنا التهديدات مرة لتطبيق واحد قبل سنة» تصبح «Yes, for some applications»، و«لدينا وثيقة سياسات لم يقرأها أحد» تصبح «Yes». لا تقم بذلك، والسبب أن الدرجة لا تمنحك أماناً، وإنما تقرر أين تضع وقت الفريق في الأشهر القادمة، فإذا ضخمت درجة ممارسة فسوف تتركها في الخطة وهي تحتاج عملاً. والطريقة الصحيحة أن تقرأ معايير الجودة تحت السؤال، فإذا لم تتحقق كلها فالإجابة «No» كما تقول صفحة التقييم، وأن تضع في عمود الملاحظات رابطاً للدليل نفسه (تقرير فحص، أو إعداد حماية الفرع، أو محضر جلسة نمذجة)، كما شرحنا في الأدلة Evidence: ما لم يوثق فهو لم يحدث. وتنصح خطوة التقييم في الدليل بأن تقرر مسبقاً كيف تعطي الإجابات الجزئية وتكتب قراراتك، وأن تسأل أكثر من شخص السؤال نفسه، وأن تحدد الأنشطة التي لا تنطبق عليك.
مثال عملي: نعبئ ملف SAMM لشركة SaaS تخيلية
لنفرض أن لدينا شركة تخيلية (ليست شركة حقيقية) فيها 15 شخصاً، تبيع خدمة فواتير SaaS للشركات الصغيرة، ولديها ثلاثة تطبيقات: تطبيق الويب للعملاء، وواجهة API عامة، ولوحة إدارة داخلية. والفريق يستخدم Git وخط CI/CD، ويشغل فحص الأسرار وSAST وفحص الاعتماديات منذ أشهر بعد قراءة DevSecOps للمبتدئين، والنشر مؤتمت، ولكن لا توجد استراتيجية أمن مكتوبة، ولا تصنيف للتطبيقات، والثغرات تتابع في رسائل المحادثة. والنطاق هو الشركة كلها، لأن الفرق تعمل بالطريقة نفسها.
كيف أجبنا عن بعض الأسئلة Questions؟
لن نعرض الأسئلة التسعين كلها، وإنما ستة منها مع سبب الإجابة، والأسئلة منقولة كما هي من ملف v2.2.0:
| النشاط | السؤال في الملف | ما وجدناه في المقابلة | الإجابة (القيمة) |
|---|---|---|---|
G-SM-1-A | Do you understand the enterprise-wide risk appetite for your applications? | المؤسسون يعرفون أن تسريب بيانات الفواتير أخطر ما قد يحدث، ولكن لا توجد وثيقة معتمدة | Yes, it covers general risks (0.25) |
D-TA-1-A | Do you classify applications according to business risk based on a simple and predefined set of questions? | لا يوجد تصنيف، والجميع يعامل التطبيقات الثلاثة بالطريقة نفسها | No (0) |
D-TA-1-B | Do you identify and manage architectural design flaws with threat modeling? | جلسة نمذجة واحدة لميزة الدفع قبل سنة، ونتيجتها في ملف | Yes, some of them (0.25) |
I-SB-1-A | Is your full build process formally described? | البناء كله في ملفات الخط داخل المستودع، والأدوات محدثة، والهاش يحسب للمخرجات | Yes, for most or all of the applications (1) |
I-DM-1-A | Do you track all known security defects in accessible locations? | نتائج الأدوات في تقارير CI، والثغرات اليدوية في المحادثة، ولا يوجد مكان واحد | Yes, for at least half of the applications (0.5) |
O-IM-1-B | Do you respond to detected incidents? | مدير التقنية هو المسؤول عملياً، ونصف الحوادث تقريباً لها توثيق | Yes, for at least half of the incidents (0.5) |
ولاحظ في السؤال الأول أن الإجابة ليست «Yes, for some applications»، لأن هذا السؤال يستخدم مجموعة إجابات خاصة تقيس عمق فهم المخاطر، من «Yes, it covers general risks» إلى «Yes, it covers risks and opportunities»، لذلك اقرأ خيارات الإجابة لكل سؤال قبل أن تختار.
تعبئة الملف الرسمي وحساب الدرجات Scores
بدلاً من أن نحسب الدرجات بأيدينا، قمنا بتعبئة الإجابات التسعين في ورقة Interview من الملف الرسمي نفسه، ثم تركنا LibreOffice يعيد حساب المعادلات، ثم قرأنا ورقة Scorecard. والملف fill.py كما يلي، وفي القاموس V إجابات كل ممارسة بالترتيب A1 وB1 وA2 وB2 وA3 وB3:
# Fill the official SAMM v2.2.0 toolbox with the answers of a fictional 15-person SaaS company
import openpyxl
V = {  # practice: [A1, B1, A2, B2, A3, B3] as answer values 0 / 0.25 / 0.5 / 1
 'G-SM':[0.25,0,0,0,0,0], 'G-PC':[0.25,0.5,0,0,0,0], 'G-EG':[0.25,0.5,0,0,0,0],
 'D-TA':[0,0.25,0,0,0,0], 'D-SR':[0.25,0.25,0,0,0,0], 'D-SA':[0.5,0.5,0.25,0.25,0,0],
 'I-SB':[1,0.5,1,0.25,0,0], 'I-SD':[1,0.5,0.5,0.5,0,0], 'I-DM':[0.5,0,0,0,0,0],
 'V-AA':[0.25,0.25,0,0,0,0], 'V-RT':[0.5,0,0,0,0,0], 'V-ST':[1,0.25,0.25,0,0,0],
 'O-IM':[0.25,0.5,0,0,0,0], 'O-EM':[1,0.5,0.25,0,0,0], 'O-OM':[0.25,0.25,0,0,0,0],
}
wb = openpyxl.load_workbook('/w/SAMM_spreadsheet.xlsx')
q = {r[0].value: r[7].value for r in wb['imp-questions'].iter_rows(min_row=2) if r[0].value}
ans = {r[0].value: [c.value for c in r[1:5]] for r in wb['imp-answers'].iter_rows(min_row=2) if r[0].value is not None}
order = {0:0, 0.25:1, 0.5:2, 1:3}
iv = wb['Interview']
iv['D10'] = 'Fictional SaaS (15 people)'; iv['D11'] = 'Whole company: 3 applications'; iv['D12'] = '2026-10-07'
n = 0
for row in iv.iter_rows(min_row=18):
    code = row[0].value
    if not code or code not in q: continue
    bf, pr, st, lvl, _ = code.split('-')
    val = V[f'{bf}-{pr}'][(int(lvl)-1)*2 + (0 if st == 'A' else 1)]
    text = ans[q[code]][order[val]]
    iv.cell(row=row[0].row, column=6, value=text); n += 1
print('answered', n)
wb.save('/w/out/SAMM_filled.xlsx')
في الكود أعلاه لاحظ التالي:
- رمز السؤال في الملف: العمود A في ورقة
Interviewيحمل رموزاً مثلD-TA-B-1-1، أي الوظيفة والممارسة والمسار ثم المستوى، وهو ترتيب يختلف قليلاً عن أسماء ملفات النموذجD-TA-1-B، والمعنى واحد. - نص الإجابة وليس الرقم: الملف يبحث عن نص الإجابة في جدول مجموعات الإجابات ليحولها إلى قيمة، لذلك نأخذ النص من الورقة المخفية
imp-answersبحسب رقم مجموعة الإجابات لكل سؤال فيimp-questions. - openpyxl لا يحسب المعادلات: هو يكتب الإجابات فقط، لذلك نفتح الملف في LibreOffice ونحفظه ليعيد حساب كل المعادلات.
والملف score.py يقرأ القيم التي حسبتها معادلات ورقة Scorecard:
# Read the scores that the toolbox formulas calculated (after LibreOffice recalculated the file)
import openpyxl
wb = openpyxl.load_workbook('/w/out/calc/SAMM_filled.xlsx', data_only=True)
s = wb['Scorecard']
for r in range(14, 29):                      # 15 practices: function, practice, score, L1, L2, L3
    a, b, c, d, e, f = (s.cell(r, k).value for k in range(1, 7))
    print(f'{a:15} {b:24} {c:<6} L1={d:<6} L2={e:<6} L3={f}')
print('---')
for r in range(14, 20):                      # 5 business functions and the overall score
    print(f'{s.cell(r, 9).value:15} {s.cell(r, 10).value:.3f}')
الآن سوف نقوم بتشغيل الثلاثة معاً في ال Container نفسه:
mkdir -p out
docker exec lab-samm-lo sh -c "cd /w && python fill.py && soffice --headless --convert-to xlsx --outdir /w/out/calc /w/out/SAMM_filled.xlsx >/dev/null 2>&1 && python score.py 2>/dev/null"
والمخرج سوف يكون كما يلي:
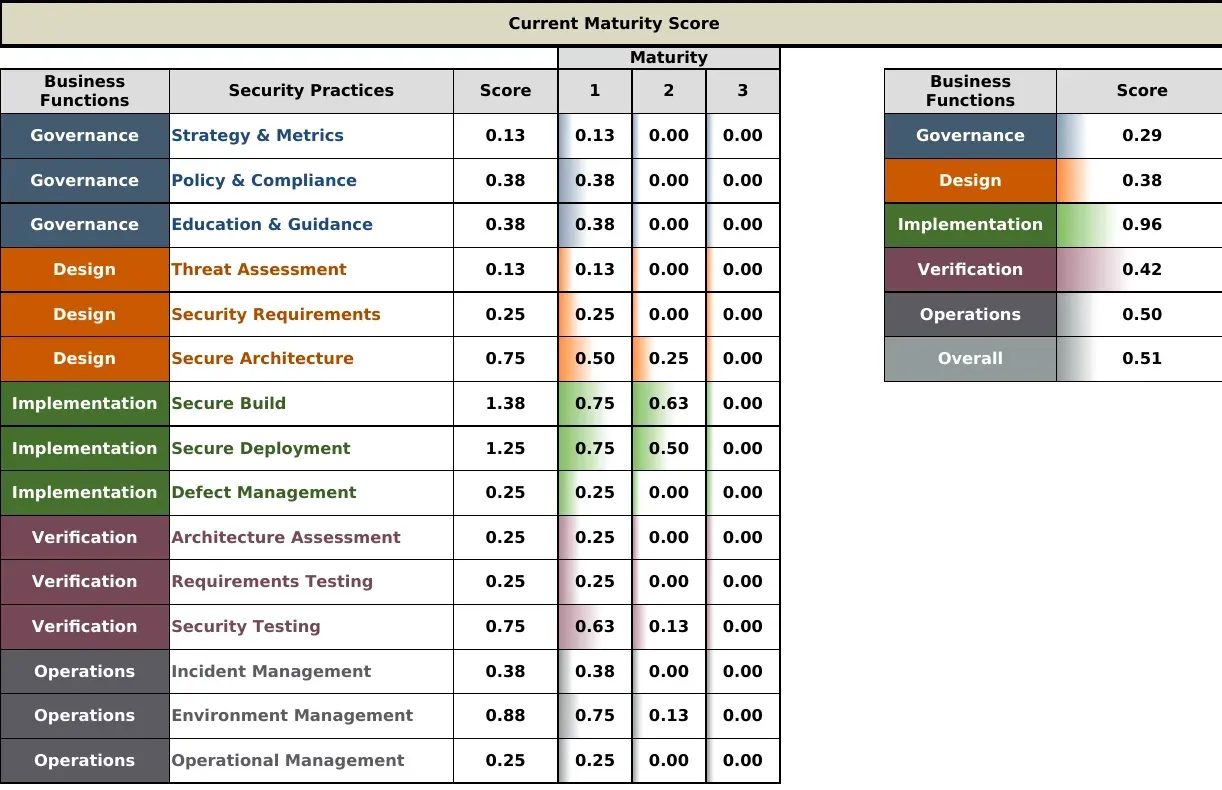
answered 90
Governance      Strategy & Metrics       0.125  L1=0.125  L2=0      L3=0
Governance      Policy & Compliance      0.375  L1=0.375  L2=0      L3=0
Governance      Education & Guidance     0.375  L1=0.375  L2=0      L3=0
Design          Threat Assessment        0.125  L1=0.125  L2=0      L3=0
Design          Security Requirements    0.25   L1=0.25   L2=0      L3=0
Design          Secure Architecture      0.75   L1=0.5    L2=0.25   L3=0
Implementation  Secure Build             1.375  L1=0.75   L2=0.625  L3=0
Implementation  Secure Deployment        1.25   L1=0.75   L2=0.5    L3=0
Implementation  Defect Management        0.25   L1=0.25   L2=0      L3=0
Verification    Architecture Assessment  0.25   L1=0.25   L2=0      L3=0
Verification    Requirements Testing     0.25   L1=0.25   L2=0      L3=0
Verification    Security Testing         0.75   L1=0.625  L2=0.125  L3=0
Operations      Incident Management      0.375  L1=0.375  L2=0      L3=0
Operations      Environment Management   0.875  L1=0.75   L2=0.125  L3=0
Operations      Operational Management   0.25   L1=0.25   L2=0      L3=0
---
Governance      0.292
Design          0.375
Implementation  0.958
Verification    0.417
Operations      0.500
Overall         0.508
ولاحظ أننا أخفينا رسائل 2>/dev/null لأن openpyxl يطبع تنبيهات بأنه لا يدعم بعض امتدادات Excel مثل التنسيق الشرطي Conditional Formatting، وهي لا تؤثر على القيم. والصورة التالية جزء من ورقة Interview بعد التعبئة، صدرناها من الملف نفسه بـ LibreOffice إلى PDF ثم إلى صورة:
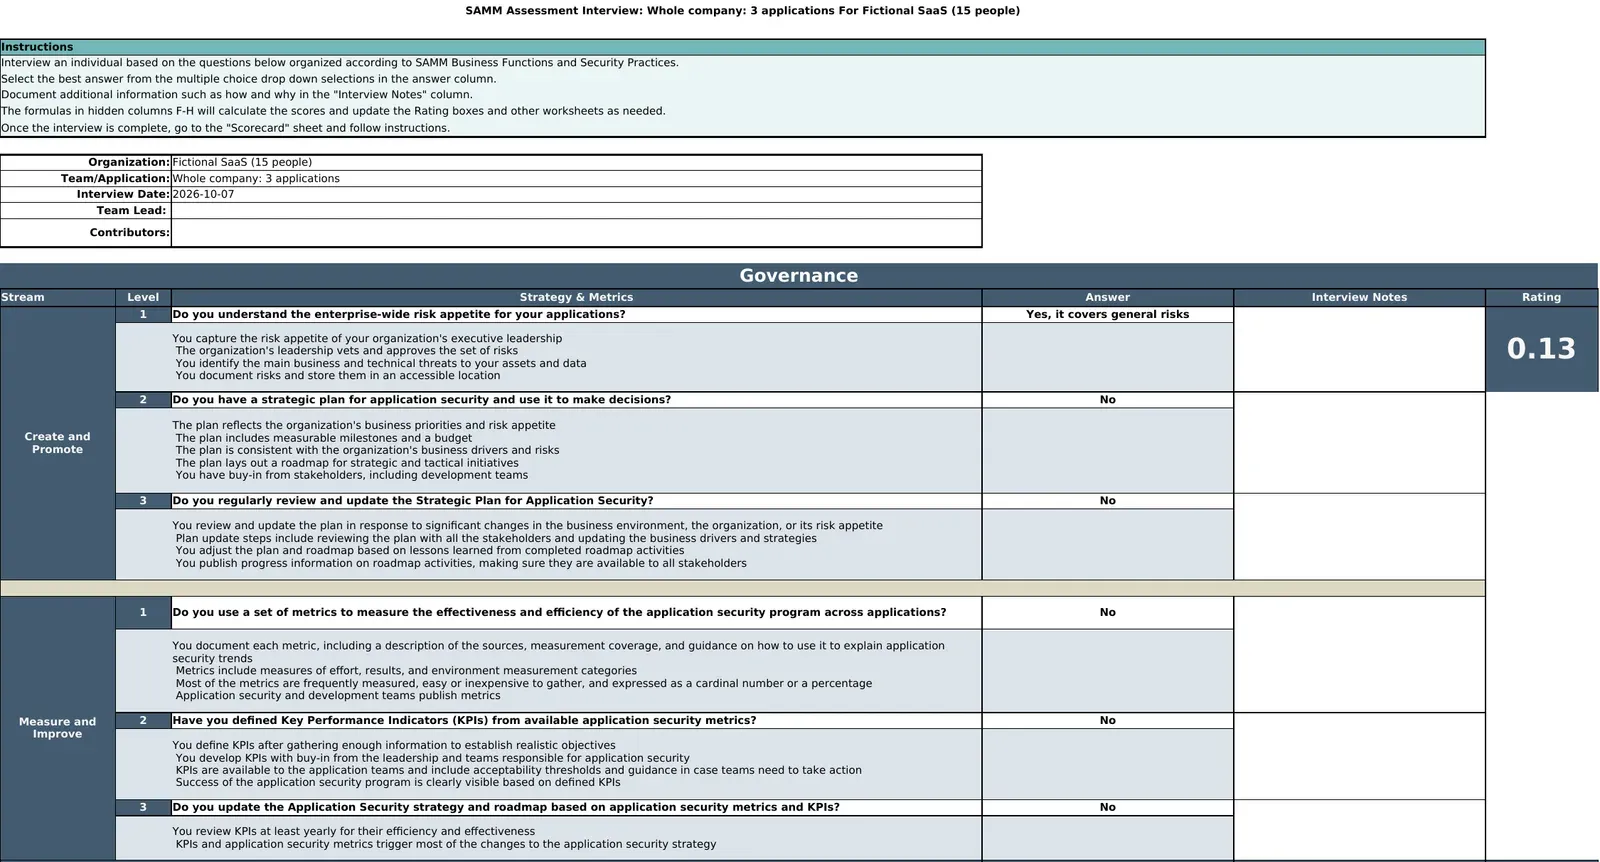
وهذه ورقة Scorecard كما حسبها الملف:
ماذا يحدث إذا كتبت الإجابة بيدك بدلاً من القائمة المنسدلة Drop-down؟
عمود الإجابة قائمة منسدلة، ولكن لا شيء يمنع شخصاً من لصق نص من مكان آخر أو كتابة «Yes» فقط. لنجرب ذلك على السؤال D-TA-B-1-1 الذي كانت إجابته «Yes, some of them»، والملف break.py كما يلي:
# Type a free-text answer that is not in the drop-down list, then recalculate
import openpyxl
wb = openpyxl.load_workbook('/w/out/SAMM_filled.xlsx')
iv = wb['Interview']
for row in iv.iter_rows(min_row=18):
    if row[0].value == 'D-TA-B-1-1':
        print(row[0].value, 'was:', row[5].value)
        row[5].value = 'Yes'
wb.save('/w/out/SAMM_broken.xlsx')
والملف score_ta.py يقرأ صف ممارسة Threat Assessment ودرجة وظيفة Design بعد إعادة الحساب:
import openpyxl
s = openpyxl.load_workbook('/w/out/calc/SAMM_broken.xlsx', data_only=True)['Scorecard']
print(s.cell(17, 2).value, s.cell(17, 3).value, '| Design', round(s.cell(15, 10).value, 3))
ثم نشغل الاثنين:
docker exec lab-samm-lo sh -c "cd /w && python break.py && soffice --headless --convert-to xlsx --outdir /w/out/calc /w/out/SAMM_broken.xlsx >/dev/null 2>&1 && python score_ta.py 2>/dev/null"والمخرج سوف يكون كما يلي:
D-TA-B-1-1 was: Yes, some of them
Threat Assessment 0 | Design 0.333
وعند تشغيل الأمر سوف تجد أن الملف لم يعط أي خطأ، وإنما نزلت درجة الممارسة من 0.125 إلى 0، ودرجة Design من 0.375 إلى 0.333، والسبب أن معادلة الإجابة تحاط بـ IFERROR(…, 0)، فأي نص لا تجده في جدول الإجابات يصبح صفراً بصمت. لذلك اختر الإجابات من القائمة دائماً، وإذا جمعت إجابات من عدة أشخاص في ملف واحد فراجع أن كل خلية فيها نص من القائمة قبل أن تقرأ الدرجات.
كيف تقرأ النتيجة Result؟
الصورة التالية ترسم الدرجات الخمس عشرة التي حسبها الملف، ومعها الهدف بعد سنة من الخطة التي سوف نبنيها في القسم التالي:
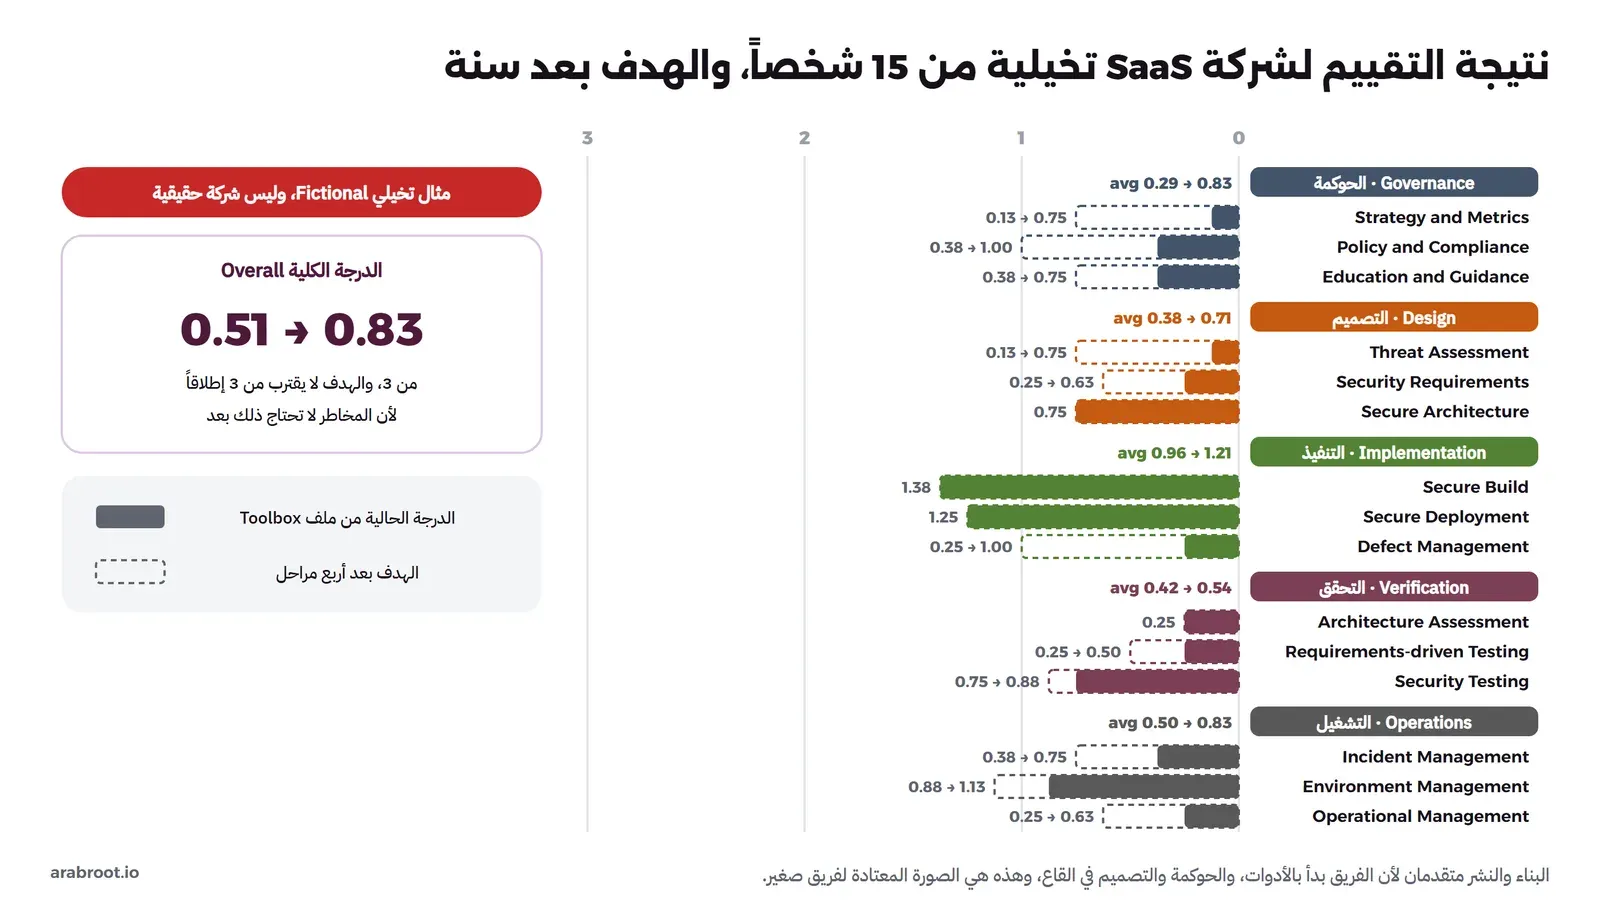
في النتيجة أعلاه لاحظ التالي:
- البناء والنشر في الأعلى: لأن الفريق بدأ بالأدوات، وهذا هو الشكل المعتاد لفريق قرأ عن DevSecOps، فالأتمتة سهلة القياس وتعطي نتيجة سريعة.
- الحوكمة وتقييم التهديدات وإدارة العيوب في القاع: لا يوجد تصنيف للتطبيقات، ولا مكان واحد للثغرات، وهذه الثلاثة تحديداً هي ما يجعل نتائج الأدوات مفيدة، فالأداة التي تجد ثغرة لا تنفع إذا ضاعت النتيجة في المحادثة.
- الدرجة الكلية 0.51 من 3: هذا الرقم يقول إن معظم الممارسات في بداية المستوى 1، وهذه نقطة بداية طبيعية لشركة بهذا الحجم، والمهم هو الرقم في التقييم القادم.
من الدرجة إلى خطة تحسين Roadmap
الخطأ الأشهر بعد التقييم أن يقول أحدهم «هدفنا المستوى 3 في كل الممارسات»، وهذا الهدف غير مناسب إطلاقاً لشركة من خمسة عشر شخصاً، لأن المستوى 3 يعني مثلاً فريق استجابة مخصصاً، ونظاماً لإدارة التدريب، ومعماريات مرجعية محدثة باستمرار، وكل هذا تكلفة لا تبررها مخاطرها اليوم. وتقول خطوة تحديد الهدف في الدليل إن الهدف يحدد بحسب ملف المخاطر Risk Profile، وإنه يحتوي عادة أنشطة من المستويات الأدنى أكثر من الأعلى، وإن تكلفة برنامج ضمان البرمجيات تقدر تقريباً بين 5% و10% من تكلفة التطوير الكلية، وهذا رقم مفيد عندما تتحدث مع الإدارة عن الميزانية.
كيف تختار الهدف Target لكل ممارسة؟
اسأل لكل ممارسة سؤالين: ما أسوأ ما يحدث إذا بقيت كما هي؟ وهل تعتمد عليها ممارسات أخرى؟ ففي مثالنا قررنا ما يلي:
- ارفع ما يجعل الأدوات مفيدة أولاً: إدارة العيوب من 0.25 إلى 1.0، وتقييم التهديدات من 0.13 إلى 0.75، لأن الشركة تحمل بيانات فواتير عملاء، وثغرة في عزل المستأجرين Tenant Isolation هي أخطر ما قد يحدث.
- ابدأ الحوكمة بخطوة صغيرة: صفحة واحدة لشهية المخاطر وبضعة مقاييس، وليس برنامج حوكمة كاملاً.
- اترك ما هو جيد بما يكفي: البناء والنشر 1.38 و1.25 يكفيان الآن، فلا تضع فيهما وقتاً هذه السنة.
- احترم الاعتماديات بين الأنشطة: لا تقم بمقاييس متقدمة للعيوب قبل أن توجد العيوب في مكان واحد، ولا تقم بنمذجة تهديدات لكل التطبيقات قبل أن تعرف أيها أخطر.
الخطة على أربع مراحل Phases
تقول خطوة الخطة في الدليل إن الخطة المعتادة من 4 إلى 6 مراحل، مدة كل مرحلة بين 3 و12 شهراً، وإن تبدأ بما ينجز بسرعة وبالتوعية والتدريب، وإن توزع الجهد بالتساوي وتحترم الاعتماديات. ولشركة صغيرة اخترنا أربع مراحل كل منها ربع سنة، والصورة التالية تبين الخطة:
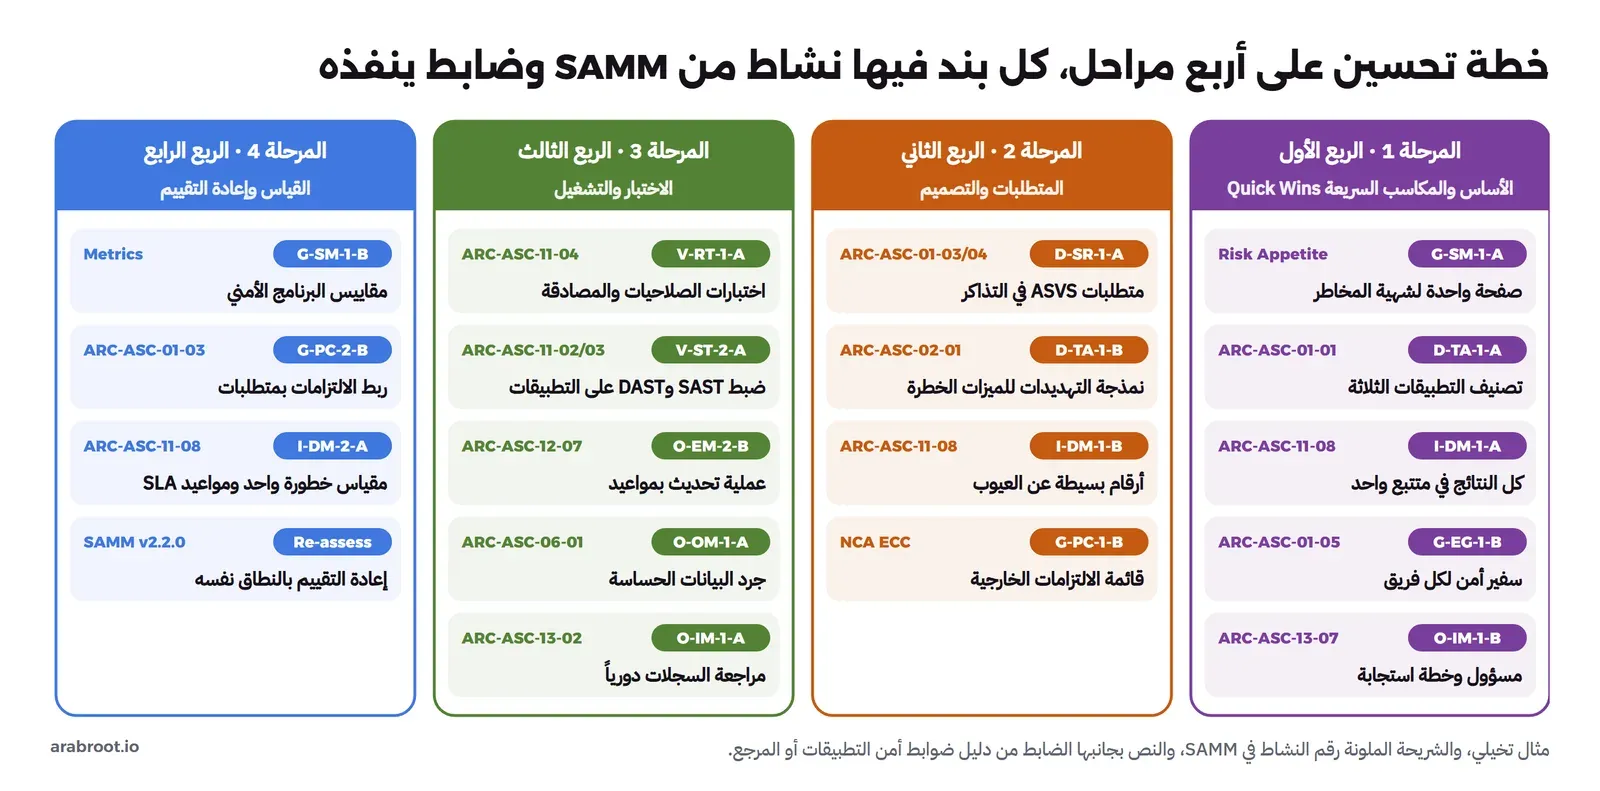
في الخطة أعلاه لاحظ التالي:
- المرحلة الأولى كلها مكاسب سريعة Quick Wins: لا يحتاج أي بند فيها أداة جديدة، وإنما قراراً وشخصاً وصفحة، ومع ذلك ترفع خمس ممارسات.
- كل بند له رمز نشاط: فعندما تعيد التقييم تعرف أي سؤال يجب أن تتغير إجابته، وإذا لم تتغير فالبند لم ينجز فعلاً.
- إعادة التقييم جزء من الخطة: وليست حدثاً منفصلاً، ونقترح أن تكون كل 6 إلى 12 شهراً بالنطاق نفسه والأسئلة نفسها، حتى تقارن الرقم بالرقم.
كيف يرتب SAMM أولوية ضوابط ARC-ASC؟
في دليل ضوابط أمن التطبيقات يقترح الدليل تسعين ضابطاً مرقماً في ثلاثة عشر نطاقاً، ولكل ضابط درجة Tier تحدد أقل أهمية للتطبيق يلزمه عندها، وفي مسار التبني يذكر الدليل أن SAMM يقيس العملية والدليل يقيس النتيجة. وعملياً فإن الدليل يقول لك «ما الذي يجب أن يكون صحيحاً في هذا التطبيق»، ولكن عندما يكون أمامك 56 ضابطاً للدرجة 1 وحدها فأنت تحتاج ترتيباً، وهنا يأتي SAMM: الممارسات الأضعف في التقييم تشير إلى النطاقات التي تبدأ بها. والجدول التالي يربط الممارسة بالمقال الذي يشرحها والضوابط التي تنفذها:
| الممارسة الضعيفة في التقييم | اقرأ | ضوابط ARC-ASC التي تبدأ بها |
|---|---|---|
| Threat Assessment | نمذجة التهديدات | 01-01 تصنيف التطبيق، و02-01 نمذجة التهديدات قبل البناء |
| Security Requirements | ASVS ومراجعة الكود | 01-02 مستوى ASVS، و01-03 وثيقة المتطلبات، و01-04 متطلبات قابلة للاختبار في التذاكر |
| Education and Guidance | سفير الأمن | 01-05 الأدوار والتدريب وسفراء الأمن |
| Defect Management | فرز النتائج Triage، ومقال إدارة الثغرات مع DefectDojo قادم في خارطة الطريق | 11-08 إدارة الثغرات المكتشفة والإفصاح عنها |
| Security Testing | SAST وDAST | 11-02 SAST، و11-03 DAST، و11-07 اختبار الاختراق |
| Requirements-driven Testing | أنواع الاختبارات | 11-04 اختبار التطبيق مقابل متطلباته، و02-06 حالات الإساءة |
| Secure Build | سلسلة التوريد | 09-02 SBOM، و09-03 فحص الاعتماديات، و10-03 حماية خط CI/CD |
| Secure Deployment | فحص الأسرار | 10-04 فحص الأسرار، و06-05 إدارة المفاتيح والأسرار، و10-07 فصل البيئات |
| Environment Management | تأمين خادم VPS، ومقال فحص ال Docker Images مع Trivy قادم | 12-07 التحديثات، و09-05 Docker Images مفحوصة، و11-05 مراجعة التحصين قبل الإطلاق |
| Incident Management | DFIR للمبتدئين وسجل التدقيق | 13-02 تسجيل الأحداث الأمنية، و13-06 سجل التدقيق، و13-07 الجاهزية للحوادث |
| Policy and Compliance | NCA ECC بلغة بسيطة | 01-03 وثيقة المتطلبات المعتمدة، و01-07 المراجعة الدورية |
| Operational Management | نطاق حماية البيانات | 06-01 جرد البيانات الحساسة، و06-06 بيانات الإنتاج خارج الإنتاج |
ولاحظ أن الربط في الاتجاهين: SAMM يقول لك أي النطاقات تبدأ بها، والدليل يعطيك جملة «يجب» قابلة للتحقق ودليلاً للمدقق، فعندما تجيب في التقييم القادم عن سؤال I-DM-1-A تستطيع أن تضع في الملاحظات رابط تقييم الضابط 11-08 في ملف Excel الخاص بالدليل، فيصبح الدليل واحداً للاثنين.
ماذا تقيس بين تقييمين؟ المقاييس Metrics
الدرجة نفسها تقاس مرة أو مرتين في السنة، وبينهما تحتاج أرقاماً قليلة تعرف منها أن الخطة تمشي، والممارسة Strategy and Metrics نفسها تطلب في المستوى 1 مقاييس سهلة الجمع ويعبر عنها بعدد أو نسبة. ومن الأمثلة المناسبة لمثالنا:
- نسبة بنود الخطة المنجزة في كل مرحلة، مع رمز النشاط لكل بند.
- عدد الثغرات المفتوحة من مستوى Critical وHigh، ومتوسط الزمن من الاكتشاف إلى الإصلاح، كما في خطة إدخال الفحوص على مراحل.
- نسبة الميزات الكبيرة التي مرت بجلسة نمذجة تهديدات.
- نسبة التطبيقات المصنفة ولها مستوى ASVS مكتوب.
ولا تقم بقياس عدد النتائج التي وجدتها الأدوات، والسبب أن هذا الرقم يرتفع كلما أضفت أداة أو قاعدة ولا يقول شيئاً عن نضج البرنامج.
قالب Template جاهز للنسخ
الجدول التالي يكفي لتبدأ قبل أن تفتح ملف Toolbox، فاكتب فيه الممارسات الضعيفة فقط، ولكل منها خطوة واحدة ومسؤول وتاريخ:
| الممارسة | الحالي | الهدف | الخطوة التالية (رمز النشاط) | المسؤول | الموعد |
|---|---|---|---|---|---|
| Threat Assessment | 0.13 | 0.75 | تصنيف التطبيقات الثلاثة بخمسة أسئلة (D-TA-1-A) | قائد التطوير | نهاية الربع الأول |
| Defect Management | 0.25 | 1.0 | كل النتائج في متتبع واحد بخطورة (I-DM-1-A) | سفير الأمن | نهاية الربع الأول |
| Incident Management | 0.38 | 0.75 | مسؤول مسمى وخطة استجابة في صفحة (O-IM-1-B) | مدير التقنية | نهاية الربع الأول |
| Security Requirements | 0.25 | 0.63 | متطلبات ASVS في تذاكر الميزات الحساسة (D-SR-1-A) | صاحب المنتج | نهاية الربع الثاني |
وهذه النسخة نفسها بصيغة CSV لتنسخها إلى أي جدول:
practice,current,target,next_action,samm_activity,owner,due
Threat Assessment,0.13,0.75,Classify the 3 applications with 5 questions,D-TA-1-A,Dev lead,Q1
Defect Management,0.25,1.0,All findings in one tracker with severity,I-DM-1-A,Security champion,Q1
Incident Management,0.38,0.75,Named owner and one-page response plan,O-IM-1-B,CTO,Q1
Security Requirements,0.25,0.63,ASVS requirements in tickets of sensitive features,D-SR-1-A,Product owner,Q2
أخطاء شائعة Common Mistakes
- معاملة التقييم كتدقيق Audit: إذا شعر الفريق أنه يمتحن فسوف يضخم الإجابات، والنموذج نفسه يقول إن المقابلة تعاون وليست تحقيقاً، فافصل بين التقييم للتحسين والتدقيق للامتثال.
- تحويله إلى قائمة تحقق: الإجابة عن 90 سؤالاً بنعم ولا دون قراءة معايير الجودة تعطيك رقماً لا معنى له، والقيمة في الإجابات الجزئية والملاحظات.
- تقييم كل شيء مرة واحدة: المؤسسة كلها في التقييم الأول تعني إجابات متوسطة تخفي الفروق بين الفرق، فابدأ بفريق واحد يمثل البقية.
- هدف المستوى 3 في كل مكان: الهدف يحدد بالمخاطر، ولشركة صغيرة قد يكون الهدف بعد سنة أقل من 1 في نصف الممارسات، وهذا صحيح.
- لا يوجد مالك: التقييم الذي لا يملكه شخص بالاسم ينتهي ملفاً في مجلد، فكل بند في الخطة له مسؤول وتاريخ.
- درجات بلا أدلة: إجابة دون رابط لدليل لا يمكن مراجعتها في التقييم القادم، ولا يمكن أن تعرف هل تغيرت فعلاً.
- تغيير النطاق أو الأسئلة بين تقييمين: إذا قيمت فريقاً في المرة الأولى والمؤسسة في الثانية، فلن تستطيع أن تقارن الرقمين أصلاً.
- كتابة الإجابات بيدك في الملف: كما رأينا، النص الذي ليس في القائمة يصبح صفراً دون أي رسالة خطأ.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- سؤال «هل نحن آمنون؟» لا إجابة له بنعم أو لا، والأدوات وحدها لا تصنع برنامجاً، ونموذج النضج يحول السؤال إلى «أين نحن، وما الخطوة التالية؟».
- OWASP SAMM v2 (آخر إصدار v2.2.0 في يوليو 2026، بترخيص CC BY-SA 4.0) فيه 5 وظائف و15 ممارسة و30 مساراً و90 نشاطاً، وكل نشاط سؤال في التقييم.
- SAMM يقيس البرنامج (المصنع) وASVS يقيس التطبيق (المنتج)، وBSIMM يصف ما تفعله الشركات، وDSOMM يفصل جزء DevSecOps.
- الإجابات 0 و0.25 و0.5 و1، ودرجة الممارسة مجموع متوسطات المسارين في المستويات الثلاثة (من 0 إلى 3)، ودرجة الوظيفة متوسط ممارساتها.
- التقييم الجيد نطاق صغير ثابت، ومقابلات قصيرة بالوظائف، وإجابات صادقة عليها أدلة، ثم أهداف بحسب المخاطر وخطة على مراحل، ثم إعادة التقييم بالطريقة نفسها.
- في مثالنا التخيلي حسب الملف الرسمي درجة كلية 0.51، والخطة لسنة ترفعها إلى 0.83 دون أي هدف قريب من المستوى 3.
- الممارسات الأضعف في SAMM تخبرك بأي نطاقات دليل ضوابط أمن التطبيقات تبدأ، والضوابط تعطيك المتطلب والدليل الذي يثبت أن النشاط حدث.
 دليلما هي OWASP؟ مشاريعها ووثائقها ومتى تستخدم كلاً منهامن يدير OWASP ولماذا كل ما تنشره مجاني، وأي مورد من مواردها تفتح في كل مرحلة من بناء تطبيقك.
 دليلOWASP ASVS ومراجعة الكود الأمنية لكل Pull Requestكيف تكتب متطلبات أمان يمكن اختبارها مع OWASP ASVS، وتراجع كل طلب دمج أمنياً في عشرين دقيقة بقائمة جاهزة.
 دليلDevSecOps للمبتدئين: الأمن داخل خط CI/CD ومتى يعمل كل فحصما الذي يجده كل فحص أمني في خط CI/CD وما الذي يفوته، وكيف ترتب نتائجه حتى تصل إلى قرار بدل قائمة طويلة.
 دليلضوابط أمن التطبيقات: دليل مقترح بنطاقات وضوابط مرقمة، مربوط بضوابط NCA وOWASP ASVSمقترح مستقل من عرب رووت بتسعين ضابطاً مرقماً لأمن تطبيقات الويب وواجهات API وخط CI/CD، لكل ضابط متطلب ودليل للمدقق، مربوط بالبنود التي يدعمها في ECC-2:2024 وCSCC وبأرقام OWASP ASVS 5.0، مع ملف Excel للتقييم الذاتي.
 دليلنمذجة التهديدات Threat Modeling للمبتدئينكيف تسأل ما الذي قد يسوء في تصميم تطبيقك قبل أن تكتب الكود، وتقرر لكل تهديد هل تصلحه أو تقبله، مع قالب جاهز للنسخ.
 دليلمصطلحات GRC للمبتدئين بمثال من شركة صغيرةما الذي يعنيه GRC فعلاً، وما الكلمات التي يستخدمها المدقق، وكيف تثبت له أن ضوابطك تعمل كما تقول.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، ومراجعة OWASP SAMM v2.2.0 من موقعه ومستودع owaspsamm/core وملفات YAML للنموذج، وتعبئة ملف SAMM_spreadsheet.xlsx الرسمي بإجابات شركة تخيلية وحساب الدرجات بمعادلاته داخل Container من python:3.12-slim (Python 3.12.15 وopenpyxl 3.1.5 وLibreOffice 25.2.3)، ومراجعة صفحات BSIMM16 وOWASP DSOMM وCMMI.