

في مقال الفرق بين NAS وSAN لخصنا أفكار ZFS في فقرة واحدة، ورأينا في تجربة Btrfs كيف يكتشف نظام الملفات الذي يحفظ مجموع تحقق Checksum لكل كتلة نسخة تالفة لا يراها RAID العادي، ثم وصلنا في مقال أنظمة NAS إلى أن TrueNAS مبني حول ZFS بالكامل. وبقي السؤال الذي يسأله كل من يبدأ مع ZFS: كيف أرتب الأقراص، وما معنى Pool وvdev وDataset، وأي إعداد أغيره وأي إعداد أتركه، وما الذي يحدث فعلاً عندما يتلف قرص؟ وهذا ما سوف نجيب عنه هنا بتجربة حقيقية على OpenZFS في Linux، نتلف فيها البيانات بأيدينا ونرى ZFS يصلحها.
وسوف نناقش في هذا المقال ما يلي:
- ال Pool وال vdev، ولماذا يضيع ال Pool كله إذا ضاع vdev واحد.
- Mirror وRAIDZ1/2/3، وتوسيع RAIDZ بقرص واحد كما أصبح ممكناً منذ OpenZFS 2.3.
- ال Dataset وال zvol، والخصائص التي تستحق التغيير: الضغط وrecordsize وatime.
- النسخ عند الكتابة Copy-on-Write، وال Snapshots وال Clones، والإرسال إلى قرص آخر بـ send وreceive.
- ذاكرة ARC وأقراص L2ARC وSLOG وspecial vdev: متى تفيد ومتى تكون مالاً ضائعاً.
- ذاكرة ECC وashift ونسبة الامتلاء والتشفير والرخصة.
- تجربة عملية على Ubuntu 26.04 مع OpenZFS 2.4.1 في جهاز افتراضي، بأقراص من ملفات.
لماذا يختلف ZFS عن RAID ونظام ملفات عادي؟
في الطريقة التقليدية تجد ثلاث طبقات منفصلة: مصفوفة RAID تجمع الأقراص، ثم مدير أقراص مثل LVM يقسمها، ثم نظام ملفات مثل ext4 فوقها، وكل طبقة لا تعرف شيئاً عن الأخرى، ولهذا رأينا في تجربة RAID 1 أن المصفوفة سلمت ملفاً تالفاً للبرنامج دون أي خطأ، والسبب أنها لا تعرف أي النسختين صحيحة. أما ZFS فيجمع الطبقات الثلاث في طبقة واحدة كما يصف توثيق OpenZFS، فهو الذي يرتب الأقراص، وهو الذي يكتب الملفات، وهو الذي يحفظ مجموع تحقق لكل كتلة في المؤشر إليها، وبالتالي عندما يقرأ كتلة لا يطابق مجموعها فإنه يعرف أنها التالفة، ويقرأ النسخة الأخرى، ويصلح التالفة. والمقال كله مبني على هذه الفكرة، وكل إعداد بعدها هو قرار في كيفية توزيع هذه الحماية.
ال Pool وال vdev: أين تكون الحماية فعلاً
ال Pool هو مساحة التخزين الكلية التي تنشئ فيها أنظمة الملفات، وهو يتكون من جهاز افتراضي vdev أو أكثر، وكل vdev إما قرص واحد، أو Mirror من قرصين أو أكثر، أو RAIDZ بتماثل واحد أو اثنين أو ثلاثة، أو dRAID. والقاعدة الأهم في ZFS كله أن الحماية تكون داخل كل vdev، وليس على مستوى ال Pool، لأن ZFS يوزع الكتابة على كل ال vdevs معاً ليزيد السرعة، وبالتالي كل ملف كبير له أجزاء على كل vdev. والصورة التالية تبين ذلك:
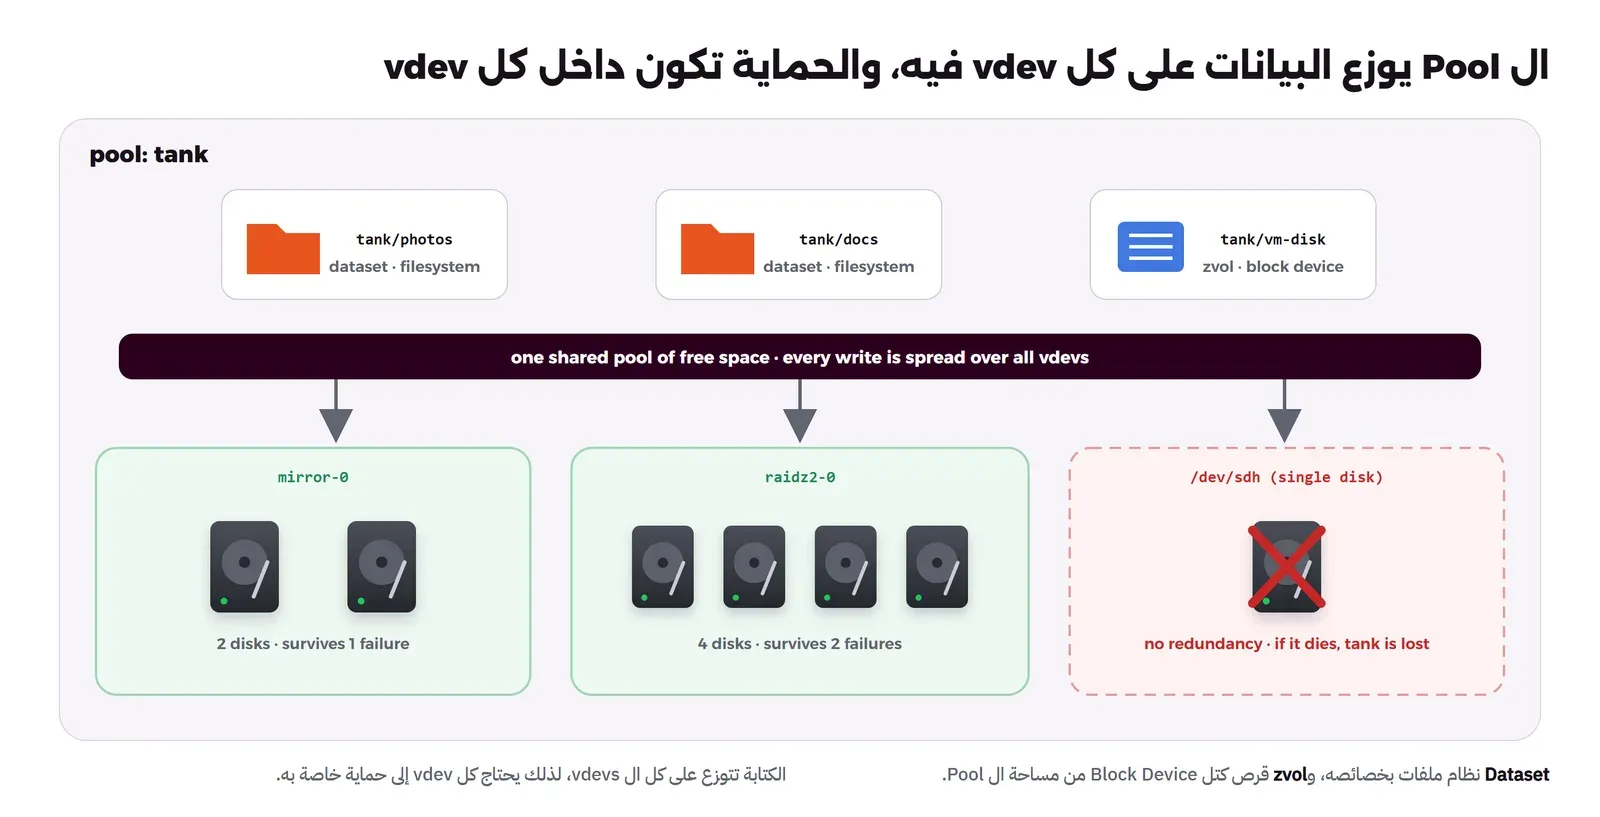
لنأخذ مثالاً: لديك Pool من vdev واحد RAIDZ2 بستة أقراص، وامتلأ، فقمت بالحل البسيط وأضفت قرصاً واحداً جديداً بالأمر zpool add. وهنا المشكلة، فهذا القرص أصبح vdev ثانياً بلا أي حماية، وبحسب صفحة مفاهيم ال Pool فإن ال Pool يصبح FAULTED عندما يتعطل vdev على المستوى الأعلى Top-level vdev ولا توجد نسخ كافية لإكماله، وهذا يعني أن عطل هذا القرص وحده يضيع ال Pool كله مع الأقراص الستة. والإجابة الصحيحة أن تخطط ال vdevs من البداية، وأن يكون كل vdev تضيفه بنفس مستوى الحماية، فإذا أردت أن تكبر Pool فيه Mirror تضيف Mirror آخر، وإذا كان فيه RAIDZ تضيف RAIDZ مثله، أو تستخدم التوسيع بقرص واحد الذي سوف نشرحه بعد قليل.
ولاحظ أن الأمر zpool add يرفض إضافة vdev بمستوى حماية مختلف إلا مع الخيار -f كما في صفحة zpool-add، فلا تقم بإضافة -f لأن الأمر رفض، والسبب أن الرفض هو التحذير الوحيد الذي سوف تراه قبل أن تربط ال Pool كله بقرص واحد.
Mirror أم RAIDZ؟ الترتيب حسب حاجتك
حساب السعة واحتمال أخطاء القراءة أثناء إعادة البناء شرحناهما بالأرقام في قسم RAID وقسم أخطاء القراءة، والجدول التالي يضعها في مصطلحات ZFS:
| الترتيب | المساحة المتاحة | يتحمل عطل | متى يناسبك |
|---|---|---|---|
| Mirror بقرصين | قرص واحد | قرص واحد | جهاز صغير بقرصين، أو أجهزة افتراضية وقواعد بيانات تحتاج قراءة وكتابة عشوائية سريعة، والتوسيع يكون بإضافة Mirror آخر |
| RAIDZ1 | كل الأقراص ناقص قرص | قرص واحد | أقراص صغيرة وعددها قليل، فإعادة البناء على أقراص كبيرة تقرأ كل شيء وأنت بلا حماية طوال الوقت |
| RAIDZ2 | كل الأقراص ناقص قرصين | قرصين | الخيار المعتاد لملفات البيت والمكتب على أقراص كبيرة |
| RAIDZ3 | كل الأقراص ناقص ثلاثة | ثلاثة أقراص | مجموعات كبيرة من أقراص ضخمة تطول إعادة بنائها |
وصفحة ضبط الأداء في OpenZFS تنصح بألا تضع أكثر من 16 قرصاً تقريباً في RAIDZ واحد، والسبب أن إعادة البناء Resilver على الأقراص الدوارة تطول جداً عندما يكون ال Pool ممتلئاً، فإذا كان لديك أقراص أكثر فقسمها إلى أكثر من vdev. أما dRAID فهو نوع من RAIDZ فيه أقراص احتياطية موزعة داخله تسرع إعادة البناء، وفكرته أن يوزع عمل إعادة البناء على كل الأقراص، فتظهر فائدته مع عدد كبير منها، ولن تحتاجه في جهاز بيت بأربعة أقراص.
توسيع RAIDZ بقرص واحد
إلى وقت قريب كانت أكبر نقطة ضعف في RAIDZ أنك لا تستطيع إضافة قرص واحد إلى مجموعة موجودة، فإما أن تضيف vdev كاملاً أو تنقل البيانات إلى Pool جديد. وفي الإصدار 2.3.0 الذي نشر في 14 يناير 2025 أضافت OpenZFS ميزة RAIDZ Expansion، فأصبح الأمر zpool attach يقبل اسم مجموعة RAIDZ ويضيف إليها قرصاً. والذي يحدث بحسب صفحة zpool-attach أن ZFS يقرأ كل البيانات من الأقراص القديمة ويعيد كتابتها موزعة على الأقراص كلها بما فيها الجديد، والحماية تبقى قائمة أثناء ذلك وبعده، ومستوى الحماية لا يتغير، فمجموعة RAIDZ2 تبقى تتحمل قرصين فقط. ولكن الكتل القديمة تحتفظ بنسبة البيانات إلى التماثل القديمة، والجديدة فقط تكتب بالنسبة الجديدة، كما في الصورة التالية:
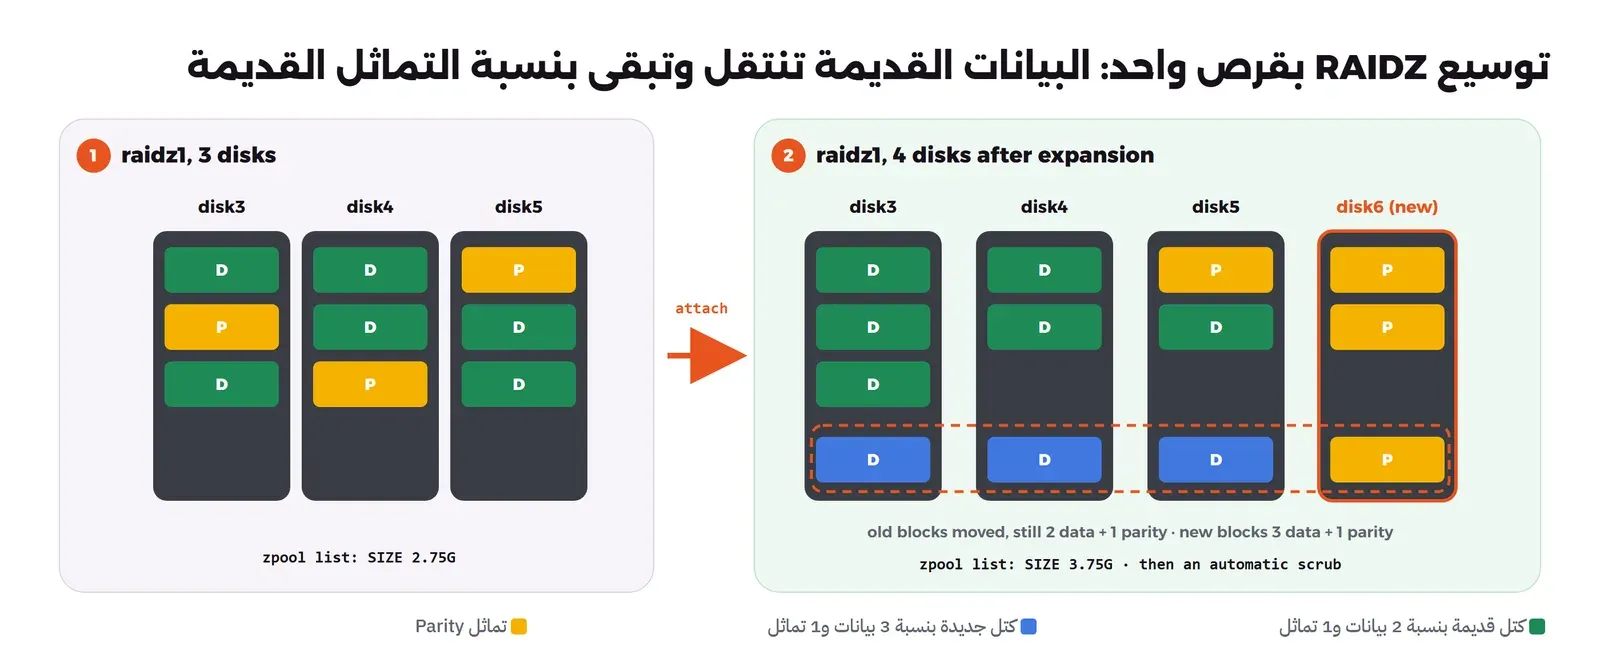
وهذا يعني أمرين تراهما في التجربة: الأول أن الصفحة نفسها تقول إن المساحة التي تعرضها أوامر مثل zfs list وdf سوف تكون أقل قليلاً من المتوقع، والسبب أن ZFS ما زال يحسب المساحة بالنسبة القديمة. والثاني أن ZFS يشغل Scrub على ال Pool كله بعد انتهاء التوسيع ليتحقق من كل الكتل التي نقلها. وإذا أردت أن تكتب البيانات القديمة بالنسبة الجديدة فإن OpenZFS 2.4 أضاف الأمر zfs rewrite الذي يعيد كتابة كتل الملفات في مكان جديد، ولكن الصفحة نفسها تنبه إلى أن إعادة كتابة كتل محفوظة في Snapshots تزيد المساحة المستخدمة، لأن ال Snapshot يحتفظ بالكتل القديمة.
ال Dataset وال zvol والخصائص
داخل ال Pool لا تنشئ أقساماً Partitions، وإنما تنشئ Datasets، وكل Dataset نظام ملفات يأخذ من المساحة المشتركة ما يحتاجه، وله خصائص Properties مثل الضغط والحصة Quota والتشفير، وكل Dataset يرث خصائص الأب ما لم تغيرها له. أما ال zvol فهو قرص كتل Block Device يأخذ مساحته من ال Pool نفسه ويظهر في Linux كجهاز تحت /dev/zvol، وتحتاجه عندما يريد البرنامج قرصاً وليس مجلداً، مثل قرص لجهاز افتراضي أو LUN في iSCSI، والفرق بين الوصول بالملفات والوصول بالكتل شرحناه في قسم الملفات والكتل. والقاعدة العملية: اجعل لكل نوع من البيانات Dataset خاصاً به، فالصور في Dataset، والمستندات في آخر، والنسخ الاحتياطية في ثالث، والسبب أن ال Snapshots والضغط والحصص والتشفير والنسخ إلى قرص آخر كلها تعمل على مستوى ال Dataset.
والخصائص التي تستحق أن تعرفها من البداية ثلاث، كما في صفحة الخصائص:
- الضغط Compression: القيمة الافتراضية
on، وهي تعني اليوم lz4 على أي Pool فيه ميزةlz4_compress، ويمكنك اختيار zstd بمستويات من 1 إلى 19 والافتراضي فيه zstd-3. وصفحة ضبط الأداء تقول إن lz4 يعالج البيانات التي لا تنضغط بسرعة كبيرة، وإن البيانات التي لا تنضغط تحفظ دون ضغط فلا تحتاج فك ضغط عند القراءة، لذلك لا تقم بإيقاف الضغط، والسبب أن الكتابة الأقل على القرص غالباً أسرع من وقت الضغط نفسه. وسوف نرى في التجربة نسباً حقيقية على كود Python وسجلات النظام وملفات مضغوطة أصلاً. - حجم السجل recordsize: هو أكبر حجم لكتلة الملف، والافتراضي 128K كما سوف ترى في مخرج التجربة. والصفحة نفسها تقول إنه مصمم لقواعد البيانات التي تقرأ وتكتب سجلات بحجم ثابت، وإن تغييره لأنظمة الملفات العامة لا ينصح به، وإنه يؤثر على الملفات الجديدة فقط. ومن أمثلة صفحة ضبط الأداء أن PostgreSQL يعمل جيداً مع 32K أو 64K أو الافتراضي، وأن ملفات InnoDB في MySQL تحتاج 16K لتتجنب الكتابة الجزئية المكلفة.
- وقت الوصول atime: الافتراضي
onمعrelatime=on، أي أن ZFS يحدث وقت آخر قراءة للملف ولكن ليس أكثر من مرة كل 24 ساعة، وصفحة ضبط الأداء تنصح بـrelatime=onأوatime=offلتقليل الكتابة الناتجة عن القراءة، وبعض الأنظمة مثل TrueNAS توقف atime على ال Pool من البداية.
النسخ عند الكتابة وال Snapshots
ZFS لا يكتب فوق الكتلة القديمة أبداً، وإنما يكتب النسخة الجديدة في مكان فارغ ثم يغير المؤشر إليها، وهذا ما يسمى النسخ عند الكتابة Copy-on-Write، وهو سبب أن انقطاع الكهرباء في منتصف الكتابة يترك النسخة القديمة سليمة. ومن هذه الفكرة نفسها يأتي ال Snapshot، فهو مؤشر ثان إلى الكتل نفسها في لحظة معينة، ولا ينسخ شيئاً عند إنشائه، كما في الصورة التالية:
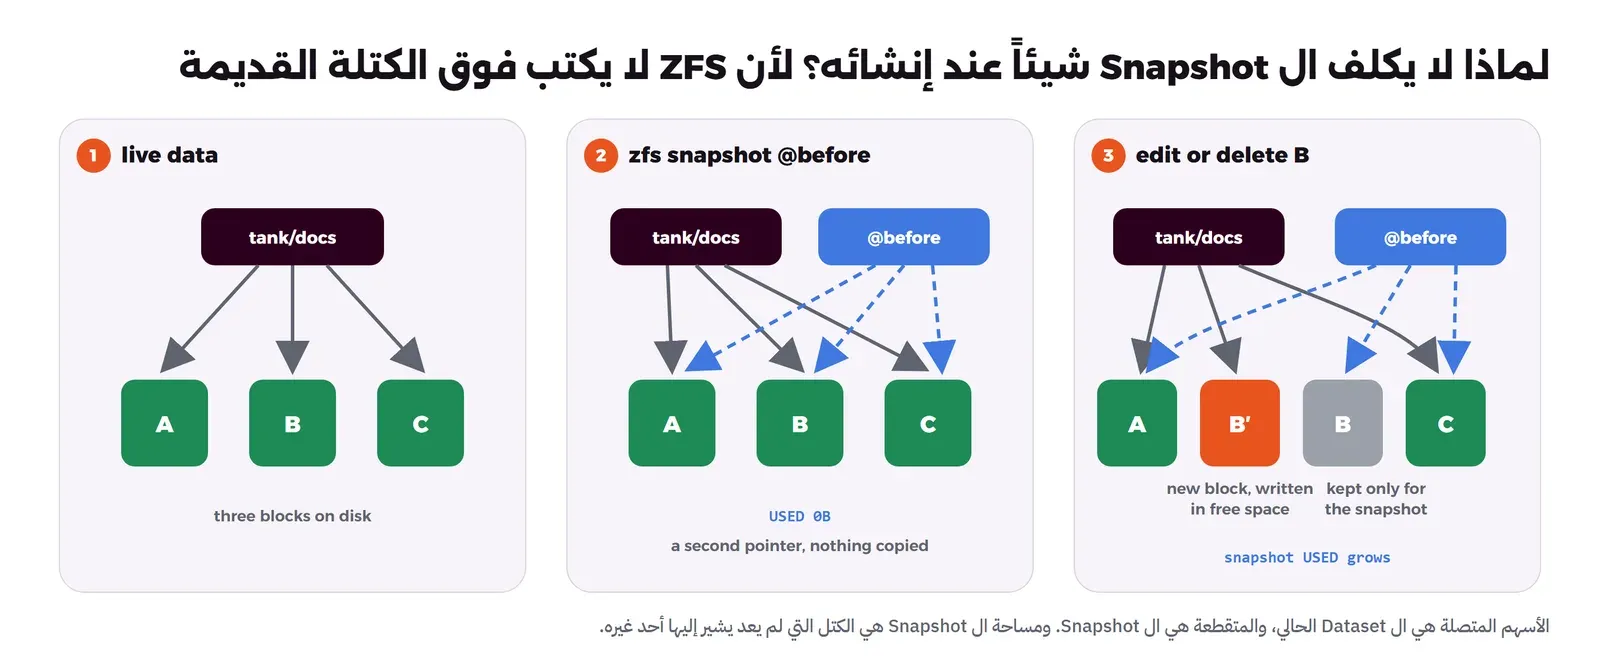
ومن هنا تفهم الأرقام التي سوف تراها في التجربة: ال Snapshot يبدأ بمساحة 0B، ثم تزيد مساحته كلما حذفت أو عدلت ملفات كانت موجودة لحظة إنشائه. ومن ال Snapshot تستطيع ثلاثة أشياء بحسب صفحات zfs-snapshot وzfs-rollback:
- قراءة أي ملف قديم من المجلد المخفي
.zfs/snapshotداخل ال Dataset ونسخه، وهذا أنسب طريقة لاستعادة ملف واحد. - إرجاع ال Dataset كله إلى لحظة ال Snapshot بالأمر
zfs rollback، وهذا يحذف كل تغيير بعده، ولا يرجع إلا إلى آخر Snapshot ما لم تضف-rالتي تحذف ال Snapshots الأحدث، لذلك فكر جيداً قبل أن تضيفها. - إنشاء Clone منه، وهو Dataset جديد قابل للكتابة يبدأ من محتوى ال Snapshot دون نسخ، ومفيد لتجربة تحديث على نسخة من البيانات، ولكنه يبقى معتمداً على ال Snapshot، فلا تستطيع حذف ال Snapshot ما دام ال Clone موجوداً.
مجموع التحقق والإصلاح الذاتي وال Scrub
فكرة مجموع التحقق والفرق بينه وبين RAID العادي رأيناها في تجربة Btrfs، والذي يهمنا هنا هو كيف تقرأ ما يقوله ZFS. فالأمر zpool status يعرض لكل قرص ثلاثة عدادات بحسب صفحته: READ لأخطاء القراءة التي أبلغ عنها القرص، وWRITE لأخطاء الكتابة، وCKSUM للكتل التي قرأها القرص دون خطأ ولكن مجموعها لا يطابق، أي التلف الصامت. والذي سوف تراه في التجربة أن ZFS يصلح الكتلة التالفة من النسخة السليمة ويزيد عداد CKSUM على القرص الذي أعطاها، ويكتب في أعلى المخرج أن جهازاً واجه خطأ وأن التطبيقات لم تتأثر، مع رابط إلى صفحة ZFS-8000-9P.
ولكن ZFS يصلح ما يقرأه فقط، وقد يتساءل البعض: ماذا عن ملف لم يفتحه أحد منذ سنة؟ والإجابة أن هذا دور ال Scrub، فهو يقرأ كل الكتل في ال Pool ويتحقق منها ويصلح ما يستطيع، ولذلك جدوله بشكل دوري. والتجربة سوف تبين أمراً أهم: إذا تلفت النسخة الوحيدة المتبقية فإن ZFS يكتشف التلف ولكنه لا يستطيع إصلاحه، فيرفض أن يعطيك البيانات التالفة ويضع اسم الملف في قائمة الأخطاء الدائمة، وهذا أفضل بكثير من ملف تالف لا تعرف أنه تالف، ولكنه يذكرك بأن مجموع التحقق يكتشف، والتكرار هو الذي يصلح.
النسخ المتماثل بـ send وreceive
الأمر zfs send يحول Snapshot إلى تيار من البيانات، والأمر zfs receive يحوله إلى Dataset في Pool آخر، على القرص نفسه أو على سيرفر آخر عبر ssh. والميزة الكبيرة في ذلك أن الإرسال الثاني لا يحتاج أن يقارن الملفات، وإنما يرسل الكتل التي تغيرت بين Snapshot وآخر فقط، كما في الصورة التالية:
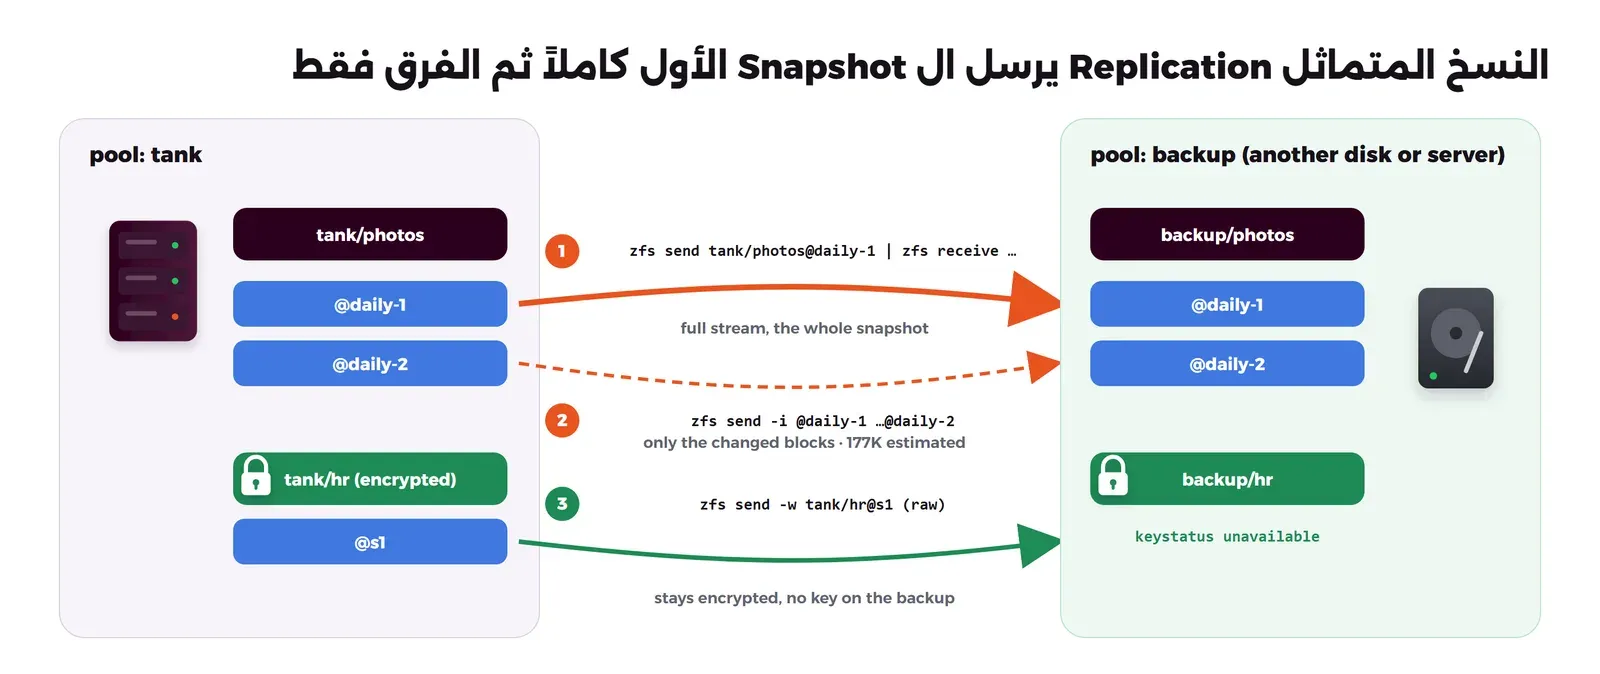
وفي صفحة zfs-send أن الخيار -w يرسل بيانات ال Dataset المشفر كما هي على القرص، فتستطيع أن تحفظ النسخة على جهاز لا تثق به لأنه لا يملك المفتاح ولا يستطيع قراءة البيانات أو تعديلها دون أن يكتشف ذلك. وهذه هي الأداة التي يبني عليها TrueNAS مهام النسخ المتماثل Replication، ولكن تذكر أن نسخة على قرص آخر في الجهاز نفسه لا تحسب نسخة خارج الموقع، فالحريق والسرقة يأخذان الاثنين معاً.
ذاكرة ARC وأقراص SSD المساعدة
معالج ال Pool Creation في TrueNAS يعرض لك خطوات Log وCache وMetadata وDedup، والحل البسيط أن تملأها كلها بأقراص SSD لأنها تبدو كأنها تسرع كل شيء، ولكن أغلب هذه الأقراص لا تفيد إلا في حالة معينة، وبعضها خطر إذا أخطأت فيه. والصورة التالية تبين أين يجلس كل واحد منها:
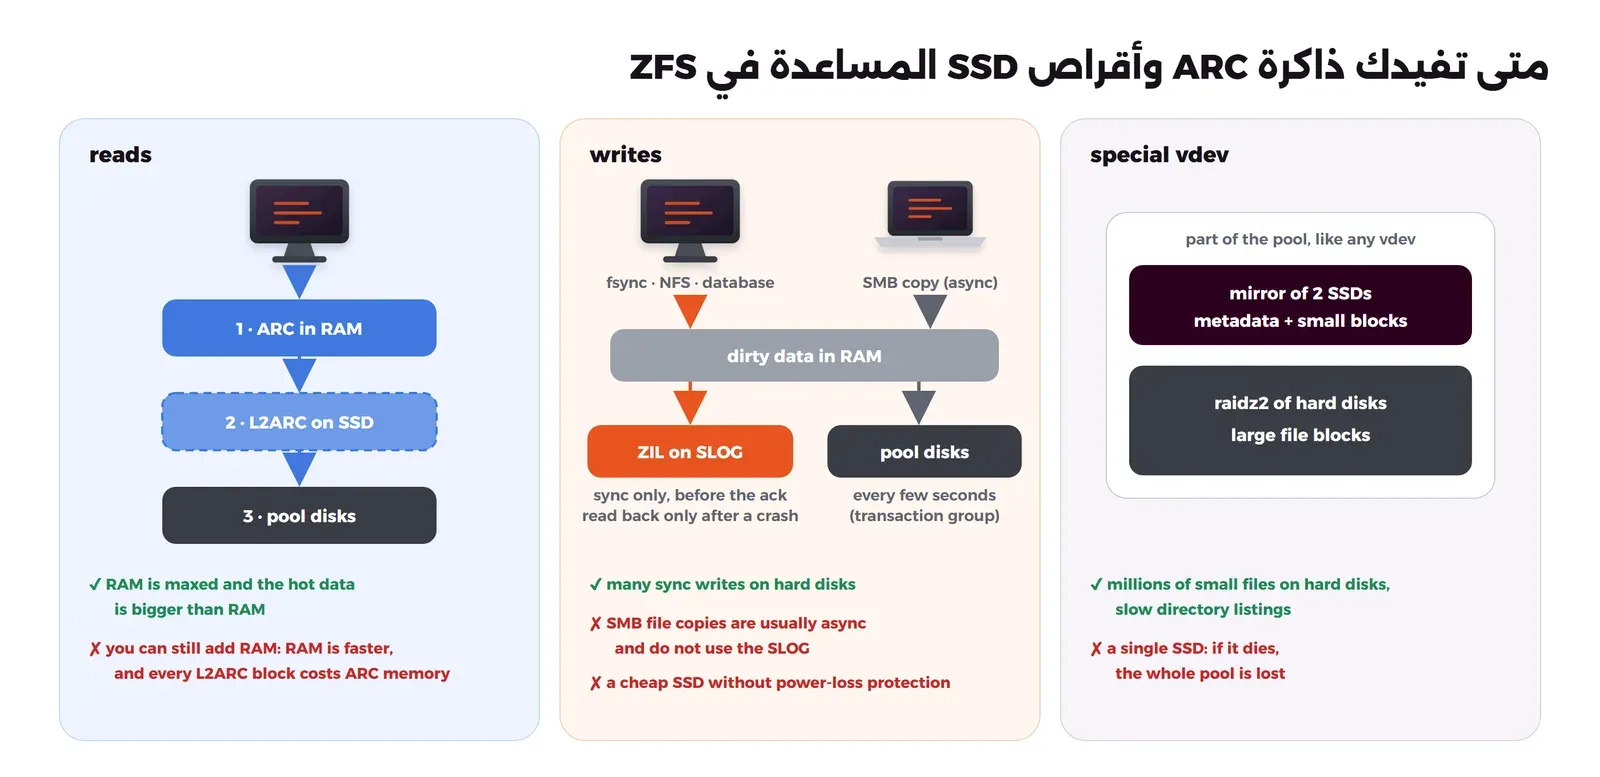
- ذاكرة ARC: هي ذاكرة القراءة المؤقتة لـ ZFS في ال RAM، وهي سبب أن ZFS يبدو كأنه يستهلك الذاكرة كلها، وهي في الحقيقة تتنازل عنها عندما تحتاجها البرامج. والحد الأعلى الافتراضي في Linux بحسب صفحة معاملات الوحدة هو الأكبر من بين ذاكرة الجهاز ناقص 1 جيجابايت و5/8 الذاكرة، وفي تجربتنا على جهاز بذاكرة 3.8 جيجابايت كان الحد 2.8 جيجابايت كما سوف ترى.
- L2ARC: قرص SSD يحمل ما يخرج من ARC، ودليل عتاد TrueNAS يقول إن ARC في الذاكرة أسرع دائماً، وإن كل كتلة في L2ARC تحتاج 96 بايتاً في ARC، فقرص L2ARC بحجم 480 جيجابايت ممتلئ بكتل 4KiB يحتاج أكثر من 10GiB من الذاكرة لفهرسه. لذلك أضف ذاكرة أولاً، ولا تفكر في L2ARC إلا إذا كانت الذاكرة في أقصاها.
- SLOG: سجل النية ZFS Intent Log واختصاراً ZIL موجود في كل Pool، ووظيفته حفظ الكتابة المتزامنة Synchronous قبل أن يؤكدها ZFS للبرنامج، وال SLOG قرص منفصل سريع يحمل هذا السجل. وصفحة ضبط الأداء تنصح به عندما يكون العمل فيه fsync أو O_SYNC وال Pool على أقراص دوارة، ودليل TrueNAS يذكر NFS وقواعد البيانات، ويقول إن حجمه يكفي لبضع ثوان من الكتابة، وإنه يحتاج حماية من انقطاع الكهرباء Power Loss Protection، والسبب أن وظيفته كلها أن يحفظ الكتابة عند الانقطاع. أما نسخ ملفات عبر SMB فهو في العادة كتابة غير متزامنة لا تمر على ال SLOG أصلاً.
- special vdev: يحمل البيانات الوصفية Metadata، واختيارياً الملفات الصغيرة، بحسب صفحة المفاهيم، فيسرع قوائم المجلدات وعمليات البحث في Pool على أقراص دوارة فيه ملايين الملفات الصغيرة. ولكنه جزء من ال Pool وليس ذاكرة مؤقتة، وصفحة Fusion Pools في TrueNAS تقول إنه إذا تعطل دون تكرار فإن ال Pool يتلف ولا تستطيع الوصول إلى بياناته، لذلك يكون Mirror على الأقل، وبمستوى حماية يساوي بقية ال Pool.
ذاكرة ECC وashift ونسبة الامتلاء
- ذاكرة ECC: شرحنا في مقال بناء NAS لماذا توصي بها OpenZFS وTrueNAS بقوة دون أن تكون شرطاً، والسبب باختصار أن مجموع التحقق يحسب بعد أن تصل البيانات إلى الذاكرة، فإذا انقلب بت قبل ذلك كتب إلى القرص بمجموع صحيح لبيانات خاطئة.
- ashift: هو أس حجم القطاع الذي يكتب به ZFS، فالقيمة 12 تعني 4096 بايتاً. وبحسب صفحة خصائص ال Pool فإن ZFS يكتشفها تلقائياً، ولكن بعض الأقراص قطاعها الحقيقي 4KiB وتبلغ النظام أنه 512 بايت، وفي هذه الحالة تحدد
ashift=12بنفسك، والصفحة نفسها تقول إن تغيير هذه القيمة لاحقاً لا يغير أي vdev موجود، لذلك حددها عند الإنشاء، وهذا ما فعلناه في التجربة. - نسبة الامتلاء: صفحة ضبط الأداء تقول أن تبقي أكثر من 10% من ال Pool فارغاً، والسبب أن ZFS عندما تقل المساحة الفارغة في أجزاء ال Pool عن 4% يتحول إلى طريقة بحث عن المساحة تستهلك المعالج وتبطئ الكتابة. أما واجهة TrueNAS فتلون مؤشر الاستخدام بالأحمر وتعرض تحذيراً فوق 80% كما في توثيق شاشة التخزين، وتنبه بعد ذلك عند 85% و90% و95% كما سوف نرى في تجربة TrueNAS. والقاعدة العملية: خطط لتشتري أقراصاً جديدة عند 80%، ولا تنتظر حتى 90%، لأن ال Snapshots تمنعك من استعادة المساحة بالحذف وحده.
التشفير
ZFS يشفر على مستوى ال Dataset، وتختار ذلك عند إنشائه، والقيمة encryption=on تعني اليوم aes-256-gcm كما في صفحة الخصائص، والمفتاح إما عبارة مرور Passphrase أو مفتاح خام. وبحسب صفحة zfs-load-key فإن ZFS يشفر محتوى الملفات وخصائصها وصلاحياتها وقوائم المجلدات، ولكنه لا يشفر أسماء ال Datasets وال Snapshots وخصائصها وأحجام الملفات، فلا تسم ال Dataset باسم يكشف ما فيه. والصفحة نفسها تقول إن الضغط يتم قبل التشفير فتبقى نسبة الضغط كما هي، وإن ال Scrub وإعادة البناء يعملان دون تحميل المفتاح، وهذا ما يجعل الإرسال الخام الذي رأيناه ممكناً.
لماذا لا يأتي ZFS داخل نواة Linux؟
OpenZFS منشور برخصة CDDL، والنواة برخصة GPL، وصفحة الرخصة في OpenZFS تقول إن الجمع بين الرخصتين يمنع خلط كود من الاثنين في ملف تنفيذي واحد، ولهذا لا يوزع OpenZFS جزءاً من النواة، ولكن لا يوجد في أي من الرخصتين ما يمنع توزيعه كوحدة منفصلة Kernel Module أو ككود مصدري. والنتيجة العملية أن كل توزيعة تتعامل معه بطريقتها: Ubuntu يأتي بالوحدة مبنية مع حزمة النواة كما سوف ترى في التجربة، فتثبت حزمة zfsutils-linux وتبدأ، أما Debian فيضعه في مستودع contrib ويبنيه على جهازك بـ DKMS كما في دليل Debian، وهذا يعني أن تحديث النواة قد يسبق تحديث ZFS، فتابع رسائل البناء بعد كل تحديث. أما TrueNAS فيأتي بنظام كامل يجمع النواة وZFS معاً، فلا تحتاج أن تهتم بذلك.
تجربة عملية: ZFS على Linux بأقراص من ملفات
الهدف من التجربة أن نرى كل ما سبق بأعيننا: نبني Pool بأقراص من ملفات، ونقيس الضغط على بيانات حقيقية، ونحذف ملفات ونستعيدها، ونتلف نسخة من البيانات بالأمر dd ونرى ZFS يكتشفها ويصلحها، ثم نوسع RAIDZ ونرسل البيانات إلى Pool آخر. والأقراص من ملفات تكفي للتعلم، ولكن لا تستخدمها لبيانات حقيقية.
تجهيز جهاز افتراضي فيه ZFS
رأينا في مقال NAS وSAN أن نواة Docker Desktop على Windows لا تحتوي على ZFS، لذلك شغلنا جهازاً افتراضياً بـ QEMU داخل Container بصلاحيات كاملة، لأن /dev/kvm متاح فيه على جهازنا. وإذا كان جهازك يعمل بـ Ubuntu فلا تحتاج هذا القسم، وانتقل مباشرة إلى تثبيت الحزمة. والأوامر التالية تنزل ملف قرص Ubuntu 26.04 الجاهز للسحابة Cloud Image، وتشغله بـ cloud-init ومفتاح ssh:
mkdir -p vm && cd vm
curl -L -o ubuntu-26.04.img https://cloud-images.ubuntu.com/releases/resolute/release/ubuntu-26.04-server-cloudimg-amd64.img
docker run -d --name lab-zfs-qemu --privileged -v "$PWD:/vm" debian:13 sleep infinity
docker exec lab-zfs-qemu sh -c 'apt-get update -qq && apt-get install -y -qq qemu-system-x86 qemu-utils genisoimage openssh-client >/dev/null 2>&1'
docker exec -i lab-zfs-qemu bash <<'EOF'
mkdir -p /work && cd /work
ssh-keygen -q -t ed25519 -N '' -f /work/id_lab
cat > user-data <<UD
#cloud-config
hostname: lab-zfs
users:
  - name: lab
    sudo: ALL=(ALL) NOPASSWD:ALL
    shell: /bin/bash
    ssh_authorized_keys:
      - $(cat /work/id_lab.pub)
UD
printf 'instance-id: lab-zfs-1\nlocal-hostname: lab-zfs\n' > meta-data
genisoimage -quiet -output /vm/lab-zfs-seed.iso -volid cidata -joliet -rock user-data meta-data
qemu-img create -q -f qcow2 -F qcow2 -b /vm/ubuntu-26.04.img /vm/lab-zfs-root.qcow2 20G
nohup qemu-system-x86_64 -enable-kvm -cpu host -smp 4 -m 4096 -nographic \
  -drive file=/vm/lab-zfs-root.qcow2,if=virtio -drive file=/vm/lab-zfs-seed.iso,if=virtio,media=cdrom \
  -netdev user,id=n0,hostfwd=tcp:127.0.0.1:2222-:22 -device virtio-net-pci,netdev=n0 > /work/console.log 2>&1 &
EOF
في الإعداد أعلاه لاحظ التالي:
- القرص
lab-zfs-root.qcow2طبقة فوق ملف Ubuntu الأصلي، فلا يتغير الملف الأصلي، وتحذف الطبقة في النهاية. - منفذ ssh للجهاز الافتراضي مربوط على
127.0.0.1داخل ال Container فقط، فلا يصل إليه أي جهاز آخر في الشبكة.
بعد دقيقة تقريباً ندخل بـ ssh ونتأكد من النواة ومن وحدة ZFS:
docker exec -it lab-zfs-qemu ssh -i /work/id_lab -p 2222 [email protected]
uname -r; head -1 /etc/os-release; modinfo zfs | grep -E '^version|^filename'
والمخرج سوف يكون كما يلي:
7.0.0-34-generic
PRETTY_NAME="Ubuntu 26.04.1 LTS"
filename:       /lib/modules/7.0.0-34-generic/ubuntu/dkms/zfs/zfs.ko.zst
version:        2.4.1-1ubuntu5.1
لاحظ أن الوحدة موجودة قبل أن نثبت أي شيء، فهي جزء من حزمة النواة في Ubuntu، وما ينقص هو أدوات سطر الأوامر فقط. ومن الآن كل الأوامر داخل الجهاز الافتراضي وبصلاحيات root:
sudo -i
apt-get update -qq && apt-get install -y -qq zfsutils-linux
أول Pool من قرصين بشكل Mirror
ننشئ سبعة ملفات بحجم 1 جيجابايت لكل منها، ثم Pool باسم tank من أول ملفين بشكل Mirror، ونحدد ashift=12 بأنفسنا كما ذكرنا:
zfs version
mkdir -p /lab
for i in 1 2 3 4 5 6 7; do truncate -s 1G /lab/disk$i.img; done
zpool create -o ashift=12 tank mirror /lab/disk1.img /lab/disk2.img
zpool status tank
zpool list tank
zfs get -o property,value,source compression,recordsize,atime,relatime tank
والمخرج سوف يكون كما يلي:
zfs-2.4.1-1ubuntu5.1
zfs-kmod-2.4.1-1ubuntu5.1
  pool: tank
 state: ONLINE
config:

	NAME                STATE     READ WRITE CKSUM
	tank                ONLINE       0     0     0
	  mirror-0          ONLINE       0     0     0
	    /lab/disk1.img  ONLINE       0     0     0
	    /lab/disk2.img  ONLINE       0     0     0

errors: No known data errors
NAME   SIZE  ALLOC   FREE  CKPOINT  EXPANDSZ   FRAG    CAP  DEDUP    HEALTH  ALTROOT
tank   960M   332K   960M        -         -     2%     0%  1.00x    ONLINE  -
PROPERTY     VALUE           SOURCE
compression  on              default
recordsize   128K            default
atime        on              default
relatime     on              default
في المخرج أعلاه لاحظ التالي:
- ال Pool من قرصين بحجم 1 جيجابايت مساحته 960M فقط، لأن ال Mirror يكتب كل كتلة مرتين، وجزء صغير يذهب للبيانات الوصفية.
- العمود CKSUM صفر على القرصين، وسوف نعود إليه بعد قليل.
- الضغط
onوrecordsize بحجم128Kوatime مع relatime كلها قيم افتراضية، أي أننا لم نغير شيئاً بعد.
الضغط على بيانات حقيقية
نختار ثلاثة أنواع من البيانات من النظام نفسه: كود مكتبة Python القياسية في /usr/lib/python3.14 وحجمه 27 ميجابايت، وسجل النظام بصيغة JSON وحجمه 3.5 ميجابايت، و979 ملفاً مضغوطاً أصلاً بـ gzip من /usr/share/doc حجمها 8.4 ميجابايت. ثم ننسخ كل نوع إلى ثلاثة Datasets: دون ضغط، وبـ lz4، وبـ zstd:
journalctl -o json --no-pager > /root/journal.json
mkdir -p /root/gz && find /usr/share/doc -type f -name '*.gz' -exec cp --parents {} /root/gz \;
for c in off lz4 zstd; do
  zfs create -o compression=$c tank/code-$c && cp -a /usr/lib/python3.14 /tank/code-$c/
  zfs create -o compression=$c tank/logs-$c && cp /root/journal.json /tank/logs-$c/
  zfs create -o compression=$c tank/gz-$c && cp -a /root/gz /tank/gz-$c/
done
zpool sync tank
zfs list -o name,used,logicalused,compressratio -r tank | grep -E 'NAME|code|logs|gz'
والمخرج سوف يكون كما يلي:
NAME             USED  LUSED  RATIO
tank/code-lz4   17.6M  29.9M  1.88x
tank/code-off   33.0M  29.9M  1.00x
tank/code-zstd  13.9M  29.9M  2.44x
tank/gz-lz4     11.3M  9.48M  1.06x
tank/gz-off     11.8M  9.48M  1.00x
tank/gz-zstd    11.3M  9.48M  1.06x
tank/logs-lz4   1.05M  3.55M  3.56x
tank/logs-off   3.60M  3.55M  1.00x
tank/logs-zstd   692K  3.55M  5.72x
في المخرج أعلاه لاحظ التالي:
- العمود LUSED هو حجم البيانات قبل الضغط، والعمود USED هو ما أخذته فعلاً من ال Pool، فالكود أخذ 17.6M بدل 29.9M مع lz4، و13.9M مع zstd.
- السجلات نص متكرر، لذلك انضغطت 3.56 مرة مع lz4 و5.72 مرة مع zstd، وهذا يعني أن Dataset للسجلات يستحق zstd.
- الملفات المضغوطة أصلاً لم تستفد تقريباً، ولكنها لم تخسر شيئاً، وهذا ما تقوله صفحة ضبط الأداء عن البيانات التي لا تنضغط.
- مع
compression=offكانت USED أكبر من LUSED، فالكود أخذ 33.0M لبيانات حجمها 29.9M، والسبب أن آخر كتلة في كل ملف صغير تأخذ قطاعاً كاملاً بحجم 4K معashift=12، والضغط يوفر هذا الفراغ أيضاً.
هذه الأرقام للتوضيح على هذا الجهاز وهذه البيانات، ونسبتك سوف تختلف بحسب ما تحفظه، فالصور والفيديو مضغوطة أصلاً مثل ملفات gz، والمستندات وقواعد البيانات والسجلات تنضغط جيداً.
حذف ملفات واستعادتها من Snapshot
نأخذ Snapshot من ال Dataset الذي فيه الكود، ثم نحذف ثلاثة مجلدات كأننا أخطأنا، ثم نستعيد ملفاً واحداً من المجلد المخفي، ثم نرجع ال Dataset كله:
cd /tank/code-lz4/python3.14
ls | wc -l
sha256sum json/__init__.py
zfs snapshot tank/code-lz4@before-cleanup
zfs list -t snapshot -o name,used,refer
rm -rf json email asyncio
zpool sync tank
ls | wc -l
zfs list -t snapshot -o name,used,refer
zfs list -o name,used,usedbysnapshots,usedbydataset tank/code-lz4
ls /tank/code-lz4/.zfs/snapshot/before-cleanup/python3.14/json/
cp /tank/code-lz4/.zfs/snapshot/before-cleanup/python3.14/json/__init__.py /root/
sha256sum /root/__init__.py
cd /
zfs rollback tank/code-lz4@before-cleanup
ls /tank/code-lz4/python3.14 | wc -l
sha256sum /tank/code-lz4/python3.14/json/__init__.py
والمخرج سوف يكون كما يلي:
197
95022d150a27a2bfd54ac21bfce35812c96b53c420bb7b018dcb573f13e52da0  json/__init__.py
NAME                           USED  REFER
tank/code-lz4@before-cleanup     0B  17.6M
194
NAME                           USED  REFER
tank/code-lz4@before-cleanup  1.56M  17.6M
NAME            USED  USEDSNAP  USEDDS
tank/code-lz4  17.8M     1.56M   16.2M
__init__.py
__main__.py
__pycache__
decoder.py
encoder.py
scanner.py
tool.py
95022d150a27a2bfd54ac21bfce35812c96b53c420bb7b018dcb573f13e52da0  /root/__init__.py
197
95022d150a27a2bfd54ac21bfce35812c96b53c420bb7b018dcb573f13e52da0  /tank/code-lz4/python3.14/json/__init__.py
في المخرج أعلاه لاحظ التالي:
- ال Snapshot بدأ بمساحة 0B كما في الصورة الثانية، وبعد الحذف أصبحت 1.56M، وهي حجم المجلدات الثلاثة التي لم يعد يشير إليها غير ال Snapshot، ولهذا تظهر في العمود USEDSNAP.
- المجلد
.zfs/snapshotلا يظهر فيls -aولكنه موجود، ونسخنا منه الملف فطابق ال Hash الأصلي95022d…. - بعد
zfs rollbackرجع عدد العناصر إلى 197، والملف نفسه بال Hash نفسه، ولاحظ أننا خرجنا من المجلد قبل الإرجاع حتى لا يبقى ال Shell داخل مجلد يتغير تحته.
ولاحظ أن الأمر zpool sync بعد الحذف ليس للزينة، فبدونه قد تبقى مساحة ال Snapshot 0B لثوان، والسبب أن ZFS يجمع التغييرات في الذاكرة ويكتبها كل بضع ثوان في مجموعة واحدة Transaction Group، وقد رأينا ذلك في المحاولة الأولى.
إتلاف نسخة من البيانات وإصلاحها بال Scrub
نكرر الآن تجربة مقال NAS وSAN على ZFS نفسه: ملف فيه مليونا سطر، ثم نغير 26 بايتاً في السطر رقم مليون على القرص الثاني وحده مباشرة، أي من تحت ZFS. ونوقف الضغط على هذا ال Dataset حتى نجد السطر بنصه داخل ملف القرص، ونجعل ذاكرة ARC تحفظ البيانات الوصفية فقط بـ primarycache=metadata حتى تأتي القراءة من القرص وليس من الذاكرة:
zfs create -o compression=off -o primarycache=metadata tank/photos
awk 'BEGIN{for(i=1;i<=2000000;i++) printf "family-photo-line-%08d\n", i}' > /tank/photos/photos.txt
zpool sync tank
sha256sum /tank/photos/photos.txt
OFF=$(grep -obUaF 'family-photo-line-01000000' /lab/disk2.img | head -1 | cut -d: -f1)
echo "corrupting disk2.img at byte $OFF"
printf 'family-photo-line-0100XXXX' | dd of=/lab/disk2.img bs=1 seek=$OFF conv=notrunc,fsync status=none
for i in 1 2 3; do sha256sum /tank/photos/photos.txt; done
zpool status tank | sed -n '/NAME/,$p'
zpool scrub -w tank
zpool status tank
echo "bad copies left on disk2: $(grep -c 'family-photo-line-0100XXXX' /lab/disk2.img)"
والمخرج سوف يكون كما يلي:
2035fd4b5755103c9085e34558e810c596b8f2125811565224e68a102a6b722b  /tank/photos/photos.txt
corrupting disk2.img at byte 248835237
2035fd4b5755103c9085e34558e810c596b8f2125811565224e68a102a6b722b  /tank/photos/photos.txt
2035fd4b5755103c9085e34558e810c596b8f2125811565224e68a102a6b722b  /tank/photos/photos.txt
2035fd4b5755103c9085e34558e810c596b8f2125811565224e68a102a6b722b  /tank/photos/photos.txt
	NAME                STATE     READ WRITE CKSUM
	tank                ONLINE       0     0     0
	  mirror-0          ONLINE       0     0     0
	    /lab/disk1.img  ONLINE       0     0     0
	    /lab/disk2.img  ONLINE       0     0     0

errors: No known data errors
  pool: tank
 state: ONLINE
status: One or more devices has experienced an unrecoverable error.  An
	attempt was made to correct the error.  Applications are unaffected.
action: Determine if the device needs to be replaced, and clear the errors
	using 'zpool clear' or replace the device with 'zpool replace'.
   see: https://openzfs.github.io/openzfs-docs/msg/ZFS-8000-9P
  scan: scrub repaired 128K in 00:00:01 with 0 errors on Fri Oct  9 20:50:45 2026
config:

	NAME                STATE     READ WRITE CKSUM
	tank                ONLINE       0     0     0
	  mirror-0          ONLINE       0     0     0
	    /lab/disk1.img  ONLINE       0     0     0
	    /lab/disk2.img  ONLINE       0     0     1

errors: No known data errors
bad copies left on disk2: 0
في المخرج أعلاه لاحظ التالي:
- القراءات الثلاث أعطت ال Hash الأصلي
2035…، وهو نفس ال Hash الذي رأيناه في مقال NAS وSAN لأن الملف نفسه، ولكن عداد CKSUM بقي صفراً، والسبب أن ZFS اختار أن يقرأ هذه الكتلة من القرص الأول في كل مرة، فلم يمر على النسخة التالفة أصلاً. - وهذا بالضبط سبب ال Scrub، فقد قرأ النسختين، ووجد أن مجموع الكتلة على القرص الثاني لا يطابق، وكتب فوقها النسخة السليمة، فأصبح السطر
scrub repaired 128K، وهي كتلة واحدة بحجم recordsize، وأصبح CKSUM يساوي 1 على disk2 وحده. - العبارة
Applications are unaffectedصحيحة، فالبرنامج لم يستلم البيانات التالفة أبداً، وفي الأسطر الأخيرة اختفى0100XXXXمن ملف القرص. - العداد يبقى حتى تمسحه بـ
zpool clear، وفي جهاز حقيقي هذا وقت قراءة SMART للقرص ومراقبته، فقرص يعطي أخطاء مجموع تحقق متكررة يقترب من نهايته أو كابله أو منفذه فيه مشكلة.
ماذا لو تلفت النسخة الوحيدة؟
الآن نكسر الإعداد عمداً: نتلف سطراً آخر على القرص الأول، ثم نفصل القرص الثاني بـ zpool offline كأنه تعطل، فلا تبقى إلا النسخة التالفة. ونصدر ال Pool ونستورده لنتأكد أن القراءة من القرص وليس من الذاكرة:
zpool clear tank
OFF=$(grep -obUaF 'family-photo-line-01500000' /lab/disk1.img | head -1 | cut -d: -f1)
echo "corrupting disk1.img at byte $OFF"
printf 'family-photo-line-0150XXXX' | dd of=/lab/disk1.img bs=1 seek=$OFF conv=notrunc,fsync status=none
zpool offline tank /lab/disk2.img
zpool export tank && zpool import -d /lab tank
sha256sum /tank/photos/photos.txt
zpool status -v tank | sed -n '/NAME/,$p'
والمخرج سوف يكون كما يلي:
corrupting disk1.img at byte 347077381
sha256sum: failed to read input: Input/output error
	NAME                STATE     READ WRITE CKSUM
	tank                DEGRADED     0     0     0
	  mirror-0          DEGRADED     0     0     0
	    /lab/disk1.img  ONLINE       0     0     2
	    /lab/disk2.img  OFFLINE      0     0     0

errors: Permanent errors have been detected in the following files:

        /tank/photos/photos.txt
هذه أهم نتيجة في المقال: ZFS رفض أن يعطي البرنامج الكتلة التالفة، فظهر خطأ Input/output error بدل ملف فيه 0150XXXX دون أن تشعر، ووضع اسم الملف في قائمة الأخطاء الدائمة. ونعيد القرص الثاني الآن ونقرأ الملف مرة أخرى:
zpool online tank /lab/disk2.img
zpool wait -t resilver tank
sha256sum /tank/photos/photos.txt
echo "bad copies left on disk1: $(grep -c 'family-photo-line-0150XXXX' /lab/disk1.img)"
zpool status -v tank | sed -n '/scan/,$p'
والمخرج سوف يكون كما يلي:
2035fd4b5755103c9085e34558e810c596b8f2125811565224e68a102a6b722b  /tank/photos/photos.txt
bad copies left on disk1: 0
  scan: resilvered 216K in 00:00:00 with 0 errors on Fri Oct  9 20:53:03 2026
config:

	NAME                STATE     READ WRITE CKSUM
	tank                ONLINE       0     0     0
	  mirror-0          ONLINE       0     0     0
	    /lab/disk1.img  ONLINE       0     0     2
	    /lab/disk2.img  ONLINE       0     0     0

errors: No known data errors
في المخرج أعلاه لاحظ التالي:
- عند إعادة القرص الثاني نسخ ZFS إليه 216K فقط، وهي ما تغير أثناء غيابه، ولم يعد بناء القرص كله، لأنه يعرف من سجله ما فاته.
- بعدها قرأنا الملف فعاد ال Hash إلى
2035…، لأن النسخة السليمة على القرص الثاني أصبحت متاحة، واختفت القائمة الدائمة، ولم يبق0150XXXXعلى القرص الأول، أي أن ZFS كتب النسخة السليمة فوق التالفة. والعداد 2 على القرص الأول بقي من محاولة القراءة السابقة حتى نمسحه. - الدرس: مجموع التحقق يكتشف التلف، والتكرار هو الذي يصلحه، فلا تشغل Pool دون تكرار لبيانات مهمة، ولا تترك Pool في حالة DEGRADED أياماً.
توسيع RAIDZ1 من ثلاثة أقراص إلى أربعة
ننشئ Pool ثانياً باسم media بشكل RAIDZ1 من ثلاثة ملفات، ونملؤه بـ 600 ميجابايت من بيانات عشوائية، ثم نضيف قرصاً رابعاً بـ zpool attach:
zpool create -o ashift=12 media raidz1 /lab/disk3.img /lab/disk4.img /lab/disk5.img
dd if=/dev/urandom of=/media/videos.bin bs=1M count=600 status=none
zpool list -o name,size,alloc,free media
zfs list -o name,used,avail media
zpool attach -w media raidz1-0 /lab/disk6.img
zpool wait -t scrub media
zpool status media
zpool list -o name,size,alloc,free media
zfs list -o name,used,avail media
والمخرج سوف يكون كما يلي:
NAME    SIZE  ALLOC   FREE
media  2.75G   831M  1.94G
NAME    USED  AVAIL
media   553M  1.17G
  pool: media
 state: ONLINE
  scan: scrub repaired 0B in 00:00:02 with 0 errors on Fri Oct  9 20:53:51 2026
expand: expanded raidz1-0 copied 888M in 00:00:15, on Fri Oct  9 20:53:49 2026
config:

	NAME                STATE     READ WRITE CKSUM
	media               ONLINE       0     0     0
	  raidz1-0          ONLINE       0     0     0
	    /lab/disk3.img  ONLINE       0     0     0
	    /lab/disk4.img  ONLINE       0     0     0
	    /lab/disk5.img  ONLINE       0     0     0
	    /lab/disk6.img  ONLINE       0     0     0

errors: No known data errors
NAME    SIZE  ALLOC   FREE
media  3.75G   902M  2.87G
NAME    USED  AVAIL
media   601M  1.79G
في المخرج أعلاه لاحظ التالي:
- السطر
expand: expanded raidz1-0 copied 888Mهو إعادة كتابة كل البيانات الموجودة على الأقراص الأربعة، وبعده مباشرة سطرscan: scrub repaired 0B، وهو ال Scrub التلقائي الذي تذكره صفحة zpool-attach. - حجم ال Pool الخام ارتفع من 2.75G إلى 3.75G، أي قرص كامل، لأن
zpool listيعرض المساحة الخام قبل التماثل. - أما المساحة المتاحة في
zfs listفارتفعت من 1.17G إلى 1.79G فقط، أي أقل من المتوقع لأربعة أقراص بتماثل واحد، وهذا ما تقوله الصفحة عن الحساب بالنسبة القديمة، فلا تفاجأ بالرقم بعد التوسيع. - الأرقام قبل التوسيع أخذت قبل أن تكتمل الكتابة، لذلك ALLOC فيها 831M وبعدها 902M، والفرق ليس من التوسيع.
الإرسال إلى Pool آخر بالكامل ثم بالفرق
ننشئ Pool ثالثاً باسم backup على الملف السابع، ثم نرسل Snapshot أول كاملاً، ونضيف سطراً إلى الملف، ونرسل الفرق فقط:
zpool create -o ashift=12 backup /lab/disk7.img
zfs snapshot tank/photos@daily-1
zfs send tank/photos@daily-1 | zfs receive backup/photos
echo "family-photo-line-02000001" >> /tank/photos/photos.txt
zfs snapshot tank/photos@daily-2
zfs send -nv -i @daily-1 tank/photos@daily-2
zfs send -i @daily-1 tank/photos@daily-2 | zfs receive backup/photos
zfs list -t all -o name,used,refer -r backup
tail -1 /backup/photos/photos.txt
zfs get -o name,property,value compression,compressratio tank/photos backup/photos
والمخرج سوف يكون كما يلي:
send from tank/photos@daily-1 to tank/photos@daily-2 estimated size is 177K
total estimated size is 177K
NAME                    USED  REFER
backup                 11.9M    96K
backup/photos          11.5M  11.4M
backup/photos@daily-1   120K  11.4M
backup/photos@daily-2     0B  11.4M
family-photo-line-02000001
NAME           PROPERTY       VALUE
backup/photos  compression    on
backup/photos  compressratio  4.53x
tank/photos    compression    off
tank/photos    compressratio  1.00x
في المخرج أعلاه لاحظ التالي:
- الخيار
-nvيحسب حجم الإرسال دون أن يرسل، والفرق بين اليومين 177K فقط مع أن الملف أكثر من 50 ميجابايت، والسبب أن ZFS يعرف من تاريخ كل كتلة ما تغير بعد @daily-1، فلا يقرأ الملف كله ليقارن. - النسخة على backup فيها الاثنان @daily-1 و@daily-2، وآخر سطر فيها هو السطر الجديد.
- الملف أخذ 11.4M على backup بدل أكثر من 50M على tank، والسبب أن ال Dataset الجديد على backup ورث
compression=onمن ال Pool فضغط البيانات عند الاستقبال 4.53 مرة، بينما الأصل على tank دون ضغط، أي أن خصائص الطرف المستقبل تحدد شكل النسخة.
Dataset مشفر وإرساله دون المفتاح
printf 'lab-passphrase-123\n' | zfs create -o encryption=on -o keyformat=passphrase tank/hr
zfs get -o property,value encryption,keyformat,keystatus tank/hr
echo "salaries 2026" > /tank/hr/salaries.txt
zfs snapshot tank/hr@s1
zfs send -w tank/hr@s1 | zfs receive backup/hr
zfs get -o name,property,value encryption,keystatus backup/hr
zfs unmount tank/hr && zfs unload-key tank/hr
zfs get -H -o value keystatus tank/hr
cat /tank/hr/salaries.txt
printf 'lab-passphrase-123\n' | zfs load-key tank/hr && zfs mount tank/hr
cat /tank/hr/salaries.txt
والمخرج سوف يكون كما يلي:
PROPERTY    VALUE
encryption  aes-256-gcm
keyformat   passphrase
keystatus   available
NAME       PROPERTY    VALUE
backup/hr  encryption  aes-256-gcm
backup/hr  keystatus   unavailable
unavailable
cat: /tank/hr/salaries.txt: No such file or directory
salaries 2026
في المخرج أعلاه لاحظ التالي:
encryption=onاختار aes-256-gcm كما تقول صفحة الخصائص.- النسخة على backup وصلت مشفرة وحالة مفتاحها
unavailable، أي أن ال Pool الذي استقبلها لا يستطيع قراءتها، وهذا ما تريده من نسخة على جهاز آخر. - بعد
unload-keyلم يعد الملف موجوداً في المسار، لأن ال Dataset غير مربوط، ورجع بعد تحميل المفتاح بعبارة المرور. وفي الإنتاج لا تكتب عبارة المرور في سطر الأوامر كما فعلنا هنا، لأنها تبقى في سجل الأوامر.
zvol كقرص لجهاز افتراضي
zfs create -V 200M tank/vm-disk
udevadm settle
ls -l /dev/zvol/tank/vm-disk
zfs get -o property,value volsize,volblocksize,refreservation tank/vm-disk
zfs list -o name,used,refer,type -r tank -d 1 | grep -E 'NAME|vm-disk|photos'
والمخرج سوف يكون كما يلي:
lrwxrwxrwx 1 root root 9 Oct  9 20:54 /dev/zvol/tank/vm-disk -> ../../zd0
PROPERTY        VALUE
volsize         200M
volblocksize    16K
refreservation  205M
NAME             USED  REFER  TYPE
tank/photos     51.9M  51.6M  filesystem
tank/vm-disk     205M    56K  volume
لاحظ أن ال zvol فارغ تقريباً، فالعمود REFER فيه 56K، ولكن USED فيه 205M، والسبب أن ZFS يحجز له مساحته كاملة بخاصية refreservation حتى لا يمتلئ ال Pool فيكتشف الجهاز الافتراضي فجأة أن قرصه لا يقبل الكتابة. وصفحة الخصائص تقول إن هذا الحجز موجود لأن ال zvol إذا نفدت مساحته قد يتلف ما فوقه من بيانات. وحجم الكتلة volblocksize الافتراضي 16K، وهو يقابل recordsize في ال Dataset، ولا يتغير بعد أن تكتب على ال zvol، لذلك تحدده عند الإنشاء.
كم أخذت ذاكرة ARC؟
في OpenZFS 2.4 أصبح اسم الأداة zarcsummary بدل arc_summary كما في ملاحظات الإصدار 2.4.0:
zarcsummary -s arc | sed -n '/ARC status/,/Available memory/p'والمخرج سوف يكون كما يلي:
ARC status:
        Total memory size:                                       3.8 GiB
        Min target size:                                3.1 %  122.2 MiB
        Max target size:                               73.8 %    2.8 GiB
        Target size (adaptive):                        21.0 %  646.0 MiB
        Current size:                                  21.0 %  605.0 MiB
        Free memory size:                                        2.1 GiB
        Available memory size:                                   2.0 GiB
الحد الأعلى 2.8 جيجابايت، وهو ذاكرة الجهاز 3.8 ناقص 1 جيجابايت، لأنه أكبر من 5/8 الذاكرة كما في صفحة المعاملات، أما الحجم الحالي فهو 605 ميجابايت فقط، لأن ARC يكبر بحسب ما يقرأ ويتنازل عند الحاجة.
التنظيف
for p in tank media backup; do zpool destroy $p; done
rm -rf /lab
exit
exit
docker rm -f lab-zfs-qemu
rm -f lab-zfs-root.qcow2 lab-zfs-seed.iso
الأمر docker rm -f يحذف ال Container بالاسم الذي أنشأناه فقط، ويوقف معه الجهاز الافتراضي، ثم نحذف قرص الجهاز وملف cloud-init، ويبقى ملف Ubuntu الأصلي إذا أردت أن تعيد التجربة.
أخطاء شائعة
- إضافة قرص منفرد إلى Pool محمي: يصبح vdev بلا حماية، وعطله يضيع ال Pool كله، ولا تضف
-fلتتجاوز رفضzpool add. - اعتبار ال Snapshots نسخة احتياطية: هي على الأقراص نفسها، فاجعل نسخة على جهاز آخر وفي مكان آخر.
- Pool دون Scrub دوري: التلف في الملفات التي لا يفتحها أحد لا يكتشف إلا بال Scrub، فجدوله واقرأ نتيجته.
- إيقاف الضغط ظناً أنه يبطئ: lz4 لا يكلف شيئاً يذكر على البيانات التي لا تنضغط، ويوفر الكثير على الباقي.
- تغيير recordsize لكل شيء: القيمة الافتراضية مناسبة للملفات العامة، وغيرها فقط ل Dataset قاعدة بيانات بحسب حجم صفحاتها.
- شراء SLOG لمشاركة SMB: نسخ الملفات عبر SMB في العادة كتابة غير متزامنة لا تستفيد منه، وSLOG دون حماية من انقطاع الكهرباء يلغي فائدته.
- special vdev على قرص واحد: عطله يتلف ال Pool كله، فاجعله Mirror على الأقل.
- ملء ال Pool حتى آخره: خطط للتوسيع عند 80%، وOpenZFS نفسه يطلب أكثر من 10% فارغة.
- نسيان مفتاح التشفير: لا توجد طريقة لاستعادة البيانات دونه.
تدريب عملي
- أعد تجربة الإتلاف على Pool من نوع RAIDZ1 بثلاثة ملفات بدل Mirror، وأتلف قرصين في كتلتين مختلفتين، ثم شغل Scrub ولاحظ عداد CKSUM لكل قرص.
- أنشئ Dataset بـ
recordsize=16Kوانسخ إليه الكود نفسه، وقارن نسبة الضغط بال Dataset الذي فيه 128K.
الخلاصة
- الحماية في ZFS داخل كل vdev، وال Pool يضيع كله إذا ضاع vdev واحد، فخطط ال vdevs من البداية بنفس مستوى الحماية.
- منذ OpenZFS 2.3 تستطيع توسيع RAIDZ بقرص واحد، والبيانات القديمة تبقى بنسبتها القديمة، والمساحة المعروضة أقل قليلاً، وفي التجربة ارتفع الحجم الخام من 2.75G إلى 3.75G.
- الضغط مفعل افتراضياً بـ lz4، وفي التجربة وفر 41% من حجم الكود، وzstd ضغط السجلات 5.72 مرة.
- ال Snapshot يبدأ بمساحة 0B ويكبر بما تحذفه أو تعدله، والاستعادة تكون لملف من
.zfs/snapshotأو لل Dataset كله بـ rollback. - عندما أتلفنا نسخة واحدة أصلحها ال Scrub وأعطى CKSUM بقيمة 1، وعندما بقيت النسخة التالفة وحدها رفض ZFS أن يعطي الملف وأعلن خطأ دائماً، ثم أصلحه عندما عاد القرص الثاني.
- send وreceive يرسلان الفرق فقط، 177K في التجربة، والإرسال الخام يحمل ال Dataset المشفر دون مفتاحه.
- ARC يكفي في أغلب الحالات، وSLOG للكتابة المتزامنة فقط، وspecial vdev جزء من ال Pool يحتاج حمايته.
 دليلالفرق بين NAS وSAN، ومتى يكفيك قرص متصل مباشرةكيف تصل الأجهزة إلى الأقراص عبر الشبكة بالملفات أو بالكتل، ولماذا قد يسلمك RAID ملفاً تالفاً دون أي خطأ.
 دليلNAS جاهز أم تبنيه بنفسك؟ ما الذي تكسبه وما تخسرهكيف تقرر بين جهاز NAS جاهز وجهاز تبنيه بنفسك، بأرقام الشركات وأسعارها الرسمية وما تعلمناه من هجمات الفدية.
 دليلأي نظام تشغيل تضعه على NAS تبنيه بنفسك؟كيف تختار نظام تشغيل لجهاز NAS تبنيه بنفسك، مع تجربة تستعيد فيها ملفاً محذوفاً وقرصاً كاملاً من التماثل.
 دليلTrueNAS عملياً: من التثبيت إلى أول مشاركة محميةكيف تثبت TrueNAS وتبني عليه مشاركات بصلاحيات واضحة، وتحمي ملفاتك بال Snapshots ونسخة على قرص آخر وخارج الجهاز.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، والتجربة على Ubuntu 26.04.1 مع OpenZFS 2.4.1 (الحزمة 2.4.1-1ubuntu5.1 والنواة 7.0.0-34) في جهاز افتراضي بـ QEMU 10.0.13 داخل Docker Engine 29.8.0، والمعلومات من توثيق OpenZFS وملاحظات الإصدارين 2.3.0 و2.4.0 وتوثيق TrueNAS 25.10 كما قرأناها في 9 أكتوبر 2026.


