إذا كنت تحلل بيانات رسالتك أو بحثك، وليس عندك ترخيص SPSS، أو ترخيص الكلية مرتبط بأجهزة المعمل فقط، فهذا المقال لك. ستعرف فيه البدائل المجانية والقانونية، وكم يكلف SPSS فعلاً، وكيف تختار الأداة المناسبة، وكيف تتعامل مع البيانات العربية، وكيف تحفظ تحليلك حتى تستطيع إعادته بعد سنة.
والفكرة الأساسية بسيطة: الاختبارات الإحصائية معادلات معروفة ومنشورة. واختبار t هو اختبار t في كل برنامج. لذلك تعطيك الأدوات المجانية الأرقام نفسها التي يعطيها SPSS، إذا اخترت الاختبار نفسه بالإعدادات نفسها.
والمقال موجه لطالب الدراسات العليا الذي يحلل بيانات رسالته، وللباحث الذي يريد تحليلاً يستطيع أن يعيده، وللمحكم ومحرر المجلة الذي يطلب من الباحثين البيانات والكود. وإذا كانت بياناتك من مشاركين بشر فاقرأ أولاً مقال أخلاقيات البحث على البشر وحماية البيانات. وإذا كنت في بداية الطريق فابدأ بمقال كيف يصل البحث العلمي من الفكرة إلى النشر.
باختصار Quick Summary
إذا كنت ستحلل بيانات لسنوات: لغة R مع RStudio، مجانية وأوسع مكتبة إحصائية.
إذا كان التحليل جزءاً من مشروع بيانات أكبر: Python.
سعر SPSS: الاشتراك الأساسي يبدأ من 99 دولاراً لكل مستخدم، وكل إضافة من 79 دولاراً، بحسب صفحة IBM. فاسأل جامعتك عن ترخيص الحرم الجامعي أولاً.
أهم قاعدتين: اختر صيغة الاختبار بنفسك ولا تعتمد على الإعداد الافتراضي، واحفظ خطوات التحليل في ملف.
والأسعار والإصدارات في هذا المقال من الصفحات الرسمية كما قرأناها في 23 أكتوبر 2026.
أربع عائلات من الأدوات
الفرق الحقيقي بين البرامج ليس في الاختبارات نفسها. الفرق في طريقة العمل:
- واجهة رسومية: تختار التحليل من القوائم بالفأرة، مثل SPSS وJASP وjamovi.
- سكربت Script: تكتب خطوات التحليل في ملف نصي تحفظه وتعيد تشغيله، مثل R وPython.
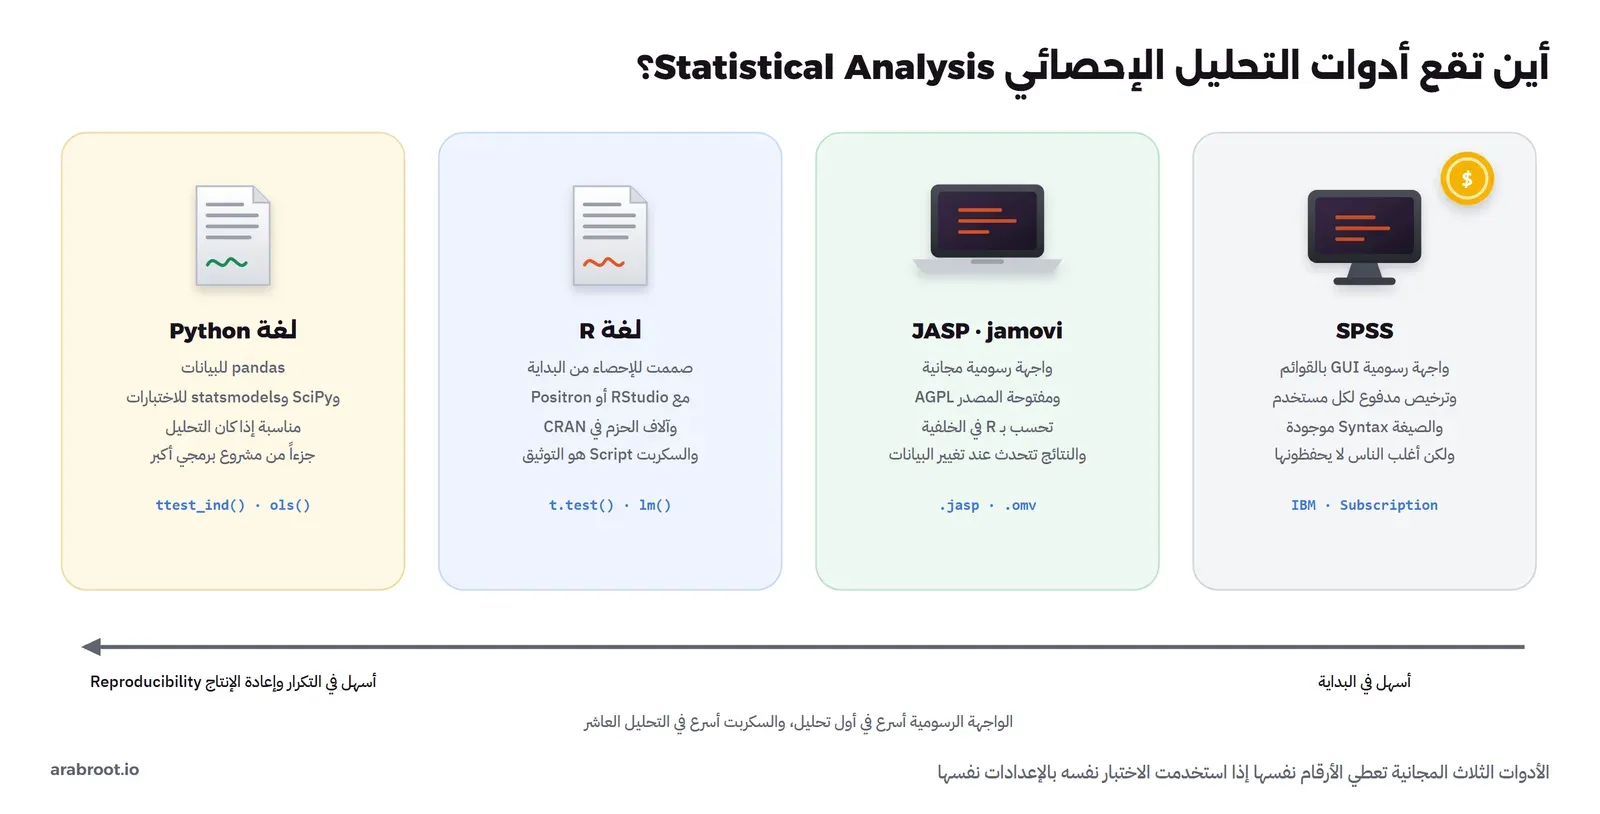
وقد تسأل: إذا كانت الأرقام واحدة، فلماذا لا أبقى على SPSS إذا وفرته جامعتي؟ تستطيع ذلك بالتأكيد. لكن المشكلة تظهر في ثلاثة مواقف:
- عندما تتخرج وتريد إعادة التحليل دون ترخيص الجامعة.
- عندما يطلب المحكم إعادة التحليل باستبعاد بعض الحالات، ولا تتذكر أي القوائم اخترت قبل ستة أشهر.
- عندما تنشر في مجلة تطلب مشاركة الكود Code Sharing مع البيانات.
والمواقف الثلاثة تحلها أداة تحفظ خطوات التحليل في ملف.
SPSS: ماذا تدفع مقابله؟
IBM SPSS Statistics برنامج تجاري. وهذه الأسعار المعلنة في صفحة الأسعار الرسمية للشراء المباشر من IBM:
| الباقة | السعر المعلن | ماذا تضيف |
|---|---|---|
| الاشتراك الأساسي Base Subscription | يبدأ من 99 دولاراً لكل مستخدم | الإحصاء الأساسي وتجهيز البيانات |
| Custom Tables and Advanced Statistics | يبدأ من 79 دولاراً لكل مستخدم | الجداول المخصصة والنماذج الخطية المعممة GLM والنماذج المختلطة Mixed Models |
| Forecasting and Decision Trees | يبدأ من 79 دولاراً لكل مستخدم | التنبؤ وأشجار القرار والشبكات العصبية |
| Complex Sampling and Testing | يبدأ من 79 دولاراً لكل مستخدم | العينات المعقدة والقيم المفقودة Missing Values والاختبارات الدقيقة |
وانتبه لأربعة أمور في هذه الأسعار:
- الصفحة لا تكتب بجوار السعر هل هو شهري أو سنوي. وتذكر أن الاشتراك يدفع شهرياً أو سنوياً.
- سعر التجديد بعد السنة الأولى هو السعر المعتمد وقتها.
- الأسعار لا تشمل الضرائب، وتختلف بحسب الدولة.
- ترخيص الطلاب Student License وترخيص الحرم الجامعي Campus Edition لا تذكر الصفحة سعرهما، وتقول إنهما بأسعار أكاديمية عبر موزعين معتمدين.
لذلك اسأل عمادة تقنية المعلومات في جامعتك أولاً قبل أن تشتري، فكثير من الجامعات تشتري ترخيصاً للحرم كاملاً.
وSPSS ليس أداة سيئة. واجهته مألوفة لأجيال من الباحثين، وتدرس عليه مقررات كثيرة لمناهج البحث. وله لغة أوامر اسمها SPSS Syntax تحفظ بها خطوات التحليل. لكن أغلب المستخدمين لا يحفظونها، فيبقى التحليل سلسلة نقرات لا أثر لها.
البدائل المجانية
الأدوات التالية كلها مجانية. وقرأنا تراخيصها وإصداراتها من صفحاتها الرسمية في 23 أكتوبر 2026.
JASP: واجهة رسومية مجانية
JASP برنامج بواجهة رسومية تطوره جامعة أمستردام، ويحسب بلغة R في الخلفية. وآخر إصدار بحسب صفحة التحميل هو 0.99.0، صدر في 21 أكتوبر 2026، ويعمل على Windows وmacOS وLinux. والصفحة تصفه بأنه مجاني بالكامل.
نقاط القوة:
- لا يحتاج برمجة، وواجهته قريبة من SPSS.
- الجدول يتحدث مباشرة عندما تغير خياراً أو تعدل البيانات.
- يعرض التحليل البايزي Bayesian بجانب التحليل التقليدي في كثير من الاختبارات.
- ملفه يحفظ البيانات والتحليلات وخياراتها معاً، فيعرف من يفتحه ماذا اخترت بالضبط.
نقاط الضعف: يعمل على جهازك فقط، والتحليلات المتاحة هي ما في قوائمه وإضافاته.
jamovi: واجهة رسومية مع نسخة سحابية
jamovi برنامج آخر بواجهة رسومية يحسب بلغة R. وآخر إصدار بحسب صفحة الإصدارات هو 28.14، صدر في 21 أكتوبر 2026. وترخيصه مفتوح المصدر بحسب ملف الترخيص.
نسخة سطح المكتب مجانية دائماً. وله نسخة سحابية jamovi Cloud تعمل في المتصفح، فيها خطة مجانية Guest، وخطة Priority بسعر يختلف بحسب المنطقة، وخطة للمؤسسات بعرض سعر.
نقاط القوة: واجهة جدول بيانات مألوفة. وإذا فعلت خيار Syntax Mode يعرض لك أوامر R المقابلة لكل تحليل، فيصبح جسراً بين القوائم والسكربت.
نقاط الضعف: ما لا يوجد في القوائم يحتاج R مباشرة. والنسخة السحابية المجانية جلساتها محدودة المدة والموارد.
إذا أردت تشغيله لطلابك على خادم الكلية: لا ننصح بذلك اليوم. النسخة المنشورة له على Docker Hub لأجهزة الخوادم المعتادة قديمة (2.7.4 من أغسطس 2025). وعندما جربناها فتحت الواجهة في المتصفح، ثم توقف الخادم تماماً عند فتح ملف البيانات. فالطريق الرسمي هو نسخة سطح المكتب أو jamovi Cloud.
لغة R مع RStudio
R لغة صممت للإحصاء من البداية، وهي مجانية ومفتوحة المصدر. وآخر إصدار عند كتابة المقال 4.6.1، صدر في 24 يونيو 2026 بحسب أرشيف CRAN. الاختبارات الأساسية جزء من اللغة نفسها، وما زاد عليها تجده في آلاف الحزم Packages الإضافية.
وتكتب R عادة داخل برنامج اسمه RStudio من شركة Posit، ونسخته المفتوحة مجانية. وللشركة نفسها برنامج أحدث اسمه Positron يدعم R وPython معاً، استخدامه مجاني، لكن ترخيصه Elastic License 2.0، وهو ليس ترخيصاً مفتوح المصدر بالمعنى الدقيق.
نقاط القوة:
- كثير من الطرق الإحصائية الجديدة تنشر أولاً كحزمة في R، وكثير من كتب الإحصاء أمثلتها بلغة R.
- مخرجات الاختبارات قريبة مما يكتب في البحث: قيمة t ودرجات الحرية وفترة الثقة Confidence Interval والمتوسطات.
- الرسوم البيانية بحزمة ggplot2 بجودة النشر، وتدعم العناوين العربية.
نقاط الضعف:
- تحتاج تعلم كتابة الأوامر، والأسبوع الأول صعب على من لم يبرمج.
- إصدارات الحزم تتغير. فإذا لم تسجلها، قد يعطي التحليل نفسه نتيجة مختلفة بعد سنتين.
ولكي ترى شكل الأمر في R، هذا اختبار t يقارن متوسط الدرجة بين مجموعتين:
t.test(score ~ group, data = d, var.equal = FALSE)ومعناه: قارن الدرجة score بحسب المجموعة group في جدول البيانات d. والجزء الأخير يقول صراحة إننا لا نفترض تساوي التباين في المجموعتين، وسنشرح أهميته بعد قليل.
لغة Python
Python لغة برمجة عامة، وليست إحصائية في الأصل. لكن ثلاث مكتبات مجانية تجعلها مناسبة للتحليل:
- pandas لقراءة البيانات وتنظيفها.
- SciPy للاختبارات الإحصائية.
- statsmodels لنماذج الانحدار، بمخرجات تشبه SPSS وR.
نقاط القوة: مناسبة إذا كان التحليل جزءاً من مشروع أكبر، مثل جمع البيانات آلياً أو تعلم الآلة Machine Learning. وإذا كنت تعرف Python من عملك فلن تتعلم لغة جديدة.
نقاط الضعف: بعض الإعدادات الافتراضية تختلف عن R وSPSS، كما سنرى. والطرق الإحصائية المتخصصة، مثل بعض نماذج القياس النفسي Psychometrics، أقل توفراً منها في R.
المقارنة في جدول واحد
| SPSS | JASP | jamovi | R | Python | |
|---|---|---|---|---|---|
| طريقة العمل | قوائم | قوائم | قوائم | سكربت | سكربت |
| يحتاج برمجة | لا | لا | لا | نعم | نعم |
| يحفظ خطوات التحليل | إذا حفظت الـ Syntax | نعم، في ملفه | نعم، في ملفه | نعم، السكربت نفسه | نعم، السكربت نفسه |
| السنة الأولى | من 99 دولاراً لكل مستخدم، أو ترخيص الجامعة | مجاني | مجاني | مجاني | مجاني |
| كل سنة بعدها | بسعر التجديد المعتمد وقتها | مجاني | مجاني | مجاني | مجاني |
المصدر: صفحة أسعار SPSS، وصفحات الأدوات المذكورة أعلاه.
هل تعطي الأدوات الأرقام نفسها؟
جربنا ذلك بأنفسنا. أخذنا بيانات عامة معروفة اسمها Palmer Penguins، وهي قياسات 344 طائر بطريق، منشورة ملكية عامة. وشغلنا عليها ثلاثة تحليلات يعرفها كل من درس مناهج البحث:
- هل يختلف متوسط كتلة الذكور عن الإناث؟ وهذا اختبار t لعينتين مستقلتين Independent Samples t-test.
- هل يرتبط طول الزعنفة بالكتلة؟ وهذا معامل ارتباط بيرسون Pearson Correlation.
- كم تزيد الكتلة مع طول الزعنفة بعد مراعاة الجنس؟ وهذا الانحدار الخطي المتعدد Multiple Linear Regression.
شغلنا التحليلات الثلاثة في R وفي Python، فخرجت الأرقام الأساسية الأربعة عشر متطابقة حتى الخانة العشرية السادسة. وهذا منطقي، لأن البرنامج الجيد ينفذ المعادلة نفسها. وهذه النتائج كما خرجت:
| السؤال | النتيجة |
|---|---|
| كم حالة دخلت التحليل؟ | 333 من 344. فـ 11 طائراً لم يسجل جنسها، واثنان منها بلا قياسات أصلاً |
| متوسط الكتلة | الإناث 3,862 غراماً، والذكور 4,546 غراماً. والفرق دال إحصائياً، وفترة الثقة للفرق بين 526 و841 غراماً تقريباً |
| الارتباط بين طول الزعنفة والكتلة | قوي جداً: r = 0.873 |
| الانحدار | كل مليمتر في طول الزعنفة يضيف قرابة 47 غراماً، والذكر أثقل بقرابة 348 غراماً عند الطول نفسه، والنموذج يفسر 80.6% من التباين (R²) |
ولاحظ السطر الأول: كل أداة استبعدت الحالات الناقصة بصمت. وهذا الرقم يجب أن يظهر في قسم المنهجية في بحثك، لأن المحكم يسأل دائماً: أين ذهبت بقية العينة؟
لكن التطابق لم يحدث تلقائياً. حدث لأننا طلبنا في Python الاختبار نفسه صراحة. وهذا يقودنا إلى أهم درس في المقال.
انتبه للإعداد الافتراضي Default
اختبار t لعينتين له صيغتان:
- صيغة Student: تفترض أن تشتت الدرجات (التباين Variance) متساو في المجموعتين.
- صيغة Welch: لا تفترض ذلك.
والمشكلة أن كل أداة تختار صيغة مختلفة إذا لم تحدد لها:
| الأداة | الصيغة إذا لم تحدد |
|---|---|
| R | Welch |
| Python بمكتبة SciPy | Student، بحسب توثيق الدالة |
| SPSS | يعرض الصيغتين في سطرين: «Equal variances assumed» و«Equal variances not assumed» |
وهذا ما خرج في تجربتنا على مقارنة كتلة الذكور والإناث، عندما تركنا كل أداة على إعدادها الافتراضي:
| الأداة | الصيغة | قيمة t | قيمة p |
|---|---|---|---|
| R | Welch | -8.554537 | 4.79 × 10⁻¹⁶ |
| Python (SciPy) | Student | -8.541720 | 4.90 × 10⁻¹⁶ |
الفرق هنا صغير، لأن العينة كبيرة والتباين متقارب. لكن في عينة صغيرة بتباين مختلف قد ينقل الفرق النتيجة من دالة إلى غير دالة. وفي SPSS ينسخ الباحث أحياناً السطر الخطأ من الجدول.
القاعدة: حدد الصيغة بنفسك في كل اختبار، واذكر في بحثك أي صيغة استخدمت.
مثال: لا تكتب p = 0.000
في تجربتنا كانت قيمة p للارتباط صغيرة جداً. فعرضتها R بالشكل «أصغر من 2.2e-16»، وعرضها جدول الانحدار في Python «0.000». أما اختبار الارتباط في Python فعرض الرقم كاملاً: 3.13 × 10-105. الرقم واحد، والعرض مختلف.
لكن قيمة p لا تساوي صفراً أبداً. لذلك لا تكتب في بحثك «p = 0.000». الصيغة المعتمدة في أغلب أدلة الكتابة هي «p < .001».
البيانات العربية
بيانات بحوثنا عربية في الغالب: استبانة بأسماء أعمدة عربية، وإجابات مثل «ذكر» و«أنثى» و«موافق بشدة». وهنا ثلاث مشكلات شائعة.
ملف CSV لا يفتح: مشكلة الترميز Encoding
الترميز هو الطريقة التي يحفظ بها الحاسب الحروف. وعندما تحفظ ملفاً من Excel بصيغة «CSV (Comma delimited)» على Windows بالعربية، يحفظه بترميز قديم اسمه Windows-1256.
وعندما فتحنا هذا الملف في R وPython دون إعداد، توقف كلاهما برسالة خطأ. لأنهما يتوقعان الترميز الحديث UTF-8.
الحل الأفضل: احفظ الملف من Excel بصيغة «CSV UTF-8 (Comma delimited)» من البداية، واجعل UTF-8 قاعدة لكل ملفات بحثك.
وإذا وصلك ملف قديم: أخبر الأداة بترميزه. في R يكون السطر هكذا:
read.csv("data.csv", fileEncoding = "CP1256")ومعناه: اقرأ الملف data.csv، وترميزه Windows-1256. وبعدها تظهر أسماء الأعمدة العربية صحيحة.
أسماء الأعمدة العربية
بعد قراءة الملف الصحيح، عمل التحليل بالأسماء العربية دون مشكلة، وخرجت الأرقام نفسها التي خرجت بالأسماء الإنجليزية.
الرسوم البيانية Charts بعناوين عربية
كانت المشكلة القديمة أن الحروف العربية تظهر منفصلة ومعكوسة في الرسوم. والوضع اليوم أفضل.
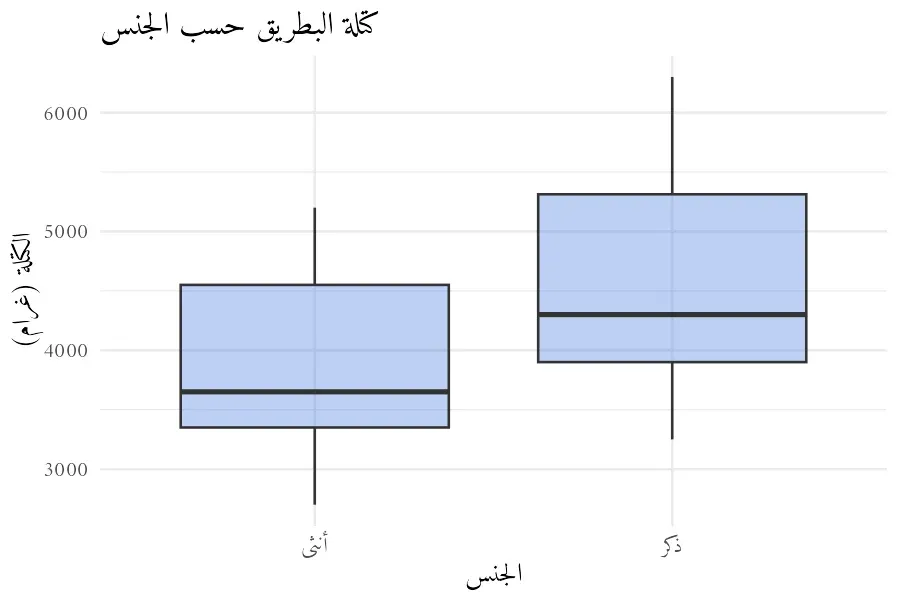
في R مع حزمة ggplot2 ظهرت العناوين العربية صحيحة ومتصلة:
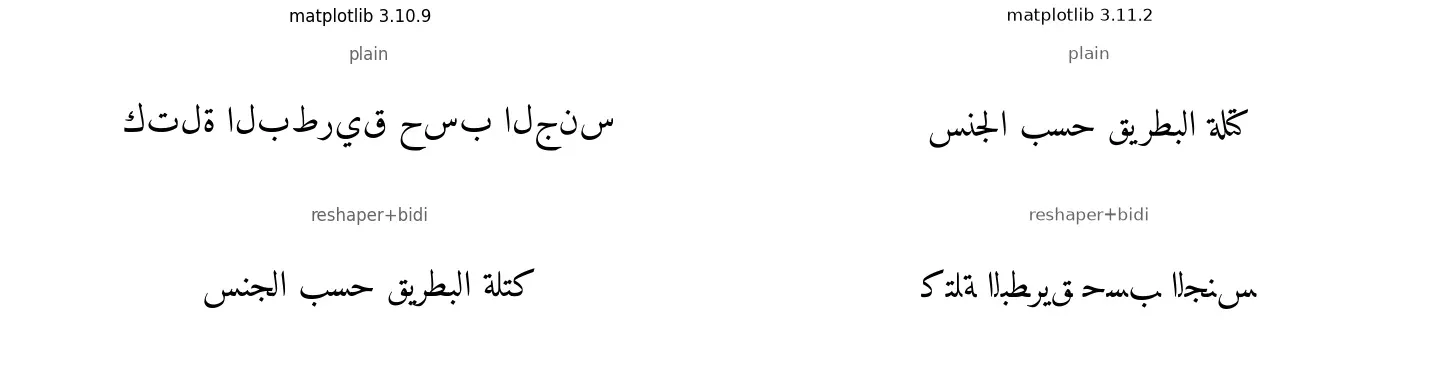
وفي Python أضافت مكتبة الرسم matplotlib في الإصدار 3.11 دعماً كاملاً للعربية، بحسب ملاحظات الإصدار. وهذا يعني أمراً مهماً لمن ورث سكربتاً قديماً من زميل:
- في الإصدارات القديمة كان الباحثون يستخدمون مكتبتين إضافيتين لإصلاح العربية.
- في الإصدار 3.11 لم تعد هاتان المكتبتان لازمتين، بل تقلبان النص إذا بقيتا.
- لذلك إذا حدثت matplotlib وظهرت عناوينك مقلوبة، فاحذف الحل القديم.
كيف تحلل بياناتك دون SPSS: ست خطوات
الخطوة 1: اسأل جامعتك عن الترخيص
لماذا تهم: إذا كان عند جامعتك ترخيص للحرم الجامعي، قد تحصل على SPSS دون دفع. وإن لم يكن، فالبدائل المجانية تكفي.
التكلفة: لا شيء.
الخطوة 2: اختر الأداة بحسب وضعك
استخدم الجدول في قسم «كيف تختار» أسفل المقال. وإذا لم تبرمج من قبل، ابدأ بـ JASP أو jamovi.
الخطوة 3: احفظ البيانات بصيغة CSV UTF-8
لماذا تهم: تتجنب مشكلة الترميز في أي أداة. واحتفظ بالملف الأصلي دون تعديل، واعمل على نسخة.
الخطوة 4: شغل التحليل وحدد الخيارات بنفسك
لماذا تهم: الإعداد الافتراضي يختلف بين الأدوات، كما رأينا في اختبار t.
وانتبه للحالات الناقصة: الأداة تستبعد الصفوف الناقصة دون أن تخبرك. لذلك سجل عدد الحالات التي دخلت كل تحليل. فالمحكم يسأل دائماً: أين ذهبت بقية العينة؟
الخطوة 5: احفظ خطوات التحليل
ما هي: ملف JASP أو jamovi، أو ملف SPSS Syntax، أو السكربت في R وPython.
لماذا تهم: لتعيد التحليل بعد ستة أشهر عندما يطلب المحكم تعديلاً، دون أن تتذكر أي القوائم اخترت.
الخطوة 6: اكتب النتائج بالصيغة الصحيحة
ما هي: اذكر الاختبار وصيغته، وعدد الحالات، وقيمة p بشكل صحيح مثل «p < .001»، وإصدار الأداة.
اجعل التحليل قابلاً لإعادة الإنتاج Reproducible
إعادة الإنتاج Reproducibility تعني أن يأخذ شخص آخر بياناتك وخطوات تحليلك، فيصل إلى الأرقام نفسها في جداولك. وتحتاج لذلك أربعة أشياء:
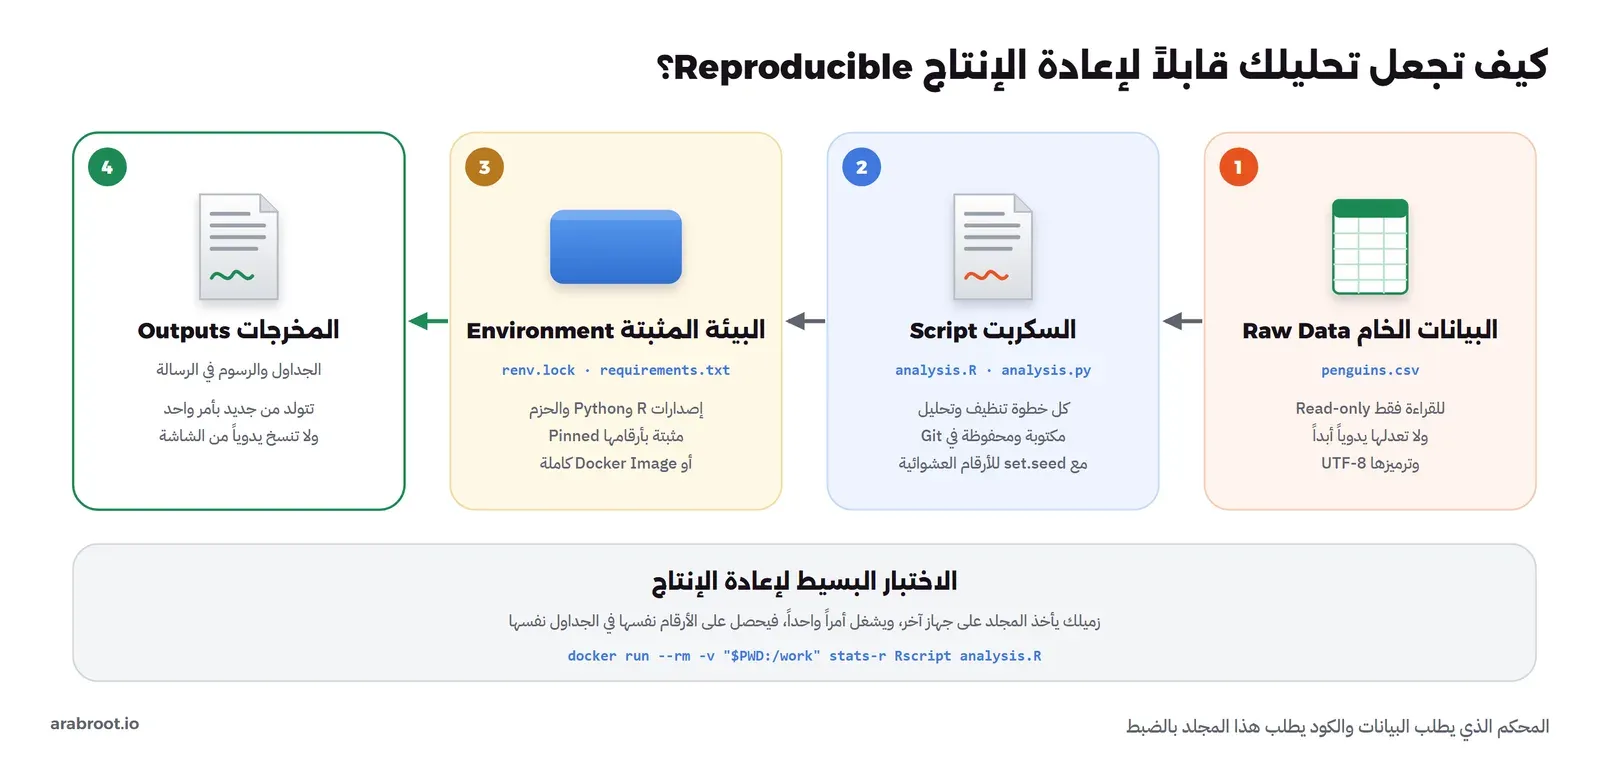
- بيانات خام Raw Data لا تعدل: لا تعدل الملف الأصلي في Excel. كل تنظيف أو استبعاد لحالات يكون خطوة مسجلة في السكربت أو ملف التحليل، لأن التعديل اليدوي لا يترك أثراً.
- خطوات محفوظة: كل خطوة من قراءة البيانات إلى آخر جدول مكتوبة ومحفوظة بتاريخها.
- إصدارات مسجلة: لا يكفي أن تكتب «R 4.6.1»، لأن إصدار R لا يحدد إصدارات الحزم. ففي تجربتنا ثبتنا R 4.6.1، ومع ذلك نزلت الحزم بأحدث إصداراتها يوم التجربة (ggplot2 4.0.3 وragg 1.5.2)، ولو أعدنا التجهيز بعد سنة لنزلت إصدارات أخرى. في R تسجلها حزمة renv تلقائياً في ملف، وفي Python تكتبها في ملف المتطلبات.
- جداول تتولد ولا تنسخ: الجدول في الرسالة يأتي من ملف تكتبه الأداة، وليس من نسخ الأرقام بيدك من الشاشة. فإذا تغير شيء، تعيد التشغيل فتتحدث الجداول كلها.
ولمن يكتب الرسالة في Quarto، فالخطوة الطبيعية التالية أن تتولد الجداول والرسوم داخل الملف مباشرة، كما شرحنا في مقال Word أم LaTeX لكتابة الرسالة وأين يقف Quarto. أما حفظ البيانات نفسها ووصفها ومشاركتها فموضوع مقال إدارة بيانات البحث ومبادئ FAIR.
كيف تختار؟
| حالتك | الأنسب | السبب |
|---|---|---|
| تحليل رسالة باختبارات معروفة، ولم تبرمج من قبل | JASP أو jamovi | مجانيان بواجهة قريبة من SPSS، والملف يحفظ خيارات التحليل |
| ستحلل بيانات لسنوات، أو قسمك يدرس الإحصاء | R مع RStudio | أوسع مكتبة إحصائية، والسكربت هو التوثيق |
| التحليل جزء من مشروع بيانات أو تعلم آلة | Python | لغة واحدة من جمع البيانات إلى النتيجة |
| جامعتك توفر SPSS وقسمك يعتمد عليه | SPSS مع حفظ الـ Syntax | استخدمه، واحفظ ملف الأوامر مع البيانات، وجرب jamovi على التحليل نفسه لتعرف أنك تستطيع الانتقال |
للمحكم ومحرر المجلة: عندما تطلب من الباحث «البيانات والكود»، فاطلب أربعة أشياء محددة:
- البيانات الخام، أو نسخة منها حذفت منها هويات المشاركين.
- خطوات التحليل كاملة، من قراءة البيانات إلى الجداول.
- إصدارات الأدوات والحزم.
- عدد الحالات المستبعدة وسبب استبعادها.
وإذا كان التحليل بواجهة رسومية فاطلب ملف JASP أو jamovi أو SPSS Syntax، لأن لقطات الشاشة لا تكفي لإعادة التحليل.
أخطاء شائعة
- الاعتماد على الإعداد الافتراضي: اختبار t في Python يفترض تساوي التباين، وفي R لا يفترضه. حدد الصيغة واذكرها في البحث.
- كتابة p = 0.000: هذا ما تعرضه الأداة عندما تكون القيمة صغيرة جداً، والصحيح «p < .001».
- ملفات CSV بالترميز القديم: احفظ بصيغة CSV UTF-8 من Excel.
- الحالات الناقصة التي تختفي بصمت: سجل عدد الحالات في كل تحليل.
- حلول قديمة للعربية في الرسوم: احذفها بعد تحديث matplotlib إلى 3.11.
- نسخة SPSS «مجانية» من مصدر مجهول: غير قانونية، وقد تحمل برامج خبيثة. والبدائل المجانية القانونية تعطي النتائج نفسها.
الخلاصة
- SPSS يبدأ من 99 دولاراً لكل مستخدم للاشتراك الأساسي، و79 دولاراً لكل إضافة، بحسب صفحة IBM. فاسأل جامعتك عن الترخيص أولاً.
- JASP وjamovi مجانيان بواجهة رسومية، وهما البداية الأنسب لمن لا يبرمج.
- R وPython تعطيان الأرقام نفسها إذا اخترت الاختبار نفسه بالإعدادات نفسها.
- الإعدادات الافتراضية تختلف بين الأدوات، فحدد صيغة كل اختبار بنفسك.
- البيانات العربية تعمل إذا حفظت الملف بترميز UTF-8، والرسوم العربية صحيحة اليوم في R وفي matplotlib 3.11.
- إعادة الإنتاج تحتاج بيانات خام لا تعدل، وخطوات محفوظة، وإصدارات مسجلة.
وفي المقال التالي من هذه المرحلة بإذن الله نتناول استخدام الذكاء الاصطناعي في الكتابة الأكاديمية: ما الذي تسمح به المجلات والجامعات، وما الذي يعد مخالفة.
سجل التحديثات
- 2026-11-13: إعادة كتابة المقال بلغة أوضح وخطوات وجداول، دون كود.
- 2026-11-14: مراجعة المقال وإعادة المعلومات المفيدة ونتائج البيانات الحقيقية التي حذفت في إعادة الكتابة.
- أكتوبر 2026: كتابة المقال وتجربة التحليلات نفسها في R 4.6.1 وPython، وقراءة أسعار SPSS في 23 أكتوبر 2026.