تطلب من الوكيل Agent ميزة Feature في سطر واحد، فيرجع بعد دقائق بكود يعمل، والاختبارات Tests التي كتبها لنفسه تمر، ثم تكتشف في المراجعة Review أنه قرر عنك عشرة أشياء لم تقلها: أن الغرامة تبدأ من أول يوم تأخير، وأنها عشر هللات في اليوم، وأنها تنطبق على الفواتير الصغيرة أيضاً، وأنها لا تتوقف عند حد. وكل قرار من هذه القرارات معقول في نظر النموذج Model، ولكنه ليس قرار الشركة، والكود Code الذي بني عليه يجب أن يعاد. والمشكلة هنا ليست في كتابة الكود، فالنموذج كتب كوداً سليماً لما فهمه، وإنما في أن أحداً لم يكتب ما يجب أن يفهمه قبل أن يبدأ. والتطوير من المواصفة Spec-driven Development، واختصاراً SDD، طريقة عمل تجعل هذه الخطوة إلزامية: مواصفة مكتوبة لما تريد ولماذا، ثم خطة لكيف، ثم مهام صغيرة، ثم الكود.
وفي مقال الفايب إنجنيرنج رأينا في مختبر صغير أن المواصفة قبل الكود حسنت النتيجة، وأن الاختبارات هي التي تثبت ذلك. وهذا المقال يأخذ الفكرة إلى أداة حقيقية تبنيها GitHub لهذا الغرض، وهي Spec Kit، فنشرح ما تنشئه في المستودع Repository وما تطلبه من الوكيل في كل خطوة، ثم نشغل الطريقة كاملة على ميزة صغيرة بنموذج محلي صغير، ونقارنها بطريقتين أبسط، ونقيس النتيجة باختبارات قبول Acceptance Tests كتبناها قبل أن يبدأ النموذج ولم يرها.
في هذا المقال سوف نتناول:
- ما هو التطوير من المواصفة، ومستوياته الثلاثة، ومن أين جاء الاسم.
- Spec Kit من الداخل: الملفات التي ينشئها، والأوامر، وحجم كل أمر بالتوكنات Tokens.
- ما الفرق بين المواصفة Spec والخطة Plan والمهام Tasks، ومن يكتب ماذا.
- تجربة: الميزة نفسها بثلاث طرق، والنتيجة باختبارات قبول مخفية.
- أين فشل النموذج الصغير، وماذا يعلمنا ذلك عن الطريقة نفسها.
- متى يستحق الأمر هذه الخطوات، ومتى تكون مطرقة كبيرة لمسمار صغير.
ما هو التطوير من المواصفة Spec-driven Development؟
الفكرة قديمة في هندسة البرمجيات، أي أن تكتب ما يجب أن يفعله النظام قبل أن تكتبه، ولكن الجديد أن القارئ الأول للمواصفة أصبح وكيلاً ينفذها، وليس مبرمجاً يقرؤها ثم يقرر وحده ما لم يكتب. ومقال GitHub الذي أعلن Spec Kit في 2 سبتمبر 2025، وكتبه Den Delimarsky، يبدأ من المشكلة نفسها التي بدأنا بها: تصف هدفك، فيرجع الوكيل بكود يبدو صحيحاً ولكنه لا يعمل كما تريد، وهذه طريقة مناسبة للنماذج الأولية السريعة Prototypes وأقل موثوقية للأنظمة الجادة. ويقترح المقال أربع مراحل: المواصفة Specify التي تصف ماذا ولماذا من زاوية المستخدم، والخطة Plan التي تحدد التقنية والبنية والقيود، والمهام Tasks التي تقسم الخطة إلى قطع صغيرة يمكن تنفيذ كل واحدة واختبارها وحدها، ثم التنفيذ Implement. ويقول في جملة مهمة إن دورك ليس أن توجه فقط، وإنما أن تتحقق، وأن تراجع وتصحح في كل مرحلة.
وفي 15 أكتوبر 2025 نشرت Birgitta Böckeler من شركة Thoughtworks مقالاً على موقع Martin Fowler جربت فيه ثلاث أدوات تحمل هذا الاسم، وهي Kiro من AWS وSpec Kit من GitHub وTessl، ووجدت أن الاسم يستعمل لثلاثة مستويات مختلفة:
- المواصفة أولاً Spec-first: تكتب مواصفة مدروسة قبل المهمة، ثم تستعملها في العمل مع الوكيل على هذه المهمة. وهذا ما تفعله كل الأدوات.
- المواصفة المرجع Spec-anchored: تبقى المواصفة بعد انتهاء المهمة، وتستعمل لتطوير الميزة وصيانتها لاحقاً، أي أنها تتغير مع الكود.
- المواصفة هي المصدر Spec-as-source: المواصفة هي الملف الأساسي، والإنسان يعدلها هي فقط ولا يلمس الكود أبداً، والكود يولد منها.
والمستوى الثالث يذكرها، كما تكتب، بالتطوير القائم على النماذج Model-driven Development الذي عملت فيه في بداية عملها، حيث كانت النماذج بلغة UML هي المواصفة والكود يولد منها، وهي تجربة لم تنتشر. وأغلب ما تحتاجه أنت كمطور اليوم هو المستوى الأول، وأحياناً الثاني.
وقد يتساءل البعض: أليس هذا شلالاً Waterfall جديداً، أي أن نكتب وثائق طويلة قبل أن نكتب سطراً؟ والإجابة أن الفرق في الحجم والزمن: الوثيقة هنا لميزة واحدة، وتكتب في دقائق لا في أشهر، ويكتب أغلبها الوكيل نفسه، ودورك أن تقرأها وتصحح القرارات قبل أن تصبح كوداً. ولكن السؤال صحيح، وسوف نرى في آخر المقال أن الخطوات نفسها قد تصبح عبئاً أكبر من الميزة.
Spec Kit من الداخل
Spec Kit أداة مفتوحة المصدر من GitHub، وأحدث إصدار منها عند كتابة هذا المقال 1.4.2 الصادر في 17 نوفمبر 2026. وهي تتكون من جزأين: أداة سطر أوامر اسمها specify تكتب بلغة Python وتثبت بالأداة uv، ومجموعة أوامر وقوالب تضعها في مستودعك ليستعملها الوكيل. والأداة نفسها لا تحتوي نموذجاً، وإنما تجهز المستودع لوكيل تختاره، مثل Copilot أو Claude Code أو Codex أو Gemini CLI، وتسمي ذلك تكاملاً Integration. والتثبيت كما في ملف README:
uv tool install specify-cli==1.4.2
specify init latefees --non-interactive --integration generic --integration-options="--commands-dir .agent/commands/"
واخترنا التكامل generic لأننا لن نستعمل أي وكيل سحابي، فهو يضع الأوامر في مجلد نحدده نحن، ويذكر شرح الأمر specify init --help أن الملفات تبنى من نسخة داخل حزمة specify-cli نفسها، أي أن التجهيز لا يحتاج اتصالاً بالشبكة وأن القوالب تطابق الإصدار المثبت. والملفات التي أنشأها في المستودع كما يلي:
./.agent/commands/speckit.analyze.md
./.agent/commands/speckit.checklist.md
./.agent/commands/speckit.clarify.md
./.agent/commands/speckit.constitution.md
./.agent/commands/speckit.converge.md
./.agent/commands/speckit.implement.md
./.agent/commands/speckit.plan.md
./.agent/commands/speckit.specify.md
./.agent/commands/speckit.tasks.md
./.specify/memory/constitution.md
./.specify/scripts/bash/check-prerequisites.sh
./.specify/scripts/bash/common.sh
./.specify/scripts/bash/create-new-feature.sh
./.specify/scripts/bash/resolve-template.sh
./.specify/scripts/bash/setup-plan.sh
./.specify/scripts/bash/setup-tasks.sh
./.specify/templates/checklist-template.md
./.specify/templates/constitution-template.md
./.specify/templates/plan-template.md
./.specify/templates/spec-template.md
./.specify/templates/tasks-template.md
./.specify/workflows/speckit/workflow.yml
في المخرج أعلاه لاحظ التالي:
- المجلد
.agent/commands/فيه تسعة أوامر، وكل أمر ملف Markdown هو في الحقيقة تعليمات طويلة للوكيل، فعندما تكتب في المحادثة/speckit.specifyومعه وصف الميزة، فإن الوكيل يقرأ هذا الملف وينفذ ما فيه. - المجلد
.specify/templates/فيه القوالب التي يملؤها الوكيل، أي شكل المواصفة والخطة والمهام، وكل قالب فيه أقسام وأمثلة وتعليقات تشرح ما يكتب في كل قسم. - السكربتات في
.specify/scripts/bash/تنشئ مجلد الميزة وفرعها، فالسكربتcreate-new-feature.shيضع كل ميزة في مجلد تحتspecs/برقم متسلسل، والوكيل يشغلها كجزء من الأوامر. - الملف
.specify/memory/constitution.mdهو «الدستور»، أي مبادئ المشروع التي تنطبق على كل ميزة، مثل «كل ميزة لها اختبارات» أو «لا مكتبات خارجية»، ويكتب مرة بالأمر/speckit.constitution، وهو قريب في فكرته من ملف التعليمات InstructionsAGENTS.md.
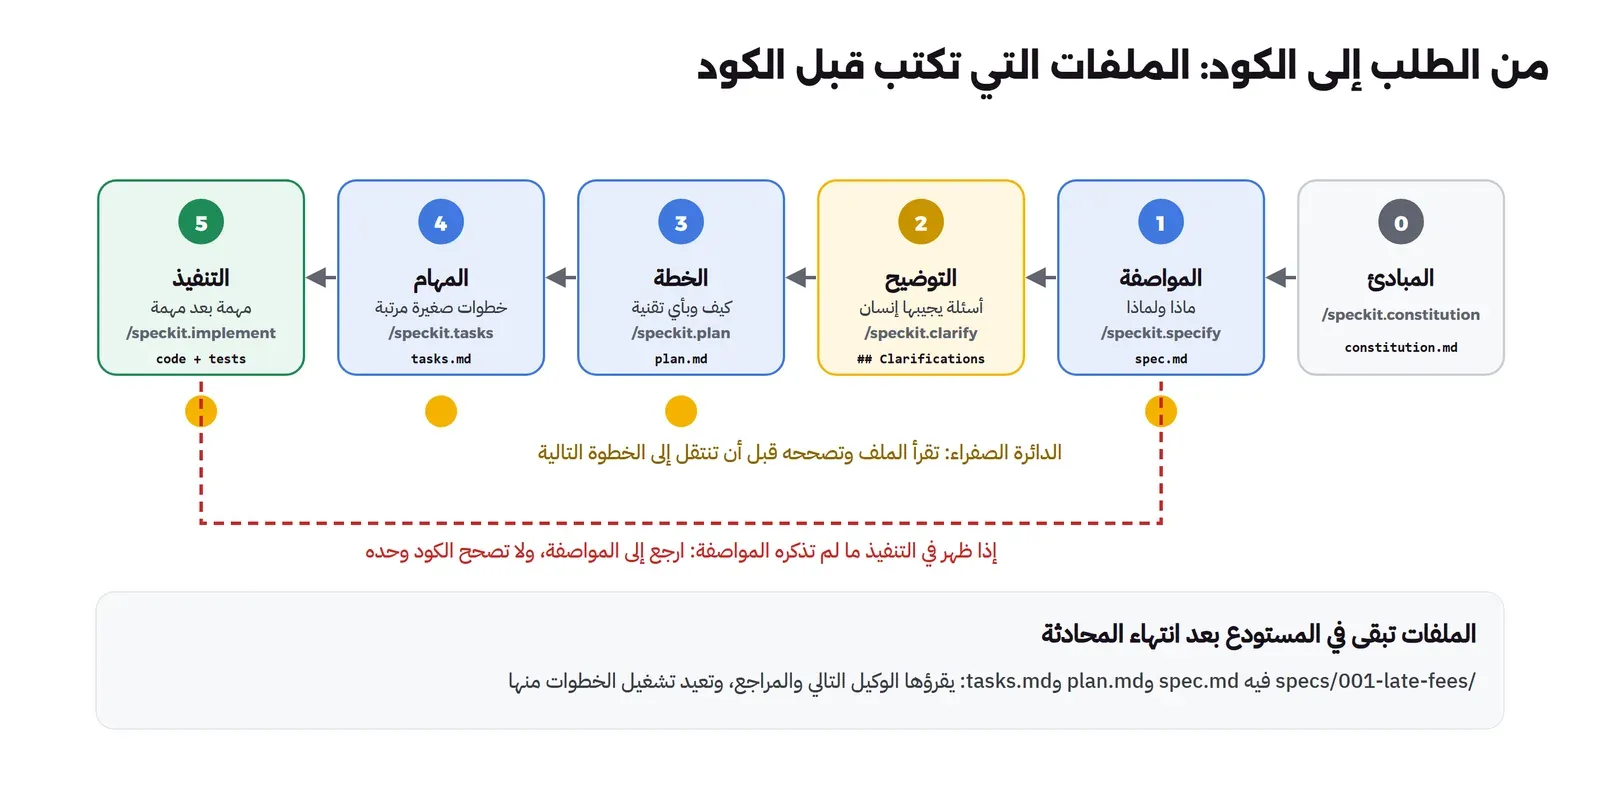
والشكل التالي يبين ترتيب الأوامر والملف الذي يكتبه كل أمر، والمكان الذي تراجع فيه أنت:
وكم يكلف كل أمر من السياق Context؟ عددنا الملفات بترميز o200k_base، والمخرج سوف يكون كما يلي:
.agent/commands/speckit.analyze.md                14710 bytes   3092 tokens
.agent/commands/speckit.checklist.md              22133 bytes   4911 tokens
.agent/commands/speckit.clarify.md                19316 bytes   4131 tokens
.agent/commands/speckit.constitution.md           10159 bytes   2158 tokens
.agent/commands/speckit.converge.md               12938 bytes   3035 tokens
.agent/commands/speckit.implement.md              12562 bytes   3158 tokens
.agent/commands/speckit.plan.md                    7952 bytes   1791 tokens
.agent/commands/speckit.specify.md                18750 bytes   4129 tokens
.agent/commands/speckit.tasks.md                  12502 bytes   2826 tokens
.specify/templates/checklist-template.md           2033 bytes    416 tokens
.specify/templates/constitution-template.md        2346 bytes    541 tokens
.specify/templates/plan-template.md                3682 bytes    924 tokens
.specify/templates/spec-template.md                4556 bytes   1077 tokens
.specify/templates/tasks-template.md               9171 bytes   2280 tokens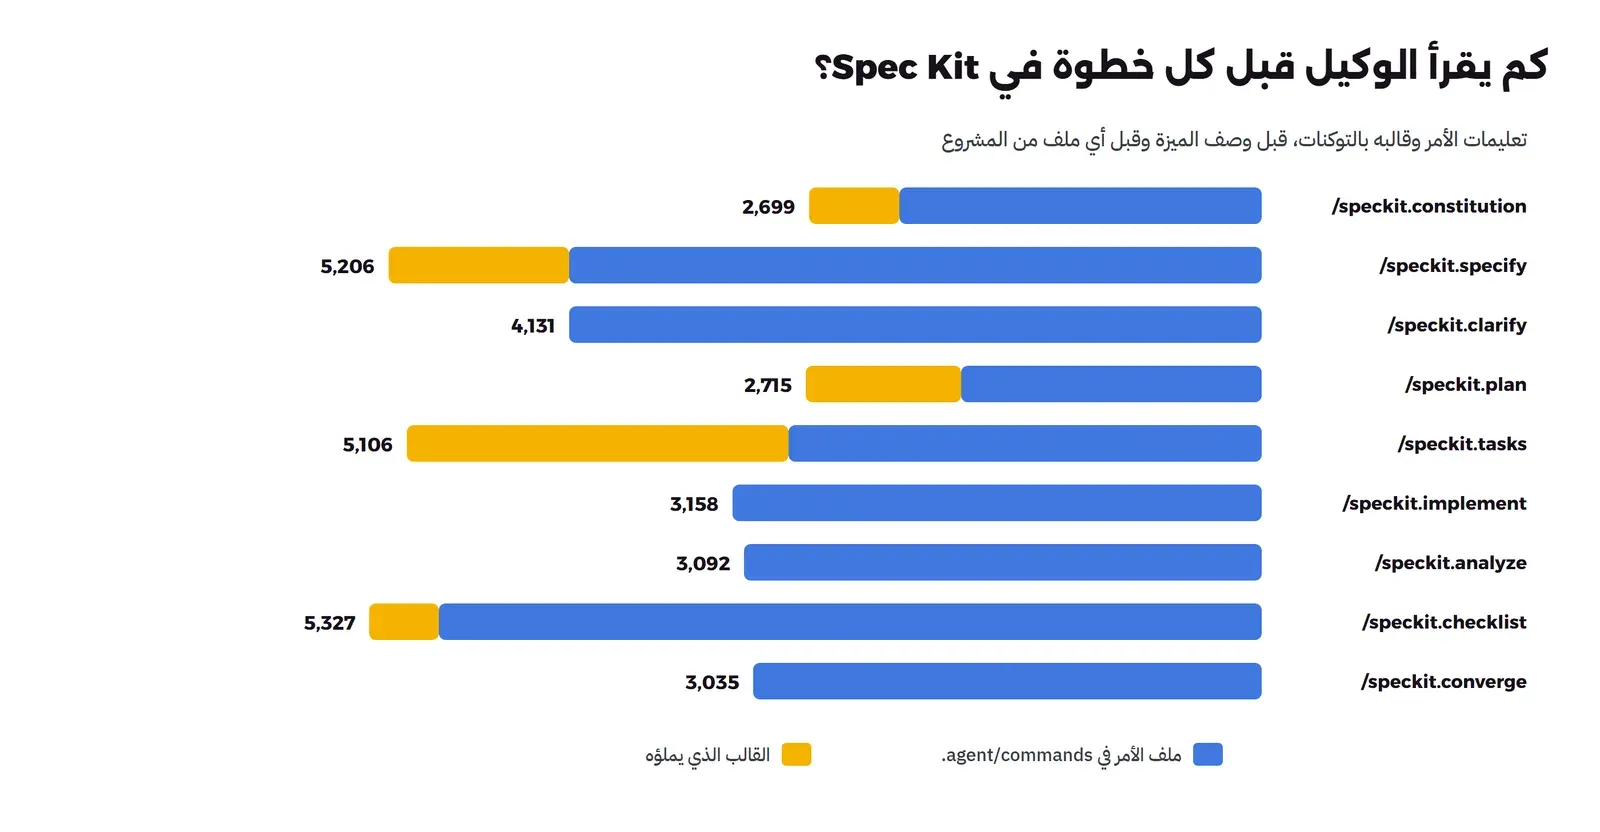
أي أن الأمر /speckit.specify وحده حوالي 4,100 توكن من التعليمات، ومعه القالب 1,077 توكناً، وهذا قبل وصف الميزة وقبل أي ملف من المشروع، وتعليماته تطلب من الوكيل أن يفحص ملف الإضافات Extensions ويشغل السكربتات وينشئ الفرع ويكتب المواصفة ثم قائمة تحقق ثم يراجع نفسه. وهذا مناسب لوكيل كبير في السحابة، أما نموذج 3B على معالج عادي فيحتاج دقائق ليقرأ هذه التعليمات وحدها، ولا يستطيع أن ينفذ عشرين خطوة متتالية بأدوات، كما رأينا في دليل الوكيل بنموذج محلي. ولذلك فإن المختبر يستعمل قوالب Spec Kit نفسها وترتيب خطواته، ولكن بتعليمات قصيرة يكتبها السكربت بدل ملفات الأوامر الطويلة، وهذا فرق يجب أن تعرفه عندما تقرأ النتائج.
مع وكيلك الحقيقي: كيف تبدأ؟
المختبر شغل القوالب بنموذج محلي صغير، أما في العمل اليومي فأنت تستعمل Spec Kit مع وكيل تعرفه، والأداة تجهز المستودع له بالخيار --integration، وشرح الأمر specify init --help يذكر أمثلة منها claude وcodex وgemini وcopilot، وأن Copilot هو الاختيار الافتراضي عندما لا يكون هناك من يجيب على الأسئلة، وأن التكامل مع Claude يثبت الأوامر كمهارات Skills افتراضياً، وهي المهارات نفسها التي شرحناها في مقال المهارات في هذه المرحلة. وفي مشروع موجود تشغله في مجلده الحالي:
uv tool install specify-cli==1.4.2
cd my-project
specify init --here --integration claude
ثم تكتب الأوامر في محادثة الوكيل لا في الطرفية Terminal، أمراً بعد أمر، وتراجع ملف كل أمر قبل التالي، وملف README يعرضها بصيغة المهارات مثل /speckit-specify متبوعاً بوصف الميزة، ويذكر أن صيغة الاستدعاء تختلف من وكيل إلى آخر. وللأداة إضافات Extensions بطرق عمل أخرى، منها طريقة لإصلاح الأخطاء تثبتها بالأمر specify extension add bug، وتقيم السبب ثم تصلح ثم تتحقق، وتنتهي بحكم من ثلاثة: verified أو partial أو failed، وطريقة لتقييم فكرة قبل أن تبدأ فيها. وتحذر الأداة نفسها في ملف README من أن وجود إضافة في قائمة الإضافات ليس مراجعة لأمانها، وأن عليك أن تقرأ كودها قبل أن تثبتها، وهي النصيحة نفسها التي قلناها عن المهارات وسيرفرات MCP، لأن الثلاثة تعليمات وكود يعملان بصلاحيات وكيلك.
المواصفة والخطة والمهام: ما الفرق؟
الفصل بين الملفات الثلاثة هو أهم فكرة في الطريقة، لأن كل ملف يجيب عن سؤال مختلف ويقرؤه شخص مختلف:
- المواصفة
spec.md: ماذا ولماذا. قالب Spec Kit يبدأ بقصص المستخدم User Stories مرتبة بالأولوية، ولكل قصة سيناريوهات قبول بصيغة «Given… When… Then…»، ثم المتطلبات الوظيفية Functional Requirements مرقمة مثلFR-001، ثم معايير النجاح Success Criteria، ثم الافتراضات Assumptions. ولا يجب أن يكون فيها ذكر للغة أو مكتبة، لأنها تكتب بلغة صاحب المنتج، ويراجعها هو. - الخطة
plan.md: كيف. فيها اللغة والمكتبات وبنية الملفات والقيود التقنية ونتيجة فحص المبادئ في الدستور، ويراجعها المهندس. - المهام
tasks.md: بأي ترتيب. قائمة بصيغة- [ ] T001 [P] [US1] الوصف ومسار الملف، والعلامة[P]تعني أن المهمة يمكن أن تنفذ بالتوازي مع غيرها، و[US1]تربطها بقصة المستخدم الأولى، والمهام مقسمة إلى مراحل: التجهيز، ثم الأساسيات، ثم مرحلة لكل قصة، ثم التحسينات.
وفي قالب المواصفة نقطة دقيقة تستحق الانتباه: عندما لا يحدد الطلب شيئاً مهماً، يكتب الوكيل في مكانه [NEEDS CLARIFICATION: السؤال] بدل أن يخمن، والقالب نفسه يضرب مثالاً بطريقة تسجيل الدخول ومدة الاحتفاظ بالبيانات. ولكن تعليمات الأمر /speckit.specify تحد ذلك بثلاث علامات على الأكثر، وتطلب من الوكيل أن يخمن تخميناً معقولاً حسب المعايير المعروفة في الباقي، وأن يكتب ما خمنه في قسم الافتراضات. ثم يأتي الأمر /speckit.clarify فيسأل خمسة أسئلة على الأكثر، سؤالاً بعد سؤال، ويكتب الإجابات في المواصفة تحت قسم ## Clarifications. وهذا التوازن مقصود، لأن الوكيل الذي يسأل عن كل شيء يتعبك، والذي لا يسأل عن شيء يقرر عنك، والقرار لك أنت في النهاية: اقرأ قسم الافتراضات، فهو المكان الذي تختبئ فيه القرارات التي لم توافق عليها.
الأوامر التي تفحص قبل أن تكتب: الدستور والتحليل وقوائم التحقق
الأوامر الأربعة الأساسية تكتب الملفات، وحولها أوامر أخرى دورها أن تفحص ما كتب قبل أن يصبح كوداً، وهي ما يميز Spec Kit عن أن تطلب من الوكيل «اكتب خطة أولاً»:
- الدستور Constitution: قالب
constitution.mdفيه مكان لخمسة مبادئ ولكل واحد مثال في تعليق، مثل «كل ميزة تبدأ مكتبة مستقلة» و«الاختبار أولاً، وهذا غير قابل للتفاوض»، ثم قسم للقيود الإضافية وقسم لطريقة العمل وقسم للحوكمة Governance، وفي آخره رقم إصدار وتاريخ اعتماد وتاريخ آخر تعديل. أي أن المبادئ تعامل كوثيقة لها نسخ، لا كملاحظات عابرة. - التحليل
/speckit.analyze: يعمل بعد المهام وقبل التنفيذ، وتعليماته تقول إنه للقراءة فقط ولا يعدل أي ملف، ويبحث في الملفات الثلاثة عن التكرار، والكلمات الغامضة مثل «سريع» و«آمن» دون معيار يقاس، والمتطلبات التي لا مهمة لها، والمهام التي لا متطلب لها، وأي تعارض مع الدستور، ويعتبر التعارض مع الدستور خطأً حرجاً يصحح في المواصفة أو الخطة، لا في الدستور. - قوائم التحقق
/speckit.checklist: تعليماته تشرحه بتشبيه جيد: إذا كانت المواصفة كوداً مكتوباً بالإنجليزية، فقائمة التحقق هي اختباراتها، أي أنها تفحص هل المتطلبات مكتوبة بشكل كامل وواضح، لا هل الكود يعمل، ويمنع الأمر الوكيل من أن يعلم البنود بأنها تمت، لأن ذلك عمل المراجع. - التقارب
/speckit.converge: يعمل بعد التنفيذ، فيقارن الكود بالمواصفة والخطة والمهام، فإذا وجد شيئاً ناقصاً أضاف مهام جديدة ولم يحذف أي كود، وإذا لم يجد شيئاً كتب أن التنفيذ «تقارب» Converged، وملف README يقترح أن تكرر التنفيذ والتقارب حتى تصل إلى هذه النتيجة.
ولاحظ أن كل هذه الأوامر يقوم بها الوكيل نفسه، أي أن النموذج الذي كتب المواصفة هو الذي يفحصها، ولذلك فإن قيمتها الحقيقية في أنها تضع أمامك أنت قائمة بما يحتاج نظرك، لا في أنها تضمن أن كل شيء صحيح.
المختبر: ميزة الغرامات المتأخرة بثلاث طرق
الميزة في المختبر صغيرة عمداً، وهي دالة late_fee(invoice, today) في الملف latefees/fees.py تحسب غرامة التأخير لفاتورة متأخرة بالهللات، والمستودع فيه فقط نموذج الفاتورة التالي:
"""Invoice model of the billing service."""
from dataclasses import dataclass
from datetime import date


@dataclass
class Invoice:
    id: int
    amount_halalas: int      # 1 SAR = 100 halalas
    due_date: date
    status: str              # "open", "paid" or "void"
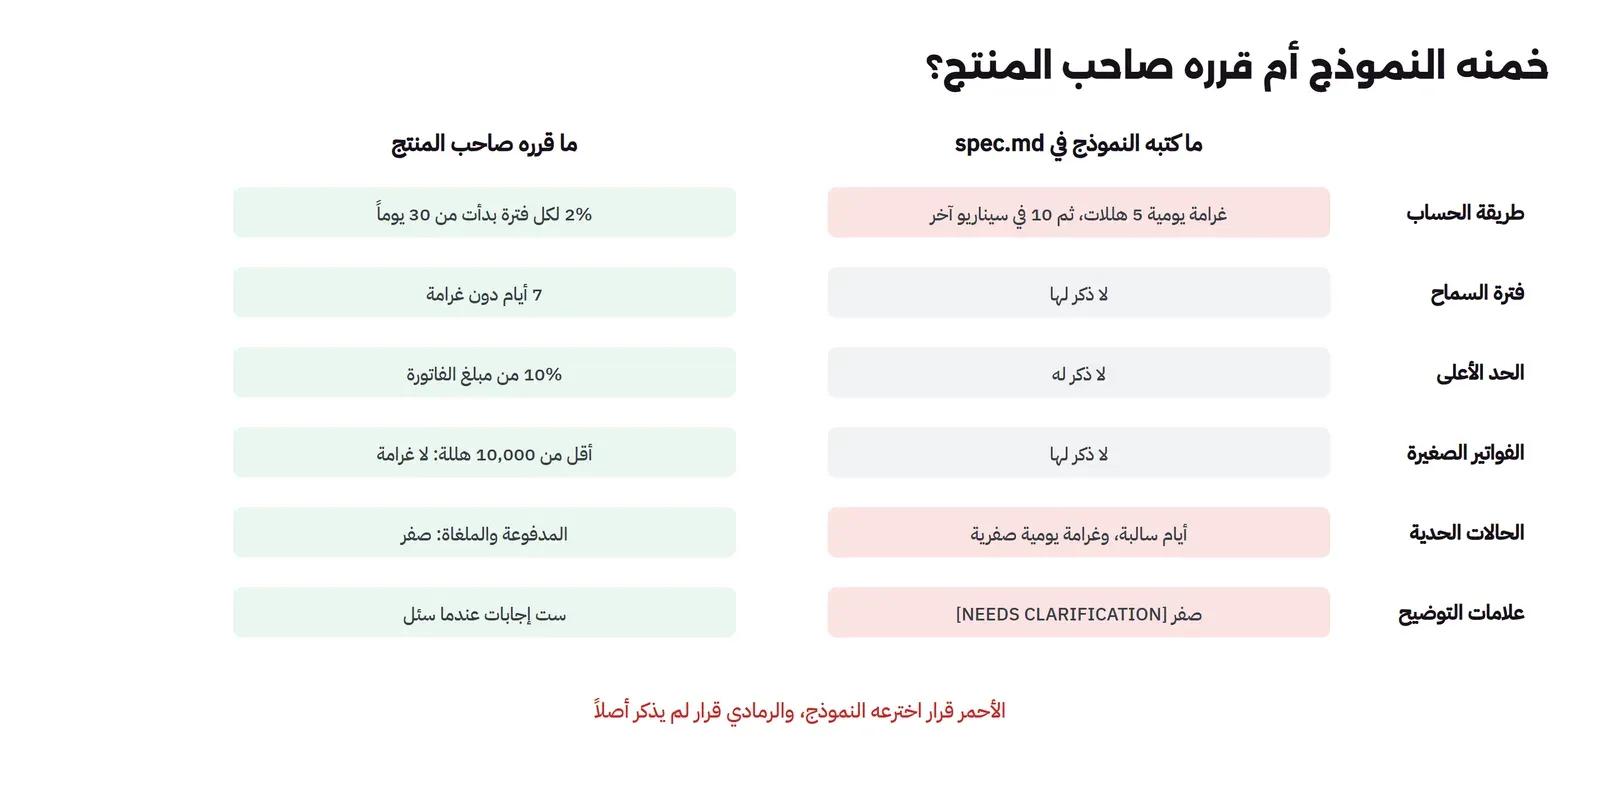
وقبل أن يبدأ أي نموذج كتبنا القرارات التي يعطيها صاحب المنتج لو سئل، في الملف decisions.md:
# Decisions (the answers a product owner gives when asked)
1. Grace period: 7 days after the due date, no fee.
2. Fee: 2% of the invoice amount for each started 30-day period after the grace period.
3. Cap: the total fee never exceeds 10% of the invoice amount.
4. Only open invoices get a fee; paid and void invoices get 0.
5. Invoices under 100 SAR (10,000 halalas) get no fee.
6. Money is int halalas; a percentage is (amount * percent + 50) // 100, round half up.
ثم كتبنا من هذه القرارات عشرة اختبارات قبول في الملف hidden/test_fees.py، مثل أن الفاتورة في اليوم السابع بعد الاستحقاق غرامتها صفر، وفي اليوم الثامن 2% من المبلغ، وأن الغرامة بعد 400 يوم لا تتجاوز 10%، وأن فاتورة من 10,025 هللة غرامتها 201 هللة لأن 200.5 تقرب إلى الأعلى. ولكي نتأكد أن الاختبارات نفسها صحيحة، كتبنا تطبيقاً مرجعياً من 15 سطراً ونجح في الاختبارات العشرة، ثم أبعدناه عن النموذج. والنموذج لا يرى الاختبارات في أي طريقة، والسكربت sdd.py يشغلها بعد كل محاولة.
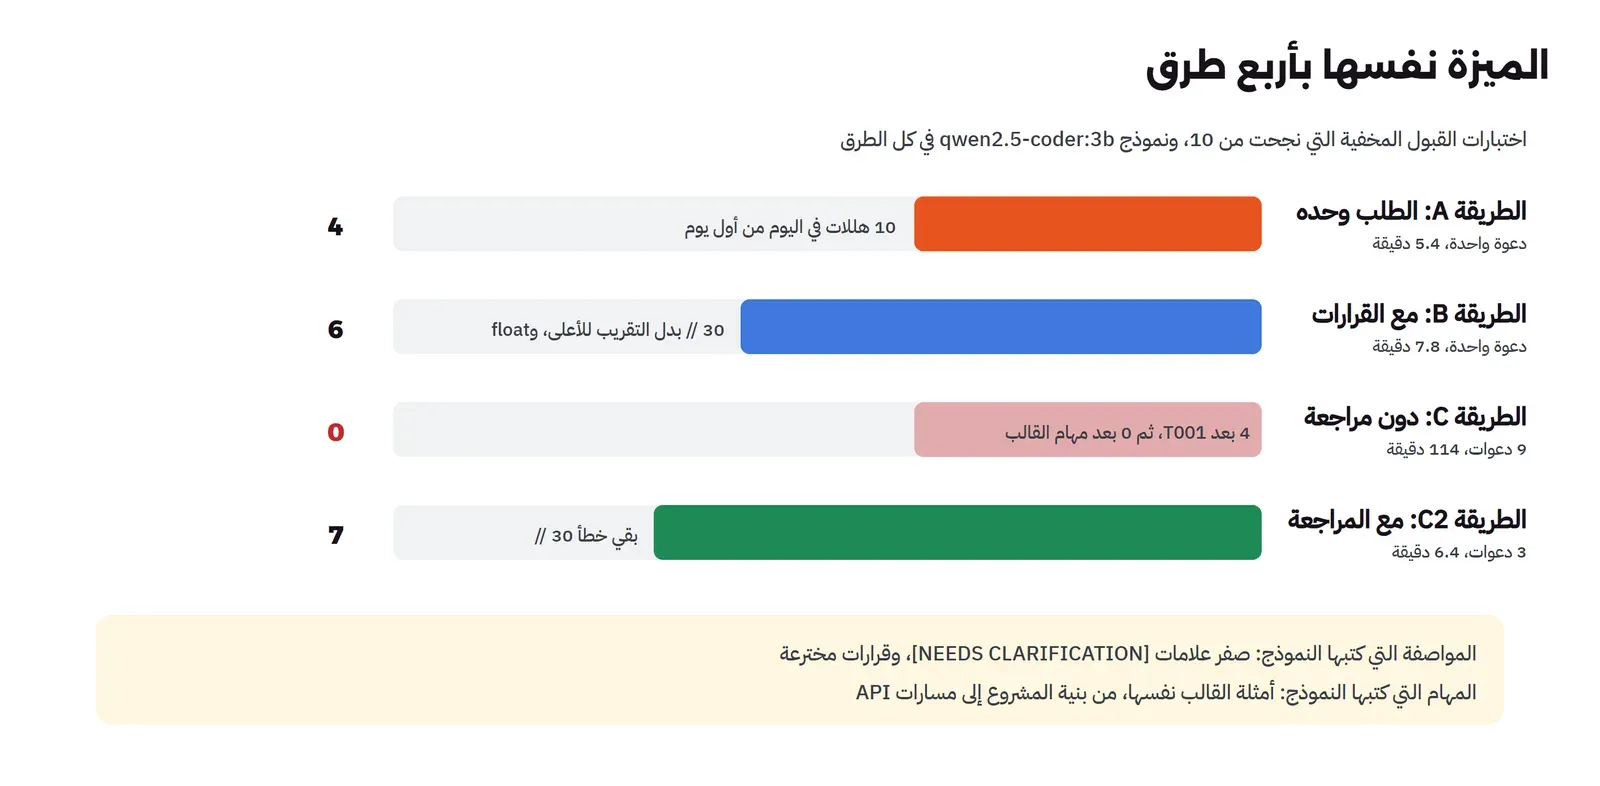
والطرق الثلاث كما يلي، والنموذج في الثلاث qwen2.5-coder:3b على Ollama 0.40.13، بدرجة حرارة صفر ونافذة 16384 توكناً، والطلب الأصلي في الثلاث هو الجملة نفسها: «أضف غرامات التأخير للفواتير المتأخرة: دالة late_fee(invoice, today) في latefees/fees.py ترجع غرامة الفاتورة بالهللات».
- الطريقة A، الطلب وحده: الطلب ونموذج الفاتورة، ثم الكود مباشرة، وهذا ما يفعله أغلبنا كل يوم.
- الطريقة B، الطلب مع القرارات: الطلب نفسه ومعه القرارات الست كما هي، دون مواصفة ولا خطة.
- الطريقة C، من المواصفة: النموذج يملأ قالب المواصفة
spec-template.mdمن الطلب وحده ويضع علامة[NEEDS CLARIFICATION]على ما لا يعرفه، ثم نضيف نحن إجابات صاحب المنتج تحت## Clarificationsكما يفعل الأمر/speckit.clarify، ثم يكتب النموذج الخطة منplan-template.md، ثم المهام منtasks-template.md، ثم ينفذ المهام واحدة بعد أخرى، ونشغل الاختبارات بعد كل مهمة.
والمقارنة بين A وB تقيس قيمة المعلومة نفسها، والمقارنة بين B وC تقيس قيمة الطريقة، أي هل تضيف المواصفة والخطة والمهام شيئاً فوق أن تعطي النموذج القرارات مباشرة. وهذا تمييز مهم، لأن كثيراً مما يقال عن التطوير من المواصفة يخلط بين الاثنين.
الطريقة A: الطلب وحده
النموذج قرأ 170 توكناً وكتب 109، وأخذ ذلك 5.4 دقيقة على المعالج المشغول، والمخرج سوف يكون كما يلي:
A: request only                    hidden tests 4/10
model calls 1, prompt tokens 170, generated 109, model time 5.4 min, wall 5.4 min
والكود الذي كتبه كاملاً كما يلي:
from datetime import date
from latefees.models import Invoice


def late_fee(invoice: Invoice, today: date) -> int:
    """Calculate the late fee for an overdue invoice."""
    if invoice.status == "open" and invoice.due_date < today:
        days_overdue = (today - invoice.due_date).days
        late_fee_amount = days_overdue * 10  # 10 halalas per day
        return late_fee_amount
    return 0
وهذا هو المثال الذي بدأنا به المقال حرفياً، فالكود سليم ومقروء ويعمل، ولكنه قرر وحده أن الغرامة عشر هللات في اليوم من أول يوم تأخير، دون فترة سماح ولا حد أعلى ولا حد أدنى للفاتورة. والاختبارات الأربعة التي نجحت هي الحالات التي لا تحتاج قراراً: فاتورة لم يحن موعدها، وفاتورة مدفوعة، وفاتورة ملغاة، ونوع الرد int، أما كل اختبار فيه قاعدة من قواعد الشركة ففشل، مثل اختبار الحد الأعلى الذي توقع 10,000 هللة فرجع 4,000. ولاحظ أن النموذج لم يسأل شيئاً، لأن الطلب لم يقل له إن هناك ما يسأل عنه، وهذا سلوك أغلب الوكلاء: يكملون الفراغ بتخمين معقول ويكملون.
الطريقة B: الطلب مع القرارات
الطلب نفسه ومعه القرارات الست، والمخرج سوف يكون كما يلي:
B: request + decisions             hidden tests 6/10
model calls 1, prompt tokens 317, generated 204, model time 7.8 min, wall 7.8 min
والكود كاملاً كما يلي:
def late_fee(invoice: Invoice, today: date) -> int:
    """Calculate the late fee for an overdue invoice."""
    if invoice.status != "open":
        return 0

    if invoice.amount_halalas < 10000:
        return 0

    grace_period = 7
    fee_rate = 0.02
    cap = 0.10

    days_overdue = (today - invoice.due_date).days
    if days_overdue <= grace_period:
        return 0

    periods_overdue = (days_overdue - grace_period) // 30
    total_fee = min(periods_overdue * invoice.amount_halalas * fee_rate, invoice.amount_halalas * cap)

    # Round half up
    return (total_fee * 100 + 50) // 100
في الكود أعلاه لاحظ التالي:
- القرارات التي لها رقم واضح طبقها كلها: فترة السماح 7 أيام، والحالة
openوحدها، والحد الأدنى 10,000 هللة، والحد الأعلى 10%، ولذلك نجح من 4 اختبارات إلى 6. - القرار الثاني يقول «لكل فترة بدأت من 30 يوماً»، والنموذج كتب
// 30، أي القسمة التي تقرب إلى الأسفل، فاليوم الأول بعد السماح يعطي صفر فترات وصفر غرامة، والصحيح فترة واحدة. وكلمة «بدأت» Started هي كل الفرق بين التقريب إلى الأسفل والتقريب إلى الأعلى، والنموذج الصغير لم يلتقطها، ففشل اختبار اليوم الثامن واختبار الفترة الثانية. - القرار السادس يقول إن المال
intوإن النسبة تحسب بالأعداد الصحيحة بصيغة محددة، والنموذج استعمل0.02و0.10، أي أعداداً عشرية Float، ثم طبق صيغة التقريب على نتيجة عشرية، فرجعfloatبدلint، وفشل اختبار النوع واختبار التقريب.
أي أن المعلومة وحدها رفعت النتيجة، ولكن النموذج الصغير لم يطبق كل ما قرأه، وهذا ما يجعل اختبارات القبول ضرورية مهما كانت المواصفة جيدة: القرار المكتوب لا يعني أن الكود يتبعه.
الطريقة C: من المواصفة، وأين انحرف كل شيء
الطريقة الثالثة أخذت تسع دعوات للنموذج، وقرأ فيها 16,822 توكناً وكتب 4,570، وأخذت 114 دقيقة، والمخرج سوف يكون كما يلي:
spec: 596 words, 0 [NEEDS CLARIFICATION] markers
tasks: 6
    T001 Create project structure per implementation plan
C: after T001 Cre                  hidden tests 4/10
    T002 Initialize Python project with necessary dependencies
C: after T002 Ini                  hidden tests 4/10
    T003 [P] Configure linting and formatting tools
C: after T003 [P]                  hidden tests 0/10
    T004 Setup database schema and migrations framework
C: after T004 Set                  hidden tests 0/10
    T005 [P] Implement authentication/authorization framework
C: after T005 [P]                  hidden tests 0/10
    T006 [P] Setup API routing and middleware structure
C: after T006 [P]                  hidden tests 0/10
model calls 9, prompt tokens 16822, generated 4570, model time 114.3 min, wall 114.3 min
وهذا المخرج يستحق أن نقرأه خطوة خطوة، لأن كل خطوة فشلت بطريقة مختلفة، وكل فشل منها درس في الطريقة نفسها:
- المواصفة لم تسأل شيئاً: طلبنا من النموذج أن يكتب
[NEEDS CLARIFICATION]عند كل قرار لا يعرفه، فكتب صفر علامات، وبدل ذلك اخترع القرارات في سيناريوهات القبول، مثل «فاتورة متأخرة 10 أيام وغرامة يومية 5 هللات… فترجع الدالة 10 هللات»، وهي أرقام لا وجود لها في الطلب ولا تتسق مع نفسها. وبقيت في المواصفة أجزاء من القالب كما هي، مثل[DATE]و[Entity 1]وقسم الافتراضات Assumptions كاملاً بأمثلته الأصلية عن الاتصال بالإنترنت والدخول الموحد. أي أن أهم ما في الطريقة، أن يظهر ما لا يعرفه الوكيل، لم يحدث، وهذا يتفق مع ما رأيناه في الطريقة A: النموذج يفضل أن يخمن على أن يسأل. - الخطة نسخت القالب: بعد أن أضفنا إجابات صاحب المنتج إلى المواصفة، كتب النموذج خطة صحيحة في أولها، Python 3.12 دون مكتبات وunittest، ثم نسخ بقية القالب بشجرة مجلدات فيها
research.mdوdata-model.mdوcontracts/لميزة هي دالة واحدة. - المهام هي أمثلة القالب نفسها: قالب المهام فيه تعليق واضح يقول إن المهام التي فيه أمثلة للتوضيح فقط، وإن الأمر يجب أن يستبدلها بمهام حقيقية من المواصفة، والنموذج نسخ الأمثلة حرفاً حرفاً: إنشاء بنية المشروع، وتهيئة الاعتماديات، وأدوات الفحص، ومخطط قاعدة البيانات Database، والمصادقة والصلاحيات Permissions، ومسارات API. ولا واحدة منها لها علاقة بالغرامة.
- التنفيذ أطاع المهام الخاطئة: بعد المهمة الأولى كتب النموذج دالة الغرامة، ونجحت في 4 اختبارات من 10، أي مثل الطريقة A، مع أن القرارات كانت أمامه في المواصفة، فقد حسب 2% من المبلغ لكل يوم بدل كل فترة، وطبقها حتى في أيام السماح. ثم جاءت مهمة أدوات الفحص فأضاف
from . import linting، ثم مهمة قاعدة البيانات فأضافfrom .database import db, session، واقترح في الرد نفسه نموذجاً بمكتبة SQLAlchemy، ثم المصادقة فأضاف معاملاً جديداًuser_idإلى الدالة وفحصاً للصلاحيات، ثم المسارات فأضافsetup_routes()في أول الملف. وكل هذه الوحدات غير موجودة، فلم يعد الملف يحمل أصلاً، ونزلت النتيجة إلى صفر:
ImportError: Failed to import test module: test_fees
ImportError: cannot import name 'linting' from 'latefees' (/r/latefees/__init__.py)
وقد يتساءل البعض: أليس هذا ظلماً للطريقة، لأنكم لم تراجعوا المهام قبل التنفيذ؟ والإجابة نعم، وهذا مقصود، فالمختبر أراد أن يرى ماذا يحدث عندما تشغل الخطوات آلياً دون أن تقف عند الدوائر الصفراء في الشكل الأول، وهذا ما يفعله من يكتب الأوامر الأربعة متتالية ثم يذهب ليشرب قهوته. وأي إنسان يقرأ tasks.md لثلاثين ثانية كان سيرى أن «Setup API routing» لا علاقة لها بدالة غرامة، ولذلك أعدنا التجربة بالمراجعة كما يلي.
الطريقة C مع المراجعة: ثلاث مهام كتبها إنسان
في الإعادة أخذنا مواصفة التشغيل السابق كما هي مع قسم التوضيح، ولكن بدل المهام الست التي نسخها النموذج من القالب، كتبنا ما يكتبه مطور بعد ثلاثين ثانية من قراءة tasks.md: ثلاث مهام صغيرة بصيغة القالب نفسها، الأولى للحالات التي ترجع صفراً، والثانية لحساب الغرامة، والثالثة للحد الأعلى، ثم نفذها النموذج مهمة بعد مهمة كما في التشغيل السابق. والمخرج سوف يكون كما يلي:
    T001 [US1] In latefees/fees.py add late_fee(invoice, today) that returns 0 unless the invoice is open, at leas
C2: after T001                     hidden tests 6/10
    T002 [US1] In latefees/fees.py compute the fee: 2% of amount_halalas for each started 30-day period after the
C2: after T002                     hidden tests 6/10
    T003 [US1] In latefees/fees.py cap the fee at 10% of amount_halalas, computed the same way
C2: after T003                     hidden tests 7/10
model calls 3, prompt tokens 4343, generated 611, model time 6.4 min, wall 6.5 min
والكود النهائي كما يلي:
def late_fee(invoice: Invoice, today: date) -> int:
    if invoice.status != "open":
        return 0
    if invoice.amount_halalas < 10000:
        return 0
    if (today - invoice.due_date).days < 7:
        return 0

    # Calculate the number of 30-day periods after the grace period
    grace_days = 7
    periods = (today - invoice.due_date).days - grace_days
    periods = periods // 30

    # Calculate the late fee
    late_fee_amount = 0
    for _ in range(periods):
        late_fee_amount += (invoice.amount_halalas * 2) // 100

    # Round half up
    late_fee_amount = (late_fee_amount * 100 + 50) // 100

    # Cap the fee at 10% of the invoice amount
    if late_fee_amount > invoice.amount_halalas * 0.1:
        late_fee_amount = invoice.amount_halalas * 0.1

    return late_fee_amount
في الكود أعلاه لاحظ التالي:
- 7 اختبارات من 10، وهي أعلى نتيجة في المختبر، في ثلاث دعوات و6.4 دقيقة فقط، بينما أخذت الطريقة C دون مراجعة 114 دقيقة لتصل إلى صفر. أي أن ثلاثين ثانية من قراءة إنسان غيرت النتيجة أكثر من كل الملفات التي كتبها النموذج.
- الخطأ الذي بقي هو نفسه خطأ الطريقة B حرفياً: «لكل فترة بدأت» تحولت إلى
// 30، أي التقريب إلى الأسفل، فاليوم الأول بعد السماح غرامته صفر. والكلمة كانت في القرارات وفي نص المهمة الثانية، أي أن الخطأ ليس في نقص المعلومة، وإنما في فهم النموذج الصغير لها، ولا يكشفه إلا اختبار. - التقريب في السطر
(late_fee_amount * 100 + 50) // 100لا يفعل شيئاً، لأن الرقم صحيح أصلاً، والتقريب الحقيقي ضاع لأن النسبة حسبت لكل فترة على حدة وقطعت، ولذلك فشل اختبار الفاتورة 10,025. - الحد الأعلى يستعمل
invoice.amount_halalas * 0.1، أي عدداً عشرياً، فالدالة ترجع10000.0في حالة الحد. واختبار الحد نجح لأن10000.0 == 10000في Python، واختبار النوع نجح لأنه يفحص حالة أخرى، أي أن في الكود خطأ لم تلتقطه اختباراتنا العشرة، وهذا تذكير بأن الاختبارات نفسها تحتاج مراجعة.
ماذا كتب النموذج في المواصفة؟
المواصفة التي كتبها النموذج في الطريقة C تستحق أن نقرأ منها جزءاً، لأنها تبين الفرق بين مواصفة تبدو كاملة ومواصفة تقرر شيئاً. والجزء الأول منها كما يلي:
### User Story 1 - Calculate Late Fees for Overdue Invoices (Priority: P1)

**Why this priority**: Late fees are a critical feature for managing overdue invoices, ensuring timely payment and maintaining financial health.

**Acceptance Scenarios**:

1. **Given** An invoice with an overdue date of 10 days and a daily late fee of 5 halalas, **When** the function `late_fee(invoice, today)` is called with today's date as 15 days, **Then** the function returns 10 halalas.
2. **Given** An invoice with an overdue date of 15 days and a daily late fee of 10 halalas, **When** the function `late_fee(invoice, today)` is called with today's date as 20 days, **Then** the function returns 20 halalas.

### User Story 2 - Handle Negative Overdue Days (Priority: P2)
...
- **FR-002**: The function `late_fee(invoice, today)` MUST handle negative overdue days by returning 0.
- **FR-003**: The function `late_fee(invoice, today)` MUST handle invoices with a daily late fee of 0 halalas by returning 0.
في المواصفة أعلاه لاحظ التالي:
- كل شيء في مكانه من القالب: قصص مستخدم بالأولوية، وسيناريوهات قبول بصيغة Given وWhen وThen، ومتطلبات مرقمة بالكلمة MUST، ولذلك فإن القراءة السريعة تعطي انطباعاً بأن العمل تم.
- القرار الأساسي، أي كيف تحسب الغرامة، اخترعه النموذج: «غرامة يومية من 5 هللات» في السيناريو الأول و«10 هللات» في الثاني، أي أن المواصفة نفسها تتناقض، والحساب فيها لا يطابق ما تقوله، فعشرة أيام بخمس هللات ليست 10 هللات.
- لا توجد علامة
[NEEDS CLARIFICATION]واحدة، مع أن تعليماتنا طلبت ذلك صراحة، ومع أن قالب Spec Kit نفسه فيه مثالان لهذه العلامة. - القصتان الثانية والثالثة عن حالات حدية، أي الأيام السالبة والغرامة الصفرية، وهي حالات اخترعها النموذج من قراره الأول، بينما الحالات الحدية الحقيقية للشركة، أي فترة السماح والحد الأدنى للفاتورة والحد الأعلى للغرامة، غائبة تماماً.
وهذا هو الخطر الذي ذكرناه في الدروس: المواصفة الرسمية الشكل تجعل التخمين يبدو قراراً. ولو أن مراجعاً قرأها لسأل في السطر الأول «من قال إن الغرامة يومية؟»، وهذا السؤال وحده هو الفائدة الحقيقية للمواصفة، ولذلك فإن الشكل التالي يضع ما خمنه النموذج بجانب ما قرره صاحب المنتج:
مواصفة من صفحة واحدة لميزة صغيرة
إذا كانت القوالب الكاملة أكبر من الميزة، فما الذي يكفي؟ والإجابة من المختبر نفسه: ما رفع النتيجة هو القرارات والمهام الصغيرة واختبارات القبول، لا الأقسام الكثيرة. والمواصفة التالية هي ما نكتبه نحن لهذه الميزة، بالإنجليزية لأنها تقرأ مع الكود، في ملف specs/001-late-fees/spec.md:
# Late fees for overdue invoices

## What and why
Open invoices that are paid late get a late fee, so customers pay on time.

## Rules (decided by the product owner)
1. No fee during a 7-day grace period after `due_date`.
2. 2% of the amount for each started 30-day period after the grace period.
3. The total fee never exceeds 10% of the amount.
4. Only `open` invoices; `paid` and `void` get 0.
5. No fee for invoices under 10,000 halalas.
6. Money is `int` halalas; a percentage is `(amount * percent + 50) // 100`.

## Acceptance examples (amount 100,000 unless noted, due 2026-03-01)
| today      | expected fee |
|------------|--------------|
| 2026-03-08 | 0            |
| 2026-03-09 | 2,000        |
| 2026-04-08 | 4,000        |
| 2027-04-05 | 10,000       |
| 2026-03-09, amount 10,025 | 201 |

## Out of scope
Showing the fee on the PDF, emails, partial payments.
في المواصفة أعلاه لاحظ التالي:
- القرارات الست مكتوبة كقواعد مرقمة، كل واحدة في سطر، ومن قررها مكتوب في العنوان، فلا يخلط أحد بين القرار والتخمين.
- الأمثلة في جدول بتواريخ وأرقام حقيقية، وكل سطر منها يتحول إلى اختبار مباشرة، والسطر الثالث مثلاً هو اليوم 38 بعد الاستحقاق، أي فترتان بدأتا بعد السماح، وهو الاختبار الذي فشل فيه النموذج مرتين. ولو كان المثال أمام النموذج لكان أصعب عليه أن يقرأ «بدأت» على أنها «اكتملت».
- قسم «خارج النطاق» Out of scope يمنع الوكيل من أن يضيف ما لم يطلب، وهو ما فعله النموذج في الطريقة C عندما أضاف المصادقة ومسارات API.
وهذه الصفحة تكتب في عشر دقائق، وتقرأ في دقيقتين، وتبقى في المستودع لمن يسأل بعد سنة لماذا الغرامة 2%، وهي ما ننصح به لأغلب الميزات التي فيها قواعد عمل، أما القوالب الكاملة فلميزة تلمس عدة فرق وعدة أنظمة.
ماذا يعلمنا المختبر عن الطريقة نفسها؟
من السهل أن تقرأ النتائج وتقول إن نموذج 3B ضعيف، وهذا صحيح، ولكن كل فشل رأيناه هو نسخة مكبرة من فشل يحدث مع النماذج الكبيرة بنسبة أقل، ولذلك فإن الدروس تنطبق على أي وكيل:
- المعلومة تصنع أكبر فرق: القرارات الست وحدها، دون أي ملف، رفعت النتيجة من 4 إلى 6. والسبب أن الاختبارات تقيس قرارات الشركة، والنموذج لا يعرفها إلا إذا قيلت له.
- الطريقة لا تفيد إذا لم يسأل الوكيل: قيمة المواصفة أن تظهر الأسئلة قبل الكود، والنموذج الذي لا يكتب علامة توضيح واحدة يحول المواصفة إلى تخمين مكتوب بشكل رسمي، وهذا أخطر من التخمين غير المكتوب، لأنه يبدو كأن أحداً قرره.
- القوالب الطويلة سيف ذو حدين: القالب يعلم النموذج الشكل، والنموذج الصغير ينسخ الشكل والأمثلة معاً، والكبير قد يفعل ذلك أحياناً، وهذا ما وصفته Böckeler عن ملفات مكررة ومهام لا تلزم.
- المراجعة بين الخطوات هي الطريقة: الملف المكتوب فرصة لإنسان أن يصحح القرار قبل أن يصبح كوداً، فإذا لم يقرأه أحد فلا فرق بينه وبين الطلب الطويل.
- الطريقة لها ثمن في الوقت والتوكنات: الطريقة C قرأت 16,822 توكناً وكتبت 4,570 في 114 دقيقة، والطريقة B قرأت 317 وكتبت 204 في أقل من ثماني دقائق، وفي خدمة سحابية يتحول هذا الفرق إلى فاتورة، وفي نموذج محلي إلى انتظار، ولذلك فإن الخطوات التي لا يقرؤها أحد هي أغلى جزء في العمل وأقله فائدة.
- الاختبار هو الحكم: في الطرق كلها، الشيء الوحيد الذي أخبرنا بالحقيقة هو الاختبارات العشرة المخفية، لا المواصفة ولا الخطة ولا ثقة النموذج.
متى يستحق الأمر هذه الخطوات؟
مقال Böckeler يذكر تجربتين تستحقان أن تقرأهما قبل أن تقرر: الأولى أنها طلبت من Kiro إصلاح خطأ صغير، فحولت وثيقة المتطلبات هذا الخطأ إلى أربع قصص مستخدم فيها 16 معيار قبول، ووصفت ذلك بأنه استعمال مطرقة ثقيلة لجوزة صغيرة، والثانية أنها جربت Spec Kit على ميزة متوسطة، فأنشأ ملفات Markdown كثيرة متكررة فيما بينها ومع الكود الموجود، وكانت مراجعتها مملة، وكتبت أنها تفضل مراجعة الكود على مراجعة كل هذه الملفات. وذكرت أيضاً أن الوكيل تجاهل في إحدى المرات ملاحظة في الخطة تقول إن الكلاسات موجودة أصلاً، فكتبها من جديد وصنع نسخاً مكررة. أي أن الملف المكتوب لا يضمن أن الوكيل سوف يتبعه، وهذا ما رأيناه في المختبر أيضاً.
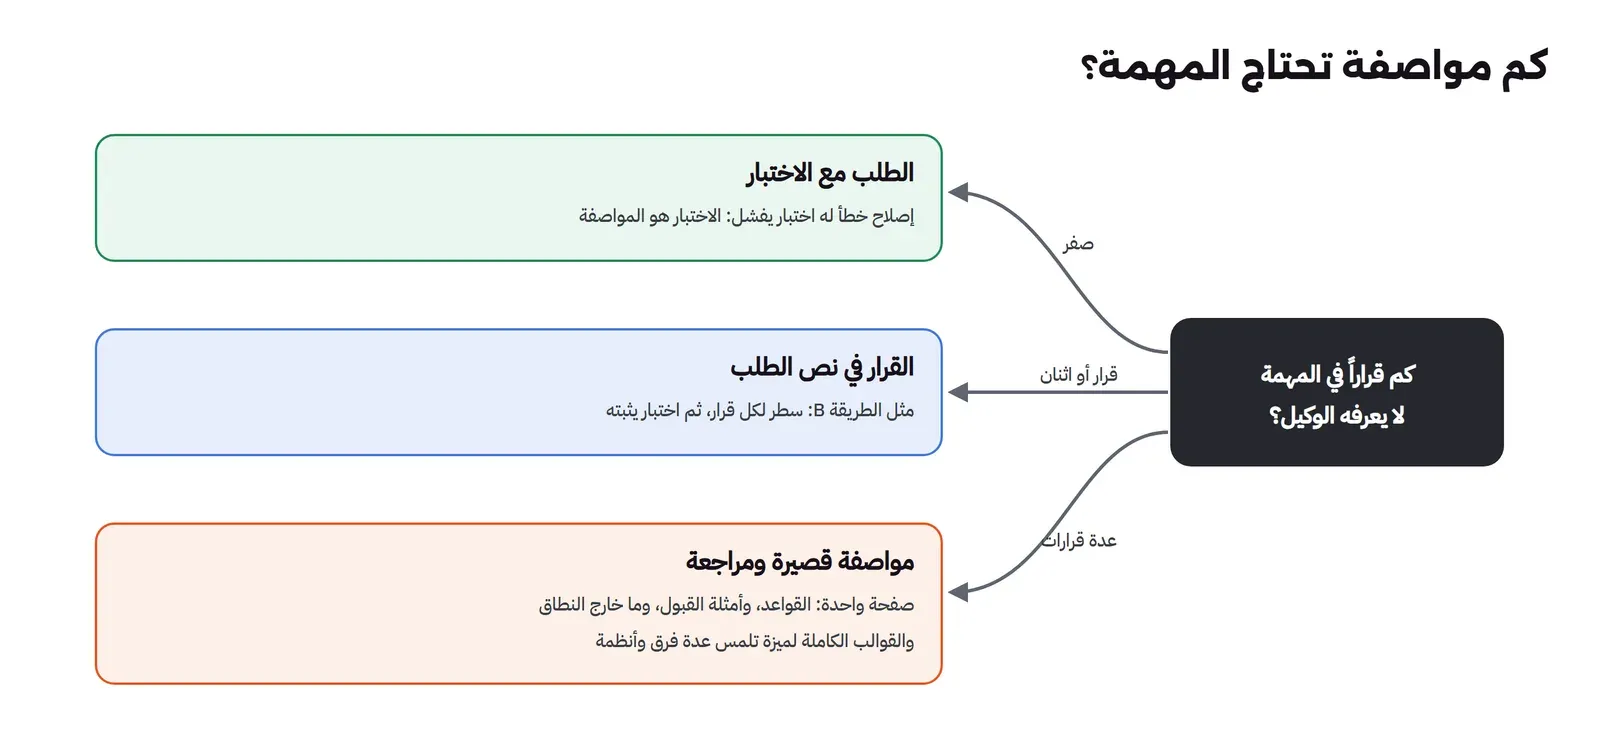
ولذلك فإن القاعدة التي نقترحها تعتمد على سؤال واحد: كم قراراً في هذه المهمة لا يعرفه الوكيل؟ وفيما يلي جدول القرار:
| المهمة | القرارات غير المعروفة | الطريقة المناسبة |
|---|---|---|
| إصلاح خطأ له اختبار يفشل | لا شيء تقريباً، الاختبار هو المواصفة | الطلب مع الاختبار، دون مواصفة |
| تغيير صغير بقاعدة واحدة واضحة | قرار أو قراران | اكتب القرار في الطلب، كما في الطريقة B |
| ميزة فيها قواعد عمل Business Rules | عدة قرارات يجب أن يوافق عليها صاحب المنتج | مواصفة قصيرة، وتوضيح، ثم الكود |
| ميزة كبيرة تلمس عدة ملفات وفرق | قرارات المنتج وقرارات التقنية | المواصفة والخطة والمهام كاملة، مع مراجعة كل ملف |
| نموذج أولي Prototype للتجربة | لا يهم، سوف يرمى | الطلب وحده، والفايب كودنج يكفي |
كيف تطبق الطريقة دون أن تغرق في الملفات؟
- ابدأ بقسم الأسئلة لا بالمواصفة كاملة: أهم ما خرج من المختبر هو قائمة الأسئلة، فاطلب من الوكيل أولاً «ما القرارات التي لا تعرفها في هذا الطلب؟»، وأجب عنها، ثم قرر هل تحتاج مواصفة كاملة.
- اقرأ قسم الافتراضات: كل ما خمنه الوكيل دون أن يسأل يكتب هناك، وهو المكان الذي تتسلل منه القرارات التي لم توافق عليها.
- حول المواصفة إلى اختبارات: سيناريوهات «Given… When… Then…» في المواصفة هي اختبارات قبول مكتوبة بالكلام، فحولها إلى كود قبل التنفيذ أو معه، لأن الاختبار هو الشيء الوحيد الذي يثبت أن الكود يتبع المواصفة.
- أبق المواصفة قصيرة: صفحة واحدة لميزة صغيرة تكفي، والقالب الكامل لميزة كبيرة فقط.
- عندما يظهر شيء جديد ارجع إلى المواصفة: إذا اكتشفت أثناء التنفيذ قراراً لم يكتب، فاكتبه في المواصفة أولاً ثم غير الكود، وإلا أصبحت المواصفة قديمة من أول أسبوع، وهذا هو الفرق بين المستوى الأول والثاني في تقسيم Böckeler.
- احفظ الملفات في المستودع: مجلد
specs/يقرؤه الوكيل التالي والمراجع، ويشرح بعد سنة لماذا الغرامة 2% وليست 3%.
أدوات أخرى بالفكرة نفسها
Kiro من AWS يبني الطريقة داخل المحرر نفسه، بثلاثة ملفات لكل ميزة: requirements.md للمتطلبات وقصص المستخدم ومعايير القبول، وdesign.md للتصميم والمخططات، وtasks.md للمهام وتتبع التقدم، ويذكر توثيقه أنواعاً أخرى مثل مواصفة لإصلاح الأخطاء ومواصفة سريعة. وBöckeler تذكر أن ثلاثة ملفات في Kiro أسهل فهماً من ملفات Spec Kit الكثيرة. وأغلب وكلاء البرمجة اليوم فيهم وضع للتخطيط قبل التنفيذ، مثل وضع Plan في Cline الذي شرحناه في مقال وكلاء البرمجة مفتوحة المصدر، وهو نسخة خفيفة من الفكرة نفسها: الخطة قبل الكود، والموافقة قبل التنفيذ. والفرق أن خطة وضع Plan تبقى في المحادثة وتضيع معها، أما المواصفة فملف في المستودع.
أخطاء شائعة
- الموافقة على المواصفة دون قراءتها: المواصفة التي كتبها الوكيل فيها افتراضاته، وإذا وافقت عليها دون قراءة فقد وافقت على قراراته.
- المواصفة الكاملة لكل تغيير صغير: إصلاح خطأ له اختبار لا يحتاج أربع قصص مستخدم، فاختر الطريقة حسب عدد القرارات غير المعروفة.
- الخلط بين المواصفة والخطة: ذكر المكتبة واللغة في المواصفة يجعل صاحب المنتج لا يفهمها، وذكر قواعد العمل في الخطة فقط يجعلها تضيع.
- الاعتماد على الملف بدل الاختبار: الوكيل قد يتجاهل جزءاً من المواصفة، والطريقة الوحيدة لتعرف ذلك اختبار يفشل.
- تقسيم المهام بلا اختبار بعد كل مهمة: فائدة المهام الصغيرة أن تعرف بعد كل واحدة هل ما زال الكود يعمل، فإذا لم تشغل الاختبارات بينها فقد ضاعت الفائدة.
- تعديل الكود وترك المواصفة: بعد شهر تقول المواصفة شيئاً والكود شيئاً آخر، والوكيل التالي يقرأ المواصفة ويرجع الخطأ.
قائمة تحقق قبل أن تبدأ التنفيذ
- هل كتبت قائمة القرارات التي لا يعرفها الوكيل، وهل أجاب عنها صاحب القرار؟
- هل قرأت قسم الافتراضات في المواصفة، ووافقت على كل سطر فيه؟
- هل كل سيناريو قبول في المواصفة له اختبار، أو سوف يكون له اختبار؟
- هل الخطة تذكر التقنية والملفات فقط، والمواصفة تذكر السلوك فقط؟
- هل كل مهمة صغيرة بحيث تختبر وحدها، وهل تشغل الاختبارات بعد كل مهمة؟
- هل حجم الطريقة مناسب لحجم المهمة؟
تدريب عملي
- شغل
python sdd.py Aثمpython sdd.py Bبنموذج آخر عندك، ثم احذف القرار الخامس منdecisions.mdوأعد B: أي اختبار فشل؟ - غير الطلب في
sdd.pyإلى طلب أكثر تفصيلاً كما يكتبه مطور خبير، وانظر كم علامة[NEEDS CLARIFICATION]تبقى في المواصفة. - خذ ميزة صغيرة من عملك، واكتب لها مواصفة من صفحة واحدة بقالب
spec-template.md، ثم اكتب من سيناريوهات القبول اختبارات قبل أن تطلب الكود من الوكيل. - شغل
python sdd.py C2بعد أن تضيف إلى المهمة الثانية مثال اليوم الثامن من جدول القبول، وانظر هل يختفي خطأ// 30عندما يرى النموذج مثالاً بالأرقام بدل الكلمة وحدها.
الخلاصة
- التطوير من المواصفة يعني مواصفة لما تريد ولماذا، ثم خطة، ثم مهام صغيرة، ثم الكود، ومستوياته ثلاثة: المواصفة أولاً، والمواصفة المرجع، والمواصفة هي المصدر.
- Spec Kit 1.4.2 ينشئ في المستودع تسعة أوامر وخمسة قوالب وسكربتات، وكل خطوة تبدأ بين 2,700 و5,300 توكن من التعليمات والقالب قبل أن يرى الوكيل الميزة.
- بالطلب وحده نجح النموذج المحلي في 4 اختبارات قبول من 10، ومع القرارات في 6، أي أن المعلومة نفسها صنعت أكبر فرق.
- بالخطوات آلياً دون مراجعة لم يكتب النموذج أي علامة توضيح، ونسخ مهام القالب حرفياً، ونفذها، فنزلت النتيجة من 4 إلى صفر في 114 دقيقة.
- بالمواصفة نفسها ومهام راجعها إنسان في ثلاثين ثانية نجح في 7 من 10 في 6.4 دقيقة، وهي أعلى نتيجة في المختبر.
- كلمة «بدأت» في «كل فترة بدأت من 30 يوماً» ضاعت في الطريقتين B وC2، ولم يكشفها إلا الاختبار، ولذلك حول سيناريوهات القبول في المواصفة إلى اختبارات.
- اختر حجم الطريقة حسب عدد القرارات التي لا يعرفها الوكيل، فإصلاح خطأ له اختبار لا يحتاج مواصفة، وميزة فيها قواعد عمل تحتاج مواصفة قصيرة ومراجعة.
وفي المقالات الأخرى من هذه المرحلة بإذن الله نتحدث عن ملف تعليمات المشروع وعن المهارات وعن MCP، وفي المرحلة التالية عن حلقة «خطط ثم نفذ ثم تحقق» والتطوير بالاختبار أولاً TDD مع الوكلاء:
 دليلملف تعليمات المشروع AGENTS.md وCLAUDE.md: ماذا تكتب فيهأين تضع ملف تعليمات الوكيل، وكيف تجمعه Codex وClaude Code وCopilot من المجلدات، ومتى يقطع دون أن يعرف النموذج، وماذا يتغير فعلاً عندما تكتبه.
 دليلهندسة السياق Context Engineering: ما يراه الوكيل وما لا يراهما الذي يرسله الوكيل فعلاً مع طلبك، ولماذا يخطئ النموذج عندما يكون أمامه ملف لا يحتاجه أو سجل طويل أو جلسة قصت من أولها، مع تجارب على نموذج محلي تغير السياق وحده.
 دليلالمهارات Agent Skills: تعليمات يحملها الوكيل عند الحاجةكيف تكتب مهارة حسب المواصفة المفتوحة، وكيف يعرضها Codex على النموذج، وهل يختار نموذج صغير المهارة الصحيحة من وصفها ويتبع ما فيها.
 دليلMCP للمطورين: اربط وكيلك بقاعدة البيانات والتذاكر والتوثيقكيف تضيف سيرفر MCP إلى Codex وClaude Code وCursor، وكيف تكتب سيرفراً للفريق يقرأ قاعدة البيانات دون أن يكتب فيها، وكم يكلف كل سيرفر من سياق الوكيل.
سجل التحديثات
- 20 نوفمبر 2026: كتابة المقال، وتجهيز مستودع بأداة Spec Kit 1.4.2، وتشغيل الطرق الثلاث على Ollama 0.40.13 بنموذج qwen2.5-coder:3b واختبارات قبول مخفية.