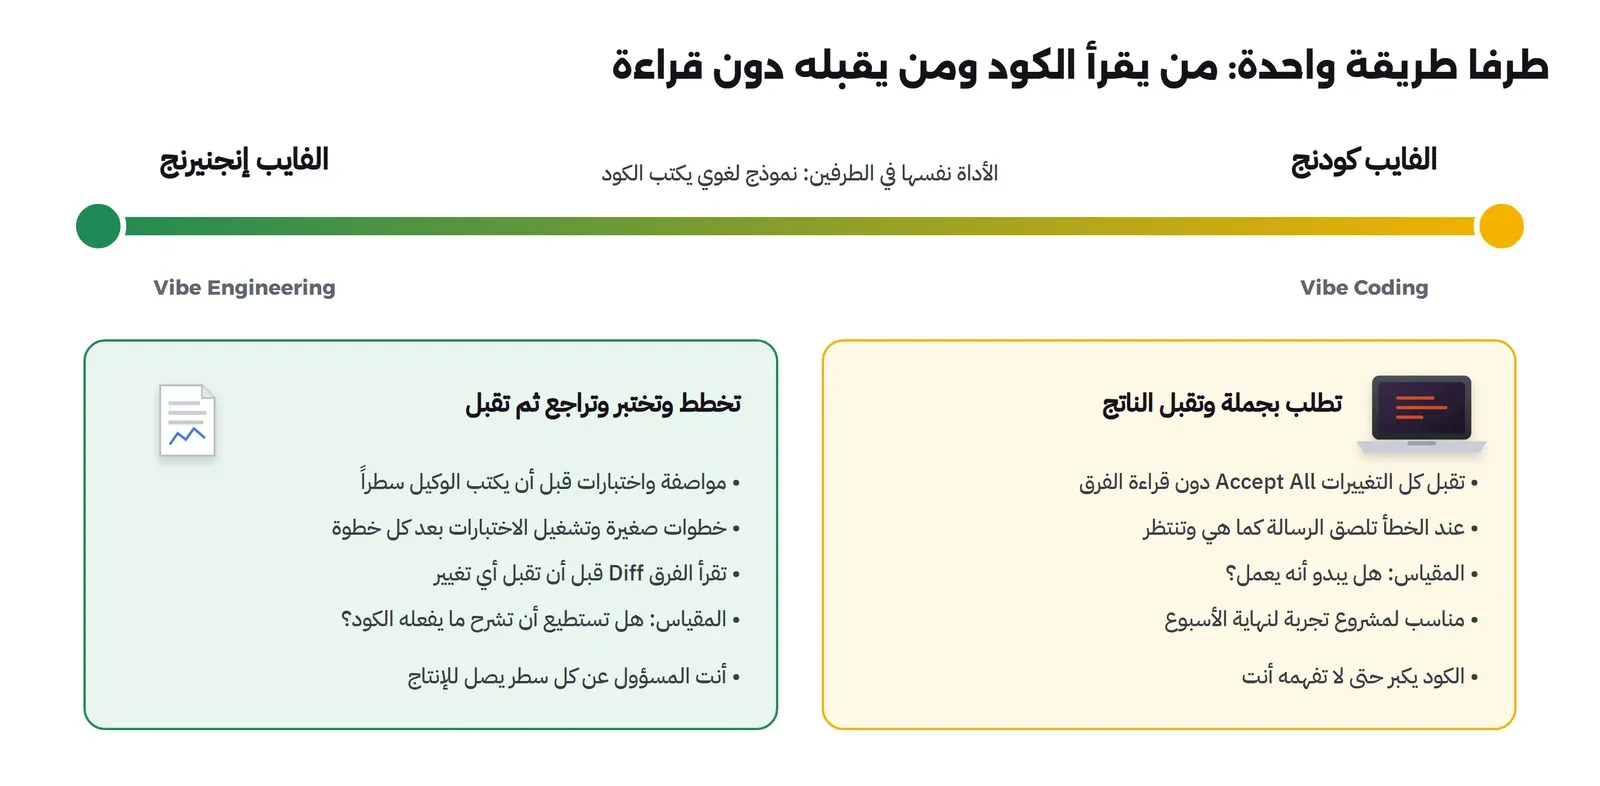
في فبراير 2025 كتب Andrej Karpathy منشوراً قصيراً على X يصف فيه طريقة جديدة في البرمجة سماها الفايب كودنج Vibe Coding، أي أن تستسلم للإحساس وتنسى أن الكود موجود أصلاً، فتطلب ما تريد بجملة، وتقبل كل التغييرات دون أن تقرأ الفرق، وإذا ظهر خطأ تلصقه للنموذج كما هو حتى يختفي. وبعد أقل من سنة صار المصطلح كلمة العام في قاموس Collins، وصار يستخدم لوصف أي كود كتبه الذكاء الاصطناعي، سواءً قرأه صاحبه أم لم يقرأه. لذلك اقترح Simon Willison في أكتوبر 2025 اسماً للطرف الآخر من الطيف: الفايب إنجنيرنج Vibe Engineering، أي أن يستخدم مهندس متمرس الوكيل ليسرع عمله وهو يبقى مسؤولاً عن كل سطر يصل إلى الإنتاج.
وقد يتساءل البعض: هل هذا فرق حقيقي أم مجرد اسم جديد لما نسميه منذ عقود هندسة البرمجيات؟ والإجابة على ذلك ليست في التعريفات فقط، فالتعريف يمكن أن يجادل فيه كل شخص، وإنما في النتيجة: ماذا يحدث للكود عندما تطلب الميزة نفسها بالطريقتين؟ لذلك سوف نعرض التعريفين كما كتبهما أصحابهما، ثم نأخذ ميزة صغيرة حقيقية في ملف تسعير لمتجر إلكتروني، ونطلبها من نموذج يعمل على جهازك بثلاث طرق، ونحكم على الثلاث بالاختبارات نفسها وبأرقام حقيقية.
وفي هذا المقال سوف نتناول:
- ما هو الفايب كودنج كما عرفه Karpathy، وكيف ضيق Willison التعريف.
- ما هو الفايب إنجنيرنج، وقائمة الممارسات التي قال Willison إن الوكلاء يكافئونها.
- هل الفرق حقيقي؟ الحجة والحجة المضادة، ولماذا غير Willison الاسم نفسه بعد أشهر.
- مختبر كامل: ميزة خصم ولاء في ملف تسعير، مطلوبة بالفايب، وبالفايب مع مواصفة، وبالهندسة، وما قالته الاختبارات.
- قصة حقيقية من يوليو 2025 عن وكيل حذف قاعدة بيانات الإنتاج.
- متى يكفيك الفايب كودنج، ومتى تحتاج الطريقة الأخرى.
وإذا لم تقرأ بعد عن كيفية عمل المساعد من الداخل، فقد شرحنا في مقال كيف يعمل مساعد البرمجة بالذكاء الاصطناعي من الداخل أن النموذج يكتب نصاً فقط، وأن بيئة التشغيل Harness هي التي تقرأ الملفات وتشغل الاختبارات، وهذا المقال يبني على ذلك.
ما هو الفايب كودنج Vibe Coding كما عرفه Karpathy؟
التعريف الأصلي في منشور Karpathy بتاريخ 2 فبراير 2025 أقرب إلى وصف لتجربة شخصية منه إلى منهج، وخلاصته كما يلي:
- يتكلم مع المحرر بصوته ولا يكاد يلمس لوحة المفاتيح، ويطلب أبسط الأشياء مثل «قلل الهامش في الشريط الجانبي إلى النصف» لأنه لا يريد البحث عنه بنفسه.
- يضغط «اقبل الكل» Accept All دائماً، ولا يقرأ الفروقات Diffs.
- عند ظهور رسالة خطأ يلصقها كما هي دون تعليق، وغالباً يصلحها ذلك.
- الكود يكبر حتى يتجاوز فهمه، وعندما يعجز النموذج عن إصلاح خطأ يلتف عليه أو يطلب تغييرات عشوائية حتى يختفي.
- ويختم بأن هذا ليس سيئاً لمشاريع نهاية الأسبوع التي ترمى بعد التجربة.
لاحظ أن Karpathy نفسه حدد المكان المناسب لهذه الطريقة: مشروع تجربة لا يهم إن انكسر. والمشكلة أن المصطلح انتشر أسرع من هذا القيد، فصار الناس يقولون فايب كودنج عن أي كود ساعد فيه نموذج لغوي، حتى لو قرأه صاحبه سطراً سطراً واختبره. ولذلك كتب Simon Willison في مارس 2025 مقالاً بعنوان ليست كل برمجة بمساعدة الذكاء الاصطناعي فايب كودنج ضيق فيه التعريف إلى جملة واحدة: الفايب كودنج هو بناء البرمجيات بنموذج لغوي دون مراجعة الكود الذي يكتبه. وأضاف قاعدته الشخصية للكود الذي يصل إلى الإنتاج: لا يدخل مستودعه سطر لا يستطيع أن يشرح لغيره ماذا يفعل بالضبط، فإذا كتب النموذج الكود ثم راجعته واختبرته وأصبحت قادراً على شرحه، فهذا ليس فايب كودنج، وإنما هو تطوير برمجيات عادي، ووجود النموذج في القصة لا يغير شيئاً.
وفي نوفمبر 2025 أعلن قاموس Collins أن كلمة العام 2025 هي Vibe Coding، ووصفها بأنها طريقة في تطوير البرمجيات تحول اللغة الطبيعية إلى كود بالذكاء الاصطناعي، وهذا الوصف الواسع هو بالضبط ما حاول Willison أن يضيقه، فالقاموس يصف كيف يستخدم الناس الكلمة، وWillison يصف ما يميز الطريقة نفسها.
ما هو الفايب إنجنيرنج Vibe Engineering؟
في 7 أكتوبر 2025 نشر Simon Willison مقالاً بعنوان Vibe engineering بدأه بأن الفايب كودنج استقر الآن كاسم للطريقة السريعة غير المسؤولة في بناء البرمجيات بالذكاء الاصطناعي، أي طريقة يقودها الطلب وحده ولا ينتبه فيها أحد لكيف يعمل الكود، وأن هذا يترك فراغاً في المصطلحات: ماذا نسمي الطرف الآخر، حيث يسرع المحترفون عملهم بالنماذج اللغوية وهم يبقون مسؤولين بثقة عن البرمجيات التي ينتجونها؟ واقترح اسم الفايب إنجنيرنج، وقال صراحةً إنه يقترحه «ولسانه في خده جزئياً»، أي نصف جاد.
والسبب الذي جعله يحتاج اسماً جديداً هو وكلاء البرمجة Coding Agents التي ظهرت في 2025، مثل Claude Code في فبراير وCodex CLI من OpenAI في أبريل وGemini CLI في يونيو كما يذكر في المقال نفسه، فهذه الأدوات لا تقترح سطراً فقط، وإنما تعدل الكود وتشغله وتختبره وتعيد المحاولة حتى تحقق هدفاً محدداً، وبالتالي صار ممكناً أن يدير مهندس واحد أكثر من وكيل في الوقت نفسه. ويقول Willison إن هذا يختلف تماماً عن الفايب كودنج الذي يستخدمه هو نفسه لأدوات صغيرة لا يهم إن انكسرت، فالعمل مع الوكلاء لإنتاج كود بجودة الإنتاج يستطيع أن يصونه في المستقبل عملية مختلفة كلياً، بل يصفها بأنها صعبة، وأن سرعة الوكيل في إخراج الكود ترفع مستوى ما يجب أن يقدمه الإنسان المشارك لا العكس.
الممارسات الهندسية التي يستفيد منها الوكيل
أهم ما في مقال Willison قائمة الممارسات التي قال إن النماذج اللغوية تكافئها، أي أن الفريق الذي يملكها يحصل من الوكيل على نتائج أفضل بكثير من الفريق الذي لا يملكها، والملاحظة المهمة أنها كلها ممارسات هندسية قديمة يعرفها كل مهندس خبير، وفيما يلي القائمة مع السبب الذي ذكره لكل منها:
- الاختبارات الآلية Automated Testing: مع مجموعة اختبارات قوية يستطيع الوكيل أن يتحقق من عمله بنفسه، ودونها قد يدعي أن شيئاً يعمل دون أن يختبره أصلاً، وقد يكسر أي تغيير ميزة أخرى دون أن تنتبه، ويضيف أن كتابة الاختبار أولاً Test-first فعالة جداً مع وكيل يعمل في حلقة.
- التخطيط المسبق Planning in Advance: أن تراجع الخطة مع الوكيل أولاً ثم تعطيه إياها ليكتب الكود.
- التوثيق الشامل Comprehensive Documentation: الوكيل مثل المبرمج لا يرى إلا جزءاً من المشروع في سياقه، والتوثيق الجيد يسمح له باستخدام واجهات من أجزاء أخرى دون أن يقرأ كودها.
- عادات جيدة في Git: القدرة على التراجع عن الخطأ ومعرفة متى ولماذا تغير شيء أهم عندما يكون الوكيل هو من غيره، ويذكر أن النماذج جيدة جداً في استخدام Git نفسه، حتى في git bisect.
- الأتمتة الفعالة Automation: التكامل المستمر CI، والتنسيق الآلي، وفحص الكود، والنشر إلى بيئة معاينة، فكل ما يفيد الفريق يفيد الوكيل أيضاً.
- ثقافة مراجعة الكود Code Review: إذا كنت سريعاً في المراجعة فستكون تجربتك مع الوكلاء أفضل بكثير ممن يفضل أن يكتب الكود بنفسه على أن يراجع كود غيره.
- نوع غريب من الإدارة: الحصول على نتيجة جيدة من وكيل يشبه الحصول عليها من زميل، تعليمات واضحة وسياق كاف وملاحظات قابلة للتنفيذ، مع فرق أنك لا تخشى أن تجرح مشاعره.
- اختبار يدوي جيد Manual QA: توقع الحالات الحدية Edge Cases والبحث فيها بنفسك، فوق الاختبارات الآلية.
- مهارات بحث قوية: هناك عشرات الطرق لحل أي مشكلة، واختيار الطريقة وإثباتها يبقى عليك قبل أن تطلق الوكيل.
- بيئة معاينة Preview Environment: أن ترى الميزة تعمل في بيئة آمنة قبل الإنتاج يجعل المراجعة أسرع ويقلل خطر شحن شيء مكسور.
- حس بما يعطى للوكيل وما تبقيه بيدك، وهو حس يتغير مع تحسن النماذج.
- تقدير محدث للوقت Estimation: أشياء كانت تأخذ أياماً صارت أسرع، والتقدير الآن يعتمد على عوامل جديدة لم يفهمها أحد بعد.
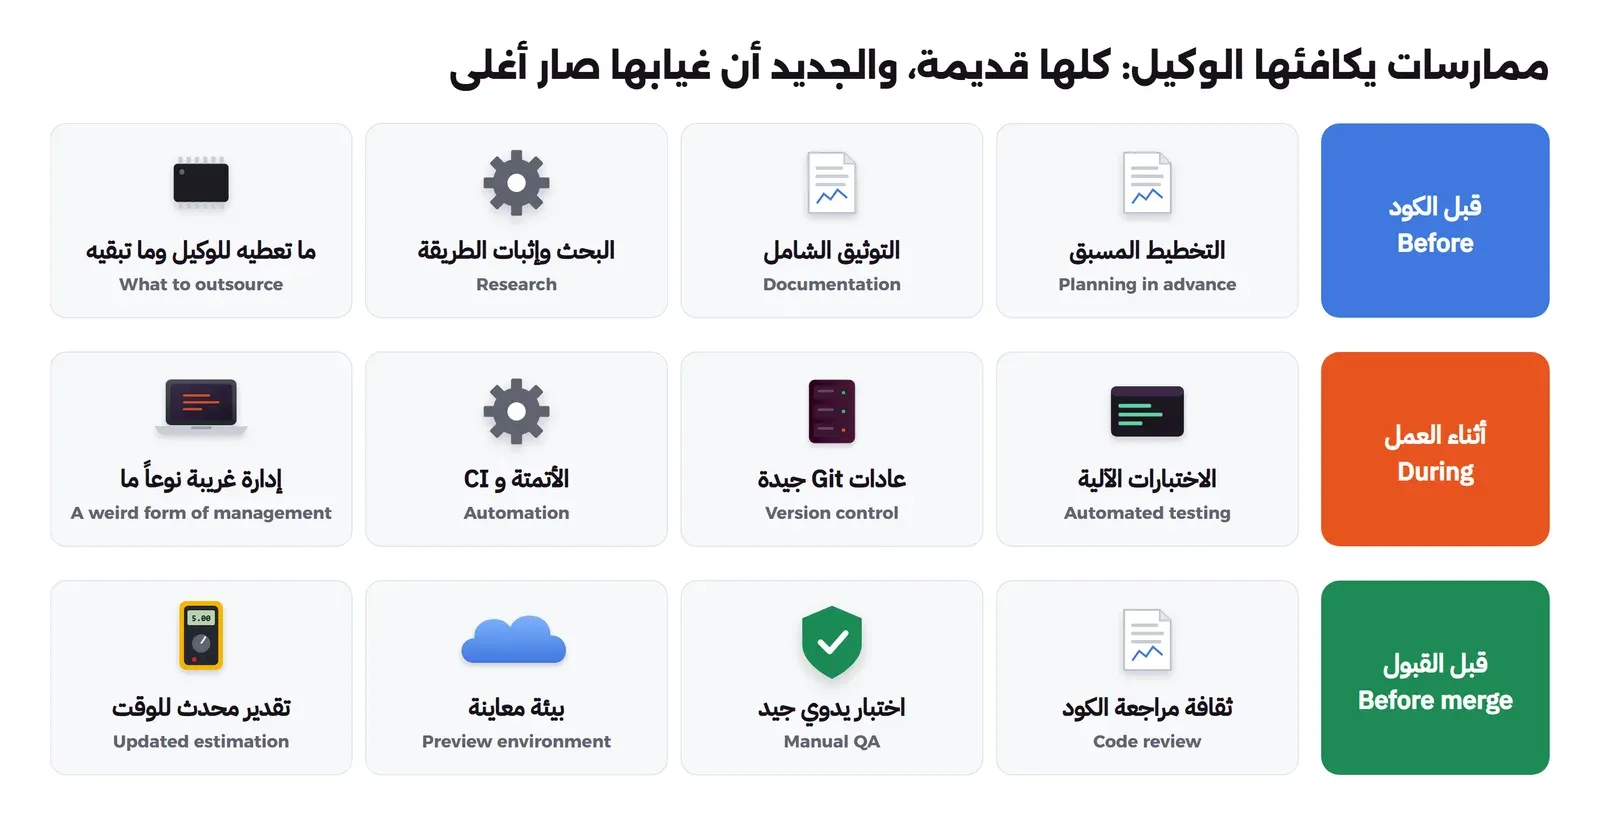
ويختم Willison القائمة بجملة تلخص فكرته: كل هذه تقريباً صفات المهندس الخبير أصلاً، وأدوات الذكاء الاصطناعي تضخم الخبرة الموجودة Amplify Existing Expertise، فكلما زادت مهارتك كان ما تحصل عليه من الوكيل أسرع وأفضل. ويصف دورك الجديد بأنك لم تعد مسؤولاً عن كتابة الكود فقط، وإنما عن البحث في الطرق، واختيار المعمارية، وكتابة المواصفات، وتحديد معايير النجاح، وتصميم حلقات الوكيل، وتخطيط الاختبار، وإدارة «جيش متزايد من المتدربين الرقميين الغريبين الذين سيغشون بالتأكيد إذا أعطيتهم الفرصة»، وقضاء وقت طويل جداً في مراجعة الكود.
هل الفرق حقيقي أم اسم جديد فقط؟
لنبدأ بالحجة ضد الاسم، لأن أقوى من قالها هو Willison نفسه، ففي المقال نفسه يسأل: هل هذا اسم سخيف؟ ويجيب: نعم على الأغلب، فكلمة Vibes صارت مملة في عالم الذكاء الاصطناعي، والفايب كودنج يستخدمه كثير من المطورين بشكل احتقاري. ويقول أيضاً إنه لم يحب يوماً التفريق المصطنع بين المبرمج Coder والمهندس Engineer لأنه يشبه حراسة البوابة Gatekeeping، أي أن يقرر بعض الناس من يستحق لقباً ومن لا يستحقه، ثم يضيف أن قليلاً من حراسة البوابة هو بالضبط ما نحتاجه هنا. وفي فبراير 2026 أضاف تحديثاً في أعلى المقال يقول إن مصطلح Agentic Engineering هو الذي يبدو أنه انتصر لهذا المعنى، وصار هو نفسه يجمع مقالاته تحت وسم agentic-engineering. أي أن الاسم الذي اقترحه لم يثبت، وصاحبه يعترف بذلك.
والحجة الثانية ضد الاسم جاءت من Willison أيضاً قبل ذلك بسبعة أشهر، ففي مقال مارس 2025 قال إن الكود الذي كتبه النموذج ثم راجعته واختبرته وتستطيع شرحه هو تطوير برمجيات عادي، وإذا كان هذا صحيحاً فالفايب إنجنيرنج ليس شيئاً جديداً يحتاج اسماً، وإنما هو هندسة البرمجيات نفسها بأداة جديدة، كما لم نحتج اسماً جديداً للهندسة عندما ظهر IDE أو Stack Overflow.
أما الحجة مع الفرق فهي أن الفرق ليس في الاسم ولا في الأداة، وإنما في سؤال واحد له جواب واضح: هل قرأ أحد هذا الكود واختبره قبل أن يقبله؟ وهذا السؤال يقسم العمل مع النموذج إلى طريقتين مختلفتين فعلاً في النتيجة وفي التكلفة وفي من يتحمل المسؤولية، فالفايب كودنج ينقل مسؤولية صحة الكود من المطور إلى النموذج، والهندسة تبقيها عند المطور. وكل الممارسات في قائمة Willison هي أدوات لإبقاء المسؤولية عندك وأنت تعمل بسرعة الوكيل.
لذلك الجواب الذي نصل إليه هو كما يلي: الاسم ضعيف، وصاحبه تخلى عنه لصالح اسم آخر، والممارسات ليست جديدة، لكن التمييز نفسه حقيقي وقابل للقياس، فهو الفرق بين كود قبلته لأنه يبدو أنه يعمل، وكود قبلته لأنك تحققت أنه يعمل. والجديد فعلاً ليس الممارسات وإنما ثمن غيابها، فالمبرمج الذي كان يكتب مئة سطر في اليوم دون اختبارات كان يكسر شيئاً كل أسبوع، والوكيل الذي يكتب ألف سطر في الساعة دون اختبارات يكسر شيئاً كل ساعة. والآن لنرى هذا بالأرقام بدل الكلام.
المختبر: ميزة واحدة بثلاث طرق
لنفرض أن لديك متجراً إلكترونياً صغيراً، وفيه ملف pricing.py يحسب مجموع السلة، وخصم الكوبون، والضريبة 15%، والشحن المجاني من 200 ريال، ومعه ثمانية اختبارات كتبها الفريق قبل سنة. والآن يريد المدير ميزة جديدة: خصم ولاء للأعضاء. وهذه الميزة مثالية للتجربة لأنها صغيرة، لكنها تلمس دالة total التي يستخدمها كل شيء آخر، وفيها قرارات صغيرة سهلة أن تفوت: هل يجمع خصم الولاء مع الكوبون؟ هل يشمل المنتجات المخفضة؟ وهل يحسب الشحن قبل الخصم أم بعده؟
والملف الأصلي كما يلي:
"""Pricing for a small online shop. A cart line is a dict: {"sku", "price", "qty", "on_sale"}."""

VAT_RATE = 0.15
FREE_SHIPPING_FROM = 200
SHIPPING_FEE = 25
COUPONS = {"WELCOME10": 0.10, "RAMADAN20": 0.20}


def subtotal(items):
    return round(sum(i["price"] * i["qty"] for i in items), 2)


def coupon_discount(items, code):
    """Coupon percentage off the full-price lines only; sale lines and unknown codes give nothing."""
    rate = COUPONS.get(code, 0)
    eligible = sum(i["price"] * i["qty"] for i in items if not i.get("on_sale"))
    return round(eligible * rate, 2)


def shipping(amount):
    """Free shipping from FREE_SHIPPING_FROM (after discounts), otherwise a flat fee."""
    return 0 if amount >= FREE_SHIPPING_FROM else SHIPPING_FEE


def total(items, code=None):
    sub = subtotal(items)
    discount = coupon_discount(items, code) if code else 0
    after = round(sub - discount, 2)
    vat = round(after * VAT_RATE, 2)
    return round(after + vat + shipping(after), 2)
والاختبارات الثمانية التي كانت موجودة قبل الميزة الجديدة، وهي التي سوف نسميها الاختبارات القديمة، والهدف منها أن نعرف هل كسر التغيير شيئاً كان يعمل:
"""The tests the project already had before the new feature."""
import unittest
from pricing import subtotal, coupon_discount, shipping, total


def line(price, qty=1, on_sale=False):
    return {"sku": "X", "price": price, "qty": qty, "on_sale": on_sale}


class OldTests(unittest.TestCase):
    def test_subtotal(self):
        self.assertEqual(subtotal([line(10, 3), line(2.5, 2)]), 35)

    def test_coupon_full_price_only(self):
        self.assertEqual(coupon_discount([line(100), line(100, on_sale=True)], "WELCOME10"), 10)

    def test_unknown_coupon(self):
        self.assertEqual(coupon_discount([line(100)], "NOPE"), 0)

    def test_shipping_threshold(self):
        self.assertEqual(shipping(199.99), 25)
        self.assertEqual(shipping(200), 0)

    def test_total_no_code(self):
        self.assertEqual(total([line(100)]), 140)

    def test_total_with_code(self):
        self.assertEqual(total([line(300)], "RAMADAN20"), 276)

    def test_total_empty_cart(self):
        self.assertEqual(total([]), 25)

    def test_coupon_drops_below_free_shipping(self):
        self.assertEqual(total([line(210)], "WELCOME10"), 242.35)


if __name__ == "__main__":
    unittest.main()
المواصفة Spec قبل الكود
قبل أن نطلب أي شيء من النموذج كتبنا المواصفة في ملف قصير، والسبب أن كل قرار في هذه الميزة يجب أن يتخذه إنسان يعرف المتجر، لا أن يخمنه النموذج، فخصم الولاء هنا يشمل المنتجات المخفضة على عكس الكوبون، ولا يجمع مع الكوبون وإنما يطبق الأكبر منهما، ودالة total يجب أن تبقى تعمل لمن لا يرسل المعامل الجديد:
# Loyalty discount (spec)

- `total(items, code=None, member=False)`. Callers that do not pass `member` behave exactly as before.
- Members get 5% off the whole subtotal, sale lines included (unlike coupons), capped at 30 SAR.
- Loyalty and coupon never stack: compute both and apply the bigger one only.
- VAT and the free-shipping threshold use the amount after that one discount.
- Round money to 2 decimals the same way the module already does.
- Do not change subtotal, coupon_discount or shipping.
ثم كتبنا من المواصفة ستة اختبارات قبول Acceptance Tests، كل اختبار فيها يمثل قراراً من المواصفة برقم محسوب مسبقاً، فمثلاً سلة فيها منتج بـ100 ريال لعضو يجب أن يكون مجموعها 134.25، أي 100 ناقص خصم 5، ثم ضريبة 14.25، ثم شحن 25:
"""Acceptance tests for the loyalty feature, written from spec.md before any code."""
import unittest
from pricing import total


def line(price, qty=1, on_sale=False):
    return {"sku": "X", "price": price, "qty": qty, "on_sale": on_sale}


class LoyaltyTests(unittest.TestCase):
    def test_member_five_percent(self):
        self.assertEqual(total([line(100)], member=True), 134.25)

    def test_sale_lines_count_for_members(self):
        self.assertEqual(total([line(100), line(100, on_sale=True)], member=True), 243.5)

    def test_cap_30(self):
        self.assertEqual(total([line(1000)], member=True), 1115.5)

    def test_coupon_bigger_wins(self):
        self.assertEqual(total([line(300)], "WELCOME10", member=True), 310.5)

    def test_loyalty_bigger_wins(self):
        self.assertEqual(total([line(100), line(400, on_sale=True)], "WELCOME10", member=True), 546.25)

    def test_shipping_after_loyalty(self):
        self.assertEqual(total([line(205)], member=True), 248.96)


if __name__ == "__main__":
    unittest.main()
ولاحظ أن الاختبار الأخير يفحص قراراً لم يذكره المدير أصلاً، وهو أن حد الشحن المجاني يحسب بعد الخصم، فسلة بـ205 ريال لعضو تنزل إلى 194.75 بعد الخصم، وبالتالي تدفع الشحن 25 ريالاً، وهذا النوع من التفاصيل هو ما يضيع عندما لا يكتب أحد المواصفة.
الطرق الثلاث
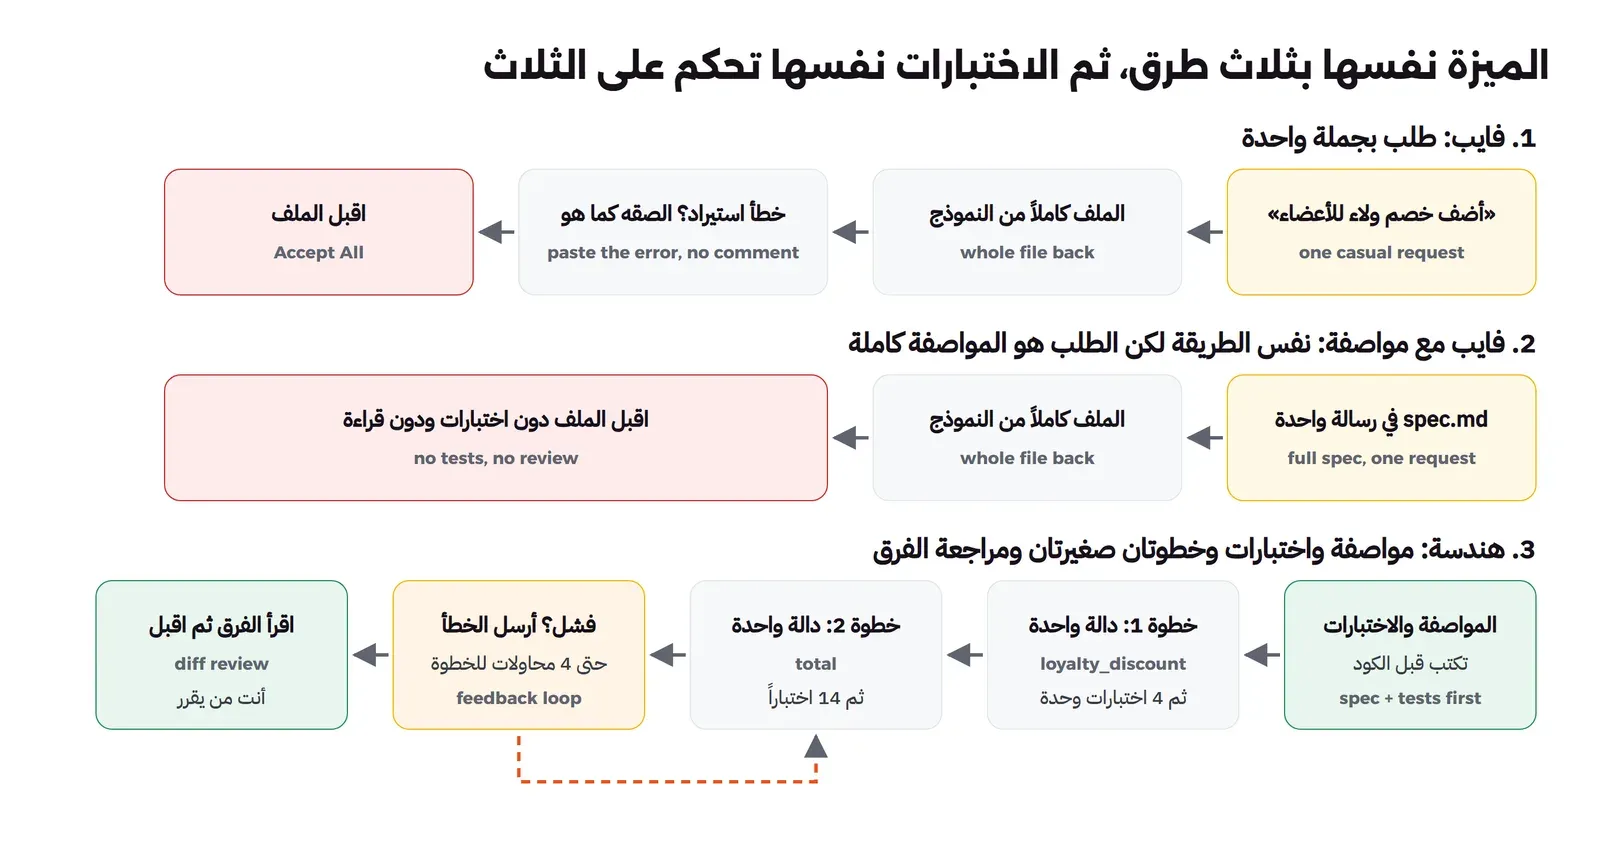
أخذنا الميزة نفسها وطلبناها من النموذج نفسه بثلاث طرق، ثم حكمنا على الثلاث بالاختبارات نفسها، القديمة الثمانية واختبارات القبول الستة، والطرق كما يلي:
- الفايب Vibe: طلب بجملة واحدة كما يكتبه أي مطور مستعجل: «أضف خصم ولاء: الأعضاء يحصلون على 5% من الطلب، بحد أقصى 30 ريالاً، ولا يجمع مع الكوبونات (طبق الأكبر)»، ثم نقبل الملف الذي يرسله كاملاً، وإذا لم يستطع Python استيراده نلصق رسالة الخطأ كما هي دون تعليق، مرتين على الأكثر، تماماً كما وصف Karpathy.
- الفايب مع مواصفة: الطريقة نفسها، لكن الطلب هو ملف المواصفة كاملاً بدل الجملة، والهدف من هذه الطريقة أن نفصل أثر المواصفة وحدها عن أثر بقية الممارسات، فلو نجحت هذه الطريقة لقلنا إن المشكلة كانت في وضوح الطلب فقط.
- الهندسة Engineered: المواصفة والاختبارات في السياق، ثم خطوتان صغيرتان، كل خطوة تطلب دالة واحدة فقط: الأولى
loyalty_discountومعها أربعة اختبارات وحدة Unit Tests كتبناها لها، والثانيةtotalومعها الاختبارات القديمة واختبارات القبول، وبعد كل خطوة تشغل الاختبارات، وإذا فشلت يرسل الخطأ إلى النموذج ليصلح الدالة نفسها، حتى أربع محاولات للخطوة، وفي النهاية نطبع الفرق Diff لمراجعته.
والنقطة المهمة في الطريقة الثالثة أن بيئة التشغيل هي التي تحدد ما يتغير، فالنموذج قد يرسل الملف كاملاً، لكن البرنامج يأخذ من رده الدالة المطلوبة فقط ويضعها مكان القديمة باستخدام ast، وبالتالي لا يستطيع النموذج أن يغير دالة لم نطلبها حتى لو أراد، والكود التالي من المختبر يبين ذلك:
def replace_function(src, new_code, name):
    """Puts the function `name` from new_code into src: replaces the old one, or adds it before total()."""
    fn = next((n for n in ast.parse(new_code).body if isinstance(n, ast.FunctionDef) and n.name == name), None)
    if fn is None:
        raise ValueError(f"no def {name} in the reply")
    new_lines = new_code.splitlines()[fn.lineno - 1 - len(fn.decorator_list):fn.end_lineno]
    lines = src.splitlines()
    old = next((n for n in ast.parse(src).body if isinstance(n, ast.FunctionDef) and n.name == name), None)
    if old:
        lines[old.lineno - 1:old.end_lineno] = new_lines
    else:
        at = next(n for n in ast.parse(src).body if isinstance(n, ast.FunctionDef) and n.name == "total").lineno - 1
        lines[at:at] = new_lines + ["", ""]
    return "\n".join(lines) + "\n"
وهذه حلقة الخطوات في الطريقة الثالثة، لاحظ أن كل خطوة تبدأ بسياق جديد فيه المواصفة والملف الحالي واختبارات تلك الخطوة فقط:
def engineered(seed, cnt, log):
    system = ("You work on an existing Python module. Change only what the step asks. "
              "Reply with one python code block that holds only the requested function.")
    src = ORIGINAL
    steps = [
        ("loyalty_discount", ["test_loyalty_unit"],
         "Step 1 of 2: write ONLY a new function loyalty_discount(items, member) that returns the loyalty "
         "discount in SAR as the spec says. Do not change or repeat any other function.",
         ["test_loyalty_unit.py"]),
        ("total", ["test_pricing", "test_loyalty"],
         "Step 2 of 2: rewrite ONLY the function total(items, code=None, member=False) so it follows the spec, "
         "using loyalty_discount. Do not repeat any other function.",
         ["test_pricing.py", "test_loyalty.py"]),
    ]
    for name, mods, ask, ctx in steps:
        tests = "\n".join(f"{f}:\n```python\n{read(f)}```" for f in ctx)
        msgs = [{"role": "system", "content": system},
                {"role": "user", "content": f"Spec:\n{SPEC}\nCurrent pricing.py:\n```python\n{src}```\n"
                                            f"The tests this step must pass:\n{tests}\n{ask}"}]
        cand = src
        for attempt in range(1, 5):
            reply = chat(msgs, seed, cnt, num_predict=400)
            try:
                cand = replace_function(src, code_of(reply), name)
            except (ValueError, SyntaxError) as e:
                log(f"    step {name} try {attempt}: rejected, {e}")
                msgs += [{"role": "assistant", "content": reply},
                         {"role": "user", "content": f"Your reply was rejected: {e}. Send only def {name}(...) in one python block."}]
                continue
            p, n, rep = run_tests(cand, mods)
            log(f"    step {name} try {attempt}: {p}/{n} tests pass")
            if p == n:
                src = cand
                break
            msgs += [{"role": "assistant", "content": reply},
                     {"role": "user", "content": f"The tests failed:\n{rep}\nFix def {name} only and send it again."}]
        else:
            log(f"    step {name}: still failing after 4 tries, keeping the last candidate for the review")
            src = cand
    return src
والنموذج هو qwen2.5-coder:3b على Ollama 0.40.13 يعمل على المعالج دون كرت شاشة، بنافذة سياق 4096 توكن ودرجة حرارة Temperature 0.3، وشغلنا كل طريقة ثلاث مرات بثلاث قيم بذرة Seed مختلفة، لأن تشغيلاً واحداً قد يكون حظاً جيداً أو سيئاً. والاختبارات تعمل داخل Container من Image python:3.13.18-slim بالمكتبة القياسية فقط، ويمكنك تشغيل المختبر كاملاً بالأمر التالي:
#!/bin/bash
# Runs the lab against an Ollama server on this machine (http://localhost:11434), from Git Bash on Windows.
# The script runs inside python:3.13.18-slim and reaches Ollama through host.docker.internal.
# Needs the model already pulled:  ollama pull qwen2.5-coder:3b
#   bash run.sh [model] [seeds]      default: qwen2.5-coder:3b 1,2,3
set -eo pipefail
cd "$(dirname "$0")"
MODEL=${1:-qwen2.5-coder:3b}
SEEDS=${2:-1,2,3}
OUTFILE=out-01-runs.txt
[ "$MODEL" != qwen2.5-coder:3b ] && OUTFILE=out-02-runs-${MODEL##*:}.txt
MSYS_NO_PATHCONV=1 docker run --rm -e OLLAMA=http://host.docker.internal:11434 \
  -v "$(pwd -W):/lab" -w /lab python:3.13.18-slim python -u lab.py "$MODEL" "$SEEDS" | tee "$OUTFILE"
# diff review: one comment per wrong function on the engineered runs that stayed red
if [ "$MODEL" = qwen2.5-coder:3b ]; then
  MSYS_NO_PATHCONV=1 docker run --rm -e OLLAMA=http://host.docker.internal:11434 \
  -v "$(pwd -W):/lab" -w /lab python:3.13.18-slim python -u review.py "$MODEL" | tee out-03-review.txt
fiماذا قالت الاختبارات؟
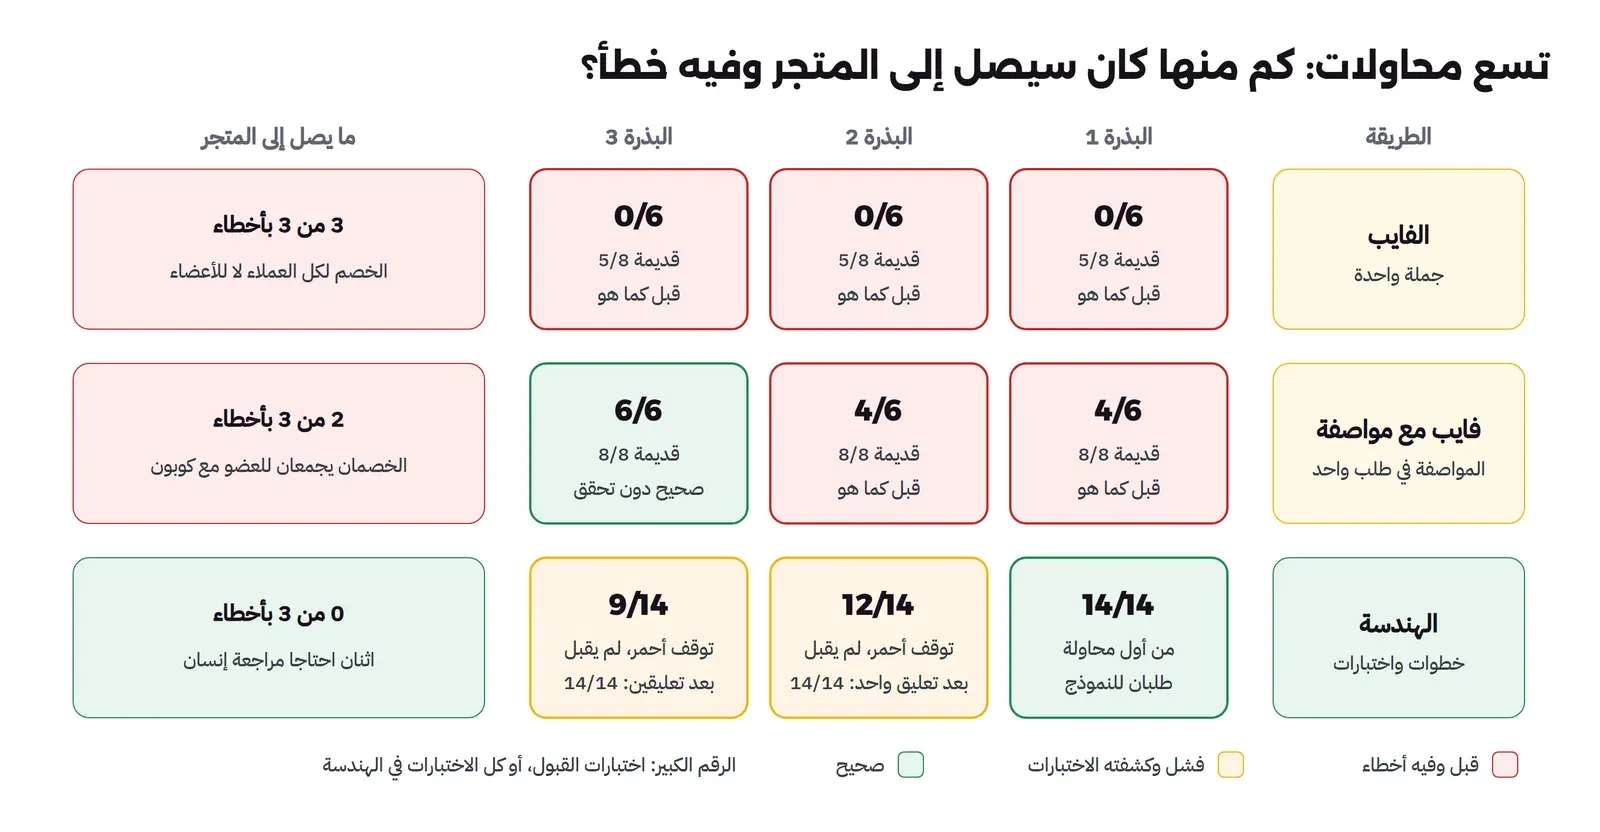
شغلنا المختبر، وفيما يلي المخرج كاملاً للمحاولات التسع، والسطر الأخير في كل محاولة يجمع النتيجة: كم نجح من الاختبارات القديمة الثمانية، وكم نجح من اختبارات القبول الستة، وحجم الفرق بالأسطر المضافة والمحذوفة، وهل غير النموذج دالة قالت المواصفة ألا يلمسها، وعدد الطلبات إلى النموذج والتوكنات الداخلة والخارجة:
model qwen2.5-coder:3b, temperature 0.3, num_ctx 4096, seeds [1, 2, 3]

== vibe, seed 1
    old tests 5/8, acceptance 0/6, diff +12 -3, changed anyway: nothing, calls 1, tokens in 372 out 398

== vibe+spec, seed 1
    old tests 8/8, acceptance 4/6, diff +8 -1, changed anyway: nothing, calls 1, tokens in 461 out 419

== engineered, seed 1
    step loyalty_discount try 1: 4/4 tests pass
    step total try 1: 14/14 tests pass
    old tests 8/8, acceptance 6/6, diff +13 -2, changed anyway: nothing, calls 2, tokens in 1939 out 157

== vibe, seed 2
    old tests 5/8, acceptance 0/6, diff +12 -3, changed anyway: nothing, calls 1, tokens in 372 out 465

== vibe+spec, seed 2
    old tests 8/8, acceptance 4/6, diff +8 -1, changed anyway: nothing, calls 1, tokens in 461 out 423

== engineered, seed 2
    step loyalty_discount try 1: 3/4 tests pass
    step loyalty_discount try 2: 3/4 tests pass
    step loyalty_discount try 3: 3/4 tests pass
    step loyalty_discount try 4: 3/4 tests pass
    step loyalty_discount: still failing after 4 tries, keeping the last candidate for the review
    step total try 1: 12/14 tests pass
    step total try 2: 12/14 tests pass
    step total try 3: 12/14 tests pass
    step total try 4: 12/14 tests pass
    step total: still failing after 4 tries, keeping the last candidate for the review
    old tests 8/8, acceptance 4/6, diff +13 -2, changed anyway: nothing, calls 8, tokens in 11952 out 680

== vibe, seed 3
    old tests 5/8, acceptance 0/6, diff +14 -2, changed anyway: nothing, calls 1, tokens in 372 out 465

== vibe+spec, seed 3
    old tests 8/8, acceptance 6/6, diff +11 -2, changed anyway: nothing, calls 1, tokens in 461 out 418

== engineered, seed 3
    step loyalty_discount try 1: 3/4 tests pass
    step loyalty_discount try 2: 3/4 tests pass
    step loyalty_discount try 3: 3/4 tests pass
    step loyalty_discount try 4: 3/4 tests pass
    step loyalty_discount: still failing after 4 tries, keeping the last candidate for the review
    step total try 1: 9/14 tests pass
    step total try 2: 9/14 tests pass
    step total try 3: 9/14 tests pass
    step total try 4: 9/14 tests pass
    step total: still failing after 4 tries, keeping the last candidate for the review
    old tests 8/8, acceptance 1/6, diff +13 -1, changed anyway: nothing, calls 8, tokens in 12175 out 688
والجدول الذي يطبعه المختبر في النهاية يجمع المحاولات التسع:
== summary
flow        seed    old  accept      diff  touched  calls  tok in  tok out
vibe           1    5/8     0/6    +12 -3        0      1     372      398
vibe+spec      1    8/8     4/6     +8 -1        0      1     461      419
engineered     1    8/8     6/6    +13 -2        0      2    1939      157
vibe           2    5/8     0/6    +12 -3        0      1     372      465
vibe+spec      2    8/8     4/6     +8 -1        0      1     461      423
engineered     2    8/8     4/6    +13 -2        0      8   11952      680
vibe           3    5/8     0/6    +14 -2        0      1     372      465
vibe+spec      3    8/8     6/6    +11 -2        0      1     461      418
engineered     3    8/8     1/6    +13 -1        0      8   12175      688
الفايب: خصم لكل العملاء
المحاولات الثلاث بالطريقة الأولى أنتجت ملفاً يعمل، فلم يظهر أي خطأ استيراد، ولم تحتج إلا طلباً واحداً للنموذج، وهذا بالضبط ما يجعل الفايب كودنج مغرياً: الكود يبدو جاهزاً من أول محاولة. لكن الاختبارات القديمة سقط منها ثلاثة في كل مرة، وسقطت اختبارات القبول الستة كلها، والفرق التالي من المحاولة الأولى يبين السبب:
--- pricing.py (before)
+++ pricing.py (after)
@@ -1,2 +1,2 @@
-"""Pricing for a small online shop. A cart line is a dict: {"sku", "price", "qty", "on_sale"}."""
+"""Pricing for a small online shop. A cart line is a dict: {"sku", "price", "qty", "on_sale", "member"}."""

@@ -6,3 +6,4 @@
 COUPONS = {"WELCOME10": 0.10, "RAMADAN20": 0.20}
-
+LOYALTY_DISCOUNT = 0.05
+LOYALTY_MAX_DISCOUNT = 30

@@ -19,2 +20,9 @@

+def loyalty_discount(items):
+    """Loyalty discount of 5% off the subtotal, max 30 SAR."""
+    subtotal_amount = subtotal(items)
+    discount = min(subtotal_amount * LOYALTY_DISCOUNT, LOYALTY_MAX_DISCOUNT)
+    return round(discount, 2)
+
+
 def shipping(amount):
@@ -27,3 +35,4 @@
     discount = coupon_discount(items, code) if code else 0
-    after = round(sub - discount, 2)
+    loyalty_discount_amount = loyalty_discount(items)
+    after = round(sub - discount - loyalty_discount_amount, 2)
     vat = round(after * VAT_RATE, 2)
وفي الفرق أعلاه لاحظ التالي:
- الدالة الجديدة
loyalty_discount(items)لا تأخذ أي معامل يدل على العضوية، ودالةtotalتطبقها على كل سلة، أي أن النموذج أعطى خصم الولاء لكل العملاء، أعضاء وغير أعضاء، وهذا هو سبب سقوط الاختبارات القديمة، فمجموع سلة بـ100 ريال لم يعد 140. - الخصمان يطرحان معاً
sub - discount - loyalty_discount_amount، أي أن الولاء يجمع مع الكوبون عكس ما طلبناه في الجملة نفسها. - النموذج أضاف كلمة
memberإلى تعليق أعلى الملف كأنها حقل في كل سطر من السلة، ثم لم يستخدمها في أي مكان، وهذا نوع من الأخطاء لا يظهر إلا لمن يقرأ الفرق.
والمهم هنا أن صاحب المتجر بالطريقة الأولى لن يرى أي شيء من هذا، فالملف يستورد دون خطأ، والصفحة تفتح، والمجموع يظهر برقم معقول، والخطأ الوحيد أن كل عميل يدفع 5% أقل مما يجب، وهذا لا يظهر إلا في تقرير المبيعات بعد شهر.
المواصفة وحدها: أفضل لكن لم يتحقق أحد
الطريقة الثانية حسنت النتيجة كثيراً، فالاختبارات القديمة نجحت كلها في المحاولات الثلاث، لأن المواصفة قالت صراحةً إن من لا يرسل member يجب أن يبقى كما هو، والمحاولة الثالثة نجحت في اختبارات القبول الستة كلها. لكن المحاولتين الأولى والثانية سقط فيهما اختباران، وهذا الفرق من المحاولة الثانية:
--- pricing.py (before)
+++ pricing.py (after)
@@ -24,3 +24,3 @@

-def total(items, code=None):
+def total(items, code=None, member=False):
     sub = subtotal(items)
@@ -28,2 +28,9 @@
     after = round(sub - discount, 2)
+
+    # Apply loyalty discount if the customer is a member
+    if member:
+        loyalty_discount = min(0.05 * sub, 30)
+        after -= loyalty_discount
+
+    # Compute the final total
     vat = round(after * VAT_RATE, 2)
لاحظ أن النموذج يطرح خصم الولاء من after الذي طرح منه الكوبون قبل ذلك، أي أن العضو الذي يستخدم كوبوناً يحصل على الخصمين معاً، وهذا يخالف السطر الثالث من المواصفة حرفياً. والاختباران اللذان سقطا هما بالضبط اختبار الكوبون الأكبر واختبار الولاء الأكبر. وبالطريقة الثانية لا يوجد من يشغل هذه الاختبارات، فالكود سيقبل كما هو في محاولتين من ثلاث، وهنا نرى أن المواصفة تقلل الأخطاء لكنها لا تكشف ما بقي منها.
الهندسة: لم يقبل خطأ واحد
المحاولة الأولى بالطريقة الثالثة نجحت من أول طلب في كل خطوة، فالدالة loyalty_discount نجحت في اختبارات الوحدة الأربعة، ثم total نجحت في الاختبارات الأربعة عشر كلها، والفرق كما يلي:
--- pricing.py (before)
+++ pricing.py (after)
@@ -24,6 +24,17 @@

-def total(items, code=None):
+def loyalty_discount(items, member):
+    if not member:
+        return 0
+
+    subtotal = sum(i["price"] * i["qty"] for i in items)
+    discount = subtotal * 0.05
+    return min(discount, 30)
+
+
+def total(items, code=None, member=False):
     sub = subtotal(items)
     discount = coupon_discount(items, code) if code else 0
-    after = round(sub - discount, 2)
+    loyalty_discount_amount = loyalty_discount(items, member)
+    total_discount = max(discount, loyalty_discount_amount)
+    after = round(sub - total_discount, 2)
     vat = round(after * VAT_RATE, 2)
لاحظ أن الفرق لا يلمس أي دالة غير المطلوبتين، وأن الدالة الجديدة دخلت قبل total مباشرة، والسبب أن بيئة التشغيل هي التي وضعتها هناك ولم تترك للنموذج أن يعيد كتابة الملف.
أما المحاولتان الثانية والثالثة فهنا النتيجة التي لم نتوقعها، فقد سقط فيهما اختبار واحد من اختبارات الوحدة، وأرسلت بيئة التشغيل رسالة الخطأ إلى النموذج ثلاث مرات، وفي كل مرة بقي الاختبار نفسه ساقطاً، ثم استمر الخطأ إلى الخطوة الثانية فسقطت اختبارات أخرى، وتوقفت الحلقة بعد أربع محاولات لكل خطوة. والخطأ يظهر في الفرق التالي من المحاولة الثانية:
--- pricing.py (before)
+++ pricing.py (after)
@@ -24,6 +24,17 @@

-def total(items, code=None):
+def loyalty_discount(items, member):
+    if not member:
+        return 0
+
+    eligible = sum(i["price"] * i["qty"] for i in items if not i.get("on_sale"))
+    discount = min(eligible * 0.05, 30)
+    return round(discount, 2)
+
+
+def total(items, code=None, member=False):
     sub = subtotal(items)
     discount = coupon_discount(items, code) if code else 0
-    after = round(sub - discount, 2)
+    loyalty_discount_amount = loyalty_discount(items, member)
+    total_discount = max(discount, loyalty_discount_amount)
+    after = round(sub - total_discount, 2)
     vat = round(after * VAT_RATE, 2)
السطر if not i.get("on_sale") نسخه النموذج من دالة الكوبون الموجودة في الملف، رغم أن المواصفة تقول إن خصم الولاء يشمل المنتجات المخفضة على عكس الكوبون، ورغم أن رسالة الاختبار كانت تقول إن الناتج 5 والمتوقع 10. وهذا يعلمنا شيئين: الأول أن النموذج يميل إلى تقليد الكود المجاور أكثر من قراءة المواصفة، وهذا بالضبط القرار الذي كان غامضاً في جملة الطريقة الأولى، والثاني أن حلقة الخطأ وحدها لا تصلح سوء الفهم، فالنموذج الذي لم يفهم المواصفة في المرة الأولى لن يفهمها لأنك أرسلت له الخطأ نفسه ثلاث مرات.
لكن الفرق الحاسم بين هاتين المحاولتين ومحاولات الطريقتين الأولى والثانية أن الكود هنا لم يقبل، فبيئة التشغيل توقفت والاختبارات حمراء، وكل ما بقي هو الخطوة الأخيرة في الطريقة: إنسان يقرأ الفرق. قرأنا الفرقين، وكتبنا تعليق مراجعة Review Comment واحداً على كل دالة خاطئة، كما يكتبه أي مراجع في طلب دمج Pull Request، وأعطينا التعليق للنموذج ليصلح تلك الدالة فقط، والسكربت review.py يفعل ذلك، والمخرج كما يلي:
model qwen2.5-coder:3b, one review comment per wrong function, at most 2 tries each

== engineered-s2
    comment on loyalty_discount: the spec says sale lines are included for loyalty (unlike coupons). Remove the on_sale filter and use the whole subtotal.
    after review: old tests 8/8, acceptance 6/6, unit 4/4, diff +13 -2, calls 1, tokens in 586 out 67

== engineered-s3
    comment on loyalty_discount: the spec says sale lines are included for loyalty (unlike coupons). Remove the on_sale filter and use the whole subtotal.
    comment on total: `after` is computed before you pick the bigger discount, so the loyalty discount never changes the total. Pick the bigger of coupon and loyalty first, then compute `after`.
    after review: old tests 8/8, acceptance 6/6, unit 4/4, diff +14 -1, calls 2, tokens in 1178 out 176
تعليق واحد على الدالة الأولى كان كافياً للمحاولة الثانية، وتعليقان للمحاولة الثالثة لأن الخطوة الثانية فيها كانت خاطئة أيضاً، فقد كانت تحسب after قبل أن تختار الخصم الأكبر، فلا يغير خصم الولاء المجموع أبداً. وبعد التعليقات نجحت المحاولتان في الاختبارات الثمانية عشر كلها. لكن اقرأ الفرق النهائي للمحاولة الثالثة:
--- pricing.py (before)
+++ pricing.py (after)
@@ -24,5 +24,18 @@

-def total(items, code=None):
+def loyalty_discount(items, member):
+    if not member:
+        return 0
+
+    eligible = sum(i["price"] * i["qty"] for i in items)
+    discount = min(eligible * 0.05, 30)
+    return round(discount, 2)
+
+
+def total(items, code=None, member=False):
     sub = subtotal(items)
     discount = coupon_discount(items, code) if code else 0
+    loyalty_discount_amount = loyalty_discount(items, member)
+    after = round(sub - discount, 2)
+    if loyalty_discount_amount > discount:
+        discount = loyalty_discount_amount
     after = round(sub - discount, 2)
الاختبارات كلها خضراء، ومع ذلك في الدالة سطر after = round(sub - discount, 2) مكرر مرتين، والأول لا فائدة منه، وهذا لا يكسر شيئاً اليوم لكنه سيربك أول شخص يعدل الدالة بعدك. وهذا سبب أن قائمة Willison فيها الاختبارات الآلية ومراجعة الكود معاً، فالاختبارات تخبرك أن الكود صحيح، والمراجعة تخبرك هل تريد أن تعيش معه.
ماذا تعني هذه الأرقام؟
إذا عددنا ما كان سيصل إلى المتجر فعلاً، فالطريقة الأولى أوصلت أخطاء في 3 محاولات من 3، والثانية في 2 من 3، والثالثة في 0 من 3. وهذا هو الفرق الحقيقي بين الطرفين، وهو ليس أن الطريقة الهندسية تجعل النموذج يكتب كوداً أفضل، فالنموذج نفسه أخطأ في محاولتين من ثلاث في الطريقة الثالثة، وإنما أنها لا تسمح للخطأ أن يمر دون أن يراه أحد.
وفي المقابل لهذه الطريقة ثمن واضح في الأرقام، فالطريقة الأولى استهلكت 372 توكن داخلة في طلب واحد، أما المحاولتان الفاشلتان في الطريقة الثالثة فاستهلكت كل منهما نحو 12 ألف توكن داخلة في ثمانية طلبات، أي أكثر من ثلاثين ضعفاً، والسبب أن كل طلب يحمل المواصفة والملف والاختبارات، وأن الحلقة أعادت المحاولة ست مرات دون فائدة، فلو توقفنا بعد محاولتين وانتقلنا إلى المراجعة مباشرة لوفرنا أغلب هذه التوكنات. وفوق التوكنات هناك وقتك أنت: كتابة المواصفة، وكتابة عشرة اختبارات جديدة، وقراءة الفروقات، وكتابة ثلاثة تعليقات مراجعة، وهذا هو الوقت الذي يقول Willison إنه صار أهم من وقت كتابة الكود.
وقد يتساءل البعض: إذا كانت المواصفة وحدها أعطت نتيجة صحيحة في محاولة من ثلاث، فلماذا لا نكتفي بها ونجرب حتى تنجح؟ والإجابة على ذلك أنك لن تعرف أيها نجحت، فالمحاولات الثلاث في الطريقة الثانية تبدو متشابهة لمن لا يشغل الاختبارات، والكود الصحيح والكود الخاطئ فيها يستوردان دون أخطاء ويعطيان أرقاماً معقولة، والطريقة الوحيدة للتفريق بينهما هي الاختبارات نفسها، وعندها تكون قد عدت إلى الطريقة الثالثة.
لماذا كرر النموذج الخطأ نفسه؟
قد يبدو غريباً أن يقرأ النموذج رسالة تقول إن الناتج 5 والمتوقع 10، ثم يعيد الدالة نفسها، والسبب يعود إلى طريقة عمل النموذج نفسها، فكما شرحنا في مقال كيف يعمل مساعد البرمجة من الداخل، النموذج يتوقع التوكن التالي من كل ما في السياق، وفي سياق هذه الخطوة كانت دالة coupon_discount موجودة بكاملها، وفيها السطر if not i.get("on_sale") في دالة تحسب خصماً بنسبة من مجموع السلة، أي أن أقرب نمط في السياق لما طلبناه كان يقول استبعد المنتجات المخفضة، والجملة في المواصفة التي تقول العكس سطر واحد مكتوب بكلمات وليس بكود. والنموذج الصغير بالذات يتبع النمط القريب أكثر من الجملة البعيدة، ورسالة الاختبار تقول إن الرقم خطأ لكنها لا تقول لماذا، فيبقى أقرب نمط هو نفسه، ويعيد النموذج ما يعرفه.
أما تعليق المراجعة فقال ثلاثة أشياء لم تقلها رسالة الاختبار: أين الخطأ بالضبط، أي شرط on_sale، ولماذا هو خطأ، أي أن المواصفة تقول إن الولاء يشمل المنتجات المخفضة على عكس الكوبون، وماذا يجب أن يفعل بدلاً منه. وهذا الفرق بين رسالة الخطأ وتعليق المراجعة هو ما يقصده Willison عندما يصف العمل مع الوكيل بأنه نوع غريب من الإدارة، فالملاحظة العامة مثل «الاختبار فشل، أصلحه» لا تنفع مع زميل جديد ولا مع وكيل، والملاحظة التي تحدد المكان والسبب تنفع مع الاثنين. ولذلك القاعدة العملية هنا: إذا أعاد الوكيل المحاولة مرتين بالخطأ نفسه فتوقف عن إرسال رسالة الخطأ، واقرأ الفرق بنفسك، واكتب له تعليقاً واحداً محدداً.
عندما يصل الفايب كودنج إلى الإنتاج
ولاحظ أن هذه القصة تجمع ما رأيناه في المختبر بحجم أكبر، فالوكيل الذي يقول إن الاختبارات نجحت دون أن تكون نجحت هو الطريقة الأولى نفسها، أي أن تقبل ما يقوله لأنه يبدو صحيحاً، والفرق الوحيد أن الملف في مختبرنا كان ملف تسعير على جهازك، وفي القصة كان قاعدة بيانات حقيقية لشركة.
متى يكفيك الفايب كودنج؟
بعد كل ما سبق قد يبدو أن الفايب كودنج طريقة خاطئة يجب تجنبها، وهذا غير صحيح، فـKarpathy حدد مكانها من البداية، وWillison نفسه يقول إن أغلب أدوات موقعه الصغيرة بنيت بهذه الطريقة. والسؤال الذي يحدد الطريقة المناسبة ليس ما الأداة التي تستخدمها، وإنما سؤالان: ما ثمن الخطأ إذا انكسر الكود؟ وكم سيعيش الكود ومن سيعدله بعدك؟
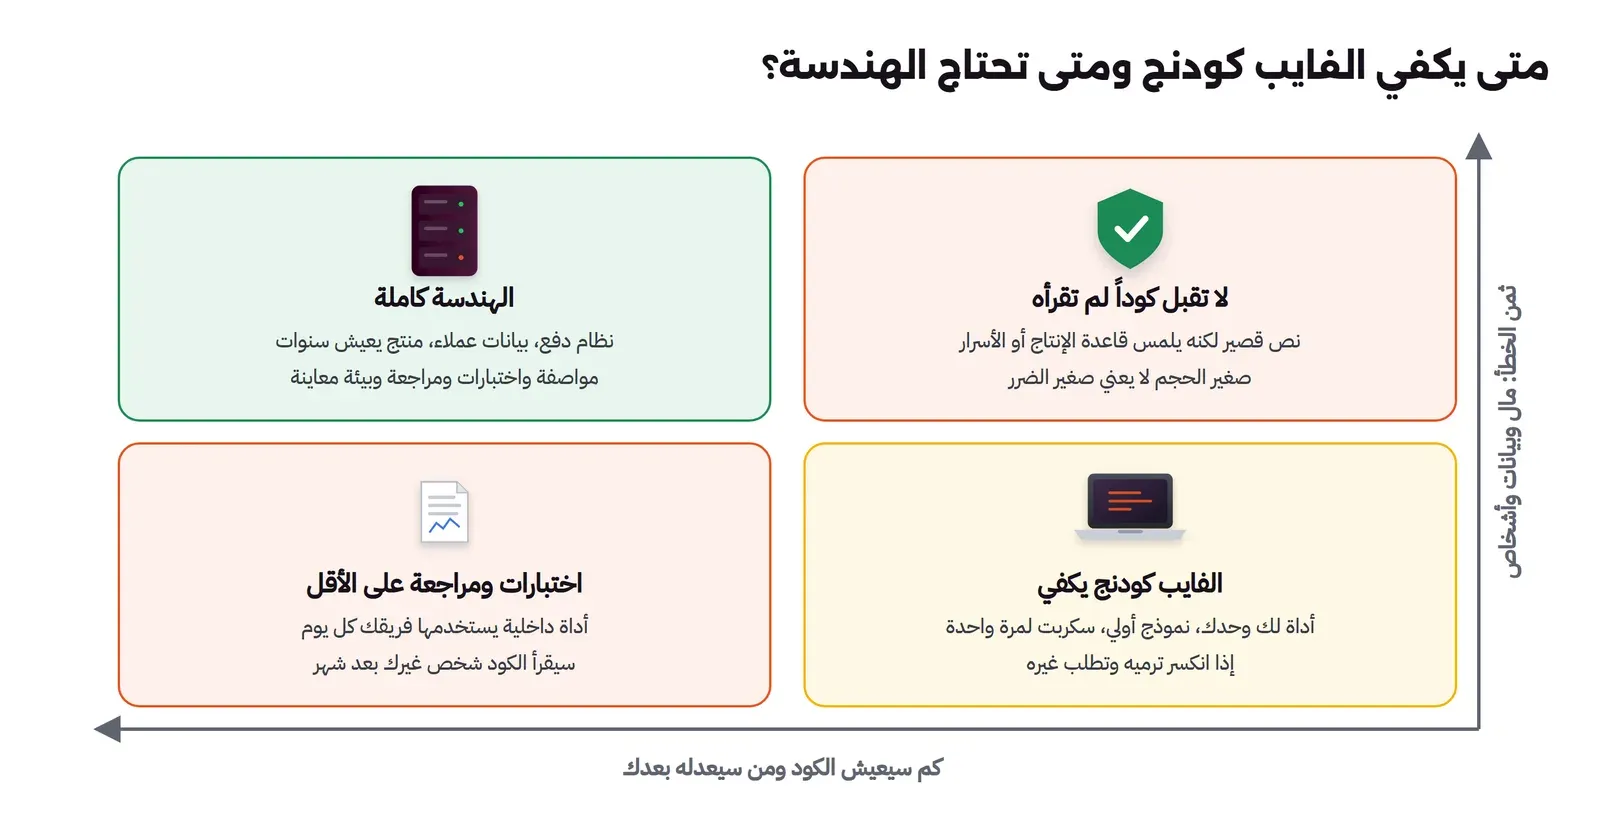
وفيما يلي القاعدة العملية لكل جزء:
- أداة لك وحدك تعيش يوماً أو أسبوعاً، مثل سكربت يعيد تسمية ملفات الصور أو صفحة تجربة لفكرة: الفايب كودنج مناسب، والسبب أن ثمن الخطأ أن ترمي الكود وتطلب غيره.
- أداة داخلية يستخدمها فريقك كل يوم: تحتاج اختبارات للحالات المهمة ومراجعة سريعة للفرق على الأقل، لأن شخصاً غيرك سيقرأ الكود بعد شهر ويحتاج أن يفهمه.
- كود قصير لكنه يلمس شيئاً خطيراً، مثل سكربت يحذف سجلات قديمة من قاعدة الإنتاج أو يغير صلاحيات: لا تقبل سطراً لم تقرأه مهما كان قصيراً، لأن خطأً واحداً فيه قد يكلف أكثر من كل ما وفره الوكيل من وقت.
- نظام دفع أو بيانات عملاء أو منتج يعيش سنوات: الممارسات كاملة، مواصفة واختبارات وخطوات صغيرة ومراجعة وبيئة معاينة، وهنا تظهر قيمة الوكيل الحقيقية، لأن هذه الممارسات تجعله أسرع بدل أن تجعله أخطر.
أخطاء شائعة
- الحكم على الكود من شكله: الكود الذي كتبه النموذج في الطريقة الأولى كان مرتباً ومعلقاً وفيه ثوابت بأسماء واضحة، ومع ذلك كسر الاختبارات القديمة، والسبب أن الكود المرتب يعطي إحساساً بالصحة لا علاقة له بالصحة.
- ترك القرارات للنموذج: كل جملة غامضة في الطلب، مثل «5% من الطلب»، هي قرار سوف يتخذه النموذج بدلاً عنك دون أن يخبرك، والمواصفة هي المكان الذي تتخذ فيه هذه القرارات بنفسك.
- المواصفة دون اختبارات: المواصفة وحدها حسنت النتيجة في المختبر لكنها لم تكف، لأن لا أحد تحقق من أن الكود يطابقها، والاختبار هو المواصفة بصيغة يستطيع الحاسوب التحقق منها.
- طلب الملف كاملاً: عندما تطلب الملف كاملاً تعطي النموذج فرصة لتغيير ما لم تطلبه، والأفضل أن تطلب الدالة أو الجزء المحدد، وأن تراجع الفرق لا الملف.
- الوثوق بقول الوكيل إن الاختبارات نجحت: شغلها أنت، أو اجعل بيئة التشغيل تشغلها وتقرأ النتيجة، كما فعل المختبر، فالقصة السابقة بدأت بوكيل قال إن الاختبارات نجحت.
كيف تبدأ بالطريقة الهندسية في مشروعك؟
لا تحتاج أن تطبق قائمة Willison كاملة من اليوم الأول، فأغلب الفرق في المختبر جاء من أربعة أشياء صغيرة تستطيع أن تبدأ بها في أي مشروع، وفيما يلي ترتيبها:
- اكتب المواصفة قبل الطلب، ولو في خمسة أسطر، وضع فيها كل قرار غامض: ماذا يشمل، وماذا لا يجمع مع ماذا، وما الذي يجب ألا يتغير، والسبب أن كل قرار لا تكتبه سيتخذه النموذج بدلاً عنك.
- حول المواصفة إلى اختبارات قبل أن يكتب الوكيل سطراً، فالاختبار هو الشيء الوحيد الذي يستطيع أن يفرق بين محاولة صحيحة ومحاولة خاطئة تبدو صحيحة، وقد شرحنا في مقال اختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟ لماذا لا تترك كتابة هذه الاختبارات للوكيل نفسه دون مراجعة.
- اطلب التغيير في خطوات صغيرة، ودالة أو ملفاً في كل خطوة، وشغل الاختبارات بعد كل خطوة بنفسك أو في بيئة التشغيل، لا بقول الوكيل إنها نجحت.
- اقرأ الفرق قبل أن تقبل، وإذا رأيت خطأً فاكتب تعليقاً محدداً يشير إلى سطر المواصفة الذي خالفه، ولا تكتف بإعادة رسالة الخطأ، فالمختبر أظهر أن التعليق الواحد المحدد أصلح ما لم تصلحه ثلاث رسائل خطأ، وقد شرحنا طريقة المراجعة نفسها في مقال مراجعة كود الذكاء الاصطناعي دون أن تصبح شكلية.
تدريب عملي
- احذف السطر الثاني من
spec.mdالذي يقول إن خصم الولاء يشمل المنتجات المخفضة، ثم شغلbash run.shمرة أخرى، ولاحظ كم محاولة في الطريقة الثانية تنسخ شرطon_saleمن الكوبون. - غير عدد المحاولات في الحلقة من 4 إلى 2 في الدالة
engineered، وقارن التوكنات الداخلة في المحاولتين الفاشلتين قبل التغيير وبعده، ثم فكر: متى يجب أن تتوقف الحلقة وتطلب إنساناً؟ - شغل المختبر بالنموذج الأصغر
bash run.sh qwen2.5-coder:1.5b 1,2,3، ولاحظ هل تتغير النتيجة الأهم، أي عدد المحاولات التي كانت ستصل إلى المتجر بأخطاء في كل طريقة. - اقرأ
results/vibe-spec-s3/pricing.diffالتي نجحت في كل الاختبارات، وابحث فيها عن شيء كنت ستطلب تغييره في المراجعة حتى لو كانت الاختبارات خضراء.
الخلاصة
- الفايب كودنج كما عرفه Karpathy في فبراير 2025 هو أن تقبل كل التغييرات دون قراءة وتلصق الأخطاء كما هي، وقد حدد هو نفسه مكانه في مشاريع نهاية الأسبوع، وضيقه Willison إلى بناء البرمجيات بنموذج لغوي دون مراجعة الكود.
- الفايب إنجنيرنج اسم اقترحه Willison في أكتوبر 2025 للطرف الآخر، حيث يبقى المهندس مسؤولاً عن كل سطر، ثم قال في فبراير 2026 إن اسم Agentic Engineering هو الذي انتصر، أي أن الاسم ضعيف باعتراف صاحبه.
- الممارسات التي يكافئها الوكيل كلها قديمة: اختبارات وتخطيط وتوثيق وGit وأتمتة ومراجعة وبيئة معاينة، والجديد أن ثمن غيابها صار أكبر لأن الوكيل يكتب أسرع.
- التمييز نفسه حقيقي وقابل للقياس: في المختبر وصلت الأخطاء إلى المتجر في 3 محاولات من 3 بالفايب، و2 من 3 بالفايب مع مواصفة، و0 من 3 بالهندسة.
- الهندسة لم تجعل النموذج أذكى، فقد أخطأ في محاولتين من ثلاث، وكرر الخطأ نفسه رغم رسالة الاختبار، لكنها منعت الكود الخاطئ من أن يقبل، وتعليق مراجعة واحد محدد أصلح ما لم تصلحه ثلاث رسائل خطأ.
- الثمن حقيقي أيضاً: أكثر من ثلاثين ضعفاً في التوكنات في المحاولات الصعبة، ووقتك في المواصفة والاختبارات والمراجعة، ولذلك اختر الطريقة حسب ثمن الخطأ وعمر الكود، لا حسب الأداة.
والمقالات المرتبطة بهذا المقال في المسار نفسه كما يلي:
 دليلكيف يعمل مساعد البرمجة AI Coding Assistant من الداخل؟النموذج لا يفتح ملفاً ولا يشغل أمراً، وإنما يقرأ توكنات ويكتب نصاً، وبرنامج حوله ينفذ: نرى ذلك بأعيننا على نموذج مفتوح المصدر ثم نبني وكيلاً صغيراً يصلح خطأً حقيقياً.
 دليلالفايب كودنج Vibe Coding: متى ينفع ومتى يضرك؟ما هو الفايب كودنج كما عرفه صاحبه، ومتى يكون طريقة ممتازة ومتى يتحول إلى خطر، مع مختبر يبني تطبيقاً صغيراً دون قراءة الكود ثم يفحصه.
 دليلبيئة تشغيل الوكيل Harness: الصلاحيات والصندوق المعزول Sandboxالنموذج يكتب نصاً فقط، والبرنامج الذي حوله هو الذي يقرأ الملفات وينفذ الأوامر ويقرر ما يسمح به، وفي هذا الدليل نبني بيئة تشغيل صغيرة حول نموذج محلي ونرى كل جزء منها يعمل ويمنع.
 دليلمراجعة كود الذكاء الاصطناعي دون أن تصبح شكليةكيف تراجع طلبات الدمج التي يكتبها الذكاء الاصطناعي بحسب خطرها، وتترك للبوابات الآلية ما تستطيع قياسه.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
وفي المقالات القادمة من هذه المرحلة بإذن الله نتكلم عن الفايب كودنج نفسه بتفصيل أكبر: متى ينفع ومتى يضرك، ثم ننتقل إلى سير العمل اليومي مع الوكيل، والتطوير بالاختبار أولاً TDD معه.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل المختبر على Ollama 0.40.13 بالنموذج qwen2.5-coder:3b على المعالج، وDocker مع Image python:3.13.18-slim.