في نهاية كل ربع تجلس إدارة المتجر الإلكتروني Online Store لتوزع ميزانية الإعلانات Ad Budget على الربع القادم Quarter، وأمامها ثلاث لوحات Dashboards: لوحة Google Ads تقول إن كل ريال في إعلانات البحث المدفوع Paid Search أعاد 4.6 ريال، ولوحة Meta تقول إن إعلانات التواصل Social Ads أعادت 1.7 ريال، وتقرير حملة الفيديو Video على YouTube يكاد لا ينسب لنفسه أي عملية شراء. والقرار يبدو واضحاً من هذه الأرقام، أي أن ننقل ميزانية الفيديو إلى البحث. ثم يسأل المدير المالي CFO سؤالاً بسيطاً: لو أوقفنا الفيديو تماماً، كم ستنقص المبيعات Sales فعلاً؟ ولا أحد في الغرفة يعرف الإجابة، لأن كل هذه اللوحات تجيب عن سؤال آخر، وهو «من آخر من لمس العميل قبل أن يشتري؟»، لا عن «ماذا أضاف هذا الإعلان إلى المبيعات؟».
والفرق بين السؤالين هو موضوع هذا المقال. فالسؤال الأول يجيب عنه الإسناد Attribution، والثاني يحتاج إلى أداتين أخريين: نموذج مزيج التسويق Marketing Mix Modeling واختصاراً MMM، الذي يقرأ تاريخ الإنفاق Spend والمبيعات أسبوعاً بأسبوع ويقدر ما أضافته كل قناة Channel، واختبارات الأثر الإضافي Incrementality Tests، التي توقف الإعلان عن جزء من السوق وتقيس ما ضاع. وكل أداة منهما تغطي ضعف الأخرى، لذلك تستخدمها الفرق الجادة معاً.
وسوف نناقش في هذا المقال ما يلي:
- لماذا يضلل تقرير النقرة الأخيرة Last-click، بالأرقام وبحالة موثقة من eBay.
- كيف يعمل نموذج MMM من الداخل: المبيعات الأساسية Base والإضافية Incremental، والأثر المتراكم Adstock، والتشبع Saturation، والموسمية Seasonality.
- البيانات التي تحتاجها قبل أن تبدأ، ولماذا سنتان من البيانات الأسبوعية هي الحد الأدنى.
- مختبر صغير بلغة Python: نصنع بيانات مصطنعة Synthetic لـ 104 أسابيع نعرف أثرها الحقيقي، ونبني نموذجاً بأيدينا، ونرى هل يجد العائد الحقيقي.
- نجرب العطل: قنوات تتحرك معاً، وتاريخ قصير، ونرى كيف يخطئ نفس النموذج.
- سؤال «ماذا لو؟»: منحنيات الاستجابة Response Curves وإعادة توزيع الميزانية.
- اختبار إيقاف جغرافي Geo Holdout مصطنع، ثم معايرة النموذج Calibration بنتيجته، والخطأ الذي يقع فيه أغلب من يعاير لأول مرة.
- الأدوات مفتوحة المصدر: Google Meridian وMeta Robyn وPyMC-Marketing، كما تصفها وثائقها الرسمية.
- خطوات البدء، والأخطاء الشائعة، وقائمة تحقق.
باختصار In Short
- تقرير النقرة الأخيرة يعطي الفضل لمن «التقط» العميل، لا لمن «صنع» رغبته، لذلك يضخم البحث باسم العلامة التجارية Brand Search ويظلم الفيديو والإعلانات التي تبني الطلب.
- نموذج MMM يستخدم بيانات مجمعة Aggregated Data أسبوعية (إنفاق كل قناة والمبيعات وعوامل أخرى)، فلا يحتاج ملفات تعريف الارتباط Cookies ولا بيانات المستخدم، ويقدر كم أضافت كل قناة.
- النموذج يحتاج على الأقل سنتين من البيانات الأسبوعية، وقنوات لا يتحرك إنفاقها معاً، وإلا أعطاك أرقاماً واثقة وخاطئة.
- اختبارات الأثر الإضافي هي الدليل الأقوى على السببية Causality، لكنها تقيس قناة واحدة في فترة واحدة، لذلك تستخدم نتائجها لمعايرة النموذج، لا بدلاً منه.
- أهم مخرج للنموذج ليس العائد المتوسط، وإنما العائد الحدي Marginal ROI، أي ماذا يجلب الريال القادم، وهو أضعف جزء في التقدير.
لماذا يضللك تقرير النقرة الأخيرة؟ Last-click Attribution
في مقال قياس التسويق: روابط UTM والإسناد شرحنا كيف تعرف القناة التي جاء منها كل عميل، وكيف توزع نماذج الإسناد Attribution Models الفضل بين القنوات التي لمسها العميل قبل الشراء. وكل هذه النماذج، سواءً كانت النقرة الأخيرة أو الأولى أو النموذج المعتمد على البيانات Data-driven، تشترك في شيء واحد، وهو أنها توزع المبيعات التي حدثت على اللمسات التي سبقتها، ولا تسأل أبداً هل كانت هذه المبيعات ستحدث بدون الإعلان. والمشكلة هنا ليست في الحساب، وإنما في السؤال نفسه، والتفصيل فيما يلي.
الفضل Credit شيء والسبب Cause شيء آخر
لنأخذ عميلاً شاهد إعلان فيديو عن المتجر يوم الأحد، ولم ينقر عليه، ثم تذكر المتجر يوم الأربعاء فكتب اسمه في Google، ونقر على أول نتيجة، وكانت إعلاناً مدفوعاً باسم المتجر، ثم اشترى. تقرير النقرة الأخيرة سوف يعطي الشراء كله لإعلان البحث، والفيديو الذي صنع الرغبة لا يأخذ شيئاً، لأنه لم يحصل على نقرة. وعميل آخر يعرف المتجر منذ سنة ويشتري منه كل شهر، ويكتب اسمه في Google في كل مرة لأنه أسرع من كتابة العنوان، فينقر على الإعلان المدفوع، فيحسب الشراء أيضاً لإعلان البحث، مع أن هذا العميل كان سيشتري لو لم يكن هناك إعلان على الإطلاق، فهو كان سينقر على النتيجة العادية Organic تحت الإعلان مباشرة.
وبالتالي فإن إعلان البحث في الحالتين «التقط» طلباً موجوداً، ولم يصنعه، والتقرير لا يستطيع أن يفرق بين الحالتين، لأنه يرى النقرة ولا يرى ما كان سيحدث بدونها. وهذا ما يسمى في الإحصاء الحالة المضادة Counterfactual، أي العالم الذي لم يظهر فيه الإعلان، ولا توجد طريقة لرؤيته من بيانات النقرات وحدها.
قصة من الواقع: eBay وإعلانات اسم العلامة
ولماذا أصبحت المشكلة أكبر في السنوات الأخيرة؟
هناك ثلاثة أسباب تجعل الاعتماد على تتبع النقرات اليوم أضعف مما كان قبل سنوات:
- الخصوصية Privacy: المتصفحات تحذف معرفات التتبع Tracking Identifiers أو تقصر عمرها، والهواتف تطلب إذن المستخدم قبل التتبع بين التطبيقات، فتضيع مسارات كاملة من بياناتك، وتبقى النقرات الأخيرة القريبة من الشراء فقط، وهي في الغالب نقرات البحث. وقد تكلمنا عن هذا في مقال الإسناد.
- كل منصة تحسب لنفسها: Google Ads تحسب العميل الذي نقر على إعلانها، وMeta تحسب نفس العميل لأنه شاهد إعلانها قبل يوم، وعند جمع ما تدعيه كل منصة تحصل على مبيعات أكثر من مبيعاتك الفعلية.
- القنوات التي لا ينقر عليها أحد: إعلان الفيديو، واللوحات الخارجية Out-of-home، والراديو، والبودكاست Podcasts، والمؤثرون Influencers، كلها تصنع طلباً دون نقرة، فلا تظهر في أي تقرير إسناد تقريباً.
والنتيجة العملية أن فريقاً يوزع ميزانيته حسب تقرير النقرة الأخيرة سوف ينقل المال تدريجياً من القنوات التي تصنع الطلب إلى القنوات التي تلتقطه، وسوف يبدو كل شيء ممتازاً في التقارير لعدة أشهر، ثم يبدأ البحث باسم المتجر بالانخفاض، لأن لا أحد يصنع الرغبة التي يلتقطها. وسوف نرى هذا بالأرقام في المختبر بعد قليل.
ثلاث أدوات لثلاثة أسئلة: الإسناد والتجربة والنموذج
قبل أن ندخل في النموذج، من المهم أن نفرق بين ثلاث أدوات يخلط بينها كثيرون، لأن لكل واحدة سؤالها الذي تجيب عنه، ولا تغني واحدة عن الأخرى:
| الأداة | السؤال الذي تجيب عنه | البيانات | نقطة قوتها | نقطة ضعفها |
|---|---|---|---|---|
| الإسناد Attribution | ما اللمسات التي سبقت هذا الشراء؟ | نقرات وزيارات على مستوى المستخدم | يومي وتفصيلي، لكل حملة Campaign وكلمة مفتاحية Keyword | لا يقيس السببية، ولا يرى القنوات التي لا ينقر عليها أحد |
| اختبار الأثر الإضافي Incrementality Test | كم أضافت هذه القناة في هذه الفترة؟ | مجموعة اختبار Test ومجموعة مقارنة Control | أقوى دليل على السببية | قناة واحدة وفترة واحدة، ويكلف مبيعات ضائعة |
| نموذج مزيج التسويق MMM | كم أضافت كل قناة خلال سنتين، وماذا لو غيرت الميزانية؟ | إنفاق ومبيعات أسبوعية مجمعة | يرى كل القنوات معاً، بما فيها التي لا ينقر عليها أحد، ويجيب عن «ماذا لو؟» | تقدير إحصائي يحتاج بيانات كثيرة، ويخطئ بثقة إذا كانت البيانات ضعيفة |
وأغلب الشركات تبدأ بالإسناد، لأنه يأتي مجاناً مع أدوات الإعلان، وهذا مناسب للقرارات اليومية الصغيرة، مثل أي إعلان داخل الحملة يعمل أفضل. أما قرار توزيع الميزانية بين القنوات، وهو أكبر قرار يتخذه فريق التسويق، فيحتاج إلى النموذج والتجربة معاً. وفي مقال ميزانية التسويق وتكلفة العميل CAC والعائد ROI ذكرنا أن العائد الحقيقي للقناة هو العملاء الإضافيون Incremental، وذكرنا طريقة بسيطة لتقديره بإيقاف قناة لفترة، وهذا المقال يكمل من هناك: كيف تقدر الأثر الإضافي لكل القنوات معاً، وكيف تجعل التجربة البسيطة تجربة يمكن الاعتماد عليها.
ما هو نموذج مزيج التسويق؟ Marketing Mix Modeling
نموذج مزيج التسويق هو نموذج إحصائي يشرح المبيعات الأسبوعية (أو أي مؤشر أداء رئيسي KPI مثل التسجيلات أو الطلبات) بدلالة إنفاق كل قناة إعلانية، مع عوامل أخرى تؤثر في المبيعات مثل الموسم والأسعار والعطلات. وتصفه صفحة مشروع Meridian من Google بأنه تقنية تحليل إحصائي تقيس أثر الحملات التسويقية لتوجيه قرارات الميزانية، وأنه يستخدم بيانات مجمعة ولا يستخدم ملفات تعريف الارتباط Cookies ولا أي بيانات على مستوى المستخدم، لذلك لا تؤثر فيه قيود الخصوصية التي أضعفت الإسناد.
والفكرة ببساطة أن المبيعات ترتفع وتنخفض من أسبوع لآخر، والإنفاق على كل قناة يرتفع وينخفض أيضاً، فإذا لاحظنا خلال سنتين أن المبيعات ترتفع في الأسابيع التي يعمل فيها الفيديو، بعد أن نزيل أثر الموسم والعطلات والقنوات الأخرى، فالفيديو على الأرجح هو السبب، ويمكن أن نقدر كم أضاف. وبالتشبيه فإن النموذج يعمل مثل من يحاول معرفة أي من ثلاثة صنابير يملأ الحوض أكثر، دون أن يرى الصنابير، وكل ما يراه هو مستوى الماء كل أسبوع، وجدول بالأوقات التي فتح فيها كل صنبور. فإذا كانت الصنابير تفتح وتغلق في أوقات مختلفة استطاع أن يعرف، وإذا كانت تفتح دائماً معاً لم يستطع، وهذه بالضبط أكبر مشكلة في النموذج كما سيأتي.
والنموذج يعطيك ثلاثة أشياء: تفكيك المبيعات Decomposition، أي كم من مبيعات كل أسبوع جاء من كل قناة، والعائد على الاستثمار ROI لكل قناة، ومنحنى الاستجابة لكل قناة، الذي يجيب عن «ماذا لو أنفقت أكثر أو أقل؟». وسوف نبني كل هذا بأيدينا في المختبر، ولكن قبل ذلك نحتاج أن نفهم أربع أفكار تقوم عليها كل نماذج MMM.
المبيعات الأساسية Base والمبيعات الإضافية Incremental
أول فكرة أن مبيعات أي متجر تتكون من جزأين: مبيعات أساسية Base Sales كانت ستحدث لو توقفت كل الإعلانات، لأن هناك عملاء يعرفون المتجر ويعودون إليه، وآخرون يصلون من البحث العادي أو من توصية صديق، ومبيعات إضافية Incremental Sales جاءت بسبب الإعلانات. وفي أغلب الشركات التي لها اسم معروف يكون الجزء الأساسي هو الأكبر، وفي بياناتنا المصطنعة كان الأساس حوالي 65% من المبيعات، والإعلانات الثلاثة معاً 35%.
ولاحظ أن العائد الحقيقي لأي قناة يحسب من المبيعات الإضافية فقط، أي أن العائد على الاستثمار ROI للقناة هو مجموع ما أضافته من مبيعات مقسوماً على ما أنفقناه عليها. وهذا يختلف عن العائد على الإنفاق الإعلاني ROAS الذي تعرضه منصات الإعلان، لأنه يقسم كل المبيعات المنسوبة للقناة على إنفاقها، بما فيها مبيعات العملاء الذين كانوا سيشترون على أي حال. وفي هذا المقال نسمي ما يقيسه النموذج والتجربة عائداً إضافياً iROAS أو ROI، وما تعرضه المنصات ROAS حسب النقرة الأخيرة، ونحسب كله بالمبيعات لا بالربح، أي أن عائداً قدره 1.3 يعني أن الريال جلب 1.3 ريال مبيعات، وقد لا يغطي تكلفة البضاعة.
الأثر المتراكم Adstock والأثر المتأخر Carryover
الفكرة الثانية أن أثر الإعلان لا ينتهي في الأسبوع الذي عرض فيه. فمن شاهد إعلان فيديو هذا الأسبوع قد يشتري بعد أسبوعين أو ثلاثة، ومن شاهد إعلان بحث اشترى غالباً في نفس اليوم. ويسمى هذا الأثر المتأخر Carryover، والطريقة الأشهر لتمثيله هي الأثر المتراكم الهندسي Geometric Adstock:
adstock[t] = spend[t] + θ × adstock[t-1]حيث θ (ثيتا) هو معدل البقاء Decay Rate بين 0 و1، أي النسبة التي يبقى من أثر الأسبوع الماضي في هذا الأسبوع. فإذا كانت θ تساوي 0 فالأثر ينتهي في نفس الأسبوع، وإذا كانت 0.7 فيبقى 70% من الأثر في الأسبوع التالي، ثم 49% في الذي بعده، وهكذا. وتقترح دليل المحللين في وثائق Robyn مدى لهذه القيمة حسب نوع القناة: من 0.3 إلى 0.8 للتلفزيون، ومن 0.1 إلى 0.4 للوحات الخارجية والمطبوعات والراديو، ومن 0 إلى 0.3 للإعلانات الرقمية. وفي المختبر اخترنا 0.1 للبحث، و0.35 لإعلانات التواصل، و0.7 للفيديو.
وهناك صيغ أخرى للأثر المتراكم، مثل صيغة Weibull التي تسمح بأن يتأخر أقصى أثر للإعلان أسبوعاً أو أكثر بعد عرضه، وهي مفيدة للتلفزيون والقنوات التي يحتاج فيها العميل وقتاً قبل أن يتصرف، وتدعمها Robyn وPyMC-Marketing. ولكن الصيغة الهندسية تكفي لفهم الفكرة، وهي الأكثر استخداماً.
التشبع Saturation وتناقص العائد Diminishing Returns
الفكرة الثالثة أن كل ريال إضافي في نفس القناة يجلب أقل من الريال الذي قبله. فأول عشرة آلاف ريال في إعلانات البحث تشتري الكلمات الأرخص والأكثر صلة بما تبيعه، والعشرة آلاف التالية تشتري كلمات أبعد بسعر أعلى، وبعد حد معين يصبح الإعلان يعرض على نفس الأشخاص مرة بعد مرة. ويسمى هذا التشبع Saturation، وأشهر دالة لتمثيله هي دالة Hill:
hill(a) = a^s / (a^s + k^s)حيث a هو الأثر المتراكم، وk هو نقطة نصف التشبع Half-saturation Point، أي مستوى الإنفاق المتراكم الذي يصل عنده أثر القناة إلى نصف أقصاه، وs يتحكم في شكل المنحنى. وفي المختبر ثبتنا s على 1 لكي يبقى النموذج صغيراً، فيصبح المنحنى مقعراً من البداية، أي أن كل ريال يجلب أقل من الذي قبله منذ الريال الأول. والصورة التالية تبين الفكرتين معاً:
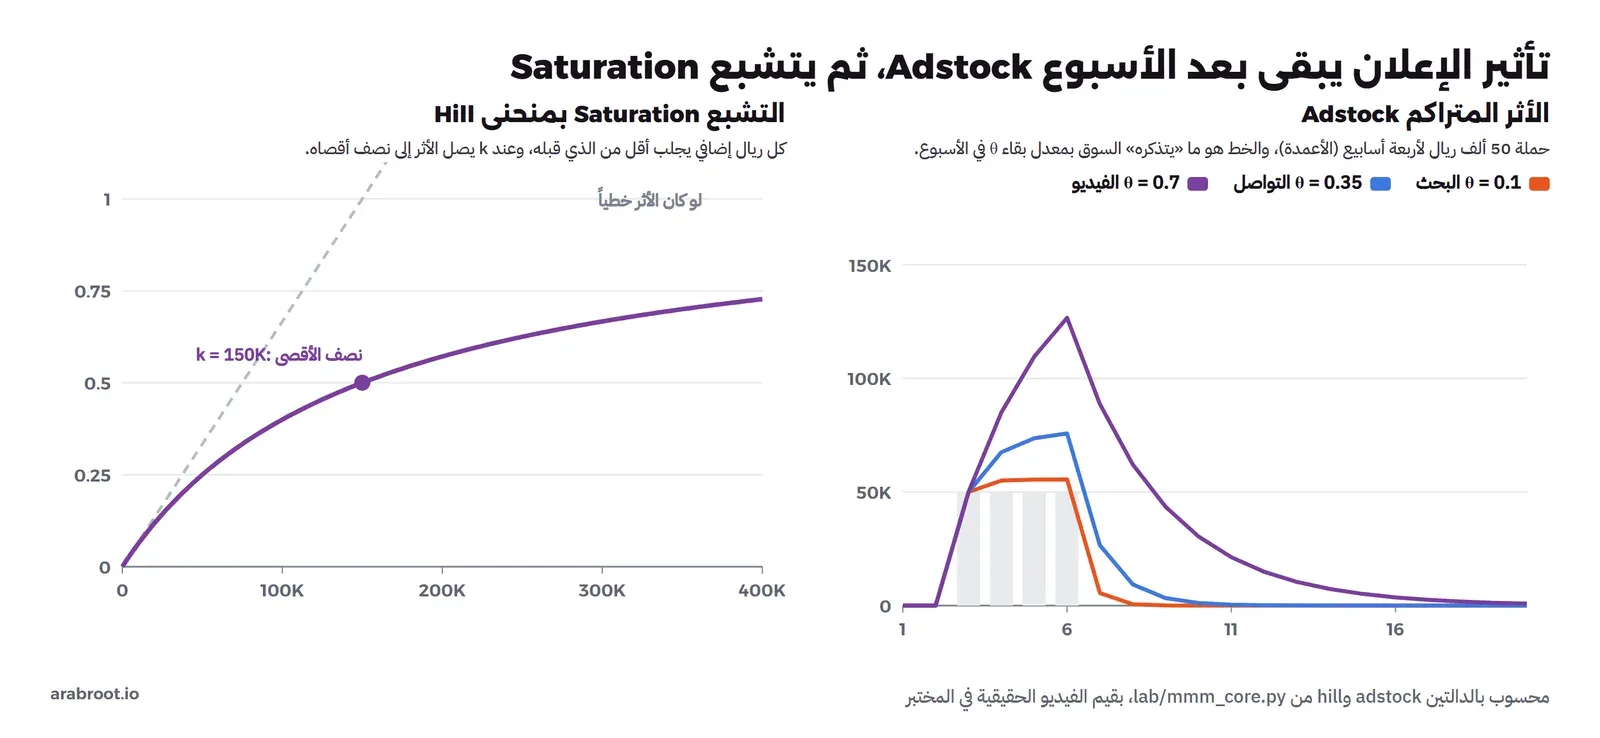
ولاحظ أن التشبع هو ما يجعل النموذج مفيداً في قرارات الميزانية، لأنه يعني أن العائد المتوسط Average ROI لقناة ما يختلف عن عائدها الحدي Marginal ROI. فقد تكون قناة متوسط عائدها 2 ريال لكل ريال، ولكنك وصلت فيها إلى منطقة التشبع، فالريال القادم فيها يجلب 0.7 فقط، بينما قناة أخرى متوسطها 1.5 ولكن الريال القادم فيها يجلب 1.4. والقرار الصحيح هنا هو أن تضع الريال القادم في القناة الثانية، مع أن متوسطها أقل، وهذه نقطة لا يراها أي تقرير يعرض رقماً واحداً لكل قناة.
الموسمية Seasonality والاتجاه Trend والعوامل الأخرى
الفكرة الرابعة أن المبيعات تتحرك لأسباب كثيرة لا علاقة لها بالإعلانات: الموسم، فمبيعات المتجر ترتفع في رمضان وفي موسم الجمعة البيضاء White Friday، والاتجاه العام Trend، فالمتجر ينمو أو ينكمش ببطء، والأسعار والعروض Promotions، ونشاط المنافسين، وحتى الرواتب في نهاية الشهر. وكل هذه تسمى متغيرات التحكم Control Variables، ويجب أن تدخل في النموذج، والسبب أن الإنفاق الإعلاني نفسه يتحرك معها.
لنفرض أن فريق التسويق يرفع ميزانية البحث في رمضان، لأن الناس تبحث أكثر في رمضان، وهذا ما يفعله أغلب الفرق ومنصات المزايدة الآلية Automated Bidding نفسها. فإذا لم يعرف النموذج أن رمضان يرفع المبيعات وحده، فسوف يرى أن المبيعات ترتفع كلما ارتفع إنفاق البحث، فيعطي البحث فضل رمضان. وهذا يسمى العامل المربك Confounder، أي عامل يحرك الإنفاق والمبيعات معاً، فيبدو كأن أحدهما يسبب الآخر. وفي بياناتنا المصطنعة جعلنا إنفاق البحث يتبع الطلب عمداً، لنرى ماذا يفعل هذا بالنموذج.
ولتمثيل الموسمية في النموذج هناك طريقتان شائعتان: إما متغيرات صفر وواحد Dummy Variables لأسابيع محددة مثل رمضان والجمعة البيضاء، وإما موجات جيبية Fourier Terms تمثل الدورة السنوية بشكل ناعم. ونحن نستخدم الاثنين معاً في المختبر، أما Robyn فتستخدم مكتبة Prophet لتفكيك الاتجاه والموسمية والعطلات، وأما Meridian فتعالج الموسمية آلياً كما تقول وثائقها.
المعادلة كاملة
وإذا جمعنا الأفكار الأربع نحصل على المعادلة التي يبنيها النموذج لكل أسبوع:
sales[t] = base[t]                                     # intercept + trend + seasonality + holidays
         + Σ  β_c × hill( adstock(spend_c, θ_c)[t], k_c )  # one term per channel c
         + noise[t]
وفي المعادلة أعلاه لاحظ التالي:
- لكل قناة ثلاثة أرقام يجب أن يقدرها النموذج: معدل البقاء θ، ونقطة نصف التشبع k، والمعامل β Coefficient الذي يحدد أقصى ما يمكن أن تضيفه القناة في الأسبوع.
- θ وk غير خطيين Nonlinear، أي لا يمكن حسابهما بالانحدار الخطي Linear Regression مباشرة، لذلك نبحث عنهما بالبحث الشبكي Grid Search ثم بخوارزمية تحسين Optimization، وعند كل قيمة لهما نحسب β والأساس بالانحدار الخطي.
- نجبر β على أن يكون موجباً أو صفراً، لأن إعلاناً يخفض المبيعات أمر غير منطقي في أغلب الحالات، وهذا قيد تضعه كل أدوات MMM بشكل أو بآخر.
- مع ثلاث قنوات وثمانية متغيرات للأساس يكون عندنا 17 رقماً نقدرها من 104 أسابيع، وهذه النسبة مهمة كما سيأتي في فقرة البيانات.
والأدوات الكبيرة مثل Meridian وPyMC-Marketing تقدر نفس هذه المعادلة تقريباً، ولكن بطريقة بايزية Bayesian، أي أنها تبدأ بتوزيع مسبق Prior لكل رقم، يعبر عما تعرفه قبل البيانات، ثم تحدثه بالبيانات فتعطيك توزيعاً لاحقاً Posterior بدلاً من رقم واحد. وهذا يفيد كثيراً في المعايرة بنتائج التجارب كما سنرى، ولكن الفكرة الأساسية نفسها.
ما البيانات التي تحتاجها؟ Data Requirements
أغلب مشاريع MMM التي تفشل تفشل بسبب البيانات لا بسبب النموذج، ووثائق Robyn تقولها بوضوح: البيانات السيئة تعطي نتائج سيئة. والجدول التالي يجمع المتطلبات كما تذكرها الوثائق الرسمية للأداتين:
| البند | ما تقوله الوثائق | لماذا |
|---|---|---|
| طول التاريخ History | Robyn: سنتان على الأقل من البيانات الأسبوعية، أو 4 إلى 5 سنوات إذا كانت البيانات شهرية. Meridian: سنتان أسبوعياً لكل منطقة في النموذج الجغرافي، وثلاث سنوات للنموذج الوطني National | لكي يرى النموذج كل موسم مرتين على الأقل، فيفصل أثر رمضان عن أثر الإعلان الذي يرتفع فيه |
| الدقة الزمنية Granularity | الأسبوعي هو الأفضل، واليومي ممكن مع تحقق إضافي، والشهري قد يجعل النموذج لا يتقارب Non-convergence أو يعطي مدى واسعاً جداً | الشهري يعطي 24 نقطة فقط في سنتين، وهذا أقل بكثير من عدد الأرقام التي نقدرها |
| عدد المتغيرات | Robyn: متغير مستقل واحد لكل 10 مشاهدات تقريباً | كل متغير إضافي يحتاج بيانات ليقدر، و104 أسابيع لا تكفي لعشرين قناة |
| المستوى الجغرافي | Meridian تنصح بالبيانات على مستوى المناطق Geo-level إن وجدت، والوطنية مقبولة. وRobyn تعتبر المنطقة أفضل ممارسة | كل منطقة تضيف مشاهدات، والفرق بين المناطق في الإنفاق يساعد النموذج على الفصل بين القنوات |
| المؤشر الرئيسي KPI | المبيعات أو الطلبات أو التسجيلات، ويجب أن يكون قابلاً للجمع عبر المناطق والأسابيع | النموذج يفكك هذا الرقم، فاختره كما تقيسه الإدارة |
| الإنفاق والتعرض Exposure | الإنفاق لكل قناة وأسبوع، ومعه مقياس تعرض مثل مرات الظهور Impressions إن وجد. وRobyn تنصح بعدم استخدام النقرات Clicks لأنها لا تشمل من شاهد ولم ينقر | الإنفاق المخطط قد يختلف عن الإنفاق الفعلي، فاستخدم الفعلي |
| متغيرات التحكم | العوامل التي تؤثر في المبيعات وفي قرار الإنفاق معاً، مثل نشاط المنافسين وحجم البحث وتغير الأسعار والعروض | بدونها يأخذ الإعلان فضل الموسم والعروض |
| القيم الناقصة | Meridian: ضع صفراً مكان الإنفاق الناقص، ولا تضع صفراً مكان المبيعات أو متغيرات التحكم الناقصة، واستخدم الاستيفاء Interpolation | صفر في المبيعات يعني أسبوعاً بلا بيع، وهذا يخرب النموذج |
والمصادر هنا هي صفحة جمع البيانات في وثائق Meridian ودليل المحللين في Robyn. وقد يتساءل البعض: لماذا لا أبدأ بستة أشهر من البيانات ثم أحسن النموذج لاحقاً؟ والإجابة على ذلك أن النموذج على ستة أشهر لن يعطيك نتيجة ضعيفة فقط، وإنما نتيجة خاطئة بثقة، وسوف نرى ذلك بالأرقام في المختبر عندما نقطع البيانات إلى 26 أسبوعاً.
ومن أهم ما في هذه المرحلة أن تتفق مع فريق المالية على رقم المبيعات نفسه، كما ذكرنا في مقال مؤشرات التسويق KPIs للمبتدئين: هل هو قبل المرتجعات أم بعدها؟ وقبل الضريبة أم بعدها؟ وهل يشمل المبيعات من المتجر الفعلي إن وجد؟ لأن النموذج سيوزع هذا الرقم على القنوات، فإذا اختلفت الإدارة معك على الرقم الأصلي فلن تثق بأي شيء يخرج منه.
المختبر: نموذج MMM صغير بلغة Python
الآن سوف نقوم ببناء كل ما سبق بأيدينا، والهدف ليس أن تستخدم هذا النموذج في شركتك، فالأدوات التي سنذكرها في آخر المقال أفضل منه بكثير، وإنما أن ترى ما يحدث داخل أي نموذج MMM، وأين يصيب وأين يخطئ، لأنك عندما تستلم تقريراً من أداة أو من وكالة سوف تعرف أي الأرقام تثق بها وأيها تسأل عنها. والمختبر لا يحتاج إلا Python مع ثلاث مكتبات: NumPy للحساب، وpandas للجداول، وSciPy للتحسين Optimization والانحدار بقيود.
المتطلبات Requirements
- Python حديث (اختبرنا على 3.13.3)، وبيئة افتراضية Virtual Environment حجمها بعد التثبيت حوالي 280 MB.
- المكتبات: NumPy وpandas وSciPy فقط، دون Docker ودون أي مكتبة تعلم آلة.
- أقل من 15 دقيقة لتشغيل كل السكربتات على حاسوب عادي، معظمها في إعادة الملاءمة المتكررة Bootstrap.
أنشئ مجلداً للمختبر وبيئة افتراضية فيه، ثم ثبت المكتبات وتأكد من الإصدارات:
mkdir mmm-lab && cd mmm-lab
python -m venv venv
venv/bin/python -m pip install numpy pandas scipy        # Windows: venv\Scripts\python
venv/bin/python -c "import numpy,pandas,scipy,sys;print(sys.version,numpy.__version__,pandas.__version__,scipy.__version__)"
والمخرج سوف يكون كما يلي:
3.13.3 (tags/v3.13.3:6280bb5, Apr 8 2025, 14:47:33) [MSC v.1943 64 bit (AMD64)] 2.5.5 3.1.1 1.18.1أي أن الإصدارات هي NumPy 2.5.5 وpandas 3.1.1 وSciPy 1.18.1. والملفات التي سنكتبها ستة، وكل واحد منها يقرأ ما كتبه الذي قبله:
| الملف | ماذا يفعل | ماذا يكتب |
|---|---|---|
mmm_core.py | النموذج نفسه: الأثر المتراكم، والتشبع، والأساس، والملاءمة Fit | لا شيء، يستورده الباقون |
generate.py | يصنع 104 أسابيع مصطنعة بتأثيرات حقيقية نعرفها | data-*.csv وtruth-*.json |
last_click.py | ماذا كان سيقول تقرير النقرة الأخيرة | جدول في الشاشة |
fit_mmm.py | يلائم النموذج ويقارنه بالحقيقة | fit-main.json |
failures.py | نفس النموذج على قنوات تتحرك معاً وتاريخ قصير | failures.json |
response.py | منحنيات الاستجابة وإعادة توزيع الميزانية | response.json |
geo_holdout.py | اختبارات جغرافية مصطنعة ومعايرة النموذج بها | geo.json |
الخطوة 1: النموذج Model في ملف واحد
نبدأ بالملف الذي يحتوي النموذج، لأن كل السكربتات الأخرى تستخدمه، واحفظه باسم mmm_core.py:
# A small marketing mix model (MMM) written by hand: geometric adstock, Hill saturation,
# and a linear regression for the base (trend, seasonality, holidays) and the media coefficients.
import numpy as np
import pandas as pd
from scipy.optimize import lsq_linear, minimize

CHANNELS = ["search", "social", "video"]


def adstock(x, theta):
    """Geometric adstock: this week's effect = this week's spend + theta * last week's effect."""
    out = np.empty(len(x))
    carry = 0.0
    for t, v in enumerate(x):
        carry = v + theta * carry
        out[t] = carry
    return out


def hill(a, k, s=1.0):
    """Hill saturation: 0 at zero spend, 0.5 at a == k, approaches 1 as spend grows."""
    a = np.maximum(a, 0.0)
    return a ** s / (a ** s + k ** s)


def controls(df):
    """Base of the model: intercept, trend, two yearly Fourier pairs, Ramadan and White Friday weeks."""
    t = np.arange(len(df))
    cols = [np.ones(len(df)), t / 52.0]
    for h in (1, 2):
        cols += [np.sin(2 * np.pi * h * t / 52.0), np.cos(2 * np.pi * h * t / 52.0)]
    cols += [df["ramadan"].to_numpy(float), df["white_friday"].to_numpy(float)]
    return np.column_stack(cols)


class MMM:
    """Nonlinear params per channel: theta (decay 0..0.95) and k (half-saturation, as a multiple of the
    mean adstocked spend). Linear params: base coefficients (free sign) and media betas (>= 0)."""

    def __init__(self, df, channels=CHANNELS):
        self.df = df.reset_index(drop=True)
        self.ch = channels
        self.X = {c: self.df[c].to_numpy(float) for c in channels}
        self.C = controls(self.df)
        self.y = self.df["sales"].to_numpy(float)

    def media(self, p):
        cols = []
        for i, c in enumerate(self.ch):
            theta, kmult = p[2 * i], p[2 * i + 1]
            a = adstock(self.X[c], theta)
            cols.append(hill(a, kmult * max(a.mean(), 1.0)))
        return np.column_stack(cols)

    def design(self, p):
        return np.hstack([self.C, self.media(p)])

    def solve(self, p, rows=None, y=None, extra=None):
        y = self.y if y is None else y
        D = self.design(p)
        r = slice(None) if rows is None else rows
        nb = self.C.shape[1]
        lb = np.r_[np.full(nb, -np.inf), np.zeros(len(self.ch))]
        A, b = D[r], y[r]
        if extra is not None:                      # calibration rows (see geo_holdout.py)
            A, b = np.vstack([A, extra[0](D, p)]), np.r_[b, extra[1]]
        res = lsq_linear(A, b, bounds=(lb, np.full(D.shape[1], np.inf)))
        return res.x, float(np.sum((A @ res.x - b) ** 2))

    def fit(self, rows=None, y=None, starts=None, extra=None, grid=True):
        bounds = [(0.0, 0.95), (0.2, 4.0)] * len(self.ch)
        obj = lambda p: self.solve(np.clip(p, [b[0] for b in bounds], [b[1] for b in bounds]), rows, y, extra)[1]
        cands = []
        if grid:                                   # coarse grid search first, then refine the best points
            import itertools
            per = [(th, km) for th in (0.0, 0.2, 0.4, 0.6, 0.8) for km in (0.4, 1.0, 2.5)]
            for combo in itertools.product(per, repeat=len(self.ch)):
                p = np.array([v for pair in combo for v in pair])
                cands.append((obj(p), p))
            cands.sort(key=lambda z: z[0])
            starts = [c[1] for c in cands[:4]] + (starts or [])
        best = None
        for s in starts:
            r = minimize(obj, s, method="Powell", bounds=bounds, options={"xtol": 1e-3, "ftol": 1e-7, "maxfev": 4000})
            if best is None or r.fun < best.fun:
                best = r
        self.p = np.clip(best.x, [b[0] for b in bounds], [b[1] for b in bounds])
        self.coef, self.rss = self.solve(self.p, rows, y, extra)
        return self

    def contributions(self, p=None, coef=None):
        p = self.p if p is None else p
        coef = self.coef if coef is None else coef
        M = self.media(p)
        nb = self.C.shape[1]
        out = {c: coef[nb + i] * M[:, i] for i, c in enumerate(self.ch)}
        out["base"] = self.C @ coef[:nb]
        return out

    def predict(self, p=None, coef=None):
        return self.design(self.p if p is None else p) @ (self.coef if coef is None else coef)

    def roi(self, rows=None, p=None, coef=None):
        con = self.contributions(p, coef)
        r = slice(None) if rows is None else rows
        return {c: con[c][r].sum() / self.X[c][r].sum() for c in self.ch}

    def params(self):
        out = {}
        for i, c in enumerate(self.ch):
            a = adstock(self.X[c], self.p[2 * i])
            out[c] = {"theta": round(float(self.p[2 * i]), 2), "k": round(float(self.p[2 * i + 1] * a.mean())),
                      "beta": round(float(self.coef[self.C.shape[1] + i]))}
        return out


def block_bootstrap(model, n=100, block=8, seed=7, extra=None):
    """Moving-block bootstrap of the residuals: refit on sales = fitted + resampled residual blocks."""
    rng = np.random.default_rng(seed)
    fitted = model.predict()
    resid = model.y - fitted
    T = len(resid)
    rois = []
    for _ in range(n):
        idx = np.concatenate([np.arange(s, s + block) for s in rng.integers(0, T - block + 1, T // block + 1)])[:T]
        yb = fitted + resid[idx]
        m = MMM(model.df, model.ch).fit(y=yb, starts=[model.p.copy()], grid=False, extra=extra)
        rois.append([m.roi()[c] for c in model.ch])
    return np.array(rois)
في الكود أعلاه لاحظ التالي:
- الدالة
adstockهي المعادلة التي شرحناها حرفياً: أثر هذا الأسبوع هو إنفاقه مضافاً إليه θ من أثر الأسبوع الماضي. - الدالة
hillبشكل s يساوي 1، وفي الكلاسMMMنكتب k كمضاعف لمتوسط الأثر المتراكم بين 0.2 و4، لأن هذا يجعل البحث عن k متشابهاً في كل القنوات مهما اختلف حجم إنفاقها. - الدالة
controlsتبني الأساس: ثابت Intercept، واتجاه خطي، وزوجين من موجات Fourier بطول 52 أسبوعاً، ومتغيرين لرمضان والجمعة البيضاء. - الدالة
solveتأخذ θ وk لكل قناة، وتحسب بقية المعاملات بانحدار خطي بقيود عن طريقlsq_linear: معاملات الأساس بلا قيد، ومعاملات القنوات β موجبة أو صفر. وهذا ما يسمى الانحدار الخطي بقيود Bounded Least Squares. - الدالة
fitتجرب أولاً 3,375 تركيبة من θ وk (خمس قيم لـ θ وثلاث لـ k في كل قناة)، ثم تأخذ أفضل أربع وتحسنها بخوارزمية Powell من SciPy، وهي خوارزمية لا تحتاج مشتقات Derivatives، وهذا مناسب لأن الخطأ يتغير بشكل غير ناعم مع θ. - الدالة
block_bootstrapتقدر عدم اليقين Uncertainty: تأخذ أخطاء النموذج Residuals في كتل من ثمانية أسابيع متتالية، وتعيد ترتيبها عشوائياً، وتصنع منها مبيعات جديدة، ثم تعيد الملاءمة 100 مرة. وأخذنا كتلاً لا أسابيع منفردة لأن أخطاء الأسابيع المتجاورة مترابطة، وخلطها أسبوعاً بأسبوع يعطي مدى أضيق من الحقيقة. - المعامل
extraفيsolveيسمح بإضافة صفوف للمعايرة، ولن نستخدمه إلا في آخر المختبر.
الخطوة 2: بيانات مصطنعة نعرف حقيقتها
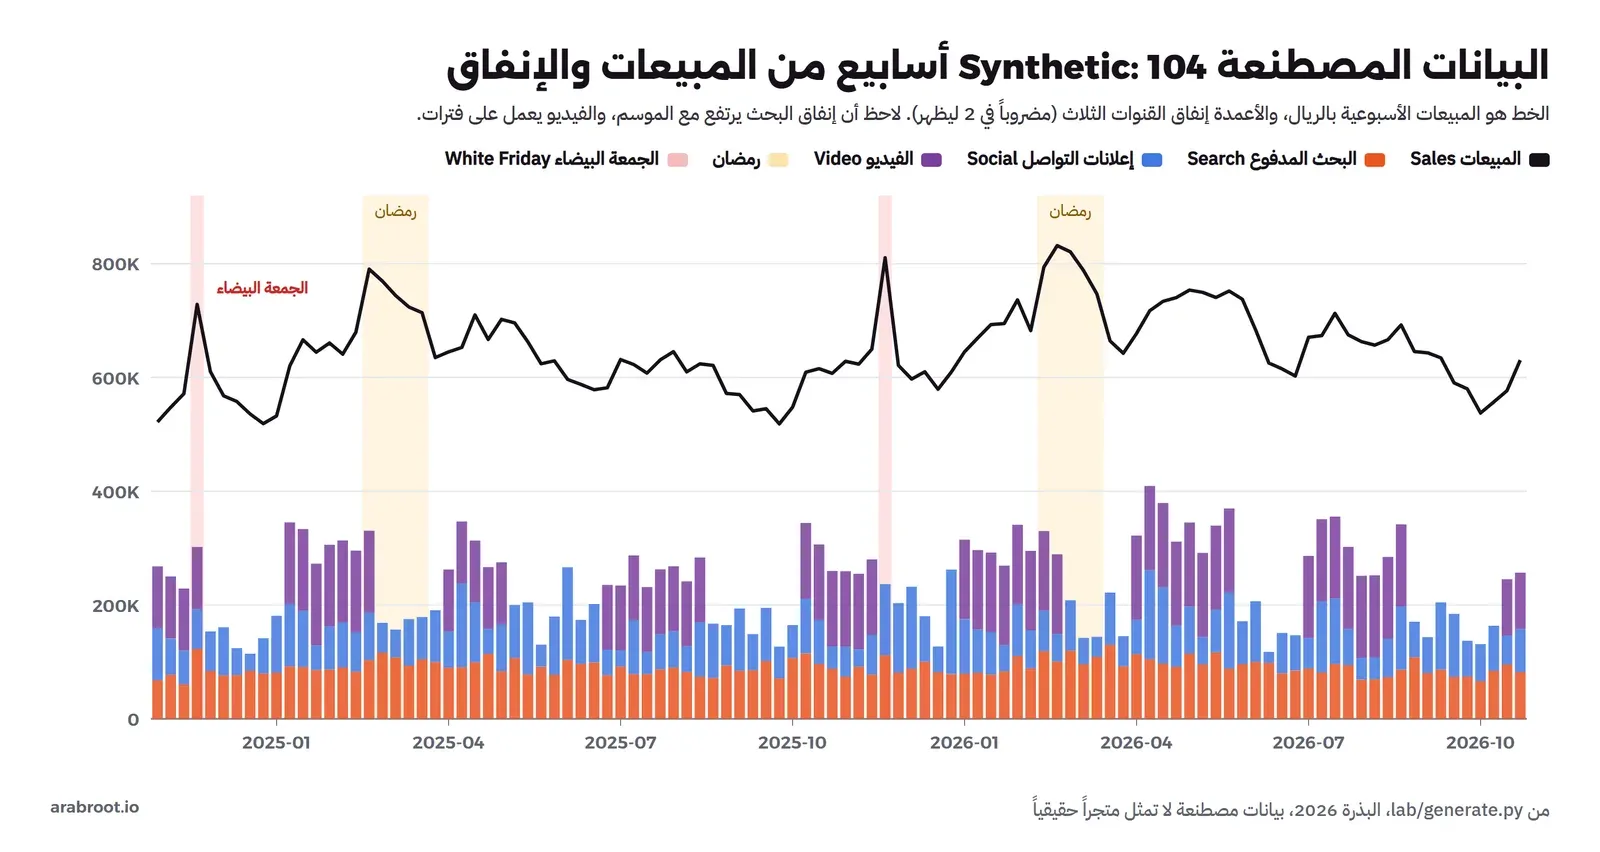
البيانات تبدأ من 4 نوفمبر 2024 وتنتهي في 26 أكتوبر 2026، أي 104 أسابيع، وفيها رمضان مرتين وموسم الجمعة البيضاء مرتين. والعائد الحقيقي الذي زرعناه هو 1.3 ريال مبيعات لكل ريال في البحث، و2.0 في إعلانات التواصل، و2.6 في الفيديو، والفكرة أن نرى هل يجد النموذج هذه الأرقام دون أن يعرفها. واحفظ الملف التالي باسم generate.py:
# SYNTHETIC data: 104 weeks of sales and spend for an online store, with true effects we choose ourselves,
# so we can check whether the model finds them. Nothing here is real data.
import sys, json
import numpy as np
import pandas as pd
from mmm_core import adstock, hill

TRUE = {  # theta = weekly carryover, k = half-saturation (SAR of adstocked spend), roi = target true ROI
    "search": {"theta": 0.10, "k": 60_000, "roi": 1.3},
    "social": {"theta": 0.35, "k": 70_000, "roi": 2.0},
    "video":  {"theta": 0.70, "k": 150_000, "roi": 2.6},
}


def make(seed=2026, weeks=104, collinear=False):
    rng = np.random.default_rng(seed)
    dates = pd.date_range("2024-11-04", periods=weeks, freq="W-MON")
    t = np.arange(weeks)
    ramadan = (((dates >= "2025-02-24") & (dates <= "2025-03-24")) | ((dates >= "2026-02-16") & (dates <= "2026-03-16"))).astype(int)
    wf = np.isin(dates.strftime("%Y-%m-%d"), ["2024-11-25", "2025-11-24"]).astype(int)
    season = 1 + 0.10 * np.sin(2 * np.pi * (t - 8) / 52)
    base = 380_000 * (1 + 0.0015 * t) * season * (1 + 0.20 * ramadan + 0.35 * wf)

    # Search budget follows demand (the team raises bids in season): this is what fools last-click.
    search = 45_000 * base / base.mean() * rng.lognormal(0, 0.12, weeks)
    # Social: always on, with campaign bursts.
    social = 30_000 * rng.lognormal(0, 0.30, weeks) + 25_000 * (rng.random(weeks) < 0.25)
    # Video: flighted, on for a few weeks then off.
    video = np.zeros(weeks)
    w = 0
    while w < weeks:
        on, off = rng.integers(4, 9), rng.integers(3, 8)
        video[w:w + on] = rng.uniform(45_000, 75_000)
        w += on + off
    if collinear:  # same media plan for social and video: they rise and fall together
        plan = 40_000 * rng.lognormal(0, 0.35, weeks)
        social = plan * rng.lognormal(0, 0.05, weeks)
        video = 1.5 * plan * rng.lognormal(0, 0.05, weeks)

    df = pd.DataFrame({"week": dates.strftime("%Y-%m-%d"), "search": search.round(), "social": social.round(),
                       "video": video.round(), "ramadan": ramadan, "white_friday": wf})
    contrib, betas = {}, {}
    for c, v in TRUE.items():
        h = hill(adstock(df[c].to_numpy(float), v["theta"]), v["k"])
        betas[c] = v["roi"] * df[c].sum() / h.sum()
        contrib[c] = betas[c] * h
    noise = rng.normal(0, 0.035 * base.mean(), weeks)
    df["sales"] = (base + sum(contrib.values()) + noise).round()
    truth = pd.DataFrame({"base": base.round(), **{c: contrib[c].round() for c in TRUE}})
    return df, truth, betas


if __name__ == "__main__":
    name = sys.argv[1] if len(sys.argv) > 1 else "main"
    df, truth, betas = make(collinear=(name == "collinear"), seed=2026 if name == "main" else 99)
    df.to_csv(f"data-{name}.csv", index=False)
    truth.to_csv(f"truth-{name}.csv", index=False)
    json.dump({c: {**TRUE[c], "beta": round(betas[c])} for c in TRUE}, open(f"truth-{name}.json", "w"), indent=1)
    pd.set_option("display.width", 120)
    print(f"[{name}] {len(df)} weeks, {df.week.iloc[0]} .. {df.week.iloc[-1]}")
    print(df.head(6).to_string(index=False))
    print("total spend (SAR):", {c: int(df[c].sum()) for c in TRUE})
    print("total sales (SAR):", int(df.sales.sum()), " true media share: %.1f%%" % (100 * sum(truth[c].sum() for c in TRUE) / df.sales.sum()))
    print("true ROI:", {c: TRUE[c]["roi"] for c in TRUE})
    print("spend correlation:\n", df[list(TRUE)].corr().round(2).to_string())
في الكود أعلاه لاحظ التالي:
- المبيعات الأساسية تنمو 0.15% في الأسبوع، وتتحرك مع موجة سنوية بنسبة 10%، وترتفع 20% في رمضان و35% في أسبوع الجمعة البيضاء.
- إنفاق البحث يتبع الطلب، أي أنه يرتفع في الموسم، وهذا العامل المربك الذي تكلمنا عنه، وضعناه عمداً لأنه موجود في كل شركة تقريباً.
- الفيديو يعمل على فترات Flights من 4 إلى 8 أسابيع، ثم يتوقف من 3 إلى 7 أسابيع، وهذا يساعد النموذج كثيراً كما سنرى، لأن كل توقف هو تجربة صغيرة.
- معامل كل قناة β يحسب بحيث يكون العائد الحقيقي خلال 104 أسابيع هو الرقم الذي اخترناه بالضبط.
- الوسيط
collinearيصنع نسخة ثانية من البيانات يشتري فيها الفريق إعلانات التواصل والفيديو بخطة واحدة، وسوف نحتاجها في العطل الأول.
الآن نقوم بتشغيله للنسختين:
venv/bin/python generate.py main
venv/bin/python generate.py collinear
والمخرج للنسخة الأولى سوف يكون كما يلي:
[main] 104 weeks, 2024-11-04 .. 2026-10-26
      week  search  social   video  ramadan  white_friday    sales
2024-11-04 33963.0 45610.0 54456.0        0             0 521721.0
2024-11-11 38818.0 31835.0 54456.0        0             0 547678.0
2024-11-18 30360.0 29674.0 54456.0        0             0 571525.0
2024-11-25 61554.0 35036.0 54456.0        0             1 728629.0
2024-12-02 42153.0 34723.0     0.0        0             0 610251.0
2024-12-09 38192.0 42332.0     0.0        0             0 567695.0
total spend (SAR): {'search': 4723012, 'social': 4052155, 'video': 3669566}
total sales (SAR): 67510201  true media share: 35.2%
true ROI: {'search': 1.3, 'social': 2.0, 'video': 2.6}
spend correlation:
         search  social  video
search    1.00    0.06  -0.03
social    0.06    1.00  -0.08
video    -0.03   -0.08   1.00
وفي المخرج أعلاه لاحظ التالي:
- الأسبوع الرابع، 25 نوفمبر 2024، هو أسبوع الجمعة البيضاء، والمبيعات فيه 728 ألف ريال مقابل 520 إلى 570 ألفاً في الأسابيع الثلاثة قبله، وإنفاق البحث فيه 61 ألفاً، أي أعلى من غيره، لأن البحث يتبع الطلب.
- الفيديو كان يعمل بـ 54,456 ريالاً في الأسابيع الأربعة الأولى، ثم توقف في الأسبوع الخامس، وهذه هي الفترات Flights.
- مجموع المبيعات 67.5 مليون ريال، منها 35.2% بسبب الإعلانات فعلاً، والباقي أساس كان سيأتي على أي حال.
- الارتباط Correlation بين إنفاق القنوات الثلاث قريب من الصفر، وهذا وضع جيد للنموذج، ونادر في الواقع.
وأما النسخة الثانية فالمهم في مخرجها هو جدول الارتباط:
spend correlation:
         search  social  video
search    1.00    0.04   0.02
social    0.04    1.00   0.98
video     0.02    0.98   1.00
أي أن ارتباط إنفاق إعلانات التواصل بإنفاق الفيديو 0.98، وهذا ما يحدث عندما تشتري الشركة القناتين من نفس الوكالة Agency بنفس الخطة الإعلامية Media Plan الشهرية: ترتفعان معاً وتنخفضان معاً. والصورة التالية تبين النسخة الأولى كاملة:
الخطوة 3: ماذا يقول تقرير النقرة الأخيرة؟
قبل النموذج نريد أن نرى ماذا كان سيقول تقرير النقرة الأخيرة عن نفس الأسابيع. ولأن البيانات مصطنعة فلا توجد نقرات حقيقية، لذلك كتبنا قاعدة بسيطة تقلد ما يحدث في الواقع: نصف مشتري الفيديو يبحثون عن اسم المتجر بعد المشاهدة، فتذهب النقرة الأخيرة للبحث، وربع العملاء الذين كانوا سيشترون على أي حال يصلون عن طريق نقرة على إعلان باسم المتجر، و70% من مشتري إعلانات التواصل ينقرون على الإعلان نفسه، و8% فقط من مشتري الفيديو ينقرون عليه. واحفظ الملف باسم last_click.py:
# What a last-click report would say for the same synthetic weeks.
# Rule we chose to imitate tracking: a buyer who saw a video and then searched the brand name is credited
# to search; a quarter of base buyers also arrive through a brand search click; video rarely gets the last click.
import pandas as pd, json

df = pd.read_csv("data-main.csv")
tr = pd.read_csv("truth-main.csv")
credit = {
    "search": tr.search + 0.5 * tr.video + 0.25 * tr.base,
    "social": 0.7 * tr.social + 0.03 * tr.base,
    "video": 0.08 * tr.video,
}
true_roi = json.load(open("truth-main.json"))
print(f"{'channel':8} {'spend':>11} {'last-click rev':>15} {'last-click ROAS':>16} {'true ROI':>9}")
for c in credit:
    s, r = df[c].sum(), credit[c].sum()
    print(f"{c:8} {s:>11,.0f} {r:>15,.0f} {r / s:>16.2f} {true_roi[c]['roi']:>9.2f}")
print(f"credited to ads: {sum(v.sum() for v in credit.values()) / df.sales.sum():.1%} of sales;"
      f" truly caused by ads: {(tr.search.sum() + tr.social.sum() + tr.video.sum()) / df.sales.sum():.1%}")
وعند تشغيل الأمر venv/bin/python last_click.py سوف تجد أنه يطبع ما يلي:
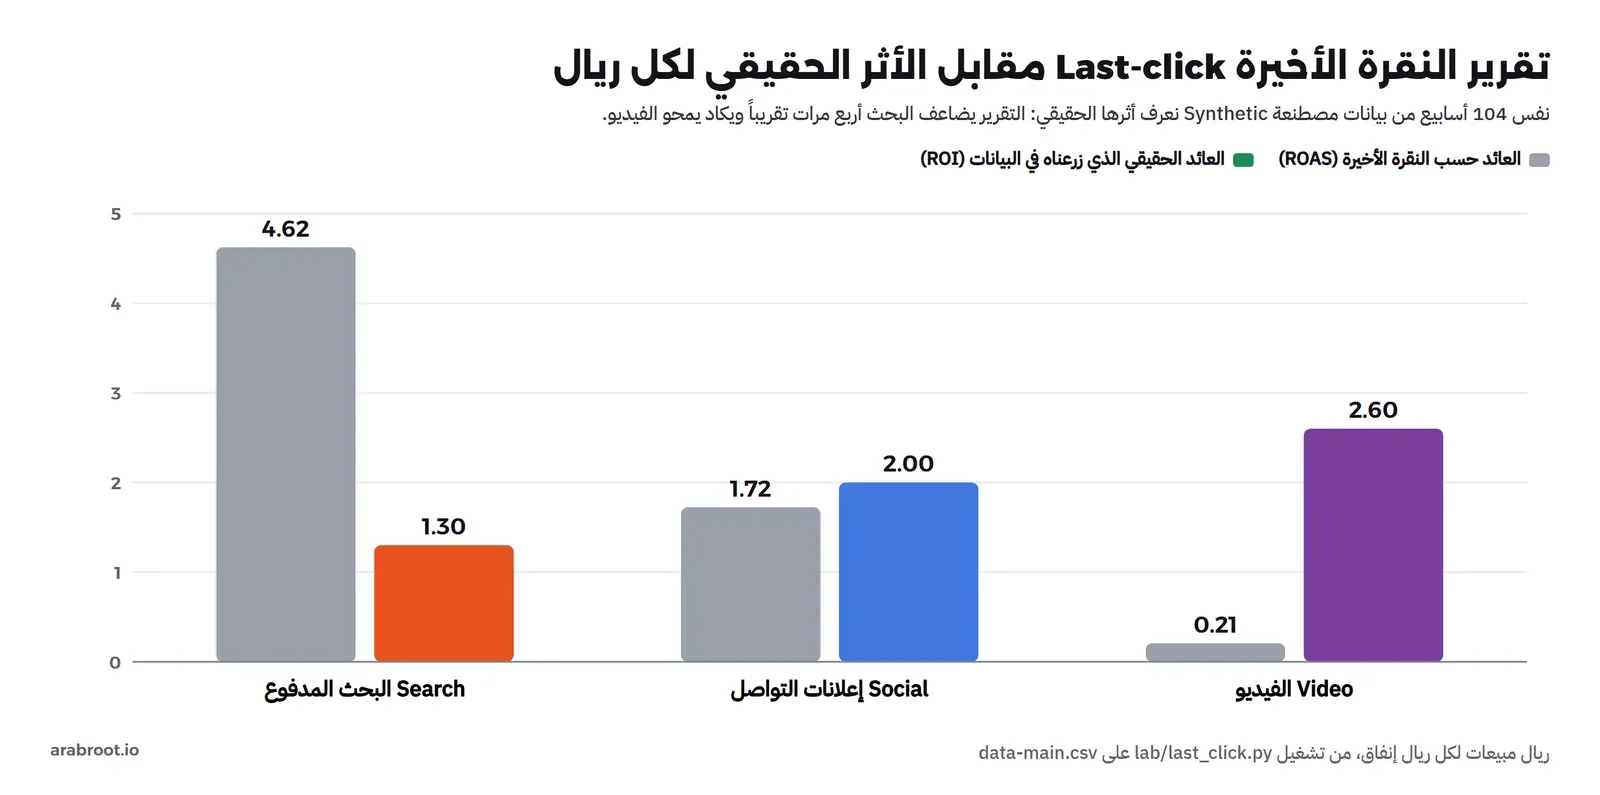
channel        spend  last-click rev  last-click ROAS  true ROI
search     4,723,012      21,833,226             4.62      1.30
social     4,052,155       6,983,763             1.72      2.00
video      3,669,566         763,270             0.21      2.60
credited to ads: 43.8% of sales; truly caused by ads: 35.2%
وهذا هو اجتماع الميزانية من بداية المقال بالأرقام. فالتقرير يقول إن البحث يعيد 4.62 ريال لكل ريال، أي أربعة أضعاف الحقيقة تقريباً، والفيديو يعيد 0.21، أي أقل من 10% من الحقيقة، والترتيب كله مقلوب: الفيديو الذي هو أفضل قناة في الحقيقة يظهر كأسوأ قناة. ولاحظ أيضاً السطر الأخير، فالتقرير ينسب للإعلانات 43.8% من المبيعات، والإعلانات سببت 35.2% فقط، والفرق هو عملاء كانوا سيشترون على أي حال ونقروا على إعلان في الطريق.
وقد يتساءل البعض: أليست القاعدة التي كتبناها هي التي صنعت هذه النتيجة؟ والإجابة نعم، فالأرقام بالضبط تأتي من القاعدة، ولكن اتجاه الخطأ ليس اختراعاً، فهو ما وجدته تجربة eBay التي ذكرناها، وهو ما يحدث كلما كانت قناة تصنع الطلب وأخرى تلتقطه. والسؤال الحقيقي الآن: هل يستطيع النموذج أن يصل إلى 1.3 و2.0 و2.6 من المبيعات والإنفاق وحدهما؟
الخطوة 4: ملاءمة النموذج Fit وقراءة النتيجة
السكربت التالي يلائم النموذج على 104 أسابيع، ويقارن ما وجده بالحقيقة، ثم يختبره على أسابيع لم يرها، ثم يقدر عدم اليقين، واحفظه باسم fit_mmm.py:
# Fit the hand-written MMM on the synthetic 104 weeks and compare with the truth we planted.
import json, time
import numpy as np, pandas as pd
from mmm_core import MMM, CHANNELS, block_bootstrap

df = pd.read_csv("data-main.csv")
truth = json.load(open("truth-main.json"))
tr = pd.read_csv("truth-main.csv")

t0 = time.time()
m = MMM(df).fit()
print(f"fit: {time.time() - t0:.1f}s, RSS {m.rss:.3e}")
pred = m.predict()
r2 = 1 - np.sum((df.sales - pred) ** 2) / np.sum((df.sales - df.sales.mean()) ** 2)
mape = np.mean(np.abs(df.sales - pred) / df.sales)
print(f"in-sample R2 {r2:.3f}, MAPE {mape:.1%}")

print(f"\n{'channel':8} {'theta':>6} {'true':>5} {'k':>9} {'true':>9} {'ROI':>6} {'true':>5}")
roi = m.roi()
for c, p in m.params().items():
    print(f"{c:8} {p['theta']:>6.2f} {truth[c]['theta']:>5.2f} {p['k']:>9,} {truth[c]['k']:>9,} {roi[c]:>6.2f} {truth[c]['roi']:>5.2f}")

con = m.contributions()
print("\nshare of sales  model / true")
for c in ["base"] + CHANNELS:
    print(f"  {c:8} {con[c].sum() / df.sales.sum():6.1%} / {tr[c].sum() / df.sales.sum():6.1%}")

# Out-of-sample check: fit on the first 91 weeks, predict the last 13.
h = MMM(df).fit(rows=slice(0, 91))
ph = h.predict()[91:]
print(f"\nholdout (last 13 weeks, fit on first 91): MAPE {np.mean(np.abs(df.sales[91:] - ph) / df.sales[91:]):.1%}")

t0 = time.time()
B = block_bootstrap(m, n=100)
print(f"\nbootstrap: 100 refits in {time.time() - t0:.0f}s, ROI 90% interval")
lo, hi = np.percentile(B, 5, axis=0), np.percentile(B, 95, axis=0)
for i, c in enumerate(CHANNELS):
    print(f"  {c:8} {roi[c]:.2f}  [{lo[i]:.2f} .. {hi[i]:.2f}]  true {truth[c]['roi']:.2f}")

json.dump({
    "weeks": df.week.tolist(), "sales": df.sales.tolist(), "pred": pred.round().tolist(),
    "spend": {c: df[c].tolist() for c in CHANNELS},
    "contrib": {k: np.round(v).tolist() for k, v in con.items()},
    "roi": roi, "lo": dict(zip(CHANNELS, lo)), "hi": dict(zip(CHANNELS, hi)),
    "params": m.params(), "p": m.p.tolist(), "coef": m.coef.tolist(), "r2": r2, "mape": mape,
    "holdout_pred": ph.round().tolist(),
}, open("fit-main.json", "w"))
وعند تشغيله بالأمر venv/bin/python fit_mmm.py سوف يكون المخرج كما يلي:
fit: 9.9s, RSS 1.960e+10
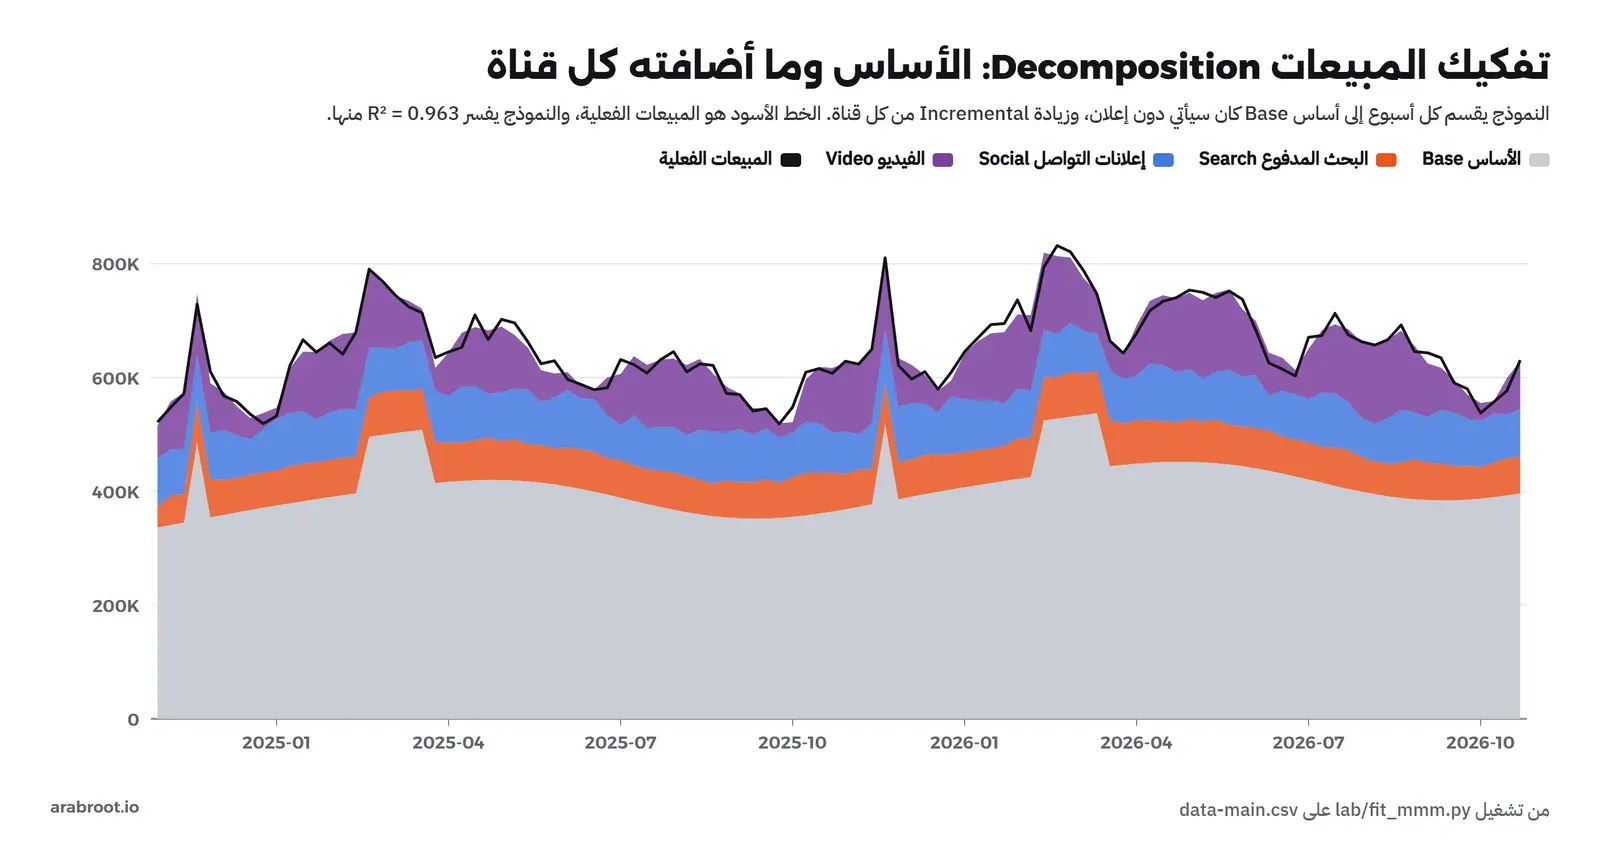
in-sample R2 0.963, MAPE 1.7%

channel   theta  true         k      true    ROI  true
search     0.39  0.10   171,153    60,000   1.46  1.30
social     0.17  0.35    20,648    70,000   2.15  2.00
video      0.70  0.70   183,537   150,000   2.52  2.60

share of sales  model / true
  base      63.1% /  64.7%
  search    10.2% /   9.1%
  social    12.9% /  12.0%
  video     13.7% /  14.1%

holdout (last 13 weeks, fit on first 91): MAPE 1.8%

bootstrap: 100 refits in 73s, ROI 90% interval
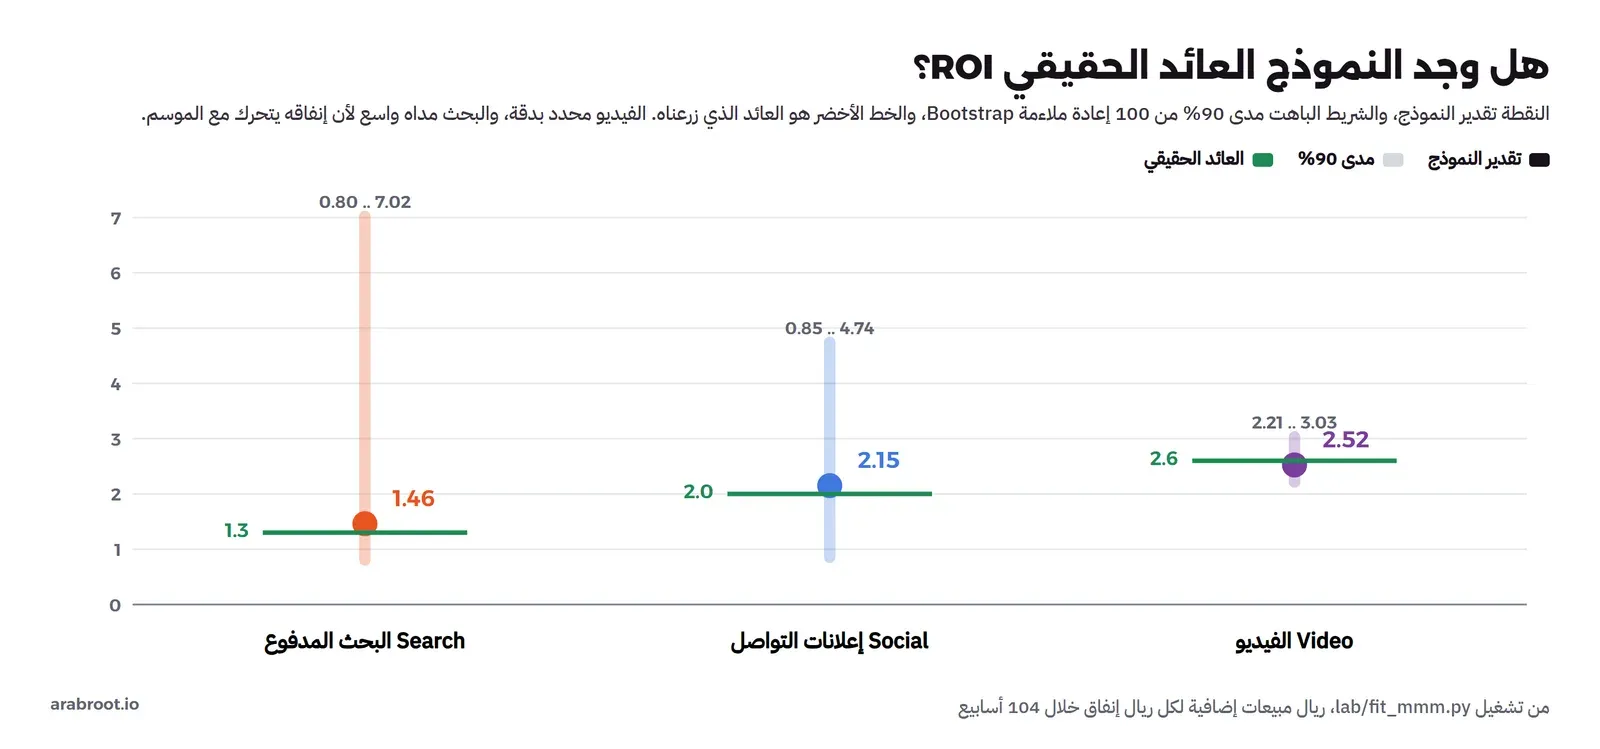
  search   1.46  [0.80 .. 7.02]  true 1.30
  social   2.15  [0.85 .. 4.74]  true 2.00
  video    2.52  [2.21 .. 3.03]  true 2.60
وهذا المخرج هو أهم ما في المختبر، لذلك سوف نمر عليه سطراً بسطر:
- سطر
fit: الملاءمة أخذت 10 ثوان تقريباً، منها البحث الشبكي في 3,375 تركيبة ثم التحسين. - سطر
R2وMAPE: النموذج يفسر 96.3% من تغير المبيعات، ومتوسط خطئه 1.7% من مبيعات الأسبوع. وهذه أرقام ممتازة، ولكنها لا تعني شيئاً عن صحة العائد كما سترى بعد قليل، لأن نموذجاً يعطي البحث فضل رمضان سوف يطابق المبيعات بنفس الدقة. - جدول θ وk: الفيديو θ فيه 0.70، أي نفس الحقيقة بالضبط، لأن فترات التشغيل والتوقف تبين بوضوح كم يبقى الأثر بعد التوقف. أما البحث فوجد له 0.39 والحقيقة 0.1، وإعلانات التواصل 0.17 والحقيقة 0.35، وk بعيدة عن الحقيقة في القناتين. والسبب أن هذه القنوات لم تتوقف أبداً، فلا يوجد في البيانات ما يبين شكل المنحنى بدقة.
- عمود ROI: 1.46 للبحث مقابل 1.3، و2.15 لإعلانات التواصل مقابل 2.0، و2.52 للفيديو مقابل 2.6. أي أن النموذج وجد العائد الحقيقي تقريباً، والترتيب صحيح، وهذا هو الفرق بينه وبين تقرير النقرة الأخيرة الذي قال 4.62 و1.72 و0.21. ولاحظ أن العائد صحيح مع أن θ وk خاطئتان في قناتين، لأن أخطاءهما تعوض بعضها: منحنى أسرع تشبعاً مع أثر أطول يعطي مجموعاً قريباً، وهذا مهم في فقرة «ماذا لو؟».
- جدول الحصص: الأساس 63.1% في النموذج و64.7% في الحقيقة، وكل قناة قريبة من حصتها الحقيقية بنقطة تقريباً.
- سطر
holdout: لاءمنا النموذج على أول 91 أسبوعاً فقط، ثم طلبنا منه أن يتنبأ بآخر 13 أسبوعاً، فكان خطؤه 1.8%. وهذا اختبار التنبؤ خارج العينة Out-of-sample Validation، وأي نموذج لا يجتازه لا تثق بعائده. ولكن العكس غير صحيح: اجتيازه لا يثبت أن العائد صحيح. - مدى 90%: الفيديو بين 2.21 و3.03، أي مدى ضيق يحتوي الحقيقة. وإعلانات التواصل بين 0.85 و4.74، والبحث بين 0.80 و7.02، وهذا مدى واسع جداً. والسبب في البحث هو العامل المربك: إنفاقه يرتفع مع الموسم، فيصعب على النموذج أن يفصل بين أثره وأثر الموسم، فإذا تغير الخطأ العشوائي قليلاً أخذ البحث فضل الموسم أحياناً، وهو ما يظهر في الطرف الأعلى 7.02.
والصورتان التاليتان تبينان تفكيك المبيعات والعائد مع المدى:
نجرب العطل: متى يخطئ نفس النموذج؟
النموذج نجح في البيانات الأولى لأننا أعطيناه ظروفاً جيدة: سنتان من البيانات، وقنوات لا يتحرك إنفاقها معاً، وفيديو يتوقف ويعود. والآن سوف نغير شيئاً واحداً في كل مرة، ونرى ماذا يحدث. واحفظ السكربت التالي باسم failures.py:
# Two ways the same model fails: channels that move together, and too few weeks.
import json
import numpy as np, pandas as pd
from mmm_core import MMM, CHANNELS, block_bootstrap

truth = json.load(open("truth-main.json"))
out = {}

dc = pd.read_csv("data-collinear.csv")
print(f"1) collinear plan: social and video bought together (corr {dc.social.corr(dc.video):.2f})")
mc = MMM(dc).fit()
roi = mc.roi()
B = block_bootstrap(mc, n=60, seed=11)
lo, hi = np.percentile(B, 5, axis=0), np.percentile(B, 95, axis=0)
for i, c in enumerate(CHANNELS):
    print(f"  {c:8} ROI {roi[c]:5.2f}  [{lo[i]:.2f} .. {hi[i]:.2f}]  true {truth[c]['roi']:.2f}")
both = (mc.contributions()["social"].sum() + mc.contributions()["video"].sum()) / (dc.social.sum() + dc.video.sum())
tc = pd.read_csv("truth-collinear.csv")
print(f"  social+video together: model {both:.2f}, true {(tc.social.sum() + tc.video.sum()) / (dc.social.sum() + dc.video.sum()):.2f}")
sv = np.corrcoef(B[:, 1], B[:, 2])[0, 1]
print(f"  bootstrap correlation between social ROI and video ROI: {sv:.2f}")
out["collinear"] = {"roi": roi, "lo": dict(zip(CHANNELS, lo)), "hi": dict(zip(CHANNELS, hi)),
                    "boot": B.round(3).tolist(), "p": mc.p.tolist(), "rss": mc.rss}

print("\n2) short history: the same main data cut to its first N weeks")
dm = pd.read_csv("data-main.csv")
out["short"] = {}
for n in (26, 52, 104):
    ms = MMM(dm.iloc[:n].copy()).fit()
    r = ms.roi()
    print(f"  {n:3} weeks: " + "  ".join(f"{c} {r[c]:5.2f}" for c in CHANNELS)
          + f"   (params per obs: {(ms.C.shape[1] + 9) / n:.2f})")
    out["short"][n] = r
json.dump(out, open("failures.json", "w"))
وعند التشغيل بالأمر venv/bin/python failures.py سوف يكون المخرج كما يلي:
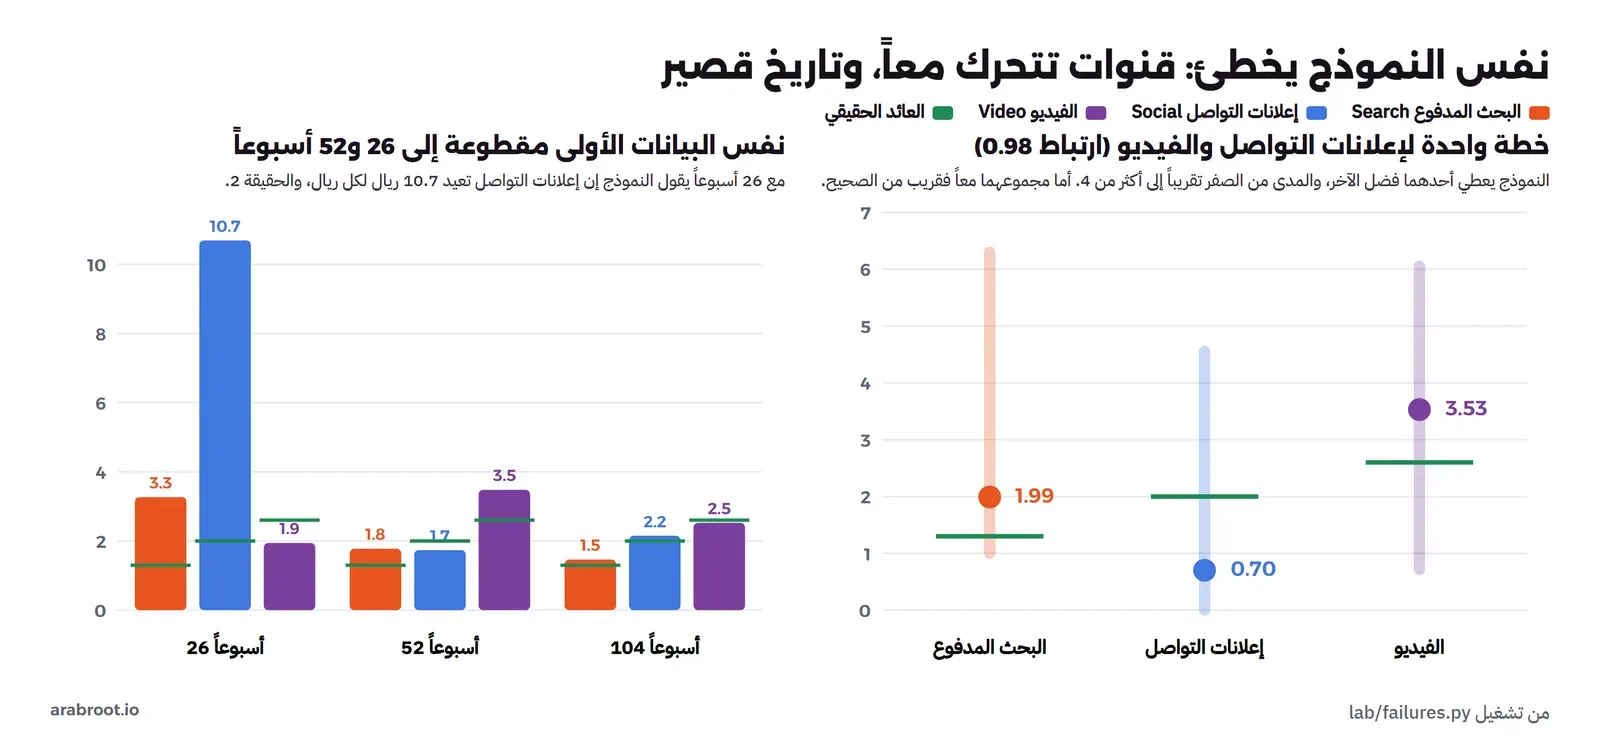
1) collinear plan: social and video bought together (corr 0.98)
  search   ROI  1.99  [1.00 .. 6.30]  true 1.30
  social   ROI  0.70  [0.00 .. 4.55]  true 2.00
  video    ROI  3.53  [0.72 .. 6.05]  true 2.60
  social+video together: model 2.39, true 2.36
  bootstrap correlation between social ROI and video ROI: -0.58

2) short history: the same main data cut to its first N weeks
   26 weeks: search  3.27  social 10.69  video  1.94   (params per obs: 0.65)
   52 weeks: search  1.78  social  1.73  video  3.48   (params per obs: 0.33)
  104 weeks: search  1.46  social  2.15  video  2.52   (params per obs: 0.16)
العطل الأول: قنوات تتحرك معاً Multicollinearity
في القسم الأول من المخرج استخدمنا نفس النموذج ونفس العائد الحقيقي، والفرق الوحيد أن إعلانات التواصل والفيديو تشترى بخطة واحدة، فارتباط إنفاقهما 0.98. والنتيجة أن النموذج أعطى إعلانات التواصل 0.70 والحقيقة 2.0، وأعطى الفيديو 3.53 والحقيقة 2.6، أي أنه نقل فضل إحداهما إلى الأخرى. ولو اتخذت الإدارة قراراً على هذا التقرير لأوقفت إعلانات التواصل، وهي تعيد ريالين لكل ريال.
وفي المخرج ثلاث علامات تكشف هذه المشكلة، ويجب أن تبحث عنها في أي تقرير:
- المدى واسع جداً: إعلانات التواصل بين 0.00 و4.55، والفيديو بين 0.72 و6.05، أي أن النموذج يقول ضمناً إنه لا يعرف.
- المجموع صحيح والتوزيع خاطئ: عائد القناتين معاً 2.39 في النموذج و2.36 في الحقيقة. فالنموذج يعرف كم أضافت القناتان معاً، ولكنه لا يعرف كيف يقسمه بينهما، والسبب أن البيانات لا تحتوي أسبوعاً واحداً تقريباً ارتفعت فيه إحداهما دون الأخرى.
- ارتباط سالب بين التقديرين: في إعادات الملاءمة المئة كان ارتباط عائد إعلانات التواصل بعائد الفيديو -0.58، أي أنه كلما أعطى النموذج إحداهما أكثر أعطى الأخرى أقل. وهذه علامة واضحة على أن القناتين تتنافسان على نفس الفضل.
وتذكر تشبيه الصنابير من بداية المقال: إذا فتحت صنبورين معاً وأغلقتهما معاً دائماً، فلن تعرف من مستوى الماء أيهما يملأ أكثر، مهما كانت طريقة الحساب ذكية. لذلك لا يحل هذه المشكلة نموذج أفضل، وإنما بيانات مختلفة، وهنا يأتي دور التجارب كما سيأتي، أو تغيير خطة الشراء بحيث تتحرك القنوات في أوقات مختلفة. ووثائق PyMC-Marketing تشرح نفس الفكرة في مثال المعايرة باختبارات الأثر، حيث تبني قناتين إنفاقهما مترابط تماماً، وتبين أن النموذج لا يستطيع التفريق بين منحنييهما من البيانات التاريخية وحدها.
العطل الثاني: تاريخ قصير Short History
في القسم الثاني من المخرج أخذنا البيانات الأولى نفسها، التي نجح فيها النموذج، وقطعناها إلى أول 26 أسبوعاً، ثم أول 52 أسبوعاً. ومع 26 أسبوعاً قال النموذج إن إعلانات التواصل تعيد 10.69 ريال لكل ريال، والحقيقة 2، وقال إن البحث يعيد 3.27 والحقيقة 1.3. ومع 52 أسبوعاً اقتربت الأرقام، ولكن الفيديو أصبح 3.48 والحقيقة 2.6. ومع 104 أسابيع عادت الأرقام إلى ما رأيناه في الخطوة السابقة.
والسبب في العمود الأخير من المخرج: عدد الأرقام التي يقدرها النموذج مقسوماً على عدد الأسابيع. فمع 26 أسبوعاً نقدر 17 رقماً من 26 مشاهدة، أي 0.65 رقم لكل مشاهدة، وهذا يعني أن النموذج يستطيع أن يطابق تقريباً أي شيء، بما فيه الضجيج العشوائي Noise. وموجات Fourier السنوية نفسها لا معنى لها مع نصف سنة، لأن النموذج لم ير السنة كاملة. وهذا ما تقصده Robyn بقاعدة المتغير لكل 10 مشاهدات، وما تقصده Meridian بالسنتين على الأقل.
والأخطر من الرقم الخاطئ أن النموذج القصير لا يبدو خاطئاً، فقد كان R² فيه مرتفعاً أيضاً، لأن نموذجاً بعدد كبير من المتغيرات يطابق البيانات القليلة دائماً. وهذا يسمى فرط الملاءمة Overfitting، والحماية منه هي اختبار التنبؤ على أسابيع لم يرها النموذج، والمقارنة بنتيجة تجربة، وطول البيانات قبل كل شيء.
ماذا لو؟ منحنيات الاستجابة Response Curves وإعادة توزيع الميزانية
العائد المتوسط يجيب عن سؤال الماضي: كم أعاد كل ريال أنفقناه؟ ولكن الإدارة تريد إجابة عن سؤال المستقبل: أين نضع الريال القادم؟ وهنا يأتي دور منحنى الاستجابة، وهو مبيعات القناة الأسبوعية إذا أنفقت عليها نفس المبلغ كل أسبوع. والسكربت التالي يرسم المنحنى لكل قناة من النموذج ومن الحقيقة، ويجرب نقل ميزانية بين القنوات، ثم يبحث عن أفضل توزيع لنفس الميزانية الكلية، واحفظه باسم response.py:
# "What if": response curves and a budget move, from the fitted model and from the planted truth.
import json
import numpy as np, pandas as pd
from scipy.optimize import minimize
from mmm_core import MMM, CHANNELS, adstock, hill

df = pd.read_csv("data-main.csv")
fit = json.load(open("fit-main.json"))
truth = json.load(open("truth-main.json"))
m = MMM(df)
m.p, m.coef = np.array(fit["p"]), np.array(fit["coef"])
nb = m.C.shape[1]

curves = {}
for i, c in enumerate(CHANNELS):
    theta, kmult = m.p[2 * i], m.p[2 * i + 1]
    k = kmult * adstock(m.X[c], theta).mean()
    curves[c] = {"model": (m.coef[nb + i], theta, k), "true": (truth[c]["beta"], truth[c]["theta"], truth[c]["k"])}


def weekly(c, x, who):
    """Steady state: spend x every week -> adstock x / (1 - theta) -> weekly sales from this channel."""
    beta, theta, k = curves[c][who]
    return beta * hill(x / (1 - theta), k)


plan = {c: df[c].mean() for c in CHANNELS}
print("average weekly spend now:", {c: round(v) for c, v in plan.items()}, " total", round(sum(plan.values())))
print(f"\n{'channel':8} {'avg ROI model':>13} {'true':>6} {'marginal model':>15} {'true':>6}")
for c in CHANNELS:
    x = plan[c]
    am, at = weekly(c, x, "model") / x, weekly(c, x, "true") / x
    mm = (weekly(c, x + 1000, "model") - weekly(c, x, "model")) / 1000
    mt = (weekly(c, x + 1000, "true") - weekly(c, x, "true")) / 1000
    print(f"{c:8} {am:>13.2f} {at:>6.2f} {mm:>15.2f} {mt:>6.2f}")


def total(alloc, who):
    return sum(weekly(c, a, who) for c, a in zip(CHANNELS, alloc))


now = [plan[c] for c in CHANNELS]
print("\nmove 10,000 SAR a week from search to video:")
moved = [now[0] - 10_000, now[1], now[2] + 10_000]
for who in ("model", "true"):
    print(f"  {who:5}: weekly media sales {total(now, who):,.0f} -> {total(moved, who):,.0f}  ({total(moved, who) - total(now, who):+,.0f})")

B = sum(now)
best = {}
for who in ("model", "true"):
    r = minimize(lambda a: -total(a, who), now, bounds=[(0.3 * v, 2.5 * v) for v in now],
                 constraints={"type": "eq", "fun": lambda a: a.sum() - B}, method="SLSQP")
    best[who] = r.x
    print(f"  best split by {who:5}: " + ", ".join(f"{c} {v:,.0f}" for c, v in zip(CHANNELS, r.x))
          + f"  -> {-r.fun:,.0f} (+{-r.fun - total(now, who):,.0f} a week by its own curve)")
gain_true = total(best["model"], "true") - total(now, "true")
print(f"  the model's split, judged by the truth: {gain_true:+,.0f} a week")
print("  (every channel is kept between 30% and 250% of its spend today)")

grid = np.linspace(0, 150_000, 61)
json.dump({"grid": grid.tolist(), "plan": plan,
           "curves": {c: {w: [float(weekly(c, x, w)) for x in grid] for w in ("model", "true")} for c in CHANNELS},
           "best": {w: list(map(float, v)) for w, v in best.items()}}, open("response.json", "w"))
وعند التشغيل بالأمر venv/bin/python response.py سوف يكون المخرج كما يلي:
average weekly spend now: {'search': 45414, 'social': 38963, 'video': 35284}  total 119661

channel  avg ROI model   true  marginal model   true
search            1.47   1.31            1.02   0.70
social            2.20   2.04            0.66   1.09
video             2.77   2.87            1.68   1.59

move 10,000 SAR a week from search to video:
  model: weekly media sales 250,622 -> 254,913  (+4,291)
  true : weekly media sales 240,157 -> 246,543  (+6,386)
  best split by model: search 38,098, social 26,068, video 55,495  -> 259,529 (+8,908 a week by its own curve)
  best split by true : search 26,723, social 39,896, video 53,042  -> 248,182 (+8,025 a week by its own curve)
  the model's split, judged by the truth: +3,559 a week
  (every channel is kept between 30% and 250% of its spend today)
وفي المخرج أعلاه لاحظ التالي:
- العائد المتوسط صحيح تقريباً: 1.47 مقابل 1.31 للبحث، و2.20 مقابل 2.04 لإعلانات التواصل، و2.77 مقابل 2.87 للفيديو. وهذه الأرقام تختلف قليلاً عن عائد الخطوة السابقة لأنها محسوبة لإنفاق ثابت كل أسبوع، لا للإنفاق الفعلي المتغير.
- العائد الحدي هو المشكلة: النموذج يقول إن الريال القادم في إعلانات التواصل يجلب 0.66 والحقيقة 1.09، ويقول إنه في البحث يجلب 1.02 والحقيقة 0.70. أي أن النموذج الذي أصاب في العائد المتوسط أخطأ في ترتيب القناتين في العائد الحدي، والسبب هو k التي رأيناها بعيدة عن الحقيقة في الخطوة السابقة: النموذج يظن أن إعلانات التواصل وصلت للتشبع، وهي لم تصل.
- نقل 10 آلاف ريال في الأسبوع من البحث إلى الفيديو: النموذج يتوقع زيادة 4,291 ريالاً في الأسبوع، والحقيقة 6,386. فالاتجاه صحيح والحجم أقل من الحقيقة، وهذا قرار جيد على أي حال.
- أفضل توزيع: النموذج يقترح أن نخفض إعلانات التواصل من 39 ألفاً إلى 26 ألفاً، والحقيقة تقول إن الأفضل أن نبقيها كما هي ونخفض البحث إلى 27 ألفاً. وعندما حكمنا على توزيع النموذج بالمنحنيات الحقيقية كان الربح 3,559 ريالاً في الأسبوع، وأفضل توزيع ممكن يربح 8,025، أي أن توصية النموذج حققت أقل من نصف الممكن.
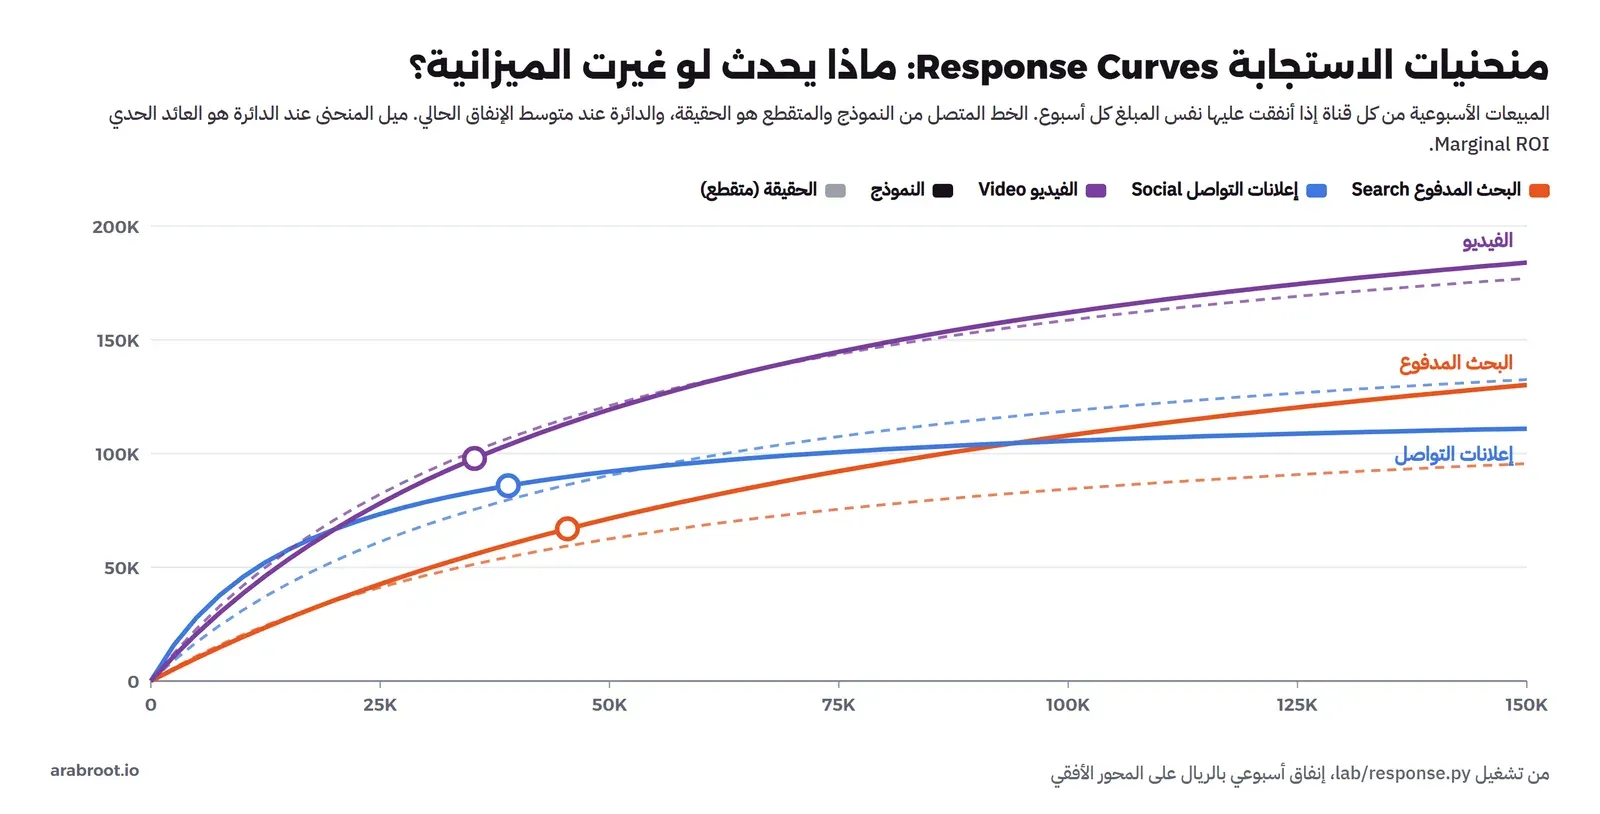
وهذا درس مهم لكل من يقرأ مخرجات أداة MMM: النموذج دقيق قرب الإنفاق الذي رآه في البيانات، وكلما ابتعدت عنه أصبح تخميناً مبنياً على شكل المنحنى الذي افترضه. لذلك لا تنفذ توصية محسن الميزانية Budget Optimizer كاملة دفعة واحدة، فوثائق Robyn نفسها تقول إن مخرجات المحسن تحتاج تحققاً قبل التنفيذ، والحل الأنسب أن تحرك الميزانية خطوة صغيرة في الاتجاه المقترح، مثل 10% إلى 20%، ثم تقيس النتيجة. وأفضل طريقة لقياسها هي التجربة، وهي موضوع القسم التالي.
اختبارات الأثر الإضافي Incrementality Tests
النموذج يقرأ الماضي ويستنتج منه، والتجربة تصنع حاضراً جديداً وتقيسه. والفكرة نفس فكرة اختبار A/B الذي شرحناه في مقال اختبارات A/B مع GrowthBook ومقال تجارب النمو عملياً: مجموعتان متشابهتان، تتعرض إحداهما للإعلان ولا تتعرض الأخرى، والفرق بينهما هو أثر الإعلان. والفرق هنا أنك لا تقسم زوار صفحة، وإنما تقسم الجمهور أو المناطق، لأن الإعلان يعرض خارج موقعك. وهناك نوعان رئيسيان:
اختبار الأثر على التحويل Conversion Lift
تقسم منصة الإعلان نفسها المستخدمين عشوائياً إلى مجموعة تشاهد الإعلان ومجموعة مستبعدة Holdout لا تشاهده، ثم تقارن نسبة الشراء في المجموعتين. وتقدم Google هذا في Google Ads باسم Conversion Lift، وتشرح صفحة المقارنة بين أنواعه أن هناك نوعين: تقسيم على مستوى المستخدمين، ويعطي تفصيلاً أكثر حسب العمر والجنس، ولكنه يعتمد في الغالب على المستخدمين الذين وافقوا على التتبع، وتقسيم على مستوى المناطق الجغرافية، وهو أوضح ويقيس التحويلات من كل القنوات بما فيها المتجر الفعلي، ولكنه يحتاج ميزانية أكبر. وMeta تقدم اختباراً مشابهاً باسم Conversion Lift أيضاً، وتذكره وثائق Robyn كأحد المصادر التي تعاير بها النموذج.
ونقطة قوة هذا النوع أن التقسيم عشوائي فعلاً، ونقطة ضعفه أن المنصة هي التي تقسم وتقيس وتعلن النتيجة عن إعلاناتها هي، وأنه يقيس منصة واحدة، ولا يرى أثر الإعلان على مبيعات لم تتبعها المنصة.
اختبار الإيقاف الجغرافي Geo Holdout
هنا تختار أنت مجموعة من المناطق وتوقف فيها الإعلان على قناة معينة لعدة أسابيع، أو تضاعفه، وتترك باقي المناطق كما هي كمجموعة مقارنة Control، ثم تقارن مبيعات المجموعتين من بياناتك أنت لا من بيانات المنصة. وقد وصف فريق Google هذه الطريقة في ورقة Measuring Ad Effectiveness Using Geo Experiments، وأداة GeoLift من Meta تطبق نفس الفكرة بطريقة التحكم المصطنع Synthetic Control التي نشرحها بعد قليل. ونقاط مهمة في تصميمه:
- المناطق يجب أن تكون منفصلة: إذا كان عملاء منطقة الاختبار يرون الإعلان لأنهم يعملون في منطقة المقارنة، فالاختبار يقيس أقل من الحقيقة. لذلك تستخدم المدن أو المناطق الإدارية الكبيرة، لا الأحياء.
- مجموعة المقارنة لا تحتاج أن تكون مطابقة: يكفي أن تتحرك مبيعاتها مع مبيعات مناطق الاختبار قبل الاختبار، لأننا نقيس الفرق عن الخط الذي كانت ستسير عليه. وهذا ما تفعله طريقة التحكم المصطنع Synthetic Control في GeoLift، حيث تبني من مجموعة مناطق «منطقة مصطنعة» تشبه منطقة الاختبار في الفترة السابقة.
- الأثر المتأخر يحتاج أسابيع بعد الاختبار: إذا أوقفت الفيديو ثمانية أسابيع، فأثره لا يختفي في الأسبوع الأول، ولا يعود كاملاً في أول أسبوع بعد التشغيل، لذلك يجب أن تستمر في القياس بعد انتهاء الاختبار، وسوف نرى في المختبر كم يضيع إذا لم تفعل.
- التكلفة حقيقية: المناطق التي أوقفت فيها الإعلان ستبيع أقل، وهذا ثمن المعرفة، لذلك احسب حجم الاختبار ومدته قبل أن تبدأ، كما في أي تجربة.
المختبر: اختبار إيقاف جغرافي مصطنع
لنعد إلى البيانات التي فشل فيها النموذج، أي المتجر الذي يشتري إعلانات التواصل والفيديو بخطة واحدة. فالنموذج قال إن عائد إعلانات التواصل 0.70 والفيديو 3.53، والحقيقة 2.0 و2.6، والإدارة لا تعرف الحقيقة. والحل أن نصنع البيانات التي ينقصها النموذج، أي أسابيع تتحرك فيها قناة دون الأخرى. لذلك صممنا ثلاثة اختبارات على 40 منطقة مصطنعة، لكل منطقة حصة من المبيعات، وفي كل اختبار 10 مناطق اختبار تقريباً ربع المبيعات:
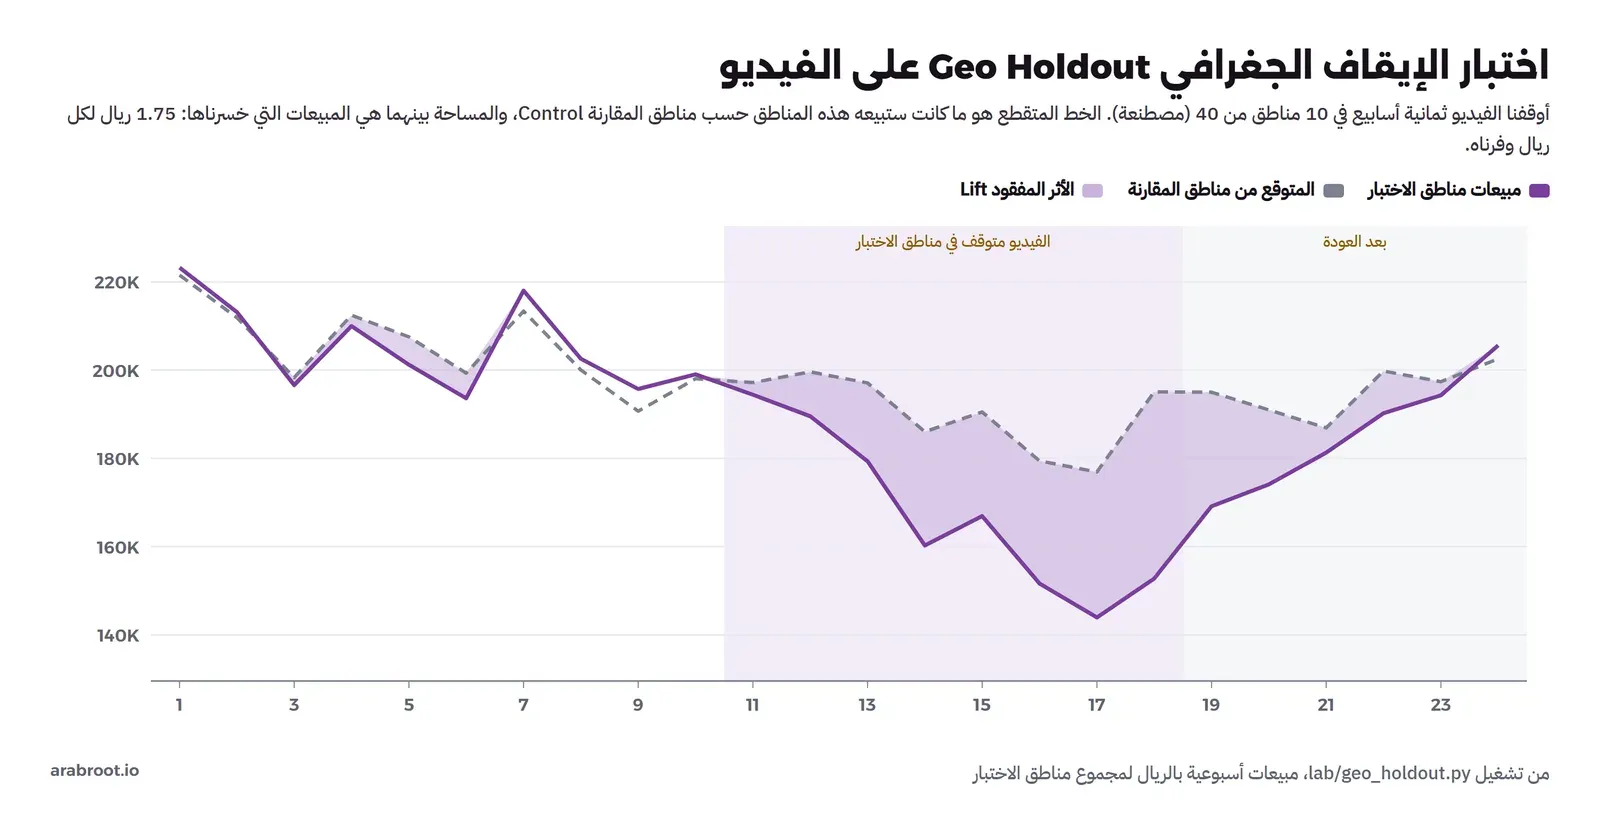
- إيقاف الفيديو ثمانية أسابيع في مناطق الاختبار.
- إيقاف إعلانات التواصل ثمانية أسابيع في مناطق أخرى.
- مضاعفة الفيديو ثمانية أسابيع في مناطق ثالثة، لكي نرى المنحنى عند مستوى إنفاق لم يره النموذج.
وفي كل اختبار عشرة أسابيع قبله نحسب منها نسبة مبيعات مناطق الاختبار إلى مناطق المقارنة، وستة أسابيع بعده نلتقط فيها الأثر المتأخر، وفي كل أسبوع صدمة عشوائية تصيب كل المناطق معاً، وضجيج مستقل في كل منطقة. والمعادلة هي أبسط صورة للتحكم المصطنع: ما كانت ستبيعه مناطق الاختبار يساوي مبيعات مناطق المقارنة مضروبة في نسبة الفترة السابقة، والفرق بين هذا الرقم والمبيعات الفعلية هو الأثر. والخطأ المعياري Standard Error نحسبه بإعادة سحب المناطق Bootstrap 500 مرة. واحفظ الملف باسم geo_holdout.py:
# Simulated geo tests for the store with the collinear plan (social and video bought together), then the
# test results used to calibrate the MMM that could not separate them. SYNTHETIC regions and sales.
import json
import numpy as np, pandas as pd
from mmm_core import MMM, CHANNELS, adstock, hill, block_bootstrap

truth = json.load(open("truth-collinear.json"))
dc = pd.read_csv("data-collinear.csv")
tc = pd.read_csv("truth-collinear.csv")
PRE, TEST, POST = 10, 8, 6                         # weeks before, weeks with the change, weeks after
W = PRE + TEST + POST
N = len(dc)
hist = dc.iloc[-W:].reset_index(drop=True)        # spend in the test window follows the same plan shape
base = tc.base.iloc[-W:].to_numpy() * 1.02
R = 40
share = np.random.default_rng(31).dirichlet(np.full(R, 3.0))   # each region's share of national sales


def effect(c, mult=1.0):
    x = np.r_[dc[c], hist[c]].astype(float)
    x[N + PRE:N + PRE + TEST] *= mult              # 0 = switched off, 2 = doubled, in the test weeks
    return truth[c]["beta"] * hill(adstock(x, truth[c]["theta"]), truth[c]["k"])[-W:]


def geo_test(c, seed, mult=0.0):
    rng = np.random.default_rng(seed)
    test = np.zeros(R, bool)
    test[rng.choice(R, 10, replace=False)] = True
    others = sum(effect(o) for o in CHANNELS if o != c)
    on, changed = effect(c), effect(c, mult)
    common = rng.normal(0, 0.03, W)               # a shock that hits every region in the same week
    sales = np.array([share[r] * (base + others + (changed if test[r] else on)) * (1 + common) * (1 + rng.normal(0, 0.04, W))
                      for r in range(R)])
    dspend = share[test].sum() * hist[c].iloc[PRE:PRE + TEST].sum() * (mult - 1)   # negative when spend was cut

    def iroas(ti, ci, window, scale=1.0):
        T, C = sales[ti].sum(0), sales[ci].sum(0)
        lift = T - T[:PRE].sum() / C[:PRE].sum() * C      # counterfactual: control scaled by the pre-period ratio
        return lift[PRE:PRE + window].sum() / (dspend * scale), lift

    what = "off" if mult == 0 else f"x{mult:g}"
    print(f"\n[{c} {what}] {R} regions, {test.sum()} in test ({share[test].sum():.1%} of sales), weeks {PRE + 1}-{PRE + TEST}")
    print(f"  {c} spend change in test regions: {dspend:+,.0f} SAR")
    true_lift = share[test].sum() * (changed - on)
    it, ic = np.where(test)[0], np.where(~test)[0]
    out = {}
    for window, label in ((TEST, "test weeks only"), (TEST + POST, f"test + {POST} weeks after")):
        est, lift = iroas(test, ~test, window)
        boots = []
        for _ in range(500):                       # bootstrap over regions for the standard error
            bt, bc = rng.choice(it, len(it)), rng.choice(ic, len(ic))
            boots.append(iroas(bt, bc, window, share[bt].sum() / share[test].sum())[0])
        se = float(np.std(boots))
        tru = true_lift[PRE:PRE + window].sum() / dspend
        print(f"  {label:22}: measured iROAS {est:.2f} (se {se:.2f}), true {tru:.2f}")
        out = {"roi": est, "se": se, "true": tru, "share": share[test].sum(), "dspend": dspend, "c": c, "mult": mult,
               "series_test": sales[test].sum(0).round().tolist(),
               "series_cf": (sales[test].sum(0)[:PRE].sum() / sales[~test].sum(0)[:PRE].sum() * sales[~test].sum(0)).round().tolist()}
    return out


tests = {"video off": geo_test("video", 31), "social off": geo_test("social", 47), "video x2": geo_test("video", 59, 2.0)}

# Calibration. A test measures the lift of changing a channel for 8 weeks in about a quarter of the market,
# read over 14 weeks. That is not the 104-week ROI the model reports, so the model has to replay the test.
m0 = MMM(dc).fit()
sigma = np.sqrt(m0.rss / (N - m0.C.shape[1] - 9))
nb = m0.C.shape[1]


def replay_per_beta(name, theta, kmult):
    t = tests[name]
    x = np.r_[dc[t["c"]], hist[t["c"]]].astype(float)
    k = kmult * adstock(dc[t["c"]].to_numpy(float), theta).mean()
    xc = x.copy(); xc[N + PRE:N + PRE + TEST] *= t["mult"]
    d = hill(adstock(xc, theta), k)[-W:] - hill(adstock(x, theta), k)[-W:]
    return t["share"] * d[PRE:PRE + TEST + POST].sum() / t["dspend"]


def rows(names, how):
    def f(D, p):
        out = np.zeros((len(names), D.shape[1]))
        for j, n in enumerate(names):
            c = tests[n]["c"]; i = CHANNELS.index(c)
            w = sigma / tests[n]["se"]
            out[j, nb + i] = w * (D[:, nb + i].sum() / dc[c].sum() if how == "naive" else replay_per_beta(n, p[2 * i], p[2 * i + 1]))
        return out
    return f, np.array([sigma / tests[n]["se"] * tests[n]["roi"] for n in names])


ALL = ["video off", "social off", "video x2"]
fits = {"none": m0,
        "video naive": MMM(dc).fit(extra=rows(["video off"], "naive")),
        "video replay": MMM(dc).fit(extra=rows(["video off"], "replay")),
        "2 tests": MMM(dc).fit(extra=rows(["video off", "social off"], "replay")),
        "3 tests": MMM(dc).fit(extra=rows(ALL, "replay"))}
print(f"\ncalibration weight = residual sigma {sigma:,.0f} / test se")
print(f"{'channel':8} " + " ".join(f"{k:>12}" for k in fits) + f" {'true':>5}")
roi = {k: m.roi() for k, m in fits.items()}
for c in CHANNELS:
    print(f"{c:8} " + " ".join(f"{roi[k][c]:>12.2f}" for k in fits) + f" {truth[c]['roi']:>5.2f}")
B = block_bootstrap(fits["3 tests"], n=60, seed=11, extra=rows(ALL, "replay"))
lo, hi = np.percentile(B, 5, axis=0), np.percentile(B, 95, axis=0)
print("90% interval, 3 tests: " + "  ".join(f"{c} [{lo[i]:.2f} .. {hi[i]:.2f}]" for i, c in enumerate(CHANNELS)))
for key in ("2 tests", "3 tests"):
    mb = fits[key]
    for n in ALL:
        c = tests[n]["c"]; i = CHANNELS.index(c)
        print(f"  [{key}] model replays '{n}' as {mb.coef[nb + i] * replay_per_beta(n, mb.p[2 * i], mb.p[2 * i + 1]):.2f} (measured {tests[n]['roi']:.2f})")
    print(f"  [{key}] video {mb.params()['video']}, social {mb.params()['social']}")
print(f"  true: video theta {truth['video']['theta']}, k {truth['video']['k']:,}; social theta {truth['social']['theta']}, k {truth['social']['k']:,}")

# What the tests fixed and what they did not: the average riyal versus the next riyal (marginal).
print("\nsteady state at today's average weekly spend: average / marginal ROI per riyal")
marg = {}
for c in ("social", "video"):
    i = CHANNELS.index(c)
    x = dc[c].mean()
    t = truth[c]
    tf = lambda s: t["beta"] * hill(s / (1 - t["theta"]), t["k"])
    line = f"  {c:7} true {tf(x) / x:.2f} / {(tf(x + 1000) - tf(x)) / 1000:.2f}"
    marg[c] = {"true": [tf(x) / x, (tf(x + 1000) - tf(x)) / 1000]}
    for key in ("none", "2 tests", "3 tests"):
        m = fits[key]
        th, km = m.p[2 * i], m.p[2 * i + 1]
        kk = km * adstock(dc[c].to_numpy(float), th).mean()
        mf = lambda s: m.coef[nb + i] * hill(s / (1 - th), kk)
        line += f"   {key} {mf(x) / x:.2f} / {(mf(x + 1000) - mf(x)) / 1000:.2f}"
        marg[c][key] = [mf(x) / x, (mf(x + 1000) - mf(x)) / 1000]
    print(line)
json.dump({"tests": tests, "roi": roi, "lo": dict(zip(CHANNELS, lo)), "hi": dict(zip(CHANNELS, hi)), "marg": marg},
          open("geo.json", "w"))
والتشغيل يأخذ عدة دقائق، معظمها في المعايرة وإعادة الملاءمة:
venv/bin/python geo_holdout.pyوالمخرج سوف يكون كما يلي:
[video off] 40 regions, 10 in test (27.1% of sales), weeks 11-18
  video spend change in test regions: -137,945 SAR
  test weeks only       : measured iROAS 1.33 (se 0.10), true 1.46
  test + 6 weeks after  : measured iROAS 1.75 (se 0.15), true 1.84

[social off] 40 regions, 10 in test (29.3% of sales), weeks 11-18
  social spend change in test regions: -99,976 SAR
  test weeks only       : measured iROAS 1.70 (se 0.11), true 1.76
  test + 6 weeks after  : measured iROAS 1.83 (se 0.19), true 1.87

[video x2] 40 regions, 10 in test (27.4% of sales), weeks 11-18
  video spend change in test regions: +139,884 SAR
  test weeks only       : measured iROAS 0.70 (se 0.09), true 0.54
  test + 6 weeks after  : measured iROAS 0.96 (se 0.10), true 0.75

calibration weight = residual sigma 15,034 / test se
channel          none  video naive video replay      2 tests      3 tests  true
search           1.99         2.22         2.20         2.27         2.26  1.30
social           0.70         3.44         3.12         2.27         2.28  2.00
video            3.53         1.76         1.92         1.91         1.92  2.60
90% interval, 3 tests: search [1.05 .. 5.03]  social [1.86 .. 3.46]  video [1.81 .. 2.08]
  [2 tests] model replays 'video off' as 1.77 (measured 1.75)
  [2 tests] model replays 'social off' as 1.84 (measured 1.83)
  [2 tests] model replays 'video x2' as 0.99 (measured 0.96)
  [2 tests] video {'theta': 0.54, 'k': 257002, 'beta': 350904}, social {'theta': 0.36, 'k': 15829, 'beta': 117939}
  [3 tests] model replays 'video off' as 1.77 (measured 1.75)
  [3 tests] model replays 'social off' as 1.84 (measured 1.83)
  [3 tests] model replays 'video x2' as 0.96 (measured 0.96)
  [3 tests] video {'theta': 0.53, 'k': 239922, 'beta': 338638}, social {'theta': 0.37, 'k': 17012, 'beta': 119722}
  true: video theta 0.7, k 150,000; social theta 0.35, k 70,000

steady state at today's average weekly spend: average / marginal ROI per riyal
  social  true 2.05 / 1.06   none 0.72 / 0.12   2 tests 2.30 / 0.45   3 tests 2.32 / 0.47
  video   true 2.67 / 1.12   none 3.61 / 1.52   2 tests 1.96 / 1.29   3 tests 1.96 / 1.26
وسوف نقرأ المخرج على قسمين، الاختبارات أولاً ثم المعايرة. وفي القسم الأول لاحظ التالي:
- إيقاف الفيديو: وفرنا 137,945 ريالاً في مناطق الاختبار، وخسرنا في الأسابيع الثمانية نفسها 1.33 ريال مبيعات لكل ريال وفرناه. ولكن عندما مددنا القياس ستة أسابيع بعد عودة الفيديو أصبح الرقم 1.75، أي أن ربع الأثر تقريباً جاء بعد انتهاء الاختبار. والسبب هو الأثر المتراكم: الفيديو θ فيه 0.7، فأثره ينزل ببطء بعد الإيقاف، ويعود ببطء بعد التشغيل. ولو قرأت الإدارة النتيجة يوم انتهاء الاختبار لقللت من قيمة الفيديو، وهذا خطأ يحدث كثيراً لأن الفريق يريد النتيجة بسرعة.
- إيقاف إعلانات التواصل: 1.70 في أسابيع الاختبار و1.83 بعد الأسابيع الستة، والفرق صغير لأن θ فيها 0.35 فقط، فأغلب أثرها في نفس الأسبوع.
- مضاعفة الفيديو: كل ريال إضافي جلب 0.96 ريال، أي أقل من نصف ما جلبه الريال الذي أوقفناه، وهذا هو التشبع بالأرقام. ولاحظ أن الحقيقة هنا 0.75، أي أن الاختبار أخطأ بحوالي خطأين معياريين، وهذا يحدث في اختبار من كل عشرين تقريباً، ويحدث في الواقع أيضاً، فالاختبار عينة واحدة لها ضجيجها.
- مقارنة بالحقيقة: لأن البيانات مصطنعة نعرف ما كان يجب أن تقيسه الاختبارات، وهو 1.84 و1.87 و0.75، والاختباران الأولان قريبان منه.
والصورة التالية تبين اختبار إيقاف الفيديو، والمساحة بين الخطين هي المبيعات التي خسرناها:
معايرة النموذج Calibration بنتائج الاختبارات
الآن عندنا نموذج يعرف الماضي كله ولكنه لا يستطيع أن يفصل بين قناتين، واختبارات تعرف ما حدث في ثمانية أسابيع بدقة. والمعايرة أن نجمع الاثنين، أي أن نقول للنموذج: ابحث عن أفضل منحنيات تفسر المبيعات، بشرط أن تتفق مع نتائج الاختبارات. وفي النماذج البايزية يتم هذا عن طريق التوزيع المسبق أو عن طريق دالة إمكان Likelihood إضافية لكل اختبار، وفي نموذجنا أضفنا لكل اختبار صفاً إضافياً في الانحدار، وزنه هو خطأ النموذج المعتاد مقسوماً على الخطأ المعياري للاختبار، أي أن الاختبار الأدق يؤثر أكثر.
ولكن ما الذي نقول للنموذج بالضبط؟ هنا الخطأ الذي يقع فيه أغلب من يعاير لأول مرة، والمخرج يبين الطريقتين:
- الطريقة المباشرة (عمود
video naive): أن نقول للنموذج إن عائد الفيديو خلال 104 أسابيع يساوي نتيجة الاختبار 1.75. وهذا يبدو منطقياً، ولكنه يقارن رقمين مختلفين: الاختبار قاس ما خسرناه عندما أوقفنا الفيديو ثمانية أسابيع في ربع السوق عند مستوى الإنفاق في تلك الفترة، والنموذج يقيس متوسط ما جلبه كل ريال من الصفر خلال سنتين. والنتيجة أن الفيديو نزل إلى 1.76 وارتفعت إعلانات التواصل إلى 3.44، أي أن النموذج نقل الخطأ من قناة إلى أخرى. - إعادة تمثيل الاختبار (عمود
video replay): أن نطلب من النموذج أن يعيد نفس الاختبار على منحناه: نفس المناطق، ونفس الأسابيع الثمانية، ونفس الأسابيع الستة بعدها، ثم يقارن ما يتوقعه بما قاسه الاختبار. وهذا ما تفعله الدالةreplay_per_betaفي السكربت، وهو نفس ما تفعلهadd_lift_test_measurementsفي PyMC-Marketing، وما تقصده وثائق Meridian عندما تحذر من أن التجربة التي تقيس أثراً حدياً لا تطابق ما يقيسه النموذج من الصفر، وتسميه عدم تطابق المقدار المقاس Estimand Mismatch.
والآن نقرأ نتيجة المعايرة في جدول المخرج عموداً بعمود:
- اختبار الفيديو وحده: حتى مع إعادة التمثيل، اختبار واحد على الفيديو حرك الفضل من الفيديو إلى إعلانات التواصل أكثر من اللازم، فأصبحت 3.12. والسبب أن النموذج لا يزال لا يعرف شيئاً عن إعلانات التواصل، فكل ما أخذه من الفيديو أعطاه لها.
- اختبارا الإيقاف معاً (
2 tests): إعلانات التواصل 2.27 والحقيقة 2.0، بعد أن كانت 0.70. وهذا أهم تغيير في الجدول، لأن القرار الذي كانت الإدارة ستتخذه على النموذج الأول، أي إيقاف إعلانات التواصل، انعكس إلى القرار الصحيح. - الفيديو: نزل من 3.53 إلى 1.91، والحقيقة 2.6، أي أنه انتقل من فوق الحقيقة إلى تحتها. والنموذج يعيد تمثيل الاختبارات الثلاثة بدقة (1.77 مقابل 1.75، و1.84 مقابل 1.83، و0.96 مقابل 0.96)، ومع ذلك عائده الكلي خاطئ.
- الاختبار الثالث لم يضف شيئاً: النموذج المعاير باختباري الإيقاف كان يتوقع لاختبار المضاعفة 0.99 قبل أن نعطيه نتيجته، والنتيجة 0.96، فلم يتغير شيء تقريباً.
- المدى بعد المعايرة: الفيديو بين 1.81 و2.08، أي مدى ضيق لا يحتوي الحقيقة 2.6. وهذا لأن إعادة الملاءمة عندنا تعيد سحب أخطاء المبيعات فقط، ولا تعيد سحب نتائج الاختبارات نفسها، فهي تعامل الاختبار كأنه حقيقة مطلقة. والأدوات البايزية تتعامل مع الخطأ المعياري للاختبار كجزء من عدم اليقين، وهذا فرق مهم.
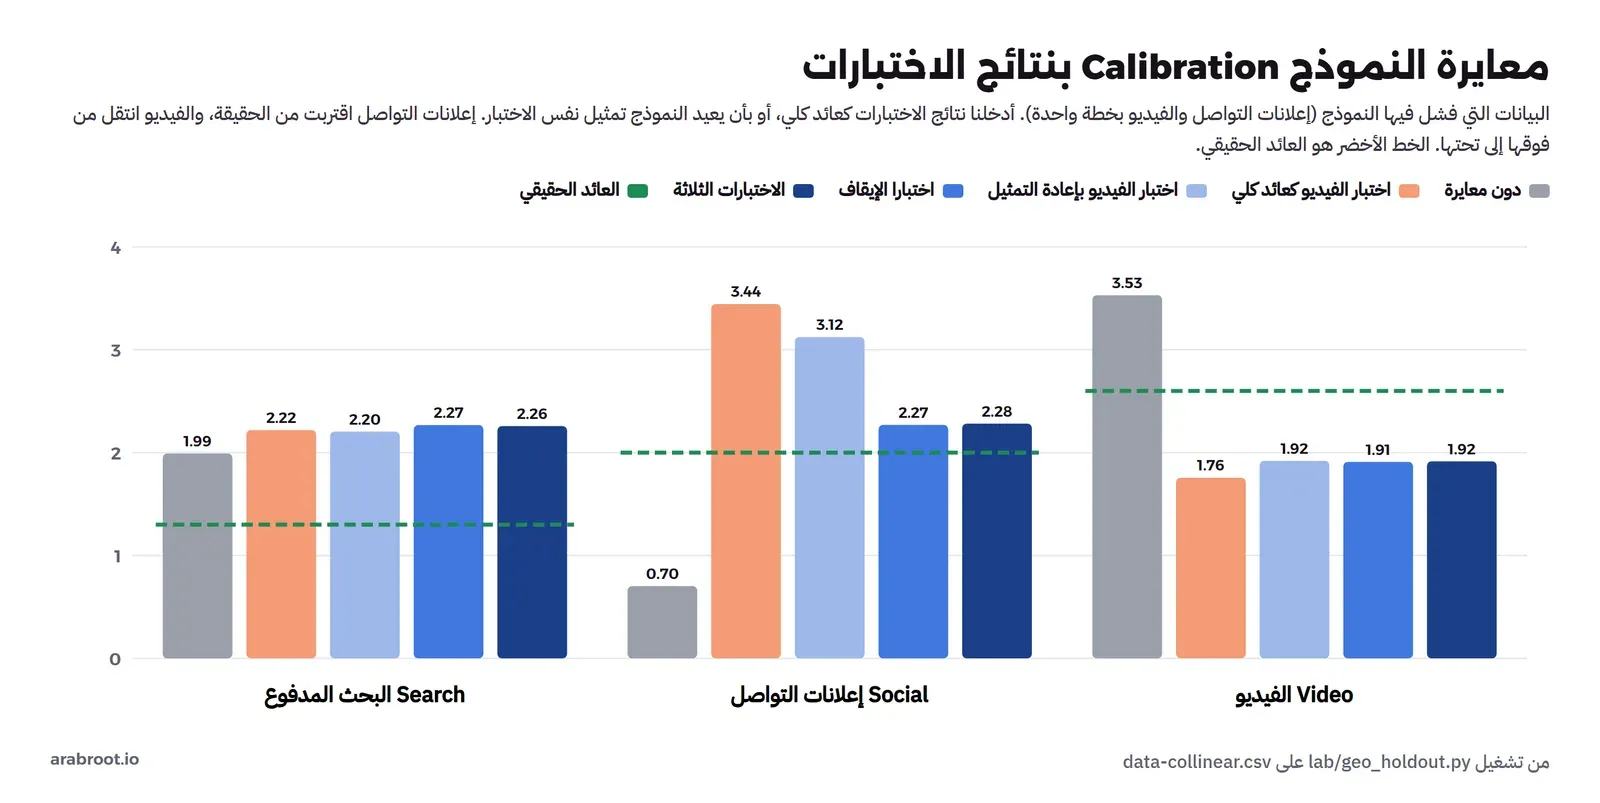
فلماذا يطابق النموذج كل الاختبارات ويخطئ في عائد الفيديو؟ والإجابة في القسم الأخير من المخرج وفي جدول المعاملات: النموذج المعاير وجد للفيديو θ تساوي 0.53 وk تساوي 240 ألفاً، والحقيقة 0.7 و150 ألفاً. أي أنه وجد منحنى آخر يمر بنفس النقاط التي قاستها الاختبارات، ولكنه يختلف عن الحقيقي في المنطقة التي لم يزرها أي اختبار، وهي الإنفاق القليل جداً قرب الصفر. وعائد السنتين محسوب من الصفر، فيتأثر بهذه المنطقة كثيراً. وهذا ما تقوله وثائق PyMC-Marketing بوضوح: اختبار الأثر يقيد متوسط الاستجابة في المدى الذي اختبره، فيفيد في العائد الحدي قرب هذا المدى أكثر مما يفيد في شكل المنحنى كله.
والخبر الجيد أن المنطقة التي يهتم بها قرار الميزانية هي المنطقة التي زارتها الاختبارات، أي قرب الإنفاق الحالي. وفي آخر سطرين من المخرج نرى العائد الحدي عند الإنفاق الحالي: الفيديو 1.26 بعد المعايرة والحقيقة 1.12، بعد أن كان 1.52 دون معايرة. وأما إعلانات التواصل فعائدها الحدي 0.47 بعد المعايرة والحقيقة 1.06، فالنموذج لا يزال يظنها أكثر تشبعاً من الحقيقة، لأن اختبارها الوحيد كان إيقافاً كاملاً.
والدروس من هذا القسم:
- عاير بإعادة تمثيل الاختبار لا بمساواة العائد بنتيجته، والأدوات الثلاث تقدم طريقة لذلك.
- اختبر القناتين المترابطتين لا إحداهما فقط، وإلا انتقل الخطأ إلى القناة التي لم تختبرها.
- اختر الاختبار القادم في المنطقة التي لا يعرفها النموذج: هنا كان اختبار المضاعفة متوقعاً، والمفيد كان اختباراً بإنفاق منخفض، مثل خفض الفيديو إلى النصف، أو اختباراً لإعلانات التواصل بمستوى آخر.
- لا تصدق مدى ضيقاً بعد المعايرة إلا إذا كانت الأداة تحسب خطأ الاختبار نفسه ضمن عدم اليقين.
- كرر الاختبارات المهمة، فاختبار المضاعفة أخطأ بخطأين معياريين، ولا يوجد ما ينبهك لذلك إلا اختبار ثان.
الأدوات مفتوحة المصدر Open Source: Meridian وRobyn وPyMC-Marketing
النموذج الذي بنيناه يكفي للفهم، ولكنه ينقصه الكثير لكي يستخدم في قرار حقيقي: توزيعات مسبقة Priors تعبر عما تعرفه، وتقدير جغرافي على مستوى المناطق، وصيغ أخرى للأثر المتراكم، وتشخيص لجودة الملاءمة، ومحسن ميزانية يحترم القيود. وهناك ثلاث أدوات مفتوحة المصدر معروفة تقدم كل هذا، والفقرات التالية تصف كل واحدة كما تصفها وثائقها الرسمية، بالإصدار المنشور حتى 19 نوفمبر 2026.
Google Meridian
Meridian هو إطار MMM من Google بلغة Python ورخصة Apache 2.0، وآخر إصدار له على PyPI هو 2.2.0 بتاريخ 5 نوفمبر 2026. ويقوم على الاستدلال السببي البايزي Bayesian Causal Inference كما يقول مستودع المشروع، ويدعم البيانات على مستوى المناطق Geo-level ويشجع عليها، مع إمكانية النموذج الوطني. ومن أهم ما فيه:
- المعايرة بالتجارب: يحول نتائج تجارب الأثر الإضافي إلى توزيعات مسبقة للعائد ROI Priors، وتشرح صفحة التوزيعات المسبقة والمعايرة أن تحويل التجربة إلى توزيع مسبق ليس معادلة ثابتة، وأن الأداة
CalibrationBuilderتراعي حداثة التجربة ومدتها والفرق بين ما قاسته التجربة وما يقيسه النموذج. - الوصول والتكرار Reach and Frequency: يستطيع أن يستخدم عدد من وصل إليهم الإعلان وعدد مرات المشاهدة بدلاً من مرات الظهور، ليقترح التكرار الأنسب.
- البيانات: سنتان أسبوعياً لكل منطقة، أو ثلاث سنوات للنموذج الوطني، كما ذكرنا في فقرة البيانات.
- البيئة: يحتاج Python من 3.11 إلى 3.13، ويعتمد على TensorFlow وTensorFlow Probability وJAX، وينصح المستودع باستخدام معالج رسوميات GPU واحد على الأقل، لأن التقدير البايزي على بيانات جغرافية كبيرة ثقيل. وهو خليفة مكتبة LightweightMMM القديمة من Google، وفي الوثائق دليل للانتقال منها.
Meta Robyn
Robyn هي حزمة MMM من فريق علوم التسويق في Meta بلغة R ورخصة MIT، وآخر إصدار لها على CRAN هو 3.12.1 بتاريخ 2 يوليو 2025، وآخر إصدار على GitHub هو v3.12.0 بتاريخ 19 ديسمبر 2024. وطريقتها تختلف عن الأداتين الأخريين، فهي ليست بايزية، والتفصيل في دليل المحللين:
- انحدار Ridge: انحدار خطي مع عقوبة Regularization تمنع المعاملات من أن تكبر بلا سبب، وهذا يخفف مشكلة القنوات المترابطة ولا يحلها.
- البحث عن θ وk بخوارزمية Nevergrad: خوارزمية تطورية Evolutionary من Meta توازن بين هدفين: دقة الملاءمة NRMSE، و«المنطق التجاري» DECOMP.RSSD الذي يعاقب النماذج التي توزع الفضل بشكل بعيد جداً عن توزيع الإنفاق. والنتيجة ليست نموذجاً واحداً، وإنما مجموعة نماذج على حد باريتو Pareto Front يختار المحلل منها.
- Prophet للموسمية: تفكك الاتجاه والموسمية والعطلات بمكتبة Prophet.
- المعايرة: تضيف هدفاً ثالثاً يقيس بعد النموذج عن نتائج التجارب، مثل اختبارات Conversion Lift أو GeoLift، وتقبل حالياً رقماً واحداً من كل تجربة لا مدى.
- البيانات: سنتان أسبوعياً على الأقل، ومتغير لكل 10 مشاهدات، والأسبوعي أفضل من اليومي.
وهناك نسخة Python تجريبية باسم robynpy على PyPI، آخر إصدار لها 0.3.6 في أبريل 2025، ولكن الحزمة الأساسية والوثائق بلغة R.
PyMC-Marketing
PyMC-Marketing هي مكتبة Python من PyMC Labs ورخصة Apache 2.0، مبنية على مكتبة PyMC البايزية، وآخر إصدار لها 1.5.0 بتاريخ 18 نوفمبر 2026، وتحتاج Python 3.12 أو أحدث. وتقول صفحة المستودع إن نموذجها مبني على ورقة Google البحثية Bayesian Methods for Media Mix Modeling with Carryover and Shape Effects عام 2017، وهي نفس الفكرة التي بنينا عليها المختبر: أثر متراكم ثم تشبع. ومن أهم ما فيها:
- صيغ متعددة للأثر المتراكم والتشبع، مع إمكانية كتابة صيغتك الخاصة.
- أساس متغير مع الزمن Time-varying Intercept وفعالية متغيرة للقنوات، عن طريق تقريب للعمليات الغاوسية Gaussian Processes.
- المعايرة باختبارات الأثر عن طريق الدالة
add_lift_test_measurements، التي تأخذ لكل اختبار القناة، والإنفاق قبل الاختبار، والتغير في الإنفاق، والتغير المقاس في المبيعات، والخطأ المعياري له. أي أن النموذج يعيد تمثيل الاختبار على منحناه بالضبط كما فعلنا في المختبر، لا أنه يساوي العائد الكلي بنتيجة الاختبار. - محسن ميزانية، والمعايرة بعائد أو تكلفة عميل معروفة عن طريق
add_cost_per_target_calibration.
مقارنة سريعة: أي أداة تختار؟
| البند | Meridian | Robyn | PyMC-Marketing |
|---|---|---|---|
| اللغة | Python | R (ونسخة Python تجريبية) | Python |
| الإصدار والتاريخ | 2.2.0، نوفمبر 2026 | 3.12.1 على CRAN، يوليو 2025 | 1.5.0، نوفمبر 2026 |
| الرخصة | Apache 2.0 | MIT | Apache 2.0 |
| الطريقة | بايزية، مع نموذج جغرافي هرمي | Ridge مع Nevergrad وحد باريتو | بايزية على PyMC |
| المعايرة بالتجارب | توزيعات مسبقة للعائد عبر CalibrationBuilder | هدف إضافي في البحث، برقم واحد لكل تجربة | إعادة تمثيل الاختبار على المنحنى عبر add_lift_test_measurements |
| الموارد | GPU موصى به | معالج عادي، ووقت بحث طويل | معالج عادي، والعينات Sampling تأخذ دقائق إلى ساعات |
| تناسب من؟ | فريق Python لديه بيانات جغرافية وخبرة إحصائية | محلل يعمل بـ R ويريد نماذج متعددة يختار منها | فريق Python يريد أن يتحكم في كل جزء من النموذج |
وأما اختبارات الأثر الجغرافية نفسها فلها أداة مفتوحة المصدر من Meta اسمها GeoLift، بلغة R ورخصة MIT، تستخدم طريقة التحكم المصطنع Synthetic Control لبناء مجموعة مقارنة من مناطق متعددة، وفيها حاسبات قوة Power Calculators تساعدك على اختيار المناطق ومدة الاختبار قبل أن تبدأ. والطريقة التي استخدمناها في المختبر، أي نسبة الفترة السابقة، هي أبسط نسخة من هذه الفكرة.
كيف تبدأ في شركتك؟ الخطوات
إذا كانت شركتك تنفق على ثلاث قنوات أو أكثر، وأصبح قرار توزيع الميزانية بينها يتكرر كل ربع، فهذه هي الخطوات بالترتيب:
الخطوة 1: اكتب السؤال قبل البيانات
ما القرار الذي سيتخذ على النموذج؟ هل هو توزيع ميزانية العام القادم بين القنوات، أم هل نبدأ قناة جديدة، أم هل نخفض الإنفاق 20% دون أن نخسر مبيعات؟ لأن السؤال يحدد مستوى التفصيل، فقرار بين القنوات لا يحتاج تفصيل كل حملة.
الخطوة 2: اجمع سنتين من البيانات الأسبوعية
الإنفاق الفعلي لكل قناة وأسبوع من فواتير المنصات لا من الخطة، ومرات الظهور إن وجدت، والمبيعات كما يحسبها قسم المالية، والأسعار والعروض، ومواسم العطلات. وإن استطعت فاجمعها على مستوى المناطق، فهذا يضاعف ما يتعلمه النموذج.
الخطوة 3: افحص الارتباط بين القنوات
احسب ارتباط إنفاق كل قناتين كما فعلنا في generate.py، فإذا تجاوز 0.8 بين قناتين فلا تتوقع أن يفرق النموذج بينهما، وخطط لتجربة على إحداهما، أو ادمجهما في قناة واحدة في النموذج.
الخطوة 4: ابدأ بنموذج بسيط ثم بأداة
نموذج مثل الذي بنيناه في يوم عمل واحد يعلمك الكثير عن بياناتك قبل أن تقضي أسابيع في إعداد أداة كاملة. ثم انتقل إلى Meridian أو PyMC-Marketing أو Robyn حسب لغة فريقك.
الخطوة 5: تحقق قبل أن تقرأ العائد
اختبر التنبؤ على آخر 8 إلى 13 أسبوعاً لم يرها النموذج، واقرأ المدى لا الرقم، وقارن حصة الأساس بما يعرفه الفريق: إذا قال النموذج إن 90% من المبيعات من الإعلانات في شركة اسمها معروف فهناك مشكلة.
الخطوة 6: صمم تجربة لأكبر سؤال مفتوح
القناة ذات المدى الأوسع، أو القناتان المترابطتان، أو القناة التي سيتغير إنفاقها أكثر في الخطة القادمة، هي أولى بالتجربة. واستخدم GeoLift أو اختبارات المنصات لتصميمها، وقد شرحنا في مقال اختبارات A/B لماذا يجب أن تحدد حجم العينة Sample Size ومدة الاختبار قبل أن تبدأ.
الخطوة 7: عاير النموذج بالتجربة، ثم حرك الميزانية خطوة صغيرة
أدخل نتيجة التجربة بطريقة إعادة التمثيل، ثم حرك الميزانية 10% إلى 20% في الاتجاه الذي يقترحه النموذج، وقس النتيجة.
الخطوة 8: أعد النموذج كل ربع
السوق يتغير، والقنوات تتشبع، والأسعار تتغير، والنموذج الذي لم يحدث منذ سنة يصف شركة أخرى. لذلك أضف بيانات الربع الجديد، وأعد الملاءمة، وقارن العائد الجديد بالقديم، فإذا تغير كثيراً دون سبب تعرفه فهذه علامة عدم استقرار.
من يعمل عليه؟ وكم يكلف؟
الأدوات مجانية، ولكن النموذج يحتاج وقت محلل يفهم الإحصاء ويفهم التسويق معاً، وهذا هو التكلفة الحقيقية. والجدول التالي تقدير لشركة متوسطة تبدأ من الصفر، وهو تقدير للوقت لا للمال لأن الأسعار تختلف كثيراً:
| البند | الوقت التقريبي | من يقوم به |
|---|---|---|
| جمع البيانات وتنظيفها والاتفاق على رقم المبيعات | 2 إلى 6 أسابيع في المرة الأولى | محلل البيانات مع المالية والتسويق |
| نموذج أول بسيط | أيام | محلل يعرف Python أو R |
| نموذج بأداة كاملة مع التحقق | 2 إلى 4 أسابيع | محلل بخبرة إحصائية |
| تجربة جغرافية واحدة | 8 إلى 14 أسبوعاً من التخطيط للنتيجة، ومبيعات ضائعة في مناطق الاختبار | التسويق مع المحلل |
| تحديث كل ربع | أيام | نفس المحلل |
وإذا قررت أن تطلب النموذج من وكالة أو شركة متخصصة، فاطلب ثلاثة أشياء مكتوبة: المدى لكل رقم لا الرقم وحده، ونتيجة اختبار التنبؤ على أسابيع لم يرها النموذج، والطريقة التي أدخلت بها نتائج التجارب. وفي مقال فريق التسويق: داخلي أم وكالة أم مستقل؟ تفصيل لكيفية كتابة الموجز Brief لمثل هذا العمل.
أخطاء شائعة Common Mistakes
- الحكم على النموذج بـ R²: نموذج يعطي البحث فضل رمضان يطابق المبيعات بنفس الدقة. احكم عليه بالتنبؤ خارج العينة، وبالمدى، وبالمقارنة مع تجربة.
- البدء بستة أشهر من البيانات: رأيت في المختبر أن 26 أسبوعاً أعطت إعلانات التواصل عائداً 10.7 بدل 2.
- قنوات تشترى معاً: لا تتوقع من أي أداة أن تفرق بين قناتين تتحركان معاً، والحل تجربة أو دمجهما.
- نسيان متغيرات التحكم: العروض والأسعار ونشاط المنافسين، فبدونها يأخذ الإعلان الذي يرتفع معها فضلها.
- استخدام النقرات كمقياس للتعرض: النقرات تحذف من شاهد ولم ينقر، فتظلم الفيديو والإعلانات المرئية.
- الإنفاق المخطط بدل الفعلي: الحملة التي خطط لها بمئة ألف وصرف منها ستون تكذب على النموذج.
- إدخال نتيجة التجربة كعائد كلي: التجربة تقيس فترتها ومستوى إنفاقها، ورأينا أن إدخالها كما هي ينقل الخطأ إلى قناة أخرى.
- تنفيذ توصية المحسن كاملة: المحسن يثق بشكل المنحنى بعيداً عن الإنفاق الحالي، وهذا أضعف جزء في النموذج.
- نموذج مرة واحدة: النموذج الذي لا يحدث كل ربع يصبح وصفاً لشركة الماضي.
- الخلط بين المبيعات والربح: عائد 1.3 ريال مبيعات لكل ريال قد يكون خسارة إذا كان هامش الربح 30%، فاحسب العائد بالربح الإجمالي Gross Margin قبل أي قرار، كما في مقال الميزانية.
قائمة تحقق Checklist
- هل كتبت القرار الذي سيتخذ على النموذج قبل أن تبدأ؟
- هل لديك 104 أسابيع على الأقل، والإنفاق الفعلي لكل قناة، والمبيعات كما تحسبها المالية؟
- هل أدخلت المواسم والعطلات والعروض والأسعار كمتغيرات تحكم؟
- هل فحصت الارتباط بين إنفاق القنوات، وهل هناك قناتان فوق 0.8؟
- هل عدد المتغيرات أقل من 10% من عدد المشاهدات تقريباً؟
- هل اختبرت التنبؤ على أسابيع لم يرها النموذج؟
- هل يعرض التقرير مدى لكل عائد، لا رقماً واحداً؟
- هل حصة الأساس منطقية لشركة بحجم شركتك واسمها؟
- هل صممت تجربة للقناة ذات المدى الأوسع أو للقناتين المترابطتين؟
- هل أدخلت نتيجة التجربة بإعادة تمثيلها، لا كعائد كلي؟
- هل حسبت العائد بالربح لا بالمبيعات قبل القرار؟
- هل ستحرك الميزانية خطوة صغيرة وتقيس، بدل أن تنفذ توصية المحسن كاملة؟
الخلاصة
- تقرير النقرة الأخيرة يوزع المبيعات على من لمس العميل آخراً، ولا يسأل هل كان سيشتري دون إعلان. وفي المختبر قال إن البحث يعيد 4.62 والفيديو 0.21، والحقيقة 1.3 و2.6.
- نموذج MMM يقدر ما أضافته كل قناة من بيانات أسبوعية مجمعة، بأربع أفكار: الأساس والإضافي، والأثر المتراكم، والتشبع، والموسمية.
- على 104 أسابيع وقنوات غير مترابطة وجد نموذجنا البسيط 1.46 و2.15 و2.52، أي قريباً من الحقيقة، مع مدى يقول بوضوح أين هو متأكد وأين لا.
- نفس النموذج أخطأ بثقة مع قناتين تشتريان معاً، ومع 26 أسبوعاً من البيانات، ولا توجد طريقة حساب تعوض بيانات لا تحتوي المعلومة.
- العائد الحدي أهم من المتوسط في قرار الميزانية، وهو أضعف ما يقدره النموذج، لذلك حرك الميزانية خطوات صغيرة.
- التجربة الجغرافية تقيس ما حدث في فترتها ومستوى إنفاقها، وتحتاج أسابيع بعد انتهائها لتلتقط الأثر المتأخر، ويجب أن يعيد النموذج تمثيلها بالضبط عند المعايرة.
- Meridian وRobyn وPyMC-Marketing تنفذ نفس الأفكار بشكل أكمل، والاختيار بينها حسب لغة فريقك ونوع بياناتك.
وللمزيد عن القياس والتجارب والميزانية في مسار التسويق:
 دليلقياس التسويق: روابط UTM والإسناد Attributionكيف تعرف القناة التي جاءت بكل عميل: روابط UTM بقواعد تسمية ثابتة، وتحويل تحدده أنت، ونموذج إسناد تفهم ما يحسبه.
 دليلميزانية التسويق وتكلفة العميل CAC والعائد ROIكيف تحسب تكلفة العميل وقيمته ومتى يعود ما أنفقته، وكيف تحدد ميزانية التسويق من هدفك بأرقام بسيطة.
 دليلاختبارات A/B: كيف تخطط لها وتقرأ نتيجتها مع GrowthBookكيف تحسم خلاف فريقك باختبار A/B: الفرضية والعدد الكافي من الزوار، وقراءة الهامش لا الرقم الأوسط، وتكلفة GrowthBook في السنة.
 دليلتجارب النمو عملياً: من الفرضية إلى القرار بالأرقامنبني مختبر GrowthBook في Docker ونختبر قائمة خطوات البداية بزيارات محاكاة، من حجم العينة إلى قرار نتيجة غير حاسمة.
 دليلمؤشرات التسويق KPIs للمبتدئين: ماذا تقيس ومتى؟كيف تختار من ثلاثة إلى خمسة مؤشرات تسويق مرتبطة بهدفك، وتعرفها كتابة، وتراجعها بإيقاع يناسب مرحلة شركتك.
 دليلأبحاث السوق والاستبيانات Surveys: من السؤال إلى القراركيف تكتب سؤال القرار قبل الاستبيان، وتصوغ أسئلة لا توحي بالإجابة، وتحسب هامش الخطأ، وتحول النتيجة إلى قرار له حدود واضحة.
 دليلتحليل المنافسين وبطاقات المواجهة Battlecardsكيف تعرف منافسيك الحقيقيين من مصادر عامة، وتقارن الأسعار لسنة كاملة، وتكتب بطاقة مواجهة يستعملها فريق المبيعات في الاجتماع.
 دليلفريق التسويق: داخلي أم وكالة Agency أم مستقل؟كيف تقرر من ينفذ تسويق شركتك التقنية، وتكتب موجزاً Brief واضحاً وعقد وكالة يحميك، وتقارن تكلفة السنة الأولى لكل خيار.
سجل التحديثات
- 19 نوفمبر 2026: كتابة المقال والمختبر وتشغيله على Python 3.13.3 مع NumPy 2.5.5 وpandas 3.1.1 وSciPy 1.18.1، ببيانات مصطنعة لـ 104 أسابيع واختبارات جغرافية مصطنعة على 40 منطقة.