

بعد ظهر الاثنين 15 يناير 1990، وكان يوم عطلة رسمية في الولايات المتحدة، بدأت مكالمات ملايين الأمريكيين إلى المدن الأخرى تفشل على شبكة AT&T، أكبر شبكة للمكالمات البعيدة Long-distance في البلد، حتى صارت قرابة نصف المكالمات لا تصل. ولم يكن هناك هجوم ولا حريق ولا انقطاع كابل، وإنما عطل بسيط في مقسم Switch واحد في نيويورك أصلح نفسه خلال ثوان كما يفعل عادة، ولكن عودته إلى العمل أطلقت سلسلة جعلت المقاسم المئة والأربعة عشر في الشبكة تخرج وتعود بشكل متكرر قرابة تسع ساعات، والسبب خلل في تحديث برمجي وصل إلى كل المقاسم قبل شهر.
والقصة تذكر عادة في سطر واحد: «سطر break في C أوقف الشبكة»، وهذا صحيح جزئياً، ولكن الأهم منه للمهندس هو كيف تحول خلل في مسار الاستعادة Recovery Path إلى تفاعل متسلسل Cascading Failure، ولماذا لم يحم التكرار Redundancy الشبكة، ولماذا وصل الخلل إلى كل المقاسم في وقت واحد. وسوف نعتمد على بيانات AT&T نفسها كما نشرتها في وقتها، وعلى النقاش الذي دار في نشرة RISKS Digest التي يحررها Peter Neumann.
وسوف نناقش في هذا المقال ما يلي:
- كيف كانت شبكة AT&T تعمل: المقاسم 4ESS وشبكة الإشارات المنفصلة CCS7.
- ما حدث في ذلك اليوم بالساعة، وكم مكالمة لم تصل بحسب أرقام AT&T.
- الخلل كما شرحته AT&T: رسالتان خلال جزء من مئة من الثانية أثناء تحديث الحالة.
- قصة
breakداخلifداخلswitch: من أين جاءت، وما الذي نعرفه عنها فعلاً. - كيف أوقف المهندسون الانهيار، وكيف أصلحوه في اليوم التالي.
- تجربة عملية Lab ببرنامج C صغير يعيد إنتاج شكل الخطأ، ومحاكاة Simulation بلغة Python لانتشار العطل بين 114 مقسماً.
- الدروس: اختبار مسار الاستعادة، والإطلاق التدريجي، والتكرار الذي يشغل نفس الكود.
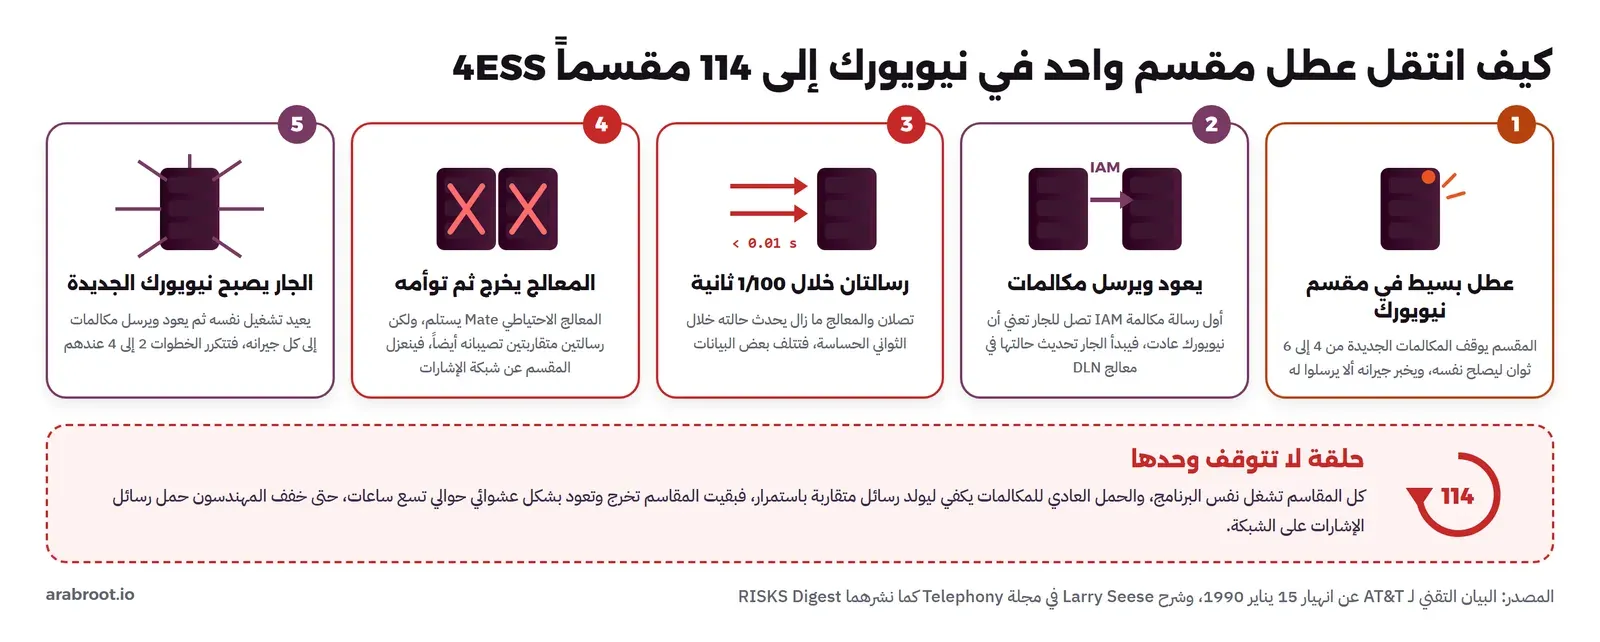
الصورة التالية تبين كيف انتقل العطل من مقسم إلى آخر، وسوف نشرح كل خطوة فيها:
كيف كانت شبكة AT&T تعمل؟
كانت شبكة المكالمات البعيدة في AT&T تعتمد على مقاسم رقمية كبيرة من نوع 4ESS، وهي أجهزة تحويل Switching تصل المكالمة من مدينة إلى أخرى، وبحسب ما نقلته مجلة Telephony عن Larry Seese مدير تطوير التقنية في AT&T، ونشره Peter Neumann في RISKS Digest 9.62، كان عددها 114 مقسماً. ولكي يجهز مقسم مكالمة مع مقسم آخر لا يرسل إشارات التجهيز على نفس خط الصوت، وإنما على شبكة إشارات منفصلة Common Channel Signaling اسمها CCS7، وهي نسخة AT&T من نظام الإشارات Signaling System 7 المعروف اختصاراً SS7، وأول رسالة في تجهيز أي مكالمة تسمى رسالة العنوان الأولية Initial Address Message واختصاراً IAM، وفيها الرقم المتصل والرقم المطلوب.
وفي كل مقسم 4ESS معالج خاص يربطه بشبكة الإشارات اسمه Direct Link Node واختصاراً DLN، وهو الذي يحفظ خريطة حالة المقاسم الأخرى: أيها يعمل وأيها خارج الخدمة، وهذا المعالج مكرر، أي أن له معالجاً توأماً Mate يستلم العمل إذا توقف. وهذا التكرار هو بالضبط ما يتوقعه أي مهندس من شبكة بهذا الحجم، وقد شرحنا فكرته في مقال مفاهيم التوفر العالي، ولكن لاحظ من الآن أن المعالجين يشغلان نفس البرنامج، وسوف نعود لهذه النقطة.
ماذا حدث يوم 15 يناير 1990؟
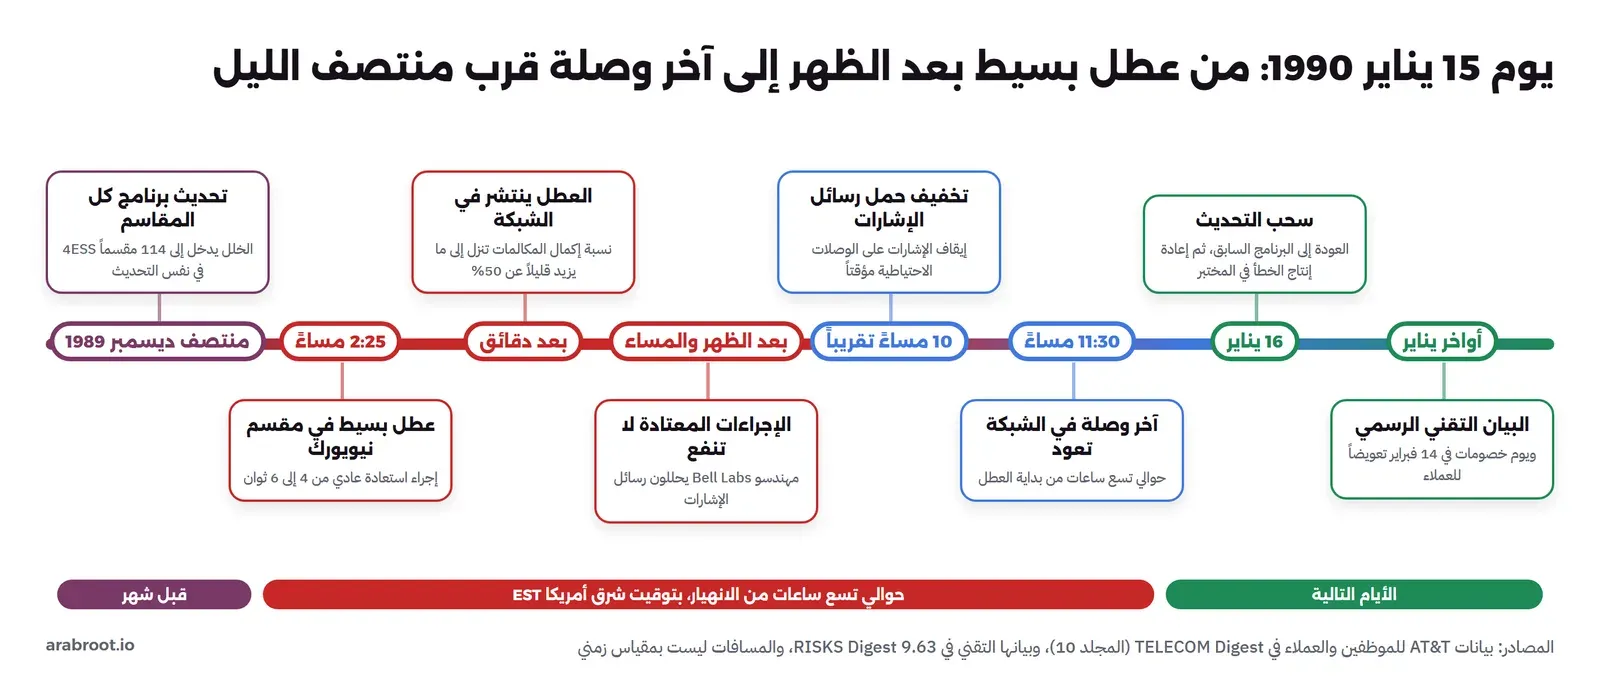
في البيان التقني الذي وزعته AT&T على عملائها بعد الحادثة، ونشر في RISKS Digest 9.63 بعنوان «Technical background on AT&T's network slowdown, January 15, 1990»، تروي الشركة الأحداث كما يلي، والأوقات بتوقيت شرق أمريكا EST:
- حوالي الساعة 2:30 بعد الظهر حدثت مشكلة بسيطة في عتاد مقسم 4ESS في مدينة نيويورك، فبدأ إجراءات الاستعادة العادية Fault Recovery، وهي تحتاج من 4 إلى 6 ثوان يتوقف فيها المقسم عن قبول مكالمات جديدة، وهذا إجراء صيانة معتاد لا يلاحظه أحد.
- أرسل المقسم إلى المقاسم المتصلة به رسائل تطلب ألا ترسل له مكالمات جديدة خلال هذه الثواني، فسجلت كل منها في برنامجها أن مقسم نيويورك خارج الخدمة مؤقتاً.
- عندما انتهى مقسم نيويورك من الاستعادة بدأ يرسل رسائل مكالمات IAM إلى جيرانه، وعندما رأى الجيران هذه الرسائل بدؤوا يعدلون برامجهم ليسجلوا أن نيويورك عادت.
- وهنا ظهر الخلل، وسوف نشرحه بالتفصيل في القسم التالي، والنتيجة أن معالجات الإشارات في المقاسم بدأت تخرج من الخدمة وتعود بشكل عشوائي في كل الشبكة.
وفي نشرة لموظفيها في اليوم التالي نشرت في TELECOM Digest المجلد 10 العدد 31 قالت AT&T إن المشكلة بدأت حوالي الساعة 2:25، وإن نسبة إكمال المكالمات نزلت في كل البلد إلى ما يزيد قليلاً عن 50%، وإن المكالمات البعيدة العادية وخدمة الأرقام المجانية 800 والشبكات الافتراضية للشركات Software Defined Network تأثرت، بينما الخطوط المؤجرة Private Lines وشبكات الحكومة الخاصة لم تتأثر. ولاحظ أن البيان التقني يذكر أن حجم المكالمات ذلك اليوم لم يكن غير عادي، بل كان أقل من يوم اثنين عادي بسبب العطلة، أي أن الحمل العادي وحده كان كافياً ليغذي الانهيار.
والصورة التالية تبين أحداث اليوم بالترتيب:
كم مكالمة لم تصل؟
ستجد في المقالات أرقاماً مختلفة لعدد المكالمات التي فشلت، من 50 إلى 75 مليوناً، لذلك نعتمد هنا على رقم AT&T نفسها. ففي أسئلة وأجوبة وزعتها الشركة على موظفيها ونشرت في نفس العدد 31 من TELECOM Digest، قالت إن الشبكة في يوم عمل عادي تتعامل مع 110 ملايين مكالمة، وإن يوم 15 يناير شهد 148 مليون محاولة اتصال، تعاملت الشبكة مع 83 مليوناً منها فقط، أي نسبة إكمال 56%، ثم أوضحت في تصحيح نشر في العدد 38 أن «تعاملت معها» تعني أن المكالمة وصلت إلى وجهتها أو أعطت إشارة مشغول أو لم يرد عليها، أي أن الشبكة أدت عملها. وبالتالي فإن قرابة 65 مليون محاولة من 148 مليوناً لم تتعامل معها الشبكة، مع ملاحظة أن جزءاً منها محاولات مكررة من نفس الأشخاص، لذلك فالرقم الدقيق للمكالمات الفاشلة غير معروف، والذي نعرفه هو نسبة الإكمال. ونفس التصحيح وصف ما حدث بأنه تعطل في الخدمة لمدة تسع ساعات nine-hour service impairment.
وقد اعتذر رئيس الشركة Bob Allen علناً في رسالة نشرت في صحف 22 مدينة بعبارة «لم نكن على مستوى معاييرنا للجودة، ولم نكن على مستوى معاييركم»، وقدمت الشركة يوم 14 فبراير 1990 خصومات بمتوسط 33% على المكالمات بين الولايات تعويضاً للعملاء، كما في النشرة التي نشرت في العدد 38 من TELECOM Digest.
الخلل: رسالتان خلال جزء من مئة من الثانية
قبل الحادثة بشهر، في منتصف ديسمبر 1989، حملت AT&T تحديثاً لبرنامج معالجات الإشارات في كل مقاسم 4ESS، والهدف بحسب البيان التقني كان تحسين أداء الشبكة كثيراً بأن تستطيع المقاسم الوصول إلى شبكة إشارات احتياطية بسرعة أكبر إذا حدثت مشكلة في شبكة CCS7 الرئيسية. وقد شرح Larry Seese في مقابلة Telephony التي نقلتها RISKS 9.62 التغيير الذي أحدثه التحديث في طريقة استقبال مقسم عائد إلى الخدمة:
- قبل التحديث: المقسم A يرسل رسالة يقول فيها إنه عاد إلى العمل، والمقسم B يتحقق مرة أخرى بنفسه من أن A عاد فعلاً.
- بعد التحديث: المقسم A يبدأ مباشرة بمعالجة المكالمات وإرسال رسائل IAM، وأول رسالة IAM يستلمها B من A هي نفسها الإشارة إلى أن A عاد، فيبدأ B بتحديث منطقه الداخلي ليسجل ذلك. والفائدة أن الاستجابة أسرع، لأنه لا توجد رسالة إضافية ولا تحقق إضافي.
والمشكلة كما يصفها البيان التقني أن معالج DLN في المقسم B أثناء تحديث خريطة الحالة بقي عرضة للخلل عدة ثوان بسبب عيب في البرنامج، وإذا وصلته خلال هذه الثواني رسالتا IAM من نيويورك بينهما أقل من 1/100 من الثانية، تتلف بعض البيانات، فيخرج المعالج من الخدمة ليعيد تهيئة نفسه. ثم يستلم المعالج التوأم الحمل، ولكن زوجاً آخر من الرسائل المتقاربة يصيبه في نفس الفترة الحساسة، فيخرج هو الآخر، وينعزل المقسم كله عن شبكة الإشارات. وقال Seese بكلماته إن الرسالة الثانية أربكت البرنامج فحاول تنفيذ تعليمة لا معنى لها، فأعلن المعالج عن نفسه أنه «insane»، وأوقف المقسم نفسه حتى لا ينشر المشكلة.
وهنا تبدأ الحلقة: المقسم B بعد أن يعزل نفسه يرسل إلى جيرانه أنه خارج الخدمة، ثم بعد أن يعيد تهيئة نفسه يعود ويرسل رسائل مكالمات، فيصيب جيرانه بنفس الطريقة التي أصابته بها نيويورك، وقال Seese: «كانت سلسلة تفاعلات Chain Reaction، أي مقسم متصل بـ B وضع في نفس الحالة»، وأضاف: «لو لم تصل المقاسم رسالة ثانية أثناء إعادة الضبط لما كانت هناك مشكلة، ولو وصلت الرسائل متباعدة أكثر لما ظهر الخلل». ولاحظ أن الحلقة لا تحتاج أي عطل جديد في العتاد، فحمل المكالمات العادي يكفي ليولد رسائل متقاربة باستمرار، والبيان التقني يقول إن الحالة غير المستقرة استمرت بسبب الطبيعة العشوائية للأعطال والضغط المستمر لحمل المكالمات.
قصة break داخل if داخل switch
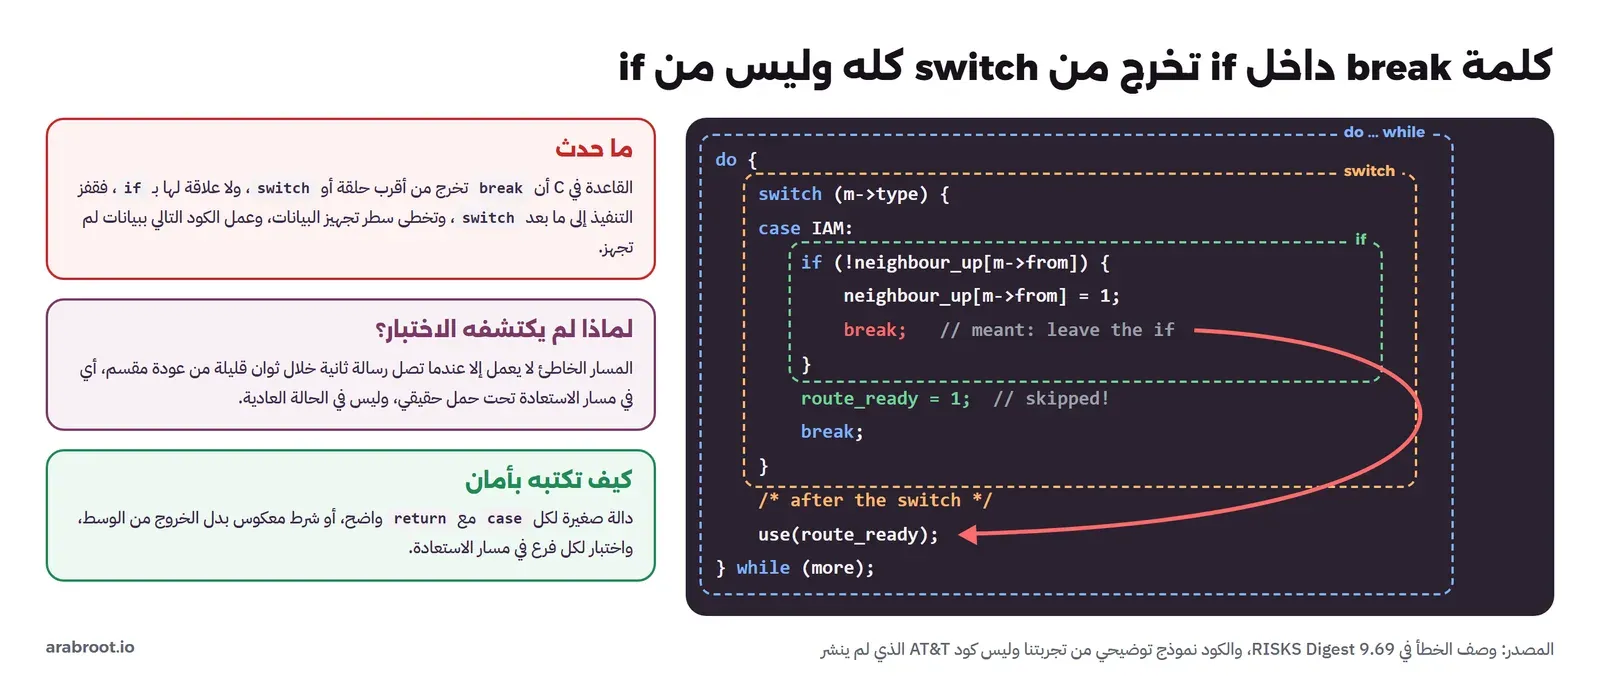
لاحظ أن بيانات AT&T الرسمية لا تذكر لغة البرمجة ولا السطر الخاطئ، وأن الكود نفسه لم ينشر أبداً، والتفصيل المشهور جاء من رسالة أرسلها مبرمج في 19 يناير 1990، أي بعد الحادثة بأربعة أيام، ونقلها Gerald Baumgartner إلى RISKS Digest 9.69، ونصها أن البرنامج المكتوب بلغة C كان فيه:
a long "do . . . while" construct, which contained
   a "switch" statement, which contained
      an "if" clause, which contained a
         "break," which was intended for
      the "if" clause, but instead broke from
   the "switch" statement.
أي أن المبرمج كتب break داخل if وهو يقصد الخروج من if فقط، ولكن break في C كما ذكر Jonathan Kamens في RISKS 9.70 نقلاً عن كتاب Kernighan وRitchie تنهي أقرب حلقة أو switch يحيط بها، ولا علاقة لها بـ if، فقفز التنفيذ إلى ما بعد switch كله وتخطى الكود الذي يجهز البيانات، وهذا يتفق مع ما قاله Seese عن تعليمة لا معنى لها ومع ما قاله البيان عن بيانات تالفة. وفي نفس العدد اختلف القراء: بعضهم رأى أن break كان مقصوداً للخروج من حلقة do ... while وليس من if، وآخرون رفضوا القول إن لغة أخرى كانت ستمنع الخطأ، لأن أي لغة فيها قفز إلى مكان خاطئ بشكل أو بآخر.
لذلك نتعامل مع قصة break على أنها الرواية الأكثر انتشاراً لشكل الخطأ، وليست تقريراً رسمياً، أما الآلية التي شرحتها AT&T، أي المسار الحساس أثناء تحديث الحالة والرسالتين المتقاربتين والتفاعل المتسلسل، فهي موثقة من الشركة نفسها. والصورة التالية تبين كيف تقفز break في نموذج يشبه الوصف:
كيف أوقف المهندسون الانهيار؟
يقول البيان التقني إن المهندسين جربوا أولاً الإجراءات المعتادة لإعادة استقرار شبكة الإشارات، وهي إجراءات كانت تكفي دائماً من قبل، ولكنها لم تنفع هذه المرة، فعرفوا مبكراً أنهم أمام مشكلة لم يروها من قبل. وانضم مهندسو Bell Labs من ثلاث ولايات، ولأنهم لم يفهموا الآلية بعد، كان عليهم أن يستنتجوا ما يحدث من الرسائل التي تمر في شبكة الإشارات ومن المقاسم نفسها. والحل الذي نجح لم يكن إصلاحاً للكود، وإنما تخفيف الحمل Load Shedding، فقد أوقفوا مؤقتاً حركة الإشارات على الوصلات الاحتياطية، فقل عدد الرسائل التي تصل إلى معالجات DLN، وقلت فرصة وصول رسالتين متقاربتين في الفترة الحساسة، فبدأت المقاسم تستقر، وفي الساعة 11:30 مساءً عادت آخر وصلة في الشبكة.
وفي اليوم التالي سحبت AT&T التحديث من المقاسم وعادت إلى البرنامج السابق، أي تراجعت Rollback إلى الإصدار الذي كان يعمل قبل شهر، ثم فحصت البرنامج الجديد سطراً سطراً حتى وجدت الجزء المشبوه، وأعادت إنتاج المشكلة في المختبر، ثم أصلحتها واختبرت الإصلاح وأعادت الوصلات الاحتياطية. ولاحظ أن الشركة قالت في بيانها إن البرنامج اختبر بدقة في المختبر قبل إطلاقه، ولكن «التركيبة الفريدة من الأحداث التي أدت إلى المشكلة لم يكن من الممكن توقعها».
التجربة العملية: شكل الخطأ ثم انتشار العطل
في هذه التجربة برنامجان، الأول بلغة C يعيد إنتاج شكل الخطأ الذي وصفته RISKS 9.69، والثاني محاكاة بلغة Python لانتشار العطل بين 114 مقسماً. ولاحظ أن كليهما نموذج توضيحي: كود AT&T لم ينشر، والأرقام في المحاكاة مثل حمل الرسائل وطول الفترة الحساسة اخترناها لتوضيح الفكرة، وليست أرقام الشبكة الحقيقية، باستثناء عدد المقاسم وزمن الاستعادة من 4 إلى 6 ثوان والفاصل 1/100 ثانية الموجودة في بيانات AT&T. ونشغل كل شيء في Containers بإصدارات محددة: gcc:14.2.0 وpython:3.13.16-slim.
break في المكان الخاطئ
الملف break.c فيه حلقة do ... while تعالج رسائل، وداخلها switch على نوع الرسالة، وفي حالة رسالة IAM من مقسم كان خارج الخدمة يسجل البرنامج أنه عاد، ثم يجب أن يجهز بيانات التوجيه route_ready ويوجه المكالمة:
/* break.c: a small model of the control-flow mistake described for the 4ESS bug.
   This is not AT&T's code (it was never published); it only has the same shape:
   do ... while  >  switch  >  case  >  if  >  break                              */
#include <stdio.h>
#include <string.h>

enum { IAM = 1, END = 9 };                 /* message types */
struct msg { int type; int from; };

int neighbour_up[4] = { 1, 0, 1, 1 };      /* switch 1 is marked "out of service" */
int route_ready;                            /* must be set before a call is routed */

static void process(const struct msg *q, int fixed)
{
    int i = 0;
    do {
        const struct msg *m = &q[i++];
        switch (m->type) {
        case IAM:                           /* a call attempt from a neighbour */
            if (!neighbour_up[m->from]) {
                neighbour_up[m->from] = 1;  /* first call: the neighbour is back */
                printf("  switch %d is back in service\n", m->from);
                if (!fixed)
                    break;                  /* meant to leave the if only, but it leaves the switch */
            }
            route_ready = 1;                /* prepare the routing data */
            printf("  call from switch %d routed (route_ready=%d)\n", m->from, route_ready);
            break;
        case END:
            break;
        }
        /* code after the switch runs for every message */
        if (m->type == IAM && !route_ready)
            printf("  ERROR: call from switch %d left without routing data\n", m->from);
        route_ready = 0;
    } while (q[i - 1].type != END);
}

int main(void)
{
    struct msg q[] = { { IAM, 1 }, { IAM, 2 }, { END, 0 } };
    puts("with the break inside the if:");
    process(q, 0);
    neighbour_up[1] = 0;
    puts("with the corrected flow:");
    process(q, 1);
    return 0;
}
docker run --rm --name lab-disaster-att -v "$PWD:/lab" -w /lab gcc:14.2.0 sh -c "gcc -O0 -Wall -o break break.c && ./break"والمخرج سوف يكون كما يلي:
with the break inside the if:
  switch 1 is back in service
  ERROR: call from switch 1 left without routing data
  call from switch 2 routed (route_ready=1)
with the corrected flow:
  switch 1 is back in service
  call from switch 1 routed (route_ready=1)
  call from switch 2 routed (route_ready=1)
في المخرج أعلاه لاحظ التالي:
- في النسخة الخاطئة سجل البرنامج أن المقسم 1 عاد، ثم خرج
breakمنswitchكله، فلم يصل التنفيذ إلىroute_ready = 1، والكود بعدswitchوجد المكالمة بدون بيانات توجيه. - المكالمة الثانية من المقسم 2 مرت بشكل طبيعي، لأن المقسم 2 لم يكن خارج الخدمة، أي أن الخطأ لا يظهر إلا في رسالة أول مقسم عائد، وهذا هو مسار الاستعادة الذي لا يمر به الكود في الأيام العادية.
- المترجم لم يعط أي تحذير رغم الخيار
-Wall، لأنbreakداخلifداخلswitchكود صحيح تماماً في C، والخطأ في نية المبرمج وليس في قواعد اللغة. - في النسخة المصححة سجل البرنامج عودة المقسم ثم أكمل إلى تجهيز البيانات في نفس المرور، والحل في الكود الحقيقي هو ألا تستخدم
breakللخروج من وسطifأصلاً، وإنما تكتب الشرط بحيث يكمل التنفيذ طبيعياً، أو تنقل كلcaseإلى دالة صغيرة.
محاكاة انتشار العطل بين 114 مقسماً
الملف cascade.py محاكاة بالأحداث Event-driven Simulation: المقسم 0 يمثل نيويورك ويتعطل في الثانية صفر، وكل مقسم يتعطل يعود بعد 4 إلى 6 ثوان، وعندما يعود يرسل مكالمات إلى كل جار بمعدل عشوائي، وكل جار يبقى حساساً 3 ثوان بعد أول رسالة، وإذا وصلته رسالتان بينهما أقل من 10 ميلي ثانية يتلف المعالج، وإذا تكرر ذلك يصيب التوأم فيخرج المقسم كله. ونقارن أربع حالات: الخلل مع الحمل العادي، والخلل مع تخفيف الحمل عند الثانية 300 كما فعل مهندسو AT&T، والبرنامج المصحح، والخلل مع حمل أخف قليلاً:
# cascade.py: a SIMULATION of the January 1990 chain reaction, not a model of the real 4ESS.
# 114 switches, each one connected to all the others. All numbers below are illustrative.
import heapq, random

N          = 114      # switches in the network
RESET      = (4, 6)   # a switch needs 4 to 6 seconds to recover (AT&T's figure)
WINDOW     = 3.0      # seconds a switch stays vulnerable while it updates its status map
GAP        = 0.010    # two calls closer than 1/100 s inside the window damage the data
SIM_END    = 600      # simulated seconds

def run(rate, buggy=True, cut_at=None, cut_rate=None, seed=1990):
    """rate: calls per second from a recovered switch to each neighbour.
       cut_at/cut_rate: from this second on, the signalling load is reduced."""
    rnd = random.Random(seed)
    events = []                       # (time, kind, switch)
    down = [False] * N
    resets = [0] * N
    timeline = {}
    heapq.heappush(events, (0.0, "fail", 0))     # switch 0 = the New York switch, a real minor fault

    def neighbours_hit(t0, y):
        """Switch y is back at t0. Find which neighbours get two close calls from it in their window."""
        r = rate if cut_at is None or t0 < cut_at else cut_rate
        for x in range(N):
            if x == y or down[x]:
                continue
            t = t0 + rnd.expovariate(r)            # first call from y: x starts updating its map
            start, last, hits = t, t, 0
            while True:
                t += rnd.expovariate(r)
                if t > start + WINDOW:
                    break
                if t - last < GAP:
                    hits += 1                       # one processor damaged; the mate takes over
                    if hits == 2:                   # the mate is hit too: x leaves the network
                        heapq.heappush(events, (t, "fail", x))
                        break
                last = t

    while events:
        t, kind, s = heapq.heappop(events)
        if t > SIM_END:
            break
        if kind == "fail":
            if down[s]:
                continue
            down[s] = True
            resets[s] += 1
            heapq.heappush(events, (t + rnd.uniform(*RESET), "back", s))
        else:                                       # "back": s sends calls again
            down[s] = False
            if buggy:
                neighbours_hit(t, s)
        sec = int(t // 30) * 30
        timeline[sec] = max(timeline.get(sec, 0), sum(down))
    return resets, timeline

def report(title, resets, timeline):
    print(title)
    print("  switches that reset at least once: %d of %d, total resets: %d"
          % (sum(1 for r in resets if r), N, sum(resets)))
    print("  most switches down at the same moment, per 30 s:")
    print("   ", " ".join("%3d" % timeline.get(s, 0) for s in range(0, SIM_END, 30)))

if __name__ == "__main__":
    report("1) the flaw, normal load (2.5 calls/s per link):", *run(2.5))
    report("2) the flaw, load cut to 1.0 call/s per link at t=300 s:", *run(2.5, cut_at=300, cut_rate=1.0))
    report("3) corrected software, normal load:", *run(2.5, buggy=False))
    report("4) the flaw, lighter load (2.0 calls/s per link):", *run(2.0))
docker run --rm --name lab-disaster-att -v "$PWD:/lab" -w /lab python:3.13.16-slim python -B cascade.pyوالمخرج سوف يكون كما يلي:
1) the flaw, normal load (2.5 calls/s per link):
  switches that reset at least once: 114 of 114, total resets: 5625
  most switches down at the same moment, per 30 s:
     39  59  65  69  60  57  60  59  58  64  62  60  66  66  60  59  60  60  62  59
2) the flaw, load cut to 1.0 call/s per link at t=300 s:
  switches that reset at least once: 114 of 114, total resets: 2733
  most switches down at the same moment, per 30 s:
     39  59  65  69  60  57  60  59  58  64  62   0   0   0   0   0   0   0   0   0
3) corrected software, normal load:
  switches that reset at least once: 1 of 114, total resets: 1
  most switches down at the same moment, per 30 s:
      1   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0
4) the flaw, lighter load (2.0 calls/s per link):
  switches that reset at least once: 4 of 114, total resets: 4
  most switches down at the same moment, per 30 s:
      2   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0
في المخرج أعلاه لاحظ التالي:
- في الحالة الأولى تعطل كل المقاسم الـ 114 مرة واحدة على الأقل، وكان المجموع 5625 إعادة تشغيل في عشر دقائق محاكاة، والأهم أن عدد المقاسم المتوقفة في نفس اللحظة بقي حول 60 حتى نهاية المحاكاة، أي أن الشبكة لا تتعافى وحدها مع أن العطل الأصلي انتهى بعد 6 ثوان.
- في الحالة الثانية نفس البداية، ولكن بعد تخفيف الحمل إلى 1.0 رسالة في الثانية عند الثانية 300 نزل عدد المقاسم المتوقفة إلى صفر خلال 30 ثانية، وهذا يشبه ما فعلته AT&T عندما أوقفت الإشارات على الوصلات الاحتياطية، مع أن الخلل نفسه ما زال في البرنامج.
- في الحالة الثالثة، أي البرنامج المصحح، تعطل مقسم نيويورك وحده مرة واحدة ثم عاد، ولم يتأثر أحد، وهذا ما كان يحدث كل يوم قبل التحديث دون أن يلاحظه أحد.
- الحالة الرابعة أهم ما في التجربة: نفس الخلل مع حمل أخف من 2.5 إلى 2.0 رسالة في الثانية أعطى 4 أعطال فقط وتوقف، أي أن الانتقال من حادثة صغيرة إلى انهيار كامل ليس تدريجياً، وإنما يحدث عند عتبة Threshold، وهذا يفسر لماذا لم يظهر الخلل في المختبر بحمل خفيف، ولماذا ظهر بعد شهر من التحديث في يوم عادي.
ماذا نتعلم كمهندسين؟
- اختبر مسار العودة وليس التعطل فقط: كتب William Murray في RISKS 9.63 أن الفشل لم يكن في مكون، وإنما في عدم القدرة على التعامل مع عودة مكون متعطل إلى الخدمة، وأننا نختبر ما يحدث عندما يتعطل الجزء، ولا نختبر ما يحدث عندما ينجح في إصلاح نفسه ويعود. وهذا يعني في عملك أن تختبر عودة قاعدة البيانات بعد انقطاع، وعودة سيرفر إلى Load Balancer، وعودة خدمة تستقبل فجأة كل الرسائل المتراكمة، وقد شرحنا اختبار التعطل في مقال التوفر العالي.
- التكرار الذي يشغل نفس الكود لا يحميك من خطأ في الكود: المعالج DLN كان له توأم، والتوأم سقط بنفس الطريقة لأنه يشغل نفس البرنامج، وكل المقاسم الـ 114 سقطت لأنها تشغل نفس البرنامج، وهذا ما يسمى الأعطال التي تصيب النسختين معاً، وقد شرحناه في قسم الأعطال المترابطة.
- لا تنشر التحديث على كل الأجهزة في وقت واحد: التحديث وصل إلى كل المقاسم في منتصف ديسمبر، فلما ظهر الخلل كان في كل مكان، والإطلاق التدريجي Canary أو الإطلاق على مراحل كان سيحصر الخلل في جزء من الشبكة، ولاحظ أن نفس الدرس تكرر في حادثة CrowdStrike سنة 2024 التي شرحناها في قسم استراتيجيات الإطلاق في مقال طرق النشر.
- التحسين في سرعة الاستجابة له ثمن: التحديث حذف خطوة تحقق ليجعل العودة أسرع، والخطوة المحذوفة كانت تعطي المقسم وقتاً ليستقر قبل أن تصله المكالمات، لذلك عندما تحذف خطوة «زائدة» من بروتوكول، اسأل لماذا وضعت أصلاً.
- جهز طريقة لتخفيف الحمل: ما أنقذ الشبكة لم يكن إصلاح الكود، وإنما تقليل الرسائل، فاجعل في نظامك مفاتيح لتخفيف الحمل، مثل إيقاف ميزة ثانوية أو تقليل معدل إعادة المحاولة Retry، فهي التي تشتري لك الوقت لتجد السبب، كما في قسم «خفف الأثر أولاً» في دليل استكشاف الأخطاء.
- جهز التراجع قبل أن تحتاجه: في اليوم التالي عادت AT&T إلى البرنامج السابق، وهذا ممكن فقط لأن الإصدار السابق كان محفوظاً وجاهزاً للتحميل، فلا تنشر إصداراً لا تعرف كيف تتراجع عنه.
- اختبر تحت حمل حقيقي ومع توقيتات عشوائية: الخلل كان يحتاج رسالتين خلال 10 ميلي ثانية في فترة من ثوان، وهذا لا يحدث في اختبار يرسل رسالة كل ثانية، وقد شرحنا أنواع الاختبارات في مقال أنواع الاختبارات، ومن المفيد أن تشغل اختبار الأحمال على النسخة الجديدة قبل نشرها.
الخلاصة
- في 15 يناير 1990 تعطلت شبكة AT&T للمكالمات البعيدة قرابة تسع ساعات، ونزلت نسبة إكمال المكالمات إلى 56%، فمن 148 مليون محاولة تعاملت الشبكة مع 83 مليوناً بحسب أرقام الشركة.
- البداية كانت عطلاً بسيطاً في مقسم 4ESS في نيويورك أصلح نفسه خلال ثوان، ولكن عودته إلى الخدمة أطلقت تفاعلاً متسلسلاً بين المقاسم الـ 114.
- السبب خلل في تحديث برمجي حمل على كل المقاسم في منتصف ديسمبر 1989: معالج الإشارات DLN كان عرضة للخلل أثناء تحديث حالة مقسم عائد، ورسالتان خلال 1/100 ثانية تتلفان بياناته، ثم يسقط توأمه بنفس الطريقة.
- قصة
breakداخلifداخلswitchبلغة C جاءت من رسالة نشرت في RISKS 9.69، وهي الرواية الأشهر لشكل الخطأ، بينما بيانات AT&T الرسمية تصف الآلية دون الكود. - استقرت الشبكة بتخفيف حمل رسائل الإشارات، وفي اليوم التالي عادت الشركة إلى البرنامج السابق ثم أصلحت الخلل.
- في التجربة رأينا
breakتتخطى سطر التجهيز دون أي تحذير من المترجم، ورأينا في المحاكاة أن نفس الخلل يعطي 4 أعطال بحمل أخف وانهياراً كاملاً بحمل أعلى قليلاً. - الدروس: اختبر مسار العودة، والتكرار بنفس الكود لا يحمي من خطأ الكود، وانشر بالتدريج، وجهز تخفيف الحمل والتراجع قبل أن تحتاجهما.
وإذا أردت أن تكمل من هنا، فهذه المقالات تشرح التوفر العالي والنشر والاختبارات، وبقية كوارث هذه المرحلة:
 دليلمفاهيم التوفر العالي High Availability للمبتدئينماذا يعني أن تبقى خدمتك تعمل رغم تعطل جزء منها، وكيف تحسب التوفر وتجد نقاط الفشل الواحدة وتقرر متى يستحق ذلك تكلفته.
 دليلطرق نشر التطبيقات من FTP إلى GitOps، وأين تقف أنتكيف تطور نشر التطبيقات عبر السنين، وما الذي يتعطل في كل طريقة، وكيف تعرف أين تقف وما خطوتك التالية.
 دليلأنواع الاختبارات للمبتدئين: من Unit إلى E2E مع Playwrightما الذي يكشفه كل نوع من الاختبارات وما الذي يفوته، وكم اختباراً تكتب من كل نوع، وأين يعمل كل منها في خط CI.
 دليلاستكشاف الأخطاء وتحليل الأداء للمبتدئين: من العرض إلى السببعندما يبطئ الموقع أو يعطي 502، هذه طريقة منظمة توصلك من العرض إلى السبب قبل أن تخمن أو تشتري سيرفراً أكبر.
 دليلMars Climate Orbiter: مسبار ضاع بسبب وحدة قياسكيف أضاع رقم بالرطل قرأه برنامج آخر بالنيوتن مسباراً كاملاً على المريخ، وكيف تمنع خطأ الوحدات في واجهات أنظمتك.
 دليلTherac-25: حين أصبح خطأ برمجي خطراً على المرضىكيف تسبب سباق بين مهمتين وعداد من بايت واحد في جرعات إشعاع زائدة، وماذا تتعلم منها عن الأنظمة الحرجة وكودك اليومي.
 دليلحريق OVHcloud في ستراسبورغ: نسخ احتياطية احترقت مع البياناتماذا حدث في حريق مركز بيانات OVHcloud سنة 2021، ولماذا فقد عملاء نسخهم الاحتياطية، وكيف تتأكد أن نسختك خارج الموقع فعلاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال اعتماداً على البيان التقني لـ AT&T وشرح Larry Seese في مجلة Telephony كما نشرا في RISKS Digest (الأعداد 9.61 و9.62 و9.63 و9.69 و9.70)، ونشرات AT&T لموظفيها في TELECOM Digest المجلد 10، مع تجربة عملية على gcc 14.2.0 وPython 3.13.16، ورسوم توضيحية من عملنا.



