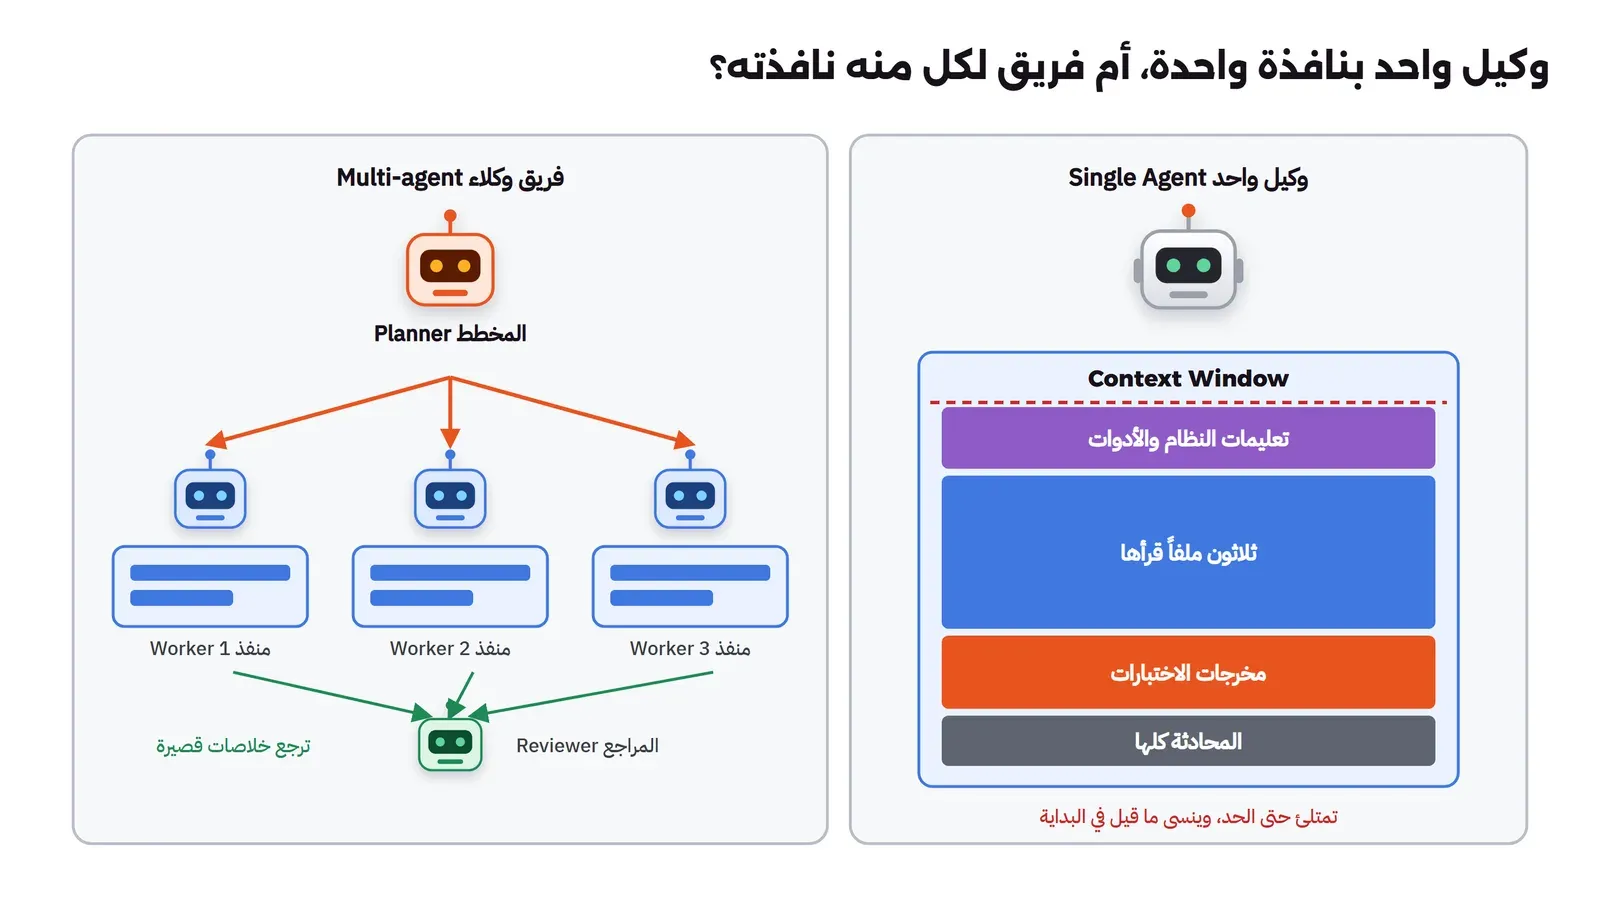
إذا كنت تعمل مع وكيل برمجة Coding Agent منذ مدة، فغالباً مررت بهذه اللحظة: أعطيته مهمة كبيرة، مثل نقل عشرين نقطة نهاية Endpoint من مكتبة قديمة إلى أخرى جديدة، فبدأ بشكل ممتاز، ثم بعد ساعة امتلأت نافذة السياق Context Window بالملفات التي قرأها ومخرجات الاختبارات التي شغلها، فبدأ ينسى ما اتفقتما عليه في البداية، وأصبح يصلح شيئاً ويفسد غيره، ولا يراجع عمله لأنه مقتنع أنه صحيح. والفكرة التي تخطر في البال مباشرة هي الفكرة نفسها التي نطبقها في فرق البشر: لماذا لا يخطط واحد، وينفذ آخرون كل منهم جزءاً صغيراً، ويراجع واحد مستقل في النهاية؟ وهذا بالضبط ما يسمى تعدد الوكلاء Multi-agent.
وفي مقال الوكيل الذكي AI Agent شرحنا الحلقة Loop التي يعمل بها وكيل واحد: النموذج Model يقرأ، ويستدعي أداة Tool، ويقرأ النتيجة، ويكرر. وفي مقال بيئة التشغيل Harness رأينا ما تبنيه الأداة حول هذه الحلقة، وفي مقال هندسة السياق Context Engineering ذكرنا أن عزل القراءة الكثيرة في وكيل فرعي Subagent أحد أربعة أشياء تفعلها بالسياق. وهذا المقال أول مقالات مرحلة تعدد الوكلاء في المسار، وهو يأخذ الفكرة من أولها: ماذا يعني أن يكون عندك أكثر من وكيل، وما هي الأدوار والأنماط، وما الذي يضيع بينهم، ثم نقيس على نموذج محلي صغير وكيلاً واحداً أمام فريق من مخطط ومنفذين ومراجع على المهمة نفسها، ونعد التوكنات والوقت والاختبارات التي نجحت.
سوف نناقش في هذا المقال:
- ما هو نظام تعدد الوكلاء Multi-agent System، وما الفرق بينه وبين وكيل واحد بأدوات كثيرة.
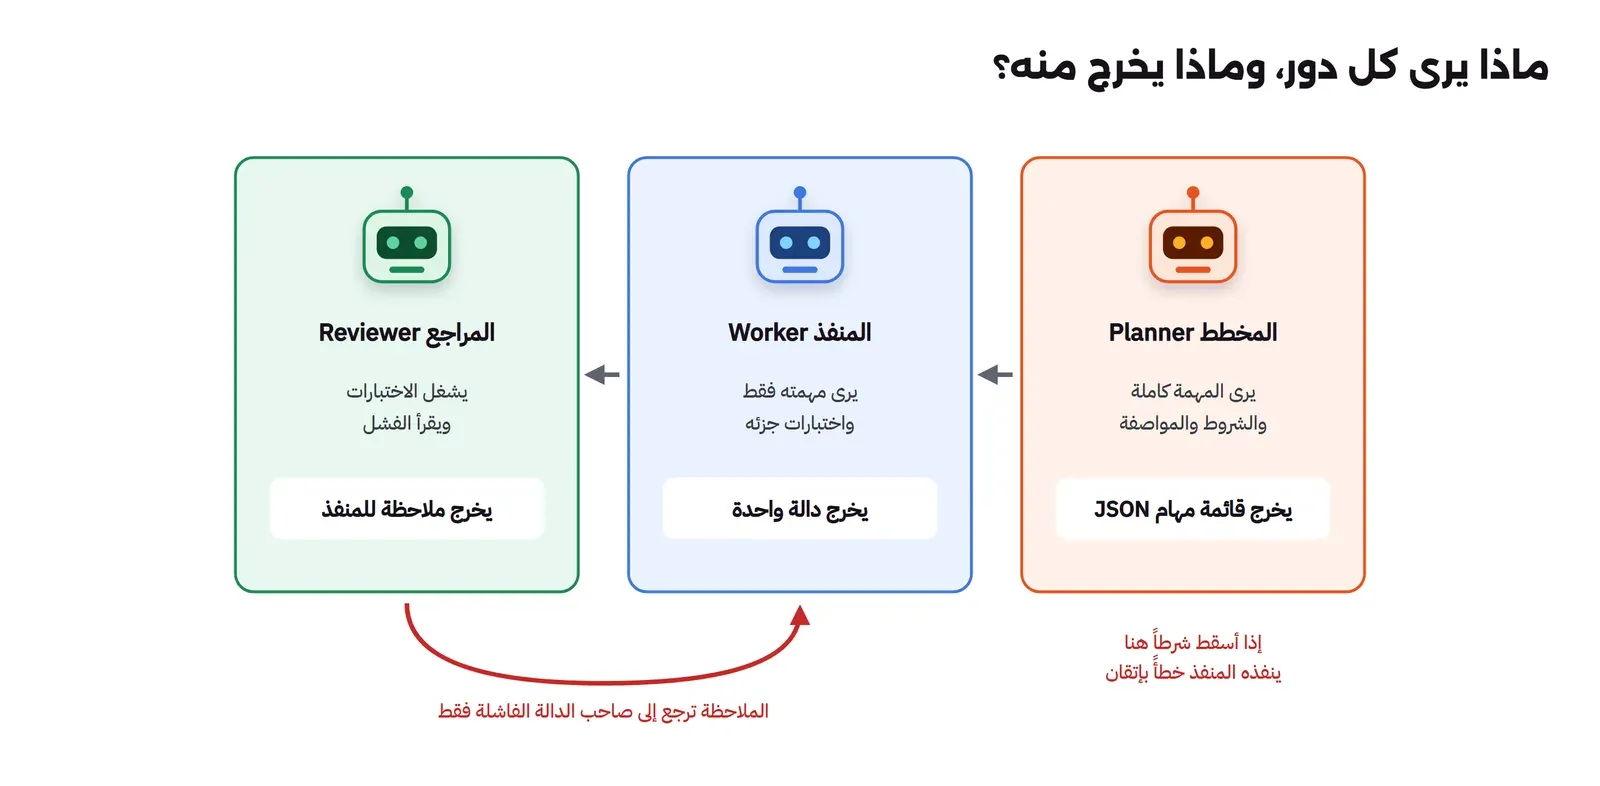
- الأدوار الثلاثة: المخطط Planner والمنفذ Worker والمراجع Reviewer، وما يراه كل منها.
- أنماط التنسيق Orchestration Patterns المعروفة، ومتى يناسب كل نمط.
- ما الذي يمر بين الوكلاء وما الذي يضيع، مع ما تقوله Anthropic وCognition والأبحاث المحكمة.
- مختبر حقيقي: وكيل واحد أمام مخطط وأربعة منفذين ومراجع، بالأرقام.
- جدول قرار متى تقسم المهمة ومتى تبقيها مع وكيل واحد، والأخطاء الشائعة، وقائمة تحقق.
ما هو نظام تعدد الوكلاء Multi-agent System؟
نظام تعدد الوكلاء هو نظام فيه أكثر من حلقة وكيل واحدة تعمل على المهمة نفسها، ولكل حلقة سياقها الخاص Context وتعليماتها Instructions وأدواتها، وبينها طريقة محددة لتبادل العمل: من يبدأ، ومن يسلم لمن، وما الذي يسلمه. ولاحظ أن «الوكيل» هنا لا يعني نموذجاً مختلفاً بالضرورة، ففي أغلب الأنظمة الحقيقية كل الوكلاء هم النموذج نفسه، والذي يختلف هو ثلاثة أشياء: التعليمات التي يبدأ بها، والسياق الذي يراه، والأدوات التي يسمح له باستدعائها. ولذلك فإن السؤال الحقيقي في هذا الموضوع ليس «كم نموذجاً عندي؟»، وإنما «كم نافذة سياق منفصلة عندي، ومن يقرر ما يدخل في كل نافذة؟».
وقد يتساءل البعض: ما الفرق إذن بين وكيل واحد يستدعي عشرين أداة، وبين مخطط يرسل العمل إلى عشرين وكيلاً؟ والإجابة أن الوكيل الواحد يرى كل نتائج أدواته في نافذة واحدة تكبر مع كل خطوة، فإذا قرأ عشرين ملفاً فكلها في نافذته، أما في تعدد الوكلاء فكل وكيل فرعي يقرأ ملفاته في نافذته هو، ثم يرجع بخلاصة قصيرة، فلا يرى المخطط إلا الخلاصات. وهذه هي الفائدة الكبرى، وهي نفسها مصدر المشكلة الكبرى: المخطط لا يرى ما رآه المنفذ، والمنفذ لا يرى ما قرره المخطط إلا بالقدر الذي كتب له في التعليمات.
والتشبيه الأقرب هو فريق تطوير صغير: قائد الفريق Tech Lead يقرأ المتطلبات ويقسمها إلى تذاكر Tickets، وكل مطور يأخذ تذكرة ويعمل عليها في فرعه دون أن يقرأ كل المستودع، ثم يراجع أحد الزملاء طلب الدمج Pull Request قبل أن يدخل. وهذا الفريق ينجح عندما تكون التذاكر مستقلة ومكتوبة بوضوح، ويفشل عندما تكون التذكرة غامضة، أو عندما يحتاج كل مطور أن يعرف ما يفعله الآخر في اللحظة نفسها، أو عندما يوافق المراجع على كل شيء دون أن يقرأ. والوكلاء يفشلون بالطريقة نفسها تقريباً، مع فرق مهم: المطور يسأل زميله في الممر إذا شك في شيء، أما الوكيل فلا يسأل إلا إذا بنيت له طريقة ليسأل.
لماذا لا يكفي وكيل واحد دائماً؟
وكيل واحد بالأدوات المناسبة يكفي لأغلب المهام اليومية، وهذه ليست مجاملة لفكرة البساطة، وإنما هي توصية من يبني هذه الأنظمة، فمقال Anthropic المعروف عن بناء الوكلاء الفعالة المنشور في 19 ديسمبر 2024 ينصح بأن تبحث عن أبسط حل ممكن، ولا تزيد التعقيد إلا عند الحاجة، لأن الأنظمة الوكيلية Agentic Systems تدفع زمن الاستجابة Latency والتكلفة Cost ثمناً لأداء أفضل. ولكن هناك ثلاثة أسباب حقيقية تجعل المهمة أكبر من وكيل واحد، وكل سبب منها يقود إلى نمط مختلف:
- حجم السياق Context Size: المهمة تحتاج قراءة أكثر مما تتسع له نافذة واحدة بجودة جيدة، مثل مراجعة خمسين ملفاً أو بحث في عشرين مصدراً. وحتى لو اتسعت النافذة فقد رأينا في مقال هندسة السياق أن النموذج يخطئ أكثر كلما امتلأت بما لا يحتاجه، وهذا ما يسمى تآكل السياق Context Rot. والحل هنا وكلاء فرعيون يقرأ كل منهم جزءاً ويرجع بخلاصة.
- التوازي Parallelism: المهمة تتكون من أجزاء مستقلة فعلاً، مثل ترجمة عشرة ملفات، أو كتابة اختبارات لعشر وحدات Modules لا تعتمد على بعضها، فتشغيلها معاً يختصر الوقت الكلي Wall Time، حتى لو لم يختصر التكلفة.
- التحقق المستقل Independent Verification: الوكيل الذي كتب الكود يميل إلى أن يقتنع بأنه صحيح، لأن سياقه مليء بأسبابه، أما وكيل آخر يقرأ الكود من جديد بنافذة نظيفة وتعليمات تطلب منه البحث عن الخطأ، فقد يرى ما لم يره الأول. وهذا هو منطق المراجع Reviewer، وهو المنطق نفسه خلف مراجعة الكود Code Review عند البشر.
وفي مقابل هذه الأسباب الثلاثة هناك ثمن ثابت لا يختفي: كل وكيل إضافي يعني استدعاءات أكثر للنموذج، وتعليمات تتكرر في كل نافذة، ونقطة تسليم Handoff جديدة يمكن أن تضيع فيها معلومة. ولذلك فإن السؤال ليس «هل تعدد الوكلاء أفضل؟»، وإنما «هل المهمة التي أمامي فيها أحد الأسباب الثلاثة بشكل يكفي لدفع هذا الثمن؟»، وسوف نرى الثمن بالأرقام في المختبر بعد قليل، ثم بالتفصيل في مقال تكلفة تعدد الوكلاء في هذه المرحلة.
وأدوات البرمجة نفسها أصبحت تقدم الأنماط الثلاثة جاهزة: Claude Code فيه وكلاء فرعيون Subagents بنوافذ منفصلة، وميزة تجريبية اسمها فرق الوكلاء Agent Teams فيها قائد وزملاء يتشاركون قائمة مهام، وCodex فيه وكلاء فرعيون بأدوار مثل explorer وworker، وCursor فيه وكلاء يعملون في السحابة على فروع منفصلة. وصفحة التكاليف في Claude Code تذكر أن فرق الوكلاء تستهلك قرابة سبعة أضعاف توكنات الجلسة العادية عندما يعمل الزملاء في وضع التخطيط، لأن كل زميل نافذة سياق كاملة. وهذه الأدوات هي موضوع المقال التالي، وهنا يكفي أن تعرف أن الزر موجود في أداتك، وأن الضغط عليه له ثمن.
الأدوار الثلاثة: المخطط والمنفذ والمراجع
أغلب أنظمة تعدد الوكلاء في البرمجة، مهما اختلفت أسماؤها، تتكون من ثلاثة أدوار، وقد تجتمع في وكيل واحد أو تتوزع على عشرة. وفهم ما يراه كل دور وما يخرج منه أهم من أسماء الأدوات، لأن أغلب الأخطاء تحدث عند الحدود بين الأدوار.
المخطط Planner أو المنسق Orchestrator
المخطط يقرأ المهمة كاملة، ويقسمها إلى مهام فرعية Subtasks، ويقرر من يأخذ كل مهمة، ثم يجمع النتائج. وهو الوحيد الذي يرى الصورة الكاملة، ولذلك فإن جودة النظام كله تبدأ من جودة التقسيم: إذا كانت المهمة الفرعية غامضة، أو ناقصة شرطاً مهماً، فإن المنفذ سوف ينفذها بإتقان على الشكل الخطأ. ومخرج المخطط في الأنظمة الجيدة ليس نصاً حراً، وإنما بنية واضحة مثل قائمة JSON فيها لكل مهمة: الهدف، والمدخلات، والشروط، وشكل النتيجة المطلوبة، ومتى تعتبر المهمة منتهية.
ولاحظ أن المخطط لا يجب أن يكون نموذجاً لغوياً دائماً، ففي أنظمة كثيرة يكون التقسيم ثابتاً ومكتوباً في الكود، مثل «لكل ملف في هذا المجلد شغل منفذاً»، وهذا أرخص وأوضح وأسهل في التتبع، ولا تحتاج نموذجاً ليقرر شيئاً تعرفه مسبقاً. ويسمي مقال Anthropic عن بناء الوكلاء هذا الفرق بين سير العمل Workflow، حيث يحدد الكود الخطوات، والوكيل Agent، حيث يحدد النموذج الخطوات بنفسه.
المنفذ Worker
المنفذ يأخذ مهمة فرعية واحدة، ويعمل عليها في نافذته الخاصة بأدواته الخاصة، ثم يرجع بنتيجة. وأهم شيء في المنفذ هو ما يراه وما لا يراه: يرى تعليمات مهمته، والملفات التي يحتاجها، وربما اختبارات جزئه فقط، ولا يرى بقية المحادثة ولا أسباب المخطط. وهذا العزل هو ما يجعل المنفذ سريعاً ورخيصاً ومركزاً، وهو أيضاً ما يجعله يتخذ قرارات صغيرة لا يعرف أنها تتعارض مع قرارات منفذ آخر، مثل أن يختار أحدهما اسم دالة بصيغة snake_case والآخر بصيغة camelCase، أو أن يرجع أحدهما المبلغ بالريال والآخر بالهللة.
المراجع Reviewer
المراجع يقرأ النتيجة بعد التجميع، ويقرر هل هي مقبولة، وإذا لم تكن فما الخطأ ومن يصلحه. وفي البرمجة أفضل مراجع ليس نموذجاً لغوياً وإنما الاختبارات Tests، لأنها لا تجامل ولا تتعب، ولذلك فإن المراجع الجيد يشغل الاختبارات أولاً، ثم يستعمل النموذج ليشرح الفشل للمنفذ المسؤول عنه بلغة يفهمها. ومقال Anthropic يسمي هذا النمط المقيم والمحسن Evaluator-optimizer: نموذج يولد، ونموذج آخر يقيم ويرسل ملاحظات في حلقة، وينصح به عندما تكون معايير التقييم واضحة. وأخطر ما في المراجع أن يكون مراجعاً بالاسم فقط، أي نموذجاً يقرأ الكود ويقول «يبدو جيداً» دون أن يشغل شيئاً، وهذا يعطيك ثقة لا تستحقها، وسوف نعود إليه في الأخطاء الشائعة.
أنماط التنسيق Orchestration Patterns
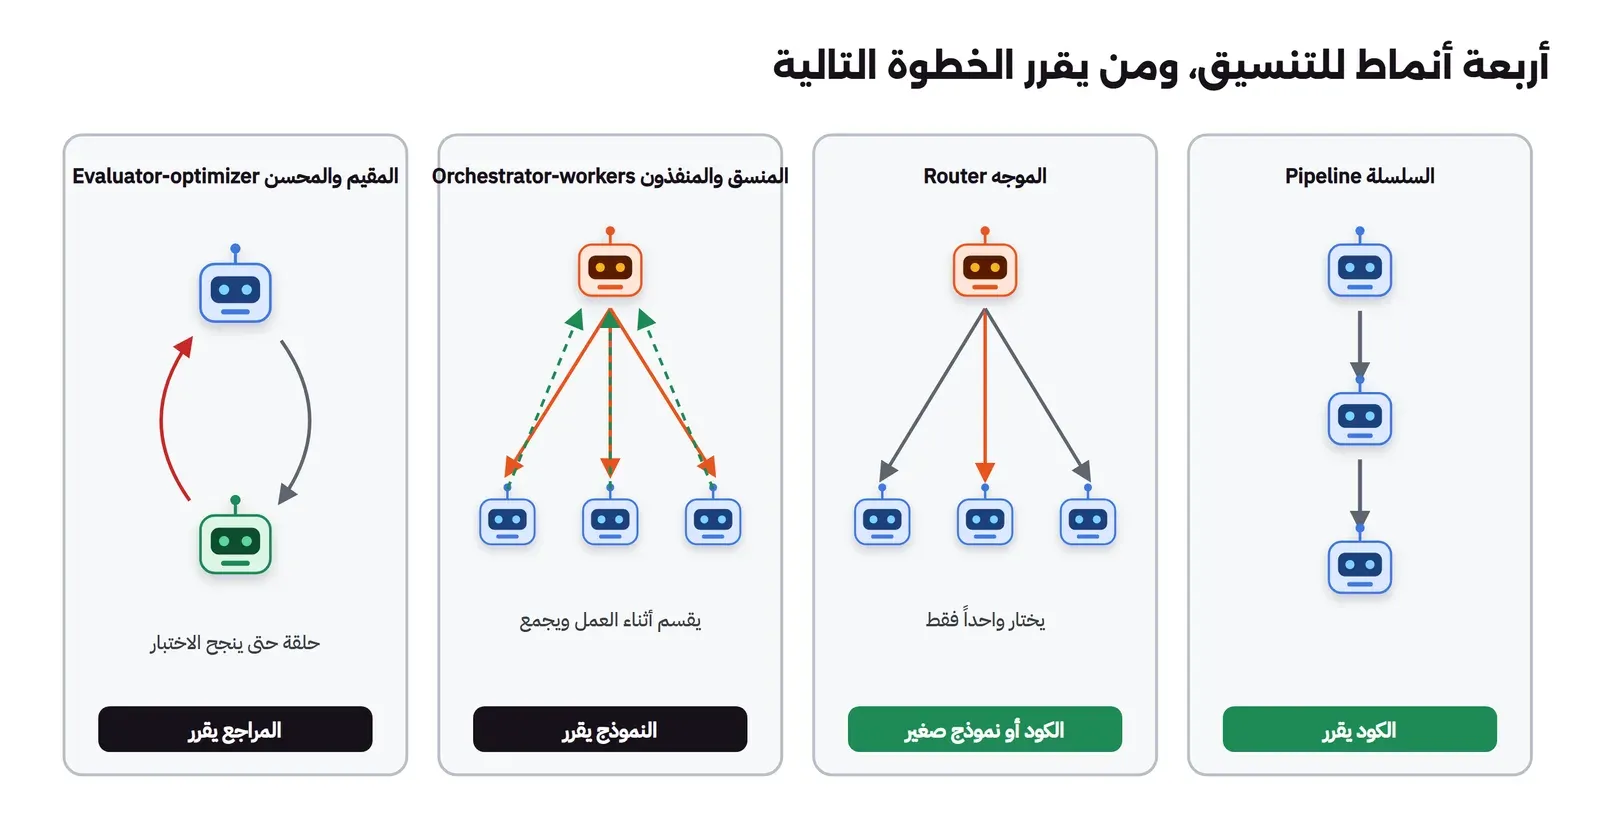
الأدوار الثلاثة تجتمع بأشكال مختلفة، ولكل شكل اسم في التوثيق والأبحاث، والجدول التالي يجمع أشهرها مع مثال من عمل المطور اليومي. والأسماء مأخوذة من مقال Anthropic عن بناء الوكلاء ومن توثيق تعدد الوكلاء في LangChain، وسوف نرى كيف يطبقها كل إطار في مقال أطر تنسيق الوكلاء:
| النمط | كيف يعمل | مثال من البرمجة | من يقرر الخطوة التالية |
|---|---|---|---|
| السلسلة Prompt Chaining أو Pipeline | خطوات ثابتة، مخرج كل خطوة مدخل التي بعدها | اكتب المواصفة، ثم الكود، ثم الاختبارات | الكود |
| الموجه Router | خطوة تصنف الطلب وترسله إلى وكيل متخصص واحد | تذكرة واجهة تذهب لوكيل الواجهة، وتذكرة قاعدة بيانات لوكيل آخر | الكود أو نموذج صغير |
| التوازي Parallelization: التقسيم Sectioning | أجزاء مستقلة تعمل معاً ثم تجمع | مراجعة عشرة ملفات، كل ملف في وكيل | الكود |
| التوازي: التصويت Voting | المهمة نفسها عدة مرات ثم يؤخذ رأي الأغلبية | ثلاث مراجعات أمنية للتغيير نفسه | الكود |
| المنسق والمنفذون Orchestrator-workers | نموذج يقسم المهمة بنفسه أثناء العمل ويوزعها ويجمع | ميزة Feature تلمس ملفات لا تعرفها مسبقاً | النموذج |
| المقيم والمحسن Evaluator-optimizer | منفذ ومراجع في حلقة حتى يرضى المراجع | اكتب الدالة حتى تنجح الاختبارات | المراجع |
| التسليم Handoff | وكيل ينقل المحادثة كلها إلى وكيل آخر يصبح هو المسؤول | وكيل الفرز يسلم المستخدم لوكيل الفواتير | الوكيل الحالي |
| المحادثة الجماعية Group Chat | عدة وكلاء في محادثة واحدة، ومدير يختار من يتكلم | مقترح وناقد وحكم على قرار تصميم | المدير، غالباً نموذج |
في الجدول أعلاه لاحظ التالي:
- العمود الأخير هو الأهم: كلما انتقل القرار من الكود إلى النموذج زادت المرونة، وزادت معها التكلفة وصعوبة التتبع واحتمال أن يتخذ النظام طريقاً لم تتوقعه. ولذلك ابدأ بالأنماط التي يقرر فيها الكود، ولا تعط النموذج قرار التوزيع إلا عندما لا تعرف التقسيم مسبقاً.
- التصويت والتقسيم كلاهما من أنواع التوازي، ولكن الأول يكرر المهمة نفسها ليرفع الثقة، والثاني يقسم المهمة ليختصر الوقت والسياق، وخلطهما في الكلام يسبب قرارات خاطئة في التكلفة.
- المحادثة الجماعية أكثر الأنماط شهرة في العروض التوضيحية Demos، وأقلها استعمالاً في أدوات البرمجة الحقيقية، لأن كل وكيل فيها يقرأ المحادثة كلها في كل دورة، فتكبر التكلفة بسرعة، وقد خصصنا لها مقال فريق الوكلاء الذي يتناقش.
ما الذي يمر بين الوكلاء، وما الذي يضيع؟
أي نقطة بين وكيلين هي نقطة تسليم، والتسليم يعني أن نافذة سياق كاملة، فيها كل ما قرأه الوكيل وفكر فيه، تتحول إلى نص قصير يدخل في نافذة وكيل آخر. وهذا يشبه لعبة الهاتف المعطوب عند الأطفال: كل مرحلة تختصر ما سمعته، وفي آخر الصف تسمع جملة لا تشبه الأولى. والفرق أن الاختصار هنا مقصود، لأن هدفنا أصلاً ألا تمتلئ نافذة المخطط، ولكن ما الذي يجب ألا يضيع؟
- الشروط Constraints: إذا قال المستخدم «بدون مكتبات خارجية» أو «المبالغ بالهللة»، فإن هذه الجملة يجب أن تصل إلى كل منفذ، والمخطط الذي يختصر المهمة الفرعية إلى «اكتب دالة السعر» أسقطها دون أن يقصد.
- القرارات المشتركة Shared Decisions: أسماء الدوال، وشكل البيانات بين الأجزاء، ونوع الأخطاء التي ترفعها الدالة. وأفضل مكان لها ليس رسالة المخطط وإنما ملف ثابت يقرؤه الجميع، مثل الواجهة Interface أو ملف المواصفة Spec، وهذا ما شرحناه في مقال التطوير من المواصفة.
- معنى «انتهيت» Definition of Done: المنفذ الذي لا يعرف متى تنتهي مهمته سوف يقرر بنفسه، وغالباً يقرر مبكراً. واكتبها كأمر يمكن تشغيله: «تنتهي عندما ينجح
python -m unittest tests.test_paging». - الدليل Evidence: المنفذ الذي يقول «أصلحت الخطأ» يجب أن يرجع معه بما يثبت ذلك، مثل مخرج الاختبار، لأن المخطط لا يملك طريقة أخرى ليعرف.
وفي يونيو 2025 نشر Walden Yan من شركة Cognition، صانعة الوكيل Devin، مقالاً بعنوان لا تبنوا أنظمة تعدد الوكلاء Don't Build Multi-Agents، وفيه مبدآن يلخصان هذا القسم: الأول أن تشارك السياق، وأن تشارك سجل الوكيل الكامل Trace وليس رسالة واحدة منه، والثاني أن الأفعال تحمل قرارات ضمنية Implicit Decisions، والقرارات المتعارضة تنتج نتائج سيئة. والمثال الذي ذكره معروف: طلب لعبة Flappy Bird قسمت إلى وكيلين، فرسم الأول خلفية بأسلوب لعبة Super Mario، ورسم الثاني طائراً لا يشبه طائر اللعبة ولا يتحرك مثله، وكل منهما نفذ مهمته «بشكل صحيح»، ولكن النتيجة لا تعمل معاً لأن أحداً منهما لم ير عمل الآخر. ونصيحة المقال أن أبسط طريقة لتطبيق المبدأين وكيل واحد يعمل بخط واحد Single-threaded، مع نموذج يضغط السجل عندما تطول المهمة.
ولاحظ أن المقالين لا يتناقضان كما يبدو من عنوانيهما: Anthropic بنت تعدد الوكلاء لمهمة بحث، حيث يقرأ كل وكيل مصادر مستقلة ويرجع بخلاصة، ولا يحتاج أن يرى ما يقرؤه غيره، وCognition تحذر منه في البرمجة، حيث كل سطر يكتبه وكيل هو قرار يؤثر على ما يكتبه الآخر. والقاعدة التي تخرج بها من الاثنين: قسم القراءة بسهولة، وقسم الكتابة بحذر شديد.
ماذا تقول الأبحاث عن فشل أنظمة تعدد الوكلاء؟
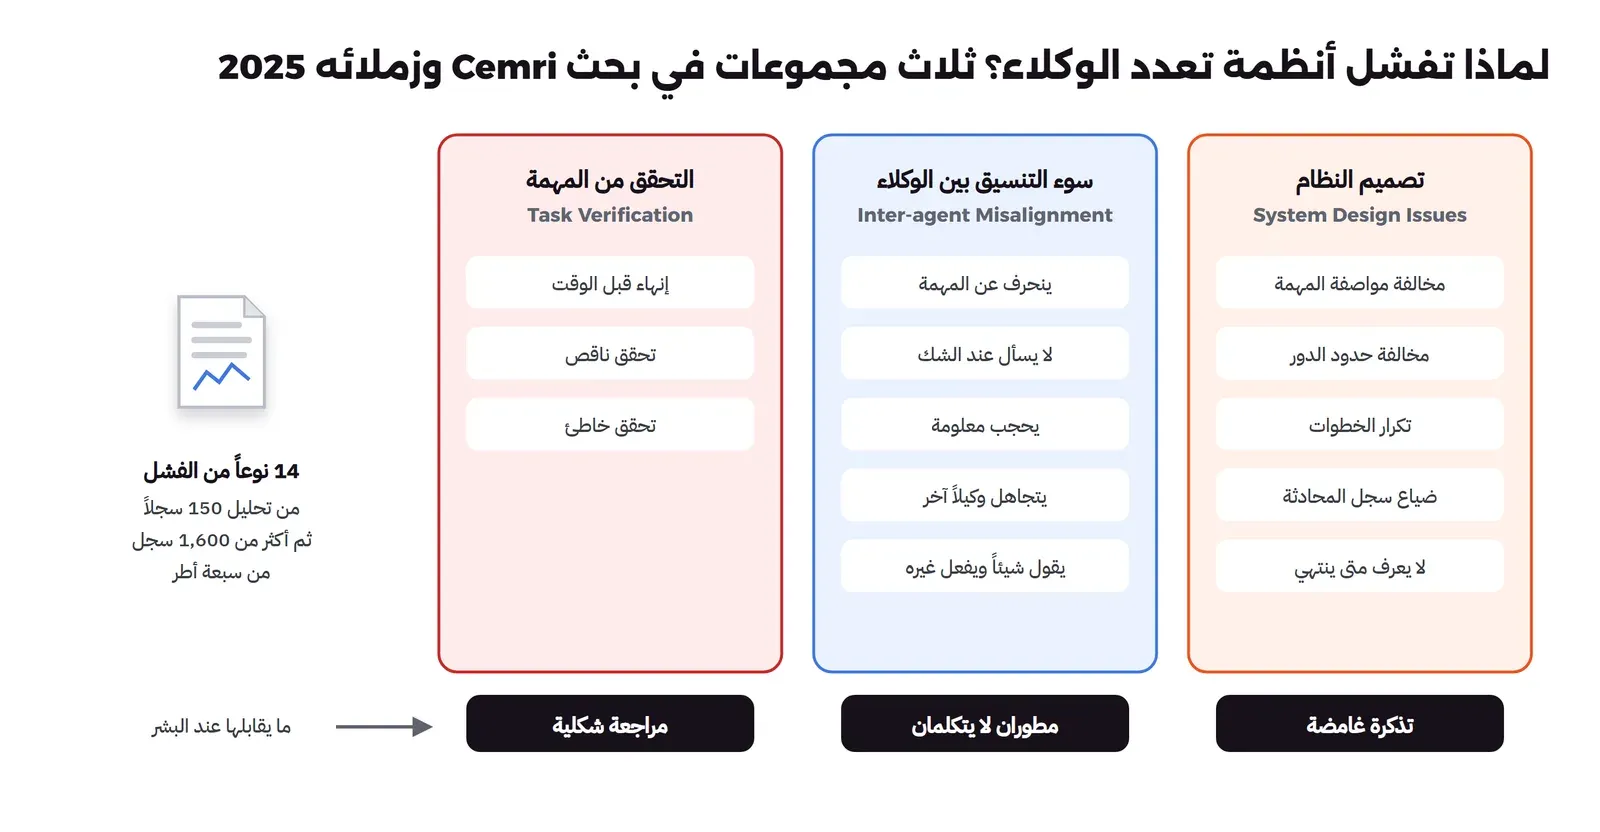
أكبر دراسة منشورة عن هذا السؤال هي بحث Cemri وزملائه من جامعة كاليفورنيا في بيركلي، بعنوان لماذا تفشل أنظمة تعدد الوكلاء؟ Why Do Multi-Agent LLM Systems Fail، المنشور أول مرة في مارس 2025. ويبدأ البحث بملاحظة مهمة: رغم الحماس لهذه الأنظمة فإن تحسنها على الاختبارات المعروفة Benchmarks مقارنة بوكيل واحد صغير في الغالب. ثم حلل الباحثون 150 سجلاً Trace بأيدي خبراء، وبنوا منها تصنيفاً من 14 نوعاً من الفشل في ثلاث مجموعات، ثم وسعوا البيانات إلى أكثر من 1,600 سجل من سبعة أطر معروفة. والمجموعات الثلاث هي:
- مشاكل تصميم النظام System Design Issues: مثل أن يخالف وكيل مواصفة المهمة أو حدود دوره، أو أن يكرر خطوات، أو أن يضيع سجل المحادثة، أو ألا يعرف متى تنتهي المهمة.
- سوء التنسيق بين الوكلاء Inter-agent Misalignment: مثل أن يكمل وكيل على افتراض خاطئ بدل أن يسأل، أو أن يحجب معلومة يحتاجها غيره، أو أن يتجاهل مدخلات وكيل آخر، أو أن يقول شيئاً ويفعل غيره.
- التحقق من المهمة Task Verification: أن تنتهي المهمة قبل وقتها، أو أن يكون التحقق ناقصاً أو خاطئاً، وهذا بالضبط ما يحدث عندما يكون المراجع مراجعاً بالاسم.
وفي ديسمبر 2025 نشر Kim وزملاؤه من Google بحثاً بعنوان نحو علم لتوسيع أنظمة الوكلاء Towards a Science of Scaling Agent Systems، قارنوا فيه 260 إعداداً على ستة اختبارات بخمس هندسات: وكيل واحد، وأربعة أشكال من تعدد الوكلاء، مع توحيد الأدوات والتعليمات والحوسبة Compute. والنتيجة التي تهمنا أن الفرق مقارنة بالوكيل الواحد تراوح بين تحسن بنسبة 80.8% في مهمة تحليل مالي يمكن تقسيمها، وتراجع بنسبة 70% في مهمة تخطيط متسلسلة، وأن الفائدة تقل عندما يكون الوكيل الواحد جيداً أصلاً، وأن المهام الكثيرة الأدوات تدفع ثمناً إضافياً للتنسيق، وأن الهندسات التي ليس فيها تحقق مركزي تنشر الأخطاء أكثر من التي فيها منسق يتحقق. وبعبارة أخرى: نوع المهمة يقرر النتيجة أكثر من عدد الوكلاء.
المختبر: وكيل واحد أمام مخطط ومنفذين ومراجع
لكي لا يبقى الكلام في الأبحاث والمقالات، بنينا تجربة صغيرة نستطيع أن نعد فيها كل شيء. والمهمة ملف Python واحد اسمه textkit.py فيه أربع دوال صغيرة، ولها مواصفة مكتوبة في task/SPEC.md، واختبارات حقيقية في task/test_textkit.py عددها عشرة:
slugify: تحول العنوان إلى نص صغير بشرطات، مثل"Hello, World!"إلىhello-world.parse_duration: تحول"1h30m"إلى 5400 ثانية، وترفعValueErrorلمدخلات مثل"5x"أو"1m1h".chunk: تقسم قائمة إلى أجزاء بحجم محدد، وترفعValueErrorإذا كان الحجم صفراً.word_freq: ترجع الكلمات الأكثر تكراراً، وعند التساوي ترتبها أبجدياً.
والدوال مستقلة عن بعضها تماماً، وهذا مقصود، لأنه أفضل حال لتعدد الوكلاء: لا يحتاج أي منفذ أن يعرف ما يكتبه الآخر. فإذا لم يربح الفريق هنا، فلن يربح في مهمة أجزاؤها مترابطة. والسكربت compare.py يشغل الطريقتين على النموذج نفسه:
- الوكيل الواحد
single: يرى المواصفة كاملة والاختبارات كاملة في رسالة واحدة، ويطلب منه الملف كاملاً. ثم يشغل الكود الاختبارات، وإذا فشل شيء أرسل له الفشل وطلب الملف مصححاً، حتى ثلاث محاولات. - الفريق
multi: المخطط يقسم المواصفة إلى مهمة لكل دالة بصيغة JSON، ثم أربعة منفذين يرى كل منهم تعليمات دالته واختبارات دالته فقط، ويعمل اثنان منهم معاً في كل مرة، ثم يجمع الكود الدوال في ملف ويشغل الاختبارات، ولكل دالة فشلت يكتب المراجع ملاحظة من ثلاثة أسطر، ويرجعها إلى منفذ تلك الدالة فقط، حتى جولتين.
والنموذج في كل الاستدعاءات qwen2.5:3b على Ollama بالإصدار 0.40.13 في Docker على المعالج فقط، وكل استدعاء يسجل في calls.jsonl بعدد توكنات المدخل prompt_eval_count والمخرج eval_count كما يرجعها Ollama، والزمن. وتشغيل التجربة كاملة بأمر واحد من مجلد المختبر:
docker network create adm-net
docker run -d --name adm-ollama --network adm-net -v adm-ollama:/root/.ollama \
  -e OLLAMA_NUM_PARALLEL=2 -e OLLAMA_CONTEXT_LENGTH=8192 ollama/ollama:0.40.13
docker exec adm-ollama ollama pull qwen2.5:3b
docker run --rm --network adm-net -v "$PWD:/lab" -w /lab python:3.13.18-slim sh run.sh
والزمن في هذه التجربة من نموذج صغير على المعالج دون بطاقة رسومية، فهو أكبر بكثير مما تراه عند مزود سحابي، والذي يهم فيه المقارنة بين الطريقتين، أما عدد الاستدعاءات والتوكنات فهو ما سوف تدفع ثمنه عند أي مزود.
الوكيل الواحد: ثلاث محاولات ولا اختبار ينجح
بدأنا بالوكيل الواحد بالبذرة Seed رقم 1، والمخرج سوف يكون كما يلي:
== single seed 1
  attempt 1: 0/11 tests pass
  attempt 2: 0/1 tests pass
  attempt 3: 0/1 tests pass
RESULT single-1: 0/1 tests, 3 model calls, prompt 4965 + output 1985 tokens, 1780 s wall
في المخرج أعلاه لاحظ التالي:
- العدد بعد الشرطة المائلة هو ما قرأه السكربت من سطر
Ran N tests، وعندما يكون 1 فهذا يعني أن ملف الاختبار لم يستطع حتى أن يستوردtextkit، فيحسبunittestالخطأ كاختبار واحد فاشل. والرقم 11 في المحاولة الأولى قيمة احتياطية في السكربت عندما لا يوجد سطرRanأصلاً، فلا تقرأه كعدد اختبارات. - كل محاولة أعادت إرسال المحادثة كلها مع الفشل، فكبر المدخل من 711 توكناً إلى 1,676 ثم 2,578، وهذا ما يحدث في أي وكيل يصحح نفسه في النافذة نفسها.
- كل محاولة أخرجت أكثر من 600 توكن، والمطلوب ملف بأربع دوال لا يحتاج نصف ذلك.
ولكي نفهم لماذا، فتحنا الملف الذي كتبه في المحاولة الأخيرة out/single-1.py، وأوله كما يلي:
import unittest
from textkit import parse_duration, chunk, word_freq
import re
from collections import Counter

def parse_duration(s):
    units = ('h', 'm', 's')
    ...
class TestSlugify(unittest.TestCase):
    def test_basic(self):
        self.assertEqual(slugify("Hello, World!"), "hello-world")
النموذج خلط بين ما طلب منه وما أعطي له للقراءة: نسخ الاختبارات كلها داخل الملف، وكتب في أوله سطراً يستورد الملف من نفسه from textkit import ...، ونسي الدالة slugify تماماً، فلا يمكن أن يعمل أي اختبار. وعندما أرسلنا له الفشل في المحاولتين التاليتين أعاد الخطأ نفسه بأشكال مختلفة. وهذا بالضبط ما تحدثنا عنه في مقال هندسة السياق: نموذج صغير أمامه مواصفة واختبارات وطلب في نافذة واحدة، فلم يعرف أين ينتهي المطلوب وأين يبدأ المرجع.
الفريق: المخطط يقسم، والمنفذون يكتبون، والمراجع يرجع الفشل
ثم شغلنا الفريق بالبذرة نفسها، والمخرج سوف يكون كما يلي:
== multi seed 1
  planner: 4 subtasks ['chunk', 'parse_duration', 'slugify', 'word_freq']; missing []
  review round 1: 7/10 tests pass, failing [('test_invalid', 'TestParseDuration'), ('test_ties', 'TestWordFreq'), ('test_values', 'TestParseDuration')]
  review round 2: 8/10 tests pass, failing [('test_invalid', 'TestParseDuration'), ('test_ties', 'TestWordFreq')]
RESULT multi-1: 8/10 tests, 13 model calls, prompt 4300 + output 2519 tokens, 2284 s wall
في المخرج أعلاه لاحظ التالي:
- المخطط أرجع JSON صالحاً بأربع مهام، واحدة لكل دالة، فلم يحتج الكود إلى الخطة الاحتياطية.
- بعد أن كتب المنفذون الأربعة نجح 7 من 10 اختبارات، أي أن
slugifyوchunkصحيحتان من أول مرة، وهذا أفضل بكثير من الوكيل الواحد الذي لم يعمل عنده شيء. - جولة المراجعة الأولى أصلحت اختباراً واحداً، هو
test_values، والثانية لم تصلح شيئاً، فانتهى الفريق عند 8 من 10. - الفريق استعمل 13 استدعاءً بدل 3، وأخرج توكنات أكثر، 2,519 مقابل 1,985، ولكن مجموع المدخلات كان أقل قليلاً، 4,300 مقابل 4,965، لأن كل نافذة كانت صغيرة: أكبر مدخل في الفريق كان 513 توكناً، وأصغره 171.
- الوقت الكلي كان أطول، 2,284 ثانية مقابل 1,780، رغم أن منفذين كانا يعملان معاً، لأن الطلبين يتقاسمان المعالج نفسه، ولأن المخطط والمراجع وجولات الإصلاح خطوات متتالية.
والسؤال المهم: لماذا بقي الاختباران test_invalid وtest_ties فاشلين بعد جولتين؟ والإجابة في أول ملف كتبه المخطط، فهذا ما أرسله لمنفذ parse_duration ومنفذ word_freq:
{"function": "parse_duration(s) -> int",
 "instructions": "Convert a string describing a duration into the number of seconds. Valid units are h, m, s. For example, parse_duration(\"1h30m\") should return 5400."},
{"function": "word_freq(text, top=3) -> list[tuple[str, int]]",
 "instructions": "Count the frequency of each word in a text, then return the top `top` most frequent word counts. Words are lowercase and consist of runs of letters a-z. For example, word_freq(\"Hello, World!\", top=1) should return [('hello', 1)]."}
قارن هذا بالمواصفة الأصلية: في parse_duration سقط شرط «الوحدات بهذا الترتيب، كل منها مرة واحدة على الأكثر، والنص الفارغ أو أي شيء آخر يرفع ValueError»، وفي word_freq سقط شرط «عند تساوي العدد ترتب الكلمات أبجدياً». والاختباران الفاشلان هما بالضبط هذان الشرطان. فالمخطط اختصر المهمة كما يفعل أي ملخص، وأسقط الجملة التي تهم، والمنفذ نفذ ما وصله بإتقان: دالة تحسب المدة بشكل صحيح ولا ترفع أي خطأ، ودالة ترتب بالتكرار فقط. والأسوأ أن المنفذ كان يرى الاختبارات نفسها، وفيها assertRaises(ValueError)، ومع ذلك تبع التعليمات المختصرة.
ثم جاءت ملاحظات المراجع، وهذه أول ملاحظتين كما كتبهما:
The test_invalid test cases are failing because the regex `re.findall(r'\d+([hms])', duration_str)` incorrectly groups the number and unit, leading to a sorted list comparison failure.
Bug: The order of elements in the list returned by `word_counts.most_common(top)` is not guaranteed to be consistent between calls, leading to a failure in the test.
والملاحظتان خاطئتان في السبب: الأولى تتحدث عن تجميع في التعبير النمطي Regex ومقارنة قوائم مرتبة، والمشكلة الحقيقية أن الدالة لا ترفع ValueError، والثانية تقول إن الترتيب غير ثابت، والمشكلة الحقيقية أنه لا يوجد ترتيب أبجدي عند التساوي. فالمراجع رأى الفشل الصحيح، لأن الاختبارات هي التي اكتشفته، ولكنه شرحه بشكل خاطئ، فأرسل المنفذ في الاتجاه الخطأ. وهذا ما يسميه بحث Cemri وزملائه التحقق الخاطئ Incorrect Verification، وهو أيضاً سبب أن الاختبارات كانت أفضل جزء في المراجع.
التشغيل الثاني: النتيجة تتغير مع البذرة
تشغيل واحد لا يكفي لحكم، فأعدنا الطريقتين بالبذرة رقم 2، والمخرج سوف يكون كما يلي:
== single seed 2
  attempt 1: 5/10 tests pass
  attempt 2: 5/10 tests pass
  attempt 3: 5/10 tests pass
RESULT single-2: 5/10 tests, 3 model calls, prompt 5120 + output 2198 tokens, 1587 s wall
== multi seed 2
  planner: 4 subtasks ['chunk', 'parse_duration', 'slugify', 'word_freq']; missing []
  review round 1: 5/10 tests pass, failing [('test_basic', 'TestSlugify'), ('test_digits', 'TestSlugify'), ('test_invalid', 'TestParseDuration'), ('test_runs', 'TestSlugify'), ('test_ties', 'TestWordFreq')]
  review round 2: 5/10 tests pass, failing [('test_basic', 'TestSlugify'), ('test_digits', 'TestSlugify'), ('test_invalid', 'TestParseDuration'), ('test_runs', 'TestSlugify'), ('test_ties', 'TestWordFreq')]
RESULT multi-2: 5/10 tests, 17 model calls, prompt 7723 + output 3486 tokens, 868 s wall
في المخرج أعلاه لاحظ التالي:
- الوكيل الواحد هذه المرة كتب ملفاً يعمل، ونجح 5 من 10، ثم أرسلنا له الفشل مرتين فأرجع الملف نفسه تقريباً، ولم يتحسن شيء.
- الفريق وصل إلى النتيجة نفسها، 5 من 10، ولكن بسبعة عشر استدعاءً، و7,723 توكن مدخل بدل 5,120، و3,486 توكن مخرج بدل 2,198.
- جولتا المراجعة لم تصلحا أي اختبار، وفي ملفات المراجع التي حفظناها في
raw/أن أول ملاحظة علىslugifyكانت «الدالة غير معرفة في الكود المعطى»، وهي معرفة، ثم أعاد المنفذ كتابتها بتعبير نمطي أسوأ من الأول، ونسخ إلى تعليقات الكود عبارة المراجع «premature stripping of dashes» كما هي. - الوقت الكلي للفريق هنا أقل من الوكيل الواحد، 868 ثانية مقابل 1,587، والسبب أن المعالج كان أقل انشغالاً عندما عمل الفريق، فلا تقرأ مقارنة الزمن بين التشغيلات المختلفة كقاعدة.
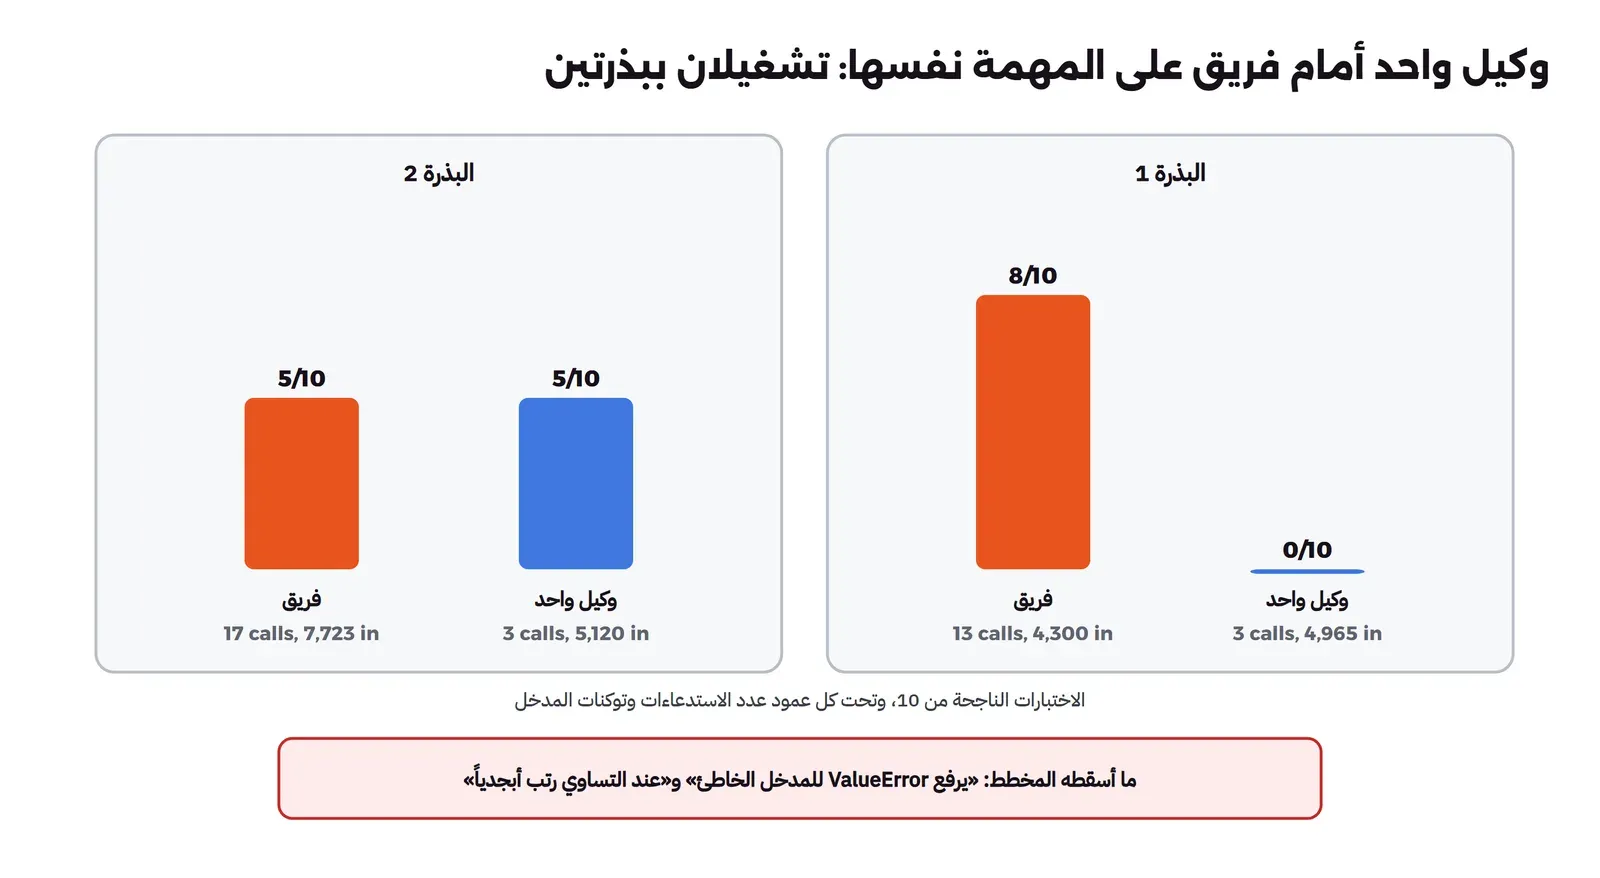
والجدول التالي يجمع التشغيلات الأربعة:
| التشغيل | الاختبارات الناجحة | الاستدعاءات | توكنات المدخل | توكنات المخرج | الزمن الكلي |
|---|---|---|---|---|---|
| وكيل واحد، بذرة 1 | 0 من 10 | 3 | 4,965 | 1,985 | 1,780 ث |
| فريق، بذرة 1 | 8 من 10 | 13 | 4,300 | 2,519 | 2,284 ث |
| وكيل واحد، بذرة 2 | 5 من 10 | 3 | 5,120 | 2,198 | 1,587 ث |
| فريق، بذرة 2 | 5 من 10 | 17 | 7,723 | 3,486 | 868 ث |
والخلاصة من الجدول ليست أن الفريق أفضل أو أسوأ، فالنتيجة تغيرت مع البذرة في الطريقتين، وإنما ثلاثة أشياء ثابتة في التشغيلين: الفريق يحتاج أربعة إلى ستة أضعاف الاستدعاءات، ونوافذه أصغر بكثير، ولم يصل في أي تشغيل إلى 10 من 10، لأن الشروط التي أسقطها المخطط لم ترجع، والمراجع النموذج لم يعرف كيف يشرح الفشل. والجزء الذي نجح في المراجعة كل مرة هو الجزء غير الذكي: الاختبارات التي شغلها الكود.
شكل المهمة الفرعية الجيدة: عقد بين المخطط والمنفذ
ما حدث في المختبر يقودنا إلى السؤال العملي: كيف تكتب المهمة الفرعية بحيث لا يضيع منها شيء؟ والإجابة أن تعاملها كعقد Contract بين طرفين لا يتكلمان إلا عبره، وليس كرسالة ودية. فالمخطط في تجربتنا كتب لكل منفذ جملة أو جملتين بأسلوب الملخص، والملخص بطبيعته يحذف التفاصيل، والتفاصيل هنا هي الشروط. والمثال التالي مهمة فرعية بالشكل الذي ننصح به لدالة parse_duration:
{
  "id": "T2",
  "goal": "Implement parse_duration(s) -> int in textkit.py",
  "spec": "Copied word for word from SPEC.md section 2",
  "constraints": [
    "Units h, m, s in this order, each at most once",
    "Empty string or anything else raises ValueError",
    "Standard library only"
  ],
  "files": {"write": ["textkit.py (only this function)"], "read": ["SPEC.md"]},
  "done_when": "python -m unittest test_textkit.TestParseDuration passes",
  "return": {"status": "done | blocked", "evidence": "last lines of the test output", "questions": []}
}
في المهمة أعلاه لاحظ التالي:
- الحقل
specنسخة حرفية من الجزء الخاص بالدالة في المواصفة، وليس صياغة جديدة له، لأن كل إعادة صياغة فرصة لإسقاط جملة، والكود الذي يقطع المواصفة إلى أجزاء أرخص وأدق من نموذج يلخصها. - الحقل
constraintsيكرر الشروط الحرجة في قائمة منفصلة، حتى لو كانت موجودة في المواصفة، لأن الشرط المكتوب في قائمة يصعب أن يتجاهله النموذج أكثر من الشرط المدفون في فقرة. - الحقل
filesيقول ما يكتبه المنفذ وما يقرؤه فقط، وهذا ما يمنع منفذين من الكتابة في الملف نفسه، وسوف نرى أهميته في مقال الوكلاء الفرعيين والعمل بالتوازي. - الحقل
done_whenأمر يمكن تشغيله، وليس وصفاً مثل «عندما تعمل الدالة»، والحقلreturnيطلب الدليل مع النتيجة، ويعطي المنفذ طريقة رسمية ليقول «لا أستطيع» أو ليسأل، بدل أن يخترع جواباً.
وقد يتساءل البعض: إذا كان المخطط سوف ينسخ المواصفة حرفياً، فما فائدته أصلاً؟ والإجابة أن فائدته في القرار وليس في النسخ: أي أجزاء مستقلة، وأيها يعتمد على غيره فيجب أن ينتظر، وأيها يكتب في أي ملف، ومن يراجع ماذا. وهذه قرارات يحتاجها النظام فعلاً، أما نسخ النص وقصه فعمل يقوم به الكود بشكل أفضل. وفي المهام التي تعرف تقسيمها مسبقاً، مثل «دالة لكل منفذ» في تجربتنا، فإن المخطط النموذج نفسه زائد، والتقسيم بالكود أرخص وأدق، وهذا ما يقصده مقال Anthropic بالفرق بين سير العمل Workflow والوكيل Agent.
من وكيل واحد إلى فريق: كيف تبدأ دون أن تخسر؟
إذا قررت أن تجرب تعدد الوكلاء في عملك، فلا تبدأ ببناء فريق من خمسة أدوار، وإنما انقل جزءاً واحداً في كل خطوة، وقس بعد كل خطوة:
- ابدأ بوكيل واحد وسجل كل شيء: عدد الاستدعاءات، والتوكنات، والوقت، وأين فشل بالضبط. وبدون هذا الأساس لن تعرف هل أفاد الفريق أم لا.
- أضف المراجع الذي لا يجامل أولاً: أي الاختبارات أو الفحص الآلي الذي يشغله الكود بعد كل تغيير، فهذا أرخص «وكيل» وأكثرها فائدة، ولا يحتاج نموذجاً.
- ثم انقل القراءة الكثيرة إلى وكلاء فرعيين: البحث في المستودع، وقراءة السجلات، وتلخيص التوثيق، وكلها قراءة لا تتعارض، وفائدتها أن نافذة الوكيل الرئيسي تبقى صغيرة.
- ثم قسم الكتابة فقط حيث الأجزاء مستقلة فعلاً: ملفات مختلفة، وواجهات مكتوبة مسبقاً، ولكل منفذ فرعه.
- وأخيراً، إن احتجت، اجعل النموذج يقرر التقسيم: فقط عندما لا تستطيع أن تعرف الأجزاء مسبقاً، ومع فحص في الكود لمخرج المخطط قبل أن توزعه.
وهذا الترتيب نفسه هو ترتيب مقالات هذه المرحلة تقريباً، فالمقال التالي عن الوكلاء الفرعيين والعمل بالتوازي في فروع منفصلة كما تقدمها Claude Code وCodex وCursor، ثم أطر التنسيق التي تقدم المخطط والمنفذين جاهزين، ثم فريق الوكلاء الذي يتناقش، ثم حساب التكلفة.
متى تقسم المهمة، ومتى تبقيها مع وكيل واحد؟
بعد ما رأيناه من التوثيق والأبحاث والمختبر يمكن أن نلخص القرار في جدول، والقاعدة العامة فيه: ابدأ دائماً بوكيل واحد، وانتقل إلى أكثر من وكيل عندما ترى أحد الأسباب الثلاثة بوضوح، وليس لأن الفكرة جميلة في العرض التوضيحي.
| الحالة | القرار | والسبب |
|---|---|---|
| مهمة صغيرة أو متوسطة تلمس ملفات قليلة | وكيل واحد | كل تسليم يضيف تكلفة واحتمال ضياع معلومة، ولا يوجد ما يستحق التقسيم |
| قراءة كثيرة قبل قرار واحد، مثل البحث في المستودع | وكيل رئيسي ووكلاء فرعيون للقراءة | القراءة لا تتعارض، والخلاصة القصيرة تحمي نافذة القرار |
| أجزاء مستقلة فعلاً، كل منها في ملفات مختلفة | منفذون بالتوازي، كل منهم في فرعه | التوازي يختصر الوقت، والفروع تمنع التداخل أثناء العمل |
| أجزاء تعتمد على قرارات بعضها، مثل واجهة وخادم يتفقان على شكل البيانات | وكيل واحد، أو مواصفة مكتوبة أولاً ثم تقسيم | القرارات الضمنية تتعارض كما في مثال Cognition |
| معيار نجاح واضح يمكن تشغيله، مثل الاختبارات | منفذ ومراجع في حلقة Evaluator-optimizer | المراجع الذي يشغل الاختبار لا يجامل |
| لا يوجد معيار نجاح آلي | مراجعة بشرية، ولا تعتمد على وكيل مراجع وحده | المراجع النموذج يقول «يبدو جيداً» بثقة لا يستحقها الكود |
| نموذج صغير أو محلي | تقسيم بالكود لا بالنموذج، ومهام صغيرة جداً لكل منفذ | النموذج الصغير يفشل في التخطيط الحر ولكنه ينجح في مهمة واضحة قصيرة |
أخطاء شائعة
- التقسيم لأن الفكرة جميلة: فريق من خمسة وكلاء لمهمة كان وكيل واحد ينهيها في عشر دقائق، والنتيجة أضعاف التوكنات ونقاط تسليم يضيع فيها شيء. ابدأ بوكيل واحد وقس، ثم قسم الجزء الذي يحتاج التقسيم فقط.
- مهام فرعية بلا شروط: المخطط يكتب «اكتب دالة السعر» وينسى «المبالغ بالهللة» و«لا مكتبات خارجية». ضع الشروط المشتركة في ملف ثابت يقرؤه كل منفذ، وليس في ذاكرة المخطط.
- منفذون يكتبون في الملفات نفسها: وكيلان يعدلان الملف نفسه في الوقت نفسه، فيضيع عمل أحدهما أو يظهر تعارض عند الدمج. قسم بالملفات، وإذا لم تستطع فلا تقسم الكتابة.
- مراجع بالاسم فقط: وكيل مراجع يقرأ الكود ولا يشغل شيئاً، فيوافق على كل شيء تقريباً، وهذا ما يصنفه بحث Cemri وزملائه تحت التحقق الناقص أو الخاطئ. اجعل المراجع يبدأ بتشغيل الاختبارات، واجعل النموذج يشرح النتيجة فقط.
- الثقة بمخرج المخطط دون فحص: المخطط نموذج، وقد يرجع JSON غير صالح، أو يسقط مهمة، أو يدمج مهمتين. افحص مخرجه في الكود قبل أن توزعه، وكن جاهزاً لما تفعله إذا فشل الفحص.
- لا حد للجولات: حلقة المنفذ والمراجع دون حد أقصى قد تدور طويلاً على خطأ لا يستطيع النموذج إصلاحه، وتدفع ثمن كل دورة. ضع حداً للجولات، وعند الوصول إليه أرجع المهمة لإنسان مع آخر فشل.
- نسيان أن كل وكيل يدفع تعليماته: كل نافذة جديدة تبدأ بتعليمات النظام وتعريف الأدوات من جديد، وفي الأدوات التجارية هذا آلاف التوكنات قبل أي عمل، وسوف نفصله في مقال التكلفة.
قائمة تحقق قبل أن تبني فريق وكلاء
- هل جربت المهمة بوكيل واحد، وعرفت أين فشل بالضبط؟
- هل سبب التقسيم واحد من الثلاثة: حجم السياق، أو التوازي، أو التحقق المستقل؟
- هل المهام الفرعية مستقلة فعلاً، كل منها في ملفات مختلفة؟
- هل الشروط المشتركة والقرارات المشتركة مكتوبة في ملف يقرؤه الجميع؟
- هل لكل مهمة فرعية معنى «انتهيت» يمكن تشغيله؟
- هل المراجع يشغل الاختبارات قبل أن يقرأ الكود؟
- هل يفحص الكود مخرج المخطط قبل التوزيع؟
- هل هناك حد للجولات وحد للتوكنات، وطريقة لإرجاع المهمة إليك؟
- هل تسجل كل استدعاء بالتوكنات والزمن، لتعرف التكلفة الحقيقية؟
تدريب عملي
- في
compare.pyاجعل المخطط ينسخ المواصفة الأصلية لكل دالة بدل أن يلخصها، أي أعط كل منفذ الجزء الخاص بدالته منSPEC.mdكما هو، وأعد التشغيل: هل نجحtest_invalidوtest_ties؟ - غير المراجع بحيث يرسل للمنفذ مخرج الاختبار الفاشل كما هو دون شرح من النموذج، وقارن عدد الاختبارات التي تصلح في الجولة الأولى.
- أضف إلى المهمة دالة خامسة تستعمل
slugifyداخلها، وانظر ماذا يحدث عندما يكتبها منفذ لا يرى كودslugify.
الخلاصة
- تعدد الوكلاء يعني أكثر من نافذة سياق تعمل على المهمة نفسها، والذي يختلف بين الوكلاء غالباً هو التعليمات والسياق والأدوات، وليس النموذج.
- هناك ثلاثة أسباب حقيقية للتقسيم: سياق أكبر من نافذة واحدة، وأجزاء مستقلة تعمل بالتوازي، وتحقق مستقل، وفي غيرها يكفي وكيل واحد كما تنصح Anthropic وCognition.
- الأدوار ثلاثة: المخطط يقسم، والمنفذ ينفذ ما وصله فقط، والمراجع يقرر، وأغلب الأخطاء تحدث في التسليم بينها.
- في مختبرنا أسقط المخطط شرطين من المواصفة عندما لخصها، فنفذ المنفذون الدوال دونهما، وبقي الاختباران المرتبطان بهما فاشلين في كل الجولات.
- المراجع النموذج شرح الفشل بشكل خاطئ أكثر من مرة، والذي اكتشف الأخطاء فعلاً هو تشغيل الاختبارات في الكود.
- الفريق احتاج أربعة إلى ستة أضعاف الاستدعاءات، ونجح أكثر من الوكيل الواحد في تشغيل وبالقدر نفسه في آخر، فلا تقسم قبل أن تقيس.
وفي المقالات التالية من هذه المرحلة بإذن الله نأخذ كل جزء على حدة: الوكلاء الفرعيون في أدوات البرمجة والعمل بالتوازي في فروع منفصلة، ثم أطر التنسيق ومقارنتها بالأرقام، ثم فريق الوكلاء الذي يتناقش، ثم متى يصبح تعدد الوكلاء أغلى وأبطأ من وكيل واحد:
 دليلالوكلاء الفرعيون Subagents والعمل بالتوازي في فروع منفصلةكيف يعمل الوكيل الفرعي في Claude Code وCodex وCursor، ومتى يفيد عزل القراءة والكتابة في Worktree لكل وكيل، مع تجربة على نموذج محلي فيها أخطاء مزروعة وإصلاحات في فروع منفصلة وتعارض حقيقي.
 دليلأطر تنسيق الوكلاء Agent Frameworks: LangGraph وCrewAI وAG2خمسة أطر لتعدد الوكلاء على مهمة واحدة ونموذج محلي واحد، مع وسيط يسجل كل طلب يرسله الإطار، لترى التعليمات المخفية والاستدعاءات وأين وقع الخطأ في كل منها.
 دليلفريق وكلاء يتناقش Multi-agent Debate: هل يتحسن الجواب؟ما تقوله الأبحاث عن النقاش بين الوكلاء، وكيف بنت ChatDev وMetaGPT ومحادثات AutoGen فرقها، وتجربة على نموذج محلي تقارن النقاش والتصويت والناقد والحكم على أسئلة معروفة الجواب.
 دليلمتى يصبح تعدد الوكلاء Multi-agent أغلى وأبطأ من وكيل واحد؟من أين تأتي التوكنات الإضافية في فرق الوكلاء، ولماذا لا يختصر التوازي الوقت دائماً، مع أرقام حقيقية من مختبرات المرحلة محولة إلى تكلفة سنة بأسعار Anthropic وOpenAI وGoogle الرسمية.
سجل التحديثات
- 20 نوفمبر 2026: كتابة المقال، وتشغيل المقارنة بين وكيل واحد وفريق من مخطط وأربعة منفذين ومراجع على Ollama 0.40.13 بنموذج qwen2.5:3b ببذرتين.