تسأل النموذج: «هل نخزن جلسات الدخول في Redis أم في جدول في PostgreSQL؟»، فيجيبك بثقة: Redis، لأنه أسرع. ثم تكتب له «ولكن عندنا PostgreSQL أصلاً ولا نريد خدمة جديدة»، فيجيبك بالثقة نفسها: معك حق، PostgreSQL أنسب. والنموذج في المرتين لم يفكر في مشروعك، وإنما مال إلى ما يبدو أنك تريد سماعه، وهذا ما يسمى المجاملة Sycophancy. وفي الاجتماعات البشرية نحل هذه المشكلة بطريقة قديمة: واحد يقترح، وواحد دوره أن يعترض حتى لو لم يكن مقتنعاً بالاعتراض، وواحد يسمع الاثنين ويقرر. فهل تنفع الطريقة نفسها مع النماذج؟ أي أن تجعل عدة وكلاء يتناقشون Multi-agent Debate قبل أن يصلوا إلى جواب؟
وفي المقالات السابقة من هذه المرحلة كان كل وكيل يأخذ جزءاً مختلفاً من المهمة، أما هنا فالوكلاء يعملون على السؤال نفسه، ويختلف دور كل منهم: مقترح Proposer وناقد Critic وحكم Judge، أو عدة وكلاء متساوين يقرأ كل منهم جواب الآخر ويراجع جوابه. وهذه الفكرة أكبر من النقاش على سؤال، فهي الأساس الذي بنيت عليه أنظمة مثل ChatDev وMetaGPT التي تحاكي شركة برمجة كاملة بمدير ومهندس ومبرمج ومختبر، والمحادثة الجماعية GroupChat في AutoGen. ولذلك نبدأ بما تقوله الأبحاث المحكمة عن النقاش بين الوكلاء، ثم نرى كيف بنت هذه الأنظمة فرقها، ثم نقيس بأنفسنا على نموذج محلي صغير: هل يرفع النقاش عدد الإجابات الصحيحة في عشرة أسئلة نعرف جوابها، مقارنة بجواب واحد، وبالتصويت Voting بين ثلاث إجابات مستقلة بالتكلفة نفسها تقريباً؟
سوف نناقش في هذا المقال:
- من أين جاءت فكرة النقاش بين الوكلاء، وما الذي وجدته الأبحاث، بما فيها التي لم تجد تحسناً.
- الأدوار: المقترح والناقد والحكم، والتصويت كبديل أبسط.
- فرق الوكلاء التي تبني برنامجاً: ChatDev وMetaGPT، كيف تعمل، وحالتها اليوم.
- المحادثة الجماعية في AutoGen وAG2، وكيف يختار المدير المتكلم التالي.
- مختبر بالأرقام: أربع طرق على عشرة أسئلة Python معروفة الجواب، ونقاش حقيقي على قرار تصميم.
- لماذا يفشل النقاش أحياناً، ومتى يستحق تكلفته، والأخطاء الشائعة.
من أين جاءت فكرة النقاش بين الوكلاء؟
في مايو 2023 نشر Yilun Du وShuang Li وAntonio Torralba وJoshua Tenenbaum وIgor Mordatch من MIT وGoogle بحثاً بعنوان تحسين صحة الحقائق والاستدلال في نماذج اللغة عبر النقاش بين الوكلاء Improving Factuality and Reasoning in Language Models through Multiagent Debate. والطريقة فيه بسيطة: عدة نسخ من النموذج تجيب عن السؤال نفسه كل منها وحدها، ثم في الجولة الثانية تقرأ كل نسخة إجابات الأخرى وتكتب إجابة جديدة، وتتكرر الجولات حتى تتفق الإجابات أو تنتهي الجولات. ووجد الباحثون أن هذه الطريقة رفعت الدقة في الاستدلال الرياضي والاستراتيجي، وقللت الإجابات التي تخترع حقائق Hallucinations، وسموها مجتمع العقول Society of Minds.
وفي الشهر نفسه نشر Tian Liang وزملاؤه بحث تشجيع التفكير المختلف عبر النقاش بين الوكلاء Encouraging Divergent Thinking in Large Language Models through Multi-Agent Debate، وفكرته مختلفة قليلاً: النموذج الذي يراجع جوابه بنفسه يميل إلى التمسك به حتى لو كان خاطئاً، وسموا هذا انحطاط التفكير Degeneration-of-Thought، والحل أن يكون هناك طرف يعارض صراحة وحكم Judge يدير النقاش ويقرر. وهذا هو أصل ثلاثي المقترح والناقد والحكم الذي نجربه في المختبر.
ولكن الصورة لم تبق بهذا الوضوح. ففي نوفمبر 2023 نشر Andries Smit وزملاؤه من InstaDeep بحثاً بعنوان هل يجب أن نتجه إلى النقاش؟ Should we be going MAD? A Look at Multi-Agent Debate Strategies for LLMs، قارنوا فيه عدة طرق نقاش بطرق أبسط على حسابات التكلفة والوقت والدقة، ووجدوا أن أنظمة النقاش بشكلها الحالي لا تتفوق بشكل ثابت على طرق أبسط مثل الاتساق الذاتي Self-consistency، وهو أن تأخذ عدة إجابات مستقلة وتختار الأكثر تكراراً. ووجدوا أيضاً أن بعض طرق النقاش تتفوق عندما تضبط إعداداتها بعناية، مثل مستوى الاتفاق بين الوكلاء، أي أنها حساسة جداً للإعداد وصعبة الضبط.
والاتساق الذاتي نفسه له بحث معروف، هو بحث Xuezhi Wang وزملائه من Google المنشور في مارس 2022 بعنوان الاتساق الذاتي يحسن استدلال سلسلة الأفكار Self-Consistency Improves Chain of Thought Reasoning in Language Models. وفي فبراير 2024 نشر Junyou Li وزملاؤه من Tencent بحثاً بعنوان مباشر هو كل ما تحتاجه وكلاء أكثر More Agents Is All You Need، وجدوا فيه أن مجرد أخذ عينات كثيرة والتصويت بينها، دون أي نقاش، يرفع الأداء كلما زاد عدد «الوكلاء»، وأن الفائدة أكبر في المهام الأصعب. والسؤال الذي تتركه هذه الأبحاث مفتوحاً وتهمنا إجابته: هل الفائدة من النقاش نفسه، أي من أن يقرأ الوكيل جواب غيره، أم من أننا دفعنا ثمن إجابات أكثر؟ ولذلك فإن المقارنة العادلة في المختبر يجب أن تضع النقاش أمام التصويت بالتكلفة نفسها تقريباً، وليس أمام جواب واحد فقط.
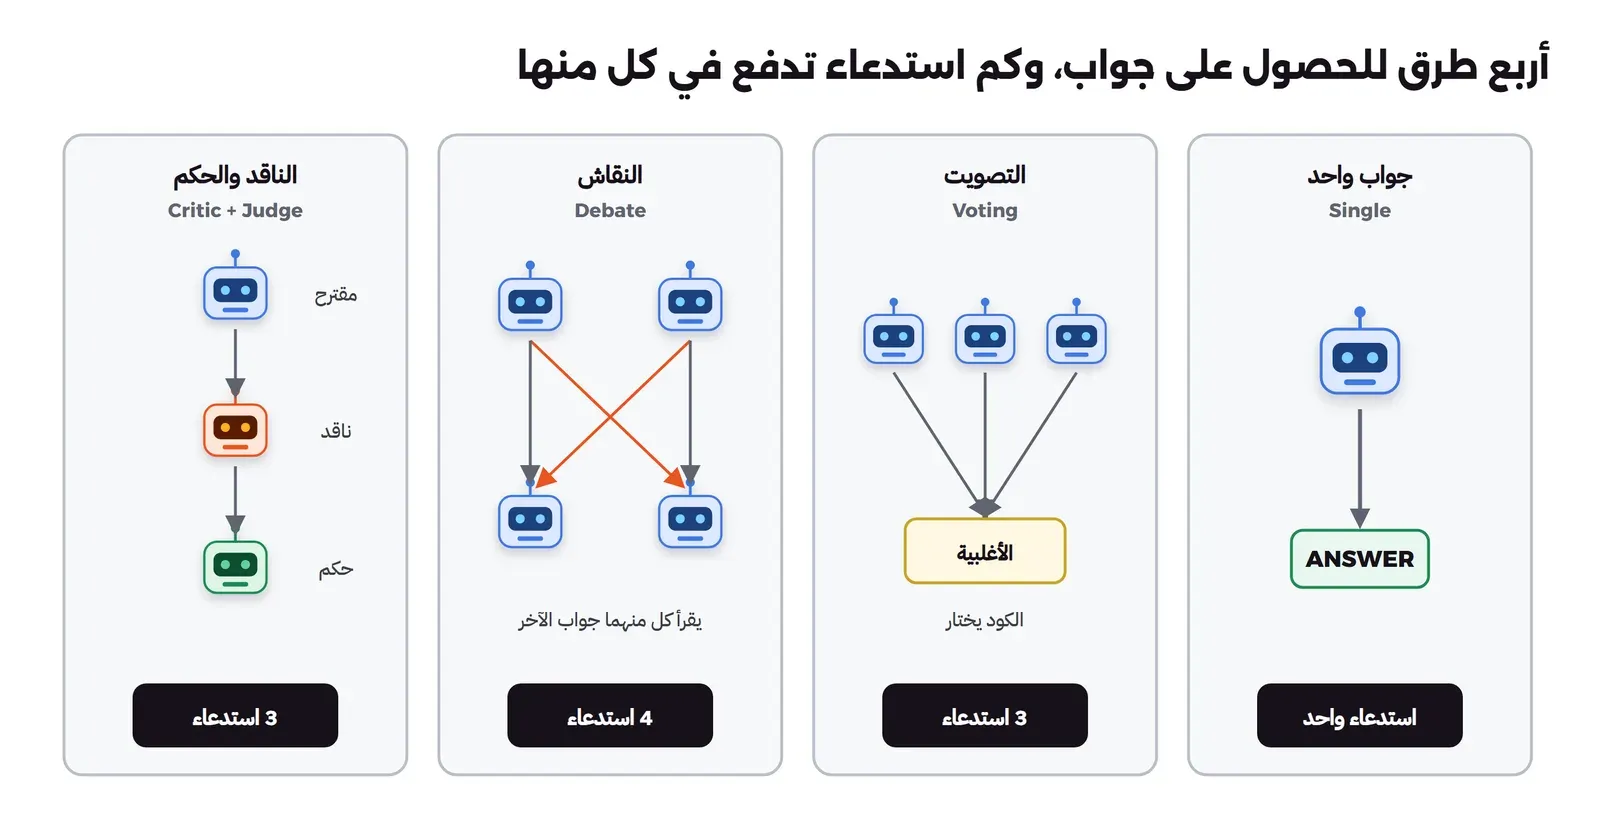
المقترح والناقد والحكم، ولماذا لا يكفي أن تقول «راجع جوابك»
الطريقة الأولى التي تخطر في البال لتحسين جواب النموذج أن تطلب منه في الرسالة التالية «راجع جوابك وتأكد منه». والمشكلة أن النموذج في هذه الحالة يقرأ جوابه هو، بأسبابه هو، في السياق نفسه، فيميل في أغلب الأحيان إلى تأكيده، وهذا ما وصفه بحث Liang بانحطاط التفكير. أما إذا جاء الجواب من «شخص آخر»، أي من نافذة سياق أخرى بتعليمات تقول له إن دوره أن يجد الخطأ، فإنه يقرؤه بعين مختلفة قليلاً. ولهذا تتكرر الأدوار الثلاثة في الأنظمة كلها:
- المقترح Proposer: يكتب الحل الأول أو القرار الأول مع أسبابه. وأفضل ما تطلبه منه أن يكتب أسبابه بإيجاز، لأن الناقد يحتاج أن يرى طريق التفكير وليس النتيجة فقط.
- الناقد Critic: يقرأ الاقتراح ويبحث عن الخطأ، أو الشرط المنسي، أو التكلفة التي لم تذكر. والتعليمات هنا مهمة جداً، فالناقد الذي يقال له «قيم الاقتراح» يوافق غالباً، والناقد الذي يقال له «ابحث عن الخطأ ولا توافق مجاملة» يعترض أكثر، وأحياناً يعترض على الصحيح، كما سنرى.
- الحكم Judge: يقرأ الطرفين ويقرر. والحكم هو نقطة الضعف الخفية في هذا الثلاثي، لأنه نموذج أيضاً، وقد يختار الطرف الأكثر ثقة في كلامه أو الأطول جواباً، وليس الأصح.
والبديل الأبسط عن هذا كله هو التصويت: ثلاثة وكلاء يجيبون كل منهم وحده دون أن يرى غيره، والكود وليس النموذج يختار الجواب الأكثر تكراراً. والتصويت لا يحتاج حكماً، ولا يتأثر فيه أحد برأي أحد، ولكنه لا يصلح إلا عندما يكون للجواب شكل يمكن مقارنته آلياً، مثل رقم أو مخرج برنامج أو اسم دالة، ولا يصلح لقرار تصميم يكتب كل وكيل أسبابه فيه بكلمات مختلفة.
فرق وكلاء تبني برنامجاً: ChatDev وMetaGPT
في صيف 2023 ظهر مشروعان أخذا الفكرة إلى أبعد من سؤال واحد، وحاكيا شركة برمجة كاملة بأدوارها. والمشروعان مهمان لفهم تاريخ تعدد الوكلاء في البرمجة، ولكنهما ليسا ما تستعمله أدوات البرمجة اليومية اليوم، والسبب سوف يتضح بعد قليل.
ChatDev: شركة برمجة افتراضية تتكلم
نشر Chen Qian وزملاؤه من جامعة Tsinghua ومجموعة OpenBMB في يوليو 2023 بحث ChatDev: وكلاء يتواصلون لتطوير البرمجيات Communicative Agents for Software Development. وفكرته أن وكلاء متخصصين، مثل المدير التنفيذي CEO والمدير التقني CTO والمبرمج Programmer والمختبر Tester، يمرون على مراحل التطوير بالترتيب: التصميم ثم البرمجة ثم الاختبار، وفي كل مرحلة يتحادث وكيلان حتى يتفقا. ويحدد البحث شيئين: ما الذي يتكلمون عنه، عبر سلسلة محادثات Chat Chain تقسم كل مرحلة إلى مهام صغيرة، وكيف يتكلمون، عبر ما سموه إزالة الهلوسة بالتواصل Communicative Dehallucination، وهو أن يسأل الوكيل المساعد عن التفاصيل الناقصة قبل أن يجيب بدل أن يخترعها. ووجد الباحثون أن اللغة الطبيعية مفيدة في مرحلة التصميم، وأن الحديث بلغة البرمجة نفسها مفيد في تصحيح الأخطاء.
والمستودع OpenBMB/ChatDev برخصة Apache 2.0 تغير كثيراً منذ البحث، ففي 7 يناير 2026 أعلن الفريق ChatDev 2.0 باسم DevAll، وهو بحسب ملف README منصة لتنسيق وكلاء متعددين دون كتابة كود Zero-Code، تعرف فيها نظامك من الإعدادات، أما ChatDev الأصلي، أي الشركة الافتراضية، فنقل إلى الفرع chatdev1.0.
MetaGPT: إجراءات العمل المعيارية SOP
وفي أغسطس 2023 نشر Sirui Hong وزملاؤه بحث MetaGPT: البرمجة الفوقية لإطار تعاون بين وكلاء متعددين Meta Programming for A Multi-Agent Collaborative Framework. وملاحظته الأساسية أن ربط النماذج ببعضها بشكل بسيط يسبب تناقضات منطقية بسبب الهلوسات المتتالية Cascading Hallucinations، أي أن خطأ الوكيل الأول يدخل في سياق الثاني فيبني عليه. والحل الذي اقترحه أن تكتب إجراءات العمل المعيارية Standard Operating Procedures، واختصاراً SOPs، التي تتبعها فرق البشر، داخل سلسلة التعليمات، فيكون لكل دور مخرج محدد الشكل: مدير المنتج يكتب المتطلبات وقصص المستخدم User Stories، والمعماري يكتب تصميم البيانات والواجهات APIs، ومدير المشروع يقسم المهام، والمهندس يكتب الكود، وكل دور يتحقق من مخرج من قبله. وشعار المشروع في ملف README هو Code = SOP(Team).
والمستودع اليوم FoundationAgents/MetaGPT برخصة MIT، وملف README يطلب Python من 3.9 إلى ما قبل 3.12، وآخر إصدار منشور في صفحة الإصدارات هو v0.8.1 من أبريل 2024، وأحدث أخبار الفريق في الملف عن منتج تجاري اسمه MGX أطلق في فبراير 2025. ولاحظ الفكرة التي تبقى من MetaGPT حتى لو لم تستعمله: الوكلاء يتواصلون أفضل عندما يتبادلون مستندات محددة الشكل، مثل المتطلبات والتصميم والمهام، وليس محادثة حرة، وهذا ما تفعله اليوم أدوات البرمجة التي تبدأ بمواصفة Spec، كما شرحنا في مقال التطوير من المواصفة.
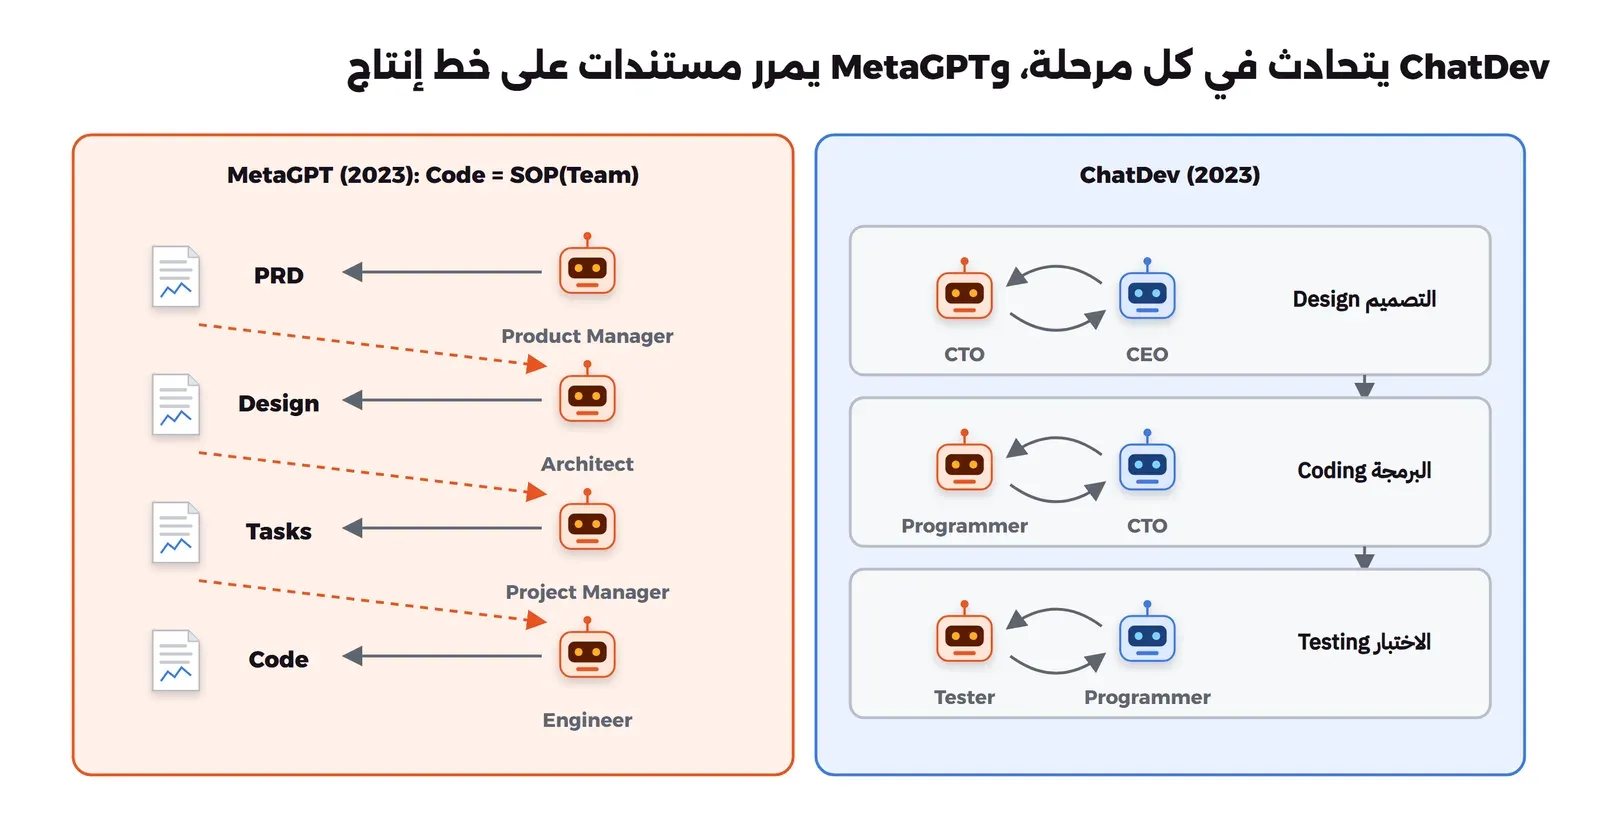
وقد يتساءل البعض: إذا كانت هذه الأنظمة تبني برامج كاملة منذ 2023، فلماذا لا تعمل أدوات البرمجة اليومية بهذه الطريقة؟ والإجابة في ثلاثة أشياء. الأول أن المهام التي قيست عليها هذه الأنظمة كانت برامج صغيرة جديدة من الصفر، مثل لعبة أو أداة رسم، وليست تعديلاً في مستودع قائم فيه آلاف الملفات، وهذا ما يفعله المطور كل يوم. والثاني التكلفة، فكل دور يقرأ مخرجات من قبله، وكل محادثة بين دورين جولات من الرسائل. والثالث ما وجده بحث Cemri وزملائه عن أسباب فشل أنظمة تعدد الوكلاء، الذي حلل سجلات من سبعة أطر منها ChatDev وMetaGPT، ووجد أن مشاكل التحقق من المهمة وسوء التنسيق بين الوكلاء من أكثر أسباب الفشل، وقد لخصناه في المقال الأول من هذه المرحلة.
المحادثة الجماعية في AutoGen وAG2
الإطار الثالث في عنوان هذه الفكرة هو AutoGen، الذي نشرت Microsoft بحثه في أغسطس 2023 بعنوان AutoGen: تطبيقات نماذج اللغة عبر محادثة بين وكلاء متعددين Enabling Next-Gen LLM Applications via Multi-Agent Conversation، لـ Qingyun Wu وزملائه. والفكرة فيه أن كل وكيل «قابل للمحادثة» Conversable، يستقبل رسالة ويرد برسالة، والتطبيق كله محادثة بين وكلاء، ومنها المحادثة الجماعية GroupChat: عدة وكلاء في محادثة واحدة يرى كل منهم كل الرسائل، ومدير GroupChatManager يقرر من يتكلم بعد كل رسالة.
وطريقة اختيار المتكلم هي قلب المحادثة الجماعية، وتوثيق المحادثة الجماعية في AG2 يذكر خمس طرق: auto وهي الافتراضية، ويختار فيها المدير المتكلم التالي بسؤال النموذج، وround_robin بالدور، وrandom عشوائياً، وmanual يختار فيها إنسان، أو دالة تكتبها أنت. ولاحظ أن الطريقة الافتراضية تعني استدعاءً إضافياً للنموذج قبل كل رسالة، ليس ليعمل وإنما ليختار من يعمل، وسوف نرى ثمن هذا في المختبر.
وحالة AutoGen اليوم تحتاج توضيحاً، لأن الأسماء تفرقت. فملف README في مستودع microsoft/autogen يقول اليوم إن المشروع مؤرشف ولم يعد يطور، ولا تقدم Microsoft له إصلاحات أخطاء ولا إصلاحات أمنية ولا ميزات جديدة، وإن Microsoft Agent Framework هو الخلف المخصص للمؤسسات. أما AG2 فهو المشروع الذي أكمله جزء من فريق AutoGen الأصلي باسم جديد في مستودع ag2ai/ag2 برخصة Apache 2.0، وفيه تغيير مهم وقعنا فيه أثناء المختبر: الحزمة ag2 بالإصدار 1.3.3 لم تعد فيها الحزمة autogen ولا الكلاسات المعروفة مثل ConversableAgent وGroupChat، وملف README فيها يقول إن هذه انتقلت إلى ما يسمى AG2 Classic، وإن تعدد الوكلاء في الإصدار الجديد اسمه Network، فيه Hub وقنوات Channels بأشكال مختلفة، منها قناة نقاش Discussion تدور على عدة وكلاء بالدور. والكود القديم يعمل إذا ثبت التوزيعة الكلاسيكية، وهي على PyPI اليوم باسم autogen، وقد ثبتنا منها الإصدار 0.14.1.
from autogen import ConversableAgent, GroupChat وثبت pip install ag2 كما يقول المثال، فسوف يفشل الاستيراد بالخطأ ModuleNotFoundError: No module named 'autogen'. والسبب أن ag2 من الإصدار 1.0 إطار مختلف يستورد بـ import ag2، والحل أن تثبت autogen الكلاسيكي بإصدار محدد، أو أن تنقل الكود إلى Network بحسب دليل الانتقال الرسمي.المختبر: هل يرفع النقاش عدد الإجابات الصحيحة؟
لكي نقيس الفرق نحتاج أسئلة نعرف جوابها يقيناً، ولذلك اخترنا عشرة مقاطع Python قصيرة، كل منها يطبع سطراً واحداً، وفيها أشياء يخطئ فيها المطورون أنفسهم أحياناً: قائمتان تشيران إلى الكائن نفسه، و0.1 + 0.2، والمعامل الافتراضي القابل للتغيير Mutable Default Argument، وround الذي يقرب إلى الزوجي، والترتيب الذي يضع الحروف الكبيرة قبل الصغيرة، وbool('False')، والقسمة الصحيحة على عدد سالب، ومجموعة فيها 1 و1.0 وTrue، وتقطيع النص، ودوال lambda داخل حلقة. والجواب الصحيح لا نكتبه بأيدينا، وإنما يشغل الملف questions.py كل مقطع ويأخذ ما طبعه:
'x = [1, 2, 3]\ny = x\ny += [4]\nprint(len(x))' -> 4
'print(0.1 + 0.2 == 0.3)' -> False
'def f(a=[]):\n    a.append(1)\n    return len(a)\nf()\nprint(f())' -> 2
'print(round(2.5), round(3.5))' -> 2 4
"print(sorted(['b', 'A', 'a', 'B']))" -> ['A', 'B', 'a', 'b']
"print(bool('False'))" -> True
'print(-7 // 2)' -> -4
'print(len({1, 1.0, True}))' -> 1
"print('abc'[::-1][1:])" -> ba
'funcs = [lambda: i for i in range(3)]\nprint([f() for f in funcs])' -> [2, 2, 2]
ثم يسأل السكربت debate.py النموذج qwen2.5:3b عن كل مقطع بأربع طرق، ويطلب في كل مرة أن يبدأ الرد بسطر ANSWER: ثم سبب في ثلاثة أسطر على الأكثر:
- جواب واحد
single: استدعاء واحد بدرجة حرارة صفر. - التصويت
vote3: ثلاث إجابات مستقلة بدرجة حرارة 0.8 وبذور مختلفة، والكود يأخذ الأكثر تكراراً. - النقاش
debate: أول إجابتين من التصويت هما الجولة الأولى، ثم يقرأ كل وكيل جواب الآخر ويراجع جوابه مرة واحدة، على طريقة بحث Du وزملائه. وإذا بقيا مختلفين يؤخذ جواب الأول. - الناقد والحكم
critic: الجواب الواحد هو المقترح، ثم ناقد يطلب منه أن يجد أي خطأ، ثم حكم يقرأ الاثنين ويقرر.
وفي أول تشغيل طلبنا من النموذج أن يفكر ثم يكتب الجواب في آخر سطر، مع حد 160 توكناً للرد، فكانت النتيجة أن النموذج كتب شرحاً طويلاً خطوة بخطوة، وانقطع الرد قبل أن يصل إلى السطر الأخير، فرجعت إجابات فارغة في أول سؤال، منها الجواب الواحد والناقد والحكم، وحسبها السكربت خطأً. فغيرنا الطلب ليبدأ بالجواب، وهذا درس صغير ينفع في أي نظام وكلاء: إذا كان الكود يقرأ شيئاً من رد النموذج، فاطلبه في أول الرد لا في آخره. والنتيجة بعد التشغيل الكامل كما يلي، مختصرة:
q1  single=x  vote3=x  debate=x  critic=ok  label='4' single='3' votes=['3', '3', '3'] revised=['3', '3'] critic='4' judge='4'
q2  single=ok vote3=ok debate=ok critic=ok  label='False' ...
q3  single=x  vote3=x  debate=ok critic=x   label='2' single='1' votes=['1', '1', '1'] revised=['2', '2'] critic='1' judge='1'
q4  single=x  vote3=x  debate=x  critic=ok  label='24' single='23' votes=['23', '23', '23'] revised=['23', '23'] critic='34' judge='24'
q5  single=x  vote3=x  debate=x  critic=x   label="['A','B','a','b']" single="['A','B','b','a']" ...
q6  single=ok vote3=ok debate=ok critic=ok  label='True' single='True' ... critic='False' judge='True'
q7  single=x  vote3=x  debate=x  critic=x   label='-4' single='-3' votes=['-3', '-3', '-3'] revised=['-3', '-3'] critic='-4' judge='-3'
q8  single=x  vote3=x  debate=x  critic=x   label='1' single='3' ...
q9  single=x  vote3=x  debate=x  critic=x   label='ba' single='c' votes=['ac', 'c', 'c'] revised=['c', 'c'] critic='a' judge='a'
q10 single=x  vote3=x  debate=x  critic=x   label='[2,2,2]' single='[0,1,2]' ...
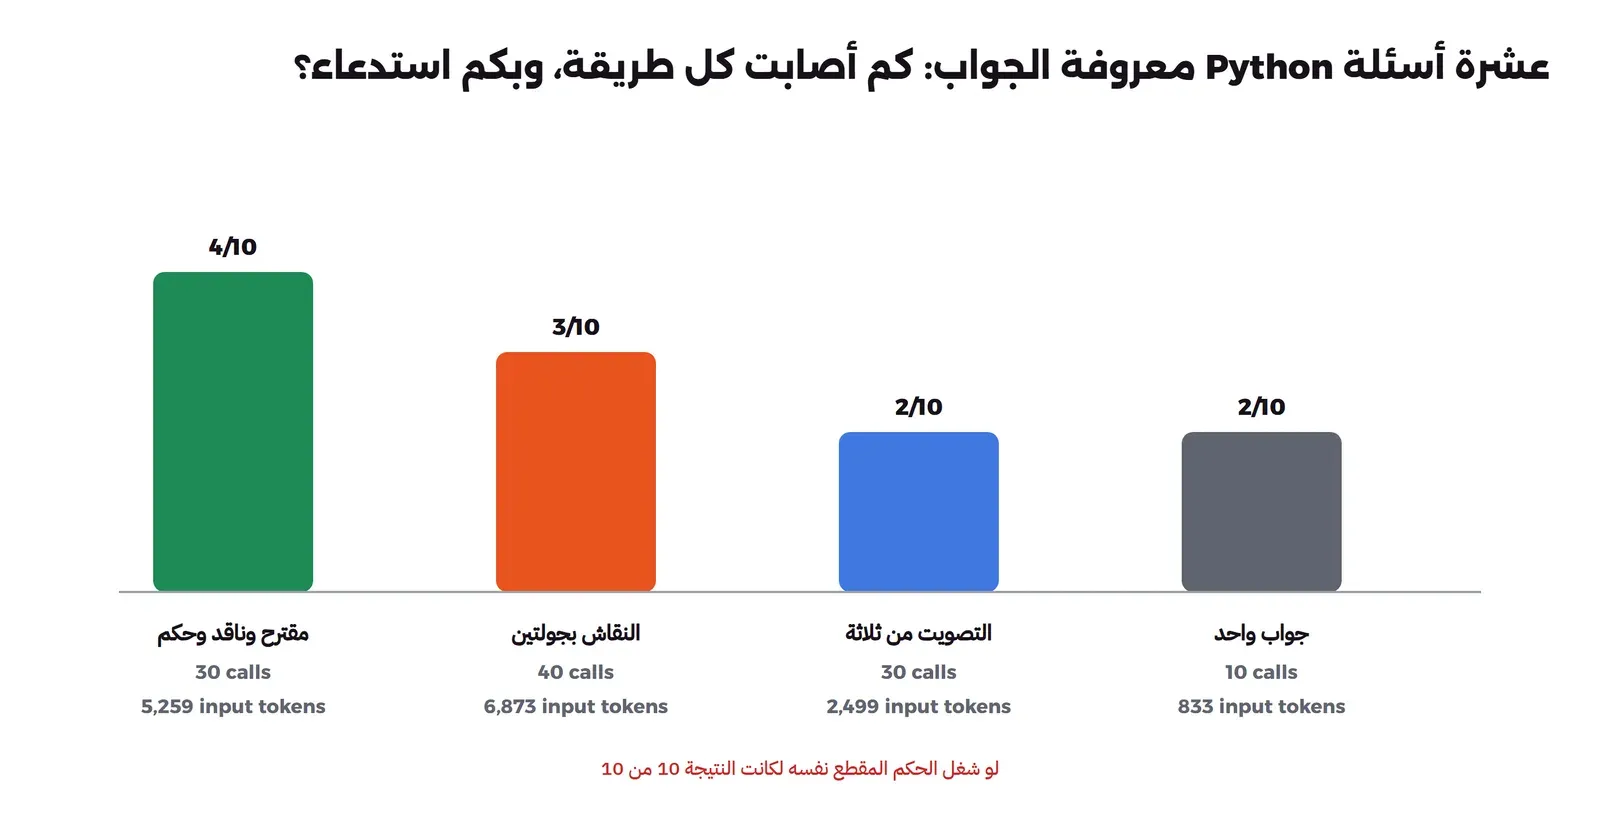
والجدول التالي يجمع النتيجة مع ما دفعته كل طريقة من الاستدعاءات والتوكنات للأسئلة العشرة، كما سجلها Ollama:
| الطريقة | الإجابات الصحيحة | الاستدعاءات | توكنات المدخل | توكنات المخرج |
|---|---|---|---|---|
| جواب واحد | 2 من 10 | 10 | 833 | 645 |
| التصويت من ثلاثة | 2 من 10 | 30 | 2,499 | 1,821 |
| النقاش، جولتان | 3 من 10 | 40 | 6,873 | 2,707 |
| المقترح والناقد والحكم | 4 من 10 | 30 | 5,259 | 2,252 |
في الجدول أعلاه لاحظ التالي:
- عمود النقاش يحسب جولته الأولى، أي أول إجابتين من التصويت، لأنها جزء من ثمنه، وكذلك عمود الناقد والحكم يحسب الجواب الواحد الذي بدأ منه.
- التصويت لم يضف أي إجابة صحيحة، والسبب ظاهر في المخرج: الإجابات الثلاث متطابقة في تسعة أسئلة من عشرة رغم درجة الحرارة 0.8، فالنموذج الصغير متأكد من خطئه، والأغلبية لخطأ واحد تبقى خطأً. وهذا يوافق ملاحظة بحث Li وزملائه أن فائدة كثرة العينات مرتبطة بصعوبة المهمة وبتنوع الإجابات.
- النقاش أصلح سؤالاً واحداً، هو السؤال الثالث عن المعامل الافتراضي، فقد بدأ الوكيلان بالجواب 1، وبعد أن قرأ كل منهما شرح الآخر غيرا إلى 2 الصحيح. وتكلفة هذا السؤال الواحد عشرة استدعاءات إضافية للأسئلة العشرة.
- الناقد والحكم أعلى نتيجة، 4 من 10، ولكن انظر كيف وصل إليها: في السؤال الأول وجد الناقد الخطأ فوافقه الحكم، وفي الرابع قال الناقد
3 4وهو خطأ أيضاً، فكتب الحكم2 4الصحيح من عنده. وفي السابع وجد الناقد الجواب الصحيح-4، فرفضه الحكم وبقي على-3. وفي التاسع غير الحكم جواباً خاطئاً بجواب خاطئ آخر. - والفرق بين 2 و4 من 10 على عشرة أسئلة فقط ليس دليلاً إحصائياً على أن طريقة أفضل من أخرى، وإنما يكفي لترى كيف تعمل كل طريقة وأين تفشل، وهذا هو الغرض.
السؤال الوحيد الذي أصلحه النقاش، ولماذا
في السؤال الثالث، عن المعامل الافتراضي القابل للتغيير، بدأ الوكيلان بالجواب الخاطئ 1، وهذا أول رد من الجولة الأولى كما حفظه السكربت:
ANSWER: 1

The function `f` modifies a list `a` that it doesn't initialize, using the default argument `[]`. Calling `f()` appends `1` to `a` and returns its length, which is `1`. Then `f()` is called again, but since `a` is still `[1]`, its length is `2`.
لاحظ أن الشرح نفسه يصل إلى 2 في آخره، أي أن الوكيل فهم السبب، ولكنه كتب الجواب في السطر الأول قبل أن يكمل التفكير، لأننا طلبنا الجواب أولاً. وفي الجولة الثانية قرأ كل وكيل شرح الآخر، وفيه الجملة نفسها تقريباً، فكتب الأول:
ANSWER: 2

The function `f` uses a mutable default argument `a=[]` which gets initialized only once when the function is defined, not each time the function is called. Therefore, both calls to `f()` modify the same list `a`, resulting in its length being `2` after both calls. The `print(f())` then prints the result of the second call to `f()`, which is `2`.
فالنقاش هنا لم يأت بمعلومة جديدة من الخارج، وإنما أعطى الوكيل فرصة ثانية ليقرأ تفكيره مكتوباً ويصلح التناقض بين شرحه وجوابه. وهذا يفسر نتيجة بحث Smit وزملائه: جزء من فائدة النقاش يأتي من أن النموذج يكتب ويقرأ أكثر، وهو ما يمكن الحصول عليه أحياناً بطرق أرخص، مثل أن تطلب التفكير قبل الجواب في الاستدعاء الأول، مع حد مخرج يكفيه.
لماذا لم يفد التصويت؟ التنوع Diversity
التصويت يفيد فقط عندما تخطئ الإجابات المستقلة بطرق مختلفة، فتغلب الإجابة الصحيحة لأنها الوحيدة التي تتكرر. وفي مختبرنا كانت الإجابات الثلاث متطابقة في تسعة أسئلة من عشرة رغم درجة الحرارة 0.8 والبذور المختلفة، أي أن النموذج كان واثقاً من خطئه، وتكرار الخطأ الواثق ثلاث مرات لا يصنع جواباً صحيحاً. والتنوع الحقيقي يأتي من مصادر أقوى من درجة الحرارة: نماذج مختلفة، أو تعليمات مختلفة تجبر كل وكيل على طريق مختلف، مثل أن يحسب أحدهم خطوة بخطوة ويبحث آخر عن الحالة الحدية ويكتب ثالث اختباراً، أو مدخلات مختلفة مثل توثيق مختلف لكل وكيل. وبدون هذا التنوع فإن التصويت والنقاش كليهما يدفعان ثمن عدة إجابات للحصول على الجواب نفسه.
ماذا قال الحكم عندما أخطأ؟
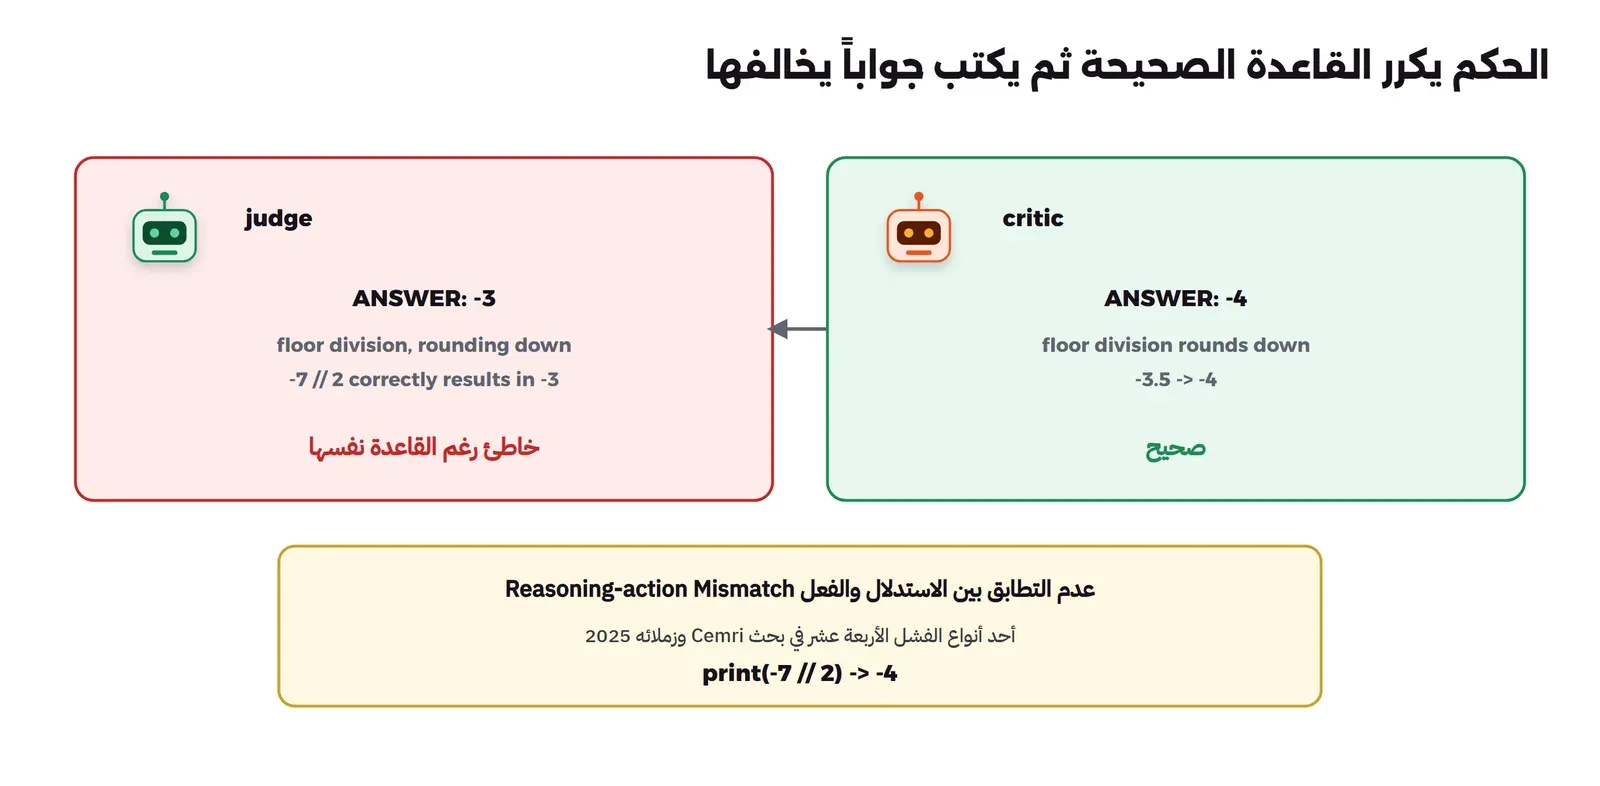
الأرقام وحدها لا تكفي، والأهم أن تقرأ ما كتبه كل وكيل، لأنه يبين لماذا لا تصلح الثقة بالحكم. فهذا ما كتبه الناقد في السؤال السابع عن -7 // 2:
ANSWER: -4

Explanation: In Python 3, the `//` operator performs floor division, which rounds down to the nearest whole number. `-7 // 2` equals `-4` because `-7` divided by `2` is `-3.5`, and rounding down gives `-4`.
والناقد هنا محق تماماً، وشرحه صحيح. ثم قرأ الحكم الشرحين وكتب:
ANSWER: -3

Explanation: In Python, the `//` operator performs floor division, rounding down to the nearest whole number. `-7 // 2` correctly results in `-3`.
لاحظ أن الحكم كرر قاعدة الناقد نفسها، أي التقريب إلى الأسفل Floor، ثم كتب نتيجة تخالفها. وهذا النوع من الفشل يسميه بحث Cemri وزملائه عدم التطابق بين الاستدلال والفعل Reasoning-action Mismatch، أي أن يقول الوكيل شيئاً ويفعل غيره. ورأينا الشيء نفسه في السؤال الرابع، حيث كتب أحد وكيلي النقاش في شرحه أن round يقرب 3.5 إلى 4، ولكن جوابه في السطر الأول كان 2 3.
وفي السؤال الثالث كتب الناقد في أول رده «جواب زميلك صحيح»، ثم بدأ يشرح أن المعامل الافتراضي يحسب مرة واحدة عند تعريف الدالة، وهذا بالضبط سبب أن الجواب الصحيح 2، ولكن الحد انتهى قبل أن يصل إلى النتيجة، فقرأ الحكم السطر الأول وثبت الجواب الخاطئ 1، وكتب سبباً غريباً: أن القائمة تمرر بالقيمة Passed by Value في Python. أي أن الناقد كان على الطريق الصحيح، والحكم أخذ أول سطر منه فقط.
نقاش حقيقي على قرار تصميم: المحادثة الجماعية في AG2 Classic
الأسئلة السابقة لها جواب يمكن تشغيله، أما قرارات التصميم فليس لها جواب واحد صحيح، وهي المكان الذي يقال إن النقاش يفيد فيه أكثر. ولذلك شغلنا محادثة جماعية GroupChat بالكود الكلاسيكي من AutoGen، أي الحزمة autogen بالإصدار 0.14.1 كما شرحنا أعلاه، على سؤال جلسات الدخول من بداية المقال، بثلاثة أدوار ومدير يختار المتكلم بالنموذج، وهي الطريقة الافتراضية auto. وبين الإطار والنموذج وضعنا الوسيط proxy.py الذي يسجل كل طلب، وهو نفسه الذي استعملناه في مقال أطر تنسيق الوكلاء. والكود كاملاً في الملف design_chat.py:
"""An AutoGen-style group chat (AG2 Classic, the autogen namespace) on one design decision:
proposer, critic and judge; the manager picks who speaks next with the model (speaker_selection_method="auto")."""
import os
from autogen import ConversableAgent, GroupChat, GroupChatManager, LLMConfig

cfg = LLMConfig({"model": "qwen2.5:3b", "base_url": "http://adm-proxy:8080/v1", "api_key": "local",
                 "api_type": "openai", "temperature": 0, "max_tokens": 300})
QUESTION = ("A team of 3 developers runs one web app on a single VPS (4 GB RAM) with about 2,000 daily users and "
            "PostgreSQL already installed. Should login sessions be stored in Redis or in a PostgreSQL table? "
            "Decide, with at most 3 reasons.")
proposer = ConversableAgent("proposer", llm_config=cfg,
    system_message="You propose a concrete design and defend it briefly (max 5 lines).")
critic = ConversableAgent("critic", llm_config=cfg,
    system_message="You look for weaknesses, costs and risks in the proposal. Max 5 lines. Never agree just to be polite.")
judge = ConversableAgent("judge", llm_config=cfg,
    system_message="After hearing proposer and critic, you give the final decision in max 4 lines and end with TERMINATE.")
user = ConversableAgent("user", llm_config=False, human_input_mode="NEVER")

chat = GroupChat(agents=[user, proposer, critic, judge], messages=[], max_round=7, speaker_selection_method=os.environ.get("SEL", "auto"))
manager = GroupChatManager(chat, llm_config=cfg, is_termination_msg=lambda m: "TERMINATE" in (m.get("content") or ""))
user.initiate_chat(manager, message=QUESTION)
print("\n===== TRANSCRIPT")
for m in chat.messages:
    print(f"--- {m.get('name')}:\n{m.get('content')}")
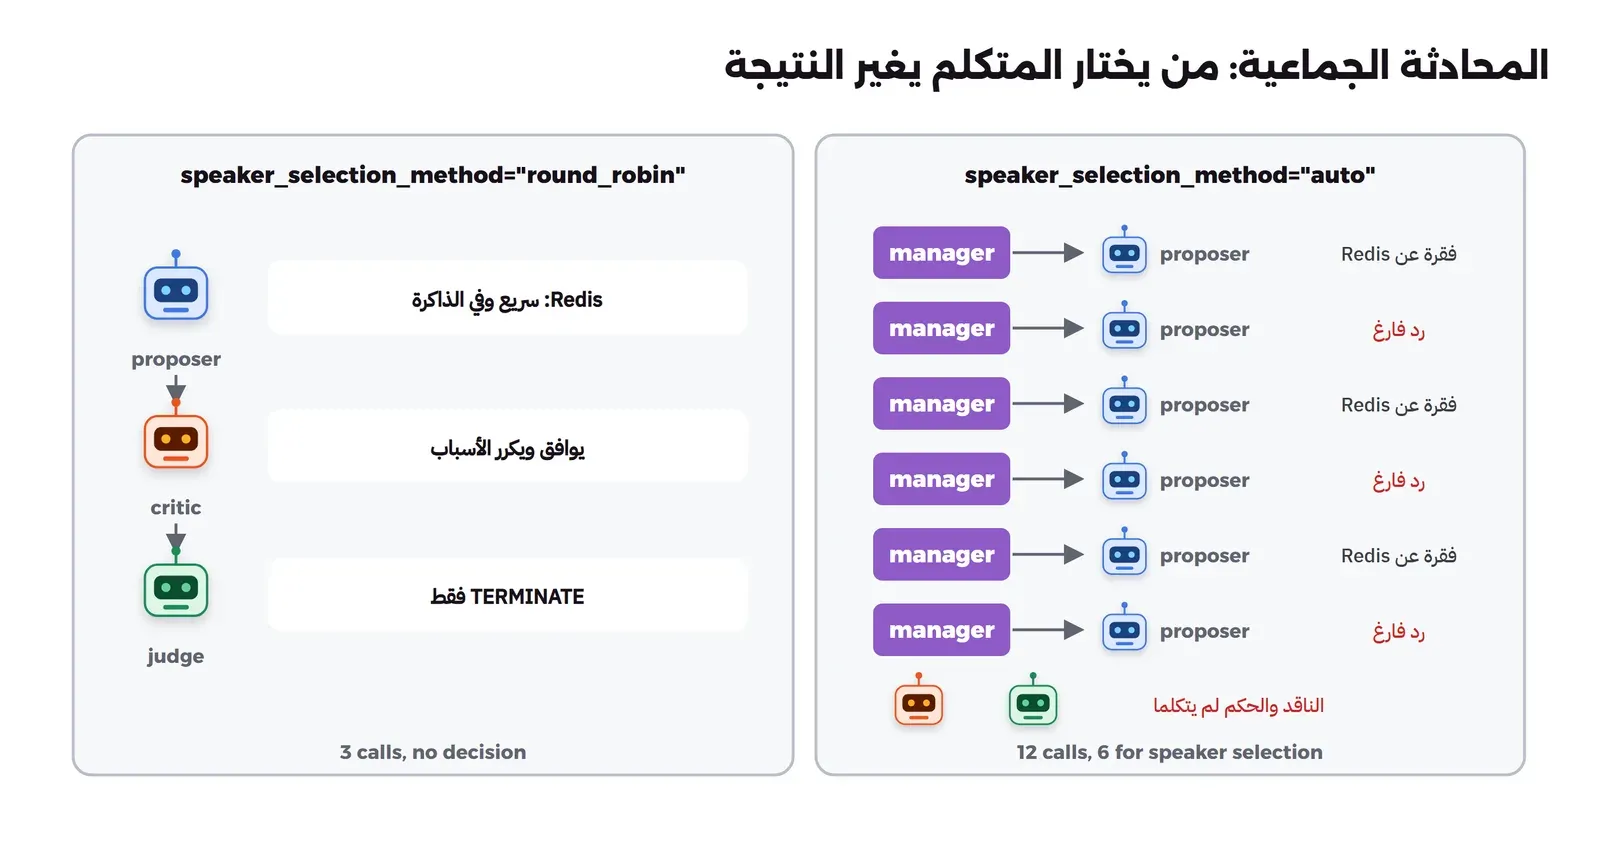
في الكود أعلاه لاحظ أن تعليمات الناقد تقول له صراحة ألا يوافق مجاملة، وأن الحكم يجب أن يعطي القرار وينهي بكلمة TERMINATE، وأن المحادثة تنتهي بعد سبع جولات على الأكثر. والمخرج مع الطريقة الافتراضية سوف يكون كما يلي، بعد حذف التحذيرات المتكررة:
Next speaker: proposer
proposer (to chat_manager):
For storing login sessions, Redis is recommended because it provides faster access times for session data compared to a relational database like PostgreSQL, which would be slower under the high load of 2,000 daily users. ...
Next speaker: proposer
proposer (to chat_manager):

Next speaker: proposer
proposer (to chat_manager):
Redis does not scale horizontally (across multiple servers) like a database and would need careful memory management, whereas PostgreSQL handles scaling out ...
Next speaker: proposer
proposer (to chat_manager):

Next speaker: proposer
...
>>>>>>>> TERMINATING RUN (50e2d002-5a5b-4e5d-a703-448614de56e2): Maximum rounds (7) reached
في المخرج أعلاه لاحظ التالي:
- المدير اختار
proposerفي كل الجولات الست، فلم يتكلم الناقد ولا الحكم ولا مرة، وانتهت المحادثة بالوصول إلى الحد دون أي قرار. - المقترح نفسه أرجع رداً فارغاً في كل جولة ثانية، والوسيط سجل لهذه الردود توكناً واحداً، ثم في الجولة التالية كتب سطراً يناقض فيه نفسه، فقال إن Redis لا يتوسع أفقياً وإن PostgreSQL يتوسع بإضافة سيرفرات، وهذا ليس دقيقاً، ثم رجع ليقول إن فوائد Redis أكبر.
- الوسيط سجل 12 استدعاءً، ستة منها للمدير ليختار المتكلم، وكل منها بتعليمات نظام من 711 حرفاً وجواب من ثلاثة توكنات، أي نصف الاستدعاءات لم تنتج أي كلمة في النقاش.
- مدخل المدير كبر في كل جولة لأنه يقرأ المحادثة كلها: 232 ثم 303 ثم 353 ثم 393 توكناً، وهذا هو النمو الذي نحسب ثمنه في مقال التكلفة.
ثم غيرنا سطراً واحداً: speaker_selection_method="round_robin"، أي أن يتكلم الأعضاء بالدور دون أن يسأل المدير النموذج، والمحادثة هذه المرة كانت كما يلي:
--- proposer:
For a web app with 2,000 daily users, storing login sessions in Redis is recommended. Reasons: Redis is highly concurrent, fast for session management with minimal overhead, and its in-memory nature prevents slow disk I/O from affecting session handling.
--- critic:
While storing login sessions in PostgreSQL is also viable, Redis offers significant advantages such as high concurrency, faster session management, and minimal impact on the main database, which is crucial given the 2,000 daily users. Additionally,Redis's in-memory model ensures quick session handling without the burden of disk I/O.
--- judge:
TERMINATE
في المخرج أعلاه لاحظ التالي:
- الترتيب أصبح صحيحاً، وثلاثة استدعاءات فقط بدل اثني عشر، لأن اختيار المتكلم صار في الكود.
- الناقد وافق المقترح وكرر أسبابه، رغم أن تعليماته تقول «لا توافق مجاملة»، ولم يذكر أي شيء من ظروف السؤال: أن PostgreSQL مثبت أصلاً، وأن السيرفر 4 GB، وأن الفريق ثلاثة مطورين، وأن 2,000 مستخدم في اليوم ضغط صغير على أي قاعدة بيانات.
- الحكم كتب كلمة الإنهاء فقط، دون قرار ودون أسباب، فانتهت المحادثة رسمياً بنجاح، والنتيجة فارغة.
والقرار الذي كان يجب أن يخرج من نقاش جيد على هذا السؤال قريب من: ابدأ بجدول في PostgreSQL لأنه موجود ولا يضيف خدمة جديدة تحتاج ذاكرة ومراقبة ونسخاً احتياطياً، و2,000 مستخدم في اليوم لا يقتربون من حدوده، وانتقل إلى Redis إذا قست أن الجلسات أصبحت عبئاً فعلياً. ولم يقترب أي من التشغيلين من هذا، لأن النموذج الصغير يكرر الإجابة الشائعة «Redis أسرع» دون أن يقرأ ظروف السؤال، وكل الأدوار هي النموذج نفسه بالعادة نفسها.
أين تجد النقاش بين الوكلاء في أدوات البرمجة اليومية؟
قد لا تبني نظام نقاش بنفسك أبداً، ولكنك سوف تقابل أشكاله في أدواتك، ومعرفة أي شكل هو تساعدك أن تعرف ماذا تتوقع منه:
- أفضل من عدة محاولات Best-of-N: الأمر
/best-of-nفي Cursor يشغل المهمة نفسها على عدة نماذج معاً، كل منها في Worktree خاصة به، بحسب توثيق الـ Worktrees في Cursor، ثم تختار أنت النتيجة. وهذا أقرب إلى التصويت منه إلى النقاش، لأن المحاولات لا ترى بعضها، والحكم أنت، وهذا ما يجعله مفيداً: تنوع حقيقي في النماذج، وحكم يعرف ظروف المشروع. - زملاء يتراسلون: في فرق الوكلاء في Claude Code يستطيع الزملاء أن يرسلوا رسائل مباشرة لبعضهم ويتشاركوا قائمة مهام، وهذه البنية التي تسمح بنقاش حقيقي بين وكلاء مستقلين، ولكنها تجريبية ومعطلة افتراضياً، وصفحة التكاليف تذكر أنها تستهلك قرابة سبعة أضعاف توكنات الجلسة العادية عندما يعمل الزملاء في وضع التخطيط.
- وكيل المراجعة في خط النشر: وكيل يقرأ طلب الدمج ويكتب ملاحظات، ثم يرد المطور أو وكيله، وهذا نقاش بين مقترح وناقد، والحكم فيه الإنسان الذي يوافق على الدمج. وقد ناقشنا كيف لا تصبح هذه المراجعة شكلية في مقال مراجعة كود الذكاء الاصطناعي.
ولاحظ القاسم المشترك: في الأشكال التي تنفع فعلاً يكون الحكم إنساناً أو اختباراً، والنموذج يولد البدائل أو الملاحظات فقط. وهذا يتفق مع ما رأيناه في المختبر، حيث كان الحكم النموذج أضعف حلقة.
إذا بنيت نقاشاً بين وكلاء: خمس قواعد
- نماذج مختلفة للأدوار المختلفة: النموذج نفسه في الأدوار الثلاثة يحمل الأخطاء نفسها، كما رأينا في التصويت الذي أعطى الجواب الخاطئ نفسه ثلاث مرات. ناقد من عائلة نماذج أخرى يرى أخطاء لا يراها المقترح، لأن عاداته مختلفة.
- أعط الناقد أداة لا رأياً فقط: الناقد الذي يستطيع أن يشغل الكود أو يبحث في التوثيق يأتي بدليل، والدليل يقنع الحكم أكثر من الثقة. وناقد السؤال السابع كان محقاً، ولكن لم يكن معه ما يثبت ذلك إلا الكلام.
- اطلب نوعاً محدداً من الأخطاء: «ابحث عن أي خطأ» تنتج اعتراضات عامة أو موافقة عامة، و«تحقق من الحالات الحدية: النص الفارغ والعدد السالب والقيمة المكررة» تنتج فحصاً حقيقياً.
- اجعل الحكم يكتب قراراً بشكل محدد: سطر
DECISION:أو JSON بحقل للقرار وحقل للسبب، ويفحص الكود أن القرار موجود قبل أن ينهي المحادثة، فلا يتكرر ما حدث عندما كتب الحكمTERMINATEوحدها. - الترتيب والحدود في الكود: من يتكلم ومتى، وكم جولة، ومتى ينتهي النقاش، كلها قرارات يعرفها الكود، والنموذج الذي يختار المتكلم استدعاء إضافي في كل جولة قد يعطي الكلمة للشخص نفسه كل مرة.
لماذا لا يتحسن الجواب بالنقاش دائماً؟
من الأبحاث ومن المختبر يمكن أن نجمع أسباب فشل النقاش في خمس نقاط، وكلها مفيدة لك حتى لو لم تبن نظام نقاش أبداً، لأنها تحدث أيضاً عندما تطلب من وكيل مراجعة عمل وكيل آخر:
- النموذج نفسه بالأخطاء نفسها: إذا كان المقترح والناقد والحكم النموذج نفسه، فإنهم يتشاركون نقاط الضعف نفسها، والخطأ الذي لا يراه الأول لا يراه الثاني في الغالب. والنقاش يساعد في الأخطاء العشوائية، مثل خطأ حسابي في عينة واحدة، ولا يساعد في الخطأ الذي يقع فيه النموذج كل مرة.
- المجاملة والامتثال Conformity: الوكيل الذي يقرأ جواباً آخر يميل إلى الموافقة عليه، خاصة إذا كان مكتوباً بثقة، فقد ينتقل الوكيل الصحيح إلى الجواب الخاطئ، وليس العكس دائماً.
- الحكم يختار الأكثر ثقة لا الأصح: الحكم يقرأ نصين ويختار، وليس عنده طريقة ليتحقق، فيميل إلى الجواب الأطول أو الأكثر حسماً.
- الناقد الذي يعترض لأنه طلب منه: إذا قلت للناقد إن دوره أن يجد الخطأ، فقد يجد خطأً غير موجود في جواب صحيح، ثم يقنع الحكم به.
- التكلفة تكبر أسرع من الفائدة: كل جولة نقاش تعني أن كل وكيل يقرأ كل ما قيل قبله، فيكبر المدخل في كل جولة، وسوف نفصل هذا بالأرقام في مقال التكلفة.
وهناك ملاحظة تربط هذا بأول المقال: المجاملة التي رأيناها عندما غير النموذج رأيه في Redis لأنك اعترضت، هي نفسها التي جعلت الناقد في المحادثة الجماعية يوافق المقترح ويكرر أسبابه، رغم أن تعليماته تقول له ألا يجامل. فالنموذج يميل إلى الموافقة على النص الذي أمامه، سواء كتبته أنت أو كتبه وكيل آخر، وتعدد الأدوار لا يلغي هذا الميل وإنما ينقله من المحادثة معك إلى المحادثة بين الوكلاء. ولذلك فإن الناقد المفيد هو الذي يقرأ الكود أو المشروع نفسه، أو يشغل شيئاً، وليس الذي يقرأ رأي المقترح فقط ويعلق عليه.
والحل المشترك لأغلب هذه النقاط هو نفسه الذي ذكرناه في المقال الأول من هذه المرحلة: إذا كان هناك تحقق آلي، مثل تشغيل الكود أو الاختبارات، فاجعله هو الحكم، واجعل النقاش لتوليد الاحتمالات فقط. فلو كان عند الحكم في المختبر أداة تشغل الكود لما احتاج أن يقتنع بأحد.
متى يستحق النقاش بين الوكلاء تكلفته؟
| الحالة | الطريقة الأنسب | والسبب |
|---|---|---|
| للجواب شكل يمكن فحصه آلياً، مثل رقم أو مخرج أو نتيجة اختبار | شغل الفحص نفسه، أو تصويت بين عدة إجابات | الفحص لا يجامل، والتصويت لا يحتاج حكماً |
| قرار تصميم أو معمارية فيه موازنات | مقترح وناقد، والقرار لك | الناقد يظهر ما نسيته، ولكن الحكم النموذج لا يعرف ظروف فريقك |
| مراجعة كود قبل الدمج | اختبارات أولاً، ثم وكيل مراجع بتعليمات تبحث عن نوع محدد من الأخطاء | المراجعة العامة تنتج ملاحظات عامة |
| برنامج جديد صغير من الصفر للتجربة | إطار بأدوار، مثل ChatDev أو MetaGPT، أو وكيل واحد بمواصفة | هذا ما صممت له هذه الأنظمة، وليس التعديل في مستودع كبير |
| نموذج صغير محلي | تصويت أو فحص آلي، وليس نقاشاً طويلاً | النموذج الصغير يتأثر بما يقرؤه ويغير جوابه الصحيح أحياناً |
أخطاء شائعة
- مقارنة النقاش بجواب واحد فقط: النقاش يدفع أربعة استدعاءات أو أكثر، فقارنه بطريقة تدفع العدد نفسه، مثل التصويت، وإلا فإنك تقيس أثر المال لا أثر النقاش.
- حكم بلا أداة: حكم يقرأ نصين ويختار بالثقة. إذا كان هناك ما يمكن تشغيله فأعطه للحكم.
- ناقد يجب أن يعترض: تعليمات مثل «اعترض دائماً» تنتج اعتراضات على الصحيح. اطلب من الناقد أن يتحقق، وأن يقول «لا يوجد خطأ» عندما لا يجد.
- محادثة جماعية بلا حد: مدير يختار المتكلم بالنموذج ولا حد للجولات، فتدور المحادثة وتكرر نفسها. ضع
max_roundوشرط إنهاء واضحاً. - الاعتماد على اختيار المتكلم الآلي عندما يكون الترتيب معروفاً: إذا كنت تعرف أن الترتيب مقترح ثم ناقد ثم حكم، فاكتبه في الكود، ووفر استدعاءً كاملاً قبل كل رسالة.
- حد مخرج أقصر من التفكير: إذا طلبت التفكير قبل الجواب ووضعت حداً صغيراً للمخرج، فقد ينقطع الرد قبل الجواب كما حدث في أول تشغيل عندنا، وإذا طلبت الجواب أولاً فقد يكتبه النموذج قبل أن يفكر. اختر واحداً عن قصد، وارفع الحد بما يكفي للتفكير الذي تطلبه، وتحقق من أن الكود وجد سطر الجواب فعلاً.
- نسخ مثال قديم لـ AutoGen: الأسماء تغيرت بين AutoGen من Microsoft وAG2 وAG2 Classic، فثبت الإصدار الذي يناسب المثال، واكتبه في ملف المتطلبات.
قائمة تحقق
- هل جربت جواباً واحداً وتصويتاً قبل أن تبني نقاشاً؟
- هل عندك أسئلة معروفة الجواب لتقيس عليها، ولو عشرة؟
- هل الحكم يملك طريقة للتحقق، أم يختار بالثقة فقط؟
- هل تعليمات الناقد تسمح له أن يقول «لا يوجد خطأ»؟
- هل ترتيب المتكلمين في الكود عندما يكون معروفاً؟
- هل هناك حد للجولات وشرط إنهاء؟
- هل تعد الاستدعاءات والتوكنات لكل طريقة؟
تدريب عملي
- في
debate.pyأعط الحكم أداة واحدة تشغل المقطع فيsubprocessوترجع ما طبعه، واطلب منه أن يشغله قبل أن يحكم، ثم قارن النتيجة بـ 4 من 10. - غير تعليمات الناقد إلى «تحقق من الجواب، وإذا لم تجد خطأً فقل ذلك»، وانظر هل يقل عدد المرات التي يغير فيها الجواب الصحيح.
- في
design_chat.pyاكتب دالة تختار المتكلم بالترتيب مقترح ثم ناقد ثم حكم، ومررها فيspeaker_selection_method، وأضف إلى تعليمات الحكم أن يذكر القرار في سطر أول يبدأ بـDECISION:قبلTERMINATE.
الخلاصة
- فكرة النقاش بين الوكلاء جاءت من بحث Du وزملائه في 2023، حيث يقرأ كل وكيل إجابات الآخرين ويراجع إجابته، ومن بحث Liang وزملائه بأدوار المعارض والحكم، ولكن بحث Smit وزملائه وجد أنها لا تتفوق بشكل ثابت على التصويت بالتكلفة نفسها.
- ChatDev وMetaGPT بنيا فرقاً تحاكي شركة برمجة: الأول بمحادثات بين أدوار في كل مرحلة، والثاني بمستندات محددة الشكل على خط إنتاج، وكلاهما تغير اليوم: ChatDev 2.0 منصة دون كود، وMetaGPT آخر إصدار منشور له من 2024.
- AutoGen الأصلي مؤرشف عند Microsoft، والمحادثة الجماعية تعيش اليوم في AG2 Classic باسم الحزمة
autogen، وAG2 الجديد يستبدلها بالـ Network. - على عشرة أسئلة Python معروفة الجواب: جواب واحد 2، والتصويت 2، والنقاش 3، والمقترح والناقد والحكم 4، بثلاثة إلى أربعة أضعاف الاستدعاءات، وحكم يملك أداة تشغيل كان سيحصل على 10.
- الحكم رفض جواب الناقد الصحيح بشرح يؤكد صحته، وفي المحادثة الجماعية أعطى الاختيار الآلي الكلمة للمقترح ست مرات، والدور بالترتيب أعطى ناقداً يوافق وحكماً لا يحكم.
- اجعل التشغيل والاختبار هو الحكم كلما أمكن، واجعل النقاش لتوليد الاحتمالات في القرارات التي لا يمكن تشغيلها، والقرار الأخير لك.
وفي المقال الأخير من هذه المرحلة بإذن الله نحسب ثمن هذا كله: لماذا تكبر المدخلات في كل جولة نقاش، ومتى يصبح تعدد الوكلاء أغلى وأبطأ من وكيل واحد، والمقالات السابقة من المرحلة هنا:
 دليلمتى يصبح تعدد الوكلاء Multi-agent أغلى وأبطأ من وكيل واحد؟من أين تأتي التوكنات الإضافية في فرق الوكلاء، ولماذا لا يختصر التوازي الوقت دائماً، مع أرقام حقيقية من مختبرات المرحلة محولة إلى تكلفة سنة بأسعار Anthropic وOpenAI وGoogle الرسمية.
 دليلتعدد الوكلاء Multi-agent: المخطط والمنفذ والمراجعمتى يحتاج العمل أكثر من وكيل، وما الذي يضيع عند التسليم بين المخطط والمنفذ والمراجع، مع تجربة على نموذج محلي تقارن وكيلاً واحداً بفريق على المهمة نفسها.
 دليلالوكلاء الفرعيون Subagents والعمل بالتوازي في فروع منفصلةكيف يعمل الوكيل الفرعي في Claude Code وCodex وCursor، ومتى يفيد عزل القراءة والكتابة في Worktree لكل وكيل، مع تجربة على نموذج محلي فيها أخطاء مزروعة وإصلاحات في فروع منفصلة وتعارض حقيقي.
 دليلأطر تنسيق الوكلاء Agent Frameworks: LangGraph وCrewAI وAG2خمسة أطر لتعدد الوكلاء على مهمة واحدة ونموذج محلي واحد، مع وسيط يسجل كل طلب يرسله الإطار، لترى التعليمات المخفية والاستدعاءات وأين وقع الخطأ في كل منها.
سجل التحديثات
- 20 نوفمبر 2026: كتابة المقال، وتشغيل أربع طرق على عشرة أسئلة Python معروفة الجواب، ومحادثة جماعية في AG2 Classic (autogen 0.14.1) بطريقتي اختيار المتكلم، على Ollama 0.40.13 بنموذج qwen2.5:3b.