رأيت عرضاً توضيحياً Demo لفريق من الوكلاء: مخطط يقسم الميزة Feature إلى خمس مهام، وخمسة وكلاء يعملون بالتوازي، ومراجع يشغل الاختبارات، وطلب دمج Pull Request جاهز في عشرين دقيقة. فتقرر أن تجربه في فريقك، وبعد شهر تصلك فاتورة أكبر بعدة أضعاف مما توقعت، والمهام لم تصبح أسرع بالقدر نفسه، وأحياناً أبطأ. وهذا ليس سوء حظ، وإنما نتيجة متوقعة لطريقة عمل تعدد الوكلاء Multi-agent: كل وكيل يقرأ تعليماته وأدواته من جديد، وكل تسليم Handoff نص يكتبه نموذج ويقرؤه نموذج آخر، وكل جولة مراجعة استدعاءات جديدة، والتوازي يختصر الوقت فقط في الأجزاء المستقلة فعلاً، أما المخطط في البداية والمراجع في النهاية فيعملان واحداً بعد الآخر.
وفي مقال تكلفة وكلاء البرمجة شرحنا أسعار الأدوات والاشتراكات والتوكنات Tokens، وكيف تقيس تكلفة طلب الدمج الواحد، وفي مقال تكلفة الذكاء الاصطناعي بالتوكنات شرحنا التسعير بالتوكن والذاكرة المؤقتة Prompt Caching والمعالجة المجمعة Batch، فلا نعيد ذلك هنا. وهذا المقال آخر مقالات مرحلة تعدد الوكلاء، ويجيب عن سؤال واحد بالأرقام: متى يصبح تعدد الوكلاء أغلى وأبطأ من وكيل واحد، ومتى يستحق ثمنه؟ والأرقام من المختبرات التي شغلناها في مقالات هذه المرحلة على نموذج محلي، حيث عددنا كل توكن دخل النموذج وخرج منه، ثم حولناها إلى دولارات بأسعار المزودين الرسمية كما قرأناها في 20 نوفمبر 2026.
سوف نناقش في هذا المقال:
- من أين تأتي التكلفة الإضافية في تعدد الوكلاء، جزءاً جزءاً.
- لماذا يكون الفريق أبطأ أحياناً رغم التوازي، والمسار الحرج Critical Path.
- الأرقام الحقيقية من مختبرات هذه المرحلة: الاستدعاءات والتوكنات والوقت، وكيلاً واحداً أمام فريق.
- لماذا تكبر المحادثة الجماعية أسرع مما تتوقع، بقياس التوكنات في كل دورة.
- من التوكنات إلى الدولار: تكلفة المهمة الواحدة وتكلفة سنة لفريق افتراضي بأسعار Anthropic وOpenAI وGoogle.
- كيف تخفض التكلفة، وجدول قرار متى يستحق تعدد الوكلاء ثمنه.
من أين تأتي التكلفة الإضافية Overhead؟
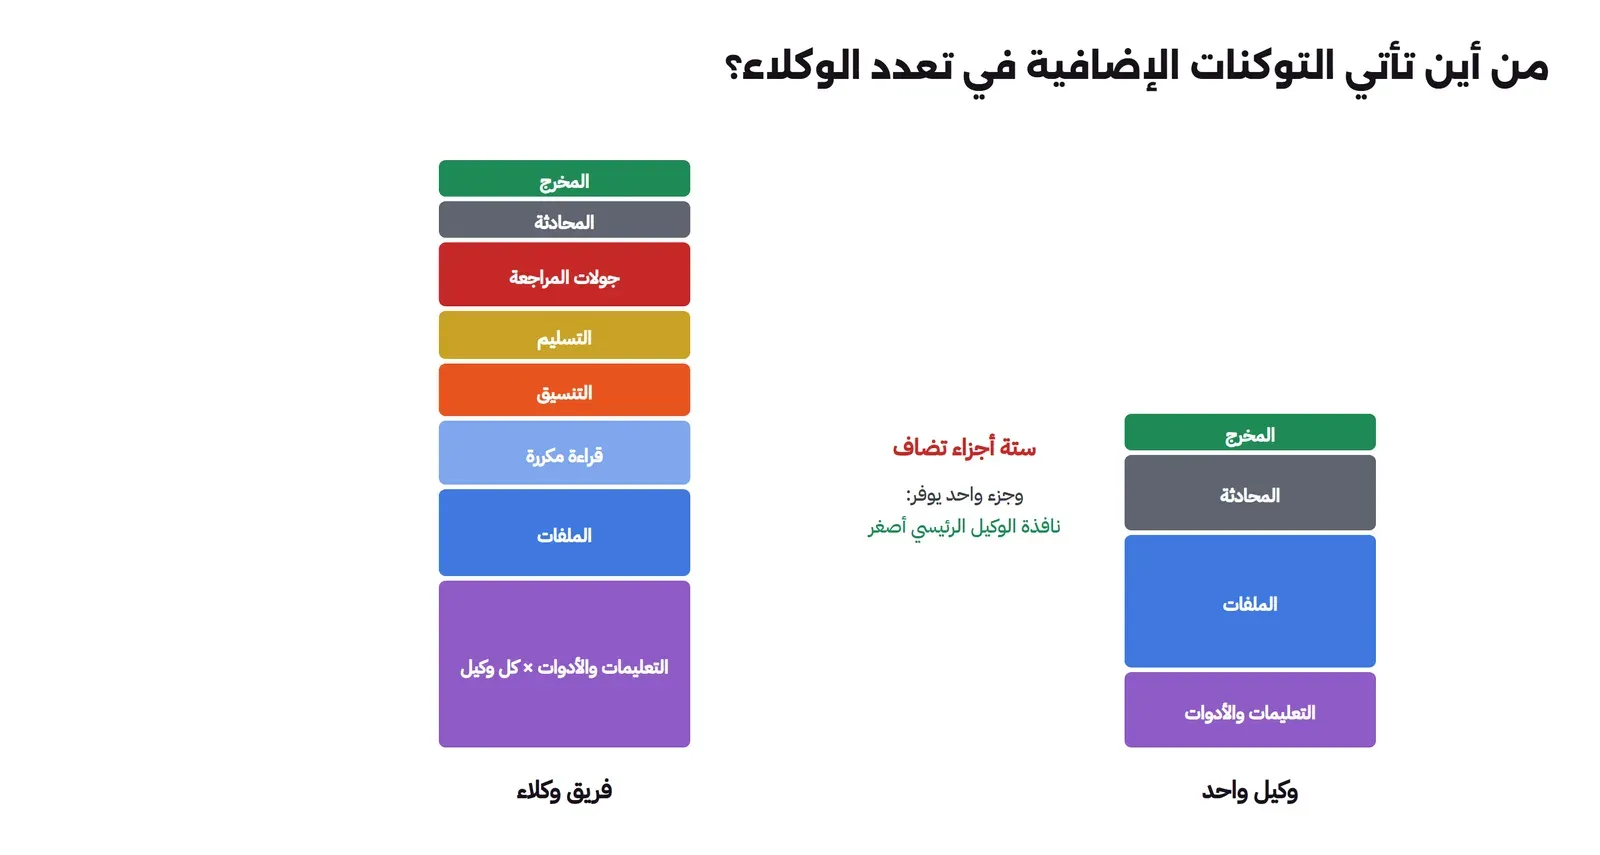
لنبدأ من تعريف بسيط: تكلفة أي نظام وكلاء هي مجموع توكنات المدخل Input وتوكنات المخرج Output في كل استدعاء للنموذج، مضروبة في سعر كل منهما، والمدخل في الغالب أكبر بكثير من المخرج، لأن الوكيل يرسل في كل دورة تعليماته وأدواته والمحادثة كلها من جديد. وفي الوكيل الواحد يتكرر هذا لنافذة واحدة، أما في تعدد الوكلاء فإنه يتكرر لكل نافذة، وتضاف إليه أجزاء لا توجد في الوكيل الواحد أصلاً:
- التعليمات والأدوات المكررة Repeated System Prompts: كل وكيل فرعي يبدأ بتعليمات نظامه وتعريف أدواته، وفي مقال هندسة السياق رأينا طلباً حقيقياً من Codex CLI فيه 8,316 توكناً قبل أن يقرأ النموذج سؤالك، منها 4,059 لتعريف الأدوات. فإذا شغلت خمسة وكلاء فرعيين بالأدوات نفسها فقد دفعت هذا الجزء خمس مرات إضافية على الأقل.
- القراءة المكررة Re-reading: الوكيل الواحد يقرأ الملف مرة ويبقى في نافذته، أما الوكلاء الفرعيون فكل منهم يقرأ ما يحتاجه من جديد، وإذا احتاج ثلاثة منهم ملف الإعدادات نفسه فقد قرئ ثلاث مرات.
- التنسيق Orchestration: استدعاءات لا تنتج عملاً وإنما تقرر من يعمل: المخطط الذي يقسم، والمدير الذي يختار المتكلم التالي في المحادثة الجماعية، والوكيل الرئيسي الذي يقرأ الخلاصات ويقرر الخطوة التالية.
- التسليم Handoff: كل نتيجة يكتبها وكيل فرعي يقرؤها الوكيل الرئيسي، وكل مهمة يكتبها المخطط يقرؤها المنفذ، وهذه النصوص مدخلات جديدة لم تكن موجودة عندما كان الوكيل يعمل وحده.
- جولات المراجعة Review Rounds: كل مرة يرفض فيها المراجع النتيجة تعني استدعاء للمراجع واستدعاء جديداً للمنفذ مع ملاحظات المراجع.
- نمو السجل History Growth: في المحادثة الجماعية كل وكيل يقرأ كل الرسائل السابقة في كل دورة، فتكبر المدخلات مع كل رسالة، ومجموعها يكبر أسرع بكثير من عدد الرسائل، كما سنقيس بعد قليل.
وفي مقابل هذه الأجزاء هناك شيء واحد يوفره تعدد الوكلاء: نافذة الوكيل الرئيسي تبقى أصغر، لأنها لا تحمل ما قرأه الوكلاء الفرعيون، فإذا كانت المهمة طويلة جداً فإن كل دورة في الوكيل الواحد كانت سوف ترسل آلاف التوكنات من ملفات قديمة لا يحتاجها، والوكيل الرئيسي في تعدد الوكلاء لا يرسلها. ولذلك فإن السؤال ليس «هل تعدد الوكلاء أغلى؟»، فهو أغلى في أغلب المهام القصيرة، وإنما «هل المهمة طويلة بما يكفي لأن يوفر صغر النافذة الرئيسية أكثر مما تكلفه الأجزاء الستة؟».
لماذا يكون الفريق أبطأ أحياناً رغم التوازي؟
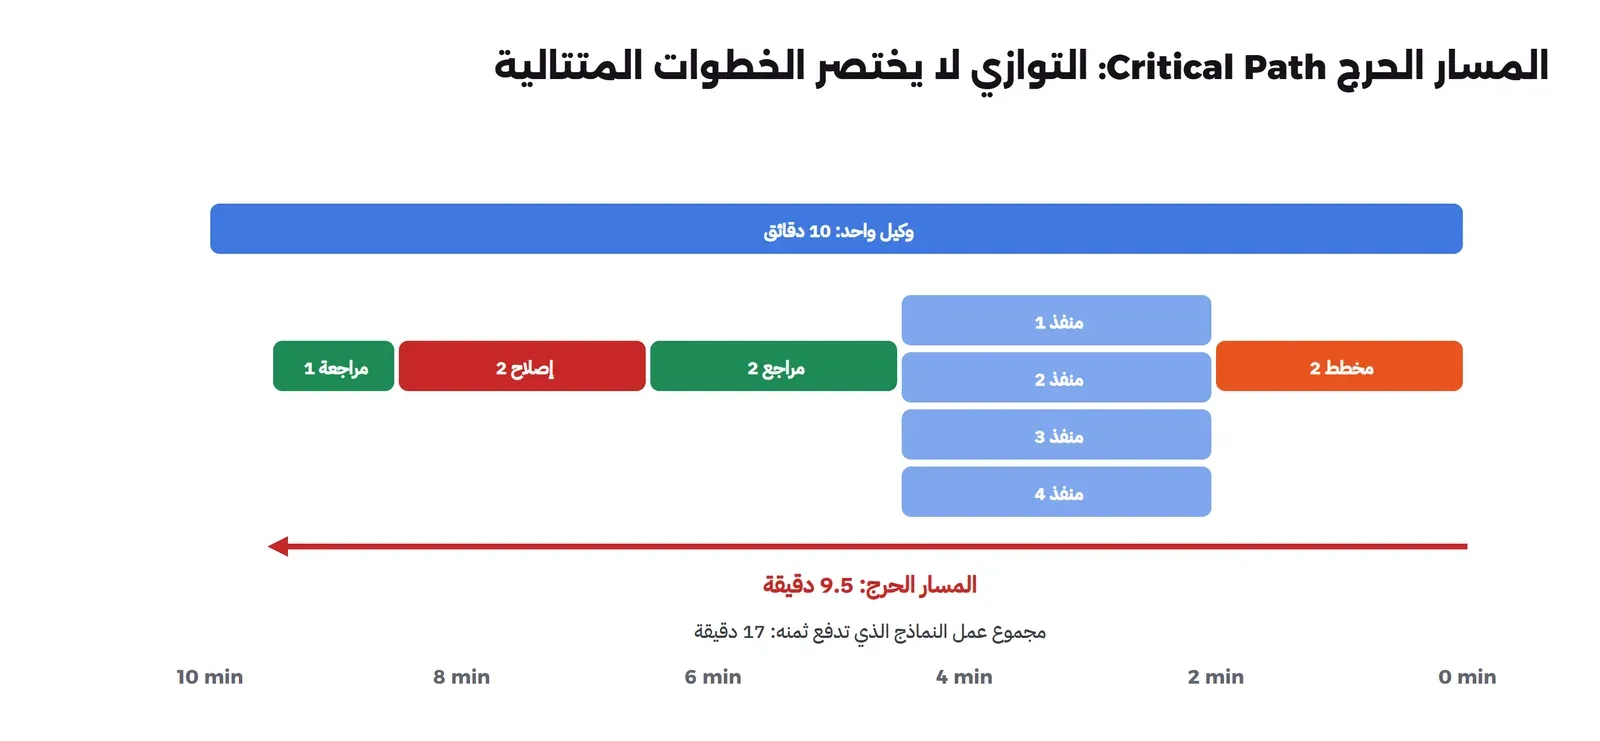
التوازي يختصر الوقت الكلي Wall Time عندما تعمل أجزاء مستقلة في الوقت نفسه، ولكن أي نظام تعدد وكلاء فيه أجزاء لا تعمل إلا واحداً بعد الآخر: المخطط يجب أن ينتهي قبل أن يبدأ المنفذون، والمراجع لا يبدأ إلا بعد أن ينتهي آخر منفذ، والإصلاح بعد المراجعة يبدأ بعدها. وهذه السلسلة من الخطوات المتتالية هي المسار الحرج Critical Path، والوقت الكلي لا يمكن أن يكون أقل منه مهما زاد عدد المنفذين. والقانون المعروف في الحوسبة المتوازية لهذا الأمر هو قانون أمدال Amdahl's Law الذي وصفه Gene Amdahl في 1967: إذا كان جزء من العمل لا يمكن توزيعه فإن هذا الجزء يحدد أقصى تسريع ممكن.
ولنأخذ مثالاً بأرقام بسيطة: وكيل واحد ينهي مهمة في عشر دقائق. نقسمها إلى مخطط يأخذ دقيقتين، وأربعة منفذين يأخذ كل منهم دقيقتين ونصف إذا عملوا معاً، ومراجع يأخذ دقيقتين، وجولة إصلاح لمنفذ واحد تأخذ دقيقتين ومراجعة ثانية تأخذ دقيقة. فالمسار الحرج هو 2 ثم 2.5 ثم 2 ثم 2 ثم 1، أي تسع دقائق ونصف، وهذا تقريباً وقت الوكيل الواحد، رغم أن مجموع عمل النماذج أصبح سبع عشرة دقيقة، أي قرابة ضعفه. وهذا قبل أن نحسب ثلاثة أشياء تجعل التوازي في الواقع أبطأ مما في الورقة:
- حدود المعدل Rate Limits: المزود يحدد عدد الطلبات والتوكنات في الدقيقة لحسابك، وخمسة وكلاء معاً يصلون إلى الحد أسرع، فينتظر بعضهم.
- العتاد المحلي Local Hardware: إذا كان النموذج على جهازك أو سيرفرك، فإن طلبين معاً يتقاسمان المعالج نفسه، والتوازي لا يضيف قدرة حسابية، وسوف نرى هذا بالأرقام في المختبر.
- أنت: خمسة طلبات دمج جاهزة في عشرين دقيقة تعني خمس مراجعات تنتظرك، والمراجعة البشرية هي أبطأ جزء في المسار الحرج في أغلب الفرق، وهذا ما ناقشناه في مقال هل يجعلك الوكيل أسرع فعلاً.
الأرقام الحقيقية من مختبرات هذه المرحلة
في مقالات هذه المرحلة شغلنا أربع تجارب على النموذج نفسه، qwen2.5:3b على Ollama 0.40.13، وسجلنا في كل منها عدد توكنات المدخل والمخرج لكل استدعاء كما يرجعها Ollama، في ملفات calls.jsonl. ونسخنا هذه الملفات إلى مجلد lab/data/ في هذا المقال، والسكربت cost.py يجمعها لكل تشغيل. والجدول التالي يضع كل تشغيل بفريق بجانب نظيره بوكيل واحد:
| التجربة | الطريقة | الاستدعاءات | توكنات المدخل | توكنات المخرج | النتيجة |
|---|---|---|---|---|---|
| أربع دوال واختبارات، بذرة 1 | وكيل واحد | 3 | 4,965 | 1,985 | 0 من 10 |
| مخطط ومنفذون ومراجع | 13 | 4,300 | 2,519 | 8 من 10 | |
| أربع دوال واختبارات، بذرة 2 | وكيل واحد | 3 | 5,120 | 2,198 | 5 من 10 |
| مخطط ومنفذون ومراجع | 17 | 7,723 | 3,486 | 5 من 10 | |
| ستة أخطاء في عشرة ملفات | وكيل واحد يقرأ الكل | 1 | 3,013 | 201 | 0 من 6 |
| عشرة وكلاء فرعيين ووكيل رئيسي | 11 | 4,157 | 531 | 2 من 6، و4 إنذارات كاذبة | |
| عشرة أسئلة Python | جواب واحد | 10 | 833 | 645 | 2 من 10 |
| تصويت من ثلاثة | 30 | 2,499 | 1,821 | 2 من 10 | |
| نقاش بجولتين | 40 | 6,873 | 2,707 | 3 من 10 | |
| مقترح وناقد وحكم | 30 | 5,259 | 2,252 | 4 من 10 |
في الجدول أعلاه لاحظ التالي:
- عدد الاستدعاءات هو أثبت رقم: الفريق احتاج من ثلاثة إلى ستة أضعاف استدعاءات الوكيل الواحد في كل تجربة، وهذا لا يتغير كثيراً مع البذرة أو النموذج، لأنه يأتي من بنية النظام نفسه.
- توكنات المدخل لم تكبر بالنسبة نفسها، بل كانت أقل في تشغيل واحد، 4,300 مقابل 4,965، لأن نوافذ المنفذين صغيرة. وهذا هو التوفير الوحيد الذي ذكرناه في أول المقال، ويظهر عندما تكون المهمة كلها في نافذة واحدة كبيرة.
- النتيجة لم تتحسن بالقدر نفسه في أي تجربة: مرة تحسنت كثيراً، ومرة بقيت كما هي، ومرة تحسنت بإجابة أو اثنتين من عشر.
وفي مقال أطر تنسيق الوكلاء قسنا المهمة نفسها في خمسة أطر، وكان الفرق في توكنات المدخل أكبر بكثير من الفرق بين وكيل واحد وفريق: من 933 توكناً في AG2 Classic إلى 19,876 في smolagents، أي أكثر من عشرين ضعفاً، لأن الإطار يضيف تعليماته إلى كل طلب. فالإطار الذي تختاره يمكن أن يغير الفاتورة أكثر مما يغيرها قرار التقسيم نفسه.
لماذا تكبر المدخلات مع كل دورة؟
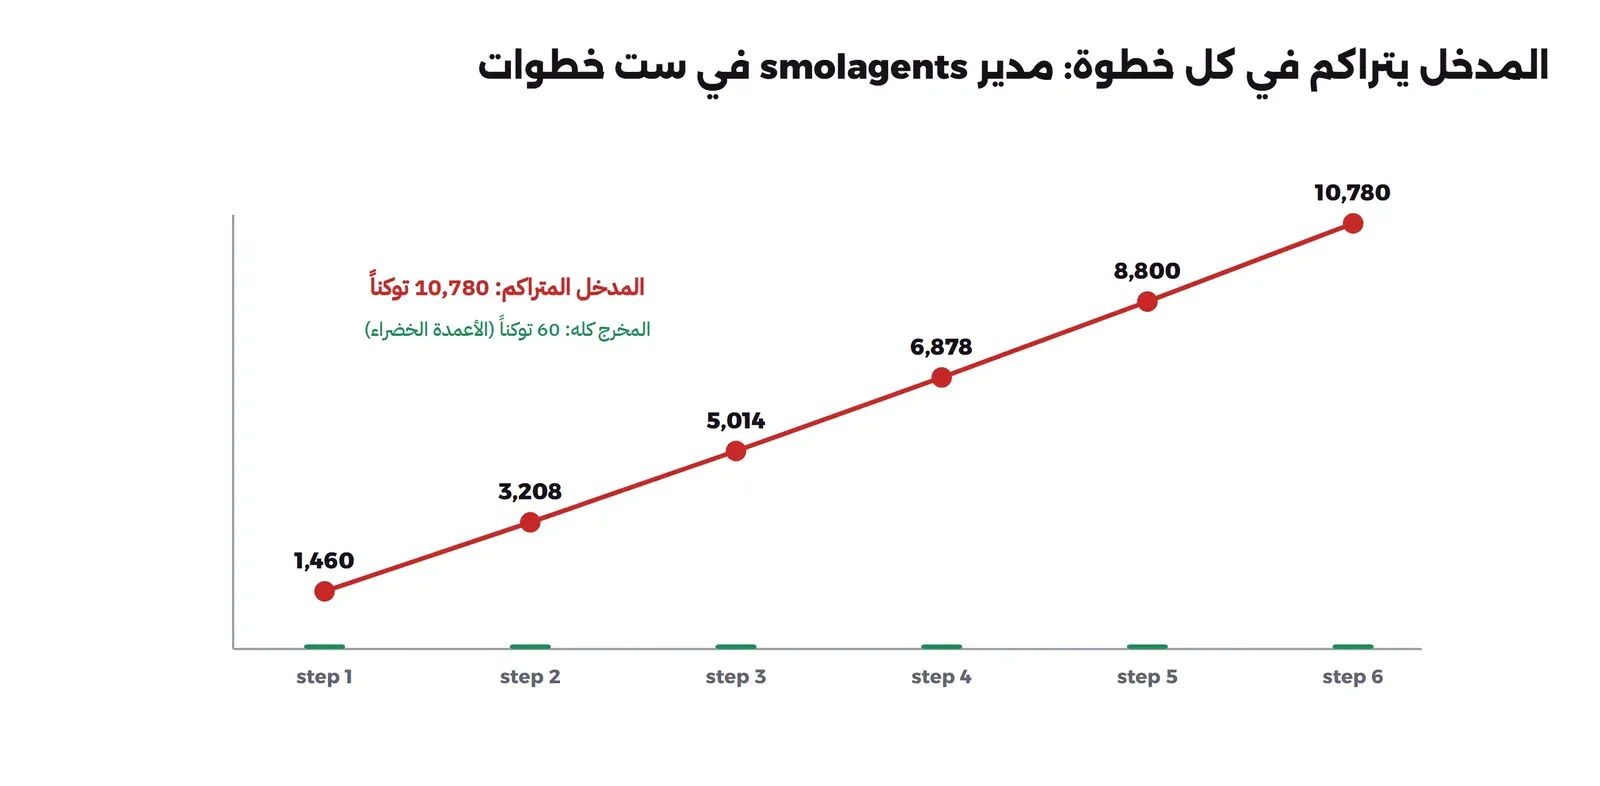
الوكيل لا يتذكر شيئاً بين استدعاء وآخر، فكل دورة ترسل المحادثة كلها من جديد مع الرسالة الجديدة. وهذا يعني أن الدورة العاشرة تدفع ثمن الدورات التسع قبلها مرة أخرى، وأن مجموع المدخلات في محادثة طولها n رسالة يكبر تقريباً مع مربع n وليس مع n. وهذا ما رأيناه في تشغيل smolagents، حيث يطبع الإطار بنفسه المدخلات المتراكمة للمدير بعد كل خطوة:
[Step 1: Duration 596.97 seconds| Input tokens: 1,460 | Output tokens: 45]
[Step 2: Duration 51.58 seconds| Input tokens: 3,208 | Output tokens: 48]
[Step 3: Duration 14.40 seconds| Input tokens: 5,014 | Output tokens: 51]
[Step 4: Duration 20.52 seconds| Input tokens: 6,878 | Output tokens: 54]
[Step 5: Duration 15.92 seconds| Input tokens: 8,800 | Output tokens: 57]
[Step 6: Duration 21.14 seconds| Input tokens: 10,780 | Output tokens: 60]
في المخرج أعلاه لاحظ التالي:
- المخرج كله في ست خطوات 60 توكناً فقط، أي ردود فارغة تقريباً، لأن المدير كان يفشل في كتابة استدعاء أداة صالح، ومع ذلك فإن المدخل وصل إلى 10,780 توكناً.
- كل خطوة أضافت بين 1,748 و1,980 توكناً، والجزء الأكبر منها تعليمات الإطار الثابتة، 4,386 حرفاً، التي ترسل في كل خطوة، ثم المحادثة التي تكبر قليلاً مع كل محاولة فاشلة.
- لو كانت تعليمات النظام في الذاكرة المؤقتة Prompt Caching عند مزود يدعمها، لكان أغلب هذه المدخلات يقرأ بسعر أقل بكثير، وهذا سبب أن الذاكرة المؤقتة أهم في تعدد الوكلاء منها في المحادثة العادية.
والمحادثة الجماعية تجمع النمو والتنسيق معاً. ففي مقال فريق الوكلاء الذي يتناقش شغلنا محادثة جماعية في AG2 Classic على قرار تصميم واحد مرتين، والفرق الوحيد بينهما طريقة اختيار المتكلم، والوسيط سجل كل طلب:
| طريقة اختيار المتكلم | الاستدعاءات | منها للاختيار | توكنات المدخل | توكنات المخرج | النتيجة |
|---|---|---|---|---|---|
auto، المدير يسأل النموذج | 12 | 6 | 2,992 | 185 | لا قرار، الحد الأقصى للجولات |
round_robin، بالدور في الكود | 3 | 0 | 440 | 122 | لا قرار، الحكم كتب TERMINATE فقط |
والنتيجة في الحالتين سيئة، ولكن الثمن مختلف بنحو سبعة أضعاف في المدخلات، والسبب أن كل استدعاء للاختيار يرسل المحادثة كلها مع تعليمات من 711 حرفاً ليرجع كلمة واحدة، ومدخله كبر من 232 إلى 393 توكناً خلال ست جولات. فإذا كنت تعرف ترتيب المتكلمين فاكتبه في الكود، ووفر نصف الاستدعاءات.
من التوكنات إلى الدولار: أسعار المزودين الرسمية
الأسعار التالية بالدولار لكل مليون توكن من صفحات الأسعار الرسمية كما قرأناها في 20 نوفمبر 2026: أسعار Claude وأسعار OpenAI وأسعار Gemini، وهي الأسعار العادية دون المعالجة المجمعة Batch، وهي في الملف prices.json:
| النموذج | المدخل Input | القراءة من الذاكرة المؤقتة Cache Read | المخرج Output |
|---|---|---|---|
| Claude Opus 5.5 | 4.00 | 0.20 | 20.00 |
| Claude Sonnet 5.5 | 2.00 | 0.10 | 10.00 |
| Claude Haiku 5.5، حتى 100 ألف توكن في الطلب | 0.10 | 0.01 | 0.50 |
| gpt-6.2-astra | 8.00 | 0.40 | 40.00 |
| gpt-5.4-mini | 0.75 | 0.075 | 4.50 |
| gemini-4-carbon | 2.00 | 0.10 | 10.00 |
| gemini-3.8-flash | 0.75 | 0.075 | 3.75 |
وتذكر صفحة Gemini أن سعر gemini-4-carbon يتضاعف في 1 ديسمبر 2026 إلى 4 دولارات للمدخل و20 للمخرج، وأن gemini-3.8-flash يتضاعف في 1 يناير 2027، فإذا قرأت هذا الجدول بعد هذين التاريخين فضاعف الرقمين. والمزودون الثلاثة يعطون خصم 50% على المعالجة المجمعة Batch.
وأول ما يظهر عندما تضرب توكنات مختبراتنا في هذه الأسعار أن المهام نفسها صغيرة جداً: تشغيل الفريق الأغلى عندنا، 17 استدعاءً بـ 7,723 توكن مدخل و3,486 توكن مخرج، يكلف بحسب cost.py نحو عشرة سنتات على Claude Opus 5.5، وعشرين سنتاً على gpt-6.2-astra، وأقل من ثلث سنت على Claude Haiku 5.5. ولذلك فإن الأرقام المطلقة من مختبر صغير لا تقول لك شيئاً عن فاتورة فريقك، والذي تأخذه منها هو النسبة: كم ضعفاً يضيف الفريق على الوكيل الواحد في المهمة نفسها.
تكلفة سنة لفريق افتراضي
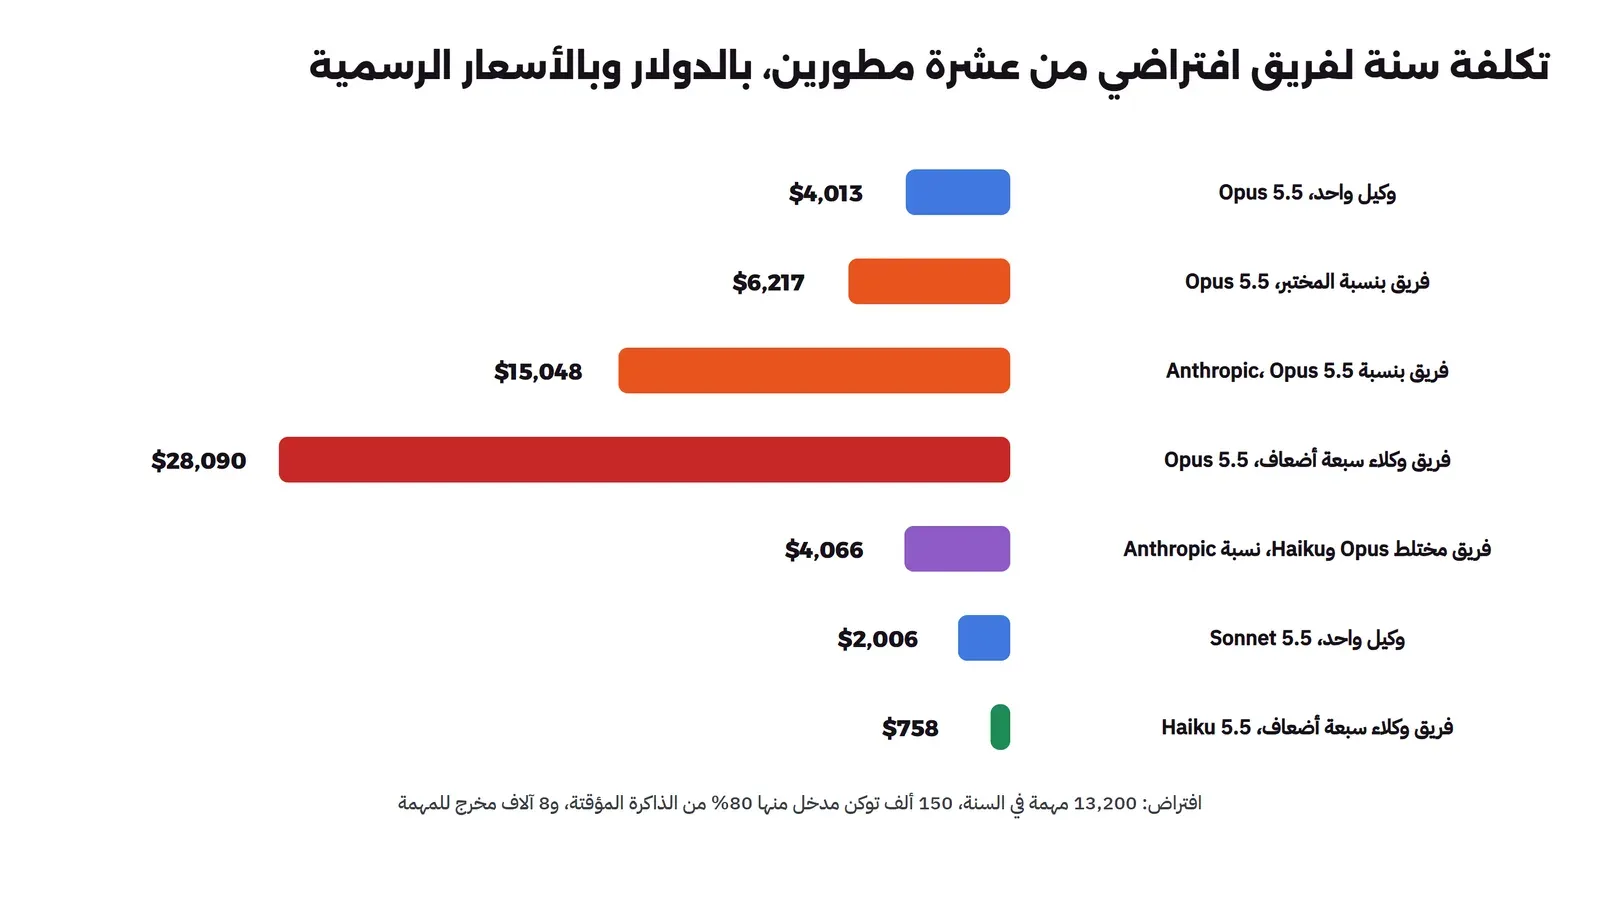
لكي نحول النسب إلى رقم سنوي نحتاج افتراضاً عن حجم العمل، وهذا الافتراض ليس قياساً، فاستبدله بأرقام فريقك: عشرة مطورين، و220 يوم عمل في السنة، وست مهام للوكيل لكل مطور في اليوم، أي 13,200 مهمة في السنة. والمهمة الواحدة بوكيل واحد 150 ألف توكن مدخل، منها 80% تقرأ من الذاكرة المؤقتة، و8 آلاف توكن مخرج. ثم نضرب المهمة في ثلاث نسب لتعدد الوكلاء: النسبة التي قسناها في المختبر في التشغيل الثاني، أي 1.5 للمدخل و1.6 للمخرج تقريباً، ونسبة Anthropic، أي خمسة عشر ضعف المحادثة مقابل أربعة أضعاف للوكيل الواحد، أي 3.75، ونسبة صفحة تكاليف Claude Code لفرق الوكلاء في وضع التخطيط، أي سبعة أضعاف. والسكربت year.py يحسب ذلك، والمخرج سوف يكون كما يلي:
hypothetical: 10 devs x 220 days x 6 tasks = 13,200 tasks/year; single task 150,000 in (80% cached) + 8,000 out
scenario                            Claude Opus 5.5 Claude Sonnet 5. Claude Haiku 5.5    gpt-6.2-astra     gpt-5.4-mini  gemini-4-carbon gemini-3.8-flash
single agent                                  4,013            2,006              108            8,026              891            2,006              812
team, our lab (seed 2)                        6,217            3,108              167           12,434            1,381            3,108            1,255
team, Anthropic (15x / 4x of chat)           15,048            7,524              406           30,096            3,341            7,524            3,044
agent team, Claude Code (~7x)                28,090           14,045              758           56,179            6,237           14,045            5,683
في المخرج أعلاه لاحظ التالي:
- الأرقام بالدولار في السنة للفريق كله، والفرق بين الصف الأول والأخير سبعة أضعاف في كل عمود، لأن النسبة تضرب المدخل والمخرج معاً.
- اختيار النموذج يغير الفاتورة أكثر من قرار التقسيم: فريق وكلاء على Claude Haiku 5.5، أي 758 دولاراً، أرخص من وكيل واحد على Claude Sonnet 5.5، أي 2,006 دولارات، والسؤال هل يكفي النموذج الأرخص لمهامك، وهذا لا يجيب عنه إلا القياس على مهامك.
- Claude Haiku 5.5 محسوب بسعر الطلبات حتى 100 ألف توكن، وعلى افتراض أن كل استدعاء في المهمة أصغر من ذلك، فإذا كانت طلباتك أكبر فالسعر خمسة أضعاف بحسب صفحة الأسعار.
والسكربت يحسب أيضاً حالتين أخريين. الأولى بدون الذاكرة المؤقتة، حيث يصبح وكيل واحد على Claude Opus 5.5 نحو 10,032 دولاراً في السنة بدل 4,013، وفريق بنسبة Anthropic نحو 37,620 دولاراً، أي أن الذاكرة المؤقتة وحدها تخفض الفاتورة إلى أقل من النصف في هذا الافتراض. والثانية فريق مختلط Mixed على طريقة نظام Anthropic للبحث: الوكيل الرئيسي على Opus يأخذ ربع التوكنات، والمنفذون على نموذج أرخص يأخذون ثلاثة أرباعها:
mixed (lead Opus 25% of tokens, workers Claude Sonnet 5.5 75%), Anthropic multiplier: 0.712 per task, 9,405 per year

mixed (lead Opus 25% of tokens, workers Claude Haiku 5.5 75%), Anthropic multiplier: 0.308 per task, 4,066 per year
والرقم الأخير يستحق التوقف: فريق بنسبة Anthropic، الرئيسي فيه على Opus والمنفذون على Haiku، يكلف تقريباً ما يكلفه وكيل واحد على Opus، أي 4,066 مقابل 4,013 دولاراً. وهذا لا يعني أن الجودة واحدة، وإنما يعني أن قرار «فريق أم وكيل واحد» لا ينفصل عن قرار «أي نموذج لكل دور».
وبالريال السعودي بسعر الصرف الثابت 3.75، فإن وكيلاً واحداً على Opus 5.5 لهذا الفريق الافتراضي نحو 15,049 ريالاً في السنة، وفريق الوكلاء بسبعة أضعاف نحو 105,338 ريالاً، والفريق المختلط نحو 15,248 ريالاً، وفريق الوكلاء على Haiku 5.5 نحو 2,843 ريالاً. وهذه أرقام تصلح لتقارن بها البدائل في ميزانية السنة، لا لتضعها في الميزانية كما هي، لأن حجم المهمة وعددها افتراضان.
ما تقوله المصادر الرسمية عن النسبة
قبل أن نصدق أرقامنا من نموذج صغير، لننظر إلى ما ينشره من يشغل هذه الأنظمة على نطاق واسع، فهي النقطة الثابتة التي نقارن بها:
- Anthropic، يونيو 2025: مقال نظام البحث متعدد الوكلاء يقول إن الوكلاء في بياناتهم يستهلكون قرابة أربعة أضعاف توكنات المحادثة العادية، وإن أنظمة تعدد الوكلاء تستهلك قرابة خمسة عشر ضعفاً، وإن هذه الأنظمة لكي تكون مجدية اقتصادياً تحتاج مهام قيمتها عالية بما يكفي لتدفع ثمن الأداء الأعلى. ويقول أيضاً إن ثلاثة عوامل فسرت 95% من الفرق في الأداء في تقييم BrowseComp، وإن عدد التوكنات وحده فسر 80%، أي أن جزءاً كبيراً من فائدة تعدد الوكلاء أنه يصرف توكنات أكثر على المهمة.
- Claude Code: صفحة التكاليف تقول إن فرق الوكلاء تستهلك قرابة سبعة أضعاف توكنات الجلسة العادية عندما يعمل الزملاء في وضع التخطيط، لأن كل زميل نافذة سياق كاملة ونسخة منفصلة من Claude، وتنصح بفرق صغيرة وبنموذج Sonnet للزملاء، وتذكر أن طلبات الوكيل الفرعي نفسه تحسب من استخدامك.
- Codex: توثيق الوكلاء الفرعيين يقول إن سير عمل الوكلاء الفرعيين يستهلك توكنات أكثر من تشغيل مشابه بوكيل واحد، دون رقم محدد.
- Cursor: توثيق الوكلاء في السحابة يقول إنها تحسب من استخدام خطتك بسعر النموذج المختار، فكل وكيل سحابي إضافي يعني استخداماً إضافياً.
ولاحظ أن نسبة Anthropic تقارن بالمحادثة وليس بوكيل واحد، فإذا قسمت خمسة عشر على أربعة فإن تعدد الوكلاء في نظامهم أغلى من الوكيل الواحد بنحو أربعة أضعاف، وهذا رقم من مهمة بحث، حيث القراءة كثيرة ومستقلة، وهي أفضل حالة لتعدد الوكلاء. وفي مختبراتنا كانت النسبة في المدخلات بين 0.87 و1.5، وفي الاستدعاءات بين ثلاثة وستة أضعاف، والفرق أن مهامنا صغيرة جداً، فالتعليمات المكررة جزء صغير من المجموع. وكلما كبرت التعليمات وتعريفات الأدوات، كما في الأدوات التجارية التي رأينا فيها أكثر من 8,000 توكن قبل أي عمل، اقتربت النسبة من أرقام Anthropic وClaude Code.
والأبحاث المحكمة تقول الشيء نفسه بطريقة أخرى. فبحث Kim وزملائه من Google المنشور في ديسمبر 2025 بعنوان نحو علم لتوسيع أنظمة الوكلاء قارن 260 إعداداً مع توحيد الأدوات والتعليمات والحوسبة، ووجد أن المهام الكثيرة الأدوات تدفع ثمناً إضافياً لتعدد الوكلاء، وأن الفائدة تقل عندما يكون الوكيل الواحد جيداً أصلاً، وأن النتيجة تراوحت بين تحسن 80.8% في مهمة يمكن تقسيمها وتراجع 70% في مهمة تخطيط متسلسلة. أي أن الثمن الإضافي ثابت تقريباً، والفائدة هي التي تتغير بحسب نوع المهمة، وهذا ما يجعل القياس على مهامك أهم من أي نسبة عامة.
التكلفة التي لا تظهر في الفاتورة
الفاتورة تعد التوكنات، ولا تعد ثلاثة أشياء ظهرت في كل مختبرات هذه المرحلة، وهي في الغالب أغلى من التوكنات نفسها:
- الجواب الخاطئ الواثق: أربعة أطر من خمسة أعطت مبلغاً خاطئاً لطلب واحد، وكل منها بجملة واثقة. وفي فريق حقيقي فإن رسالة للعميل بمبلغ خاطئ، أو إصلاحاً لدالة غير الدالة الخاطئة، يكلف وقت إنسان يكتشفه ويصلحه، وهذا الوقت لا يظهر في أي لوحة استخدام.
- وقت المراجعة: كل فرع يخرجه وكيل يحتاج من يقرؤه، وفي مختبر الوكلاء الفرعيين خرجت ستة فروع لإصلاح ستة أخطاء، خمسة منها فاشلة، وكل فرع فاشل يحتاج أن يفتحه أحد ويعرف لماذا فشل قبل أن يحذفه.
- الإنذار الكاذب: الوكلاء الفرعيون العشرة وجدوا «خطأً» في كل ملف سليم، والوكيل الرئيسي بنى خطته عليها. ولو تبع الفريق هذه الخطة لأمضى وقته في إصلاح ما ليس معطلاً.
ولذلك فإن السؤال الصحيح عن التكلفة ليس «كم دولاراً للمهمة؟» وإنما «كم دولاراً للمهمة التي وصلت إلى main صحيحة؟». فإذا كان الفريق يدفع ضعف التوكنات وينجح مرتين أكثر، فهو بالسعر نفسه، وإذا كان يدفع ضعفها وينجح بالقدر نفسه، فقد دفعت الضعف مقابل لا شيء، كما حدث في التشغيل الثاني من مختبر المخطط والمنفذين.
كيف تقيس تكلفة تعدد الوكلاء في فريقك؟
كل الأرقام في هذا المقال جاءت من سطر واحد يكتب لكل استدعاء، وهذا أهم ما تأخذه منه: لا تبن فريق وكلاء قبل أن تسجل كل استدعاء. والسجل الذي استعملناه في llm.py وproxy.py فيه خمسة حقول تكفي لأغلب الأسئلة:
{"run": "multi-2", "role": "worker:parse_duration", "prompt_tokens": 494, "output_tokens": 368, "seconds": 312.7}في السطر أعلاه لاحظ التالي:
- الحقل
runيجمع استدعاءات المهمة الواحدة، فتعرف تكلفة المهمة كاملة، وليس تكلفة الاستدعاء فقط. - الحقل
roleيقول من صرف التوكنات: المخطط أم المنفذ أم المراجع أم المدير الذي يختار المتكلم. ومن هنا عرفنا أن نصف استدعاءات المحادثة الجماعية كانت لاختيار المتكلم. - التوكنات من المزود نفسه، أي الحقل
usageفي الرد أو عدادات Ollama، وليست تقديراً بعدد الحروف، لأن التقدير قد يخطئ كثيراً، وقد رأينا CrewAI نفسه يحذر أنه يقدر توكناً لكل أربعة حروف عندما لا يعرف النموذج. - الزمن لكل استدعاء، لأن مجموعه مقارنة بالزمن الكلي يقول لك كم وفر التوازي فعلاً.
وبعد أسبوع من هذا السجل على مهامك الحقيقية، احسب لكل نوع مهمة ثلاثة أرقام: التكلفة بوكيل واحد، والتكلفة بالفريق، ونسبة المهام التي وصلت صحيحة في الحالتين، ثم ضعها في year.py بدل افتراضاتنا.
مثال محسوب: متى يربح الفريق؟
لنأخذ الأرقام من الصف الثالث في جدول السنة، أي فريق بنسبة Anthropic على Claude Opus 5.5: المهمة تكلف 1.14 دولار بدل 0.304 بوكيل واحد، أي 0.836 دولار إضافية. ولنفترض، وهذا افتراض للتوضيح فقط، أن الفريق يختصر انتظار المطور سبع دقائق في كل مهمة، وأن ساعة المطور تكلف الشركة 40 دولاراً، فقيمة الدقائق السبع نحو 4.67 دولار، وهي أكبر من التكلفة الإضافية بخمسة أضعاف. ولكن هذا الحساب يصح فقط بشرطين: أن يستعمل المطور الدقائق السبع في عمل آخر فعلاً، وأن تكون نسبة النجاح في الفريق مثل الوكيل الواحد على الأقل. فإذا كان الفريق ينجح أقل، أو يخرج فروعاً تحتاج مراجعة أطول، فإن الدقائق التي وفرها في الانتظار تضيع في المراجعة. وفي مختبرنا لم يكن الفريق أسرع في كل التشغيلات، ولم يكن أنجح في كلها، ولذلك فإن هذا الحساب لا يصح إلا بأرقام فريقك.
والوقت؟ ما قالته المختبرات
الوعد الثاني لتعدد الوكلاء بعد الجودة هو السرعة، والجدول التالي يجمع الزمن الكلي لكل تشغيل كما طبعته السكربتات، مع ملاحظة مهمة: المعالج كان مشتركاً مع أعمال أخرى في أغلب الوقت، فقارن داخل الصف الواحد فقط:
| التجربة | وكيل واحد | فريق | ما حدث |
|---|---|---|---|
| أربع دوال، بذرة 1 | 1,780 ث | 2,284 ث | الفريق أبطأ رغم منفذين معاً |
| أربع دوال، بذرة 2 | 1,587 ث | 868 ث | الفريق أسرع، والمعالج كان أقل انشغالاً وقتها |
| عشرة ملفات، تشغيل أول | 141 ث | 350 ث متتالياً، 104 ث متوازياً | مجموع زمن الاستدعاءات في المتوازي 176 ث |
| عشرة ملفات، تشغيل أهدأ | 270 ث متتالياً، 112 ث متوازياً | 129 ث منها تحميل النموذج في أول استدعاء |
والخلاصة من الجدول أن الوكيل الواحد بنافذة واحدة كان في مهمة القراءة أسرع من الوكلاء الفرعيين المتتالين، 141 ثانية مقابل 350 و270، وأبطأ قليلاً من الوكلاء المتوازيين، 104 و112 ثانية، رغم أنه لم يجد شيئاً. وفي مهمة الكتابة كان الفريق أبطأ مرة وأسرع مرة. فالسرعة في تعدد الوكلاء ليست مضمونة، وتأتي من شيئين لا من عدد الوكلاء: أن تكون الأجزاء مستقلة فعلاً، وأن يكون عندك قدرة حسابية أو حدود معدل تكفي لتشغيلها معاً. وعند مزود سحابي تكون الثانية أسهل بكثير منها على جهاز واحد، ولكن الأولى تبقى شرطاً في كل مكان.
متى يكون الفريق أرخص فعلاً؟
قلنا في أول المقال إن تعدد الوكلاء يوفر شيئاً واحداً: نافذة رئيسية أصغر. وهذا التوفير يصبح أكبر من الإضافة في حالة واحدة واضحة: مهمة طويلة يقرأ فيها الوكيل الواحد كثيراً في أولها، ثم يعمل دورات كثيرة بعدها وكل ما قرأه ما زال في نافذته. لنأخذ مثالاً بأرقام افتراضية للتوضيح: وكيل واحد يقرأ 60 ألف توكن من الملفات في البحث، ثم يعمل 30 دورة أخرى في التعديل والاختبار، فكل دورة من الثلاثين ترسل الستين ألفاً من جديد، أي 1.8 مليون توكن مدخل للقراءة القديمة وحدها. أما إذا أعطى البحث لوكيل فرعي يقرأ الستين ألفاً مرة ويرجع بخلاصة من ألفي توكن، فإن الدورات الثلاثين ترسل الألفين فقط، أي 60 ألف توكن، والمجموع مع قراءة الوكيل الفرعي نحو 120 ألفاً بدل 1.8 مليون. وهذا الفرق يصغر كثيراً إذا كانت القراءة القديمة في الذاكرة المؤقتة، ولكنه لا يختفي، ويضاف إليه أن النافذة الأصغر تعني أخطاء أقل بسبب تآكل السياق.
وفي الاتجاه الآخر، تكون القسمة أغلى في الحالة المعاكسة: مهمة قصيرة، أو مهمة يحتاج فيها كل وكيل الخلفية نفسها، فيقرأ كل منهم الملفات نفسها، أو نظام فيه نموذج يختار من يتكلم في كل جولة. ومهام مختبراتنا كانت كلها من هذا النوع، ولذلك لم نر التوفير، ورأينا الإضافة فقط.
أين تذهب التوكنات داخل الفريق؟
الرقم الكلي للمهمة يقول كم دفعت، ولكنه لا يقول أين تخفض. ولذلك قسمنا استدعاءات تشغيلي الفريق في مختبر المخطط والمنفذين بحسب الدور، من الحقل role في السجل:
| الدور | تشغيل 1: استدعاءات | مدخل / مخرج | تشغيل 2: استدعاءات | مدخل / مخرج |
|---|---|---|---|---|
| المخطط Planner | 1 | 344 / 295 | 1 | 344 / 408 |
| المنفذون Workers | 8 | 2,393 / 2,081 | 10 | 3,851 / 2,848 |
| المراجع Reviewer | 4 | 1,563 / 143 | 6 | 3,528 / 230 |
في الجدول أعلاه لاحظ التالي:
- المخطط استدعاء واحد صغير في التشغيلين، فهو أرخص دور، رغم أنه أكثر دور يؤثر في النتيجة، لأن الشروط التي أسقطها هي التي بقيت فاشلة حتى النهاية. وهذا يعني أن إعطاءه نموذجاً أقوى لا يكلف إلا قليلاً.
- المنفذون أكبر مستهلك للمخرج، وهو أغلى التوكنات، والسبب الأكبر في التشغيل الثاني جولات الإصلاح: عشرة استدعاءات بدل أربعة في الأصل، أي أن ستة استدعاءات كانت إعادة كتابة لدوال فشلت.
- المراجع في التشغيل الثاني استهلك 3,528 توكن مدخل ليكتب 230 توكناً من الملاحظات، وأغلب ملاحظاته كانت خاطئة كما رأينا في المقال الأول من المرحلة. فهذا دور يدفع كثيراً في المدخل ويعطي قليلاً، والبديل الأرخص أن يرسل الكود مخرج الاختبار الفاشل للمنفذ مباشرة دون نموذج في الوسط.
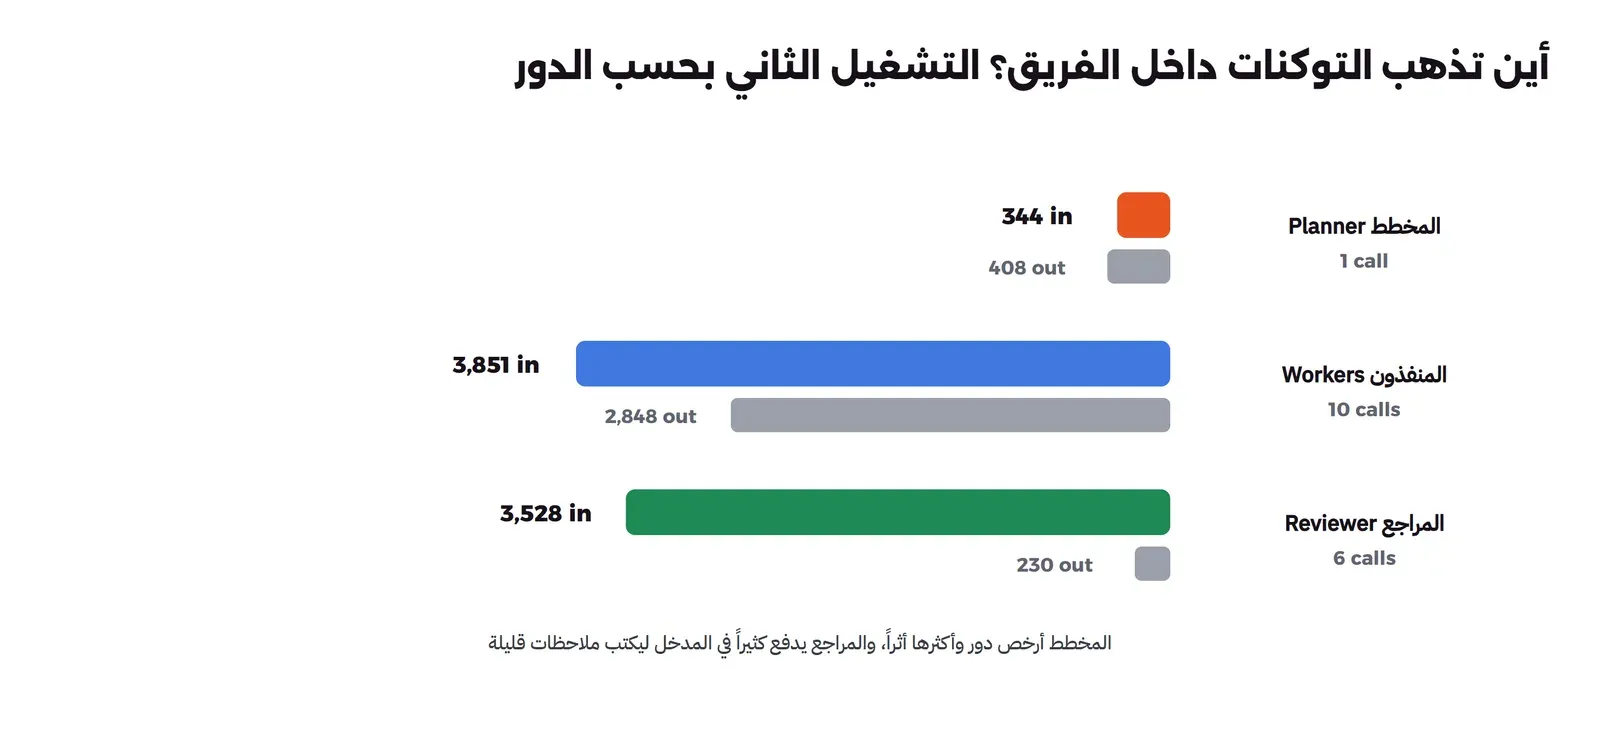
وهذا التقسيم بالدور هو ما يجعلك تقرر بأرقام: أي دور يأخذ نموذجاً أرخص، وأي دور يستحق نموذجاً أقوى، وأي دور يمكن أن يستبدل بكود.
الذاكرة المؤقتة Prompt Caching في تعدد الوكلاء
في جدول السنة كانت الذاكرة المؤقتة وحدها تخفض الفاتورة إلى أقل من النصف في افتراضنا، وهذا لأن تعدد الوكلاء يكرر الشيء نفسه كثيراً: تعليمات الدور نفسها، وتعريفات الأدوات نفسها، وأحياناً الخلفية المشتركة نفسها، في كل وكيل وفي كل دورة. والذاكرة المؤقتة تجعل الجزء المكرر في أول الطلب يقرأ بسعر أقل بكثير، فعند Anthropic سعر القراءة من الذاكرة المؤقتة لنموذجي Opus 5.5 وSonnet 5.5 عشرون مرة أقل من المدخل العادي بحسب صفحة الأسعار. ولكي تستفيد منها في نظام وكلاء هناك ثلاثة أشياء تعتمد عليك:
- الثابت في أول الطلب: تعليمات الدور وتعريف الأدوات والخلفية المشتركة في أول الرسائل، والمهمة المتغيرة بعدها. فإذا وضعت اسم الملف أو رقم المهمة في أول تعليمات النظام فقد جعلت كل طلب مختلفاً من أول حرف، ولن يقرأ شيء من الذاكرة.
- تعليمات واحدة لكل دور، لا لكل مهمة: عشرة وكلاء فرعيين بالتعليمات نفسها حرفياً يشتركون في البادئة نفسها، أما عشرة وكلاء كتب المخطط لكل منهم تعليمات مختلفة من أولها فلا يشتركون في شيء.
- اقرأ شروط مزودك: المدة التي تبقى فيها البادئة في الذاكرة، والحد الأدنى لطولها، وسعر كتابتها أول مرة، تختلف بين المزودين والنماذج، وقد شرحنا ذلك في مقال تكلفة الذكاء الاصطناعي بالتوكنات.
ولاحظ أن الأطر تختلف هنا أيضاً: الإطار الذي يضع تعليمات طويلة ثابتة في أول كل طلب، مثل smolagents، يستفيد من الذاكرة المؤقتة أكثر من غيره إذا كان مزودك يدعمها، فالتعليمات الطويلة ليست مشكلة في السعر بقدر ما هي مشكلة في أن النموذج الصغير يتوه فيها.
وإذا كان فريقك على اشتراك لا على الاستخدام؟
قد تقول إن هذا كله لا يخصك لأن فريقك يدفع اشتراكاً ثابتاً لكل مطور، كما في خطط Claude وCopilot وCursor التي قارناها في مقال تكلفة وكلاء البرمجة. والإجابة أن الاشتراك لا يلغي التوكنات وإنما يحولها إلى حدود استخدام: كل خطة لها سقف، وتعدد الوكلاء يصل إلى السقف أسرع بالنسبة نفسها التي حسبناها، فإذا كان الوكيل الواحد يصل إلى الحد في آخر الأسبوع فقد يصل إليه فريق بسبعة أضعاف في يومه الأول. وتوثيق Cursor يقول صراحة إن الوكلاء في السحابة تحسب من استخدام خطتك بسعر النموذج المختار، وصفحة تكاليف Claude Code تقول إن طلبات الوكيل الفرعي تحسب من استخدامك. فالسؤال نفسه يبقى، ولكن بوحدة مختلفة: كم من حد الأسبوع تريد أن تصرفه على مهمة واحدة؟
والنموذج المحلي، هل هو مجاني؟
كل مختبرات هذه المرحلة عملت على نموذج محلي، فلم ندفع دولاراً واحداً للتوكنات. ولكن السجلات نفسها تقول إن مجموع زمن الاستدعاءات في الملفات المنسوخة إلى lab/data/ قرابة خمس ساعات لـ 202 استدعاء، على معالج كان يعمل بكامل طاقته تقريباً طوال هذا الوقت، والجواب في أغلب المهام كان خاطئاً أو ناقصاً. فالتكلفة هنا تتحول من الفاتورة إلى ثلاثة أشياء: الكهرباء، وقد شرحنا حسابها في مقال استهلاك الكهرباء، والوقت الذي تنتظره، والجودة التي تقبلها. وتعدد الوكلاء على نموذج محلي يضاعف الوقت قبل أن يضاعف أي شيء آخر، لأن التوازي لا يضيف قدرة حسابية على الجهاز نفسه، كما رأينا في مقال الوكيل بنموذج محلي.
كيف تخفض تكلفة تعدد الوكلاء؟
إذا قررت أن مهمتك تستحق أكثر من وكيل، فهناك طرق تخفض التكلفة دون أن تلغي الفائدة، وكلها تأتي من الأجزاء الستة التي عددناها في أول المقال:
- نموذج أرخص للمنفذين: نظام Anthropic للبحث استعمل Claude Opus 4 للوكيل الرئيسي وClaude Sonnet 4 للوكلاء الفرعيين، وصفحة التكاليف في Claude Code تنصح باستعمال Sonnet للزملاء في فرق الوكلاء. والفرق في السعر بين أغلى نموذج وأرخصه عند المزود نفسه عشرات المرات، كما في الجدول أعلاه، والقراءة والتلخيص والمهام الصغيرة الواضحة لا تحتاج الأغلى.
- التوجيه في الكود لا في النموذج: كل مرة يختار فيها نموذج من يتكلم بعد ذلك تدفع استدعاءً كاملاً لا ينتج عملاً. إذا كان الترتيب معروفاً، مثل مخطط ثم منفذين ثم مراجع، فاكتبه في الكود.
- خلاصات قصيرة بشكل محدد: النتيجة التي يرجع بها الوكيل الفرعي يقرؤها الوكيل الرئيسي في كل دورة بعدها، فاطلب JSON بحقول قليلة بدل تقرير طويل.
- الذاكرة المؤقتة Prompt Caching: التعليمات وتعريف الأدوات التي تتكرر في كل وكيل هي أفضل ما يوضع في الذاكرة المؤقتة، لأنها ثابتة وفي أول الطلب، وسعر قراءتها من الذاكرة عند Anthropic عشرين مرة أقل من سعر المدخل العادي لنموذجي Opus 5.5 وSonnet 5.5 بحسب صفحة الأسعار. وشرحنا شروطها في مقال تكلفة الذكاء الاصطناعي بالتوكنات.
- حد للجولات وحد للتوكنات: حلقة المراجعة دون حد، والمحادثة الجماعية دون
max_round، يمكن أن تدفع ثمن عشرات الجولات على خطأ لا يتغير. - المعالجة المجمعة Batch للعمل الذي لا ينتظر: مراجعة ليلية لكل طلبات الدمج بوكلاء فرعيين لا تحتاج رداً فورياً، والمزودون الثلاثة يعطون خصم 50% على المعالجة المجمعة.
جدول القرار: متى يستحق تعدد الوكلاء ثمنه؟
| السؤال | إذا كانت الإجابة نعم | إذا كانت الإجابة لا |
|---|---|---|
| هل وكيل واحد ينهي المهمة بنجاح في وقت مقبول؟ | ابق عليه، فالتقسيم سوف يزيد التكلفة فقط | انظر لماذا فشل قبل أن تقسم |
| هل الفشل بسبب امتلاء السياق بقراءة كثيرة؟ | وكلاء فرعيون للقراءة، بنموذج أرخص | التقسيم لا يحل مشكلة غموض المهمة |
| هل الأجزاء مستقلة فعلاً وفي ملفات مختلفة؟ | منفذون بالتوازي، والوقت ينخفض بقدر الأجزاء المستقلة | وكيل واحد، أو مواصفة ثم تقسيم |
| هل الوقت أغلى عندك من التوكنات؟ | التوازي يستحق حتى لو تضاعفت التكلفة | وكيل واحد أو Batch بنصف السعر |
| هل هناك فحص آلي للنتيجة؟ | منفذ ومراجع يشغل الفحص، بحد للجولات | المراجع النموذج يضيف تكلفة وثقة لا يستحقها |
| هل النموذج محلي على جهاز واحد؟ | التوازي لا يضيف سرعة، والتقسيم يضيف مدخلات فقط | حدود المعدل عند المزود هي سقفك |
أخطاء شائعة
- حساب التكلفة بالمخرجات فقط: المخرج أغلى للتوكن الواحد، ولكن المدخل أكبر بكثير في الأنظمة الوكيلية، ففي مختبراتنا كان المدخل أضعاف المخرج في كل تشغيل.
- مقارنة الفريق بوكيل فشل: إذا كان الوكيل الواحد يفشل لأن المهمة غامضة، فإن الفريق سوف يفشل أيضاً بتكلفة أكبر. أصلح وصف المهمة أولاً.
- توقع أن التوازي يختصر الفاتورة: التوازي يختصر الوقت في أحسن الأحوال، والفاتورة تجمع كل الوكلاء.
- نسيان استدعاءات التنسيق: المخطط، واختيار المتكلم، وقراءة الخلاصات، استدعاءات لا تظهر في تصورك للمهمة، ولكنها تظهر في الفاتورة.
- الاعتماد على أرقام العرض التوضيحي: أرقام المزود متوسطات لمؤسسات مختلفة، وأرقامنا من نموذج صغير ومهام صغيرة، والرقم الذي يهمك هو رقم فريقك على مهامه، فقسه شهراً قبل أن تبني ميزانية سنة.
- قياس الوقت مرة واحدة: زمن التشغيل يتأثر بانشغال الجهاز أو المزود في تلك اللحظة، وبتحميل النموذج في أول استدعاء، كما رأينا في مختبر الوكلاء الفرعيين حيث كان 129 ثانية من أصل 270 تحميلاً فقط. قس عدة مرات، وقارن مجموع زمن الاستدعاءات بالزمن الكلي قبل أن تحكم على التوازي.
- لا يوجد حد للإنفاق: نظام فيه حلقات ووكلاء يشغلون وكلاء يمكن أن يستهلك في ليلة واحدة ما توقعته لشهر. ضع حدود إنفاق Spend Limits عند المزود قبل أن تبدأ.
قائمة تحقق قبل أن تشغل فريق وكلاء
- هل قست تكلفة المهمة نفسها بوكيل واحد، بالتوكنات والوقت؟
- هل تعرف كم استدعاء ينتجه النظام لكل مهمة، وما الذي يرسله كل استدعاء؟
- هل المنفذون على نموذج أرخص من المخطط؟
- هل الترتيب المعروف في الكود، وليس في نموذج يختار المتكلم؟
- هل التعليمات والأدوات المتكررة في الذاكرة المؤقتة؟
- هل هناك حد للجولات وحد للتوكنات وحد للإنفاق؟
- هل حسبت تكلفة سنة بأرقامك أنت، وقارنتها بقيمة الوقت الذي يوفره؟
تدريب عملي
- ضع أرقام فريقك في
year.py: عدد المطورين، والمهام في اليوم، وحجم المهمة بالتوكنات من لوحة الاستخدام عند مزودك، وقارن الصفوف الأربعة. - أضف إلى
prices.jsonسعر gemini-4-carbon بعد 1 ديسمبر 2026، وأعد الحساب. - سجل أسبوعاً من استدعاءات وكيلك بحقلي
runوrole، واحسب أي دور يصرف أكثر التوكنات.
الخلاصة
- تعدد الوكلاء يضيف ستة أجزاء إلى التكلفة: التعليمات والأدوات المكررة، والقراءة المكررة، والتنسيق، والتسليم، وجولات المراجعة، ونمو السجل، ويوفر جزءاً واحداً: نافذة رئيسية أصغر.
- التوازي يختصر الوقت في الأجزاء المستقلة فقط، والمسار الحرج من المخطط إلى المراجعة يبقى متتالياً، وعلى معالج واحد وفر التوازي عندنا بين 20% و40% فقط.
- في مختبراتنا احتاج الفريق من ثلاثة إلى ستة أضعاف الاستدعاءات، والمدخلات بين 0.87 و1.5 ضعف، والنتيجة تحسنت مرة وبقيت كما هي مرة، والإطار وحده غير المدخلات أكثر من عشرين ضعفاً.
- Anthropic تقول إن تعدد الوكلاء عندها خمسة عشر ضعف المحادثة، وClaude Code تقول إن فرق الوكلاء قرابة سبعة أضعاف الجلسة العادية في وضع التخطيط.
- لفريق افتراضي من عشرة مطورين كانت السنة على Opus 5.5 بين 4,013 دولاراً لوكيل واحد و28,090 لفريق بسبعة أضعاف، واختيار النموذج لكل دور والذاكرة المؤقتة يغيران الفاتورة أكثر من قرار التقسيم.
- احسب التكلفة لكل مهمة وصلت صحيحة، لا لكل مهمة، وسجل كل استدعاء بالدور والتوكنات قبل أن تقرر.
وبهذا تكتمل مرحلة تعدد الوكلاء، وهذه مقالاتها، ومعها مقال تكلفة وكلاء البرمجة الذي يشرح الاشتراكات وأسعار الأدوات:
 دليلتعدد الوكلاء Multi-agent: المخطط والمنفذ والمراجعمتى يحتاج العمل أكثر من وكيل، وما الذي يضيع عند التسليم بين المخطط والمنفذ والمراجع، مع تجربة على نموذج محلي تقارن وكيلاً واحداً بفريق على المهمة نفسها.
 دليلالوكلاء الفرعيون Subagents والعمل بالتوازي في فروع منفصلةكيف يعمل الوكيل الفرعي في Claude Code وCodex وCursor، ومتى يفيد عزل القراءة والكتابة في Worktree لكل وكيل، مع تجربة على نموذج محلي فيها أخطاء مزروعة وإصلاحات في فروع منفصلة وتعارض حقيقي.
 دليلأطر تنسيق الوكلاء Agent Frameworks: LangGraph وCrewAI وAG2خمسة أطر لتعدد الوكلاء على مهمة واحدة ونموذج محلي واحد، مع وسيط يسجل كل طلب يرسله الإطار، لترى التعليمات المخفية والاستدعاءات وأين وقع الخطأ في كل منها.
 دليلفريق وكلاء يتناقش Multi-agent Debate: هل يتحسن الجواب؟ما تقوله الأبحاث عن النقاش بين الوكلاء، وكيف بنت ChatDev وMetaGPT ومحادثات AutoGen فرقها، وتجربة على نموذج محلي تقارن النقاش والتصويت والناقد والحكم على أسئلة معروفة الجواب.
 دليلكم تكلف وكلاء البرمجة Coding Agents في السنة؟أسعار Copilot وClaude وCursor والتوكنات من صفحاتها الرسمية، وتكلفة سنة لفريقك بحسب حجمه، وكيف تحسب تكلفة طلب الدمج الواحد.
سجل التحديثات
- 20 نوفمبر 2026: كتابة المقال، وحساب التكلفة من سجلات مختبرات المرحلة على Ollama 0.40.13 بنموذج qwen2.5:3b، بأسعار Anthropic وOpenAI وGoogle الرسمية كما قرأناها في التاريخ نفسه.