عندما تقرر أن مهمتك تحتاج أكثر من وكيل، فإن أول ما تجده عند البحث قائمة طويلة من الأطر Frameworks، كل منها يقول إنه يجعل تعدد الوكلاء Multi-agent سهلاً: LangGraph وCrewAI وAutoGen وAG2 وOpenAI Agents SDK وsmolagents، والأمثلة في صفحاتها كلها تعمل في عشرة أسطر. ولكن الأسئلة التي تهمك كمطور لا تجيب عنها الأمثلة: ما الذي يرسله الإطار إلى النموذج فعلاً من تعليمات لم تكتبها؟ وكم استدعاء للنموذج يحتاج لمهمة صغيرة؟ وماذا يحدث عندما يكون النموذج صغيراً ولا يتبع التعليمات بدقة؟ وهل المشروع ما زال يطور أصلاً؟
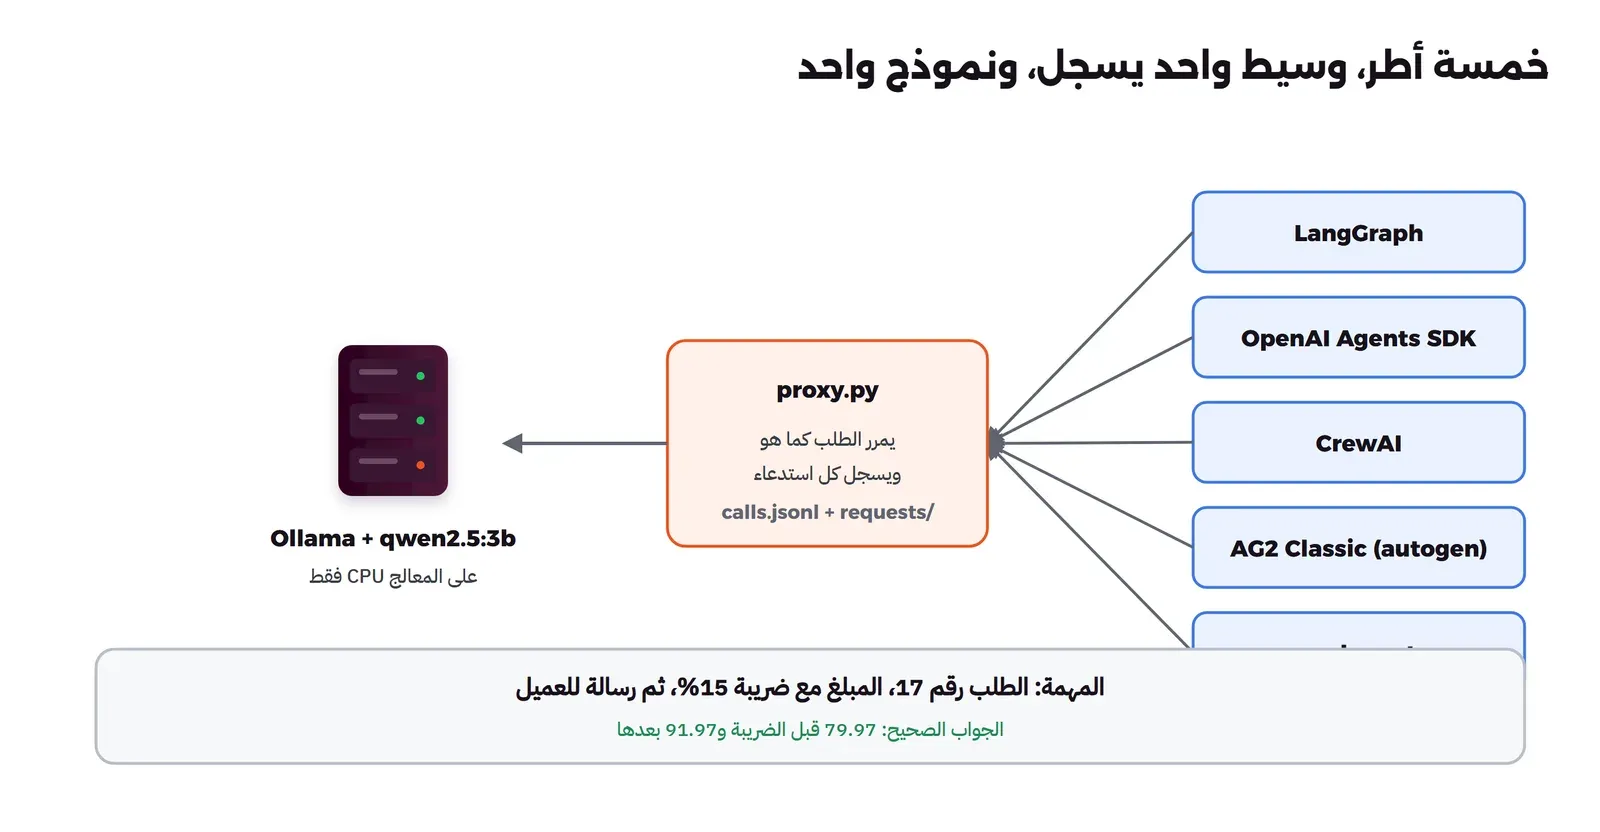
ولذلك فإننا في هذا المقال لا نعيد صفحات التوثيق، وإنما نعطي الأطر الخمسة المهمة نفسها بالأدوات نفسها والنموذج المحلي نفسه، ونضع بينها وبين النموذج وسيطاً صغيراً Proxy يسجل كل طلب يمر، فنرى عدد الاستدعاءات والتوكنات Tokens وحجم التعليمات المخفية في كل إطار. وقد شرحنا في مقال تعدد الوكلاء، أول مقالات هذه المرحلة، الأدوار والأنماط، وهنا نرى كيف يطبقها كل إطار، والمقالات التالية تشرح الأساس الذي يقوم عليه هذا المقال:
 دليلالوكيل الذكي AI Agent: استدعاء الأدوات Tool Calling والحلقةكيف يعمل الوكيل الذكي من الداخل: حلقة صغيرة تكتبها بيدك بثلاث أدوات، والأعطال الحقيقية التي تقع فيها، والحراسات التي تمنع ضررها في الكود.
 دليلLangChain: متى يفيدك إطار العمل ومتى يكفيك الكودما الذي تحله LangChain فعلاً في تطبيقات نماذج اللغة، وكيف تجربها على سيرفرك مع Ollama، ومتى يكفيك استدعاء مباشر دونها.
 دليلLangGraph: بناء Agent يحفظ حالته ويطلب الموافقةكيف تبني Agent بخطوات واضحة في LangGraph، يحفظ حالته في قاعدة بيانات ويكمل بعد التوقف، ولا ينفذ أي فعل قبل موافقتك.
 دليلتعدد الوكلاء Multi-agent: المخطط والمنفذ والمراجعمتى يحتاج العمل أكثر من وكيل، وما الذي يضيع عند التسليم بين المخطط والمنفذ والمراجع، مع تجربة على نموذج محلي تقارن وكيلاً واحداً بفريق على المهمة نفسها.
سوف نناقش في هذا المقال:
- ما الذي يقدمه إطار التنسيق Orchestration Framework فعلاً، وما الذي تستطيع كتابته بنفسك.
- طريقة المقارنة: مهمة واحدة، وأداتان، ونموذج محلي، ووسيط يسجل كل طلب.
- كل إطار على حدة: الفكرة، والكود، وما حدث في التشغيل، ونقاط القوة ونقاط الضعف.
- جدول المقارنة بالأرقام: الاستدعاءات والتوكنات وحجم التعليمات المخفية والنتيجة.
- حالة كل مشروع اليوم ورخصته، ولماذا لم يعد
pip install ag2يعطيك AutoGen الذي تعرفه. - جدول قرار: أي إطار لأي حالة، ومتى لا تحتاج إطاراً أصلاً.
ما الذي يقدمه إطار التنسيق فعلاً؟
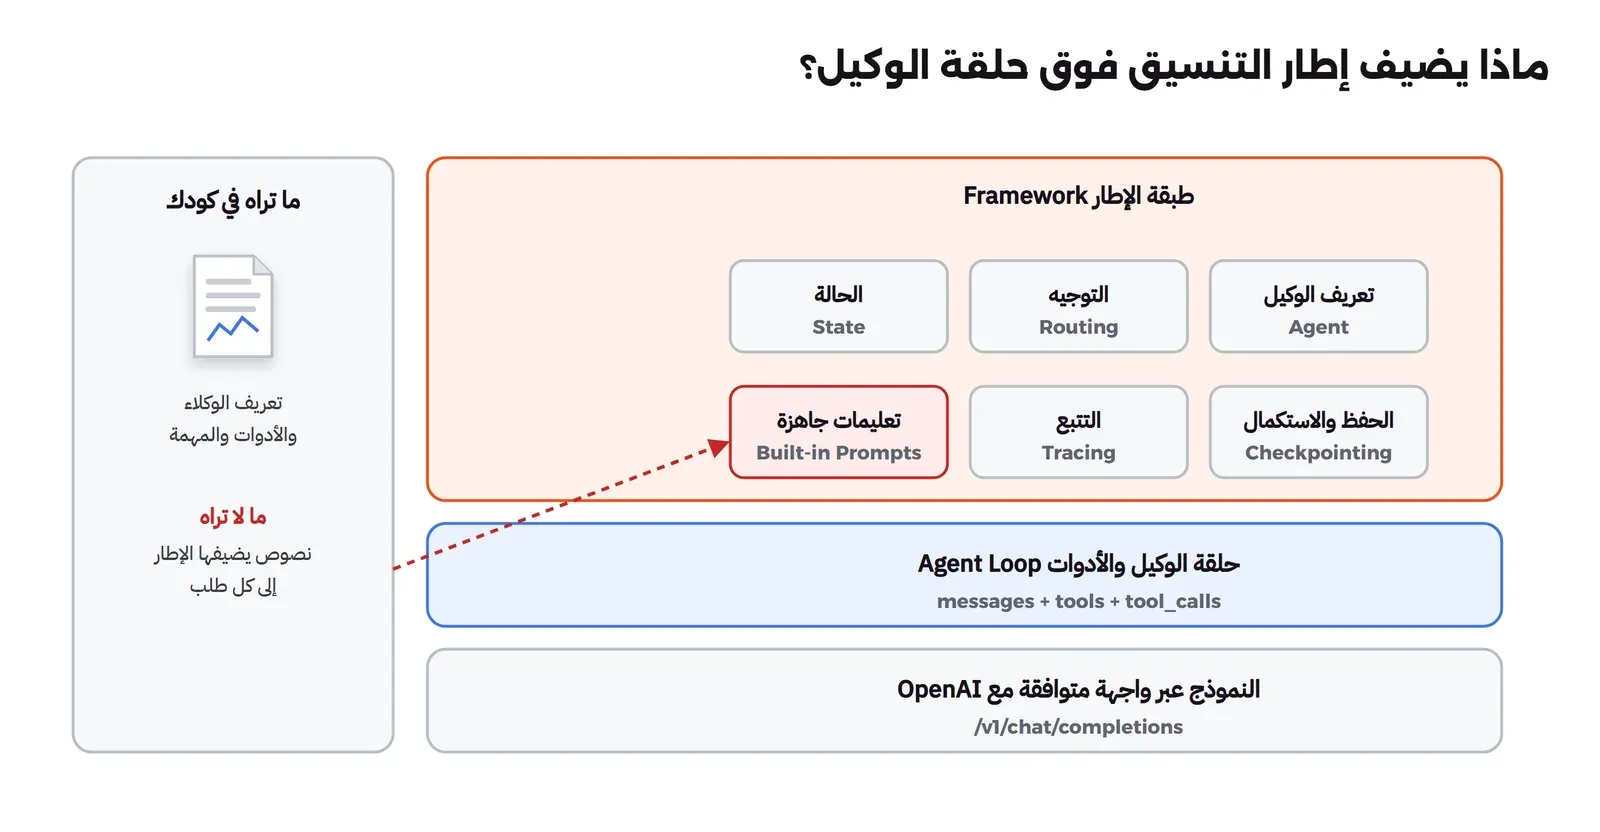
قبل المقارنة يجب أن نعرف ما الذي نقارنه. فالوكيل الواحد، كما بنيناه بأيدينا في مقال الوكيل الذكي، حلقة من بضعة أسطر: أرسل الرسائل وتعريف الأدوات إلى النموذج، فإذا طلب أداة فشغلها وأضف نتيجتها وكرر، وإذا رد بنص فانته. وإطار التنسيق يضيف فوق هذه الحلقة أشياء تحتاجها عندما يكثر الوكلاء:
- تعريف الوكيل Agent Definition: اسم ووصف وتعليمات وأدوات ونموذج، في كائن واحد تمرره لغيره.
- التوجيه Routing: من يعمل بعد من، سواء قرر ذلك الكود في رسم بياني Graph، أو قرره نموذج مدير يختار المتكلم التالي.
- الحالة Shared State: ما الذي يراه كل وكيل من عمل الآخرين، هل هي المحادثة كاملة أم متغيرات محددة.
- الحفظ والاستكمال Checkpointing: أن تتوقف المهمة وتكمل بعد إعادة التشغيل أو بعد موافقة إنسان Human-in-the-loop.
- التتبع Tracing: سجل لكل خطوة وكل استدعاء، لأن تصحيح الأخطاء Debugging في نظام فيه خمسة وكلاء دون سجل شبه مستحيل.
- التعليمات الجاهزة Built-in Prompts: نصوص يضيفها الإطار إلى تعليماتك، مثل وصف الدور وطريقة استدعاء الأدوات وشكل الإجابة النهائية. وهذه أخطر نقطة لأنها لا تظهر في كودك، وسوف نقيسها بالتوكنات.
والأطر تختلف في أي هذه الأشياء تجعله في يدك وأيها تخفيه عنك، وهذا هو أهم فرق بينها، أهم من عدد الأسطر. فبعضها يعطيك الرسم البياني والحالة وتكتب أنت كل شيء آخر، وبعضها يعطيك «فريقاً» جاهزاً بأدوار وتعليمات، وتكتب أنت الوصف فقط.
كيف قارنا الأطر الخمسة؟
أعطينا كل إطار المهمة نفسها بالكلمات نفسها: «الطلب رقم 17: احسب المبلغ الذي يدفعه العميل مع ضريبة القيمة المضافة VAT بنسبة 15%، ثم اكتب له رسالة من جملة واحدة فيها المبلغ بالريال». وأعطيناه أداتين مكتوبتين بـ Python عادية في الملف shop_tools.py: الأولى get_order ترجع اسم العميل وسطور الطلب، والثانية calculate تحسب تعبيراً حسابياً بأرقام عشرية دقيقة Decimal، لأن النماذج الصغيرة تخطئ في الضرب كثيراً. والإجابة الصحيحة معروفة: ثلاثة كوابل بـ 9.99 ولوحتا مفاتيح بـ 25، أي 79.97 قبل الضريبة و91.97 بعدها.
وفي كل إطار بنينا النمط نفسه قدر الإمكان، وهو نمط المشرف Supervisor مع وكيلين فرعيين: وكيل فواتير Billing معه الأداتان، ووكيل كاتب Writer دون أدوات، ومشرف يستدعيهما بالترتيب. وفي CrewAI استعملنا العملية الهرمية Hierarchical Process لأنها المقابل لهذا النمط فيه، وفي AutoGen استعملنا المحادثة الجماعية GroupChat لأنها طريقته المعروفة. والنموذج في كل التشغيلات qwen2.5:3b على Ollama في Docker على المعالج CPU فقط، بدرجة حرارة Temperature صفر حيث يسمح الإطار، وكل إطار يتصل بالنموذج عبر الواجهة المتوافقة مع OpenAI، أي /v1/chat/completions، كما في توثيق Ollama.
وبين الإطار والنموذج وضعنا الملف proxy.py، وهو سيرفر صغير بمكتبة Python القياسية يمرر كل طلب كما هو إلى Ollama ويرجع الرد كما هو، ويكتب لكل استدعاء سطراً فيه: عدد الرسائل، وعدد الأدوات المعرفة، وحجم تعليمات النظام System Prompt بالحروف، وعدد توكنات المدخل والمخرج كما رجعت في الحقل usage، والزمن. ويحفظ أيضاً الطلب كاملاً في مجلد requests/ لنقرأ ما أضافه الإطار. والمفتاح في كل الأمثلة الكلمة local، فلا يوجد أي مفتاح API حقيقي، ولا يخرج أي طلب من الجهاز.
والأداتان مشتركتان بين الأطر الخمسة، وهذا ملف shop_tools.py كاملاً:
"""The same two tools for every framework: read an order, and do exact arithmetic."""
from decimal import Decimal

ORDERS = {17: {"customer": "Huda", "lines": [{"item": "USB-C cable", "price": "9.99", "qty": 3},
                                             {"item": "Keyboard", "price": "25.00", "qty": 2}]}}

def get_order(order_id: int) -> str:
    """Return the customer name and the lines (item, unit price in SAR, quantity) of an order."""
    o = ORDERS.get(int(order_id))
    if not o:
        return f"order {order_id} not found"
    lines = "; ".join(f"{l['item']}: {l['price']} SAR x {l['qty']}" for l in o["lines"])
    return f"customer {o['customer']}; lines: {lines}"

def calculate(expression: str) -> str:
    """Evaluate an arithmetic expression with + - * / and parentheses, using exact decimals. Example: (9.99*3+25*2)*1.15"""
    allowed = set("0123456789.+-*/() ")
    if not set(expression) <= allowed:
        return "only numbers and + - * / ( ) are allowed"
    import re
    expr = re.sub(r"(\d+(?:\.\d+)?)", r"Decimal('\1')", expression)
    return str(eval(expr, {"Decimal": Decimal}).quantize(Decimal("0.01")))

TASK = ("Order 17: find the total the customer pays including 15% VAT, then write a one-sentence message "
        "to the customer that states this total in SAR.")
EXPECTED = "91.97"     # (9.99*3 + 25.00*2) * 1.15 = 91.9655
في الملف أعلاه لاحظ أن الأداة calculate ترفض أي شيء غير الأرقام والعمليات الأربع والأقواس، وهذا مقصود لسببين: لا نريد أن تشغل eval كوداً يكتبه النموذج، ونريد أن نرى ماذا يفعل كل إطار عندما ترجع الأداة خطأً، وهذا ما حدث فعلاً في أول إطار.
LangGraph: رسم بياني تبنيه بنفسك
LangGraph من شركة LangChain برخصة MIT، وفكرته أن التطبيق رسم بياني Graph: عقد Nodes تعمل على حالة State مشتركة، وحواف Edges تقرر الخطوة التالية، وقد بنينا به وكيلاً يحفظ حالته ويطلب الموافقة في دليل LangGraph. وتوثيق تعدد الوكلاء عندهم يذكر خمسة أنماط: الوكلاء الفرعيون Subagents، والتسليم Handoffs، والمهارات Skills، والموجه Router، وسير العمل المخصص Custom Workflow. واستعملنا هنا نمط الوكلاء الفرعيين: مشرف بأداتين، كل أداة تستدعي وكيلاً كاملاً وترجع رسالته الأخيرة:
from langchain_core.tools import tool
from langchain_openai import ChatOpenAI
from langgraph.prebuilt import create_react_agent
import shop_tools as S

llm = ChatOpenAI(model="qwen2.5:3b", base_url="http://adm-proxy:8080/v1", api_key="local", temperature=0, max_tokens=400)

billing = create_react_agent(llm, [tool(S.get_order), tool(S.calculate)],
                             prompt="You are the billing agent. Use get_order, then calculate. Reply with the total only.")
writer = create_react_agent(llm, [], prompt="You write one short, polite sentence to a customer.")

@tool
def ask_billing(question: str) -> str:
    """Ask the billing agent a question about an order total."""
    return billing.invoke({"messages": [("user", question)]})["messages"][-1].content

@tool
def ask_writer(brief: str) -> str:
    """Ask the writer agent to write the customer message. Include the name and the total in the brief."""
    return writer.invoke({"messages": [("user", brief)]})["messages"][-1].content

supervisor = create_react_agent(llm, [ask_billing, ask_writer],
                                prompt="You are the supervisor. First ask_billing for the total, then ask_writer for the message. Return the message.")
out = supervisor.invoke({"messages": [("user", S.TASK)]}, {"recursion_limit": 20})
print("FINAL:", out["messages"][-1].content)
في الكود أعلاه لاحظ التالي:
- كل وكيل هنا رسم بياني صغير يرجع من الدالة
create_react_agent، والوكيلان الفرعيان أدوات عادية بالمزخرف@tool، والنص الموجود في docstring هو وصف الأداة الذي يقرؤه المشرف. - لا يوجد شيء مخفي تقريباً: تعليمات النظام هي النص الذي كتبناه في
prompt، والوسيط سجل تعليمات المشرف بطول 109 حروف، أي الجملة التي كتبناها فقط. - عند التشغيل ظهر تحذير
LangGraphDeprecatedSinceV10يقول إنcreate_react_agentانتقلت إلىlangchain.agentsباسمcreate_agent، وإنها سوف تحذف في الإصدار 2.0. والكود يعمل، ولكن الطريقة الموصى بها اليوم تحتاج الحزمةlangchainأيضاً، وهي التي استعملناها في دليل LangGraph.
والمخرج سوف يكون كما يلي، بعد حذف التحذيرات:
FINAL: Your total comes to SAR 54.63 including VAT.
TIME langgraph 972 s
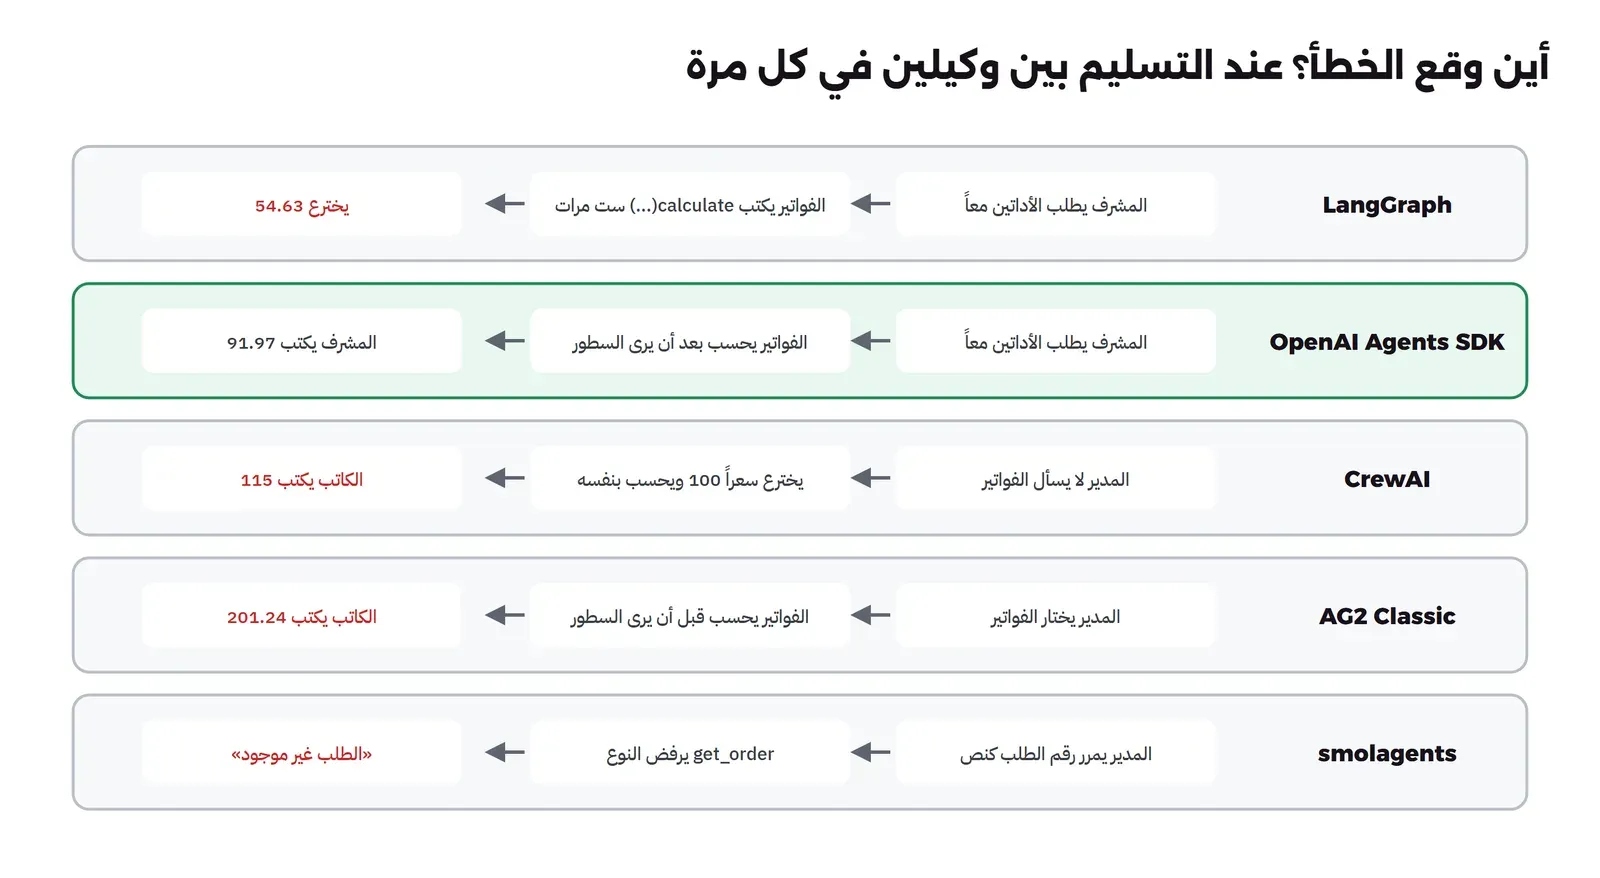
والجواب خاطئ، فالصحيح 91.97. ولكي نعرف السبب قرأنا الطلبات الاثني عشر التي حفظها الوسيط في requests/، والقصة كما يلي:
- المشرف في أول استدعاء طلب الأداتين معاً في دورة واحدة،
ask_billingوask_writer، رغم أن تعليماته تقول «أولاً ثم»، لأن الواجهة تسمح بعدة استدعاءات أدوات في رد واحد Parallel Tool Calls. فذهب الكاتب يكتب رسالة دون أن يعرف المبلغ، ورجع بالنصSAR [total amount]. - وكيل الفواتير طلب
get_orderوأخذ السطور الصحيحة، ولكنه في الدورة نفسها طلبcalculateبالتعبيرcalculate((total_before_vat*1.15))، أي كتب اسم الأداة داخل مدخلها ومتغيراً لم يحسبه. - الأداة رفضت بالرسالة
only numbers and + - * / ( ) are allowed، فأعاد المحاولة ست مرات، وفي الثالثة كتب الأرقام الصحيحة(3*9.99+2*25)*1.15ولكن ما زالت داخلcalculate(...)، فرفضت الأداة كل مرة. - بعد الرفض السادس توقف الوكيل عن طلب الأداة وكتب بنفسه «54.63»، وهو رقم لا يخرج من أي حساب للطلب، أي أنه اخترع النتيجة.
- المشرف قرأ «54.63» من الفواتير، ورأى أن رسالة الكاتب فيها نص فارغ، فطلب الكاتب مرة ثانية بالمبلغ الخاطئ، وأرجع رسالته.
والدرس هنا ليس عن LangGraph نفسه، فالإطار فعل بالضبط ما بنيناه، وإنما عن تعدد الوكلاء: الخطأ حدث في الوكيل الفرعي، ووصل إلى المشرف كجملة واثقة من سطر واحد، والمشرف لا يملك طريقة ليعرف أن خلفها ستة رفضات. ولو كان الوكيل واحداً لكانت رسائل الرفض في نافذته نفسها. والإصلاح العملي في الكود وليس في التعليمات: أن ترجع الأداة رسالة خطأ تشرح المطلوب بمثال، وأن يرجع الوكيل الفرعي مع النتيجة ما يثبتها، مثل مخرج calculate نفسه، وأن يفحص المشرف ذلك.
والوسيط سجل 12 استدعاءً، فيها 4,536 توكن مدخل و407 توكنات مخرج، وأطولها الاستدعاء التاسع لوكيل الفواتير بـ 684 توكناً، لأن كل محاولة فاشلة بقيت في نافذته وأعيد إرسالها في كل دورة بعدها.
نقاط القوة: تحكم كامل في الخطوات والحالة، ولا يضيف تعليمات مخفية تقريباً، ومعه الحفظ والاستكمال والموافقة البشرية التي شرحناها في دليله.
نقاط الضعف: أنت تكتب كل شيء، بما فيه منطق المشرف، والواجهة تغيرت بين الإصدارات حتى أن الدالة التي في أغلب الأمثلة على الإنترنت أصبحت قديمة، ويعتمد على langchain-core دائماً.
OpenAI Agents SDK: وكلاء كأدوات بأقل كود
OpenAI Agents SDK برخصة MIT، وهو إطار صغير فيه أربعة مفاهيم تقريباً: الوكيل Agent، والأداة Tool، والتسليم Handoff، والحراسات Guardrails، مع تتبع Tracing مدمج. ويذكر توثيق تعدد الوكلاء فيه طريقتين: وكيل مدير يبقى مسؤولاً ويستدعي المتخصصين بالدالة Agent.as_tool()، أو وكيل فرز يسلم المحادثة لمتخصص يصبح هو المسؤول. ورغم الاسم فإنه يعمل مع أي واجهة متوافقة مع OpenAI، ومنها Ollama، كما في الكود التالي:
import asyncio
from openai import AsyncOpenAI
from agents import Agent, ModelSettings, Runner, function_tool, OpenAIChatCompletionsModel, set_tracing_disabled
import shop_tools as S

set_tracing_disabled(True)          # no traces are sent to OpenAI
model = OpenAIChatCompletionsModel(model="qwen2.5:3b",
                                   openai_client=AsyncOpenAI(base_url="http://adm-proxy:8080/v1", api_key="local"))
settings = ModelSettings(temperature=0, max_tokens=400)

billing = Agent(name="billing", model=model, model_settings=settings, tools=[function_tool(S.get_order), function_tool(S.calculate)],
                instructions="You are the billing agent. Use get_order, then calculate. Reply with the total only.")
writer = Agent(name="writer", model=model, model_settings=settings, instructions="You write one short, polite sentence to a customer.")
supervisor = Agent(name="supervisor", model=model, model_settings=settings,
                   instructions="First ask_billing for the total, then ask_writer for the message. Return the message.",
                   tools=[billing.as_tool(tool_name="ask_billing", tool_description="Ask the billing agent for an order total."),
                          writer.as_tool(tool_name="ask_writer", tool_description="Ask the writer for the customer message; include name and total.")])

async def main():
    r = await Runner.run(supervisor, S.TASK, max_turns=10)
    print("FINAL:", r.final_output)
asyncio.run(main())
في الكود أعلاه لاحظ التالي:
- السطر
set_tracing_disabled(True)مهم إذا لم تكن تستعمل OpenAI، لأن التتبع يرسل سجل التشغيل إلى خوادم OpenAI افتراضياً، وقد شرحنا التتبع في مقال الوكيل الذكي. - الوكيل الفرعي يصبح أداة بسطر واحد
billing.as_tool(...)، وهذا أقصر ما رأيناه في الأطر الخمسة. - هذا الإطار ثبتناه في مجلد منفصل
/opt/oaبالإصدار 0.25.0 معopenai3.57.0، لأن CrewAI في الصورة نفسها يحتاجopenaiأقدم من الإصدار 3، فلم يستطعpipأن يضع الاثنين معاً بأحدث إصدار. وهذا شيء تواجهه عندما تجرب عدة أطر في بيئة واحدة: اجعل لكل إطار بيئته الافتراضية Virtual Environment.
والمخرج سوف يكون كما يلي:
FINAL: The total for Order 17, including a 15% VAT, is SAR 91.97. Please note this amount.
TIME openai_agents 366 s
والجواب صحيح، في ستة استدعاءات فقط، بـ 1,551 توكن مدخل و242 توكن مخرج. ولكن الطلبات المحفوظة تقول إن النجاح لم يأت من اتباع التعليمات:
- المشرف طلب الأداتين معاً في أول دورة، مثلما حدث في LangGraph تماماً، فوصل للكاتب نص فيه
[total_amount]مكان المبلغ، ورجع برسالة فيها النص نفسه. - وكيل الفواتير وصله طلب من كلمتين فقط هو
Order 17، فطلبget_orderوحدها، وبعد أن رأى السطور كتب التعبير الصحيح(9.99*3 + 25*2) * 1.15، فرجعت الأداة بـ91.97. - المشرف في الدورة الأخيرة رأى أمامه نتيجة الفواتير الصحيحة ورسالة الكاتب الناقصة، فكتب الرسالة النهائية بنفسه بالمبلغ الصحيح.
والفرق بين نجاح هذا الإطار وفشل LangGraph في هذه النقطة ليس في الإطار، وإنما في أن وكيل الفواتير في LangGraph طلب get_order وcalculate في الرد نفسه، أي قبل أن يرى أي رقم، فكتب اسم متغير لم يحسبه، أما هنا فطلب أداة واحدة وانتظر نتيجتها. والنموذج والأدوات ودرجة الحرارة نفسها في الحالتين، والذي اختلف هو النص الذي كتبه المشرف للوكيل الفرعي: جملة كاملة في LangGraph، وكلمتان هنا. وهذا يعني أن تشغيلاً واحداً لكل إطار لا يكفي لتقول إن أحدهما أفضل في النتيجة، وما يمكن أن تقيسه من تشغيل واحد هو ما يرسله الإطار وكم يستدعي، وهو ما نجمعه في جدول المقارنة.
نقاط القوة: أقل كود وأوضح مفاهيم، والوكيل كأداة سطر واحد، والتسليم والحراسات والتتبع جاهزة، وتعريف الأدوات يرسل بصيغة صارمة strict: true مع additionalProperties: false.
نقاط الضعف: لا يوجد فيه رسم بياني صريح أو حفظ واستكمال للحالة مثل LangGraph، فالمهام الطويلة التي تتوقف وتكمل تحتاج أن تبنيها، والتتبع يتجه إلى OpenAI افتراضياً فيجب أن تتذكر تعطيله أو توجيهه.
CrewAI: فريق بأدوار ومدير جاهز
CrewAI برخصة MIT، وطريقته في التفكير مختلفة: لا تكتب رسماً بيانياً ولا مشرفاً، وإنما تصف فريقاً Crew: لكل وكيل دور Role وهدف Goal وخلفية Backstory، ولكل مهمة Task وصف وشكل للنتيجة المتوقعة. ويقسم توثيق CrewAI العمل إلى نوعين: الفرق Crews، وهي وكلاء مستقلون يتعاونون على مهام، والتدفقات Flows، وهي سير عمل منظم يقوده الحدث Event-driven ويحمل الحالة ويتحكم في التنفيذ. وفي الفريق طريقتان للتشغيل بحسب صفحة العمليات Processes: متتالية Sequential تنفذ المهام بالترتيب، وهرمية Hierarchical فيها مدير يوزع ويراجع، ويجب أن تعطيه manager_llm أو manager_agent. واستعملنا الهرمية لأنها المقابل لنمط المشرف:
from crewai import Agent, Crew, LLM, Process, Task
from crewai.tools import tool
import shop_tools as S

llm = LLM(model="openai/qwen2.5:3b", base_url="http://adm-proxy:8080/v1", api_key="local", temperature=0, max_tokens=400)

@tool("get_order")
def get_order(order_id: int) -> str:
    """Return the customer name and the lines (item, unit price in SAR, quantity) of an order."""
    return S.get_order(order_id)

@tool("calculate")
def calculate(expression: str) -> str:
    """Evaluate an arithmetic expression with + - * / and parentheses. Example: (9.99*3+25*2)*1.15"""
    return S.calculate(expression)

billing = Agent(role="Billing agent", goal="Compute exact order totals with VAT", backstory="You check every number.",
                tools=[get_order, calculate], llm=llm, allow_delegation=False)
writer = Agent(role="Writer", goal="Write short polite customer messages", backstory="You write one sentence.",
               llm=llm, allow_delegation=False)
task = Task(description=S.TASK, expected_output="One sentence to the customer with the total in SAR.")
crew = Crew(agents=[billing, writer], tasks=[task], process=Process.hierarchical, manager_llm=llm, verbose=False)
print("FINAL:", crew.kickoff().raw)
في الكود أعلاه لاحظ التالي:
- لم نكتب أي تعليمات للمدير، فقط
manager_llm=llm، والإطار ينشئه بنفسه. - النموذج يكتب بالصيغة
openai/qwen2.5:3bليعرف CrewAI أن الواجهة متوافقة مع OpenAI، معbase_urlللوسيط. - الأدوات تعرف بمزخرف
@toolخاص بـ CrewAI، فلم نستطع تمرير دوالshop_tools.pyكما هي، وكتبنا حولها غلافاً صغيراً.
والمخرج سوف يكون كما يلي، مع التحذيرات التي طبعها الإطار:
Using an approximate input token count for model 'qwen2.5:3b': assuming one token per four characters because a native token count is unavailable.
The context window of model 'qwen2.5:3b' is unknown, so CrewAI assumes 8,192 tokens (6,963 usable). If the model's window is different, pass it as LLM(model=..., context_window_size=<tokens>).
FINAL: The message to the customer is as follows:

"Dear Customer, the total amount for Order 17, including a 15% VAT, is SAR 115."
TIME crewai 396 s
في المخرج أعلاه لاحظ التالي:
- التحذيران الأولان مفيدان فعلاً: CrewAI لا يعرف حجم نافذة النموذج المحلي فيفترض 8,192 توكناً، ويقدر التوكنات بحرف لكل أربعة. وإذا كانت نافذة نموذجك أصغر، فإن الإطار قد يرسل أكثر مما يتسع له، فمرر
context_window_sizeبالقيمة الصحيحة. - الجواب خاطئ، 115 بدل 91.97، ورسالة الكاتب لا تذكر المبلغ الصحيح.
- كل التشغيل ثلاثة استدعاءات فقط، وهذا وحده يقول إن وكيل الفواتير لم يعمل أصلاً.
والطلبات المحفوظة تشرح ما حدث. فالمدير الذي أنشأه CrewAI وصل إليه في أول طلب تعليمات نظام لم نكتبها طولها 486 حرفاً، أولها:
You are Crew Manager. You are a seasoned manager with a knack for getting the best out of your team.
You are also known for your ability to delegate work to the right people, and to ask the right questions to get the best out of your team.
Even though you don't perform tasks by yourself, you have a lot of experience in the field, ...
ومعها أداتان لم نكتبهما: delegate_work_to_coworker وask_question_to_coworker، ووصف كل منهما يقول للمدير أن يعطي زميله كل السياق لأنه لا يعرف شيئاً عن المهمة، وتعريفهما معاً 1,616 حرفاً. ثم اختار المدير أن يسأل الكاتب مباشرة، وكتب في حقل السياق context هذا النص:
The total the customer pays including 15% VAT is calculated as follows: Total = (Price * (1 + VAT/100)).
For Order 17, the price is $100 and the VAT is 15%. The total amount is $115. ...
أي أن المدير اخترع سعراً للطلب، 100 دولار، دون أن يسأل وكيل الفواتير الذي يملك الأداة، ثم حسب الضريبة عليه بنفسه، وأرسله للكاتب كحقيقة، والكاتب كتب الرسالة بأمانة على ما وصله. وهذا من أنواع الفشل التي يصنفها بحث Cemri وزملائه تحت سوء التنسيق: وكيل يكمل على افتراض بدل أن يسأل من عنده المعلومة. ولاحظ أن تعليمات المدير الجاهزة تقول له إنه لا ينفذ المهام بنفسه، ومع ذلك نفذ الحساب بنفسه وبرقم مخترع.
نقاط القوة: أسرع طريقة لتصف فريقاً بأدوار ومهام دون كتابة منطق التوجيه، والعملية الهرمية تعطيك مديراً جاهزاً، والتدفقات Flows تعطيك تحكماً أكثر عندما تحتاجه، وتحذيراته عن النافذة والتوكنات واضحة ومفيدة.
نقاط الضعف: يضيف للمدير تعليمات وأدوات لم تكتبها، والمدير الجاهز يقرر بنفسه من يسأل وماذا يكتب له، فإذا أخطأ النموذج في القرار فليس في كودك مكان لتمنعه إلا بتعليمات أكثر، ويطلب openai بإصدار أقدم من 3 فلا يجتمع مع أحدث OpenAI Agents SDK في بيئة واحدة.
AutoGen وAG2: محادثة جماعية ومدير يختار المتكلم
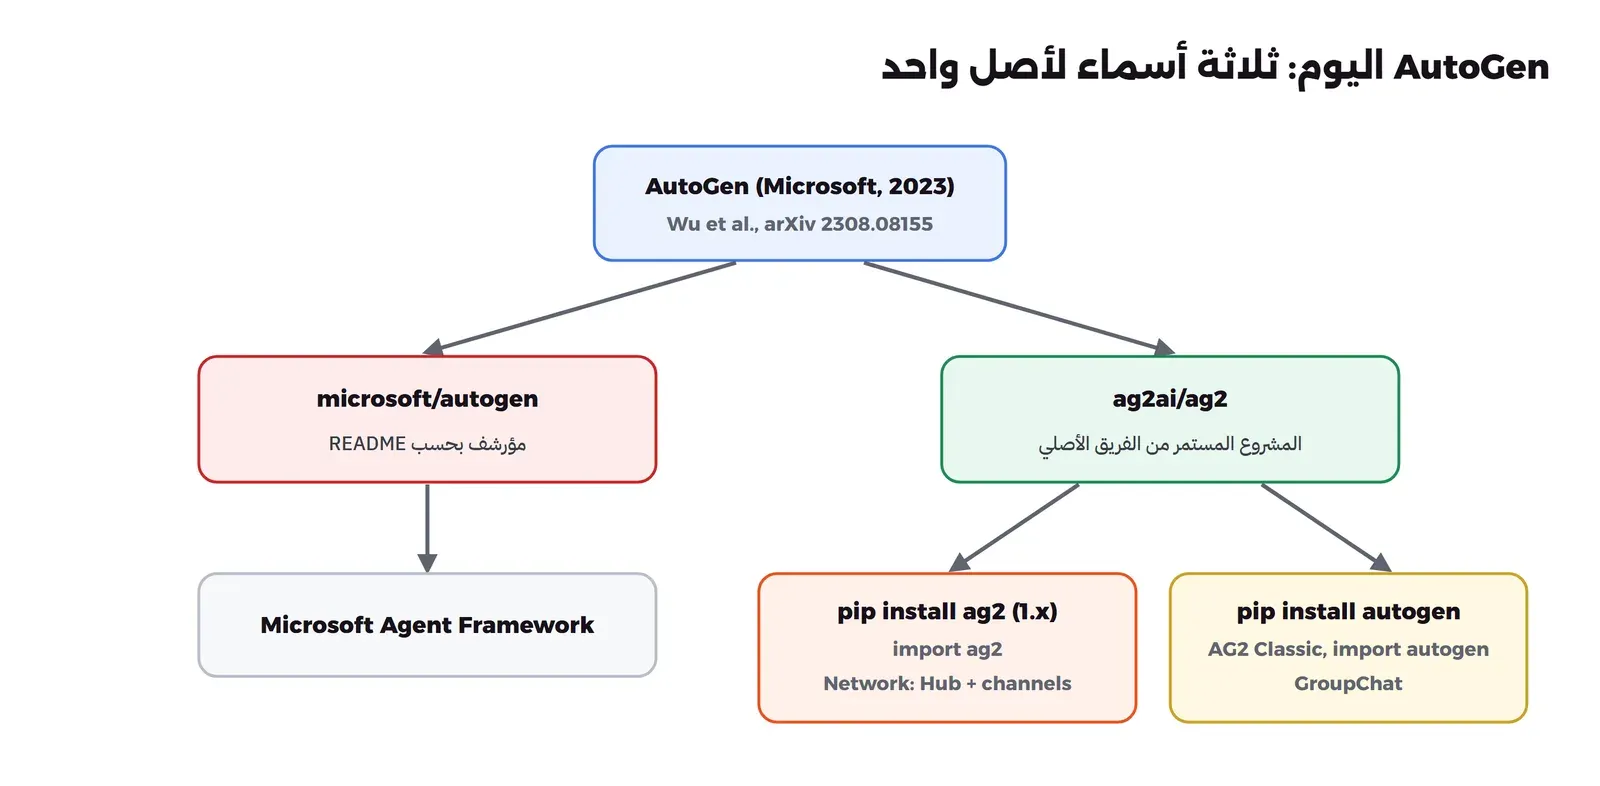
AutoGen من Microsoft هو أقدم الأطر الخمسة، ونشر بحثه Qingyun Wu وزملاؤه في أغسطس 2023، وفكرته أن التطبيق محادثة بين وكلاء «قابلين للمحادثة» Conversable. ولكن اسمه اليوم يدل على ثلاثة أشياء مختلفة، ويجب أن تعرف أيها تثبت:
- Microsoft AutoGen: ملف README في مستودع Microsoft يقول اليوم إن المشروع مؤرشف ولم يعد يطور، ولا يحصل على إصلاحات أخطاء ولا إصلاحات أمنية، وإن Microsoft Agent Framework هو الخلف المخصص للمؤسسات.
- AG2: المشروع الذي أكمله جزء من فريق AutoGen الأصلي في مستودع ag2ai/ag2 برخصة Apache 2.0. والحزمة
ag2بالإصدار 1.3.3 الذي ثبتناه إطار جديد يستورد بـimport ag2، وتعدد الوكلاء فيه اسمه Network، ولا توجد فيه الحزمةautogenأصلاً. - AG2 Classic: الكود المعروف بـ
from autogen import ConversableAgent, GroupChat، وهو على PyPI اليوم باسمautogen، وثبتنا منه الإصدار 0.14.1.
وقد وقعنا في هذا الفرق أثناء المختبر: ثبتنا ag2 كما تقول أغلب المقالات، فكانت النتيجة عند أول استيراد كما يلي:
ModuleNotFoundError: No module named 'autogen'وبعد أن قرأنا ملف README في الحزمة نفسها ثبتنا autogen==0.14.1 في مجلد منفصل، واستعملنا المحادثة الجماعية GroupChat لأنها الطريقة المعروفة لتعدد الوكلاء في AutoGen، وفيها مدير يختار المتكلم التالي بالنموذج، وهي الطريقة الافتراضية auto:
from autogen import ConversableAgent, GroupChat, GroupChatManager, LLMConfig, register_function
import shop_tools as S

cfg = LLMConfig({"model": "qwen2.5:3b", "base_url": "http://adm-proxy:8080/v1", "api_key": "local",
                 "api_type": "openai", "temperature": 0, "max_tokens": 400})
billing = ConversableAgent("billing", llm_config=cfg,
                           system_message="You are the billing agent. Call get_order, then calculate. Reply with the total.")
writer = ConversableAgent("writer", llm_config=cfg,
                          system_message="You write one short polite sentence to the customer with the total. End with TERMINATE.")
executor = ConversableAgent("executor", llm_config=False, human_input_mode="NEVER")   # runs the tools, no model
for f in (S.get_order, S.calculate):
    register_function(f, caller=billing, executor=executor, description=f.__doc__)

chat = GroupChat(agents=[executor, billing, writer], messages=[], max_round=8, speaker_selection_method="auto")
manager = GroupChatManager(chat, llm_config=cfg,
                           is_termination_msg=lambda m: "TERMINATE" in (m.get("content") or ""))
res = executor.initiate_chat(manager, message=S.TASK)
print("FINAL:", chat.messages[-1]["content"])
print("SPEAKERS:", " > ".join(m.get("name", "?") for m in chat.messages))
في الكود أعلاه لاحظ التالي:
- الوكيل
executorبدون نموذجllm_config=False، ودوره أن ينفذ الأدوات التي يطلبها وكيل الفواتير، وهذا تقسيم معروف في AutoGen: وكيل يقترح استدعاء الأداة، ووكيل آخر ينفذه. - المحادثة تنتهي عندما تظهر الكلمة
TERMINATEفي رسالة، لذلك طلبنا من الكاتب أن ينهي بها. - كل الوكلاء في المحادثة الجماعية يرون كل الرسائل، وهذا فرق كبير عن الأطر السابقة التي يرى فيها كل وكيل فرعي مهمته فقط.
والمخرج سوف يكون كما يلي، مختصراً:
***** Response from calling tool (call_47euj7pj) *****
201.24
[autogen.oai.client: 11-20 06:47:59] {734} WARNING - Model qwen2.5:3b is not found. The cost will be 0. In your config_list, add field {"price" : [prompt_price_per_1k, completion_token_price_per_1k]} for customized pricing.

Next speaker: writer

writer (to chat_manager):

Your total including 15% VAT comes to 201.24 SAR. TERMINATE
FINAL: Your total including 15% VAT comes to 201.24 SAR. TERMINATE
SPEAKERS: executor > billing > executor > writer
TIME ag2 620 s
في المخرج أعلاه لاحظ التالي:
- الجواب خاطئ مرة أخرى، 201.24. والطلبات المحفوظة تقول إن وكيل الفواتير طلب
get_orderوcalculateفي الرد نفسه، كما حدث في LangGraph، فكتب التعبير((25*2 + (25+99.99)*1)*1.15)قبل أن يرى السطور، أي بأرقام من خياله، والأداة حسبته بدقة لأنه تعبير صالح. - التحذير
The cost will be 0يعني أن AutoGen يحسب التكلفة من جدول أسعار داخلي للنماذج المعروفة، وأنه لا يعرف نموذجنا. وإذا كنت تعتمد على هذا الرقم لمتابعة التكلفة فأضف الحقلpriceكما يقول التحذير. - الوسيط سجل أربعة استدعاءات فقط، منها اثنان للمدير ليختار المتكلم، أي أن نصف الاستدعاءات لم تنتج عملاً. وطلب الاختيار يرسل تعليمات نظام من 469 حرفاً يبنيها الإطار من تعليمات الوكلاء الثلاثة، أولها
You are in a role play game، ثم المحادثة كلها، ثم رسالة أخرى تطلب اسم الدور، والجواب كلمة واحدة من توكنين.
نقاط القوة: المحادثة الجماعية تجعل نقاش عدة أدوار سهلاً جداً، وطرق اختيار المتكلم متعددة، منها round_robin وأي دالة تكتبها، وفصل من يطلب الأداة عمن ينفذها مفيد لموافقة إنسان قبل التنفيذ.
نقاط الضعف: الأسماء والحزم مربكة اليوم بين Microsoft وAG2 وAG2 Classic، والاختيار الآلي للمتكلم استدعاء إضافي قبل كل رسالة، وكل وكيل يقرأ المحادثة كلها فتكبر المدخلات مع كل دورة. ولهذا الإطار وأنظمة النقاش بين الوكلاء مقال خاص في هذه المرحلة.
smolagents: وكيل يدير وكلاء بتعليمات جاهزة طويلة
smolagents من Hugging Face برخصة Apache 2.0، وفيه نوعان من الوكلاء: CodeAgent الذي يكتب أفعاله ككود Python ينفذ، وToolCallingAgent الذي يستدعي الأدوات بصيغة JSON مثل باقي الأطر. وتعدد الوكلاء فيه بحسب مثال الوكلاء المتعددين في التوثيق أن تمرر الوكلاء الفرعيين للمدير في المعامل managed_agents، ويجب أن يكون لكل منهم اسم ووصف ليستطيع المدير أن يستدعيه. واستعملنا ToolCallingAgent لكل الوكلاء، لأن كتابة كود Python صحيح أصعب على نموذج صغير، ولكي تكون المقارنة مع الأطر الأخرى على الطريقة نفسها:
from smolagents import OpenAIServerModel, ToolCallingAgent, tool
import shop_tools as S

model = OpenAIServerModel(model_id="qwen2.5:3b", api_base="http://adm-proxy:8080/v1", api_key="local", temperature=0, max_tokens=400)

@tool
def get_order(order_id: int) -> str:
    """Return the customer name and the lines (item, unit price in SAR, quantity) of an order.
    Args:
        order_id: the order number
    """
    return S.get_order(order_id)

@tool
def calculate(expression: str) -> str:
    """Evaluate an arithmetic expression with + - * / and parentheses.
    Args:
        expression: for example (9.99*3+25*2)*1.15
    """
    return S.calculate(expression)

billing = ToolCallingAgent(tools=[get_order, calculate], model=model, name="billing", max_steps=5,
                           description="Computes an order total with VAT. Give it the order number.")
writer = ToolCallingAgent(tools=[], model=model, name="writer", max_steps=2,
                          description="Writes one polite sentence to a customer. Give it the name and total.")
manager = ToolCallingAgent(tools=[], model=model, managed_agents=[billing, writer], max_steps=6)
print("FINAL:", manager.run(S.TASK))
في الكود أعلاه لاحظ أن الأدوات في smolagents تحتاج docstring بقسم Args يشرح كل معامل، وإلا يرفض المزخرف @tool إنشاءها. وقد جربنا دالة بسطر وصف واحد دون Args فكان الخطأ كما يلي:
DocstringParsingException Cannot generate JSON schema for f because the docstring has no description for the argument 'x'ولذلك كتبنا غلافاً للأداتين كما في CrewAI. والمخرج عند تشغيل المهمة سوف يكون كما يلي، مختصراً:
[Step 1: Duration 596.97 seconds| Input tokens: 1,460 | Output tokens: 45]
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ Step 2 ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
Error while parsing tool call from model output: The model output does not
contain any JSON blob.
[Step 2: Duration 51.58 seconds| Input tokens: 3,208 | Output tokens: 48]
...
[Step 6: Duration 21.14 seconds| Input tokens: 10,780 | Output tokens: 60]
Reached max steps.
[Step 7: Duration 39.74 seconds| Input tokens: 11,493 | Output tokens: 105]
FINAL: It appears that there is no available order with the number 17 in the system. Therefore, I cannot calculate the total including 15% VAT for this order. Please check the order number and try again.
TIME smolagents 765 s
في المخرج أعلاه لاحظ التالي:
- smolagents يطبع بنفسه توكنات المدخل والمخرج لكل خطوة للمدير، وهذا مفيد جداً، والأرقام تتراكم: المدخل بعد الخطوة السادسة 10,780 توكناً، لأن كل خطوة تعيد إرسال كل ما قبلها.
- الجواب النهائي يقول إن الطلب 17 غير موجود، وهو موجود. والسبب ظهر في الطلبات المحفوظة: المدير استدعى وكيل الفواتير وأعطاه المعامل الإضافي
{'order_number': '17'}كنص، فاستدعى وكيل الفواتيرget_orderبالنص، فرد الإطار بالرسالةArgument order_id has type 'string' but should be 'integer'، فاستنتج الوكيل الفرعي أن الطلب غير موجود في النظام، ورجع إلى المدير بتقرير طويل بهذا المعنى. - بعد التقرير لم يستطع المدير أن يكتب استدعاء أداة صالحاً خمس مرات متتالية، وكل مرة يرد بثلاثة توكنات تقريباً، والإطار يرد عليه بالرسالة
The model output does not contain any JSON blob، حتى وصل إلى الحدmax_steps=6، فأرسل الإطار طلباً أخيراً بتعليمات تقول إن الوكيل علق وفشل، ويطلب جواباً من الذاكرة، فكان هذا الجواب.
ولكن الرقم الأهم في smolagents ظهر في أول طلب: تعليمات النظام التي أرسلها الإطار للمدير طولها 4,386 حرفاً، وللوكيل الفرعي 3,592 حرفاً، وأولها:
You are an expert assistant who can solve any task using tool calls. You will be given a task to solve as best you can.
To do so, you have been given access to some tools.

The tool call you write is an action: after the tool is executed, you will get the result of the tool call as an "observation".
This Action/Observation can repeat N times, you should take several steps when needed.
وهذه التعليمات فيها أمثلة كاملة لطريقة العمل، وهي التي جعلت أول طلب للمدير 1,460 توكناً، وسؤالنا فيه 152 حرفاً فقط. والإطار يطلب أيضاً tool_choice: required، أي يجبر النموذج على استدعاء أداة في كل رد، ويضيف stop بالكلمتين Observation: وCalling tools:. والوكيل الفرعي يطلب منه في المهمة أن يرجع تقريراً بثلاثة أقسام: النتيجة باختصار، والنتيجة بتفصيل كبير، وسياق إضافي، وهذا ما جعل تقرير «الطلب غير موجود» طويلاً ومقنعاً.
نقاط القوة: كود قصير، وتعليمات جاهزة فيها أمثلة كاملة لطريقة العمل، وطباعة التوكنات والزمن لكل خطوة دون إعداد، وCodeAgent الذي يكتب أفعاله ككود يناسب المهام الحسابية والتحويلات عندما يكون النموذج قوياً.
نقاط الضعف: أكبر تعليمات مخفية بين الأطر الخمسة بفرق كبير، وهذا ثمن يدفع في كل خطوة لكل وكيل، والتعليمات الطويلة ثقيلة على نموذج صغير، والإجبار على استدعاء أداة في كل رد يجعل النموذج الذي لا يجيد الصيغة يدور في حلقة أخطاء حتى الحد.
جدول المقارنة بالأرقام
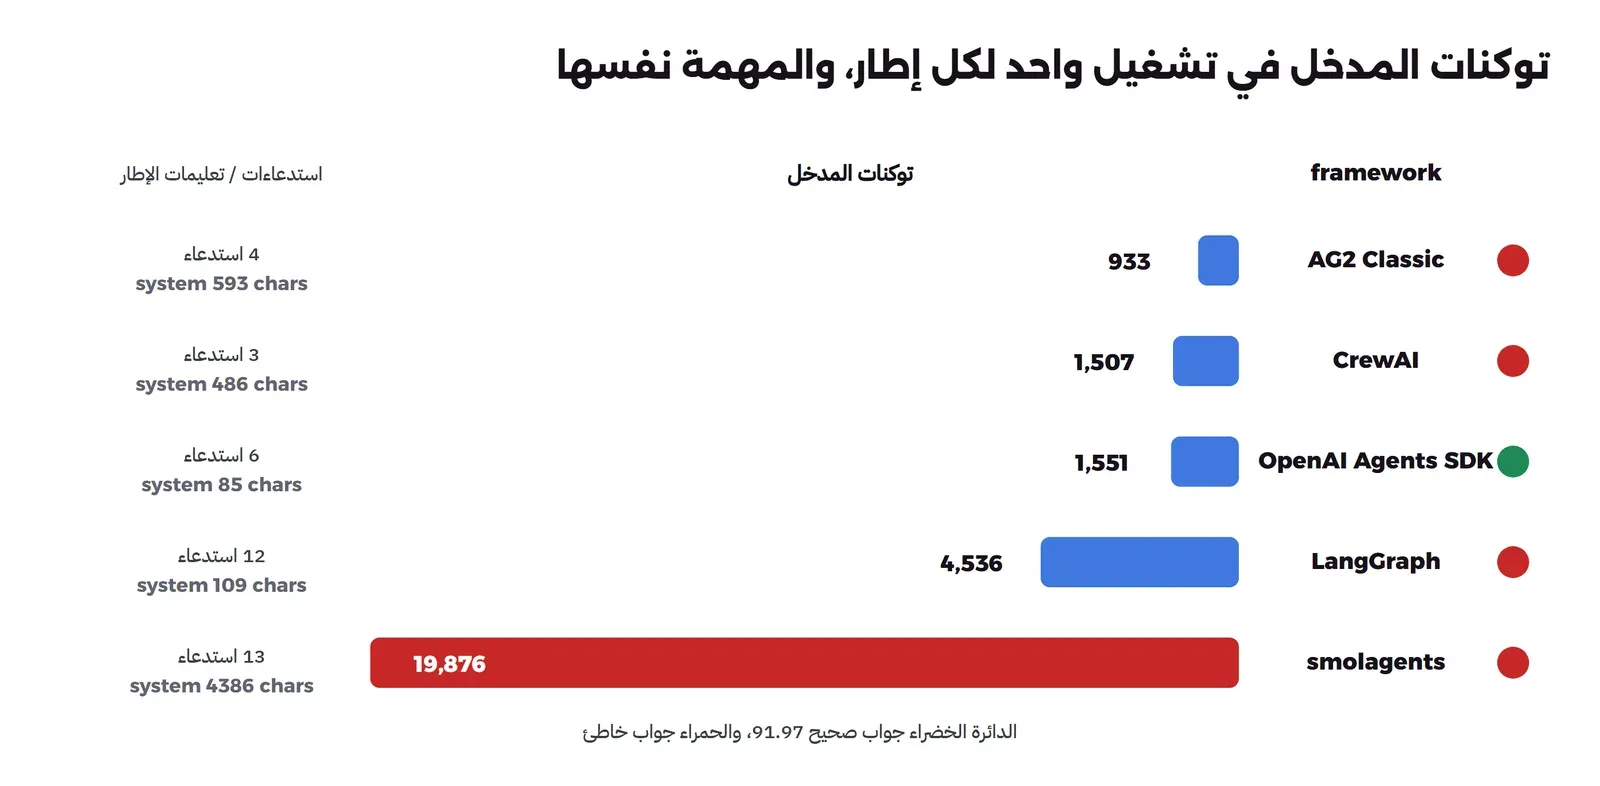
الجدول التالي يجمع ما سجله الوسيط للأطر الخمسة في التشغيل نفسه، بالمهمة نفسها والنموذج نفسه ودرجة الحرارة صفر وحد 400 توكن للمخرج في كل استدعاء. والعمود «تعليمات الإطار» هو طول تعليمات النظام في أول طلب للمشرف أو المدير بالحروف، أي ما وصل للنموذج فعلاً، وفي LangGraph وOpenAI Agents SDK هو النص الذي كتبناه نحن تقريباً، وفي الثلاثة الأخرى أغلبه من الإطار:
| الإطار والإصدار | الرخصة | النمط | أسطر الكود | الاستدعاءات | توكنات المدخل | توكنات المخرج | تعليمات الإطار | النتيجة |
|---|---|---|---|---|---|---|---|---|
| LangGraph 1.2.24 | MIT | وكلاء فرعيون كأدوات | 20 | 12 | 4,536 | 407 | 109 | 54.63، خاطئ |
| OpenAI Agents SDK 0.25.0 | MIT | as_tool | 19 | 6 | 1,551 | 242 | 85 | 91.97، صحيح |
| CrewAI 1.15.44 | MIT | عملية هرمية بمدير جاهز | 19 | 3 | 1,507 | 207 | 486 | 115، خاطئ |
| AG2 Classic (autogen 0.14.1) | Apache 2.0 | محادثة جماعية auto | 17 | 4 | 933 | 269 | 593 | 201.24، خاطئ |
| smolagents 1.26.0 | Apache 2.0 | managed_agents | 23 | 13 | 19,876 | 672 | 4,386 | «الطلب غير موجود»، خاطئ |
في الجدول أعلاه لاحظ التالي:
- أسطر الكود متقاربة جداً، من 17 إلى 23 سطراً غير فارغ، فعدد الأسطر ليس معياراً للاختيار بين هذه الأطر.
- توكنات المدخل تختلف بأكثر من عشرين ضعفاً، من 933 في AG2 إلى 19,876 في smolagents، والسبب في smolagents مجموع أمرين: تعليمات طويلة في كل طلب، وثلاثة عشر طلباً يعيد كل منها إرسال كل ما قبله.
- أربعة من خمسة أعطت جواباً خاطئاً، والخطأ في كل مرة حدث عند التسليم بين وكيلين: مشرف يطلب الكاتب قبل الفواتير، ووكيل فواتير يكتب الحساب قبل أن يرى السطور، ومدير يخترع السعر بدل أن يسأل، ووكيل فرعي يستنتج أن الطلب غير موجود من خطأ في نوع المعامل. والجواب الصحيح الوحيد جاء لأن المشرف كتب الرسالة النهائية بنفسه بعد أن رأى الرقم.
- هذه نتيجة تشغيل واحد بنموذج من 3 مليارات معامل، ولا تقول إن LangGraph أو CrewAI أسوأ من OpenAI Agents SDK في الدقة، فالنموذج نفسه أخطأ وأصاب في الإطارين بحسب جملة واحدة كتبها المشرف. والذي يمكن الاعتماد عليه من هذا الجدول هو ما يرسله كل إطار وكم مرة.
حالة كل مشروع ورخصته اليوم
قبل أن تبني على إطار فانظر إلى حالته، لأن هذا المجال يتغير بسرعة، والجدول التالي من المستودعات وصفحات الحزم كما قرأناها في 20 نوفمبر 2026:
| الإطار | الرخصة | الحالة | ما يجب أن تعرفه |
|---|---|---|---|
| LangGraph | MIT | يطور بنشاط | create_react_agent قديمة وسوف تحذف في 2.0، والبديل create_agent في langchain، والمنصة المدفوعة شيء منفصل عن المكتبة كما شرحنا في دليله |
| OpenAI Agents SDK | MIT | يطور بنشاط | يحتاج openai 3 أو أحدث، والتتبع يذهب إلى OpenAI افتراضياً |
| CrewAI | MIT | يطور بنشاط | يحتاج openai أقدم من 3، فلا يجتمع مع أحدث OpenAI Agents SDK في بيئة واحدة |
| Microsoft AutoGen | MIT للكود | مؤرشف بحسب README، والخلف Microsoft Agent Framework | لا تبدأ عليه مشروعاً جديداً |
| AG2 | Apache 2.0 | يطور بنشاط، والإصدار 1.x إطار جديد | pip install ag2 لا يعطيك autogen، والكلاسيكي اسمه autogen على PyPI |
| smolagents | Apache 2.0 | يطور بنشاط | تعليمات جاهزة طويلة، ووكيل يكتب أفعاله ككود إذا أردت |
أي إطار تختار؟
| حالتك | الأنسب | والسبب |
|---|---|---|
| خطوات تعرفها مسبقاً، وتحتاج حفظاً واستكمالاً وموافقة إنسان | LangGraph | الرسم البياني والحالة في يدك، ولا يضيف تعليمات |
| مشرف ووكلاء فرعيون بأقل كود، مع تسليم وحراسات | OpenAI Agents SDK | الوكيل كأداة سطر واحد، والتعليمات المخفية قليلة |
| تريد أن تصف فريقاً بأدوار ومهام وتجربه بسرعة | CrewAI | المدير والتفويض جاهزان، ولكن راقب ما يقرره المدير |
| نقاش بين عدة أدوار في محادثة واحدة | AG2 Classic أو قنوات Network في AG2 | المحادثة الجماعية وطرق اختيار المتكلم جاهزة |
| نموذج قوي، ومهام تحسب وتحول البيانات | smolagents بـ CodeAgent | الوكيل يكتب أفعاله ككود، والتعليمات الطويلة لا تثقل نموذجاً كبيراً |
| نموذج صغير أو محلي، أو تقسيم معروف مسبقاً | لا إطار: حلقة بيدك وتوجيه في الكود | كما فعلنا في المقال الأول من هذه المرحلة، كل قرار تعرفه اكتبه في الكود |
وقد يتساءل البعض: إذا كانت الأطر كلها فشلت أو نجحت بالصدفة على نموذج صغير، فلماذا نستعملها أصلاً؟ والإجابة أن الإطار لا يجعل النموذج أذكى، وإنما يوفر عليك كتابة البنية حوله: الحالة، والحفظ، والتتبع، وطريقة استدعاء الأدوات. وعلى نموذج كبير تقل أخطاء التسليم التي رأيناها كثيراً، ولكنها لا تختفي، ولذلك فإن السؤال الأهم عند اختيار الإطار: هل يسمح لك أن ترى كل ما يرسله، وأن تضع فحصاً في الكود عند كل تسليم؟
أخطاء شائعة
- اختيار الإطار من عدد الأسطر في المثال: كل الأطر الخمسة كتبت المهمة في عشرين سطراً تقريباً، والفرق الحقيقي في التعليمات المخفية وعدد الاستدعاءات.
- عدم قراءة ما يرسله الإطار: ضع وسيطاً مثل
proxy.pyأو فعل التتبع، واقرأ أول طلب كاملاً قبل أي شيء آخر، فقد تجد آلاف الحروف من التعليمات في كل خطوة. - ترك حد المخرج مفتوحاً: في أول تشغيل لم نضع حداً، فكتب النموذج في أحد الاستدعاءات أكثر من 1,800 توكن قبل أن نوقفه. ضع
max_tokensفي إعداد كل إطار. - الثقة بنتيجة الوكيل الفرعي: في أربعة أطر من خمسة كانت المشكلة جملة واثقة من وكيل فرعي. اطلب من الوكيل الفرعي أن يرجع الدليل، مثل مخرج الأداة، وافحصه في الكود.
- استدعاء الأدوات المعتمدة على بعضها في رد واحد: النموذج طلب
get_orderوcalculateمعاً قبل أن يرى السطور. إذا كانت أداة تحتاج نتيجة أخرى، فقل ذلك في وصفها، أو عطل الاستدعاءات المتوازية إذا كان الإطار يسمح بذلك. - نسخ مثال قديم:
create_react_agentقديمة في LangGraph، وimport autogenلا يعمل معag2الجديد. اقرأ التحذيرات، وثبت الإصدار في ملف المتطلبات. - تثبيت كل الأطر في بيئة واحدة: CrewAI وأحدث OpenAI Agents SDK يطلبان إصدارين متعارضين من
openai، وpip يحل التعارض بإصدار أقدم دون أن ينبهك بوضوح. لكل إطار بيئة افتراضية.
قائمة تحقق قبل أن تعتمد إطاراً
- هل قرأت أول طلب يرسله الإطار كاملاً، وعرفت كم توكناً فيه قبل مهمتك؟
- هل تعرف كم استدعاءً تحتاج مهمة نموذجية، ومن يقرر الخطوة التالية: الكود أم النموذج؟
- هل وضعت حداً للمخرج وحداً للخطوات؟
- هل يرجع كل وكيل فرعي دليلاً مع نتيجته، وهل يفحصه الكود؟
- هل المشروع يطور بنشاط، وما رخصته، وهل المثال الذي تتبعه للإصدار الذي ثبته؟
- هل التتبع يذهب إلى خدمة خارجية افتراضياً؟
- هل جربت المهمة نفسها دون إطار، بحلقة صغيرة بيدك، لتعرف ماذا يضيف الإطار فعلاً؟
تدريب عملي
- شغل
proxy.pyأمام الإطار الذي تستعمله في عملك، ونفذ مهمة واحدة عادية، ثم افتح أول طلب فيrequests/وعد الحروف التي لم تكتبها أنت. - في
fw_langgraph.pyغير وصف الأداةcalculateليقول «لا تكتب اسم الأداة داخل التعبير، ومثال صحيح:(9.99*3+25*2)*1.15»، وأعد التشغيل: هل تغير عدد المحاولات الفاشلة؟ - في
fw_ag2.pyغيرspeaker_selection_methodإلىround_robin، وقارن عدد الاستدعاءات والتوكنات بالتشغيل الأول.
الخلاصة
- كل إطار تنسيق يبني فوق الحلقة نفسها: نموذج وأدوات ورسائل، والفرق بينها فيما يتركه لك من قرارات، وفيما يضيفه إلى كل طلب دون أن تراه.
- بالمهمة نفسها والنموذج نفسه اختلفت توكنات المدخل من 933 في AG2 Classic إلى 19,876 في smolagents، وتعليمات النظام التي أضافها الإطار للمدير من نحو 100 حرف في LangGraph وOpenAI Agents SDK إلى 4,386 حرفاً في smolagents.
- أربعة أطر من خمسة أعطت جواباً خاطئاً على نموذج 3B، والخطأ في كل مرة وقع عند التسليم بين وكيلين: أدوات معتمدة على بعضها في رد واحد، ومدير يخترع رقماً بدل أن يسأل، ووكيل فرعي يحول خطأ نوع إلى «الطلب غير موجود».
- أسماء AutoGen تفرقت: Microsoft أرشفته، وAG2 بالإصدار 1.x إطار جديد، والكود الكلاسيكي على PyPI باسم
autogen. - اختر الإطار الذي يسمح لك أن ترى كل ما يرسله، وأن تضع فحصاً في الكود عند كل تسليم، وضع حداً للمخرج والخطوات في كل الأحوال، ولكل إطار بيئته الافتراضية.
وفي المقالات التالية من هذه المرحلة بإذن الله نرى الوكلاء الفرعيين الذين تقدمهم أدوات البرمجة نفسها، ثم فريق الوكلاء الذي يتناقش، ثم حساب التكلفة بالأرقام:
 دليلالوكلاء الفرعيون Subagents والعمل بالتوازي في فروع منفصلةكيف يعمل الوكيل الفرعي في Claude Code وCodex وCursor، ومتى يفيد عزل القراءة والكتابة في Worktree لكل وكيل، مع تجربة على نموذج محلي فيها أخطاء مزروعة وإصلاحات في فروع منفصلة وتعارض حقيقي.
 دليلفريق وكلاء يتناقش Multi-agent Debate: هل يتحسن الجواب؟ما تقوله الأبحاث عن النقاش بين الوكلاء، وكيف بنت ChatDev وMetaGPT ومحادثات AutoGen فرقها، وتجربة على نموذج محلي تقارن النقاش والتصويت والناقد والحكم على أسئلة معروفة الجواب.
 دليلمتى يصبح تعدد الوكلاء Multi-agent أغلى وأبطأ من وكيل واحد؟من أين تأتي التوكنات الإضافية في فرق الوكلاء، ولماذا لا يختصر التوازي الوقت دائماً، مع أرقام حقيقية من مختبرات المرحلة محولة إلى تكلفة سنة بأسعار Anthropic وOpenAI وGoogle الرسمية.
سجل التحديثات
- 20 نوفمبر 2026: كتابة المقال، وتشغيل المهمة نفسها في LangGraph 1.2.24 وOpenAI Agents SDK 0.25.0 وCrewAI 1.15.44 وAG2 Classic (autogen 0.14.1) وsmolagents 1.26.0 على Ollama 0.40.13 بنموذج qwen2.5:3b.