في أغلب المكاتب الصغيرة تصل الوثائق من ثلاثة طرق في وقت واحد: فواتير PDF في البريد، وعقود موقعة تمسح بالماسح الضوئي Scanner وتحفظ في مجلد مشترك باسم مثل «سكان 2026»، وصور يلتقطها الموظف بهاتفه لسند قبض أو شهادة. وبعد سنة يسألك المحاسب عن فاتورة مورد معين بمبلغ تقريبي، أو يطلب منك المدير عقد إيجار المكتب، فتفتح المجلد وتجد مئات الملفات بأسماء مثل scan_0042.pdf وIMG_2231.jpg، ولا يفيدك البحث في Windows لأن الملف صورة لا نص فيها. وهذه هي المشكلة التي يحلها نظام إدارة الوثائق Document Management System واختصاراً DMS: يقرأ كل وثيقة بالتعرف الضوئي على الحروف OCR، ويستخرج منها النص والتاريخ والجهة، ويصنفها ويحفظها بحيث تجدها بكلمة واحدة.
وقد شرحنا في مقال OCR مع Tesseract كيف يقرأ المحرك النص العربي من الصور ولماذا العربية أصعب عليه، وشرحنا في دليل Nextcloud كيف تشارك ملفات الفريق على سيرفرك. أما هنا فنبني نظام أرشفة كاملاً فوق هذين: Paperless-ngx، وهو أشهر نظام وثائق مفتوح المصدر Open Source تستضيفه بنفسك، ونشغله بلغة عربية حقيقية على تسع وثائق عربية صنعناها لهذا الغرض، ونقيس ما يقرؤه وما يضيعه. وسوف نناقش في هذا المقال ما يلي:
- مما يتكون Paperless-ngx من الداخل، وماذا يحدث للملف من لحظة وضعه في مجلد الاستهلاك Consumption Folder إلى أن يظهر في البحث.
- تثبيت كامل بملف Docker Compose مع PostgreSQL وRedis، وتفعيل اللغة العربية في OCR وفي الواجهة.
- جهات التراسل Correspondents وأنواع المستندات Document Types والوسوم Tags، وقواعد المطابقة Matching التي تصنف الوثيقة تلقائياً، وأيها نجح مع العربية وأيها فشل.
- المشكلة الأولى التي ستقابلها: ملفات توضع في المجلد ولا يدخل منها شيء.
- قياس جودة OCR العربي في ثلاثة أوضاع، ولماذا جعل الإعداد «المحسن» النتيجة أسوأ.
- البحث الكامل في النص Full-text Search بالعربية: ما يجده وما لا يجده.
- سير العمل Workflow والصلاحيات Permissions، وثغرة في الوثائق التي لا مالك لها.
- النسخ الاحتياطي Backup ثم الاستعادة Restore على تثبيت فارغ، وما يلزم للتشغيل في الإنتاج Production.
وهذا المقال من سلسلة الوثائق في مسار التطبيقات:
- نظام إدارة الوثائق DMS: ما هو ومتى تحتاجه
- أرشفة المستندات مع Paperless-ngx (الموضوع الحالي)
- Paperless-ngx أم Mayan EDMS أم Docspell؟ اختيار نظام الوثائق
ما هو Paperless-ngx، وأين يقف بين أدوات الوثائق؟
Paperless-ngx نظام لإدارة الوثائق مكتوب بلغة Python وإطار Django، وواجهته بإطار Angular، وهو امتداد لمشروعين أقدم: Paperless الأصلي ثم Paperless-ng، وانتقل إلى فريق من المتطوعين على GitHub بعد أن توقف صاحب Paperless-ng عن تطويره. وفكرته بسيطة: أنت تعطيه الوثيقة بأي طريقة، وهو يحولها إلى PDF قابل للبحث، ويستخرج منها النص، ويقترح لها جهة ونوعاً ووسوماً وتاريخاً، ثم يحفظ الأصل كما هو بجانب نسخة الأرشيف. والمشروع مرخص بالرخصة GPL-3.0، والإصدار الذي جربناه هو 3.5.1 الصادر في 18 نوفمبر 2026.
وقبل أن تبدأ لاحظ الفرق بينه وبين أداتين قد تكون تستخدمهما الآن. فمجلد مشترك على Samba أو Nextcloud يحفظ الملف ويشاركه ويزامنه، ولكنه لا يقرأ ما في الصورة، ولا يعرف أن هذا الملف فاتورة من مورد معين بتاريخ معين، والبحث فيه بالاسم غالباً. أما Paperless-ngx فلا يصلح للمزامنة ولا للتحرير المشترك، فهو لا يعدل الوثيقة أصلاً، وإنما يستقبلها ويفهرسها ويحفظها. لذلك الشكل الشائع أن يبقى Nextcloud للملفات التي يعمل عليها الفريق، وأن تذهب الوثائق المنتهية، أي الفاتورة المستلمة والعقد الموقع والشهادة الصادرة، إلى Paperless-ngx. والمقارنة الكاملة مع Mayan EDMS وDocspell والأنظمة المؤسسية في مقال المقارنة من هذه السلسلة.
ولمن يناسب Paperless-ngx؟ يناسب المكتب الصغير والمتوسط، والعيادة، ومكتب المحاسبة، والجمعية، والأسرة التي تريد أرشفة فواتيرها وأوراقها الرسمية، أي كل جهة تريد أن تجد الوثيقة بسرعة وأن تصنفها تلقائياً دون إدارة معقدة. ولكنه لا يناسب جهة تحتاج دورة اعتماد رسمية للوثيقة، أي مسودة ثم مراجعة ثم موافقة مديرين بالتسلسل ثم نشر، فهو لا يعرف حالات الوثيقة Document States ولا يعرف من وافق ومتى. ولا يفرض مدة احتفاظ Retention Period على كل نوع، ولا يمنع حذف وثيقة مطلوبة لقضية Legal Hold. وقد أضافت سلسلة الإصدارات 3 سجلاً لإصدارات الملف File Versions، أي أن تضيف ملفاً جديداً للوثيقة نفسها فيبقى القديم بلاحقة مثل _v1، ولكنه سجل للملفات لا نظام لاعتماد الإصدارات. فإذا كانت هذه متطلباتك فاقرأ مقال المقارنة قبل أن تبدأ، لأن الانتقال من نظام إلى آخر بعد سنة من الأرشفة عمل مكلف.
كيف يعمل Paperless-ngx من الداخل؟
التثبيت الذي سوف نبنيه فيه ثلاث Containers: خادم الويب، وقاعدة بيانات PostgreSQL، ووسيط الرسائل Redis. ولكن Container خادم الويب نفسه يشغل في داخله عدة عمليات Processes، والصورة التالية تبين ماذا يحدث للملف خطوة بخطوة:
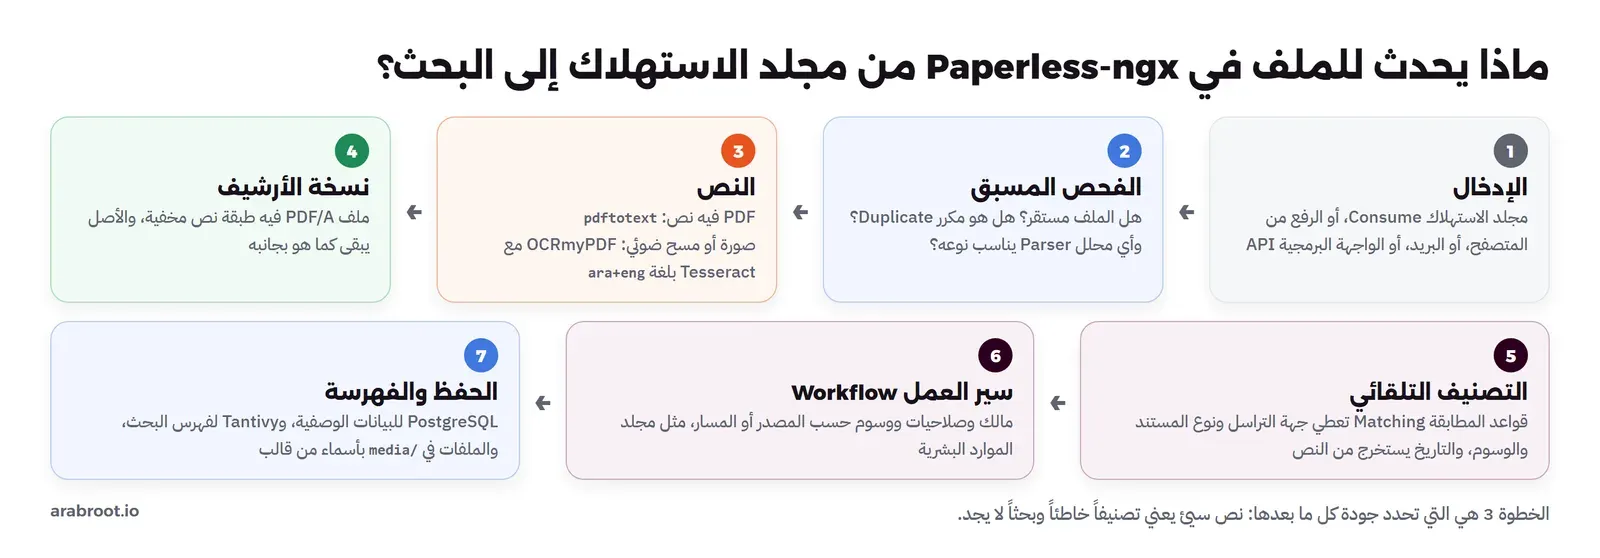
وفي الصورة أعلاه لاحظ التالي:
- المستهلك Consumer: عملية تراقب مجلد الاستهلاك، وعندما يستقر حجم الملف ووقت تعديله 5 ثوان (القيمة الافتراضية) تضعه في طابور المهام Task Queue. والرفع من المتصفح والبريد والواجهة البرمجية API تضع الملف في الطابور نفسه.
- العامل Worker: عملية Celery تأخذ المهام من Redis وتنفذها واحدة واحدة بشكل افتراضي، وهي التي تشغل OCR وتأخذ معظم وقت المعالج CPU. ولهذا تحتاج Redis: فهو الطابور بين خادم الويب والعامل.
- المحلل Parser: إذا كان الملف PDF فيه طبقة نص يكفي
pdftotextلقراءتها، وإذا كان صورة أو PDF ممسوحاً ضوئياً يمرره إلى OCRmyPDF، الذي ينظف الصورة ويعدل ميلها ثم يستدعي Tesseract، ثم يبني ملف PDF/A فيه طبقة نص مخفية فوق الصورة. - المصنف Classifier وقواعد المطابقة: بعد استخراج النص يبحث فيه عن الكلمات التي حددتها لكل جهة ونوع ووسم، ويستخرج أول تاريخ يجده ليجعله تاريخ الإنشاء Created Date.
- الفهرس Index: محرك بحث مضمن اسمه Tantivy مكتوب بلغة Rust، يحفظ فهرسه في مجلد
data/index، ولا تحتاج معه Elasticsearch أو أي خدمة أخرى.
وقد يتساءل البعض: لماذا يحفظ نسختين من كل وثيقة؟ والإجابة أن الأصل Original هو الدليل، فالفاتورة التي وصلتك بالبريد يجب أن تبقى كما وصلت بالضبط، أما نسخة الأرشيف Archive فهي ملف PDF/A موحد فيه طبقة نص، تعرضه الواجهة وتبحث فيه. وإذا أفسد OCR نسخة الأرشيف يوماً فالأصل ما زال سليماً، وتستطيع أن تعيد المعالجة Reprocess منه.
المتطلبات Requirements: كم يحتاج من الذاكرة والقرص؟
هذه أرقام قسناها بأنفسنا على التثبيت الذي سوف نبنيه، وليست من التوثيق:
| البند | القيمة في التجربة | ملاحظة |
|---|---|---|
| حجم الـ Image بعد التنزيل | 3.57 GB | منها Tesseract وGhostscript وPython 3.14 ومكتبات OCRmyPDF |
| حجم التنزيل المضغوط | نحو 820 MB | كما يظهر في Docker Hub للإصدار 3.5.1 |
| الذاكرة RAM أثناء OCR | 770 MB لخادم الويب | مع عامل واحد، ويزيد مع كل عامل إضافي |
| الذاكرة وهو خامل | 628 MB + 49 MB لقاعدة البيانات + 10 MB لـ Redis | أقل من 700 MB للتثبيت كله |
| زمن OCR للوثيقة | من 15 إلى 40 ثانية للصفحة | على معالج سطح مكتب، وأطول على VPS صغير |
| القرص لكل وثيقة | الأصل + نسخة أرشيف أكبر منه بمرة إلى مرتين + صورة مصغرة | عشر وثائق أخذت 2.2 MB |
لذلك يكفي مكتباً صغيراً VPS بمعالجين Two vCPU و4 GB من الذاكرة، ويبقى المعالج هو ما يحدد سرعة إدخال الأرشيف القديم، فإذا كان لديك عشرة آلاف صفحة ممسوحة فاحسب أنها تحتاج أياماً على معالجين، لا ساعات.
التجربة العملية: تسع وثائق عربية
الوثائق التجريبية
لا يصح أن نجرب نظاماً عربياً على وثائق إنجليزية، ولا أن نضع وثائق حقيقية فيها بيانات أشخاص، لذلك صنعنا تسع وثائق عربية وهمية بأسماء شركات وأرقام مخترعة، تشبه ما يصل إلى أي مكتب: فاتورتان ضريبيتان من مورد واحد، وعقد إيجار، وتعميم داخلي، وعرض سعر، وشهادة تعريف بالراتب، ومحضر اجتماع، وسند قبض، وأمر شراء نصفه بالإنجليزية. وثلاث منها ملفات PDF رقمية خرجت من برنامج مباشرة، والست الباقية «ممسوحة ضوئياً»: حولناها إلى صور رمادية بدقة 150 DPI، وأملناها بزاوية بين 0.4 و2.2 درجة، وأضفنا ضجيجاً Noise وضبابية Blur وضغط JPEG، وجعلنا سند القبض الأسوأ جودة عن قصد. والصورة التالية جزء من إحدى الفاتورتين:
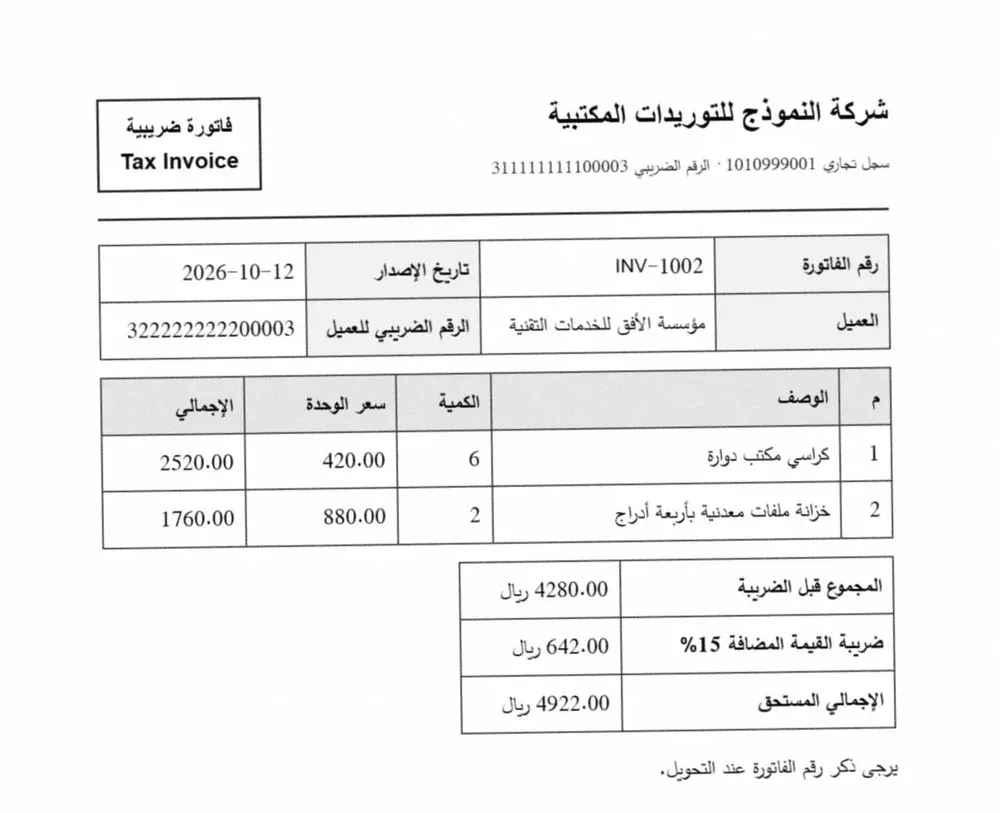
ولأننا نعرف النص الأصلي لكل وثيقة، نستطيع أن نقيس ما يقرؤه النظام بدقة بدل الانطباع، كما سيأتي في قسم جودة OCR.
ملف Docker Compose
بدأنا من ملف docker-compose.postgres.yml الرسمي، ثم أضفنا ما تحتاجه العربية. والملف التالي هو النسخة النهائية التي وصلنا إليها بعد التجارب في هذا المقال:
# Paperless-ngx with Arabic OCR: web server + PostgreSQL + Redis
#   docker compose -p dms-paperless up -d
name: dms-paperless
services:
  broker:
    image: redis:8.10.3-alpine
    restart: unless-stopped
    volumes:
      - redisdata:/data

  db:
    image: postgres:18.6-alpine
    restart: unless-stopped
    environment:
      POSTGRES_DB: paperless
      POSTGRES_USER: paperless
      POSTGRES_PASSWORD: ${DB_PASSWORD:-change-me-db}
    volumes:
      - pgdata:/var/lib/postgresql

  webserver:
    image: ghcr.io/paperless-ngx/paperless-ngx:3.5.1
    restart: unless-stopped
    depends_on: [db, broker]
    ports:
      - "127.0.0.1:8000:8000"
    environment:
      PAPERLESS_REDIS: redis://broker:6379
      PAPERLESS_DBHOST: db
      PAPERLESS_DBPASS: ${DB_PASSWORD:-change-me-db}
      PAPERLESS_SECRET_KEY: ${SECRET_KEY:-change-me-to-a-long-random-string}
      PAPERLESS_URL: http://localhost:8000
      PAPERLESS_TIME_ZONE: Asia/Riyadh
      # Arabic first, then English for the mixed documents; ara is installed on first start
      PAPERLESS_OCR_LANGUAGES: ara
      PAPERLESS_OCR_LANGUAGE: ara+eng
      PAPERLESS_OCR_USER_ARGS: '{"invalidate_digital_signatures": true}'
      # Arabic PDFs: rasterize every page and OCR it, instead of trusting a broken text layer
      PAPERLESS_OCR_MODE: force
      # bind mounts from Windows/macOS or SMB/NFS shares do not send file events: poll every 10 s
      PAPERLESS_CONSUMER_POLLING_INTERVAL: "10"
      PAPERLESS_CONSUMER_RECURSIVE: "true"
      PAPERLESS_CONSUMER_SUBDIRS_AS_TAGS: "true"
      PAPERLESS_FILENAME_FORMAT: "{{ created_year }}/{{ correspondent }}/{{ document_type }}/{{ title }}"
      PAPERLESS_ADMIN_USER: admin
      PAPERLESS_ADMIN_PASSWORD: ${ADMIN_PASSWORD:-change-me-admin}
    volumes:
      - data:/usr/src/paperless/data
      - media:/usr/src/paperless/media
      - ${CONSUME_DIR:-./consume}:/usr/src/paperless/consume
      - ${EXPORT_DIR:-./export}:/usr/src/paperless/export

volumes:
  data:
  media:
  pgdata:
  redisdata:
في الإعداد أعلاه لاحظ التالي:
PAPERLESS_OCR_LANGUAGESبالجمع تعني «حزم اللغات التي تثبت»، أماPAPERLESS_OCR_LANGUAGEبالمفرد فتعني «اللغات التي يستخدمها OCR». والـ Image تأتي بالإنجليزية والألمانية والفرنسية والإيطالية والإسبانية فقط، كما يقول توثيق الإعدادات Configuration، فإذا كتبتaraفي المفرد ونسيت الجمع فشلت كل عملية OCR.ara+engتعني أن Tesseract يجرب النموذجين معاً على كل سطر، وهذا ضروري لأمر الشراء الذي فيه أسماء بنود بالإنجليزية، ولكن له ثمن سوف نراه في قسم الجودة.- الخادم يستمع على
127.0.0.1فقط، لأن مكانه في الإنتاج خلف Reverse Proxy مع شهادة TLS، ولا يصح أن تفتح المنفذ 8000 للشبكة كلها. PAPERLESS_FILENAME_FORMATيحدد أين يحفظ الأصل داخلmedia: سنة الإنشاء، ثم الجهة، ثم النوع، ثم العنوان. وبدونه تحفظ الملفات بأرقام متسلسلة لا تفهم منها شيئاً إذا فتحت المجلد يوماً دون النظام.PAPERLESS_ADMIN_USERينشئ حساب المدير عند أول تشغيل فقط، وبعده تستطيع حذف السطرين، والأفضل أن تحذفهما حتى لا تبقى كلمة المرور في ملف الإعداد.- أما
PAPERLESS_OCR_MODE: forceوPAPERLESS_CONSUMER_POLLING_INTERVALفلم يكونا في الملف أول مرة، وأضفناهما بعد مشكلتين سوف نشرحهما بالتفصيل.
التشغيل الأول
شغلنا الملف بكلمات مرور في متغيرات البيئة Environment Variables، ثم تابعنا سجل خادم الويب:
export DB_PASSWORD=... ADMIN_PASSWORD=... SECRET_KEY=...
docker compose up -d
docker logs -f dms-paperless-webserver-1
والمخرج سوف يكون كما يلي (اختصرنا الأسطر المتكررة):
[init-start] paperless-ngx docker container starting...
[init-tesseract-langs] Checking if additional teseract languages needed
Installing languages...
[init-db-wait] Waiting for PostgreSQL to start...
db:5432 - no response
[init-db-wait] Attempt 1 failed! Trying again in 1 seconds...
...
[init-tesseract-langs] Installing package tesseract-ocr-ara...
[init-tesseract-langs] Installed tesseract-ocr-ara
[init-db-wait] Connected to PostgreSQL
[init-migrations] Apply database migrations...
Created superuser "admin" with provided password.
[init-complete] paperless-ngx docker container init completed in 142 seconds
[init-complete] Starting services
[INFO] Starting granian (main PID: 334)
[INFO] Listening at: http://:::8000
وفي المخرج أعلاه لاحظ التالي:
- استغرق التشغيل الأول 142 ثانية، وجزء كبير منها تنزيل الحزمة
tesseract-ocr-araمن مستودعات Debian. وهذا يعني أن الـ Container يحتاج إنترنت عند كل إنشاء جديد له، لا عند أول تشغيل فقط، لأن الحزمة تثبت داخل الـ Container ولا تحفظ في Volume. وعندما أعدنا إنشاءه بعد تغيير الإعدادات ثبت الحزمة من جديد في كل مرة، وكان التشغيل بين 85 و130 ثانية. - محاولات الاتصال الفاشلة بقاعدة البيانات طبيعية في أول تشغيل، لأن PostgreSQL يجهز ملفاته، وخادم الويب ينتظره ولا يتوقف.
- خادم الويب الآن Granian، وهو خادم مكتوب بلغة Rust يقدم تطبيق Django.
tesseract-ocr-ara مرة واحدة، أو أن تضع ملف ara.traineddata في Volume وتربطه بمجلد tessdata.الواجهة بالعربية
الواجهة مترجمة إلى العربية ضمن ملفات اللغة في الإصدار، وتغيير اللغة من صفحة الإعدادات Settings لكل مستخدم، أو من الواجهة البرمجية كما فعلنا:
curl -u admin:... -X POST http://localhost:8000/api/ui_settings/ \
  -H 'Content-Type: application/json' -d '{"settings":{"language":"ar-AR"}}'
والصورة التالية قائمة المستندات بعد إدخال الوثائق التسع:
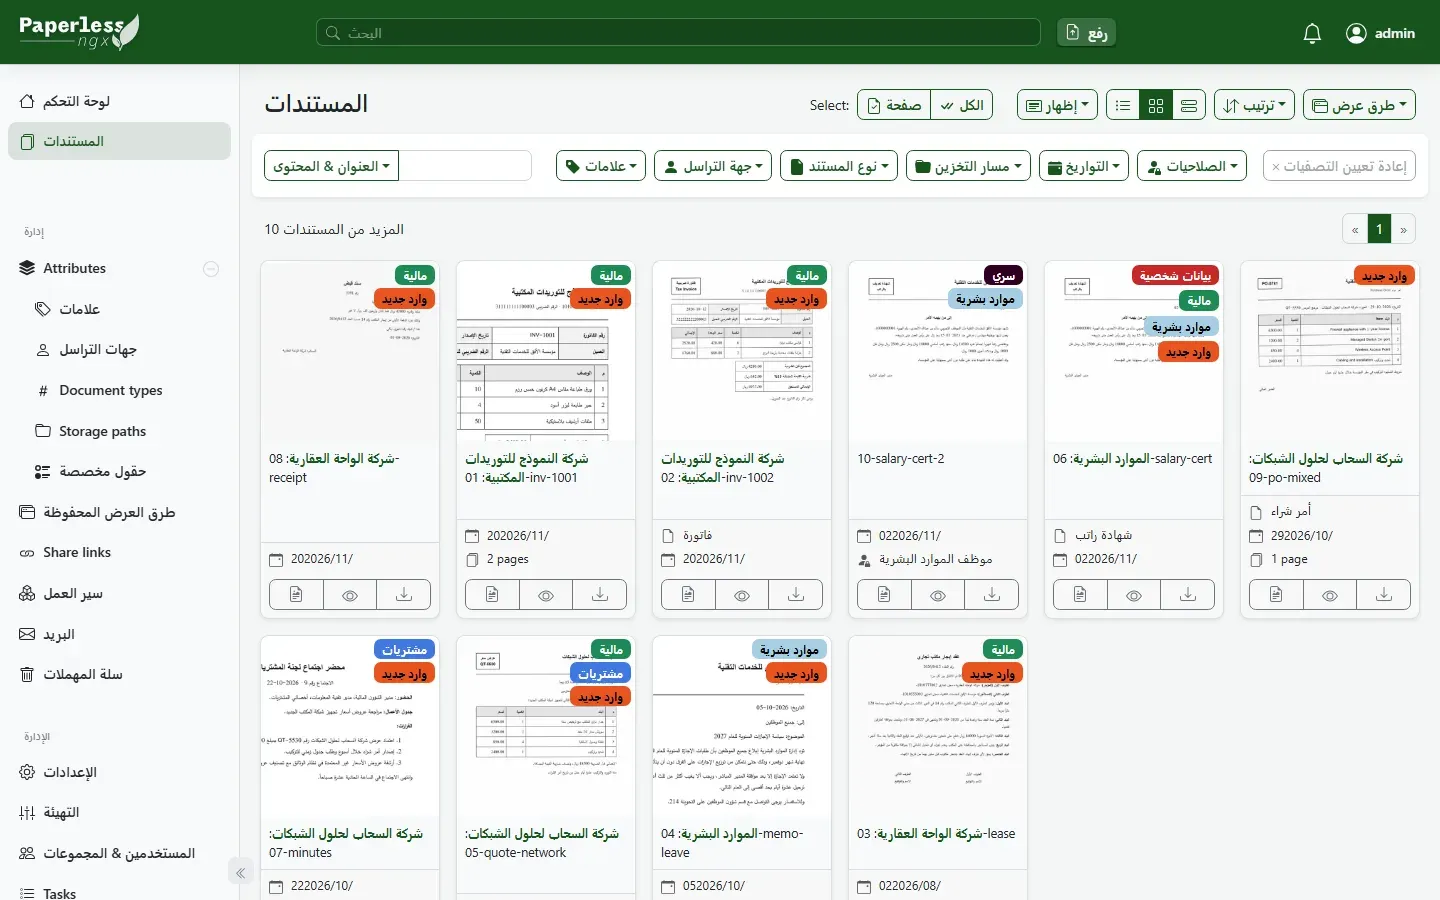
والواجهة تعمل من اليمين إلى اليسار RTL بشكل جيد، ولكن لاحظ أمرين في الصورة: بعض العناوين ما زالت بالإنجليزية مثل Document types وStorage paths، والتاريخ في أسفل كل بطاقة يظهر بشكل مثل «202026/11/» لأن التاريخ الإنجليزي وضع داخل نص عربي دون عزل لاتجاهه. وهذه مشكلة عرض فقط، فالتاريخ نفسه صحيح في صفحة الوثيقة.
التصنيف: جهات التراسل وأنواع المستندات والوسوم
قبل أن تدخل أي وثيقة جهز التصنيف، لأن القواعد تعمل عند الإدخال. وفي Paperless-ngx أربعة أشياء تصف الوثيقة غير نصها:
- جهة التراسل Correspondent: من أرسل الوثيقة أو من تخصه، مثل المورد أو المؤجر. وكل وثيقة لها جهة واحدة فقط.
- نوع المستند Document Type: فاتورة أو عقد أو عرض سعر، ونوع واحد لكل وثيقة.
- الوسوم Tags: مثل «مالية» و«بيانات شخصية»، والوثيقة تحمل أي عدد منها. والوسم الذي تجعله وسم الوارد Inbox Tag يوضع على كل وثيقة جديدة، حتى يراجعها إنسان ثم يزيله.
- الحقول المخصصة Custom Fields: مثل رقم الفاتورة أو تاريخ انتهاء العقد، وهي اختيارية.
وأنشأنا التصنيف بسكربت صغير على الواجهة البرمجية REST API بدل النقر في الواجهة، حتى نستطيع إعادة التجربة بالقواعد نفسها. وهذا جزء منه:
// matching_algorithm: 0 none, 1 any, 2 all, 3 literal, 4 regex, 5 fuzzy, 6 auto
const C = [
  ['شركة النموذج للتوريدات المكتبية', 3, '311111111100003'],
  ['شركة الواحة العقارية', 1, 'الواحة'],
  ['شركة السحاب لحلول الشبكات', 1, 'السحاب'],
  ['الموارد البشرية', 3, 'إدارة الموارد البشرية'],
];
const T = [
  ['فاتورة', 4, 'فاتورة ضريبية|Tax Invoice'],
  ['عقد', 3, 'عقد إيجار'],
  ['عرض سعر', 3, 'عرض سعر'],
  ['شهادة راتب', 3, 'شهادة تعريف'],
];
for (const [name, a, m] of C) await post('correspondents/', { name, matching_algorithm: a, match: m, is_insensitive: true });
والصورة التالية نافذة تعديل إحدى جهات التراسل، وفيها خوارزمية المطابقة والنص الذي تبحث عنه:
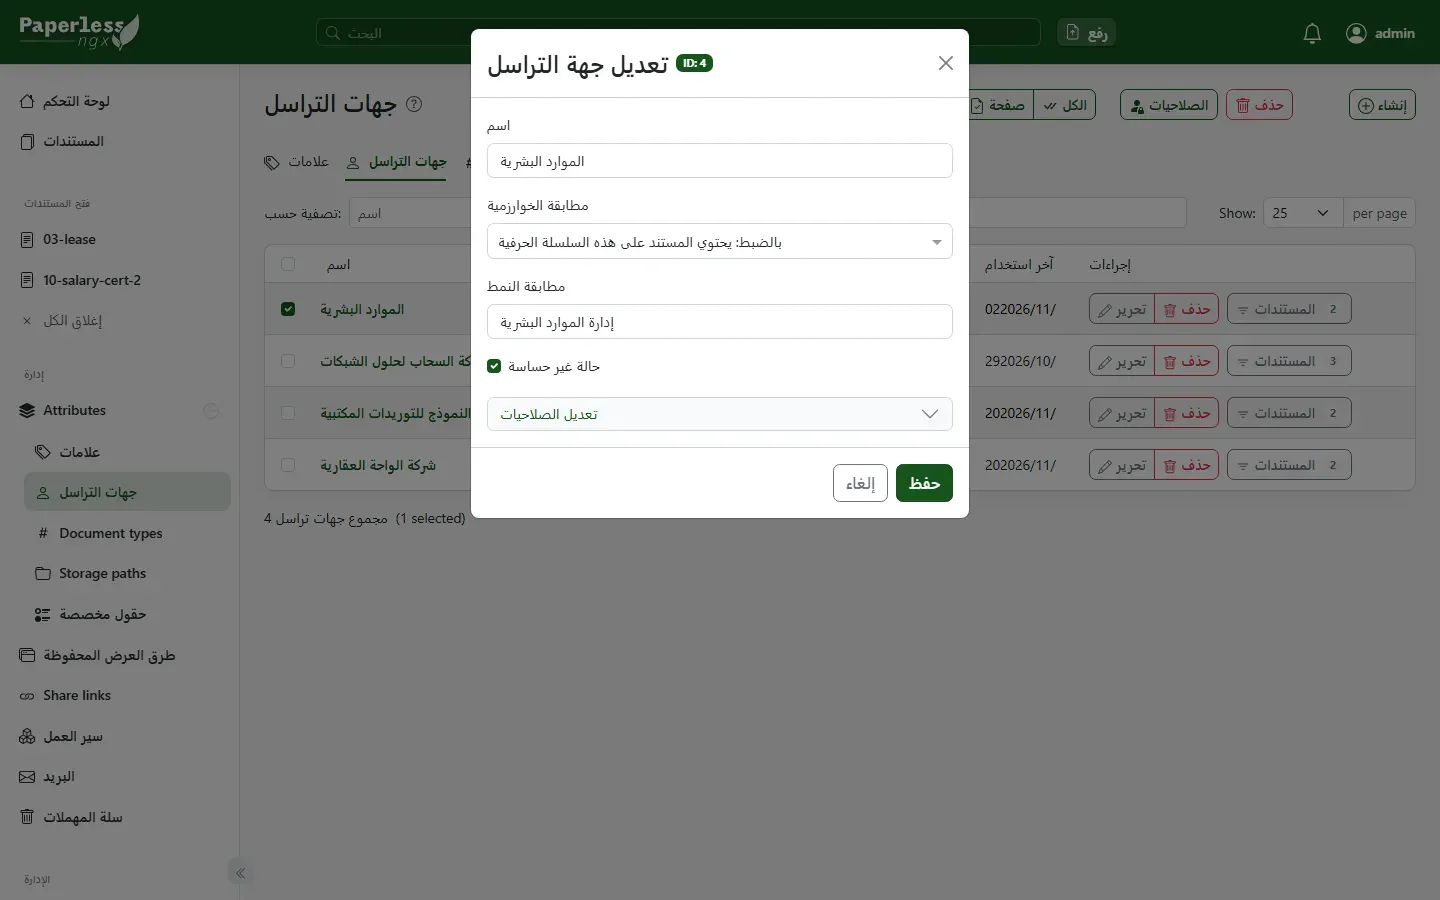
أي خوارزمية مطابقة تختار؟
هناك ست خوارزميات، والجدول التالي يلخصها مع القواعد التي جربناها وما حدث لها:
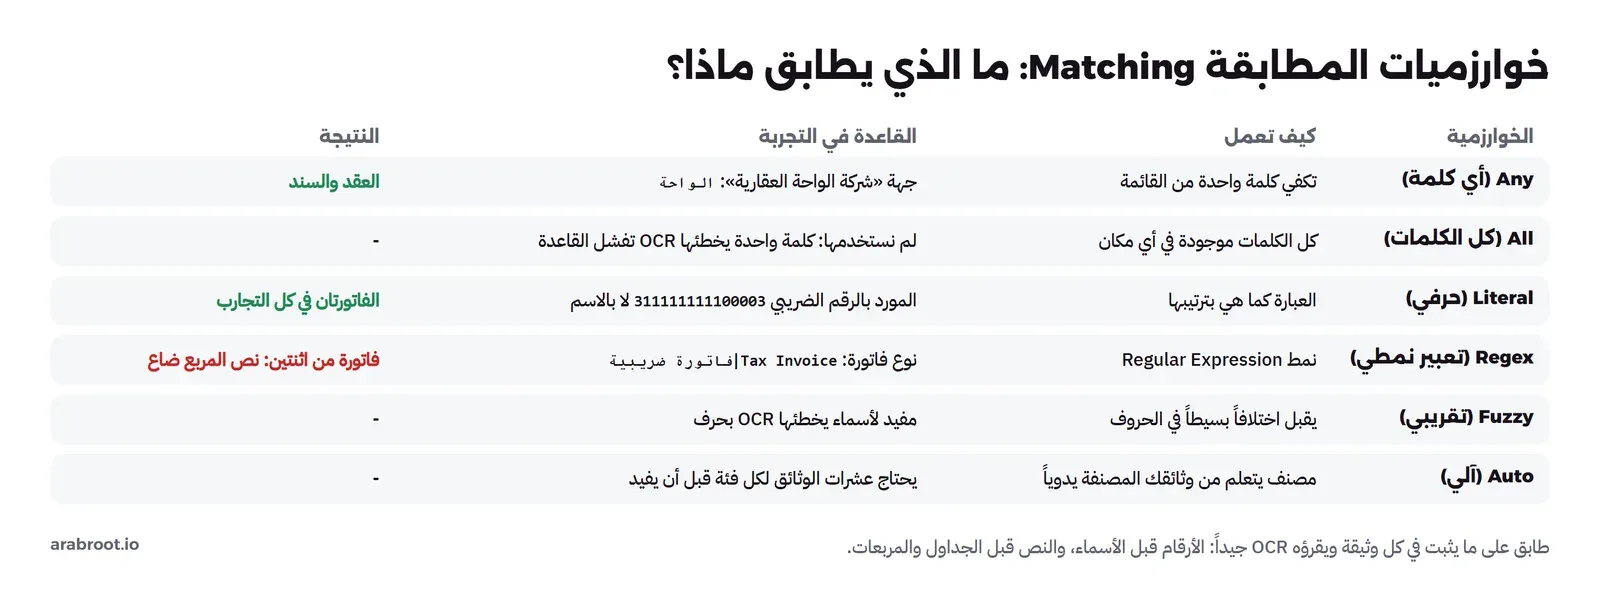
والدرس الأهم من التجربة أن المطابقة تعمل على النص الذي خرج من OCR، لا على النص الذي تراه بعينك في الوثيقة. فقاعدة «فاتورة ضريبية» صحيحة، ولكن هذه العبارة مكتوبة في مربع بإطار في رأس الفاتورة، وTesseract يضيع النص داخل الإطارات والجداول كثيراً، فطابقت قاعدة النوع فاتورة واحدة من اثنتين. أما الرقم الضريبي للمورد فهو سطر عادي من الأرقام، وطابق الفاتورتين في كل الجولات. لذلك طابق المورد برقمه الضريبي أو رقم سجله التجاري، وطابق النوع بعبارة تظهر في سطر نص عادي، ولا تستخدم «All» مع العربية، لأن كلمة واحدة يخطئها OCR تفشل القاعدة كلها.
أما «Auto» فهو مصنف تعلم آلي Machine Learning يتدرب كل ساعة على الوثائق التي صنفتها بيدك، ويصبح مفيداً عندما تجمع عشرات الوثائق من كل فئة. والطريقة العملية أن تبدأ بالقواعد الصريحة، ثم تحول الفئات الكبيرة مثل الفواتير إلى «Auto» بعد أشهر من العمل.
مجلد الاستهلاك، والمشكلة الأولى: الملفات لا تدخل
نسخنا الوثائق التسع إلى مجلد الاستهلاك، ووضعنا التعميم وشهادة الراتب في مجلد فرعي اسمه «موارد بشرية»، لأن الإعداد PAPERLESS_CONSUMER_SUBDIRS_AS_TAGS يجعل اسم المجلد الفرعي وسماً. ثم انتظرنا، وكان الجواب من الواجهة البرمجية كل عشر ثوان كما يلي:
22:49:59  (نسخ الملفات)
22:50:02 "count":0
22:50:14 "count":0
...
22:52:48 "count":0
22:53:02 "count":0
22:53:29 "count":1
ثلاث دقائق ونصف دون أن يدخل ملف واحد. والسجل يشرح السبب:
[22:48:04] [paperless.management.consumer] Watching /usr/src/paperless/consume using native file system events
[22:53:09] [paperless.management.consumer] File is stable: /usr/src/paperless/consume/01-inv-1001.pdf
المستهلك يعتمد على إشعارات نظام الملفات Filesystem Events من نواة Linux (inotify) ليعرف أن ملفاً جديداً وصل، وهذه الإشعارات لا تصل عندما يكون المجلد مربوطاً من Windows أو macOS إلى Docker، ولا تصل من مشاركات الشبكة مثل SMB وNFS، وهي بالضبط الطريقة التي يضع بها الماسح الضوئي في المكتب ملفاته. فالملفات دخلت متأخرة فقط لأن شيئاً آخر حرك المجلد، ولو كان هذا سيرفراً حقيقياً لبقيت هناك إلى أن يعيد أحد تشغيل الخدمة.
والحل في التوثيق نفسه: PAPERLESS_CONSUMER_POLLING_INTERVAL بقيمة أكبر من صفر يجعل المستهلك يفحص المجلد كل عدد من الثواني بدل انتظار الإشعارات. وبعد إضافته بقيمة 10 أصبح السجل:
[23:04:25] [paperless.management.consumer] Watching /usr/src/paperless/consume using polling (interval: 10.0s)
[23:05:10] [paperless.management.consumer] File is stable: /usr/src/paperless/consume/07-minutes.pdf
نسخنا الملفات في 23:05:04، فبدأ الإدخال بعد ست ثوان. وثمن الفحص الدوري قراءة قائمة المجلد كل عشر ثوان، وهذا لا يذكر لمجلد يصله عشرات الملفات في اليوم.
جودة OCR العربي: ثلاث جولات وقياس حقيقي
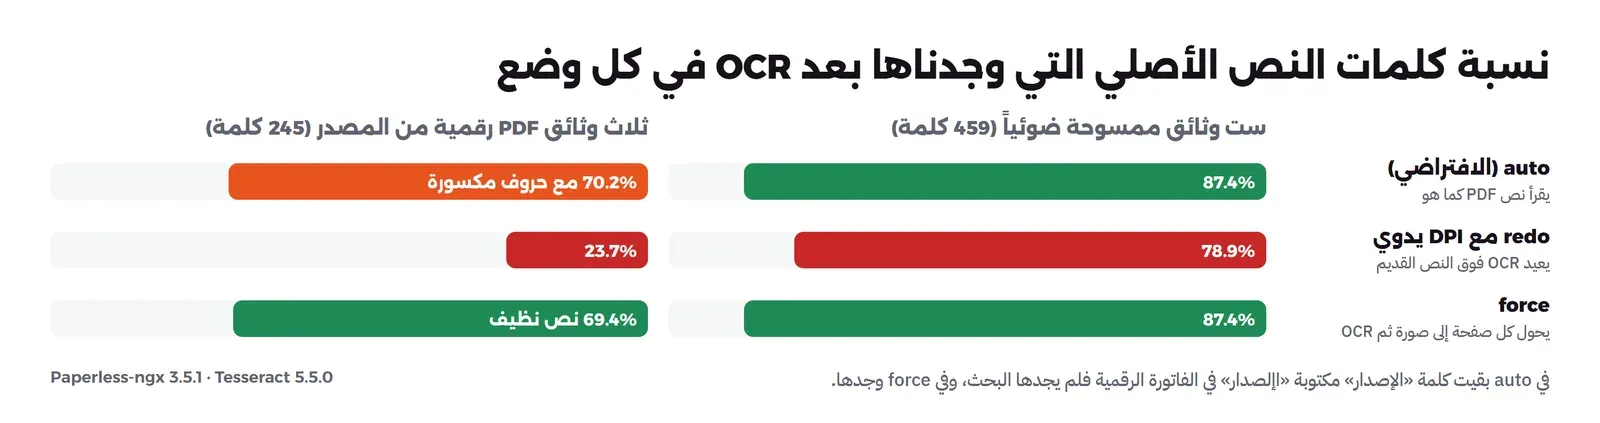
لكل وثيقة نص أصلي نعرفه، فقسنا النص الذي خرج من النظام بمقياس واحد بسيط: كم كلمة من كلمات النص الأصلي وجدناها في النص المستخرج، بعد توحيد أشكال الألف والتاء المربوطة والياء حتى لا نحاسب OCR على «أ» و«ا». وهذا المقياس قريب مما يهمك فعلاً، لأن البحث يعمل بالكلمات. وأعدنا إدخال الوثائق التسع ثلاث مرات بثلاثة إعدادات، والنتيجة في الصورة التالية:
الجولة الأولى: الإعداد الافتراضي auto
في الوضع الافتراضي auto يفحص النظام ملف PDF، فإذا وجد فيه نصاً كافياً قرأه بالأداة pdftotext ولم يشغل OCR. وكانت نتيجة الوثائق الممسوحة جيدة، 87.4% من الكلمات، وأفضلها سند القبض رغم أنه الأسوأ جودة، لأنه نص بلا جداول. أما الفواتير والعروض ففقدت أكثر، وهذا ناتج قياس صحيح لكل وثيقة:
02-inv-1002       56/67   83.6%
03-lease         119/132  90.2%
05-quote-network  54/75   72.0%
06-salary-cert    80/86   93.0%
08-receipt        41/44   93.2%
09-po-mixed       51/55   92.7%
TOTAL            401/459  87.4%
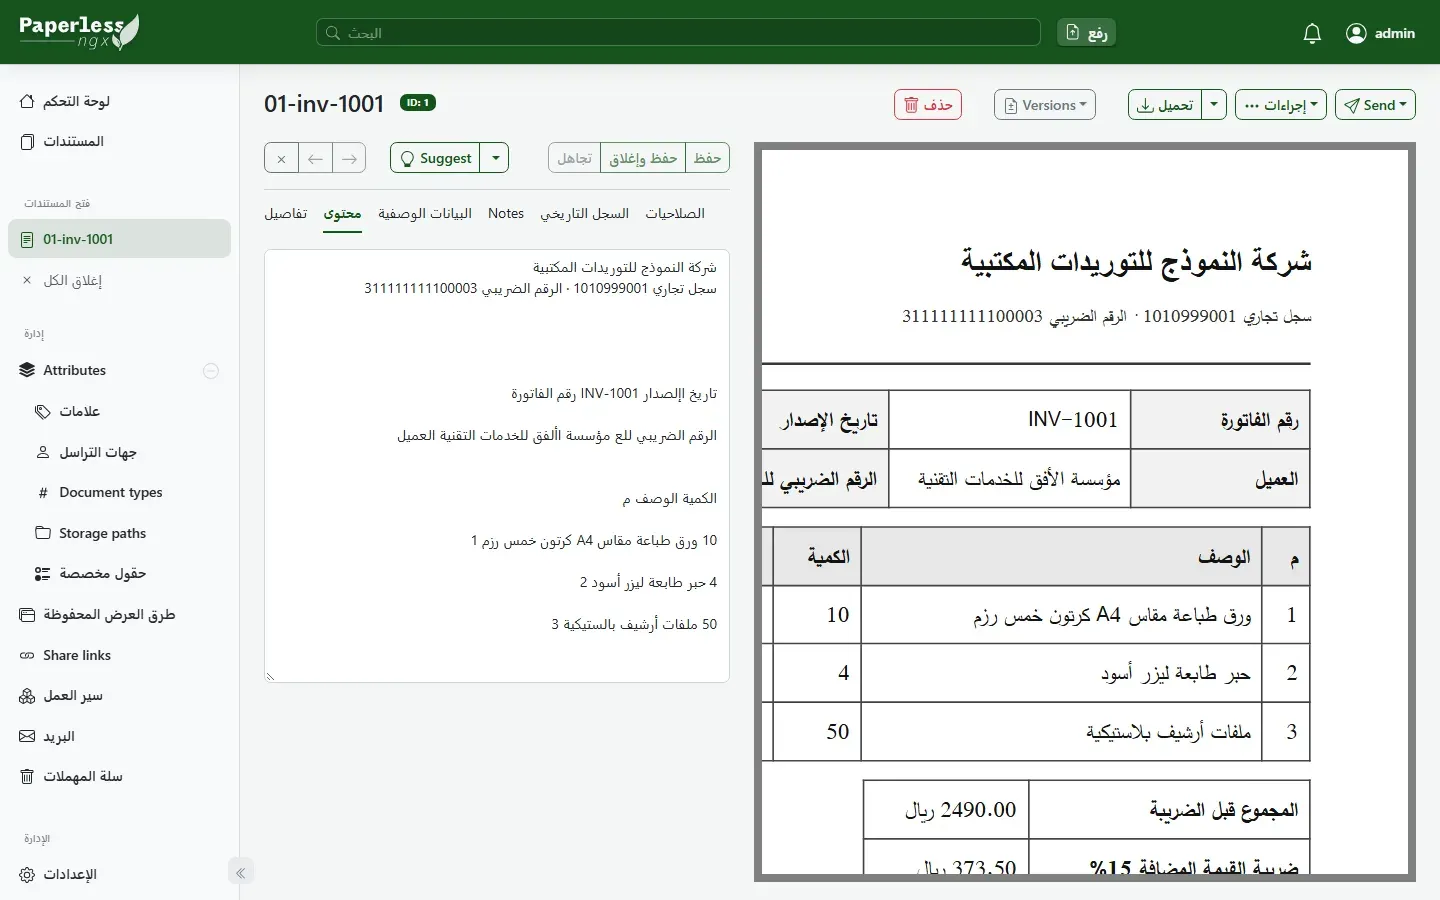
والمفاجأة كانت في ملفات PDF الرقمية، وهي المفروض أن تكون أسهل شيء: 70% فقط. وعندما فتحنا محتوى الفاتورة الرقمية INV-1001 وجدنا هذا:
تاريخ اإلصدار INV-1001 رقم الفاتورة
الرقم الضريبي للع مؤسسة األفق للخدمات التقنية العميلكلمة «الإصدار» أصبحت «اإلصدار» وكلمة «الأفق» أصبحت «األفق»، والسبب أن البرنامج الذي أنتج الملف كتب «لا» و«لأ» كحرف مركب واحد Ligature، وعندما فككه pdftotext رتب الحروف بشكل خاطئ، وأضاف حول كل جملة علامات اتجاه خفية Unicode Bidi Marks. والنص في الواجهة يبدو مقبولاً بالعين كما في الصورة التالية، ولكن البحث عن «الإصدار» لا يجد هذه الفاتورة:
وهذه مشكلة معروفة في ملفات PDF العربية عموماً، وتختلف بحسب البرنامج الذي أنتجها، فبعض البرامج تكتب الحروف بأشكالها المتصلة Presentation Forms، وبعضها يكتب الكلمة مقلوبة. لذلك لا تثق بطبقة النص في PDF عربي حتى تبحث فيه بكلمات فيها «لا» و«ال».
الجولة الثانية: redo، والإعداد الذي جعل كل شيء أسوأ
التوثيق يقول إن الوضع redo يعيد OCR لكل الصفحات ويستبدل طبقة النص الموجودة، فبدا هذا حلاً لمشكلة الفواتير الرقمية. وفي الوقت نفسه ظهر في السجل تحذير لكل صورة JPG:
[WARNING] [paperless.parsing.tesseract] Error while getting DPI from image /tmp/paperless/.../02-inv-1002.jpg: 'dpi'فالصور لا تحمل دقتها DPI في بياناتها، فأضفنا PAPERLESS_OCR_IMAGE_DPI: "150" وهي الدقة الحقيقية التي صنعنا بها الصور. وكانت النتيجة أسوأ في الاثنين: الوثائق الممسوحة نزلت من 87.4% إلى 78.9%، والرقمية انهارت إلى 23.7%، ومحتوى الفاتورة الرقمية أصبح هكذا:
دات ا
اله وذج ور
للتوريدات شركة االنموذج
تجا ري · 1010999001ا رم م ا ضريب 311111111100003وللنتيجتين سببان مختلفان. أما الرقمية: فالوضع redo يخفي النص الموجود ثم يشغل OCR على ما بقي في الصفحة، ومع خطوط عربية مركبة يبقى جزء من الحروف ويختفي جزء، فيقرأ Tesseract أشلاء كلمات. وأما الممسوحة: فالتوثيق يذكر في شرح الخيار PAPERLESS_OCR_DESKEW أن تعديل الميل Deskew لا يعمل مع الوضع redo، فدخلت الصور المائلة كما هي، وTesseract أضعف كثيراً مع السطور المائلة. أي أن الخيار الذي أضفناه لإصلاح الملفات الرقمية أطفأ دون أن ننتبه خطوة تحتاجها الملفات الممسوحة. ولذلك لم يكن الـ DPI هو السبب: الحساب التلقائي للدقة يفترض صفحة بمقاس A4، وصورنا بعرض 1264 نقطة، أي قرابة 150 DPI لصفحة A4، وهو الرقم نفسه الذي كتبناه.
الجولة الثالثة: force
الوضع force يحول كل صفحة إلى صورة Rasterize ثم يشغل OCR عليها، ويحتفظ بتعديل الميل والتنظيف. والنتيجة أن الوثائق الممسوحة رجعت إلى 87.4% بالضبط، لأنها صور أصلاً، والرقمية أصبح نصها نظيفاً دون حروف مكسورة ودون علامات اتجاه، فأصبح البحث عن «الإصدار» يجد الفاتورة INV-1001. أما النسبة نفسها فبقيت قريبة، 69.4%، لأن الأرقام داخل جداول الفاتورة ضاعت في OCR كما ضاعت في الفواتير الممسوحة. وثمن هذا الوضع أن نسخة الأرشيف للملف الرقمي تصبح صورة فيها طبقة نص، فهي أكبر حجماً وأقل حدة عند التكبير، ولكن الأصل محفوظ كما هو بجانبها.
ara وحدها أم ara+eng؟
في شهادة الراتب أخطأ OCR في اسم الموظف بطريقة غريبة:
تشهد مؤسسة الأفق للخدمات التقنية ob الموظف التجريبي alle بن عبدالله الأحمديءكلمة «بأن» أصبحت ob واسم «سالم» أصبح alle، لأن النموذج الإنجليزي ظن أن الكلمة العربية المشوشة أقرب إلى حروف لاتينية. فشغلنا Tesseract مباشرة داخل الـ Container على الصور الأربع بلغة ara وحدها مرة، وara+eng مرة:
docker exec dms-paperless-webserver-1 tesseract /tmp/t/06-salary-cert.jpg - -l ara --dpi 150
docker exec dms-paperless-webserver-1 tesseract /tmp/t/06-salary-cert.jpg - -l ara+eng --dpi 150
والنتيجة:
| الوثيقة | ara وحدها | ara+eng |
|---|---|---|
| فاتورة INV-1002 | 76.1%، ولا تظهر INV-1002 ولا Tax Invoice | 89.6% |
| عرض السعر | 86.7% | 90.7% |
| شهادة الراتب | 95.3%، والاسم «سالم» صحيح | 93.0%، والاسم أصبح alle |
| سند القبض | 84.1% | 81.8% |
| المجموع | 86.4% | 89.7% |
فالعربية وحدها أدق في الوثائق العربية الخالصة، وخاصة في الأسماء، ولكنها تضيع كل كلمة إنجليزية، ومنها أرقام الفواتير المكتوبة بحروف لاتينية مثل INV-1002، وهي أهم ما تبحث به. لذلك أبقينا ara+eng، وإذا كان أرشيفك عربياً خالصاً، كخطابات جهة حكومية، فجرب ara وحدها على عينة من وثائقك وقس بنفسك. وفي الحالتين الأسماء هي أضعف ما يقرؤه OCR، فلا تعتمد على البحث باسم شخص وحده.
البحث بالعربية: ما يجده وما لا يجده
جربنا ثماني عشرة عبارة بحث على الواجهة البرمجية بعد الجولة الأولى ثم بعد الجولة الثالثة، والجدول التالي العدد ورقم الوثيقة التي وجدها:
| عبارة البحث | auto | force | الملاحظة |
|---|---|---|---|
| فاتورة / الفاتورة | 01، 02 | 01، 02 | «ال» لا تمنع التطابق |
| فواتير | لا شيء | لا شيء | الجمع المكسر لا يرجع إلى مفرده |
| الإصدار / الاصدار | 02، 07 | 01، 02 | الهمزة لا تهم، و01 ظهرت بعد إصلاح النص |
| إيجار / ايجار / الإيجار | 08 | 08 | العقد نفسه لم يظهر: عنوانه ضاع في OCR |
| سالم / الأحمدي | لا شيء | لا شيء | الاسم قرئ خطأ |
| 4922 | لا شيء | لا شيء | المبلغ داخل جدول |
| QT-5530 | 05، 07، 09 | 05، 07، 09 | الأرقام المرجعية في النص ممتازة |
| Firewall | 09 | 09 | الإنجليزية تعمل |
| جدار ناري | لا شيء | لا شيء | لا توجد مرادفات Synonyms |
| التوريدت (خطأ إملائي) | لا شيء | لا شيء | لا يوجد بحث تقريبي Fuzzy عن الأخطاء |
| مكتب* | 6 وثائق | 5 وثائق | البحث ببداية الكلمة Wildcard يعمل |
| "عرض سعر" | 05 | 05 | البحث بعبارة كاملة بين علامتي تنصيص يعمل |
والنتيجة أن الفهرس نفسه يتعامل مع العربية بشكل معقول، فهو يتجاهل «ال» والهمزات، لأن Paperless-ngx يختار لغة التجذيع Stemming من لغة OCR، كما يشرح الخيار PAPERLESS_SEARCH_LANGUAGE في التوثيق، وTantivy فيه مجذع Stemmer عربي. ولكن الجمع المكسر مثل «فواتير» لا يرجع إلى «فاتورة»، ولا توجد مرادفات. وأغلب ما لم يجده البحث سببه OCR لا البحث: العقد لم يظهر عند البحث عن «إيجار» لأن عنوانه «عقد إيجار مكتب تجاري» لم يقرأ أصلاً. والصورة التالية البحث نفسه من الواجهة:
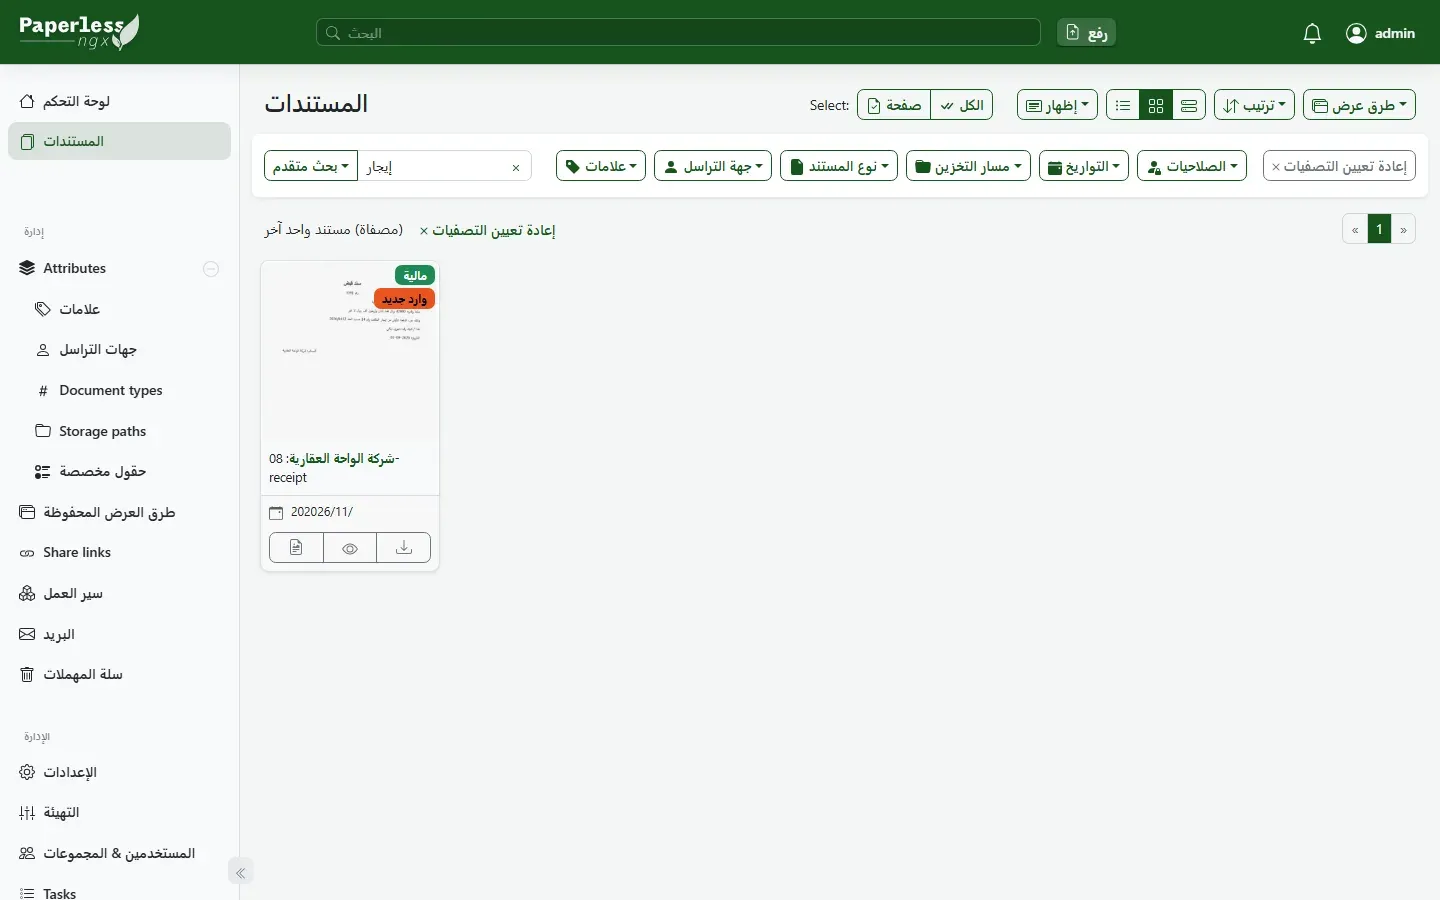
لذلك عود فريقك على البحث بما يقرؤه OCR جيداً: رقم الفاتورة ورقم العقد والرقم الضريبي، ثم الجهة والنوع من الفلاتر Filters بدل البحث الحر، فهذه حقول ثابتة لا تعتمد على جودة القراءة.
سير العمل Workflow والصلاحيات Permissions
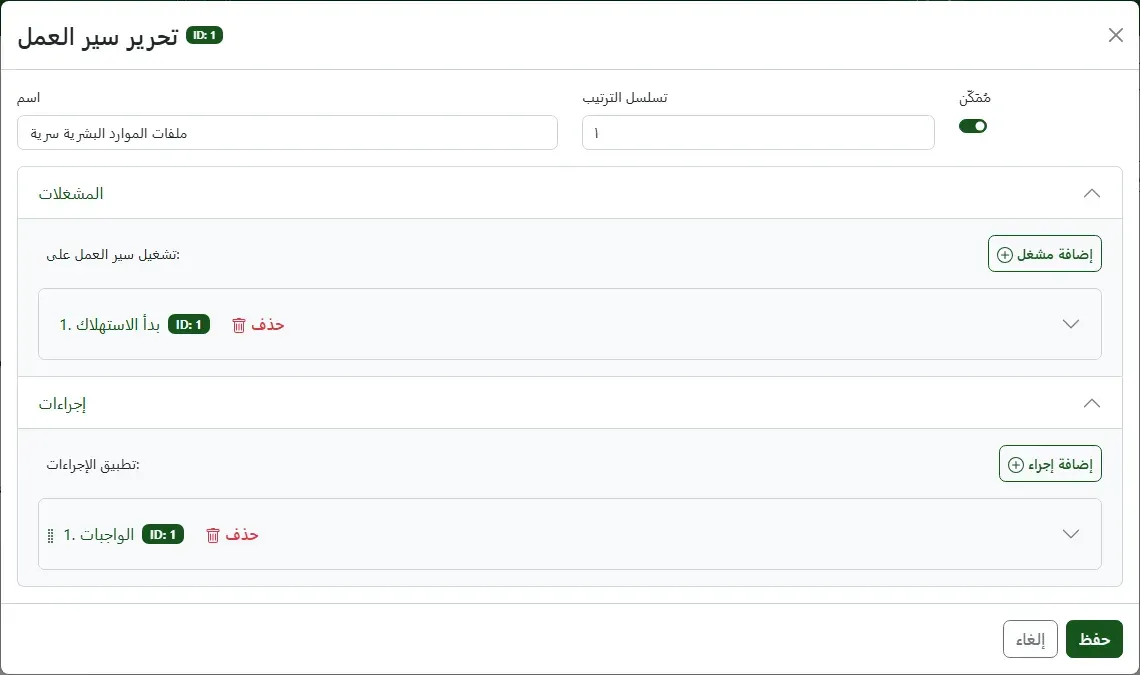
شهادة الراتب فيها بيانات شخصية، فلا يصح أن يراها كل موظف عنده حساب في النظام. والنموذج في Paperless-ngx أن لكل وثيقة مالكاً Owner، وللمالك أن يعطي مستخدمين أو مجموعات Groups صلاحية العرض أو التعديل. فأنشأنا مجموعة «الموارد البشرية» ومستخدمين: hr1 فيها، وsales1 خارجها، وكلاهما عنده صلاحية عرض المستندات عموماً. ثم أنشأنا سير عمل يعمل عند بدء الإدخال Consumption Started على أي ملف في مسار يطابق */موارد بشرية/*، فيجعل hr1 مالكاً، ويعطي المجموعة العرض والتعديل، ويضع وسم «سري»:
await req('POST', 'workflows/', {
  name: 'ملفات الموارد البشرية سرية', order: 1, enabled: true,
  triggers: [{ type: 1, sources: [1, 2, 3], filter_path: '*/موارد بشرية/*' }],
  actions: [{ type: 1, assign_tags: [t.id], assign_owner: u.id, assign_view_groups: [g.id], assign_change_groups: [g.id] }],
});
ثم وضعنا نسخة ثانية من شهادة الراتب في مجلد «موارد بشرية»، وسألنا الواجهة البرمجية بكل مستخدم كم وثيقة يرى:
admin  "count":10
hr1    "count":10
sales1 "count":9
الشهادة الجديدة اختفت عن sales1 كما أردنا، ولكن الرقم 9 يعني أنه ما زال يرى الشهادة الأولى، والصورة التالية تشرح السبب:
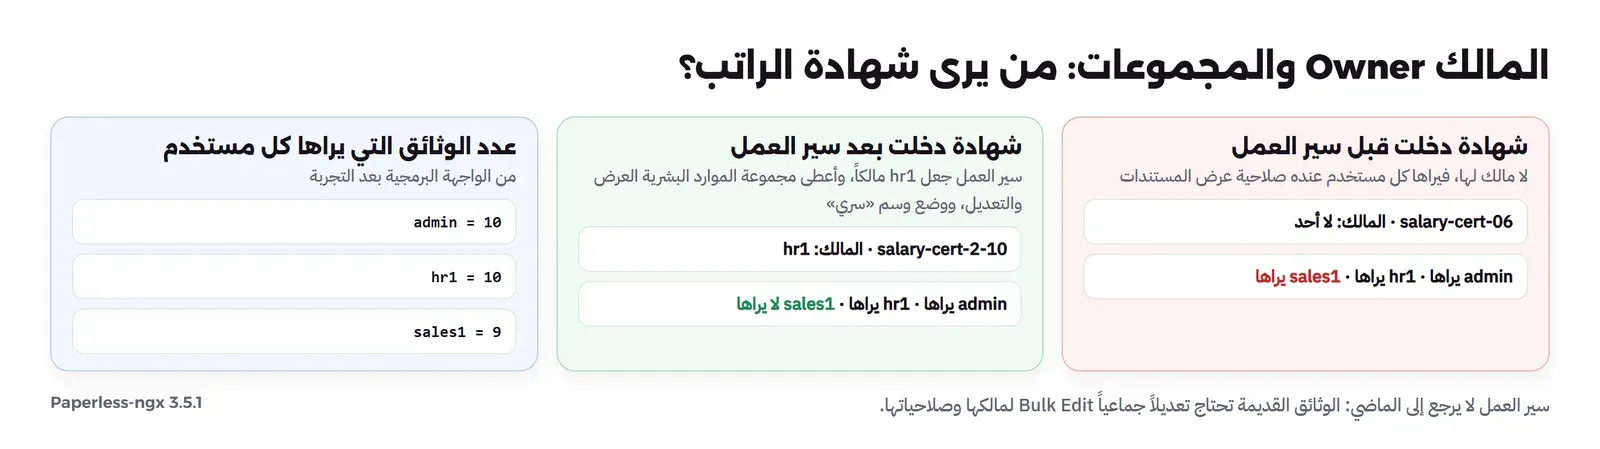
فالشهادة الأولى دخلت قبل أن ننشئ سير العمل، ولم يكن لها مالك، وتوثيق الاستخدام يقول بوضوح إن الكائن الذي لا مالك له مرئي لأي مستخدم، وذلك للتوافق مع الإصدارات القديمة. والتوثيق نفسه يذكر أن الوثائق التي تدخل من مجلد الاستهلاك لا يكون لها مالك بشكل افتراضي، بعكس ما يرفعه المستخدم من الواجهة فيصبح مالكه. وهذا يعني ثلاث قواعد: أنشئ المجموعات والصلاحيات قبل إدخال أي وثيقة، واجعل لكل مسار في مجلد الاستهلاك سير عمل يحدد المالك، حتى لو كان سير عمل عاماً يجعل مدير الأرشيف مالكاً لكل ما يدخل، وإذا كان لديك أرشيف دخل قبل ذلك فابحث عن الوثائق التي لا مالك لها من فلتر الصلاحيات وصحح مالكها بالتعديل الجماعي Bulk Edit.
النسخ الاحتياطي والاستعادة
في Paperless-ngx ثلاثة أشياء يجب أن تنسخها معاً: قاعدة البيانات، ومجلد media الذي فيه الأصول ونسخ الأرشيف، ومجلد data الذي فيه فهرس البحث والمصنف. ونسخ الـ Volumes وهي تعمل قد يعطيك قاعدة بيانات لا تطابق الملفات، لذلك يوفر النظام أداة تصدير document_exporter تخرج كل شيء في مجلد واحد أو ملف ZIP، مع ملف manifest.json فيه كل البيانات الوصفية، وأداة document_importer تعيده. والصورة التالية ما فعلناه:
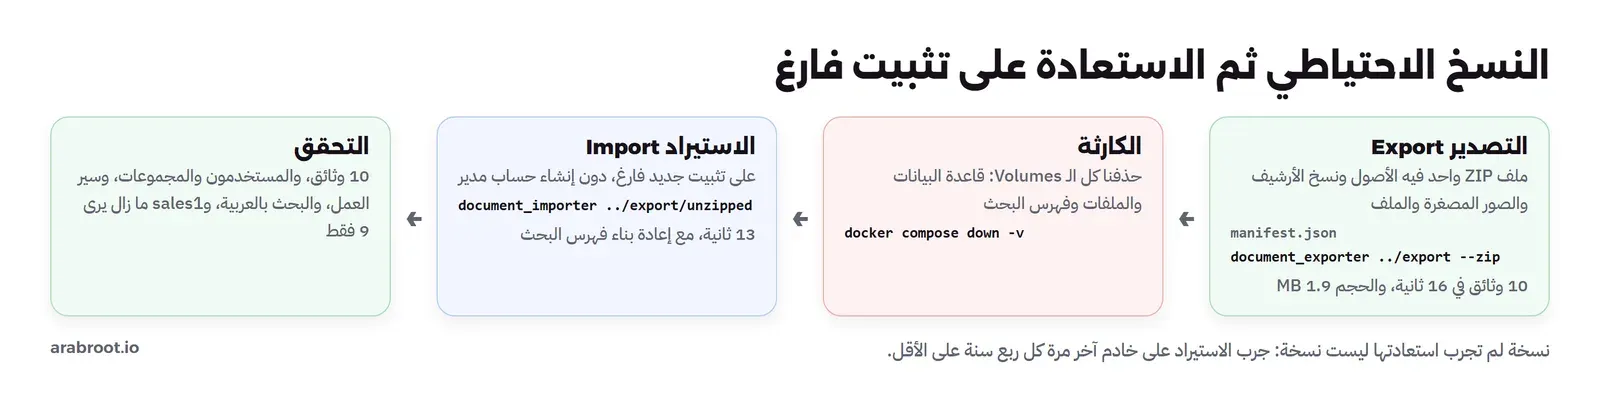
صدرنا أولاً:
docker compose exec -T webserver document_exporter ../export --zip --zip-name paperless-backup Exporting documents... ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 10/10 0:00:00 0:00:00
real 0m16.012sثم حذفنا كل شيء بالأمر docker compose down -v، أي قاعدة البيانات والملفات والفهرس، وشغلنا تثبيتاً جديداً فارغاً بعد أن حذفنا منه PAPERLESS_ADMIN_USER، لأن المستخدمين سيأتون من النسخة، ثم استوردنا:
docker compose exec -T webserver document_importer ../export/unzippedChecking the manifest
Copy files into paperless...
Updating search index...
Indexing documents... ━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━ 10/10 0:00:00 0:00:00
real 0m13.184sوبعد الاستيراد سألنا الواجهة البرمجية: عشر وثائق، والمستخدمون الثلاثة بكلمات مرورهم، وsales1 ما زال يرى تسعاً فقط، وسير العمل موجود باسمه العربي، والبحث عن «إيجار» يجد سند القبض. أي أن النسخة استعادت الصلاحيات أيضاً، لا الملفات وحدها.
وفي الإنتاج اجعل التصدير مهمة مجدولة كل ليلة، وانقل الملف خارج السيرفر، كما شرحنا في قاعدة 3-2-1 والنسخة خارج السيرفر مع restic. ولاحظ أن الأداة تقبل الخيار --passphrase لتشفير الحقول الحساسة في النسخة، وأن الملف نفسه فيه شهادات الرواتب، فعامله كما تعامل قاعدة البيانات.
media/documents/originals أصبحت بالعربية حسب القالب الذي وضعناه، مثل 2026/شركة النموذج للتوريدات المكتبية/فاتورة/02-inv-1002.jpg، والوثيقة التي لا نوع لها تذهب إلى مجلد اسمه none. وهذه فائدة كبيرة يوم تحتاج الملفات دون النظام.كيف تدخل أرشيفاً ورقياً قديماً، ولا تضيع الورقة الأصلية؟
التجربة السابقة كانت تسع وثائق، أما المكتب الحقيقي فعنده خزانة فيها آلاف الأوراق، وبعض هذه الأوراق يجب أن يبقى ورقاً، مثل العقد الموقع باليد أو الشهادة المختومة. والسؤال الذي يهمك هنا ليس «كيف أمسحها؟» وإنما «إذا وجدت الوثيقة في النظام، كيف أجد ورقتها في الخزانة؟». وتوثيق الاستخدام يقترح طريقة بسيطة اسمها الرقم التسلسلي للأرشيف Archive Serial Number واختصاراً ASN، وهي كما يلي:
- ضع كل ورقة تصلك في صندوق وارد واحد، وراجعه مرة في الأسبوع.
- قرر لكل ورقة: هل يجب أن يبقى أصلها الورقي؟ فإذا كان الجواب لا، فامسحها ثم أتلفها حسب سياسة الإتلاف عندك.
- إذا كان يجب أن يبقى أصلها فاكتب عليها رقماً متسلسلاً يبدأ من 1 قبل المسح، أو الصق عليها ملصقاً فيه باركود Barcode بالشكل
ASN00001. - امسحها، ثم ضعها في ملف واحد مرتب بهذا الرقم فقط، لا بالجهة ولا بالتاريخ، وعندما يمتلئ الملف اكتب عليه مدى الأرقام التي فيه.
وبهذا لن تبحث في الخزانة أبداً: تبحث في Paperless-ngx، وترى الرقم في الوثيقة، ثم تأخذ الملف الذي فيه هذا الرقم. وإذا فعلت الخيار PAPERLESS_CONSUMER_ENABLE_ASN_BARCODE قرأ النظام الباركود من الصفحة ووضع الرقم في حقل ASN دون أن تكتبه بيدك.
والمشكلة الثانية في الأرشيف القديم أن الماسح الضوئي السريع يمسح رزمة من خمسين ورقة في ملف واحد، والرزمة فيها عشرون وثيقة مختلفة. والحل الذي يقدمه النظام صفحات فاصلة Separator Pages: تطبع صفحة فيها باركود بالنص PATCHT وتضعها بين كل وثيقتين، وعندما تفعل الخيار PAPERLESS_CONSUMER_ENABLE_BARCODES يقسم النظام الملف عند كل صفحة فاصلة إلى وثائق منفصلة، ويحذف الصفحة الفاصلة نفسها. وهذه الطريقة أسرع بكثير من مسح كل وثيقة وحدها، ولكن جربها أولاً على رزمة صغيرة، لأن صفحة فاصلة لم تقرأ تعني وثيقتين في ملف واحد.
أما الوثائق التي تصل بالبريد الإلكتروني، مثل فواتير الموردين، فلا تحتاج أن يحفظها أحد يدوياً: يتصل النظام بصندوق بريد مخصص عبر IMAP، وتحدد قاعدة بريد Mail Rule تقول مثلاً «كل مرفق PDF في مجلد الفواتير يدخل بنوع فاتورة»، ثم ينقل الرسالة إلى مجلد آخر بعد إدخالها. والطريقة العملية أن تنشئ عنواناً مثل invoices@ وتطلب من الموردين إرسال الفواتير إليه، فتدخل كل فاتورة إلى الأرشيف دون أن يلمسها أحد. وفي الحالتين، الورق والبريد، اعرف قبل أن تبدأ كم سنة يجب أن تحتفظ بكل نوع، وهذا ما شرحناه في المقال الأول من السلسلة عن مدد الاحتفاظ في الأنظمة السعودية.
ماذا يحدث إذا…؟
- ظهر ERROR من Tesseract في السجل: رأينا «Too few characters. Skipping this page» ثم «Error during processing» في ثلاث وثائق رقمية، وكلها لها صفحة ثانية فارغة. والوثيقة دخلت بشكل سليم، فاقرأ السطر الذي قبل الخطأ قبل أن تبحث عن مشكلة.
- ظهر تحذير Ghostscript عن الحروف المركبة: في الإصدار الذي جربناه يحذر OCRmyPDF من أن Ghostscript 10.05 يسقط تحويلات النص للحروف المركبة عند كتابة PDF/A، وأن النسخ من نسخة الأرشيف قد لا يعطي النص الصحيح. والبحث داخل Paperless-ngx لا يتأثر لأنه يبحث في النص المستخرج لا في ملف الأرشيف.
- غيرت
PAPERLESS_SECRET_KEY: كل الجلسات Sessions المفتوحة تنتهي ويطلب من الجميع الدخول من جديد، لذلك ضعه مرة واحدة واحفظه مع كلمات المرور. - شغلت أكثر من عامل: الخيار
PAPERLESS_TASK_WORKERSيسرع إدخال الأرشيف القديم، ولكن كل عامل يأخذ قرابة 700 MB أثناء OCR، فاحسب الذاكرة قبل أن ترفعه.
قبل الإنتاج
- Reverse Proxy مع TLS: ضع النظام خلف Reverse Proxy واجعل
PAPERLESS_URLهو العنوان الحقيقي بـ https، وإلا رفضت الواجهة الطلبات بسبب حماية CSRF. - لا تنشره على الإنترنت مباشرة: هذا أرشيف فيه فواتير ورواتب وعقود، فالأفضل أن يصل إليه الموظفون عبر VPN أو صفحة دخول أمامه مثل التي شرحناها في مقال Pomerium وauthentik، ومعها التحقق بخطوتين Two-factor Authentication المدمج في النظام.
- الماسح الضوئي: اجعله يحفظ إلى مشاركة SMB تشير إلى مجلد الاستهلاك، ولا تنس الفحص الدوري، واضبطه على 300 DPI بالأبيض والأسود أو الرمادي، فدقة 150 التي جربنا بها هي الحد الأدنى.
- ميزات الذكاء الاصطناعي AI: الإصدار فيه اقتراحات ومحادثة مع الوثائق عبر نموذج لغوي، وخدمة OCR بعيدة Remote OCR عبر Azure. والتوثيق نفسه يحذر من أن هذه الميزات ترسل محتوى الوثيقة إلى المزود الذي تختاره، فإذا كانت الوثائق فيها بيانات شخصية فراجع ما يقوله نظام حماية البيانات الشخصية عن نقلها خارج المملكة قبل أن تفعلها، أو استخدم نموذجاً محلياً.
- التحديث Upgrade: ثبت رقم الإصدار في ملف Compose، واقرأ ملاحظات الإصدار، وصدر نسخة قبل كل تحديث، لأن التحديث يشغل ترحيلات Migrations على قاعدة البيانات لا رجوع عنها إلا من النسخة.
أخطاء شائعة
- كتابة
araفيPAPERLESS_OCR_LANGUAGEدونPAPERLESS_OCR_LANGUAGES: الحزمة غير مثبتة فيفشل كل OCR. - الاعتماد على الإشعارات في مجلد شبكة: الملفات تبقى في المجلد ولا يحدث شيء، والحل الفحص الدوري.
- اختيار
redoلإصلاح ملفات PDF العربية: قسناه فوجدناه الأسوأ، لأنه يكتب OCR فوق أشلاء النص ويطفئ تعديل الميل. - مطابقة المورد باسمه: الاسم يقرأ خطأ أحياناً، والرقم الضريبي أو رقم السجل التجاري ثابت.
- إدخال الأرشيف قبل الصلاحيات: كل ما يدخل دون مالك يراه الجميع.
- نسخ الـ Volumes فقط: دون تصدير متسق ودون تجربة استعادة لا تعرف هل تعمل النسخة.
- الثقة بتاريخ الإنشاء التلقائي: راجعه في الوارد، فقد يأخذ تاريخ اليوم إذا ضاع التاريخ في جدول.
قائمة تحقق Checklist
- رقم إصدار ثابت للـ Image، وحزمة
araمثبتة أو مضمنة في Image خاصة. PAPERLESS_OCR_MODE: forceإذا كانت لديك ملفات PDF عربية رقمية، بعد أن تجربها على عينة من وثائقك.PAPERLESS_CONSUMER_POLLING_INTERVALلأي مجلد استهلاك على شبكة أو مربوط من نظام آخر.- جهات التراسل بالرقم الضريبي أو رقم السجل، والأنواع بعبارات في نص عادي، ووسم وارد يراجعه إنسان.
- المجموعات والصلاحيات الافتراضية وسير العمل قبل أول وثيقة، ولا وثيقة دون مالك.
- قالب أسماء الملفات
PAPERLESS_FILENAME_FORMATقبل الإدخال. - تصدير ليلي خارج السيرفر، وتجربة استيراد على تثبيت فارغ كل ربع سنة.
- الوصول عبر VPN أو صفحة دخول، مع التحقق بخطوتين، وميزات الذكاء الاصطناعي البعيدة مطفأة حتى تراجعها.
تدريب عملي
- أضف حقلاً مخصصاً باسم «المبلغ الإجمالي» من نوع Monetary، وأدخل قيمته بيدك للفاتورتين، ثم جرب الفلتر على الحقل بدل البحث عن الرقم في النص.
- غير خوارزمية نوع «فاتورة» إلى Auto بعد أن تصنف عشر فواتير بيدك، وشغل مهمة تدريب المصنف من صفحة المهام Tasks، ثم أدخل فاتورة جديدة ولاحظ هل يقترح النوع.
الخلاصة
- Paperless-ngx يستقبل الوثيقة من مجلد أو بريد أو متصفح، ويحولها إلى PDF/A قابل للبحث مع OCR، ويحفظ الأصل كما هو، ويصنفها بقواعد مطابقة على النص المستخرج.
- التثبيت كله أقل من 700 MB من الذاكرة وهو خامل، والـ Image نفسها 3.57 GB، والمعالج هو ما يحدد سرعة إدخال الأرشيف.
- العربية تحتاج حزمة
araفي الجمع واللغة في المفرد، وara+engأفضل للفواتير، وaraوحدها أدق في الأسماء. - في تجربتنا وجد OCR 87.4% من كلمات الوثائق الممسوحة، وضاعت الأرقام داخل الجداول، وطبقة النص في ملفات PDF العربية الرقمية فيها حروف مكسورة يصلحها الوضع
force، أماredoفجعل النتيجة أسوأ. - البحث يتجاهل «ال» والهمزات، ولا يعرف الجمع المكسر ولا المرادفات ولا الأخطاء الإملائية، وأفضل ما تبحث به الأرقام المرجعية.
- الوثيقة التي لا مالك لها يراها الجميع، فأنشئ الصلاحيات وسير العمل قبل الإدخال.
- التصدير والاستيراد استعادا كل شيء، ومنه الصلاحيات، في أقل من 30 ثانية لعشر وثائق.
 دليلنظام إدارة الوثائق DMS: ما هو ومتى تحتاجهما الذي يضيفه نظام إدارة الوثائق فوق المجلد المشترك وNextcloud، ومتى تحتاجه، وماذا تطلب الأنظمة السعودية في حفظ الوثائق وإتلافها، وكم يكلف في سنة.
 دليلاستخراج النص العربي من الصور OCR مع Tesseractكيف يقرأ Tesseract النص العربي من صور الفواتير والمستندات، وأين يخطئ بالضبط، وكيف تكتشف أخطاءه قبل أن تصل إلى نظامك.
 دليلNextcloud: ملفات فريقك وتقويمه وجهات اتصاله على سيرفرككيف تثبت Nextcloud على سيرفرك وتربطه بأجهزة فريقك وبالدخول الموحد، ثم تحميه وتحدثه دون أن تفقد بياناتك.
 دليلالأرشيف والوثائق بمعيار ISAD(G) مع AtoM وArchivesSpaceكيف تصف وثائق مؤسستك بمعيار ISAD(G) في AtoM بالعربية، مع مقارنة بـ ArchivesSpace ومختبر كشف ثلاث مشكلات في الاستيراد والبحث العربي وحلولها.
 دليلالتوقيع الإلكتروني على سيرفرك: DocuSeal أم Documenso؟ما الفرق بين التوقيع الإلكتروني والرقمي، وكيف توقع مستنداتك على سيرفرك وتتحقق أن الملف لم يتغير بعد التوقيع.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
 دليلالنسخة خارج السيرفر Off-site: إلى S3 مع restic أو Kopiaمتى تكون النسخة خارج الموقع فعلاً، وأين تضعها، وكم تحتاج النسخة الأولى من الوقت، ومن يملك صلاحية حذفها، مع تجربة أربعين يوماً من النسخ إلى Garage وتمرين استعادة على سيرفر جديد.
 دليلحماية البيانات الشخصية PDPL للخدمات التي تستضيفهاما يعنيه نظام حماية البيانات الشخصية لمن يشغل خدمة على سيرفراته، من العقد مع العميل والإشعار بالتسرب إلى النسخ والسجلات والنقل للخارج.
 دليلما هو Reverse Proxy ولماذا تحتاجه أمام خدماتك؟كيف يستقبل برنامج واحد على المنفذ 443 كل الزوار ويوصل كل طلب إلى خدمته الصحيحة بالاسم، وما الذي يحدث للتشفير والترويسات والمهلات وWebSocket في الطريق.
سجل التحديثات
- 2026-11-20: كتابة المقال، وتشغيل Paperless-ngx 3.5.1 مع PostgreSQL 18.6 وRedis 8.10.3 وTesseract 5.5.0 على تسع وثائق عربية وهمية، وقياس OCR في ثلاثة أوضاع، واختبار البحث والصلاحيات، والتصدير ثم الاستيراد على تثبيت فارغ.