لنفرض أن لديك شركة ناشئة تقدم خدمة محاسبة للمنشآت الصغيرة، ويرسل لها العملاء كل شهر صور فواتير الموردين: صورة بالهاتف لفاتورة ورقية من محل قطع غيار، وملف PDF ممسوح بالماسح الضوئي من مورد قديم، وصورة شاشة لفاتورة أرسلها مورد عبر تطبيق المحادثة. ويقضي محاسبان من الفريق أغلب يومهما في إدخال رقم الفاتورة والتاريخ والرقم الضريبي والمبالغ يدوياً، ومع زيادة العملاء صار الإدخال يتأخر أسبوعاً، وصارت الأخطاء في الأرقام تظهر عند إعداد الإقرارات. وعندها اقترح أحد المطورين الحل الذي يخطر على بال الجميع: «نستخرج النص من الصور تلقائياً ونحفظه، ونرتاح». وبعد أسبوع من التجربة اكتشف الفريق أن الأداة تقرأ أغلب الكلمات بشكل صحيح، لكنها تقرأ رقم الفاتورة INV كأنه 1117، وتضيع جدول الأصناف كاملاً في بعض الإعدادات، وتحول الفاصلة العربية إلى همزة، وأن المشكلة الحقيقية ليست في نسبة الخطأ، وإنما في أن الخطأ يمر إلى النظام دون أن يلاحظه أحد.
وهذا هو موضوع التعرف الضوئي على الحروف Optical Character Recognition، واختصاراً OCR: تحويل صورة فيها نص إلى نص يستطيع الحاسب أن يبحث فيه ويعالجه، وأشهر محرك مفتوح المصدر له هو Tesseract، وهو يدعم العربية ضمن أكثر من مئة لغة. وفي مقالي معالجة الصور على السيرفر وخدمة تصغير الصور عند الطلب، ضمن نفس المرحلة من خارطة الطريق، تعاملنا مع الصورة كبكسلات نصغرها ونحولها، أما هنا فنريد أن نفهم ما في الصورة نفسها. وسوف نتبع قصة شركة المحاسبة خطوة خطوة، ونقيس كل شيء بنصوص عربية حقيقية كتبناها بأربعة خطوط مختلفة، ونرى أين يخطئ Tesseract بالضبط ولماذا.
وسوف نناقش في هذا المقال ما يلي:
- ما هو OCR، ومن أين جاء Tesseract، ولماذا العربية أصعب عليه من الإنجليزية.
- كيف يعمل Tesseract من الداخل: من البكسلات إلى الأسطر إلى الشبكة العصبية LSTM إلى النص.
- النماذج المتاحة للعربية: السريع tessdata_fast والأدق tessdata_best، والفرق بينهما بالأرقام.
- تجربة عملية: فقرة عربية بأربعة خطوط وثلاث حالات للصورة، ثم فاتورة بجدول وأرقام ونص إنجليزي، مع قياس نسبة الخطأ في الحروف والكلمات والزمن.
- الأخطاء التي ظهرت فعلاً: جدول ضاع بسبب وضع تقسيم الصفحة، وسطر كامل اختفى من صورة الهاتف، ومعالجة مسبقة جعلت النتيجة أسوأ.
- كيف تستخرج الحقول وتتحقق منها بقواعد المحاسبة نفسها، وكيف تبني خط معالجة فيه مراجعة بشرية، ومتى لا تحتاج OCR أصلاً.
ما هو التعرف الضوئي على الحروف OCR؟
الصورة بالنسبة للحاسب شبكة من البكسلات، فصورة الفاتورة في التجربة هي 2480 في 1633 بكسلاً، أي أربعة ملايين رقم تقريباً لكل قناة لون، ولا يوجد فيها حرف واحد يستطيع البرنامج أن يبحث عنه. ووظيفة OCR أن يجد في هذه الشبكة المناطق التي فيها كتابة، ثم يقسمها إلى أسطر وكلمات، ثم يقرر ما الحروف التي تمثلها، ثم يعيد النص مع موضع كل كلمة ودرجة الثقة فيها. والتشبيه الأقرب هو طفل تعلم القراءة حديثاً، فهو يرى الحروف بوضوح، لكنه يتعثر في الخط المزخرف، وفي الحروف المتشابهة، وفي الصفحة المائلة أو الباهتة، ويقرأ أسرع وأدق عندما يعرف اللغة ويتوقع الكلمة التالية.
وستجد OCR في أماكن كثيرة في أي مؤسسة دون أن تسميه بهذا الاسم: أرشيف إلكتروني يحول ملفات ورقية قديمة إلى ملفات يمكن البحث فيها، وتطبيق يقرأ بيانات الهوية أو السجل التجاري عند تسجيل عميل جديد، ونظام بريد صادر ووارد يقرأ رقم المعاملة من الخطاب الممسوح، وتطبيق مصروفات يقرأ مبلغ الإيصال من صورة الموظف. والقاسم المشترك بينها أن OCR ليس الهدف، وإنما خطوة في خط أطول ينتهي ببيانات منظمة في نظام، لذلك يقاس نجاحه بعدد الحقول الصحيحة التي وصلت إلى النظام، وبالوقت الذي وفره على الإنسان، وليس بنسبة الحروف الصحيحة وحدها، وهذا ما سوف نصل إليه في نهاية التجربة.
وقصة Tesseract طويلة، فبحسب صفحة المشروع طورته مختبرات Hewlett-Packard بين 1985 و1994، ثم فتحت HP مصدره سنة 2005، وطورته Google من 2006 حتى أغسطس 2017، ثم انتقل إلى مجتمع مفتوح المصدر برخصة Apache-2.0. والتحول الأهم في تاريخه جاء مع الإصدار 4، عندما أضاف محركاً جديداً مبنياً على الشبكات العصبية من نوع LSTM، يقرأ السطر كاملاً بدل أن يقطعه إلى حروف منفصلة، وهذا مهم جداً للعربية كما سوف نرى، ويشرحه توثيق الشبكات العصبية في Tesseract 4. والإصدار الذي نجربه هو Tesseract 5.5.0 من حزم Debian 13.
لماذا العربية أصعب على OCR؟
محركات OCR الأولى صممت للنصوص اللاتينية المطبوعة، حيث كل حرف شكل منفصل له مسافة حوله، فتستطيع البرنامج أن تقطع الكلمة إلى حروف ثم تتعرف على كل حرف وحده. أما العربية فتجمع عدة صعوبات في نفس الوقت، وكل واحدة منها ظهرت في نتائج تجربتنا:
- الكتابة المتصلة Cursive: الحروف في الكلمة متصلة، فلا توجد مسافة تقطع عندها، وتقطيع الكلمة إلى حروف هو نفسه مشكلة صعبة، وهذا سبب أن المحركات القديمة كانت ضعيفة جداً في العربية، وأن محرك LSTM الذي يقرأ السطر كاملاً حسن النتيجة كثيراً.
- أشكال الحرف بحسب موضعه: معظم الحروف لها شكل في أول الكلمة وآخر في وسطها وثالث في آخرها ورابع منفرداً، فحرف الهاء وحده له أربعة أشكال مختلفة جداً.
- النقاط: الفرق بين الباء والتاء والثاء والنون والياء في أول الكلمة هو عدد النقاط وموضعها فقط، والنقطة في صورة هاتف ضبابية بضعة بكسلات قد تختفي أو تلتصق، لذلك رأينا في التجربة «بياناتها» تقرأ «بجاناتها» و«يدويا» تقرأ «بدويا».
- الحروف المركبة Ligatures في الخطوط التقليدية: خط النسخ الكلاسيكي مثل Amiri يكتب بعض الحروف فوق بعضها، مثل اللام والميم في «المحاسبة»، فيختلف شكلها كثيراً عن الخطوط الحديثة البسيطة، وكان هذا الخط الأصعب في التجربة.
- الاتجاه المختلط Bidirectional Text: الفاتورة العربية فيها أرقام وكلمات إنجليزية تكتب من اليسار إلى اليمين داخل سطر يكتب من اليمين إلى اليسار، وترتيب العرض على الشاشة يختلف عن ترتيب التخزين في الملف كما تشرح خوارزمية الاتجاه في Unicode، فرأينا في التجربة «HP 305» تخرج بترتيب معكوس، و«15%» تخرج «%15»، ورأينا علامات اتجاه غير مرئية في النص.
- علامات الترقيم والأرقام: الفاصلة العربية «،» تشبه في بعض الخطوط همزة صغيرة، فقرأها Tesseract همزة أو فاصلة لاتينية في أغلب الحالات، والأرقام قد تكون غربية أو عربية هندية Arabic-Indic مثل ٣٠٠ في نفس المستند.
- التشكيل والتطويل: الحركات والتطويل Kashida تغير شكل الكلمة دون أن تغير حروفها، وفي المقابل قد يضيف المحرك حركات لم تكن في الأصل، كما سترى في المخرج.
لذلك لا تحكم على أداة OCR من نص إنجليزي، ولا من خط واحد، وإنما من عينة من مستنداتك العربية الحقيقية بخطوطها وجودة صورها، وهذا ما سوف نفعله في التجربة.
كيف يعمل Tesseract من الداخل؟
عندما تعطي Tesseract صورة فإنها تمر بأربع مراحل رئيسية، وفهمها يفسر أغلب الأخطاء التي سوف تراها وأين تصلحها:
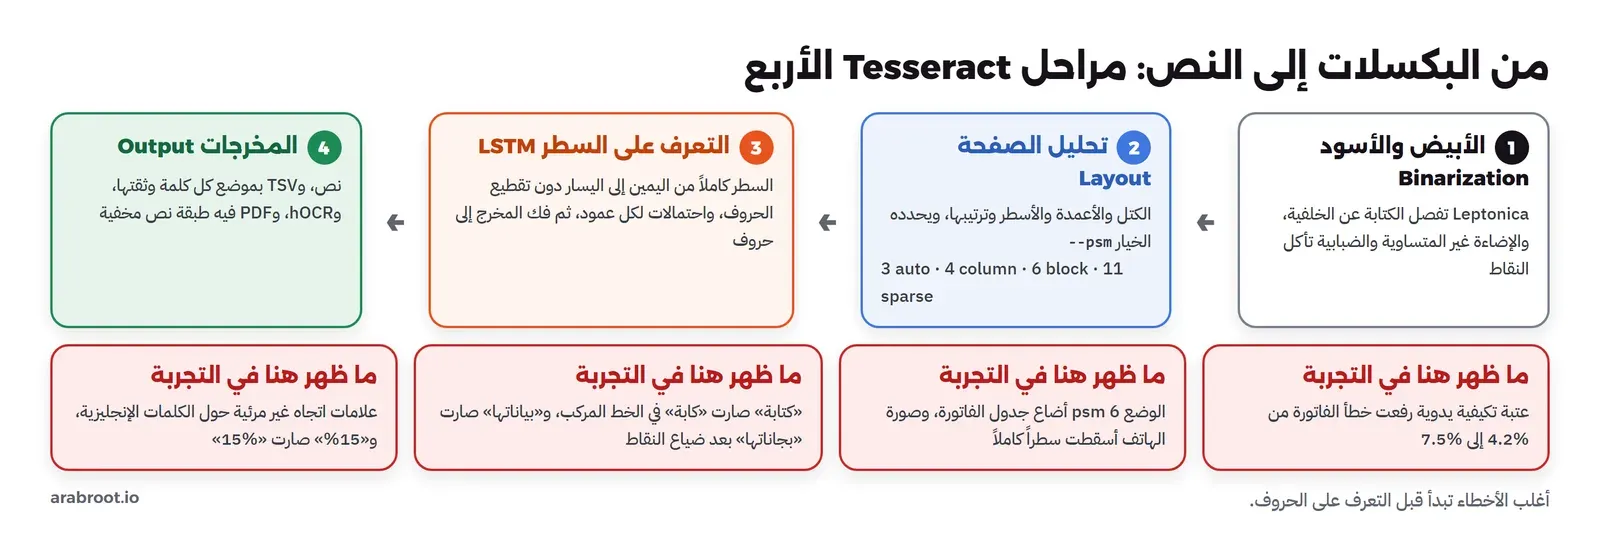
- التحويل إلى أبيض وأسود Binarization: يحول Tesseract الصورة الرمادية أو الملونة إلى بكسلات سوداء للكتابة وبيضاء للخلفية باستخدام مكتبة Leptonica، وإذا كانت الإضاءة غير متساوية أو الخلفية مزخرفة فقد تختفي كتابة أو تظهر بقع، ويشرح دليل تحسين جودة المخرجات هذه المرحلة.
- تحليل تخطيط الصفحة Page Layout Analysis: يجد الكتل والأعمدة والأسطر وترتيب قراءتها، وتحدد سلوكه بالخيار
--psm، أي وضع تقسيم الصفحة Page Segmentation Mode، فالقيمة 3 تعني تحليلاً تلقائياً كاملاً، و4 عموداً واحداً بأسطر مختلفة الأحجام، و6 كتلة نص واحدة متجانسة، و11 كلمات متفرقة دون ترتيب، كما في توثيق سطر الأوامر. واختيار الوضع الخطأ قد يضيع جزءاً كاملاً من الصفحة كما سترى. - التعرف على السطر Line Recognition: كل سطر يقطع كصورة طويلة ويمر على شبكة LSTM تقرؤه شريحة بعد شريحة وتخرج لكل موضع احتمالات الحروف، ثم يختار المحرك أرجح تسلسل، والسبب في أن هذا يناسب العربية أن الشبكة تتعلم أشكال الحروف المتصلة في سياقها دون أن تحتاج إلى تقطيع الكلمة أولاً.
- المخرجات Output: نص عادي، أو جدول TSV فيه لكل كلمة موضعها في الصورة ودرجة الثقة Confidence من 0 إلى 100، أو hOCR بصيغة HTML، أو ملف PDF فيه الصورة مع طبقة نص مخفية تجعل الملف قابلاً للبحث والنسخ.
كيف تقرأ الشبكة سطراً عربياً دون أن تقطعه؟
هذه أهم نقطة لفهم سلوك Tesseract مع العربية، فلنأخذها بهدوء. الشبكة لا ترى حروفاً، وإنما ترى صورة السطر بعد تصغيرها إلى ارتفاع ثابت، ثم تمر عليها عموداً بعد عمود في الاتجاه الذي تكتب به اللغة، وفي كل موضع تخرج قائمة احتمالات لكل حرف تعرفه، ومعها احتمال خاص يعني «لا شيء هنا». فإذا كانت كلمة «شهر» تمتد على خمسين عموداً، فالمخرج الخام هو خمسون قائمة، فيها مثلاً «ش» في عدة أعمدة متتالية، ثم «لا شيء»، ثم «ه» في أعمدة، ثم «ر». ثم تأتي مرحلة فك المخرج Decoding التي تدمج التكرار المتتالي وتحذف «لا شيء» فتخرج «شهر»، وهذه الفكرة هي طريقة CTC التي تظهر نوافذ مخرجاتها في توثيق التدريب، وهي ما يسمح للشبكة أن تتعلم من سطور كاملة مع نصها دون أن يحدد أحد أين يبدأ كل حرف.
وهذا يفسر عدة أشياء رأيناها في التجربة: أن الشبكة تقرأ الحرف في سياقه، فتتعامل مع أشكال الحرف الأربعة دون قواعد مكتوبة، وأن الخط الذي لم تر مثله في التدريب، مثل الحروف المركبة في Amiri، يعطي احتمالات مشتتة فتظهر كلمات غريبة مثل «كابة» بدل «كتابة»، وأن النقطة الضائعة في صورة ضبابية تغير الاحتمال إلى حرف آخر له نفس الهيكل. ويفسر أيضاً لماذا تضيع الأسطر في الصور المائلة: الشبكة تقرأ ما يعطيها إياه تحليل الصفحة، فإذا لم يجد التحليل السطر أصلاً فلن تراه الشبكة أبداً، وهذا ما حدث في صورة الخط الكوفي.
النماذج Models: السريع أم الأدق؟
Tesseract نفسه محرك، والمعرفة باللغة في ملف نموذج اسمه ara.traineddata للعربية وeng.traineddata للإنجليزية، ويشرح توثيق ملفات البيانات أن هناك ثلاث مجموعات رسمية دربتها Google: tessdata_fast بنماذج أصغر بأرقام صحيحة Integer، ويصفها التوثيق بأنها أفضل توازن بين السرعة والدقة وأنها ما توزعه توزيعات Linux، وtessdata_best بنماذج أكبر بأرقام عشرية Float، أبطأ وأدق، وهي الوحيدة التي تصلح أساساً لإعادة التدريب Fine-tuning، وtessdata الأصلية التي تجمع المحرك القديم مع LSTM. وفي التجربة كان حجم النموذج العربي من حزمة Debian 1.4 ميجابايت، ونموذج tessdata_best العربي 12.6 ميجابايت، أي تسعة أضعاف تقريباً.
| المجموعة | الحجم للعربية | السرعة | الدقة | متى تختارها |
|---|---|---|---|---|
| tessdata_fast | 1.4 ميجابايت | الأسرع | جيدة مع الصور النظيفة | كميات كبيرة من مستندات مطبوعة واضحة |
| tessdata_best | 12.6 ميجابايت | أبطأ مرتين إلى ثلاث في التجربة | الأفضل مع الصور الرديئة والخطوط الصعبة | صور هواتف وخطوط تقليدية، أو أساس لإعادة التدريب |
| tessdata | أكبر | متوسطة | تجمع المحرك القديم مع LSTM | عندما تحتاج المحرك القديم --oem 0 لسبب خاص |
تجربة عملية: فقرة عربية بأربعة خطوط وفاتورة بجدول
الآن سوف نقيس كل ما سبق بدل أن نصدق الكلام العام عن دقة OCR. والفكرة أن نعرف النص الصحيح مسبقاً، أي الحقيقة الأرضية Ground Truth، ثم نقارن به ما يقرؤه Tesseract، ونحسب مقياسين معروفين: نسبة الخطأ في الحروف Character Error Rate، واختصاراً CER، وهي عدد الحروف التي يجب أن تضاف أو تحذف أو تستبدل لتصبح النتيجة مطابقة للأصل مقسوماً على طول الأصل، ونسبة الخطأ في الكلمات Word Error Rate، واختصاراً WER، وهي نفس الحساب على الكلمات. والفرق بينهما مهم: خطأ في حرف واحد في كلمة طويلة يجعل CER صغيرة، لكنه يجعل الكلمة كلها خطأ في WER، وفي الفواتير كلمة خطأ في رقم يعني مبلغاً خطأ.
تجهيز الأدوات
نبني Image فيها Tesseract والنموذجان العربي والإنجليزي من Debian، ثم نضيف نموذجي tessdata_best في مجلد منفصل حتى نقارن بينهما:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends \
      tesseract-ocr tesseract-ocr-ara tesseract-ocr-eng imagemagick python3 time ca-certificates curl \
 && rm -rf /var/lib/apt/lists/*
RUN mkdir -p /opt/tessdata_best && cd /opt/tessdata_best \
 && curl -fsSLO https://github.com/tesseract-ocr/tessdata_best/raw/4.1.0/ara.traineddata \
 && curl -fsSLO https://github.com/tesseract-ocr/tessdata_best/raw/4.1.0/eng.traineddata
WORKDIR /work
docker build -t ocr-lab:1 .
docker run --rm ocr-lab:1 sh -c 'tesseract --version 2>&1 | head -2; tesseract --list-langs;
ls -l /usr/share/tesseract-ocr/5/tessdata/ara.traineddata /opt/tessdata_best/ara.traineddata'tesseract 5.5.0
leptonica-1.84.1
List of available languages in "/usr/share/tesseract-ocr/5/tessdata/" (3):
ara
eng
osd
-rw-r--r-- 1 root root 1432056 Oct 30 2019 /usr/share/tesseract-ocr/5/tessdata/ara.traineddata
-rw-r--r-- 1 root root 12603724 Oct 28 11:15 /opt/tessdata_best/ara.traineddataلاحظ أن ملف النموذج من Debian تاريخه 2019 والإصدار 4.1.0، فالنماذج لم تتغير منذ سنوات رغم أن المحرك نفسه 5.5.0، وهذا طبيعي في Tesseract، لأن النماذج الرسمية المنشورة تعود إلى سبتمبر 2017 كما يذكر توثيق ملفات البيانات، والتحسينات بعدها في المحرك وليس في النماذج.
المستندات: نص نعرفه مسبقاً بأربعة خطوط
كتبنا فقرة عربية من 65 كلمة عن قصة شركة المحاسبة نفسها، وفاتورة وهمية فيها عنوان ورقم فاتورة بحروف إنجليزية وتاريخ ورقم ضريبي وجدول بثلاثة أصناف ومجاميع، ثم رسمناها في متصفح Chrome بدقة تعادل 300 نقطة في البوصة DPI، أي بحجم ورقة A4 بعرض 2480 بكسلاً. واخترنا للفقرة أربعة خطوط عربية مفتوحة برخصة OFL من Google Fonts تمثل أنواع الخطوط الشائعة في المستندات: Amiri كخط نسخ تقليدي فيه حروف مركبة، وNoto Naskh Arabic كخط نسخ حديث بسيط، وIBM Plex Sans Arabic كخط حديث بلا زخارف، وNoto Kufi Arabic كخط كوفي هندسي. والصورة التالية تبين بداية الفقرة بالخطوط الأربعة:
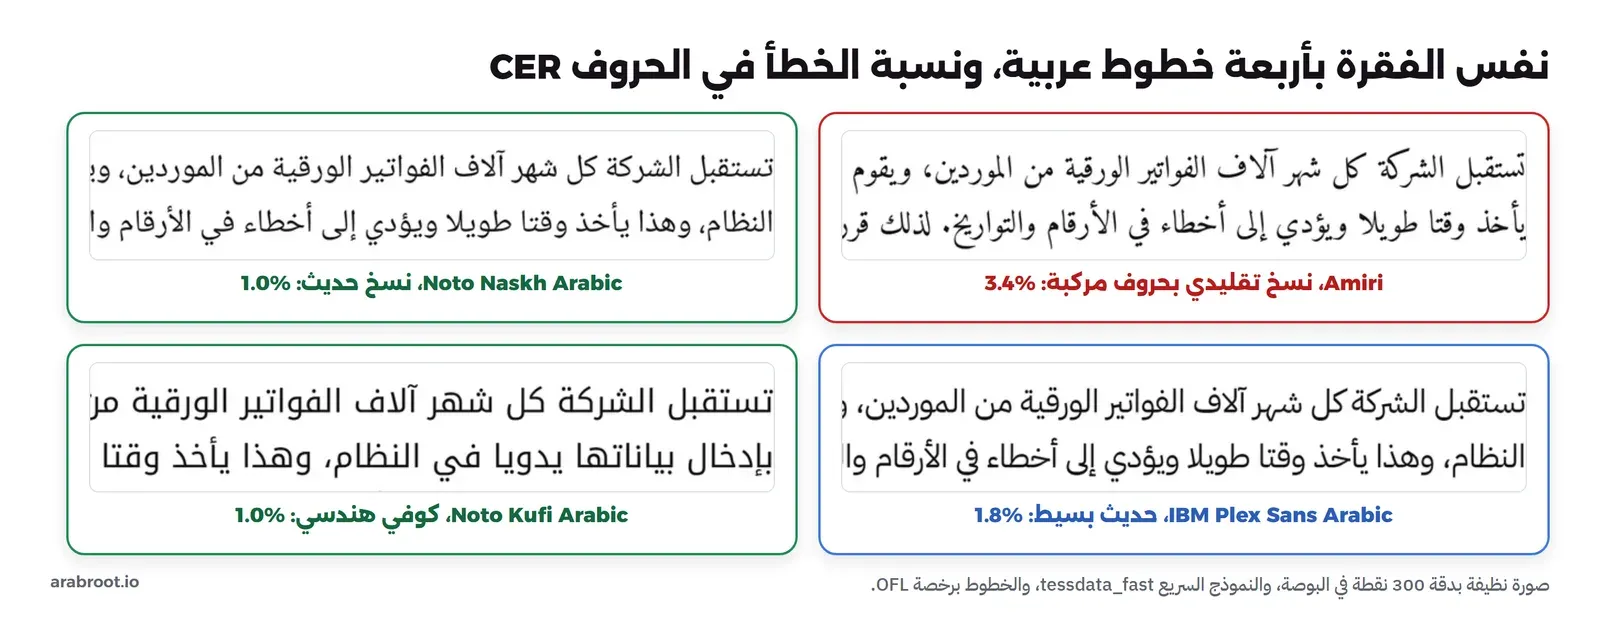
ثم صنعنا من كل صورة نسختين أسوأ بأوامر ImageMagick، الأولى بنصف الدقة، أي 150 نقطة في البوصة كما يخرج كثير من الماسحات الرخيصة والفاكس، والثانية تحاكي صورة هاتف لورقة على مكتب: ميلان 2.5 درجة، وضبابية خفيفة، وضجيج، وإضاءة تخفت نحو زاوية، وضغط JPEG بجودة 55:
mk() { # $1=source image  $2=name
  magick docs/$1.png -density 300 -units PixelsPerInch /tmp/o/$2-clean.png
  magick docs/$1.png -resize 50% -density 150 -units PixelsPerInch /tmp/o/$2-lowres.png
  magick docs/$1.png -background white -rotate 2.5 -blur 0x1.6 -attenuate 0.5 +noise Gaussian \
    \( +clone -sparse-color Barycentric '0,0 gray(95%) %w,%h gray(70%)' \) -compose multiply -composite \
    -quality 55 -density 300 -units PixelsPerInch /tmp/o/$2-photo.jpg
}
for f in amiri naskh plex kufi; do mk para-$f $f; done; mk invoice inv
وحساب النسبتين في سكربت Python صغير cer.py يستخدم مسافة Levenshtein، وهي أقل عدد من عمليات الإضافة والحذف والاستبدال يحول نصاً إلى آخر، ويحسب أيضاً نسبة ثالثة بعد توحيد ما لا يهمنا في المحاسبة: الهمزات على الألف، والتاء المربوطة، والألف المقصورة، والتشكيل، وعلامات الترقيم، والأرقام العربية الهندية:
import re, sys
def lev(a, b):
    prev = list(range(len(b) + 1))
    for i, ca in enumerate(a, 1):
        cur = [i]
        for j, cb in enumerate(b, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (ca != cb)))
        prev = cur
    return prev[-1]
def clean(s): return re.sub(r"\s+", " ", s).strip()
def norm(s):
    s = re.sub(r"[ً-ْـ]", "", s)                 # diacritics and tatweel
    s = s.translate(str.maketrans("أإآىة٠١٢٣٤٥٦٧٨٩", "اااية0123456789"))
    s = re.sub(r"[،,.:;%]", "", s)                              # punctuation
    return clean(s)
def score(truth, out):
    t, o = clean(truth), clean(out)
    cer = lev(t, o) / len(t)
    tw, ow = t.split(), o.split()
    wer = lev(tw, ow) / len(tw)
    ncer = lev(norm(truth), norm(out)) / len(norm(truth))
    return cer, wer, ncer
if __name__ == "__main__":
    t = open(sys.argv[1], encoding="utf-8").read(); o = open(sys.argv[2], encoding="utf-8").read()
    print("CER %.1f%%  WER %.1f%%  CER-normalized %.1f%%" % tuple(x * 100 for x in score(t, o)))
النتائج: أربعة خطوط في ثلاث حالات بنموذجين
شغلنا Tesseract على كل صورة بالنموذجين، بالوضع --psm 6 لأن الفقرة كتلة نص واحدة، وبخيط معالجة واحد OMP_THREAD_LIMIT=1 حتى تكون الأزمنة قابلة للمقارنة:
for model in fast best; do
  td=/usr/share/tesseract-ocr/5/tessdata; [ $model = best ] && td=/opt/tessdata_best
  OMP_THREAD_LIMIT=1 tesseract $img /tmp/o/$base-$model --tessdata-dir $td -l ara --psm 6
  python3 cer.py truth-para.txt /tmp/o/$base-$model.txt
done
والمخرج سوف يكون كما يلي:
amiri-clean    fast    445 ms  CER 3.4%  WER 18.5%  CER-normalized 2.9%
amiri-clean    best   1081 ms  CER 2.1%  WER 12.3%  CER-normalized 2.1%
amiri-lowres   fast    306 ms  CER 2.4%  WER 13.8%  CER-normalized 2.4%
amiri-lowres   best    889 ms  CER 1.8%  WER 9.2%  CER-normalized 1.9%
amiri-photo    fast    582 ms  CER 7.9%  WER 27.7%  CER-normalized 6.7%
amiri-photo    best   1506 ms  CER 3.1%  WER 16.9%  CER-normalized 2.9%
naskh-clean    fast    404 ms  CER 1.0%  WER 6.2%  CER-normalized 0.3%
naskh-clean    best   1239 ms  CER 1.0%  WER 6.2%  CER-normalized 0.3%
naskh-lowres   fast    322 ms  CER 1.0%  WER 6.2%  CER-normalized 0.5%
naskh-lowres   best   1037 ms  CER 1.0%  WER 6.2%  CER-normalized 0.0%
naskh-photo    fast    721 ms  CER 1.3%  WER 6.2%  CER-normalized 0.5%
naskh-photo    best   1607 ms  CER 1.3%  WER 7.7%  CER-normalized 0.5%
plex-clean     fast    449 ms  CER 1.8%  WER 9.2%  CER-normalized 1.6%
plex-clean     best   1819 ms  CER 1.6%  WER 9.2%  CER-normalized 1.1%
plex-lowres    fast    267 ms  CER 1.3%  WER 7.7%  CER-normalized 0.8%
plex-lowres    best    799 ms  CER 1.6%  WER 9.2%  CER-normalized 0.8%
plex-photo     fast    558 ms  CER 1.6%  WER 9.2%  CER-normalized 1.1%
plex-photo     best   1643 ms  CER 2.1%  WER 10.8%  CER-normalized 1.9%
kufi-clean     fast    473 ms  CER 1.0%  WER 6.2%  CER-normalized 0.3%
kufi-clean     best   1518 ms  CER 1.0%  WER 6.2%  CER-normalized 0.3%
kufi-lowres    fast    370 ms  CER 1.0%  WER 6.2%  CER-normalized 0.3%
kufi-lowres    best   1448 ms  CER 1.0%  WER 6.2%  CER-normalized 0.3%
kufi-photo     fast    655 ms  CER 20.2%  WER 23.1%  CER-normalized 19.8%
kufi-photo     best   2346 ms  CER 1.0%  WER 6.2%  CER-normalized 0.8%
والصورة التالية تضع نسبة الخطأ في الكلمات لكل حالة في رسم واحد:
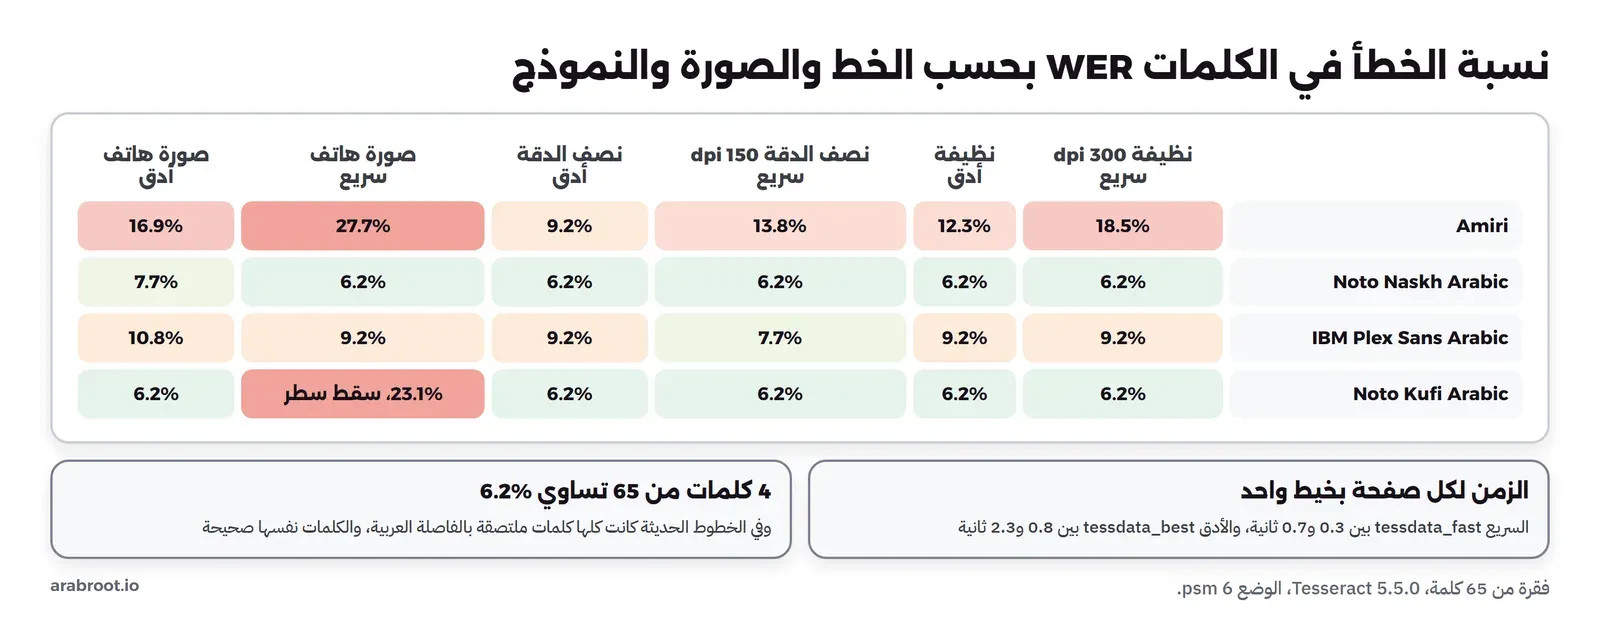
في النتائج أعلاه لاحظ التالي:
- الخطوط الحديثة البسيطة قرئت بخطأ حروف 1% تقريباً حتى في صورة الهاتف، وبعد التوحيد نزل الخطأ إلى أقل من نصف في المئة، أي أن أغلب «الأخطاء» في هذه الخطوط كانت في علامات الترقيم وليس في الكلمات.
- خط Amiri التقليدي كان الأصعب في كل الحالات، وفي صورة الهاتف بالنموذج السريع أخطأ في أكثر من ربع الكلمات، ونموذج tessdata_best خفض ذلك إلى 16.9%، فإذا كانت مستنداتك بخطوط تقليدية مثل الصكوك والكتب القديمة فالنموذج الأدق يستحق ثمنه.
- صورة الهاتف بالخط الكوفي والنموذج السريع قفزت إلى خطأ 20% في الحروف، وليس السبب حروفاً خاطئة كثيرة، وإنما أن سطراً كاملاً من الفقرة اختفى من المخرج، وهذا ما سنراه في المخرج بعد قليل، أما النموذج الأدق فقرأ السطر.
- نصف الدقة، أي 150 نقطة في البوصة، لم يضر في الخطوط الواضحة بحجم الخط الذي اخترناه، بل أسرع القراءة، لأن الخط في التجربة بحجم 14 نقطة فبقي ارتفاع الحرف كافياً حتى بنصف الدقة، أما دليل تحسين الجودة فيذكر أن Tesseract يعمل أفضل بدقة 300 نقطة في البوصة على الأقل، فمع خطوط الفواتير الصغيرة لا تنزل عنها.
- النموذج الأدق أبطأ مرتين إلى ثلاث مرات في كل الحالات، بين 0.8 و2.3 ثانية للصفحة بخيط واحد، مقابل 0.3 إلى 0.7 ثانية للنموذج السريع.
أين أخطأ بالضبط؟
الأرقام وحدها لا تكفي، فالسؤال المهم هو نوع الخطأ، لأن بعض الأخطاء لا تهمك وبعضها يفسد البيانات. والسكربت wdiff.mjs يقارن الكلمات بين الأصل والمخرج ويطبع ما اختلف فقط، وهذه نتائج أربع حالات:
== naskh-clean-fast
  الموردين،  =>  الموردين,
  النظام،  =>  النظام,
  تلقائيا،  =>  تلقائياء
  المراجعة،  =>  المراجعة,
== amiri-clean-fast
  تستقبل  =>  استقبل
  شهر  =>  شهبر
  الموردين،  =>  الموردين»
  النظام،  =>  النظامء
  يأخذ  =>  ِأَخذ
  لذلك  =>  إذلك
  تلقائيا،  =>  تلقائياء
  والهدف  =>  والحدف
  المراجعة، وإنما  =>  المراجعة» وإئما
  تدقيقا  =>  تدقيقًا
  كتابة  =>  كابة
== amiri-photo-fast
  شهر  =>  شبر
  الورقية من الموردين، ويقوم  =>  س الوردن ويُوم
  المحاسبة  =>  المحاسية
  بياناتها يدويا  =>  بجاناتها بدويا
== kufi-photo-fast
  الموردين،  =>  الموردين؛
  النظام،  =>  النظام,
  تلقائيا،  =>  تلقائياء
  الموظف النتيجة ويصحح ما فيها قبل الحفظ. والهدف ليس الاستغناء عن المراجعة،  =>
في المخرج أعلاه لاحظ التالي:
- في خط النسخ الحديث كانت كل الأخطاء في الفاصلة العربية: مرة قرئت فاصلة لاتينية، ومرة همزة ملتصقة بالكلمة «تلقائياء»، والكلمات نفسها صحيحة كلها، وهذا خطأ يصلحه سطر واحد بعد OCR يستبدل الفاصلة اللاتينية بالعربية، لكن الهمزة الملتصقة أصعب لأنها قد تكون همزة حقيقية.
- في Amiri كانت الأخطاء في الحروف المركبة والنقاط: «لذلك» صارت «إذلك»، و«كتابة» صارت «كابة» لأن التاء ملتصقة بالكاف في هذا الخط، والمحرك أضاف حركات لم تكن في الأصل إلى كلمتي «يأخذ» و«تدقيقا» كما ترى في المخرج أعلاه.
- في صورة الهاتف بنفس الخط ضاعت النقاط فصارت «بياناتها» «بجاناتها»، و«يدويا» «بدويا»، و«المحاسبة» «المحاسية»، وهي أخطاء تنتج كلمات عربية صحيحة أحياناً، فلا يكتشفها مدقق إملائي.
- في الخط الكوفي بصورة الهاتف كانت الكلمات صحيحة، لكن 11 كلمة متتالية اختفت، أي سطر كامل لم يجده تحليل الصفحة بسبب الميلان والإضاءة، وهذا أخطر من خطأ الحروف، لأن النص الناتج يبدو سليماً ومقروءاً، ولا يدل شيء على أن جزءاً منه مفقود.
الفاتورة: جدول ضاع ثم رجع
الآن ننتقل إلى ما يهم شركة المحاسبة فعلاً، أي الفاتورة. وفيها نص عربي وإنجليزي وأرقام وجدول، لذلك نستخدم اللغتين معاً -l ara+eng، ونبدأ بنفس الوضع --psm 6 الذي نجح مع الفقرة:
inv-clean      fast    682 ms  CER 29.4%  WER 40.8%  CER-normalized 29.1%
inv-clean      best   1459 ms  CER 29.7%  WER 38.8%  CER-normalized 29.4%
inv-lowres     fast    411 ms  CER 38.1%  WER 49.0%  CER-normalized 37.7%
inv-photo      best   3109 ms  CER 33.3%  WER 51.0%  CER-normalized 32.6%
خطأ 30% في الحروف حتى مع الصورة النظيفة والنموذج الأدق، فلما قرأنا المخرج وجدنا السبب:
فاتورة ضريبية
رقم الفاتورة: 1117-2026-0457
التاريخ: 2026/10/14
المورد: شركة الأفق للتجهيزات المكتبية
الرقم الضريبي: 300123456700003
=
حبر طابعة 305 HP 95.00 380.00
المجموع قبل الضريبة: 862.50
ضريبة القيمة المضافة %15: 129.38
الإجمالي: 991.88 ريالجدول الأصناف ضاع تقريباً كله، وبقي منه سطر واحد ناقص، وظهرت علامة = مكان الخطوط. والسبب أن الوضع 6 يفترض أن الصفحة كتلة نص واحدة متجانسة، فلما وجد خطوط الجدول وأعمدته المتباعدة اختلط عليه ترتيب الأسطر. وهنا جربنا الأوضاع الأخرى على نفس الصورة النظيفة، ثم جربنا حذف خطوط الجدول قبل OCR بعملية مورفولوجية Morphology في ImageMagick تجد الخطوط الأفقية والعمودية الطويلة وتبيضها:
for psm in 3 4 6 11; do
  tesseract out/inv-clean.png /tmp/p$psm --tessdata-dir /opt/tessdata_best -l ara+eng --psm $psm
  echo "psm $psm: $(python3 cer.py truth-invoice.txt /tmp/p$psm.txt)"
done
magick out/inv-clean.png -colorspace gray -threshold 60% \( +clone -negate -morphology Open rectangle:200x1 \) \
  \( -clone 0 -negate -morphology Open rectangle:1x200 \) \( -clone 1 -clone 2 -compose lighten -composite \) \
  -delete 1,2 -compose plus -composite /tmp/nolines.png
psm 3: CER 4.8% WER 10.2% CER-normalized 4.4%
psm 4: CER 4.8% WER 10.2% CER-normalized 4.4%
psm 6: CER 29.7% WER 38.8% CER-normalized 29.4%
psm 11: CER 27.0% WER 32.7% CER-normalized 26.6%
no-lines psm 4: CER 4.8% WER 10.2% CER-normalized 4.4%
no-lines psm 6: CER 4.2% WER 10.2% CER-normalized 3.8%تغيير رقم واحد في الأمر خفض الخطأ من 30% إلى أقل من 5%، والوضع 4 الذي يفترض عموداً واحداً بأسطر مختلفة الأحجام قرأ الجدول صفاً صفاً، وهذا مخرجه:
فاتورة ضريبية
رقم الفاتورة: 1117-2026-0457
التاريخ: 2026/10/14
المورد: شركة الأفق للتجهيزات المكتبية
الرقم الضريبي: 300123456700003
الصنف الكمية السعر الإجمالي
ورق طباعة Ad 20 18.50 370.00
حبر طابعة 305 HP 4 95.00 380.00
ملفات بلاستيكية 50 2.25 112.50
المجموع قبل الضريبة: 862.50
ضريبة القيمة المضافة %15: 129.38
الإجمالي: 991.88 ريالفي المخرج أعلاه لاحظ التالي:
- كل الأرقام صحيحة: الرقم الضريبي بخمسة عشر رقماً، والكميات والأسعار والمجاميع، وهذا ما يهم المحاسب أكثر من أي شيء آخر.
- «INV» قرئت «1117»، والسبب أن الحروف الإنجليزية الكبيرة I وN وV في هذا الخط تشبه الأرقام 1 و1 و7 عندما تكون بجوار أرقام، وبعد حذف خطوط الجدول قرئت صحيحة، أي أن الخطوط القريبة غيرت تقسيم السطر. و«A4» قرئت «Ad».
- «HP 305» خرجت «305 HP» بترتيب معكوس، و«15%» خرجت «%15»، ومعها علامتا اتجاه غير مرئيتين U+200E وU+200F حول الكلمات الإنجليزية، فإذا قارنت النص بنص آخر حرفاً بحرف فسوف تفشل المقارنة دون أن ترى السبب على الشاشة.
وإذا كانت فواتير مورد معين بنفس القالب دائماً، فهناك طريقة أدق من قراءة الصفحة كاملة، وهي القراءة بالمناطق Zonal OCR: تحدد مرة واحدة مستطيل رقم الفاتورة ومستطيل التاريخ ومستطيل الجدول في قالب هذا المورد، ثم تقص كل منطقة من الصورة وتقرؤها وحدها بالوضع المناسب لها، مثل --psm 7 لسطر واحد، فلا يتأثر رقم الفاتورة بخطوط الجدول القريبة منه كما حدث معنا. وثمن هذه الطريقة أنك تدير قالباً لكل مورد كبير، وأن القالب يفشل بصمت إذا غير المورد تصميم فاتورته، لذلك تبقى فحوص الحقول ضرورية معها.
صورة الهاتف للفاتورة، وتحسين جعل النتيجة أسوأ
الآن نجرب صورة الهاتف المائلة للفاتورة، وهذه هي الصورة كما دخلت إلى Tesseract، مع الصورة النظيفة بجانبها:
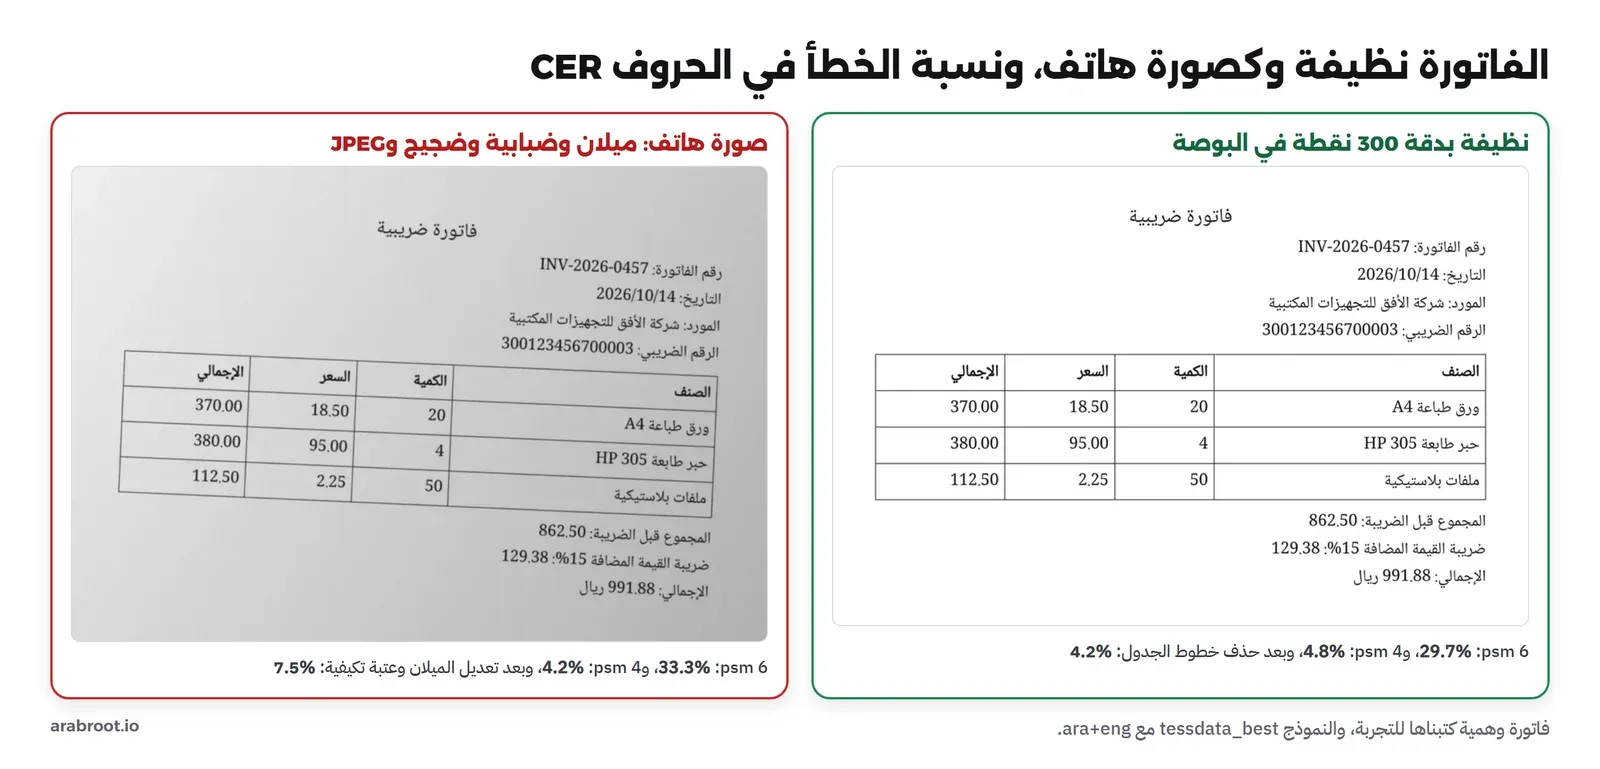
والطبيعي أن تفكر أولاً في تحسين الصورة قبل OCR، فجربنا ما تنصح به مقالات كثيرة: تحويلها إلى رمادي، وتصحيح الميلان Deskew، ثم عتبة تكيفية Adaptive Threshold تحول كل منطقة إلى أبيض وأسود بحسب ما حولها:
tesseract out/inv-photo.jpg /tmp/a --tessdata-dir /opt/tessdata_best -l ara+eng --psm 6
tesseract out/inv-photo.jpg /tmp/b --tessdata-dir /opt/tessdata_best -l ara+eng --psm 4
magick out/inv-photo.jpg -colorspace gray -deskew 40% -lat 60x60-8% /tmp/fixed.png
tesseract /tmp/fixed.png /tmp/c --tessdata-dir /opt/tessdata_best -l ara+eng --psm 4
psm 6: CER 33.3% WER 51.0% CER-normalized 32.6%
psm 4: CER 4.2% WER 14.3% CER-normalized 3.5%
deskew+adaptive threshold psm 4: CER 7.5% WER 16.3% CER-normalized 7.3%الوضع 4 وحده على الصورة المائلة كما هي أعطى خطأ 4.2%، أما بعد «التحسين» فارتفع الخطأ إلى 7.5%. والسبب أن Tesseract 5 يحول الصورة إلى أبيض وأسود بنفسه وبطريقة جيدة، ويتحمل ميلاناً صغيراً، والعتبة التكيفية بالقيم التي اخترناها أكلت أطراف بعض الحروف الرفيعة ونقاطها. والدرس العملي ليس أن المعالجة المسبقة سيئة، وإنما ألا تضيفها إلا إذا قستها على عينة من صورك ورأيت أنها تحسن الرقم، فكل خطوة هنا لها معاملات تناسب نوعاً من الصور وتفسد غيره.
درجة الثقة Confidence: كيف يدلك Tesseract على أخطائه؟
المخرج النصي لا يقول لك أي كلمة يشك فيها المحرك، لكن مخرج TSV يقول ذلك لكل كلمة. وفي أول محاولة كتبنا tsv في آخر الأمر كما في التوثيق، فلم يظهر أي ملف، والسبب أن هذه الكلمة اسم ملف إعداد يبحث عنه Tesseract داخل مجلد النماذج، ونحن غيرنا المجلد ب --tessdata-dir إلى مجلد tessdata_best الذي ليس فيه مجلد الإعدادات، والحل أن تمرر الإعداد مباشرة بالخيار -c:
tesseract out/inv-clean.png /tmp/t --tessdata-dir /opt/tessdata_best -l ara+eng --psm 4 -c tessedit_create_tsv=1
awk -F'\t' 'NR>1 && $12!="" && $11>=0 && $11<85 {printf "conf %5.1f  %s\n", $11, $12}' /tmp/t.tsv
conf 68.8 1117-2026-0457
conf 81.0 Ad
conf 84.0 18.50
conf 83.2 %15:من 54 كلمة في الفاتورة كانت هناك أربع كلمات فقط ثقتها أقل من 85، ومنها الخطآن الحقيقيان الوحيدان في المخرج: رقم الفاتورة بثقة 68.8، و«Ad» بثقة 81. وهذا هو الاستخدام الأهم لدرجة الثقة: لا تعتمد عليها لتقرر أن النص صحيح، لأن «18.50» صحيحة رغم ثقتها 84، لكن استخدمها لتلون للمراجع الكلمات التي يجب أن ينظر إليها، فيراجع أربع كلمات بدل 54.
من النص إلى حقول: التحقق بقواعد المحاسبة نفسها
النص وحده لا يفيد نظام المحاسبة، فهو يحتاج حقولاً: رقم الفاتورة والتاريخ والرقم الضريبي والأصناف والمجاميع. والسكربت التالي extract.py يستخرجها بتعابير نمطية Regular Expressions، ثم يفعل ما يفعله المحاسب نفسه: يضرب الكمية في السعر، ويجمع الأصناف، ويتحقق أن الضريبة 15% من المجموع وأن الإجمالي يساوي المجموع مع الضريبة، ويتحقق من شكل الرقم الضريبي:
import re, sys
from decimal import Decimal as D
text = open(sys.argv[1], encoding="utf-8").read()
text = re.sub("[]", "", text) # bidi marks added by the OCR
text = re.sub(r"\s+:", ":", text) # "التاريخ :" -> "التاريخ:"
text = text.translate(str.maketrans("٠١٢٣٤٥٦٧٨٩", "0123456789"))
def find(pattern):
m = re.search(pattern, text); return m.group(1) if m else None
inv = {
"number": find(r"رقم الفاتورة:\s*(\S+)"),
"date": find(r"التاريخ:\s*(\d{4}/\d{2}/\d{2})"),
"vat_no": find(r"الرقم الضريبي:\s*(\d+)"),
"subtotal": find(r"المجموع قبل الضريبة:\s*([\d.]+)"),
"vat": find(r"المضافة\s*%?15%?:\s*([\d.]+)"),
"total": find(r"الإجمالي:\s*([\d.]+)"),
}
lines = [tuple(map(D, m)) for m in re.findall(r"(\d+)\s+(\d+\.\d{2})\s+(\d+\.\d{2})\s*$", text, re.M)]
print(inv); print("items:", [(str(q), str(p), str(t)) for q, p, t in lines])
problems = [f"missing field: {k}" for k, v in inv.items() if v is None]
if not (inv["number"] or "").startswith("INV-"): problems.append(f"invoice number looks wrong: {inv['number']}")
if not re.fullmatch(r"3\d{13}3", inv["vat_no"] or ""): problems.append("VAT number is not 15 digits starting and ending with 3")
for q, p, t in lines:
if q * p != t: problems.append(f"line {q} x {p} != {t}")
if lines and inv["subtotal"] and sum(t for _, _, t in lines) != D(inv["subtotal"]): problems.append("items do not add up to subtotal")
if inv["subtotal"] and inv["vat"] and (D(inv["subtotal"]) * D("0.15")).quantize(D("0.01")) != D(inv["vat"]): problems.append("VAT is not 15% of subtotal")
if inv["subtotal"] and inv["vat"] and inv["total"] and D(inv["subtotal"]) + D(inv["vat"]) != D(inv["total"]): problems.append("subtotal + VAT != total")
print("needs review:" if problems else "all checks passed", problems)في الكود أعلاه لاحظ أن المبالغ تحسب بالنوع Decimal وليس بالأعداد العشرية العادية، والسبب أن 0.1 لا تمثل بدقة في الأعداد العشرية الثنائية، فتفشل مقارنة مثل 20 × 18.50 = 370.00 لأسباب لا علاقة لها ب OCR. ثم شغلناه على مخرج الصورة النظيفة ومخرج صورة الهاتف بالوضع 4:
== inv-clean-p4
{'number': '1117-2026-0457', 'date': '2026/10/14', 'vat_no': '300123456700003', 'subtotal': '862.50', 'vat': '129.38', 'total': '991.88'}
items: [('20', '18.50', '370.00'), ('4', '95.00', '380.00'), ('50', '2.25', '112.50')]
needs review: ['invoice number looks wrong: 1117-2026-0457']
== inv-photo-p4
{'number': 'INV-2026-0457', 'date': '2026/10/14', 'vat_no': '300123456700003', 'subtotal': '862.50', 'vat': '129.38', 'total': '991.88'}
items: [('20', '18.50', '370.00'), ('4', '95.00', '380.00'), ('50', '2.25', '112.50')]
all checks passed []
الفاتورة الأولى ذهبت إلى المراجعة بسبب رقم الفاتورة، وهو نفس الخطأ الذي كانت ثقته 68.8، والثانية مرت كل فحوصها. ولاحظ أن النسخة الأولى من هذا السكربت كانت فيها ثغرة: في مخرج صورة الهاتف كتب Tesseract «التاريخ :» بمسافة قبل النقطتين ومعها علامة اتجاه، فلم يجد التعبير النمطي التاريخ، وكانت النتيجة 'date': None مع «all checks passed»، أي أن الفاتورة كانت ستمر دون تاريخ. فأضفنا سطرين: تنظيف المسافات قبل النقطتين وعلامات الاتجاه، وفحصاً يعتبر أي حقل مفقود سبباً للمراجعة. وهذه بالضبط طبيعة أخطاء OCR في الإنتاج: لا تأتي من الحروف فقط، وإنما من شكل المخرج الذي لم تتوقعه، لذلك اجعل الفحص الافتراضي «يحتاج مراجعة» حتى يثبت العكس.
تنظيف النص العربي بعد OCR
بين مخرج Tesseract وأي استخدام له خطوة تنظيف يجب أن تكون صريحة في الكود، وأن تعرف ما تغيره بالضبط، لأن كل قاعدة هنا تصلح حالة وقد تفسد أخرى. والقواعد التي احتجناها في التجربة كانت كما يلي:
- حذف علامات الاتجاه U+200E وU+200F: لا تظهر على الشاشة، لكنها تفسد المقارنة والبحث والتعابير النمطية، وحذفها آمن في كل الحالات تقريباً.
- توحيد الأرقام: تحويل الأرقام العربية الهندية مثل ٣٠٠ إلى 300 قبل أي تحويل إلى رقم، لأن الفواتير السعودية تستخدم النوعين، وقد يخلط المحرك بينهما في نفس السطر.
- المسافة قبل النقطتين وبعد الكلمات: «التاريخ :» و«التاريخ:» يجب أن تعاملا نفس المعاملة، وإلا ضاع الحقل كما حدث في صورة الهاتف.
- الفاصلة اللاتينية بين كلمتين عربيتين تعاد فاصلة عربية: قاعدة آمنة، لكن الهمزة الملتصقة في آخر الكلمة مثل «تلقائياء» لا تحذف آلياً، لأن كلمات كثيرة تنتهي بهمزة حقيقية مثل «أخطاء».
- للبحث وليس للعرض: توحيد الهمزات والتاء المربوطة والألف المقصورة، كما في الدالة
normفي سكربت القياس، يفيد في البحث والمقارنة، لكن لا تحفظ النص الموحد مكان الأصل، لأن «الإدارة» و«الاداره» ليستا نفس الكتابة في مستند رسمي.
ولاحظ أن نسبة الخطأ بعد التوحيد في التجربة نزلت في الخطوط الحديثة من 1% إلى 0.3% تقريباً، أي أن أغلب ما يسميه المقياس خطأ كان في الترقيم، وهذا سبب أن تقيس دائماً بالطريقتين، فالمقياس الخام يخبرك بجودة النص للعرض، والموحد يخبرك بجودته للبحث واستخراج البيانات.
السرعة والملف القابل للبحث
قسنا زمن الفاتورة النظيفة بالنموذج الأدق ثلاث مرات لكل حالة، بخيط واحد ثم بأربعة خيوط:
psm 4 threads 1: 1871 ms
psm 4 threads 1: 3109 ms
psm 4 threads 1: 4108 ms
psm 4 threads 4: 1360 ms
psm 4 threads 4: 1356 ms
psm 4 threads 4: 1249 ms
psm 6 threads 1: 1524 ms
psm 6 threads 1: 1819 ms
psm 6 threads 1: 1729 ms
psm 6 threads 4: 1022 ms
psm 6 threads 4: 1101 ms
psm 6 threads 4: 1371 ms
الأزمنة بخيط واحد تفاوتت كثيراً لأن الجهاز كان يشغل أعمالاً أخرى في نفس الوقت، لكن الصورة العامة واضحة: الصفحة تأخذ بين ثانية وأربع ثوان بالنموذج الأدق، والخيوط الأربعة تخفض زمن الصفحة الواحدة قليلاً فقط. وفي الإنتاج الأفضل غالباً أن تشغل عدة صفحات بالتوازي، كل صفحة بخيط واحد OMP_THREAD_LIMIT=1، بدل صفحة واحدة بعدة خيوط، والسبب أن توزيع الصفحات على الأنوية لا يحتاج أي تنسيق بينها. وبحساب تقريبي من هذه الأرقام فإن نواة واحدة تعالج بين 900 و3,600 صفحة في الساعة بحسب النموذج وجودة الصور، فشركة تستقبل عشرة آلاف فاتورة في الشهر تحتاج ساعات معالج قليلة فقط، والوقت الحقيقي في المراجعة البشرية وليس في OCR.
وأخيراً يستطيع Tesseract أن يخرج ملف PDF فيه الصورة الأصلية ومن تحتها طبقة نص مخفية، فيستطيع الموظف أن يبحث في الأرشيف وينسخ النص من الملف:
tesseract out/inv-clean.png /tmp/inv --tessdata-dir /opt/tessdata_best -l ara+eng --psm 4 -c tessedit_create_pdf=1
ls -l /tmp/inv.pdf
-rw-r--r-- 1 root root 112002 Oct 28 11:24 /tmp/inv.pdfوإذا كانت مستنداتك ملفات PDF ممسوحة متعددة الصفحات فأداة OCRmyPDF المبنية على Tesseract تضيف طبقة النص إلى الملف نفسه، وتعالج الصفحات بالتوازي، وتحافظ على الصفحات التي فيها نص أصلاً.
حذف التجربة
docker image rm ocr-lab:1
rm -rf out docs
خط OCR في الإنتاج: آلة تقرأ وإنسان يراجع
بعد التجربة غيرت شركة المحاسبة هدفها: لم يعد الهدف أن يستغني النظام عن المحاسب، وإنما أن يتحول عمله من كتابة كل حقل إلى مراجعة ما يشك فيه النظام. والصورة التالية تبين الخط الذي بنته:
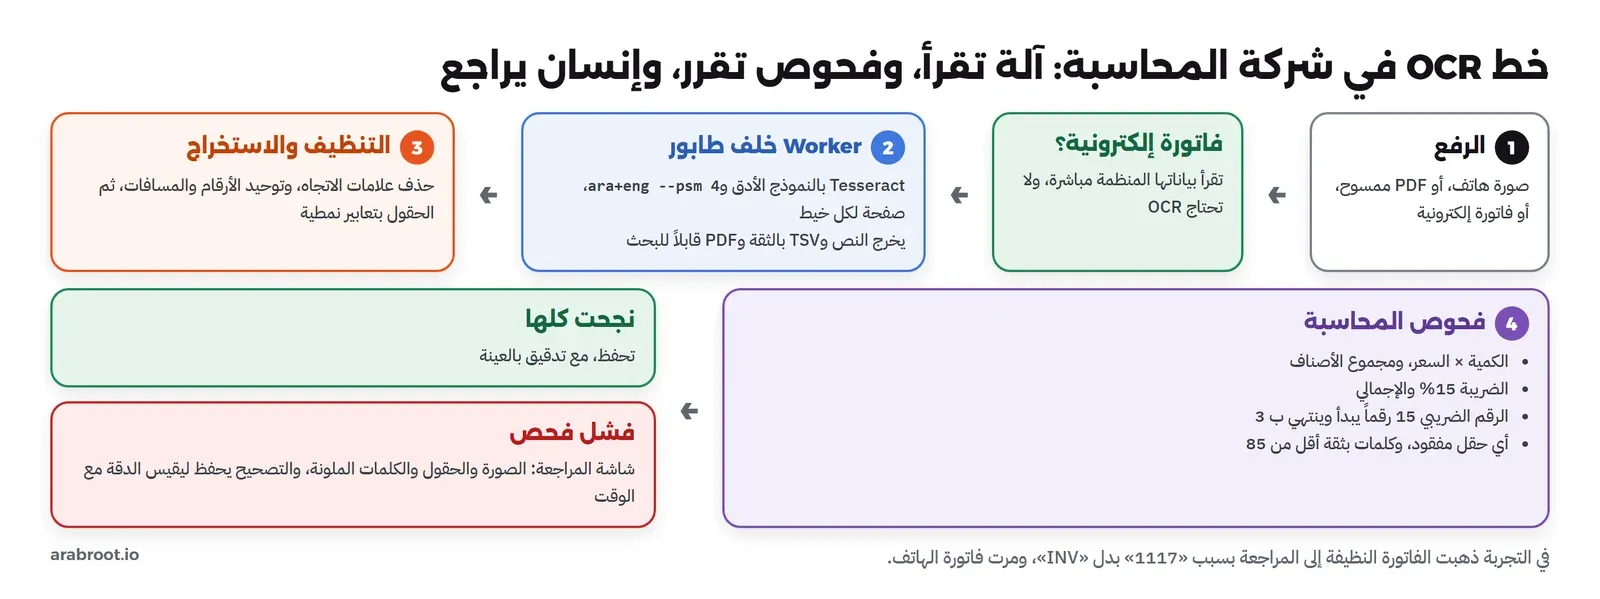
- ابحث أولاً عن المصدر الإلكتروني: إذا وصلت الفاتورة من نظام فوترة إلكترونية فبياناتها موجودة بصيغة منظمة، ولا معنى لقراءتها من صورة. وقد ألزمت هيئة الزكاة والضريبة والجمارك بإصدار الفواتير إلكترونياً في المرحلة الأولى من 4 ديسمبر 2021 كما في صفحة الفوترة الإلكترونية، وشرحنا الربط مع منصة فاتورة في الفوترة الإلكترونية فاتورة. لذلك يبقى OCR للحالات التي تصلك فيها صورة أو ورقة فقط.
- المعالجة في Worker خلف طابور: صفحة كل ثانية إلى أربع ثوان لا تناسب طلب HTTP ينتظر، فضع الملف في التخزين والمهمة في الطابور كما شرحنا في مفاهيم الطوابير، وشغل عدة صفحات بالتوازي بخيط واحد لكل صفحة.
- احفظ ثلاثة أشياء لا واحداً: النص للبحث، وملف TSV بمواضع الكلمات وثقتها لشاشة المراجعة التي تلون الكلمات المشكوك فيها على الصورة نفسها، والصورة الأصلية كدليل، لأن المحاسب والمدقق يحتاجان أن يريا ما كان في الورقة.
- الفحوص قبل الحفظ: كل قاعدة تعرفها عن المستند هي فحص مجاني لنتيجة OCR، مثل مجموع الأصناف، والضريبة، وشكل الرقم الضريبي، وأن التاريخ ليس في المستقبل، وأن المورد موجود في قائمة الموردين.
- قس الدقة باستمرار: كل تصحيح يكتبه المحاسب في شاشة المراجعة هو حقيقة أرضية جديدة، فاحفظه واحسب منه نسبة الخطأ لكل مورد ولكل نوع مستند، فإذا ساءت عند مورد معين فقد غير شكل فاتورته.
- الخصوصية: الفواتير والمستندات فيها بيانات شخصية وتجارية، فأين تحفظ الصور ومن يراها ومتى تحذف هي أسئلة يجب أن تجيب عنها، وقد شرحنا ما يخص الخدمات المستضافة في حماية البيانات الشخصية PDPL.
- البحث في النص العربي الناتج: النص الخارج من OCR فيه همزات وتاءات وأخطاء نقاط، فلا تبحث فيه بمطابقة حرفية، وإنما بمحرك بحث يوحد هذه الحروف ويتحمل الأخطاء كما في البحث في النصوص العربية.
متى لا يكفي Tesseract؟
Tesseract ممتاز في النصوص المطبوعة الواضحة، وهو مجاني ويعمل على سيرفرك دون أن تخرج المستندات منه، لكن له حدود يجب أن تعرفها قبل أن تبني عليه منتجاً:
- الكتابة اليدوية: النماذج الرسمية مدربة على نصوص مطبوعة، والخط اليدوي العربي خارج ما صممت له.
- التخطيطات المعقدة: الجداول المتداخلة والأعمدة المتعددة والنماذج ذات الحقول تحتاج تحليلاً للتخطيط أقوى مما في Tesseract، أو أن تقص كل منطقة وتقرأها وحدها.
- الخطوط والزخارف الخاصة: كما رأينا مع Amiri، فإذا كانت مستنداتك كلها بخط معين فقد يحسن النتيجة أن تعيد تدريب نموذج tessdata_best على عينات منه.
وفي هذه الحالات هناك مشاريع مفتوحة أحدث تعتمد على نماذج تعلم عميق، مثل PaddleOCR الذي يدعم العربية ضمن لغات كثيرة، وهناك خدمات سحابية تجارية لاستخراج البيانات من المستندات، ونماذج اللغة الكبيرة التي تقرأ الصور، وقد شرحنا طريقة عملها في كيف تعمل نماذج اللغة الكبيرة. لكن لا تنتقل إلى أي منها بناءً على عرض تسويقي، وإنما بنفس الطريقة التي في هذه التجربة: عينة من مستنداتك بحقيقتها الأرضية، وCER وWER لكل أداة، وزمن الصفحة وتكلفتها، وأين تذهب المستندات، فالخدمة السحابية تعني أن صور فواتير عملائك تخرج من سيرفرك.
متى تستحق إعادة التدريب Fine-tuning؟
إذا كانت أغلب مستنداتك بخط واحد أو قالب واحد، مثل نماذج جهة حكومية أو فواتير مورد كبير أو صكوك بخط معين، فقد تحسن النتيجة كثيراً إذا أكملت تدريب نموذج tessdata_best العربي على سطور من مستنداتك نفسها، وهذا ما يسميه توثيق التدريب الضبط الدقيق Fine-tuning، ويبدأ من نقطة حفظ في النموذج الموجود بالخيار --continue_from، وتجد أدوات تجهيز البيانات والتدريب في مستودع tesstrain. لكن اعرف الثمن قبل أن تبدأ: تحتاج مئات أو آلاف السطور المقصوصة من مستنداتك مع نصها الصحيح، وهذا عمل بشري، وتحتاج مجموعة اختبار منفصلة لم يرها التدريب حتى لا تخدع نفسك بأرقام جميلة، وتحتاج أن تعيد القياس بعد كل تدريب على نفس العينة بنفس السكربت الذي استخدمناه. والطريقة العملية أن تبدأ بما في هذا المقال: النموذج الأدق ووضع التقسيم الصحيح والفحوص والمراجعة، ثم تجمع تصحيحات المراجعين مع الوقت، فإذا تراكمت لديك آلاف السطور المصححة من خط واحد صار التدريب خطوة طبيعية وبياناته جاهزة.
أخطاء شائعة وكيف تكتشفها
- الحكم على الدقة من صورة واحدة نظيفة: اكتشفه بأن تقيس CER وWER على عينة من مستنداتك الحقيقية بكل أنواع جودتها.
- ترك الوضع الافتراضي أو اختيار
--psm 6لكل شيء: يضيع الجداول كما رأينا، فجرب الأوضاع 3 و4 و6 على عينتك واختر بالأرقام. - معالجة مسبقة لم تقسها: قد تحسن نوعاً من الصور وتسيء لغيره، كما رفعت العتبة التكيفية الخطأ من 4.2% إلى 7.5%.
- الاعتماد على النص وحده دون فحوص: سطر كامل قد يختفي ويبقى النص سليم الشكل، والحقل المفقود قد يمر إذا لم يفحصه أحد.
- تجاهل علامات الاتجاه غير المرئية والفاصلة العربية والأرقام العربية الهندية: اكتشفها بطباعة النص بترميز يظهر هذه الرموز، ونظفها قبل الاستخراج.
--tessdata-dirيغير مكان ملفات الإعداد أيضاً: إذا لم يظهر ملف TSV أو PDF فمرر الإعداد بالخيار-c.- تشغيل عدة صفحات وكل منها بعدة خيوط: تتزاحم الخيوط على الأنوية، فاجعل كل صفحة بخيط واحد ووزع الصفحات.
قائمة تحقق قبل أن تضع OCR في نظامك
| السؤال | ما فعلته شركة المحاسبة |
|---|---|
| هل البيانات متاحة إلكترونياً دون OCR؟ | الفاتورة الإلكترونية تقرأ مباشرة، وOCR للصور والورق فقط |
| هل لديك عينة بحقيقة أرضية من مستنداتك؟ | عينة من فواتير موردين مختلفين أدخلها المحاسبون يدوياً |
| أي نموذج ووضع تقسيم؟ | tessdata_best مع ara+eng و--psm 4 بعد القياس |
| ما الفحوص التي تقرر المراجعة؟ | الحقول المفقودة، والمجاميع والضريبة، والرقم الضريبي، والكلمات بثقة أقل من 85 |
| ماذا تحفظ؟ | النص وTSV والصورة الأصلية وPDF قابلاً للبحث |
| كيف تقيس الدقة مع الوقت؟ | كل تصحيح في شاشة المراجعة يحفظ ويدخل في حساب CER لكل مورد |
| أين تبقى المستندات؟ | على سيرفرات الشركة، وتحذف الصور بحسب سياسة الاحتفاظ |
الخلاصة
- Tesseract محرك OCR مفتوح المصدر عمره عشرات السنين، ومحرك LSTM الذي يقرأ السطر كاملاً جعله صالحاً للعربية المتصلة، والنماذج الرسمية للعربية نوعان: سريع صغير، وأدق أكبر وأبطأ مرتين إلى ثلاث.
- في التجربة قرأ الخطوط الحديثة بخطأ حروف 1% تقريباً حتى في صورة هاتف، وكانت أغلب الأخطاء في الفاصلة العربية، أما الخط التقليدي المزخرف فوصل خطؤه في الكلمات إلى 27.7%، وخفضه النموذج الأدق إلى 16.9%.
- أخطر الأخطاء ليست الحروف وإنما ما يختفي: سطر كامل من صورة الهاتف، وجدول كامل بالوضع الخطأ، وحقل لم يجده التعبير النمطي، لأن النص يبقى سليم الشكل.
- اختيار وضع تقسيم الصفحة خفض خطأ الفاتورة من 30% إلى أقل من 5%، والمعالجة المسبقة غير المقيسة رفعته، فقس كل تغيير على عينتك.
- درجة الثقة تدل المراجع على الكلمات المشكوك فيها، وقواعد المستند نفسه مثل المجاميع والضريبة هي أقوى فحص لنتيجة OCR، والهدف الواقعي أن يصبح عمل الإنسان مراجعة سريعة وليس الاستغناء عنه.
وفي المقال التالي من نفس المرحلة ننتقل من قراءة النص إلى فهم ما في الصورة نفسها، بمدخل إلى الرؤية الحاسوبية، وهذه مقالات قريبة من الموضوع:
 دليلصيغ الصور: كيف تختار الصيغة المناسبة لموقعككيف تحفظ كل صيغة صور البكسلات والألوان، ولماذا يصغر الملف نفسه إلى الثلث أو أقل عندما تختار الصيغة والمقاس المناسبين.
 دليلمعالجة اللغة الطبيعية NLP للعربية ولماذا تصعب على البرامجلماذا تصعب العربية على البرامج من الزوائد واللهجات إلى تكلفة التوكنز، وما الأدوات والنماذج المتاحة لمن يبني مساعداً عربياً.
 دليلالبحث في النصوص العربية مع OpenSearch وMeilisearchلماذا يرجع البحث صفحة فارغة لمن يكتب «مستشفي» أو «اجازه»، وكيف تضبط محركك حتى يجد الكلمة بكل أشكالها.
 دليلالفوترة الإلكترونية فاتورة ZATCA: كيف تربط نظامكبنينا فاتورة مبسطة بصيغة XML ورمز QR بلغة Python، وتحققنا منهما بأداة الهيئة، وحسبنا الهاش بأنفسنا وجربنا الأخطاء الشائعة.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلحماية البيانات الشخصية PDPL للخدمات التي تستضيفهاما يعنيه نظام حماية البيانات الشخصية لمن يشغل خدمة على سيرفراته، من العقد مع العميل والإشعار بالتسرب إلى النسخ والسجلات والنقل للخارج.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على Tesseract 5.5.0 مع Leptonica 1.84.1 ونماذج tessdata_fast وtessdata_best للعربية والإنجليزية في Docker Engine 29.8.0.