في أغلب الجامعات والوزارات والشركات القديمة غرفة لا يدخلها أحد كثيراً، فيها صناديق من المحاضر والمراسلات والصور والخرائط، وكل من يعرف ما فيها موظف قارب التقاعد. ثم يأتي يوم يطلب فيه باحث «محضر الاجتماع الذي تقرر فيه إنشاء نظام الإعارة»، أو تحتاج الإدارة صورة افتتاح المبنى في ذكرى التأسيس، فيبدأ البحث في الصناديق يدوياً. وعندما يقرر أحد أن يضع هذه الوثائق في نظام، فأول ما يخطر له النظام الموجود: نظام المكتبة Koha، أو المستودع DSpace، ثم يكتشف بعد أسابيع أن كل وثيقة دخلت النظام كأنها كتاب مستقل، فضاع الشيء الأهم: أن هذا المحضر جزء من سلسلة محاضر لجنة بعينها، وأن معناه لا يفهم إلا مع ما قبله وما بعده.
وفي هذا المقال سوف نناقش:
- لماذا يختلف وصف الأرشيف عن فهرسة الكتب، ومبدأ المصدر Provenance والنظام الأصلي Original Order ومستويات الوصف.
- معيار الوصف الأرشيفي ISAD(G) بحقوله السبعة، والمعايير المرافقة له، وملف التبادل EAD.
- نظاما AtoM وArchivesSpace: من صمم كلاً منهما ولمن، ونقاط القوة ونقاط الضعف في كل منهما للأرشيف العربي.
- مختبر عملي: تشغيل AtoM 2.10.2 من ملف Docker Compose الرسمي، ووصف وحدة أرشيفية عربية من أربعة مستويات بملف CSV، والواجهة العربية، والتصدير والاستيراد بصيغة EAD.
- ثلاث مشكلات حقيقية ظهرت في المختبر وحلولها: مصطلحات مكررة بسبب لغة الاستيراد، ورمز مرجعي تكرر، وبحث عربي لا يجد «انشاء» إذا كتبت «إنشاء».
وهذا المقال ضمن مرحلة «المستودعات والأرشيف الرقمي»، وقبله مقالا المستودع والحصاد:
 دليلمستودع الجامعة Institutional Repository مع DSpaceكيف تشغل DSpace لأرشفة رسائل الطلاب وأبحاث الجامعة، من الإيداع ومراجعته حتى الحصاد عبر OAI-PMH، وما يحتاج تعريباً قبل الإطلاق.
 دليلالحصاد OAI-PMH: كيف تجمع البوابات سجلات المستودعاتكيف تحصد البوابات تسجيلات المستودعات بالبروتوكول OAI-PMH، مع حاصد صغير جربناه على مستودعين عربيين حقيقيين وما وجدناه فيهما من أخطاء في التواريخ واللغة والحذف.
 دليلخريطة أنظمة المكتبة: ILS والمستودع وبوابة البحثما الأنظمة التي تتكون منها المكتبة الحديثة وكيف تتكلم مع بعضها، مع مختبر ينسخ تسجيلة كتاب من مكتبة الكونغرس عبر Z39.50 ويحصد مستودعاً عبر OAI-PMH.
لماذا لا يصلح نظام المكتبة للأرشيف؟
الكتاب في المكتبة عمل مستقل، له عنوان ومؤلف وناشر، وتوجد منه نسخ في مكتبات كثيرة، لذلك تصفه المكتبة بتسجيلة MARC21 واحدة، وتستطيع أن تنسخ هذه التسجيلة من مكتبة أخرى كما رأينا في خريطة أنظمة المكتبة، وترتبه على الرف حسب موضوعه. أما الوثيقة في الأرشيف فهي نسخة وحيدة غالباً، ولا عنوان لها في أغلب الأحوال، ومعناها يأتي من الجهة التي أنشأتها ومن الوثائق التي حولها. فمحضر اجتماع واحد من عام 1985 لا يقول لك شيئاً إذا قرأته وحده، أما إذا عرفت أنه من محاضر لجنة المكتبة، وأن اللجنة كانت تدير المكتبة قبل إنشاء العمادة، وأن المحضر الذي بعده يتابع القرار نفسه، فقد أصبح وثيقة لها قيمة للباحث. والصورة التالية تلخص الفرق:
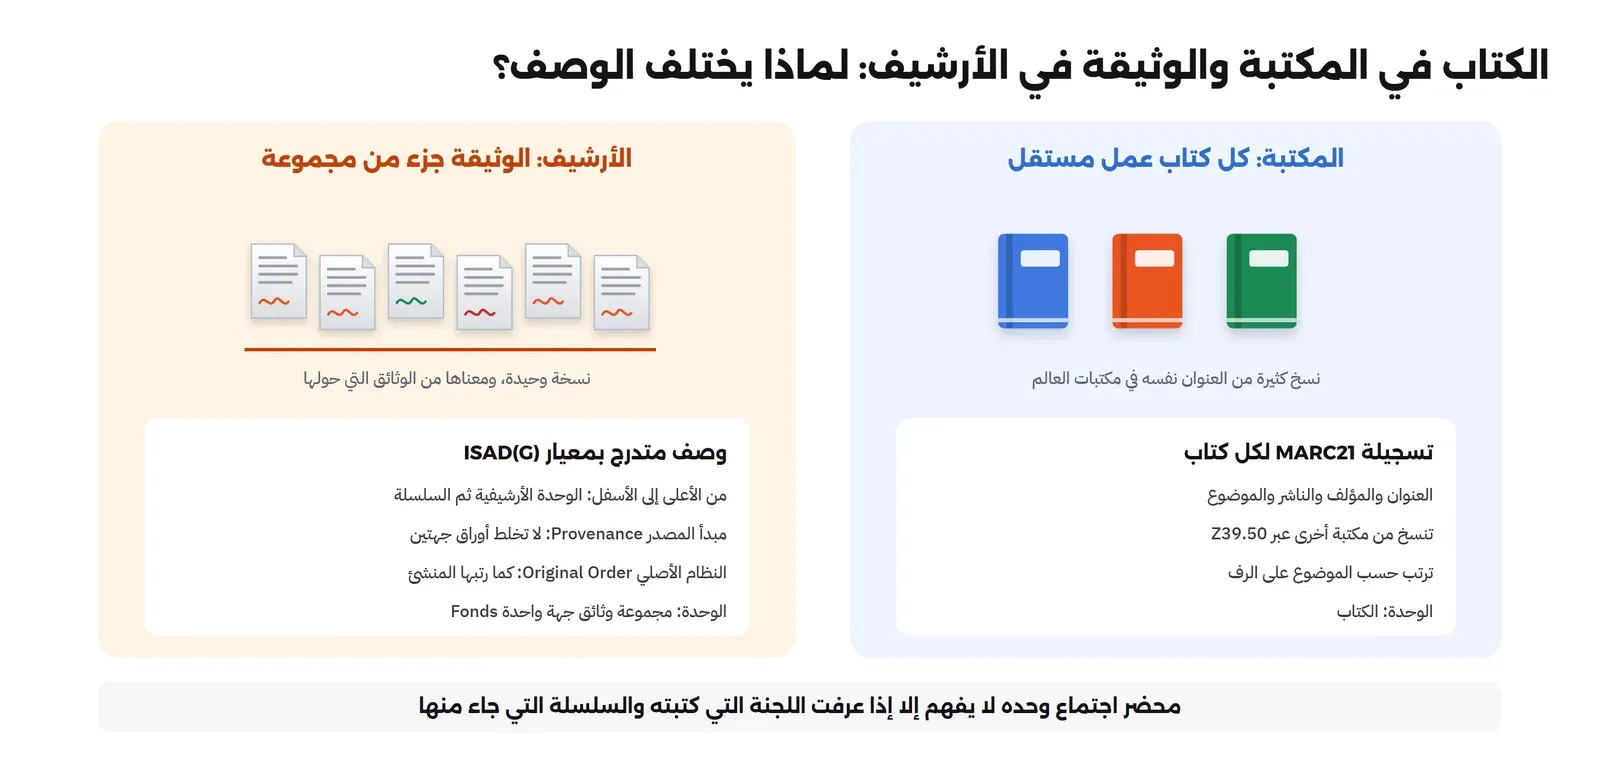
ومن هذا الفرق جاء مبدآن يقوم عليهما علم الأرشيف كله، ويجب أن يعرفهما من يعد أي نظام أرشيفي حتى لو لم يكن أرشيفياً:
- مبدأ المصدر Provenance: وثائق كل جهة تبقى معاً ولا تخلط بوثائق جهة أخرى، حتى لو كان الموضوع واحداً. فمراسلات المكتبة مع الناشرين تبقى في أوراق المكتبة، ولا تنقل إلى ملف «الناشرين» الذي جمعته إدارة المشتريات، والسبب أن الباحث يحتاج أن يعرف من كتب الوثيقة ولماذا.
- النظام الأصلي Original Order: تبقى الوثائق بالترتيب الذي رتبتها به الجهة التي أنشأتها، لأن هذا الترتيب نفسه معلومة عن طريقة عملها، والأرشيفي الذي يعيد الترتيب حسب الموضوع يمحو هذه المعلومة.
ونظام المكتبة مبني على عكس هذين المبدأين: كل تسجيلة مستقلة، والترتيب حسب الموضوع. ونظام المستودع مثل DSpace أقرب قليلاً، ففيه مجتمعات ومجموعات، ولكنه مصمم لإيداع ملفات منشورة مثل الرسائل والأبحاث، وليس لوصف وثائق ورقية لم تنشر، ولا يعرف شيئاً عن مستويات الوصف التي سوف نشرحها الآن.
مستويات الوصف Levels of Description
الأرشيف يصف من الأعلى إلى الأسفل، كما تصف مدينة قبل أن تصف شارعاً فيها. والمستويات المعتادة أربعة، ولها أسماء في الواجهة العربية لـ AtoM سوف تراها في المختبر:
- الوحدة الأرشيفية Fonds: كل وثائق جهة واحدة أو شخص واحد، مثل «أوراق مكتبة الجامعة المركزية» من 1978 إلى 2005. وفي الترجمة العربية لـ AtoM اسمها «الوحدة الأرشيفية».
- السلسلة Series: مجموعة وثائق من نوع واحد أو نشاط واحد داخل الوحدة، مثل «محاضر لجنة المكتبة» أو «الصور الفوتوغرافية».
- الملف File: مجموعة وثائق جمعتها الجهة معاً في ملف واحد، مثل «محاضر عام 1985».
- المفردة Item: وثيقة واحدة، مثل محضر اجتماع بعينه أو صورة بعينها.
وليس مطلوباً أن تصف كل وثيقة. في الواقع أغلب الأرشيفات تصف الوحدة والسلاسل جيداً، وتصف الملفات بعناوين وتواريخ فقط، ولا تنزل إلى المفردة إلا للوثائق المهمة أو المطلوبة كثيراً، والسبب بسيط: أرشيف فيه مئة ألف ورقة لن يصف كل ورقة في عمر موظف واحد. وهذا فرق آخر عن المكتبة، حيث كل كتاب له تسجيلة كاملة.
معيار ISAD(G): ماذا تكتب في كل وصف؟
المعيار الدولي العام للوصف الأرشيفي General International Standard Archival Description، واختصاراً ISAD(G)، أصدره المجلس الدولي للأرشيف ICA، وطبعته الثانية صدرت في 2000 وما زالت المعتمدة. والمعيار لا يحدد شكل النظام ولا قاعدة البيانات، وإنما يحدد ما الذي يجب أن يوجد في الوصف، في 26 عنصراً موزعة على سبعة حقول كما في الصورة التالية:
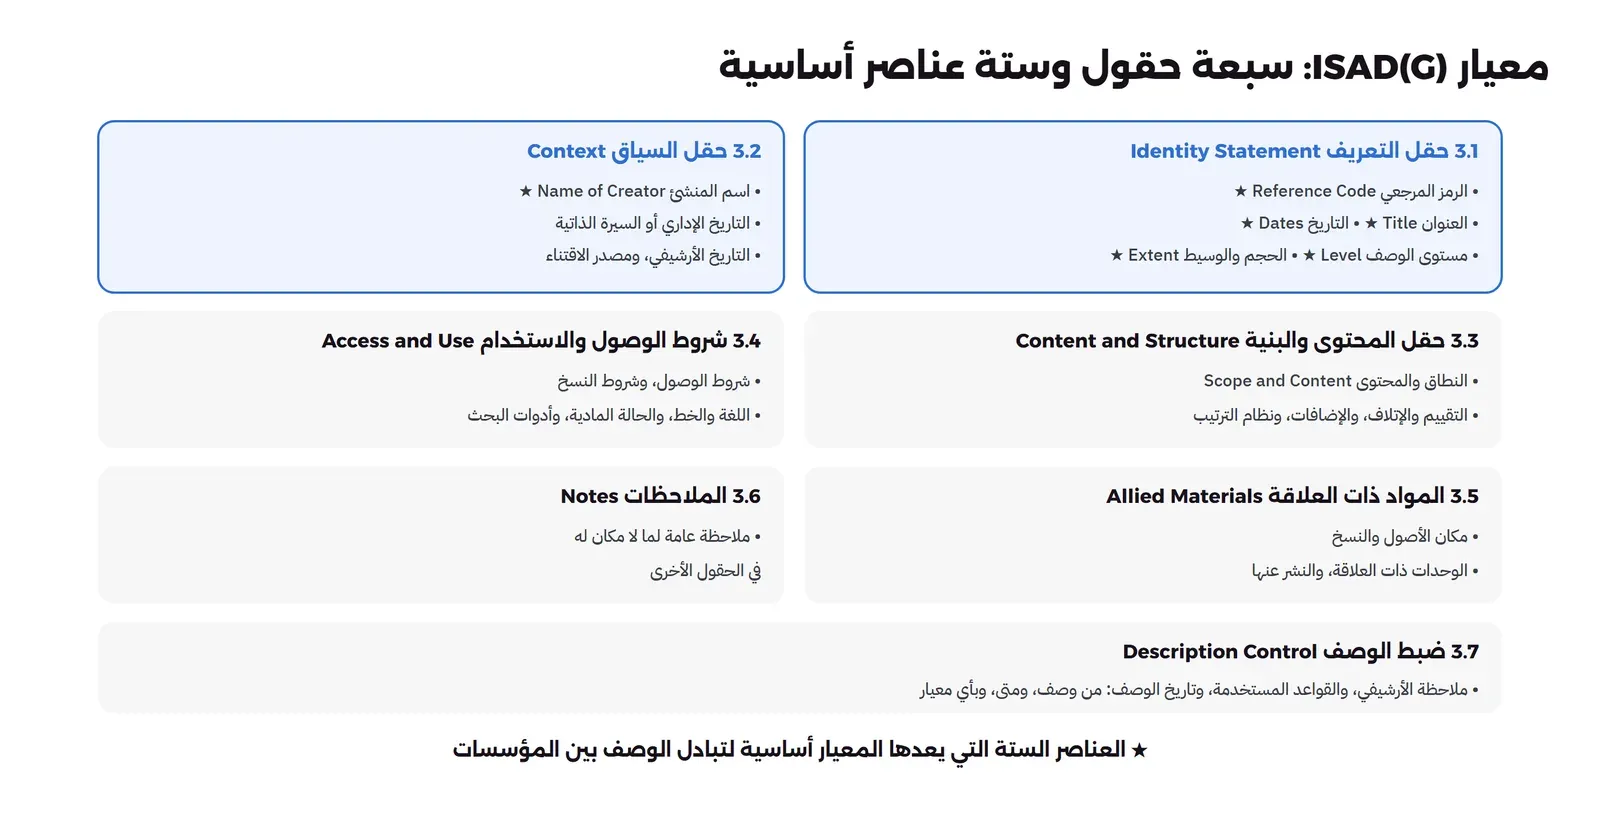
والمعيار يعد ستة عناصر أساسية لتبادل الوصف بين المؤسسات: الرمز المرجعي، والعنوان، والمنشئ، والتاريخ، والحجم، ومستوى الوصف، وهذا هو الحد الأدنى الذي يجب أن يوجد في كل وصف مهما كان مستواه. ومعها أربع قواعد للوصف متعدد المستويات Multilevel Description يجب أن تعرفها لأنها تفسر سلوك الأنظمة:
- من العام إلى الخاص: صف الوحدة أولاً، ثم أجزاءها، فيرث كل مستوى سياق المستوى الذي فوقه.
- المعلومة في مستواها: تاريخ الجهة المنشئة يكتب في الوحدة الأرشيفية، ولا يكرر في كل ملف.
- ربط المستويات: كل وصف يعرف المستوى الذي فوقه، وهذا ما يجعل النظام يبني الشجرة والرمز المرجعي.
- عدم التكرار: لا تكرر في المستوى الأدنى ما كتبته في الأعلى، وإنما ما يختلف فقط.
والقاعدة الثالثة بالذات هي التي سببت لنا مشكلة في المختبر كما سوف ترى، فالنظام بنى الرمز المرجعي من رموز المستويات، ونحن كتبنا الرمز كاملاً في كل مستوى.
المعايير المرافقة وملف التبادل EAD
ISAD(G) يصف الوثائق، ولكن الأرشيف فيه ثلاثة أشياء أخرى تحتاج وصفاً: الجهة أو الشخص الذي أنشأ الوثائق، والمؤسسة التي تحفظها، والوظيفة التي أنتجتها. ولكل منها معيار من المجلس نفسه، ولأكثرها صيغة XML لنقل الوصف بين الأنظمة، والصورة التالية تجمعها:
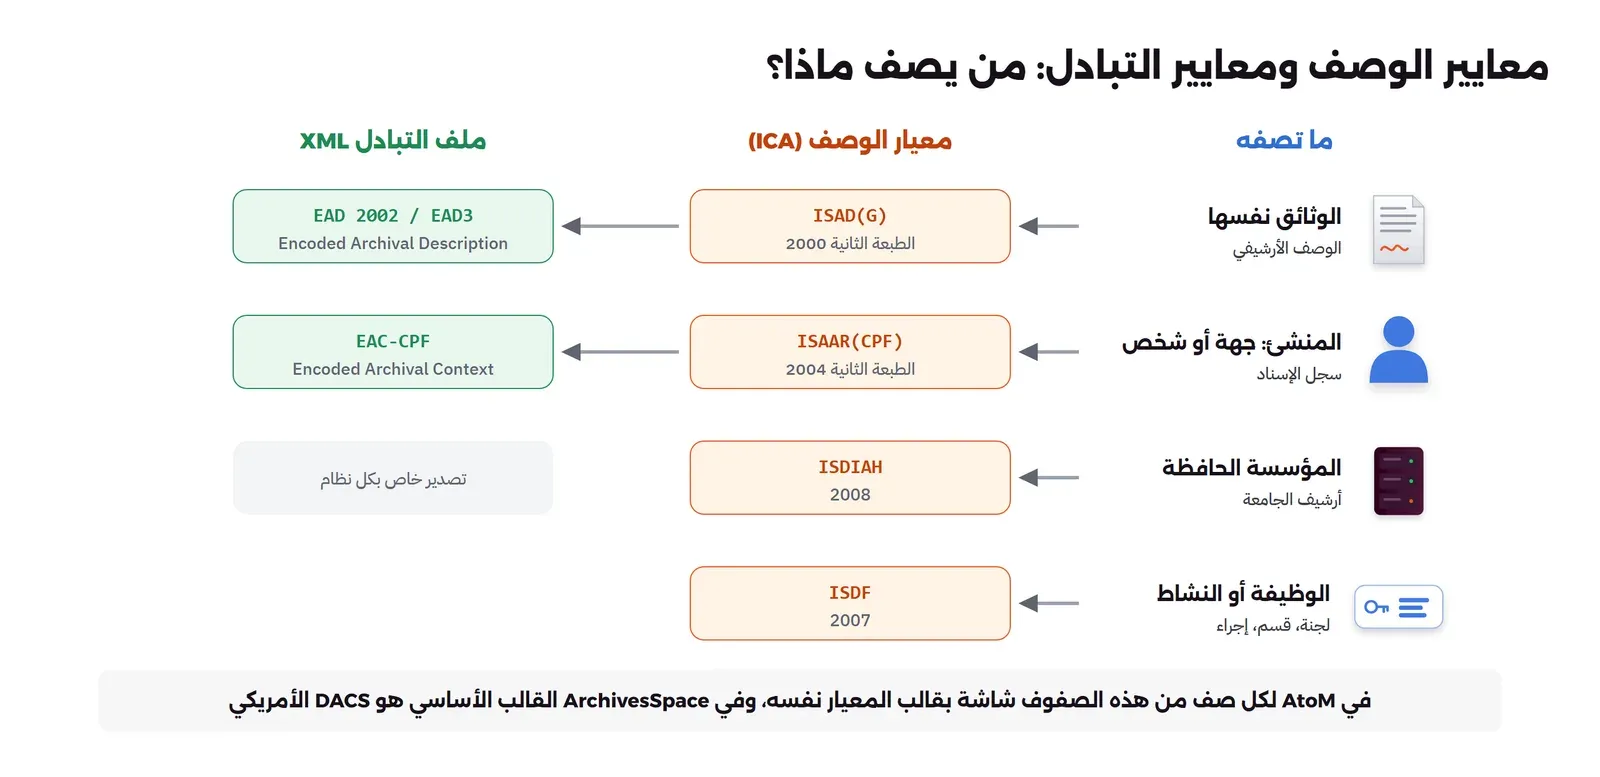
وأهم هذه الصيغ لمن يدير نظاماً هي EAD، أي الوصف الأرشيفي المرمز Encoded Archival Description، وتديرها مكتبة الكونغرس مع جمعية الأرشيفيين الأمريكيين. والنسخة EAD 2002 هي الأكثر انتشاراً في الأنظمة الحالية، وبعدها EAD3. وملف EAD الواحد يحمل الوحدة الأرشيفية كلها بكل مستوياتها في شجرة واحدة، وسوف نرى ملفاً حقيقياً صدره AtoM في المختبر. وقيمة هذه الصيغة كقيمة MARC للمكتبات: الوصف الذي تكتبه اليوم في نظام يمكن أن ينتقل إلى نظام آخر بعد عشر سنوات دون أن تعيد كتابته، بشرط أن يكون الوصف نظيفاً.
أما ملفات الإسناد للأشخاص والجهات، أي التسجيلة الواحدة لـ «مكتبة الجامعة المركزية» التي ترتبط بها كل الوثائق التي أنشأتها، فهي الفكرة نفسها التي في ملفات الإسناد في المكتبات، وصيغتها في الأرشيف EAC-CPF، ولها مقال في مرحلة الفهرسة.
AtoM وArchivesSpace: نظامان لمدرستين
في عالم الأرشيف المفتوح المصدر نظامان يذكران دائماً، وكل منهما ابن مدرسة أرشيفية مختلفة، وهذا أهم من أي مقارنة في الخصائص. AtoM، واسمه الكامل Access to Memory، بدأ مشروعاً للمجلس الدولي للأرشيف نفسه، وتطوره اليوم شركة Artefactual الكندية، ولذلك بني حول معايير المجلس: لكل وصف قالب ISAD(G)، ولكل منشئ قالب ISAAR(CPF)، ولكل مؤسسة قالب ISDIAH، وصمم من البداية ليكون متعدد اللغات، فكل حقل يمكن أن يحمل ترجمته. أما ArchivesSpace فبنته مكتبات جامعية أمريكية، وتديره اليوم منظمة LYRASIS بنموذج عضوية، وقالبه الأساسي هو DACS، أي النسخة الأمريكية من قواعد الوصف، ويهتم كثيراً بإدارة المقتنيات نفسها: الاقتناء، والصناديق، وأماكنها على الرفوف.
| AtoM 2.10 | ArchivesSpace 4.2 | |
|---|---|---|
| المدرسة | معايير المجلس الدولي للأرشيف ISAD(G) وISAAR(CPF) وISDIAH | DACS الأمريكي، مع تصدير EAD وMARCXML وEAC-CPF |
| البنية | PHP 8 مع MySQL وElasticsearch 7، وGearman للمهام الخلفية | JRuby على Java مع MySQL وSolr |
| الواجهة العربية | موجودة ضمن ترجمات المشروع، والواجهة تنقلب من اليمين لليسار كما في صور المختبر | ملفات اللغات في الإصدار 4.2.1 لا تشمل العربية، وفيها العبرية |
| الوصف بعدة لغات | كل حقل له ترجمات، والاستيراد بملف CSV يقبل صف الترجمة تحت الصف الأصلي | حقل لغة للوصف، دون نموذج ترجمة لكل حقل |
| الذاكرة | نحو 1.9GB بعد التشغيل في المختبر، و7GB لبيئة العرض عند Artefactual | 1GB على الأقل حسب توثيق Docker، ويوصي بـ 2GB |
| الدعم التجاري | Artefactual ومزودون آخرون | LYRASIS ومزودون معتمدون |
والخلاصة العملية للأرشيف العربي أن AtoM أقرب لك في أمرين يصعب تعويضهما: الواجهة العربية، والوصف بالعربية والإنجليزية للوحدة نفسها، والثاني مهم للأرشيفات التي يخدم موقعها باحثين من خارج المنطقة. أما ArchivesSpace فيستحق النظر إذا كانت مؤسستك تتبع قواعد DACS، أو كان أكبر همك إدارة الصناديق والمخازن وطلبات الباحثين داخل قاعة الاطلاع، مع العلم أن الواجهة ستكون بغير العربية. وفي هذا المقال شغلنا AtoM وحده، أما ArchivesSpace فقارناه من توثيقه الرسمي وملفات مشروعه.
نقاط القوة ونقاط الضعف في AtoM
- نقاط القوة: قوالب المعايير الدولية جاهزة، وواجهة عربية، ووصف متعدد اللغات لكل حقل، واستيراد وتصدير بصيغ CSV وEAD وEAC-CPF وMODS وDublin Core، وواجهة OAI-PMH للحصاد.
- نقاط الضعف: يحتاج Elasticsearch وذاكرة أكثر من أغلب أنظمة المكتبات، والبحث العربي يحتاج تعديلاً كما سوف نرى، والاستيراد بلغة غير الإنجليزية له فخاخ موثقة جزئياً، وبعض أجزاء الترجمة العربية حرفية مثل «حقل» لكلمة Area.
نقاط القوة ونقاط الضعف في ArchivesSpace
- نقاط القوة: إدارة كاملة للمقتنيات من الاقتناء إلى مكان الصندوق، ومجتمع جامعي كبير، وواجهة عامة للباحثين، وتصدير EAD وMARCXML.
- نقاط الضعف: لا توجد واجهة عربية في ملفات اللغات، والقالب الأساسي DACS وليس ISAD(G)، ومجموعة الخدمات Java وSolr وMySQL ليست أخف من AtoM.
أيهما تختار؟
| حالتك | الأنسب | والسبب |
|---|---|---|
| أرشيف عربي يخدم الباحثين من موقعه بالعربية | AtoM | الواجهة العربية ونموذج الترجمة لكل حقل |
| أرشيف يصف بالعربية والإنجليزية معاً | AtoM | صف الترجمة في CSV، وتبديل الواجهة بين اللغتين |
| مؤسسة تتبع قواعد DACS أو شريكة لجامعات أمريكية | ArchivesSpace | القالب نفسه، وتبادل أسهل مع شركائها |
| همك الأكبر الصناديق والمخازن وطلبات قاعة الاطلاع | ArchivesSpace | إدارة المقتنيات فيه أعمق |
| أرشيف صغير، وموظف تقنية واحد مشترك | AtoM مستضاف عند مزود، أو البدء بجداول منظمة بأعمدة ISAD(G) | النظامان يحتاجان من يدير Elasticsearch أو Solr ويتابع التحديثات |
والصف الأخير مهم أكثر مما يبدو. فالجدول المنظم الذي أعمدته عناصر ISAD(G) الستة ليس نظاماً، ولكنه ينتقل غداً إلى AtoM بملف CSV كما سوف ترى في المختبر، بينما النظام الذي ثبت ثم ترك دون تحديث أو نسخ احتياطي يصبح مشكلة أمنية ومخاطرة على الوصف نفسه.
قبل النظام: من الصناديق إلى خطة الوصف
أكثر مشاريع الأرشيف التي تتعثر تبدأ من النظام، فيثبت الفريق AtoM في الأسبوع الأول، ثم يكتشف بعد شهر أنه لا يعرف ما في الصناديق، ولا من أين يبدأ. والترتيب الأصح أن يسبق العمل الأرشيفي العمل التقني بخطوات بسيطة يستطيع أي موظف مكتبة أن يقوم بها:
- الحصر Survey: جدول بسيط لكل صندوق: رقمه، والجهة التي جاء منها، والفترة التقريبية، ونوع الوثائق، وحالتها المادية. والهدف أن تعرف حجم ما عندك، وليس أن تصف شيئاً بعد.
- تحديد الوحدات الأرشيفية: من الحصر تظهر الجهات المنشئة، وكل جهة وحدة أرشيفية، حتى لو كانت أوراقها موزعة على صناديق كثيرة. وهنا يطبق مبدأ المصدر: لا تجمع وثائق جهتين في وحدة واحدة لأنها في صندوق واحد.
- الأولويات: ما الذي يطلبه الباحثون أكثر، وما الذي حالته المادية أسوأ، وما الذي فيه قيود قانونية مثل البيانات الشخصية. والوحدات الأعلى أولوية توصف أولاً، وتوصف لمستوى أعمق.
- سجلات الإسناد: قائمة بالجهات والأشخاص المنشئين بأسمائهم المعتمدة وتواريخهم، لأنها تتكرر في كل وصف، وكتابتها مرة واحدة تمنع أن يكتب الاسم بعدة أشكال.
- الوصف ثم النظام: وصف الوحدات والسلاسل في جدول بأعمدة القالب، ثم الاستيراد، ثم ينزل الوصف إلى الملفات والمفردات تدريجياً.
وبهذا الترتيب يصبح النظام أداة لعمل واضح، وليس مشروعاً في حد ذاته، ويكون أول ما يراه الباحث في الموقع وصفاً كاملاً لعدد قليل من الوحدات، بدلاً من مئات الأوراق بعناوين مثل «وثيقة 1» و«وثيقة 2».
المختبر: AtoM 2.10.2 من ملف Docker Compose الرسمي
شركة Artefactual تنشر ملف Docker Compose رسمياً داخل مستودع المشروع في المجلد docker، وهو مكتوب لبيئة التطوير، ولكنه أسرع طريق لترى النظام كاملاً بكل خدماته على جهازك. والإصدار الذي جربناه هو AtoM 2.10.2 الصادر في 24 أغسطس 2026. أما للإنتاج فالتوثيق يشرح التثبيت على Ubuntu مباشرة، ويطلب في صفحة المتطلبات PHP 8 وMySQL 8 وElasticsearch 7، ويذكر أن بيئة العرض عند Artefactual نفسها تعمل بذاكرة 7GB.
بناء الـ Image من وسم الإصدار
الطريقة الموثقة أن تنسخ المستودع بالأمر git clone ثم تشغل Compose من داخله. وعلى Windows فشل النسخ نفسه، لأن بعض المسارات داخل مكتبة Symfony القديمة التي يعتمد عليها AtoM أطول من الحد الذي يقبله Windows، فظهرت رسائل Filename too long وتوقف الـ checkout. والحل الذي لا يحتاج تغيير إعدادات النظام أن تبني الـ Image مباشرة من رابط المستودع ووسم الإصدار، فيقوم Docker بالنسخ داخل بيئة Linux:
docker build -t lb3-atom:2.10.2 "https://github.com/artefactual/atom.git#v2.10.2"واستغرق البناء دقائق، لأن الـ Dockerfile يبني إضافات PHP من المصدر ثم يثبت حزم Composer وnpm ويبني ملفات الواجهة بـ webpack، وكان حجم الـ Image الناتج 2.66GB. ثم نزلنا من المستودع ملف Compose الرسمي ومجلد etc الذي معه فقط، وكتبنا ملف Override صغيراً يجعل الخدمات تستخدم الـ Image الذي بنيناه، ويضع الكود في Volume مشترك بين الخدمات بدلاً من ربطه بمجلد على Windows، ولا ينشر على الجهاز إلا المنفذ الخاص بـ nginx:
# lb3 override of the official docker-compose.dev.yml (AtoM 2.10.2):
# the AtoM image is built from the release tag, the source inside it is shared through a named volume,
# and only nginx is published on the host.
volumes:
  atom_src:
services:
  atom:
    build: !reset null
    image: lb3-atom:2.10.2
    volumes: !override
      - atom_src:/atom/src
  atom_worker:
    build: !reset null
    image: lb3-atom:2.10.2
    volumes: !override
      - atom_src:/atom/src
  nginx:
    volumes: !override
      - atom_src:/atom/src:ro
      - ./etc/nginx/nginx.conf:/etc/nginx/nginx.conf:ro
    ports: !override
      - "127.0.0.1:63101:80"
  elasticsearch:
    ports: !reset []
  percona:
    # MySQL 8.4 (already on this machine) instead of the 2.2 GB percona-server:8.4 image; same server family
    image: lb3-mysql:8.4
    # mysqld ignores a world-writable my.cnf (every bind mount from Windows is 777), so pass the same settings as flags
    command: >-
      --character-set-server=utf8mb4 --collation-server=utf8mb4_0900_ai_ci
      --sql-mode=STRICT_TRANS_TABLES,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION
      --optimizer-switch=block_nested_loop=off
    volumes: !override
      - percona_data:/var/lib/mysql:rw
    ports: !reset []
  memcached:
    ports: !reset []
  gearmand:
    ports: !reset []
في الملف أعلاه لاحظ التالي:
- الوسوم !override و!reset: من Docker Compose نفسه، وتستبدل القائمة في الملف الرسمي بدلاً من أن تضيف إليها، فبقي الملف الرسمي كما هو دون تعديل.
- الـ Volume المسمى atom_src: عند أول تشغيل ينسخ Docker محتوى المجلد
/atom/srcمن الـ Image إلى الـ Volume الفارغ، فيقرأ nginx الملفات الثابتة نفسها التي ينفذها PHP. - MySQL بدلاً من Percona: الملف الرسمي يستخدم
percona/percona-server:8.4، وحجمه على الجهاز 2.2GB، فاستبدلناه بـmysql:8.4الموجود على الجهاز أصلاً، وهو من عائلة الخادم نفسها، وهذا تغيير لظروف المختبر وليس توصية.
ماذا يحدث إذا ربطت ملف إعداد MySQL من Windows؟
في المحاولة الأولى ربطنا ملف mysqld.cnf الرسمي كما هو، وفيه إعداد الترميز utf8mb4 وقيمة sql_mode التي يحتاجها AtoM، فعمل كل شيء، ثم وجدنا هذا السطر في سجل قاعدة البيانات:
percona-1 | mysqld: [Warning] World-writable config file '/etc/mysql/conf.d/mysqld.cnf' is ignored.والسبب أن كل ملف يربط من Windows إلى Container يظهر داخل Linux بصلاحيات 777، أي أن أي مستخدم يستطيع تعديله، وMySQL يرفض لأسباب أمنية أن يقرأ ملف إعداد يستطيع أي أحد أن يغيره، فيتجاهله بتحذير فقط ويكمل التشغيل. وبالتالي كانت قاعدة البيانات تعمل بالقيمة الافتراضية لـ sql_mode، وفيها ONLY_FULL_GROUP_BY وNO_ZERO_DATE اللذان حذفهما AtoM عن قصد من إعداده. والأخطر أن هذا لا يسبب خطأ عند التشغيل، وإنما قد يظهر بعد أسابيع في استعلام بعينه. لذلك نقلنا الإعدادات نفسها إلى سطر الأوامر في ملف Override كما رأيت، وتحققنا بعدها:
@@sql_mode
STRICT_TRANS_TABLES,ERROR_FOR_DIVISION_BY_ZERO,NO_ENGINE_SUBSTITUTION
وإذا كنت تشغل أي قاعدة بيانات MySQL أو MariaDB على Docker Desktop في Windows، فابحث في سجلها عن كلمة ignored بعد أول تشغيل.
التشغيل وإنشاء قاعدة البيانات
بعد ذلك شغلنا الخدمات، ثم أنشأنا قاعدة البيانات وفهرس البحث بالأمر الذي يذكره التوثيق الرسمي:
export COMPOSE_FILE="docker-compose.dev.yml;docker-compose.lb3.yml" COMPOSE_PATH_SEPARATOR=";"
docker compose -p lb3-atom up -d
docker compose -p lb3-atom exec atom php -d memory_limit=-1 symfony tools:purge --demo
docker compose -p lb3-atom restart atom_worker
والأمر tools:purge --demo ينشئ الجداول، ويحمل المصطلحات الأساسية بلغاتها، وينشئ الفهرس، وينشئ مستخدماً تجريبياً بريده [email protected] وكلمة مروره demo، وآخر سطر في مخرجه:
>> purge     Creating search index
>> purge     Adding site configuration
>> purge     Creating admin user
>> purge     Purge completed
والصورة التالية تبين الخدمات السبع التي تعمل، مع الذاكرة التي قسناها بالأمر docker stats بعد الاستيراد:
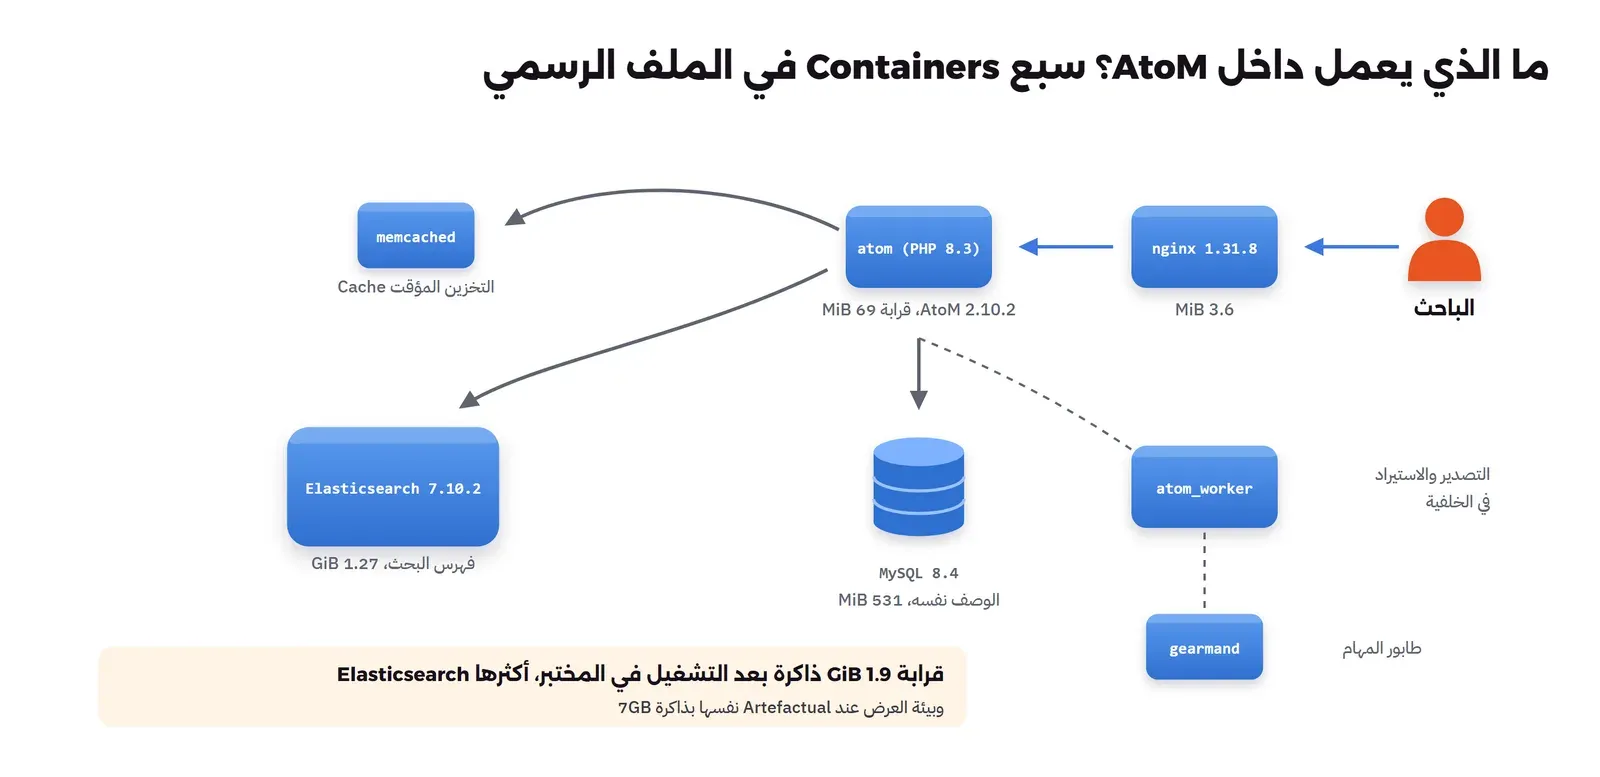
في الصورة أعلاه لاحظ التالي:
- البيانات في مكانين: الوصف نفسه في MySQL، ونسخة منه للبحث في Elasticsearch. والأول هو الذي تأخذ منه النسخة الاحتياطية، أما الثاني فيعاد بناؤه بالأمر
search:populateفي ثوان لأرشيف صغير. - العامل Worker: التصدير والاستيراد من الواجهة، وإنشاء الصور المصغرة للملفات الرقمية، كلها مهام ترسل إلى gearmand وينفذها
atom_worker، فإذا توقف بقيت المهام معلقة في الواجهة دون خطأ واضح.
تفعيل الواجهة العربية
العربية موجودة ضمن ترجمات AtoM، ولكنها ليست مفعلة افتراضياً. دخلنا بالمستخدم التجريبي، ومن الإعدادات Settings ثم اللغات I18n languages أضفنا العربية، ثم فتحنا الموقع بالرابط /?sf_culture=ar. ففتحت الواجهة بالعربية، ولكن صفحة تصفح الأوصاف ردت بهذه الرسالة:
واجه خطأ في البحث
خطأ إلاستيك سيرش: Elastica\Exception\ResponseException
والسبب أن فهرس Elasticsearch أنشئ عند tools:purge، وفيه حقول لكل لغة كانت مفعلة وقتها: الإنجليزية والفرنسية والإسبانية والهولندية والبرتغالية. فعندما طلبت الواجهة العربية البحث في حقول i18n.ar، لم يجدها Elasticsearch في الفهرس. والحل أن تعيد بناء الفهرس بعد إضافة أي لغة:
docker compose -p lb3-atom exec atom php -d memory_limit=-1 symfony search:populateوبعدها ظهرت في الفهرس حقول عربية تستخدم محللاً اسمه arabic، وعملت الصفحة. ولاحظ هذا الاسم، فسوف نعود إليه في قسم البحث.
وصف وحدة أرشيفية بملف CSV
تستطيع أن تصف الوحدة من الواجهة حقلاً حقلاً، ولكن أغلب الأرشيفات التي تنتقل من جداول Excel إلى AtoM تبدأ بالاستيراد من CSV، وهو موثق في صفحة استيراد CSV مع قالب جاهز لمعيار ISAD(G)، كل عمود فيه يقابل عنصراً في المعيار. وكتبنا وحدة أرشيفية تعليمية لمكتبة جامعة افتراضية، من أربعة مستويات وثماني أوصاف، وهذه أهم أعمدتها:
legacyId,parentId,identifier,levelOfDescription,title,eventDates,eventTypes,culture
1,,UA-LIB,الوحدة الأرشيفية,أوراق مكتبة الجامعة المركزية,1978-2005,إنشاء,ar
2,1,S1,سلسلة,محاضر لجنة المكتبة,1978-2005,إنشاء,ar
3,2,F1985,ملف,محاضر عام 1985,1985,إنشاء,ar
4,3,01,مفردة,محضر الاجتماع الأول لعام 1985: إنشاء نظام الإعارة الآلي,12 فبراير 1985,إنشاء,ar
5,1,S2,سلسلة,المراسلات مع الناشرين والموردين,1980-2000,إنشاء,ar
6,5,F03,ملف,مراسلات الاشتراك في الدوريات الأجنبية,1986-1991,إنشاء,ar
7,1,S3,سلسلة,الصور الفوتوغرافية,1978-1999,إنشاء,ar
8,7,0092,مفردة,افتتاح مبنى المكتبة الجديد,1992,إنشاء,ar
في الملف أعلاه لاحظ التالي:
- legacyId وparentId: رقم كل صف ورقم الصف الأب، وبهما يبني AtoM الشجرة: السلسلة 2 أبوها الوحدة 1، والملف 3 أبوه السلسلة 2، وهكذا.
- identifier: رمز المستوى نفسه فقط، S1 وF1985 و01، وسوف ترى بعد قليل لماذا لم نكتب الرمز كاملاً.
- culture: لغة الوصف، والقيمة
arتجعل النصوص تحفظ عربية أصلاً، وليست ترجمة لوصف إنجليزي. - levelOfDescription وeventTypes: مكتوبة بالعربية كما هي في AtoM، أي «الوحدة الأرشيفية» و«سلسلة» و«إنشاء». وهذا ليس اختياراً جمالياً، وإنما هو الدرس الأول من المختبر.
وفي الملف أعمدة أخرى كثيرة: النطاق والمحتوى، والتاريخ الإداري للجهة المنشئة، والتاريخ الأرشيفي، ومصدر الاقتناء، وشروط الوصول والنسخ، واللغة والخط، ورؤوس الموضوعات، والقواعد المستخدمة في الوصف. والملف كاملاً في مجلد المختبر lab/fonds-ar.csv.
الاستيراد الأول: مصطلحات بالإنجليزية في وصف عربي
في المحاولة الأولى كتبنا قيم الأعمدة التي تأتي من قوائم ثابتة بالإنجليزية كما في القالب الرسمي: Fonds وSeries وFull وFinal وPublished وCreation، مع culture بقيمة ar. واستوردنا الملف:
docker cp fonds-ar.csv lb3-atom-atom-1:/tmp/fonds-ar.csv
docker compose -p lb3-atom exec atom php symfony csv:import /tmp/fonds-ar.csv
والمخرج سوف يكون كما يلي، وهذا أوله:
Term Full not found in description details level taxonomy, creating it...

Term Final not found in description status taxonomy, creating it...

Publication status: 'Published' is invalid. Using default.
.
Publication status: 'Published' is invalid. Using default.
أي أن AtoM بحث عن «Full» في أسماء المصطلحات العربية فلم يجدها، فأنشأ مصطلحاً عربياً جديداً اسمه «Full»، وكذلك «Final»، أما حالة النشر فرفضها ووضع القيمة الافتراضية «مسودة»، فأصبحت الأوصاف كلها مسودات لا يراها الزوار. ولم يظهر أي تحذير عن مستوى الوصف ونوع الحدث، فظننا أنها صحيحة، ثم سألنا قاعدة البيانات عن المصطلحات بلغتيها:
id	taxonomy_id	en	ar
233	31	Full	كامل (مُكتملة)
234	31	Partial	جزئي
235	31	Minimal	حد أدنى
451	31	NULL	Full
230	33	Final	نهائي
231	33	Revised	مُنقَح
232	33	Draft	مسودة
452	33	NULL	Final
236	34	Fonds	الوحدة الأرشيفية
237	34	Subfonds	وحدة أرشيفية فرعية
238	34	Collection	مجموعة أرشيفية
239	34	Series	سلسلة
240	34	Subseries	سلسلة فرعية
241	34	File	ملف
242	34	Item	مفردة
299	34	Part	جزء
434	34	Record group	مجموعة وثائقية
449	34	NULL	Fonds
461	34	NULL	Series
464	34	NULL	File
467	34	NULL	Item
159	60	Draft	مسودة
160	60	Published	نشرت
في الجدول أعلاه لاحظ التالي:
- المصطلحات الأصلية: لكل مصطلح اسم إنجليزي واسم عربي في السطر نفسه، مثل 236 «Fonds» و«الوحدة الأرشيفية»، و241 «File» و«ملف».
- المصطلحات الجديدة: الأسطر 449 و461 و464 و467 لها اسم عربي فقط هو الكلمة الإنجليزية نفسها، أي أن الاستيراد أنشأ مستوى وصف جديداً اسمه «Fonds» بجانب «الوحدة الأرشيفية» دون أي تحذير.
- الأثر: قائمة مستويات الوصف في الواجهة أصبحت فيها الكلمتان، والتصفح حسب المستوى يقسم الأوصاف على مصطلحين، والتصدير إلى EAD لا يعرف أن «Fonds» العربي هو المستوى
fonds.
والدرس الذي يجب أن تخرج به: قيم القوائم الثابتة في CSV تكتب بلغة العمود culture، فإذا كان الوصف عربياً فاكتب «الوحدة الأرشيفية» و«سلسلة» و«ملف» و«مفردة» و«نشرت» و«إنشاء» كما تظهر في الواجهة العربية. وقبل أي استيراد كبير اعرض المصطلحات بلغتيها كما فعلنا، أو جرب ملفاً من عشرة صفوف على نسخة اختبار. وحذفنا قاعدة البيانات وأعدنا الاستيراد بالقيم العربية، فانتهى دون أي تحذير.
الرمز المرجعي الذي تكرر
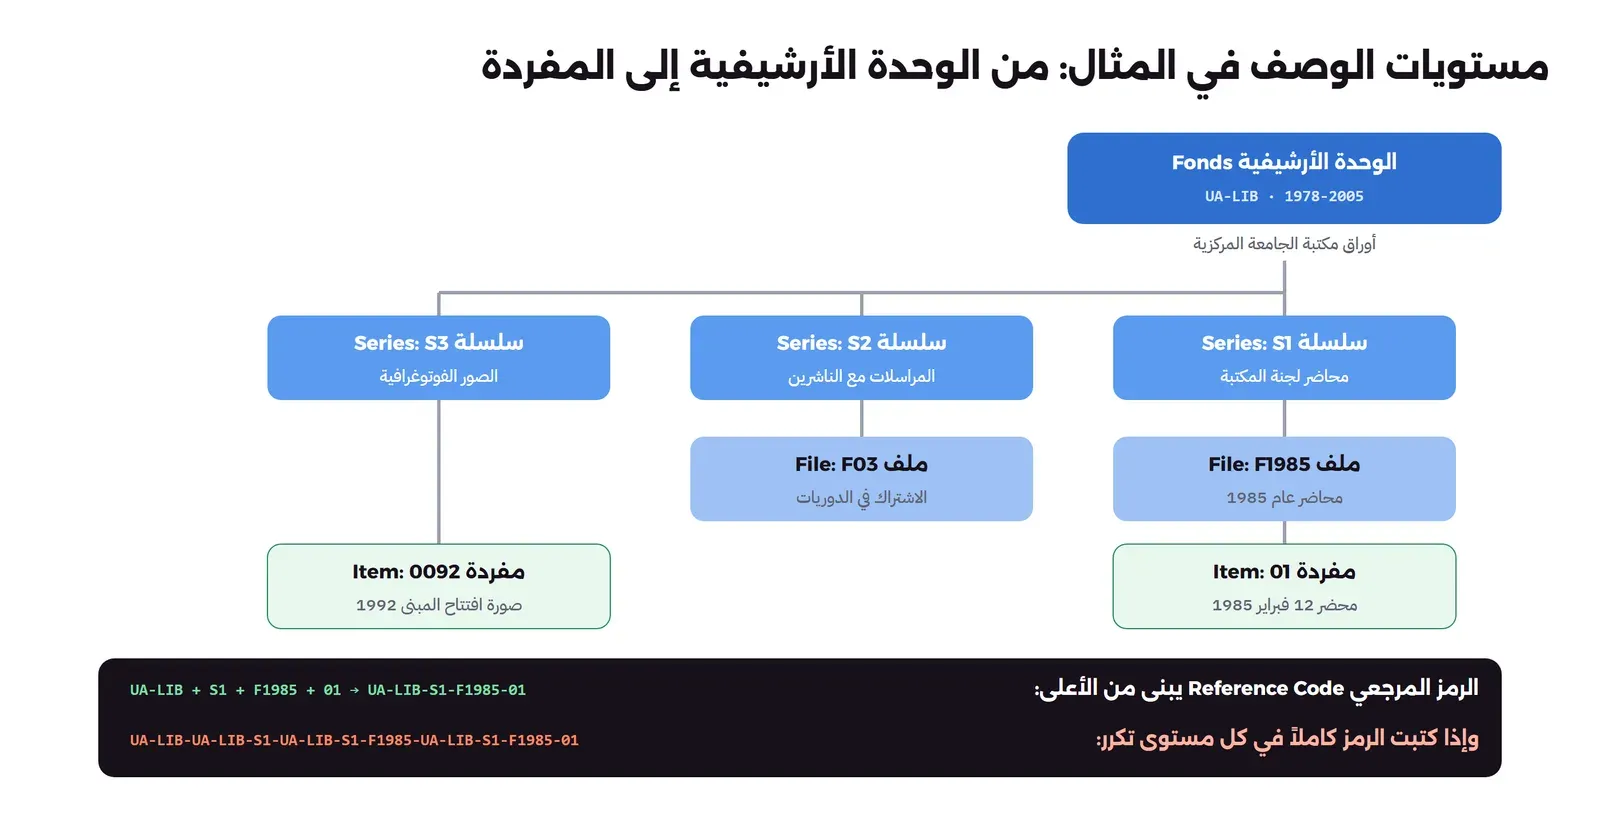
في المحاولة الثانية كتبنا الرمز المرجعي كاملاً في كل مستوى، كما يكتبه أغلب الناس في جدول Excel: UA-LIB للوحدة، وUA-LIB-S1 للسلسلة، وUA-LIB-S1-F1985 للملف. ثم صدرنا الوحدة إلى EAD، فوجدنا رمز المحضر بهذا الشكل:
<unitid encodinganalog="3.1.1">UA-LIB-UA-LIB-S1-UA-LIB-S1-F1985-UA-LIB-S1-F1985-01</unitid>والسبب قاعدة الوصف متعدد المستويات نفسها: AtoM يبني الرمز المرجعي لكل وصف من رمز أبيه ثم رمزه هو، وهذا السلوك مفعل افتراضياً. فإذا كتبت الرمز الكامل في كل مستوى، تكرر في كل خطوة. والصحيح أن تكتب في كل مستوى الجزء الخاص به فقط، والنظام يركبه، كما في الصورة التالية:
وفي المحاولة نفسها لاحظنا في ملف EAD أن الجهة المنشئة لم تظهر في عنصر origination، وإنما في نقاط الوصول بدور فارغ role=""، ولم يظهر تاريخها الإداري. والسبب أن العمود eventTypes كان ما زال Creation بالإنجليزية، فأنشأ AtoM نوع حدث عربياً جديداً اسمه «Creation»، فلم يعرف أن هذه الجهة هي المنشئ. أي أن الدرس الأول نفسه ظهر مرة ثانية في عمود نسيناه، ولم يكتشفه إلا التصدير. لذلك صدر أول وحدة تستوردها إلى EAD واقرأ الملف، فهو يريك كيف فهم النظام بياناتك.
الوصف كما يراه الباحث
بعد الاستيراد الثالث بالقيم الصحيحة، وإعادة بناء الفهرس، هذه صفحة الوحدة الأرشيفية بالواجهة العربية:
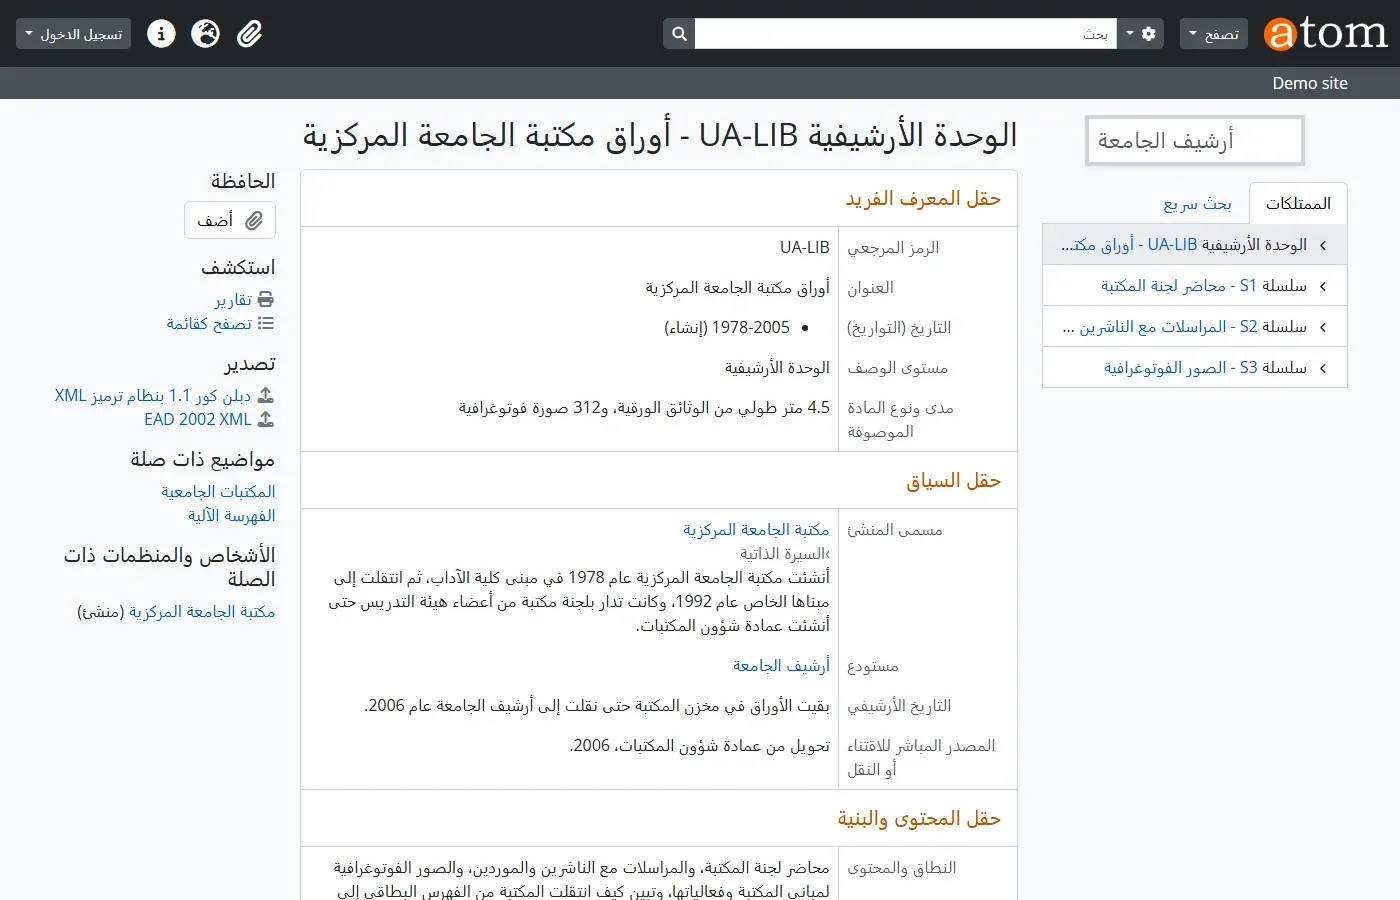
في الصفحة أعلاه لاحظ التالي:
- الحقول بترتيب المعيار: «حقل المعرف الفريد» هو حقل التعريف 3.1، و«حقل السياق» هو 3.2، و«حقل المحتوى والبنية» هو 3.3. والترجمة العربية استخدمت «حقل» لكلمة Area، فإذا كان الأرشيفيون عندك يستخدمون مصطلحاً آخر فالترجمة قابلة للتعديل من الواجهة كما في توثيق ترجمة الواجهة.
- الشجرة: على اليمين شجرة المقتنيات، والباحث يتنقل فيها من الوحدة إلى السلسلة إلى الملف دون بحث.
- التصدير للعموم: رابطا Dublin Core وEAD 2002 ظاهران لأي زائر، فأي نظام آخر يستطيع أن يأخذ الوصف بصيغة قياسية.
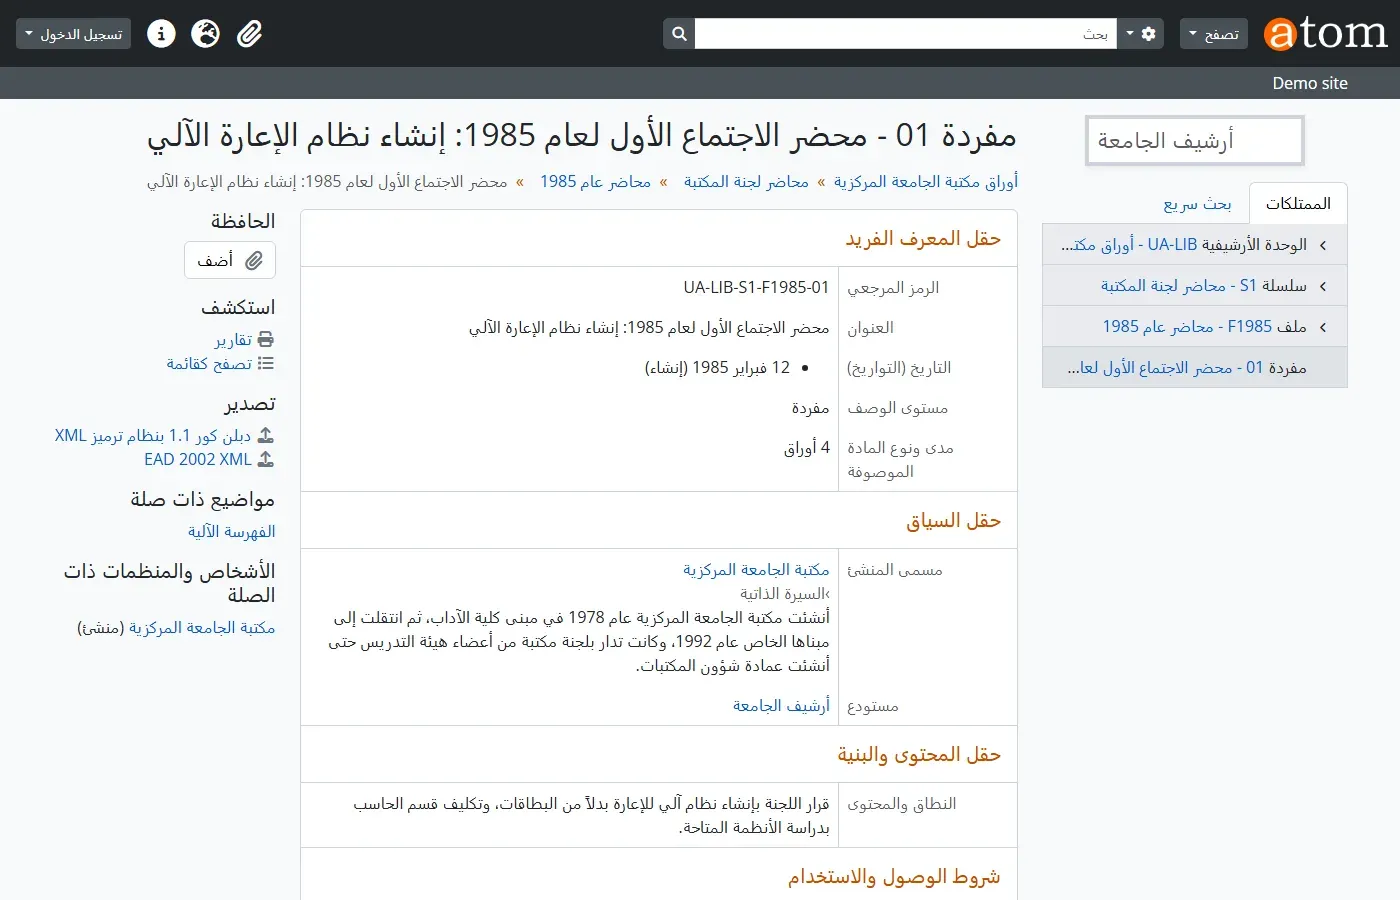
وهذه صفحة المحضر، أي المفردة في أدنى الشجرة، ولاحظ مسار التنقل فوق الحقول، والرمز المرجعي المركب UA-LIB-S1-F1985-01، والمنشئ الذي ورثته من الوحدة:
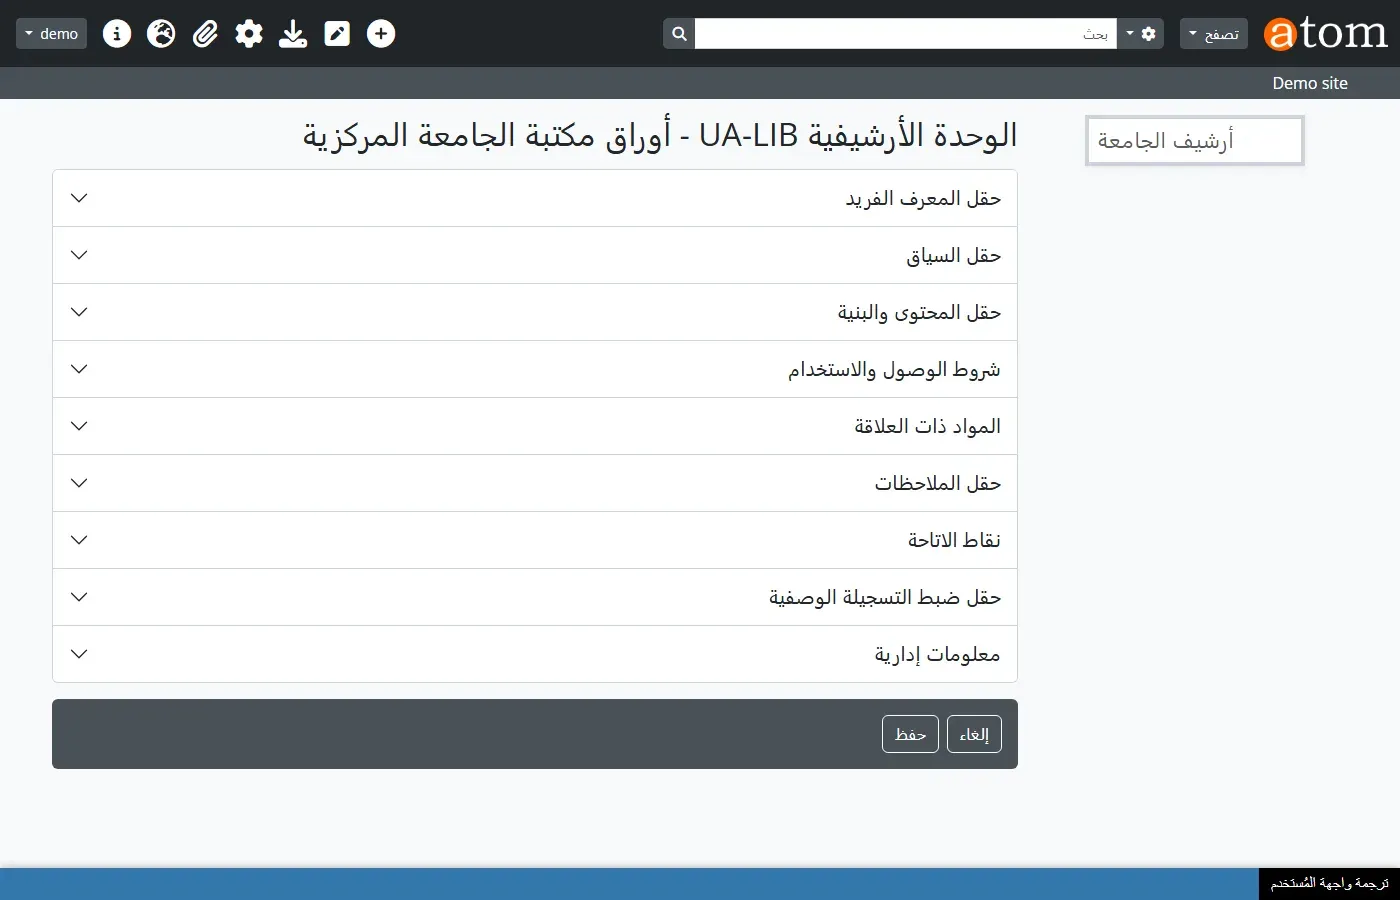
وشاشة التعديل لأي وصف مقسمة بالحقول نفسها، كل حقل في قسم يفتح ويغلق، وهذه هي الصورة التي سوف يعمل عليها الأرشيفي يومياً:
وصف واحد بلغتين
كثير من الأرشيفات العربية يزورها باحثون لا يقرؤون العربية، والحل في AtoM ليس وصفين منفصلين، وإنما وصف واحد له ترجمة. وتوثيق استيراد CSV يشرح الطريقة: صف بالعربية، وتحته مباشرة صف بالرقم نفسه في legacyId ولغة أخرى في culture، وفيه الحقول المترجمة فقط. وجربنا ذلك بوحدة ثانية:
legacyId,parentId,identifier,title,levelOfDescription,scopeAndContent,repository,eventDates,eventTypes,eventStartDates,eventEndDates,publicationStatus,culture
101,,UA-PRES,أوراق مكتب رئيس الجامعة,الوحدة الأرشيفية,القرارات والتعاميم والمراسلات الصادرة من مكتب رئيس الجامعة.,أرشيف الجامعة,1975-2000,إنشاء,1975-01-01,2000-12-31,نشرت,ar
101,,,Records of the University President's Office,,"Decisions, circulars and correspondence issued by the University President's Office.",,,,,,,en
وبعد الاستيراد وإعادة بناء الفهرس، كان في قاعدة البيانات عنوانان للوصف نفسه بالـ slug نفسه:
slug	culture	title
49az-rbfx-ewn3	ar	أوراق مكتب رئيس الجامعة
49az-rbfx-ewn3	en	Records of the University President's Office
ثم بحثنا من الواجهتين:
interface=ar query=مكتب رئيس  results=1 ['أوراق مكتب رئيس الجامعة']
interface=en query=University results=1 ["Records of the University President's Office"]
interface=en query=Office     results=1 ["Records of the University President's Office"]
interface=ar query=Office     results=1 ['أوراق مكتب رئيس الجامعة']
في النتائج أعلاه لاحظ التالي:
- العنوان يتبع الواجهة: الباحث في الواجهة الإنجليزية يرى العنوان الإنجليزي، والباحث في الواجهة العربية يرى العربي، والرابط واحد.
- البحث يعبر اللغتين: كلمة Office من الواجهة العربية وجدت الوصف وعرضته بعنوانه العربي، لأن البحث يمر على حقول كل اللغات.
- ملاحظة صغيرة: كلمة President وحدها لم تجد الوصف، لأن العنوان فيه President's بعلامة الملكية، والمحلل الإنجليزي في AtoM يبقيها كلمة واحدة. وهذا تذكير بأن كل لغة لها مشكلاتها في البحث، وليست العربية وحدها.
البحث العربي: ما لا يجده AtoM
الآن الاختبار الذي يهم الباحث العربي. كتبنا سكربتاً صغيراً يفتح الواجهة العربية، ويبحث بكل كلمة، ويعد النتائج من الأوصاف الثمانية:
"""Count AtoM search results per query in the Arabic interface: python search.py BASE q1 q2 ..."""
import sys, re, urllib.request, urllib.parse, http.cookiejar
base, qs = sys.argv[1], sys.argv[2:]
op = urllib.request.build_opener(urllib.request.HTTPCookieProcessor(http.cookiejar.CookieJar()))
op.open(base + "/?sf_culture=ar").read()
sys.stdout.reconfigure(encoding="utf-8")
for q in qs:
    u = base + "/informationobject/browse?" + urllib.parse.urlencode({"topLod": 0, "query": q})
    html = op.open(u).read().decode("utf-8")
    titles = re.findall(r'class="search-result[^"]*".*?<a[^>]*>\s*([^<]+?)\s*</a>', html, re.S)
    print(f"{q:<14} {len(titles)}  " + " | ".join(t[:28] for t in titles[:3]))
وفي أول تجربة كتبنا السكربت بالأمر curl من سطر أوامر Windows، فأعادت كل كلمة عربية من خمسة حروف ثمانية نتائج، حتى كلمة «زرافة» التي لا توجد في أي وصف. والسبب لم يكن في AtoM، وإنما في أن curl على Windows حول الكلمة العربية إلى علامات استفهام ????? بسبب ترميز سطر الأوامر، وعلامة الاستفهام في لغة البحث تعني «أي حرف»، فطابقت كل كلمة من خمسة حروف. وظهر هذا في سجل Elasticsearch، فأعدنا كتابة السكربت بلغة Python التي ترسل UTF-8 صحيحاً. لذلك إذا اختبرت البحث العربي من سطر الأوامر، فتأكد أولاً أن الكلمة وصلت كما هي.
وهذه نتائج السكربت الصحيح، الكلمة ثم عدد النتائج ثم أول العناوين:
زرافة          0
إنشاء          1  محضر الاجتماع الأول لعام 198
انشاء          0
الإنشاء        0
محضر           1  محضر الاجتماع الأول لعام 198
المحاضر        0
محاضر          3  محاضر عام 1985 | محاضر لجنة المكتبة | أوراق مكتبة الجامعة المركزية
الدوريات       2  مراسلات الاشتراك في الدوريات | المراسلات مع الناشرين والمور
الدورية        1  محاضر لجنة المكتبة
مكتبة          8  أوراق مكتبة الجامعة المركزية | افتتاح مبنى المكتبة الجديد | محضر الاجتماع الأول لعام 198
المكتبة        5  محاضر لجنة المكتبة | الصور الفوتوغرافية | أوراق مكتبة الجامعة المركزية
مكتبه          0
الآلي          1  محضر الاجتماع الأول لعام 198
الالي          0
الصور          1  الصور الفوتوغرافية
صورة           3  افتتاح مبنى المكتبة الجديد | أوراق مكتبة الجامعة المركزية | الصور الفوتوغرافية
المراسلات      1  المراسلات مع الناشرين والمور
مراسلات        2  مراسلات الاشتراك في الدوريات | المراسلات مع الناشرين والمور
في النتائج أعلاه لاحظ التالي:
- الهمزة: «إنشاء» وجدت المحضر، و«انشاء» دون همزة لم تجد شيئاً، وأغلب الناس يكتبون في مربع البحث دون همزات.
- أداة التعريف: «محاضر» وجدت 3، و«المحاضر» لم تجد شيئاً، و«المكتبة» وجدت 5 بينما «مكتبة» وجدت 8.
- التاء المربوطة والمد: «مكتبه» بالهاء لم تجد شيئاً، و«الالي» دون مد لم تجد شيئاً.
ولمعرفة السبب سألنا Elasticsearch عن إعدادات الفهرس، فكان المحلل الذي اسمه arabic في AtoM هو:
{"filter": ["lowercase", "arabic_stop", "preserved_asciifolding"], "tokenizer": "standard"}أي أنه يقطع النص إلى كلمات، ويحذف الكلمات الشائعة مثل «في» و«من»، ولا يفعل شيئاً آخر. والمحلل العربي الكامل الذي يأتي مع Elasticsearch فيه مرشحان آخران كما في توثيق محللات اللغات: arabic_normalization الذي يوحد الهمزات والتاء المربوطة والألف المقصورة ويحذف التشكيل، وarabic_stem الذي يحذف «ال» وبعض اللواحق. وقد شرحنا هذه المرشحات بالتفصيل في البحث في النصوص العربية. وAtoM يعرف محللاته في ملف إعداد داخل الإضافة الخاصة بالبحث، فأضفنا المرشحين:
--- /tmp/search.yml.orig
+++ plugins/arElasticSearchPlugin/config/search.yml
@@ -48,7 +48,7 @@

             arabic:
               tokenizer: standard
-              filter: [lowercase, arabic_stop, preserved_asciifolding]
+              filter: [lowercase, arabic_stop, arabic_normalization, arabic_stem, preserved_asciifolding]
             armenian:
               tokenizer: standard
               filter: [lowercase, armenian_stop, preserved_asciifolding]
ثم مسحنا ذاكرة Symfony المؤقتة وأعدنا بناء الفهرس:
docker compose -p lb3-atom exec atom php symfony cc
docker compose -p lb3-atom exec atom php -d memory_limit=-1 symfony search:populate
وأعدنا السكربت نفسه بالكلمات نفسها:
زرافة          0
إنشاء          1  محضر الاجتماع الأول لعام 198
انشاء          1  محضر الاجتماع الأول لعام 198
الإنشاء        1  محضر الاجتماع الأول لعام 198
محضر           1  محضر الاجتماع الأول لعام 198
المحاضر        3  محاضر عام 1985 | محاضر لجنة المكتبة | أوراق مكتبة الجامعة المركزية
محاضر          3  محاضر عام 1985 | محاضر لجنة المكتبة | أوراق مكتبة الجامعة المركزية
الدوريات       3  مراسلات الاشتراك في الدوريات | محاضر لجنة المكتبة | المراسلات مع الناشرين والمور
الدورية        3  مراسلات الاشتراك في الدوريات | محاضر لجنة المكتبة | المراسلات مع الناشرين والمور
مكتبة          8  أوراق مكتبة الجامعة المركزية | محاضر لجنة المكتبة | الصور الفوتوغرافية
المكتبة        8  أوراق مكتبة الجامعة المركزية | محاضر لجنة المكتبة | الصور الفوتوغرافية
مكتبه          8  أوراق مكتبة الجامعة المركزية | محاضر لجنة المكتبة | الصور الفوتوغرافية
الآلي          2  محضر الاجتماع الأول لعام 198 | أوراق مكتبة الجامعة المركزية
الالي          2  محضر الاجتماع الأول لعام 198 | أوراق مكتبة الجامعة المركزية
الصور          3  الصور الفوتوغرافية | أوراق مكتبة الجامعة المركزية | افتتاح مبنى المكتبة الجديد
صورة           3  الصور الفوتوغرافية | أوراق مكتبة الجامعة المركزية | افتتاح مبنى المكتبة الجديد
المراسلات      3  مراسلات الاشتراك في الدوريات | المراسلات مع الناشرين والمور | أوراق مكتبة الجامعة المركزية
مراسلات        3  مراسلات الاشتراك في الدوريات | المراسلات مع الناشرين والمور | أوراق مكتبة الجامعة المركزية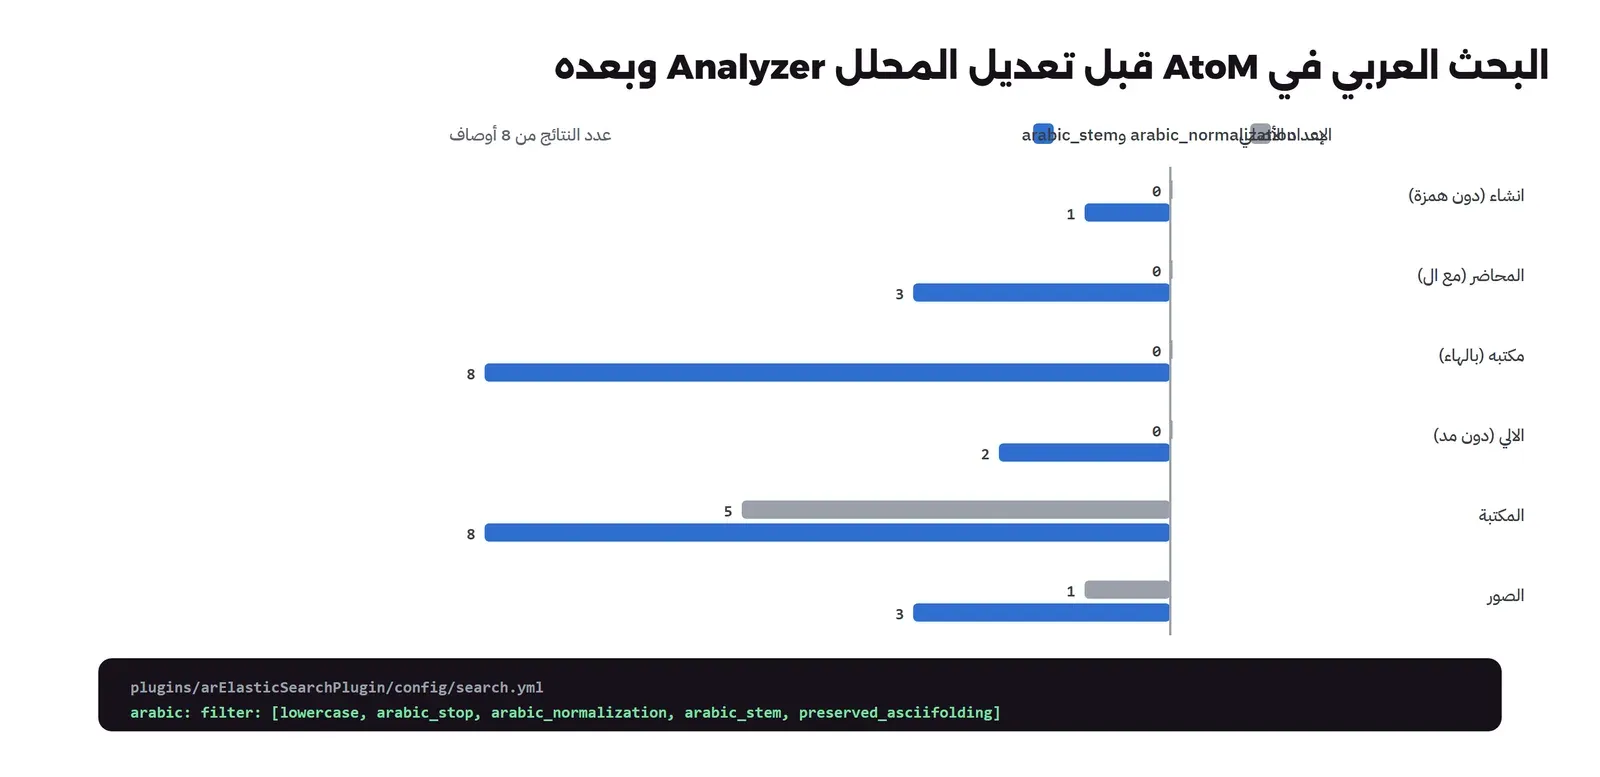
والصورة التالية من الواجهة نفسها بعد التعديل، والبحث بكلمة «انشاء» دون همزة وجد المحضر الذي عنوانه «إنشاء»:
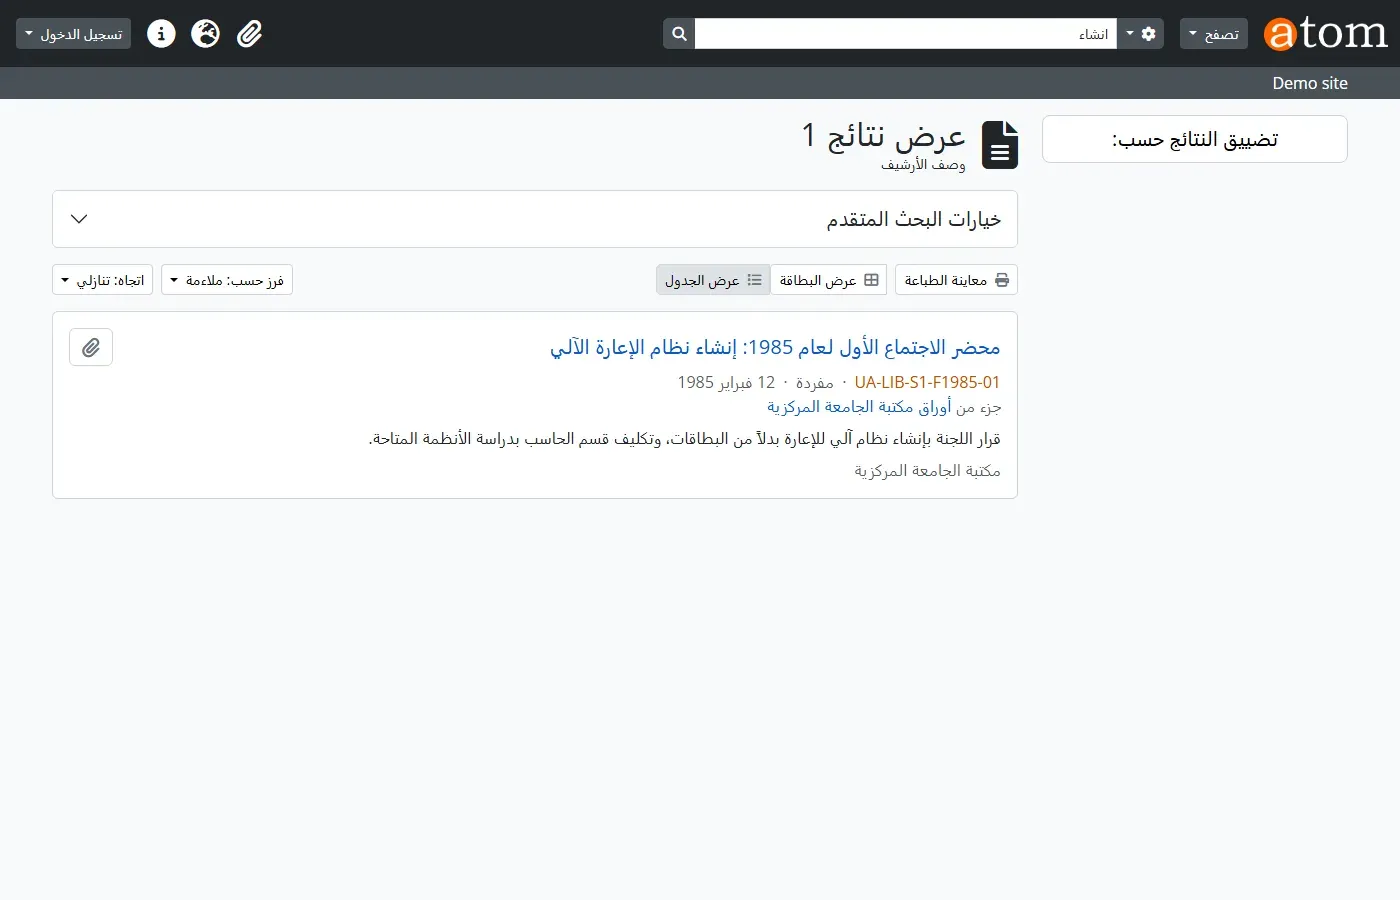
وقد يتساءل البعض: هل في هذا التعديل ثمن؟ نعم، ولكنه صغير مقارنة بالفائدة. فالمرشح arabic_stem يحذف اللواحق بقواعد بسيطة، فيجمع أحياناً كلمتين مختلفتين في المعنى، فقد صارت «الدورية» و«الدوريات» تجد النتائج الثلاث نفسها، ومنها محاضر اللجنة لأن فيها «الاجتماعات الدورية» بمعنى المنتظمة وليس المجلات، والباحث في الأرشيف يفضل نتيجة زائدة يتجاوزها على وثيقة لا يجدها. والثمن الثاني أهم: هذا الملف جزء من كود AtoM، وأي تحديث للإصدار سوف يعيده كما كان، لذلك احفظ التعديل ملفاً مستقلاً مثل search-yml.diff في مستودع إعداداتك، وطبقه وأعد بناء الفهرس بعد كل تحديث، ثم أعد السكربت نفسه لتتأكد.
التصدير إلى EAD 2002
صدرنا الوحدة الأرشيفية كاملة بملف EAD من سطر الأوامر، كما في توثيق الاستيراد والتصدير من سطر الأوامر. والأمر يحتاج الـ slug الخاص بالوحدة، أي الجزء الأخير من رابطها:
docker compose -p lb3-atom exec atom php symfony export:bulk --single-slug=cd37-hkk9-586k /tmp/ead/ua-lib.xmlوهذا جزء من الملف الناتج، من أعلى الوحدة الأرشيفية:
<archdesc level="fonds" relatedencoding="isad">
    <did>
      <unittitle encodinganalog="3.1.2">أوراق مكتبة الجامعة المركزية</unittitle>
      <unitid encodinganalog="3.1.1">UA-LIB</unitid>
      <unitdate id="atom_456_event" normal="1978-01-01/2005-12-31" encodinganalog="3.1.3">1978-2005</unitdate>
      <physdesc encodinganalog="3.1.5">
        4.5 متر طولي من الوثائق الورقية، و312 صورة فوتوغرافية    </physdesc>
      <repository>
        <corpname>أرشيف الجامعة</corpname>
      </repository>
      <langmaterial encodinganalog="3.4.3">
        <language langcode="ara">Arabic</language>
        <language langcode="eng">English</language>
      ...
      <origination encodinganalog="3.2.1">
        <name id="atom_456_actor">مكتبة الجامعة المركزية</name>
      </origination>
    </did>
    <bioghist id="md5-8cbd6e95b65f614328875c7c07c92378" encodinganalog="3.2.2">
    ...
    <dsc type="combined">
      <c level="series">
في الملف أعلاه لاحظ التالي:
- encodinganalog: كل عنصر يحمل رقم العنصر المقابل في ISAD(G)، فـ
unittitleهو 3.1.2 العنوان، وoriginationهو 3.2.1 اسم المنشئ، وهذا ما يجعل الملف مفهوماً لنظام آخر يعرف المعيار. - الشجرة في ملف واحد: داخل
dscعناصرcمتداخلة لكل مستوى، فالوحدة الأرشيفية كاملة تنتقل في ملف واحد. - رموز اللغات: EAD يستخدم رموز ISO 639-2 بثلاثة حروف
ara، بينما ملف CSV كان بحرفينar، والنظام يحول بينهما. - الـ slug غير مقروء: رابط الوحدة
cd37-hkk9-586k، والسبب أن AtoM يبني الرابط من العنوان بحروف لاتينية، فإذا كان العنوان عربياً صنع رمزاً عشوائياً، أما الملف «محاضر عام 1985» فأصبح رابطه1985، والمفردة بعده1985-2. والروابط تعمل، ولكنها لا تقول شيئاً، فإذا كان الرابط الدائم مهماً لك فاعتمد على الرمز المرجعي في الاستشهاد.
ماذا يحدث إذا استوردت الملف نفسه مرتين؟
EAD هو ما سوف تستخدمه عند الانتقال من نظام قديم، أو عند تبادل الوصف مع أرشيف آخر. لذلك جربنا أن نستورد الملف الذي صدرناه في AtoM نفسه، بالأمر import:bulk، ثم نستورده مرة ثانية، وهذا آخر مخرج الاستيراد الثاني:
Importing 1 files from /tmp/in (indexing is DISABLED) ...

.(/tmp/in/ua-lib.xml): libxml error 513 on line 102 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 128 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 154 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 188 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 216 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 240 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 262 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): Creating a new record: أوراق مكتبة الجامعة المركزية
(/tmp/in/ua-lib.xml): Creating a new record: محاضر لجنة المكتبة
(/tmp/in/ua-lib.xml): Creating a new record: محاضر عام 1985
(/tmp/in/ua-lib.xml): Creating a new record: محضر الاجتماع الأول لعام 1985: إنشاء نظام الإعارة الآلي
(/tmp/in/ua-lib.xml): Creating a new record: المراسلات مع الناشرين والموردين
(/tmp/in/ua-lib.xml): Creating a new record: مراسلات الاشتراك في الدوريات الأجنبية
(/tmp/in/ua-lib.xml): Creating a new record: الصور الفوتوغرافية
(/tmp/in/ua-lib.xml): Creating a new record: افتتاح مبنى المكتبة الجديد
.
Imported 1 XML/CSV files in 1.55 s. 23061808 bytes used.
في المخرج أعلاه لاحظ التالي:
- نسخة جديدة كل مرة: «Creating a new record» لكل مستوى، فبعد استيرادين أصبح في النظام ثلاث وحدات بالعنوان نفسه. وAtoM لا يفترض أن الملف تحديث لوصف موجود إلا إذا طلبت ذلك.
- تحذير libxml 513: AtoM نفسه كتب عند التصدير المعرف
md5-8cbd...لعنصرbioghistفي كل مستوى، لأن الجهة المنشئة واحدة، والمعرف ID في XML يجب ألا يتكرر، فاعترض المحلل عند القراءة. والتحذير لم يمنع الاستيراد، ولكنه يعني أن الملف الذي يصدره AtoM ليس صالحاً تماماً، وقد يرفضه نظام أكثر تشدداً.
وهناك أثر ثالث لم يظهر في المخرج، ووجدناه عندما سألنا قاعدة البيانات عن اللغة الأصلية Source Culture للأوصاف بهذه العناوين:
source_culture	count(*)
ar	4
en	8
أي أن الأوصاف الأربعة الأصلية التي استوردناها من CSV مسجلة بالعربية، أما النسخ الثماني التي جاءت من ملف EAD فمسجلة بالإنجليزية رغم أن نصها عربي، والأرجح أن السبب أن الأمر يعمل من سطر الأوامر بلغة النظام الافتراضية، وهي الإنجليزية. والنتيجة أن نص هذه الأوصاف يفهرس في حقول اللغة الإنجليزية ويمر على محللها، فلا يطبق عليه تعديل المحلل العربي الذي شرحناه. لذلك إذا نقلت وصفاً عربياً بملف EAD، فتأكد بعد الاستيراد من لغته الأصلية في عينة منه قبل أن تكمل.
ثم أعدنا الاستيراد مع الخيار --skip-matched:
Importing 1 files from /tmp/in (indexing is DISABLED) ...

.(/tmp/in/ua-lib.xml): libxml error 513 on line 102 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 128 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 154 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 188 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 216 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 240 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): libxml error 513 on line 262 in input file: ID md5-8cbd6e95b65f614328875c7c07c92378 already defined

(/tmp/in/ua-lib.xml): Found duplicated record for أوراق مكتبة الجامعة المركزية, skipping
.
Imported 1 XML/CSV files in 0.25 s. 17986696 bytes used.
فتعرف AtoM على الوحدة الموجودة وتجاوزها. وهناك أيضاً الخيار --update بقيمتين match-and-update وdelete-and-replace لتحديث وصف موجود من ملف أحدث. والقاعدة: لا تستورد ملف EAD في نظام فيه بيانات إلا بأحد هذه الخيارات، وجربه أولاً على نسخة اختبار.
الملفات الرقمية والحصاد
AtoM يقبل ربط ملف رقمي بأي وصف، صورة أو PDF أو صوت، وينشئ له العامل Worker صورة مصغرة ونسخة للعرض. ولكن AtoM ليس المكان المناسب لحفظ النسخة الأصلية عالية الدقة من المسح الضوئي، فهذه لها مسار حفظ خاص، وسوف نشرح في المقال التالي كيف تمر الصفحة من الماسح إلى ملف TIFF أصلي ثم إلى نسخ العرض والنص المستخرج، وأين يوضع كل منها.
وفي AtoM أيضاً إضافة لـ OAI-PMH، كما في توثيقها، تجعل الأوصاف قابلة للحصاد بصيغة Dublin Core وبصيغة EAD، فيظهر أرشيفك في البوابات نفسها التي تحصد المستودعات، وكل ما ذكرناه في مقال الحصاد عن المعرفات والتواريخ والحذف ينطبق هنا أيضاً.
قبل الإنتاج: النسخ الاحتياطي والتحديث
- ما يجب نسخه: قاعدة بيانات MySQL كاملة، والمجلد
uploadsالذي فيه الملفات الرقمية، وملفات الإعداد المعدلة مثلsearch.yml. أما فهرس Elasticsearch فلا يحتاج نسخاً، لأنه يعاد بناؤه من قاعدة البيانات بالأمرsearch:populate. - بعد كل تحديث: طبق تعديل المحلل العربي من جديد، وأعد بناء الفهرس، وشغل سكربت البحث بالكلمات نفسها، فإذا تغيرت الأرقام فالتعديل ضاع.
- بعد إضافة لغة: أعد بناء الفهرس، وإلا ظهر خطأ البحث الذي رأيناه.
- واجهة الإدارة: الأوصاف المنشورة للعموم، أما حسابات الأرشيفيين فيجب أن تكون بكلمات مرور قوية، ويفضل أن تكون واجهة الدخول داخل شبكة المؤسسة أو خلف الدخول الموحد كما شرحنا في ما هو الدخول الموحد SSO.
أخطاء شائعة وحلولها
| الخطأ | ما الذي يحدث | الحل |
|---|---|---|
| وصف الوثائق في نظام مكتبة كأنها كتب | يضيع المصدر والتسلسل، وتصبح كل ورقة تسجيلة يتيمة | نظام أرشيفي بمستويات وصف، أو على الأقل وصف الوحدة والسلاسل أولاً |
| إعادة ترتيب الوثائق حسب الموضوع | يمحى النظام الأصلي، وهو معلومة عن عمل الجهة | الترتيب كما وصل، والموضوع في نقاط الوصول |
| قيم القوائم بالإنجليزية في CSV عربي | مصطلحات مكررة مثل «Fonds» بجانب «الوحدة الأرشيفية»، وأوصاف مسودة | القيم بلغة العمود culture، وتجربة عشرة صفوف أولاً |
| الرمز المرجعي كاملاً في كل مستوى | رمز مكرر مثل UA-LIB-UA-LIB-S1-... | الجزء الخاص بكل مستوى فقط |
| إضافة لغة دون إعادة بناء الفهرس | خطأ Elasticsearch في صفحة التصفح | search:populate بعد كل لغة |
| الاعتماد على المحلل العربي الافتراضي | «انشاء» لا تجد «إنشاء»، و«المحاضر» لا تجد «محاضر» | إضافة arabic_normalization وarabic_stem وحفظ التعديل |
| استيراد EAD دون خيار تحديث | نسخة جديدة من الوحدة كل مرة | --skip-matched أو --update |
| ربط ملف إعداد MySQL من Windows | يتجاهله الخادم بتحذير ويعمل بالإعداد الافتراضي | الإعداد في سطر الأوامر، أو ملف داخل Volume |
قائمة تحقق قبل أن تبدأ الوصف
- قررت مستويات الوصف التي سوف تصل إليها لكل سلسلة، ولم تقرر وصف كل ورقة.
- لكل جهة منشئة سجل إسناد واحد بالاسم المعتمد، قبل أن تستورد الأوصاف.
- خطة الرموز المرجعية مكتوبة: رمز المؤسسة، ثم رمز الوحدة، ثم الجزء الخاص بكل مستوى.
- الواجهة العربية مفعلة، والفهرس أعيد بناؤه بعدها.
- المحلل العربي معدل ومحفوظ في مستودع الإعدادات، وسكربت البحث جاهز للتحقق بعد كل تحديث.
- ملف CSV تجريبي من عشرة صفوف استورد على نسخة اختبار، وصدر إلى EAD وقرئ.
- النسخة الاحتياطية تشمل قاعدة البيانات ومجلد الملفات الرقمية، وجربت استعادتها مرة.
تدريب عملي
- اختر صندوقاً واحداً من وثائق جهتك، وصفه بمستويين فقط: الوحدة الأرشيفية بعناصر ISAD(G) الستة الأساسية، ثم سلسلة أو سلسلتين، وقس كم استغرق ذلك.
- أضف صف ترجمة إنجليزية لسلسلة من سلاسل وحدتك بنفس legacyId، ثم ابحث بكلمة إنجليزية من الواجهة العربية، وتأكد أن الوصف يظهر بعنوانه العربي.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الأرشيف يصف مجموعات من الأعلى إلى الأسفل، ويحفظ مصدر الوثائق وترتيبها الأصلي، ولذلك لا يصلح له نظام المكتبة.
- ISAD(G) يحدد ما تكتبه في سبعة حقول، وستة عناصر منها أساسية، ومعه ISAAR(CPF) للمنشئ وISDIAH للمؤسسة، وEAD لنقل الوصف بين الأنظمة.
- AtoM مبني على معايير المجلس الدولي للأرشيف، وفيه واجهة عربية ووصف متعدد اللغات، وArchivesSpace مبني على DACS ويهتم بإدارة المقتنيات، ولا توجد فيه واجهة عربية.
- في المختبر عمل AtoM 2.10.2 بسبع Containers ونحو 1.9GB ذاكرة، وظهرت ثلاثة دروس: قيم القوائم بلغة الوصف، والرمز المرجعي يكتب لكل مستوى جزؤه فقط، والفهرس يعاد بناؤه بعد إضافة لغة.
- المحلل العربي الافتراضي في AtoM لا يوحد الهمزة ولا يحذف «ال»، وإضافة مرشحين في سطر واحد جعلت «انشاء» تجد «إنشاء»، بشرط أن تعيد التعديل بعد كل تحديث.
- ملف EAD الذي يصدره AtoM يحمل الوحدة كاملة بأرقام عناصر ISAD(G)، واستيراده مرتين ينشئ نسختين إلا بخيار التحديث.
وفي المقال التالي بإذن الله ننتقل من وصف الوثائق إلى صورها: كيف تمر صفحة مخطوطة أو كتاب قديم من الماسح إلى نص عربي قابل للبحث:
 دليلرقمنة الكتب Digitization: من الماسح إلى نص عربيسلسلة رقمنة كاملة على صفحة من كتاب طبع في بولاق 1906: نسخة حفظ TIFF وبصمة، وOCR نقيس خطأه على نص كتبناه بأيدينا، وPDF/A، وعرض عميق عبر IIIF.
 دليلملفات الإسناد Authority Files وأسماء المؤلفين العربنبحث في ملف أسماء مكتبة الكونغرس عن مؤلفين عرب، ونقيس كم اسماً حقيقياً في فهرس مفتوح يجد صاحبه بالشكل المعتمد والإحالات والتوحيد.
 دليلDublin Core وBIBFRAME: البيانات الوصفية بعد MARCنحول تسجيلتين حقيقيتين من مكتبة الكونغرس إلى Dublin Core وإلى BIBFRAME بالأدوات الرسمية، ونرى ما يبقى وما يضيع من الوصف العربي.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال، وتشغيل AtoM 2.10.2 من ملف Docker Compose الرسمي (PHP 8.3.36، وElasticsearch 7.10.2، وMySQL 8.4.11) بوحدة أرشيفية عربية من ثماني أوصاف، واختبار البحث العربي قبل تعديل المحلل وبعده، والتصدير والاستيراد بصيغة EAD 2002.