إذا كنت في مكتبة جامعة وطلبت منك العمادة أن تظهر رسائل الماجستير والدكتوراه في بوابة وطنية أو في محرك بحث أكاديمي عالمي، أو كنت في الطرف الآخر وطلب منك أن تبني بوابة واحدة تجمع رسائل عدة جامعات، فسوف تسمع الاسم نفسه في الحالتين: OAI-PMH. والفكرة تبدو بسيطة، فالبوابة تطلب من كل مستودع تسجيلاته ثم تبحث فيها، ولكن ما يحدث في الواقع أن البوابة تعرض تسجيلات حذفت من المستودع قبل سنة، أو لا تجد رسائل أضيفت الأسبوع الماضي، أو تعرض اسم الباحث بثلاثة أشكال، أو تتوقف عن الحصاد من مستودع كامل دون أن يلاحظ أحد. وكل هذه المشكلات لها سبب محدد في البروتوكول نفسه أو في طريقة إعداده، وهذا ما سوف نراه على مستودعات عربية حقيقية.
وقد مررنا على البروتوكول باختصار في دليل مستودع الجامعة مع DSpace، ورأينا هناك كيف يملأ DSpace فهرس OAI الخاص به، وفي خريطة أنظمة المكتبة أرسلنا الأفعال الأساسية إلى نسخة DSpace التجريبية. أما هذا المقال فهو عن الحصاد نفسه من الطرفين: ما الذي يطلبه الحاصد، وما الذي يجب أن يرد به المستودع، وأين تضيع التسجيلات.
وفي هذا المقال سوف نناقش:
- لماذا تجمع البوابات نسخة من السجلات بالحصاد Harvesting بدلاً من أن تبحث في كل مستودع لحظة السؤال.
- الأفعال الستة في البروتوكول، والمعرف والتاريخ والمجموعات والصيغ، وكيف تعمل الصفحات بالرمز resumptionToken.
- مختبر عملي: حاصد صغير بلغة Python يحصد مستودع جامعة قطر QSpace ومستودع جامعة قاصدي مرباح ورقلة، حصاداً كاملاً ثم تزايدياً، ويلتقط التسجيلات المحذوفة.
- الأخطاء التي يعيدها البروتوكول، وما وجدناه من مشكلات حقيقية في ثلاثة مستودعات، منها تاريخ مكتوب بصيغة خاطئة يجعل المستودع يعيد كل شيء.
- تقرير جودة نحسبه بأنفسنا على 856 تسجيلة: رموز اللغة، والتواريخ، والأسماء، والتكرار، وما يضيع عند التحويل إلى Dublin Core.
- قائمة تحقق لمن يدير المستودع، وأخرى لمن يبني الحاصد.
وهذا المقال ضمن مرحلة «المستودعات والأرشيف الرقمي»:
 دليلخريطة أنظمة المكتبة: ILS والمستودع وبوابة البحثما الأنظمة التي تتكون منها المكتبة الحديثة وكيف تتكلم مع بعضها، مع مختبر ينسخ تسجيلة كتاب من مكتبة الكونغرس عبر Z39.50 ويحصد مستودعاً عبر OAI-PMH.
 دليلمستودع الجامعة Institutional Repository مع DSpaceكيف تشغل DSpace لأرشفة رسائل الطلاب وأبحاث الجامعة، من الإيداع ومراجعته حتى الحصاد عبر OAI-PMH، وما يحتاج تعريباً قبل الإطلاق.
 دليلواجهة البحث Discovery مع VuFind فوق Kohaكيف تضع VuFind فوق Koha والمستودع الرقمي ليبحث القارئ في مربع واحد، مع حالة الكتاب من Koha مباشرة وبحث عربي يجد العنوان المكتوب في الحقل 880.
 دليلالأرشيف والوثائق بمعيار ISAD(G) مع AtoM وArchivesSpaceكيف تصف وثائق مؤسستك بمعيار ISAD(G) في AtoM بالعربية، مع مقارنة بـ ArchivesSpace ومختبر كشف ثلاث مشكلات في الاستيراد والبحث العربي وحلولها.
لماذا الحصاد Harvesting وليس البحث في كل مستودع؟
لنفرض أن لديك عشرين جامعة، ولكل منها مستودع، وتريد مربع بحث واحداً للباحث. هناك طريقتان. الأولى البحث الموزع Federated Search، أي أن البوابة تأخذ كلمة البحث وترسلها إلى المستودعات العشرين في اللحظة نفسها، وتنتظر الردود، ثم تدمجها في صفحة واحدة. وهذه الطريقة تبدو مثالية لأنها تعرض أحدث البيانات دائماً، ولكنها في الواقع بطيئة بقدر أبطأ مستودع، وإذا كان أحد المستودعات متوقفاً للصيانة اختفت رسائله من النتائج، وكل مستودع يرتب النتائج بطريقته فلا يمكن ترتيبها معاً ترتيباً عادلاً، والأهم أن البحث العربي يعالج في كل مستودع بقواعد مختلفة، فالكلمة نفسها تجد في مستودع ولا تجد في آخر.
والطريقة الثانية هي الحصاد، أي أن البوابة تجمع مسبقاً نسخة من وصف كل التسجيلات في فهرس خاص بها، ثم تبحث في هذه النسخة. وبالتالي يكون البحث سريعاً لأنه محلي، ويعالج العربية بقاعدة واحدة كما شرحنا في البحث في النصوص العربية، ويستمر حتى لو توقف أحد المستودعات، والثمن أن النسخة المحلية متأخرة عن المستودع بقدر الفترة بين حصادين. وهذا الثمن مقبول في عالم المستودعات، فالرسالة الجامعية لا تتغير كل دقيقة، وتأخير يوم في ظهورها في البوابة لا يضر أحداً.
لذلك اتفقت المستودعات في 1999، في اجتماع في مدينة سانتا في الأمريكية، على أن تقدم كل منها سجلاتها بطريقة واحدة يفهمها أي حاصد، وصدرت النسخة 2.0 من البروتوكول في 2002، وهي النسخة المعتمدة حتى اليوم. واسمه بروتوكول مبادرة الأرشيف المفتوح لحصاد البيانات الوصفية Open Archives Initiative Protocol for Metadata Harvesting، ولاحظ الكلمة الأخيرة: البروتوكول ينقل الوصف Metadata، أي العنوان والمؤلف والتاريخ ورابط الملف، ولا ينقل ملفات PDF نفسها، فالقارئ الذي يجد الرسالة في البوابة يضغط الرابط فيذهب إلى المستودع الأصلي ليقرأها.
الطرفان: مزود البيانات Data Provider ومزود الخدمة Service Provider
في البروتوكول طرفان فقط. مزود البيانات Data Provider هو المستودع الذي يملك التسجيلات ويرد على الطلبات، مثل DSpace في الجامعة، أو مجلة على OJS، أو فهرس المكتبة في Koha. ومزود الخدمة Service Provider هو من يحصد ويقدم خدمة فوق ما حصده، مثل بوابة وطنية للرسائل، أو طبقة اكتشاف مثل VuFind، أو محرك بحث أكاديمي، والصورة التالية تبين العلاقة بينهما:
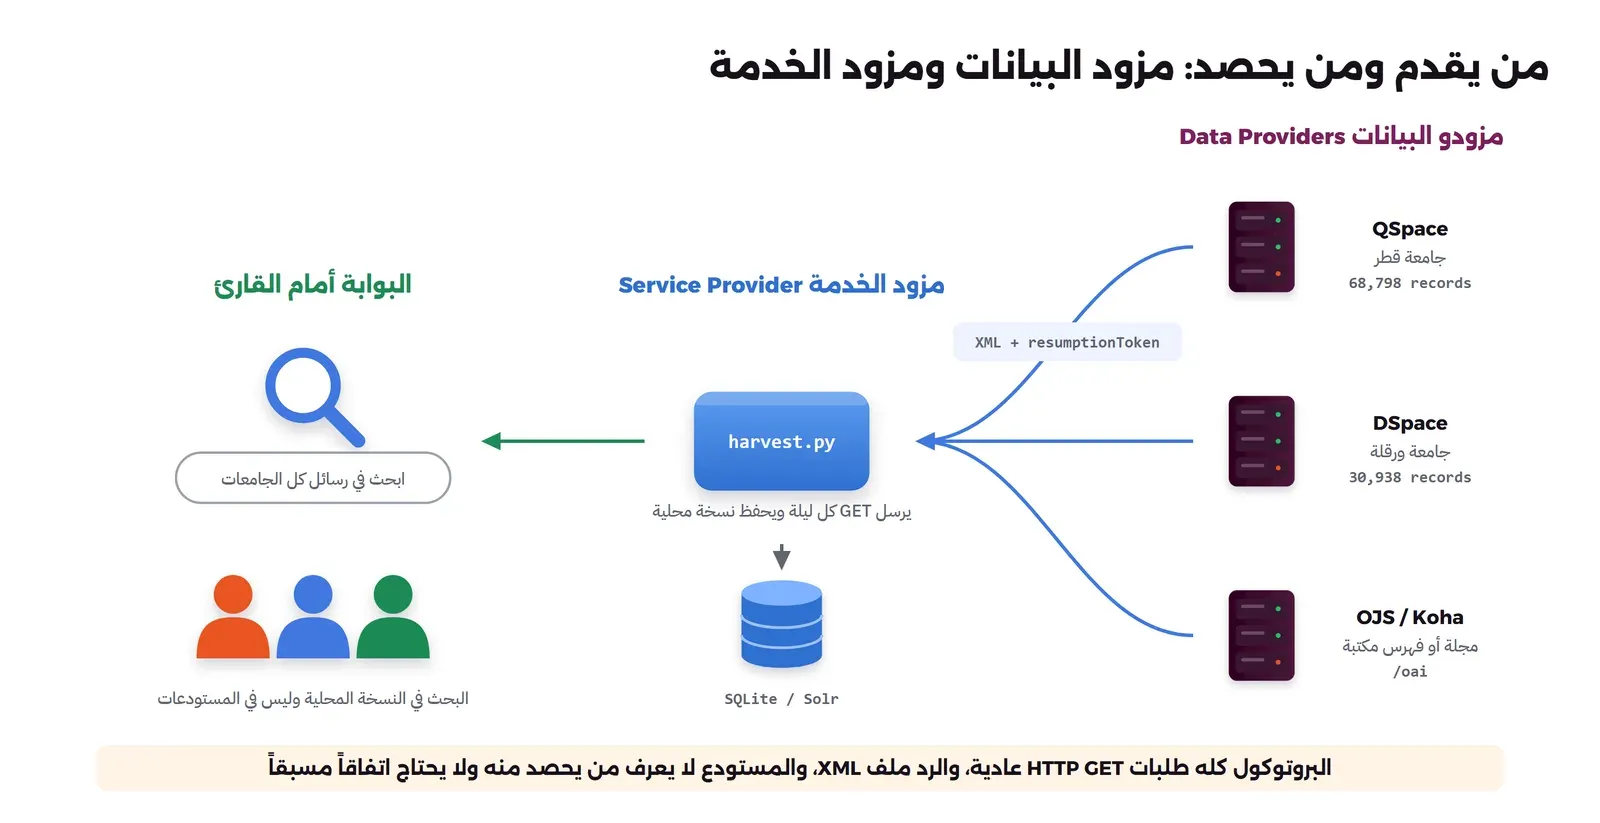
في الصورة أعلاه لاحظ التالي:
- المستودع سلبي تماماً: لا يرسل شيئاً من نفسه، ولا يعرف من يحصد منه، وكل ما عليه أن يرد على الطلب. لذلك إذا أضفت رسالة جديدة فلن تظهر في البوابة حتى تسأل البوابة.
- الطلب رابط عادي: كل طلب في البروتوكول هو طلب HTTP GET مثل الذي يرسله المتصفح، والرد ملف XML. وبالتالي تستطيع أن تجرب أي مستودع من المتصفح نفسه بإضافة
?verb=Identifyإلى عنوانه. - لا يوجد تسجيل ولا مفتاح: أغلب المستودعات تترك واجهة OAI مفتوحة لأي حاصد، والهدف أصلاً أن تنتشر التسجيلات، وهذا ما يجعل البروتوكول سهلاً ويجعل أخطاء الإعداد ظاهرة لكل العالم في الوقت نفسه.
ستة أفعال Verbs فقط
البروتوكول كله ستة أوامر، تسمى في المعيار أفعالاً Verbs، وترسل في المعامل verb. والجدول التالي يبينها بالترتيب الذي يستخدمه أي حاصد عادة:
| الفعل | ما الذي يعيده | متى يستخدمه الحاصد |
|---|---|---|
Identify | اسم المستودع، والبريد المسؤول، وأقدم تاريخ فيه، ودقة التاريخ، وطريقته في التعامل مع المحذوف | مرة واحدة عند إضافة المستودع، ثم عند كل مشكلة |
ListMetadataFormats | الصيغ التي يستطيع المستودع أن يرسل بها التسجيلة، مثل oai_dc وmods وmarc | لاختيار أغنى صيغة يفهمها الحاصد |
ListSets | المجموعات Sets، أي أقسام المستودع التي يمكن حصاد كل منها وحده | عندما يريد الحاصد كلية أو نوعاً واحداً فقط |
ListIdentifiers | رؤوس التسجيلات فقط: المعرف والتاريخ والمجموعات، دون الوصف | للعد السريع، أو لمعرفة المحذوف دون تنزيل كل شيء |
ListRecords | التسجيلات كاملة، صفحة بعد صفحة | الحصاد نفسه، الكامل والتزايدي |
GetRecord | تسجيلة واحدة بمعرفها | لإعادة جلب تسجيلة بعينها أو لفحص مشكلة |
وفوق هذه الأفعال أربعة مفاهيم يجب أن تفهمها قبل أن تكتب أي حاصد أو تعد أي مستودع، لأن كل مشكلات الحصاد التي سوف نراها في المختبر ترجع إلى أحدها.
المعرف Identifier والتاريخ Datestamp
كل تسجيلة في المستودع لها معرف ثابت بشكل مثل oai:qspace.qu.edu.qa:10576/17724، والجزء الأوسط اسم المستودع، والأخير رقم المادة. وهذا المعرف هو ما يحفظه الحاصد ليعرف أن التسجيلة التي وصلت اليوم هي نفسها التي وصلت أمس فيستبدلها ولا يضيف نسخة ثانية، لذلك إذا تغير المعرف تغيرت التسجيلة في نظر كل الحاصدين، حتى لو كانت الرسالة نفسها.
ولكل تسجيلة أيضاً تاريخ Datestamp، وهو تاريخ آخر تغيير في وصفها، وليس تاريخ نشر الرسالة. وهذا التاريخ هو أساس الحصاد التزايدي Incremental Harvesting، فالحاصد يقول للمستودع: أعطني ما تغير منذ from هذا التاريخ، فيرد بالتسجيلات التي تاريخها بعده فقط. ودقة التاريخ Granularity نوعان في المعيار: باليوم YYYY-MM-DD، أو بالثانية YYYY-MM-DDThh:mm:ssZ، والتوقيت دائماً بالتوقيت العالمي UTC، وحرف Z في النهاية يعني ذلك.
المجموعات Sets
المجموعة طريقة اختيارية لتقسيم المستودع، فالبوابة التي تجمع رسائل الشريعة فقط لا تحتاج أن تحصد أبحاث الهندسة. وفي DSpace كل مجتمع Community وكل مجموعة Collection تصبح Set تلقائياً، باسم مثل com_10576_60 للمجتمع وcol_10576_3036 للمجموعة. ولاحظ أن التسجيلة الواحدة قد تكون في عدة مجموعات في الوقت نفسه، فرسالة في قسم الفقه تظهر في مجموعة القسم وفي مجتمع الكلية وفي مجتمع الرسائل الجامعية، والحاصد الذي يحصد المجموعات الثلاث منفصلة سوف يأخذها ثلاث مرات، ولذلك يجب أن يحفظ التسجيلة بمعرفها وليس بالمجموعة التي جاءت منها.
الصيغ Metadata Formats: لماذا oai_dc إلزامية؟
المعيار يلزم كل مستودع بصيغة واحدة على الأقل هي oai_dc، أي Dublin Core البسيط بعناصره الخمسة عشر، وهذا ما يضمن أن أي حاصد في العالم يستطيع أن يقرأ أي مستودع. ثم يضيف كل مستودع ما يشاء من الصيغ الأغنى، فـ DSpace يقدم mods وmarc وetdms للرسائل وdim وهي صيغته الداخلية، وKoha يقدم marc21. والحاصد الذكي يسأل ListMetadataFormats ويختار أغنى صيغة يفهمها، لأن Dublin Core البسيط يضيع تفاصيل مهمة كما سوف نرى في المختبر، وسوف نشرح Dublin Core وما بعده في مقال مستقل ضمن مرحلة الفهرسة.
الصفحات والرمز resumptionToken
المستودع الذي فيه سبعون ألف تسجيلة لا يرسلها في رد واحد، وإنما يرسل صفحة، مئة تسجيلة مثلاً في DSpace، وفي نهايتها رمز اسمه resumptionToken، فيرسل الحاصد الرمز في الطلب التالي فيأخذ الصفحة الثانية، وهكذا حتى يصل رد فيه رمز فارغ، وهذا معناه أن القائمة انتهت. وفي الرمز سمتان اختياريتان: completeListSize وهو العدد الكلي، وcursor وهو عدد ما أرسل قبل هذه الصفحة. والمعيار يترك شكل الرمز للمستودع، فهو نص لا يحاول الحاصد أن يفهمه أو يعدله، وإنما يعيده كما هو.
التسجيلات المحذوفة Deleted Records
هذه أكثر نقطة يغفل عنها من يبني بوابة. عندما تسحب الجامعة رسالة من المستودع، لسبب قانوني أو لأنها أضيفت مرتين، كيف تعرف البوابة التي حصدتها قبل سنة؟ المستودع يعلن في رد Identify طريقته في الحقل deletedRecord، وله ثلاث قيم كما في الصورة التالية:
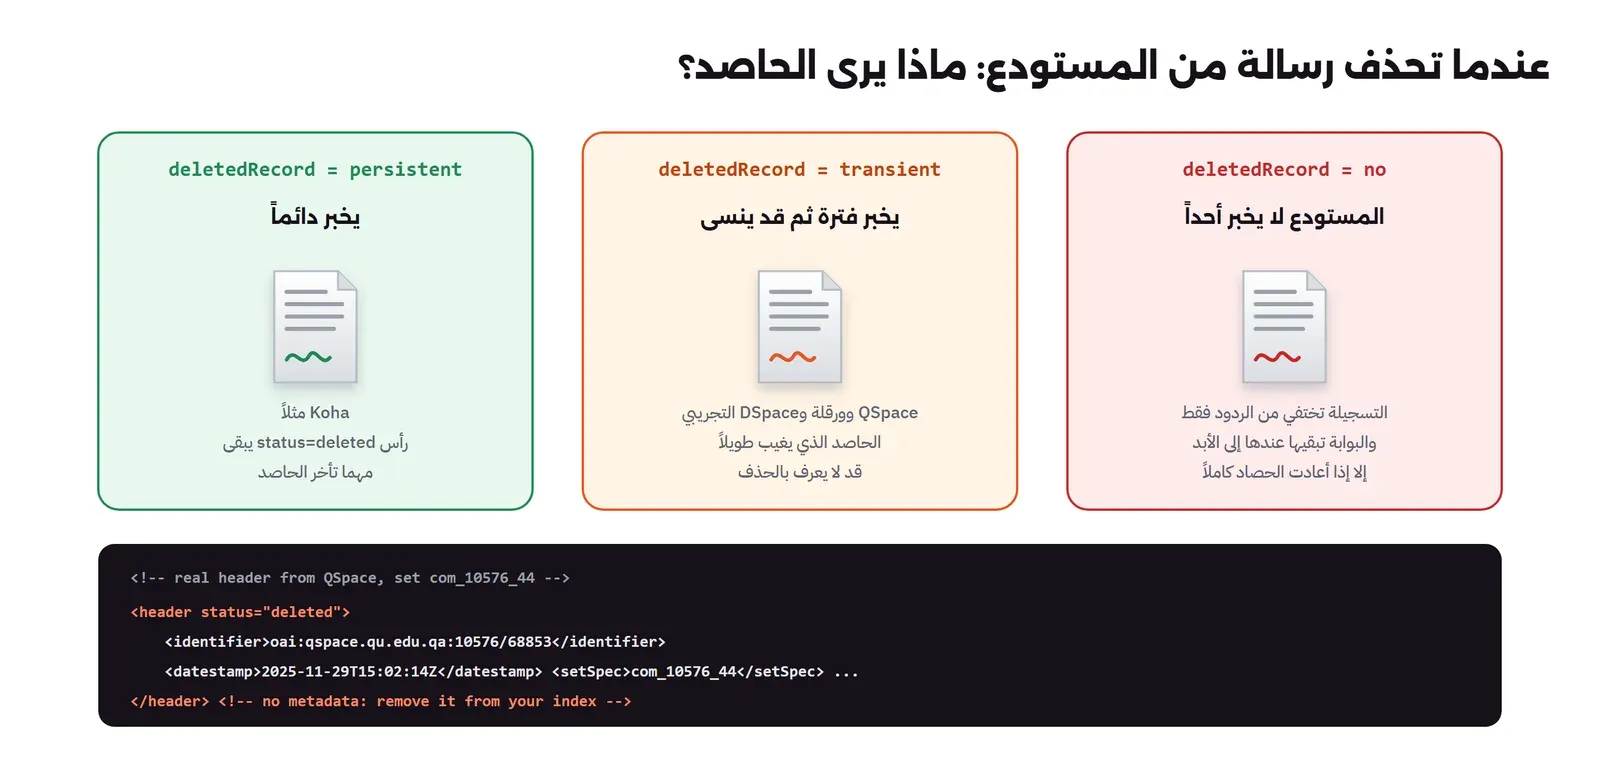
والحاصد الذي يرى رأساً عليه status="deleted" يجب أن يحذف التسجيلة من فهرسه، وهذا سطر واحد في الكود، ولكن الحاصد الذي لا يتعامل معه يجعل البوابة تعرض رسالة لم تعد موجودة، فيضغط القارئ الرابط فيجد صفحة خطأ 404، وهي أسوأ تجربة يمكن أن تقدمها بوابة.
المختبر: حاصد صغير بلغة Python
توجد أدوات حصاد جاهزة كثيرة، منها مكتبة Sickle للغة Python، والسكربت pyoaiharvester، وأداة الحصاد المدمجة في VuFind التي استخدمناها في دليل VuFind. ولكننا سوف نكتب حاصداً صغيراً بأنفسنا بمكتبات Python القياسية فقط، دون أي مكتبة خارجية، والسبب أن الهدف هنا أن ترى كل خطوة في البروتوكول بعينك: الطلب، والرمز، والحذف، والخطأ، فإذا استخدمت بعد ذلك أي أداة جاهزة عرفت ما الذي تفعله خلف الواجهة. والحاصد يحفظ التسجيلات في قاعدة SQLite، وهي ملف واحد لا يحتاج سيرفراً، ويتذكر تاريخ آخر حصاد لكل مستودع ومجموعة.
شغلنا كل شيء داخل Container من Image الرسمي python:3.13-slim، وفيه Python 3.13.18، والملفات في مجلد على الجهاز:
docker tag python:3.13-slim lb3-py:1
docker run --rm -v "$PWD:/lab" -w /lab lb3-py:1 python -V
وهذا هو الحاصد كاملاً، وسوف نشرح أجزاءه بعده:
"""A small OAI-PMH harvester: python harvest.py BASE_URL DB [--set S] [--from DATE] [--prefix oai_dc]
Stores every record (or deletion) in SQLite and remembers the last responseDate for the next run."""
import sqlite3, sys, time, json, argparse, datetime, urllib.request, urllib.parse, urllib.error
import xml.etree.ElementTree as ET

NS = {"oai": "http://www.openarchives.org/OAI/2.0/",
      "dc": "http://purl.org/dc/elements/1.1/",
      "oai_dc": "http://www.openarchives.org/OAI/2.0/oai_dc/"}

def fetch(base, params, tries=4):
    url = base + "?" + urllib.parse.urlencode(params)
    for n in range(1, tries + 1):
        try:
            req = urllib.request.Request(url, headers={"User-Agent": "lb3-harvester/1.0 (ArabRoot lab)"})
            with urllib.request.urlopen(req, timeout=120) as r:
                ctype = r.headers.get("Content-Type", "")
                body = r.read()
            if not body.lstrip().startswith(b"<?xml") and b"<OAI-PMH" not in body[:2000]:
                raise RuntimeError(f"not an OAI-PMH response (Content-Type: {ctype}), first bytes: {body[:80]!r}")
            return ET.fromstring(body)
        except urllib.error.HTTPError as e:
            wait = int(e.headers.get("Retry-After", "0") or 0) or 10 * n
            print(f"  HTTP {e.code}, try {n}/{tries}, waiting {wait}s", flush=True)
            time.sleep(wait)
        except (urllib.error.URLError, TimeoutError) as e:
            print(f"  network error: {e}, try {n}/{tries}", flush=True)
            time.sleep(10 * n)
    raise RuntimeError("giving up after %d tries" % tries)

def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("base"); ap.add_argument("db")
    ap.add_argument("--set"); ap.add_argument("--from", dest="frm"); ap.add_argument("--until")
    ap.add_argument("--prefix", default="oai_dc"); ap.add_argument("--incremental", action="store_true")
    a = ap.parse_args()
    db = sqlite3.connect(a.db)
    db.executescript("""create table if not exists rec(id text primary key, datestamp text, deleted int,
                          sets text, md text, harvested text);
                        create table if not exists state(base text, setspec text, last text, primary key(base, setspec));""")
    frm = a.frm
    if a.incremental:
        row = db.execute("select last from state where base=? and setspec=?", (a.base, a.set or "")).fetchone()
        if row:  # overlap by a few minutes, as the OAI harvester guidelines advise
            last = datetime.datetime.strptime(row[0], "%Y-%m-%dT%H:%M:%SZ")
            frm = (last - datetime.timedelta(minutes=5)).strftime("%Y-%m-%dT%H:%M:%SZ")
        print("last run started", row[0] if row else None, "-> asking from", frm)
    params = {"verb": "ListRecords", "metadataPrefix": a.prefix}
    if a.set: params["set"] = a.set
    if frm: params["from"] = frm
    if a.until: params["until"] = a.until
    page, new, upd, dele, started = 0, 0, 0, 0, None
    while True:
        root = fetch(a.base, params)
        started = started or root.findtext("oai:responseDate", namespaces=NS)
        err = root.find("oai:error", NS)
        if err is not None:
            if err.get("code") == "noRecordsMatch":
                print("noRecordsMatch: nothing new"); break
            raise SystemExit(f"OAI error {err.get('code')}: {err.text}")
        page += 1
        recs = root.findall("oai:ListRecords/oai:record", NS)
        for r in recs:
            h = r.find("oai:header", NS)
            oid = h.findtext("oai:identifier", namespaces=NS)
            ds = h.findtext("oai:datestamp", namespaces=NS)
            sets = [s.text for s in h.findall("oai:setSpec", NS)]
            deleted = 1 if h.get("status") == "deleted" else 0
            md = {}
            dcroot = r.find("oai:metadata/oai_dc:dc", NS)
            if dcroot is not None:
                for el in dcroot:
                    tag = el.tag.split("}")[1]
                    if el.text and el.text.strip():
                        md.setdefault(tag, []).append(el.text.strip())
            old = db.execute("select datestamp from rec where id=?", (oid,)).fetchone()
            if deleted: dele += 1
            elif old: upd += 1
            else: new += 1
            db.execute("insert or replace into rec values(?,?,?,?,?,?)",
                       (oid, ds, deleted, json.dumps(sets), json.dumps(md, ensure_ascii=False), started))
        tok = root.find("oai:ListRecords/oai:resumptionToken", NS)
        size = tok.get("completeListSize") if tok is not None else None
        cur = tok.get("cursor") if tok is not None else None
        print(f"page {page}: {len(recs)} records, cursor={cur}, completeListSize={size}, token={tok.text if tok is not None else None}", flush=True)
        db.commit()
        if tok is None or not (tok.text or "").strip():
            break
        params = {"verb": "ListRecords", "resumptionToken": tok.text.strip()}
        time.sleep(1)
    db.execute("insert or replace into state values(?,?,?)", (a.base, a.set or "", started))
    db.commit()
    total = db.execute("select count(*), sum(deleted) from rec").fetchone()
    print(f"done: {new} new, {upd} updated, {dele} deleted in this run; database now {total[0]} records ({total[1]} deleted); next run from {started}")

main()
في الكود أعلاه لاحظ التالي:
- الدالة fetch: ترسل الطلب، وتتعرف على User-Agent باسم واضح حتى يعرف صاحب المستودع من يحصد منه إذا راجع السجلات Logs، ثم تتأكد أن الرد XML فعلاً قبل أن تحاول قراءته، وسوف ترى بعد قليل لماذا أضفنا هذا الفحص.
- إعادة المحاولة: إذا رد المستودع بخطأ HTTP مثل 503، تقرأ الدالة الترويسة
Retry-Afterوتنتظر المدة التي يطلبها المستودع، ثم تحاول أربع مرات فقط، لأن إرشادات الحاصدين في موقع المبادرة تقول صراحة إن الحاصد يجب ألا يعيد المحاولة إلى ما لا نهاية. - الحلقة while: هي قلب البروتوكول. الطلب الأول فيه
metadataPrefixوsetوfrom، والطلبات التالية فيهاresumptionTokenفقط، لأن المعيار يمنع إرسال أي معامل آخر مع الرمز. - الحذف: الرأس الذي فيه
status="deleted"يحفظ بقيمة 1 في العمودdeleted، والبوابة التي تبنى فوق هذه القاعدة تعرض فقط ما قيمته 0. - التاريخ للحصاد التالي: يحفظ الكود
responseDateمن أول رد في هذا الحصاد، وليس ساعة جهازنا، ثم يطرح منه خمس دقائق في المرة التالية، وسوف نشرح السبب في قسم الحصاد التزايدي.
أول حصاد: كلية الشريعة في مستودع جامعة قطر
مستودع جامعة قطر اسمه QSpace، ويعمل على DSpace، وفيه وقت التجربة 68,798 تسجيلة كما أعلن الرمز في أول صفحة. ولن نحصده كله، وإنما نختار مجموعة واحدة، فأرسلنا ListSets فوجدنا كليات الجامعة كل منها مجتمع، واخترنا مجتمع كلية الشريعة والدراسات الإسلامية com_10576_60:
docker run --rm -v "$PWD:/lab" -w /lab lb3-py:1 \
  python harvest.py https://qspace.qu.edu.qa/server/oai/request qspace.db --set com_10576_60
والمخرج سوف يكون كما يلي:
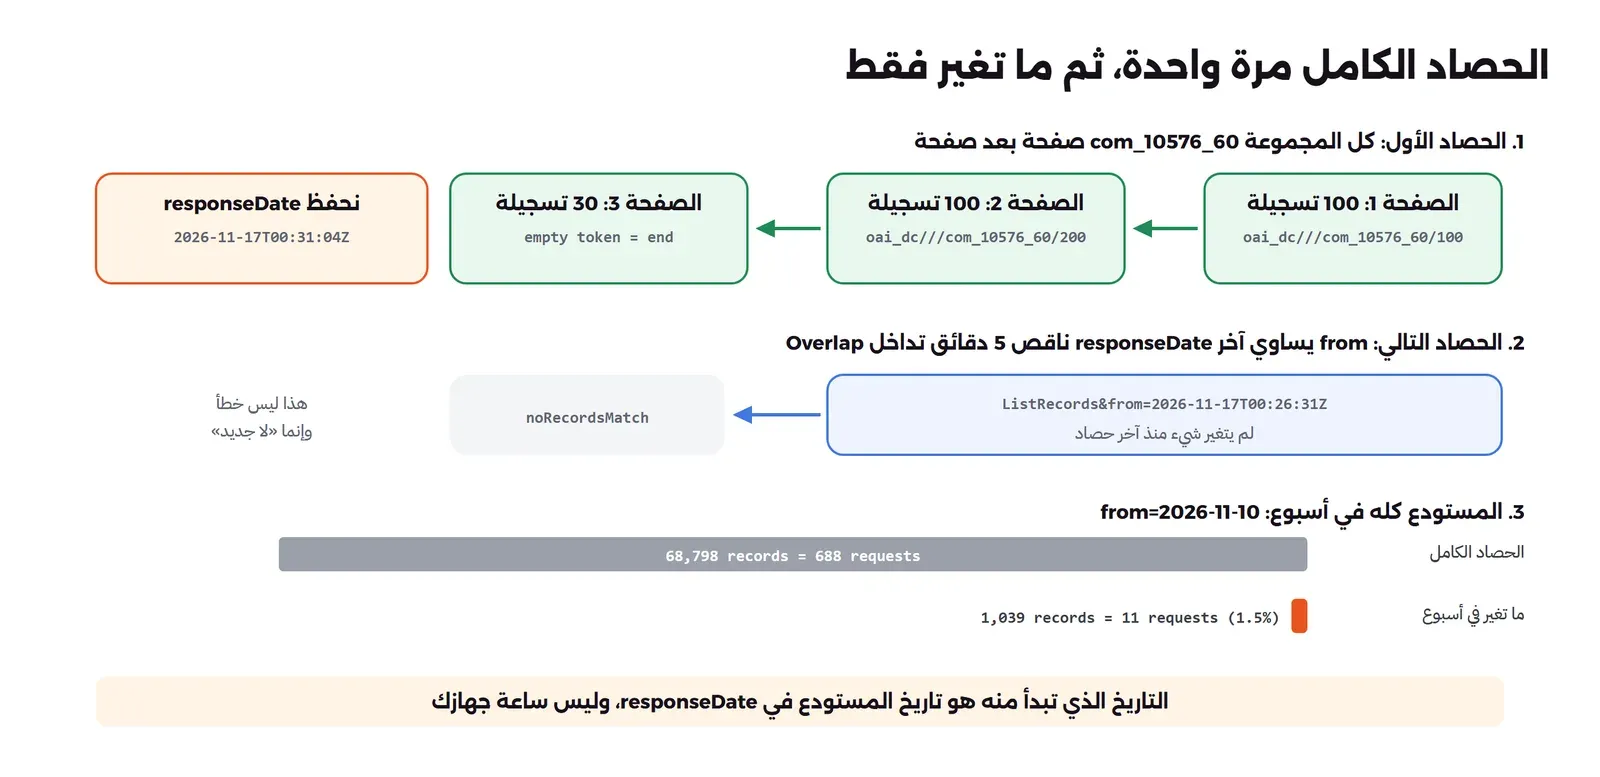
page 1: 100 records, cursor=0, completeListSize=230, token=oai_dc///com_10576_60/100
page 2: 100 records, cursor=1, completeListSize=230, token=oai_dc///com_10576_60/200
page 3: 30 records, cursor=2, completeListSize=230, token=None
done: 230 new, 0 updated, 0 deleted in this run; database now 230 records (0 deleted); next run from 2026-11-17T00:31:04Z
في المخرج أعلاه لاحظ التالي:
- ثلاثة طلبات لـ 230 تسجيلة: مئة ثم مئة ثم ثلاثون، والرمز في كل صفحة يحمل اسم الصيغة والمجموعة ورقم البداية
oai_dc///com_10576_60/100، أي أن DSpace يكتب في الرمز كل ما يحتاجه ليكمل، ولا يحفظ شيئاً عنده، وهذا تصميم جيد لأن الرمز لا تنتهي صلاحيته إذا تأخر الحاصد. - الصفحة الأخيرة بلا رمز: فيها العنصر
<resumptionToken completeListSize="230" cursor="2"/>فارغاً، وهذه هي علامة النهاية في المعيار. - قيمة cursor غريبة: المعيار يقول إن
cursorهو عدد التسجيلات التي أرسلت قبل هذه الصفحة، أي 0 ثم 100 ثم 200، ولكن DSpace يرسل رقم الصفحة 0 ثم 1 ثم 2. ولا تعتمد على هذه القيمة في حساب التقدم إذن، واحسب أنت عدد ما وصلك. - الصفحة الأولى الحقيقية: هذا أولها وآخرها، والوصف يأتي داخل عنصر
metadataلكل تسجيلة، والرمز في آخر الملف:
<responseDate>2026-11-17T00:48:23Z</responseDate>
<request verb="ListRecords" metadataPrefix="oai_dc" set="com_10576_60">https://qspace.qu.edu.qa/server/oai/request</request>
<ListRecords><record><header><identifier>oai:qspace.qu.edu.qa:10576/17724</identifier>
<datestamp>2024-07-23T11:23:23Z</datestamp><setSpec>com_10576_60</setSpec><setSpec>com_10576_33</setSpec> ...
...
   <dc:type>Master Thesis</dc:type>
   <dc:identifier>http://hdl.handle.net/10576/21410</dc:identifier>
   <dc:language>ar</dc:language>
   <dc:format>application/pdf</dc:format>
   <dc:accessType>Open Access</dc:accessType>
</oai_dc:dc></metadata></record><resumptionToken completeListSize="230" cursor="0">oai_dc///com_10576_60/100</resumptionToken></ListRecords>
ثم حصدنا مجتمعاً ثانياً في المستودع نفسه هو com_10576_44، وفيه 461 تسجيلة في خمس صفحات، وهنا ظهر الحذف لأول مرة:
page 1: 100 records, cursor=0, completeListSize=461, token=oai_dc///com_10576_44/100
page 2: 100 records, cursor=1, completeListSize=461, token=oai_dc///com_10576_44/200
page 3: 100 records, cursor=2, completeListSize=461, token=oai_dc///com_10576_44/300
page 4: 100 records, cursor=3, completeListSize=461, token=oai_dc///com_10576_44/400
page 5: 61 records, cursor=4, completeListSize=461, token=None
done: 458 new, 0 updated, 3 deleted in this run; database now 691 records (3 deleted); next run from 2026-11-17T00:31:33Z
أي أن 3 من 461 وصلت رؤوساً محذوفة، وعندما سألنا المستودع عن إحداها بالفعل GetRecord كان الرد رأساً عليه status="deleted" بلا أي وصف، كما في الصورة السابقة. ولاحظ أن تاريخ حذف اثنتين منها 2022-02-09، أي أن QSpace ما زال يتذكر حذفاً عمره أكثر من أربع سنوات رغم أنه يعلن transient، وهذا جيد للحاصدين، ولكنه وعد لا يلزمه به المعيار، لذلك لا تبن عليه.
ماذا يحدث إذا شغلته مرة ثانية؟ الحصاد التزايدي
الحصاد الكامل يحدث مرة واحدة، أما الحصاد اليومي فيجب أن يأخذ ما تغير فقط. شغلنا الأمر نفسه مع --incremental:
docker run --rm -v "$PWD:/lab" -w /lab lb3-py:1 \
  python harvest.py https://qspace.qu.edu.qa/server/oai/request qspace.db --set com_10576_60 --incremental
والمخرج سوف يكون كما يلي:
last run started 2026-11-17T00:31:31Z -> asking from 2026-11-17T00:26:31Z
noRecordsMatch: nothing new
done: 0 new, 0 updated, 0 deleted in this run; database now 691 records (3 deleted); next run from 2026-11-17T00:40:03Z
في المخرج أعلاه لاحظ التالي:
- noRecordsMatch ليس خطأ: المعيار يستخدم عنصر الخطأ
errorليقول «لا توجد تسجيلات بهذه الشروط»، والحاصد الذي يعامل كلerrorعلى أنه عطل سوف يرسل لك تنبيهاً كل ليلة لا يتغير فيها شيء. لذلك عامل هذا الرمز بالذات على أنه «لا جديد». - التداخل Overlap: آخر حصاد بدأ في 00:31:31 بتوقيت المستودع، فسأل الحاصد من 00:26:31. والسبب أن المستودع قد يكون عدل تسجيلة أثناء الحصاد السابق، فتاريخها قبل لحظة انتهائه ولكنها لم تكن في الصفحات التي وصلت. وإرشادات الحاصدين تطلب صراحة أن يبدأ الحصاد التالي من
responseDateفي أول رد من الحصاد السابق، وأن يتداخل قليلاً مع المستودعات التي دقتها بالثانية. والتداخل لا يضر، فالتسجيلة التي تصل مرتين تستبدل بمعرفها.
ولنرى الفرق الحقيقي في الحجم، سألنا المستودع كله عما تغير خلال أسبوع، من 10 نوفمبر:
docker run --rm -v "$PWD:/lab" -w /lab lb3-py:1 \
  python harvest.py https://qspace.qu.edu.qa/server/oai/request qspace-week.db --from 2026-11-10T00:00:00Z
page 1: 100 records, cursor=0, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///100
page 2: 100 records, cursor=1, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///200
page 3: 100 records, cursor=2, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///300
page 4: 100 records, cursor=3, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///400
page 5: 100 records, cursor=4, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///500
page 6: 100 records, cursor=5, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///600
page 7: 100 records, cursor=6, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///700
page 8: 100 records, cursor=7, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///800
page 9: 100 records, cursor=8, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///900
page 10: 100 records, cursor=9, completeListSize=1039, token=oai_dc/2026-11-10T00:00:00Z///1000
page 11: 39 records, cursor=10, completeListSize=1039, token=None
done: 1039 new, 0 updated, 0 deleted in this run; database now 1039 records (0 deleted); next run from 2026-11-17T00:40:18Zأي أن 1,039 تسجيلة تغيرت في أسبوع من أصل 68,798، وهذا 1.5% فقط، وأخذناها في 11 طلباً، بينما الحصاد الكامل يحتاج 688 طلباً، ومع انتظار ثانية بين كل طلبين يصبح الفرق دقائق مقابل ساعة تقريباً، وعلى سيرفر المستودع الفرق أكبر لأن كل صفحة استعلام على قاعدة بياناته. والصورة التالية تلخص الحصادين:
وإذا كان المستودع لا يتذكر الحذف؟ المقارنة الدورية
الحاصد الذي يعتمد على رؤوس الحذف وحدها يثق بالمستودع، ولكن ماذا لو كان المستودع يعلن deletedRecord بقيمة no، أو كان transient وغاب الحاصد شهرين بسبب عطل؟ في هذه الحالة لا يوجد في الحصاد التزايدي ما يخبرك بالحذف، والتسجيلة تبقى في بوابتك. والحل المعتاد مقارنة دورية Reconciliation، مرة في الأسبوع أو في الشهر بحسب حجم المستودع: يطلب الحاصد ListIdentifiers للمجموعة كلها، وهو رد خفيف فيه الرؤوس فقط دون الوصف، ثم يقارن قائمة المعرفات التي وصلت بقائمة المعرفات الحية في قاعدته، وكل معرف موجود عنده وغير موجود في رد المستودع يعلمه محذوفاً. وفي مجموعة ورقلة مثلاً، كانت قائمة ListIdentifiers صفحتين لـ 175 رأساً، وهذا أخف بكثير من إعادة حصاد الوصف كاملاً.
ولاحظ أن هذه المقارنة لا تغني عن رؤوس الحذف، وإنما تلتقط ما فاتها، ويجب أن تكون حذرة: إذا عاد رد ListIdentifiers فارغاً أو ناقصاً بسبب عطل في المستودع، فلا تحذف نصف بوابتك بناء عليه. لذلك ضع حداً، فإذا كان عدد المعرفات التي سوف تحذف أكثر من نسبة صغيرة، 5% مثلاً، فأوقف الحذف وأرسل تنبيهاً لإنسان يراجع، فالأرجح أن المشكلة في الرد وليس في المستودع.
مستودع جامعة ورقلة: ساعة السيرفر وتاريخ البداية
المستودع الثاني هو مستودع جامعة قاصدي مرباح في ورقلة بالجزائر، ويعمل أيضاً على DSpace، وفيه 30,938 تسجيلة، أغلب أسماء مجموعاته بالفرنسية وأغلب رسائل الآداب فيه بالعربية. حصدنا مجموعة رسائل الدكتوراه في قسم اللغة العربية col_123456789_224:
page 1: 100 records, cursor=0, completeListSize=175, token=oai_dc///col_123456789_224/100
page 2: 75 records, cursor=1, completeListSize=175, token=None
done: 168 new, 0 updated, 7 deleted in this run; database now 175 records (7 deleted); next run from 2026-11-17T01:22:02Z
أي 175 تسجيلة، منها 7 رؤوس محذوفة. وحتى الآن كل شيء طبيعي، ولكن عندما نظرنا في الردود نفسها ظهرت ثلاث مشكلات يجب أن يعرفها كل من يدير مستودعاً:
- ساعة السيرفر متقدمة 50 دقيقة: في اللحظة نفسها التي كانت الساعة فيها 00:32:49 بالتوقيت العالمي على جهازنا، رد المستودع بـ
responseDateقيمته 01:22:30، وترويسة HTTPDateفيها 01:22:31 GMT، أي أن ساعة السيرفر نفسها متقدمة نحو خمسين دقيقة، وليست مشكلة منطقة زمنية. وهذا هو سبب أن حاصدنا يأخذ التاريخ من رد المستودع وليس من ساعة الجهاز، فالتواريخ في تسجيلاته مكتوبة بساعته هو، فإذا سألته بساعتنا ضاعت التسجيلات التي تغيرت في هذه الخمسين دقيقة. والحل الصحيح عند صاحب المستودع أن يفعل مزامنة الوقت NTP على السيرفر. - أقدم تاريخ هو أمس: رد
Identifyيقول إنearliestDatestampهو 2026-11-16، بينما التسجيلات التي حصدناها تواريخها من 2020-03-10. والمعيار يقول إن هذه القيمة هي الحد الأدنى لكل التواريخ في المستودع، والحاصد الذي يثق بها ويبدأ منها سوف يفقد كل ما قبلها. - المعرفات باسم localhost: كل المعرفات بالشكل
oai:localhost:123456789/...، والرقم 123456789 هو البادئة التجريبية التي يأتي بها DSpace قبل تسجيل Handle حقيقي، وlocalhost هو الاسم الافتراضي. وقد حذرنا من هذا بالضبط في دليل DSpace، والنتيجة هنا أن أي بوابة تحصد عدة مستودعات بهذا الإعداد سوف ترى معرفات من عدة جامعات تبدأ كلها بـoai:localhost:123456789، وتعتمد على المسار وحده لتفرق بينها.
ثم وجدنا مشكلة رابعة أغرب. أخذنا معرفاً من القائمة oai:localhost:123456789/39143، وهو ما زال يظهر في ListIdentifiers رأساً عادياً غير محذوف، وطلبناه بالفعل GetRecord، فكان الرد:
<request verb="GetRecord" identifier="oai:localhost:123456789/39143" metadataPrefix="oai_dc">https://dspace.univ-ouargla.dz/oai/request</request>
<error code="idDoesNotExist">The given id does not exist</error>
بينما معرف آخر من القائمة نفسها 123456789/40030 عاد بوصفه كاملاً. والتفسير الأرجح ما شرحناه في دليل DSpace: واجهة OAI لا تقرأ قاعدة البيانات مباشرة، وإنما تقرأ فهرساً منفصلاً في Solr تملؤه المهمة dspace oai import، فإذا حذفت مادة أو نقلت ولم تعمل هذه المهمة بعدها، أصبح الفهرس يعلن تسجيلة لا يجدها النظام عندما يطلب تفاصيلها. ولاحظ أن رسالة 39143 لها تسجيلة أخرى بالعنوان نفسه رقمها 39363، كما سوف نرى في تقرير الجودة، فالأرجح أنها حذفت لأنها مكررة. لذلك إذا كنت تدير DSpace فتأكد أن مهمة oai import في جدول المهام المجدولة وأنها تنجح، ولا تكتف بأنها موجودة.
عندما لا يرد المستودع بـ XML
المستودع الثالث الذي جربناه هو مستودع جامعة الملك عبدالله للعلوم والتقنية KAUST، فرد على كل طلب برمز HTTP 200، وهو رمز النجاح، ولكن المحتوى كان صفحة HTML من جدار حماية تطبيقات الويب WAF يطلب التحقق من أن الزائر ليس برنامجاً. وهذا ما قاله حاصدنا:
  File "/lab/harvest.py", line 19, in fetch
    raise RuntimeError(f"not an OAI-PMH response (Content-Type: {ctype}), first bytes: {body[:80]!r}")
RuntimeError: not an OAI-PMH response (Content-Type: text/html), first bytes: b'<html style="height:100%"><head><META NAME="ROBOTS" CONTENT="NOINDEX, NOFOLLOW">'
وهذا هو سبب الفحص الذي وضعناه في الدالة fetch. فالحاصد البسيط الذي ينظر إلى رمز HTTP فقط يرى 200، ثم يبحث عن تسجيلات في الرد فلا يجد، فيسجل أن المستودع فارغ أو أن لا جديد فيه، ويستمر على ذلك أشهراً دون أن ينتبه أحد. والمشكلة هنا ليست عند الحاصد، فالمستودع حمى نفسه من البرامج الآلية، والحاصد برنامج آلي بطبيعته، والحل عند صاحب المستودع أن يستثني المسار /oai من فحص الزوار، أو أن يعطي الحاصدين المعروفين استثناء. وإذا كان مستودعك خلف Cloudflare أو أي جدار مشابه، فجرب واجهة OAI من سيرفر خارجي بالأمر curl، وليس من المتصفح، لأن المتصفح يجتاز الفحص ولا يريك المشكلة.
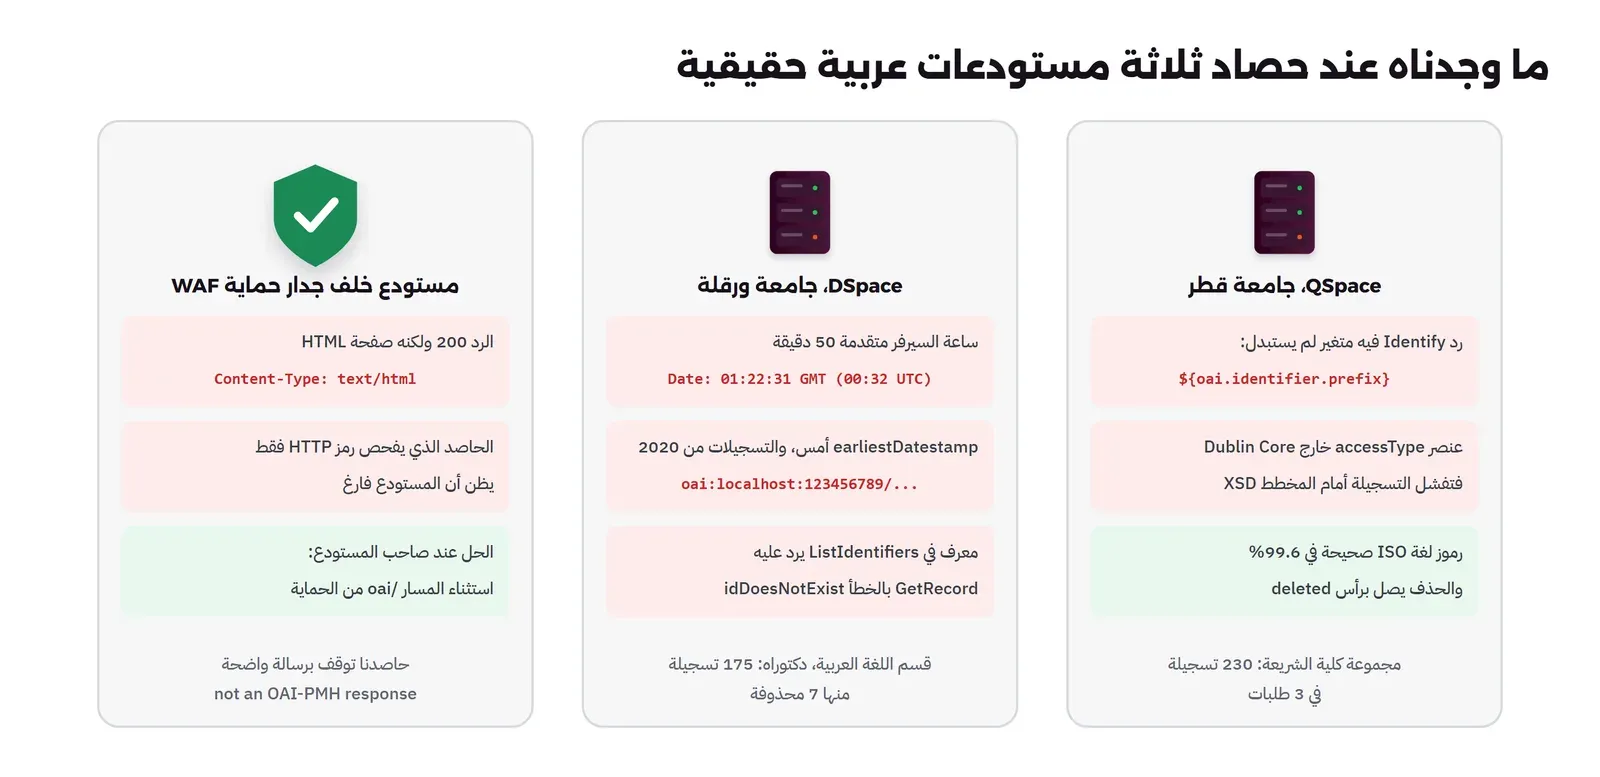
وفي الصورة لاحظ مشكلة أخرى في QSpace لم نذكرها بعد: رد Identify فيه العنصر repositoryIdentifier بالقيمة ${oai.identifier.prefix} حرفياً، أي متغير في ملف إعداد لم يستبدل بقيمته عند التثبيت. ومع ذلك فالمعرفات الحقيقية في التسجيلات صحيحة oai:qspace.qu.edu.qa:...، أي أن الخطأ في الوصف فقط، ولكن أدوات التحقق من المستودعات التي تقرأ Identify سوف تعترض عليه. وهذا يذكرك بأن رد Identify هو بطاقة تعريف مستودعك أمام كل الحاصدين، فاقرأه بنفسك بعد كل تحديث.
الأخطاء التي يعيدها البروتوكول، وتاريخ يعيد كل شيء
المعيار يعرف رموز أخطاء محددة يعيدها المستودع داخل عنصر error، والحاصد الجيد يفرق بينها، لأن بعضها خطأ عنده هو، وبعضها مجرد «لا يوجد». كتبنا سكربتاً يسأل QSpace أسئلة خاطئة عن قصد، وشغلناه من Container الرسمي curlimages/curl بالإصدار 8.23.0:
#!/bin/sh
# Ask the repository wrong questions on purpose and print the error element (or the request echo if none).
B=${1:-https://qspace.qu.edu.qa/server/oai/request}
ask() {
  r=$(curl -s -m 60 "$B?$1")
  e=$(printf '%s' "$r" | grep -o '<error[^>]*>[^<]*</error>' | head -1)
  [ -z "$e" ] && e="NO ERROR, echo: $(printf '%s' "$r" | grep -o '<request[^>]*>' | head -1)"
  printf '%s\n    %s\n' "$1" "$e"
}
ask "verb=ListRecord&metadataPrefix=oai_dc"
ask "verb=ListRecords"
ask "verb=ListRecords&metadataPrefix=marc21"
ask "verb=ListRecords&metadataPrefix=oai_dc&from=17-11-2026"
ask "verb=ListRecords&metadataPrefix=oai_dc&from=2026-11-10&until=2026-11-01"
ask "verb=ListRecords&metadataPrefix=oai_dc&from=2030-01-01"
ask "verb=ListRecords&metadataPrefix=oai_dc&set=com_10576_51"
ask "verb=ListRecords&resumptionToken=hello"
ask "verb=GetRecord&metadataPrefix=oai_dc&identifier=oai:qspace.qu.edu.qa:10576/0"
والمخرج سوف يكون كما يلي:
verb=ListRecord&metadataPrefix=oai_dc
    <error code="badVerb">Illegal verb</error>
verb=ListRecords
    <error code="badArgument">ListRecords verb must receive the metadataPrefix parameter</error>
verb=ListRecords&metadataPrefix=marc21
    <error code="cannotDisseminateFormat">Unknown metadata format</error>
verb=ListRecords&metadataPrefix=oai_dc&from=17-11-2026
    NO ERROR, echo: <request verb="ListRecords" metadataPrefix="oai_dc" from="0023-05-19T00:00:00Z">
verb=ListRecords&metadataPrefix=oai_dc&from=2026-11-10&until=2026-11-01
    <error code="badArgument">The 'from' date must be less then the 'until' one</error>
verb=ListRecords&metadataPrefix=oai_dc&from=2030-01-01
    <error code="noRecordsMatch">No matches for the query</error>
verb=ListRecords&metadataPrefix=oai_dc&set=com_10576_51
    <error code="noRecordsMatch">No matches for the query</error>
verb=ListRecords&resumptionToken=hello
    <error code="badResumptionToken">The resumption token is invalid</error>
verb=GetRecord&metadataPrefix=oai_dc&identifier=oai:qspace.qu.edu.qa:10576/0
    <error code="idDoesNotExist">The given id does not exist</error>
وهذه الأخطاء مع معناها وما يفعله الحاصد في كل منها:
| الرمز | متى ظهر | ما يفعله الحاصد |
|---|---|---|
badVerb | فعل مكتوب خطأ ListRecord | خطأ في الكود، يتوقف ويبلغ |
badArgument | معامل ناقص، أو from بعد until | خطأ في الكود، يتوقف ويبلغ |
cannotDisseminateFormat | صيغة لا يعرفها المستودع marc21، وهو يسميها marc | يرجع إلى ListMetadataFormats ويختار من القائمة |
noRecordsMatch | تاريخ في المستقبل، أو مجموعة فارغة | ليس خطأ: لا جديد |
badResumptionToken | رمز معدل أو منتهي الصلاحية | يعيد الحصاد من آخر تاريخ ناجح |
idDoesNotExist | معرف غير موجود | يسجل التسجيلة للمراجعة |
ولكن أهم سطر في المخرج هو السطر الذي لا خطأ فيه. أرسلنا التاريخ بالصيغة التي يكتبها أغلبنا يومياً 17-11-2026، أي اليوم ثم الشهر ثم السنة، والمعيار يلزم المستودع أن يرد على أي تاريخ بغير صيغة ISO 8601 بالخطأ badArgument. ولكن DSpace قبله، وفسره على أنه السنة 0023 من الميلاد، كما يظهر في صدى الطلب from="0023-05-19T00:00:00Z"، ثم أعاد كل تسجيلات المستودع منذ ذلك التاريخ، أي كل شيء. وجربنا الطلب نفسه على نسخة DSpace التجريبية الرسمية فكانت النتيجة نفسها، أي أن هذا سلوك البرنامج وليس إعداد جامعة بعينها.
تخيل الآن حاصداً كتبه مبرمج يحفظ التاريخ بصيغة يوم-شهر-سنة: كل ليلة يظن أنه يأخذ ما تغير منذ أمس، وفي الحقيقة يحصد سبعين ألف تسجيلة كاملة، فيضغط على سيرفر المستودع ساعة كل ليلة، والبوابة تعمل جيداً فلا يشك أحد. لذلك اكتب التاريخ دائماً بصيغة YYYY-MM-DDThh:mm:ssZ من الكود وليس يدوياً، وراقب عدد التسجيلات في كل حصاد تزايدي، فإذا كان قريباً من حجم المستودع كله فهناك خطأ في التاريخ.
request داخل الرد، فهو يبين كيف فهم المستودع التاريخ الذي أرسلته.ما الذي يضيع في Dublin Core؟
قلنا إن oai_dc صيغة يفهمها الجميع، ولكن ما الثمن؟ أخذنا رسالة ماجستير واحدة من QSpace، رقمها 10576/17724، وطلبناها مرتين: مرة بـ oai_dc، ومرة بـ dim وهي الصيغة الداخلية في DSpace التي فيها كل الحقول كما أدخلها المفهرس:
B=https://qspace.qu.edu.qa/server/oai/request
curl -s "$B?verb=GetRecord&metadataPrefix=oai_dc&identifier=oai:qspace.qu.edu.qa:10576/17724" > rec-oai_dc.xml
curl -s "$B?verb=GetRecord&metadataPrefix=dim&identifier=oai:qspace.qu.edu.qa:10576/17724"    > rec-dim.xml
وهذه الحقول المهمة في dim، الاسم المؤهل ثم القيمة:
dc.contributor.advisor        صالح, أيمن
dc.contributor.author         المري, سارة محمد
dc.date.available             2021-02-18T08:13:48Z
dc.date.issued                2021-01
dc.title                      إحلال المفاهيم عوامله وآثارها : الجهاد والإرهاب أنموذجًا
dc.title.alternative          Substitution of Concepts: Factors and Their Effects, ...
dc.department                 الفقه وأصوله
dc.accessType                 Open Access
وهذه الحقول نفسها كما وصلت في oai_dc:
<dc:title>إحلال المفاهيم عوامله وآثارها : الجهاد والإرهاب أنموذجًا</dc:title>
<dc:title>Substitution of Concepts: Factors and Their Effects, Jihad and terrorism as a Model, An Analytical Study.</dc:title>
<dc:creator>المري, سارة محمد</dc:creator>
<dc:contributor>صالح, أيمن</dc:contributor>
<dc:date>2021-02-18T08:13:48Z</dc:date>
<dc:date>2021-01</dc:date>
<dc:type>Master Thesis</dc:type>
<dc:language>ar</dc:language>
<dc:accessType>Open Access</dc:accessType>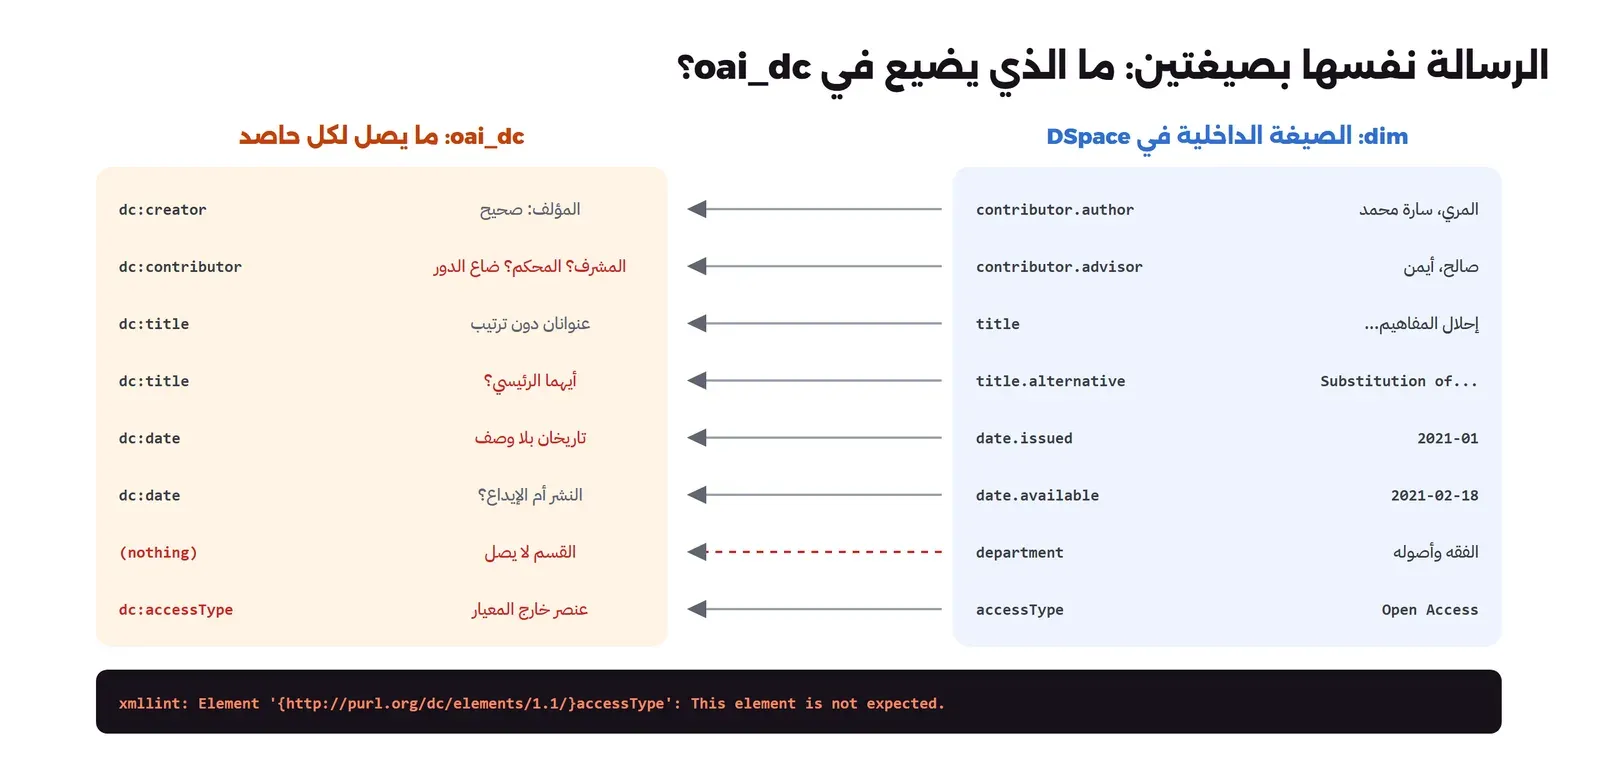
في المقارنة أعلاه لاحظ التالي:
- المشرف أصبح مساهماً:
advisorتحول إلىdc:contributorدون أي إشارة إلى الدور، فالبوابة التي تريد أن تعرض «الرسائل التي أشرف عليها الدكتور فلان» لا تستطيع أن تفرق بين المشرف والمحكم والمترجم. - تاريخان دون وصف: تاريخ الإتاحة في المستودع وتاريخ إصدار الرسالة كلاهما
dc:date، والحاصد يجب أن يخمن، والتخمين المعتاد أن السنة القصيرة هي تاريخ النشر. - القسم لم يصل:
dc.departmentحقل محلي أضافته الجامعة، وليس له مقابل في Dublin Core، فلم يرسل أصلاً. - العنصر الزائد:
dc:accessTypeليس من عناصر Dublin Core الخمسة عشر، والجامعة أضافته إلى تحويل oai_dc.
والنقطة الأخيرة لها أثر أكبر مما تبدو، فتحققنا من التسجيلة أمام مخطط oai_dc.xsd الرسمي من موقع المبادرة بالأداة xmllint من libxml2 2.9.14 في Container من Debian 13:
#!/bin/sh
# Extract the oai_dc:dc element of a GetRecord response and validate it against the official oai_dc schema.
xmlstarlet sel -N d=http://www.openarchives.org/OAI/2.0/oai_dc/ -t -c "//d:dc" "$1" > /tmp/dc.xml
xmllint --noout --schema oai_dc.xsd /tmp/dc.xml
/tmp/dc.xml:19: element accessType: Schemas validity error : Element '{http://purl.org/dc/elements/1.1/}accessType': This element is not expected.
/tmp/dc.xml fails to validate
/tmp/dc.xml:1: parser error : Document is empty
^
/tmp/dc.xml:1: parser error : Document is empty
^أي أن التسجيلة غير صالحة حسب المخطط الرسمي، والحاصد المتشدد الذي يتحقق من كل رد قبل قبوله سوف يرفضها، أما تسجيلة ورقلة فنجحت في الفحص نفسه. وإذا كنت تريد أن تنشر حقلاً محلياً للحاصدين فمكانه صيغة أغنى تسمح به، وليس oai_dc. وإذا كنت الحاصد وتحتاج الأدوار والتفاصيل، فاحصد صيغة أغنى من المستودعات التي تقدمها، مثل mods، أو صيغة متخصصة في الرسائل مثل etdms التي يقدمها DSpace، وارجع إلى oai_dc فقط للمستودعات التي لا تقدم غيرها.
ولاحظ شيئاً آخر في الملخص العربي لهذه الرسالة كما وصل في الحصاد: «أن للمفاهيم أربع حالت» و«ودللتها»، والصحيح «حالات» و«ودلالتها». والأرجح أن الملخص نسخ من ملف PDF، وأداة النسخ أسقطت حرفي «لا» حين يرسمهما الخط شكلاً واحداً Ligature. وهذه مشكلة لا يراها الحاصد ولا البروتوكول، ولكنها تجعل البحث عن «دلالة» لا يجد هذه الرسالة، وسوف نعود إلى استخراج النص العربي من الصفحات في مقال رقمنة المخطوطات.
تقرير الجودة: أرقام من 856 تسجيلة
بعد الحصاد صار عندنا 856 تسجيلة حية في ملفي SQLite، 688 من QSpace و168 من ورقلة، والسؤال الذي يهم من يبني بوابة: هل هذه التسجيلات صالحة للبحث والعرض كما هي؟ كتبنا سكربتاً صغيراً يحسب ذلك:
"""Quality report for a harvested SQLite file: python stats.py DB"""
import sqlite3, sys, json, re, collections
ARABIC = re.compile(r"[\u0600-\u06FF]")
db = sqlite3.connect(sys.argv[1])
rows = [(i, json.loads(m)) for i, m in db.execute("select id, md from rec where deleted=0")]
n = len(rows)
dele = db.execute("select count(*) from rec where deleted=1").fetchone()[0]
print(f"live records: {n}, deleted: {dele}")
print("field presence (% of live records):")
for f in ["title", "creator", "contributor", "subject", "description", "date", "type", "language", "identifier", "rights", "publisher", "format"]:
    c = sum(1 for _, m in rows if f in m)
    print(f"  {f:<12} {c:>4}  {100*c/n:5.1f}%")
ar_title = sum(1 for _, m in rows if any(ARABIC.search(t) for t in m.get("title", [])))
print(f"titles in Arabic script: {ar_title} ({100*ar_title/n:.1f}%)")
multi_title = sum(1 for _, m in rows if len(m.get("title", [])) > 1)
print(f"records with more than one title: {multi_title}")
def top(field, k=8, fn=lambda v: v):
    c = collections.Counter(fn(v) for _, m in rows for v in m.get(field, []))
    print(f"{field} values ({len(c)} distinct):", ", ".join(f"{v!r}:{x}" for v, x in c.most_common(k)))
top("language"); top("type")
top("date", 6, lambda v: re.sub(r"\d", "9", v))
ids = collections.Counter()
for _, m in rows:
    for v in m.get("identifier", []):
        ids["handle" if "hdl.handle.net" in v or "/handle/" in v else "doi" if "doi" in v.lower() else "isbn/issn" if re.match(r"^(97[89]|\d{4}-\d{3})", v) else "other"] += 1
print("identifier kinds:", dict(ids))
norm = lambda t: re.sub(r"[\u064B-\u0652\u0640]", "", re.sub(r"[أإآ]", "ا", re.sub(r"ة", "ه", re.sub(r"ى", "ي", t)))).lower()
norm2 = lambda t: re.sub(r"[^\w]", "", norm(t))
titles = collections.Counter(norm2(m["title"][0]) for _, m in rows if m.get("title"))
dups = {t: c for t, c in titles.items() if c > 1}
print(f"possible duplicates (same normalised first title): {sum(dups.values())} records in {len(dups)} groups")
for t, c in list(dups.items())[:3]:
    ex = [i for i, m in rows if m.get("title") and norm2(m["title"][0]) == t]
    print("  e.g.", c, ex[:3])
creators = collections.Counter(v for _, m in rows for v in m.get("creator", []))
print("creator name forms sample:", list(creators.items())[:6])
وهذا تقرير QSpace:
live records: 688, deleted: 3
field presence (% of live records):
  title         688  100.0%
  creator       688  100.0%
  contributor   321   46.7%
  subject       688  100.0%
  description   688  100.0%
  date          688  100.0%
  type          688  100.0%
  language      688  100.0%
  identifier    688  100.0%
  rights          0    0.0%
  publisher     446   64.8%
  format        514   74.7%
titles in Arabic script: 665 (96.7%)
records with more than one title: 323
language values (4 distinct): 'ar':653, 'en':25, 'tr':7, 'en_ar':3
type values (8 distinct): 'Article':335, 'Master Thesis':221, 'Book':64, 'Conference':32, 'Book chapter':25, 'Dissertation':9, 'Presentation':3, 'Book Review':1
date values (4 distinct): '9999-99-99T99:99:99Z':688, '9999':341, '9999-99':272, '9999-99-99':75
identifier kinds: {'handle': 690, 'other': 1416, 'isbn/issn': 432, 'doi': 147}
possible duplicates (same normalised first title): 4 records in 2 groups
  e.g. 2 ['oai:qspace.qu.edu.qa:10576/4217', 'oai:qspace.qu.edu.qa:10576/17457']
  e.g. 2 ['oai:qspace.qu.edu.qa:10576/42334', 'oai:qspace.qu.edu.qa:10576/61596']
creator name forms sample: [('المري, سارة محمد', 2), ('المهندي, شريفة علي عيسى الحسن', 1), ('سالم, سعد', 1), ('المري, مريم حمد جابر الغياثين', 1), ('مقارح, نورة راشد', 1), ('عبد العزيز, آية فكري عبد المقتدر', 1)]
وهذا تقرير ورقلة:
live records: 168, deleted: 7
field presence (% of live records):
  title         168  100.0%
  creator       168  100.0%
  contributor   166   98.8%
  subject       148   88.1%
  description   168  100.0%
  date          168  100.0%
  type          167   99.4%
  language      112   66.7%
  identifier    168  100.0%
  rights          0    0.0%
  publisher      91   54.2%
  format          0    0.0%
titles in Arabic script: 168 (100.0%)
records with more than one title: 1
language values (2 distinct): 'other':111, 'fr':1
type values (3 distinct): 'Thesis':163, 'Other':3, 'theses':1
date values (3 distinct): '9999-99-99T99:99:99Z':324, '9999':168, '9999T99:99:99Z':12
identifier kinds: {'handle': 168}
possible duplicates (same normalised first title): 8 records in 4 groups
  e.g. 2 ['oai:localhost:123456789/39143', 'oai:localhost:123456789/39363']
  e.g. 2 ['oai:localhost:123456789/40030', 'oai:localhost:123456789/40607']
  e.g. 2 ['oai:localhost:123456789/40311', 'oai:localhost:123456789/40652']
creator name forms sample: [('بولنوار, سعد', 1), ('خليفة, بولفعة', 1), ('حسيني, الطاهر', 1), ('محــدادي, عــلي', 1), ('شتيح, ابن يوسف', 1), ('سـليـم عـواريـب', 1)]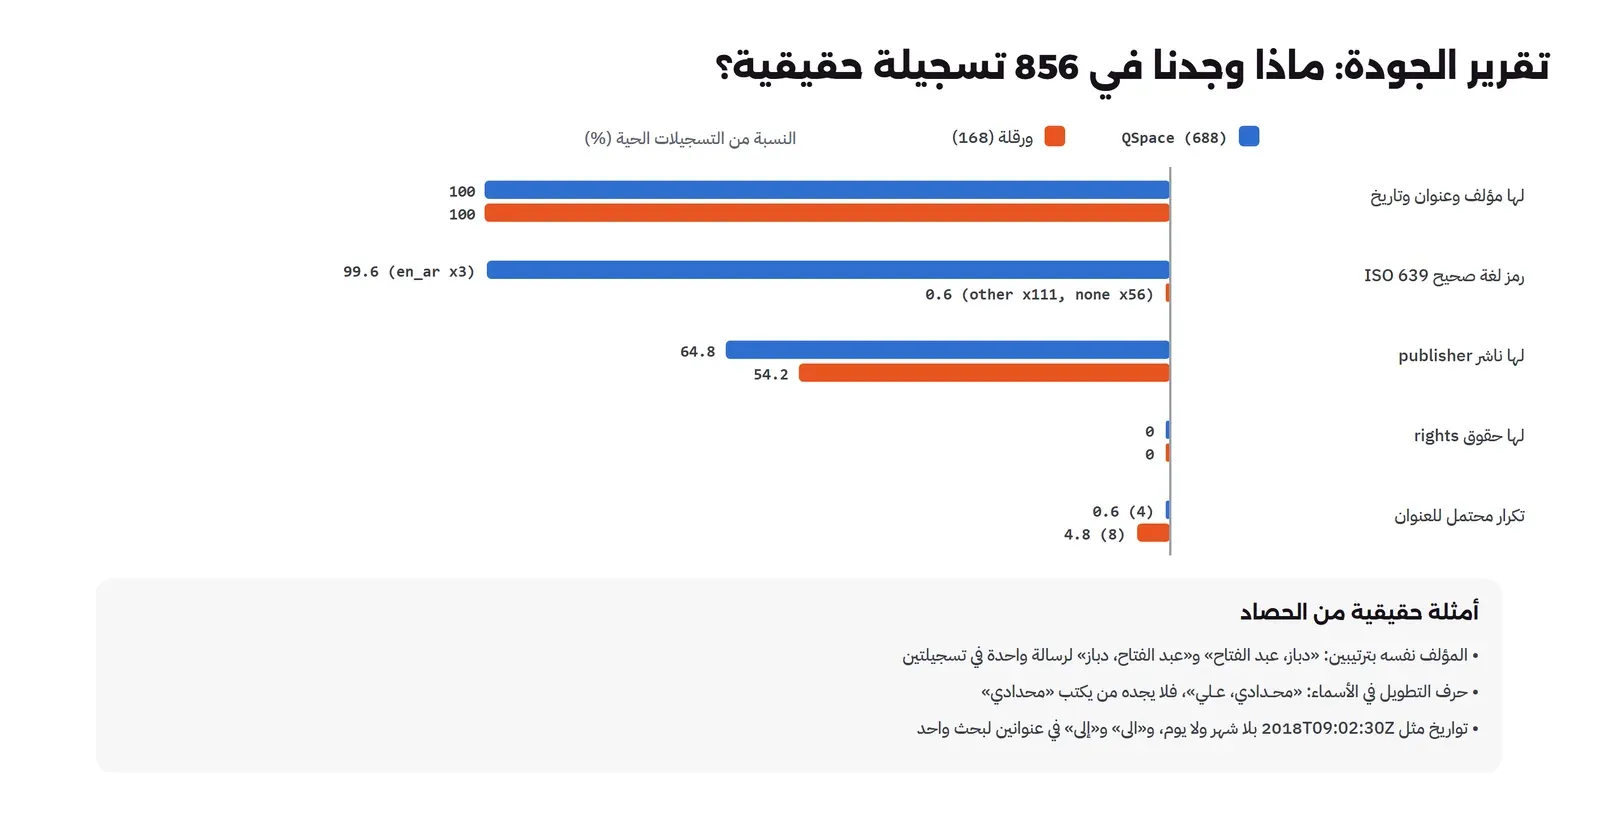
والآن نقرأ الأرقام معاً، لأن كل رقم منها له أثر مباشر على البوابة:
- اللغة: QSpace يستخدم رموز ISO 639 القياسية
arوenوtr، إلا ثلاث تسجيلات بالرمزen_arالذي لا يوجد في أي معيار. أما ورقلة فيضعotherفي 111 رسالة كل عناوينها عربية، ولا يضع شيئاً في 56، ويضعfrلرسالة عنوانها «معجم مفردات أسماء النبات في معجم لسان العرب». وبالتالي إذا وضعت البوابة مرشحاً «اللغة: العربية» اختفت كل رسائل ورقلة من النتائج، وهي كلها رسائل عربية. والسبب في الغالب أن قائمة اللغات في نموذج الإيداع في DSpace لا تحتوي العربية افتراضياً، فيختار الموظف «أخرى». - التاريخ: في QSpace التواريخ بأربعة أشكال: سنة فقط، وسنة وشهر، وتاريخ كامل، وتاريخ ووقت، وكلها صحيحة حسب ISO 8601. أما في ورقلة فهناك 12 تاريخاً بالشكل
2018T09:02:30Z، أي سنة ثم وقت دون شهر ولا يوم، وهذا ليس تاريخاً صالحاً، والبوابة التي تفرز بالسنة يجب أن تأخذ أول أربعة أرقام وتتجاهل الباقي. - التكرار: بعد توحيد الهمزات والتاء المربوطة والياء وحذف التشكيل والترقيم، وجد السكربت 4 تسجيلات في مجموعتين في QSpace، و8 في أربع مجموعات في ورقلة. ومثال ورقلة واضح: الرسالة «أصول النحو عند ابن قيم الجوزية من خلال مؤلفاته» موجودة برقمين 39143 و39363، والمؤلف مرة «دباز، عبد الفتاح» ومرة «عبد الفتاح، دباز»، أي أن الرسالة أودعت مرتين وبترتيب مختلف للاسم. ومثال QSpace مختلف: «وسائل دعوة الصم الى الإسلام» في 2015 و«وسائل دعوة الصم إلى الإسلام» في 2020، والفرق همزة واحدة، فقد يكون البحث نفسه نشر مرتين، أو إيداعاً مكرراً، وهذا يحتاج إنساناً يقرر.
- الأسماء: في ورقلة أسماء مكتوبة بحرف التطويل Tatweel مثل «محــدادي، عــلي» و«سـليـم عـواريـب»، ومن يبحث عن «محدادي» لن يجدها إلا إذا حذفت البوابة هذا الحرف قبل الفهرسة. وبعض الأسماء بالترتيب «العائلة، الاسم» وبعضها «الاسم العائلة» دون فاصلة، وتوحيد الأسماء موضوع مقال ملفات الإسناد في مرحلة الفهرسة.
- الحقوق: لا توجد تسجيلة واحدة في المستودعين فيها
dc:rights. وهذا يعني أن البوابة لا تعرف هل يحق لها أن تعرض الملخص كاملاً أو أن تشير إلى ترخيص، وQSpace يضع المعلومة فيdc:accessTypeغير القياسي، فلا يراها إلا الحاصد الذي يعرف هذا الحقل بالذات. - العنوان المتعدد: 323 تسجيلة في QSpace فيها أكثر من عنوان، والثاني عادة الترجمة الإنجليزية أو التركية، ولأن oai_dc لا يقول أيهما الرئيسي، فالبوابة التي تعرض أول عنوان تعرضه بالعربية في الغالب، وهذا صحيح هنا، ولكنه صدفة الترتيب وليس قاعدة.
وقد يتساءل البعض: هل نصلح هذه البيانات في البوابة أم نطلب من المستودعات إصلاحها؟ والإجابة: الاثنان، ولكل منهما دوره. البوابة تطبق تنظيفاً آلياً لا يغير المعنى، مثل حذف التطويل وتوحيد الهمزات في فهرس البحث فقط، وتحويل other إلى «غير محدد» وليس إلى «العربية»، لأن التخمين في البيانات الوصفية يصنع أخطاء جديدة. أما ما يحتاج قراراً، مثل دمج التسجيلتين المكررتين أو تصحيح اللغة، فمكانه المستودع نفسه، فترسل البوابة لكل مستودع تقريراً دورياً مثل الذي حسبناه، والمستودع يصحح عنده، فيصل التصحيح لكل الحاصدين في الحصاد التالي وليس لبوابة واحدة فقط.
أين تذهب تسجيلاتك بعد الحصاد؟
عندما يكون مستودعك سليماً، فهذه أمثلة على من يحصده، ولكل منهم شروطه:
- المجمعات الأكاديمية العالمية: مثل BASE من مكتبة جامعة بيليفيلد، وCORE البريطاني، وOpenAIRE الأوروبي الذي ينشر إرشادات مفصلة لما يجب أن يكون في التسجيلة، وكلها تبدأ من رابط OAI-PMH تسجله لديها.
- البوابات الوطنية والمتخصصة: مثل اتحاد NDLTD للرسائل الجامعية، والبوابات الوطنية للرسائل في الدول التي لديها مثلها.
- طبقة الاكتشاف في جامعتك: مثل VuFind الذي جمع Koha وDSpace في مربع بحث واحد.
أما Google Scholar فطريقه مختلف، فهو لا يعتمد على الحصاد، وإنما يزحف إلى صفحات المستودع نفسها ويقرأ وسوم meta في رأس كل صفحة مثل citation_title، كما تقول إرشادات الإدراج عنده، ويوصي فيها المستودعات الجامعية باستخدام أحدث إصدار من DSpace. لذلك لا تحكم على مستودعك من ظهوره في Google Scholar وحده، فقد يظهر هناك ويكون OAI فيه معطلاً تماماً، والعكس.
إذا كنت أنت المستودع: إعدادات تحمي الحاصدين
كل ما وجدناه في المختبر يمكن تجنبه بإعدادات يراجعها مدير المستودع مرة واحدة، ثم بعد كل تحديث. وهذه القائمة مبنية على إرشادات المستودعات في موقع المبادرة وعلى توثيق OAI في DSpace:
- اقرأ رد Identify بنفسك: الاسم الحقيقي للمستودع، وبريد يقرؤه إنسان، وبادئة المعرفات باسم نطاقك وليس localhost، ولا يوجد أي متغير بالشكل
${...}. - اختر البادئة مرة واحدة: تغيير بادئة المعرفات بعد أن يحصد منك أحد يجعل كل تسجيلاتك جديدة في نظره، وكل القديمة باقية عنده لا يعرف أنها نفسها.
- زامن الساعة: فعل NTP على السيرفر، فالتواريخ هي أساس الحصاد التزايدي كله.
- تأكد من المهمة التي تملأ OAI: في DSpace هي
dspace oai import، وضعها في جدول المهام وراقب أنها تنجح، وقارن عدد التسجيلات فيcompleteListSizeبعدد المواد في المستودع. - تذكر المحذوف: إذا استطعت أن تجعل
deletedRecordبقيمةpersistentفافعل، وإذا بقيتtransientفلا تحذف رؤوس المحذوف إلا بعد مدة طويلة. - رموز لغة قياسية: أضف العربية إلى قائمة اللغات في نموذج الإيداع بالرمز
ar، ولا تتركotherخياراً سهلاً. - لا تضف عناصر إلى oai_dc: الحقول المحلية مكانها صيغة أغنى، واختبر التسجيلة أمام المخطط بعد كل تعديل على قوالب التحويل.
- استثن /oai من حماية الزوار: وجرب من سيرفر خارجي بالأمر curl بعد كل تغيير في جدار الحماية.
إذا كنت الحاصد: أي أداة تستخدم؟
الحاصد الذي كتبناه يكفي لتفهم البروتوكول ولتحسب تقارير الجودة، ولكن في الإنتاج قد تكون الأداة الجاهزة أنسب، والجدول التالي يساعدك في القرار:
| الحالة | الأنسب | والسبب |
|---|---|---|
| طبقة اكتشاف تجمع فهرس المكتبة والمستودع | أداة الحصاد في VuFind | تحصد وتفهرس في Solr بقواعد جاهزة لـ MARC وDublin Core |
| بوابة رسائل تجمع مستودعات عدة جامعات | حاصد مكتوب بمكتبة مثل Sickle، مع قاعدة بيانات وتقرير جودة | تحتاج تحكماً في التنظيف والتكرار والتنبيهات لكل مستودع |
| تحليل لمرة واحدة أو تقرير لمستودعك | سكربت مثل الذي في هذا المقال | بسيط، ونتيجته ملف SQLite تفتحه بأي أداة |
| تريد أن يظهر مستودعك في البوابات العالمية | لا تحتاج حاصداً | تحتاج مستودعاً سليماً وتسجيل رابطه لدى كل مجمع |
وأياً كانت الأداة، فهذه قواعد الحاصد الجيد: يحفظ responseDate من أول رد ويبدأ منه مع تداخل، ويتعامل مع الحذف، ويفرق بين noRecordsMatch والخطأ، ويحترم Retry-After، ويتحقق أن الرد XML، وينتظر ثانية على الأقل بين الطلبات، ويعرف نفسه باسم وبريد في User-Agent.
أخطاء شائعة في الحصاد وحلولها
| الخطأ | ما الذي يحدث | الحل |
|---|---|---|
| التاريخ بصيغة يوم-شهر-سنة | DSpace يفهمه سنة 0023 ويعيد المستودع كله كل ليلة | صيغة ISO 8601 من الكود، ومراقبة حجم كل حصاد |
| البدء من ساعة جهاز الحاصد | تضيع التسجيلات التي تغيرت بين الساعتين، كما في ورقلة | responseDate من المستودع مع تداخل بضع دقائق |
| تجاهل رؤوس الحذف | البوابة تعرض رسائل سحبت، وروابطها 404 | حذف التسجيلة من الفهرس عند status="deleted" |
| اعتبار noRecordsMatch عطلاً | تنبيه كل ليلة لا جديد فيها، فيتجاهل الفريق التنبيهات كلها | معاملته على أنه «لا جديد» |
| فحص رمز HTTP فقط | صفحة WAF برمز 200 تبدو مستودعاً فارغاً | التأكد أن الرد XML فيه OAI-PMH |
| حفظ التسجيلة حسب المجموعة | الرسالة نفسها ثلاث مرات من ثلاث مجموعات | المفتاح هو المعرف وحده |
| الثقة بـ earliestDatestamp | البدء من أمس وفقدان كل ما قبله | الحصاد الأول دون from |
| تصحيح البيانات في البوابة وحدها | التصحيح يضيع مع الحصاد التالي | تقرير جودة يرسل للمستودع، وتنظيف آلي محدود في البوابة |
قائمة تحقق قبل أن تضيف مستودعاً إلى بوابتك
- رد
Identifyصحيح: الاسم والبريد والبادئة، وdeletedRecordمعروف. - الرد XML حقيقي من سيرفر خارجي، وليس صفحة حماية.
- الصيغة المختارة أغنى صيغة يقدمها المستودع وتفهمها البوابة.
- المجموعات المطلوبة معروفة، والتسجيلة تحفظ بمعرفها.
- الحصاد الأول كامل دون
from، وعدد ما وصل يساويcompleteListSize. - تاريخ الحصاد التالي من
responseDateمع تداخل. - تقرير الجودة الأول أرسل إلى المستودع: اللغة، والتواريخ، والتكرار، والحقوق.
- تنبيه إذا فشل الحصاد، أو إذا كان الحصاد التزايدي كبيراً بشكل غير طبيعي، أو إذا توقف عدد التسجيلات عن التغير شهوراً.
تدريب عملي
- شغل الحاصد على مستودع جامعتك أو جامعة تعرفها، واقرأ رد
Identify: هل البادئة صحيحة؟ وهل ساعة السيرفر قريبة من الساعة الحقيقية؟ - شغل
stats.pyعلى ما حصدته، واكتب لإدارة المستودع ثلاث ملاحظات من التقرير، مع معرف تسجيلة لكل ملاحظة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الحصاد يجمع نسخة من وصف التسجيلات مسبقاً، فيكون البحث سريعاً وموحداً ومستقلاً عن توقف أي مستودع، والثمن تأخير يوم أو أقل.
- البروتوكول ستة أفعال فوق HTTP، وأساسه المعرف الثابت والتاريخ والصفحات بالرمز
resumptionTokenورؤوس الحذف. - الحصاد التزايدي يبدأ من
responseDateفي رد المستودع مع تداخل، وأخذ ما تغير في أسبوع من QSpace احتاج 11 طلباً بدلاً من 688. - المستودعات الحقيقية فيها أخطاء إعداد ظاهرة: ساعة متقدمة، وبادئة localhost، وتاريخ بداية خاطئ، وفهرس OAI غير متزامن، وجدار حماية يرد بـ HTML، وDSpace يقبل تاريخاً بصيغة خاطئة ويعيد كل شيء.
- oai_dc يضيع الأدوار والتفاصيل، فاحصد أغنى صيغة متاحة، ولا تضف عناصر إليه إذا كنت المستودع.
- جودة البيانات مشكلة قيم أكثر منها مشكلة حقول: رموز اللغة، والتواريخ، والتطويل، والتكرار، والحقوق، وإصلاحها مكانه المستودع بتقرير من البوابة.
وفي المقال التالي من هذه المرحلة بإذن الله ننتقل من المستودع إلى الأرشيف، حيث الوثيقة جزء من مجموعة لها تسلسل وليست عملاً مستقلاً:
دليلالأرشيف والوثائق بمعيار ISAD(G) مع AtoM وArchivesSpaceكيف تصف وثائق مؤسستك بمعيار ISAD(G) في AtoM بالعربية، مع مقارنة بـ ArchivesSpace ومختبر كشف ثلاث مشكلات في الاستيراد والبحث العربي وحلولها. دليلرقمنة الكتب Digitization: من الماسح إلى نص عربيسلسلة رقمنة كاملة على صفحة من كتاب طبع في بولاق 1906: نسخة حفظ TIFF وبصمة، وOCR نقيس خطأه على نص كتبناه بأيدينا، وPDF/A، وعرض عميق عبر IIIF.
 دليلDublin Core وBIBFRAME: البيانات الوصفية بعد MARCنحول تسجيلتين حقيقيتين من مكتبة الكونغرس إلى Dublin Core وإلى BIBFRAME بالأدوات الرسمية، ونرى ما يبقى وما يضيع من الوصف العربي.
 دليلملفات الإسناد Authority Files وأسماء المؤلفين العربنبحث في ملف أسماء مكتبة الكونغرس عن مؤلفين عرب، ونقيس كم اسماً حقيقياً في فهرس مفتوح يجد صاحبه بالشكل المعتمد والإحالات والتوحيد.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال، وحصاد مستودع جامعة قطر QSpace (مجتمعا com_10576_60 وcom_10576_44 وتغييرات أسبوع كامل) ومستودع جامعة قاصدي مرباح ورقلة (رسائل الدكتوراه في قسم اللغة العربية) بحاصد Python 3.13.18، واختبار رموز الأخطاء بـ curl 8.23.0، والتحقق من oai_dc بـ xmllint من libxml2 2.9.14.