إذا كانت مكتبتك تعمل بنظام Koha، ولها مستودع رقمي على DSpace فيه رسائل الماجستير وأبحاث الأساتذة، فالطالب الذي يبحث عن موضوع يحتاج اليوم أن يفتح موقعين: الفهرس العام OPAC ليجد الكتب، والمستودع ليجد الرسائل، وكل موقع له مربع بحث مختلف وطريقة مختلفة في فهم الكلمة العربية، وأغلب الطلاب يكتفون بالأول ولا يعرفون أن الثاني موجود. وهذه هي المشكلة التي صنعت لها المكتبات ما يسمى طبقة الاكتشاف Discovery Layer، أي واجهة بحث واحدة فوق كل مصادر المكتبة، تجمع سجلاتها في فهرس بحث واحد، وتسأل نظام المكتبة عن حالة الكتاب لحظة عرضه. وفي دليل نظام المكتبة Koha ثبتنا النظام وأصلحنا البحث العربي في Zebra، وفي دليل مستودع الجامعة مع DSpace شغلنا المستودع وبروتوكول الحصاد OAI-PMH، وفي هذا المقال سوف نضع فوقهما واجهة بحث واحدة هي VuFind، وهي مشروع مفتوح المصدر بدأته مكتبة جامعة Villanova، ومكتوب بلغة PHP فوق محرك البحث Apache Solr.
وهذا المقال موجه لموظف المكتبة الذي يريد أن يفهم ما الذي سوف يتغير على القارئ، ولموظف تقنية المعلومات الذي سوف يثبت النظام ويربطه، لذلك سوف نشرح كل مصطلح عند أول ظهوره، ونترك الأوامر كاملة لمن يريد أن ينفذها. وفي هذا المقال سوف نناقش:
- ما هي طبقة الاكتشاف، ولماذا لا يكفي الفهرس العام الذي يأتي مع Koha، ومتى لا تحتاجها أصلاً.
- تثبيت VuFind 11.1.1 من حزمة Debian الرسمية، ومعالج الإعداد وما يفشل فيه أول مرة.
- نقل تسجيلات Koha إلى VuFind عبر OAI-PMH، والخطأ الصامت في رقم التسجيلة الذي يجعل حالة الكتاب لا تظهر.
- ربط VuFind بـ Koha لعرض الحالة المباشرة للنسخ: متاحة أم معارة، وماذا يحدث للقارئ إذا توقف Koha.
- البحث بالعربية: ما يعالجه VuFind دون أي إعداد، وما لا يعالجه، والحقل 880 الذي يخفي العنوان العربي في تسجيلات المكتبات الكبرى.
- إضافة المستودع DSpace إلى البحث نفسه، ثم قائمة تحقق قبل الإطلاق.
 دليلنظام المكتبة Koha: فهرسة MARC21 بالعربية والإعارةكيف تثبت Koha من حزمه الرسمية بالعربية، وتفهرس كتباً عربية بـ MARC21 وتعيرها، وتصلح البحث العربي الذي لا يعمل في الإعداد الافتراضي.
 دليلمستودع الجامعة Institutional Repository مع DSpaceكيف تشغل DSpace لأرشفة رسائل الطلاب وأبحاث الجامعة، من الإيداع ومراجعته حتى الحصاد عبر OAI-PMH، وما يحتاج تعريباً قبل الإطلاق.
 دليلخريطة أنظمة المكتبة: ILS والمستودع وبوابة البحثما الأنظمة التي تتكون منها المكتبة الحديثة وكيف تتكلم مع بعضها، مع مختبر ينسخ تسجيلة كتاب من مكتبة الكونغرس عبر Z39.50 ويحصد مستودعاً عبر OAI-PMH.
 دليلKoha أم Evergreen أم FOLIO؟ اختيار نظام المكتبةمقارنة عملية شغلنا فيها Koha وEvergreen على التسجيلات نفسها وقسنا الذاكرة والاستيراد والبحث العربي، مع FOLIO من توثيقه الرسمي وأرقام السوق لعام 2026.
ما هي طبقة الاكتشاف Discovery Layer؟
نظام المكتبة المتكامل Integrated Library System، واختصاراً ILS، مثل Koha، صمم في الأساس لعمل الموظف: الفهرسة والإعارة والتزويد والدوريات، وفيه فهرس عام للقارئ، ولكن هذا الفهرس يبحث في الكتب التي في النظام فقط، أي أنه نافذة على قاعدة بيانات واحدة. أما طبقة الاكتشاف فهي نظام منفصل لا يدير الإعارة ولا الفهرسة، وإنما يأخذ نسخة من سجلات كل مصدر (نظام المكتبة، والمستودع الرقمي، والأرشيف، وقواعد البيانات المشتركة إن وجدت) ويبني منها فهرس بحث واحداً سريعاً، ثم يعرض للقارئ نتيجة واحدة مرتبة، وفيها حدود Facets يضيق بها النتائج حسب السنة واللغة والمؤلف والمصدر.
والتشبيه الأقرب هو محرك البحث على الإنترنت: Google لا يملك المواقع التي يبحث فيها، وإنما يزورها ويحفظ نسخة من محتواها في فهرسه، ولذلك يعطيك النتيجة في جزء من الثانية، ثم يحولك إلى الموقع الأصلي عندما تضغط عليها. وطبقة الاكتشاف تفعل الشيء نفسه مع مصادر المكتبة، مع فرق مهم: حالة الكتاب (هل هو على الرف أم معار) تتغير كل دقيقة، فلا يمكن أن تؤخذ من النسخة المحفوظة، لذلك تسأل طبقة الاكتشاف نظام المكتبة عنها لحظة عرض النتيجة. والصورة التالية تبين الأجزاء التي سوف نبنيها في هذا المقال:
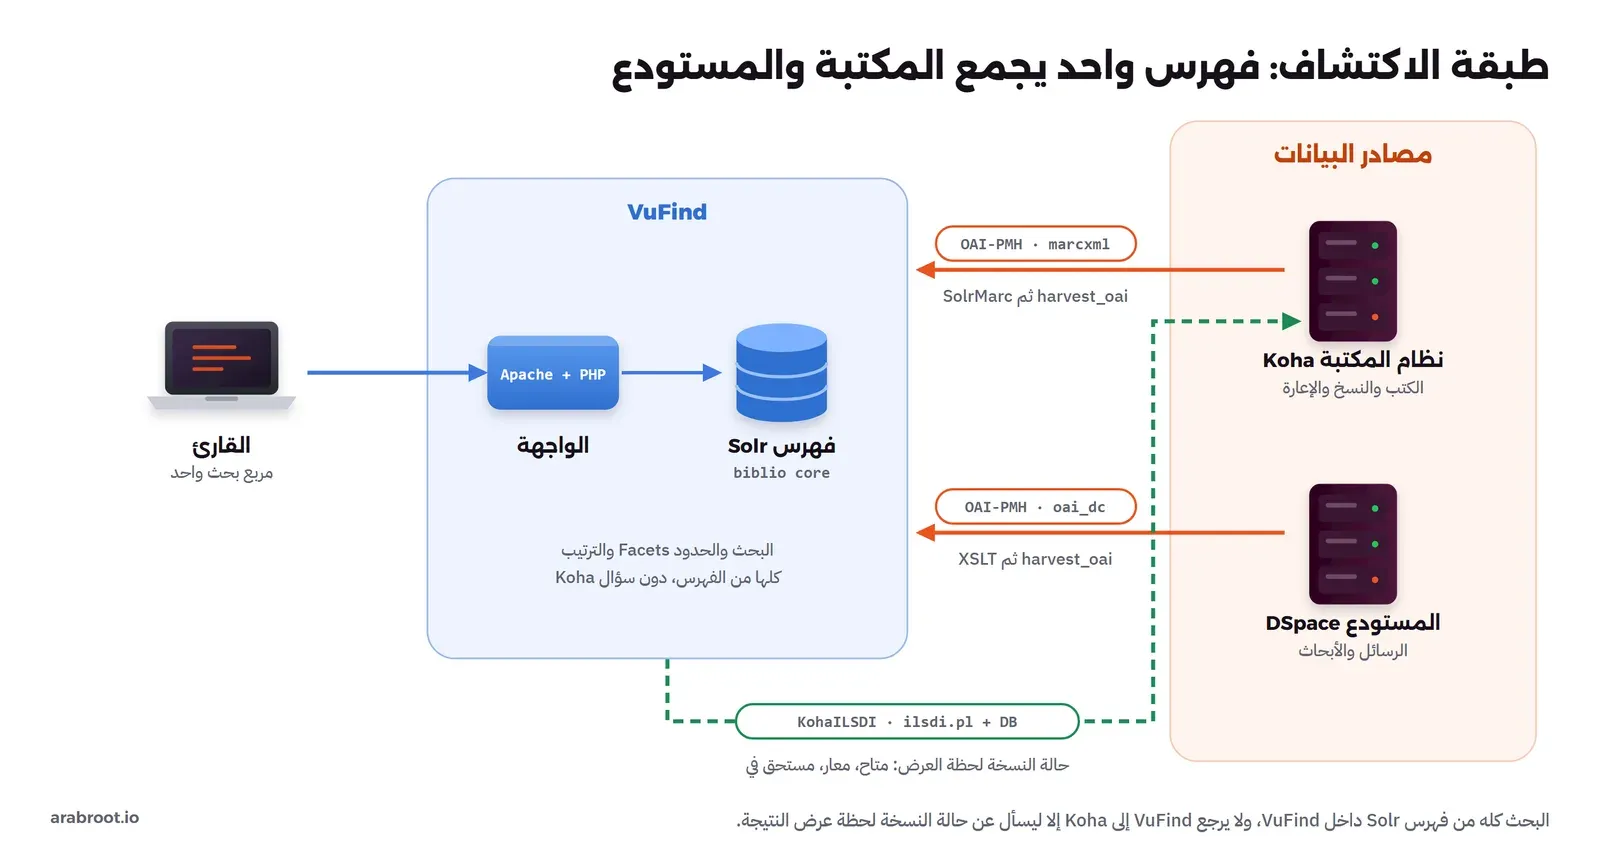
في المخطط أعلاه لاحظ التالي:
- البحث لا يلمس Koha: كل عملية بحث، وكل حد من الحدود، وكل ترتيب، يأتي من فهرس Solr داخل VuFind، وبالتالي إذا بحث ألف طالب في وقت واحد أيام الاختبارات فالضغط Load يقع على VuFind وليس على النظام الذي يعمل عليه موظف الإعارة.
- النقل دوري وليس لحظياً: الكتاب الذي يفهرسه الموظف الآن لا يظهر في VuFind حتى يعمل الحصاد التالي، فإذا جعلته كل ساعة فأقصى تأخير ساعة، وهذا مقبول لأغلب المكتبات.
- الحالة لحظية: «متاح» و«معار ومستحق في تاريخ كذا» تأتي من Koha في كل مرة يعرض فيها القارئ التسجيلة، وهذا الجزء الوحيد الذي يعتمد على أن Koha يعمل في تلك اللحظة.
الفهرس المحلي أم الفهرس المركزي Central Index؟
هناك نوعان من طبقات الاكتشاف، ومن المهم أن تعرف الفرق قبل أن تقارن العروض. النوع الأول يبني فهرساً محلياً من مصادرك أنت، وهذا ما يفعله VuFind وBlacklight وAspen Discovery، فيبحث في كتب مكتبتك ومستودعك وأي مصدر يمكنك حصاده. والنوع الثاني تجاري، مثل EBSCO Discovery Service وPrimo وSummon، وفيه فهرس مركزي يديره المورد ويضم مئات الملايين من المقالات من الناشرين، فيجد الطالب المقالة داخل المجلة وليس المجلة فقط، ولذلك تشترك فيه الجامعات التي عندها اشتراكات كبيرة في قواعد البيانات. وVuFind يستطيع أن يعرض نتائج بعض هذه الفهارس المركزية بجانب نتائجه إذا كان عندك اشتراك فيها، ولكنه لا يملك هذا المحتوى بنفسه، فلا تتوقع منه أن يجد المقالات داخل المجلات إذا لم يكن عندك هذا الاشتراك.
متى لا تحتاج طبقة اكتشاف؟
إذا كانت مكتبتك مكتبة مدرسة أو مكتبة عامة صغيرة، ومصدرها الوحيد هو Koha، فالفهرس العام الذي يأتي معه كاف بعد إصلاح البحث العربي كما في دليل Koha، وإضافة VuFind عندها تعني نظاماً ثانياً يحتاج تحديثاً ونسخاً احتياطياً ومراقبة دون فائدة حقيقية للقارئ. أما إذا كان عندك أكثر من مصدر، أو كان فهرسك العام ضعيفاً في البحث ولا تستطيع تغييره، أو كنت تخطط لتغيير نظام المكتبة نفسه بعد سنوات وتريد أن يبقى رابط البحث الذي يعرفه الطلاب ثابتاً، فهنا تظهر فائدة الطبقة المنفصلة. والنقطة الأخيرة لا ينتبه لها كثيرون: عندما تنتقل المكتبة من نظام إلى آخر يتغير عنوان الفهرس العام وشكله، أما طبقة الاكتشاف فيتغير فقط مصدر البيانات خلفها، والقارئ لا يشعر بالانتقال.
VuFind وبدائله
البدائل المفتوحة المصدر الأشهر ثلاثة، ولكل واحد منها مكانه:
| النظام | اللغة والأساس | نقاط القوة | نقاط الضعف |
|---|---|---|---|
| VuFind | PHP فوق Solr | حزمة Debian جاهزة، ومحركات ILS لأغلب أنظمة المكتبات منها Koha وFOLIO وEvergreen، وترجمة عربية ضمن المشروع | تخصيص الواجهة يحتاج معرفة بالقوالب Themes، والتوثيق موزع على صفحات Wiki كثيرة |
| Aspen Discovery | PHP فوق Solr | واسع الانتشار مع Koha في المكتبات العامة الأمريكية، وفيه حساب القارئ والكتب الإلكترونية في واجهة واحدة | أغلب المكتبات التي تستخدمه تشغله عبر شركات الدعم كما في الأرقام أدناه، والتثبيت الذاتي أقل توثيقاً |
| Blacklight | Ruby on Rails فوق Solr | مرن جداً لمن يبني واجهة خاصة، وتستخدمه جامعات كبيرة لمجموعاتها الرقمية | إطار عمل Framework تبني عليه أكثر من كونه منتجاً جاهزاً، ويحتاج مطور Ruby |
وفي تقرير أنظمة المكتبات لعام 2026 من Library Technology Guides، تقول شركة ByWater إنها تدعم Aspen Discovery في 792 مكتبة، وإن التطبيقات الجديدة لـ Koha في المكتبات العامة الأمريكية تأتي معها Aspen تقريباً دائماً، وهذا يبين أن فكرة الطبقة المنفصلة فوق Koha أصبحت هي القاعدة وليست الاستثناء. واخترنا VuFind في هذا المقال لأن تثبيته الذاتي موثق وله حزمة رسمية، ولأنه يربط مصادر من أنواع مختلفة (MARC من Koha، وDublin Core من DSpace) بأدوات مدمجة.
المتطلبات
VuFind 11.1.1 هو الإصدار الحالي، وقد صدر في 9 نوفمبر 2026 مع ملف tar وملف zip وحزمة Debian باسم vufind_11.1.1.deb. وملف control في الحزمة يطلب Apache، وPHP مع إضافات php-intl وphp-mbstring وphp-mysql وphp-xml وغيرها، وMySQL أو MariaDB، وJava لأن Solr يأتي داخل VuFind نفسه. وهذه الإصدارات التي ثبتت على Debian 13 مع الحزمة:
- PHP 8.4.27 وApache 2.4.71 وMariaDB 11.8.6 من مستودعات Debian.
- OpenJDK 21.0.13 من الحزمة
default-jdk-headless. - Solr 9.8.1، وهو مضمن في المجلد
/usr/local/vufind/solr/vendor، فلا تثبته منفصلاً. - الذاكرة: بعد تحميل 589 تسجيلة كان الـ Container كله يستخدم 1.57GB، منها 1.3GB لعملية Java التي تشغل Solr، و514MB لعمليات Apache، و157MB لـ MariaDB. والسبب أن السكربت
solr.shيعطي Solr ذاكرة Heap مقدارها 1G إذا لم تحدد المتغيرSOLR_HEAP، لذلك ابدأ بسيرفر فيه 4GB على الأقل، وارفعSOLR_HEAPعندما يتجاوز فهرسك مئات الآلاف من التسجيلات.
التثبيت من حزمة Debian
في المختبر وضعنا VuFind في Container من Debian 13 يعمل فيه systemd، وKoha في Container آخر على الشبكة نفسها، والأوامر التالية هي نفسها التي تنفذها على سيرفر Debian عادي. أولاً نزل الحزمة وثبتها مع Java وMariaDB، والأداة apt تسحب بقية الاعتماديات من ملف control:
wget https://github.com/vufind-org/vufind/releases/download/v11.1.1/vufind_11.1.1.deb
sudo apt-get update
sudo apt-get install -y default-jdk-headless mariadb-server ./vufind_11.1.1.deb
والحزمة تضع VuFind في /usr/local/vufind، وتضيف ملف إعداد Apache باسم vufind.conf يجعل الواجهة على المسار /vufind، وتكتب متغيرات البيئة في الملف /etc/profile.d/vufind.sh:
export JAVA_HOME="/usr/lib/jvm/default-java"
export VUFIND_HOME=/usr/local/vufind
export VUFIND_LOCAL_DIR=/usr/local/vufind/local
export SOLR_PORT=8983
في الإعداد أعلاه لاحظ التالي:
VUFIND_HOMEهو كود VuFind كما جاء من الحزمة، وVUFIND_LOCAL_DIRهو مكان تعديلاتك أنت: الإعدادات والقوالب والترجمات. والقاعدة الأهم في VuFind أنك لا تعدل أي ملف داخلconfig/vufindالأصلي، وإنما تنسخه إلىlocal/config/vufindوتعدل النسخة، والسبب أن التحديث يستبدل الملفات الأصلية، فإذا عدلتها ضاعت تعديلاتك مع أول تحديث.- المنفذ 8983 هو منفذ Solr، وVuFind يتحدث معه من داخل السيرفر نفسه.
تشغيل Solr بمستخدم خاص
Solr يرفض العمل بالمستخدم root إلا إذا أجبرته، وهذا صحيح من ناحية الأمان، لذلك أنشئ له مستخدماً واجعله مالك مجلده ثم شغله:
sudo useradd -r -m solr
sudo chown -R solr:solr /usr/local/vufind/solr
sudo -u solr bash -c '. /etc/profile.d/vufind.sh; /usr/local/vufind/solr.sh start'
Java 21 detected. Incubating Panama Vector APIs have been enabled
Waiting up to 180 seconds to see Solr running on port 8983
Started Solr server on port 8983 (pid=282). Happy searching!ثم سألنا Solr عن الفهارس Cores التي فيه، فظهرت فهارس VuFind كلها فارغة، ومنها biblio للتسجيلات الببليوغرافية وauthority لملفات الإسناد. ولاحظ شيئاً مهماً جربناه: من داخل الـ Container رد Solr على localhost:8983، ومن خارج الـ Container لم يرد رغم أننا فتحنا المنفذ في Docker، والسبب أن Solr 9 يستمع افتراضياً على 127.0.0.1 فقط. وهذا السلوك هو ما تريده في الإنتاج، فلوحة إدارة Solr تسمح بحذف الفهرس كله بطلب واحد ولا تحتاج كلمة مرور في هذا الإعداد، لذلك لا تقم بتغييره ولا تفتح المنفذ 8983 في الجدار الناري Firewall. وعلى السيرفر الحقيقي اكتب وحدة systemd تشغل Solr عند الإقلاع بدلاً من الأمر اليدوي، كما شرحنا في الخدمات Services والسجلات مع systemd.
معالج الإعداد Auto Configure
افتح http://server/vufind/Install/Home، فيظهر معالج الإعداد ويفحص ثمانية أشياء، والصورة التالية من أول تشغيل عندنا:
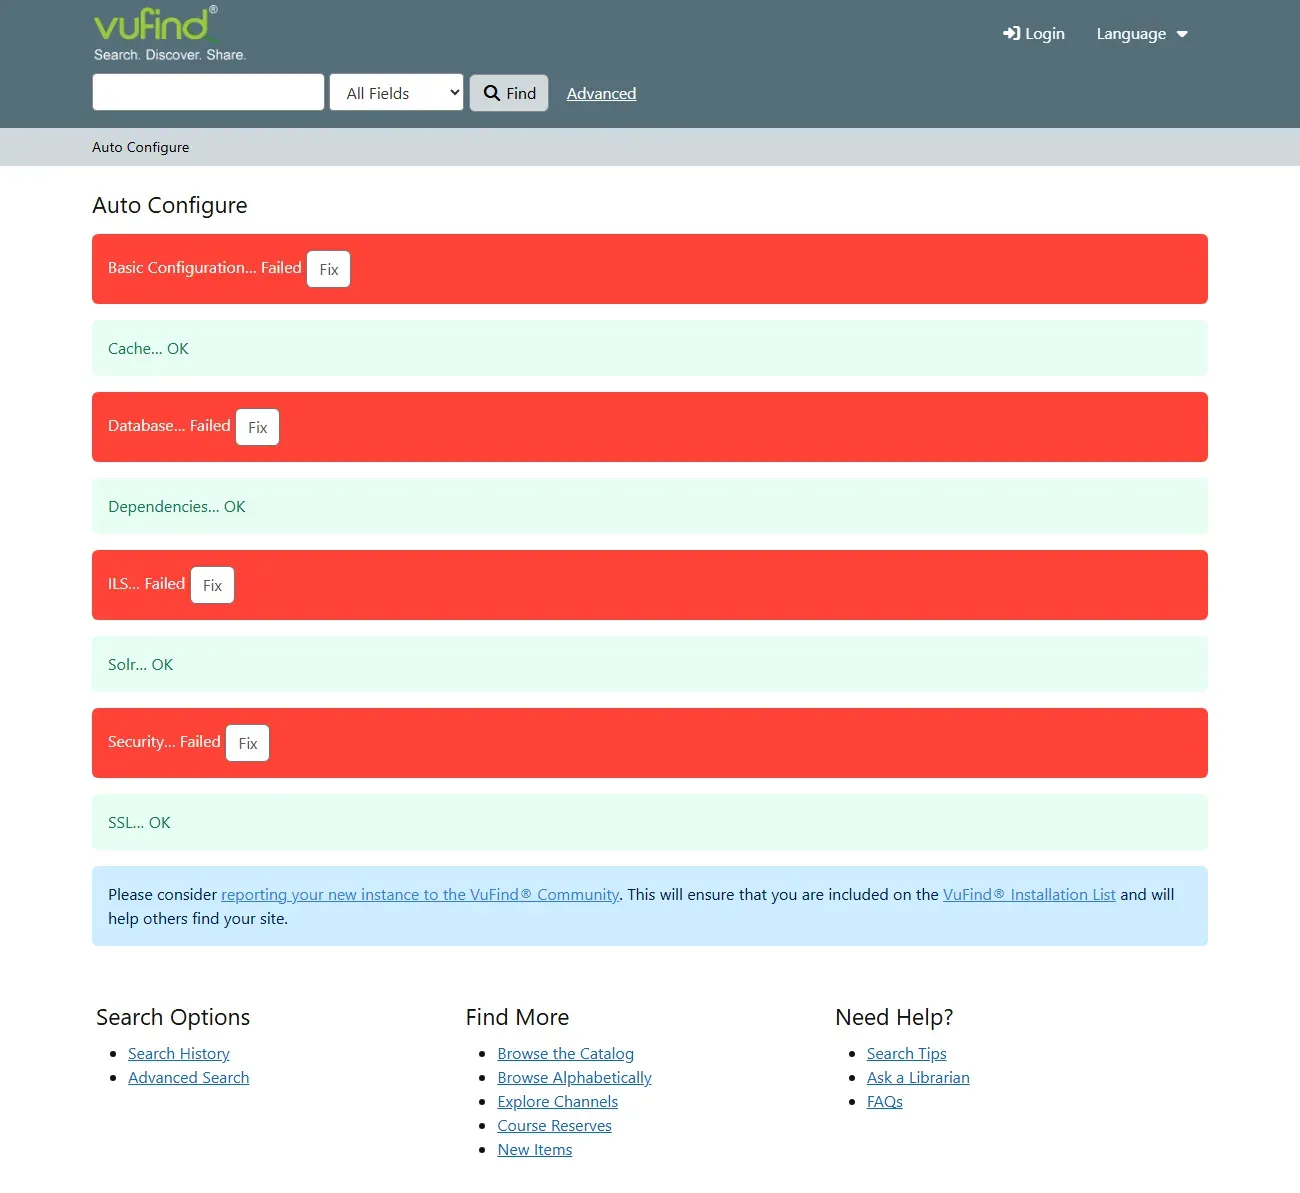
والفحوص التي فشلت كلها متوقعة، وكل واحد له زر Fix:
- Basic Configuration: لا يوجد ملف
config.iniفي المجلد المحلي، وزر Fix ينسخه ويكتب فيه عنوان الموقع. - Database: لا توجد قاعدة بيانات VuFind، وهي التي تحفظ حسابات القراء وقوائمهم المفضلة وسجل البحث، وليس فيها أي تسجيلة ببليوغرافية. وزر Fix ينشئها ويطلب حساب مدير MariaDB، وهنا المشكلة الأولى: المستخدم
rootفي MariaDB على Debian يدخل عبر الـ Unix Socket فقط، فلا يقبله VuFind بكلمة مرور، لذلك أنشأنا حساب مدير مؤقتاً، ثم حذفناه بعد إنشاء القاعدة. - Security: يفعل تشفير كلمات المرور المحفوظة في قاعدة البيانات، ولا تتركه دون إصلاح.
- ILS: المحرك الافتراضي هو
Sampleالذي يعطي بيانات وهمية، وسوف نغيره إلى Koha بعد قليل.
وحساب المدير المؤقت أنشأناه بهذين السطرين، واحذفه بعد أن ينجح الفحص:
sudo mariadb -e "CREATE USER 'vfsetup'@'localhost' IDENTIFIED BY 'change-me-now'; GRANT ALL ON *.* TO 'vfsetup'@'localhost' WITH GRANT OPTION;"
sudo mariadb -e "DROP USER 'vfsetup'@'localhost';"autoConfigure = false في قسم [System] من local/config/vufind/config.ini، والسبب أن من يصل إليه يستطيع أن يغير إعدادات قاعدة البيانات ومحرك ILS.نقل التسجيلات من Koha إلى VuFind
الآن نحتاج أن تصل تسجيلات Koha إلى فهرس Solr، وهناك طريقتان. الطريقة البسيطة أن تصدر الكتب من Koha في ملف MARC وتستورده في VuFind يدوياً، وهذا مناسب للتجربة الأولى، ولكنه لا يصلح للتشغيل اليومي، لأن الكتاب الذي يفهرس غداً يحتاج تصديراً جديداً، والكتاب الذي يحذف من Koha يبقى في VuFind. والطريقة الصحيحة هي الحصاد عبر بروتوكول OAI-PMH، وهو بروتوكول يسأل فيه الحاصد Harvester المصدر: «أعطني كل التسجيلات التي تغيرت منذ تاريخ كذا»، فيأخذ في المرة الأولى كل شيء، وفي المرات التالية الجديد والمعدل والمحذوف فقط.
وفي Koha هذه خدمة مدمجة تفعلها بتفضيل واحد من تفضيلات النظام System Preferences، وغير معها التفضيل OAI-PMH:archiveID، فقيمته الافتراضية KOHA-OAI-TEST وهي التي تظهر في معرف كل تسجيلة يحصدها أي نظام آخر:
sudo koha-shell library -c "perl /usr/share/koha/bin/admin/koha-preferences set OAI-PMH 1"
sudo koha-shell library -c "perl /usr/share/koha/bin/admin/koha-preferences set OAI-PMH:archiveID ARABLIB"
ثم نتأكد من الخدمة بالفعل Identify، وهو أول ما يرسله أي حاصد:
curl -s "http://koha/cgi-bin/koha/oai.pl?verb=Identify" | xmllint --format -<Identify>
<repositoryName/>
<baseURL>http://koha/opac/oai.pl</baseURL>
<protocolVersion>2.0</protocolVersion>
<adminEmail>root@localhost</adminEmail>
<earliestDatestamp>2026-11-16T21:16:08Z</earliestDatestamp>
<deletedRecord>persistent</deletedRecord>
<granularity>YYYY-MM-DDThh:mm:ssZ</granularity>
<compression>gzip</compression>
</Identify>في المخرج أعلاه لاحظ التالي:
deletedRecordقيمتهpersistent، أي أن Koha يتذكر التسجيلات المحذوفة ويبلغ عنها الحاصد، وهذا هو الذي يجعل الكتاب المحذوف من Koha يختفي من VuFind في الحصاد التالي.repositoryNameفارغ وadminEmailهوroot@localhost، والأول يأتي من اسم المكتبة في التفضيلLibraryNameوالثاني منKohaAdminEmailAddress، فاضبطهما قبل أن تعلن عن الخدمة لأي جهة خارجية.- الصيغ المتاحة كما ظهرت في
ListMetadataFormatsهيoai_dcوmarc21وmarcxml، ونحن نريدmarcxmlلأنه يحمل التسجيلة كاملة بكل حقولها، أماoai_dcفيختصرها إلى خمسة عشر عنصراً ويضيع منها الكثير.
الحصاد ثم الفهرسة
في VuFind أداة حصاد جاهزة تقرأ مصادرها من الملف local/harvest/oai.ini، وكل قسم فيه مصدر:
[KohaLib]
url = http://koha/cgi-bin/koha/oai.pl
metadataPrefix = marcxml
dateGranularity = auto
harvestedIdLog = harvest.log
cd /usr/local/vufind
php harvest/harvest_oai.php KohaLib[400 records harvested] Processing 50 records...
[450 records harvested] Processing 3 records...
Completed without errors -- 1 source(s) processed.
real 0m41.787sأي أن الأداة طلبت التسجيلات من Koha خمسين خمسين، وحفظت كل تسجيلة في ملف XML منفصل داخل local/harvest/KohaLib، فكانت 453 تسجيلة في 42 ثانية. ثم السكربت batch-import-marc.sh يأخذ هذه الملفات ويمررها على SolrMarc، وهو البرنامج الذي يقرأ حقول MARC ويحولها إلى حقول Solr حسب قواعد الملف import/marc.properties، ثم ينقل الملفات إلى مجلد processed حتى لا تفهرس مرتين:
cd /usr/local/vufind
MAX_BATCH_COUNT=500 ./harvest/batch-import-marc.sh KohaLib
INFO [main] (IndexDriver.java:391) - 453 records read
INFO [main] (IndexDriver.java:392) - 453 records indexed and
INFO [main] (IndexDriver.java:399) - 453 records sent to Solr in 21.40 secondsوالوقت الكلي كان دقيقة و22 ثانية، أغلبه بدء Java وتحميل SolrMarc وليس الفهرسة نفسها، فالفهرسة كانت 21 ثانية لـ 453 تسجيلة. وفي التشغيل اليومي تضع الأمرين في مهمة مجدولة Cron Job كل ساعة مثلاً، والحصاد التالي يأخذ فقط ما تغير بعد التاريخ المحفوظ في last_harvest.txt.
والتسجيلات التي في المختبر ليست بيانات تجريبية مصطنعة، وإنما 453 تسجيلة حقيقية جلبناها من فهرس مكتبة الكونغرس عبر بروتوكول SRU لكتب ابن خلدون والجاحظ والمتنبي وابن سينا وابن رشد ومحمود درويش وغيرهم، ثم أضفنا لها نسخاً بباركود في Koha، وسوف ترى بعد قليل لماذا اخترنا هذه التسجيلات بالذات لاختبار البحث العربي.
رقم التسجيلة: الخطأ الصامت
هذه أهم نقطة في الربط كله. التسجيلة التي تأتي من مكتبة أخرى فيها رقم في الحقل 001 هو رقم التحكم Control Number في تلك المكتبة، ثم يضيف Koha عند الحفظ رقمه هو، وهو رقم التسجيلة biblionumber، في الحقل 999 الفرعي c. والإعداد الافتراضي في VuFind يأخذ معرف التسجيلة من الحقل 001، وهذا يعمل في البحث دون أي مشكلة، ولكن عندما يسأل VuFind نظام Koha عن نسخ التسجيلة فإنه يرسل هذا الرقم، وKoha لا يعرفه:
curl -s "http://koha/cgi-bin/koha/ilsdi.pl?service=GetAvailability&id=3822390&id_type=bib"<dlf:collection xmlns:dlf="http://diglib.org/ilsdi/1.1" ...>
</dlf:collection>لاحظ أن الرد ليس خطأ، وإنما قائمة فارغة، فلا يظهر في السجلات أي شيء، ويرى القارئ كل كتاب بلا نسخ، ويظن الموظف أن الربط لا يعمل لسبب في الشبكة أو الصلاحيات. والحل سطر واحد في الملف import/marc_local.properties، وهو الملف الذي تضع فيه تعديلاتك على قواعد الفهرسة دون أن تلمس marc.properties الأصلي:
# Records come from Koha: the biblionumber (999$c) is the id the ILS driver understands
id = 999c, first
institution = "مكتبة الجامعة"
building = "المكتبة المركزية"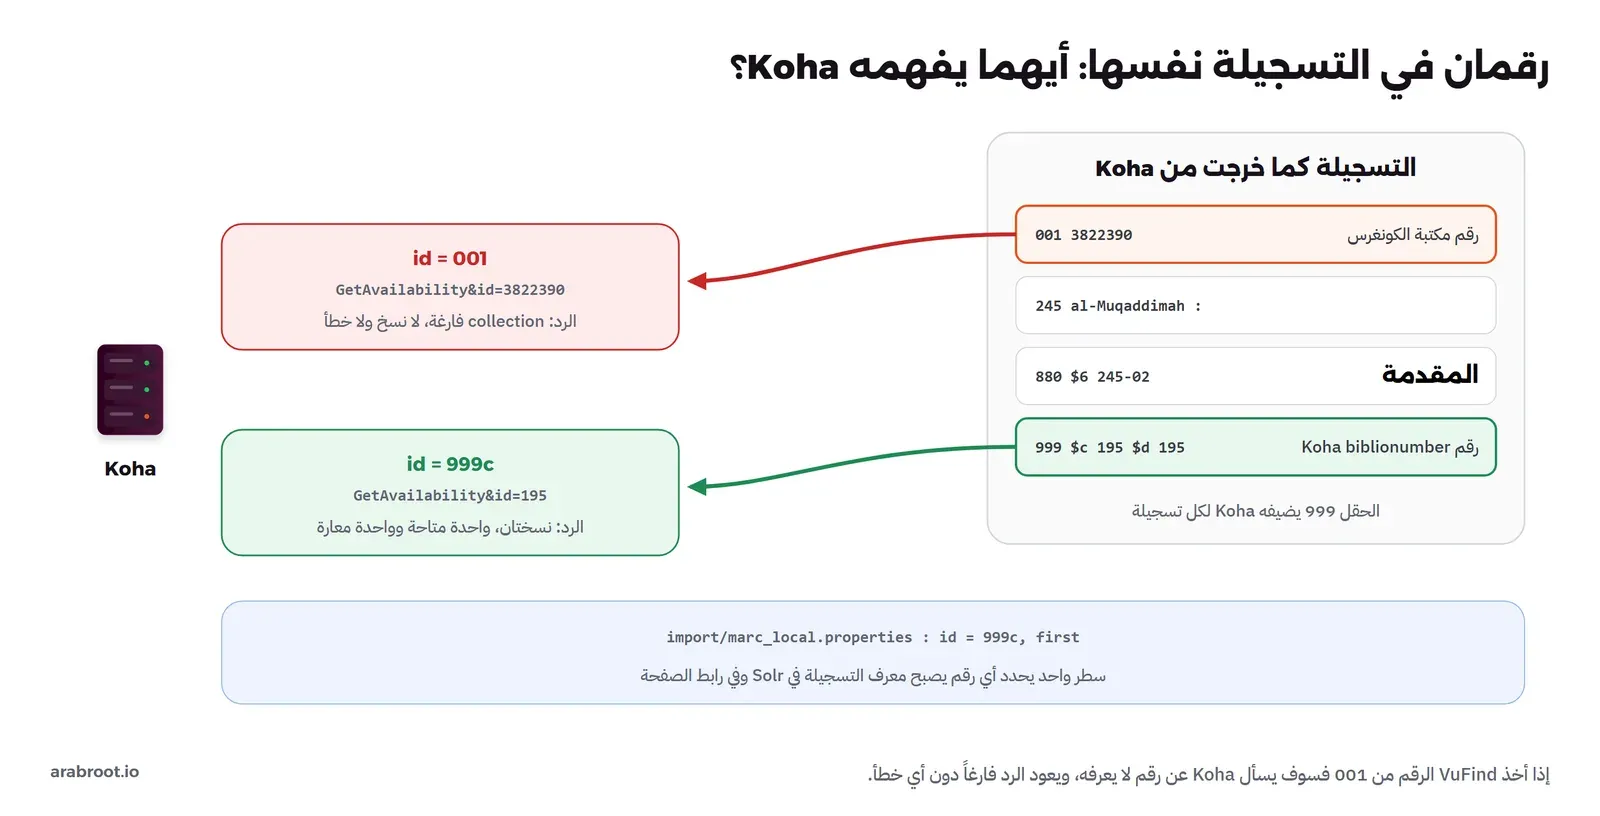
وبعد هذا التعديل أعدنا الفهرسة، فأصبح رابط التسجيلة في VuFind /vufind/Record/195، وهو الرقم نفسه في رابط الفهرس العام لـ Koha، وهذا يسهل على الموظف أن ينتقل بين النظامين. ولاحظ أن تسجيلات OAI-PMH من Koha لم يكن فيها الحقل 952 الذي يحمل النسخ، وفيها الحقل 999 فقط، وهذا لا يضر، لأن VuFind لا يأخذ النسخ من الفهرس وإنما من Koha مباشرة كما في القسم التالي.
حالة النسخة من Koha مباشرة
محرك ILS في VuFind هو الكود الذي يعرف كيف يسأل نظام مكتبة بعينه عن النسخ وحالتها، وعن حساب القارئ وإعاراته وحجوزاته. ولـ Koha محركان في VuFind، والصورة التالية تبين الفرق بينهما:
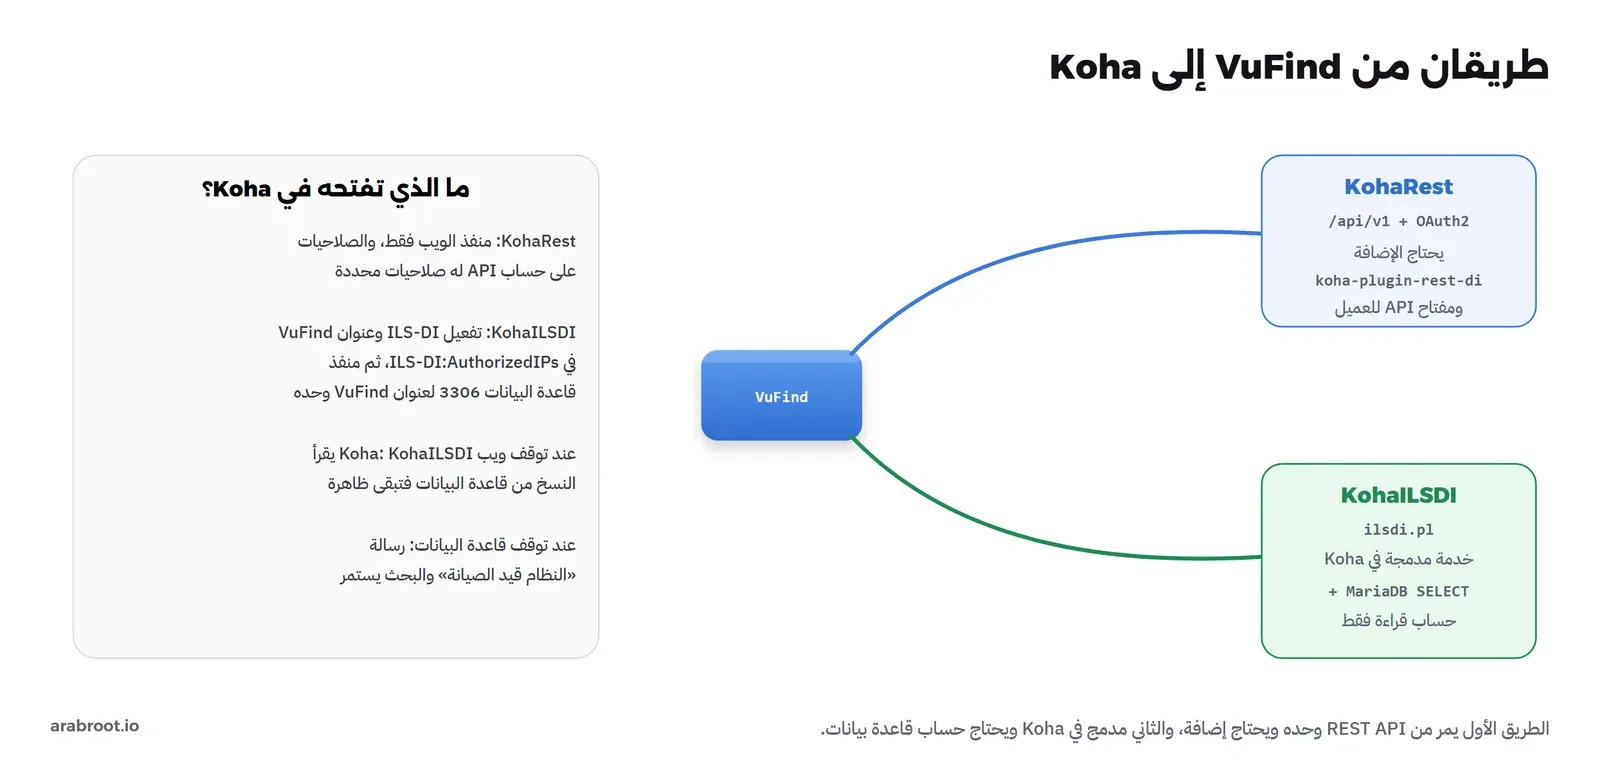
- KohaRest: كما يقول ملف إعداده KohaRest.ini، يستخدم REST API الخاص بـ Koha فقط، ولا يحتاج الوصول إلى قاعدة البيانات، ولكنه يحتاج تفعيل الإضافات Plugins في Koha، وتثبيت الإضافة koha-plugin-rest-di من المكتبة الوطنية الفنلندية، وتفعيل مصادقة OAuth2 بالتفضيل
RestOAuth2ClientCredentials، وإنشاء مفتاح API لحساب موظف له صلاحيات محددة. وهذا الطريق أنظف أمنياً، ولكنه يضيف إضافة خارجية يجب أن تتابع توافقها مع كل إصدار رئيسي من Koha. - KohaILSDI: يستخدم خدمة ILS-DI المدمجة في Koha، وهي واجهة قديمة مبنية على توصية مجموعة Digital Library Federation لربط أنظمة المكتبات بواجهات البحث، ويكمل ما لا توفره هذه الخدمة بالقراءة المباشرة من قاعدة بيانات Koha. ولا يحتاج أي إضافة، وهو الذي استخدمناه في المختبر.
إعداد KohaILSDI خطوة بخطوة
أولاً فعل الخدمة في Koha بالتفضيل ILS-DI الموثق في تفضيلات خدمات الويب. وعندما جربناها من VuFind كان الرد:
<ilsdi>
  <code>NotAllowed</code>
  <message>Unauthorized IP address: 172.24.0.2.</message>
</ilsdi>
والسبب أن التفضيل ILS-DI:AuthorizedIPs يحدد العناوين المسموح لها، فكتبنا فيه عنوان VuFind. ثم جربنا مرة أخرى فجاء الرد نفسه، ولم يتغير حتى أعدنا تشغيل Memcached وPlack، والسبب أن Koha يحفظ تفضيلات النظام في الذاكرة المؤقتة، فالتعديل المباشر في قاعدة البيانات لا يظهر حتى تمسحها، أما التعديل من صفحة الإدارة أو بالأداة koha-preferences فيمسحها بنفسه، لذلك عدل التفضيلات دائماً من هذين الطريقين:
sudo koha-shell library -c "perl /usr/share/koha/bin/admin/koha-preferences set ILS-DI 1"
sudo koha-shell library -c "perl /usr/share/koha/bin/admin/koha-preferences set ILS-DI:AuthorizedIPs 172.24.0.2"
وبعدها رد Koha بالنسخة وحالتها ومكانها ورقم الطلب Call Number:
<dlf:record>
    <dlf:bibliographic id="152" />
    <dlf:items>
      <dlf:item id="182">
        <dlf:simpleavailability>
          <dlf:identifier>182</dlf:identifier>
          <dlf:availabilitystatus>available</dlf:availabilitystatus>
          <dlf:location>المكتبة المركزية</dlf:location>
          <dlf:itemcallnumber>901</dlf:itemcallnumber>
        </dlf:simpleavailability>
      </dlf:item>
    </dlf:items>
</dlf:record>
ثانياً أنشئ في MariaDB الخاص بـ Koha حساباً للقراءة فقط، مسموحاً له من عنوان VuFind وحده، واجعل MariaDB يستمع على عنوان الشبكة الداخلية، لأنه في Debian يستمع على 127.0.0.1 فقط:
sudo sed -i 's/^bind-address.*/bind-address = 0.0.0.0/' /etc/mysql/mariadb.conf.d/50-server.cnf
sudo systemctl restart mariadb
sudo mariadb -e "CREATE USER 'vufind_ro'@'172.24.0.2' IDENTIFIED BY 'change-me'; GRANT SELECT ON koha_library.* TO 'vufind_ro'@'172.24.0.2';"
وهنا يجب أن تكون صريحاً مع نفسك في الأمان: هذا الحساب يقرأ كل جداول Koha، ومنها بيانات القراء وأرقام هواتفهم وإعاراتهم، فإذا اخترق سيرفر VuFind فهذه البيانات مكشوفة. لذلك افتح المنفذ 3306 في الجدار الناري لعنوان VuFind وحده، ولا تقم بنشره على الإنترنت أبداً، وإذا كانت سياسة جامعتك لا تسمح بأي وصول مباشر لقاعدة البيانات من نظام آخر فالطريق المناسب لك هو KohaRest.
ثالثاً اكتب إعداد المحرك في local/config/vufind/KohaILSDI.ini، وغير المحرك في config.ini:
[Catalog]
host        = koha
port        = 3306
username    = vufind_ro
password    = change-me
database    = koha_library
url         = http://koha/cgi-bin/koha/ilsdi.pl

[Holds]
HMACKeys = item_id:id:level
defaultRequiredDate = 0:1:0
extraHoldFields = pickUpLocation
; local/config/vufind/config.ini, section [Catalog]
driver = KohaILSDIبعدها أصبح فحص ILS في معالج الإعداد ناجحاً. ولنجرب الربط بشيء يتغير فعلاً، أعرنا من Koha نسخة من «المقدمة» طبعة تونس 1984، وهي التسجيلة رقم 195 ولها نسختان، فرد Koha بتاريخ الإرجاع بعد 14 يوماً:
{"checkout_date":"2026-11-16T21:43:18+00:00","checkout_id":1,"due_date":"2026-11-30T23:59:00+00:00","item_id":233,"library_id":"MAIN","patron_id":2,"renewals_count":0, ...}ثم فتحنا التسجيلة نفسها في VuFind:
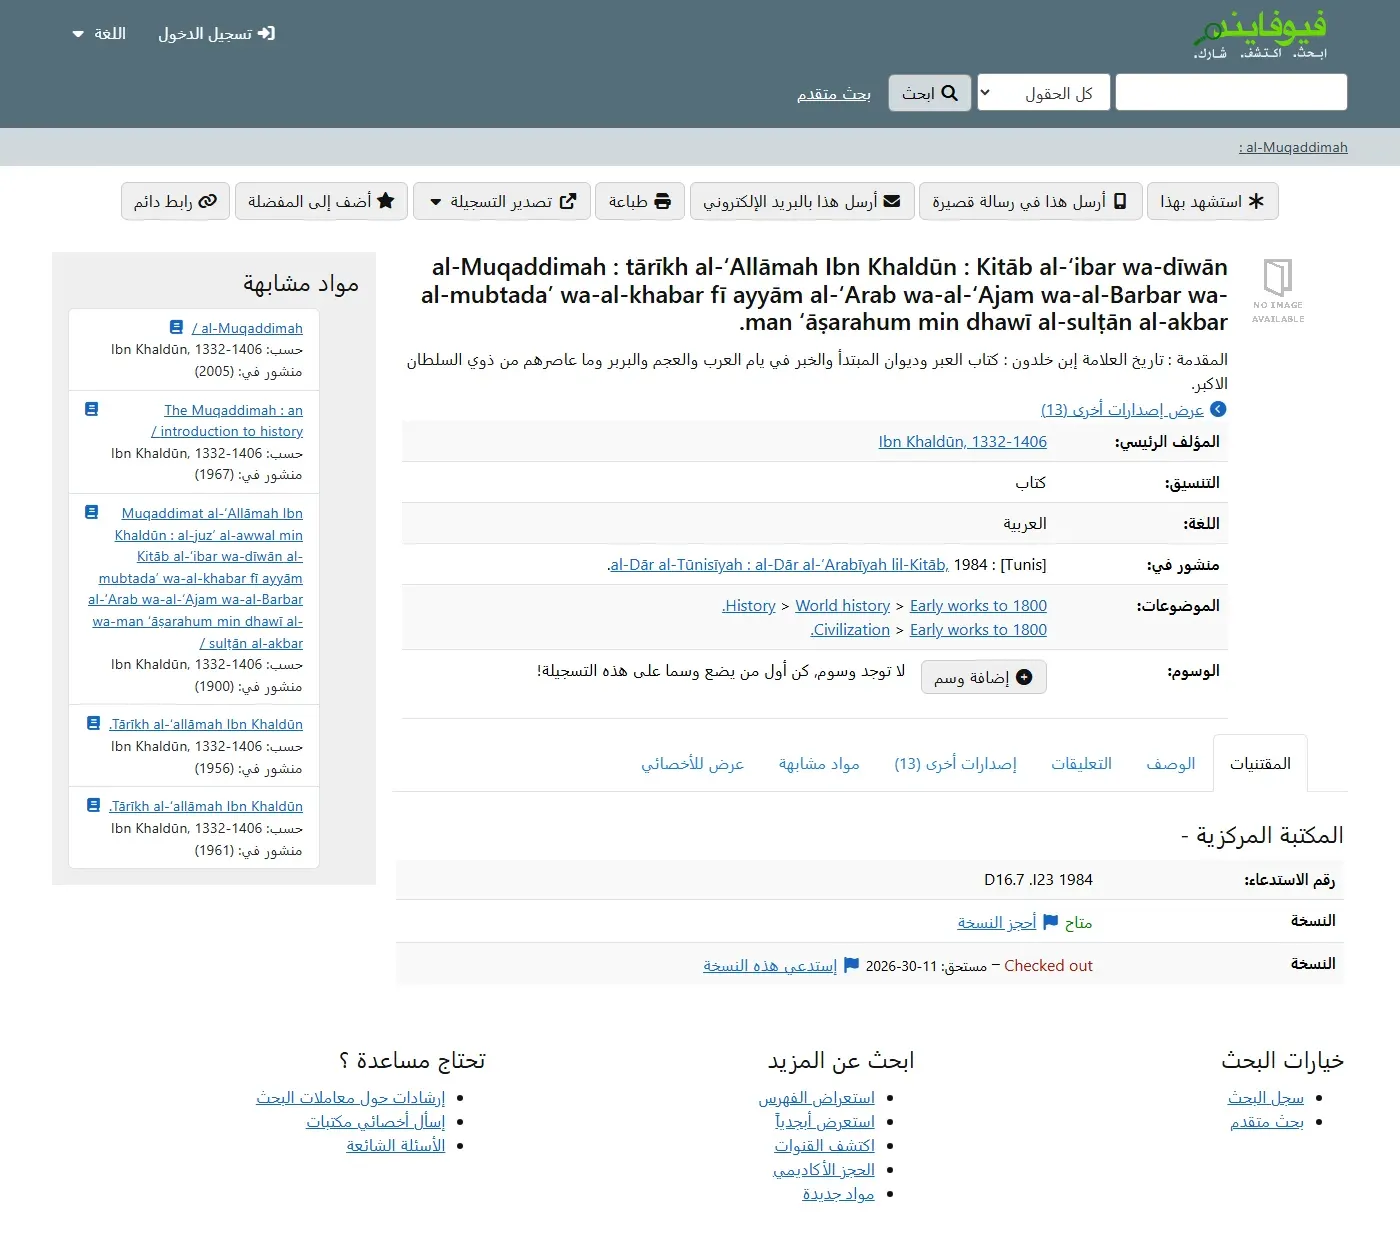
في الصورة أعلاه لاحظ التالي:
- العنوان العربي ظهر تحت العنوان اللاتيني دون أي إعداد منا، وهو من الحقل 880 الذي سوف نشرحه في قسم البحث العربي.
- النسخة المعارة ظهرت بعبارة «Checked out» بالإنجليزية وسط واجهة عربية، لأن هذه الحالة تأتي من محرك ILS ولا ترجمة لها في ملف
languages/ar.iniلهذا الإصدار. والحل أن تضيف السطر المترجم في ملف لغة محلي داخلlocal/languages، ولا تقم بتعديل الملف الأصلي لأنه يستبدل مع التحديث. - «أحجز النسخة» و«إستدعي هذه النسخة» روابط تعمل فقط بعد أن يدخل القارئ بحسابه، وهذا يحتاج ربط حسابات القراء بين VuFind وKoha، وأغلب الجامعات تفعله عبر الدخول الموحد SSO كما في ما هو الدخول الموحد SSO.
ماذا يحدث إذا توقف Koha؟
هذا سؤال يجب أن تعرف جوابه قبل الإطلاق، لأن Koha يتوقف للتحديث مرتين في السنة على الأقل. جربنا حالتين. في الأولى أوقفنا Apache في Koha، أي أن الفهرس العام وواجهة الموظفين وخدمة ILS-DI كلها متوقفة، فظهرت النسخ في VuFind كما هي، متاحة ومعارة، والسبب أن KohaILSDI يقرأ النسخ من قاعدة البيانات مباشرة وليس من ILS-DI. وفي الثانية أوقفنا MariaDB في Koha، فاستمر البحث يعمل بشكل طبيعي لأنه من Solr، وفي صفحة التسجيلة ظهرت رسالة بدلاً من النسخ:
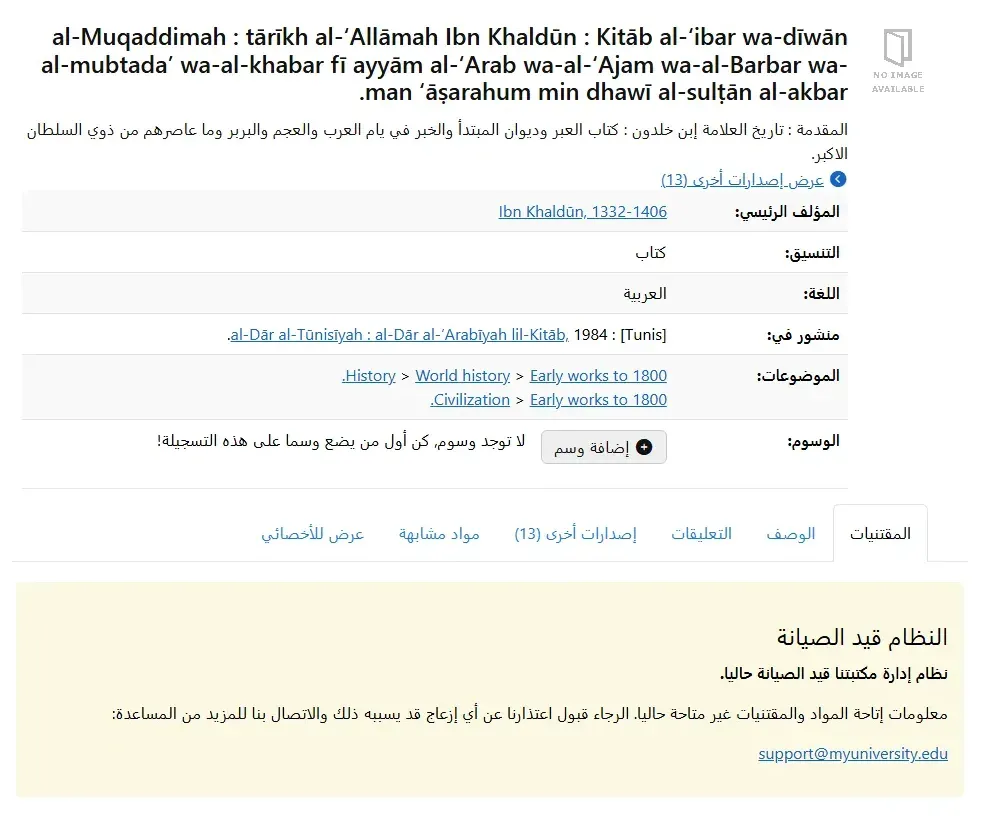
وفي صفحة النتائج ظهر تحت كل كتاب «لقد حدث خطأ» و«الحالة المباشرة غير متاحة» بدلاً من «متاح». وهذا سلوك جيد في رأينا، فالقارئ يجد الكتاب ويعرف رقم الطلب ويذهب إلى الرف، ولكن لاحظ البريد في الرسالة: [email protected]، وهو القيمة الافتراضية للإعداد email في قسم [Site]، وكثير من المكتبات تطلق النظام وهذا البريد فيه، فيرسل القراء رسائلهم إلى نطاق لا وجود له. غيره قبل الإطلاق، وغير معه title الذي قيمته الافتراضية "Library Catalog".
البحث بالعربية في VuFind
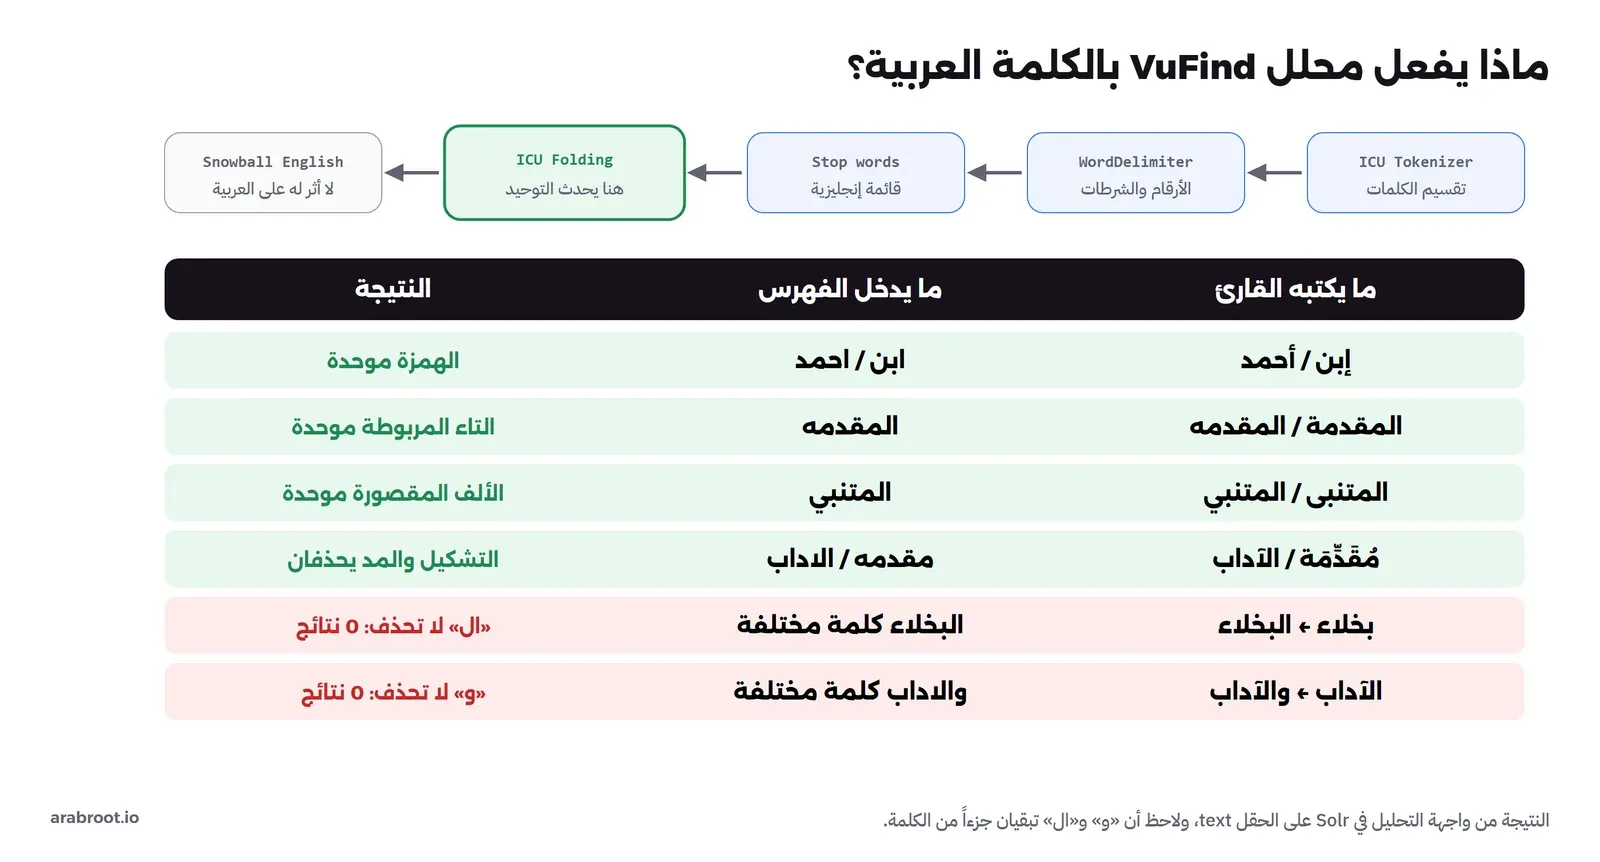
في دليل Koha رأينا أن محرك Zebra في إعداده الافتراضي لا يعرف الحروف العربية أصلاً، فيعيد كل الكتب لأي كلمة عربية حتى نفعل ICU. ولذلك أول ما أردنا معرفته في VuFind: ماذا يفعل بالكلمة العربية دون أي إعداد؟ والجواب في ملف schema.xml للفهرس biblio، فنوع الحقل text الذي تستخدمه أغلب حقول البحث يمر على سلسلة من المرشحات Filters عند الفهرسة وعند البحث، ويمكنك أن ترى أثرها على أي كلمة من واجهة التحليل Analysis في Solr:
curl -s -G "http://localhost:8983/solr/biblio/analysis/field" \
  --data-urlencode "analysis.fieldtype=text" \
  --data-urlencode "analysis.fieldvalue=المقدمة" --data-urlencode "wt=json"
وكتبنا سكربتاً صغيراً يمرر عدة كلمات ويطبع آخر مرحلة فقط، أي الكلمة كما تدخل الفهرس:
المقدمة => المقدمه
المقدمه => المقدمه
المتنبي => المتنبي
المتنبى => المتنبي
الآداب => الاداب
إبن => ابن
أحمد => احمد
مُقَدِّمَة => مقدمه
Khaldūn => khaldun
وهذه نتيجة أفضل بكثير مما توقعنا، والسبب هو المرشح icuFolding، وهو مرشح من مكتبة ICU يطبق قواعد طي الحروف Character Folding الموصوفة في معيار Unicode، فيحذف التشكيل، ويحول أشكال الهمزة على الألف إلى ألف، والتاء المربوطة إلى هاء، والألف المقصورة إلى ياء، والمد إلى ألف، ويحذف علامات الحروف اللاتينية مثل ū في Khaldūn. أي أن ما أصلحناه في Koha بقاعدة تحويل يدوية موجود هنا في الإعداد الافتراضي:
ثم جربنا البحث نفسه من واجهة VuFind على التسجيلات الـ 453، والجدول التالي من المخرج الحقيقي للبحث عبر API الخاص بـ VuFind:
| كلمة البحث | النتائج | التعليق |
|---|---|---|
| المقدمة | 2 | تسجيلتان فيهما العنوان العربي في الحقل 880 |
| المقدمه (بالهاء) | 2 | النتيجة نفسها، التاء المربوطة موحدة |
| ابن خلدون / إبن خلدون | 9 / 9 | الهمزة لا تغير شيئاً |
| المتنبي / المتنبى | 13 / 13 | الألف المقصورة موحدة |
| البخلاء | 1 | «كتاب البخلاء» للجاحظ |
| بخلاء (دون ال) | 0 | لا يوجد تجذيع Stemming عربي |
| والآداب / الآداب | 1 / 0 | الكلمة في التسجيلة مسبوقة بالواو |
| Muqaddimah / muqaddima | 17 / 7 | صيغ الكتابة اللاتينية لا تتوحد |
| Mutanabbi / Mutanabbī | 50 / 50 | العلامة فوق الحرف تحذف |
في الجدول أعلاه لاحظ التالي:
- «ال» التعريف وحرف العطف «و» يبقيان جزءاً من الكلمة، فالقارئ الذي يكتب «بخلاء» لا يجد «البخلاء»، والذي يكتب «الآداب» لا يجد «والآداب». والسبب أن المحلل الافتراضي فيه مجذع Snowball للإنجليزية فقط، أي أنه يحول «histories» إلى «histori» ولا يلمس العربية. ويمكنك أن تضيف مرشحات Solr العربية مثل
ArabicNormalizationFilterوArabicStemFilterالموثقة في دليل مرشحات Solr، ولكن هذا تعديل فيschema.xmlيحتاج إعادة فهرسة كاملة واختباراً على بياناتك، لأن المجذع الخفيف يحذف «ال» و«و» من كل كلمة، فيطابق كلمات لم تقصدها. وقد قسنا هذا الأثر بالتفصيل في البحث في النصوص العربية مع OpenSearch وMeilisearch، والنتائج تنطبق على Solr لأن المحلل نفسه من Lucene. - الكتابة بالحروف اللاتينية Romanization لها مشكلتها الخاصة، فـ «Muqaddimah» و«muqaddima» صيغتان لكلمة واحدة، ولا يوحدهما أي مرشح، وهذا ليس مشكلة VuFind وإنما مشكلة قواعد النقل الحرفي التي تغيرت عبر العقود، وحلها في ملفات الإسناد Authority Records وليس في محرك البحث.
الحقل 880: العنوان العربي الذي لا يبحث فيه أحد
هنا السبب الذي اخترنا من أجله تسجيلات مكتبة الكونغرس. المكتبات الكبرى في العالم تفهرس الكتاب العربي بحقول رئيسية مكتوبة بالحروف اللاتينية، فالعنوان في الحقل 245 هو «al-Muqaddimah»، والمؤلف في الحقل 100 هو «Ibn Khaldūn»، ثم تضع الكتابة الأصلية بالحروف العربية في حقل مستقل رقمه 880، واسمه في معيار MARC21 التمثيل الخطي البديل Alternate Graphic Representation، ويربط بين الحقلين حقل فرعي رقمه 6. وعندما تشتري المكتبة العربية تسجيلات جاهزة أو تنسخها عبر Z39.50 من هذه المكتبات، فهذا هو الشكل الذي يصلها:
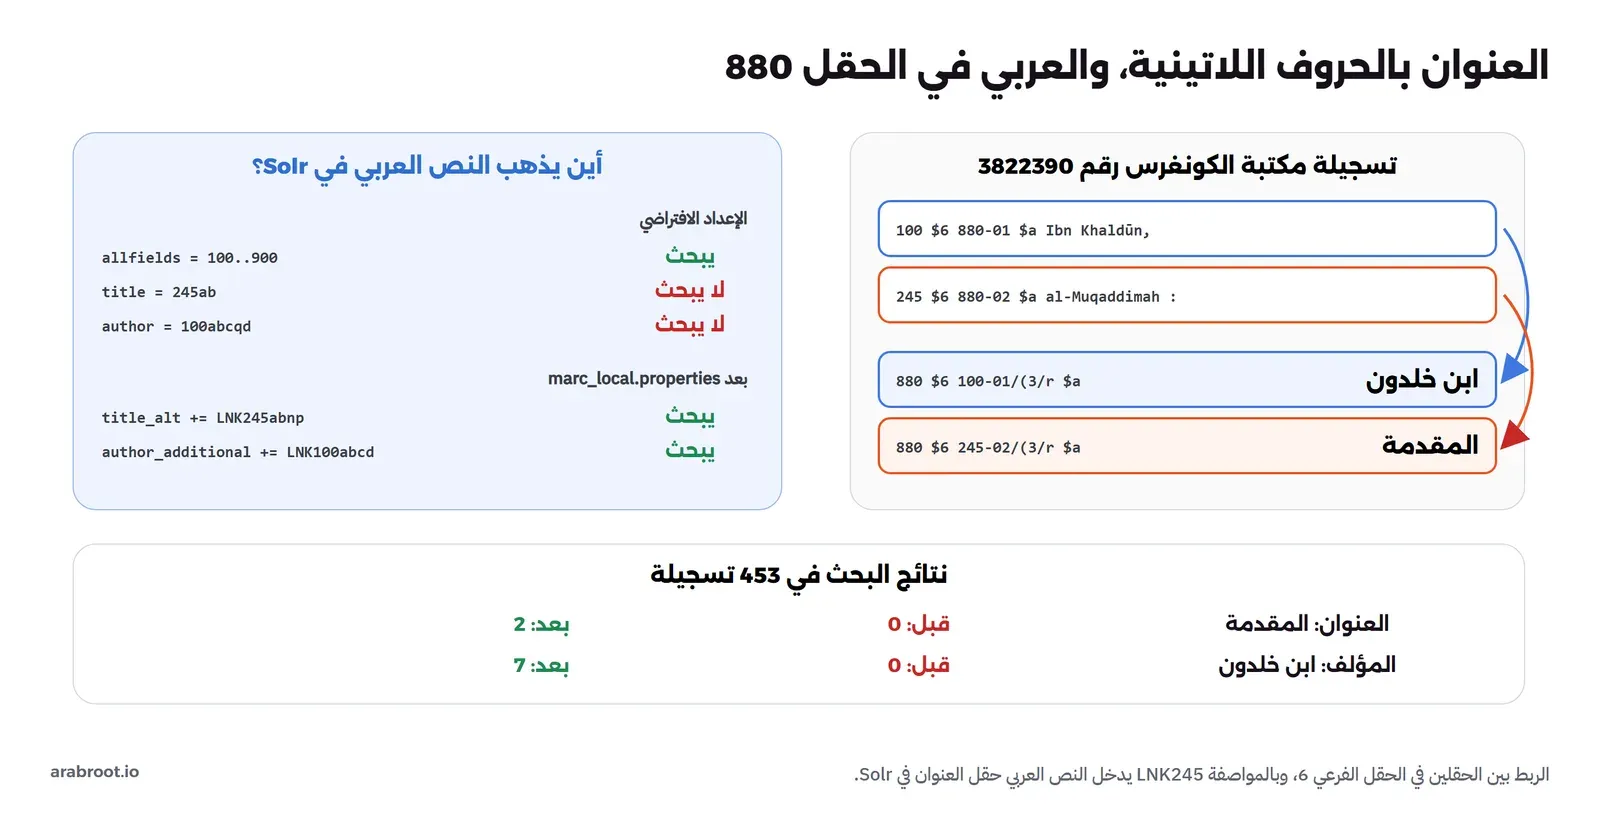
والقاعدة الافتراضية في marc.properties تضع في حقل allfields كل الحقول من 100 إلى 900، ومنها 880، لذلك وجد البحث في «كل الحقول» كلمة «المقدمة». ولكن عندما اخترنا من القائمة «العنوان» أو «المؤلف» كانت النتيجة صفراً، لأن حقل العنوان يأخذ 245 فقط، وحقل المؤلف يأخذ 100 و700 فقط:
Title     المقدمة      0  -
Title     Muqaddimah   7  The Muqaddimah : an introduction to history /
Author    ابن خلدون    0  -
Author    Ibn Khaldun 50  Teoria de la sociedad y de la historia /
أي أن الطالب العربي الذي يختار «المؤلف» ويكتب «ابن خلدون» لا يجد شيئاً، والطالب الأجنبي الذي يكتب «Ibn Khaldun» يجد خمسين كتاباً، في مكتبة عربية! والحل في SolrMarc نفسه، فهو يفهم البادئة LNK التي تعني «حقول 880 المرتبطة بهذا الحقل»، فأضفنا إلى marc_local.properties:
# Arabic script lives in 880 fields linked to 245/246/100/700: index them too
title_alt = 100t:130adfgklnpst:240a:246abnp:505t:700t:710t:711t:730adfgklnpst:740a:LNK245abnp:LNK246abnp
author_additional = 505r:LNK100abcd:LNK700abcd:LNK110ab
واخترنا هذين الحقلين بالذات لأن ملف searchspecs.yaml يجعل title_alt من حقول بحث العنوان، وauthor_additional من حقول بحث المؤلف، فلا نحتاج تعديل قواعد البحث. وفي title_alt كتبنا القائمة الأصلية كاملة ثم أضفنا عليها، لأن السطر في الملف المحلي يستبدل السطر الأصلي ولا يضيف إليه. ثم أعدنا الفهرسة بنقل الملفات من processed وتشغيل batch-import-marc.sh مرة أخرى، فأصبحت النتيجة:
Title     المقدمة      2  al-Muqaddimah /
Title     Muqaddimah   7  The Muqaddimah : an introduction to history /
Author    ابن خلدون    7  Hākadhā takallama Ibn Khaldūn /
Author    Ibn Khaldun 50  Teoria de la sociedad y de la historia /
والفرق بين 7 بالعربية و50 باللاتينية ليس خطأ، فأغلب تسجيلات مكتبة الكونغرس القديمة لكتب ابن خلدون فيها الحروف اللاتينية فقط دون حقل 880، لأن إضافة الحرف العربي بدأت متأخرة، وهذه حقيقة في بياناتك يجب أن تعرفها: البحث بالعربية لن يجد إلا ما فهرس بالعربية. والصورة التالية للبحث عن «ابن خلدون» في «كل الحقول» من الواجهة العربية:
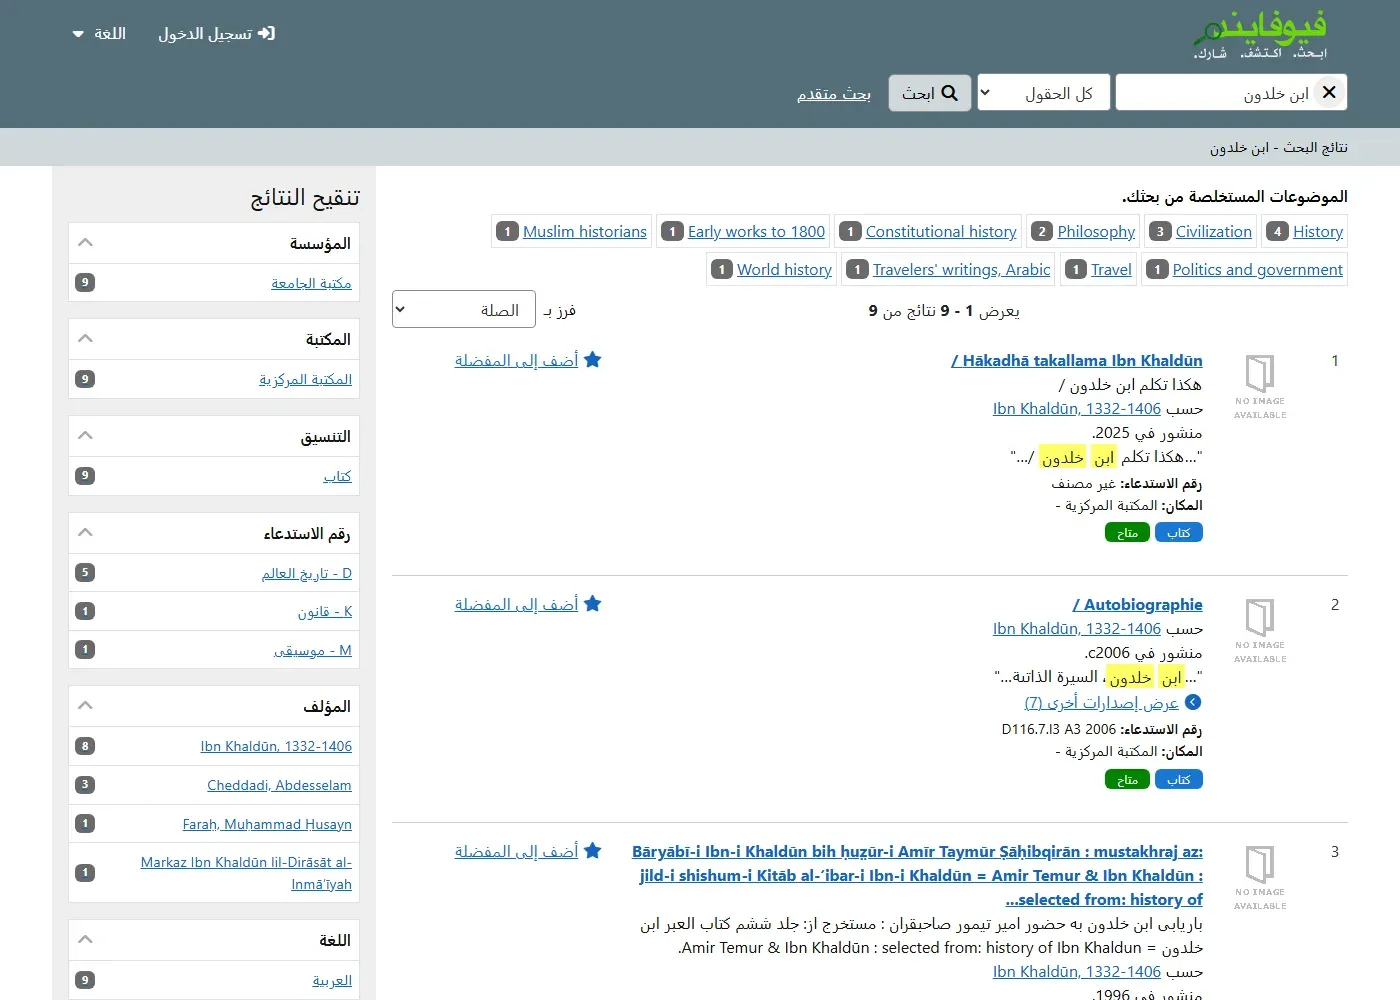
ولاحظ النتيجة الثالثة، فهي كتاب بالفارسية، لأن الحرف العربي مشترك بين العربية والفارسية والأردية، والتوحيد الذي يفعله ICU لا يفرق بين اللغات، فإذا كانت مكتبتك فيها مجموعة فارسية كبيرة فاستخدم حد «اللغة» على الجانب.
كيف يرتب VuFind النتائج؟
عندما يكتب القارئ كلمة ويختار «العنوان»، لا يبحث VuFind في حقل واحد، وإنما في مجموعة حقول لكل منها وزن، وهذه الأوزان مكتوبة في الملف config/vufind/searchspecs.yaml. وهذا جزء بحث العنوان كما هو في الإصدار الذي جربناه:
Title:
  DismaxFields:
    - title_short^500
    - title_full_unstemmed^450
    - title_full^400
    - title^300
    - title_alt^200
    - title_new^100
    - title_old
    - series^100
    - series2
  DismaxHandler: edismax
في الإعداد أعلاه لاحظ التالي:
- الرقم بعد العلامة
^هو وزن الحقل Boost، فالكلمة التي توجد في العنوان المختصرtitle_shortترفع التسجيلة أكثر من الكلمة نفسها في العنوان البديلtitle_altبمرتين ونصف تقريباً، والسبب منطقي: من يكتب عنوان الكتاب كما هو يريد هذا الكتاب أولاً، وليس كتاباً آخر ذكر العنوان في محتوياته. - العنوان العربي الذي أدخلناه من الحقل 880 ذهب إلى
title_altبوزن 200، أما العنوان اللاتيني ففيtitle_shortبوزن 500. وهذا يعني أن ترتيب النتائج في البحث العربي يعتمد على حقل أضعف، فإذا كانت مكتبتك تفهرس كتبها العربية بالحروف العربية مباشرة في الحقل 245، كما تفعل أغلب المكتبات العربية، فلا تحتاج هذا التعديل أصلاً، لأن العنوان العربي سوف يكون فيtitle_shortمن البداية. أما إذا كانت أغلب تسجيلاتك منقولة من مكتبات أجنبية بحقول 880، فأنشئ نسخة محلية منsearchspecs.yamlوارفع وزنtitle_altبعد أن تجرب أسئلة حقيقية من القراء وتقارن الترتيب قبل التعديل وبعده. edismaxهو محلل الأسئلة في Solr الذي يسمح بالبحث في عدة حقول بأوزان مختلفة، ويفهم علامات البحث مثل الاقتباس للعبارة الكاملة والنجمة للبحث بالبداية، وقد جربنا النجمة على كتاب البخلاء:البخلا*وجد الكتاب، وبخلا*لم يجد شيئاً، و*بخلاءلم يجد شيئاً أيضاً، والسبب أن النجمة تكمل نهاية الكلمة فقط، و«ال» في بدايتها جزء منها في الفهرس.
ولا تقم بتغيير الأوزان بناءً على سؤال واحد أو شكوى واحدة، والسبب أن كل تغيير يحسن سؤالاً ويضر أسئلة أخرى لا تراها، والطريقة الصحيحة أن تجمع عشرين أو ثلاثين سؤالاً حقيقياً من سجل البحث في VuFind، وتعرف لكل سؤال الكتاب الصحيح، ثم تقيس ترتيبه قبل التعديل وبعده، كما فعلنا في مقال البحث العربي.
إضافة المستودع DSpace إلى البحث نفسه
الآن نصل إلى السبب الذي من أجله نبني طبقة الاكتشاف. تسجيلات DSpace ليست MARC، وإنما Dublin Core، وهو معيار أبسط فيه عناصر مثل dc:title وdc:creator وdc:subject، وكل عنصر فيه قابل للتكرار ودون حقول فرعية، فلا يوجد فيه فرق بين المؤلف الأول والمؤلف المشارك كما في الحقلين 100 و700 في MARC، ولا يوجد فيه مكان لرقم الطلب أو النسخ، وهذا مناسب لرسالة جامعية لها ملف PDF وليس لها رف. لذلك لا يمر على SolrMarc، وإنما على ملف تحويل XSLT يأتي مع VuFind باسم dspace.xsl، وإعداده في import/dspace.properties. وفي المختبر استخدمنا نسخة DSpace التجريبية الرسمية كمصدر حقيقي يعمل على الإنترنت، وأضفنا لها قسماً في oai.ini:
[DSpaceDemo]
url = https://demo.dspace.org/server/oai/request
metadataPrefix = oai_dc
injectId = identifier
idSearch[] = "/^oai:demo.dspace.org:/"
idReplace[] = "dspace-"
dateGranularity = auto
في الإعداد أعلاه لاحظ التالي:
injectIdيضع معرف OAI داخل التسجيلة، لأن ملف XSLT يأخذ منه معرف التسجيلة في Solr.idSearchوidReplaceيحولانoai:demo.dspace.org:10673/24266إلىdspace-10673/24266، والسبب أن معرفات Koha أرقام مثل 195، فإذا جاء من مصدر آخر معرف يساوي رقماً موجوداً فإن التسجيلة الثانية تستبدل الأولى في Solr دون أي رسالة.
وفي المحاولة الأولى أضفنا السطر set = col_10673_50406 لنحصد مجموعة Collection واحدة فقط، لأن المستودع التجريبي فيه أكثر من 25 ألف تسجيلة، فرد الحاصد «No new records found»، ولما سألنا المستودع مباشرة كان الرد noRecordsMatch، رغم أن هذه المجموعة نفسها ظاهرة في رأس تسجيلة حصدناها قبل دقائق. والسبب أن DSpace يبني فهرس المجموعات الخاص بـ OAI بمهمة منفصلة، فإذا لم تعمل هذه المهمة بعد إضافة المحتوى فإن الحصاد بالمجموعة يعود فارغاً، وهذا ما شرحناه في قسم المهام المجدولة في دليل DSpace. لذلك حصدنا بالتاريخ بدلاً من المجموعة:
php harvest/harvest_oai.php --from=2026-11-12T07:57:00Z --until=2026-11-12T07:58:00Z DSpaceDemo
./harvest/batch-import-xsl.sh DSpaceDemo dspace.properties
[0 records harvested] Processing 100 records...
[100 records harvested] Processing 36 records...
Completed without errors -- 1 source(s) processed.وقبل الاستيراد نسخنا dspace.properties إلى local/import وغيرنا فيه institution إلى «المستودع الرقمي»، فأصبح عندنا في الفهرس 589 تسجيلة: 453 من Koha و136 من DSpace، وكل تسجيلة تعرف مصدرها في الحقل institution، وهذا الحقل يظهر للقارئ حداً على الجانب اسمه «المؤسسة»:
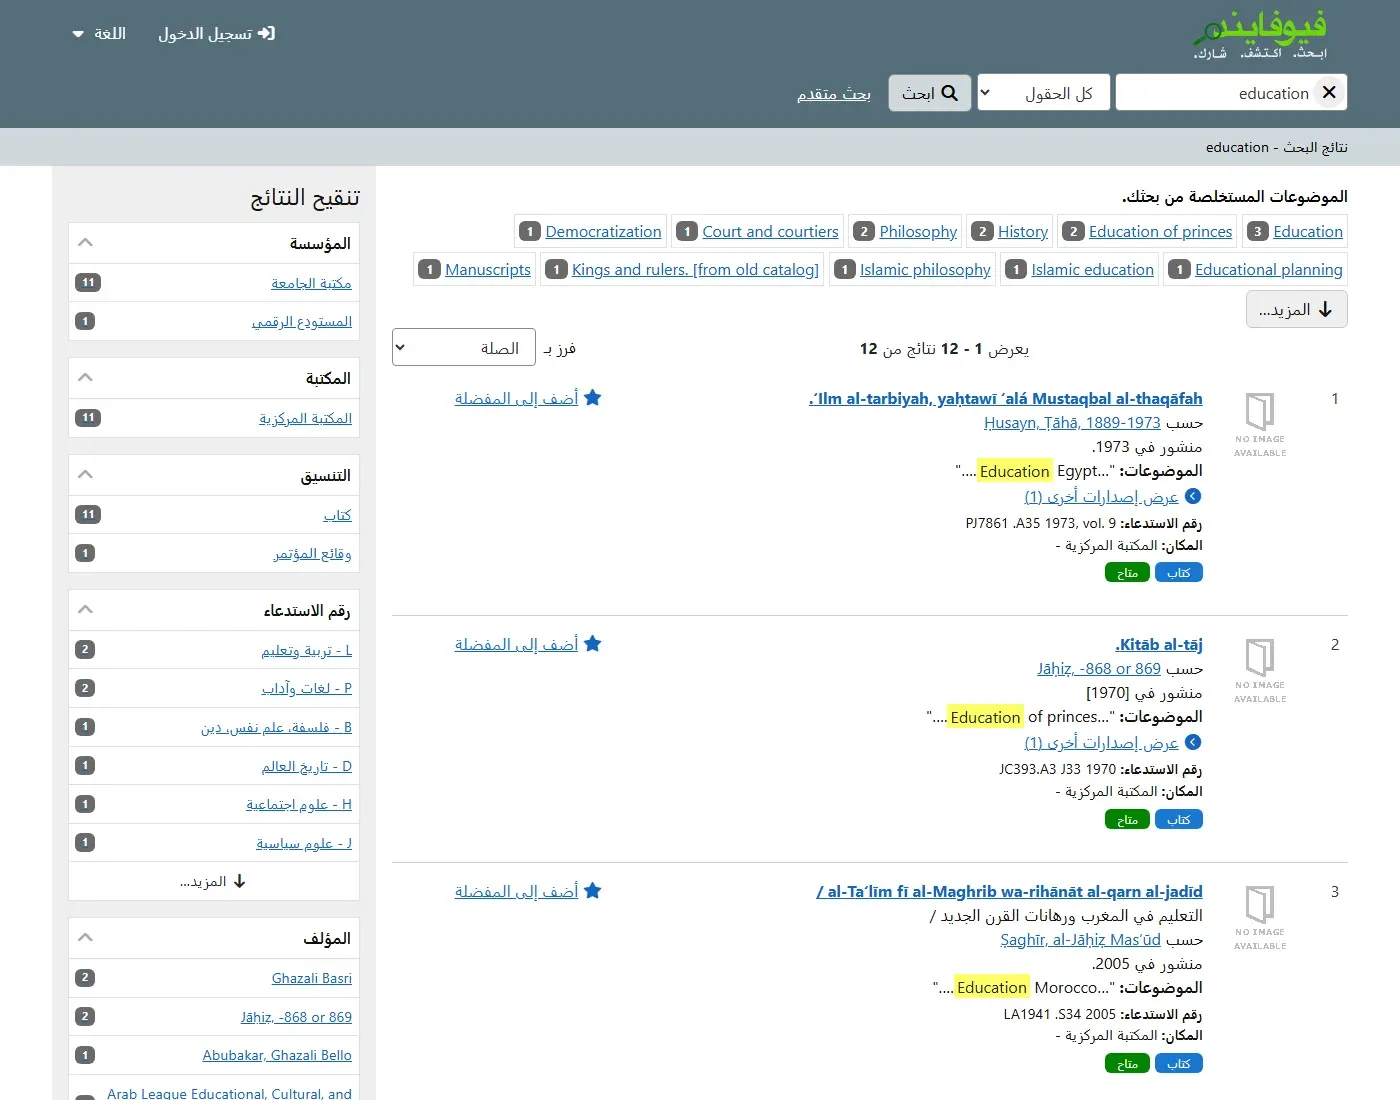
ولاحظ في حصاد DSpace شيئاً آخر: من أول مئة تسجيلة رجعت كان فيها 48 تسجيلة فقط لها عنوان، والباقي فيه التاريخ والرابط فقط، وهذه تسجيلات محذوفة أو فارغة في المستودع التجريبي. وفي مستودعك الحقيقي قد يحدث الشيء نفسه مع الرسائل المحجوبة Embargoed أو المسحوبة Withdrawn، فراجع عينة من التسجيلات المحصودة قبل أن تفهرسها، لأن التسجيلة دون عنوان تظهر للقارئ سطراً فارغاً في النتائج.
الواجهة العربية
الترجمة العربية جزء من VuFind في الملف languages/ar.ini، والقالب الافتراضي sandal5 يقلب الصفحة من اليمين إلى اليسار عندما تكون اللغة عربية، كما ترى في الصور أعلاه. ولتجعل العربية لغة الموقع الافتراضية غير السطر language في قسم [Site]:
language = arوالترجمة ليست كاملة، فقد رأينا «Checked out» في حالة النسخة، وبعض عبارات المساعدة، والموضوعات نفسها بالإنجليزية لأنها من رؤوس موضوعات مكتبة الكونغرس، وهذه بيانات وليست واجهة. وإذا كنت ستطلق النظام لجامعة عربية فخصص وقتاً لمراجعة الترجمة صفحة صفحة، وضع تعديلاتك في local/languages/ar.ini، وأرسل ما تصلحه إلى المشروع، فهذا أسهل طريق للمساهمة في مشروع مفتوح المصدر دون كتابة كود.
قبل الإنتاج: النطاق والمهام والنسخ الاحتياطي
- النطاق والشهادة: ضع VuFind خلف Reverse Proxy بشهادة HTTPS كما في تثبيت Caddy، وغير
urlفي قسم[Site]إلى العنوان النهائي، لأن VuFind يبني منه روابط التسجيلات في البريد والتصدير. وهذا الجزء لم نختبره في المختبر لأنه يحتاج نطاقاً حقيقياً. - المهام المجدولة: الحصاد من Koha ومن DSpace ثم الفهرسة كل ساعة أو كل ليلة، ومعها حذف التسجيلات التي أبلغ عنها المصدر أنها محذوفة، والسكربت
batch-delete.shمع الحصاد يفعل ذلك. - النسخ الاحتياطي: انسخ المجلد
localكله، فيه إعداداتك وقواعد الفهرسة وملفات اللغة، وانسخ قاعدة بيانات VuFind بالأداةmariadb-dumpلأن فيها حسابات القراء وقوائمهم. أما فهرس Solr فلا تحتاج نسخه إذا كانت مصادرك تعمل، لأنك تستطيع إعادة بنائه بالحصاد الكامل، وقد استغرق عندنا أقل من دقيقتين لـ 453 تسجيلة، فاحسب الوقت على حجم مكتبتك وقرر. - التحديث: ثبت حزمة الإصدار الجديد، ثم افتح معالج الإعداد ليرقي قاعدة البيانات، وراجع ملفات
local/configمقابل الملفات الأصلية الجديدة، لأن الإعدادات الجديدة تظهر في الأصلية فقط. وإذا تغيرschema.xmlبين الإصدارات فأعد الفهرسة كاملة.
أخطاء شائعة وحلولها
| العرض | السبب | الحل |
|---|---|---|
| كل الكتب تظهر دون نسخ ودون أي خطأ | معرف التسجيلة من 001 وليس رقم Koha | id = 999c, first في marc_local.properties ثم إعادة الفهرسة |
Unauthorized IP address من ILS-DI | عنوان VuFind ليس في ILS-DI:AuthorizedIPs | أضفه بالأداة koha-preferences، فالتعديل المباشر في الجدول لا يظهر حتى تمسح Memcached |
| البحث بالعنوان أو المؤلف بالعربية يعيد صفراً، و«كل الحقول» يعمل | النص العربي في 880 فقط | حقول LNK245 وLNK100 في marc_local.properties |
| «بخلاء» لا تجد «البخلاء» | لا يوجد تجذيع عربي في المحلل الافتراضي | علم القراء البحث بالكلمة كاملة أو بالنجمة، أو أضف مرشحات Solr العربية بعد اختبارها |
حصاد مجموعة من DSpace يعيد noRecordsMatch | فهرس OAI في DSpace لم يحدث | شغل dspace oai import في المستودع، أو احصد بالتاريخ |
| تسجيلة من DSpace اختفت تسجيلة من Koha | معرفان متساويان من مصدرين | بادئة لكل مصدر عبر idSearch وidReplace |
القراء يراسلون [email protected] | البريد الافتراضي في [Site] | غير email وtitle قبل الإطلاق |
| إعداداتك ضاعت بعد التحديث | عدلت الملفات الأصلية في config/vufind | كل تعديل في local/config/vufind |
قائمة تحقق قبل الإطلاق
- كل فحوص معالج الإعداد ناجحة، ثم
autoConfigure = false. - Solr لا يرد من خارج السيرفر، والمنفذ 3306 في Koha مفتوح لعنوان VuFind وحده.
- رابط تسجيلة في VuFind فيه رقم Koha نفسه، وصفحتها تعرض النسخ وحالتها.
- كتاب تعيره من Koha يظهر معاراً في VuFind دون إعادة فهرسة، وكتاب تفهرسه اليوم يظهر بعد الحصاد التالي.
- البحث بالعنوان والمؤلف بالعربية يجد التسجيلات التي فيها 880، والبحث بالهمزة ودونها والتاء المربوطة والهاء يعطي النتيجة نفسها.
- حد «المؤسسة» يفصل بين المكتبة والمستودع، ولا توجد في النتائج تسجيلات بلا عنوان.
- البريد والعنوان في
[Site]للمكتبة الحقيقية، والترجمة العربية مراجعة في الصفحات الأساسية. - جربت إيقاف Koha وعرفت ماذا يرى القارئ، وأعلنت للموظفين أن البحث يستمر أثناء الصيانة.
تدريب عملي
- أضف إلى
marc_local.propertiesحقل الموضوع من 880 المرتبط بالحقل 650، ثم ابحث عن موضوع بالعربية وقارن النتيجة قبل التعديل وبعده. - أعر نسخة من Koha، ثم اجعل VuFind يعرض حالة «Checked out» بالعربية عبر ملف لغة محلي.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- طبقة الاكتشاف تبحث في نسخة من سجلات كل مصادرك داخل Solr، وتسأل Koha عن حالة النسخة فقط لحظة العرض، لذلك يستمر البحث حتى عندما يتوقف Koha.
- VuFind 11.1.1 يثبت من حزمة Debian الرسمية ومعه Solr 9.8.1، واستخدم في المختبر 1.57GB من الذاكرة، أغلبها لـ Solr.
- النقل من Koha بالحصاد OAI-PMH بصيغة
marcxml، ومعرف التسجيلة يجب أن يكون من الحقل 999c، وإلا تظهر الكتب بلا نسخ دون أي خطأ. - KohaILSDI لا يحتاج إضافة ولكنه يحتاج حساب قراءة في قاعدة بيانات Koha، وKohaRest يعمل عبر REST API وحده ويحتاج إضافة koha-plugin-rest-di.
- المحلل الافتراضي يوحد الهمزة والتاء المربوطة والألف المقصورة والتشكيل، ولا يفصل «ال» و«و»، والعنوان العربي في الحقل 880 لا يدخل بحث العنوان والمؤلف حتى تضيف
LNK245وLNK100. - DSpace يدخل الفهرس نفسه عبر
dspace.xsl، مع بادئة لمعرفاته، وحد «المؤسسة» يفصل المصادر للقارئ.
وفي مقالات قادمة بإذن الله سوف نشرح معيار MARC21 وحقوله بالتفصيل، وكيف تجمع البوابات سجلات المستودعات بالحصاد OAI-PMH:
سجل التحديثات
- نوفمبر 2026: كتابة الدليل وتجربته على VuFind 11.1.1 مع Solr 9.8.1 فوق Koha 26.05.05 وDSpace التجريبي، بـ 453 تسجيلة حقيقية من فهرس مكتبة الكونغرس.