إذا طلب منك أن تشارك في اختيار نظام جديد لمكتبة الجامعة أو المدرسة، فأول ما سوف تلاحظه في عروض الشركات أن كل عرض يبدأ بقائمة من الاختصارات: ILS وLSP وOPAC وDiscovery وIR وERM وZ39.50 وOAI-PMH وSIP2 وOpenURL، وكل شركة تستخدمها بطريقة مختلفة قليلاً، وكل واحدة تقول إن نظامها «متكامل» ويغني عن غيره. والمشكلة أن موظف المكتبة يعرف عمله جيداً، يعرف الفهرسة والإعارة والتزويد، ولكنه لا يعرف بالضرورة أين ينتهي نظام ويبدأ الآخر، وموظف تقنية المعلومات يعرف السيرفرات وقواعد البيانات ولكنه لا يعرف لماذا تحتاج المكتبة بروتوكولاً عمره أكثر من ثلاثين سنة اسمه Z39.50، والنتيجة أن القرار يتخذ من العرض الأجمل وليس من فهم الأنظمة. وفي مقال الأنظمة التي تحتاجها الجامعة رسمنا خريطة الجامعة كلها، وكانت المكتبة فيها صندوقاً واحداً، وفي هذا المقال سوف نفتح هذا الصندوق.
وفي هذا المقال سوف نناقش:
- الأنظمة التي تتكون منها المكتبة الحديثة: نظام المكتبة المتكامل، وطبقة البحث، والمستودع الرقمي، والمجلات، والأرشيف، وما حولها من أنظمة الجامعة.
- الفرق بين نظام المكتبة المتكامل ILS ومنصة خدمات المكتبة LSP، ولماذا انتقلت مكتبات كبرى من الأول إلى الثانية.
- المعايير التي تجعل هذه الأنظمة تتكلم مع بعضها، ولماذا يجب أن تسأل عنها قبل أن تسأل عن شكل الواجهة.
- مختبر عملي: نسخ تسجيلة كتاب من فهرس مكتبة الكونغرس عبر Z39.50 وSRU، والبحث بالحرف العربي، وسؤال Koha كما يسأله نظام آخر، وحصاد مستودع DSpace عبر OAI-PMH.
- ما تعلمته المكتبة البريطانية عندما توقفت أنظمتها كلها معاً في 2023، ثم أسئلة تطرحها على أي مورد.
وهذا المقال هو الأول في مرحلة «أنظمة المكتبات الرقمية»، وبعده تأتي أدلة الأنظمة نفسها:
 دليلنظام المكتبة Koha: فهرسة MARC21 بالعربية والإعارةكيف تثبت Koha من حزمه الرسمية بالعربية، وتفهرس كتباً عربية بـ MARC21 وتعيرها، وتصلح البحث العربي الذي لا يعمل في الإعداد الافتراضي.
 دليلواجهة البحث Discovery مع VuFind فوق Kohaكيف تضع VuFind فوق Koha والمستودع الرقمي ليبحث القارئ في مربع واحد، مع حالة الكتاب من Koha مباشرة وبحث عربي يجد العنوان المكتوب في الحقل 880.
 دليلKoha أم Evergreen أم FOLIO؟ اختيار نظام المكتبةمقارنة عملية شغلنا فيها Koha وEvergreen على التسجيلات نفسها وقسنا الذاكرة والاستيراد والبحث العربي، مع FOLIO من توثيقه الرسمي وأرقام السوق لعام 2026.
 دليلمستودع الجامعة Institutional Repository مع DSpaceكيف تشغل DSpace لأرشفة رسائل الطلاب وأبحاث الجامعة، من الإيداع ومراجعته حتى الحصاد عبر OAI-PMH، وما يحتاج تعريباً قبل الإطلاق.
الخريطة كاملة: ما الذي تتكون منه المكتبة؟
المكتبة الحديثة ليست برنامجاً واحداً، وإنما مجموعة أنظمة لكل منها قاعدة بياناته وعمله، والصورة التالية تبين أهمها في مكتبة جامعية، والمكتبة العامة أو المدرسية تحتاج جزءاً منها فقط:
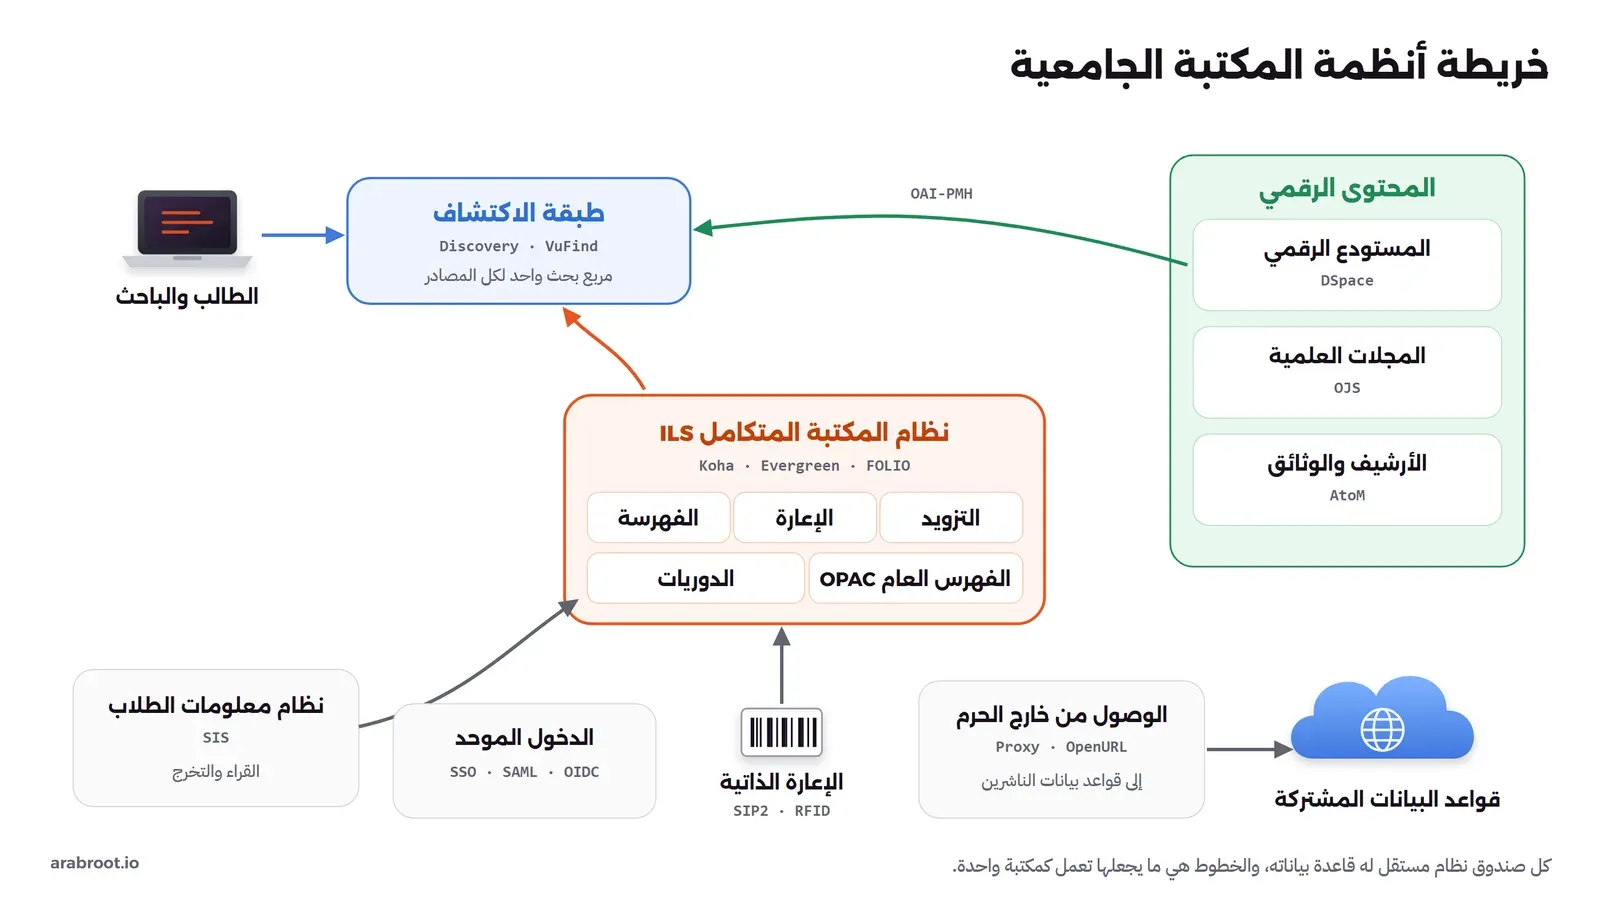
في الخريطة أعلاه لاحظ التالي:
- المركز هو نظام المكتبة المتكامل: فيه الكتاب ونسخه والقارئ وإعاراته، وكل الأنظمة الأخرى إما تقرأ منه أو تكتب فيه.
- القارئ لا يرى المركز: الطالب يرى مربع البحث، وجهاز الإعارة الذاتية، وصفحة الدخول، أما نظام المكتبة فيعمل خلفها، ولذلك قد تغير المكتبة نظامها دون أن يغير الطالب عاداته إذا كانت الواجهات حوله ثابتة.
- المحتوى الرقمي منفصل عن الكتب: رسائل الجامعة وأبحاثها ومجلاتها ووثائقها التاريخية في أنظمة أخرى، لأن طبيعتها مختلفة: ملف PDF له رابط دائم وليس كتاباً له رف ونسخ.
والآن نمر على كل صندوق، ونبدأ بالمركز.
نظام المكتبة المتكامل Integrated Library System
نظام المكتبة المتكامل، واختصاراً ILS، هو البرنامج الذي يدير العمل اليومي للمكتبة، وسمي متكاملاً لأنه جمع في السبعينيات والثمانينيات أنظمة كانت منفصلة: نظام للفهرسة، ونظام للإعارة، ونظام للمشتريات، في قاعدة بيانات واحدة. وأي نظام من هذا النوع فيه الوحدات Modules التالية، مهما اختلفت أسماؤها:
- الفهرسة Cataloguing: وصف الكتاب بمعيار مثل MARC21، أي العنوان والمؤلف والناشر والموضوع، وهذه هي التسجيلة الببليوغرافية Bibliographic Record، وكل نسخة على الرف لها سجل نسخة Item مستقل بباركود ورقم طلب Call Number. والتسجيلة الواحدة قد يكون لها عشر نسخ في ثلاثة فروع، والإعارة تكون للنسخة وليس للتسجيلة.
- الإعارة Circulation: القراء وفئاتهم وقواعد الإعارة: كم كتاباً، وكم يوماً، وكم تجديداً، والحجوزات، والغرامات، وإخلاء الطرف عند التخرج.
- التزويد Acquisitions: طلبات الشراء من الموردين والميزانيات والفواتير، وهي الوحدة التي يتعامل معها قسم المالية.
- الدوريات Serials: المجلات التي تصل أعدادها دورياً، وتوقع العدد القادم، والمطالبة بالعدد المتأخر.
- الفهرس العام OPAC: واجهة البحث التي يرى منها القارئ الكتب وحالتها ويحجز ويرى إعاراته.
وقد شرحنا هذه الوحدات عملياً في دليل نظام المكتبة Koha، وهو أشهر نظام مفتوح المصدر من هذا النوع، وفيه رأينا التسجيلة والنسخة وقاعدة الإعارة على كتب عربية حقيقية. وأشهر الأنظمة المفتوحة المصدر الأخرى Evergreen، الذي بنته مكتبات ولاية جورجيا الأمريكية لشبكة مكتباتها العامة، وسوف نقارن بينها في مقال الاختيار.
طريق كتاب واحد بين الأنظمة
لنفهم كيف تعمل هذه الوحدات معاً، لنتبع كتاباً واحداً من لحظة طلبه إلى لحظة إعادته. يطلب أستاذ في قسم التاريخ نسخاً من «مقدمة ابن خلدون» بتحقيق جديد، فتنشئ موظفة التزويد طلب شراء في وحدة التزويد، وتخصم قيمته من ميزانية القسم، ويصل الطلب إلى المورد بالبريد أو بملف إلكتروني. وبعد أسابيع تصل الكتب، فتسجل الموظفة الاستلام، ويتحول الطلب إلى فاتورة تراها المالية.
بعد ذلك ينتقل الكتاب إلى المفهرس، وهنا الخطوة التي توفر أكبر وقت: بدلاً من أن يكتب التسجيلة من الصفر، يبحث برقم ISBN في فهرس مكتبة كبرى عبر Z39.50، فيجد التسجيلة جاهزة، فيستوردها ويراجعها ويضيف لها ما يخص مكتبته، ثم ينشئ نسختين بباركود ورقم طلب. وفي هذه اللحظة يظهر الكتاب في الفهرس العام لنظام المكتبة، ويظهر في طبقة الاكتشاف بعد الحصاد التالي، أي بعد ساعة إذا كان الحصاد كل ساعة.
يبحث طالب في مربع البحث عن «ابن خلدون»، فيجد الكتاب، ويرى أن نسخة متاحة على الرف، وهذه الحالة جاءت من نظام المكتبة لحظة فتح الصفحة. يأخذ الكتاب إلى جهاز الإعارة الذاتية، فيمسح بطاقته الجامعية والكتاب، فيسأل الجهاز نظام المكتبة عبر SIP2: هل هذا القارئ مسموح له؟ وهل هذه النسخة قابلة للإعارة؟ ثم يسجل الإعارة، ويطبع إيصالاً بتاريخ الإرجاع. وهذا القارئ موجود في نظام المكتبة لأنه جاء من نظام معلومات الطلاب في الاستيراد الليلي، ودخل إلى حسابه في المكتبة بحساب الجامعة عبر الدخول الموحد.
ثم ينسى الطالب الكتاب، فترسل مهمة مجدولة في نظام المكتبة تذكيراً قبل الموعد بيومين، ثم إشعار تأخير، ثم غرامة إذا كانت المكتبة تفرضها. وفي نهاية السنة يتقدم الطالب للتخرج، فيسأل نظام الطلاب نظام المكتبة: هل على هذا الطالب كتب أو غرامات؟ فلا يكتمل إخلاء الطرف حتى يعيد الكتاب. وفي هذا الطريق القصير مر الكتاب على خمسة أنظمة على الأقل، وكل انتقال بينها اعتمد على معيار أو ربط، وإذا تعطل أي ربط ظهر في مكان بعيد عنه: طالب متخرج ما زال يستعير، أو كتاب على الرف لا يجده أحد في البحث.
من ILS إلى منصة خدمات المكتبة LSP
صمم نظام المكتبة المتكامل حول الكتاب المطبوع، ثم جاءت الألفية الجديدة فأصبحت ميزانية المكتبة الجامعية تذهب في أغلبها إلى اشتراكات إلكترونية: قواعد بيانات ومجلات وكتب إلكترونية، ولها تراخيص وفترات وصول وقوائم عناوين تتغير كل شهر، ولا يناسبها نموذج «تسجيلة ونسخ على الرف». لذلك ظهرت فئة جديدة اسمها منصة خدمات المكتبة Library Services Platform، واختصاراً LSP، تدير المطبوع والإلكتروني معاً، وفيها قاعدة معرفة Knowledge Base تعرف ما الذي تشترك فيه المكتبة من كل ناشر، وأغلبها مبني كخدمات Services صغيرة خلف APIs، ويقدم مستضافاً لدى المورد:
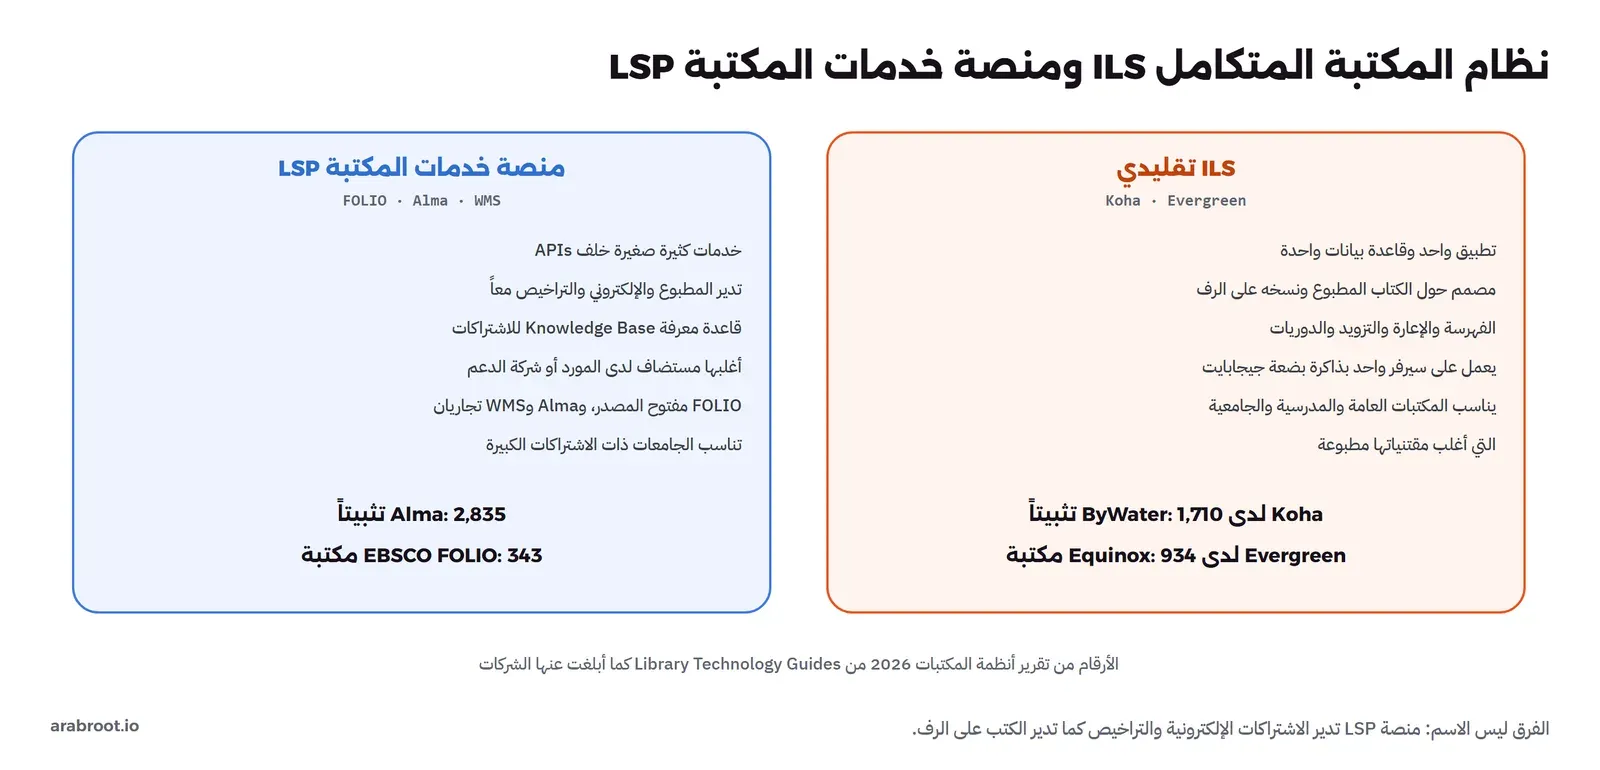
والأرقام في الصورة من تقرير أنظمة المكتبات لعام 2026 الذي ينشره Marshall Breeding في Library Technology Guides كل سنة، وهو المرجع الذي تعتمد عليه المكتبات في معرفة السوق. ويقول التقرير إن Alma من Clarivate ما زال يتصدر المكتبات الأكاديمية بـ 2,835 تثبيتاً، وإن FOLIO أصبح منافساً جاداً في المكتبات الأكاديمية، فـ EBSCO تبلغ عن 343 مكتبة تشترك في خدمتها المستضافة لـ FOLIO، وشركة Index Data عن 41 مؤسسة. وأشهر هذه الانتقالات أن مكتبة الكونغرس اختارت الانتقال إلى FOLIO عبر خدمات EBSCO، وهي المكتبة نفسها التي سوف نجلب من فهرسها التسجيلات في المختبر بعد قليل.
وقد يتساءل البعض: هل يعني هذا أن ILS أصبح قديماً ويجب أن نختار LSP؟ والإجابة لا، فالسؤال هو أين تذهب ميزانية مكتبتك. إذا كانت مكتبة مدرسة أو كلية أو مكتبة عامة، وأغلب مقتنياتها كتب مطبوعة، فنظام مثل Koha يغطي عملها كله، ويعمل على سيرفر واحد، ولا تحتاج قاعدة معرفة لاشتراكات لا تملكها. أما الجامعة التي تدفع أغلب ميزانيتها في اشتراكات إلكترونية، فإدارة هذه الاشتراكات في جداول Excel بجانب ILS هي المشكلة التي صنعت LSP لحلها. ونترك تفصيل هذا القرار لمقال المقارنة بين Koha وFOLIO وEvergreen.
طبقة الاكتشاف Discovery Layer
الفهرس العام الذي يأتي مع نظام المكتبة يبحث في الكتب التي في هذا النظام فقط، فإذا كان عندك مستودع رقمي ومجلات وأرشيف، فالطالب يحتاج أن يبحث في كل واحد على حدة. وطبقة الاكتشاف نظام منفصل يجمع نسخة من سجلات كل المصادر في فهرس بحث واحد، ويعرض نتيجة واحدة، ويسأل نظام المكتبة عن حالة الكتاب لحظة العرض. ومن الأنظمة المفتوحة المصدر في هذا المجال VuFind وAspen Discovery وBlacklight، ومن التجارية Primo وEBSCO Discovery Service وSummon، وهذه التجارية فيها فهرس مركزي بمقالات الناشرين يجد المقالة داخل المجلة. وفي التقرير نفسه تقول ByWater إنها تدعم Aspen Discovery في 792 مكتبة، وإن تطبيقات Koha الجديدة في المكتبات العامة الأمريكية تأتي معها Aspen تقريباً دائماً، أي أن فصل البحث عن نظام المكتبة أصبح هو القاعدة. وقد بنينا طبقة اكتشاف كاملة فوق Koha وDSpace في دليل VuFind.
المستودع الرقمي والمجلات والأرشيف
هذه أنظمة لمحتوى تنتجه المؤسسة أو تحفظه، وليس لكتب تشتريها:
- المستودع المؤسسي Institutional Repository: يحفظ رسائل الماجستير والدكتوراه وأبحاث الأساتذة ملفات بروابط دائمة، ويجعلها قابلة للبحث من محركات البحث العلمية، وأشهره DSpace الذي شرحناه في دليل مستودع الجامعة مع DSpace.
- نظام المجلات: يدير المجلة العلمية المحكمة من استلام البحث إلى التحكيم والنشر، وأشهره Open Journal Systems الذي شرحناه في دليل إصدار مجلة علمية محكمة مع OJS.
- الأرشيف والوثائق: يصف الوثائق والمخطوطات بمعايير أرشيفية مختلفة عن معايير الكتب، لأن الوثيقة جزء من مجموعة لها تسلسل وليست عملاً مستقلاً، ومن أنظمته AtoM وArchivesSpace.
والقاسم المشترك بينها أنها كلها تنشر سجلاتها عبر بروتوكول الحصاد OAI-PMH، وهذا هو الذي يسمح لطبقة الاكتشاف وللبوابات الوطنية والعالمية أن تجمعها، كما سوف نرى في المختبر.
ما حول المكتبة من أنظمة
المكتبة لا تعمل وحدها، وهذه الأنظمة هي التي يكثر فيها الخطأ لأنها تقع بين قسمين:
- نظام معلومات الطلاب SIS: مصدر القراء، فالطالب الجديد يجب أن يظهر في نظام المكتبة دون أن يدخله الموظف يدوياً، والمتخرج يجب أن تنتهي صلاحية بطاقته، وشؤون الطلاب تحتاج من المكتبة حالة إخلاء الطرف. وإذا لم يكن هذا الربط آلياً فسوف يكون عندك بعد سنتين آلاف القراء الذين تخرجوا وما زالت حساباتهم فعالة.
- الدخول الموحد SSO: ليدخل الطالب إلى حسابه في المكتبة وإلى قواعد البيانات بحساب الجامعة نفسه، عبر SAML أو OIDC كما في ما هو الدخول الموحد SSO.
- الإعارة الذاتية: أجهزة يمسح عليها الطالب بطاقته والكتاب، وتتكلم مع نظام المكتبة ببروتوكول SIP2، وأغلبها اليوم يقرأ شرائح RFID في الكتب بدلاً من الباركود.
- الوصول من خارج الحرم: قواعد البيانات المشتركة تسمح بالوصول من عناوين IP الجامعة، فالطالب في البيت يحتاج وكيلاً Proxy يمر عبره، والرابط من نتيجة البحث إلى النص الكامل يحمل بيانات المقالة بمعيار OpenURL.
- تقارير الاستخدام: الناشرون يرسلون إحصاءات استخدام الاشتراكات بمعيار COUNTER، وتجمعها المكتبة آلياً بمعيار SUSHI، وهذه الأرقام هي التي تقرر تجديد الاشتراك أو إلغاءه.
المعايير التي تجعل الأنظمة تتكلم
لو كان لكل نظام طريقته الخاصة في وصف الكتاب وتبادله، لكانت كل مكتبة جزيرة، ولكان تغيير النظام يعني إعادة فهرسة كل كتاب من الصفر. وما يجعل المكتبات مختلفة عن أغلب القطاعات أنها اتفقت منذ عقود على معايير مشتركة، والصورة التالية تجمعها حسب العمل الذي يقوم به كل معيار:
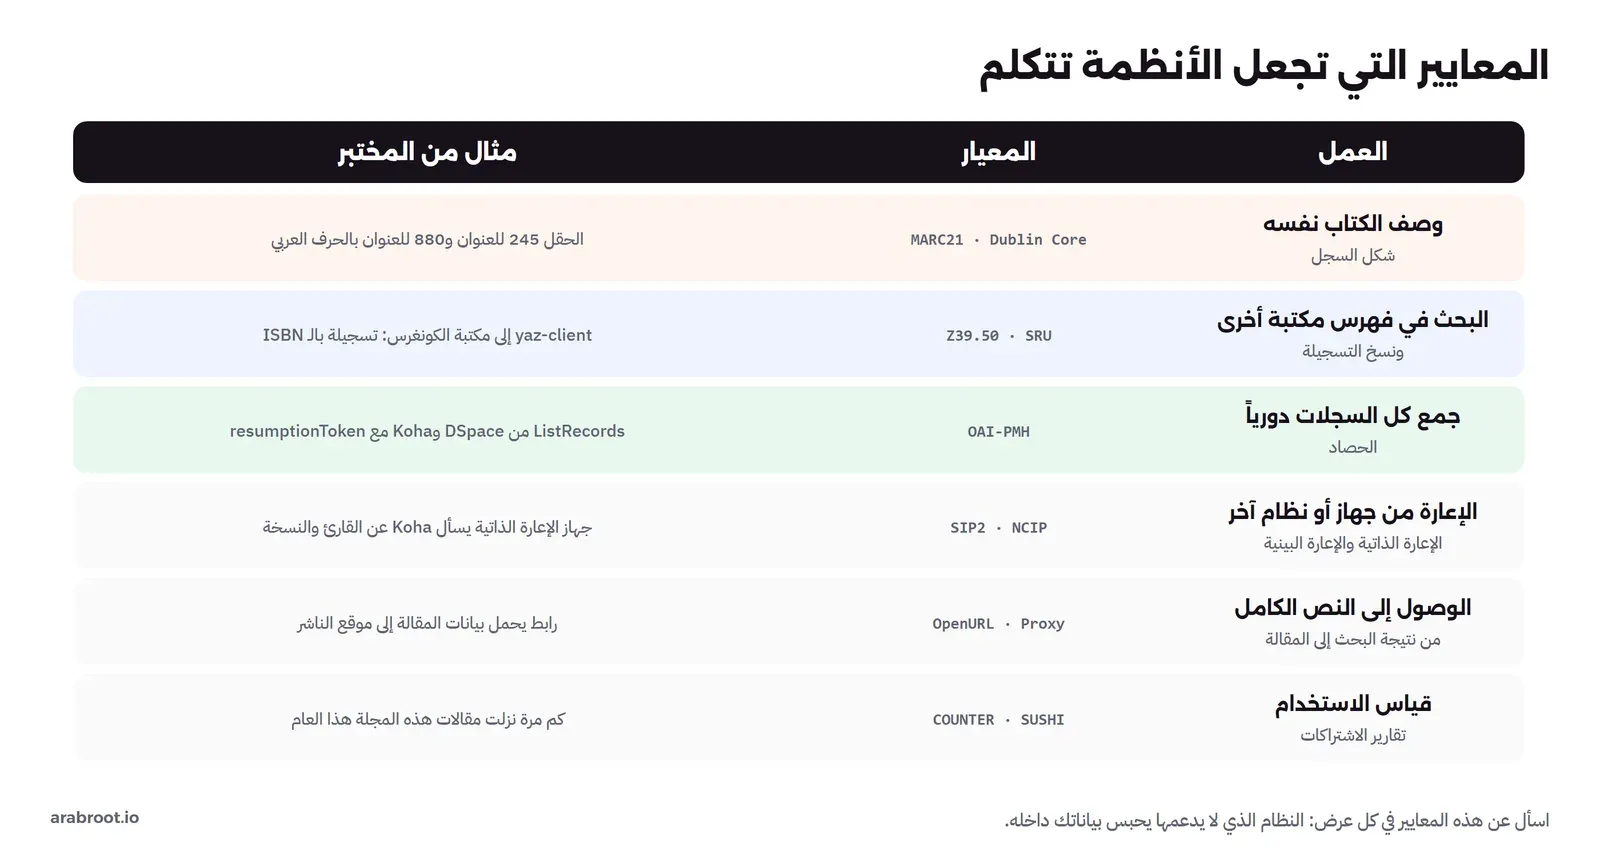
وأهم ثلاثة منها لمن يبدأ هي التالية، وسوف نجربها كلها في المختبر:
- MARC21: معيار مكتبة الكونغرس لوصف الكتاب في حقول مرقمة، 100 للمؤلف و245 للعنوان و650 للموضوع، وهو اللغة المشتركة لأغلب المكتبات في العالم، وله مقال قادم مستقل.
- Z39.50 وSRU: بروتوكولان للبحث في فهرس مكتبة أخرى وجلب التسجيلة منها، فبدلاً من أن يكتب المفهرس تسجيلة كتاب مشهور من الصفر، ينسخها من مكتبة فهرسته قبله. والأول بروتوكول ثنائي قديم على المنفذ 210 عادة، صدرت نسخته الأولى معياراً أمريكياً في 1988، والثاني نسخته الحديثة على HTTP، ويديرهما مكتب المعايير في مكتبة الكونغرس.
- OAI-PMH: بروتوكول مبادرة الأرشيف المفتوح للحصاد، ولا يبحث عن تسجيلة بعينها، وإنما يأخذ كل التسجيلات أو ما تغير منها منذ تاريخ معين، وهو الذي تبنى عليه طبقات الاكتشاف والبوابات الوطنية للرسائل الجامعية.
ثلاث طرق لوصف الكتاب: MARC21 وDublin Core وBIBFRAME
وصف الكتاب هو أساس كل ما سبق، وهناك ثلاثة معايير سوف تسمعها كثيراً. الأول MARC21، وهو غني ودقيق، وفيه مكان لكل تفصيل: المؤلف الأول والمشاركون والمترجم، والعنوان وبقيته، والطبعة، والسلسلة، والموضوعات من قوائم معتمدة، والحرف الأصلي في الحقل 880، ولكنه صعب على غير المفهرس، لأنه أرقام وحروف فرعية ومؤشرات. والثاني Dublin Core، وهو خمسة عشر عنصراً بأسماء مفهومة مثل العنوان والمنشئ والموضوع والتاريخ، وتستخدمه المستودعات لأن من يودع رسالته طالب وليس مفهرساً، وكل حاصد OAI-PMH يفهمه، ولكنه يضيع التفاصيل، فلا يفرق مثلاً بين المؤلف والمحقق. والثالث BIBFRAME، وهو المعيار الذي تعمل عليه مكتبة الكونغرس ليحل محل MARC، ويصف الكتاب كروابط بين كيانات: العمل، ونسخه المنشورة، والأشخاص، على طريقة البيانات المترابطة Linked Data في الويب. وما زال MARC21 هو ما تتبادله أغلب المكتبات اليوم، لذلك يجب أن يقرأه ويكتبه أي نظام تختاره، وسوف نشرح الثلاثة في مرحلة الفهرسة والبيانات الوصفية.
ومعها مفهوم رابع لا يقل أهمية للمكتبة العربية: ملفات الإسناد Authority Records. فالمؤلف الواحد يكتب اسمه بأشكال كثيرة: «ابن خلدون» و«عبد الرحمن بن محمد بن خلدون» و«Ibn Khaldūn» و«Ibn Khaldun»، وإذا فهرس كل كتاب بشكل مختلف فالطالب الذي يبحث بشكل واحد يجد جزءاً من الكتب فقط. وملف الإسناد سجل واحد للمؤلف فيه الشكل المعتمد وكل الأشكال الأخرى، وتربط به كل التسجيلات، فيجد البحث كل كتبه بأي شكل كتب اسمه. ولاحظ في المختبر أن مكتبة الكونغرس تكتب الاسم «Ibn Khaldūn, 1332-1406» بنفس الشكل في كل تسجيلاتها، وهذا أثر ملف الإسناد عندها، ولذلك كانت أعمدة المؤلف في نتائج Koha متطابقة.
لماذا ما زال بروتوكول من الثمانينيات حياً؟
قد يتساءل موظف تقنية المعلومات: لماذا نتعامل اليوم مع بروتوكول ثنائي على منفذ خاص، والعالم كله انتقل إلى REST وJSON؟ والإجابة أن قيمة البروتوكول ليست في تقنيته، وإنما في عدد من يتكلمه. فـ Z39.50 أصبح معياراً دولياً باسم ISO 23950، وتكلمته أغلب أنظمة المكتبات التي بنيت خلال أربعين سنة، فالمكتبة التي تضيف خادم Z39.50 تستطيع أن تبحث في فهارس آلاف المكتبات دون أي اتفاق ثنائي معها. وSRU جاء ليقدم القدرة نفسها عبر HTTP، ويديره مكتب المعايير في مكتبة الكونغرس، ولكنه لم يلغ الأول، وكما رأيت في المختبر فإن الخادم الواحد في Koha وفي مكتبة الكونغرس يرد على الاثنين. والنتيجة العملية لك: لا تختر نظاماً لا يدعم الاثنين عميلاً، وإذا كنت تكتب برنامجاً جديداً يبحث في الفهارس فابدأ بـ SRU لأنه أسهل في أي لغة برمجة.
المختبر: كيف تتكلم الأنظمة فعلاً؟
الكلام عن المعايير لا يكفي لتفهم ما الذي يحدث بين الأنظمة، لذلك سوف نتصل بأنظمة حقيقية ونرى ما ترد به. والأداة الأساسية هي yaz-client من شركة Index Data، وهي عميل Z39.50 وSRU من سطر الأوامر، ومكتبتها YAZ هي التي تستخدمها Koha وكثير من أنظمة المكتبات في الداخل. وبنينا لها Image صغيراً من Debian 13:
FROM debian:trixie-20261005-slim
RUN apt-get update && apt-get install -y --no-install-recommends yaz curl ca-certificates xmlstarlet libxml2-utils jq && rm -rf /var/lib/apt/lists/*
WORKDIR /work
docker build -t lib-tools:1 .
docker run --rm lib-tools:1 yaz-client -VYAZ version: 5.34.4 b42e25e840666ea3422c3bd5cb566b07f78a99cdوبجانبه شغلنا Koha 26.05.05 من حزمه الرسمية على الشبكة نفسها، كما في دليل Koha، وفيه 453 تسجيلة حقيقية جلبناها في هذا المختبر.
نسخ تسجيلة من مكتبة الكونغرس عبر Z39.50
لنفرض أن مكتبتك اشترت الترجمة الإنجليزية لمقدمة ابن خلدون من مطبعة جامعة برنستون، ومعك رقمها الدولي ISBN فقط. الأوامر التالية تتصل بفهرس مكتبة الكونغرس، وتبحث بالرقم، وتطلب التسجيلة بصيغة MARC21:
open lx2.loc.gov:210/LCDB
find @attr 1=7 9780691166285
format marc21
show 1
quit
docker run --rm -v "$PWD:/t" lib-tools:1 yaz-client -f /t/loc-isbn.yazوالمخرج سوف يكون كما يلي، وهذا أوله:
Connecting...OK.
Sent initrequest.
Connection accepted by v3 target.
ID     : 81
Name   : Metaproxy/YAZ
Version: 1.22.4/5.37.3
Options: search present scan namedResultSets
Sent searchRequest.
Received SearchResponse.
Search was a success.
Number of hits: 1, setno 1
records returned: 0
Sent presentRequest (1+1).
Records: 1
[LCDB]Record type: USmarc
03202cam a22006257i 4500
001 18444693
008 150109t20051967nju      b    001 0 eng d
020    $a 9780691166285 $q (paperback)
040    $a GYG $b eng $e rda $c GYG $d OCLCO ... $d DLC
041 1  $a eng $h ara
050 00 $a DS36.85 $b .I2613 2015
082 04 $a 901 $2 23
100 0  $a Ibn Khaldūn, $d 1332-1406, $e author.
240 10 $a Kitāb al-ʻibar. $p Muqaddimah. $k Selections. $l English
245 14 $a The Muqaddimah : $b an introduction to history / $c Ibn Khaldûn ; translated and introduced by Franz Rosenthal ...
264  1 $a Princeton, NJ : $b Princeton University Press, $c 2015.
300    $a xxxv, 465 pages ; $c 22 cm.
650  0 $a Islamic civilization.
650  0 $a History $x Philosophy.
في المخرج أعلاه لاحظ التالي:
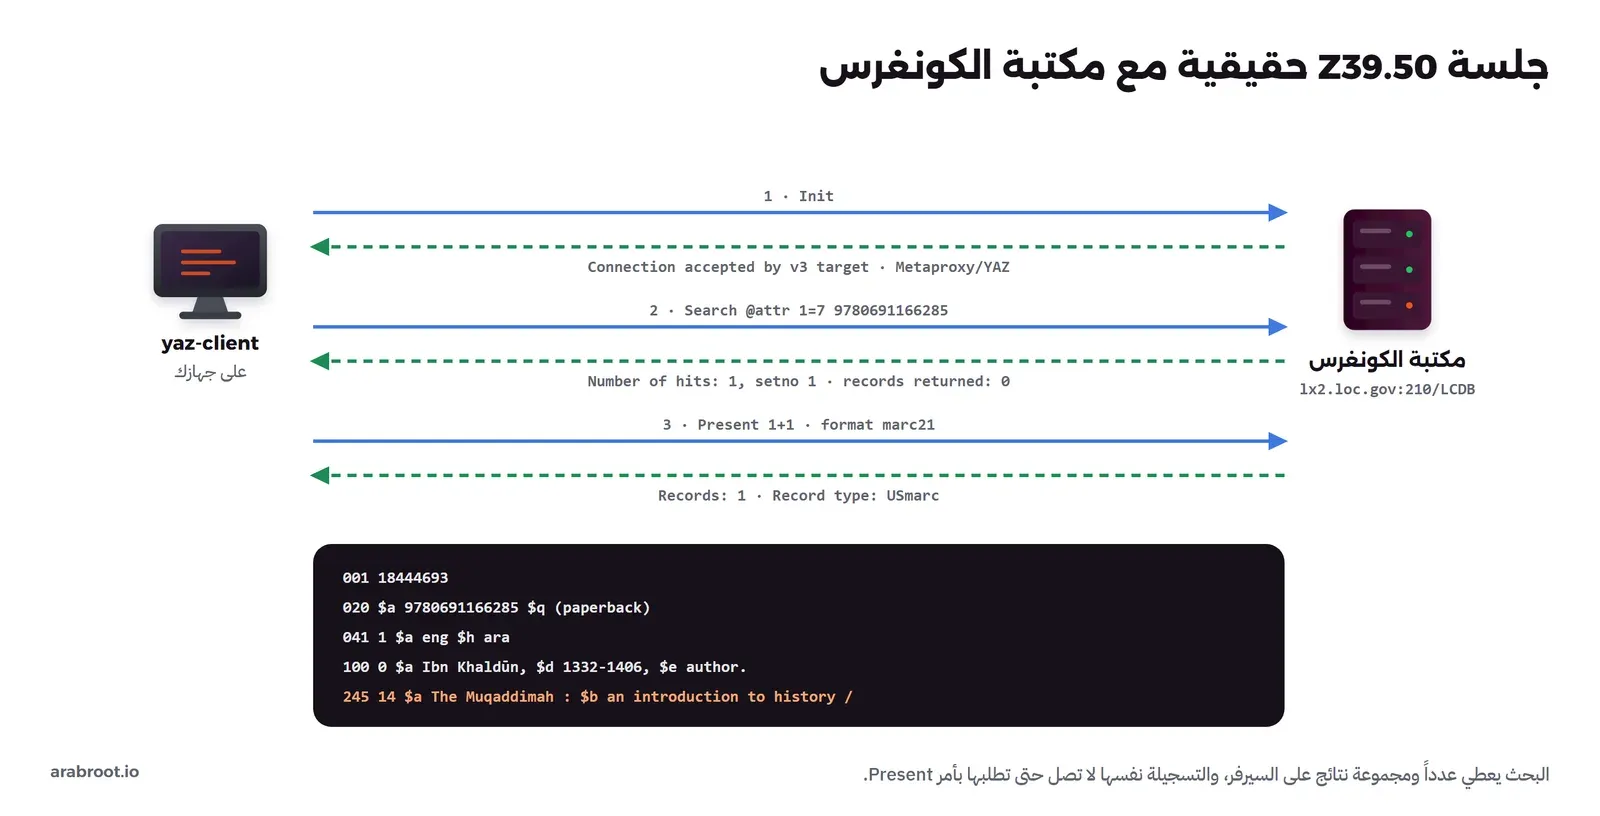
- الجلسة ثلاث مراحل كما في الصورة التالية: التعارف Init، ثم البحث Search الذي يعيد عدد النتائج فقط ويحفظها على السيرفر في مجموعة رقمها 1، ثم العرض Present الذي يجلب التسجيلة. وهذا الفصل بين البحث والعرض من تصميم الثمانينيات، حين كان الاتصال بطيئاً، فلا ترسل آلاف التسجيلات قبل أن يعرف المستخدم كم عددها.
- السيرفر يعرف نفسه بـ
Metaproxy/YAZ، أي أن مكتبة الكونغرس تضع أمام فهرسها بوابة من Index Data تترجم Z39.50 إلى نظامها الداخلي، وهذا ما يجعل البروتوكول يبقى ثابتاً للعالم حتى وهي تغير نظامها. @attr 1=7معناها «ابحث في حقل ISBN»، وهذه أرقام سمات Bib-1 المعرفة في المعيار، 4 للعنوان و1003 للمؤلف و7 للـ ISBN، وكل عميل Z39.50 يترجم اختيارك في الواجهة إلى هذه الأرقام.- الحقل 040 يحكي تاريخ التسجيلة: فهرستها مكتبة رمزها GYG، ثم عدلتها مكتبات أخرى، وآخرها DLC وهي مكتبة الكونغرس، فالتسجيلة التي ننسخها هي عمل مشترك بين عدة مكتبات، وهذا هو معنى الفهرسة التعاونية Copy Cataloguing.
- الحقل 041 يقول إن الكتاب بالإنجليزية
engمترجم من العربيةara، والحقل 082 يعطي رقم تصنيف ديوي 901 للتاريخ، فإذا كانت مكتبتك تصنف بديوي فرقم الطلب جاهز.
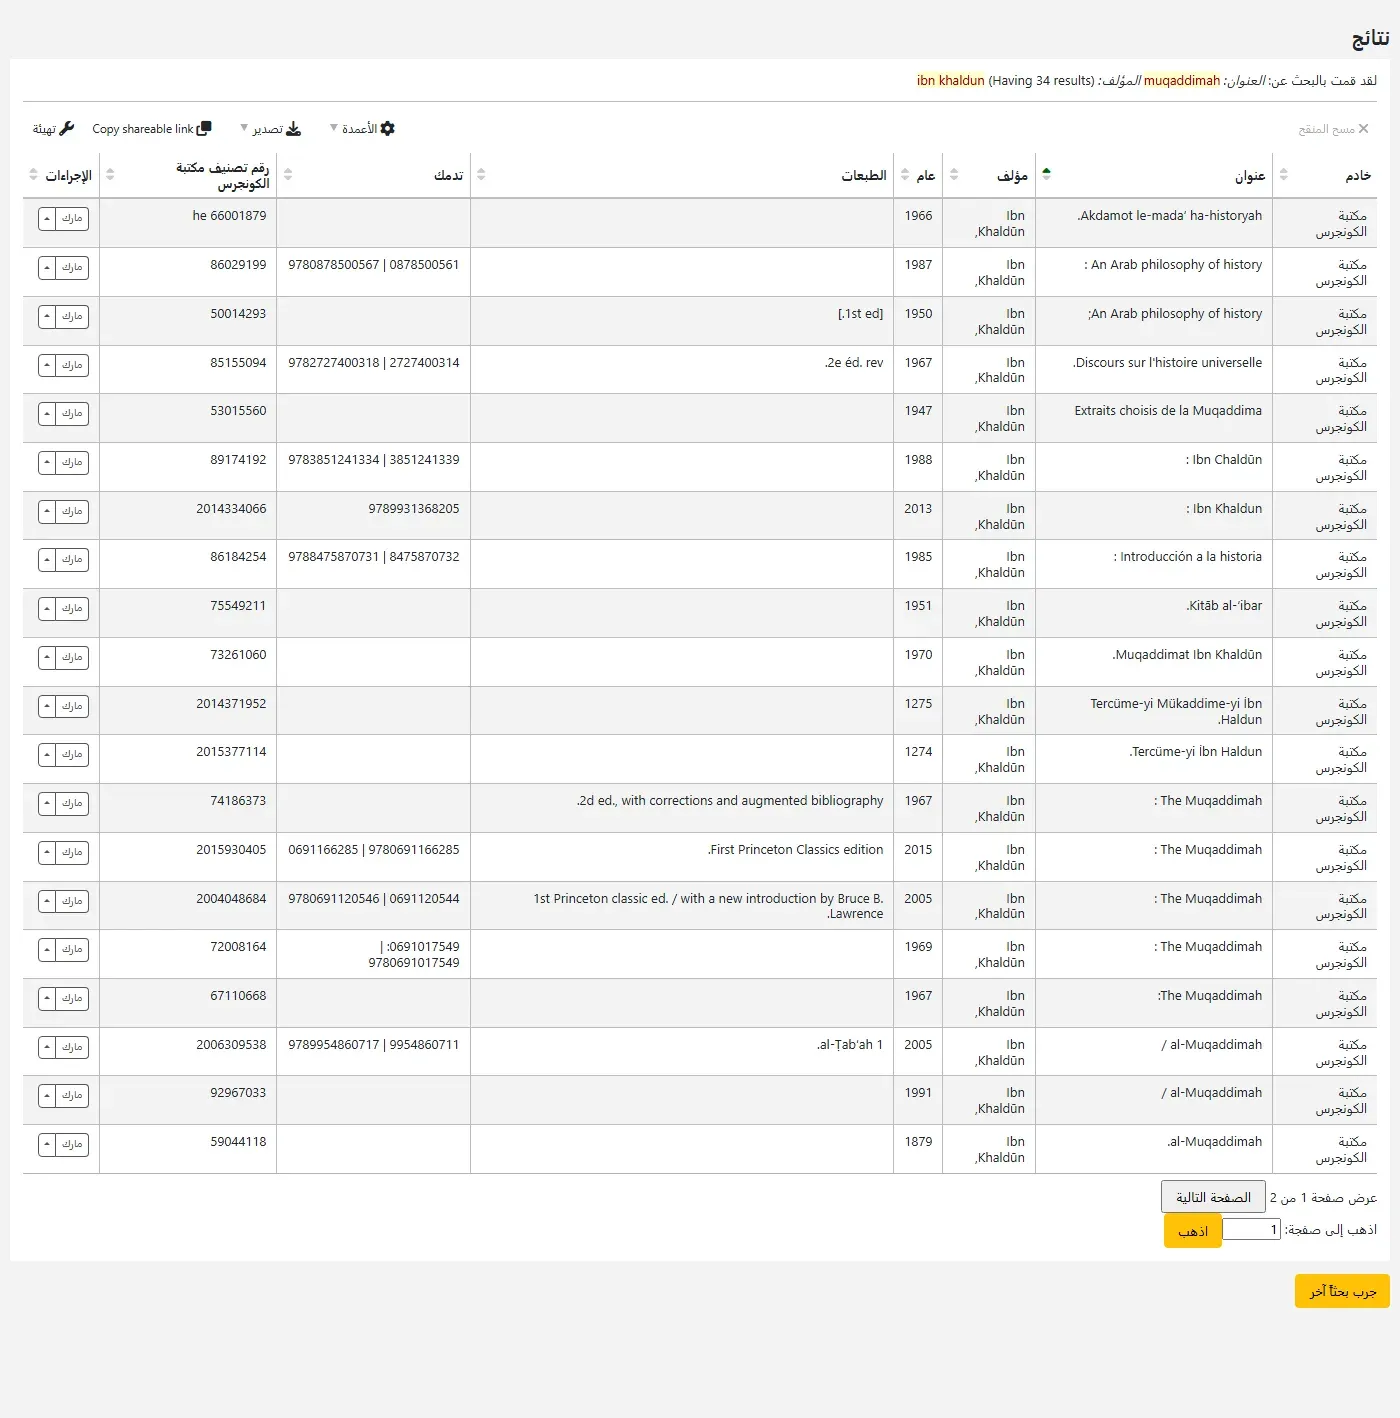
وهذا ما يفعله زر «Z39.50/SRU» في محرر الفهرسة في Koha، فالنظام يأتي بخوادم مكتبة الكونغرس جاهزة إذا اخترت البيانات الاختيارية في معالج التثبيت. والصورة التالية من بحث في Koha عن العنوان «muqaddimah» والمؤلف «ibn khaldun» في فهرس مكتبة الكونغرس، فأعاد 34 نتيجة، ولكل نتيجة زر «مارك» يعرض التسجيلة كاملة قبل أن تستوردها:
البحث بالحرف العربي ومفاوضة الترميز
الآن السؤال الذي يهم المكتبة العربية: هل أستطيع البحث في فهرس مكتبة الكونغرس بالحرف العربي؟ أضفنا إلى الجلسة السطر charset UTF-8، وهو يطلب من السيرفر أن يتفق معنا على ترميز UTF-8، ثم بحثنا بالعنوان والمؤلف بالعربية:
open lx2.loc.gov:210/LCDB
charset UTF-8
find @attr 1=4 المقدمة
find @attr 1=1003 "ابن خلدون"
find @attr 1=4 muqaddimah
quit
Character set negotiation : UTF-8
Number of hits: 7533, setno 1
Number of hits: 1551, setno 2
Number of hits: 1231, setno 3أي أن الفهرس يبحث بالحرف العربي، و«المقدمة» كلمة تظهر في عناوين آلاف الكتب العربية لأنها تعني «المدخل» أيضاً، لذلك كان عددها أكبر من «muqaddimah». ثم جربنا البحث نفسه بالعربية من نافذة Z39.50 في Koha، فرد السيرفر برسائل «Present request out of range» لأغلب النتائج، وظهرت تسجيلة تشيكية لا علاقة لها بالبحث، بينما البحث باللاتينية من النافذة نفسها أعاد النتائج الصحيحة كما في الصورة أعلاه. والأرجح أن السبب في ترميز الحروف الذي يرسل به العميل كلمة البحث، فإذا لم يتفق الطرفان على UTF-8 وصلت الكلمة العربية إلى السيرفر بايتات لا يفهمها، لذلك إذا كان المفهرسون عندك يبحثون بالعربية فجرب كل خادم Z39.50 تضيفه بكلمة عربية قبل أن تعتمد عليه، وراجع إعداد الترميز Encoding لكل خادم في صفحة إدارة خوادم Z39.50.
ولاحظنا في النافذة نفسها شيئاً آخر: خادم المكتبة الوطنية الفرنسية الذي يأتي مع Koha أعاد نتائج بأعمدة فيها تواريخ ورموز بدلاً من العناوين، والسبب أن هذا الخادم يرسل تسجيلاته بمعيار UNIMARC، ومكتبتنا مثبتة على MARC21، والحقول في المعيارين بأرقام مختلفة. لذلك لا تضف خادماً لا يرسل بالمعيار الذي اخترته عند التثبيت.
SRU: البحث نفسه عبر HTTP
Z39.50 يحتاج عميلاً خاصاً، أما SRU فهو البحث نفسه عبر طلب HTTP عادي يعود بملف XML، ولذلك هو أسهل لمن يكتب برنامجاً اليوم. والطلب التالي يبحث في الفهرس نفسه بالعنوان والمؤلف بلغة الاستعلام CQL:
curl -s -G "http://lx2.loc.gov:210/LCDB" \
  --data-urlencode "version=1.1" --data-urlencode "operation=searchRetrieve" \
  --data-urlencode 'query=bath.title=muqaddimah and bath.author="ibn khaldun"' \
  --data-urlencode "maximumRecords=10" --data-urlencode "recordSchema=marcxml"
فأعاد numberOfRecords بقيمة 34، وهو العدد نفسه الذي رأيناه في Koha، وفي إحدى التسجيلات، وهي طبعة الدار البيضاء 2005 من «المقدمة»، وجدنا هذا الجزء:
<datafield tag="245" ind1="1" ind2="2">
  <subfield code="6">880-02</subfield>
  <subfield code="a">al-Muqaddimah /</subfield>
  ...
<datafield tag="880" ind1="1" ind2="2">
  <subfield code="6">245-02/(3/r</subfield>
  <subfield code="a">المقدمة /</subfield>
  <subfield code="c">عبد الرحمن بن خلدون ؛ حققها وقدم لها وعلق عليها عبد السلام الشدادي.</subfield>
</datafield>
في الجزء أعلاه لاحظ التالي:
- العنوان الرئيسي في الحقل 245 مكتوب بالحروف اللاتينية «al-Muqaddimah»، والعنوان العربي في حقل منفصل رقمه 880، واسمه في المعيار التمثيل الخطي البديل.
- الحقل الفرعي 6 يربط الحقلين: في 245 القيمة
880-02أي «نسختي بحرف آخر في حقل 880 رقم 02»، وفي 880 القيمة245-02/(3/rأي «أنا نسخة الحقل 245 رقم 02، والحرف عربي(3، والاتجاه من اليمينr». - هذا الشكل مهم جداً للمكتبة العربية التي تنسخ التسجيلات، لأن نظام البحث الذي لا يعرف الحقل 880 سوف يعرض للطالب العربي «al-Muqaddimah» ولن يجد الكتاب إذا بحث بـ «المقدمة» في حقل العنوان، وقد رأينا هذا بالضبط في دليل VuFind وأصلحناه.
وبهذا الطلب نفسه جمعنا 453 تسجيلة لكتب ابن خلدون والجاحظ والمتنبي وابن سينا وابن رشد وطه حسين ونجيب محفوظ ومحمود درويش ونزار قباني والغزالي، خمسين تسجيلة لكل اسم، ثم وحدناها في ملف MARCXML واحد بالأداة xmlstarlet وحذفنا التكرار بالحقل 001، وهي التسجيلات التي استوردناها في Koha.
ماذا يحدث إذا استوردت التسجيلة كما هي؟
عند أول استيراد لهذه التسجيلات في Koha ظهر هذا السطر في مخرج أداة الاستيراد:
400..Item not added (bib 399, item tag #1, barcode ): invalid homebranch 08/20/96 T;03/19/96 Tوالسبب درس مهم في نسخ التسجيلات: الحقول التي تبدأ بالرقم 9 حقول محلية، أي أن كل مكتبة تستخدمها لأغراضها الداخلية، ومكتبة الكونغرس تضع فيها معلومات إدارية مثل الحقول 906 و925 و955، وإحدى التسجيلات فيها حقل 952. أما Koha فيستخدم الحقل 952 لسجلات النسخ، فقرأ هذا الحقل على أنه نسخة مكتبتها الرئيسية «08/20/96 T»، ورفضها لأن هذه ليست مكتبة عنده. وفي هذه الحالة كان الخطأ ظاهراً، ولكن تخيل حقلاً محلياً لم يسبب خطأ ودخل نظامك صامتاً بمعنى آخر. لذلك احذف كل حقول 9XX من التسجيلات المنسوخة قبل أن تضيف حقولك أنت، وهذا ما فعلناه في السكربت قبل الاستيراد الثاني، فدخلت التسجيلات الـ 453 ومعها 543 نسخة دون أي خطأ.
Koha يرد كما ترد مكتبة الكونغرس
نظام المكتبة ليس عميلاً فقط، وإنما يمكن أن يكون خادماً أيضاً، فتفهرس المكتبات الأخرى من فهرسك أنت، أو يسأله نظام في الجامعة عن كتبك. وفي Koha خادم Z39.50 وSRU تفعله لكل نسخة بأمر واحد:
sudo koha-z3950-responder --enable library
sudo koha-z3950-responder --start library
Z39.50/SRU enabled for library - edit files in /etc/koha/sites/library/z3950 to configure
Starting Z39.50/SRU daemon for library:.فأصبح يستمع على المنفذ 2100، ثم سألناه من Container الأدوات كما سألنا مكتبة الكونغرس:
Connection accepted by v3 target.
Name   : Koha/GFS/YAZ
Version: 26.05.05.000/5.34.4
Number of hits: 17, setno 1
Records: 1
001 9768541
041 1  $a eng $a ara
100 0  $a Ibn Khaldūn, $d 1332-1406.
245 13 $a An Arab philosophy of history; $b selections from the Prolegomena of Ibn Khaldun of Tunis.
942    $c BK
999    $c 152 $d 152
952    $a MAIN $b MAIN $o 901 $p LIB-01521 $y BK ...
في المخرج أعلاه لاحظ التالي:
- السيرفر يعرف نفسه
Koha/GFS/YAZ، أي أن Koha بنى خادمه على مكتبة YAZ نفسها التي في العميل. - التسجيلة خرجت ومعها حقول Koha: 999 فيه رقم التسجيلة في Koha وهو 152، و952 فيه النسخة بمكتبتها ورقم طلبها وباركودها، وهذا ما يجعل أي نظام آخر يعرف أن لديك نسخة على الرف.
- بحثنا أيضاً بالحرف العربي: «المقدمة» أعادت تسجيلتين، و«المقدمه» بالهاء أعادت التسجيلتين نفسيهما، لأننا فعلنا في هذا الـ Koha قاعدة توحيد التاء المربوطة في Zebra كما في دليل Koha، فالخادم يطبق على البحث القادم من الخارج قواعد البحث نفسها التي في الفهرس العام.
والخادم نفسه يرد على SRU، فالطلب http://koha:2100/biblios?operation=searchRetrieve&query=dc.title=muqaddimah أعاد numberOfRecords بقيمة 17، وهو العدد نفسه الذي أعاده Z39.50. وقبل أن تفتح هذا المنفذ للعالم قرر ما الذي تريد مشاركته، فالخادم يرسل حقول النسخ 952 كما رأيت، وفيها مكان كل نسخة وحالتها، وهذا مفيد لمكتبات شريكة في الإعارة البينية، ولكنه قد لا يناسب مكتبة فيها مجموعة خاصة لا تريد إظهارها. وملفات الإعداد في المجلد /etc/koha/sites/library/z3950 فيها إعداد هذا الخادم فراجعها، وافتح المنفذ في الجدار الناري للمكتبات الشريكة فقط حتى تراجعها.
الحصاد OAI-PMH من مستودع حقيقي
الآن البروتوكول الثالث. استخدمنا نسخة DSpace التجريبية الرسمية، وهي مستودع حقيقي يعمل على الإنترنت ويتجدد محتواه دورياً، وكتبنا سكربتاً يرسل الأفعال Verbs الأساسية بالترتيب الذي يرسله أي حاصد:
B=https://demo.dspace.org/server/oai/request
curl -s "$B?verb=Identify" | xmllint --format -
curl -s "$B?verb=ListMetadataFormats" | xmllint --format - | grep metadataPrefix
curl -s "$B?verb=ListSets" | xmllint --format - | grep -E "setSpec|setName" | head -6
curl -s "$B?verb=ListRecords&metadataPrefix=oai_dc" > lr.xml
والمخرج سوف يكون كما يلي، مختصراً:
== Identify
    <repositoryName>DSpace Demo</repositoryName>
    <protocolVersion>2.0</protocolVersion>
    <earliestDatestamp>2026-11-16T03:12:22Z</earliestDatestamp>
    <deletedRecord>transient</deletedRecord>
    <granularity>YYYY-MM-DDThh:mm:ssZ</granularity>
== ListMetadataFormats
      <metadataPrefix>didl</metadataPrefix>
      <metadataPrefix>mods</metadataPrefix>
      ...
      <metadataPrefix>oai_dc</metadataPrefix>
      <metadataPrefix>marc</metadataPrefix>
== ListSets (first 3)
      <setSpec>com_10673_1249</setSpec>
      <setSpec>com_10673_1156</setSpec>
      <setName>Anatomy</setName>
== records in page
100
== resumptionToken
    <resumptionToken completeListSize="25829" cursor="0">oai_dc////100</resumptionToken>
في المخرج أعلاه لاحظ التالي:
ListMetadataFormatsأعاد 14 صيغة، والصيغة الإلزامية في البروتوكول هيoai_dcأي Dublin Core، ولذلك يستطيع أي حاصد أن يقرأ أي مستودع، أما الصيغ الأغنى مثلmodsوmarcفيختارها الحاصد الذي يعرفها.ListSetsأعاد المجموعات، وفي DSpace كل مجتمع Community ومجموعة Collection تصبح Set، فإذا أرادت بوابة رسائل الماجستير أن تحصد كلية واحدة فقط فإنها تطلب Set هذه الكلية.- الصفحة الأولى من
ListRecordsفيها 100 تسجيلة، ومعهاresumptionTokenيقول إن العدد الكلي 25829، فيرسل الحاصد الرمز في الطلب التالي ليأخذ الصفحة الثانية، وهكذا حتى يعود رد بلا رمز. deletedRecordهناtransient، أي أن المستودع لا يعد بأن يتذكر التسجيلات المحذوفة دائماً، فالحاصد الذي يغيب طويلاً قد لا يعرف أن تسجيلة حذفت، أما Koha فقيمتها عندهpersistent.
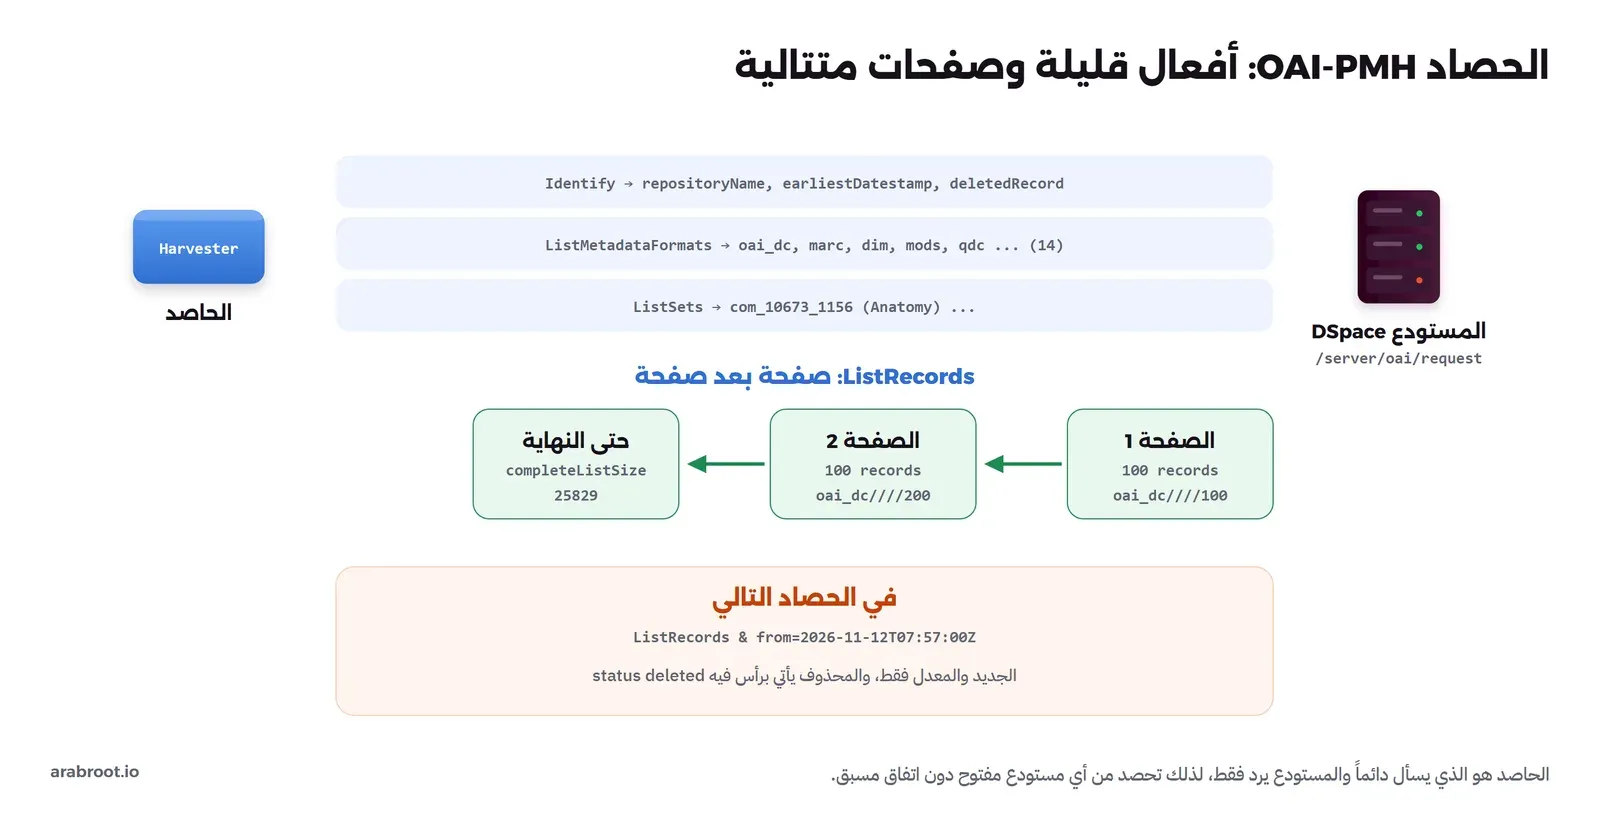
وأول تسجيلة في الصفحة الأولى لم يكن فيها إلا التاريخ والرابط، دون عنوان ولا مؤلف، ومن المئة الأولى كانت 48 تسجيلة فقط لها عنوان. وهذه هي تسجيلة كاملة منها كما تصل للحاصد:
<header>
  <identifier>oai:demo.dspace.org:10673/71818</identifier>
  <datestamp>2026-11-11T07:57:06Z</datestamp>
  <setSpec>col_10673_50406</setSpec>
</header>
<metadata>
  <oai_dc:dc>
    <dc:title>Wind Climatology And Relations With Sst And Sea Ice In The Chukchi-Beaufort Seas Region</dc:title>
    <dc:creator>Stegall, Steve T.</dc:creator>
    <dc:contributor>Zhang, Jing</dc:contributor>
    <dc:subject>Winds; Climatology (Research) Chukchi Sea; Beaufort Sea;  Sea ice (Arctic regions)</dc:subject>
    <dc:date>2013-01-01T08:00:00Z</dc:date>
    <dc:identifier>https://demo.dspace.org/handle/10673/71818</dc:identifier>
  </oai_dc:dc>
</metadata>
ولاحظ الفرق بينها وبين تسجيلة MARC: لا يوجد هنا حقل للمؤلف الأول وحقل للمشارك، وإنما dc:creator وdc:contributor، ولا يوجد مكان للنسخ ولا لرقم الطلب، لأن الرسالة ملف له رابط دائم في dc:identifier. وهذا ما يجعل Dublin Core سهلاً لكل مستودع، وفقيراً عندما تريد وصفاً دقيقاً، ولذلك تحصد البوابات المتخصصة الصيغ الأغنى إذا كانت متاحة.
وKoha أيضاً مصدر OAI-PMH، تفعله بالتفضيل OAI-PMH، وعندما سألناه بالفعل ListIdentifiers كانت المعرفات بهذا الشكل:
<identifier>KOHA-OAI-TEST:1</identifier>
<identifier>KOHA-OAI-TEST:2</identifier>
أي أن البادئة الافتراضية للمعرفات فيها كلمة TEST، وهذه البادئة تبقى في كل نظام يحصد منك، فغير التفضيل OAI-PMH:archiveID إلى اسم مكتبتك قبل أن يحصد منك أي أحد، والسبب أن تغييرها بعد ذلك يجعل الحاصد يرى كل تسجيلاتك تسجيلات جديدة.
عندما يتوقف كل شيء معاً: المكتبة البريطانية 2023
الخريطة التي رسمناها ليست تمريناً نظرياً، والدليل ما حدث للمكتبة البريطانية، وهي المكتبة الوطنية للمملكة المتحدة وإحدى أكبر مكتبات العالم:
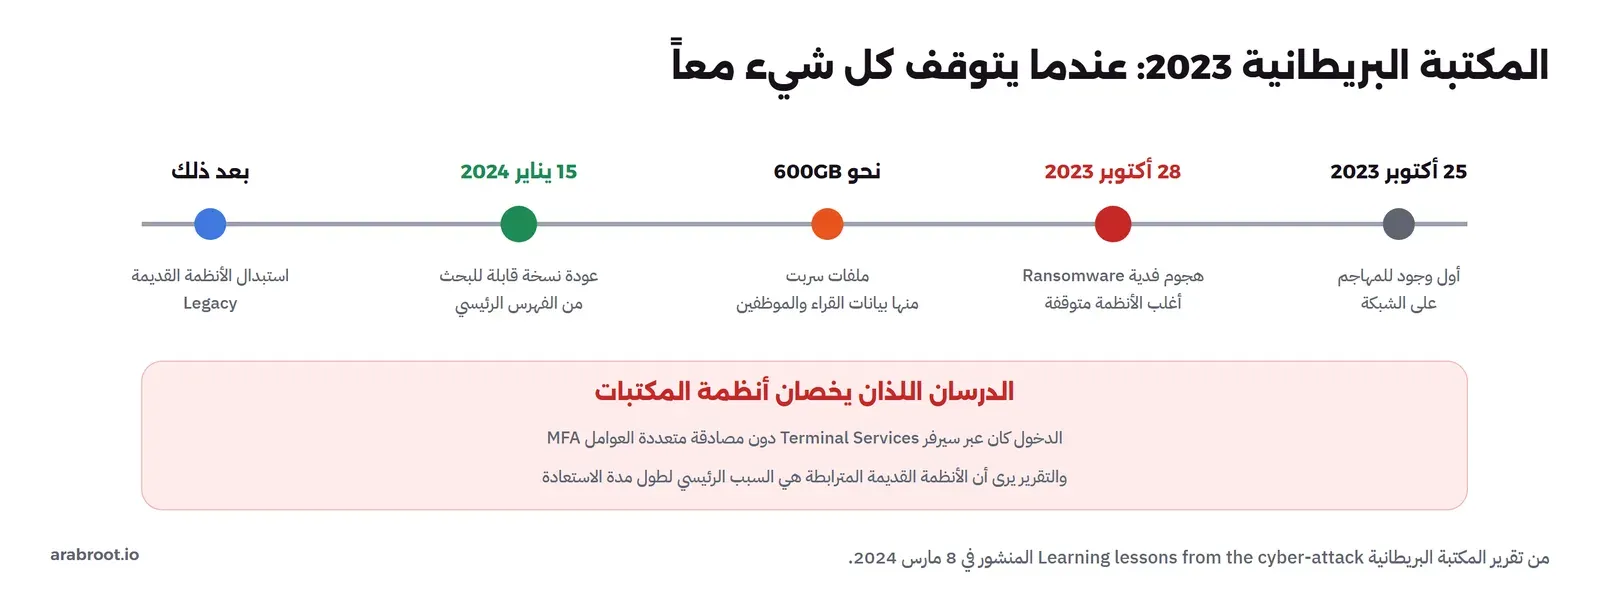
والدروس التي تخص من يرسم خريطة أنظمة مكتبته ثلاثة:
- اعرف ما يعتمد على ماذا: عندما يتوقف نظام المكتبة، ماذا يحدث للبحث والإعارة الذاتية والوصول إلى قواعد البيانات؟ وفي دليل VuFind جربنا هذا بالفعل، فالبحث استمر لأنه من فهرس منفصل، والنسخ تحولت إلى رسالة صيانة. ارسم هذه الإجابات على الخريطة قبل أن تحتاجها.
- البيانات بمعيار مفتوح نسخة احتياطية من نوع آخر: مكتبة تستطيع أن تصدر كل تسجيلاتها بـ MARC وأن يحصدها نظام آخر بـ OAI-PMH، تستطيع أن تبني فهرساً للبحث على نظام جديد في أيام، أما المكتبة التي بياناتها في صيغة لا يقرؤها غير نظامها فتنتظر هذا النظام.
- واجهات الإدارة لا تفتح للإنترنت دون MFA: واجهة الموظفين في نظام المكتبة فيها بيانات كل القراء، والاتصال عن بعد بسيرفرات المكتبة كان باب الدخول في هذه الحادثة.
ما الذي تحتاجه مكتبتك فعلاً؟
ليست كل مكتبة تحتاج كل صندوق في الخريطة، وأكبر خطأ مالي نراه أن تشتري مكتبة صغيرة منظومة جامعة كبرى لأنها رأتها في عرض. والجدول التالي نقطة بداية، ثم تعدلها بحسب حجم مقتنياتك وميزانيتك ومن سوف يدير الأنظمة:
| نوع المكتبة | ما تحتاجه | ما يمكن تأجيله |
|---|---|---|
| مكتبة مدرسة | نظام ILS بفهرس عام عربي، وربط بسيط لقائمة الطلاب | طبقة الاكتشاف، والمستودع، والإعارة الذاتية |
| مكتبة عامة | ILS، وإعارة ذاتية SIP2 إذا كان الإقبال كبيراً، وفهرس عام جيد على الجوال | المستودع، وقاعدة المعرفة للاشتراكات |
| كلية أو جامعة صغيرة | ILS، ومستودع للرسائل، وطبقة اكتشاف تجمعهما، وربط مع نظام الطلاب والدخول الموحد | منصة LSP كاملة إذا كانت الاشتراكات الإلكترونية قليلة |
| جامعة كبيرة باشتراكات واسعة | منصة LSP أو ILS مع نظام لإدارة الموارد الإلكترونية، وطبقة اكتشاف بفهرس مركزي، ووكيل للوصول من الخارج، وتقارير COUNTER | قليل، والسؤال هنا عن التكامل وليس عن الوحدات |
ولاحظ أن العمود الأخير ليس «لا تحتاجه أبداً»، وإنما «ابدأ بدونه»، والسبب أن كل نظام إضافي يحتاج من يحدثه ويراقبه ويأخذ نسخته الاحتياطية، والمكتبة التي فيها موظف تقنية واحد مشترك مع أقسام أخرى لا تستطيع أن تدير خمسة أنظمة جيداً. والقاعدة التي ننصح بها: نظام المكتبة المتكامل أولاً، وبيانات نظيفة فيه بمعيار مفتوح، ثم أضف الأنظمة حوله واحداً واحداً، وكل نظام تضيفه يجب أن يتكلم مع ما قبله بمعيار من المعايير التي في هذا المقال، وليس بربط خاص كتبه مبرمج ثم ترك الجامعة.
وهناك سؤال أخير يغفل عنه كثيرون عند المقارنة: من سوف يدير النظام؟ النظام المفتوح المصدر لا يعني أنه مجاني في التشغيل، فإما أن يكون عندك فريق يعرف Linux وقواعد البيانات ويتابع التحديثات الأمنية، وإما أن تتعاقد مع شركة دعم تستضيف النظام وتديره، كما تفعل أغلب المكتبات التي تستخدم Koha وEvergreen حسب أرقام التقرير أعلاه. والفرق عن النظام التجاري أنك تستطيع تغيير شركة الدعم دون تغيير النظام، لأن الكود والبيانات معك.
الانتقال من نظام قديم
أغلب المكتبات لا تبدأ من الصفر، وإنما تنتقل من نظام قديم أو من جداول Excel، والانتقال هو المكان الذي تظهر فيه قيمة المعايير بوضوح. إذا كان النظام القديم يصدر تسجيلاته بـ MARC، فالكتب تنتقل في يوم واحد كما نقلنا 453 تسجيلة بأداة الاستيراد في Koha، والعمل الحقيقي في التنظيف: الحقول المحلية، وأرقام الطلب المكتوبة بطرق مختلفة، والنسخ التي لا باركود لها. أما القراء والإعارات المفتوحة والغرامات فلا يوجد لها معيار تبادل مثل MARC، فتنقل عادة بملفات CSV وسكربتات خاصة لكل نظام، لذلك اطلب من المورد الجديد أن يبين لك كيف ينقل هذه البيانات بالذات، واطلب تجربة على نسخة من بياناتك الحقيقية قبل التوقيع. وإذا كانت بياناتك في Excel فلا تنقلها كما هي، وإنما خذ هذه الفرصة لتنسخ تسجيلات الكتب المشهورة من فهارس المكتبات الكبرى برقم ISBN، فتحصل على وصف أدق في وقت أقل من كتابة كل شيء يدوياً.
أخطاء شائعة عند اختيار الأنظمة وربطها
| الخطأ | لماذا يحدث | ما تفعله بدلاً منه |
|---|---|---|
| اختيار النظام من الواجهة في العرض | الواجهة هي ما يراه الجميع في الاجتماع | اطلب تصدير عينة من بياناتك واستيرادها، وجرب البحث العربي عليها |
| نسخ التسجيلات بحقولها المحلية 9XX | التسجيلة تبدو كاملة فتستورد كما هي | احذف 9XX قبل الاستيراد، فقد رأينا Koha يرفض نسخة بسبب حقل 952 من مكتبة أخرى |
| إضافة خادم Z39.50 بمعيار مختلف | القائمة الافتراضية فيها خوادم UNIMARC | خوادم بمعيار مكتبتك فقط، وجربها بكلمة عربية |
| ترك القراء يدخلون يدوياً | الربط مع نظام الطلاب يحتاج قسمين | استيراد دوري من SIS، وانتهاء الصلاحية مع التخرج |
| إطلاق OAI-PMH بالإعدادات الافتراضية | الخدمة تعمل فوراً | غير بادئة المعرفات والاسم والبريد قبل أن يحصد منك أحد |
| ربط كل نظام بالآخر مباشرة | كل ربط جديد يبدو صغيراً | خريطة مكتوبة لكل ربط: المعيار، والاتجاه، وما يحدث إذا توقف الطرف الآخر |
أسئلة تطرحها على أي مورد
- هل أستطيع تصدير كل التسجيلات الببليوغرافية والنسخ والقراء والإعارات بصيغة مفتوحة دون الرجوع إليكم؟ وكم يستغرق ذلك لمكتبة بحجم مكتبتنا؟
- هل يدعم النظام Z39.50 وSRU عميلاً وخادماً، وOAI-PMH مصدراً، وSIP2 لأجهزة الإعارة الذاتية؟
- كيف يعالج البحث الكلمة العربية: الهمزة، والتاء المربوطة، و«ال»، والحقل 880؟ اطلب التجربة على كتبك وليس على عرضهم.
- هل الواجهة العربية مترجمة بالكامل، ومن يصلح الترجمة إذا وجدنا خطأ؟
- كيف يربط النظام بالدخول الموحد في الجامعة، وبنظام معلومات الطلاب؟
- إذا توقف النظام، ماذا يرى القارئ في البحث، وماذا يحدث لأجهزة الإعارة الذاتية؟
- هل الواجهات الإدارية محمية بمصادقة متعددة العوامل، وأين تحفظ النسخ الاحتياطية؟
تدريب عملي
- شغل yaz-client على فهرس مكتبة الكونغرس، وابحث برقم ISBN لكتاب عربي في مكتبتك، ثم قارن الحقل 245 والحقل 880 بالتسجيلة التي عندكم.
- إذا كان لجامعتك مستودع رقمي، أرسل له الطلب
?verb=IdentifyثمListSets، واعرف كم مجموعة فيه وهل يتذكر التسجيلات المحذوفة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- المكتبة الحديثة مجموعة أنظمة: نظام المكتبة المتكامل في المركز، وطبقة الاكتشاف أمام القارئ، والمستودع والمجلات والأرشيف للمحتوى الرقمي، وحولها نظام الطلاب والدخول الموحد والإعارة الذاتية والوصول إلى قواعد البيانات.
- منصة خدمات المكتبة LSP تدير الاشتراكات الإلكترونية والتراخيص بجانب المطبوع، وتناسب الجامعات ذات الاشتراكات الكبيرة، أما المكتبة التي أغلب مقتنياتها مطبوعة فنظام ILS يكفيها.
- MARC21 يصف الكتاب، وZ39.50 وSRU ينسخان التسجيلة من مكتبة أخرى، وOAI-PMH يحصد كل السجلات دورياً، وهذه المعايير هي التي تحمي بياناتك من أن تحبس في نظام واحد.
- تسجيلات المكتبات الكبرى للكتب العربية فيها العنوان باللاتينية في 245 والعربي في 880، وحقول 9XX محلية يجب حذفها قبل الاستيراد.
- جرب البحث بالعربية في كل خادم وكل نظام قبل أن تعتمد عليه، فالترميز ومعالجة الحرف العربي يختلفان من نظام لآخر.
- حادثة المكتبة البريطانية تبين قيمة أن تعرف ما يعتمد على ماذا، وأن تبقى بياناتك قابلة للتصدير بمعيار مفتوح.
وفي مقالات قادمة بإذن الله سوف نشرح معيار MARC21 وملفات الإسناد والحصاد OAI-PMH بالتفصيل:
 دليلمعيار MARC21 للمبتدئين: بطاقة الفهرسة في الحاسبنقرأ تسجيلتين حقيقيتين من فهرس مكتبة الكونغرس حقلاً حقلاً، ونرى أين يذهب العنوان العربي، ولماذا ضاعت همزة عند التحويل إلى MARC-8.
 دليلملفات الإسناد Authority Files وأسماء المؤلفين العربنبحث في ملف أسماء مكتبة الكونغرس عن مؤلفين عرب، ونقيس كم اسماً حقيقياً في فهرس مفتوح يجد صاحبه بالشكل المعتمد والإحالات والتوحيد.
 دليلالحصاد OAI-PMH: كيف تجمع البوابات سجلات المستودعاتكيف تحصد البوابات تسجيلات المستودعات بالبروتوكول OAI-PMH، مع حاصد صغير جربناه على مستودعين عربيين حقيقيين وما وجدناه فيهما من أخطاء في التواريخ واللغة والحذف.
 دليلالأرشيف والوثائق بمعيار ISAD(G) مع AtoM وArchivesSpaceكيف تصف وثائق مؤسستك بمعيار ISAD(G) في AtoM بالعربية، مع مقارنة بـ ArchivesSpace ومختبر كشف ثلاث مشكلات في الاستيراد والبحث العربي وحلولها.
سجل التحديثات
- نوفمبر 2026: كتابة المقال، والتجربة على فهرس مكتبة الكونغرس عبر Z39.50 وSRU بأداة yaz-client 5.34.4، وعلى Koha 26.05.05 خادماً لـ Z39.50 وSRU وOAI-PMH، وعلى نسخة DSpace التجريبية عبر OAI-PMH.