عندما يطلب الطبيب تحليل سكر لمريض، فالرقم الذي يراه بعد ساعة على الشاشة مر بسلسلة طويلة: طلب في السجل السريري، وعينة سحبت ولصق عليها ملصق برقم، وجهاز قرأ الملصق وحلل العينة وأرسل النتيجة، ومختص راجع النتيجة واعتمدها، ثم تقرير وصل إلى العيادة. وفي مقال المستشفى من الداخل عرفنا نظام معلومات المختبر Laboratory Information System واختصاراً LIS في فقرة واحدة، وقلنا إن النتيجة ليست رقماً فقط وإنما رقم ووحدة ومدى مرجعي وحالة. وفي هذا المقال سوف نشغل نظام مختبر مفتوح المصدر حقيقياً، ونمر بالعينة في كل خطوة من هذه السلسلة، ونربطه بجهاز تحاليل نحاكيه برسائل HL7 v2، ونرى الأخطاء التي تحدث في كل وصلة.
لنفرض أنك مطور في مختبر طبي صغير يعمل على جداول Excel ونظام قديم، أو في شركة ناشئة تريد أن تبني خدمة تحاليل منزلية، وتبحث عن نظام مختبر مفتوح المصدر بدل أن تكتب واحداً من الصفر. وسوف نناقش ما يلي:
- ماذا يفعل نظام المختبر، والفرق بين LIS في المستشفى ونظام إدارة المختبرات LIMS.
- OpenELIS Global وSENAITE: نقاط القوة ونقاط الضعف، ومتى تختار كلاً منهما.
- تشغيل SENAITE 2.6.0 وتجهيز المختبر: القسم والفئة ونوع العينة والتحاليل برموز LOINC، ومشكلة حقيقية في واجهة API الإصدار الحالي.
- دورة حياة العينة: الطلب، والاستلام والرقم Accession والملصق Barcode، وإدخال النتائج، والاعتماد Verification بشخص آخر، والتقرير.
- المدى المرجعي Reference Range والقيم الحرجة Critical Values، وكيف عرضها النظام.
- واجهات الأجهزة Analyzer Interfaces: معيار ASTM ورسائل HL7 v2 ORU، وبرنامج وسيط Middleware كتبناه يستقبل رسالة حقيقية ويرد بإقرار ACK.
- ما يحدث عندما يضيع الإقرار، أو تأتي النتيجة بوحدة مختلفة، أو برقم عينة لا يعرفه النظام.
ماذا يفعل نظام المختبر LIS، وما الفرق بينه وبين LIMS؟
نظام معلومات المختبر في المستشفى يدير العينة من لحظة الطلب حتى اعتماد النتيجة، كما شرحنا في مقال الخريطة. وستقابل أيضاً اسماً قريباً هو نظام إدارة معلومات المختبرات Laboratory Information Management System واختصاراً LIMS. والفرق في الأصل أن LIS يدور حول المريض والطلب الطبي، أما LIMS فيدور حول العينة والعميل والجودة، ويستخدم في مختبرات المياه والأغذية والبيئة والصناعة والأبحاث. ولكن الحد بينهما أصبح ضبابياً، فأغلب الأنظمة اليوم تفعل الأمرين بدرجات مختلفة، وهذا بالضبط ما سوف تراه في المشروعين اللذين نقارنهما: OpenELIS بدأ كنظام مختبرات صحة عامة يدور حول المريض، وSENAITE بدأ كنظام LIMS عام يدور حول العميل والعينة ثم أضيفت إليه وحدات للمريض.
وفي المختبرات الطبية هناك معيار جودة دولي خاص بها هو ISO 15189، وجهات اعتماد المختبرات تقيس عليه، وكثير من متطلباته تقع على النظام مباشرة: التعرف على العينة دون لبس، وتتبع من فعل كل خطوة، والاعتماد قبل الإصدار، وإبلاغ القيم الحرجة، وضبط الجودة، وحفظ السجلات. لذلك عندما يقول مشروع إنه يدعم متطلبات الاعتماد، فالمقصود أن هذه المفاهيم موجودة فيه، أما الاعتماد نفسه فيمنح للمختبر بإجراءاته وموظفيه وليس للبرنامج.
وأياً كان الاسم، فالنظام يجب أن يجيب عن الأسئلة التالية في كل لحظة:
- هوية العينة: أي مريض، وأي طلب، وأي نوع عينة (مصل، دم كامل، بول)، ومتى سحبت ومتى وصلت.
- ما المطلوب: قائمة التحاليل، وكل تحليل له رمز داخلي في المختبر ورمز عالمي من LOINC كما شرحنا في مقال المصطلحات الطبية الموحدة.
- من فعل ماذا: من استلم، ومن أدخل النتيجة، ومن اعتمدها، ومتى، ومن عدلها بعد ذلك.
- ما معنى النتيجة: الوحدة، والمدى المرجعي، والعلامة إن كانت خارجه، وهل هي حرجة تستوجب الاتصال بالطبيب الآن.
- أين النتيجة الآن: أولية أم نهائية أم مصححة، ومن استلم التقرير.
OpenELIS Global أم SENAITE؟
المشروعان مفتوحا المصدر ونشطان، ولكنهما مختلفان في الأصل والتقنية والجمهور، والجدول التالي يلخص ما يهمك قبل الاختيار:
| OpenELIS Global | SENAITE | |
|---|---|---|
| الأصل | نظام لمختبرات الصحة العامة والمختبرات الوطنية والمستشفيات | نظام LIMS عام انفصل عن مشروع Bika LIMS |
| التقنية | Java مع Spring، وواجهة React، وقاعدة PostgreSQL | Python فوق Plone وZope، وقاعدة ZODB الكائنية |
| آخر إصدار | 3.3.0 في أكتوبر 2026 | 2.6.0 في أبريل 2025، والفرع 2.x يتحدث باستمرار |
| التشغيل | مجموعة Containers: الواجهة والخلفية والقاعدة وخادم FHIR وجسر الأجهزة والـ Proxy | Container واحدة، أو ZEO مع عدة نسخ للإنتاج |
| المريض | في قلب النظام | عبر الإضافة senaite.patient |
| الأجهزة | جسر أجهزة Analyzer Bridge وإضافات لأجهزة محددة | استيراد ملفات النتائج، وإضافة senaite.astm، وواجهة JSON لأي وسيط |
نقاط القوة في OpenELIS Global: صمم لمختبرات طبية من البداية، ويقول مستودعه إنه يستخدم على مستوى وطني في مختبرات من المستشفى الصغير إلى المختبر المرجعي، وإنه يلبي متطلبات اعتماد المختبرات ISO وSLIPTA، ويستورد النتائج من الأجهزة، ويستقبل الطلبات ويرسل النتائج بمعايير تبادل البيانات. وتوزيعة openelis-docker فيها خادم FHIR وجسر للأجهزة كخدمات جاهزة، والإصدار 3.3.0 صدر قبل شهر بتحديثات في الطلبات والاعتماد والجودة الخارجية.
نقاط الضعف في OpenELIS Global: التشغيل أثقل، فالتوزيعة الحالية تطلب في توثيقها حاسوباً بمعالج x86-64 ونظام Linux وDocker Engine 29 فأحدث مع مخزن الـ Images من containerd، وتثبت إصدارات الـ Images بمعرفاتها، وعدد الخدمات كبير على مختبر صغير. والتخصيص يحتاج مطوري Java.
نقاط القوة في SENAITE: يعمل في Container واحدة ويبدأ في دقائق، ونموذج البيانات مرن جداً: أنواع العينات والتحاليل والمواصفات والحسابات بين التحاليل كلها إعدادات، وفيه سير عمل واضح بحالات وسجل تدقيق لكل تغيير، وواجهة JSON API تقرأ وتكتب كل شيء تقريباً، وتقارير PDF قابلة للتخصيص.
نقاط الضعف في SENAITE: قاعدة Plone وZope على Python 2.7 في الإصدار 2.x، وهذه تقنية قديمة يقل من يعرفها، والإصدار الرسمي الأخير عمره أكثر من سنة ونصف، وبعض الإصلاحات المهمة موجودة في الفرع فقط كما سوف ترى. والمريض والوحدات الطبية إضافات منفصلة، فهو ليس نظاماً طبياً جاهزاً من البداية.
فكيف تختار؟ إذا كان مختبرك مختبر صحة عامة أو مختبراً مرجعياً يخدم مستشفيات تستخدم OpenMRS أو نظاماً يتكلم FHIR، ويحتاج سير عمل طبياً جاهزاً للمريض والطلب والاعتماد، فـ OpenELIS أقرب إليك، وتحمل ثقل تشغيله مقابل ذلك. وإذا كان مختبراً صغيراً خاصاً، أو مختبر أبحاث أو مياه أو أغذية، أو شركة ناشئة تريد نظاماً تبني فوقه بواجهة API وتتحكم في كل إعداد، فـ SENAITE أخف وأسرع في البداية، بشرط أن يكون في الفريق من يتحمل Plone وPython 2.7 أو يتابع انتقال المشروع إلى الإصدارات الجديدة. وإذا كان المختبر في مستشفى كبير يطلب دعماً على مدار الساعة وعقود صيانة وتكاملاً معتمداً مع أجهزة كثيرة، فقد يكون النظام التجاري هو القرار الصحيح، واستخدم ما تتعلمه هنا لتسأل المورد الأسئلة الصحيحة.
وفي هذا المقال شغلنا SENAITE، لأنه يعمل في Container واحدة على أي جهاز تطوير، ولأن نموذجه العام يجعل كل خطوة في دورة العينة واضحة أمامك. وما تتعلمه عن الحالات والمدى المرجعي والاعتماد ورسائل الأجهزة ينطبق على OpenELIS وعلى أي نظام تجاري، فالمفاهيم واحدة والشاشات تختلف.
أين يقف نظام المختبر بين الأنظمة؟
نظام المختبر لا يعمل وحده، وإنما في منتصف طريق له طرفان. فالطرف الأول هو السجل السريري الذي يكتب فيه الطبيب الطلب، والطلب يصل إلى المختبر برسالة HL7 v2 من نوع ORM^O01 أو OML^O21 في الأنظمة القديمة، أو كمورد FHIR من نوع ServiceRequest في الأنظمة الحديثة. والطرف الثاني هو نفس السجل، والنتيجة ترجع إليه برسالة ORU^R01 أو كمورد DiagnosticReport ومعه موارد Observation، كما فعلنا يدوياً في مقال خادم FHIR على سيرفرك. وبين الطرفين أجهزة المختبر بلغاتها الخاصة.
وهذا يعني أن كل عينة تحمل رقمين على الأقل: رقم الطلب الذي أصدره السجل السريري ويسمى في HL7 رقم الطالب Placer Order Number، ورقم المختبر الذي يطبع على الملصق ويسمى رقم المنفذ Filler Order Number. وأغلب مشاكل التكامل في المختبرات تأتي من هذا الربط: نتيجة رجعت برقم المختبر فقط فلم يعرف السجل لأي طلب هي، أو طلب ألغي في السجل ولم يصل الإلغاء إلى المختبر فحللت العينة دون داع، أو طلب عدل بعد أن سحبت العينة. لذلك عندما تقيم أي نظام مختبر، اسأل كيف يستقبل الإلغاء والتعديل وليس الطلب الجديد فقط، وكيف يرسل النتيجة المصححة، فهذه هي الحالات التي تفشل فيها التكاملات في الأسبوع الأول من التشغيل.
تجهيز المختبر: SENAITE وبرنامج وسيط وجهاز نحاكيه
الصورة التالية تبين ما سوف نبنيه:
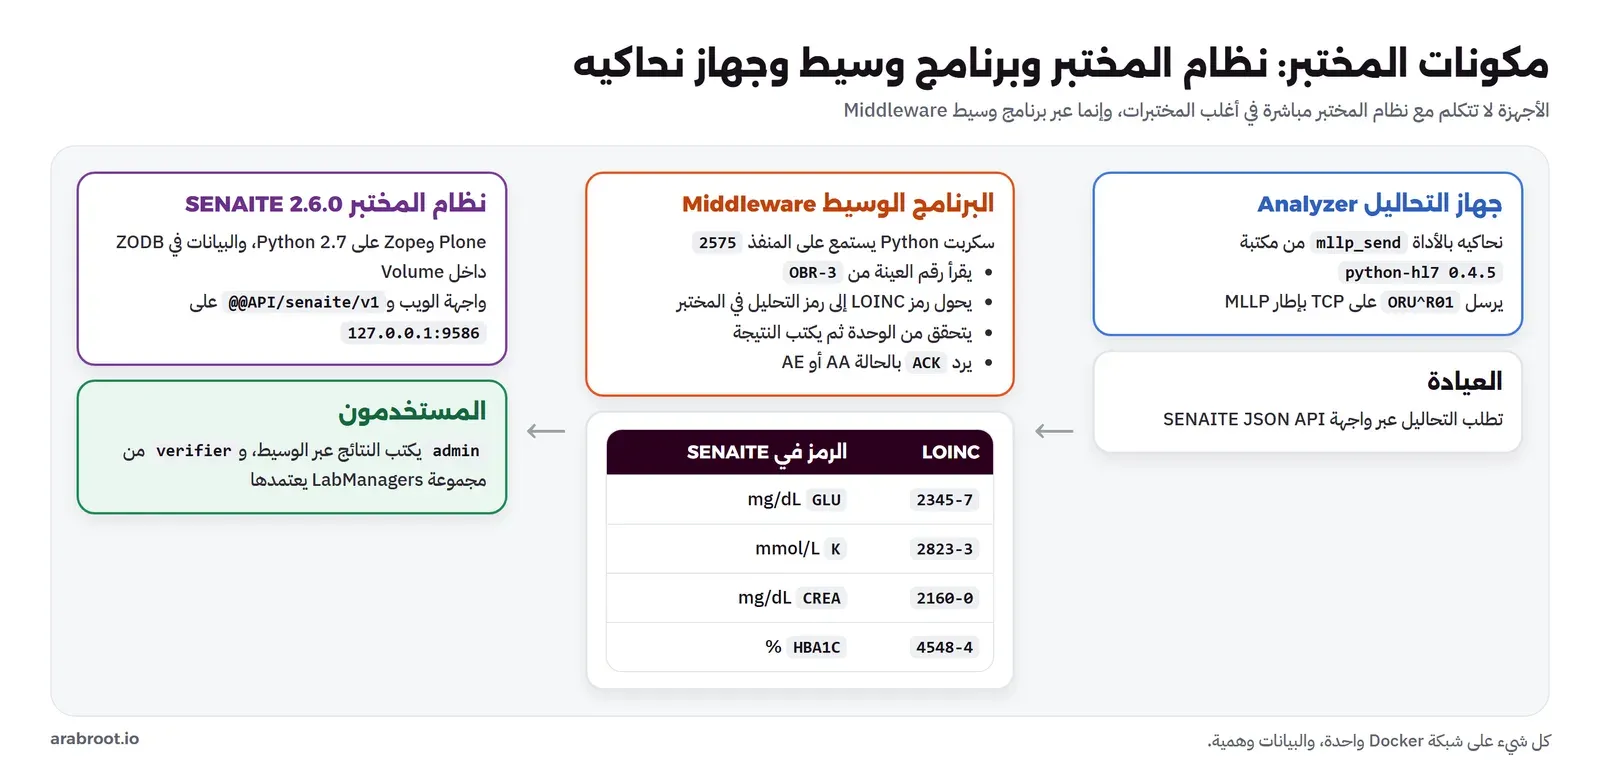
والسبب في وجود برنامج وسيط Middleware بين الجهاز ونظام المختبر أن هذا هو الحال في أغلب المختبرات: كل جهاز يتكلم بلهجته، ورموز التحاليل في الجهاز تختلف عن رموزها في النظام، وبعض القواعد مثل رفض نتيجة بوحدة غريبة أو إعادة التحليل التلقائي تطبق قبل أن تصل النتيجة إلى النظام. وملف Compose لنظام المختبر بسيط:
name: hi2-lis
services:
  senaite:
    image: senaite/senaite:v2.6.0-docker2
    container_name: hi2-senaite
    environment:
      SITE: senaite
      PASSWORD: ${ADMIN_PASSWORD:?set ADMIN_PASSWORD in .env}
    volumes:
      - hi2-senaite-data:/data
    ports:
      - "127.0.0.1:9586:8080"
volumes:
  hi2-senaite-data:
    name: hi2-senaite-data
networks:
  default:
    name: hi2-lis-net
في الإعداد أعلاه لاحظ التالي:
- الوسم
v2.6.0-docker2هو الإصدار الرسمي 2.6.0 في بنائه الثاني، ويوجد وسم آخر اسمه2.xيتبع الفرع الذي يتطور يومياً، ويقول مستودع الـ Image صراحة إن الإعدادات فيه ليست للإنتاج، فاستخدم الإصدار الثابت. - المتغير
SITEيجعل الـ Container تنشئ موقع SENAITE عند أول تشغيل بدل أن تنشئه من المتصفح، وPASSWORDهي كلمة مرور المدير بدل القيمة الافتراضية admin. - كل البيانات في قاعدة ZODB داخل
/data، أي ملفات كائنات Python وليست جداول SQL، وهذا يغير طريقة النسخ الاحتياطي كما سوف نرى في قسم الإنتاج.
echo "ADMIN_PASSWORD=$(openssl rand -hex 10)" > .env
docker compose up -d
curl -s -u admin:$ADMIN_PASSWORD http://127.0.0.1:9586/senaite/@@API/senaite/v1/version
{"url": "http://127.0.0.1:9586/senaite/@@API/senaite/v1/version", "date": "2025-04-04", "version": "2.6.0", "_runtime": 0.013287067413330078}أول تشغيل استغرق عدة دقائق، لأن الـ Container تبني بيئة Plone ثم تنشئ الموقع وتفهرس محتواه الأساسي، والسطر الذي تنتظره في السجل هو Serving on http://0.0.0.0:8080.
مساعد صغير لواجهة JSON API
كل خطوات الإعداد سوف نكتبها سكربتات بدل النقر في الواجهة، حتى تستطيع إعادتها على مختبر جديد. والسكربتات تعمل في Container فيها Python 3.13 ومكتبتا hl7 وrequests، وتستخدم هذا المساعد:
# small helper around senaite.jsonapi (lab only)
import json, os, sys, requests
B = "http://hi2-senaite:8080/senaite/@@API/senaite/v1"
S = requests.Session(); S.auth = ("admin", os.environ["ADMIN_PASSWORD"])
def post(route, data):
    r = S.post(f"{B}/{route}", json=data)
    try: j = r.json()
    except Exception: print(r.status_code, r.text[:500]); raise
    if r.status_code >= 400 or not j.get("items") and "items" in j and route != "update": print(r.status_code, json.dumps(j, ensure_ascii=False)[:800])
    return j
def get(route, **q): return S.get(f"{B}/{route}", params=q).json()
def create(portal_type, parent, **fields):
    j = post("create", dict(portal_type=portal_type, parent_path=parent, **fields))
    if not j.get("items"): print("create failed:", json.dumps(j, ensure_ascii=False)[:600])
    return j["items"][0] if j.get("items") else j
def find(portal_type, **q): return get("search", portal_type=portal_type, complete="yes", **q)["items"]
هيكل المختبر: القسم والفئة ونوع العينة
قبل أن يستقبل المختبر أي عينة يحتاج هيكلاً: قسم Department يديره مسؤول، وفئة تحاليل Analysis Category تتبع القسم، ونوع عينة Sample Type له بادئة تدخل في رقم العينة، وعميل Client وهو هنا العيادة التي تطلب، ومعه جهة اتصال Contact هي الطبيب. وهذا السكربت ينشئها كلها:
# step 1: lab structure through senaite.jsonapi (types that the 2.6.0 API can create)
from api import *
lc = create("LabContact", "/senaite/bika_setup/bika_labcontacts", Firstname="Lab", Surname="Manager", EmailAddress="[email protected]")
dep = create("Department", "/senaite/setup/departments", title="Clinical Chemistry", department_id="CHEM", manager={"uid": lc["uid"]})
cat = create("AnalysisCategory", "/senaite/setup/analysiscategories", title="Chemistry", department={"uid": dep["uid"]})
st = create("SampleType", "/senaite/setup/sampletypes", title="Serum", prefix="SER", min_volume="2 mL",
            retention_period={"days": 7, "hours": 0, "minutes": 0})
cl = create("Client", "/senaite/clients", Name="Internal Medicine Clinic", ClientID="IMC")
ct = create("Contact", cl["path"], Firstname="Clinic", Surname="Physician", EmailAddress="[email protected]")
for o in (lc, dep, cat, st, cl, ct):
    print(f'{o["portal_type"]:16} {o["uid"]}  {o["path"]}')
LabContact 7dcd5f308350429f98c2f24cca2e7490 /senaite/bika_setup/bika_labcontacts/labcontact-1
Department 508f5c7fb7c9454bbb0d85537d2084ea /senaite/setup/departments/department-1
AnalysisCategory e61aee82e314477185dafde165686117 /senaite/setup/analysiscategories/analysiscategory-1
SampleType dd8e08b4379643e981c85fcc47c31a4a /senaite/setup/sampletypes/sampletype-1
Client 09f0cec68d6e4d10a06581515df4c020 /senaite/clients/client-1
Contact d3a0d1f6432a4c0daeaaa6bdd0e336dd /senaite/clients/client-1/contact-1ولم يعمل السكربت من أول مرة. فقد أرسلنا القسم أولاً دون مسؤول فرجع الخطأ {"manager": "required field", "department_id": "required field"}، ثم أرسلنا المسؤول كرقم UID نصي فرجع {"manager": ""} دون أي تفسير. والسبب أن SENAITE 2.x في مرحلة انتقال بين نوعين من الكائنات: الأنواع القديمة المبنية على Archetypes تقبل المرجع كنص UID، والأنواع الجديدة المبنية على Dexterity مثل القسم والفئة ونوع العينة تريده بالشكل {"uid": "..."}. والطريقة الوحيدة لتعرف أي نوع أمامك هي المسار: ما كان تحت /senaite/setup/ فهو جديد، وما كان تحت /senaite/bika_setup/ فهو قديم.
التحاليل Analysis Services ورموز LOINC: خطأ في الإصدار الحالي
الخطوة التالية هي تعريف التحاليل الأربعة: السكر والبوتاسيوم والكرياتينين والسكر التراكمي، ولكل منها رمز داخلي Keyword يستخدم في الحسابات والاستيراد، ووحدة، ودقة. فأرسلنا السكر بنفس الطريقة:
s = create("AnalysisService", "/senaite/bika_setup/bika_analysisservices", title="Glucose", Keyword="GLU", Unit="mg/dL", Category=c, Department=d)create failed: {"_runtime": 0.1302328109741211, "message": "'NoneType' object has no attribute 'form'", "success": false}وفي سجل الـ Container كان مصدر الخطأ:
  File "/home/senaite/senaitelims/eggs/cp27mu/senaite.core-2.6.0-py2.7.egg/bika/lims/validators.py", line 1486, in __call__
    form = kwargs["REQUEST"].form
AttributeError: 'NoneType' object has no attribute 'form'
أي أن أداة التحقق من حد الكشف الأدنى LLOD في الإصدار 2.6.0 تفترض أن الطلب جاء من نموذج ويب، فإذا جاء من الـ API لا يوجد نموذج فيتوقف. وقد أصلح المشروع ذلك في الفرع 2.x بالتعديلين #3000 في يوليو 2026 و#3050 في نوفمبر 2026، ولكن لا يوجد إصدار رسمي بعد 2.6.0 يحملهما. والأسوأ اكتشفناه بعد ذلك: عندما بحثنا في المجلد وجدنا خمسة تحاليل باسم Glucose، نصفها بالرمز GLU، ولا يظهر أي منها في البحث العادي:
9f3bbc733c374ef59290d4aab7601226 analysisservice-1 AnalysisService Glucose GLU {...analysiscategory-1...}
613ea92cc99049e7896d48b147ededd6 analysisservice-2 AnalysisService Glucose GLU {...analysiscategory-1...}
20430158137542e197bef88582d02614 analysisservice-3 AnalysisService Glucose None {}
ffe86d29957e4514851ec42df81f06ff analysisservice-4 AnalysisService Glucose None {...analysiscategory-1...}
39967b3c28ea4ccb8d445ca97046ab7a analysisservice-5 AnalysisService Glucose GLU {...analysiscategory-1...}
فالـ API أنشأ الكائن أولاً ثم فشل في التحقق، ورجع رسالة خطأ دون أن يتراجع عن الإنشاء، فبقيت كائنات ناقصة لا يراها فهرس البحث. وعندما حاولنا بعد ذلك إنشاء التحليل من الواجهة رفضته بالرسالة Validation failed: keyword is already in use، لأن الرمز GLU محجوز لكائن لا نراه. وهذا درس عام في أي نظام تتكامل معه: رسالة الخطأ لا تعني دائماً أن شيئاً لم يحدث، فتحقق من الحالة بعد كل خطأ، ولا تعد المحاولة في حلقة دون ذلك.
ولأن المختبر تجربة، أعدنا إنشاء الموقع من الصفر بحذف الـ Volume، ثم أنشأنا الهيكل بالسكربت السابق، وأنشأنا التحاليل الأربعة من نموذج الويب نفسه بسكربت يقود المتصفح، فيملأ الحقول ويختار الفئة والقسم من قائمة البحث ثم يحفظ. والصورة التالية من نموذج السكر قبل الحفظ. ولاحظ أن SENAITE لا يحتوي حقلاً مخصصاً لرمز LOINC، فوضعناه في الحقل CommercialID وهو حقل نصي حر يظهر في قائمة التحاليل، وهذه تسوية وليست تصميماً مثالياً، والأصح أن يكون الربط بين LOINC ورمز المختبر في جدول يملكه البرنامج الوسيط أو في إضافة تعرف الحقل كما يجب:
docker run --rm --network hi2-lis-net -e ADMIN_PASSWORD -v "$PWD:/lab" hi2-hl7:1 python list_services.pyCREA Creatinine mg/dL LOINC 2160-0 category=e61aee82 uid=ae49f452e94143c8870d3bf0eee413e1
GLU Glucose mg/dL LOINC 2345-7 category=e61aee82 uid=7787654ff75d4e11b3f7c902261c5707
HBA1C Hemoglobin A1c % LOINC 4548-4 category=e61aee82 uid=ab7262a4ecf64f95897ac41ca08cb21c
K Potassium mmol/L LOINC 2823-3 category=e61aee82 uid=2b3c9edbe9e3487e89f021fb1d67107aوالرموز الأربعة من LOINC اخترناها بعناية، فرمز السكر 2345-7 معناه السكر في المصل أو البلازما بوحدة كتلة على حجم، وهناك رمز آخر للسكر نفسه بوحدة مول على حجم، ورمز ثالث للسكر في الدم الكامل، فرمز LOINC يحمل نوع العينة وطريقة التعبير عن الكمية وليس اسم التحليل فقط، كما شرحنا في أجزائه الستة في مقال المصطلحات. وهذا ما سوف يحمينا بعد قليل عندما يرسل الجهاز وحدة مختلفة.
المدى المرجعي Reference Range والقيمة الحرجة Critical Value
النتيجة دون مدى مرجعي رقم لا يعني شيئاً. وفي SENAITE يكتب المدى في مواصفة Specification مرتبطة بنوع العينة، ولكل تحليل فيها حدان للطبيعي min وmax، وحدان خارجيان warn_min وwarn_max يسميهما النظام الهامش Shoulder: النتيجة بين الحد الطبيعي والحد الخارجي خارج المدى ولكنها في الهامش، والنتيجة بعد الحد الخارجي خارج كل شيء. واستخدمنا هذا الهامش لنعبر عن القيم الحرجة، وهي القيم التي تعني خطراً على حياة المريض وتلزم المختبر بإبلاغ الطبيب فوراً وتوثيق من أبلغ ومتى:
# reference ranges (min..max) and the outer "shoulder" (warn_min..warn_max): beyond it we treat the value as critical
from api import *
svc = {s["Keyword"]: s["uid"] for s in find("AnalysisService")}
st = find("SampleType")[0]["uid"]
ranges = [
    dict(keyword="GLU",   min="70",  max="99",  warn_min="50",  warn_max="400", rangecomment="fasting"),
    dict(keyword="K",     min="3.5", max="5.1", warn_min="2.8", warn_max="6.0"),
    dict(keyword="CREA",  min="0.6", max="1.2", warn_min="0.4", warn_max="4.0"),
    dict(keyword="HBA1C", min="4.0", max="5.6", warn_min="",    warn_max=""),
]
for r in ranges:
    r.update(uid=svc[r["keyword"]], hidemin="", hidemax="")
sp = create("AnalysisSpec", "/senaite/bika_setup/bika_analysisspecs", title="Adult serum ranges", SampleType=st, ResultsRange=ranges)
print(sp.get("uid"), sp.get("title"))
for r in (sp.get("ResultsRange") or []): print(r["keyword"], r["min"], r["max"], r.get("warn_min"), r.get("warn_max"))
ebd1f1c38d6f4bd6a77cc09975945b59 Adult serum ranges
GLU 70 99 50 400
K 3.5 5.1 2.8 6.0
CREA 0.6 1.2 0.4 4.0
HBA1C 4.0 5.6ومواصفة واحدة لكل البالغين تبسيط كبير، فالكرياتينين الطبيعي للرجل غير المرأة، والهيموجلوبين للطفل غير البالغ، وبعض التحاليل يتغير مداها للمرأة الحامل أو بحسب وقت السحب. ولهذا يحتوي SENAITE على المواصفات الديناميكية Dynamic Analysis Specs، ورأيت مجلدها في قائمة الإعدادات، وهي جدول يحدد المدى بحسب قيم أخرى في العينة مثل العمر والجنس، وتحتاج لذلك أن تكون هذه القيم موجودة في العينة، أي أن تثبت إضافة المريض أولاً. وهذه نقطة تكررت معنا: النظام العام يصبح طبياً بقدر ما تضيف إليه من معرفة بالمريض.
والأرقام في هذا المثال للتوضيح فقط. فالمدى المرجعي يختلف باختلاف المختبر والجهاز وطريقة القياس والعمر والجنس، وحدود القيم الحرجة يعتمدها المدير الطبي للمختبر بالاتفاق مع الأطباء، ولا يكتبها المطور من مقال. ولاحظ أننا لم نعط السكر التراكمي هامشاً، وسوف نرى أثر ذلك في العرض.
دورة حياة العينة من الطلب إلى التقرير
الصورة التالية تبين الخطوات الخمس التي سوف نمر بها، وأسماء الحالات كما ظهرت في النظام:
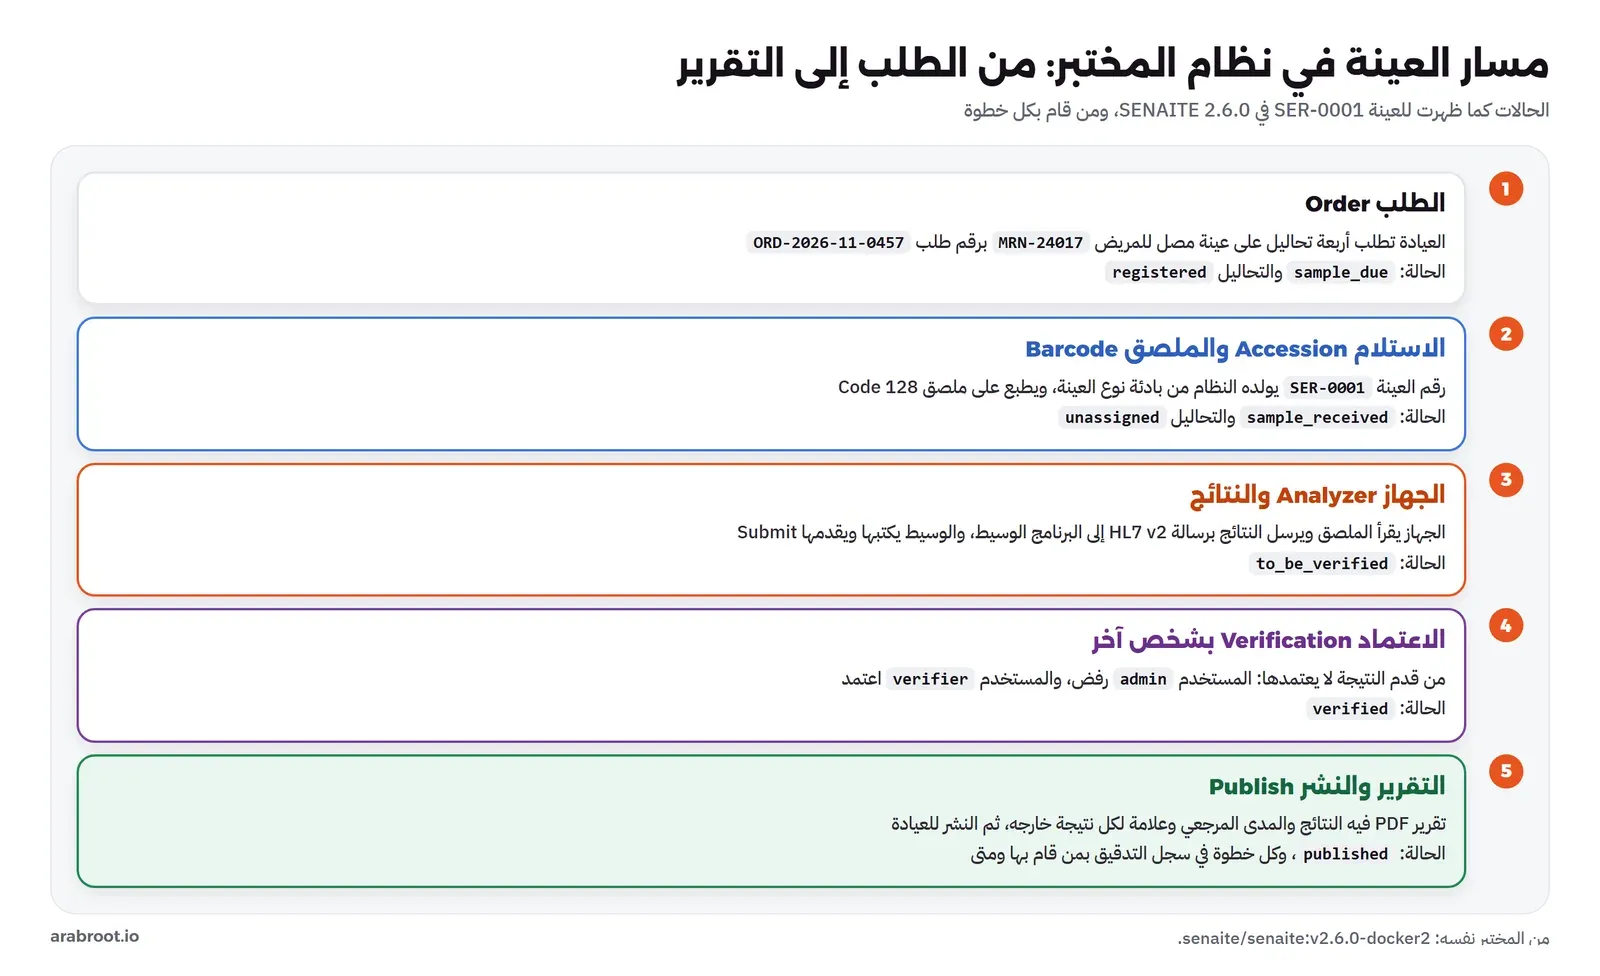
الطلب Order
العيادة تطلب أربعة تحاليل على عينة مصل لمريضة وهمية، ورقم ملفها في العيادة MRN-24017:
# the clinic orders a serum panel for patient MRN-24017: one sample with four tests
from api import *
cl = find("Client")[0]; ct = find("Contact")[0]
svc = {s["Keyword"]: s["uid"] for s in find("AnalysisService")}
spec = find("AnalysisSpec")[0]["uid"]; st = find("SampleType")[0]["uid"]
j = post("create", {
    "portal_type": "AnalysisRequest", "parent_uid": cl["uid"],
    "Contact": ct["uid"], "SampleType": st, "Specification": spec,
    "DateSampled": "2026-11-18 08:10", "ClientSampleID": "MRN-24017", "ClientOrderNumber": "ORD-2026-11-0457",
    "Analyses": [svc[k] for k in ("GLU", "K", "CREA", "HBA1C")],
})
s = j["items"][0]
print(s["id"], s["review_state"], s["ClientSampleID"], s["getClientOrderNumber"] if "getClientOrderNumber" in s else s.get("ClientOrderNumber"))
SER-0001 sample_due MRN-24017 ORD-2026-11-0457في المخرج أعلاه لاحظ التالي:
- العينة تسمى في الكود
AnalysisRequestلأسباب تاريخية من مشروع Bika، وفي الواجهة Sample. - رقم العينة
SER-0001ولده النظام من بادئة نوع العينة ورقم تسلسلي، وهذا هو رقم الاستلام Accession Number الذي يطبع على الملصق ويقرؤه الجهاز. - رقم المريض وضعناه في
ClientSampleID، لأن SENAITE دون إضافة senaite.patient لا يعرف المريض ككائن. وفي مختبر طبي حقيقي ثبت هذه الإضافة، حتى يكون المريض بتاريخ ميلاده وجنسه مصدراً للمدى المرجعي المناسب، ولا يكون رقماً نصياً في حقل حر. - رقم الطلب في العيادة
ORD-2026-11-0457محفوظ بجانب رقم المختبر، فالنظامان يعرفان العينة برقمين مختلفين، والربط بينهما هو ما يجعل النتيجة تعود إلى الطلب الصحيح.
الاستلام والملصق Barcode
عندما تصل العينة إلى المختبر يستلمها الموظف، وفي SENAITE هذا انتقال في سير العمل اسمه receive، ونرسله عبر الـ API بالمسار update مع الحقل transition:
from api import *
s = find("AnalysisRequest", id="SER-0001")[0]
j = post("update", {"uid": s["uid"], "transition": "receive"})
s = find("AnalysisRequest", id="SER-0001")[0]
print(s["id"], s["review_state"], s.get("DateReceived"))
for a in get("search", portal_type="Analysis", getAncestorsUIDs=s["uid"], complete="yes")["items"]:
    print(" ", a["Keyword"], a["review_state"])
SER-0001 sample_received 2026-11-18T13:40:37+00:00
HBA1C unassigned
CREA unassigned
GLU unassigned
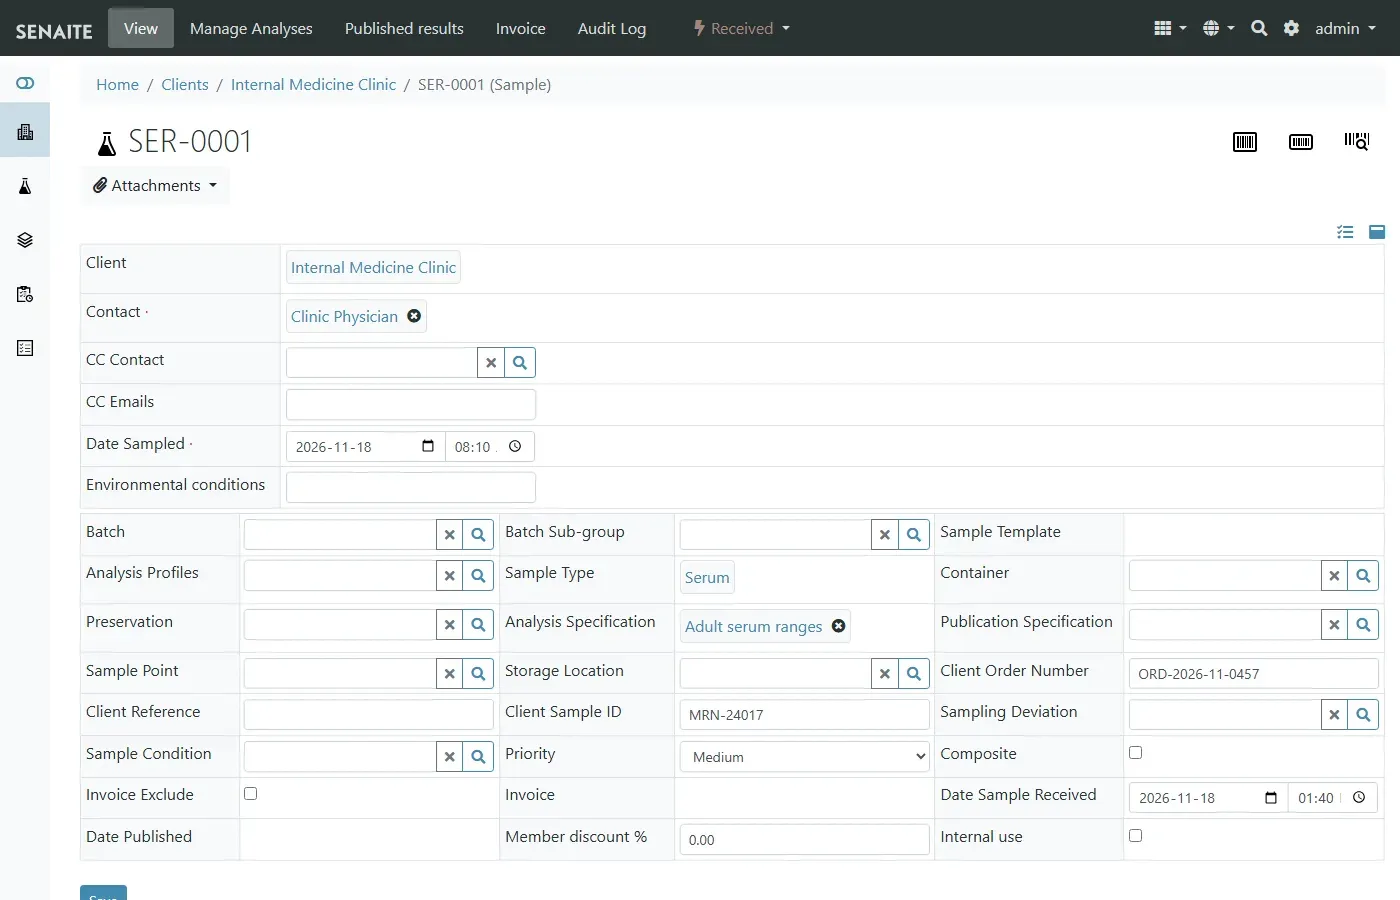
K unassignedوجربنا قبل ذلك مساراً اسمه doActionFor ظناً أنه مسار الانتقالات، فرجع دون خطأ وبقيت العينة sample_due. فإذا لم تتغير الحالة بعد طلب ناجح، فاقرأ الحالة من جديد ولا تفترض أن الطلب نفذ. والتحاليل الآن unassigned أي تنتظر أن توزع على ورقة عمل أو جهاز. والصورة التالية من صفحة العينة في الواجهة بعد الاستلام:
ثم طلبنا صفحة الملصقات للعينة، فظهر هذا الخطأ مكان الملصق:
SER-0001 - Failed to load sticker '':
ValueError: ('No such file', '/home/senaite/senaitelims/eggs/cp27mu/senaite.core-2.6.0-py2.7.egg/senaite/core/browser/stickers/templates/stickers/')
اسم القالب فارغ ''، والسبب أننا أنشأنا نوع العينة من الـ API دون أن نحدد له قوالب الملصقات المسموحة والقالب الافتراضي، والنموذج في الواجهة يملؤها تلقائياً، أما الـ API فلا. والحل أن تختار القالب من القائمة في نفس الصفحة، أو تمرره في الرابط بالمعامل template=Code_128_1x48mm.pt، أو تضبطه في نوع العينة مرة واحدة. وهذا الملصق بعد اختيار القالب:
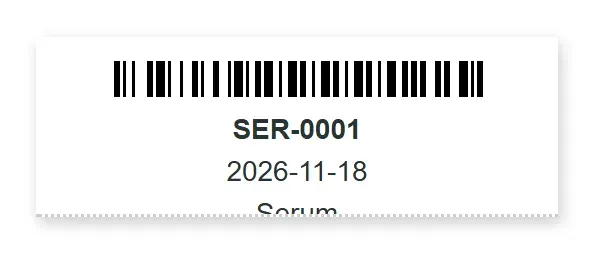
والملصق هو أهم وسيلة أمان في المختبر، لأن كل خطأ في التعرف على العينة يعني نتيجة صحيحة لمريض خطأ، وهذا أخطر من نتيجة خاطئة لأن أحداً لن يشك فيها. لذلك تشترط إجراءات المختبرات أن يطبع الملصق ويلصق بجانب المريض وقت السحب وليس قبله، وأن يتحقق الموظف من معرفين للمريض على الأقل مثل الاسم وتاريخ الميلاد. وصيغة Code 128 التي اخترناها شائعة لأنها كثيفة وتحمل حروفاً وأرقاماً ومعها رقم تحقق Check Digit يكتشف القراءة الخاطئة، أما Code 39 الأقدم فيحتاج مساحة أكبر لنفس الرقم، وهذا مهم على أنبوب قطره صغير.
ولاحظ أن السطر الأخير مقطوع، لأن القالب مصمم لملصق بارتفاع صغير. وهذه تفصيلة تبدو تافهة حتى يطبع المختبر ألف ملصق على أنابيب صغيرة، فاختبر القالب على الطابعة والأنبوب الحقيقيين قبل التشغيل، وتأكد أن قارئ الجهاز يقرأ الباركود من الزاوية التي يدخل بها الأنبوب.
كيف يتكلم جهاز التحاليل مع نظام المختبر؟
قبل أن نرسل النتائج من «الجهاز» نحتاج أن نعرف كيف تتكلم الأجهزة الحقيقية. وفي وثائق أي جهاز تحاليل سوف تجد قسماً اسمه واجهة الحاسوب Host Interface أو LIS Interface، وفيه أحد معيارين أو كلاهما:
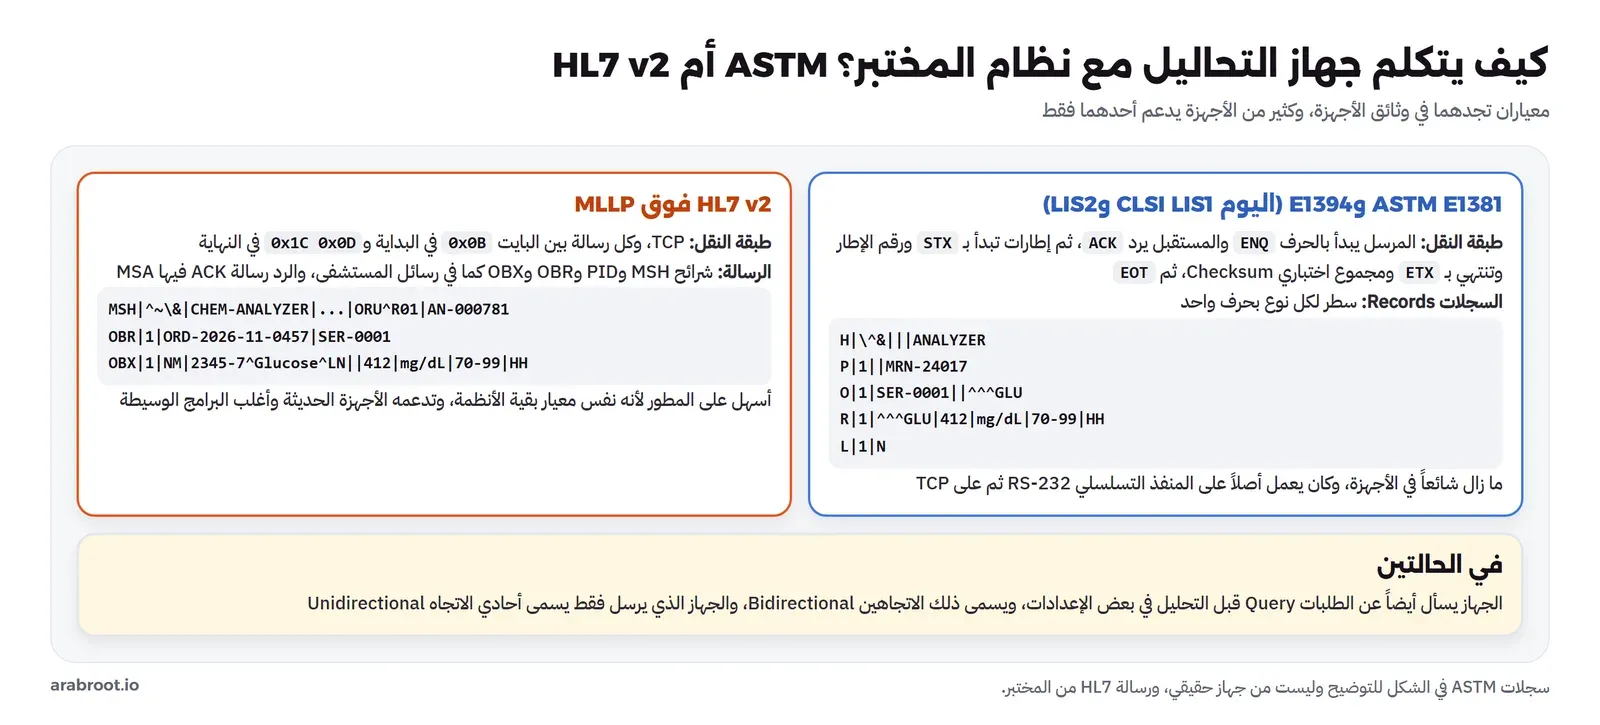
- ASTM E1381 وE1394: معياران قديمان لنقل نتائج الأجهزة، وتديرهما اليوم منظمة CLSI باسمي LIS01 وLIS02. الأول يعرف طبقة النقل: المرسل يطلب الإذن بحرف
ENQ، ثم يرسل الرسالة في إطارات مرقمة لكل منها مجموع اختباري Checksum، والمستقبل يرد على كل إطار بـACKأوNAK. والثاني يعرف شكل السجلات: H للرأس وP للمريض وO للطلب وR للنتيجة وL للنهاية. وكثير من الأجهزة ما زالت تتكلم به، وبعضها على المنفذ التسلسلي. - HL7 v2: نفس معيار الرسائل الذي شرحناه في مقال تبادل البيانات الصحية، ورسالة النتائج فيه
ORU^R01، وتنقل على TCP بإطار بسيط اسمه MLLP: بايت0x0Bقبل الرسالة، و0x1C 0x0Dبعدها. والأجهزة الحديثة والبرامج الوسيطة تفضله، لأنه نفس لغة بقية أنظمة المستشفى.
وفي الواقع ستجد بين الجهاز ونظام المختبر طبقات أخرى: محول من المنفذ التسلسلي إلى الشبكة للأجهزة القديمة التي لا تعرف إلا RS-232، وبرنامج وسيط تجاري يجمع كل أجهزة المختبر في شاشة واحدة ويطبق قواعد الاعتماد التلقائي Autoverification للنتائج الطبيعية، أو محرك تكامل عام مثل الذي ذكرناه في مقال الخريطة. والمهم أن تعرف أين يطبق كل قرار: من يحول الرموز، ومن يتحقق من الوحدة، ومن يقرر أن النتيجة حرجة، حتى لا يطبق قراران متعارضان في طبقتين مختلفتين.
وفي الحالتين هناك نمطان: الجهاز أحادي الاتجاه Unidirectional يحلل ما يدخله الفني ويرسل النتائج فقط، والجهاز ثنائي الاتجاه Bidirectional يقرأ الباركود ثم يسأل نظام المختبر ما المطلوب لهذه العينة، فلا يكتب الفني شيئاً. والثاني أقل أخطاء بكثير، ولكنه يحتاج أن يجيب نظام المختبر أو الوسيط على الاستعلام في ثوان، وإلا تأخر الجهاز. وفي هذا المختبر نحاكي الاتجاه الأول برسائل HL7 v2، لأن مكتبة python-hl7 فيها أداة إرسال جاهزة.
البرنامج الوسيط Middleware: من رسالة ORU إلى النتيجة
الوسيط برنامج Python صغير يستمع على المنفذ 2575 بإطار MLLP، ويقرأ كل رسالة نتائج، ويبحث عن العينة برقمها في الحقل OBR-3، ويحول رمز LOINC في OBX-3 إلى رمز التحليل في المختبر، ويتحقق من أن العينة تنتظر نتيجة وأن الوحدة هي الوحدة التي يتوقعها المختبر، ثم يكتب النتيجة ويقدمها Submit، ويرد على الجهاز بإقرار:
# middleware.py: receives HL7 v2 ORU^R01 results over MLLP (port 2575) and writes them into SENAITE.
# The analyzer sends the sample barcode in OBR-3 and a LOINC code in OBX-3; we map LOINC to the
# SENAITE keyword, set the result, submit it, and answer with ACK AA (accepted) or AE (error).
import asyncio, os, sys, requests, hl7
from hl7.mllp import start_hl7_server

API = "http://hi2-senaite:8080/senaite/@@API/senaite/v1"
S = requests.Session(); S.auth = ("admin", os.environ["ADMIN_PASSWORD"])
LOINC_TO_KEYWORD = {"2345-7": "GLU", "2823-3": "K", "2160-0": "CREA", "4548-4": "HBA1C"}

def log(*a): print(*a, flush=True)

def find_sample(sample_id):
    items = S.get(f"{API}/search", params={"portal_type": "AnalysisRequest", "id": sample_id}).json()["items"]
    return items[0] if items else None

def analyses_of(sample_uid):
    r = S.get(f"{API}/search", params={"portal_type": "Analysis", "getAncestorsUIDs": sample_uid, "complete": "yes"})
    return {a["Keyword"]: a for a in r.json()["items"]}

def handle(msg):
    sample_id = str(msg.segment("OBR")[3]).split("^")[0]
    sample = find_sample(sample_id)
    if not sample:
        return "AE", f"unknown sample {sample_id}"
    analyses = analyses_of(sample["uid"])
    done = []
    for obx in msg.segments("OBX"):
        loinc = str(obx[3][0][0])
        value, unit, flag = str(obx[5]), str(obx[6]), str(obx[8])
        kw = LOINC_TO_KEYWORD.get(loinc)
        if kw is None or kw not in analyses:
            return "AE", f"{sample_id}: no test for LOINC {loinc}"
        a = analyses[kw]
        if a["review_state"] not in ("unassigned", "assigned"):
            return "AE", f"{sample_id}/{kw} is already {a['review_state']}"
        if unit != a.get("Unit"):
            return "AE", f"{sample_id}/{kw}: unit {unit} but LIS expects {a.get('Unit')}"
        r = S.post(f"{API}/update", json={"uid": a["uid"], "Result": value, "transition": "submit"}).json()
        state = r["items"][0]["review_state"] if r.get("items") else r.get("message")
        done.append(f"{kw}={value}{unit} flag={flag or '-'} -> {state}")
    log(f"  {sample_id}: " + "; ".join(done))
    return "AA", f"{len(done)} results stored"

async def process(reader, writer):
    peer = writer.get_extra_info("peername")
    try:
        while not writer.is_closing():
            try:
                msg = await reader.readmessage()
            except asyncio.IncompleteReadError:
                break
            log(f"<- {peer[0]} {msg.segment('MSH')[9]} control id {msg.segment('MSH')[10]}")
            try:
                code, text = handle(msg)
            except Exception as e:
                code, text = "AE", f"error: {e}"
            ack = msg.create_ack(ack_code=code, message_id=f"ACK{msg.segment('MSH')[10]}", application="LIS-MW", facility="LAB1")
            # MSA-3 carries a short text for the analyzer operator (the result or the reason for AE)
            ack = hl7.parse("\r".join(s + "|" + text if s.startswith("MSA") else s for s in str(ack).split("\r")))
            log(f"-> {code} {text}")
            writer.writemessage(ack)
            await writer.drain()
    finally:
        writer.close()

async def main():
    async with await start_hl7_server(process, host="0.0.0.0", port=2575) as server:
        log("listening on MLLP port 2575")
        await server.serve_forever()

asyncio.run(main())
والرسالة التي يرسلها «الجهاز» للعينة SER-0001 فيها أربع نتائج، والصورة التالية تفكك حقولها المهمة:
MSH|^~\&|CHEM-ANALYZER|LAB1|LIS-MW|LAB1|20261118104200+0300||ORU^R01^ORU_R01|AN-000781|P|2.5.1
PID|1||MRN-24017^^^CLINIC^MR
OBR|1|ORD-2026-11-0457|SER-0001|PANEL^Chemistry panel^L|||20261118081000+0300
OBX|1|NM|2345-7^Glucose [Mass/volume] in Serum or Plasma^LN||412|mg/dL|70-99|HH|||F|||20261118104000+0300
OBX|2|NM|2823-3^Potassium [Moles/volume] in Serum or Plasma^LN||5.4|mmol/L|3.5-5.1|H|||F|||20261118104000+0300
OBX|3|NM|2160-0^Creatinine [Mass/volume] in Serum or Plasma^LN||1.08|mg/dL|0.6-1.2|N|||F|||20261118104000+0300
OBX|4|NM|4548-4^Hemoglobin A1c/Hemoglobin.total in Blood^LN||8.1|%|4.0-5.6|H|||F|||20261118104000+0300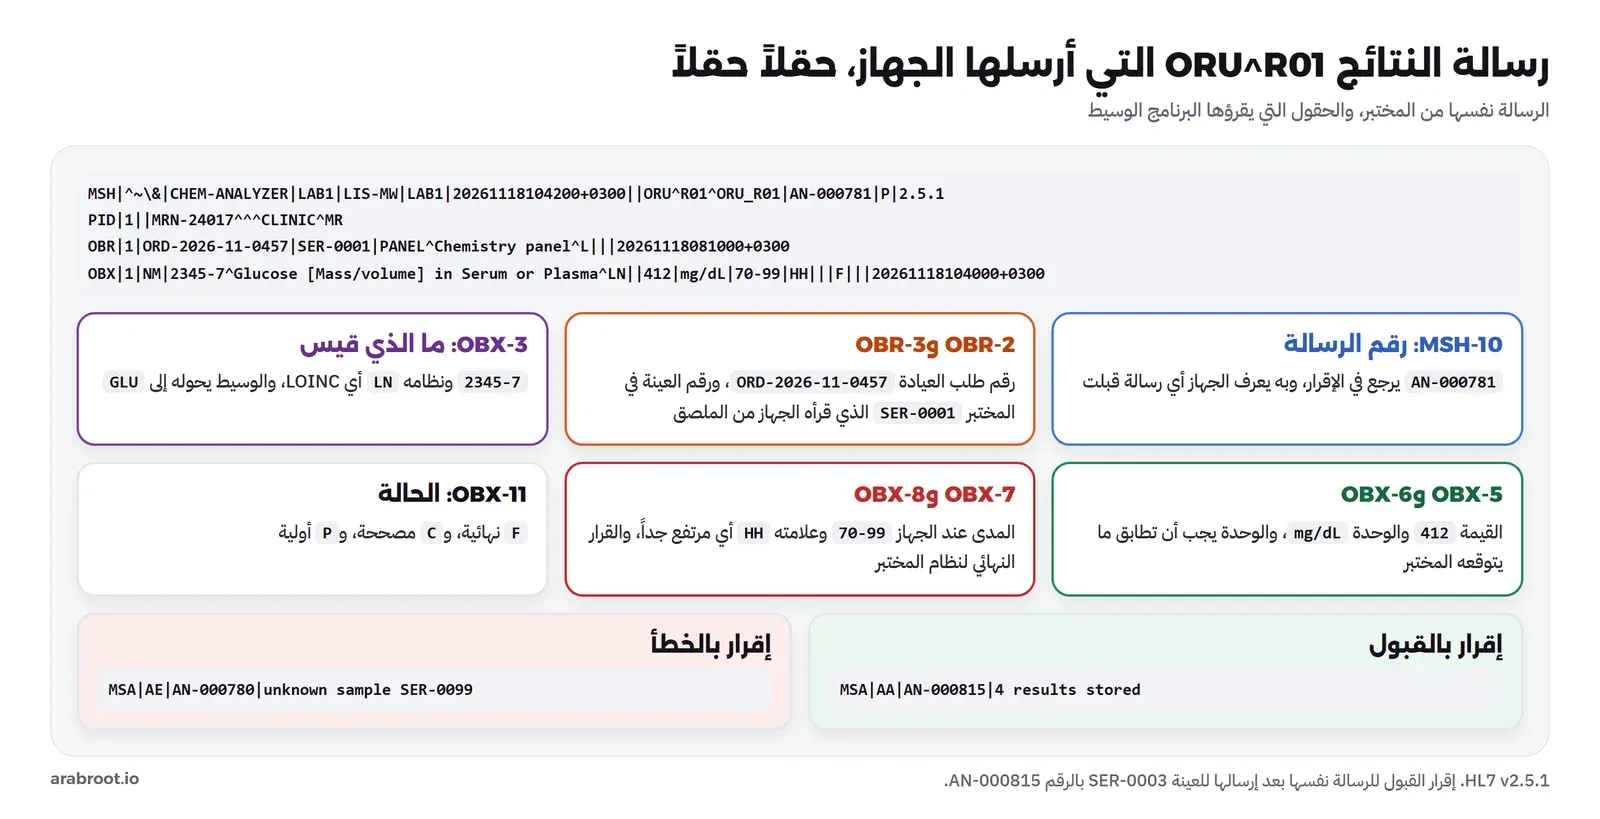
ولاحظ أن الجهاز يرسل مداه المرجعي وعلامته H أو HH، ولكن الوسيط يتجاهلهما ويترك الحكم للمواصفة في نظام المختبر، والسبب أن المختبر هو صاحب المدى المعتمد، والجهاز قد يكون مضبوطاً على مدى المصنع الافتراضي.
التشغيل الأول: النتائج حفظت والإقرار لم يصل
شغلنا الوسيط وأرسلنا ثلاث رسائل: رسالة برقم عينة غير موجود SER-0099، ثم رسالة العينة SER-0001، ثم نفس الرسالة مرة ثانية كما يفعل الجهاز إذا لم يصله إقرار:
snd() { docker run --rm --network hi2-lis-net -v "$PWD:/lab" hi2-hl7:1 \
          sh -c "mllp_send --loose --port 2575 --file /lab/$1 hi2-lis-mw | tr '\r' '\n'"; }
snd oru-unknown.hl7; snd oru-ser-0001.hl7; snd oru-ser-0001.hl7
والخيار --loose يجعل الأداة تقبل ملفاً بأسطر عادية وتحولها إلى الفاصل \r الذي يطلبه المعيار. والنسخة الأولى من الوسيط كانت تضيف نص الإقرار إلى الحقل MSA-3 بطريقة خاطئة، فتوقف معالج الاتصال بهذا الخطأ بعد أن نفذ handle():
<- 172.25.0.4 ORU^R01^ORU_R01 control id AN-000781
  SER-0001: GLU=412mg/dL flag=HH -> to_be_verified; K=5.4mmol/L flag=H -> to_be_verified; CREA=1.08mg/dL flag=N -> to_be_verified; HBA1C=8.1% flag=H -> to_be_verified
Task exception was never retrieved
future: <Task finished name='Task-6' coro=<process() done, defined at /lab/middleware.py:45> exception=AssertionError()>
Traceback (most recent call last):
  File "/lab/middleware.py", line 59, in process
    ack.segment("MSA").append(hl7.Field("^", [text]))
  File "/usr/local/lib/python3.13/site-packages/hl7/containers.py", line 784, in __init__
    assert not separator or separator == separators[2]
AssertionError
أي أن النتائج الأربع كتبت في نظام المختبر وقدمت، ثم انهار الوسيط قبل أن يرسل الإقرار، فلم يتلق الجهاز أي رد. وبعد أن أصلحنا السطر كما في الكود أعلاه، أعدنا إرسال نفس الرسائل:
### unknown
MSH|^~\&|LIS-MW|LAB1|CHEM-ANALYZER|LAB1|20261118135223||ACK^R01^ACK|ACKAN-000780|P|2.5.1
MSA|AE|AN-000780|unknown sample SER-0099
### good
MSH|^~\&|LIS-MW|LAB1|CHEM-ANALYZER|LAB1|20261118135230||ACK^R01^ACK|ACKAN-000781|P|2.5.1
MSA|AE|AN-000781|SER-0001/GLU is already to_be_verified
والآن انظر إلى الحالة الثانية بعناية، لأنها أهم ما في هذا القسم: النتائج محفوظة بالفعل منذ المحاولة السابقة، والجهاز لا يعرف ذلك، فأعاد الإرسال، والوسيط رفض لأن التحاليل تنتظر الاعتماد. والرفض هنا صحيح، لأن البديل أن يكتب النتيجة فوق نتيجة قدمت، فإذا كانت القيمة مختلفة لن يعرف أحد أيهما الصحيحة. ولكن رد AE يجعل الفني يظن أن النتائج لم تصل، فيعيد التحليل ويستهلك عينة المريض. والحل الأفضل أن يتذكر الوسيط أرقام الرسائل التي عالجها MSH-10 ونتيجة كل منها، فإذا جاءت نفس الرسالة برقمها مرة أخرى رجع نفس الإقرار AA دون أن يكتب شيئاً، وهذا بالضبط مبدأ Idempotency الذي شرحناه في مقال Idempotency. ولاحظ أيضاً أن أداة الإرسال في التشغيل الأول انتظرت الإقرار دون أي مهلة حتى أوقفناها، والجهاز الحقيقي له مهلة يعيد بعدها الإرسال، فاعرفها من وثيقته.
ولنرى الإقرار بالقبول، أنشأنا عينة ثالثة SER-0003 بنفس التحاليل، وأرسلنا لها نفس الرسالة برقم رسالة جديد AN-000815:
MSH|^~\&|LIS-MW|LAB1|CHEM-ANALYZER|LAB1|20261118142051||ACK^R01^ACK|ACKAN-000815|P|2.5.1
MSA|AA|AN-000815|4 results stored
---
<- 172.25.0.4 ORU^R01^ORU_R01 control id AN-000815
  SER-0003: GLU=412mg/dL flag=HH -> to_be_verified; K=5.4mmol/L flag=H -> to_be_verified; CREA=1.08mg/dL flag=N -> to_be_verified; HBA1C=8.1% flag=H -> to_be_verified
-> AA 4 results stored
نجرب العطل: الجهاز يرسل بوحدة مختلفة
بعض الأجهزة تضبط على وحدات النظام الدولي SI فترسل السكر بوحدة mmol/L، والمختبر يكتبه بوحدة mg/dL. وإذا وصل الرقم 5.2 دون الوحدة إلى حقل يفهم mg/dL، فهو سكر منخفض جداً قد يعطى المريض بسببه علاجاً لا يحتاجه. أرسلنا للعينة SER-0002 رسالة فيها السكر 5.2 mmol/L والبوتاسيوم 4.1 mmol/L:
MSH|^~\&|LIS-MW|LAB1|CHEM-ANALYZER|LAB1|20261118140340||ACK^R01^ACK|ACKAN-000802|P|2.5.1
MSA|AE|AN-000802|SER-0002/GLU: unit mmol/L but LIS expects mg/dL
رفض الوسيط الرسالة، والبوتاسيوم لم يكتب أيضاً، لأن السكر جاء أولاً في الرسالة والوسيط يتوقف عند أول خطأ. ولكن انتبه إلى أن هذا الترتيب صدفة، فلو جاء السكر ثانياً لكتب البوتاسيوم ثم رفض السكر، وأصبحت العينة نصفها نتائج ونصفها ينتظر، والجهاز يظن أن الرسالة كلها رفضت. والتصميم الأسلم أن يتحقق الوسيط من كل الشرائح أولاً ثم يكتب، أو يقبل الصحيح ويرد AE يذكر الشريحة المرفوضة بالتحديد. والتحويل التلقائي بين الوحدات ممكن، ولكن لا تقم به إلا بجدول تحويل معتمد لكل تحليل، فمعامل التحويل للسكر يختلف عن الكرياتينين.
الاعتماد Verification: لا أحد يعتمد نتيجته
النتائج الأربع للعينة SER-0001 الآن بالحالة to_be_verified. فنقرأها مع المدى الذي طبقه النظام:
SER-0001 to_be_verified
  CREA     1.08 mg/dL   range 0.6-1.2 shoulder 0.4-4.0  to_be_verified  submitted by None
  GLU       412 mg/dL   range 70-99 shoulder 50-400  to_be_verified  submitted by None
  HBA1C     8.1 %       range 4.0-5.6 shoulder -  to_be_verified  submitted by None
  K         5.4 mmol/L  range 3.5-5.1 shoulder 2.8-6.0  to_be_verified  submitted by None
ثم حاولنا الاعتماد بنفس المستخدم الذي كتب النتائج عبر الوسيط:
CREA   verify -> Failed to perform transition 'verify' on <Analysis at CREA>: Invalid transition 'verify'.
Valid transitions are:
reject
retract
وهذا الرفض هو أهم إعداد في نظام مختبر: من قدم النتيجة لا يعتمدها، ويسمى في SENAITE التحقق الذاتي Self-verification وقيمته الافتراضية «لا». والسبب أن الاعتماد هو المراجعة الثانية التي تكتشف الخطأ قبل أن يصل إلى الطبيب، فإذا اعتمد الشخص عمله بنفسه صارت المراجعة شكلية. فأنشأنا مستخدماً ثانياً اسمه verifier من صفحة المستخدمين، وأضفناه إلى مجموعة Lab Managers، واعتمدنا به:
docker run --rm --network hi2-lis-net -e ADMIN_PASSWORD -e AS_USER=verifier -e AS_PASS=$VERIFIER_PASSWORD -v "$PWD:/lab" hi2-hl7:1 python verify.pyCREA verify -> verified
GLU verify -> verified
HBA1C verify -> verified
K verify -> verified
verifiedوفي نموذج التحليل الذي ملأناه حقلان لهذا الموضوع رأيتهما في قائمة حقوله: SelfVerification لتغيير القاعدة لتحليل بعينه، وNumberOfRequiredVerifications الذي يسمح باشتراط اعتماد شخصين أو ثلاثة لتحاليل حساسة. فلا تفتح التحقق الذاتي لتسريع العمل في وردية ليلية فيها مختص واحد، والأصح أن يكون في الإجراء من يعتمد عن بعد، أو أن توثق الحالة الاستثنائية في سجل خاص.
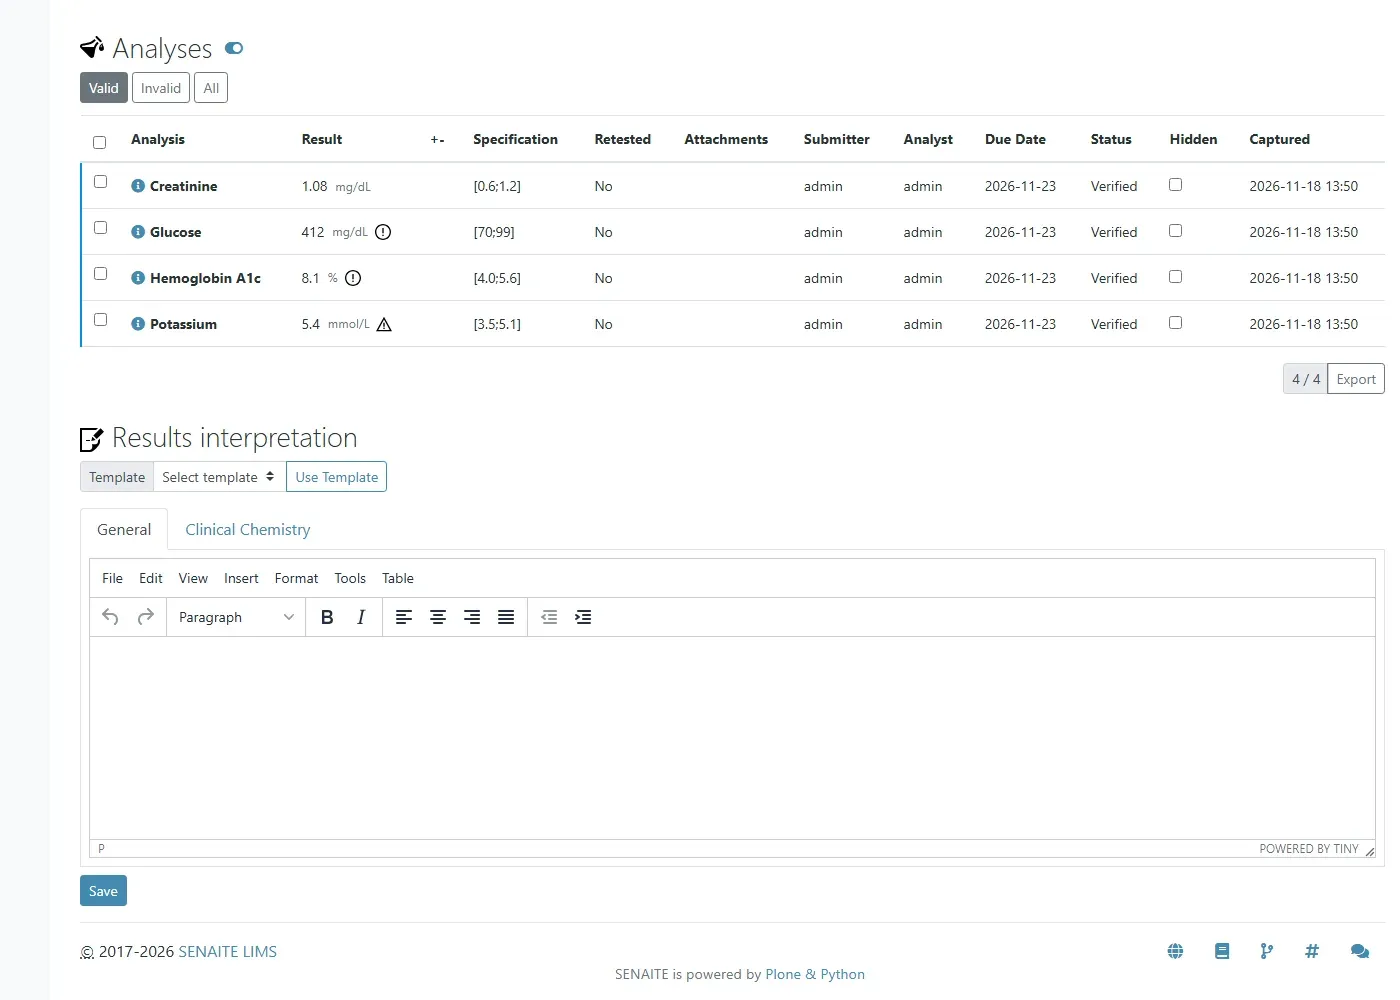
ولاحظ في المخرج السابق أن الحقل submitted by فارغ عبر الـ API، مع أن النظام يعرف من قدم النتيجة، ولولا ذلك ما رفض الاعتماد. وفي التصميم الصحيح يكون للوسيط مستخدم خاص به من مجموعة Analysts وليس المدير، حتى يظهر في سجل التدقيق أن النتيجة جاءت من الجهاز، ولا يملك الوسيط صلاحيات لا يحتاجها. والصورة التالية من قائمة التحاليل في صفحة العينة بعد الاعتماد:
كيف ظهرت القيم الحرجة؟
في الصورة السابقة ثلاث أيقونات مختلفة، والصورة التالية تضع قيمتين منها على الحدود التي كتبناها:
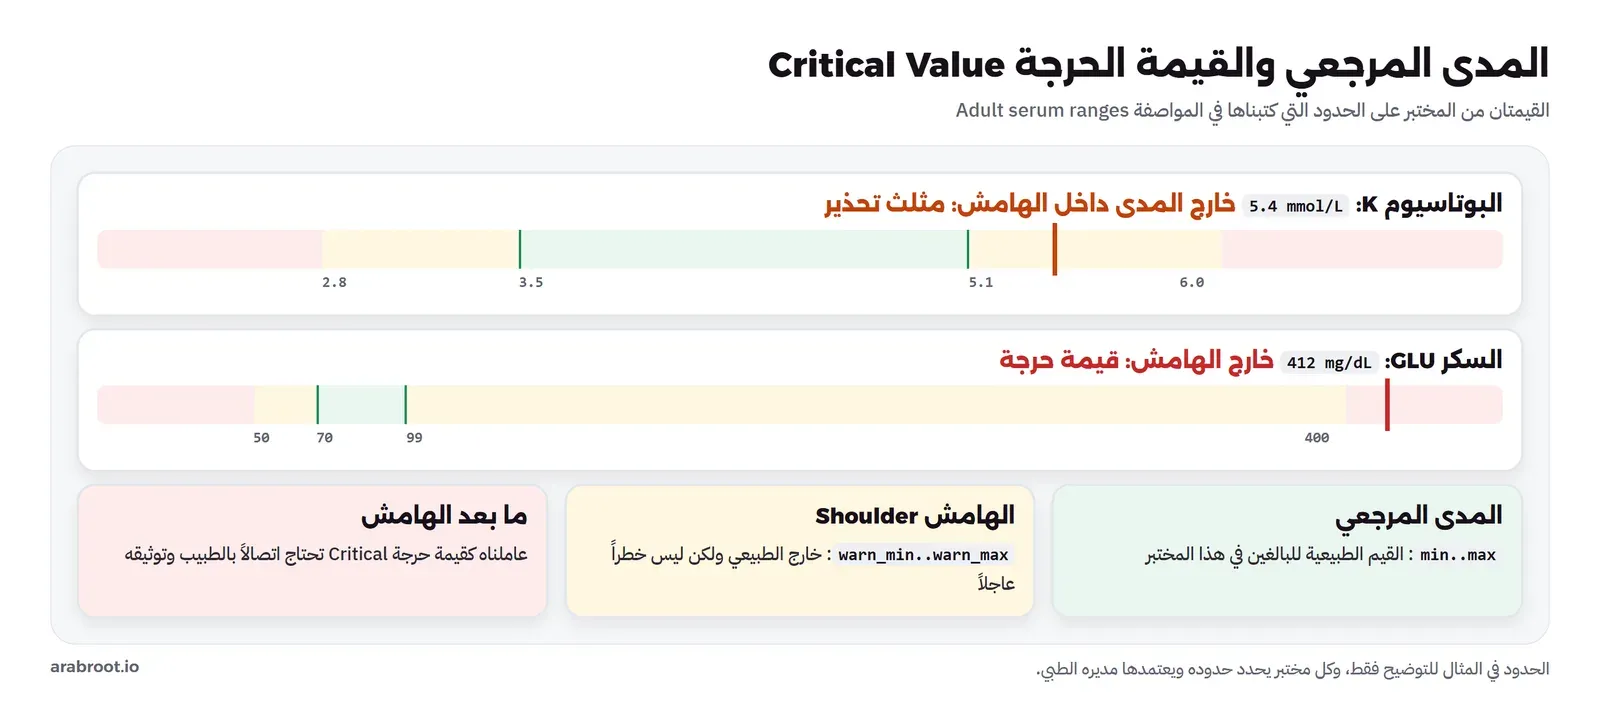
- البوتاسيوم 5.4 بين الحد الطبيعي 5.1 والحد الخارجي 6.0، فأعطاه النظام مثلث تحذير: خارج المدى ولكنه في الهامش.
- السكر 412 بعد الحد الخارجي 400، فأعطاه النظام دائرة فيها علامة تعجب: خارج كل الحدود، وهذه في تعريفنا قيمة حرجة.
- السكر التراكمي 8.1 أخذ نفس الدائرة، مع أنه ليس حالة طارئة، والسبب أننا لم نعطه هامشاً، فكل ما يخرج عن المدى يعامل كأنه بعد الهامش. وهذا يعلمك قاعدة: إذا لم تعرف الهامش لكل تحليل، فسوف تتساوى في الشاشة القيمة الطارئة والقيمة المرتفعة المزمنة، ويتعلم المختصون تجاهل الدائرة، وهذا ما يسمى إرهاق التنبيهات Alert Fatigue.
وقد يتساءل البعض: هل تكفي الأيقونة؟ والإجابة لا. فالقيمة الحرجة في أي مختبر طبي إجراء وليس أيقونة: يتصل المختص بالطبيب أو الممرضة المسؤولة خلال وقت محدد، ويطلب منهم إعادة قراءة القيمة عليه، ويسجل من أبلغ ومن استلم ومتى، وهذا ما تفحصه جهات اعتماد المختبرات. وSENAITE يعطيك العلامة فقط، أما الإبلاغ وتوثيقه فتحتاج أن تضيفهما بإضافة أو إجراء خارجي، مثلاً أن يرسل الوسيط تنبيهاً عندما يرى قيمة بعد الهامش، وأن يسجل المختص الإبلاغ في ملاحظات النتيجة. وفي OpenELIS وفي الأنظمة التجارية الطبية ستجد هذه المفاهيم أقرب إلى الشاشة لأنها صممت لمختبر طبي من البداية.
التقرير والنشر Publish وسجل التدقيق
بعد الاعتماد يولد النظام تقرير PDF بمحرك القوالب senaite.impress. والصورة التالية من معاينة التقرير:
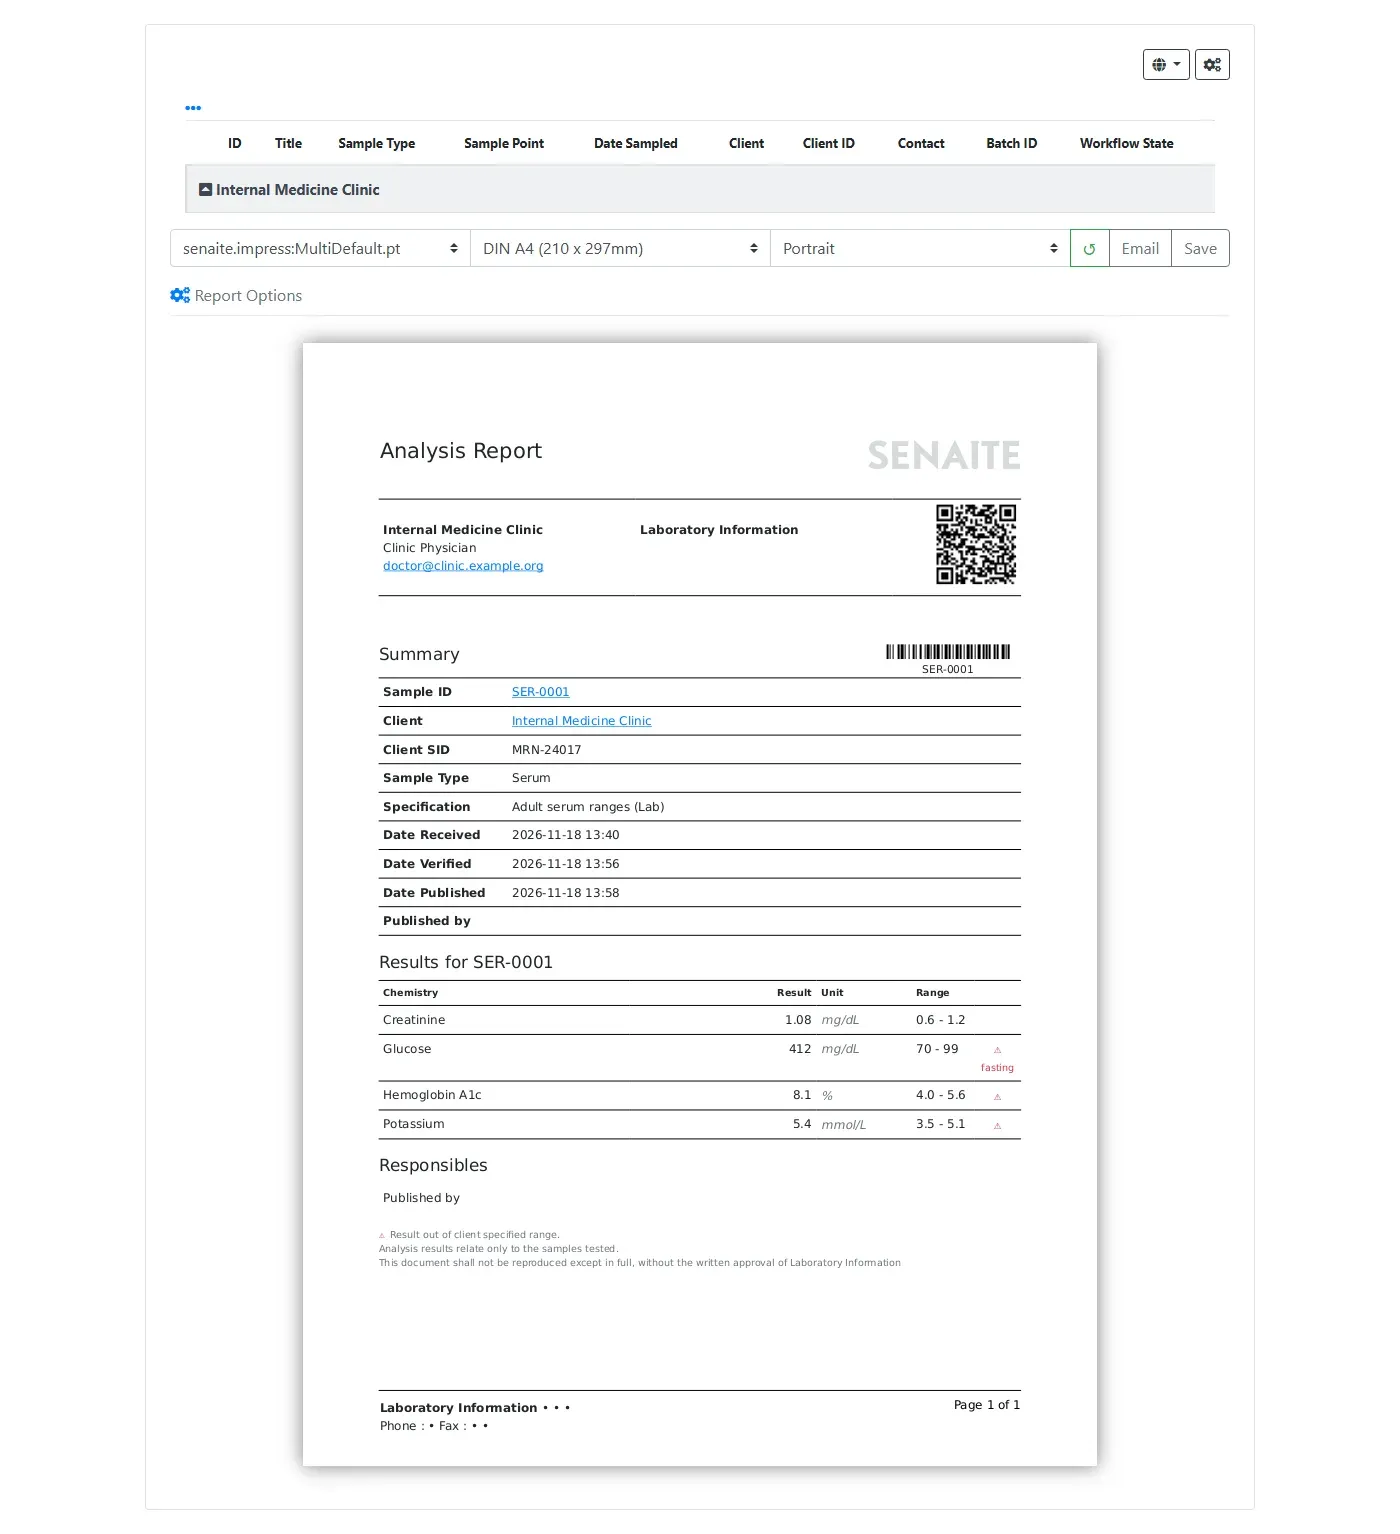
وفي التقرير ثلاث ملاحظات قبل أن ترسله لأي طبيب: العلامة واحدة لكل ما خرج عن المدى، فالتقرير لا يفرق بين البوتاسيوم في الهامش والسكر الحرج، والتعليق fasting الذي كتبناه في المواصفة ظهر بجانب السكر وهو مفيد. وبيانات المختبر في الرأس والتذييل فارغة Laboratory Information لأننا لم نملأ صفحة المختبر، والتقرير الرسمي يحمل اسم المختبر وترخيصه وعنوانه وتوقيع المعتمد. ثم نشرنا العينة، وهذا هو سجل التدقيق Audit Log لها كما تعرضه الواجهة:
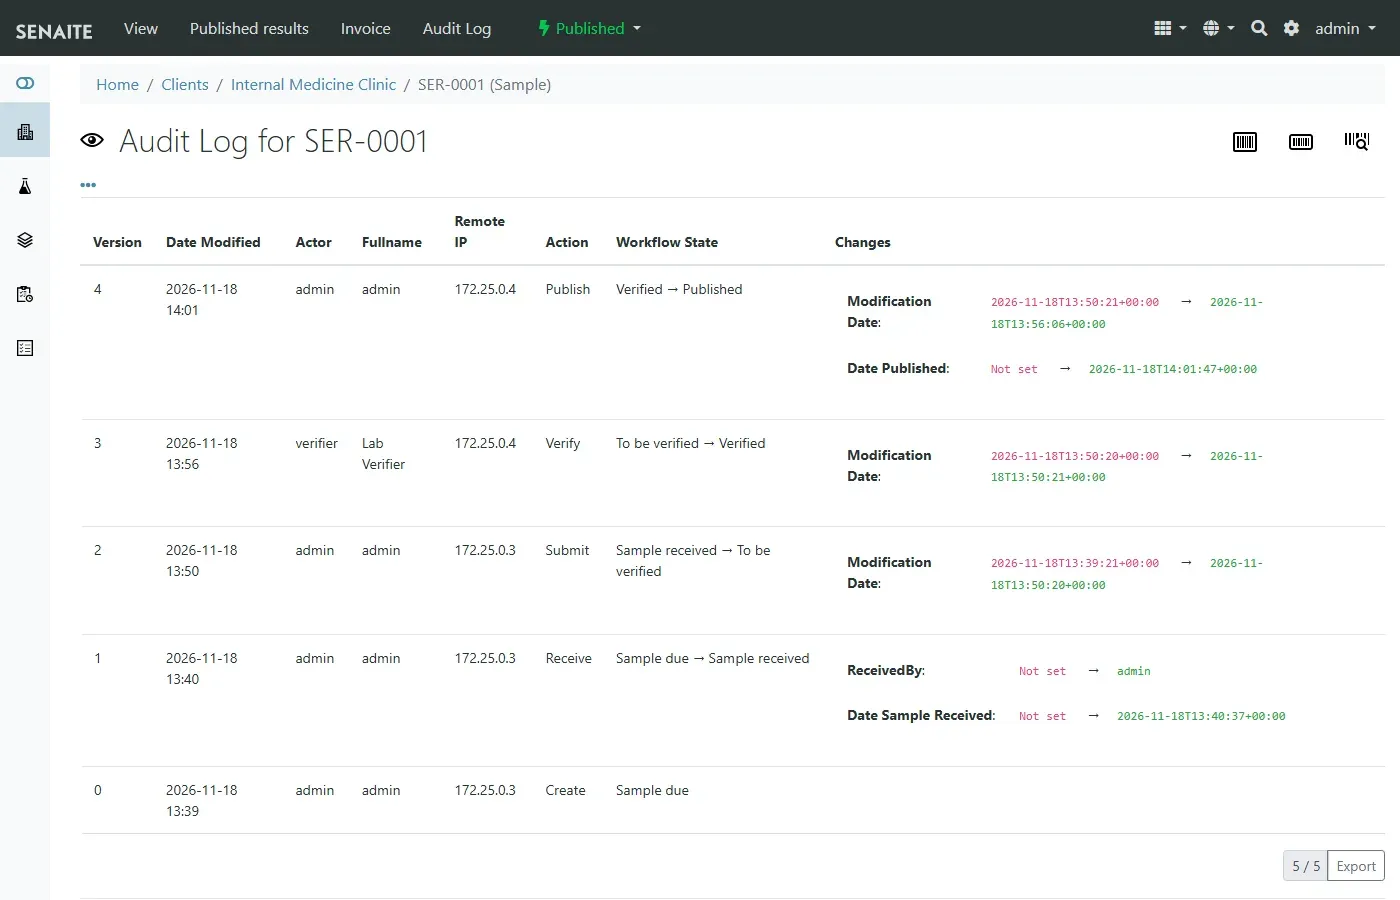
وكل سطر فيه رقم النسخة والوقت والمستخدم وعنوان IP الذي جاء منه الطلب والانتقال والحقول التي تغيرت. ولاحظ أن الاعتماد مسجل باسم المستخدم الثاني، وأن عنوان الطلب هو عنوان الـ Container التي شغلت السكربت. وقد شرحنا أهمية هذا النوع من السجلات في مقال سجل التدقيق.
ضبط الجودة Quality Control: هل يقيس الجهاز صحيحاً اليوم؟
النتيجة التي اعتمدناها صحيحة فقط إذا كان الجهاز يقيس صحيحاً في تلك الساعة. لذلك يشغل كل مختبر طبي عينات ضبط معروفة القيمة Control Samples على كل جهاز بانتظام، عادة في بداية كل وردية وبعد أي صيانة أو تغيير في الكواشف، ويقارن النتيجة بالقيمة المتوقعة. وتستخدم المختبرات لذلك قواعد إحصائية معروفة باسم قواعد Westgard، مثل رفض التشغيل إذا خرجت نتيجة الضبط عن المتوسط بثلاثة انحرافات معيارية، أو خرجت نتيجتان متتاليتان عن انحرافين في نفس الاتجاه، وهذا يدل على انزياح في الجهاز وليس خطأ عشوائياً.
وفي SENAITE توجد هذه المفاهيم في الإعدادات: تعريفات العينات المرجعية Reference Definitions، والعينات المرجعية Reference Samples التي تضاف إلى ورقة العمل Worksheet مع عينات المرضى، وقد رأيت مجلديهما في قائمة الإعدادات. وما يهمك كمطور أن نتائج الضبط بيانات مثل نتائج المرضى، تصل من الجهاز بنفس الرسائل، ويجب أن يعرف الوسيط أن هذه العينة ضبط وليست مريضاً، وإلا كتب نتيجة الضبط في ملف مريض أو أهملها. وفي أغلب الأجهزة يميز نوع العينة في الرسالة بين الضبط والمريض، فاقرأ وثيقة الجهاز في هذه النقطة بالذات.
النتيجة المصححة: ماذا لو اكتشفنا خطأ بعد الاعتماد؟
عندما حاولنا الاعتماد بالمستخدم الأول، ذكر النظام الانتقالين المسموحين: reject وretract. والسحب Retract هو ما يحدث عندما يكتشف المختص أن النتيجة خاطئة قبل الاعتماد، مثل عينة متحللة أو خطأ في الجهاز، فتسحب النتيجة وتنشأ نسخة جديدة من نفس التحليل تنتظر نتيجة جديدة، وتبقى القديمة في السجل بحالة مسحوبة ولا تحذف. أما بعد النشر فالتصحيح أخطر، لأن الطبيب ربما رأى النتيجة الخاطئة وتصرف بناء عليها. والمعيار هنا واضح في HL7 v2: النتيجة المصححة ترسل بالحالة C في الحقل OBX-11 بدل F، والنظام المستقبل يجب أن يستبدل القديمة ويبين أنها صححت، ولا يضيف نتيجة ثانية بجانبها. وإذا بنيت أي تطبيق ينسخ نتائج المختبر، فتأكد أنه يفهم الحالة C، وإلا عرض للطبيب نتيجتين متناقضتين لنفس العينة.
من المختبر إلى الإنتاج Production
| البند | ما رأيناه في المختبر | ماذا تفعل في الإنتاج |
|---|---|---|
| الإصدار | 2.6.0 فيه خطأ الـ API والإصلاح في الفرع | اختبر كل تكامل على الإصدار الذي ستشغله، وثبت الإصدار |
| المريض | رقم المريض في حقل نصي | إضافة senaite.patient أو نظام طبي مثل OpenELIS |
| رموز LOINC | في حقل حر | جدول ربط معتمد يراجعه المختبر، ويستخدمه الوسيط والتقارير |
| المدى | مواصفة واحدة للبالغين | مدى بحسب العمر والجنس ونوع العينة، يعتمده المدير الطبي |
| القيم الحرجة | أيقونة فقط | إجراء إبلاغ موثق، وتنبيه آلي، وهامش لكل تحليل |
| الأجهزة | الإقرار ضاع والجهاز أعاد | تذكر أرقام الرسائل، والتحقق من كل الشرائح قبل الكتابة |
| الوحدات | رفض mmol/L | رفض أو تحويل بجدول معتمد، وتنبيه للفني |
| الصلاحيات | الوسيط يكتب بحساب المدير | مستخدم للوسيط من مجموعة Analysts، ولا تحقق ذاتي |
| النسخ الاحتياطي | ZODB في Volume | أداة repozo أو نسخ ZEO، واختبار الاستعادة |
| التشغيل | نسخة واحدة | ZEO مع أكثر من نسخة خلف Load Balancer كما في وثائق الـ Image |
والنسخ الاحتياطي لـ ZODB يختلف عن قواعد SQL: البيانات ملف Data.fs يضاف إليه في نهايته، ومعه مجلد للملفات الكبيرة blobstorage، والـ Image نفسها فيها أداة repozo التي رأينا اسمها في سجل التشغيل الأول، وهي تأخذ نسخاً كاملة وتزايدية من الملف دون إيقاف الخدمة. واضغط القاعدة دورياً بالأداة zeopack، لأن ZODB يحتفظ بكل نسخ الكائنات حتى تضغطه، وانتبه إلى أن الضغط يحذف النسخ القديمة التي قد يعتمد عليها سجل التدقيق، فاقرأ إعداداته قبل أن تجدوله.
أخطاء شائعة
- الثقة في رسالة الخطأ وحدها: الـ API رجع خطأ وأبقى خمسة كائنات ناقصة.
- الاكتفاء بنجاح الطلب: مسار
doActionForرجع دون خطأ ولم تتغير الحالة. - معالجة الرسالة قبل التأكد من إرسال الإقرار: النتائج حفظت والجهاز لم يعرف، فأعاد الإرسال.
- قبول النتيجة دون الوحدة: 5.2 mmol/L تقرأ 5.2 mg/dL.
- مدى دون هامش: كل نتيجة مرتفعة تبدو حرجة، فيتجاهل الناس العلامة.
- حساب واحد للوسيط والمدير: لا تعرف من السجل هل جاءت النتيجة من الجهاز أم من شخص.
- إنشاء الإعدادات بالـ API دون القيم الافتراضية التي يملؤها النموذج: الملصق فشل لأن قالبه فارغ.
- الاعتماد على علامة الجهاز H وHH: المدى المعتمد هو مدى المختبر وليس مدى الجهاز.
تنظيف المختبر
docker rm -f hi2-lis-mw
docker compose down -v
docker rmi hi2-hl7:1
الخيار -v يحذف قاعدة ZODB كاملة، فلا تستخدمه على مختبر فيه بيانات.
تدريب عملي
- أضف إلى الوسيط ذاكرة لأرقام الرسائل
MSH-10ونتيجة كل منها، ثم أعد إرسال نفس الرسالة وتأكد أنه يرجع AA دون أن يكتب شيئاً. - عدل الوسيط ليتحقق من كل شرائح OBX قبل أن يكتب أي نتيجة، ثم أرسل رسالة فيها البوتاسيوم أولاً والسكر بوحدة خاطئة ثانياً.
- أضف هامشاً للسكر التراكمي، وقارن الأيقونة قبل التعديل وبعده على عينة جديدة.
- أنشئ مستخدماً للوسيط من مجموعة Analysts وشغله به، ثم اقرأ سجل التدقيق وقارن.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- OpenELIS Global نظام مختبر طبي ثقيل التشغيل صمم للمختبرات الوطنية والمستشفيات، وSENAITE نظام LIMS مرن في Container واحدة يحتاج إضافات ليصبح طبياً.
- العينة مرت بخمس حالات: الطلب والاستلام بالرقم SER-0001 والملصق، ثم النتائج من الجهاز، ثم الاعتماد بشخص آخر، ثم النشر، وكل خطوة في سجل التدقيق.
- SENAITE 2.6.0 لا ينشئ التحاليل عبر الـ API ويترك كائنات ناقصة، والإصلاح في الفرع 2.x، فأنشأناها من النموذج.
- رموز LOINC تحمل نوع العينة والوحدة، والوسيط رفض السكر بوحدة mmol/L لأن المختبر يتوقع mg/dL.
- الإقرار الضائع جعل الجهاز يعيد رسالة حفظت نتائجها، والحل تذكر أرقام الرسائل وليس الكتابة فوق النتيجة.
- الهامش في المواصفة فرق بين نتيجة خارج المدى ونتيجة حرجة، والقيمة الحرجة إجراء إبلاغ موثق وليست أيقونة.
 دليلالمستشفى من الداخل: خريطة الأنظمة HIS وEMRما هي أنظمة المستشفى من التسجيل والسجل الطبي إلى المختبر والأشعة والصيدلية والفوترة، وكيف تتصل ببعضها، ومن أين تبدأ.
 دليلتبادل البيانات الصحية بين الأنظمة: HL7 وFHIRكيف تنتقل نتائج المختبر وبيانات المريض بين أنظمة المستشفى برسائل HL7 وواجهات FHIR، وكيف تبني ذلك وتختبره بنفسك.
 دليلالمصطلحات الطبية الموحدة: ICD وSNOMED CT وLOINCكيف تفهم الآلة أن الأسماء الطبية المختلفة مفهوم واحد، وكيف تختار نظام الرموز المناسب للتشخيص والتحليل والدواء، برموز حقيقية.
 دليلخادم FHIR على سيرفرك: تجربة عملية مع HAPI FHIRكيف تشغل سيرفر FHIR يحفظ في PostgreSQL ويتحقق من البيانات بدليل نفيس، مع البحث بالأسماء العربية والنسخ والمعاملات.
 دليلالسجل الصحي الإلكتروني EMR مع OpenEMR وOpenMRSكيف تشغل سجلاً سريرياً مفتوح المصدر بواجهة عربية، وتسجل فيه مريضاً وزيارة ووصفة، ثم تتكامل معه عبر OAuth2 وFHIR وتعرف ما يتغير في الطريق.
 دليلأرشيف الصور الطبية PACS على سيرفرك مع Orthancكيف تشغل أرشيف صور طبية يستقبل من أجهزة الأشعة ويخدم غرفة القراءة وقوائم العمل، مع قياس الضغط وإغلاق الأرشيف أمام الأجهزة المجهولة.
 دليلIdempotency: كيف تجعل العملية آمنة عند تكرارهالماذا تصل الرسالة نفسها أكثر من مرة، وكيف تكتب مستهلكاً يطبقها مرة واحدة فقط مهما تكررت.
 دليلAudit Trail: كيف تبني سجل تدقيق لا يقبل العبثكيف تصمم سجلاً يجيب عن سؤال من غير هذه الصلاحية ومتى، وتحميه من الحذف والتعديل بعد كتابته.
سجل التحديثات
- 2026-11-18: كتابة المقال، وتنفيذ المختبر على SENAITE 2.6.0 (senaite/senaite:v2.6.0-docker2)، وبرنامج وسيط بلغة Python 3.13.18 مع python-hl7 0.4.5 وrequests 2.34.2، ورسائل HL7 v2.5.1 ببيانات وهمية، على Docker Engine 29.8.0.