لنفرض أنك في فريق البيانات في شركة تأمين أو شركة إدارة مطالبات TPA، ويصلك كل ربع سنة أكثر من 150 ألف مطالبة من 120 عيادة، وفريق المراجعة عندكم يستطيع أن يفتح ملفات عشرين عيادة فقط في الشهر، أي أن يطلب السجلات الطبية ويقارنها بما فوتر ويزور العيادة إن احتاج. والسؤال الذي يأتيك من مدير الفريق كل شهر واحد: أي عشرين عيادة نبدأ بها؟ فإذا اخترتها عشوائياً فأغلب الوقت يذهب على عيادات سليمة، وإذا اخترتها بأكبر مبلغ فسوف تكون كلها المستشفيات الكبيرة التي يكبر مبلغها لأنها كبيرة. وهذا هو موضوع كشف الاحتيال في المطالبات الصحية: ليس أن تمسك الاحتيال آلياً، وإنما أن ترتب للمراجع البشري أين ينظر أولاً، وأن تشرح له لماذا.
وقد قارنا في مقال كشف الاحتيال Fraud Detection القواعد بنموذجين لتعلم الآلة على عمليات دفع بالبطاقات، حيث الاحتيال في الغالب عملية واحدة تحتاج قراراً خلال ثوان. أما في المطالبات الصحية فالصورة مختلفة: المحتال في الغالب مقدم خدمة له رخصة وعقد، وكل مطالبة يرسلها تبدو طبيعية وحدها، والنمط لا يظهر إلا عندما تجمع مطالباته على أسابيع وتقارنها بعيادات تشبهه. وفي مقال تدقيق المطالبات في نفس المرحلة بنينا محرك قواعد يقرر ما يدفع لكل مطالبة، وهنا نبني الطبقة التي فوقه: قواعد ونموذج غير موجه Unsupervised اسمه Isolation Forest على مطالبات وهمية زرعنا فيها خمسة أنماط من الاحتيال وثلاث عيادات سليمة غير عادية، ونقيس الدقة والاستدعاء، ونقرأ لماذا رفع النموذج كل عيادة، ونرى أين أخطأ.
وسوف نناقش في هذا المقال ما يلي:
- الفرق بين الاحتيال والهدر وإساءة الاستخدام Fraud, Waste and Abuse كما تعرفه المصادر الرسمية، ولماذا يهم المبرمج.
- أشهر الأنماط: رفع مستوى الترميز Upcoding، والتفكيك Unbundling، والفوترة الوهمية Phantom Billing، والمطالبات المكررة، وأثر كل منها في البيانات.
- خصوصية البيانات قبل التحليل: لماذا يرى المحلل رقماً مستعاراً وليس رقم المريض.
- قواعد على مستوى المطالبة، وخطأ في اتجاه قاعدة التكرار جعلها تمسك الأصل بدل النسخة.
- خصائص على مستوى العيادة مقارنة بعيادات تشبهها، وخطأ ثان أخفى أقوى الإشارات عن النموذج.
- الدقة Precision والاستدعاء Recall للقواعد والنموذج ومعاً، ونمط لا تعرفه القواعد أمسكه النموذج وحده.
- الشرح للمراجع، والإنذارات الكاذبة False Positives من عيادات سليمة غير عادية، وما الذي لا يجوز أن يفعله النظام آلياً.
الاحتيال والهدر وإساءة الاستخدام Fraud, Waste and Abuse
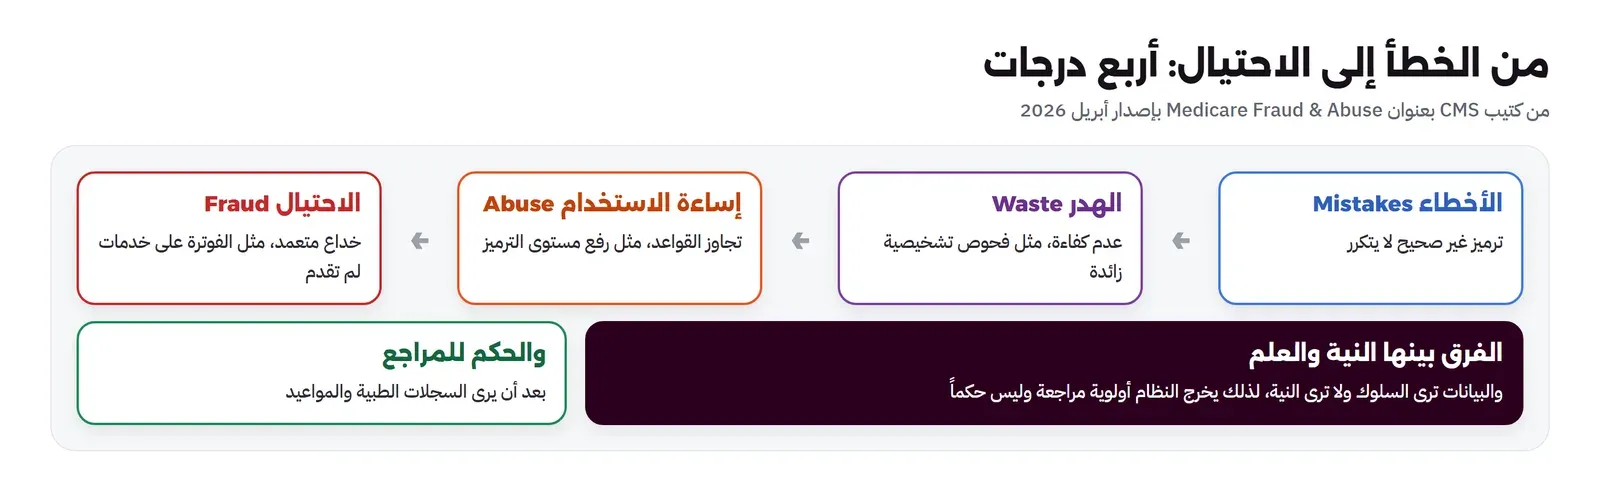
أوضح تقسيم رسمي لهذه المفاهيم في كتيب مراكز خدمات Medicare وMedicaid الأمريكية Medicare Fraud & Abuse: Prevent, Detect, Report بإصداره في أبريل 2026. فالكتيب يضع أسباب الدفع غير الصحيح على خط واحد بأربع درجات: الأخطاء Mistakes مثل ترميز غير صحيح لا يتكرر، ثم عدم الكفاءة الذي ينتج الهدر Waste مثل طلب فحوص تشخيصية زائدة، ثم تجاوز القواعد الذي ينتج إساءة الاستخدام Abuse مثل ممارسات فوترة غير سليمة كرفع مستوى الترميز، ثم الخداع المتعمد الذي ينتج الاحتيال Fraud مثل الفوترة على خدمات أو مستلزمات لم تقدم. ويقول الكتيب إن الفرق بين الاحتيال وإساءة الاستخدام يعتمد على الوقائع والظروف والنية والعلم، ومن أمثلة الاحتيال عنده: الفوترة بمستوى تعقيد أعلى مما قدم أو وثق عن علم، والفوترة على خدمات لم تقدم، وطلب خدمات لا يحتاجها المريض، والفوترة على مواعيد لم يحضرها المريض.
ولماذا يهم هذا التقسيم من يكتب الكود؟ لأن البيانات لا تعرف النية. فالعيادة التي ترفع مستوى الترميز في 40% من زياراتها قد تكون محتالة، وقد يكون مرمزها لم يتدرب جيداً، وقد تكون عيادة حالاتها معقدة فعلاً كما سوف نرى في المختبر. والنظام الذي يسمي نتيجته «احتيالاً» يحكم على النية من رقم، وهذا خطأ مهني وقانوني. لذلك نسمي ما يخرجه النظام «مؤشراً» أو «أولوية مراجعة»، والحكم للمراجع بعد أن يرى السجلات.
وتعرف الجمعية الوطنية الأمريكية لمكافحة الاحتيال في الرعاية الصحية NHCAA الأنماط الشائعة تعريفاً قصيراً في صفحة الأسئلة الشائعة: رفع مستوى الترميز هو الفوترة على خدمة أغلى من التي قدمت فعلاً، والتفكيك هو الفوترة على كل مرحلة من الإجراء كأنها إجراء مستقل، والفوترة على خدمات لم تقدم. وتقدر الجمعية في صفحة تحدي الاحتيال الخسائر بعشرات المليارات سنوياً، وتصف 3% من الإنفاق الصحي بأنه تقدير متحفظ، بينما تضعها بعض الجهات الحكومية حتى 10%. ولكي ترى الحجم بأرقام موثقة لا بالتقديرات، أعلنت وزارة العدل الأمريكية في 30 يونيو 2025 اتهام 324 شخصاً في قضايا احتيال صحي بخسائر مقصودة تتجاوز 14.6 مليار دولار، وذكرت أن فريق تحليل البيانات في وحدة الاحتيال الصحي كشف إحدى القضايا الكبيرة بتحليل استباقي للفوترة غير العادية، وأنها تنشئ مركزاً لدمج بيانات الاحتيال يستخدم التحليلات المتقدمة والذكاء الاصطناعي.
وفي السعودية نشر البنك المركزي SAMA لائحة مكافحة الاحتيال لشركات التأمين في ديسمبر 2008، وهي منشورة في دليل الأنظمة، وفيها جداول مؤشرات للاحتيال، منها في قسم الرعاية الصحية تحت سلوك الأطباء: أن يجدول العلاج في أيام العطل أو الأيام التي تكون فيها المنشآت مغلقة عادة. وهذا المؤشر بالذات سوف نجده قاعدة في مختبرنا. وأعلنت هيئة التأمين في يوليو 2024 توقيع مذكرة تعاون مع الجمعية السعودية لمكافحة الاحتيال لتدريب وتأهيل المختصين في التحقيق في احتيال التأمين وكشفه.
الأنماط وأثر كل منها في البيانات
كل نمط يترك أثراً مختلفاً، وبعضها لا يظهر إلا على مستوى العيادة. وهذا الجدول هو أساس كل ما سوف نبنيه:
| النمط | ماذا يحدث | الأثر في البيانات | أين يظهر |
|---|---|---|---|
| رفع مستوى الترميز Upcoding | زيارة بسيطة تفوتر كزيارة معقدة | نسبة الزيارات بالمستوى الأعلى أكبر من عيادات مثلها | العيادة فقط، فكل مطالبة وحدها طبيعية |
| التفكيك Unbundling | لوحة تحاليل لها رمز واحد تفوتر كمكوناتها | المكونات معاً في مطالبة واحدة دون رمز اللوحة | المطالبة نفسها |
| الفوترة الوهمية Phantom Billing | خدمات لم تقدم لمرضى لم يأتوا | زيارات في أيام الإغلاق، وعدد زيارات للطبيب في اليوم أعلى من المعقول، ومرضى يتكررون عند عيادة واحدة كثيراً | العيادة والطبيب والعضو |
| المطالبات المكررة Duplicate Claims | نفس المطالبة برقم جديد، أحياناً بتاريخ بعدها بيوم | نفس العضو ونفس الخدمات في نفس اليوم أو اليوم التالي | المطالبة مقارنة بما قبلها |
| الخدمات الزائدة Overservicing | فحوص وأشعة لكل زيارة سواء احتاجها المريض أم لا | بنود أكثر ومبلغ أعلى للزيارة مقارنة بالأقران | العيادة فقط |
والنمط الأخير لم نكتب له أي قاعدة عن قصد، لأننا نريد أن نعرف ماذا يحدث لنمط لا يعرفه فريق القواعد، وهو ما يحدث في الواقع دائماً: المحتالون يتعلمون القواعد ويغيرون أسلوبهم. وفي كتيب CMS يقع هذا النمط بين الهدر والاحتيال بحسب النية، فطلب فحوص زائدة هدر، وطلب خدمات لا يحتاجها المريض عن علم احتيال.
لماذا نموذج غير موجه، ولماذا Isolation Forest؟
في مقال كشف الاحتيال في المدفوعات استخدمنا نماذج موجهة Supervised تتعلم من عمليات صنفت سابقاً كاحتيال أو سليمة. وفي المطالبات الصحية هذا صعب لسببين. الأول أن التصنيفات قليلة جداً: كل حالة احتيال مؤكدة نتيجة تحقيق يأخذ شهوراً، فقد يكون عندك عشرات الحالات في سنة. والثاني أن التصنيفات متحيزة: الحالات المؤكدة هي التي اختار المراجعون فحصها، فالنموذج الذي يتعلم منها يتعلم ما يبحث عنه المراجعون أصلاً، ولا يرى ما لم يبحثوا عنه.
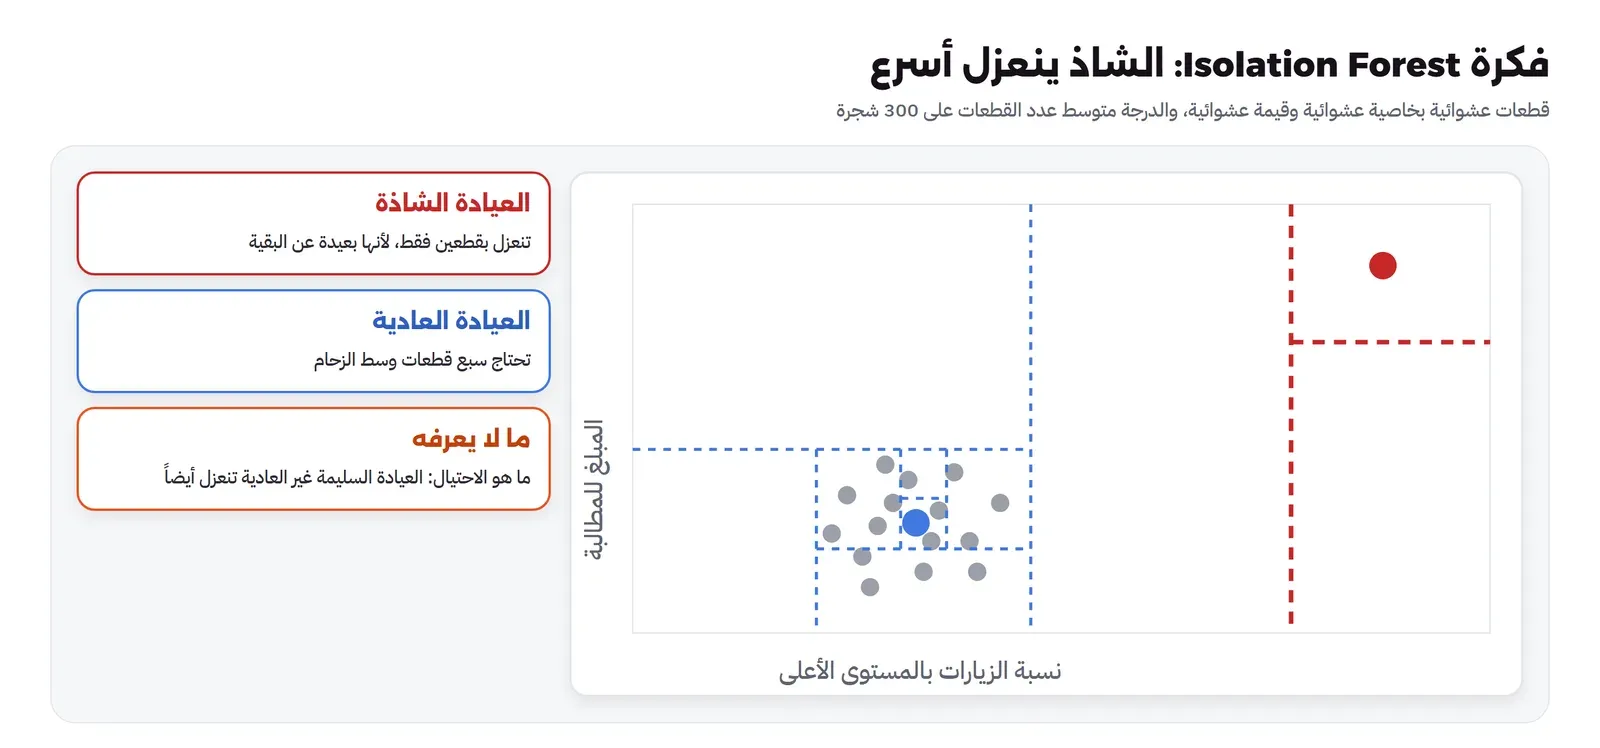
والنموذج غير الموجه لا يحتاج تصنيفات، وإنما يبحث عن ما يختلف عن الأغلبية. وفكرة Isolation Forest التي نشرها Liu وTing وZhou في ورقة مؤتمر ICDM سنة 2008 بسيطة: اختر خاصية عشوائية وقيمة قطع عشوائية بين أصغر قيمة وأكبرها، وقسم العيادات إلى مجموعتين، ثم كرر على كل مجموعة حتى تبقى كل عيادة وحدها. فالعيادة الشاذة تنعزل بعد قطعات قليلة لأنها بعيدة عن البقية، والعيادة العادية تحتاج قطعات كثيرة لأنها وسط زحام. ثم كرر ذلك على مئات الأشجار العشوائية، واحسب متوسط عدد القطعات لكل عيادة، فكلما قل كانت أكثر شذوذاً. وتوثيق IsolationForest في scikit-learn يشرح أن الدالة score_samples ترجع عكس درجة الشذوذ، لذلك نضربها في سالب واحد في الكود. ويقارنه دليل كشف القيم الشاذة في المكتبة بطرق أخرى.
ولكن لاحظ ما لا يفعله: هو لا يعرف ما هو الاحتيال، وإنما ما هو غير العادي. فالعيادة السليمة غير العادية سوف تظهر عنده كما تظهر المحتالة، وهذا ليس خطأ في النموذج وإنما في السؤال. لذلك زرعنا ثلاث عيادات سليمة غير عادية لنرى أين تقع.
ولماذا هذا النموذج بالذات وليس غيره من نماذج كشف الشذوذ؟ لأنه سريع، ولا يفترض أن البيانات تتبع توزيعاً معيناً، ولا يحتاج أن تختار مقياساً للمسافة بين العيادات كما تحتاج طرق الجيران الأقرب، ومعاملاته قليلة: عدد الأشجار، وحجم العينة لكل شجرة، والعتبة. وعلى 120 عيادة بثماني خصائص لا يأخذ تدريبه إلا جزءاً من الثانية. والطرق الأخرى، مثل عامل الشذوذ المحلي LOF أو الشبكات العصبية التي تعيد بناء مدخلاتها Autoencoders، لها مكانها مع بيانات أكبر وأعقد، ولكن البداية بالنموذج الأبسط الذي تستطيع أن تشرح نتيجته أفضل من البداية بالأعقد.
المختبر: 120 عيادة وتسعون يوماً
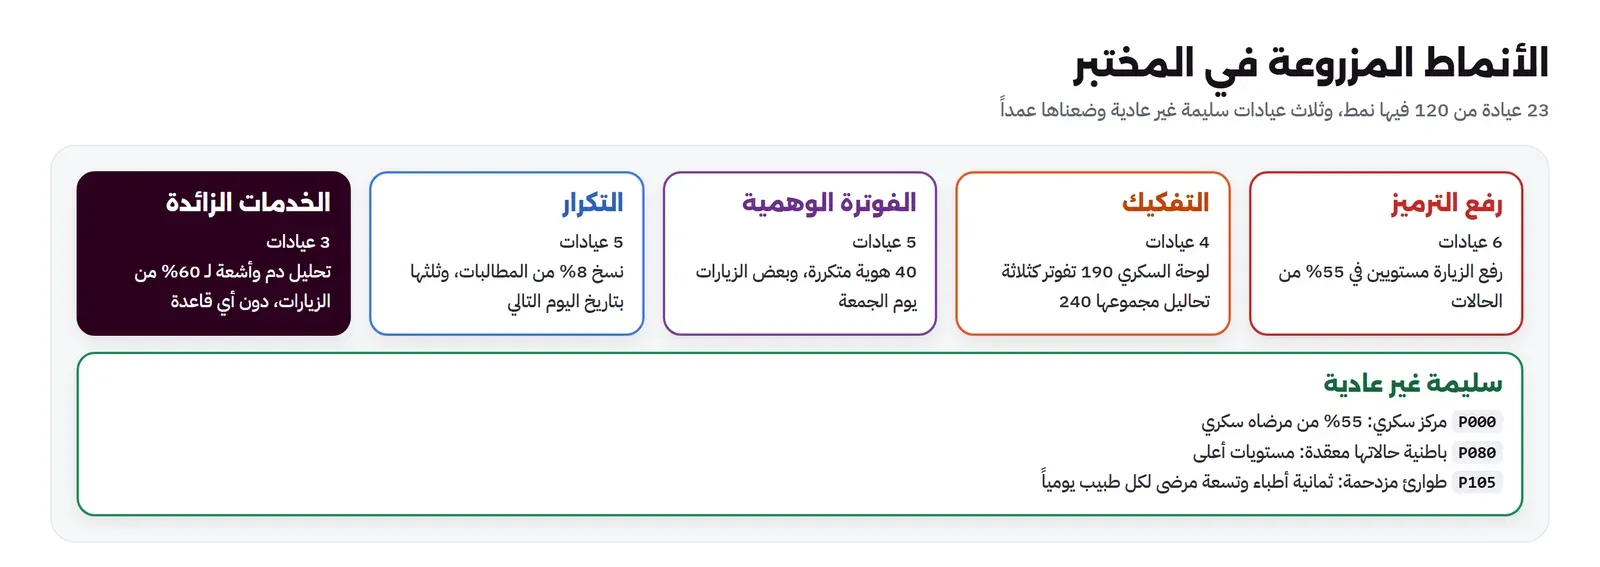
كتبنا مولداً ببذرة ثابتة يصنع 120 عيادة: 80 طب عام، و25 باطنية، و15 طوارئ عاجلة Urgent Care، لكل منها بين طبيب وأربعة أطباء، تعمل من السبت إلى الخميس، والطوارئ كل يوم. وكل طبيب يرى عدداً من المرضى يتبع توزيع Poisson بمتوسط ستة في اليوم، والمريض يختار من ستة آلاف عضو وهمي عشوائياً. ولكل زيارة مستوى استشارة من أربعة بأسعار 100 و150 و250 و400، بتوزيع يختلف بحسب التخصص، ثم تحاليل وأشعة وأدوية باحتمالات ثابتة. والأسعار والأسماء كلها وهمية. ثم زرعنا الأنماط الخمسة في 23 عيادة، والعيادات السليمة غير العادية الثلاث:
docker build -t fraud-lab .
docker run --rm -v "$PWD:/lab" -w /lab fraud-lab python gen_fraud.py
328390 claim lines, 156630 claims, 120 clinics, 90 days
lines by label: {'none': 305616, 'upcoding': 6347, 'phantom': 8717, 'unbundling': 2150, 'overservicing': 4494, 'duplicates-copy': 1066}
fraud clinics: {'upcoding': 6, 'duplicates': 5, 'phantom': 5, 'unbundling': 4, 'overservicing': 3} | honest outliers: {'complex-im': 'P080', 'busy-uc': 'P105', 'diabetes-center': 'P000'}في المخرج أعلاه لاحظ التالي:
- من 328 ألف بند، 22,774 فقط مصنفة كاحتيال، أي قرابة 7%. والتصنيف على مستوى البند: الزيارة التي رفع مستواها فعلاً، والمطالبة المفككة فعلاً، وزيارات الهويات الوهمية، والنسخ المكررة. فالعيادة المحتالة لها أيضاً زيارات سليمة كثيرة، وهذا واقعي.
- العيادة P000 مركز سكري سليم، نسبة مرضى السكري فيه 55% بدل 12%، فكل مطالباته أكبر من عيادات الطب العام. والعيادة P080 باطنية حالاتها معقدة فعلاً، فمستويات الاستشارة فيها أعلى. والعيادة P105 طوارئ فيها ثمانية أطباء وكل طبيب يرى تسعة مرضى في المتوسط.
- في التفكيك جعلنا مجموع أسعار المكونات 240 مقابل 190 للوحة، أي أن التفكيك يرفع المبلغ هنا، عكس ما رأينا في جداول مقال تدقيق المطالبات حيث كان مجموع المكونات أقل من اللوحة.
الخصوصية قبل التحليل: رقم مستعار Pseudonym
أول سطر في سكربت التحليل لا يحسب شيئاً عن الاحتيال، وإنما يستبدل رقم العضو برقم مستعار:
# privacy first: the analysis never sees the member number, only a keyed hash of it
KEY = os.environ.get("PSEUDO_KEY", "lab-only-key").encode()
L["member"] = [hmac.new(KEY, m.encode(), hashlib.sha256).hexdigest()[:16] for m in L["member"]]
والسبب أن المحلل الذي يبحث عن أنماط العيادات لا يحتاج أن يعرف من هو المريض، ويحتاج فقط أن يعرف أن نفس المريض زار نفس العيادة عشرين مرة. والهاش بمفتاح سري HMAC يحقق ذلك: نفس الرقم يعطي نفس الرقم المستعار دائماً، فتعمل كل القواعد كما هي، ولكن من لا يملك المفتاح لا يستطيع أن يجرب أرقام الهوية الممكنة ويعيد الرقم الأصلي، وهي مشكلة الهاش العادي دون مفتاح لأن أرقام الهوية محدودة العدد. والمفتاح يبقى عند فريق آخر، ولا يعود الرقم الحقيقي إلا عندما يقرر المراجع فتح ملف عيادة بعينها. وهذا تطبيق لمبدأ الحد الأدنى من البيانات في نظام حماية البيانات الشخصية، وقد شرحنا الإخفاء والأسماء المستعارة بالتفصيل في مقال خصوصية البيانات الصحية، وشرحنا دوال الهاش في مقال جداول الهاش. ولاحظ أن الرقم المستعار ليس إخفاء كاملاً للهوية، فتاريخ الزيارات وحده قد يكشف شخصاً، لذلك تبقى هذه البيانات تحت ضوابط الوصول نفسها.
القواعد على مستوى المطالبة
بدأنا بأربع قواعد على المطالبة، كل منها مأخوذ من أثر أحد الأنماط في الجدول السابق:
R1_duplicate: مطالبة لنفس العيادة ونفس العضو بنفس مجموعة الرموز في نفس اليوم، أو في اليوم التالي لمطالبة مطابقة.R2_unbundled: مكونات لوحة السكري الثلاثة في مطالبة واحدة دون رمز اللوحة.R3_closed_day: مطالبة يوم الجمعة من عيادة ليست طوارئ، وهو مؤشر لائحة SAMA عن العلاج في أيام الإغلاق.R4_frequent_member: عضو له أكثر من ثماني زيارات لنفس العيادة في تسعين يوماً، وهذا نادر جداً في بياناتنا لأن العضو يتوزع على 120 عيادة.
docker run --rm -v "$PWD:/lab" -w /lab fraud-lab python detect_v1.py328390 lines, 156630 claims loaded and pseudonymised in 22.8 s
claim rules ran in 3275 ms
== claim-level rules (precision = flagged claims that are that scheme)
R1_duplicate flagged 695 precision 53.2% recall 71.7% (of 516 duplicates-copy claims)
R2_unbundled flagged 430 precision 100.0% recall 100.0% (of 430 unbundling claims)
R3_closed_day flagged 288 precision 96.5% recall 6.6% (of 4191 phantom claims)
R4_frequent_member flagged 3986 precision 100.0% recall 95.1% (of 4191 phantom claims)
any rule flagged 5020 precision 96.2% recall 51.3% (of 9408 fraud claims of all kinds)
upcoded claims caught by any claim rule: 2 of 3017والدقة Precision هنا نسبة ما رفعته القاعدة وكان فعلاً من النمط الذي تبحث عنه، والاستدعاء Recall نسبة ما أمسكته من كل حالات النمط. وفي المخرج أعلاه لاحظ التالي:
- قاعدة التفكيك مثالية: 430 من 430 دون أي خطأ، لأن أثر النمط في البيانات حرفي تماماً. وهذا ما يجعل القواعد ممتازة عندما تعرف النمط بالضبط.
- قاعدة أيام الإغلاق دقيقة بنسبة 96.5% ولكنها لا تمسك إلا 6.6% من الزيارات الوهمية، لأن أغلب هذه الزيارات في أيام عمل عادية. ومع ذلك فهي مفيدة على مستوى العيادة كما سوف نرى، لأن عيادة واحدة فيها زيارات يوم الجمعة إشارة قوية.
- قاعدة العضو المتكرر أمسكت 95% من الزيارات الوهمية بدقة كاملة، لأن المولد استخدم أربعين هوية فقط لكل عيادة وهمية. وفي الواقع قد تستخدم العيادة آلاف الهويات المسروقة، فلا تعتمد على أن هذه القاعدة سوف تعمل بنفس الكفاءة.
- رفع مستوى الترميز لم تمسكه أي قاعدة على المطالبة، تقريباً صفر من ثلاثة آلاف، لأن الزيارة بالمستوى الرابع مطالبة سليمة تماماً وحدها.
- قاعدة التكرار دقتها 53% واستدعاؤها 72% فقط، رغم أن النسخ المكررة حرفية. وهذا غريب، والسبب خطأ في الكود.
الخطأ الأول: القاعدة أمسكت الأصل بدل النسخة
النسخ المكررة في المولد ثلثها بتاريخ اليوم التالي للأصل. وللبحث عن مطالبة مطابقة في اليوم السابق، كتبنا في النسخة الأولى سطراً ينقل كل مطالبة يوماً ثم يبحث عن المطابقة:
prev_day = claims.assign(day=claims["day"] - pd.Timedelta(days=1))والسطر ينقل التاريخ إلى الخلف، فالمطالبة التي تطابق «يوم أمس» بعد النقل هي المطالبة التي لها نسخة في الغد، أي الأصل وليس النسخة. فالقاعدة رفعت المطالبات الأصلية السليمة وتركت النسخ المتأخرة يوماً، وهذا يفسر الاستدعاء 72%: النسخ في نفس اليوم أمسكتها، والنسخ في اليوم التالي فاتتها، ورفعت أصولها مكانها. والإصلاح إشارة واحدة:
prev_day = claims.assign(day=claims["day"] + pd.Timedelta(days=1)) # yesterday's claims moved onto today R1_duplicate flagged 695 precision 74.2% recall 100.0% (of 516 duplicates-copy claims)
R1 flags by true label: {'duplicates-copy': 516, 'phantom': 130, 'none': 48, 'upcoding': 1}الاستدعاء أصبح 100%. والدقة 74%، وحين فصلنا ما رفعته القاعدة بحسب التصنيف الحقيقي وجدنا أن 130 من الإنذارات الأخرى زيارات وهمية، أي احتيال من نمط آخر، و48 فقط إنذارات كاذبة حقيقية لعضو زار نفس العيادة بنفس الخدمات في يومين متتاليين. والدرس هنا أكبر من الإشارة: كل قاعدة على البيانات تحتاج حالة اختبار صغيرة تعرف نتيجتها، مثل مطالبة ونسختها بعد يوم، وتتحقق أن القاعدة رفعت النسخة وليس الأصل. لأن القاعدة الخاطئة هنا لم تفشل، وإنما أعطت أرقاماً تبدو معقولة، ولولا أن عندنا التصنيف الحقيقي لما عرفنا.
خصائص العيادة مقارنة بأقرانها
رفع مستوى الترميز والخدمات الزائدة لا يظهران في أي مطالبة وحدها، فننتقل إلى مستوى العيادة. لكل عيادة ثماني خصائص على التسعين يوماً: نسبة الزيارات بالمستوى الثالث أو الرابع، ومتوسط المبلغ للمطالبة، ومتوسط عدد البنود، ونسبة المطالبات المفككة، ونسبة المكررة، ونسبة مطالبات أيام الإغلاق، ونسبة زيارات الأعضاء المتكررين، والمئين 95 لعدد زيارات الطبيب في اليوم. ولا نقارن عيادة الطب العام بالطوارئ، فالطوارئ تعمل الجمعة طبيعياً، والباطنية مستوياتها أعلى طبيعياً. لذلك نحول كل خاصية إلى درجة معيارية متينة Robust Z-score مقارنة بعيادات نفس التخصص: الفرق عن الوسيط مقسوماً على انحراف الوسيط المطلق MAD، لأن الوسيط والـ MAD لا يتأثران بالعيادات الشاذة نفسها كما يتأثر المتوسط والانحراف المعياري.
med = F.groupby("spec")[feat].transform("median")
mad = F.groupby("spec")[feat].transform(lambda s: (s - s.median()).abs().median()).replace(0, np.nan)
Z = ((F[feat] - med) / (1.4826 * mad)).fillna(0).clip(-50, 50)       # robust z against the clinic's peers
كيف اخترنا الخصائص Features؟
كل خاصية في القائمة لها سبب، والقاعدة التي اتبعناها أن تكون كل خاصية نسبة أو متوسطاً وليس عدداً. فعدد الزيارات بالمستوى الرابع يكبر مع حجم العيادة، والعيادة التي فيها أربعة أطباء سوف يكون عددها أربعة أضعاف عيادة فيها طبيب واحد دون أن تكون أكثر شذوذاً. أما نسبة الزيارات بالمستوى الرابع فلا تتأثر بالحجم، وهي ما يقارن فعلاً بالأقران. ونفس الشيء مع المبلغ: المجموع يقيس الحجم، والمتوسط للمطالبة يقيس السلوك. والاستثناء الوحيد هو عدد زيارات الطبيب في اليوم، لأن هذا العدد له حد طبيعي لا تغيره كبر العيادة: الطبيب لا يستطيع أن يرى مئة مريض في يوم مهما كانت عيادته كبيرة. واستخدمنا المئين 95 وليس الأقصى، لأن الأقصى يتأثر بيوم واحد غير عادي، مثل يوم حملة تطعيم، بينما المئين 95 يقول إن الطبيب يرى هذا العدد في أيام كثيرة.
ولاحظ أن ثلاثاً من الخصائص الثماني هي نسب القواعد على مستوى المطالبة نفسها: نسبة المطالبات المفككة، والمكررة، ومطالبات أيام الإغلاق. وهذا تصميم مقصود، فالقاعدة على المطالبة ترفع حالات فردية، ونسبتها في العيادة تحول هذه الحالات إلى سلوك. فعيادة فيها مطالبة واحدة يوم جمعة قد تكون خطأ في إدخال التاريخ، وعيادة فيها 5% من مطالباتها يوم الجمعة نمط يستحق السؤال. وبهذا تتعاون القواعد والنموذج: القاعدة تعطي النموذج إشارة، والنموذج يزنها مع بقية سلوك العيادة.
ثم القواعد على مستوى العيادة، وهي عتبات يستطيع المراجع أن يقرأها: رفع الترميز إذا زادت درجة نسبة المستوى الأعلى على 4، والتفكيك إذا زادت نسبة المطالبات المفككة على 2%، والتكرار إذا زادت النسخ على 1%، والوهمية إذا زادت مطالبات أيام الإغلاق على 1% أو زيارات الأعضاء المتكررين على 5%. والنموذج Isolation Forest بثلاثمئة شجرة على الدرجات المعيارية الثماني. وهذه نتيجة النسخة الأولى:
== provider level (120 clinics, 23 with a scheme)
  rules                        flagged  21  TP 20  FP  1  FN  3  precision  95.2%  recall  87.0%
  isolation forest top 10      flagged  10  TP  8  FP  2  FN 15  precision  80.0%  recall  34.8%
  isolation forest top 20      flagged  20  TP 16  FP  4  FN  7  precision  80.0%  recall  69.6%
  isolation forest top 30      flagged  30  TP 17  FP 13  FN  6  precision  56.7%  recall  73.9%
  isolation forest (auto)      flagged  16  TP 12  FP  4  FN 11  precision  75.0%  recall  52.2%
  rules OR forest top 20       flagged  27  TP 23  FP  4  FN  0  precision  85.2%  recall 100.0%

== recall by scheme
  upcoding    rules 6/6   forest top 20 6/6
  unbundling  rules 4/4   forest top 20 4/4
  phantom     rules 5/5   forest top 20 1/5
  duplicates  rules 5/5   forest top 20 2/5
  overservicing rules 0/3   forest top 20 3/3
النموذج أمسك رفع الترميز والتفكيك والخدمات الزائدة كلها، وفاتته الفوترة الوهمية تقريباً كلها رغم أنها أقوى الإشارات في البيانات: عيادة فيها زيارات يوم الجمعة وأعضاء يزورونها عشرين مرة. فلماذا لم يرها؟
الخطأ الثاني: درجة صفر لأقوى الإشارات
انظر إلى سطر الـ MAD مرة أخرى. في أغلب عيادات الطب العام نسبة مطالبات الجمعة صفر، ونسبة الأعضاء المتكررين صفر، ونسبة التكرار صفر. فالوسيط صفر، والانحراف عن الوسيط صفر لأغلب العيادات، فالـ MAD نفسه صفر. والكود يستبدل الصفر بقيمة فارغة لتجنب القسمة على صفر، ثم يملأ الفارغ بصفر. أي أن العيادة التي فيها 5% من مطالباتها يوم الجمعة أخذت درجة صفر في هذه الخاصية، مثل أي عيادة سليمة، لأن أقرانها كلهم عند الصفر. فالخصائص الثلاث التي تصف الأنماط النادرة، وهي أهم ما نبحث عنه، أخفيت عن النموذج بالكامل.
والإصلاح أن نستخدم الانحراف المعياري للأقران عندما يكون الـ MAD صفراً، وقيمة صغيرة ثابتة إذا كان الانحراف المعياري صفراً أيضاً:
mad = F.groupby("spec")[feat].transform(lambda s: (s - s.median()).abs().median())
std = F.groupby("spec")[feat].transform("std")
scale = (1.4826 * mad).where(mad > 0, std).where(lambda x: x > 0, 1e-3)   # most clinics at 0: MAD is 0, fall back
Z = ((F[feat] - med) / scale).clip(-50, 50)                                # robust z against the clinic's peers
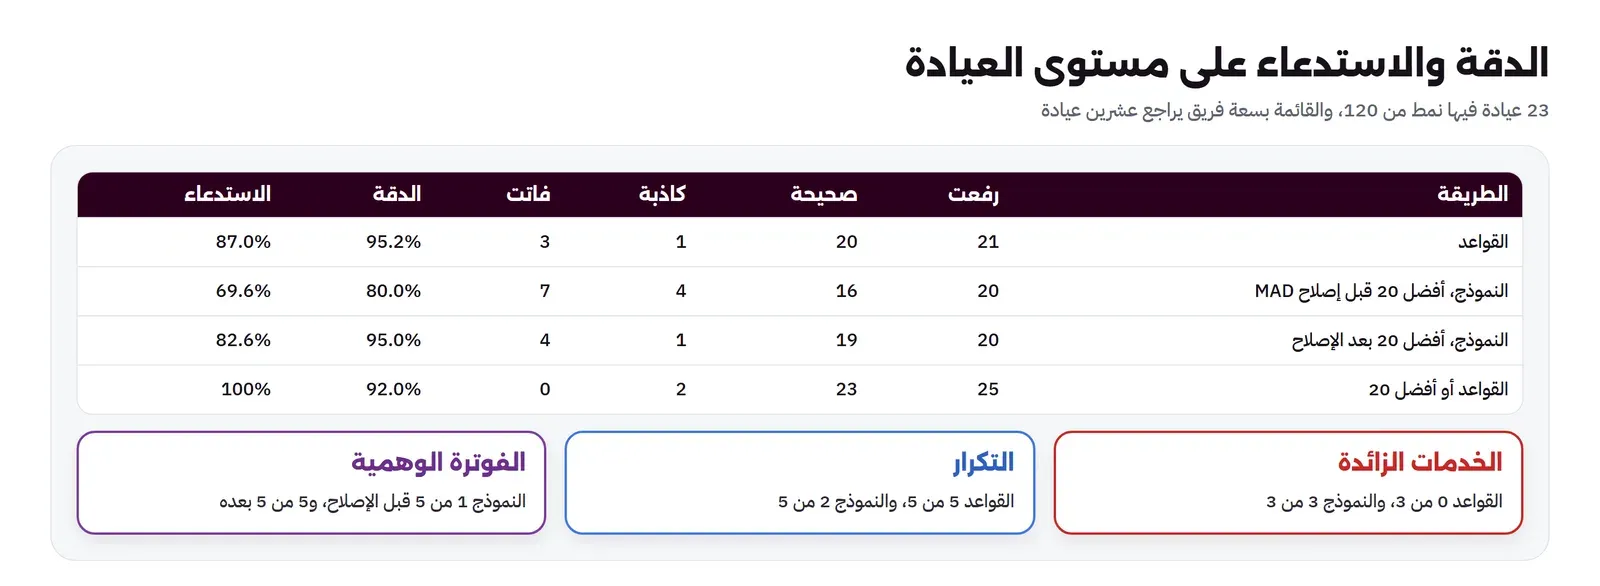
== provider level (120 clinics, 23 with a scheme)
rules flagged 21 TP 20 FP 1 FN 3 precision 95.2% recall 87.0%
isolation forest top 10 flagged 10 TP 10 FP 0 FN 13 precision 100.0% recall 43.5%
isolation forest top 20 flagged 20 TP 19 FP 1 FN 4 precision 95.0% recall 82.6%
isolation forest top 30 flagged 30 TP 23 FP 7 FN 0 precision 76.7% recall 100.0%
isolation forest (auto) flagged 23 TP 21 FP 2 FN 2 precision 91.3% recall 91.3%
rules OR forest top 20 flagged 25 TP 23 FP 2 FN 0 precision 92.0% recall 100.0%
== recall by scheme
upcoding rules 6/6 forest top 20 5/6
unbundling rules 4/4 forest top 20 4/4
phantom rules 5/5 forest top 20 5/5
duplicates rules 5/5 forest top 20 2/5
overservicing rules 0/3 forest top 20 3/3أفضل عشرين عيادة في ترتيب النموذج أصبح فيها 19 محتالة بدل 16، والعيادات الوهمية الخمس هي المراكز الخمسة الأولى بالضبط. والعتبة التلقائية للنموذج contamination="auto" رفعت 23 عيادة، منها 21 محتالة. ولاحظ أن أفضل عشر عيادات كلها محتالة، أي أن المراجع الذي يبدأ من رأس القائمة لن يضيع وقتاً في أول عشر زيارات.
من أين جاءت العتبات، ولماذا أفضل عشرين؟
العتبات في القواعد، مثل 2% للتفكيك و1% للتكرار، اخترناها بالنظر إلى البيانات: العيادات السليمة كلها تحت 0.3% في التكرار، فأي عتبة بين ذلك وبين 7% تعطي نفس النتيجة هنا. وفي الواقع لا يكون الفاصل واضحاً هكذا، والعتبة قرار بين إنذارات كاذبة أكثر وحالات فائتة أكثر. والطريقة العملية أن تبدأ بعتبة محافظة، وتنظر في العيادات القريبة منها شهرياً، وتعدلها بناء على ما وجده المراجعون، وأن تكتب كل تعديل وسببه، لأن القاعدة التي تتغير عتبتها دون سجل تصبح صندوقاً أسود مثل أي نموذج.
أما النموذج فله معامل اسمه contamination، يعني نسبة البيانات التي تتوقع أنها شاذة، ويحدد العتبة التي يقول بعدها إن العيادة شاذة. والقيمة auto تستخدم العتبة التي اقترحتها الورقة الأصلية، ورفعت هنا 23 عيادة، وهو رقم قريب جداً من عدد المحتالين بالمصادفة، وليس لأن النموذج يعرف عددهم. والأفضل في رأينا ألا تعتمد على هذه العتبة أصلاً، وأن تستخدم الترتيب فقط، ثم تأخذ من رأسه عدداً يساوي سعة الفريق، وهذا ما فعلناه بأفضل عشرة وعشرين وثلاثين. فالسؤال العملي ليس «هل هذه العيادة شاذة؟» وإنما «إذا كان عندي وقت لعشرين عيادة، فكم محتالاً سوف أجد فيها؟». ولهذا السبب أيضاً لا نقيس بالدقة العامة Accuracy، فنظام يقول إن كل العيادات سليمة يحقق دقة عامة 81% هنا دون أن يمسك محتالاً واحداً، كما شرحنا في مقال المدفوعات.
من يمسك ماذا؟
القواعد أمسكت كل نمط كتبت له، وفاتتها العيادات الثلاث ذات الخدمات الزائدة لأنه لا توجد قاعدة لها. والنموذج أمسك الخدمات الزائدة كلها، ولكن فاتته ثلاث من عيادات التكرار الخمس. والسبب في التكرار مثير: نسبة النسخ في هذه العيادات 7.3% إلى 7.4%، والعيادات السليمة كلها تحت 0.3%، أي أن الإشارة واضحة جداً. ولكن عندما يكون الـ MAD صفراً نستخدم الانحراف المعياري للأقران، وهذا الانحراف يحسب والعيادات المكررة نفسها بين الأقران، فيكبر بسببها، فتصغر درجتها إلى قرابة 5 في الطب العام وقرابة 3 في الباطنية والطوارئ. أي أن المحتال يخفي نفسه جزئياً لأنه يرفع المقياس الذي يقاس به، وهذا ما يسمى أثر الإخفاء Masking في الإحصاء. والحل الأفضل أن تحسب مقاييس الأقران على فترة سابقة نظيفة، أو أن تستبعد العيادة نفسها عند حساب مقياس أقرانها، وتركنا ذلك تدريباً في آخر المقال.
والقراءة العملية للنتائج أن القاعدة والنموذج لا يتنافسان، وإنما يغطيان شيئين مختلفين: القاعدة تمسك ما تعرفه بدقة عالية وتشرح نفسها بجملة، والنموذج يرفع ما لا تعرفه. ومعاً أمسكا العيادات الـ 23 كلها في قائمة من 25، أي بإنذارين كاذبين فقط. ولكن هنا تحذير مهم سبق أن قلناه في مقال المدفوعات: القواعد كتبها من صمم الأنماط نفسها، فهي تعرف بالضبط ما تبحث عنه، وفي الواقع لن يكون هذا الحال. لذلك فاستدعاء القواعد 87% هنا أعلى مما تتوقعه في الواقع، والنمط الذي لم نكتب له قاعدة هو الأقرب لما سوف تراه.
لماذا رفع النموذج هذه العيادة؟
المراجع لا يستطيع أن يعمل برقم شذوذ، فهو يحتاج أن يعرف أين ينظر في ملف العيادة. لذلك نطبع لكل عيادة في رأس القائمة الخصائص الثلاث الأبعد عن أقرانها، بدرجتها المعيارية:
== the 12 most isolated clinics and why (three largest peer z-scores)
  P111 uc score 0.650  rules=Y  claims_per_prac_day_p95 +10.5, frequent_member_share +3.9, lines_per_claim +1.0  [phantom]
  P075 gp score 0.639  rules=Y  closed_day_share +5.9, frequent_member_share +5.4, claims_per_prac_day_p95 +4.7  [phantom]
  P086 im score 0.636  rules=Y  closed_day_share +5.0, frequent_member_share +5.0, claims_per_prac_day_p95 +4.8  [phantom]
  P011 gp score 0.636  rules=Y  claims_per_prac_day_p95 +5.5, frequent_member_share +5.2, closed_day_share +4.6  [phantom]
  P069 gp score 0.620  rules=Y  frequent_member_share +5.1, closed_day_share +5.1, claims_per_prac_day_p95 +4.7  [phantom]
  P116 uc score 0.619  rules=Y  lines_per_claim +13.9, unbundled_share +3.9, amount_per_claim +3.1  [unbundling]
  P029 gp score 0.606  rules=-  lines_per_claim +30.2, amount_per_claim +23.3, claims_per_prac_day_p95 +0.8  [overservicing]
  P081 im score 0.585  rules=Y  amount_per_claim +22.7, high_level_share +15.5, lines_per_claim +2.2  [upcoding]
  P004 gp score 0.585  rules=Y  duplicate_share +5.2, amount_per_claim -2.5, high_level_share -2.0  [duplicates]
  P077 gp score 0.581  rules=-  lines_per_claim +30.3, amount_per_claim +24.1, high_level_share +2.0  [overservicing]
  P031 gp score 0.573  rules=Y  high_level_share +30.9, amount_per_claim +23.0, lines_per_claim -0.1  [upcoding]
  P064 gp score 0.563  rules=-  lines_per_claim +29.2, amount_per_claim +23.5, high_level_share +0.9  [overservicing]
والعمود الأخير بين القوسين هو التصنيف الحقيقي، ولا يراه المراجع في الواقع. واقرأ السطور كما يقرؤها المراجع:
- العيادة P075: مطالبات يوم الجمعة أعلى من أقرانها بست درجات، وأعضاء يتكررون فيها، وطبيب يرى في أيامه المزدحمة أكثر من الطبيعي. والسؤال الذي يذهب به المراجع: افتح سجل المواعيد ليوم جمعة واحد، وقارن أسماء المرضى بسجل الحضور.
- العيادة P029: عدد البنود في المطالبة أعلى من أقرانها بثلاثين درجة، والمبلغ بـ 23 درجة، ولا قاعدة واحدة رفعتها. والسؤال: أي البنود تتكرر؟ وسوف يجد تحليل الدم والأشعة في أغلب الزيارات، فيطلب عينة من الملفات ليرى هل كان لها مبرر.
- العيادة P031: نسبة الزيارات بالمستوى الأعلى بعيدة جداً عن أقرانها، وهذا ما يوجه المراجع إلى مقارنة التوثيق في الملف بمستوى الاستشارة المفوتر، وهو ما يصفه كتيب CMS كمثال على رفع مستوى الترميز.
- العيادة P004: نسبة المكررة أعلى، والمبلغ أقل من أقرانها، وهذا منطقي لأن النسخ تكرار لمطالبات عادية. والسؤال: قائمة المطالبات المتطابقة في نفس اليوم أو اليوم التالي، وهي جاهزة من قاعدة التكرار.
وهذه الطريقة في الشرح بسيطة عن قصد: الدرجة المعيارية للعيادة مقارنة بأقرانها شيء يفهمه أي مراجع دون أن يعرف كيف يعمل النموذج. وهي لا تقول بالضبط لماذا عزل النموذج العيادة، فهناك طرق أدق لذلك مثل SHAP، ولكنها تقول ما يحتاجه المراجع: ما الذي يختلف في هذه العيادة عن غيرها. وإذا رفع النموذج عيادة ولم تكن أي خاصية بعيدة عن أقرانها بشكل واضح، فهذه إشارة إلى أن الرفع قد يكون من تركيبة خصائص، ويستحق أن ينظر فيه محلل البيانات قبل المراجع.
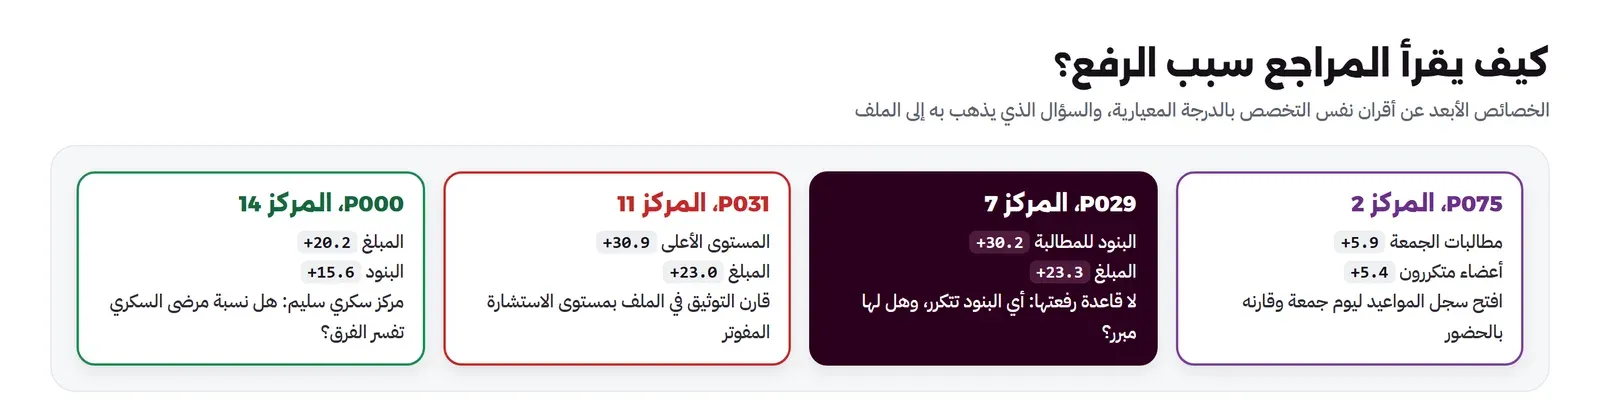
الإنذارات الكاذبة: العيادات السليمة غير العادية
== honest outliers
  P000 diabetes-center  forest rank 14  rules=-
  P080 complex-im       forest rank 22  rules=Y
  P105 busy-uc          forest rank 26  rules=-
في المخرج أعلاه لاحظ التالي:
- مركز السكري P000 في المركز 14، أي داخل أفضل عشرين، وهو الإنذار الكاذب الوحيد فيها. وقبل إصلاح الـ MAD كان في المركز الخامس، لأن النموذج وقتها لم يكن يرى الإشارات الأقوى للعيادات الوهمية فارتفع غيرها. فالإصلاح لم يغير المركز فقط، وإنما دفع السليم إلى الأسفل لأن المحتال أصبح مرئياً.
- العيادة الباطنية المعقدة P080 رفعتها قاعدة رفع الترميز، وهي الإنذار الكاذب الوحيد للقواعد. وهذا متوقع تماماً: القاعدة تقول إن مستوياتها أعلى من أقرانها، وهذا صحيح، ولكن السبب أن مرضاها أعقد. والقاعدة لا تعرف شدة الحالات.
- الطوارئ المزدحمة P105 في المركز 26، رغم أن عدد زيارات الطبيب في اليوم فيها أعلى من أقرانها بست درجات. والسبب أن هذه الخاصية وحدها لا تكفي لعزلها، فبقية خصائصها عادية.
وكيف تقلل هذه الإنذارات دون أن تخسر المحتالين؟ بإضافة ما يفسر الفرق إلى المقارنة: نسبة مرضى السكري في العيادة، أو مؤشر شدة الحالات من التشخيصات، فتقارن العيادة بعيادات تخدم مرضى مثل مرضاها. وفي الواقع تستخدم الشركات لذلك مجموعات أقران أدق من التخصص وحده، مثل التخصص مع حجم العيادة ونوع المرضى. ولكن لا توجد طريقة تجعل الإنذارات الكاذبة صفراً، والسؤال الصحيح هو ماذا يحدث للعيادة السليمة التي رفعت. فإذا كان الجواب أن مراجعاً يفتح ملفها ويغلقه بعد ساعة، فالتكلفة ساعة. وإذا كان الجواب أن مطالباتها توقف تلقائياً، فالتكلفة أن عيادة سليمة لا تأخذ مستحقاتها، ومرضى سكري يفقدون مركزهم.
ولماذا لا نشغل النموذج على كل مطالبة؟
جربنا ذلك أيضاً: نموذج على مستوى المطالبة بثلاث خصائص فقط، المبلغ وعدد البنود ومستوى الاستشارة، ورفع 5% من المطالبات:
== claim-level forest on amount, lines, level (5% flagged)
  upcoding         recall  17.1%
  unbundling       recall 100.0%
  phantom          recall   3.7%
  duplicates-copy  recall   3.3%
  overservicing    recall  59.7%
  precision  26.8% of 6967 flagged claims
رفع قرابة سبعة آلاف مطالبة، ثلاثة أرباعها سليمة، وفاتته الزيارات الوهمية والنسخ المكررة تقريباً كلها، لأن الزيارة الوهمية والنسخة كل منهما مطالبة عادية تماماً وحدها. وأمسك التفكيك كاملاً لأن المطالبة المفككة فيها خمسة بنود أو أكثر، وهذا نادر. والاستنتاج نفس استنتاج القواعد: الأنماط في المطالبات الصحية تعيش في السياق، أي في العيادة وفي تاريخ العضو وفي اليوم، وليس في المطالبة الواحدة. لذلك فالنموذج الذي يرى مطالبة واحدة يرى القليل.
من الترتيب إلى المراجعة: ما الذي لا يفعله النظام آلياً
بعد المختبر نستطيع أن نكتب كيف يعمل هذا في شركة حقيقية، والقاعدة الأولى أن النظام يرتب ولا يحكم:
- قائمة شهرية بسعة الفريق: إذا كان الفريق يراجع عشرين عيادة، فالقائمة عشرون، مرتبة بالدمج بين القواعد والنموذج، ومع كل عيادة الخصائص الأبعد عن أقرانها والمطالبات التي رفعتها القواعد.
- قرار المراجع يعود إلى النظام: كل عيادة يغلقها المراجع كسليمة أو كمخالفة يحفظ قراره وسببه، وبعد سنة يصبح هذا تصنيفاً تستطيع أن تدرب عليه نموذجاً موجهاً، أو على الأقل تقيس به النموذج الحالي.
- لا رفض تلقائي بسبب درجة الشذوذ: قواعد التسوية في محرك المطالبات هي التي تقرر الدفع، بأسباب رسمية يستطيع المستشفى الاعتراض عليها، كما شرحنا في مقال تدقيق المطالبات. وقائمة الاحتيال تقرر أين ينظر الإنسان فقط.
- مراقبة الانجراف Drift: عندما تعرف العيادات أن قاعدة ما تراقبها، يتغير السلوك. فراقب كم عيادة ترفعها كل قاعدة شهرياً، فإذا هبط العدد فجأة فقد يكون الاحتيال توقف، وقد يكون تغير شكله.
- الوصول للبيانات: المحلل يرى الأرقام المستعارة، والمراجع يفتح الهوية لعيادة بعينها بعد قرار موثق، وكل فتح يسجل في سجل التدقيق.
- الإبلاغ: ما يثبت بعد المراجعة يتبع إجراءات الإبلاغ النظامية في الشركة والجهات المختصة، وليس قراراً يتخذه فريق البيانات.
ما الذي لا يراه هذا المختبر؟
المختبر يعمل على عيادات منفصلة، وكل نمط فيه تقوم به عيادة وحدها. ولكن أخطر أشكال الاحتيال في الواقع لا تعيش في عيادة واحدة. فتعرف NHCAA ضمن أنماط مقدمي الخدمة قبول العمولات Kickbacks مقابل تحويل المرضى، وكتيب CMS يضع دفع المقابل لتحويل المرضى ضمن أمثلة الاحتيال. وهذا النمط لا يظهر في خصائص أي عيادة وحدها، وإنما في العلاقات: طبيب يحول أغلب مرضاه إلى مركز أشعة واحد، ومركز الأشعة يفوتر لكل محول بنفس الأسلوب، ومرضى يمرون على نفس السلسلة من العيادات بنفس الترتيب. وكشف هذا يحتاج تحليل شبكات Network Analysis على الرسم البياني الذي يربط المرضى والأطباء والمنشآت، وهو موضوع أكبر من مقال واحد.
وهناك حد آخر: كل ما رأيناه يعتمد على أن البيانات نفسها صحيحة في شكلها. فالعيادة التي تفوتر زيارات وهمية بأسماء مرضى حقيقيين وفي أيام عمل عادية وبتوزيع يشبه زياراتها الحقيقية لن ترفعها قاعدة ولا نموذج، والذي يكشفها هو ما خارج المطالبات: المريض الذي يصله إشعار بزيارة لم يقم بها فيبلغ، أو مقارنة المطالبات بسجل الوصفات في منصة أخرى، أو زيارة ميدانية. لذلك فالبيانات ترتب العمل، ولكنها لا تغني عن قنوات الإبلاغ ولا عن المراجعين.
والحد الثالث هو الوقت. فمختبرنا يرى تسعين يوماً دفعة واحدة، بينما في الواقع تصل المطالبات يومياً، والعيادة الجديدة ليس لها تاريخ، والعيادة القديمة قد تغير سلوكها في الشهر الأخير فقط. والحل المعتاد أن تحسب الخصائص على نوافذ متحركة، شهر وثلاثة أشهر، وأن تنظر إلى التغير في سلوك العيادة مقارنة بنفسها في الفترة السابقة، وليس فقط مقارنة بأقرانها. فالعيادة التي ارتفعت نسبة المستوى الرابع فيها من 5% إلى 30% في شهر تستحق السؤال حتى لو بقيت داخل نطاق أقرانها.
ليس كل ما يرفع يحتاج تحقيقاً
نعود إلى تقسيم كتيب CMS: الأخطاء والهدر وإساءة الاستخدام والاحتيال. فأغلب العيادات التي ترفعها القائمة في الواقع لن تكون محتالة بالمعنى القانوني، وإنما عيادات تخطئ في الترميز بشكل متكرر، أو تطلب فحوصاً أكثر من حاجة مرضاها. وهذه لا يناسبها تحقيق، وإنما يناسبها حوار: رسالة إلى العيادة فيها مقارنتها بأقرانها بالأرقام، مثل أن نسبة الزيارات بالمستوى الأعلى عندها ثلاثة أضعاف متوسط عيادات الطب العام، مع أمثلة من مطالباتها، ودعوة لمراجعة التوثيق أو لتدريب المرمزين. وكثير من العيادات يتغير سلوكها بعد رسالة كهذه، وهذا بالضبط ما يقيسه مراقبة الانجراف التي ذكرناها. والقرار بين الحوار والتحقيق للمراجع وليس للنموذج، ولكن الشرح الذي يخرجه النظام هو نفسه في الحالتين: ما الذي يختلف في هذه العيادة عن أقرانها، وبكم. لذلك اكتب الشرح بلغة يفهمها مدير العيادة، وليس بلغة فريق البيانات، لأنه قد يكون أول من يقرؤه.
أخطاء شائعة
- تسمية النتيجة احتيالاً: البيانات ترى السلوك ولا ترى النية، والنتيجة أولوية مراجعة.
- قاعدة دون حالة اختبار تعرف نتيجتها: رأينا قاعدة تكرار تمسك الأصل بدل النسخة وتعطي أرقاماً تبدو معقولة.
- الدرجة المعيارية مع MAD صفر: أخفت أقوى الإشارات، لأن الأنماط النادرة هي بالضبط التي يكون فيها أغلب الأقران عند الصفر.
- مقياس الأقران يحسب والمحتالون بينهم: يكبر المقياس فتصغر درجتهم، كما حدث مع عيادات التكرار.
- مقارنة عيادة بكل العيادات: الطوارئ تعمل الجمعة، والباطنية مستوياتها أعلى، فقارن بالأقران.
- النموذج على المطالبة الواحدة: دقة 27% وفاتته الأنماط التي تعيش في السياق.
- الثقة في أرقام القواعد من بيانات صممتها: القواعد تعرف الأنماط المزروعة، والواقع لا يعطيك هذه الميزة.
- رقم المريض الحقيقي في بيئة التحليل: المحلل يحتاج أن يعرف أن نفس الشخص تكرر، ولا يحتاج أن يعرف من هو.
- إيقاف مطالبات العيادة تلقائياً: الإنذار الكاذب يتحول إلى ضرر على عيادة سليمة ومرضاها.
قائمة تحقق Checklist لنظام كشف الاحتيال في المطالبات
| البند | كيف تتحقق منه |
|---|---|
| البيانات مستعارة قبل أن يراها المحلل | هاش بمفتاح سري، والمفتاح عند فريق آخر |
| كل قاعدة لها حالة اختبار | مطالبة يجب أن ترفعها وأخرى تشبهها يجب ألا ترفعها |
| المقارنة بالأقران | مجموعات بالتخصص على الأقل، ومقاييس محسوبة على فترة نظيفة أو دون العيادة نفسها |
| معالجة المقياس الصفري | اختبار لخاصية أغلب أقرانها عند الصفر |
| القياس بالدقة والاستدعاء عند سعة الفريق | كم محتالاً في أفضل عشرين، وليس الدقة العامة Accuracy |
| شرح لكل عيادة مرفوعة | الخصائص الأبعد عن الأقران، والمطالبات التي رفعتها القواعد |
| قرار المراجع يحفظ | سليمة أو مخالفة مع السبب، ليصبح تصنيفاً لاحقاً |
| لا أثر مالي تلقائي | قائمة الاحتيال لا توقف دفعاً دون قرار بشري |
| مراقبة الانجراف | عدد العيادات لكل قاعدة شهرياً مع تنبيه للتغير |
| سجل الوصول | كل فتح لهوية حقيقية مسجل بمن ومتى ولماذا |
تدريب عملي
- احسب مقياس الأقران لكل عيادة دون العيادة نفسها Leave-one-out، وانظر هل دخلت عيادات التكرار الخمس في أفضل عشرين.
- أضف خاصية «نسبة مرضى السكري في العيادة» وقارن مركز P000 قبلها وبعدها.
- غير المولد ليوزع الهويات الوهمية على ألف هوية بدل أربعين، وانظر ماذا يحدث لقاعدة العضو المتكرر وللنموذج.
تنظيف المختبر
rm -f lines.csv providers.json
docker rmi fraud-lab
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- كتيب CMS يضع الأخطاء والهدر وإساءة الاستخدام والاحتيال على خط واحد، والفرق النية والعلم، لذلك يخرج النظام أولوية مراجعة وليس حكماً.
- أنماط المطالبات الصحية تعيش في السياق: رفع الترميز لم تمسكه أي قاعدة على المطالبة، ونموذج المطالبة الواحدة دقته 27%.
- القواعد ممتازة لما تعرفه: التفكيك 430 من 430، ولكنها لا تعرف ما لم يكتب لها، والخدمات الزائدة صفر من ثلاث.
- Isolation Forest على خصائص العيادة مقارنة بأقرانها أمسك 19 محتالاً في أفضل عشرين من 23، ومع القواعد أمسكا الـ 23 بإنذارين كاذبين.
- خطآن في الكود غيرا كل شيء دون أن يفشل شيء: قاعدة تكرار بالاتجاه الخاطئ، ودرجة صفر لأقوى الإشارات عندما يكون الـ MAD صفراً.
- العيادات السليمة غير العادية ظهرت كإنذارات كاذبة، والحل مقارنة أدق بالأقران ومراجع بشري، وليس إيقافاً تلقائياً.
- المحلل يرى رقماً مستعاراً بهاش بمفتاح، وفتح الهوية قرار موثق في سجل التدقيق.
 دليلكشف الاحتيال Fraud Detection: قواعد أم تعلم آلة؟قارنا القواعد بنموذجين لتعلم الآلة على بيانات دفع مولدة بنفس سعة المراجعة، ورأينا من يمسك الأنماط المعروفة ومن يتأخر عن النمط الجديد.
 دليلتدقيق المطالبات Claims Adjudication: محرك القواعدنبني محرك قواعد صغيراً لتدقيق المطالبات الصحية بمراحل مرتبة، ونشغله على 200 مطالبة وهمية فيها 70 مشكلة مزروعة، ونقيس ما أمسكه وما فاته ولماذا.
 دليلربط المطالبات بمنصة نفيس NPHIES: الرسائل والأخطاءنبني مطالبة من كل نوع بدليل نفيس ونتحقق منها، ونشغل محاكياً يرد فورياً ومؤجلاً ويطلب معلومات ويقبل الإلغاء، ثم نجمع الأخطاء الشائعة ومن يصلح كل واحد.
 دليلالأهلية Eligibility والموافقة المسبقة Prior Authorizationنبني رسائل الأهلية والموافقة المسبقة بدليل نفيس، ونتحقق منها في HAPI FHIR، ونرد عليها بشركة تأمين وهمية تفحص التغطية والحدود والتشخيص.
 دليلالتأمين الصحي من الداخل: الشركة وTPA والوسيط والمستشفىمن يدفع القسط ومن يقرر الموافقة ومن يدير المطالبة في التأمين الصحي السعودي، وكيف يتحرك المال من صاحب العمل إلى المستشفى.
 دليلخصوصية البيانات الصحية وإخفاء الهوية De-identificationما يقوله النظام السعودي عن البيانات الصحية، ومن يحق له أن يراها، وكيف تخفي هوية المرضى وتقيس أن البيانات لم تعد تدل عليهم.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلتحليل البيانات Data Analysis مع pandas للمبتدئيننجيب على سؤال حقيقي من بيانات 32 محطة طقس سعودية: كم يوماً فوق 45 درجة في كل منطقة ومتى، ونتعلم في الطريق تنظيف البيانات والربط والتجميع والتواريخ مع pandas وأخطاءها الشائعة.
سجل التحديثات
- 2026-11-18: كتابة المقال، وتنفيذ المختبر بلغة Python 3.13.18 مع scikit-learn 1.7.2 وNumPy 2.5.5 وpandas 3.1.1 في Image مبنية من python:3.13.18-slim، على 328,390 بنداً وهمياً ببذرة ثابتة، وDocker Engine 29.8.0.