


كل يوم تكتب سطراً مثل cache[key] أو if email in seen أو تقرأ حقلاً من كائن JSON، وتتوقع أن تأتيك الإجابة فوراً سواءً كان في القاموس عشرة مفاتيح أو عشرة ملايين، وغالباً لا تفكر في السبب، لأن الأمر يعمل دائماً. ولكن في يوم ما سوف تجد خدمة يرتفع فيها استهلاك المعالج فجأة عند تحميل ملف كبير، أو قاموساً يحجز 40 ميجابايت مع أنه لا يحمل إلا عشرة عناصر، أو مفتاحاً أضفته بنفسك ثم «اختفى» من القاموس مع أنه ما زال موجوداً فيه، وكل هذه المشكلات تفهمها في دقيقة إذا عرفت ما يحدث داخل جدول الهاش Hash Table، وتبقى لغزاً إذا لم تعرفه.
وهذا المقال من مرحلة هياكل البيانات والخوارزميات، وقد شرحنا في مقال هياكل البيانات للمبتدئين فكرة جدول الهاش والتصادم بشكل عام، وحسبنا في مقال الاحتمالات للمبرمجين متى يبدأ التصادم بمعادلة يوم الميلاد. أما هنا فسوف نفتح الصندوق: نكتب جدول هاش بأيدينا بطريقتين، ونعد الخانات التي يفحصها كل بحث، ونقيس لحظات تكبير القاموس في Python، ونرى كيف يرتب CPython القاموس في الذاكرة. ولنأخذ مثالاً نعود إليه في كل قسم: خدمة تحفظ بيانات المستخدمين في الذاكرة وتبحث عن المستخدم بالبريد الإلكتروني في كل طلب، ونريد أن يبقى هذا البحث سريعاً عندما يصل عدد المستخدمين إلى مليون.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا تكفي القائمة List للبحث بالمفتاح، وكيف تقود فكرة العنونة المباشرة Direct Addressing إلى دالة الهاش Hash Function.
- ماذا تعيد الدالة
hash()في Python، وما الذي يجعل دالة الهاش جيدة أو سيئة، مع قياس ثلاث دوال على عشرة آلاف بريد. - التصادم Collision وحلاه: التسلسل المنفصل Separate Chaining والعنونة المفتوحة Open Addressing، والتكتل Clustering وعلامة الحذف Tombstone.
- تجربة عملية Lab نكتب فيها الجدولين ونقيس عدد الخانات التي يفحصها البحث عند كل نسبة امتلاء، ومشكلة حقيقية ظهرت مع مفاتيح تتشارك البتات المنخفضة.
- معامل التحميل Load Factor وتكبير الجدول Resize، مع قياس كل إدخال من مليون إدخال، وماذا يحدث للذاكرة إذا حذفت أغلب المفاتيح.
- القاموس
dictفي Python من الداخل: القاموس المضغوط Compact Dict، وتسلسل الفحص، والمفاتيح المتساوية والمفاتيح القابلة للتغيير. - جداول الهاش في Java وGo وRust، وهجوم إغراق الهاش Hash Flooding باختصار، ثم الأخطاء الشائعة وجدول قرار وقائمة تحقق.
لماذا لا تكفي القائمة List للبحث بالمفتاح Key؟
أول حل يخطر على بال أي مبرمج لخدمة المستخدمين هو قائمة من السجلات، وكل سجل فيه البريد والاسم وباقي البيانات، وعند كل طلب نمر على القائمة من أولها حتى نجد السجل الذي بريده يساوي البريد المطلوب. وهذا هو البحث الخطي Linear Search الذي شرحناه في مقال Big-O للمبتدئين، وهو O(n)، أي أن الزمن يكبر مع عدد المستخدمين، فمع ألف مستخدم لا تشعر بشيء، ومع مليون مستخدم يمر كل طلب في المتوسط على نصف مليون سجل، وإذا كانت الخدمة تستقبل مئات الطلبات في الثانية فإن المعالج يقضي وقته كله في المقارنة.
والحل الثاني أن نرتب القائمة بالبريد ونستخدم البحث الثنائي Binary Search، فينخفض البحث إلى O(log n)، أي نحو عشرين مقارنة لمليون مستخدم، وهذا تحسن كبير. ولكن الترتيب له ثمن عند الإضافة، فكل مستخدم جديد يجب أن يدخل في مكانه الصحيح، وإدخال عنصر في وسط مصفوفة مرتبة يحرك كل ما بعده خطوة، أي O(n) لكل إضافة. والحل الثالث شجرة بحث متوازنة تجعل البحث والإضافة O(log n) معاً، وهي مناسبة عندما تحتاج الترتيب نفسه، مثل «كل المستخدمين الذين يبدأ بريدهم بحرف a». ولكن خدمتنا لا تحتاج الترتيب، وإنما تحتاج سؤالاً واحداً: «أين سجل هذا البريد؟»، وهنا نسأل: هل يمكن أن نصل إلى السجل بخطوة واحدة دون أي مقارنة بالسجلات الأخرى؟
العنونة المباشرة Direct Addressing: الفكرة التي يبدأ منها كل شيء
إذا كان المفتاح رقماً صغيراً فالإجابة نعم، فلو كان لكل مستخدم رقم من 0 إلى 999 لحجزنا مصفوفة Array من ألف خانة ووضعنا سجل المستخدم رقم 42 في الخانة 42، والوصول إلى أي خانة في المصفوفة خطوة واحدة لأن عنوانها في الذاكرة يحسب بالضرب والجمع من عنوان البداية، كما شرحنا في مقال هياكل البيانات. وهذا ما يسمى العنونة المباشرة Direct Addressing، وهو أسرع شيء ممكن: لا توجد مقارنة ولا بحث، وإنما حساب عنوان ثم قراءة.
والمشكلة أن المفاتيح الحقيقية ليست أرقاماً صغيرة متتالية، فالبريد نص، ولو حولنا كل نص ممكن إلى رقم فريد لاحتجنا مصفوفة بحجم كل النصوص الممكنة، وهو رقم أكبر من عدد الذرات في الكون. وحتى المعرفات الرقمية من نوع 64 بت تحتاج مصفوفة من 264 خانة لو استخدمناها مباشرة، مع أن لدينا مليون مستخدم فقط. ومن هنا تأتي الفكرة الأساسية لجدول الهاش: نحجز مصفوفة بحجم قريب من عدد المفاتيح الفعلي، ونستخدم دالة تحول أي مفتاح إلى رقم خانة داخل هذه المصفوفة، ونقبل أن مفتاحين مختلفين قد يقعان في الخانة نفسها ثم نتعامل مع ذلك. وهذه الدالة هي دالة الهاش Hash Function، والمصفوفة هي جدول الهاش Hash Table، والخانة تسمى Bucket أو Slot.
دالة الهاش Hash Function: من المفتاح إلى رقم
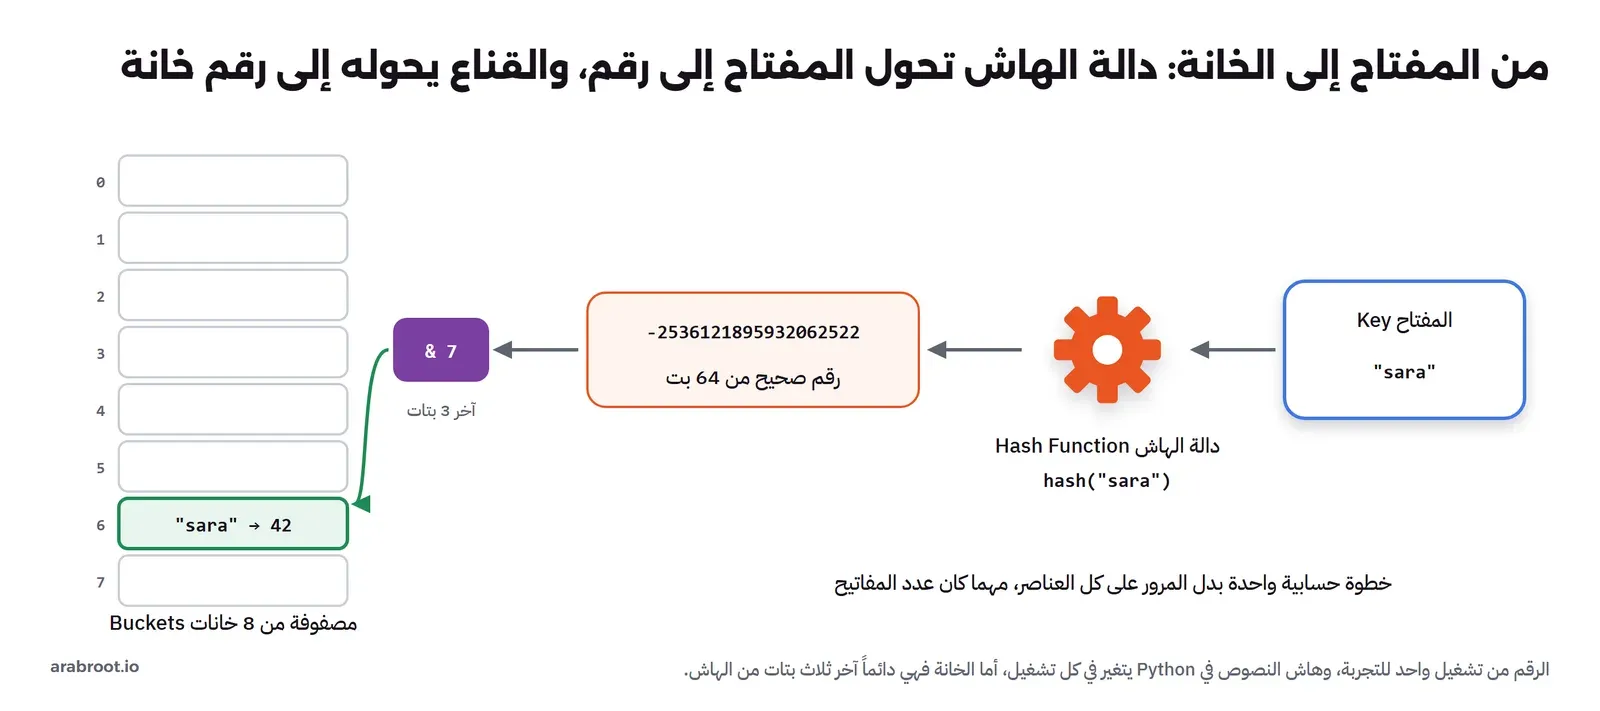
دالة الهاش هي دالة تأخذ مفتاحاً من أي نوع وتعيد رقماً صحيحاً، ولها شرط واحد لا يمكن التنازل عنه: المفتاحان المتساويان يجب أن يعطيا الرقم نفسه دائماً، وإلا فإننا نحفظ المفتاح في خانة ونبحث عنه في خانة أخرى. أما العكس فليس شرطاً، أي أن مفتاحين مختلفين قد يعطيان الرقم نفسه، وهذا هو التصادم Collision الذي سوف نتعامل معه بعد قليل. والصورة التالية تبين الطريق الكامل من المفتاح إلى الخانة:
ماذا تعيد الدالة hash() في Python؟
في Python كل كائن قابل للهاش Hashable له الدالة __hash__ التي تستدعيها hash()، والقاموس dict والمجموعة set يستخدمان هذه القيمة. ولكي نرى القيم الحقيقية كتبنا ملفاً صغيراً يطبع هاش بعض المفاتيح، ثم يحولها إلى رقم خانة، ثم يقارن ثلاث دوال هاش على عشرة آلاف بريد إلكتروني. والملف hashes.py كاملاً كما يلي:
# hashes.py: what a hash function returns, and how keys spread over buckets
#   python hashes.py
import sys

print('== 1) hash() of some keys')
for k in [1, 2, 1000, -1, -2, 2**61 - 1, 2**61, 1.0, 1.5, True]:
    print(f'   hash({k!r:>22}) = {hash(k)}')
print('   hash("salem")  =', hash('salem'))
print('   hash(("salem", 7)) =', hash(('salem', 7)))
print('   hash.width =', sys.hash_info.width, ' modulus =', sys.hash_info.modulus, ' algorithm =', sys.hash_info.algorithm)

print('\n== 2) from hash to bucket index in a table of 8 buckets (hash & 7)')
for k in ['ali', 'sara', 'omar', 'huda', 'zaid']:
    h = hash(k)
    print(f'   {k:5} hash={h:>21}  & 7 = {h & 7}')

print('\n== 3) 10,000 e-mail keys in 1,024 buckets: three hash functions')
keys = [f'user{i:05d}@example.com' for i in range(10_000)]

def by_length(s):
    return len(s)

def by_sum(s):
    return sum(map(ord, s))

def report(name, fn, buckets=1024):
    counts = [0] * buckets
    for k in keys:
        counts[fn(k) % buckets] += 1
    used = sum(1 for c in counts if c)
    print(f'   {name:12} used buckets {used:5,}   empty {buckets - used:5,}   longest chain {max(counts):6,}')

report('len(s)', by_length)
report('sum of ord', by_sum)
report('hash(s)', hash)

print('\n== 4) anagrams under the sum-of-ord hash')
for w in ['listen', 'silent', 'enlist', 'tinsel']:
    print(f'   {w:7} sum={by_sum(w)}  hash()={hash(w)}')
ونشغله في Container من Python 3.13.17 حتى لا يحتاج القارئ إلى تثبيت أي شيء، والأمر نفسه يشغل كل ملفات التجربة في هذا المقال بتغيير اسم الملف فقط:
docker run --rm -v "$PWD:/lab" -w /lab python:3.13.17-slim python hashes.pyوالمخرج سوف يكون كما يلي:
== 1) hash() of some keys
   hash(                     1) = 1
   hash(                     2) = 2
   hash(                  1000) = 1000
   hash(                    -1) = -2
   hash(                    -2) = -2
   hash(   2305843009213693951) = 0
   hash(   2305843009213693952) = 1
   hash(                   1.0) = 1
   hash(                   1.5) = 1152921504606846977
   hash(                  True) = 1
   hash("salem")  = 3996951643986645045
   hash(("salem", 7)) = 4697412606158220081
   hash.width = 64  modulus = 2305843009213693951  algorithm = siphash13

== 2) from hash to bucket index in a table of 8 buckets (hash & 7)
   ali   hash= -3972562181814955645  & 7 = 3
   sara  hash= -2536121895932062522  & 7 = 6
   omar  hash=  8212186302368099365  & 7 = 5
   huda  hash=  -559890596024407291  & 7 = 5
   zaid  hash= -5993834241644798056  & 7 = 0

== 3) 10,000 e-mail keys in 1,024 buckets: three hash functions
   len(s)       used buckets     1   empty 1,023   longest chain 10,000
   sum of ord   used buckets    37   empty   987   longest chain    670
   hash(s)      used buckets 1,024   empty     0   longest chain     19

== 4) anagrams under the sum-of-ord hash
   listen  sum=655  hash()=-5955208603578021297
   silent  sum=655  hash()=5054720986908802671
   enlist  sum=655  hash()=7397403526359779457
   tinsel  sum=655  hash()=-6360200605372986139
في المخرج أعلاه لاحظ التالي:
- هاش الأعداد الصحيحة الصغيرة هو العدد نفسه، فـ
hash(1000)يساوي 1000، وهذا مقصود في CPython لأنه سريع جداً ويوزع المفاتيح المتتالية على خانات متتالية دون أي تصادم. أما الأعداد الكبيرة فتؤخذ بباقي القسمة على العدد الأولي 261 − 1 كما يظهر في السطرmodulus، ولذلك أعاد هذا العدد نفسه صفراً، وأعاد العدد الذي بعده 1. hash(-1)أعاد-2وليس-1، والسبب أن الدوال المكتوبة بلغة C داخل CPython تستخدم-1للإشارة إلى خطأ، فلا يسمح لأي كائن أن يكون هاشه-1، ولذلك يتساوى هاش العددين-1و-2، وهذا تصادم حقيقي بين مفتاحين صغيرين جداً، ولا يسبب مشكلة لأن القاموس يقارن المفتاحين بعد الهاش كما سوف نرى.1و1.0وTrueلها الهاش نفسه 1، وهذا شرط لا اختيار، لأن Python تعتبرها متساوية (1 == 1.0 == True)، والمتساويان يجب أن يكون هاشهما واحداً. وسوف نرى نتيجة ذلك في قسم القاموس من الداخل.- هاش النصوص يحسب بخوارزمية
siphash13كما يظهر في السطر الأخير من القسم الأول، وهي دالة بمفتاح سري عشوائي يتغير في كل تشغيل، ولذلك إذا شغلت الملف عندك فسوف تحصل على أرقام مختلفة لـ"salem"وللأسماء في القسم الثاني، وهذا مقصود للحماية من هجوم سوف نذكره في آخر المقال. - في القسم الثاني تحول كل هاش إلى رقم خانة بالعملية
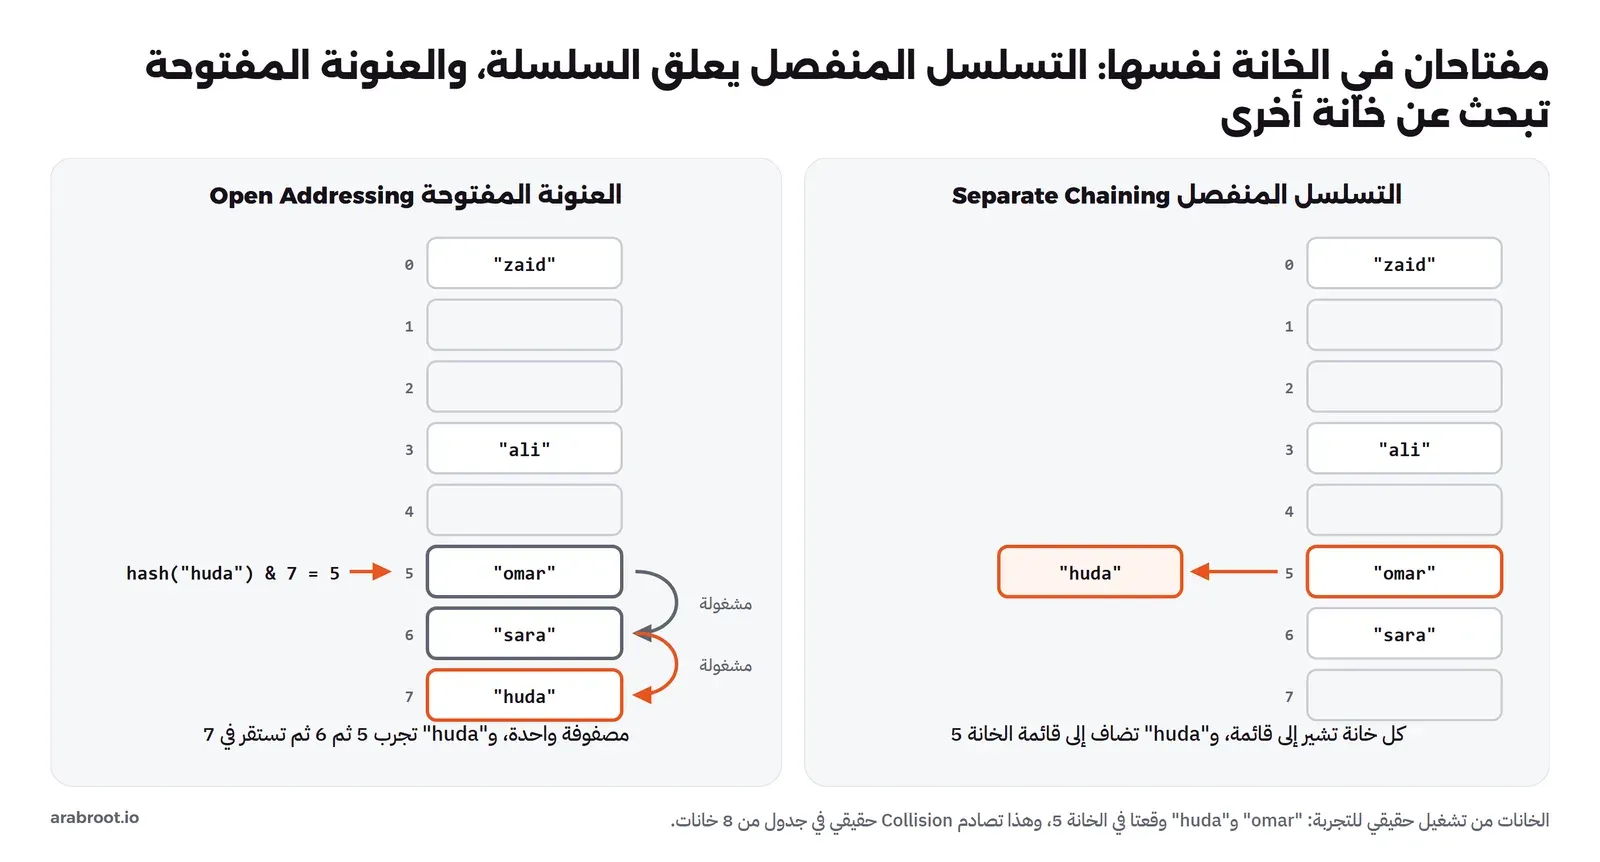
& 7، أي آخر ثلاث بتات، ولاحظ أنomarوhudaوقعا في الخانة 5 معاً، أي أن خمسة مفاتيح فقط في ثماني خانات كانت كافية لظهور أول تصادم.
ما الذي يجعل دالة الهاش Hash Function جيدة؟
القسم الثالث من المخرج هو أهم ما في الملف، لأنه يبين أن كل دالة تحقق شرط «المتساويان لهما الهاش نفسه» صحيحة، ولكن ليست كل دالة صحيحة مفيدة. فالدالة الأولى len(s) تعيد طول النص، وهي صحيحة تماماً، ولكن كل البريد في التجربة بالطول نفسه، فوقعت عشرة آلاف مفتاح في خانة واحدة من 1,024 خانة، وأصبح جدول الهاش قائمة واحدة طويلة، أي أننا عدنا إلى البحث الخطي مع تكلفة إضافية. والدالة الثانية تجمع رموز الحروف، وهي أفضل قليلاً، ولكن المجموع لا يتغير كثيراً بين user00001 وuser09999، فاستخدمت 37 خانة فقط وكانت أطول سلسلة 670 مفتاحاً. أما hash(s) فاستخدمت كل الخانات، وأطول سلسلة 19 مفتاحاً، والمتوسط نحو عشرة لأن عدد المفاتيح عشرة أضعاف عدد الخانات.
والقسم الرابع يبين عيباً آخر لدالة المجموع: الكلمات التي حروفها واحدة بترتيب مختلف Anagrams تعطي المجموع نفسه 655، والدالة الجيدة تعطي أرقاماً بعيدة جداً. ومن هذه الأمثلة نستخرج صفات دالة الهاش الجيدة لجدول هاش:
- الثبات Deterministic: المفتاح نفسه يعطي الرقم نفسه طوال عمر الجدول، وهذا شرط الصحة.
- التوزيع المتساوي Uniform Distribution: المفاتيح الحقيقية، وهي غالباً متشابهة جداً مثل البريد المتسلسل، تتوزع على الخانات كأنها عشوائية.
- تأثير الانهيار Avalanche Effect: تغيير حرف واحد أو تبديل ترتيب حرفين يغير الرقم كله، وإلا فإن المفاتيح المتقاربة تتجمع في خانات متقاربة.
- السرعة: الدالة تحسب في كل إدخال وكل بحث، فالدالة البطيئة تلغي فائدة الجدول.
دالة الهاش للجدول ودالة الهاش للتشفير Cryptographic Hash
قد يتساءل البعض: لماذا لا نستخدم SHA-256 في جداول الهاش ما دامت توزع المفاتيح بشكل ممتاز؟ والإجابة أن دالة الهاش للتشفير Cryptographic Hash، التي شرحناها في مقال التشفير للمطورين، مصممة لهدف آخر: أن يستحيل عملياً إيجاد مفتاحين لهما الهاش نفسه، أو إيجاد مفتاح من هاشه، وهذا يحتاج 256 بت وحسابات كثيرة. أما جدول الهاش فيستخدم في النهاية بضع بتات فقط من الهاش، 3 بتات لجدول من 8 خانات و21 بتاً لجدول من مليوني خانة، والتصادم فيه أمر طبيعي يتعامل معه الجدول، فلا فائدة من دفع ثمن مقاومة التصادم الكاملة. ولذلك تستخدم اللغات دوالاً سريعة متوسطة، مثل SipHash الذي صممه Jean-Philippe Aumasson وDaniel J. Bernstein في ورقة SipHash عام 2012 ليكون سريعاً على النصوص القصيرة ومعه مفتاح سري يمنع المخترق من توقع التصادم، وهو ما تستخدمه Python للنصوص والبايتات بحسب PEP 456. والخلاصة أن لكل نوع دالة هدفاً مختلفاً، فلا تستخدم hash() لحفظ كلمات المرور، ولا تستخدم SHA-256 لتوزيع المفاتيح على خانات قاموس داخل الذاكرة.
من الرقم إلى الخانة Bucket: باقي القسمة Modulo والقناع Mask
دالة الهاش تعيد رقماً من 64 بت، والجدول فيه ثماني خانات أو ألف أو مليون، فنحتاج خطوة ثانية تحول الرقم الكبير إلى رقم خانة صحيح. والطريقة الطبيعية هي باقي القسمة Modulo: h % size، وهي تعمل مع أي حجم، ولكن القسمة من أبطأ عمليات المعالج الحسابية. لذلك تختار أغلب التطبيقات حجماً من قوى العدد 2، مثل 8 و16 و1,024، لأن باقي القسمة على 2k يساوي آخر k بت من الرقم، ويحسب بعملية AND واحدة مع القناع Mask: h & (size - 1)، وهي أسرع من القسمة بكثير. وقد شرحنا هذه العمليات على البتات في مقال الأنظمة العددية والثنائي.
ولكن القناع له ثمن، فهو يأخذ البتات المنخفضة Low Bits فقط ويتجاهل الباقي، فإذا كانت المفاتيح تختلف في البتات العالية فقط، مثل أرقام كلها من مضاعفات 1,024، فإنها تقع كلها في الخانات نفسها. وهذه ليست مشكلة نظرية، فقد ظهرت فعلاً في التجربة العملية كما سوف ترى، وحلها في أسلوب البحث عن الخانة التالية، وليس في دالة الهاش. أما الحجم الأولي Prime Number مع باقي القسمة فهو الخيار الآخر الذي تستخدمه بعض التطبيقات، لأنه يخلط كل بتات الرقم في النتيجة، ويدفع ثمن القسمة مقابل ذلك.
التصادم Collision: لماذا لا يمكن تجنبه؟
التصادم Collision هو أن يقع مفتاحان مختلفان في الخانة نفسها، وهو أمر محتوم لسببين. الأول مبدأ برج الحمام Pigeonhole Principle: عدد المفاتيح الممكنة، كل النصوص مثلاً، أكبر بلا حدود من عدد الخانات، فلا بد أن تتشارك مفاتيح كثيرة الخانة نفسها. والثاني أن التصادم يظهر مبكراً جداً حتى في جدول شبه فارغ، كما رأيت في القسم الثاني من المخرج حيث تصادم مفتاحان من خمسة في ثماني خانات، وهذه هي مسألة يوم الميلاد التي حسبناها في مقال الاحتمالات، حيث يظهر أول تصادم بعد نحو جذر عدد الخانات وليس بعد امتلائها.
ولذلك لا يحاول جدول الهاش منع التصادم، وإنما يقرر ماذا يفعل عندما يحدث، وهنا يوجد طريقان رئيسيان: أن تحمل كل خانة أكثر من مفتاح، وهذا التسلسل المنفصل Separate Chaining، أو أن يبحث المفتاح الجديد عن خانة فارغة أخرى في المصفوفة نفسها، وهذه العنونة المفتوحة Open Addressing. والصورة التالية تبين الطريقين على المفاتيح الخمسة نفسها من مخرج التجربة:
الحل الأول: التسلسل المنفصل Separate Chaining
في التسلسل المنفصل Separate Chaining كل خانة لا تحمل مفتاحاً واحداً، وإنما تحمل قائمة، وقد تكون قائمة مترابطة Linked List أو مصفوفة صغيرة، وكل المفاتيح التي تقع في الخانة تضاف إلى قائمتها. والإدخال يحسب الخانة، ثم يمر على قائمتها ليتأكد أن المفتاح غير موجود، ثم يضيفه في آخرها، والبحث يحسب الخانة ثم يمر على قائمتها وحدها ويقارن كل مفتاح فيها بالمفتاح المطلوب. ولاحظ أن المقارنة هنا مقارنة كاملة بالمساواة، وليست مقارنة هاش فقط، ولذلك فالتصادم لا يسبب نتيجة خاطئة أبداً، وإنما يسبب مقارنات إضافية.
ونقاط القوة في هذه الطريقة أنها بسيطة، وأن أداءها يتدهور ببطء عندما يمتلئ الجدول، فلو كان عدد المفاتيح ضعف عدد الخانات لكان متوسط طول القائمة اثنين فقط، والحذف فيها سهل لأنك تحذف العنصر من قائمته ولا يتأثر أي شيء آخر. ونقاط الضعف أن كل عنصر في قائمة مترابطة كائن مستقل في الذاكرة يحمل مؤشراً إلى ما بعده، فتكلف كل إضافة حجز ذاكرة جديد، وتقفز المقارنات بين أماكن متباعدة في الذاكرة، وهذا سيئ لذاكرة المعالج المؤقتة Cache التي تحب القراءة من أماكن متجاورة. وهذه الطريقة هي التي يستخدمها HashMap في Java كما سوف نرى في قسم اللغات الأخرى.
الحل الثاني: العنونة المفتوحة Open Addressing
في العنونة المفتوحة Open Addressing كل المفاتيح تعيش في المصفوفة نفسها، ولا توجد قوائم ولا مؤشرات، فإذا وجد المفتاح الجديد خانته مشغولة بمفتاح آخر جرب خانة ثانية حسب قاعدة ثابتة، ثم ثالثة، حتى يجد خانة فارغة. والبحث يتبع القاعدة نفسها بالترتيب نفسه، فيفحص الخانة الأولى، فإذا وجد فيها المفتاح المطلوب انتهى، وإذا وجد مفتاحاً آخر انتقل إلى الخانة التالية في التسلسل، وإذا وجد خانة فارغة عرف أن المفتاح غير موجود، لأنه لو كان موجوداً لوضع في هذه الخانة الفارغة أو قبلها. والترتيب الذي تفحص به الخانات يسمى تسلسل الفحص Probe Sequence، وأبسطه الفحص الخطي Linear Probing: الخانة التالية مباشرة، ثم التي بعدها.
ونقاط القوة في العنونة المفتوحة أن كل شيء في مصفوفة واحدة متجاورة، فالفحص يقرأ خانات قريبة من بعضها غالباً وتكون في ذاكرة المعالج المؤقتة، ولا يوجد حجز ذاكرة لكل عنصر. ونقاط الضعف أن الجدول لا يحتمل الامتلاء، فكلما قلت الخانات الفارغة طال الفحص، وعند امتلاء الجدول تماماً لا يوجد مكان لأي مفتاح جديد، ولذلك يجب أن يكبر الجدول قبل أن يقترب من الامتلاء بكثير، كما سوف نقيس في التجربة.
التكتل Primary Clustering: عيب الفحص الخطي Linear Probing
الفحص الخطي له عيب معروف اسمه التكتل الأولي Primary Clustering: عندما تتجمع عدة مفاتيح في خانات متتالية تتكون كتلة، وأي مفتاح جديد يقع هاشه في أي خانة من هذه الكتلة يمشي حتى آخرها ويضاف إليها، فتكبر الكتلة، وكلما كبرت زاد احتمال أن يقع فيها مفتاح جديد. أي أن الكتل الكبيرة تكبر أسرع من الصغيرة، وفي جدول ممتلئ بنسبة عالية تصبح الكتل طويلة جداً، فالبحث عن مفتاح غير موجود يمشي على الكتلة كلها حتى يجد خانة فارغة. وهذا ما سوف تراه بالأرقام في التجربة، حيث احتاج البحث عن مفتاح غير موجود في جدول ممتلئ بنسبة 99% إلى فحص أكثر من ثلاثة آلاف خانة في المتوسط.
الفحص التربيعي Quadratic Probing والهاش المزدوج Double Hashing
ولتخفيف التكتل توجد قواعد أخرى للقفز بين الخانات. في الفحص التربيعي Quadratic Probing تكون المسافات 1 ثم 4 ثم 9، أي مربعات الأرقام، فيقفز المفتاح بعيداً عن الكتلة بسرعة، وفي الهاش المزدوج Double Hashing يحسب لكل مفتاح طول الخطوة من دالة هاش ثانية، فالمفتاحان اللذان يبدآن من الخانة نفسها يتبعان طريقين مختلفين. أما CPython فيستخدم طريقة خاصة به، فهو يبدأ بالبتات المنخفضة ثم يدخل باقي بتات الهاش تدريجياً في حساب الخانة التالية، وسوف نرى هذه الطريقة بالتفصيل في قسم القاموس من الداخل، لأنها هي التي حلت مشكلة البتات المنخفضة في التجربة. وكل هذه الطرق تقلل التكتل، ولكنها تخسر جزءاً من ميزة الفحص الخطي، وهي أن الخانات المفحوصة متجاورة في الذاكرة.
الحذف في العنونة المفتوحة وعلامة الحذف Tombstone
الحذف في العنونة المفتوحة أصعب مما يبدو. لنفرض أن huda في الشكل السابق وصلت إلى الخانة 7 بعد أن وجدت 5 و6 مشغولتين، ثم حذفنا sara من الخانة 6 وجعلناها فارغة، فإن البحث عن huda يبدأ من 5 فيجد omar، ثم ينتقل إلى 6 فيجدها فارغة، فيقرر أن huda غير موجودة، وهي موجودة في الخانة 7. والسبب أن الخانة الفارغة تعني في قاعدة البحث «توقف هنا»، فإذا أفرغناها كسرنا السلسلة التي مر بها مفتاح آخر. والحل أن نضع في الخانة المحذوفة علامة حذف Tombstone، أي علامة تقول «كان هنا مفتاح، تابع البحث»، فالبحث يتجاوزها، والإدخال يستطيع أن يعيد استخدامها. وفي CPython تسمى هذه العلامة DKIX_DUMMY كما يذكر الكود المصدري للقاموس، وهي سبب أن الجدول الذي حذفت منه كثيراً يبقى بطيئاً أو كبيراً حتى يعاد بناؤه، كما سوف نرى في قسم تكبير الجدول.
التجربة العملية Lab: نكتب الجدولين ونعد الخانات
الكلام عن التكتل وعن «الأداء يتدهور مع الامتلاء» يبقى غامضاً حتى نرى الأرقام، لذلك كتبنا جدولي هاش بسيطين في Python: الأول بالتسلسل المنفصل، والثاني بالعنونة المفتوحة بالفحص الخطي، ومعه خيار لاستخدام قاعدة CPython. وكل جدول يعد الخانات أو المفاتيح التي فحصها في كل بحث، ثم نملأ الجدولين بنسب مختلفة من 25% إلى 99%، ونقيس متوسط الفحص لمفتاح موجود ولمفتاح غير موجود. ونقارن كل رقم بالقيمة النظرية: للتسلسل 1 + α/2 للموجود و1 + α لغير الموجود في طريقة العد التي اخترناها، وللفحص الخطي المعادلتان المشهورتان من تحليل Donald Knuth: ½(1 + 1/(1−α)) للموجود و½(1 + 1/(1−α)²) لغير الموجود، حيث α هي نسبة الامتلاء. والملف tables.py كاملاً كما يلي:
# tables.py: two hash tables written by hand, separate chaining and linear probing,
# and how many slots each one looks at per lookup as the table fills up.
#   python tables.py
import random


class ChainingTable:
    """Each bucket holds a Python list of (key, value) pairs."""

    def __init__(self, size):
        self.buckets = [[] for _ in range(size)]
        self.probes = 0                      # keys compared during lookups

    def put(self, key, value):
        b = self.buckets[hash(key) % len(self.buckets)]
        for i, (k, _) in enumerate(b):
            if k == key:
                b[i] = (key, value)
                return
        b.append((key, value))

    def get(self, key):
        b = self.buckets[hash(key) % len(self.buckets)]
        for k, v in b:
            self.probes += 1
            if k == key:
                return v
        self.probes += 1                     # count reaching the end of the chain as one look
        return None


class LinearProbingTable:
    """All pairs live in one array; on a collision, try the next slot."""
    EMPTY = object()

    def __init__(self, size, step=None):
        self.keys = [self.EMPTY] * size
        self.vals = [None] * size
        self.probes = 0
        self.step = step                     # None means linear probing (+1)

    def _slots(self, key):
        mask = len(self.keys) - 1            # size is a power of two
        h = hash(key)
        i = h & mask
        if self.step is None:
            while True:
                yield i
                i = (i + 1) & mask
        perturb = h & 0xFFFFFFFFFFFFFFFF     # the CPython recurrence (Objects/dictobject.c)
        while True:
            yield i
            perturb >>= 5
            i = (i * 5 + perturb + 1) & mask

    def put(self, key, value):
        for i in self._slots(key):
            if self.keys[i] is self.EMPTY or self.keys[i] == key:
                self.keys[i], self.vals[i] = key, value
                return

    def get(self, key):
        for i in self._slots(key):
            self.probes += 1
            if self.keys[i] is self.EMPTY:
                return None
            if self.keys[i] == key:
                return self.vals[i]


SIZE = 1 << 16                               # 65,536 slots
rnd = random.Random(7)
universe = rnd.sample(range(10**12), int(SIZE * 1.0) + 20_000)
present, absent = universe[:SIZE], universe[SIZE:]

def measure(table, n):
    table.probes = 0
    for k in present[:n]:
        table.get(k)
    hit = table.probes / n
    table.probes = 0
    for k in absent[:10_000]:
        table.get(k)
    miss = table.probes / 10_000
    return hit, miss

print('== 1) average slots looked at per lookup, 65,536 slots, random integer keys')
print('   load   chaining hit/miss   theory      linear probing hit/miss   theory (Knuth)')
for alpha in [0.25, 0.5, 0.75, 0.9, 0.95, 0.99]:
    n = int(SIZE * alpha)
    ch, lp = ChainingTable(SIZE), LinearProbingTable(SIZE)
    for k in present[:n]:
        ch.put(k, 1)
        lp.put(k, 1)
    chh, chm = measure(ch, n)
    lph, lpm = measure(lp, n)
    t_ch = (1 + alpha / 2, 1 + alpha)
    t_lp = (0.5 * (1 + 1 / (1 - alpha)), 0.5 * (1 + 1 / (1 - alpha) ** 2))
    print(f'   {alpha:4.2f}   {chh:6.2f} / {chm:6.2f}    {t_ch[0]:4.2f}/{t_ch[1]:4.2f}     '
          f'{lph:7.2f} / {lpm:8.2f}       {t_lp[0]:6.2f}/{t_lp[1]:8.2f}')

print('\n== 2) keys that share their low bits: 3,000 ids that are multiples of 1,024, in 8,192 slots')
ids = [i * 1024 for i in range(3000)]
for name, table in [('linear probing', LinearProbingTable(8192)), ('CPython-style perturbation', LinearProbingTable(8192, step='perturb'))]:
    for k in ids:
        table.put(k, 1)
    table.probes = 0
    for k in ids:
        table.get(k)
    print(f'   {name:28} average slots per hit {table.probes / len(ids):8.2f}')
في الكود أعلاه لاحظ التالي:
- الجدولان يستخدمان
hash()من Python نفسها، والمفاتيح أرقام عشوائية بين صفر وتريليون من مولد ببذرة ثابتة 7، فكل تشغيل يعطي نفس المفاتيح ونفس الأرقام. - عداد
probesفي جدول التسلسل يعد المفاتيح التي قارنها البحث في القائمة، ويضيف واحداً عند الوصول إلى نهاية القائمة دون نتيجة، حتى يكون البحث في قائمة فارغة خطوة واحدة مثل فحص خانة فارغة في الجدول الآخر. - الدالة
_slotsتولد تسلسل الفحص: في الفحص الخطي الخانة التالية مباشرة، وفي الخيار الثاني القاعدة نفسها التي يستخدمها CPython، وقد نسخناها منObjects/dictobject.c. - الحجم 65,536 خانة، أي 216، لأن القناع
& maskيحتاج حجماً من قوى العدد 2.
تشغيل التجربة وقراءة المخرج Output
نشغل الملف بنفس أمر Docker السابق مع تغيير اسم الملف إلى tables.py، والتشغيل أخذ قرابة 40 ثانية، أغلبها في البحث عن المفاتيح غير الموجودة عند الامتلاء 99%. والمخرج سوف يكون كما يلي:
== 1) average slots looked at per lookup, 65,536 slots, random integer keys
   load   chaining hit/miss   theory      linear probing hit/miss   theory (Knuth)
   0.25     1.13 /   1.26    1.12/1.25        1.17 /     1.39         1.17/    1.39
   0.50     1.25 /   1.51    1.25/1.50        1.49 /     2.48         1.50/    2.50
   0.75     1.37 /   1.76    1.38/1.75        2.47 /     8.64         2.50/    8.50
   0.90     1.45 /   1.91    1.45/1.90        5.52 /    51.11         5.50/   50.50
   0.95     1.47 /   1.96    1.48/1.95       10.01 /   169.83        10.50/  200.50
   0.99     1.49 /   2.00    1.50/1.99       29.84 /  3215.27        50.50/ 5000.50

== 2) keys that share their low bits: 3,000 ids that are multiples of 1,024, in 8,192 slots
   linear probing               average slots per hit   188.00
   CPython-style perturbation   average slots per hit     2.94
في المخرج أعلاه لاحظ التالي:
- في التسلسل المنفصل بقي البحث عن مفتاح موجود بين 1.13 و1.49 مقارنة حتى عند امتلاء 99%، والبحث عن غير الموجود بين 1.26 و2.00، والأرقام المقاسة تطابق النظرية إلى الخانة الثانية تقريباً، وهذا ما يجعل التسلسل متسامحاً مع الامتلاء.
- في الفحص الخطي كانت الأرقام عند 25% و50% قريبة من التسلسل، ولكن عند 75% أصبح البحث عن غير الموجود 8.64 خانة، وعند 90% أصبح 51.11، وعند 99% قفز إلى 3,215.27 خانة لكل بحث، أي أن البحث في جدول شبه ممتلئ أصبح بحثاً خطياً في كتلة ضخمة، وهذا هو التكتل الذي شرحناه.
- القيم المقاسة للفحص الخطي تطابق معادلة Knuth حتى 90%، ثم تبتعد عنها عند 95% و99%، فقد قسنا 29.84 للموجود والمعادلة تقول 50.50. والسبب أن المعادلة تصف المتوسط لجدول ضخم جداً، أما قرب الامتلاء الكامل فالنتيجة تعتمد كثيراً على شكل الكتل في جدول بعينه، وعشرة آلاف بحث على جدول واحد لا تمثل هذا المتوسط بدقة. ولا يهمك هذا الفرق عملياً، لأن أي جدول حقيقي يكبر قبل أن يصل إلى هذه النسبة بكثير.
والصورة التالية ترسم هذه الأرقام على مقياس لوغاريتمي، حتى يظهر الفرق بين ثلاثة آلاف خانة وخانتين في الصورة نفسها:
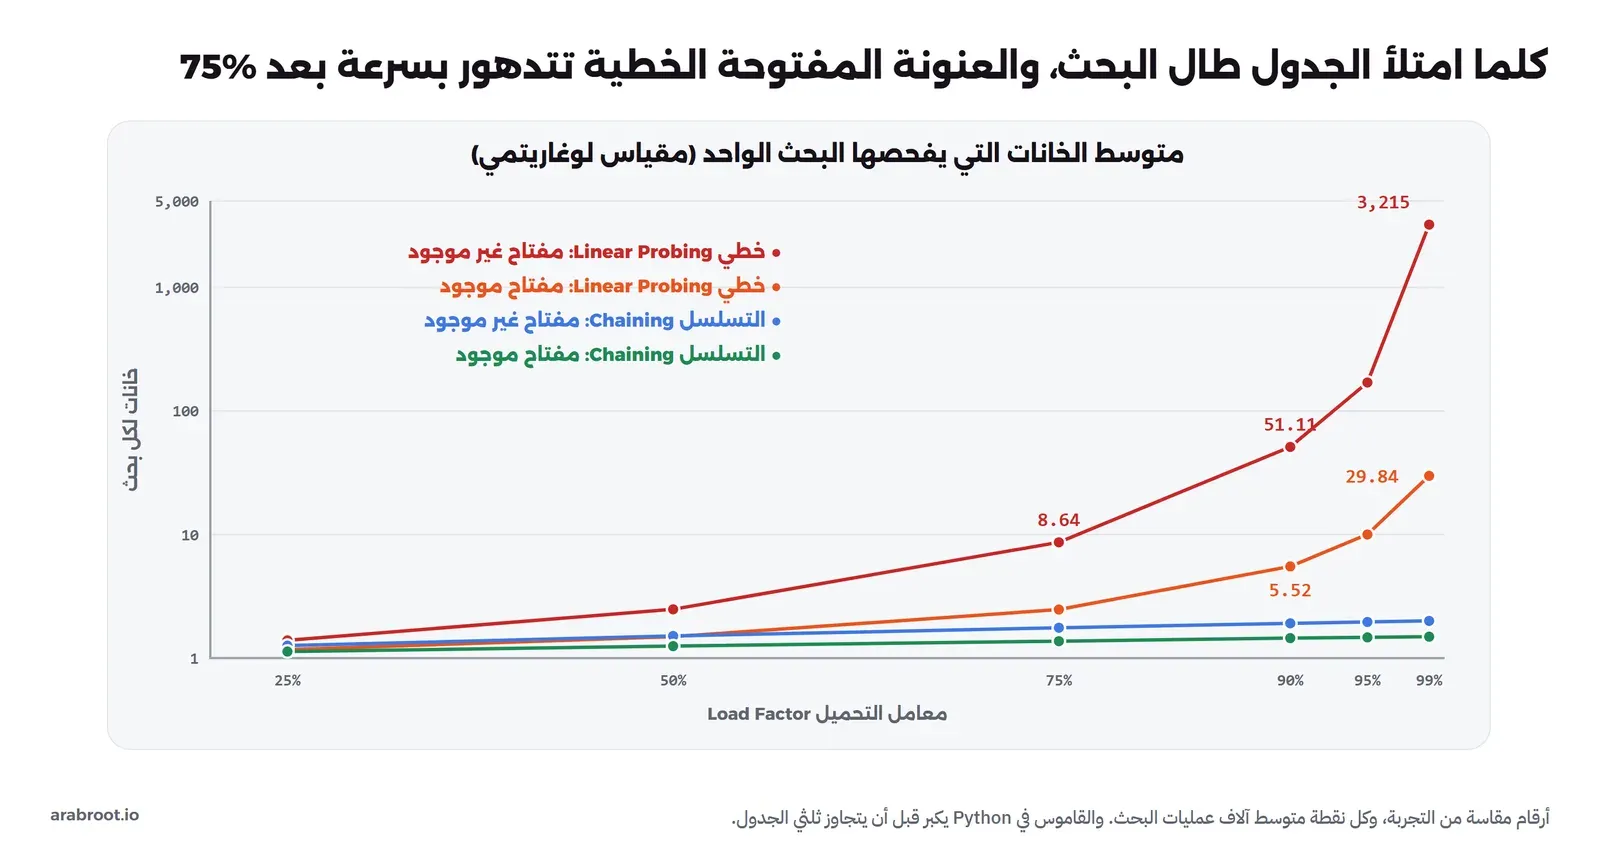
والدرس من هذا القسم أن السؤال «هل جدول الهاش O(1)؟» إجابته: نعم في المتوسط، بشرط أن يبقى الجدول بعيداً عن الامتلاء، وأن تكون دالة الهاش جيدة. فإذا سقط أحد الشرطين أصبح البحث خطياً، وهذا ما سوف نراه مرتين أخريين في هذا المقال.
المشكلة التي ظهرت: مفاتيح تتشارك البتات المنخفضة Low Bits
عند كتابة التجربة استخدمنا في البداية مفاتيح مثل أرقام المستخدمين، وهي أرقام متتالية أو أرقام بقفزات ثابتة، ومع الفحص الخطي ظهرت أرقام سيئة جداً لا تفسرها نسبة الامتلاء. والسبب أن hash() للعدد الصحيح هو العدد نفسه، والقناع يأخذ البتات المنخفضة فقط، فإذا كانت المفاتيح من مضاعفات 1,024 فإن آخر عشر بتات فيها كلها أصفار، وفي جدول من 8,192 خانة لا يوجد أمامها إلا ثماني خانات بداية ممكنة، فتتكدس ثلاثة آلاف مفتاح في كتل ضخمة. ولذلك جعلنا التجربة الرئيسية بمفاتيح عشوائية، وأضفنا القسم الثاني ليقيس هذه الحالة وحدها: البحث عن مفتاح موجود احتاج 188 خانة في المتوسط بالفحص الخطي، مع أن الجدول ممتلئ بنسبة 37% فقط، وانخفض إلى 2.94 خانة بقاعدة CPython على المفاتيح نفسها والجدول نفسه.
وهذه الحالة ليست غريبة في الأنظمة الحقيقية، فالمعرفات التي تتولد بقفزات ثابتة، والعناوين في الذاكرة التي تكون غالباً من مضاعفات 8 أو 16، والطوابع الزمنية بالمللي ثانية المقربة إلى الثانية، كلها مفاتيح تتشارك بتاتها المنخفضة. وقد ذكر مطورو CPython هذا المثال تقريباً في تعليقات dictobject.c نفسها، بمفاتيح من الشكل i << 16 تقع كلها في الخانة نفسها، وقرروا أن يبقى حساب الخانة الأولى سريعاً بالبتات المنخفضة، وأن يتولى تسلسل الفحص إدخال باقي البتات. والقاعدة لك إذا كتبت جدول هاش بنفسك، أو اخترت دالة هاش لكلاس خاص بك: لا تفترض أن مفاتيحك عشوائية، واختبر الجدول بمفاتيحك الحقيقية وانظر إلى أطول سلسلة أو أطول فحص، وليس إلى المتوسط فقط.
معامل التحميل Load Factor: متى يعتبر الجدول ممتلئاً؟
معامل التحميل Load Factor هو عدد المفاتيح مقسوماً على عدد الخانات، ويكتب غالباً α، فجدول فيه 750 مفتاحاً في ألف خانة معامله 0.75. وهو الرقم الذي يحكم أداء الجدول كما رأيت في التجربة، ولذلك يحدد كل تطبيق حداً أعلى له، فإذا تجاوزه الجدول كبر نفسه. والحد قرار بين الذاكرة والسرعة: الحد المنخفض يعني خانات فارغة كثيرة، أي ذاكرة تدفعها مقابل فحص أقصر، والحد المرتفع يعني ذاكرة أقل وفحصاً أطول.
والحدود الفعلية تختلف بحسب طريقة حل التصادم. فالتسلسل المنفصل يحتمل معاملاً قريباً من 1 وحتى أكثر، لأن القوائم تطول ببطء، ولذلك فالقيمة الافتراضية في HashMap في Java هي 0.75، ويقول توثيقه إن الجدول عند تجاوزها يعاد بناؤه بنحو ضعف عدد الخانات. أما العنونة المفتوحة فتحتاج حداً أقل، لأن الفحص يطول بسرعة كما رأيت، ولذلك يبقي CPython القاموس تحت ثلثي الخانات، أي معامل 0.67 تقريباً، كما يظهر في الماكرو USABLE_FRACTION في الكود المصدري. وعند 0.67 تقول معادلة Knuth إن البحث عن غير الموجود يحتاج قرابة خمس خانات بالفحص الخطي، وقاعدة CPython أفضل من ذلك في الحالات الشائعة.
تكبير الجدول Resize وإعادة التوزيع Rehashing
عندما يتجاوز الجدول حده يحجز مصفوفة جديدة أكبر، غالباً ضعف الحجم أو أكثر، ثم يمر على كل المفاتيح القديمة ويحسب خانة كل مفتاح في الجدول الجديد ويضعه فيها، وهذه العملية تسمى إعادة التوزيع Rehashing. ولا يمكن نسخ المفاتيح كما هي إلى المواقع نفسها، لأن رقم الخانة يعتمد على حجم الجدول، فالقناع في جدول من 16 خانة يأخذ أربع بتات، وفي جدول من 32 خانة يأخذ خمس بتات، فيتغير مكان نصف المفاتيح تقريباً. لذلك فالتكبير يمر على كل المفاتيح، أي أنه عملية O(n) تحدث في منتصف إدخال عادي.
نقيس لحظات التكبير Resize في القاموس dict
لكي نرى التكبير في القاموس الحقيقي كتبنا ملفاً يراقب حجم القاموس في الذاكرة بالدالة sys.getsizeof أثناء إدخال مئتي ألف مفتاح، ثم يقيس زمن كل إدخال من مليون إدخال على حدة بالدالة time.perf_counter_ns، ويأخذ أفضل زمن من ثلاث مرات تشغيل لكل موقع حتى نقلل أثر ما يحدث في الخلفية، ثم يجرب حذف أغلب المفاتيح. والملف resize.py كاملاً كما يلي:
# resize.py: watch a Python dict grow, measure the inserts that pay for a resize,
# and see what deleting does (and does not do) to its memory.
#   python resize.py
import sys
import time

print('== 1) sys.getsizeof(d) each time it changes while inserting 0..199,999')
d, last = {}, sys.getsizeof({})
print(f'   items {0:>7,}   bytes {last:>9,}')
for i in range(200_000):
    d[i] = i
    s = sys.getsizeof(d)
    if s != last:
        print(f'   items {len(d):>7,}   bytes {s:>9,}   (x{s / last:4.2f})')
        last = s

print('\n== 2) time of each single insert, 1,000,000 inserts (best of 3 runs per position)')
N = 1_000_000
best = [float('inf')] * N
for run in range(3):
    d = {}
    t = time.perf_counter_ns
    for i in range(N):
        a = t(); d[i] = i; b = t()
        if b - a < best[i]:
            best[i] = b - a
order = sorted(range(N), key=lambda i: best[i], reverse=True)
srt = sorted(best)
print(f'   median insert {srt[N // 2]:>9,} ns   99th percentile {srt[int(N * 0.99)]:>9,} ns')
print('   the 8 slowest inserts (position = number of items before the insert):')
for i in sorted(order[:8]):
    print(f'      position {i:>9,}   {best[i]:>12,} ns')
print(f'   total of all inserts {sum(best) / 1e6:8.1f} ms, of which the 8 slowest {sum(best[i] for i in order[:8]) / 1e6:6.1f} ms')

print('\n== 3) deleting does not shrink the table')
d = {i: i for i in range(1_000_000)}
print(f'   1,000,000 items          {sys.getsizeof(d):>12,} bytes')
for i in range(999_990):
    del d[i]
print(f'   after deleting to {len(d):>2} items {sys.getsizeof(d):>12,} bytes')
d2 = dict(d)
print(f'   dict(d) copy of {len(d2):>2} items   {sys.getsizeof(d2):>12,} bytes')
d.clear()
print(f'   d.clear()                {sys.getsizeof(d):>12,} bytes')
والمخرج سوف يكون كما يلي:
== 1) sys.getsizeof(d) each time it changes while inserting 0..199,999
   items       0   bytes        64
   items       1   bytes       224   (x3.50)
   items       6   bytes       352   (x1.57)
   items      11   bytes       632   (x1.80)
   items      22   bytes     1,168   (x1.85)
   items      43   bytes     2,264   (x1.94)
   items      86   bytes     4,688   (x2.07)
   items     171   bytes     9,304   (x1.98)
   items     342   bytes    18,512   (x1.99)
   items     683   bytes    36,952   (x2.00)
   items   1,366   bytes    73,808   (x2.00)
   items   2,731   bytes   147,544   (x2.00)
   items   5,462   bytes   294,992   (x2.00)
   items  10,923   bytes   589,912   (x2.00)
   items  21,846   bytes 1,310,800   (x2.22)
   items  43,691   bytes 2,621,528   (x2.00)
   items  87,382   bytes 5,242,960   (x2.00)
   items 174,763   bytes 10,485,848   (x2.00)

== 2) time of each single insert, 1,000,000 inserts (best of 3 runs per position)
   median insert       300 ns   99th percentile       400 ns
   the 8 slowest inserts (position = number of items before the insert):
      position     5,461         38,503 ns
      position    10,922         85,806 ns
      position    21,845        209,015 ns
      position    43,690        474,433 ns
      position    87,381      1,354,697 ns
      position   174,762      2,958,911 ns
      position   349,525      7,717,951 ns
      position   699,050     28,862,061 ns
   total of all inserts    314.8 ms, of which the 8 slowest   41.7 ms

== 3) deleting does not shrink the table
   1,000,000 items            41,943,128 bytes
   after deleting to 10 items   41,943,128 bytes
   dict(d) copy of 10 items            352 bytes
   d.clear()                          64 bytes
في المخرج أعلاه لاحظ التالي:
- القاموس الفارغ 64 بايت فقط، لأنه لا يحجز جدولاً حتى أول إدخال، ثم يحجز جدولاً من ثماني خانات يتسع لخمسة مفاتيح فقط، أي ثلثي الخانات، ولذلك كبر عند المفتاح السادس، ثم عند الحادي عشر، ثم عند الثاني والعشرين.
- من بعد ذلك يتضاعف الحجم في كل مرة تقريباً، والمفاتيح التي كبر عندها هي 5,462 و10,923 و21,846، وكل رقم منها يزيد بواحد عن ثلثي حجم الجدول: ثلثا 8,192 هو 5,461، وثلثا 16,384 هو 10,922. وهذا يطابق الماكرو
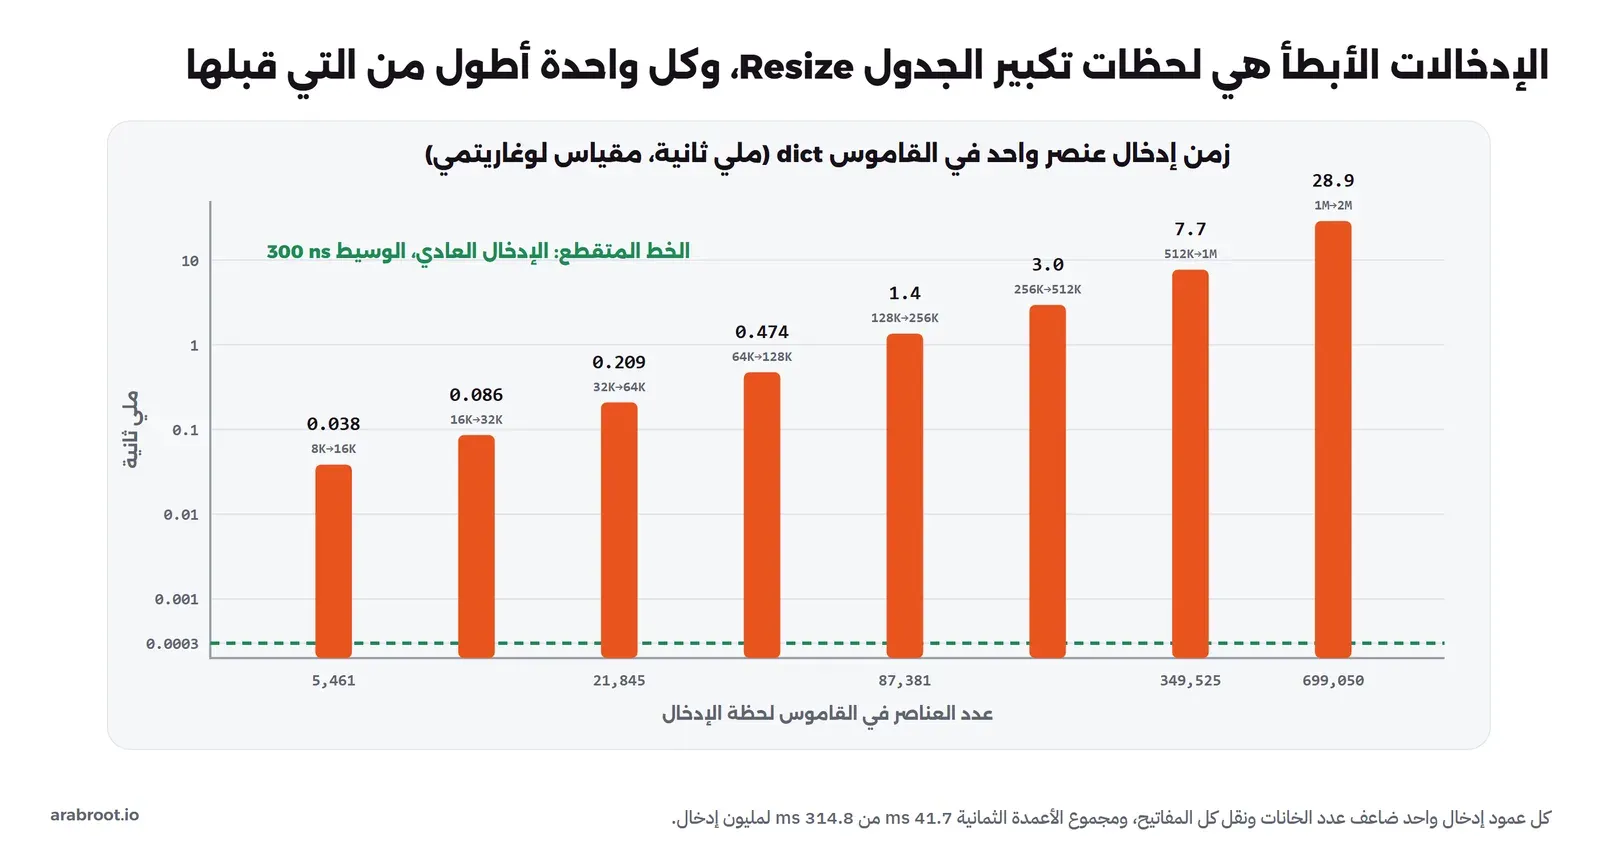
GROWTH_RATEفي CPython 3.13، فالحجم الجديد أول قوة للعدد 2 أكبر من ثلاثة أضعاف عدد المفاتيح. - في القسم الثاني كان الإدخال العادي 300 نانو ثانية في الوسيط، و400 في المئين 99، وهذه الأرقام تشمل زمن استدعاء المؤقت نفسه، فالإدخال الفعلي أسرع من ذلك. أما أبطأ ثمانية إدخالات فكانت بالضبط عند المواقع 5,461 و10,922 و21,845 وهكذا، أي عند لحظات التكبير، وأبطؤها عند 699,050 أخذ 28.9 مللي ثانية، وهو زمن نقل قرابة سبعمئة ألف مفتاح إلى جدول من مليوني خانة.
- مجموع الإدخالات الثمانية البطيئة 41.7 مللي ثانية من 314.8 مللي ثانية لكل المليون إدخال، أي أن ثماني عمليات من مليون أخذت قرابة 13% من الزمن الكلي.
التكلفة الموزعة Amortized Cost: لماذا يبقى الإدخال O(1) رغم التكبير؟
قد يتساءل البعض: إذا كان التكبير O(n) فكيف نقول إن الإدخال في جدول الهاش O(1)؟ والإجابة في فكرة التكلفة الموزعة Amortized Cost، وهي نفس الفكرة التي شرحناها في المصفوفة الديناميكية Dynamic Array في مقال هياكل البيانات. فالجدول يتضاعف في كل تكبير، فإذا وصلنا إلى n مفتاح فإن التكبيرات السابقة نقلت n/2 مفتاحاً ثم n/4 ثم n/8 وهكذا، ومجموع هذه السلسلة أقل من n. أي أن كل التكبيرات معاً نقلت أقل من مفتاح واحد لكل مفتاح أدخلناه، فإذا وزعنا تكلفتها على كل الإدخالات أصبح متوسط الإدخال ثابتاً. وهذا ما تراه في المخرج: الأعمدة تتضاعف، ولكن المسافة بينها تتضاعف أيضاً، فمجموعها نسبة ثابتة تقريباً من الزمن الكلي.
ولكن «في المتوسط» لا يعني «في كل مرة»، فالمستخدم الذي وصل طلبه في لحظة التكبير انتظر 28.9 مللي ثانية بدل 300 نانو ثانية. وفي أغلب البرامج هذا لا يهم، أما في الأنظمة التي يهمها زمن كل طلب، مثل سيرفر ألعاب أو نظام تداول، فهو سبب لحجز الحجم مسبقاً عند الإنشاء إذا كانت اللغة تسمح بذلك، مثل السعة الأولية Initial Capacity في HashMap بلغة Java. وبعض الأنظمة تكبر الجدول تدريجياً بدل مرة واحدة، فتنقل جزءاً من المفاتيح مع كل عملية، ومثال ذلك القاموس داخل Redis الذي يكبر بطريقة Incremental Rehashing كما في الملف dict.c، وقد شرحنا Redis في مقال Redis وValkey.
ماذا يحدث إذا حذفت أغلب المفاتيح Keys؟
القسم الثالث من المخرج هو تجربة «ماذا يحدث إذا…» في هذا المقال: أنشأنا قاموساً بمليون مفتاح فكان حجمه 41,943,128 بايت، ثم حذفنا كل المفاتيح إلا عشرة، فبقي الحجم 41,943,128 بايت بالضبط، أي أن القاموس لم يصغر أبداً. والسبب أن CPython لا يصغر القاموس عند الحذف، وإنما يضع علامات الحذف في الخانات ويترك الجدول بحجمه، والفكرة أن البرنامج الذي ملأ القاموس مرة سوف يملؤه غالباً مرة أخرى، فلا داعي لتصغيره ثم تكبيره. أما نسخ القاموس بـ dict(d) فبنى قاموساً جديداً بحجم مناسب لعشرة مفاتيح، أي 352 بايت، وd.clear() أعاده إلى 64 بايت.
وهذا يفسر مشكلة تظهر في الخدمات التي تعمل لأيام: قاموس يستخدم كذاكرة مؤقتة Cache لجلسات المستخدمين، يمتلئ في وقت الذروة إلى مليون جلسة، ثم تحذف الجلسات المنتهية فيبقى فيه بضعة آلاف، ولكن ذاكرة الخدمة لا تنخفض أبداً عن قيمة الذروة. فإذا رأيت هذا النمط فلا تبحث عن تسرب ذاكرة Memory Leak قبل أن تتأكد من حجم القواميس الكبيرة، والحل أن تعيد بناء القاموس بعد موجة حذف كبيرة، أو أن تستخدم مكتبة ذاكرة مؤقتة لها حد أعلى للحجم بدل قاموس يكبر بلا حد.
القاموس dict في Python من الداخل
الآن لدينا كل الأجزاء لنفهم القاموس الحقيقي في CPython: دالة هاش، وجدول من قوى العدد 2 يحسب الخانة بالقناع، وعنونة مفتوحة بتسلسل فحص خاص، وحد امتلاء عند الثلثين، وتكبير بالمضاعفة، وعلامات حذف. وبقي جزء واحد يميز قاموس Python عن الجدول الذي كتبناه، وهو طريقة ترتيبه في الذاكرة. ولكي نراه كتبنا الملف pydict.py:
# pydict.py: a look inside the Python dict (CPython 3.13)
#   python pydict.py
import sys

print('== 1) where does 41,943,128 bytes come from? (1,000,000 int keys)')
d = {i: i for i in range(1_000_000)}
size = 1 << 21                         # slots in the index array (a power of two)
usable = (size << 1) // 3              # at most two thirds of the slots are used
index_bytes = size * 4                 # each slot is a 4-byte position while positions fit in int32
entry_bytes = usable * 24              # each entry: hash, key pointer, value pointer (8 bytes each)
print(f'   index array   {size:>9,} slots x 4 bytes  = {index_bytes:>11,}')
print(f'   entries array {usable:>9,} entries x 24   = {entry_bytes:>11,}')
print(f'   sum           {index_bytes + entry_bytes:>39,}')
print(f'   getsizeof(d)  {sys.getsizeof(d):>39,}')
s = {str(i): i for i in range(1_000_000)}
print(f'   the same with str keys: getsizeof = {sys.getsizeof(s):,}  (entries x 16: {index_bytes + usable * 16:,})')

print('\n== 2) the probe sequence CPython follows for one hash in a table of 8 slots')
def probes(h, mask, count):
    perturb = h & 0xFFFFFFFFFFFFFFFF
    i = h & mask
    out = [i]
    while len(out) < count:
        perturb >>= 5
        i = (i * 5 + perturb + 1) & mask
        out.append(i)
    return out
for h in [8, 16, 1032, 2**20 + 8, 2**40 + 8]:
    print(f'   hash={h:<17,} slots tried: {probes(h, 7, 8)}')

print('\n== 3) keys that are equal are the same key')
d = {}
d[1] = 'int'; d[1.0] = 'float'; d[True] = 'bool'
print('   d =', d)

print('\n== 4) a key whose hash changes after it is stored')
class Point:
    def __init__(self, x, y): self.x, self.y = x, y
    def __eq__(self, o): return (self.x, self.y) == (o.x, o.y)
    def __hash__(self): return hash((self.x, self.y))
p = Point(1, 2)
seen = {p: 'shop A'}
p.x = 5
print('   p in seen           :', p in seen)
print('   Point(1, 2) in seen :', Point(1, 2) in seen)
print('   Point(5, 2) in seen :', Point(5, 2) in seen)
print('   len(seen)           :', len(seen), ' list(seen.values()) =', list(seen.values()))
try:
    {[1, 2]: 'x'}
except TypeError as e:
    print('   list as a key       :', e)

print('\n== 5) NaN as a key')
nan = float('nan')
d = {nan: 'first'}
d[float('nan')] = 'second'
print('   len(d) =', len(d), ' nan in d =', nan in d, ' float("nan") in d =', float('nan') in d)

print('\n== 6) insertion order is kept, and deleting then re-adding moves a key to the end')
d = {'b': 1, 'a': 2, 'c': 3}
del d['b']; d['b'] = 1
print('   ', list(d))
والمخرج سوف يكون كما يلي:
== 1) where does 41,943,128 bytes come from? (1,000,000 int keys)
   index array   2,097,152 slots x 4 bytes  =   8,388,608
   entries array 1,398,101 entries x 24   =  33,554,424
   sum                                        41,943,032
   getsizeof(d)                               41,943,128
   the same with str keys: getsizeof = 30,758,320  (entries x 16: 30,758,224)

== 2) the probe sequence CPython follows for one hash in a table of 8 slots
   hash=8                 slots tried: [0, 1, 6, 7, 4, 5, 2, 3]
   hash=16                slots tried: [0, 1, 6, 7, 4, 5, 2, 3]
   hash=1,032             slots tried: [0, 1, 7, 4, 5, 2, 3, 0]
   hash=1,048,584         slots tried: [0, 1, 6, 7, 5, 2, 3, 0]
   hash=1,099,511,627,784 slots tried: [0, 1, 6, 7, 4, 5, 2, 3]

== 3) keys that are equal are the same key
   d = {1: 'bool'}

== 4) a key whose hash changes after it is stored
   p in seen           : False
   Point(1, 2) in seen : False
   Point(5, 2) in seen : False
   len(seen)           : 1  list(seen.values()) = ['shop A']
   list as a key       : unhashable type: 'list'

== 5) NaN as a key
   len(d) = 2  nan in d = True  float("nan") in d = False

== 6) insertion order is kept, and deleting then re-adding moves a key to the end
    ['a', 'c', 'b']
القاموس المضغوط Compact Dict وحفظ الترتيب Insertion Order
حتى Python 3.5 كان القاموس جدولاً واحداً، وكل خانة فيه تحمل الهاش والمفتاح والقيمة، أي 24 بايت لكل خانة، ومع حد الثلثين يبقى ثلث هذه الخانات الكبيرة فارغاً. وفي ديسمبر 2012 اقترح Raymond Hettinger في رسالة إلى قائمة python-dev أن يقسم القاموس إلى مصفوفتين: مصفوفة فهارس Indices صغيرة هي جدول الهاش الفعلي، وكل خانة فيها رقم صغير يشير إلى موقع في مصفوفة ثانية، ومصفوفة مدخلات Entries تحمل الهاش والمفتاح والقيمة متتالية بترتيب الإدخال. ودخل هذا التصميم في Python 3.6 كتحسين في الذاكرة، ثم أصبح حفظ ترتيب الإدخال جزءاً رسمياً من اللغة في Python 3.7. والصورة التالية تبين الفكرة على ثلاثة مفاتيح:
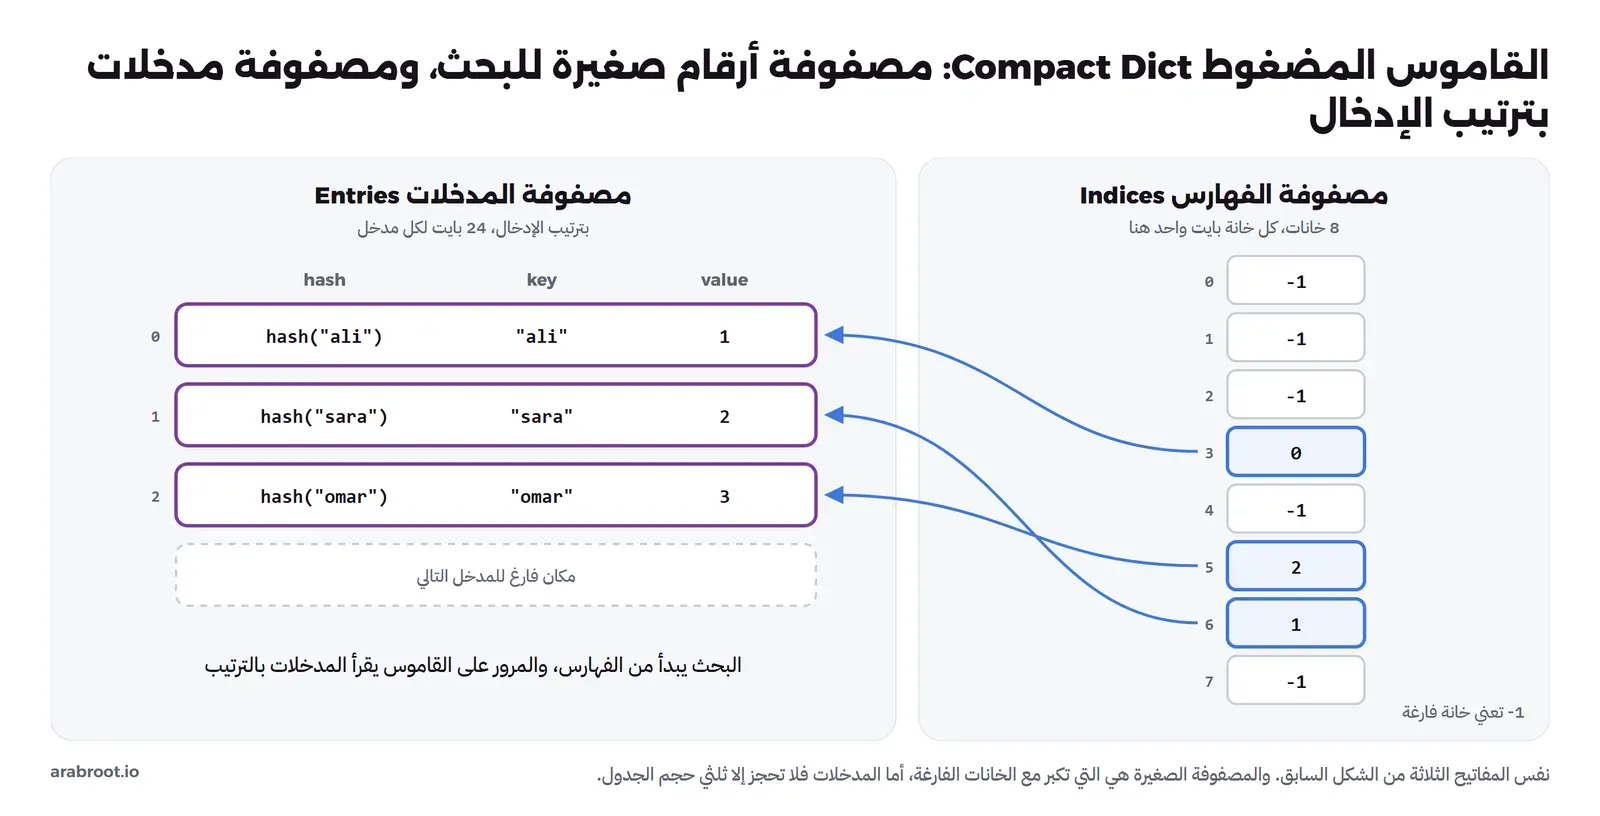
والقسم الأول من المخرج يثبت هذا التصميم بالأرقام: القاموس الذي فيه مليون مفتاح عددي له مصفوفة فهارس من 2,097,152 خانة، كل خانة 4 بايتات لأن المواقع تتسع في عدد صحيح من 32 بت، أي 8,388,608 بايت، ومصفوفة مدخلات تتسع لثلثي الخانات، أي 1,398,101 مدخل، كل مدخل 24 بايت، أي 33,554,424 بايت. والمجموع 41,943,032 بايت، والفرق بينه وبين getsizeof 96 بايت فقط هي رأس الكائن. ولاحظ أن القاموس الذي مفاتيحه نصوص فقط أصغر، 30,758,320 بايت، لأن CPython يستخدم له مدخلاً من 16 بايت بدون حقل الهاش، فالنص يحفظ هاشه داخله بعد أول حساب. وفي التصميم القديم كانت كل خانة من المليوني خانة 24 بايت، أي قرابة 50 ميجابايت، فالفهارس الصغيرة توفر الذاكرة لأن الخانات الفارغة أصبحت أرقاماً صغيرة بدل مدخلات كاملة.
والقسم السادس يبين أثراً جانبياً للترتيب: عندما حذفنا 'b' ثم أضفناه مرة أخرى انتقل إلى آخر القاموس، لأن الإضافة الجديدة تكتب مدخلاً جديداً في آخر مصفوفة المدخلات. فإذا كان كودك يعتمد على ترتيب القاموس، مثل ترتيب الحقول في JSON تكتبه لعميل، فتذكر أن الحذف ثم الإضافة يغير الترتيب، وأن تعديل قيمة مفتاح موجود لا يغيره.
تسلسل الفحص Probe Sequence في CPython
عندما يجد CPython الخانة الأولى مشغولة بمفتاح آخر لا ينتقل إلى الخانة التالية مباشرة، وإنما يحسب الخانة التالية بالمعادلة i = (5*i + perturb + 1) & mask، حيث perturb يبدأ بالهاش كاملاً ثم يزاح خمس بتات إلى اليمين في كل خطوة. والجزء 5*i + 1 وحده يمر على كل خانات الجدول مرة واحدة قبل أن يتكرر، وهذا ما تراه في المخرج للهاش 8 و16: [0, 1, 6, 7, 4, 5, 2, 3]، وهو التسلسل نفسه المكتوب في تعليقات dictobject.c. أما perturb فيدخل البتات العالية من الهاش في الحساب تدريجياً، فالمفاتيح التي تبدأ من الخانة نفسها وتختلف بتاتها العالية تفترق بعد خطوة أو اثنتين، كما في السطرين 1,032 و1,048,584. ولاحظ أن 8 و16 أعطيا التسلسل نفسه، لأن الفرق بينهما في البت الرابع، وهذا البت يختفي من perturb بعد الإزاحة الأولى، وفي جدول حقيقي أكبر يدخل هذا البت في القناع نفسه من البداية. وهذه القاعدة هي التي خفضت متوسط الفحص من 188 إلى 2.94 في مشكلة البتات المنخفضة، لأن المفاتيح المتكدسة في البداية تخرج إلى أماكن متفرقة بسرعة بدل أن تمشي في الكتلة نفسها.
المفاتيح المتساوية والمفاتيح القابلة للتغيير Mutable Keys
في القسم الثالث أضفنا ثلاثة مفاتيح: 1 بالقيمة 'int'، ثم 1.0 بالقيمة 'float'، ثم True بالقيمة 'bool'، وكانت النتيجة قاموساً فيه مفتاح واحد: {1: 'bool'}. والسبب أن الثلاثة متساوية ولها الهاش نفسه، فالإضافة الثانية والثالثة عدلتا قيمة المفتاح الموجود، وبقي المفتاح الأول 1 نفسه لأن القاموس لا يستبدل المفتاح عند تعديل القيمة. وهذا قد يظهر في الواقع إذا جمعت بيانات من مصادر مختلفة في قاموس واحد، فرقم مخزن كعدد صحيح في مصدر وكعدد عشري في آخر يصبح مفتاحاً واحداً، وهذا غالباً ما تريده، ولكن تذكر أنه يحدث.
والقسم الرابع أخطر: كلاس Point هاشه محسوب من حقليه، أضفنا نقطة إلى قاموس، ثم غيرنا p.x بعد الإضافة. والنتيجة أن p in seen أعاد False، لأن الهاش الجديد يقود إلى خانة أخرى، وPoint(1, 2) in seen أعاد False أيضاً، لأنه يصل إلى الخانة الصحيحة ولكنه يقارن نفسه بالمفتاح المحفوظ الذي أصبح (5, 2)، ومع ذلك len(seen) يقول إن القاموس فيه عنصر واحد، والقيمة 'shop A' ما زالت فيه. أي أن العنصر أصبح عالقاً: موجود في القاموس ولا يمكن الوصول إليه بأي مفتاح. ولهذا السبب ترفض Python أن تستخدم القائمة list كمفتاح كما في آخر سطر من القسم، فالقائمة قابلة للتغيير، والقاعدة في توثيق نموذج البيانات أن الكائن القابل للتغيير لا يعرف __hash__، وأن الهاش يجب ألا يتغير طوال عمر الكائن. فإذا كتبت كلاساً سوف يستخدم كمفتاح فاجعل الحقول التي يحسب منها الهاش ثابتة، والطريقة الأسهل في Python هي @dataclass(frozen=True)، أو استخدم tuple بدل الكائن.
والقسم الخامس حالة طريفة: float('nan') لا يساوي نفسه حسب معيار الأعداد العشرية، وقد شرحنا ذلك في مقال الأرقام العشرية Floating Point، ولذلك أصبح في القاموس مفتاحان من NaN، وnan in d أعاد True لأن القاموس يقارن هوية الكائن قبل المساواة، فوجد الكائن نفسه، أما float("nan") الجديد فلم يجده. وإذا كانت بياناتك قد تحتوي NaN، مثل قراءات حساسات أو أعمدة فارغة من ملف CSV، فلا تستخدمها مفاتيح في قاموس أو مجموعة قبل أن تحولها إلى قيمة ثابتة مثل None.
جداول الهاش Hash Tables في اللغات الأخرى
كل اللغات الشائعة توفر جدول هاش في مكتبتها القياسية، ولكن القرارات التي رأيناها في هذا المقال تختلف بينها، والجدول التالي يجمع أهمها من التوثيق الرسمي لكل لغة:
| اللغة | الهيكل | حل التصادم | ملاحظة من التوثيق |
|---|---|---|---|
| Python | dict وset | عنونة مفتوحة بتسلسل الفحص الذي رأيناه، وحد امتلاء الثلثين | القاموس يحفظ ترتيب الإدخال منذ 3.7، وهاش النصوص SipHash بمفتاح عشوائي |
| Java | HashMap | تسلسل منفصل، والخانة التي تطول كثيراً تتحول إلى شجرة | معامل التحميل الافتراضي 0.75، ويعاد البناء بنحو ضعف الخانات |
| Go | map | عنونة مفتوحة بتصميم Swiss Table منذ Go 1.24 | تفحص عدة خانات معاً بتعليمات SIMD بحسب مدونة Go |
| Rust | HashMap | Swiss Table بالفحص التربيعي | دالة الهاش الافتراضية تقاوم هجمات HashDoS بحسب توثيق HashMap |
في الجدول أعلاه لاحظ التالي:
- تصميم Swiss Table الذي نشرته Google في مكتبة Abseil، وشرحته في صفحة تصميم Swiss Tables، يحفظ بجانب كل خانة بايتاً صغيراً فيه جزء من الهاش، فيقارن المعالج ستة عشر بايتاً منها بتعليمة واحدة قبل أن يقارن أي مفتاح، وهذا تطوير للعنونة المفتوحة يستفيد من قرب الخانات في الذاكرة.
- Java اختارت التسلسل المنفصل، وحتى لا تصبح الخانة الطويلة قائمة خطية تحولها إلى شجرة متوازنة منذ Java 8 بحسب JEP 180، فيبقى أسوأ بحث في الخانة O(log n) بدل O(n). وقد ذكرنا هذا القرار في مقال الاحتمالات عند الحديث عن هجوم إغراق الهاش.
- كل هذه الجداول لا تضمن ترتيباً للمفاتيح إلا قاموس Python، فلا تعتمد في Go أو Java على ترتيب المرور على
mapأوHashMap، فـ مواصفة Go تقول إن ترتيب المرور علىmapغير محدد، ويتغير عملياً بين مرة وأخرى.
هجوم إغراق الهاش Hash Flooding باختصار
رأينا أن جدول الهاش O(1) بشرطين: جدول غير ممتلئ ودالة هاش توزع المفاتيح، وقد رأينا ما يحدث إذا امتلأ، والآن نرى ما يحدث إذا سقط الشرط الثاني تماماً، أي إذا أعادت كل المفاتيح الهاش نفسه. والملف التالي يقارن كلاسين: الأول هاشه من قيمته، والثاني يعيد 42 لكل المفاتيح، ثم يقيس زمن إدخال عدد متضاعف من المفاتيح، ويأخذ أفضل زمن من خمس مرات للحالة السريعة، ومرة واحدة للحالة البطيئة لأنها تأخذ دقائق:
# flood.py: what happens when many keys share one hash value
#   python flood.py
#   PYTHONHASHSEED=1 python flood.py      (the str hashes in part 2 change with the seed)
import time

class SameHash:
    """Different keys that all return the same hash: the worst case for any hash table."""
    __slots__ = ('v',)
    def __init__(self, v): self.v = v
    def __hash__(self): return 42
    def __eq__(self, o): return self.v == o.v

class GoodHash(SameHash):
    __slots__ = ()
    def __hash__(self): return hash(self.v)

print('== 1) time to insert n keys into a dict (good hash: best of 5 runs)')
print('        n     good hash      same hash     ratio')
for n in [1_000, 2_000, 4_000, 8_000, 16_000]:
    row = []
    for cls, runs in ((GoodHash, 5), (SameHash, 1)):   # the slow case runs once
        keys = [cls(i) for i in range(n)]
        best = float('inf')
        for _ in range(runs):
            t = time.perf_counter()
            d = {}
            for k in keys:
                d[k] = 1
            best = min(best, time.perf_counter() - t)
        row.append(best)
    print(f'   {n:>6,}   {row[0] * 1000:8.2f} ms   {row[1] * 1000:10.1f} ms   {row[1] / row[0]:7,.0f}x')

print('\n== 2) str hashes in this process (they change from run to run unless PYTHONHASHSEED is fixed)')
for w in ['salem', 'arabroot']:
    print(f'   hash({w!r}) = {hash(w)}')
والمخرج سوف يكون كما يلي:
== 1) time to insert n keys into a dict (good hash: best of 5 runs)
        n     good hash      same hash     ratio
    1,000       0.27 ms        211.7 ms       774x
    2,000       0.70 ms        937.5 ms     1,341x
    4,000       1.36 ms       3338.9 ms     2,453x
    8,000       2.79 ms      11448.4 ms     4,110x
   16,000       6.98 ms      47972.4 ms     6,877x

== 2) str hashes in this process (they change from run to run unless PYTHONHASHSEED is fixed)
   hash('salem') = 2237884871460666724
   hash('arabroot') = 3451761641543440588
في المخرج أعلاه لاحظ التالي:
- مع دالة هاش جيدة تضاعف الزمن تقريباً مع كل مضاعفة لعدد المفاتيح، من 0.27 مللي ثانية لألف مفتاح إلى 6.98 لستة عشر ألفاً، وهذا هو الإدخال O(1) لكل مفتاح، أي O(n) للإدخال كله.
- مع الهاش الثابت تضاعف الزمن أربع مرات تقريباً مع كل مضاعفة، من 211.7 مللي ثانية إلى قرابة 48 ثانية لستة عشر ألف مفتاح فقط، والسبب أن كل مفتاح جديد يمشي على تسلسل الفحص نفسه ويقارن نفسه بكل المفاتيح السابقة، فأصبح الإدخال O(n) لكل مفتاح، وO(n²) للإدخال كله، والنسبة بين العمودين وصلت إلى 6,877 مرة.
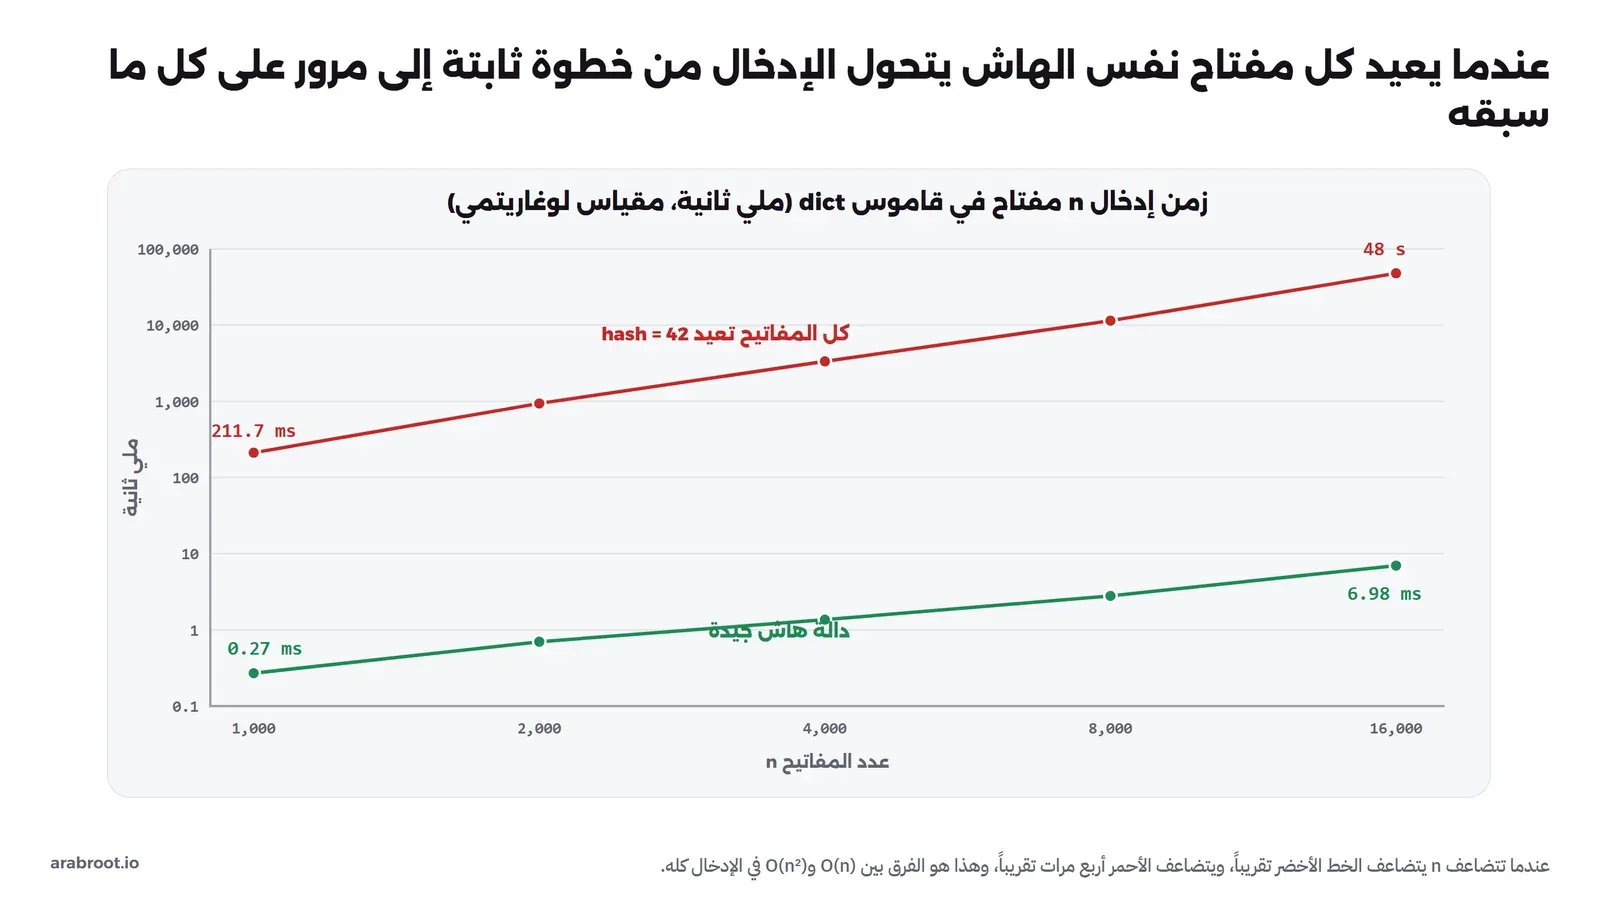
وهذا بالضبط ما يفعله هجوم إغراق الهاش Hash Flooding: إذا كانت دالة هاش النصوص ثابتة ومعروفة، يحسب المخترق مسبقاً آلاف النصوص التي تقع في الخانة نفسها، ويرسلها في طلب واحد كأسماء حقول في نموذج أو مفاتيح في JSON، فيقضي السيرفر ثواني أو دقائق في إدخالها في قاموس. وقد نشرت oCERT في نهاية 2011 التحذير oCERT-2011-003 عن هذه الثغرة في عدة لغات وسيرفرات، وشرحنا تفاصيله في مقال الاحتمالات فلن نكررها. والعلاج الذي اختارته Python هو المفتاح السري العشوائي في دالة SipHash، ولذلك يتغير هاش النصوص في كل تشغيل كما رأيت، والأمر التالي يشغل القسم الثاني من الملف مرتين دون بذرة ثم مرتين ببذرة ثابتة عبر المتغير PYTHONHASHSEED:
docker run --rm -v "$PWD:/lab" -w /lab python:3.13.17-slim sh -c 'python flood.py | tail -2; python flood.py | tail -2; PYTHONHASHSEED=1 python flood.py | tail -2; PYTHONHASHSEED=1 python flood.py | tail -2'والمخرج سوف يكون كما يلي:
   hash('salem') = 6244206504934414230
   hash('arabroot') = 4864279575366486373
   hash('salem') = -1027870559732148056
   hash('arabroot') = 1677384752179482529
   hash('salem') = -5179873367476889682
   hash('arabroot') = 1220649006570229238
   hash('salem') = -5179873367476889682
   hash('arabroot') = 1220649006570229238
التشغيلان الأولان أعطيا أرقاماً مختلفة تماماً للنص نفسه، والتشغيلان مع PYTHONHASHSEED=1 أعطيا الأرقام نفسها. والبذرة الثابتة مفيدة في الاختبارات فقط، عندما تريد أن يتكرر ترتيب set من النصوص بين تشغيل وآخر، أما في الإنتاج فلا تقم بتثبيتها، والسبب أنها تعيد الثغرة التي أغلقها المفتاح العشوائي. ولاحظ أيضاً أن الحماية تخص النصوص والبايتات فقط، فهاش الأعداد الصحيحة ما زال العدد نفسه، فإذا كانت خدمتك تحفظ في قاموس أرقاماً يرسلها المستخدم بأعداد كبيرة، فضع حداً لعدد الحقول في الطلب الواحد، وهذا ما فعلته أغلب أطر الويب بعد تحذير 2011.
أخطاء شائعة Common Mistakes
- البحث في قائمة داخل حلقة بدل المجموعة أو القاموس:
if x in itemsعلى قائمة O(n)، وداخل حلقة يصبح O(n²)، وتغييرitemsإلىsetيحل المشكلة دون تغيير المنطق، وقد قسنا هذا الفرق في مقال Big-O. - تغيير مفتاح بعد إضافته: كما رأيت في القسم الرابع، العنصر يبقى في القاموس ولا يمكن الوصول إليه. اجعل المفاتيح ثابتة، وإذا احتجت تغيير المفتاح فاحذف العنصر ثم أضفه بالمفتاح الجديد.
- كتابة
__eq__دون__hash__أو العكس: إذا عرفت__eq__في كلاس دون__hash__فإن Python تجعل الكلاس غير قابل للهاش، وإذا عرفت__hash__يعتمد على حقول لا تدخل في__eq__فقد يتساوى كائنان وهاشهما مختلف، فيصبحان مفتاحين في القاموس. القاعدة أن يحسب الهاش من الحقول نفسها التي تقارنها المساواة. - دالة هاش ضعيفة في كلاس خاص بك: مثل إرجاع رقم ثابت، أو جمع حقول قيمها متقاربة، والنتيجة رأيتها في التجربة. أسهل حل في Python أن تعيد
hash((self.a, self.b))على tuple من الحقول. - الاعتماد على ترتيب المرور في لغة لا تضمنه: قاموس Python يحفظ ترتيب الإدخال، ولكن
setفي Python وmapفي Go وHashMapفي Java لا تضمن أي ترتيب، فإذا احتجت الترتيب فرتب المفاتيح صراحة. - الاعتماد على قيمة
hash()خارج العملية: هاش النصوص يتغير في كل تشغيل، فلا تحفظه في قاعدة بيانات ولا تستخدمه لتوزيع المستخدمين على سيرفرات، واستخدم لذلك دالة ثابتة مثل SHA-256 أوzlib.crc32بحسب الحاجة. - توقع أن ينكمش القاموس بعد الحذف: القاموس الذي امتلأ مرة يبقى بحجمه، فإذا كانت الذاكرة مهمة فأعد بناءه بعد موجة الحذف.
- استخدام جدول الهاش لما يحتاج ترتيباً أو مدى: سؤال مثل «كل الطلبات بين تاريخين» لا يستفيد من الهاش أبداً، لأن الهاش يفرق المفاتيح المتقاربة عمداً، وهنا تحتاج قائمة مرتبة مع بحث ثنائي أو شجرة أو فهرس B-tree كما في مقال الفهارس وقراءة EXPLAIN.
جدول القرار Decision Table: هل تحتاج جدول هاش Hash Table؟
| السؤال الذي يسأله الكود | الهيكل المناسب | السبب |
|---|---|---|
| «هل هذا العنصر موجود؟» أو «ما قيمة هذا المفتاح؟» | جدول هاش: dict أو set | O(1) في المتوسط مهما كبرت البيانات |
| «ما العناصر بين قيمتين؟» أو «أعطني الأصغر» | قائمة مرتبة مع bisect، أو شجرة، أو كومة Heap | الهاش يفرق المفاتيح المتقاربة ولا يحفظ أي ترتيب |
| مفاتيح أرقام صغيرة متتالية مثل 0 إلى 999 | مصفوفة عادية بالعنونة المباشرة | لا تحتاج هاشاً ولا تصادماً، والمصفوفة أصغر وأسرع |
| مفاتيح يرسلها مستخدم من الإنترنت | جدول هاش بدالة بمفتاح سري، مع حد لعدد المفاتيح في الطلب | الحماية من إغراق الهاش |
| زمن كل عملية مهم وليس المتوسط فقط | حجز السعة مسبقاً، أو جدول يكبر تدريجياً | لحظة التكبير قد تكون أبطأ من الإدخال العادي آلاف المرات |
| توزيع مفاتيح على سيرفرات أو ملفات يبقى بعد إعادة التشغيل | دالة هاش ثابتة معروفة مثل SHA-256 أو CRC32 | hash() يتغير بين التشغيلات |
| مقارنة حجم الذاكرة لملايين المفاتيح | قس بـ sys.getsizeof وجرب مفاتيح نصية أو tuples | المفاتيح النصية أصغر في القاموس كما رأيت، والمدخل يتغير بحسب النوع |
قائمة تحقق Checklist
- هل البحث بالمفتاح في الكود الساخن على
dictأوset، وليس على قائمة؟ - هل كل كلاس يستخدم كمفتاح ثابت الحقول، وهاشه محسوب من الحقول نفسها التي تقارنها المساواة؟
- هل اختبرت دالة الهاش الخاصة بك على مفاتيحك الحقيقية، وقست أطول سلسلة وليس المتوسط فقط؟
- هل يمكن أن تحتوي المفاتيح على NaN أو على أنواع مختلفة متساوية مثل 1 و1.0؟
- هل تعتمد على ترتيب المرور في هيكل لا يضمنه؟
- هل يوجد قاموس كبير يمتلئ ثم يفرغ في خدمة تعمل طويلاً، وهل تعيد بناءه بعد الحذف؟
- هل المفاتيح القادمة من المستخدم محدودة العدد في الطلب الواحد؟
- هل
PYTHONHASHSEEDغير مثبت في بيئة الإنتاج؟ - إذا كان زمن كل طلب مهماً، فهل قست لحظات التكبير وليس المتوسط فقط؟
تدريب عملي Practice
- عدل
tables.pyحتى يستخدم الفحص التربيعي، أي أن تكون الخانة التالية(h + k*k) & maskفي الخطوة k، ثم قارن أرقامه عند 90% و95% بالفحص الخطي وبقاعدة CPython. - أضف إلى
LinearProbingTableدالة حذف تضع علامة حذف Tombstone، ثم احذف نصف المفاتيح وأضف مفاتيح جديدة بالعدد نفسه، وقس متوسط الفحص قبل الحذف وبعده. - غير في
hashes.pyالمفاتيح إلى أرقام هواتف بالشكل05xxxxxxxxكنصوص، وقارن توزيع دالة المجموع ودالةhash()عليها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- جدول الهاش يحول المفتاح إلى رقم بدالة الهاش، ثم إلى رقم خانة بالقناع أو باقي القسمة، فيصل إلى القيمة بخطوة أو اثنتين بدل المرور على كل العناصر.
- التصادم محتوم، وحله إما بالتسلسل المنفصل الذي بقي في التجربة بين 1.13 و2.00 مقارنة حتى عند 99% امتلاء، أو بالعنونة المفتوحة التي تحفظ كل شيء في مصفوفة واحدة وتتدهور بسرعة بعد 75%، حيث وصل الفحص الخطي إلى 3,215 خانة لكل بحث عند 99%.
- دالة الهاش الجيدة توزع المفاتيح المتشابهة، والدوال الضعيفة جمعت عشرة آلاف بريد في خانة واحدة أو في 37 خانة، والمفاتيح التي تتشارك البتات المنخفضة احتاجت 188 خانة بالفحص الخطي و2.94 بقاعدة CPython.
- القاموس في Python يكبر عند ثلثي الخانات بمضاعفة الحجم، ولحظات التكبير هي أبطأ الإدخالات، وأكبرها 28.9 مللي ثانية لمليون مفتاح، ولكن التكلفة الموزعة تبقي الإدخال O(1) في المتوسط، والقاموس لا يصغر بعد الحذف.
- القاموس المضغوط يفصل الفهارس الصغيرة عن المدخلات المرتبة، وهذا يفسر حجم 41,943,128 بايت لمليون مفتاح، ويفسر حفظ ترتيب الإدخال منذ Python 3.7.
- المفتاح الذي يتغير هاشه بعد إضافته يصبح عالقاً في القاموس، و1 و1.0 وTrue مفتاح واحد، وNaN لا يجد نفسه إلا بالكائن نفسه.
- الهاش الثابت حول الإدخال إلى O(n²) وأبطأ 6,877 مرة عند ستة عشر ألف مفتاح، ولذلك تستخدم Python مفتاحاً سرياً عشوائياً لهاش النصوص.
وفي المرحلة نفسها يأتي مقال البحث والترتيب ومقال خوارزميات الرسوم البيانية، وهذه المقالات المنشورة التي يعتمد عليها هذا المقال أو يكملها:
 دليلهياكل البيانات Data Structures للمبتدئينلماذا تكون نفس العملية سريعة في هيكل بيانات وبطيئة في آخر، وأين تقابل كل هيكل في السيرفرات وقواعد البيانات.
 دليلBig-O للمبتدئين: لماذا يبطؤ كودك عندما تكبر البياناتلماذا يعمل الكود بسرعة على مئة صف ثم يتوقف على مئة ألف، وكيف تقرأ Big-O وتكتشف الخوارزمية البطيئة في كودك.
 دليلالاحتمالات Probability للمبرمجين: التصادم Collision والتوفركم معرفاً أو رابطاً قصيراً تنشئ قبل أول تكرار، ولماذا يخدعك افتراض الاستقلال في حساب التوفر والإعادة، بأرقام محسوبة ومحاكاة حقيقية.
 دليلالرقم المتسلسل أم UUID؟ كيف تختار المعرف الفريدلماذا يفشل الرقم المتسلسل في الروابط وعند تعدد السيرفرات، وكيف يؤثر نوع المعرف الذي تختاره على فهرس قاعدة البيانات.
 دليلالتعبيرات النمطية Regex للمبتدئين، مع النص العربيكيف تقرأ وتكتب تعبيراً نمطياً جزءاً بجزء، ولماذا يختلف سلوكه مع النص العربي بين اللغات، وكيف يوقف نمط واحد سيرفرك.
 دليلالتشفير للمطورين: ماذا تستخدم ولماذا لا تخترع خوارزميتكأي هاش تستخدم لكلمات المرور، ومتى تحتاج التشفير المتماثل أو غير المتماثل، وأين تحفظ المفاتيح بأمان في تطبيقك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ ملفات التجربة في Container من
python:3.13.17-slim(Python 3.13.17) على Docker Engine 29.8.0.


