لنفرض أنك تعمل في شركة مقاولات صغيرة لها فرق صيانة تعمل في الشارع في أكثر من منطقة من مناطق المملكة، وفي اجتماع التخطيط للسنة القادمة سأل مدير العمليات سؤالاً يبدو بسيطاً: كم يوماً في السنة تتجاوز فيه الحرارة 45 درجة في كل منطقة نعمل فيها، وفي أي الأشهر تأتي هذه الأيام، وكم منها يقع خارج فترة حظر العمل تحت أشعة الشمس التي تعلنها الوزارة كل صيف؟ والسبب أن الشركة تريد أن تعرف متى تقدم مواعيد الفرق إلى الصباح الباكر، ومتى توفر مياهاً ومظلات إضافية، وفي أي منطقة تحتاج إلى فرق احتياطية لأن ساعات العمل الفعلية سوف تقل. والمطلوب منك أن ترجع بإجابة مكتوبة بالأرقام خلال يومين، وليس بانطباع عام من نوع «الصيف حار في الشرقية».
والبيانات موجودة ومجانية، فالإدارة الوطنية الأمريكية للمحيطات والغلاف الجوي NOAA تنشر قراءات يومية لمحطات الطقس في العالم كله، ومنها 32 محطة داخل المملكة بعضها يبدأ سجله في الأربعينيات، ولكن عندما تفتح ملفاتها سوف تجد 482 ألف صف موزعة على 32 ملف CSV، وأعمدة بأسماء مختصرة، ودرجات حرارة مكتوبة بأعشار الدرجة، وأياماً كثيرة مفقودة، وقراءات عليها علامات تقول إنها فشلت في فحص الجودة. وهذا الحجم أكبر من أن تفتحه في Excel وتعمل عليه براحة، وأصغر بكثير من أن يحتاج إلى قاعدة بيانات أو Cluster. وهذه بالضبط هي المنطقة التي صممت لها مكتبة pandas في Python: جدول في الذاكرة تقرؤه وتنظفه وتجمعه وتربطه بجداول أخرى وترسمه بأسطر قليلة من الكود، وتستطيع أن تعيد تشغيل التحليل كله بأمر واحد إذا وصلت بيانات جديدة.
وفي هذا المقال سوف نجيب على سؤال مدير العمليات خطوة بخطوة، وكل رقم في المقال هو مخرج حقيقي من تشغيل الكود الموجود في مجلد lab داخل Container من نوع python:3.13-slim مع pandas 3.1.0. وسوف نناقش في هذا المقال ما يلي:
- لماذا وجدت pandas، ومتى تكون أنسب من Excel ومن قاعدة البيانات.
- مصدر البيانات GHCN-Daily وكيف نقرأ وصفها قبل أن نقرأ أرقامها.
- الجدول DataFrame والعمود Series والفهرس Index والنوع dtype، من أول نظرة على ملف واحد.
- تنظيف البيانات Data Cleaning: قراءة 32 ملفاً، وعلامات الجودة، والوحدات، والقيم الشاذة التي تمر من الفحص.
- الربط Merge مع جدول المناطق، والتجميع GroupBy، ولماذا يجب أن نقيس التغطية Coverage قبل أن نصدق أي متوسط.
- التواريخ Dates: الأشهر والمتوسطات المتحركة والجدول المحوري Pivot Table وفترة حظر العمل.
- الأخطاء التي وقعنا فيها فعلاً، ومنها النوع المختلط وNaN والإسناد المتسلسل Chained Assignment والمفتاح المكرر.
- تجربة «ماذا يحدث إذا» على شرط التغطية، ثم نظرة قصيرة على Polars، وقائمة تحقق قبل أن ترسل أي رقم للإدارة.
لماذا pandas؟ Why pandas
بدأ تطوير pandas في سنة 2008 داخل شركة AQR Capital Management للاستثمار، وأصبحت مفتوحة المصدر في نهاية 2009 كما يذكر تاريخ المشروع في موقعه الرسمي. والمشكلة التي كانت تحلها في ذلك الوقت هي نفس مشكلتنا اليوم: بيانات على شكل جداول وسلاسل زمنية Time Series، تحتاج إلى عمليات متكررة مثل التصفية والتجميع والربط وحساب المتوسطات على فترات، وكانت تكتب إما في Excel يدوياً، أو في R، أو في حلقات Python طويلة تمر على الصفوف صفاً صفاً. ففكرة pandas أن تعطيك هيكلاً واحداً هو الجدول، وعمليات على الجدول كله دفعة واحدة، بحيث تكتب «اجمع هذا العمود حسب المحطة والسنة» بدل أن تكتب حلقة وقاموساً وشروطاً.
وقد يتساءل البعض: لماذا لا أستخدم Excel؟ والإجابة أن Excel ممتاز لجدول تراه بعينك وتعدله بيدك، ولكن فيه مشكلتين مع عملنا هذا. الأولى أن الخطوات لا تحفظ، فإذا حذفت صفوفاً أو عدلت قيمة لا يبقى أثر لما فعلت، وعندما يسألك المدير بعد شهر «كيف وصلت إلى 77 يوماً؟» لن تستطيع أن تعيد الطريق. والثانية أن Excel يغير البيانات وهو يقرؤها، فيحول نصوصاً إلى تواريخ ويحذف الأصفار من أول الأرقام دون أن يسألك. أما قاعدة البيانات ولغة SQL التي شرحناها في أساسيات SQL للمطورين فهي أنسب عندما تكون البيانات أكبر من الذاكرة أو يشترك فيها نظام يعمل طوال الوقت، ولكنها تحتاج إلى تحميل الملفات أولاً وتصميم جداول، وهذا عمل زائد لسؤال تحليلي ينتهي في يومين. وpandas تقع في الوسط: كل خطوة كود يمكن قراءته وإعادة تشغيله، والبيانات في الذاكرة، والجواب يخرج في ثوان.
ولاحظ أننا نستخدم في هذا المقال pandas 3، التي صدرت في 21 يناير 2026 بتغييرين يهمان المبتدئ مباشرة: أعمدة النصوص أصبحت بنوع نصي خاص بدل النوع العام object، والنسخ أصبح بقاعدة Copy-on-Write التي سوف نراها عندما نصل إلى الأخطاء الشائعة. وإذا قرأت شرحاً قديماً على الإنترنت فقد تجد أن سلوكه يختلف عما تراه هنا، والسبب غالباً هذا الإصدار.
مصدر البيانات GHCN-Daily: اقرأ الوصف قبل الأرقام
الشبكة العالمية للمناخ اليومي Global Historical Climatology Network Daily، واختصاراً GHCN-Daily، هي قاعدة بيانات تجمع ملخصات يومية من محطات أرضية حول العالم، وبحسب صفحتها الرسمية فيها سجلات أكثر من 100 ألف محطة في 180 دولة، وتمر كلها بمجموعة واحدة من فحوص الجودة. ولكل محطة رمز من 11 حرفاً، يبدأ بحرفين للدولة، والمحطات السعودية تبدأ بالحرفين SA. وأول خطوة في أي تحليل ليست كتابة كود، وإنما قراءة ملف الوصف، لأن الأرقام في هذه الملفات لا تعني ما تظنه من النظرة الأولى.
ففي ملف readme الرسمي سوف تجد ثلاث معلومات غيرت كل ما بعدها في تحليلنا:
- العمود
TMAXهو درجة الحرارة العظمى في اليوم، وهو مكتوب بأعشار الدرجة المئوية، فالقيمة 472 تعني 47.2 درجة. ولو حسبت المتوسط مباشرة لخرج لك رقم مثل 336 درجة، وهذا خطأ يكتشفه أي شخص، ولكن الخطأ الأخطر أن تقارن 450 بـ 45 في شرط ولا ينجح أي صف دون أن تنتبه. - بجانب كل قيمة عمود اسمه
TMAX_ATTRIBUTESفيه ثلاث علامات مفصولة بفواصل: علامة القياس، وعلامة الجودة Quality Flag، ومصدر القراءة. وعلامة الجودة إذا كانت فارغة فالقراءة نجحت في كل الفحوص، وإذا كانت حرفاً فهي فشلت في فحص معين، مثلXلفحص الحدود Bounds Check، وOلفحص القيم الشاذة مقارنة بالمناخ المعتاد، وIلفحص التناسق الداخلي. - الأيام التي لا توجد فيها قراءة ليست صفراً، وإنما غير موجودة، وهذا فرق سوف يظهر في كل خطوة.
والملفات بصيغة CSV لكل محطة موصوفة في ملف وصف الملفات حسب المحطة، وحجمها لكل المحطات السعودية قرابة 53 ميجابايت، ولذلك لم نضعها في مجلد lab، وإنما وضعنا سكربت fetch.py الذي ينزلها من موقع NCEI، وعينة صغيرة لمحطة واحدة في lab/data لمن يريد أن ينظر قبل التنزيل. والبيانات منشورة من جهة حكومية أمريكية للاستخدام العام، ولكن الوصف يطلب ذكر المصدر عند النشر، وهذا ما نفعله هنا.
# Downloads the daily records of every Saudi station in NOAA GHCN-Daily (public domain, about 53 MB) into data/ghcn/
import os, urllib.request

BASE = "https://www.ncei.noaa.gov"
os.makedirs("data/ghcn", exist_ok=True)
urllib.request.urlretrieve(f"{BASE}/pub/data/ghcn/daily/ghcnd-stations.txt", "data/ghcnd-stations.txt")
ids = [line[:11] for line in open("data/ghcnd-stations.txt") if line.startswith("SA")]
for i in ids:
    urllib.request.urlretrieve(f"{BASE}/data/global-historical-climatology-network-daily/access/{i}.csv", f"data/ghcn/{i}.csv")
print(len(ids), "stations")
وتشغيل التجربة كاملة يتم بأمر واحد من داخل المجلد، فالسكربت run.sh يشغل Container مؤقتاً، ويثبت فيه الإصدارات المحددة من المكتبات، ثم ينزل البيانات ويشغل الخطوات بالترتيب:
#!/bin/sh
# Run from this folder. Everything happens inside a throwaway python:3.13-slim container.
docker run --rm --name lab-pandas -v "$PWD":/work -w /work python:3.13-slim sh -c '
  pip install -q --root-user-action=ignore pandas==3.1.0 pyarrow==26.0.0 matplotlib==3.11.2 polars==2.1.0 &&
  python fetch.py &&
  for s in step1_first_look step2_first_try step2_load_all step2b_outliers step3_heat_days step4_months_trend step5_pitfalls step6_polars step7_whatif; do
    echo "=== $s"; python $s.py
  done'
في السكربت أعلاه لاحظ التالي:
- الإصدارات مثبتة بالرقم
pandas==3.1.0وليس بأحدث إصدار، لأن سلوك pandas تغير بين الإصدارات الرئيسية، ونريد أن يحصل من يعيد التجربة بعد سنة على نفس المخرج. - المكتبة
pyarrowمطلوبة لحفظ الجدول بصيغة Parquet التي سوف نستخدمها بين الخطوات، وmatplotlibللرسم، وpolarsللمقارنة في آخر المقال. - لا شيء يثبت على جهازك، فإذا انتهت التجربة يحذف الـ Container مع الخيار
--rm.
النظرة الأولى First Look: ملف واحد قبل 32 ملفاً
الخطأ الشائع عند المبتدئ أن يقرأ كل الملفات مرة واحدة ثم يبدأ في الحساب. والطريقة الأصح أن تفتح ملفاً واحداً وتنظر إلى شكله وأنواع أعمدته وكم فيه من القيم المفقودة، لأن ما تراه في ملف واحد سوف يتكرر غالباً في البقية. واخترنا محطة مطار الملك خالد الدولي SAM00040437:
# Step 1: open one station file and look before touching anything
import pandas as pd

df = pd.read_csv("data/ghcn/SAM00040437.csv")
print(df.shape)
print(df.dtypes)
print(df[["DATE", "TMAX", "TMAX_ATTRIBUTES", "TMIN", "PRCP"]].head(3))
print(df.isna().sum()[["TMAX", "TMIN", "PRCP"]])
print(df["TMAX"].describe().round(1))
والمخرج سوف يكون كما يلي:
(15199, 14)
STATION                str
DATE                   str
LATITUDE           float64
LONGITUDE          float64
ELEVATION          float64
NAME                   str
PRCP               float64
PRCP_ATTRIBUTES        str
TMAX               float64
TMAX_ATTRIBUTES        str
TMIN               float64
TMIN_ATTRIBUTES        str
TAVG                 int64
TAVG_ATTRIBUTES        str
dtype: object
         DATE  TMAX TMAX_ATTRIBUTES  TMIN  PRCP
0  1983-12-23   NaN             NaN   NaN   NaN
1  1983-12-24   NaN             NaN   NaN   NaN
2  1983-12-25   NaN             NaN   NaN   NaN
TMAX     3715
TMIN     3563
PRCP    14435
dtype: int64
count    11484.0
mean       336.5
std         90.1
min         74.0
25%        260.0
50%        352.0
75%        420.0
max        488.0
Name: TMAX, dtype: float64
في المخرج أعلاه لاحظ التالي:
- السطر الأول
(15199, 14)هو شكل الجدول Shape: 15,199 صفاً، أي يوماً، و14 عموداً. والصفوف تمتد من ديسمبر 1983 إلى أغسطس 2025 دون أيام ناقصة تقريباً، ولكن وجود صف لليوم لا يعني وجود قراءة فيه، كما سوف نرى بعد سطرين. - عمود التاريخ
DATEنوعهstr، أي نص. فـ pandas لا تخمن أن العمود تاريخ إلا إذا طلبت ذلك، وهذا جيد لأن التخمين في Excel هو مصدر مشاكل كثيرة، ولكنه يعني أنك إذا رتبت أو قارنت هذا العمود فأنت ترتب نصوصاً. - الأعمدة
TMAXوTMINوPRCPنوعهاfloat64، أي أرقام عشرية، رغم أن القيم في الملف أعداد صحيحة مثل 352. والسبب أن في هذه الأعمدة قيماً مفقودة، والقيمة المفقودة في pandas هيNaN، وهي قيمة من نوع العدد العشري كما شرحنا في مقال Floating Point من الداخل، فلا يمكن وضعها في عمود أعداد صحيحةint64، فيتحول العمود كله إلى عشري. - العمود
TAVGنوعهint64، أي أعداد صحيحة، لأنه ليس فيه أي قيمة مفقودة: هذا المتوسط اليومي موجود في كل الصفوف، وعلامته في الملفHأي أنه محسوب من القراءات الساعية. ولكن سؤالنا عن الحرارة العظمى في اليوم، لأن الحر الذي يرهق العامل في الظهر هو العظمى وليس المتوسط، فلا نستخدمه. - أول ثلاثة أيام في الملف، من 23 ديسمبر 1983، كلها
NaN، أي أن المحطة لها صف لليوم ولكن بلا قراءة حرارة. - عدد القيم المفقودة في
TMAXهو 3,715 من 15,199، أي قرابة ربع الأيام. وفيPRCPالمطر 14,435، أي أن هذه المحطة تقريباً لا ترسل قراءة المطر، وهذا منطقي في منطقة لا تمطر أغلب السنة، ولكنه يعني أيضاً أن غياب القراءة لا يعني أن المطر صفر. - الدالة
describe()أعطت المتوسط 336.5 والأعلى 488، وهنا تظهر الوحدة: هذه أعشار الدرجة، فالأعلى 48.8 درجة. ولاحظ أنcountهو 11,484 وليس 15,199، لأن الدوال الإحصائية في pandas تتجاهلNaNافتراضياً.
الجدول DataFrame والعمود Series والفهرس Index
قبل أن نكمل، لنضع أسماء صحيحة للأشياء التي رأيناها، لأن كل خطأ لاحق سوف يكون في أحدها. فالجدول في pandas اسمه DataFrame، وهو مجموعة أعمدة متساوية الطول، وكل عمود فيه هو Series، أي مصفوفة قيم من نوع واحد dtype مع فهرس. والفهرس Index هو عنوان كل صف، وهو في حالتنا رقم الصف في الجدول المدمج، ولكنه يمكن أن يكون تاريخاً أو رمز محطة، وعندها تصبح عمليات مثل اختيار فترة زمنية أسهل بكثير. والنقطة المهمة هنا أن النوع للعمود كله وليس للخلية، فإذا وجدت خلية واحدة نصية في عمود أرقام، أو خلية مفقودة في عمود أعداد صحيحة، فإن العمود كله يتغير نوعه، ويتغير معه سلوك كل عملية عليه.
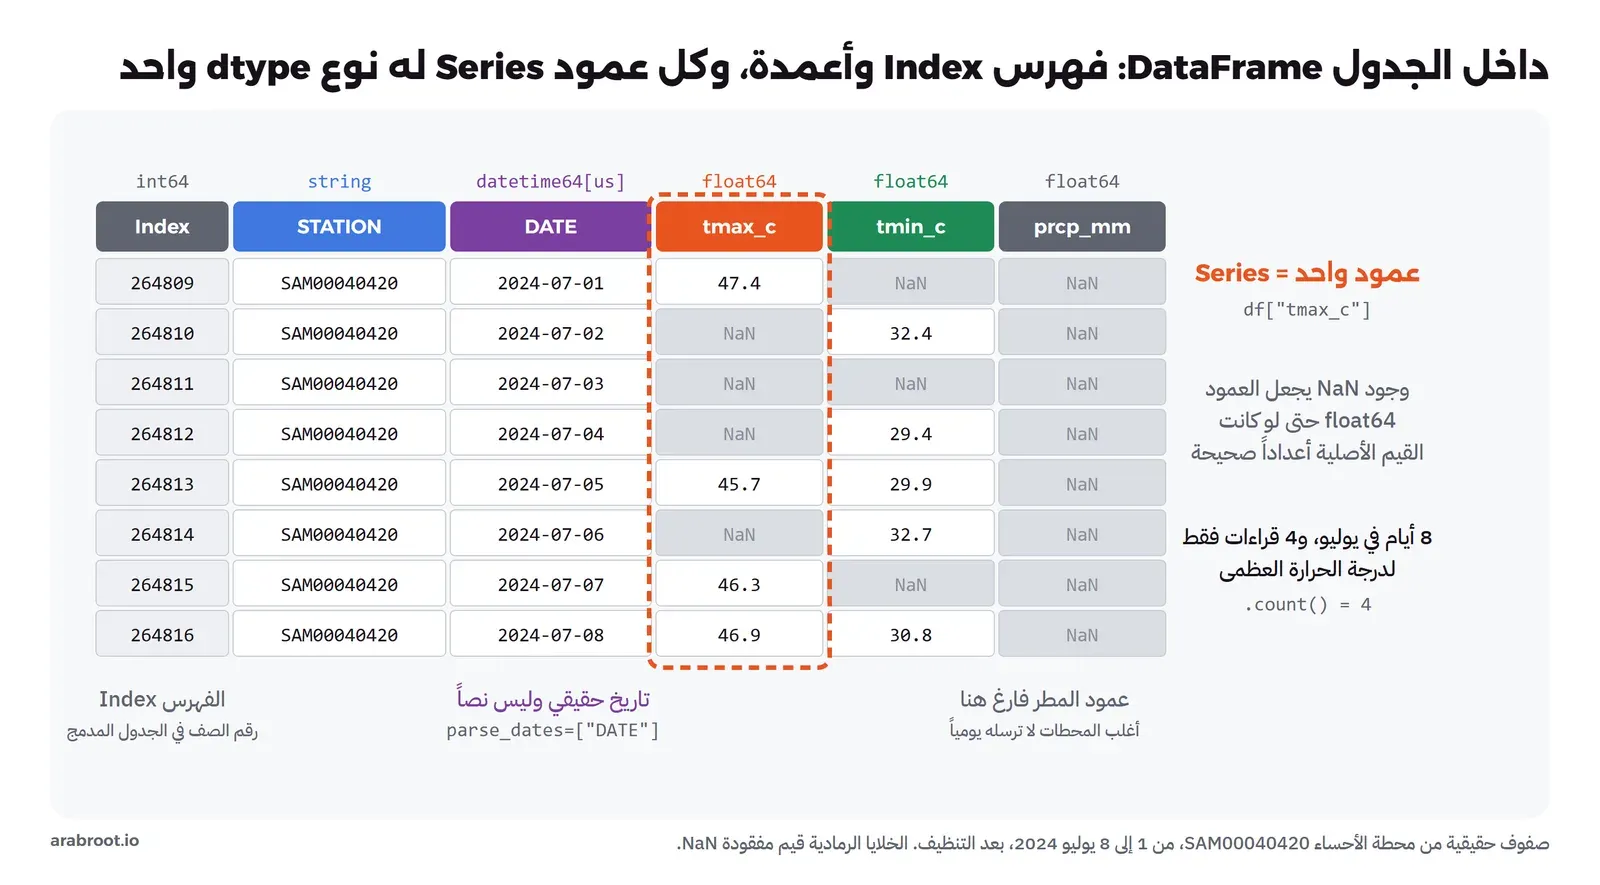
count() تعد القيم الموجودة فقط.وفي الشكل أعلاه ثمانية أيام من يوليو 2024 في محطة الأحساء، وهي من أحر المحطات في البيانات، ومع ذلك فيها أربع قراءات فقط للحرارة العظمى من ثمانية أيام. وهذه الملاحظة الصغيرة هي أهم ما في المقال كله، وسوف نعود إليها عندما نحسب عدد الأيام الحارة: فإذا كان نصف الأيام مفقوداً، فإن «عدد الأيام التي تجاوزت 45 درجة» سوف يخرج نصف الحقيقة تقريباً.
تنظيف البيانات Data Cleaning: من 32 ملفاً إلى جدول واحد
الآن نقرأ كل الملفات في جدول واحد. والفكرة بسيطة: نمر على الملفات بالدالة glob، ونقرأ كل ملف بالدالة read_csv، ثم ندمجها بالدالة concat. ولأننا لا نحتاج كل الأعمدة، فالأفضل أن نطلب الأعمدة التي نحتاجها فقط بالخيار usecols، وهذا يقلل الذاكرة ويمنع مشاكل الأنواع في الأعمدة التي لا تهمنا. وهذه كانت محاولتنا الأولى:
# Step 2, first try: usecols as a list (fails on one file)
import glob
import pandas as pd

cols = ["STATION", "DATE", "NAME", "TMAX", "TMAX_ATTRIBUTES", "TMIN", "TMIN_ATTRIBUTES", "PRCP"]
for f in sorted(glob.glob("data/ghcn/*.csv")):
    try:
        pd.read_csv(f, usecols=cols)
    except ValueError as e:
        print(f, "->", e)
data/ghcn/SAM00040410.csv -> Usecols do not match columns, columns expected but not found: ['PRCP']وهذه أول مشكلة حقيقية واجهتنا: محطة واحدة من 32، وهي محطة خيبر SAM00040410، ليس في ملفها عمود PRCP أصلاً، لأنها لم ترسل أي قراءة مطر في تاريخها، فلم ينشئ الملف العمود. والدالة read_csv عندما تعطيها قائمة أعمدة فهي تعتبرها شرطاً، وإذا نقص منها عمود ترفض الملف كله. ولو كنا نقرأ الملفات في حلقة دون try لتوقف السكربت عند هذا الملف، وهذا أفضل من أن يمر بصمت. والحل أن نعطي usecols دالة بدل القائمة، فتسأل pandas الدالة عن كل عمود موجود «هل أقرؤه؟»، فإذا لم يوجد العمود لا تشتكي، ويصبح العمود في الجدول المدمج NaN لصفوف هذه المحطة. وهذا هو الكود الكامل للخطوة الثانية:
# Step 2: all 32 stations in one DataFrame, typed and cleaned
# (one file, SAM00040410, has no PRCP column: usecols as a list fails, a function accepts it)
import glob
import pandas as pd

cols = ["STATION", "DATE", "NAME", "TMAX", "TMAX_ATTRIBUTES", "TMIN", "TMIN_ATTRIBUTES", "PRCP"]
frames = [pd.read_csv(f, usecols=lambda c: c in cols, dtype={"STATION": "string", "NAME": "string"},
                      parse_dates=["DATE"]) for f in sorted(glob.glob("data/ghcn/*.csv"))]
raw = pd.concat(frames, ignore_index=True)
print(raw.shape)
print(raw.dtypes)
print(f"memory: {raw.memory_usage(deep=True).sum() / 1e6:.1f} MB")

# The attributes column is "measurement,quality,source"; a non-empty quality flag means a failed check
flags = raw["TMAX_ATTRIBUTES"].str.split(",", expand=True)
raw["tmax_q"] = flags[1].replace("", pd.NA)
print(raw["tmax_q"].value_counts(dropna=False))

df = raw.copy()
df.loc[df["tmax_q"].notna(), "TMAX"] = pd.NA      # drop flagged readings, keep the row
df["tmax_c"] = df["TMAX"] / 10                     # tenths of a degree -> degrees
df["tmin_c"] = df["TMIN"] / 10
df["prcp_mm"] = df["PRCP"] / 10
df = df.drop(columns=["TMAX", "TMIN", "PRCP", "TMAX_ATTRIBUTES", "TMIN_ATTRIBUTES"])
print(df["tmax_c"].describe().round(1))
print(df.nlargest(4, "tmax_c")[["STATION", "NAME", "DATE", "tmax_c"]])
df.to_parquet("data/clean.parquet")
print("saved", len(df))
والمخرج سوف يكون كما يلي:
(482433, 8)
STATION                    string
DATE               datetime64[us]
NAME                       string
PRCP                      float64
TMAX                      float64
TMAX_ATTRIBUTES               str
TMIN                      float64
TMIN_ATTRIBUTES               str
dtype: object
memory: 45.2 MB
tmax_q
NaN    482328
O          97
I           7
X           1
Name: count, dtype: int64
count    387896.0
mean         32.2
std           8.3
min           1.2
25%          26.0
50%          33.0
75%          39.0
max          54.7
Name: tmax_c, dtype: float64
            STATION                           NAME       DATE  tmax_c
152339  SAM00040362                      RAFHA, SA 2006-08-25    54.7
199144  SAM00040377  KING KHALED MILITARY CITY, SA 1999-08-14    54.0
66022   SA000041024          JEDDAH KING ABDUL, SA 2010-06-22    52.0
66021   SA000041024          JEDDAH KING ABDUL, SA 2010-06-21    51.8
saved 482433
في المخرج أعلاه لاحظ التالي:
- الجدول المدمج فيه 482,433 صفاً و8 أعمدة، ويأخذ 45.2 ميجابايت في الذاكرة. والخيار
deep=Trueمهم هنا، لأن بدونه لا تحسب pandas الحجم الحقيقي للنصوص، فيخرج رقم أصغر من الحقيقة. - عمود التاريخ أصبح
datetime64[us]بفضلparse_dates، أي تاريخ حقيقي يمكن أن نستخرج منه السنة والشهر ونرتب عليه ونحسب الفروق بين الأيام. والوحدةusهي الميكروثانية، وهي الدقة التي اختارتها pandas 3 لهذا العمود. - عمودا
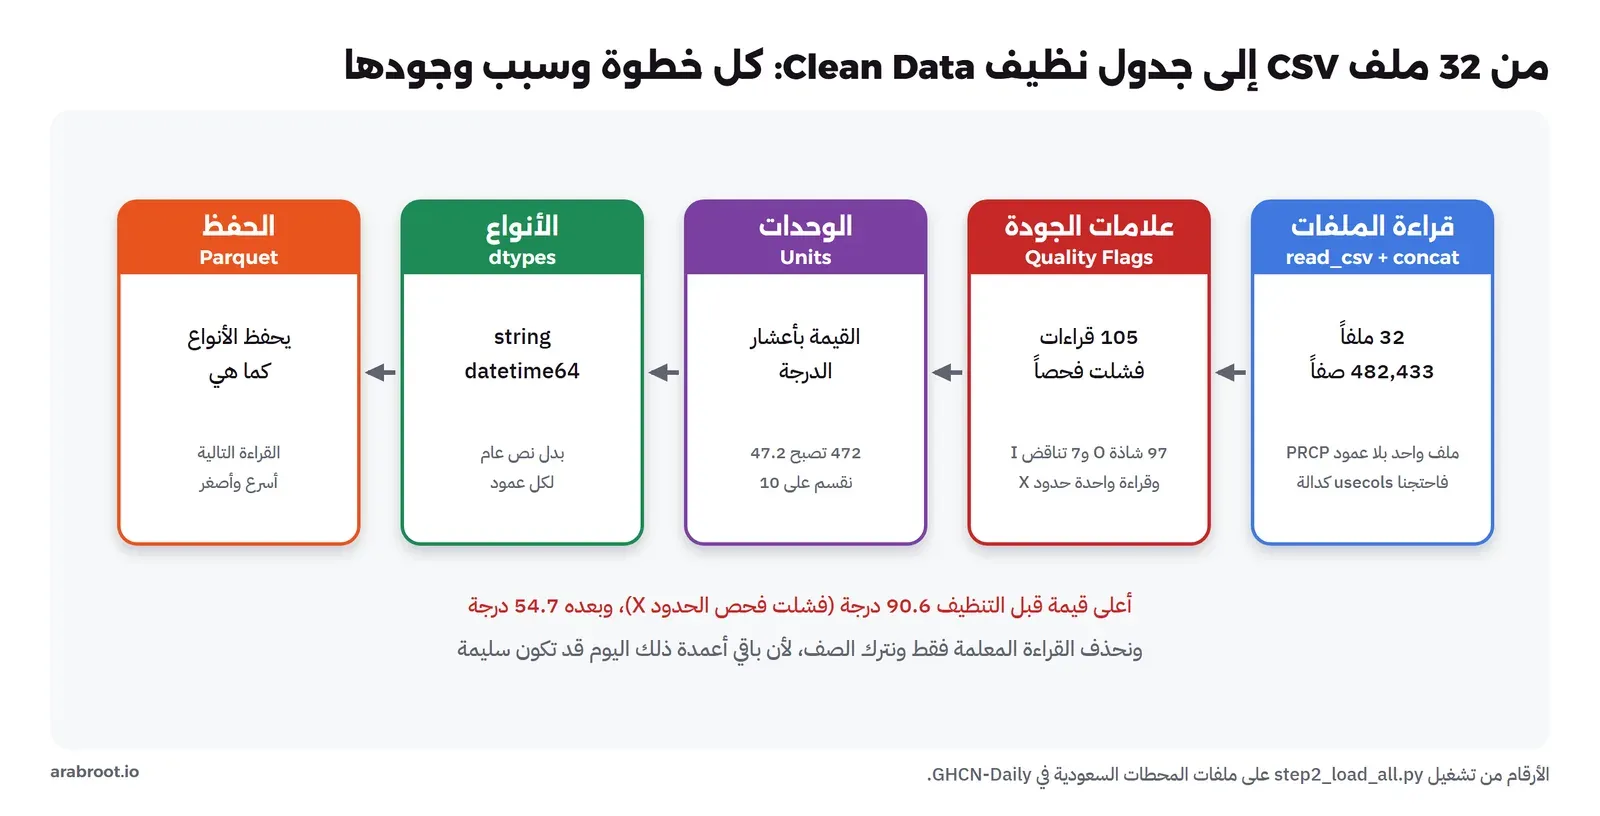
STATIONوNAMEنوعهماstringلأننا طلبنا ذلك فيdtype، أما عمودا العلامات فبقياstr، وهو النوع النصي الافتراضي الجديد في pandas 3. والفرق بينهما تفصيل داخلي، والمهم أن أياً منهما ليسobjectكما كان في الإصدارات القديمة. - علامة الجودة: من 482,433 قراءة، هناك 97 قراءة عليها
O، أي فشلت في فحص القيم الشاذة، و7 عليهاI، وقراءة واحدة عليهاX. وهذه القراءة الواحدة هي 906 في محطة الظهران سنة 1958، أي 90.6 درجة، ولو لم نقرأ العلامات لكانت هي أعلى حرارة في تاريخ المملكة في تحليلنا. - بعد حذف القراءات المعلمة والقسمة على 10، أصبح المتوسط 32.2 درجة والأعلى 54.7، وعدد القراءات الموجودة 387,896، أي أن قرابة 95 ألف صف ليس فيها حرارة عظمى أصلاً.
وقد يسأل القارئ: لماذا جعلنا القراءة المعلمة NA ولم نحذف الصف كله؟ والسبب أن الصف فيه أيضاً الحرارة الصغرى والمطر لنفس اليوم، وقد تكون سليمة، فإذا حذفنا الصف خسرنا قراءات صحيحة لأجل قراءة واحدة خاطئة. والقاعدة التي نعمل بها: احذف القيمة وليس الصف، واترك الصف إلا إذا كان كله بلا معنى. ولاحظ أيضاً أننا عملنا على نسخة raw.copy() وليس على الجدول الأصلي، حتى نستطيع أن نقارن قبل وبعد إذا احتجنا.
وفي آخر الخطوة حفظنا الجدول النظيف بصيغة Parquet بدل CSV. والسبب أن CSV نص لا يحفظ الأنواع، فإذا قرأته مرة أخرى عادت التواريخ نصوصاً وعدت إلى نفس العمل، أما Parquet فيحفظ نوع كل عمود ويضغط البيانات عموداً عموداً، فالملف هنا 2.1 ميجابايت بدل عشرات الميجابايت، وكل الخطوات التالية تقرؤه في جزء من الثانية بالأنواع الصحيحة.
step2_load_all.py: أعلى قيمة قبل التنظيف كانت 90.6 درجة بعلامة X، وبعده 54.7.القيم الشاذة Outliers التي تمر من فحص الجودة
بعد التنظيف أصبحت أعلى قراءة 54.7 درجة في محطة رفحاء يوم 25 أغسطس 2006، وليس عليها أي علامة جودة. فهل هي حقيقية؟ الرقم يبدو مرتفعاً جداً، لأنه قريب من أعلى درجات سجلت على الأرض، ولكن الشك وحده لا يكفي لحذف قراءة، فنحتاج طريقة نختبر بها. والطريقة الأولى أن ننظر إلى الجيران: محطات قريبة في نفس الأيام. والطريقة الثانية أن نقارن كل قراءة بالأيام المحيطة بها في نفس المحطة:
# Step 2b: the hottest reading passed the quality flags. Is it real? Look at the neighbours, then test every reading
import pandas as pd

df = pd.read_parquet("data/clean.parquet")
near = ["SAM00040357", "SAM00040362", "SAM00040373"]          # Arar, Rafha, Qaisumah
w = df[df["DATE"].between("2006-08-23", "2006-08-27") & df["STATION"].isin(near)]
print(w.pivot(index="DATE", columns="STATION", values="tmax_c"))

# each reading against the median of the same station over the 7 days around it
df = df.sort_values(["STATION", "DATE"])
med = (df.set_index("DATE").groupby("STATION")["tmax_c"]
         .rolling("7D", center=True, min_periods=3).median().reset_index(name="med7"))
df = df.merge(med, on=["STATION", "DATE"], how="left", validate="one_to_one")
df["jump"] = df["tmax_c"] - df["med7"]
sus = df[df["jump"].abs() >= 8]
print(len(sus), "readings 8 degrees or more away from their week")
print(sus.nlargest(5, "jump")[["STATION", "NAME", "DATE", "tmax_c", "med7"]].to_string(index=False))
print(df[(df["STATION"] == "SAM00040362") & (df["DATE"] == "2006-08-25")][["tmax_c", "med7", "jump"]].round(1).to_string(index=False))
print(sus.groupby(sus["DATE"].dt.month).size().to_string())
والمخرج سوف يكون كما يلي:
STATION     SAM00040357  SAM00040362  SAM00040373
DATE
2006-08-23         44.2         45.6         49.0
2006-08-24         45.2         43.3         47.0
2006-08-25         46.0         54.7         47.0
2006-08-26         46.2         46.1         46.0
2006-08-27         45.2          NaN         47.4
1435 readings 8 degrees or more away from their week
    STATION                   NAME       DATE  tmax_c  med7
SAW00032502            DHAHRAN, SA 1949-04-20    43.3  27.2
SAM00040400               WEJH, SA 2022-05-14    45.8  30.6
SA000040430         AL MADINAH, SA 1977-12-12    39.0  25.0
SAM00040362              RAFHA, SA 2008-02-18    29.6  15.7
SA000040438 RIYADH OBS. O.A.P., SA 2008-02-19    32.0  19.0
 tmax_c  med7  jump
   54.7  45.6   9.1
DATE
1     143
2     284
3     344
4     279
5     100
6      41
7       9
8       6
9       9
10     14
11     81
12    125
في المخرج أعلاه لاحظ التالي:
- الجدول الأول نتيجة الدالة
pivot، فهي تحول الصفوف إلى جدول فيه التاريخ صفوفاً والمحطة أعمدة، وهذا شكل مناسب للمقارنة بالعين. وفي يوم 25 أغسطس كانت عرعر 46.0 والقيصومة 47.0، ورفحاء التي تقع بينهما 54.7، ثم في اليوم التالي عادت رفحاء إلى 46.1. فارتفاع ثماني درجات في يوم واحد ثم رجوعها في اليوم التالي، والجيران على بعد 250 إلى 300 كيلومتر تقريباً لم يتحركوا، يقول إن هذه القراءة غالباً خطأ في التسجيل. - الدالة
rolling("7D", center=True)تحسب لكل يوم الوسيط Median للأيام السبعة حوله في نفس المحطة. واخترنا الوسيط وليس المتوسط لأن القيمة الشاذة نفسها لا تحرك الوسيط كثيراً، وهذا الفرق شرحناه في الإحصاء للمهندسين. وقراءة رفحاء أعلى من وسيط أسبوعها بـ 9.1 درجة. - القاعدة البسيطة «ابحث عن كل قراءة تبعد ثماني درجات أو أكثر عن أسبوعها» أعطت 1,435 قراءة، وأعلاها ليست قراءة رفحاء، وإنما أيام في الشتاء والربيع. والتوزيع على الأشهر في آخر المخرج يشرح السبب: 284 في فبراير و344 في مارس، و6 فقط في أغسطس. ففي الشتاء والربيع تتغير الحرارة فعلاً بسرعة مع المنخفضات والرياح، أما في عز الصيف فالحرارة ثابتة تقريباً، فالقراءة التي تبعد تسع درجات في أغسطس نادرة جداً.
وهذا هو الدرس من هذه الخطوة: القاعدة الآلية تحدد لك أين تنظر، ولكنها لا تقرر بدلاً عنك، فلو حذفنا كل القراءات الـ 1,435 لحذفنا أياماً حقيقية من الربيع. والقرار الذي اتخذناه أن سؤالنا عن أيام 45 درجة فأكثر، وقراءة رفحاء واحدة من مئات الأيام فوق 45، فوجودها أو غيابها لا يغير أي رقم في التقرير، ولذلك تركناها وكتبنا في التقرير أنها مشكوك فيها. ولو كان السؤال «ما أعلى حرارة سجلت؟» لكانت هي الإجابة الخاطئة، وكان يجب أن نستبعدها.
الربط Merge: من رمز المحطة إلى اسم المنطقة
مدير العمليات لا يعرف ما هي SAM00040420، وإنما يسأل عن المناطق. والبيانات ليس فيها عمود المنطقة، ففيها اسم المحطة بالإنجليزية وإحداثياتها فقط، ولذلك كتبنا جدولاً صغيراً بيدنا regions.csv فيه رمز كل محطة والمنطقة الإدارية التي تقع فيها بالعربية والإنجليزية، وراجعناه بالإحداثيات الموجودة في ملف المحطات ghcnd-stations.txt. والآن نربط الجدول الكبير بهذا الجدول الصغير بالدالة merge، وهي نفس فكرة JOIN في SQL التي شرحناها في درس الربط في SQL:
df = df.merge(regions, left_on="STATION", right_on="station", how="left", validate="many_to_one")وفي هذا السطر ثلاثة قرارات لكل منها سبب:
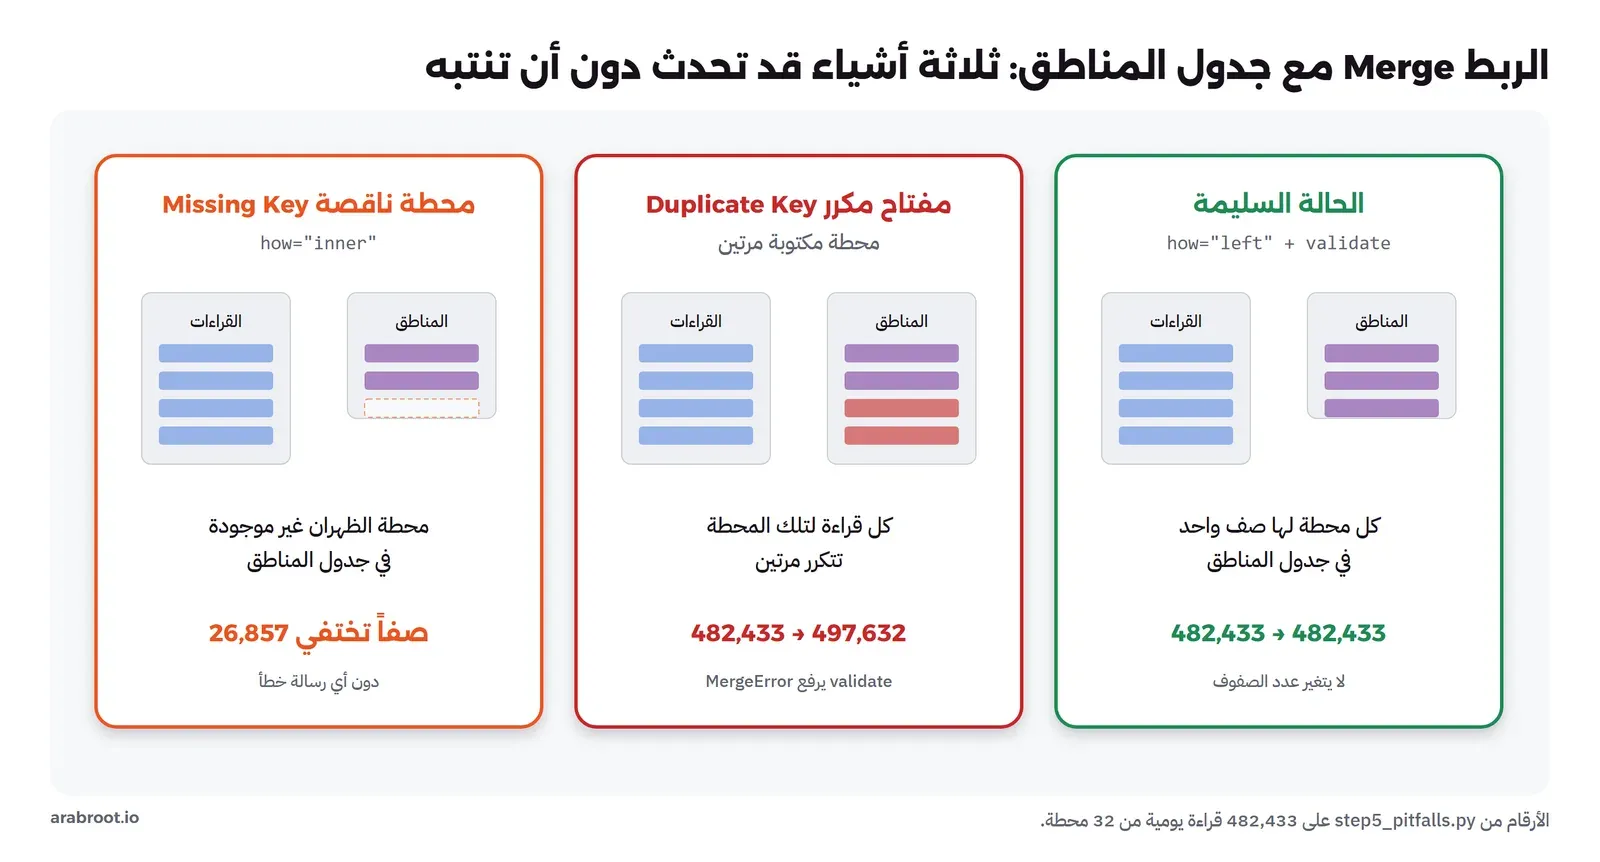
left_onوright_on: اسم عمود الربط مختلف في الجدولين، فالكبير فيهSTATIONوالصغيرstation، فنحدد كلاً منهما.how="left": نريد كل صفوف الجدول الكبير حتى لو لم توجد المحطة في جدول المناطق، فإذا نسينا محطة سوف تظهر لنا بمنطقة فارغة بدل أن تختفي. والنوع الافتراضيinnerيحذف الصفوف التي لا تطابق دون أي رسالة، وسوف نرى أثره بالأرقام بعد قليل.validate="many_to_one": نقول لـ pandas إن الجدول الكبير فيه صفوف كثيرة لكل محطة، والجدول الصغير يجب أن يكون فيه صف واحد فقط لكل محطة. فإذا كتب أحدهم المحطة مرتين في الجدول الصغير، يتوقف الكود بخطأ بدل أن يتضاعف عدد الصفوف.
وأول سطر في مخرج الخطوة الثالثة هو 0 rows without a region، أي أن كل محطة وجدت منطقتها. وهذا السطر ليس زينة، فنحن نكتبه بعد كل ربط لأنه أرخص اختبار يمكن أن تكتبه. والشكل التالي يلخص ما يحدث في الحالات الثلاث، والأرقام فيه من تجربة أجريناها عمداً في خطوة الأخطاء الشائعة:
inner بصمت.التجميع GroupBy: كم يوماً حاراً في كل منطقة؟
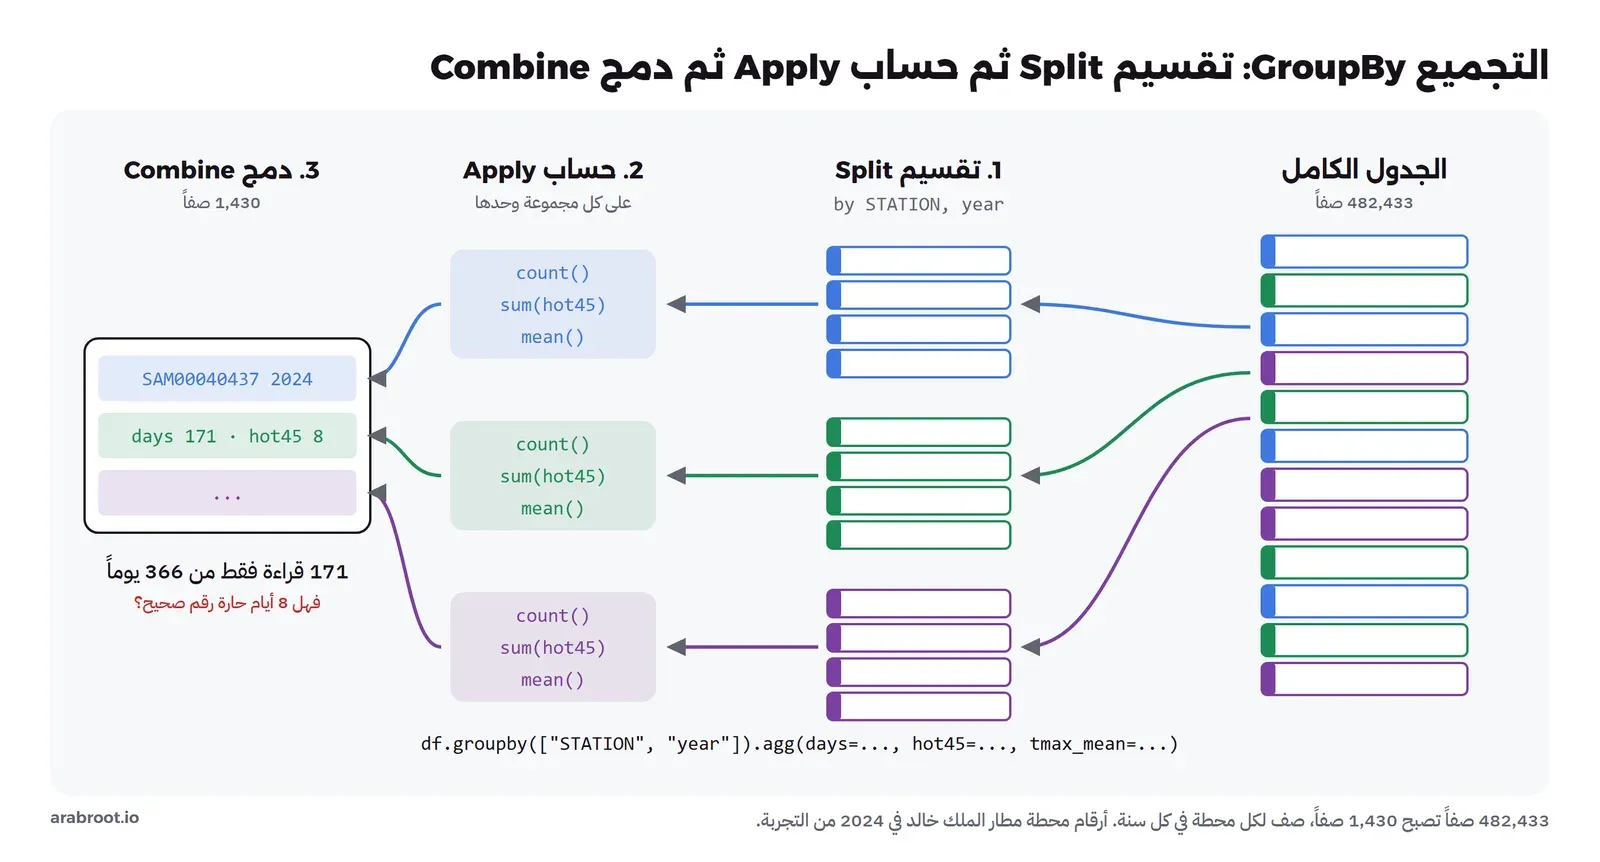
الآن نصل إلى السؤال نفسه. والعملية التي نحتاجها اسمها في pandas GroupBy، وتوصف في التوثيق بثلاث كلمات: تقسيم Split، ثم حساب Apply، ثم دمج Combine. فنقسم الصفوف إلى مجموعات حسب المحطة والسنة، ثم نحسب على كل مجموعة وحدها عدد القراءات وعدد الأيام الحارة والمتوسط، ثم ندمج النتائج في جدول جديد فيه صف لكل محطة في كل سنة. وهي نفس فكرة GROUP BY في SQL، والفرق أن النتيجة جدول pandas تكمل عليه مباشرة.
# Step 3: join the regions table, count heat days per region and year
import pandas as pd

df = pd.read_parquet("data/clean.parquet")
regions = pd.read_csv("regions.csv", dtype="string")
df = df.merge(regions, left_on="STATION", right_on="station", how="left", validate="many_to_one")
print(df["region_en"].isna().sum(), "rows without a region")

df["year"] = df["DATE"].dt.year
df["month"] = df["DATE"].dt.month

# coverage first: how many days with a reading does each station have in each year?
cov = df.groupby(["STATION", "year"])["tmax_c"].count().rename("days_with_tmax")
print(cov.loc["SAM00040437"].loc[2015:2025])

df["hot45"] = df["tmax_c"] >= 45
yearly = (df.groupby(["region_en", "STATION", "year"])
            .agg(days=("tmax_c", "count"), hot45=("hot45", "sum"), tmax_mean=("tmax_c", "mean"))
            .reset_index())
good = yearly[yearly["days"] >= 330]               # keep station-years with at least 330 readings
print(len(yearly), "station-years,", len(good), "with enough coverage")

recent = good[good["year"].between(2015, 2024)]
table = (recent.groupby("region_en")
               .agg(stations=("STATION", "nunique"), hot45_per_year=("hot45", "mean"))
               .sort_values("hot45_per_year", ascending=False).round(1))
print(table)
والمخرج سوف يكون كما يلي:
0 rows without a region
year
2015    225
2016    240
2017    195
2018    187
2019    265
2020    302
2021    199
2022    191
2023    183
2024    171
2025     84
Name: days_with_tmax, dtype: int64
1430 station-years, 617 with enough coverage
                  stations  hot45_per_year
region_en
Eastern                  2            77.0
Qassim                   1            39.7
Makkah                   2            23.5
Riyadh                   2            21.6
Madinah                  2            18.2
Najran                   2             3.5
Al-Jouf                  1             2.1
Northern Borders         1             0.5
Asir                     1             0.0
Al-Baha                  1             0.0
Jazan                    1             0.0
Tabuk                    1             0.0
في المخرج أعلاه لاحظ التالي:
- قبل أي متوسط حسبنا التغطية Coverage، أي عدد الأيام التي فيها قراءة في كل سنة لمحطة مطار الملك خالد. والنتيجة صادمة: 225 يوماً في 2015، و302 في أفضل سنة 2020، و171 في 2024، ولا سنة واحدة كاملة. والسنة 2025 فيها 84 يوماً فقط لأن الملف المنشور لم يكتمل لها بعد.
- لاحظ الصيغة
cov.loc["SAM00040437"].loc[2015:2025]: الجدول الناتج منgroupbyعلى عمودين له فهرس من مستويين MultiIndex، المحطة ثم السنة، فنختار المحطة أولاً ثم نطاق السنوات. - الدالة
aggمع الأسماء، مثلdays=("tmax_c", "count")، تعطي كل عمود في النتيجة اسماً واضحاً بدل اسم مركب، وهذا ما يجعل الكود يقرأ كجملة. - العمود
hot45نوعه منطقي Boolean،TrueأوFalse، وعندما نجمعه بالدالةsumفإن كلTrueيحسب 1، فيصبح المجموع عدد الأيام الحارة. ولاحظ أن اليوم المفقود قيمتهNaN، والمقارنةNaN >= 45نتيجتهاFalse، فاليوم المفقود يحسب يوماً غير حار، وهذا مصدر الخطأ الذي سوف نشرحه الآن. - من 1,430 سنة لمحطة، هناك 617 فقط فيها 330 قراءة أو أكثر. أي أن أكثر من نصف البيانات سنوات ناقصة.
- الجدول الأخير هو الجواب الأول لمدير العمليات: المنطقة الشرقية 77 يوماً فوق 45 درجة في السنة في المتوسط، ثم القصيم 39.7، ثم مكة المكرمة 23.5، والرياض 21.6، والمدينة المنورة 18.2. والعمود
stationsيقول كم محطة دخلت في كل رقم، وهو مهم، فرقم القصيم من محطة واحدة فقط.
التغطية Coverage: لماذا لا تقارن سنة فيها 171 قراءة بسنة فيها 365
لنفرض أننا لم نحسب التغطية، وحسبنا مباشرة عدد الأيام الحارة لكل محطة في كل سنة ثم المتوسط. فالسنة التي فيها 171 قراءة سوف تعطي عدد أيام حارة أقل من الحقيقة بالضرورة، ليس لأن الصيف كان أبرد، وإنما لأن نصف أيامه لم تسجل. وإذا كانت محطات منطقة ما أسوأ في التسجيل من محطات منطقة أخرى، فإن الترتيب بين المناطق نفسه يتغير. ولذلك استبعدنا السنوات التي فيها أقل من 330 قراءة، وهذا رقم اخترناه نحن وليس قاعدة علمية، والفكرة أن يكون غياب القراءات قليلاً بحيث لا يغير العد كثيراً. وفي قسم «ماذا يحدث إذا» سوف نرى كيف يتغير الجواب مع تغيير هذا الرقم.
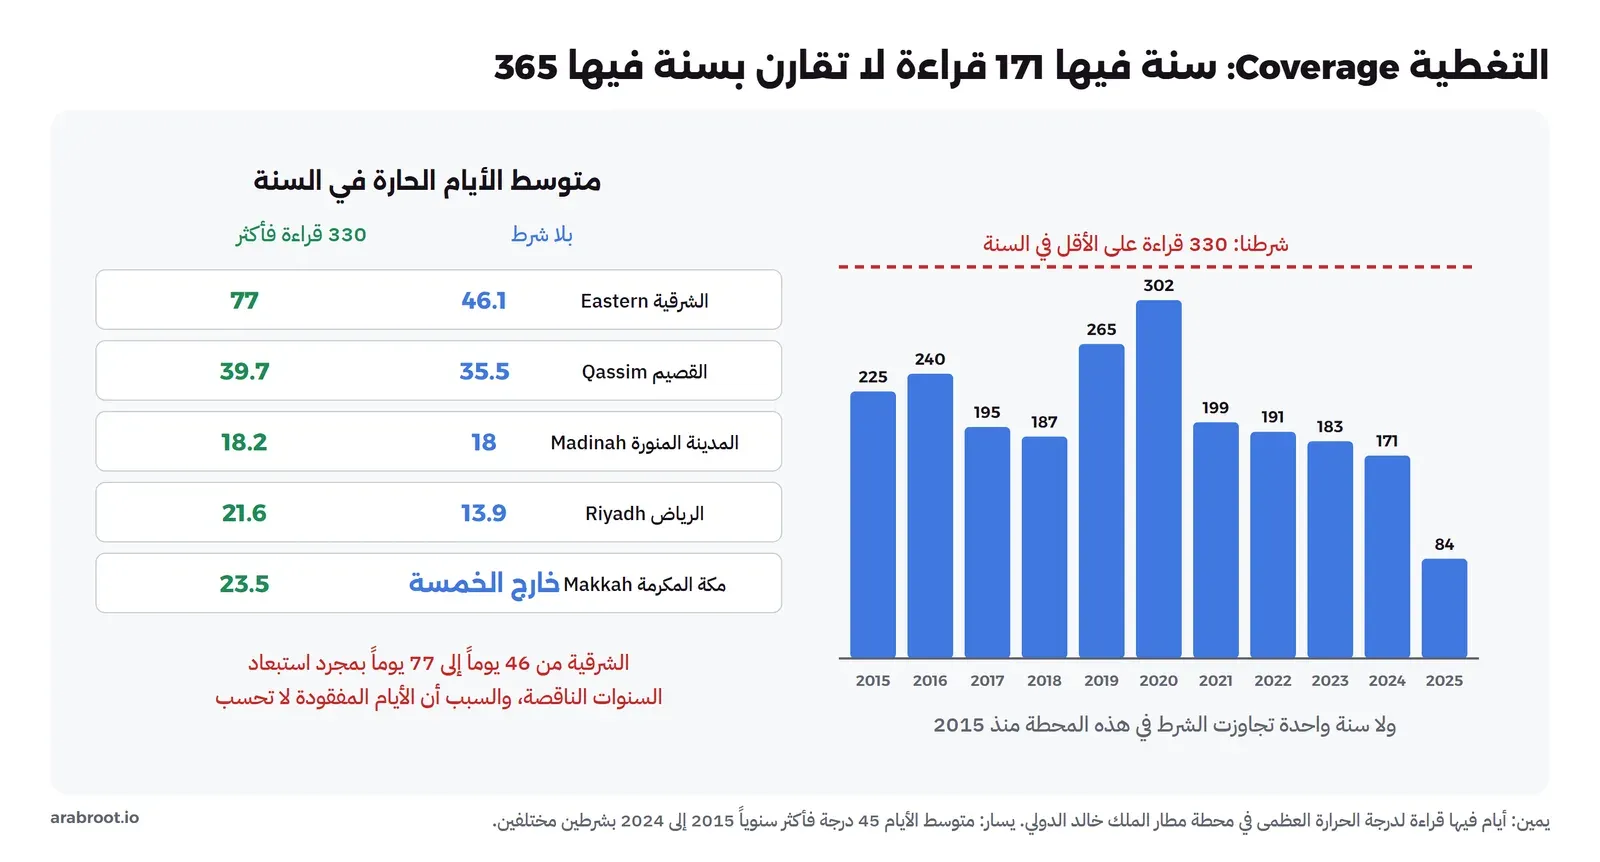
وهنا يجب أن نكون صادقين في التقرير مع مدير العمليات: شرط 330 قراءة يجعل الرقم أقرب للحقيقة، ولكنه يقلل عدد المحطات في كل منطقة، فالقصيم ممثلة بمحطة واحدة، والشرقية بمحطتين من خمس. فالرقم الذي سوف نرسله ليس «عدد الأيام الحارة في المنطقة الشرقية»، وإنما «متوسط الأيام الحارة في المحطات الشرقية التي لها سنوات كاملة من 2015 إلى 2024». والفرق بين الجملتين هو الفرق بين تقرير يمكن الدفاع عنه وتقرير يسقط عند أول سؤال.
التواريخ Dates: الأشهر والصيف وفترة حظر العمل
الجزء الثاني من سؤال المدير هو «في أي الأشهر؟»، والجزء الثالث «كم منها خارج فترة الحظر؟». وهنا تظهر قوة عمود التاريخ الحقيقي، فمن datetime64 نستخرج الشهر بـ .dt.month، ونجمع على فترات بالدالة resample، ونحسب متوسطاً متحركاً بالدالة rolling، وكلها مشروحة في دليل السلاسل الزمنية Time Series في توثيق pandas. وهذا كود الخطوة الرابعة كاملاً، وهو أطول خطوة في التجربة لأنه يجيب على أربعة أسئلة:
# Step 4: which months, and is it getting hotter? (dates, resample, rolling, pivot)
import pandas as pd
import matplotlib
matplotlib.use("Agg")
import matplotlib.pyplot as plt

df = pd.read_parquet("data/clean.parquet")
regions = pd.read_csv("regions.csv", dtype="string")
df = df.merge(regions, left_on="STATION", right_on="station", how="left", validate="many_to_one")

# 1) months: heat days per calendar month at Al-Ahsa, 2015-2024
st = df[df["STATION"] == "SAM00040420"].set_index("DATE").sort_index()
hot = st[st.index.year.isin(range(2015, 2025))]
print((hot["tmax_c"] >= 45).groupby(hot.index.month).sum().to_string())

# 2) monthly means with resample, and how many readings each month has
monthly = st["tmax_c"].resample("MS").agg(["mean", "count"])
print(monthly.loc["2024-05":"2024-09"].round(1))

# 3) summers (June-August) per station and year, only complete summers
summer = df[df["DATE"].dt.month.isin([6, 7, 8])]
m = (summer.groupby(["STATION", summer["DATE"].dt.year.rename("year"), summer["DATE"].dt.month.rename("month")])
           ["tmax_c"].agg(["mean", "count"]))
m = m[m["count"] >= 25]                                    # a month with fewer readings is not trusted
s = m.groupby(["STATION", "year"])["mean"].agg(["mean", "count"])
jja = s[s["count"] == 3]["mean"]                            # all three months present
old = jja[jja.index.get_level_values("year").isin(range(1985, 1995))].groupby("STATION").agg(["mean", "count"])
new = jja[jja.index.get_level_values("year").isin(range(2015, 2025))].groupby("STATION").agg(["mean", "count"])
cmp = old.join(new, lsuffix="_8594", rsuffix="_1524", how="inner")
cmp = cmp[(cmp["count_8594"] >= 5) & (cmp["count_1524"] >= 5)]
cmp["change"] = cmp["mean_1524"] - cmp["mean_8594"]
cmp = cmp.join(regions.set_index("station")["region_en"])
print(cmp.round(2).sort_values("change", ascending=False).to_string())
print("median change:", round(cmp["change"].median(), 2), "stations:", len(cmp))

# 4) one long series with a rolling mean, and the plot
one = jja.loc["SAM00040356"]                                # Turaif: the most complete summers
roll = one.rolling(10, min_periods=8).mean()
print(len(one), "complete summers,", one.index.min(), "to", one.index.max())
fig, ax = plt.subplots(figsize=(9, 4))
one.plot(ax=ax, marker="o", lw=1, label="June-August mean of daily max (C)")
roll.plot(ax=ax, lw=3, label="10-year rolling mean")
ax.set_title("Turaif (GHCN-Daily SAM00040356)"); ax.set_xlabel("year"); ax.legend(); ax.grid(alpha=.3)
fig.tight_layout(); fig.savefig("data/jja_trend.png", dpi=150)
print("saved plot")

pivot = (df[df["DATE"].dt.year.between(2015, 2024)]
         .assign(month=lambda d: d["DATE"].dt.month)
         .pivot_table(index="region_en", columns="month", values="tmax_c", aggfunc="mean")
         .round(1))
print(pivot[[1, 4, 7, 10]].sort_values(7, ascending=False))

# 5) heat days outside the midday-work-ban window (15 June to 15 September)
d = df[df["DATE"].dt.year.between(2015, 2024) & (df["tmax_c"] >= 45)].copy()
md = d["DATE"].dt.month * 100 + d["DATE"].dt.day           # 615 = 15 June, 915 = 15 September
d["window"] = pd.cut(md, bins=[0, 614, 915, 1231], labels=["before 15 Jun", "inside the ban", "after 15 Sep"])
print(pd.crosstab(d["region_en"], d["window"]).sort_values("inside the ban", ascending=False).head(6))
والمخرج سوف يكون كما يلي:
/work/step4_months_trend.py:29: Pandas4Warning: The 'lsuffix' and 'rsuffix' keywords in DataFrame.join are deprecated and will be removed in a future version. Use the 'suffixes' keyword instead.
  cmp = old.join(new, lsuffix="_8594", rsuffix="_1524", how="inner")
DATE
1       0
2       0
3       0
4       0
5      43
6     171
7     238
8     219
9      65
10      0
11      0
12      0
            mean  count
DATE
2024-05-01  42.5     17
2024-06-01  47.3     18
2024-07-01  47.6     18
2024-08-01  46.0     22
2024-09-01  43.8     19
             mean_8594  count_8594  mean_1524  count_1524  change         region_en
STATION
SAM00040373      43.62           6      45.73           7    2.10           Eastern
SAM00041036      34.73           7      36.47           7    1.74            Makkah
SAM00040360      37.75           8      39.24           7    1.49           Al-Jouf
SAM00040356      36.30           9      37.38           8    1.09  Northern Borders
SAM00041055      34.66           5      35.66           8    1.00           Al-Baha
SAM00041136      42.35          10      42.86           7    0.51            Najran
SAM00041140      38.57           9      38.36           7   -0.22             Jazan
median change: 1.09 stations: 7
43 complete summers, 1979 to 2022
saved plot
month               1     4     7     10
region_en
Eastern           21.3  34.8  46.3  37.6
Qassim            20.7  33.0  44.7  36.3
Riyadh            23.3  34.0  43.7  35.6
Madinah           25.0  34.8  42.4  37.1
Najran            27.5  35.9  41.6  34.5
Northern Borders  15.7  28.9  41.6  32.3
Al-Jouf           16.6  29.5  40.7  32.2
Hail              18.4  29.6  40.6  33.5
Makkah            27.8  34.0  38.8  35.2
Jazan             31.2  35.6  38.4  37.1
Tabuk             22.4  30.2  36.7  32.9
Al-Baha           24.0  29.7  36.0  29.7
Asir              23.2  28.4  34.3  29.0
window            before 15 Jun  inside the ban  after 15 Sep
region_en
Eastern                     232            1262            27
Riyadh                       48             482             0
Madinah                      79             450            12
Northern Borders             23             335             9
Qassim                       30             324             1
Makkah                       53             106            17
وسوف نقرأ المخرج جزءاً جزءاً، لأن كل جزء فيه أداة مختلفة.
الأيام الحارة حسب الشهر Monthly Counts
الجزء الأول اختار محطة الأحساء، وجعل التاريخ هو الفهرس بالدالة set_index("DATE")، ثم صفى سنوات 2015 إلى 2024. وعندما يكون الفهرس تاريخاً، فإن hot.index.month تعطي الشهر مباشرة، فنجمع الأيام الحارة حسبه. والنتيجة في عشر سنوات: لا يوم حار من أكتوبر إلى أبريل، و43 يوماً في مايو، ثم 171 في يونيو و238 في يوليو و219 في أغسطس، و65 في سبتمبر. أي أن الموسم الحار في هذه المحطة يبدأ في مايو، قبل فترة الحظر بشهر ونصف.
والجزء الثاني استخدم resample("MS")، وهي تجمع السلسلة الزمنية في سلال حسب الشهر، وMS تعني أن يكون عنوان كل سلة أول يوم في الشهر Month Start. وطلبنا مع المتوسط عدد القراءات، فظهر أن يوليو 2024 متوسطه 47.6 درجة ولكن من 18 قراءة فقط من 31 يوماً. وهذا هو سبب الشرط count >= 25 في الجزء الثالث: الشهر الذي فيه أقل من 25 قراءة لا نثق في متوسطه.
هل يزداد الصيف حرارة؟ Rolling Mean
الجزء الثالث سؤال جانبي سأله المدير في نفس الاجتماع: «هل تزداد الحرارة سنة بعد سنة، أم هذا انطباع؟». ولكي نجيب بصدق نحتاج مقارنة عادلة: متوسط الحرارة العظمى في أشهر الصيف الثلاثة، يونيو ويوليو وأغسطس، في كل سنة، ثم نقارن عشر سنوات قديمة 1985 إلى 1994 بعشر سنوات حديثة 2015 إلى 2024، ونقبل فقط الصيف الذي فيه الأشهر الثلاثة كاملة، والمحطة التي فيها خمسة أصياف كاملة على الأقل في كل فترة. وبعد كل هذه الشروط بقيت سبع محطات فقط من 32، وهذا وحده درس: البيانات المفتوحة كثيرة في الحجم، قليلة في السنوات الكاملة المتصلة.
والنتيجة أن ست محطات من سبع ارتفع فيها متوسط الصيف، من 0.51 درجة في شرورة إلى 2.10 درجة في القيصومة، ومحطة جازان انخفضت 0.22، والوسيط Median للتغير 1.09 درجة. وهذا رقم نكتبه للمدير مع حدوده: سبع محطات فقط، وطريقة مقارنة بسيطة، وليس دراسة مناخية. والشكل التالي يرسم محطة طريف، وهي صاحبة أكبر عدد من الأصياف الكاملة، 43 صيفاً من 1979 إلى 2022، مع متوسط متحرك لعشر سنوات بالدالة rolling(10, min_periods=8)، حيث يعني min_periods=8 أن نقبل النافذة إذا كان فيها ثماني سنوات على الأقل بدل أن نرفضها لغياب سنة أو اثنتين:
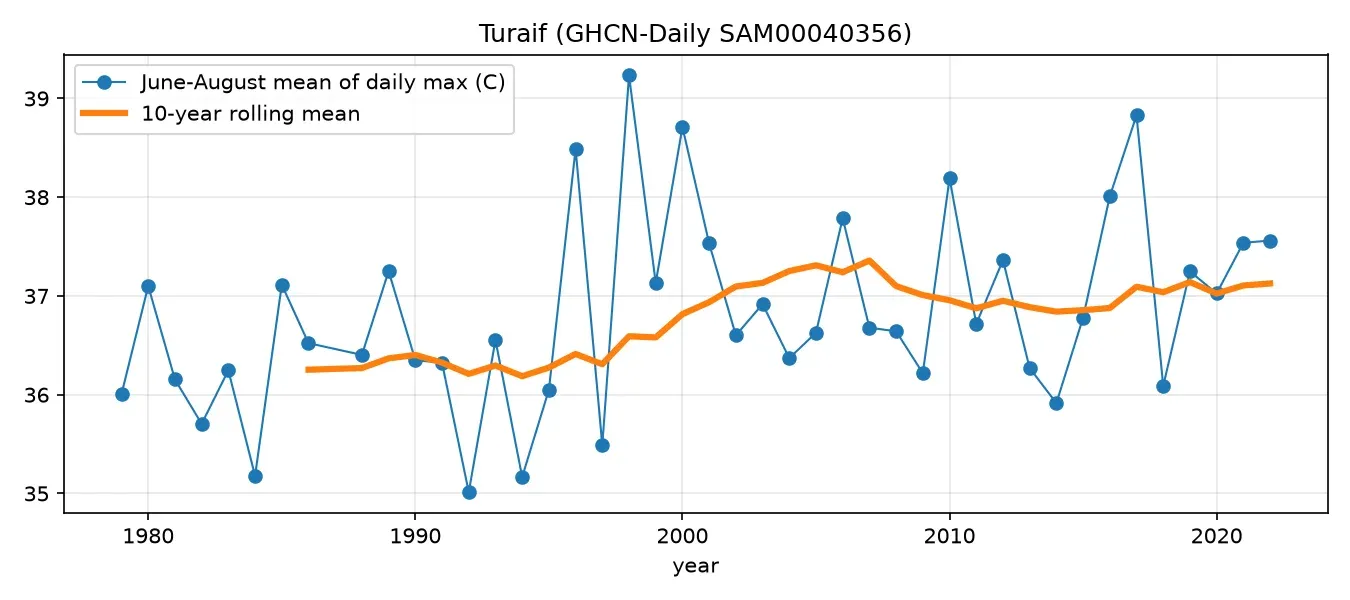
step4_months_trend.py: الصيف الواحد يتذبذب أربع درجات، والمتوسط المتحرك وحده يظهر الاتجاه.ولاحظ في الرسم أن الفرق بين صيف وآخر قد يصل إلى أربع درجات، مثل 35.0 في 1992 و39.2 في 1998، بينما المتوسط المتحرك تحرك قرابة درجة واحدة في أربعين سنة. ولهذا لا تقارن سنة بسنة إذا أردت أن تتكلم عن اتجاه، لأن الضجيج Noise بين السنوات أكبر بكثير من الاتجاه نفسه. ولاحظ أيضاً أن الرسم كله سطران من الكود: one.plot() وroll.plot()، لأن pandas تستدعي matplotlib من داخلها، وهذا يكفي لرسم سريع تفهم به البيانات، أما الرسم الذي يقدم للإدارة فيستحق وقتاً أكثر في العناوين والألوان.
الجدول المحوري Pivot Table: المنطقة مقابل الشهر
الجزء الرابع يجيب على سؤال «ما شكل السنة في كل منطقة؟» بجدول واحد. والدالة pivot_table هي نفس الجدول المحوري في Excel: نختار ما يكون صفوفاً، وهو المنطقة، وما يكون أعمدة، وهو الشهر، وما نحسبه في كل خلية، وهو متوسط الحرارة العظمى. وعرضنا أربعة أشهر فقط، يناير وأبريل ويوليو وأكتوبر، حتى يكون الجدول مقروءاً. والترتيب حسب يوليو يضع الشرقية في الأعلى بمتوسط 46.3 درجة، ثم القصيم 44.7 والرياض 43.7، وفي الأسفل عسير 34.3 والباحة 36.0. وهذا الجدول يقول للمدير شيئاً لم يسأل عنه: الفرق بين المناطق في يوليو 12 درجة، فخطة الصيف لا يمكن أن تكون واحدة لكل الفرق.
الأيام الحارة خارج فترة الحظر Work Ban Window
وزارة الموارد البشرية والتنمية الاجتماعية تعلن كل سنة حظر العمل تحت أشعة الشمس في منشآت القطاع الخاص، ففي سنة 2024 مثلاً أعلنت الوزارة أن الحظر من الساعة 12 ظهراً إلى الساعة 3 مساء، من 15 يونيو إلى 15 سبتمبر. والسؤال الأخير للمدير: كم يوماً حاراً يقع قبل هذه الفترة أو بعدها، أي في أيام لا يحميها الحظر وتبقى مسؤوليتها على الشركة وحدها؟
ولحساب ذلك حولنا كل تاريخ إلى رقم واحد: الشهر في 100 زائد اليوم، فيصبح 15 يونيو 615 و15 سبتمبر 915، ثم قسمنا الأرقام إلى ثلاث فترات بالدالة pd.cut التي تضع كل قيمة في الفترة التي تقع فيها، ثم استخدمنا pd.crosstab لعد الأيام في كل منطقة وكل فترة. والنتيجة في عشر سنوات لكل المحطات: في الشرقية 232 يوماً حاراً قبل 15 يونيو و27 بعد 15 سبتمبر، وفي المدينة المنورة 79 قبل و12 بعد، وفي مكة المكرمة 53 قبل و17 بعد. أي أن أغلب الأيام الحارة داخل الفترة، ولكن الأيام التي خارجها ليست قليلة، وأغلبها في مايو وأول يونيو.
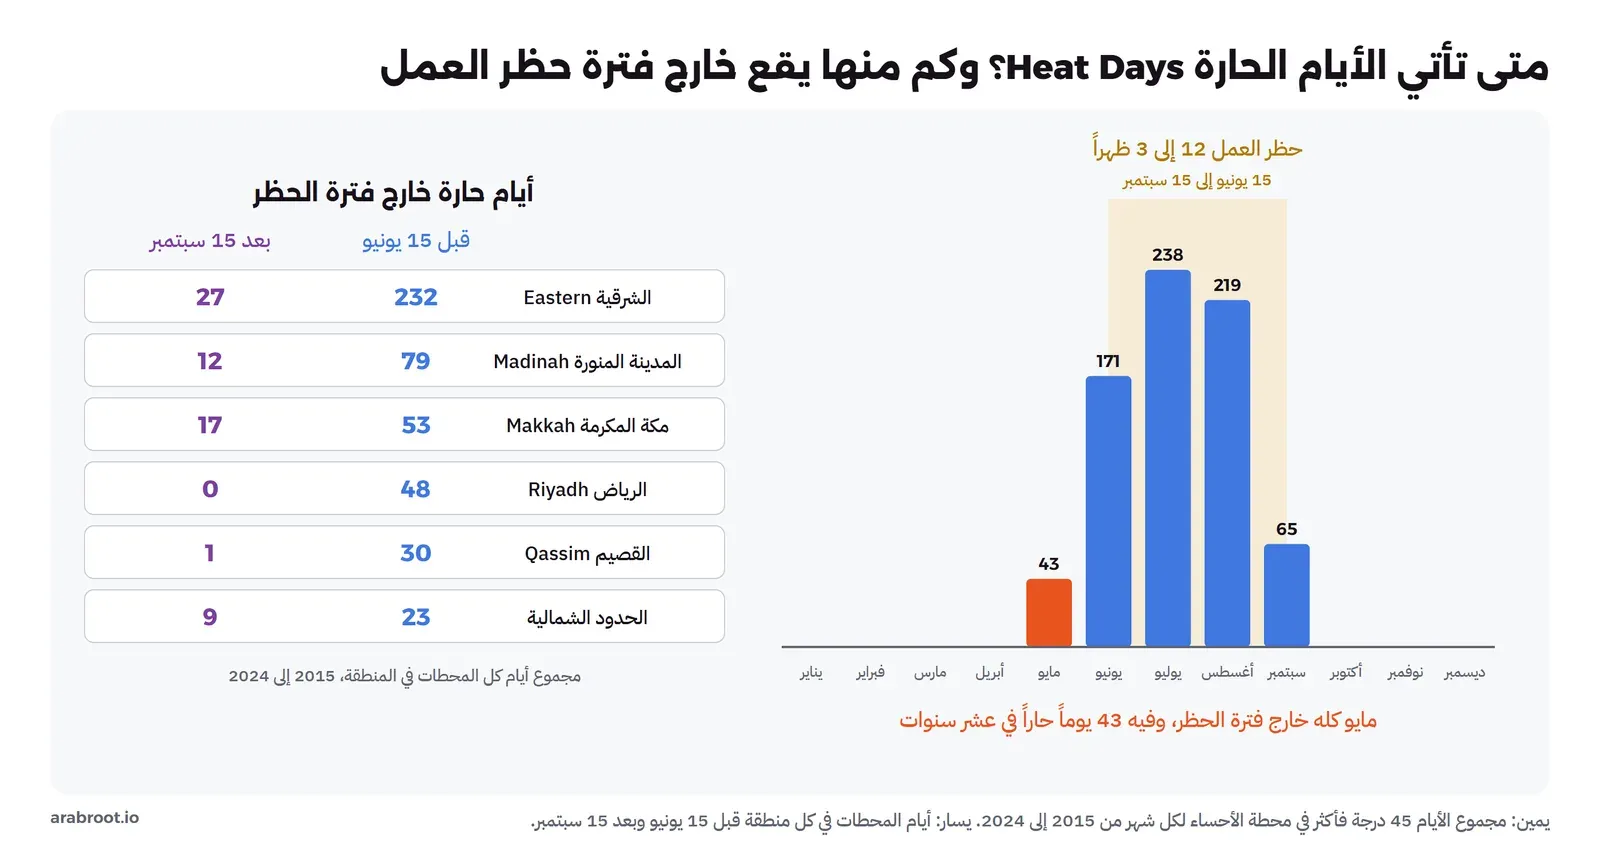
ولاحظ أن الأرقام في هذا الجزء مجموع لكل المحطات في المنطقة ولكل السنوات، دون شرط التغطية، لأن السؤال هنا عن توزيع الأيام الحارة على الفترات وليس عن عددها في السنة. فالنسبة بين «قبل» و«داخل» أصدق من الرقم نفسه، والشرقية فيها 232 يوماً قبل الحظر مقابل 1,262 داخله، أي قرابة يوم من كل سبعة أيام حارة يأتي قبل أن يبدأ الحظر. وهذه الجملة هي التي سوف تغير جدول الفرق في مايو.
أخطاء شائعة Common Pitfalls: الأخطاء التي وقعنا فيها فعلاً
أثناء بناء التحليل وقعنا في أخطاء لم تظهر كلها برسالة خطأ، وبعضها كان سيخرج رقماً خاطئاً في التقرير دون أن ننتبه. وجمعناها في خطوة واحدة نعيد فيها كل خطأ عمداً حتى ترى شكله:
# Step 5: the mistakes we actually hit, reproduced on purpose
import glob, warnings
import pandas as pd

print("pandas", pd.__version__)

# 1) reading all columns of all files: mixed types
warnings.simplefilter("always")
with warnings.catch_warnings(record=True) as w:
    raw = pd.concat([pd.read_csv(f) for f in sorted(glob.glob("data/ghcn/*.csv"))], ignore_index=True)
    print([str(x.category.__name__) for x in w][:3])
print(raw["WT01_ATTRIBUTES"].map(type).value_counts())

# 2) NaN turns an integer column into float, and mean() skips NaN silently
s = pd.Series([400, None, 460])
print(s.dtype, s.mean(), s.sum(), s.count(), len(s))

# 3) chained assignment under Copy-on-Write (pandas 3)
df = pd.read_parquet("data/clean.parquet")
small = df[df["STATION"] == "SAM00040437"].head(5).copy()
small[small["tmax_c"].isna()]["tmax_c"] = 0          # chained: changes a temporary copy only
print(small["tmax_c"].isna().sum(), "NaN left after chained assignment")
small.loc[small["tmax_c"].isna(), "tmax_c"] = 0       # one .loc call: changes small itself
print(small["tmax_c"].isna().sum(), "NaN left after .loc")

# 4) a duplicated key in the lookup table multiplies rows
regions = pd.read_csv("regions.csv", dtype="string")
bad = pd.concat([regions, regions[regions["station"] == "SAM00040437"]])
m = df.merge(bad, left_on="STATION", right_on="station", how="left")
print(len(df), "->", len(m), "rows after merge with a duplicated key")
try:
    df.merge(bad, left_on="STATION", right_on="station", how="left", validate="many_to_one")
except Exception as e:
    print(type(e).__name__, e)

# 5) a station missing from the lookup table: inner join drops it silently
short = regions[regions["station"] != "SAW00032502"]
inner = df.merge(short, left_on="STATION", right_on="station", how="inner")
print(len(df) - len(inner), "rows dropped by the inner join")

# 6) dates as text sort and compare as text
t = pd.Series(["2024-9-1", "2024-10-1", "2024-09-15"])
print(sorted(t), pd.to_datetime(t, format="mixed").sort_values().dt.date.tolist())
والمخرج سوف يكون كما يلي:
/work/step5_pitfalls.py:21: ChainedAssignmentError: A value is being set on a copy of a DataFrame or Series through chained assignment.
Such chained assignment never works to update the original DataFrame or Series, because the intermediate object on which we are setting values always behaves as a copy (due to Copy-on-Write).

Try using '.loc[row_indexer, col_indexer] = value' instead, to perform the assignment in a single step.

See the documentation for a more detailed explanation: https://pandas.pydata.org/docs/dev/user_guide/migration.html#chained-assignment
  small[small["tmax_c"].isna()]["tmax_c"] = 0          # chained: changes a temporary copy only
pandas 3.1.0
['DtypeWarning']
WT01_ATTRIBUTES
<class 'float'>    482102
<class 'str'>         331
Name: count, dtype: int64
float64 430.0 860.0 2 3
5 NaN left after chained assignment
0 NaN left after .loc
482433 -> 497632 rows after merge with a duplicated key
MergeError Merge keys are not unique in right dataset; not a many-to-one merge

Duplicates in right:
     station
SAM00040437 ...
26857 rows dropped by the inner join
['2024-09-15', '2024-10-1', '2024-9-1'] [datetime.date(2024, 9, 1), datetime.date(2024, 9, 15), datetime.date(2024, 10, 1)]
وفيما يلي شرح كل خطأ بالترتيب.
النوع المختلط Mixed Types عند قراءة كل الأعمدة
عندما قرأنا كل الأعمدة من كل الملفات ظهر تحذير DtypeWarning، وسببه العمود WT01_ATTRIBUTES الذي يصف ظاهرة الضباب في بعض الأيام: في 482,102 صف قيمته NaN من نوع float، وفي 331 صفاً نص. فالدالة read_csv تقرأ الملف الكبير على أجزاء وتخمن نوع كل عمود في كل جزء، فإذا اختلف التخمين بين الأجزاء يصبح العمود خليطاً من أنواع. وهذا التحذير يسهل تجاهله، ولكن أي عملية على عمود مختلط سوف تعطي نتائج غريبة، مثل الترتيب الذي يفشل أو المقارنة التي ترجع False دائماً. والحل الذي استخدمناه في الخطوة الثانية: اقرأ الأعمدة التي تحتاجها فقط، وحدد نوع الأعمدة النصية بنفسك.
القيمة المفقودة NaN تغير النوع والمتوسط
السلسلة [400, None, 460] أصبح نوعها float64 مباشرة بسبب القيمة المفقودة، والمتوسط 430 وليس 286.7، لأن mean() تتجاهل المفقود وتقسم على 2 وليس على 3. والمجموع 860، وcount() تعطي 2 بينما len() تعطي 3. وهذا السلوك هو الصحيح غالباً، فالقراءة المفقودة ليست صفراً، ولكن يجب أن تعرفه حتى لا تخلط بين «عدد الصفوف» و«عدد القراءات». وفي دليل القيم المفقودة في توثيق pandas تجد كل الدوال التي تتعامل معها، مثل isna وfillna وdropna. ولا تقم بـ fillna(0) على عمود حرارة أبداً، والسبب أن الصفر درجة قراءة حقيقية وليست «لا أعرف»، فسوف تنخفض كل المتوسطات وتظهر أيام شتاء في يوليو.
الإسناد المتسلسل Chained Assignment مع Copy-on-Write
هذا الخطأ هو الأشهر في pandas، وسببه أن السطر small[small["tmax_c"].isna()]["tmax_c"] = 0 فيه عمليتان: الأولى تختار الصفوف المفقودة وترجع جدولاً جديداً، والثانية تعدل العمود في هذا الجدول الجديد، وليس في small. ففي الإصدارات القديمة كان هذا السطر يعطي تحذير SettingWithCopyWarning المشهور، وأحياناً كان يعدل الأصل وأحياناً لا، حسب تفاصيل داخلية في الذاكرة. أما في pandas 3 فالقاعدة أصبحت واضحة بفضل Copy-on-Write: أي جدول ناتج من عملية يتصرف كنسخة، والإسناد المتسلسل لا يعدل الأصل أبداً، وتظهر رسالة ChainedAssignmentError كما في أول المخرج. ولاحظ النتيجة في المخرج: بقيت 5 قيم مفقودة بعد الإسناد المتسلسل، و0 بعد السطر الصحيح الذي يستخدم .loc مرة واحدة بالصفوف والعمود معاً. والقاعدة: إذا أردت أن تعدل جدولاً، فاكتب التعديل في استدعاء واحد df.loc[الصفوف, العمود] = القيمة.
المفتاح المكرر Duplicate Key والصفوف المفقودة
كررنا محطة مطار الملك خالد في جدول المناطق، وهو خطأ يحدث عندما يجمع شخصان الجدول أو عندما تنسخ صفاً لتعدله ثم تنسى حذف القديم. والنتيجة أن الجدول المدمج أصبح 497,632 صفاً بدل 482,433، لأن كل قراءة لهذه المحطة طابقت صفين في جدول المناطق فتكررت. ولو حسبنا بعدها عدد الأيام الحارة لأصبحت أيام هذه المحطة ضعفها. أما مع validate="many_to_one" فقد توقف الكود بخطأ MergeError يقول إن المفاتيح غير فريدة في الجدول الأيمن، وهذا بالضبط ما نريده.
وفي الاتجاه المعاكس، حذفنا محطة الظهران من جدول المناطق وربطنا بالنوع inner، فاختفى 26,857 صفاً دون أي رسالة. وهذه أخطر حالة في الثلاث، لأن الأرقام تخرج طبيعية، فقط أقل قليلاً، ولا أحد يلاحظ أن منطقة خسرت محطة. والحل: استخدم left واختبر عدد القيم الفارغة بعد الربط، أو قارن عدد الصفوف قبل الربط وبعده في كل مرة. وتجد أنواع الربط كلها مشروحة في دليل الدمج والربط في توثيق pandas.
التواريخ كنص Dates as Text
آخر خطأ في المخرج: القائمة ["2024-9-1", "2024-10-1", "2024-09-15"] عندما ترتب كنص تصبح 2024-09-15 ثم 2024-10-1 ثم 2024-9-1، لأن المقارنة حرف بحرف، والحرف 0 يأتي قبل 1 قبل 9. فالأول من سبتمبر أصبح آخر القائمة. وبعد التحويل بـ pd.to_datetime(t, format="mixed") رتبت التواريخ صحيحة. والخيار format="mixed" يقول لـ pandas إن الصيغ مختلفة بين الصفوف فتقرأ كل صف وحده، وهذا أبطأ، ولذلك إذا كانت كل التواريخ بصيغة واحدة فحددها بنفسك مثل format="%Y-%m-%d". وفي بياناتنا كانت كل التواريخ بصيغة ISO الكاملة، ولذلك كفى parse_dates، ولكنك سوف تقابل في ملفات Excel المصدرة من أنظمة محلية تواريخ بصيغ مختلفة، وبعضها بالتقويم الهجري، فلا تفترض الصيغة قبل أن تنظر.
تحذير الإيقاف Deprecation Warning
وفي أول مخرج الخطوة الرابعة ظهر تحذير Pandas4Warning يقول إن الخيارين lsuffix وrsuffix في join سوف يحذفان في إصدار قادم، والبديل suffixes. والكود يعمل الآن، ولكن هذا التحذير هو سبب تثبيتنا للإصدار في run.sh: فلو ثبت أحدهم pandas 4 بعد سنة سوف يتوقف السكربت. ولا تتجاهل هذه التحذيرات في كود يعمل كل شهر، وإنما عدل الكود عندما تراها، لأنها تخبرك بالضبط ما الذي سوف يتعطل.
ماذا يحدث إذا غيرنا شرط التغطية؟ What If
قلنا إن الرقم 330 اخترناه نحن، فماذا يحدث إذا غيرناه؟ هذه تجربة يجب أن تجريها على أي شرط تضعه في تحليل، لأنها تقول لك هل الجواب ثابت أم أنه نتيجة اختيارك. وأضفنا إليها طريقة رابعة لا تحتاج إلى سنوات كاملة أصلاً: بدل عدد الأيام الحارة، نحسب نسبة الأيام الحارة من الأيام التي فيها قراءة، ثم نضربها في 365:
# Step 7: what if we skip the coverage filter? The same question, three thresholds
import pandas as pd

df = pd.read_parquet("data/clean.parquet")
regions = pd.read_csv("regions.csv", dtype="string")
df = df.merge(regions, left_on="STATION", right_on="station", how="left", validate="many_to_one")
df["year"] = df["DATE"].dt.year
yearly = (df[df["year"].between(2015, 2024)]
          .groupby(["region_en", "STATION", "year"])
          .agg(days=("tmax_c", "count"), hot45=("tmax_c", lambda s: (s >= 45).sum()))
          .reset_index())
for min_days in (0, 300, 330):
    t = (yearly[yearly["days"] >= min_days].groupby("region_en")["hot45"].mean()
         .round(1).sort_values(ascending=False))
    print(f"min_days={min_days}:", t.head(5).to_dict())
# the share of hot days instead of the count: does not need full years
yearly["share"] = yearly["hot45"] / yearly["days"]
print((yearly.groupby("region_en")["share"].mean() * 365).round(1).sort_values(ascending=False).head(5).to_dict())
والمخرج سوف يكون كما يلي:
min_days=0: {'Eastern': 46.1, 'Qassim': 35.5, 'Madinah': 18.0, 'Riyadh': 13.9, 'Northern Borders': 12.2}
min_days=300: {'Eastern': 74.9, 'Qassim': 39.7, 'Riyadh': 24.2, 'Madinah': 20.2, 'Makkah': 20.1}
min_days=330: {'Eastern': 77.0, 'Qassim': 39.7, 'Makkah': 23.5, 'Riyadh': 21.6, 'Madinah': 18.2}
{'Eastern': 70.7, 'Qassim': 42.1, 'Riyadh': 24.1, 'Madinah': 23.7, 'Northern Borders': 19.0}
في المخرج أعلاه لاحظ التالي:
- بلا شرط،
min_days=0، الشرقية 46.1 يوماً، والشمالية في المركز الخامس بـ 12.2. ومع 300 قراءة أصبحت الشرقية 74.9، ومع 330 أصبحت 77.0. أي أن الشرط يغير الرقم بأكثر من 30 يوماً. - الترتيب نفسه تغير: مكة المكرمة لم تكن في الخمسة الأولى بلا شرط، ودخلت في المركز الثالث مع 330. والسبب أن محطاتها كانت فيها سنوات ناقصة كثيرة سحبت متوسطها إلى الأسفل.
- بين 300 و330 تغيرت الأرقام قليلاً، والترتيب العام ثابت تقريباً، وهذا يعني أن الجواب مستقر بعد أن نستبعد السنوات الناقصة جداً، وأن اختيار 330 بالضبط ليس هو ما يصنع النتيجة.
- طريقة النسبة أعطت الشرقية 70.7 والقصيم 42.1 والرياض 24.1، وهي قريبة من نتيجة الشرط. وميزتها أنها تستخدم كل السنوات، وعيبها أنها تفترض أن الأيام المفقودة تشبه الأيام الموجودة، وهذا ليس مضموناً، فلو كانت المحطة تتعطل في أشد أيام الصيف لكانت النسبة أقل من الحقيقة.
والخلاصة التي نكتبها في التقرير: الشرقية بين 70 و77 يوماً في السنة فوق 45 درجة، والقصيم قرابة 40، ومكة المكرمة والرياض والمدينة المنورة بين 18 و24. وهذا المدى أصدق من رقم واحد بفاصلة عشرية، لأنه يظهر للمدير أن الرقم تقدير له حدود وليس قياساً دقيقاً.
ماذا عن Polars؟ pandas Alternatives
إذا بحثت عن تحليل البيانات في Python اليوم فسوف تقابل Polars كثيراً، وهي مكتبة جداول كتبت بلغة Rust، وتنفذ العمليات على كل أنوية المعالج، وتستطيع أن تؤجل التنفيذ Lazy Execution حتى ترى الاستعلام كاملاً فتحسنه قبل أن تقرأ البيانات. ولنعرف الفرق على بياناتنا، كتبنا نفس عملية التجميع بالمكتبتين وشغلنا كلاً منهما خمس مرات:
# Step 6: the same heat-day count with pandas and with Polars, timed five times each
# (the first run of each pays for reading the file and warming up; compare the later runs)
import time
import pandas as pd
import polars as pl

def with_pandas():
    pdf = pd.read_parquet("data/clean.parquet")
    return (pdf.assign(year=pdf["DATE"].dt.year, hot=pdf["tmax_c"] >= 45)
               .groupby(["STATION", "year"]).agg(days=("tmax_c", "count"), hot=("hot", "sum")))

def with_polars():
    return (pl.scan_parquet("data/clean.parquet")
              .with_columns(pl.col("DATE").dt.year().alias("year"))
              .group_by("STATION", "year")
              .agg(pl.col("tmax_c").count().alias("days"), (pl.col("tmax_c") >= 45).sum().alias("hot"))
              .collect())

for name, fn in (("pandas", with_pandas), ("polars", with_polars)):
    times = []
    for _ in range(5):
        t = time.perf_counter(); r = fn(); times.append((time.perf_counter() - t) * 1000)
    print(f"{name}: " + ", ".join(f"{x:.0f}" for x in times) + f" ms  rows={len(r)}")

r2 = with_polars()
print(r2.filter((pl.col("STATION") == "SAM00040437") & (pl.col("year") == 2024)))
والمخرج سوف يكون كما يلي:
pandas: 692, 838, 423, 359, 607 ms  rows=1430
polars: 599, 353, 240, 146, 238 ms  rows=1430
shape: (1, 4)
┌─────────────┬──────┬──────┬─────┐
│ STATION     ┆ year ┆ days ┆ hot │
│ ---         ┆ ---  ┆ ---  ┆ --- │
│ str         ┆ i32  ┆ u32  ┆ u32 │
╞═════════════╪══════╪══════╪═════╡
│ SAM00040437 ┆ 2024 ┆ 171  ┆ 8   │
└─────────────┴──────┴──────┴─────┘
في المخرج أعلاه لاحظ التالي:
- المكتبتان أعطتا نفس العدد 1,430 صفاً، ونفس النتيجة لمحطة مطار الملك خالد في 2024: 171 قراءة و8 أيام حارة. وهذا أول ما يجب أن تتحقق منه قبل أي مقارنة سرعة.
- الأزمنة متذبذبة بين التشغيلات، فـ pandas بين 359 و838 ميلي ثانية، وPolars بين 146 و599. والسبب أن الجهاز الذي شغلنا عليه التجربة كان يشغل أعمالاً أخرى في نفس الوقت، وفي تشغيل سابق لنفس السكربت كانت أول قراءة لـ Polars أبطأ من pandas، لأن أول تشغيل يدفع ثمن قراءة الملف وتهيئة الخيوط Threads. ولذلك لا تقس السرعة بتشغيل واحد أبداً، وإنما بعدة تشغيلات، وانظر إلى الأفضل أو الوسيط.
- في التشغيلات الأخيرة كانت Polars أسرع بمرتين إلى ثلاث تقريباً. ولكن لاحظ الحجم: كلاهما أقل من ثانية، ومدير العمليات لن يلاحظ الفرق.
- الكود في Polars مختلف في الأسلوب:
pl.col("tmax_c")بدلdf["tmax_c"]، وgroup_byبدلgroupby، وscan_parquetثمcollect()بدل القراءة المباشرة. فالانتقال ليس تغيير اسم المكتبة فقط، ودليل الانتقال من pandas في توثيق Polars يشرح هذه الفروق.
فمتى تختار Polars؟ عندما تكون البيانات بالملايين أو عشرات الملايين من الصفوف ويصبح الوقت محسوساً، أو عندما يكون الملف أكبر من الذاكرة وتريد قراءته على أجزاء. أما لبيانات بحجم نصف مليون صف، ولفريق يعرف pandas، ومع مكتبات كثيرة مثل scikit-learn وstatsmodels تستقبل جدول pandas مباشرة، فإن pandas هي الاختيار الأبسط. والجدول التالي يلخص الخيارات التي ذكرناها:
| الأداة | تناسب | لا تناسب |
|---|---|---|
| Excel | جدول صغير تراه وتعدله بيدك، وتقرير لمرة واحدة | خطوات تتكرر كل شهر، وملفات بمئات الآلاف من الصفوف، وتتبع ما عدلته |
| pandas | تحليل حتى ملايين قليلة من الصفوف في الذاكرة، وتنظيف وربط وتجميع ورسم بكود يعاد تشغيله | بيانات أكبر من ذاكرة الجهاز، ونظام يعمل طوال الوقت ويشترك فيه كثيرون |
| Polars | نفس عمل pandas بحجم أكبر وسرعة أعلى، والملفات الكبيرة بالتنفيذ المؤجل | فريق يعتمد على مكتبات تنتظر جدول pandas، وكود pandas موجود ويعمل |
| قاعدة بيانات SQL | بيانات تتحدث باستمرار، وتقارير يقرؤها نظام آخر أو لوحة مثل Metabase | سؤال تحليلي سريع على ملفات تصلك مرة واحدة |
من الكود إلى التقرير Report: ماذا نرسل للمدير؟
بعد كل هذا العمل يجب أن نتذكر أن المدير لن يقرأ الكود. فالتقرير الذي أرسلناه كان صفحة واحدة فيها أربع جمل وجدول: الشرقية بين 70 و77 يوماً في السنة فوق 45 درجة، والقصيم قرابة 40، ثم مكة المكرمة والرياض والمدينة المنورة بين 18 و24، وعسير والباحة وجازان وتبوك صفر تقريباً. والموسم الحار يبدأ في مايو، وفي الشرقية قرابة يوم من كل سبعة أيام حارة يأتي قبل بداية فترة الحظر في 15 يونيو، فالخطة يجب أن تبدأ في مايو وليس في يونيو. ومتوسط الصيف ارتفع في ست محطات من سبع لها سجلات كاملة بين الثمانينيات والعقد الأخير، بوسيط قرابة درجة واحدة. وفي آخر الصفحة سطران عن الحدود: البيانات من محطات المطارات وليست من مواقع العمل، والمحطات ليست كلها كاملة، وعدد المحطات في بعض المناطق محطة واحدة.
وأهم من التقرير أن التحليل كله في مجلد واحد يعاد تشغيله بأمر واحد. فإذا وصلت بيانات 2025 كاملة، أو أضافت الشركة منطقة جديدة، أو طلب المدير 43 درجة بدل 45، فالتغيير سطر واحد ثم sh run.sh. وهذا هو الفرق الحقيقي بين pandas وExcel في العمل اليومي، وليس السرعة. وإذا تحول هذا السؤال إلى تقرير يتكرر كل أسبوع، فالخطوة التالية أن تحمل الجدول النظيف إلى قاعدة بيانات وتبني عليه لوحة كما شرحنا في مقال Metabase، وإذا أردت أن تبني على هذه البيانات نموذجاً يتوقع شيئاً، فأساسيات ذلك في مقدمة التعلم الآلي Machine Learning.
قائمة تحقق Checklist قبل أن ترسل أي رقم
- هل قرأت ملف الوصف، وتعرف وحدة كل عمود ومعنى كل علامة؟
- هل نظرت إلى ملف واحد بـ
shapeوdtypesوisna().sum()وdescribe()قبل أن تقرأ الكل؟ - هل الأعمدة بالأنواع الصحيحة: التاريخ
datetime64وليس نصاً، والأرقام أرقام وليست نصوصاً مختلطة؟ - هل حذفت القيم المعلمة بأنها فاشلة وتركت بقية الصف؟
- هل نظرت إلى أعلى وأدنى القيم بعد التنظيف، وتحققت من الشاذ منها بالجيران أو بالأيام المحيطة؟
- هل كل
mergeفيهvalidate، وهل اختبرت عدد الصفوف والقيم الفارغة بعده؟ - هل حسبت التغطية قبل أي عد أو متوسط، وهل تعرف كم سنة أو محطة دخلت في كل رقم؟
- هل جربت أكثر من قيمة لكل شرط وضعته، ورأيت هل يتغير الجواب؟
- هل تعدل الجداول بـ
.locفي استدعاء واحد، ولا يوجد في المخرجChainedAssignmentErrorأو تحذيرات تجاهلتها؟ - هل الإصدارات مثبتة، والتحليل كله يعاد تشغيله بأمر واحد من البيانات الخام؟
- هل كتبت حدود الأرقام في التقرير بجملة يفهمها غير المتخصص؟
تدريب عملي Practice
- غير الحد في الخطوة الثالثة من 45 درجة إلى 48، وانظر هل يبقى ترتيب المناطق كما هو. ثم احسب الليالي الحارة بدل الأيام: الأيام التي لا تنزل فيها الحرارة الصغرى
tmin_cعن 30 درجة. - أضف إلى الخطوة الرابعة عموداً بأول يوم في كل سنة تجاوز 45 درجة في محطة الأحساء، واحسب هل يأتي هذا اليوم أبكر في العقد الأخير من الثمانينيات. ولا تنس شرط التغطية.
- اكتب الخطوة الثالثة كلها بـ Polars، وقارن النتيجة بنتيجة pandas صفاً بصف بدل أن تقارن الأزمنة.
- عدل الخطوة الرابعة حتى يختفي تحذير
Pandas4Warning، وتأكد أن المخرج لم يتغير.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- pandas تعطيك جدولاً في الذاكرة وعمليات على الأعمدة كاملة، وقيمتها الحقيقية أن التحليل يصبح كوداً يقرأ ويعاد تشغيله، وليس السرعة.
- كل عمود Series له نوع واحد dtype، وقيمة مفقودة واحدة تحول الأعداد الصحيحة إلى عشرية، ونص واحد يجعل العمود مختلطاً.
- اقرأ وصف البيانات قبل الكود: الحرارة في GHCN-Daily بأعشار الدرجة، وعلامة الجودة تحذف 105 قراءات منها قراءة 90.6 درجة.
- القاعدة الآلية للقيم الشاذة تحدد أين تنظر، والقرار لك: قراءة رفحاء 54.7 أعلى من أسبوعها بـ 9.1 درجة، و1,435 قراءة أخرى أغلبها تغيرات طقس حقيقية في الشتاء والربيع.
- الربط بـ
leftمعvalidateيحميك من المفتاح المكرر الذي رفع الصفوف إلى 497,632، ومنinnerالذي حذف 26,857 صفاً بصمت. - التغطية قبل المتوسط: شرط 330 قراءة رفع الشرقية من 46 يوماً حاراً إلى 77، وغير ترتيب المناطق.
- في pandas 3 الإسناد المتسلسل لا يعدل الأصل أبداً، فعدل بـ
.locفي استدعاء واحد. - Polars أسرع على بياناتنا بمرتين إلى ثلاث، وكلاهما أقل من ثانية، فاختر Polars عندما يصبح الحجم مشكلة حقيقية.
وهذا المقال أول مقالات مرحلة مشاريع تعلم الآلة العملية، وهذه مقالات منشورة ترتبط به:
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلالإحصاء Statistics للمهندسين: لماذا يخدعك المتوسط Mean؟كيف تقرأ زمن الاستجابة بالوسيط والمئين p95 وp99 والمدرج التكراري بدل المتوسط، ولماذا لا يجوز حساب متوسط المئين، مع تجربة حقيقية لسيرفر تحت الضغط.
 دليلتعلم SQL (1): ما هو SQL وكيف تكتب أول استعلامتتعلم SQL من الصفر: ما هي قاعدة البيانات العلائقية، وكيف تنشئ الجداول وتضيف البيانات وتكتب أول استعلام بأمان.
 دليلتعلم SQL (2): الربط JOIN والتجميع والاستعلامات الفرعيةكيف تجمع الصفوف من أكثر من جدول وتلخصها بالتجميع والاستعلامات الفرعية، دون أن تتضاعف أرقام تقاريرك.
 دليلPython للمطورين: التركيب Syntax والأدوات في يوم واحددليل لمن يبرمج بلغة أخرى ويريد أن يبدأ بـ Python 3.15 من أول يوم: التثبيت، وما يختلف في التركيب، والأدوات uv وruff وmypy وpytest على مشروع حقيقي بمخرجه الفعلي.
 دليلFloating Point من الداخل: كيف يخزن الحاسب الكسوركيف يحفظ معيار IEEE 754 الكسور في البتات، ولماذا تكبر الفجوة بين الأرقام وتضيع خانات المعرفات، ومتى تحتاج النوع العشري.
 دليلMetabase: لوحات وتقارير من بياناتك دون كتابة كودكيف تثبت Metabase على سيرفرك، وتبني منه أسئلة ولوحة مبيعات من بيانات شركتك بالنقر أو بلغة SQL.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل التحليل على 32 محطة سعودية من GHCN-Daily بـ pandas 3.1.0 وPolars 2.1.0 وmatplotlib 3.11.2 على Python 3.13 داخل Docker.