لنفرض أنك المطور الوحيد في فريق البيانات في شركة ناشئة تقدم تطبيقاً للادخار بالذهب، يشتري فيه المستخدم جرامات صغيرة كل شهر بدل أن يشتري سبيكة دفعة واحدة. وفي أحد الاجتماعات يعرض مدير المنتج فكرة يراها بسيطة: شاشة جديدة في التطبيق عنوانها «توقع سعر الذهب للشهر القادم»، فيها رقم واحد وسهم أخضر أو أحمر، ويقول إن المنافسين لا يقدمونها، وإن المستخدمين سوف يفتحون التطبيق أكثر. ثم يلتفت إليك ويسأل: كم أسبوعاً تحتاج لتبني النموذج؟ والسؤال الذي يجب أن تسأله قبل أن تجيب ليس «أي مكتبة أستخدم؟»، وإنما: هل يمكن أصلاً أن يتوقع أي نموذج سعر الذهب الشهر القادم أفضل من أبسط تخمين ممكن، وهو أن سعر الشهر القادم مثل سعر هذا الشهر؟ وإذا لم يستطع، فما الذي سوف نعرضه للمستخدم بالضبط؟
وفي هذا المقال سوف نجيب عن هذا السؤال بالتجربة لا بالرأي. فسوف نأخذ سلسلة زمنية Time Series حقيقية لسعر الذهب الشهري من مصدر رسمي مجاني، ونقيس عليها سبعة نماذج من الأبسط إلى الأعقد: النموذج البسيط Naive، والانجراف Drift، والمتوسطات المتحركة Moving Averages، ونموذج ARIMA، ونموذجين من التعلم الآلي هما Ridge وGradient Boosting. وكل نموذج سوف يتوقع 249 شهراً من يناير 2006 إلى سبتمبر 2026، كل شهر منها وهو لا يرى إلا ما قبله، وهذه الطريقة تسمى التحقق المتدحرج Walk-Forward Validation. ثم نجري ثلاث تجارب «ماذا يحدث إذا» تكشف كيف يخدع الإنسان نفسه في هذا النوع من المسائل: تفوق صغير يظهر حتى على بيانات عشوائية تماماً، ونموذج يبدو ممتازاً لأننا سمحنا له أن يرى المستقبل دون أن ننتبه، ونموذج شجري لا يستطيع أن يتوقع سعراً أعلى من أعلى سعر رآه. وكل رقم في المقال مخرج حقيقي من كود في مجلد lab شغلناه داخل Container على معالج CPU.
وسوف نناقش في هذا المقال ما يلي:
- مصدر البيانات وماذا تعني بالضبط: متوسط الشهر لا سعر يوم، والدولار للأونصة لا الريال للجرام.
- لماذا يعتبر النموذج البسيط «الشهر القادم مثل هذا الشهر» خصماً صعباً، وما علاقته بنظرية كفاءة السوق Efficient Market Hypothesis.
- النماذج السبعة وكيف يعمل كل منها من الداخل، ولماذا نتوقع التغير بدل السعر.
- التحقق المتدحرج، ومقاييس الخطأ MAE وRMSE وMAPE، ونسبة الخطأ إلى النموذج البسيط، واختبار Diebold-Mariano.
- النتائج: من تجاوز النموذج البسيط، وبكم، وهل الفرق حقيقي.
- ثلاث تجارب: أثر المتوسط Averaging Effect، والتسرب Leakage، وسقف النماذج الشجرية.
- التوقع لسنة كاملة، ثم ما الذي يستطيعه النموذج فعلاً وما الذي لا يستطيعه، وماذا نعرض في التطبيق.
البيانات Data: سعر الذهب الشهري من البنك الدولي
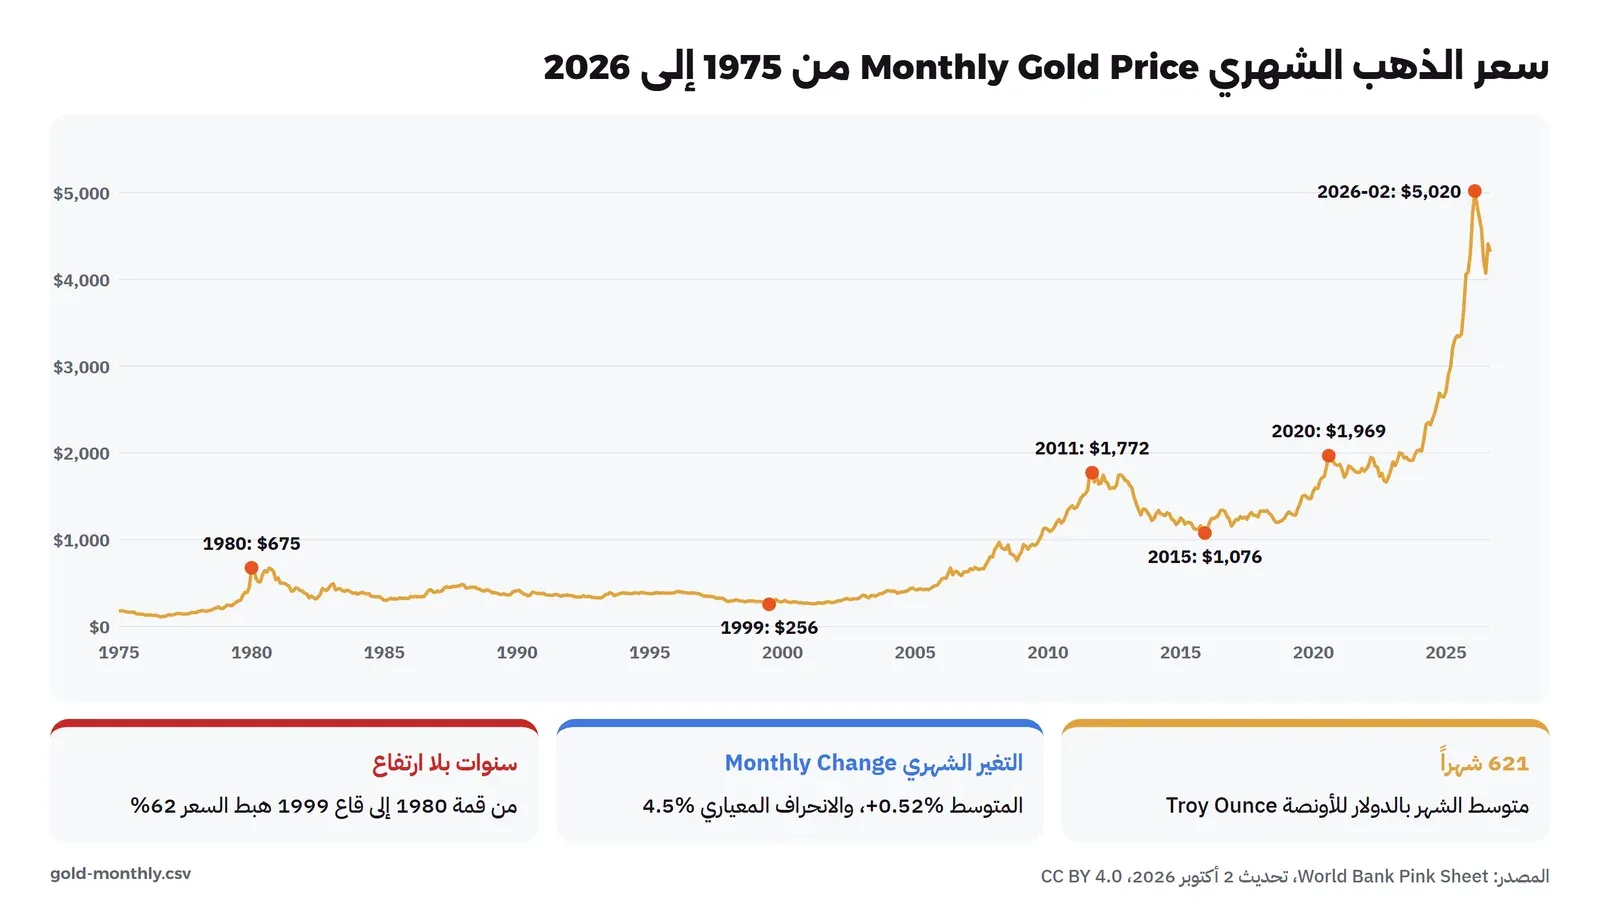
أول قرار في أي مشروع توقع هو مصدر البيانات، وفي الذهب ستجد عشرات المواقع التي تعرض أسعاراً تاريخية، ولكن أغلبها لا يذكر مصدره، أو يمنع إعادة الاستخدام، أو يغير طريقة حساب السعر بين فترة وأخرى دون أن يخبرك. والمصدر الذي اخترناه هو بيانات أسعار السلع من البنك الدولي، المعروفة باسم Pink Sheet، وهي ملف Excel مجاني يحدث في أول كل شهر، فيه الأسعار الشهرية لعشرات السلع منذ يناير 1960، ومنها الذهب بالدولار الأمريكي للأونصة Troy Ounce، والأونصة تساوي 31.1034768 جراماً. والسكربت lab/fetch_gold.py ينزل الملف ويأخذ عمود الذهب فقط ويحفظه في ملف gold-monthly.csv صغير داخل المجلد، والمخرج كان كما يلي:
Updated on October 02, 2026
unit: ($/troy oz)
801 months: 1960-01 to 2026-09
وهنا ملاحظتان مهمتان قبل أي نموذج، لأنهما سوف تغيران فهمنا للنتائج لاحقاً:
- السعر هنا متوسط الشهر Monthly Average، أي متوسط الأسعار اليومية خلال الشهر، لا سعر آخر يوم فيه. وهذا الفرق يبدو تفصيلاً صغيراً، ولكنه سوف يصنع أهم «اكتشاف» في المقال، ثم يهدمه.
- الأسعار قبل السبعينات ثابتة تقريباً، فالسعر 35 دولاراً في يناير 1960، وكان مربوطاً رسمياً في نظام بريتون وودز Bretton Woods حتى بداية السبعينات، ولذلك بدأنا التحليل من يناير 1975 حتى لا يتعلم النموذج من فترة لم يكن فيها السعر يتحرك بحرية.
وإذا أردت السعر بالريال للجرام كما يراه المستخدم في التطبيق، فاضرب سعر الأونصة في سعر الصرف الثابت 3.75 ريال للدولار، ثم اقسم على 31.1035، فمتوسط سبتمبر 2026 وهو 4,319 دولاراً للأونصة يساوي قرابة 520.7 ريالاً لجرام الذهب الخالص. وبما أن الريال مربوط بالدولار فإن هذا التحويل لا يضيف أي حركة إلى السلسلة، ولذلك سوف نعمل بالدولار للأونصة كما هو في المصدر.
والسكربت الرئيسي lab/forecast.py يبدأ بطباعة ملخص السلسلة:
621 months 1975-01 .. 2026-09, last price $4,319
monthly log change: mean +0.0052, std 0.0450; autocorrelation lag1..3: +0.204, -0.078, +0.015
في المخرج أعلاه لاحظ التالي:
- لدينا 621 شهراً، أي قرابة 52 سنة، وآخر سعر 4,319 دولاراً.
- نحن نعمل بلوغاريتم السعر Log Price، والتغير في اللوغاريتم يساوي تقريباً نسبة التغير، فمتوسط التغير الشهري +0.0052 يعني أن الذهب ارتفع في المتوسط قرابة 0.52% في الشهر خلال هذه الفترة.
- الانحراف المعياري للتغير الشهري 0.045، أي 4.5%، وهذا يعني أن التغير المعتاد في شهر واحد أكبر بتسع مرات تقريباً من متوسط التغير، فالاتجاه العام صغير جداً مقارنة بالضوضاء.
- الارتباط الذاتي Autocorrelation بتأخير شهر واحد +0.204، أي أن تغير هذا الشهر مرتبط بتغير الشهر السابق، فإذا ارتفع السعر في شهر فهناك ميل خفيف لأن يرتفع في الشهر الذي بعده. وهذا الرقم هو أول ما سوف يفرح به من يريد أن يبني نموذجاً، وسوف نرجع إليه.
وإذا أردت مراجعة معنى الانحراف المعياري والارتباط وكيف تقرؤهما، فقد شرحناهما بأمثلة من أنظمة حقيقية في مقال الإحصاء للمهندسين، وإذا أردت أن تتعامل مع هذا النوع من الملفات في Python بشكل عام فابدأ من مقال تحليل البيانات مع pandas.
النموذج البسيط Naive Baseline: لماذا هو خصم صعب؟
قبل أن نبني أي نموذج نحتاج شيئاً نقارن به، وفي السلاسل الزمنية المالية أهم خط أساس Baseline هو النموذج البسيط: توقع الشهر القادم يساوي قيمة هذا الشهر. وقد يبدو هذا النموذج سخيفاً حتى إن بعض المطورين لا يكلف نفسه عناء حسابه، ولكن في الواقع هو أصعب خصم في هذه المسألة، والسبب في نظرية معروفة في الاقتصاد اسمها فرضية كفاءة السوق Efficient Market Hypothesis، التي لخصها الاقتصادي Eugene Fama في ورقته المراجعة سنة 1970. والفكرة فيها أن السعر في سوق يتداول فيه عدد كبير من الناس يحتوي بالفعل على كل المعلومات المتاحة للجميع، فإذا كانت هناك معلومة متاحة تقول إن الذهب سوف يرتفع الشهر القادم، فإن المتداولين سوف يشترون اليوم، فيرتفع السعر اليوم لا الشهر القادم. والنتيجة أن التغيرات المستقبلية تأتي من معلومات جديدة لم تكن معروفة، والمعلومات الجديدة لا يمكن توقعها بالتعريف، وبالتالي يقترب السعر من سلوك يسمى السير العشوائي Random Walk: سعر الغد هو سعر اليوم مضافاً إليه خطوة عشوائية.
وفي السير العشوائي يكون النموذج البسيط هو أفضل توقع ممكن، لا لأنه ذكي، وإنما لأنه لا يوجد شيء آخر يمكن معرفته. وهذا ليس كلاماً نظرياً فقط، فأشهر دراسة في هذا الباب هي دراسة Meese وRogoff سنة 1983، التي قارنت نماذج اقتصادية معقدة لتوقع أسعار صرف العملات بالنموذج البسيط، ووجدت أن النموذج البسيط لم يكن أسوأ منها في توقع الأشهر القادمة، وهذه النتيجة أصبحت مرجعاً يقاس عليه أي نموذج جديد في هذا المجال. ولكن الذهب ليس عملة، والأسواق ليست كفؤة تماماً، ولذلك فإن السؤال العملي هو: كم يقترب الذهب من السير العشوائي؟ وهل هناك شيء صغير يمكن أن يستفيد منه نموذج؟
وقد يتساءل البعض: إذا كان السعر لا يمكن توقعه، فكيف تكسب صناديق الاستثمار؟ والإجابة أن أغلبها لا يكسب من توقع سعر الشهر القادم، وإنما من أشياء أخرى مثل الاحتفاظ طويل المدى وتوزيع المخاطر والرسوم، وأن الذي يحاول التوقع يحتاج معلومات أسرع أو أفضل من السوق، لا نموذجاً على الأسعار التاريخية التي يراها الجميع. وهذا بالضبط ما سوف نختبره: نموذج على الأسعار التاريخية فقط.
النماذج السبعة Models: من الأبسط إلى الأعقد
قمنا باختيار النماذج بحيث يمثل كل منها فكرة مختلفة عن ما يمكن أن يحمله الماضي من معلومات عن المستقبل، وفيما يلي كل نموذج وفكرته:
- النموذج البسيط Naive: الشهر القادم مثل هذا الشهر. الفكرة: لا شيء في الماضي يفيد.
- الانجراف Drift: هذا الشهر مضافاً إليه متوسط التغير الشهري في كل التاريخ السابق. الفكرة: الماضي يقول شيئاً واحداً فقط، وهو الاتجاه العام طويل المدى. وهذا النموذج والذي قبله من النماذج المرجعية الأساسية في كتاب Forecasting: Principles and Practice لـ Rob Hyndman وGeorge Athanasopoulos، وهو كتاب مجاني على الإنترنت وأفضل مرجع عملي في هذا الموضوع.
- المتوسط المتحرك Moving Average لآخر 3 أشهر ولآخر 12 شهراً: التوقع هو متوسط آخر أشهر. الفكرة: السعر يرجع إلى متوسطه، والتقلبات مؤقتة. وهذه فكرة شائعة جداً في تطبيقات التداول، وسوف نرى ثمنها.
- ARIMA(1,1,1): نموذج إحصائي كلاسيكي، والحروف الثلاثة تعني الانحدار الذاتي AutoRegressive، والتكامل Integrated، والمتوسط المتحرك للأخطاء Moving Average. والأرقام بين القوسين تعني أن النموذج يعمل على التغير الشهري بدل السعر (الرقم 1 في الوسط)، وأن تغير هذا الشهر يعتمد على تغير الشهر الماضي (الرقم الأول)، وعلى خطأ توقع الشهر الماضي (الرقم الأخير). وأضفنا إليه اتجاهاً ثابتاً، وهو نفس فكرة الانجراف. واستخدمنا تنفيذ ARIMA في statsmodels.
- Ridge على 12 تأخيراً Lags: انحدار خطي يأخذ آخر 12 تغيراً شهرياً ويتوقع التغير القادم، مع عقوبة Regularization تمنع المعاملات من أن تكبر. الفكرة: ربما هناك نمط في السنة الأخيرة.
- Gradient Boosting على 12 تأخيراً: نفس المدخلات، ولكن بنموذج من مئات الأشجار الصغيرة يستطيع أن يجد علاقات غير خطية. الفكرة: ربما النمط معقد ولا يراه الانحدار الخطي. وإذا كنت جديداً على هذه النماذج فقد شرحنا فكرتها في مقال التعلم الآلي للمبتدئين.
ولاحظ أن نموذجي التعلم الآلي لا يتوقعان السعر نفسه، وإنما التغير الشهري في لوغاريتم السعر، ثم نضيفه إلى السعر الحالي. والسبب أن السعر نفسه يتحرك من 150 دولاراً في السبعينات إلى أكثر من 4,000 اليوم، فلو تعلم النموذج السعر مباشرة لتعلم أرقاماً لن تتكرر، أما التغير بالنسبة فله نفس المعنى في 1980 وفي 2026. وسوف نرى في التجارب ماذا يحدث بالضبط لو لم نقم بذلك.
التحقق المتدحرج Walk-Forward Validation
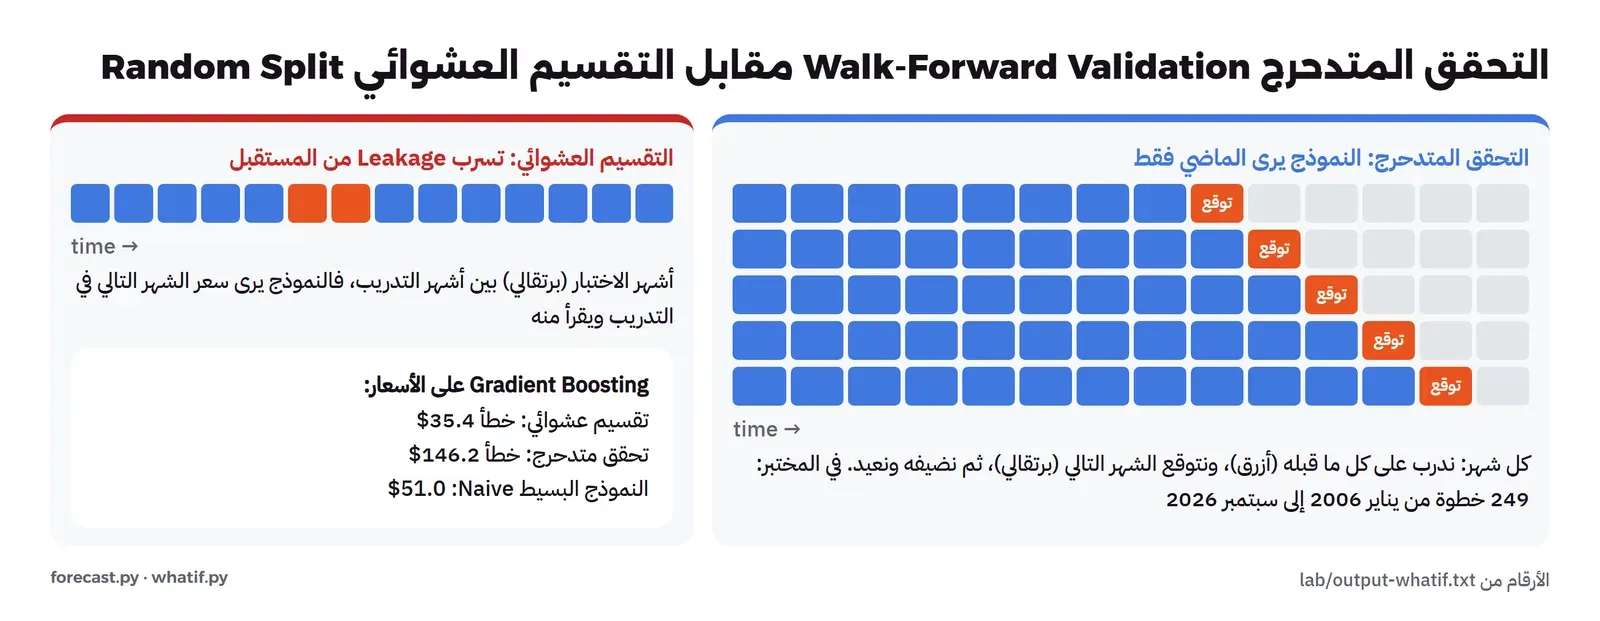
في أغلب مسائل التعلم الآلي نقسم البيانات عشوائياً إلى تدريب واختبار، ونقيس الأداء على الاختبار. ولكن هذا خطأ قاتل في السلاسل الزمنية، لأن التقسيم العشوائي يضع أشهراً من المستقبل في التدريب، فيتعلم النموذج من سعر مارس ثم نختبره على فبراير، وفي الواقع لن يرى النموذج أبداً سعر مارس عندما يتوقع فبراير. والطريقة الصحيحة تسمى التحقق المتدحرج أو التحقق المتقاطع للسلاسل الزمنية Time Series Cross-Validation، وشرحها مفصل في فصل التحقق في كتاب Hyndman، وتوفرها مكتبة scikit-learn في الكلاس TimeSeriesSplit. والفكرة أن نقف عند كل شهر في فترة الاختبار، وندرب النموذج على كل الأشهر التي قبله فقط، ونتوقع هذا الشهر، ثم ننتقل إلى الشهر التالي ونعيد التدريب بعد أن نضيف الشهر الذي انتهى. وبذلك يحاكي الاختبار تماماً ما سوف يحدث في التطبيق: كل أول شهر يتدرب النموذج على ما هو معروف، ويتوقع الشهر الجديد.
وهذا الجزء من الحلقة الرئيسية في lab/forecast.py:
for t in range(TEST, len(g)):
    hist = y.iloc[:t]                              # everything strictly before month t
    last = hist.iloc[-1]
    preds["Naive (next = last)"].append(last)
    preds["Drift"].append(last + hist.diff().mean())
    preds["Moving average 3"].append(hist.iloc[-3:].mean())
    preds["Moving average 12"].append(hist.iloc[-12:].mean())
    preds["ARIMA(1,1,1)"].append(ARIMA(hist.values, order=(1, 1, 1), trend="t").fit().forecast(1)[0])
    X, z = ml_data(r, t)
    x = feats(r, t)[None, :]
    preds["Ridge on 12 lags"].append(last + Ridge(alpha=1.0).fit(X, z).predict(x)[0])
    preds["Gradient Boosting on 12 lags"].append(
        last + GradientBoostingRegressor(n_estimators=200, max_depth=2, learning_rate=0.05, random_state=0).fit(X, z).predict(x)[0])
في الكود أعلاه لاحظ التالي:
- السطر
hist = y.iloc[:t]هو أهم سطر في الملف، فكل نموذج يرى فقط الأشهر قبل الشهرt، وأي خطأ هنا، مثل[:t + 1]، يعطي نتائج ممتازة وكاذبة. - كل النماذج تعاد من الصفر في كل شهر، أي 249 مرة لكل نموذج، وهذا بطيء: الحلقة كلها احتاجت قرابة 18 دقيقة على CPU، وأغلب الوقت في ARIMA وGradient Boosting. وفي الإنتاج لا تحتاج هذا، لأنك تدرب مرة واحدة في الشهر، ولكن في التقييم هو الطريقة الوحيدة الصادقة.
- الدالة
featsتأخذ آخر 12 تغيراً قبل الشهرt، والدالةml_dataتبني جدول التدريب من كل الأشهر قبلtفقط، فلا يدخل أي تغير من المستقبل في المدخلات ولا في الهدف.
مقاييس الخطأ Error Metrics: MAE أو RMSE أو MAPE
بعد أن نحصل على 249 توقعاً لكل نموذج نحتاج طريقة نلخص بها جودتها، وكل مقياس يجيب عن سؤال مختلف قليلاً، وشرحها الكامل في فصل الدقة في نفس الكتاب:
- متوسط الخطأ المطلق Mean Absolute Error، واختصاراً MAE: متوسط الفرق بين التوقع والفعلي بالدولار بغض النظر عن الإشارة. وهو أسهل مقياس في الشرح للمدير: «في المتوسط يخطئ النموذج بكذا دولاراً».
- جذر متوسط مربع الخطأ Root Mean Squared Error، واختصاراً RMSE: يربع الأخطاء قبل المتوسط، فيعاقب الأخطاء الكبيرة أكثر. وإذا كان الفرق بينه وبين MAE كبيراً، فهذا يعني أن هناك أشهراً قليلة بأخطاء ضخمة.
- متوسط الخطأ النسبي Mean Absolute Percentage Error، واختصاراً MAPE: الخطأ كنسبة من السعر، وهو مهم هنا لأن خطأ 50 دولاراً في 2006 والسعر 550 يختلف تماماً عن خطأ 50 دولاراً والسعر 4,300.
- النسبة إلى النموذج البسيط: MAE النموذج مقسوماً على MAE النموذج البسيط، وهي فكرة مقياس MASE نفسها. فإذا كانت أقل من 1 فالنموذج أفضل من البسيط، وهذا أهم عمود في الجدول.
- دقة الاتجاه Direction Accuracy: كم مرة توقع النموذج الاتجاه الصحيح، أي ارتفاعاً أم انخفاضاً. وهذا هو السهم الأخضر أو الأحمر الذي يريده مدير المنتج.
- اختبار Diebold-Mariano: اختبار إحصائي يجيب عن سؤال: هل الفرق بين خطأ النموذج وخطأ البسيط أكبر مما يمكن أن تصنعه الصدفة؟ والرقم الذي نطبعه هو قيمة p، فكلما صغرت كان الفرق أصعب تفسيراً بالصدفة، والعادة أن يعتبر الفرق حقيقياً إذا كانت أقل من 0.05.
النتائج Results: من تجاوز النموذج البسيط؟
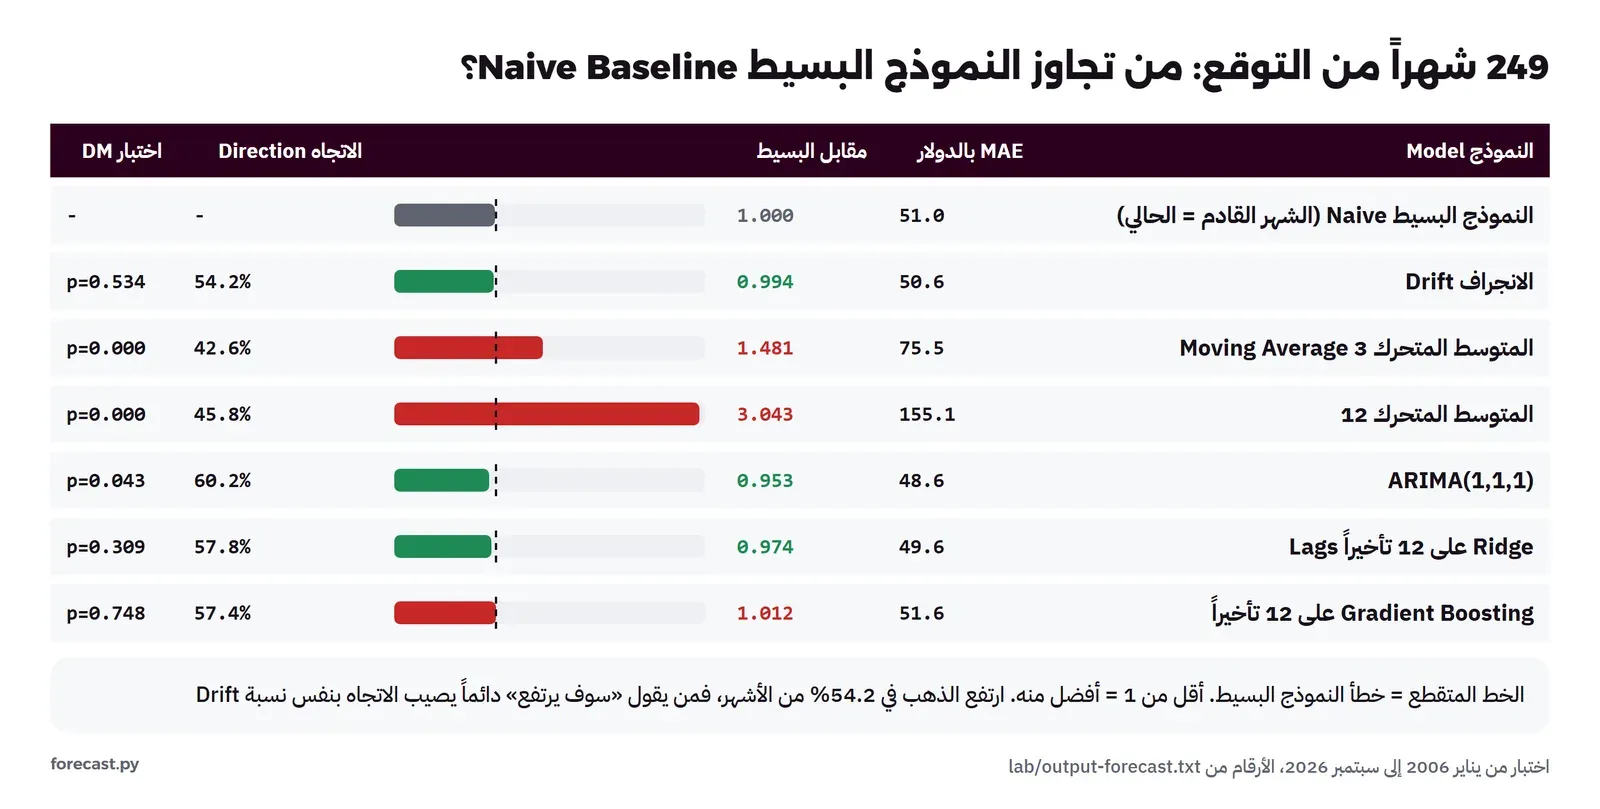
وهذا هو الجدول الذي ينتظره مدير المنتج، وهو المخرج الكامل لـ forecast.py بعد 249 خطوة:
249 walk-forward steps (2006-01 .. 2026-09) in 1107 s

model                             MAE $   RMSE $   MAPE  vs naive  direction   DM p
Naive (next = last)                51.0     80.1  3.08%     1.000       nan%    nan
Drift                              50.6     78.6  3.07%     0.994      54.2%  0.534
Moving average 3                   75.5    121.3  4.39%     1.481      42.6%  0.000
Moving average 12                 155.1    257.6  8.78%     3.043      45.8%  0.000
ARIMA(1,1,1)                       48.6     74.1  3.00%     0.953      60.2%  0.043
Ridge on 12 lags                   49.6     76.4  3.04%     0.974      57.8%  0.309
Gradient Boosting on 12 lags       51.6     77.6  3.22%     1.012      57.4%  0.748

months where gold went up: 54.2% of 249
في المخرج أعلاه لاحظ التالي:
- النموذج البسيط يخطئ في المتوسط 51 دولاراً، أي 3.08% من السعر. وهذا هو الخط الذي يجب أن يتجاوزه أي نموذج حتى يستحق مكاناً في التطبيق.
- الانجراف أفضل بنسبة 0.6% فقط، وقيمة p تساوي 0.534، أي أن الفرق لا يمكن تمييزه عن الصدفة. والاتجاه العام للذهب حقيقي على مدى عقود، ولكنه صغير جداً في شهر واحد مقارنة بالتقلب.
- المتوسطات المتحركة أسوأ بكثير: المتوسط لثلاثة أشهر أسوأ من البسيط بنسبة 48%، ولاثني عشر شهراً بثلاثة أضعاف. والسبب أن الذهب ارتفع كثيراً في فترة الاختبار، والمتوسط يتأخر دائماً عن السعر في الاتجاه، فهو يتوقع رجوعاً إلى متوسط لم يرجع إليه السعر. ودقة الاتجاه فيهما أقل من 50%، أي أسوأ من رمي عملة. وهذا مهم لأن المتوسط المتحرك هو أول ما يقترحه كثير من الناس.
- ARIMA هو الوحيد الذي تجاوز البسيط بفرق له قيمة p أقل من 0.05: خطأ 48.6 دولاراً بدل 51، أي تحسن 4.7%، ودقة اتجاه 60.2%. وهذا هو السطر الذي سوف يأخذه أي شخص متحمس إلى الاجتماع.
- Ridge قريب من ARIMA، أفضل من البسيط بنسبة 2.6%، ولكن قيمة p تساوي 0.309، أي أن الفرق غير مؤكد.
- Gradient Boosting، وهو أعقد النماذج، أسوأ من البسيط قليلاً. ومئات الأشجار على 12 تأخيراً لم تجد شيئاً لا يجده الانحدار الخطي، ووجدت أشياء غير موجودة، وهذا ما يسمى فرط التخصيص Overfitting.
- دقة الاتجاه: الذهب ارتفع في 54.2% من الأشهر، فالسهم الأخضر الدائم يصيب بنفس نسبة الانجراف. وARIMA عند 60.2% أفضل من ذلك بست نقاط، وهذا رقم يبدو جذاباً.
فهل نذهب إلى مدير المنتج ونقول: لدينا نموذج ARIMA يتوقع اتجاه الذهب في 60% من الأشهر، وبفرق مؤكد إحصائياً؟ قبل أن تقوم بذلك، تذكر الرقم +0.204 في بداية المقال، وتذكر أن البيانات متوسط الشهر لا سعر يوم. ثم اسأل نفسك سؤالاً مزعجاً: ماذا سيحدث لو شغلنا نفس النموذج على بيانات نعرف يقيناً أنه لا يمكن توقعها؟
ماذا يحدث إذا كانت البيانات عشوائية تماماً؟ Averaging Effect
هذه هي التجربة الأولى في lab/whatif.py، وهي أهم تجربة في المقال. فبدل أن نجادل هل الذهب قابل للتوقع أم لا، نصنع سلسلة نعرف يقيناً أنها غير قابلة للتوقع: سير عشوائي يومي، كل يوم فيه هو اليوم السابق مضافاً إليه رقم عشوائي، وبنفس حجم تقلب الذهب. ثم نحسب منها شيئين: متوسط كل شهر، كما يفعل البنك الدولي، وآخر يوم في كل شهر. ونطبق على الاثنين نموذج AR(1) على التغيرات، وهو قلب ARIMA، ونقارنه بالنموذج البسيط بنفس التحقق المتدحرج، ونكرر التجربة 200 مرة. والمخرج كان كما يلي:
1) Monthly AVERAGES of a pure random walk
   real gold (monthly averages): AR(1) MAE / naive MAE = 0.961, AR(1) closer in 52.6% of months
   simulated random walk, monthly AVERAGE  : lag-1 autocorrelation of changes +0.246, AR(1) MAE / naive MAE = 0.973 (mean of 40 runs)
   simulated random walk, LAST DAY of month: lag-1 autocorrelation of changes +0.000, AR(1) MAE / naive MAE = 1.003 (mean of 40 runs)
في المخرج أعلاه لاحظ التالي:
- على الذهب الحقيقي، AR(1) أفضل من البسيط بنسبة 3.9%، وهذا قريب من نتيجة ARIMA في الجدول السابق.
- على السير العشوائي بمتوسط الشهر، الارتباط الذاتي +0.246، وAR(1) أفضل من البسيط بنسبة 2.7%. أي أن النموذج «تفوق» على بيانات لا يمكن توقعها بالتعريف.
- على نفس السير العشوائي بآخر يوم في الشهر، الارتباط صفر تماماً، وAR(1) أسوأ من البسيط قليلاً، كما يجب أن يكون.
والسبب في ذلك ظاهرة إحصائية معروفة منذ أكثر من ستين سنة، نشرها الاقتصادي Holbrook Working في ملاحظة قصيرة في مجلة Econometrica سنة 1960، حيث بين أن الفروق بين متوسطات فترات متتالية من سير عشوائي يكون بينها ارتباط قرابة 0.25، مع أن السير نفسه لا ارتباط فيه. والفكرة يمكن فهمها دون معادلات: لنفرض أن السعر ارتفع فجأة في آخر أسبوع من مارس، فمتوسط مارس سوف يرتفع قليلاً لأن أسبوعاً واحداً فقط من الشهر كان مرتفعاً، ومتوسط أبريل سوف يرتفع أكثر لأن الشهر كله يبدأ من المستوى الجديد. وبالتالي يظهر نفس الارتفاع في تغير مارس وتغير أبريل معاً، فيبدو كأن الارتفاع في شهر «يتنبأ» بارتفاع في الشهر الذي بعده.
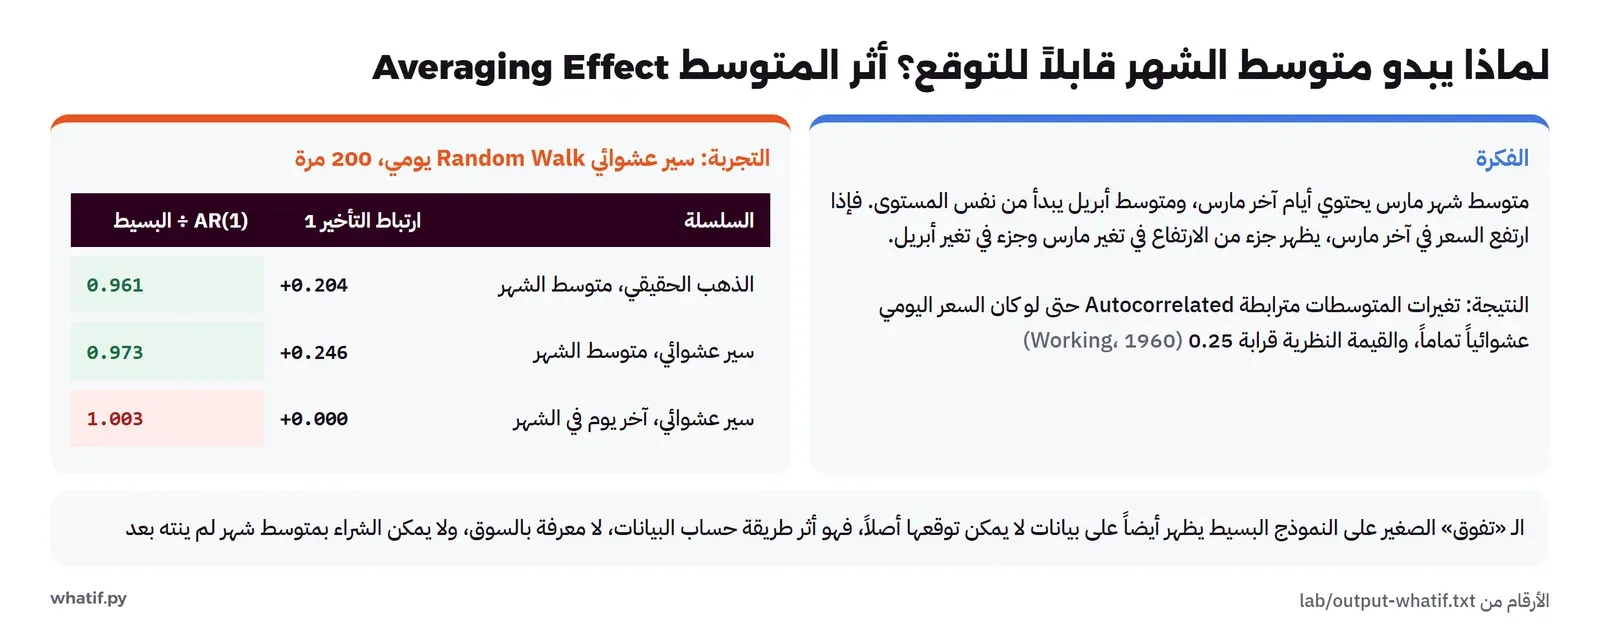
والارتباط في الذهب الحقيقي +0.204، أي أقل قليلاً من +0.246 في السير العشوائي، وهذا يعني أن أغلب الارتباط الذي فرحنا به، وربما كله، يأتي من طريقة حساب البيانات لا من سلوك السوق. وأهم من ذلك أن هذا «التفوق» لا يمكن استخدامه: فالمستخدم لا يستطيع أن يشتري بمتوسط شهر أبريل في أول أبريل، لأنه متوسط أيام لم تأت بعد. فلو عرضنا في التطبيق «متوسط الشهر القادم سوف يرتفع»، لكان الكلام صحيحاً إحصائياً بنسبة صغيرة، ولكنه بلا قيمة لمن يريد أن يقرر متى يشتري. والدرس الأعم هنا أنك قبل أن تحتفل بأي نموذج يتجاوز خط الأساس، اسأل: هل يتجاوز أيضاً على بيانات عشوائية مصنوعة بنفس طريقة بياناتي؟ فإذا كانت الإجابة نعم، فالتفوق من البيانات لا من النموذج.
وهذه هي المشكلة الحقيقية الأولى التي ظهرت في هذا المختبر: أول نتيجة جيدة كانت في الواقع خاصية في البيانات. ولو كانت لدينا أسعار يومية من مصدر رسمي مجاني لاستخدمنا سعر آخر يوم في الشهر وانتهينا، ولكن البنك الدولي ينشر المتوسطات الشهرية فقط، ولذلك فإن الطريقة الصحيحة هي أن تعرف هذا القيد وتقيس أثره، كما قمنا بالضبط.
ماذا يحدث إذا قسمنا البيانات عشوائياً؟ Data Leakage
التجربة الثانية تبين الخطأ الذي يقع فيه أغلب من ينقل خبرة التعلم الآلي العادية إلى السلاسل الزمنية. فهنا نأخذ Gradient Boosting، ولكن هذه المرة نعطيه الأسعار نفسها لآخر 12 شهراً، لا التغيرات، ونقيسه بطريقتين: الأولى تقسيم عشوائي 80% للتدريب و20% للاختبار، كما في أي درس تعلم آلي، والثانية التحقق المتدحرج من 2006. والمخرج كان كما يلي:
2) Leakage: Gradient Boosting on price LEVELS (features = the last 12 prices)
   shuffled 80/20 split : MAE $35.4 (naive on the same rows $32.5)
   walk-forward 2006..  : MAE $146.2 (naive $51.0)
   last 24 months (2024-10..2026-09): MAE $589, naive $164; highest prediction $4,304, highest actual $5,020
في التقسيم العشوائي كان الخطأ 35.4 دولاراً، وهو رقم يبدو ممتازاً، أقل من خطأ النموذج البسيط في جدولنا الرئيسي بثلث تقريباً. ولكن في التحقق المتدحرج أصبح الخطأ 146.2 دولاراً، أي قرابة ثلاثة أضعاف النموذج البسيط. والسبب أن التقسيم العشوائي يعطي النموذج في التدريب أشهراً بعد الشهر الذي يختبر عليه وقبله، فيتعلم أن السعر في 2019 كان قرابة 1,400 دولار من أشهر 2019 الأخرى، ثم «يتوقع» شهراً في 2019 بسهولة. وهذا ما يسمى التسرب Data Leakage، أي أن معلومة من المستقبل تسربت إلى التدريب. ولاحظ أن الرقم الصحيح للمقارنة في التقسيم العشوائي هو 32.5 دولاراً للنموذج البسيط على نفس الأشهر، أي أن النموذج كان أسوأ من البسيط حتى مع التسرب، ولكن من لا يحسب خط الأساس لن يرى ذلك أبداً، وسوف يعرض رقم 35.4 دولاراً في الاجتماع.
سقف النماذج الشجرية Tree Models لا تتوقع سعراً لم تره
والسطر الأخير في المخرج يكشف مشكلة ثانية أخطر: في آخر 24 شهراً كان خطأ النموذج 589 دولاراً، وأعلى توقع أعطاه 4,304 دولارات، بينما وصل السعر الفعلي إلى 5,020. والسبب في طريقة عمل الأشجار نفسها: كل شجرة قرار تقسم المدخلات إلى مناطق، وتعطي لكل منطقة متوسط القيم التي رأتها في التدريب في هذه المنطقة. وبالتالي فإن أعلى توقع ممكن هو أعلى متوسط رأته في التدريب، ولا تستطيع أي شجرة ولا أي مجموع أشجار أن يعطي رقماً أعلى من أعلى رقم في التدريب، وهذا ما يسمى عدم القدرة على الاستقراء Extrapolation. وفي سوق في أعلى مستوى تاريخي له، مثل الذهب في 2025 و2026، فإن كل شهر جديد هو رقم لم يره النموذج، فيبقى توقعه عالقاً عند السقف.
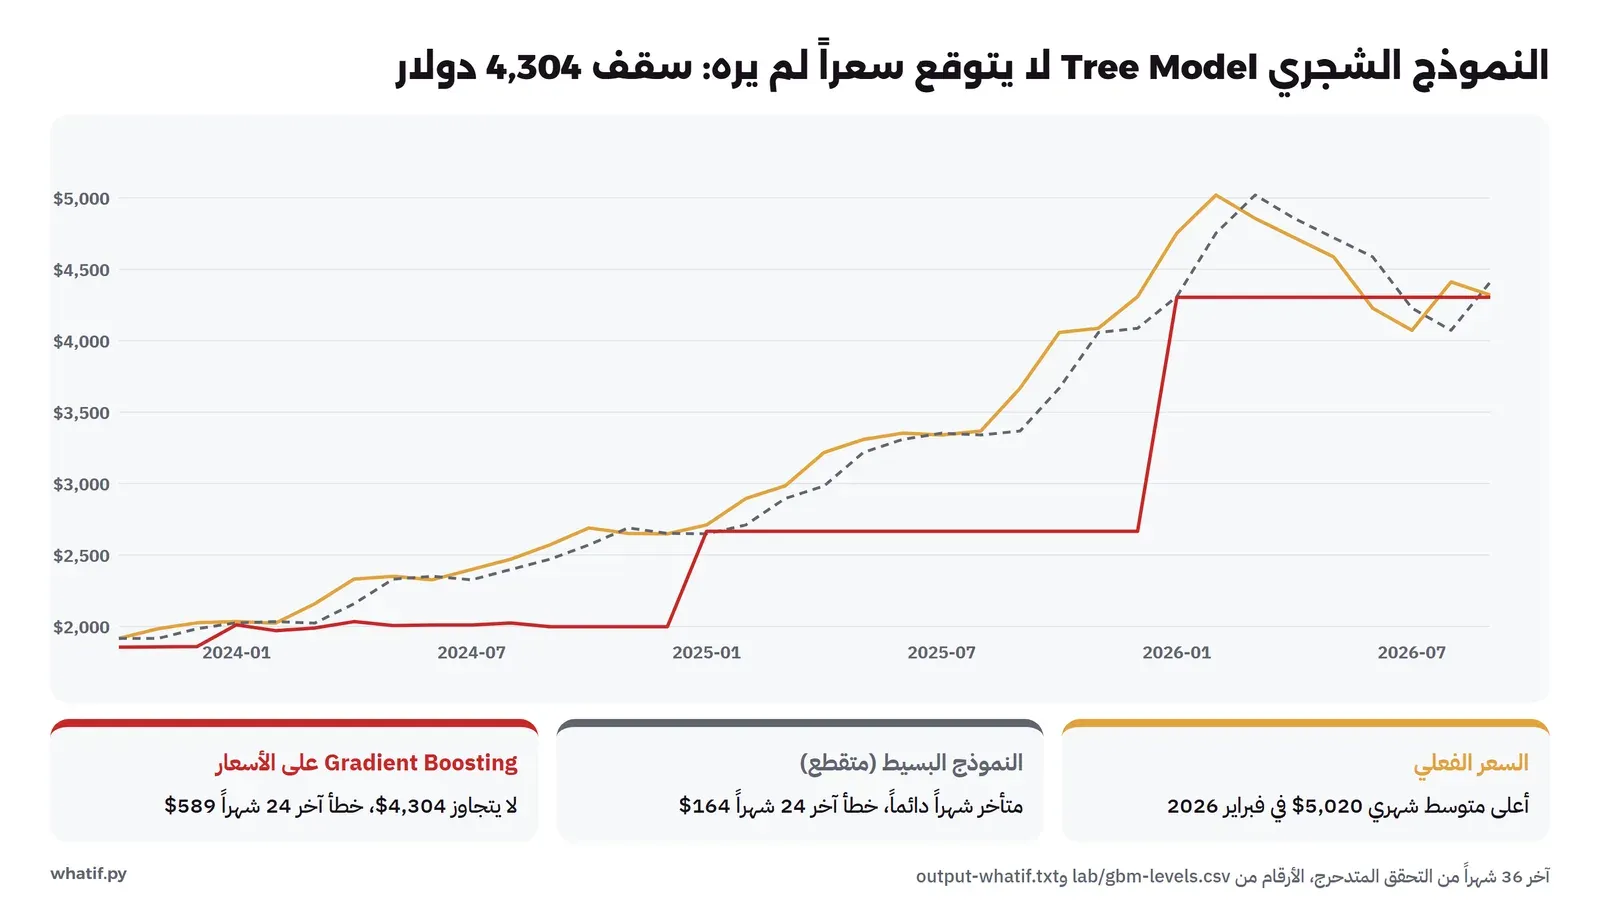
والدرجات المسطحة في الرسم سببها أيضاً أننا أعدنا تدريب هذا النموذج مرة كل 12 شهراً في هذه التجربة لتوفير الوقت، فبين كل تدريب وآخر يبقى السقف ثابتاً. وهذا هو السبب نفسه الذي جعلنا في الجدول الرئيسي نعطي النماذج التغيرات بالنسبة لا الأسعار، فالتغير الشهري في 2026 من نفس نطاق التغيرات في الماضي، ولو كان أكبر شهر في التاريخ. والقاعدة العملية: لا تقم بإعطاء نموذج شجري قيمة لها اتجاه طويل، مثل سعر أو عدد مستخدمين أو مبيعات سنوية، دون أن تحولها إلى تغير أو نسبة، والسبب أن النموذج سوف يعمل جيداً في الاختبار التاريخي، ثم يفشل في أول مرة يتجاوز فيها الواقع أعلى ما رآه.
ماذا عن سنة كاملة؟ Forecast Horizon
قد يقول مدير المنتج: حسناً، الشهر القادم صعب، ماذا عن السنة القادمة؟ المستخدم الذي يدخر يهمه السعر بعد سنة أكثر من الشهر القادم. والتجربة الثالثة في whatif.py تقارن النموذج البسيط بالانجراف في توقع السعر بعد 12 شهراً:
3) Twelve months ahead (2006..): naive vs drift
   naive MAE $265, drift MAE $247, typical 12-month move 12.2%
الخطأ في توقع سنة كاملة 265 دولاراً للبسيط و247 للانجراف، والتحرك المعتاد للذهب في سنة 12.2% في الوسيط. وهنا يظهر الاتجاه العام بوضوح أكبر قليلاً، فالانجراف أفضل بنسبة 7% تقريباً، لأن 0.52% في الشهر تصبح قرابة 6% في السنة، وهذا رقم بدأ يقترب من حجم التقلب. ولكن انتبه إلى أن هذا الاتجاه هو متوسط خمسين سنة، وأن فترة اختبارنا من 2006 إلى 2026 كانت فترة ارتفاع قوي للذهب، ولو كانت فترة الاختبار بين 1980 و1999، حين هبط الذهب 62% على عشرين سنة كما في الرسم الأول، لكان الانجراف المحسوب من الماضي يتوقع ارتفاعاً كل سنة والسعر ينخفض. أي أن الاتجاه طويل المدى حقيقي على مدى عقود، ولكنه لا يضمن شيئاً لسنة بعينها.
لماذا تتبع كل التوقعات السعر بشهر؟ Forecast Lag
إذا رسمت توقعات أي نموذج من الجدول الرئيسي على نفس الرسم مع السعر الفعلي، فسوف ترى شيئاً يتكرر في كل محاولات توقع الأسعار: خط التوقع هو خط السعر نفسه مزاحاً شهراً إلى اليمين. والرسم التالي يبين آخر 24 شهراً للسعر الفعلي والنموذج البسيط وARIMA، ولاحظ أن خط ARIMA الأزرق ملتصق تقريباً بالخط المتقطع للنموذج البسيط، ولا يتقدم عليه إلا قليلاً في الأشهر التي استمر فيها الاتجاه.
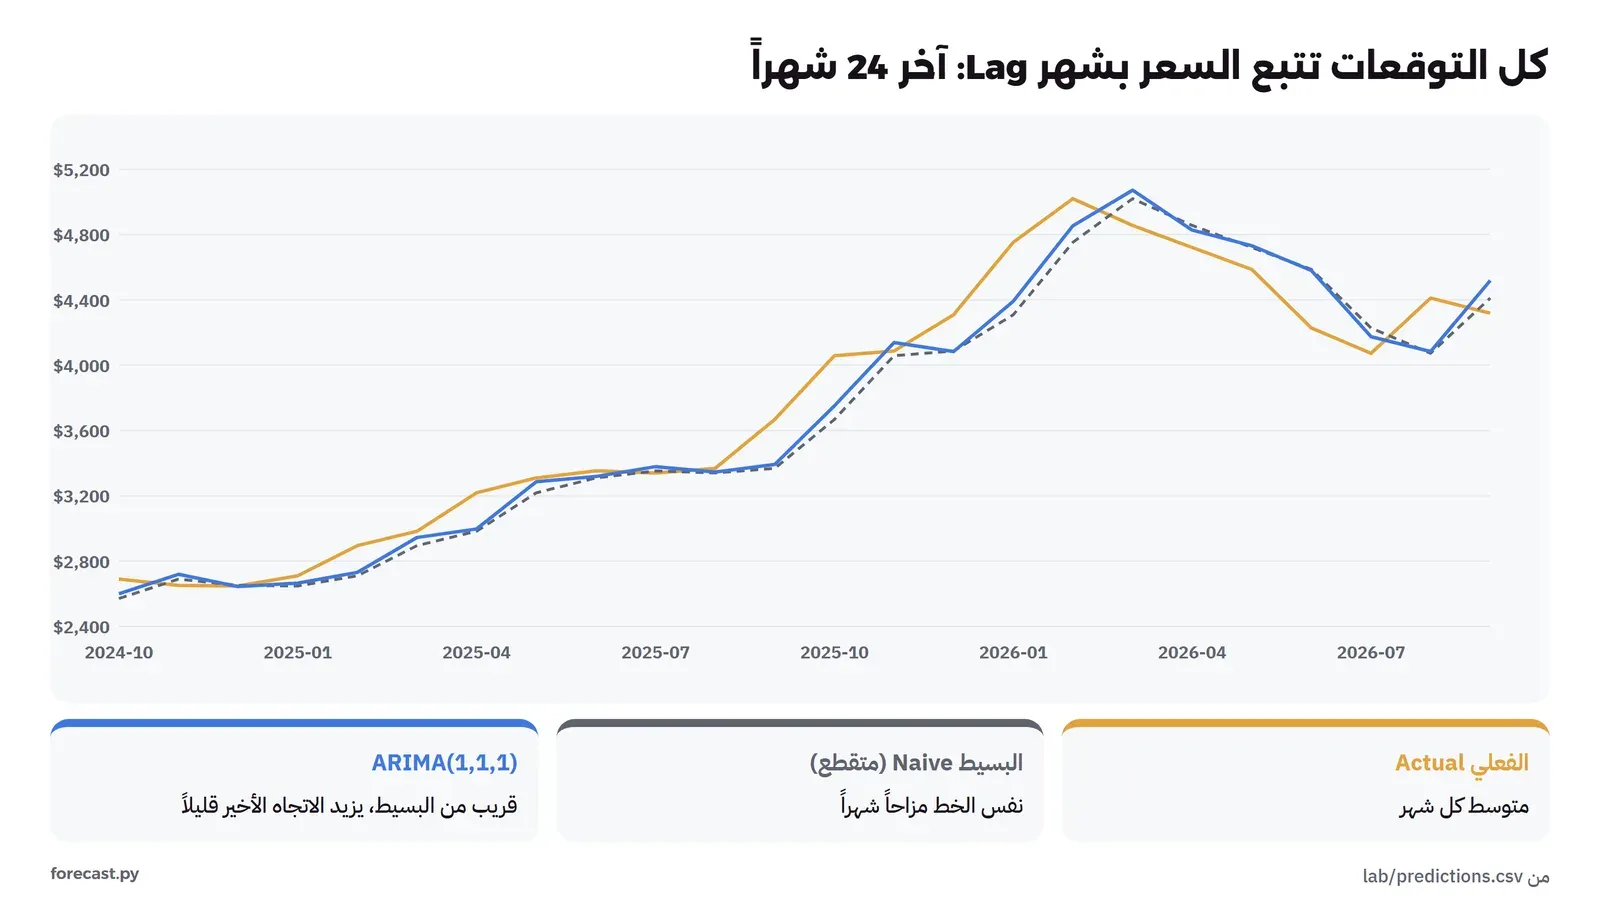
وهذا الشكل علامة سهلة تكشف بها أي نموذج يعرضه عليك أحد: إذا كان خط التوقع هو خط الفعلي مزاحاً بخطوة، فالنموذج تعلم أن أفضل توقع هو القيمة الأخيرة، وكل ما أضافه فوق ذلك صغير. وكثير من الرسوم التي تنتشر بعنوان «نموذج ذكاء اصطناعي يتوقع سعر الذهب بدقة 98%» هي هذا الشكل بالضبط، والدقة العالية فيها تأتي من أن السعر هذا الشهر قريب من سعر الشهر الماضي، وليس من أي معرفة بالمستقبل. فـ MAPE عند 3% يعني «دقة 97%» إذا أردت أن تكتبها بهذه الطريقة، والنموذج البسيط يحققها دون أي تدريب.
ما الذي يستطيعه النموذج؟ What Forecasting Can Do
قد يبدو المقال حتى الآن كأنه يقول إن توقع السلاسل الزمنية لا فائدة منه، وهذا غير صحيح، فنفس الأدوات التي فشلت مع الذهب تعمل بشكل ممتاز في مسائل أخرى، والفرق في طبيعة السلسلة لا في الأدوات. فالسلاسل التي يمكن توقعها لها واحدة من هذه الصفات على الأقل:
- موسمية Seasonality ثابتة: الطلب على الكهرباء في الصيف، وعدد الطلبات في تطبيق توصيل يوم الخميس مساءً، وزيارات موقع تعليمي في أيام الاختبارات. هذه أنماط لا تختفي عندما يعرفها الجميع، لأن أحداً لا يستطيع أن «يتداول» عليها.
- قصور ذاتي Inertia فيزيائي أو تشغيلي: استهلاك القرص في السيرفر، وعدد المستخدمين النشطين، وحجم المخزون. فالقيمة غداً مرتبطة بالقيمة اليوم بسبب الواقع، لا بسبب طريقة الحساب، وقد ذكرنا أمثلة على تخزين هذا النوع من البيانات في مقال قواعد بيانات السلاسل الزمنية.
- متغيرات خارجية معروفة مسبقاً: حملة تسويق مخطط لها، أو عطلة رسمية، أو موعد صرف الرواتب، وكلها معلومات تعرفها أنت ولا يعرفها النموذج إلا إذا أعطيته إياها.
أما سعر أصل يتداوله ملايين الناس، فإن أي نمط يمكن أن يراه نموذج على الأسعار التاريخية يراه غيرك أيضاً، والتداول عليه يزيله. ولذلك فإن السؤال الأول في أي مشروع توقع هو: من يستفيد لو كان هذا النمط معروفاً؟ فإذا كان الجواب «كل المتداولين في العالم»، فالأغلب أنه لم يعد موجوداً.
ومن الأشياء التي يستطيعها النموذج حتى في الذهب أن يقدر حجم التقلب Volatility لا اتجاهه. فالانحراف المعياري للتغير الشهري 4.5%، وهذا يعني أن مدى السعر المعقول الشهر القادم يمكن حسابه بثقة أكبر بكثير من السعر نفسه، وهذا ما يسمى توقع الفترة Interval Forecast، أي «السعر الشهر القادم غالباً بين كذا وكذا»، بدل رقم واحد بسهم. وقد شرحنا فكرة الاحتمال والفترات في مقال الاحتمالات للمبرمجين.
ماذا نعرض في التطبيق؟ Product Decision
نرجع الآن إلى الاجتماع. والإجابة الصادقة لمدير المنتج ليست «لا نستطيع»، وإنما «نستطيع أن نعرض شيئاً مفيداً، ولكنه ليس سهماً أخضر». وفيما يلي ما يمكن أن تقترحه بناءً على النتائج:
- لا نعرض اتجاهاً للشهر القادم، لأن أفضل نموذج عندنا يتفوق على «سوف يرتفع دائماً» بست نقاط في الاتجاه، وجزء كبير من ذلك أثر المتوسط الذي لا يستفيد منه المستخدم. وعرض سهم بهذه الثقة سوف يجعل المستخدم يتخذ قرارات شراء بناءً على شيء قريب من الصدفة.
- نعرض مدى التقلب: «خلال الشهر الماضي تحرك السعر بين كذا وكذا، والتغير المعتاد في شهر واحد قرابة 4.5%». وهذه معلومة صحيحة ومفيدة لمن يدخر، لأنها تشرح له لماذا لا يجب أن يقلق من انخفاض 3% في أسبوع.
- نعرض أثر الادخار المنتظم: كيف كان سيكون متوسط سعر الشراء لو اشترى المستخدم نفس المبلغ كل شهر خلال السنوات الماضية، وهذا حساب على بيانات حقيقية لا توقع.
- إذا أصرت الإدارة على شاشة توقع، فاعرض فترة لا رقماً، واكتب تحتها خطأ النموذج البسيط كمرجع، واحفظ كل توقع مع تاريخه حتى تقيس الأداء الحقيقي بعد سنة، لا الأداء على الاختبار التاريخي.
وهذا القرار له جانب تنظيمي أيضاً، فالتطبيق المالي الذي يعرض توقعات أسعار يقترب من تقديم مشورة استثمارية، ولها في المملكة جهات تنظمها، وهذا سؤال لقسم الالتزام في الشركة قبل أن يكون سؤالاً تقنياً، وقد شرحنا لغة قسم المالية وأسئلته في مقال المالية للتقنيين.
أخطاء شائعة Common Mistakes
- عدم حساب النموذج البسيط: دون خط أساس لا معنى لـ «الخطأ 35 دولاراً»، فقد يكون البسيط أفضل منه كما رأينا في تجربة التسرب.
- التقسيم العشوائي في سلسلة زمنية: أعطى 35.4 دولاراً بدل 146.2. استخدم دائماً التحقق المتدحرج أو TimeSeriesSplit.
- نموذج شجري على قيمة لها اتجاه: Gradient Boosting على الأسعار لم يتجاوز 4,304 دولارات والسعر 5,020. حول القيم إلى تغيرات بالنسبة.
- الاحتفال بتفوق صغير دون اختبار على بيانات عشوائية: AR(1) تفوق على سير عشوائي محسوب بمتوسط الشهر، فالتفوق كان من البيانات.
- تجاهل طريقة حساب البيانات: متوسط الشهر وآخر يوم في الشهر سلسلتان مختلفتان في الخصائص الإحصائية، فاقرأ وصف المصدر قبل أن تبني عليه.
- المتوسط المتحرك كتوقع في سوق له اتجاه: أسوأ من البسيط بنسبة 48% و204%، ودقة اتجاه أقل من 50%.
- الاعتماد على «دقة 97%»: MAPE عند 3% يحققها النموذج البسيط دون تدريب. اعرض دائماً النسبة إلى البسيط.
- فترة اختبار واحدة: 2006 إلى 2026 فترة ارتفاع، وأي نموذج يتعلم «الارتفاع» سوف يبدو جيداً فيها. اختبر على فترات مختلفة، منها فترة هبوط.
- اختيار النموذج على نفس فترة الاختبار: إذا جربت عشرين نموذجاً واخترت أفضلها على نفس الأشهر، فبعض تفوقه صدفة. احجز فترة أخيرة لا تنظر إليها حتى تختار.
قائمة تحقق Checklist قبل أي مشروع توقع أسعار
- هل المصدر رسمي ومعروف طريقة حسابه، متوسط أم إغلاق، وبأي عملة ووحدة؟
- هل حسبت النموذج البسيط والانجراف على نفس الأشهر، وتعرض كل نتيجة كنسبة إليهما؟
- هل التقييم بالتحقق المتدحرج، وكل نموذج يرى فقط ما قبل الشهر الذي يتوقعه؟
- هل المدخلات والهدف تغيرات بالنسبة لا مستويات، خاصة مع النماذج الشجرية؟
- هل اختبرت الفرق إحصائياً، مثل Diebold-Mariano، لا بالنظر إلى الرقم فقط؟
- هل شغلت نفس النموذج على سير عشوائي مصنوع بنفس طريقة بياناتك، وتأكدت أن التفوق يختفي؟
- هل اختبرت على فترة ارتفاع وفترة هبوط؟
- هل يعرض المنتج فترة وتقلباً لا رقماً واحداً، وهل راجع قسم الالتزام الشاشة؟
- هل تحفظ كل توقع مع تاريخه لتقيس الأداء الحقيقي بعد التشغيل؟
تدريب عملي Practice
- غير بداية فترة الاختبار في
forecast.pyإلى يناير 1981 ونهايتها إلى ديسمبر 2000، وهي فترة هبوط الذهب، وشاهد ماذا يحدث للانجراف والمتوسطات المتحركة. - أضف نموذجاً يعطي فترة لا رقماً: التوقع هو السعر الحالي، والفترة زائد وناقص 1.64 من الانحراف المعياري للتغيرات السابقة، ثم احسب كم مرة وقع السعر الفعلي داخل الفترة. هل هي قريبة من 90%؟
- جرب في
whatif.pyمتوسط أسبوع بدل متوسط شهر، أي 5 أيام بدل 21. هل يتغير الارتباط الذاتي للتغيرات؟ - استخدم نفس الكود على سلسلة أخرى من نفس ملف البنك الدولي، مثل القمح أو النفط، وقارن النتيجة بالذهب.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- بيانات البنك الدولي Pink Sheet مصدر رسمي ومجاني لسعر الذهب الشهري منذ 1960، ولكنها متوسطات شهرية، وهذا يغير خصائصها الإحصائية.
- في 249 شهراً من التحقق المتدحرج أخطأ النموذج البسيط بمتوسط 51 دولاراً، وARIMA بـ 48.6، وRidge بـ 49.6، والانجراف بـ 50.6، وGradient Boosting بـ 51.6، والمتوسطات المتحركة بـ 75.5 و155.1.
- التفوق الوحيد المؤكد إحصائياً، ARIMA بنسبة 4.7%، يظهر بنفس الحجم تقريباً على سير عشوائي محسوب بمتوسط الشهر، فهو أثر المتوسط الذي وصفه Working سنة 1960، ولا يستفيد منه من يشتري.
- التقسيم العشوائي أعطى خطأ 35.4 دولاراً لنموذج خطؤه الحقيقي 146.2، وهذا هو التسرب.
- النماذج الشجرية على الأسعار لا تتجاوز أعلى ما رأته، فتوقف توقعها عند 4,304 دولارات والسعر 5,020.
- المفيد في الذهب هو حجم التقلب وفترات التوقع، والمفيد في التوقع عموماً هو السلاسل التي لها موسمية أو قصور ذاتي أو متغيرات معروفة مسبقاً.
وهذا المقال من مرحلة مشاريع التعلم الآلي، وهذه مقالات منشورة ترتبط به:
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلتحليل البيانات Data Analysis مع pandas للمبتدئيننجيب على سؤال حقيقي من بيانات 32 محطة طقس سعودية: كم يوماً فوق 45 درجة في كل منطقة ومتى، ونتعلم في الطريق تنظيف البيانات والربط والتجميع والتواريخ مع pandas وأخطاءها الشائعة.
 دليلالإحصاء Statistics للمهندسين: لماذا يخدعك المتوسط Mean؟كيف تقرأ زمن الاستجابة بالوسيط والمئين p95 وp99 والمدرج التكراري بدل المتوسط، ولماذا لا يجوز حساب متوسط المئين، مع تجربة حقيقية لسيرفر تحت الضغط.
 دليلالاحتمالات Probability للمبرمجين: التصادم Collision والتوفركم معرفاً أو رابطاً قصيراً تنشئ قبل أول تكرار، ولماذا يخدعك افتراض الاستقلال في حساب التوفر والإعادة، بأرقام محسوبة ومحاكاة حقيقية.
 دليلTimescaleDB وInfluxDB لبيانات السلاسل الزمنية Time-Seriesكيف تحفظ قراءات الأجهزة والمقاييس سنوات دون أن يكبر القرص بلا حد، ومتى يناسبك TimescaleDB أو InfluxDB.
 دليلالمالية للتقنيين: اللغة التي يتحدث بها قسم الماليةكيف تقرأ القوائم المالية الثلاث وتفرق بين الربح والنقد، وماذا يقصد قسم المالية بالاستحقاق ومركز التكلفة والإقفال.
 دليلكشف الاحتيال Fraud Detection: قواعد أم تعلم آلة؟قارنا القواعد بنموذجين لتعلم الآلة على بيانات دفع مولدة بنفس سعة المراجعة، ورأينا من يمسك الأنماط المعروفة ومن يتأخر عن النمط الجديد.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل النماذج السبعة بالتحقق المتدحرج على سعر الذهب الشهري من البنك الدولي (تحديث 2 أكتوبر 2026) من يناير 2006 إلى سبتمبر 2026، وتجارب أثر المتوسط والتسرب والتوقع لسنة، باستخدام statsmodels 0.15.0 وscikit-learn 1.9.1 داخل Docker.