لنفرض أنك تعمل في شركة ناشئة تدير منصة إعلانات مبوبة لبيع الأغراض المستعملة، فيها مئات الآلاف من الإعلانات، وكل إعلان معه صورة أو أكثر يرفعها البائع من جواله. وفي أحد الاجتماعات الأسبوعية يصل فريق الدعم ومعه ثلاث شكاوى متكررة: الأولى أن بعض البائعين ينشرون نفس الإعلان خمس مرات بنفس الصورة حتى يظهر في أعلى النتائج، والثانية أن محتالين يأخذون صورة سيارة أو جوال من إعلان بائع حقيقي ويضعونها في إعلان وهمي بعد أن يقصوا منها الشعار أو يضيفوا عليها شريطاً مكتوباً فيه «تخفيض»، والثالثة ليست شكوى وإنما طلب من فريق المنتج: نريد قسماً تحت كل إعلان اسمه «إعلانات مشابهة» يعرض منتجات تشبه هذا المنتج، لا نسخاً منه. ويبدو للوهلة الأولى أن الطلبات الثلاثة سؤال واحد هو «هل هاتان الصورتان متشابهتان؟»، ولكن في الواقع هي ثلاثة أسئلة مختلفة، ولكل منها أداة مختلفة، والخلط بينها هو أكثر سبب يجعل مشاريع كشف الصور المتشابهة Similar Images تفشل بعد أشهر من التشغيل.
وفي هذا المقال سوف نبني الأدوات الثلاث بأنفسنا ونقيسها على صور حقيقية: الهاش العادي للملف SHA-256 الذي يكشف النسخة المطابقة بايتاً ببايت، ثم البصمات الإدراكية Perceptual Hashes الثلاث aHash وdHash وpHash التي نكتبها من الصفر بلغة Python في أقل من خمسين سطراً، ثم التضمينات Embeddings التي تخرجها الشبكات العصبية مثل ResNet-18 وCLIP. وسوف نعدل كل صورة عشرة تعديلات من التي يقوم بها البائعون والمحتالون فعلاً، أي التصغير والضغط وتغيير السطوع وإضافة شريط نص والإطار والقص والتدوير والقلب، ونرى أي طريقة تجد الأصل بعد كل تعديل وأيها تخطئ وتربط صوراً لا علاقة بينها. وفي النهاية ننقل التجربة من 308 صور إلى أكثر من مليون متجه، ونقارن البحث الدقيق بفهارس FAISS التقريبية من حيث السرعة والذاكرة والدقة. وكل رقم في المقال هو مخرج حقيقي لكود موجود في مجلد lab، شغلناه داخل Container على معالج CPU فقط دون كرت شاشة.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا يكفي الهاش العادي لكشف الصور المكررة، وما الفرق بين «نفس الملف» و«نفس الصورة» و«نفس الموضوع».
- كيف تعمل البصمات الإدراكية aHash وdHash وpHash من الداخل، ولماذا تستخدم pHash نفس تحويل DCT الذي تستخدمه JPEG.
- كيف تحول الشبكة العصبية الصورة إلى متجه أرقام، وما الذي يضيفه CLIP عندما يتعلم من الصور والنصوص معاً.
- المختبر: 308 صور من Wikimedia Commons، وعشرة تعديلات، وخمس طرق، والجدول الذي يبين من صمد أمام أي تعديل.
- المشاكل الحقيقية التي ظهرت: aHash التي ترى المناظر الطبيعية كلها متشابهة، وعتبة CLIP التي ترفض نسخاً واضحة، ونسخة مكررة حقيقية داخل Wikimedia Commons نفسها.
- اختيار العتبة Threshold، وماذا يحدث إذا قلب المحتال الصورة أو دورها.
- البحث في مليون صورة: البحث الدقيق Flat مقابل HNSW وIVF-PQ في FAISS، وبصمات pHash في فهرس ثنائي.
- تصميم خط المعالجة في المنصة، والهجمات المتعمدة على البصمات، والأخطاء الشائعة، وجدول قرار.
ثلاثة أسئلة لا سؤال واحد: Exact أم Near-Duplicate أم Similar؟
قبل أن نكتب أي كود علينا أن نفصل الأسئلة الثلاثة، لأن كل خطأ في التصميم يبدأ من دمجها في سؤال واحد. السؤال الأول هو: هل هذا الملف هو نفس الملف الذي رفعه أحد من قبل؟ وهذا سؤال عن البايتات، وإجابته سهلة ورخيصة: نحسب هاش الملف ونبحث عنه في جدول. والسؤال الثاني هو: هل هذه الصورة هي نفس الصورة بعد أن مرت على تعديل؟ أي أن البائع أخذ الصورة وصغرها أو أعاد حفظها بجودة أقل أو أضاف عليها نصاً، فتغيرت البايتات كلها تقريباً ولكن العين ترى نفس اللقطة، وهذا ما يسمى في المجال Near-Duplicate Detection، وهو سؤال المحتال الذي ينسخ صور غيره. أما السؤال الثالث فهو: هل هذه الصورة تعرض نفس الشيء الذي تعرضه تلك؟ أي صورتان مختلفتان لجملين، أو لقطتان لبرج خليفة من زاويتين، وهذا سؤال عن المعنى Semantic Similarity، وهو سؤال فريق المنتج الذي يريد «إعلانات مشابهة».
والخلط بين السؤالين الثاني والثالث يظهر في الإنتاج بشكل مؤلم. فإذا استخدمت أداة السؤال الثالث لكشف المحتالين، فسوف تتهم كل بائع يبيع جوالاً من نفس الطراز بأنه سرق صورة غيره، لأن كل صور هذا الطراز تعرض نفس الشيء. وإذا استخدمت أداة السؤال الثاني لقسم «إعلانات مشابهة»، فلن تعرض إلا نسخ نفس الإعلان، وهي بالضبط ما لا تريده. ولذلك فإن أول قرار في هذا المشروع ليس اختيار المكتبة، وإنما كتابة السؤال بوضوح: ماذا نعتبر «متشابهاً» في هذه الميزة بالذات؟
لماذا لا يكفي الهاش العادي SHA-256؟
الحل الأول الذي يخطر على بال أي مطور هو دالة الهاش Hash Function التي يعرفها من تخزين الملفات، أي SHA-256 أو MD5 على محتوى الملف، وقد شرحنا فكرة الهاش وجداوله في مقال جداول الهاش Hash Tables. وهذه الدالة مصممة عمداً بحيث يغير أي تعديل في بت واحد من الملف نصف بتات الهاش تقريباً، وهذه الخاصية تسمى أثر الانهيار الجليدي Avalanche Effect، وهي ما يجعلها ممتازة لكشف أي تلاعب في ملف، وسيئة جداً لسؤالنا. والسبب أن الصورة التي تراها العين واحدة يمكن أن تحفظ بآلاف الطرق المختلفة في البايتات: جودة ضغط مختلفة، أو بيانات EXIF محذوفة، أو تطبيق جوال يعيد ضغط كل صورة قبل رفعها، وقد شرحنا في مقال صيغ الصور كيف يحذف ضغط JPEG تفاصيل لا تلاحظها العين.
وفي المختبر أخذنا 52 صورة أصلية، وأعدنا حفظ كل منها بصيغة JPEG بجودة 30، ثم بحثنا عن هاش SHA-256 لكل نسخة بين هاشات الأصول، والمخرج كان هذا السطر:
SHA-256 matches after re-saving as JPEG: 0/52أي أن الهاش العادي لم يجد ولا نسخة واحدة من 52، مع أن كل نسخة هي نفس الصورة تماماً بعين الإنسان. ولكن هذا لا يعني أن نحذف SHA-256 من التصميم، فهو أرخص فحص يمكن أن تقوم به، ويكشف حالة شائعة جداً: نفس البائع يرفع نفس الملف من جواله مرة ثانية دون أي تعديل. ولذلك سوف نضعه كأول طبقة في خط المعالجة، ثم نضيف بعده ما يجيب عن السؤالين الآخرين.
البصمة الإدراكية Perceptual Hash: هاش يتسامح مع التعديل
الفكرة التي حلت السؤال الثاني بسيطة جداً، وهي عكس فكرة SHA-256 تماماً: بدل دالة تجعل أي تغيير صغير يغير الناتج كله، نريد دالة تجعل التغييرات الصغيرة في الصورة تغير بتات قليلة فقط في الناتج، وتجعل الصور المختلفة فعلاً تختلف في بتات كثيرة. فيمكن أن تتخيلها مثل وصف شخص من بعيد: لا ترى تفاصيل وجهه ولا لون قميصه بدقة، ولكنك تعرف طوله وشكله العام، وهذا الوصف لا يتغير إذا غير ملابسه أو وقف تحت إضاءة مختلفة. والبصمة الإدراكية تقوم بنفس الشيء: تصغر الصورة جداً حتى تختفي التفاصيل، وتحولها إلى درجات الرمادي حتى يختفي اللون، ثم تستخرج من الشكل العام الباقي 64 بتاً.
وأشهر من شرح هذه الفكرة للمبرمجين هو الباحث Neal Krawetz في مقاله Looks Like It سنة 2011، حيث وصف خوارزمية متوسط السطوع aHash وخوارزمية pHash، ثم أضاف بعدها خوارزمية الفرق dHash في مقال Kind of Like That. وقبل ذلك كانت هناك مكتبة C++ مفتوحة المصدر اسمها pHash تحمل نفس الاسم، واليوم تجد هذه الخوارزميات جاهزة في Python في مكتبة imagehash. ولكننا في هذا المقال سوف نكتبها بأنفسنا، لأنها قصيرة، ولأنك عندما تعرف ما تفعله كل خطوة تفهم بالضبط لماذا تنجح مع تعديل وتفشل مع آخر.
متوسط السطوع aHash (Average Hash)
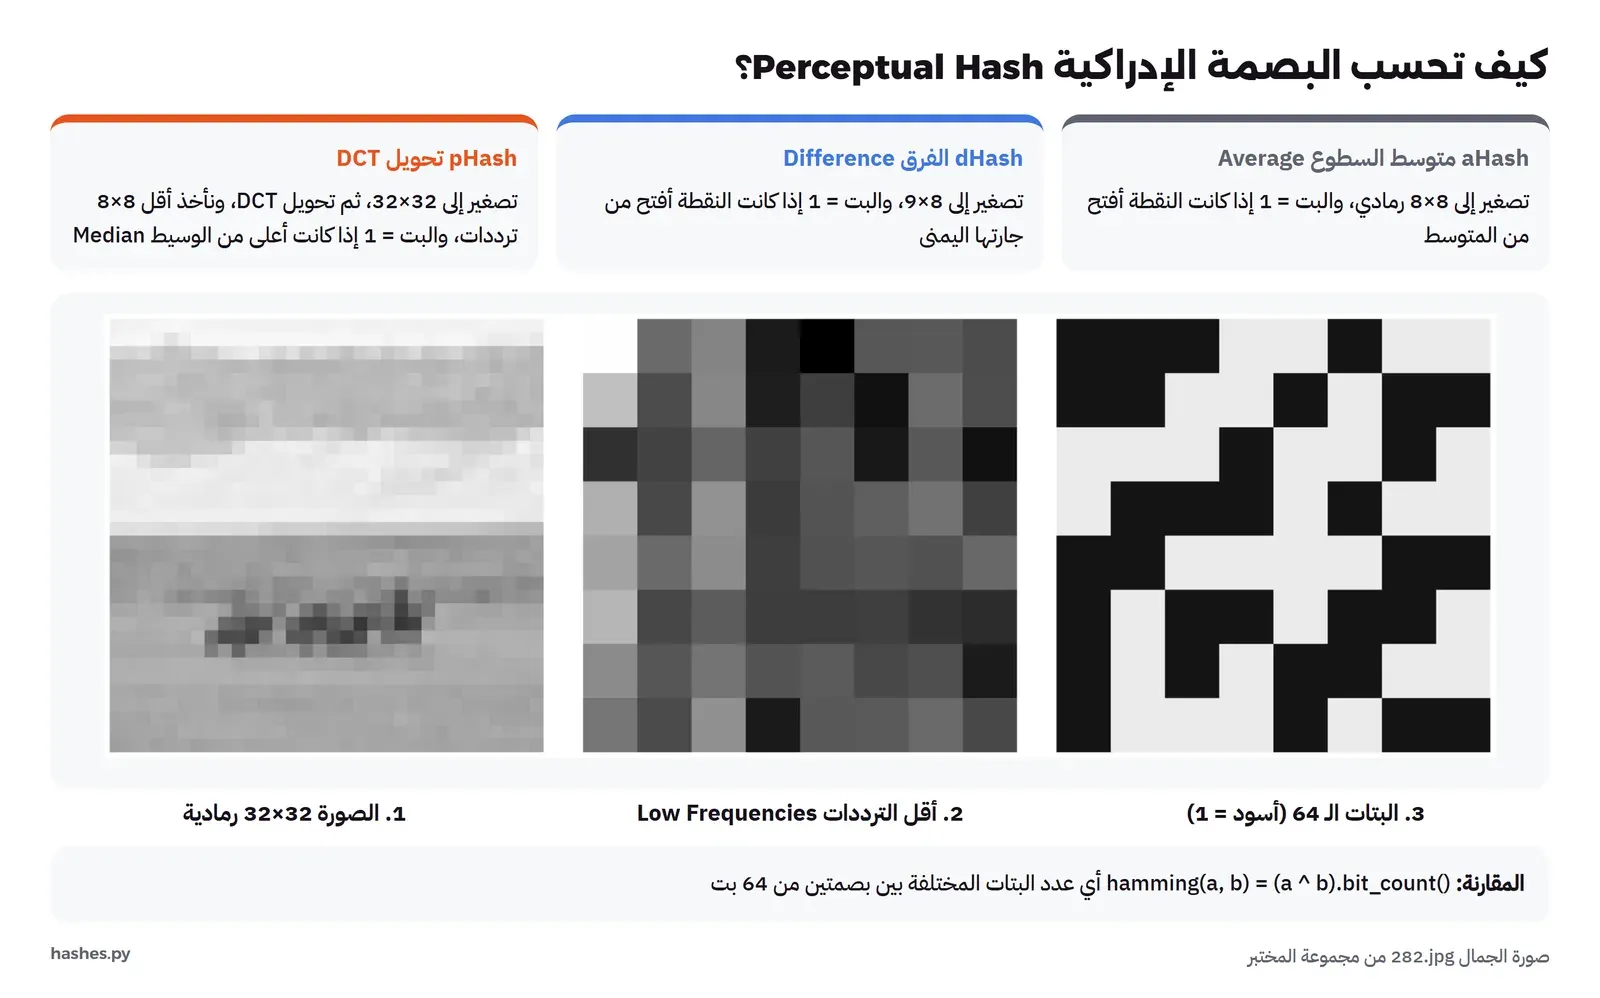
أبسط البصمات: نصغر الصورة إلى شبكة 8 في 8 نقاط رمادية، أي 64 نقطة، ونحسب متوسط سطوعها، ثم نعطي كل نقطة بتاً قيمته 1 إذا كانت أفتح من المتوسط و0 إذا كانت أغمق. والنتيجة 64 بتاً تصف أين الأماكن الفاتحة وأين الأماكن الغامقة في الصورة. وهذه البصمة لا تتأثر بالتصغير لأن الصورة تصغر إلى 8 في 8 في كل الأحوال، ولا تتأثر كثيراً بالضبط في السطوع لأن المتوسط يتحرك مع النقاط كلها. ولكن لها نقطة ضعف كبيرة سوف تراها في المختبر بوضوح: كل الصور التي فيها سماء فاتحة في الأعلى وأرض غامقة في الأسفل لها نفس البصمة تقريباً.
الفرق بين الجيران dHash (Difference Hash)
هنا نصغر الصورة إلى 9 أعمدة في 8 صفوف، ونقارن كل نقطة بجارتها في نفس الصف، فيكون البت 1 إذا كانت النقطة أفتح من جارتها. وبالتالي نحصل على 8 مقارنات في كل صف، أي 64 بتاً، والبصمة هنا لا تصف السطوع نفسه، وإنما اتجاه تغيره، أي الحواف Edges والتدرجات Gradients. وهذا يجعلها أدق من aHash في التمييز بين الصور، لأن صورتين لهما نفس توزيع السطوع العام نادراً ما تكون لهما نفس الحواف.
البصمة بالترددات pHash وتحويل DCT
هذه أذكى الثلاث، وتستخدم تحويل جيب التمام المتقطع Discrete Cosine Transform واختصاراً DCT، وهو نفس التحويل الذي تطبقه JPEG على كل مربع 8 في 8 نقاط في الصورة. والفكرة أن أي صورة صغيرة يمكن أن تكتب كمجموع موجات بترددات مختلفة: الترددات المنخفضة Low Frequencies تصف الشكل العام، مثل أن النصف الأيسر أفتح من الأيمن، والترددات العالية تصف التفاصيل الدقيقة مثل الملمس والضوضاء وحواف الحروف الصغيرة. والتعديلات التي نريد أن نتسامح معها، أي الضغط والتصغير وتغيير السطوع، تغير الترددات العالية أكثر من المنخفضة، ولذلك فإن pHash تصغر الصورة إلى 32 في 32، وتطبق تحويل DCT ثنائي الأبعاد، ثم ترمي كل شيء ما عدا الزاوية 8 في 8 التي فيها أقل الترددات، وتعطي كل معامل بتاً حسب كونه أعلى من الوسيط Median أم لا.
والكود الكامل للبصمات الثلاث في lab/hashes.py، وهذا الجزء الخاص بـ pHash:
def _gray(img, w, h):
    # LANCZOS shrink to a tiny grayscale grid: details and colour disappear, the overall shape stays
    return np.asarray(img.convert("L").resize((w, h), Image.Resampling.LANCZOS), dtype=np.float64)

def _dct_matrix(n):
    # Orthonormal DCT-II matrix, the same transform JPEG uses on 8x8 blocks
    k = np.arange(n)[:, None]
    i = np.arange(n)[None, :]
    m = np.cos(np.pi * (2 * i + 1) * k / (2 * n)) * np.sqrt(2 / n)
    m[0] /= np.sqrt(2)
    return m

_D32 = _dct_matrix(32)

def phash(img):
    """Perceptual hash: 32x32 grid -> 2D DCT -> keep the 8x8 lowest frequencies -> bit = above their median."""
    g = _gray(img, 32, 32)
    freq = _D32 @ g @ _D32.T
    low = freq[:8, :8]
    return _bits_to_int(low > np.median(low))

def hamming(a, b):
    return (a ^ b).bit_count()
في الكود أعلاه لاحظ التالي:
- تحويل DCT ثنائي الأبعاد هو ضرب مصفوفتين:
D @ g @ D.T، فالضرب من اليسار يحول الأعمدة، والضرب من اليمين يحول الصفوف، ولا نحتاج مكتبة SciPy لذلك. - العنصر
freq[0, 0]هو متوسط السطوع كله، وهو داخل الزاوية 8 في 8، وبعض التطبيقات تستبعده لأنه لا يحمل معلومة عن الشكل، والفرق في النتائج صغير. - العتبة هي الوسيط وليست المتوسط، وهذا يضمن أن نصف البتات تقريباً قيمته 1 ونصفها 0، وبالتالي تكون البصمة متوازنة وتستفيد من كل بتاتها.
- المقارنة بين بصمتين هي عدد البتات المختلفة بينهما، ويسمى هذا العدد مسافة هامنغ Hamming Distance، ويحسب بعملية XOR ثم عد البتات التي قيمتها 1، وهي من أسرع العمليات التي يمكن أن يقوم بها المعالج.
وقد يتساءل البعض: إذا كانت البصمة 64 بتاً فقط، أليس من الممكن أن تتشابه بصمتان لصورتين مختلفتين تماماً؟ والإجابة نعم، وهذا ليس عيباً في التنفيذ وإنما في طبيعة الفكرة، فالبصمة تختصر الصورة إلى شكلها العام، وصورتان مختلفتان يمكن أن يكون لهما نفس الشكل العام. والسؤال العملي ليس «هل يحدث هذا؟» وإنما «كم مرة يحدث على صورنا، وعند أي عتبة؟»، وهذا ما سوف نقيسه في المختبر بدل أن نخمنه.
التضمين Embeddings: من البكسلات إلى المعنى
البصمات الإدراكية لا تعرف شيئاً عن محتوى الصورة، فهي لا تعرف أن هذا جمل وذاك برج، وإنما تعرف أين الفاتح وأين الغامق. ولذلك فهي لا تستطيع أن تجيب عن السؤال الثالث، أي «صورة أخرى لنفس الموضوع»، لأن صورتين لجملين من زاويتين مختلفتين لهما توزيع سطوع مختلف تماماً. وهنا يأتي دور الشبكات العصبية، وتحديداً الشبكات الالتفافية Convolutional Neural Networks واختصاراً CNN، التي تعلمت من ملايين الصور أن تحول كل صورة إلى متجه Vector من مئات الأرقام، بحيث تكون متجهات الصور المتشابهة في المعنى قريبة من بعضها، وهذا المتجه هو ما يسمى التضمين Embedding. وإذا كنت جديداً على فكرة التعلم الآلي فابدأ من مقال التعلم الآلي Machine Learning للمبتدئين، وإذا أردت أن ترى كيف تعمل الرؤية الحاسوبية بشكل عام فارجع إلى مقال الرؤية الحاسوبية Computer Vision.
ميزات شبكة التصنيف ResNet-18 Features
الطريقة الأقدم لاستخراج التضمين هي أن تأخذ شبكة دربت على تصنيف الصور، مثل شبكة ResNet التي نشرها باحثو Microsoft سنة 2015 ودربت على مجموعة ImageNet بألف تصنيف، ثم تحذف منها الطبقة الأخيرة التي تختار التصنيف، وتأخذ الأرقام التي قبلها. ففي ResNet-18 في مكتبة torchvision تكون هذه الطبقة 512 رقماً، وهي ما تعلمته الشبكة عن الصورة قبل أن تقرر أنها «جمل» أو «برج». وفي الكود يكفي سطر واحد لذلك:
resnet = torchvision.models.resnet18(weights=rn_w).eval()
resnet.fc = torch.nn.Identity()            # drop the 1000-class layer, keep the 512-number feature vector
ثم نقسم كل متجه على طوله حتى يصبح طوله 1، وبالتالي يصبح الضرب النقطي Dot Product بين متجهين هو تشابه جيب التمام Cosine Similarity، وهو رقم بين سالب واحد وواحد، وكلما اقترب من 1 كانت الصورتان أقرب في نظر الشبكة. ونقطة الضعف هنا أن الشبكة تعلمت ما يكفي لتمييز ألف تصنيف من ImageNet فقط، فإذا كان الشيء الذي تبحث عنه ليس بين هذه التصنيفات، مثل برج معين، فإنها تراه كمبنى عام.
الصورة والنص معاً CLIP
في سنة 2021 نشرت OpenAI نموذج CLIP، والفكرة فيه أنه لم يتدرب على تصنيفات ثابتة، وإنما على مئات الملايين من أزواج «صورة ونص يصفها» من الإنترنت، فيتعلم مشفرين Encoders: واحداً للصور وواحداً للنصوص، بحيث يضع الصورة والنص الذي يصفها في نقطتين متقاربتين في نفس الفضاء. والنتيجة أن تضمين CLIP يعرف مفاهيم أكثر بكثير من ألف تصنيف، ويمكنك أن تبحث في الصور بنص مكتوب مثل «a photo of a camel» دون أن تدرب أي شيء. وفي المختبر استخدمنا النسخة المفتوحة OpenCLIP بنموذج ViT-B-32 المدرب على LAION-2B، وهو يعطي متجهاً من 512 رقماً لكل صورة. وفكرة التضمين هنا هي نفس فكرة تضمين النصوص التي شرحناها في مقال البحث الدلالي Semantic Search، والفرق فقط في نوع المدخل.
ولكن هذه القوة لها ثمن، وسوف نرى في المختبر أنه ثمن مزدوج: الأول في الوقت، فالتضمين أبطأ من البصمة بعشرات المرات، والثاني في السؤال نفسه، لأن CLIP يرى صورة الجمل مع شريط «SALE 50% OFF» صورة مختلفة في المعنى، فهي الآن «إعلان تخفيضات فيه جمل»، وهذا صحيح من ناحية المعنى، ولكنه خطأ تماماً إذا كان سؤالك «هل سرق هذا البائع صورة غيره؟».
المختبر Lab: الصور والتعديلات والطرق الخمس
لا نملك صور منصة الإعلانات في قصتنا، ولا يجوز أن نستخدم صور مستخدمين حقيقيين في تجربة، ولذلك بنينا مجموعة صور حرة الترخيص من Wikimedia Commons تقوم بنفس الدور. والسكربت lab/fetch_images.py يستخدم واجهة MediaWiki API ليجلب نسخاً مصغرة بعرض 960 بكسل من خمس فئات، ويحتفظ فقط بالملفات المرخصة بـ CC0 أو الملكية العامة أو CC BY أو CC BY-SA، ويكتب اسم المصور والترخيص ورابط كل صورة في ملف credits.csv. والفئات هي: 200 صورة مختارة Featured لمناظر طبيعية، و49 صورة مختارة لمبان، و21 صورة لبرج إيفل، و16 صورة من فئة صور الجمال عالية الجودة، و22 صورة من فئة برج خليفة. والفئات الثلاث الأخيرة تعطينا «مواضيع» نختبر بها السؤال الثالث، أما المناظر الطبيعية فتعطينا عدداً كبيراً من الصور المتقاربة في الشكل العام، وهذا أصعب اختبار لأي بصمة.
والتعديلات العشرة في lab/edits.py اخترناها لأنها ما يحدث للصورة فعلاً عندما تنسخ وتنشر من جديد:
EDITS = {
    "resize 50%": lambda im: im.resize((im.size[0] // 2, im.size[1] // 2)),
    "jpeg q=30": lambda im: reencode(im, 30),
    "brightness +40%": lambda im: ImageEnhance.Brightness(im).enhance(1.4),
    "text banner": text,
    "white border": border,
    "crop 10%": lambda im: crop(im, 0.10),
    "crop 30%": lambda im: crop(im, 0.30),
    "rotate 5deg": lambda im: im.rotate(5, expand=False, fillcolor=(0, 0, 0)),
    "mirror": ImageOps.mirror,
    "rotate 90deg": lambda im: im.rotate(90, expand=True),
}
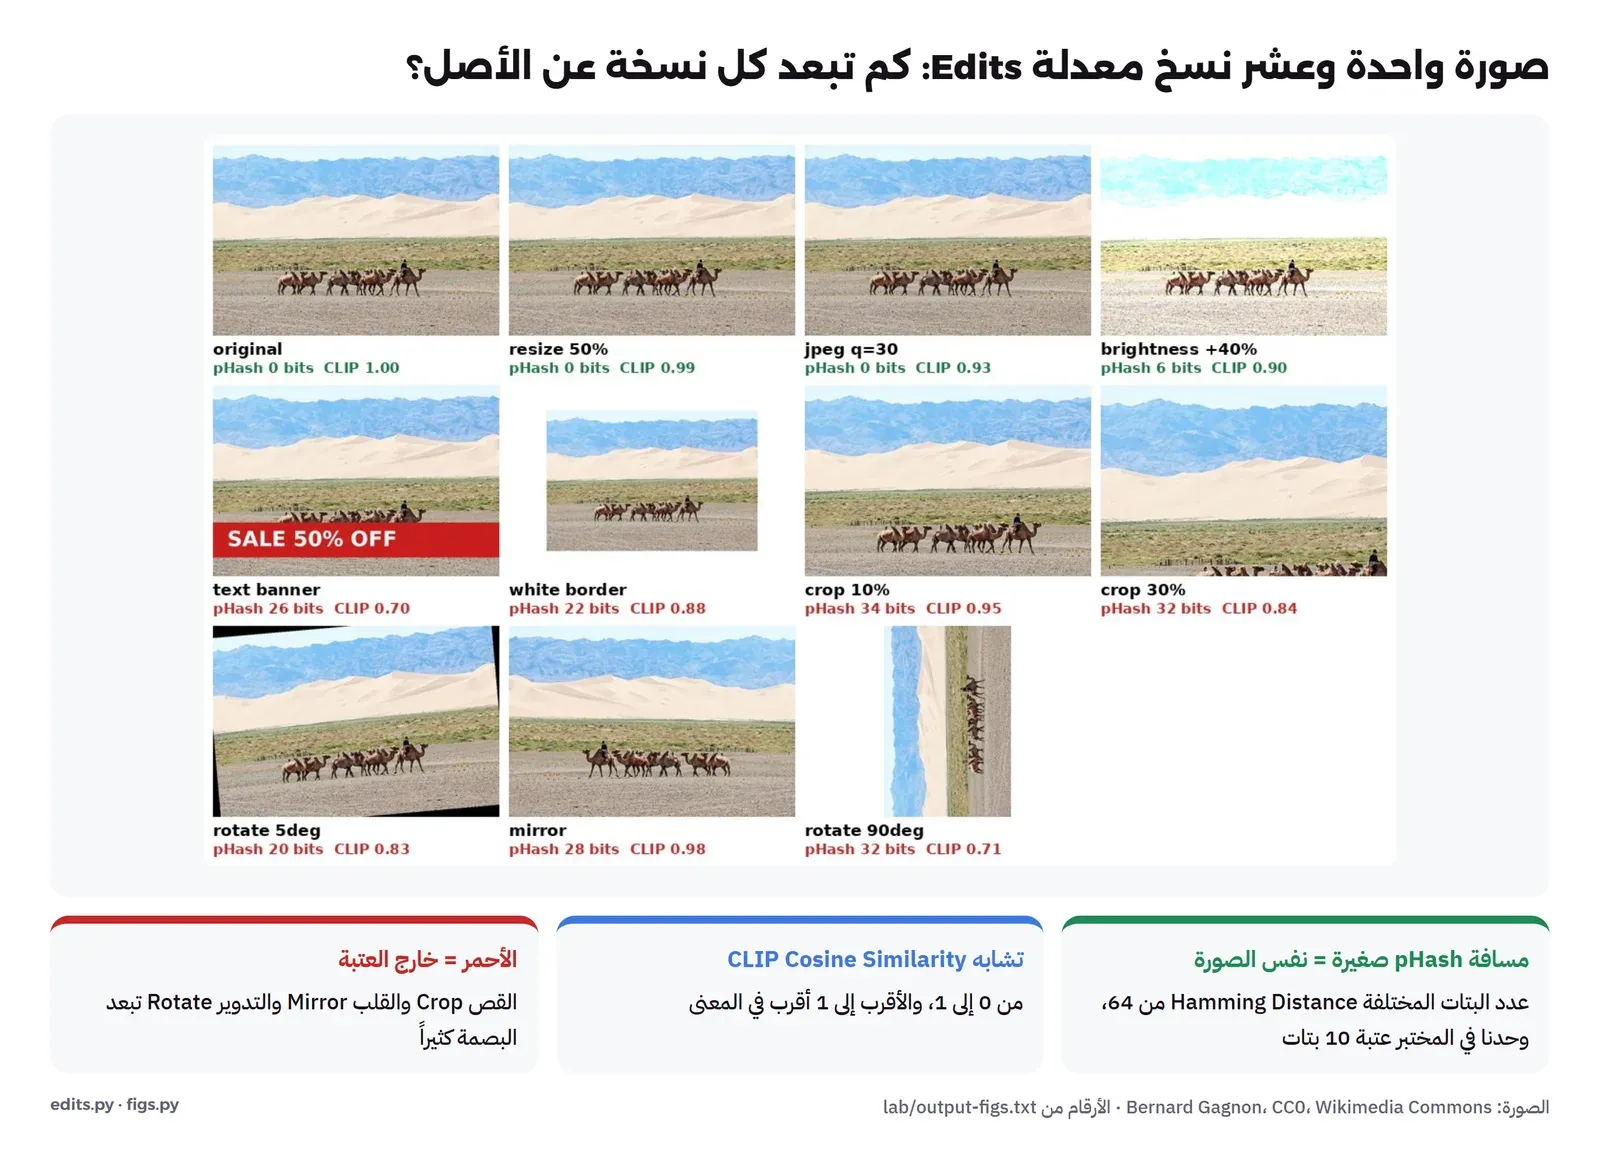
فالتصغير والضغط يحدثان تلقائياً عندما يحفظ أحد الصورة من المتصفح أو يرسلها في تطبيق محادثة، والسطوع من فلاتر الجوال، وشريط النص هو ما يضيفه المحتال ليجعل الإعلان يبدو مختلفاً، والإطار الأبيض هو ما تحصل عليه عندما يأخذ أحد لقطة شاشة Screenshot للإعلان بدل أن يحفظ الصورة، والقص يحدث عندما يريد أحد أن يتخلص من شعار أو علامة مائية Watermark في زاوية الصورة، والقلب الأفقي Mirror حيلة معروفة لتجاوز فحص التكرار، والتدوير 90 درجة يحدث كثيراً بالخطأ عندما يتجاهل النظام اتجاه الصورة المحفوظ في بيانات EXIF.
ثم يأخذ السكربت lab/robustness.py كل صورة سادسة من المجموعة، أي 52 صورة أصلية، ويطبق عليها التعديلات العشرة، فيصبح لدينا 520 نسخة معدلة، ويبحث لكل نسخة عن أقرب صورة بين الأصول الـ 308 بكل طريقة من الطرق الخمس. ونشغل كل شيء بأمر واحد من مجلد lab:
DATA=/path/to/data sh run.shوالأمر يبني على Image فيها Python 3.13.17 وPyTorch 2.15.0 بنسخة CPU وOpenCLIP 3.3.0 وFAISS 1.15.1، والصور ونماذج الشبكات تحفظ في مجلد البيانات خارج المستودع لأن حجمها أكثر من 600 ميجابايت.
النتائج Results: من صمد أمام أي تعديل؟
أول جزء في المخرج هو الوقت الذي تحتاجه كل طريقة لكل صورة على CPU بثمانية Threads:
308 images, groups: landscape=200, architecture=49, eiffel=21, camel=16, burj=22

ms per image (8 threads, CPU): aHash 3.4, dHash 3.4, pHash 3.6, ResNet-18 69.1, CLIP ViT-B-32 159.6
والفرق واضح: البصمة تحتاج أقل من 4 ميلي ثانية للصورة، ومعظم هذا الوقت في تصغير الصورة نفسها لا في الحساب، بينما يحتاج CLIP قرابة 160 ميلي ثانية، أي أبطأ بأكثر من 40 مرة. وهذا يعني في منصة تستقبل مائة ألف صورة في اليوم أن البصمات تنتهي في ست دقائق من وقت معالج واحد، بينما يحتاج CLIP قرابة أربع ساعات ونصف، وهذا قبل أن نتكلم عن البحث نفسه.
ثم الجزء الأهم، وهو الجدول الذي يبين لكل تعديل ولكل طريقة رقمين: الأول كم مرة كان الأصل هو أقرب صورة إلى النسخة المعدلة بين كل الصور، ويسمى Top-1، والثاني كم نسخة كانت داخل العتبة التي حددناها، أي مسافة 10 بتات أو أقل للبصمات، وتشابه 0.90 أو أكثر للتضمينات، وبين القوسين الوسيط للمسافة أو التشابه:
Edits on 52 originals: top-1 = original ranked first; ok = within threshold (hash <= 10 bits, cosine >= 0.9)
edit                        aHash            dHash            pHash        ResNet-18    CLIP ViT-B-32
resize 50%         52/52 (d= 0.0)   52/52 (d= 0.0)   52/52 (d= 0.0)   52/51 (c=1.00)   52/41 (c=0.99)
jpeg q=30          52/52 (d= 0.0)   52/52 (d= 0.0)   52/52 (d= 0.0)   52/51 (c=0.99)   52/37 (c=0.93)
brightness +40%    51/52 (d= 1.0)   51/50 (d= 2.5)   52/52 (d= 4.0)   52/49 (c=0.98)   52/47 (c=0.96)
text banner        38/41 (d= 7.0)   51/51 (d= 6.0)   49/21 (d=12.0)   51/29 (c=0.91)   50/ 0 (c=0.69)
white border        0/ 0 (d=28.5)    6/ 0 (d=23.0)    9/ 0 (d=24.0)   50/36 (c=0.92)   51/10 (c=0.87)
crop 10%           26/34 (d= 9.0)   30/ 3 (d=18.5)   26/ 1 (d=20.0)   52/50 (c=0.95)   50/47 (c=0.94)
crop 30%            3/ 7 (d=21.5)    2/ 0 (d=28.5)    0/ 0 (d=32.0)   44/ 7 (c=0.86)   50/ 6 (c=0.85)
rotate 5deg        40/39 (d= 6.5)   43/18 (d=13.0)   32/ 7 (d=16.0)   51/50 (c=0.97)   52/20 (c=0.88)
mirror              9/18 (d=16.0)    7/ 4 (d=28.5)    0/ 0 (d=32.0)   52/52 (c=0.97)   52/52 (c=0.97)
rotate 90deg        0/ 0 (d=32.0)    3/ 1 (d=32.5)    0/ 0 (d=32.0)   29/ 3 (c=0.74)   47/ 4 (c=0.73)
في المخرج أعلاه لاحظ التالي:
- التصغير والضغط: البصمات الثلاث أعطت مسافة صفر بت في الوسيط، أي أن البصمة لم تتغير أصلاً في أغلب النسخ، وهذا ما صممت له. وهذان التعديلان هما أكثر ما يحدث للصور في الواقع، فلو توقفت هنا لقلت إن pHash تكفي.
- السطوع: تحركت pHash أربعة بتات في الوسيط، وdHash بتين ونصف، وكلها بقيت داخل العتبة تقريباً.
- شريط النص: هنا بدأ الاختلاف، فالشريط الأحمر يغطي قرابة خمس الصورة، وpHash وجدت الأصل أولاً في 49 من 52، ولكن 21 فقط كانت داخل عتبة 10 بتات، لأن الوسيط أصبح 12 بتاً. أما CLIP فوجد الأصل أولاً في 50 حالة، ولكن ولا نسخة واحدة تجاوزت 0.90، والوسيط 0.69 فقط، وهذا ما ذكرناه: CLIP يرى الشريط جزءاً من المعنى.
- الإطار الأبيض والقص: انهارت البصمات الثلاث، فالإطار يغير الشكل العام كله لأنه يصغر الصورة داخل مساحة بيضاء، والقص 30% يحذف ثلث الصورة تقريباً، فلم تجد pHash ولا نسخة. والتضمينات صمدت أكثر بكثير في ترتيب الأصل أولاً، فـ CLIP وجد الأصل أولاً في 50 من 52 حتى بعد قص 30%.
- القلب والتدوير 90 درجة: البصمات الثلاث صفر تقريباً، ووسيط pHash 32 بتاً، أي نصف البتات، وهذا يعني أن البصمة أصبحت مثل بصمة صورة عشوائية. وCLIP وجد الأصل في 52 من 52 بعد القلب، لأن الجمل المقلوب أفقياً ما زال جملاً.
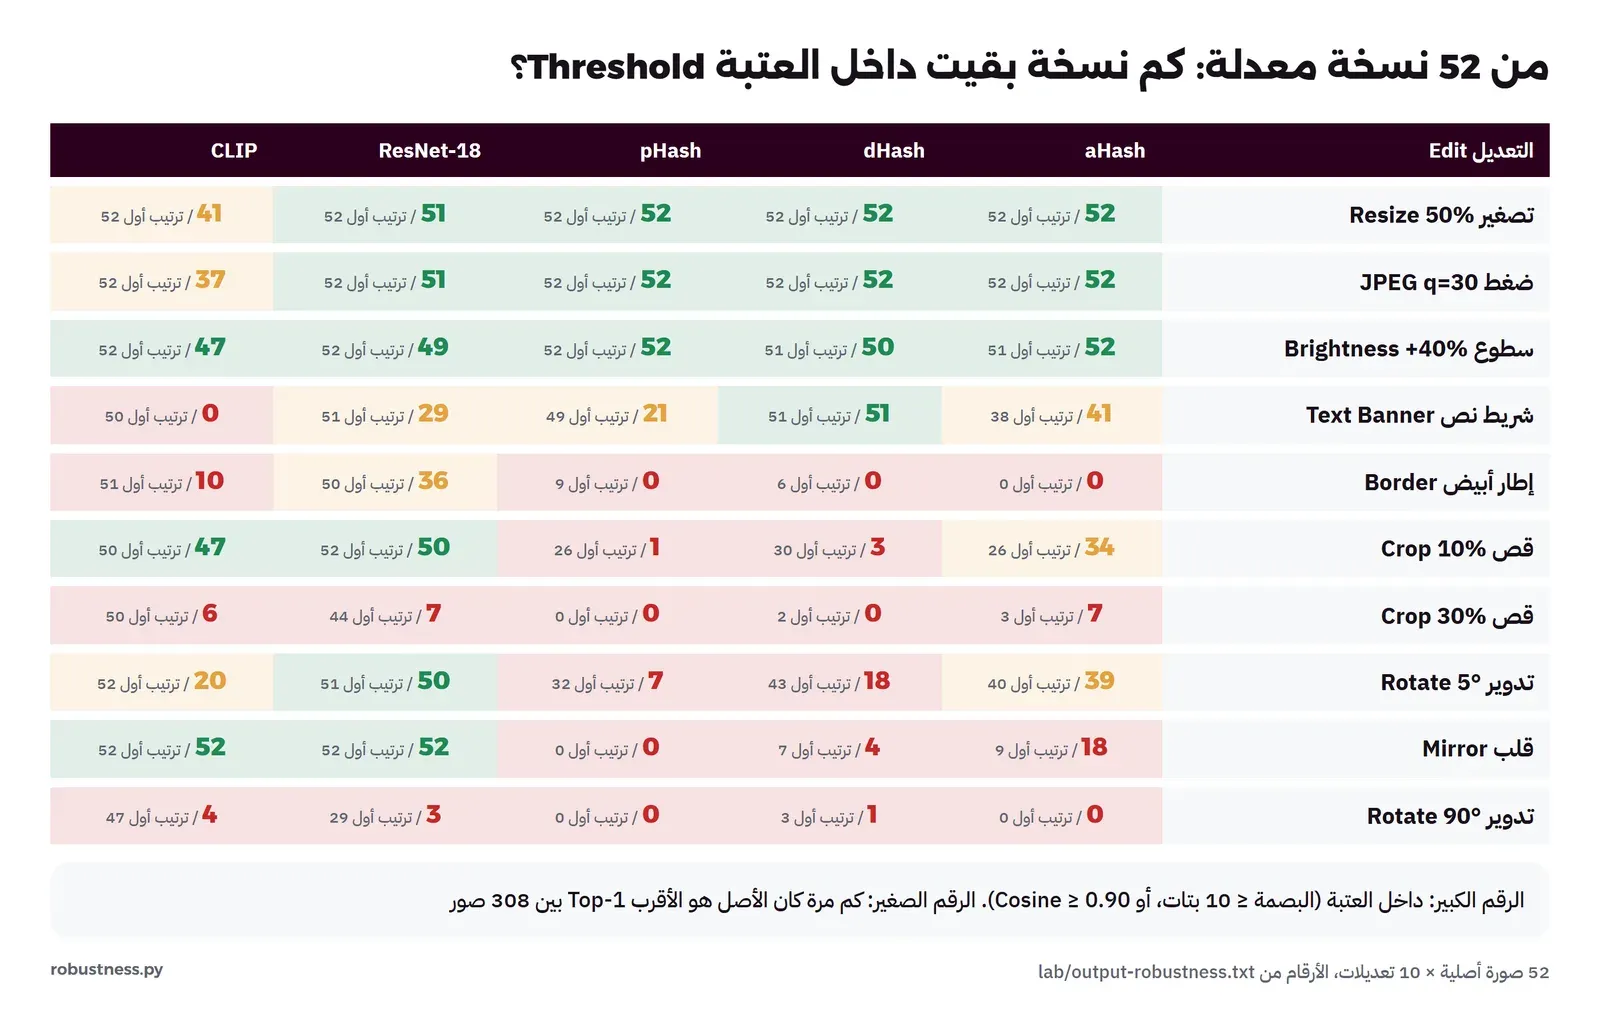
وهنا ملاحظة مهمة على الجدول تستحق أن تقف عندها: لاحظ الفرق بين الرقمين في عمود CLIP. ففي سطر الضغط JPEG كان الأصل هو الأقرب في 52 من 52، ولكن 37 فقط تجاوزت عتبة 0.90، وهذا يعني أن مشكلة CLIP هنا ليست في الترتيب، وإنما في العتبة المطلقة. فلو كان سؤالك «ما أقرب صورة إلى هذه؟» لكان CLIP ممتازاً، أما إذا كان سؤالك «هل يوجد عندنا نسخة من هذه الصورة؟ نعم أم لا»، فإنك تحتاج عتبة، والعتبة هي ما يحدد النتيجة. وهذا يقودنا إلى المشكلة الحقيقية الأولى التي ظهرت في المختبر.
المشكلة التي ظهرت: aHash ترى المناظر الطبيعية متشابهة False Positives
قبل اختبار التعديلات طبع السكربت جزءاً آخر يجيب عن سؤال لا يسأله أغلب من يستخدم البصمات: كم تبعد الصور المختلفة فعلاً عن بعضها؟ أي إذا أخذنا كل صورة أصلية، وبحثنا عن أقرب صورة أخرى إليها بين الأصول، فكم تكون المسافة؟ والمخرج كان كما يلي:
Distinct originals: the closest OTHER image for each original
  aHash  min  0 bits, 5th percentile 1, pairs <= 10 bits: 1965
  dHash  min  1 bits, 5th percentile 14, pairs <= 10 bits: 4
  pHash  min  0 bits, 5th percentile 16, pairs <= 10 bits: 1
  ResNet-18     max cosine 0.996, 95th percentile of nearest 0.894, pairs >= 0.90: 5
  CLIP ViT-B-32 max cosine 0.996, 95th percentile of nearest 0.905, pairs >= 0.90: 12
والسطر الأول هو المفاجأة: aHash وجدت 1,965 زوجاً من صور مختلفة تماماً بمسافة 10 بتات أو أقل، و5% من الصور لها صورة أخرى على بعد بت واحد فقط. وعندما فتحنا بعض هذه الأزواج كان السبب واضحاً: أغلبها مناظر طبيعية فيها سماء فاتحة في النصف الأعلى وأرض أو بحر أغمق في النصف الأسفل، وaHash لا ترى إلا هذا، فبصمة كل هذه الصور تقريباً 32 بتاً من الواحدات في الأعلى و32 من الأصفار في الأسفل. ولو استخدمنا aHash في المنصة بعتبة 10 بتات لاعتبرنا كل إعلانين فيهما سيارة مصورة في الشارع تحت السماء نسخة واحدة، وهذا يعني أن جدول التعديلات وحده كان سيخدعنا، لأن aHash ظهرت فيه جيدة في التصغير والضغط والسطوع. والدرس هنا أن أي تقييم لطريقة كشف التكرار يحتاج رقمين لا رقماً واحداً: كم نسخة حقيقية وجدت، وكم صورة مختلفة اعتبرتها نسخة بالخطأ، أي التطابقات الخاطئة False Positives.
أما dHash فوجدت 4 أزواج فقط، وpHash زوجاً واحداً، وأقرب صورة أخرى لـ 95% من الصور تبعد 16 بتاً أو أكثر عند pHash، وهذا ما يجعل عتبة 10 بتات آمنة نسبياً معها. والتضمينات لها قصة أخرى: 12 زوجاً من صور مختلفة تجاوزت 0.90 في CLIP، ولكن هذه ليست أخطاء بالضرورة، لأن كثيراً منها صورتان لبرج إيفل أو لبرج خليفة، أي نفس الموضوع، وهذا بالضبط ما يجب أن يقوله CLIP.
نسخة مكررة حقيقية داخل Wikimedia Commons
وفي نفس المخرج سطر آخر يستحق النظر: أصغر مسافة عند pHash كانت صفر بت، وأعلى تشابه عند CLIP كان 0.996، أي أن هناك صورتين مختلفتين في المجموعة متطابقتين تقريباً. ولذلك كتبنا السكربت lab/pairs.py الذي يطبع كل الأزواج القريبة مع أسماء الملفات، والمخرج كان كما يلي:
pHash <= 10 or dHash <= 10 or CLIP >= 0.97:
  037.jpg 053.jpg  pHash 26  dHash  7  CLIP 0.443  | Algar do Carvao, isla de Terceira, Azore | Bergtocht van Gimillan (1805m.) naar Col | (960, 569) (960, 517)
  037.jpg 289.jpg  pHash 28  dHash  9  CLIP 0.324  | Algar do Carvao, isla de Terceira, Azore | Burj Khalifa Dubai, UAE at Sunset 001 by | (960, 569) (960, 720)
  053.jpg 289.jpg  pHash 22  dHash  8  CLIP 0.323  | Bergtocht van Gimillan (1805m.) naar Col | Burj Khalifa Dubai, UAE at Sunset 001 by | (960, 517) (960, 720)
  307.jpg 308.jpg  pHash  0  dHash  1  CLIP 0.996  | एक इमारत जो सपनो को हौसला देती है और जज़ | एक इमारत जो सपनो को हौसला देती है और जज़ | (960, 1280) (960, 1280)
السطر الأخير هو ملفان في فئة برج خليفة لهما نفس العنوان تقريباً، وعند فتح صفحتيهما في Commons يتضح أن الثاني نسخة مشتقة من الأول نشرت كملف مستقل، أي أن الكشف هنا صحيح، وهذه نسخة مكررة حقيقية لم يضعها أحد عمداً في التجربة. وهذا يحدث في أي مجموعة صور كبيرة، وهو تذكير بأن «الخطأ» في تقييمك قد يكون خطأ في التصنيف الذي تقيس عليه، لا في الطريقة. ولذلك عاملنا هذا الزوج في السكربت التالي كنسخة حقيقية لا كتطابق خاطئ. أما الأزواج الثلاثة الأولى فهي ما يحدث مع dHash: صورة بحيرة في جزر الأزور وصورة جبل وصورة برج خليفة عند الغروب، وثلاثتها بتوزيع سطوع متشابه، فاقتربت في dHash إلى 7 و8 و9 بتات، بينما أبعدتها pHash إلى أكثر من 20 بتاً، وCLIP إلى تشابه 0.32 فقط، وهذا مثال حي على أن dHash أقرب إلى الخطأ من pHash في الصور ذات الشكل العام المتشابه.
اختيار العتبة Threshold: نسخ أكثر أم أخطاء أقل؟
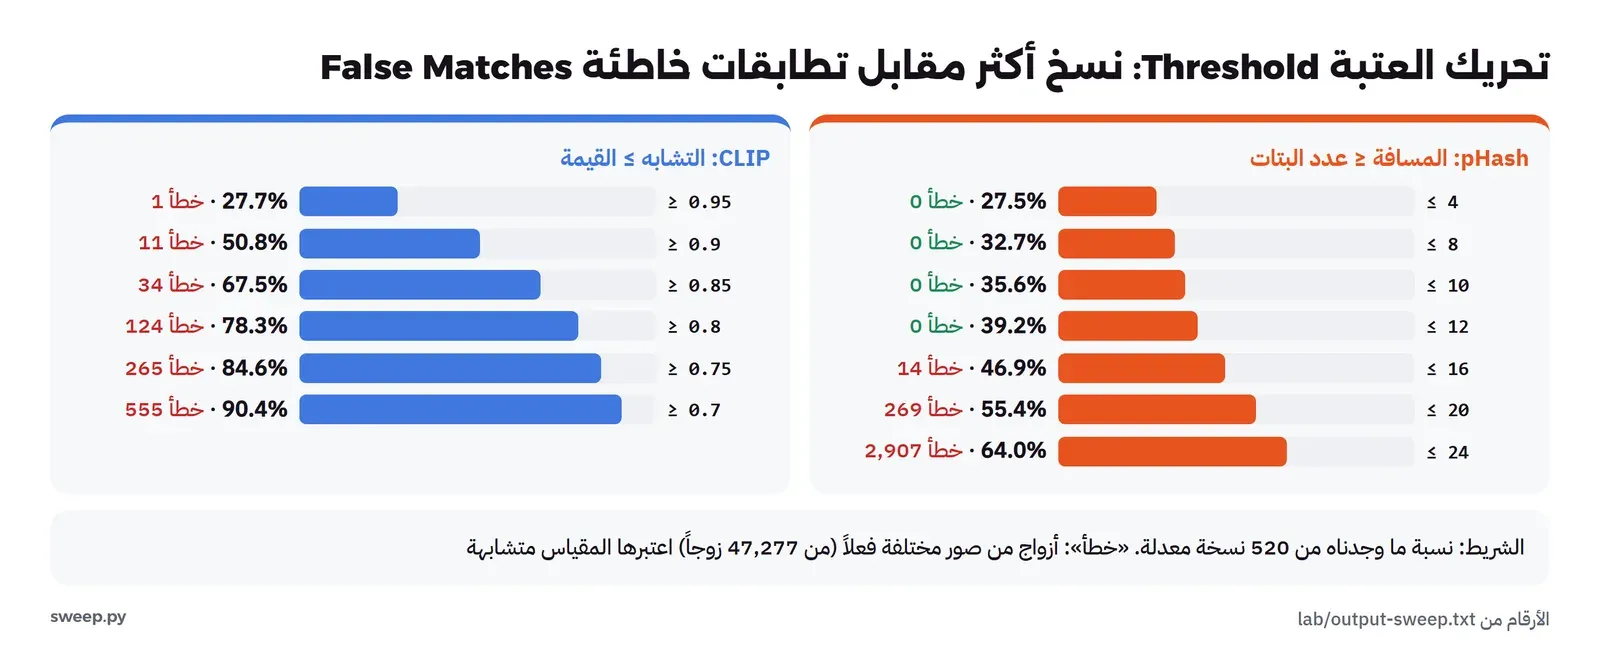
كل نظام لكشف التكرار يقوم في النهاية بقرار ثنائي: نسخة أم لا. والعتبة هي ما يحول المسافة المستمرة إلى هذا القرار، وتحريكها هو موازنة بين مقياسين: الاستدعاء Recall، أي نسبة النسخ الحقيقية التي وجدناها، والتطابقات الخاطئة، أي أزواج الصور المختلفة التي اعتبرناها نسخاً. وإذا أردت مراجعة هذه المقاييس وكيف تقرأها فقد شرحناها في مقال الإحصاء للمهندسين. والسكربت lab/sweep.py يأخذ النسخ المعدلة الـ 520 كلها، ويأخذ كل الأزواج الممكنة من الصور الأصلية المختلفة، وهي 47,277 زوجاً، ويحسب المقياسين عند عتبات مختلفة:
520 edited copies, 47277 pairs of different originals
pHash threshold  copies found  false pairs
   <=  4 bits      27.5%           0
   <=  8 bits      32.7%           0
   <= 10 bits      35.6%           0
   <= 12 bits      39.2%           0
   <= 16 bits      46.9%          14
   <= 20 bits      55.4%         269
   <= 24 bits      64.0%        2907
CLIP threshold   copies found  false pairs
   >= 0.95         27.7%           1
   >= 0.90         50.8%          11
   >= 0.85         67.5%          34
   >= 0.80         78.3%         124
   >= 0.75         84.6%         265
   >= 0.70         90.4%         555
في المخرج أعلاه لاحظ التالي:
- pHash لم تعط أي تطابق خاطئ حتى 12 بتاً، ثم بدأت الأخطاء عند 16 بتاً، وتضاعفت بسرعة كبيرة بعدها حتى وصلت إلى 2,907 زوجاً عند 24 بتاً. وهذا يعني أن العتبة الآمنة لصورنا بين 10 و12 بتاً، وأن أي محاولة لرفع الاستدعاء بتوسيع العتبة لها ثمن مرتفع جداً.
- الاستدعاء عند 10 بتات 35.6% فقط، وقد يبدو هذا رقماً سيئاً، ولكن تذكر أن النسخ الـ 520 تشمل القلب والتدوير والقص 30% والإطار، وهي تعديلات لا تستطيع البصمة رؤيتها أصلاً كما رأينا. فالرقم لا يقول إن pHash سيئة، وإنما يقول إن نصف التعديلات خارج ما صممت له.
- CLIP يجد نسخاً أكثر عند كل مستوى، فعند 0.80 وجد 78.3%، ولكن مع 124 زوجاً خاطئاً، وعند 0.70 وصل إلى 90.4% مع 555 زوجاً. وبعض هذه «الأخطاء» صور لنفس البرج من زاوية أخرى، وهي ليست نسخاً، وبالتالي فإن أي عتبة تجد معظم النسخ بـ CLIP تجد معها صوراً لنفس الموضوع.
وقد يتساءل البعض: ما العتبة الصحيحة إذن؟ والإجابة أنها تعتمد على ما يحدث بعد القرار. فإذا كان القرار حذف الإعلان آلياً، فإنك تريد صفر أخطاء تقريباً، أي pHash بعتبة 10 بتات. وإذا كان القرار إرسال الإعلان إلى مراجع بشري يقارن الصورتين، فيمكنك أن تتحمل عشرات الأخطاء في اليوم مقابل اكتشاف نسخ أكثر، أي أن تضيف CLIP بعتبة أقل. ولا تقم بنقل هذه الأرقام إلى منصتك كما هي، والسبب أن توزيع المسافات يعتمد على نوع الصور: فصور منتجات على خلفية بيضاء مثلاً أقرب إلى بعضها بكثير من المناظر الطبيعية، وبالتالي سوف تبدأ الأخطاء عند عتبة أقل. والصحيح أن تشغل نفس السكربت على عينة من صورك أنت.
ماذا يحدث إذا قلب المحتال الصورة؟ What If: Mirror and Rotation
رأينا أن القلب الأفقي والتدوير 90 درجة يجعلان pHash عمياء تماماً، والمحتال الذي يعرف أن المنصة تستخدم بصمة سوف يقلب الصورة قبل رفعها، فهل نستسلم ونستخدم CLIP لكل شيء؟ هناك حل أرخص بكثير: بدل أن نحسب بصمة واحدة للصورة المرفوعة، نحسب ثماني بصمات، واحدة لكل اتجاه ممكن، أي الصورة كما هي ومدورة 90 و180 و270 درجة، ونفس الأربعة بعد القلب الأفقي، ثم نأخذ أقل مسافة بينها وبين كل صورة مخزنة. وبذلك يبقى المخزن ببصمة واحدة لكل صورة، والتكلفة الإضافية فقط في حساب سبع بصمات أخرى للصورة الجديدة، أي قرابة 25 ميلي ثانية. والمخرج من lab/sweep.py كان كما يلي:
pHash of all 8 orientations of the query (best distance), threshold 10:
  mirror        found 52/52, median 0 bits, false matches 0
  rotate 90deg  found 52/52, median 0 bits, false matches 0
  jpeg q=30     found 52/52, median 0 bits, false matches 0
أي أن القلب والتدوير 90 درجة أصبحا مثل الضغط تماماً: 52 من 52 بمسافة صفر في الوسيط، ودون أي تطابق خاطئ إضافي على المجموعة كلها. وسطر الضغط موجود للتأكد أن البصمات الثماني لا تضيف أخطاء على الحالة العادية. ولكن هذه الحيلة تعمل فقط لأن التحويلات الثمانية هي تحويلات «نظيفة» لا تفقد أي نقطة من الصورة، أما التدوير خمس درجات أو القص فلا يمكن أن تجربه بكل زواياه الممكنة، ولذلك يبقى هذا النوع من التعديلات من نصيب التضمينات.
وجربنا أيضاً ماذا يحدث إذا رفعنا العتبة إلى 16 بتاً لنلتقط التدوير الخفيف، وكانت النتيجة في الجدول أعلاه: 14 زوجاً خاطئاً على 308 صور فقط، وهذا العدد يكبر مع حجم المجموعة كما سوف نرى في قسم البحث في مليون صورة، فكل صورة جديدة تزيد عدد الأزواج الممكنة بعدد الصور الموجودة كلها.
نفس الموضوع Same Subject والبحث بالنص Text Search
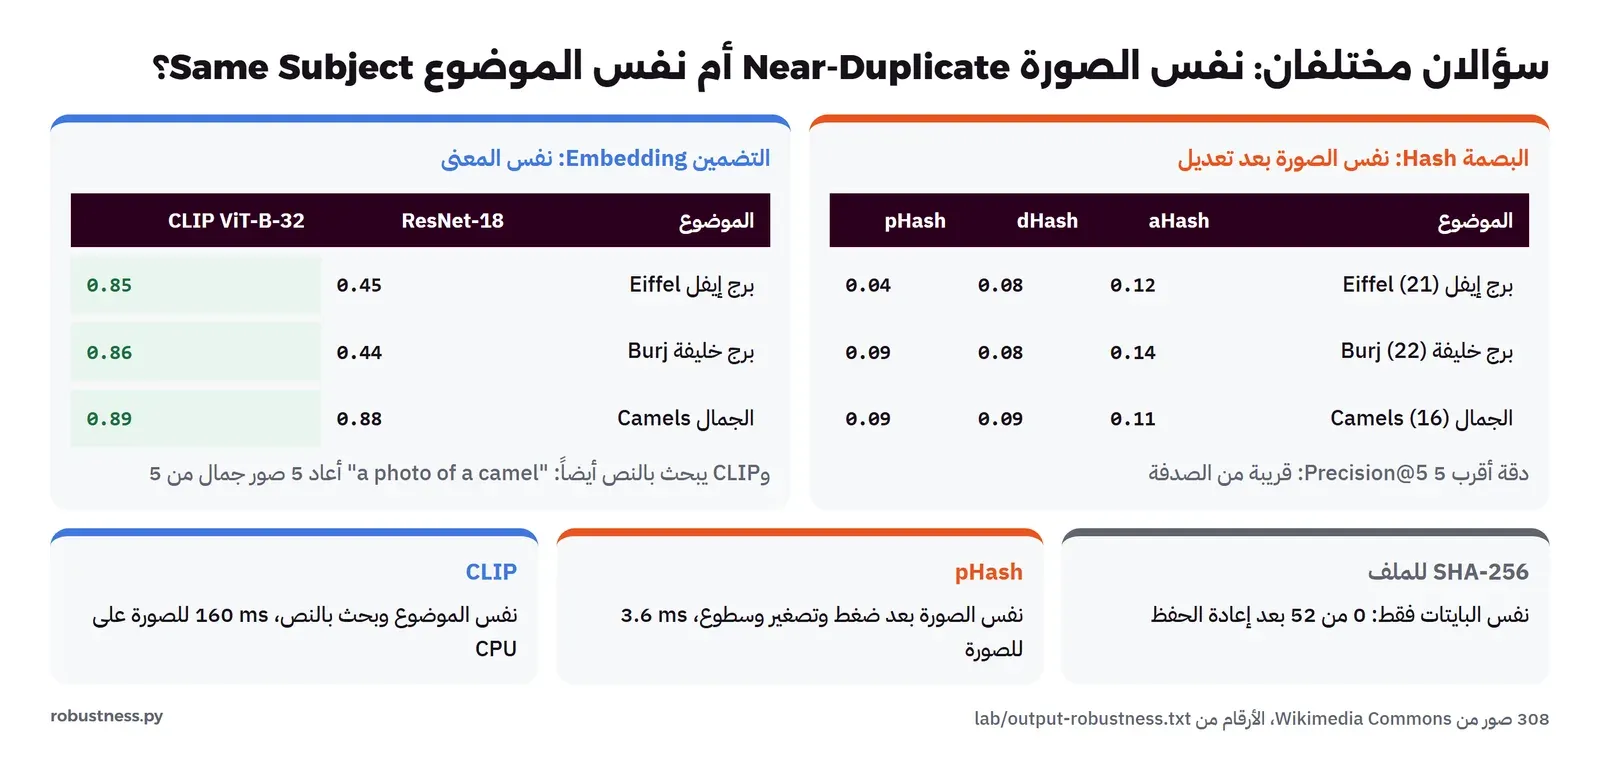
الآن ننتقل إلى السؤال الثالث، وهو طلب فريق المنتج. والسكربت يأخذ كل صورة من فئات برج إيفل وبرج خليفة والجمال، ويبحث عن أقرب خمس صور أخرى إليها، ويحسب كم منها من نفس الفئة، وهذا المقياس يسمى الدقة في أول خمس نتائج Precision@5:
Same subject: of the 5 nearest OTHER images, how many show the same subject (precision@5)
  eiffel   aHash 0.12  dHash 0.08  pHash 0.04  ResNet-18 0.45  CLIP ViT-B-32 0.85
  burj     aHash 0.14  dHash 0.08  pHash 0.09  ResNet-18 0.44  CLIP ViT-B-32 0.86
  camel    aHash 0.11  dHash 0.09  pHash 0.09  ResNet-18 0.88  CLIP ViT-B-32 0.89
والبصمات هنا قريبة من الصدفة، فبرج إيفل 21 صورة من 308، أي أن الاختيار العشوائي يعطي قرابة 0.07، وpHash أعطت 0.04، وهذا متوقع لأنها لا تعرف ما في الصورة. أما ResNet-18 فأعطت 0.88 للجمال لأن الجمل من تصنيفات ImageNet التي تدربت عليها، ولكنها أعطت 0.45 فقط لبرج إيفل و0.44 لبرج خليفة، لأنها تعرف «مبنى» و«برج» بشكل عام ولا تعرف برجاً بعينه. وCLIP وصل إلى 0.85 و0.86 و0.89 في الفئات الثلاث، لأنه تعلم من نصوص الإنترنت التي تذكر أسماء الأماكن. ولاحظ أن بعض «أخطاء» CLIP ليست أخطاء فعلاً، ففئة الجمال في Commons فيها صورة لأبي الهول، وفئة برج خليفة فيها صورة لبرج من قطع LEGO وصور من داخل القرية العالمية، وهذا تذكير آخر بأن التصنيفات التي نقيس عليها ليست نظيفة تماماً.
ثم الميزة التي لا تملكها أي طريقة أخرى، وهي البحث بالنص، حيث نحول جملة إنجليزية إلى متجه بمشفر النصوص في CLIP، ونبحث عن أقرب الصور إليها:
CLIP text search, top 5 groups:
  'a photo of a camel'             279.jpg:camel(0.33) 280.jpg:camel(0.33) 285.jpg:camel(0.32) 284.jpg:camel(0.29) 271.jpg:camel(0.29)
  'the Eiffel Tower at night'      259.jpg:eiffel(0.29) 252.jpg:eiffel(0.28) 262.jpg:eiffel(0.28) 269.jpg:eiffel(0.28) 267.jpg:eiffel(0.26)
  'a very tall skyscraper'         300.jpg:burj(0.28) 290.jpg:burj(0.28) 266.jpg:eiffel(0.27) 298.jpg:burj(0.26) 299.jpg:burj(0.25)
  'a snowy mountain lake'          165.jpg:landscape(0.28) 134.jpg:landscape(0.27) 162.jpg:landscape(0.27) 160.jpg:landscape(0.27) 161.jpg:landscape(0.26)
كل النتائج الخمس صحيحة في جملة الجمال وجملة برج إيفل، وفي جملة «ناطحة سحاب عالية جداً» جاءت أربع صور لبرج خليفة وصورة لبرج إيفل، وهذا معقول. ولاحظ أن قيم التشابه بين النص والصورة بين 0.25 و0.33 فقط، وهي أقل بكثير من تشابه صورتين، لأن النص والصورة لا يقعان في نفس المنطقة من الفضاء تماماً حتى في CLIP، ولذلك لا تقم باستخدام نفس العتبة للبحث بالنص والبحث بالصورة. وهذه الميزة وحدها قد تكون سبباً كافياً لإضافة CLIP إلى المنصة، لأنها تسمح بالبحث في الإعلانات بوصف مكتوب حتى لو كتب البائع عنواناً سيئاً. والنموذج الذي استخدمناه يفهم الإنجليزية، وللبحث بالعربية تحتاج نموذجاً متعدد اللغات من نفس عائلة OpenCLIP، أو أن تترجم الاستعلام أولاً.
من مئات الصور إلى مليون Scale: البحث الدقيق Flat أم ANN في FAISS؟
كل ما سبق كان على 308 صور، والبحث فيها يعني مقارنة الاستعلام بكل صورة، وهذا ما يسمى البحث الدقيق أو البحث الشامل Exact Search أو Brute Force. ولكن المنصة في قصتنا فيها مئات الآلاف من الإعلانات، وبعد سنتين قد تصل إلى ملايين الصور، فكم يكلف البحث وقتها؟ وهنا تأتي مكتبة FAISS التي نشرها فريق Facebook AI Research، وشرح تصميمها في ورقة سنة 2017، وهي مكتبة للبحث عن أقرب المتجهات Nearest Neighbour Search، فيها البحث الدقيق وعدة أنواع من الفهارس التقريبية Approximate Nearest Neighbour واختصاراً ANN، وقائمة الفهارس كلها في صفحة Faiss indexes.
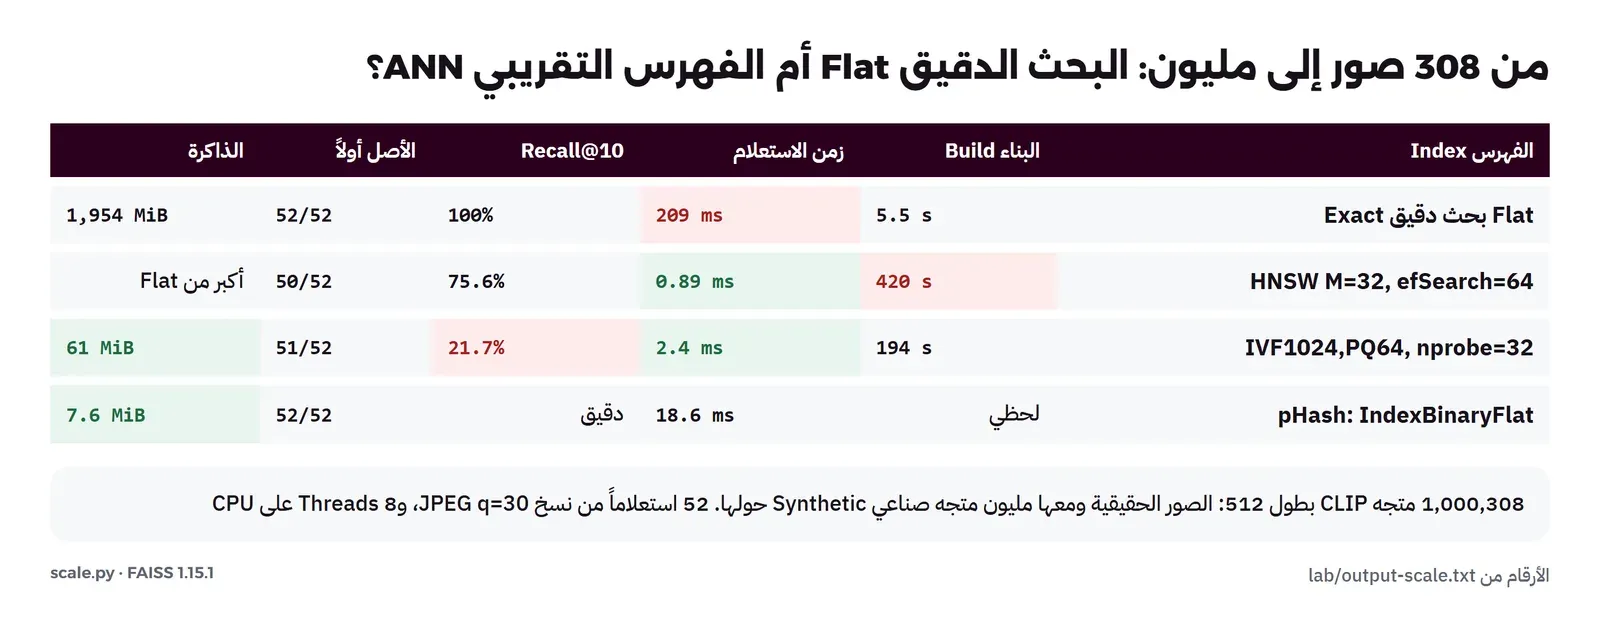
ولم يكن عندنا مليون صورة حقيقية، ولا تسمح المساحة بتنزيلها، لذلك قام السكربت lab/scale.py بشيء نقوله بوضوح: أخذ متجهات CLIP للصور الـ 308 الحقيقية، وأضاف إليها مليون متجه صناعي Synthetic، كل منها متجه حقيقي مضاف إليه ضوضاء عشوائية ثم مقسوم على طوله، بحيث يكون تشابه الوسيط بين المتجه الصناعي وأصله 0.78. والسبب أننا لا نريد متجهات عشوائية تماماً، لأنها سوف تكون بعيدة عن كل الصور الحقيقية، فيصبح البحث سهلاً بشكل غير واقعي، وإنما نريد أحياء مزدحمة حول كل صورة، مثل منصة فيها آلاف الصور لنفس طراز الجوال. والاستعلامات هي نسخ JPEG بجودة 30 من الصور الـ 52 الحقيقية، والإجابة الصحيحة هي البحث الدقيق. والمخرج كان كما يلي:
synthetic cosine to centre: median 0.78
database: 1,000,308 vectors x 512 dims = 1,954 MiB as float32

CLIP vectors, 52 queries (JPEG q=30 copies), 8 threads:
  Flat (exact)                 build     5.5 s  search  209.15 ms/query  recall@10 100.0%  original first 52/52
  HNSW M=32 efSearch=16        build   419.7 s  search    0.60 ms/query  recall@10 69.2%  original first 50/52
  HNSW M=32 efSearch=64        build   419.7 s  search    0.89 ms/query  recall@10 75.6%  original first 50/52
  HNSW M=32 efSearch=256       build   419.7 s  search    1.97 ms/query  recall@10 76.3%  original first 50/52
  IVF1024,PQ64 nprobe=4        build   194.3 s  search    2.03 ms/query  recall@10 20.6%  original first 51/52
  IVF1024,PQ64 nprobe=32       build   194.3 s  search    2.43 ms/query  recall@10 21.7%  original first 51/52
  IVF1024,PQ64 nprobe=128      build   194.3 s  search    5.68 ms/query  recall@10 21.7%  original first 51/52
  memory: Flat 1,954 MiB, IVF-PQ codes 61 MiB (64 bytes per vector)
وقبل أن نقرأ الأرقام نعرف كل فهرس في جملة:
- Flat يخزن المتجهات كما هي، ويقارن الاستعلام بكل واحد منها. لا بناء تقريباً، ودقة كاملة، ولكن الوقت يكبر خطياً مع عدد الصور.
- HNSW، أي Hierarchical Navigable Small World من ورقة Malkov وYashunin، يبني رسماً بيانياً Graph يربط كل متجه بجيرانه في عدة طبقات، ويبدأ البحث من الطبقة العليا ثم ينزل مثل من يبحث عن عنوان: المدينة ثم الحي ثم الشارع. والمعامل
Mهو عدد الجيران لكل نقطة، وefSearchهو عدد المرشحين الذين يتابعهم البحث. - IVF-PQ يقسم الفضاء إلى 1024 خلية بخوارزمية K-Means، ويبحث فقط في الخلايا الأقرب، وعددها
nprobe، ثم يضغط كل متجه من 2,048 بايتاً إلى 64 بايتاً بتقنية التكميم بالضرب Product Quantization، أي أنه يقطع المتجه إلى 64 جزءاً ويستبدل كل جزء برقم أقرب نموذج له.
في المخرج أعلاه لاحظ التالي:
- البحث الدقيق في مليون متجه يحتاج 209 ميلي ثانية للاستعلام الواحد على 8 Threads، وهذا مقبول في مهمة خلفية تفحص صورة جديدة كل عدة ثوان، وغير مقبول في صفحة «إعلانات مشابهة» تفتح آلاف المرات في الدقيقة.
- HNSW أسرع بأكثر من 200 مرة، أقل من ميلي ثانية، والأصل جاء أولاً في 50 من 52، ولكن بناء الفهرس احتاج سبع دقائق، والذاكرة أكبر من Flat لأنه يخزن المتجهات كاملة ومعها الرسم البياني.
- Recall@10، أي كم من أقرب عشر نتائج حقيقية ظهرت في نتائج الفهرس، كان 69% إلى 76% في HNSW، وهذا رقم منخفض مقارنة بما تقرؤه في المقارنات المنشورة، والسبب في بياناتنا: كل صورة حقيقية حولها قرابة 3,000 متجه صناعي بتشابه متقارب جداً، فترتيب الجيران من الثاني إلى العاشر يكاد يكون عشوائياً، وأي فهرس تقريبي يخطئ في هذا الترتيب. ولكن ما يهمنا في كشف النسخ هو المركز الأول، وهو صحيح في 50 من 52.
- IVF-PQ أعطى Recall@10 قرابة 21% فقط، ولكن الأصل جاء أولاً في 51 من 52، والذاكرة 61 ميجابايت بدل 1,954. والسبب أن الضغط يفقد الفروق الصغيرة بين الجيران المتقاربين، ويحافظ على الفرق الكبير بين النسخة الحقيقية وما حولها. ولاحظ أن زيادة
nprobeمن 32 إلى 128 لم تحسن شيئاً، فالخطأ هنا من الضغط لا من عدد الخلايا.
ثم البصمات، وهي قصة مختلفة تماماً لأن كل بصمة 8 بايتات فقط. وهنا استخدمنا مليون بصمة عشوائية مع البصمات الحقيقية، والسبب أن البصمات العشوائية تمثل الصور المختلفة جيداً، فقد رأينا أن أقرب صورة مختلفة تبعد 16 بتاً أو أكثر في الغالب:
pHash, 64-bit codes, the same 52 queries against 1,000,309 codes (309 real + 1,000,000 random):
  IndexBinaryFlat: 18.63 ms/query, original first 52/52, random codes within 10 bits of any query: 1
  numpy XOR + popcount over all codes: 21.66 ms/query, memory 7.6 MiB
البحث الدقيق في مليون بصمة احتاج 19 ميلي ثانية فقط بفهرس IndexBinaryFlat، و22 ميلي ثانية بسطر NumPy واحد يقوم بعملية XOR وعد البتات على المصفوفة كلها، والذاكرة 7.6 ميجابايت. أي أن البصمات لا تحتاج أي فهرس تقريبي حتى عشرات الملايين من الصور، وهذا سبب إضافي لجعلها الطبقة الأولى. والسطر الأخير مهم: بصمة عشوائية واحدة من المليون وقعت على بعد 10 بتات أو أقل من أحد الاستعلامات، وهذا هو التطابق الخاطئ الذي يظهر عندما يكبر الحجم، ويؤكد ما قلناه عن رفع العتبة. وملاحظة صغيرة على المخرج: عنوان هذا الجزء يقول 309 صور حقيقية، والصحيح 308، وهذا خطأ في نص الطباعة في السكربت فقط، وعدد البصمات الفعلي 1,000,308.
التصميم في المنصة Architecture: ماذا يحدث عند رفع صورة؟
بعد كل هذه الأرقام نرجع إلى المنصة في قصتنا ونصمم خط المعالجة Pipeline الذي يعمل عند رفع كل صورة. والفكرة الأساسية أن الطبقات مرتبة من الأرخص إلى الأغلى، وكل طبقة تجيب عن سؤال واحد فقط:
- SHA-256 للملف: إذا وجدنا نفس الهاش في إعلان آخر لنفس البائع، فهذا تكرار مباشر، ونرفض الإعلان أو ندمجه. وهذا الفحص يتم في أجزاء من الميلي ثانية بفهرس عادي في قاعدة البيانات.
- pHash بثمانية اتجاهات: إذا وجدنا صورة على بعد 10 بتات أو أقل، فهي نفس الصورة بعد تعديل. وإذا كانت لنفس البائع فهذا تكرار، وإذا كانت لبائع آخر فهذه إشارة قوية على نسخ صورة غيره، ونرسل الإعلان إلى المراجعة مع الصورتين جنباً إلى جنب.
- تضمين CLIP: يحسب في مهمة خلفية لا تؤخر نشر الإعلان، ويخزن في فهرس HNSW، ويستخدم لشيئين: قسم «إعلانات مشابهة» وبحث النص، وكطبقة ثانية لكشف النسخ المقصوصة أو ذات الإطار، بعتبة عالية وبمراجعة بشرية دائماً، لأن CLIP لا يفرق بين نسخة مقصوصة وصورة أخرى لنفس المنتج.
وقبل أي طبقة من هذه، طبق اتجاه الصورة المحفوظ في EXIF، أي ما يقوم به السطر ImageOps.exif_transpose في السكربت، والسبب أن صور الجوال تحفظ أحياناً بالعرض مع علامة تقول «دورها 90 درجة عند العرض»، فإذا لم تطبقها حصلت على بصمة صورة مدورة، ورأينا أن هذا يجعل pHash عمياء. ومن ناحية التخزين فبصمة 64 بتاً تخزن في عمود BIGINT في أي قاعدة بيانات، والتضمينات يمكن أن تخزن في قاعدة متجهات أو في PostgreSQL مع إضافة pgvector، وهذا قرار يعتمد على حجمك أكثر مما يعتمد على الخوارزمية. وإذا كانت صورك تمر بخدمة معالجة قبل التخزين، مثل التي شرحناها في مقال خدمة تصغير الصور، فاحسب البصمة من الصورة الأصلية التي رفعها المستخدم، أو من نسخة ثابتة الحجم دائماً، حتى لا يختلف أساس المقارنة بين صورة وأخرى.
هل يمكن خداع البصمة؟ Adversarial Attacks
كل ما سبق يفترض أن المحتال يعدل الصورة بأدوات عادية، ولكن ماذا لو كان يعرف الخوارزمية ويريد أن يخدعها عمداً؟ هنا يصبح السؤال أمنياً لا هندسياً، والإجابة المختصرة أن البصمات الإدراكية لم تصمم لتقاوم مهاجماً يعرفها. وأشهر مثال موثق على ذلك حدث في أغسطس 2021، عندما أعلنت Apple عن نظام لفحص صور iCloud يستخدم بصمة إدراكية مبنية على شبكة عصبية اسمها NeuralHash، وخلال أيام استخرج أحد المطورين النموذج من نظام iOS ونشره في مستودع AppleNeuralHash2ONNX، وبعدها بساعات نشر باحث آخر في أول بلاغ في المستودع صورتين مختلفتين تماماً لهما نفس البصمة بالضبط، صورة كلب وصورة رمادية مصنوعة، وأكد صاحب المستودع أن الصورتين تعطيان نفس الهاش على جهاز iPhone. والدرس هنا أن أي بصمة يمكن حساب تدرجها Gradient أو تجربة تعديلاتها آلياً يمكن أن يصنع لها المهاجم تصادماً Collision، أي صورة مختلفة ببصمة مطلوبة، أو العكس، أي تعديلاً صغيراً لا تلاحظه العين يبعد البصمة إلى أكثر من العتبة.
فماذا يعني هذا لمنصة الإعلانات؟ يعني أن كشف النسخ بالبصمة طبقة تصفية جيدة ضد الأغلبية التي تعدل الصور بتطبيقات عادية، ولكنها ليست حماية ضد مهاجم مصمم، ولذلك لا تجعل قرار حظر حساب يعتمد على البصمة وحدها، واجمعها مع إشارات أخرى مثل عمر الحساب وعدد الإعلانات في الساعة ورقم الجوال المكرر، وقد شرحنا فكرة جمع الإشارات في مقال كشف الاحتيال Fraud Detection.
أخطاء شائعة Common Mistakes
- قياس الاستدعاء وحده: aHash بدت ممتازة في جدول التعديلات، ثم ظهر أنها تعطي 1,965 زوجاً خاطئاً على 308 صور. قس دائماً المسافة بين الصور المختلفة فعلاً قبل أن تختار العتبة.
- استخدام أداة «نفس الموضوع» لكشف السرقة: CLIP يرى صورتين لنفس الجوال متشابهتين، وهذا صحيح في المعنى، ولكنه يتهم كل البائعين الشرفاء.
- استخدام أداة «نفس الصورة» لقسم المشابهات: pHash لا تجد إلا النسخ، فيصبح القسم قائمة بنفس الإعلان المكرر.
- نسخ العتبة من مقال: العتبة تعتمد على نوع الصور. شغل سكربت المسافات على عينة من صورك.
- تجاهل اتجاه EXIF: صورة الجوال المحفوظة بالعرض تعطي بصمة مختلفة تماماً إذا لم تطبق
exif_transposeقبل الحساب. - بصمة واحدة للاستعلام: القلب والتدوير 90 درجة يعميان pHash، وحساب ثمانية اتجاهات يحل المشكلة بتكلفة صغيرة ودون أخطاء إضافية في تجربتنا.
- عتبة واحدة للنص والصورة في CLIP: تشابه النص مع الصورة كان بين 0.25 و0.33، وتشابه صورتين فوق 0.85، فالعتبة نفسها لا تصلح للاثنين.
- فهرس تقريبي قبل الحاجة: البحث الدقيق في مليون بصمة 19 ميلي ثانية. لا تضف HNSW إلى البصمات، وأضفه للتضمينات عندما يصبح البحث الدقيق أبطأ مما تحتمله الصفحة.
- قراءة Recall@10 كأنه دقة كشف النسخ: IVF-PQ أعطى 21% في Recall@10 و51 من 52 في المركز الأول. قس ما تحتاجه ميزتك فعلاً.
- الحذف الآلي على البصمة وحدها: البصمات يمكن خداعها عمداً كما حدث مع NeuralHash، فاجعل القرارات الكبيرة تمر بمراجعة أو بإشارات إضافية.
جدول القرار Decision Table
| ما تريده | الطريقة | العتبة في تجربتنا | التكلفة | ما لا تكشفه |
|---|---|---|---|---|
| نفس الملف المرفوع مرة ثانية | SHA-256 | تطابق كامل | أجزاء من ميلي ثانية | أي إعادة حفظ أو تعديل |
| نفس الصورة بعد ضغط أو تصغير أو سطوع | pHash | 10 بتات أو أقل | 3.6 ميلي ثانية للصورة، 8 بايتات | القص والإطار والتدوير الخفيف |
| نفس الصورة بعد قلب أو تدوير 90 | pHash بثمانية اتجاهات | 10 بتات أو أقل | ثمانية أضعاف حساب البصمة للاستعلام فقط | نفس ما سبق |
| نسخة مقصوصة أو بإطار | CLIP مع مراجعة بشرية | بين 0.85 و0.90 كبداية | 160 ميلي ثانية على CPU، 2 كيلوبايت | يخلط النسخة بصورة أخرى لنفس المنتج |
| منتجات مشابهة وبحث بالنص | CLIP مع HNSW | ترتيب لا عتبة | فهرس في الذاكرة، بناء بالدقائق | لا يفهم العربية في هذا النموذج |
| مليون متجه بذاكرة محدودة | IVF-PQ | ترتيب لا عتبة | 64 بايتاً للمتجه | الفروق الدقيقة بين الجيران |
تدريب عملي Practice
- أضف إلى
edits.pyتعديلاً جديداً هو تحويل الصورة إلى أبيض وأسود، ثم تعديلاً يضع الصورة فوق خلفية بلون آخر بنسبة 80%، وتوقع قبل التشغيل أي الطرق سوف تصمد. - عدل
phashبحيث تستبعد المعاملfreq[0, 0]، وشغلsweep.pyمرة أخرى: هل تغير عدد الأزواج الخاطئة عند 16 بتاً؟ - اكتب دالة تقسم البصمة إلى أربعة أجزاء من 16 بتاً، وتخزن كل جزء في فهرس عادي، ثم تبحث فقط في الصور التي تطابق جزءاً واحداً على الأقل. لماذا يضمن هذا أن تجد كل صورة على بعد 3 بتات أو أقل؟ وماذا يحدث مع 10 بتات؟
- غير
scale.pyبحيث تكون الضوضاء أكبر، أي تشابه 0.5 مع الأصل بدل 0.78، وراقب كيف يتغير Recall@10 في HNSW.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- كشف الصور المتشابهة ثلاثة أسئلة: نفس الملف، ونفس الصورة بعد تعديل، ونفس الموضوع، ولكل منها أداة: SHA-256 ثم pHash ثم CLIP.
- SHA-256 لم يجد أي نسخة من 52 بعد إعادة الحفظ بصيغة JPEG، ولكنه يبقى أرخص طبقة أولى.
- pHash صمدت تماماً أمام التصغير والضغط والسطوع، ولم تعط أي تطابق خاطئ حتى 12 بتاً، وانهارت أمام القص والإطار والقلب والتدوير، وحساب ثمانية اتجاهات للاستعلام أعاد القلب والتدوير 90 درجة إلى 52 من 52.
- aHash أعطت 1,965 زوجاً خاطئاً على 308 صور لأنها ترى السماء والأرض فقط، فلا تقم بتقييم أي طريقة على النسخ الحقيقية وحدها.
- CLIP وجد الأصل أولاً في أغلب التعديلات، وأعطى دقة 0.85 إلى 0.89 في سؤال نفس الموضوع، وسمح بالبحث بالنص، ولكنه أبطأ من البصمة بأكثر من 40 مرة، وعتبته المطلقة تخلط النسخ بالصور المشابهة.
- في مليون متجه احتاج البحث الدقيق 209 ميلي ثانية، وHNSW أقل من ميلي ثانية، وIVF-PQ قلل الذاكرة من 1,954 إلى 61 ميجابايت، أما مليون بصمة فبحثها الدقيق 19 ميلي ثانية في 7.6 ميجابايت.
- البصمات يمكن خداعها عمداً كما حدث مع NeuralHash سنة 2021، فاجعلها طبقة تصفية لا حكماً نهائياً.
وهذا المقال من مرحلة مشاريع التعلم الآلي، وهذه مقالات منشورة ترتبط به:
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلالرؤية الحاسوبية للمبتدئين: كيف يرى الحاسب الصورة؟كيف يتحول جدول من الأرقام إلى «قطة على كنبة»، وما الذي يفعله نموذج التصنيف والكشف فعلاً، وأين يخطئ ولماذا.
 دليلالبحث الدلالي Semantic Search بالـ Embeddingsمتى يتفوق البحث بالمعنى على البحث بالكلمات في النص العربي، وكيف تقيس ذلك على أسئلتك قبل أن تختار.
 دليلصيغ الصور: كيف تختار الصيغة المناسبة لموقعككيف تحفظ كل صيغة صور البكسلات والألوان، ولماذا يصغر الملف نفسه إلى الثلث أو أقل عندما تختار الصيغة والمقاس المناسبين.
 دليلجداول الهاش Hash Tables: كيف يجد القاموس قيمتك فوراًماذا يحدث داخل القاموس من دالة الهاش إلى التصادم والتكبير، ولماذا يبقى البحث فيه خطوة أو اثنتين، بأرقام من تجربة حقيقية في Python.
 دليلالإحصاء Statistics للمهندسين: لماذا يخدعك المتوسط Mean؟كيف تقرأ زمن الاستجابة بالوسيط والمئين p95 وp99 والمدرج التكراري بدل المتوسط، ولماذا لا يجوز حساب متوسط المئين، مع تجربة حقيقية لسيرفر تحت الضغط.
 دليلكشف الاحتيال Fraud Detection: قواعد أم تعلم آلة؟قارنا القواعد بنموذجين لتعلم الآلة على بيانات دفع مولدة بنفس سعة المراجعة، ورأينا من يمسك الأنماط المعروفة ومن يتأخر عن النمط الجديد.
 دليلتحليل البيانات Data Analysis مع pandas للمبتدئيننجيب على سؤال حقيقي من بيانات 32 محطة طقس سعودية: كم يوماً فوق 45 درجة في كل منطقة ومتى، ونتعلم في الطريق تنظيف البيانات والربط والتجميع والتواريخ مع pandas وأخطاءها الشائعة.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل aHash وdHash وpHash المكتوبة من الصفر وResNet-18 وCLIP ViT-B-32 على 308 صور من Wikimedia Commons وعشرة تعديلات، ومقارنة Flat وHNSW وIVF-PQ في FAISS 1.15.1 على مليون متجه داخل Docker على CPU.