إذا كنت مسؤولاً عن حساب تطبيق خدمي على منصة X، فأنت تعرف ما يحدث بعد كل تحديث كبير: مئات الردود في أول يومين، بعضها «ما قصرتوا والله، التطبيق صار اسرع»، وبعضها «من بعد التحديث الدفع يعلق كل مرة»، وبعضها «يا سلام على السرعة، الطلب وصل بعد ثلاث ساعات 👏»، والأخيرة ليست مدحاً كما تعرف. وفي اجتماع الأحد يسأل مدير المنتج سؤالاً واحداً: هل الناس راضون عن التحديث أم لا؟ وكم نسبة الغاضبين، وهل ارتفعت عن الشهر الماضي؟ وقراءة كل الردود بيدك تنجح في أول أسبوع، ثم تصبح مستحيلة عندما تتكرر كل أسبوع، وعندما يريد المدير رقماً يقارنه بين شهر وآخر بدل انطباعك.
وهذه المسألة اسمها تحليل المشاعر Sentiment Analysis: أن يقرأ برنامج النص ويقرر هل هو إيجابي أم سلبي أم محايد. وهي من أقدم مسائل معالجة اللغة الطبيعية، ولكنها في العربية أصعب بكثير مما تبدو، لأن الناس يكتبون بلهجاتهم، وينفون بكلمات مختلفة في كل بلد، «مو» و«مش» و«ما» و«موب»، ويسخرون، ويضعون إيموجي بدل الكلمة. وفي هذا المقال سوف نبني مصنفين: الأول خط أساس Baseline بسيط بطريقة TF-IDF مع الانحدار اللوجستي Logistic Regression، يتدرب في ثوان، والثاني نموذج عربي مدرب مسبقاً من عائلة BERT هو CAMeLBERT، يعمل على المعالج CPU دون بطاقة رسوميات. ونقيسهما على مجموعتي تغريدات عربية عامتين، ثم على ردود كتبناها بأنفسنا بلهجة خليجية فيها نفي وسخرية وإيموجي، ونعرض الأخطاء كما هي. وكل مخرج في المقال هو مخرج حقيقي من تشغيل الكود الموجود في مجلد lab داخل Container مبني على python:3.13-slim.
وسوف نناقش في هذا المقال ما يلي:
- لماذا لا نسحب التغريدات من X مباشرة، وما البيانات العربية المفتوحة المتاحة ورخصها.
- الفكرة الأولى التي يجربها الجميع: قاموس كلمات مع قاعدة نفي، وحدودها بالأرقام.
- لماذا المشاعر في العربية صعبة، وما الذي في هذه البيانات فعلاً قبل أي نموذج.
- خط الأساس TF-IDF: الكلمات مقابل مقاطع الحروف، وماذا يتعلم النموذج.
- ماذا يحدث عندما تتغير اللهجة بين التدريب والاستخدام.
- النموذج المدرب مسبقاً CAMeLBERT على CPU: كيف يعمل، وكم يستغرق، وكيف نقيسه بعدل.
- الحالات الصعبة: النفي والسخرية والإيموجي والرد المختلط، والأخطاء الحقيقية للنموذجين.
- تجربة «ماذا يحدث إذا» على التطبيع، ثم كيف نبني التقرير الأسبوعي، وقائمة تحقق.
من أين نأتي بالتغريدات؟ X API and Open Datasets
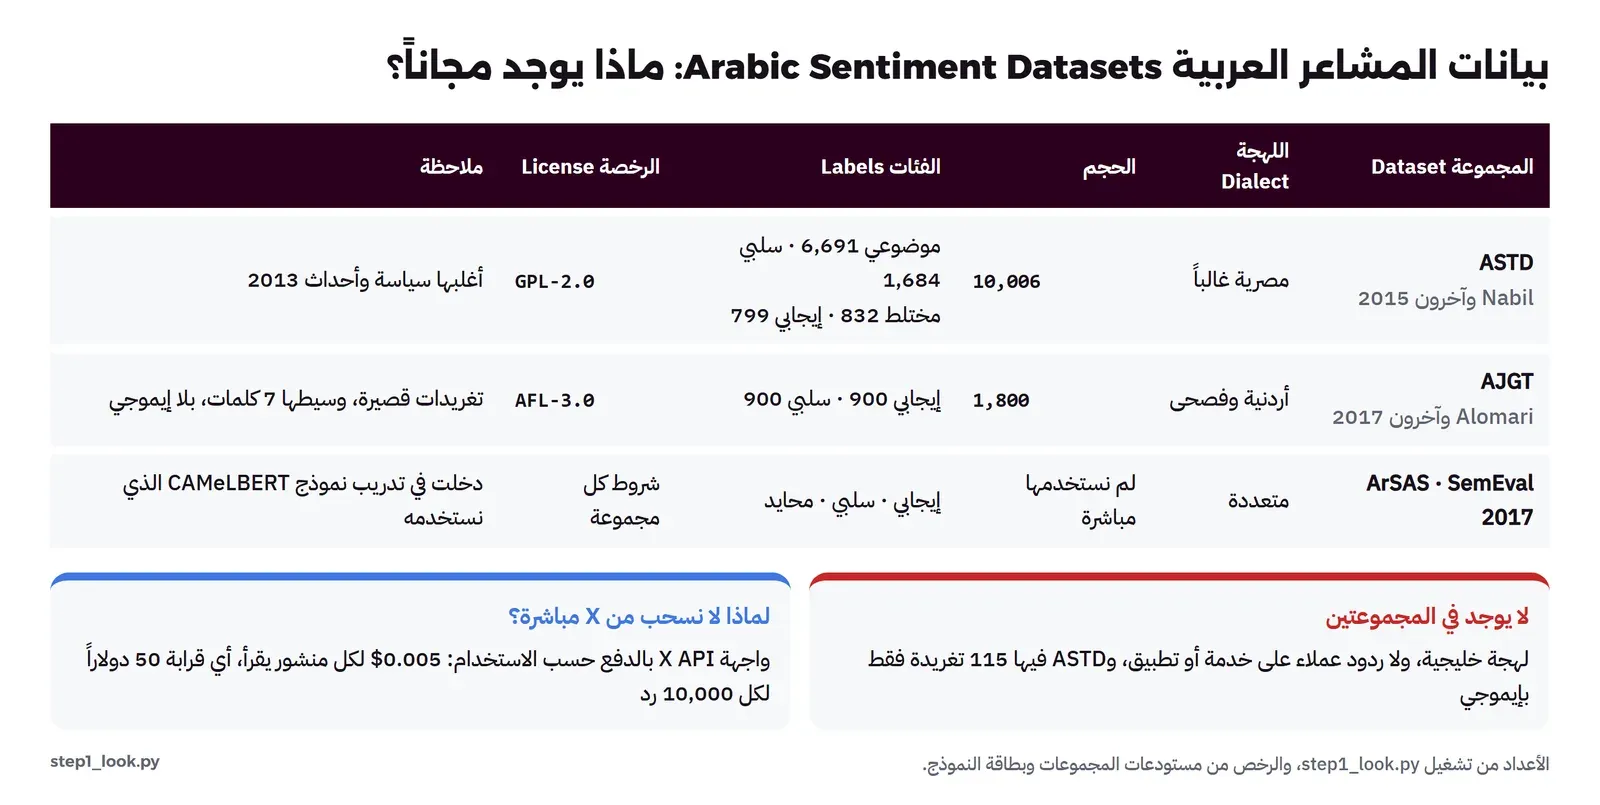
أول فكرة أن نسحب الردود من X ونصنفها. ولكن واجهة X البرمجية لم تعد مجانية للقراءة، فبحسب صفحة الأسعار الرسمية النظام بالدفع حسب الاستخدام، وقراءة المنشور الواحد بـ 0.005 دولار، أي قرابة 50 دولاراً لكل عشرة آلاف رد، مع حد أعلى للقراءات في الشهر. وهذا مبلغ معقول لجهة تعرف ما تريد، ولكنه لا يناسب مرحلة التجربة التي لا نعرف فيها بعد أي نموذج يصلح، ثم إن سحب الردود لا يحل المشكلة الأصعب: أننا نحتاج ردوداً مصنفة بيد إنسان حتى نقيس أي نموذج. والقاعدة التي نعمل بها في هذا المقال: ابدأ بالبيانات المفتوحة المصنفة لتختار الطريقة، ثم صنف عينة صغيرة من ردودك أنت لتقيس عليها قبل أن تعتمد أي رقم.
والبيانات العربية المفتوحة لتحليل المشاعر قليلة، وأغلبها من سنوات مضت. واخترنا مجموعتين يمكن تنزيلهما مباشرة برخصة واضحة:
- ASTD، مجموعة التغريدات العربية للمشاعر Arabic Sentiment Tweets Dataset، نشرها Mahmoud Nabil وزملاؤه في 2015، وفيها قرابة عشرة آلاف تغريدة أغلبها باللهجة المصرية، في أربع فئات: إيجابي، وسلبي، ومختلط، وموضوعي لا رأي فيه. وهي منشورة في مستودعها على GitHub برخصة GPL-2.0.
- AJGT، مجموعة التغريدات الأردنية العامة Arabic Jordanian General Tweets، وفيها 1,800 تغريدة بالأردنية والفصحى، نصفها إيجابي ونصفها سلبي، برخصة Academic Free License 3.0.
وهناك مجموعات أخرى معروفة مثل ArSAS ومهمة SemEval 2017 للتغريدات العربية، ولن نستخدمها مباشرة، ولكن سوف نراها بعد قليل لأن النموذج المدرب مسبقاً الذي نستخدمه درب عليها. والتنزيل في التجربة يتم بسكربت صغير:
# Downloads the two public datasets into data/ (about 1.7 MB); the model is downloaded by Transformers on first use (about 440 MB)
#   ASTD, Nabil et al. 2015 (GPL-2.0)   AJGT, Alomari et al. 2017 (Academic Free License 3.0)
import os, urllib.request

os.makedirs("data", exist_ok=True)
for url, name in (("https://raw.githubusercontent.com/mahmoudnabil/ASTD/master/data/Tweets.txt", "astd-tweets.txt"),
                  ("https://raw.githubusercontent.com/komari6/Arabic-twitter-corpus-AJGT/master/AJGT.xlsx", "AJGT.xlsx")):
    urllib.request.urlretrieve(url, f"data/{name}")
print(sorted(os.listdir("data")))
والتجربة كلها في Image واحدة بنيناها لهذا المقال، فيها PyTorch من فهرس الحزم الرسمي للمعالج CPU، ثم Transformers وscikit-learn، والإصدارات مثبتة بالرقم:
# CPU-only image for the lab: PyTorch from the official CPU wheel index, then Transformers and scikit-learn
FROM python:3.13-slim
RUN pip install --no-cache-dir --root-user-action=ignore torch==2.15.0 --index-url https://download.pytorch.org/whl/cpu \
 && pip install --no-cache-dir --root-user-action=ignore transformers==5.22.1 scikit-learn==1.9.1 pandas==3.1.0 openpyxl==3.1.5
WORKDIR /w
#!/bin/sh
# Runs the lab of this article from this folder: one CPU-only image, a volume that keeps the downloaded model
set -e
docker build -t hml-nlp:1 .
mkdir -p outs
for s in fetch step1_look step2a_lexicon step2_tfidf step3_bert step4_hard step5_errors; do
echo "=== $s"
docker run --rm --name hml-nlp -v "$PWD:/w" -v hml-hf:/root/.cache/huggingface -w /w hml-nlp:1 python $s.py | tee output-$s.txt
done
# clean up afterwards: docker rmi hml-nlp:1 && docker volume rm hml-hfفي الملفين أعلاه لاحظ التالي:
- الفهرس
download.pytorch.org/whl/cpuيعطي نسخة PyTorch دون مكتبات CUDA، ولو ثبتها من الفهرس العادي لنزلت معها مكتبات بطاقات NVIDIA بعدة جيجابايت لن نستخدمها. - الـ Volume المسمى
hml-hfيحفظ النموذج بعد أول تنزيل، وحجمه قرابة 440 ميجابايت، فلا ينزل مرة أخرى مع كل خطوة. - كل خطوة تعمل في Container مؤقت يحذف بعدها، وفي آخر السكربت أمر الحذف للـ Image والـ Volume.
لماذا المشاعر في العربية صعبة؟ Why Arabic Is Hard
قد يبدو تحليل المشاعر مسألة واحدة في كل اللغات، ولكن العربية تضيف فوقها طبقات لا تجدها في الإنجليزية بنفس الحجم، وقد شرحنا أغلبها بالتفصيل في مقال NLP للعربية، وهذه أهمها لمسألتنا:
- اللهجات Dialects: الفصحى في الأخبار والبيانات الرسمية، أما الردود فباللهجة، والفرق بين المصرية والأردنية والخليجية والمغاربية ليس في النطق فقط، وإنما في الكلمات نفسها. فـ «بايخ» و«ماصخ» و«سخيف» معناها متقارب، و«يهبل» مدح في الخليج، و«عادي» قد تكون رضا أو استخفافاً حسب السياق.
- النفي Negation: كل لهجة تنفي بطريقتها، «مو» و«مب» و«موب» و«مش» و«ما ... ش»، وبعض عبارات النفي معناها مدح مثل «ما قصرتوا» و«ما عليك زود»، وبعضها ذم مثل «ما ينفع».
- الصرف Morphology: الكلمة الواحدة تلتصق بها السوابق واللواحق، «وبالتطبيق» و«تطبيقكم» و«التطبيقات»، فعد الكلمات كما هي يفرق الكلمة الواحدة إلى عشرات الأشكال، وهذا ما سوف يجعل مقاطع الحروف تفيدنا.
- الإملاء غير الموحد: الهمزات والتاء المربوطة والألف المقصورة تكتب بأشكال مختلفة، والتكرار للتعبير «حلووووو»، والكتابة بالحروف اللاتينية والأرقام أحياناً، المسماة عربيزي Arabizi، مثل «7elo».
- الدين والمجاملة: كثير من الكلمات الإيجابية في الشكل عبارات يومية لا تحمل رأياً، «الله يعطيك العافية» قد تكون شكراً أو بداية شكوى، و«الحمد لله» تأتي مع الرضا ومع المصيبة. فالنموذج الذي يتعلم أن «الله» كلمة إيجابية سوف يخطئ في نصف الحالات.
- قلة البيانات المصنفة: مقارنة بالإنجليزية، البيانات العربية المصنفة للمشاعر قليلة، وأغلبها تغريدات من سنوات مضت عن أحداث سياسية أو رياضية، وليس ردود عملاء.
وكل نقطة من هذه سوف نراها بالأرقام في التجارب التالية، وبعضها سوف يكسب فيه النموذج الكبير، وبعضها يخسر فيه النموذجان معاً.
ما الذي في البيانات؟ First Look
كما فعلنا في مقال تحليل البيانات مع pandas، لا نبدأ بنموذج قبل أن ننظر إلى البيانات. وهذه أول خطوة:
# Loading the two datasets and the light Arabic normalisation shared by every step
import re
import pandas as pd

def load_astd():
    """ASTD (Nabil et al. 2015, GPL-2.0): about 10k Egyptian tweets, POS / NEG / NEUTRAL (mixed) / OBJ"""
    df = pd.read_csv("data/astd-tweets.txt", sep="\t", header=None, names=["text", "label"], quoting=3)
    return df.dropna()

def load_ajgt():
    """AJGT (Alomari et al. 2017, AFL-3.0): 1,800 Jordanian / MSA tweets, Positive / Negative"""
    df = pd.read_excel("data/AJGT.xlsx")
    df = df.rename(columns={"Feed": "text", "Sentiment": "label"})[["text", "label"]]
    df["label"] = df["label"].map({"Positive": "POS", "Negative": "NEG"})
    return df

EMOJI = re.compile("[\U0001F300-\U0001FAFF☀-➿]")

def normalize(text):
    text = re.sub(r"https?://\S+", " ", str(text))
    text = re.sub(r"@\w+", " ", text)
    text = re.sub(r"[ً-ْـ]", "", text)          # harakat and tatweel
    text = re.sub("[إأآا]", "ا", text).replace("ى", "ي").replace("ة", "ه")
    text = re.sub(r"(.)\1{2,}", r"\1\1", text)                 # «حلوووو» -> «حلوو»
    text = EMOJI.sub(lambda m: f" {m.group(0)} ", text)        # each emoji becomes its own token
    return re.sub(r"\s+", " ", text).strip()
# Step 1: what is inside the two datasets before any model
import pandas as pd
from common import load_astd, load_ajgt, EMOJI
astd, ajgt = load_astd(), load_ajgt()
for name, df in (("ASTD", astd), ("AJGT", ajgt)):
print(f"== {name}: {len(df)} tweets")
print(df["label"].value_counts().to_string())
words = df["text"].str.split().str.len()
print(f"words per tweet: median {words.median():.0f}, 90th percentile {words.quantile(.9):.0f}")
print("tweets with an emoji:", int(df["text"].str.contains(EMOJI).sum()),
"| exact duplicates:", int(df["text"].duplicated().sum()))
pd.set_option("display.max_colwidth", 80)
short = lambda df: df[df["text"].str.split().str.len().between(5, 12)]
print("-- AJGT examples")
print(short(ajgt).sample(8, random_state=11)[["label", "text"]].to_string(index=False))والمخرج سوف يكون كما يلي:
== ASTD: 10006 tweets
label
OBJ        6691
NEG        1684
NEUTRAL     832
POS         799
words per tweet: median 14, 90th percentile 22
tweets with an emoji: 115 | exact duplicates: 4
== AJGT: 1800 tweets
label
POS    900
NEG    900
words per tweet: median 7, 90th percentile 17
tweets with an emoji: 0 | exact duplicates: 0
-- AJGT examples
label                                                             text
  NEG                                       اخ يا بطني عورني من الضحكك
  POS  كلام بليغ اللهم ارزقنا الزوج الصالح من يعرف معني رفقا بالقوارير
  NEG                     ما يستحون هم جايين لو انا منهم اروح اقشر بصل
  NEG                             الظاهر انه جايين يستهبلون عالحكام بس
  NEG في خطبه وحده رفض شيخ اخواني النووي الاردني و مدح النووي الايراني
  NEG                        سخافه الشاميين ابدا ما ينفع لهم الكوميديا
  POS                          الصادق ينتظر الفرج ولا يياس من روح الله
  NEG                               ولا مستحيل يطلع واحد يفشل نفسه كذا
في المخرج أعلاه لاحظ التالي:
- في ASTD الفئة الأكبر بكثير هي الموضوعي
OBJ، 6,691 تغريدة، أي ثلثا المجموعة لا رأي فيه. والإيجابي 799 فقط مقابل 1,684 سلبي. وهذا يشبه الواقع كثيراً: أغلب ما يكتب أخبار أو أسئلة، والناس يكتبون عندما يغضبون أكثر مما يكتبون عندما يرضون. - في AJGT الفئتان متساويتان تماماً، 900 و900، لأن من جمعها اختار ذلك. وهذا يجعلها جيدة للمقارنة بين النماذج، ولكن النسبة فيها لا تشبه أي حساب حقيقي.
- تغريدة ASTD وسيطها 14 كلمة، وتغريدة AJGT وسيطها 7 كلمات. والنص القصير صعب على أي نموذج، لأن الدليل فيه قليل، فكلمة واحدة تحسم القرار.
- الإيموجي شبه غائب: 115 تغريدة فقط في ASTD، وصفر في AJGT، والأغلب أن من جمعها نظفها. وهذا مهم لنا لأن ردود العملاء اليوم مليئة بالإيموجي، فالنموذج الذي يتدرب على هذه البيانات لن يعرف معنى 😡.
- عينة AJGT في آخر المخرج تكشف أشياء لا تراها في الأرقام. فالتغريدة «اخ يا بطني عورني من الضحكك» مصنفة سلبية، وهي في الحقيقة ضحك ومدح، وقد يكون من صنفها قرأ «عورني» فقط. و«ما يستحون هم جايين لو انا منهم اروح اقشر بصل» سخرية مصنفة سلبية وهذا صحيح، ولكن السلبية فيها تأتي من المعنى كله أكثر من كلمة بعينها. أي أن التصنيف البشري نفسه فيه أخطاء، والنموذج الذي يصل إلى 100% على هذه البيانات يكون قد حفظ الأخطاء أيضاً.
وهناك ملاحظة لا تظهر في المخرج لأننا أخفيناها عمداً: عندما طبعنا عينات من ASTD كانت أغلبها سياسية، عن أحداث مصر في 2013، وبعضها فيه شتائم ووسوم سياسية لا نريد نشرها، ولذلك لم نطبع عينة منها. وهذه المعلومة سوف تفسر لنا بعد قليل لماذا يتعلم النموذج أسماء سياسيين كدليل على الغضب.
الفكرة الأولى: قاموس الكلمات Sentiment Lexicon
قبل أي تعلم آلة، أول ما يخطر لأي مطور هو قائمتان: كلمات إيجابية مثل «حلو» و«ممتاز» و«شكرا»، وكلمات سلبية مثل «سيء» و«فاشل» و«زفت»، ثم نعد في كل رد كم كلمة من كل قائمة، والفائز يحدد القرار. وهذه الطريقة لها اسم هو التحليل بالقاموس Lexicon-Based Analysis، وهي ليست فكرة ضعيفة كما قد تظن، فهناك قواميس مشاعر عربية منشورة في البحوث بآلاف الكلمات، وميزتها أنك تستطيع أن تشرح كل قرار: «سلبي لأن فيه كلمة فاشل». ولكي نعرف حدودها بالأرقام، كتبنا قاموساً صغيراً من 24 كلمة لكل جهة، وأضفنا قاعدة نفي بسيطة: إذا جاءت كلمة النفي «مو» أو «مش» أو «ما» قبل الكلمة مباشرة نقلب إشارتها:
# Step 2a: the first idea everyone tries: a word list, with and without a negation rule
from common import load_ajgt, normalize

POS = {"حلو", "حلوه", "جميل", "جميله", "رائع", "رائعه", "ممتاز", "ممتازه", "احسن", "افضل", "شكرا", "الحمد",
       "مبروك", "يسلمو", "تسلم", "ابداع", "روعه", "احب", "بحب", "فرحه", "سعاده", "نجاح", "خير", "الله"}
NEG = {"سيء", "سيئه", "زفت", "فاشل", "فاشله", "فشل", "تخلف", "حرام", "ظلم", "كذب", "حزن", "مشكله", "غلط",
       "سخيف", "سخافه", "خساره", "قرف", "مقرف", "فساد", "حراميه", "اسوا", "تعبان", "زعلان", "ضد"}
NEGATORS = {"مو", "مش", "ما", "لا", "ليس", "مب", "موب", "مافي", "ماهو"}

def score(text, negation):
    words, s = normalize(text).split(), 0
    for i, w in enumerate(words):
        w = w[1:] if w.startswith("و") and w[1:] in POS | NEG else w      # «وحلو» -> «حلو»
        v = 1 if w in POS else -1 if w in NEG else 0
        if negation and v and i > 0 and words[i - 1] in NEGATORS:
            v = -v                                                       # «مو حلو» flips
        s += v
    return s

ajgt = load_ajgt()
for negation in (False, True):
    s = ajgt["text"].map(lambda t: score(t, negation))
    hit = s != 0
    acc_hit = ((s[hit] > 0) == (ajgt["label"][hit] == "POS")).mean()
    acc_all = ((s > 0) == (ajgt["label"] == "POS")).mean()             # no word found counts as negative
    print(f"negation rule={negation}: tweets with a list word {hit.mean():.1%}, accuracy on those {acc_hit:.3f}, on all {acc_all:.3f}")
for t in ["التحديث مو ممتاز", "ما قصرتوا والله", "مو سيء", "التطبيق حلو بس الدفع يعلق"]:
    print(score(t, True), t)
والمخرج سوف يكون كما يلي:
negation rule=False: tweets with a list word 30.9%, accuracy on those 0.727, on all 0.611
negation rule=True: tweets with a list word 30.8%, accuracy on those 0.742, on all 0.616
-1 التحديث مو ممتاز
1 ما قصرتوا والله
1 مو سيء
1 التطبيق حلو بس الدفع يعلق
في المخرج أعلاه لاحظ التالي:
- أكبر مشكلة ليست الدقة، وإنما التغطية Coverage: 30.9% فقط من التغريدات فيها كلمة واحدة على الأقل من القاموس. أي أن سبعين بالمئة من الردود لا يعرف القاموس عنها شيئاً، وعلى كل البيانات الدقة 0.611، قريبة من رمي عملة. ولو كبرنا القاموس إلى ألف كلمة سوف ترتفع التغطية، ولكن اللهجات لا تنتهي، فكل منطقة لها كلماتها للمدح والذم، «يهبل» و«خرافي» و«تحفة» و«بايخ» و«ماله داعي».
- على التغريدات التي وجد فيها كلمة، الدقة 0.727، وقاعدة النفي رفعتها إلى 0.742 فقط. فالنفي مهم، ولكن النفي المباشر قبل الكلمة قليل نسبياً في البيانات، والنفي الحقيقي غالباً أبعد، «ما كان التحديث بهذا الجمال».
- «التحديث مو ممتاز» خرجت -1، وهذا صحيح بفضل القاعدة. و«ما قصرتوا والله» خرجت +1، وهذا صحيح، ولكن لسبب خاطئ: القاموس لا يعرف «قصرتوا»، ووجد «الله» داخل «والله» في قائمة الإيجابي. وهذه هي مشكلة القواعد اليدوية: تعطيك الجواب الصحيح أحياناً بالصدفة، فتظن أنها تعمل.
- «مو سيء» خرجت +1 بفضل قلب النفي، وهذا صحيح هنا، ولكن نفس القاعدة تقلب «مو بس سيء، زفت» إلى إيجابي. و«التطبيق حلو بس الدفع يعلق» خرجت +1، لأن «يعلق» ليست في القاموس، وهي بالضبط الشكوى التي يريدها فريق المنتج.
فالقاموس يصلح كأداة مساعدة، مثل قاعدة الإيموجي التي سوف نقترحها لاحقاً، أو كطريقة سريعة لتصفية الردود التي فيها كلمات قوية جداً، ولكنه لا يصلح كمصنف رئيسي لردود بلهجات مختلفة. والخطوة التالية أن نترك البيانات المصنفة تختار الكلمات وأوزانها بدلاً عنا، وهذا ما يفعله التعلم الآلي.
خط الأساس TF-IDF Baseline
قبل أي نموذج كبير نحتاج خط أساس Baseline بسيطاً، لسببين: الأول أنه يقول لنا كم يستحق النموذج الكبير، فإذا كان الفرق بينهما صغيراً فلماذا ندفع ثمن الكبير؟ والثاني أن خط الأساس سريع ويمكن فهمه، فنعرف منه ماذا في البيانات. والطريقة التي اخترناها اسمها TF-IDF، وهي اختصار تكرار المصطلح في المستند Term Frequency مضروباً في معكوس تكرار المستندات Inverse Document Frequency. والفكرة أن كل تغريدة تتحول إلى متجه، فيه رقم لكل كلمة أو جزء، والرقم كبير إذا تكررت الكلمة في التغريدة، وصغير إذا كانت الكلمة موجودة في كل التغريدات مثل «من» و«في». وبعد ذلك يتعلم الانحدار اللوجستي وزناً لكل كلمة، موجباً للإيجابي وسالباً للسلبي، والقرار مجموع الأوزان. وهي قريبة من فكرة Naive Bayes التي شرحناها في مقال كشف الرسائل المزعجة، والفرق أن الانحدار اللوجستي يتعلم الأوزان معاً بدل أن يحسب كل كلمة وحدها.
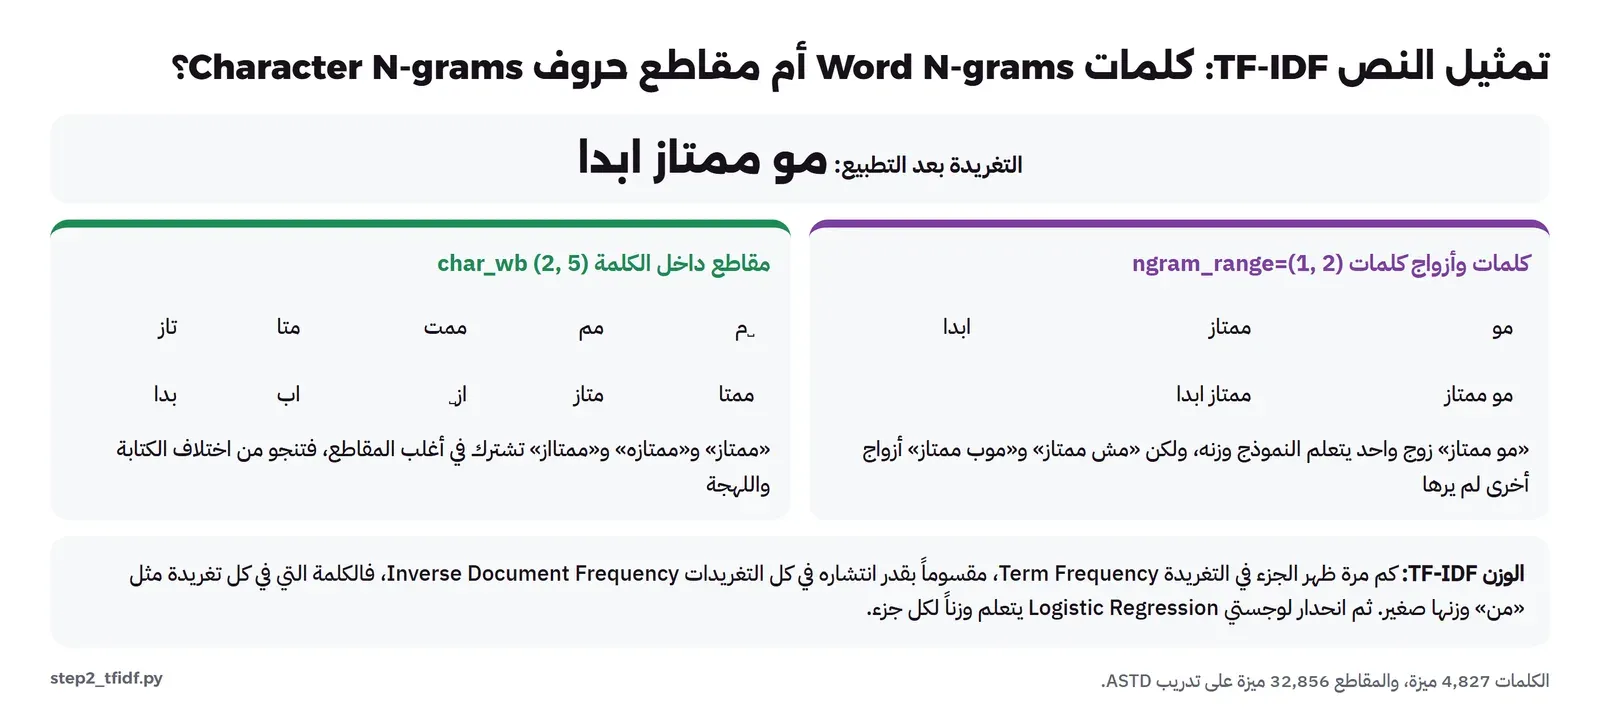
وهناك قرار مهم في TF-IDF: ما هي الوحدة؟ الكلمة، أم أزواج الكلمات، أم مقاطع الحروف؟ وفي العربية لهذا القرار أثر كبير، لأن الكلمة الواحدة لها أشكال كثيرة بالسوابق واللواحق والإملاء واللهجة، «ممتاز» و«ممتازه» و«والممتاز» و«ممتااز»، وكل شكل كلمة مختلفة في عد الكلمات. أما مقاطع الحروف Character N-grams، أي كل سلسلة من حرفين إلى خمسة أحرف داخل الكلمة، فتجعل هذه الأشكال تشترك في أغلب مقاطعها. والخيار char_wb في TfidfVectorizer يأخذ المقاطع داخل حدود الكلمة فقط، فلا يخلط آخر كلمة بأول التي بعدها.
ونقتصر في كل التجارب على إيجابي مقابل سلبي، ونترك المحايد والمختلط والموضوعي، لأن AJGT فيها فئتان فقط، ونريد أن نقارن على نفس السؤال. وهذا كود الخطوة الثانية:
# Step 2: the TF-IDF baseline, inside one dataset and across dialects (positive vs negative only)
import time
import numpy as np
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.model_selection import train_test_split, cross_val_score, StratifiedKFold
from sklearn.metrics import classification_report, f1_score
from common import load_astd, load_ajgt, normalize

astd = load_astd(); astd = astd[astd["label"].isin(["POS", "NEG"])].copy()
ajgt = load_ajgt()
for df in (astd, ajgt):
    df["clean"] = df["text"].map(normalize)

def model(kind):
    if kind == "word":   # words and word pairs; the token rule keeps emoji as tokens
        vec = TfidfVectorizer(ngram_range=(1, 2), min_df=2, sublinear_tf=True, token_pattern=r"\S+")
    else:                # character pieces inside words: survives spelling and dialect variation better
        vec = TfidfVectorizer(analyzer="char_wb", ngram_range=(2, 5), min_df=2, sublinear_tf=True)
    return make_pipeline(vec, LogisticRegression(max_iter=3000, class_weight="balanced"))

tr, te = train_test_split(astd, test_size=0.2, stratify=astd["label"], random_state=42)
print(f"ASTD positive/negative: train {len(tr)}, test {len(te)} ({(te['label'] == 'NEG').mean():.0%} negative)")
for kind in ("word", "char"):
    t = time.perf_counter()
    m = model(kind).fit(tr["clean"], tr["label"])
    pred = m.predict(te["clean"])
    print(f"-- {kind} n-grams, trained in {time.perf_counter() - t:.1f} s, features {len(m[0].vocabulary_)}")
    print(classification_report(te["label"], pred, digits=3))
    if kind == "word":
        coef, names = m[1].coef_[0], m[0].get_feature_names_out()      # classes_ = [NEG, POS]
        words = lambda idx: [n for n in names[idx] if not n.startswith("#")][:12]   # hashtags hidden (political slogans)
        print("most positive:", " | ".join(words(np.argsort(coef)[::-1][:30])))
        print("most negative:", " | ".join(words(np.argsort(coef)[:30])))
    # the same model on Jordanian tweets it never saw
    t = time.perf_counter(); pj = m.predict(ajgt["clean"]); dt = time.perf_counter() - t
    print(f"   predicted {len(ajgt)} tweets in {dt:.2f} s ({len(ajgt) / dt:,.0f} tweets/s)")
    print(f"   on AJGT (other dialect): accuracy {(pj == ajgt['label']).mean():.3f}, macro F1 {f1_score(ajgt['label'], pj, average='macro'):.3f}")

cv = StratifiedKFold(5, shuffle=True, random_state=42)
for kind in ("word", "char"):
    s = cross_val_score(model(kind), ajgt["clean"], ajgt["label"], cv=cv, scoring="accuracy")
    print(f"AJGT trained on AJGT, 5-fold, {kind}: accuracy {s.mean():.3f} (folds {' '.join(f'{x:.3f}' for x in s)})")
والمخرج سوف يكون كما يلي:
ASTD positive/negative: train 1986, test 497 (68% negative)
-- word n-grams, trained in 0.3 s, features 4827
              precision    recall  f1-score   support

         NEG      0.818     0.828     0.823       337
         POS      0.628     0.613     0.620       160

    accuracy                          0.759       497
   macro avg      0.723     0.720     0.722       497
weighted avg      0.757     0.759     0.758       497

most positive: الله | شكرا | :) | ♡ | اللهم | تحيه | انك | احسن | افضل | ، | رائعه | لي
most negative: الاخوان | الانقلاب | مرسي | علي | ده | لم | مش | من | بس | هل | لا | قانون
   predicted 1800 tweets in 0.09 s (20,824 tweets/s)
   on AJGT (other dialect): accuracy 0.717, macro F1 0.716
-- char n-grams, trained in 3.7 s, features 32856
              precision    recall  f1-score   support

         NEG      0.875     0.849     0.861       337
         POS      0.700     0.744     0.721       160

    accuracy                          0.815       497
   macro avg      0.787     0.796     0.791       497
weighted avg      0.818     0.815     0.816       497

   predicted 1800 tweets in 0.41 s (4,405 tweets/s)
   on AJGT (other dialect): accuracy 0.726, macro F1 0.722
AJGT trained on AJGT, 5-fold, word: accuracy 0.834 (folds 0.850 0.839 0.875 0.819 0.786)
AJGT trained on AJGT, 5-fold, char: accuracy 0.864 (folds 0.864 0.853 0.886 0.864 0.853)
في المخرج أعلاه لاحظ التالي:
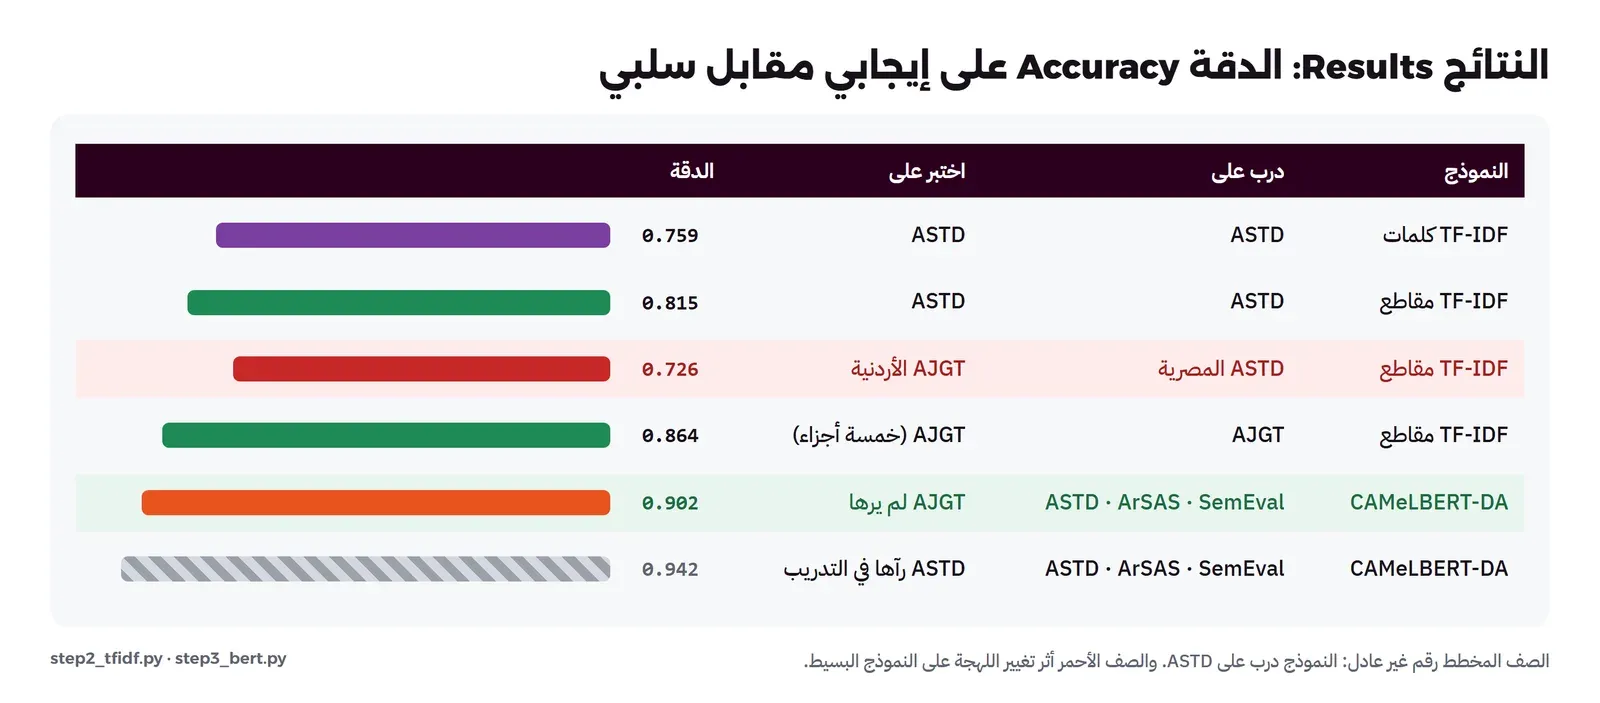
- بعد إبقاء الإيجابي والسلبي فقط في ASTD بقيت 2,483 تغريدة، 1,986 للتدريب و497 للاختبار، و68% من الاختبار سلبي. فالنموذج الذي يقول «سلبي» دائماً يحصل على دقة 0.68، وهذا هو الحد الأدنى الذي يجب أن نتجاوزه، وليس 0.5.
- نموذج الكلمات دقته 0.759، ولكن الأهم الصف
POS: الضبط 0.628 والاستدعاء 0.613، أي أن النموذج يخطئ في قرابة 40% من التغريدات الإيجابية. والسبب أن الإيجابي قليل في التدريب، 639 تغريدة تقريباً، ولذلك وضعناclass_weight="balanced"حتى لا يميل النموذج كلياً إلى الفئة الكبيرة. - أقوى الكلمات الإيجابية: «الله» و«شكرا» و«اللهم» و«:)» و«♡» و«تحيه» و«احسن» و«افضل» و«رائعه». وهذه منطقية، ولاحظ أن الرمز
:)والقلب دخلا لأن قاعدة التقطيع في هذا النموذج تقبل أي سلسلة غير المسافة. وأخفينا من القائمة الوسوم Hashtags لأن أقواها شعارات سياسية. - أقوى الكلمات السلبية تكشف مشكلة البيانات: «الاخوان» و«الانقلاب» و«مرسي» و«قانون»، أي أسماء وأحداث سياسية، ثم «مش» و«لم» و«لا» و«بس» و«هل». فالنموذج تعلم أن الكلام عن السياسة في تلك السنة غاضب غالباً، وهذا صحيح في هذه البيانات وعديم الفائدة لردود تطبيق. وتعلم أن أدوات النفي علامة سلبية بذاتها، وسوف نرى ثمن ذلك في «ما قصرتوا».
- مقاطع الحروف رفعت الدقة من 0.759 إلى 0.815، والضبط في الإيجابي من 0.628 إلى 0.700، وعدد الميزات من 4,827 إلى 32,856. والتدريب أبطأ، 11.2 ثانية بدل 0.7، ولكنه ما زال ثوان.
- التوقع على 1,800 تغريدة أخذ 0.09 ثانية بالكلمات و0.41 ثانية بالمقاطع، أي آلاف التغريدات في الثانية على المعالج، وتذكر هذا الرقم عندما نصل إلى BERT.
تغير اللهجة Dialect Shift: من المصرية إلى الأردنية
الآن السطر الأهم في المخرج: on AJGT (other dialect). فقد أخذنا نفس النموذج المدرب على ASTD المصرية، وطبقناه على 1,800 تغريدة أردنية لم يرها، فانخفضت الدقة إلى 0.717 بالكلمات و0.726 بالمقاطع، أي قرابة تسع نقاط أقل من اختباره على المصرية. وهذا ما سوف يحدث لك بالضبط إذا أخذت نموذجاً دربه غيرك على لهجة أو موضوع آخر وشغلته على ردود عملائك: الأرقام المنشورة معه لن تكون أرقامك. والسبب في TF-IDF واضح، فالنموذج يعرف الكلمات التي رآها فقط، و«مش» المصرية التي تعلمها لا تفيده في «مو» الخليجية، و«بحكي» و«هسا» الأردنية لم يرها أصلاً.
وفي آخر سطرين دربنا النموذج على AJGT نفسها وقيمناه بالتحقق المتقاطع Cross Validation بخمسة أجزاء، أي نقسم البيانات خمسة أقسام، وندرب على أربعة ونختبر على الخامس، ونكرر خمس مرات. والنتيجة 0.834 بالكلمات و0.864 بالمقاطع، والفرق بين الأجزاء الخمسة من 0.786 إلى 0.875 بالكلمات، وهذا تذبذب يجب أن تعرفه: رقم واحد من تقسيم واحد قد يبعد عن الحقيقة بأربع نقاط في بيانات بهذا الحجم. والدرس من القسم كله: 1,800 تغريدة مصنفة من نفس اللهجة أفادت أكثر من 2,483 تغريدة من لهجة أخرى، فالبيانات القريبة من الاستخدام أهم من البيانات الأكثر.
النموذج المدرب مسبقاً CAMeLBERT على CPU
النماذج المدربة مسبقاً Pretrained Models من عائلة BERT تحل مشكلة الكلمات غير المرئية بطريقة مختلفة. فالنموذج يتدرب أولاً على كمية ضخمة من النص دون أي تصنيف، فيتعلم كيف تستخدم الكلمات في سياقها، ثم يضبط Fine-tuning على مهمة محددة مثل المشاعر ببيانات مصنفة قليلة نسبياً. وقد شرحنا الفكرة العامة للنماذج اللغوية والانتباه Attention في كيف تعمل نماذج اللغة الكبيرة، والفرق أن BERT لا يولد نصاً، وإنما يقرأ الجملة كلها مرة واحدة ويعطي تمثيلاً لها، وفوقه طبقة صغيرة تصنف.
واخترنا CAMeLBERT-DA للمشاعر من مختبر CAMeL في جامعة نيويورك أبوظبي، وهو منشور برخصة Apache-2.0. وحرفا DA يعنيان العربية اللهجية Dialectal Arabic، فالنموذج الأساسي درب مسبقاً على 54 جيجابايت من نصوص اللهجات، وبحسب بطاقة النموذج ضبط بعد ذلك على ثلاث مجموعات للمشاعر: ASTD وArSAS وSemEval. وهذه المعلومة هي سبب اختيارنا لـ AJGT للاختبار: النموذج لم يرها، فهي اختبار عادل له، أما ASTD فقد رآها في الضبط، فأي رقم عليها سوف يكون أعلى من الحقيقة. والفريق شرح النماذج ونتائجها في ورقة منشورة في ورشة WANLP 2021، ومن نتائجها أن قرب لهجة بيانات التدريب المسبق من لهجة المهمة أهم من حجم البيانات.
# The pretrained CAMeLBERT-DA sentiment model (Apache-2.0), pinned to one revision, on CPU
import torch
from transformers import pipeline

MODEL = "CAMeL-Lab/bert-base-arabic-camelbert-da-sentiment"
REVISION = "b0df630d23e5aa5f8a326017605337f6d0863ecd"

def load():
    return pipeline("text-classification", model=MODEL, revision=REVISION, top_k=None, device="cpu")

def scores(clf, texts, batch_size=32):
    """one dict per text: {'positive': p, 'negative': p, 'neutral': p}"""
    out = clf(list(texts), batch_size=batch_size, truncation=True, max_length=128)
    return [{d["label"]: d["score"] for d in row} for row in out]
# Step 3: the pretrained Arabic model on the Jordanian tweets it was never trained on
import time
import pandas as pd
import torch, transformers
from sklearn.metrics import classification_report, confusion_matrix
from sklearn.model_selection import train_test_split
from common import load_astd, load_ajgt
from bert import load, scores
print("torch", torch.__version__, "| transformers", transformers.__version__, "| CPU threads", torch.get_num_threads())
t = time.perf_counter(); clf = load(); print(f"model loaded in {time.perf_counter() - t:.1f} s")
print("parameters:", f"{sum(p.numel() for p in clf.model.parameters()):,}")
ajgt = load_ajgt()
t = time.perf_counter(); s = scores(clf, ajgt["text"]); dt = time.perf_counter() - t
print(f"AJGT: {len(ajgt)} tweets in {dt:.1f} s ({len(ajgt) / dt:.1f} tweets/s)")
ajgt["top"] = [max(x, key=x.get) for x in s]
ajgt["pos"] = [x["positive"] for x in s]; ajgt["neg"] = [x["negative"] for x in s]
print("3-class output:", ajgt["top"].value_counts().to_dict())
ajgt["pred"] = (ajgt["pos"] > ajgt["neg"]).map({True: "POS", False: "NEG"}) # positive vs negative only
print(confusion_matrix(ajgt["label"], ajgt["pred"], labels=["NEG", "POS"]))
print(classification_report(ajgt["label"], ajgt["pred"], digits=3))
ajgt.to_pickle("outs/ajgt_bert.pkl")
# what if we test on ASTD? the model was fine-tuned on ASTD, so this number is not a fair test
astd = load_astd(); astd = astd[astd["label"].isin(["POS", "NEG"])]
_, te = train_test_split(astd, test_size=0.2, stratify=astd["label"], random_state=42)
st = scores(clf, te["text"])
pred = ["POS" if x["positive"] > x["negative"] else "NEG" for x in st]
print(f"ASTD test split (seen in fine-tuning): accuracy {(pd.Series(pred, index=te.index) == te['label']).mean():.3f}")والمخرج سوف يكون كما يلي:
torch 2.15.0+cpu | transformers 5.22.1 | CPU threads 4
model loaded in 174.4 s
parameters: 109,083,651
AJGT: 1800 tweets in 250.3 s (7.2 tweets/s)
3-class output: {'positive': 844, 'negative': 838, 'neutral': 118}
[[804  96]
 [ 81 819]]
              precision    recall  f1-score   support

         NEG      0.908     0.893     0.901       900
         POS      0.895     0.910     0.902       900

    accuracy                          0.902      1800
   macro avg      0.902     0.902     0.902      1800
weighted avg      0.902     0.902     0.902      1800

ASTD test split (seen in fine-tuning): accuracy 0.942
في المخرج أعلاه لاحظ التالي:
- ثبتنا النموذج بمراجعة Revision محددة بالهاش في
bert.py، لأن صاحب النموذج يستطيع أن يرفع نسخة جديدة بنفس الاسم، فتتغير نتائجك دون أن تغير سطراً. - تحميل النموذج أخذ 174.4 ثانية في أول تشغيل، وأغلبها تنزيل 440 ميجابايت. وفي التشغيلات التالية يقرأ من الـ Volume في ثوان.
- النموذج فيه 109 ملايين معامل Parameter تقريباً، وهو حجم BERT الأساسي. وعلى 4 خيوط Threads في المعالج صنف 1,800 تغريدة في 250 ثانية، أي 7.2 تغريدة في الثانية، مقابل آلاف في الثانية لـ TF-IDF. والجهاز كان يشغل أعمالاً أخرى في نفس الوقت، فالرقم على جهاز مخصص أعلى، ولكن الفرق بين النموذجين يبقى مئات المرات.
- النموذج يعطي ثلاث فئات، وصنف 118 تغريدة من 1,800 محايدة، رغم أن AJGT ليس فيها محايد. ولكي نقارن على نفس السؤال، نأخذ الأعلى بين الإيجابي والسلبي فقط ونتجاهل المحايد.
- الدقة على AJGT 0.902، والفئتان متوازنتان: 96 سلبية صنفها إيجابية، و81 إيجابية صنفها سلبية. وهذا أعلى من TF-IDF المدرب على AJGT نفسها، 0.864، رغم أن BERT لم ير تغريدة أردنية واحدة مصنفة. وأعلى بكثير من TF-IDF المدرب على المصرية، 0.726. وهذا هو المكسب الحقيقي للنموذج المدرب مسبقاً: يتحمل تغير اللهجة لأنه رأى اللهجات في التدريب المسبق.
- آخر سطر هو تجربة «ماذا لو» على التقييم نفسه: على قسم الاختبار من ASTD أعطى 0.942. وهذا رقم لا نستخدمه للمقارنة، لأن النموذج ضبط على ASTD، والأرجح أنه رأى بعض هذه التغريدات بعينها. ولو وضعنا هذا الرقم في تقرير لقارنا خط أساس لم ير الاختبار بنموذج رآه.
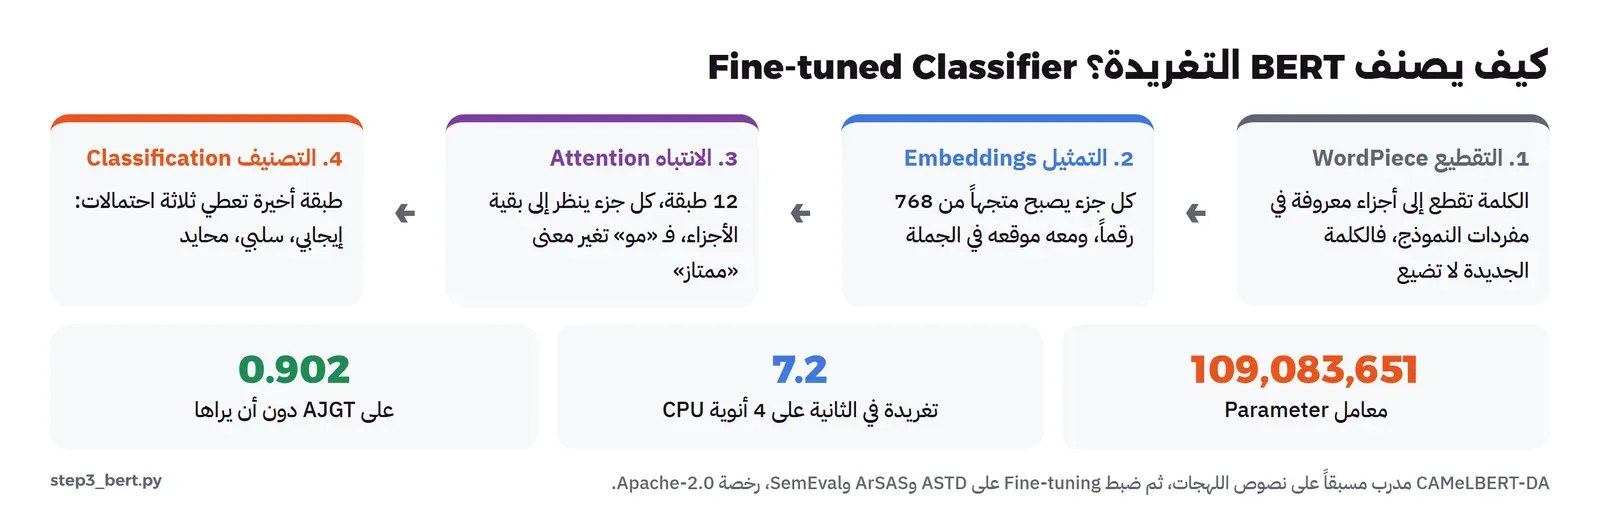
وفي داخل النموذج، التقطيع WordPiece يقسم الكلمة غير المعروفة إلى أجزاء معروفة من مفردات حجمها 30,000 جزء، فلا توجد كلمة «غير مرئية» تماماً كما في TF-IDF. ثم يتحول كل جزء إلى متجه من 768 رقماً، وتمر المتجهات على 12 طبقة انتباه، في كل طبقة ينظر كل جزء إلى بقية أجزاء الجملة ويعدل تمثيله بناءً عليها. وهذا ما يسمح للنموذج أن يفهم أن «ممتاز» بعد «مو» ليست مدحاً، وهو ما لا يستطيعه نموذج يعد الكلمات منفصلة.
الحالات الصعبة Hard Cases: النفي والسخرية والإيموجي
الأرقام على البيانات العامة تقول إن CAMeLBERT أفضل، ولكن سؤال مدير المنتج عن ردود عملاء تطبيقنا، بلهجة خليجية غالباً، وفيها إيموجي، وليست تغريدات سياسية من 2013. ولأنه ليس عندنا بعد ردود مصنفة، كتبنا عشرة ردود بأنفسنا تمثل ما يصلنا فعلاً، وكتبنا بجانب كل منها قراءتنا لها، ثم مررناها على النموذجين. ودربنا TF-IDF هذه المرة على كل ما عندنا، ASTD وAJGT معاً، حتى نعطيه أفضل فرصة:
# Step 4: negation, sarcasm, emoji and mixed replies, written by us in Gulf dialect, through both models
import pandas as pd
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from common import load_astd, load_ajgt, normalize
from bert import load, scores

astd = load_astd(); astd = astd[astd["label"].isin(["POS", "NEG"])]
train = pd.concat([astd, load_ajgt()])                       # every labelled tweet we have
tfidf = make_pipeline(TfidfVectorizer(analyzer="char_wb", ngram_range=(2, 5), min_df=2, sublinear_tf=True),
                      LogisticRegression(max_iter=3000, class_weight="balanced"))
tfidf.fit(train["text"].map(normalize), train["label"])
pos_col = list(tfidf.classes_).index("POS")

probes = [  # (our own reading, text)
    ("POS", "التحديث الجديد ممتاز والتطبيق صار اسرع"),
    ("NEG", "التحديث الجديد مو ممتاز ابدا"),
    ("NEG", "ما عجبني التحديث"),
    ("POS", "ما قصرتوا والله"),
    ("POS", "مو سيء"),
    ("NEG", "يا سلام على السرعة، الطلب وصل بعد ثلاث ساعات 👏"),
    ("NEG", "خدمة العملاء ما ترد 😡"),
    ("POS", "😍😍"),
    ("NEG", "التطبيق حلو بس الدفع يعلق كل مرة"),
    ("POS", "الله يعطيكم العافية على سرعة الرد"),
]
bert = load()
b = scores(bert, [t for _, t in probes])
t = tfidf.predict_proba([normalize(t) for _, t in probes])[:, pos_col]
print("ours  tfidf p(pos)  bert pos/neg/neutral       text")
for (want, text), tp, bp in zip(probes, t, b):
    print(f"{want}   {tp:5.2f}            {bp['positive']:.2f}/{bp['negative']:.2f}/{bp['neutral']:.2f}   {text}")
والمخرج سوف يكون كما يلي:
ours  tfidf p(pos)  bert pos/neg/neutral       text
POS    0.46            0.97/0.01/0.02   التحديث الجديد ممتاز والتطبيق صار اسرع
NEG    0.48            0.09/0.69/0.22   التحديث الجديد مو ممتاز ابدا
NEG    0.40            0.06/0.47/0.48   ما عجبني التحديث
POS    0.47            0.99/0.01/0.00   ما قصرتوا والله
POS    0.29            0.06/0.85/0.09   مو سيء
NEG    0.50            0.96/0.02/0.02   يا سلام على السرعة، الطلب وصل بعد ثلاث ساعات 👏
NEG    0.57            0.03/0.41/0.56   خدمة العملاء ما ترد 😡
POS    0.57            0.28/0.09/0.63   😍😍
NEG    0.42            0.50/0.08/0.42   التطبيق حلو بس الدفع يعلق كل مرة
POS    0.76            0.99/0.00/0.00   الله يعطيكم العافية على سرعة الرد
وسوف نقرأ الردود في مجموعات، لأن كل مجموعة تختبر شيئاً مختلفاً.
النفي Negation
«التحديث الجديد مو ممتاز ابدا» أخذت عند BERT 0.69 سلبي، وهذا صحيح، أما TF-IDF فأعطاها 0.48 إيجابي، أي لا يعرف، لأن «ممتاز» تدفع للإيجابي و«مو» تدفع للسلبي وتلغيان بعضهما. و«ما قصرتوا والله» عبارة شكر شائعة جداً في الخليج، شكلها نفي ومعناها مدح، فأعطاها BERT 0.99 إيجابي، وTF-IDF 0.47، لأنه تعلم من ASTD أن «ما» وأخواتها علامة سلبية. أما «مو سيء» فأخطأ فيها النموذجان: BERT أعطاها 0.85 سلبي، وTF-IDF 0.29 إيجابي، أي سلبية أيضاً. والسبب أن «سيء» دليل سلبي قوي، ونفي الكلمة السلبية أقل شيوعاً في بيانات التدريب من نفي الإيجابية، فالنموذج لم يتعلمه جيداً. و«ما عجبني التحديث» صنفها BERT محايدة بفارق صغير جداً، 0.48 محايد مقابل 0.47 سلبي، فإذا قارنا الإيجابي بالسلبي فقط خرجت سلبية، ولكن النموذج غير متأكد في جملة يفهمها أي طفل.
السخرية Sarcasm
«يا سلام على السرعة، الطلب وصل بعد ثلاث ساعات 👏» أخذت عند BERT 0.96 إيجابي، أي أنه متأكد أنها مدح. وهذا أسوأ خطأ في الجدول، لأن الثقة عالية والمعنى عكسي تماماً. فالسخرية تحتاج معرفة لا توجد في الجملة: أن ثلاث ساعات للتوصيل كثير، وأن التصفيق هنا تهكم. والنموذج يرى «يا سلام» و«السرعة» و👏 فيقرر. وTF-IDF أعطاها 0.50، أي لا يعرف، وهذا أقل ضرراً من الخطأ الواثق. ولا يوجد حل بسيط للسخرية، وقد رأينا في عينة AJGT أعلاه أن حتى التصنيف البشري يختلف فيها. والحل العملي في التقرير الأسبوعي أن نعرض الردود التي صنفها النموذج إيجابية وفيها كلمات شكوى، مثل «ساعات» و«تأخير»، لإنسان يراجعها.
الإيموجي Emoji
«😍😍» وحدها أخذت عند BERT 0.63 محايد و0.28 إيجابي، و«خدمة العملاء ما ترد 😡» أخذت 0.56 محايد و0.41 سلبي، فكلاهما يميل إلى المحايد، أي أن النموذج لا يعرف معنى الوجه الغاضب ولا القلوب. والسبب ما رأيناه في الخطوة الأولى: ASTD فيها 115 تغريدة بإيموجي، وAJGT صفر، والأغلب أن بيانات الضبط الأخرى نظفت منه، فالنموذج لم يتعلم أن 😡 غضب. وTF-IDF أعطى 😍😍 0.57 إيجابي، وهو صحيح بالصدفة تقريباً، لأن مقاطع الحروف لا تجد إيموجي في التدريب أصلاً، فالرقم قريب من الاحتمال المسبق. والحل في هذه الحالة سهل نسبياً: قائمة صغيرة من الإيموجي الشائعة مع معناها، تضاف كقاعدة بجانب النموذج، أو تتحول إلى كلمات قبل التصنيف، مثل 😡 إلى «غاضب».
الرد المختلط Mixed
«التطبيق حلو بس الدفع يعلق كل مرة» أخذت عند BERT 0.50 إيجابي و0.42 محايد و0.08 سلبي، أي أنه قرأ «حلو» ولم ير الشكوى. ولكن هذا النوع من الردود هو الأهم لفريق المنتج، لأن فيه مشكلة محددة، الدفع، في رد يبدو إيجابياً. ورد واحد له مشاعر مختلفة تجاه أجزاء مختلفة، وهذه مسألة لها اسم هو تحليل المشاعر على مستوى الجانب Aspect-Based Sentiment Analysis، أي أن تصنف المشاعر تجاه كل جانب، الدفع والتوصيل والسرعة، وليس الرد كله. وهي أصعب، وتحتاج بيانات مصنفة بالجوانب، ولكنك تستطيع أن تقترب منها بخطوة بسيطة: قسم الرد عند «بس» و«لكن» و«بينما»، وصنف كل جزء وحده.
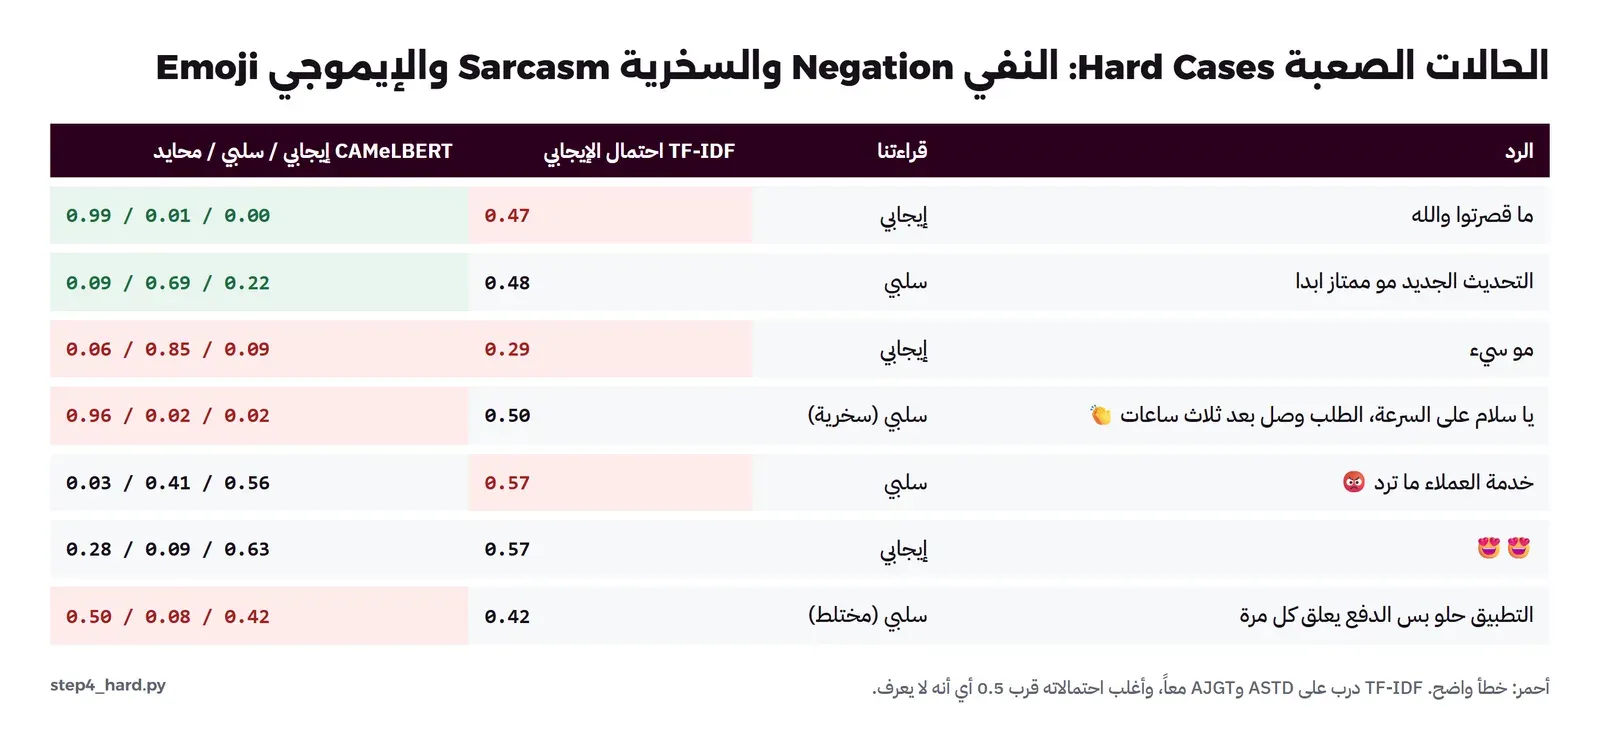
ولاحظ في عمود TF-IDF أن أغلب الأرقام بين 0.40 و0.57، حتى في الردود الواضحة مثل «التحديث الجديد ممتاز والتطبيق صار اسرع» التي أخذت 0.46. فالنموذج المدرب على تغريدات سياسية مصرية وأردنية لا يعرف لغة تطبيق خليجي، وهذا يعيدنا إلى درس تغير اللهجة. والرد الوحيد الذي صنفه بثقة هو «الله يعطيكم العافية على سرعة الرد» بـ 0.76، لأن «الله» كانت أقوى كلمة إيجابية في ASTD.
الأخطاء الحقيقية Honest Errors على AJGT
الردود التي كتبناها عشرة فقط، فلننظر إلى أخطاء BERT على 1,800 تغريدة حقيقية:
# Step 5: where the pretrained model is wrong on AJGT, and what if we normalise its input like the TF-IDF model
import pandas as pd
from common import normalize
from bert import load, scores

ajgt = pd.read_pickle("outs/ajgt_bert.pkl")
wrong = ajgt[ajgt["pred"] != ajgt["label"]].copy()
wrong["conf"] = (wrong["pos"] - wrong["neg"]).abs()
print(len(wrong), "errors;", int((wrong["conf"] > 0.8).sum()), "of them with a margin above 0.8")
print(wrong.groupby("label").size().rename("errors by true label").to_string())
pd.set_option("display.max_colwidth", 70)
short = wrong[wrong["text"].str.split().str.len().between(4, 12)]
print(short.sort_values("conf", ascending=False).head(12)[["label", "pos", "neg", "text"]].round(2).to_string(index=False))

clf = load()
s = scores(clf, ajgt["text"].map(normalize))
pred = ["POS" if x["positive"] > x["negative"] else "NEG" for x in s]
print(f"accuracy on raw text {(ajgt['pred'] == ajgt['label']).mean():.3f}, "
      f"on normalised text {(pd.Series(pred, index=ajgt.index) == ajgt['label']).mean():.3f}")
والمخرج سوف يكون كما يلي:
177 errors; 66 of them with a margin above 0.8
label
NEG    96
POS    81
label  pos  neg                                                                  text
  POS 0.00 1.00 الله يرحم هلبلاد من الحراميه والمتسلقين على قوت الشعب لك الله ياشعبنا
  NEG 0.99 0.00                                      انا مع الاخ محمد سلامه بهالموضوع
  NEG 1.00 0.00                               الله حيك شيخ ابراهيم بالفعل حكم يا نشمي
  POS 0.00 1.00                                                  عنجد الكذب اكبر ورطه
  NEG 0.99 0.00                              اعطيه علي راسي هدا الصح ياحاجه الله اكبر
  NEG 0.99 0.01                                 ما اجمل من مثل هذا الحُب الصادق الشفا
  NEG 0.99 0.00                وادم علينا يارب نعمه الامن والامان وسائر بلاد المسلمين
  POS 0.00 0.99                                          وياريت بتظبط الكذب ماوش رجلي
  NEG 0.99 0.01               يا ربي شو هالولد الله مجنون مبيستحييش متاكدين انو مغربي
  NEG 0.99 0.01                                           من ضحك عليك وحكالك صوتك حلو
  NEG 0.99 0.01                                                   واثق من نفسه الحبيب
  POS 0.01 0.98                                          يا هيك الاكل يا بلا لش الحكي
accuracy on raw text 0.902, on normalised text 0.904
في المخرج أعلاه لاحظ التالي:
- من 177 خطأ، هناك 66 بفارق أكبر من 0.8 بين الإيجابي والسلبي، أي أن النموذج كان واثقاً جداً وهو مخطئ في ثلث أخطائه تقريباً. وهذا يعني أن احتمال النموذج لا يصلح وحده لتحديد ما يراجعه الإنسان، فالخطأ الواثق لن يظهر في قائمة «غير المتأكد».
- عندما قرأنا الأخطاء الواثقة بأعيننا وجدنا ثلاثة أنواع. الأول أخطاء حقيقية في النموذج، مثل «الله حيك شيخ ابراهيم بالفعل حكم يا نشمي»، وهي مدح أردني واضح صنفته المجموعة سلبية والنموذج إيجابية، أي أن النموذج على الأرجح محق والتصنيف البشري هو الخطأ. ومثلها «واثق من نفسه الحبيب» و«ما اجمل من مثل هذا الحب الصادق»، وكلها مصنفة سلبية في البيانات.
- النوع الثاني السخرية، مثل «من ضحك عليك وحكالك صوتك حلو»، وهي سخرية مصنفة سلبية بحق، والنموذج قرأ «صوتك حلو» فأعطاها 0.99 إيجابي، وهو نفس خطأ رد التوصيل.
- النوع الثالث الدعاء على الظالم والكلام الديني، مثل «الله يرحم هلبلاد من الحراميه والمتسلقين على قوت الشعب» المصنفة إيجابية في البيانات وسلبية عند النموذج. والحقيقة أنها مختلطة، فيها دعاء وفيها غضب، وكل قارئ قد يصنفها بشكل مختلف.
- أي أن جزءاً من «الأخطاء» ليس أخطاء نموذج، وإنما خلاف على التصنيف نفسه أو خطأ فيه. ولذلك لا تتوقع من أي نموذج أن يصل إلى 100% على بيانات المشاعر، فالحد الأعلى هو اتفاق البشر أنفسهم، وفي المشاعر هذا الاتفاق أقل بكثير من 100%.
ماذا يحدث إذا طبعنا مدخل BERT؟ What If
آخر سطر في المخرج تجربة مقصودة: TF-IDF يحتاج التطبيع، توحيد الهمزات والتاء المربوطة والألف المقصورة، حتى لا تتشتت الكلمة الواحدة في أشكال، فهل يحتاجه BERT أيضاً؟ مررنا نفس التغريدات بعد دالة normalize من common.py، فأصبحت الدقة 0.904 بدل 0.902، أي تغيير في ثلاث أو أربع تغريدات فقط من 1,800، وهذا داخل حدود الصدفة. والسبب أن النموذج المدرب مسبقاً رأى في التدريب كل أشكال الكتابة، فتعلم أن «مدرسة» و«مدرسه» نفس الكلمة تقريباً. والدرس العملي: لا تنقل خطوات التنظيف من النموذج البسيط إلى الكبير دون قياس، فبعضها لا يفيد، وبعضها قد يضر، مثل حذف الإيموجي أو علامات الترقيم التي يفهم منها النموذج النبرة. والقاعدة: نظف للنموذج الكبير بنفس الطريقة التي نظفت بها بيانات تدريبه، وإذا لم تعرفها فأرسل النص كما هو.
أي نموذج تختار؟ TF-IDF or BERT
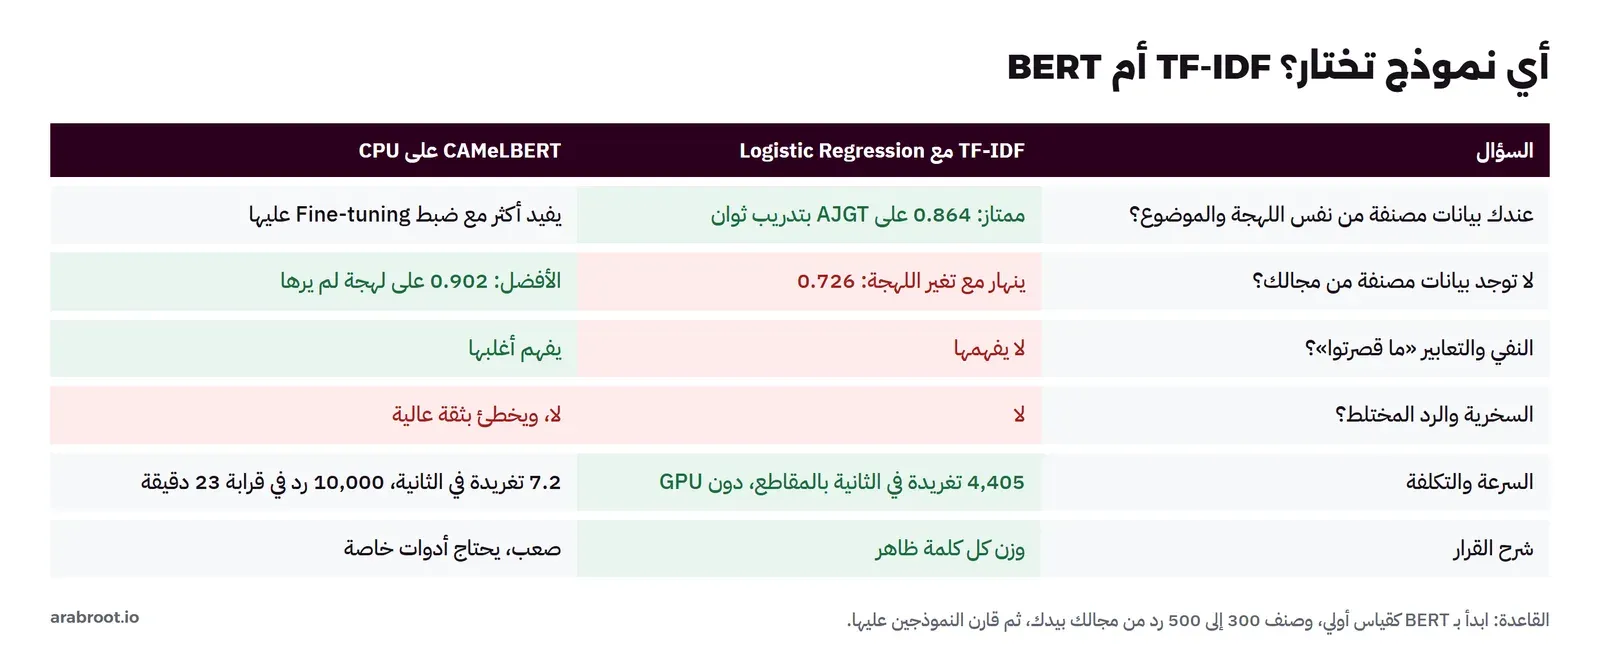
بعد هذه التجارب أصبح القرار لفريقنا واضحاً، ونلخصه كما في الجدول أعلاه. فإذا لم تكن عندك ردود مصنفة من مجالك، فالنموذج المدرب مسبقاً هو الاختيار الوحيد المعقول، لأن TF-IDF المدرب على لهجة أخرى ينهار. وعشرة آلاف رد في الأسبوع تحتاج قرابة 23 دقيقة على المعالج بسرعة 7.2 تغريدة في الثانية، وهذا مقبول تماماً لتقرير أسبوعي يعمل في الليل، ولا يحتاج بطاقة رسوميات. أما إذا كنت تريد التصنيف لحظياً على كل رد يصل، أو تملك ملايين النصوص، فالفرق بين 4,405 و7.2 تغريدة في الثانية يصبح مهماً، ويستحق أن تصنف بيدك بضع مئات من ردودك وتدرب عليها TF-IDF بمقاطع الحروف، فقد رأينا أن 1,800 تغريدة من نفس اللهجة أوصلته إلى 0.864.
وقد يسأل البعض: لماذا لا أرسل الردود إلى نموذج لغة كبير وأسأله؟ والإجابة أن ذلك ممكن، والنماذج الكبيرة تفهم السخرية أحياناً أفضل من BERT الصغير، ولكن الثمن تكلفة لكل رد، وإرسال ردود العملاء إلى خدمة خارجية، وصعوبة في الحصول على نفس الإجابة مرتين. وإذا أردت أن تجرب ذلك على جهازك دون إرسال البيانات للخارج، فقد شرحنا ما تحتاجه في تشغيل نماذج اللغة على جهازك. وفي كل الأحوال تحتاج نفس الشيء: عينة مصنفة بيد إنسان من ردودك، تقيس عليها كل الخيارات.
ماذا عن ضبط النموذج على بياناتك؟ Fine-tuning
النموذج الذي استخدمناه ضبطه غيرنا على تغريدات مصرية وغيرها، ولم نغير فيه شيئاً. والخطوة الطبيعية التالية عندما تجمع ردوداً مصنفة من مجالك أن تضبطه عليها، أي تكمل تدريب نفس النموذج بضع دورات Epochs على ردودك، فيتعلم أن «يعلق» شكوى، وأن 👏 بعد «ثلاث ساعات» سخرية. وهذا ممكن على المعالج لبضع مئات أو آلاف من الردود القصيرة، ولكنه أبطأ بكثير من التصنيف نفسه، لأن التدريب يحسب التدرجات Gradients لكل معامل من 109 ملايين، والتفاصيل في توثيق Transformers وأدلته. ولم نضبط النموذج في هذا المقال لأنه ليس عندنا بعد ردود مصنفة من مجال التطبيق، وضبطه على تغريدات أخرى لا يقربه من مسألتنا.
وقبل أن تضبط، انتبه لثلاثة أمور. الأول أن تفصل بيانات الاختبار قبل أي شيء، ولا تستخدمها في الضبط أبداً، وإلا تكرر خطأ ASTD الذي رأيناه. والثاني أن الضبط على بيانات قليلة قد ينسي النموذج ما تعلمه من قبل، فيتحسن على ردودك ويسوء على غيرها، ولذلك قارن قبل الضبط وبعده على عينة من AJGT أيضاً. والثالث أن الضبط يعطيك نموذجاً جديداً تحتاج أن تحفظه وتثبت إصداره وتعيد قياسه، فأصبح عندك نظام تديره وليس سطر pipeline واحداً.
التقرير الأسبوعي Weekly Report: من النموذج إلى الرقم
الرقم الذي يريده مدير المنتج ليس دقة النموذج، وإنما نسبة الردود السلبية هذا الأسبوع مقارنة بالأسبوع الماضي. وهنا يجب أن تنتبه لنقطتين. الأولى أن خطأ النموذج يدخل في هذه النسبة: فإذا كان النموذج يصنف 10% من الإيجابي سلبياً، فإن نسبة السلبي في التقرير ترتفع كلما زاد عدد الردود الإيجابية، وليس فقط عندما يغضب الناس. ولكن ما دام النموذج نفسه لم يتغير بين أسبوعين، فإن الاتجاه، صعوداً أو هبوطاً، أصدق من النسبة نفسها. ولذلك لا تغير النموذج في منتصف السلسلة دون أن تعيد حساب الأسابيع السابقة به.
والثانية أن الرقم وحده لا يكفي، فمع النسبة ضع في التقرير عينة من الردود السلبية الأكثر تكراراً، وعينة من الردود الإيجابية التي فيها «بس» أو «لكن»، لأن فيها المشاكل المحددة. والتصميم الذي نقترحه لفريقنا يعمل كما يلي:
- كل ليلة تسحب الردود الجديدة على حساب الجهة، وتحذف المكررة والردود الآلية.
- تمر الردود على CAMeLBERT، ويحفظ معها الاحتمالات الثلاثة وليس الفئة فقط.
- قاعدة صغيرة للإيموجي الشائعة تعدل القرار عندما يكون الرد إيموجي فقط أو ينتهي بإيموجي واضح.
- الرد الذي فيه «بس» أو «لكن» يقسم ويصنف كل جزء وحده.
- كل أسبوع يصنف موظف خمسين رداً عشوائياً بيده، وتقارن بتصنيف النموذج، فإذا انخفض الاتفاق عن المعتاد فهذا إنذار أن لغة الردود تغيرت، مثلاً بسبب مصطلح جديد أو حملة.
- بعد أشهر تكون عندك مئات الردود المصنفة من مجالك، وعندها تضبط النموذج عليها، أو تدرب TF-IDF أسرع وأرخص، وتقارن الاثنين على نفس العينة.
وهذه الخطوة الأخيرة هي التي تحول التجربة إلى نظام يتحسن. وللحساب الإحصائي للنسب وفترات الثقة حولها، والفرق بين تغير حقيقي وتذبذب عادي بين أسبوعين، ارجع إلى الإحصاء للمهندسين.
أخطاء شائعة Common Mistakes
- تقييم النموذج على بيانات رآها: CAMeLBERT على ASTD أعطى 0.942 لأنه ضبط عليها، والرقم العادل على AJGT 0.902. اقرأ بطاقة النموذج Model Card قبل أن تختار بيانات الاختبار.
- الثقة في أرقام لهجة أخرى: TF-IDF انخفض من 0.815 إلى 0.726 عندما تغيرت اللهجة.
- نسيان خط الأساس: دقة 0.68 على ASTD يحققها نموذج يقول «سلبي» دائماً، فقارن دائماً بأبسط نموذج ممكن.
- قراءة الاحتمال كثقة: ثلث أخطاء BERT على AJGT بفارق أكبر من 0.8، فالخطأ الواثق شائع.
- حذف الإيموجي في التنظيف: في ردود العملاء الإيموجي قد يكون الدليل الوحيد.
- اعتبار تصنيف البيانات حقيقة مطلقة: «اخ يا بطني عورني من الضحكك» مصنفة سلبية، وجزء من «أخطاء» النموذج أخطاء في التصنيف.
- تغيير النموذج في منتصف سلسلة التقارير: النسب الأسبوعية لا تقارن إذا تغير النموذج بينها.
- عدم تثبيت إصدار النموذج: اسم النموذج على Hugging Face قد يشير إلى نسخة جديدة غداً، فثبت المراجعة بالهاش.
قائمة تحقق Checklist قبل أول تقرير
- هل قرأت رخصة كل مجموعة بيانات وكل نموذج، وهل تسمح باستخدامك؟
- هل تعرف على ماذا درب النموذج المدرب مسبقاً، وهل بيانات اختبارك خارجها؟
- هل صنفت بيدك عينة من ردودك أنت، 300 رد على الأقل، وقست عليها كل الخيارات؟
- هل قارنت بخط أساس بسيط، وبنموذج يقول الفئة الأكبر دائماً؟
- هل اختبرت النفي باللهجة المحلية، «مو» و«ما» و«موب» و«مش»، والعبارات مثل «ما قصرتوا»؟
- هل عندك قاعدة للإيموجي الشائعة، وطريقة للردود المختلطة؟
- هل يحفظ النظام الاحتمالات الثلاثة وليس الفئة فقط؟
- هل الإصدارات مثبتة، والنموذج مثبت بالمراجعة، والتجربة تعاد بأمر واحد؟
- هل يراجع إنسان عينة كل أسبوع، وتعرف معدل الاتفاق المعتاد؟
- هل يعرض التقرير الاتجاه مع حدود الرقم، وأمثلة من الردود، وليس النسبة وحدها؟
تدريب عملي Practice
- اكتب ثلاثين رداً بلهجتك على تحديث تطبيق تستخدمه، عشرة إيجابية وعشرة سلبية وعشرة مختلطة أو ساخرة، ومررها على النموذجين في
step4_hard.py. كم نسبة الاتفاق مع قراءتك؟ - أضف إلى
normalizeقاموساً صغيراً يحول عشرة إيموجي شائعة إلى كلمات، وأعد تشغيل الخطوة الرابعة: هل تغيرت نتيجة 😡 و😍؟ - جرب نموذج
bert-base-arabic-camelbert-mix-sentimentمن نفس المختبر بدل نموذج اللهجات على AJGT، وقارن الدقة والسرعة. - قسم الردود عند «بس» و«لكن» وصنف كل جزء، وانظر ماذا يحدث لرد «التطبيق حلو بس الدفع يعلق كل مرة».
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- قراءة منشورات X بـ 0.005 دولار للمنشور، فابدأ بالبيانات المفتوحة المصنفة لتختار الطريقة، ثم قس على عينة مصنفة من ردودك.
- ASTD مصرية سياسية من 2013 بأربع فئات، وAJGT أردنية متوازنة 1,800 تغريدة، وكلتاهما تقريباً بلا إيموجي ولا لهجة خليجية.
- TF-IDF بمقاطع الحروف أفضل من الكلمات في العربية: 0.815 مقابل 0.759 على ASTD، ويتوقع آلاف التغريدات في الثانية.
- تغير اللهجة يكلف: من المصرية إلى الأردنية انخفض TF-IDF إلى 0.726، بينما 1,800 تغريدة أردنية أوصلته إلى 0.864.
- CAMeLBERT-DA على CPU أعطى 0.902 على AJGT دون أن يراها، بسرعة 7.2 تغريدة في الثانية، والرقم 0.942 على ASTD غير عادل لأنه ضبط عليها.
- BERT يفهم أغلب النفي مثل «ما قصرتوا والله»، ويخطئ بثقة في السخرية والرد المختلط، ولا يعرف الإيموجي.
- ثلث أخطاء BERT واثقة، وجزء منها أخطاء في التصنيف البشري نفسه.
وهذا المقال من مرحلة مشاريع تعلم الآلة العملية، وهذه مقالات منشورة ترتبط به:
 دليلمعالجة اللغة الطبيعية NLP للعربية ولماذا تصعب على البرامجلماذا تصعب العربية على البرامج من الزوائد واللهجات إلى تكلفة التوكنز، وما الأدوات والنماذج المتاحة لمن يبني مساعداً عربياً.
 دليلكشف الرسائل المزعجة Spam بخوارزمية Naive Bayesنكتب Naive Bayes من الصفر ونقارنه بـ scikit-learn على رسائل SMS وتغريدات عربية حقيقية، ونختار العتبة التي لا تضيع رسالة عميل، ونكشف كيف تخدعنا أرقام التقييم عندما تكون البيانات متحيزة.
 دليلتحليل البيانات Data Analysis مع pandas للمبتدئيننجيب على سؤال حقيقي من بيانات 32 محطة طقس سعودية: كم يوماً فوق 45 درجة في كل منطقة ومتى، ونتعلم في الطريق تنظيف البيانات والربط والتجميع والتواريخ مع pandas وأخطاءها الشائعة.
 دليلكيف تعمل نماذج اللغة الكبيرة LLM من الداخل؟كيف يحول النموذج سؤالك إلى أرقام ويختار الكلمة التالية حتى تكتمل الإجابة، ولماذا يخطئ بنفس الثقة.
 دليلالتعلم الآلي Machine Learning للمبتدئينكيف تتعلم الآلة القواعد من الأمثلة، وكيف تعرف أن النموذج تعلم فعلاً ولم يحفظ الإجابات، ومتى تختار كل خوارزمية.
 دليلالإحصاء Statistics للمهندسين: لماذا يخدعك المتوسط Mean؟كيف تقرأ زمن الاستجابة بالوسيط والمئين p95 وp99 والمدرج التكراري بدل المتوسط، ولماذا لا يجوز حساب متوسط المئين، مع تجربة حقيقية لسيرفر تحت الضغط.
 دليلتشغيل نماذج اللغة على جهازك: كم ذاكرة وأي GPU تحتاج؟كيف تحسب الذاكرة التي يحتاجها النموذج، وماذا تتوقع من جهازك الحالي قبل أن تشتري بطاقة رسومية GPU.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة المقال، وتشغيل TF-IDF مع scikit-learn 1.9.1 وCAMeLBERT-DA للمشاعر مع Transformers 5.22.1 وPyTorch 2.15.0 على CPU، على ASTD وAJGT، داخل Docker.