

سبعة آلاف وأربعمئة زائر في شهر، وتسعة وثلاثون عميلاً دفعوا. هذا الرقم وحده لا يقول لك شيئاً مفيداً، فهل المشكلة أن الزوار قليلون؟ أم أنهم يصلون ولا يسجلون؟ أم يسجلون ثم يتركون المنتج قبل أن يجربوه فعلاً؟ وكل سؤال من هذه الأسئلة له حل مختلف تماماً، فإذا زدت الإعلانات والمشكلة في صفحة التسجيل فأنت تدفع لتجلب زواراً يخرجون من نفس الباب. والأداة التي تفصل هذا الرقم إلى مراحل وتبين أين يخرج الناس هي قمع التسويق Marketing Funnel.
وفي مقال «التسويق للمهندسين» من هذا المسار ذكرنا أن التسويق يحمل الجزء الأول من مسار العميل، وفي هذا المقال سوف نتناول:
- ما هو قمع التسويق، ومراحله من الوعي Awareness إلى الشراء Purchase وما بعده.
- تقسيم أعلى القمع ووسطه وأسفله TOFU وMOFU وBOFU، وإطار AARRR المشهور.
- ما تقيسه في كل مرحلة، وأين تقيسه.
- تجربة عملية: نحسب القمع بأنفسنا من سجل أحداث بسكربت Python في Docker، ونرى الفرق بين المصادر.
- أخطاء حساب القمع الشائعة، وكيف تحسن كل مرحلة.
ما هو قمع التسويق Marketing Funnel؟
القمع هو تقسيم الطريق من أول زيارة إلى الشراء إلى مراحل متتالية، وحساب عدد من وصل إلى كل مرحلة، فيظهر الشكل كقمع لأن كل مرحلة أضيق من التي قبلها. والفائدة ليست في الشكل وإنما في النسب بين المراحل، فنسبة من انتقل من مرحلة إلى التالية تسمى نسبة التحويل Conversion Rate، والمرحلة التي تنخفض فيها النسبة كثيراً هي المكان الذي تبدأ منه العمل.
ويمكن تشبيه القمع بطلب HTTP يمر بعدة طبقات: موازن الحمل، ثم الـ Reverse Proxy، ثم التطبيق، ثم قاعدة البيانات، فإذا كان زمن الاستجابة Latency سيئاً فلا تزيد عدد السيرفرات قبل أن تعرف أي طبقة هي البطيئة. والقمع هو نفس الفكرة للعملاء: لا تجلب زواراً أكثر قبل أن تعرف في أي مرحلة يضيعون.
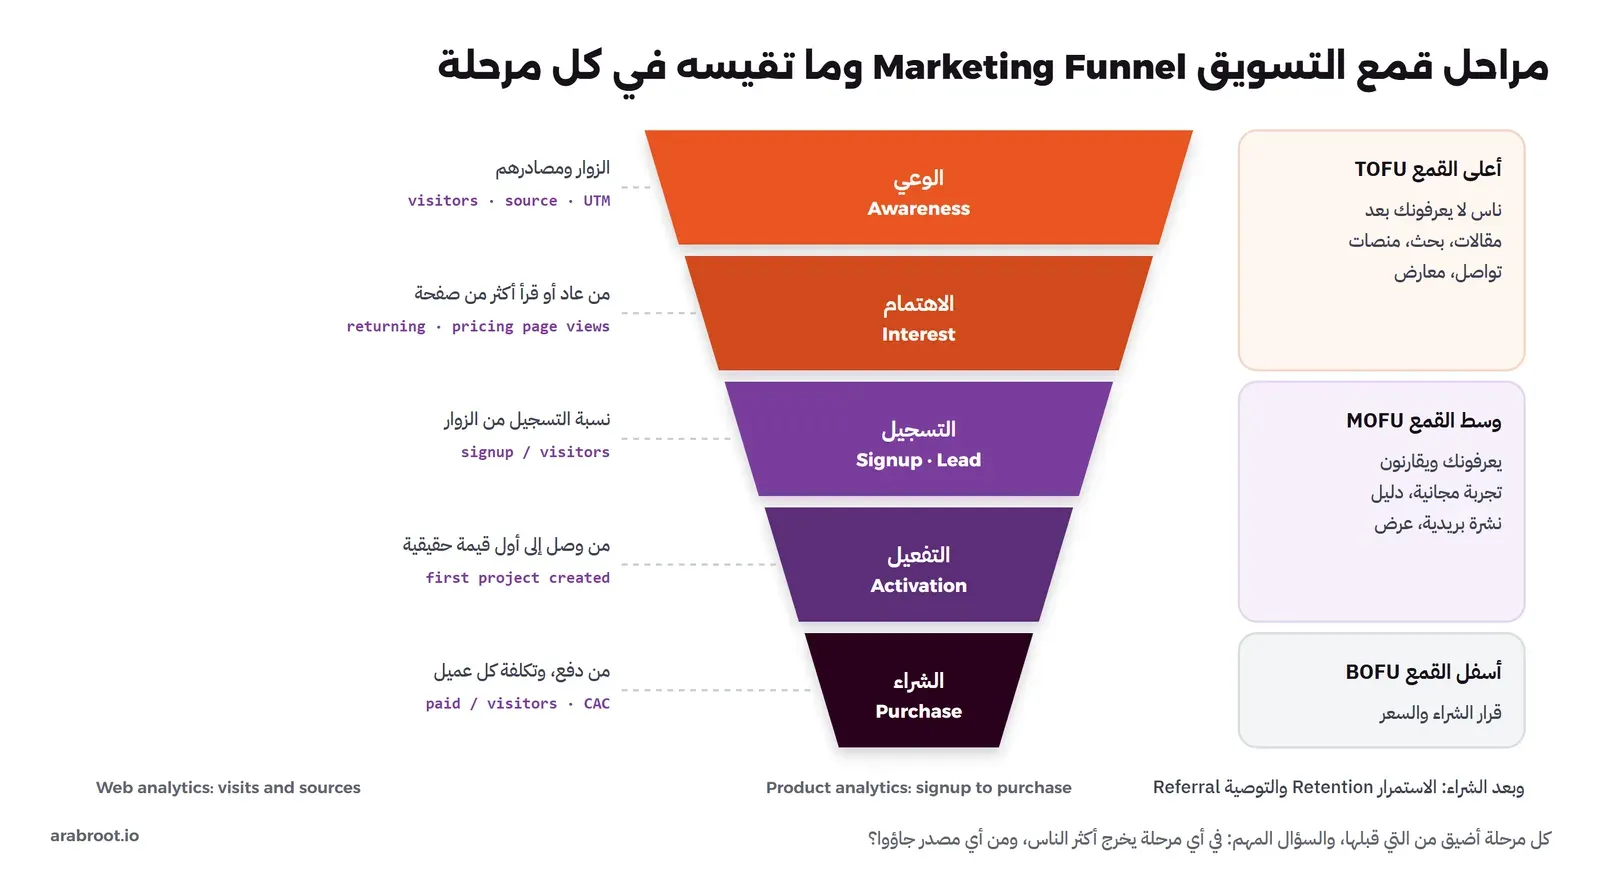
وفي الصورة أعلاه لاحظ التالي:
- الوعي Awareness: الشخص سمع بك لأول مرة، من بحث أو مقال أو منشور أو زميل. والمقياس هنا عدد الزوار ومصدر كل زيارة، ويحدد المصدر عادة من رابط الإحالة أو من معاملات UTM التي سوف نشرحها في مقال قياس التسويق.
- الاهتمام Interest: الزائر لم يغادر بعد الصفحة الأولى، فقرأ صفحة الأسعار أو التوثيق أو عاد مرة ثانية.
- التسجيل Signup: ترك بريده أو أنشأ حساباً تجريبياً، وفي الشركات التي تبيع للشركات B2B تسمى هذه المرحلة غالباً العميل المحتمل Lead.
- التفعيل Activation: وصل إلى أول قيمة حقيقية في المنتج، مثل إنشاء أول مشروع أو ربط أول خادم. وهذه المرحلة تنساها الفرق كثيراً مع أنها تفسر أغلب الفرق بين التسجيل والدفع.
- الشراء Purchase: دفع أو وقع العقد، ومنها تحسب تكلفة اكتساب العميل CAC، وهي موضوع مقال الميزانية في نفس المسار.
ولاحظ أن الأداة تختلف بين أعلى القمع وأسفله، فالزيارات ومصادرها تقيسها أداة تحليلات الموقع Web Analytics، أما ما يحدث بعد التسجيل داخل المنتج فتقيسه أداة تحليلات المنتج Product Analytics أو جدول الأحداث في قاعدة بياناتك، كما شرحنا في مقال مقاييس المنتج.
أعلى القمع ووسطه وأسفله: TOFU وMOFU وBOFU
يقسم المسوقون القمع عادة إلى ثلاثة أجزاء، والسبب أن كل جزء يحتاج محتوى مختلفاً، فالشخص الذي لم يسمع بك بعد لا يريد صفحة الأسعار، والشخص الذي يقارن بين ثلاثة منتجات لا يريد مقالاً عاماً عن أهمية النسخ الاحتياطي:
| الجزء | ماذا يعرف عنك | ماذا يحتاج | مثال لمنتج نسخ احتياطي |
|---|---|---|---|
| أعلى القمع Top of Funnel، واختصاراً TOFU | لا يعرفك، ولكن عنده المشكلة | محتوى يشرح المشكلة ويجيب عن سؤاله | مقال «كيف تختبر أن النسخة الاحتياطية تعمل فعلاً؟» |
| وسط القمع Middle of Funnel، واختصاراً MOFU | يعرفك ويقارن | مقارنة صادقة، وتجربة مجانية، ودليل عملي | صفحة مقارنة مع البدائل، وتجربة 14 يوماً |
| أسفل القمع Bottom of Funnel، واختصاراً BOFU | قريب من القرار | السعر الواضح، والأمان، ومن يستخدمه، والدعم | صفحة الأسعار، وأسئلة الأمن، ودراسة حالة عميل |
والخطأ المعتاد أن تكتب الشركة كل محتواها لأسفل القمع، أي صفحات تشرح الميزات والأسعار، فلا يصل إليها إلا من يعرفها أصلاً، أو أن تكتب كل محتواها لأعلى القمع فتجلب زواراً كثيرين لا يوجد ما ينقلهم إلى الخطوة التالية.
إطار AARRR
في عرض Startup Metrics for Pirates قسم Dave McClure مقاييس الشركة الناشئة إلى خمس مراحل، وتعرف من أحرفها الأولى باسم AARRR: الاكتساب Acquisition، والتفعيل Activation، والاستمرار Retention، والإحالة Referral، والإيراد Revenue. والفرق بينه وبين القمع التقليدي أنه لا يتوقف عند الشراء، فيضيف الاستمرار والإحالة، وهما المرحلتان اللتان تجعلان الشركة تنمو دون أن تدفع لكل عميل جديد. لذلك إذا كان منتجك اشتراكاً شهرياً فلا تقف عند «من دفع»، وإنما تابع «من دفع وبقي بعد ثلاثة أشهر».
هل يمشي العميل في القمع بالترتيب فعلاً؟
لا، فالعميل الحقيقي قد يقرأ مقالاً، ثم ينسى، ثم يسمع عنك من زميل بعد شهرين، ثم يعود من محرك البحث فيسجل مباشرة. والقمع تبسيط مفيد للقياس، ولكنه لا يصف ما يحدث في رأس كل شخص. وهذا يعني أمرين عملياً: أن تحدد نافذة زمنية Conversion Window واضحة لما تعتبره «نفس المحاولة»، وأن تعرف أن نسبة الفضل لكل مصدر Attribution قرار تتخذه أنت عند الحساب، وليس حقيقة تخرج من الأداة، وهذا ما سوف نراه في التجربة.
تجربة عملية: نحسب القمع بأنفسنا
أدوات التحليلات تعرض القمع بنقرتين، ولكن الفهم الحقيقي يأتي عندما تحسبه بنفسك مرة واحدة وترى القرارات المخفية في الحساب. لذلك كتبنا سكربت Python صغيراً لا يحتاج أي مكتبة خارجية، يقوم بأمرين: ينشئ سجل أحداث مثال Event Log لشهر سبتمبر 2026 بأربعة مصادر وأرقام ثابتة البذرة Seed فيخرج نفس الملف في كل تشغيل، ثم يقرأ السجل ويحسب القمع كما تحسبه أداة تحليلات. ولاحظ أن الاحتمالات داخل السكربت أرقام افترضناها للتمرين، وليست متوسطات لأي سوق، أما المخرج فهو ما خرج فعلاً من التشغيل.
والسكربت كاملاً كما يلي:
# Funnel from raw events: the same calculation an analytics tool does, in plain Python.
#   python funnel.py make     -> writes events.csv (example data, fixed seed, so every run gives the same file)
#   python funnel.py report   -> reads events.csv and prints the funnel, by source, and two common counting mistakes
import csv, random, sys
from collections import defaultdict
from datetime import datetime, timedelta

STEPS = ["visit", "signup", "activated", "paid"]
# Example sources with different visitor counts and step probabilities (assumed, for the exercise only)
SOURCES = {
    "google":     dict(visitors=4000, p=[0.040, 0.45, 0.20]),
    "linkedin":   dict(visitors=2500, p=[0.020, 0.35, 0.12]),
    "newsletter": dict(visitors=600,  p=[0.090, 0.60, 0.30]),
    "referral":   dict(visitors=300,  p=[0.120, 0.70, 0.35]),
}
WINDOW_DAYS = 30


def make(path="events.csv"):
    rnd = random.Random(42)
    start = datetime(2026, 9, 1)
    rows, uid = [], 0
    for src, cfg in SOURCES.items():
        for _ in range(cfg["visitors"]):
            uid += 1
            t = start + timedelta(minutes=rnd.randrange(0, 30 * 24 * 60))
            rows.append((f"u{uid}", src, "visit", t))
            # some visitors come back and view the landing page again (duplicate events)
            if rnd.random() < 0.3:
                rows.append((f"u{uid}", src, "visit", t + timedelta(days=rnd.randrange(1, 5))))
            for i, p in enumerate(cfg["p"]):
                if rnd.random() >= p:
                    break
                t = t + timedelta(hours=rnd.randrange(1, 24 * 12))
                rows.append((f"u{uid}", src, STEPS[i + 1], t))
    # signups that never visited the landing page (invited by a colleague inside the product)
    for _ in range(40):
        uid += 1
        t = start + timedelta(minutes=rnd.randrange(0, 30 * 24 * 60))
        rows.append((f"u{uid}", "(none)", "signup", t))
    rows.sort(key=lambda r: r[3])
    with open(path, "w", newline="") as f:
        w = csv.writer(f)
        w.writerow(["user_id", "source", "event", "time"])
        for r in rows:
            w.writerow([r[0], r[1], r[2], r[3].isoformat()])
    print(f"wrote {len(rows)} events for {uid} users to {path}")


def load(path="events.csv"):
    with open(path) as f:
        return [dict(r, time=datetime.fromisoformat(r["time"])) for r in csv.DictReader(f)]


def funnel(events, source=None):
    """Unique users who did each step in order, each step within WINDOW_DAYS of the first visit."""
    first = defaultdict(dict)   # user -> event -> first time
    src = {}
    for e in events:
        first[e["user_id"]].setdefault(e["event"], e["time"])
        src.setdefault(e["user_id"], e["source"])
    counts = [0] * len(STEPS)
    for u, ev in first.items():
        if source and src[u] != source:
            continue
        if "visit" not in ev:
            continue
        t0, prev = ev["visit"], ev["visit"]
        for i, s in enumerate(STEPS):
            t = ev.get(s)
            if t is None or t < prev or t - t0 > timedelta(days=WINDOW_DAYS):
                break
            counts[i] += 1
            prev = t
    return counts


def pct(a, b):
    return f"{100 * a / b:5.1f}%" if b else "  -  "


def report(path="events.csv"):
    ev = load(path)
    c = funnel(ev)
    print(f"Funnel ({WINDOW_DAYS}-day window, unique users, steps in order)")
    print(f"{'step':<10}{'users':>7}{'from prev':>11}{'from visit':>12}")
    for i, s in enumerate(STEPS):
        print(f"{s:<10}{c[i]:>7}{pct(c[i], c[i-1]) if i else '':>11}{pct(c[i], c[0]):>12}")
    print()
    print("By source")
    print(f"{'source':<11}{'visit':>7}{'signup':>8}{'activ.':>8}{'paid':>6}{'visit->paid':>13}{'share of paid':>15}")
    total_paid = c[-1]
    for s in SOURCES:
        k = funnel(ev, s)
        print(f"{s:<11}{k[0]:>7}{k[1]:>8}{k[2]:>8}{k[3]:>6}{pct(k[3], k[0]):>13}{pct(k[3], total_paid):>15}")
    print()
    raw = defaultdict(int)
    for e in ev:
        raw[e["event"]] += 1
    print("Mistake 1: counting raw events instead of unique users")
    print(f"  visit events = {raw['visit']}  vs unique visitors = {c[0]}")
    print(f"  signup rate from raw events = {pct(raw['signup'], raw['visit']).strip()}  vs real = {pct(c[1], c[0]).strip()}")
    print("Mistake 2: dividing step totals without checking order")
    print(f"  all signup events = {raw['signup']} (includes {raw['signup'] - c[1]} users with no landing visit or outside the window)")


if __name__ == "__main__":
    {"make": make, "report": report}[sys.argv[1]]()
في الكود أعلاه لاحظ التالي:
- دالة
funnelتعد المستخدمين وليس الأحداث، وتأخذ أول مرة قام فيها كل مستخدم بكل خطوة، ثم تشترط أن تأتي الخطوات بالترتيب، وأن تقع كلها خلال 30 يوماً من أول زيارة. - بعض الزوار يزورون الصفحة مرتين، وبعض المستخدمين سجلوا دون أن يمروا بالصفحة الرئيسية لأن زميلاً دعاهم من داخل المنتج، وهذا ما يحدث في السجلات الحقيقية أيضاً.
- المصدر Source يؤخذ من أول حدث للمستخدم، أي أننا اخترنا نموذج الإسناد للمصدر الأول First-touch Attribution، ولو اخترنا آخر مصدر لتغيرت الأرقام.
ونشغل السكربت في Container مؤقت من Docker Image الرسمية لـ Python، دون تثبيت أي شيء على الجهاز:
docker run --rm --name mka-funnel -v "$(pwd)":/lab -w /lab python:3.13.17-slim \
  sh -c "python --version && python funnel.py make && python funnel.py report"
والمخرج سوف يكون كما يلي:
Python 3.13.17
wrote 10232 events for 7440 users to events.csv
Funnel (30-day window, unique users, steps in order)
step        users  from prev  from visit
visit        7400                 100.0%
signup        303       4.1%        4.1%
activated     155      51.2%        2.1%
paid           39      25.2%        0.5%

By source
source       visit  signup  activ.  paid  visit->paid  share of paid
google        4000     164      74    14         0.3%          35.9%
linkedin      2500      52      22     5         0.2%          12.8%
newsletter     600      51      32    10         1.7%          25.6%
referral       300      36      27    10         3.3%          25.6%

Mistake 1: counting raw events instead of unique users
  visit events = 9695  vs unique visitors = 7400
  signup rate from raw events = 3.5%  vs real = 4.1%
Mistake 2: dividing step totals without checking order
  all signup events = 343 (includes 40 users with no landing visit or outside the window)
والصورة التالية ترسم جدول المصادر من نفس المخرج:
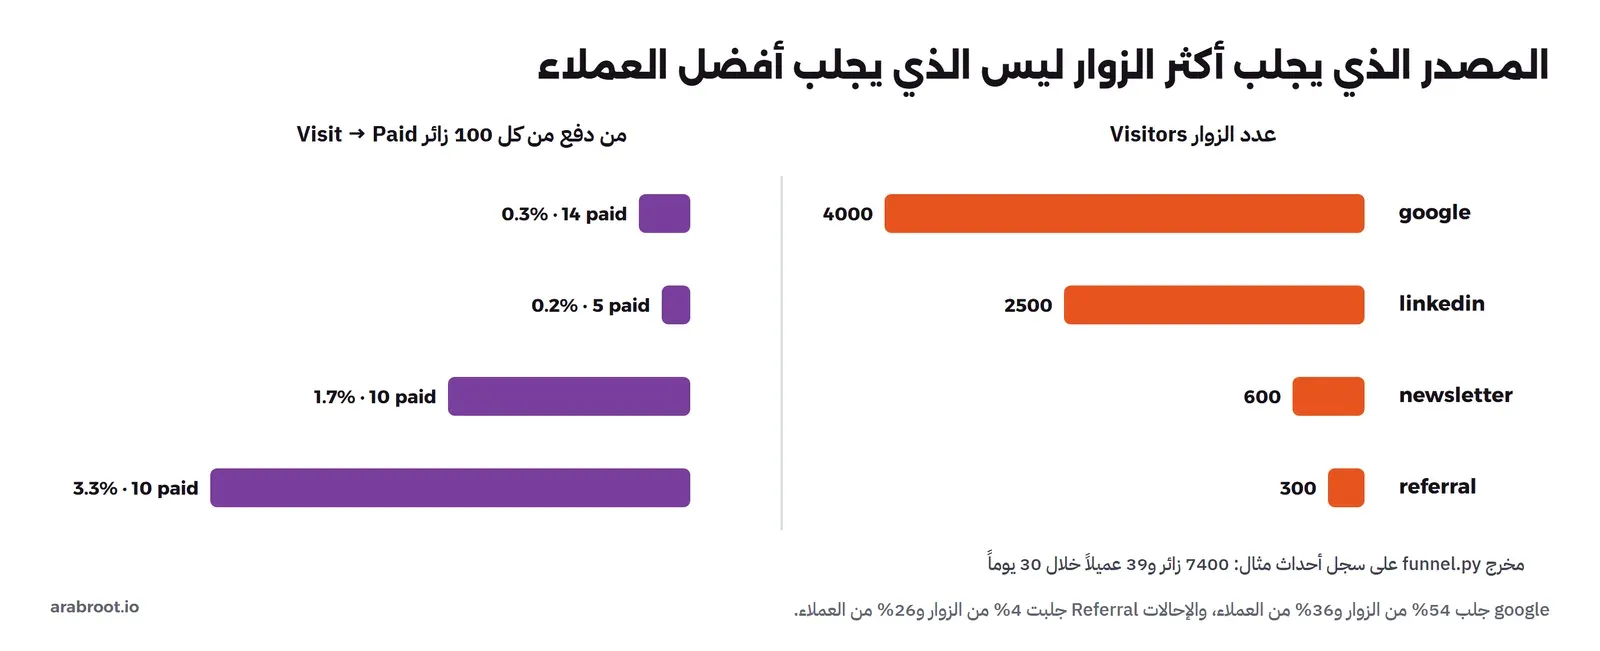
وفي المخرج أعلاه لاحظ التالي:
- أكبر خسارة في الخطوة الأولى: من 7400 زائر سجل 303 فقط، أي 4.1%، بينما انتقل 51.2% ممن سجلوا إلى التفعيل، و25.2% ممن فعلوا إلى الدفع. فإذا أردت أن تحسن مرحلة واحدة هذا الشهر فهي الصفحة التي يصل إليها الزائر وما يدعوه للتسجيل، وليس الإعلانات.
- المصادر ليست متساوية: google جلب 4000 زائر و14 عميلاً، والإحالات Referral جلبت 300 زائر و10 عملاء، أي أن الزائر القادم من توصية أكثر احتمالاً للدفع بعشر مرات تقريباً في هذا المثال. ولو قست المصادر بعدد الزوار وحده لوضعت وقتك في المكان الخطأ.
- عد الأحداث بدل المستخدمين يغير النسبة: عدد أحداث الزيارة 9695 بينما الزوار الفعليون 7400، فإذا قسمت التسجيلات على الأحداث خرجت النسبة 3.5% بدلاً من 4.1%، والخطأ يمكن أن يذهب في الاتجاه الآخر أيضاً إذا كان المستخدم يسجل أكثر من حدث تسجيل.
- الترتيب والنافذة الزمنية: في السجل 343 حدث تسجيل، منها 40 لمستخدمين سجلوا دون أي زيارة للصفحة. فإذا قسمت كل التسجيلات على كل الزوار نسبت إلى صفحتك مستخدمين لم يمروا بها أصلاً.
وهذه القرارات نفسها موجودة في كل أداة تحليلات، ولكنها تختلف في التفاصيل، فقمع Umami يطلب نافذة بالدقائق بين كل خطوتين متتاليتين، وقمع PostHog يسمح باختيار ترتيب متتابع Sequential أو صارم Strict أو بأي ترتيب Any order، وقمع Plausible من 2 إلى 8 خطوات وهو من ميزات خطة Business في خدمته السحابية، وفي Google Analytics يسمى Funnel exploration، وفي Matomo له دليل خاص. لذلك إذا قارنت رقمين من أداتين مختلفتين فتأكد أولاً أنهما يحسبان نفس الشيء. وتجد مقارنة هذه الأدوات وبدائلها في مقال خريطة الأدوات.
وأخيراً احذف التجربة، فالـ Container يحذف نفسه بسبب --rm، ويبقى ملف events.csv فقط:
rm events.csvكيف تحسن كل مرحلة؟
بعد أن تعرف المرحلة التي يخرج منها أكثر الناس، تختار التحسين المناسب لها، والجدول التالي يجمع أشهر الأسباب وأول ما تجربه:
| المرحلة التي تخسر فيها | السبب المعتاد | أول ما تجربه |
|---|---|---|
| زوار قليلون | لا أحد يعرف بك، أو تكتب لجمهور لا يبحث عن المشكلة | محتوى يجيب عن الأسئلة التي يبحث عنها عميلك، وقناة واحدة منتظمة |
| زوار كثيرون وتسجيل قليل | الصفحة لا تقول بوضوح لمن المنتج وماذا يحل، أو الزوار من الجمهور الخطأ | عنوان واضح في أول شاشة، وزر واحد، ومراجعة مصادر الزوار |
| تسجيل كثير وتفعيل قليل | الخطوة الأولى في المنتج صعبة أو طويلة | تقليل خطوات الإعداد، ورسالة ترحيب تقود إلى أول نتيجة |
| تفعيل جيد ودفع قليل | السعر غير واضح، أو القيمة لا تظهر قبل نهاية التجربة | صفحة أسعار واضحة، وتذكير قبل نهاية التجربة، ومكالمة مع العملاء الكبار |
| دفع جيد ثم إلغاء | المنتج لا يحقق ما وعد به التسويق | مراجعة الرسالة التسويقية، ومقابلة من ألغى، وهو موضوع نجاح العملاء |
وغير الصفحة أو الخطوة مرة واحدة ثم قس، لأنك إذا غيرت ثلاثة أشياء في نفس الأسبوع فلن تعرف أيها صنع الفرق، وهذا أساس اختبارات A/B التي لها مقال مستقل في المسار.
أخطاء شائعة
- مقاييس الغرور Vanity Metrics: عدد المتابعين والزيارات والإعجابات يرتفع بسهولة ولا يقول شيئاً عن المال، والسؤال الصحيح دائماً: كم عميلاً جاء من هذا؟
- مقارنة فترات بنوافذ مختلفة: قمع بنافذة 7 أيام وقمع بنافذة 30 يوماً لا يقارنان، والفترة التي لم تكتمل نافذتها بعد تظهر أسوأ مما هي.
- قمع واحد لكل الشرائح: العميل الفردي والشركة الكبيرة يمران بمسارين مختلفين، والمتوسط بينهما يخفي المشكلة في كل منهما.
- إهمال ما بعد الشراء: قمع ممتاز حتى الدفع مع إلغاء نصف العملاء في الشهر الثاني يعني أنك تملأ دلواً مثقوباً.
- جمع أحداث دون موافقة: تتبع الزائر بملفات تعريف الارتباط Cookies أو بربط هويته بأحداثه بيانات شخصية، فاقرأ ما يطلبه نظام حماية البيانات الشخصية قبل أن تجمع أكثر مما تحتاج، والأدوات التي لا تستخدم Cookies مثل Umami وPlausible تقلل هذا العبء.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- قمع التسويق يقسم الطريق من الزيارة إلى الشراء إلى مراحل، وقيمته في نسب التحويل بينها وليس في عدد الزوار.
- TOFU وMOFU وBOFU تذكرك بأن كل جزء من القمع يحتاج محتوى مختلفاً، وAARRR يضيف الاستمرار والإحالة بعد الشراء.
- في التجربة كانت أكبر خسارة بين الزيارة والتسجيل (4.1%)، وجلبت الإحالات 26% من العملاء من 4% فقط من الزوار.
- عد المستخدمين لا الأحداث، وحدد الترتيب والنافذة الزمنية ونموذج الإسناد قبل أن تقارن، فكل أداة تحسب بطريقتها.
- حسن المرحلة الأضعف أولاً، وغير شيئاً واحداً في كل مرة.
وفي المقالات القادمة في المسار بإذن الله سوف نشرح التموضع Positioning وخريطة أدوات التسويق، ثم قياس التسويق بروابط UTM والإسناد:
 دليلالتسويق للمهندسين Marketing: لماذا لا يكفي منتج جيد؟لماذا لا يصل المنتج الجيد إلى عملائه وحده، وما الذي يجيده المهندس في التسويق، ومن أين تبدأ إذا لم يكن لديك فريق تسويق.
 دليلالتموضع Positioning: لمن منتجك ولماذا يختارك؟كيف تحدد البدائل التي يقارنك بها العميل وما تنفرد به ولمن، ثم تختار فئة السوق التي تجعل قيمتك واضحة، مع مثال كامل.
 دليلخريطة أدوات التسويق Marketing Stack وبدائلها مفتوحة المصدراثنتا عشرة حاجة تسويقية، لكل منها الأداة التجارية المشهورة وسعرها، والبدائل مفتوحة المصدر بترخيصها وآخر إصدار ودعم العربية.
 دليلقياس التسويق: روابط UTM والإسناد Attributionكيف تعرف القناة التي جاءت بكل عميل: روابط UTM بقواعد تسمية ثابتة، وتحويل تعرفه أنت، ونموذج إسناد تفهم ما يحسبه.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، مع تجربة حساب القمع بسكربت Python 3.13.17 في Docker على سجل أحداث مثال، وروابط توثيق القمع في Umami وPostHog وPlausible وGoogle Analytics وMatomo.