

يصل البحث إلى المجلة، وقبل أن يقرأه المحرر أو يدعو له محكماً يمر على برنامج فحص يخرج رقماً واحداً، مثل 23%، ثم تجد طالب الدراسات العليا يسأل في كل مجموعة: «كم النسبة المقبولة؟» وكأن الرقم حكم نهائي، والحقيقة أن هذا الرقم لا يقيس الانتحال أصلاً، وإنما يقيس كمية النص المطابق لنصوص أخرى، وقد يكون بحث بنسبة 30% سليماً تماماً، وبحث بنسبة 8% منتحلاً من أوله إلى آخره. هذا المقال للطلاب والباحثين الذين يفحصون أبحاثهم ورسائلهم قبل الإرسال، وللمحكمين والمحررين الذين يقرؤون تقرير التشابه Similarity Report ويقررون بناءً عليه. وفي هذا المقال سوف نتناول:
- الفرق بين الانتحال Plagiarism والتشابه Similarity، وأشكال الانتحال التي يجب أن تعرفها.
- كيف يحسب iThenticate نسبة التشابه، وماذا تعني الألوان ومرشحات الاستبعاد، من الأدلة الرسمية.
- تجربة عملية بسكربت صغير تبين لماذا لا تعني النسبة المنخفضة غياب الانتحال.
- أدوات إعادة الصياغة والعبارات المشوهة Tortured Phrases، وعمل Cabanac وزملائه في Problematic Paper Screener، مع بحث حقيقي في OpenAlex.
- الانتحال الذاتي Self-Plagiarism وإعادة استخدام النص Text Recycling.
- ما نشرته جهات سعودية رسمية عن نسب الاقتباس والتشابه.
وهذا المقال جزء من مرحلة النشر في مسار الباحثين، فإذا أردت أن ترى أين يقع فحص التشابه في دورة حياة البحث كلها، وماذا يفعل المحكم بعده، فاقرأ:
 دليلإرسال البحث والرد على المحكمين Response to Reviewersمن خطاب التقديم وحالات نظام الإرسال إلى قرار المحرر، مع قالب للرد على المحكمين ومتى يستحق الرفض أن تتظلم منه.
 دليلالتحكيم العلمي Peer Review من الداخل: كيف تكون محكماً؟أنواع التحكيم من مزدوج التعمية إلى الشفاف، وكيف تصبح محكماً وتكتب تقريراً عادلاً، وقضايا موثقة لمحكمين مزيفين انتهت بسحب مئات الأبحاث.
الانتحال شيء، والتشابه شيء آخر
الانتحال Plagiarism أن تقدم أفكار غيرك أو نتائجه أو كلماته على أنها لك دون عزو، وسياسة أخلاقيات النشر عند Elsevier تعده بكل أشكاله سلوكاً غير مقبول، وتذكر منه أن تقدم بحث غيرك على أنه بحثك، أو أن تنسخ أجزاء كبيرة منه دون عزو، أو أن تدعي نتائج بحث أجراه غيرك. أما التشابه Similarity فهو مجرد نص في بحثك يطابق نصاً موجوداً في مكان آخر، وقد يكون هذا النص اقتباساً موثقاً، أو جملة شائعة في التخصص، أو قائمة المراجع نفسها. ودليل iThenticate and Plagiarism الرسمي يقول ذلك بوضوح: كثيرون يظنون أن النسبة المرتفعة تعني الانتحال تلقائياً وهذا غير صحيح دائماً، و«النسبة المنخفضة لا تضمن غياب الانتحال»، والحكم يحتاج إلى قراءة السياق.
وأشكال الانتحال التي تراها في الأبحاث أكثر من النسخ الحرفي، وأهمها:
- النسخ الحرفي Verbatim: فقرة منقولة كما هي دون علامات اقتباس أو دون مرجع، وهذا أسهل ما يكشفه البرنامج.
- الترقيع Mosaic Plagiarism: جمل من عدة مصادر مركبة معاً مع تغيير كلمات قليلة، فتظهر مطابقات صغيرة كثيرة.
- إعادة الصياغة دون عزو: تأخذ الفكرة أو النتيجة وتكتبها بكلماتك ولا تذكر صاحبها، وهذا انتحال حتى لو كانت النسبة صفراً.
- الانتحال بالترجمة: ترجمة بحث من لغة إلى أخرى ونسبته لنفسك، وصفحة سياسات مجلة العلوم الشرعية بجامعة الإمام محمد بن سعود الإسلامية تذكره صراحة في تعريف الانتحال: «نقلها بإعادة الصياغة أو الترجمة دون عزو».
- الانتحال الذاتي Self-Plagiarism: إعادة نشر نصك أو بياناتك المنشورة سابقاً على أنها جديدة، ولها قسم مستقل أدناه.
كيف تحسب نسبة التشابه في iThenticate؟
أغلب الناشرين يفحصون الأبحاث بخدمة Crossref Similarity Check، وهي وصول بسعر مخفض لبرنامج iThenticate من شركة Turnitin، ومتاحة لأعضاء Crossref الذين ينشرون محتوى له DOI، وشرطها أن يضع الناشر روابط النص الكامل لأبحاثه في بيانات Crossref حتى تضيفها Turnitin إلى قاعدة المقارنة، فكل ناشر يستخدم الخدمة يضيف أبحاثه إلى ما يقارن به غيره. والصورة التالية تبين كيف يبنى الرقم:
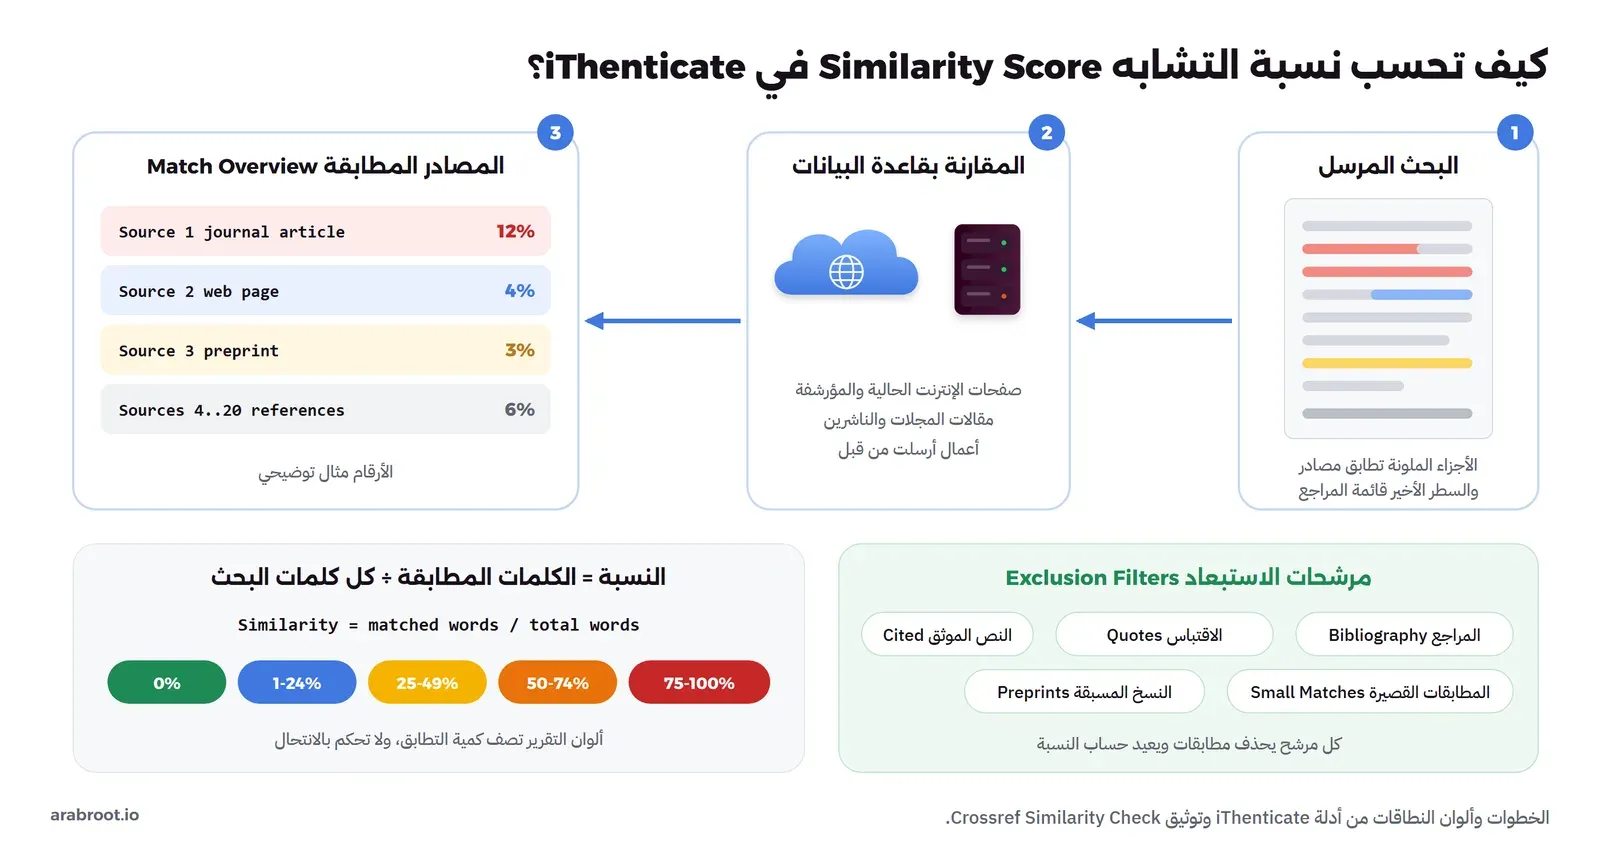
- المعادلة: توثيق Crossref لفهم التقرير يشرح أن البرنامج يجمع الكلمات المطابقة ويقسمها على مجموع كلمات البحث، لذلك البحث الطويل الذي فيه مراجعة أدبيات كبيرة يحصل على نسبة أعلى بطبيعته.
- قاعدة المقارنة: حسب دليل Understanding the Similarity Report تشمل مليارات صفحات الإنترنت الحالية والمؤرشفة، ومستودع أعمال الطلاب التي أرسلت إلى Turnitin من قبل، وآلاف الدوريات والمنشورات، وينبه الدليل إلى أن النص المقتبس بين علامات تنصيص ومعه مرجع يظهر مطابقاً أيضاً ما لم تستبعده.
- الألوان: الأخضر 0%، والأزرق من 1% إلى 24%، والأصفر من 25% إلى 49%، والبرتقالي من 50% إلى 74%، والأحمر من 75% إلى 100%، وهي ألوان تصف كمية النص المطابق ولا تحكم بشيء.
- مرشحات الاستبعاد Exclusion Filters: دليل How exclusion filters refine the Similarity Report يشرح استبعاد قائمة المراجع Bibliography، والنص المقتبس Quotes بأنواع علامات التنصيص ومنها «…» العربية، والنص الموثق Cited Text في النسخة الجديدة من التقرير، والمطابقات القصيرة Small Matches تحت عدد كلمات تحدده، والمصادر الصغيرة. وكل استبعاد يحذف المطابقات ويعيد حساب النسبة، لذلك رقمان من بحث واحد قد يختلفان لأن الإعدادات مختلفة.
- النسخ المسبقة Preprints: إذا نشرت بحثك نسخة مسبقة ثم أرسلته لمجلة فسوف يطابق نفسه، ودليل Preprints يشرح كيف تعلم هذه المصادر أو تستبعد، وتوثيق Crossref يقول إن مطابقة نسخة مسبقة للمؤلفين أنفسهم ليست انتحالاً، أما إذا اختلف المؤلفون فهذا يستحق التحقيق.
وقد يتساءل البعض: لماذا لا تضع المجلات حداً واحداً وترفض كل بحث فوقه؟ والإجابة أن توثيق Crossref نفسه ينصح بألا تحدد نسبة ترفض فوقها الأبحاث آلياً، وأن يقرر المحررون والمحكمون هل المطابقة مقبولة كجزء من التحكيم، والسبب أن 25% موزعة على عشرين مرجعاً بجمل منهجية شائعة تختلف تماماً عن 25% من مصدر واحد في قسم النتائج. لذلك عندما تقرأ التقرير فابدأ بقائمة المصادر لا بالرقم الكلي، وابحث عن أكبر مصدر منفرد، ثم اقرأ أين تقع مطابقاته: في المقدمة والمنهج أمرها أخف، وفي النتائج والمناقشة أمرها أخطر.
تجربة: لماذا لا تكفي النسبة المنخفضة؟
لكي نرى المشكلة بأرقام حقيقية كتبنا سكربت صغيراً يحسب نسبة التشابه بالطريقة نفسها تقريباً: يعد الكلمة مطابقة إذا كانت ضمن خمس كلمات متتالية موجودة كما هي في المصدر، ثم يقسم الكلمات المطابقة على مجموع الكلمات. وهو ليس iThenticate بالطبع، ولكنه يكفي لنفهم سلوك أي برنامج يعتمد على المطابقة النصية. والمصدر فقرة كتبناها لهذا الغرض عن كشف التسلل، وأمامه خمس نسخ: نسخ حرفي، وتعديل خفيف، ونسخة بدلنا كلماتها بمرادفات بالأسلوب نفسه الذي وثقه Cabanac وزملاؤه في أدوات إعادة الصياغة، وترجمة عربية، وفقرة مكتوبة بكلماتنا مع مرجع:
import re

SOURCE = """Intrusion detection systems increasingly rely on machine learning. In our
experiments, a random forest trained on network flow features detected 97 percent of
attacks, while a deep learning model reached 98 percent but required ten times more
training data. Artificial intelligence can therefore help security teams, but big data
pipelines and careful labelling remain the main cost."""

SUBMISSIONS = {
    "1 copied": SOURCE,
    "2 lightly edited": """Intrusion detection systems rely more and more on machine learning. In our
tests, a random forest trained on network flow features detected 97 percent of attacks,
while a deep learning model reached 98 percent but needed ten times more training data.
Artificial intelligence can therefore help security teams, but big data pipelines and
careful labelling remain the main cost.""",
    "3 synonym-swapped": """Interruption location frameworks progressively depend on machine learning. In
our tests, an irregular woodland prepared on organization stream highlights identified 97
percent of assaults, while a profound learning model arrived at 98 percent however
required multiple times more preparing information. Counterfeit consciousness can thusly
assist security groups, however colossal information pipelines and cautious naming stay
the primary expense.""",
    "4 translated": """تعتمد أنظمة كشف التسلل بشكل متزايد على تعلم الآلة، وفي تجاربنا اكتشفت
الغابة العشوائية 97 بالمئة من الهجمات، بينما وصل نموذج التعلم العميق إلى 98 بالمئة
لكنه احتاج بيانات تدريب أكثر بعشر مرات.""",
    "5 own words + citation": """Tree-based models detect most network attacks with far
less training data than neural models (Author, 2026), so for a small security team the
data pipeline, not the model, is usually the larger expense.""",
}

TORTURED = {  # fingerprint: expected term (examples from the Problematic Paper Screener work)
    "irregular woodland": "random forest",
    "profound learning": "deep learning",
    "counterfeit consciousness": "artificial intelligence",
    "colossal information": "big data",
}

N = 5  # a match needs 5 consecutive identical words

def words(text):
    return re.findall(r"\w+", text.lower())

def score(sub, src):
    s, w = words(src), words(sub)
    grams = {tuple(s[i:i + N]) for i in range(len(s) - N + 1)}
    hit = [False] * len(w)
    for i in range(len(w) - N + 1):
        if tuple(w[i:i + N]) in grams:
            hit[i:i + N] = [True] * N
    return 100 * sum(hit) / len(w), len(w)

for name, text in SUBMISSIONS.items():
    pct, n = score(text, SOURCE)
    flags = [f"{k} (= {v})" for k, v in TORTURED.items() if k in " ".join(words(text))]
    print(f"{name:<24} words {n:>3}  similarity {pct:5.1f}%  tortured: {', '.join(flags) or '-'}")
احفظه باسم similarity.py وشغله:
python similarity.pyوالمخرج سوف يكون كما يلي:
1 copied                 words  57  similarity 100.0%  tortured: -
2 lightly edited         words  59  similarity  84.7%  tortured: -
3 synonym-swapped        words  58  similarity   8.6%  tortured: irregular woodland (= random forest), profound learning (= deep learning), counterfeit consciousness (= artificial intelligence), colossal information (= big data)
4 translated             words  33  similarity   0.0%  tortured: -
5 own words + citation   words  34  similarity   0.0%  tortured: -
في المخرج أعلاه لاحظ التالي:
- التعديل الخفيف، أي تغيير خمس كلمات تقريباً، أنزل النسبة من 100% إلى 84.7% فقط، فمن يظن أن تغيير بعض الكلمات يحميه سوف يكتشف أن المطابقة باقية.
- النسخة التي بدلت كلماتها بمرادفات نزلت إلى 8.6%، أي داخل النطاق الأزرق الذي لا يلفت نظر أحد، مع أنها الفقرة نفسها بالأرقام نفسها، وهذا بالضبط ما تفعله أدوات إعادة الصياغة Paraphrasing Tools: تقطع سلاسل الكلمات المتطابقة فيسقط الرقم.
- الثمن ظهر في العمود الأخير: «random forest» صارت «irregular woodland» و«deep learning» صارت «profound learning»، وهذه هي البصمة التي سوف نتحدث عنها في القسم التالي، ولا يكتبها باحث يعرف تخصصه.
- الترجمة العربية حصلت على 0%، لأن المطابقة النصية لا تعبر اللغات، والفقرة رقم 5 حصلت على 0% أيضاً، فالرقم نفسه ظهر لنص منتحل بالترجمة ولنص سليم مكتوب بكلمات صاحبه مع مرجع، وهذا هو المعنى العملي لعبارة «النسبة المنخفضة لا تضمن غياب الانتحال».
جرب بنفسك أن تغير قيمة N إلى 3 ثم إلى 8: كلما صغرت ارتفعت النسب بسبب العبارات الشائعة مثل «in our tests»، وكلما كبرت انخفضت، وهذا يشبه مرشح المطابقات القصيرة في التقرير الحقيقي، ويوضح لماذا لا تقارن رقمين خرجا بإعدادات مختلفة.
العبارات المشوهة Tortured Phrases وأدوات إعادة الصياغة
في يوليو 2021 نشر Guillaume Cabanac وCyril Labbé وAlexander Magazinov بحثاً على arXiv بعنوان Tortured phrases: A dubious writing style emerging in science، وصفوا فيه عبارات غريبة تحل محل مصطلحات علمية معروفة، وتقرير Nature عن البحث ذكر منها «counterfeit consciousness» بدلاً من «artificial intelligence» و«profound neural organization» بدلاً من «deep neural network» و«colossal information» بدلاً من «big data». والتفسير الذي يطرحه البحث أن بعض المواقع تعيد كتابة النصوص مجاناً، فيأخذ المنتحل نصاً منشوراً ويمرره عليها حتى تنخفض نسبة التشابه، والأداة لا تعرف أن «random forest» اسم خوارزمية فتستبدل كل كلمة بمرادفها. ثم بنى الفريق موقع Problematic Paper Screener الذي يفحص الأدبيات المنشورة بحثاً عن هذه البصمات Fingerprints وعن أبحاث مولدة ببرامج مثل SCIgen، ويسحب بياناته من Crossref وDimensions وPubMed وPubPeer، وتنشر نتائجه على PubPeer ليراها الناشرون والقراء.
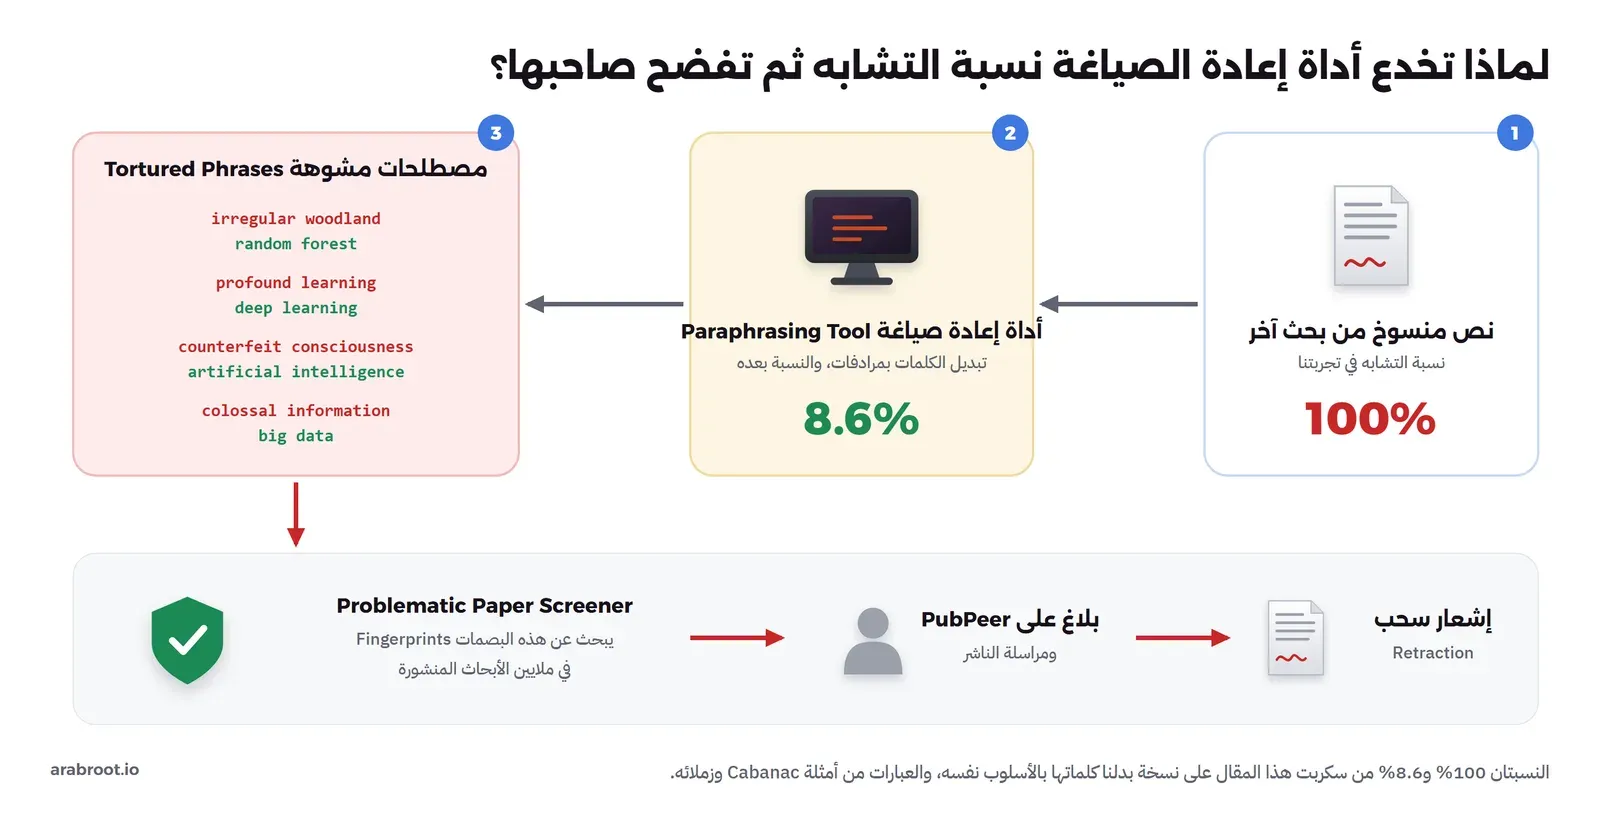
ولنرى حجم الظاهرة بأرقام حقيقية، السكربت التالي يبحث في عناوين وملخصات الأبحاث المفهرسة في OpenAlex عن خمس عبارات، ويعد كم منها مسحوب، ثم يوزع أكثرها انتشاراً على التخصصات، واحفظه باسم tortured.py:
import json, urllib.parse, urllib.request

API = "https://api.openalex.org/works"
PHRASES = ["counterfeit consciousness", "profound neural organization",
           "irregular woodland", "colossal information", "profound learning"]

def count(filters):
    url = f"{API}?filter={filters}&per_page=1&[email protected]"
    with urllib.request.urlopen(url, timeout=60) as r:
        return json.load(r)["meta"]["count"]

for p in PHRASES:
    q = urllib.parse.quote(f'"{p}"')
    total = count(f"title_and_abstract.search:{q}")
    retracted = count(f"title_and_abstract.search:{q},is_retracted:true")
    print(f"{p:<30} works {total:>5}  retracted {retracted}")

q = urllib.parse.quote('"counterfeit consciousness"')
url = f"{API}?filter=title_and_abstract.search:{q}&per_page=8&select=publication_year,type,is_retracted,primary_location,doi&[email protected]"
with urllib.request.urlopen(url, timeout=60) as r:
    for w in json.load(r)["results"]:
        src = ((w.get("primary_location") or {}).get("source") or {}).get("display_name") or "-"
        print(w["publication_year"], w["type"], "retracted" if w["is_retracted"] else "", src[:45], w["doi"] or "")

q = urllib.parse.quote('"profound learning"')
url = f"{API}?filter=title_and_abstract.search:{q}&group_by=primary_topic.field.id&[email protected]"
with urllib.request.urlopen(url, timeout=60) as r:
    print("profound learning by field:", ", ".join(f"{g['key_display_name']} {g['count']}" for g in json.load(r)["group_by"][:4]))
python tortured.pyوالمخرج سوف يكون كما يلي، من تشغيل في 23 أكتوبر 2026:
counterfeit consciousness      works    15  retracted 1
profound neural organization   works    17  retracted 2
irregular woodland             works    27  retracted 3
colossal information           works    40  retracted 0
profound learning              works  1649  retracted 87
2021 article  Journal of Management and Research
2023 report  - https://doi.org/10.25012/blog.06.06.2023
2017 article  International Journal for Research in Applied https://doi.org/10.22214/ijraset.2017.4273
2018 conference-paper  IEEE Annual Information Technology, Electroni https://doi.org/10.1109/iemcon.2018.8614941
2022 preprint  arXiv (Cornell University) https://doi.org/10.48550/arxiv.2210.13024
2017 article  IJARCCE https://doi.org/10.17148/ijarcce.2017.6433
2021 preprint  arXiv (Cornell University) https://doi.org/10.48550/arxiv.2107.06751
2017 retraction  International Conference on Current Trends in https://doi.org/10.1109/ctceec42587.2017.10702651
profound learning by field: Computer Science 498, Social Sciences 283, Medicine 233, Psychology 135
في المخرج أعلاه لاحظ التالي:
- البحث هنا في العنوان والملخص فقط، والعبارات المشوهة تكون غالباً في متن البحث، لذلك هذه الأرقام حد أدنى، وProblematic Paper Screener يفحص النص الكامل حيث يتاح.
- «profound learning» ظهرت في 1649 عملاً، والسطر الأخير يبين توزيعها: 498 في علوم الحاسب حيث تكون غالباً بديلاً مشوهاً لـ deep learning، و283 في العلوم الاجتماعية و135 في علم النفس حيث قد تكون استخداماً لغوياً سليماً بمعنى «التعلم العميق» في التربية، لذلك العبارة وحدها لا تدين أحداً، والبصمة تعني شيئاً عندما تظهر في سياق خاطئ، مثل نموذج حاسوبي في بحث هندسي.
- في قائمة نتائج «counterfeit consciousness» تجد بحث Cabanac نفسه على arXiv لأنه يذكر العبارة في ملخصه، وتجد إشعار سحب Retraction مسجلاً كعمل مستقل، فالنتيجة دليل يحتاج قراءة وليس حكماً، تماماً مثل تقرير التشابه.
- الأعمال المسحوبة قليلة مقارنة بالموجودة، لأن السحب يحتاج تحقيقاً من الناشر، وأغلب ما يبلغ عنه ينتظر سنوات.
الانتحال الذاتي وإعادة استخدام النص
قد يتساءل الباحث: كيف أنتحل من نفسي وأنا صاحب النص؟ والإجابة أن المشكلة ليست في ملكية الكلمات، وإنما في أن القارئ والمجلة يظنان أن ما أمامهما جديد وهو ليس كذلك، أو أن حقوق النص المنشور انتقلت إلى ناشر آخر. ودليل مكتب نزاهة البحث الأمريكي ORI عن الكتابة الأخلاقية الذي أعده Miguel Roig يذكر أن الانتحال الذاتي ليس سوء سلوك بحثي بالتعريف القانوني الأمريكي، ولكنه يخصص أقساماً للنشر المكرر Duplicate Publication وتقسيم البحث الواحد إلى أبحاث صغيرة Salami Publication وإعادة استخدام النص من أعمالك السابقة Text Recycling، والمجلات تتعامل معها بجدية: سياسة Elsevier تذكر أن البحث قد يرفض في الفحص الأولي بسبب الانتحال أو إعادة استخدام نص لم يفصح عنه Undisclosed Text Re-use.
وعملياً هذه الحالات الشائعة وحكمها:
| الحالة | الحكم العملي |
|---|---|
| تحويل فصل من رسالتك إلى بحث | مقبول غالباً، فسياسة Elsevier تستثني النشر السابق كجزء من رسالة جامعية أو ملخص أو نسخة مسبقة، ولكن اذكر الرسالة في خطاب التقديم وفي البحث. |
| إعادة جمل وصف المنهج Methods من بحثك السابق | منطقة رمادية، فوصف الجهاز أو الإجراء نفسه لا يكتب بعشر طرق، ولكن أشر إلى البحث السابق واختصر، ولا تنقل المقدمة والمناقشة. |
| نشر النتائج نفسها في مجلتين أو بلغتين | نشر مكرر، وتوصيات ICMJE في النشر المتداخل تمنعه إلا بشروط وإفصاح كامل وموافقة المجلتين. |
| بحث مؤتمر ثم نسخة موسعة في مجلة | مقبول في تخصصات كثيرة إذا أضفت جديداً حقيقياً وأفصحت عن البحث الأول، وبعض المجلات تحدد نسبة إضافة، فاقرأ دليلها. |
ولاحظ أن هذا ليس شأناً بين المؤلف والمجلة فقط، ففي وثيقة أسباب عدم اجتياز النتاج العلمي من قبل المحكمين في طلبات الترقيات العلمية التي نشرتها جامعة القصيم، وأعدت من ملاحظات المحكمين الواردة إلى أمانة المجلس العلمي، تجد بين الأسباب التي تؤدي إلى درجة متدنية قد ترفض بسببها الترقية: التشابه الذاتي Self-plagiarism بمعنى التشابه الجزئي أو الكامل مع أبحاث سابقة للباحث نفسه وإعادة استخدام بيانات أو نصوص أو رسومات، والانتحال من مصادر أخرى، والاستخدام المخل لأدوات الذكاء الاصطناعي أو عدم توثيقه.
ماذا تقول الجهات السعودية عن النسبة؟
بحثنا في الصفحات الرسمية عن حد وطني لنسبة التشابه في الرسائل أو الأبحاث فلم نجد حداً واحداً منشوراً على مستوى الوزارة، والموجود قواعد على مستوى المجلة أو الجامعة، وهذه أمثلة منشورة رسمياً:
- مجلة العلوم الشرعية بجامعة الإمام: تنص سياساتها على عزو كل اقتباس إلى مصدره، وألا تزيد نسبة الاقتباس الموثق على 25% من كلمات البحث من مجموع المصادر، أو 10% من مصدر واحد، وعلى أن هيئة التحرير تفحص الأبحاث، بما في ذلك الكشف عن الانتحال، قبل إرسالها إلى التحكيم. ولاحظ أن الحد هنا للاقتباس الموثق، أي أن النص المنقول دون عزو ممنوع أصلاً بأي نسبة.
- أدوات الفحص في الجامعات: عمادات البحث العلمي والمكتبات توفر iThenticate وTurnitin لمنسوبيها، ومثال ذلك صفحة مكتبات جامعة الملك فيصل التي تذكر البرنامجين ضمن قواعد المعلومات المتاحة، لذلك اسأل عمادتك قبل أن تدفع لخدمة تجارية، ولا ترفع رسالتك إلى موقع فحص مجاني مجهول، لأن بعض هذه المواقع يحتفظ بالنص.
- الترقيات: وثيقة جامعة القصيم المذكورة أعلاه تجعل الانتحال والتشابه الذاتي من أسباب عدم اجتياز التحكيم في طلب الترقية.
والقاعدة العملية: اقرأ لائحة الدراسات العليا في جامعتك ودليل المؤلفين في المجلة لمعرفة الحد الذي يطبق عليك وإعدادات الفحص المعتمدة، فإذا لم يذكر حد فتذكر أن المحرر سوف يقرأ قائمة المصادر لا الرقم.
قبل أن ترسل: قائمة فحص قصيرة
- افحص البحث بالأداة التي توفرها جامعتك، واستبعد المراجع والاقتباسات الموثقة، ثم اقرأ قائمة المصادر من الأكبر إلى الأصغر.
- أي مصدر منفرد بنسبة ملحوظة: هل هو بحثك السابق أو نسختك المسبقة؟ أفصح عنه. وهل هو بحث لغيرك؟ أعد الكتابة بفهمك وضع المرجع.
- ابحث في نصك عن مصطلحات تخصصك الأساسية، وتأكد أنها مكتوبة كما يكتبها أهل التخصص، خاصة إذا استعنت بأداة ترجمة أو تحسين لغة.
- إذا ترجمت فقرة من مصدر بلغة أخرى فضع المرجع، فالنسبة صفر لا تعني أن المحكم لا يعرف المصدر.
- إذا أعدت استخدام نص من بحث منشور لك فأشر إليه، واذكر ذلك في خطاب التقديم كما شرحنا في مقال إرسال البحث والرد على المحكمين.
الخلاصة
- نسبة التشابه هي الكلمات المطابقة مقسومة على كل الكلمات، وتقيس التطابق لا الانتحال، وألوانها وصف لا حكم.
- مرشحات الاستبعاد تغير الرقم، لذلك لا تقارن رقمين بإعدادات مختلفة، واقرأ قائمة المصادر قبل الرقم الكلي.
- في تجربتنا نزلت فقرة منسوخة من 100% إلى 8.6% بتبديل الكلمات بمرادفات، ونزلت ترجمتها إلى 0%، فالنسبة المنخفضة لا تضمن شيئاً.
- أدوات إعادة الصياغة تترك عبارات مشوهة Tortured Phrases يبحث عنها Problematic Paper Screener، وانتهت حالات موثقة بسحب مئات الأبحاث.
- الانتحال الذاتي والنشر المكرر يرفضان في المجلات، ويؤثران في الترقية كما في وثيقة جامعة القصيم.
- لا يوجد حد وطني منشور للنسبة، والحدود في المجلات والجامعات، مثل 25% للاقتباس الموثق و10% من مصدر واحد في مجلة العلوم الشرعية بجامعة الإمام.
وفي المقال القادم بإذن الله سوف نتحدث عن النشر المسبق Preprints: أين تنشر نسختك قبل التحكيم، وماذا يحدث لحقوقك وللفحص عند المجلة بعد ذلك.
سجل التحديثات
- أكتوبر 2026: كتابة المقال من أدلة iThenticate وتوثيق Crossref والصفحات الرسمية كما كانت في 23 أكتوبر 2026، وتشغيل السكربتين في اليوم نفسه.