إذا كان فريقك يستخدم أدوات الذكاء الاصطناعي في كتابة البرامج، أو تفكر في السماح بها، وتسأل: هل يجب أن نغير طريقة عملنا في Scrum أو Kanban؟ فهذا المقال لك. وهو مكتوب للمديرين، ومكتب إدارة المشاريع PMO، ومالكي المنتجات، وقادة الفرق.
ستعرف فيه ما تقوله الأبحاث المنشورة فعلاً، وما الذي يتغير في الفريق، والمخاطر، وقالب سياسة جاهزاً لفريقك، وما الذي لا يتغير مهما تغيرت الأدوات.
ستجد على الإنترنت إجابات كثيرة واثقة جداً، من «إنتاجية عشرة أضعاف» إلى «Scrum ماتت»، وأغلبها لا يستند إلى قياس. لذلك نلتزم هنا بقاعدة واحدة: ما تقوله الأبحاث نذكره مع مصدره وحدوده ومن مولها، وما هو رأي نكتب أنه رأي ونذكر من قاله.
وهذا المقال يبني على مقال Agile بلا شعارات، الذي شرح Scrum وKanban كما تصفها أدلتها الرسمية.
باختصار In Short
ما يتغير: الضغط ينتقل من كتابة البرنامج إلى مراجعته واختباره.
ماذا تفعل: قصص أصغر لا أكبر، وحد لعدد التغييرات المنتظرة للمراجعة، ومعايير قبول مكتوبة قبل البدء.
الأدوار: المسؤوليات الثلاث في Scrum لا تتغير، لأن الأداة لا يمكن أن تكون مسؤولة.
السياسة: ثلاث خانات: ممنوع، ومسموح بضوابط، ومسموح.
ما تقيسه: ما يصل إلى المستخدم ويستقر، لا عدد الأسطر التي كتبتها الأداة.
ماذا تقول الأبحاث حتى الآن؟ Evidence
قبل الأرقام، انتبه: كل دراسة قاست شيئاً مختلفاً. بعضها قاس مهمة واحدة صغيرة في مختبر، وبعضها قاس عدد المهام المنجزة في شركات، وبعضها سأل آلاف الفرق عن التسليم كله. والصورة التالية تضعها بجانب بعضها:
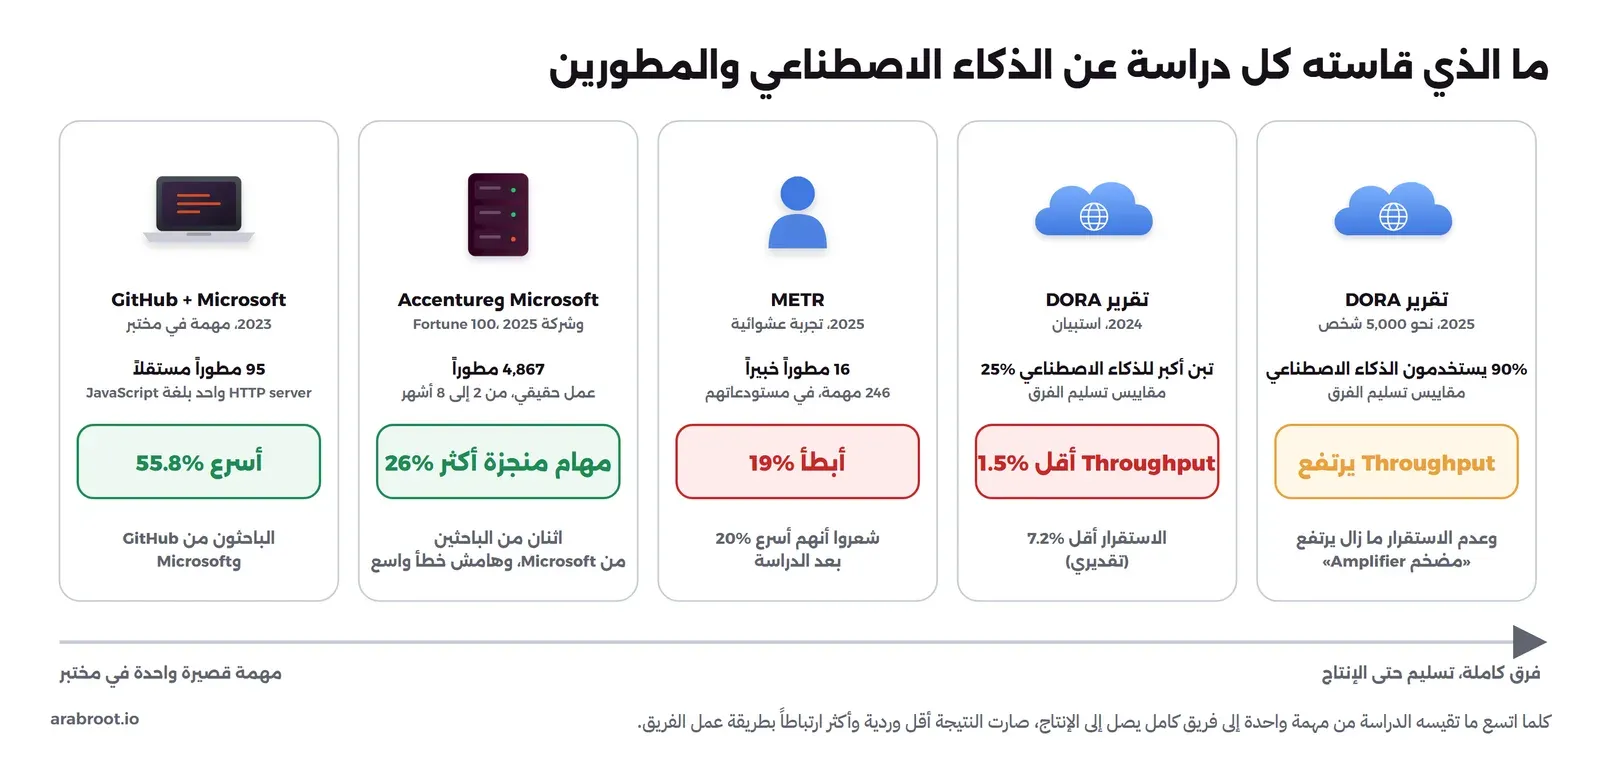
تقرير DORA 2024: الأفراد أسرع، والتسليم Delivery أقل استقراراً
ما هو: أبحاث DORA تديرها Google Cloud منذ سنوات، وتعتمد على استبيان كبير يربط ممارسات الفرق بنتائج التسليم.
ماذا وجد: في ملخص تقرير 2024 الذي كتبه Nathen Harvey وDerek DeBellis:
- 75% من المشاركين يعتمدون على الذكاء الاصطناعي في مهمة يومية واحدة على الأقل.
- أكثر من الثلث شعروا بزيادة متوسطة أو كبيرة في إنتاجيتهم.
- 39% يثقون قليلاً أو لا يثقون إطلاقاً في الكود الذي يكتبه الذكاء الاصطناعي.
وقدر التقرير أثر زيادة الاستخدام بنسبة 25%:
| تحسن | انخفض |
|---|---|
| جودة التوثيق بنحو 7.5% | إنتاجية التسليم Delivery Throughput بنحو 1.5% |
| جودة الكود بنحو 3.4% | استقرار التسليم Delivery Stability بنحو 7.2% |
| سرعة مراجعة الكود Code Review بنحو 3.1% |
التفسير الذي يقترحه التقرير: تسريع الكتابة وحده لا يحسن التسليم إذا لم يلتزم الفريق بالأساسيات، مثل العمل على دفعات صغيرة Small Batches والاختبارات القوية.
تقرير DORA 2025: الذكاء الاصطناعي يضخم ما هو موجود
في 2025 خصصت DORA تقريرها كله للموضوع باسم State of AI-assisted Software Development. وكما في ملخص التقرير، شارك فيه قرابة خمسة آلاف شخص، مع أكثر من مئة ساعة من المقابلات:
- 90% يستخدمون الذكاء الاصطناعي في العمل.
- أكثر من 80% قالوا إنه رفع إنتاجيتهم.
- 30% يثقون قليلاً أو لا يثقون في الكود الذي يكتبه.
الجديد عن 2024: صار الاستخدام مرتبطاً بإنتاجية تسليم أعلى وأداء منتج أفضل. لكنه ما زال مرتبطاً بانخفاض الاستقرار.
الخلاصة بكلمة التقرير: الذكاء الاصطناعي «مضخم» Amplifier. يكبر نقاط القوة الموجودة في المؤسسة، ويكبر نقاط ضعفها. فالفريق الذي عنده اختبارات وتغييرات صغيرة ونشر آلي يستفيد، والفريق الذي ليس عنده هذا يصل إلى مشاكله أسرع.
ومع التقرير نشرت DORA نموذج AI Capabilities Model، وهو سبع قدرات تجدها موسومة بكلمة AI في قائمة قدرات DORA:
- موقف واضح ومعلن من الذكاء الاصطناعي Clear and Communicated AI Stance.
- بيانات داخلية سليمة Healthy Data Ecosystems.
- بيانات داخلية يصل إليها الذكاء الاصطناعي AI-accessible Internal Data.
- إدارة النسخ Version Control.
- العمل على دفعات صغيرة Working in Small Batches.
- التركيز على المستخدم User-centric Focus.
- هندسة المنصات Platform Engineering.
لاحظ أن ثلاثاً منها على الأقل ممارسات Agile وDevOps قديمة. وهذا يقول لك أين تستثمر.
تجربة METR العشوائية Randomized Trial: الشعور بالسرعة ليس قياساً
في يوليو 2025 نشرت مؤسسة METR تجربة عشوائية بعنوان Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity:
- 16 مطوراً خبيراً عملوا على 246 مهمة في مشاريع يعرفونها جيداً.
- المهام التي سمح فيها بالذكاء الاصطناعي أخذت وقتاً أطول بنسبة 19%.
- بينما قدر المطورون بعد الانتهاء أنه اختصر وقتهم بنسبة 20%.
وفي تحديث فبراير 2026 ظهرت أرقام تشير إلى تسريع مع أدوات أحدث. لكن METR نفسها وصفت بياناتها الجديدة بأنها دليل ضعيف جداً، لأن كثيراً من المطورين رفضوا العمل دون ذكاء اصطناعي. وشرحنا التجربة وحدودها في مقال تمارين Kata.
ما يهمك كمدير: شعور الفريق بأنه أسرع لا يكفي لتعدل خطتك عليه. قس قبل أن تغير.
دراسات GitHub وMicrosoft، ومن أجراها
| الدراسة | ماذا قاست | النتيجة | انتبه إلى |
|---|---|---|---|
| تجربة Peng وزملائه 2023 | 95 مبرمجاً مستقلاً من منصة Upwork، في مهمة واحدة: بناء خادم ويب صغير من الصفر | المجموعة التي معها GitHub Copilot أنهت أسرع بنسبة 55.8%، بمجال ثقة من 21% إلى 89% | مهمة واحدة صغيرة تبدأ من الصفر، وهي أسهل ما يمكن للأداة. وثلاثة من الكتاب الأربعة من Microsoft Research وGitHub، الشركة التي تبيع الأداة |
| ثلاث تجارب ميدانية لـ Kevin Zheyuan Cui وزملائه، فبراير 2025 | 4,867 مطوراً في عملهم الحقيقي داخل Microsoft وAccenture وشركة من قائمة Fortune 100 | زيادة 26.08% في عدد المهام المنجزة أسبوعياً، بخطأ معياري 10.3%. والأقل خبرة استخدموا الأداة أكثر واستفادوا أكثر | أقوى من المختبر لأنها في عمل حقيقي. لكن اثنين من الكتاب يعملان في Microsoft، والمقياس عدد المهام لا جودتها، والكتاب يقولون إن كل تجربة وحدها كانت مشوشة Noisy |
استبيان Stack Overflow Survey: الاستخدام يرتفع والثقة مشروطة
| السؤال | استبيان 2025 |
|---|---|
| يستخدمون أدوات الذكاء الاصطناعي أو يخططون لذلك | 84% |
| المحترفون الذين يستخدمونها يومياً | 51% |
| لا يثقون في دقة مخرجاتها، مقابل من يثقون | 46% مقابل 33%، و3% فقط يثقون ثقة عالية |
| أكبر مشكلة: حلول «almost right, but not quite»، أي صحيحة تقريباً | 66% |
| تصحيح أخطاء ما تكتبه الأداة يأخذ وقتاً أطول | 45% |
وفي استبيان 2026: 73% يستخدمون مساعدات البرمجة والوكلاء Agents يومياً، و31% منهم أكثر من أربع ساعات في اليوم. لكن 48% يثقون بالذكاء الاصطناعي فقط عندما يستطيعون التحقق من إجابته بسهولة، و16% فقط يثقون به في أغلب المهام غير المهمة.
وتذكر أن الاستبيان يجيب عليه من يختار أن يجيب. فهو يقيس ما يقوله المطورون، لا ما يحدث بعد الإطلاق.
ما الذي تثبته الأدلة، وما الذي لا تثبته؟
| ما تقوله الأدلة بثقة معقولة | ما لا تثبته حتى الآن |
|---|---|
| الاستخدام أصبح شبه عام في الفرق (DORA 2025 وStack Overflow 2026) | أن كل فريق يستخدمه أصبح أسرع في التسليم إلى المستخدم |
| المهام الصغيرة المعزولة تنجز أسرع مع الأداة (Peng 2023 وCui 2025) | أن السرعة في المهمة تعني سرعة في المنتج كله أو جودة أعلى |
| استقرار التسليم ينخفض مع زيادة الاستخدام في بيانات DORA للسنتين | أن الأداة هي السبب المباشر، فبيانات DORA ارتباطات من استبيان |
| شعور المطور بسرعته قد يختلف عن القياس (METR 2025) | أن الأداة تبطئ الخبراء دائماً، فالأدوات تتغير والتحديث الأخير يشير إلى عكس ذلك بدليل ضعيف |
| الثقة مشروطة بقدرة الإنسان على التحقق (Stack Overflow 2025 و2026) | الأثر على المهارات وجودة الأنظمة بعد سنوات، فلا توجد دراسة طويلة بعد |
ما الذي يتغير في الفريق؟
ما في هذا القسم آراء نبنيها على الأدلة أعلاه وعلى قدرات DORA، وليست نتائج دراسات. فاقرأها على أنها فرضيات Hypotheses يختبرها فريقك في الاستعادة Retrospective.
الفكرة الأساسية: عندما تصبح كتابة البرنامج أرخص، لا يختفي العمل. ينتقل إلى المرحلة التالية، أي المراجعة والاختبار:
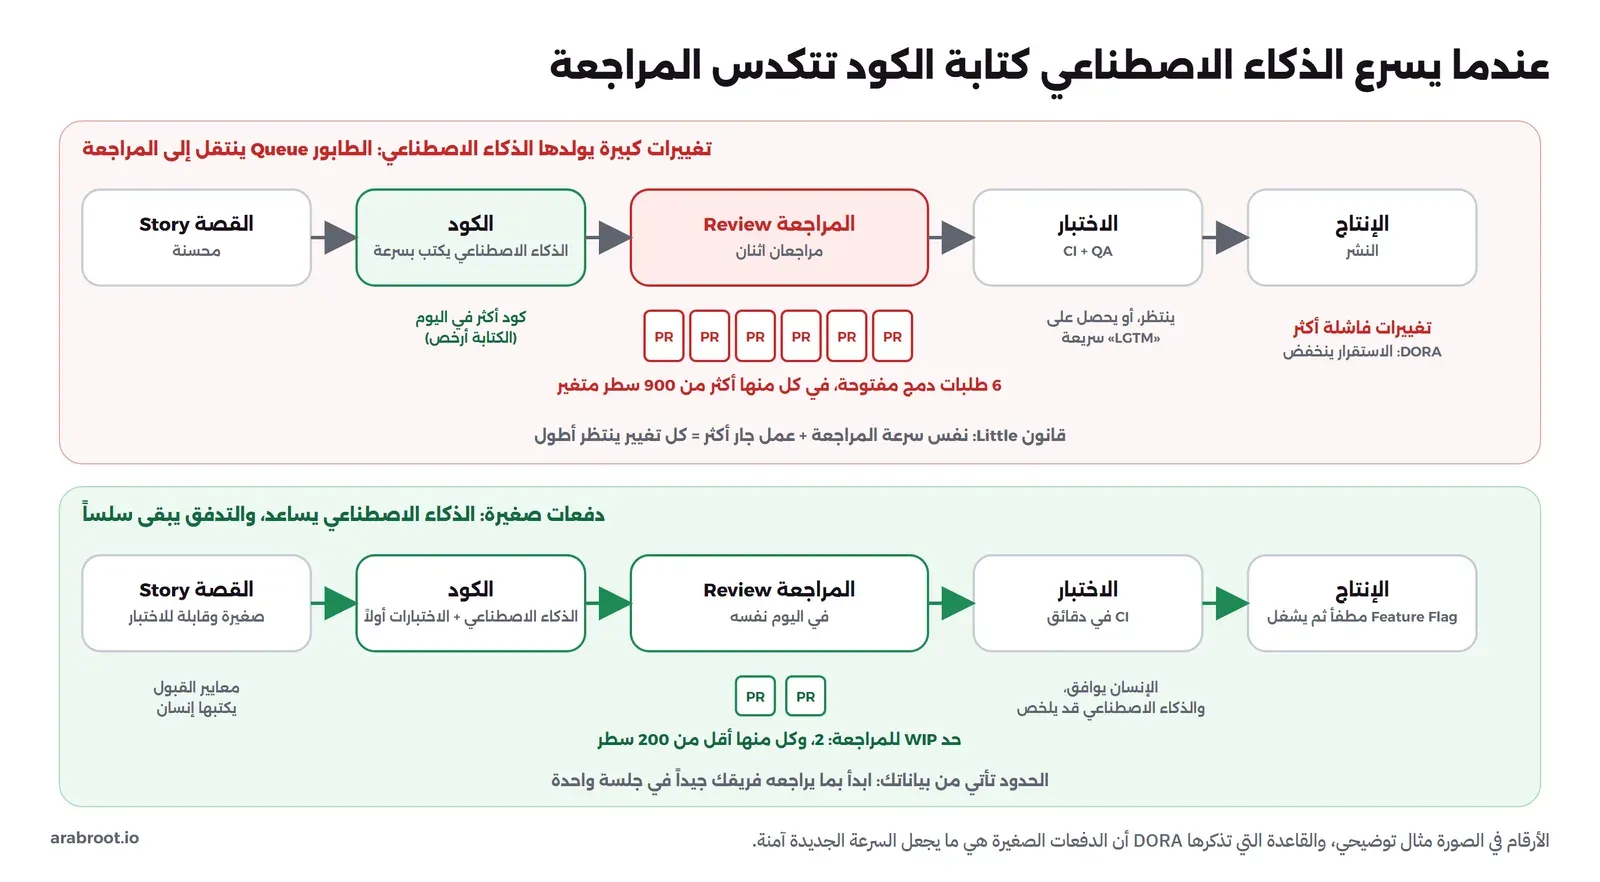
قصص User Stories أصغر، لا قصص أكبر
الخطأ الشائع: «الفريق صار أسرع، فليأخذ قصصاً أكبر في كل سبرنت»، أو تطلب من الأداة أن تكتب الميزة كلها في تغيير واحد كبير.
لماذا يفشل: التغيير الكبير صعب المراجعة والاختبار والدمج. وهذا ما تقوله صفحة DORA عن الدفعات الصغيرة: الذكاء الاصطناعي يكتب كتلاً كبيرة بسرعة، لكن التغييرات الكبيرة صعب أن تراجع وتختبر بأمان. والدفعات الصغيرة هي العلاج الذي يقابل انخفاض الاستقرار.
الأفضل: استخدم الوقت الذي وفرته الأداة لتقسم العمل أكثر. كل قصة يمكن أن تصل إلى المستخدمين وحدها، وكل تغيير يقرؤه زميلك في جلسة واحدة.
المراجعة Code Review تصبح عنق الزجاجة Bottleneck
إذا كان الفريق يكتب ضعف ما كان يكتبه، ويراجع بالسرعة نفسها، فبحسب قانون Little سيتضاعف الانتظار أمام المراجعة. وعندها يحدث أحد أمرين، وكلاهما سيئ:
- تنتظر التغييرات أياماً.
- أو يوافق المراجع بسرعة دون أن يقرأ.
العلاج من أدوات Kanban نفسها:
- حد للعمل الجاري WIP Limit على عمود المراجعة.
- حد لحجم كل تغيير. وشرحنا شكل التغييرات الصغيرة في التطوير على الفرع الرئيسي.
- من ينتهي من عمله ويجد المراجعة ممتلئة، يراجع قبل أن يبدأ شيئاً جديداً.
ويمكن أن يساعد الذكاء الاصطناعي في المراجعة نفسها، بأن يلخص التغيير ويشير إلى الأجزاء الخطرة. لكن الموافقة تبقى لإنسان يفهم التغيير.
معايير القبول Acceptance Criteria والاختبارات Tests أهم من قبل
عندما يكتب شخص البرنامج، فهو يفهم عادة ما يجب أن يحدث. وعندما تكتبه أداة، فهي تكتب شيئاً يبدو صحيحاً. وفي استبيان Stack Overflow كانت أكبر شكوى أن الحلول «صحيحة تقريباً».
لذلك تصبح معايير القبول المكتوبة قبل البدء هي المرجع الذي يحكم به على ما كتبته الأداة. ويجب أن يقرر إنسان ما هو الصحيح في الاختبارات، كما شرحنا في أتمتة الاختبارات بالذكاء الاصطناعي.
عملياً: أضف إلى تعريف الإنجاز Definition of Done بندين:
- تحقق من معايير القبول شخص غير الكاتب.
- الاختبارات التي كتبتها الأداة راجعها إنسان، وتأكد أنها تفشل عندما يكون البرنامج خاطئاً.
الأداة تكتب مسودة القصة User Story، ومالك المنتج Product Owner يملكها
استخدام مفيد: أعط الأداة ملاحظات اجتماع أو مجموعة تذاكر دعم، فتقترح قصص مستخدمين ومعايير قبول وحالات حدية Edge Cases لم يفكر فيها أحد.
المشكلة: القصة التي تكتبها الأداة مقنعة الشكل، حتى لو كانت تحل المشكلة الخطأ. ودليل Scrum يقول إن مالك المنتج هو المسؤول عن عناصر القائمة وشرحها وترتيبها. وهذه مسؤولية لا تنتقل إلى أداة.
القاعدة التي نقترحها: كل قصة كتبت الأداة مسودتها، يقرؤها مالك المنتج ويعدلها ويقبلها باسمه قبل أن تدخل التخطيط. وكيف تكتب المتطلبات Requirements الجيدة أصلاً موضوع مقالين مستقلين:
 دليلهندسة المتطلبات Requirements Engineering من الطلب إلى ما يبنىما هو المتطلب Requirement، وكيف تجمعه وتكتبه وتراجعه وتدير تغييره، ولماذا تفشل مشاريع كبيرة عندما تهمل هذه الخطوة.
 دليلمن فكرة غامضة إلى متطلبات Requirements واضحة: خطوات وقوالبثماني خطوات بقوالب جاهزة تحول طلباً من سطر واحد إلى متطلبات Requirements واضحة يوقع عليها العميل ويبني عليها الفريق.
نماذج أولية Prototypes أسرع في مراجعة السبرنت Sprint Review
صار من السهل أن يبني الفريق نموذجاً أولياً يعمل في يوم بدل أسبوع. وهذا يعيدنا إلى نصيحة Royce القديمة: ابن نسخة تجريبية قبل النسخة الحقيقية.
فاستخدمه في مراجعة السبرنت لتعرض على المستخدمين فكرتين أو ثلاثاً قبل أن تلتزم بواحدة. لكن لا تطلق النموذج للمستخدمين كما هو. فقد كتب ليجيب عن سؤال، لا ليعيش سنوات، ولم يمر بتعريف الإنجاز ولا بالمراجعة الأمنية.
هل تتغير الأدوار؟
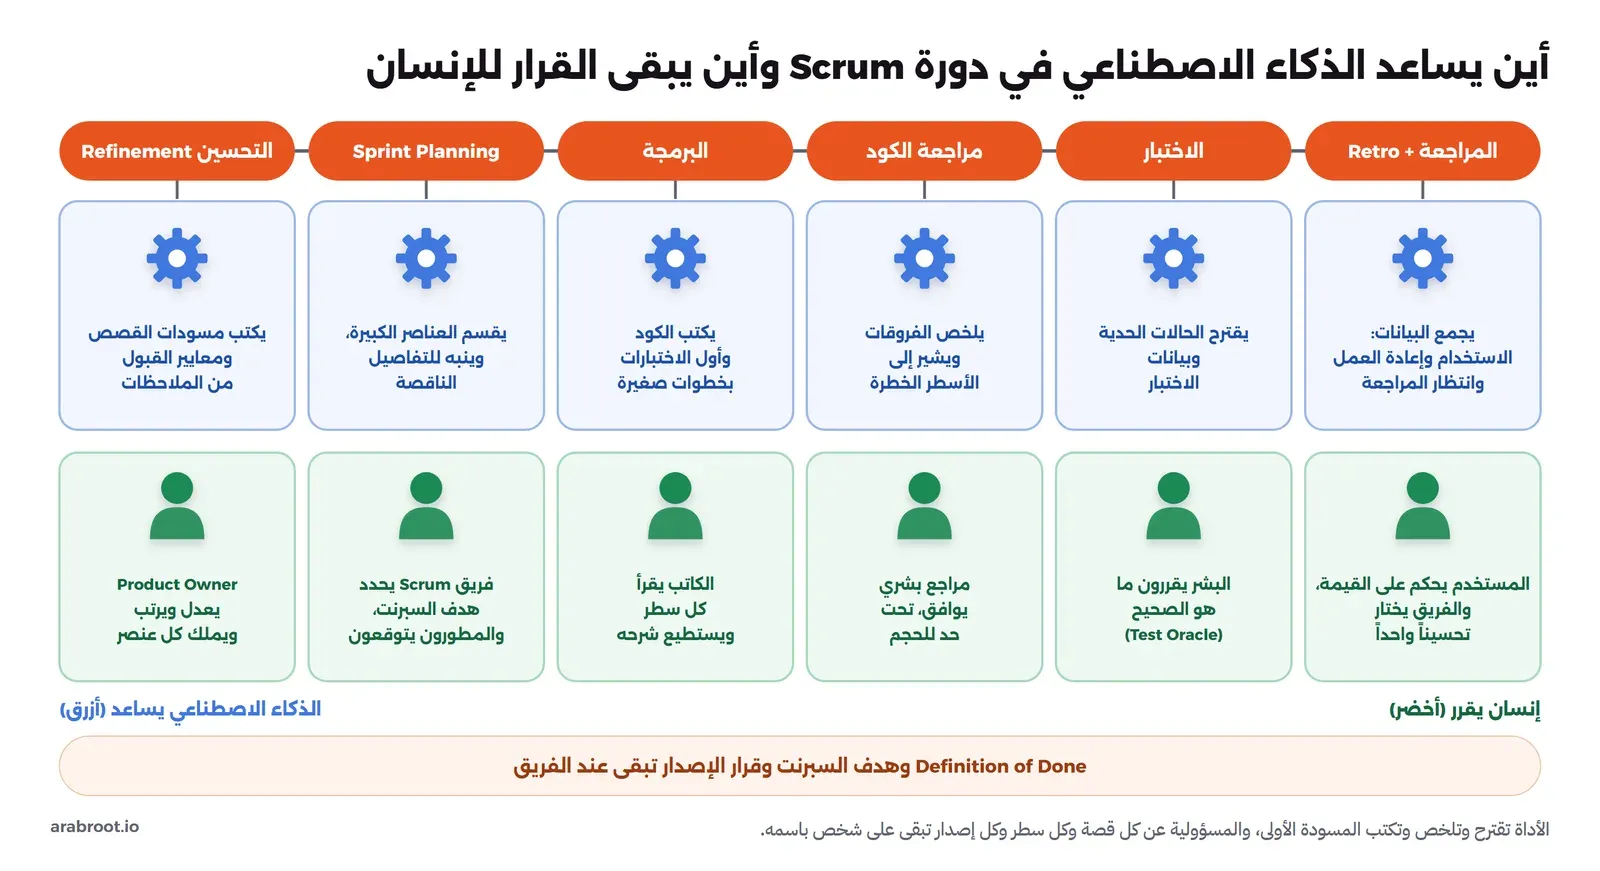
رأينا أن المسؤوليات الثلاث في دليل Scrum تبقى كما هي. فالدليل يعرفها بالمسؤولية Accountability، لا بالعمل اليدوي. ووكيل الذكاء الاصطناعي AI Agent لا يمكن أن يكون مسؤولاً عن شيء:
- المطورون مسؤولون عن الجودة وتعريف الإنجاز، حتى لو كتب الوكيل نصف البرنامج.
- مالك المنتج مسؤول عن القيمة.
- Scrum Master مسؤول عن فعالية الفريق، ومن ذلك أن يلاحظ أن المراجعة صارت العائق.
وتوقعنا، وهو رأي لا نتيجة بحث: سينتقل وقت المطور من الكتابة إلى تحديد المطلوب بدقة والتحقق منه. والصورة التالية تبين أين تساعد الأداة في كل خطوة، وأين يبقى القرار لشخص:
المخاطر وكيف تتعامل معها
| الخطر | كيف يحدث | كيف تتعامل معه |
|---|---|---|
| ضغط المراجعة والموافقة السريعة Rubber Stamping | المراجع يرى عشرة تغييرات كبيرة في اليوم فيتعب، فيوافق دون قراءة، ويدخل البرنامج «الصحيح تقريباً» | حدود لحجم التغيير وعدده. وقاعدة: الكاتب يستطيع شرح كل سطر دون الرجوع إلى الأداة، وإلا فالتغيير غير جاهز للمراجعة |
| الجودة Quality والاستقرار Stability | انخفاض الاستقرار في بيانات DORA للسنتين هو الإشارة الأوضح حتى الآن | قس ما يحدث بعد الإطلاق: نسبة التغييرات التي تحتاج إصلاحاً عاجلاً، وزمن التعافي، وكم من العمل عاد كأخطاء. ولا تقس عدد الأسطر أو نسبة ما كتبته الأداة |
| ضعف المهارات Deskilling | المهارة التي لا تستخدم تضعف. والدراسة الميدانية وجدت أن الأقل خبرة هم الأكثر استخداماً للأداة، وهم من يحتاج أن يتعلم | وقت للتمرين داخل السبرنت، كما في جلسة أسبوعية مع الفريق |
| الأمن Security | الوكيل الذي يقرأ تذاكر أو صفحات قد تصله تعليمات مخفية. والوكيل الذي له صلاحية كتابة قد يفعل أكثر مما تريد. والأداة قد تقترح مكونات بأسماء غير موجودة يسجلها مهاجم لاحقاً | الوكيل يعمل في بيئة معزولة Sandbox، دون مفاتيح الأنظمة الحية، وكل مكون جديد يقترحه يتحقق منه إنسان |
وللتفاصيل: قياس الاستقرار ومقاييس DORA في خارطة CTO لشركة SaaS ناشئة. والأبحاث عن تسليم التفكير للأدوات في مقال تمارين Kata.
وعن الأمن: حقن التعليمات Prompt Injection، والصلاحيات الزائدة Excessive Agency، وسلسلة التوريد من قائمة OWASP لتطبيقات نماذج اللغة Language Models. وحماية المكونات الخارجية في أمن سلسلة التوريد البرمجية، واكتشاف كلمات المرور Passwords والمفاتيح المسربة في اكتشاف الأسرار المسربة.
قالب سياسة فريق لاستخدام الذكاء الاصطناعي Team AI Policy
توصي صفحة DORA عن الموقف الواضح من الذكاء الاصطناعي بأن تكون السياسة في ثلاث خانات بدل «مسموح أو ممنوع»: ممنوع، ومسموح بضوابط، ومسموح. وأن تكون وثيقة حية سهلة الوصول تتطور مع الأسئلة.
لماذا؟ لأن الغموض نفسه خطر. المطور الذي لا يعرف المسموح إما أن يتجنب الأداة كلها، أو يستخدمها في الخفاء.
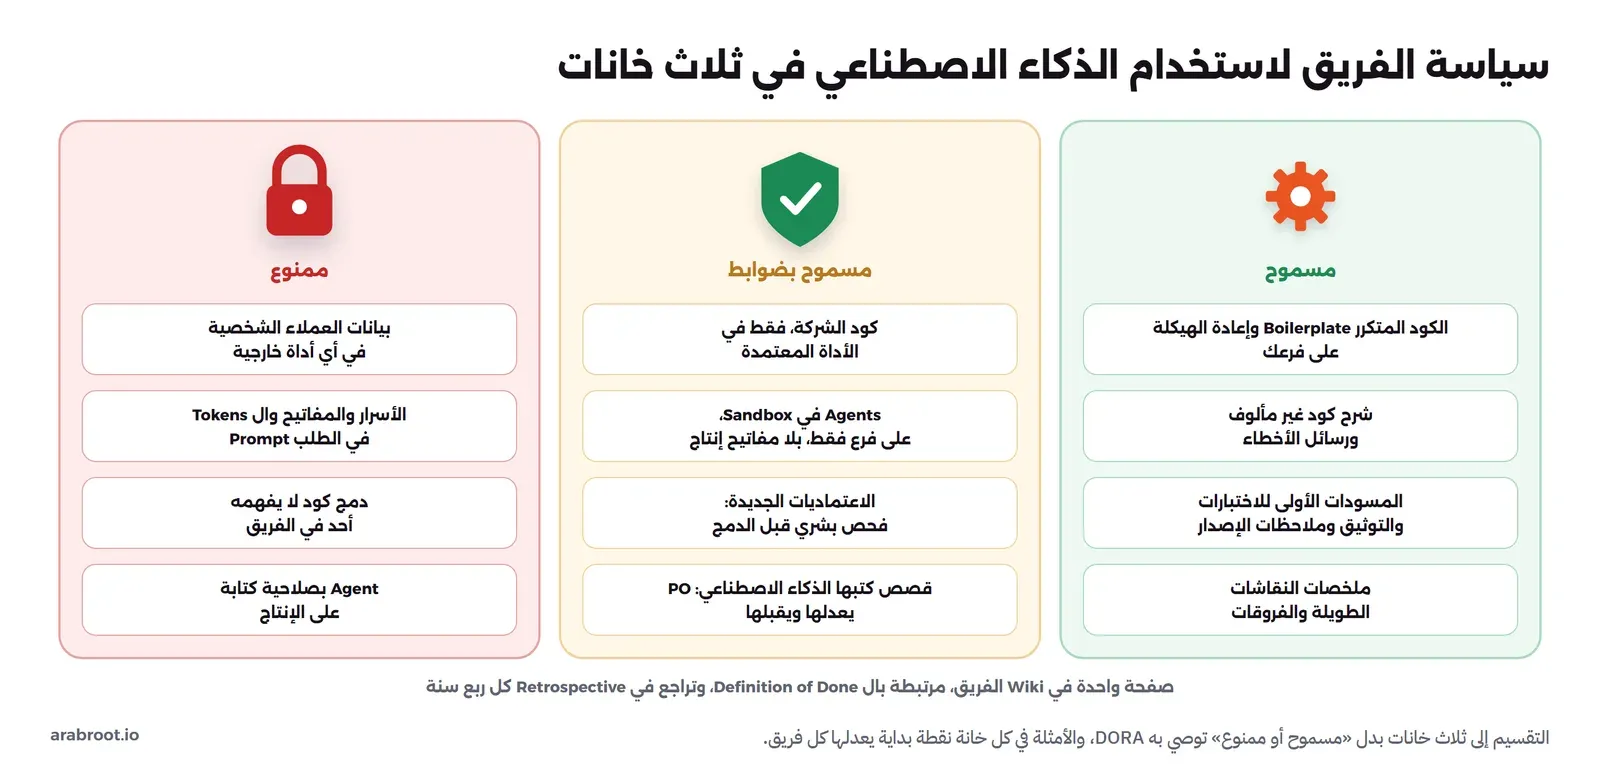
والقالب التالي صفحة واحدة تضعها في مساحة توثيق الفريق، وعدله بما يناسبك:
| البند | القاعدة |
|---|---|
| المالك والمراجعة | مالك السياسة: Scrum Master. تراجع كل ربع سنة |
| الأدوات المعتمدة | مساعد برمجة محدد بحساب الشركة فقط. ونموذج محادثة معتمد للتوثيق والقصص، أو نموذج تشغله المؤسسة بنفسها |
| ممنوع | بيانات العملاء الشخصية، أو سجلات الأنظمة الحية، أو كلمات المرور والمفاتيح في أي طلب للأداة. ودمج برنامج لا يستطيع كاتبه شرحه سطراً سطراً. ووكيل له صلاحية كتابة على الأنظمة الحية أو النسخة الرئيسية |
| مسموح بضوابط | برنامج الشركة في الأدوات المعتمدة فقط. والوكلاء في بيئة معزولة دون مفاتيح الأنظمة الحية. وكل مكون خارجي جديد تقترحه الأداة يتحقق إنسان من اسمه ومصدره وترخيصه. والقصص التي كتبت الأداة مسودتها يعدلها مالك المنتج ويقبلها |
| مسموح | الأجزاء المتكررة وتحسين التصميم وشرح البرنامج. والمسودات الأولى للاختبارات والتوثيق وملاحظات الإصدار، ويراجعها إنسان |
| قواعد سير العمل | كل تغيير أقل من نحو 200 سطر، وما هو أكبر يقسم. وحد المراجعة: تغييران لكل مراجع. والمراجعة في يوم العمل نفسه. والكاتب يجيب عن أسئلة المراجعة دون أن يسأل الأداة |
| إضافات تعريف الإنجاز | معايير القبول تحقق منها غير الكاتب. والاختبارات التي كتبتها الأداة روجعت وجربت على برنامج خاطئ ففشلت. ولا كلمات مرور جديدة في البرنامج، ولا مكونات خارجية دون فحص |
| ما نقيسه | على مستوى الفريق فقط، وليس الأفراد: مقاييس DORA، وزمن الإنجاز، ووقت الانتظار للمراجعة، والعمل الذي عاد بعد الإطلاق |
ثلاث ملاحظات على القالب:
- الأرقام نقطة بداية لا قاعدة علمية. مثل 200 سطر وحد المراجعة 2. ابدأ بها، ثم عدلها من بيانات لوحتك بعد سبرنتين أو ثلاثة.
- المقاييس للفريق فقط. قياس الأفراد بعدد التغييرات أو بنسبة ما كتبته الأداة يدفع الناس إلى تضخيم الأرقام، كما حدث مع النقاط.
- إذا كانت بيانات مؤسستك لا يجوز أن تخرج إليها، فالنموذج المحلي خيار يستحق النظر، كما في أتمتة الاختبارات بالذكاء الاصطناعي.
ما الذي لا يتغير في Agile؟
إذا رجعت إلى المبادئ الاثني عشر في بيان Agile، فلن تجد مبدأً واحداً تلغيه الأداة. البرنامج الذي يعمل ما زال المقياس الأول للتقدم. والتسليم المتكرر ما زال أفضل من الكبير. والأعمال والمطورون ما زالوا يحتاجون العمل معاً كل يوم. والوتيرة التي يمكن الاستمرار عليها ربما صارت أهم، عندما يستطيع كل شخص أن يبدأ عشرة أعمال في صباح واحد.
ويبقى كذلك:
- الأشخاص والمسؤولية Accountability: كل قصة وكل سطر وكل إصدار له شخص يملكه ويستطيع شرحه.
- حلقات التغذية الراجعة Feedback Loops: مراجعة مع المستخدمين، واختبارات آلية سريعة، ومراقبة بعد الإطلاق. فالأداة تسرع الكتابة، ولا تسرع معرفة هل ما كتبته مفيد.
- الدفعات الصغيرة Small Batches: وهي في بيانات DORA ما يحول السرعة الجديدة إلى قيمة، بدل أن يحولها إلى عدم استقرار.
توقعات للسنوات القادمة، بوصفها آراء
ما يلي توقعات لا نتائج، ولكل منها من قاله:
- الأثر يعتمد على الفريق أكثر من الأداة: رأي تقرير DORA 2025 الذي وصف الذكاء الاصطناعي بأنه مضخم. فالتوقع أن تتسع الفجوة بين الفرق التي عندها الأساسيات والفرق التي ليس عندها.
- السرعة الفردية ترتفع مع الأدوات الأحدث: ما تعتقده METR في تحديث فبراير 2026 من حديثها مع المشاركين، مع تأكيدها أن بياناتها لا تكفي لتقدير الحجم.
- أطر العمل التجارية تعيد تسويق نفسها حول الذكاء الاصطناعي: أضافت SAFe نسخة باسم AI-Native SAFe. وتذكر نقد Schwaber وFowler لأطر التوسع في المقال السابق، فاسم جديد للإطار لا يغير المشكلة.
- رأينا نحن: قيد التخطيط في السبرنت سيكون أقل في الكتابة، وأكثر في المراجعة والاختبار وفهم المطلوب. لذلك نتوقع أن تهتم الفرق الناجحة بحد المراجعة وجودة معايير القبول، أكثر من عدد النقاط.
قائمة تحقق قبل أن يعتمد فريقك على الذكاء الاصطناعي Checklist
- هل عند الفريق سياسة مكتوبة بثلاث خانات، ولها مالك وموعد مراجعة؟
- هل على عمود المراجعة حد للعمل الجاري، ولكل تغيير حد للحجم؟
- هل يشمل تعريف الإنجاز التحقق من معايير القبول ومراجعة الاختبارات التي كتبتها الأداة؟
- هل كل قصة كتبت الأداة مسودتها قبلها مالك المنتج باسمه؟
- هل تعمل الوكلاء في بيئة معزولة دون مفاتيح الأنظمة الحية، وتفحص المكونات الجديدة التي تقترحها؟
- هل تقيسون التسليم والاستقرار بعد الإطلاق، لا عدد الأسطر أو نسبة ما كتبته الأداة؟
- هل في السبرنت وقت لتمرين المهارات، خاصة للمطورين الجدد؟
الخلاصة
- الاستخدام صار شبه عام، لكن النتائج تختلف بحسب ما تقيسه: المهمة الصغيرة أسرع، والتسليم في بيانات DORA أقل استقراراً، وشعور المطور بسرعته قد يخالف القياس.
- دراسات GitHub وMicrosoft مفيدة، لكن أجرتها جهات تبيع الأداة، وتقيس السرعة أو عدد المهام لا الجودة بعد الإطلاق.
- الذكاء الاصطناعي ينقل الضغط من الكتابة إلى المراجعة والاختبار. فضع حداً للعمل الجاري على المراجعة، وحداً لحجم كل تغيير.
- القصص أصغر لا أكبر. ومعايير القبول والاختبارات التي يقررها إنسان أهم من قبل. والأداة تكتب مسودة القصة، ومالك المنتج يملكها.
- المسؤوليات الثلاث في Scrum لا تتغير، لأن الأداة لا يمكن أن تكون مسؤولة. والسياسة الواضحة في ثلاث خانات تقلل الخطر وتشجع الاستخدام الصحيح.
- ما لا يتغير هو الأهم: الأشخاص، وحلقات التغذية الراجعة، والدفعات الصغيرة.
 دليلAgile بلا شعارات: Scrum وKanban كما يطبقان فعلاًمن أين جاءت Agile، وكيف تعمل Scrum وKanban كما تصفها أدلتها الرسمية، وما الأخطاء التي تحولها إلى اجتماعات بلا فائدة.
 دليللماذا تتمرن دون ذكاء اصطناعي؟ تمارين Kata لك ولفريقكما الذي تقوله الأبحاث عن تسليم التفكير للأدوات، وكيف يحفظ روتين صغير من التمارين تحلها بيدك مهارتك وحدك ومع فريقك.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليلOWASP Top 10 لتطبيقات LLM: المخاطر وكيف تحمي تطبيقكأخطر عشر مشكلات في التطبيقات المبنية على نماذج اللغة، من حقن التعليمات Prompt Injection إلى تسرب البيانات، وكيف تمنع كلاً منها.
 دليلأمن سلسلة التوريد البرمجية Software Supply Chain للمبتدئينكل ما بين كود غيرك وسيرفرك قد يحمل كود المهاجم، وهنا تعرف التهديدات الحقيقية بحوادث موثقة والدفاع المناسب لكل حلقة.
 دليلTrunk-Based Development: فروع قصيرة ودمج يوميلماذا تنفجر الفروع الطويلة يوم الإصدار، وكيف يدمج الفريق عمله في main كل يوم بأمان مع CI وFeature Flags.
سجل التحديثات
- 2026-11-13: إعادة كتابة المقال بلغة أوضح وخطوات وجداول، دون كود.
- أكتوبر 2026: كتابة المقال من تقارير DORA 2024 و2025، وتجربة METR 2025 وتحديثها في فبراير 2026، ودراستي Peng 2023 وCui 2025، واستبياني Stack Overflow 2025 و2026، مع رسومات للأدلة وعنق الزجاجة في المراجعة ودورة Scrum وقالب السياسة.