عندما تكتب kubectl apply -f لأول مرة ثم kubectl get pods فترى ال Pods تظهر وتعمل خلال ثوان، يبدو الأمر كأن أمراً واحداً شغل التطبيق Application، ولكن الذي حدث في الحقيقة أن خمسة برامج مختلفة على أكثر من جهاز تبادلت الرسائل عبر قاعدة بيانات Database واحدة، وكل واحد منها لا يعرف شيئاً عن الآخر. ولا تحتاج إلى معرفة ذلك ما دام كل شيء يعمل، ولكن في أول يوم يبقى فيه Pod على الحالة Status Pending، أو تختفي عقدة Node فتبقى ال Pods عليها بحالة Running خمس دقائق، أو يتوقف DNS في العنقود Cluster كله لأن سيرفراً Server واحداً توقف، سوف تحتاج أن تعرف من المسؤول عن ماذا، وأين تبحث.
وفي هل تحتاج Kubernetes فعلاً؟ ناقشنا متى يستحق Kubernetes تكلفته، وفي مصطلحات Kubernetes بالرسم شرحنا الكلمات نفسها من Pod إلى Ingress دون عنقود حقيقي. أما هذا المقال فيشغل عنقوداً حقيقياً من ثلاث عقد على جهازك بأداة kind، ثم يفتحه من الداخل: نقرأ مفتاحاً Key حقيقياً من etcd، ونشاهد حلقة التحكم Control Loop تعيد Pod حذفناه، ونجعل المجدول Scheduler يرفض Pod ونقرأ رسالته، ثم نوقف عقدة كاملة ونقيس كم ثانية احتاج العنقود ليلاحظ، وماذا تعطل في الطريق ولم نكن نتوقعه.
وسوف نناقش في هذا المقال ما يلي:
- تشغيل عنقود من ثلاث عقد مع kind، والخطأ الذي منع ال kubelet من البدء على جهاز يستخدم cgroup v1.
- أجزاء التحكم Control Plane: ال API Server وetcd والمجدول Scheduler ومدير المتحكمات Controller Manager، وكيف يشغلها ال kubelet من ملفات.
- قراءة حالة العنقود مباشرة من etcd، ولماذا تظهر كلمة مرور ال Secret فيها كما هي.
- ما يعمل على كل عقدة: ال kubelet وcontainerd وkube-proxy، وكيف يصل الطلب إلى Pod عبر قواعد iptables.
- حلقة التحكم Reconcile Loop والجدولة Scheduling والعلامات Taints، بأمثلة فشلت ثم أصلحناها.
- ماذا يحدث عندما تتوقف عقدة عاملة، وعندما تتوقف أجزاء التحكم نفسها، بالتوقيتات المقاسة.
عنقود Cluster حقيقي على جهازك مع kind
لكي ترى أجزاء Kubernetes تعمل تحتاج عنقوداً فيه عقدة تحكم وعقد عاملة، وليس عقدة واحدة تقوم بكل شيء، لأن أهم ما سنراه هو ما يحدث بين العقد. والخيارات المعروفة لتشغيل عنقود على جهاز واحد هي minikube الذي يشغل العنقود في جهاز افتراضي أو Container، وk3d الذي يشغل K3s داخل Containers، وkind واسمه اختصار Kubernetes in Docker، وهو الذي يستخدمه مشروع Kubernetes نفسه في اختباراته. واخترنا kind لأنه يشغل Kubernetes القياسي كما يثبته kubeadm على سيرفر حقيقي، بنفس أسماء الملفات والمكونات، فما تراه هنا هو ما ستجده على عنقود حقيقي، بينما يجمع K3s أجزاء التحكم في برنامج واحد ويستبدل etcd افتراضياً بقاعدة SQLite، وهذا مناسب للتشغيل ولكنه يخفي ما نريد رؤيته الآن. وتثبيت K3s على سيرفر حقيقي له مقال مستقل في هذه المرحلة من المسار.
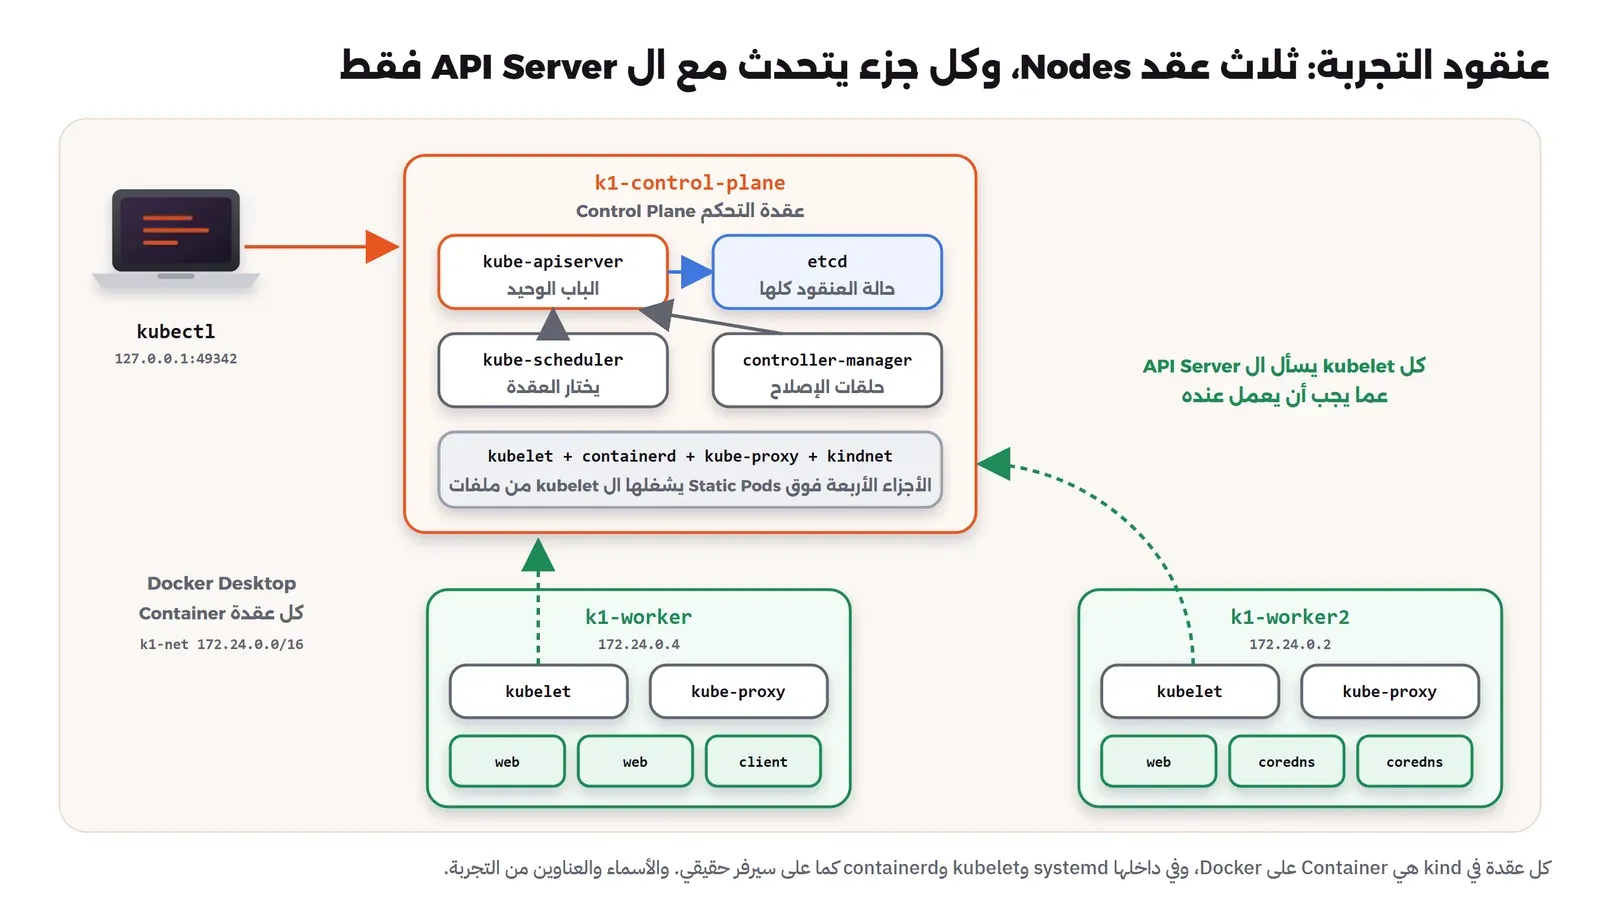
وكل عقدة في kind هي Container على Docker، وفي داخله systemd وال kubelet وcontainerd كما على أي سيرفر Linux، والصورة التالية تبين العنقود الذي سنبنيه بالأسماء والعناوين التي ظهرت في التجربة:
وملف الإعداد التالي ينشئ عقدة تحكم وعقدتين عاملتين، مع تثبيت صورة العقدة بالإصدار Version وال Digest حتى تحصل على نفس النسخة التي جربناها:
# kind 0.33.0: one control plane and two workers, each node is a Docker container.
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: k1
nodes:
  - role: control-plane
    image: kindest/node:v1.36.4@sha256:099e049362a1526b2db71494e1947aae99bd16290d7c895f2b7ea312e3cbfaed
  - role: worker
    image: kindest/node:v1.36.4@sha256:099e049362a1526b2db71494e1947aae99bd16290d7c895f2b7ea312e3cbfaed
  - role: worker
    image: kindest/node:v1.36.4@sha256:099e049362a1526b2db71494e1947aae99bd16290d7c895f2b7ea312e3cbfaed
# Only for hosts that still use cgroup v1 (Docker Desktop on WSL2 here): since Kubernetes 1.35
# the kubelet refuses to start on cgroup v1 unless this is set. Remove it on a cgroup v2 host.
kubeadmConfigPatches:
  - |
    kind: KubeletConfiguration
    failCgroupV1: false
والجزء الأخير من الملف لم يكن موجوداً في المحاولة الأولى، فقد بقي الأمر kind create cluster على خطوة Starting control-plane ثلاث دقائق ثم فشل، وكان أول سطر في مخرجه Output تحذيراً من cgroup v1 لم ننتبه له. وعندما قرأنا سجل Log ال kubelet داخل عقدة التحكم وجدنا السبب:
docker exec k1-control-plane journalctl -u kubelet --no-pager | grep "cgroup v1"E1118 17:35:59.887982 521 run.go:72] "command failed" err="failed to validate kubelet configuration, error: kubelet is configured to not run on a host using cgroup v1. cgroup v1 support is unsupported and will be removed in a future release, path: &TypeMeta{Kind:,APIVersion:,}"
Nov 18 17:35:59 k1-control-plane systemd[1]: kubelet.service: Main process exited, code=exited, status=1/FAILUREومجموعات التحكم cgroups هي ما يستخدمه ال kubelet ليحدد ذاكرة Memory كل Container ومعالجه CPU، وقد شرحناها في ما هي ال Containers. ومنذ Kubernetes 1.35 أصبح ال kubelet يرفض البدء على النسخة القديمة cgroup v1 ما لم تضبط الحقل failCgroupV1: false، كما تشرح وثائق cgroups في Kubernetes ومقترح إزالة cgroup v1. ونواة Kernel في WSL2 التي يستخدمها Docker Desktop هنا ما زالت على cgroup v1، فأضفنا الحقل عبر kubeadmConfigPatches كما تشرح صفحة إعداد kind. وفي مقال CloudNativePG اخترنا حلاً آخر للمشكلة نفسها، وهو النزول إلى Kubernetes 1.34. وعلى أي سيرفر Linux حديث بنظام cgroup v2 لن تحتاج أياً منهما، فلا تنسخ هذا الحقل إلى عنقود حقيقي، والسبب أن دعم cgroup v1 سوف يزال تماماً، والحقل يؤجل المشكلة فقط.
وبعد إضافة الحقل نجح الإنشاء، ونستخدم ملف kubeconfig خاصاً بالتجربة حتى لا يغير kind إعدادات kubectl الأخرى على جهازك، واسماً خاصاً لشبكة Docker Network:
export KUBECONFIG=$PWD/k1.kubeconfig
export KIND_EXPERIMENTAL_DOCKER_NETWORK=k1-net
kind create cluster --config kind-k1.yaml
kubectl get nodes -o wide
docker ps --filter name=k1-
NAME STATUS ROLES AGE VERSION INTERNAL-IP EXTERNAL-IP OS-IMAGE KERNEL-VERSION CONTAINER-RUNTIME
k1-control-plane NotReady control-plane 37s v1.36.4 172.24.0.3 <none> Debian GNU/Linux 13 (trixie) 5.15.167.4-microsoft-standard-WSL2 (amd64) containerd://2.3.4
k1-worker NotReady <none> 11s v1.36.4 172.24.0.4 <none> Debian GNU/Linux 13 (trixie) 5.15.167.4-microsoft-standard-WSL2 (amd64) containerd://2.3.4
k1-worker2 NotReady <none> 11s v1.36.4 172.24.0.2 <none> Debian GNU/Linux 13 (trixie) 5.15.167.4-microsoft-standard-WSL2 (amd64) containerd://2.3.4
NAMES IMAGE STATUS PORTS
k1-control-plane kindest/node:v1.36.4 Up About a minute 127.0.0.1:49342->6443/tcp
k1-worker kindest/node:v1.36.4 Up About a minute
k1-worker2 kindest/node:v1.36.4 Up About a minute في المخرج أعلاه لاحظ التالي:
- العقد الثلاث بحالة
NotReadyفي الثواني الأولى، والسبب أن إضافة الشبكة CNI لم تكن قد بدأت بعد، وال kubelet لا يعلن جاهزية Readiness العقدة قبل أن تعمل شبكة ال Pods. وبعد أقل من دقيقة أصبحت كلهاReady، ولكن k1-worker تأخرت عن k1-worker2 قليلاً، وسوف نرى لاحقاً أن هذا التأخير الصغير كان سبب أكبر عطل في التجربة. - عقدة التحكم وحدها تنشر منفذاً Port على جهازك، وهو 49342 الموجه إلى 6443، وهذا منفذ ال API Server، فكل ما يفعله kubectl يمر من هنا.
- بيئة التشغيل Container Runtime هي containerd 2.3.4 وليست Docker، فال Containers داخل العقد لا تظهر في
docker psعلى جهازك، وإنما تظهر بالأداةcrictlداخل كل عقدة. - النواة واحدة للعقد الثلاث، وهي نواة جهازك، لأنها كلها Containers على نفس الجهاز، وهذا أهم فرق بين kind وعنقود حقيقي، ونعود إليه في الجدولة.
أجزاء التحكم Control Plane: أين تعمل وكيف تبدأ؟
أجزاء التحكم هي البرامج التي تحفظ ما تطلبه وتقرر ما يحدث، وتصف صفحة مكونات Kubernetes أربعة أجزاء أساسية منها. ولننظر إليها أولاً كما تعمل فعلاً على عقدة التحكم، قبل أن نشرح كل واحد:
kubectl get pods -n kube-system -o wideNAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
coredns-589f44dc88-5pblr 0/1 ContainerCreating 0 77s <none> k1-worker2 <none> <none>
coredns-589f44dc88-g5d9c 0/1 ContainerCreating 0 77s <none> k1-worker2 <none> <none>
etcd-k1-control-plane 1/1 Running 0 81s 172.24.0.3 k1-control-plane <none> <none>
kindnet-f7lzb 1/1 Running 0 68s 172.24.0.4 k1-worker <none> <none>
kindnet-krjf7 1/1 Running 0 76s 172.24.0.3 k1-control-plane <none> <none>
kindnet-mb8dq 1/1 Running 0 68s 172.24.0.2 k1-worker2 <none> <none>
kube-apiserver-k1-control-plane 1/1 Running 0 81s 172.24.0.3 k1-control-plane <none> <none>
kube-controller-manager-k1-control-plane 1/1 Running 1 (45s ago) 89s 172.24.0.3 k1-control-plane <none> <none>
kube-proxy-99cz7 1/1 Running 0 68s 172.24.0.2 k1-worker2 <none> <none>
kube-proxy-ft8pv 1/1 Running 0 68s 172.24.0.4 k1-worker <none> <none>
kube-proxy-lls2k 1/1 Running 0 78s 172.24.0.3 k1-control-plane <none> <none>
kube-scheduler-k1-control-plane 1/1 Running 1 (40s ago) 87s 172.24.0.3 k1-control-plane <none> <none>في المخرج أعلاه لاحظ التالي:
- أجزاء التحكم الأربعة تظهر كأنها Pods عادية في ال Namespace المسمى
kube-system، وأسماؤها تنتهي باسم العقدةk1-control-plane، وهذا ليس صدفة كما سيأتي. - عنوان IP لهذه ال Pods هو عنوان العقدة نفسها 172.24.0.3، لأنها تعمل على شبكة العقدة مباشرة Host Network، فهي التي تبني شبكة ال Pods ولا تستطيع أن تعتمد عليها.
- kube-proxy وkindnet لهما نسخة على كل عقدة، لأنهما DaemonSet، أما CoreDNS فنسختان فقط، وكلاهما على k1-worker2، وتذكر هذا السطر.
- المجدول ومدير المتحكمات أعادا التشغيل مرة بعد أقل من دقيقة من البدء، وسنعرف السبب بعد قليل.
من يشغل أجزاء التحكم؟ Static Pods
قد يتساءل البعض: إذا كان المجدول هو الذي يختار لكل Pod عقدته، فمن جدول المجدول نفسه؟ ومن شغل ال API Server قبل أن يوجد API Server يستقبل الطلبات؟ والإجابة أن ال kubelet على عقدة التحكم يقرأ ملفات YAML من مجلد Directory على القرص Disk ويشغلها بنفسه دون أن يسأل أحداً، وتسمى هذه Static Pods كما في صفحة ال Static Pods:
docker exec k1-control-plane ls /etc/kubernetes/manifests
docker exec k1-control-plane grep -E 'staticPodPath|failCgroupV1|cgroupDriver|clusterDNS' -A1 /var/lib/kubelet/config.yaml
docker exec k1-control-plane crictl ps
etcd.yaml
kube-apiserver.yaml
kube-controller-manager.yaml
kube-scheduler.yaml
cgroupDriver: systemd
cgroupRoot: /kubelet
clusterDNS:
- 10.96.0.10
--
failCgroupV1: false
failSwapOn: false
--
staticPodPath: /etc/kubernetes/manifests
streamingConnectionIdleTimeout: 0s
CONTAINER IMAGE CREATED STATE NAME ATTEMPT POD ID POD NAMESPACE
4ae6512a43620 c27613cea70f9 14 seconds ago Running kube-controller-manager 2 b734ab83556cd kube-controller-manager-k1-control-plane kube-system
fa421fc6eb638 11ce0d8bbc73b 14 seconds ago Running kube-scheduler 2 3a09e2d16a0ab kube-scheduler-k1-control-plane kube-system
9043fdb231b20 4626fe10df5b9 2 minutes ago Running kindnet-cni 0 f6828d6b28507 kindnet-krjf7 kube-system
be5bd6027cd8f a5280d36e1aa3 2 minutes ago Running kube-proxy 0 94d18e3e443df kube-proxy-lls2k kube-system
4f1d83a4ffd39 ee85eb1f0edd2 2 minutes ago Running etcd 0 b6f45e0648111 etcd-k1-control-plane kube-system
607de004d96c9 b0f70fa6ec47e 2 minutes ago Running kube-apiserver 0 a3ca5ec1803f8 kube-apiserver-k1-control-plane kube-systemفي الإعداد أعلاه لاحظ التالي:
- الحقل
staticPodPathفي إعداد ال kubelet يشير إلى المجلد الذي فيه الملفات الأربعة، فكل ملف تضعه هناك يصبح Pod يعمل، وكل ملف تحذفه يتوقف Pod الخاص به، وهذه هي الطريقة التي يغير بها kubeadm إعدادات ال API Server عند الترقية Upgrade. - ما تراه في
kubectl get podsلهذه الأجزاء هو نسخة عرض Mirror Pod ينشئها ال kubelet في ال API Server لكي تراها، فإذا حذفتها بkubectl deleteعادت فوراً، لأن مصدرها الملف وليس ال API Server. - العمود
ATTEMPTفيcrictl psيقول 2 للمجدول ومدير المتحكمات، أي أنهما توقفا مرتين خلال دقيقتين، وclusterDNSهو العنوان 10.96.0.10 الذي سيكتبه ال kubelet في ملف/etc/resolv.confداخل كل Pod.
وال kubelet نفسه ليس Pod، وإنما خدمة systemd عادية على كل عقدة، كما شرحنا الخدمات في الخدمات والسجلات مع systemd، ولذلك قرأنا خطأه بالأمر journalctl -u kubelet. وهذا ترتيب منطقي: systemd يشغل containerd وال kubelet، وال kubelet يشغل أجزاء التحكم من الملفات، وأجزاء التحكم تدير كل ما بعدها. وإذا أردت أن تعرف كم تستهلك هذه الأجزاء من الذاكرة فهذا ما ظهر على عقدة التحكم بعد دقيقتين:
docker exec k1-control-plane ps -eo pid,comm,rss --sort=-rss | head -9 PID COMMAND RSS
661 kube-apiserver 274860
815 kubelet 86816
209 containerd 71000
1417 kube-controller 65444
1424 kube-scheduler 58124
751 etcd 56260
1018 kube-proxy 44792
1189 kindnetd 38472أي قرابة 700 ميجابايت لعنقود فارغ تقريباً، نصفها تقريباً لل API Server وحده، وهذا رقم مهم عندما تفكر في تشغيل Kubernetes على سيرفر صغير، وهو أحد أسباب وجود K3s الذي يجمع هذه الأجزاء في عملية واحدة أخف.
ال API Server: الباب الوحيد إلى العنقود
ال API Server واسمه kube-apiserver هو البرنامج الوحيد في العنقود الذي يقرأ من etcd ويكتب فيها، وكل ما عداه يتحدث معه هو: kubectl والمجدول والمتحكمات وال kubelet على كل عقدة. وهو خادم HTTPS عادي يستقبل طلبات REST، يتحقق من هوية الطالب Authentication ثم من صلاحيته Authorization، ثم يمرر الطلب على متحكمات القبول Admission Controllers التي قد تعدله أو ترفضه، ثم يحفظه. ويمكنك أن ترى الطلبات التي يرسلها kubectl بالخيار -v=6:
kubectl get pods -l app=web -v=6 2>&1 | grep -E 'GET|Config loaded'I1118 20:44:30.471181 31944 loader.go:407] Config loaded from file: C:/Users/…/tech-k1/k1.kubeconfig
I1118 20:44:30.634721 31944 round_trippers.go:632] "Response" verb="GET" url="https://127.0.0.1:49342/api/v1/namespaces/default/pods?labelSelector=app%3Dweb&limit=500" status="200 OK" milliseconds=113فالأمر kubectl get pods -l app=web ليس إلا طلب GET إلى المسار /api/v1/namespaces/default/pods مع ال Selector في الرابط، وأي برنامج يملك شهادة Certificate صحيحة يستطيع أن يرسل الطلب نفسه، وهذا ما تفعله كل الأدوات التي تدير Kubernetes. وال API Server يكشف أيضاً فحوصه الداخلية، فهذه أول أسطر من فحص الجاهزية:
kubectl get --raw '/readyz?verbose' | head -5[+]ping ok
[+]log ok
[+]etcd ok
[+]etcd-readiness ok
[+]informer-sync okوالسطر الثالث هو الأهم: ال API Server لا يكون جاهزاً إذا لم يصل إلى etcd، والسبب أنه لا يحفظ شيئاً عنده، فهو بلا حالة Stateless، ويمكنك أن تشغل منه ثلاث نسخ خلف موزع طلبات Load Balancer في العنقود الحقيقي، وكلها تقرأ وتكتب في etcd نفسها.
وأهم ما يقدمه ال API Server بعد القراءة والكتابة هو المراقبة Watch، فبدل أن يسأل كل جزء كل ثانية «هل تغير شيء؟»، يفتح اتصالاً Connection واحداً طويلاً ويقول «أخبرني عن كل تغيير في ال Pods»، فيرسل له ال API Server كل حدث فور حدوثه. وهذه هي الآلية التي تجعل الأجزاء كلها تعمل دون أن يتحدث أحدها مع الآخر، وتشرحها صفحة مفاهيم ال API بالتفصيل، وسوف نراها تعمل في قسم حلقة التحكم.
etcd: حالة العنقود كلها في مفاتيح Keys
etcd قاعدة بيانات من نوع مفتاح وقيمة Key-Value تعمل بالإجماع Consensus عبر خوارزمية Raft التي شرحناها في الأنظمة الموزعة، وكل كائن في العنقود محفوظ فيها كمفتاح واحد. ولكي تقرأ منها مباشرة تحتاج الأداة etcdctl وشهادات العميل، وكلاهما موجود داخل Pod ال etcd نفسه، فلنعرف أمراً قصيراً ثم نسأل:
alias etcdctl='kubectl exec -n kube-system etcd-k1-control-plane -- etcdctl \
  --endpoints=https://127.0.0.1:2379 --cacert=/etc/kubernetes/pki/etcd/ca.crt \
  --cert=/etc/kubernetes/pki/etcd/server.crt --key=/etc/kubernetes/pki/etcd/server.key'
etcdctl version
etcdctl endpoint status -w table
etcdctl get /registry --prefix --keys-only | grep -c .
etcdctl get /registry/namespaces --prefix --keys-only
etcdctl version: 3.6.8
API version: 3.6
+------------------------+------------------+---------+-----------------+---------+--------+-----------------------+--------+-----------+------------+-----------+------------+--------------------+--------+
| ENDPOINT | ID | VERSION | STORAGE VERSION | DB SIZE | IN USE | PERCENTAGE NOT IN USE | QUOTA | IS LEADER | IS LEARNER | RAFT TERM | RAFT INDEX | RAFT APPLIED INDEX | ERRORS |
+------------------------+------------------+---------+-----------------+---------+--------+-----------------------+--------+-----------+------------+-----------+------------+--------------------+--------+
| https://127.0.0.1:2379 | 13d7cb64633b7da5 | 3.6.8 | 3.6.0 | 1.8 MB | 1.8 MB | 0% | 2.1 GB | true | false | 2 | 989 | 989 | |
+------------------------+------------------+---------+-----------------+---------+--------+-----------------------+--------+-----------+------------+-----------+------------+--------------------+--------+
440
/registry/namespaces/default
/registry/namespaces/kube-node-lease
/registry/namespaces/kube-public
/registry/namespaces/kube-system
/registry/namespaces/local-path-storageفي المخرج أعلاه لاحظ التالي:
- العنقود كله بعد دقائق من إنشائه 440 مفتاحاً في قاعدة حجمها 1.8 ميجابايت، والحد الأعلى
QUOTAهو 2.1 جيجابايت، وإذا وصلت قاعدة etcd إليه تتوقف عن قبول الكتابة، فيتوقف العنقود عن قبول أي تغيير. IS LEADERصحيح لأنها نسخة واحدة، وفي العنقود الحقيقي ثلاث نسخ أو خمس، ويحتاج أي تغيير موافقة الأغلبية، ولذلك يكون العدد فردياً كما شرحنا في تجربة عنقود etcd من ثلاثة سيرفرات.- المفاتيح مرتبة كمسارات:
/registry/ثم نوع الكائن ثم ال Namespace ثم الاسم، وهذا الترتيب هو ما يجعل طلب «كل ال Pods في default» قراءة لمجموعة مفاتيح تبدأ بنفس البادئة.
والآن لننشئ Deployment صغيراً من ثلاث نسخ nginx مع Service أمامها، وسوف نتابعه في بقية المقال، ثم نبحث عن كل مفتاح ظهر بسببه:
# Three nginx replicas and a Service in front of them: the object we follow through the cluster.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: web
  labels:
    app: web
spec:
  replicas: 3
  selector:
    matchLabels:
      app: web
  template:
    metadata:
      labels:
        app: web
    spec:
      containers:
        - name: nginx
          image: nginx:1.29.8-alpine
          ports:
            - containerPort: 80
          resources:
            requests:
              cpu: 100m
              memory: 32Mi
---
apiVersion: v1
kind: Service
metadata:
  name: web
spec:
  selector:
    app: web
  ports:
    - port: 80
      targetPort: 80
kubectl apply -f web.yaml
etcdctl get /registry --prefix --keys-only | grep -E '/web' | grep -v events/registry/deployments/default/web
/registry/endpointslices/default/web-n6lm6
/registry/pods/default/web-84c845fd87-f2mdz
/registry/pods/default/web-84c845fd87-xnt6b
/registry/pods/default/web-84c845fd87-z69cb
/registry/replicasets/default/web-84c845fd87
/registry/services/endpoints/default/web
/registry/services/specs/default/webملف واحد كتبناه فيه كائنان، فأصبح في etcd ثمانية مفاتيح، وكل مفتاح زائد كتبه جزء مختلف: ال ReplicaSet كتبه متحكم ال Deployment، وال Pods الثلاثة كتبها متحكم ال ReplicaSet، وendpointslices كتبها متحكم ال EndpointSlice عندما وجد Pods تطابق ال Selector. وأزلنا من المخرج 19 مفتاحاً من نوع events، فكل حدث Event تراه في kubectl describe محفوظ في etcd أيضاً، ولذلك تحذفه Kubernetes بعد ساعة افتراضياً حتى لا تمتلئ القاعدة.
والقيمة نفسها ليست JSON، وإنما صيغة ثنائية Protobuf تبدأ بالبادئة k8s، وهذا ما يظهر عندما نطبعها ونستبدل الحروف غير المقروءة بنقاط:
etcdctl get /registry/deployments/default/web --print-value-only | head -c 400 | tr -c '[:print:]\n' '.'k8s.
.
.apps/v1.
Deployment...
..
.web....default".*$3bb70d4a-f8ea-4402-8f9e-4e80cc15e0682.8.B.........Z
.app..webb&
!deployment.kubernetes.io/revision..1b..
0kubectl.kubernetes.io/last-applied-configuration...{"apiVersion":"apps/v1","kind":"Deployment","metadata":{"annotations":{},"labels":{"app":"web"},"name":"web","namespace":"default"},"spec":{"replicas":3,"selector":{"matchLabels":{"app":"weولاحظ في آخر المخرج أن الملف الذي أرسلناه ب kubectl apply محفوظ كما هو بصيغة JSON داخل التعليق last-applied-configuration، وهو ما يقارن به kubectl في المرة التالية ليعرف ما الذي حذفته من الملف.
لماذا تظهر كلمة المرور Password في etcd؟
لننشئ Secret فيه كلمة مرور، ثم نبحث عنها في etcd كنص عادي:
kubectl create secret generic k1-demo --from-literal=password=Kube-Secret-123
kubectl get secret k1-demo -o jsonpath='{.data.password}'; echo
etcdctl get /registry/secrets/default/k1-demo --print-value-only | tr -c '[:print:]' '.' | grep -o 'Kube-Secret-123'
S3ViZS1TZWNyZXQtMTIz
Kube-Secret-123الأمر الأول يعرض القيمة بترميز Base64، وهذا ترميز يعاد بأمر واحد وليس تشفيراً Encryption كما شرحنا في الترميز Base64، والأمر الثاني وجد كلمة المرور كما كتبناها حرفاً حرفاً داخل ملفات etcd. وهذا هو السلوك الافتراضي في Kubernetes: ال Secrets محفوظة في etcd دون تشفير ما لم تفعل التشفير أثناء التخزين Encryption at Rest كما تشرح صفحة تشفير البيانات المخزنة.
والنسخة الاحتياطية من etcd هي النسخة الاحتياطية للعنقود كله، فإذا فقدت etcd ونسختها فقدت كل الكائنات التي أنشأتها، وأخذها أمر واحد كما في صفحة تشغيل etcd لعنقود Kubernetes:
etcdctl snapshot save /var/lib/etcd/k1-snap.db{"level":"info","ts":"2026-11-18T18:16:39.434606Z","caller":"snapshot/v3_snapshot.go:83","msg":"created temporary db file","path":"/var/lib/etcd/k1-snap.db.part"}
{"level":"info","ts":"2026-11-18T18:16:41.668708Z","logger":"client","caller":"[email protected]/maintenance.go:302","msg":"completed snapshot read; closing"}
Snapshot saved at /var/lib/etcd/k1-snap.db
Server version 3.6.0
{"level":"info","ts":"2026-11-18T18:16:41.763623Z","caller":"snapshot/v3_snapshot.go:111","msg":"fetched snapshot","endpoint":"https://127.0.0.1:2379","size":"5.2 MB","took":"2.328730077s","etcd-version":"3.6.0"}وحجمها 5.2 ميجابايت بعد نصف ساعة من التجربة، فالقاعدة كبرت مع الأحداث والتغييرات، وأخذت 2.3 ثانية. ولاحظ أن الملف حفظ داخل عقدة التحكم، ونسخة احتياطية على نفس السيرفر ليست نسخة احتياطية، فانقلها خارجه كما شرحنا في قاعدة 3-2-1.
etcd والقرص البطيء Slow Disk: أول عطل في التجربة
نعود الآن إلى إعادة التشغيل التي رأيناها للمجدول ومدير المتحكمات. عندما قرأنا سجل النسخة التي توقفت من المجدول وجدنا هذا في آخره:
I1118 17:41:10.299321       1 leaderelection.go:272] "Successfully acquired lease" lock="kube-system/kube-scheduler"
E1118 17:41:32.751118       1 leaderelection.go:461] "Error retrieving lease lock" err="Get \"https://172.24.0.3:6443/apis/coordination.k8s.io/v1/namespaces/kube-system/leases/kube-scheduler?timeout=5s\": context deadline exceeded" lock="kube-system/kube-scheduler"
I1118 17:41:32.751516       1 leaderelection.go:304] "Failed to renew lease" lock="kube-system/kube-scheduler" err="context deadline exceeded"
E1118 17:41:42.279957       1 server.go:328] "Leaderelection lost"
والقصة في أربعة أسطر: المجدول أصبح القائد Leader في الثانية 10، ثم حاول أن يجدد عقد القيادة Lease في الثانية 32، فلم يرد ال API Server خلال 5 ثوان، فاعتبر المجدول أنه فقد القيادة وأوقف نفسه، فأعاد ال kubelet تشغيله. ولماذا لم يرد ال API Server؟ لأنه كان ينتظر etcd، وهذا ما وجدناه في سجلها:
{"level":"warn","ts":"2026-11-18T17:42:23.323056Z","caller":"txn/util.go:93","msg":"apply request took too long","took":"2.235755552s","expected-duration":"100ms","prefix":"read-only range ","request":"key:\"/registry/masterleases/172.24.0.3\" limit:1 ","response":"range_response_count:1 size:127"}أي أن قراءة مفتاح واحد أخذت 2.2 ثانية، والمتوقع 100 مللي ثانية، وفي السجل أكثر من 500 تحذير مثله خلال الدقائق الأولى، لأن جهاز التجربة كان مشغولاً بأعمال أخرى تستهلك المعالج والقرص. وتقول صفحة متطلبات etcd إن etcd حساسة جداً لزمن الكتابة على القرص، لأنها تكتب كل تغيير وتنتظر أن يصل إلى القرص فعلاً fsync قبل أن ترد، وتنصح بقرص SSD مخصص لها. وهذا درس مهم لك: إذا رأيت المجدول أو مدير المتحكمات يعيدان التشغيل في عنقودك، فلا تبحث في إعداداتهما أولاً، وإنما ابحث في سجل etcd عن took too long.
لماذا يوقف المجدول نفسه؟ انتخاب القائد Leader Election
في العنقود الحقيقي توجد ثلاث نسخ من المجدول ومن مدير المتحكمات، واحدة على كل عقدة تحكم، ولو عملت النسخ الثلاث معاً لاختار كل مجدول عقدة مختلفة لنفس ال Pod. لذلك تعمل نسخة واحدة فقط، وهي التي تملك كائناً من نوع Lease باسمها، وتجدده كل ثانيتين، فإذا توقفت عن تجديده أكثر من 15 ثانية أخذه غيرها، كما تشرح صفحة ال Leases:
kubectl get lease -n kube-system
kubectl get lease kube-scheduler -n kube-system -o yaml | grep -E 'holderIdentity|leaseDurationSeconds|renewTime|leaseTransitions'
NAME HOLDER AGE
apiserver-qnj6j5jce5qv56a3ewrjudm6wq apiserver-qnj6j5jce5qv56a3ewrjudm6wq_e83077be-d860-40f8-b7d2-ddbbefa1de5c 4m50s
kube-controller-manager k1-control-plane_a22c0ef0-f0e4-4f46-b0d7-9fdb28d13040 4m42s
kube-scheduler k1-control-plane_22eab439-18cd-4bae-ae08-dd747d33c338 4m34s
holderIdentity: k1-control-plane_1f4caca7-70d1-4820-a36e-2fe62a957194
leaseDurationSeconds: 15
leaseTransitions: 4
renewTime: "2026-11-18T17:48:49.303494Z"والقيمة leaseTransitions: 4 تعني أن القيادة انتقلت أربع مرات خلال تسع دقائق، وكلها بين نسخ المجدول نفسه على نفس العقدة بعد كل إعادة تشغيل. ولماذا يوقف المجدول نفسه بدل أن ينتظر؟ لأنه لا يستطيع أن يعرف هل أخذ غيره القيادة أثناء انقطاعه، والخطأ في هذا الاتجاه أخطر بكثير، فقائدان في وقت واحد يعني قرارين متعارضين، أما التوقف ثم البدء من جديد فيعني تأخيراً لبضع ثوان فقط. وتذكر هذه الفكرة، لأنها سوف تؤثر في توقيت قسم توقف العقدة.
ما الذي يعمل على كل عقدة Node؟
على كل عقدة عاملة ثلاثة أشياء: ال kubelet الذي يسأل ال API Server «ما ال Pods المطلوبة على هذه العقدة؟» ثم يطلب من containerd تشغيل Containers كل Pod ويرسل حالتها، وkube-proxy الذي يحول كل Service إلى قواعد شبكة في نواة العقدة، وإضافة الشبكة CNI، وهي في kind برنامج kindnet الذي يعطي كل Pod عنواناً ويربط شبكات العقد ببعضها. وال kubelet يثبت أن العقدة حية بطريقتين كما في صفحة العقد Nodes: يجدد كائن Lease باسم العقدة في ال Namespace المسمى kube-node-lease كل 10 ثوان، ويحدث حالة العقدة الكاملة عند أي تغيير أو كل خمس دقائق:
kubectl get lease -n kube-node-leaseNAME HOLDER AGE
k1-control-plane k1-control-plane 4m42s
k1-worker k1-worker 4m17s
k1-worker2 k1-worker2 4m17sوهذه ال Leases الثلاثة هي نبض العقد Heartbeat، والمتحكم الذي يراقب العقد في مدير المتحكمات ينظر إلى آخر تجديد لكل واحد منها، وإذا مرت مدة دون تجديد اعتبر العقدة غير جاهزة. وسوف نوقف عقدة ونرى ذلك بالأرقام.
حلقة التحكم Reconcile Loop: كيف يعود Pod حذفته؟
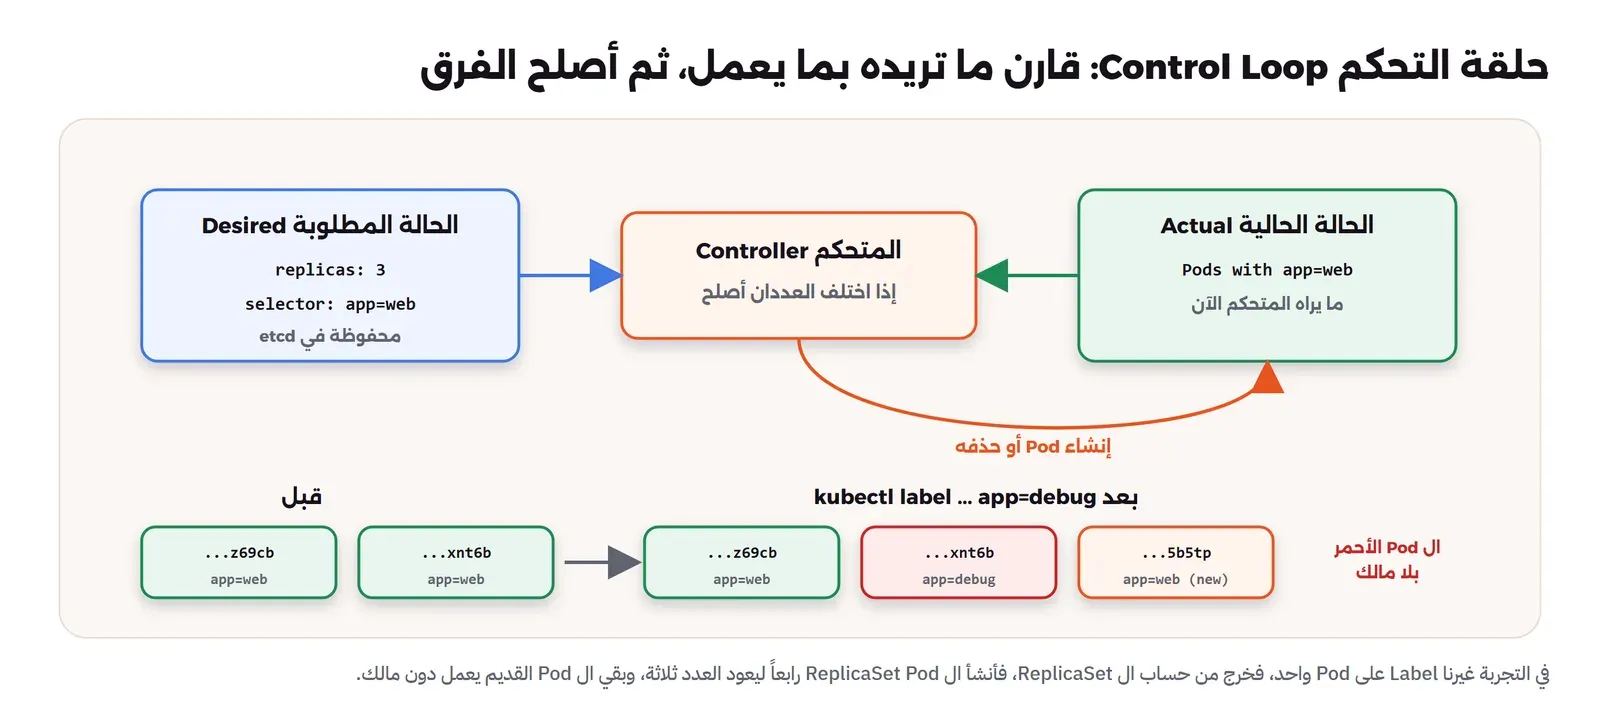
المتحكم Controller في Kubernetes حلقة لا تنتهي تفعل ثلاثة أشياء: تقرأ الحالة المطلوبة Desired State التي كتبتها، وتنظر إلى الحالة الحالية Actual State، ثم تفعل ما يلزم لتقريب الثانية من الأولى، كما تشرح صفحة المتحكمات. والتشبيه الأقرب هو منظم الحرارة في الغرفة: أنت تضبط 22 درجة، وهو لا يعرف لماذا ارتفعت الحرارة ولا يهمه، يرى الفرق فيشغل التكييف. ولنراقب ذلك وهو يحدث، فهنا نشغل مراقبة على ال Pods مع وقت كل سطر، ثم نحذف Pod واحداً من الثلاثة:
kubectl get pods -l app=web -w --output-watch-events &
kubectl delete pod web-84c845fd87-f2mdz
20:44:49.054 delete
20:44:49.991 MODIFIED web-84c845fd87-f2mdz 1/1 Terminating 0 74s
20:44:50.318 ADDED web-84c845fd87-ntcl8 0/1 Pending 0 0s
20:44:50.488 MODIFIED web-84c845fd87-ntcl8 0/1 Pending 0 0s
20:44:50.780 MODIFIED web-84c845fd87-ntcl8 0/1 ContainerCreating 0 0s
20:44:52.302 MODIFIED web-84c845fd87-f2mdz 0/1 Completed 0 77s
20:44:53.222 DELETED web-84c845fd87-f2mdz 0/1 Completed 0 78s
20:44:53.462 MODIFIED web-84c845fd87-ntcl8 1/1 Running 0 3sفي المخرج أعلاه لاحظ التالي:
- بعد أقل من ثانية من الحذف أصبح ال Pod القديم
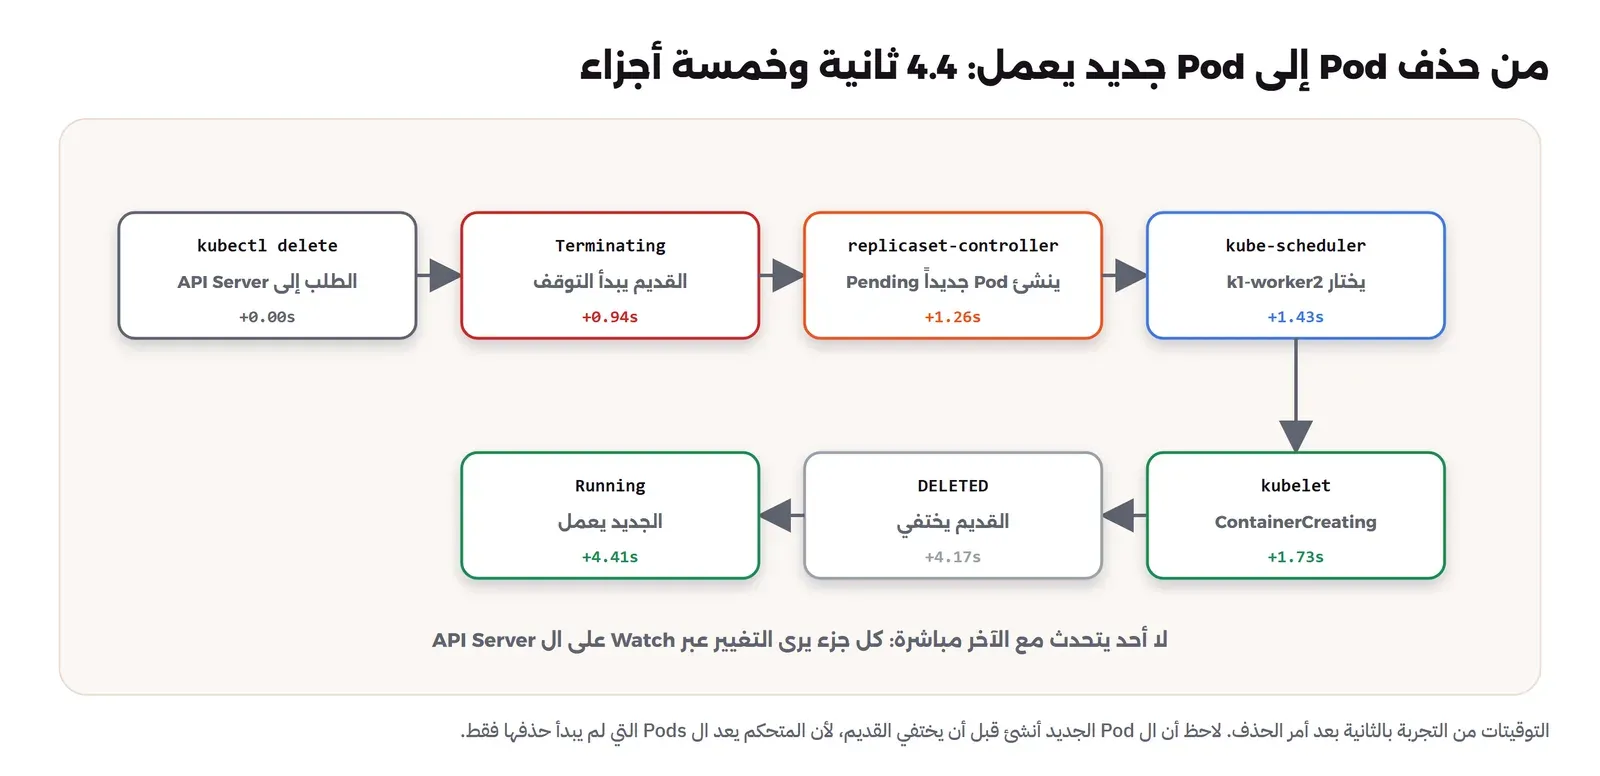
Terminating، وهذا ال API Server الذي سجل وقت الحذف، ولم يحذفه فعلاً بعد، لأن ال kubelet يحتاج أن يوقف ال Container أولاً بالإشارة Signal المسماة SIGTERM كما شرحنا في أوامر Docker الأساسية. - بعد 1.26 ثانية ظهر Pod جديد باسم جديد
ntcl8بحالةPending، أي أن متحكم ال ReplicaSet رأى أن ال Pods التي لم يبدأ حذفها اثنان، والمطلوب ثلاثة، فأنشأ ثالثاً، قبل أن يختفي القديم. - السطر الثاني للجديد
MODIFIED Pendingهو المجدول الذي كتب اسم العقدة فيه، ثمContainerCreatingهو ال kubelet على تلك العقدة الذي رأى Pod جديداً باسم عقدته. - ال Pod الجديد عمل بعد 4.4 ثانية، لأن ال Image كانت موجودة على العقدة من قبل، وفي الأحداث الخاصة به سطر
Container image "nginx:1.29.8-alpine" already present on machine.
والصورة التالية ترتب الخطوات بالأجزاء التي قامت بها، ولاحظ أن خمسة أجزاء شاركت ولم يرسل أي منها رسالة لغيره، فكل واحد كتب في ال API Server، والآخر رأى التغيير عبر ال Watch:
والأحداث Events تحكي القصة نفسها من جهة كل جزء، والأمر kubectl events يعرضها مرتبة:
kubectl events --for replicaset/web-84c845fd87
kubectl events --for pod/web-84c845fd87-ntcl8
LAST SEEN TYPE REASON OBJECT MESSAGE
86s Normal SuccessfulCreate ReplicaSet/web-84c845fd87 Created pod: web-84c845fd87-xnt6b
86s Normal SuccessfulCreate ReplicaSet/web-84c845fd87 Created pod: web-84c845fd87-z69cb
86s Normal SuccessfulCreate ReplicaSet/web-84c845fd87 Created pod: web-84c845fd87-f2mdz
11s Normal SuccessfulCreate ReplicaSet/web-84c845fd87 Created pod: web-84c845fd87-ntcl8
LAST SEEN TYPE REASON OBJECT MESSAGE
27s Normal Scheduled Pod/web-84c845fd87-ntcl8 Successfully assigned default/web-84c845fd87-ntcl8 to k1-worker2
27s Normal Pulled Pod/web-84c845fd87-ntcl8 Container image "nginx:1.29.8-alpine" already present on machine and can be accessed by the pod
26s Normal Created Pod/web-84c845fd87-ntcl8 Container created
26s Normal Started Pod/web-84c845fd87-ntcl8 Container startedماذا لو غيرت Label على Pod؟
المتحكم لا يعد ال Pods التي أنشأها بالاسم، وإنما يعد ال Pods التي تطابق ال Selector، وهذا فرق صغير في الكلام وكبير في النتيجة. ولنتأكد من ذلك نغير ال Label على Pod واحد من app=web إلى app=debug:
kubectl label pod web-84c845fd87-xnt6b app=debug --overwrite
kubectl get pods -L app -o wide
kubectl get pod web-84c845fd87-xnt6b -o jsonpath='{.metadata.ownerReferences}'; echo
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES APP
web-84c845fd87-5b5tp 1/1 Running 0 4s 10.244.1.4 k1-worker <none> <none> web
web-84c845fd87-ntcl8 1/1 Running 0 33s 10.244.2.6 k1-worker2 <none> <none> web
web-84c845fd87-xnt6b 1/1 Running 0 108s 10.244.1.3 k1-worker <none> <none> debug
web-84c845fd87-z69cb 1/1 Running 0 108s 10.244.1.2 k1-worker <none> <none> web
أصبح لدينا أربعة Pods، والرابع 5b5tp عمره 4 ثوان: ال ReplicaSet رأى أن ال Pods التي تطابق app=web اثنان، فأنشأ ثالثاً. وال Pod الذي غيرنا Label الخاص به ما زال يعمل، ولكن حقل المالك ownerReferences فيه أصبح فارغاً، فلا أحد يملكه الآن، ولن يعيده أحد إذا توقف، ولن يحذفه أحد إذا حذفت ال Deployment، ولن تصله طلبات ال Service لأن Selector ال Service هو app=web أيضاً. وهذه طريقة مفيدة فعلاً عندما يكون عندك Pod فيه مشكلة وتريد أن تفحصه دون أن يصله المستخدمون ودون أن تخسره: غير Label الخاص به، فيخرج من ال Service ويأتي بديله، ويبقى هو لك تفحصه ثم تحذفه بيدك.
وقد يتساءل البعض: ماذا لو فات المتحكم حدث الحذف نفسه، لأنه كان يعيد التشغيل مثلاً كما رأينا؟ والإجابة أن هذا لا يهم، لأن المتحكم لا يعمل على الأحداث وإنما على الحالة، فعندما يبدأ من جديد يقرأ كل شيء ويقارن، ويجد أن العدد ناقص فيصلحه. ولذلك تصمد Kubernetes أمام إعادة تشغيل أجزائها، فلا يوجد حدث واحد إذا ضاع ضاعت معه الحالة.
كيف يختار المجدول Scheduler العقدة؟
المجدول يبحث عن كل Pod ليس فيه اسم عقدة، ثم يمر بمرحلتين كما تشرح صفحة kube-scheduler: التصفية Filtering التي تستبعد كل عقدة لا يمكن أن يعمل عليها ال Pod، ثم الترتيب Scoring الذي يعطي العقد الباقية درجات ويختار الأعلى، ثم يكتب اسم العقدة في ال Pod. ولكي نرى التصفية تعمل نطلب أكثر مما يوجد، فهذا Deployment من ثلاث نسخ تطلب كل واحدة 5 معالجات:
# Each replica asks the scheduler for 5 CPUs. Requests reserve capacity; they do not use it.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: big
spec:
  replicas: 3
  selector:
    matchLabels:
      app: big
  template:
    metadata:
      labels:
        app: big
    spec:
      containers:
        - name: app
          image: busybox:1.37
          command: ["sleep", "3600"]
          resources:
            requests:
              cpu: "5"
              memory: 64Mi
kubectl apply -f big.yaml
kubectl get pods -l app=big -o wide
kubectl describe pod big-848f47d947-bxmg4 | sed -n '/Events:/,$p'NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
big-848f47d947-bxmg4 0/1 Pending 0 65s <none> <none> <none> <none>
big-848f47d947-mjjsq 1/1 Running 0 65s 10.244.2.7 k1-worker2 <none> <none>
big-848f47d947-p26l4 1/1 Running 0 65s 10.244.1.6 k1-worker <none> <none>
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
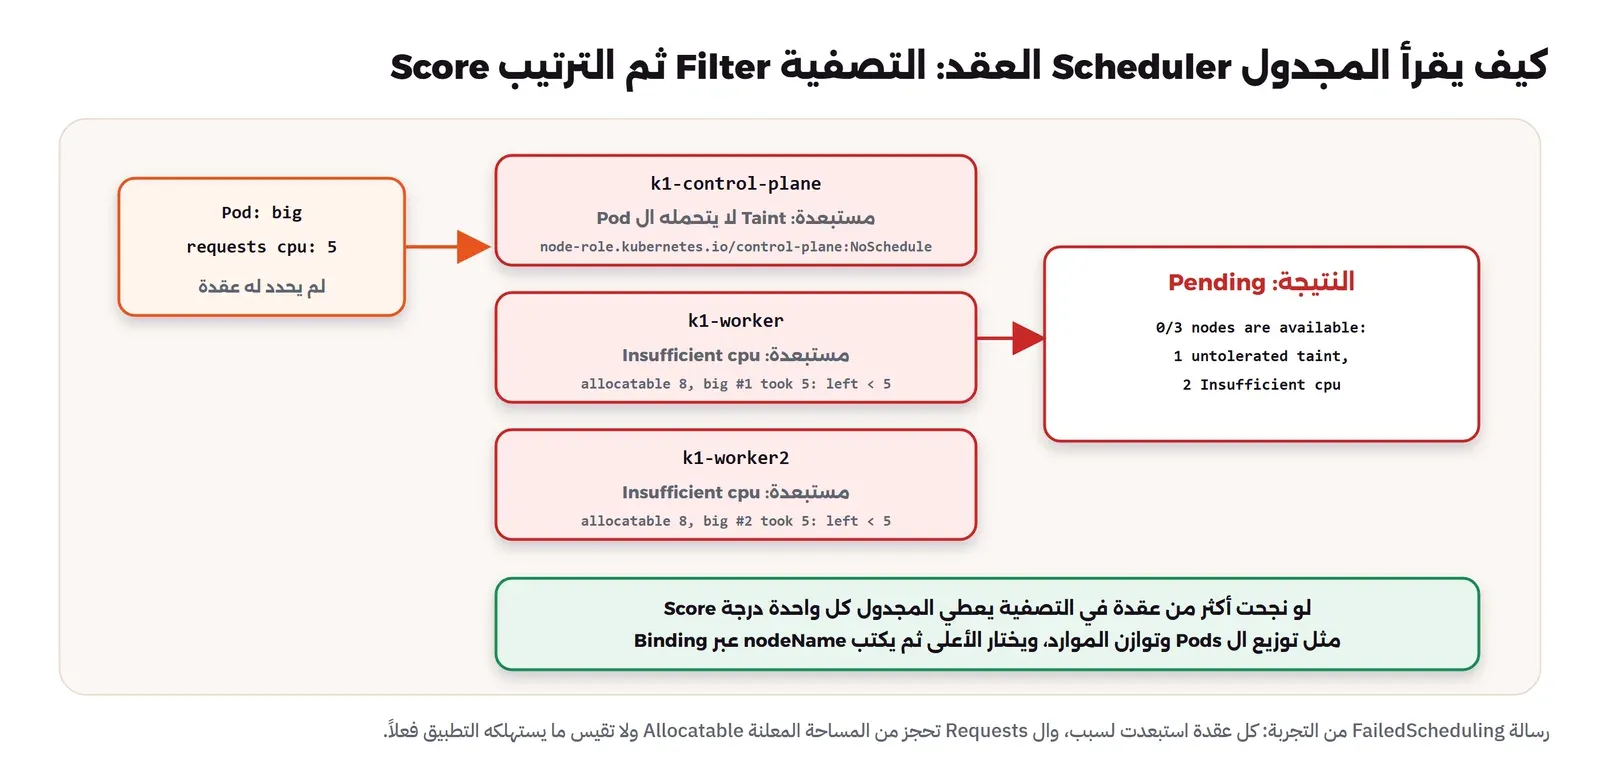
Warning FailedScheduling 41s default-scheduler 0/3 nodes are available: 1 node(s) had untolerated taint(s), 2 Insufficient cpu. no new claims to deallocate, preemption: 0/3 nodes are available: 1 Preemption is not helpful for scheduling, 2 No preemption victims found for incoming pod.ورسالة FailedScheduling هي أهم رسالة تقرؤها عندما يبقى Pod على Pending، لأنها تعطيك سبب استبعاد كل عقدة:
0/3 nodes are available: ثلاث عقد ولا تصلح واحدة منها.1 node(s) had untolerated taint(s): عقدة التحكم عليها علامة تمنع ال Pods العادية، وهذا ما سنشرحه بعد قليل.2 Insufficient cpu: كل عقدة عاملة معلن فيها 8 معالجات، وأخذ ال Pod الأول منها 5 على واحدة والثاني 5 على الأخرى، فلم يبق في أي منهما 5 للثالث.- الجزء الخاص ب
preemptionيقول إن المجدول حاول أن يجد Pods أقل أولوية يمكن إخراجها لإفساح المكان، فلم يجد، لأن كل ال Pods هنا بنفس الأولوية.
ولاحظ شيئاً مهماً في الرقم 8: جهاز التجربة فيه 8 معالجات، وكل عقدة من الثلاث تعلن أنها تملك 8 معالجات و32 جيجابايت ذاكرة، لأنها كلها Containers ترى نفس الجهاز:
kubectl get nodes -o custom-columns=NAME:.metadata.name,CPU:.status.allocatable.cpu,MEM:.status.allocatable.memory,TAINTS:.spec.taints[*].keyNAME CPU MEM TAINTS
k1-control-plane 8 32804872Ki node-role.kubernetes.io/control-plane
k1-worker 8 32804872Ki <none>
k1-worker2 8 32804872Ki <none>فالمجدول قبل أن يعمل Pod يطلب 10 معالجات على جهاز فيه 8، والسبب أن ال Requests ليست قياساً، وإنما حجز في دفتر حسابات المجدول، فهو يطرح ما تطلبه ال Pods مما تعلنه العقدة Allocatable، ولا ينظر أبداً إلى ما يستهلكه التطبيق فعلاً. وفي العنقود الحقيقي يكون كل رقم معلن جهازاً حقيقياً منفصلاً، ولكن القاعدة نفسها: إذا طلبت أقل مما يحتاجه تطبيقك سوف يضع المجدول على العقدة أكثر مما تحتمل، وإذا طلبت أكثر بقيت العقد فارغة وال Pods على Pending. وضبط ال Requests والحدود Limits بالقياس موضوع مقال مستقل في هذه المرحلة.
العلامات Taints والتحمل Tolerations
العلامة Taint توضع على العقدة وتقول «لا تضع هنا أي Pod إلا إذا كان يتحملني»، والتحمل Toleration يوضع في ال Pod ويقول «أنا أقبل هذه العلامة»، كما تشرح صفحة ال Taints وال Tolerations. وعقدة التحكم عليها علامة node-role.kubernetes.io/control-plane:NoSchedule لكي لا تزاحم تطبيقاتك أجزاء التحكم. ولنجرب بأنفسنا: نضع علامة على k1-worker2 كأننا نحجزها لقاعدة البيانات، ثم نزيد نسخ web إلى ست:
kubectl delete -f big.yaml
kubectl taint nodes k1-worker2 dedicated=db:NoSchedule
kubectl scale deployment web --replicas=6
kubectl get pods -l app=web -o wide --sort-by=.spec.nodeName
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
web-84c845fd87-5b5tp 1/1 Running 0 3m58s 10.244.1.4 k1-worker <none> <none>
web-84c845fd87-gv65z 1/1 Running 0 11s 10.244.1.8 k1-worker <none> <none>
web-84c845fd87-mqpjh 1/1 Running 0 11s 10.244.1.7 k1-worker <none> <none>
web-84c845fd87-wnnjj 1/1 Running 0 11s 10.244.1.9 k1-worker <none> <none>
web-84c845fd87-z69cb 1/1 Running 0 5m42s 10.244.1.2 k1-worker <none> <none>
web-84c845fd87-ntcl8 1/1 Running 0 4m27s 10.244.2.6 k1-worker2 <none> <none>ال Pods الثلاثة الجديدة ذهبت كلها إلى k1-worker، أما ntcl8 القديم فبقي على k1-worker2، لأن الأثر NoSchedule يمنع الجدولة الجديدة فقط ولا يخرج ما يعمل، والأثر الذي يخرج ال Pods التي تعمل هو NoExecute، وسوف نراه يعمل وحده عندما نوقف العقدة. أما ال Pod الذي نريده على العقدة المحجوزة فيحتاج شيئين معاً:
# A pod that tolerates the taint AND asks for the tainted node. A toleration only allows; it does not attract.
apiVersion: v1
kind: Pod
metadata:
  name: k1-dbpod
spec:
  tolerations:
    - key: dedicated
      operator: Equal
      value: db
      effect: NoSchedule
  nodeSelector:
    kubernetes.io/hostname: k1-worker2
  containers:
    - name: app
      image: busybox:1.37
      command: ["sleep", "3600"]
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
k1-dbpod 1/1 Running 0 14s 10.244.2.8 k1-worker2 <none> <none>وال Toleration وحده يسمح لل Pod أن يعمل على العقدة ولا يجذبه إليها، فلو حذفنا nodeSelector لربما ذهب إلى k1-worker، والذي يجذبه هو nodeSelector أو قواعد التقارب Affinity الموجودة في صفحة توزيع ال Pods على العقد. فالعلامة تبعد الآخرين، والاختيار يقرب صاحبها، وتحتاج الاثنين لتحجز عقدة لعمل معين.
كيف يصل الطلب Request إلى Pod؟ CoreDNS وkube-proxy
ال Service له عنوان ثابت ClusterIP لا يتغير ما دام موجوداً، بينما تتغير عناوين ال Pods مع كل استبدال كما رأينا. ولكن ال Service ليس برنامجاً يستقبل الطلبات ويمررها، وإنما قواعد في نواة كل عقدة يكتبها kube-proxy. ولنتتبع طلباً من Pod صغير فيه busybox إلى http://web، ونبدأ بالاسم:
kubectl run k1-client --image=busybox:1.37 --restart=Never -- sleep 3600
kubectl exec k1-client -- cat /etc/resolv.conf
kubectl exec k1-client -- nslookup web
search default.svc.cluster.local svc.cluster.local cluster.local
nameserver 10.96.0.10
options ndots:5
Server: 10.96.0.10
Address: 10.96.0.10:53
** server can't find web.cluster.local: NXDOMAIN
Name: web.default.svc.cluster.local
Address: 10.96.19.171
** server can't find web.svc.cluster.local: NXDOMAINفي المخرج أعلاه لاحظ التالي:
- العنوان 10.96.0.10 هو نفسه
clusterDNSالذي رأيناه في إعداد ال kubelet، وهو ClusterIP لل Service المسمىkube-dnsالذي خلفه CoreDNS. - السطر
searchمعndots:5يعني أن أي اسم فيه أقل من خمس نقاط يجرب مع كل بادئة من الثلاث، ولذلك يظهرNXDOMAINمرتين، فالأداة جربتweb.svc.cluster.localوweb.cluster.localأيضاً، والصحيح هوweb.default.svc.cluster.local. وهذا يعني أن كل طلب لاسم خارجي مثلapi.github.comيمر على ثلاثة أسماء خاطئة قبل الصحيح، وهو سبب معروف لزيادة طلبات DNS في العناقيد المزدحمة كما تشرح صفحة DNS لل Services وال Pods. - الأمر خرج برمز خطأ رغم أنه وجد العنوان، لأن busybox يعتبر أي NXDOMAIN فشلاً، فلا تعتمد على رمز خروج Exit Code الأمر
nslookupفي السكربتات Scripts.
والآن العنوان 10.96.19.171 لا يملكه أي جهاز ولا أي Pod، فلننظر ماذا يفعل kube-proxy به على العقدة k1-worker:
kubectl get endpointslices -l kubernetes.io/service-name=web
docker exec k1-worker iptables-save -t nat | grep -E 'default/web'
NAME ADDRESSTYPE PORTS ENDPOINTS AGE
web-n6lm6 IPv4 80 10.244.1.2,10.244.2.6,10.244.1.4 2m8s
-A KUBE-SEP-MQ4W7Q2CV67URU6Q -p tcp -m comment --comment "default/web" -m tcp -j DNAT --to-destination 10.244.1.2:80
-A KUBE-SEP-OD4NQTAG4GNU2XE5 -p tcp -m comment --comment "default/web" -m tcp -j DNAT --to-destination 10.244.1.4:80
-A KUBE-SEP-YUPMFTK3IHSQP2LT -p tcp -m comment --comment "default/web" -m tcp -j DNAT --to-destination 10.244.2.6:80
-A KUBE-SERVICES -d 10.96.19.171/32 -p tcp -m comment --comment "default/web cluster IP" -m tcp --dport 80 -j KUBE-SVC-LOLE4ISW44XBNF3G
-A KUBE-SVC-LOLE4ISW44XBNF3G -m comment --comment "default/web -> 10.244.1.2:80" -m statistic --mode random --probability 0.33333333349 -j KUBE-SEP-MQ4W7Q2CV67URU6Q
-A KUBE-SVC-LOLE4ISW44XBNF3G -m comment --comment "default/web -> 10.244.1.4:80" -m statistic --mode random --probability 0.50000000000 -j KUBE-SEP-OD4NQTAG4GNU2XE5
-A KUBE-SVC-LOLE4ISW44XBNF3G -m comment --comment "default/web -> 10.244.2.6:80" -j KUBE-SEP-YUPMFTK3IHSQP2LTوهذه القواعد تقرأ من الأسفل إلى الأعلى بالترتيب التالي:
- القاعدة في
KUBE-SERVICESتلتقط أي حزمة متجهة إلى 10.96.19.171 على المنفذ 80 وترسلها إلى سلسلة خاصة بال Service. - في سلسلة ال Service ثلاث قواعد، الأولى تأخذ الحزمة باحتمال الثلث، والثانية تأخذ نصف ما بقي، والثالثة تأخذ الباقي كله، فيكون نصيب كل Pod ثلث الاتصالات.
- كل سلسلة
KUBE-SEPتغير عنوان الوجهة DNAT إلى عنوان Pod حقيقي، فتخرج الحزمة من العقدة إلى ال Pod مباشرة.
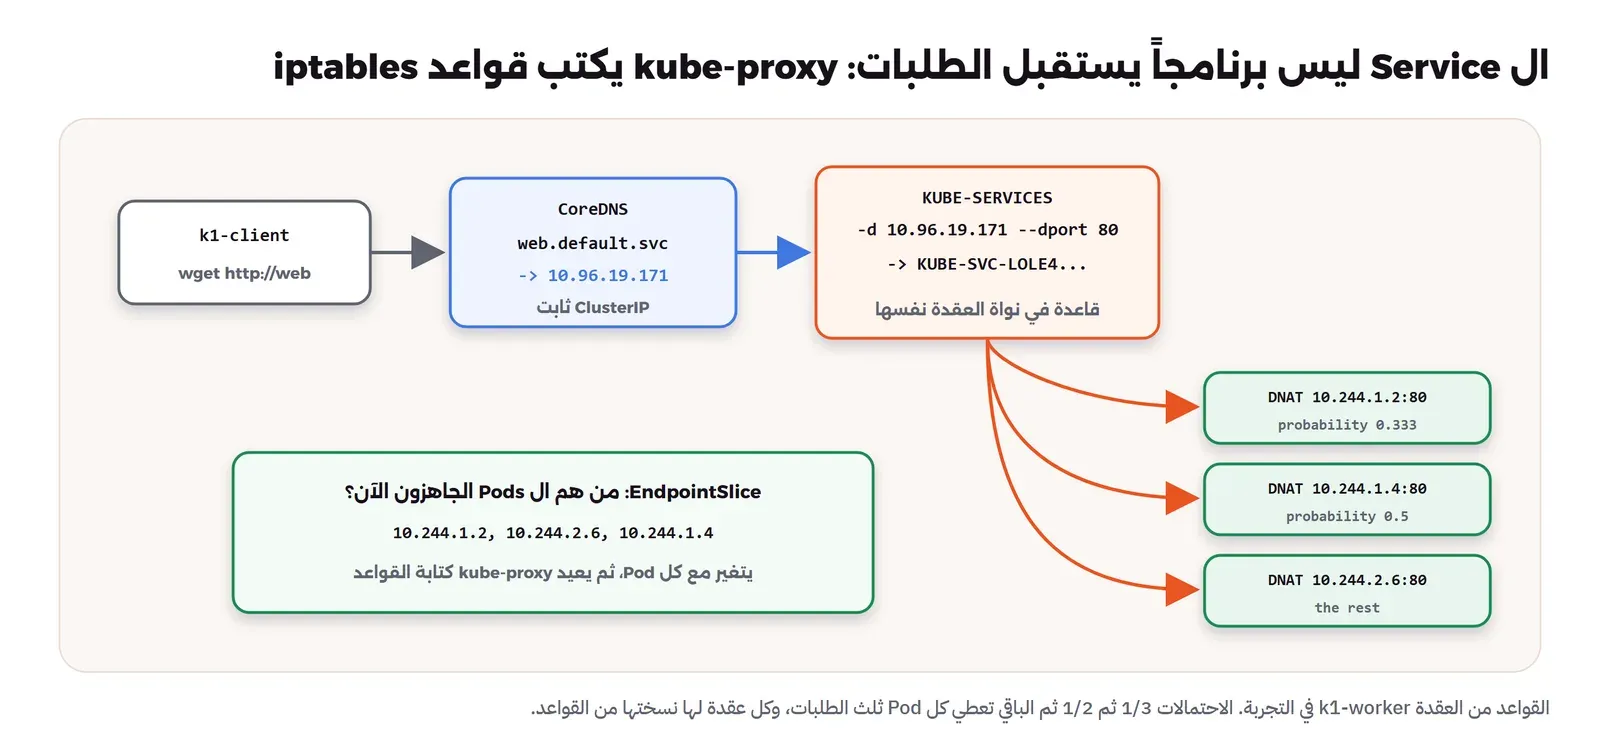
وهذا التصميم يفسر أشياء كثيرة ستراها لاحقاً: لا يوجد برنامج اسمه Service يمكن أن يتوقف، ولكن القواعد تحتاج أن تكتب من جديد كلما تغير Pod، وkube-proxy يعرف التغيير من ال EndpointSlice الذي يحدثه متحكم في مدير المتحكمات، فإذا تأخر المتحكم في إخراج Pod متوقف من ال EndpointSlice بقيت الطلبات تذهب إليه. والتوزيع لكل اتصال جديد وليس لكل طلب، فإذا كان عميلك يفتح اتصالاً واحداً طويلاً مثل gRPC فسوف يذهب كل شيء إلى Pod واحد، وتفاصيل الأوضاع الأخرى مثل IPVS وnftables في صفحة العناوين الافتراضية وkube-proxy.
ماذا يحدث عندما تتوقف عقدة Node؟
هذا هو الاختبار الذي يقال إن Kubernetes بنيت من أجله: يتوقف سيرفر فيعيد العنقود تشغيل تطبيقاتك على غيره. والسؤال الذي لا يجيب عليه أغلب الشرح هو: بعد كم ثانية؟ وماذا يحدث في هذه الثواني؟ لذلك جهزنا التجربة التالية: أربع نسخ من web، اثنتان على كل عقدة عاملة، وال Pod الصغير k1-client على k1-worker يرسل طلباً إلى http://web كل ثانية ويسجل النتيجة، ومراقبة للعقد وال Pods بالوقت، ثم أوقفنا العقدة k1-worker2 بالأمر docker stop، وهذا يشبه انقطاع الكهرباء عن سيرفر أكثر مما يشبه إيقافه بطريقة منظمة.
kubectl get pod -l app=web -o jsonpath='{.items[0].spec.tolerations}'; echo
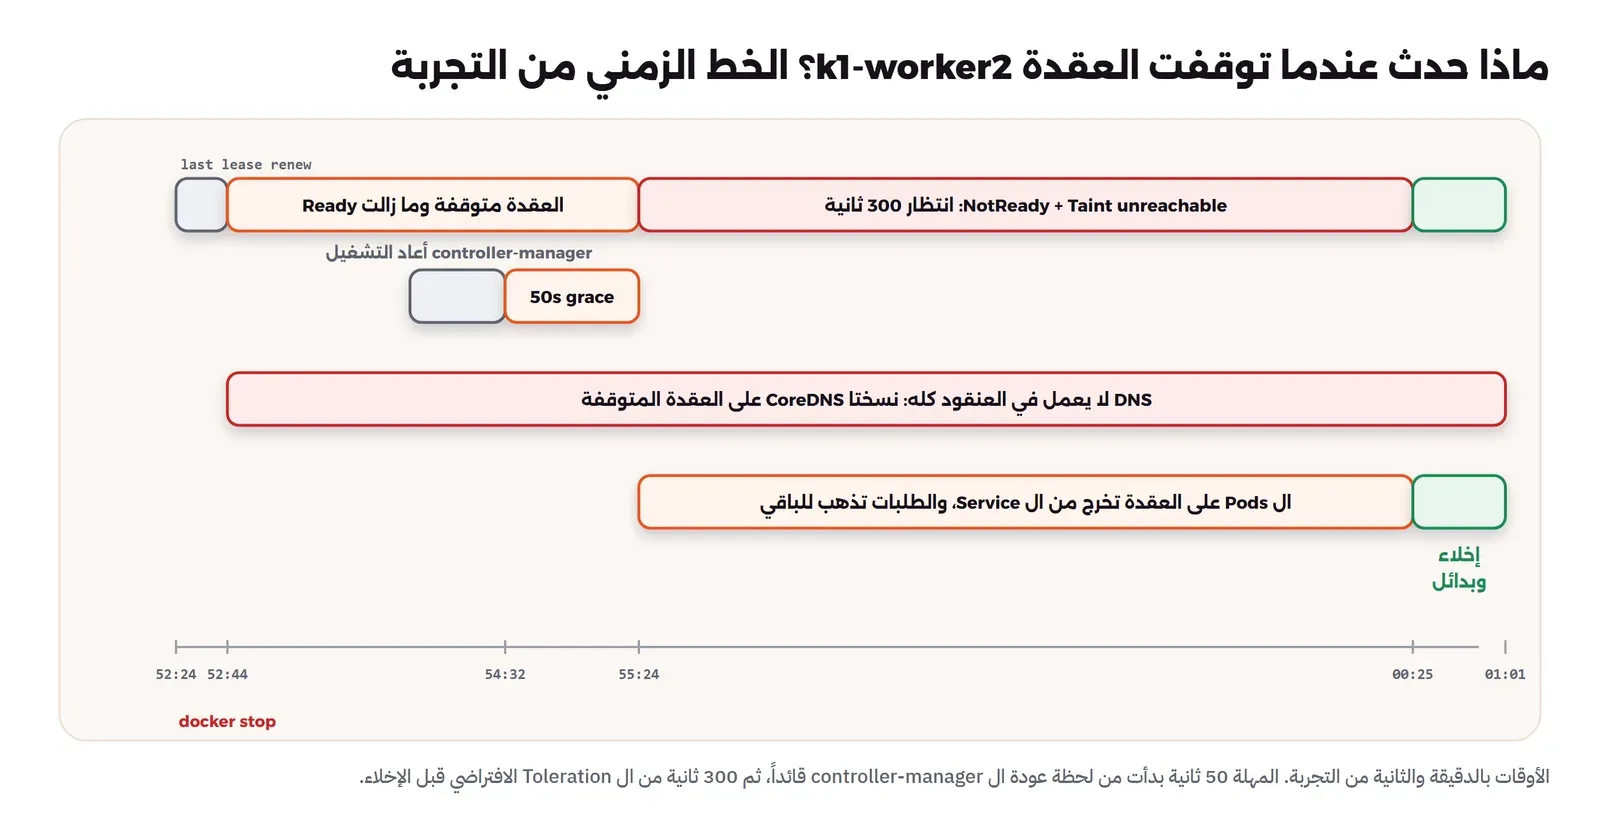
docker stop k1-worker2[{"effect":"NoExecute","key":"node.kubernetes.io/not-ready","operator":"Exists","tolerationSeconds":300},{"effect":"NoExecute","key":"node.kubernetes.io/unreachable","operator":"Exists","tolerationSeconds":300}]وقبل الإيقاف لاحظ هذين التحملين في كل Pod، فنحن لم نكتبهما في الملف، وإنما أضافهما متحكم قبول في ال API Server تلقائياً لكل Pod، ومعناهما: إذا أصبحت عقدتي غير جاهزة أو غير قابلة للوصول فاتركوني عليها 300 ثانية قبل إخراجي. وهذا هو الرقم الذي يحكم ما سيحدث. وهذه الأسطر من مراقبة العقد وأحداث العنقود بعد الإيقاف:
20:52:44 docker stop k1-worker2
20:55:24 k1-worker2         NotReady   <none>          15m   v1.36.4

$ kubectl get node k1-worker2 -o jsonpath='{.spec.taints}'
[{"effect":"NoSchedule","key":"node.kubernetes.io/unreachable","timeAdded":"2026-11-18T17:55:24Z"},{"effect":"NoExecute","key":"node.kubernetes.io/unreachable","timeAdded":"2026-11-18T17:55:24Z"}]

$ kubectl describe node k1-worker2 | sed -n '/Conditions:/,/Addresses:/p'
  Type             Status    LastHeartbeatTime                 LastTransitionTime                Reason              Message
  Ready            Unknown   Wed, 18 Nov 2026 20:48:08 +0300   Wed, 18 Nov 2026 20:55:24 +0300   NodeStatusUnknown   Kubelet stopped posting node status.

$ kubectl get events -A --field-selector reason=TaintManagerEviction
NS                   OBJ                                       FIRST                  MSG
default              web-6dc48cc575-ts9bq                      2026-11-18T18:00:25Z   Marking for deletion Pod default/web-6dc48cc575-ts9bq
default              web-6dc48cc575-tskqt                      2026-11-18T18:00:25Z   Marking for deletion Pod default/web-6dc48cc575-tskqt
kube-system          coredns-589f44dc88-5pblr                  2026-11-18T18:00:25Z   Marking for deletion Pod kube-system/coredns-589f44dc88-5pblr
kube-system          coredns-589f44dc88-g5d9c                  2026-11-18T18:00:25Z   Marking for deletion Pod kube-system/coredns-589f44dc88-g5d9c
local-path-storage   local-path-provisioner-56c4685b7c-5pmsd   2026-11-18T18:00:25Z   Marking for deletion Pod local-path-storage/local-path-provisioner-56c4685b7c-5pmsd
والوقت في سطرين بتوقيت الجهاز +0300 وفي الباقي بتوقيت UTC، أي أن 17:55:24 هي 20:55:24 نفسها. والقصة كاملة كما يلي:
- 20:52:44 أوقفنا العقدة. وآخر تجديد ل Lease العقدة كان في 20:52:24، أي قبل الإيقاف بعشرين ثانية، وال kubelet يجدد كل 10 ثوان، فالأرجح أن التجديد تأخر بسبب بطء ال API Server الذي رأيناه في قسم etcd.
- من 20:52:44 إلى 20:55:24 بقيت العقدة
Readyفي نظر العنقود، وال Pods عليهاRunning، لمدة دقيقتين وأربعين ثانية. والمتوقع أقل من ذلك بكثير، فالمدة التي ينتظرها متحكم العقد قبل أن يعلن العقدة غير جاهزة هي--node-monitor-grace-periodوقيمتها الافتراضية 50 ثانية كما في صفحة خيارات kube-controller-manager. والسبب في الفرق أن مدير المتحكمات نفسه فقد القيادة وأعاد التشغيل أثناء ذلك، وأصبح قائداً من جديد في 20:54:32، وأول ما كتبه سجله عن العقدة:"Missing timestamp for Node. Assuming now as a timestamp" node="k1-worker2"، أي أنه بدأ عد الخمسين ثانية من لحظة عودته، وبعد 52 ثانية بالضبط أعلن العقدةNotReady. - 20:55:24 وضع متحكم العقد علامتين على العقدة:
NoScheduleلكي لا يذهب إليها Pod جديد، وNoExecuteالتي يتحملها كل Pod 300 ثانية. وفي اللحظة نفسها أصبحت ال Pods على العقدةReady=Falseفخرجت من ال EndpointSlice، فلم تعد الطلبات تذهب إليها. - 21:00:25 بعد 301 ثانية من العلامة انتهى التحمل، فأخرج المتحكم ال Pods الخمسة التي كانت على العقدة، وفي الثانية التالية أنشأت ال ReplicaSets بدائلها على العقد الباقية.
أي أن ال Pods لم تعد إلا بعد ثماني دقائق تقريباً من توقف العقدة، وهذا ليس خطأ في Kubernetes، وإنما هو الإعداد الافتراضي المقصود، لأن العقدة التي لا ترد قد تكون منقطعة عن الشبكة لثوان فقط وال Pods عليها ما زالت تعمل، ونقل قاعدة بيانات كاملة إلى عقدة أخرى بسبب انقطاع لعشر ثوان أسوأ من الانتظار. فإذا كانت تطبيقاتك لا تحفظ حالة وتريد إخراجها أسرع، فاكتب لها تحملاً بمدة أقصر:
tolerations:
  - key: node.kubernetes.io/unreachable
    operator: Exists
    effect: NoExecute
    tolerationSeconds: 30
العطل الذي لم نتوقعه: DNS توقف في العنقود Cluster كله
توقعنا أن يفشل ربع الطلبات أو نصفها في الدقائق الأولى، لأن نسختين من أربع كانتا على العقدة المتوقفة، ولكن سجل ال Pod الذي يرسل الطلبات قال شيئاً آخر:
wget: bad address 'web'
17:53:32 FAIL
wget: bad address 'web'
17:53:53 FAIL
...
18:00:46 FAIL
18:01:01 ok
18:01:02 ok
كل الطلبات فشلت، وعددها 70 محاولة، ولم يكن الخطأ اتصالاً مرفوضاً وإنما bad address 'web'، أي أن الاسم نفسه لم يعد يترجم إلى عنوان. ولو عدت إلى أول مخرج في قسم أجزاء التحكم ستجد السبب: نسختا CoreDNS كانتا على k1-worker2، فعندما توقفت العقدة توقف DNS في العنقود كله، وكل تطبيق يتصل بغيره بالاسم، أي كل التطبيقات تقريباً، توقف معه، رغم أن نسختي web على k1-worker كانتا تعملان طوال الوقت.
ولماذا كانت النسختان على عقدة واحدة؟ لأن CoreDNS أنشئ مع العنقود في 17:39:56، وفي تلك اللحظة كانت k1-worker2 جاهزة وk1-worker ما زالت NotReady كما رأينا في أول مخرج، ولم تصبح جاهزة إلا في 17:41:00. فوضع المجدول النسختين على العقدة الوحيدة المتاحة، وهذا قرار صحيح في وقته، ولكن المجدول لا يعيد النظر في قراراته أبداً، فال Pod الذي جدول يبقى في مكانه حتى يحذف، ولو أصبحت عقد أخرى جاهزة بعد ثانية. وظهر الأمر نفسه بعد عودة k1-worker2، فقد بقيت نسخ web الأربع كلها على k1-worker، ولم ينقل أي منها إلى العقدة العائدة.
kubectl get pods -o wide بعد إنشاء العنقود وبعد إضافة عقد جديدة، وإذا وجدتها مجتمعة فأعد توزيعها بالأمر kubectl rollout restart deployment coredns -n kube-system، واكتب لتطبيقاتك قيود التوزيع Topology Spread Constraints الموجودة في صفحة قيود التوزيع حتى يرفض المجدول جمعها من الأصل. وإذا أردت أن يعيد العنقود التوزيع بنفسه مع الوقت فهذا عمل مشروع descheduler وليس عمل المجدول.وفي ديسمبر 2024 توقفت خدمات OpenAI كلها أكثر من أربع ساعات بسبب تفاعل مشابه بين أجزاء التحكم وDNS، فبحسب تقرير الحادثة الرسمي نشر الفريق خدمة مراقبة جديدة جعلت كل عقدة في العناقيد الكبيرة ترسل طلبات ثقيلة إلى ال API Server، فانهارت أجزاء التحكم، ولأن DNS في عناقيدهم يعتمد على أجزاء التحكم توقف اكتشاف الخدمات Service Discovery، فتوقفت التطبيقات رغم أن أغلبها كان يعمل. وزاد الأمر صعوبة أن الفريق احتاج الوصول إلى ال API Server نفسه لكي يتراجع عن التغيير، وهو المتوقف. والدرس الذي كتبوه قريب مما رأيناه على عنقود من ثلاث عقد: اعرف ما الذي تعتمد عليه خدمة الأسماء في عنقودك، ولا تفترض أن ال Pods التي تعمل تعني أن التطبيق يعمل.
عندما تعود العقدة Node
أعدنا تشغيل العقدة بالأمر docker start k1-worker2 في 21:10:16، فأصبحت Ready بعد أقل من دقيقة، وحصلت على نفس العنوان 172.24.0.2، واختفت ال Pods القديمة التي كانت عالقة بحالة Terminating طوال المدة، لأن الحذف النهائي ل Pod يحتاج أن يؤكد ال kubelet على عقدته أنه أوقفه، وال kubelet لم يكن موجوداً. وهذا تفصيل مهم في حالة StatefulSet مثل قاعدة البيانات، فال Pod البديل باسم ثابت لا ينشأ حتى يختفي القديم تماماً، فإذا لم تعد العقدة أبداً فأنت الذي يحذفها من العنقود بالأمر kubectl delete node بعد أن تتأكد أنها متوقفة فعلاً.
وماذا لو توقفت أجزاء التحكم Control Plane نفسها؟
في المقال مصطلحات Kubernetes ذكرنا أن ال Containers تبقى تعمل إذا توقفت أجزاء التحكم، لأن ال kubelet على كل عقدة هو الذي يشغلها. ولنتأكد من ذلك جمدنا عقدة التحكم بالأمر docker pause، وهذا يوقف كل عملياتها دون أن يغلقها، ثم أرسلنا طلبات من داخل العقدة k1-worker مباشرة، لأن kubectl exec نفسه يمر عبر ال API Server:
docker pause k1-control-plane
kubectl get nodes --request-timeout=5s
docker exec k1-worker curl -s -o /dev/null -w '%{http_code}\n' http://10.96.19.171/
docker exec k1-worker crictl exec 184bfa9e277e wget -qO- -T 2 http://web | head -4
Unable to connect to the server: net/http: request canceled while waiting for connection (Client.Timeout exceeded while awaiting headers)
200
<!DOCTYPE html>
<html>
<head>
<title>Welcome to nginx!</title>فلم يعد kubectl يصل إلى العنقود، ولكن الطلب إلى ClusterIP نجح، لأن قواعد iptables مكتوبة في نواة العقدة ولا تحتاج أحداً، والطلب بالاسم من داخل ال Pod نجح أيضاً عبر crictl الذي يتحدث مع containerd على العقدة مباشرة. ولكن عندما كررنا طلبات DNS خلال التجميد ظهر هذا:
kubectl get pods -n kube-system -l k8s-app=kube-dns -o wide
for i in 1 2 3 4 5 6 7 8; do docker exec k1-worker crictl exec 184bfa9e277e nslookup -timeout=2 web.default.svc.cluster.local 2>&1 | grep -E 'Address: 10.96|timed out' | head -1; done
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
coredns-589f44dc88-8njxv 1/1 Running 0 21m 10.244.1.15 k1-worker <none> <none>
coredns-589f44dc88-hf67t 1/1 Running 0 21m 10.244.0.2 k1-control-plane <none> <none>
;; connection timed out; no servers could be reached
;; connection timed out; no servers could be reached
;; connection timed out; no servers could be reached
Address: 10.96.19.171
Address: 10.96.19.171
;; connection timed out; no servers could be reached
;; connection timed out; no servers could be reached
;; connection timed out; no servers could be reachedنجح طلبان من ثمانية فقط. والسبب أن الإخلاء السابق وضع إحدى نسختي CoreDNS الجديدتين على عقدة التحكم، فCoreDNS يتحمل علامة عقدة التحكم، فلما جمدنا العقدة تجمدت معها تلك النسخة، وبقيت قواعد iptables على k1-worker توزع طلبات DNS بالتساوي على النسختين، لأن أحداً لم يعد موجوداً ليخرج النسخة المجمدة من ال Service. وعندما أعدنا العقدة بالأمر docker unpause عاد كل شيء خلال ثوان دون أن يعاد تشغيل أي Pod. والخلاصة أن توقف أجزاء التحكم لا يوقف التطبيقات التي تعمل، ولكنه يوقف كل إصلاح، فأي Pod يتوقف لن يعود، وأي تغيير في العنقود لن يحدث، وأي نسخة لا ترد ستبقى تستقبل نصيبها من الطلبات، ولذلك تجد عقد التحكم في الإنتاج Production ثلاثاً على الأقل.
ما الفرق بين عنقود kind والعنقود الحقيقي Production Cluster؟
كل ما رأيته في هذا المقال يعمل بنفس الطريقة على عنقود حقيقي، ولكن بعض الأرقام والسلوك يختلف، وهذا الجدول يلخص الفروق التي تهمك عندما تنقل ما تعلمته:
| الموضوع | في kind على جهاز واحد | في عنقود حقيقي |
|---|---|---|
| العقد | Containers على Docker تشترك في نواة واحدة | سيرفرات أو أجهزة افتراضية، لكل واحدة نواتها |
| الموارد المعلنة Allocatable | كل عقدة تعلن الجهاز كله، فالأرقام لا تعني شيئاً | كل عقدة تعلن مواردها الحقيقية ناقص ما يحجزه النظام |
| etcd وأجزاء التحكم | نسخة واحدة، وتوقفها يوقف العنقود | ثلاث نسخ على ثلاث عقد تحكم، وتصمد أمام توقف واحدة |
| توقف عقدة | docker stop أو docker pause | انقطاع كهرباء أو شبكة أو نواة متجمدة، والتوقيت نفسه: 50 ثانية ثم 300 |
| الشبكة CNI | kindnet بسيط | Cilium أو Calico أو Flannel، ومعها سياسات الشبكة Network Policies |
| التخزين | local-path على قرص العقدة | تخزين شبكي أو Longhorn أو أقراص السحابة |
| الاستخدام المناسب | التعلم واختبار ملفات YAML وCI | تشغيل التطبيقات للمستخدمين |
أخطاء شائعة Common Mistakes
- البحث في المكان الخطأ عندما يعيد المجدول التشغيل: السبب في التجربة كان etcd البطيئة وليس المجدول، فابدأ بسجل etcd وابحث عن
took too long. - تشغيل etcd على قرص بطيء أو مشترك: كل كتابة تنتظر القرص، والتأخير يصل إلى ال API Server ثم إلى انتخاب القادة.
- اعتبار Base64 تشفيراً: كلمة المرور كانت مقروءة في etcd كما كتبناها، فالتشفير أثناء التخزين خيار تفعله أنت.
- نسخة احتياطية من etcd على عقدة التحكم نفسها: تضيع مع العقدة، وتحتوي كل أسرار العنقود، فانقلها مشفرة.
- توقع عودة ال Pods خلال ثوان من توقف العقدة: الافتراضي 50 ثانية ثم 300 ثانية، وفي التجربة ثماني دقائق.
- نسختان من خدمة مهمة على عقدة واحدة: CoreDNS في التجربة، والنتيجة توقف DNS في العنقود كله.
- افتراض أن المجدول يعيد التوزيع: يقرر مرة واحدة عند الجدولة، ولا ينقل ما يعمل حتى لو عادت عقدة أو أضيفت.
- ال Toleration دون nodeSelector لحجز عقدة: التحمل يسمح ولا يجذب، فقد يذهب ال Pod إلى عقدة أخرى.
- ال Requests كتقدير عشوائي: المجدول يصدقها حرفياً، فالقليل يزاحم العقدة والكثير يتركها فارغة.
- حذف Pod لأجزاء التحكم ب kubectl: يعود فوراً لأن مصدره ملف في
/etc/kubernetes/manifests، والتعديل يكون في الملف. - نسخ
failCgroupV1: falseإلى عنقود حقيقي: هذا لجهاز تجربة على cgroup v1 فقط، والسيرفر الحديث يحتاج cgroup v2.
جدول التشخيص Troubleshooting: عندما ترى هذا فابحث هنا
| ما تراه | الجزء المسؤول | أين تبحث |
|---|---|---|
Pod على Pending دون عقدة | المجدول | رسالة FailedScheduling في kubectl describe pod |
عدد ال Pods أقل من replicas | متحكم ال ReplicaSet | kubectl events --for replicaset/…، ثم حصة ال Namespace |
| Pod على عقدة ولكنه لا يبدأ | ال kubelet وcontainerd | أحداث ال Pod، ثم journalctl -u kubelet على العقدة |
عقدة NotReady | ال kubelet أو الشبكة إلى ال API Server | kubectl describe node، ثم kubectl get lease -n kube-node-lease |
| المجدول أو المتحكمات تعيد التشغيل | etcd أو ال API Server | سجل etcd، وkubectl get --raw '/readyz?verbose' |
| الاسم لا يترجم داخل ال Pods | CoreDNS | مكان نسخه ب -o wide، وEndpointSlice الخاص ب kube-dns |
| ال Service لا يوصل إلى ال Pods | ال Selector أو kube-proxy | kubectl get endpointslices، ثم iptables-save -t nat على العقدة |
| kubectl لا يتصل أبداً | ال API Server أو etcd | عقدة التحكم نفسها: crictl ps وسجلات ال Static Pods |
حذف المختبر Cleanup
العنقود كله ثلاثة Containers، وحذفه أمر واحد يزيلها مع ملف kubeconfig الخاص بها، ثم نحذف شبكة Docker التي أنشأناها باسمنا:
kind delete cluster --name k1
docker network rm k1-net
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ال API Server هو الباب الوحيد، وetcd تحفظ حالة العنقود كلها كمفاتيح، وكل جزء آخر يقرأ ويكتب عبر ال API Server ويرى التغييرات عبر ال Watch، ولا يتحدث مع غيره مباشرة.
- أجزاء التحكم Static Pods يشغلها ال kubelet من ملفات، والمجدول ومدير المتحكمات يعمل منهما قائد واحد بعقد Lease، ويوقف نفسه إذا لم يستطع تجديده، وهذا ما حدث في التجربة بسبب etcd بطيئة.
- المتحكم يقارن الحالة المطلوبة بالحالة الحالية بال Selector، فأعاد Pod محذوفاً خلال 4.4 ثانية، وأنشأ بديلاً لل Pod الذي غيرنا Label الخاص به.
- المجدول يستبعد العقد ثم يرتبها، ويصدق ال Requests حرفياً، ولا يعيد النظر في قراره، وال Taint يبعد وال nodeSelector يقرب.
- عند توقف عقدة انتظر العنقود 50 ثانية ثم 300 ثانية بالإعداد الافتراضي، وتوقف DNS في العنقود كله لأن نسختي CoreDNS كانتا على العقدة المتوقفة، فتحقق من توزيع الخدمات المهمة.
والمقال التالي في هذه المرحلة يأخذك إلى الأوامر التي تستخدمها كل يوم على هذا العنقود نفسه، ثم ننقل تطبيقاً كاملاً من Docker Compose إليه:
 دليلkubectl للمبتدئين: الأوامر التي تستخدمها كل يومالأوامر التي تكتبها كل يوم على عنقود Kubernetes بالترتيب الذي تحتاجها فيه، مع إعادة إنتاج CrashLoopBackOff وImagePullBackOff وإصلاحهما على عنقود حقيقي.
 دليلنقل تطبيق Docker Compose إلى Kubernetes خطوة بخطوةننقل تطبيقاً من أربع خدمات من Docker Compose إلى Kubernetes، ونرى ما أخطأ فيه kompose وما تعلمناه من كل عطل حتى عمل التطبيق.
 دليلمصطلحات Kubernetes مشروحة بالترتيب، من Pod إلى Ingressشرح مصطلحات Kubernetes بالترتيب الذي يبني بعضها على بعض، مع رسم لكل مفهوم وملفات YAML حقيقية.
 دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
 دليلالأنظمة الموزعة للمبتدئين: ماذا يحدث عندما تنقطع الشبكةلماذا تتصرف الأنظمة الموزعة بشكل غريب عند انقطاع الشبكة، وكيف تتفق السيرفرات على قرار واحد رغم ذلك.
 دليلPostgreSQL على Kubernetes مع CloudNativePGكيف يدير CloudNativePG عنقود PostgreSQL على Kubernetes بنسخ متماثلة وانتقال تلقائي ونسخ احتياطي، وما الذي يحدث عندما يتوقف الرئيسي.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجربة على kind 0.33.0 بصورة العقدة kindest/node:v1.36.4 (Kubernetes 1.36.4 وcontainerd 2.3.4 وetcd 3.6.8) فوق Docker Engine 29.8.0 على WSL2.