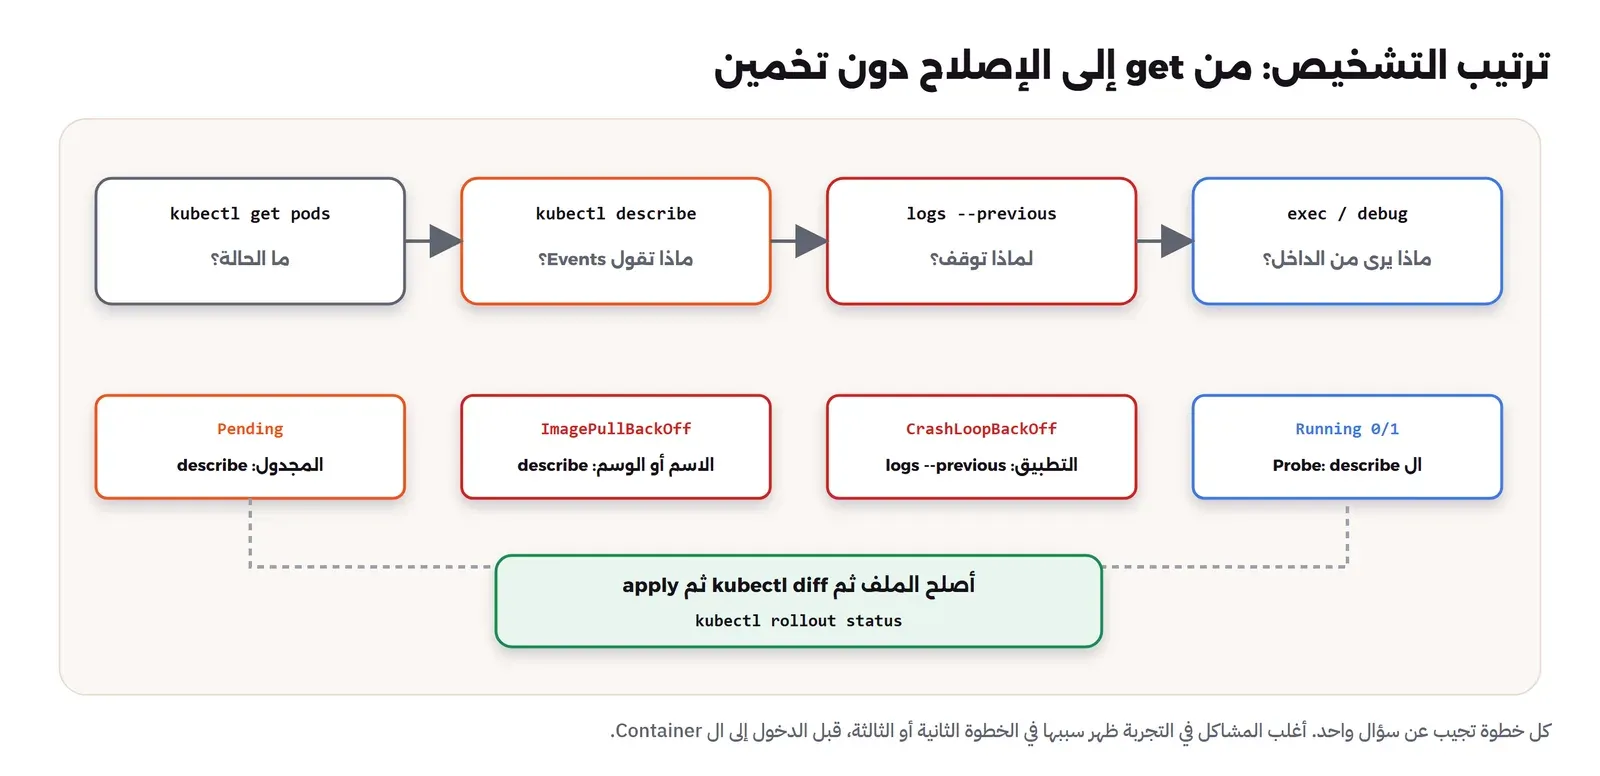
في أول أسبوع مع Kubernetes سوف تكتب الأمر kubectl get pods مئات المرات، ثم يأتي يوم تكتبه فيرد عليك بسطر واحد: No resources found in default namespace، وأنت متأكد أن تطبيقك Application يعمل. وفي يوم آخر ترى ال Pod بالحالة Status CrashLoopBackOff فتكتب kubectl logs فتجد السجل Log فارغاً، أو تحدث ال Image بوسم Tag فيه خطأ مطبعي فيبقى نصف التطبيق على النسخة Version القديمة ونصفه لا يعمل. وأغلب هذه المواقف لا تحتاج أمراً جديداً، وإنما تحتاج أن تعرف ماذا يفعل الأمر الذي تكتبه كل يوم، وأين يبحث، وما الذي لا يقوله لك.
وفي مصطلحات Kubernetes بالرسم شرحنا الكائنات Objects نفسها، وفي مقال Kubernetes من الداخل بنينا عنقوداً Cluster من ثلاث عقد Nodes بأداة kind ورأينا كيف يتعامل ال API Server مع كل طلب Request. وهذا المقال يعمل على العنقود نفسه، فيمر على الأوامر التي تحتاجها كل يوم بالترتيب الذي تستخدمها فيه، ثم يعيد إنتاج أشهر عطلين يواجههما المبتدئ، وهما CrashLoopBackOff وImagePullBackOff، ويصلحهما خطوة خطوة، والمخرجات Outputs كلها من التجربة.
وسوف نناقش في هذا المقال ما يلي:
- ملف الإعداد kubeconfig والسياقات Contexts وال Namespaces، وكيف تعرف على أي عنقود تعمل قبل أن تكتب أمراً.
- القراءة:
getبصيغ العرض Output Formats المختلفة، وdescribeوالأحداث Events، والأمرexplain. - الوصول إلى التطبيق:
logsوexecوport-forwardوdebug. - التغيير:
applyوdiffوrolloutوscale، والفرق الذي يظهر بين الملف والعنقود. - العلامات Labels والمحددات Selectors، واستهلاك الموارد بالأمر
top. - تشخيص الأعطال Troubleshooting: إعادة إنتاج CrashLoopBackOff وImagePullBackOff وإصلاحهما.
ماذا يفعل kubectl فعلاً؟
kubectl برنامج عميل Client فقط، فهو لا يشغل Containers ولا يتصل بالعقد، وإنما يحول كل أمر تكتبه إلى طلب HTTPS إلى ال API Server ثم يطبع الرد بشكل مقروء. وهذا يفسر أشياء كثيرة ستراها: الأمر kubectl apply ينجح فور أن يحفظ ال API Server ما أرسلته، وليس عندما يعمل التطبيق، والأمر kubectl logs يطلب من ال API Server أن يجلب السجل من ال kubelet على العقدة، فإذا كانت العقدة متوقفة فلن تحصل على السجل. ولذلك تحتاج بعد كل تغيير أمراً ثانياً يخبرك بالنتيجة، مثل kubectl rollout status، وسوف نستخدمه كثيراً.
وهناك طريقتان لاستخدام kubectl في التغيير، وسوف تراهما في كل شرح. الطريقة المباشرة Imperative أن تكتب ما تريد فعله في الأمر نفسه: kubectl create deployment وkubectl scale وkubectl set image، وهي سريعة ومناسبة للتجربة والطوارئ. والطريقة التصريحية Declarative أن تكتب ما تريد أن يكون في ملف، ثم ترسل الملف ب kubectl apply، فيحسب kubectl والعنقود الفرق ويطبقانه. وهذا المقال يستخدم الطريقتين، ولكن تذكر من الآن القاعدة التي سنصل إليها بالتجربة في قسم التراجع: كل تغيير مباشر يجعل العنقود مختلفاً عن ملفاتك، حتى تصححها.
وقبل أن تبدأ اجعل الكتابة أسهل، فأغلب من يعمل مع Kubernetes كل يوم يعرف اختصاراً Alias من حرف واحد مثل alias k=kubectl، ويفعل الإكمال التلقائي Completion بالأمر kubectl completion bash أو kubectl completion zsh في ملف إعداد الطرفية Shell، فيكمل له أسماء ال Pods وال Namespaces بالمفتاح Tab بدل نسخها. وهذا ليس ترفاً، فأسماء ال Pods فيها حروف عشوائية، والخطأ في حرف واحد يعني أمراً على Pod آخر أو رسالة NotFound.
والإصدار Version مهم، لأن kubectl يدعم فرقاً بإصدار واحد عن ال API Server صعوداً ونزولاً بحسب سياسة اختلاف الإصدارات Version Skew Policy، والنسخة التي استخدمناها v1.36.1 مع عنقود v1.36.4:
kubectl versionClient Version: v1.36.1
Kustomize Version: v5.8.1
Server Version: v1.36.4على أي عنقود Cluster تعمل الآن؟ kubeconfig والسياقات Contexts
kubectl يقرأ عنوان Address العنقود وشهادة الدخول Certificate من ملف واحد اسمه kubeconfig، وهو افتراضياً ~/.kube/config، أو الملف الذي يشير إليه متغير البيئة Environment Variable KUBECONFIG، وفي التجربة جعلناه ملفاً خاصاً بالعنقود حتى لا نخلطه بغيره. والملف فيه ثلاث قوائم: العناقيد Clusters، والمستخدمون Users، والسياقات Contexts، والسياق هو اسم يجمع عنقوداً ومستخدماً وNamespace افتراضياً:
kubectl config get-contexts
kubectl config view --minify
CURRENT NAME CLUSTER AUTHINFO NAMESPACE
* kind-k1 kind-k1 kind-k1
apiVersion: v1
clusters:
- cluster:
certificate-authority-data: DATA+OMITTED
server: https://127.0.0.1:49342
name: kind-k1
contexts:
- context:
cluster: kind-k1
user: kind-k1
name: kind-k1
current-context: kind-k1
kind: Config
users:
- name: kind-k1
user:
client-certificate-data: DATA+OMITTED
client-key-data: DATA+OMITTEDفي المخرج أعلاه لاحظ التالي:
- النجمة في العمود
CURRENTهي السياق الحالي Current Context، وكل أمر لا تذكر فيه--contextيذهب إليه، وعمودNAMESPACEفارغ، أي أن ال Namespace الافتراضي هوdefault. - الخيار
--minifyيعرض السياق الحالي فقط، وkubectl يخفي الشهادات بالكلمةDATA+OMITTED. ولكن الملف نفسه فيه المفتاح الخاص Private Key كاملاً، وهو يعطي صلاحية Permission المدير على العنقود كله، فعامله معاملة كلمة المرور ولا ترسله في محادثة أو تضعه في مستودع Git.
والآن ننشئ Namespace للتجربة اسمه demo، وسياقاً ثانياً على العنقود نفسه يجعله الافتراضي، حتى لا نكتب -n demo في كل أمر:
kubectl create namespace demo
kubectl config set-context demo --cluster=kind-k1 --user=kind-k1 --namespace=demo
kubectl config use-context demo
kubectl config get-contexts
kubectl get pods
namespace/demo created
Context "demo" created.
Switched to context "demo".
CURRENT NAME CLUSTER AUTHINFO NAMESPACE
* demo kind-k1 kind-k1 demo
kind-k1 kind-k1 kind-k1
No resources found in demo namespace.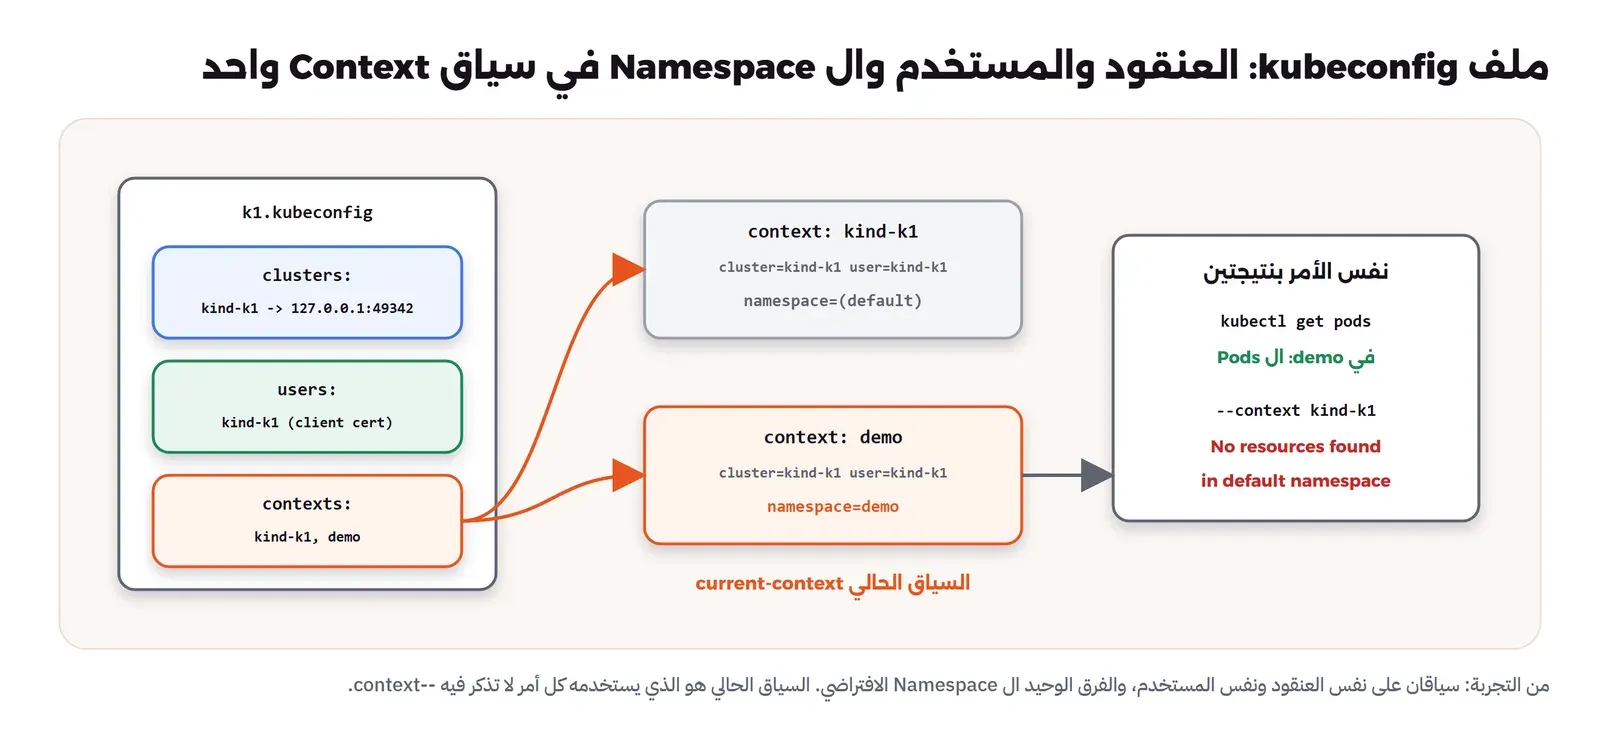
وهذا هو أول خطأ يقع فيه كل من يعمل على أكثر من عنقود: يكتب أمراً وهو يظن أنه على عنقود التجربة، وهو على عنقود الإنتاج Production. والحل ليس أن تنتبه أكثر، وإنما أن تجعل السياق ظاهراً دائماً، فاعرضه في سطر الأوامر Prompt كما شرحنا في تخصيص سطر الأوامر مع Starship، واكتب --context صراحة في السكربتات Scripts، واجعل لعنقود الإنتاج ملف kubeconfig منفصلاً لا تحمله إلا عندما تحتاجه.
والعكس أيضاً يحدث، وهو أن تبحث عن شيء موجود في Namespace آخر. فهنا نسأل بالسياق القديم الذي يستخدم default، ثم نذكر ال Namespace صراحة:
kubectl --context kind-k1 get pods
kubectl get pods -n demo --context kind-k1 -l app=crashy
No resources found in default namespace.
NAME READY STATUS RESTARTS AGE
crashy-6968d5bd47-kkxxk 1/1 Running 0 5mفالرسالة No resources found لا تعني أن تطبيقك غير موجود، وإنما أنه غير موجود في هذا ال Namespace، واقرأ آخر كلمة فيها دائماً. وإذا لم تعرف أين هو فالخيار -A واختصاره من --all-namespaces يبحث في كل ال Namespaces.
أنواع الكائنات Objects واختصاراتها: api-resources
كل نوع من الكائنات له اسم كامل واسم مختصر Short Name، والأمر api-resources يعرضها كلها من العنقود نفسه، ومعها المجموعة API Group والإصدار، وهل الكائن داخل Namespace أم على مستوى العنقود كله:
kubectl api-resources | grep -E '^(pods|services|deployments|replicasets|namespaces|configmaps|persistentvolumeclaims|nodes|events) 'configmaps cm v1 true ConfigMap
events ev v1 true Event
namespaces ns v1 false Namespace
nodes no v1 false Node
persistentvolumeclaims pvc v1 true PersistentVolumeClaim
pods po v1 true Pod
services svc v1 true Service
deployments deploy apps/v1 true Deployment
replicasets rs apps/v1 true ReplicaSet
events ev events.k8s.io/v1 true Eventفي المخرج أعلاه لاحظ التالي:
- العمود الثاني هو الاختصار الذي تستخدمه في الأوامر، فالأمر
kubectl get deploy,rs,svcيساوي الأسماء الكاملة، وهذا ما سنستخدمه في بقية المقال. - العمود الرابع يقول هل النوع داخل Namespace، فال Nodes وال Namespaces نفسها قيمتها
false، ولذلك لا يؤثر الخيار-nعليها، والأمرkubectl get nodes -n demoيعرض كل العقد. - النوع
eventsيظهر مرتين، مرة في المجموعة الأساسيةv1ومرة فيevents.k8s.io/v1الأحدث، وهو نفس الكائن بواجهتين، وهذا سبب الفرق بينkubectl get eventsوkubectl eventsالذي سيأتي.
وإذا ثبت أداة تضيف أنواعاً جديدة، مثل المشغل Operator في CloudNativePG، فسوف تظهر أنواعها هنا أيضاً، ويعمل معها get وdescribe وexplain بنفس الطريقة، فهذه الأوامر لا تعرف الأنواع مسبقاً وإنما تسأل ال API Server عنها.
ابدأ ملف YAML من kubectl نفسه
كتابة ملف Deployment من الذاكرة تنتهي غالباً بخطأ في المسافات أو في اسم حقل، والأسهل أن تجعل kubectl يكتب لك البداية بالخيار --dry-run=client -o yaml، فيطبع الكائن الذي كان سيرسله دون أن يرسله:
kubectl create deployment hello --image=nginx:1.29.8-alpine --replicas=2 --port=80 --dry-run=client -o yaml > hello.yamlapiVersion: apps/v1
kind: Deployment
metadata:
labels:
app: hello
name: hello
spec:
replicas: 2
selector:
matchLabels:
app: hello
strategy: {}
template:
metadata:
labels:
app: hello
spec:
containers:
- image: nginx:1.29.8-alpine
name: nginx
ports:
- containerPort: 80
resources: {}
status: {}ولا تستخدم الملف كما هو، فالحقول الفارغة strategy: {} وresources: {} وstatus: {} لا تفيد، وstatus بالذات يكتبه العنقود وليس أنت. وإذا لم تعرف ماذا يقبل حقل ما فالأمر explain يقرأ الوصف من ال API Server نفسه، فهو مطابق لإصدار عنقودك دائماً، وهذا أفضل من صفحة وثائق لإصدار آخر:
kubectl explain deployment.spec.strategyGROUP: apps
KIND: Deployment
VERSION: v1
FIELD: strategy <DeploymentStrategy>
DESCRIPTION:
The deployment strategy to use to replace existing pods with new ones.
DeploymentStrategy describes how to replace existing pods with new ones.
FIELDS:
rollingUpdate <RollingUpdateDeployment>
Rolling update config params. Present only if DeploymentStrategyType =
RollingUpdate.
type <string>
enum: Recreate, RollingUpdate
Type of deployment. Can be "Recreate" or "RollingUpdate". Default is
RollingUpdate.وبعد التنظيف أضفنا Label ثانياً اسمه tier، وحدوداً للموارد Resources، وService أمام ال Pods، فأصبح الملف كما يلي:
# Started from: kubectl create deployment hello ... --dry-run=client -o yaml
# then cleaned up: empty fields removed, labels, resources and a Service added.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: hello
  labels:
    app: hello
    tier: frontend
spec:
  replicas: 2
  selector:
    matchLabels:
      app: hello
  template:
    metadata:
      labels:
        app: hello
        tier: frontend
    spec:
      containers:
        - name: nginx
          image: nginx:1.29.8-alpine
          ports:
            - containerPort: 80
          resources:
            requests:
              cpu: 50m
              memory: 32Mi
            limits:
              memory: 64Mi
---
apiVersion: v1
kind: Service
metadata:
  name: hello
spec:
  selector:
    app: hello
  ports:
    - port: 80
      targetPort: 80
kubectl apply -f hello.yaml
kubectl rollout status deploy/hello --timeout=120sdeployment.apps/hello created
service/hello created
deployment "hello" successfully rolled outالقراءة بالأمر get: كائن Object واحد وعدة طرق لعرضه
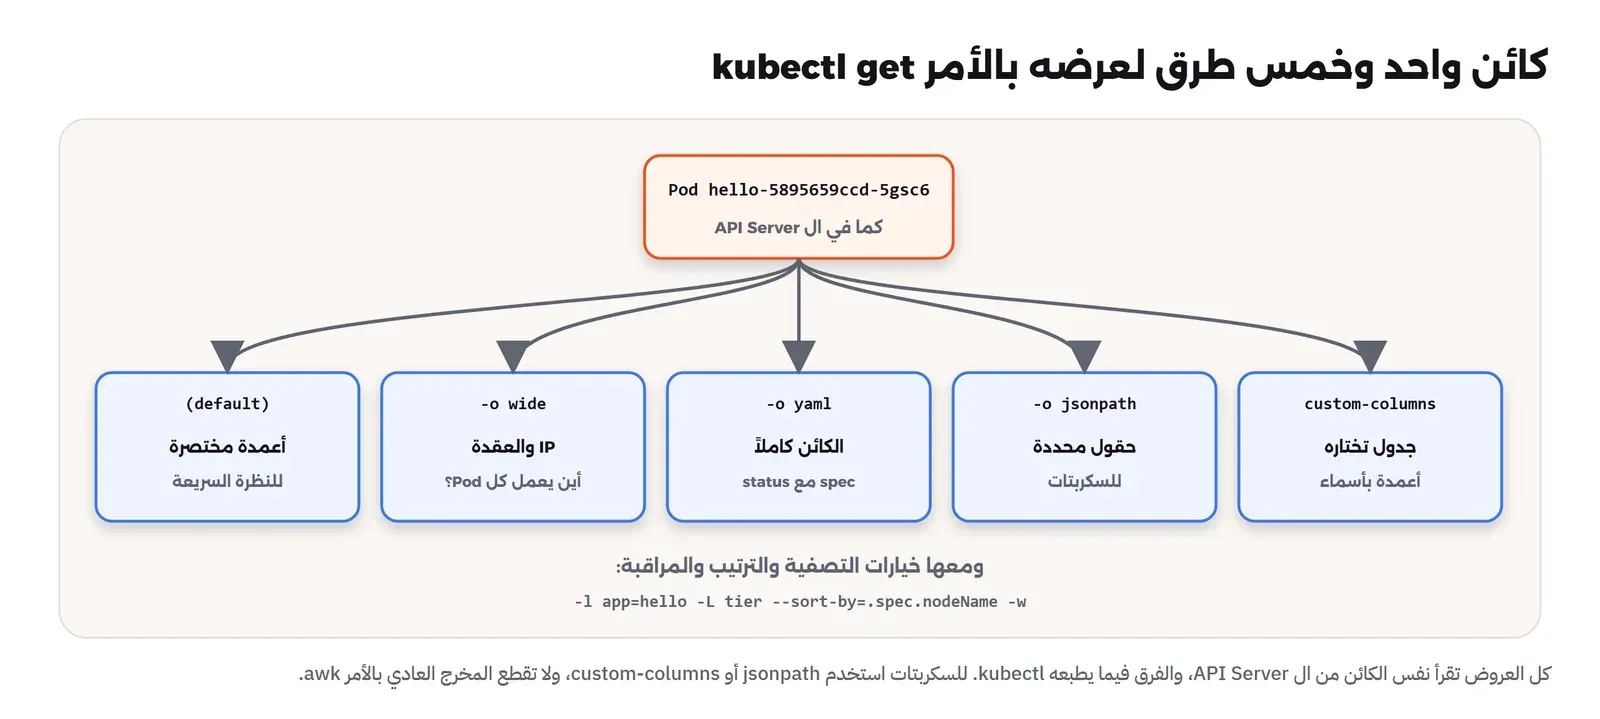
الأمر get يقرأ الكائنات ويعرضها جدولاً مختصراً، والخيار -o يغير طريقة العرض Output Format دون أن يغير ما يقرؤه، فكل العروض التالية جاءت من نفس الطلب إلى ال API Server:
kubectl get pods
kubectl get pods -o wide
kubectl get pods --show-labels
NAME READY STATUS RESTARTS AGE
hello-5895659ccd-5gsc6 1/1 Running 0 21s
hello-5895659ccd-sqfgc 1/1 Running 0 21s
NAME READY STATUS RESTARTS AGE IP NODE NOMINATED NODE READINESS GATES
hello-5895659ccd-5gsc6 1/1 Running 0 23s 10.244.1.16 k1-worker <none> <none>
hello-5895659ccd-sqfgc 1/1 Running 0 23s 10.244.2.2 k1-worker2 <none> <none>
NAME READY STATUS RESTARTS AGE LABELS
hello-5895659ccd-5gsc6 1/1 Running 0 24s app=hello,pod-template-hash=5895659ccd,tier=frontend
hello-5895659ccd-sqfgc 1/1 Running 0 24s app=hello,pod-template-hash=5895659ccd,tier=frontendفي المخرج أعلاه لاحظ التالي:
- اسم كل Pod فيه ثلاثة أجزاء: اسم ال Deployment، ثم بصمة ال Template، ثم خمسة حروف عشوائية، والبصمة
5895659ccdتظهر أيضاً كقيمة لل Label المسمىpod-template-hash، وهو ما يميز Pods كل نسخة من الملف عن الأخرى أثناء التحديث Update. - العمود
READYيقول1/1، أي Container واحد من واحد جاهز، وهذا يختلف عنSTATUS، فقد يكون ال Pod بحالةRunningوجاهزيته0/1لأن فحص الجاهزية Readiness Probe لم ينجح بعد. - الخيار
-o wideيضيف عنوان ال Pod والعقدة، وهو أول ما تحتاجه عندما تشك أن المشكلة في عقدة واحدة.
وتستطيع أن تطلب أكثر من نوع في أمر واحد، ولكن انتبه لما يحدث مع ال Selector:
kubectl get deploy,rs,svc,pods -l app=helloNAME READY UP-TO-DATE AVAILABLE AGE
deployment.apps/hello 2/2 2 2 27s
NAME DESIRED CURRENT READY AGE
replicaset.apps/hello-5895659ccd 2 2 2 26s
NAME READY STATUS RESTARTS AGE
pod/hello-5895659ccd-5gsc6 1/1 Running 0 26s
pod/hello-5895659ccd-sqfgc 1/1 Running 0 26sال Service غير موجود في المخرج رغم أنه موجود في العنقود، والسبب أن الخيار -l app=hello يبحث عن الكائنات التي تحمل هذا ال Label، وال Service في ملفنا ليس عليه Labels أصلاً، وإنما فيه Selector بنفس القيمة، والاثنان شيئان مختلفان: ال Label اسم على الكائن نفسه، وال Selector سؤال يطرحه الكائن عن غيره. لذلك ضع Labels على كل كائن في ملفاتك، وليس على ال Pods فقط، حتى يعمل البحث والحذف بال Label كما تتوقع.
لماذا لا يعرض get all كل شيء؟
الأمر kubectl get all يبدو كأنه يعرض كل ما في ال Namespace، وهذا ما ظهر في ال Namespace المسمى demo بعد تجارب هذا المقال:
kubectl get all -n demoNAME READY STATUS RESTARTS AGE
pod/crashy-6968d5bd47-kkxxk 1/1 Running 0 4m19s
pod/hello-5895659ccd-2qng5 1/1 Running 0 18m
pod/hello-5895659ccd-98tcj 1/1 Running 0 17m
pod/hello-5895659ccd-rpzmv 1/1 Running 0 17m
pod/hello-5895659ccd-xns99 1/1 Running 0 70s
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
service/hello ClusterIP 10.96.127.172 <none> 80/TCP 25m
NAME READY UP-TO-DATE AVAILABLE AGE
deployment.apps/crashy 1/1 1 1 9m35s
deployment.apps/hello 4/4 4 4 25m
NAME DESIRED CURRENT READY AGE
replicaset.apps/crashy-6968d5bd47 1 1 1 4m20s
replicaset.apps/crashy-8478b79f97 0 0 0 9m35s
replicaset.apps/hello-5895659ccd 4 4 4 25m
replicaset.apps/hello-6795db798f 0 0 0 20m
replicaset.apps/hello-6f45595854 0 0 0 3m43sوال ConfigMap المسمى crashy-config الذي أنشأناه في قسم CrashLoopBackOff غير موجود في المخرج، وكذلك ال Secrets وال PersistentVolumeClaims وال Ingresses، لأن all مجموعة ثابتة من الأنواع الشائعة فقط، وليست كل شيء. فلا تعتمد عليه لتعرف ما سيحذف مع ال Namespace، واطلب الأنواع بالاسم: kubectl get cm,secret,pvc -n demo. ولاحظ أيضاً ال ReplicaSets القديمة بعدد صفر، فكل واحدة منها مراجعة يمكن الرجوع إليها، ويحتفظ ال Deployment بعشر منها افتراضياً بحسب الحقل revisionHistoryLimit.
jsonpath وcustom-columns للسكربتات Scripts
عندما تحتاج حقلاً واحداً في سكربت فلا تقطع الجدول العادي بأدوات مثل awk، لأن الأعمدة تتغير بين الإصدارات وبين الخيارات، وإنما اطلب الحقل بالاسم من الكائن نفسه:
kubectl get pods -o jsonpath='{range .items[*]}{.metadata.name}{"\t"}{.status.podIP}{"\t"}{.spec.nodeName}{"\n"}{end}'
kubectl get pods -o custom-columns=NAME:.metadata.name,IMAGE:.spec.containers[0].image,NODE:.spec.nodeName,START:.status.startTime
hello-5895659ccd-5gsc6 10.244.1.16 k1-worker
hello-5895659ccd-sqfgc 10.244.2.2 k1-worker2
NAME IMAGE NODE START
hello-5895659ccd-5gsc6 nginx:1.29.8-alpine k1-worker 2026-11-18T18:26:31Z
hello-5895659ccd-sqfgc nginx:1.29.8-alpine k1-worker2 2026-11-18T18:26:30Zوكيف تعرف اسم الحقل؟ اعرض الكائن كاملاً بالخيار -o yaml مرة واحدة، وابحث فيه عن القيمة التي تريدها، ثم اكتب مسارها. وهذا جزء الحالة status من أحد ال Pods، وهو الجزء الذي يكتبه العنقود ولا تكتبه أنت:
kubectl get pod hello-5895659ccd-5gsc6 -o yaml | sed -n '/^status:/,$p' | head -24status:
allocatedResources:
cpu: 50m
memory: 32Mi
conditions:
- lastProbeTime: null
lastTransitionTime: "2026-11-18T18:26:36Z"
observedGeneration: 1
status: "True"
type: PodReadyToStartContainers
- lastProbeTime: null
lastTransitionTime: "2026-11-18T18:26:31Z"
observedGeneration: 1
status: "True"
type: Initialized
- lastProbeTime: null
lastTransitionTime: "2026-11-18T18:26:39Z"
observedGeneration: 1
status: "True"
type: Ready
- lastProbeTime: null
lastTransitionTime: "2026-11-18T18:26:39Z"
observedGeneration: 1
status: "True"
type: ContainersReadyوالأوقات هنا تحكي ما حدث لل Pod بالترتيب: جدولته في 18:26:30، ثم التهيئة Initialized في 18:26:31، ثم جاهزية الشبكة في 18:26:36، ثم أصبح جاهزاً Ready في 18:26:39، أي تسع ثوان من الجدولة إلى استقبال الطلبات. والقواعد الكاملة لكتابة المسارات في صفحة JSONPath في kubectl.
describe والأحداث Events: ماذا حدث لهذا الكائن؟
الأمر describe يجمع في صفحة واحدة الكائن نفسه مع ما يتعلق به، وأهم ما فيه آخر قسم، وهو الأحداث Events التي كتبتها الأجزاء المختلفة عن هذا الكائن:
kubectl describe pod hello-5895659ccd-5gsc6Name: hello-5895659ccd-5gsc6
Namespace: demo
Node: k1-worker/172.24.0.4
Labels: app=hello
pod-template-hash=5895659ccd
tier=frontend
Status: Running
IP: 10.244.1.16
Controlled By: ReplicaSet/hello-5895659ccd
Containers:
nginx:
Image: nginx:1.29.8-alpine
Image ID: docker.io/library/nginx@sha256:5616878291a2eed594aee8db4dade5878cf7edcb475e59193904b198d9b830de
State: Running
Started: Wed, 18 Nov 2026 21:26:39 +0300
Ready: True
Restart Count: 0
Limits:
memory: 64Mi
Requests:
cpu: 50m
memory: 32Mi
QoS Class: Burstable
Tolerations: node.kubernetes.io/not-ready:NoExecute op=Exists for 300s
node.kubernetes.io/unreachable:NoExecute op=Exists for 300s
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal Scheduled 69s default-scheduler Successfully assigned demo/hello-5895659ccd-5gsc6 to k1-worker
Normal Pulled 64s kubelet spec.containers{nginx}: Container image "nginx:1.29.8-alpine" already present on machine and can be accessed by the pod
Normal Created 63s kubelet spec.containers{nginx}: Container created
Normal Started 61s kubelet spec.containers{nginx}: Container startedواختصرنا من المخرج بعض الأسطر، وفيما بقي لاحظ التالي:
Controlled Byيقول من يملك هذا ال Pod، وهو ال ReplicaSet، فإذا حذفته سوف ينشئ ال ReplicaSet بديلاً، وإذا أردت أن يختفي فاحذف المالك أو غير عدد النسخ.Image IDهو البصمة Digest التي سحبها ال kubelet فعلاً، وهي التي تحدد ما يعمل، وليس الوسم، كما شرحنا في ما هي ال Containers.QoS Class: Burstableلأن الطلب أقل من الحد، وهذه الفئة تحدد من يخرج أولاً عندما تمتلئ ذاكرة العقدة، ونعود إليها في مقال حدود الموارد.- عمود
Fromفي الأحداث يقول من كتب كل حدث: المجدولdefault-schedulerكتب الجدولة، والkubeletكتب الباقي، فإذا توقفت الأحداث عند Scheduled فالمشكلة على العقدة، وإذا لم يوجد Scheduled أصلاً فالمشكلة في الجدولة.
والأحداث تحفظ ساعة واحدة افتراضياً ثم تحذف، فإذا جئت تبحث في عطل حدث أمس فلن تجد شيئاً هنا، ولذلك تحتاج نظام سجلات يجمعها كما في سجل التدقيق Audit Trail. ولعرض أحداث ال Namespace كلها مرتبة بالوقت استخدم kubectl events، فهو أوضح من kubectl get events القديم الذي قد يعرض الأحداث دون ترتيب صحيح.
السجلات Logs والدخول: logs وexec وport-forward
kubectl logs
السجل Log الذي تقرؤه هو ما كتبه ال Container على المخرج القياسي stdout والخطأ القياسي stderr، تماماً كما في docker logs الذي شرحناه في أوامر Docker الأساسية، فإذا كان تطبيقك يكتب سجله في ملف داخل ال Container فلن تراه هنا. والفرق أن ال Pods كثيرة وأسماؤها تتغير، فتحتاج طرقاً تختار بها:
kubectl logs hello-5895659ccd-5gsc6 --tail=3
kubectl logs -l app=hello --prefix --tail=2
kubectl logs deploy/hello --since=5m | tail -2
2026/11/18 18:26:41 [notice] 1#1: start worker process 39
2026/11/18 18:26:41 [notice] 1#1: start worker process 40
2026/11/18 18:26:41 [notice] 1#1: start worker process 41
[pod/hello-5895659ccd-5gsc6/nginx] 2026/11/18 18:26:41 [notice] 1#1: start worker process 40
[pod/hello-5895659ccd-5gsc6/nginx] 2026/11/18 18:26:41 [notice] 1#1: start worker process 41
[pod/hello-5895659ccd-sqfgc/nginx] 127.0.0.1 - - [18/Nov/2026:18:28:25 +0000] "GET /missing HTTP/1.1" 404 153 "-" "curl/8.12.1" "-"
[pod/hello-5895659ccd-sqfgc/nginx] 2026/11/18 18:28:25 [error] 37#37: *2 open() "/usr/share/nginx/html/missing" failed (2: No such file or directory), client: 127.0.0.1, server: localhost, request: "GET /missing HTTP/1.1", host: "127.0.0.1:9573"
Found 2 pods, using pod/hello-5895659ccd-sqfgc
127.0.0.1 - - [18/Nov/2026:18:28:25 +0000] "GET /missing HTTP/1.1" 404 153 "-" "curl/8.12.1" "-"في المخرج أعلاه لاحظ التالي:
- الخيار
-l app=helloيجمع سجلات كل ال Pods التي تطابق ال Selector، و--prefixيضيف أمام كل سطر اسم ال Pod وال Container، ودونه لن تعرف أي سطر من أي نسخة. - الأمر
logs deploy/helloيختار Pod واحداً فقط ويقول ذلك في السطرFound 2 pods, using pod/…، فإذا كان الطلب الذي تبحث عنه وصل إلى النسخة الأخرى فلن تجده، وهذا خطأ شائع عند البحث عن طلب فشل. - الطلب إلى
/missingظهر في سجل ال Pod الثاني فقط، لأن ال Service وزع الاتصال Connection على نسخة واحدة، وعنوان العميل127.0.0.1لأن الطلب جاء عبر port-forward كما سيأتي.
kubectl exec
الأمر exec يشغل برنامجاً داخل Container يعمل، وهو أسرع طريقة لتعرف ماذا يرى التطبيق من الداخل: هل يجد ال Service بالاسم؟ ما المتغيرات Environment Variables التي وصلته؟ وما الإصدار الذي يعمل فعلاً؟
kubectl exec hello-5895659ccd-5gsc6 -- nginx -v
kubectl exec hello-5895659ccd-5gsc6 -- sh -c 'hostname; head -2 /etc/os-release; wget -qO- http://hello | grep -o "<title>.*</title>"'
kubectl exec hello-5895659ccd-5gsc6 -- env | grep -E 'HELLO_SERVICE|KUBERNETES_SERVICE_HOST'
nginx version: nginx/1.29.8
hello-5895659ccd-5gsc6
NAME="Alpine Linux"
ID=alpine
<title>Welcome to nginx!</title>
HELLO_SERVICE_HOST=10.96.127.172
HELLO_SERVICE_PORT=80
KUBERNETES_SERVICE_HOST=10.96.0.1والعلامة -- تفصل خيارات kubectl عن الأمر الذي يشغله، فكل ما بعدها يذهب إلى ال Container كما هو. ولاحظ المتغيرات في آخر المخرج، فال kubelet يضيف لكل Pod متغيرين لكل Service كان موجوداً في ال Namespace عند إنشاء ال Pod، وهذه طريقة قديمة لاكتشاف الخدمات Service Discovery، ولا تعتمد عليها، والسبب أن ال Service الذي ينشأ بعد ال Pod لا يظهر في متغيراته، أما الاسم hello عبر DNS فيعمل دائماً.
kubectl port-forward
ال Service من النوع ClusterIP لا يصل إليه أحد من خارج العنقود، والأمر port-forward يفتح منفذاً Port على جهازك وينقل كل اتصال عليه إلى ال Service أو إلى Pod، عبر ال API Server وال kubelet:
kubectl port-forward svc/hello 9573:80 &
curl -s http://127.0.0.1:9573/ | grep -o '<title>.*</title>'
curl -sI http://127.0.0.1:9573/ | head -3
Forwarding from 127.0.0.1:9573 -> 80
Forwarding from [::1]:9573 -> 80
Handling connection for 9573
<title>Welcome to nginx!</title>
Handling connection for 9573
HTTP/1.1 200 OK
Server: nginx/1.29.8
Date: Wed, 18 Nov 2026 18:30:41 GMTوالمنفذ مفتوح على 127.0.0.1 فقط، أي على جهازك وحده، وهذا هو الصحيح، فلا تضف --address 0.0.0.0 إلا إذا كنت تعرف من يستطيع الوصول إلى جهازك. ولاحظ أن port-forward إلى Service لا يوزع الطلبات على ال Pods كما يفعل ال Service الحقيقي، وإنما يختار Pod واحداً عند البدء ويبقى عليه، فإذا توقف ذلك ال Pod توقف الأمر كله برسالة lost connection to pod، وسوف نرى هذا في مقال نقل تطبيق Compose. فهو أداة للتطوير والتشخيص، وليس طريقة لنشر تطبيق للمستخدمين، وذلك عمل Ingress أو Gateway.
kubectl debug: أدوات لا توجد في ال Image
كثير من ال Images الصغيرة لا تحتوي على shell ولا على أدوات مثل ps وwget، وهذا جيد للأمان كما شرحنا في تقليل حجم Docker Images وتأمينها، ولكنه يجعل exec بلا فائدة. والأمر debug يضيف إلى ال Pod الذي يعمل Container مؤقتاً Ephemeral Container من Image أخرى فيها الأدوات، ومع الخيار --target يرى عمليات ال Container الأصلي:
kubectl debug hello-5895659ccd-2qng5 --image=busybox:1.37 --target=nginx --container=k1-dbg -- sh -c 'ps; wget -qO- http://127.0.0.1/ | head -4'
kubectl logs hello-5895659ccd-2qng5 -c k1-dbg
Targeting container "nginx". If you don't see processes from this container it may be because the container runtime doesn't support this feature.
PID USER TIME COMMAND
1 root 0:00 nginx: master process nginx -g daemon off;
34 101 0:00 nginx: worker process
35 101 0:00 nginx: worker process
36 101 0:00 nginx: worker process
37 101 0:00 nginx: worker process
38 101 0:00 nginx: worker process
39 101 0:00 nginx: worker process
40 101 0:00 nginx: worker process
41 101 0:00 nginx: worker process
42 root 0:00 sh -c ps; wget -qO- http://127.0.0.1/ | head -4
53 root 0:00 ps
<!DOCTYPE html>
<html>
<head>
<title>Welcome to nginx!</title>وال Container المؤقت يرى nginx بالرقم 1 لأنه يشترك معه في مساحة أسماء العمليات PID Namespace التي شرحناها في ما هي ال Containers، ويصل إليه على 127.0.0.1 لأنهما في نفس شبكة ال Pod. ولاحظ أيضاً عدد عمليات العامل worker process، فهي ثمانية، لأن nginx يضبط عددها تلقائياً بعدد معالجات الجهاز CPUs، وهو يرى المعالجات الثمانية كلها رغم أن ال Pod طلب 50m فقط، أي جزءاً من عشرين من معالج، فالطلب Request لا يخفي المعالجات عن التطبيق. ولا يحذف ال Container المؤقت بعد انتهائه، وإنما يبقى في وصف ال Pod حتى يحذف ال Pod نفسه:
kubectl get pod hello-5895659ccd-2qng5 -o jsonpath='{.spec.ephemeralContainers[*].name}'; echok1-dbgالتغيير Change: apply وdiff وrollout
الطريقة التي ننصح بها لكل تغيير هي أن تعدل الملف ثم ترسله ب kubectl apply، والسبب أن الملف يبقى في Git ويصبح هو مصدر الحقيقة، كما شرحنا في GitOps ببساطة. وقبل أن ترسل اسأل العنقود ماذا سيتغير بالأمر kubectl diff، فهو يرسل الملف إلى ال API Server في وضع تجربة Dry Run ويقارن النتيجة بما يعمل الآن. فهنا غيرنا وسم nginx في الملف من 1.29.8 إلى 1.31.6:
sed -i 's#image: nginx:1.29.8-alpine#image: nginx:1.31.6-alpine#' hello.yaml
kubectl diff -f hello.yaml
@@ -6,7 +6,7 @@
kubectl.kubernetes.io/last-applied-configuration: |
{"apiVersion":"apps/v1","kind":"Deployment",…}
creationTimestamp: "2026-11-18T18:26:29Z"
- generation: 1
+ generation: 2
labels:
app: hello
tier: frontend
@@ -33,7 +33,7 @@
tier: frontend
spec:
containers:
- - image: nginx:1.29.8-alpine
+ - image: nginx:1.31.6-alpine
imagePullPolicy: IfNotPresent
name: nginx
ports:واختصرنا السطر الطويل الذي يحفظ آخر ملف أرسلته، وفي الباقي سطران تغيرا: الوسم كما توقعنا، والحقل generation الذي يزيده ال API Server عند كل تغيير في المواصفات spec. والأمر diff يخرج بالرمز 1 عندما يجد فرقاً وبالرمز 0 عندما لا يجد، وهذا مفيد في خطوط النشر Pipelines، فبعد أن أرسلنا الملف خرج diff بالرمز 0. ثم أرسلنا الملف وتابعنا التحديث:
kubectl apply -f hello.yaml
kubectl annotate deployment/hello kubernetes.io/change-cause='nginx 1.29.8 to 1.31.6'
kubectl rollout status deploy/hello
kubectl rollout history deploy/hello
kubectl get rs -l app=hello
deployment.apps/hello configured
service/hello unchanged
deployment.apps/hello annotated
Waiting for deployment "hello" rollout to finish: 1 out of 2 new replicas have been updated...
Waiting for deployment "hello" rollout to finish: 1 old replicas are pending termination...
deployment "hello" successfully rolled out
deployment.apps/hello
REVISION CHANGE-CAUSE
1 <none>
2 nginx 1.29.8 to 1.31.6
NAME DESIRED CURRENT READY AGE
hello-5895659ccd 0 0 0 6m46s
hello-6795db798f 2 2 2 2m10sفي المخرج أعلاه لاحظ التالي:
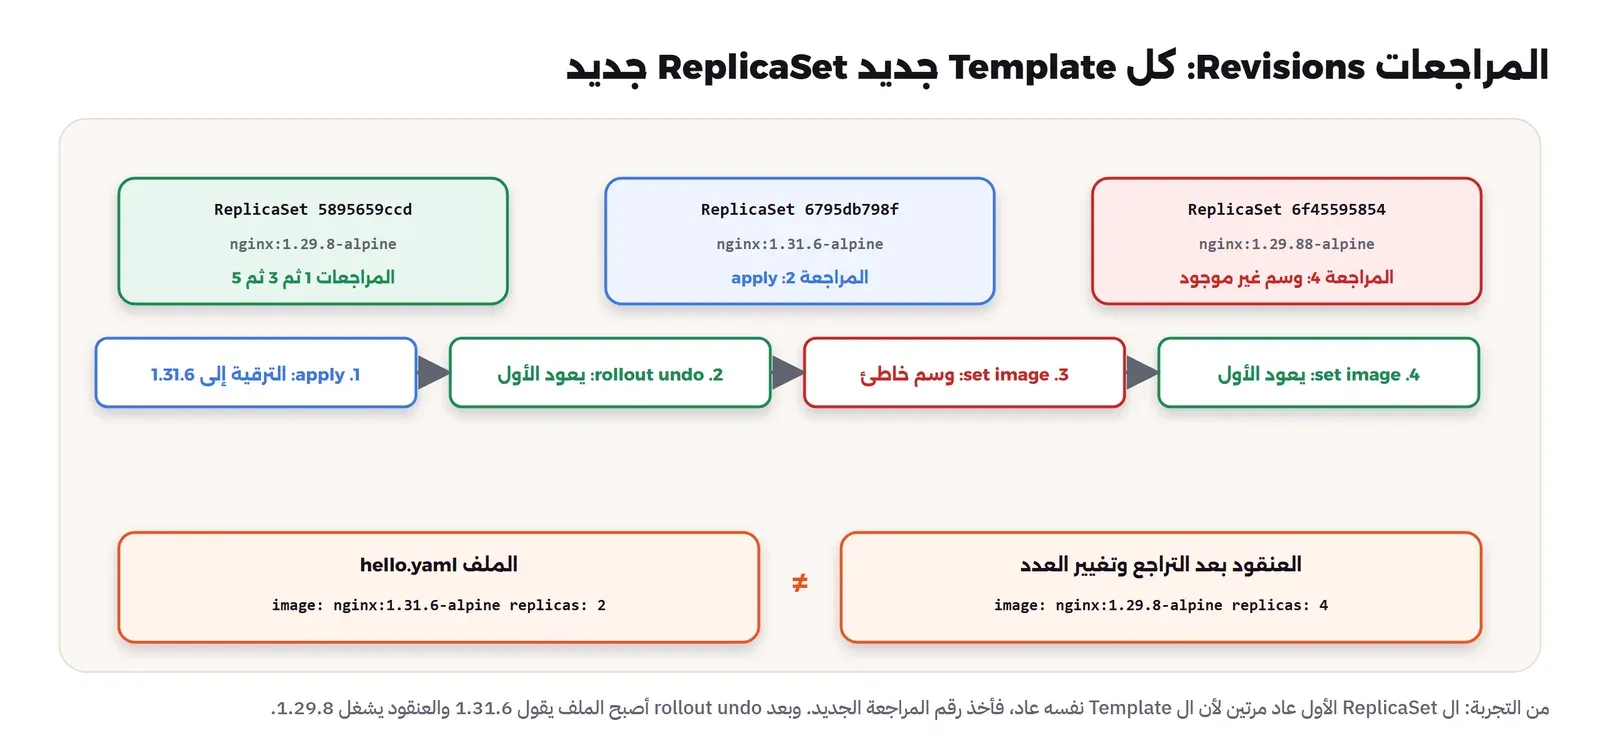
- التحديث التدريجي Rolling Update أنشأ ReplicaSet جديداً ونقل إليه ال Pods واحداً واحداً، وأبقى القديم بعدد صفر، فهو الذي يرجع إليه التراجع Rollback.
- عمود
CHANGE-CAUSEيقرأ التعليق Annotation المسمىkubernetes.io/change-cause، فإذا لم تكتبه بقي<none>ولن تعرف بعد شهر لماذا حدثت كل مراجعة، والأفضل أن تجعل خط النشر يكتبه مع رقم ال Commit.
التراجع rollout undo والانحراف Drift بين الملف والعنقود
لنفرض أن النسخة الجديدة فيها مشكلة وتريد الرجوع فوراً، فالأمر rollout undo يعيد ال Template السابق:
kubectl rollout undo deploy/hello
kubectl rollout status deploy/hello
kubectl get deploy hello -o jsonpath='{.spec.template.spec.containers[0].image}'; echo
kubectl rollout history deploy/hello
Warning: resource deployments/hello was previously managed with 'kubectl apply'. Rolling back will not update the kubectl.kubernetes.io/last-applied-configuration annotation, which may cause unexpected behavior on future 'kubectl apply' operations. Consider using 'kubectl apply' with your previous configuration file instead.
deployment.apps/hello rolled back
deployment "hello" successfully rolled out
nginx:1.29.8-alpine
deployment.apps/hello
REVISION CHANGE-CAUSE
2 nginx 1.29.8 to 1.31.6
3 <none>نجح التراجع، والمراجعة 1 اختفت من القائمة وأصبحت 3، لأن التراجع لا يعيد رقماً قديماً وإنما ينشئ مراجعة جديدة بنفس ال Template. ولكن اقرأ التحذير في أول المخرج بعناية، فهو أهم سطر فيه: العنقود الآن يشغل 1.29.8، والملف عندك وفي Git ما زال يقول 1.31.6. ثم زدنا عدد النسخ بالأمر scale، وهو تغيير آخر لا يعرفه الملف:
kubectl scale deploy/hello --replicas=4
kubectl diff -f hello.yaml | grep -E '^[-+] '
deployment.apps/hello scaled
- generation: 5
+ generation: 6
- replicas: 4
+ replicas: 2
- - image: nginx:1.29.8-alpine
+ - image: nginx:1.31.6-alpineوهذا ما يسمى الانحراف Drift: أول شخص يكتب kubectl apply -f hello.yaml لأي سبب سوف يعيد النسخة التي تراجعنا عنها، ويخفض النسخ من أربع إلى اثنتين، دون أن يقصد. لذلك استخدم undo وscale في الطوارئ فقط، ثم صحح الملف فوراً ليطابق العنقود، واجعل kubectl diff خطوة ثابتة قبل كل apply، فهو الذي كشف الفرق هنا قبل أن يحدث.
kubectl wait في السكربتات
عندما يحتاج سكربت أن ينتظر حالة معينة قبل الخطوة التالية فلا تكتب حلقة فيها sleep وgrep، وإنما استخدم kubectl wait، فهو يراقب الكائن عبر ال API Server ويخرج فور تحقق الشرط، أو بخطأ عند انتهاء المهلة Timeout:
kubectl wait --for=condition=Available deploy/hello --timeout=30sdeployment.apps/hello condition metوالشرط Available من حالة ال Deployment، ويمكنك أن تنتظر condition=Ready على Pod، أو --for=delete حتى يختفي كائن، أو حقلاً بعينه بالصيغة --for=jsonpath=…. والفرق بينه وبين rollout status أن الثاني يتابع تحديثاً جارياً حتى ينتهي، أما wait فيسأل عن حالة، فاستخدم الأول بعد كل apply والثاني قبل خطوة تحتاج شيئاً جاهزاً، مثل اختبار يتصل بقاعدة بيانات Database بدأت للتو.
العلامات Labels والمحددات Selectors في الأوامر اليومية
ال Labels أزواج من مفتاح وقيمة تضعها على الكائنات، والمحدد Selector سؤال عنها، وكل ما يربط الكائنات ببعض في Kubernetes يعمل بها، كما في صفحة ال Labels وال Selectors. وفي الأوامر اليومية تستخدمها لتختار ما تريد بدل الأسماء العشوائية:
kubectl get pods -l 'app in (hello,crashy)' -L app,tier
kubectl get pods -l 'app!=hello'
kubectl get pods -l tier=frontend,app=hello -o name
NAME READY STATUS RESTARTS AGE APP TIER
crashy-6968d5bd47-kkxxk 1/1 Running 0 3m50s crashy
hello-5895659ccd-2qng5 1/1 Running 0 17m hello frontend
hello-5895659ccd-98tcj 1/1 Running 0 16m hello frontend
hello-5895659ccd-rpzmv 1/1 Running 0 17m hello frontend
hello-5895659ccd-xns99 1/1 Running 0 41s hello frontend
NAME READY STATUS RESTARTS AGE
crashy-6968d5bd47-kkxxk 1/1 Running 0 3m53s
pod/hello-5895659ccd-2qng5
pod/hello-5895659ccd-98tcj
pod/hello-5895659ccd-rpzmv
pod/hello-5895659ccd-xns99في الأوامر أعلاه لاحظ التالي:
- الصيغة
in (…)تختار من مجموعة قيم، والفاصلة بين شرطين تعني «و» وليس «أو»، فالأمر الأخير يختار ما عليهtier=frontendوapp=helloمعاً. - الخيار
-Lيعرض قيمة Label كعمود، وهو أوضح من--show-labelsعندما تهمك قيمة واحدة. - الخيار
-o nameيطبع الأسماء بصيغةpod/…التي يقبلها أي أمر آخر، فيمكنك أن تمررها إلىkubectl deleteأوkubectl logsفي سكربت.
وتغيير Label على Pod يعمل له يغير من يراه، فهنا غيرنا tier على Pod واحد، ثم أعدناه:
kubectl label pod hello-5895659ccd-2qng5 tier=canary --overwrite
kubectl get pods -l app=hello -L tier
kubectl label pod hello-5895659ccd-2qng5 tier=frontend --overwrite
pod/hello-5895659ccd-2qng5 labeled
NAME READY STATUS RESTARTS AGE TIER
hello-5895659ccd-2qng5 1/1 Running 0 18m canary
hello-5895659ccd-98tcj 1/1 Running 0 17m frontend
hello-5895659ccd-rpzmv 1/1 Running 0 17m frontend
hello-5895659ccd-xns99 1/1 Running 0 67s frontend
pod/hello-5895659ccd-2qng5 labeledهنا لم يحدث شيء آخر، فال Pods ما زالت أربعة، والسبب أن Selector ال Deployment هو app=hello فقط، والتغيير كان في tier. ولو غيرنا app لخرج ال Pod من حساب ال ReplicaSet ومن ال Service، ولجاء بديله، كما رأينا في مقال Kubernetes من الداخل. فاعرف أي Labels يستخدمها ال Selector في كل كائن قبل أن تغير أياً منها، وأسرع طريقة لذلك:
kubectl get svc hello -o wide
kubectl get endpointslices -l kubernetes.io/service-name=hello
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE SELECTOR
hello ClusterIP 10.96.127.172 <none> 80/TCP 25m app=hello
NAME ADDRESSTYPE PORTS ENDPOINTS AGE
hello-chzts IPv4 80 10.244.2.4,10.244.1.18,10.244.1.19 + 1 more... 25mوال EndpointSlice هو القائمة الحقيقية لل Pods التي يصلها ال Service الآن، فإذا كان ال Service لا يوصل إلى تطبيقك فهذا أول ما تنظر إليه: إذا كانت القائمة فارغة فال Selector لا يطابق أي Pod جاهز، والخطأ غالباً حرف في Label أو فحص جاهزية لا ينجح.
استهلاك الموارد Resources: kubectl top
الأمر top لا يقيس شيئاً بنفسه، وإنما يقرأ من واجهة المقاييس Metrics API التي يقدمها برنامج منفصل اسمه metrics-server، ولا يأتي مع kind ولا مع أغلب العناقيد التي تثبتها بنفسك:
kubectl top nodeserror: Metrics API not availableفثبتناه من ملف الإصدار الرسمي 0.9.1، ثم أضفنا الخيار --kubelet-insecure-tls، والسبب أن شهادات ال kubelet في kind موقعة ذاتياً Self-signed ولا تحتوي على عناوين العقد، فيرفض metrics-server الاتصال بها دون هذا الخيار. ولا تستخدم هذا الخيار في عنقود حقيقي، وإنما اجعل ال kubelet يطلب شهادات موقعة من العنقود كما تشرح وثائق metrics-server:
kubectl apply -f https://github.com/kubernetes-sigs/metrics-server/releases/download/v0.9.1/components.yaml
kubectl -n kube-system patch deployment metrics-server --type=json \
  -p='[{"op":"add","path":"/spec/template/spec/containers/0/args/-","value":"--kubelet-insecure-tls"}]'
kubectl -n kube-system rollout status deploy/metrics-server
kubectl top nodes
kubectl top pods
kubectl top pods -A --sort-by=memory | head -6
deployment.apps/metrics-server patched
deployment "metrics-server" successfully rolled out
NAME CPU(cores) CPU(%) MEMORY(bytes) MEMORY(%)
k1-control-plane 353m 4% 923Mi 2%
k1-worker 163m 2% 400Mi 1%
k1-worker2 156m 1% 252Mi 0%
NAME CPU(cores) MEMORY(bytes)
hello-5895659ccd-2qng5 0m 8Mi
hello-5895659ccd-98tcj 0m 7Mi
hello-5895659ccd-lmmzx 0m 7Mi
hello-5895659ccd-rpzmv 0m 8Mi
NAMESPACE NAME CPU(cores) MEMORY(bytes)
kube-system kube-apiserver-k1-control-plane 89m 279Mi
kube-system etcd-k1-control-plane 34m 62Mi
kube-system kube-controller-manager-k1-control-plane 23m 51Mi
kube-system kube-proxy-99cz7 2m 29Mi
kube-system kindnet-f7lzb 3m 24Mi وقارن هذه الأرقام بما في الملف: كل Pod من hello يستخدم 7 إلى 8 ميجابايت، وطلبنا له 32 ميجابايت وحددنا 64، فالطلب أعلى من الحاجة بأربع مرات، وفي عنقود من مئات ال Pods يعني هذا عقداً محجوزة لا تعمل. ولا تبن قرارك على قراءة واحدة، فالأرقام لحظية ومتوسطها على دقيقة تقريباً، وال metrics-server لا يحفظ تاريخاً، فللقياس على أيام تحتاج Prometheus. والنسبة المئوية في top nodes هنا صغيرة لأن كل عقدة في kind تعلن الجهاز كله، وهذا ما لن تراه في عنقود حقيقي.
إعادة إنتاج CrashLoopBackOff وإصلاحه
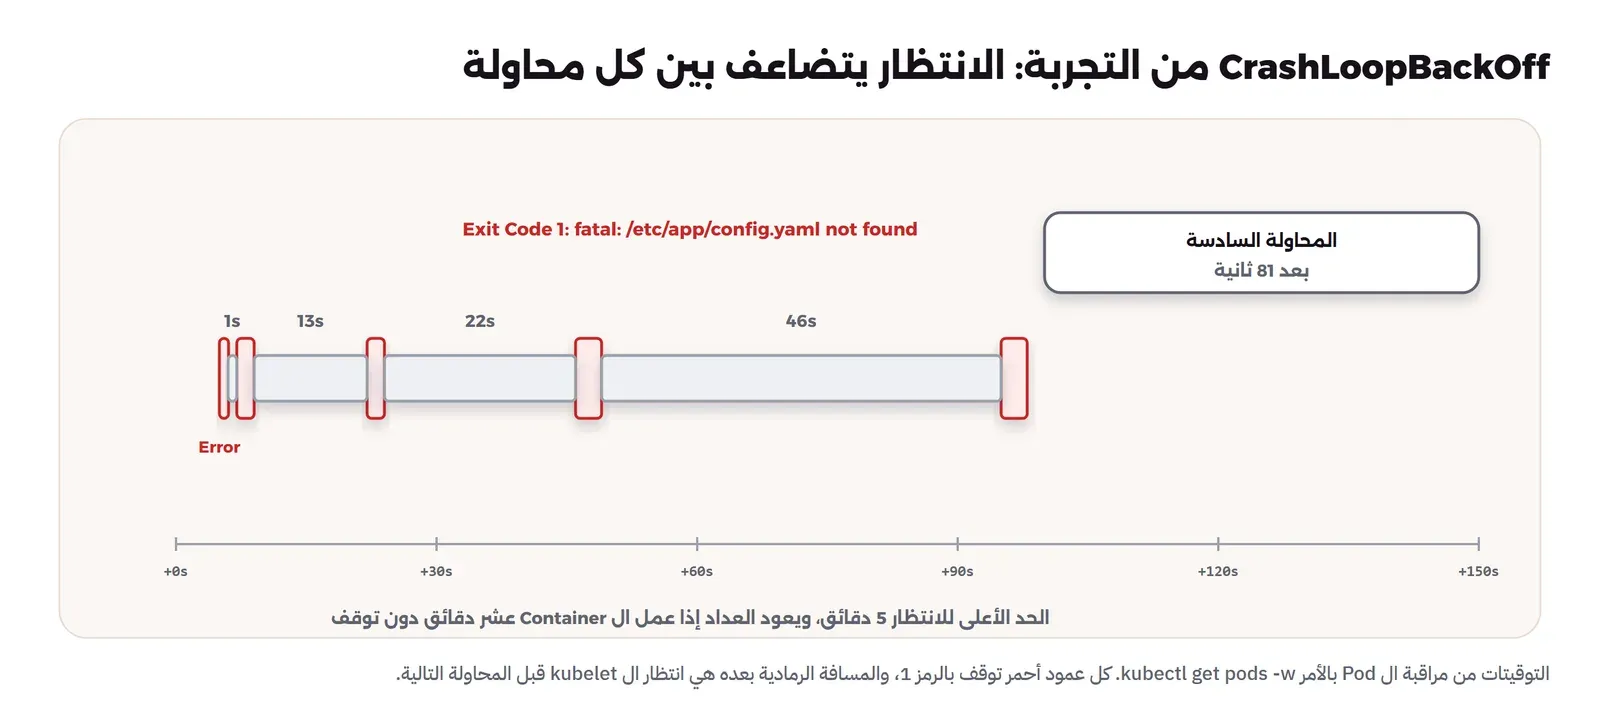
CrashLoopBackOff ليس سبب المشكلة، وإنما وصف لما يفعله ال kubelet معها: ال Container يتوقف، فيعيد تشغيله، فيتوقف، فينتظر مدة أطول قبل المحاولة التالية. ولكي نراه كتبنا تطبيقاً صغيراً يبحث عن ملف إعداد غير موجود فيخرج بالرمز 1، كما يفعل أي تطبيق حقيقي نسي أحدهم أن يعطيه إعداده:
# An app that cannot find its config file and exits with code 1, like a real misconfigured service.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: crashy
spec:
  replicas: 1
  selector:
    matchLabels:
      app: crashy
  template:
    metadata:
      labels:
        app: crashy
    spec:
      containers:
        - name: app
          image: busybox:1.37
          command: ["sh", "-c"]
          args:
            - |
              echo "starting, reading $CONFIG_FILE"
              if [ ! -f "$CONFIG_FILE" ]; then echo "fatal: $CONFIG_FILE not found" >&2; exit 1; fi
              echo "config ok"; exec sleep 3600
          env:
            - name: CONFIG_FILE
              value: /etc/app/config.yaml
kubectl apply -f crashy.yaml
kubectl get pods -l app=crashy -w21:42:35 crashy-8478b79f97-9rkhq 1/1 Running 0 6s
21:42:36 crashy-8478b79f97-9rkhq 0/1 Error 0 8s
21:42:37 crashy-8478b79f97-9rkhq 1/1 Running 1 (3s ago) 9s
21:42:39 crashy-8478b79f97-9rkhq 0/1 Error 1 (4s ago) 10s
21:42:40 crashy-8478b79f97-9rkhq 0/1 CrashLoopBackOff 1 (2s ago) 11s
21:42:52 crashy-8478b79f97-9rkhq 1/1 Running 2 (15s ago) 24s
21:42:54 crashy-8478b79f97-9rkhq 0/1 Error 2 (16s ago) 25s
21:43:14 crashy-8478b79f97-9rkhq 0/1 CrashLoopBackOff 2 (22s ago) 46s
21:43:16 crashy-8478b79f97-9rkhq 1/1 Running 3 (24s ago) 48s
21:43:19 crashy-8478b79f97-9rkhq 0/1 Error 3 (26s ago) 50s
21:44:03 crashy-8478b79f97-9rkhq 0/1 CrashLoopBackOff 3 (47s ago) 94s
21:44:05 crashy-8478b79f97-9rkhq 1/1 Running 4 (50s ago) 97s
21:44:08 crashy-8478b79f97-9rkhq 0/1 Error 4 (52s ago) 99s
21:45:28 crashy-8478b79f97-9rkhq 0/1 CrashLoopBackOff 4 (83s ago) 2m59s
21:45:29 crashy-8478b79f97-9rkhq 1/1 Running 5 (85s ago) 3m1s
21:45:30 crashy-8478b79f97-9rkhq 0/1 Error 5 (86s ago) 3m2sفي المخرج أعلاه لاحظ التالي:
- ال Pod يظهر
Runningو1/1لثانية أو ثانيتين قبل كل توقف، فإذا نظرت إليه في تلك اللحظة ظننت أنه يعمل، ولذلك انظر دائماً إلى عمودRESTARTSوليس إلىSTATUSوحده. - المسافة بين التوقف والمحاولة التالية كانت ثانية ثم 13 ثم 22 ثم 46 ثم 81 ثانية، أي أنها تتضاعف تقريباً. وتقول صفحة دورة حياة ال Pod إن الانتظار يتضاعف حتى خمس دقائق، ويعود إلى البداية إذا عمل ال Container عشر دقائق دون توقف.
- الحالة تتنقل بين
ErrorوCrashLoopBackOffوRunning، والحالة الأولى هي سبب التوقف من آخر تشغيل، والثانية تعني «أنا أنتظر»، فلا تبحث عن معنى خاص لكل واحدة.
والآن نبحث عن السبب، وأول خطأ يقع فيه الناس هنا هو قراءة سجل التشغيل الحالي، وهو غالباً فارغ أو في بدايته، لأن ال Container الحالي إما ينتظر أو بدأ للتو. والسجل الذي فيه السبب هو سجل المحاولة السابقة التي توقفت، والخيار --previous يجلبه:
kubectl logs pod/crashy-8478b79f97-9rkhq --previous
kubectl logs pod/crashy-8478b79f97-9rkhq --timestamps
kubectl describe pod/crashy-8478b79f97-9rkhq | sed -n '/State:/,/Restart Count/p'
fatal: /etc/app/config.yaml not found
starting, reading /etc/app/config.yaml
2026-11-18T18:45:29.131105519Z fatal: /etc/app/config.yaml not found
2026-11-18T18:45:29.131166946Z starting, reading /etc/app/config.yaml
State: Waiting
Reason: CrashLoopBackOff
Last State: Terminated
Reason: Error
Exit Code: 1
Started: Wed, 18 Nov 2026 21:45:29 +0300
Finished: Wed, 18 Nov 2026 21:45:29 +0300
Ready: False
Restart Count: 5في المخرج أعلاه لاحظ التالي:
- السبب واضح في سطر واحد: الملف
/etc/app/config.yamlغير موجود، والرمزExit Code: 1يعني أن التطبيق نفسه قرر الخروج، وهذا يختلف عن 137 الذي يعني أن أحداً قتله بالإشارة Signal المسماة SIGKILL، مثل نفاد الذاكرة، كما شرحنا رموز الخروج Exit Codes في أوامر Docker الأساسية. - السطران في السجل بترتيب معكوس، فسطر الخطأ ظهر قبل سطر البداية رغم أن التطبيق كتب البداية أولاً، والسبب أن الأول على stderr والثاني على stdout، ويجمعهما containerd من قناتين، والأوقات مع
--timestampsتختلف بستين ميكروثانية فقط. فلا تعتمد على ترتيب الأسطر بين القناتين، واجعل تطبيقك يكتب سجله كله على قناة واحدة مع وقت لكل سطر. StartedوFinishedفي نفس الثانية، أي أن التطبيق لا يعمل أصلاً، فلا فائدة من زيادة مهلة الفحوص أو انتظار أطول.
والإصلاح أن نعطي التطبيق ملفه، فننشئ ConfigMap فيه الملف ونركبه في المجلد Directory الذي يتوقعه التطبيق، والتفاصيل الكاملة لل ConfigMaps لها مقال مستقل في هذه المرحلة:
# Mount the ConfigMap where the app expects its file.
spec:
  template:
    spec:
      containers:
        - name: app
          volumeMounts:
            - name: config
              mountPath: /etc/app
      volumes:
        - name: config
          configMap:
            name: crashy-config
kubectl create configmap crashy-config --from-literal=config.yaml='level: info'
kubectl patch deployment crashy --patch-file crashy-fixed-patch.yaml
kubectl rollout status deploy/crashy --timeout=120s
kubectl get pods -l app=crashy
kubectl logs deploy/crashyconfigmap/crashy-config created
deployment.apps/crashy patched
deployment "crashy" successfully rolled out
NAME READY STATUS RESTARTS AGE
crashy-6968d5bd47-kkxxk 1/1 Running 0 18s
crashy-8478b79f97-9rkhq 0/1 Error 5 (2m32s ago) 5m33s
Found 2 pods, using pod/crashy-6968d5bd47-kkxxk
starting, reading /etc/app/config.yaml
config okوال Pod القديم ظهر للحظة بحالة Error قبل أن يحذف، والجديد يعمل دون إعادة تشغيل. واستخدمنا patch هنا لنبين أنه موجود، ولكن الصحيح في مشروع حقيقي أن تضيف هذه الأسطر إلى ملف ال Deployment نفسه ثم apply، للسبب الذي رأيناه في قسم التراجع.
إعادة إنتاج ImagePullBackOff وإصلاحه
العطل الثاني يحدث قبل أن يبدأ التطبيق أصلاً: ال kubelet لا يستطيع سحب ال Image. ولكي نراه غيرنا وسم nginx بخطأ مطبعي يحدث كل يوم، فكتبنا 1.29.88 بدل 1.29.8:
kubectl set image deployment/hello nginx=nginx:1.29.88-alpine
kubectl get pods -l app=hello -w
deployment.apps/hello image updated
21:48:21 hello-5895659ccd-lmmzx 1/1 Terminating 0 13m
21:48:21 hello-6f45595854-w7nm9 0/1 ContainerCreating 0 1s
21:48:22 hello-6f45595854-wgtrw 0/1 Pending 0 0s
21:48:30 hello-6f45595854-w7nm9 0/1 ErrImagePull 0 10s
21:48:32 hello-6f45595854-wgtrw 0/1 ErrImagePull 0 10s
21:48:44 hello-6f45595854-wgtrw 0/1 ImagePullBackOff 0 22s
21:48:45 hello-6f45595854-w7nm9 0/1 ImagePullBackOff 0 25s
21:48:57 hello-6f45595854-w7nm9 0/1 ErrImagePull 0 37s
21:49:13 hello-6f45595854-w7nm9 0/1 ImagePullBackOff 0 53s
21:49:27 hello-6f45595854-w7nm9 0/1 ErrImagePull 0 67skubectl get pods -l app=hello
kubectl rollout status deploy/hello --timeout=10s
kubectl describe pod hello-6f45595854-w7nm9 | sed -n '/Events:/,$p'NAME READY STATUS RESTARTS AGE
hello-5895659ccd-2qng5 1/1 Running 0 15m
hello-5895659ccd-98tcj 1/1 Running 0 14m
hello-5895659ccd-rpzmv 1/1 Running 0 15m
hello-6f45595854-w7nm9 0/1 ErrImagePull 0 76s
hello-6f45595854-wgtrw 0/1 ErrImagePull 0 75s
Waiting for deployment "hello" rollout to finish: 2 out of 4 new replicas have been updated...
error: timed out waiting for the condition
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Normal Scheduled 91s default-scheduler Successfully assigned demo/hello-6f45595854-w7nm9 to k1-worker2
Normal Pulling 40s (x3 over 86s) kubelet spec.containers{nginx}: Pulling image "nginx:1.29.88-alpine"
Warning Failed 37s (x3 over 83s) kubelet spec.containers{nginx}: Failed to pull image "nginx:1.29.88-alpine": rpc error: code = NotFound desc = failed to pull and unpack image "docker.io/library/nginx:1.29.88-alpine": failed to resolve reference "docker.io/library/nginx:1.29.88-alpine": docker.io/library/nginx:1.29.88-alpine: not found
Warning Failed 37s (x3 over 83s) kubelet spec.containers{nginx}: Error: ErrImagePull
Normal BackOff 1s (x5 over 83s) kubelet spec.containers{nginx}: Back-off pulling image "nginx:1.29.88-alpine"
Warning Failed 1s (x5 over 83s) kubelet spec.containers{nginx}: Error: ImagePullBackOffفي المخرج أعلاه لاحظ التالي:
ErrImagePullهي المحاولة التي فشلت الآن، وImagePullBackOffهي الانتظار قبل المحاولة التالية، والفكرة نفسها في CrashLoopBackOff ولكن على مرحلة السحب.- السبب الحقيقي في سطر
Failed to pull image:not foundتعني أن الاسم أو الوسم غير موجود في السجل Registry. ولو كانت الرسالةpull access deniedأوunauthorizedلكان السبب صلاحية دخول إلى سجل خاص، ولو كانتi/o timeoutلكان السبب شبكة العقدة، فكل نوع له إصلاح مختلف، ولذلك اقرأ الرسالة كاملة. - ثلاث نسخ من القديمة ما زالت تعمل، والتحديث التدريجي توقف بعد أن أنشأ نسختين جديدتين لا تعملان، والسبب أن ال Deployment لا يحذف نسخة قديمة إلا عندما تصبح نسخة جديدة جاهزة، فالتطبيق ما زال يخدم المستخدمين بثلاث نسخ من أربع. وهذه حماية مهمة، ولكنها لا تعمل إلا إذا كان لتطبيقك فحص جاهزية صحيح.
- الأمر
rollout statusمع--timeoutخرج بخطأ، وهذا ما تريده في خط النشر: أن يفشل الخط ويتوقف، بدل أن يقول «تم النشر» والتحديث عالق.
والإصلاح أن نعيد الوسم الصحيح:
kubectl set image deployment/hello nginx=nginx:1.29.8-alpine
kubectl rollout status deploy/hello --timeout=120s
kubectl get pods -l app=hello
kubectl rollout history deploy/hello
deployment.apps/hello image updated
Waiting for deployment "hello" rollout to finish: 3 of 4 updated replicas are available...
deployment "hello" successfully rolled out
NAME READY STATUS RESTARTS AGE
hello-5895659ccd-2qng5 1/1 Running 0 17m
hello-5895659ccd-98tcj 1/1 Running 0 16m
hello-5895659ccd-rpzmv 1/1 Running 0 16m
hello-5895659ccd-xns99 1/1 Running 0 8s
deployment.apps/hello
REVISION CHANGE-CAUSE
2 nginx 1.29.8 to 1.31.6
4 <none>
5 <none>ولاحظ شيئاً جميلاً هنا: ثلاثة من ال Pods عمرها 16 دقيقة وأكثر، ولم يعد تشغيلها، وواحد فقط جديد. والسبب أن ال Template بعد الإصلاح أصبح مطابقاً تماماً لل ReplicaSet الأول 5895659ccd، فلم ينشئ ال Deployment ReplicaSet جديداً، وإنما رفع عدد القديم من ثلاثة إلى أربعة وحذف ال Pods المعطلة، وأخذ ال ReplicaSet الأول رقم المراجعة الجديد 5.
وهناك حالة ثالثة لا تظهر فيها أي كلمة حمراء، وهي ال Pod الذي حالته Running وجاهزيته 0/1 لدقائق. والتطبيق هنا يعمل، ولكن فحص الجاهزية Readiness Probe يفشل، فلا يدخل ال Pod إلى ال Service ولا يصله أي طلب، وإذا كان التحديث جارياً بقي عالقاً لأن ال Deployment ينتظر نسخاً جاهزة. والسبب يكتبه ال kubelet في الأحداث بسطر يبدأ ب Readiness probe failed ومعه الرد الذي وصله، مثل رمز HTTP خاطئ أو اتصال مرفوض، فابدأ ب describe هنا أيضاً، ثم ب exec لتجرب الفحص نفسه من داخل ال Container. وسوف ترى هذه الحالة في مقال نقل تطبيق Compose، عندما تتوقف قاعدة البيانات ويتوقف معها ال API.
الحذف Delete: ماذا يحذف وماذا يبقى؟
الحذف هو الأمر الوحيد في هذا المقال الذي لا رجوع عنه، فلا توجد سلة محذوفات في Kubernetes، ولذلك جرب الأمر أولاً بالخيار --dry-run=server، فيرسل ال API Server الطلب على كل مراحل التحقق ولا ينفذه، ثم احذف بنفس الملف الذي أنشأت به:
kubectl delete -n demo -f crashy.yaml --dry-run=server
kubectl delete -n demo -f crashy.yaml
kubectl get pods -n demo -l app=crashy
kubectl get configmap -n demo
deployment.apps "crashy" deleted from demo namespace (server dry run)
deployment.apps "crashy" deleted from demo namespace
NAME READY STATUS RESTARTS AGE
crashy-6968d5bd47-kkxxk 1/1 Terminating 1 (40m ago) 100m
NAME DATA AGE
crashy-config 1 100m
kube-root-ca.crt 1 124mفي المخرج أعلاه لاحظ التالي:
- حذف ال Deployment حذف معه ال ReplicaSets وال Pods التي يملكها، فهذا عمل جامع المهملات Garbage Collector الذي يتبع حقل المالك
ownerReferences، ولذلك لا تحذف ال Pods بيدك إذا أردت أن يختفي التطبيق، فسيعيدها مالكها. - ال Pod بقي
Terminatingبعد الأمر، لأن ال kubelet يرسل SIGTERM ثم ينتظر 30 ثانية افتراضياً قبل SIGKILL، والبرنامج في هذا ال Pod هوsleepالذي لا يتعامل مع الإشارة، فينتظر المدة كاملة. وتطبيقك الحقيقي يجب أن يتوقف بنفسه عند SIGTERM، كما شرحنا في الإيقاف النظيف Graceful Shutdown. - ال ConfigMap المسمى
crashy-configبقي، لأننا أنشأناه بأمر مباشر وليس في الملف، فالحذف ب-fيحذف ما في الملف فقط. وهذه حجة أخرى لأن يكون كل شيء في ملفات: ما لا يوجد في ملف ينسى في العنقود. أماkube-root-ca.crtفينشئه العنقود في كل Namespace، وفيه شهادة ال API Server لل Pods التي تتحدث معه.
وأخطر أمر حذف هو kubectl delete namespace، لأنه يحذف كل ما في ال Namespace دون أن يسأل، ومعه الأقراص الدائمة إذا كانت سياسة الاسترجاع Reclaim Policy في موفر التخزين Storage Provisioner هي الحذف، وهي الافتراضية في أغلب الموفرين. ولا تستخدم الخيار --force --grace-period=0 لتسريع حذف Pod عالق إلا إذا كنت متأكداً أن عقدته متوقفة فعلاً، لأنه يحذف الكائن من ال API Server وال Container قد يكون ما زال يعمل على العقدة.
الأوامر اليومية Cheat Sheet في جدول واحد
| ما تريده | الأمر | انتبه إلى |
|---|---|---|
| على أي عنقود أنا؟ | kubectl config get-contexts | النجمة وعمود NAMESPACE |
| تبديل السياق | kubectl config use-context NAME | يبقى حتى تغيره، في كل نوافذ الطرفية |
| كل ما في Namespace | kubectl get all -n NS | لا يعرض ConfigMaps وSecrets وPVCs |
| أين يعمل كل Pod؟ | kubectl get pods -o wide | العقدة والعنوان |
| لماذا هذه الحالة؟ | kubectl describe pod NAME | قسم Events في الأسفل |
| سبب التوقف | kubectl logs NAME --previous | دون --previous تقرأ التشغيل الحالي |
| سجلات كل النسخ | kubectl logs -l app=X --prefix | deploy/X يختار Pod واحداً |
| أمر داخل ال Container | kubectl exec NAME -- CMD | يحتاج الأداة داخل ال Image |
| أداة غير موجودة في ال Image | kubectl debug NAME --image=busybox --target=C | ال Container المؤقت يبقى في ال Pod |
| الوصول من جهازك | kubectl port-forward svc/X 9573:80 | Pod واحد، ويتوقف إذا توقف |
| ماذا سيتغير؟ | kubectl diff -f FILE | الرمز 1 يعني يوجد فرق |
| تطبيق التغيير | kubectl apply -f FILE ثم rollout status | النجاح يعني الحفظ وليس التشغيل |
| التراجع | kubectl rollout undo deploy/X | صحح الملف بعده |
| شرح حقل | kubectl explain KIND.FIELD | مطابق لإصدار عنقودك |
| الاستهلاك الآن | kubectl top pods | يحتاج metrics-server، ولا يحفظ تاريخاً |
أخطاء شائعة Common Mistakes
- العمل على السياق الخطأ: أمر حذف على عنقود الإنتاج وأنت تظنه التجربة، والحل أن يظهر السياق في سطر الأوامر وأن يكون للإنتاج ملف منفصل.
- قراءة
No resources foundكأن التطبيق غير موجود: آخر كلمة في الرسالة هي ال Namespace الذي بحث فيه. kubectl logsدون--previousفي CrashLoopBackOff: السجل الحالي فارغ غالباً، والسبب في المحاولة السابقة.logs deploy/Xللبحث عن طلب معين: يقرأ من Pod واحد، والطلب قد يكون في غيره.- اعتبار
applyالناجح نشراً ناجحاً: تابعه دائماً بrollout status --timeout. rollout undoوscaleدون تصحيح الملف: أولapplyبعدها يعيد ما تراجعت عنه.- Labels على ال Pods فقط: البحث والحذف ب
-lيتجاهل ال Services والكائنات الأخرى. - تقطيع مخرج
getبawkفي السكربتات: استخدم-o jsonpathأو-o name. - ملف kubeconfig في محادثة أو مستودع: فيه مفتاح خاص يعطي صلاحية المدير.
- port-forward كطريقة نشر: يتوقف مع ال Pod ومع جهازك، وهو للتشخيص فقط.
- الخيار
--kubelet-insecure-tlsفي عنقود حقيقي: هو لعنقود التجربة فقط.
قائمة تحقق Checklist قبل كل تغيير
kubectl config current-context: هل هذا العنقود الذي أقصده؟- الملف في Git، وال Labels على كل كائن فيه.
kubectl diff -f: هل الفرق هو ما أتوقعه فقط؟ وهل فيه شيء لم أغيره، مثل عدد النسخ؟kubectl apply -fثمkubectl rollout status --timeout=….- إذا فشل:
getثمdescribeثمlogs --previousبهذا الترتيب. - بعد أي
undoأوscaleأوset imageمباشر: صحح الملف ليطابق العنقود.
حذف المختبر Cleanup
كل ما أنشأناه في هذا المقال موجود في ال Namespace المسمى demo، فحذفه يحذفها كلها، ثم نعيد السياق الأصلي ونحذف السياق الذي أنشأناه:
kubectl delete namespace demo
kubectl config use-context kind-k1
kubectl config delete-context demo
kubectl delete -f https://github.com/kubernetes-sigs/metrics-server/releases/download/v0.9.1/components.yaml
وإذا انتهيت من العنقود كله فالأمر kind delete cluster --name k1 يحذفه، ولكن سوف نحتاجه في المقال التالي.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- kubectl عميل يرسل طلبات إلى ال API Server، والسياق في kubeconfig يحدد العنقود والمستخدم وال Namespace، و
No resources foundتعني غالباً أنك في Namespace آخر. getبصيغه للنظر، وdescribeللأحداث، وlogs --previousلسبب التوقف، وexecوdebugللنظر من الداخل، وport-forwardللوصول من جهازك وحده.diffقبلapplyوrollout statusبعده، وundoوscaleيتركان الملف مختلفاً عن العنقود، وقد رأينا ذلك فيdiffمباشرة.- CrashLoopBackOff سببه في سجل المحاولة السابقة ورمز الخروج، وانتظاره يتضاعف حتى خمس دقائق، وImagePullBackOff سببه في رسالة السحب في الأحداث، والتحديث التدريجي أبقى النسخ القديمة تعمل حتى أصلحنا الوسم.
والخطوة التالية في هذه المرحلة أن نأخذ تطبيقاً حقيقياً من أربع خدمات يعمل على Docker Compose وننقله إلى هذا العنقود:
 دليلنقل تطبيق Docker Compose إلى Kubernetes خطوة بخطوةننقل تطبيقاً من أربع خدمات من Docker Compose إلى Kubernetes، ونرى ما أخطأ فيه kompose وما تعلمناه من كل عطل حتى عمل التطبيق.
 دليلKubernetes من الداخل: Control Plane وetcd والعقد Nodesعنقود حقيقي من ثلاث عقد نفتحه من الداخل، فنقرأ etcd ونشاهد حلقة التحكم والمجدول، ثم نوقف عقدة ونقيس كم احتاج العنقود ليلاحظ وماذا تعطل في الطريق.
 دليلمصطلحات Kubernetes مشروحة بالترتيب، من Pod إلى Ingressشرح مصطلحات Kubernetes بالترتيب الذي يبني بعضها على بعض، مع رسم لكل مفهوم وملفات YAML حقيقية.
 دليلأفضل الممارسات Best Practices في ملفات Docker Composeكيف تكتب ملف Compose يبدأ خدماته بالترتيب الصحيح ويحمي كلمات المرور ويضبط الذاكرة ويفصل التطوير عن الإنتاج، مع تجربة أظهرت أين يخدعك كل إعداد افتراضي.
 دليلأوامر Docker الأساسية: التشغيل والسجلات والإيقافنشغل خدمة صغيرة ونتابعها بأوامر Docker اليومية، ثم نفهم لماذا ينتظر docker stop ثم يقتل، وماذا تعني رموز الخروج 0 و1 و127 و137 و143.
سجل التحديثات Changelog
- 18 نوفمبر 2026: كتابة المقال، وتنفيذ التجربة بالأداة kubectl v1.36.1 على عنقود kind 0.33.0 بالإصدار Kubernetes 1.36.4، مع metrics-server 0.9.1 وال Images nginx:1.29.8-alpine وnginx:1.31.6-alpine وbusybox:1.37.