

إذا كانت تطبيقاتك تعمل على Kubernetes، فالسؤال يأتي عاجلاً أو آجلاً: هل نضع قاعدة البيانات هناك أيضاً؟ والطريقة البسيطة أن تكتب StatefulSet فيه صورة postgres وقرص دائم كما في أي دليل للمبتدئين، وهذا يعطيك سيرفر PostgreSQL واحداً يعود إذا توقف ال Pod، ولكنه لا يعطيك نسخة متماثلة Replica، ولا انتقالاً تلقائياً Failover، ولا نسخاً احتياطياً، ولا ترقية آمنة، وكل ذلك هو العمل الحقيقي في تشغيل قاعدة بيانات. وفي مقال عناقيد قواعد البيانات شرحنا ما يحتاجه العنقود الحقيقي، وفي هذا المقال سوف نأخذ المشغل Operator الذي يفعل ذلك على Kubernetes، وهو CloudNativePG: نبني عنقوداً من ثلاث نسخ على kind، ونرسل النسخ الاحتياطية إلى تخزين كائنات، ثم نوقف السيرفر الرئيسي فجأة ونقيس كم ثانية توقفت الكتابة، ولماذا.
وسوف نناقش في هذا المقال ما يلي:
- ما هو المشغل Operator، وما الذي يفعله CloudNativePG، وترخيصه.
- المورد Cluster: النسخ، والتخزين، والخدمات، والمستخدمون.
- تجهيز المختبر على kind بإصدارات مثبتة، والخطأ الذي منع Kubernetes 1.36 من البدء.
- النسخ الاحتياطي واستمرار أرشفة WAL إلى تخزين كائنات عبر Barman Cloud Plugin، والاستعادة في عنقود جديد.
- إيقاف السيرفر الرئيسي فجأة وقياس الانتقال التلقائي، ثم التبديل المخطط Switchover.
- لماذا تحتاج قواعد البيانات على Kubernetes إلى حذر، ومتى لا تضعها هناك.
وإذا كنت ما زلت تسأل هل تحتاج Kubernetes أصلاً فابدأ ب مقال هل تحتاج Kubernetes فعلاً؟، والمصطلحات مثل Pod وPVC وService في مقال مصطلحات Kubernetes.
ما هو المشغل Operator، ولماذا CloudNativePG؟
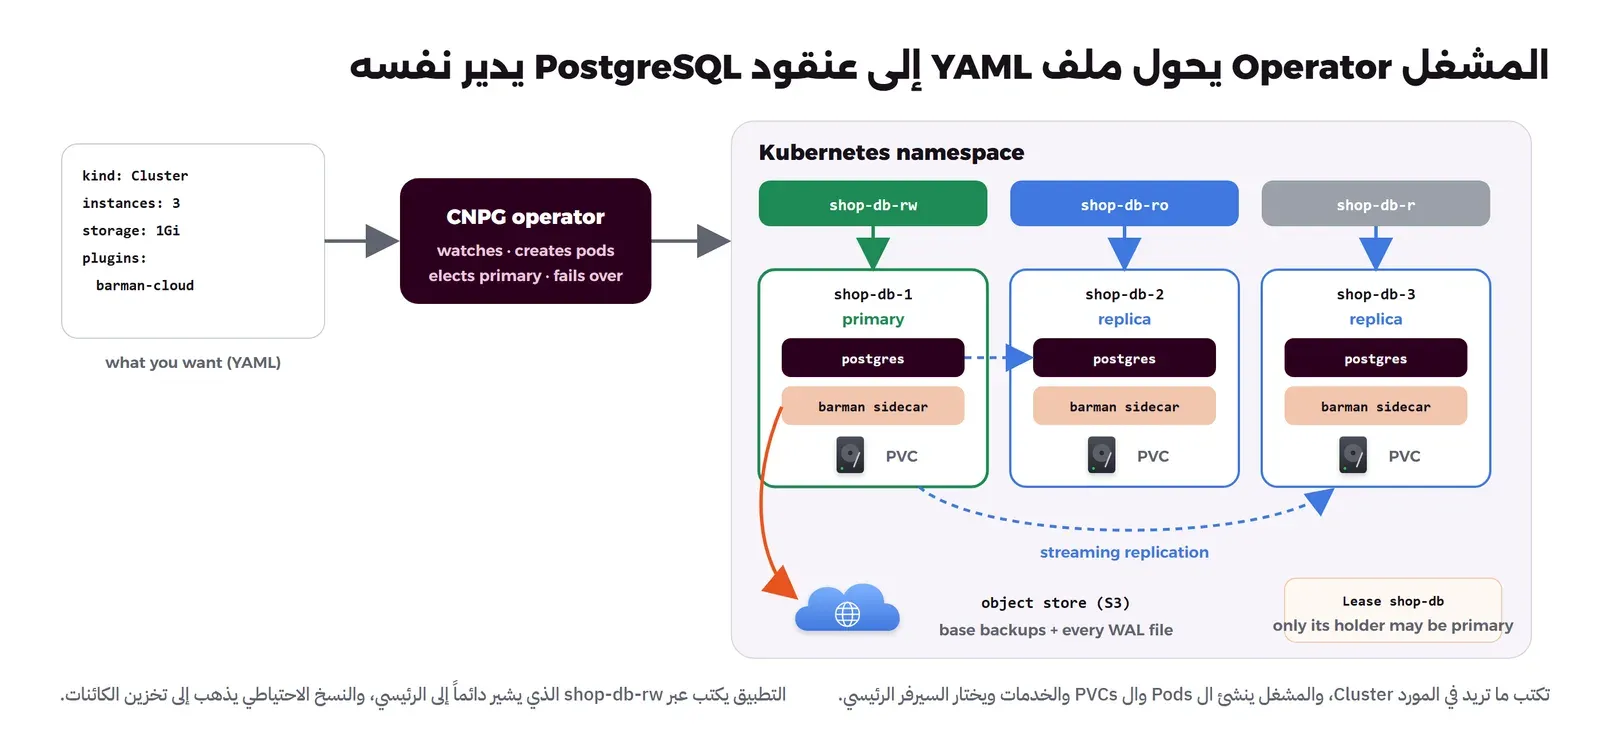
المشغل Operator برنامج يعمل داخل Kubernetes ويحمل خبرة مدير قاعدة البيانات في شكل كود: أنت تكتب ما تريده في ملف YAML، مثل «ثلاث نسخ PostgreSQL 18 بقرص 1 جيجابايت ونسخ احتياطي إلى S3»، والمشغل يراقب الوضع الحالي باستمرار ويقارنه بما طلبت، ثم يفعل ما يلزم: ينشئ ال Pods والأقراص، ويجهز النسخ المتماثلة، ويختار سيرفراً رئيسياً جديداً إذا توقف القديم، ويجري الترقيات بالترتيب الصحيح. وهذه الفكرة نفسها التي يعمل بها Kubernetes مع ال Deployment، ولكن لمورد يعرف معنى «السيرفر الرئيسي» و«WAL».
وCloudNativePG مشروع بترخيص Apache 2.0، وقبلته مؤسسة CNCF في 21 يناير 2025 بمستوى Sandbox، وآخر إصدار له 1.30.1، ويدعم بحسب صفحة الإصدارات نسخ Kubernetes 1.34 و1.35 و1.36 وPostgreSQL من 14 إلى 18، وكل إصدار صغير مدعوم مدة محدودة (1.30 حتى ديسمبر 2026 تقريباً)، لذلك ترقية المشغل عمل دوري وليس مرة واحدة. وما يميزه عن الحلول التي تضع Patroni داخل Kubernetes أنه لا يحتاج أداة خارجية للإجماع Consensus مثل etcd خاص، وإنما يستخدم واجهة Kubernetes نفسها لمعرفة السيرفر الرئيسي، كما سنرى في عقد الإيجار Lease.
الصورة التالية تبين ما ينشئه المشغل من ملف YAML واحد:
تجهيز المختبر على kind
استخدمنا kind الإصدار 0.33.0 الذي يشغل Kubernetes داخل Containers على Docker، وثبتنا صورة العقدة بالإصدار وال Digest حتى يعيد القارئ نفس البيئة، وجعلنا ملف kubeconfig في مجلد المختبر بالخيار --kubeconfig حتى لا يغير إعدادات kubectl الأخرى على الجهاز:
# kind 0.33.0: a single node (control plane that also runs pods), enough to watch failover between pods.
# On a real cluster spread the instances over three nodes (CloudNativePG prefers that by default).
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: lab-cnpg
nodes:
  - role: control-plane
    image: kindest/node:v1.34.11@sha256:44e222ee2132dab25ff87301682f89eb82c7880ea3a1bf543bfe9708fd08d67d
وفي المحاولة الأولى استخدمنا Kubernetes 1.36.4 الذي يدعمه CloudNativePG 1.30، ففشل إنشاء العنقود بعد دقائق بالرسالة:
ERROR: failed to create cluster: failed to init node with kubeadm: command "docker exec --privileged lab-cnpg-control-plane kubeadm init ..." failed with error: exit status 1
error: error execution phase wait-control-plane: cannot obtain client without bootstrap ...
والرسالة لا تقول السبب، فقرأنا سجل ال kubelet داخل العقدة:
docker exec lab-cnpg-control-plane journalctl -u kubelet --no-pager | grep -i error | tail -2
docker info --format '{{.CgroupVersion}} {{.KernelVersion}}'
"command failed" err="failed to validate kubelet configuration, error: kubelet is configured to not run on a host using cgroup v1. cgroup v1 support is uns...
1 5.15.167.4-microsoft-standard-WSL2جهاز المختبر Docker Desktop على WSL2 بنواة تستخدم cgroup v1، وكما تذكر وثائق Kubernetes عن cgroups أصبح cgroup v1 مهملاً منذ Kubernetes 1.35 ولم يعد ال kubelet يبدأ عليه افتراضياً. فاستخدمنا Kubernetes 1.34.11 وهو مدعوم أيضاً، ونجح الإنشاء. وعلى أي سيرفر Linux حديث بنظام cgroup v2 لن تواجه هذا، ولكنه درس مفيد: اقرأ سجل ال kubelet قبل أن تبحث عن الخطأ في مكان آخر. ولاحظ أيضاً أننا استخدمنا عقدة واحدة لأن جهاز المختبر كان مشغولاً، فالنسخ الثلاث على نفس العقدة، وهذا يكفي لمشاهدة الانتقال بين ال Pods، أما في الإنتاج فكل نسخة على عقدة مختلفة، والمشغل يفضل ذلك افتراضياً.
بعد ذلك ثبتنا المشغل، ثم cert-manager الذي تحتاجه إضافة النسخ الاحتياطي لشهادات الاتصال بينها وبين المشغل، ثم الإضافة نفسها، وكلها بإصدارات مثبتة كما في دليل التثبيت:
kind create cluster --config kind.yaml --kubeconfig ./lab-cnpg.config
export KUBECONFIG=./lab-cnpg.config
kubectl apply --server-side -f https://github.com/cloudnative-pg/cloudnative-pg/releases/download/v1.30.1/cnpg-1.30.1.yaml
kubectl apply -f https://github.com/cert-manager/cert-manager/releases/download/v1.21.2/cert-manager.yaml
kubectl -n cert-manager rollout status deployment/cert-manager-webhook
kubectl apply -f https://github.com/cloudnative-pg/plugin-barman-cloud/releases/download/v0.15.1/manifest.yaml
kubectl -n cnpg-system get pods
NAME READY STATUS RESTARTS AGE
barman-cloud-864b947c56-f8245 1/1 Running 0 37s
cnpg-controller-manager-576c84c7fd-w8fxz 1/1 Running 0 108sواستخدمنا أيضاً إضافة kubectl الرسمية kubectl cnpg بنفس الإصدار، لأنها تعرض حالة العنقود والنسخ والأرشفة في شاشة واحدة.
تخزين الكائنات للنسخ الاحتياطي
منذ الإصدار 1.26 بدأ CloudNativePG نقل النسخ الاحتياطي إلى تخزين الكائنات من داخل المشغل إلى إضافات منفصلة، وتقول وثائق النسخ الاحتياطي إن الدعم المدمج barmanObjectStore مهمل لصالح Barman Cloud Plugin، فاستخدمنا الإضافة. وللمختبر شغلنا SeaweedFS داخل العنقود كتخزين متوافق مع S3، وأنشأنا فيه الدلو backups:
# Lab object storage inside the cluster: SeaweedFS 4.48 with an S3 endpoint (plain HTTP inside the cluster only).
# In production point the ObjectStore at real S3-compatible storage outside this cluster.
apiVersion: v1
kind: Secret
metadata:
  name: s3-creds
stringData:
  ACCESS_KEY_ID: labbackupkey
  ACCESS_SECRET_KEY: lab-only-secret-change-me
  s3.json: |
    {"identities":[{"name":"backup","credentials":[{"accessKey":"labbackupkey","secretKey":"lab-only-secret-change-me"}],
      "actions":["Admin","Read","Write","List","Tagging"]}]}
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: s3
spec:
  replicas: 1
  selector: { matchLabels: { app: s3 } }
  template:
    metadata: { labels: { app: s3 } }
    spec:
      containers:
        - name: seaweedfs
          image: chrislusf/seaweedfs:4.48
          args: ["server", "-dir=/data", "-s3", "-s3.port=8333", "-s3.config=/etc/seaweedfs/s3.json"]
          ports: [{ containerPort: 8333 }]
          volumeMounts:
            - { name: data, mountPath: /data }
            - { name: cfg, mountPath: /etc/seaweedfs }
      volumes:
        - { name: data, emptyDir: {} }
        - name: cfg
          secret: { secretName: s3-creds, items: [{ key: s3.json, path: s3.json }] }
---
apiVersion: v1
kind: Service
metadata:
  name: s3
spec:
  selector: { app: s3 }
ports: [{ port: 8333, targetPort: 8333 }]المورد Cluster: ثلاث نسخ وأرشفة مستمرة
# Where backups and WAL go (Barman Cloud plugin 0.15.1)
apiVersion: barmancloud.cnpg.io/v1
kind: ObjectStore
metadata:
  name: lab-store
spec:
  configuration:
    destinationPath: s3://backups/
    endpointURL: http://s3.default.svc:8333
    s3Credentials:
      accessKeyId:     { name: s3-creds, key: ACCESS_KEY_ID }
      secretAccessKey: { name: s3-creds, key: ACCESS_SECRET_KEY }
    wal:
      compression: gzip
    data:
      compression: gzip
  retentionPolicy: "7d"
---
# Three PostgreSQL 18 instances: one primary, two streaming replicas, automatic failover by the operator
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: shop-db
spec:
  instances: 3
  imageName: ghcr.io/cloudnative-pg/postgresql:18.6-system-trixie
  primaryUpdateStrategy: unsupervised
  storage:
    size: 1Gi
  resources:
    requests: { memory: 256Mi, cpu: 100m }
    limits:   { memory: 512Mi }
  postgresql:
    parameters:
      shared_buffers: 128MB
  bootstrap:
    initdb:
      database: shop
      owner: shop_app
  plugins:
    - name: barman-cloud.cloudnative-pg.io
      isWALArchiver: true
      parameters:
        barmanObjectName: lab-store
---
apiVersion: postgresql.cnpg.io/v1
kind: ScheduledBackup
metadata:
  name: shop-db-daily
spec:
  schedule: "0 0 2 * * *"      # seconds minutes hours ...: every day at 02:00
  backupOwnerReference: self
  cluster: { name: shop-db }
  method: plugin
  pluginConfiguration:
    name: barman-cloud.cloudnative-pg.io
في الإعداد أعلاه لاحظ التالي:
ObjectStoreمورد منفصل يصف مكان النسخ ومفاتيحه من Secret، وretentionPolicy: "7d"يجعل الإضافة تحذف النسخ وملفات WAL الأقدم من أسبوع.instances: 3يعني سيرفراً رئيسياً ونسختين متماثلتين، وimageNameمثبت بإصدار PostgreSQL الكامل، وتغييره لاحقاً يجعل المشغل يرقي النسخ المتماثلة أولاً ثم ينقل الدور الرئيسي ثم يرقي القديم، وprimaryUpdateStrategy: unsupervisedيسمح له بذلك دون انتظار موافقتك.bootstrap.initdbينشئ قاعدةshopومالكهاshop_app، ويضع كلمة المرور وعنوان الاتصال في Secret اسمهshop-db-appيقرؤه التطبيق، فلا تكتب كلمة مرور في أي ملف.isWALArchiver: trueيجعل كل ملف WAL يرسل إلى تخزين الكائنات، وهذا ما يسمح بالاستعادة إلى نقطة زمنية، وهي نفس فكرة مقال pgBackRest والاستعادة إلى نقطة زمنية ولكن بأداة Barman.ScheduledBackupنسخة أساسية كل يوم الساعة الثانية، ولاحظ أن الجدول فيه ست خانات تبدأ بالثواني وليس خمساً كما في cron المعتاد.
بعد التطبيق انتظرنا حتى يصبح العنقود جاهزاً، وأخذ ذلك خمس دقائق تقريباً على جهازنا المشغول:
kubectl apply -f cluster.yaml
kubectl wait cluster/shop-db --for=condition=Ready --timeout=900s
kubectl get pods -L cnpg.io/instanceRole
kubectl get svc -l cnpg.io/cluster=shop-db
NAME READY STATUS RESTARTS AGE INSTANCEROLE
shop-db-1 2/2 Running 0 2m25s primary
shop-db-2 2/2 Running 0 58s replica
shop-db-3 2/2 Running 0 23s replica
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE
shop-db-r ClusterIP 10.96.70.114 <none> 5432/TCP 5m33s
shop-db-ro ClusterIP 10.96.90.244 <none> 5432/TCP 5m33s
shop-db-rw ClusterIP 10.96.141.113 <none> 5432/TCP 5m33sلاحظ 2/2 في كل Pod: حاوية PostgreSQL وحاوية Barman الجانبية Sidecar. والخدمات الثلاث كما في وثائق الخدمات: rw تشير دائماً إلى الرئيسي فيستخدمها التطبيق للكتابة، وro إلى النسخ المتماثلة فقط، وr إلى أي نسخة. والحالة الكاملة من الإضافة:
$ kubectl cnpg status shop-db
Cluster Summary
Name                     default/shop-db
PostgreSQL Image:        ghcr.io/cloudnative-pg/postgresql:18.6-system-trixie
Primary instance:        shop-db-1
Status:                  Cluster in healthy state
Instances:               3
Ready instances:         3

Continuous Backup status (Barman Cloud Plugin)
Working WAL archiving:        OK
WALs waiting to be archived:  0
Last Archived WAL:            000000010000000000000005.00000028.backup   @   2026-10-11T10:55:51.826231Z

Streaming Replication status
Replication Slots Enabled
Name       Sent LSN   Write LSN  Flush LSN  Replay LSN  Write Lag  Flush Lag  Replay Lag  State      Sync State
shop-db-2  0/6000060  0/6000060  0/6000060  0/6000060   00:00:00   00:00:00   00:00:00    streaming  async
shop-db-3  0/6000060  0/6000060  0/6000060  0/6000060   00:00:00   00:00:00   00:00:00    streaming  async
ثم طلبنا نسخة أساسية فورية بمورد Backup، وانتهت في 13 ثانية:
apiVersion: postgresql.cnpg.io/v1
kind: Backup
metadata:
  name: shop-db-first
spec:
  cluster: { name: shop-db }
  method: plugin
  pluginConfiguration:
    name: barman-cloud.cloudnative-pg.io
$ kubectl get backup shop-db-first -o jsonpath='{.status.phase} {.status.startedAt} {.status.stoppedAt}'
completed 2026-10-11T10:57:02Z 2026-10-11T10:57:15Zالمختبر: إيقاف السيرفر الرئيسي فجأة
لنقيس الانتقال من وجهة نظر التطبيق، شغلنا Pod يكتب صفاً كل نصف ثانية عبر الخدمة shop-db-rw، ويسجل نجاح كل محاولة أو فشلها مع الوقت، وعنوان السيرفر الذي خدمها:
# Writes one row every 0.5 s through the read-write service and logs each success or failure with a timestamp
apiVersion: v1
kind: Pod
metadata:
  name: writer
spec:
  restartPolicy: Never
  containers:
    - name: writer
      image: ghcr.io/cloudnative-pg/postgresql:18.6-system-trixie
      env:
        - name: DB_URI
          valueFrom: { secretKeyRef: { name: shop-db-app, key: uri } }
      command: ["bash", "-c"]
      args:
        - |
          psql "$DB_URI" -qc "CREATE TABLE IF NOT EXISTS ticks (id bigserial PRIMARY KEY, at timestamptz DEFAULT clock_timestamp(), served_by text DEFAULT inet_server_addr()::text)"
          while true; do
            if out=$(psql "$DB_URI" -XAtqc "INSERT INTO ticks DEFAULT VALUES RETURNING served_by" 2>&1); then
              echo "$(date -u +%T.%3N) OK   $out"
            else
              echo "$(date -u +%T.%3N) FAIL $(echo "$out" | head -1 | cut -c1-90)"
            fi
            sleep 0.5
          done
ثم حذفنا Pod السيرفر الرئيسي بالقوة، كأن العقدة توقفت فجأة:
kubectl delete pod shop-db-1 --grace-period=0 --force
kubectl logs writer --since=75s | awk '{print $2}' | uniq -c
delete at 10:57:46.269
23 OK
34 FAIL
43 OK
10:57:47.324 OK 10.244.0.13/32
10:57:48.078 FAIL psql: error: connection to server at "shop-db-rw.default" (10.96.141.113), port 5432 faile
...
10:58:16.775 FAIL psql: error: connection to server at "shop-db-rw.default" (10.96.141.113), port 5432 faile
10:58:17.564 OK 10.244.0.19/32توقفت الكتابة 31 ثانية تقريباً، ثم عادت إلى عنوان آخر هو shop-db-3، دون أن يتغير شيء في التطبيق، لأن الخدمة shop-db-rw أصبحت تشير إلى الرئيسي الجديد. ولكن أين ذهبت هذه الثواني؟ من سجل المشغل وسجل shop-db-3:
10:57:47.268  operator          Current primary isn't healthy, initiating a failover
10:57:47.492  operator          Waiting for all WAL receivers to be down to elect a new primary
10:57:50.003  operator          Failing over
10:57:50.763  shop-db-3         Acquiring primary lease
10:58:06.924  shop-db-3         Acquired primary lease
10:58:06.964  shop-db-3         Promoting instance
10:58:12.426  shop-db-3/postgres  selected new timeline ID: 2
10:58:14.451  shop-db-3/postgres  database system is ready to accept connections
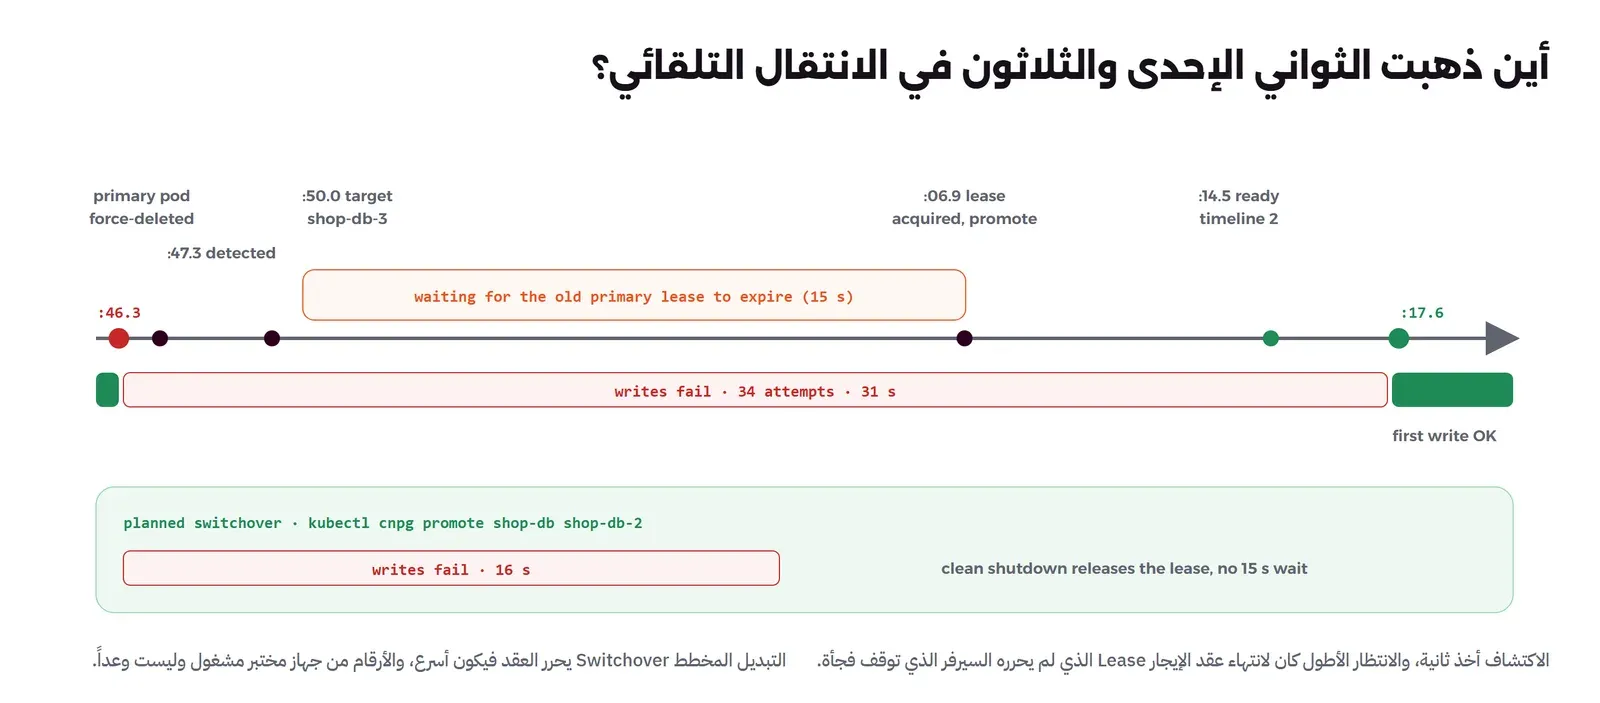
الصورة التالية تضع هذه الأحداث على خط زمني واحد:
في السجل أعلاه لاحظ التالي:
- المشغل اكتشف التوقف خلال ثانية، واختار النسخة الأحدث خلال ثلاث ثوان، فالاكتشاف ليس المشكلة.
- أطول جزء، 16 ثانية، كان انتظار عقد الإيجار Lease: تقول وثائق الانتقال إن السيرفر الرئيسي يمسك مورد Lease في Kubernetes مدته الافتراضية 15 ثانية، ولا تستطيع نسخة أخرى أن تصبح رئيسية حتى ينتهي، وإذا توقف الرئيسي بشكل سليم فإنه يحرره فوراً. والسبب هو منع انقسام الدماغ Split Brain الذي شرحناه في مقال التوفر العالي: إذا كان الرئيسي القديم حياً ولكنه منفصل عن الشبكة، فهو يتوقف عن الكتابة عندما يعجز عن تجديد العقد، قبل أن يبدأ الجديد.
- بعد الترقية أخذ PostgreSQL ثماني ثوان حتى أصبح جاهزاً، ثم ثلاث ثوان حتى نجحت الكتابة، وهذا الجزء أبطأ من المعتاد لأن جهاز المختبر كان مشغولاً بأعمال أخرى، فلا تأخذ الرقم 31 كوعد، وإنما قس على عنقودك.
- السيرفر القديم
shop-db-1أعاده المشغل بعد ذلك كنسخة متماثلة على نفس قرصه PVC، دون أن نفعل شيئاً.
ولو كانت الكتابات المؤكدة مهمة جداً، فاعلم أن النسخ المتماثلة هنا غير متزامنة async، أي أن آخر معاملات أكدها الرئيسي قبل توقفه المفاجئ قد لا تكون وصلت إلى النسخة التي ترقت، وCloudNativePG يدعم النسخ المتزامن بالإعداد postgresql.synchronous مقابل زمن أطول لكل كتابة.
التبديل المخطط Switchover
عندما تريد نقل الدور الرئيسي عمداً، لصيانة عقدة مثلاً، فلا تحذف ال Pod، وإنما اطلب التبديل:
$ kubectl cnpg promote shop-db shop-db-2
Node shop-db-2 in cluster shop-db will be promoted
$ kubectl logs writer --since=50s | awk '{print $2}' | uniq -c
      7 OK
     20 FAIL
     39 OK
11:00:15.864 FAIL ...
11:00:31.377 OK   10.244.0.16/32
توقفت الكتابة 16 ثانية بدل 31، لأن الرئيسي أغلق بشكل سليم وحرر العقد، فلم ينتظر الجديد انتهاءه. وهذا ما يفعله المشغل أيضاً عند ترقية PostgreSQL أو المشغل نفسه، لذلك اجعل تطبيقك يعيد محاولة الاتصال تلقائياً، فكل صيانة تعني ثواني دون كتابة.
الاستعادة من تخزين الكائنات
النسخة التي لم تجرب استعادتها لا يعتمد عليها، والطريقة في CloudNativePG أن تنشئ عنقوداً جديداً يبدأ من النسخ في تخزين الكائنات بدل initdb:
# A new single-instance cluster restored from the object store (backup + WAL), e.g. to test restores
apiVersion: postgresql.cnpg.io/v1
kind: Cluster
metadata:
  name: shop-db-restore
spec:
  instances: 1
  imageName: ghcr.io/cloudnative-pg/postgresql:18.6-system-trixie
  storage:
    size: 1Gi
  bootstrap:
    recovery:
      source: origin
  externalClusters:
    - name: origin
      plugin:
        name: barman-cloud.cloudnative-pg.io
        parameters:
          barmanObjectName: lab-store
          serverName: shop-db
kubectl exec shop-db-2 -c postgres -- psql -XAtc "select count(*), max(at) from ticks" shop
kubectl exec shop-db-2 -c postgres -- psql -XAtc "select pg_switch_wal()"
kubectl apply -f restore.yaml
kubectl wait cluster/shop-db-restore --for=condition=Ready --timeout=900s
kubectl exec shop-db-restore-1 -c postgres -- psql -XAtc "select count(*), max(at) from ticks" shop301|2026-10-11 11:01:32.772134+00
0/80138F0
cluster.postgresql.cnpg.io/shop-db-restore created
cluster.postgresql.cnpg.io/shop-db-restore condition met
303|2026-10-11 11:01:34.087297+00العنقود الجديد أخذ النسخة الأساسية وأعاد تنفيذ ملفات WAL من الأرشيف، فوصل إلى آخر صف قبل pg_switch_wal() الذي أغلق ملف WAL الحالي حتى يؤرشف، وأخذ ذلك دقيقة ونصفاً. وتستطيع إضافة recoveryTarget.targetTime للاستعادة إلى لحظة محددة قبل خطأ بشري، كما في وثائق الاستعادة.
لماذا تحتاج قواعد البيانات على Kubernetes إلى حذر؟
المشغل يحل الجزء الصعب من الأتمتة، ولكنه لا يجعل Kubernetes مكاناً آمناً للبيانات تلقائياً، وهذه النقاط التي تقرر النجاح:
- التخزين Storage: في kind كان نوع التخزين
standardمنrancher.io/local-path، أي مجلد على قرص العقدة، فإذا ضاعت العقدة ضاع القرص، ويعيد المشغل بناء النسخة من الأخرى. وفي الإنتاج اختر نوع تخزين بأداء معروف، والمشغل نفسه لا ينصح بالنسخ المتماثل على مستوى التخزين مع PostgreSQL لأن PostgreSQL ينسخ بياناته بنفسه. - الموارد Resources: ظهرت النسخ في حالة
Burstableلأن الطلب أقل من الحد، وفي الإنتاج اجعلrequestsمساوياً لlimitsفي الذاكرة حتى يكون Pod قاعدة البيانات آخر ما يطرده Kubernetes عند ضيق الذاكرة، واضبطshared_buffersبحسب الحد كما في مقال ضبط الأداء. - التوزيع على العقد: ثلاث نسخ على عقدة واحدة كما في مختبرنا لا تحمي من توقف العقدة، فتأكد من أن كل نسخة على عقدة مختلفة، ويفضل في منطقة توفر Availability Zone مختلفة.
- الصيانة: المشغل أنشأ
PodDisruptionBudgetيمنع إخراج الرئيسي وأكثر من نسخة في نفس الوقت عند صيانة العقد، ولكن ترقية Kubernetes نفسه وترقية المشغل كل بضعة أشهر عمل يحتاج تخطيطاً. - الفريق: عند العطل تحتاج من يفهم PostgreSQL وKubernetes معاً، فإذا كان فريقك صغيراً وقاعدتك واحدة، فسيرفر PostgreSQL على VM مع نسخ احتياطي جيد، أو خدمة مدارة، قد يكون أبسط وأرخص من عنقود Kubernetes لقاعدة واحدة.
أخطاء شائعة
- StatefulSet مكتوب يدوياً لقاعدة إنتاج: دون نسخ متماثلة أو انتقال أو نسخ احتياطي.
- النسخ الاحتياطي داخل نفس العنقود: يضيع معه.
- التطبيق يتصل بعنوان Pod وليس بالخدمة
rw: لا يتبع الرئيسي الجديد بعد الانتقال. - تطبيق لا يعيد محاولة الاتصال: كل انتقال أو صيانة يصبح أخطاء للمستخدمين بدل ثوان من الانتظار.
- حذف ال Pod لنقل الدور الرئيسي: استخدم
kubectl cnpg promoteفهو أسرع وأسلم. - ترك المشغل دون ترقية: كل إصدار صغير مدعوم بضعة أشهر فقط.
- اختبار الانتقال على عقدة واحدة والاطمئنان: كما فعلنا في المختبر، فهو يثبت سلوك المشغل ولا يثبت تحمل توقف العقدة.
حذف المختبر
kind delete cluster --name lab-cnpg --kubeconfig ./lab-cnpg.configالخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- CloudNativePG مشغل بترخيص Apache 2.0 يحول مورداً واحداً من نوع Cluster إلى نسخ PostgreSQL متماثلة وخدمات وانتقال تلقائي ونسخ احتياطي، دون أداة إجماع خارجية.
- النسخ الاحتياطي في الإصدارات الحديثة عبر Barman Cloud Plugin إلى تخزين كائنات خارج العنقود، مع أرشفة مستمرة لملفات WAL، واستعدنا منها عنقوداً جديداً في دقيقة ونصف.
- عند إيقاف الرئيسي فجأة توقفت الكتابة 31 ثانية، منها 16 ثانية انتظار عقد الإيجار الذي يمنع وجود سيرفرين رئيسيين، والتبديل المخطط أخذ 16 ثانية.
- على Docker Desktop مع cgroup v1 لا يبدأ Kubernetes 1.35 وما بعده افتراضياً، فاستخدمنا 1.34، وعلى سيرفر حديث لن تواجه ذلك.
- قاعدة البيانات على Kubernetes تحتاج تخزيناً مناسباً وموارد مضمونة ونسخاً على عقد مختلفة وفريقاً يفهم الطرفين، وإلا فالسيرفر المنفصل أبسط.
 دليلهل تحتاج Kubernetes فعلاً؟ متى يكفي Docker Composeما الذي يحله Kubernetes وما الذي يكلفك، ومتى يكفيك Docker Compose على سيرفر واحد أو بضعة سيرفرات.
 دليلمصطلحات Kubernetes مشروحة بالترتيب، من Pod إلى Ingressشرح مصطلحات Kubernetes بالترتيب الذي يبني بعضها على بعض، مع رسم لكل مفهوم وملفات YAML حقيقية.
 دليلعناقيد قواعد البيانات Database Clustering ومتى تحتاجهاماذا تعني كلمة Cluster في كل قاعدة بيانات، ومتى تحتاج نسخاً أو انتقالاً تلقائياً، ومتى يكفيك سيرفر واحد مع نسخ احتياطية جيدة.
 دليلاستعادة PostgreSQL إلى أي لحظة مع pgBackRestكيف تأخذ نسخاً احتياطية من PostgreSQL مع أرشيف WAL، وتستعيد القاعدة إلى الثانية التي سبقت حذفاً خاطئاً.
سجل التحديثات
- أكتوبر 2026: كتابة المقال واختباره على CloudNativePG 1.30.1 مع Barman Cloud Plugin 0.15.1 وcert-manager 1.21.2 وPostgreSQL 18.6، على kind 0.33.0 بعقدة Kubernetes 1.34.11 وDocker Engine 29.8.0.


