إذا وصلك تقرير يقول «النسخة الجديدة من صفحة الدفع رفعت المبيعات 8%، والنتيجة دالة إحصائياً»، فهل تطلقها للجميع؟ أغلب مديري المنتجات يقولون نعم. ولكن قبل هذا القرار هناك أسئلة يجب أن تعرف إجاباتها: كم مستخدماً دخل التجربة؟ ومتى توقفت، ولماذا؟ وهل انقسم المستخدمون بالنسبة التي خططنا لها؟ وهل ساءت أرقام أخرى بينما تحسن هذا الرقم؟ فإذا لم تعرف الإجابات، فقد يكون الفرق الذي تراه صدفة أو خطأ في القياس.
هذا المقال لمديري المنتجات والمؤسسين وقادة الفرق الذين يقرؤون نتائج اختبارات A/B ويتخذون قرارات بناء عليها، ولا يحتاجون أن يحسبوا الإحصاء بأنفسهم. ستجد فيه ما يجعل النتيجة موثوقة، بالكلمات وبأمثلة محسوبة في جداول، دون معادلات معقدة ودون كود. ومصدره الأساسي كتاب Trustworthy Online Controlled Experiments (Cambridge University Press، 2020) لـ Ron Kohavi وDiane Tang وYa Xu، الذين قادوا التجارب في Microsoft وGoogle وLinkedIn، ومقالات Evan Miller المعروفة عن الأخطاء في اختبارات A/B.
سوف نناقش في هذا المقال:
- لماذا تحتاج التجربة أصلاً، وكم فكرة تنجح فعلاً في الشركات الكبيرة.
- ما تكتبه قبل أن تبدأ: الفرضية، والمقياس الرئيسي، ومقاييس الحماية، وقاعدة القرار.
- حجم العينة وأصغر فرق يمكن اكتشافه، بمثال محسوب لصفحة دفع.
- النظر المبكر Peeking، وأثر الجديد Novelty Effect، واختلال نسبة التقسيم SRM.
- كيف تقرأ النتيجة، ومتى لا تستخدم اختبار A/B أصلاً.
باختصار
حجم العينة: يحدد مسبقاً، وأغلب صفحات التسجيل والدفع تحتاج عشرات الآلاف في كل مجموعة لاكتشاف تحسن صغير.
المدة: أسبوع كامل على الأقل، وبأسابيع كاملة، حتى لو اكتمل العدد قبل ذلك.
لا تتوقف مبكراً: التوقف عند أول نتيجة دالة يرفع نسبة النتائج الكاذبة من 5% إلى أكثر من 26% في مثال Evan Miller.
قبل أن تقرأ النتيجة: افحص نسبة التقسيم SRM، ومقاييس الحماية، وأثر الجديد.
نتيجة أجمل من المتوقع: افترض أنها خطأ حتى يثبت العكس.
لا تستخدمه: مع آلاف قليلة من المستخدمين، أو قرارات لا رجوع عنها، أو منتجات يؤثر فيها المستخدمون على بعضهم.
لماذا تحتاج التجربة Experiment؟ أغلب الأفكار لا تنجح
اختبار A/B تجربة مضبوطة Controlled Experiment: تقسم المستخدمين عشوائياً إلى مجموعتين، الأولى ترى النسخة الحالية وتسمى مجموعة المقارنة Control، والثانية ترى النسخة الجديدة وتسمى مجموعة التجربة Treatment، وكل مستخدم يبقى في مجموعته في كل زيارة. ثم تقارن سلوك المجموعتين. ولأن التقسيم عشوائي، فالفرق الوحيد المنتظم بينهما هو النسخة، فإذا ظهر فرق كبير بما يكفي، فسببه النسخة غالباً.
ولماذا لا نكتفي بمقارنة الأرقام قبل الإطلاق وبعده، أو بمقارنة من استخدم الميزة بمن لم يستخدمها؟ لأن الارتباط ليس سبباً. والمثال الذي يذكره Kohavi من Microsoft Office 365: المستخدمون الذين تظهر لهم رسائل خطأ ويتعطل عندهم البرنامج أقل إلغاء للاشتراك من غيرهم. وهذا لا يعني أن تزيد الأخطاء، وإنما أن الثلاثة لها سبب واحد: كثرة الاستخدام. فمن يستخدم البرنامج كثيراً يرى أخطاء أكثر، ويبقى مشتركاً أكثر. والتجربة العشوائية هي الطريقة التي تفصل الأثر الحقيقي عن هذا النوع من الارتباط.
والسبب الثاني أن حدسنا عن الأفكار ضعيف جداً، حتى في أفضل الفرق. والأرقام التي يجمعها Kohavi من شركات مختلفة:
| الشركة أو الشخص | النسبة المنشورة |
|---|---|
| Microsoft، منصة التجارب | ثلث الأفكار فقط حسنت المقياس الذي صممت لتحسينه |
| Google، كما كتب Jim Manzi سنة 2012 | نحو 10% فقط من التجارب المضبوطة أدت إلى تغيير في العمل |
| Netflix، كما نقل Mike Moran | تعتبر 90% مما تجربه خطأ |
| Quicken Loans، كما نقل Mike Moran | من يدير التجارب خمس سنوات يخمن النتيجة الصحيحة في نحو 33% من المرات |
ويذكر Kohavi أيضاً أن النجاح أصعب في المنتجات التي حسنت كثيراً، مثل محرك البحث Bing. وفي الطرف الآخر، قد تأتي فكرة صغيرة بأثر كبير: في Bing بقيت فكرة لتغيير طريقة عرض عناوين الإعلانات أكثر من ستة أشهر في قائمة الانتظار لأنها صنفت «أولوية منخفضة»، ثم جربها مهندس، فرفعت الإيراد 12% دون أن تضر مقاييس تجربة المستخدم، وهو ما يساوي أكثر من 100 مليون دولار في السنة في الولايات المتحدة وحدها.
المصدر: مدخل Online Controlled Experiments and A/B Tests لـ Ron Kohavi وRoger Longbotham في Encyclopedia of Machine Learning and Data Science (Springer، 2023)، ومقال The Surprising Power of Online Experiments لـ Kohavi وStefan Thomke في Harvard Business Review (سبتمبر 2017).
ما تكتبه قبل أن تبدأ: الفرضية Hypothesis وقاعدة القرار
أغلب الأخطاء في قراءة التجارب تبدأ قبل التجربة، عندما لا يكتب الفريق ما يتوقعه. فإذا لم تكتب قبل البدء ما الذي تقيسه وكيف ستقرر، فستختار بعد النتيجة الرقم الذي يناسب رأيك. والجدول التالي قالب صفحة التجربة:
| البند | ماذا تكتب | مثال افتراضي لصفحة دفع |
|---|---|---|
| الفرضية Hypothesis | لأننا لاحظنا [كذا]، نعتقد أن [التغيير] سوف [يغير السلوك] عند [من] | لأن 40% ممن يتركون الدفع يتوقفون عند نموذج العنوان، نعتقد أن تعبئة العنوان تلقائياً سترفع نسبة من يكمل الدفع |
| المقياس الرئيسي Primary Metric | رقم واحد تقرر به، ويسميه Kohavi معيار التقييم العام OEC | نسبة من أكمل الدفع ممن وصل إلى صفحة الدفع |
| مقاييس الحماية Guardrail Metrics | أرقام يجب ألا تسوء حتى لو تحسن الرئيسي | زمن تحميل الصفحة، وأخطاء الدفع، والطلبات المرتجعة |
| أصغر فرق يهمك MDE | أقل تحسن يستحق أن تطلق التغيير من أجله | من 3.0% إلى 3.6%، أي تحسن نسبي 20% |
| حجم العينة والمدة | من حاسبة، مقرباً إلى أسابيع كاملة | نحو 13,000 في كل مجموعة، أي 3 أسابيع |
| من يدخل التجربة | من يمكن أن يتأثر بالتغيير فقط | من وصل إلى صفحة الدفع، لا كل زوار الموقع |
| قاعدة القرار | ماذا نفعل في كل نتيجة ممكنة | نطلق إذا تحسن الرئيسي ولم تسؤ مقاييس الحماية، ونبقي الحالية إذا لم يظهر فرق |
وبند «من يدخل التجربة» مهم أكثر مما يبدو. فإذا كان التغيير في صفحة الدفع، والذين يصلون إليها 10% من الزوار، ثم أدخلت كل الزوار في التجربة، فـ 90% من بياناتك ضجيج من أشخاص لم يروا أي فرق. وينصح Kohavi بأن تحلل فقط من كان يمكن أن يرى الفرق، لأن هذا يقلل التشويش ويجعل النتيجة أدق.
وكيف تختار المقياس الرئيسي؟ يجب أن يتحرك في مدة التجربة، أي في أسابيع، وأن يرتبط بالقيمة الطويلة للمنتج. ويشرح Kohavi لماذا لا يكفي الإيراد القصير: محرك بحث يستطيع أن يرفع إيراده اليوم بإظهار إعلانات أكثر، ولكن المستخدمين سيجدون بديلاً على المدى الطويل. لذلك فالمقياس الرئيسي الجيد قريب من مقياس النجم الشمالي لمنتجك أو من أحد مدخلاته.
حجم العينة Sample Size وأصغر فرق يمكن اكتشافه MDE
شرحنا في اكتشاف المنتج العوامل الأربعة التي تحدد حجم العينة: النسبة الحالية، وأصغر فرق تريد اكتشافه Minimum Detectable Effect، ومستوى الدلالة الذي يكون عادة 5%، وقوة الاختبار Statistical Power التي تكون عادة 80%. وهنا نرى ماذا تعني بالأرقام لمدير منتج يريد أن يقرر.
وأصغر فرق يمكن اكتشافه هو أهم قرار في التصميم، وهو قرار منتج لا قرار إحصاء. والسؤال الذي يجيب عنه: ما أصغر تحسن يستحق أن نطلق التغيير من أجله؟ فإذا كان التغيير يكلف صيانة كبيرة، فتحسن 2% لا يستحق. وإذا كان التحسن الأصغر من ذلك لا يهمك، فلا داعي لتجربة تكتشفه.
ولاحظ الفرق بين الفرق النسبي والمطلق: إذا كانت النسبة الحالية 3% وتريد اكتشاف تحسن نسبي 10%، فالهدف 3.3%، أي فرق مطلق 0.3 نقطة مئوية فقط. وأغلب الحاسبات تسألك أيهما تقصد، والخلط بينهما يغير حجم العينة كثيراً.
مثال محسوب: صفحة دفع
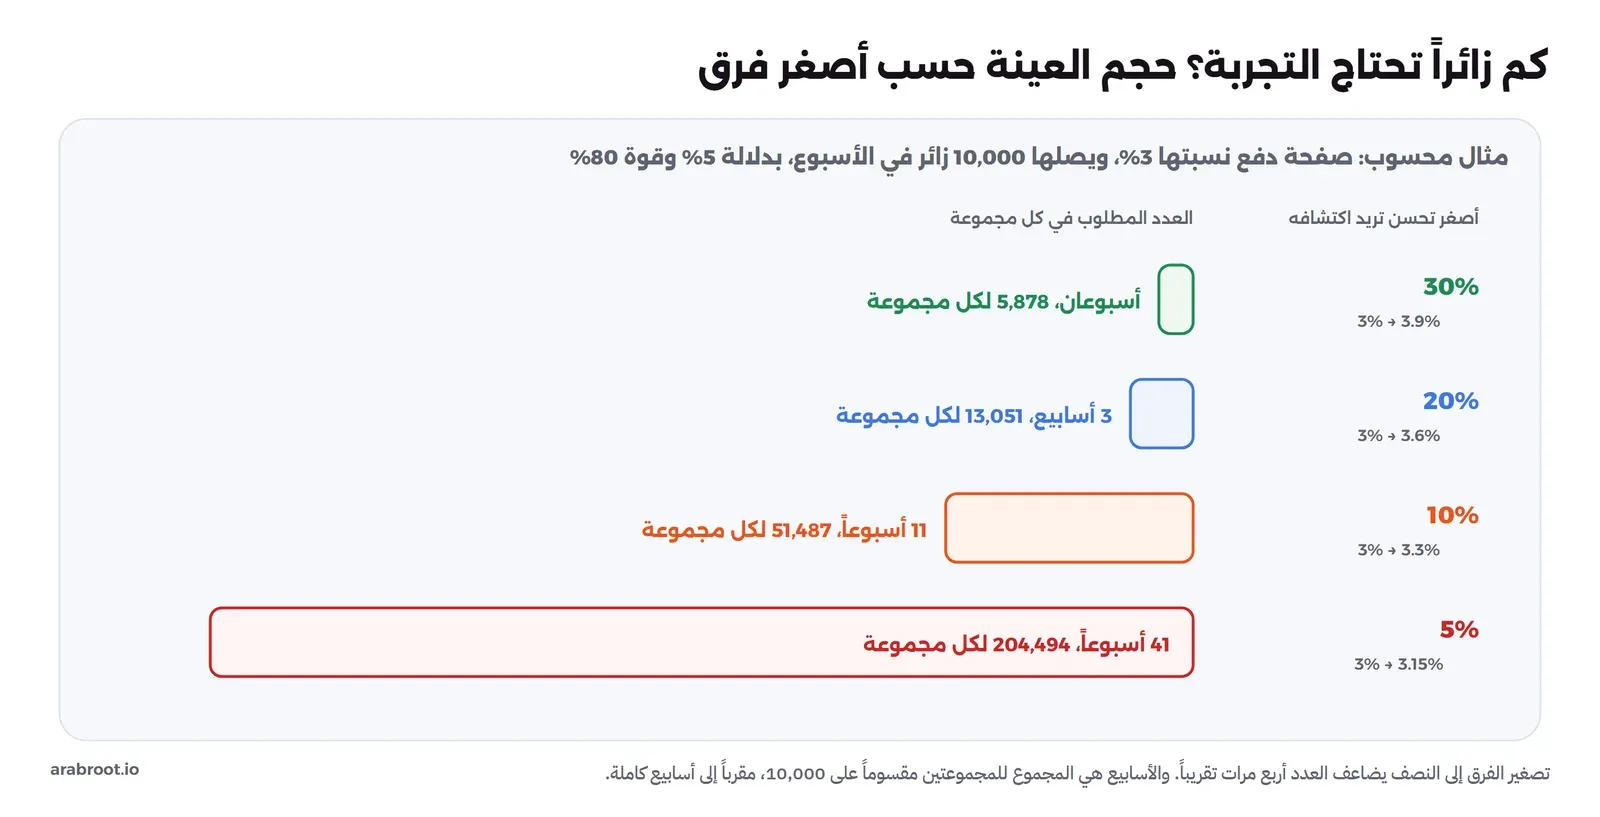
لنفرض متجراً إلكترونياً يصل إلى صفحة الدفع فيه 10,000 زائر في الأسبوع، ونسبة من يكمل الدفع منهم 3%. والجدول التالي يبين كم زائراً تحتاج التجربة لكل حجم من الفرق، بمستوى دلالة 5% وقوة 80%، والزوار يقسمون بالتساوي بين المجموعتين:
| أصغر فرق تريد اكتشافه (نسبي) | من 3% إلى | في كل مجموعة | المجموع | الأسابيع بـ 10,000 في الأسبوع |
|---|---|---|---|---|
| 5% | 3.15% | 204,494 | 408,988 | 41 أسبوعاً |
| 10% | 3.3% | 51,487 | 102,974 | 11 أسبوعاً |
| 20% | 3.6% | 13,051 | 26,102 | 3 أسابيع |
| 30% | 3.9% | 5,878 | 11,756 | أسبوعان (العدد يكتمل في أقل من أسبوعين، والمدة تقرب لأسابيع كاملة) |
حسبنا الأعداد بنفس المعادلة التي تستخدمها حاسبة Evan Miller لحجم العينة، وعمود الأسابيع هو المجموع مقسوماً على 10,000 ومقرباً إلى الأعلى. وما الذي يعنيه الجدول؟
- تصغير الفرق إلى النصف يضاعف العدد أربع مرات تقريباً: من 20% إلى 10% انتقل العدد من 13 ألفاً إلى 51 ألفاً في كل مجموعة.
- المتجر في المثال يستطيع أن يكتشف تحسناً بـ 20% في 3 أسابيع، ولكنه يحتاج قرابة ثلاثة أشهر ليكتشف تحسناً بـ 10%. وأغلب التغييرات الصغيرة في الواجهة تأتي بتحسن أقل من 10% إذا جاءت بشيء أصلاً.
- تحسن 5% غير قابل للاكتشاف عملياً في هذا المتجر، فهو يحتاج قرابة عشرة أشهر. والقرار الصحيح هنا ألا تجرب هذا النوع من التغييرات بـ A/B أصلاً.
وهناك قاعدة تقريبية يذكرها Evan Miller تسمح لك بالتحقق بالآلة الحاسبة: العدد في كل مجموعة يساوي تقريباً 16 مضروبة في التباين، مقسومة على مربع الفرق المطلق. وللنسب يكون التباين النسبة مضروبة في واحد ناقص النسبة. وفي سطر 10%: التباين 0.03 × 0.97 = 0.0291، ومربع الفرق 0.003 × 0.003 = 0.000009، والنتيجة 16 × 0.0291 ÷ 0.000009 = 51,733 في كل مجموعة، أي قريب جداً من 51,487 في الجدول.
المصدر: مقال How Not To Run an A/B Test لـ Evan Miller (2010)، وفيه القاعدة التقريبية.
كم يوماً تستمر التجربة؟ المدة Duration
حتى لو اكتمل العدد في ثلاثة أيام، لا توقف التجربة قبل أسبوع كامل. ويقول Kohavi إن الممارسة الأفضل أن تستمر التجربة أسبوعاً على الأقل، لتشمل دورة أسبوعية كاملة، ثم أسابيع أخرى بعدها. والسبب أن سلوك المستخدمين يوم الجمعة ليس سلوكهم يوم الأحد، ومن يزور متجراً في نهاية الشهر بعد الراتب ليس من يزوره في منتصفه. فإذا توقفت بعد أربعة أيام، فنتيجتك تمثل هذه الأيام فقط.
ويذكر Kohavi أيضاً أن عدد المستخدمين المتاح لأي تجربة يجب أن يكون بالآلاف على الأقل. والمواقع الكبيرة تدخل مئات الآلاف أو الملايين وتكتشف فروقاً صغيرة، والمواقع الصغيرة تستطيع أن تكتشف الفروق المتوسطة والكبيرة فقط.
كيف تقرأ النتيجة؟ قيمة p ومدى الثقة Confidence Interval
أغلب أدوات التجارب تعطيك ثلاثة أرقام: الفرق، وقيمة p، ومدى الثقة. وهذا معنى كل منها بكلام بسيط:
| الرقم | معناه | ما ليس معناه |
|---|---|---|
| الفرق Lift | الفرق بين المجموعتين في العينة التي رأيناها، مثل +10% | ليس الأثر الحقيقي بالضبط، فهو تقدير قد يكون أكبر أو أصغر |
| قيمة p | لو لم يكن هناك أي فرق حقيقي، فما احتمال أن نرى فرقاً بهذا الحجم أو أكبر بالصدفة؟ وإذا كانت أقل من 5%، نقول إن النتيجة دالة إحصائياً Statistically Significant | ليست احتمال أن النسخة الجديدة أفضل، وليست حجم الأثر |
| مدى الثقة Confidence Interval | المجال الذي يقع فيه الأثر الحقيقي غالباً، مثل «من +3% إلى +17%» | ليس ضماناً، ولكنه أفضل رقم تقرأه لأنه يقول لك الحجم والشك معاً |
والنصيحة العملية: اقرأ مدى الثقة قبل قيمة p. والمثال التالي يبين السبب. نفس الفرق الذي رأيناه، من 3.0% إلى 3.3%، بعينتين مختلفتين:
| العدد في كل مجموعة | الفرق المرئي | مدى الثقة 95% للفرق | القراءة |
|---|---|---|---|
| 10,000 | +0.3 نقطة | من −0.18 إلى +0.78 نقطة | المدى يشمل الصفر، فقد لا يوجد أثر، وقد يكون الأثر كبيراً. لا نعرف |
| 53,000 | +0.3 نقطة | من +0.09 إلى +0.51 نقطة | الأثر إيجابي غالباً، وحجمه بين صغير ومتوسط |
حسبنا المديين بالطريقة المعتادة لمدى الثقة للفرق بين نسبتين. ولاحظ أن الفرق المرئي واحد في السطرين، والذي تغير هو مقدار ما نعرفه عنه. ولهذا فجملة «الفرق 10%» وحدها لا تكفي لأي قرار.
ولاحظ أيضاً الفرق بين الدلالة الإحصائية والأهمية العملية Practical Significance. فقد تكون النتيجة دالة، والأثر حقيقياً، ولكنه أصغر من أن يستحق تكلفة صيانة الميزة. لذلك قارن مدى الثقة بأصغر فرق كتبته قبل البدء: إذا كان المدى كله فوقه، فالقرار سهل. وإذا كان المدى يشمله، فالأثر قد يكون أقل مما يهمك.
لا تنظر مبكراً: مشكلة Peeking
هذا أشهر خطأ في اختبارات A/B، وأكثرها ضرراً. يبدأ الفريق التجربة، ويفتح لوحة النتائج كل يوم، وفي اليوم الرابع تظهر النتيجة «دالة إحصائياً» فيوقف التجربة ويعلن الفائز. والمشكلة أن قيمة p محسوبة على افتراض أنك ستنظر مرة واحدة فقط في النهاية. فكل مرة تنظر فيها وتكون مستعداً للتوقف، تعطي الصدفة فرصة جديدة لتبدو نتيجة.
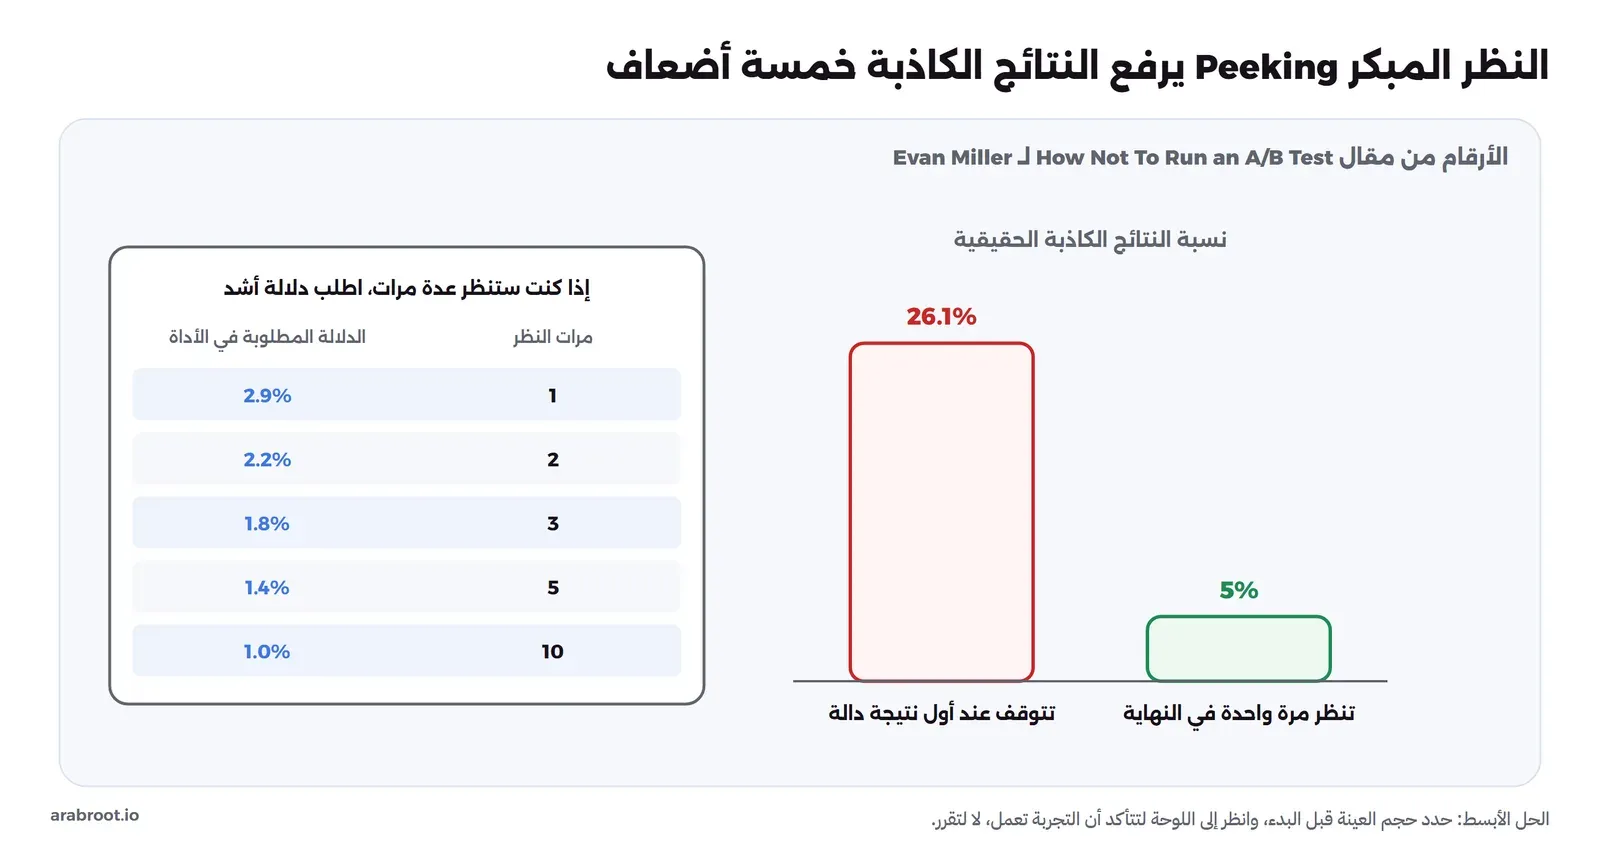
ويبين Evan Miller ذلك بمثال: إذا أوقفت التجربة عند أول مرة تظهر فيها النتيجة دالة بمستوى 5%، فنسبة النتائج الكاذبة الحقيقية تصبح 26.1%، أي أكثر من خمسة أضعاف ما تظن. وبمعنى آخر، من كل أربع تجارب «ناجحة» أعلنتها بهذه الطريقة، قد تكون واحدة نتيجة صدفة، رغم أن التغيير لم يفعل شيئاً.
وإذا كنت ستنظر عدة مرات مهما حدث، فيجب أن تطلب دلالة أشد في كل نظرة. والجدول التالي من نفس المقال، ويبين مستوى الدلالة الذي يجب أن تراه في الأداة حتى تبقى نسبة النتائج الكاذبة الحقيقية 5%:
| عدد مرات النظر | 1 | 2 | 3 | 5 | 10 |
|---|---|---|---|---|---|
| الدلالة التي تحتاجها في الأداة | 2.9% | 2.2% | 1.8% | 1.4% | 1.0% |
أي إذا كنت ستنظر عشر مرات، فما تراه على أنه دلالة 1% هو في الحقيقة دلالة 5% فقط. وما الحل؟
- الطريقة البسيطة: حدد حجم العينة قبل البدء، ولا تقرر حتى تصل إليه. انظر إلى اللوحة لتتأكد أن التجربة تعمل وأن البيانات تصل، لا لتقرر.
- التصميم المتتابع Sequential Testing: نقاط نظر محددة مسبقاً، بمستويات دلالة محسوبة لكل نقطة. وبعض الأدوات تدعمه مباشرة.
- الطريقة البايزية Bayesian: طريقة أخرى للحساب تسمح بالنظر في أي وقت إذا استخدمت بشكل صحيح. وتدعمها أدوات مثل GrowthBook، وجربناها في قياس أثر الميزة مع GrowthBook.
والاستثناء الوحيد للتوقف المبكر هو الضرر: إذا ساءت مقاييس الحماية بوضوح، مثل ارتفاع أخطاء الدفع، فأوقف التجربة فوراً. فهذا قرار حماية للعملاء، لا قرار إعلان فائز.
المصدر: مقال How Not To Run an A/B Test لـ Evan Miller (2010).
أثر الجديد Novelty Effect وأثر الاعتياد Primacy Effect
أحياناً يتغير سلوك المستخدمين في الأيام الأولى لأن الشيء جديد، لا لأنه أفضل. وهذان أثران متعاكسان:
- أثر الجديد Novelty Effect: المستخدمون يضغطون على زر جديد لأنهم لاحظوه وأرادوا أن يعرفوا ما هو. فيبدو أثره كبيراً في الأسبوع الأول، ثم يتراجع.
- أثر الاعتياد Primacy Effect: المستخدمون معتادون على الشكل القديم، فيتعثرون في الجديد أول أيام. فيبدو أثره سيئاً في البداية، ثم يتحسن عندما يعتادون عليه.
ويقول Kohavi إنه عندما تشك في أحد الأثرين، أي عندما يكون الأثر الأول للتغيير مختلفاً عن أثره الطويل، فيجب أن تستمر التجربة مدة كافية لتقدير الأثر بعد أن يستقر. وكيف تكتشف ذلك عملياً؟
- ارسم الفرق بين المجموعتين يوماً بيوم. فإذا كان ينخفض باستمرار، فغالباً ترى أثر الجديد.
- قارن المستخدمين الجدد بالمستخدمين القدامى. فالمستخدم الجديد لا يعرف الشكل القديم، فلا يتأثر بالجديد ولا بالاعتياد.
- إذا كان التغيير كبيراً في الواجهة، فخطط لمدة أطول من الحد الأدنى منذ البداية.
مقاييس الحماية Guardrail Metrics
كل تغيير قد يحسن رقماً ويسيء إلى آخر. ولذلك يسأل Kohavi في قائمة الثقة بالتجارب: هل توجد مقاييس حماية تنبهك إلى فروق غير معتادة بين المجموعتين؟ ومقاييس الحماية نوعان:
| النوع | يحمي من | أمثلة |
|---|---|---|
| حماية العمل Business Guardrails | تحسن الرقم الرئيسي على حساب رقم مهم آخر | الإيراد لكل مستخدم، والطلبات المرتجعة، وإلغاء الاشتراك، وتذاكر الدعم |
| حماية الثقة Trust Guardrails | نتيجة خاطئة بسبب مشكلة في التجربة نفسها | نسبة التقسيم بين المجموعتين، وزمن تحميل الصفحة، ونسبة الأحداث التي تصل إلى أداة التحليلات |
ومثال حقيقي من Bing يذكره Kohavi: أضاف الفريق روابط إضافية داخل الإعلانات Site Links، تأخذ المستخدم مباشرة إلى قسم في موقع المعلن. فارتفع الإيراد، ولكن ساءت مقاييس تجربة المستخدم وزمن تحميل الصفحة، غالباً لأن الإعلانات أصبحت تأخذ مساحة أكبر. ولم يطلق الفريق التغيير كما هو. وإنما عوض المساحة بتقليل عدد الإعلانات التي تظهر في أعلى الصفحة، فبقي الإيراد أعلى بعشرات الملايين من الدولارات في السنة، دون أثر على تجربة المستخدم. ولولا مقاييس الحماية، لأطلق الفريق النسخة الأولى واحتفل بالإيراد.
وفي مقال GrowthBook مثال كامل لمقياس حماية من نوع أخطاء الدفع، وكيف اتفق الفريق عليه قبل البدء.
المصدر: مدخل Online Controlled Experiments and A/B Tests لـ Kohavi وLongbotham.
اختلال نسبة التقسيم Sample Ratio Mismatch
هذا أهم فحص في المقال، وأقلها شهرة. إذا خططت لتقسيم المستخدمين 50% و50%، فيجب أن يكون العدد في المجموعتين متقارباً جداً. فإذا كان الفرق أكبر مما تسمح به الصدفة، فهناك مشكلة في التجربة نفسها، وكل الأرقام الأخرى مشكوك فيها. وهذا ما يسمى اختلال نسبة التقسيم Sample Ratio Mismatch، واختصاراً SRM.
ولماذا يحدث؟ أسباب معتادة:
- النسخة الجديدة أبطأ، فيغلق بعض المستخدمين الصفحة قبل أن يسجل دخولهم في التجربة، فتختفي من مجموعة التجربة أسوأ الزيارات تحديداً.
- تحويل Redirect في نسخة واحدة يفقد بعض المستخدمين.
- الروبوتات Bots تتصرف بشكل مختلف مع النسختين.
- خطأ في الكود يسجل الدخول في التجربة لمجموعة دون الأخرى.
ويقول Kohavi إن نظام التجارب يجب أن يقارن دائماً النسبة الفعلية بالمخطط لها، وأن يظهر تحذيراً قوياً ويخفي النتائج إذا كانت قيمة p لهذه المقارنة منخفضة جداً، مثل أقل من 0.001. والجدول التالي ثلاثة أمثلة لتجربة مخططة 50% و50%:
| مجموعة المقارنة | مجموعة التجربة | نسبة المقارنة | قيمة p للتقسيم | القراءة |
|---|---|---|---|---|
| 10,000 | 10,100 | 49.75% | 0.48 | طبيعي، الفرق في حدود الصدفة |
| 10,000 | 10,400 | 49.02% | 0.005 | مريب، ابحث عن السبب قبل أن تثق بالنتيجة |
| 10,000 | 10,600 | 48.54% | 0.00003 | اختلال واضح، لا تقرأ أي نتيجة |
وكيف حسبنا قيمة p؟ باختبار مربع كاي Chi-squared المعتاد: المتوقع في كل مجموعة نصف المجموع، ففي السطر الأخير المتوقع 10,300، والفرق عن المتوقع 300 في كل مجموعة. ومربع الفرق مقسوماً على المتوقع لكل مجموعة، ثم المجموع، يعطي 17.5، وحد الـ 0.001 لهذا الاختبار هو 10.83. وتستطيع أن تحسبه دون جهد بـ حاسبة Chi-Squared من Evan Miller.
ولاحظ في الجدول أن فرقاً يبدو صغيراً، 48.5% بدل 50%، كاف ليكون اختلالاً واضحاً عندما يكون العدد بعشرات الآلاف. فلا تحكم بالعين، واحسب. وفي مقال GrowthBook ظهر تحذير SRM فعلاً أثناء التجربة، وشرحنا كيف قرأناه.
المصدر: ورقة Diagnosing Sample Ratio Mismatch in Online Controlled Experiments لـ Fabijan وزملائه (KDD 2019)، المبنية على تجارب في أربع شركات وأكثر من 25 منتجاً، ومدخل Kohavi وLongbotham.
نتيجة أجمل من المتوقع؟ قانون Twyman
في فصل كامل من كتابه، يذكر Kohavi قانون Twyman: أي رقم يبدو مثيراً أو غير عادي، فهو غالباً خطأ. ويشرح السبب: عندما نرى نتيجة إيجابية مفاجئة، نميل إلى أن نبني حولها قصة ونحتفل بها، وعندما نرى نتيجة سلبية مفاجئة، نبحث عن عيب في التجربة لنتجاهلها. والتجربة تقول إن أغلب النتائج المتطرفة سببها خطأ في التسجيل، أو بيانات ضاعت أو تكررت، أو خطأ في الحساب.
وحتى نتيجة Bing التي ذكرناها في البداية، تحسن الإيراد 12%، أطلقت عند ظهورها تنبيه «أجمل من أن تكون حقيقية» Too Good to Be True، الذي يعني عادة وجود خطأ. فحتى فريق بهذه الخبرة بدأ بالشك قبل الاحتفال.
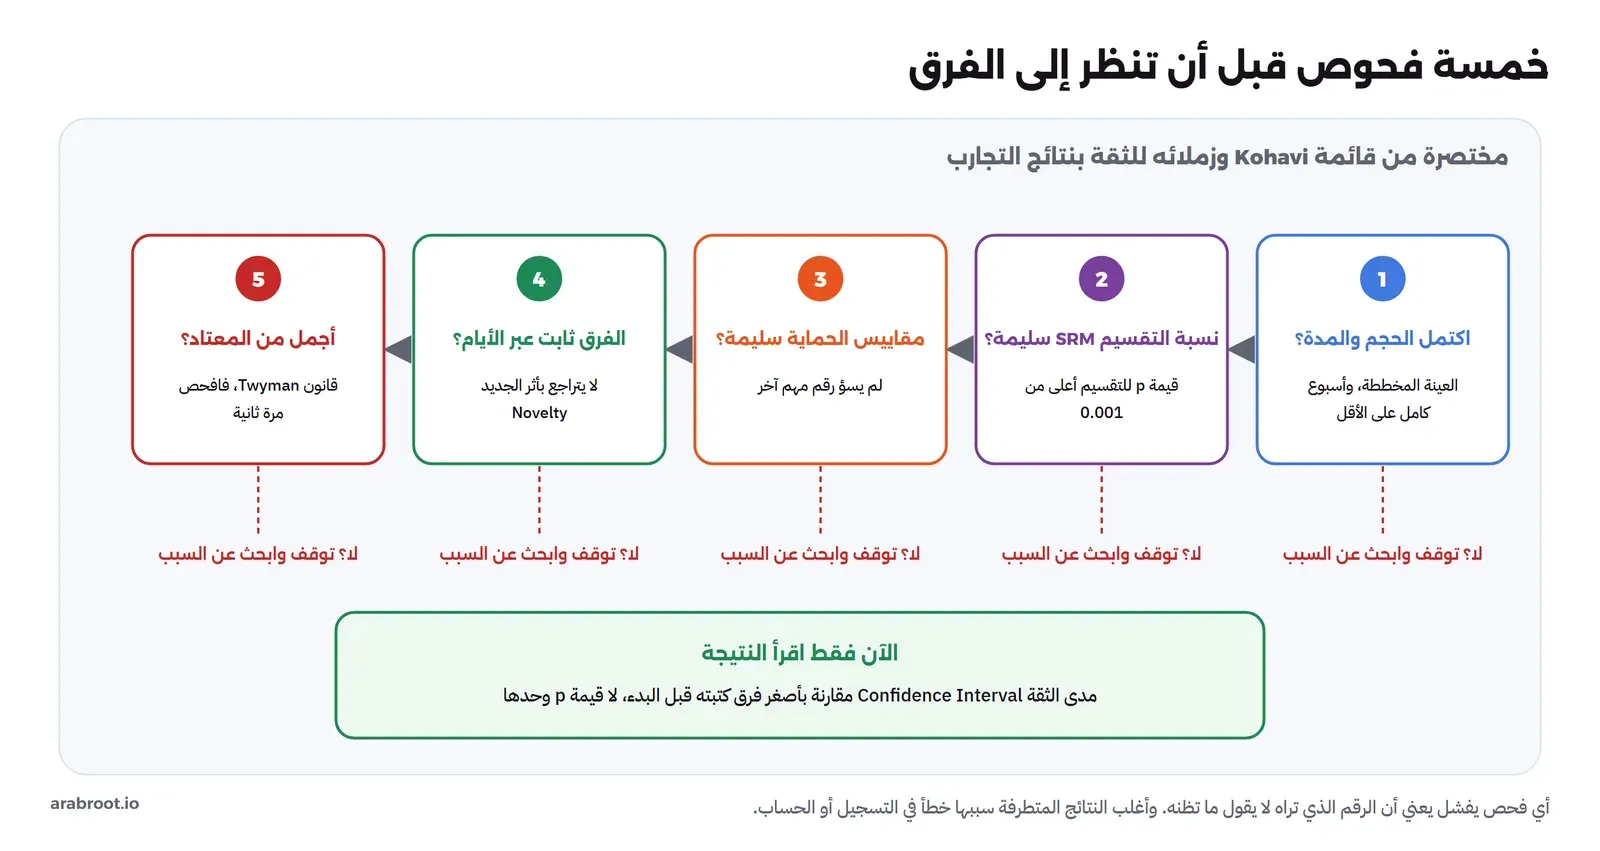
والقاعدة العملية: كلما كانت النتيجة أكبر من المعتاد في منتجك، فاطلب فحصاً أكثر قبل أن تعلنها. وقائمة الفحص التالية مختصرة من قائمة Kohavi:
| الفحص | السؤال |
|---|---|
| التلوث Contamination | هل رأى كل مستخدم نسخة واحدة فقط؟ |
| القوة Power | هل وصلت التجربة إلى حجم العينة المخطط؟ |
| نسبة التقسيم SRM | هل النسبة الفعلية قريبة من المخططة؟ |
| من دخل التجربة Triggering | هل حللنا فقط من كان يمكن أن يرى الفرق؟ |
| مقاييس الحماية | هل ساء رقم مهم آخر؟ |
| الروبوتات Bots | هل استبعدنا الزيارات الآلية؟ |
| التأثير بين المستخدمين | هل يمكن أن يؤثر مستخدم في مجموعة على مستخدم في الأخرى؟ |
من النتيجة إلى القرار Decision
بعد الفحوص، تبقى أربع نتائج ممكنة، ولكل منها قرار. والأفضل أن تكون هذه القواعد مكتوبة في صفحة التجربة قبل البدء:
| النتيجة | القرار المعتاد |
|---|---|
| الرئيسي تحسن بوضوح، ومدى الثقة فوق أصغر فرق يهمك، ومقاييس الحماية سليمة | أطلق للجميع، وتابع الرقم بعد الإطلاق |
| الرئيسي تحسن، ولكن مقياس حماية ساء | لا تطلق كما هي. افهم السبب وعدل التصميم، كما فعل فريق Bing مع الإعلانات |
| لا فرق واضح، ومدى الثقة حول الصفر | التغيير لم يحرك الرقم بالقدر الذي يهمك. اختر النسخة الأبسط والأقل تكلفة صيانة، وغالباً الحالية |
| الرئيسي ساء بوضوح | لا تطلق، واكتب ما تعلمته. فهذه نتيجة مفيدة لأنها منعت ضرراً |
وكيف تقول «لا يوجد فرق» للإدارة دون أن يبدو أن الفريق ضيع الوقت؟ هذه مهارة بحد ذاتها، وفي تجارب النمو عملياً مثال كامل على تجربة غير حاسمة وكيف عرضها الفريق.
واحفظ كل تجربة في سجل واحد: الفرضية، والتصميم، والنتيجة، والقرار، وما تعلمه الفريق. فبعد سنة يصبح هذا السجل أهم من أي تجربة منفردة، لأنه يمنع تكرار التجارب الفاشلة، ويبين للفريق أي أنواع الأفكار تنجح في منتجه.
متى لا تستخدم اختبار A/B؟
اختبار A/B أقوى طريقة لمعرفة أثر تغيير، ولكنه ليس مناسباً لكل قرار. ويذكر Kohavi نفسه حالات لا يصلح فيها:
| الحالة | لماذا لا يصلح | البديل |
|---|---|---|
| عدد المستخدمين قليل | العينة لن تكفي لاكتشاف إلا فروق كبيرة جداً، كما رأينا في الجدول | المقابلات، واختبارات قابلية الاستخدام، والنماذج الأولية، كما في اكتشاف المنتج |
| قرار لا يتكرر ولا يقسم | لا يمكن تجربة شراء شركة أخرى على نصف المستخدمين | دراسة القرار وتحليل الافتراضات، كما في قرار Build vs Buy |
| منتجات مادية بدورة تصنيع طويلة | تعديل جهاز بعد تصنيعه صعب ومكلف | نماذج أولية واختبارات مع مجموعات صغيرة |
| المستخدمون يؤثرون على بعضهم | في الشبكات الاجتماعية، وأدوات الاتصال مثل Zoom، وأدوات الكتابة المشتركة، والأسواق ذات الطرفين مثل Airbnb وUber، يتأثر مستخدم المقارنة بمستخدم التجربة، فتختلط المجموعتان | تصاميم خاصة مثل التقسيم بالمدن أو بالفترات، وتحتاج مختصاً |
| تغيير مطلوب في كل الأحوال | إصلاح خطأ أمني أو قانوني لا ينتظر نتيجة تجربة | أطلق بإطلاق تدريجي وراقب مقاييس الحماية |
| تغيير استراتيجي كبير | المقياس قصير المدى لا يقيس هدفاً يأخذ سنوات | قرار مكتوب بافتراضاته، ومتابعة طويلة بعده |
وتذكر الفرق بين التجربة والإطلاق التدريجي: الإطلاق التدريجي يسأل «هل الميزة آمنة؟» ويرفع النسبة كلما اطمأن، والتجربة تسأل «كم غيرت الميزة؟» وتثبت النسبة حتى تكتمل العينة. ومقارنة من حصل على الميزة في إطلاق تدريجي بمن لم يحصل عليها ليست تجربة صحيحة، لأن الموظفين رأوها أولاً، والنسبة تغيرت في أيام مختلفة.
أخطاء شائعة
| الخطأ | لماذا يضر | ماذا تفعل بدلاً منه |
|---|---|---|
| البدء دون فرضية ومقياس مكتوبين | تختار بعد النتيجة الرقم الذي يناسبك | صفحة التجربة قبل البدء |
| التوقف عند أول نتيجة دالة | نسبة النتائج الكاذبة تصل إلى 26% بدل 5% | حجم عينة محدد مسبقاً، أو تصميم متتابع |
| تجربة لأيام قليلة | النتيجة تمثل هذه الأيام فقط | أسبوع كامل على الأقل، بأسابيع كاملة |
| تجاهل فحص SRM | تقرأ أرقاماً من تجربة معطوبة | افحص النسبة قبل أي رقم آخر |
| عشرون مقياساً والفائز أي واحد تحسن | مع 20 مقياساً بدلالة 5%، يظهر واحد «دال» غالباً بالصدفة | قرار بمقياس رئيسي واحد، والبقية للفهم |
| إدخال كل الزوار في تجربة صفحة واحدة | من لم ير الفرق يخفف الأثر ويزيد العينة المطلوبة | من يمكن أن يرى الفرق فقط |
| تجربة كل تغيير صغير في منتج صغير | أشهر من الانتظار لنتيجة غير حاسمة | جرب التغييرات الكبيرة فقط، وقرر الباقي بالحكم والمقابلات |
| الاحتفال بنتيجة مفاجئة | أغلب النتائج المتطرفة أخطاء | فحص إضافي، وتكرار التجربة إذا كان القرار كبيراً |
| «لا فرق» تعني «فشلنا» | الفريق يتوقف عن التجربة، أو يخفي النتائج | سجل تجارب يحفظ كل النتائج، والنتيجة غير الحاسمة معلومة |
قائمة تحقق Checklist
قبل البدء:
- هل الفرضية مكتوبة، ومعها المقياس الرئيسي ومقاييس الحماية وقاعدة القرار؟
- هل حددنا أصغر فرق يهمنا، وحسبنا حجم العينة والمدة بأسابيع كاملة؟
- هل المدة المطلوبة معقولة؟ وإذا كانت أشهراً، هل التجربة هي الأداة المناسبة أصلاً؟
- هل يدخل التجربة فقط من يمكن أن يرى الفرق، وهل يبقى كل مستخدم في مجموعته؟
قبل قراءة النتيجة:
- هل وصلنا إلى حجم العينة، وأكملنا أسبوعاً على الأقل؟
- هل نسبة التقسيم سليمة؟
- هل مقاييس الحماية سليمة؟
- هل الفرق ثابت عبر الأيام، أم يتراجع؟
- إذا كانت النتيجة أكبر من المعتاد، هل فحصناها مرة ثانية؟
- هل قرأنا مدى الثقة، لا قيمة p فقط، وقارناه بأصغر فرق يهمنا؟
الخلاصة
- التجربة العشوائية تفصل الأثر الحقيقي عن الارتباط، وتكشف أن أغلب الأفكار لا تنجح: ثلثها فقط في Microsoft، ونحو 10% في Google حسب Jim Manzi.
- اكتب قبل البدء الفرضية، والمقياس الرئيسي، ومقاييس الحماية، وأصغر فرق يهمك، وقاعدة القرار.
- حجم العينة يكبر بمربع صغر الفرق: صفحة دفع نسبتها 3% تحتاج نحو 13 ألفاً في كل مجموعة لتحسن 20%، ونحو 51 ألفاً لتحسن 10%.
- أسبوع كامل على الأقل، ولا توقف عند أول نتيجة دالة، لأن هذا يرفع نسبة النتائج الكاذبة إلى أكثر من 26%.
- افحص نسبة التقسيم SRM قبل أي رقم آخر، وراقب أثر الجديد، وعامل النتيجة المفاجئة على أنها خطأ حتى يثبت العكس.
- اقرأ مدى الثقة، لا قيمة p وحدها، وقارنه بأصغر فرق يهمك.
- لا تستخدم A/B مع عدد قليل من المستخدمين، أو قرارات لا تقسم، أو منتجات يؤثر فيها المستخدمون على بعضهم.
وبهذا المقال نكمل بإذن الله مرحلة «المقاييس والتجارب». وإذا أردت أن ترى كل هذا في تجربة حقيقية من البداية إلى القرار، فانظر الدليلين العمليين في البطاقات التالية.
 دليلمقياس النجم الشمالي North Star Metric: كيف تختاره؟كيف تختار رقماً واحداً يعبر عن القيمة التي يحصل عليها مستخدموك، وتبني تحته مدخلات يعمل عليها كل فريق.
 دليلمقاييس المنتج Product Metrics وكيف تعرف أن الميزة نجحتكيف تختار رقماً رئيسياً North Star لمنتجك، وتقرأ قمع التحويل Funnel وجدول العودة Retention دون أن تخدعك لوحة الأرقام.
 دليلقياس أثر الميزة مع GrowthBook: الإيراد ومقاييس الحمايةنحول صفحة الدفع الجديدة إلى تجربة في GrowthBook بحركة نعرف حقيقتها، ونرى كيف صنع طلبان كبيران فرقاً وهمياً في الإيراد، ولماذا أوقف مقياس الأخطاء قرار الإطلاق.
 دليلتجارب النمو عملياً: من الفرضية إلى القرار بالأرقامنبني مختبر GrowthBook في Docker ونختبر قائمة خطوات البداية بزيارات محاكاة، من حجم العينة إلى قرار نتيجة غير حاسمة.
 دليلاكتشاف المنتج Product Discovery: تحقق قبل أن تبنيكيف تعرف أن المشكلة حقيقية وأن الحل ينفع بمقابلات ونماذج أولية وتجارب رخيصة، قبل أن تصرف أشهراً على البناء.
 دليلالإحصاء Statistics للمهندسين: لماذا يخدعك المتوسط Mean؟كيف تقرأ زمن الاستجابة بالوسيط والمئين p95 وp99 والمدرج التكراري بدل المتوسط، ولماذا لا يجوز حساب متوسط المئين، مع تجربة حقيقية لسيرفر تحت الضغط.
 دليلFeature Flags: انشر الكود وفعل الميزة لاحقاًكيف يفصل ال Feature Flag بين نشر الكود وإطلاق الميزة، وكيف تطلقها لجزء من المستخدمين أولاً وتوقفها فوراً إذا تعطلت.
 دليلإطلاق الميزة Feature Launch: خطة الأسبوع الأولكيف تجهز ميزة للإطلاق وتفتحها للمستخدمين على مراحل، وتعرف من الأرقام متى تكمل ومتى تتراجع في أيامها السبعة الأولى.
سجل التحديثات
- 2026-11-16: كتابة المقال من كتاب Trustworthy Online Controlled Experiments (Kohavi وTang وXu، 2020) ومدخل Kohavi وLongbotham في Encyclopedia of Machine Learning and Data Science (2023)، ومقال Kohavi وThomke في HBR (2017)، ومقال Evan Miller «How Not To Run an A/B Test» (2010)، وورقة Fabijan وزملائه عن SRM (KDD 2019)، مع جداول حجم العينة ومدى الثقة وSRM التي حسبناها بالمعادلات المعتادة، وثلاث رسومات.