إذا كنت تقود فريق برمجة، أو تفكر في شراء أداة برمجة بالذكاء الاصطناعي لزملائك، فقد سمعت أرقاماً لا يجتمع بعضها مع بعض. دراسة تقول إن المبرمج أنهى مهمته أسرع بنسبة 55.8%، ودراسة أخرى تقول إن المبرمجين الخبراء كانوا أبطأ بنسبة 19%، وتقرير ثالث يقول إن 90% من المهنيين يستخدمون الأداة وأكثر من 80% منهم يشعرون أنها رفعت إنتاجيتهم Productivity. فأي رقم تصدق؟ وأي رقم تضعه في خطة فريقك؟
هذا المقال لمن يريد أن يفهم هذه الدراسات من الداخل: من شارك فيها، وما المهمة، وماذا قاست بالضبط، وما الذي لا تثبته. والهدف أن تخرج بقاعدة عملية تعرف بها ماذا تتوقع في وضعك أنت، وكيف تقيس الأثر في فريقك بدل أن تنقل رقماً من دراسة إلى خطة.
وقد وضعنا ملخصاً قصيراً لأهم هذه الدراسات في جدول داخل مقال إنتاجية المطورين بعد DORA، وعرضنا أثرها على طريقة عمل فريق Agile في مقال Agile في عصر الذكاء الاصطناعي. أما هنا فنفتح كل دراسة على حدة، ونقرأ تصميمها وأرقامها التفصيلية وحدودها كما كتبها أصحابها.
وهذا المقال من مرحلة الأمان والتكلفة والجودة في مسار التطوير مع وكلاء الذكاء الاصطناعي. وسوف نناقش في هذا المقال ما يلي:
- كيف تقرأ دراسة إنتاجية: التجربة العشوائية، والاستبيان، ومجال الثقة، والمقياس.
- تجربة Peng وزملائه 2023، والتجارب الميدانية في Microsoft وAccenture، وتجربة Google 2024.
- تجربة METR 2025 على المبرمجين الخبراء، وتحديثها في فبراير 2026.
- الفجوة بين ما يشعر به المبرمج وما يقيسه الباحث.
- ما يقوله تقريرا DORA 2024 و2025 عن الفريق كله لا عن الفرد.
- أثر الأداة على تعلم المهارة، من تجربة نشرتها Anthropic في 2026.
- لماذا تختلف النتائج، وجدول قرار لوضعك، وتجربة صغيرة تقيس بها فريقك.
الخلاصة السريعة Quick Summary
العمل الحقيقي في مشروع كبير تعرفه جيداً: قد تبطئك الأداة، كما حدث للخبراء في تجربة METR 2025 (19% أبطأ).
الشعور ليس قياساً: المبرمجون في METR قدروا أنهم أسرع بنسبة 20% وهم أبطأ.
الفريق كله: DORA وجد أن الاستخدام يرفع سرعة التسليم في 2025، ولكنه ما زال يرتبط بعدم ثبات أعلى بعد النشر.
المهارة: من تعلم مكتبة جديدة بالأداة حصل على 50% في الاختبار مقابل 67% لمن كتب بيده.
القاعدة: لا تنقل رقماً من دراسة إلى خطتك. قس في فريقك على مهامك أنت، بمقياس محدد قبل البدء.
والأرقام في هذا المقال من الأوراق والتقارير الأصلية كما قرأناها في 19 نوفمبر 2026، وكل رقم معه رابط مصدره.
قبل الأرقام: كيف تقرأ دراسة إنتاجية Productivity Study؟
الدراسات التي سوف نمر عليها ليست من نوع واحد، ولكل نوع قوة وحدود. لذلك خذ دقيقتين لهذه المصطلحات، لأنها تشرح لماذا تختلف الأرقام قبل أن نصل إليها.
| المصطلح | ما معناه ببساطة | لماذا يهمك |
|---|---|---|
| التجربة العشوائية المنضبطة Randomized Controlled Trial، واختصاراً RCT | يقسم الباحث الناس أو المهام بالقرعة إلى مجموعتين: واحدة مع الأداة وواحدة دونها. | القرعة تجعل الفرق بين المجموعتين بسبب الأداة غالباً، وليس بسبب أن الأقوى اختاروا الأداة. |
| التجربة الميدانية Field Experiment | تجربة عشوائية داخل العمل اليومي الحقيقي في شركة، وليس في مهمة مصنوعة. | أقرب إلى واقعك، ولكنها أكثر ضجيجاً Noise لأن العمل اليومي يختلف من أسبوع لآخر. |
| الاستبيان Survey | أسئلة يجيب عليها الناس عن أنفسهم وعن فرقهم. | يعطيك صورة واسعة، ولكنه يقيس الارتباط Correlation وليس السبب Causation. |
| المقياس Outcome Measure | الشيء الذي تقيسه الدراسة: وقت المهمة، أو عدد طلبات الدمج Pull Requests، أو تقدير الشخص لنفسه. | الأداة قد ترفع عدد الطلبات دون أن يزيد العمل الحقيقي، فاسأل دائماً: ماذا قاسوا؟ |
| مجال الثقة Confidence Interval | المدى الذي يقع فيه الأثر الحقيقي غالباً، وليس رقماً واحداً. | رقم 21% بمجال من 40% أسرع إلى 3% أبطأ يختلف كثيراً عن 21% بمجال ضيق. |
| تضارب المصالح Conflict of Interest | أن يكون الباحث من الشركة التي تبيع الأداة. | لا يلغي النتيجة، ولكنه سبب لتنتظر تجارب مستقلة تؤكدها. |
وتذكر قاعدة واحدة وأنت تقرأ بقية المقال: كلما كانت المهمة أصغر وأوضح وأبعد عن مشروع حقيقي، كان قياسها أدق، ولكن نقلها إلى عملك أصعب. وكلما كانت أقرب إلى عملك الحقيقي، كانت أصدق، ولكن قياسها أصعب.
النتائج جنباً إلى جنب Results at a Glance
قبل أن نفتح كل دراسة، الصورة التالية تضع الدراسات التي قاست وقت المهمة في رسم واحد. الشريط إلى اليسار يعني أن المهمة أخذت وقتاً أقل مع الأداة، وإلى اليمين يعني وقتاً أطول، والخط الرفيع هو مجال الثقة حيث نشره الباحثون.
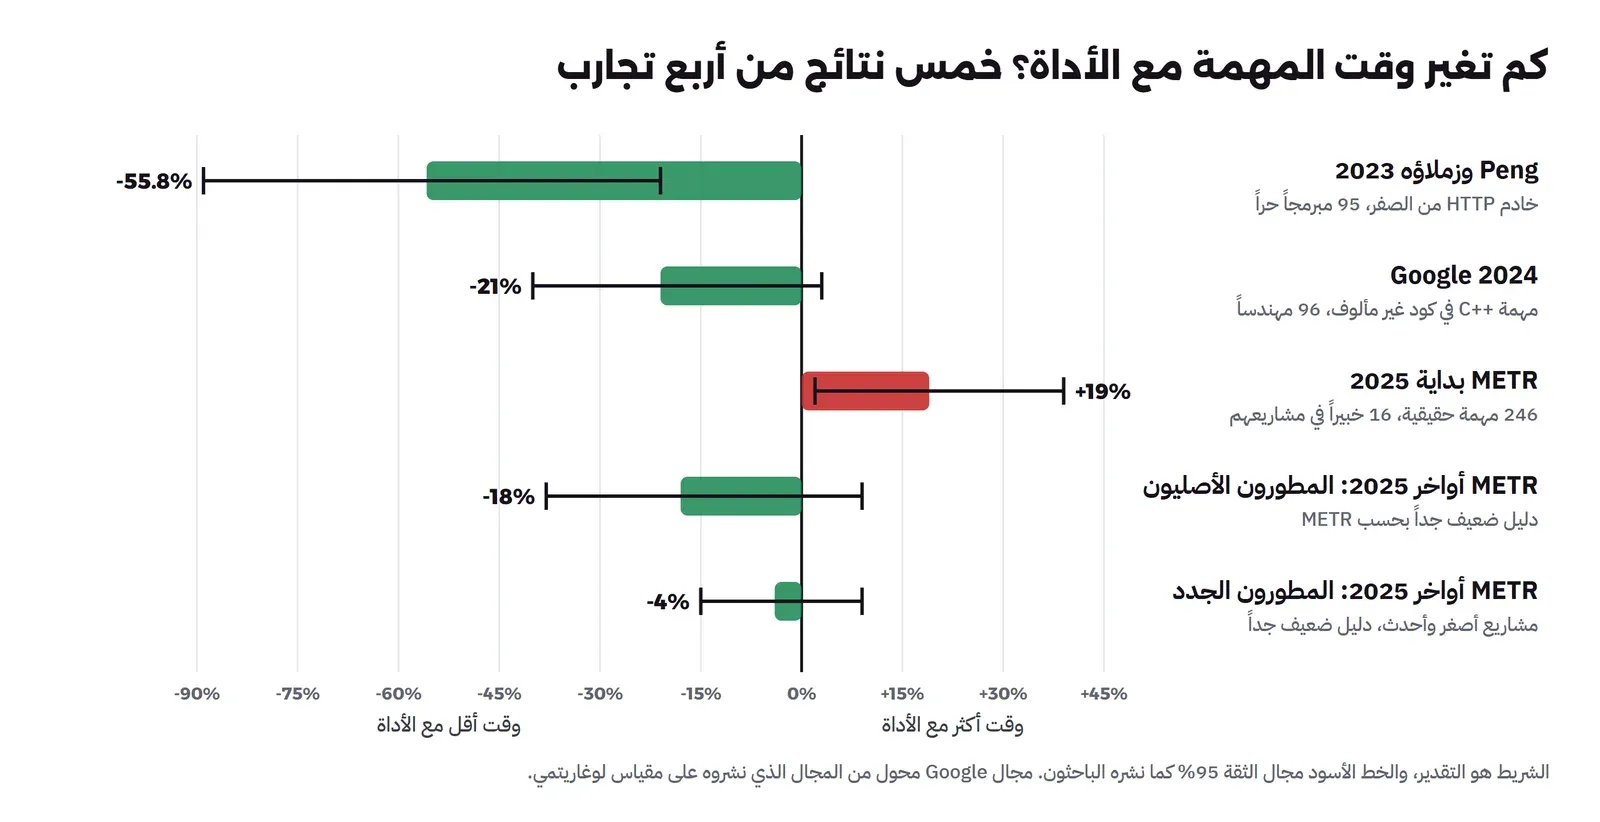
ولاحظ أن مجال الثقة في أغلب الدراسات واسع، وأن مجالات تحديث METR الأخير تعبر الصفر، أي أن البيانات لا تستطيع أن تقول هل الأثر تسريع أم إبطاء. وسوف نشرح سبب كل رقم في الأقسام التالية.
تجربة Peng وزملائه 2023: خادم HTTP في 71 دقيقة بدل 161
هذه أشهر دراسة في الموضوع، ومنها جاء رقم «55.8% أسرع» الذي تراه في العروض التقديمية Presentations. وكتبها أربعة باحثين: واحد من Microsoft Research، واثنان من GitHub، وواحد من MIT.
كيف صممت التجربة؟
- جرت بين 15 مايو و20 يونيو 2022، قبل أن تصبح GitHub Copilot متاحة للجميع.
- أرسل الباحثون 166 عرضاً على منصة العمل الحر Upwork، وقبل منها 95 مبرمجاً.
- قسموا المبرمجين بالقرعة: 45 في مجموعة الأداة و50 في المجموعة الضابطة Control Group.
- المهمة واحدة للجميع: أن يكتب خادم HTTP بلغة JavaScript بأسرع ما يمكن.
- في المستودع 12 اختباراً، والوقت يحسب من إنشاء المستودع حتى أول Commit ينجح في الاختبارات الاثني عشر.
- المجموعة الضابطة تستطيع البحث في الإنترنت وفي Stack Overflow، ولكن دون الأداة.
ماذا وجدت؟ من أكمل المهمة في مجموعة الأداة أنهاها في متوسط 71.17 دقيقة، ومن أكملها في المجموعة الضابطة أنهاها في 160.89 دقيقة. وهذا فرق 55.8%، بمجال ثقة من 21% إلى 89%، وقيمة p تساوي 0.0017. أما نسبة من أكمل المهمة فكانت أعلى في مجموعة الأداة بسبع نقاط مئوية، ولكن هذا الفرق لم يكن ذا دلالة إحصائية Statistically Significant.
ووجد الباحثون أيضاً أن الأقل خبرة، والأكبر سناً، ومن يبرمج ساعات أكثر في اليوم، استفادوا أكثر من غيرهم. وفي استبيان الخروج قدر المشاركون أن الأداة رفعت إنتاجيتهم بنحو 35%، أي أقل من الأثر الذي قيس. وكان المبلغ الذي قالوا إنهم مستعدون لدفعه شهرياً 27.25 دولاراً في مجموعة الأداة و16.91 دولاراً في المجموعة الضابطة.
ما حدودها؟ الباحثون أنفسهم يذكرون أنها مهمة واحدة موحدة، وليست عملاً في مشروع كبير مع فريق، وأن الدراسة لم تقس جودة الكود Code Quality أصلاً. وتنبه ورقة METR التي سوف نصل إليها إلى نقطة أخرى: خادم HTTP بسيط مع اختبارات ظاهرة مهمة تشبه كثيراً ما تعلمه النموذج من الإنترنت، وهذا يعطي الأداة أفضلية لا تجدها في كود شركتك. وتضيف ورقة Google أن 45% تقريباً من المشاركين كانوا يعملون لحسابهم، ونحو نصفهم يكسب أقل من 10,000 دولار في السنة، فهم ليسوا عينة من مبرمجي الشركات.
المصدر: ورقة Peng وزملائه على arXiv.
التجارب الميدانية Field Experiments في Microsoft وAccenture: 26% مهام أكثر
إذا كانت تجربة Peng مهمة مصنوعة، فهذه الدراسة هي العكس تماماً: ثلاث تجارب عشوائية أجرتها ثلاث شركات داخل عملها اليومي لتقرر هل تشتري الأداة، ثم شاركت بياناتها مع الباحثين.
- الشركات: Microsoft، وAccenture، وشركة مجهولة الاسم من قائمة Fortune 100 تصنع الإلكترونيات.
- العدد: 4,867 مطوراً، أعطي بعضهم بالقرعة GitHub Copilot ولم يعط الباقون، لمدة من شهرين إلى ثمانية أشهر، ثم أعطي الجميع.
- المقياس: عدد المهام المنجزة أسبوعياً، وهي عملياً طلبات الدمج Pull Requests.
- النتيجة: زيادة 26.08% في المهام المنجزة لمن استخدم الأداة، بخطأ معياري Standard Error قدره 10.3%. ومعها زيادة 13.55% في عدد الـ Commits، و38.38% في عدد مرات بناء الكود Builds.
- الخبرة: الأقل خبرة استخدموا الأداة أكثر واستفادوا أكثر، وفي Microsoft ظهرت الزيادة عند الموظفين الجدد وأصحاب المناصب الأقل، ولم تظهر عند الأقدم والأعلى منصباً.
ما حدودها؟ الكتاب يقولون إن كل تجربة وحدها كانت مشوشة Noisy، وإن الرقم جاء بعد جمع التجارب الثلاث. والتجارب صممتها الشركات لأغراض تجارية، فكان تطبيقها كما يصفه الكتاب «مرتجلاً» Ad-hoc، ففي Microsoft مثلاً بدأ الاستخدام ضعيفاً ثم أعطيت المجموعة الضابطة الأداة بعد وقت قصير. والمقياس عدد المهام وليس حجمها ولا جودتها، والأداة قد تجعل المبرمج يقسم عمله إلى طلبات أصغر دون أن يزيد العمل نفسه. وأخيراً، اثنان من الكتاب الستة يعملان في Microsoft. وهي ورقة عمل Working Paper نشرت في فبراير 2025.
المصدر: ورقة Cui وزملائه، فبراير 2025.
تجربة Google العشوائية 2024: 21% بمجال ثقة واسع
أرادت Google أن تعرف أثر أدواتها الداخلية على مهمة تشبه العمل الحقيقي في الشركة، وليس على مهمة من الصفر. فصمم فريق من المهندسين والباحثين مهمة معقدة، وأجرى عليها تجربة عشوائية في صيف 2024.
- المشاركون: 96 مهندساً بدوام كامل في Google، 48 في كل مجموعة.
- الأدوات: ثلاث ميزات Features داخلية: إكمال الكود AI Code Completion، واللصق الذكي Smart Paste، وتحويل الوصف إلى كود Natural Language to Code.
- المهمة: إضافة مكون لتسجيل البيانات Data Logging بلغة C++، مع تعديل ملفات البناء والبيانات والاختبارات. والمهندسون لا يعرفون الكود الذي يعدلونه مسبقاً، وجربت المهمة قبل ذلك على 8 مهندسين وأخذت بين 30 دقيقة وساعتين ونصف.
ماذا وجدت؟ من استخدم الأدوات أنهى المهمة في متوسط 96 دقيقة، ومن لم يستخدمها في 114 دقيقة. وعندما ضبط الباحثون العوامل الأخرى مثل ساعات البرمجة اليومية والمستوى الوظيفي، كان التقدير أن الأدوات جعلت المهندسين أسرع بين 21% و26%. ولكن الباحثين يقولون بوضوح إن مجال الثقة كبير، وإن هذا التقدير المضبوط لم يصل إلى مستوى الدلالة المعتاد (p = 0.086). وإذا حولنا مجال الثقة الذي نشروه إلى نسب، فهو يمتد من نحو 40% أسرع إلى نحو 3% أبطأ، وهذا ما تراه في الرسم أعلاه.
ووجدوا أيضاً أن من يبرمج خمس ساعات أو أكثر في اليوم كان أسرع بنحو 32% ممن يبرمج من صفر إلى أربع ساعات، وأن من يبرمج أكثر استفاد من الأداة أكثر، ولكن هذا الأثر الأخير لم يصل إلى الدلالة الإحصائية.
ما حدودها؟ الفريق يقيم أدوات فريقه، والباحثون يذكرون ذلك صراحة، ويقولون إنهم لم يستطيعوا إجراء التجربة خارج Google لأن الأدوات داخلية. والمهمة صممت لتنتهي في أقل من ثلاث ساعات، والعمل الحقيقي كثيراً ما لا يكون له حل واضح. ويضيفون أن الرقم «هدف متحرك» Moving Target، لأن الأدوات تتحسن والمهندسين يتعلمون استخدامها.
المصدر: ورقة Paradis وزملائه على arXiv.
تجربة METR 2025: الخبراء أبطأ بنسبة 19%
هذه الدراسة غيرت النقاش، لأنها أول تجربة عشوائية على عمل حقيقي يختاره المبرمج بنفسه، في مشروع يعرفه منذ سنوات. وأجرتها مؤسسة بحثية مستقلة اسمها METR بين فبراير ويونيو 2025.
من شارك؟
- 16 مبرمجاً خبيراً، أغلبهم بخبرة تزيد على عشر سنوات، ويدفع لكل منهم 150 دولاراً في الساعة.
- كل منهم يعمل في مشروعه مفتوح المصدر Open Source منذ 5 سنوات في المتوسط، وقدم فيه نحو 1,500 Commit.
- المشاريع كبيرة وناضجة: 23,000 نجمة في المتوسط، ونحو 1,100,000 سطر كود، ومعايير مراجعة عالية.
- 93% منهم استخدموا نماذج اللغة من قبل، و44% فقط استخدموا Cursor من قبل.
كيف صممت؟ كل مبرمج كتب قائمة مهام حقيقية من مشروعه: إصلاح خطأ Bug، أو ميزة جديدة، أو تحسين. وقدر لكل مهمة كم تأخذ معه ومع الأداة ودونها. ثم وزعت المهام بالقرعة: نصفها يسمح فيه بأي أداة ذكاء اصطناعي، ونصفها يمنع. وعندما سمح بالأداة استخدم المبرمجون غالباً Cursor Pro مع نماذج Claude 3.5 و3.7 Sonnet. وكانت المهمة تأخذ ساعتين في المتوسط، وتنتهي بطلب دمج يراجعه شخص آخر ويقبله، وسجلت شاشات المبرمجين أثناء العمل.
ماذا وجدت؟ أنجز المبرمجون 136 مهمة مع الأداة و110 دونها. وعندما سمح بالأداة أخذت المهمة وقتاً أطول بنسبة 19%، بمجال ثقة من 2% إلى 39%. والنسبة الخام قبل الضبط كانت 34%، ولكن الباحثين صححوها لأن المهام التي وقعت في جانب الأداة كانت أصعب قليلاً بحسب تقديرات المبرمجين أنفسهم.
أين ذهب الوقت؟ Time Breakdown
حلل الباحثون 143 ساعة من تسجيلات الشاشة بدقة عشر ثوان. ووجدوا أن المبرمج مع الأداة يقضي وقتاً أقل في كتابة الكود والبحث عن المعلومات، ووقتاً أكثر في كتابة التعليمات للأداة، وانتظار ردها، ومراجعة ما كتبته، وفي وقت خامل Idle لا يظهر فيه نشاط على الشاشة. وهذه أهم الأرقام من الورقة:
- قبل المبرمجون أقل من 44% مما ولدته الأداة، والباقي رفضوه أو أعادوا المحاولة.
- نحو 9% من الوقت ذهب في مراجعة كود الأداة وتنظيفه، ونحو 4% في انتظارها.
- 75% قالوا إنهم يقرؤون كل سطر تكتبه الأداة، و56% قالوا إنهم يحتاجون غالباً إلى تعديلات كبيرة، وكلهم قالوا إنهم يعدلون كودها.
- قال أحدهم إنه أضاع ساعة على الأقل يحاول حل مشكلة بالأداة، ثم أرجع كل التعديلات وحلها بنفسه.
وهذا يفسر جزءاً من النتيجة: من يعرف مشروعه جيداً يكتب الحل بسرعة، والأداة لا تعرف الاتفاقيات غير المكتوبة في المشروع، فيقضي المبرمج وقته في شرحها لها ثم في إصلاح ما فهمته خطأ.
لماذا كانوا أبطأ؟ خمسة عوامل Slowdown Factors
درس الباحثون 21 عاملاً قد تفسر البطء، ووجدوا دليلاً على خمسة منها:
| العامل | ما الدليل عليه |
|---|---|
| التفاؤل الزائد بالأداة Over-optimism | توقع المبرمجون قبل التجربة أن الأداة تختصر 24% من الوقت، فاستخدموها حتى حين لا تفيد. |
| معرفة المبرمج العالية بمشروعه | كان البطء أكبر في المهام التي يعرفها المبرمج أكثر، وقالوا إن الأداة تفيد أكثر في المهام غير المألوفة. |
| المشاريع الكبيرة المعقدة | المشاريع عمرها نحو عشر سنوات وفيها أكثر من مليون سطر، والمبرمجون قالوا إن الأداة أضعف في هذه البيئة. |
| ضعف موثوقية الأداة Low Reliability | قبول أقل من 44% من المقترحات، ووقت يضيع في مراجعة كود يرفض في النهاية. |
| السياق غير المكتوب Implicit Context | الأداة لا تعرف ما يعرفه المبرمج عن تاريخ المشروع وقواعده غير المكتوبة. |
ما الذي لا تثبته الدراسة؟ Misreadings
كتب الباحثون جدولاً خاصاً بما لا يجب أن تفهمه من نتيجتهم، وهو من أفضل ما في الورقة. فهم لا يقولون إن الأداة لا تسرع أغلب المبرمجين، لأن مشاركيهم لا يمثلون أغلب العمل البرمجي. ولا يقولون إن الأدوات القادمة لن تسرع هؤلاء المبرمجين أنفسهم، فالتقدم سريع. ولا يقولون إنه لا توجد طريقة أفضل لاستخدام الأدوات الحالية تعطي تسريعاً. ويقولون إن بعض المبرمجين في دراستهم كانوا أسرع مع الأداة فعلاً.
ومن الأرقام اللافتة أن 69% من المبرمجين استمروا في استخدام Cursor بعد انتهاء التجربة، رغم أن القياس قال إنها أبطأتهم. والتفسير الذي يطرحه الباحثون أن العمل مع الأداة قد يكون أسهل ذهنياً عند بعضهم، فيقبلون بطئاً قليلاً مقابل جهد أقل.
المصدر: ورقة METR على arXiv، وملخص METR للدراسة.
تحديث فبراير 2026: لماذا غيرت METR تصميمها؟
في أغسطس 2025 بدأت METR دراسة ثانية بالتصميم نفسه: 57 مبرمجاً، منهم 10 من الدراسة الأولى و47 جديداً، في 143 مستودعاً وأكثر من 800 مهمة، بخبرة وسيطة Median قدرها عشر سنوات، وبأجر 50 دولاراً في الساعة بدل 150. وجاءت مشاريع المبرمجين الجدد أصغر وأحدث وأقل نضجاً من مشاريع الدراسة الأولى.
والنتيجة هذه المرة اتجهت إلى التسريع: المهام أخذت وقتاً أقل بنحو 18% عند المبرمجين الأصليين، بمجال ثقة من 38% أقل إلى 9% أكثر، وأقل بنحو 4% عند الجدد، بمجال من 15% أقل إلى 9% أكثر. ولاحظ أن المجالين يعبران الصفر.
ولكن METR نفسها تقول إن هذه البيانات «دليل ضعيف جداً» على حجم الزيادة، والسبب أن كثيراً من المبرمجين رفضوا المشاركة لأنهم لا يريدون العمل دون الأداة، وأن 30% إلى 50% ممن سئلوا قالوا إنهم لم يقدموا بعض المهام لأنهم لا يريدون إنجازها دون الأداة. وهذا يعني أن المهام التي تفيد فيها الأداة أكثر خرجت من التجربة، وأن التسريع الحقيقي قد يكون أكبر بكثير. ولذلك أعلنت METR أنها تغير تصميم التجربة.
المصدر: تحديث METR في 24 فبراير 2026.
الفجوة بين الشعور والقياس Perception Gap
إذا أخذت من هذا المقال فكرة واحدة فلتكن هذه: شعور المبرمج بأنه أسرع لا يكفي لتعرف هل هو أسرع. والصورة التالية تجمع التوقعات والتقديرات مع القياس في تجربتي METR وPeng:
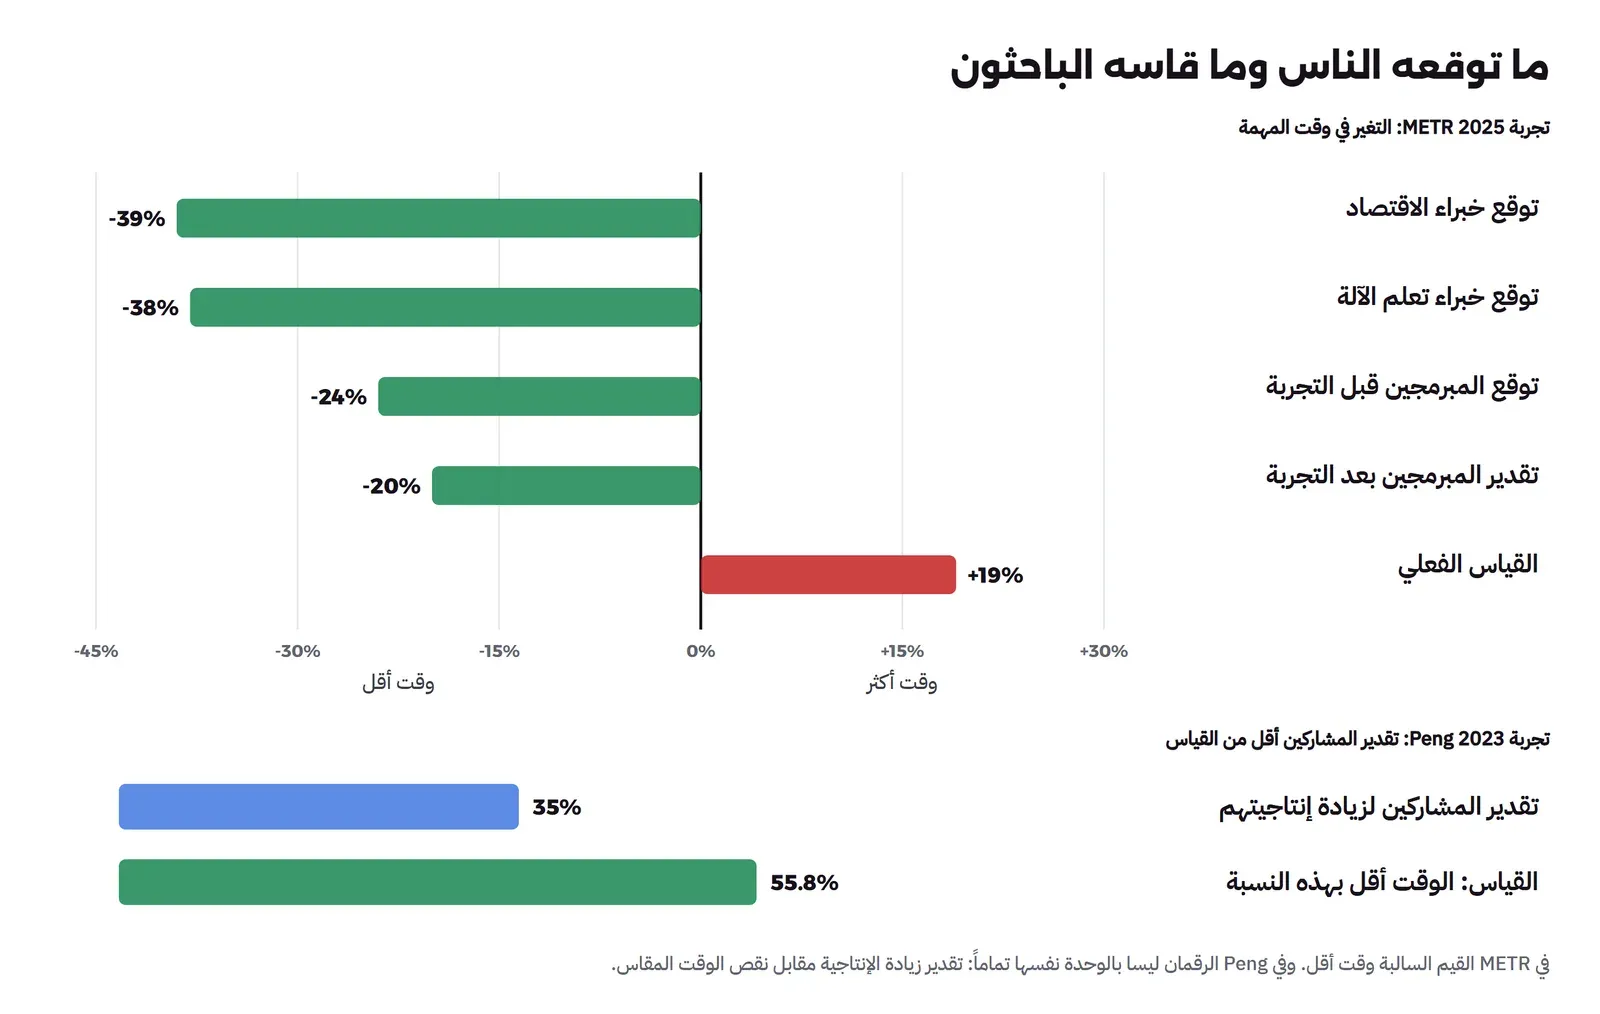
لاحظ أن الخطأ في التقدير يذهب في الاتجاهين. ففي تجربة Peng قدر المشاركون أثراً أقل من الأثر الحقيقي، وفي تجربة METR قدر المبرمجون والخبراء أثراً معاكساً للأثر الحقيقي. والدرس أن التقدير الشخصي لا يعطيك حتى الاتجاه، فلا تبن قرار شراء على استبيان رضا وحده.
وقد يتساءل البعض: لماذا يشعر المبرمج بالسرعة وهو أبطأ؟ والإجابة المحتملة من تسجيلات METR أن المبرمج مع الأداة يكتب أقل ويقرأ أكثر، والكتابة متعبة وتشعرك بمرور الوقت، والانتظار والمراجعة أخف على النفس. ولكن هذا تفسير وليس قياساً، فالباحثون لم يثبتوه.
تقريرا DORA 2024 و2025: ماذا يحدث للفريق كله؟
التجارب السابقة قاست وقت المهمة للفرد. أما أبحاث DORA التي تديرها Google Cloud فتسأل سؤالاً آخر: ماذا يحدث لسرعة التسليم Delivery وثباته عندما يزيد استخدام الأداة في المؤسسة؟ وهي استبيانات كبيرة تقيس الارتباط بين الممارسات والنتائج، وشرحنا مقاييسها الأربعة في مقال مقاييس DORA عملياً.
تقرير 2024: الكود أفضل والتسليم Delivery أقل ثباتاً
شارك في استبيان 2024 نحو 3,000 مهني، وأجري في بداية 2024. وقال 75.9% منهم إنهم يعتمدون على الذكاء الاصطناعي في مهمة يومية واحدة على الأقل، وقال 39.2% إنهم يثقون قليلاً أو لا يثقون في ما يكتبه. ثم قدر التقرير ما يحدث مع كل زيادة 25% في الاستخدام، والصورة التالية تبين أهم النتائج:
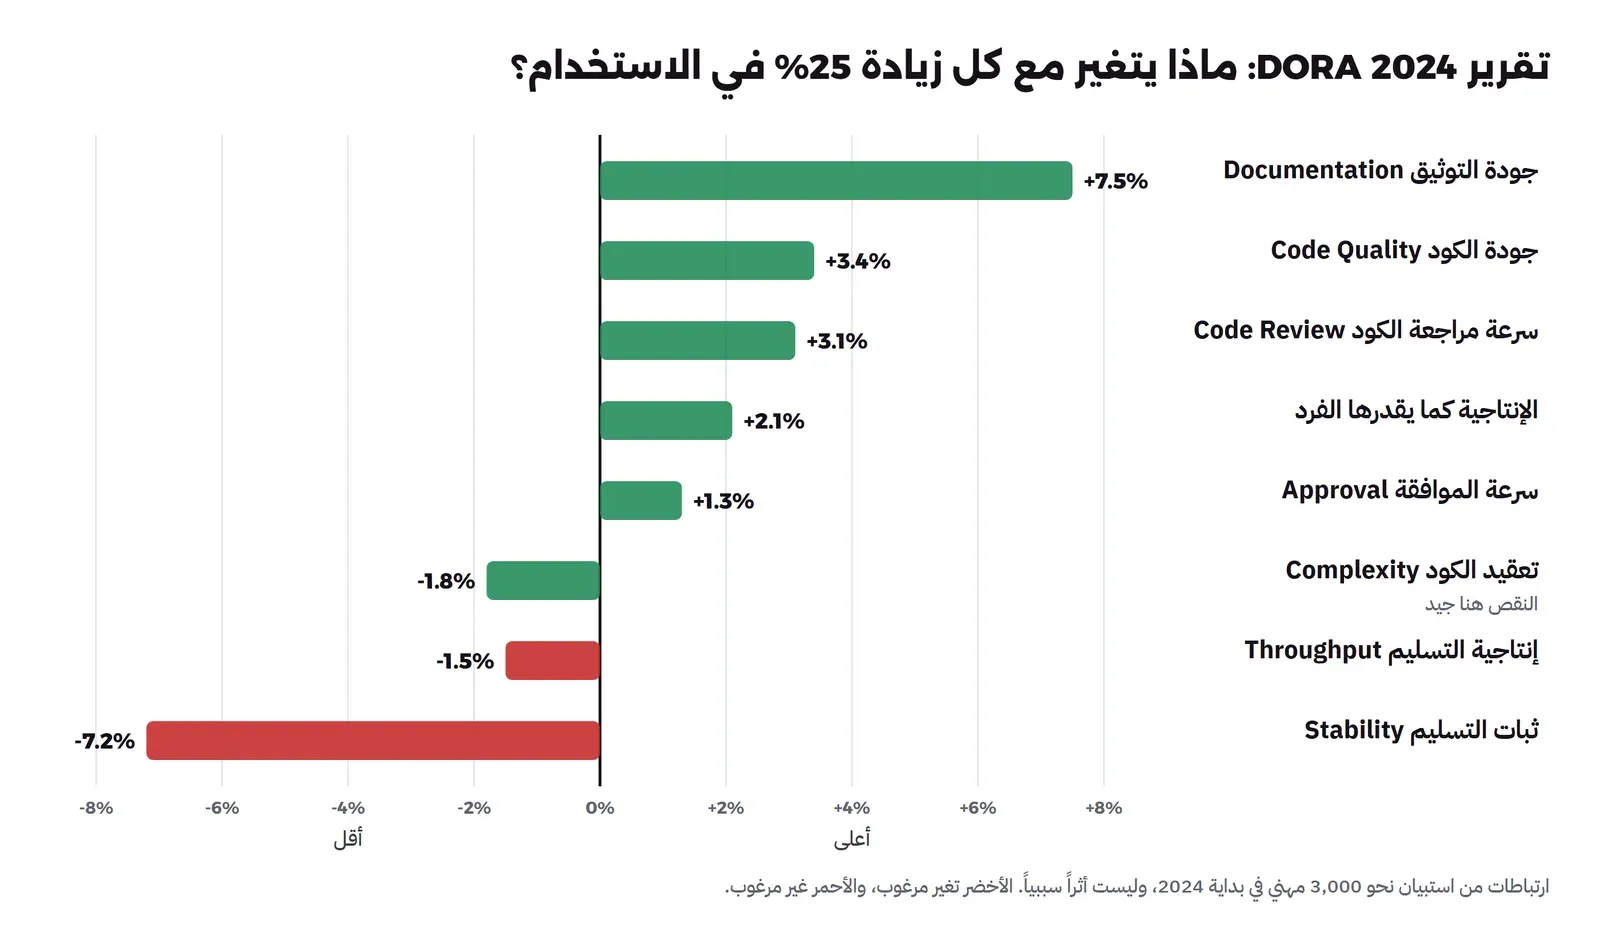
وأهم ما في الصورة الجزء الأحمر: مع كل زيادة 25% في الاستخدام انخفضت إنتاجية التسليم Delivery Throughput بنحو 1.5%، وانخفض ثبات التسليم Delivery Stability بنحو 7.2%. وتفاجأ الباحثون بذلك، لأن تحسن التوثيق والمراجعة كان يرتبط في السنوات السابقة بتحسن التسليم. والفرضية التي يطرحونها أن الأداة تجعل كتابة الكود أسهل، فيكبر حجم التغيير الواحد، والتغيير الكبير كما أثبتت DORA سنوات أبطأ وأكثر عرضة للأعطال.
وفي الفرد نفسه وجد التقرير أن زيادة 25% في الاستخدام ترتبط بتدفق Flow أعلى بنحو 2.6%، ورضا وظيفي Job Satisfaction أعلى بنحو 2.2%، وإنتاجية يقدرها الفرد أعلى بنحو 2.1%، ولكن الوقت الذي يقضيه في عمل يعتبره ذا قيمة Valuable Work أقل بنحو 2.6%.
المصدر: تقرير DORA 2024 كاملاً، وصفحة التقرير على dora.dev.
تقرير 2025: الذكاء الاصطناعي مضخم Amplifier لما هو موجود
في 2025 خصصت DORA تقريرها كله للموضوع باسم State of AI-assisted Software Development، من استبيان أجري بين 13 يونيو و21 يوليو 2025 شارك فيه قرابة 5,000 مهني، مع أكثر من 100 ساعة من المقابلات. وأهم أرقامه:
- 90% يستخدمون الذكاء الاصطناعي في عملهم، وأكثر من 80% يرون أنه رفع إنتاجيتهم.
- الوسيط Median لخبرة المشاركين مع الأدوات 16 شهراً، والوسيط لوقت استخدامها ساعتان في آخر يوم عمل، أي ربع يوم العمل تقريباً.
- 30% يثقون قليلاً (23%) أو لا يثقون إطلاقاً (7%) في جودة ما تكتبه، و24% يثقون كثيراً أو كثيراً جداً.
- الجديد عن 2024: الاستخدام أصبح يرتبط بإنتاجية تسليم أعلى، ولكنه ما زال يرتبط بعدم ثبات Instability أعلى.
والجملة التي اختصر بها التقرير كل شيء أن الذكاء الاصطناعي «مضخم» Amplifier: يكبر نقاط القوة في المؤسسة القوية، ويكبر الخلل في المؤسسة الضعيفة. ولذلك نشر معه نموذج القدرات AI Capabilities Model، وفيه سبع ممارسات تزيد أثر الأداة الإيجابي، منها موقف معلن من استخدامها، وبيانات داخلية سليمة، والعمل على دفعات صغيرة Small Batches، ومنصة داخلية Internal Platform جيدة.
وتذكر وأنت تقرأ أرقام DORA أمرين. الأول أنها ارتباطات من استبيان، فلا تقول إن الأداة هي السبب. والثاني أن المجالات في رسوماتهم مجالات مصداقية 89% Credible Intervals من تحليل بايزي Bayesian، وليست مجال الثقة 95% المعتاد في التجارب السابقة.
المصدر: تقرير DORA 2025 كاملاً، ونموذج القدرات AI Capabilities Model.
السرعة اليوم والمهارة غداً: تجربة Anthropic 2026
كل الدراسات السابقة سألت: هل ينجز المبرمج أسرع؟ وفي يناير 2026 نشر باحثان من Anthropic تجربة تسأل سؤالاً مختلفاً: هل يتعلم المبرمج مع الأداة كما يتعلم دونها؟ ولاحظ أن Anthropic تبيع أداة برمجة، فخذ ذلك في الحساب كما أخذناه مع Microsoft وGoogle.
- المشاركون: 52 مهندساً أغلبهم في بداية مسارهم، يستخدمون Python أسبوعياً منذ أكثر من سنة، ولم يستخدموا مكتبة Trio للبرمجة غير المتزامنة Asynchronous من قبل.
- المهمة: بناء ميزتين بمكتبة Trio، ثم اختبار قصير في فهمها. نصفهم بالقرعة معهم مساعد ذكاء اصطناعي في الشريط الجانبي، والنصف الآخر يكتب بيده.
- النتيجة: متوسط من استخدم الأداة في الاختبار 50%، ومتوسط من كتب بيده 67%، وكان الفرق ذا دلالة (p = 0.01). وأكبر فرق كان في أسئلة تصحيح الأخطاء Debugging.
- السرعة: مجموعة الأداة أنهت أسرع بنحو دقيقتين فقط، والفرق لم يكن ذا دلالة (p = 0.391).
والأهم من المتوسط هو طريقة الاستخدام. فمن سلم كتابة الكود كلها للأداة، أو اعتمد عليها في تصحيح الأخطاء، حصل على أقل من 40% في الاختبار. ومن سأل الأداة أسئلة عن المفاهيم فقط وحل الأخطاء بنفسه حصل على 65% أو أكثر، وكان مع ذلك ثاني أسرع مجموعة.
والباحثون يذكرون حدودها: العينة صغيرة، والاختبار جاء مباشرة بعد المهمة فلا يقيس المهارة بعد أشهر، والأداة كانت مساعد محادثة وليست وكيلاً Agent يعمل وحده، ويتوقعون أن أثر الوكيل على المهارة أكبر. وإذا كنت تخشى على مهارتك من الاعتماد على الأداة، فقد وضعنا تمارين عملية لذلك في مقال تمارين Kata.
المصدر: صفحة الدراسة لدى Anthropic، والورقة على arXiv.
لماذا تختلف النتائج؟ خمسة عوامل Factors
بعد أن رأيت الدراسات واحدة واحدة، يمكنك أن ترى أن التناقض بينها ليس تناقضاً فعلاً. فكل دراسة قاست وضعاً مختلفاً، وهذه العوامل الخمسة تفسر أغلب الفرق:
| العامل | متى تفيد الأداة أكثر | متى تفيد أقل | من أي دراسة |
|---|---|---|---|
| نوع المهمة Task Type | مهمة صغيرة جديدة من الصفر، باختبارات واضحة | تعديل في مشروع كبير قديم بمعايير عالية | Peng مقابل METR 2025 |
| معرفة المبرمج بالكود Familiarity | كود جديد عليه، أو مكتبة لم يستخدمها | مشروع يعمل فيه منذ سنوات | Google (كود غير مألوف) مقابل METR |
| خبرة المبرمج Experience | المبتدئ والموظف الجديد | الخبير صاحب المنصب الأعلى | Peng وCui |
| المقياس Measure | عدد الطلبات وعدد الـ Commits يرتفع بسهولة | وقت مهمة محددة قبل البدء، أو ثبات التسليم | Cui مقابل METR وDORA |
| جيل الأداة Tool Generation | أدوات أحدث، ومستخدم تعود عليها | أدوات أقدم، ومستخدم جديد عليها | تحديث METR 2026 وحدود Google |
ولاحظ أن الدراسات كلها تقريباً لم تقس جودة الكود على المدى البعيد، ولا تكلفة صيانته بعد سنة. وهذا فراغ حقيقي في الأدلة حتى اليوم، والأقرب إليه هو ما وجده DORA من انخفاض ثبات التسليم.
جدول القرار Decision Table: ماذا تتوقع في وضعك؟
الجدول التالي يحول ما سبق إلى توقع عملي. ابحث عن الوضع الأقرب إلى فريقك، ولكن اعتبر التوقع فرضية تختبرها، وليس وعداً:
| وضعك | ماذا تتوقع | لماذا |
|---|---|---|
| نموذج أولي Prototype أو أداة داخلية صغيرة من الصفر | تسريع واضح | يشبه مهمة Peng: كود جديد، ومتطلبات بسيطة، واختبارات واضحة |
| مبرمجون جدد على كود لا يعرفونه | تسريع متوسط، مع خطر على التعلم | Google وCui يشيران إلى الفائدة، وتجربة Anthropic تحذر من أثرها على الفهم |
| خبراء في مشروع كبير قديم بمعايير مراجعة عالية | قد لا يتغير شيء، وقد يبطئون | هذا وضع METR 2025 بالضبط |
| فريق بلا اختبارات آلية ولا نشر آلي، ويدمج تغييرات كبيرة | كود أكثر وأعطال أكثر | DORA: الأداة تضخم الخلل، والتغيير الكبير أقل ثباتاً |
| فريق يعمل بدفعات صغيرة مع اختبارات ومراجعة جادة | أفضل فرصة لتحسن حقيقي في التسليم | DORA 2025: هذه من القدرات السبع التي تزيد الأثر الإيجابي |
والذي يحدد مكانك في هذا الجدول ليس الأداة، وإنما طريقة عمل الفريق حولها. ولذلك كتبنا عن المراجعة في مقال مراجعة كود الذكاء الاصطناعي، وعن الاختبارات في مقال اختبارات يكتبها الذكاء الاصطناعي.
كيف تقيس الأثر في فريقك؟ تجربة صغيرة Pilot في ست خطوات
أفضل دليل لقرارك هو دليل من فريقك. ولا تحتاج إلى فريق بحث لتصل إليه، وإنما إلى انضباط بسيط تأخذه من تصميم METR. والصورة التالية تبين الخطوات بالترتيب:
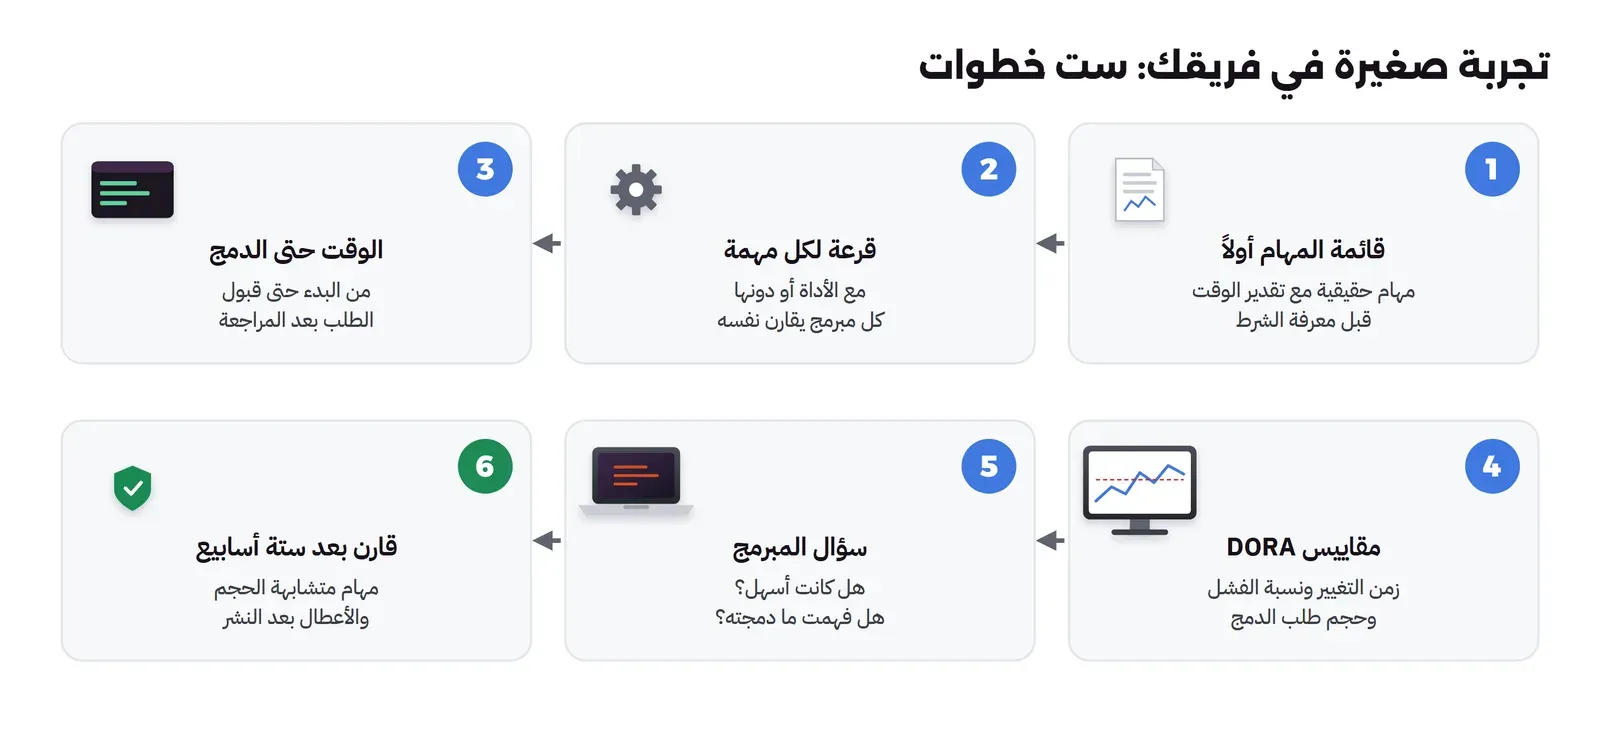
الخطوة 1: اكتب قائمة المهام Tasks قبل القرعة
اطلب من كل مبرمج قائمة مهام حقيقية من عمله القادم، وأن يقدر لكل منها الوقت. والسبب أن المهام إذا اخترت بعد معرفة هل الأداة مسموحة، فسوف يختار الناس المهام التي تناسب الأداة، وهذا بالضبط ما أفسد تحديث METR الأخير.
الخطوة 2: قرعة لكل مهمة Randomization
أعط كل مهمة بالقرعة: مع الأداة أو دونها. القرعة على المهمة وليس على الشخص تجعل كل مبرمج يقارن نفسه بنفسه، فلا تحتاج إلى فريق كبير. وإذا لم تستطع المنع لأسباب عملية، فقارن على الأقل فترة قبل الأداة بفترة بعدها، واعترف بأن هذا أضعف.
الخطوة 3: قس الوقت حتى الدمج Time to Merge
قس الوقت من بدء المهمة حتى دمج طلبها بعد المراجعة، وليس حتى أول نسخة تعمل. والسبب أن وقت المراجعة والإصلاح جزء من التكلفة، والأداة قد تنقل الوقت من الكتابة إلى المراجعة.
الخطوة 4: راقب مقاييس الفريق DORA Metrics
اجمع مقاييس DORA الأربعة قبل التجربة وأثناءها: زمن التغيير Lead Time، وتكرار النشر Deployment Frequency، ونسبة فشل التغيير Change Failure Rate، ووقت الاستعادة Recovery Time. وأضف إليها حجم طلب الدمج، لأن DORA يشك أن الأداة تكبره. وطريقة حسابها من Git شرحناها في مقال مقاييس DORA عملياً.
الخطوة 5: اسأل عن التجربة Developer Experience
أضف سؤالاً أو سؤالين بعد كل مهمة: هل كانت المهمة أسهل؟ هل فهمت الكود الذي دمجته؟ والسبب أن الأرقام وحدها لا تكفي، والشعور وحده لا يكفي كما رأيت، فاجمع الاثنين معاً كما يقترح إطار DevEx في مقال إنتاجية المطورين بعد DORA.
الخطوة 6: قارن Compare بعد وقت كاف
لا تقرر بعد أسبوع. أعط التجربة ستة أسابيع على الأقل، حتى يتعود الناس على الأداة، وحتى تظهر الأعطال التي تأتي بعد النشر. ثم قارن متوسط الوقت للمهام المتشابهة في الحجم، وانظر إلى نسبة فشل التغيير قبل أن تحتفل بأي تسريع. واحسب تكلفة الأداة لكل مهمة، وقد شرحنا الحساب في مقال تكلفة وكلاء البرمجة القادم في هذه المرحلة.
أخطاء شائعة Common Mistakes
- نقل رقم 55% إلى خطة الفريق: هذا رقم مهمة واحدة صغيرة من الصفر، والسبب أن مهامك غالباً ليست كذلك.
- الاعتماد على استبيان رضا وحده: في METR قال المبرمجون إنهم أسرع بنسبة 20% وهم أبطأ بنسبة 19%.
- قياس عدد الأسطر أو الطلبات: الأداة ترفعهما بنفسها، فالرقم يرتفع دون أن يزيد العمل.
- تجاهل ما بعد الدمج: السرعة في الكتابة لا تعني سرعة التسليم ولا ثباته، كما بين DORA في السنتين.
- قراءة ارتباط DORA كأنه سبب: الاستبيان يقول إن الأمرين يحدثان معاً، ولا يقول إن أحدهما سبب الآخر.
- نسيان من أجرى الدراسة: أغلب الدراسات الإيجابية كتبها باحثون من الشركات التي تبيع الأداة، وهذا لا يلغيها ولكنه سبب للحذر.
- الحكم على أداة اليوم بدراسة أداة الأمس: METR 2025 قاست أدوات بداية 2025، والأدوات تتغير كل بضعة أشهر.
- نسيان المبتدئين: الأداة قد تسرعهم اليوم وتضعف تعلمهم، فضع لهم قواعد مختلفة.
قائمة تحقق Checklist قبل أن تقرر
- عرفت نوع مهام فريقك: جديدة صغيرة، أم تعديلات في مشروع كبير قديم.
- عرفت خبرة الفريق ومعرفته بالكود الذي يعمل عليه.
- حددت المقياس قبل البدء: وقت المهمة حتى الدمج، ومقاييس DORA الأربعة، وحجم طلب الدمج.
- كتبت قائمة المهام قبل القرعة، ولم تترك اختيارها بعد معرفة الشرط.
- جمعت رأي المبرمجين بجانب الأرقام، ولم تكتف بأحدهما.
- أعطيت التجربة ستة أسابيع على الأقل.
- وضعت قاعدة للمبتدئين تحمي تعلمهم، مثل أن يكتبوا الحل الأول بأيديهم في المهام التعليمية.
- تأكدت أن عند الفريق اختبارات آلية ومراجعة جادة ودفعات صغيرة قبل أن توسع الاستخدام.
- أعلنت أن النتائج لن تستخدم لتقييم الأفراد.
الخلاصة
- الدراسات لا تتناقض بقدر ما تقيس أوضاعاً مختلفة: مهمة صغيرة جديدة، ومهمة داخل شركة، وعمل حقيقي في مشروع يعرفه الخبير.
- في المهام الصغيرة الجديدة الأداة أسرع بوضوح: 55.8% في Peng، ونحو 21% بمجال واسع في Google.
- في عمل الخبراء على مشاريعهم الكبيرة كانت الأداة في بداية 2025 أبطأ بنسبة 19%، والتحديث الأخير يشير إلى تسريع بدليل تصفه METR نفسها بأنه ضعيف جداً.
- الشعور بالسرعة لا يعطيك حتى الاتجاه، فقس.
- على مستوى الفريق، الأداة مضخم: الفريق المنضبط يستفيد، والفريق الذي يدمج تغييرات كبيرة دون اختبارات يصل إلى أعطاله أسرع.
- الاعتماد الكامل على الأداة في التعلم أضعف الفهم في تجربة Anthropic، وخاصة في تصحيح الأخطاء.
- أفضل دليل لقرارك تجربة صغيرة في فريقك: مهام قبل القرعة، وقرعة لكل مهمة، ووقت حتى الدمج، ومقاييس DORA، وستة أسابيع.
وفي المقال القادم من هذه المرحلة بإذن الله نحسب الطرف الآخر من المعادلة: كم تكلف هذه الأدوات في السنة، وكيف تحسب تكلفة المهمة الواحدة. وأقرب المقالات المنشورة إلى هذا الموضوع:
 دليلكم تكلف وكلاء البرمجة Coding Agents في السنة؟أسعار Copilot وClaude وCursor والتوكنات من صفحاتها الرسمية، وتكلفة سنة لفريقك بحسب حجمه، وكيف تحسب تكلفة طلب الدمج الواحد.
 دليلإنتاجية المطورين بعد DORA: إطار SPACE وتجربة المطور DevExماذا تقيس في فريق التطوير بعد مقاييس DORA، وكيف تجمع إطار SPACE وتجربة المطور ومقاييس التدفق في لوحة صغيرة واستبيان قصير.
 دليلمقاييس DORA عملياً: احسبها من Git والنشر والحوادثكيف تحسب مقاييس DORA الخمسة لفريقك من سجل Git والنشر والحوادث، ولماذا تختلف أرقام الأدوات، ومتى تتحول المقاييس إلى أهداف يتلاعب بها الفريق.
 دليلAgile في عصر الذكاء الاصطناعي: ما الذي تغير فعلاً؟ما الذي تقوله الأبحاث عن الذكاء الاصطناعي في فرق البرمجيات، وكيف تعدل طريقة عمل فريقك في Scrum وKanban دون أن تخسر الجودة.
 دليلمراجعة كود الذكاء الاصطناعي دون أن تصبح شكليةكيف تراجع طلبات الدمج التي يكتبها الذكاء الاصطناعي بحسب خطرها، وتترك للبوابات الآلية ما تستطيع قياسه.
 دليلاختبارات يكتبها الذكاء الاصطناعي: متى تثق بها؟أين يساعدك الذكاء الاصطناعي في كتابة الاختبارات وأين يخدعك، ولماذا يبقى قرار ما هو الصحيح بيد الإنسان.
 دليللماذا تتمرن دون ذكاء اصطناعي؟ تمارين Kata لك ولفريقكما الذي تقوله الأبحاث عن تسليم التفكير للأدوات، وكيف يحفظ روتين صغير من التمارين تحلها بيدك مهارتك وحدك ومع فريقك.
 دليلالفايب كودنج Vibe Coding: متى ينفع ومتى يضرك؟ما هو الفايب كودنج كما عرفه صاحبه، ومتى يكون طريقة ممتازة ومتى يتحول إلى خطر، مع مختبر يبني تطبيقاً صغيراً دون قراءة الكود ثم يفحصه.
 دليلوكيل برمجة بنموذج محلي Local LLM مع Ollama: ماذا تتوقع؟خمسة نماذج برمجة على معالج عادي دون بطاقة رسومية: كم تأخذ من الذاكرة، وكم تنتظر قبل أول كلمة، وكم دالة تكتبها صحيحة، وهل يصلح الوكيل علة بنفسه.
سجل التحديثات
- 2026-11-19: كتابة المقال من ورقة Peng وزملائه 2023، وورقة Cui وزملائه فبراير 2025، وورقة Google (Paradis وزملاؤه) نسخة نوفمبر 2024، وورقة METR يوليو 2025 وتحديثها في فبراير 2026، وتقريري DORA 2024 و2025 كاملين، ودراسة Anthropic عن المهارة يناير 2026، كما قرأناها في 19 نوفمبر 2026.