عندما تسأل إدارة أي سلسلة فروع، صيدليات أو بنوك أو محطات وقود، أين نفتح الفرع التالي، فالإجابة المعتادة تأتي من الخبرة والإحساس بالسوق، ثم من جولة بالسيارة في الأحياء المرشحة. وهذه الطريقة ليست خاطئة، ولكنها لا تجيب عن أسئلة يمكن حسابها بالأرقام: كم شخصاً يسكن على بعد كيلومترين من أقرب فرع لنا اليوم؟ وما الأحياء التي يقطع سكانها أطول مسافة؟ وهل المسافة على الخريطة هي نفسها المسافة على الطريق؟ وإذا فتحنا فرعاً هنا فكم شخصاً سوف يصبح أقرب إليه من أي فرع آخر؟ وكل هذه الأسئلة تجيب عنها أدوات مفتوحة على سيرفرك، وبيانات مفتوحة عن الطرق والسكان، وهذا ما يسمى التحليل المكاني Spatial Analysis.
وفي مقال PostGIS من هذه المرحلة حملنا بيانات OpenStreetMap لمدينة الرياض إلى PostgreSQL، وتعلمنا النوعين geometry وgeography والفهرس GiST والدوال الأساسية، وهنا نبني عليه مثالاً واحداً كاملاً بأرقام حقيقية: الصيدليات المسجلة في OpenStreetMap داخل مستطيل المدينة، ومدارسها، وتقدير السكان من WorldPop، وشبكة الطرق في pgRouting. وسوف نناقش في هذا المقال ما يلي:
- أقرب صيدلية لكل مدرسة بالبحث عن الجار الأقرب KNN والمعامل
<->، والخطأ الذي يغير الإجابة لواحدة من كل 22 مدرسة. - تحميل ملف السكان الشبكي Raster إلى PostGIS وتحويله إلى خلايا يمكن جمعها.
- بناء شبكة طرق قابلة للتوجيه بأداة osm2pgrouting، ومناطق الخدمة Service Areas على الطريق بالدالة
pgr_drivingDistance. - الفرق بين التغطية بالخط المستقيم والتغطية بالطريق، بالكيلومتر المربع وبعدد السكان.
- مناطق فورونوي Voronoi لكل صيدلية، وعدد السكان الأقرب إلى كل واحدة منها.
- حدود هذا التحليل، وما الذي يجعل أرقامه مضللة إذا لم تنتبه.
السؤال قبل الأداة
أول خطأ في التحليل المكاني أن تبدأ بالخريطة قبل السؤال، فترسم كل النقاط وتنظر إليها وتستنتج «يبدو أن الشرق ناقص». والعين تخدع هنا لسببين: الأول أن كثافة السكان غير ظاهرة على الخريطة، فحي فيه صيدلية واحدة قد يكون فيه سكان أكثر من ثلاثة أحياء فيها خمس صيدليات، والثاني أن المسافة على الخريطة ليست المسافة التي يقطعها الناس، فطريق سريع بلا مخرج قريب يجعل الصيدلية على الجانب الآخر بعيدة جداً. لذلك نكتب الأسئلة أولاً بشكل يمكن قياسه:
- القرب: ما المسافة من كل نقطة طلب، مثل المدرسة أو المنزل، إلى أقرب صيدلية، وما توزيع هذه المسافة؟
- التغطية Coverage: كم شخصاً يسكن على بعد كيلومترين أو أقل من صيدلية، مقاسة على الطريق لا بالخط المستقيم؟
- منطقة كل فرع Catchment: لكل صيدلية، كم شخصاً هي أقرب صيدلية إليهم؟
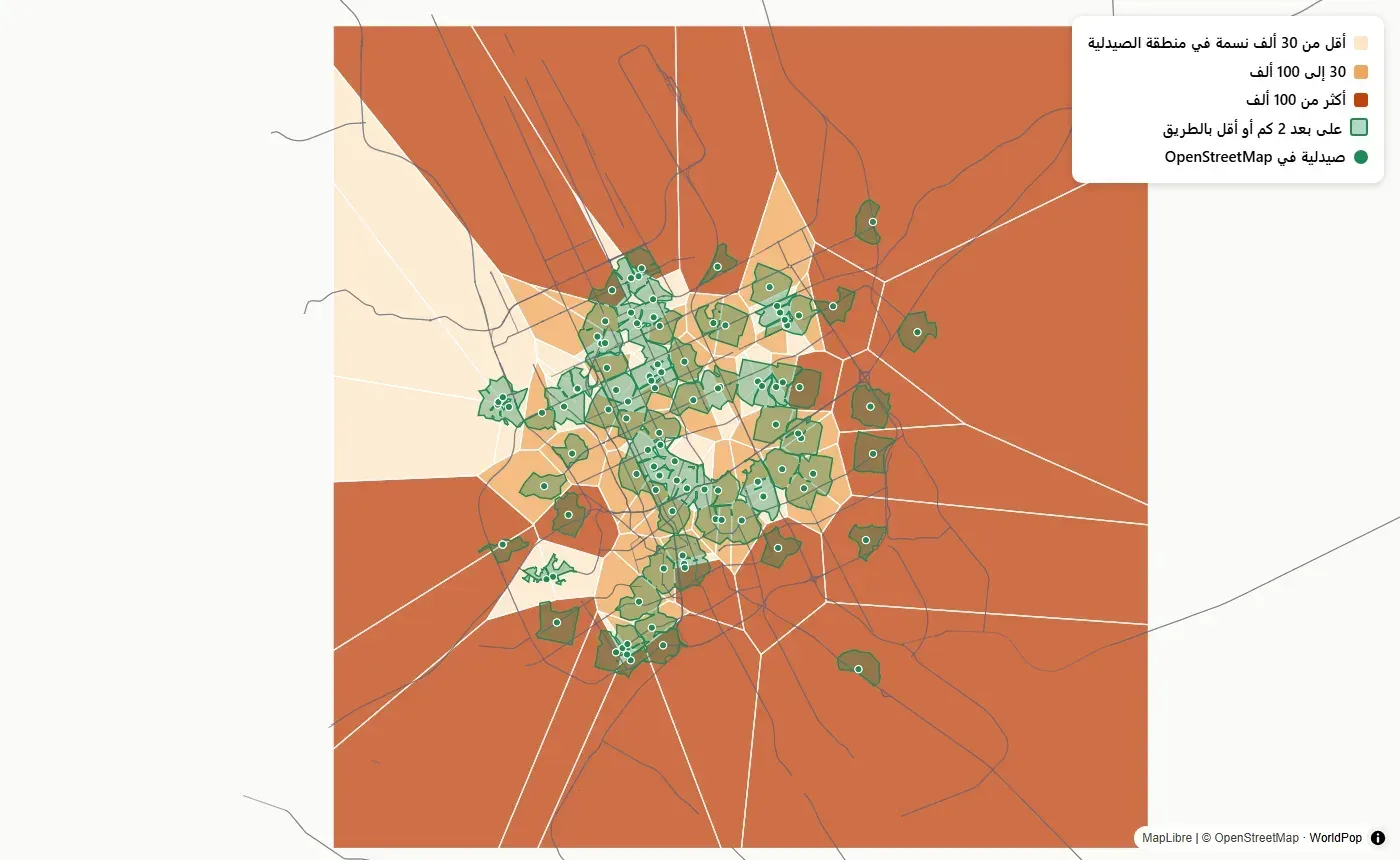
ولكل سؤال طريقة حساب مختلفة، والصورة التالية تبين النتيجة النهائية التي سوف نصل إليها على مستطيل المدينة كاملاً، ثم نشرح كل طبقة فيها:
البيانات: ثلاثة مصادر مفتوحة وحدود كل منها
التحليل لا يكون أدق من بياناته، لذلك نعرف كل مصدر ورخصته وما ينقصه قبل أي استعلام:
| المصدر | ما نأخذه منه | الرخصة | ما ينقصه |
|---|---|---|---|
| OpenStreetMap من Geofabrik | الصيدليات والمدارس وشبكة الطرق | ODbL 1.0 | التغطية غير كاملة، ففي المستطيل 109 صيدليات فقط، وهو أقل بكثير من الواقع |
| WorldPop R2025A | عدد السكان المقدر لعام 2025 في خلايا 100 متر تقريباً | CC BY 4.0 | تقدير بنموذج إحصائي من صور الأقمار الصناعية والتعداد، وليس عداً، والمشروع يصف هذا الإصدار بأنه أولي Alpha |
| سرعات الطرق في osm2pgrouting | زمن عبور كل طريق | من إعداد الأداة | السرعة القصوى لكل نوع طريق، لا السرعة الحقيقية مع الإشارات والزحام |
ولاحظ أن نقص الصيدليات في OpenStreetMap يجعل أرقام التغطية في هذا المقال أقل من الحقيقة بكثير، ولذلك فإن هدف المثال هو الطريقة لا الحكم على المدينة. وفي عملك الحقيقي سوف تضع مكان هذا الجدول بيانات فروعك من نظامك، وهي أدق ما يمكن، وتأخذ من OpenStreetMap الطرق والسياق فقط. ورخصة WorldPop تطلب ذكر المصدر عند عرض النتائج، لذلك تجد اسمه في زاوية الخريطة بجانب نسبة OpenStreetMap.
وقد يتساءل البعض: لماذا خلايا من 100 متر بدل عدد سكان كل حي من التعداد؟ والإجابة أن عدد سكان الحي يفترض أن السكان موزعون بالتساوي داخل حدوده، فإذا كان نصف الحي أرضاً فضاء أو منطقة صناعية، ومنطقة الخدمة تغطي النصف المسكون فقط، فسوف تحسب لها نصف سكان الحي وهي في الحقيقة تغطي أغلبهم. أما الخلايا الصغيرة فتضع السكان حيث توجد المباني، فتقترب النتيجة من الواقع كلما صغرت الخلية. والنسخة المقيدة Constrained من WorldPop التي استخدمناها تضع السكان فقط في الخلايا التي فيها مبان، ولهذا السبب كانت 60% من خلايا المستطيل فقط فيها قيمة، وهذا مناسب لسؤالنا، لأن الصيدلية تخدم من يسكن لا الأرض الفضاء. والثمن أن الرقم في كل خلية تقدير بنموذج، فقد يخطئ في حي جديد لم تظهر مبانيه في صور الأقمار الصناعية التي بني عليها، فاستخدمه للمقارنة بين المناطق، لا كعدد دقيق لسكان شارع.
تجهيز المختبر
نستخدم Image مبنية على postgis/postgis:18-3.7 ونضيف إليها pgRouting وأدوات PostGIS لسطر الأوامر مثل raster2pgsql، وهو الملف lab/Dockerfile.pg:
FROM postgis/postgis:18-3.7
RUN apt-get update && apt-get install -y --no-install-recommends postgresql-18-pgrouting postgis \
 && rm -rf /var/lib/apt/lists/*
وأدوات التحميل من Debian 13 مع osm2pgrouting، وهو الملف lab/Dockerfile.tools:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends gdal-bin osm2pgsql osmium-tool osm2pgrouting curl ca-certificates jq postgresql-client \
 && rm -rf /var/lib/apt/lists/*
WORKDIR /work
ثم نشغل القاعدة ونحمل بيانات OpenStreetMap بالملف city.lua نفسه الذي شرحناه في مقال PostGIS، فينتج الجداول pois وroads وbuildings وdistricts بالرقم 4326:
mkdir -p sa-lab && cd sa-lab     # Dockerfile.pg, Dockerfile.tools, city.lua and the .sql files
docker build -q -t lab-sa-pg -f Dockerfile.pg .
docker build -q -t lab-sa-tools -f Dockerfile.tools .
docker network create lab-sa-net
docker volume create lab-sa-data
docker run -d --name lab-sa-pg --network lab-sa-net --shm-size=512m -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=gis lab-sa-pg
docker run --rm -v lab-sa-data:/data lab-sa-tools bash -c 'cd /data &&
  curl -fsSLO https://download.geofabrik.de/asia/gcc-states-latest.osm.pbf &&
  osmium extract -b 46.45,24.45,47.05,25.00 gcc-states-latest.osm.pbf -o riyadh.osm.pbf &&
  curl -fsSLO https://data.worldpop.org/GIS/Population/Global_2015_2030/R2025A/2025/SAU/v1/100m/constrained/sau_pop_2025_CN_100m_R2025A_v1.tif &&
  gdal_translate -q -projwin 46.45 25.00 47.05 24.45 -co COMPRESS=DEFLATE sau_pop_2025_CN_100m_R2025A_v1.tif riyadh_pop.tif'
docker run --rm --network lab-sa-net -e PGPASSWORD=lab -v lab-sa-data:/data -v "$PWD:/work" lab-sa-tools \
  osm2pgsql -H lab-sa-pg -U postgres -d gis -O flex -S /work/city.lua /data/riyadh.osm.pbf
docker exec lab-sa-pg psql -U postgres -d gis -c "CREATE EXTENSION pgrouting;" -c "SELECT pgr_version();"
والسطر الأخير يعيد 4.0.2، وهو الإصدار الذي اختبرنا عليه، ولاحظ أن الإصدار 4 من pgRouting حذف الدالة القديمة pgr_createTopology التي ستجدها في أغلب الشروحات المنشورة على الإنترنت، لذلك سوف نبني الشبكة بأداة خارجية كما يأتي.
السؤال الأول: أقرب صيدلية بالبحث KNN
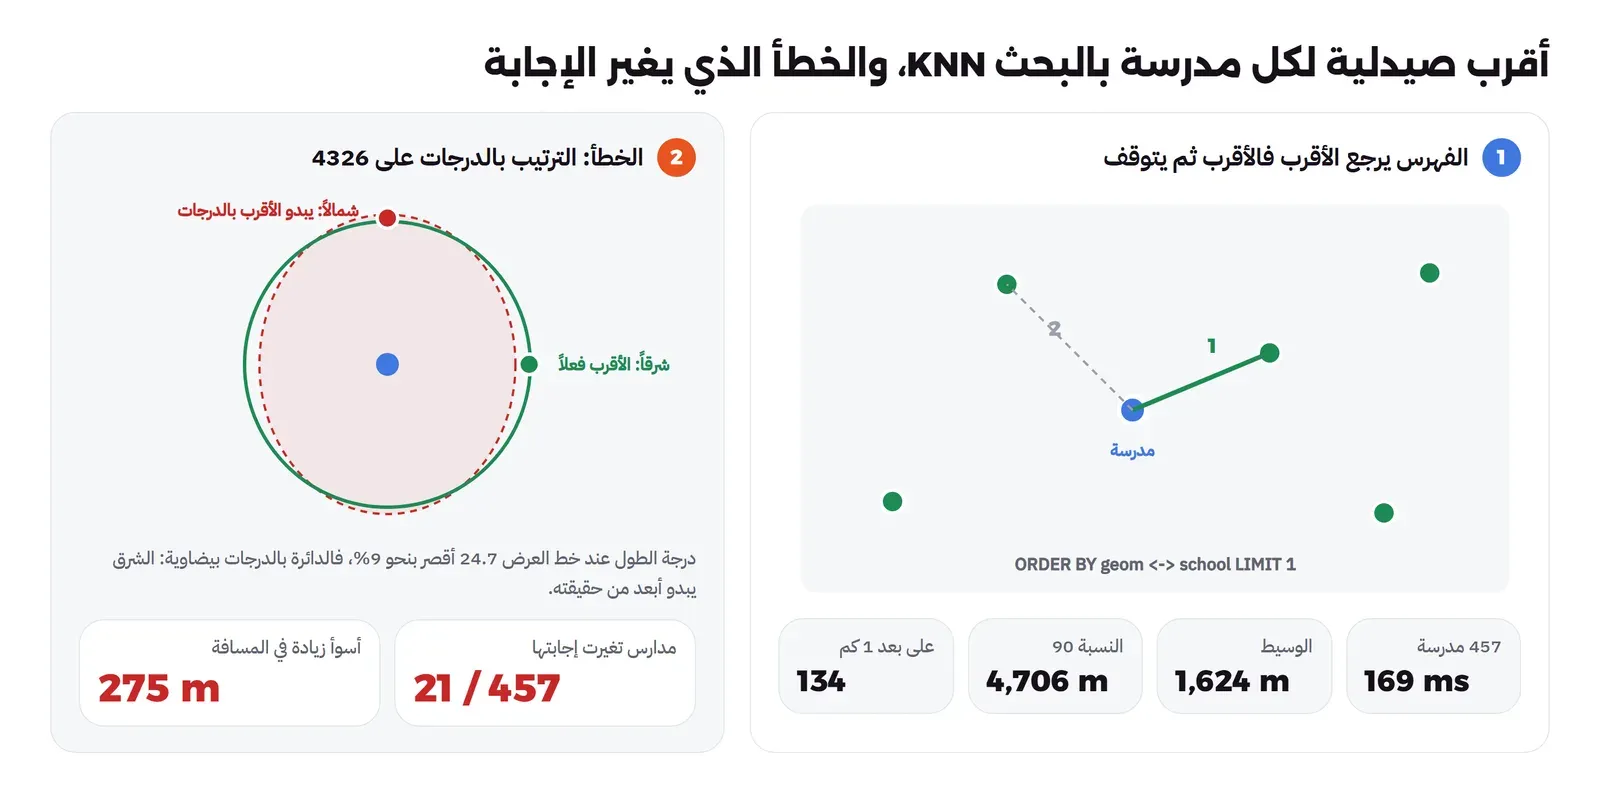
الطريقة البسيطة لإيجاد أقرب صيدلية لكل مدرسة أن تحسب المسافة بين كل مدرسة وكل صيدلية ثم تأخذ الأصغر، أي 457 في 109، قرابة خمسين ألف حساب، وهذا مقبول هنا، ولكنه يكبر بضرب الرقمين: مئة ألف عميل في ألف فرع تصبح مئة مليون حساب. والحل في PostGIS هو البحث عن الجار الأقرب K-Nearest Neighbours واختصاراً KNN بالمعامل <-> داخل ORDER BY، فيمشي الفهرس GiST في الشجرة من المستطيلات الأقرب إلى الأبعد، ويتوقف بعد أول نتيجة، دون حساب المسافة لباقي الصيدليات. والصورة التالية تبين الفكرة والخطأ الذي سوف نراه:
نبدأ بجدولين صغيرين للصيدليات والمدارس من جدول الأماكن، ثم نسأل عن أقرب صيدلية لكل مدرسة بالربط الجانبي CROSS JOIN LATERAL، الذي ينفذ الاستعلام الداخلي مرة لكل مدرسة. وهو الملف lab/01-knn.sql:
CREATE TABLE IF NOT EXISTS pharmacy AS
  SELECT osm_id AS id, name, geom FROM pois WHERE kind = 'amenity:pharmacy';
CREATE TABLE IF NOT EXISTS school AS
  SELECT osm_id AS id, name, geom FROM pois WHERE kind = 'amenity:school';
CREATE INDEX IF NOT EXISTS pharmacy_geom_idx ON pharmacy USING gist (geom);
ANALYZE pharmacy; ANALYZE school;

\timing on
CREATE TABLE school_nearest AS
SELECT s.id, s.name, p.id AS pharmacy_id, p.name AS pharmacy,
       ST_Distance(s.geom::geography, p.geom::geography) AS meters
FROM school s
CROSS JOIN LATERAL (
  SELECT id, name, geom FROM pharmacy
  ORDER BY pharmacy.geom <-> s.geom
  LIMIT 1
) p;
\timing off

SELECT count(*) AS schools,
       round(percentile_cont(0.5) WITHIN GROUP (ORDER BY meters)) AS median_m,
       round(percentile_cont(0.9) WITHIN GROUP (ORDER BY meters)) AS p90_m,
       round(max(meters)) AS max_m,
       count(*) FILTER (WHERE meters <= 1000) AS within_1km
FROM school_nearest;
والمخرج سوف يكون كما يلي:
SELECT 109
SELECT 457
Time: 169.008 ms
 schools | median_m | p90_m | max_m | within_1km
---------+----------+-------+-------+------------
     457 |     1624 |  4706 | 15414 |        134
(1 row)
في المخرج أعلاه لاحظ التالي:
- 457 بحثاً عن الأقرب أخذت 169 مللي ثانية، أي أقل من نصف مللي ثانية للمدرسة الواحدة.
- نصف المدارس أقرب صيدلية مسجلة لها على بعد 1.6 كيلومتر أو أقل بالخط المستقيم، و10% منها أبعد من 4.7 كيلومتر، و134 مدرسة فقط، أي 29%، على بعد كيلومتر أو أقل. وتذكر أن هذا عن الصيدليات المسجلة في OpenStreetMap فقط.
- استخدمنا الوسيط Median والنسبة المئوية 90 بدل المتوسط، لأن المسافات في أطراف المدينة تصل إلى 15 كيلومتراً، والمتوسط يتأثر بها كثيراً فيعطي صورة لا تمثل أغلب المدارس.
كيف يجد الفهرس الأقرب دون أن يحسب كل شيء؟
قد يبدو غريباً أن يرتب الفهرس بالمسافة، فالفهرس بني مرة واحدة ونقطة السؤال تتغير في كل استعلام. والذي يحدث أن PostgreSQL يدعم منذ سنوات ما يسمى الترتيب بمساعدة الفهرس Index-Assisted Ordering، حيث يمشي في شجرة GiST بطابور أولويات Priority Queue: يبدأ من الجذر، ويحسب لكل مستطيل في المستوى التالي أقصر مسافة ممكنة بينه وبين نقطة السؤال، ويضعه في الطابور بحسب هذه المسافة، ثم يفتح دائماً أقرب عنصر في الطابور. فإذا كان العنصر مستطيلاً فتحه وأضاف أبناءه، وإذا كان صفاً حقيقياً أعاده كنتيجة. وبما أن أقصر مسافة إلى المستطيل لا يمكن أن تكون أكبر من المسافة إلى أي شيء داخله، فأول صف يخرج من الطابور هو الأقرب فعلاً، والثاني هو الثاني، وهكذا، والاستعلام يتوقف بعد العدد الذي طلبته في LIMIT. ولهذا السبب فإن LIMIT ضروري مع <->، وبدونه يتحول الأمر إلى ترتيب الجدول كله.
ولاحظ شرطاً آخر: لكي يستخدم الفهرس يجب أن يكون أحد طرفي المعامل ثابتاً أثناء تنفيذ الاستعلام الداخلي، وهذا ما يحققه LATERAL، حيث تكون نقطة المدرسة ثابتة في كل تنفيذ. أما إذا كتبت ORDER BY a.geom <-> b.geom في ربط عادي بين جدولين، فالمخطط لا يستطيع استخدام الفهرس، ويحسب كل الأزواج.
ماذا يحدث إذا رتبنا بالدرجات؟
المعامل <-> على عمود geometry بالرقم 4326 يرتب بالمسافة المسطحة بالدرجات، وقد رأينا في مقال PostGIS أن درجة الطول عند خط عرض 24.7 أقصر من درجة العرض بنحو 9%، أي أن الصيدلية شرق المدرسة تبدو أبعد مما هي، والتي شمالها تبدو أقرب. وعادة لا يغير هذا الإجابة، ولكن عندما تكون صيدليتان على مسافتين متقاربتين في اتجاهين مختلفين، فقد يختار الترتيب بالدرجات الأبعد منهما. ولمعرفة حجم المشكلة نعيد السؤال مرتباً بالمسافة الحقيقية على الإهليلج، وذلك بالمعامل نفسه على النوع geography مع فهرس على التحويل، ثم نعد المدارس التي تغيرت إجابتها:
CREATE INDEX IF NOT EXISTS pharmacy_geog_idx ON pharmacy USING gist ((geom::geography));
ANALYZE pharmacy;
\timing on
CREATE TABLE school_nearest_geog AS
SELECT s.id, p.id AS pharmacy_id, ST_Distance(s.geom::geography, p.geom::geography) AS meters
FROM school s
CROSS JOIN LATERAL (SELECT id, geom FROM pharmacy ORDER BY pharmacy.geom::geography <-> s.geom::geography LIMIT 1) p;
\timing off
SELECT count(*) AS different_answer, round(max(a.meters - b.meters)) AS worst_extra_m
FROM school_nearest a JOIN school_nearest_geog b USING (id)
WHERE a.pharmacy_id <> b.pharmacy_id;
SELECT 457
Time: 131.331 ms
different_answer | worst_extra_m
------------------+---------------
21 | 275
(1 row)أي أن 21 مدرسة من 457، واحدة من كل 22 تقريباً، أخذت صيدلية ليست الأقرب، وفي أسوأ حالة كانت الصيدلية المختارة أبعد بمقدار 275 متراً من الأقرب الحقيقية. والإصدار الصحيح لم يكن أبطأ، بل أخذ 131 مللي ثانية. وهذا خطأ لا يظهر في أي اختبار بسيط، لأن أغلب الإجابات صحيحة، ولكنه يظهر عندما يشتكي عميل من أن التطبيق أرسله إلى الفرع الأبعد. والقاعدة أن تستخدم <-> على geography، أو على عمود بإسقاط محلي بالمتر، كلما كان الترتيب نفسه هو القرار، أما على 4326 فاستخدمه فقط لتصفية مرشحين ثم أعد ترتيبهم بالمسافة الحقيقية.
السكان: من ملف شبكي إلى خلايا يمكن جمعها
المسافة وحدها لا تكفي لقرار فتح فرع، فالسؤال الحقيقي هو كم شخصاً يتأثر، وهنا نحتاج تقدير السكان. وملف WorldPop للمملكة لعام 2025 ملف GeoTIFF، أي بيانات شبكية Raster، كل خلية فيها عدد السكان المقدر. وقد قصصنا منه مستطيل المدينة في خطوة التجهيز بالأمر gdal_translate إلى ملف riyadh_pop.tif حجمه 1.1 ميغابايت، والآن ندخله إلى القاعدة بالأداة raster2pgsql التي تقسم الملف إلى مربعات من 100 في 100 خلية، وتضيف فهرساً وقيوداً:
docker run --rm --network lab-sa-net -e PGPASSWORD=lab -v lab-sa-data:/data lab-sa-pg bash -c '
  raster2pgsql -s 4326 -I -C -M -t 100x100 /data/riyadh_pop.tif public.population | psql -q -h lab-sa-pg -U postgres -d gis'
والمخرج سوف يكون كما يلي:
Processing 1/1: /data/riyadh_pop.tif
ERROR:  type "raster" does not exist
LINE 1: ...blic"."population" ("rid" serial PRIMARY KEY,"rast" raster);
وهذا خطأ حقيقي ستراه غالباً في أول مرة، والسبب أن دعم البيانات الشبكية خرج من إضافة PostGIS الأساسية إلى إضافة مستقلة منذ الإصدار 3، والـ Image الرسمية لا تنشئها. والحل:
docker exec lab-sa-pg psql -U postgres -d gis -c "CREATE EXTENSION postgis_raster;"ثم نعيد الأمر نفسه، فيكتمل في 4 ثوان، ونتحقق من مجموع السكان في الملف كاملاً:
SELECT count(*) AS tiles, round(sum((ST_SummaryStats(rast)).sum)) AS people FROM population; tiles | people
-------+---------
56 | 7440427
(1 row)أي 56 مربعاً فيها قرابة 7.44 مليون شخص مقدرين داخل المستطيل. والآن نحتاج أن نجمع السكان داخل مناطق كثيرة ومتداخلة، والدالة ST_Clip على المربعات الشبكية تعمل جيداً لمضلع واحد، ولكنها تصبح بطيئة ومعقدة مع مئات المضلعات المتداخلة. لذلك نحول كل خلية فيها سكان إلى نقطة في مركزها مع عدد سكانها، فيصبح السؤال «كم شخصاً داخل هذه المنطقة» مجرد sum على النقاط التي تقع داخلها، وهي عملية يفهرسها GiST. وهو الملف lab/02-pop-cells.sql:
\timing on
CREATE TABLE pop_cell AS
SELECT row_number() OVER () AS id, (pc).val AS people, (pc).geom AS geom
FROM (SELECT ST_PixelAsCentroids(rast) AS pc FROM population) s
WHERE (pc).val > 0;
CREATE INDEX ON pop_cell USING gist (geom);
ANALYZE pop_cell;
\timing off
SELECT count(*) AS cells, round(sum(people)) AS people, round(max(people)::numeric, 1) AS max_per_cell FROM pop_cell;
SELECT 286755
Time: 39491.184 ms (00:39.491)
CREATE INDEX
Time: 43784.926 ms (00:43.785)
cells | people | max_per_cell
--------+---------+--------------
286755 | 7440427 | 84.8
(1 row)286 ألف خلية فيها سكان، والمجموع نفسه 7,440,427، أي لم نخسر شيئاً في التحويل، وأكثف خلية فيها قرابة 85 شخصاً. وأخذ التحويل 40 ثانية والفهرس مثلها تقريباً على جهاز مشغول بأعمال أخرى، وهي عملية تقوم بها مرة واحدة. والثمن هنا دقة الحدود: الخلية كلها تحسب داخل المنطقة إذا وقع مركزها داخلها، وبما أن الخلية قرابة 90 متراً، فالخطأ صغير في مناطق مساحتها كيلومترات، وكبير في منطقة صغيرة بحجم مبنى، فلا تستخدم هذه الطريقة لسؤال عن شارع واحد.
شبكة الطرق: من OpenStreetMap إلى pgRouting
المسافة بالخط المستقيم تفترض أن الناس يطيرون، والسؤال الحقيقي هو المسافة على الطريق. ولحسابها نحتاج الطرق كرسم بياني Graph: عقد Nodes عند كل تقاطع، وحواف Edges بين العقد لكل منها تكلفة، كما شرحنا في خوارزميات الرسم البياني وDijkstra. وفي جدول roads عندنا كل طريق كخط واحد طويل، ولكن الطريق في OpenStreetMap يمر عبر تقاطعات كثيرة دون أن ينقطع، فلا يصلح كما هو، ويجب تقسيمه عند كل نقطة يشترك فيها مع طريق آخر. وهذا ما تقوم به أداة osm2pgrouting، فهي تقرأ معرفات النقاط في بيانات OpenStreetMap وتقسم الطرق عند النقاط المشتركة فقط، فلا تربط جسراً بالطريق الذي تحته، وتحسب لكل جزء طوله وزمن عبوره بحسب نوع الطريق.
والأداة تقرأ صيغة OSM XML فقط لا PBF، لذلك نأخذ الطرق وحدها من ملف المدينة بالأمر osmium tags-filter ونحفظها كنص XML، ثم نحملها إلى مخطط Schema منفصل باسم net:
docker exec lab-sa-pg psql -U postgres -d gis -c "CREATE SCHEMA net;"
docker run --rm --network lab-sa-net -v lab-sa-data:/data lab-sa-tools bash -c 'cd /data &&
  osmium tags-filter riyadh.osm.pbf w/highway -o roads.osm --overwrite && ls -lh roads.osm &&
  time osm2pgrouting --f roads.osm --conf /usr/share/osm2pgrouting/mapconfig_for_cars.xml \
    --host lab-sa-pg --dbname gis --username postgres --password lab --schema net --clean'
والمخرج سوف يكون كما يلي (اختصرنا شريط التقدم):
-rw-r--r-- 1 root root 77M Nov 16 17:49 roads.osm
Export Ways ...
    Processing 111216 ways:
[**************************************************|] (100%) Total processed: 111216	 Vertices inserted: 7755	Split ways inserted 18077
Creating indexes ...
size of streets: 111216
Elapsed time: 332.179 Seconds.
real	5m32.299s
في المخرج أعلاه لاحظ أن ملف الطرق وحدها بصيغة XML أصبح 77 ميغابايت، بينما المدينة كاملة بصيغة PBF كانت 9.6 ميغابايت، لأن XML نص يكتب كل نقطة بإحداثياتها وأسماء خصائصها. والأداة أخذت خمس دقائق ونصفاً لأنها تحمل البيانات على دفعات وتحدث الجداول بعد كل دفعة، وهي مناسبة لمدينة أو منطقة، أما لدولة كاملة فالأنسب محرك توجيه مخصص مثل OSRM أو Valhalla كما في مقال حساب الطريق. ونتحقق من الشبكة:
SELECT count(*) AS edges, (SELECT count(*) FROM net.ways_vertices_pgr) AS vertices FROM net.ways;
SELECT tag_value, maxspeed FROM net.configuration WHERE tag_value IN ('motorway','primary','tertiary','residential');
edges | vertices
--------+----------
301608 | 203821
(1 row)
tag_value | maxspeed
-------------+----------
motorway | 130
primary | 90
residential | 50
tertiary | 90
(4 rows)أي أن 111 ألف طريق أصبحت 301 ألف حافة بين 203 آلاف عقدة. ولاحظ السرعات التي تفترضها الأداة: 90 كيلومتراً في الساعة على الطرق الثالثة Tertiary و50 في الشوارع السكنية، وهذه حدود قصوى لا سرعات حقيقية داخل مدينة، وسوف نرى أثرها بعد قليل.
ربط كل صيدلية بأقرب عقدة
الصيدلية نقطة خارج الشبكة، والخوارزمية تبدأ من عقدة، لذلك نربط كل صيدلية بأقرب عقدة إليها، ونحفظ مسافة الربط حتى نعرف إن كانت معقولة، وهو الملف lab/03-snap.sql:
ALTER TABLE pharmacy ADD COLUMN IF NOT EXISTS node bigint, ADD COLUMN IF NOT EXISTS snap_m int;
UPDATE pharmacy p
SET node = (SELECT v.id FROM net.ways_vertices_pgr v ORDER BY v.the_geom <-> p.geom LIMIT 1);
UPDATE pharmacy p
SET snap_m = round(ST_Distance(p.geom::geography, v.the_geom::geography))
FROM net.ways_vertices_pgr v WHERE v.id = p.node;

SELECT count(*) AS pharmacies, count(DISTINCT node) AS distinct_nodes,
       round(percentile_cont(0.5) WITHIN GROUP (ORDER BY snap_m)) AS median_snap_m, max(snap_m) AS max_snap_m
FROM pharmacy;
pharmacies | distinct_nodes | median_snap_m | max_snap_m
------------+----------------+---------------+------------
109 | 105 | 27 | 151
(1 row)نصف الصيدليات على بعد 27 متراً أو أقل من عقدة، وأبعدها 151 متراً، وهذا مقبول. ولاحظ أن 109 صيدليات أصبحت 105 عقد، أي أن بعض الصيدليات المتجاورة، كاثنتين في المجمع التجاري نفسه، ربطت بالعقدة ذاتها. ولو وجدت صيدلية على بعد كيلومتر من أقرب عقدة لكان ذلك علامة على طريق ناقص في البيانات أو إحداثيات خاطئة.
السؤال الثاني: منطقة الخدمة على الطريق
منطقة الخدمة Service Area لفرع هي كل مكان يصل منه الناس إلى الفرع بتكلفة أقل من حد معين، كيلومترين أو خمس دقائق مثلاً، وعندما يكون الحد زمناً تسمى في أغلب الأدوات Isochrone. والدالة pgr_drivingDistance تبدأ من عقدة أو عدة عقد، وتمشي في الشبكة بخوارزمية Dijkstra حتى تصل إلى الحد، وتعيد كل عقدة وصلتها مع تكلفة الوصول. والخيار equicost مهم هنا: عندما تبدأ من كل الصيدليات معاً، يسند كل عقدة إلى الصيدلية الأقرب إليها على الطريق فقط، فتحصل على تقسيم للمدينة لا على مناطق متداخلة. وهو الملف lab/04-service-area.sql:
\timing on
CREATE TABLE reach AS
SELECT start_vid AS pharmacy_node, node, agg_cost AS road_m
FROM pgr_drivingDistance(
  'SELECT gid AS id, source, target, length_m AS cost FROM net.ways',
  (SELECT array_agg(DISTINCT node) FROM pharmacy),
  2000, directed => false, equicost => true);
\timing off
والمخرج سوف يكون كما يلي:
ERROR:  Unexpected Null value in column cost
HINT:  SELECT gid AS id, source, target, length_m AS cost FROM net.ways
CONTEXT:  SQL function "pgr_drivingdistance" statement 1
Time: 10302.319 ms (00:10.302)
وهذه مشكلة حقيقية ظهرت في المختبر: حافة واحدة من 301 ألف حافة ليس لها طول بالمتر length_m، رغم أن شكلها موجود، وهي جزء من طريق ثانوي معرفه في OpenStreetMap هو 1102350255. وpgRouting ترفض الشبكة كلها إذا وجدت تكلفة فارغة واحدة، وهذا تصرف صحيح، فهي لا تعرف هل الفراغ يعني «طريق مغلق» أم «صفر». والحل أن تحسب الطول من الشكل عندما يكون فارغاً:
SELECT count(*) FILTER (WHERE length_m IS NULL) AS null_length FROM net.ways;
-- and in the edges query:
'SELECT gid AS id, source, target, coalesce(length_m, ST_Length(the_geom::geography)) AS cost FROM net.ways'
ثم نعيد الملف بعد التعديل ونعد العقد التي وصلناها:
SELECT count(*) AS nodes_reached,
       (SELECT count(*) FROM net.ways_vertices_pgr) AS all_nodes,
       round(100.0 * count(*) / (SELECT count(*) FROM net.ways_vertices_pgr), 1) AS pct
FROM reach;
SELECT 63006
Time: 126852.759 ms (02:06.853)
nodes_reached | all_nodes | pct
---------------+-----------+------
63006 | 203821 | 30.9
(1 row)في المخرج أعلاه لاحظ التالي:
- 31% فقط من عقد الشبكة على بعد كيلومترين أو أقل على الطريق من صيدلية مسجلة.
- الحساب أخذ دقيقتين، وأغلب الوقت ليس في Dijkstra نفسها، وإنما في قراءة 301 ألف حافة من الجدول وبناء الرسم البياني في الذاكرة في كل استدعاء. لذلك إذا كنت ستستدعيها كثيراً، فقلل الحواف التي تقرأها بشرط مكاني حول نقاط البداية، مثل
WHERE the_geom && ST_Expand(...)، بدل الشبكة كلها. - استخدمنا
directed => falseوالطول بالمتر، أي أننا نقيس المسافة كمن يمشي أو يقود دون اعتبار الاتجاه الواحد، وهذا مناسب لسؤال «كم يبعد»، أما للقيادة الفعلية فاستخدم الأعمدةcost_sوreverse_cost_sمعdirected => true.
التغطية بالسكان: الخط المستقيم مقابل الطريق
الآن نجيب عن السؤال بعدد الأشخاص لا بعدد العقد، وذلك بربط كل خلية سكان بأقرب عقدة إليها، ثم نعتبر الخلية مغطاة إذا كانت عقدتها ضمن منطقة الخدمة وكانت الخلية نفسها على بعد 250 متراً أو أقل من الطريق. ونقارن ذلك بالتغطية بالخط المستقيم، أي كل خلية على بعد كيلومترين من صيدلية بغض النظر عن الطرق. وهو الملف lab/05-coverage.sql:
\timing on
CREATE TABLE cell_node AS
SELECT c.id, c.people, n.id AS node, ST_Distance(c.geom::geography, n.the_geom::geography) AS to_road_m
FROM pop_cell c
CROSS JOIN LATERAL (SELECT id, the_geom FROM net.ways_vertices_pgr v ORDER BY v.the_geom <-> c.geom LIMIT 1) n;
\timing off

WITH straight AS (
  SELECT sum(c.people) AS people FROM pop_cell c
  WHERE EXISTS (SELECT 1 FROM pharmacy p WHERE ST_DWithin(c.geom::geography, p.geom::geography, 2000))
), road AS (
  SELECT sum(cn.people) AS people FROM cell_node cn JOIN reach r USING (node)
  WHERE cn.to_road_m <= 250
)
SELECT round((SELECT sum(people) FROM pop_cell)) AS all_people,
       round(straight.people) AS straight_2km, round((100 * straight.people / (SELECT sum(people) FROM pop_cell))::numeric, 1) AS straight_pct,
       round(road.people) AS road_2km, round((100 * road.people / (SELECT sum(people) FROM pop_cell))::numeric, 1) AS road_pct
FROM straight, road;
SELECT 286755
Time: 130970.859 ms (02:10.971)
all_people | straight_2km | straight_pct | road_2km | road_pct
------------+--------------+--------------+----------+----------
7440427 | 3529306 | 47.4 | 2376226 | 31.9
(1 row)
Time: 5872.275 ms (00:05.872)وهذا هو الرقم الأهم في المقال، والصورة التالية تبينه:
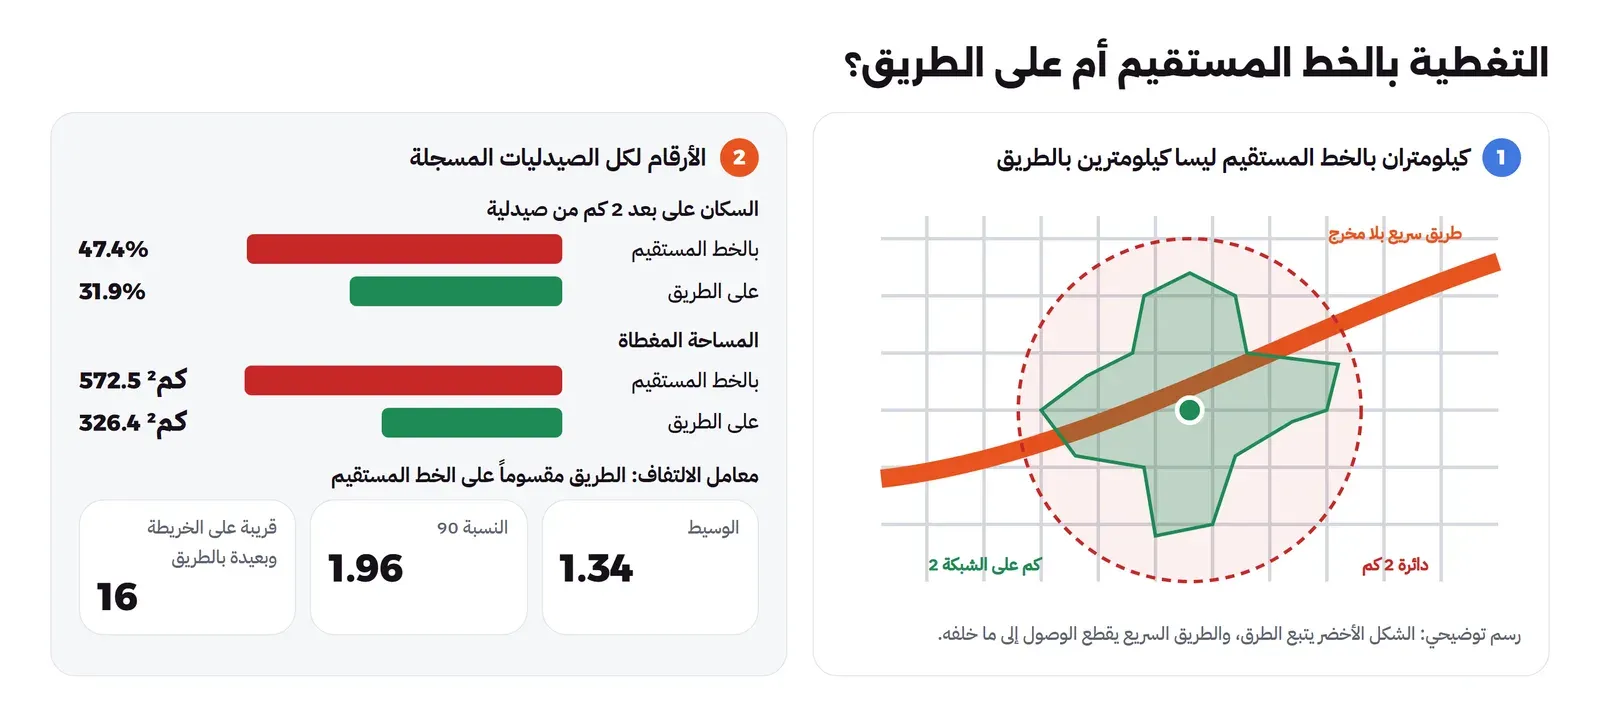
- بالخط المستقيم يبدو أن 47.4% من السكان على بعد كيلومترين من صيدلية، أما على الطريق فالنسبة 31.9%، أي أن الدائرة تعد 1.15 مليون شخص زيادة، وهؤلاء يرون الصيدلية على الخريطة ولكن الطريق إليها أطول من كيلومترين.
- بالمساحة، اتحاد الدوائر 572.5 كيلومتراً مربعاً، واتحاد مناطق الخدمة على الطريق 326.4 كيلومتراً مربعاً، وقد رسمنا كل منطقة خدمة بالدالة
ST_ConcaveHullحول العقد التي وصلتها، وهي في الملفlab/08-service-polygons.sql. - ربط الخلايا بأقرب عقدة أخذ دقيقتين، وهو 286 ألف بحث KNN على 203 آلاف عقدة، وتقوم به مرة واحدة ثم تعيد استخدامه لكل سؤال تغطية بعد ذلك، بأي حد وبأي مجموعة فروع.
- وسيط بعد الخلية عن أقرب عقدة 74 متراً، ولكن 60,934 خلية أبعد من 250 متراً عن أي طريق، وفيها 215,582 شخصاً فقط، أي 3% من السكان، وأغلبها في الأطراف حيث الطرق غير مرسومة بعد، لذلك استبعدناها من التغطية بالطريق.
من عقد متفرقة إلى مضلع: اختيار الشكل
نتيجة pgr_drivingDistance قائمة عقد لا مضلع، والخريطة تحتاج مضلعاً، وهناك ثلاث طرق شائعة لرسمه ولكل منها أثر على المساحة التي تعلنها. الأولى الغلاف المحدب Convex Hull، وهو أصغر مضلع محدب يحتوي كل العقد، وهو سريع ولكنه يملأ الفراغات بين الطرق، فيضم أرضاً فضاء أو حياً خلف طريق سريع لم تصله الشبكة. والثانية الغلاف المقعر Concave Hull بالدالة ST_ConcaveHull، وهي التي استخدمناها بالمعامل 0.3، وكلما صغر المعامل اقترب الشكل من العقد وصغرت المساحة، وكلما كبر اقترب من الغلاف المحدب. والثالثة أن توسع الحواف التي وصلتها الخوارزمية بمسافة ثابتة، 100 متر مثلاً، ثم تجمعها، فيصبح الشكل شريطاً حول الطرق الفعلية، وهو أدق الطرق لمن يمشي، وأثقلها حساباً. والقاعدة أن تختار الطريقة وتكتبها مع الرقم، لأن مساحة منطقة الخدمة نفسها قد تتغير بعشرات في المئة بين الطرق الثلاث، أما عدد السكان المغطين الذي حسبناه فلا يعتمد على المضلع أصلاً، لأنه محسوب من العقد مباشرة، ولهذا السبب اعتمدنا عليه.
كم يلتف الطريق؟
معامل الالتفاف Detour Factor هو المسافة على الطريق مقسومة على المسافة بالخط المستقيم، وهو رقم يختلف من مدينة إلى أخرى بحسب شكل الشبكة والطرق السريعة والأحياء المغلقة. ونقيسه هنا لكل مدرسة وأقرب صيدلية لها بالدالة pgr_dijkstraCost التي تحسب تكلفة أقصر طريق بين أزواج من العقد في استدعاء واحد، وهو الملف lab/07-detour.sql:
ALTER TABLE school_nearest_geog ADD COLUMN IF NOT EXISTS school_node bigint;
UPDATE school_nearest_geog sn
SET school_node = (SELECT v.id FROM net.ways_vertices_pgr v, school s
                   WHERE s.id = sn.id ORDER BY v.the_geom <-> s.geom LIMIT 1);
\timing on
CREATE TABLE detour AS
SELECT sn.id, sn.meters AS straight_m, d.agg_cost AS road_m
FROM school_nearest_geog sn
JOIN pharmacy p ON p.id = sn.pharmacy_id
JOIN pgr_dijkstraCost(
  'SELECT gid AS id, source, target, coalesce(length_m, ST_Length(the_geom::geography)) AS cost FROM net.ways',
  'SELECT DISTINCT sn.school_node AS source, p.node AS target
     FROM school_nearest_geog sn JOIN pharmacy p ON p.id = sn.pharmacy_id',
  directed => false) d ON d.start_vid = sn.school_node AND d.end_vid = p.node;
\timing off
SELECT count(*) AS pairs,
       round(percentile_cont(0.5) WITHIN GROUP (ORDER BY road_m / straight_m)::numeric, 2) AS median_ratio,
       round(percentile_cont(0.9) WITHIN GROUP (ORDER BY road_m / straight_m)::numeric, 2) AS p90_ratio,
       count(*) FILTER (WHERE straight_m <= 1000 AND road_m > 1500) AS close_but_far
FROM detour WHERE straight_m > 200;
SELECT 457
Time: 4921.742 ms (00:04.922)
pairs | median_ratio | p90_ratio | close_but_far
-------+--------------+-----------+---------------
450 | 1.34 | 1.96 | 16
(1 row)في المخرج أعلاه لاحظ التالي:
- الطريق في الوسيط أطول من الخط المستقيم بنسبة 34%، وفي 10% من الحالات يقارب ضعفه، وهذا يوافق ما رأيناه في التغطية: نصف قطر 2 كيلومتر على الطريق يقابل قرابة 1.5 كيلومتر بالخط المستقيم.
- 16 مدرسة تبدو قريبة من صيدلية، أقل من كيلومتر على الخريطة، ولكن الطريق إليها أطول من كيلومتر ونصف، وهذه هي الحالات التي يخطئ فيها التطبيق الذي يعرض «الأقرب» بالخط المستقيم.
- استبعدنا الأزواج الأقرب من 200 متر، لأن خطأ ربط النقطتين بالعقد يصبح فيها أكبر من المسافة نفسها، فتظهر نسب لا معنى لها.
- 457 زوجاً حسبت في 5 ثوان، لأن الدالة تبني الرسم البياني مرة واحدة لكل الأزواج، فلا تستدعها في حلقة في كود التطبيق زوجاً زوجاً.
ماذا يحدث إذا قسنا بالزمن؟
السؤال الذي يطرحه الناس غالباً بالزمن لا بالمسافة: «خمس دقائق بالسيارة». والأعمدة cost_s وreverse_cost_s في جدول osm2pgrouting فيها زمن عبور كل حافة بالثواني بحسب سرعة نوع الطريق، ولكل اتجاه، حيث القيمة السالبة تعني أن الاتجاه ممنوع. والملف lab/09-five-minutes.sql يحسب ما يصل إليه سائق في خمس دقائق من صيدلية واحدة:
WITH start AS (SELECT node FROM pharmacy WHERE name = 'صيدلية الدواء' LIMIT 1),
dd AS (
  SELECT d.node, d.agg_cost FROM pgr_drivingDistance(
    'SELECT gid AS id, source, target, cost_s AS cost, reverse_cost_s AS reverse_cost FROM net.ways WHERE cost_s IS NOT NULL',
    (SELECT node FROM start), 300, directed => true) d
)
SELECT count(*) AS nodes,
       round((ST_Area(ST_ConcaveHull(ST_Collect(v.the_geom), 0.3)::geography) / 1e6)::numeric, 1) AS km2,
       round(max(ST_Distance(v.the_geom::geography, (SELECT the_geom FROM net.ways_vertices_pgr WHERE id = (SELECT node FROM start))::geography))) AS farthest_m
FROM dd JOIN net.ways_vertices_pgr v ON v.id = dd.node;
nodes | km2 | farthest_m
-------+------+------------
15458 | 98.4 | 8707
(1 row)
Time: 10639.916 ms (00:10.640)خمس دقائق أعطت منطقة مساحتها 98 كيلومتراً مربعاً، وأبعد نقطة فيها على بعد 8.7 كيلومتر بالخط المستقيم، أي أن السائق يجب أن يقطع أكثر من 104 كيلومترات في الساعة كخط مستقيم داخل المدينة، وهذا غير ممكن مع الإشارات والتقاطعات والزحام. والسبب أن الأداة افترضت أن كل طريق يقطع بسرعته القصوى، وهذا هو الفرق بين بيانات تعمل وبيانات صحيحة: الاستعلام لم يخطئ، والرقم مقنع، ولكنه لا يمثل الواقع. وأمامك ثلاثة حلول: أن تعدل جدول net.configuration بسرعات أقرب للواقع قبل التحميل، أو أن تضرب الزمن في معامل تقيسه من رحلات حقيقية، أو أن تستخدم محرك توجيه بملف سرعات مدروس مثل OSRM وValhalla، وقد شرحنا مناطق الزمن Isochrones في Valhalla في مقال حساب الطريق، وكيف تعرف الخرائط سرعة الطريق الحقيقية في مقال الزحام وسرعة الطريق. ولهذا السبب اخترنا في هذا المقال المسافة على الطريق كمقياس رئيسي، فهي لا تعتمد على افتراض للسرعة.
السؤال الثالث: منطقة كل صيدلية بمخطط فورونوي
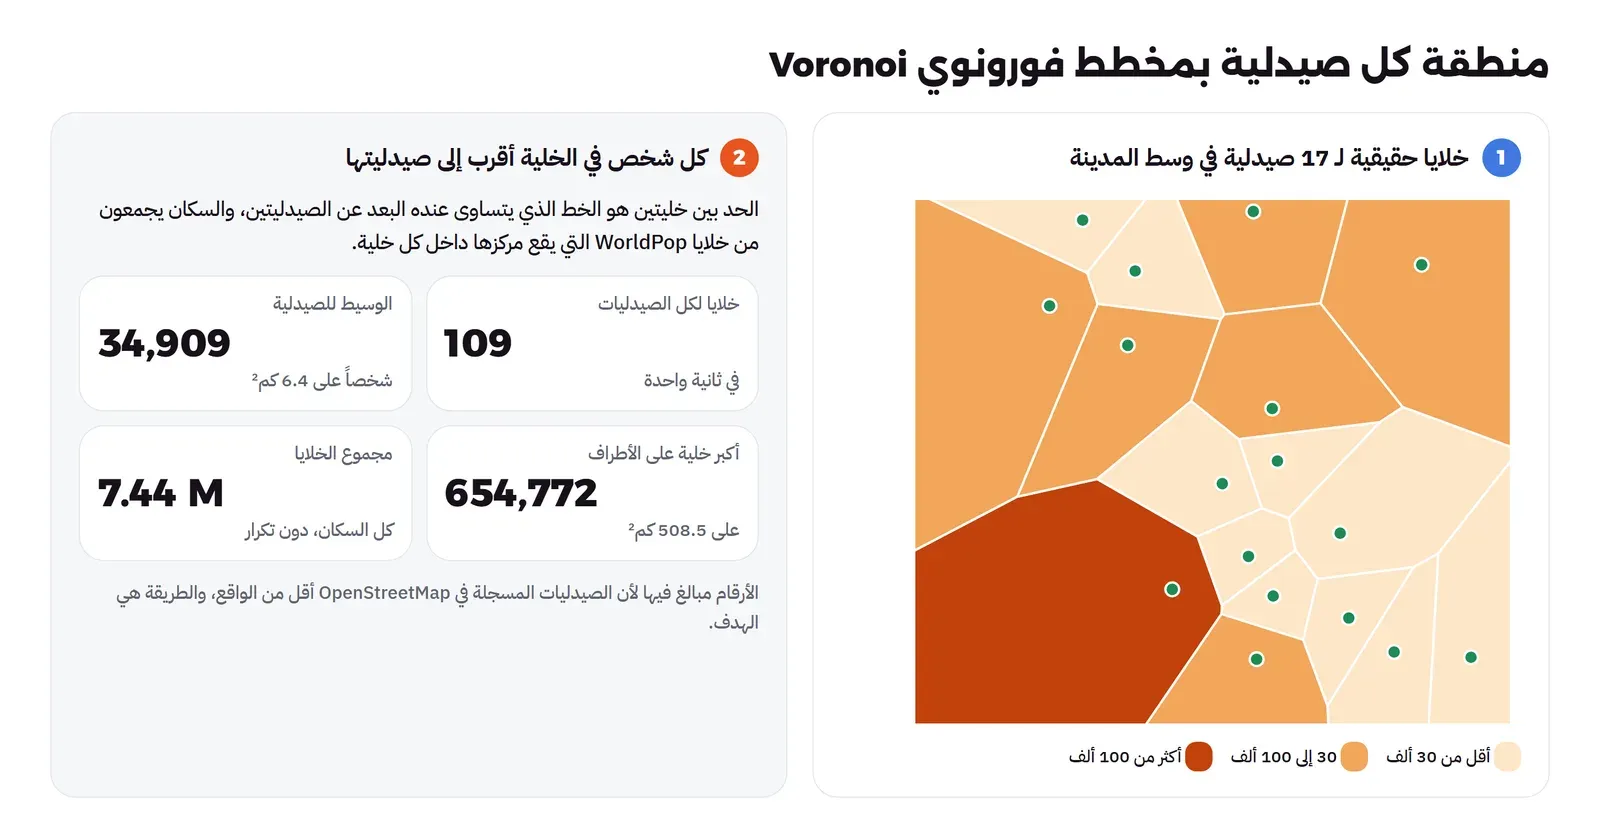
مخطط فورونوي Voronoi Diagram يقسم المساحة إلى خلية لكل نقطة، بحيث تكون كل نقطة في الخلية أقرب إلى نقطتها من أي نقطة أخرى، والحد بين خليتين هو الخط الذي يتساوى عنده البعد عن النقطتين. وهو أبسط نموذج لمنطقة الفرع Catchment Area: إذا ذهب كل شخص إلى أقرب فرع بالخط المستقيم، فمن يذهب إلى أي فرع؟ والصورة التالية تبين الفكرة وأرقامها:
والدالة ST_VoronoiPolygons في PostGIS تبني المخطط من مجموعة نقاط، ونعطيها مستطيل المدينة حتى تقص الخلايا الخارجية عنده بدل أن تمتد إلى ما لا نهاية، ثم نربط كل خلية بصيدليتها، ونجمع السكان داخلها، وهو الملف lab/06-voronoi.sql:
\timing on
CREATE TABLE catchment AS
SELECT p.id AS pharmacy_id, p.name, v.geom
FROM (
  SELECT (ST_Dump(ST_VoronoiPolygons(ST_Collect(geom), 0,
          ST_MakeEnvelope(46.45, 24.45, 47.05, 25.00, 4326)))).geom AS geom
  FROM (SELECT DISTINCT ON (geom) geom FROM pharmacy) d
) v
JOIN pharmacy p ON ST_Contains(v.geom, p.geom);
UPDATE catchment SET geom = ST_Intersection(geom, ST_MakeEnvelope(46.45, 24.45, 47.05, 25.00, 4326));
ALTER TABLE catchment ADD COLUMN people numeric;
UPDATE catchment k SET people = (SELECT round(sum(c.people)) FROM pop_cell c WHERE ST_Within(c.geom, k.geom));
\timing off

SELECT count(*) AS cells,
       round(percentile_cont(0.5) WITHIN GROUP (ORDER BY people)) AS median_people,
       min(people) AS min_people, max(people) AS max_people,
       round((percentile_cont(0.5) WITHIN GROUP (ORDER BY ST_Area(geom::geography)) / 1e6)::numeric, 1) AS median_km2
FROM catchment;

SELECT name, people, round((ST_Area(geom::geography) / 1e6)::numeric, 1) AS km2
FROM catchment ORDER BY people DESC LIMIT 5;
SELECT 109
Time: 1029.095 ms (00:01.029)
UPDATE 109
Time: 973.855 ms
cells | median_people | min_people | max_people | median_km2
-------+---------------+------------+------------+------------
109 | 34909 | 36 | 654772 | 6.4
(1 row)
name | people | km2
-----------------------------+--------+-------
| 654772 | 508.5
صيدلية أركان الرياض الرابعة | 473996 | 223.2
صيدلية الدواء | 360387 | 89.2
| 236393 | 47.4
صيدلية كاريزما | 235626 | 111.0
(5 rows)في المخرج أعلاه لاحظ التالي:
- الصيدلية الوسيطة يقع في منطقتها قرابة 35 ألف شخص على 6.4 كيلومتر مربع، وهذا رقم مبالغ فيه لأن الصيدليات المسجلة ناقصة، ولو كانت البيانات كاملة لصغرت الخلايا كثيراً.
- أكبر الخلايا على أطراف المدينة، مثل الأولى بمساحة 508 كيلومترات مربعة وأكثر من 650 ألف شخص، والسبب أنها آخر صيدلية مسجلة في اتجاهها، فكل من خلفها حتى حد المستطيل يحسب لها. وهذه الخلايا هي المرشح الأول لفرع جديد، أو للتحقق من أن الصيدليات هناك غير مسجلة فقط.
- الصف الأول والرابع بلا اسم، لأن 29 صيدلية من 109 مسجلة دون اسم في OpenStreetMap، وهذه مشكلة جودة بيانات أخرى يجب أن تعرفها قبل أن تعرض النتائج لأحد.
- تحققنا أن مجموع الخلايا 7,440,426، أي السكان كلهم بفرق شخص واحد من التقريب، فلم يسقط أحد بين خليتين ولم يحسب أحد مرتين.
وقد يتساءل البعض: لماذا الخط المستقيم هنا بعد أن رأينا أنه يخطئ؟ والإجابة أن فورونوي سريعة ومفهومة وتصلح لنظرة أولى على المدينة كلها في ثانية، أما القرار النهائي فيعتمد على النسخة على الطريق، وهي موجودة عندنا أصلاً: الجدول reach الذي بنيناه بالخيار equicost يسند كل عقدة إلى أقرب صيدلية على الطريق، أي أنه مخطط فورونوي على الشبكة Network Voronoi، ولكنه محدود بكيلومترين. وإذا أزلت الحد، أو جعلته كبيراً، حصلت على تقسيم المدينة كلها بالطريق.
كيف تقرأ الخريطة الأولى؟
بعد أن عرفنا كل طبقة، نعود إلى الخريطة في أول المقال ونقرأها بالترتيب. الألوان الخلفية هي خلايا فورونوي ملونة بعدد السكان الأقرب إلى كل صيدلية، والفاتح منها في الوسط والغرب حيث الصيدليات المسجلة متقاربة، والبني في الأطراف حيث آخر صيدلية مسجلة مسؤولة عن مساحات واسعة. والمناطق الخضراء فوقها هي مناطق الخدمة على الطريق بكيلومترين، ولاحظ أنها ليست دوائر، وإنما أشكال تتمدد على طول الطرق الرئيسية وتنكمش عند الطرق السريعة والأراضي الفضاء. وما يهم القرار هو المكان الذي يجتمع فيه لونان: خلية بنية أو برتقالية، أي سكان كثيرون، دون غطاء أخضر، أي لا توجد صيدلية مسجلة على كيلومترين منهم على الطريق. وفي الخريطة ستجد هذه المناطق في الشرق والجنوب والشمال الغربي، وهي التي يبدأ منها التحقق على الأرض.
وتذكر أن الخريطة تعرض ما تعرفه البيانات، فالمنطقة الفارغة من الأخضر قد تكون فيها صيدليات حقيقية غير مسجلة، ولذلك فإن أول خطوة بعد هذا التحليل في مشروع حقيقي هي استبدال جدول الصيدليات بقائمة دقيقة من مصدر رسمي أو من نظامك، ثم إعادة الملفات نفسها دون أي تغيير في الكود، وهذه فائدة أن يكون التحليل ملفات SQL قابلة للإعادة لا عملاً يدوياً على الخريطة. وإذا كنت تبحث عن مصادر رسمية مفتوحة للبيانات الجغرافية والسكانية في المملكة ورخصها، فهي موضوع مقال مستقل في هذه المرحلة.
الناس لا يذهبون دائماً إلى الأقرب
فورونوي، على الخط المستقيم أو على الطريق، تفترض أن كل شخص يذهب إلى أقرب فرع، والواقع غير ذلك: الناس يشترون في طريق العودة من العمل، ويفضلون الصيدلية الأكبر أو التي فيها مواقف، ويذهبون إلى فرع أبعد قليلاً داخل مجمع تجاري. ولهذا السبب تستخدم دراسات التجزئة نماذج جذب Gravity Models، أشهرها نموذج Huff، حيث تكون احتمالية ذهاب شخص إلى فرع متناسبة مع جاذبية الفرع، كمساحته أو تنوعه، ومتناسبة عكسياً مع المسافة مرفوعة لأس يقاس من بيانات حقيقية. والنتيجة مناطق متداخلة ذات احتمالات بدل حدود حادة. وهذه النماذج تكتب بسهولة في SQL فوق جدول cell_node وجدول المسافات على الطريق، ولكن معاملاتها تحتاج بيانات زيارات حقيقية لا تتوفر في البيانات المفتوحة، لذلك نكتفي هنا بالإشارة إليها. فإذا كان عندك سجل طلبات بعناوين العملاء، فهذا أفضل مصدر لمعايرة النموذج، وهو أدق من أي افتراض.
وهناك مشكلة أخرى معروفة في التحليل المكاني اسمها مشكلة وحدة المساحة القابلة للتعديل Modifiable Areal Unit Problem، وملخصها أن النتيجة تتغير بتغير الحدود التي تجمع بها البيانات. فإذا جمعت السكان غير المغطين بالأحياء الإدارية فقد يظهر حي كبير في الأطراف كأسوأ حي، وإذا جمعتهم بمربعات من كيلومتر فقد يظهر مربع في وسط المدينة، والبيانات هي نفسها. لذلك لا تعرض ترتيباً واحداً، وإنما جرب أكثر من حجم للتجميع، وانظر ما الذي يبقى في القمة في كل مرة، فهذا هو المرشح القوي.
من الأرقام إلى قرار: أين الفرع التالي؟
الآن عندنا ثلاثة جداول تجيب عن ثلاثة أسئلة، والخطوة الأخيرة أن نحولها إلى قائمة مرشحين يمكن مناقشتها. والفكرة البسيطة أن الموقع الجيد لفرع جديد هو المكان الذي فيه سكان كثيرون غير مغطين على الطريق، وبعيد عن الفروع الحالية. وهذا سؤال يمكن كتابته بسطر SQL على الجداول التي بنيناها: اجمع السكان غير المغطين في مربعات بحجم كيلومتر، ورتبها من الأكثر سكاناً، واستبعد المربعات التي فيها صيدلية أصلاً. وهذا تدريب في آخر المقال، والمهم هنا أن تعرف ما الذي لا تخبرك به الأرقام: إيجار الموقع، ومواقف السيارات، ومنافسون غير مسجلين، وأنظمة البلدية، وطرق الوصول من الاتجاه الصحيح للشارع. لذلك فإن التحليل المكاني يختصر القائمة من ألف موقع إلى عشرة تستحق الزيارة، ولا يغني عن الزيارة نفسها.
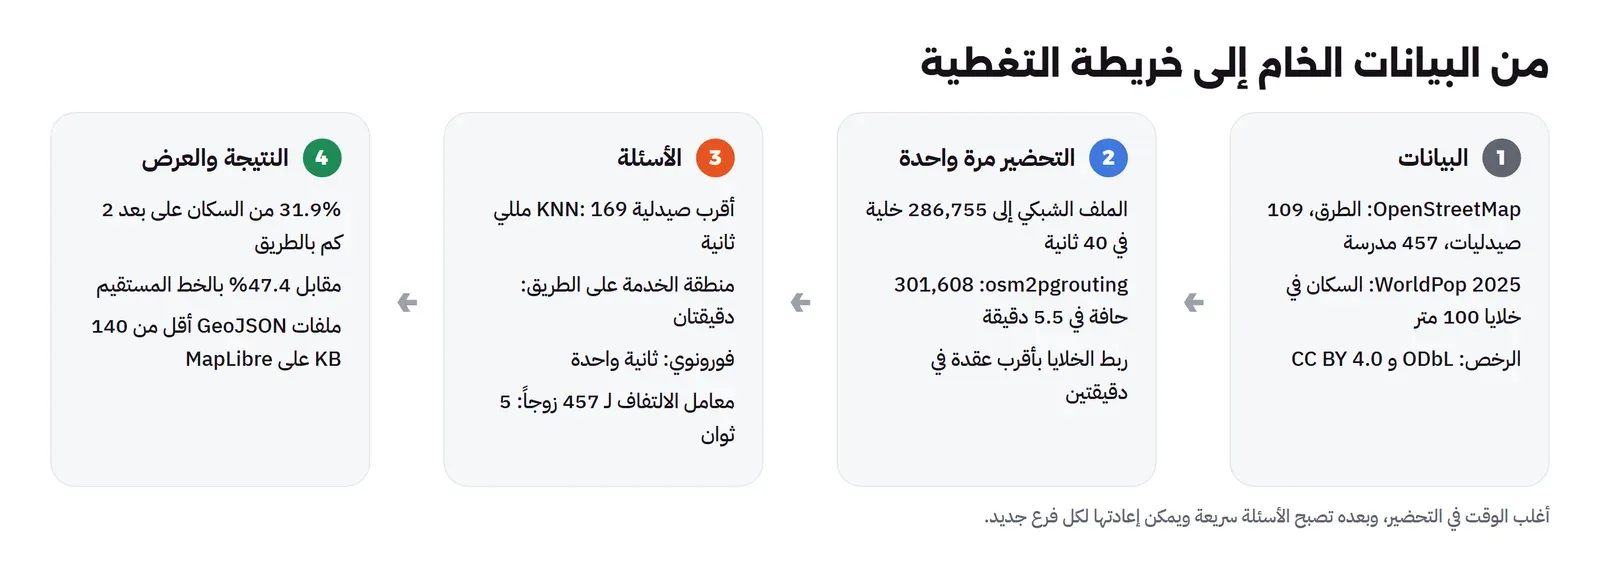
والصورة التالية تلخص المسار الذي مشينا فيه من البيانات الخام إلى الخريطة الأولى في المقال:
ولعرض النتائج على الخريطة نخرج الجداول إلى ملفات GeoJSON صغيرة بالأداة ogr2ogr، مع تبسيط حدود الخلايا بالدالة ST_SimplifyPreserveTopology حتى لا يحمل المتصفح تفاصيل لا تظهر:
docker run --rm --network lab-sa-net -e PGPASSWORD=lab -v "$PWD/web/data:/out" lab-sa-tools bash -c '
PG="PG:host=lab-sa-pg user=postgres dbname=gis"
ogr2ogr -f GeoJSON /out/catchment.geojson "$PG" -sql "SELECT name, people::int AS people, ST_SimplifyPreserveTopology(geom, 0.0002) AS geom FROM catchment" -lco COORDINATE_PRECISION=5
ogr2ogr -f GeoJSON /out/service.geojson "$PG" -sql "SELECT ST_Union(geom) AS geom FROM service_area" -lco COORDINATE_PRECISION=5
ogr2ogr -f GeoJSON /out/pharmacy.geojson "$PG" -sql "SELECT name, geom FROM pharmacy" -lco COORDINATE_PRECISION=5
ls -l /out'
-rw-r--r-- 1 root root 33044 Nov 16 18:14 catchment.geojson
-rw-r--r-- 1 root root 15694 Nov 16 18:14 pharmacy.geojson
-rw-r--r-- 1 root root 87924 Nov 16 18:14 service.geojsonأي أن نتيجة التحليل كلها أقل من 140 كيلوبايت، وهي تكفي صفحة lab/analysis.html التي رسمت الخريطة الأولى بمكتبة MapLibre GL JS فوق طبقة الطرق، وطريقة تقديم الطرق كمربعات متجهة من PostGIS بخادم Martin وتنسيقها مشروحة في مقال نشر الخرائط من هذه المرحلة.
ماذا تحفظ وماذا تعيد حسابه؟
إذا تحول هذا التحليل من تجربة لمرة واحدة إلى صفحة يفتحها فريق التخطيط كل أسبوع، فإن ترتيب العمل يصبح مهماً، لأن بعض الخطوات تأخذ دقائق وبعضها مللي ثوان. والمبدأ أن تفصل ما يتغير نادراً عما يتغير كثيراً:
- يتغير نادراً: شبكة الطرق وخلايا السكان وربط كل خلية بأقرب عقدة
cell_node. هذه تبنى مرة عند كل تحديث للبيانات، شهرياً أو ربع سنوياً، وتأخذ دقائق، ولا داعي لإعادتها مع كل سؤال. - يتغير أحياناً: قائمة الفروع وجدول
reachلمناطق الخدمة. عند إضافة فرع واحد لا تحتاج أن تعيد كل الفروع، وإنما تحسب منطقة الفرع الجديد وحده ثم تعدل العقد التي أصبح أقرب إليها، لأن الفرع الجديد لا يغير شيئاً خارج منطقته. - يحسب عند الطلب: المجاميع النهائية مثل نسبة التغطية والسكان لكل فرع، وهي استعلامات من ثوان على الجداول السابقة، ويمكن أن تحفظها في Materialized View تحدثها بعد كل تغيير في الفروع.
وبهذا الشكل يصبح سؤال «ماذا لو فتحنا فرعاً هنا؟» تجربة من ثوان يقوم بها المستخدم من الخريطة، بدل مهمة من نصف ساعة يطلبها من فريق البيانات. ولاحظ أن كل ذلك يعمل داخل قاعدة PostgreSQL واحدة، دون خدمة إضافية، وهذا ما يجعل PostGIS مع pgRouting خياراً عملياً للتحليل الدوري على مستوى مدينة.
المقاييس والطرق: جدول للمقارنة
| الطريقة | ماذا تقيس | الزمن في المختبر | نقاط القوة | نقاط الضعف |
|---|---|---|---|---|
KNN بالخط المستقيم <-> | الأقرب لكل نقطة | 169 مللي ثانية لـ 457 مدرسة | سريعة جداً وبسيطة | تتجاهل الطرق، وعلى 4326 تخطئ في 5% من الحالات |
دائرة بالخط المستقيم ST_DWithin | التغطية | جزء من استعلام 6 ثوان | لا تحتاج شبكة | بالغت بالتغطية من 31.9% إلى 47.4% |
منطقة خدمة بالطريق pgr_drivingDistance | التغطية ومن يخدم من | دقيقتان لكل الصيدليات | تتبع الطرق الفعلية وتقسم المدينة بالطريق | تحتاج شبكة نظيفة، والزمن يعتمد على افتراض السرعة |
أقصر طريق للأزواج pgr_dijkstraCost | معامل الالتفاف | 5 ثوان لـ 457 زوجاً | أرقام دقيقة لكل زوج | يكبر مع عدد الأزواج |
فورونوي ST_VoronoiPolygons | منطقة كل فرع | ثانية واحدة | نظرة سريعة على المدينة كلها | خط مستقيم، وخلايا الأطراف تمتد حتى حد المستطيل |
أخطاء شائعة وحلولها
- الترتيب بالدرجات:
<->على عمود 4326 غير الإجابة في 21 من 457 حالة، فاستخدم geography أو إسقاطاً محلياً عندما يكون الترتيب هو القرار. - الخطأ
type "raster" does not exist: أنشئ الإضافةpostgis_rasterقبل تحميل أي ملف شبكي. - الخطأ
Unexpected Null value in column cost: حافة واحدة بلا تكلفة توقف pgRouting، فاحسب الطول من الشكل بالدالةcoalesceأو استبعد الحافة بشرط. - الدالة
pgr_createTopologyغير موجودة: حذفت في pgRouting 4، فابن الشبكة بأداة osm2pgrouting، أو بالدوال الجديدة مثلpgr_extractVerticesإذا كانت طرقك من مصدر آخر. - مناطق زمن كبيرة جداً: السرعات الافتراضية حدود قصوى، فخمس دقائق أصبحت 8.7 كيلومتر، فعدل السرعات أو استخدم محرك توجيه بملف سرعات واقعي.
- المتوسط بدل الوسيط: المسافات في الأطراف تسحب المتوسط بعيداً، فاعرض الوسيط والنسبة المئوية 90.
- الثقة في اكتمال البيانات: 109 صيدليات و29 منها بلا اسم، فقارن بمصدر آخر، وضع بيانات فروعك الحقيقية مكان بيانات OpenStreetMap.
- نسيان النسبة: النتائج مبنية على OpenStreetMap برخصة ODbL وعلى WorldPop برخصة CC BY 4.0، فاذكر المصدرين على كل خريطة أو تقرير تنشره.
قائمة تحقق قبل أن تعرض التحليل على أحد
- هل كتبت السؤال بشكل يمكن قياسه، بالمسافة أو الزمن والحد، قبل أن تبدأ؟
- هل تعرف تغطية كل مصدر بيانات وتاريخه ورخصته، وكتبتها في التقرير؟
- هل المسافات بالمتر الحقيقي، وهل الترتيب بالمسافة الحقيقية لا بالدرجات؟
- هل قارنت الخط المستقيم بالطريق على عينة على الأقل، وعرفت معامل الالتفاف في مدينتك؟
- إذا قست بالزمن، هل السرعات واقعية، وهل جربتها على رحلات تعرف زمنها؟
- هل يساوي مجموع السكان في المناطق مجموع الملف، فلا أحد سقط ولا أحد حسب مرتين؟
- هل استخدمت الوسيط والنسب المئوية بدل المتوسط؟
- هل وضعت نسبة OpenStreetMap وWorldPop على الخريطة؟
تنظيف المختبر
docker rm -f lab-sa-pg
docker volume rm lab-sa-data
docker network rm lab-sa-net
docker image rm lab-sa-pg lab-sa-tools postgis/postgis:18-3.7
تدريب عملي
- اكتب الاستعلام الذي يقسم السكان غير المغطين على الطريق إلى مربعات بحجم كيلومتر بالدالة
ST_SquareGrid، ويرتبها من الأكثر سكاناً، ويستبعد المربعات التي فيها صيدلية، ثم أضف صيدلية افتراضية في المربع الأول وأعد حساب التغطية وقارن. - أعد سؤال الخمس دقائق بعد أن تضرب السرعات في 0.5، وقارن المساحة والمسافة بما رأيناه، ثم قارن بخريطة زمن Valhalla من مقال حساب الطريق للنقطة نفسها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- ابدأ بالسؤال لا بالخريطة، واكتبه بشكل يمكن قياسه: القرب، والتغطية، ومنطقة كل فرع.
- البحث KNN بالمعامل
<->أعطى أقرب صيدلية لـ 457 مدرسة في 169 مللي ثانية، ولكن على 4326 أخطأ في 21 مدرسة، وعلى geography كان صحيحاً وبالسرعة نفسها. - ملف السكان الشبكي أصبح 286 ألف خلية يمكن جمعها داخل أي منطقة بفهرس GiST، دون أن نخسر أحداً من 7.44 مليون.
- بالخط المستقيم يغطي كيلومتران 47.4% من السكان، وعلى الطريق 31.9%، والطريق أطول بنسبة 1.34 في الوسيط، فلا تعرض الدوائر على أنها تغطية.
- السرعات الافتراضية تجعل خمس دقائق تقطع 8.7 كيلومتر، فالأرقام المقنعة ليست دائماً صحيحة.
- فورونوي يعطي منطقة كل فرع في ثانية، والنسخة على الطريق موجودة في نتيجة
equicost. - التحليل يختصر قائمة المواقع من مئات إلى عشرة، ولا يغني عن معرفة السوق وزيارة الموقع بنفسك.
- احفظ ما يتغير نادراً، مثل الشبكة وربط الخلايا بالطرق، وأعد حساب المجاميع فقط، فيصبح سؤال «ماذا لو» تجربة من ثوان.
 دليلالبيانات الجغرافية GIS في PostgreSQL مع PostGISكيف تخزن الأحياء والطرق والفروع في PostgreSQL وتسألها بالمتر الصحيح وبفهرس يعمل فعلاً، بمختبر على بيانات OpenStreetMap لمدينة كاملة.
 دليلنشر الخرائط مع GeoServer والمربعات المتجهة Vector Tilesكيف تنشر طبقات PostGIS كخرائط بمعايير WMS وWFS مع GeoServer، وكمربعات متجهة صغيرة مع Martin، وكم يزن كل مربع وكيف تخزنه مؤقتاً.
 دليلQGIS للمبتدئين: الطبقات Layers والتحليل المكانيكيف تحول جدول مواقع إلى طبقة على الخريطة في QGIS، وتربطها بالمناطق وتحسب النطاقات بالأمتار الصحيحة، ثم تعيد التحليل كله بأمر واحد.
 دليلالمرجع الجيوديسي Datum: لماذا تنحرف نقطتك مئات الأمتار؟لماذا تقع نفس الإحداثيات في مكانين بينهما مئة متر، وكيف تحول بين Ain el Abd وKSA-GRF17 وWGS 84 ومناطق UTM دون أن تنقل بياناتك إلى المكان الخطأ.
 دليلالبيانات الجغرافية المفتوحة Open Data في السعوديةأين تجد البيانات الجغرافية عن المملكة، وما الذي يمكن تحميله فعلاً من كل مصدر وبأي رخصة، وكيف تفحص الملف الرسمي قبل أن تبني عليه.
 دليلما هي OpenStreetMap؟ البيانات والرخصة والمساهمةكيف تبنى أكبر قاعدة بيانات جغرافية مفتوحة من نقاط وطرق ووسوم، وما الذي تلزمك به رخصتها، وكيف تفحص جودتها في مدينتك قبل أن تبني عليها.
 دليلحساب أقصر طريق وزمن الوصول مع OSRM وValhallaكيف يحسب محرك المسارات أقصر طريق وزمن الوصول على شوارع مدينتك، وكيف تشغله على سيرفرك وتقيس سرعته بنفسك.
 دليلخوارزميات الرسم البياني Graph: من BFS إلى Dijkstraكيف يمشي apt على اعتماديات الحزم وكيف يجد تطبيق الخرائط أقصر طريق، بخوارزميات BFS وDFS والترتيب الطوبولوجي وDijkstra مجربة على بيانات حقيقية.
سجل التحديثات
- 16 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على PostgreSQL 18.7 وPostGIS 3.7.0 وpgRouting 4.0.2، وosm2pgrouting 2.3.8 وosm2pgsql 2.1.1 وGDAL 3.10.3 على Debian 13، وبيانات Geofabrik لدول الخليج بتاريخ 15 نوفمبر 2026، وملف السكان WorldPop R2025A لعام 2025 للمملكة، وعرض النتائج في MapLibre GL JS 6.13.0.