إذا طلب منك أحد طبقة بكل المباني في حي أو بلدة، لحساب السكان كما فعلنا في مقال التحليل المكاني، أو لتخطيط شبكة ألياف، أو لتقدير أثر سيل على البيوت، فأول ما تفعله أن تفتح OpenStreetMap، وغالباً ستجد بعض المباني مرسومة وأغلبها لا. والحل التقليدي أن يجلس شخص أمام صورة جوية ويرسم كل مبنى بيده، وهذا عمل يقاس بالأسابيع للحي الواحد. ومنذ قرابة عشر سنوات ظهر حل آخر: شبكة عصبية تنظر إلى الصورة وترسم المباني وحدها، وهذا ما بنت به Microsoft وGoogle طبقات بمئات الملايين من المباني ونشرتها مجاناً. فهل يكفي أن تنزل نموذجاً جاهزاً وتشغله على صورة مدينتك؟ وكم يأخذ على حاسب عادي دون بطاقة رسومية؟ وكيف تعرف أن ما رسمه صحيح؟
هذا ما سوف نجربه في هذا المقال بالأرقام: نموذج منشور ومفتوح المصدر، دربه صاحبه على صور جوية أمريكية، نشغله على المعالج على نافذتين من كيلومتر مربع، الأولى من صور أمريكية مثل صور تدريبه، والثانية من صور أقمار صناعية لحي سكني كثيف في مقديشو، ثم نقارن ما رسمه بطبقات OpenStreetMap وMicrosoft وGoogle للمكان نفسه. وسوف نناقش في هذا المقال ما يلي:
- المهام الأربع: التصنيف والكشف والتقسيم الدلالي والتقسيم حسب الكائن، وأيها يعطيك طبقة مبان.
- ما الذي يجب أن يكون في الصورة حتى يرى النموذج المبنى، ولماذا لا تكفي صور Sentinel-2.
- طبقات المباني المفتوحة الجاهزة، وبيانات التدريب، ورخصة كل منها.
- عائلات النماذج: U-Net وMask R-CNN وSAM وYOLO-OBB، ومتى تناسب كل واحدة.
- مختبر كامل على المعالج: من ملف COG إلى مضلعات، والزمن الحقيقي لكل خطوة.
- كيف تقيس النتيجة بالدقة Precision والاستدعاء Recall والتقاطع على الاتحاد IoU، ولماذا انهار النموذج نفسه في المدينة الثانية.
- الطرق، وحدود كل هذا، ومتى تنزل طبقة جاهزة ومتى تدرب نموذجك.
لماذا نحتاج التعلم الآلي لرسم المباني؟
المبنى في الصورة الجوية شكل بسيط لعين الإنسان: سطح بلون مختلف عن الأرض حوله، بحواف مستقيمة غالباً، وظل على جانب واحد. ولكن الطريقة البسيطة في البرمجة، أي قواعد مكتوبة باليد مثل «كل بقعة رمادية مستطيلة أكبر من 30 متراً مربعاً مبنى»، تفشل بسرعة: الطريق رمادي ومستطيل أيضاً، والسطح الأحمر في حي والأزرق في حي آخر، والشجرة تغطي نصف البيت، والظل يجعل السطح نفسه بلونين. وقد شرحنا في مقال الرؤية الحاسوبية كيف حلت الشبكات الالتفافية CNN هذه المشكلة، بأن تتعلم المرشحات من آلاف الأمثلة بدل أن نكتبها نحن، فلن نعيد الشرح هنا، وسوف نركز على ما يختلف عندما تكون الصورة من الأعلى وتكون النتيجة طبقة على خريطة.
وهناك فرقان مهمان عن صور الكاميرا العادية. الأول أن الناتج يجب أن يكون في مكانه الصحيح على الأرض، فكل بكسل في الصورة الجوية له إحداثيات، والقناع الذي يخرجه النموذج يجب أن يتحول إلى مضلع بإحداثيات حقيقية، وهذا ما تفعله المكتبات الجغرافية مثل rasterio وGDAL كما سنرى. والثاني أن الصورة الجوية ضخمة: كيلومتر مربع واحد بدقة نصف متر هو 4 ملايين بكسل، والنماذج تدربت على صور من 512 أو 1024 بكسل، لذلك نقسم الصورة إلى رقع Chips، ونشغل النموذج على كل رقعة، ثم نجمع النتائج ونعالج المباني التي قطعتها حدود الرقع.
أربع مهام لصورة واحدة
عندما تقرأ عن «الذكاء الاصطناعي على صور الأقمار الصناعية» فقد يقصد الكاتب واحدة من أربع مهام مختلفة، ولكل منها ناتج مختلف، والصورة التالية تبينها على المربع نفسه:
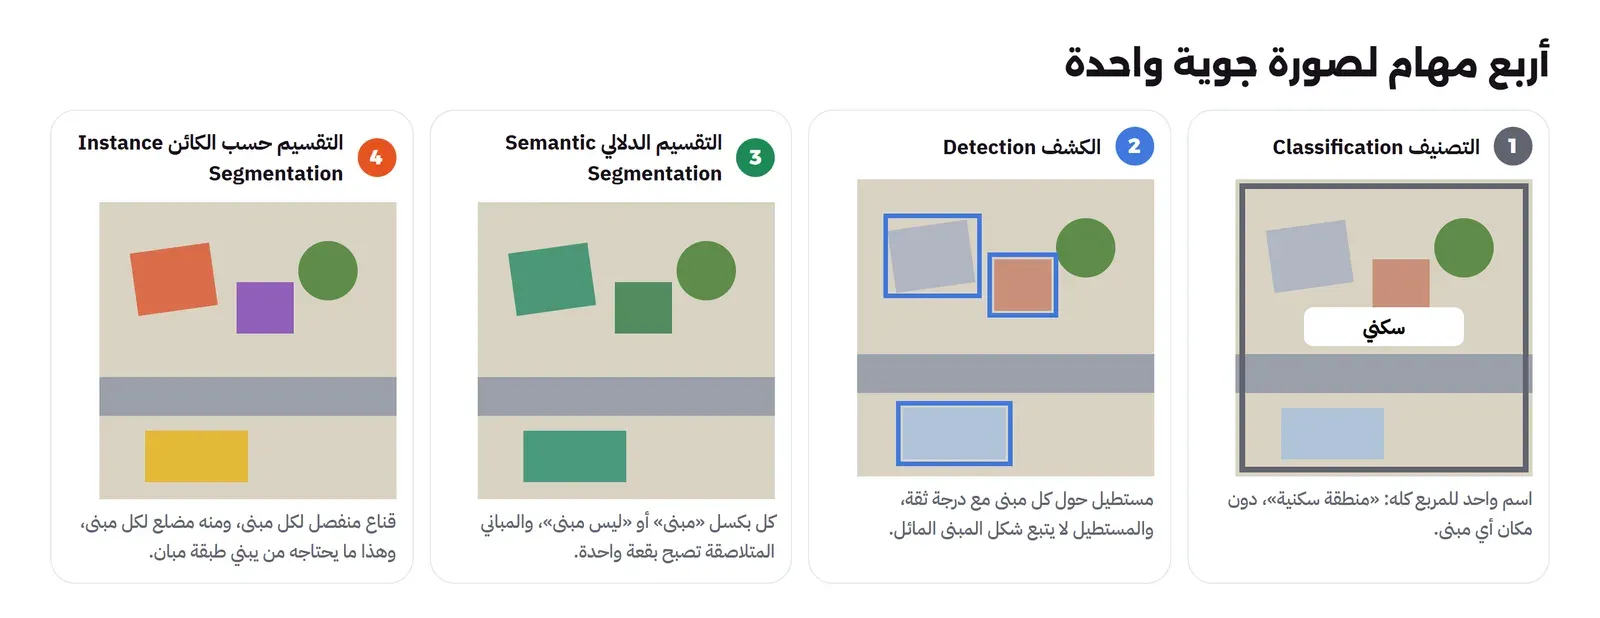
- التصنيف Classification: اسم واحد للرقعة كلها، مثل «سكني» أو «زراعي» أو «صحراء». ويستخدم لخرائط استعمال الأراضي على مساحات كبيرة، ولا يعطيك أي مبنى.
- الكشف Object Detection: مستطيل حول كل مبنى مع درجة ثقة. يكفي للعد، مثل «كم خيمة في هذا المخيم» أو «كم سيارة في هذا الموقف»، ولكن المستطيل الأفقي لا يتبع شكل المبنى المائل.
- التقسيم الدلالي Semantic Segmentation: كل بكسل يأخذ فئة، «مبنى» أو «ليس مبنى». وهو ما تستخدمه Microsoft كخطوة أولى بحسب صفحة مشروعها، ثم تحول البكسلات إلى مضلعات في خطوة ثانية. ومشكلته أن البيوت المتلاصقة تخرج بقعة واحدة.
- التقسيم حسب الكائن Instance Segmentation: قناع منفصل لكل مبنى، ومن كل قناع مضلع. وهذا ما يقوم به النموذج في مختبرنا.
وقد يتساءل البعض: إذا كان التقسيم حسب الكائن يعطي كل شيء، فلماذا لا نستخدمه دائماً؟ والإجابة أن كل مهمة أصعب من التي قبلها وأبطأ، وتحتاج بيانات تدريب أغلى: التصنيف يحتاج اسماً لكل صورة، والكشف يحتاج مستطيلاً لكل مبنى، والتقسيم يحتاج حدود كل مبنى مرسومة بدقة. لذلك اختر أبسط مهمة تجيب عن سؤالك: إذا كان السؤال «كم مبنى؟» فالكشف يكفي، وإذا كان «أين ينتهي العمران؟» فالتقسيم الدلالي يكفي، وإذا كان «أريد طبقة مبان أحسب عليها المساحات وأربطها بالعناوين» فأنت تحتاج مضلعاً لكل مبنى.
ماذا يجب أن تحمل الصورة؟
أول سؤال قبل أي نموذج هو حجم البكسل على الأرض Ground Sample Distance، لأن النموذج لا يرى ما ليس في الصورة. فصور Sentinel-2 المجانية بكسلها 10 أمتار، أي أن بيتاً من 10 في 15 متراً يغطي بكسلاً أو بكسلين، وهذا يكفي لتصنيف العمران وقياس توسع المدينة، ولا يكفي لرسم بيت واحد. والنماذج التي ترسم المباني تعمل عادة على صور بدقة نصف متر أو أقل، وهذه صور تجارية في الغالب، ولكن هناك مصادر مفتوحة يجب أن تعرفها:
- NAIP: صور جوية لكل الولايات المتحدة بدقة 0.6 متر أو أفضل، بأربع قنوات، تتجدد كل ثلاث سنوات تقريباً، ورخصتها بحسب سجل AWS للبيانات المفتوحة ملك عام مع ذكر المصدر. وهي موجودة كملفات COG على Microsoft Planetary Computer.
- OpenAerialMap: مستودع مفتوح يرفع إليه الناس والمنظمات صوراً جوية وصور طائرات مسيرة وبعض صور الأقمار الصناعية، ولكل صورة رخصتها، وأغلبها CC BY 4.0 ولكن بعضها غير تجاري، فاقرأ رخصة كل صورة قبل استخدامها. ومنها الفسيفساء Mosaic التي استخدمناها لمقديشو من صور Maxar لعام 2019 برخصة CC BY 4.0.
- صور طائراتك المسيرة: وقد شرحنا كيف تبني منها خريطة مصححة Orthophoto في مقال الخرائط بالطائرات المسيرة، وهي بدقة سنتيمترات، أي أدق بكثير مما تدربت عليه أغلب النماذج، فقد تحتاج تصغيرها قبل التشغيل.
وهناك أمور أخرى في الصورة تؤثر على النموذج بقدر الدقة. الأول زاوية التصوير: صور الأقمار الصناعية تلتقط غالباً بزاوية مائلة، فترى سطح المبنى العالي مزاحاً عن قاعدته، وترى جداراً جانبياً، والنموذج يرسم السطح لا القاعدة، فتنزاح المضلعات عن مكان المبنى على الأرض بقدر ارتفاعه. والثاني السحب، وقد قابلناها في أول نافذتين اخترناهما في مقديشو، فنقلنا النافذة إلى مكان صاف. والثالث الوقت: الصورة من 2019 لا تعرف عن مبنى بني في 2023.
طبقات جاهزة وبيانات تدريب، ورخصة كل منها
قبل أن تشغل أي نموذج، تحقق أن أحداً لم يقم بالعمل عنك. فهناك اليوم ثلاث طبقات مبان عالمية مجانية من التعلم الآلي، وطبقة رابعة تدمجها مع OpenStreetMap، وقد مررنا على بعضها في مقال البيانات الجغرافية المفتوحة في المملكة، وهنا نقارنها من زاوية من يريد استخدامها أو التدرب عليها:
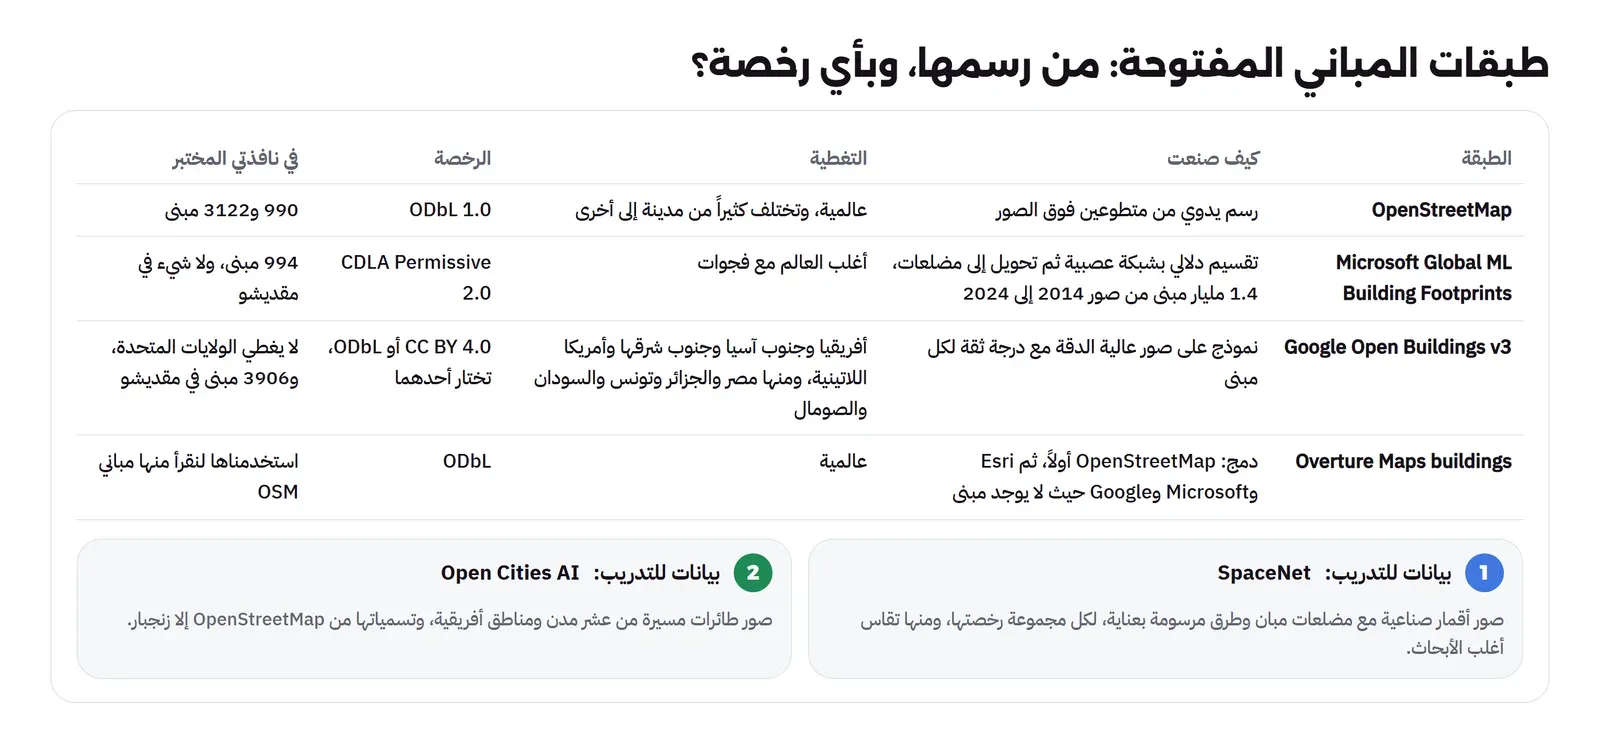
في الجدول أعلاه لاحظ التالي:
- Microsoft Global ML Building Footprints: بحسب صفحة المشروع 1.4 مليار مبنى من صور Bing بين 2014 و2024، برخصة CDLA Permissive 2.0، وهي رخصة متساهلة تسمح بالاستخدام التجاري دون شرط المشاركة بالمثل. ولاحظ أن بعض الكتابات القديمة تذكر رخصة ODbL، وهذه كانت رخصة الإصدارات الأولى للولايات المتحدة، فاقرأ الرخصة في صفحة الإصدار الذي تنزله. والمشروع ينشر أرقام جودته لكل منطقة، ففي الشرق الأوسط مثلاً دقة 95.7% واستدعاء 85.4% بحسب قياسه هو، والملفات مقسمة بمربعات من المستوى 9 تسمى QuadKey، فتنزل منها المربع الذي يغطي منطقتك فقط.
- Google Open Buildings: الإصدار الثالث يغطي بحسب صفحة المشروع أفريقيا وجنوب آسيا وجنوب شرقها وأمريكا اللاتينية والكاريبي، ومن الدول العربية فيه مصر والجزائر وتونس والسودان والصومال وموريتانيا وجيبوتي وجزر القمر، ولا يغطي المملكة ولا الولايات المتحدة. ولكل مبنى درجة ثقة، والرخصة تختارها أنت: CC BY 4.0 أو ODbL.
- Overture Maps buildings: بحسب وثيقة Overture تعطي OpenStreetMap أعلى أولوية في الدمج، ثم تضيف مباني Esri وMicrosoft وGoogle حيث لا يوجد مبنى، وتستخدم IoU لتقرر أن مبنيين هما المبنى نفسه. ولأنها تحتوي OpenStreetMap فرخصتها ODbL، أي أن أي قاعدة بيانات تبنيها منها وتنشرها يجب أن تنشرها بالرخصة نفسها.
- OpenStreetMap: رسم يدوي، فهو الأدق شكلاً حيث يوجد، والأقل تغطية في أغلب المدن العربية، وقد قسنا تغطيته في المملكة في مقال البيانات المفتوحة. ورخصته ODbL مع شرط المشاركة بالمثل.
أما إذا أردت أن تدرب نموذجك، فأشهر مجموعتين مفتوحتين للمباني هما SpaceNet، وهي صور أقمار صناعية لعدة مدن مع مضلعات مبان وطرق مرسومة بعناية ومسابقات بمقاييس موحدة، ولكل مجموعة فيها رخصتها، وOpen Cities AI Challenge، وهي صور طائرات مسيرة من عشر مدن ومناطق أفريقية، وتسمياتها مأخوذة من OpenStreetMap إلا صور زنجبار. وكلاهما يعلمك شيئاً مهماً: النموذج يتعلم شكل المباني في المدن التي تدرب عليها، والمدينة العربية بأسطحها المسطحة وخزانات المياه فوقها وأسوارها العالية ليست في أي منهما تقريباً.
أي نموذج؟ أربع عائلات
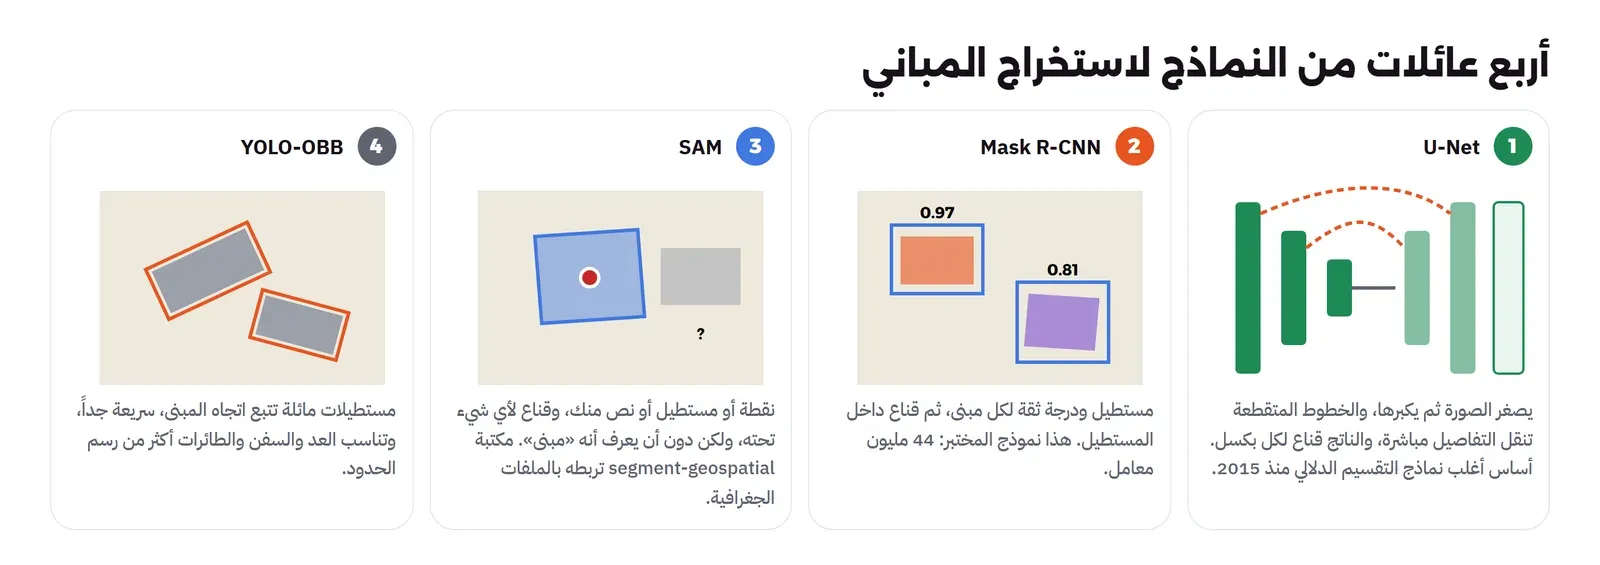
U-Net: التقسيم الدلالي
نشر U-Net في 2015 لصور طبية، ثم أصبح أساس أغلب نماذج التقسيم في صور الأقمار الصناعية. والفكرة نصفان: نصف يصغر الصورة خطوة بعد خطوة ويستخرج منها معاني أعم، «هنا سطح، هنا طريق»، ونصف يكبرها مرة أخرى إلى الحجم الأصلي ليعطي قراراً لكل بكسل، ووصلات مباشرة بين النصفين تنقل التفاصيل الدقيقة، مثل حافة السطح، التي ضاعت أثناء التصغير. وهو خفيف وسريع التدريب، ويعمل جيداً مع بضع مئات من الصور المرسومة، ولكنه يعطيك بكسلات لا مبان، فتحتاج بعده خطوة تحويل إلى مضلعات وتقسيم البقع المتلاصقة.
Mask R-CNN: مبنى لكل قناع
نموذج Mask R-CNN من 2017 يعمل على مرحلتين: الأولى تقترح مستطيلات يحتمل أن فيها جسماً، والثانية تقرر لكل مستطيل هل هو مبنى وبأي ثقة، وترسم قناعاً للمبنى داخل المستطيل. فالناتج قائمة من المباني، لكل منها درجة وقناع، وهذا ما يجعل تحويله إلى طبقة سهلاً. والنموذج الذي نستخدمه في المختبر من هذه العائلة، بعمود فقري ResNet-50 وطبقات FPN، من مكتبة geoai برخصة MIT، والوزن منشور على Hugging Face باسم building_footprints_usa.pth.
SAM: قسم أي شيء تشير إليه
نموذج Segment Anything من Meta برخصة Apache 2.0 لا يعرف ما هو المبنى، وإنما يعرف حدود الأشياء: تعطيه نقطة أو مستطيلاً، فيعطيك قناع الشيء تحته. ومكتبة segment-geospatial برخصة MIT تربطه بملفات GeoTIFF، وتضيف إليه نموذجاً آخر يحول النص مثل «building» إلى مستطيلات، فتحصل على تقسيم بالنص. وهو مفيد جداً لتسريع الرسم اليدوي: تضغط على السطح فيرسم حدوده بدقة، ولكنه نموذج كبير، والتشغيل الآلي على مدينة كاملة على المعالج بطيء، ونتائجه بالنص تحتاج مراجعة لأنه يقسم كل ما يشبه شيئاً، ظل الشجرة والسيارة والملعب.
YOLO-OBB: مستطيلات مائلة
عائلة YOLO من أسرع نماذج الكشف، وقد استخدمنا قريباً منها في مقال الرؤية الحاسوبية، ونسخة OBB من Ultralytics تخرج مستطيلات مائلة Oriented Bounding Boxes تتبع اتجاه الجسم، وهي مدربة مسبقاً على مجموعة DOTA للصور الجوية التي فيها طائرات وسفن ومركبات وملاعب. وتناسب العد والتتبع أكثر من رسم الحدود، ولاحظ أن مكتبة Ultralytics برخصة AGPL-3.0، أي أن استخدامها داخل خدمة تقدمها لغيرك عبر الشبكة يلزمك بنشر كود الخدمة، أو بشراء رخصة تجارية منهم.
المختبر: نموذج جاهز على المعالج
هدف المختبر أن نجيب بالأرقام عن سؤالين: كم يأخذ نموذج حقيقي على حاسب دون بطاقة رسومية، وما جودة ما يرسمه في مكان يشبه بيانات تدريبه وفي مكان لا يشبهها. والجهاز معالج Intel Core i7-7700K بأربع أنوية وثمانية Threads، والنموذج هو Mask R-CNN من geoai، وصاحبه يشرح في صفحة النماذج أنه دربه بنفسه على صور NAIP بثلاث قنوات RGB، ودفتر التدريب المنشور يستخدم صورة تدريب واحدة بدقة 0.6 متر من منطقة سبوكين في ولاية واشنطن، قرابة كيلومتر ونصف في 700 متر، مع مضلعات مبانيها. لذلك اخترنا نافذتين:
- سبوكين: كيلومتر مربع من حي سكني في المدينة نفسها، ليس من منطقة التدريب، من صور NAIP لعام 2023 بالدقة نفسها 0.6 متر. هذه هي الحالة الأفضل للنموذج.
- مقديشو: كيلومتر مربع من حي سكني كثيف، من فسيفساء صور Maxar لعام 2019 بدقة 0.5 متر على OpenAerialMap. مدينة بأسطح معدنية متلاصقة وأشجار بين البيوت، لم ير النموذج مثلها، وهي من المدن القليلة التي تغطيها Google وOpenStreetMap معاً بشكل جيد، فنستطيع المقارنة بمرجعين.
تجهيز البيئة
نحتاج PyTorch وtorchvision للنموذج، وrasterio لقراءة الصور الجغرافية، وshapely وOpenCV للمضلعات، وDuckDB لقراءة ملفات Parquet من الإنترنت. والملف lab/Dockerfile:
FROM python:3.12-slim
RUN pip install --no-cache-dir --index-url https://download.pytorch.org/whl/cpu torch==2.15.0 torchvision==0.29.2 \
 && pip install --no-cache-dir rasterio==1.5.2 shapely==2.2.0 pyproj==3.8.0 opencv-python-headless==5.0.0.93 duckdb==2.0.0 numpy==2.5.4 pillow==13.0.0
# rasterio's bundled GDAL needs libexpat, which the slim image does not have
RUN apt-get update && apt-get install -y --no-install-recommends libexpat1 && rm -rf /var/lib/apt/lists/*
WORKDIR /work
في الملف أعلاه لاحظ التالي:
- نثبت PyTorch من فهرس
whl/cpuالخاص به، فيأتي دون مكتبات CUDA، فكانت الـ Image النهائية 2.1 غيغابايت على القرص، و480 ميغابايت عند التنزيل المضغوط، بينما نسخة CUDA وحدها أكبر من ذلك بعدة أضعاف. - السطر الأخير لم يكن في النسخة الأولى، وعند أول تشغيل ظهر الخطأ التالي عند
import rasterio:
ImportError: libexpat.so.1: cannot open shared object file: No such file or directoryوالسبب أن حزمة rasterio تأتي ومعها نسخة من GDAL مبنية داخلها، وهذه النسخة تحتاج مكتبة expat من النظام، والـ Image المصغرة python:3.12-slim لا تحملها. وهذا النوع من الأخطاء يظهر كثيراً مع مكتبات Python الجغرافية على الصور المصغرة، والحل أن تضيف المكتبة الناقصة بـ apt، لا أن تنتقل إلى Image كاملة أكبر بكثير. ثم ننزل وزن النموذج مرة واحدة إلى مجلد نربطه للقراءة فقط:
mkdir -p geoai-lab/work/model && cd geoai-lab     # Dockerfile and the scripts from lab/
docker build -q -t geoai-lab .
curl -fsSL -o work/model/building_footprints_usa.pth https://huggingface.co/giswqs/geoai/resolve/main/building_footprints_usa.pth
والملف 176,225,905 بايت، أي 176 ميغابايت، وهو تقريباً حجم 44 مليون معامل بأرقام عشرية من 4 بايت.
قص النافذتين من ملفات COG
الصورتان ملفات COG ضخمة على الإنترنت: مربع NAIP 8540 في 12290 بكسلاً، وفسيفساء مقديشو 65536 في 49152 بكسلاً، ولا نحتاج تنزيل أي منهما كاملاً، وهي الطريقة نفسها التي نقص بها نماذج الارتفاع في مقال نماذج الارتفاع DEM من هذه المرحلة. والسكربت lab/fetch_image.py يحول حدود النافذة من الطول والعرض إلى نظام إحداثيات الصورة، ويقرأ النافذة فقط، ويستطيع أن يغير الدقة أثناء القراءة:
# Cut a small RGB window from a Cloud Optimized GeoTIFF over HTTP, in the image's own CRS.
#   python fetch_image.py <cog-url> <lon_min> <lat_min> <lon_max> <lat_max> <out.tif> [target_res_m]
import sys, time
import rasterio
from rasterio.windows import from_bounds
from rasterio.warp import transform_bounds
from rasterio.enums import Resampling
url, x0, y0, x1, y1, out = sys.argv[1], *map(float, sys.argv[2:6]), sys.argv[6]
res = float(sys.argv[7]) if len(sys.argv) > 7 else None
t = time.time()
with rasterio.open(url) as src:
    b = transform_bounds("EPSG:4326", src.crs, x0, y0, x1, y1)
    win = from_bounds(*b, transform=src.transform).round_offsets().round_lengths()
    scale = (res / src.res[0]) if res else 1.0
    h, w = int(win.height / scale), int(win.width / scale)
    data = src.read([1, 2, 3], window=win, out_shape=(3, h, w), resampling=Resampling.bilinear)
    tr = src.window_transform(win) * rasterio.Affine.scale(win.width / w, win.height / h)
    prof = dict(driver="GTiff", width=w, height=h, count=3, dtype="uint8", crs=src.crs, transform=tr, compress="deflate", photometric="RGB")
    with rasterio.open(out, "w", **prof) as dst:
        dst.write(data)
    print(f"source {src.width}x{src.height} px at {src.res[0]:.3f} m, {src.crs}")
print(f"wrote {out}: {w}x{h} px at {tr.a:.3f} m in {time.time() - t:.1f} s")
والملف lab/01-fetch.sh يطلب توكن قراءة مجانياً من Planetary Computer لصور NAIP، ثم يقص النافذتين، ونسخة ثالثة من مقديشو بدقة 0.6 متر لنختبر أثر الدقة لاحقاً:
#!/usr/bin/env bash
# Two 1 km windows: Spokane (NAIP 2023, same kind of imagery the model was trained on) and Mogadishu (Maxar 2019 mosaic on OpenAerialMap).
set -euo pipefail
cd /work
TOKEN=$(python -c "import json,urllib.request;print(json.load(urllib.request.urlopen('https://planetarycomputer.microsoft.com/api/sas/v1/token/naip'))['token'])")
NAIP="https://naipeuwest.blob.core.windows.net/naip/v002/wa/2023/wa_060cm_2023/47117/m_4711721_ne_11_060_20230701_20230911.tif?$TOKEN"
OAM="https://oin-hotosm-temp.s3.amazonaws.com/5f919d881d40480007fef7ad/0/5f919d881d40480007fef7ae.tif"
python /lab/fetch_image.py "$NAIP" -117.4200 47.7000 -117.4070 47.7090 spokane.tif
python /lab/fetch_image.py "$OAM" 45.3225 2.0455 45.3315 2.0545 mogadishu.tif
python /lab/fetch_image.py "$OAM" 45.3225 2.0455 45.3315 2.0545 mogadishu_06.tif 0.6
docker run --rm -v "$PWD/work:/work" -v "$PWD:/lab" geoai-lab bash /lab/01-fetch.shsource 8540x12290 px at 0.600 m, EPSG:26911
wrote spokane.tif: 1634x1676 px at 0.600 m in 6.5 s
source 65536x49152 px at 0.500 m, EPSG:32638
wrote mogadishu.tif: 2002x1990 px at 0.500 m in 7.9 s
source 65536x49152 px at 0.500 m, EPSG:32638
wrote mogadishu_06.tif: 1668x1658 px at 0.600 m in 12.5 sكل نافذة أخذت بين 6 و13 ثانية، وكل صورة بنظام إحداثياتها الأصلي: NAIP على UTM للمنطقة 11 بمرجع NAD83 (الرقم 26911)، ومقديشو على UTM 38N بمرجع WGS 84. ولاحظ أننا لم نعد إسقاط أي منهما، لأن إعادة الإسقاط تعيد حساب البكسلات فتنعم الحواف قليلاً، والنموذج يعتمد على هذه الحواف، والمقارنة بعد ذلك تتم في نظام إحداثيات كل صورة.
المراجع: ثلاث طبقات للمكان نفسه
نحتاج ما نقارن به، والسكربت lab/refs.py يجمع لكل نافذة ثلاث طبقات، كل منها من مصدرها الأصلي، ويحولها إلى نظام إحداثيات الصورة، ويبقي ما يلمس النافذة:
- OpenStreetMap: كانت الخطة أن نستعلم من خادم Overpass العام، ولكنه كان يرد بالخطأ
406 Not Acceptableعلى كل طلب من جهازنا، فقرأنا مباني OpenStreetMap من إصدار Overture بتاريخ 2026-10-21، لأن Overture تعطي مباني OpenStreetMap أعلى أولوية وتسجل مصدر كل مبنى، فنأخذ الصفوف التي مصدرها OpenStreetMap فقط. - Microsoft: نحسب مربع QuadKey من المستوى 9 الذي يقع فيه مركز النافذة، ونبحث عنه في ملف الروابط الرسمي
dataset-links.csv، وننزل ملفاً واحداً مضغوطاً. - Google: نقرأ من نسخة GeoParquet لكل دولة نشرها مشروع VIDA على Source Cooperative، لأن ملفات Google الرسمية مقسمة بخلايا كبيرة حجم الواحدة منها مئات الميغابايت، ونسخة VIDA تحمل لكل مجموعة صفوف حدودها، فتقرأ DuckDB الأجزاء التي تلمس النافذة فقط.
docker run --rm -v "$PWD/work:/work" -v "$PWD:/lab" -w /work geoai-lab bash -c '
  python /lab/refs.py spokane.tif spokane UnitedStates
  python /lab/refs.py mogadishu.tif mogadishu Somalia SOM'
overture: 1057 rows in 122 s, by source: Esri Community Maps=6, Microsoft ML Buildings=43, OpenStreetMap=1008
osm 990 buildings touching the image
microsoft: quadkey 021231021, 1 file(s)
microsoft 994 buildings touching the image
overture: 3334 rows in 68 s, by source: Google Open Buildings=209, OpenStreetMap=3125
osm 3122 buildings touching the image
microsoft: quadkey 123222202, 0 file(s)
microsoft 0 buildings touching the image
google: 3907 rows in 9 s, confidence 0.65 to 0.96
google 3906 buildings touching the imageفي المخرج أعلاه لاحظ التالي:
- في سبوكين الطبقتان متقاربتان في العدد: 990 مبنى في OpenStreetMap و994 في Microsoft، أي أن الحي مرسوم في OpenStreetMap بشكل كامل تقريباً، وهذا ما يجعله مرجعاً جيداً للمقارنة.
- في مقديشو لا يوجد أي ملف لـ Microsoft في هذا المربع، ولم نجد مبنى واحداً منها في مستطيل يغطي المدينة كلها في نسخة VIDA أيضاً، أي أن الطبقة «العالمية» لها فجوات بحجم مدن كاملة، فلا تفترض وجودها قبل أن تتحقق.
- Google فيها 3906 مبنى في النافذة، وOpenStreetMap فيها 3122، وأقل درجة ثقة في ملف Google 0.65، لأن هذه النسخة لا تحمل المباني الأقل ثقة.
- Overture أضافت في مقديشو 209 مبان من Google فقط فوق 3125 من OpenStreetMap، لأنها لا تضيف مبنى من مصدر آلي إذا تداخل مع مبنى موجود، فطبقة Overture ليست مجموع الطبقات وإنما دمجها.
- استعلام Overture أخذ دقيقة أو دقيقتين، لأن DuckDB يقرأ ترويسة كل ملف من مئات ملفات Parquet ليعرف أي أجزائها تلمس النافذة، وهذا ثمن القراءة المباشرة من الإنترنت دون تنزيل.
تشغيل النموذج على المعالج
والآن الجزء الأساسي، السكربت lab/infer.py. يبني بنية Mask R-CNN من torchvision بفئتين، الخلفية والمبنى، بنفس قيم التطبيع التي استخدمها صاحب النموذج في مكتبة geoai، ثم يحمل الوزن، ويقسم الصورة إلى رقع، ويحول كل قناع إلى مضلع بإحداثيات حقيقية:
# Building instances with the geoai Mask R-CNN checkpoint (trained on US NAIP RGB), on CPU, then masks to polygons.
# Writes every detection with score >= 0.3 (before removing duplicates); post.py picks the threshold later.
#   python infer.py <image.tif> <model.pth> <raw.geojson>
import sys, time, json
import numpy as np, torch, rasterio, cv2
from torchvision.models.detection import maskrcnn_resnet50_fpn
from shapely.geometry import Polygon, mapping
from shapely import affinity
img_path, model_path, out_path = sys.argv[1:4]
thr = 0.3
CHIP, STEP = 512, 384                       # 128 px overlap between chips
torch.set_num_threads(8)
t0 = time.time()
model = maskrcnn_resnet50_fpn(weights=None, weights_backbone=None, num_classes=2,
                              image_mean=[0.485, 0.456, 0.406], image_std=[0.229, 0.224, 0.225])
model.load_state_dict(torch.load(model_path, map_location="cpu"))
model.eval()
print(f"model loaded in {time.time() - t0:.1f} s, {sum(p.numel() for p in model.parameters()) / 1e6:.1f} M parameters")
with rasterio.open(img_path) as src:
    img = src.read([1, 2, 3]); tr = src.transform; crs = src.crs
H, W = img.shape[1:]
starts = lambda n: sorted(set(list(range(0, max(n - CHIP, 0) + 1, STEP)) + [max(n - CHIP, 0)]))
cands = []                                   # (score, polygon in pixel coords)
t1 = time.time(); chips = 0
with torch.no_grad():
    for r in starts(H):
        for c in starts(W):
            chip = torch.from_numpy(img[:, r:r + CHIP, c:c + CHIP].astype(np.float32) / 255.0)
            out = model([chip])[0]; chips += 1
            for s, m in zip(out["scores"].numpy(), out["masks"].numpy()):
                if s < thr:
                    continue
                mask = (m[0] > 0.5).astype(np.uint8)
                cs, _ = cv2.findContours(mask, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
                if not cs:
                    continue
                cnt = max(cs, key=cv2.contourArea)
                if cv2.contourArea(cnt) < 20 or len(cnt) < 3:      # 20 px at 0.5 m = 5 m2
                    continue
                p = Polygon((pt[0][0] + c, pt[0][1] + r) for pt in cnt).buffer(0)
                if p.is_valid and not p.is_empty:
                    cands.append((float(s), p))
t2 = time.time()
print(f"{chips} chips of {CHIP}x{CHIP} in {t2 - t1:.1f} s ({(t2 - t1) / chips:.2f} s per chip), {len(cands)} raw detections")
feats = [{"type": "Feature", "properties": {"score": round(s, 3)},
          "geometry": mapping(affinity.affine_transform(p, [tr.a, tr.b, tr.d, tr.e, tr.c, tr.f]))} for s, p in cands]
json.dump({"type": "FeatureCollection", "features": feats}, open(out_path, "w"))
print(f"total {time.time() - t0:.1f} s -> {out_path}")
في الكود أعلاه لاحظ التالي:
- الرقع 512 في 512 بكسلاً، والخطوة 384، أي تداخل 128 بكسلاً بين كل رقعتين متجاورتين، وهو قرابة 77 متراً بدقة 0.6 متر، وهذا أكبر من أغلب البيوت، فكل بيت يقع كاملاً داخل رقعة واحدة على الأقل. والدالة
startsتضيف رقعة أخيرة ملاصقة للحافة حتى لا يبقى شريط بلا تغطية. - النموذج يأخذ البكسلات مقسومة على 255، أي بين 0 و1، ويطبعها داخله بالمتوسط والانحراف المعطيين، فإذا نسيت القسمة على 255 فلن يظهر أي خطأ، وإنما لا شيء: جربنا ذلك بالسكربت
lab/no_scale.pyعلى أربع رقع من سبوكين، فخرج 228 كشفاً بثقة 0.5 أو أكثر مع القسمة، وصفر بدونها. - القناع الذي يخرجه النموذج احتمالات بين 0 و1 لكل بكسل داخل الرقعة، فنحوله إلى قناع ثنائي عند 0.5، ونأخذ أكبر حد خارجي فيه بالدالة
cv2.findContours، ونهمل ما هو أصغر من 20 بكسلاً. - المضلع بإحداثيات البكسل داخل الرقعة، فنضيف إليه موقع الرقعة، ثم نطبق عليه التحويل الجغرافي للصورة
trفيصبح بالمتر في نظام إحداثياتها. وهذا السطر هو الفرق بين «صورة عليها أشكال» و«طبقة على خريطة». - نحفظ كل كشف بثقة 0.3 أو أكثر دون إزالة التكرار، حتى نجرب عتبات مختلفة لاحقاً دون إعادة تشغيل النموذج، فالتشغيل هو الجزء المكلف.
والملف lab/02-infer.sh يشغله على الصور الثلاث:
docker run --rm -v "$PWD/work:/work" -v "$PWD:/lab" -v "$PWD/work/model:/model:ro" geoai-lab bash /lab/02-infer.shCPUs: 8
== spokane
model loaded in 1.7 s, 44.0 M parameters
20 chips of 512x512 in 111.8 s (5.59 s per chip), 1184 raw detections
total 114.4 s -> spokane-raw.geojson
== mogadishu
model loaded in 1.4 s, 44.0 M parameters
25 chips of 512x512 in 120.7 s (4.83 s per chip), 881 raw detections
total 123.1 s -> mogadishu-raw.geojson
== mogadishu_06
model loaded in 1.3 s, 44.0 M parameters
20 chips of 512x512 in 94.7 s (4.74 s per chip), 1044 raw detections
total 96.9 s -> mogadishu_06-raw.geojsonكل رقعة أخذت بين 4.7 و5.6 ثانية على المعالج، أي قرابة دقيقتين لكل كيلومتر مربع. وفي تشغيل سابق للسكربت نفسه أثناء عمل حاويات أخرى على الجهاز أخذت رقعة مقديشو 7.1 ثانية، فخذ هذه الأرقام كترتيب حجم لا كرقم ثابت. والحساب البسيط يقول إن مدينة مساحتها المبنية 500 كيلومتر مربع تحتاج قرابة 17 ساعة على هذا الجهاز، وهذا مقبول لعمل يتم مرة واحدة في الليل، وغير مقبول لخدمة يطلب منها المستخدم منطقة وينتظر. وبطاقة رسومية تختصر ذلك كثيراً، ولكن لاحظ أن المعالج كاف تماماً لتجربة نموذج على منطقتك قبل أن تقرر أي شيء.
العتبة وإزالة التكرار
المبنى الذي يقع في منطقة التداخل بين رقعتين يكشف مرتين، وأحياناً بشكلين مختلفين قليلاً، والسكربت lab/post.py يبقي الكشف الأعلى ثقة إذا تداخل كشفان بنسبة IoU أكبر من 0.3، ثم يبسط حدود المضلع بمسافة بكسل واحد:
# Keep detections above a score, drop duplicates from overlapping chips, simplify the outline.
#   python post.py <raw.geojson> <threshold> <out.geojson> <pixel_size_m>
import sys, json
from shapely.geometry import shape, mapping
raw, thr, out, px = sys.argv[1], float(sys.argv[2]), sys.argv[3], float(sys.argv[4])
c = [(f["properties"]["score"], shape(f["geometry"])) for f in json.load(open(raw))["features"] if f["properties"]["score"] >= thr]
c.sort(key=lambda x: -x[0]); keep = []
for s, p in c:   # chips overlap by 128 px, so one building can be found twice: keep the higher score
    if all(p.intersection(q).area / p.union(q).area <= 0.3 for _, q in keep):
        keep.append((s, p))
json.dump({"type": "FeatureCollection", "features": [{"type": "Feature", "properties": {"score": s},
           "geometry": mapping(p.simplify(px))} for s, p in keep]}, open(out, "w"))
print(f"threshold {thr}: {len(c)} detections -> {len(keep)} buildings")
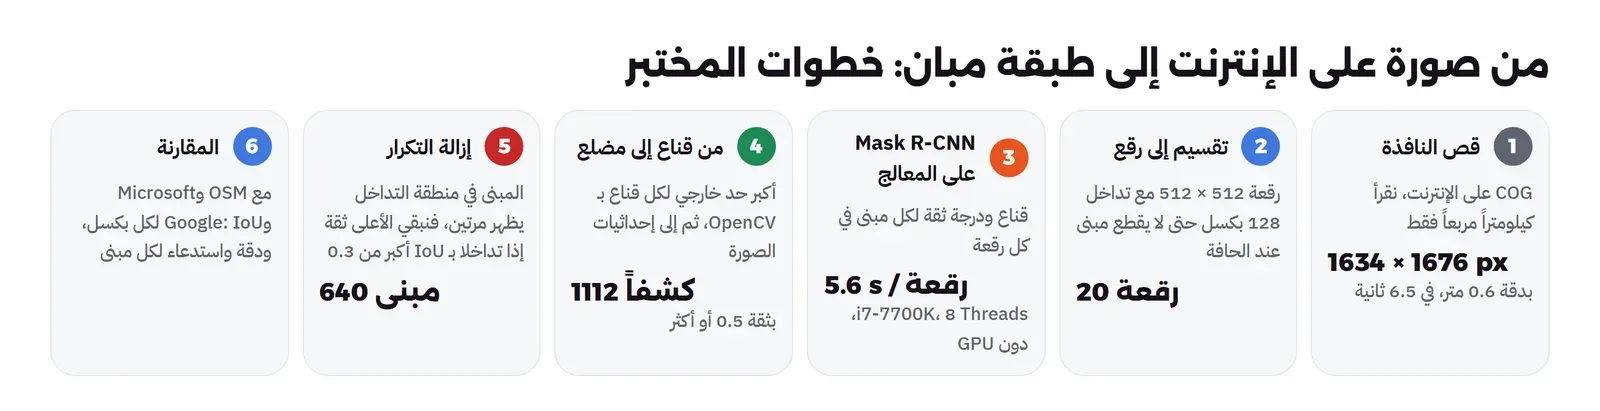
threshold 0.5: 1112 detections -> 640 buildings
threshold 0.5: 696 detections -> 482 buildings
threshold 0.5: 864 detections -> 538 buildingsأي أن قرابة 40% من الكشوف في سبوكين كانت تكراراً بسبب التداخل، وهذه نسبة طبيعية مع تداخل ربع الرقعة. والحلقة هنا تقارن كل كشف بكل ما قبله، وهذا مناسب لمئات المباني، أما لمئات الآلاف فاستخدم فهرساً مكانياً مثل STRtree كما في سكربت التقييم. والصورة التالية تجمع خطوات المختبر بالأرقام:
كيف نقيس؟ IoU والدقة والاستدعاء
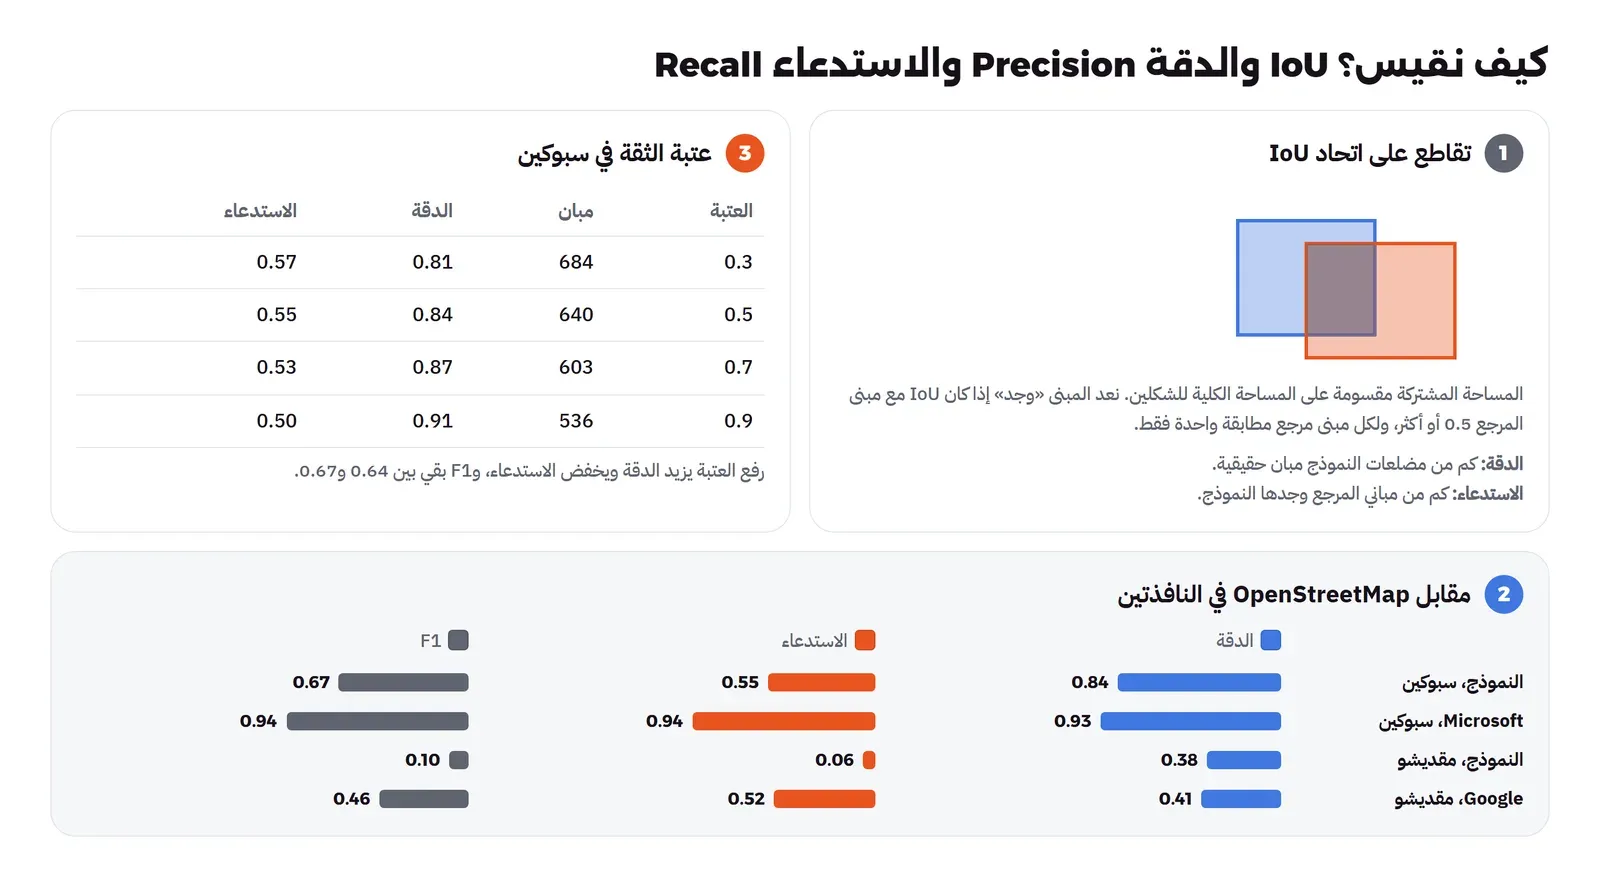
عندنا الآن مضلعات من النموذج ومضلعات من المرجع، والسؤال: ما معنى «صحيح»؟ والمقياس الأساسي هو التقاطع على الاتحاد Intersection over Union واختصاراً IoU: مساحة الجزء المشترك بين شكلين مقسومة على مساحة الشكلين معاً. فإذا تطابقا تماماً كان 1، وإذا لم يتلامسا كان 0. ومنه نبني مقياسين:
- IoU بالبكسل: نرسم كل المباني من الطرفين على شبكة الصورة نفسها، ونقسم البكسلات المشتركة على كل البكسلات المبنية في أي منهما. وهذا يقيس «هل وجد النموذج المساحة المبنية؟» دون اهتمام بعدد المباني.
- الدقة Precision والاستدعاء Recall لكل مبنى: نطابق كل مضلع من النموذج مع مبنى واحد من المرجع إذا كان IoU بينهما 0.5 أو أكثر، ولا يطابق مبنى المرجع إلا مرة واحدة. فالدقة نسبة مضلعات النموذج التي وجدت مطابقة، أي «كم مما رسمه صحيح؟»، والاستدعاء نسبة مباني المرجع التي وجدت، أي «كم مما يجب أن يرسمه رسم؟». وF1 متوسطهما التوافقي. وعتبة 0.5 هي المستخدمة في مسابقات SpaceNet وفي مطابقة Overture نفسها.
وقد شرحنا الدقة والاستدعاء بالتفصيل في مقال الرؤية الحاسوبية، والجديد هنا شرط IoU: الكشف الذي يغطي نصف المبنى فقط لا يعد كشفاً. والسكربت lab/evaluate.py يحسب كل ذلك، ويضيف بالخيار --sizes الاستدعاء لكل فئة من أحجام المباني:
# Compare predicted footprints with a reference: pixel IoU over the whole image, and per-building precision/recall.
#   python evaluate.py <image.tif> <pred.geojson> <ref.geojson> [label]
import sys, json
import numpy as np, rasterio
from rasterio.features import rasterize
from shapely.geometry import shape, box
from shapely.strtree import STRtree
img, pred_f, ref_f = sys.argv[1:4]; label = sys.argv[4] if len(sys.argv) > 4 else ref_f
with rasterio.open(img) as src:
    ext = box(*src.bounds); tr = src.transform; H, W = src.height, src.width; px = abs(tr.a * tr.e)
load = lambda f: [g for g in (shape(x["geometry"]).intersection(ext) for x in json.load(open(f))["features"]) if g.area > 5]
P, R = load(pred_f), load(ref_f)
mp = rasterize(P, out_shape=(H, W), transform=tr) if P else np.zeros((H, W), np.uint8)
mr = rasterize(R, out_shape=(H, W), transform=tr) if R else np.zeros((H, W), np.uint8)
inter = (mp & mr).sum(); union = (mp | mr).sum()
# one-to-one matching: a predicted building counts when it overlaps one reference building with IoU >= 0.5
tree = STRtree(R); used = set(); tp = 0; ratios = []
for p in sorted(P, key=lambda g: -g.area):
    best, bi = 0, None
    for i in tree.query(p):
        if i in used:
            continue
        iou = p.intersection(R[i]).area / p.union(R[i]).area
        if iou > best:
            best, bi = iou, i
    if best >= 0.5:
        tp += 1; used.add(bi); ratios.append(p.area / R[bi].area)
prec = tp / len(P) if P else 0; rec = tp / len(R) if R else 0
f1 = 2 * prec * rec / (prec + rec) if prec + rec else 0
print(f"{label:<14} ref {len(R):>4} | pred {len(P):>4} | matched {tp:>4} | precision {prec:.2f} recall {rec:.2f} F1 {f1:.2f} | "
      f"pixel IoU {inter / union if union else 0:.2f} | built-up ref {mr.sum() * px / 1e4:.2f} ha pred {mp.sum() * px / 1e4:.2f} ha")
if "--sizes" in sys.argv:
    for lo, hi in [(0, 100), (100, 300), (300, 1e9)]:
        idx = [i for i, g in enumerate(R) if lo <= g.area < hi]
        hit = sum(1 for i in idx if i in used)
        print(f"   ref {lo:>4.0f}-{hi if hi < 1e9 else 'max':>4} m2: {len(idx):>4} buildings, found {hit:>4} ({100 * hit / max(len(idx), 1):.0f}%)")
    if ratios:
        print(f"   matched pairs: median predicted/reference area {sorted(ratios)[len(ratios) // 2]:.2f}")
ولاحظ أن السكربت يقص كل المضلعات بحدود الصورة أولاً، لأن مبنى في المرجع نصفه خارج النافذة لا يمكن أن يجده النموذج كاملاً، ويهمل القطع الأصغر من 5 أمتار مربعة الناتجة عن القص. والملف lab/03-evaluate.sh يشغل post.py ثم المقارنات كلها.
النتيجة في سبوكين: المدينة التي تشبه بيانات التدريب
== Spokane (NAIP 2023, 0.6 m)
model vs OSM   ref  983 | pred  640 | matched  540 | precision 0.84 recall 0.55 F1 0.67 | pixel IoU 0.32 | built-up ref 18.46 ha pred 7.92 ha
   ref    0- 100 m2:  620 buildings, found  261 (42%)
   ref  100- 300 m2:  324 buildings, found  254 (78%)
   ref  300- max m2:   39 buildings, found   25 (64%)
   matched pairs: median predicted/reference area 1.05
model vs MS    ref  986 | pred  640 | matched  543 | precision 0.85 recall 0.55 F1 0.67 | pixel IoU 0.34 | built-up ref 19.51 ha pred 7.92 ha
MS vs OSM      ref  983 | pred  986 | matched  921 | precision 0.93 recall 0.94 F1 0.94 | pixel IoU 0.80 | built-up ref 18.46 ha pred 19.51 ha
   ref    0- 100 m2:  620 buildings, found  573 (92%)
   ref  100- 300 m2:  324 buildings, found  316 (98%)
   ref  300- max m2:   39 buildings, found   32 (82%)
   matched pairs: median predicted/reference area 1.03
في المخرج أعلاه لاحظ التالي:
- الدقة 0.84: من كل 100 مضلع رسمه النموذج، 84 يطابق مبنى في OpenStreetMap بـ IoU لا يقل عن 0.5. وعندما يجد النموذج مبنى فإنه يرسمه بحجمه تقريباً، فوسيط نسبة المساحة بين المضلع ومرجعه 1.05.
- الاستدعاء 0.55 فقط: وجد النموذج 540 مبنى من 983. والتفصيل بالحجم يبين أين ضاعت البقية: 78% من البيوت بين 100 و300 متر مربع، و42% فقط من المباني الأصغر من 100 متر مربع، وهي في هذا الحي المستودعات الصغيرة والمرائب خلف البيوت، وفيها 620 مبنى، أي أكثر من نصف المرجع.
- والمباني الكبيرة فوق 300 متر مربع وجد منها 64%، وفي النافذة مركز تجاري ضخم ومبان تجارية، والنموذج تدرب على حي سكني، فلم ير كثيراً من الأسطح البيضاء الواسعة.
- IoU بالبكسل 0.32، والمساحة المبنية في رسم النموذج 7.9 هكتار مقابل 18.5 في المرجع، وأغلب الفرق هو المركز التجاري والمباني الكبيرة التي فاتته، فهي قليلة العدد كبيرة المساحة.
- المقارنة مع Microsoft تعطي الأرقام نفسها تقريباً، لأن Microsoft وOpenStreetMap متفقتان هنا بشكل كبير: F1 بينهما 0.94، وIoU بالبكسل 0.80، ووجدت Microsoft 92% من المباني الصغيرة التي فاتت نموذجنا.
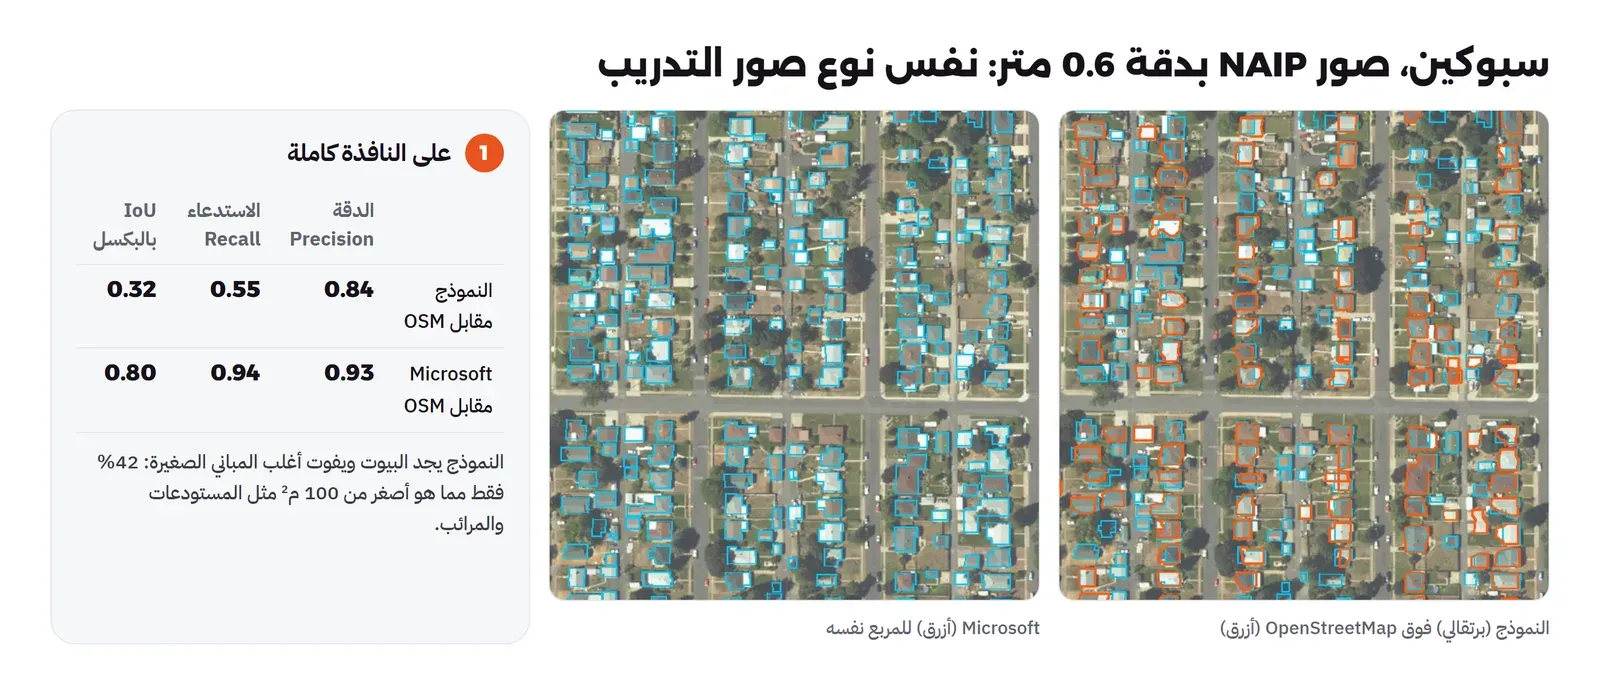
فهل هذه نتيجة جيدة؟ لنموذج تدرب على صورة واحدة بحجم كيلومتر ونصف، ويعمل على المعالج، فهي نتيجة معقولة: أغلب ما يرسمه صحيح، ويجد ثلاثة أرباع البيوت. ولكنها أقل بوضوح من طبقة Microsoft المجانية الموجودة أصلاً لهذا المكان، والتي تدربت على كمية بيانات لا تقارن، لذلك فالقرار الصحيح في سبوكين ليس تشغيل النموذج، وإنما تنزيل الطبقة الجاهزة. وهذا الدرس الأول من المختبر: النموذج الذي تشغله بنفسك يجب أن يتفوق على ما هو منشور مجاناً، وإلا فأنت تدفع زمن الحساب مقابل نتيجة أسوأ.
النتيجة في مقديشو: المدينة التي لم يرها النموذج
== Mogadishu (Maxar 2019, 0.5 m)
model vs OSM   ref 3096 | pred  482 | matched  182 | precision 0.38 recall 0.06 F1 0.10 | pixel IoU 0.11 | built-up ref 45.16 ha pred 7.04 ha
   ref    0- 100 m2: 1067 buildings, found    9 (1%)
   ref  100- 300 m2: 1861 buildings, found  164 (9%)
   ref  300- max m2:  168 buildings, found    9 (5%)
   matched pairs: median predicted/reference area 0.92
model vs Google ref 3858 | pred  482 | matched  180 | precision 0.37 recall 0.05 F1 0.08 | pixel IoU 0.11 | built-up ref 51.19 ha pred 7.04 ha
Google vs OSM  ref 3096 | pred 3858 | matched 1601 | precision 0.41 recall 0.52 F1 0.46 | pixel IoU 0.62 | built-up ref 45.16 ha pred 51.19 ha
   ref    0- 100 m2: 1067 buildings, found  263 (25%)
   ref  100- 300 m2: 1861 buildings, found 1244 (67%)
   ref  300- max m2:  168 buildings, found   94 (56%)
   matched pairs: median predicted/reference area 1.09
== Mogadishu resampled to 0.6 m (the training resolution)
model vs OSM   ref 3096 | pred  538 | matched  203 | precision 0.38 recall 0.07 F1 0.11 | pixel IoU 0.17 | built-up ref 45.15 ha pred 10.81 ha
النموذج نفسه، بالإعدادات نفسها، وجد 6% فقط من المباني، و38% مما رسمه لا يطابق أي مبنى. أي أنه عملياً لا يعمل هنا. وفي المخرج أعلاه لاحظ التالي:
- في النافذة أكثر من 3000 مبنى في كيلومتر مربع، أي ثلاثة أضعاف سبوكين، والبيوت متلاصقة بأسطح معدنية متشابهة، دون حدائق تفصل بينها، فلا توجد الحواف التي تعلم النموذج أن يبحث عنها.
- والقليل الذي وجده هو البيوت المتوسطة بين 100 و300 متر مربع التي تقف منفردة نسبياً، 9% منها، أما الصغيرة فوجد منها 9 من 1067.
- والمقارنة بـ Google تعطي الصورة نفسها، فالمشكلة في النموذج لا في المرجع.
- وتغيير الدقة إلى 0.6 متر، أي دقة صور التدريب، رفع الاستدعاء من 0.06 إلى 0.07 فقط، فالمشكلة ليست حجم البكسل وإنما شكل المدينة نفسها.
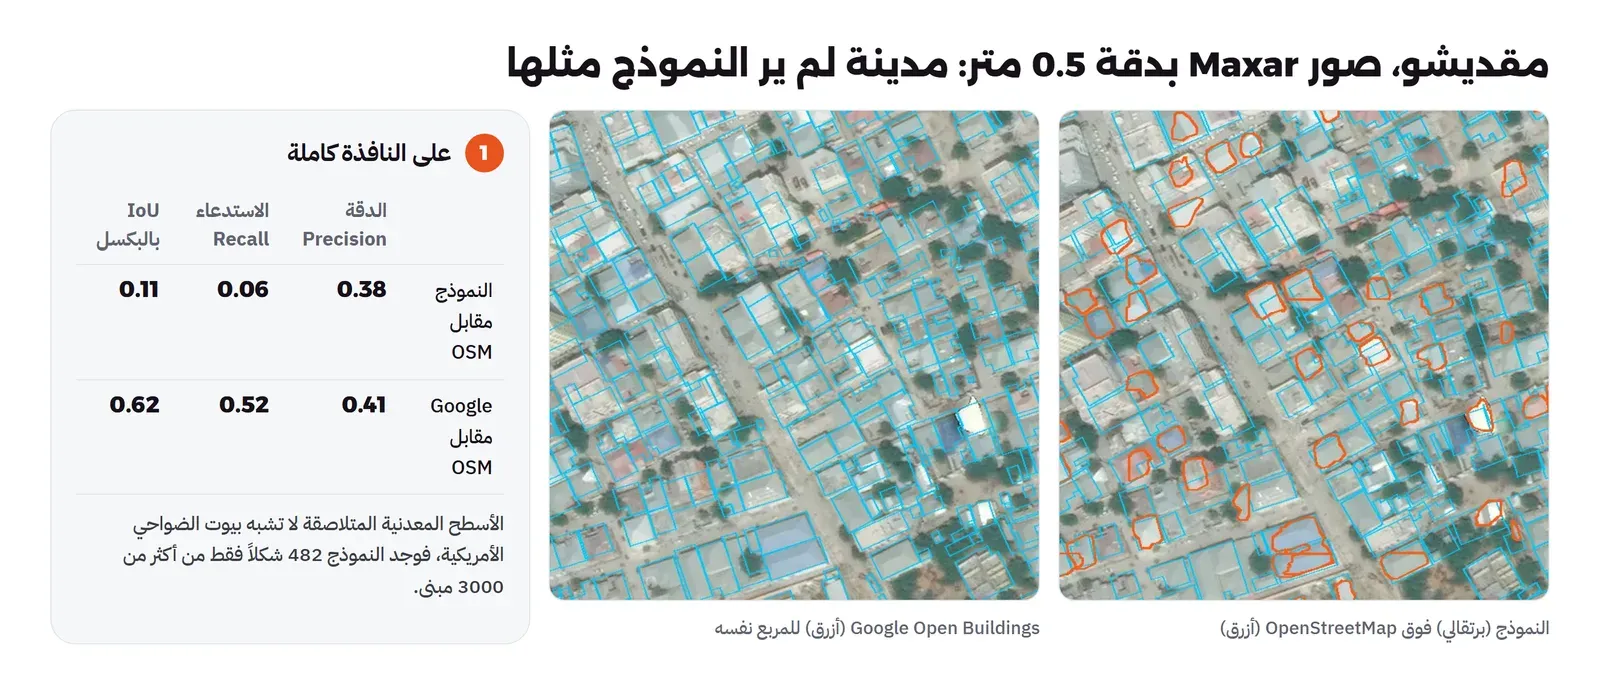
وهذا ما يسمى انزياح المجال Domain Shift: النموذج يتعلم الأنماط الموجودة في بيانات تدريبه، لا مفهوم «المبنى» بشكل عام. فبيوت الضواحي الأمريكية بأسطحها المائلة وحدائقها وممراتها الإسفلتية شيء، وحي كثيف بأسطح معدنية متلاصقة شيء آخر، والمدينة العربية بأسطحها الخرسانية المسطحة وخزانات المياه والأسوار العالية شيء ثالث. ولا يوجد رقم سحري يصلح ذلك أثناء التشغيل، لا العتبة ولا الدقة، والحل الوحيد أن يرى النموذج أمثلة من المكان الجديد، وهذا ما نتحدث عنه بعد قليل.
قبل أن تتهم النموذج: هل المرجع في مكانه؟
عندما نظرنا إلى صورة مقديشو بعد رسم مضلعات OpenStreetMap فوقها، بدت لنا المضلعات مزاحة قليلاً عن الأسطح، وقد يتساءل البعض: أليس السبب أن المرجع نفسه في غير مكانه؟ فالصورة من مصدر، والمباني رسمت فوق صورة أخرى، وفرق بضعة أمتار يكفي لإسقاط IoU تحت 0.5. لذلك كتبنا السكربت lab/shift.py الذي يحرك طبقة فوق الأخرى حتى 15 متراً في كل اتجاه، ويبحث عن الإزاحة التي تعطي أعلى IoU بالبكسل:
mogadishu-pred vs mogadishu-osm
pixel IoU as is: 0.111; best 0.112 when the second layer moves +1.0 m east and +0.0 m north
mogadishu-pred vs mogadishu-google
pixel IoU as is: 0.110; best 0.112 when the second layer moves +0.5 m east and -1.5 m north
mogadishu-google vs mogadishu-osm
pixel IoU as is: 0.624; best 0.649 when the second layer moves +0.5 m east and +1.5 m north
spokane-pred vs spokane-osm
pixel IoU as is: 0.316; best 0.316 when the second layer moves +0.0 m east and +0.0 m north
spokane-microsoft vs spokane-osm
pixel IoU as is: 0.808; best 0.808 when the second layer moves +0.0 m east and +0.0 m north
أفضل إزاحة في كل الحالات متر ونصف أو أقل، ولا تغير IoU إلا في الرقم الثاني بعد الفاصلة، أي أن الطبقات منطبقة على الصورة، وما رأيناه بالعين سببه على الأغلب ميل الأسطح في صورة القمر الصناعي، لا خطأ في المرجع. وهذا فحص رخيص يجب أن تقوم به قبل أي مقارنة، لأن إزاحة 5 أمتار كانت ستجعل أي نموذج يبدو سيئاً مهما كانت جودته.
ولماذا لا تتفق Google وOpenStreetMap في مقديشو؟
F1 بين Google وOpenStreetMap في مقديشو 0.46 فقط، مع أن IoU بالبكسل 0.62، أي أن الطبقتين تغطيان المساحة المبنية نفسها تقريباً، ولكنهما تقسمانها إلى مبان بشكل مختلف. وفي حي بيوته متلاصقة لا يوجد جواب واحد صحيح: المتطوع في OpenStreetMap قد يرسم البيت مع ملحقه مبنى واحداً أو مبنيين، والنموذج قد يدمج بيتين متلاصقين بسقف متشابه في مضلع واحد. لذلك لا تعتمد على مقياس واحد: IoU بالبكسل يجيب عن «هل المساحة المبنية صحيحة؟»، وهو ما يكفي لتقدير السكان أو أثر السيل، والمطابقة لكل مبنى تجيب عن «هل عدد المباني وحدودها صحيحة؟»، وهو ما يهمك عند ربط المباني بالعناوين أو العدادات.
ماذا يحدث إذا غيرنا العتبة؟
آخر جزء من lab/03-evaluate.sh يعيد المعالجة بعتبات ثقة مختلفة على الكشوف المحفوظة نفسها، دون إعادة تشغيل النموذج:
threshold 0.3: 1184 detections -> 684 buildings
threshold 0.3  ref  983 | pred  684 | matched  557 | precision 0.81 recall 0.57 F1 0.67 | pixel IoU 0.33 | built-up ref 18.46 ha pred 8.30 ha
threshold 0.7: 1045 detections -> 603 buildings
threshold 0.7  ref  983 | pred  603 | matched  525 | precision 0.87 recall 0.53 F1 0.66 | pixel IoU 0.31 | built-up ref 18.46 ha pred 7.61 ha
threshold 0.9: 930 detections -> 536 buildings
threshold 0.9  ref  983 | pred  536 | matched  488 | precision 0.91 recall 0.50 F1 0.64 | pixel IoU 0.29 | built-up ref 18.46 ha pred 6.89 ha
رفع العتبة من 0.3 إلى 0.9 رفع الدقة من 0.81 إلى 0.91، وخفض الاستدعاء من 0.57 إلى 0.50، وبقي F1 بين 0.64 و0.67. والعتبة إذاً قرار عمل لا إعداد تقني: إذا كانت الطبقة ستراجع بيد إنسان، فعتبة منخفضة تعطيه مرشحين أكثر يحذف الخطأ منها بسرعة، وإذا كانت ستنشر مباشرة، فعتبة عالية تقلل الأشكال الوهمية على حساب مبان ناقصة. ولاحظ أن العتبة لم تصلح أهم مشكلة، المرائب الصغيرة، لأن النموذج لا يراها أصلاً بأي درجة ثقة.
كيف تجعل النموذج يعمل في مدينتك؟
إذا لم تجد طبقة جاهزة جيدة لمنطقتك، والنماذج المنشورة لا تعرف شكل مبانيها، فالطريق المعروف هو الضبط الدقيق Fine-tuning: تأخذ نموذجاً مدرباً مسبقاً، وتكمل تدريبه على أمثلة من منطقتك. والنموذج لا يبدأ من الصفر، فهو يعرف الحواف والأسطح والظلال، ويحتاج فقط أن يتعلم شكلها المحلي، لذلك يكفيه عدد أقل بكثير من الأمثلة مقارنة بالتدريب من البداية. والخطوات:
- اختر رقعاً تمثل التنوع: أحياء قديمة وجديدة، كثيفة ومتفرقة، تجارية وسكنية، ومن الصور نفسها التي ستعمل عليها لاحقاً، لأن النموذج يتعلم شكل الصورة أيضاً، لونها وزاوية تصويرها ودقتها.
- ارسم المباني بدقة: كل مبنى في الرقعة، لا بعضها، لأن المبنى غير المرسوم يعلم النموذج أن هذا الشكل «ليس مبنى». وهنا يفيدك SAM: تضغط على السطح فيرسم حدوده، وأنت تصحح.
- احجز رقعاً للاختبار لم يرها التدريب: ومن أحياء مختلفة، وقس عليها بالمقاييس نفسها التي استخدمناها هنا، وقارن النتيجة بالطبقات الجاهزة قبل أي قرار.
- درب ثم راجع الأخطاء بالعين: الأرقام تقول لك كم أخطأ النموذج، والصور تقول لك لماذا، وأغلب التحسن يأتي من إضافة أمثلة للحالات التي فشل فيها.
ومكتبة geoai التي أخذنا منها النموذج فيها دوال جاهزة لتقسيم الصورة والمضلعات إلى رقع تدريب وتدريب Mask R-CNN، وقد استخدمها صاحبها لتدريب النموذج نفسه كما في دفتر التدريب المنشور. ولاحظ أمراً عملياً: التشغيل على المعالج مقبول كما رأينا، أما التدريب على المعالج فبطيء جداً، فاستأجر بطاقة رسومية سحابية بالساعة لهذه الخطوة فقط، ثم شغل النموذج الناتج على سيرفرك.
وقبل كل ذلك اسأل: هل تحتاج مضلعات أصلاً؟ فإذا كان هدفك تقدير السكان، فخلايا العمران من Sentinel-2 أو ملف السكان من WorldPop الذي استخدمناه في مقال التحليل المكاني قد تكفي، وإذا كان هدفك عنوان كل مبنى، فأنت تحتاج مضلعات دقيقة ومراجعة بشرية في كل الأحوال.
وماذا عن الطرق؟
استخراج الطرق يبدو أسهل، فالطريق خط طويل واضح، ولكنه في الحقيقة مشكلة مختلفة. فالمطلوب ليس بكسلات الطريق، وإنما شبكة متصلة يمكن التوجيه عليها، وشجرة واحدة تغطي جزءاً من الطريق في الصورة تقطع الشبكة، فيصبح الحي معزولاً في حساب أقصر طريق. لذلك تعمل أغلب الطرق على مرحلتين: تقسيم دلالي للبكسلات، ثم تحويل البقعة إلى خط مركزي Skeleton، ثم وصل الخطوط إلى شبكة بعقد عند التقاطعات. ومسابقة SpaceNet للطرق قاست النتيجة بمقياس اسمه APLS يقارن أطوال أقصر الطرق بين أزواج من النقاط على الشبكتين، لأن IoU بالبكسل لا يرى أن قطعاً صغيراً في الطريق يغير المسار كله. وإذا أردت طبقة جاهزة، فقد نشرت Microsoft طرقاً مستخرجة من الصور بطول 54.2 مليون كيلومتر برخصة ODbL. وقد شرحنا كيف تبنى شبكة قابلة للتوجيه من OpenStreetMap في مقال التحليل المكاني، وهي الخطوة التي تأتي بعد الاستخراج.
جدول القرار: تنزل أم تشغل أم تدرب؟
| الحالة | الخيار | نقاط القوة | نقاط الضعف |
|---|---|---|---|
| منطقتك مغطاة في OpenStreetMap جيداً | OpenStreetMap مباشرة | رسم بشري، أشكال دقيقة، يحدث باستمرار | ODbL بشرط المشاركة بالمثل، والتغطية غير منتظمة |
| OSM ناقص وMicrosoft أو Google تغطي المنطقة | Overture أو الطبقة الآلية الأنسب | جاهزة ومجانية، وجودتها منشورة | تاريخ الصور قديم أحياناً، وفجوات بحجم مدن |
| لا توجد طبقة، والصور من نوع ما تدرب عليه نموذج منشور | تشغيل نموذج جاهز | دقيقتان للكيلومتر المربع على المعالج | جودة أقل من الطبقات الكبيرة، كما رأينا في سبوكين |
| لا توجد طبقة، والمدينة لا تشبه بيانات أي نموذج | ضبط دقيق على أمثلة محلية | النموذج الوحيد الذي يعرف مدينتك | يحتاج رسماً يدوياً وبطاقة رسومية للتدريب |
| تحتاج طبقة رسمية دقيقة للعناوين والملكية | رسم أو مراجعة بشرية بمساعدة SAM | أدق نتيجة | أبطأ وأغلى، ولكنه ما يناسب البيانات الرسمية |
أخطاء شائعة وحلولها
- تشغيل نموذج على مدينة لا تشبه تدريبه: F1 هبط من 0.67 في سبوكين إلى 0.10 في مقديشو بالنموذج نفسه، فاختبر على رقعة مرسومة من منطقتك قبل التشغيل الكامل.
- نسيان القسمة على 255: لا يظهر خطأ، وإنما صفر مبان، فتحقق من التطبيع الذي تدرب عليه النموذج، وشغل رقعة واحدة وانظر إلى النتيجة قبل تشغيل مدينة.
- الرقع دون تداخل: المباني على حدود الرقع تقطع نصفين، فاجعل التداخل أكبر من أكبر مبنى تتوقعه، ثم أزل التكرار بـ IoU.
- الحكم بمقياس واحد: IoU بالبكسل 0.62 والمطابقة 0.46 للطبقتين نفسيهما في مقديشو، فاختر المقياس الذي يجيب عن سؤالك، واعرض الاثنين.
- اعتبار OpenStreetMap حقيقة مطلقة: هو مرجع رسمه بشر في وقت معين فوق صورة معينة، فتحقق من الإزاحة بين الطبقات، وراجع عينة من الأخطاء بعينك.
- افتراض أن الطبقة العالمية تغطي كل شيء: لم نجد مبنى واحداً من Microsoft في مقديشو، وGoogle لا تغطي المملكة، فتحقق من منطقتك قبل أن تبني خطة عليها.
- إهمال الرخص: ODbL تلزمك بنشر قاعدة البيانات المشتقة بالرخصة نفسها، وAGPL في Ultralytics تلزمك بنشر كود الخدمة، والصور على OpenAerialMap بعضها غير تجاري، فاقرأ كل رخصة قبل أن تخلط المصادر.
- صور Sentinel-2 لرسم المباني: البكسل 10 أمتار لا يرى بيتاً، فاستخدمها لتصنيف العمران فقط.
قائمة تحقق قبل أن تنشر طبقة مبان من نموذج
- هل بحثت عن طبقة جاهزة لمنطقتك في OpenStreetMap وOverture وMicrosoft وGoogle، وقارنت بها؟
- هل دقة الصور قريبة من دقة صور التدريب، وهل الصور حديثة وخالية من السحب؟
- هل اختبرت على رقعة من منطقتك مرسومة بيد إنسان، وحسبت الدقة والاستدعاء وIoU؟
- هل الرقع متداخلة، وأزلت التكرار، وتحققت أن المضلعات في نظام إحداثيات الصورة الصحيح؟
- هل تحققت من الإزاحة بين المرجع والصورة قبل الحكم على النموذج؟
- هل اخترت العتبة بحسب الاستخدام: مراجعة بشرية أم نشر مباشر؟
- هل تعرف رخصة الصور والنموذج والمرجع، وكتبت النسبة المطلوبة لكل منها؟
تنظيف المختبر
docker image rm geoai-lab
rm -rf work      # images, references, predictions and the 176 MB model
تدريب عملي
- اختر كيلومتراً مربعاً من مدينتك على OpenAerialMap برخصة CC BY 4.0، وشغل عليه المختبر، وقارن بمباني OpenStreetMap وOverture، ثم انظر إلى عشرة مبان فاتت النموذج وعشرة أشكال رسمها خطأً، واكتب ما المشترك بينها.
- عدل
infer.pyليحفظ القناع الكامل لكل رقعة بدل المضلعات، ثم احسب IoU بالبكسل مباشرة من الأقنعة، وقارن بالرقم الذي خرج من المضلعات بعد التبسيط.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- طبقة المباني تحتاج تقسيماً حسب الكائن، أي مضلعاً لكل مبنى، وصوراً بدقة نصف متر تقريباً، فصور Sentinel-2 لا ترى البيوت.
- قبل أي نموذج ابحث عن الطبقات الجاهزة: OpenStreetMap برخصة ODbL، وMicrosoft برخصة CDLA Permissive 2.0، وGoogle برخصة CC BY 4.0 أو ODbL، وOverture التي تدمجها، وتحقق من تغطية منطقتك فعلاً.
- نموذج Mask R-CNN منشور عمل على المعالج بقرابة 5 ثوان للرقعة، أي دقيقتين للكيلومتر المربع.
- في سبوكين، المدينة التي تشبه تدريبه، كانت الدقة 0.84 والاستدعاء 0.55، وفاتته المباني الصغيرة، وطبقة Microsoft الجاهزة كانت أفضل منه بوضوح.
- في مقديشو انهار النموذج نفسه إلى استدعاء 0.06، ولم يغير ذلك تغيير الدقة ولا العتبة، فالنموذج يتعلم مدن تدريبه لا فكرة المبنى.
- قس دائماً بمقياسين، IoU بالبكسل والمطابقة لكل مبنى، وتحقق أن المرجع منطبق على الصورة قبل الحكم.
- لمدينة لا تعرفها النماذج المنشورة، الطريق هو الضبط الدقيق على أمثلة محلية مرسومة بدقة، مع مراجعة بشرية لما ينشر رسمياً.
 دليلالرؤية الحاسوبية للمبتدئين: كيف يرى الحاسب الصورة؟كيف يتحول جدول من الأرقام إلى «قطة على كنبة»، وما الذي يفعله نموذج التصنيف والكشف فعلاً، وأين يخطئ ولماذا.
 دليلنماذج الارتفاع DEM: الانحدار والرؤية ومستجمع المياهكيف تحسب من نموذج ارتفاع مجاني الانحدار ومجال الرؤية ومجاري الأودية على جبال حقيقية، والأخطاء التي تجعل الأرقام مقنعة وهي خاطئة.
 دليلصور الأقمار الصناعية: Sentinel-2 وLandsat مجاناًكيف يرى القمر الصناعي الأرض، وما الذي تعنيه الحزم والدقة والغيوم، وكيف تقرأ مستطيلك من صور Sentinel-2 المجانية وتحسب منها NDVI بنفسك.
 دليلرسم الخرائط بالطائرات المسيرة مع OpenDroneMapكيف تتحول عشرات الصور الجوية إلى خريطة مصححة ونموذج ارتفاعات على سيرفرك، وما الذي يحدد دقتها قبل أن تقلع الطائرة.
 دليلالتحليل المكاني Spatial Analysis: أقرب فرع والتغطيةكيف تحسب بالأرقام أقرب فرع لكل عميل وكم شخصاً يغطي كل فرع على الطريق لا بالخط المستقيم، بأدوات PostGIS وpgRouting وبيانات سكان مفتوحة.
 دليلالبيانات الجغرافية المفتوحة Open Data في السعوديةأين تجد البيانات الجغرافية عن المملكة، وما الذي يمكن تحميله فعلاً من كل مصدر وبأي رخصة، وكيف تفحص الملف الرسمي قبل أن تبني عليه.
 دليلتحليل البيانات الجغرافية في Python مع GeoPandasكيف تجيب بكود Python يعاد تشغيله عن أسئلة مثل كم مستشفى في كل منطقة وما القرى البعيدة عن أقرب مستشفى، ببيانات OpenStreetMap حقيقية للمملكة وأرقام مقارنة مع PostGIS.
 دليلأول خريطة تفاعلية في موقعك مع MapLibre GL JSخريطة تفاعلية في صفحتك خطوة بخطوة بمكتبة MapLibre: طبقات وعلامات ونوافذ وأسماء عربية وتجميع لآلاف الأماكن، مع الأعطال التي ستقابلها وحلها.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على Python 3.12.16 مع PyTorch 2.15.0 وtorchvision 0.29.2 على المعالج، والنموذج building_footprints_usa.pth من geoai، وصور NAIP لعام 2023 وفسيفساء Maxar لعام 2019 على OpenAerialMap، والمقارنة مع Overture بتاريخ 2026-10-21 وMicrosoft Global ML Building Footprints وGoogle Open Buildings v3.