إذا كنت تعمل بالبيانات في Python فغالباً وصلك في يوم ما ملف فيه عمودان للإحداثيات، أو ملف GeoJSON من فريق آخر، ومعه سؤال يبدو بسيطاً: كم مستشفى في كل منطقة؟ وما القرى التي يبعد أقرب مستشفى عنها أكثر من خمسين كيلومتراً؟ وأين نرسم ذلك على خريطة نضعها في التقرير؟ والطريقة الأولى التي تخطر على البال أن تفتح الملف في pandas وتكتب حلقة تحسب المسافة بين كل نقطتين بمعادلة Haversine، ثم تكتشف بعد ساعة أنك تحتاج أيضاً أن تعرف هل النقطة داخل حدود منطقة أم لا، وأن الحدود مضلعات فيها آلاف الرؤوس، وأن الخريطة تحتاج إسقاطاً، وأن الأسماء العربية تظهر حروفاً مقطعة. وهنا يأتي دور GeoPandas، وهي مكتبة تضيف إلى جدول pandas الذي تعرفه عموداً للأشكال الجغرافية ونظام إحداثيات، وتعطيك العمليات المكانية كدوال على الجدول نفسه.
وفي هذه المرحلة من مسار الخرائط شرحنا التحليل بالواجهة الرسومية في QGIS، والتحليل داخل قاعدة البيانات في PostGIS والتحليل المكاني على الطرق، وهذا المقال هو الطريق الثالث: التحليل بالكود في Python، حيث يكون الناتج سكربتاً يعاد تشغيله، أو Notebook يقرؤه زميلك، أو خطوة في Pipeline بيانات. وسوف نستخدم بيانات حقيقية للمملكة من OpenStreetMap: حدود المناطق الثلاث عشرة، والمستشفيات المسجلة، والمدن والبلدات والقرى. وسوف نناقش في هذا المقال ما يلي:
- ما هو GeoPandas، والمكتبات الأربع التي يقوم عليها، ومتى تختاره بدل QGIS أو PostGIS.
- تجهيز بيئة في Container، وتحويل ملف Geofabrik إلى GeoPackage بثلاث طبقات.
- نظام الإحداثيات CRS: لماذا الدرجات ليست أمتاراً، وأي إسقاط تختار لدولة تمتد على خمس مناطق UTM.
- الربط المكاني Spatial Join، ولماذا يغير اتجاه السؤال الزمن من 14 إلى 433 مللي ثانية.
- أقرب مستشفى لكل قرية بالأمر
sjoin_nearest، والمنطقة العازلة Buffer بالمتر، والدمج Dissolve، والتقاطع Overlay. - رسم خرائط بعناوين عربية، والوصفة القديمة التي أصبحت ترسم الكلمات معكوسة في matplotlib 3.11.
- مقارنة الأداء مع PostGIS على السؤالين نفسيهما، وأخطاء لا تظهر كرسالة خطأ.
لماذا Python وليس QGIS أو PostGIS؟
الأدوات الثلاث تقوم على المكتبات نفسها تقريباً: GEOS للعمليات على الأشكال، وPROJ لأنظمة الإحداثيات، وGDAL للقراءة والكتابة، لذلك فإن الفرق بينها ليس في صحة النتيجة، وإنما في مكان العمل وطريقة إعادته. وقد يتساءل البعض: إذا كان QGIS يقوم بالربط المكاني بزر، فلماذا أكتب كوداً؟ والإجابة أن الزر لا يحفظ ما فعلته بطريقة يراجعها غيرك، فإذا تغيرت البيانات الشهر القادم ستضغط الأزرار نفسها مرة أخرى وتأمل أن تتذكر الترتيب، أما السكربت فيعاد تشغيله بأمر واحد، ويدخل في Git، ويمكن أن يعمل كل ليلة في Cron Job. ولذلك فإن القاعدة العملية بسيطة:
- QGIS: عندما تريد أن ترى البيانات وتستكشفها بعينك، أو تخرج خريطة مطبوعة بتنسيق دقيق، وقد شرحنا فيه أيضاً تشغيل الأدوات من سطر الأوامر.
- PostGIS: عندما تكون البيانات كبيرة أو تتحدث باستمرار، أو يسأل عنها تطبيق في كل طلب، أو يعمل عليها عدة أشخاص في الوقت نفسه.
- GeoPandas: عندما تكون البيانات بحجم يتسع في الذاكرة، والسؤال تحليلي لمرة واحدة أو لتقرير دوري، وتريد أن تخلط المكان مع باقي أدوات Python: pandas للجداول، وscikit-learn للنماذج، وmatplotlib للرسم.
ولاحظ أن هذا الاختيار ليس نهائياً، ففي العمل الحقيقي ستجد الثلاثة في مشروع واحد: البيانات في PostGIS، والتحليل في Notebook يقرأ منها بـ GeoPandas، والخريطة النهائية تراجع في QGIS. وإذا كانت pandas جديدة عليك فابدأ بمقال تحليل البيانات مع pandas، لأن كل ما فيه يعمل هنا كما هو.
ما هو GeoPandas؟
الكلاس الأساسي في المكتبة هو GeoDataFrame، وهو DataFrame عادي من pandas فيه عمود خاص نوعه GeoSeries، كل خلية فيه شكل هندسي Geometry: نقطة Point، أو خط LineString، أو مضلع Polygon، أو مجموعة منها. ومع العمود يحفظ الجدول نظام الإحداثيات CRS الذي كتبت به الأرقام، فالرقم 46.7 وحده لا معنى له حتى تعرف أنه خط طول بالدرجات على المرجع WGS 84. والصورة التالية تبين ما الذي يوجد خلف هذا الجدول:
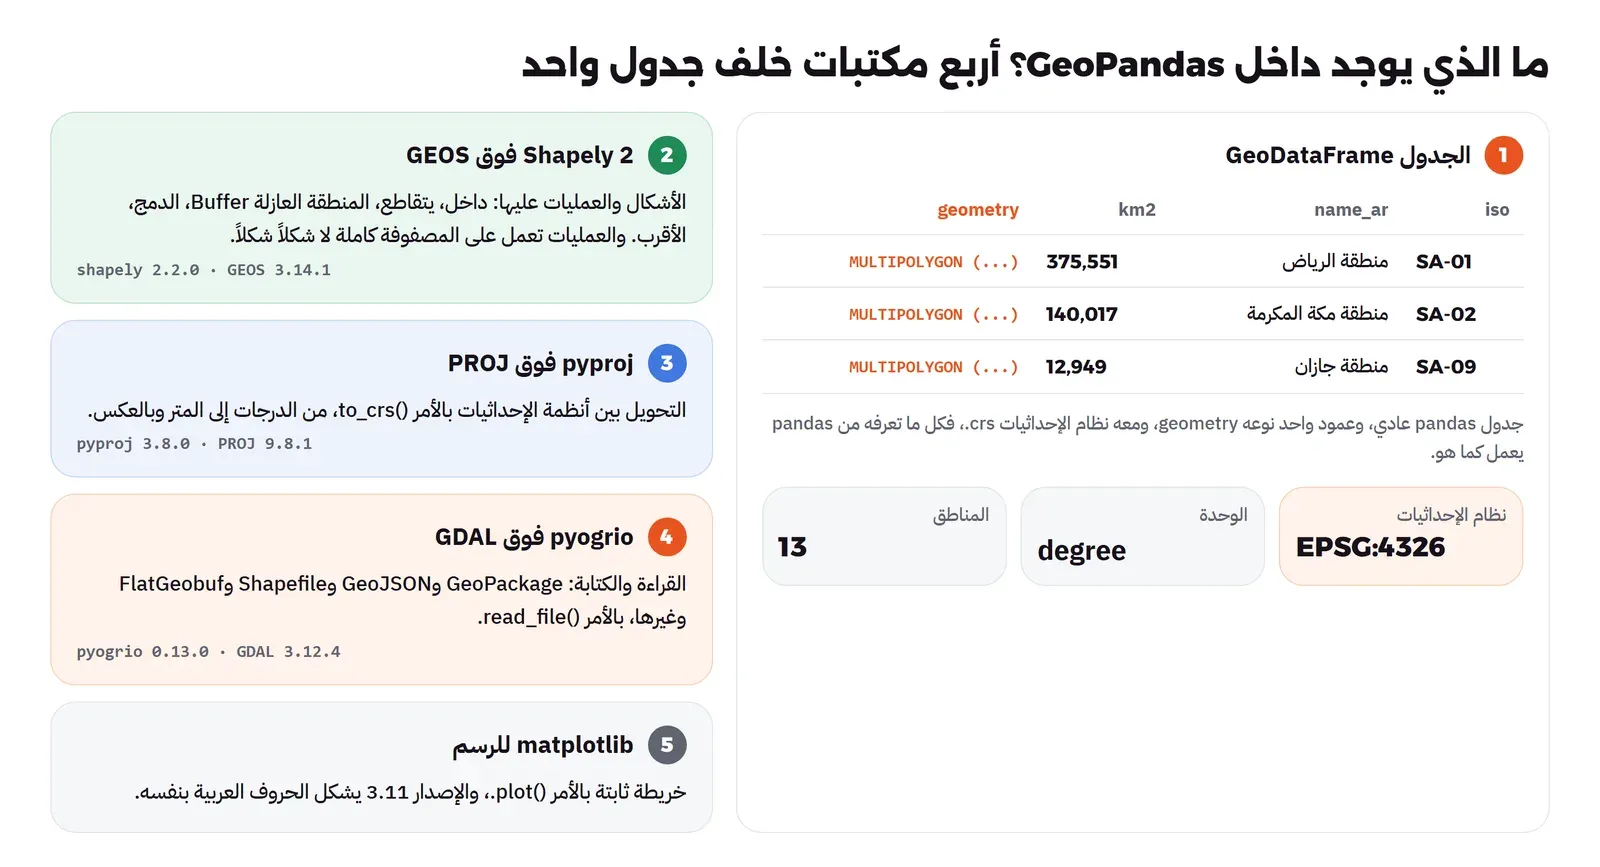
- Shapely تمثل الأشكال وتنفذ العمليات عليها عبر مكتبة GEOS المكتوبة بلغة C++، ومنذ الإصدار 2 تعمل الدوال على مصفوفة الأشكال كاملة دفعة واحدة Vectorized بدل حلقة Python على كل شكل، وهذا سبب أغلب السرعة التي سوف نراها.
- pyproj واجهة لمكتبة PROJ، وهي التي تنفذ
to_crs()وتعرف آلاف أنظمة الإحداثيات من سجل EPSG. - pyogrio واجهة سريعة لمكتبة GDAL، وهي المحرك الافتراضي للقراءة والكتابة منذ GeoPandas 1.0، فتقرأ GeoPackage وGeoJSON وShapefile وFlatGeobuf وعشرات الصيغ الأخرى.
- matplotlib للرسم، والأمر
.plot()على الجدول يرسم خريطة ثابتة تصلح لتقرير أو ورقة بحث.
وبالتالي فإن أغلب أخطاء GeoPandas ليست في GeoPandas نفسها، وإنما في الطبقة التي تحتها: خطأ في ترتيب المحاور يأتي من PROJ، وشكل مكسور يرفضه GEOS، وصيغة لا يعرفها GDAL. وعندما تعرف أي مكتبة تنفذ العملية، تعرف أين تبحث في التوثيق عن رسالة الخطأ.
تجهيز المختبر
نستخدم Container من python:3.13-slim، وهو مبني على Debian 13، ونضيف إليه أدوات سطر الأوامر osmium وGDAL وعميل PostgreSQL، ثم المكتبات من PyPI، وهو الملف lab/Dockerfile:
FROM python:3.13-slim
RUN apt-get update && apt-get install -y --no-install-recommends osmium-tool gdal-bin postgresql-client curl \
 && rm -rf /var/lib/apt/lists/*
RUN pip install --no-cache-dir geopandas shapely pyproj pyogrio matplotlib arabic-reshaper python-bidi psycopg[binary]
WORKDIR /work
لاحظ أننا لم نثبت GDAL للمكتبة pyogrio من Debian، فحزمة pyogrio من PyPI تأتي ومعها نسخة GDAL خاصة بها، وهي 3.12.4 في الإصدار الذي اختبرناه، بينما الأداة ogr2ogr من Debian هي 3.10.3، والفرق لا يضر هنا لأن كلاً منهما يعمل مستقلاً، ولكن تذكره إذا رأيت سلوكاً مختلفاً بين سطر الأوامر والكود. ثم نبني الـ Image وننشئ Volume للبيانات ونحمل ملف دول الخليج من Geofabrik:
mkdir -p gp-lab/fonts && cd gp-lab     # the lab/ files of this article, and an Arabic font in fonts/
docker build -t lab-gp .
docker volume create lab-gp-data
docker run --rm -v lab-gp-data:/data lab-gp \
  curl -fsSLo /data/gcc-states-latest.osm.pbf https://download.geofabrik.de/asia/gcc-states-latest.osm.pbf
# every later step runs the same way:
alias gp='docker run --rm -v lab-gp-data:/data -v "$PWD:/lab:ro" -v "$PWD/fonts:/fonts:ro" -w /data lab-gp'
gp python -c "import geopandas, shapely, pyproj, pyogrio; print(geopandas.__version__, shapely.__version__, pyproj.__version__, pyogrio.__version__)"
والسطر الأخير يطبع 1.2.0 2.2.0 3.8.0 0.13.0، وهي الإصدارات التي اختبرنا عليها. والملف الذي حملناه حجمه 257 ميغابايت، وتاريخ بياناته 15 نوفمبر 2026 كما يظهر في osmium fileinfo. وفي مجلد fonts ضع خطاً عربياً برخصة مفتوحة مثل IBM Plex Sans Arabic، لأن الـ Image لا يوجد فيها خط عربي، وسوف نحتاجه في الرسم.
البيانات: من ملف Geofabrik إلى GeoPackage
ملف PBF فيه كل شيء في دول الخليج: الطرق والمباني والمحلات والحدود، ونحن نحتاج ثلاثة أنواع فقط. لذلك نقص ما نحتاجه بأداة osmium أولاً، ثم نصدره كأشكال GeoJSON، وهو الملف lab/00-prepare.sh:
#!/bin/sh
# Cut the layers this lab needs out of the Geofabrik extract, one GeoPackage with three layers.
set -e
cd /data
PBF=gcc-states-latest.osm.pbf
osmium tags-filter -O "$PBF" \
  r/boundary=administrative nwr/amenity=hospital n/place=city,town,village \
  -o ksa-pick.osm.pbf
osmium export -O ksa-pick.osm.pbf -f geojsonseq -o ksa-pick.geojsonseq \
  --attributes=type,id
ls -lh ksa-pick.osm.pbf ksa-pick.geojsonseq
gp sh /lab/00-prepare.shوالمخرج سوف يكون كما يلي:
-rw-r--r-- 1 root root  54M Nov 16 22:50 ksa-pick.geojsonseq
-rw-r--r-- 1 root root 4.8M Nov 16 22:50 ksa-pick.osm.pbf
في المخرج أعلاه لاحظ التالي:
- الأمر
tags-filterأنتج ملفاً من 4.8 ميغابايت فقط، لأنه يبقي العناصر التي تطابق الشروط ومعها النقاط التي تحتاجها خطوطها، وأخذت الخطوتان معاً 53 ثانية. - الأمر
exportيبني من الخطوط والعلاقات مضلعات حقيقية، فحدود المنطقة في OpenStreetMap علاقة Relation تجمع عشرات الخطوط، وosmium يركبها في مضلع واحد. - الصيغة GeoJSONSeq تكتب كل شكل في سطر مستقل، فتقرؤها البرامج سطراً سطراً دون أن تحمل الملف كاملاً، وهذا مناسب لمخرج كبير. وتفاصيل الصيغ ومتى تختار كل واحدة في مقال صيغ البيانات الجغرافية من هذا المسار.
ثم نقرأ الملف في GeoPandas، ونفصله إلى ثلاث طبقات ونحفظها في ملف GeoPackage واحد، وهو الملف lab/01_build_gpkg.py:
# Read the GeoJSONSeq export of osmium and write one GeoPackage with three layers.
import time
import geopandas as gpd

t = time.perf_counter()
raw = gpd.read_file("/data/ksa-pick.geojsonseq", engine="pyogrio")
print(f"read {len(raw):,} features in {time.perf_counter() - t:.1f} s, crs={raw.crs}")
print(raw.geom_type.value_counts().to_string())

# 13 regions of Saudi Arabia: admin_level 4 and an ISO 3166-2 code that starts with SA-
regions = raw[(raw["admin_level"] == "4") & raw["ISO3166-2"].fillna("").str.startswith("SA-")
              & raw.geom_type.isin(["Polygon", "MultiPolygon"])]
regions = regions[["ISO3166-2", "name", "name:ar", "name:en", "geometry"]].rename(
    columns={"ISO3166-2": "iso", "name:ar": "name_ar", "name:en": "name_en"})

hosp = raw[raw["amenity"] == "hospital"].copy()
hosp["geometry"] = hosp.geometry.representative_point()   # buildings and sites become one point
hosp = hosp[["@type", "@id", "name", "name:ar", "healthcare", "geometry"]].rename(
    columns={"@type": "osm_type", "@id": "osm_id", "name:ar": "name_ar"})

places = raw[raw["place"].isin(["city", "town", "village"]) & (raw.geom_type == "Point")]
places = places[["@id", "place", "name", "name:ar", "population", "geometry"]].rename(
    columns={"@id": "osm_id", "name:ar": "name_ar"})

for name, layer in [("regions", regions), ("hospitals", hosp), ("places", places)]:
    layer.to_file("/data/ksa.gpkg", layer=name, driver="GPKG", engine="pyogrio")
    print(f"{name:10} {len(layer):6,} rows  {layer.geom_type.unique().tolist()}")
gp python /lab/01_build_gpkg.pyread 85,786 features in 133.1 s, crs=EPSG:4326
Point 71746
LineString 7641
MultiPolygon 6399
regions 13 rows ['MultiPolygon']
hospitals 2,178 rows ['Point']
places 6,634 rows ['Point']في المخرج أعلاه لاحظ التالي:
- القراءة أخذت 133 ثانية لـ 85,786 شكلاً، وهذا بطيء، والسبب أن GeoJSON نص يجب تحليله رقماً رقماً، وأن كل شكل فيه كل وسوم OpenStreetMap كأعمدة. ولهذا السبب نحول مرة واحدة إلى GeoPackage، وبعدها تصبح القراءة أقل من نصف ثانية كما سوف نرى.
- في الملف 6,399 مضلعاً متعدداً MultiPolygon، أغلبها حدود إدارية لكل دول الخليج، ومنها 13 فقط هي مناطق المملكة، وقد اخترناها بشرطين: المستوى الإداري 4، ورمز ISO 3166-2 الذي يبدأ بـ SA.
- المستشفى في OpenStreetMap قد يكون نقطة أو مضلع مبنى أو مضلع أرض المستشفى كاملة، لذلك حولنا كل مستشفى إلى نقطة واحدة بالدالة
representative_point()، وهي نقطة مضمونة داخل الشكل، بخلافcentroidالذي قد يقع خارج مضلع على شكل حرف L. - 2,178 مستشفى و6,634 مكاناً مأهولاً، ولكن هذه أرقام دول الخليج كلها، وسوف نقصها على حدود المملكة بالربط المكاني نفسه بعد قليل.
ولماذا GeoPackage؟ لأنه ملف SQLite واحد فيه عدة طبقات ونظام الإحداثيات وفهرس مكاني، بلا حد لطول اسم العمود كما في Shapefile، وبلا ملفات جانبية تضيع عند الإرسال. وتذكر أن بيانات OpenStreetMap برخصة ODbL، فأي خريطة أو جدول تنشره منها يجب أن يذكر المصدر.
النظرة الأولى على الملف
قبل أي تحليل نعرف ماذا وصلنا: الطبقات، ونظام الإحداثيات، والحدود، وهل الأشكال سليمة. وهو الملف lab/02_explore.py:
# First look at the GeoPackage: layers, CRS, bounds, validity.
import pyogrio
import geopandas as gpd

for name, gtype in pyogrio.list_layers("/data/ksa.gpkg"):
    print(f"layer {name:10} {gtype}")

regions = gpd.read_file("/data/ksa.gpkg", layer="regions")
print(regions.crs.name, "| EPSG:", regions.crs.to_epsg(), "| units:", regions.crs.axis_info[0].unit_name)
print(regions[["iso", "name_ar", "name_en"]].sort_values("iso").to_string(index=False))
print("bounds:", regions.total_bounds.round(3))
print("valid:", regions.is_valid.value_counts().to_dict())
print("vertices:", regions.count_coordinates().sum())
layer regions MultiPolygon
layer hospitals Point
layer places Point
WGS 84 | EPSG: 4326 | units: degree
iso name_ar name_en
SA-01 منطقة الرياض Riyadh Region
SA-02 منطقة مكة المكرمة Makkah Region
SA-03 منطقة المدينة المنورة Medina Province
SA-04 المنطقة الشرقية Eastern Province
SA-05 منطقة القصيم Al-Qassim Province
SA-06 منطقة حائل Ḥa'il Province
SA-07 منطقة تبوك Tabuk Province
SA-08 منطقة الحدود الشمالية Northern Borders Province
SA-09 منطقة جازان Jazan Province
SA-10 منطقة نجران Najran Region
SA-11 منطقة الباحة Al-Bahah Province
SA-12 منطقة الجوف Al Jawf Region
SA-14 منطقة عسير 'Asir Province
bounds: [34.494 16.38 55.667 32.154]
valid: {True: 13}
vertices: 190447في المخرج أعلاه لاحظ التالي:
pyogrio.list_layersيقرأ أسماء الطبقات ونوع أشكالها دون أن يقرأ البيانات، فاستخدمه عندما يصلك ملف لا تعرف ما فيه.- نظام الإحداثيات EPSG:4326 ووحدته الدرجة degree، وهذه أهم معلومة في المخرج كله، لأن أي مسافة أو مساحة نحسبها الآن ستكون بالدرجات.
- الأسماء الإنجليزية في OpenStreetMap غير موحدة: Region مرة وProvince مرة، وحائل مكتوبة بحرف خاص، لذلك اعتمد على رمز ISO كمفتاح للربط مع أي جدول آخر، لا على الاسم.
- الرمز SA-13 غير موجود، وبعد SA-12 يأتي SA-14 لعسير، وهذا من المعيار نفسه لا خطأ في البيانات، فلا تكتب حلقة تفترض أن الأرقام متتالية.
- الحدود الثلاث عشرة فيها 190,447 رأساً Vertex، وهذا رقم سوف نعود إليه عندما نتحدث عن سرعة الربط المكاني.
نظام الإحداثيات CRS: الدرجات ليست أمتاراً
شرحنا المراجع والإسقاطات بالتفصيل في مقال المرجع الجيوديسي، وهنا يهمنا سؤال عملي واحد: أي نظام تستخدم عندما تحسب مسافة أو مساحة أو منطقة عازلة في GeoPandas؟ لأن GeoPandas تحسب على الأرقام كما هي في مستو مسطح، ولا تعرف أن الأرض كروية، فإذا كانت الأرقام درجات فالمسافة الناتجة درجات، وهي لا تساوي طولاً ثابتاً، فدرجة الطول عند خط العرض 28 أقصر بنحو 12% من درجة العرض. لذلك نجرب المسافة نفسها بين مدينتين في طرفي المملكة بعدة أنظمة، وهو الملف lab/04_crs.py:
# Which CRS for metres? The same distance and the same 30 km buffer in several CRS.
import warnings
import geopandas as gpd
from pyproj import Geod
from shapely.geometry import Point

G = "/data/ksa.gpkg"
places = gpd.read_file(G, layer="places")
cities = places[places["place"] == "city"].dropna(subset=["name"])

def pick(name):
    row = cities[cities["name"] == name]
    return row.iloc[0]

a, b = pick("تبوك"), pick("الدمام")      # far west and far east
print("A:", a["name"], a.geometry.coords[0], "| B:", b["name"], b.geometry.coords[0])

geod = Geod(ellps="WGS84")
_, _, true_m = geod.inv(a.geometry.x, a.geometry.y, b.geometry.x, b.geometry.y)
print(f"geodesic (ellipsoid)      {true_m / 1000:10.1f} km")

pts = gpd.GeoSeries([a.geometry, b.geometry], crs=4326)
with warnings.catch_warnings(record=True) as w:
    warnings.simplefilter("always")
    deg = pts.iloc[0].distance(pts.iloc[1])
    print(f"EPSG:4326 (degrees)       {deg:10.3f} deg   <- not a distance")
    _ = pts.buffer(0.3)
    print("warning:", w[-1].message if w else None)

for label, crs in [("UTM 38N EPSG:32638", 32638), ("UTM 36N EPSG:32636", 32636),
                   ("LAEA lon_0=45", "+proj=laea +lat_0=24 +lon_0=45 +datum=WGS84 +units=m"),
                   ("Web Mercator EPSG:3857", 3857)]:
    p = pts.to_crs(crs)
    d = p.iloc[0].distance(p.iloc[1])
    print(f"{label:24} {d / 1000:10.1f} km  error {100 * (d - true_m) / true_m:+6.2f}%")

# A 30 km buffer drawn in each CRS, area measured on the ellipsoid
for label, crs in [("UTM 36N (Tabuk's zone)", 32636), ("UTM 38N", 32638), ("Web Mercator", 3857)]:
    circle = gpd.GeoSeries([a.geometry], crs=4326).to_crs(crs).buffer(30_000).to_crs(4326)
    area, _ = geod.geometry_area_perimeter(circle.iloc[0])
    print(f"30 km buffer in {label:24} true area {abs(area) / 1e6:8.1f} km2 (circle = 2827.4)")
A: تبوك (36.567049, 28.4012536) | B: الدمام (50.1039991, 26.4367824)
geodesic (ellipsoid) 1355.4 km
EPSG:4326 (degrees) 13.679 deg <- not a distance
warning: Geometry is in a geographic CRS. Results from 'buffer' are likely incorrect. Use 'GeoSeries.to_crs()' to re-project geometries to a projected CRS before this operation.
UTM 38N EPSG:32638 1357.8 km error +0.17%
UTM 36N EPSG:32636 1375.3 km error +1.47%
LAEA lon_0=45 1355.2 km error -0.02%
Web Mercator EPSG:3857 1526.9 km error +12.66%
30 km buffer in UTM 36N (Tabuk's zone) true area 2816.6 km2 (circle = 2827.4)
30 km buffer in UTM 38N true area 2777.9 km2 (circle = 2827.4)
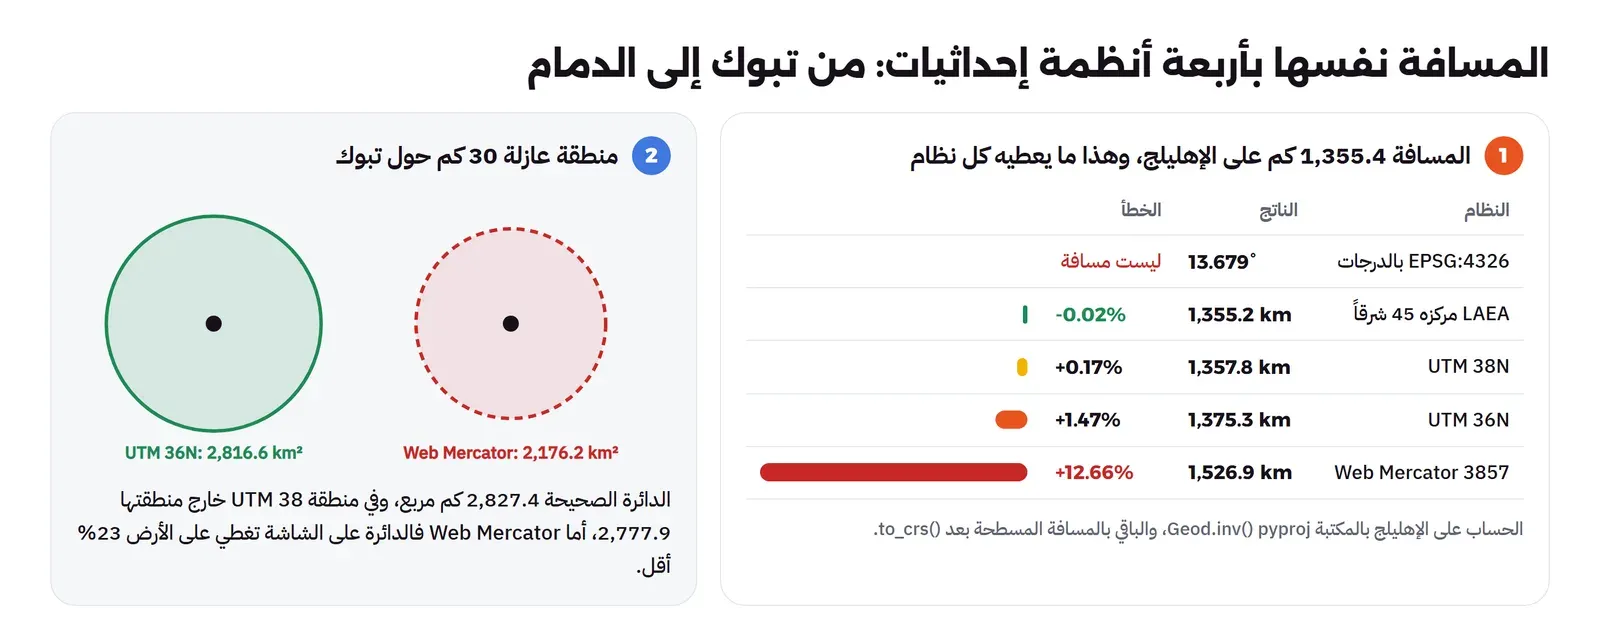
30 km buffer in Web Mercator true area 2176.2 km2 (circle = 2827.4)والصورة التالية تلخص الأرقام:
في المخرج أعلاه لاحظ التالي:
- المسافة الصحيحة 1,355.4 كيلومتراً، حسبناها على الإهليلج بالدالة
Geod.invمن pyproj، وهي المرجع الذي نقارن به كل شيء. - بالدرجات أعطت GeoPandas الرقم 13.679، ولم تعترض لأن الدالة
distanceعلى شكلين لا تعرف وحدة الأرقام، أماbufferعلى الجدول فأعطت تحذيراً صريحاً:Geometry is in a geographic CRS، وهو تحذير لا يوقف الكود، فإذا كان الكود في Pipeline لا يقرأ أحد مخرجاته فسيمر الخطأ دون أن يراه أحد. - الإسقاط المتساوي المساحة Lambert Azimuthal Equal Area واختصاراً LAEA، بمركز عند خط عرض 24 وخط طول 45، أعطى خطأ 0.02% فقط على مسافة 1,355 كيلومتراً، لأن مركزه في وسط المملكة، فلا توجد نقطة بعيدة عنه كثيراً.
- UTM 38 هو منطقة الرياض ووسط المملكة، والخطأ فيه صغير حتى لمدينة خارج منطقته، أما UTM 36، وهي منطقة تبوك، فأخطأت بنسبة 1.47% لأن الدمام بعيدة جداً عن خط طولها المركزي.
- Web Mercator، وهو إسقاط خرائط الويب، أخطأ بنسبة 12.66% في المسافة، والدائرة التي رسمها بنصف قطر 30 كيلومتراً تغطي على الأرض 2,176 كيلومتراً مربعاً بدل 2,827، أي أقل بنحو 23%. وهذا متوقع، فهو إسقاط للعرض على الشاشة لا للقياس، فلا تستخدمه في أي حساب.
أي نظام تختار؟
المملكة تمتد من خط الطول 34.5 إلى 55.7 تقريباً، أي على خمس مناطق UTM من 36 إلى 40، ولذلك لا توجد منطقة UTM واحدة تصلح للدولة كلها. والقاعدة التي نتبعها في هذا المقال:
- عمل داخل مدينة أو منطقة واحدة: منطقة UTM التي تقع فيها، مثل 32637 لمكة المكرمة وجدة، و32638 للرياض، و32639 للمنطقة الشرقية، فالخطأ فيها جزء من الألف.
- مساحات ومسافات على مستوى الدولة: إسقاط متساوي المساحة بمركز في وسط المملكة مثل LAEA الذي استخدمناه، وتكتبه كنص PROJ كما في الكود، ولا تحتاج أن يكون له رقم EPSG.
- مسافات بين مدن متباعدة بدقة عالية: الحساب على الإهليلج مباشرة بـ
pyproj.Geod، أو في PostGIS بالنوع geography. - الحفظ والتبادل: ابق على EPSG:4326 في الملف، وحول إلى الإسقاط المناسب داخل الكود فقط قبل الحساب، لأن كل البرامج تفهم 4326.
وتذكر أن to_crs لا تغير الجدول الأصلي، وإنما تعيد جدولاً جديداً، فإذا كتبت regions.to_crs(LAEA) في سطر وحده ثم حسبت المساحة على regions فأنت ما زلت بالدرجات.
الربط المكاني Spatial Join: كم مستشفى في كل منطقة؟
الربط العادي في pandas بالأمر merge يربط صفين إذا تساوت قيمة عمود، أما الربط المكاني فيربط صفين إذا تحققت علاقة بين شكليهما: النقطة داخل المضلع within، أو المضلعان يتقاطعان intersects، أو الخط يلمس المضلع touches. وهذه العلاقات معرفة في نموذج يسمى DE-9IM يستخدمه GEOS وPostGIS وكل أدوات GIS، لذلك فإن within هنا تعني الشيء نفسه في ST_Within. وهو الملف lab/03_sjoin.py:
# Spatial join: which region is each hospital in, and how many hospitals per region.
import time
import geopandas as gpd

G = "/data/ksa.gpkg"
regions = gpd.read_file(G, layer="regions")
hosp = gpd.read_file(G, layer="hospitals")
print("hospitals in the file (all GCC):", len(hosp))

t = time.perf_counter()
joined = gpd.sjoin(hosp, regions[["iso", "name_ar", "geometry"]], how="inner", predicate="within")
print(f"sjoin within: {len(joined)} rows in {(time.perf_counter() - t) * 1000:.0f} ms")
print("hospitals matched to two regions:", joined.index.duplicated().sum())

# Area in km2 needs an equal-area CRS, not degrees
LAEA = "+proj=laea +lat_0=24 +lon_0=45 +datum=WGS84 +units=m"
regions["km2"] = regions.to_crs(LAEA).area / 1e6

per_region = (joined.groupby("iso").size().rename("hospitals").to_frame()
              .join(regions.set_index("iso")[["name_ar", "km2"]]))
per_region["per_10k_km2"] = per_region["hospitals"] / per_region["km2"] * 1e4
print(per_region.sort_values("hospitals", ascending=False)
      .round({"km2": 0, "per_10k_km2": 2}).to_string())
print("total in Saudi regions:", per_region["hospitals"].sum())

# the same join written with the spatial index directly, in both directions
t = time.perf_counter()
pairs = regions.sindex.query(hosp.geometry, predicate="within")      # tree of 13 polygons, 2,178 points asked
print(f"regions.sindex.query(points, within): {pairs.shape[1]} pairs in {(time.perf_counter() - t) * 1000:.0f} ms")
_ = hosp.sindex                                                         # build the points tree first
t = time.perf_counter()
pairs = hosp.sindex.query(regions.geometry, predicate="contains")    # tree of points, 13 polygons asked
print(f"hosp.sindex.query(regions, contains): {pairs.shape[1]} pairs in {(time.perf_counter() - t) * 1000:.0f} ms")
hospitals in the file (all GCC): 2178
sjoin within: 1144 rows in 24 ms
hospitals matched to two regions: 0
hospitals name_ar km2 per_10k_km2
iso
SA-02 285 منطقة مكة المكرمة 140017.0 20.35
SA-01 267 منطقة الرياض 375551.0 7.11
SA-04 169 المنطقة الشرقية 523772.0 3.23
SA-05 98 منطقة القصيم 70388.0 13.92
SA-03 77 منطقة المدينة المنورة 144845.0 5.32
SA-09 69 منطقة جازان 12949.0 53.28
SA-14 47 منطقة عسير 76981.0 6.11
SA-12 38 منطقة الجوف 87647.0 4.34
SA-07 35 منطقة تبوك 135984.0 2.57
SA-06 24 منطقة حائل 120111.0 2.00
SA-10 19 منطقة نجران 127211.0 1.49
SA-08 11 منطقة الحدود الشمالية 98215.0 1.12
SA-11 5 منطقة الباحة 11146.0 4.49
total in Saudi regions: 1144
regions.sindex.query(points, within): 1144 pairs in 433 ms
hosp.sindex.query(regions, contains): 1144 pairs in 14 msفي المخرج أعلاه لاحظ التالي:
- من 2,178 مستشفى في ملف الخليج، 1,144 فقط داخل مناطق المملكة، والربط من النوع
innerأسقط الباقي تلقائياً، وهذه طريقة نظيفة لقص البيانات على حدود دولة دون عملية قص Clip للأشكال نفسها. - لا يوجد مستشفى ربط بمنطقتين، ولكن تحقق من ذلك دائماً بالأمر
index.duplicated()، لأن نقطة على الحد تماماً، أو منطقتين متداخلتين قليلاً بسبب خطأ في الرسم، تجعل الصف يتكرر، فيعد المستشفى مرتين في المجموع. - المساحة محسوبة بعد التحويل إلى LAEA، ومجموع مساحات المناطق في OpenStreetMap 1.92 مليون كيلومتر مربع، وهو أقل من الرقم الرسمي المتداول لمساحة المملكة، والفرق من رسم الحدود في OpenStreetMap نفسها، فلا تستخدم هذه المساحات كأرقام رسمية.
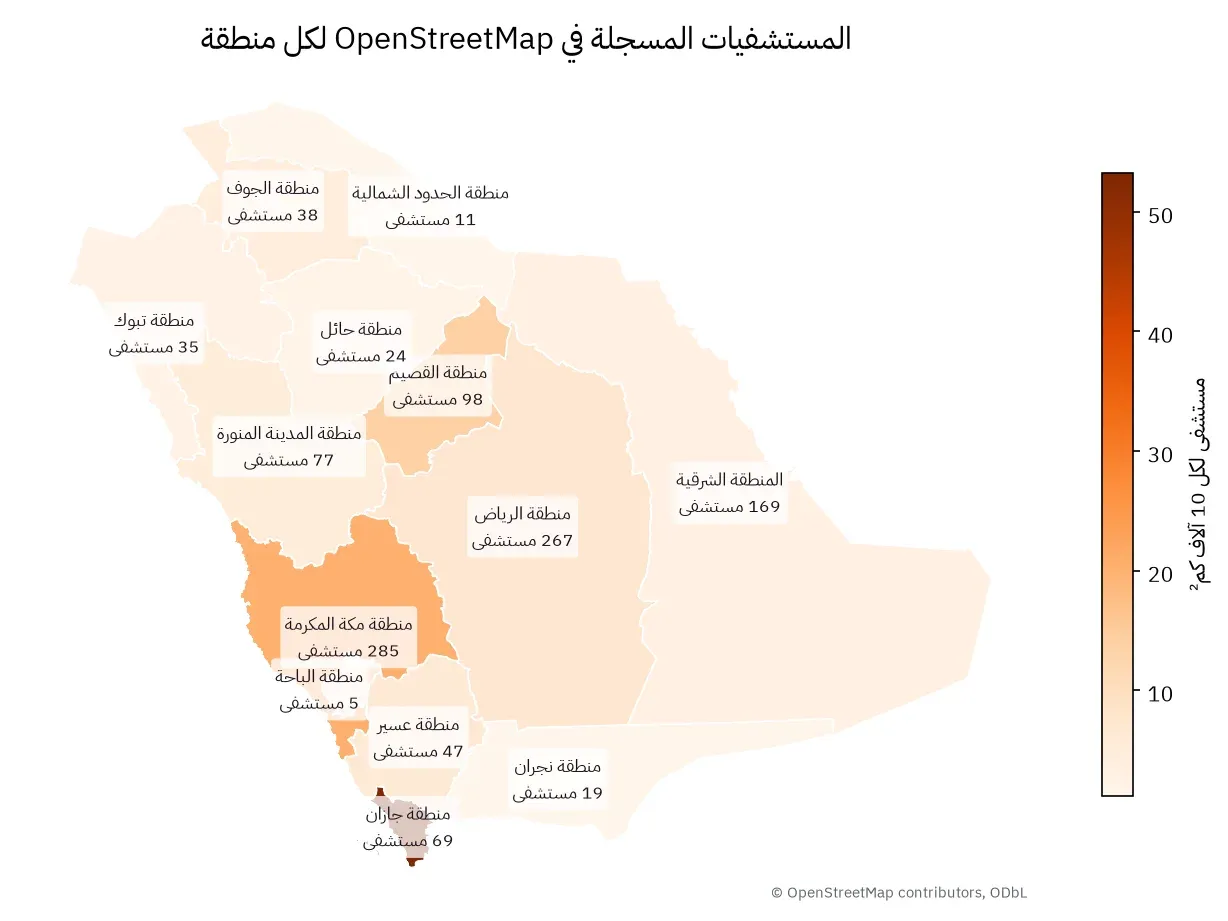
- جازان أكثر المناطق كثافة بالمستشفيات بالنسبة للمساحة، 53 مستشفى لكل عشرة آلاف كيلومتر مربع، لأنها صغيرة المساحة، بينما الحدود الشمالية 1.1 فقط. والمقياس بالمساحة مضلل لمنطقة فيها صحراء واسعة، والأصح أن تقسم على عدد السكان، كما فعلنا في مقال التحليل المكاني بخلايا WorldPop.
- الباحة فيها 5 مستشفيات فقط في OpenStreetMap، وهذا الرقم يقول شيئاً عن اكتمال الخريطة أكثر مما يقول عن المنطقة، وقد ناقشنا تغطية OpenStreetMap في المملكة في مقال البيانات الجغرافية المفتوحة في السعودية.
والخريطة التالية رسمناها من هذه النتيجة نفسها، والكود في قسم الرسم بعد قليل:
كيف يعمل الربط من الداخل؟
الطريقة البسيطة أن تختبر كل مستشفى مع كل منطقة، أي 2,178 في 13، وكل اختبار يمر على آلاف الرؤوس في حدود المنطقة، وهذا يصبح بطيئاً بسرعة. والذي يحدث فعلاً على مرحلتين: الأولى تصفية Filter بفهرس مكاني من نوع STRtree، وهو شجرة من المستطيلات المحيطة Bounding Boxes، فتعطي لكل نقطة المناطق التي يحتوي مستطيلها على النقطة، وهي عملية سريعة جداً لأنها مقارنة أربعة أرقام، وفي مختبرنا أعطت 2,393 مرشحاً في مللي ثانية واحدة. والثانية تحقق Refine دقيق بالعلاقة نفسها على المرشحين فقط، وهنا يمر GEOS على رؤوس المضلع.
والمخرج الأخير في الملف يبين أمراً مهماً: نفس السؤال كتبناه مرتين بالفهرس مباشرة، فأخذ 433 مللي ثانية في اتجاه، و14 مللي ثانية في الاتجاه الآخر، والنتيجة نفسها 1,144 زوجاً. والسبب في المرحلة الثانية: عندما نسأل شجرة المناطق عن النقاط، يجهز GEOS كل نقطة سائلة كشكل مجهز Prepared Geometry ويقارنها بالمضلع الكبير غير المجهز، فيمر على رؤوسه في كل مرة. أما عندما نسأل شجرة النقاط عن المناطق، فيجهز كل مضلع مرة واحدة، والمضلع المجهز يبني فهرساً داخلياً لحوافه، فيصبح اختبار كل نقطة بعده سريعاً. والصورة التالية تبين ذلك:
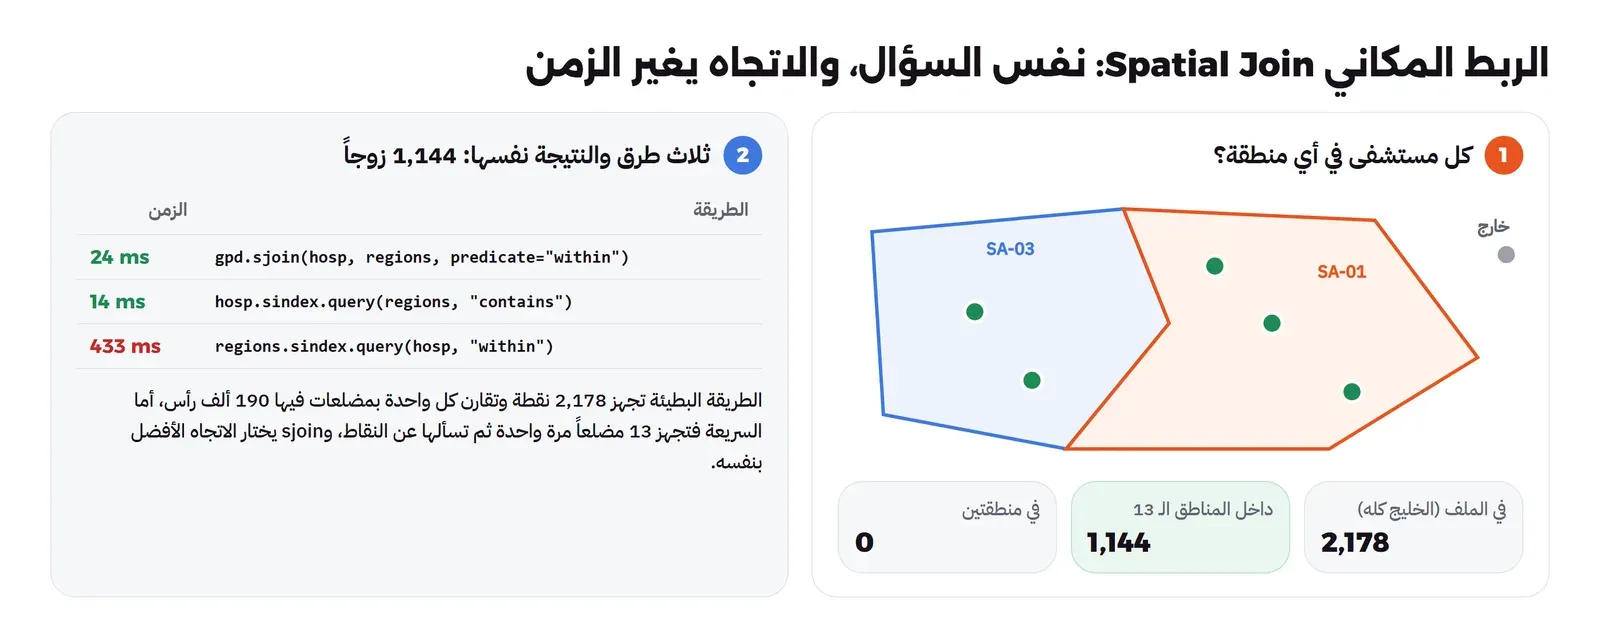
ولاحظ أن sjoin نفسها أخذت 24 مللي ثانية، أي أنها اختارت الاتجاه الصحيح بنفسها. لذلك فالقاعدة: استخدم sjoin ما دامت تكفيك، وإذا نزلت إلى sindex.query لسبب خاص، فاجعل الشجرة على الجدول الكثير الصغير، والسؤال بالأشكال القليلة الكبيرة.
أقرب مستشفى لكل قرية
السؤال الثاني الذي طرحناه في البداية: ما القرى التي يبعد أقرب مستشفى عنها أكثر من 50 كيلومتراً؟ والدالة sjoin_nearest تربط كل صف بأقرب صف في الجدول الآخر، وتضيف عموداً بالمسافة إذا طلبت. وهو الملف lab/05_nearest.py:
# Nearest join: distance from every town and village in Saudi Arabia to the nearest hospital.
import time
import geopandas as gpd

G = "/data/ksa.gpkg"
LAEA = "+proj=laea +lat_0=24 +lon_0=45 +datum=WGS84 +units=m"
regions = gpd.read_file(G, layer="regions")[["iso", "name_ar", "geometry"]].rename(columns={"name_ar": "region"})
hosp = gpd.read_file(G, layer="hospitals")
places = gpd.read_file(G, layer="places")

# keep only what lies inside the 13 regions, and attach the region code
hosp = gpd.sjoin(hosp, regions, predicate="within").drop(columns="index_right")
places = gpd.sjoin(places, regions, predicate="within").drop(columns="index_right")
print("inside KSA: hospitals", len(hosp), "| places", places["place"].value_counts().to_dict())

hosp_m, places_m = hosp.to_crs(LAEA), places.to_crs(LAEA)
t = time.perf_counter()
near = gpd.sjoin_nearest(places_m, hosp_m[["name", "geometry"]], how="left",
                         distance_col="dist_m", lsuffix="place", rsuffix="hosp")
print(f"sjoin_nearest: {len(near)} rows for {len(places_m)} places in {(time.perf_counter() - t) * 1000:.0f} ms")
near = near[~near.index.duplicated()]          # ties return one row per equally near hospital

d = near["dist_m"] / 1000
print(f"median {d.median():.1f} km | p90 {d.quantile(.9):.1f} km | max {d.max():.1f} km")
for km in (10, 30, 50, 100):
    print(f"farther than {km:3} km: {(d > km).sum():5}  ({100 * (d > km).mean():.1f}%)")

far = near[near["dist_m"] > 50_000]
print(far.groupby("region")["osm_id"].count().rename("places_over_50km")
      .sort_values(ascending=False).to_string())

# max_distance limits the search radius: places with no hospital within 30 km get NaN
t = time.perf_counter()
capped = gpd.sjoin_nearest(places_m, hosp_m[["geometry"]], how="left", max_distance=30_000, distance_col="dist_m")
print(f"with max_distance=30 km: {capped['dist_m'].isna().sum()} places without a hospital, "
      f"{(time.perf_counter() - t) * 1000:.0f} ms")
near.to_crs(4326).to_file("/data/out.gpkg", layer="places_nearest", driver="GPKG")
inside KSA: hospitals 1144 | places {'village': 3629, 'town': 221, 'city': 55}
sjoin_nearest: 3905 rows for 3905 places in 57 ms
median 25.6 km | p90 67.0 km | max 560.2 km
farther than 10 km: 3071 (78.6%)
farther than 30 km: 1694 (43.4%)
farther than 50 km: 799 (20.5%)
farther than 100 km: 97 (2.5%)
region
منطقة المدينة المنورة 204
منطقة الرياض 134
منطقة مكة المكرمة 116
منطقة عسير 99
منطقة القصيم 62
منطقة حائل 56
منطقة تبوك 44
المنطقة الشرقية 32
منطقة الحدود الشمالية 18
منطقة الباحة 12
منطقة الجوف 9
منطقة نجران 8
منطقة جازان 5
with max_distance=30 km: 1694 places without a hospital, 37 msوالصورة التالية تبين الأرقام وما يحدث داخل الدالة:
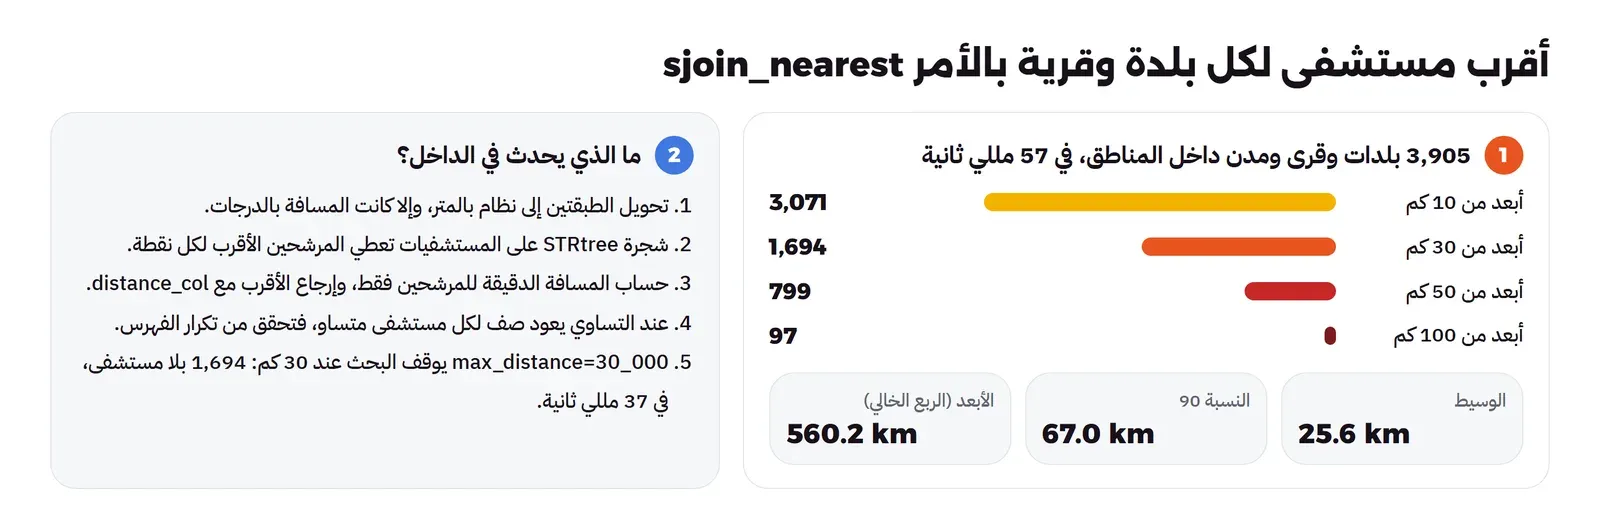
في المخرج أعلاه لاحظ التالي:
- داخل المملكة 3,905 أماكن مأهولة في هذه الطبقة: 55 مدينة و221 بلدة و3,629 قرية، والربط بأقرب مستشفى لها كلها أخذ 57 مللي ثانية.
- الوسيط 25.6 كيلومتراً بالخط المستقيم، و20.5% من الأماكن، أي 799، أبعد من 50 كيلومتراً عن أقرب مستشفى مسجل في OpenStreetMap.
- أبعد مكان 560 كيلومتراً، وهو قرية في الربع الخالي قرب الحدود الشرقية، وقد فتحناه وتحققنا أنه مكان حقيقي لا خطأ في الإحداثيات. وهذه عادة جيدة: كلما رأيت رقماً متطرفاً، افتح الصف نفسه قبل أن تحذفه أو تبني عليه.
- المدينة المنورة تتصدر القائمة بـ 204 أماكن أبعد من 50 كيلومتراً، ثم الرياض ومكة المكرمة وعسير، والسبب أن القرى المسجلة فيها كثيرة ومتفرقة.
- الخيار
max_distanceيوقف البحث عند حد، فالمكان الذي لا يوجد مستشفى ضمن 30 كيلومتراً منه يأخذ قيمة فارغة NaN، وهذا أسرع قليلاً، 37 مللي ثانية، وأوضح في الكود عندما يكون سؤالك نفسه «هل يوجد ضمن كذا؟».
وقد يتساءل البعض: لماذا حذفنا الصفوف المكررة في السطر near[~near.index.duplicated()]؟ والإجابة أن التوثيق يذكر أنه عند تساوي مسافة مستشفيين أو أكثر من النقطة نفسها تعاد كل المستشفيات المتساوية، فيظهر المكان أكثر من مرة، وإذا لم تحذف التكرار فستعد هذا المكان مرتين في كل مجموع بعدها. وفي بياناتنا لم يتكرر شيء، ولكن الحالة تحدث فعلاً عندما يكون مستشفيان في المبنى نفسه بالإحداثيات نفسها.
المنطقة العازلة Buffer والدمج Dissolve والتقاطع Overlay
السؤال الثالث بصيغة المساحة: كم من مساحة كل منطقة يقع على بعد 30 كيلومتراً أو أقل من مستشفى؟ والطريقة: نرسم حول كل مستشفى دائرة نصف قطرها 30 كيلومتراً، وهي المنطقة العازلة Buffer، ثم ندمج الدوائر المتداخلة في شكل واحد، ثم نقاطع الشكل مع كل منطقة ونحسب المساحة. وهو الملف lab/06_buffer_dissolve.py:
# Buffer in metres, dissolve, overlay: how much of each region lies within 30 km of a hospital.
import time
import geopandas as gpd

G = "/data/ksa.gpkg"
LAEA = "+proj=laea +lat_0=24 +lon_0=45 +datum=WGS84 +units=m"
regions = gpd.read_file(G, layer="regions")[["iso", "name_ar", "geometry"]].to_crs(LAEA)
hosp = gpd.read_file(G, layer="hospitals").to_crs(LAEA)
hosp = gpd.sjoin(hosp, regions[["geometry"]], predicate="within").drop(columns="index_right")

t = time.perf_counter()
rings = hosp.buffer(30_000)                      # metres, because the CRS is in metres
print(f"{len(rings)} buffers, area sum {rings.area.sum() / 1e6:,.0f} km2  ({(time.perf_counter() - t) * 1000:.0f} ms)")

t = time.perf_counter()
covered = gpd.GeoDataFrame(geometry=[rings.union_all()], crs=LAEA)
print(f"union_all: {covered.area.iloc[0] / 1e6:,.0f} km2, {covered.count_coordinates().iloc[0]:,} vertices "
      f"({(time.perf_counter() - t) * 1000:.0f} ms)")

country = regions.dissolve()                     # 13 regions -> one polygon
print(f"dissolve regions: {len(regions)} -> {len(country)}, area {country.area.iloc[0] / 1e6:,.0f} km2")

t = time.perf_counter()
inter = gpd.overlay(regions, covered, how="intersection", keep_geom_type=True)
print(f"overlay intersection: {len(inter)} rows ({(time.perf_counter() - t) * 1000:.0f} ms)")
inter["covered_km2"] = inter.area / 1e6
regions["km2"] = regions.area / 1e6
share = regions.merge(inter[["iso", "covered_km2"]], on="iso", how="left").fillna({"covered_km2": 0})
share["pct"] = 100 * share["covered_km2"] / share["km2"]
print(share[["iso", "name_ar", "km2", "covered_km2", "pct"]].sort_values("pct")
      .round({"km2": 0, "covered_km2": 0, "pct": 1}).to_string(index=False))
print(f"country: {100 * share['covered_km2'].sum() / share['km2'].sum():.1f}% of the area within 30 km")
covered.to_crs(4326).to_file("/data/out.gpkg", layer="covered_30km", driver="GPKG")
share.drop(columns="geometry").to_csv("/data/coverage.csv", index=False)
1144 buffers, area sum 3,229,390 km2 (36 ms)
union_all: 403,698 km2, 7,296 vertices (202 ms)
dissolve regions: 13 -> 1, area 1,924,818 km2
overlay intersection: 13 rows (673 ms)
iso name_ar km2 covered_km2 pct
SA-04 المنطقة الشرقية 523772.0 42758.0 8.2
SA-08 منطقة الحدود الشمالية 98215.0 10813.0 11.0
SA-10 منطقة نجران 127211.0 15051.0 11.8
SA-07 منطقة تبوك 135984.0 19310.0 14.2
SA-06 منطقة حائل 120111.0 23004.0 19.2
SA-12 منطقة الجوف 87647.0 17007.0 19.4
SA-01 منطقة الرياض 375551.0 73584.0 19.6
SA-03 منطقة المدينة المنورة 144845.0 33547.0 23.2
SA-02 منطقة مكة المكرمة 140017.0 46048.0 32.9
SA-14 منطقة عسير 76981.0 26692.0 34.7
SA-05 منطقة القصيم 70388.0 37379.0 53.1
SA-11 منطقة الباحة 11146.0 6605.0 59.3
SA-09 منطقة جازان 12949.0 11041.0 85.3
country: 18.9% of the area within 30 kmفي المخرج أعلاه لاحظ التالي:
- مجموع مساحات الدوائر 3.23 مليون كيلومتر مربع، وهو أكبر من مساحة المملكة نفسها، لأن الدوائر في المدن متداخلة جداً، فالمستشفى الواحد في وسط الرياض تتداخل دائرته مع عشرات الدوائر. وبعد الدمج
union_allأصبحت المساحة الحقيقية 403,698 كيلومتراً مربعاً، وهذا هو الرقم الذي يعني شيئاً. dissolve()دمج المناطق الثلاث عشرة في شكل واحد للدولة، وهو مثلgroupbyولكن للأشكال، فإذا أعطيته عموداً مثلdissolve(by="region")دمج كل الأشكال التي لها القيمة نفسها، ويمكن أن يجمع الأعمدة الأخرى بالخيارaggfunc.overlayمعintersectionأعاد 13 صفاً، جزء كل منطقة الذي يقع داخل الشكل المدمج، مع أعمدة المنطقة، وأخذ 673 مللي ثانية، وهي أبطأ عملية في المقال لأنها تحسب حدوداً جديدة بين أشكال معقدة.- جازان 85% من مساحتها ضمن 30 كيلومتراً من مستشفى، والمنطقة الشرقية 8.2% فقط، وعلى مستوى المملكة 18.9%. وتذكر مرة أخرى أن المساحة ليست الناس، فأغلب مساحة الشرقية صحراء الربع الخالي، والسؤال عن السكان يحتاج بيانات سكان.
ولاحظ أن نصف القطر 30,000 مكتوب بالمتر، وهذا صحيح فقط لأننا حولنا الطبقة إلى LAEA قبل buffer، ولو تركناها على 4326 لكان الرقم 30,000 درجة، وهو رقم يغطي الكرة الأرضية عدة مرات. وفي الإصدارات القديمة كان الحل المتداول أن تكتب نصف القطر بالدرجات، 0.27 مثلاً، وهذا خطأ، لأن الدائرة بالدرجات تصبح بيضاوية على الأرض كما رأينا في قسم نظام الإحداثيات.
خريطة بعناوين عربية
الرسم بالأمر .plot() يكفي لخريطة تقرير: تلوين المضلعات بقيمة عمود Choropleth، ونقاط فوقها، وعناوين. والعقبة المعروفة عند العرب كانت دائماً الحروف العربية، فقد كانت matplotlib لسنوات تكتب الحروف منفصلة ومن اليسار إلى اليمين، والحل المتداول في كل الشروحات أن تمرر النص على مكتبتين قبل الرسم: arabic-reshaper التي تختار شكل كل حرف بحسب موقعه في الكلمة، وpython-bidi التي تعكس ترتيب النص ليظهر من اليمين. وهذا ما كتبناه في المحاولة الأولى للملف lab/07_plot.py، ثم رأينا النتيجة:
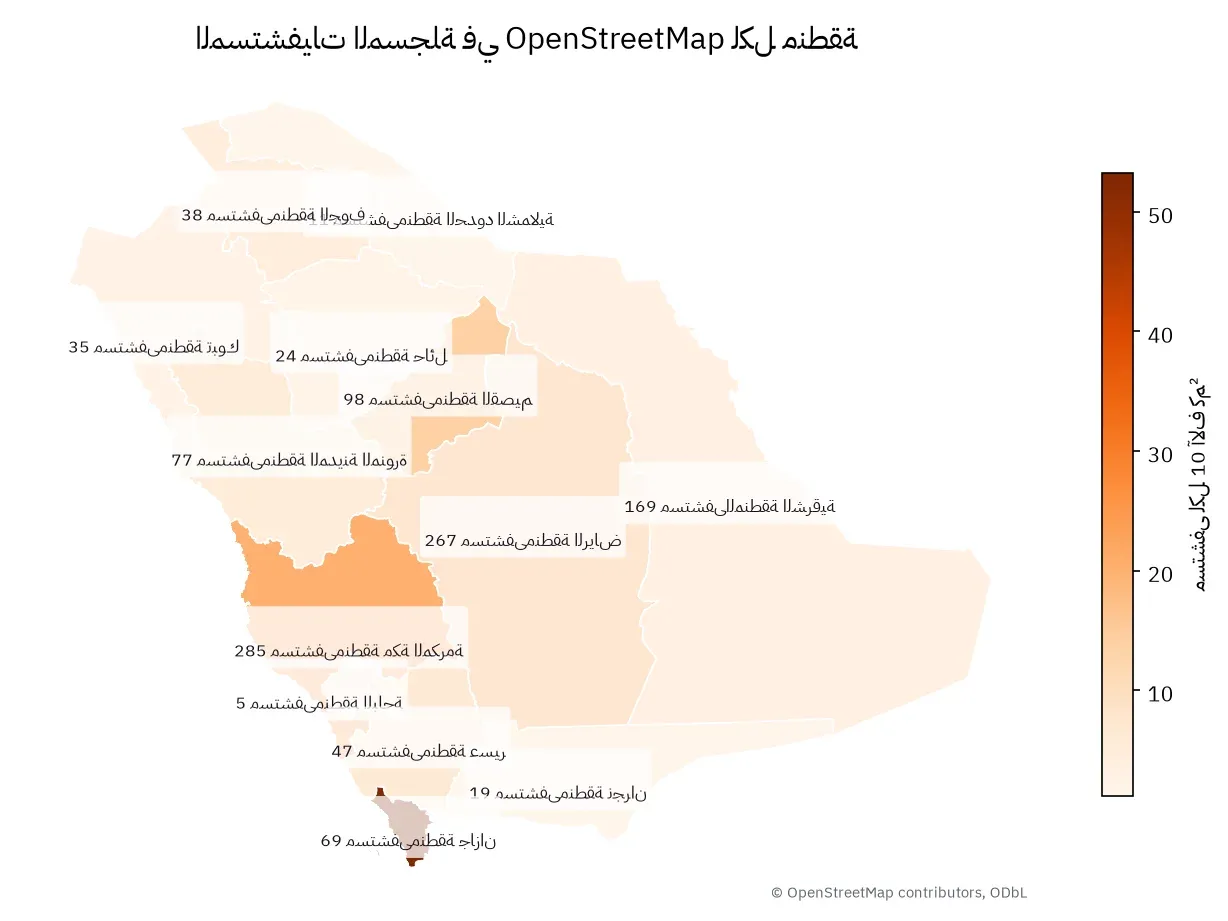
والسبب موثق في ملاحظات إصدار matplotlib 3.11: أصبحت المكتبة تستخدم libraqm لتخطيط النص المعقد، فتشكل الحروف العربية وترتبها من اليمين بنفسها، وبالتالي فإن النص الذي رتبته python-bidi مسبقاً يعاد ترتيبه مرة ثانية فيظهر معكوساً، دون أي رسالة خطأ. والملاحظات تقول ذلك صراحة، وتنبه أن من لا يقرأ العربية سيرى نصاً يبدو صحيحاً، فيمر الخطأ إلى التقرير. والحل على 3.11 وما بعده أن تمرر النص العربي كما هو، وهو ما يفعله الملف الآن بشكل افتراضي، مع خيار --old-recipe لإعادة التجربة:
# Two maps with Arabic labels: hospitals per 10,000 km2 by region, and places far from a hospital.
import sys
import arabic_reshaper
import geopandas as gpd
import matplotlib
import pandas as pd
from bidi import get_display
from matplotlib import font_manager

matplotlib.use("Agg")
import matplotlib.pyplot as plt

OLD = "--old-recipe" in sys.argv            # the reshaper + bidi workaround from older tutorials
font_manager.fontManager.addfont("/fonts/IBMPlexSansArabic-Regular.ttf")
plt.rcParams["font.family"] = "IBM Plex Sans Arabic"

def ar(text):
    """Matplotlib 3.11 shapes Arabic itself (libraqm); the old recipe pre-shapes and reorders the string."""
    return get_display(arabic_reshaper.reshape(text)) if OLD else text

LAEA = "+proj=laea +lat_0=24 +lon_0=45 +datum=WGS84 +units=m"
G = "/data/ksa.gpkg"
regions = gpd.read_file(G, layer="regions").to_crs(LAEA)
hosp = gpd.read_file(G, layer="hospitals").to_crs(LAEA)
hosp = gpd.sjoin(hosp, regions[["iso", "geometry"]], predicate="within")
regions["km2"] = regions.area / 1e6
regions = regions.merge(hosp.groupby("iso").size().rename("n").reset_index(), on="iso")
regions["density"] = regions["n"] / regions["km2"] * 1e4

fig, ax = plt.subplots(figsize=(11, 9), dpi=150)
regions.plot(ax=ax, column="density", cmap="Oranges", edgecolor="white", linewidth=0.8,
             legend=True, legend_kwds={"label": ar("مستشفى لكل 10 آلاف كم²"), "shrink": 0.6})
NUDGE = {"SA-11": (-60_000, -10_000), "SA-08": (40_000, 0), "SA-12": (-40_000, 0)}   # small regions next to each other
for _, r in regions.iterrows():
    p = r.geometry.representative_point()
    dx, dy = NUDGE.get(r["iso"], (0, 0))
    p = type(p)(p.x + dx, p.y + dy)
    ax.annotate(ar(f"{r['name_ar']}\n{r['n']} مستشفى"), (p.x, p.y), ha="center", va="center", fontsize=8.5,
                color="#17111A", bbox={"boxstyle": "round,pad=0.25", "fc": "white", "ec": "none", "alpha": .75})
ax.set_title(ar("المستشفيات المسجلة في OpenStreetMap لكل منطقة"), fontsize=15)
ax.set_axis_off()
ax.text(0.99, 0.01, "© OpenStreetMap contributors, ODbL", transform=ax.transAxes, ha="right", fontsize=7, color="#5F6470")
out = "/data/map-density-old-recipe.png" if OLD else "/data/map-density.png"
fig.savefig(out, bbox_inches="tight")
print("saved", out)

if not OLD:
    near = gpd.read_file("/data/out.gpkg", layer="places_nearest").to_crs(LAEA)
    covered = gpd.read_file("/data/out.gpkg", layer="covered_30km").to_crs(LAEA)
    fig, ax = plt.subplots(figsize=(11, 9), dpi=150)
    regions.plot(ax=ax, color="#F6F7F9", edgecolor="#9AA0AA", linewidth=0.6)
    covered.clip(regions.dissolve()).plot(ax=ax, color="#1F8A55", alpha=0.18)
    hosp.plot(ax=ax, color="#1F8A55", markersize=4, label=ar("مستشفى"))
    far = near[near["dist_m"] > 50_000]
    far.plot(ax=ax, color="#C62828", markersize=7, label=ar(f"بلدة أو قرية أبعد من 50 كم ({len(far)})"))
    ax.legend(loc="lower left", fontsize=10)
    ax.set_title(ar("الأخضر: على بعد 30 كم أو أقل من مستشفى، والأحمر: أبعد من 50 كم"), fontsize=14)
    ax.set_axis_off()
    ax.text(0.99, 0.01, "© OpenStreetMap contributors, ODbL", transform=ax.transAxes, ha="right", fontsize=7, color="#5F6470")
    fig.savefig("/data/map-far.png", bbox_inches="tight")
    print("saved /data/map-far.png")
gp python /lab/07_plot.py
gp python /lab/07_plot.py --old-recipesaved /data/map-density.png
saved /data/map-far.png
saved /data/map-density-old-recipe.pngفي الكود أعلاه لاحظ التالي:
- الخط العربي يضاف بـ
font_manager.fontManager.addfontمن ملف، ثم يختار بالاسم فيrcParams، والخط الافتراضي DejaVu Sans لا يحتوي على كل أشكال الحروف العربية. - الحساب كله على LAEA، والرسم أيضاً، فتظهر المملكة بنسبها الحقيقية لا ممطوطة كما في الرسم بالدرجات.
- القاموس
NUDGEيزيح ثلاثة عناوين لمناطق صغيرة متجاورة حتى لا تتراكب، وهذا عمل يدوي لا مفر منه في الخرائط الثابتة، أما الخرائط التفاعلية فتتعامل مع تراكب العناوين بنفسها. - نسبة OpenStreetMap مكتوبة في زاوية كل خريطة، وهذا شرط الرخصة لا زينة.
وإذا كان كودك سيعمل على إصدارات قديمة وجديدة من matplotlib معاً، فالملاحظات نفسها تقترح أن تحيط النص المعالج مسبقاً بالمحرفين LEFT-TO-RIGHT OVERRIDE وPOP DIRECTIONAL FORMATTING، فيظهر صحيحاً في الحالتين، مع اختلاف بسيط في المسافات بين الحروف. والخريطة الثانية من الملف نفسه تجمع كل ما حسبناه:
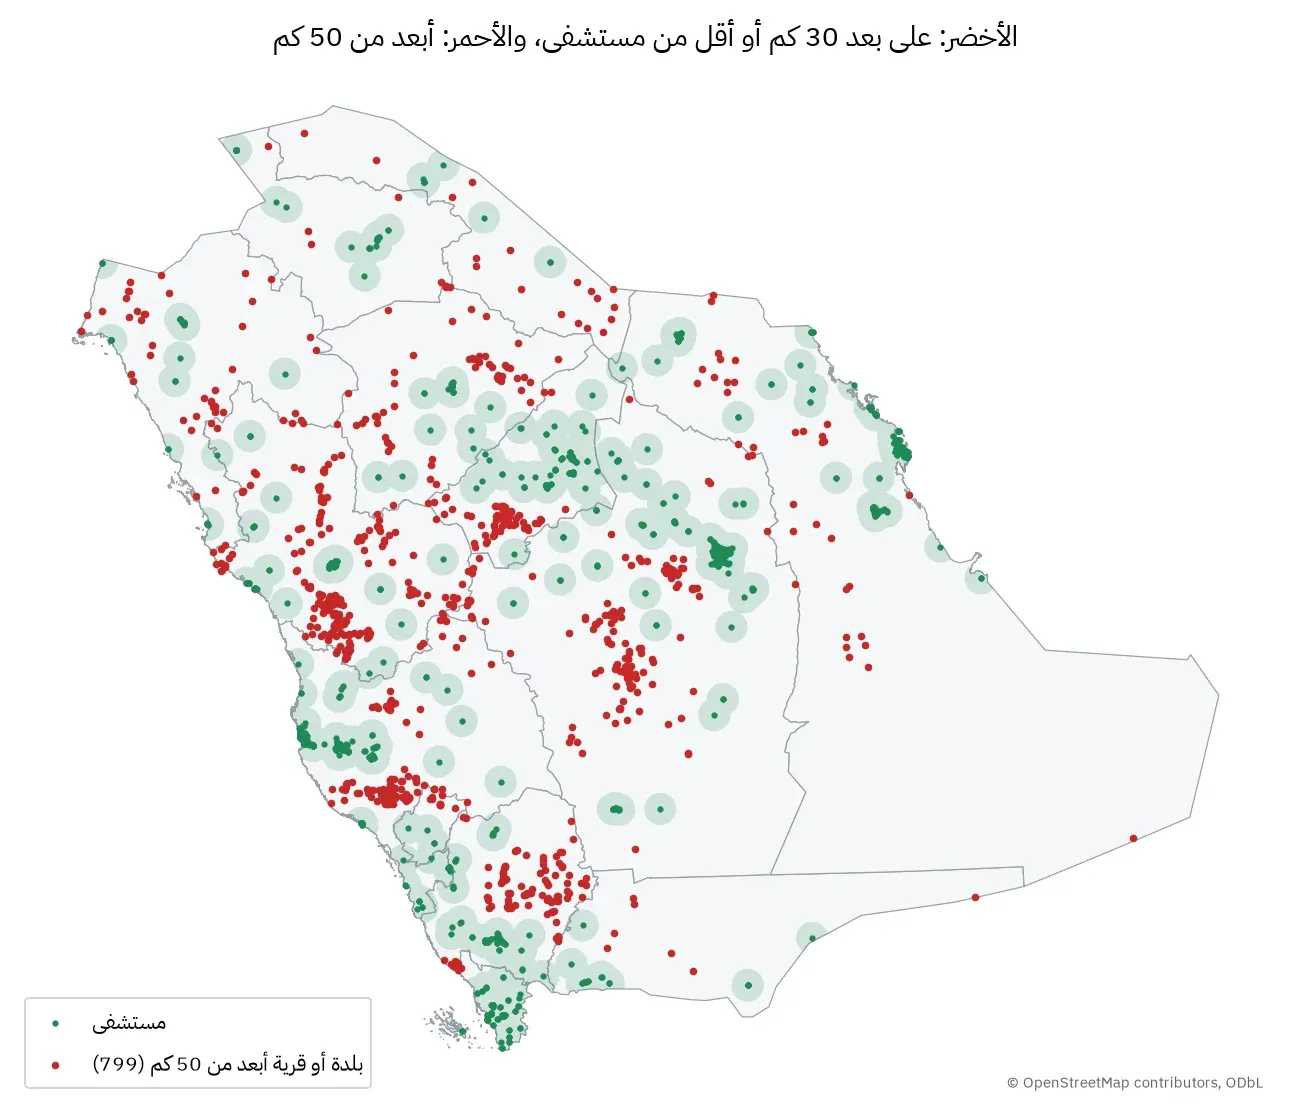
ولاحظ في الخريطة أن النقاط الحمراء ليست في الصحراء الفارغة، وإنما في مجموعات واضحة في المرتفعات الغربية وحول المدينة المنورة وجنوب غرب المملكة، وهذا ما لا يظهر في جدول الأرقام. ولكن قبل أن تكتب في التقرير أن هذه القرى بلا خدمة، تذكر أن المستشفيات المسجلة في OpenStreetMap أقل من الواقع، وأن المراكز الصحية الأولية غير موجودة في هذا التحليل أصلاً، لأننا اخترنا الوسم amenity=hospital فقط.
GeoPandas أم PostGIS؟ نفس السؤالين على نفس الملف
بما أن المكتبات تحت الأداتين متشابهة، فالسؤال العملي: أيهما أسرع لعملي؟ لذلك حملنا ملف GeoPackage نفسه إلى PostGIS 3.7 على PostgreSQL 18، ونفذنا السؤالين نفسيهما، وهو الملفان lab/08_postgis.sh وlab/08_postgis.sql:
#!/bin/sh
# Load the same GeoPackage into PostGIS and run the same two questions there, timed.
set -e
until pg_isready -q -h lab-gp-pg; do sleep 1; done      # the server needs a few seconds on first start
PG="PG:host=lab-gp-pg user=postgres password=lab dbname=gis"
for L in regions hospitals places; do
  ogr2ogr -f PostgreSQL "$PG" /data/ksa.gpkg "$L" -nln "$L" -lco GEOMETRY_NAME=geom -overwrite
done
export PGPASSWORD=lab
psql -h lab-gp-pg -U postgres -d gis -f /lab/08_postgis.sql
-- The same two questions as 03_sjoin.py and 05_nearest.py, in PostGIS.
\timing on
-- hospitals per region (point in polygon)
SELECT r.iso, count(*) AS hospitals
FROM hospitals h JOIN regions r ON ST_Within(h.geom, r.geom)
GROUP BY r.iso ORDER BY hospitals DESC LIMIT 3;
-- the nearest hospital for every town and village inside the regions, metres on the ellipsoid
CREATE TEMP TABLE ksa_places AS
SELECT p.* FROM places p JOIN regions r ON ST_Within(p.geom, r.geom);
CREATE TEMP TABLE ksa_hosp AS
SELECT h.* FROM hospitals h JOIN regions r ON ST_Within(h.geom, r.geom);
CREATE INDEX ON ksa_hosp USING gist ((geom::geography));
ANALYZE ksa_hosp;
SELECT count(*) AS places,
round(percentile_cont(0.5) WITHIN GROUP (ORDER BY d) / 1000) AS median_km,
count(*) FILTER (WHERE d > 50000) AS over_50km
FROM (
SELECT ST_Distance(p.geom::geography, n.geom::geography) AS d
FROM ksa_places p
CROSS JOIN LATERAL (SELECT geom FROM ksa_hosp ORDER BY ksa_hosp.geom::geography <-> p.geom::geography LIMIT 1) n
) s;
-- the same question on planar metres, the projection GeoPandas used (LAEA centred on the Kingdom)
INSERT INTO spatial_ref_sys (srid, auth_name, auth_srid, proj4text)
VALUES (990001, 'lab', 990001, '+proj=laea +lat_0=24 +lon_0=45 +datum=WGS84 +units=m +no_defs')
ON CONFLICT DO NOTHING;
CREATE TEMP TABLE ksa_hosp_m AS SELECT ST_Transform(geom, 990001) AS geom FROM ksa_hosp;
CREATE TEMP TABLE ksa_places_m AS SELECT ST_Transform(geom, 990001) AS geom FROM ksa_places;
CREATE INDEX ON ksa_hosp_m USING gist (geom);
ANALYZE ksa_hosp_m;
SELECT count(*) AS places,
round(percentile_cont(0.5) WITHIN GROUP (ORDER BY d) / 1000) AS median_km,
count(*) FILTER (WHERE d > 50000) AS over_50km
FROM (
SELECT ST_Distance(p.geom, n.geom) AS d
FROM ksa_places_m p
CROSS JOIN LATERAL (SELECT geom FROM ksa_hosp_m ORDER BY ksa_hosp_m.geom <-> p.geom LIMIT 1) n
) s;
\timing offdocker network create lab-gp-net
docker run -d --name lab-gp-pg --network lab-gp-net -e POSTGRES_PASSWORD=lab -e POSTGRES_DB=gis postgis/postgis:18-3.7
docker run --rm --network lab-gp-net -v lab-gp-data:/data -v "$PWD:/lab:ro" lab-gp sh /lab/08_postgis.shوفي أول تشغيل، قبل أن نضيف سطر الانتظار، شغلنا ogr2ogr مباشرة بعد docker run، فكان المخرج كما يلي:
ERROR 1: PQconnectdb failed.
connection to server at "lab-gp-pg" (172.22.0.2), port 5432 failed: Connection refused
	Is the server running on that host and accepting TCP/IP connections?

ERROR 1: PQconnectdb failed.
connection to server at "lab-gp-pg" (172.22.0.2), port 5432 failed: Connection refused
	Is the server running on that host and accepting TCP/IP connections?

ERROR 1: PQconnectdb failed.
connection to server at "lab-gp-pg" (172.22.0.2), port 5432 failed: Connection refused
	Is the server running on that host and accepting TCP/IP connections?

ERROR 1: PostgreSQL driver doesn't currently support database creation.
Please create database with the `createdb' command.
ERROR 1: PostgreSQL driver failed to create PG:host=lab-gp-pg user=postgres password=XXX dbname=gis
والسبب أن الـ Container يبدأ فوراً، ولكن PostgreSQL يحتاج ثواني في أول تشغيل لإنشاء قاعدة البيانات وإضافة PostGIS، فالاتصال يرفض حتى ينتهي. وogr2ogr حاول ثلاث مرات، ثم ظن أن قاعدة البيانات غير موجودة وحاول أن ينشئها، فظهرت الرسالة الأخيرة المضللة عن createdb، والقاعدة في الحقيقة موجودة ولكن السيرفر لم يكن جاهزاً بعد. لذلك أضفنا السطر until pg_isready الذي تراه في الملف، وهو ينتظر حتى يقبل السيرفر الاتصالات. وبعد ذلك كان المخرج كما يلي:
Timing is on.
  iso  | hospitals
-------+-----------
 SA-02 |       285
 SA-01 |       267
 SA-04 |       169
(3 rows)

Time: 85.520 ms
SELECT 3905
Time: 39.401 ms
SELECT 1144
Time: 17.440 ms
CREATE INDEX
Time: 5.454 ms
ANALYZE
Time: 22.659 ms
 places | median_km | over_50km
--------+-----------+-----------
   3905 |        26 |       799
(1 row)

Time: 343.380 ms
INSERT 0 1
Time: 2.815 ms
SELECT 1144
Time: 31.288 ms
SELECT 3905
Time: 24.543 ms
CREATE INDEX
Time: 9.278 ms
ANALYZE
Time: 8.403 ms
 places | median_km | over_50km
--------+-----------+-----------
   3905 |        26 |       799
(1 row)

Time: 386.854 ms
Timing is off.
ولأن الجهاز الذي اختبرنا عليه كانت تعمل عليه حاويات أخرى، كررنا التشغيل عدة مرات، والصورة التالية تعرض المدى لا رقماً واحداً:
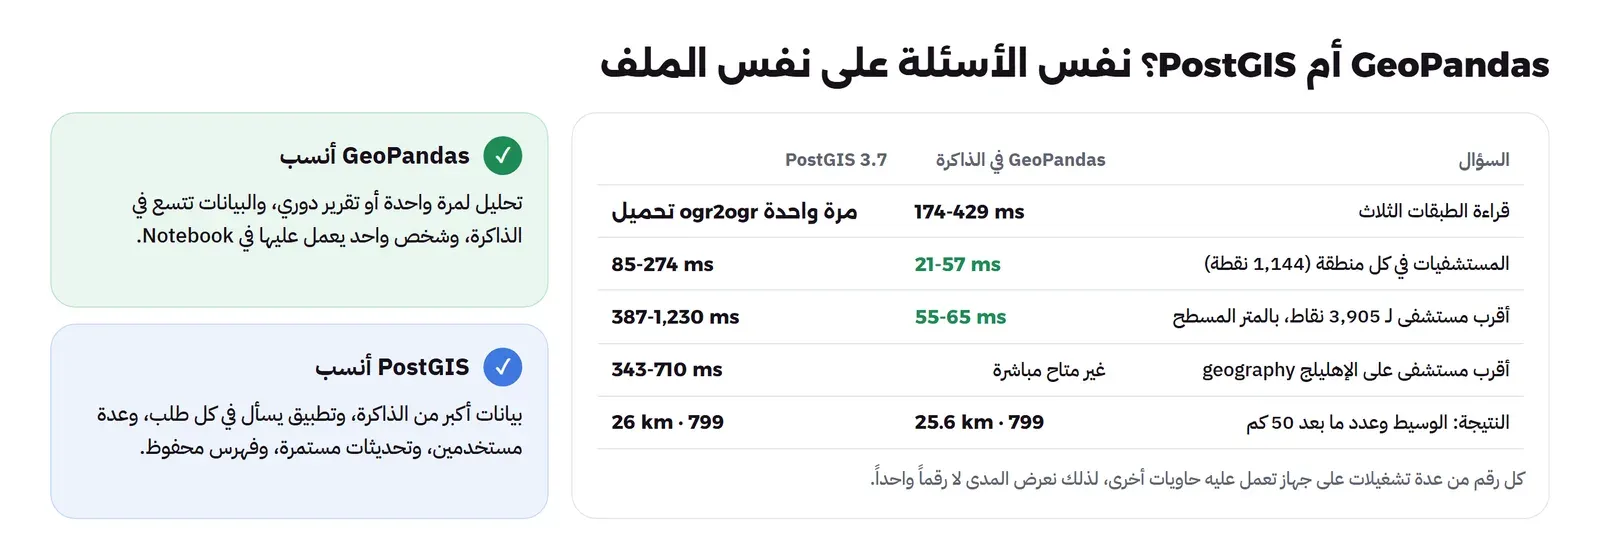
في المخرج أعلاه لاحظ التالي:
- النتيجة واحدة في الأداتين: 799 مكاناً أبعد من 50 كيلومتراً، والوسيط 26 كيلومتراً في PostGIS بعد التقريب و25.6 في GeoPandas، وهذا ما تتوقعه عندما يكون GEOS وPROJ تحت الاثنين.
- على 3,905 نقاط، كان
sjoin_nearestفي الذاكرة أسرع بست مرات على الأقل من KNN في PostGIS، والسبب أن GeoPandas تنفذ البحث على المصفوفة كاملة في استدعاء واحد لـ GEOS، بينما الربط الجانبيLATERALفي PostGIS يمر على الفهرس مرة لكل صف، ومع كل مرة تكلفة تنفيذ الاستعلام الداخلي. - PostGIS وحدها تعطيك المسافة على الإهليلج بالنوع geography مع فهرس، أما GeoPandas فتحسب في المستوي فقط، وتحتاج pyproj إذا أردت المسافة على الإهليلج لكل زوج.
- الأرقام هنا لبيانات صغيرة تتسع في الذاكرة بسهولة، وهي ليست حكماً عاماً. فإذا كانت عندك عشرات الملايين من النقاط، أو كان التطبيق يسأل عن أقرب فرع في كل طلب، فالفهرس المحفوظ في PostGIS يجيب عن السؤال الواحد في أجزاء من المللي ثانية دون تحميل أي شيء، بينما GeoPandas تحتاج أن تقرأ البيانات كلها إلى الذاكرة قبل أول سؤال.
أخطاء لا تظهر كرسالة خطأ
أخطر أخطاء التحليل المكاني ليست التي توقف الكود، وإنما التي تعطي رقماً معقولاً وخاطئاً. لذلك جمعنا أربعة منها على البيانات نفسها في الملف lab/09_pitfalls.py:
# Four mistakes that give no error, or a confusing one, on the same data.
import warnings
import geopandas as gpd
import pandas as pd
import shapely
from pyproj import Transformer

G = "/data/ksa.gpkg"
regions = gpd.read_file(G, layer="regions")
hosp = gpd.read_file(G, layer="hospitals")
sample = gpd.sjoin(hosp, regions[["iso", "geometry"]], predicate="within").head(200)

# 1) a CSV with lat, lon columns: x must be the longitude
df = pd.DataFrame({"lat": sample.geometry.y, "lon": sample.geometry.x})
wrong = gpd.GeoDataFrame(df, geometry=gpd.points_from_xy(df["lat"], df["lon"]), crs=4326)
right = gpd.GeoDataFrame(df, geometry=gpd.points_from_xy(df["lon"], df["lat"]), crs=4326)
for label, g in [("x=lat (wrong)", wrong), ("x=lon (right)", right)]:
    n = len(gpd.sjoin(g, regions[["geometry"]], predicate="within"))
    print(f"{label:14} first point {g.geometry.iloc[0].coords[0]}, inside KSA: {n}/200")

# 2) pyproj follows the CRS axis order: EPSG:4326 is latitude first
lon, lat = right.geometry.iloc[0].x, right.geometry.iloc[0].y
t_auth = Transformer.from_crs("EPSG:4326", "EPSG:32638")
t_xy = Transformer.from_crs("EPSG:4326", "EPSG:32638", always_xy=True)
print("authority order, given (lon, lat):", t_auth.transform(lon, lat))
print("always_xy=True,   given (lon, lat):", t_xy.transform(lon, lat))

# 3) set_crs labels the data, to_crs converts it
utm = right.to_crs(32638)
try:
    utm.set_crs(4326)
except ValueError as e:
    print("set_crs on data that has a CRS:", str(e)[:90], "...")
mislabeled = right.set_crs(32638, allow_override=True).to_crs(4326)
print("degrees labelled as metres, back to 4326:", mislabeled.geometry.iloc[0].coords[0])

# 4) invalid polygons: osmium drops what it cannot build (see -e), GDAL's OSM driver keeps it
raw = gpd.read_file("/data/ksa-pick.geojsonseq", engine="pyogrio", columns=["amenity"])
polys = raw[raw.geom_type.isin(["Polygon", "MultiPolygon"])]
print(f"osmium export: {len(polys)} polygons, invalid: {(~polys.is_valid).sum()}")
with warnings.catch_warnings():
    warnings.simplefilter("ignore")
    mp = gpd.read_file("/data/ksa-pick.osm.pbf", layer="multipolygons", engine="pyogrio")
bad = mp[~mp.is_valid]
print(f"GDAL OSM driver: {len(mp)} polygons, invalid: {len(bad)}")
for _, r in bad.iterrows():
    print("  relation", r["osm_id"], r["name"], "|", shapely.is_valid_reason(r.geometry))
    a = r.geometry
    try:
        print("  intersection with a 0.01 degree buffer of itself, no error:", round(a.intersection(a.buffer(0.01)).area, 6))
    except shapely.errors.GEOSException as e:
        print("  GEOSException:", str(e)[:80])
    fixed = shapely.make_valid(a)
    print("  make_valid:", fixed.geom_type, "valid", fixed.is_valid, f"area {a.area:.6f} -> {fixed.area:.6f} deg2")
x=lat (wrong) first point (21.5320022, 39.1781249), inside KSA: 0/200
x=lon (right) first point (39.1781249, 21.5320022), inside KSA: 200/200
authority order, given (lon, lat): (-1537394.2876290306, 4608592.25768829)
always_xy=True, given (lon, lat): (-103654.69749195175, 2392310.6438483717)
set_crs on data that has a CRS: The GeoSeries already has a CRS which is not equal to the passed CRS. Specify 'allow_overr ...
degrees labelled as metres, back to 4326: (40.51160711236304, 0.00019420531379685452)
osmium export: 6399 polygons, invalid: 0
GDAL OSM driver: 5170 polygons, invalid: 1
relation 15621952 مجتمع القوز | Self-intersection[55.2575072 25.1441995]
intersection with a 0.01 degree buffer of itself, no error: 0.002435
make_valid: GeometryCollection valid True area 0.002435 -> 0.002435 deg2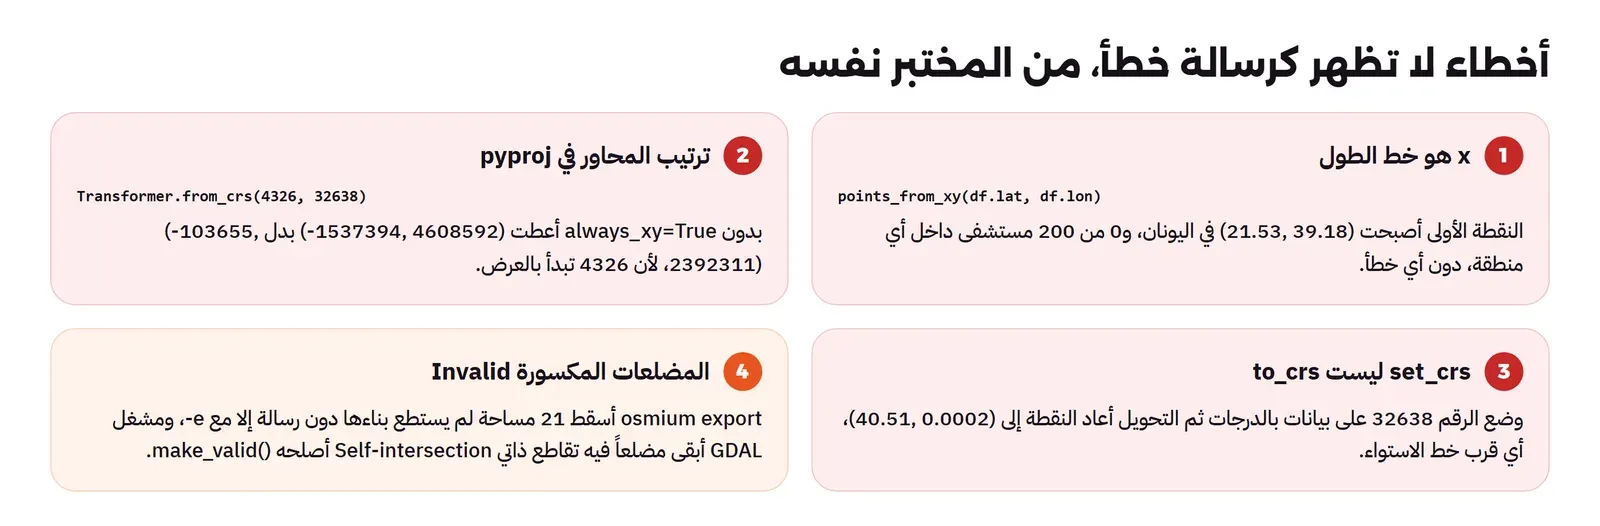
وفيما يلي شرح كل واحد:
- ترتيب خط الطول وخط العرض: الدالة
points_from_xyتأخذ x أولاً، وx في أي نظام جغرافي هو خط الطول. وعندما مررنا العرض أولاً أصبحت النقطة الأولى في اليونان، ولم يظهر أي خطأ، وفقط عدد المستشفيات داخل المناطق صار صفراً من 200. وهذا الخطأ شائع جداً لأن الناس يقولون «العرض والطول» بهذا الترتيب، وخرائط Google تعرض الإحداثيات بهذا الترتيب أيضاً. - ترتيب المحاور في pyproj: النظام EPSG:4326 معرف في سجل EPSG بالعرض أولاً، و
Transformerيلتزم بهذا الترتيب افتراضياً، فعندما أعطيناه (الطول، العرض) فهمها مقلوبة، وأعطى رقماً لا علاقة له بالنقطة. والحل الخيارalways_xy=Trueالذي يجعل الترتيب دائماً (x, y)، وهو موثق في صفحة Gotchas في توثيق pyproj. ولاحظ أن GeoPandas نفسها تستخدم هذا الخيار داخلياً، فالخطأ يظهر فقط عندما تستخدم pyproj مباشرة. - set_crs وto_crs: الأولى تكتب اسم النظام على البيانات دون أن تغير الأرقام، والثانية تحول الأرقام. وGeoPandas تحميك من وضع نظام فوق نظام، فترفض
set_crsعلى جدول له نظام إلا معallow_override=True، وعندما فرضناه على بيانات بالدرجات وقلنا إنها أمتار، ثم حولناها إلى 4326، انتهت النقطة على بعد أمتار من خط الاستواء. وتستخدمset_crsفي حالة واحدة: ملف وصلك بلا نظام إحداثيات، وأنت تعرف من مصدره ما هو. - المضلعات المكسورة Invalid Geometries: المضلع الذي تتقاطع حدوده مع نفسها Self-intersection ليس شكلاً صالحاً في معيار Simple Features، وأي عملية عليه قد تعطي مساحة خاطئة أو خطأ من GEOS. وفي ملفنا لم نجد مضلعاً مكسوراً واحداً في مخرج osmium، والسبب ليس أن البيانات سليمة، وإنما أن osmium أسقط 21 مساحة لم يستطع بناءها دون أن يقول شيئاً، والرسالة تظهر فقط مع الخيار
-e. أما مشغل GDAL لملفات OSM فأبقى مضلعاً مكسوراً لحي في دبي، وعملية التقاطع عليه في GEOS 3.14 لم تعط خطأ، فلو كان في تحليلك لمر دون أن تراه. والحل أن تفحصis_validبعد كل قراءة من مصدر لا تثق فيه، وتصلح بـmake_valid()وتنظر في نوع الناتج، فقد يصبح المضلع GeometryCollection فيها خطوط ونقاط مع المضلع.
والأمر الذي استخدمناه لعد المساحات التي أسقطها osmium:
gp sh -c 'osmium export -O ksa-pick.osm.pbf -f geojsonseq -o /tmp/x.geojsonseq -e 2>&1 | grep -c "Geometry error"'21من Notebook إلى تحليل يعاد تشغيله
أغلب التحليل الجغرافي في Python يبدأ في Jupyter Notebook، وهذا مناسب للاستكشاف، لأنك ترى الجدول والخريطة بعد كل خطوة. ولكن المشكلة تظهر بعد شهر، عندما يطلب منك أحد الرقم نفسه ببيانات أحدث، فتجد أن الخلايا نفذت بترتيب لا تتذكره، وأن متغيراً عرفته في خلية حذفتها ما زال في الذاكرة، وأن النتيجة لا تخرج مرة أخرى كما كانت. لذلك قسمنا المختبر في هذا المقال إلى ملفات مرقمة، كل ملف يقرأ من ملف ويكتب إلى ملف، ولا يعتمد على ذاكرة ملف قبله، فتعيد التحليل كله من ملف Geofabrik الجديد بتشغيل الملفات بالترتيب.
وهناك ثلاث عادات صغيرة تجعل هذا التحليل قابلاً للمراجعة. الأولى أن تثبت الإصدارات، فالفرق بين matplotlib 3.10 و3.11 غير شكل كل عنوان عربي في خرائطنا كما رأينا، وفرق مثله في pandas 3 جعل to_numpy() تعيد مصفوفة للقراءة فقط بسبب نظام النسخ عند الكتابة Copy-on-Write، لذلك اكتب الإصدارات في requirements.txt أو في الـ Dockerfile كما فعلنا في سجل التحديثات. والثانية أن تحفظ تاريخ البيانات مع النتيجة، فملف Geofabrik يتغير كل يوم، والرقم 1,144 مستشفى صحيح لبيانات 15 نوفمبر 2026 فقط. والثالثة أن تطبع في كل خطوة الأعداد التي تتوقعها، كما يفعل كل ملف في المختبر: عدد الصفوف قبل وبعد، وعدد المكرر، وعدد الأشكال المكسورة، فإذا تغير رقم منها في التشغيل القادم عرفت أين تبحث قبل أن يصل الخطأ إلى التقرير. وقد شرحنا هذه الطريقة بتفصيل أكبر في مقال البحث القابل لإعادة الإنتاج مع Jupyter وGit وDocker.
وقد يتساءل البعض: هل أكتب كل هذا في Notebook أم في ملفات .py؟ والإجابة أن الاثنين يعملان معاً، فاكتب الدوال الثابتة في ملفات، واستدعها من Notebook للاستكشاف والرسم، فتحصل على راحة Notebook دون أن يصبح الكود الوحيد الذي يحمل منطق التحليل.
عندما تكبر البيانات
GeoPandas تعمل في الذاكرة، والجدول كله يجب أن يتسع في RAM مع نسخ وسيطة أثناء العمليات، وقد تحتاج ضعفي أو ثلاثة أضعاف حجم البيانات. وقبل أن تنتقل إلى أداة أخرى، جرب ما يقلل الحجم من المصدر:
- اقرأ الأعمدة التي تحتاجها فقط:
read_file(..., columns=["amenity"])كما فعلنا في ملف الأخطاء، فطبقة OpenStreetMap فيها مئات الأعمدة الفارغة. - اقرأ المنطقة التي تحتاجها فقط: الخيار
bboxأوmaskفيread_fileيمرر الحدود إلى GDAL، فيستخدم الفهرس المكاني في GeoPackage ولا يقرأ الباقي. - صف بالـ SQL في القراءة: الخيار
whereيمرر شرطاً إلى GDAL، مثلwhere="place = 'village'". - قلل الرؤوس:
simplify()بقيمة بالمتر على حدود المناطق للرسم، فالخريطة لا تحتاج 190 ألف رأس، ولكن لا تبسط قبل الربط المكاني أو حساب المساحة. - صيغة أسرع للتخزين الوسيط: GeoParquet بالأمر
to_parquetأسرع قراءة وأصغر حجماً من GeoPackage للجداول الكبيرة، ويقرؤه DuckDB وغيره.
فإذا لم يكف ذلك، فهذه علامة أن البيانات مكانها قاعدة بيانات، والمقال PostGIS يبدأ من هنا، ويمكنك أن تبقي التحليل في Python وتقرأ نتيجة الاستعلام فقط بالدالة read_postgis.
جدول قرار سريع
| السؤال | الدالة | انتبه إلى |
|---|---|---|
| ما المنطقة التي فيها كل نقطة؟ | gpd.sjoin(..., predicate="within") | الصفوف المكررة عند الحدود، والنقاط خارج كل المناطق تسقط مع inner |
| ما أقرب X لكل Y؟ | gpd.sjoin_nearest(..., distance_col=...) | نظام بالمتر قبلها، والتكرار عند التساوي، وmax_distance للحد |
| ما يقع ضمن مسافة من X؟ | buffer() ثم sjoin، أو sjoin_nearest مع max_distance | نصف القطر بوحدة النظام، فلا تستخدم 4326 |
| دمج أشكال بحسب عمود | dissolve(by=...) | جمع الأعمدة الأخرى بـ aggfunc |
| جزء كل منطقة داخل شكل آخر | gpd.overlay(..., how="intersection") | أبطأ عملية، والأشكال المكسورة تفسد الناتج |
| مساحة أو طول | to_crs(متساو المساحة).area | لا مساحة بالدرجات، ولا بإسقاط Web Mercator |
| خريطة لتقرير | .plot(column=...) | matplotlib 3.11 لا تحتاج arabic-reshaper |
أخطاء شائعة وحلولها
- التحذير
Geometry is in a geographic CRS: حول إلى نظام بالمتر قبلbufferوareaوdistance، ولا تتجاهله لأنه لا يوقف الكود. - عدد الصفوف بعد
sjoinأكبر من الأصل: نقطة طابقت أكثر من مضلع، فافحصindex.duplicated()وقرر أي صف تبقي. - عدد الصفوف بعد
sjoinصفر: غالباً الطبقتان بنظامين مختلفين، وGeoPandas تحذرك من ذلك، أو الطول والعرض مقلوبان في إحداهما. - الأسماء العربية معكوسة في الرسم: احذف arabic-reshaper وpython-bidi على matplotlib 3.11 وما بعدها.
- القراءة بطيئة جداً: حول الملف مرة إلى GeoPackage أو GeoParquet، واقرأ الأعمدة والمنطقة التي تحتاجها فقط.
- الخطأ
Connection refusedمع PostGIS في Docker: انتظر بـpg_isready، فالسيرفر لا يقبل الاتصال في أول ثوان. - اختفاء أشكال من التصدير: شغل
osmium exportمع-eمرة واحدة على الأقل، وقارن العدد بما تتوقعه. - نسيان النسبة: بيانات OpenStreetMap برخصة ODbL، فاكتب «© OpenStreetMap contributors» على كل خريطة.
قائمة تحقق قبل أن ترسل النتيجة
- هل طبعت
crsلكل طبقة، وهل كل حساب مسافة أو مساحة على نظام بالمتر مناسب لمنطقتك؟ - هل الطول هو x في كل مكان أنشأت فيه نقاطاً من أعمدة؟
- هل فحصت
is_validبعد القراءة، وعدد الأشكال مقابل المصدر؟ - هل عدد الصفوف بعد كل ربط كما تتوقع، بلا تكرار وبلا سقوط غير مقصود؟
- هل فتحت أكبر القيم وأصغرها بنفسك قبل أن تبني عليها؟
- هل الأرقام بالوسيط والنسب المئوية، لا بالمتوسط وحده؟
- هل العناوين العربية في الخريطة مقروءة، والنسبة مكتوبة؟
- هل السكربت يعيد كل النتائج من الملف الخام بأمر واحد؟
تنظيف المختبر
docker rm -f lab-gp-pg
docker network rm lab-gp-net
docker volume rm lab-gp-data
docker image rm lab-gp postgis/postgis:18-3.7
تدريب عملي
- أضف إلى ملف
00-prepare.shالوسمamenity=clinicوالمراكز الصحيةhealthcare=centre، وأعد السؤال الثاني، وقارن عدد القرى الأبعد من 50 كيلومتراً قبل وبعد. - أعد حساب المساحة المغطاة لكل منطقة مرتين: مرة بـ LAEA ومرة بمنطقة UTM 38 للدولة كلها، وقارن الفرق في تبوك والمنطقة الشرقية، وفسره بما رأيته في قسم نظام الإحداثيات.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- GeoPandas جدول pandas فيه عمود أشكال ونظام إحداثيات، والعمل الحقيقي في Shapely وGEOS وpyproj وPROJ وpyogrio وGDAL، وأغلب الأخطاء تأتي من هذه الطبقات.
- الدرجات ليست أمتاراً، وعلى مستوى المملكة أعطى إسقاط LAEA بمركز في وسطها خطأ 0.02% فقط، بينما أخطأ Web Mercator بنسبة 12.7% في المسافة و23% في مساحة الدائرة.
sjoinقص 2,178 مستشفى من ملف الخليج إلى 1,144 داخل المملكة في 24 مللي ثانية، والفهرس بالاتجاه الخاطئ أخذ 433 مللي ثانية للنتيجة نفسها.sjoin_nearestأعطى أقرب مستشفى لـ 3,905 أماكن في 57 مللي ثانية، و799 منها أبعد من 50 كيلومتراً بالخط المستقيم.- matplotlib 3.11 تشكل العربية بنفسها، والوصفة القديمة arabic-reshaper مع python-bidi ترسم الكلمات معكوسة دون أي خطأ.
- على هذا الحجم كانت GeoPandas أسرع من PostGIS، والنتائج متطابقة، أما البيانات الكبيرة والتطبيقات وعدة مستخدمين فمكانها PostGIS.
- أخطر الأخطاء صامتة: الطول والعرض مقلوبان، وset_crs بدل to_crs، وأشكال أسقطها التصدير دون رسالة.
 دليلQGIS للمبتدئين: الطبقات Layers والتحليل المكانيكيف تحول جدول مواقع إلى طبقة على الخريطة في QGIS، وتربطها بالمناطق وتحسب النطاقات بالأمتار الصحيحة، ثم تعيد التحليل كله بأمر واحد.
 دليلالبيانات الجغرافية GIS في PostgreSQL مع PostGISكيف تخزن الأحياء والطرق والفروع في PostgreSQL وتسألها بالمتر الصحيح وبفهرس يعمل فعلاً، بمختبر على بيانات OpenStreetMap لمدينة كاملة.
 دليلالتحليل المكاني Spatial Analysis: أقرب فرع والتغطيةكيف تحسب بالأرقام أقرب فرع لكل عميل وكم شخصاً يغطي كل فرع على الطريق لا بالخط المستقيم، بأدوات PostGIS وpgRouting وبيانات سكان مفتوحة.
 دليلالمرجع الجيوديسي Datum: لماذا تنحرف نقطتك مئات الأمتار؟لماذا تقع نفس الإحداثيات في مكانين بينهما مئة متر، وكيف تحول بين Ain el Abd وKSA-GRF17 وWGS 84 ومناطق UTM دون أن تنقل بياناتك إلى المكان الخطأ.
 دليلصيغ البيانات الجغرافية: GeoJSON وShapefile وGeoPackageنحول نفس المباني والأماكن من OpenStreetMap إلى سبع صيغ ونقيس الحجم والسرعة وما يضيع في الطريق، ومنه النص العربي في Shapefile، ثم نختار الصيغة المناسبة لكل عمل.
 دليلالبيانات الجغرافية المفتوحة Open Data في السعوديةأين تجد البيانات الجغرافية عن المملكة، وما الذي يمكن تحميله فعلاً من كل مصدر وبأي رخصة، وكيف تفحص الملف الرسمي قبل أن تبني عليه.
 دليلتحليل البيانات Data Analysis مع pandas للمبتدئيننجيب على سؤال حقيقي من بيانات 32 محطة طقس سعودية: كم يوماً فوق 45 درجة في كل منطقة ومتى، ونتعلم في الطريق تنظيف البيانات والربط والتجميع والتواريخ مع pandas وأخطاءها الشائعة.
 دليلأول خريطة تفاعلية في موقعك مع MapLibre GL JSخريطة تفاعلية في صفحتك خطوة بخطوة بمكتبة MapLibre: طبقات وعلامات ونوافذ وأسماء عربية وتجميع لآلاف الأماكن، مع الأعطال التي ستقابلها وحلها.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال وتنفيذ المختبر على GeoPandas 1.2.0 وShapely 2.2.0 (GEOS 3.14.1) وpyproj 3.8.0 (PROJ 9.8.1) وpyogrio 0.13.0 (GDAL 3.12.4) وmatplotlib 3.11.2 وpandas 3.1.1 على Python 3.13.18 وDebian 13، وosmium 1.18.0، وPostGIS 3.7.0 على PostgreSQL 18.7، وبيانات Geofabrik لدول الخليج بتاريخ 15 نوفمبر 2026.