يطلب منك مدير المشروع أن تعرض فروع الشركة على خريطة في الموقع، فتصلك القائمة من ثلاث جهات: ملف Excel فيه عمودان للإحداثيات من قسم المبيعات، وملف مضغوط فيه أربعة ملفات بامتدادات غريبة .shp و.dbf و.shx و.prj من مكتب هندسي، وملف .kml صدره أحدهم من Google Earth. وتفتح الملف المضغوط فتجد أسماء الأحياء علامات استفهام، وأسماء الأعمدة مقطوعة عند الحرف العاشر، وتحاول رفع ملف GeoJSON حجمه 400 ميجابايت إلى صفحة الويب فيتجمد المتصفح. وقد يتساءل البعض: لماذا كل هذه الصيغ لشيء واحد هو «نقاط ومضلعات على الخريطة»؟ وأيها تختار لمشروعك؟
هذا المقال من أول مرحلة في مسار الخرائط، وهو عن الملفات التي ستقابلها في كل مشروع خرائط قبل أي أداة. وقد شرحنا في كيف تعمل الخرائط الرقمية الإحداثيات والطبقات، وفي المرجع الجيوديسي Datum ملف .prj ونظام الإحداثيات، وفي مقال OpenStreetMap صيغة PBF التي تنشر بها بيانات OSM، فلن نكرر ذلك، وإنما نأخذ بيانات حقيقية واحدة ونحولها إلى كل الصيغ المشهورة ونقيس الفرق. وسوف نناقش في هذا المقال ما يلي:
- البيانات المتجهة Vector والبيانات الشبكية Raster: النوعان اللذان تنتمي إليهما كل الصيغ.
- الصيغ المتجهة السبع: GeoJSON وShapefile وGeoPackage وFlatGeobuf وGeoParquet وKML وCSV، كيف يحفظ كل منها البيانات من الداخل، ولماذا وجد.
- الصيغة الشبكية GeoTIFF ونسختها المناسبة للسحابة Cloud Optimized GeoTIFF.
- الفخاخ الحقيقية: النص العربي في Shapefile وملف
.cpg، وأسماء الحقول ذات العشرة أحرف، والدقة، وترتيب المحاور. - تجربة عملية بأداة ogr2ogr من GDAL: نحول 55 ألف مبنى في وسط الرياض و24 ألف مكان مسمى في المملكة إلى كل الصيغ، ونقيس الحجم وزمن التحميل وما يضيع في الطريق.
- جدول قرار: أي صيغة لأي عمل.
نوعان من البيانات: المتجهة Vector والشبكية Raster
قبل الصيغ نحتاج أن نفرق بين نوعين من البيانات الجغرافية، لأن كل صيغة تخدم نوعاً منهما:
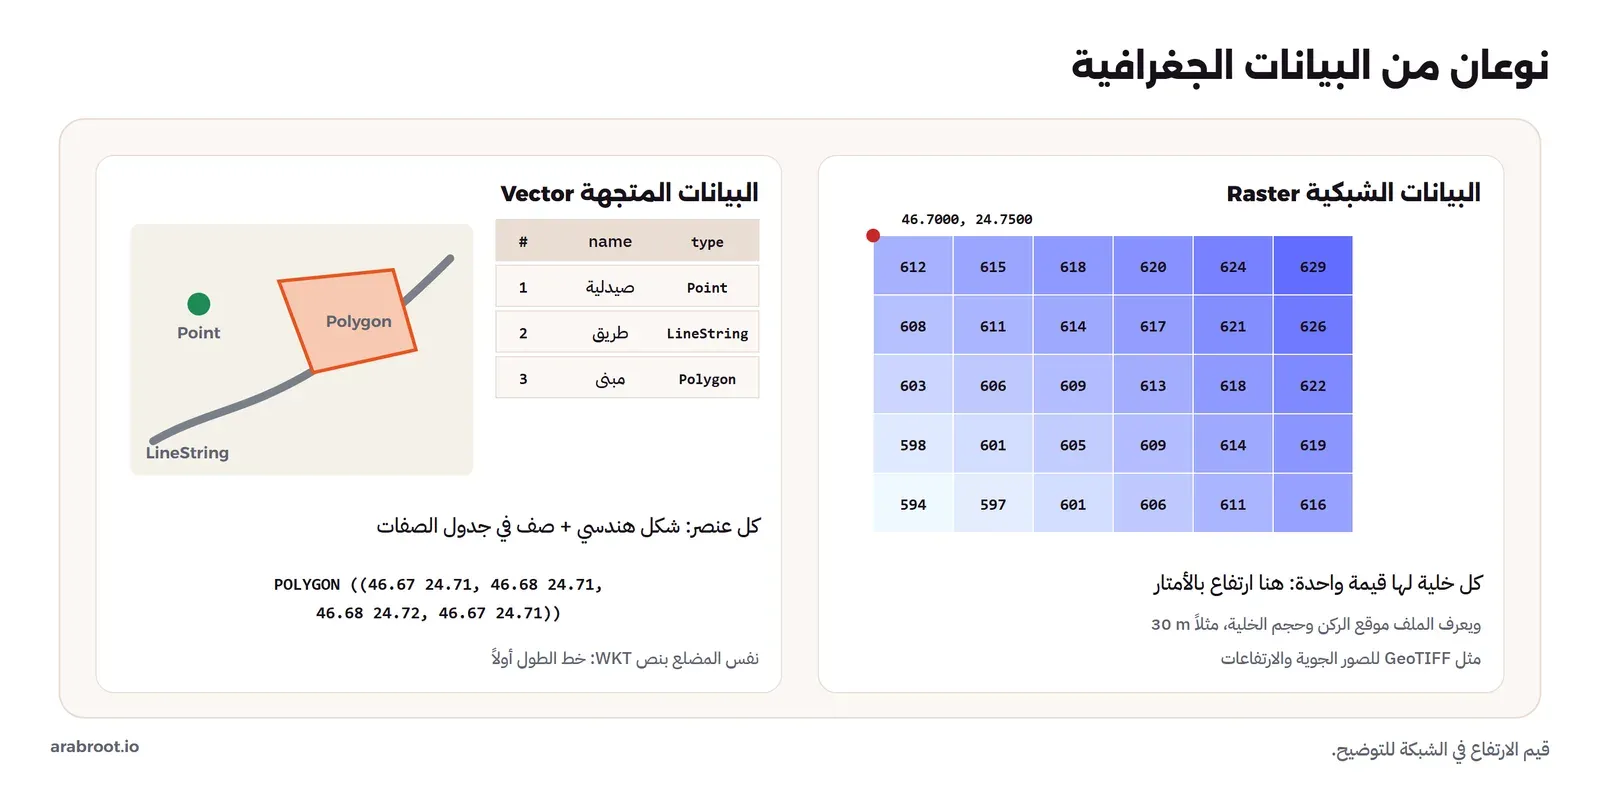
- البيانات المتجهة Vector: أشياء منفصلة لكل منها شكل هندسي Geometry وصفات Attributes. والشكل نقطة Point مثل صيدلية، أو خط LineString مثل طريق، أو مضلع Polygon مثل مبنى أو حي. والصفات جدول عادي: الاسم والنوع وعدد الطوابق. وكل صف في الجدول مع شكله يسمى عنصراً Feature، ومجموعة العناصر من نفس النوع تسمى طبقة Layer.
- البيانات الشبكية Raster: صورة، أي شبكة من الخلايا Pixels لكل خلية قيمة: لون في الصورة الجوية، أو ارتفاع عن سطح البحر في نموذج الارتفاعات، أو درجة حرارة. والفرق عن صورة الهاتف أن الملف يعرف أين تقع كل خلية على الأرض وكم متراً تغطي.
ولنأخذ مثالاً: حدود حي في الرياض مضلع متجه، يكفيه بضع مئات من النقاط مهما كبرت مساحته، أما ارتفاع الأرض في نفس الحي فشبكة من الخلايا، كل خلية 30 متراً مثلاً ولها رقم واحد، وعدد الخلايا يكبر مع المساحة. لذلك تجد المتجهات في الطرق والمباني والحدود والأماكن، والشبكات في الصور الجوية وصور الأقمار الصناعية والارتفاعات والطقس. وقد شرحنا الفرق بينهما مع أمثلة في مقال PostGIS، والمهم هنا أن أغلب هذا المقال عن الصيغ المتجهة لأنها الأكثر تنوعاً، ثم نعود للشبكية في قسم GeoTIFF.
كيف يحفظ الشكل الهندسي؟ WKT وWKB
كل الصيغ المتجهة تحتاج أن تحفظ الشكل بطريقة ما، وأغلبها يستخدم واحدة من طريقتين عرفهما اتحاد OGC في معيار Simple Features:
- النص المقروء Well-Known Text واختصاراً WKT: مثل
POINT (46.6753 24.7136)أوPOLYGON ((46.67 24.71, 46.68 24.71, 46.68 24.72, 46.67 24.71))، وتقرؤه بعينك، وهو ما سوف نضعه في ملف CSV. - الصيغة الثنائية Well-Known Binary واختصاراً WKB: نفس المعلومة بالبايتات، كل رقم 8 بايت بدقة Double كاملة، وهي ما تخزنه GeoPackage وGeoParquet وPostGIS داخلياً، لأنها أصغر وأسرع في القراءة ولا تفقد أي رقم.
ولاحظ في المثال ترتيب الرقمين: خط الطول أولاً ثم خط العرض، أي x ثم y، وهذا ترتيب كل الصيغ في هذا المقال تقريباً، وعكس ما تكتبه عادة في محرك البحث «24.71, 46.67». وقد رأينا في مقال المرجع الجيوديسي ماذا يحدث عندما يختلط الترتيب: تنتقل الرياض إلى رومانيا دون أي رسالة خطأ.
الصيغ المتجهة: كيف يعمل كل منها من الداخل؟
الصيغ كثيرة لأن كلاً منها ولد لحل مشكلة في زمنه: صيغة لبرامج سطح المكتب في التسعينيات، وصيغة لتبادل البيانات عبر الويب، وصيغة لعرض الأماكن في Google Earth، وصيغ حديثة للملفات الكبيرة والتحليل. والطريقة الصحيحة لاختيار صيغة هي أن تفهم كيف تحفظ البيانات من الداخل، لأن هذا ما يحدد حجمها وسرعتها وما تفقده في الطريق. وفيما يلي الصيغ السبع بالترتيب الذي ستقابلها به غالباً.
GeoJSON: صيغة الويب
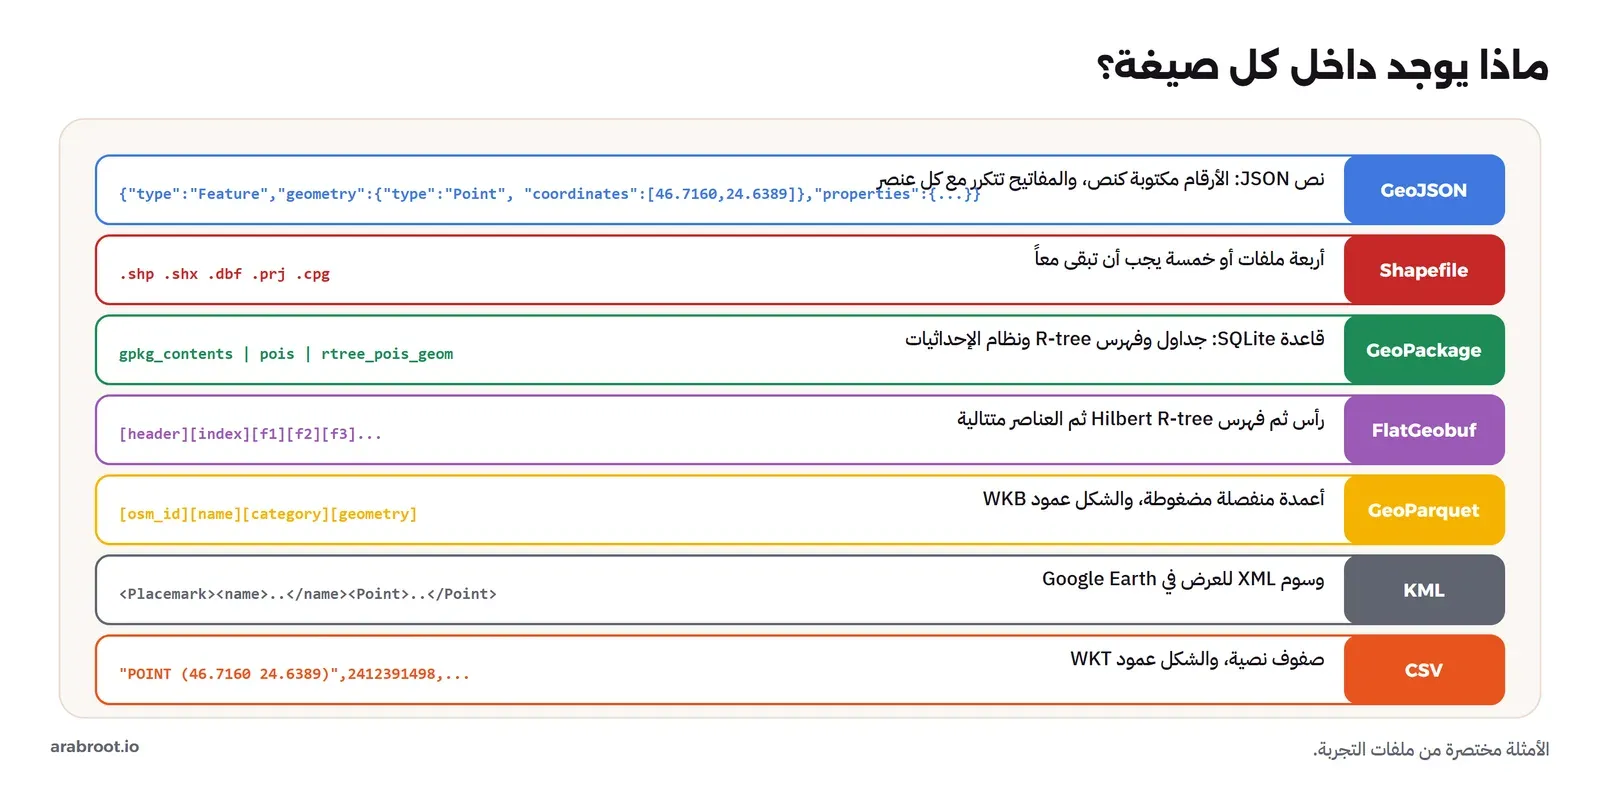
GeoJSON هي JSON عادي بمفاتيح متفق عليها، وعرفها المعيار RFC 7946 في 2016. والملف كائن FeatureCollection فيه قائمة features، ولكل عنصر geometry فيها النوع والإحداثيات كمصفوفات أرقام، وproperties فيها الصفات كما هي في JSON. ولأنه JSON فكل لغة برمجة تقرؤه دون مكتبة إضافية، وكل مكتبة خرائط ويب تعرضه مباشرة، وتقرؤه بعينك في أي محرر نصوص، وهذا سر انتشاره.
وللمعيار ثلاثة قرارات مهمة يجب أن تعرفها: الإحداثيات دائماً على WGS 84 بالدرجات، فلا يحمل الملف نظام إحداثيات آخر؛ والترتيب دائماً خط الطول ثم خط العرض؛ والنص بترميز UTF-8، فالعربية فيه لا مشكلة لها. أما ثمن البساطة فهو الحجم والسرعة: كل رقم مكتوب كنص، و46.6753214 تأخذ عشرة بايتات بدل ثمانية، ومفاتيح الصفات مثل "building" تتكرر مع كل عنصر، ولا يوجد فهرس مكاني، فلكي تجد المباني في حي واحد عليك أن تقرأ الملف كله وتحلل كل سطر فيه. ولذلك فهو ممتاز لمئات أو آلاف العناصر في واجهة API أو صفحة ويب، وسيئ لملايين العناصر.
وقد تقابل ملفات GeoJSON قديمة كتبت قبل المعيار بالمواصفة الأولى من 2008، وفيها عنصر crs يحدد نظام إحداثيات آخر غير WGS 84، والمعيار الحالي ألغى هذا العنصر، فبعض المكتبات تتجاهله وتعرض البيانات في المكان الخطأ. وفي المعيار تفصيلتان أخريان تستحقان المعرفة: اتجاه رسم المضلع، فالحدود الخارجية عكس عقارب الساعة والثقوب معها، وتقسيم الشكل الذي يعبر خط طول 180 إلى جزأين. ولا يحتاج أغلبنا هاتين التفصيلتين في المملكة، ولكن إذا كتبت GeoJSON لتقرأه أداة صارمة، فالخيار RFC7946=YES في GDAL يطبق المعيار كاملاً، ومنه قص الإحداثيات إلى سبعة أرقام بعد الفاصلة، كما في توثيق GDAL لـ GeoJSON.
Shapefile: الصيغة القديمة التي لا تموت
نشرت شركة Esri مواصفات Shapefile في 1998 في ورقة تقنية ما زالت مرجع الصيغة، وما زالت أكثر صيغة تصلك من الجهات الحكومية والمكاتب الهندسية. واسمها مضلل، فهي ليست ملفاً واحداً وإنما مجموعة ملفات بنفس الاسم يجب أن تبقى معاً:
.shp: الأشكال الهندسية بالأرقام الثنائية..shx: فهرس يقول أين يبدأ كل شكل داخل.shp..dbf: جدول الصفات بصيغة dBase، وهي قاعدة بيانات من ثمانينيات القرن الماضي، ومنها تأتي أغلب مشكلات Shapefile..prj: نظام الإحداثيات بنص WKT، وقد شرحنا قراءته في مقال المرجع الجيوديسي..cpg: سطر واحد يقول ترميز النصوص في.dbf، مثلUTF-8، وهو اختياري، وهنا الفخ الأول للعربية.
ومن جدول dBase تأتي القيود التي يذكرها توثيق GDAL لـ Shapefile: اسم الحقل عشرة أحرف على الأكثر، فيصبح opening_hours مثلاً opening_ho؛ والنص 254 حرفاً على الأكثر في الحقل؛ ولا يوجد نوع للتاريخ والوقت معاً؛ ولا توجد قيمة فارغة NULL حقيقية للأرقام؛ وحجم كل ملف لا يتجاوز 2 جيجابايت؛ ونوع شكل واحد لكل ملف، فلا تجمع النقاط والمضلعات في طبقة واحدة. وكل هذا سوف نراه بأعيننا في التجربة.
GeoPackage: قاعدة بيانات في ملف واحد
GeoPackage معيار من اتحاد OGC منذ 2014، وفكرته ذكية: الملف .gpkg قاعدة بيانات SQLite عادية، فيها جداول متفق على أسمائها وأعمدتها، والشكل الهندسي عمود بصيغة WKB، ومعه فهرس مكاني R-tree، وجدول يسجل نظام إحداثيات كل طبقة. فالملف الواحد يحمل عدة طبقات، متجهة وشبكية، وأسماء حقول بأي طول، ونصوصاً بترميز UTF-8 دائماً، ويمكنك أن تفتحه بأداة sqlite3 وتكتب عليه استعلام SQL مباشرة كما سوف نفعل.
ولذلك أصبحت GeoPackage الصيغة الافتراضية في QGIS، وهي ما ننصح به في مقال QGIS لحفظ عملك. ونقطة ضعفها الوحيدة المهمة أنها ملف قاعدة بيانات، فلا تقرأ جزءاً منها مباشرة من الإنترنت بكفاءة، ولا تفتحها عدة برامج للكتابة في نفس الوقت، كما يحذر توثيق GDAL لـ GeoPackage من وضعها على مجلد شبكي مشترك.
FlatGeobuf: ملف للبث المباشر
FlatGeobuf صيغة ثنائية حديثة مفتوحة صممت لهدف واحد: أن تقرأ منها بسرعة، وحتى من الإنترنت دون تحميل الملف كله. فهي تحفظ العناصر متتالية بتنسيق FlatBuffers الذي يقرأ مباشرة من الذاكرة دون تحويل، وتضع في بداية الملف فهرساً مكانياً مرتباً بطريقة Hilbert R-tree. فإذا طلبت من صفحة ويب المباني في حي واحد من ملف على خادم، فإنها تقرأ الفهرس أولاً، ثم تطلب بأوامر HTTP Range البايتات التي فيها مباني الحي فقط. ونقطة ضعفها أنها صيغة للقراءة: الملف يكتب مرة واحدة بالترتيب، ولا تعدل فيه عنصراً دون أن تعيد كتابته كله.
GeoParquet: صيغة التحليل والبيانات الكبيرة
Apache Parquet صيغة أعمدة Columnar تستخدمها أدوات البيانات الكبيرة مثل Spark وDuckDB وpandas، وGeoParquet مواصفة من OGC تضيف إليها عمود الشكل الهندسي بصيغة WKB ووصفاً لنظام الإحداثيات في بيانات الملف. والفكرة المهمة أن الصيغة تحفظ كل عمود منفصلاً ومضغوطاً: كل أسماء المباني معاً، وكل أنواعها معاً، وعمود النوع الذي فيه «yes» مئات الآلاف من المرات يضغط إلى بضعة بايتات. فإذا أردت عمودين فقط من عشرين، فإن الأداة تقرأ العمودين ولا تلمس الباقي. وعلى هذه الصيغة تنشر Overture Maps بياناتها للعالم كله، ونقطة ضعفها أن أدوات سطح المكتب القديمة لا تقرؤها، وأن GDAL يحتاج مكتبة Arrow حتى يدعمها، وهذه المكتبة غير موجودة في GDAL الذي تأتي به Debian 13 كما سوف نرى.
KML: صيغة Google Earth
KML صيغة XML ولدت مع Google Earth ثم أصبحت معياراً من OGC في 2008، وما زالت ما يصدره Google Earth وGoogle My Maps وكثير من أجهزة GPS. وهي صيغة للعرض أكثر منها للبيانات: فيها الأشكال ومعها الألوان والأيقونات ونوافذ الوصف، والإحداثيات دائماً على WGS 84، والصفات تحفظ في عنصر ExtendedData كنصوص. وهي أكبر الصيغ حجماً لأن XML يكرر أسماء العناصر مع كل قيمة، وأبطؤها قراءة، فاستخدمها عندما يكون المستلم إنساناً سيفتح الملف في Google Earth، ولا تستخدمها لتبادل البيانات بين الأنظمة.
CSV: الجدول الذي يفهمه الجميع
ملف CSV ليس صيغة جغرافية أصلاً، ولكنه ما يصلك غالباً من قسم المبيعات ومن أي نظام يصدر تقارير. والنقاط فيه سهلة: عمودان لخط العرض وخط الطول، أما الخطوط والمضلعات فتحتاج عموداً واحداً فيه نص WKT، وهذا ما يكتبه GDAL بالخيار GEOMETRY=AS_WKT كما في توثيق GDAL لـ CSV. ومشكلات CSV معروفة: لا يحمل نظام الإحداثيات، فعليك أن تعرفه وتكتبه في التوثيق؛ ولا يحمل أنواع الأعمدة، فرقم المبنى 0012 قد يصبح 12؛ والفاصلة داخل النص تحتاج علامات تنصيص. وللعربية فخ مع Excel تحديداً: إذا لم يبدأ الملف بالعلامة BOM فإن Excel في كثير من الإعدادات يقرؤه بترميز غير UTF-8 فتظهر الحروف رموزاً، والحل هو الخيار WRITE_BOM=YES في GDAL عند التصدير لمستخدم سيفتحه في Excel.
الصيغة الشبكية GeoTIFF وCloud Optimized GeoTIFF
في البيانات الشبكية صيغة واحدة تسيطر على أغلب الاستخدامات هي GeoTIFF، وهي صورة TIFF عادية أضيفت إليها وسوم Tags تقول نظام الإحداثيات وموقع ركن الصورة وحجم الخلية بالأمتار أو الدرجات. فبرنامج الصور العادي يفتحها كصورة، وبرنامج الخرائط يضعها في مكانها على الأرض. ويمكن أن تكون قيم الخلايا ألواناً من 0 إلى 255، أو أرقاماً عشرية مثل الارتفاع بالأمتار، وقد تحمل عدة نطاقات Bands، مثل نطاقات صور الأقمار الصناعية المختلفة.
وتحمل الصيغة خيارات تؤثر كثيراً في الحجم والسرعة، وكلها في توثيق GDAL لـ GeoTIFF:
- الضغط Compression: دون ضغط، أو LZW، أو DEFLATE، أو ZSTD، وكلها دون فقدان، أو JPEG مع فقدان للصور الجوية فقط، ولا تستخدمه للارتفاعات أبداً لأنه يغير القيم.
- المتنبئ Predictor: يحفظ الفرق بين كل خلية والتي قبلها بدل القيمة نفسها، والارتفاعات المتجاورة متقاربة فتصبح الفروق صغيرة وتضغط أفضل بكثير.
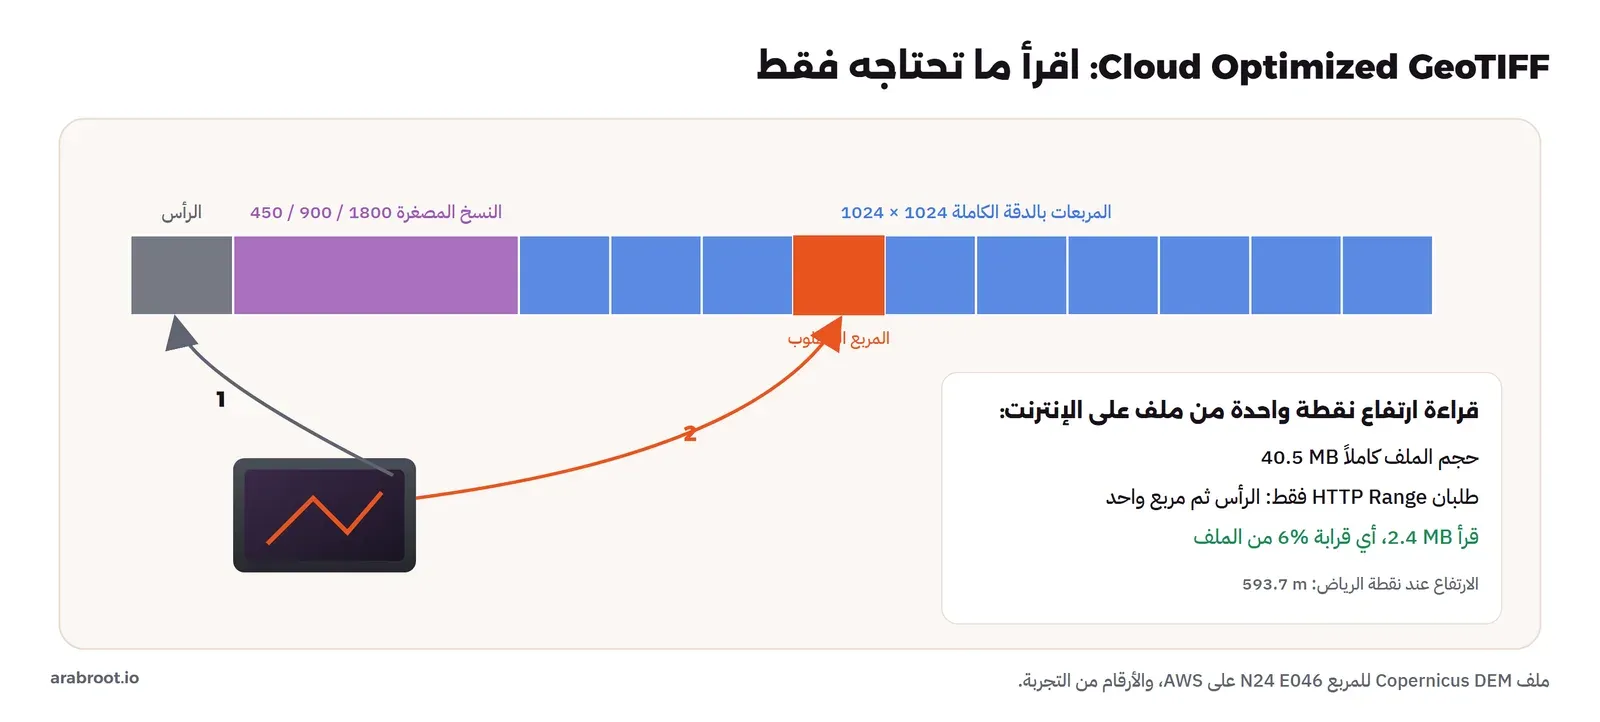
- التقسيم إلى مربعات Tiling: تقسم الصورة إلى مربعات 512 × 512 مثلاً بدل أسطر كاملة، فتقرأ منطقة صغيرة دون أن تقرأ عرض الصورة كله.
- النسخ المصغرة Overviews: نسخ أصغر من نفس الصورة داخل الملف، فعندما تعرض الدولة كاملة يقرأ البرنامج النسخة الصغيرة بدل ملايين الخلايا.
وإذا رتبت هذه الأجزاء في الملف بترتيب معين، الوسوم أولاً ثم النسخ المصغرة ثم المربعات، أصبح الملف ما يسمى Cloud Optimized GeoTIFF واختصاراً COG: ملف GeoTIFF عادي يفتحه أي برنامج، ولكن يمكن قراءة جزء منه من الإنترنت بطلبات HTTP Range دون تحميله كله، تماماً كما تفعل FlatGeobuf مع المتجهات. وعلى هذه الصيغة تنشر كثير من البيانات المفتوحة الكبيرة، ومنها نموذج الارتفاعات Copernicus DEM الذي سوف نستخدمه في التجربة، وأما تحليل الارتفاعات والانحدار فهو موضوع مقال نماذج الارتفاع في مرحلة متقدمة من المسار.
مسار الملف في مشروع حقيقي
قد تبدو المسألة من الوهلة الأولى اختيار صيغة واحدة «أفضل» ثم استخدامها في كل شيء، ولكن في الواقع فالمشروع الواحد يمر بعدة صيغ، ولكل مرحلة صيغة تناسبها. ولنعد إلى مثال الفروع في أول المقال، فالبيانات تمر بأربع مراحل:
- الاستلام Ingest: يصلك ما يصلك، Excel وShapefile وKML، ولا تتحكم في ذلك. والمهم هنا أن تقرأ كل ملف بإعداداته الصحيحة: الترميز في Shapefile، وأسماء أعمدة الإحداثيات في CSV، ونظام الإحداثيات في
.prj، ثم تتحقق من عدد العناصر وعينة من الأسماء العربية قبل أي خطوة أخرى. - التوحيد Normalize: تحول كل ما وصلك إلى صيغة عمل واحدة، ونظام إحداثيات واحد، وأسماء حقول متفق عليها. وصيغة العمل الطبيعية هنا GeoPackage، أو جدول في PostGIS إذا كان المشروع أكبر من جهاز واحد، كما في مقال PostGIS.
- التحليل Analyze: تعمل على صيغة العمل، أو تصدر نسخة GeoParquet إذا كان التحليل في Python أو أداة بيانات، لأنها أسرع قراءة وأصغر حجماً كما سنرى.
- النشر Publish: تصدر ما يحتاجه كل مستهلك: GeoJSON صغير لواجهة API، وFlatGeobuf أو مربعات متجهة لخريطة الويب، وShapefile لجهة تطلبه بالاسم، وCSV لقسم المبيعات.
والقاعدة التي تخرج من هذا المسار: صيغة العمل واحدة ولا تتغير، والصيغ الأخرى نسخ تنتج منها بأمر واحد عند الحاجة، ولا تعدل في النسخ أبداً، والسبب أنك إذا عدلت في نسخة Shapefile ثم في نسخة GeoJSON فسوف يكون عندك بعد شهر نسختان مختلفتان من نفس البيانات ولا تعرف أيهما الصحيحة. وهذا يشبه ما يفعله المطور مع الكود: ملف المصدر واحد، والملفات المبنية منه تنتج من جديد ولا تعدل باليد.
خمسة أسئلة قبل أن تختار صيغة
بدل أن تحفظ جدولاً للصيغ، اسأل خمسة أسئلة عن الاستخدام، والإجابات تختار لك الصيغة:
- من سيقرأ الملف؟ إنسان في Google Earth، أم برنامج GIS، أم متصفح، أم أداة تحليل. فالمتصفح يفهم GeoJSON دون مكتبة، وبرنامج GIS يفهم كل شيء، والإنسان في Excel يفهم CSV فقط.
- كم حجم البيانات؟ مئات العناصر لا تحتاج تفكيراً، أما مئات الآلاف فتجعل الفرق بين صيغة نصية وصيغة ثنائية مضغوطة فرقاً بين ثانية وعشر ثوان في كل قراءة.
- هل تقرأ الملف كاملاً أم جزءاً منه؟ إذا كان التطبيق يعرض حياً واحداً من مدينة كاملة، فأنت تحتاج صيغة فيها فهرس مكاني تقرأ منه جزءاً، مثل FlatGeobuf أو GeoPackage أو COG للبيانات الشبكية.
- هل ستعدل البيانات؟ GeoPackage تقبل الإضافة والتعديل والحذف كقاعدة بيانات، أما FlatGeobuf وGeoParquet فتكتب مرة واحدة ثم تقرأ، وأي تعديل يعني إعادة كتابة الملف.
- ما الذي يجب ألا يضيع؟ النص العربي، والأنواع، ونظام الإحداثيات، والأسماء الطويلة للحقول. وكل صيغة تفقد شيئاً من هذه القائمة، فاعرف ما تفقده الصيغة التي اخترتها قبل أن تكتشف ذلك من شكوى مستخدم.
ولاحظ أن «الصيغة الأشهر» ليست ضمن الأسئلة. فقد يطلب منك أحدهم Shapefile لأنه ما يعرفه، والإجابة الصحيحة ليست الرفض، وإنما أن تسأله أي برنامج سيقرأ الملف، فإذا كان QGIS أو ArcGIS الحديث فهما يقرآن GeoPackage، وإذا كان نظاماً قديماً يقبل Shapefile فقط فاصنعه له بالإعدادات الصحيحة التي سنراها في التجربة.
وماذا عن خرائط الويب الكبيرة؟
كل الصيغ السابقة ملفات تحمل الطبقة كاملة، والمتصفح لا يستطيع أن يرسم مليون مبنى من ملف واحد مهما كانت الصيغة سريعة. لذلك تستخدم خرائط الويب طريقة أخرى شرحناها في مقال الخرائط الرقمية، وهي المربعات Tiles: تقطع البيانات مسبقاً إلى مربعات صغيرة لكل مستوى تقريب، وتبسط الأشكال في المستويات البعيدة، فيحمل المتصفح المربعات التي على الشاشة فقط. ومن صيغ المربعات المتجهة MVT ومجموعتها في ملف واحد PMTiles، ونشرها على سيرفرك موضوع مرحلة خدمات الخرائط في هذا المسار. والمهم هنا أن المربعات صيغة نشر وعرض، وليست صيغة حفظ للبيانات، فهي مبسطة ومقطعة، فاحفظ الأصل دائماً في GeoPackage أو PostGIS، وأنتج المربعات منه.
الفخاخ التي تضيع فيها البيانات
التحويل بين الصيغ يبدو عملية آمنة، أمر واحد ثم ملف جديد، ولكن كل صيغة لا تستطيع أن تحمل كل ما تحمله الأخرى، وما لا تستطيع حمله يضيع أحياناً بصمت. وهذه أشهر المواضع، وسوف نرى أغلبها بالأرقام في التجربة:
- الترميز Encoding: GeoJSON وGeoPackage وGeoParquet وFlatGeobuf كلها UTF-8 دائماً، فالعربية فيها مضمونة. أما Shapefile فيعتمد على ترميز يكتب في ملف
.cpgأو في بايت داخل.dbf، فإذا غاب أو اختلف ظهرت العربية علامات استفهام أو رموزاً غريبة. - أسماء الحقول: عشرة أحرف في Shapefile، فتصبح
addr_streetوaddr_streeمتشابهتين، وإذا كان عندك حقلان يبدآن بنفس الأحرف العشرة يغير GDAL أحدهما برقم في آخره، وأي كود يقرأ الحقل باسمه الكامل يتوقف. - الأنواع: رقم OSM من 64 بت لا يدعمه KML فيتحول إلى رقم عشري، وCSV لا يحمل أنواعاً أصلاً، فكل شيء نص حتى تقول للبرنامج غير ذلك.
- نظام الإحداثيات: GeoJSON وKML على WGS 84 دائماً، فإذا حولت إليهما بيانات على UTM فلا بد أن تحولها إلى الدرجات، وCSV لا يحمل النظام أصلاً.
- الدقة: GDAL يكتب أرقام GeoJSON بـ 15 رقماً معنوياً افتراضياً فلا يضيع شيء، ولكن بعض الأدوات تقصها إلى 6 أو 7 أرقام بعد الفاصلة لتصغير الملف، وقد شرحنا في مقال الخرائط الرقمية أن سبعة أرقام تعني قرابة سنتيمتر، فهذا مقبول للخرائط وغير مقبول للمساحة.
التجربة العملية
سوف نستخدم ogr2ogr من GDAL 3.10 في Container من Debian 13، وهي الأداة التي تقرأ وتكتب كل الصيغ المتجهة، ومعها مكتبة GeoPandas في Python لصيغة GeoParquet وللقياس، والسبب أن GDAL الذي تأتي به Debian 13 مبني دون مكتبة Arrow، فلا يدعم Parquet كما ترى في قائمة صيغه. ملف lab/Dockerfile:
FROM debian:trixie-slim
RUN apt-get update && apt-get install -y --no-install-recommends gdal-bin python3-gdal osmium-tool sqlite3 curl ca-certificates \
      python3-venv file && rm -rf /var/lib/apt/lists/*
# GeoParquet: Debian's GDAL 3.10 has no Parquet driver, so we write and read it with GeoPandas and pyarrow
RUN python3 -m venv /opt/venv && /opt/venv/bin/pip install --no-cache-dir geopandas==1.1.1 pyogrio==0.11.1 pyarrow==21.0.0 shapely==2.1.1
ENV PATH=/opt/venv/bin:$PATH
docker build -t formats-lab lab/
docker run --rm formats-lab sh -c 'ogrinfo --version; ogrinfo --formats | grep -ciE "parquet|arrow"'GDAL 3.10.3, released 2025/04/01
0البيانات: طبقتان حقيقيتان من OpenStreetMap
نبدأ من مقتطف Geofabrik لدول الخليج gcc-states-261115.osm.pbf، وقد شرحنا تحميله والتحقق منه في مقال OpenStreetMap. ونقصه على حدود المملكة، ثم نستخرج طبقتين بطبيعتين مختلفتين: الأماكن المسماة، وهي نقاط بحقول نصية كثيرة وأسماء عربية وأسماء حقول طويلة، والمباني في وسط الرياض، وهي مضلعات كثيرة النقاط بحقول قليلة. ملف lab/prepare.sh:
#!/bin/sh
# Two real layers from the Geofabrik GCC extract (OpenStreetMap data up to 2026-11-15):
#   pois.gpkg       named places in Saudi Arabia (points, Arabic and English names, long field names)
#   buildings.gpkg  every building polygon inside a box of about 20 x 22 km over central Riyadh
set -e
PBF=gcc-states-261115.osm.pbf

# 1. The Kingdom's outline, to cut the extract to Saudi Arabia only
osmium tags-filter -O -o /tmp/sa-rel.osm.pbf $PBF "r/ISO3166-1=SA"
osmium export -O --geometry-types=polygon -o /tmp/sa.geojson /tmp/sa-rel.osm.pbf
rm -f sa.geojson; ogr2ogr -f GeoJSON sa.geojson /tmp/sa.geojson -where "\"ISO3166-1\" = 'SA'"
[ -f sa.osm.pbf ] || osmium extract -O -p sa.geojson -o sa.osm.pbf $PBF

# 2. Named points of interest
osmium tags-filter -O -o /tmp/poi.osm.pbf sa.osm.pbf "n/amenity,shop,tourism,healthcare,office" --omit-referenced
osmium export -O -f geojsonseq -a id -o /tmp/poi.geojsonseq /tmp/poi.osm.pbf
ogr2ogr -f GPKG -overwrite pois.gpkg /tmp/poi.geojsonseq -nln pois -dialect SQLite -sql "
  select geometry, \"@id\" as osm_id, coalesce(amenity, shop, tourism, healthcare, office) as category,
         name, \"name:ar\" as name_ar, \"name:en\" as name_en, opening_hours, \"addr:street\" as addr_street,
         \"addr:postcode\" as addr_postcode, phone, website
  from \"poi\" where name is not null"

# 3. Buildings in central Riyadh (bounding box 46.60-46.80 E, 24.60-24.80 N)
osmium extract -O -b 46.60,24.60,46.80,24.80 -o /tmp/ruh.osm.pbf sa.osm.pbf
osmium tags-filter -O -o /tmp/bld.osm.pbf /tmp/ruh.osm.pbf "wa/building"
osmium export -O -f geojsonseq --geometry-types=polygon -a id -o /tmp/bld.geojsonseq /tmp/bld.osm.pbf
ogr2ogr -f GPKG -overwrite buildings.gpkg /tmp/bld.geojsonseq -nln buildings -nlt MULTIPOLYGON -dialect SQLite -sql "
  select geometry, \"@id\" as osm_id, building, name, \"building:levels\" as levels, \"addr:housenumber\" as housenumber from \"bld\""

for f in pois buildings; do ogrinfo -so $f.gpkg $f | grep -E "Geometry:|Feature Count"; done
docker run --rm -v "$PWD/lab:/lab:ro" -v "$PWD/data:/data" -w /data formats-lab sh /lab/prepare.shGeometry: Point
Feature Count: 24503
Geometry: Multi Polygon
Feature Count: 55187في الإعداد أعلاه لاحظ التالي:
- استخدمنا
-dialect SQLiteمع الاستعلام، والسبب مشكلة واجهناها في أول تشغيل: لغة SQL المدمجة في OGR لا تعرف الدالةcoalesceفتوقف الأمر برسالةUndefined function 'coalesce' used، أما لهجة SQLite فتدعمها، ولكنها تحتاج أن تكتب عمود الشكلgeometryصراحة في قائمة الأعمدة وإلا خرج جدول بلا أشكال. - وفي التشغيل الأول أيضاً رفض ogr2ogr أن يكتب
sa.geojsonفوق ملف موجود بالخيار-overwrite، لأن صيغة GeoJSON لا تدعم حذف طبقة داخل الملف، فحذفنا الملف قبل الكتابة. وهذه أول علامة على أن الصيغ ليست متساوية: GeoPackage تحذف طبقة وتضيف أخرى في نفس الملف، وGeoJSON ملف واحد لطبقة واحدة. - أعدنا تسمية الحقول بشرطة سفلية بدل النقطتين، مثل
name:arإلىname_ar، لأن النقطتين في اسم الحقل تسبب مشاكل في أغلب الصيغ وقواعد البيانات.
نفس الطبقتين في سبع صيغ
الآن نحول كل طبقة إلى كل الصيغ، ونقيس زمن كل تحويل وحجم الناتج، ثم نقرأ كل ملف من جديد ونقارنه بالأصل. ونعمل داخل الـ Container في /tmp وليس في المجلد المشترك مع Windows، والسبب أن الكتابة عبر المجلد المشترك أبطأ بكثير، فتقيس سرعة المجلد وليس سرعة الصيغة. ملف lab/convert.sh:
#!/bin/sh
# The same two layers in seven formats: conversion time, size on disk, then read-back checks (bench.py).
# Work happens inside the container (/tmp/out) so the timings measure the formats, not the shared folder.
set -e
rm -rf /tmp/out && mkdir /tmp/out && cp buildings.gpkg pois.gpkg /tmp/out/ && cd /tmp/out
t() {   # run a command, show its first messages and how long it took
  s=$(date +%s.%N); "$@" 2>&1 | grep -v "^$" | head -3 || true
  echo "$s $(date +%s.%N)" | awk '{printf "    %.2f s\n", $2 - $1}'
}
for L in buildings pois; do
  for f in "GeoJSON geojson" "ESRI_Shapefile shp" "FlatGeobuf fgb" "KML kml" "CSV csv"; do
    set -- $f; drv=$(echo $1 | tr _ ' ')
    echo "$L -> $2"; t ogr2ogr -f "$drv" $L.$2 $L.gpkg $( [ $2 = csv ] && echo -lco GEOMETRY=AS_WKT )
  done
  echo "$L -> parquet"; t python3 -c "import geopandas as g; g.read_file('$L.gpkg').to_parquet('$L.parquet')"
done
echo; echo "size in KB (Shapefile = .shp + .shx + .dbf + .prj)"
for L in buildings pois; do
  for e in gpkg geojson fgb parquet kml csv; do printf "%-10s %-8s %8d\n" $L $e $(( $(stat -c %s $L.$e) / 1024 )); done
  printf "%-10s %-8s %8d\n" $L shp $(( $(cat $L.shp $L.shx $L.dbf $L.prj | wc -c) / 1024 ))
  [ -f $L.cpg ] || echo "           ($L: no .cpg file was written)"
done
for L in buildings pois; do echo; python3 /lab/bench.py $L; done
rm -rf /data/out && cp -r /tmp/out /data/out
docker run --rm -v "$PWD/lab:/lab:ro" -v "$PWD/data:/data" -w /data formats-lab sh /lab/convert.shوالجزء الأول من المخرج، التحويل:
buildings -> geojson
    1.85 s
buildings -> shp
Warning 6: Normalized/laundered field name: 'housenumber' to 'housenumbe'
Warning 1: One or several characters couldn't be converted correctly from UTF-8 to ISO-8859-1.  This warning will not be emitted anymore.
    0.68 s
buildings -> fgb
    0.32 s
buildings -> kml
    3.43 s
buildings -> csv
    1.86 s
buildings -> parquet
    1.53 s
pois -> geojson
    0.35 s
pois -> shp
Warning 6: Normalized/laundered field name: 'opening_hours' to 'opening_ho'
Warning 6: Normalized/laundered field name: 'addr_street' to 'addr_stree'
Warning 6: Normalized/laundered field name: 'addr_postcode' to 'addr_postc'
    1.08 s
pois -> fgb
    0.19 s
pois -> kml
Warning 1: The output driver does not seem to natively support Integer64 type for field osm_id. Converting it to Real instead. -mapFieldType can be used to control field type conversion.
    0.42 s
pois -> csv
    0.43 s
pois -> parquet
    1.83 s
في المخرج أعلاه لاحظ التالي:
- أهم سطر في التجربة كلها هو التحذير الثاني تحت
buildings -> shp: «بعض الحروف لم تتحول بشكل صحيح من UTF-8 إلى ISO-8859-1، ولن يظهر هذا التحذير مرة أخرى». أي أن ogr2ogr كتب Shapefile بالترميز الافتراضي ISO-8859-1، وهو ترميز لاتيني لا توجد فيه حروف عربية، فاستبدل كل حرف عربي بعلامة استفهام، وطبع التحذير مرة واحدة فقط ثم تابع. وفي طبقة الأماكن لم يظهر التحذير أصلاً في الأسطر الثلاثة الأولى لأن تحذيرات أسماء الحقول سبقته، ونفس الضياع حدث كما سنرى. - أسماء الحقول قطعت إلى عشرة أحرف:
opening_hoوaddr_streeوaddr_postcوhousenumbe. - KML حول رقم OSM من عدد صحيح بـ 64 بت إلى رقم عشري Real، وهذا يكفي هنا، ولكن الأرقام العشرية تفقد الدقة فوق قرابة 9 آلاف تريليون، فلا تحفظ معرفات طويلة في صيغة لا تدعمها.
- FlatGeobuf أسرع الصيغ كتابة، وKML أبطؤها، أما زمن GeoParquet فيشمل تشغيل Python وتحميل GeoPandas وقراءة الأصل، فلا تقارنه بأوامر ogr2ogr مباشرة.
والجزء الثاني، الحجم:
size in KB (Shapefile = .shp + .shx + .dbf + .prj)
buildings  gpkg        13460
buildings  geojson     19905
buildings  fgb         14469
buildings  parquet      4709
buildings  kml         32710
buildings  csv          9292
buildings  shp         26461
           (buildings: no .cpg file was written)
pois       gpkg         4028
pois       geojson      8380
pois       fgb          4665
pois       parquet      1178
pois       kml          9557
pois       csv          2503
pois       shp         25508
           (pois: no .cpg file was written)
في المخرج أعلاه لاحظ التالي:
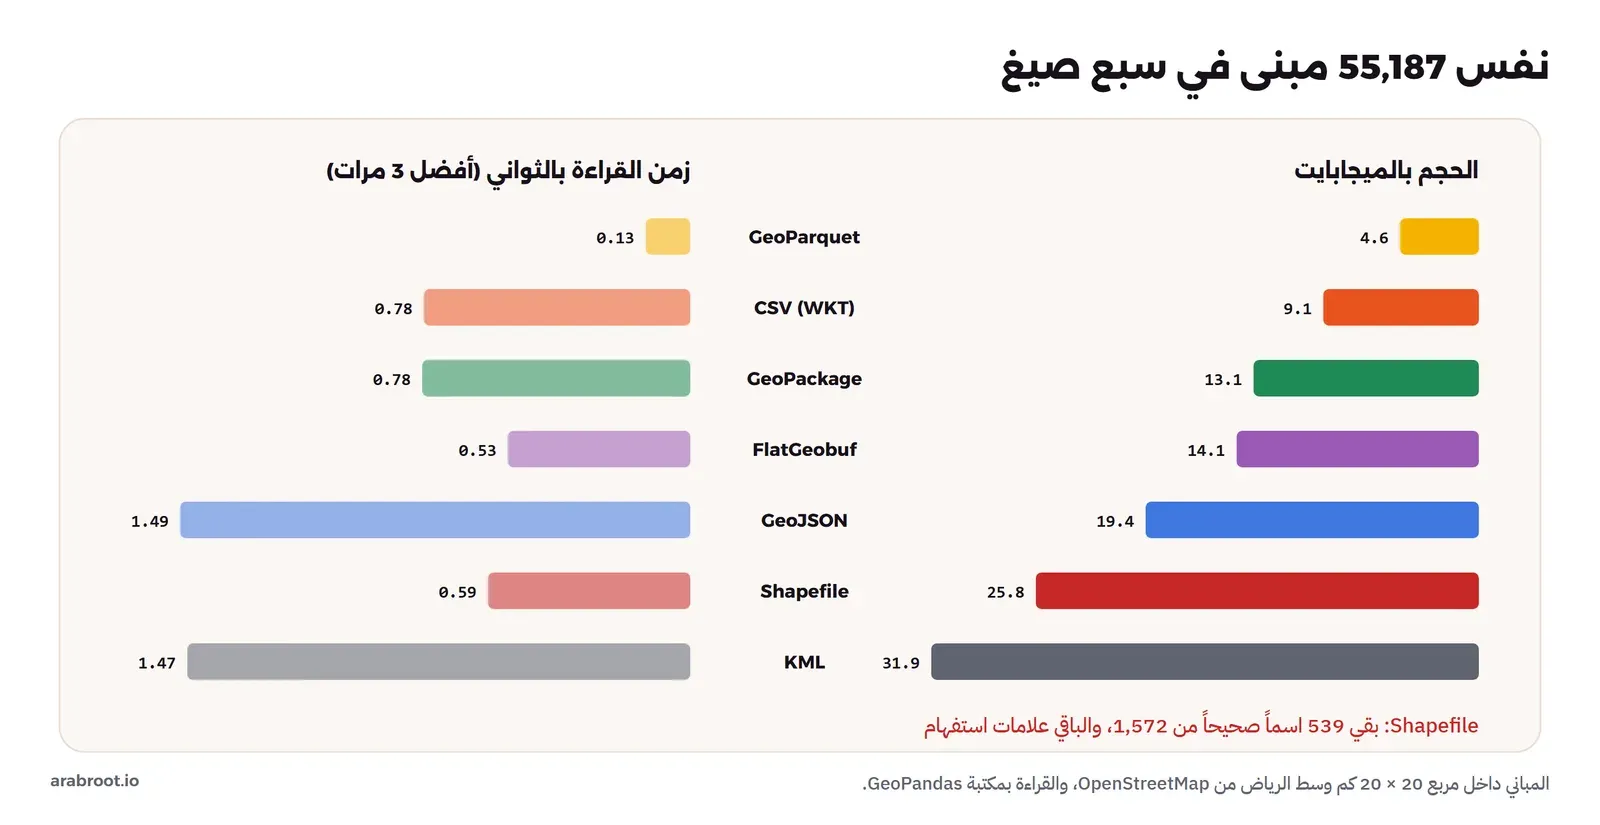
- GeoParquet أصغر الصيغ بفارق كبير: 4.6 ميجابايت للمباني مقابل 13.1 لـ GeoPackage و19.4 لـ GeoJSON، والسبب الضغط بالأعمدة، فعمود
buildingالذي تتكرر فيه قيمةyesعشرات الآلاف من المرات يضغط إلى لا شيء تقريباً. - CSV أصغر من GeoJSON لأن أسماء الحقول تكتب مرة واحدة في أول سطر بدل تكرارها مع كل عنصر، ولكنه لا يحمل الأنواع ولا النظام.
- Shapefile لطبقة الأماكن 24.9 ميجابايت، أي ستة أضعاف GeoPackage، رغم أنها نقاط فقط. وسوف نرى السبب في جدول dBase بعد قليل.
- KML أكبر الصيغ في الطبقتين، وهذا ثمن XML.
- ولا يوجد ملف
.cpgلأي من الطبقتين، وهذا هو الدليل على مشكلة الترميز قبل أن تفتح الملف.
نقرأ كل ملف من جديد: ماذا بقي؟
الحجم لا يكفي، فالسؤال الأهم: هل خرجت البيانات كما دخلت؟ ملف lab/bench.py يقرأ كل نسخة ثلاث مرات ويأخذ أسرعها، ويقارن عدد العناصر والحقول، وعدد الأسماء المطابقة للأصل، وأكبر انزياح في الأشكال بالأمتار، بربط كل عنصر بنظيره عبر رقم OSM:
# Read every copy back: load time (best of 3), feature count, fields, Arabic names, coordinate changes
import time, sys, warnings
warnings.filterwarnings("ignore")                   # CRS notes about degrees; the shift is only a rough sanity check
import geopandas as gpd

layer = sys.argv[1]                                     # buildings or pois
ref = gpd.read_file(f"{layer}.gpkg").set_index("osm_id")
named = ref["name"].dropna()
print(f"reference GeoPackage: {len(ref)} features, {len(named)} with a name")

print("format    load (s)  features  fields  names equal  max shift (m)")
for ext in ["gpkg", "geojson", "fgb", "parquet", "shp", "kml", "csv"]:
    path = f"{layer}.{ext}"
    best = 1e9
    for _ in range(3):
        t = time.perf_counter()
        if ext == "parquet":
            df = gpd.read_parquet(path)
        elif ext == "csv":                              # tell the CSV reader which column holds the WKT
            df = gpd.read_file(path, GEOM_POSSIBLE_NAMES="GEOMETRY", KEEP_GEOM_COLUMNS="NO")
        else:
            df = gpd.read_file(path)
        best = min(best, time.perf_counter() - t)
    cols = [c for c in df.columns if c != "geometry"]
    if "osm_id" in df:                                  # match every feature to the reference by its OSM id
        df = df.set_index(df["osm_id"].astype(ref.index.dtype))
        same = (df.loc[named.index, "name"] == named).sum()
        shift = f"{ref.geometry.hausdorff_distance(df.geometry.reindex(ref.index), align=True).max() * 111_000:.2e}"
    else:                                               # no id came back: compare the set of names only
        same = named.isin(set(df["Name"].dropna())).sum() if "Name" in df else 0
        shift = "-"
    print(f"{ext:<9} {best:8.3f}  {len(df):8d}  {len(cols):6d}  {same:>6}/{len(named):<5} {shift:>12}")
    if ext in ("shp", "kml", "csv"):
        print(f"          {', '.join(cols)}")
والمخرج، وهو الجزء الأخير من مخرج convert.sh:
reference GeoPackage: 55187 features, 1572 with a name
format    load (s)  features  fields  names equal  max shift (m)
gpkg         0.782     55187       5    1572/1572      0.00e+00
geojson      1.488     55187       5    1572/1572      0.00e+00
fgb          0.532     55187       5    1572/1572      0.00e+00
parquet      0.130     55187       5    1572/1572      0.00e+00
shp          0.590     55187       5     539/1572      0.00e+00
          osm_id, building, name, levels, housenumbe
kml          1.467     55187       2    1572/1572             -
          Name, Description
csv          0.777     55187       5    1572/1572      0.00e+00
          osm_id, building, name, levels, housenumber

reference GeoPackage: 24503 features, 24503 with a name
format    load (s)  features  fields  names equal  max shift (m)
gpkg         0.344     24503      10   24503/24503     0.00e+00
geojson      0.681     24503      10   24503/24503     0.00e+00
fgb          0.337     24503      10   24503/24503     0.00e+00
parquet      0.061     24503      10   24503/24503     0.00e+00
shp          0.402     24503      10    5497/24503     0.00e+00
          osm_id, category, name, name_ar, name_en, opening_ho, addr_stree, addr_postc, phone, website
kml          0.390     24503       2   24471/24503            -
          Name, Description
csv          0.443     24503      10   24503/24503     0.00e+00
          osm_id, category, name, name_ar, name_en, opening_hours, addr_street, addr_postcode, phone, website
في المخرج أعلاه لاحظ التالي:
- Shapefile حافظ على الأشكال بدقة كاملة، ولكنه أبقى 539 اسماً صحيحاً فقط من 1,572 اسم مبنى، و5,497 من 24,503 اسم مكان، وهي الأسماء المكتوبة بحروف لاتينية فقط. أي أن قرابة 78% من أسماء الأماكن ضاعت دون أي خطأ، وكل ما يدل على ذلك تحذير واحد في التحويل.
- KML أعاد عمودين فقط:
NameوDescription. والسبب أن الحقول الأخرى محفوظة فيExtendedDataداخل الملف، ولكن أداة القراءة الافتراضية لا تعيدها كأعمدة، فرقم OSM والتصنيف وساعات العمل لم تعد موجودة كبيانات. وفي طبقة الأماكن لم يطابق الأصل 32 اسماً من 24,503، وعندما فحصناها وجدناها أسماء فيها سطر جديد داخل الاسم، مثل «مكتب خدمات» ثم سطر ثم «شركة الكهرباء»، أو مسافة في أولها، فـ XML يعامل المسافات والأسطر الجديدة بطريقته فلا يعود الاسم كما كان. - CSV احتاج أن نقول له إن العمود
GEOMETRYفيه الشكل، وفي أول تشغيل قرأه GeoPandas جدولاً عادياً بلا أشكال، لأن القارئ لا يعرف أي عمود نصي هو WKT. وهذا ما يحدث لمن يفتح CSV في برنامج لا يعرف هذا الاتفاق. - GeoParquet أسرع الصيغ قراءة بفارق كبير: 0.13 ثانية للمباني مقابل 1.49 لـ GeoJSON، أي أسرع بأكثر من 11 مرة، وFlatGeobuf ثانية بعد GeoParquet.
- عمود الانزياح صفر في كل الصيغ التي أعادت رقم OSM، فلا GDAL ولا GeoPandas قص الإحداثيات في هذه الصيغ بإعداداتهما الافتراضية.
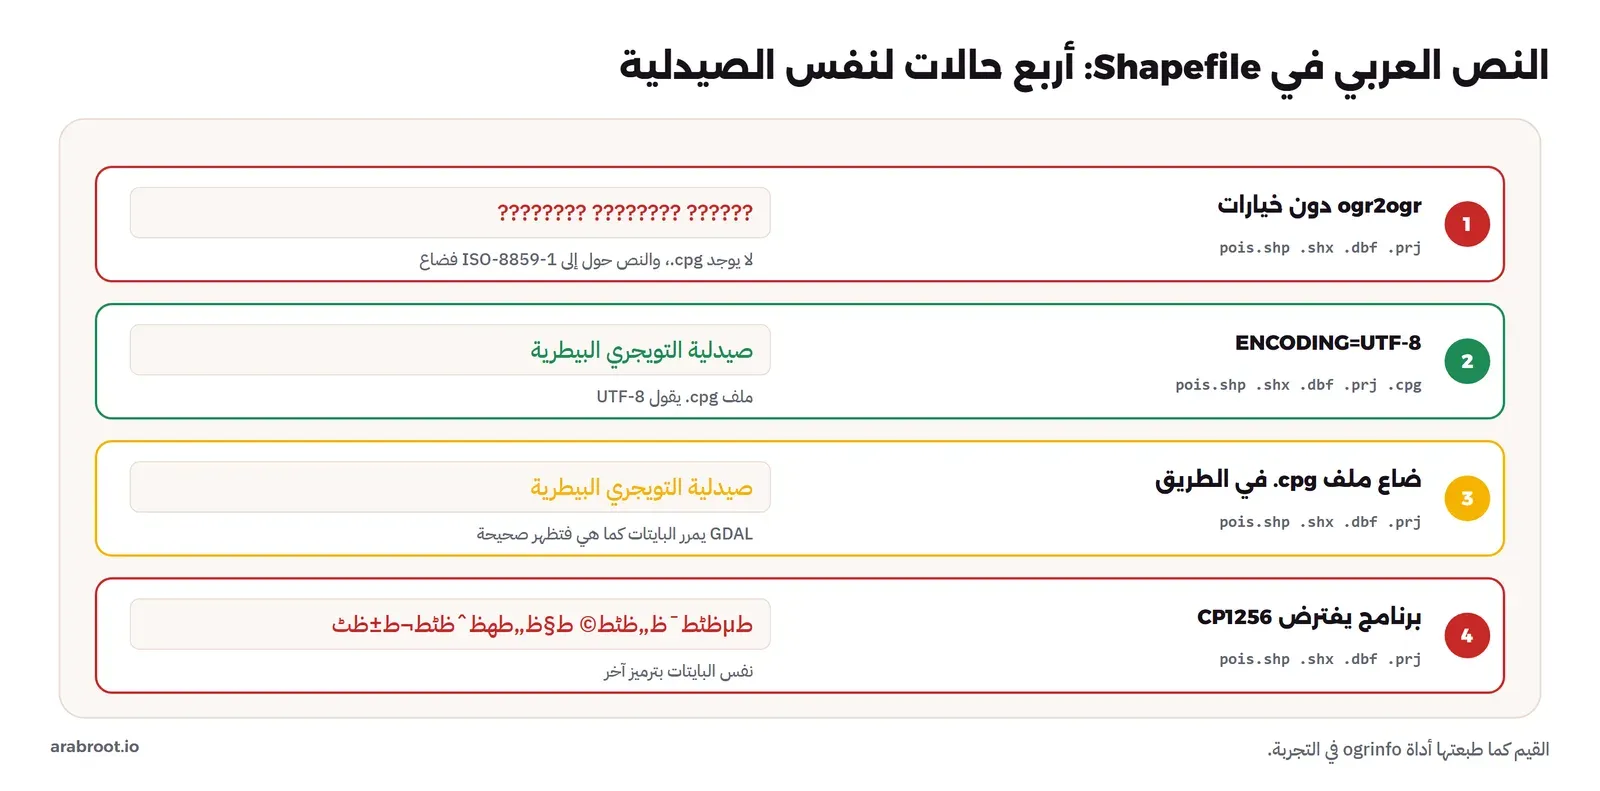
نجرب العطل: العربية في Shapefile
نتتبع صيدلية واحدة من طبقة الأماكن عبر أربع حالات: الأصل، وShapefile الافتراضي، وShapefile بترميز UTF-8، ثم نفس الملف بعد أن يضيع ملف .cpg في الطريق، كما يحدث عندما يرسل أحدهم ثلاثة ملفات فقط لأنه يظن أن الباقي غير مهم. ملف lab/arabic-shp.sh:
#!/bin/sh
# The Arabic text trap in Shapefile: default encoding, .cpg, and a file whose .cpg went missing
cd out
ID=9762738617                                   # one pharmacy from the OpenStreetMap layer
SQL="select osm_id, name, opening_ho, addr_stree from pois where osm_id = $ID"

echo "== 0. the same feature in the GeoPackage"
ogrinfo -ro -q pois.gpkg -sql "select osm_id, name, opening_hours, addr_street from pois where osm_id = $ID" | grep -E " = "

echo "== 1. default ogr2ogr output: which files, and what is left of the Arabic text?"
ls pois.* | tr '\n' ' '; echo
ogrinfo -ro -q pois.shp -sql "$SQL" | grep -E " = "

echo "== 2. written again with ENCODING=UTF-8"
mkdir -p utf8 && ogr2ogr -f "ESRI Shapefile" -lco ENCODING=UTF-8 utf8/pois.shp pois.gpkg 2>/dev/null
ls utf8/ | tr '\n' ' '; echo; echo "pois.cpg says: $(cat utf8/pois.cpg)"
ogrinfo -ro -q utf8/pois.shp -sql "$SQL" | grep -F "name ("

echo "== 3. the same file after the .cpg is lost on the way"
rm utf8/pois.cpg
ogrinfo -ro -q utf8/pois.shp -sql "$SQL" | grep -F "name ("
echo "   ...and in a program that assumes the Windows Arabic code page (CP1256):"
ogrinfo -ro -q -oo ENCODING=CP1256 utf8/pois.shp -sql "$SQL" | grep -F "name ("

echo "== 4. why the .dbf is so large: fixed-width text fields"
ogrinfo -ro -so utf8/pois.shp pois | grep -E "String|Integer|Real"
ls -l --block-size=K utf8/pois.dbf pois.gpkg | awk '{print $5, $9}'
docker run --rm -v "$PWD/lab:/lab:ro" -v "$PWD/data:/data" -w /data formats-lab sh /lab/arabic-shp.sh== 0. the same feature in the GeoPackage
osm_id (Integer64) = 9762738617
name (String) = صيدلية التويجري البيطرية
opening_hours (String) = Mo-Su 08:00-23:00
addr_street (String) = الجنادرية
== 1. default ogr2ogr output: which files, and what is left of the Arabic text?
pois.csv pois.dbf pois.fgb pois.geojson pois.gpkg pois.kml pois.parquet pois.prj pois.shp pois.shx
osm_id (Integer64) = 9762738617
name (String) = ?????? ???????? ????????
opening_ho (String) = Mo-Su 08:00-23:00
addr_stree (String) = ?????????
== 2. written again with ENCODING=UTF-8
pois.cpg pois.dbf pois.prj pois.shp pois.shx
pois.cpg says: UTF-8
name (String) = صيدلية التويجري البيطرية
== 3. the same file after the .cpg is lost on the way
name (String) = صيدلية التويجري البيطرية
...and in a program that assumes the Windows Arabic code page (CP1256):
name (String) = طµظٹط¯ظ„ظٹط© ط§ظ„طھظˆظٹط¬ط±ظٹ ط§ظ„ط¨ظٹط·ط±ظٹط©
== 4. why the .dbf is so large: fixed-width text fields
osm_id: Integer64 (18.0)
category: String (80.0)
name: String (140.0)
name_ar: String (121.0)
name_en: String (238.0)
opening_ho: String (112.0)
addr_stree: String (139.0)
addr_postc: String (80.0)
phone: String (80.0)
website: String (254.0)
4028K pois.gpkg
30223K utf8/pois.dbfفي المخرج أعلاه لاحظ التالي:
- في الحالة الأولى ضاع الاسم والشارع نهائياً، وعلامات الاستفهام محفوظة في الملف نفسه، فلا يوجد أي إعداد في أي برنامج يعيد الاسم. والحقل اللاتيني
Mo-Su 08:00-23:00بقي سليماً، وهذا ما يجعل المشكلة خادعة: تفتح الملف فتجد بعض البيانات صحيحة. - الخيار
-lco ENCODING=UTF-8يكتب النص كما هو ويضيف ملفpois.cpgفيه كلمة واحدة:UTF-8، وهذا هو الحل الذي يذكره توثيق GDAL لـ Shapefile. - في الحالة الثالثة، بعد حذف
.cpg، ظهر الاسم صحيحاً في GDAL، لأن الملف لم يعد يقول ترميزه فمرر GDAL البايتات كما هي، وهي UTF-8 أصلاً. ولكن البرنامج الذي يفترض ترميز Windows العربي CP1256، كما تفعل برامج كثيرة على أجهزة عربية، عرض نفس البايتات رموزاً مثلطµظٹط¯ظ„ظٹط©. وإذا رأيت هذا النمط من الحروف يوماً فاعرف أنه نص UTF-8 قرئ بترميز آخر، وأن البيانات سليمة وتحتاج فقط أن تخبر البرنامج بالترميز الصحيح. - الحقول النصية في dBase بعرض ثابت، فكل اسم يحجز 140 بايتاً حتى لو كان «صيدلية» فقط، وحقل الموقع الإلكتروني 254 بايتاً لكل صف حتى لو كان فارغاً، ولهذا السبب أصبح
pois.dbfوحده 29.5 ميجابايت مقابل 3.9 ميجابايت لـ GeoPackage كاملة. ولاحظ أنه أكبر من ملف الحالة الأولى، لأن الحرف العربي في UTF-8 بايتان، فطالت الحقول.
نفتح الملفات من الداخل
نرى الآن ما شرحناه عن البنية الداخلية بأعيننا: سطر من GeoJSON، وجداول GeoPackage، والبيانات الوصفية في GeoParquet. ملف lab/inspect.sh:
#!/bin/sh
# Look inside three of the files: one GeoJSON feature, the tables of a GeoPackage, the metadata of a GeoParquet file
cd out
echo "== GeoJSON: the pharmacy from the Shapefile test, as one line of pois.geojson"
grep -m1 "9762738617" pois.geojson

echo "== GeoPackage: it is an SQLite database"
sqlite3 pois.gpkg ".tables"
sqlite3 -header pois.gpkg "select table_name, data_type, srs_id, min_x, max_y from gpkg_contents;"
sqlite3 pois.gpkg "select count(*) || ' entries in the R-tree spatial index' from rtree_pois_GEOMETRY;"

echo "== GeoParquet: columns and the 'geo' metadata"
python3 - <<'EOF'
import json, pyarrow.parquet as pq
f = pq.ParquetFile("pois.parquet")
print(f.schema_arrow.names, f"row groups: {f.num_row_groups}")
geo = json.loads(f.schema_arrow.metadata[b"geo"])
col = geo["columns"]["geometry"]
print("version", geo["version"], "| encoding", col["encoding"], "| types", col["geometry_types"], "| crs id", col["crs"]["id"])
EOF
docker run --rm -v "$PWD/lab:/lab:ro" -v "$PWD/data:/data" -w /data formats-lab sh /lab/inspect.sh== GeoJSON: the pharmacy from the Shapefile test, as one line of pois.geojson
{ "type": "Feature", "properties": { "osm_id": 9762738617, "category": "pharmacy", "name": "صيدلية التويجري البيطرية", "name_ar": "صيدلية التويجري البيطرية", "name_en": "Pharmacy Altwijri Vetrinary", "opening_hours": "Mo-Su 08:00-23:00", "addr_street": "الجنادرية", "addr_postcode": null, "phone": null, "website": null }, "geometry": { "type": "Point", "coordinates": [ 46.8472776, 24.8689934 ] } },
== GeoPackage: it is an SQLite database
gpkg_contents gpkg_tile_matrix_set
gpkg_extensions pois
gpkg_geometry_columns rtree_pois_GEOMETRY
gpkg_ogr_contents rtree_pois_GEOMETRY_node
gpkg_spatial_ref_sys rtree_pois_GEOMETRY_parent
gpkg_tile_matrix rtree_pois_GEOMETRY_rowid
table_name|data_type|srs_id|min_x|max_y
pois|features|4326|33.9470147|32.1121135
24503 entries in the R-tree spatial index
== GeoParquet: columns and the 'geo' metadata
['osm_id', 'category', 'name', 'name_ar', 'name_en', 'opening_hours', 'addr_street', 'addr_postcode', 'phone', 'website', 'geometry'] row groups: 1
version 1.0.0 | encoding WKB | types ['Point'] | crs id {'authority': 'EPSG', 'code': 4326}في المخرج أعلاه لاحظ التالي:
- سطر GeoJSON نص تقرؤه بعينك: الأسماء العربية كما هي، والإحداثيات خط الطول أولاً، ومفاتيح مثل
"opening_hours"تتكرر مع كل واحد من 24,503 عنصراً، ومن هنا يأتي حجمه. - GeoPackage جداول SQLite عادية:
gpkg_contentsيقول إن الطبقةpoisعناصر Features على النظام 4326 ويحفظ حدودها، وجداولrtree_pois_GEOMETRYهي الفهرس المكاني، وفيه مدخل لكل عنصر. فتستطيع أن تكتب عليها أي استعلام SQL دون أي أداة جغرافية. - GeoParquet يحفظ وصف الشكل في بيانات وصفية اسمها
geo: نسخة المواصفة، وطريقة الترميز WKB، ونوع الأشكال، ونظام الإحداثيات EPSG:4326، فالملف يصف نفسه بالكامل، عكس CSV.
GeoTIFF: ارتفاعات الرياض من السحابة
للبيانات الشبكية نستخدم مربعاً واحداً من نموذج الارتفاعات Copernicus DEM المنشور على AWS Open Data بصيغة COG، وهو المربع الذي يغطي الرياض، درجة × درجة بخلايا قرابة 30 متراً. ونجرب ثلاثة أشياء: قراءة ارتفاع نقطة واحدة من الإنترنت دون تحميل الملف، ثم خصائص الملف، ثم نفس البيانات بخمسة إعدادات ضغط. ملف lab/raster.sh:
#!/bin/sh
# One raster: the Copernicus DEM tile over Riyadh (1 x 1 degree, about 30 m cells), published as a COG on AWS Open Data
set -e
URL=https://copernicus-dem-30m.s3.amazonaws.com/Copernicus_DSM_COG_10_N24_00_E046_00_DEM/Copernicus_DSM_COG_10_N24_00_E046_00_DEM.tif
mkdir -p dem && cd dem

echo "== 1. read one height straight from the cloud, without downloading the file"
CPL_DEBUG=ON CPL_CURL_VERBOSE=NO gdallocationinfo -wgs84 -valonly /vsicurl/$URL 46.7160104 24.638916 2> /tmp/curl.log
echo "   range requests: $(grep -c 'Downloading' /tmp/curl.log), bytes: $(grep -o 'Downloading [0-9]*-[0-9]*' /tmp/curl.log | awk -F'[ -]' '{s += $3 - $2 + 1} END {print s}')"

echo "== 2. the whole file"
curl -sfo cop.tif $URL
gdalinfo cop.tif | grep -E "Size is|Pixel Size|Type=|COMPRESSION|LAYOUT|Overviews|Block=|PREDICTOR" | sed 's/^ *//' | head -8

echo "== 3. the same heights stored five ways (size in KB)"
gdal_translate -q -co COMPRESS=NONE                    cop.tif none.tif
gdal_translate -q -co COMPRESS=LZW                     cop.tif lzw.tif
gdal_translate -q -co COMPRESS=DEFLATE                 cop.tif deflate.tif
gdal_translate -q -co COMPRESS=DEFLATE -co PREDICTOR=3 cop.tif deflate-pred.tif
gdal_translate -q -of COG -co COMPRESS=DEFLATE -co PREDICTOR=YES cop.tif cog.tif
for f in cop none lzw deflate deflate-pred cog; do printf "%-14s %8d\n" $f $(( $(stat -c %s $f.tif) / 1024 )); done

echo "== 4. are the heights identical after all that?"
for f in none lzw deflate-pred cog; do printf "%-14s " $f; gdalinfo -stats $f.tif 2>/dev/null | grep -m1 -oE "Minimum=[^,]*, Maximum=[^,]*, Mean=[^,]*"; done
docker run --rm -v "$PWD/lab:/lab:ro" -v "$PWD/data:/data" -w /data formats-lab sh /lab/raster.sh== 1. read one height straight from the cloud, without downloading the file
593.7431640625
range requests: 2, bytes: 2424832
== 2. the whole file
Size is 3600, 3600
Pixel Size = (0.000277777777778,-0.000277777777778)
LAYOUT=COG
COMPRESSION=DEFLATE
PREDICTOR=3
Band 1 Block=1024x1024 Type=Float32, ColorInterp=Gray
Overviews: 1800x1800, 900x900, 450x450
== 3. the same heights stored five ways (size in KB)
cop 39567
none 50646
lzw 51794
deflate 41963
deflate-pred 29200
cog 39381
== 4. are the heights identical after all that?
none Minimum=460.070, Maximum=1131.192, Mean=710.334
lzw Minimum=460.070, Maximum=1131.192, Mean=710.334
deflate-pred Minimum=460.070, Maximum=1131.192, Mean=710.334
cog Minimum=460.070, Maximum=1131.192, Mean=710.334في المخرج أعلاه لاحظ التالي:
- قرأنا ارتفاع نقطة الرياض، 593.7 متر، من ملف حجمه 40.5 ميجابايت بطلبين HTTP فقط و2.4 ميجابايت، أي قرابة 6% من الملف، وهذه فائدة COG كما في الشكل السابق، فتطبيق ويب يعرض ارتفاع نقطة لا يحتاج أن يخزن الملف.
- الملف 3600 × 3600 خلية، كل خلية 1/3600 درجة، أي ثانية قوسية واحدة وقرابة 30 متراً، والقيم أرقام عشرية Float32، ومقسم إلى مربعات 1024 × 1024، ومعه ثلاث نسخ مصغرة.
- LZW دون متنبئ أكبر من الملف غير المضغوط، 51,794 مقابل 50,646 كيلوبايت، لأن الأرقام العشرية المتجاورة تختلف في بتاتها الأخيرة فلا يجد الضاغط تكراراً، فالضغط بإعدادات خاطئة قد يكبر الملف.
- DEFLATE مع المتنبئ العشري
PREDICTOR=3أصغرها، 29,200 كيلوبايت، أي 58% من غير المضغوط، لأنه يضغط الفرق بين كل ارتفاع وجاره، والارتفاعات المتجاورة متقاربة. - الإحصاءات متطابقة في كل النسخ، فكل هذه الطرق دون فقدان، وهذا ما يجب أن تتحقق منه قبل أن تعتمد على أي إعداد ضغط للارتفاعات.
تنظيف التجربة
docker image rm formats-lab
rm -rf data/out data/dem data/*.gpkg data/sa.osm.pbf data/sa.geojson
أخطاء شائعة
- Shapefile دون
ENCODING=UTF-8: رأينا أن قرابة 78% من أسماء الأماكن تحولت إلى علامات استفهام لا رجوع عنها، فاكتب الخيار دائماً، وتأكد من وجود.cpgقبل الإرسال. - إرسال ملف
.shpوحده: الصيغة خمسة ملفات، فاضغطها معاً في ملف ZIP واحد، وGDAL يقرأ الملف المضغوط مباشرة. - الوثوق في أسماء الحقول بعد Shapefile:
addr_streetأصبحتaddr_stree، فالكود الذي يقرأ الحقل باسمه سوف يتوقف. - GeoJSON كبير في صفحة ويب: المتصفح يحمل الملف كله ويحلله قبل أن يرسم شيئاً، فإذا تجاوز بضعة ميجابايتات استخدم FlatGeobuf أو المربعات المتجهة.
- CSV دون توثيق: اكتب مع كل ملف CSV نظام الإحداثيات واسم عمود الشكل وترتيب الأعمدة، وأضف
WRITE_BOM=YESإذا كان المستلم سيفتحه في Excel. - KML لتبادل البيانات بين الأنظمة: رأينا أن الحقول عادت عمودين فقط، فاستخدمه للعرض في Google Earth فقط.
- ضغط الارتفاعات دون متنبئ أو بضغط مع فقدان: LZW دون متنبئ كبر الملف، وJPEG يغير القيم، فاستخدم DEFLATE أو ZSTD مع
PREDICTOR=3للأرقام العشرية. - عدم مقارنة الأصل بالنسخة: بعد كل تحويل قارن عدد العناصر وعينة من القيم العربية، فالتحذير الوحيد قد يضيع بين عشرات الأسطر.
أي صيغة لأي عمل؟
| العمل | الصيغة | والسبب |
|---|---|---|
| حفظ عملك اليومي في QGIS أو تسليم مشروع كامل | GeoPackage | ملف واحد، عدة طبقات، UTF-8، فهرس مكاني، وأي أداة GIS تقرؤه |
| واجهة API أو بيانات صغيرة في صفحة ويب | GeoJSON | كل لغة تقرؤه، ومعيار RFC 7946، والعربية فيه مضمونة |
| طبقة كبيرة تعرض من ملف على خادم أو CDN | FlatGeobuf | فهرس مكاني وقراءة جزء من الملف عبر HTTP |
| تحليل بيانات كبيرة، أو مستودع بيانات، أو Overture Maps | GeoParquet | أصغر حجم وأسرع قراءة، وتقرؤه أدوات البيانات مثل DuckDB وpandas |
| جهة أو برنامج يطلب Shapefile بالاسم | Shapefile مع ENCODING=UTF-8 | للتسليم فقط، مع .cpg وكل الملفات في ZIP |
| إنسان سيفتح الملف في Google Earth | KML أو KMZ | للعرض مع الألوان والأيقونات |
| جدول لقسم آخر أو نقاط في Excel | CSV مع عمودي خط العرض والطول | يفهمه الجميع، مع توثيق النظام وBOM للعربية |
| صور جوية وارتفاعات | GeoTIFF، ويفضل COG مع DEFLATE وPREDICTOR | دون فقدان، ويقرأ جزؤه من السحابة |
تدريب عملي
- أضف إلى
convert.shصيغة GeoJSON بالخيار-lco RFC7946=YES، وقارن حجمها وعدد الأرقام بعد الفاصلة بالنسخة العادية. - اكتب
pois.csvمرة ثانية بالخيار-lco WRITE_BOM=YES، وافتح النسختين في Excel على جهازك، وقارن ظهور الأسماء العربية.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- البيانات نوعان: متجهة لها أشكال وصفات، وشبكية لها خلايا وقيم، ولكل نوع صيغه.
- GeoPackage هي الصيغة الافتراضية لعملك، وGeoJSON للويب والـ API، وFlatGeobuf للبث من خادم، وGeoParquet للتحليل والبيانات الكبيرة.
- في تجربتنا كان GeoParquet أصغر من GeoJSON بأربع مرات وأسرع قراءة بأكثر من 11 مرة لنفس 55,187 مبنى.
- Shapefile الافتراضي في ogr2ogr حول قرابة 78% من أسماء الأماكن إلى علامات استفهام لا رجوع عنها، والحل
ENCODING=UTF-8وملف.cpg. - الحروف مثل
طµظٹط¯ظ„ظٹط©تعني نصاً سليماً قرئ بترميز خاطئ، وعلامات الاستفهام تعني نصاً ضاع. - KML وCSV يفقدان الأنواع أو الحقول أو نظام الإحداثيات، فهما للعرض والتبادل البسيط فقط.
- COG يسمح بقراءة ارتفاع نقطة بـ 6% من الملف، وDEFLATE مع المتنبئ يصغر الارتفاعات إلى 58% دون أي فقدان، بينما LZW دون متنبئ كبرها.
والخطوة التالية في هذه المرحلة: كيف يتحول العنوان المكتوب إلى نقطة في هذه الملفات، ثم في المراحل القادمة تحمل هذه الطبقات في QGIS وPostGIS وتعرضها في خريطة ويب.
 دليلالمرجع الجيوديسي Datum: لماذا تنحرف نقطتك مئات الأمتار؟لماذا تقع نفس الإحداثيات في مكانين بينهما مئة متر، وكيف تحول بين Ain el Abd وKSA-GRF17 وWGS 84 ومناطق UTM دون أن تنقل بياناتك إلى المكان الخطأ.
 دليلما هي OpenStreetMap؟ البيانات والرخصة والمساهمةكيف تبنى أكبر قاعدة بيانات جغرافية مفتوحة من نقاط وطرق ووسوم، وما الذي تلزمك به رخصتها، وكيف تفحص جودتها في مدينتك قبل أن تبني عليها.
 دليلكيف يتحول العنوان إلى نقطة؟ العنوان الوطني وPlus Codesكيف يحول محرك البحث عن العناوين جملة مكتوبة إلى نقطة، وما الذي يضيفه العنوان الوطني وPlus Codes، مع اختبار 40 عنواناً حقيقياً على Nominatim وPhoton وقياس كم منها يصل إلى المبنى الصحيح.
 دليلQGIS للمبتدئين: الطبقات Layers والتحليل المكانيكيف تحول جدول مواقع إلى طبقة على الخريطة في QGIS، وتربطها بالمناطق وتحسب النطاقات بالأمتار الصحيحة، ثم تعيد التحليل كله بأمر واحد.
 دليلالبيانات الجغرافية GIS في PostgreSQL مع PostGISكيف تخزن الأحياء والطرق والفروع في PostgreSQL وتسألها بالمتر الصحيح وبفهرس يعمل فعلاً، بمختبر على بيانات OpenStreetMap لمدينة كاملة.
 دليلتحليل البيانات الجغرافية في Python مع GeoPandasكيف تجيب بكود Python يعاد تشغيله عن أسئلة مثل كم مستشفى في كل منطقة وما القرى البعيدة عن أقرب مستشفى، ببيانات OpenStreetMap حقيقية للمملكة وأرقام مقارنة مع PostGIS.
 دليلأول خريطة تفاعلية في موقعك مع MapLibre GL JSخريطة تفاعلية في صفحتك خطوة بخطوة بمكتبة MapLibre: طبقات وعلامات ونوافذ وأسماء عربية وتجميع لآلاف الأماكن، مع الأعطال التي ستقابلها وحلها.
 دليلنماذج الارتفاع DEM: الانحدار والرؤية ومستجمع المياهكيف تحسب من نموذج ارتفاع مجاني الانحدار ومجال الرؤية ومجاري الأودية على جبال حقيقية، والأخطاء التي تجعل الأرقام مقنعة وهي خاطئة.
سجل التحديثات
- 17 نوفمبر 2026: كتابة المقال، وتنفيذ التجربة بـ GDAL 3.10.3 وosmium 1.18.0 وsqlite3 على Debian 13، مع GeoPandas 1.1.1 وpyogrio 0.11.1 وpyarrow 21.0.0، على مقتطف Geofabrik لدول الخليج بتاريخ 2026-11-15، ومربع Copernicus DEM N24 E046 من AWS Open Data، مع Docker Desktop على Windows 11.