


عندما تكتب apt install أو npm install تظهر لك قائمة بعشرات الحزم التي سوف تثبت معها، بترتيب محدد، وأحياناً رسالة تقول إن حزمة لا يمكن تثبيتها لأن حزمة أخرى تعتمد عليها. وعندما تفتح تطبيق الخرائط يقترح عليك طريقاً أطول في المسافة وأقصر في الزمن، ومنصات التواصل تقترح عليك «أشخاصاً قد تعرفهم» من أصدقاء أصدقائك، وأداة CI تشغل مراحل البناء والاختبار بترتيب لا يسمح بالنشر قبل نجاح الاختبار. وكل هذه الأنظمة، مع اختلافها الكبير، تحل المسألة نفسها: أشياء بينها علاقات، ونريد أن نمشي على هذه العلاقات بطريقة صحيحة. وهذه الأشياء والعلاقات هي الرسم البياني Graph، والطرق التي نمشي بها عليه هي موضوع هذا المقال.
وهذا المقال من مرحلة هياكل البيانات والخوارزميات، وقد عرفنا الرسم البياني Graph في مقال هياكل البيانات للمبتدئين كهيكل من عقد وروابط، أما هنا فنمشي عليه بالخوارزميات الأساسية الأربع، وكل خوارزمية نجربها على بيانات حقيقية: رسم الاعتماديات الكامل لكل الحزم المثبتة داخل Container من Debian، أي الرسم نفسه الذي يمشي عليه apt قبل أن يثبت أي شيء، ثم خريطة توصيل صغيرة بأزمنة على الطرق لنرى أقصر طريق، ثم خرائط شبكية تكبر حتى مليون تقاطع لنقيس الزمن.
وسوف نناقش في هذا المقال ما يلي:
- ما هو الرسم البياني Graph وأنواعه: الموجه وغير الموجه، والموزون، والرسم بلا دورات DAG.
- تمثيل الرسم في الكود بقائمة الجوار Adjacency List أو مصفوفة الجوار Adjacency Matrix، ولماذا اخترنا الأولى بالأرقام.
- تجربة عملية Lab على 87 حزمة و209 اعتمادية حقيقية في Debian 13: البحث بالعرض BFS لمعرفة ما تحتاجه الحزمة وما ينكسر إذا حذفنا مكتبة، والبحث بالعمق DFS لاكتشاف الدورات.
- الترتيب الطوبولوجي Topological Sort لترتيب التثبيت، والمشكلة التي ظهرت: دورتان حقيقيتان أوقفتا الترتيب، وحلها بالمكونات المترابطة بقوة SCC.
- أقصر طريق بالأوزان بخوارزمية Dijkstra، ولماذا يختلف عن أقل عدد من الطرق، وماذا يحدث إذا كان في الرسم وزن سالب.
- قياس الزمن على خرائط من 900 إلى مليون تقاطع، مع الكومة Heap وبدونها، ثم أين تقابل هذه الخوارزميات في عملك، والأخطاء الشائعة وجدول قرار وقائمة تحقق.
ما هو الرسم البياني Graph؟ العقد Nodes والحواف Edges
الرسم البياني Graph هو مجموعة من العقد Nodes، وتسمى أيضاً Vertices، تربط بينها حواف Edges، وكل حافة تربط عقدتين. وفي رسم الاعتماديات كل حزمة عقدة، وكل «تعتمد على» حافة، وفي الخريطة كل تقاطع عقدة وكل طريق حافة، وفي شبكة التواصل كل شخص عقدة وكل صداقة حافة. وقد يبدو التعريف بسيطاً لدرجة أنه لا يستحق اسماً خاصاً، ولكن قوته أن مسائل كثيرة تبدو مختلفة تصبح المسألة نفسها عندما تكتبها كرسم، فـ «ما الحزم التي يحتاجها apt؟» و«من أصدقاء أصدقائي؟» و«ما الصفحات التي يصل إليها الزاحف من هذه الصفحة؟» كلها سؤال واحد: ما العقد التي يمكن الوصول إليها من هذه العقدة؟
ويختلف الرسم بحسب ثلاث صفات تحدد الخوارزمية التي تستخدمها:
- الموجه Directed وغير الموجه Undirected: الاعتمادية لها اتجاه، فـ apt يعتمد على libc6 والعكس غير صحيح، أما الصداقة في أغلب الشبكات والطريق ذو الاتجاهين فلا اتجاه لهما. والرسم غير الموجه يكتب في الكود كرسم موجه فيه حافة في كل اتجاه.
- الموزون Weighted وغير الموزون Unweighted: الطريق في الخريطة له زمن أو مسافة، وهذا وزن الحافة، أما الاعتمادية فلا وزن لها، فهي موجودة أو غير موجودة. والفرق مهم لأن أقصر طريق في رسم غير موزون هو أقل عدد من الحواف، وفي رسم موزون هو أقل مجموع أوزان، وهما سؤالان مختلفان بخوارزميتين مختلفتين.
- بدورات Cyclic أو بدون دورات Acyclic: الدورة Cycle هي طريق يبدأ من عقدة ويعود إليها، والرسم الموجه الذي لا توجد فيه دورة يسمى DAG، اختصاراً لـ Directed Acyclic Graph، وهو الشكل الذي تفترضه أدوات البناء ومراحل CI وجداول المهام، لأن الدورة فيها تعني أن المهمة تنتظر نفسها.
والفكرة أقدم من الحاسب نفسه، فالقصة المشهورة التي تذكر كبداية لنظرية الرسوم البيانية هي جسور مدينة كونيغسبرغ في القرن الثامن عشر: سبعة جسور تربط ضفتي نهر وجزيرتين، وسؤال أهل المدينة هل يمكن أن يمشي أحد على كل جسر مرة واحدة بالضبط ويعود إلى حيث بدأ. وقد أثبت Leonhard Euler أن ذلك مستحيل، ولم يحتج إلى رسم المدينة ولا قياس المسافات، وإنما إلى عد الجسور التي تخرج من كل قطعة أرض، أي أنه حول الخريطة إلى عقد وحواف ونسي كل شيء آخر. وهذا بالضبط ما نفعله عندما نكتب الاعتماديات أو الطرق كرسم: نحتفظ بالعلاقات التي تهم السؤال، ونترك الباقي.
وهناك صفة رابعة تهم في الأداء: الرسم المتناثر Sparse الذي فيه حواف قليلة مقارنة بعدد العقد، والرسم الكثيف Dense الذي ترتبط فيه أغلب العقد ببعضها. وأغلب الرسوم الحقيقية متناثرة، فكل حزمة تعتمد على بضع حزم وليس على كل الحزم، وكل تقاطع في المدينة يتصل بأربعة طرق تقريباً مهما كبرت المدينة، وهذا ما سوف يحدد طريقة تمثيل الرسم في القسم التالي.
تمثيل الرسم في الكود: قائمة الجوار Adjacency List ومصفوفة الجوار Adjacency Matrix
هناك طريقتان رئيسيتان لحفظ الرسم في الذاكرة. الأولى مصفوفة الجوار Adjacency Matrix: جدول مربع بعدد العقد في الاتجاهين، والخانة في الصف i والعمود j فيها 1 إذا كانت هناك حافة من i إلى j، أو فيها الوزن في الرسم الموزون. والثانية قائمة الجوار Adjacency List: لكل عقدة قائمة بالعقد التي تخرج إليها حواف منها، وفي Python هي قاموس مفاتيحه العقد وقيمه قوائم، مثل graph['apt'] = ['base-passwd', 'libc6', ...]. والصورة التالية تبين الطريقتين على سبع حزم حقيقية من التجربة:
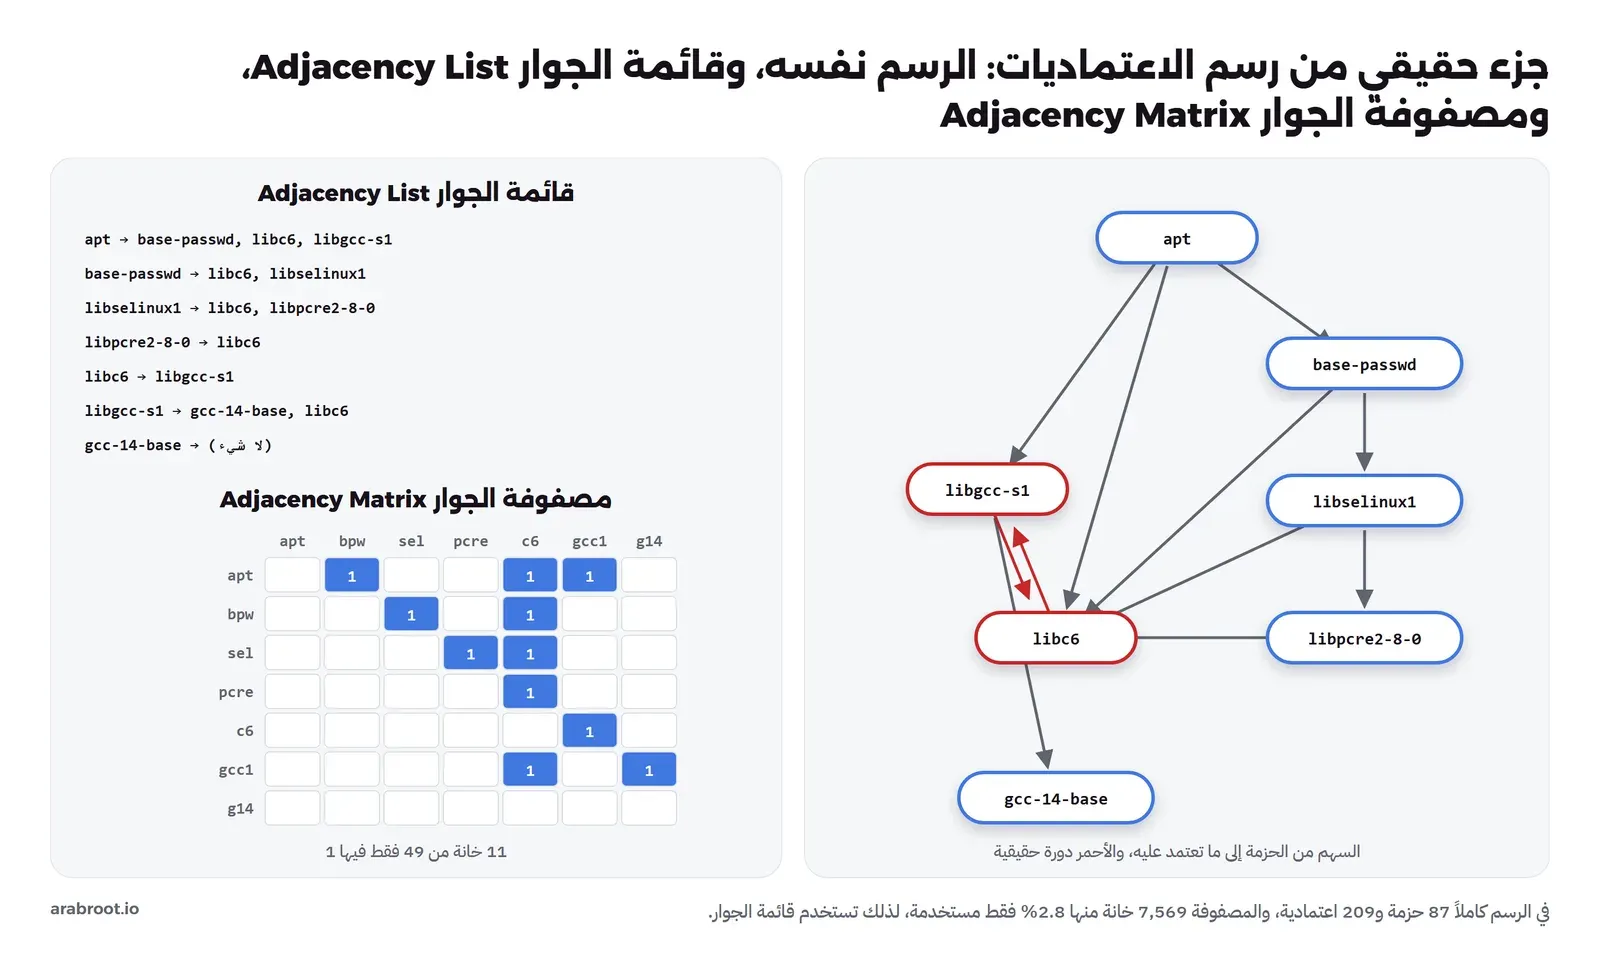
والمقارنة بين الطريقتين مقارنة بين الذاكرة وسرعة سؤال واحد. فالمصفوفة تجيب عن سؤال «هل توجد حافة من i إلى j؟» بخطوة واحدة، ولكنها تحجز n² خانة مهما كان عدد الحواف، وتحتاج n خطوة لتعرف جيران عقدة واحدة لأنها تمر على الصف كله. أما القائمة فتحجز بقدر عدد الحواف فقط، وتعطي جيران العقدة مباشرة، وهذا هو السؤال الذي تسأله كل خوارزميات المرور على الرسم. ولذلك فالقائمة هي الاختيار الطبيعي للرسوم المتناثرة، والمصفوفة مناسبة للرسوم الصغيرة الكثيفة أو عندما تحتاج عمليات المصفوفات نفسها. وفي التجربة كان الرسم الكامل 87 حزمة و209 اعتمادية، فالمصفوفة 7,569 خانة منها 2.8% فقط مستخدمة، أما الخريطة الشبكية بمليون تقاطع في آخر المقال فمصفوفتها تريليون خانة، أي أنها لا تتسع في ذاكرة أي سيرفر، وقائمتها قرابة أربعة ملايين مدخل.
التجربة العملية Lab: رسم الاعتماديات الحقيقي في Debian
كل نظام Debian يحفظ قائمة الحزم المثبتة في الملف /var/lib/dpkg/status، ولكل حزمة فيه حقل Depends وأحياناً Pre-Depends فيهما أسماء الحزم التي تحتاجها، مع شروط إصدارات وبدائل مثل libfoo | libbar. وهذا الملف هو المصدر الذي يقرأ منه dpkg وapt العلاقات، فهو رسم بياني حقيقي جاهز داخل كل Container من Debian. والـ Image python:3.13.17-slim مبنية على Debian 13، وفيها Python جاهزة، فنقرأ الملف بـ Python من المكتبة القياسية فقط. والملف deps.py كاملاً كما يلي، وسوف نشرح كل جزء منه في القسم الخاص به:
# deps.py: the real package dependency graph of a Debian container, with BFS, DFS and topological sort
#   python deps.py [status-file]        (default /var/lib/dpkg/status)
import sys
from collections import deque

STATUS = sys.argv[1] if len(sys.argv) > 1 else '/var/lib/dpkg/status'

# 1) read the packages and their Depends + Pre-Depends fields
pkgs, cur = {}, {}
for line in open(STATUS, encoding='utf8').read().split('\n') + ['']:
    if not line.strip():
        if 'Package' in cur:
            pkgs[cur['Package']] = cur
        cur = {}
    elif line[0] not in ' \t' and ':' in line:
        k, v = line.split(':', 1)
        cur[k] = v.strip()

def targets(field):
    """'libc6 (>= 2.34), libfoo | libbar' -> ['libc6', 'libfoo' or 'libbar' whichever is installed]"""
    out = []
    for group in filter(None, (g.strip() for g in field.split(','))):
        names = [alt.split()[0].split(':')[0] for alt in group.split('|')]
        hit = next((n for n in names if n in pkgs), None)
        if hit:
            out.append(hit)
    return out

graph = {p: sorted(set(targets(d.get('Depends', '')) + targets(d.get('Pre-Depends', ''))) - {p}) for p, d in pkgs.items()}
edges = sum(len(v) for v in graph.values())
print(f'== 1) {len(graph)} packages (nodes), {edges} dependencies (edges)')
reverse = {p: [] for p in graph}
for p, deps in graph.items():
    for q in deps:
        reverse[q].append(p)
top = sorted(reverse, key=lambda p: len(reverse[p]), reverse=True)[:5]
print('   most depended on:', ', '.join(f'{p} ({len(reverse[p])})' for p in top))
n = len(graph)
print(f'   adjacency list: {edges} entries   adjacency matrix: {n}x{n} = {n * n:,} cells, {edges / (n * n):.1%} of them used')

# 2) BFS: everything a package needs, level by level, and the shortest chain between two packages
def bfs(start, g):
    dist, parent, q = {start: 0}, {start: None}, deque([start])
    while q:
        u = q.popleft()
        for v in g[u]:
            if v not in dist:
                dist[v], parent[v] = dist[u] + 1, u
                q.append(v)
    return dist, parent

dist, parent = bfs('apt', graph)
print(f'\n== 2) BFS from apt: {len(dist) - 1} packages needed, by level')
for lvl in range(1, max(dist.values()) + 1):
    names = sorted(p for p, d in dist.items() if d == lvl)
    print(f'   level {lvl}: {len(names):2}  {" ".join(names[:7])}{" ..." if len(names) > 7 else ""}')
path, p = [], 'libpcre2-8-0'
while p is not None:
    path.append(p); p = parent[p]
print('   shortest chain apt -> libpcre2-8-0:', ' -> '.join(reversed(path)))

rdist, _ = bfs('libc6', reverse)
print(f'   reverse BFS: removing libc6 breaks {len(rdist) - 1} of {n - 1} other packages')

# 3) DFS: find cycles (a back edge points to a package still on the current path)
WHITE, GREY, BLACK = 0, 1, 2
color, stack, cycles = {p: WHITE for p in graph}, [], []
def dfs(u):
    color[u] = GREY; stack.append(u)
    for v in graph[u]:
        if color[v] == GREY:
            cycles.append(stack[stack.index(v):] + [v])
        elif color[v] == WHITE:
            dfs(v)
    stack.pop(); color[u] = BLACK
for p in sorted(graph):
    if color[p] == WHITE:
        dfs(p)
print(f'\n== 3) DFS found {len(cycles)} cycle(s)')
for c in cycles:
    print('   ', ' -> '.join(c))

# 4) topological sort (Kahn): install a package only after everything it depends on
def kahn(g):
    need = {p: len(g[p]) for p in g}                 # dependencies not yet installed
    rev = {p: [] for p in g}
    for p, deps in g.items():
        for q in deps:
            rev[q].append(p)
    ready = deque(sorted(p for p in g if need[p] == 0))
    order = []
    while ready:
        u = ready.popleft(); order.append(u)
        for v in sorted(rev[u]):
            need[v] -= 1
            if need[v] == 0:
                ready.append(v)
    return order, sorted(p for p in g if need[p] > 0)

order, stuck = kahn(graph)
print(f'\n== 4) topological sort: {len(order)} of {n} packages ordered, {len(stuck)} stuck')
print('   first 8:', ' '.join(order[:8]))
print('   stuck  :', ' '.join(stuck[:10]), '...' if len(stuck) > 10 else '')

# 5) the fix: collapse each cycle into one node (strongly connected components, Tarjan), then sort
index, low, onstack, st, comps, counter = {}, {}, set(), [], [], [0]
def strong(u):
    index[u] = low[u] = counter[0]; counter[0] += 1
    st.append(u); onstack.add(u)
    for v in graph[u]:
        if v not in index:
            strong(v); low[u] = min(low[u], low[v])
        elif v in onstack:
            low[u] = min(low[u], index[v])
    if low[u] == index[u]:
        comp = []
        while True:
            w = st.pop(); onstack.discard(w); comp.append(w)
            if w == u:
                break
        comps.append(sorted(comp))
for p in sorted(graph):
    if p not in index:
        strong(p)
big = [c for c in comps if len(c) > 1]
print(f'\n== 5) {len(comps)} strongly connected components, {len(big)} with more than one package: {big}')
# Tarjan emits components in reverse topological order of the condensed graph: dependencies first
print('   install order of the condensed graph, first 8:', ' | '.join('+'.join(c) for c in comps[:8]))
pos = {p: i for i, c in enumerate(comps) for p in c}
bad = [(p, q) for p in graph for q in graph[p] if pos[q] > pos[p]]
print('   dependencies installed after the package that needs them:', len(bad))

# 6) the standard library does the same check: graphlib.TopologicalSorter refuses a graph with a cycle
from graphlib import TopologicalSorter, CycleError
try:
    list(TopologicalSorter(graph).static_order())
except CycleError as e:
    print('\n== 6) graphlib:', e.args[0], e.args[1])
ونشغله بالأمر التالي، وهو الأمر نفسه للملف الثاني routes.py بعد تغيير اسمه:
docker run --rm -v "$PWD:/lab" -w /lab python:3.13.17-slim python deps.pyوالمخرج سوف يكون كما يلي:
== 1) 87 packages (nodes), 209 dependencies (edges)
   most depended on: libc6 (71), libselinux1 (13), libsystemd0 (7), libaudit1 (6), libcrypt1 (6)
   adjacency list: 209 entries   adjacency matrix: 87x87 = 7,569 cells, 2.8% of them used

== 2) BFS from apt: 26 packages needed, by level
   level 1: 10  base-passwd debian-archive-keyring libapt-pkg7.0 libc6 libgcc-s1 libseccomp2 libssl3t64 ...
   level 2: 15  gcc-14-base libbz2-1.0 libcap2 libdebconfclient0 libgmp10 libhogweed6t64 liblz4-1 ...
   level 3:  1  libpcre2-8-0
   shortest chain apt -> libpcre2-8-0: apt -> base-passwd -> libselinux1 -> libpcre2-8-0
   reverse BFS: removing libc6 breaks 74 of 86 other packages

== 3) DFS found 2 cycle(s)
    libc6 -> libgcc-s1 -> libc6
    libssl3t64 -> openssl-provider-legacy -> libssl3t64

== 4) topological sort: 12 of 87 packages ordered, 75 stuck
   first 8: base-files debconf debian-archive-keyring gcc-14-base init-system-helpers libaudit-common libsemanage-common login.defs
   stuck  : adduser apt base-passwd bash bsdutils ca-certificates coreutils dash debianutils diffutils ...

== 5) 85 strongly connected components, 2 with more than one package: [['libc6', 'libgcc-s1'], ['libssl3t64', 'openssl-provider-legacy']]
   install order of the condensed graph, first 8: gcc-14-base | libc6+libgcc-s1 | libdebconfclient0 | libpcre2-8-0 | libselinux1 | base-passwd | libacl1 | libattr1
   dependencies installed after the package that needs them: 0

== 6) graphlib: nodes are in a cycle ['libc6', 'libgcc-s1', 'libc6']
في الجزء الأول من الكود والمخرج لاحظ التالي:
- الدالة
targetsتحذف شروط الإصدار مثل(>= 2.34)واسم المعمارية مثل:any، ومن البدائل تختار أول حزمة مثبتة فعلاً، لأن الحافة التي تهمنا هي التي سوف يمشي عليها النظام في هذا الجهاز بالذات. - الرسم فيه 87 حزمة و209 اعتمادية، أي أن متوسط ما تعتمد عليه الحزمة الواحدة أقل من ثلاث حزم، وهذا رسم متناثر نموذجي.
- الحزمة الأكثر طلباً
libc6، وهي مكتبة C الأساسية، وتعتمد عليها 71 حزمة مباشرة، ثمlibselinux1بـ 13. وهذا الشكل، عقد قليلة يرتبط بها الجميع وأغلب العقد بروابط قليلة، شائع في الرسوم الحقيقية من الإنترنت إلى شبكات التواصل. - الرسم المعكوس
reverseفيه الحواف نفسها بالاتجاه المعاكس، أي «من يعتمد علي؟» بدل «على من أعتمد؟»، وسوف نحتاجه في البحث عن ما ينكسر عند الحذف، وفي الترتيب الطوبولوجي.
البحث بالعرض BFS: مستوى بعد مستوى
البحث بالعرض BFS، اختصاراً لـ Breadth-First Search، يبدأ من عقدة ويزور كل جيرانها أولاً، ثم جيران الجيران، ثم الذين بعدهم، أي مستوى بعد مستوى، مثل الموجة التي تنتشر في الماء من نقطة سقوط الحجر. والأداة التي تحقق هذا الترتيب هي الطابور Queue: نضع البداية في الطابور، ثم نكرر: نأخذ أول عقدة في الطابور، ونضيف إلى آخره كل جار لم نزره بعد. ولأن الطابور يخرج العقد بترتيب دخولها، فلا تخرج أي عقدة من المستوى الثالث قبل أن تخرج كل عقد المستوى الثاني. وفي الدالة bfs استخدمنا deque من الوحدة collections، لأن أخذ العنصر الأول من قائمة list عادية بالدالة pop(0) يحرك كل العناصر الباقية خطوة، أي O(n) في كل مرة، أما popleft في deque فهي O(1).
ومن هذا الترتيب نحصل على أهم خاصية للبحث بالعرض: أول مرة يصل فيها إلى عقدة تكون بأقصر طريق ممكن من حيث عدد الحواف، لأن كل الطرق الأقصر كانت في مستويات سابقة. ولذلك نحفظ مع كل عقدة dist وهو مستواها، وparent وهي العقدة التي وصلنا منها، ومن parent نعيد بناء الطريق بالمشي إلى الخلف حتى البداية. والصورة التالية تبين البحث من apt كما ظهر في الجزء الثاني من المخرج:
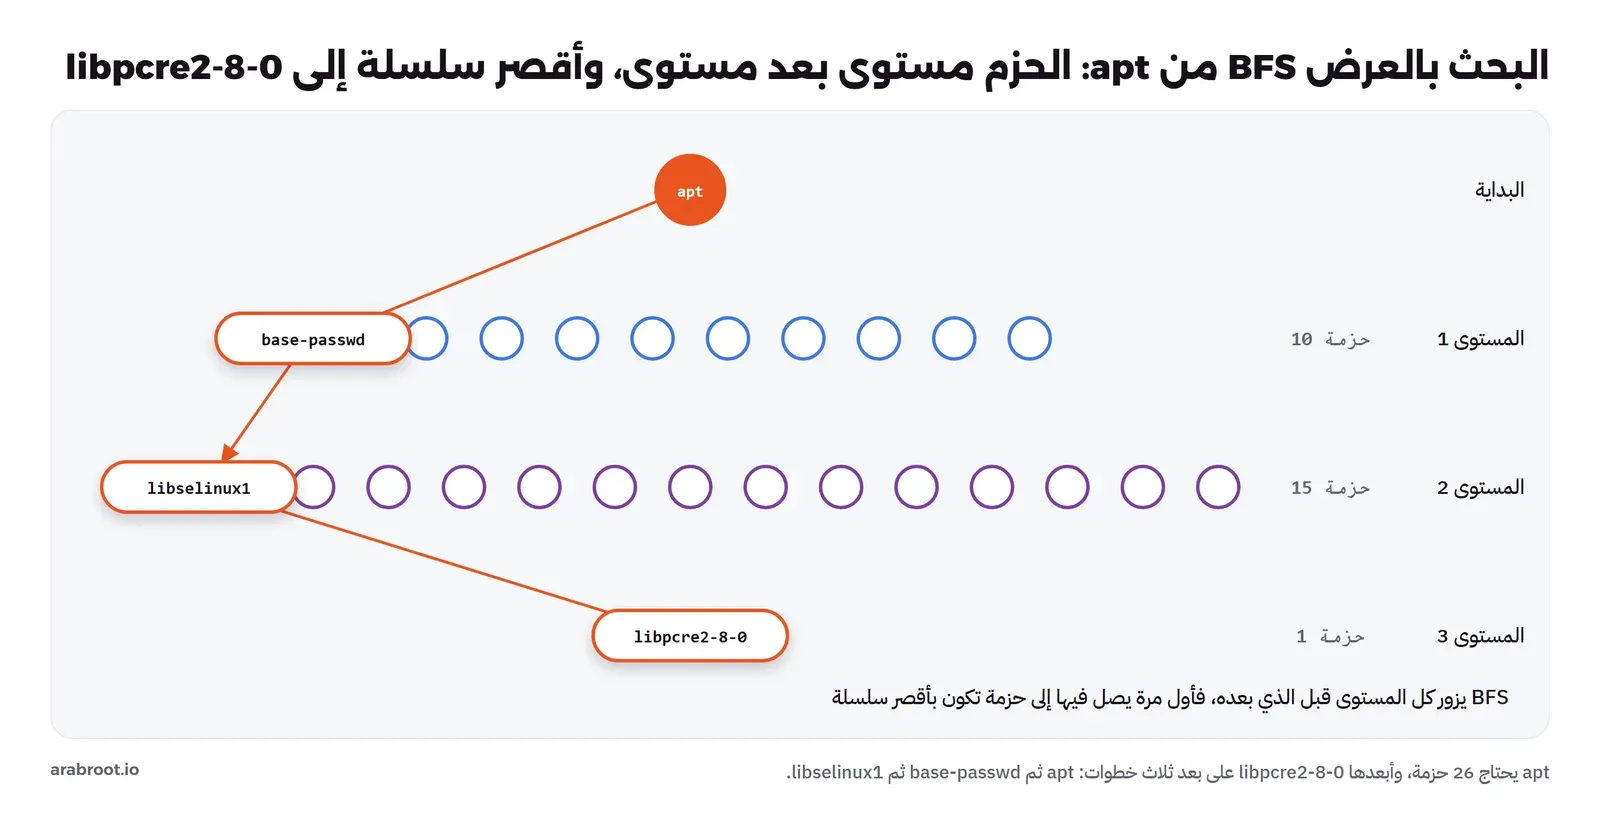
في الجزء الثاني من المخرج لاحظ التالي:
- apt يحتاج 26 حزمة، منها 10 يعتمد عليها مباشرة في المستوى الأول، و15 في المستوى الثاني تحتاجها حزم المستوى الأول، وحزمة واحدة في المستوى الثالث. وهذا هو العمل نفسه الذي يقوم به
aptعندما يحسب ما يجب تثبيته معه، مع فرق أنaptيختار أيضاً بين البدائل والإصدارات. - أقصر سلسلة من apt إلى
libpcre2-8-0مرت بـbase-passwdثمlibselinux1، أي أن السبب في وجود مكتبة التعبيرات النمطية PCRE2 في نظام لا يحتاج أي برنامج فيه تعبيرات نمطية ظاهرة هو SELinux. وهذا النوع من الأسئلة، «لماذا هذه الحزمة مثبتة أصلاً؟»، يجيب عنه البحث بالعرض معparent. - البحث بالعرض على الرسم المعكوس من
libc6أعطى 74 حزمة من 86، أي أن حذف مكتبة C يكسر 74 حزمة مباشرة أو عبر حزم أخرى. وهذا هو تحليل الأثر Impact Analysis: قبل أن تحذف مكتبة أو تغير واجهة API، امش على الرسم المعكوس لتعرف كل من سيتأثر.
البحث بالعرض BFS في الكود خطوة بخطوة Step by Step
لنتابع الدالة bfs في أول خطواتها من apt حتى يصبح الطابور شيئاً ملموساً. في البداية يكون في الطابور apt وحده، ومسافته صفر. نخرج apt ونمر على قائمة جيرانه العشرة، وكل واحد منها لم نره بعد، فنعطيه المسافة 1 ونسجل أن أباه apt ونضيفه إلى آخر الطابور، فيصبح الطابور عشر حزم كلها في المستوى الأول. ثم نخرج أولها، base-passwd، ونمر على جيرانه: libc6 رأيناها من قبل فنتجاهلها، وlibdebconfclient0 وlibselinux1 جديدتان فنعطيهما المسافة 2 ونضيفهما إلى آخر الطابور خلف حزم المستوى الأول التسع الباقية. وهكذا لا تخرج libselinux1 من الطابور إلا بعد أن تخرج كل حزم المستوى الأول، وعندما تخرج نجد عندها libpcre2-8-0 لأول مرة فنعطيها المسافة 3. ولاحظ أن شرط «لم نره بعد» هو ما يمنع زيارة libc6 71 مرة، وهو ما يمنع الدوران إلى الأبد في الدورة بين libc6 وlibgcc-s1، ولذلك نضع العقدة في dist لحظة إضافتها إلى الطابور وليس لحظة إخراجها منه، حتى لا تدخل الطابور مرتين من جارين مختلفين.
وتقابل البحث بالعرض في كل مكان يكون فيه السؤال «الأقرب أولاً»: درجات الصداقة في شبكات التواصل، فأصدقاء الأصدقاء هم المستوى الثاني، والزاحف Crawler الذي يجمع صفحات موقع ويريد الصفحات القريبة من الصفحة الرئيسية قبل البعيدة، وإيجاد أقصر طريق في متاهة أو شبكة كل خطواتها متساوية. وتكلفته O(V + E)، أي أنه يزور كل عقدة مرة وكل حافة مرة، وهذا أسرع ما يمكن لأي خوارزمية تحتاج أن ترى الرسم كله.
البحث بالعمق DFS والدورات Cycles
البحث بالعمق DFS، اختصاراً لـ Depth-First Search، يعمل بالعكس: يأخذ أول جار ويتعمق فيه إلى أبعد نقطة ممكنة، ثم يرجع خطوة ويجرب الجار التالي، مثل من يحل متاهة بأن يمشي في الممر حتى نهايته ثم يرجع إلى آخر تفرع. والأداة هنا المكدس Stack بدل الطابور، والأسهل أن نستخدم مكدس الاستدعاءات نفسه بأن تستدعي الدالة نفسها لكل جار، كما في الدالة dfs في الجزء الثالث. والبحث بالعمق لا يعطي أقصر طريق، ولكنه يعطي شيئاً آخر لا يعطيه البحث بالعرض: معرفة متى «دخلنا» عقدة ومتى «خرجنا» منها، أي متى انتهينا من كل ما تحتها.
وهذه المعرفة هي طريقة اكتشاف الدورات. ففي الكود ثلاثة ألوان لكل عقدة: أبيض لم نزرها، ورمادي دخلناها ولم نخرج منها بعد، أي أنها على الطريق الحالي من البداية إلى حيث نحن، وأسود انتهينا منها ومن كل ما بعدها. فإذا وجدنا أثناء التعمق حافة إلى عقدة رمادية، فهذه العقدة على طريقنا الحالي، أي أننا وصلنا إليها مرة أخرى من داخلها، وهذه دورة. أما الحافة إلى عقدة سوداء فليست دورة، لأن تلك العقدة انتهت ولا يوجد طريق منها إلينا، وإنما وصلنا إليها من طريقين مختلفين، وهذا طبيعي في رسم الاعتماديات حيث تصل 71 حزمة إلى libc6.
والجزء الثالث من المخرج وجد دورتين حقيقيتين في نظام Debian نفسه: libc6 تعتمد على libgcc-s1 وهذه تعتمد على libc6، وlibssl3t64 تعتمد على openssl-provider-legacy وهذه تعتمد عليها. وقد يبدو هذا خطأً في التغليف، ولكن سياسة Debian تذكر الاعتماديات الدائرية صراحة، وتقول إن الترتيب الذي يحترم كل الاعتماديات مستحيل عندها، وإن dpkg يكسر الدورة في نقطة ما، وتطلب من الحزم تجنبها قدر الإمكان. والمكتبتان الأساسيتان في نظام البناء، مكتبة C ومكتبة دعم GCC، تحتاج كل منهما الأخرى فعلاً، فالدورة هنا حقيقة يتعامل معها النظام وليست خطأً يمكن إصلاحه بسهولة.
list بدل الاستدعاء الذاتي.الترتيب الطوبولوجي Topological Sort: بأي ترتيب نثبت الحزم؟
السؤال الذي يسأله apt قبل التثبيت ليس «ما الحزم المطلوبة؟» فقط، وإنما «بأي ترتيب؟»، لأن الحزمة لا تهيأ قبل أن تهيأ الحزم التي تعتمد عليها. والترتيب الذي يضع كل عقدة بعد كل ما تعتمد عليه يسمى الترتيب الطوبولوجي Topological Sort، وهو موجود فقط في رسم بلا دورات، لأن الدورة تعني أن كل عقدة فيها يجب أن تأتي قبل الأخرى. وهو السؤال نفسه في أداة البناء التي تبني المكتبات قبل البرنامج، وفي جدول المهام الذي يشغل مهمة التصدير بعد مهمة الاستخراج، وفي ملف docker compose الذي فيه depends_on.
وأشهر طريقة لحسابه خوارزمية Kahn في الدالة kahn: نعد لكل حزمة عدد الحزم التي تنتظرها ولم تثبت بعد، ونبدأ بالحزم التي عددها صفر، أي التي لا تعتمد على شيء، ونضعها في الطابور. وفي كل خطوة نأخذ حزمة من الطابور ونضيفها إلى الترتيب، ثم ننقص واحداً من عداد كل حزمة تعتمد عليها، ومن يصل عداده إلى صفر يدخل الطابور. فإذا انتهى الطابور وكل الحزم في الترتيب فالرسم بلا دورات والترتيب صحيح، وإذا بقيت حزم عدادها أكبر من صفر فهي إما في دورة أو تعتمد على حزمة في دورة.
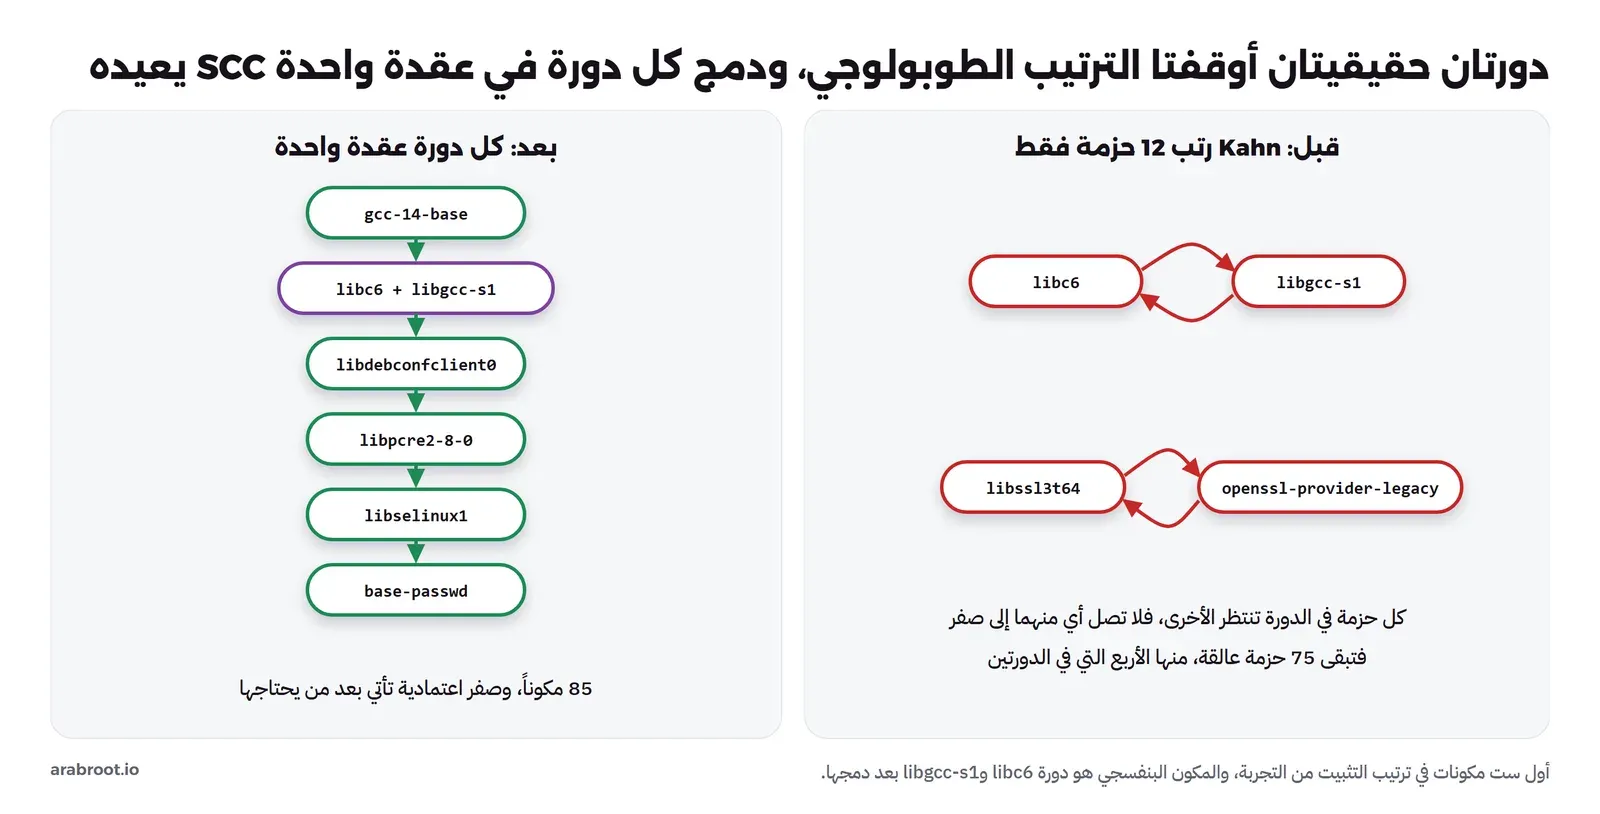
وهنا ظهرت المشكلة الحقيقية في التجربة: الجزء الرابع من المخرج يقول إن Kahn رتب 12 حزمة فقط من 87، وبقيت 75 حزمة عالقة، ومنها apt وbash وcoreutils، أي أغلب النظام. والسبب أن libc6 في دورة، فعدادها لا يصل إلى صفر أبداً لأنها تنتظر libgcc-s1 التي تنتظرها، وكل حزمة تعتمد على libc6، أي 74 حزمة كما عرفنا من البحث المعكوس، تبقى معها في الانتظار. أي أن دورة واحدة صغيرة بين حزمتين أوقفت ترتيب النظام كله، وهذا ما يحدث في أي أداة تفترض أن الرسم DAG ثم تقابل دورة. والمكتبة القياسية في Python تفعل الشيء نفسه بطريقة أوضح، فالوحدة graphlib التي أضيفت في Python 3.9 رفضت الرسم في الجزء السادس من المخرج بخطأ CycleError وطبعت الدورة نفسها: ['libc6', 'libgcc-s1', 'libc6'].
الحل: المكونات المترابطة بقوة Strongly Connected Components
الحل الذي يطابق ما تقوله سياسة Debian أن نعامل كل دورة كوحدة واحدة: الحزم التي تعتمد على بعضها في دورة تثبت معاً، ثم نرتب هذه الوحدات. والوحدة هنا اسمها المكون المترابط بقوة SCC، اختصاراً لـ Strongly Connected Component، وهو أكبر مجموعة من العقد يمكن الوصول من أي عقدة فيها إلى كل عقدة أخرى فيها. والعقدة التي ليست في أي دورة مكون وحدها، والدورة كلها مكون واحد. وعندما نستبدل كل مكون بعقدة واحدة نحصل على رسم بلا دورات أبداً، لأن أي دورة بين مكونين كانت ستجعلهما مكوناً واحداً.
وفي الجزء الخامس استخدمنا خوارزمية Tarjan، وهي بحث بالعمق واحد يحفظ لكل عقدة رقم زيارتها وأصغر رقم يمكن الوصول إليه منها عبر الطريق الحالي، فإذا كانت العقدة لا تصل إلى أي شيء أقدم منها فهي بداية مكون، وكل ما فوقها في المكدس ينتمي إليه. والنتيجة 85 مكوناً من 87 حزمة، اثنان منهما فيهما حزمتان، وهما الدورتان نفسهما. ومن خصائص Tarjan أنه يخرج المكونات بترتيب يضع ما تعتمد عليه العقدة قبلها، فالقائمة التي يعطيها هي ترتيب التثبيت نفسه: gcc-14-base أولاً لأنها لا تعتمد على شيء، ثم libc6 وlibgcc-s1 معاً، ثم باقي الحزم. وللتأكد مر الكود على كل الاعتماديات وعد الحالات التي تأتي فيها الحزمة قبل ما تحتاجه، فكان العدد صفراً.
والدرس العملي أبعد من حزم Debian: إذا كتبت أداة ترتب مهام أو خدمات أو ترحيلات Migrations حسب اعتمادياتها، فلا تفترض أن المستخدم لن يكتب دورة. اكتشف الدورة قبل الترتيب، واطبعها للمستخدم كاملة كما فعلت graphlib، لأن رسالة «لا يمكن الترتيب» وحدها لا تساعد أحداً في رسم فيه مئات العقد. وإذا كانت الدورات مقبولة في مجالك كما في Debian، فرتب المكونات وليس العقد.
أقصر طريق بالأوزان: خوارزمية Dijkstra
البحث بالعرض يعطي أقصر طريق بعدد الحواف، وهذا يكفي عندما تكون كل الحواف متساوية مثل الاعتماديات، ولكن في الخريطة الطرق ليست متساوية، فطريق سريع لعشرة كيلومترات قد يكون أسرع من شارعين داخل حي مزدحم. ولكي نرى الفرق كتبنا خريطة توصيل صغيرة كمثال: مستودع W، وعميل C، وخمسة تقاطعات بينهما، وعلى كل طريق زمنه بالدقائق في الاتجاهين. والملف routes.py كاملاً كما يلي:
# routes.py: fewest roads (BFS) against fewest minutes (Dijkstra) on a small map,
# then what a negative edge does, then both algorithms on growing grid maps
#   python routes.py
import heapq
import random
import time
from collections import deque

# a small delivery map: warehouse W, customer C, and five junctions; minutes on each road (both ways)
ROADS = [('W', 'A', 4), ('W', 'B', 2), ('A', 'C', 9), ('B', 'D', 3), ('D', 'E', 2),
         ('E', 'C', 3), ('B', 'A', 1), ('D', 'F', 6), ('F', 'C', 1)]
graph = {}
for u, v, w in ROADS:
    graph.setdefault(u, []).append((v, w))
    graph.setdefault(v, []).append((u, w))

def bfs_path(g, s, t):
    parent, q = {s: None}, deque([s])
    while q:
        u = q.popleft()
        for v, _ in g[u]:
            if v not in parent:
                parent[v] = u
                q.append(v)
    path = [t]
    while parent[path[-1]] is not None:
        path.append(parent[path[-1]])
    return path[::-1]

def dijkstra(g, s):
    dist, parent, done = {s: 0}, {s: None}, set()
    heap, pops = [(0, s)], 0
    while heap:
        d, u = heapq.heappop(heap); pops += 1
        if u in done:
            continue                          # an old, longer entry for a node already finished
        done.add(u)
        for v, w in g[u]:
            nd = d + w
            if nd < dist.get(v, float('inf')):
                dist[v], parent[v] = nd, u
                heapq.heappush(heap, (nd, v))
    return dist, parent, pops

def path_to(parent, t):
    path = [t]
    while parent[path[-1]] is not None:
        path.append(parent[path[-1]])
    return path[::-1]

def minutes(path, g):
    return sum(dict(g[u])[v] for u, v in zip(path, path[1:]))

p = bfs_path(graph, 'W', 'C')
print('== 1) W to C')
print(f'   BFS (fewest roads)       : {" -> ".join(p):28} roads={len(p) - 1}  minutes={minutes(p, graph)}')
dist, parent, pops = dijkstra(graph, 'W')
p = path_to(parent, 'C')
print(f'   Dijkstra (fewest minutes): {" -> ".join(p):28} roads={len(p) - 1}  minutes={dist["C"]}')
print('   shortest minutes from W to every point:', dict(sorted(dist.items())))

print('\n== 2) what if one road has a negative weight? (one-way roads, B -> A is a -5 "discount")')
g2 = {'W': [('A', 1), ('B', 5)], 'A': [('C', 2)], 'B': [('A', -5)], 'C': []}
dist2, _, _ = dijkstra(g2, 'W')
def bellman_ford(g, s):
    dist = {u: float('inf') for u in g}; dist[s] = 0
    for _ in range(len(g) - 1):
        for u in g:
            for v, w in g[u]:
                if dist[u] + w < dist[v]:
                    dist[v] = dist[u] + w
    return dist
bf = bellman_ford(g2, 'W')
print('   Dijkstra     :', dict(sorted(dist2.items())))
print('   Bellman-Ford :', dict(sorted(bf.items())))
print('   points where Dijkstra is wrong:', [u for u in sorted(bf) if bf[u] != dist2[u]])

print('\n== 3) grid maps: k x k junctions, random minutes 1..9 per road, corner to corner (ms)')
def grid(k, rnd):
    g = {i: [] for i in range(k * k)}
    for r in range(k):
        for c in range(k):
            u = r * k + c
            for v in ([u + 1] if c + 1 < k else []) + ([u + k] if r + 1 < k else []):
                w = rnd.randint(1, 9)
                g[u].append((v, w)); g[v].append((u, w))
    return g

def dijkstra_array(g, s):
    """Dijkstra without a heap: scan all nodes for the closest unfinished one, O(V^2)."""
    dist = {u: float('inf') for u in g}; dist[s] = 0
    done = set()
    for _ in range(len(g)):
        u = min((x for x in g if x not in done), key=dist.__getitem__)
        done.add(u)
        for v, w in g[u]:
            if dist[u] + w < dist[v]:
                dist[v] = dist[u] + w
    return dist

print('        k      nodes      edges       BFS   Dijkstra(heap)   Dijkstra(no heap)')
for k in [30, 50, 70, 100, 300, 1000]:
    g = grid(k, random.Random(k))
    e = sum(len(v) for v in g.values()) // 2
    t = time.perf_counter(); bfs_path(g, 0, k * k - 1); tb = (time.perf_counter() - t) * 1000
    t = time.perf_counter(); d, _, pops = dijkstra(g, 0); th = (time.perf_counter() - t) * 1000
    ta = '-'
    if k <= 100:
        t = time.perf_counter(); da = dijkstra_array(g, 0); ta = f'{(time.perf_counter() - t) * 1000:10.1f}'
        assert da == d
    print(f'   {k:>6} {k * k:>10,} {e:>10,} {tb:9.1f} {th:14.1f}   {ta:>14}    corner={d[k * k - 1]}  heap pops={pops:,}')
والمخرج سوف يكون كما يلي:
== 1) W to C
   BFS (fewest roads)       : W -> A -> C                  roads=2  minutes=13
   Dijkstra (fewest minutes): W -> B -> D -> E -> C        roads=4  minutes=10
   shortest minutes from W to every point: {'A': 3, 'B': 2, 'C': 10, 'D': 5, 'E': 7, 'F': 11, 'W': 0}

== 2) what if one road has a negative weight? (one-way roads, B -> A is a -5 "discount")
   Dijkstra     : {'A': 0, 'B': 5, 'C': 3, 'W': 0}
   Bellman-Ford : {'A': 0, 'B': 5, 'C': 2, 'W': 0}
   points where Dijkstra is wrong: ['C']

== 3) grid maps: k x k junctions, random minutes 1..9 per road, corner to corner (ms)
        k      nodes      edges       BFS   Dijkstra(heap)   Dijkstra(no heap)
       30        900      1,740       0.8            4.6            136.7    corner=155  heap pops=1,113
       50      2,500      4,900       1.9           12.5            776.9    corner=258  heap pops=3,092
       70      4,900      9,660       6.0           17.8           2966.7    corner=380  heap pops=6,061
      100     10,000     19,800       7.4           52.2          12633.6    corner=540  heap pops=12,425
      300     90,000    179,400     130.9          514.9                -    corner=1571  heap pops=112,233
     1000  1,000,000  1,998,000    2638.2         7654.5                -    corner=5181  heap pops=1,247,939
الجزء الأول من المخرج يبين المشكلة: البحث بالعرض اختار W -> A -> C لأنه طريقان فقط، ولكن زمنه 13 دقيقة، أما Dijkstra فاختار W -> B -> D -> E -> C بأربعة طرق وزمن 10 دقائق. والصورة التالية تبين الطريقين على الخريطة:
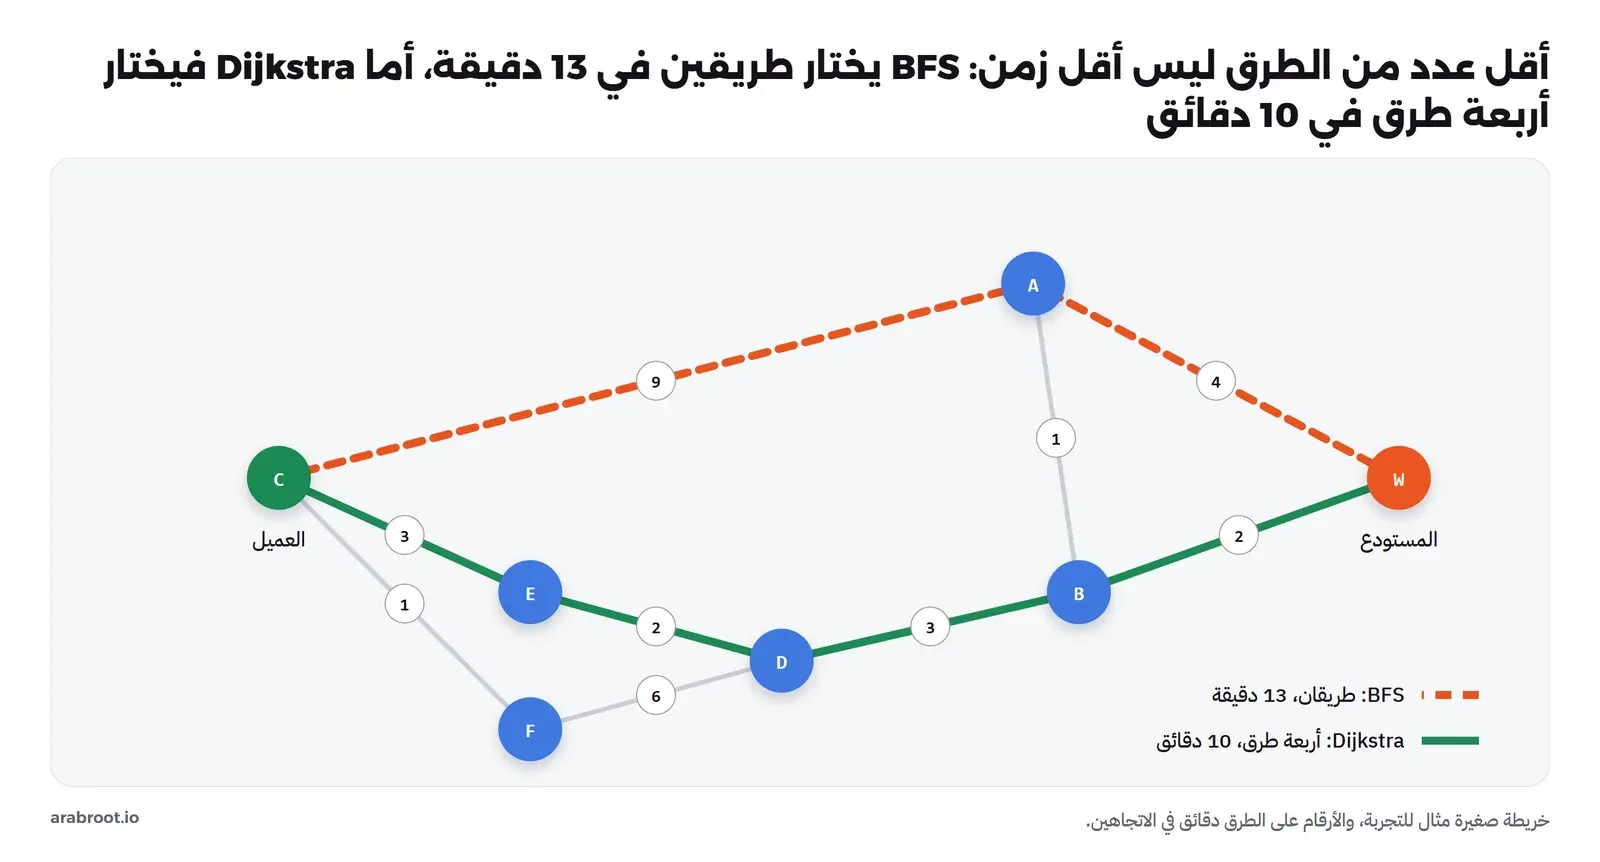
وخوارزمية Dijkstra، التي نشرها Edsger Dijkstra عام 1959، تشبه البحث بالعرض مع فرق واحد: بدل الطابور الذي يخرج العقد بترتيب دخولها، تستخدم طابور الأولوية Priority Queue الذي يخرج دائماً العقدة الأقرب إلى البداية من بين العقد التي لم ننته منها. والفكرة أن العقدة الأقرب الآن لا يمكن أن نجد لها طريقاً أقصر لاحقاً، لأن أي طريق آخر يمر بعقدة أبعد منها، والأوزان موجبة، فلا يمكن أن يصبح أقصر. لذلك عندما نخرج عقدة من الطابور نعتبرها منتهية، ونجرب كل طريق خارج منها، فإذا كان الطريق عبرها إلى جار أقصر من أفضل ما نعرفه لذلك الجار نحدث مسافته ونضيفه إلى الطابور.
في الكود أعلاه لاحظ التالي:
- طابور الأولوية هو الكومة Heap من الوحدة heapq، وقد شرحنا الكومة في مقال هياكل البيانات، وكل عنصر فيها tuple من المسافة ثم العقدة، فتخرج الأقرب أولاً.
- الكومة في Python لا تسمح بتعديل أولوية عنصر موجود فيها، لذلك عندما نجد طريقاً أقصر لعقدة نضيفها مرة أخرى بالمسافة الجديدة ونترك القديمة، وعندما تخرج النسخة القديمة لاحقاً نتجاهلها بالسطر
if u in done: continue. وهذا ما يسمى الحذف الكسول Lazy Deletion، ولذلك كان عدد مرات الإخراجheap popsفي الجزء الثالث أكبر قليلاً من عدد العقد، فمع مليون عقدة كان 1,247,939. - السطر الأخير من الجزء الأول يبين أن Dijkstra لا يعطي طريقاً واحداً فقط، وإنما أقصر زمن من المستودع إلى كل نقطة في الخريطة في تشغيل واحد، وهذا مفيد لشركة توصيل تريد أن تعرف أبعد عميل عن كل مستودع.
لماذا تحتاج Dijkstra الكومة Heap؟ حساب التكلفة Cost
في كل خطوة يسأل Dijkstra سؤالاً واحداً: ما العقدة غير المنتهية الأقرب إلى البداية؟ والطريقة البسيطة أن يمر على كل العقد ويختار الأصغر، وهذا ما تفعله الدالة dijkstra_array في الملف، وتكلفته V خطوة لكل سؤال، والسؤال يتكرر V مرة، فالمجموع O(V²). أما الكومة فتعطي الأصغر في O(log n) وتقبل الإضافة في O(log n)، وكل حافة تسبب إضافة واحدة على الأكثر، فيصبح المجموع O((V + E) log V). وفي رسم متناثر مثل الخريطة، حيث E قريب من 2V، الفرق بين V² و V log V هو الفرق بين أيام وثوان عند مليون عقدة، كما سوف ترى في قسم الأداء.
ولكن الكومة ليست أفضل دائماً، ففي رسم كثيف جداً، حيث كل عقدة متصلة بأغلب العقد الأخرى، يقترب E من V²، فتصبح تكلفة الكومة O(V² log V)، أي أسوأ من المرور البسيط O(V²). لذلك اختر حسب شكل الرسم: الكومة للرسوم المتناثرة، وهي الأغلب، والمرور البسيط للرسوم الصغيرة الكثيفة مثل جدول مسافات بين بضع عشرات من المدن. وهذا مثال آخر على أن Big-O الذي شرحناه في مقال Big-O للمبتدئين لا يكتمل بدون شكل البيانات.
ماذا يحدث إذا كان هناك وزن سالب Negative Weight؟
هذه تجربة «ماذا يحدث إذا…» في المقال، والجزء الثاني من الملف يجيب عنها. والوزن السالب ليس غريباً كما يبدو: في رسم تكون أوزانه تكلفة مالية، قد يكون هناك طريق فيه خصم أو استرداد نقدي Cashback فتصبح تكلفته سالبة، وفي رسوم تحويل العملات تظهر الأوزان السالبة عندما نحول نسب التحويل إلى لوغاريتمات. وقد كتبنا رسماً موجهاً صغيراً: من W إلى A بدقيقة، ومن W إلى B بخمس، ومن A إلى C بدقيقتين، ومن B إلى A بوزن -5. والنتيجة أن Dijkstra أعطى C المسافة 3، وأعطت خوارزمية Bellman-Ford المسافة 2، وهي الصحيحة عبر W ثم B ثم A ثم C: 5 ناقص 5 زائد 2. والصورة التالية تبين أين أخطأ:
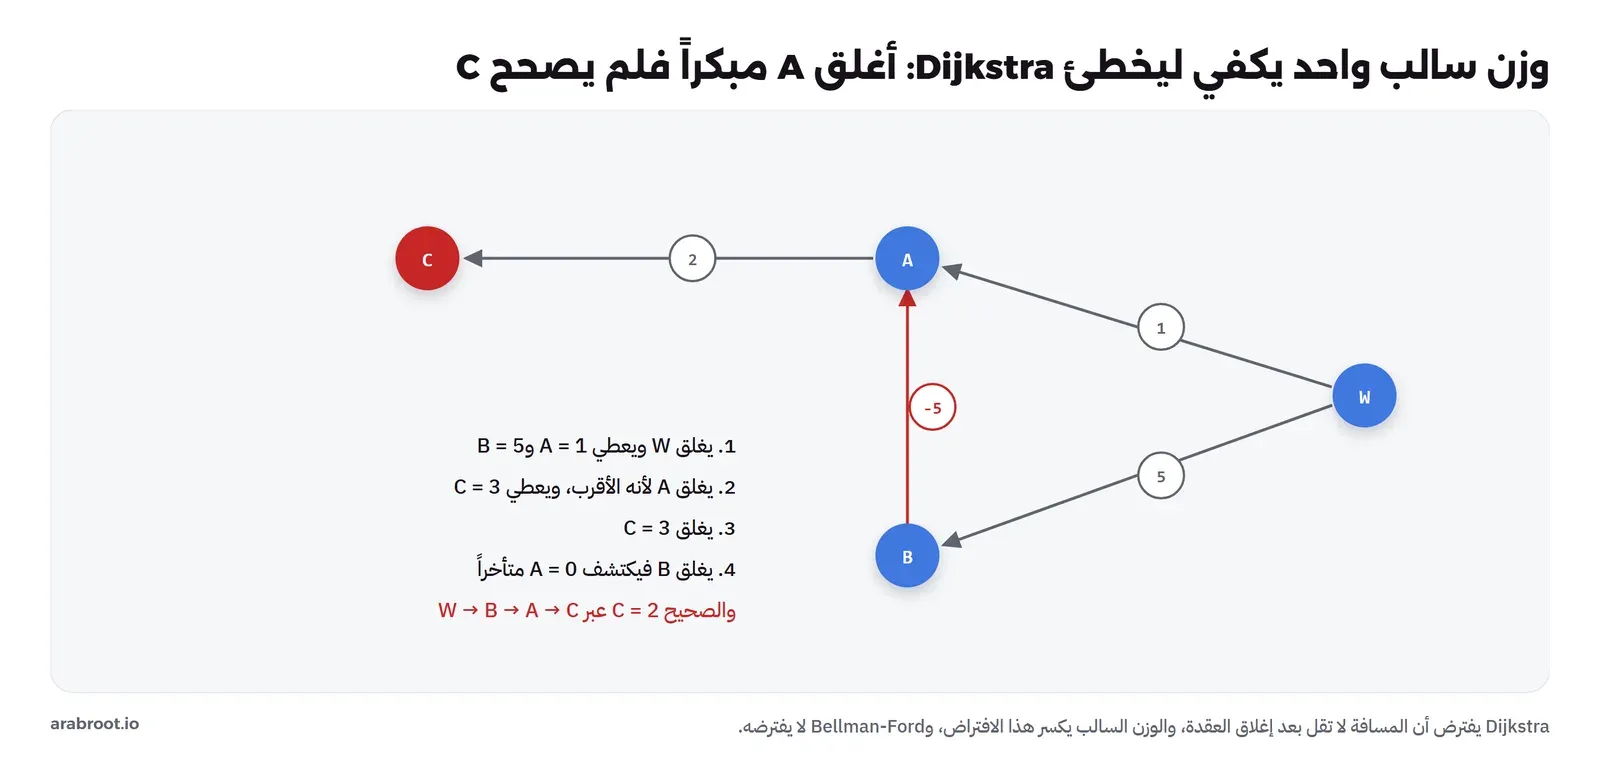
والسبب هو الافتراض الذي شرحناه: Dijkstra يغلق العقدة A لأنها الأقرب بمسافة 1، ثم يحسب C منها ويغلقها بمسافة 3، وبعد ذلك فقط يصل إلى B ويكتشف أن الطريق عبرها يجعل A صفراً، ولكن A وC مغلقتان، فيحدث مسافة A ولا يعيد حساب C. أما Bellman-Ford فلا يغلق أي عقدة، وإنما يمر على كل الحواف V − 1 مرة ويحدث كل مسافة يمكن تحسينها، وتكلفته O(V × E) بدل O((V + E) log V)، ولكنه صحيح مع الأوزان السالبة، ويكتشف أيضاً الدورة السالبة Negative Cycle التي يصبح فيها «أقصر طريق» غير موجود لأن كل لفة تقلله.
وهنا أيضاً مشكلة واجهناها أثناء كتابة التجربة: النسخة الأولى من هذا الجزء أضافت الوزن السالب إلى خريطة التوصيل نفسها، وكانت نتيجة Dijkstra صحيحة بالصدفة، لأن ترتيب الإغلاق في تلك الخريطة جعل الخوارزمية تصل إلى الطريق السالب قبل أن تغلق العقدة المتأثرة. أي أن اختباراً واحداً نجح مع أن الخوارزمية لا تدعم هذه الحالة أصلاً. والدرس أن نجاح Dijkstra على بيانات فيها وزن سالب لا يثبت شيئاً، فإذا كانت أوزانك قد تكون سالبة فاستخدم Bellman-Ford، أو تحقق من الأوزان قبل التشغيل وارفض السالب منها برسالة واضحة.
الأداء على خرائط تكبر: قياس BFS وDijkstra
الجزء الثالث من routes.py يبني خرائط شبكية، كل خريطة k في k تقاطع، وكل تقاطع متصل بجيرانه الأربعة بطرق زمنها عشوائي من 1 إلى 9 دقائق، ثم يقيس زمن البحث بالعرض، وزمن Dijkstra مع الكومة، وزمن Dijkstra بدون كومة، حيث تمر الخوارزمية في كل خطوة على كل العقد لتجد الأقرب، وهي الطريقة الأصلية قبل استخدام الكومة. والصورة التالية ترسم الأرقام على مقياس لوغاريتمي:
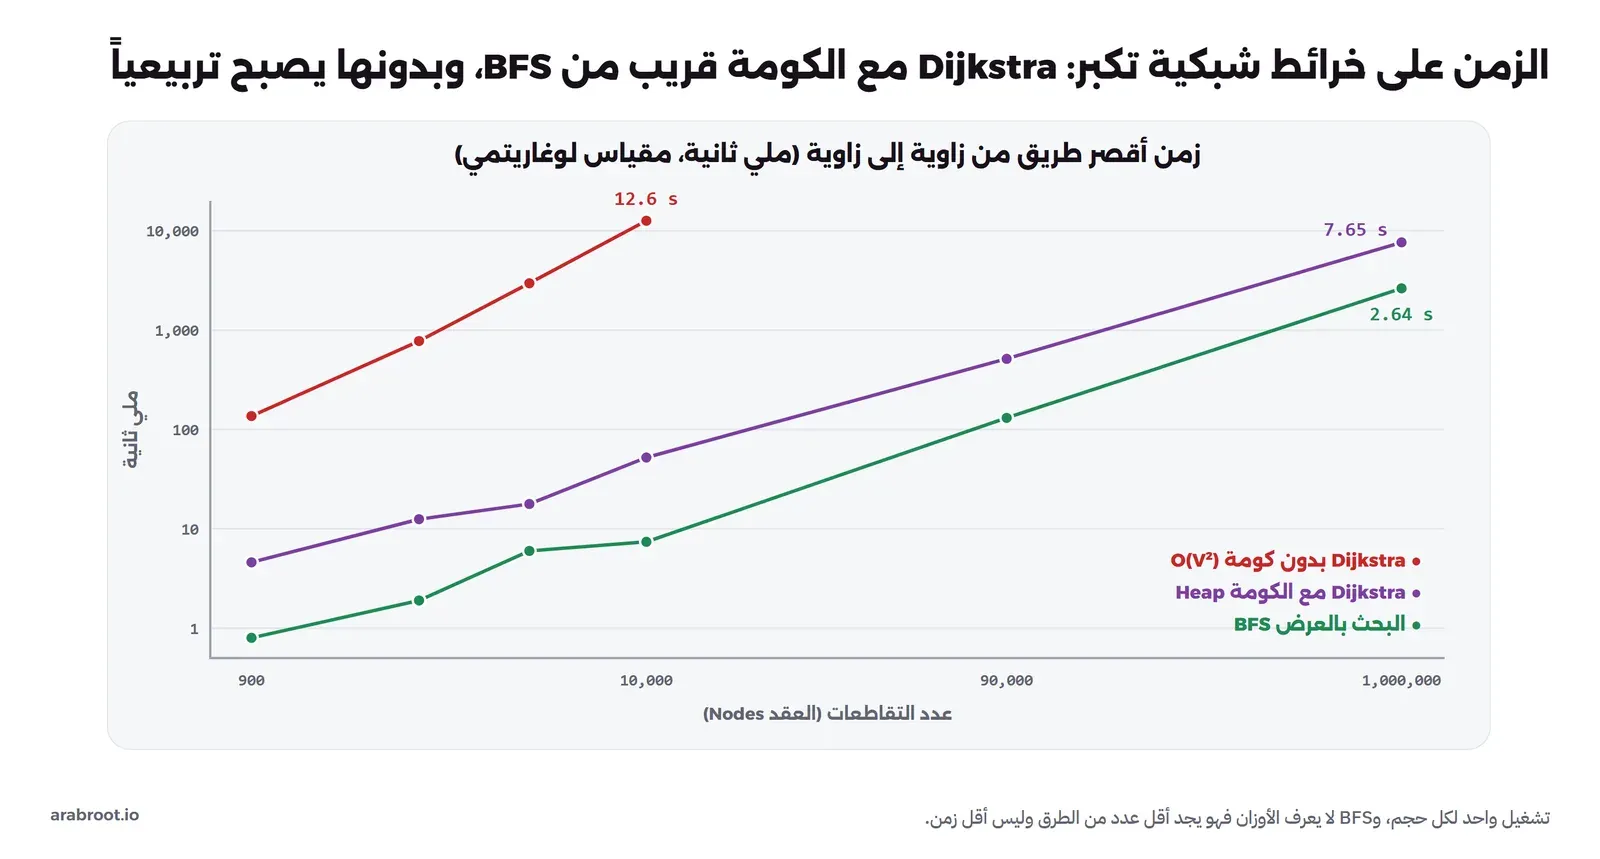
في الجزء الثالث من المخرج لاحظ التالي:
- Dijkstra بدون كومة انتقل من 136.7 مللي ثانية لـ 900 عقدة إلى 12633.6 لعشرة آلاف عقدة، أي أن العقد زادت إحدى عشرة مرة والزمن زاد أكثر من تسعين مرة، وهذا O(V²). ولذلك لم نشغله على الأحجام الأكبر، فمع مليون عقدة كان سيحتاج أياماً بحسب هذا الاتجاه.
- Dijkstra مع الكومة على عشرة آلاف عقدة أخذ 52.2 مللي ثانية، أي أسرع من النسخة بدون كومة بأكثر من مئتي مرة على البيانات نفسها، وقد تحقق الكود بالسطر
assert da == dمن أن النسختين أعطتا المسافات نفسها لكل العقد. وعلى مليون عقدة وقرابة مليوني طريق أخذ 7.65 ثانية في Python. - البحث بالعرض أسرع من Dijkstra مع الكومة بنحو ثلاث مرات في الأحجام الكبيرة، لأنه لا يحتاج كومة ولا مقارنات بين المسافات، ولكنه يجيب عن سؤال آخر. فإذا كانت كل الحواف متساوية فاستخدمه بدل Dijkstra.
- عمود
cornerهو أقصر زمن من الزاوية إلى الزاوية المقابلة، والأرقام بالمللي ثانية من تشغيل واحد، والصغيرة منها متذبذبة، فالبحث بالعرض أخذ 6.0 عند 4,900 عقدة و7.4 عند عشرة آلاف، وهذا ضجيج القياس في الأرقام الصغيرة.
وقد يتساءل البعض: إذا كان Dijkstra يأخذ ثماني ثوان على مليون تقاطع، فكيف تعطيك تطبيقات الخرائط الطريق في جزء من الثانية على خريطة دولة كاملة فيها عشرات الملايين من التقاطعات؟ والإجابة أن محركات التوجيه لا تشغل Dijkstra كما هو، وإنما تجهز الخريطة مسبقاً بطرق مثل Contraction Hierarchies، التي تضيف طرقاً مختصرة بين التقاطعات المهمة، فيصبح البحث على عدد صغير جداً من العقد، وقد شرحنا ذلك عملياً في مقال حساب أقصر طريق مع OSRM وValhalla. والخوارزمية الأساسية تبقى فكرة Dijkstra نفسها.
أين تقابل خوارزميات الرسم البياني Graph Algorithms في عملك؟
- مدير الحزم Package Manager:
aptوnpmوpipتبني رسم اعتماديات وتمشي عليه بالبحث لتعرف ما يجب تثبيته، وترتبه طوبولوجياً لتعرف الترتيب، وتكتشف الدورات والتعارضات. - أدوات البناء ومراحل CI:
makeوأدوات بناء المشاريع الكبيرة ومراحل CI التي فيهاneedsأوdepends_onكلها DAG، والأداة ترتبه طوبولوجياً وتشغل ما لا يعتمد على بعضه بالتوازي. وفي Linux توجد أداة صغيرة اسمها tsort تقوم بالترتيب الطوبولوجي من سطر الأوامر. - تاريخ Git: كل Commit عقدة تشير إلى أبيها أو أبويها في الدمج، أي أن التاريخ DAG، والأمر git log مع خيار
--topo-orderيعرضه بترتيب طوبولوجي، والبحث عن أقرب أب مشترك Merge Base قبل الدمج مرور على هذا الرسم. وقد شرحنا Git في مقال إدارة النسخ وGit. - الشبكات: بروتوكول التوجيه OSPF الذي تستخدمه الموجهات داخل الشبكات الكبيرة يحسب أقصر الطرق بخوارزمية Dijkstra كما يذكر معيار RFC 2328.
- الخرائط والتوصيل: أقصر طريق وزمن الوصول وتوزيع الطلبات على المندوبين، وقد شرحنا أساسيات الخرائط الرقمية في مقال كيف تعمل الخرائط الرقمية.
- الأنظمة الموزعة والخدمات المصغرة: رسم الخدمات التي يستدعي بعضها بعضاً، والبحث المعكوس فيه يجيب عن «ما الذي يتوقف إذا توقفت خدمة الدفع؟»، والدورة فيه علامة تصميم تستحق المراجعة.
أخطاء شائعة Common Mistakes
- نسيان علامة «تمت الزيارة»: في رسم فيه دورة يدور البحث بدونها إلى الأبد، وفي رسم بلا دورات يزور العقدة نفسها مرات كثيرة، مثل
libc6التي تصل إليها 71 حافة. - استخدام
list.pop(0)كطابور: كل إخراج O(n)، فيصبح البحث بالعرض O(V²)، والحلcollections.deque. - البحث بالعمق بالاستدعاء الذاتي على رسم عميق: RecursionError بعد ألف مستوى في Python، والحل مكدس صريح.
- البحث بالعرض لأقصر طريق موزون: يعطي أقل عدد من الحواف وليس أقل وزن، كما رأيت في 13 دقيقة مقابل 10.
- Dijkstra مع أوزان سالبة: نتيجة خاطئة بصمت، وقد تنجح الاختبارات بالصدفة، والحل Bellman-Ford أو رفض الأوزان السالبة.
- Dijkstra بدون كومة على رسم كبير: O(V²) جعلت عشرة آلاف عقدة 12.6 ثانية بدل 52 مللي ثانية.
- افتراض أن الرسم بلا دورات: دورة بين حزمتين أوقفت ترتيب 75 حزمة، فاكتشف الدورات واطبعها قبل الترتيب.
- مصفوفة جوار لرسم كبير متناثر: مليون عقدة تعني تريليون خانة، والقائمة تكفي بقدر الحواف.
- نسيان الحافة العكسية في رسم غير موجه: الطريق ذو الاتجاهين حافتان، ونسيان إحداهما يجعل نصف الطرق غير موجودة في نظر الخوارزمية.
جدول القرار Decision Table: أي خوارزمية لأي سؤال؟
| السؤال | الخوارزمية | التكلفة |
|---|---|---|
| ما العقد التي يمكن الوصول إليها من هذه العقدة؟ | BFS أو DFS | O(V + E) |
| أقصر طريق بعدد الحواف، أو الأقرب أولاً | BFS | O(V + E) |
| هل في الرسم دورة، وما هي؟ | DFS بثلاثة ألوان | O(V + E) |
| بأي ترتيب أنفذ مهاماً لها اعتماديات؟ | Topological Sort بخوارزمية Kahn أو graphlib | O(V + E) |
| رسم اعتماديات فيه دورات مقبولة | SCC بخوارزمية Tarjan ثم ترتيب المكونات | O(V + E) |
| من سيتأثر إذا حذفت هذه العقدة؟ | BFS على الرسم المعكوس | O(V + E) |
| أقصر طريق بأوزان موجبة | Dijkstra مع كومة | O((V + E) log V) |
| أقصر طريق مع أوزان سالبة، أو كشف دورة سالبة | Bellman-Ford | O(V × E) |
| أقصر طريق على خريطة دولة في أجزاء من الثانية | محرك توجيه بتجهيز مسبق مثل OSRM | تجهيز طويل مرة واحدة، ثم استعلام سريع |
قائمة تحقق Checklist
- هل الرسم ممثل بقائمة جوار إذا كان متناثراً؟
- هل يوجد في كل مرور على الرسم علامة للعقد التي تمت زيارتها؟
- هل الطابور في البحث بالعرض
deque، والكومة في Dijkstra منheapq؟ - هل يمكن أن يكون الرسم أعمق من حد الاستدعاء الذاتي، وهل كتبت البحث بالعمق بمكدس صريح إذا كان كذلك؟
- هل الأوزان كلها موجبة قبل استخدام Dijkstra، وهل يتحقق الكود من ذلك؟
- هل تكتشف أداتك الدورات وتطبعها كاملة قبل الترتيب الطوبولوجي؟
- هل الرسم غير الموجه مكتوب بحافتين لكل رابط؟
- هل اختبرت الخوارزمية على حالة خاصة يعرف جوابها، مثل رسم فيه دورة أو وزن سالب أو عقدة لا يمكن الوصول إليها؟
تدريب عملي Practice
- عدل
deps.pyحتى يطبع لكل حزمة عدد الحزم التي تحتاجها بشكل غير مباشر، ثم رتب الحزم بهذا العدد، وابحث عن الحزمة التي تحتاج أكثر من غيرها. - شغل
deps.pyداخل Container منdebian:trixie-slimبعد تثبيت Python فيه، وقارن عدد الحزم والدورات بالـ Image التي استخدمناها. - أضف إلى
routes.pyدالة تكتشف الدورة السالبة بتمرير إضافي في Bellman-Ford، وجربها على رسم فيه دورة مجموع أوزانها سالب.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الرسم البياني عقد وحواف، وصفاته من اتجاه ووزن ودورات تحدد الخوارزمية، وأغلب الرسوم الحقيقية متناثرة فتمثل بقائمة جوار، فالمصفوفة في رسم الاعتماديات كانت 2.8% مستخدمة فقط.
- البحث بالعرض BFS يمشي مستوى بعد مستوى بطابور، فيعطي أقصر طريق بعدد الحواف، ووجد أن apt يحتاج 26 حزمة في ثلاثة مستويات، وأن حذف libc6 يكسر 74 حزمة.
- البحث بالعمق DFS يتعمق بمكدس ويعرف متى ينتهي من كل عقدة، وبثلاثة ألوان وجد دورتين حقيقيتين في Debian 13.
- الترتيب الطوبولوجي يضع كل عقدة بعد ما تعتمد عليه، ودورة واحدة أوقفت Kahn عند 12 حزمة من 87، والحل دمج كل دورة في مكون مترابط بقوة SCC ثم ترتيب المكونات.
- Dijkstra يجد أقصر طريق بالأوزان بطابور أولوية، وأعطى 10 دقائق بأربعة طرق مقابل 13 دقيقة بطريقين للبحث بالعرض، ولكنه يخطئ بصمت مع الأوزان السالبة حيث يلزم Bellman-Ford.
- الكومة تجعل Dijkstra O((V + E) log V)، فكان 52 مللي ثانية لعشرة آلاف عقدة مقابل 12.6 ثانية بدونها، و7.65 ثانية لمليون عقدة.
وبهذا المقال تكتمل مقالات الخوارزميات في المرحلة مع مقالي جداول الهاش والبحث والترتيب، وهذه المقالات المنشورة التي يعتمد عليها هذا المقال أو يكملها:
 دليلهياكل البيانات Data Structures للمبتدئينلماذا تكون نفس العملية سريعة في هيكل بيانات وبطيئة في آخر، وأين تقابل كل هيكل في السيرفرات وقواعد البيانات.
 دليلBig-O للمبتدئين: لماذا يبطؤ كودك عندما تكبر البياناتلماذا يعمل الكود بسرعة على مئة صف ثم يتوقف على مئة ألف، وكيف تقرأ Big-O وتكتشف الخوارزمية البطيئة في كودك.
 دليلالتعبيرات النمطية Regex للمبتدئين، مع النص العربيكيف تقرأ وتكتب تعبيراً نمطياً جزءاً بجزء، ولماذا يختلف سلوكه مع النص العربي بين اللغات، وكيف يوقف نمط واحد سيرفرك.
 دليلالاحتمالات Probability للمبرمجين: التصادم Collision والتوفركم معرفاً أو رابطاً قصيراً تنشئ قبل أول تكرار، ولماذا يخدعك افتراض الاستقلال في حساب التوفر والإعادة، بأرقام محسوبة ومحاكاة حقيقية.
 دليلحساب أقصر طريق وزمن الوصول مع OSRM وValhallaكيف يحسب محرك المسارات أقصر طريق وزمن الوصول على شوارع مدينتك، وكيف تشغله على سيرفرك وتقيس سرعته بنفسك.
 دليلإدارة النسخ وGit للمبتدئين: لماذا نحتاجها وكيف تعمللماذا تضيع الملفات بأسماء final_v2 ويمسح الزملاء عمل بعضهم، وكيف يحل Git ذلك على مشروع حقيقي من أول commit.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ ملفات التجربة في Container من
python:3.13.17-slim(Python 3.13.17 على Debian 13) على Docker Engine 29.8.0.