

لنفرض أن منتجك يستقبل 330 تسجيلاً جديداً في الأسبوع، وأن فريق التسويق سعيد بالرقم لأنه يرتفع كل شهر، ثم تفتح قاعدة البيانات بعد عشرة أسابيع فتجد أن 14% فقط من هؤلاء ما زالوا يستخدمون المنتج، وأن 65% منهم لم يعودوا بعد الأسبوع الأول أصلاً. هنا لا تنفعك حملة إعلانية جديدة، لأنك تصب الماء في دلو مثقوب، والسؤال الصحيح هو: ماذا يحدث للمستخدم في أيامه الأولى؟ ولماذا يبقى بعضهم ويغادر أكثرهم؟
في مقال قمع التسويق ذكرنا أن التفعيل Activation هو المرحلة التي تنساها الفرق كثيراً، وفي مقال مقاييس المنتج شرحنا تعريف العودة Retention وجدول المجموعات Cohort Table. وفي هذا المقال سوف نتناول:
- ما هي لحظة التفعيل Activation Moment، ولماذا لا يكفي التسجيل.
- كيف تبحث عن هذه اللحظة في بياناتك بدل أن تخمنها.
- التهيئة Onboarding: كيف تختصر الطريق إلى أول قيمة.
- منحنى الاحتفاظ Retention Curve وأشكاله، ومعنى أن «يستقر» المنحنى.
- تجربة عملية: نحسب جدول المجموعات ومنحنى الاحتفاظ ونبحث عن لحظة التفعيل بـ Python وSQL في Docker.
- التسرب Churn: كيف تحسبه، ولماذا يخدعك المنحنى المستقر أحياناً.
ما هي لحظة التفعيل Activation Moment؟
التفعيل هو أول مرة يحصل فيها المستخدم على القيمة التي سجل من أجلها، ويعرف بحدث محدد في مدة محددة، مثل «ربط قناة تنبيه خلال 7 أيام من التسجيل» في أداة مراقبة الخوادم، أو «إرسال أول فاتورة» في نظام فوترة، أو «نشر أول موقع» في منصة استضافة. والتسجيل وحده ليس تفعيلاً، لأن الشخص الذي أنشأ حساباً ثم أغلق الصفحة لم ير شيئاً من المنتج بعد، وغالباً لن يعود.
ويمكن تشبيه ذلك بالمطعم: الزبون الذي دخل وجلس ثم خرج قبل أن يأكل لم يتذوق الطعام، فإذا لم يعد فالسبب ليس جودة الطبخ وإنما أن الطلب أخذ وقتاً طويلاً أو أن قائمة الطعام لم تكن واضحة. والصورة التالية تبين المراحل الأولى للمستخدم الجديد:
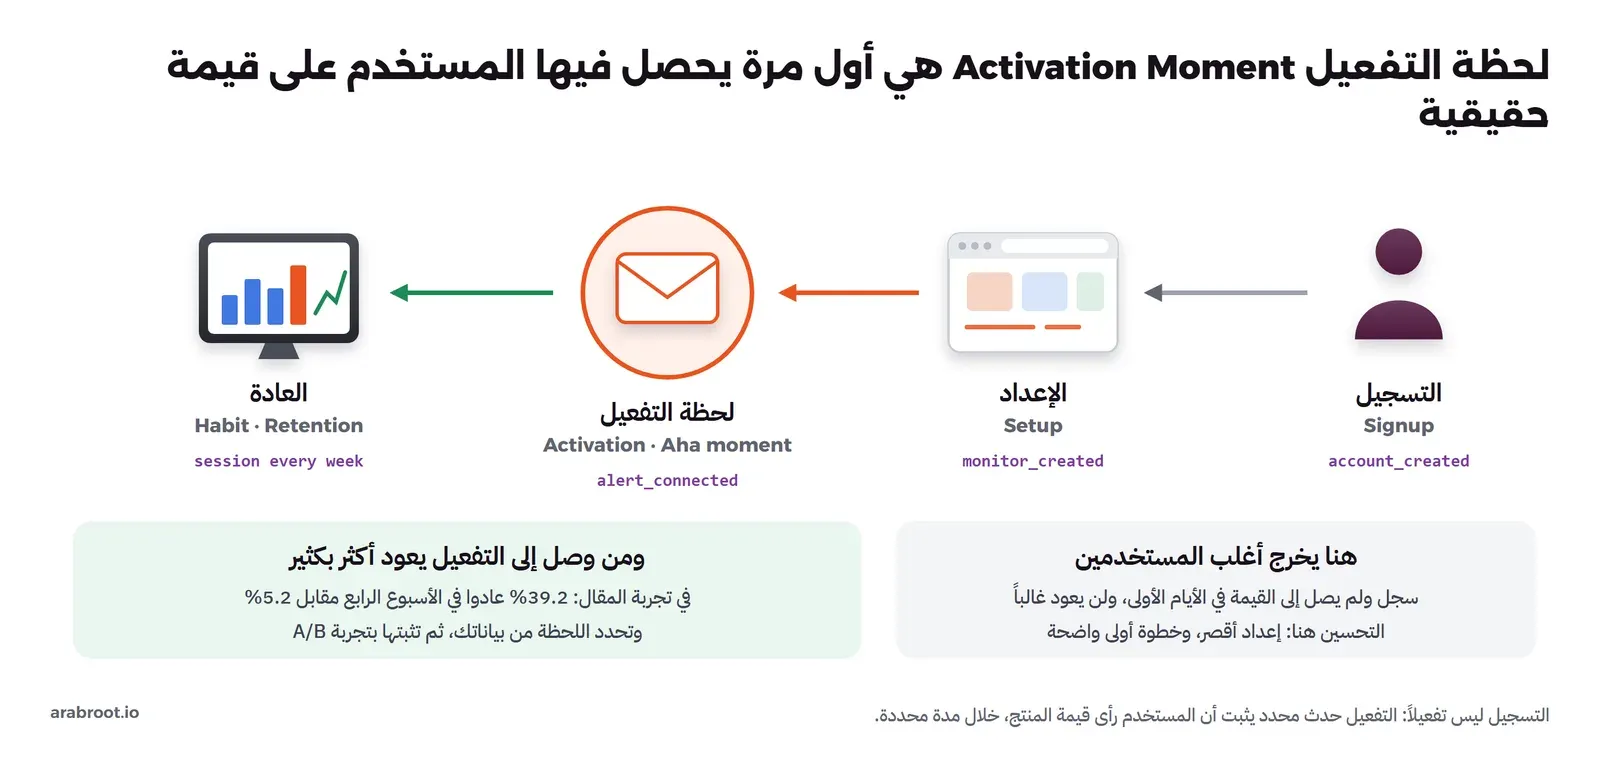
وفي الصورة أعلاه لاحظ التالي:
- كل مرحلة مربوطة بحدث Event تسجله في قاعدة البيانات أو أداة التحليلات، وبدون هذا الحدث لن تستطيع أن تقيس شيئاً.
- لحظة التفعيل ليست أول نقرة في المنتج، وإنما اللحظة التي يقول فيها المستخدم «هذا ما أحتاجه»، وفي أداة المراقبة هي أن يصله أول تنبيه حقيقي عن سيرفره.
- المدة جزء من التعريف، فالمستخدم الذي يربط قناة التنبيه بعد شهرين كان على الأرجح سيغادر لولا سبب آخر، ولذلك نقول «خلال 7 أيام» وليس «في أي وقت».
كيف تجد لحظة التفعيل في بياناتك؟
الطريقة البسيطة أن يجتمع الفريق ويختار حدثاً يبدو منطقياً، ومشكلة هذه الطريقة أن الفريق يعرف المنتج أكثر من المستخدم، فيختار ما يراه هو مهماً. والطريقة الأفضل أن تجعل البيانات تقترح عليك، وذلك بثلاث خطوات:
- اجمع المرشحين: كل فعل يمكن أن يقوم به المستخدم في أسبوعه الأول، مثل إكمال الملف الشخصي، وإضافة أول خادم، ودعوة زميل، وربط قناة التنبيه.
- قارن العودة: لكل فعل، احسب نسبة من عاد في الأسبوع الرابع ممن قام به، ونسبة من عاد ممن لم يقم به. والفعل الذي يصنع أكبر فرق هو المرشح الأقوى.
- ابحث عن العتبة Threshold: هل يكفي خادم واحد؟ أم أن من أضاف ثلاثة يعود أكثر بوضوح؟ فبعض الأفعال لا تظهر قيمتها إلا بعد عدد معين.
وقد يتساءل البعض: إذا وجدنا أن من ربط قناة التنبيه يعود أكثر بسبع مرات، فهل يعني هذا أن ربط القناة هو سبب العودة؟ والإجابة: ليس بالضرورة، فهذا ارتباط Correlation وليس سببية Causation، وقد يكون المستخدم الجاد هو من يربط القناة ويعود في نفس الوقت، أي أن الجدية هي السبب في الاثنين. لذلك فالبيانات تعطيك فرضية، ثم تثبتها بتجربة A/B تدفع فيها نصف المستخدمين نحو هذا الفعل وتقيس هل ارتفعت العودة فعلاً، وهذا ما نفعله في مقال تجارب النمو العملي من نفس المرحلة.
التهيئة Onboarding: اختصر الطريق إلى أول قيمة
بعد أن تعرف لحظة التفعيل، يصبح هدف التهيئة واضحاً: أن يصل أكبر عدد من المستخدمين إلى هذه اللحظة بأقل وقت ممكن، والمقياس هنا هو الوقت حتى القيمة Time to Value. وفيما يلي أشهر الأساليب، وكلها تخدم نفس الهدف:
| الأسلوب | ماذا يفعل | مثال في أداة المراقبة |
|---|---|---|
| قائمة خطوات البداية Onboarding Checklist | ثلاث أو أربع خطوات تنتهي بلحظة التفعيل، ويرى المستخدم تقدمه فيها | أضف خادماً، اربط قناة التنبيه، جرب تنبيهاً تجريبياً |
| الشاشة الفارغة Empty State | الصفحة التي لا تحتوي بيانات بعد تشرح الخطوة التالية بدل أن تبقى فارغة | «لا توجد خوادم بعد، أضف أول خادم في دقيقة» |
| القيم الافتراضية Defaults | تقليل الحقول التي يجب أن يملأها المستخدم قبل أن يرى النتيجة | فحص كل دقيقة على المنفذ 443 دون أن يختار شيئاً |
| بيانات تجريبية Sample Data | يرى المستخدم شكل المنتج وهو ممتلئ قبل أن يضيف بياناته | لوحة فيها خادم تجريبي وتنبيه سابق |
| رسائل التهيئة Onboarding Emails | تذكير بالخطوة التي توقف عندها المستخدم، لا رسالة ترحيب عامة | «أضفت خادماً ولم تربط التنبيه بعد، وهذا يأخذ دقيقة» |
ولاحظ أن كل أسلوب في الجدول يقلل خطوة أو يوضح خطوة، ولا يضيف شيئاً جديداً، والخطأ المعتاد أن يضيف الفريق جولة تعريفية Product Tour من عشر شاشات تشرح كل الميزات، فيغلقها المستخدم بعد الشاشة الثانية. وأما رسائل التهيئة فهي رسائل خدمة مرتبطة بحساب أنشأه المستخدم، ولكن إذا خلطتها بعروض ترويجية فقد دخلت في التسويق المباشر الذي يحتاج موافقة منفصلة كما شرحنا في مقال التسويق الرقمي في السعودية، لذلك افصل بين النوعين من البداية.
منحنى الاحتفاظ Retention Curve: هل يستقر؟
منحنى الاحتفاظ يرسم نسبة من عاد من مجموعة واحدة في كل فترة بعد التسجيل، فيبدأ من 100% في الأسبوع صفر ثم ينزل. والسؤال المهم فيه ليس كم ينزل في الأسبوع الأول، لأنه ينزل كثيراً في كل المنتجات تقريباً، وإنما ماذا يحدث بعد ذلك، وهنا ثلاثة أشكال:
- منحنى ينزل حتى الصفر: كل مجموعة تختفي بعد أسابيع، وهذا يعني أن المنتج لا يحل مشكلة متكررة لأحد، وأي إنفاق على الاكتساب Acquisition هنا خسارة.
- منحنى يستقر Flattening: ينزل ثم يثبت عند نسبة معينة، مثل 20% أو 30%، وهؤلاء هم من وجدوا قيمة حقيقية، وهذا هو الشكل الذي تبحث عنه قبل أن تزيد الإنفاق على التسويق.
- منحنى يرتفع بعد النزول Smile Curve: بعض المستخدمين الذين غادروا يعودون لاحقاً، وهذا يحدث عندما يضيف المنتج قيمة جديدة أو عندما يحتاجه الناس في مواسم معينة.
والمنحنى الواحد لكل المستخدمين يخفي الكثير، لذلك ارسمه لكل شريحة على حدة: من وصل إلى التفعيل ومن لم يصل، ومن جاء من الإحالات ومن جاء من الإعلانات، وهذا ما سوف نراه في التجربة التالية.
تجربة عملية: الاحتفاظ ولحظة التفعيل من سجل أحداث
كتبنا سكربت Python لا يحتاج أي مكتبة خارجية، ويستخدم SQLite المدمجة في Python لكي تكون الحسابات بـ SQL كما تكتبها على PostgreSQL أو أي قاعدة بيانات تحليلية. والسكربت يقوم بأمرين: ينشئ سجل أحداث مثال لأداة مراقبة خوادم Server Monitoring بعشر مجموعات أسبوعية من 1 يونيو إلى 3 أغسطس 2026، ثم يحسب منه جدول المجموعات ومنحنيات الاحتفاظ ومرشحي التفعيل والتسرب. ولاحظ أن الاحتمالات داخل دالة make أرقام افترضناها للتمرين، منها أن قائمة خطوات البداية ظهرت للمجموعات ابتداءً من 13 يوليو، وليست متوسطات لأي سوق، أما المخرج فهو ما خرج فعلاً من التشغيل.
والسكربت كاملاً كما يلي:
# Cohort retention and the activation moment from a raw event log, with plain Python and SQL (SQLite).
#   python retention.py make     -> writes events.db: example events of a server-monitoring SaaS (fixed seed)
#   python retention.py report   -> cohort table, retention curves, activation candidates, churn (SQL queries below)
# The probabilities in make() are assumptions for the exercise, not benchmarks of any market.
import json, math, random, sqlite3, sys
from datetime import date, datetime, timedelta

FIRST_COHORT = date(2026, 6, 1)        # a Monday
COHORTS = 10                           # ten weekly signup cohorts: 1 June to 3 August 2026
WEEKS = 10                             # we read weeks 0..10 after signup (all complete before 19 October 2026)
CHECKLIST_FROM = date(2026, 7, 13)     # the onboarding checklist shipped for cohorts from this Monday


def make(path="events.db"):
    rnd = random.Random(7)
    rows, uid = [], 0
    for c in range(COHORTS):
        monday = FIRST_COHORT + timedelta(weeks=c)
        checklist = monday >= CHECKLIST_FROM
        for _ in range(rnd.randint(280, 360)):
            uid += 1
            u = f"u{uid}"
            t0 = datetime.combine(monday, datetime.min.time()) + timedelta(minutes=rnd.randrange(7 * 24 * 60))
            rows.append((u, "signup", t0))
            # first week: the actions we will test as activation candidates
            alert = rnd.random() < (0.45 if checklist else 0.30)       # connected an alert channel (Slack, email, SMS)
            invite = rnd.random() < (0.22 if alert else 0.10)           # invited a teammate
            monitors = min(8, int(rnd.expovariate(1 / (2.6 if alert else 1.6))))  # monitors created
            profile = rnd.random() < 0.55                                # filled the profile (does not matter)
            day = lambda: t0 + timedelta(hours=rnd.randrange(1, 6 * 24))
            for _ in range(monitors):
                rows.append((u, "monitor_created", day()))
            if alert:
                rows.append((u, "alert_connected", day()))
            if invite:
                rows.append((u, "teammate_invited", day()))
            if profile:
                rows.append((u, "profile_completed", day()))
            rows.append((u, "session", t0 + timedelta(minutes=5)))
            # later weeks: chance to come back, it decays and then flattens (the floor) for users who got value
            floor = (0.30 if alert else 0.04) + (0.08 if invite else 0.0)
            for w in range(1, 25):
                p = floor + (0.45 if alert else 0.40) * math.exp(-w / (2.0 if alert else 1.2))
                if rnd.random() < p:
                    for _ in range(rnd.randint(1, 4)):
                        rows.append((u, "session", t0 + timedelta(days=7 * w + rnd.uniform(0, 6.99))))
    con = sqlite3.connect(path)
    con.executescript("DROP TABLE IF EXISTS events; CREATE TABLE events (user_id TEXT, event TEXT, ts TEXT);")
    end = datetime(2026, 10, 19)
    con.executemany("INSERT INTO events VALUES (?,?,?)", [(u, e, t.isoformat(" ")) for u, e, t in rows if t < end])
    con.execute("CREATE INDEX ev_user ON events(user_id, event)")
    con.commit()
    n = con.execute("SELECT COUNT(*), COUNT(DISTINCT user_id) FROM events").fetchone()
    print(f"wrote {n[0]} events for {n[1]} users to {path}")


# Two helper tables built once: each user's signup time and cohort (the Monday of the signup week),
# and the weeks after signup in which the user had at least one session
SETUP_SQL = """
CREATE TEMP TABLE signup AS
  SELECT user_id, MIN(ts) AS t0, date(MIN(ts), '-6 days', 'weekday 1') AS cohort
  FROM events WHERE event = 'signup' GROUP BY user_id;
CREATE TEMP TABLE active AS
  SELECT DISTINCT e.user_id, CAST((julianday(e.ts) - julianday(s.t0)) / 7 AS INTEGER) AS wk
  FROM events e JOIN signup s USING (user_id)
  WHERE e.event = 'session';
CREATE INDEX temp.active_user ON active(user_id, wk);
CREATE TEMP TABLE first_week AS          -- what each user did in the first 7 days after signup
  SELECT e.user_id, e.event, COUNT(*) AS n
  FROM events e JOIN signup s USING (user_id)
  WHERE julianday(e.ts) - julianday(s.t0) < 7
  GROUP BY e.user_id, e.event;
CREATE INDEX temp.fw_user ON first_week(user_id, event);
"""

COHORT_SQL = """
SELECT s.cohort, COUNT(DISTINCT s.user_id) AS users,
""" + ",\n".join(f"  ROUND(100.0 * COUNT(DISTINCT CASE WHEN a.wk = {w} THEN a.user_id END) / COUNT(DISTINCT s.user_id), 1) AS w{w}"
                  for w in range(WEEKS + 1)) + """
FROM signup s LEFT JOIN active a USING (user_id)
GROUP BY s.cohort ORDER BY s.cohort
"""

# Activation candidates: did the action in the first 7 days, then week-4 retention of doers and non-doers
CANDIDATE_SQL = """
SELECT :event AS action,
  SUM(fw.user_id IS NOT NULL) AS did,
  ROUND(100.0 * SUM(fw.user_id IS NOT NULL AND a.user_id IS NOT NULL) / SUM(fw.user_id IS NOT NULL), 1) AS ret_w4_did,
  ROUND(100.0 * SUM(fw.user_id IS NULL AND a.user_id IS NOT NULL) / SUM(fw.user_id IS NULL), 1) AS ret_w4_not
FROM signup s
LEFT JOIN first_week fw ON fw.user_id = s.user_id AND fw.event = :event AND fw.n >= :min_n
LEFT JOIN active a ON a.user_id = s.user_id AND a.wk = 4
"""

CURVE_SQL = """
WITH seg AS (            -- activated = connected an alert channel in the first 7 days
  SELECT s.user_id, fw.user_id IS NOT NULL AS activated
  FROM signup s LEFT JOIN first_week fw ON fw.user_id = s.user_id AND fw.event = 'alert_connected'
),
size AS (SELECT activated, COUNT(*) AS n FROM seg GROUP BY activated)
SELECT seg.activated, a.wk, ROUND(100.0 * COUNT(*) / size.n, 1)
FROM seg JOIN active a USING (user_id) JOIN size USING (activated)
WHERE a.wk BETWEEN 0 AND :weeks
GROUP BY seg.activated, a.wk ORDER BY seg.activated, a.wk
"""

CHURN_SQL = """
SELECT
  (SELECT COUNT(*) FROM active WHERE wk = :w - 1) AS prev,
  (SELECT COUNT(*) FROM active p WHERE p.wk = :w - 1
     AND NOT EXISTS (SELECT 1 FROM active n WHERE n.user_id = p.user_id AND n.wk = :w)) AS lost,
  (SELECT COUNT(*) FROM active n WHERE n.wk = :w AND :w >= 2
     AND NOT EXISTS (SELECT 1 FROM active p WHERE p.user_id = n.user_id AND p.wk = :w - 1)) AS back
"""


def report(path="events.db"):
    con = sqlite3.connect(path)
    con.executescript(SETUP_SQL)
    rows = con.execute(COHORT_SQL).fetchall()
    print("Weekly cohorts: % of the cohort with a session in week N after signup")
    print(f"{'cohort':<11}{'users':>6}" + "".join(f"{'w' + str(w):>6}" for w in range(WEEKS + 1)))
    for r in rows:
        print(f"{r[0]:<11}{r[1]:>6}" + "".join(f"{v:>6.1f}" for v in r[2:]))
    before = [r for r in rows if r[0] < CHECKLIST_FROM.isoformat()]
    after = [r for r in rows if r[0] >= CHECKLIST_FROM.isoformat()]
    avg = lambda rs, w: sum(r[2 + w] * r[1] for r in rs) / sum(r[1] for r in rs)
    print(f"average week 4: cohorts before the checklist {avg(before, 4):.1f}%  from the checklist on {avg(after, 4):.1f}%")
    print(f"average week 8: cohorts before the checklist {avg(before, 8):.1f}%  from the checklist on {avg(after, 8):.1f}%")
    print()

    print("Activation candidates: action in the first 7 days -> active in week 4")
    print(f"{'action':<26}{'users':>7}{'did':>9}{'did not':>9}{'ratio':>7}")
    for ev, mn in [("profile_completed", 1), ("monitor_created", 1), ("monitor_created", 3),
                   ("teammate_invited", 1), ("alert_connected", 1)]:
        a, did, rd, rn = con.execute(CANDIDATE_SQL, {"event": ev, "min_n": mn}).fetchone()
        name = ev + (f" >= {mn}" if mn > 1 else "")
        print(f"{name:<26}{did:>7}{rd:>8.1f}%{rn:>8.1f}%{rd / rn:>7.1f}")
    print()

    curves = {0: [], 1: []}
    for seg, wk, pct in con.execute(CURVE_SQL, {"weeks": WEEKS}):
        curves[seg].append(pct)
    total = [r[1] for r in rows]
    allc = [round(sum(r[2 + w] * r[1] for r in rows) / sum(total), 1) for w in range(WEEKS + 1)]
    print("Retention curve (% active in week N), all users and by activation (alert channel in the first 7 days)")
    print(f"{'segment':<16}" + "".join(f"{'w' + str(w):>6}" for w in range(WEEKS + 1)))
    for name, c in [("all", allc), ("activated", curves[1]), ("not activated", curves[0])]:
        print(f"{name:<16}" + "".join(f"{v:>6.1f}" for v in c))
    print()

    print("Churn: of the users active in week N-1, how many had no session in week N (and who came back)")
    for w in (1, 2, 4, 8):
        prev, lost, back = con.execute(CHURN_SQL, {"w": w}).fetchone()
        print(f"  week {w - 1} -> {w}: active {prev:>4}, did not return {lost:>4} ({100 * lost / prev:4.1f}%),"
              f" came back after a quiet week {back:>3}   curve change {allc[w] - allc[w - 1]:+.1f} points")
    lifetime = sum(allc) / 100
    print(f"  active weeks per signup over weeks 0..{WEEKS}: {lifetime:.2f}")
    with open("curves.json", "w") as f:
        json.dump({"weeks": list(range(WEEKS + 1)), "all": allc, "activated": curves[1], "not_activated": curves[0]}, f)
    print("wrote curves.json")


if __name__ == "__main__":
    {"make": make, "report": report}[sys.argv[1]]()
في الكود أعلاه لاحظ التالي:
- جدول
signupيحفظ وقت تسجيل كل مستخدم ومجموعته، والمجموعة هي يوم الإثنين من أسبوع التسجيل، وتحسبها الدالةdate(ts, '-6 days', 'weekday 1')في SQLite، وفي PostgreSQL تكتبهاdate_trunc('week', ts). - جدول
activeيحسب رقم الأسبوع بعد التسجيل لكل جلسة، ثم يأخذ القيم المختلفة فقط بـDISTINCT، لأن المستخدم الذي دخل عشر مرات في أسبوع واحد يعد مرة واحدة. - بنينا الجداول المساعدة مرة واحدة كجداول مؤقتة TEMP TABLE مع فهرس Index، والسبب أنك إذا كتبتها كـ CTE داخل كل استعلام فإن SQLite تعيد حسابها لكل سطر في الربط Join، وعندها يتجاوز التقرير دقيقتين على سجل من 35 ألف حدث فقط بدل ثوان.
- استعلام المرشحين
CANDIDATE_SQLيقارن مجموعتين لكل فعل: من قام به في أول 7 أيام ومن لم يقم به، ويقيس العودة في الأسبوع الرابع لكل منهما.
ونشغل السكربت في Container مؤقت من Docker Image الرسمية لـ Python:
docker run --rm --name mki-retention -v "$(pwd)":/lab -w /lab python:3.13.17-slim \
sh -c "python --version && python -c 'import sqlite3;print(\"SQLite\", sqlite3.sqlite_version)' && python retention.py make && python retention.py report"MSYS_NO_PATHCONV=1 قبل الأمر واستبدل $(pwd) بـ $(pwd -W)، والسبب أن Git Bash يحول المسارات التي تبدأ بـ / إلى مسارات Windows فيفشل ربط المجلد.والمخرج سوف يكون كما يلي:
Python 3.13.17
SQLite 3.46.1
wrote 34661 events for 3324 users to events.db
Weekly cohorts: % of the cohort with a session in week N after signup
cohort      users    w0    w1    w2    w3    w4    w5    w6    w7    w8    w9   w10
2026-06-01    321 100.0  32.4  24.3  17.8  14.6  15.3  12.5  13.1  16.8  10.3  16.2
2026-06-08    337 100.0  35.3  23.4  13.6  13.6  15.4  12.8  12.8  13.1  13.4  11.9
2026-06-15    322 100.0  34.2  24.5  14.6  14.0  14.3  12.1  13.0  12.1  12.7  13.4
2026-06-22    359 100.0  35.7  22.0  19.2  16.2  16.4  13.6  12.0  17.3  16.2  13.6
2026-06-29    317 100.0  33.8  21.1  14.5  14.8  12.6  10.4  10.1  13.2  10.7   9.1
2026-07-06    327 100.0  29.7  21.4  16.2  16.8  15.0  15.9  15.3  11.9  14.1  11.3
2026-07-13    360 100.0  40.6  23.3  22.5  20.0  16.1  18.1  21.1  16.7  17.2  17.2
2026-07-20    305 100.0  37.0  26.6  24.6  19.3  18.0  18.4  15.4  16.4  13.8  14.8
2026-07-27    358 100.0  35.2  29.3  26.0  20.4  15.4  17.6  19.6  15.9  15.9  18.2
2026-08-03    318 100.0  38.1  28.9  25.8  22.3  18.6  14.8  16.4  16.0  16.0  11.3
average week 4: cohorts before the checklist 15.0%  from the checklist on 20.5%
average week 8: cohorts before the checklist 14.1%  from the checklist on 16.3%

Activation candidates: action in the first 7 days -> active in week 4
action                      users      did  did not  ratio
profile_completed            1818    16.7%    17.9%    0.9
monitor_created              1967    19.7%    13.7%    1.4
monitor_created >= 3          696    24.7%    15.3%    1.6
teammate_invited              448    31.0%    15.1%    2.1
alert_connected              1179    39.2%     5.2%    7.5

Retention curve (% active in week N), all users and by activation (alert channel in the first 7 days)
segment             w0    w1    w2    w3    w4    w5    w6    w7    w8    w9   w10
all              100.0  35.2  24.5  19.5  17.2  15.7  14.7  15.0  15.0  14.1  13.8
activated        100.0  58.9  46.8  39.7  39.2  34.7  31.6  33.2  33.6  32.0  30.1
not activated    100.0  22.2  12.2   8.4   5.2   5.3   5.4   4.9   4.8   4.3   4.8

Churn: of the users active in week N-1, how many had no session in week N (and who came back)
  week 0 -> 1: active 3324, did not return 2153 (64.8%), came back after a quiet week   0   curve change -64.8 points
  week 1 -> 2: active 1171, did not return  790 (67.5%), came back after a quiet week 433   curve change -10.7 points
  week 3 -> 4: active  649, did not return  456 (70.3%), came back after a quiet week 380   curve change -2.3 points
  week 7 -> 8: active  497, did not return  352 (70.8%), came back after a quiet week 353   curve change +0.0 points
  active weeks per signup over weeks 0..10: 2.85
wrote curves.json
وسوف نقرأ المخرج على أربعة أجزاء، كل جزء يجيب عن سؤال.
هل تحسنت المجموعات الجديدة؟
الصورة التالية ترسم الجزء الأول من المخرج كجدول ملون، كل صف مجموعة وكل عمود أسبوع:
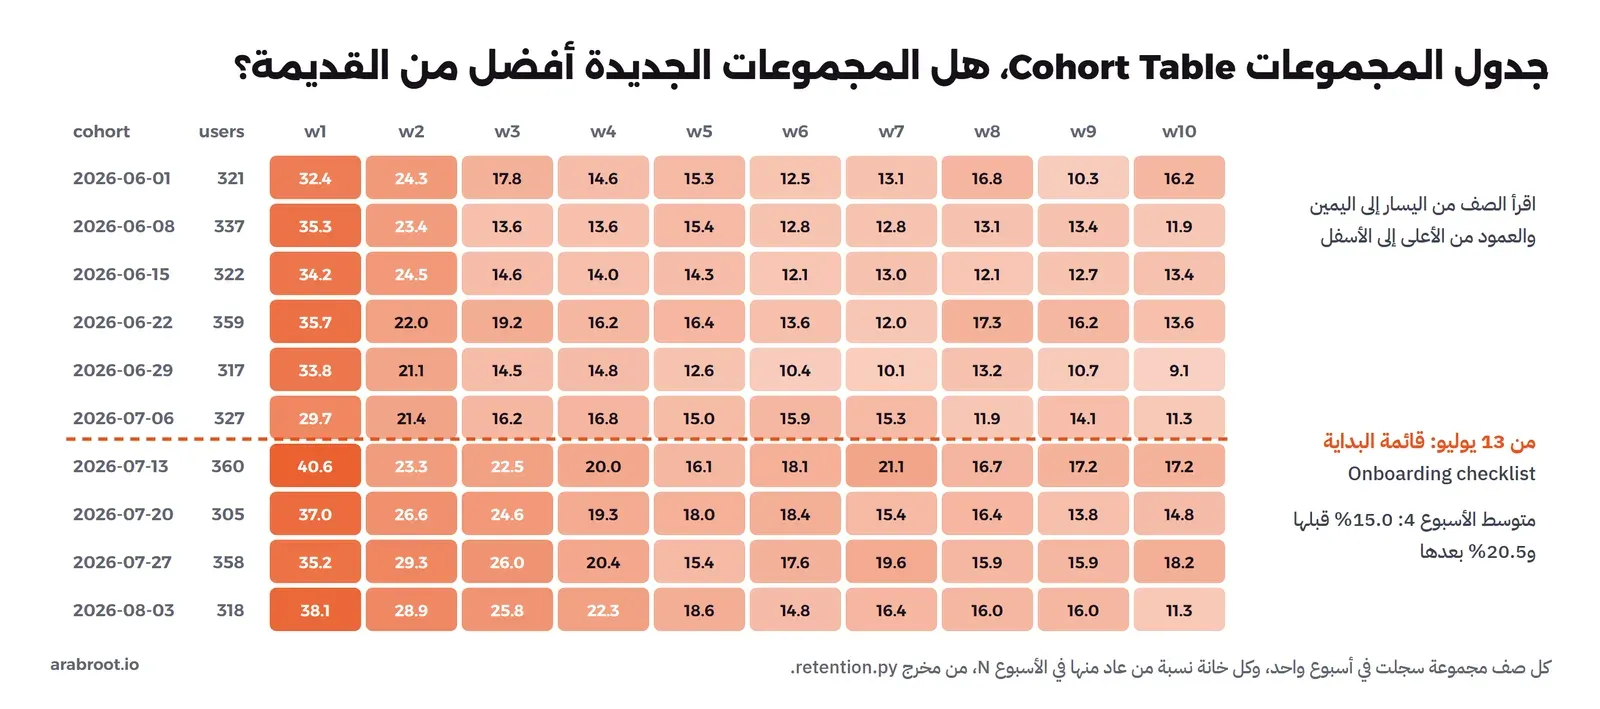
متوسط العودة في الأسبوع الرابع كان 15.0% للمجموعات قبل قائمة خطوات البداية و20.5% بعدها، وفي الأسبوع الثامن 14.1% مقابل 16.3%. والفرق في الأسبوع الثامن أصغر، ولاحظ أن الخانات تتذبذب بين أسبوع وآخر بنقطتين أو ثلاث في نفس المجموعة، والسبب أن كل مجموعة فيها حوالي 330 مستخدماً فقط، فلا تحكم على تغيير من خانة واحدة، وانظر إلى عدة مجموعات وعدة أسابيع معاً.
أي فعل يصنع الفرق؟
الجزء الثاني من المخرج هو جدول المرشحين، والعمود الأخير ratio يقسم عودة من قام بالفعل على عودة من لم يقم به:
- إكمال الملف الشخصي
profile_completed: النسبة 0.9، أي لا فرق تقريباً، فلا تضعه في التهيئة كخطوة إلزامية لأنه يؤخر المستخدم ولا ينفعه. - إضافة خادم
monitor_created: النسبة 1.4، وترتفع إلى 1.6 لمن أضاف ثلاثة أو أكثر، فهو فعل مفيد ولكنه ليس اللحظة الحاسمة. - دعوة زميل
teammate_invited: النسبة 2.1، وهي إشارة قوية، ولكن 448 مستخدماً فقط من 3324 قاموا بها. - ربط قناة التنبيه
alert_connected: 39.2% عادوا في الأسبوع الرابع مقابل 5.2%، أي أكثر بسبع مرات ونصف، وقام به 1179 مستخدماً، وهذا هو المرشح الأقوى للحظة التفعيل.
وهذه النتيجة منطقية في أداة مراقبة، لأن القيمة لا تظهر إلا عندما يصلك تنبيه، فالمستخدم الذي أضاف عشرة خوادم ولم يربط التنبيه لن يعرف أن سيرفره توقف إلا إذا فتح اللوحة بنفسه، وعندها لا فرق بين الأداة وبين أن يفحص السيرفر يدوياً.
منحنى من وصل ومنحنى من لم يصل
الجزء الثالث من المخرج يرسم منحنى الاحتفاظ لكل المستخدمين ولكل شريحة، والصورة التالية ترسمه:
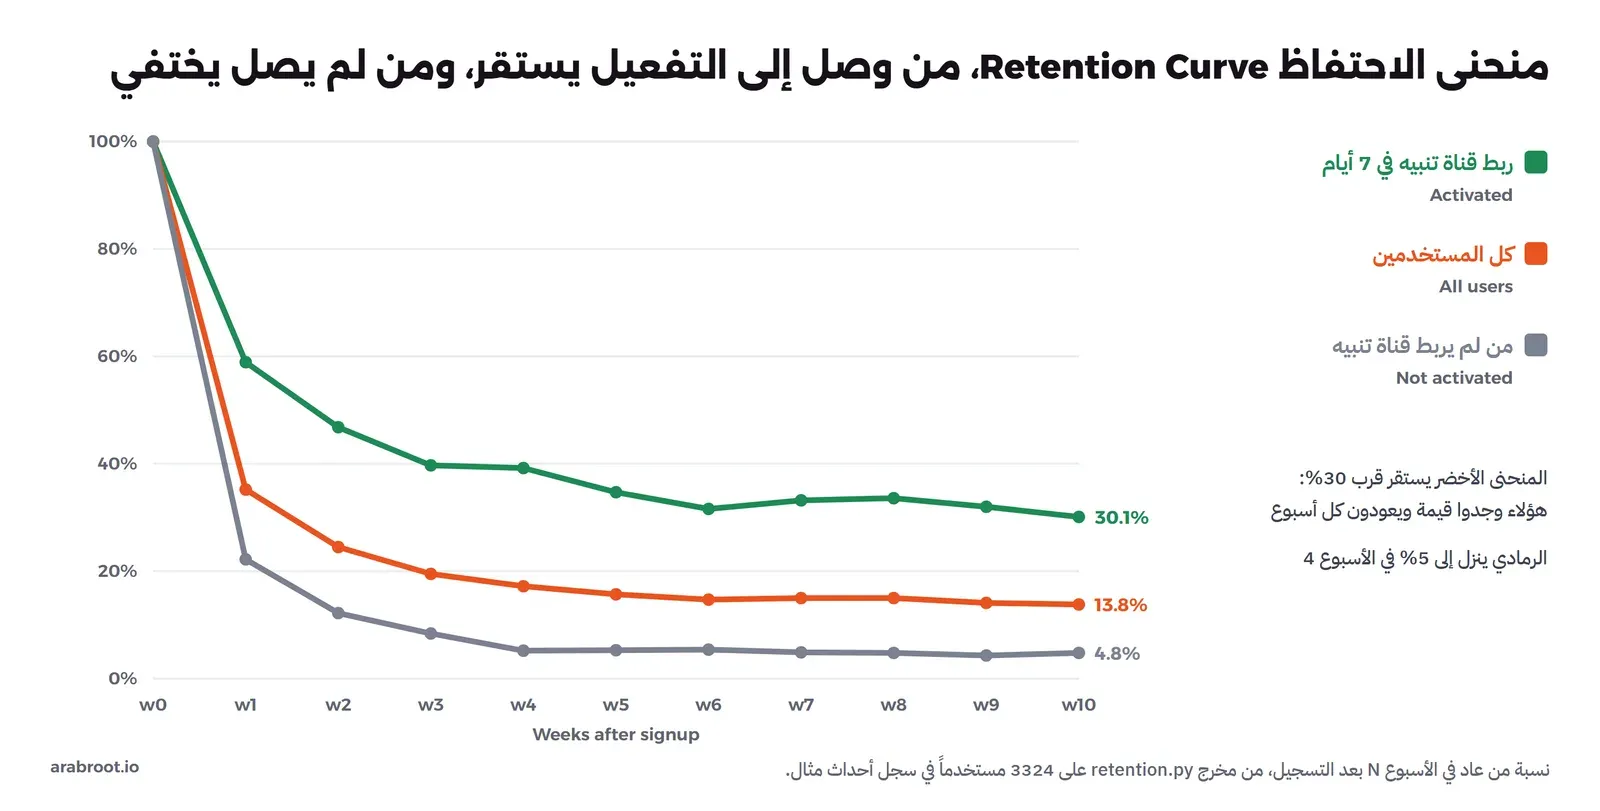
ولاحظ أن المنحنى العام، أي البرتقالي، يستقر قرب 14%، وقد تظن أن هذا رقم متوسط لمنتج متوسط، ولكن الحقيقة أن عندك مجموعتين: من وصل إلى التفعيل ويبقى منه 30% بعد عشرة أسابيع، ومن لم يصل ويبقى منه أقل من 5%. وبالتالي فإن رفع نسبة من يصل إلى التفعيل من 35% إلى 45% مثلاً يرفع المنحنى العام كله، دون أن تغير شيئاً في المنتج نفسه بعد التفعيل.
نجرب العطل: المنحنى المستقر الذي يخفي التسرب
في الجزء الأخير من المخرج حسبنا التسرب Churn بطريقتين، والفرق بينهما مهم. فإذا نظرت إلى المنحنى العام بين الأسبوع السابع والثامن وجدت أنه لم يتغير، 15.0% في الأسبوعين، فتظن أن لا أحد غادر. ولكن عندما نحسب من كان نشطاً في الأسبوع السابع ولم يعد في الثامن نجد 352 مستخدماً من 497، أي 70.8%، وفي نفس الوقت عاد 353 مستخدماً كانوا غائبين في الأسبوع السابع، فتساوى الرقمان وبقي المنحنى ثابتاً.
وهذا يعني أن مستخدمي هذا المنتج لا يدخلون كل أسبوع، وإنما يدخلون عندما يصلهم تنبيه، وهذا طبيعي في أداة مراقبة. والدرس هنا أمران:
- اختر فترة القياس التي تناسب طريقة استخدام المنتج، فأداة يستخدمها الناس مرة في الشهر لا تقاس بالعودة الأسبوعية، لأنها سوف تبدو سيئة وهي ليست كذلك.
- المنحنى يقيس الصافي Net، أي من خرج ناقص من عاد، فإذا أردت أن تفهم سلوك المستخدمين فاحسب الخروج والعودة كلاً على حدة، والمستخدمون الذين يعودون بعد غياب Resurrected لهم قصة مختلفة عمن لم يغادر أصلاً.
وأخيراً احذف ملف قاعدة البيانات الذي أنشأه السكربت، فالـ Container يحذف نفسه بسبب --rm:
rm events.db curves.jsonالتسرب Churn: الأرقام التي تهم الإدارة
في المنتجات المدفوعة يتحول الاحتفاظ إلى سؤال مالي: كم عميلاً يلغي اشتراكه كل شهر؟ وهنا ثلاثة مقاييس تسمعها كثيراً:
| المقياس | كيف يحسب | ماذا يقول |
|---|---|---|
| تسرب العملاء Logo Churn | العملاء الذين ألغوا في الشهر ÷ العملاء في بداية الشهر | كم عميلاً تخسر، بغض النظر عن حجمه |
| تسرب الإيراد Revenue Churn | الإيراد الشهري المفقود من الإلغاء والتخفيض ÷ الإيراد في بداية الشهر | كم من المال تخسر، فخسارة عميل كبير أسوأ من عشرة صغار |
| صافي الاحتفاظ بالإيراد Net Dollar Retention | إيراد نفس العملاء بعد سنة ÷ إيرادهم قبل سنة، شاملاً الترقيات | هل يكبر العملاء الحاليون أسرع مما يغادر غيرهم |
وقد يبدو التسرب الشهري صغيراً، ولكنه يتراكم: فإذا كان 5% في الشهر، فإن ما يبقى بعد سنة هو 0.95 مرفوعة للقوة 12، أي 54%، وبالتالي تخسر 46% من عملائك في السنة، وتحتاج أن تكسب نصف قاعدة عملائك كل سنة فقط لكي تبقى في مكانك. وفي المقابل ذكرت Slack في نشرة الاكتتاب S-1 سنة 2019 أن صافي الاحتفاظ بالإيراد عندها كان 143% في 31 يناير 2019، أي أن نفس العملاء دفعوا بعد سنة 43% أكثر رغم من غادر منهم، وذلك لأن استخدام Slack ينتشر داخل الشركة الواحدة من فريق إلى فريق.
أخطاء شائعة
- اعتبار التسجيل تفعيلاً: يرتفع الرقم مع كل حملة تسويق ولا يقول شيئاً عن القيمة، والتفعيل يجب أن يكون فعلاً يثبت أن المستخدم رأى المنتج يعمل.
- اختيار لحظة التفعيل بالرأي: قارن العودة لكل فعل مرشح كما فعلنا في التجربة، ثم اختبر المرشح الأقوى بتجربة قبل أن تبني عليه التهيئة كلها.
- عد الأحداث بدل المستخدمين: المستخدم الذي دخل عشر مرات في أسبوع واحد يعد مرة واحدة في منحنى الاحتفاظ، وإلا ارتفعت النسب فوق الواقع.
- فترة قياس لا تناسب المنتج: العودة اليومية لتطبيق محادثة، والأسبوعية لأداة عمل، والشهرية لأداة فوترة، والخطأ في الفترة يجعل منتجاً جيداً يبدو سيئاً.
- الإنفاق على الاكتساب قبل أن يستقر المنحنى: إذا كانت كل مجموعة تنزل إلى الصفر، فكل ريال في الإعلانات يجلب مستخدمين سوف يغادرون، فأصلح الاحتفاظ أولاً.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- التفعيل هو أول قيمة حقيقية يحصل عليها المستخدم، ويعرف بحدث محدد في مدة محددة، والتسجيل ليس تفعيلاً.
- ابحث عن لحظة التفعيل بمقارنة العودة لكل فعل مرشح، ففي التجربة عاد 39.2% ممن ربطوا قناة التنبيه مقابل 5.2% ممن لم يربطوها، ثم أثبت السبب بتجربة A/B.
- التهيئة الجيدة تختصر الطريق إلى لحظة التفعيل، ولا تشرح كل الميزات.
- المنحنى الذي يستقر هو علامة أن المنتج يحل مشكلة حقيقية، وارسمه لكل شريحة لأن المتوسط يخفي الفرق.
- المنحنى يقيس الصافي، وقد يبقى ثابتاً بينما يخرج 70% من النشطين ويعود غيرهم، فاحسب الخروج والعودة كلاً على حدة.
وفي المقالات التالية من هذه المرحلة بإذن الله سوف نشرح كيف يجلب المستخدم الراضي مستخدماً آخر، ثم كيف تختبر تغييراً مثل قائمة خطوات البداية بتجربة حقيقية:
 دليلتسويق النمو Growth Marketing: مقاييس AARRR وحلقات النموكيف يعمل فريق النمو على كل مرحلة من مسار المستخدم، ولماذا تنمو الشركات بالحلقات لا بالقمع، وكم تجربة تحتاج.
 دليلالنمو بقيادة المنتج Product-Led Growth: متى يبيع المنتج نفسه؟كيف تبيع Slack وDropbox وAtlassian وFigma بالمنتج قبل المبيعات، والتجربة المجانية مقابل النسخة المجانية، والعميل المؤهل PQL.
 دليلبرامج الإحالة Referral: كيف يجلب المستخدم مستخدماً آخرمتى يجلب برنامج الإحالة نمواً حقيقياً، وكيف تحسب معامل الانتشار K وتكلفة المكافأة، وتفحص الاحتيال قبل أن تدفع.
 دليلتجارب النمو عملياً: من الفرضية إلى القرار بالأرقامنبني مختبر GrowthBook في Docker ونختبر قائمة خطوات البداية بزيارات محاكاة، من حجم العينة إلى قرار نتيجة غير حاسمة.
 دليلتحليلات المنتج Product Analytics مع PostHog على سيرفركنشغل PostHog على سيرفرنا ونتتبع المستخدم من أول زيارة إلى أول فاتورة، ونقيس ما يحتاجه من ذاكرة ووقت إقلاع.
 دليلأنظمة التسويق الرقمي Digital Marketing في السعوديةما تشترطه الأنظمة السعودية في موافقة العميل والرسائل التسويقية والإعلان الإلكتروني وإعلانات المؤثرين، وكيف تطبقه في الكود.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، مع تجربة حساب جدول المجموعات ومنحنيات الاحتفاظ ولحظة التفعيل والتسرب بسكربت Python 3.13.17 وSQLite 3.46.1 في Docker على سجل أحداث مثال.