


شركة ناشئة تبيع أجهزة المطابخ بدأت بمكتب واحد وRouter واحد، وكان جدول التوجيه فيه سطرين: الشبكة الداخلية، والبوابة الافتراضية إلى المزود. ثم افتتحت مستودعاً في مكان آخر، فربطت المكتب بالمستودع بخط ألياف، وأضاف مسؤول الشبكة مساراً ثابتاً في كل جهة. وبعد شهرين انقطع خط الألياف ساعة كاملة، فاشترت الشركة خطاً احتياطياً أبطأ يمر عبر موقع ثالث، وأضاف المسؤول مسارات ثابتة جديدة بأولوية أقل. والآن أصبح عنده أربعة أجهزة Router، وكل جهاز يحتاج أن يعرف كل الشبكات، وكلما أضاف شبكة فرعية جديدة عدل أربعة جداول، وفي الانقطاع الأخير بقيت الحركة متوقفة لأن الخط سقط من جهة المزود بينما بقيت واجهة ال Router مضاءة، فلم يعرف الجدول الثابت شيئاً.
هذه بالضبط اللحظة التي تحتاج فيها الشبكة أن تتعلم طرقها بنفسها، وهذا هو التوجيه الديناميكي Dynamic Routing: برنامج على كل Router يتحدث مع جيرانه، ويعرف منهم الشبكات الموجودة وحالة الروابط، ويغير جدول التوجيه عندما يتغير شيء. وقد شرحنا في مقال التوجيه وجدول التوجيه كيف يقرر الجهاز بأطول بادئة مطابقة وكيف تكتب المسارات الثابتة، ومر ذكر BGP في مقال وصول الإنترنت إلى بيتك، وهذا المقال يكمل من حيث توقفا، وسوف نناقش فيه ما يلي:
- متى تصبح المسارات الثابتة Static Routes عبئاً، وما الأنواع الثلاثة لبروتوكولات التوجيه: متجه المسافة Distance Vector وحالة الرابط Link State ومتجه المسار Path Vector.
- OSPF من الداخل: الجيران Neighbors ورسائل Hello، وحالات بناء العلاقة، وإعلانات حالة الرابط LSAs وقاعدة البيانات LSDB، والكلفة Cost وحساب أقصر طريق SPF، والمناطق Areas.
- مختبر بأربعة Routers من FRRouting في Containers: نشغل OSPF ونراقب الجدول وهو يتقارب Convergence ثانية بثانية، ثم نقطع رابطاً ونقيس كم تتوقف الحركة، مرة مع واجهة تسقط ومرة مع فشل صامت، ثم مع BFD.
- BGP: الأنظمة المستقلة AS، ولماذا يعمل الإنترنت به وليس ب OSPF، ثم جلسة eBGP صغيرة بين شبكتين، وما يحدث عندما يعلن جار جزءاً من شبكتك.
- جدول يساعدك أن تختار بين الثابت وOSPF وBGP، والأخطاء الشائعة، وقائمة تحقق.
ما المشكلة في المسارات الثابتة؟
المسار الثابت سطر تكتبه بيدك: «للوصول إلى الشبكة كذا أرسل إلى الجهاز كذا». وهو ممتاز في شبكة صغيرة لا تتغير، فهو لا يستهلك شيئاً من المعالج، ولا يرسل حزمة واحدة على الشبكة، وتعرف بالضبط ما فيه لأنك كتبته. ولكن له ثلاث مشكلات تكبر مع كل جهاز تضيفه.
الأولى أن عدد السطور يكبر بسرعة. فإذا كان عندك أربعة أجهزة Router وعشر شبكات فكل جهاز يحتاج سطراً لكل شبكة ليست متصلة به، وطريقاً للعودة أيضاً عند الطرف الآخر، وهو السطر الذي ينساه الجميع كما في قسم طريق العودة. وكل شبكة جديدة تعني تعديل كل الأجهزة، وكل تعديل فرصة لخطأ إملائي في قناع أو عنوان.
والثانية أن المسار الثابت لا يعرف شيئاً عن حالة الطريق. فإذا سقط الرابط وكانت الواجهة نفسها تعرف ذلك، أزال النظام المسار المتصل بها، ولكن إذا سقط الجهاز التالي أو انقطع الخط عند المزود وبقيت الواجهة مضاءة، بقي المسار في الجدول وضاعت الحزم فيه. وتستطيع أن تضيف مساراً احتياطياً بمقياس Metric أكبر، ولكنه لن يعمل إلا إذا اختفى المسار الأساسي، وهو لن يختفي.
والثالثة أن الشبكة لا تعرف الطريق الأفضل إلا كما رسمته أنت في ذهنك يوم كتبت السطور. فإذا أضفت رابطاً أسرع بين موقعين فلن يستخدمه أحد حتى تعدل الجداول، وإذا كانت هناك طريقان متساويتان فلن تتوزع الحركة عليهما إلا إذا كتبت ذلك بيدك.
والتوجيه الديناميكي يحل الثلاث: يعلن كل جهاز ما يعرفه، فتنتشر الشبكة الجديدة إلى الجميع، ويراقب الجيران بعضهم بعضاً فيعرف الجميع عندما يختفي جار، ويحسب كل جهاز الطريق الأفضل من جديد. والثمن أن عندك الآن برنامجاً يعمل على كل Router، وحزماً تدور على الشبكة طوال الوقت، وقرارات تتخذها الأجهزة بنفسها، وكلها أشياء تحتاج أن تفهمها حتى تثق بها وتشخصها.
أنواع بروتوكولات التوجيه
قبل أن نختار بروتوكولاً نحتاج تقسيمين. التقسيم الأول بحسب المكان: بروتوكولات داخل شبكة تديرها جهة واحدة، وتسمى Interior Gateway Protocols واختصاراً IGP، مثل OSPF وIS-IS وRIP، وهدفها أن تجد أسرع طريق داخل شبكتك وأن تتقارب بسرعة عند العطل. وبروتوكولات بين شبكات جهات مختلفة، وتسمى Exterior Gateway Protocols، وهي اليوم BGP وحده، وهدفه ليس أسرع طريق، وإنما أن تطبق كل جهة سياستها: من تقبل منه، ولمن تعلن، وأي طريق تفضل.
والتقسيم الثاني بحسب طريقة التفكير، وهو الذي يفسر سلوك كل بروتوكول:
| النوع | ماذا يرسل كل Router | ماذا يعرف | مثال |
|---|---|---|---|
| متجه المسافة Distance Vector | جدوله: «أصل إلى الشبكة كذا بمسافة كذا» | ما قاله جيرانه فقط، كأنه يسأل عن الطريق في الشارع | RIP |
| حالة الرابط Link State | وصف روابطه هو وكلفة كل رابط | خريطة كاملة للشبكة، متطابقة عند الجميع | OSPF وIS-IS |
| متجه المسار Path Vector | البادئات ومعها قائمة الأنظمة التي مرت بها | المسار كاملاً على مستوى الشبكات، لا على مستوى الأجهزة | BGP |
وRIP مثال جيد على حدود الطريقة الأولى، فكما في RFC 1058 يقيس المسافة بعدد أجهزة Router في الطريق فقط، وهو ما يسمى Hop Count، ويعتبر الرقم 16 لا نهاية، فلا تتجاوز شبكته 15 Router في الطريق، ولا يفرق بين خط ألياف وخط بطيء، وعند العطل قد تتبادل الأجهزة معلومات قديمة فترة حتى يستقر الجدول، وهي المشكلة المعروفة بالعد إلى اللانهاية Count to Infinity. ولذلك تجده اليوم في شبكات صغيرة قديمة، أما الشبكات الجديدة داخل الشركات فتستخدم OSPF في الغالب، وهو موضوع الجزء الأكبر من هذا المقال.
OSPF: كيف يبني كل Router خريطة الشبكة؟
الاسم Open Shortest Path First، والنسخة المستخدمة مع IPv4 هي OSPFv2 الموصوفة في RFC 2328، ولها أخت ل IPv6 هي OSPFv3 في RFC 5340. وفكرته بسيطة إذا قسمتها إلى ثلاث خطوات: كل Router يكتشف جيرانه، ثم ينشر إلى الجميع وصفاً لروابطه، ثم يحسب كل Router من الخريطة التي تجمعت عنده أقصر طريق إلى كل شبكة. وكل خطوة لها رسائلها وتوقيتاتها، وكل مشكلة في OSPF تقع في واحدة منها.
الجيران ورسائل Hello
كل Router يرسل على كل واجهة فعل عليها OSPF رسالة Hello إلى العنوان المتعدد 224.0.0.5 الذي تستمع إليه كل أجهزة OSPF، ولا يستخدم TCP ولا UDP، وإنما بروتوكول IP رقمه 89 كما في المعيار. والرسالة تقول: «أنا Router رقمه كذا، في المنطقة كذا، وأرسل Hello كل 10 ثوان، وأعتبر جاري ميتاً إذا لم أسمعه 40 ثانية، وهؤلاء الجيران الذين أسمعهم». والتطابق في بعض هذه الحقول شرط، فإذا اختلف رقم المنطقة أو قناع الشبكة أو مدتا Hello وDead بين جهازين على الرابط نفسه، فلن يصبحا جارين أبداً، ولن تجد رسالة خطأ واضحة إلا إذا قرأت السجل.
والقائمة في آخر الرسالة هي التي تبني الثقة في الاتجاهين: عندما يرى r1 رقمه في Hello القادم من r2 يعرف أن r2 يسمعه أيضاً، فالرابط يعمل في الاتجاهين. وهذا مهم لأن الروابط أحياناً تعمل في اتجاه واحد، مثل ألياف تعطلت شعرة الإرسال فيها، فيظن كل جهاز أن جاره صامت وليس أن الرابط معطل.
من Init إلى Full: كيف يصبح Router جاراً لآخر
العلاقة بين جارين تمر بحالات تراها في الأمر show ip ospf neighbor، ومعرفة معناها تختصر عليك نصف التشخيص:
- Init: وصلني Hello من الجار، ولكني لم أر اسمي فيه بعد.
- 2-Way: رأيت اسمي في Hello جاري، فالاتصال في الاتجاهين. وعلى الشبكات من نوع Broadcast قد تبقى العلاقة هنا عمداً، كما سنرى في قسم DR.
- ExStart وExchange: يتفق الجاران على من يبدأ، ثم يتبادلان ملخص ما في قاعدة كل منهما برسائل Database Description، ويقارن كل طرف القائمة بما عنده.
- Loading: يطلب كل طرف ما ينقصه بالتفصيل برسائل Link State Request، ويأتيه الجواب في Link State Update.
- Full: القاعدتان متطابقتان، والعلاقة مكتملة، ومن الآن يتبادلان التغييرات فقط.
فإذا رأيت جاراً عالقاً في Init فالمشكلة غالباً أن Hello يصل في اتجاه واحد، كجدار ناري يمنع البروتوكول 89 في اتجاه أو ACL على الواجهة، وإذا رأيته عالقاً في ExStart أو Exchange فأول ما تفحصه هو MTU، وسوف نصنع هذه المشكلة بأيدينا في المختبر.
إعلانات حالة الرابط LSA وقاعدة البيانات LSDB
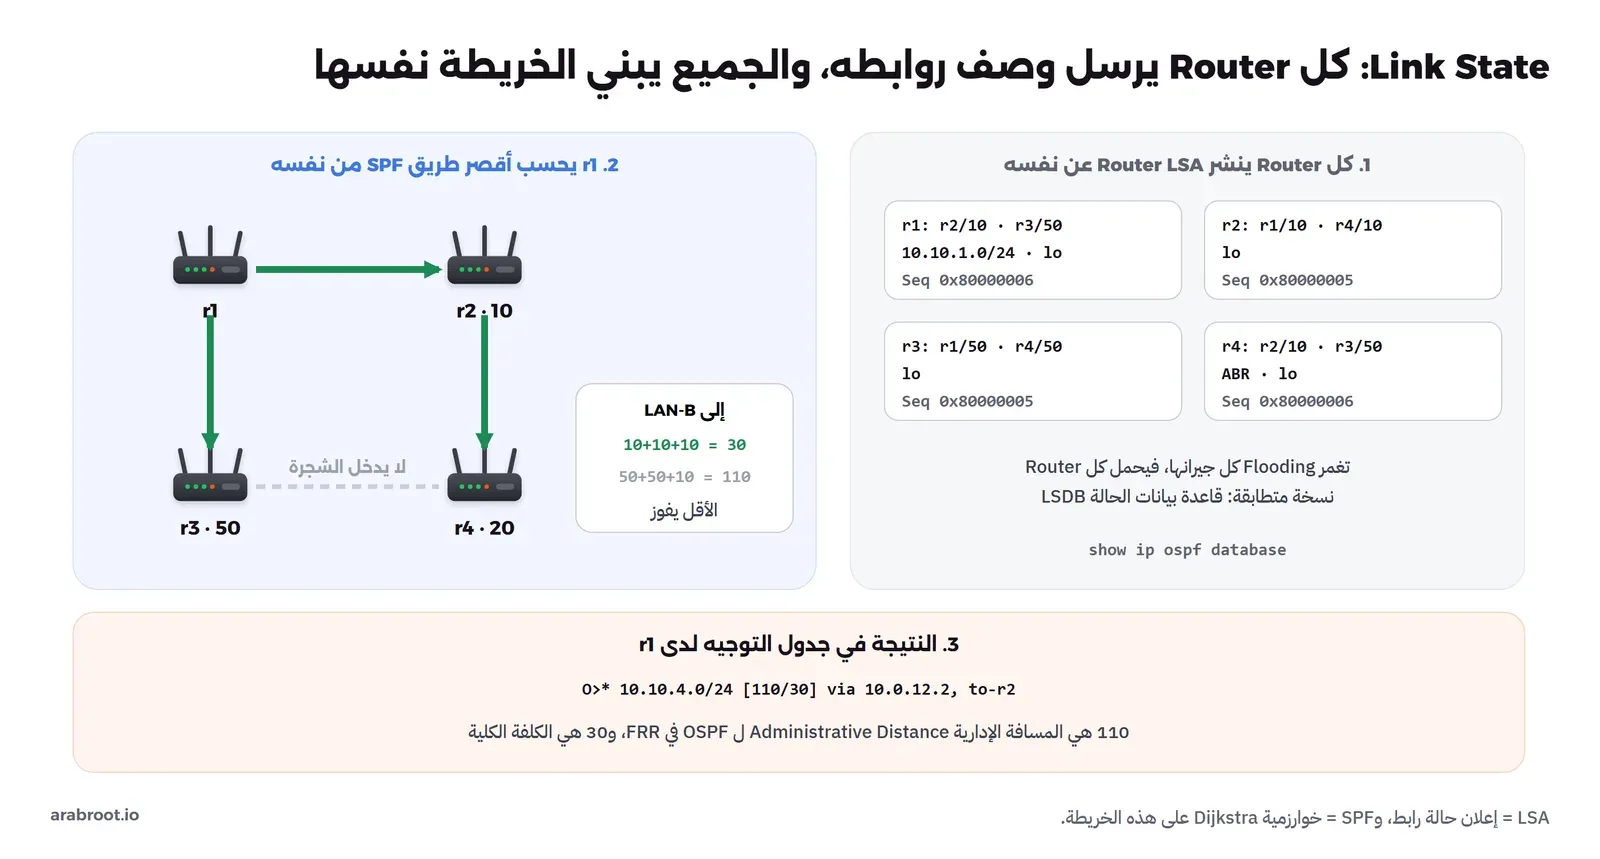
بعد أن يكتمل الجوار يصف كل Router نفسه في إعلان اسمه Router LSA: هذه روابطي، وهذا الجار على كل رابط، وهذه كلفة كل رابط، وهذه الشبكات المتصلة بي. ويرسل هذا الإعلان إلى جيرانه، وكل جار يرسله إلى جيرانه، حتى يصل إلى كل Router في المنطقة، وهذا اسمه الإغراق Flooding. ولكل إعلان رقم تسلسل Sequence Number يزيد كلما تغير، فإذا وصل إلى Router إعلان يعرفه برقم أقدم تجاهله، وبهذا لا تدور الإعلانات القديمة بلا نهاية. وكل إعلان يتجدد من صاحبه كل 30 دقيقة حتى لو لم يتغير شيء، ويحذف إذا بلغ عمره ساعة دون تجديد.
والنتيجة أن كل Router في المنطقة يحمل مجموعة الإعلانات نفسها، وهي قاعدة بيانات حالة الروابط Link State Database، أي خريطة كاملة للشبكة متطابقة عند الجميع. وهذا الفرق الأساسي عن RIP: لا أحد يصدق جاره في «أفضل طريق»، وإنما يصدقه في وصف روابطه هو فقط، ثم يحسب الطريق بنفسه.
الكلفة Cost وحساب أقصر طريق SPF
من الخريطة يحسب كل Router شجرة أقصر الطرق من نفسه إلى كل نقطة بخوارزمية Dijkstra، والاسم في OSPF هو Shortest Path First. و«الأقصر» هنا بمجموع الكلفة لا بعدد الأجهزة في الطريق، ولكل واجهة كلفة، والطريق الفائز هو الأقل مجموعاً. والكلفة إما تكتبها بيدك بالأمر ip ospf cost، وإما يحسبها البرنامج بقسمة عرض نطاق مرجعي Reference Bandwidth على سرعة الواجهة. والمشكلة في الحساب التلقائي أن المرجع الافتراضي القديم 100 Mbit/s، فكل واجهة بسرعة 100 Mbit/s أو أكثر تأخذ الكلفة 1، فلا يفرق البروتوكول بين 1 Gbit/s و10 Gbit/s، لذلك تكتب أغلب الشبكات الكلفة بيدها أو ترفع المرجع على كل الأجهزة معاً، كما يقول توثيق ospfd في FRR: هذا الإعداد يجب أن يتطابق على كل Router في النطاق.
وإذا تساوى طريقان في الكلفة يضعهما OSPF في الجدول معاً، فتتوزع الحركة عليهما، وهذا اسمه Equal-Cost Multi-Path واختصاراً ECMP، وسوف نراه في المختبر. والحساب سريع: في شبكة المختبر من أربعة أجهزة يعرض show ip ospf أن آخر حساب أخذ 74 ميكروثانية، والذي يأخذ الوقت الحقيقي عند العطل ليس الحساب، وإنما معرفة أن العطل حدث، وهذا ما سيظهره المختبر بوضوح.
لماذا ينتخب OSPF موجهاً مختاراً DR؟
على شبكة يتصل بها أجهزة كثيرة، مثل Switch عليه عشرة أجهزة Router، لو أصبح كل جهاز جاراً كاملاً لكل جهاز آخر لكان عدد العلاقات 45، ولأغرق كل تغيير الشبكة بنسخ مكررة. لذلك ينتخب OSPF على هذا النوع من الشبكات، ويسميه Broadcast، جهازاً مختاراً Designated Router واختصاراً DR، واحتياطياً له BDR، ويصبح كل جهاز جاراً كاملاً لهذين فقط، ويبقى مع البقية في حالة 2-Way. وال DR ينشر إعلاناً من نوع آخر، Network LSA، يصف الشبكة المشتركة ومن عليها.
ولكن هذا الانتخاب له ثمن: قبل أن ينتخب الجهاز ينتظر مدة تسمى Wait Timer تساوي مدة Dead، أي 40 ثانية افتراضياً، حتى يعرف كل المرشحين. وعلى رابط لا يوجد عليه إلا جهازان، وهذا حال أغلب الروابط بين المواقع، لا فائدة من الانتخاب أصلاً، فالحل أن تخبر OSPF بأن الرابط من نقطة إلى نقطة Point-to-Point، فلا ينتخب ولا ينتظر. وسوف نقيس الفرق بين النوعين في المختبر، وهو فرق كبير في هذه الشبكة.
المناطق Areas
كل Router في المنطقة يحمل الخريطة كاملة ويعيد الحساب عند أي تغيير فيها، وهذا جيد في شبكة متوسطة، ولكن في شبكة بمئات الأجهزة يصبح كل رابط يتأرجح في فرع بعيد سبباً لإعادة الحساب في كل مكان. لذلك يقسم OSPF الشبكة إلى مناطق Areas، لكل منطقة خريطتها التفصيلية، والمناطق كلها تتصل بمنطقة مركزية رقمها 0 تسمى العمود الفقري Backbone. والجهاز الذي يقف على حدود منطقتين اسمه Area Border Router واختصاراً ABR، ويرسل إلى كل منطقة ملخصاً عن الأخرى في إعلان من نوع Summary LSA، أي «الشبكة كذا موجودة عندي بكلفة كذا»، دون تفاصيل الروابط. والجهاز الذي يدخل إلى OSPF طرقاً من خارجه، مثل طرق BGP أو مسارات ثابتة، اسمه ASBR، وينشرها في إعلانات External LSA.
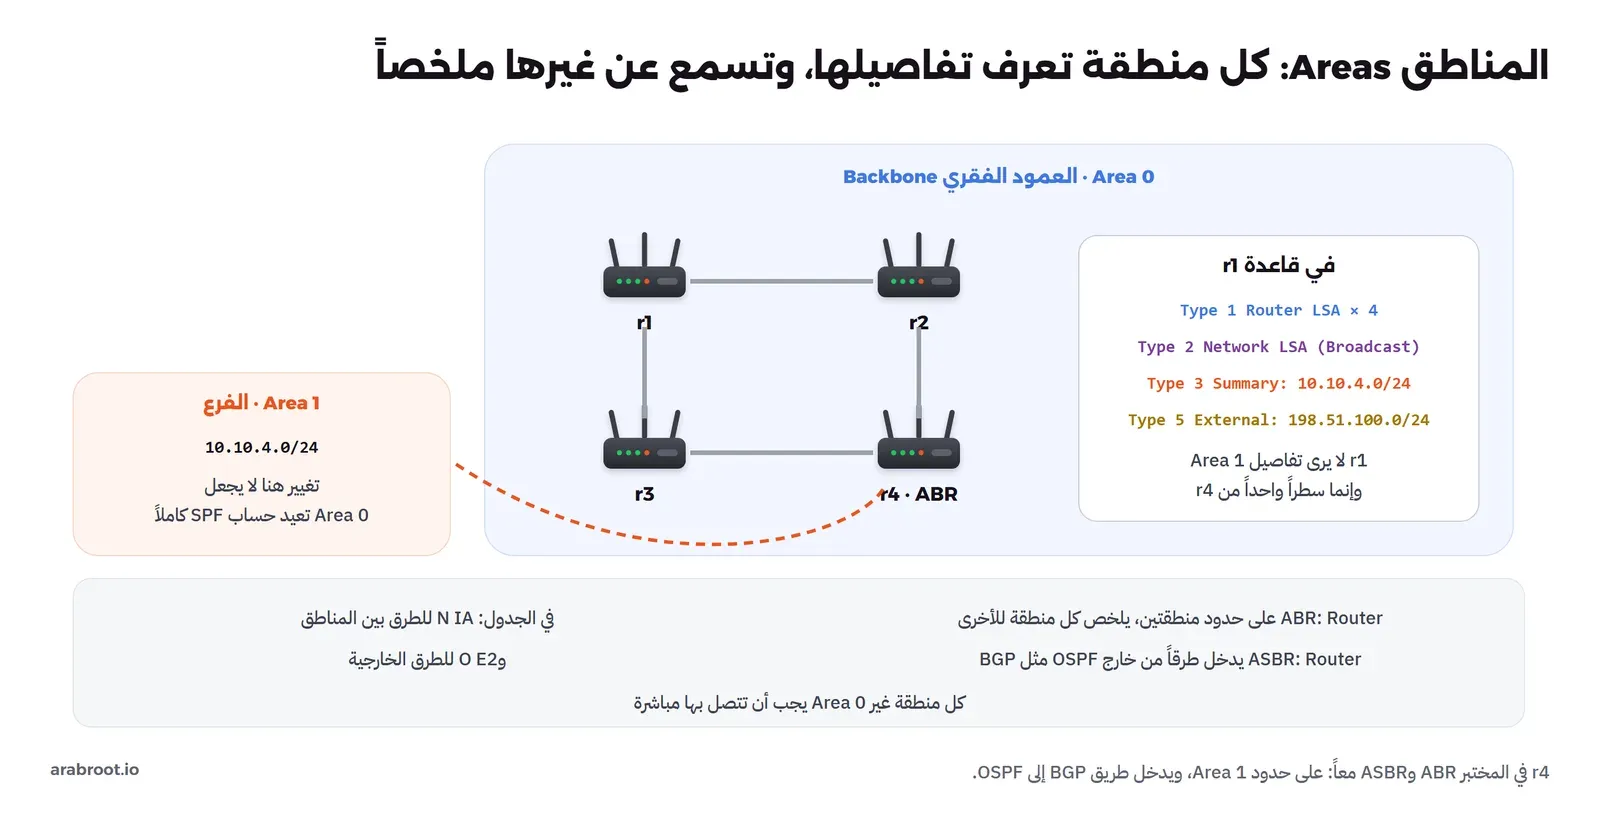
وفي شركة صغيرة أو متوسطة تكفي غالباً منطقة واحدة، فلا تقسم قبل أن تحتاج. وفي المختبر وضعنا شبكة الفرع في Area 1 فقط حتى ترى شكل الإعلان الملخص وكيف يظهر في الجدول.
FRRouting: البرنامج الذي يجعل Linux يتكلم OSPF وBGP
جدول التوجيه في Linux يقبل المسارات من أي مصدر، ولكن النواة لا تتكلم OSPF ولا BGP، وإنما تحتاج برنامجاً يفعل ذلك ويكتب النتيجة في الجدول. وأشهر هذه البرامج المفتوحة هو FRRouting، واختصاراً FRR، وهو كما يقول موقعه امتداد لمشروع Quagga بدأه مطورون قدامى فيه، ويعمل اليوم تحت مظلة Linux Foundation، وتجده داخل أنظمة Router مفتوحة المصدر مثل VyOS. وتصميمه مجموعة برامج صغيرة، لكل بروتوكول برنامج، وكلها تتكلم مع برنامج وسيط اسمه zebra هو الذي يكتب في جدول النواة، كما في توثيق الإعداد:
zebra: يجمع الطرق من كل البروتوكولات، ويختار بينها بالمسافة الإدارية Administrative Distance، ويكتب الفائز في النواة.ospfdوbgpdوbfdd: برنامج لكل بروتوكول، تفعل منها ما تحتاجه في الملف/etc/frr/daemons.vtysh: واجهة أوامر موحدة تشبه أجهزة Cisco، تكتب فيهاshowوconfigure terminalوتحفظ كل الإعداد في ملف واحد/etc/frr/frr.conf.
وأوامر FRR قريبة جداً من أوامر الأجهزة التجارية، فما تتعلمه هنا تنقله إلى Router حقيقي بتعديلات صغيرة، ومنها أجهزة MikroTik التي تدعم OSPF وBGP أيضاً.
المختبر: أربعة Routers في مربع وفرعان
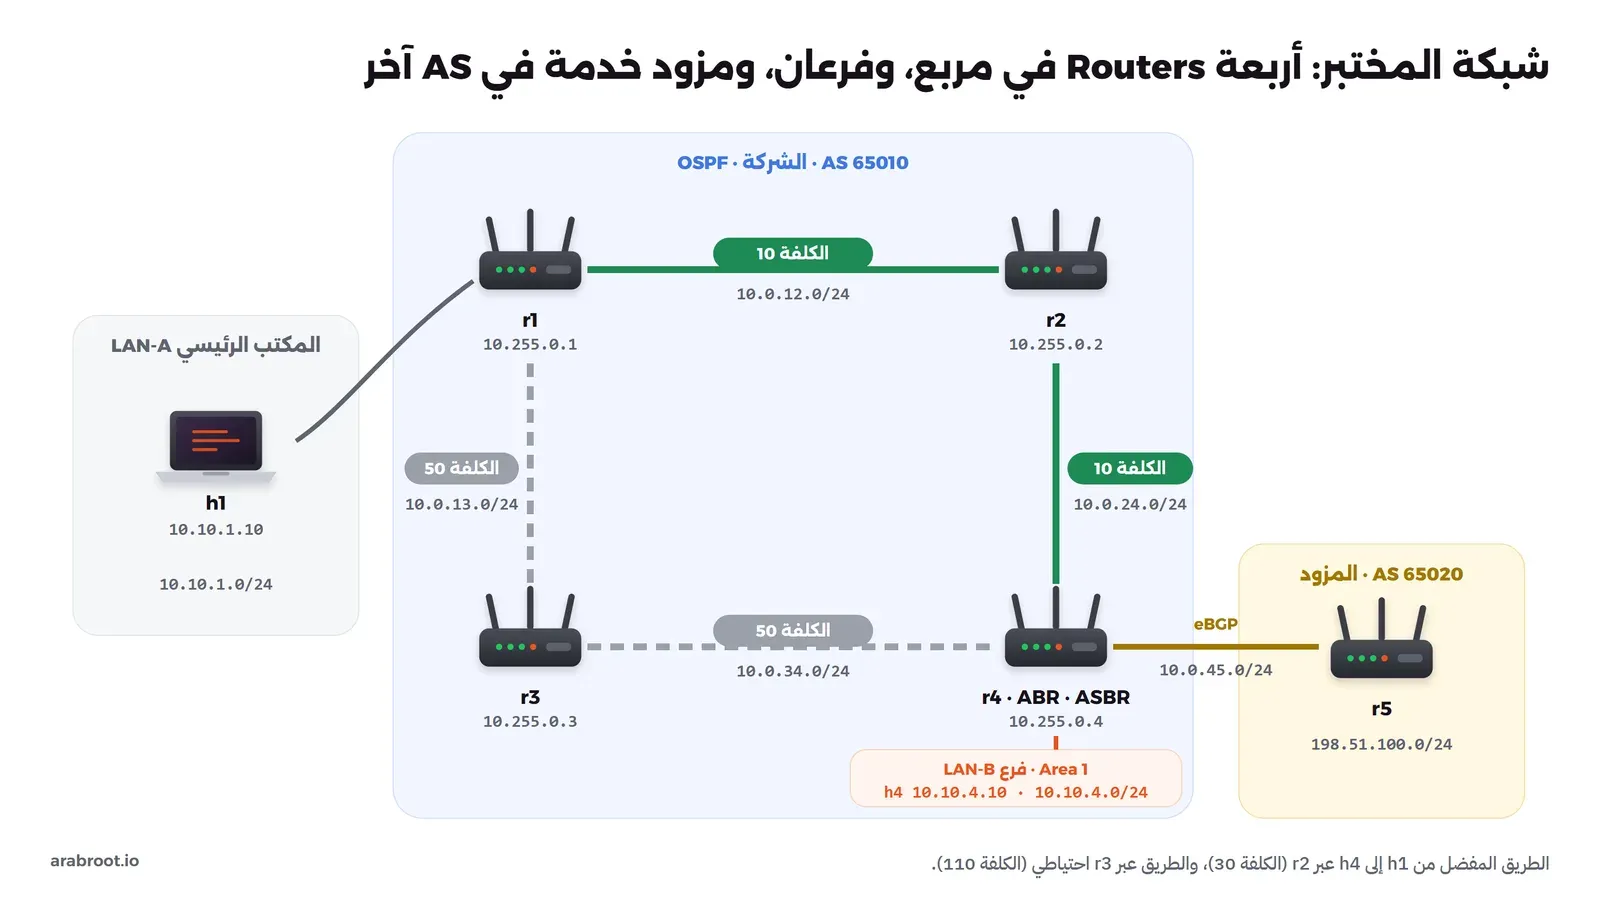
نبني الآن شبكة الشركة في القصة: المكتب الرئيسي LAN-A خلف r1، والمستودع LAN-B خلف r4، وبينهما طريقان: الطريق السريع عبر r2 بكلفة 10 لكل رابط، والطريق الاحتياطي عبر r3 بكلفة 50 لكل رابط. ثم r5 في شبكة مزود الخدمة، نستخدمه في جزء BGP. وكل رابط بين جهازين شبكة Docker مستقلة، وكل ما ننشئه يبدأ اسمه ب infp-. والصورة التالية هي الشبكة كاملة:
تجهيز ال Image والشبكات
ال Image مبنية على Alpine، وفيها حزمة frr من مستودع Alpine، مع أدوات المراقبة:
# Lab image for the dynamic-routing post: FRRouting plus the tools to watch it.
FROM alpine:3.24
RUN apk add --no-cache frr iproute2 nftables tcpdump tshark iputils-ping busybox-extras
وفي الملف daemons نفعل البرامج التي نحتاجها، وFRR يشغل zebra دائماً:
ospfd=yes
bgpd=yes
bfdd=yes
vtysh_enable=yes
والسكربت setup.sh في مجلد التجربة ينشئ سبع شبكات، واحدة لكل رابط ولكل فرع، ويشغل خمسة Routers وجهازين. وفيه ثلاثة تفاصيل تستحق الشرح لأن كل واحد منها ظهر كمشكلة حقيقية عند بناء هذا المختبر:
router() { name=$1; shift
  docker run -d --init --ulimit nofile=65536:65536 --name infp-$name --hostname $name --cap-add NET_ADMIN --cap-add NET_RAW --cap-add SYS_ADMIN \
    --sysctl net.ipv4.ip_forward=1 infp-frr:1 sleep infinity >/dev/null
  docker network disconnect bridge infp-$name
  docker cp daemons infp-$name:/etc/frr/daemons
  [ -f $name.conf ] && docker cp $name.conf infp-$name:/etc/frr/frr.conf
  true; }
# link <router> <network> <address> <interface name inside the router>
link() { docker network connect --ip $3 infp-$2 infp-$1
  dev=$(docker exec infp-$1 sh -c "ip -o -4 addr show | awk '/ $3\\//{print \$2}'")
  docker exec infp-$1 sh -c "ip link set $dev down && ip link set $dev name $4 && ip link set $4 up"; }
الأول الخيار --init: بدونه يكون أول برنامج في ال Container هو sleep، وهو لا يجمع البرامج المنتهية، فإذا أوقفت FRR بقيت برامجه في حالة Zombie، وانتظر سكربت الإيقاف frrinit.sh stop اختفاءها إلى الأبد. والخيار --init يضع برنامجاً صغيراً في المقدمة يقوم بهذه المهمة. والثاني أسماء الواجهات: Docker يسمي الواجهات eth0 وeth1 بحسب ترتيب الربط، والترتيب ليس مضموناً، فالدالة link تجد الواجهة بعنوانها ثم تعيد تسميتها باسم واضح مثل to-r2، فتصبح ملفات الإعداد والمخرجات مقروءة. والثالث --ulimit: بدونه يطبع كل برنامج من FRR تحذيراً بأن حد الملفات المفتوحة كبير جداً، وهو تحذير لا يضر ولكنه يملأ المخرج.
ثم ملف الإعداد لكل Router، وهذا ملف r1:
frr defaults traditional
hostname r1
!
interface lo
 ip address 10.255.0.1/32
!
interface to-r3
 ip ospf cost 50
!
router ospf
 ospf router-id 10.255.0.1
 network 10.255.0.1/32 area 0
 network 10.0.12.0/24 area 0
 network 10.0.13.0/24 area 0
 network 10.10.1.0/24 area 0
 passive-interface lan
!
كل سطر هنا له سبب: router-id هو اسم الجهاز في OSPF، ونكتبه بيدنا ونضع مثله عنواناً على واجهة lo، لأن البرنامج إذا اختاره تلقائياً أخذ أحد عناوين الواجهات، فيتغير الاسم إذا تغير العنوان. وسطور network لا تعلن شبكات كما يظن كثيرون، وإنما تقول: «فعل OSPF على كل واجهة عنوانها داخل هذا النطاق، وضعها في هذه المنطقة»، والإعلان نتيجة لذلك. والسطر passive-interface lan يقول: أعلن شبكة المكتب، ولكن لا ترسل Hello على واجهتها، لأنه لا يوجد Router في المكتب، ولأنك لا تريد أن يصبح حاسوب موظف جاراً في OSPF ويعلن طرقاً لشبكتك. وملف r4 يضع شبكة المستودع في المنطقة 1، فيصبح r4 هو ال ABR:
 network 10.10.4.0/24 area 1
 passive-interface lan
نراقب الجدول وهو يتقارب
السؤال الأول: كم يأخذ OSPF حتى يعرف r1 الطريق إلى المستودع بعد تشغيل الأجهزة الأربعة؟ السكربت cold-start.sh يوقف FRR في الأجهزة الأربعة، ثم يشغلها معاً، ثم يطبع كل ثانية حالة جيران r1 وهل في جدوله طريق إلى 10.10.4.0/24:
sh cold-start.shوالمخرج طويل، وهذه أسطره عند كل تغير، والأسطر بينها مكررة:
t=0s  neighbours: Init/DROther   route: none
t=9s  neighbours: Init/DROther   route: none
t=10s  neighbours: 2-Way/DROther 2-Way/DROther   route: none
t=38s  neighbours: 2-Way/DROther 2-Way/DROther   route: none
t=39s  neighbours: Full/DR Full/DR   route: none
t=49s  neighbours: Full/DR Full/DR   route: none
t=50s  neighbours: Full/DR Full/DR   route: 10.10.4.0/24 nhid 16 via 10.0.12.2 dev to-r2 proto ospf metric 20
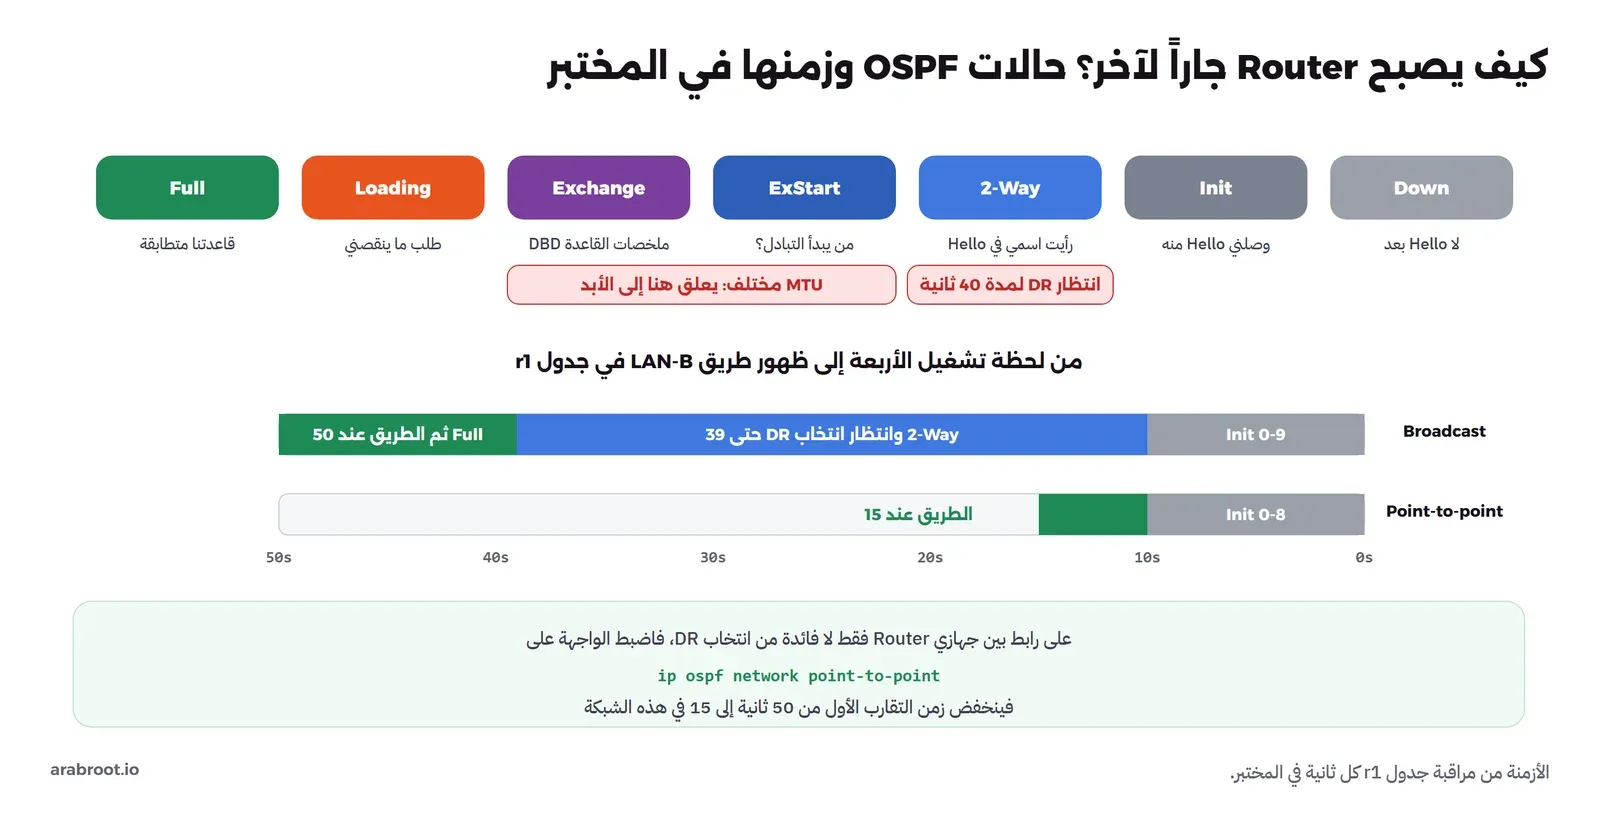
خمسون ثانية حتى يظهر الطريق. وفي الثواني العشر الأولى يرى r1 جاراً واحداً في Init، أي وصله Hello ولم ير اسمه فيه بعد، لأن الجيران بدؤوا لتوهم ويرسلون Hello كل 10 ثوان. ثم بين الثانية 10 والثانية 38 يرى الجارين في 2-Way، والحالة DROther تقول إن أحداً لم ينتخب بعد، فكل جهاز ينتظر Wait Timer قبل انتخاب DR. ثم في الثانية 39 يكتمل الانتخاب ويصبح كل جار Full، ولكل منهما الصفة DR على رابطه. ثم عشر ثوان أخرى حتى تكتمل الروابط البعيدة، r2 مع r4 وr3 مع r4، لأنها بدأت متأخرة قليلاً وتمر بالانتظار نفسه، ثم يصل إعلان r4 ويحسب r1 الطريق.
ولاحظ أن الرقم metric 20 في السطر الأخير من جدول النواة ليس الكلفة الكلية للطريق، فهي 30 كما سنرى، لذلك لا تقرأ كلفة OSPF من الأمر ip route، وإنما من vtysh.
الروابط من نقطة إلى نقطة: من 50 ثانية إلى 15
كل روابطنا بين جهازين فقط، فانتخاب DR هنا لا يفيد شيئاً، ويكلف 40 ثانية في كل تشغيل. السكربت p2p.sh يضبط كل رابط بين Routers على النوع Point-to-Point ويحفظ الإعداد، وهو يكتب هذا لكل واجهة:
docker exec infp-r1 vtysh -c 'conf t' -c 'interface to-r2' -c 'ip ospf network point-to-point' -c 'end' -c 'write memory'ثم نعيد القياس نفسه:
t=0s  neighbours: Init/-   route: none
t=1s  neighbours: Init/-   route: none
t=2s  neighbours: Init/-   route: none
t=3s  neighbours: Init/-   route: none
t=4s  neighbours: Init/-   route: none
t=5s  neighbours: Init/-   route: none
t=6s  neighbours: Init/-   route: none
t=7s  neighbours: Init/-   route: none
t=8s  neighbours: Init/-   route: none
t=9s  neighbours: Full/-   route: none
t=10s  neighbours: Full/- Full/-   route: none
t=11s  neighbours: Full/- Full/-   route: none
t=12s  neighbours: Full/- Full/-   route: none
t=13s  neighbours: Full/- Full/-   route: none
t=14s  neighbours: Full/- Full/-   route: none
t=15s  neighbours: Full/- Full/-   route: none
t=15s  neighbours: Full/- Full/-   route: 10.10.4.0/24 nhid 16 via 10.0.12.2 dev to-r2 proto ospf metric 20
الطريق ظهر في الثانية 15 بدل 50، والعلامة - بعد Full تعني أن لا DR ولا BDR على الرابط. وما بقي من الزمن هو انتظار أول Hello من الجار، فقد يصل بعد 10 ثوان في أسوأ الأحوال، ثم بضع ثوان لأن FRR لا يعيد إنشاء إعلانه أسرع من مرة كل 5 ثوان، وهي القيمة LSA minimum interval 5000 msecs في show ip ospf، حتى لا يغرق الشبكة بالإعلانات عند تأرجح رابط. والصورة التالية تقارن بين الحالتين:
ماذا يعرف r1 الآن؟ الجيران والجدول والقاعدة
الأوامر الثلاثة التي تبدأ بها كل تشخيص في OSPF هي الجيران، ثم الطرق، ثم القاعدة:
docker exec infp-r1 vtysh -c 'show ip ospf neighbor' -c 'show ip route ospf' -c 'show ip ospf database'Neighbor ID Pri State Up Time Dead Time Address Interface RXmtL RqstL DBsmL
10.255.0.2 1 Full/- 22.086s 37.914s 10.0.12.2 to-r2:10.0.12.1 0 0 0
10.255.0.3 1 Full/- 22.423s 38.274s 10.0.13.3 to-r3:10.0.13.1 0 0 0
IPv4 unicast VRF default:
O 10.0.12.0/24 [110/10] is directly connected, to-r2, weight 1, 00:00:32
O 10.0.13.0/24 [110/50] is directly connected, to-r3, weight 1, 00:00:32
O>* 10.0.24.0/24 [110/20] via 10.0.12.2, to-r2, weight 1, 00:00:16
O>* 10.0.34.0/24 [110/70] via 10.0.12.2, to-r2, weight 1, 00:00:16
O 10.10.1.0/24 [110/10] is directly connected, lan, weight 1, 00:00:32
O>* 10.10.4.0/24 [110/30] via 10.0.12.2, to-r2, weight 1, 00:00:16
O 10.255.0.1/32 [110/0] is directly connected, lo, weight 1, 00:00:32
O>* 10.255.0.2/32 [110/10] via 10.0.12.2, to-r2, weight 1, 00:00:16
O>* 10.255.0.3/32 [110/50] via 10.0.13.3, to-r3, weight 1, 00:00:17
O>* 10.255.0.4/32 [110/20] via 10.0.12.2, to-r2, weight 1, 00:00:16
Router Link States (Area 0.0.0.0)
Link ID ADV Router Age Seq# CkSum Link count
10.255.0.1 10.255.0.1 22 0x80000006 0xf3df 6
10.255.0.2 10.255.0.2 21 0x80000005 0x3801 5
10.255.0.3 10.255.0.3 17 0x80000005 0x86f6 5
10.255.0.4 10.255.0.4 19 0x80000006 0xbdf2 5
Summary Link States (Area 0.0.0.0)
Link ID ADV Router Age Seq# CkSum Link count
10.10.4.0 10.255.0.4 32 0x80000001 0x36f6 10.10.4.0/24في جدول الجيران العمود Dead Time يعد تنازلياً من 40 ويعود إلى 40 كلما وصل Hello، فإذا رأيته ينزل تحت 30 فقد ضاع Hello واحد على الأقل. والأعمدة الثلاثة الأخيرة عدد الإعلانات التي تنتظر تأكيد الاستلام أو الطلب أو الوصف، وتكون أصفاراً في شبكة مستقرة.
وفي جدول الطرق كل سطر يبدأ ب O أي من OSPF، والرقمان بين القوسين المسافة الإدارية 110 ثم الكلفة الكلية. والعلامتان >* تعنيان أن الطريق هو المختار وأنه مكتوب في جدول النواة. والسطور التي ليس عليها العلامتان، مثل 10.0.12.0/24، شبكات متصلة مباشرة يعرفها OSPF أيضاً، ولكن الطريق المتصل Connected يفوز عليها لأن مسافته الإدارية صفر. وانظر إلى السطر الأهم: 10.10.4.0/24 [110/30] via 10.0.12.2، أي أن الطريق إلى المستودع عبر r2 بكلفة 10 ثم 10 ثم 10، وهو ما رسمناه في المخطط.
وفي القاعدة أربعة Router LSA، واحد من كل جهاز، وكل جهاز في المنطقة يحمل الجدول نفسه بالأرقام نفسها، وتستطيع أن تتحقق من ذلك بتنفيذ الأمر على r3 ومقارنة عمود CkSum. وتحتها إعلان Summary واحد من r4 عن شبكة المستودع، فهذه كل معرفة r1 بالمنطقة 1. ولنقرأ إعلان r4 نفسه بالتفصيل:
docker exec infp-r1 vtysh -c 'show ip ospf database router 10.255.0.4' LS age: 19
Options: 0x2 : *|-|-|-|-|-|E|-
LS Flags: 0x6
Flags: 0x1 : ABR
LS Type: router-LSA
Link State ID: 10.255.0.4
Advertising Router: 10.255.0.4
LS Seq Number: 80000006
Checksum: 0xbdf2
Length: 84
Number of Links: 5
Link connected to: another Router (point-to-point)
(Link ID) Neighboring Router ID: 10.255.0.2
(Link Data) Router Interface address: 10.0.24.4
Number of TOS metrics: 0
TOS 0 Metric: 10
Link connected to: Stub Network
(Link ID) Net: 10.0.24.0
(Link Data) Network Mask: 255.255.255.0
Number of TOS metrics: 0
TOS 0 Metric: 10
Link connected to: another Router (point-to-point)
(Link ID) Neighboring Router ID: 10.255.0.3
(Link Data) Router Interface address: 10.0.34.4
Number of TOS metrics: 0
TOS 0 Metric: 50هذا هو وصف r4 لنفسه كما وصل إلى r1: العلامة Flags: 0x1 : ABR تقول إنه على حدود منطقتين، ثم خمسة روابط، منها رابطان إلى جارين من نوع Point-to-Point بكلفة 10 إلى r2 و50 إلى r3، ولكل رابط سطر Stub Network يعلن الشبكة الفرعية نفسها. ولا تجد هنا شبكة المستودع، فهي في المنطقة 1، وتصل إلى المنطقة 0 في الإعلان الملخص. وهذا الفرق يظهر في جدول OSPF الداخلي، حيث يكتب FRR النوع بجانب كل طريق:
N    10.10.1.0/24          [10] area: 0.0.0.0
                           directly attached to lan
N IA 10.10.4.0/24          [30] area: 0.0.0.0
                           via 10.0.12.2, to-r2

============ OSPF router routing table =============
R    10.255.0.4            [20] area: 0.0.0.0, ABR
                           via 10.0.12.2, to-r2
IA اختصار Inter-Area، أي أن الطريق جاء من منطقة أخرى عبر ABR، والجدول الثاني يقول إن r1 يعرف r4 بصفته ABR ويصل إليه بكلفة 20.
رسالة Hello على السلك
لنر رسالة Hello كما هي، نلتقط على r2 من جهة r1 ونقرأ بأداة tshark:
docker exec infp-r2 sh -c 'timeout 12 tcpdump -i to-r1 -nn -U -w /tmp/hello.pcap proto ospf
tshark -r /tmp/hello.pcap -Y "frame.number==1" -O ospf'
Open Shortest Path First
OSPF Header
Version: 2
Message Type: Hello Packet (1)
Packet Length: 48
Source OSPF Router: 10.255.0.1
Area ID: 0.0.0.0 (Backbone)
Checksum: 0xe699 [correct]
Instance ID: Base IPv4 Unicast Instance (0)
Auth Type: Null (0)
Auth Data (none): 0000000000000000
OSPF Hello Packet
Network Mask: 255.255.255.0
Hello Interval [sec]: 10
Router Priority: 1
Router Dead Interval [sec]: 40
Designated Router: 0.0.0.0
Backup Designated Router: 0.0.0.0
Active Neighbor: 10.255.0.2كل ما شرحناه في قسم Hello موجود هنا: رقم المرسل، والمنطقة، والقناع، والمدتان 10 و40، وفي آخرها الجار الذي يسمعه r1، وهو r2. والحقلان DR وBDR أصفار لأن الرابط Point-to-Point. ولاحظ السطر Auth Type: Null: لا توجد مصادقة، فأي جهاز على هذا الرابط يستطيع أن يرسل Hello ويصبح جاراً ويعلن ما يشاء. وفي شبكة حقيقية فعل المصادقة بالأمر ip ospf authentication message-digest مع مفتاح على كل واجهة، أو على الأقل لا تفعل OSPF إلا على الواجهات التي تحتاجه، وهذا سبب passive-interface. والحزم كلها في الملف، فإذا أردت أن ترى الإعلانات نفسها فابحث فيه بالفلتر ospf.msg == 4 وهو نوع Link State Update.
الكلفة: ماذا يحدث إذا تساوى الطريقان؟
قبل أن نقطع الروابط، تجربة صغيرة على الكلفة. أولاً ما الذي يحسبه FRR تلقائياً على هذه الواجهات؟ على r2 حيث لم نكتب أي كلفة:
  ifindex 3, MTU 1500 bytes, BW 10000 Mbit <UP,LOWER_UP,BROADCAST,RUNNING,MULTICAST>
  Router ID 10.255.0.2, Network Type POINTOPOINT, Cost: 10
الواجهة بسرعة 10000 Mbit/s والكلفة 10. والتوثيق يقول إن المرجع الافتراضي 100 Mbit/s، أي أن الكلفة المتوقعة 1، ولكن الرقم الظاهر في هذه النسخة 10، وعندما رفعنا المرجع بالأمر auto-cost reference-bandwidth 1000000 أصبحت الكلفة 100، أي مليون مقسوماً على عشرة آلاف، ثم عادت 10 عند حذف الأمر. والدرس العملي أن الحساب التلقائي يختلف بين الإصدارات والأجهزة، فلا تبن تصميمك عليه، واكتب الكلفة بيدك على الروابط المهمة، أو وحد المرجع على كل الأجهزة، وFRR نفسه يذكرك بهذا عند التغيير:
% OSPF: Reference bandwidth is changed.
        Please ensure reference bandwidth is consistent across all routers
والآن نجعل الطريق عبر r3 بكلفة 10 أيضاً على الروابط الأربعة، فيتساوى الطريقان بكلفة 30:
for p in "r1 to-r3" "r3 to-r1" "r3 to-r4" "r4 to-r3"; do set -- $p
  docker exec infp-$1 vtysh -c 'conf t' -c "interface $2" -c 'ip ospf cost 10' -c end
done
docker exec infp-r1 vtysh -c "show ip route 10.10.4.0/24"
Routing entry for 10.10.4.0/24
Known via "ospf", distance 110, metric 30, best
Last update 00:00:02 ago
Flags: Selected
Status: Installed
* 10.0.12.2, via to-r2, weight 1
* 10.0.13.3, via to-r3, weight 1طريقان بنجمتين، فالنواة توزع الاتصالات عليهما، وتوزعها بحسب كل اتصال لا كل حزمة، حتى لا تصل حزم الاتصال الواحد بترتيب مختلف. وهذا مفيد عندما يكون الخطان متساويين فعلاً، وخطير عندما لا يكونان، فإذا كان أحدهما خط ألياف والآخر خطاً لاسلكياً بزمن أعلى، فإن نصف الاتصالات سوف تشعر بالبطء دون سبب واضح. وبعد التجربة نعيد الكلفة 50 إلى الطريق الاحتياطي.
نقطع الرابط: كم تتوقف الحركة؟
هذا هو السؤال الذي يهم الشركة في القصة: إذا انقطع الخط السريع، كم ثانية تتوقف الحركة بين المكتب والمستودع قبل أن تتحول إلى الخط الاحتياطي؟ السكربت fail-link.sh يجعل h1 يرسل ping إلى h4 عشر مرات في الثانية مدة 70 ثانية، ثم يقطع الرابط بين r2 وr4 بعد ثلاث ثوان، ثم يعد الردود التي لم تصل، وكل رد ضائع يعني قرابة عشر ثانية من التوقف. وقبل كل تجربة نتأكد أن الحركة تمر عبر r2:
docker exec infp-h1 traceroute -n -w1 10.10.4.10traceroute to 10.10.4.10 (10.10.4.10), 30 hops max, 46 byte packets
1 10.10.1.1 0.006 ms 0.005 ms 0.005 ms
2 10.0.12.2 0.005 ms 0.005 ms 0.004 ms
3 10.0.24.4 0.005 ms 0.015 ms 0.006 ms
4 10.10.4.10 0.005 ms 0.004 ms 0.006 msالحالة الأولى: الواجهة تسقط
نطفئ الواجهة على r2 بالأمر ip link set to-r4 down، كأن أحداً نزع الكابل من r2:
sh fail-link.sh down06:51:26 failing r2-r4 (down)
628 packets transmitted, 628 received, 0% packet loss, time 69908ms
rtt min/avg/max/mdev = 0.093/0.180/10.381/0.413 ms
no answer: 0 of 628 probes (each probe = 0.1 s)
traceroute to 10.10.4.10 (10.10.4.10), 30 hops max, 46 byte packets
1 10.10.1.1 0.009 ms 0.006 ms 0.006 ms
2 10.0.13.3 0.004 ms 0.004 ms 0.004 ms
3 10.0.34.4 0.010 ms 0.004 ms 0.005 ms
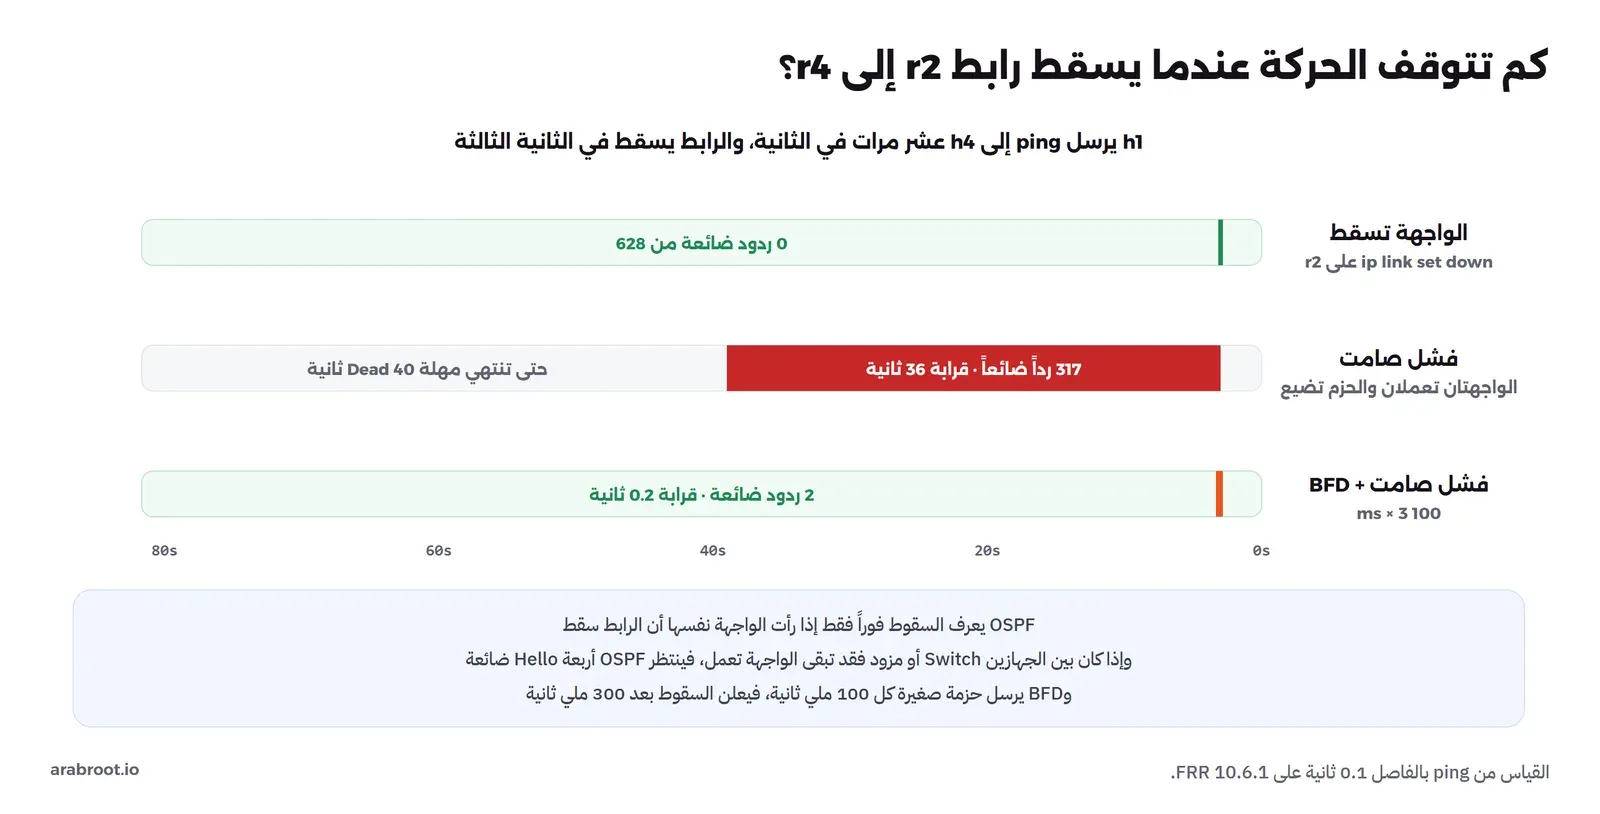
4 10.10.4.10 0.005 ms 0.005 ms 0.005 msلا رد ضائع، والطريق انتقل إلى r3 كما يظهر في traceroute. وأكبر زمن ذهاب وعودة 10 ملي ثوان، أي أن رداً واحداً تأخر أثناء التحول ولم يضع. والسبب أن r2 عرف بسقوط الواجهة فوراً من النواة، فأزال الجار وأعاد إنشاء إعلانه دون الرابط إلى r4، وأرسله، وحسب الجميع الطريق من جديد. وr4 لم يعرف بسقوط واجهته، فواجهته ما زالت تعمل لأن الرابط في المختبر Switch من Docker، ولكنه عندما يرى إعلان r2 الجديد يجد أن r2 لم يعد يذكره، وOSPF لا يستخدم رابطاً إلا إذا ذكره الطرفان، فيتخلى عنه فوراً دون أن ينتظر مدة Dead.
الحالة الثانية: فشل صامت
ولكن هذا ليس ما حدث في القصة، فالخط هناك سقط عند المزود والواجهتان بقيتا مضاءتين. ولنمثل هذا نترك الواجهتين تعملان، ونضيف على r2 قاعدة nftables تسقط كل ما يدخل من الواجهة to-r4 وكل ما يخرج منها، كأن جهازاً في المنتصف مات:
sh fail-link.sh silent06:56:14 failing r2-r4 (silent)
619 packets transmitted, 302 received, 51.2116% packet loss, time 69947ms
rtt min/avg/max/mdev = 0.102/0.175/0.384/0.034 ms
no answer: 317 of 619 probes (each probe = 0.1 s)317 رداً ضائعاً، ومع الفاصل الفعلي بين الحزم، 70 ثانية على 619 حزمة، أي قرابة 0.11 ثانية لكل حزمة، فهذا توقف قرابة 36 ثانية. وفي منتصف التجربة، بعد 25 ثانية من القطع، كان هذا حال r4 وr1:
Neighbor ID     Pri State           Up Time         Dead Time Address         Interface                        RXmtL RqstL DBsmL
10.255.0.2        1 Full/-          35.621s           14.380s 10.0.24.2       to-r2:10.0.24.4                      1     0     0
10.255.0.3        1 Full/-          34.615s           35.386s 10.0.34.3       to-r3:10.0.34.4                      0     0     0

10.10.4.0/24 nhid 14 via 10.0.12.2 dev to-r2 proto ospf metric 20
r4 ما زال يرى r2 جاراً كاملاً، ولكن عداد Dead Time نزل إلى 14 ثانية لأن Hello لم يصل منذ ربع دقيقة، والعمود RXmtL صار 1، أي أن هناك إعلاناً أرسله r4 ولم يؤكد r2 استلامه. وr1 ما زال يرسل إلى r2. فلا أحد يعرف أن الرابط ميت حتى تنتهي مدة Dead كاملة، ثم يحسب الجميع الطريق في أجزاء من الثانية. فالحساب لم يكن البطيء، وإنما الاكتشاف.
والحل الأول الذي يخطر على البال أن تقصر مدتي Hello وDead، مثلاً Hello كل ثانية وDead بعد ثلاث ثوان، وFRR يسمح حتى بأقل من ثانية بالأمر ip ospf dead-interval minimal hello-multiplier. ولكن رسائل Hello تمر عبر برنامج OSPF نفسه، فإذا انشغل المعالج لحظة في Router مشغول ضاعت رسائل وسقط جوار سليم، وهذا أسوأ من البطء. والحل الذي صمم لهذه المشكلة بروتوكول منفصل.
الحالة الثالثة: الفشل الصامت مع BFD
بروتوكول Bidirectional Forwarding Detection، واختصاراً BFD، الموصوف في RFC 5880 وطريقة استخدامه مع IP في RFC 5881، لا يفعل شيئاً إلا أن يرسل حزمة UDP صغيرة جداً بين جارين بفاصل قصير، ويعلن سقوط الطريق إذا ضاعت عدة حزم متتالية، ثم يخبر OSPF أو BGP فوراً. ولأنه بسيط وخفيف يمكن أن يعمل بفاصل عشرات الملي ثواني، وفي الأجهزة الكبيرة تنفذه بطاقة الشبكة نفسها. السكربت bfd.sh يفعله على طرفي الرابط بملف تعريف اسمه fast، كما في توثيق BFD في FRR:
docker exec infp-r2 vtysh -c 'conf t' -c 'bfd' -c 'profile fast' -c 'transmit-interval 100' -c 'receive-interval 100' \
  -c 'detect-multiplier 3' -c 'exit' -c 'exit' -c 'interface to-r4' -c 'ip ospf bfd' -c 'ip ospf bfd profile fast' \
  -c 'end' -c 'write memory'
docker exec infp-r2 vtysh -c 'show bfd peers'
peer 10.0.24.4 local-address 10.0.24.2 vrf default interface to-r4
Status: up
Peer Type: dynamic
Profile: fast
Local timers:
Detect-multiplier: 3
Receive interval: 100ms
Transmission interval: 100ms
Transmission interval (actual with jitter): 77ms
Detection timeout: 300msالجلسة تعمل، وPeer Type: dynamic تعني أن OSPF هو من طلبها ولم نعرفها بيدنا، وDetection timeout: 300ms هو حاصل ضرب 100 ملي ثانية في 3. والفاصل الفعلي 77 ملي ثانية لأن المعيار يطلب تغييراً عشوائياً صغيراً في الفاصل حتى لا تتزامن الجلسات الكثيرة. ونعيد الفشل الصامت نفسه:
06:58:15 failing r2-r4 (silent)
630 packets transmitted, 628 received, 0.31746% packet loss, time 69890ms
rtt min/avg/max/mdev = 0.084/0.177/3.168/0.174 ms
no answer: 2 of 630 probes (each probe = 0.1 s)
ردان ضائعان فقط، أي توقف قرابة 0.2 ثانية بدل 36 ثانية، والفشل نفسه تماماً. وبعد التجربة يعرض show bfd peers brief على r4 صفر جلسات، لأن OSPF أسقط الجار فأزال جلسة BFD الخاصة به. والصورة التالية تجمع الحالات الثلاث:
وهذا هو الحل الذي احتاجته الشركة في القصة: BFD على الروابط التي يمكن أن تفشل بصمت، وهي كل رابط يمر عبر مزود أو Switch أو جهاز تحويل وسيط. أما الروابط المباشرة بكابل بين جهازين فاكتشاف الواجهة يكفيها غالباً.
ماذا لو اختلف MTU على طرفي الرابط؟
بقيت تجربة أخيرة في OSPF، لأنها أشهر مشكلة تصادفها عند ربط جهازين من نوعين مختلفين أو عبر نفق. نغير MTU على واجهة r3 المتجهة إلى r1 إلى 1400 بدل 1500، ونعيد تشغيل الواجهة حتى تبدأ العلاقة من جديد، ثم ننتظر 45 ثانية:
docker exec infp-r3 sh -c 'ip link set to-r1 mtu 1400; ip link set to-r1 down; ip link set to-r1 up'
docker exec infp-r1 vtysh -c 'show ip ospf neighbor'
docker exec infp-r3 vtysh -c 'show ip ospf neighbor'
Neighbor ID Pri State Up Time Dead Time Address Interface RXmtL RqstL DBsmL
10.255.0.2 1 Full/- 4m58s 33.370s 10.0.12.2 to-r2:10.0.12.1 0 0 0
10.255.0.3 1 Exchange/- 37.842s 34.514s 10.0.13.3 to-r3:10.0.13.1 0 0 0
Neighbor ID Pri State Up Time Dead Time Address Interface RXmtL RqstL DBsmL
10.255.0.4 1 Full/- 4m54s 36.848s 10.0.34.4 to-r4:10.0.34.3 0 0 0
10.255.0.1 1 ExStart/- 38.230s 31.770s 10.0.13.1 to-r1:10.0.13.3 0 0 0Hello يمر، فالجاران يعرفان بعضهما ولم يسقط أحد، ولكن العلاقة عالقة: r1 في Exchange وr3 في ExStart، وسوف تبقى هكذا إلى الأبد. والسبب أن رسائل Database Description تحمل حقل MTU، وOSPF يرفض الرسالة إذا كان MTU جاره أكبر من MTU واجهته، لأن جاره قد يرسل له حزماً لا يستطيع استقبالها. والمشكلة أن الطرفين لا يقولان ذلك بنفس الوضوح، فعندما فعلنا السجل في الجهازين وجدنا في r3، صاحب MTU الأصغر:
OSPF: [XZZ9Y-NNTMQ][EC 134217741] Packet[DD]: Neighbor 10.255.0.1 MTU 1500 is larger than [to-r1:10.0.13.3]'s MTU 1400أما r1 فلا يكتب إلا هذا كل خمس ثوان:
OSPF: [HCD35-SD5XN] Packet[DD] [Slave]: Neighbor 10.255.0.3 packet duplicated.فإذا رأيت جاراً عالقاً في ExStart أو Exchange فاقرأ سجل الطرفين، وابحث عن كلمة MTU في الطرف ذي MTU الأصغر. والحل أن توحد MTU على طرفي الرابط، وهذا هو الحل الصحيح، أما الأمر ip ospf mtu-ignore الذي يتجاهل الفحص فيخفي المشكلة ولا يحلها، فقد تكتمل العلاقة ثم تضيع الإعلانات الكبيرة لاحقاً. وبعد أن أعدنا MTU إلى 1500 اكتملت العلاقة خلال ثوان.
BGP: كيف تتبادل الشبكات طرقها على الإنترنت؟
OSPF يعمل جيداً داخل شبكة تثق أجزاؤها ببعضها ويديرها فريق واحد، فكل جهاز يصدق ما يقوله الآخرون عن روابطهم، والهدف واحد هو أقصر طريق. أما الإنترنت فهو عشرات آلاف الشبكات المستقلة، لكل منها مالك وعقود وسياسة: شبكة مزود لا تريد أن تمرر حركة منافسها مجاناً، وشركة تريد أن تستخدم خطاً لأنه أرخص لا لأنه أسرع، وجامعة لا تريد أن تعلن طرقها التجارية لجيرانها الأكاديميين. وخريطة بتفاصيل روابط كل هذه الشبكات لا يمكن أن يحملها جهاز، ولو حملها لما أرادت أي شبكة أن تكشف تفاصيلها للعالم.
لذلك يعمل الإنترنت ببروتوكول مختلف هو Border Gateway Protocol بنسخته الرابعة الموصوفة في RFC 4271. والوحدة فيه ليست الجهاز وإنما النظام المستقل Autonomous System، واختصاراً AS، وهو كما يعرفه RFC 1930 مجموعة شبكات تحت إدارة واحدة بسياسة توجيه واحدة، ولكل AS رقم ASN تسجله جهة الأرقام الإقليمية. وكانت الأرقام بطول 16 بتاً ثم أصبحت 32 بتاً في RFC 6793، وخصص RFC 6996 نطاقاً للاستخدام الخاص يبدأ من 64512 حتى 65534، ومنه الرقمان 65010 و65020 في المختبر، كما أن العناوين 198.51.100.0/24 من نطاقات التوثيق في RFC 5737.
وكل جهاز BGP يعلن لجاره البادئات Prefixes التي يعرف الطريق إليها، ومع كل بادئة صفات Attributes، أهمها مسار الأنظمة AS_PATH، أي قائمة أرقام الأنظمة التي مر بها هذا الإعلان. ومن هذه القائمة يأتي منع الحلقات: إذا وصل إلى نظام إعلان فيه رقمه هو رفضه، لأن الإعلان دار وعاد. ومنها يأتي معيار الاختيار الافتراضي: المسار الأقصر بعدد الأنظمة يفوز، بعد معايير أخرى تضعها السياسة أولاً مثل Local Preference. والجلسة بين جارين اتصال TCP عادي على المنفذ 179، والجيران لا يكتشفون بعضهم كما في OSPF، وإنما تكتب عنوان كل جار بيدك، لأن كل جوار علاقة تجارية أو إدارية مقصودة. وتسمى الجلسة eBGP إذا كانت بين نظامين مختلفين، وiBGP إذا كانت داخل النظام نفسه لتوزيع طرق الخارج على أجهزته.
وحجم الجدول يفسر لماذا لا يصلح OSPF هنا: تقرير BGP Routing Table Analysis الذي يتابعه Geoff Huston من نقطة مراقبة واحدة سجل بتاريخ 16 نوفمبر 2026 قرابة 1,092,000 بادئة IPv4 نشطة. وكل Router في قلب الإنترنت يحمل هذا الجدول ويحدثه مع كل تغيير في أي مكان في العالم، وهذا ممكن لأن BGP لا يحمل تفاصيل الروابط، وإنما البادئات ومساراتها فقط.
متى تحتاج BGP في شركتك؟
أغلب الشركات لا تحتاج BGP أصلاً، فإذا كان عندك اتصال واحد بالإنترنت من مزود واحد فالمسار الافتراضي الثابت إلى المزود يكفيك، والمزود يعلن عناوينك للعالم من جهته. وتحتاجه في ثلاث حالات: عندما يكون لك مزودان وتريد أن تبقى عناوينك نفسها مرئية عبر أي منهما إذا سقط الآخر، وهذا اسمه Multihoming ويحتاج عناوين خاصة بك ورقم AS، أو عندما تربط مواقعك أو مزودك السحابي عبر خطوط خاصة تتطلب BGP، مثل كثير من خدمات الربط المباشر بالسحابة وشبكات VPN بين المواقع عند المزودين، أو عندما تبني داخل مركز بيانات شبكة كبيرة وتستخدم BGP بدل OSPF لأنه يتوسع أفضل ويعطيك تحكماً أدق. وفي المختبر نمثل الحالة الأولى بشكل مبسط: الشركة في AS 65010 تتصل بمزود في AS 65020، تعلن له شبكتيها، ويعلن لها شبكة على الإنترنت.
عندما يخطئ BGP: حادثتان حقيقيتان
لأن BGP مبني على الثقة بين الجيران، فإن خطأ واحداً في سياسة نظام واحد قد يصل إلى العالم كله في دقائق. والحادثة المشهورة في تحليل RIPE NCC: في 24 فبراير 2008 بدأت شركة Pakistan Telecom، ورقمها AS17557، تعلن البادئة 208.65.153.0/24 التي تتبع YouTube، وكانت تريد أن تحجب الموقع داخل بلدها، ولكن مزودها PCCW Global مرر الإعلان إلى بقية الإنترنت دون فلتر. وYouTube كان يعلن 208.65.152.0/22، والبادئة /24 أطول، وقاعدة أطول بادئة مطابقة تجعلها تفوز في كل Router رآها، فذهبت حركة YouTube من أماكن كثيرة في العالم إلى باكستان أكثر من ساعتين، حتى أعلن YouTube بادئات /25 أطول منها، ثم سحب المزود الإعلان الخاطئ.
والحادثة الثانية في تقرير Facebook عن انقطاع أكتوبر 2021: أمر صيانة روتيني قطع كل روابط الشبكة الداخلية بين مراكز البيانات، وثغرة في أداة التدقيق لم توقفه، وسيرفرات DNS عندهم مصممة لأن تسحب إعلانات BGP الخاصة بها إذا فقدت الاتصال بمراكز البيانات، فسحبتها، فاختفت عناوين DNS من الإنترنت، وأصبح العالم لا يجد facebook.com رغم أن السيرفرات تعمل، والمهندسون أنفسهم فقدوا أدواتهم الداخلية التي تعتمد على الشبكة نفسها.
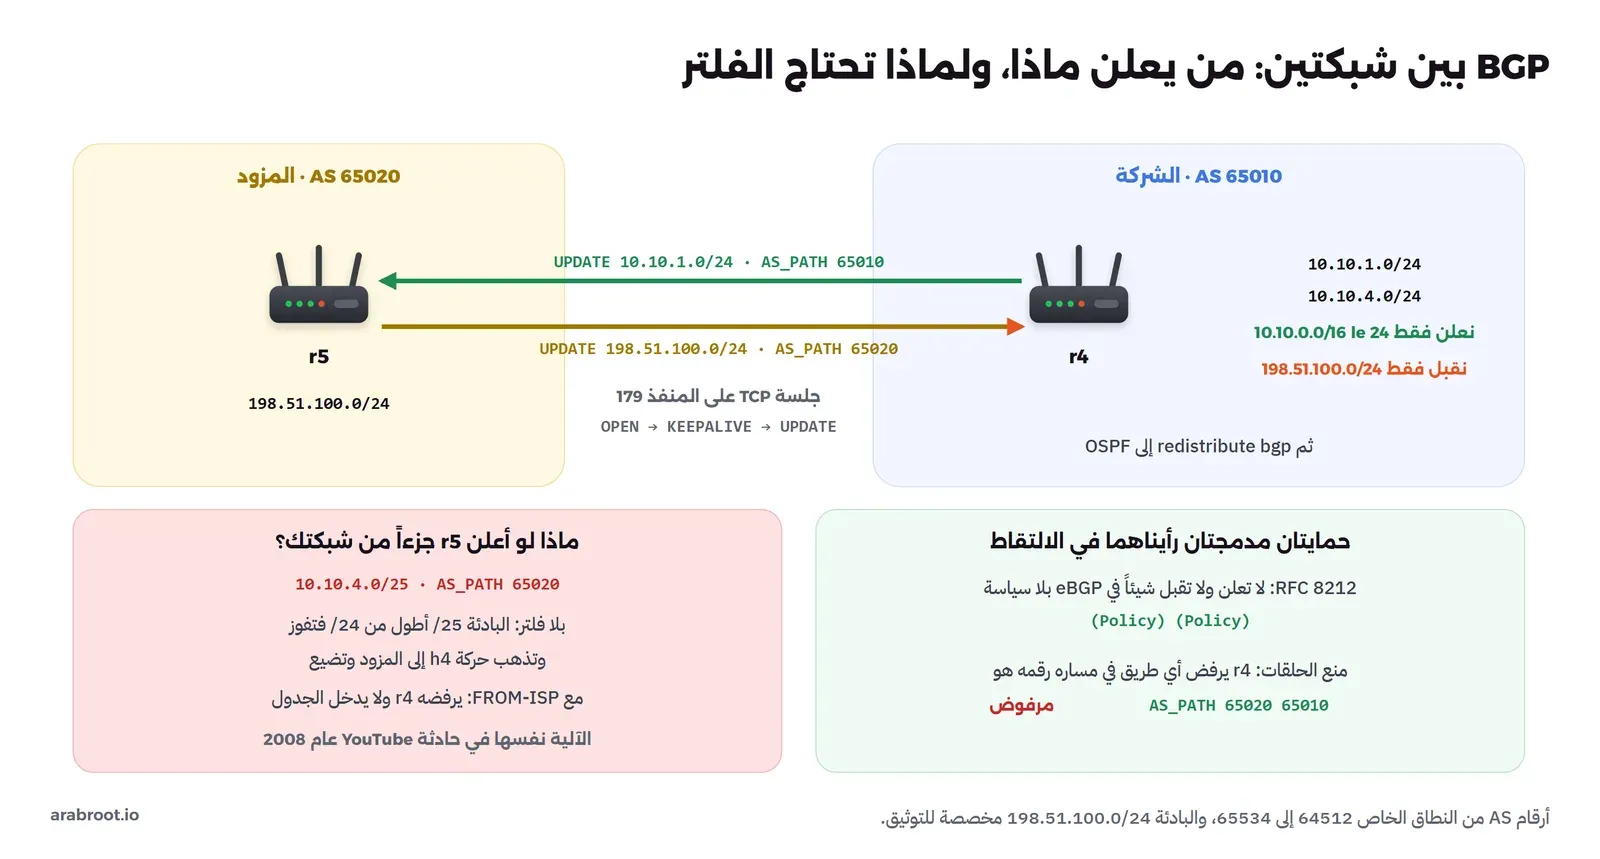
ومن هذه الحوادث جاءت الحمايات التي سوف تراها في المختبر: RFC 8212 يطلب ألا يقبل جهاز BGP أي طريق من جار خارجي ولا يعلن له شيئاً حتى تكتب سياسة صريحة لذلك، وFRR يطبقه افتراضياً في إعداد traditional كما في توثيق bgpd. والحماية الأقوى للإنترنت كله هي التحقق من صاحب البادئة RPKI في RFC 6811، حيث يوقع صاحب العناوين شهادة تقول أي AS يحق له أن يعلنها، ويرفض المزودون الإعلانات المخالفة.
المختبر: جلسة eBGP بين الشركة والمزود
نعطي r4 جلسة BGP مع r5. ملف الإعداد r4-bgp.conf بسيط: رقم النظام، والجار ورقم نظامه، والبادئتان اللتان نعلنهما:
router bgp 65010
 bgp router-id 10.255.0.4
 neighbor 10.0.45.5 remote-as 65020
 neighbor 10.0.45.5 description isp-r5
 !
 address-family ipv4 unicast
  network 10.10.1.0/24
  network 10.10.4.0/24
 exit-address-family
!
والسطر network في BGP معناه مختلف عن OSPF: هنا يعني «أعلن هذه البادئة إذا كانت موجودة في جدول التوجيه»، والبادئتان موجودتان في جدول r4، الأولى من OSPF والثانية متصلة به. والسكربت bgp.sh يشغل r5 ويعطيه البادئة 198.51.100.0/24 على واجهة وهمية dummy، ويحمل إعداد r4، ثم نسأل عن حال الجلسة:
sh bgp.sh
docker exec infp-r4 vtysh -c 'show bgp summary' -c 'show bgp ipv4 unicast'
BGP router identifier 10.255.0.4, local AS number 65010 VRF default vrf-id 0
BGP table version 2
RIB entries 3, using 456 bytes of memory
Peers 1, using 17 KiB of memory
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
10.0.45.5 4 65020 3 3 2 0 0 00:00:11 (Policy) (Policy) isp-r5
Network Next Hop Metric LocPrf Weight Path
*> 10.10.1.0/24 0.0.0.0 0 32768 i
*> 10.10.4.0/24 0.0.0.0 0 32768 iالجلسة قائمة منذ 11 ثانية، والطرفان تبادلا ثلاث رسائل، ولكن العمودين الأخيرين لا يحويان أرقاماً، وإنما الكلمة (Policy): لم نستقبل شيئاً ولم نرسل شيئاً، لأننا لم نكتب سياسة، وهذا هو RFC 8212 أمامك. والجدول يحوي بادئتينا فقط، والمسار i يعني أن أصلهما IGP داخلي. وهذه حماية جيدة، فلو نسيت الفلتر فلن تعلن جدولك كاملاً لمزودك ولن تقبل منه ما لا تريده.
والسياسة في r4-policy.conf تتكون من قائمتي بادئات Prefix Lists وخريطتي طرق Route Maps: نعلن للمزود شبكاتنا فقط، أي ما داخل 10.10.0.0/16 حتى طول 24، ونقبل منه البادئة التي نتوقعها فقط:
ip prefix-list OUR-NETS seq 10 permit 10.10.0.0/16 le 24
ip prefix-list FROM-ISP seq 10 permit 198.51.100.0/24
!
route-map TO-ISP permit 10
 match ip address prefix-list OUR-NETS
exit
route-map FROM-ISP permit 10
 match ip address prefix-list FROM-ISP
exit
!
router bgp 65010
 address-family ipv4 unicast
  neighbor 10.0.45.5 route-map FROM-ISP in
  neighbor 10.0.45.5 route-map TO-ISP out
 exit-address-family
!
وفي الواقع لا تقبل من مزود الإنترنت بادئة واحدة، وإنما طريقاً افتراضياً أو جدولاً كاملاً، ولكن الفكرة واحدة: كل ما لا تذكره القائمة صراحة مرفوض، لأن كل Route Map تنتهي برفض ضمني. وفي جهة المزود سياسة تسمح بكل شيء لتبسيط المختبر. ثم نطبق السياستين وننظر من جديد:
sh bgp.sh policy
docker exec infp-r4 vtysh -c 'show bgp summary' -c 'show bgp ipv4 unicast' -c 'show bgp ipv4 unicast 198.51.100.0/24'
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
10.0.45.5 4 65020 19 15 3 0 0 00:00:45 1 2 isp-r5
Network Next Hop Metric LocPrf Weight Path
*> 10.10.1.0/24 0.0.0.0 0 32768 i
*> 10.10.4.0/24 0.0.0.0 0 32768 i
*> 198.51.100.0/24 10.0.45.5 0 0 65020 i
BGP routing table entry for 198.51.100.0/24, version 3
Paths: (1 available, best #1, table default)
Not advertised to any peer
65020
10.0.45.5 from 10.0.45.5 (10.255.0.5)
Origin IGP, metric 0, valid, external, best (First path received)
198.51.100.0/24 nhid 34 via 10.0.45.5 dev to-r5 proto bgp metric 20 الآن استقبلنا بادئة واحدة وأرسلنا اثنتين. والبادئة الجديدة مسارها 65020 i: نشأت داخل AS 65020 ولم تمر بغيره، والجار التالي Next Hop هو r5، والسطر external يقول إنها من جلسة eBGP، وNot advertised to any peer لأن r4 لا يعلن لمزوده ما تعلمه منه، وهذا صحيح، فالشركة ليست مزوداً يمرر الحركة بين الآخرين. وفي جهة r5 تظهر بادئتانا بالمسار 65010 i.
رسائل BGP على السلك
كنا قد شغلنا tcpdump على واجهة r4 المتجهة إلى r5 قبل بدء الجلسة، وهذا ما التقطه:
    4   0.001165    10.0.45.4 → 10.0.45.5    BGP 165 OPEN Message
    6   0.001480    10.0.45.5 → 10.0.45.4    BGP 165 OPEN Message
    8   0.001814    10.0.45.4 → 10.0.45.5    BGP 85 KEEPALIVE Message
    9   0.002874    10.0.45.5 → 10.0.45.4    BGP 85 KEEPALIVE Message
   11   1.055518    10.0.45.4 → 10.0.45.5    BGP 89 UPDATE Message
   13   1.103270    10.0.45.5 → 10.0.45.4    BGP 89 UPDATE Message
   15  35.640136    10.0.45.4 → 10.0.45.5    BGP 89 ROUTE-REFRESH Message
   17  35.640532    10.0.45.5 → 10.0.45.4    BGP 89 ROUTE-REFRESH Message
   19  35.740676    10.0.45.4 → 10.0.45.5    BGP 125 UPDATE Message
بعد مصافحة TCP، وهي الحزم الثلاث الأولى، يرسل كل طرف رسالة OPEN فيها رقم نظامه ومدة Hold Time ورقم تعريفه وقدراته، ويرد الآخر ب KEEPALIVE فتقوم الجلسة. ثم في الثانية الأولى رسالتا UPDATE قصيرتان طول كل منهما 89 بايتاً، وهما علامة نهاية الجدول End-of-RIB بلا أي بادئة، لأن السياسة كانت غائبة. ثم في الثانية 35، حين طبقنا السياسة، طلب كل طرف من الآخر أن يعيد إرسال جدوله برسالة ROUTE-REFRESH دون أن تسقط الجلسة، ثم جاءت رسائل UPDATE فيها البادئات. وهذه تفاصيل رسالة OPEN من r4:
Border Gateway Protocol - OPEN Message
    Marker: ffffffffffffffffffffffffffffffff
    Length: 99
    Type: OPEN Message (1)
    Version: 4
    My AS: 65010
    Hold Time: 180
    BGP Identifier: 10.255.0.4
مدة Hold Time هنا 180 ثانية، أي أن BGP في إعداد traditional لا يعلن سقوط جار إلا بعد ثلاث دقائق من الصمت، وهذا أبطأ بكثير من OSPF، ولذلك تحتاج BFD مع BGP أكثر مما تحتاجه مع OSPF على أي رابط قد يفشل بصمت، والأمر في FRR هو neighbor 10.0.45.5 bfd.
إيصال الطريق إلى بقية الشبكة
r4 يعرف الطريق إلى 198.51.100.0/24، ولكن هل يعرفه h1 في المكتب؟
docker exec infp-h1 ping -c2 -W1 198.51.100.1
docker exec infp-r1 ip route get 198.51.100.1
2 packets transmitted, 0 received, +2 errors, 100% packet loss, time 1033ms
RTNETLINK answers: Network unreachableلا، فطرق BGP تبقى في r4 حتى ننقلها إلى OSPF. ولشبكة صغيرة مثل هذه نطلب من OSPF في r4 أن يعيد توزيع Redistribute طرق BGP، فيصبح r4 جهاز ASBR وينشرها في إعلانات External. وفي شبكة حقيقية تأخذ جدول الإنترنت كاملاً لا تفعل هذا أبداً، فمليون إعلان في OSPF يعطل الشبكة، وإنما تنشر في OSPF طريقاً افتراضياً واحداً بالأمر default-information originate:
docker exec infp-r4 vtysh -c 'conf t' -c 'router ospf' -c 'redistribute bgp metric-type 2 metric 20' -c end -c 'write memory'
docker exec infp-r1 vtysh -c 'show ip route 198.51.100.0/24' -c 'show ip ospf database external'
docker exec infp-h1 sh -c 'ping -c3 198.51.100.1 | tail -2; traceroute -n -w1 198.51.100.1'
Routing entry for 198.51.100.0/24
Known via "ospf", distance 110, metric 20, best
* 10.0.12.2, via to-r2, weight 1
LS Type: AS-external-LSA
Link State ID: 198.51.100.0 (External Network Number)
Advertising Router: 10.255.0.4
Network Mask: /24
Metric Type: 2 (Larger than any link state path)
Metric: 20
3 packets transmitted, 3 received, 0% packet loss, time 2025ms
traceroute to 198.51.100.1 (198.51.100.1), 30 hops max, 46 byte packets
1 10.10.1.1 0.008 ms 0.009 ms 0.067 ms
2 10.0.12.2 0.004 ms 0.004 ms 0.004 ms
3 10.0.24.4 0.005 ms 0.004 ms 0.004 ms
4 198.51.100.1 0.005 ms 0.005 ms 0.005 msالنوع 2 من الطرق الخارجية E2 يعني أن الكلفة الخارجية 20 تبقى كما هي في كل مكان ولا تضاف إليها كلفة الطريق الداخلي إلى r4، والسطر Larger than any link state path يقول إن أي طريق داخلي يفوز على الخارجي. والحركة من المكتب تصل الآن عبر r1 ثم r2 ثم r4 ثم المزود. والصورة التالية تلخص ما بنيناه، ومعه التجربة التالية:
ماذا لو أعلن المزود جزءاً من شبكتك؟
نعيد حادثة YouTube في المختبر: نجعل r5 يعلن البادئة 10.10.4.0/25، أي النصف الأول من شبكة المستودع، وفيه h4:
docker exec infp-r5 sh -c 'ip addr add 10.10.4.1/25 dev isp0; vtysh -c "conf t" -c "router bgp 65020" -c "address-family ipv4 unicast" -c "network 10.10.4.0/25" -c end'
docker exec infp-r4 vtysh -c 'show bgp summary'
Neighbor V AS MsgRcvd MsgSent TblVer InQ OutQ Up/Down State/PfxRcd PfxSnt Desc
10.0.45.5 4 65020 22 17 3 0 0 00:02:04 1 2 isp-r5وصلت رسالة جديدة، ولكن عدد البادئات المقبولة بقي 1، لأن القائمة FROM-ISP لا تذكر هذه البادئة. فالفلتر عمل. والآن لنر ما يحدث لو كان مسؤول الشبكة قد كتب سياسة تقبل كل شيء من المزود، وهو أمر شائع لأنه «أسهل»:
docker exec infp-r4 vtysh -c 'conf t' -c 'route-map ANY permit 10' -c exit -c 'router bgp 65010' \
  -c 'address-family ipv4 unicast' -c 'neighbor 10.0.45.5 route-map ANY in' -c end
docker exec infp-r4 sh -c 'vtysh -c "show bgp ipv4 unicast"; ip route get 10.10.4.10'
docker exec infp-h1 sh -c 'ping -c2 -W1 10.10.4.10 | tail -2; traceroute -n -w1 -m5 10.10.4.10'
Network Next Hop Metric LocPrf Weight Path
*> 10.10.1.0/24 0.0.0.0 0 32768 i
*> 10.10.4.0/24 0.0.0.0 0 32768 i
*> 10.10.4.0/25 10.0.45.5 0 0 65020 i
*> 198.51.100.0/24 10.0.45.5 0 0 65020 i
10.10.4.10 via 10.0.45.5 dev to-r5 src 10.0.45.4 uid 0
2 packets transmitted, 0 received, 100% packet loss, time 1038ms
traceroute to 10.10.4.10 (10.10.4.10), 5 hops max, 46 byte packets
1 10.10.1.1 0.006 ms 0.004 ms 0.004 ms
2 10.0.12.2 0.004 ms 0.004 ms 0.004 ms
3 10.0.24.4 0.005 ms 0.005 ms 0.004 ms
4 10.0.45.5 0.005 ms 0.005 ms 0.007 ms
5 * * *هذا هو الخطف Hijack بأبسط صوره: r4 متصل مباشرة بالمستودع، وh4 على بعد خطوة منه، ولكن البادئة /25 القادمة من المزود أطول من /24 المتصلة، وأطول بادئة تفوز قبل أي اعتبار آخر، فأرسل r4 حركة المستودع إلى المزود، وتوقف المستودع عن العمل مع أن كل كابل في الشركة سليم. وهذا ما حدث ل YouTube في 2008 على مستوى العالم.
وفي الالتقاط نفسه تفصيل آخر جميل. فهذه رسائل UPDATE كما قرأها tshark بالحقول:
frame.number	ip.src	bgp.update.path_attribute.as_path_segment.as4	bgp.nlri_prefix	bgp.prefix_length
1	10.0.45.5	65020	10.10.4.0	25
9	10.0.45.5	65020,65010,65020	10.10.1.0,10.10.4.0,10.10.4.0,198.51.100.0	24,24,25,24
11	10.0.45.4	65010	10.10.1.0,10.10.4.0	24,24
13	10.0.45.4	65010	10.10.1.0,10.10.4.0	24,24
الحزمة 9 تحمل رسالتي UPDATE معاً، والأولى منهما أعاد فيها r5 إلى r4 بادئتينا 10.10.1.0/24 و10.10.4.0/24 بمسار 65020 65010، لأن سياسته تسمح بكل شيء فأعاد كل ما يعرفه. ولكن r4 لم يضع هذا في جدوله، والجدول أعلاه يثبت ذلك، فالمسار فيه رقمه 65010، وهذه قاعدة منع الحلقات تعمل دون أي إعداد. ثم نعيد الفلتر FROM-ISP وتعود الحركة إلى المستودع، ونحذف الخريطة ANY.
والدرس للشركة الصغيرة واضح: اقبل من مزودك ما تتوقعه فقط، طريقاً افتراضياً أو قائمة محددة، وارفض صراحة أي بادئة من شبكاتك أنت تأتيك من الخارج. ودرس المزودين أكبر، وهو ما يجمعه دليل RFC 7454 لعمليات BGP الآمنة: فلتر كل جار بحسب ما يحق له إعلانه، وتحقق من RPKI، ولا تمرر إعلانات العملاء دون فحص.
ثابت أم OSPF أم BGP؟
بعد المختبر تستطيع أن تختار وأنت تعرف ثمن كل خيار. وهذا الجدول يلخص الحالات التي تصادفها في شركة صغيرة أو متوسطة أو في الهوم لاب:
| الحالة | الاختيار | السبب |
|---|---|---|
| موقع واحد، Router واحد، مزود واحد | مسار افتراضي ثابت | لا يوجد ما يتعلمه بروتوكول |
| موقعان بخط واحد بينهما | مساران ثابتان في الجهتين | طريق واحد لا بديل له، والثابت أبسط |
| موقعان أو أكثر بخطين أو أكثر، أو شبكات تتغير | OSPF، ومعه BFD على الخطوط التي تمر عبر مزود | تحول تلقائي عند العطل، وكل شبكة جديدة تنتشر وحدها |
| فروع عبر الإنترنت بأنفاق WireGuard أو IPsec | OSPF أو BGP فوق الأنفاق | النفق يبدو واجهة عادية، والبروتوكول يختار بين الأنفاق |
| مزودان وعناوين خاصة بالشركة | BGP مع المزودين، وOSPF في الداخل | عناوينك تبقى مرئية عبر أي مزود |
| ربط خاص بمزود سحابي أو بين مراكز بيانات | BGP | هذه الخدمات تتكلم BGP غالباً، والسياسة مهمة |
وحالة الأنفاق تستحق سطراً إضافياً، لأنها الأكثر شيوعاً اليوم: إذا ربطت فروعك بشبكة WireGuard فكل نفق يظهر في الجهاز واجهة عادية، وتستطيع أن تشغل OSPF عليها كما شغلناه على شبكات Docker، فإذا سقط نفق تحولت الحركة إلى نفق آخر. ولكن تذكر أن النفق يمر عبر الإنترنت، فسقوطه صامت دائماً، والواجهة لا تسقط، فهذا بالضبط المكان الذي تحتاج فيه BFD أو مدد Hello قصيرة، وتذكر أيضاً أن MTU النفق أصغر من 1500، فوحده على الطرفين كما رأيت في تجربة MTU. والأنفاق نفسها مشروحة في مقال الأنفاق.
أخطاء شائعة
- تفعيل OSPF على واجهات المستخدمين: فيصبح أي جهاز في المكتب قادراً على إرسال Hello وإعلان طرق. استخدم
passive-interfaceعلى كل واجهة لا يوجد خلفها Router، وفعل المصادقة على روابط ال Routers. - ترك الكلفة للحساب التلقائي: فتتساوى واجهات 1 Gbit/s و10 Gbit/s، أو تختلف الأرقام بين إصدارات. اكتب الكلفة بيدك على الروابط المهمة أو وحد المرجع على كل الأجهزة.
- ترك الروابط الثنائية على النوع Broadcast: فتضيع 40 ثانية في كل تشغيل كما رأيت. اضبطها Point-to-Point.
- الاعتماد على مدة Dead وحدها: فيتوقف كل شيء قرابة 40 ثانية عند فشل صامت. استخدم BFD على الخطوط التي تمر بأجهزة وسيطة.
- MTU مختلف على طرفي الرابط: فتعلق العلاقة في ExStart أو Exchange. وحد MTU ولا تكتف ب
mtu-ignore. - router-id تلقائي: فيتغير اسم الجهاز إذا تغير عنوان واجهة، وتتكرر الأسماء أحياناً عند نسخ الإعداد. اكتبه بيدك وفريداً.
- إعادة توزيع جدول BGP كاملاً في OSPF: انشر طريقاً افتراضياً بدلاً منه.
- جلسة eBGP بلا فلتر أو بفلتر يقبل كل شيء: فتقبل خطفاً لشبكتك أو تعلن جدولك لمن لا يجب. اكتب قائمة بادئات للدخول وللخروج، وارفض بادئاتك القادمة من الخارج.
- نسيان مدة Hold Time في BGP: ثلاث دقائق قبل أن يعرف BGP بسقوط جار صامت. استخدم BFD أو قصر المدة باتفاق مع الجار.
قائمة تحقق قبل أن تشغل التوجيه الديناميكي
- رسمت الشبكة وعناوين كل رابط، وكل رابط بين جهازين له شبكة صغيرة خاصة، ولكل Router عنوان
loثابت تستخدمه router-id. - قررت الكلفة لكل رابط بحسب ما تريد أن يحدث، لا بحسب سرعة الواجهة فقط، ورسمت الطريق الأساسي والاحتياطي بين كل موقعين.
- كل رابط ثنائي على النوع Point-to-Point، وكل واجهة مستخدمين
passive-interface، والمصادقة مفعلة على الروابط. - MTU متطابق على طرفي كل رابط، خاصة عبر الأنفاق.
- BFD مفعل على كل رابط قد يفشل بصمت، ومدده مناسبة لقدرة الأجهزة.
- في BGP: قائمة بادئات للدخول وأخرى للخروج لكل جار، وطريق افتراضي إلى OSPF بدل جدول كامل، وBFD أو Hold Time أقصر.
- اختبرت قطع كل رابط، بالواجهة وبالفشل الصامت، وقست مدة التوقف كما في هذا المختبر، قبل أن يحدث القطع الحقيقي.
- تعرف الأوامر الثلاثة للتشخيص:
show ip ospf neighborوshow ip routeوshow ip ospf database، ومعهاshow bgp summaryوshow bfd peers.
تنظيف المختبر
السكربت cleanup.sh في مجلد التجربة يحذف كل شيء:
docker rm -f infp-r1 infp-r2 infp-r3 infp-r4 infp-r5 infp-h1 infp-h4
for n in n12 n13 n24 n34 n45 lana lanb; do docker network rm infp-$n; done
docker rmi infp-frr:1
الخلاصة
- المسارات الثابتة ممتازة لشبكة صغيرة لا تتغير، ولكنها لا تعرف حالة الطريق ولا تتوسع، والتوجيه الديناميكي يجعل الأجهزة تتعلم الشبكات وتتحول عند العطل بنفسها.
- OSPF بروتوكول حالة رابط: يكتشف الجيران ب Hello، ويغرق المنطقة بإعلانات LSA حتى يحمل كل جهاز الخريطة نفسها، ثم يحسب كل جهاز أقصر طريق بالكلفة بخوارزمية SPF.
- في المختبر احتاج OSPF 50 ثانية ليتقارب على روابط Broadcast بسبب انتظار انتخاب DR، و15 ثانية بعد ضبطها Point-to-Point.
- عند قطع رابط تعرف الواجهة بسقوطه لم تضع حزمة، وعند فشل صامت توقفت الحركة قرابة 36 ثانية حتى انتهت مدة Dead، ومع BFD بفاصل 100 ملي ثانية توقفت قرابة 0.2 ثانية. فالحساب سريع، والاكتشاف هو ما يأخذ الوقت.
- اختلاف MTU يعلق الجوار في ExStart وExchange، والسجل يذكر السبب في الطرف ذي MTU الأصغر.
- BGP بروتوكول متجه مسار بين الأنظمة المستقلة، يقرر بالسياسة لا بالسرعة، وFRR لا يعلن ولا يقبل شيئاً في eBGP بلا سياسة كما يطلب RFC 8212.
- بادئة أطول من جار بلا فلتر تخطف جزءاً من شبكتك، كما في حادثة YouTube 2008، والفلتر على الدخول هو الحماية.
 دليلالتوجيه Routing: جدول التوجيه والبوابة الافتراضيةكيف يختار كل جهاز الخطوة التالية للحزمة، ولماذا يصل الطلب إلى السيرفر ولا يعود الرد، مع تجربة نبني فيها المسارات ونعطلها عن قصد.
 دليلSubnets وCIDR: كيف تقسم عناوين IP وتحسبها بيدكماذا يعني /26 وكيف تحسب الشبكة ومدى الأجهزة بيدك، ثم تبني خطة عناوين كاملة لشركة صغيرة لا تتعارض فيها الشبكات.
 دليلكيف يصل الإنترنت إلى بيتك؟ من ال Router إلى الكابلات البحريةنتتبع طلباً واحداً من حاسوبك إلى سيرفر في بلد آخر ثم عودته، فتعرف من يحمله في كل محطة ولماذا يتأخر الرد.
 دليلما هو NAT؟ شرح ترجمة العناوين وتوجيه المنافذلماذا تخرج كل أجهزة بيتك بعنوان عام واحد، وكيف يترجم ال Router العناوين، ولماذا يفشل توجيه المنافذ خلف CGNAT.
 دليلما هو النفق Tunnel في الشبكات؟ ومتى تحتاج إليهكيف تصل إلى قاعدة بيانات لا تراها من الإنترنت، وتنشر خدمة من خلف CGNAT دون فتح منافذ، ومتى تحتاج إلى VPN بدل النفق.
 دليلشبكة خاصة مع WireGuard وواجهة wg-easyكيف تنشئ شبكة VPN خاصة مع WireGuard وواجهة wg-easy، فلا يصل إلى لوحات الإدارة على سيرفرك إلا أجهزة فريقك.
 دليلMikroTik وRouterOS للمبتدئين: أول إعداد آمنتعرف على أجهزة MikroTik وتراخيص RouterOS، ثم قم بتأمين جهازك من أول دخول حتى لا يصبح جزءاً من شبكة مخترقة.
 دليلVyOS: راوتر وجدار ناري مفتوح المصدر للشركاتنبني مكتباً وفرعاً براوترين VyOS حقيقيين: NAT وDHCP وDNS وجدار ناري بالمناطق ونفق WireGuard بين الموقعين، ثم نرجع عن خطأ قفل SSH بالأمر commit-confirm.
 دليلتحليل حركة الشبكة مع Wireshark وtcpdumpكيف تلتقط الحزم وتقرؤها حتى تعرف لماذا يتأخر طلب DNS أو يرفض اتصال أو يتباطأ نقل ملف، بمختبر حقيقي تحل فيه أربع شكاوى من شبكة شركة.
سجل التحديثات
- 16 نوفمبر 2026: كتابة المقال، وبناء المختبر بخمسة Routers من FRRouting 10.6.1 وجهازين على Alpine 3.24، وقياس التقارب وزمن التحول بثلاث حالات قطع مع BFD، وجلسة eBGP بسياسة وتجربة خطف بادئة، على Docker Engine 29.8.0.


