

الواجب المنزلي في مقرر البرمجة كان لسنوات طويلة يقيس شيئاً واضحاً: الطالب الذي يسلم دالة تعمل وتجتاز الاختبارات فهم الحلقات والشروط بدرجة ما، والطالب الذي يكتب تقريراً متماسكاً قرأ وفكر قبل أن يكتب. أما اليوم فالطالب يلصق نص الواجب في نافذة محادثة، ويحصل على كود يعمل في ثوان، والمصحح الآلي Autograder يعطيه الدرجة الكاملة، ولا يوجد في الملف المسلم ما يفرق بين من فهم ومن نسخ. وهذا لا يعني أن كل الطلاب يغشون، وإنما يعني أن الشيء الذي كنا نقيسه لم يعد دليلاً على الشيء الذي نريد معرفته.
وهذا المقال هو الأول في سلسلة عن التدريس الجامعي في زمن الذكاء الاصطناعي، ونأخذ فيها مقرر البرمجة مثالاً لأن البرمجة هي المجال الذي ظهر فيه أثر هذه الأدوات أولاً وبأوضح صورة.
المواضيع في السلسلة:
- الواجبات والاختبارات الجامعية في زمن الذكاء الاصطناعي (الموضوع الحالي).
- أدوات التعليم في زمن الذكاء الاصطناعي: الكشف والمراقبة والمصححات الآلية والمساعدات.
- مساعد تدريس بالذكاء الاصطناعي لمقرر البرمجة: تجربة عملية على سيرفرك.
وسوف نناقش في هذا المقال ما يلي:
- ما الذي تغير فعلاً في طريقة استخدام الطلاب للذكاء الاصطناعي، بحسب بيانات منشورة وليس بحسب الانطباع.
- لماذا تفشل أدوات كشف النصوص المولدة في إثبات الغش، ولماذا تظلم الطلاب الذين يكتبون بلغة غير لغتهم الأم.
- كيف نعيد تصميم التقييم: العملية قبل الناتج، والدفاع الشفهي، والاختبار داخل القاعة، والاختبار على مرحلتين، والسماح بالذكاء الاصطناعي مع الإفصاح، ومستويات الاستخدام.
- ما الذي يجب أن تحتويه سياسة النزاهة الأكاديمية Academic Integrity Policy للمقرر والجامعة.
- ما الذي ندرسه الآن في مقرر البرمجة، وكيف يبدو مقرر أول بعد إعادة التصميم.
- ماذا تقول المصادر الموثقة عن المستقبل القريب.
ما الذي تغير فعلاً؟
أغلب ما يكتب عن الطلاب والذكاء الاصطناعي مبني على استبانات يجيب فيها الطالب عن نفسه، ولذلك نبدأ من مصدر مختلف وهو بيانات استخدام حقيقية. ففي أبريل 2025 نشرت شركة Anthropic تقرير Anthropic Education Report: How university students use Claude، وحللت فيه قرابة مليون محادثة مجهولة الهوية من حسابات مرتبطة ببريد جامعي، ثم صفتها إلى 574,740 محادثة لها علاقة بالدراسة. ومن نتائج التقرير التي تهم من يدرس البرمجة:
- طلاب علوم الحاسب في المقدمة: تخصص Computer Science يمثل 5.4% فقط من شهادات البكالوريوس في الولايات المتحدة، ولكنه كان مصدر أكثر من ثلث المحادثات (يذكر التقرير 36.8% في الملخص و38.6% في التفاصيل).
- ثلث الاستخدام تقريباً حل وشرح للواجبات التقنية: 33.5% من المحادثات كانت طلب شرح أو حل لمهام أكاديمية تقنية، مثل تصحيح أخطاء كود الواجبات وتنفيذ الخوارزميات وهياكل البيانات.
- نصف المحادثات تقريباً مباشرة: قرابة 47% من المحادثات كانت من النوع المباشر Direct، أي أن الطالب يريد الإجابة أو المحتوى بأقل تفاعل ممكن، ومن الأمثلة التي ذكرها التقرير نفسه طلب إجابات أسئلة اختيار من متعدد في تعلم الآلة، وإعادة صياغة نصوص لتفادي كشف الانتحال.
ويجدر الإشارة هنا إلى أن التقرير نفسه يقول إن المحادثة المباشرة ليست غشاً بالضرورة، فالطالب الذي يطلب حل سؤال قد يكون يتحقق من إجابته في اختبار تدريبي، والسياق هو الذي يحدد. ولكن الرسالة واضحة: الواجب الذي يسلم من البيت لم يعد يخبرك من كتبه.
هل يتعلم الطالب أقل؟
وقد يتساءل البعض: إذا كان الطالب ينجز الواجب أسرع وبدرجة أعلى، فأين المشكلة؟ والإجابة في تجربة ميدانية نشرت في مجلة PNAS سنة 2025 بعنوان Generative AI without guardrails can harm learning، كتبها Hamsa Bastani وزملاؤه، وأعطوا فيها قرابة ألف طالب رياضيات في المرحلة الثانوية أداة مبنية على GPT-4 أثناء حل مسائل التدريب، في نسختين:
- نسخة GPT Base: واجهة تشبه ChatGPT العادي، تجيب عن أي شيء.
- نسخة GPT Tutor: نفس النموذج مع تعليمات مصممة لحماية التعلم، فهي تعطي تلميحات ولا تعطي الإجابة مباشرة.
وكانت النتيجة أن الدرجات أثناء التدريب ارتفعت 48% مع النسخة الأولى و127% مع الثانية، ولكن عندما سحبت الأداة واختبر الطلاب وحدهم، كان أداء من استخدم النسخة الأولى أسوأ بنسبة 17% من الطلاب الذين لم يستخدموا الأداة أصلاً، أما النسخة ذات الضوابط Guardrails فقد خففت هذا الأثر السلبي إلى حد كبير. ويصف الباحثون ما حدث بأن الطلاب استخدموا الأداة عكازاً Crutch، فأنجزوا التدريب دون أن يتعلموا منه.
لاحظ أن الدراسة على طلاب ثانوية في مادة الرياضيات وليست على طلاب جامعة في البرمجة، فلا تنقل أرقامها كما هي إلى مقررك، ولكن الفكرة التي تثبتها مهمة جداً لما يأتي في هذه السلسلة: تصميم الأداة يحدد هل تساعد على التعلم أم تحل محله، والأداة نفسها بلا ضوابط قد تضر. وهذا بالضبط ما سوف نبنيه ونقيسه في المقال الثالث.
لماذا تفشل أدوات الكشف في إثبات الغش؟
أول رد فعل لكثير من الجامعات كان شراء أداة تكشف النص المولد بالذكاء الاصطناعي، وهي أداة تعطي النص نسبة احتمال أنه مولد. والفكرة تبدو منطقية من الوهلة الأولى، ولكن الأبحاث التي اختبرت هذه الأدوات وصلت إلى نتيجة مختلفة تماماً.
أدوات غير دقيقة وغير ثابتة
أوسع اختبار منشور لهذه الأدوات هو ورقة Testing of detection tools for AI-generated text التي كتبتها Debora Weber-Wulff وزملاؤها، ونشرت في International Journal for Educational Integrity في ديسمبر 2023. واختبر الباحثون 12 أداة متاحة للعموم وأداتين تجاريتين منها Turnitin، على نصوص كتبها بشر ونصوص ولدها ChatGPT ونصوص مولدة ثم معدلة بأدوات إعادة الصياغة أو بالترجمة الآلية، ووجدوا ما يلي:
- لم تتجاوز أي أداة دقة 80%، ولم يتجاوز 70% إلا خمس أدوات.
- الأدوات أخطأت في الاتجاهين: نصوص بشرية صنفت مولدة، وهذه هي الإيجابية الكاذبة False Positive، ونصوص مولدة صنفت بشرية.
- تعديل النص المولد بإعادة الصياغة أو الترجمة الآلية أضعف الأدوات بشكل كبير.
وخلاصة الورقة بنص الباحثين أن هذه الأدوات غير مناسبة لاستخدامها دليلاً على سوء السلوك الأكاديمي، وأن الأدوات التي اختبروها لا ينبغي أن تستخدم في البيئة الأكاديمية، والسبب أن الالتفاف عليها سهل، وأنها لا تقدم دليلاً يمكن عرضه كما تفعل أدوات مطابقة النصوص.
ظلم الطلاب الذين يكتبون بغير لغتهم الأم
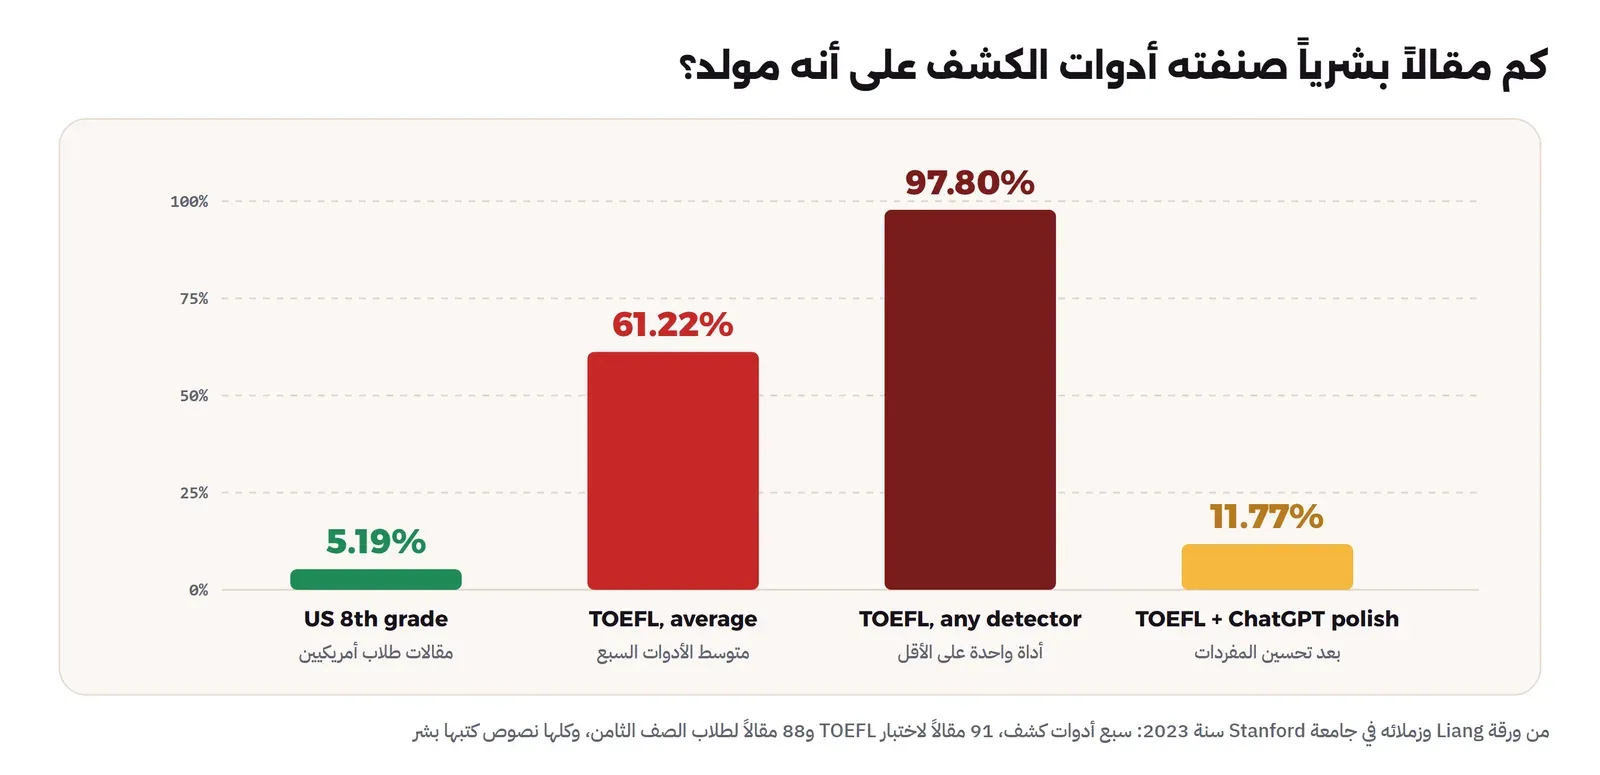
والمشكلة الثانية أخطر على طلابنا بالذات، ففي ورقة GPT detectors are biased against non-native English writers التي كتبها Weixin Liang وزملاؤه في جامعة Stanford، ونشرت في مجلة Patterns سنة 2023، اختبر الباحثون سبع أدوات كشف شائعة على 91 مقالاً كتبها بشر لاختبار TOEFL، أي طلاب يكتبون الإنجليزية لغة ثانية، وعلى 88 مقالاً لطلاب أمريكيين في الصف الثامن. والصورة التالية تبين النتيجة:
في الصورة أعلاه لاحظ التالي:
- متوسط الإيجابية الكاذبة لمقالات TOEFL كان 61.22%، بينما كان متوسطها مع مقالات الطلاب الأمريكيين 5.19% فقط.
- 18 مقالاً من 91 (19.78%) صنفتها الأدوات السبع كلها على أنها مولدة، و89 من 91 (97.80%) صنفتها أداة واحدة على الأقل، وهذا يعني أن الطالب الذي كتب مقاله بنفسه يكاد يكون متهماً بالتأكيد إذا جربت عليه أكثر من أداة.
- عندما طلب الباحثون من ChatGPT أن يحسن مفردات مقالات TOEFL نزلت النسبة إلى 11.77%، أي أن الطالب الذي يستخدم الذكاء الاصطناعي لتجميل نصه ينجو من الأداة، والطالب الذي كتب بنفسه بمفردات بسيطة يتهم.
والسبب أن أغلب هذه الأدوات تعتمد على مقياس يسمى الحيرة Perplexity، وهو مقدار «مفاجأة» النموذج اللغوي بالكلمة التالية، والنص الذي يستخدم مفردات شائعة وتراكيب بسيطة يكون قليل المفاجأة، وهذه صفة كتابة من يتعلم اللغة بالضبط. والطالب العربي الذي يكتب تقريره بالإنجليزية في كلية الهندسة أو الحاسب هو من هذه الفئة، ولم نجد دراسة منشورة تختبر هذه الأدوات على النص العربي نفسه، فلا تفترض أنها أفضل.
أما في كود البرمجة فالمشكلة أصعب، لأن الكود الصحيح لمسألة صغيرة يتشابه بطبيعته مهما كان كاتبه، فدالة تعد الكلمات في نص لها عدد محدود من الطرق المعقولة، ولذلك لن نعتمد على الكشف في هذه السلسلة، وإنما على تصميم تقييم لا يحتاج إليه.
إعادة تصميم التقييم
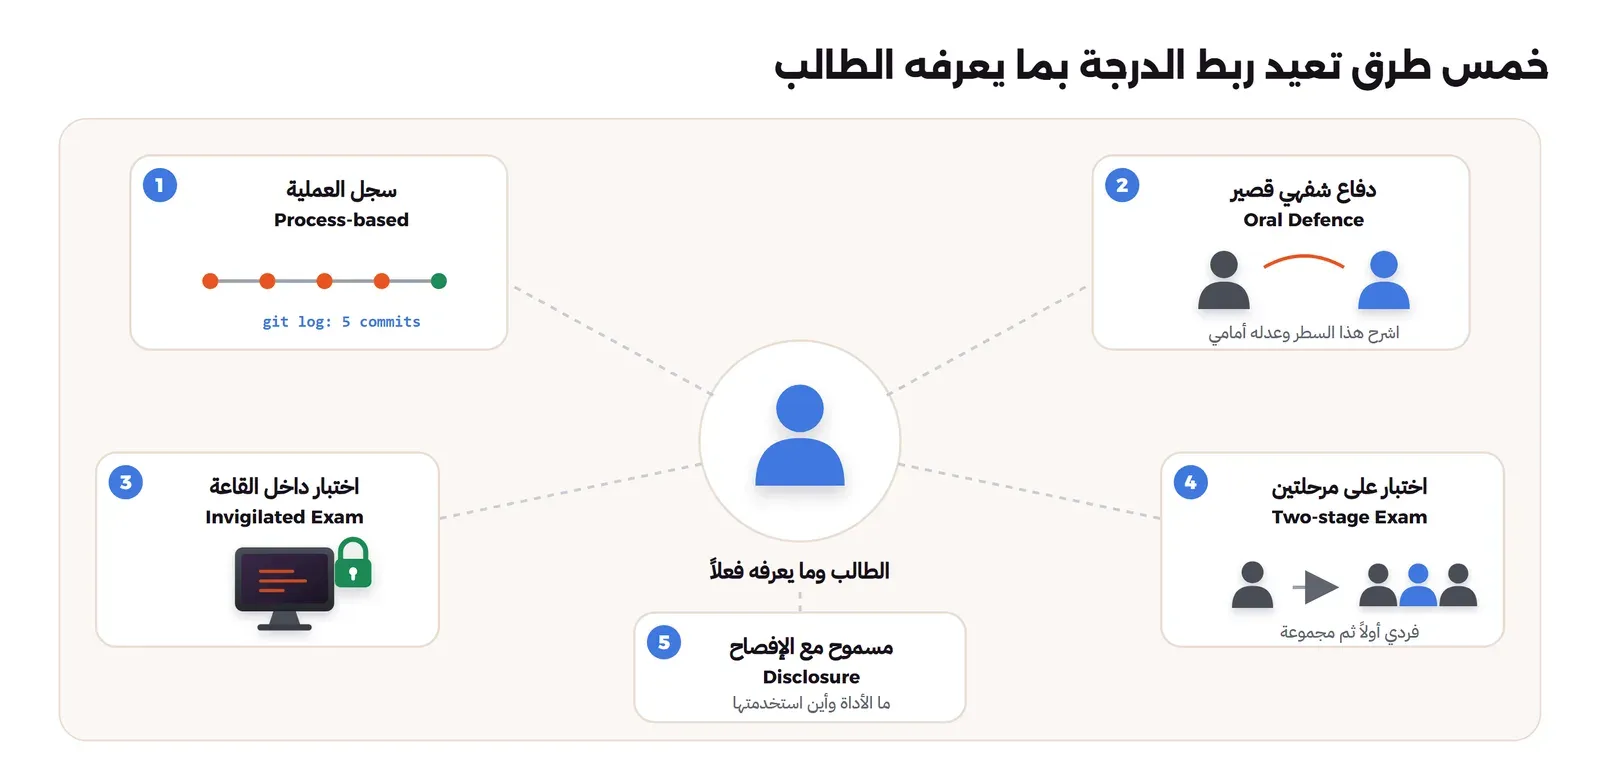
إذا كان الناتج النهائي لم يعد دليلاً، فالحل ليس منع الأدوات ولا مطاردتها، وإنما تغيير ما نقيسه. والصورة التالية تجمع الطرق التي سوف نشرحها:
العملية قبل الناتج
التقييم المبني على العملية Process-based Assessment يعني أن الدرجة لا تعطى للملف النهائي وحده، وإنما للطريق الذي وصل منه الطالب إليه. وفي مقرر البرمجة لدينا أداة جاهزة لهذا وهي Git، فإذا طلبت من الطالب أن يعمل في مستودع ويرفع تغييراته Commits على مراحل، فسوف ترى كيف بدأ، وأين أخطأ، وكيف أصلح. وقد شرحنا أساسيات ذلك في مقال إدارة النسخ وGit للمبتدئين.
ويجدر الإشارة هنا إلى أن سجل Git ليس دليلاً قاطعاً، فالطالب يستطيع أن يقسم كوداً منسوخاً على عشرة Commits بتواريخ متباعدة، ولكنه يرفع تكلفة الغش، ويعطيك مادة للأسئلة في الدفاع الشفهي، مثل: لماذا غيرت هذه الدالة في الـ Commit الرابع؟
الدفاع الشفهي القصير
الدفاع الشفهي Oral Defence، ويسمى في الجامعات البريطانية Viva، هو أقدم طريقة تحقق في الجامعات وأقواها في زمن الذكاء الاصطناعي، لأن الطالب يشرح كوده بنفسه أمامك. ولا يحتاج إلى ساعة لكل طالب، فخمس إلى عشر دقائق تكفي إذا كانت الأسئلة على الكود نفسه:
- اشرح لي هذا السطر، وماذا يحدث لو كانت القائمة فارغة؟
- غير الدالة الآن لتقبل حالة جديدة، وأنا أشاهد.
- هذا الاختبار فشل عندي، ما سببه في رأيك؟
وهي نفس الطريقة التي نستخدمها لكشف مستوى المرشح في المقابلة التقنية، فطلب تعديل صغير على الكود أمامك يكشف الفهم أسرع من أي سؤال نظري، وقد شرحنا ذلك في مقال كيف تدير مقابلة تقنية تكشف مستوى المرشح. ولمقرر فيه مئات الطلاب يمكن أن يكون الدفاع على عينة عشوائية من الطلاب في كل واجب، مع إعلان ذلك مسبقاً، فيعرف كل طالب أنه قد يسأل عن كوده.
الاختبار داخل القاعة والاختبار على مرحلتين
الاختبار داخل القاعة Invigilated Exam يعود إلى الواجهة لأنه المكان الوحيد الذي تعرف فيه بدقة ما هي الأدوات المتاحة للطالب، سواء كان على الورق أو على جهاز مقفل بمتصفح اختبارات آمن، وهو ما سوف نتحدث عنه في المقال الثاني. والفكرة ليست أن نعود بكل التقييم إلى الورق، وإنما أن يكون جزء من الدرجة في مكان مضبوط يثبت أن الطالب يملك المهارة الأساسية بنفسه.
والاختبار على مرحلتين Two-stage Exam طريقة معروفة في تدريس العلوم يحل فيها الطالب الاختبار وحده أولاً ويسلمه، ثم يحل الأسئلة نفسها أو أسئلة قريبة منها مع مجموعة صغيرة من زملائه، وتجمع الدرجتان بوزن أكبر للمرحلة الفردية. والفائدة هنا أن المرحلة الثانية تحول الاختبار إلى نقاش يتعلم فيه الطالب من خطئه مباشرة، وهي فائدة لا يعطيها نموذج يكتب الإجابة.
السماح بالذكاء الاصطناعي مع الإفصاح
بعض المهارات تحتاج الذكاء الاصطناعي نفسه، فالمبرمج اليوم يعمل مع مساعد برمجة في وظيفته، والمقرر الذي يمنعه في كل شيء لا يجهز الطالب لذلك. والحل الأنسب في هذه الواجبات هو الإفصاح Disclosure، أي أن يرفق الطالب مع تسليمه فقرة قصيرة تقول ما هي الأداة، وفي أي جزء استخدمها، وماذا غير في مخرجها، وكيف تحقق منه. والمثال التالي يبين نموذجاً لهذه الفقرة:
إفصاح عن استخدام الذكاء الاصطناعي (الواجب الثالث)
الأداة: مساعد المقرر CS101 فقط.
الاستخدام: سألته عن معنى IndexError، وطلبت تلميحاً عن الحالات الحدية.
ما كتبته بنفسي: الدالة is_balanced كاملة والاختبارات الخمسة.
التحقق: شغلت الاختبارات، واكتشفت أن الحالة "}{" كانت تفشل فأصلحتها.
والقيمة الحقيقية للإفصاح أنه يغير السؤال من «هل استخدمت الذكاء الاصطناعي؟» الذي يجيب عنه الجميع بلا، إلى «كيف استخدمته؟» الذي يمكن مناقشته في الدفاع الشفهي، وهو قريب مما طبقه مقرر CS50 في جامعة Harvard كما سيأتي.
مستويات الاستخدام المسموح
بين المنع الكامل والسماح الكامل توجد درجات، وأشهر إطار لها هو مقياس تقييم الذكاء الاصطناعي AI Assessment Scale واختصاراً AIAS، الذي نشره Mike Perkins وLeon Furze وJasper Roe وJason MacVaugh، وصدرت نسخته الأولى في Journal of University Teaching and Learning Practice سنة 2024، ثم نشروا نسخة معدلة في ديسمبر 2024 فيها خمسة مستويات:
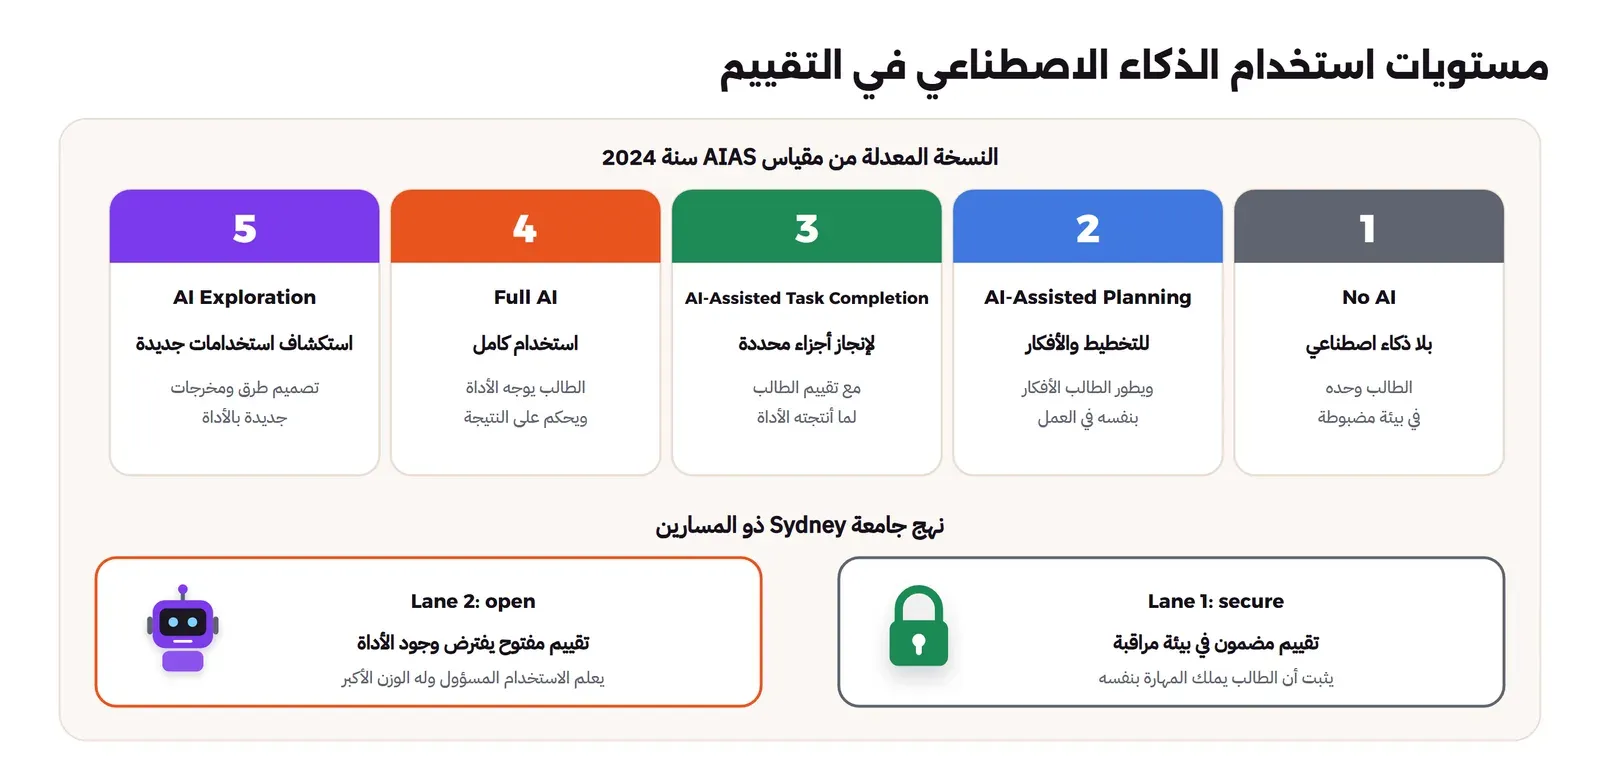
وفي الصورة أعلاه لاحظ أن الإطار لا يفرض مستوى واحداً للمقرر كله، فواجب يقيس فهم الحلقات قد يكون في المستوى الأول، ومشروع نهاية الفصل قد يكون في المستوى الرابع. ويوجد نقد معروف لفكرة المستويات من جامعة Sydney، وهو النهج ذو المسارين Two-lane Approach الذي كتبه Danny Liu وAdam Bridgeman سنة 2023، ويقسم التقييم إلى مسارين فقط:
- المسار الأول: تقييم مضمون Secure Assessment يتم في بيئة مراقبة، ويثبت أن الطالب حقق مخرجات التعلم بنفسه.
- المسار الثاني: تقييم مفتوح يتعامل مع الذكاء الاصطناعي على أنه موجود ويعلم الطالب استخدامه بمسؤولية، ويكون له الوزن الأكبر.
ويرى أصحاب هذا النهج أنه لا يوجد حل وسط حقيقي، لأن أي تقييم غير مراقب يجب أن يفترض أن الذكاء الاصطناعي استخدم فيه. وفي رأينا أن الفكرتين تكمل إحداهما الأخرى: المساران يحددان أين تثبت المهارة، والمستويات توضح للطالب ما المسموح في المسار المفتوح.
مقارنة طرق التقييم
الجدول التالي تقدير منا لما يثبته كل نوع من التقييم وتكلفته، وليس نتيجة دراسة، والغرض منه مساعدتك على المزج بينها:
| نوع التقييم | ما الذي يثبته | التكلفة على المعلم | أثر الذكاء الاصطناعي عليه |
|---|---|---|---|
| واجب منزلي يصححه مصحح آلي | أن الكود يعمل فقط | منخفضة | كبير جداً، فالحل المولد يجتاز الاختبارات |
| سجل العملية مع Git والمسودات | طريقة العمل والتدرج | متوسطة | متوسط، ويرفع تكلفة النسخ |
| دفاع شفهي قصير | الفهم والقدرة على التعديل | مرتفعة، وتقل مع العينة العشوائية | منخفض |
| اختبار داخل القاعة | المهارة الأساسية دون مساعدة | متوسطة | منخفض إذا ضبطت البيئة |
| اختبار على مرحلتين | الفهم الفردي ثم النقاش | متوسطة | منخفض في المرحلة الفردية |
| مشروع مفتوح مع الإفصاح | استخدام الأدوات بمسؤولية | متوسطة | مسموح ومقصود |
سياسة النزاهة الأكاديمية
الطالب لا يستطيع أن يلتزم بقاعدة لا يعرفها، وأغلب المشاكل التي نسمعها تبدأ من مقرر لم يقل بوضوح ما المسموح. ولذلك نبدأ بما نشرته جهات معروفة، ثم نصل إلى ما يحتاجه مقررك.
ماذا تقول الجهات الدولية والمحلية؟
في يوليو 2023 نشرت مجموعة Russell Group للجامعات البحثية البريطانية خمسة مبادئ لاستخدام أدوات الذكاء الاصطناعي التوليدي في التعليم:
- تدعم الجامعات طلابها وموظفيها ليصبحوا ملمين بالذكاء الاصطناعي AI-literate، أي يعرفون فرصه وحدوده وقضاياه الأخلاقية.
- يجب أن يكون الموظفون قادرين على توجيه الطلاب لاستخدام الأدوات بشكل فعال ومناسب، مع اختلاف الاستخدام المناسب بين التخصصات.
- تعدل الجامعات التدريس والتقييم ليشمل الاستخدام الأخلاقي للذكاء الاصطناعي، وتحرص على عدالة الوصول، لأن بعض الأدوات خلف اشتراكات مدفوعة.
- تحافظ الجامعات على الصرامة العلمية والنزاهة الأكاديمية بسياسات واضحة، وببيئة يسأل فيها الطالب عن حالته دون خوف من العقوبة.
- تتعاون الجامعات لتبادل أفضل الممارسات مع تطور التقنية.
وفي سبتمبر 2023 نشرت منظمة UNESCO أول دليل عالمي في هذا الموضوع بعنوان Guidance for generative AI in education and research من إعداد Fengchun Miao وWayne Holmes، وهو متاح بالعربية أيضاً، ويقترح بحسب البيان الصحفي للمنظمة سبع خطوات للحكومات لتنظيم هذه الأدوات، منها حماية خصوصية البيانات، ويحدد سن 13 حداً أدنى لاستخدامها في الفصل، ويدعو إلى تدريب المعلمين.
ومحلياً، ذكرت صفحة أخبار جامعة الملك سعود في نوفمبر 2025 أن كلية الطب في الجامعة اعتمدت في مارس 2025 دليلاً لاستخدام الذكاء الاصطناعي التوليدي لأعضاء هيئة التدريس والطلاب، بني على «دليل استخدام الذكاء الاصطناعي التوليدي في التعليم العام (2025)» الصادر عن وزارة التعليم والهيئة السعودية للبيانات والذكاء الاصطناعي SDAIA، وعلى مبادئه الستة: الاستخدام المسؤول، والخصوصية وأمن البيانات، والرفاه والتركيز على الإنسان، والعدالة وإمكانية الوصول، والشفافية والمساءلة، والتعلم المستمر والتغذية الراجعة. ولم نتمكن من الوصول إلى نص الدليل نفسه من موقع رسمي، فننقل هنا ما ذكرته الجامعة عنه فقط، وإذا كانت جامعتك في المملكة فارجع إلى النسخة الرسمية منه، وإلى نظام حماية البيانات الشخصية عند اختيار أي أداة تعالج بيانات الطلاب.
ما الذي تحتاجه سياسة المقرر؟
المبادئ أعلاه عامة، والطالب يحتاج أن يعرف ماذا يفعل في الواجب الثالث بالذات. والسياسة الجيدة للمقرر تجيب عن الأسئلة التالية:
- المستوى لكل تقييم: ما هو المستوى المسموح في كل واجب واختبار، مكتوباً بجانب الواجب نفسه وليس في صفحة منفصلة.
- الأدوات: هل توجد أداة رسمية للمقرر، وهل الأدوات العامة مسموحة، وما الذي لا يجوز إدخاله فيها مثل بيانات حقيقية أو كود من مشروع شركة.
- الإفصاح: متى يجب، وبأي شكل، وما الذي يحدث إذا لم يفصح الطالب.
- التحقق: أن الدفاع الشفهي أو سجل العملية جزء معلن من التقييم، وليس عقوبة تظهر عند الشك فقط.
- الكشف: أن المقرر لا يتخذ قراراً بناء على أداة كشف وحدها، والسبب ما ذكرناه في القسم السابق.
- السؤال الآمن: قناة يسأل فيها الطالب «هل هذا الاستخدام مسموح؟» قبل التسليم دون أن يحسب عليه.
ومثال واقعي على سياسة من هذا النوع مقرر CS50 في جامعة Harvard، فبحسب ورقة الفريق في مؤتمر SIGCSE 2024 سمح المقرر للطلاب باستخدام أدواته الخاصة المبنية على الذكاء الاصطناعي، وحد من استخدام الأدوات التجارية العامة مثل ChatGPT وGitHub Copilot، وهو مثال على أداة رسمية مع ضوابط بدلاً من المنع. وسوف نعود إلى هذه الورقة بالتفصيل في المقالين القادمين.
ماذا ندرس الآن في مقرر البرمجة؟
إذا كان النموذج يكتب الدالة، فما الذي يجب أن يتعلمه الطالب؟ والإجابة أن المهارات التي كانت تأتي بعد كتابة الكود صارت هي الأساس، والسبب أن الكود المولد يحتاج من يقرؤه ويحكم عليه. وهذه أهم المهارات التي نقترح أن تأخذ وقتاً أكبر في المقرر:
- التحقق Verification: أن يعرف الطالب أن النموذج يخطئ بثقة كاملة، وأن يتحقق بالتشغيل والتوثيق، وقد شرحنا أنماط هذه الأخطاء في مقال متى يكون الذكاء الاصطناعي واثقاً ومخطئاً؟.
- قراءة الكود: أن يتتبع الطالب كوداً لم يكتبه ويتوقع مخرجه قبل تشغيله، وهذه مهارة يمكن اختبارها داخل القاعة بسهولة.
- تتبع الأخطاء Debugging: أن يقرأ رسالة الخطأ Traceback ويضع فرضية ويختبرها، بدلاً من لصق الخطأ في المحادثة وانتظار الحل.
- كتابة الاختبارات Testing: أن يكتب الطالب الاختبارات قبل أن يطلب الكود، فيصبح هو من يحدد الصحيح، وقد شرحنا حدود الاختبارات المولدة في مقال أتمتة الاختبارات بالذكاء الاصطناعي.
- المراجعة وجودة الكود: أن يعرف متى يكون الكود صحيحاً ولكنه سيئ، وقد شرحنا ذلك في مقال جودة الكود Code Quality وفي مقال مراجعة كود الذكاء الاصطناعي.
- فهم الأداة نفسها: كيف يولد النموذج النص كلمة بعد كلمة، ولماذا لا يعرف ما لم يتدرب عليه، وقد شرحنا ذلك في مقال كيف تعمل نماذج اللغة الكبيرة.
كيف يبدو مقرر أول بعد إعادة التصميم؟
لنأخذ مثالاً مقرراً أول في البرمجة CS1 بلغة Python، فيه واجبات أسبوعية ومشروع واختبار نهائي. والجدول التالي اقتراح منا لتوزيع التقييم، وليس مقرراً قائماً:
| التقييم | الوزن | مستوى AIAS | كيف نتحقق |
|---|---|---|---|
| واجبات أسبوعية مع مصحح آلي | 15% | الثاني: تلميحات من مساعد المقرر فقط | سجل Git ودفاع شفهي لعينة عشوائية |
| اختبارات قصيرة داخل القاعة لقراءة الكود | 20% | الأول: بلا ذكاء اصطناعي | على الورق أو بمتصفح اختبارات آمن |
| اختبار منتصف الفصل على مرحلتين | 15% | الأول | المرحلة الفردية ثم مجموعات من ثلاثة |
| مشروع جماعي | 25% | الرابع: مسموح مع الإفصاح | عرض ودفاع لكل عضو عن جزئه |
| اختبار نهائي عملي | 25% | الأول | داخل المختبر على أجهزة مضبوطة |
لاحظ في الجدول أن الواجبات الأسبوعية بقيت، ولكن وزنها قل، لأنها صارت تدريباً أكثر منها دليلاً، ولاحظ أن 60% من الدرجة في المسار المضمون حتى لو كان كل ما في البيت مولداً. وفي المقال الثاني سوف نتحدث عن الأدوات التي تنفذ هذا الجدول، وفي الثالث نبني المساعد الذي يعطي التلميحات دون الحلول.
ماذا عن المستقبل؟
التوقعات في هذا الموضوع كثيرة، ولذلك نكتفي بما تقوله المصادر التي قرأناها:
- المساعد الرسمي للمقرر صار واقعاً: بحسب ورقة CS50، استخدم أداتهم أكثر من 50,000 مستخدم حتى ديسمبر 2023، وعالجت أكثر من 1.8 مليون سؤال، بتكلفة قدرها الفريق بنحو 1.90 دولار للطالب في الشهر، ووسعوها إلى 10 مقررات أخرى من مقررات CS50 المفتوحة.
- التصحيح بالذكاء الاصطناعي هو الخطوة التالية: نفس الورقة تذكر خطة لأداة تصحح تصميم الكود Code Design بناء على واجبات صححها البشر سابقاً، مع بقاء المراجعة والتأكيد للمعلم.
- الضوابط هي الفرق: تجربة Bastani وزملائه تبين أن الأداة نفسها تضر أو تنفع بحسب تصميمها، وهذا يعني أن قرار الجامعة الحقيقي ليس «هل نسمح؟» وإنما «أي أداة وبأي ضوابط؟».
- التنظيم يتقدم: دليل UNESCO وضع إطاراً للحكومات، والمملكة لديها دليل للتعليم العام بحسب ما نقلته جامعة الملك سعود، والجامعات بدأت تبني أدلتها الخاصة عليه.
أخطاء شائعة
- شراء أداة كشف واعتماد نسبتها دليلاً: الأبحاث تقول إنها غير دقيقة وتظلم من يكتب بلغة ثانية.
- المنع الكامل في كل شيء: المنع لا يطبق في البيت، والطالب يتخرج إلى عمل يستخدم فيه هذه الأدوات يومياً.
- السماح الكامل دون ضوابط: تجربة Bastani تبين أن الطالب قد ينجح في التدريب ويفشل وحده.
- سياسة عامة للجامعة دون تفاصيل في المقرر: الطالب يحتاج المستوى المسموح بجانب كل واجب.
- الدفاع الشفهي عقوبة وليس جزءاً من التقييم: عندما يكون معلناً للجميع يصبح طبيعياً، وعندما يظهر عند الشك يصبح اتهاماً.
- إبقاء وزن الواجبات المنزلية كما هو: الواجب الذي لا يثبت شيئاً لا يجب أن يحدد نصف الدرجة.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- الناتج النهائي للواجب المنزلي لم يعد دليلاً على التعلم، وبيانات الاستخدام تبين أن طلاب علوم الحاسب هم الأكثر استخداماً لهذه الأدوات.
- أدوات كشف النصوص المولدة غير دقيقة، وتظلم بشكل خاص من يكتب بلغة ثانية، فلا تستخدمها دليلاً.
- الحل في إعادة التصميم: العملية قبل الناتج، والدفاع الشفهي، والاختبار داخل القاعة، والاختبار على مرحلتين، والإفصاح، ومستوى معلن لكل تقييم.
- سياسة المقرر يجب أن تكون محددة لكل واجب، ومبنية على مبادئ معروفة مثل مبادئ Russell Group ودليل UNESCO والدليل السعودي للتعليم العام.
- المهارات التي تأخذ الوقت الأكبر الآن هي التحقق وقراءة الكود وتتبع الأخطاء والاختبار والمراجعة.
- الأداة نفسها قد تضر أو تنفع بحسب ضوابطها، وهذا ما سوف نختبره عملياً في المقالين القادمين بإذن الله.
 دليلأدوات التعليم في زمن الذكاء الاصطناعي: من الكشف إلى التصحيحما الذي تقدمه أدوات الكشف والمراقبة والمصححات الآلية والمساعدات للمقرر، وأين يجتاز الحل المولد المصحح الآلي.
 دليلمساعد تدريس بالذكاء الاصطناعي لمقرر البرمجةكيف تبني مساعداً محلياً يجيب طلاب البرمجة من ملاحظات المقرر ويعطي تلميحات بدلاً من حل الواجبات.
 دليلأنظمة إدارة التعلم LMS: ماذا تحتاج منها مؤسستك التعليمية؟ما الذي يفعله نظام إدارة التعلم LMS، وما الذي تحتاجه منه مدرستك أو جامعتك فعلاً قبل أن تختار بين الأنظمة المفتوحة.
 دليلMoodle: منصة تعلم بالعربية على سيرفرككيف تثبت Moodle على سيرفرك وتجهزه بالعربية، ثم تنشئ مقرراً واختباراً وتسجل الطلاب وتأخذ له نسخة احتياطية كاملة.
 دليلالمصادر المفتوحة للجامعات: خطة وأدوات بالترتيبدليل لقيادة الجامعة يشرح ما تكسبه فعلاً من المصادر المفتوحة وما تكلفه، وبأي ترتيب تنقل خدماتها إليها.
 دليلمتى يكون الذكاء الاصطناعي واثقاً ومخطئاً؟أنماط الأخطاء التي يكتبها مساعد البرمجة بثقة كاملة، ولماذا تحدث، وكيف تكشف كل واحد منها قبل أن يصل إلى الإنتاج.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وكل المصادر المذكورة قرئت من صفحاتها الأصلية في 13 أكتوبر 2026: تقرير Anthropic Education Report (أبريل 2025)، وورقة Bastani وزملائه في PNAS (يونيو 2025)، وورقة Weber-Wulff وزملائها في International Journal for Educational Integrity (ديسمبر 2023)، وورقة Liang وزملائه في Patterns (2023)، ونسختا مقياس AIAS (2024)، وصفحة جامعة Sydney عن المسارين (2023)، ومبادئ Russell Group (يوليو 2023)، ودليل UNESCO وبيانه الصحفي (سبتمبر 2023)، وصفحة أخبار جامعة الملك سعود (نوفمبر 2025)، وورقة CS50 في SIGCSE 2024.