


إذا كنت تحمل هاتف المناوبة في فريق صغير فأنت تعرف هذا الشعور: يرن التنبيه في الثالثة فجراً، والرسالة تقول إن نسبة أخطاء الدفع فوق الحد، وأنت تعرف هذه الخدمة من الكود ولكنك لم تشغلها في الإنتاج من قبل، والشخص الوحيد الذي يعرف «ماذا نفعل عندما يحدث هذا» في إجازة، أو نائم ولا يرد. فتفتح صفحة الويكي فتجد عنوانها «ملاحظات السيرفر» وآخر تعديل عليها قبل سنتين، وفيها أوامر لا تعرف هل ما زالت صحيحة. فتبدأ من الصفر: تقرأ السجلات، وتبحث في الإنترنت عن رسالة الخطأ، وتجرب، وكل دقيقة تمر هي عملاء لا يستطيعون الدفع.
والفرق بين هذه الليلة وليلة أخرى ينتهي فيها العطل في دقيقتين ليس في ذكاء المناوب، وإنما في وثيقة واحدة كتبها أحد الزملاء في وقت هادئ: دليل التشغيل Runbook، أي صفحة تقول لك متى تستخدمها، وما الذي تأثر، وما لا يجوز أن تفعله أبداً، والأوامر بالترتيب، وكيف تتأكد أن المشكلة انتهت، ومن تتصل به إذا لم تنته. وفي هذا المقال سوف نتابع فريق المتجر الإلكتروني نفسه الذي وضع معنا أهداف الخدمة SLO، وقد اكتشف بعد أول شهر أن أغلب الميزانية ذهبت في حوادث تكررت بنفس الشكل، وكل مرة حلها شخص مختلف بطريقة مختلفة. فنكتب معه أول دليل تشغيل لعطل حقيقي في قاعدة البيانات، ثم نختبره في يوم تجربة Game Day على PostgreSQL، ونرى أن الدليل نفسه كان فيه خطأ لم يظهر إلا عند التنفيذ.
وسوف نناقش في هذا المقال ما يلي:
- ما هو دليل التشغيل، وما الفرق بينه وبين التوثيق العادي ومراجعة ما بعد الحادثة، وماذا يقول كتاب Google SRE عن أثره على زمن الإصلاح.
- لماذا تفشل الوثائق الموجودة عادة، وأقسام الدليل الجيد، وكيف تكتب خطوة يستطيع أن ينفذها شخص لم ير النظام.
- مستويات الدليل من الوثيقة إلى الأتمتة الكاملة، ومتى تنتقل من مستوى إلى الذي بعده.
- مختبر حقيقي: قرص PostgreSQL يمتلئ بالنسخ الاحتياطية، ودليل DB-01 ننفذه بالثواني، ومشكلة في الدليل نفسه، وتجربة «ماذا لو» تحذف ملفات pg_wal.
- ربط التنبيه بالدليل، وأين تحفظ الأدلة، واختبارها، وقصة Amazon S3 في 2017 مع دليل معتمد ومدخل خاطئ.
- الأخطاء الشائعة، وقالب تبدأ به، وقائمة تحقق.
ما هو دليل التشغيل Runbook؟
دليل التشغيل وثيقة قصيرة تصف كيف تنفذ إجراء معيناً في النظام، خطوة خطوة، بحيث يستطيع أي شخص في الفريق أن ينفذه دون أن يكون هو من بنى النظام. وأغلب الأدلة تكتب لحالة عطل معروفة، مثل «القرص ممتلئ» أو «الشهادة انتهت» أو «خدمة الدفع ترفض الطلبات»، ولكن الكلمة تشمل كذلك الإجراءات المخطط لها، مثل إضافة سيرفر جديد، أو تدوير Rotate باسورد قاعدة البيانات، أو استعادة نسخة احتياطية. والقاسم المشترك أنه إجراء يحدث أكثر من مرة، ونتيجته مهمة، والخطأ فيه مكلف.
وتختلط الكلمة بكلمات قريبة منها، فمن المفيد أن نفرق بينها. فالدليل Playbook يستخدم أحياناً بنفس المعنى، وأحياناً لوثيقة أوسع تصف كيف تتعامل مع نوع كامل من الحوادث، مثل «حوادث الأمن»، وتحتها عدة أدلة تشغيل. وإجراءات التشغيل القياسية Standard Operating Procedures واختصاراً SOP مصطلح إداري أوسع يشمل أي إجراء متكرر في المؤسسة. ومراجعة ما بعد الحادثة Postmortem وثيقة تكتب بعد الحادثة لتفهم ماذا حدث ولماذا، أما دليل التشغيل فيكتب قبلها ليقول ماذا تفعل. والعلاقة بينهما مهمة: أغلب الأدلة الجيدة تولد من مراجعة حادثة، فالسؤال «ماذا كان سيجعل هذه الليلة أقصر؟» إجابته غالباً دليل تشغيل.
ويقول الفصل الأول من كتاب Google SRE إن المقياس الأهم في الاستجابة للطوارئ هو سرعة إعادة النظام إلى حالته الطبيعية، أي متوسط زمن الإصلاح Mean Time To Repair واختصاراً MTTR، وإن الإنسان يضيف تأخيراً، ثم يذكر أن فريق Google وجد أن التفكير المسبق في أفضل الممارسات وكتابتها في دليل يعطي تحسناً في زمن الإصلاح بنحو ثلاثة أضعاف مقارنة بالارتجال. ويضيف جملة تلخص الفكرة كلها: المهندس البطل الذي يعرف كل شيء ينجح، ولكن المهندس المتمرن الذي يحمل دليلاً ينجح أكثر بكثير. ويقول الفصل كذلك إن الدليل لا يغني عن مهندس يفكر، ولكن الخطوات الواضحة لها قيمة كبيرة عندما يكون الضغط عالياً والوقت قصيراً، وهذا هو المكان الصحيح للأدلة: ليست بديلاً عن الفهم، وإنما طريقة لتجعل الفهم متاحاً في الثالثة فجراً.
لماذا لا تنفع الوثائق الموجودة؟ Why Docs Fail
أغلب الفرق لديها توثيق، ومع ذلك لا يفتحه أحد أثناء الحادثة، والسبب ليس الكسل، وإنما أن التوثيق العادي يكتب لهدف مختلف. فوثيقة التصميم تشرح لماذا بني النظام بهذا الشكل، ووثيقة التثبيت تشرح كيف تبنيه من الصفر، وصفحة «ملاحظات السيرفر» مجموعة أوامر كتبها شخص لنفسه. ولا واحدة منها تجيب عن السؤال الذي يسأله المناوب: «ما الذي يحدث الآن، وماذا أفعل في الدقائق الخمس القادمة؟».
وفي قصة الفريق كانت هناك أربع مشاكل في الوثائق الموجودة، وهي المشاكل نفسها التي ستجدها في أغلب الفرق:
- لا يمكن العثور عليها: الصفحة موجودة في الويكي، ولكن عنوانها لا يحتوي الكلمات التي في التنبيه، فلا يجدها البحث، والمناوب لا يعرف أنها موجودة أصلاً.
- قديمة: الأوامر تشير إلى سيرفر حذف قبل سنة، ومسار تغير مع آخر ترقية، ولا أحد يعرف هل الباقي صحيح.
- طويلة وتشرح: ثلاث صفحات عن تاريخ النظام قبل أول أمر، والمناوب يحتاج الأمر الأول في الثانية الأولى.
- تفترض معرفة: «أعد تشغيل العامل Worker كالمعتاد»، والمعتاد معروف لمن كتب الجملة فقط.
وهناك مشكلة خامسة أخطر من هذه الأربع، وهي أن الوثيقة تخبرك بما تفعل ولا تخبرك بما لا يجوز أن تفعله. فالمناوب الذي يرى قرصاً ممتلئاً سوف يبحث عن أكبر الملفات ويحذفها، وهذا منطقي، إلا إذا كانت أكبر الملفات هي ملفات سجل قاعدة البيانات، كما سنرى في المختبر. والدليل الجيد يضع الممنوع في أعلى الصفحة، قبل الخطوات، لأن المناوب المتعب يقرأ أول الصفحة بعناية ثم يبدأ يتصفح.
أقسام الدليل الجيد Runbook Anatomy
لا يوجد قالب رسمي واحد، ولكن الأدلة التي تستخدمها الفرق الناضجة تتفق على أقسام متقاربة. ومن أفضل الأمثلة المنشورة للعموم أدلة مشروع Prometheus Operator لتنبيهات Kubernetes، فكل دليل فيها يبدأ بالمعنى Meaning، ثم الأثر Impact، ثم التشخيص Diagnosis، ثم المعالجة Mitigation، ومثال ذلك دليل امتلاء ال Volume، وفيه أن أسرع وأرخص حل هو حذف البيانات التي لم تعد مطلوبة، بعد أن تسأل مالك الخدمة. وكذلك تنشر GitLab مستودع أدلتها كاملاً للعموم. والصورة التالية تبين الأقسام كما كتبناها لدليل المختبر:
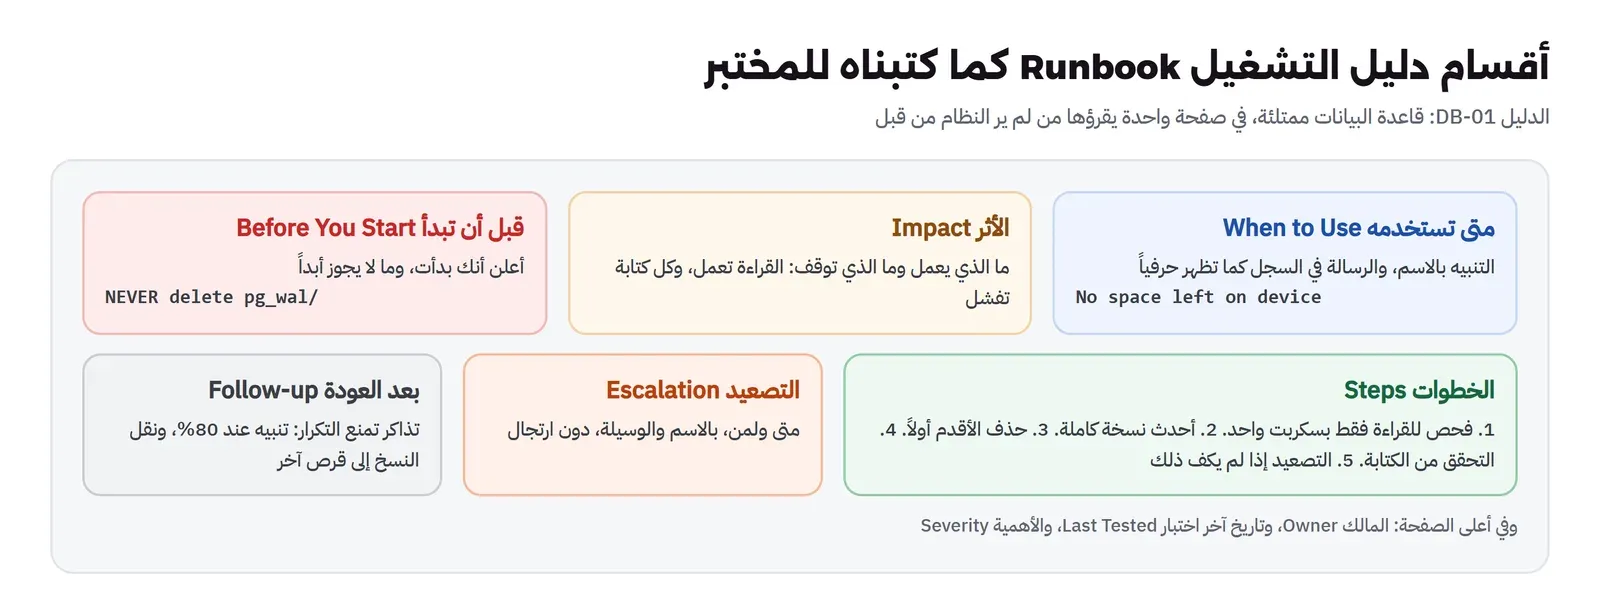
ولكل قسم سبب، فلنمر عليها بالترتيب:
- الرأس Header: المالك Owner، وتاريخ آخر اختبار Last Tested، والأهمية. والتاريخ هو أهم سطر في الصفحة كلها، لأنه يقول للمناوب كم يثق بما يقرأ، فالدليل الذي اختبر الشهر الماضي يختلف عن الذي اختبر قبل سنتين.
- متى تستخدمه When to Use: اسم التنبيه كما يظهر في الهاتف، ورسالة الخطأ كما تظهر في السجل حرفياً، لأن هذا ما سيبحث عنه المناوب.
- الأثر Impact: ما الذي يعمل وما الذي توقف، بكلام المستخدم. وهذا القسم يساعد المناوب أن يقرر الأولوية، وأن يكتب أول رسالة للفريق أو لصفحة الحالة.
- قبل أن تبدأ Before You Start: الإعلان عن البدء في قناة الحوادث، والأشياء التي لا يجوز فعلها أبداً، وأي شيء يجب أن تتأكد منه قبل أول أمر.
- الخطوات Steps: مرقمة، وكل خطوة أمر واحد يمكن نسخه، والنتيجة المتوقعة بجانبه، ونقاط القرار واضحة: «إذا رأيت كذا فانتقل إلى الخطوة 4».
- التحقق Verification: كيف تعرف أن المشكلة انتهت فعلاً من جهة المستخدم، وليس فقط أن الأمر نفذ بنجاح.
- التصعيد Escalation: متى تتوقف عن المحاولة، ومن تتصل به، وبأي وسيلة، بالاسم أو بجدول المناوبة.
- بعد العودة Follow-up: ما يجب أن يحدث في يوم العمل التالي لكي لا يتكرر العطل، وغالباً تذاكر في نظام المهام.
كيف تكتب خطوة يستطيع أي شخص أن ينفذها؟ Writing Steps
الخطوة الجيدة في دليل التشغيل تشبه سطراً في وصفة طبخ أكثر مما تشبه فقرة في كتاب، فهي أمر واحد كامل، والنتيجة المتوقعة، وماذا تفعل إذا لم تحصل على هذه النتيجة. وفيما يلي القواعد التي اتفق عليها الفريق بعد أول يوم تجربة، وكل قاعدة جاءت من خطأ حقيقي:
- أوامر كاملة تنسخ كما هي: مع اسم ال Container أو السيرفر الحقيقي، وليس
<container>يضطر المناوب أن يعرف ماذا يضع مكانه. وإذا كان الاسم يختلف بين البيئات فاكتب الأمر لكل بيئة. - الفحص قبل التغيير: أول الخطوات للقراءة فقط Read-only، ولا تغير شيئاً، فيستطيع المناوب أن ينفذها دون خوف، وتعطيه ما يحتاجه للقرار.
- النتيجة المتوقعة مكتوبة: «يجب أن ترى 100% في عمود Use%»، فإذا رأى شيئاً آخر فهو يعرف أن الدليل ربما لا يطابق هذه الحالة.
- الممنوع قبل المسموح: وبصيغة الأمر وسببه، مثل «لا تحذف أي ملف في
pg_wal، والسبب أن قاعدة البيانات لن تبدأ بعدها». - القرار مكتوب كقاعدة: «احذف الأقدم أولاً، واترك أحدث نسخة كاملة»، وليس «احذف ما لا تحتاجه»، لأن المناوب في الثالثة فجراً لا يعرف ما لا تحتاجه.
- نقطة توقف واضحة: «إذا لم تنخفض النسبة بعد الخطوة 3 فتوقف واتصل بفلان»، لأن أخطر لحظة في الحادثة هي عندما ينتهي الدليل ويبدأ المناوب في الارتجال تحت الضغط.
- بدون شرح طويل: الشرح مكانه رابط في آخر الصفحة لمن يريد أن يفهم، والصفحة نفسها للتنفيذ.
وقد يتساءل البعض: إذا كانت الخطوات أوامر تنسخ كما هي، فلماذا لا نجعلها سكربتاً من البداية؟ والإجابة أن بعض الخطوات تحتاج قراراً لا يستطيعه السكربت بعد، مثل أي النسخ الاحتياطية تحذف، وأن الخطوة التي لم ينفذها إنسان بنجاح عدة مرات لا تعرف بعد كل حالاتها الخاصة، فإذا أتمتتها مبكراً فقد تؤتمت الخطأ. وهذا يقودنا إلى مستويات الدليل.
من الوثيقة إلى الأتمتة: مستويات الدليل Runbook Levels
الدليل ليس شيئاً ثابتاً، وإنما مرحلة في طريق ينتهي غالباً بأن يعالج النظام المشكلة بنفسه. والصورة التالية تبين المستويات التي مر بها الفريق في القصة:
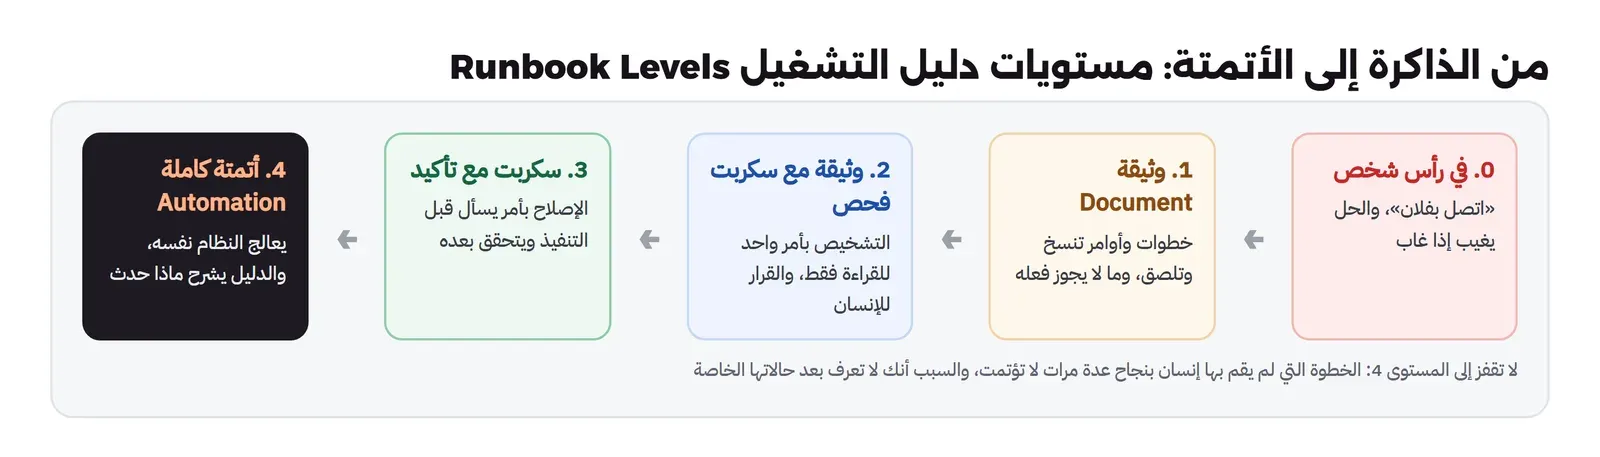
والمستوى صفر هو ما بدأ منه الفريق: المعرفة في رأس شخص واحد. والمستوى الأول وثيقة مكتوبة، وهو أكبر تحسن في الفائدة لأنه ينقل المعرفة من شخص إلى الفريق. والمستوى الثاني يضيف سكربت فحص يجمع كل المعلومات التي يحتاجها القرار في أمر واحد، وهذا ما بنيناه في المختبر، وفائدته أن المناوب لا يكتب خمسة أوامر تحت الضغط، وأن الفحص نفسه يختبر في كل يوم تجربة. والمستوى الثالث سكربت يصلح أيضاً، ولكنه يعرض ما سيفعله ويطلب تأكيداً، ثم يتحقق من النتيجة. والمستوى الرابع أتمتة كاملة، مثل مهمة تحذف النسخ القديمة تلقائياً قبل أن يمتلئ القرص أصلاً، وعندها لا يحتاج أحد أن يستيقظ.
ويسمي كتاب SRE العمل اليدوي المتكرر الذي يمكن أتمتته ولا يضيف قيمة دائمة العمل الروتيني Toil، ويقترح أن يبقى أقل من نصف وقت المهندس، والأدلة هي الطريقة العملية لقياسه: كل دليل ينفذ أكثر من مرة في الشهر مرشح للانتقال إلى المستوى التالي. ولكن لاحظ أن الأتمتة لا تلغي الدليل، وإنما تغير محتواه، فالدليل في المستوى الرابع يشرح ما يفعله النظام تلقائياً، وكيف تعرف أنه فعله، وماذا تفعل إذا فشلت الأتمتة نفسها.
المختبر Lab: الدليل DB-01 مع PostgreSQL
الآن سوف نعيش العطل الذي دفع الفريق إلى كتابة أول دليل: قرص قاعدة البيانات يمتلئ. وسوف نستخدم PostgreSQL 18.6 من Image postgres:18-alpine، ونضع مجلد البيانات على قرص صغير حجمه 120 ميجابايت لكي يمتلئ بسرعة، عبر tmpfs في Docker، وهو نظام ملفات في الذاكرة بحجم محدد، كما في توثيق Docker. ونضع على نفس القرص مجلد النسخ الاحتياطية الليلية، كما كان الفريق يفعل فعلاً.
التجهيز Setup: والنسخة الاحتياطية تملأ القرص
docker run -d --name dvo-rb-db --tmpfs /var/lib/postgresql:rw,size=120m,uid=70,gid=70 \
  -e POSTGRES_PASSWORD=lab-only-pass -e POSTGRES_DB=shop postgres:18-alpine
docker exec dvo-rb-db sh -c 'df -h /var/lib/postgresql; echo $PGDATA; postgres --version'
Filesystem Size Used Available Use% Mounted on
tmpfs 120.0M 46.0M 74.0M 38% /var/lib/postgresql
/var/lib/postgresql/18/docker
postgres (PostgreSQL) 18.6ولاحظ أن مجلد البيانات في PostgreSQL 18 داخل ال Image الرسمية أصبح /var/lib/postgresql/18/docker، وهذا تغيير عن الإصدارات السابقة يجب أن يكون في أي دليل يكتب بمسارات حقيقية، وإلا فإن المناوب سوف يبحث في المسار القديم. ثم أنشأنا جدول الطلبات وأضفنا إليه 40 ألف طلب، وشغلنا النسخ الاحتياطية الليلية لأربعة أيام بالأمر pg_dump إلى مجلد dumps على نفس القرص:
docker exec dvo-rb-db psql -U postgres -d shop -qc "create table orders(id bigserial primary key, created timestamptz default now(), customer int, note text);"
docker exec dvo-rb-db psql -U postgres -d shop -qc "insert into orders(customer,note) select g%500, repeat(md5(g::text),8) from generate_series(1,40000) g;"
docker exec dvo-rb-db sh -c 'mkdir -p /var/lib/postgresql/dumps && for d in 2026-10-30 2026-10-31 2026-11-01 2026-11-02; do
  pg_dump -U postgres -d shop -Fp -f /var/lib/postgresql/dumps/shop-$d.sql; done
  ls -lh /var/lib/postgresql/dumps; df -h /var/lib/postgresql'
pg_dump: error: could not write to file: No space left on device
-rw-r--r-- 1 root root 11.3M Nov 3 10:31 shop-2026-10-30.sql
-rw-r--r-- 1 root root 11.3M Nov 3 10:31 shop-2026-10-31.sql
-rw-r--r-- 1 root root 11.3M Nov 3 10:31 shop-2026-11-01.sql
-rw-r--r-- 1 root root 10.9M Nov 3 10:31 shop-2026-11-02.sql
Filesystem Size Used Available Use% Mounted on
tmpfs 120.0M 120.0M 0 100% /var/lib/postgresqlوهنا حدث شيء لم نخطط له بهذا الشكل: كنا نريد أن نملأ القرص بطلبات جديدة بعد النسخ الاحتياطية، ولكن النسخة الاحتياطية الرابعة هي التي ملأته، وفشلت هي نفسها في المنتصف، وتركت ملفاً حجمه 10.9 ميجابايت يبدو مثل غيره. وهذا بالضبط ما يحدث في الواقع: مهمة النسخ الاحتياطي تكتب بجانب البيانات ولا تحذف القديم، والقرص يمتلئ في منتصف الليل وقت النسخ، وآخر نسخة، وهي التي تظن أنك ستعتمد عليها، ناقصة.
الأعراض Symptoms: القراءة تعمل والكتابة تفشل
بعد ذلك جربنا ما يجربه التطبيق: كتابة طلبات جديدة، وقراءة الطلبات الموجودة:
docker exec dvo-rb-db psql -U postgres -d shop -c "insert into orders(customer,note) select g%500, repeat(md5(g::text),8) from generate_series(1,2000) g;"
docker exec dvo-rb-db psql -U postgres -d shop -tc "select count(*) from orders"
docker logs --since 2m dvo-rb-db 2>&1 | tail -8
ERROR: could not extend file "base/16384/16386": No space left on device
HINT: Check free disk space.
40000
...
2026-11-03 10:31:04.576 UTC [111] ERROR: could not extend file "base/16384/16386_vm": No space left on device
2026-11-03 10:31:04.576 UTC [111] CONTEXT: while scanning block 0 of relation "public.orders"
automatic vacuum of table "shop.public.orders"
2026-11-03 10:31:20.672 UTC [118] ERROR: could not extend file "base/16384/16386": No space left on deviceولنقرأ ما حدث لأنه يحدد قسم الأثر في الدليل:
- الكتابة فشلت بالخطأ
could not extend file، أي أن PostgreSQL أراد أن يكبر ملف الجدول ولم يجد مساحة، والإشارةHINTتقول ببساطة: تحقق من مساحة القرص. - القراءة نجحت، فالعدد 40000 رجع بشكل طبيعي. أي أن المتجر يعرض المنتجات وتاريخ الطلبات، ولكن لا أحد يستطيع أن يطلب، وهذا يكتب في قسم الأثر حرفياً، لأن المناوب الذي يفتح الموقع ويراه يعمل قد يظن أن التنبيه خاطئ.
- عملية الصيانة التلقائية Autovacuum فشلت كذلك، وهذا يعني أن المشكلة لن تحل نفسها مع الوقت.
وبحسب توثيق PostgreSQL عن امتلاء القرص فإن امتلاء قرص البيانات لا يفسد البيانات، ولكنه يمنع العمل المفيد، أما إذا امتلأ القرص الذي عليه ملفات WAL فقد تتوقف قاعدة البيانات بحالة PANIC. ويقول التوثيق كذلك إنك إذا لم تستطع أن تحرر مساحة بحذف أشياء أخرى فيمكنك نقل بعض ملفات قاعدة البيانات إلى قرص آخر عبر Tablespaces، وينصح بألا تنتظر حتى يمتلئ القرص تماماً.
الدليل DB-01 كما كتبه الفريق
كتب الفريق الدليل في ملف Markdown داخل مستودع الخدمة نفسها، ومعه سكربت الفحص، والدليل كما يلي:
# DB-01: PostgreSQL data disk full

Owner: platform team. Last tested: 2026-11-03 (game day). Severity when it fires: critical (orders cannot be saved).

## When to use
- Alert `PostgresDiskAlmostFull` or `CheckoutErrors`, and the app log shows `could not extend file ... No space left on device`.

## Impact
- Reads still work (catalog, order history). Every write fails: new orders, carts, logins that update `last_login`.

## Before you start
- Post in #incidents: "DB-01 started by <name>". Do not restart PostgreSQL to "free space"; it does not.
- NEVER delete files in `pg_wal/` or `base/`. That destroys the database. Space comes from the list below only.

## Steps
1. Check (read-only): `sh db-disk-check.sh dvo-rb-db`. Expect disk at 100% and the error in the log.
2. Find the newest COMPLETE dump in the "dumps" output (status `complete`). A `PARTIAL` dump is useless: delete it first.
3. Free space, oldest first, keep the newest complete dump:
   `docker exec dvo-rb-db rm /var/lib/postgresql/dumps/<file>.sql`
4. Verify writes: step 5 of the check script must print a timestamp, not an error.
5. If still full after step 3: escalate to the DBA on call (phone in the on-call sheet). Do not improvise.

## After recovery (next working day)
- Copy the newest complete dump off the server, then move the dump job to another disk.
- Ticket: alert at 80% disk, dump job deletes dumps older than 3 days and checks the "dump complete" line.
وسكربت الفحص db-disk-check.sh في نسخته الأولى، قبل يوم التجربة، كان كما يلي:
#!/bin/sh
# Runbook DB-01, steps 1-3: read-only checks. Safe to run at any time; changes nothing.
# Usage: sh db-disk-check.sh <container>
C=${1:-dvo-rb-db}; D=/var/lib/postgresql
echo "== 1. disk";        docker exec "$C" df -h "$D" | tail -1
echo "== 2. last errors"; docker logs --since 15m "$C" 2>&1 | grep -E "No space left|PANIC" | tail -3
echo "== 3. biggest";     docker exec "$C" sh -c "du -sh $D/dumps $D/18/docker/base $D/18/docker/pg_wal 2>/dev/null"
echo "== 4. dumps";       docker exec "$C" sh -c "for f in $D/dumps/*.sql; do
  if tail -c 300 \"\$f\" | grep -q 'dump complete'; then s=complete; else s=PARTIAL; fi
  echo \"\$(du -h \"\$f\" | cut -f1)  \$s  \$f\"; done"
echo "== 5. writes";      docker exec "$C" psql -U postgres -d shop -tAc "insert into runbook_probe default values returning now()" 2>&1 | tail -1
في السكربت أعلاه لاحظ التالي:
- كل خطوة للقراءة فقط، ما عدا الخامسة التي تكتب صفاً واحداً في جدول خاص بالفحص، لكي تجيب عن السؤال الوحيد الذي يهم المستخدم: هل الكتابة تعمل الآن؟
- الخطوة الرابعة تتحقق من كل نسخة احتياطية: الملف الذي ينتجه
pg_dumpبالصيغة النصية ينتهي بالسطر-- PostgreSQL database dump complete، فإذا لم يوجد في آخره فالنسخة ناقصة. وهذا أهم سطر في السكربت، والسبب أن الحجم وحده لا يكشف النسخة الناقصة. - الخطوة الثالثة تعرض المجلدات الثلاثة الكبيرة بأسمائها، ومعها في الدليل ما يجوز حذفه منها وما لا يجوز.
يوم التجربة Game Day: التنفيذ بالثواني
بعد أن امتلأ القرص نفذنا الدليل كما هو، كأننا المناوب الذي استيقظ للتو، وسجلنا الوقت بتوقيت UTC في كل خطوة:
date -u +"%T game day start"; sh db-disk-check.sh dvo-rb-db; date -u +"%T step 1 done"10:32:14 game day start
== 1. disk
tmpfs 120.0M 120.0M 0 100% /var/lib/postgresql
== 2. last errors
2026-11-03 10:31:24.610 UTC [126] FATAL: could not write init file: No space left on device
2026-11-03 10:31:44.608 UTC [144] FATAL: could not write init file: No space left on device
2026-11-03 10:32:04.593 UTC [145] ERROR: could not extend file "base/16384/16386_vm": No space left on device
== 3. biggest
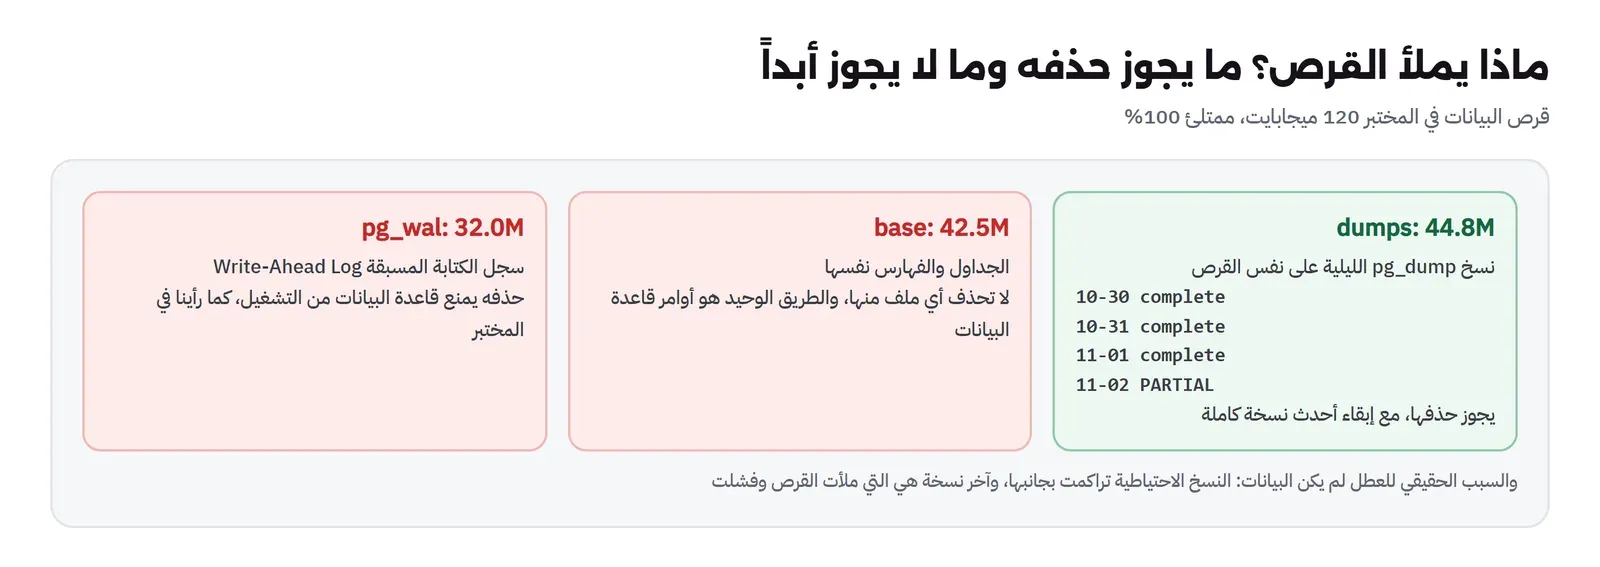
44.8M /var/lib/postgresql/dumps
42.5M /var/lib/postgresql/18/docker/base
32.0M /var/lib/postgresql/18/docker/pg_wal
== 4. dumps
11.3M complete /var/lib/postgresql/dumps/shop-2026-10-30.sql
11.3M complete /var/lib/postgresql/dumps/shop-2026-10-31.sql
11.3M complete /var/lib/postgresql/dumps/shop-2026-11-01.sql
10.9M PARTIAL /var/lib/postgresql/dumps/shop-2026-11-02.sql
== 5. writes
^
10:32:17 step 1 doneفي ثلاث ثوان كان لدى المناوب كل ما يحتاجه للقرار: القرص 100%، والخطأ في السجل، والنسخ الاحتياطية أكبر من الجداول نفسها، وآخر نسخة ناقصة. ولاحظ السطر FATAL: could not write init file، وهذا يعني أن بعض الاتصالات الجديدة بقاعدة البيانات كانت تفشل أيضاً، وليس الكتابة فقط، وهذا أضفناه إلى قسم الأثر في الدليل بعد التجربة. والصورة التالية تبين ما على القرص:
مشكلة في الدليل نفسه Runbook Bug
ولكن الخطوة الخامسة طبعت علامة ^ فقط، وهذا لا يعني شيئاً لمن يقرؤه. والمناوب في هذه اللحظة لا يعرف هل الكتابة فشلت بسبب القرص كما هو متوقع، أم بسبب شيء آخر. فشغلنا أمر الخطوة دون tail:
docker exec dvo-rb-db psql -U postgres -d shop -tAc "insert into runbook_probe default values returning now()"ERROR: relation "runbook_probe" does not exist
LINE 1: insert into runbook_probe default values returning now()
^الجدول الذي يعتمد عليه الدليل غير موجود أصلاً، فمن كتب الدليل افترض أنه أنشئ، ولم ينشئه أحد. وكان tail -1 يخفي رسالة الخطأ ويترك آخر سطر منها فقط، وهو العلامة ^ تحت مكان الخطأ. أي أن في الدليل خطأين: افتراض غير صحيح عن النظام، وطريقة عرض تخفي الخطأ عن المناوب. ولم يكن أي منهما سيظهر لو قرأنا الدليل فقط، فكلاهما ظهر في التنفيذ. وهذا هو السبب الوحيد الذي يكفي لتقتنع بأيام التجربة: الدليل الذي لم ينفذ لا تعرف هل يعمل.
ثم أكملنا الخطوات الباقية: حذفنا النسخة الناقصة أولاً كما يقول الدليل، ثم النسختين الأقدم، وأبقينا أحدث نسخة كاملة، ثم أنشأنا جدول الفحص، وتحققنا من الكتابة بطلب حقيقي:
date -u +"%T step 3 start"
docker exec dvo-rb-db rm /var/lib/postgresql/dumps/shop-2026-11-02.sql /var/lib/postgresql/dumps/shop-2026-10-30.sql /var/lib/postgresql/dumps/shop-2026-10-31.sql
docker exec dvo-rb-db df -h /var/lib/postgresql | tail -1; date -u +"%T step 3 done"
docker exec dvo-rb-db psql -U postgres -d shop -c "create table runbook_probe(id serial primary key, at timestamptz default now());"
docker exec dvo-rb-db psql -U postgres -d shop -c "insert into orders(customer,note) values (7,'after DB-01') returning id, created;"
date -u +"%T verified"
10:32:47 step 3 start
tmpfs 120.0M 86.5M 33.5M 72% /var/lib/postgresql
10:32:51 step 3 done
CREATE TABLE
id | created
-------+-------------------------------
40016 | 2026-11-03 10:32:56.374894+00
(1 row)
INSERT 0 1
10:32:56 verified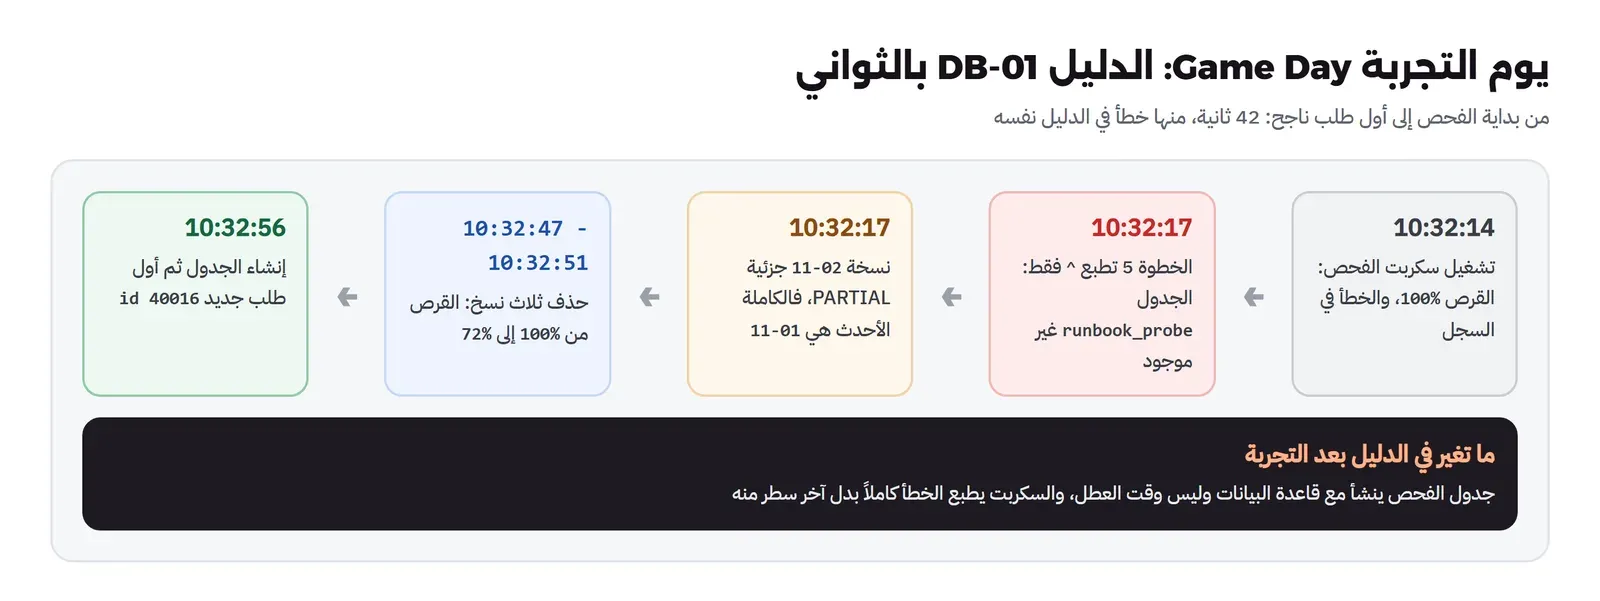
من بداية الفحص إلى أول طلب جديد ناجح 42 ثانية، منها قرابة 30 ثانية ضاعت في التحقيق في خطأ الدليل نفسه. ولاحظ رقم الطلب الجديد 40016 وليس 40001، والسبب أن الطلبات التي فشلت أثناء امتلاء القرص استهلكت أرقاماً من التسلسل Sequence رغم فشلها، وهذا سلوك طبيعي في PostgreSQL، ولكنه سؤال سيسأله أحدهم في الصباح، والإجابة عليه في الدليل توفر نقاشاً.
ما تغير في الدليل بعد التجربة Runbook v2
بعد يوم التجربة عدل الفريق ثلاثة أشياء. الأول أن جدول الفحص runbook_probe أصبح جزءاً من ترحيل قاعدة البيانات Migration، فينشأ مع قاعدة البيانات نفسها وليس وقت العطل، لأن إنشاء جدول على قرص ممتلئ قد يفشل هو أيضاً. والثاني أن الخطوة الخامسة في السكربت أصبحت تطبع الخطأ كاملاً، وتخفي سطر الحالة فقط:
echo "== 5. writes"; docker exec "$C" psql -U postgres -d shop -qtAc "insert into runbook_probe default values returning now()" 2>&1 | head -2== 5. writes
2026-11-03 10:33:15.916107+00والخيار -q يخفي سطر INSERT 0 1، فيبقى الوقت فقط عند النجاح، وhead -2 يعرض أول سطرين من أي خطأ، وفيهما الرسالة الحقيقية. والثالث أن قسم الأثر أضيف إليه أن بعض الاتصالات الجديدة تفشل برسالة could not write init file، وتاريخ آخر اختبار تحدث.
ماذا لو حذف المناوب ملفات pg_wal؟ What If
الآن التجربة التي تبرر السطر الممنوع في أعلى الدليل. ففي الحالة التي رأيناها كان مجلد pg_wal 32 ميجابايت، وأسماء ملفاته أرقام طويلة تبدو مثل ملفات مؤقتة، والمناوب الذي يبحث عن مساحة بسرعة قد يحذفها. وملفات سجل الكتابة المسبقة Write-Ahead Log هي ما تكتب فيه قاعدة البيانات كل تغيير قبل أن تكتبه في الجداول، لكي تستطيع أن تعود إلى حالة متسقة بعد أي توقف، كما يشرح فصل WAL في توثيق PostgreSQL، وتوثيق شكل الملفات يذكر المجلد pg_wal بالاسم.
وقبل هذه التجربة حدث معنا شيء يستحق الذكر: جربنا أولاً على نفس ال Container الذي يعمل على tmpfs، فحذفنا الملفات وأعدنا تشغيله، فبدأت قاعدة البيانات بنجاح، ولكنها كانت فارغة تماماً، فقد طبعت السجلات PostgreSQL init process complete، أي أنها أنشئت من جديد. والسبب أن tmpfs في الذاكرة، ويختفي محتواه مع إيقاف ال Container، أي أن إعادة التشغيل نفسها كانت ستمسح كل البيانات حتى بدون حذف أي ملف. وهذا درس إضافي لأي دليل: اعرف أين تعيش البيانات فعلاً قبل أن تكتب «أعد التشغيل» في أي خطوة. ثم أعدنا التجربة على Volume حقيقي:
docker run -d --name dvo-rb-wal -v dvo-rb-wal:/var/lib/postgresql -e POSTGRES_PASSWORD=lab-only-pass -e POSTGRES_DB=shop postgres:18-alpine
docker exec dvo-rb-wal psql -U postgres -d shop -qc "create table orders(id bigserial primary key, note text); insert into orders(note) select md5(g::text) from generate_series(1,1000) g;"
docker exec dvo-rb-wal psql -U postgres -d shop -tAc "select count(*) from orders"
docker exec dvo-rb-wal sh -c 'ls $PGDATA/pg_wal; rm $PGDATA/pg_wal/0000*'
docker restart dvo-rb-wal
docker logs --since 10s dvo-rb-wal 2>&1 | grep -E "checkpoint|PANIC|shut down"
docker ps -a --filter name=dvo-rb-wal --format '{{.Status}}'
1000
000000010000000000000001
archive_status
summaries
LOG: database system was shut down at 2026-11-03 10:35:49 UTC
LOG: invalid checkpoint record
PANIC: could not locate a valid checkpoint record at 0/1C0CA78
LOG: database system is shut down
Exited (1) 3 seconds ago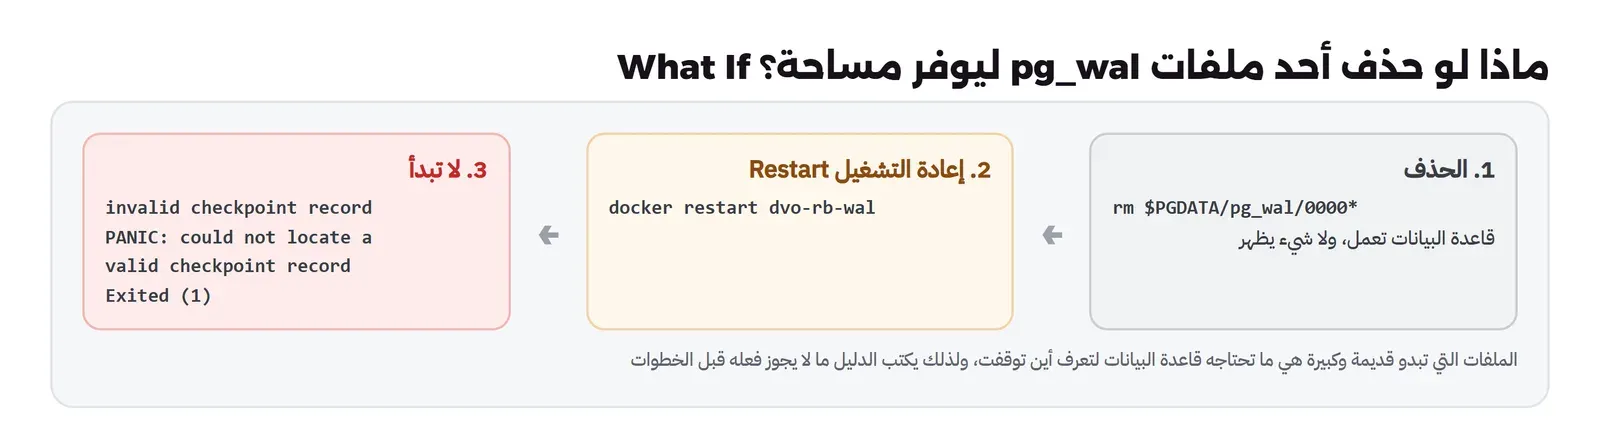
والخطير في هذه التجربة أن الحذف لم يظهر أي أثر في لحظته، فقاعدة البيانات استمرت تعمل، والمناوب الذي حذف الملفات سوف يظن أنه حل المشكلة. ثم عند أول إعادة تشغيل، ربما بعد أيام في صيانة عادية، لم تعد قاعدة البيانات تبدأ أصلاً، لأنها لا تجد نقطة التفتيش Checkpoint التي تبدأ منها. والإصلاح بعد ذلك يحتاج أدوات خاصة مع احتمال فقد بيانات، أو استعادة من نسخة احتياطية، وهذا ما يجعل السطر «لا تحذف أي ملف في pg_wal» أهم سطر في الدليل كله.
أدلة الإجراءات المخطط لها Planned Procedures
ركزنا حتى الآن على أدلة الأعطال، ولكن نصف الأدلة المفيدة في أي فريق لإجراءات لا يوجد فيها عطل أصلاً، وإنما عمل يحدث مرة كل بضعة أشهر، فلا يتذكر أحد خطواته عندما يأتي وقته. ومن أوضح الأمثلة في قصة الفريق تغيير باسورد قاعدة البيانات Credential Rotation: الإجراء يحدث مرة كل ستة أشهر، أو فوراً إذا غادر موظف يعرف الباسورد، وفيه ترتيب دقيق، فإذا غيرت الباسورد في قاعدة البيانات قبل أن تضعه في ملف السر الذي يقرؤه التطبيق، كما شرحنا في مقال متغيرات البيئة، فكل اتصال جديد يفشل حتى تنتهي، وإذا وضعته في ملف السر أولاً وأعدت إنشاء التطبيق قبل أن تغيره في قاعدة البيانات فالنتيجة نفسها. والترتيب الصحيح يحتاج غالباً مستخدماً ثانياً مؤقتاً أو فترة يقبل فيها النظام الباسوردين، وهذا لا يتذكره أحد بعد ستة أشهر إلا إذا كان مكتوباً.
ومن الأمثلة الأخرى استعادة نسخة احتياطية إلى سيرفر جديد، وتجديد شهادة يدوية لا يجددها النظام تلقائياً، وإضافة عضو جديد إلى جدول المناوبة مع كل صلاحياته، وإزالة صلاحيات موظف غادر. والفرق بين هذه الأدلة وأدلة الأعطال أن الوقت ليس ضيقاً، ولذلك تستطيع أن تكون أطول قليلاً، وأن تحتوي خطوات تحقق قبل البدء، مثل «تأكد أن آخر نسخة احتياطية كاملة وعمرها أقل من يوم قبل أي تغيير»، وخطة تراجع Rollback مكتوبة لكل خطوة تغير شيئاً. وأهم ما فيها أنها تحول الإجراء النادر من مخاطرة يقوم بها شخص واحد يعرفه إلى عمل روتيني يستطيعه أي شخص في الفريق، وهذا ما يجعل الإجازات ممكنة.
وهناك فائدة جانبية لهذه الأدلة يغفل عنها الكثير: الإجراء المخطط له هو أفضل يوم تجربة مجاني، فإذا نفذ الفريق دليل الاستعادة كل ربع سنة كجزء من اختبار الاستعادة الدوري، فهو يختبر الدليل والنسخ الاحتياطية معاً، ويعرف كم يحتاج من الوقت فعلاً لكي يعيد الخدمة من الصفر، وهذا الرقم هو ما يحتاجه أي حديث جاد عن أهداف التعافي.
ربط التنبيه بالدليل Runbook Links in Alerts
الدليل الذي لا يجده المناوب لا قيمة له، وأفضل مكان لرابطه هو التنبيه نفسه. وقد شرحنا في مقال التنبيهات Alerting كيف تضع في كل قاعدة تنبيه في Prometheus الحقل runbook_url داخل annotations، فيصل الرابط مع الرسالة إلى الهاتف. والصورة التالية تبين الطريق الكامل كما يجب أن يكون:
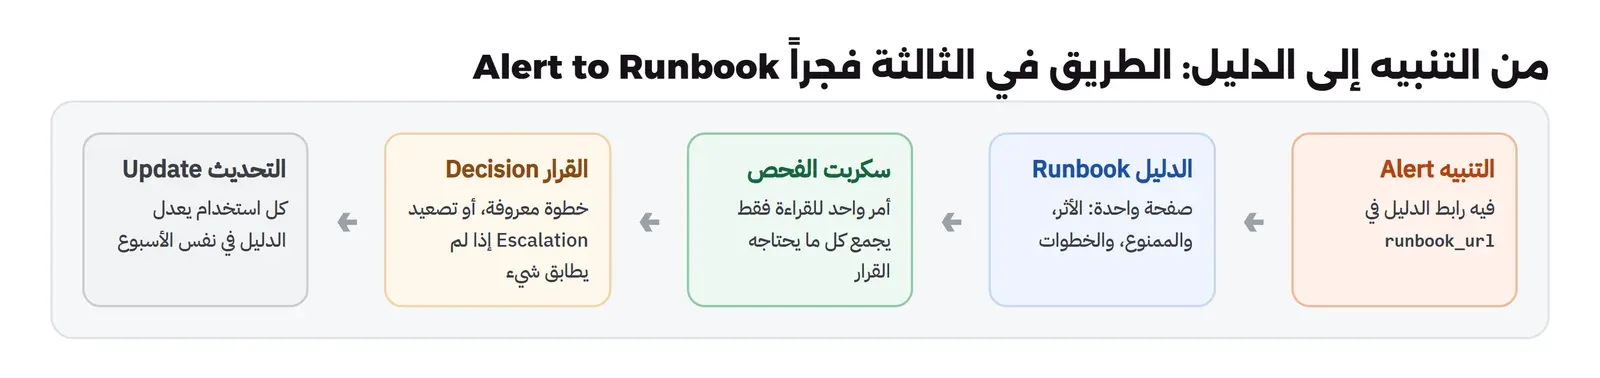
واتفق الفريق في القصة على قاعدة بسيطة: لا تقبل قاعدة تنبيه عاجلة جديدة في مراجعة الكود إذا لم يكن لها runbook_url يشير إلى دليل موجود، حتى لو كان الدليل في البداية ثلاثة أسطر تقول «تحقق من كذا، ثم اتصل بفلان». والسبب أن التنبيه الذي لا يعرف أحد ماذا يفعل به إما أن يكون تنبيهاً لا يستحق أن يوقظ أحداً، أو أن هناك معرفة يجب أن تكتب الآن قبل أن يحتاجها أحد. وأضاف الفريق كذلك في سكربت CI فحصاً يمر على كل قواعد التنبيه، ويتأكد أن كل رابط يفتح فعلاً، لأن الروابط تتعطل عندما تنقل الصفحات أو تغير أسماء الملفات.
أين تحفظ الأدلة؟ Runbook Storage
السؤال يبدو إدارياً، ولكنه يحدد هل يجد المناوب الدليل في ليلة العطل. وهناك ثلاثة شروط اتفق عليها الفريق. الأول أن الدليل يجب أن يكون متاحاً عندما يكون النظام معطلاً، فإذا كان الويكي يعمل على نفس السيرفر الذي توقف، أو يحتاج الدخول الموحد SSO الذي يعتمد على قاعدة البيانات المعطلة، فقد خسرت الدليل في اللحظة التي تحتاجه فيها. ولذلك تحفظ أدلة الخدمات الحرجة في مكان مستقل، أو تصدر نسخة منها دورياً إلى مكان يصل إليه المناوب دائماً.
والثاني أن الدليل يعيش بجانب الكود، في مجلد runbooks داخل مستودع الخدمة، أو في مستودع أدلة واحد للفريق كما تفعل GitLab، والسبب أن التغيير في الخدمة وتحديث الدليل يحدثان في نفس طلب الدمج ويراجعهما نفس الشخص، فإذا غير المطور مسار النسخ الاحتياطية فالمراجع يسأل: هل حدثت DB-01؟ والثالث أن لكل دليل رابطاً ثابتاً لا يتغير، لأن هذا الرابط موجود في قواعد التنبيه وفي أدلة أخرى.
وفي قصة الفريق كانت الأدلة في مجلد داخل مستودع البنية التحتية في Gitea، وGitea يعمل على سيرفر مستقل عن سيرفرات المتجر، مع نسخة تصدر كل ليلة كملفات إلى أجهزة المناوبين. وهذا ليس الحل الوحيد، ولكنه يحقق الشروط الثلاثة بأدوات يملكها الفريق أصلاً.
الأماكن المعتادة لحفظ الأدلة Storage Options
وقد يتساءل البعض: نحن نستخدم Jira أو Confluence أو ويكي داخلياً، فهل نحفظ الأدلة هناك؟ والإجابة أن المكان أقل أهمية من الشروط الثلاثة السابقة، فأي مكان يصلح إذا كان متاحاً أثناء العطل، ويراجع مع تغيير الخدمة، وله رابط ثابت. والجدول التالي يلخص الأماكن التي تستخدمها أغلب الفرق، مع ما يناسب كل مكان وما يجب أن تنتبه له:
| المكان | أمثلة | يناسب | انتبه إلى |
|---|---|---|---|
| مستودع Git مع ملفات Markdown | مجلد runbooks في Gitea أو GitLab أو GitHub | الفرق التقنية، لأن الدليل يراجع في نفس طلب الدمج مع تغيير الخدمة | غير المطورين قد لا يجدونه بسهولة، فاجعل له صفحة فهرس |
| ويكي أو قاعدة معرفة Knowledge Base | Confluence (مدفوع)، وOutline وBookStack وWiki.js (مفتوحة المصدر) | الفرق المختلطة، والأدلة التي يقرؤها الدعم الفني ومكتب الخدمة | لا مراجعة إلزامية للتغيير، ولذلك تحتاج مالكاً وتاريخ مراجعة على كل صفحة، وتأكد أنه لا يعمل على السيرفر نفسه الذي يوثقه |
| نظام التذاكر وإدارة الخدمات ITSM | Jira Service Management مع قاعدة معرفة Confluence، أو الأنظمة في مقارنة أنظمة التذاكر | ربط الحادثة أو الطلب بالدليل الذي نفذ، وتتبع من نفذ ماذا ومتى | نظام التذاكر نفسه قد يكون من الأنظمة المعطلة، فلا يكون المكان الوحيد للدليل |
| داخل التنبيه نفسه | رابط runbook_url في قاعدة التنبيه، كما في مقال التنبيهات، أو حقل الدليل في منصات المناوبة مثل PagerDuty | أن يصل المناوب إلى الدليل من رسالة التنبيه مباشرة | هذا رابط إلى الدليل وليس مكاناً لحفظه |
| أداة أتمتة | Ansible مع واجهة مثل Semaphore، أو Rundeck | المستوى الأخير من الدليل، عندما تصبح الخطوات أمراً واحداً يشغله المناوب بزر | اترك نسخة مكتوبة من الخطوات، لأن الأتمتة نفسها قد تفشل |
والترتيب الذي ننصح به لفريق صغير هو أن يكون الأصل في Git لأنه يراجع مع الكود، وأن تعرض الأدلة في ويكي الفريق إذا كان يستخدم Outline أو BookStack أو Confluence حتى يجدها غير المطورين، وأن يحمل كل تنبيه رابط دليله، وأن تحفظ نسخة من أدلة الخدمات الحرجة في مكان مستقل عن السيرفرات التي تصفها.
اختبار الأدلة: أيام التجربة Game Days
رأينا في المختبر أن الدليل كان فيه خطآن لم يظهرا إلا عند التنفيذ، وهذا ليس استثناء، وإنما القاعدة في كل دليل لم يختبر. ويوم التجربة Game Day طريقة منظمة لاكتشاف ذلك قبل الحادثة الحقيقية: تختار دليلاً، وتصنع العطل نفسه في بيئة تجريبية تشبه الإنتاج، ثم ينفذ الدليل شخص لم يكتبه، ويفضل أن يكون الأحدث في الفريق، بينما يراقب كاتب الدليل دون أن يتدخل، ويسجل كل مكان توقف فيه المنفذ أو سأل أو اجتهد.
واتفق الفريق في القصة على ثلاث قواعد لأيام التجربة. الأولى أن كل دليل لعطل حرج يختبر مرة كل ربع سنة على الأقل، وبعد أي تغيير كبير في الخدمة، ويحدث تاريخ آخر اختبار في رأس الدليل. والثانية أن كل نقطة توقف فيها المنفذ تتحول إلى تعديل في الدليل في نفس الأسبوع، وليس إلى ملاحظة في اجتماع. والثالثة أن الوقت يسجل بالثواني كما فعلنا، لأن الرقم يقول هل الدليل يحقق ما تحتاجه أهداف الخدمة: فإذا كان الهدف 99.9% يعطيك 43 دقيقة في الشهر، والدليل يحتاج 25 دقيقة في أحسن الأحوال، فحادثتان من هذا النوع تنهيان الميزانية، وهذه معلومة تدفع الفريق إلى المستوى التالي من الأتمتة.
ولا يحتاج يوم التجربة أن يكون حدثاً كبيراً، ففي فريق من أربعة أشخاص يكفي ساعة واحدة كل أسبوعين، ودليل واحد، وبيئة staging، وشخص يسجل الوقت والملاحظات. والمهم أن يحدث بانتظام، وأن تتحول نتيجته إلى تعديل مكتوب في الدليل، وأن يتغير المنفذ في كل مرة، لكي لا يبقى الدليل مفهوماً لشخص واحد فقط كما كانت المعرفة قبل أن يكتب.
ويذكر فصل المناوبة في SRE Workbook أن تدريب المناوبين على سيناريوهات حقيقية قبل أن يحملوا الهاتف من أهم ما يخفف الضغط عليهم، والأدلة المختبرة هي أفضل مادة لهذا التدريب، فالمهندس الجديد الذي نفذ DB-01 مرة في يوم تجربة لن يفتحها لأول مرة في الثالثة فجراً. وقد تكلمنا عن هذا الجانب الإنساني في مقال ضغط المناوبة.
قصة من الواقع: دليل معتمد ومدخل خاطئ في Amazon S3
قد يظن البعض أن الدليل يحمي من كل الأخطاء، والواقع أن الدليل نفسه قد يكون الطريق إلى العطل إذا كانت أوامره بلا حماية. ففي 28 فبراير 2017، وبحسب التقرير الذي نشرته AWS، كان فريق S3 يحقق في بطء نظام الفوترة، فنفذ أحد أعضاء الفريق المصرح لهم أمراً من دليل معتمد Established Playbook لحذف عدد صغير من السيرفرات من نظام فرعي، ولكن أحد مدخلات الأمر كتب بشكل خاطئ، فحذف عدداً أكبر بكثير، ومن بينها سيرفرات نظامين فرعيين أساسيين، فتوقفت خدمة S3 في المنطقة ساعات، ومعها خدمات أخرى تعتمد عليها، وقد ذكرنا تفاصيل المدة في مقال أهداف الخدمة.
والمهم هنا ما غيرته AWS بعد الحادثة كما كتبت في التقرير: عدلت الأداة لتحذف السيرفرات ببطء أكبر، وأضافت حماية تمنع الحذف إذا كان سيأخذ أي نظام فرعي تحت الحد الأدنى من السعة المطلوبة، وبدأت مراجعة بقية أدوات التشغيل لتتأكد أن فيها فحوصاً مشابهة. أي أن الدرس لم يكن «كن أكثر حرصاً عند الكتابة»، وإنما «اجعل الأداة ترفض المدخل الخطير». وهذا ينطبق على أي دليل: الخطوة التي تحذف أو توقف شيئاً يجب أن يكون فيها حد أعلى أو تأكيد يعرض ما سيحدث قبل أن يحدث، مثل أن يعرض سكربت تنظيف النسخ قائمة الملفات التي سيحذفها وحجمها، ويرفض حذف آخر نسخة كاملة مهما كتب المناوب.
ملكية الأدلة Ownership مع مراجعتها
الدليل الذي لا يملكه أحد يصبح قديماً بعد أشهر، ولذلك لكل دليل مالك مكتوب في رأسه، وهو غالباً الفريق الذي يملك الخدمة نفسها، كما شرحنا في مقال المسؤولية عندما يتعطل الإنتاج. والمالك لا يعني أن يكتب كل الأدلة بنفسه، وإنما أن يتأكد أنها صحيحة ومختبرة. واتفق الفريق في القصة على ثلاث مناسبات لمراجعة الأدلة: بعد كل استخدام حقيقي، فيسأل المناوب في مراجعة الحادثة «ماذا كان ناقصاً في الدليل؟»، وبعد كل يوم تجربة، وعند كل تغيير في الخدمة يمس خطوة في الدليل، وهذه الأخيرة هي التي تحميها مراجعة الكود.
ومن العلامات التي يراقبها الفريق لصحة الأدلة: عدد التنبيهات العاجلة التي ليس لها دليل، وعدد الأدلة التي لم تختبر منذ أكثر من ستة أشهر، وعدد المرات التي قال فيها مناوب في مراجعة حادثة «لم أجد دليلاً» أو «الدليل كان قديماً». وهذه الأرقام الثلاثة تعرض في نفس لوحة أهداف الخدمة، لأنها تؤثر مباشرة في زمن الإصلاح، وبالتالي في الميزانية.
قالب الدليل Runbook Template
وهذا القالب الذي يبدأ به الفريق كل دليل جديد، ويمكنك أن تنسخه كما هو إلى مستودعك:
# <ID>: <what is broken, in the words of the alert>

Owner: <team>. Last tested: <date> (<game day or real incident>). Severity: <critical/warning>.

## When to use
- Alert `<AlertName>`, and/or this exact log line: `<message>`.

## Impact
- What still works: ...
- What fails, for whom: ...

## Before you start
- Announce in <channel>: "<ID> started by <name>".
- NEVER: <the tempting wrong fix>, because <what it destroys>.

## Steps
1. Check (read-only): `<one command>`. Expect: <what you should see>.
2. If <condition>, go to step 4. Otherwise: `<command>`. Expect: ...
3. ...
4. Verify from the user's side: `<command or URL>`. Expect: ...
5. Stop and escalate if <condition>: <who>, <how>.

## After recovery
- Tickets: <what prevents the next one>.
- Update this page: Last tested, anything that was missing.
أخطاء شائعة Common Mistakes
- دليل لم ينفذ أبداً: فيه افتراضات خاطئة لا تظهر إلا في الحادثة، كما ظهر جدول الفحص المفقود في المختبر.
- الممنوع غير مكتوب: فيحذف المناوب أكبر الملفات، وقد تكون ملفات
pg_wal. - أوامر بقوالب تحتاج تعديلاً:
<container>و<server>تضيع وقتاً وتسبب أخطاء تحت الضغط. - إخفاء الأخطاء في السكربت:
tail -1أو2>/dev/nullيتركان المناوب أمام علامة لا معنى لها. - «أعد التشغيل» كخطوة أولى: لا يحرر مساحة، وقد يمسح بيانات إذا كانت في مكان مؤقت، كما رأينا مع tmpfs.
- التحقق من نجاح الأمر بدل نجاح الخدمة: الأمر
rmنجح لا يعني أن الطلبات تعمل. - لا نقطة توقف: ينتهي الدليل ويستمر المناوب في الارتجال بدل أن يصعد.
- الدليل على النظام المعطل نفسه: الويكي على نفس السيرفر أو خلف الدخول الموحد الذي توقف.
- دليل بلا مالك ولا تاريخ اختبار: لا يعرف المناوب كم يثق به.
- أوامر خطيرة بلا حماية: كما في حادثة S3، الحل في الأداة وليس في الحرص.
- النسخ الاحتياطية بجانب البيانات: وهي التي ملأت القرص في المختبر، وآخرها كانت ناقصة.
قائمة تحقق Checklist لكل دليل
| البند | كيف تتحقق منه |
|---|---|
| كل تنبيه عاجل له دليل | runbook_url في كل قاعدة critical، وفحص في CI أن الرابط يفتح |
| الدليل متاح أثناء العطل | مكان مستقل عن الخدمة، أو نسخة على أجهزة المناوبين |
| في الرأس مالك وتاريخ آخر اختبار | تقرير شهري بالأدلة التي لم تختبر منذ ستة أشهر |
| الأثر مكتوب بكلام المستخدم | ما يعمل وما لا يعمل، ولمن |
| الممنوع قبل الخطوات | سطر NEVER مع سببه في أعلى الصفحة |
| الخطوات أوامر كاملة مع النتيجة المتوقعة | منفذ جديد ينفذها دون أن يسأل |
| الفحص الأول للقراءة فقط | سكربت لا يغير شيئاً، ويطبع الأخطاء كاملة |
| التحقق من جهة المستخدم | طلب حقيقي ينجح، وليس فقط أن الأمر نفذ |
| نقطة التصعيد واضحة | شرط التوقف، والاسم، والوسيلة |
| الدليل مختبر في يوم تجربة | مرة كل ربع سنة على الأقل، والوقت مسجل بالثواني |
| الدليل يتحدث مع الكود | طلب الدمج الذي يغير الخدمة يغير الدليل معه |
تدريب عملي Practice
- اكتب لسكربت المختبر خطوة إصلاح من المستوى الثالث: سكربت يعرض النسخ التي سيحذفها وحجمها، ويرفض حذف أحدث نسخة كاملة، ويطلب كتابة
yesقبل التنفيذ، ثم يشغل خطوة التحقق تلقائياً. - اختر أكثر تنبيه عاجل تكرر في فريقك خلال الشهر الماضي، واكتب له دليلاً بالقالب أعلاه، ثم اطلب من أحدث عضو في الفريق أن ينفذه في بيئة تجريبية وسجل أين توقف.
حذف المختبر Cleanup
docker rm -f dvo-rb-db dvo-rb-wal
docker volume rm dvo-rb-wal
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- دليل التشغيل صفحة واحدة للتنفيذ وليس للشرح، وكتاب Google SRE يقدر أثر الأدلة بنحو ثلاثة أضعاف في زمن الإصلاح مقارنة بالارتجال.
- الأقسام: الرأس بالمالك وتاريخ الاختبار، ومتى تستخدمه، والأثر، والممنوع قبل البدء، والخطوات بأوامر كاملة، والتحقق من جهة المستخدم، والتصعيد، وما بعد العودة.
- في المختبر ملأت النسخة الاحتياطية القرص وفشلت في المنتصف، والقراءة استمرت والكتابة توقفت، والدليل أعاد الكتابة في 42 ثانية.
- الدليل نفسه كان فيه خطآن لم يظهرا إلا في التنفيذ: جدول فحص غير موجود، و
tail -1يخفي الخطأ، ولذلك الدليل الذي لم يختبر لا تعرف هل يعمل. - حذف ملفات
pg_walلم يظهر أثره حتى إعادة التشغيل، ثم PANIC ولا تبدأ قاعدة البيانات، وإعادة تشغيل Container على tmpfs تمسح كل شيء. - الدليل يرتبط بالتنبيه بالرابط، ويعيش بجانب الكود في مكان متاح أثناء العطل، ويتطور نحو الأتمتة، والأوامر الخطيرة تحتاج حماية في الأداة كما تعلمت AWS.
وفي المقال القادم بإذن الله نكمل من حيث يقف الدليل: إدارة الحادثة نفسها، من لحظة التنبيه إلى عودة الخدمة، ومن يقرر ومن يتواصل، وكيف تعرف أن الحادثة انتهت.
 دليلالتنبيهات Alerting: ماذا تنبه عليه ومتى توقظ أحداً؟نبني مع Alertmanager تنبيهات تصل فيها المشكلة الواحدة في رسالة واحدة، والعاجل فوراً والروتيني في ملخص صباحي، ونجرب كل قرار بالثواني.
 دليلماذا تعني 99.9%؟ أهداف الخدمة SLO للمبتدئيننقيس خدمة حقيقية من أربعة أماكن فنحصل على أربعة أرقام، ونحول الهدف إلى دقائق مسموحة وميزانية أخطاء وسياسة تحكم قرارات الفريق.
 دليلضغط المناوبة On-call والحوادث: كيف تحمي نفسك وفريقكما الحدود التي يضعها كتاب Google SRE للمناوبة المستدامة، وكيف تقلل التنبيهات وتصمم الجدول وتطلب التعويض والراحة دون صدام.
 دليلمن يتحمل المسؤولية Accountability عندما يتعطل الإنتاج؟كيف تحدد ملكية الخدمات وتدير الحادثة بأدوار واضحة، ثم تكتب تقرير ما بعد الحادثة دون لوم وبإجراءات تغلق فعلاً.
 دليلالنسخ الاحتياطي بقاعدة 3-2-1 واختبار الاستعادةكيف تحدد كم بيانات تقبل أن تخسر، وتبني نسخاً لا يستطيع المخترق حذفها، وتتأكد أنك تستطيع استعادتها فعلاً.
سجل التحديثات Changelog
- نوفمبر 2026: كتابة الدليل وتنفيذ المختبر ويوم التجربة على PostgreSQL 18.6 من postgres:18-alpine وDocker Engine 29.8.0.


