عندما تقرأ عن السحابة الخاصة Private Cloud ستجد دائماً من يقول إنها فكرة جميلة على الورق، وإنها لا تصلح إلا لشركة صغيرة تجرب، أما الحجم الحقيقي فمكانه السحابة العامة Public Cloud. وأفضل رد على هذا الكلام ليس رأياً، وإنما تجربة موثقة: المنظمة الأوروبية للأبحاث النووية CERN تشغل منذ يوليو 2013 سحابة خاصة على OpenStack، وقد وصلت إلى أكثر من 300,000 نواة معالج Core، وتقول صفحتها الرسمية اليوم إن أكثر من 90% من الحوسبة في مركز بياناتها تعمل على هذه السحابة.
وهذه التجربة مهمة لأي جهة تفكر في بناء سحابتها بنفسها، سواءً كانت جهة حكومية تريد أن تبقى بياناتها تحت سيطرتها، أو شركة كبيرة تدفع للمزود أكثر مما تحتمل، لأن CERN نشرت عن سحابتها بالتفصيل: العروض التقديمية Slides لفريقها في المؤتمرات، ومدونتها التقنية، والأرقام سنة بعد سنة، والأخطاء التي وقعت فيها والحلول التي وصلت إليها. لذلك سوف نعتمد في هذا المقال على ما نشره فريق CERN نفسه فقط، مع تاريخ كل رقم ومصدره.
سوف نناقش في هذا المقال:
- لماذا احتاجت CERN إلى سحابة في 2012، وما المشكلة التي أرادت حلها.
- كيف انتقلت من النماذج التجريبية Prototypes إلى خدمة إنتاج Production خلال سنة تقريباً.
- كيف كبرت السحابة من 27,000 نواة إلى أكثر من 300,000 نواة، بالأرقام والتواريخ.
- القرارات التقنية التي جعلت هذا الحجم ممكناً: الخلايا Cells، والترقية مكوناً بعد مكون، والأجهزة الحقيقية Bare Metal، والتخزين على Ceph.
- قصة مركز البيانات في المجر، وكيف أعادت CERN بياناتها منه.
- الدروس كما قالها مهندسو CERN بأنفسهم، وما ينطبق منها على جهتك وما لا ينطبق.
وهذا المقال من مرحلة السحابة السيادية والحكومية Sovereign Cloud في مسار الحوسبة السحابية وبدائلها. والمواضيع في هذه المرحلة:
- السحابة السيادية Sovereign Cloud: ما معناها وما الذي يجعلها سيادية
- الحوسبة السحابية في الأنظمة السعودية
- حكومات بنت سحابتها على المصادر المفتوحة Open Source
- دراسة حالة: سحابة CERN على OpenStack (الموضوع الحالي)
- نقل أنظمة جهة حكومية إلى السحابة: التصنيف والمزود والخطة
باختصار In Short
منذ متى: خدمة إنتاج منذ يوليو 2013 على إصدار Grizzly من OpenStack، وما زال النشر نفسه في مركز Meyrin يرقى في مكانه منذ ذلك اليوم.
الحجم: نحو 27,000 نواة في نوفمبر 2013، ثم أكثر من 300,000 نواة على أكثر من 9,000 سيرفر في مايو 2018، ونحو 10,000 جهاز حقيقي و15,000 جهاز افتراضي في يونيو 2024.
السبب: عدد السيرفرات سيتضاعف، وعدد الموظفين لن يزيد، والأدوات القديمة لن تتحمل.
أهم قرار: «لسنا حالة خاصة» We're not special، أي استخدام أدوات مفتوحة المصدر يستخدمها العالم بدل الأدوات التي بنتها CERN بنفسها.
أهم درس: المساهمة في المشروع الأصلي Upstream هي الطريق الوحيد لبقاء السحابة صحية على المدى الطويل.
لماذا تحتاج CERN إلى كل هذه الحوسبة؟
CERN مختبر أبحاث في فيزياء الجسيمات، وأشهر ما فيه مصادم الهادرونات الكبير Large Hadron Collider واختصاراً LHC. والمصادم يولد كميات ضخمة من البيانات في كل تجربة، وهذه البيانات تحتاج إلى تخزين ثم معالجة وتحليل من آلاف الباحثين حول العالم. ولذلك لا تعمل CERN وحدها، وإنما في شبكة عالمية اسمها شبكة الحوسبة العالمية للمصادم Worldwide LHC Computing Grid واختصاراً WLCG، وتقول CERN في فبراير 2024 إنها تضم نحو 170 مركز حوسبة في أكثر من 40 دولة، بنحو مليون نواة معالج، وإن المصادم ينتج نحو 45 PB من البيانات كل أسبوع.
ومركز البيانات في CERN نفسه هو قلب هذه الشبكة. ففي 29 سبتمبر 2023 أعلنت CERN أن مساحة الأقراص Disk Storage عندها تجاوزت 1 Exabyte على نحو 111,000 جهاز تخزين، وفي 17 ديسمبر 2025 أعلنت أن بيانات تجارب المصادم المحفوظة وصلت وحدها إلى 1 Exabyte على نحو 60,000 شريط Tape، وأضافت أن هذا الرقم «10% فقط مما سنحتاج إلى تخزينه ومعالجته في السنوات العشر القادمة». والExabyte هو مليون Terabyte، فإذا كان حاسوبك يحمل قرصاً بحجم 1 TB، فأنت تحتاج إلى مليون حاسوب مثله لتحمل هذه البيانات.
وقد يتساءل البعض: ما علاقة فيزياء الجسيمات بجهة حكومية تريد أن تنقل أنظمتها إلى سحابة؟ والإجابة أن المشكلة التي واجهتها CERN في 2012 ليست مشكلة فيزياء، وإنما مشكلة إدارة تقنية يعرفها كل مدير تقنية معلومات: الطلب على الموارد يزيد بسرعة، والميزانية والموظفون لا يزيدون بالسرعة نفسها، والأدوات التي بنيت قبل عشر سنوات لم تعد تتحمل.
المصدر: CERN: مركز بيانات جديد (23 فبراير 2024)، وCERN: Exabyte من الأقراص (29 سبتمبر 2023)، وCERN: Exabyte من بيانات المصادم (17 ديسمبر 2025).
المشكلة في 2012: ضعف السيرفرات Servers بلا موظفين جدد
قبل OpenStack لم تكن CERN بلا محاكاة افتراضية Virtualization. فقد كان لديها مشروع اسمه CVI على Microsoft Hyper-V، وكان يستضيف أكثر من 3,500 جهاز افتراضي Virtual Machine عندما بدأ إيقافه في يوليو 2013، ومشروع آخر اسمه LxCloud لتشغيل مهام المعالجة الدفعية Batch على أجهزة افتراضية، جرب فيه الفريق OpenNebula وأدوات أخرى، وشغل في اختباراته أكثر من 16,000 جهاز افتراضي. أي أن الفريق كان يعرف المحاكاة الافتراضية جيداً، وكانت المشكلة في مكان آخر.
وفي 2012 بدأت CERN مشروعاً سمته «البنية التحتية المرنة» Agile Infrastructure، وعرض فريقها أسبابه في أكثر من مؤتمر. ففي عرض نوفمبر 2013 كانت الأسباب ثلاثة سطور واضحة:
- سنحتاج إلى إدارة ضعف عدد السيرفرات الموجودة اليوم.
- لن يزيد عدد الموظفين.
- الأدوات أصبحت هشة، ولن تتحمل هذا الحجم كما هي.
وفي عرض 2024 الذي روى فيه رئيس قسم الحوسبة Arne Wiebalck القصة كاملة، أضاف أسباباً أخرى: المصادم كان على وشك التوقف الطويل الأول Long Shutdown واختصاراً LS1، فكانت تلك فرصة للتغيير دون أن يتأثر العمل، والمشاريع الأوروبية التي كانت تمول بعض المطورين انتهت فقل عدد من يطور الأدوات الداخلية، واحتياجات المصادم من المعالجة والتخزين تزيد بشكل كبير، وجهات أخرى في العالم بنت أنظمة أكبر من أنظمة CERN.
ولاحظ هذا السبب الأخير جيداً، لأنه يغير طريقة التفكير كلها. فقد كانت CERN لسنوات أكبر من أي جهة حولها، ولذلك بنت أدواتها بنفسها، مثل نظام الإعداد Quattor ونظام المراقبة Lemon. وعندما ظهرت شركات تشغل مئات الآلاف من السيرفرات، أصبحت أدوات CERN الخاصة عبئاً: لا يعرفها أحد خارج CERN، ولا يطورها إلا فريقها، وكل موظف جديد يحتاج أشهراً ليتعلمها.
وكان الهدف المكتوب في 2012 طموحاً: أن تصبح 90% من الأجهزة افتراضية، وأن تستعد السحابة لـ 300,000 جهاز افتراضي.
المصدر: مدونة CERN التقنية: 10 سنوات من OpenStack، الجزء الأول (28 أكتوبر 2020)، وعرض Jan van Eldik في لندن (29 نوفمبر 2013)، وعرض Arne Wiebalck عن تاريخ السحابة (6 يونيو 2024)، وعرض José Castro León في HEPiX (أبريل 2012).
«لسنا حالة خاصة» We're not special: القرار الذي غير كل شيء
أهم ما في تجربة CERN ليس اختيار OpenStack نفسه، وإنما المبدأ الذي جاء الاختيار بسببه. ففي ورقة قدمها Gavin McCance في مؤتمر CHEP في أكتوبر 2013 عن تطوير نظام الإعداد، تجد العبارة بوضوح: «لسنا حالة خاصة» We're not special، ومعها السبب العملي: «استخدم أدوات معيارية Standard Tools، فنستطيع أن نوظف من يعرفها، ويستطيع من يعمل عندنا أن يجد عملاً بها عندما يغادر».
وهذه الجملة الأخيرة تستحق أن تقف عندها، لأن CERN مختبر يتغير فيه الموظفون باستمرار، فكثير منهم يأتي بعقد لسنوات محددة ثم يغادر. فإذا كانت الأدوات خاصة بـ CERN، فكل موظف يغادر يأخذ معه معرفة لا تجدها في السوق، وكل موظف جديد يبدأ من الصفر. أما إذا كانت الأدوات هي نفسها التي تستخدمها آلاف الشركات، فالموظف الجديد يأتي وهو يعرفها، ومن يغادر يحمل معه خبرة لها قيمة في سوق العمل، وهذا يجعل العمل في CERN أكثر جاذبية أيضاً.
ولذلك كان المبدأ في عرض نوفمبر 2013 ثلاثة أجزاء:
- الحوسبة في CERN لم تعد حالة خاصة.
- تبني سلسلة أدوات مفتوحة المصدر Open Source Tool Chain بدل الأدوات الداخلية.
- المساهمة بالميزات الجديدة Features في المشروع الأصلي، وعدم الاحتفاظ بها داخل CERN.
وبناءً على ذلك اختار الفريق مجموعة أدوات كاملة، وليس OpenStack وحده. فقد ذكرت ورقة CHEP في 2013 أن نظام البنية التحتية الجديد يتكون من Puppet لإدارة الإعدادات Configuration Management، وForeman لجرد الأجهزة وتصنيفها، وOpenStack للسحابة، وJenkins وKoji لبناء الحزم، وأدوات Elasticsearch وKibana للمراقبة. وكان Puppet وقتها يدير أكثر من 4,000 جهاز، وكان المستخدم يستطيع أن يحصل على جهاز معد بالكامل خلال 15 دقيقة.
وهل هذا يعني أن CERN لم تكتب كوداً خاصاً بها؟ لا، فقد كتبت الكثير، ولكنها كانت تكتبه في المشروع الأصلي متى استطاعت. فمثلاً ربطت خدمة الهوية Keystone بنظام Active Directory الذي كان يحمل وقتها 44,000 مستخدم و29,000 مجموعة، ويستقبل نحو 200 موظف جديد أو مغادر كل شهر، وأرسلت التعديلات اللازمة لذلك إلى OpenStack نفسه، فدخلت 7 تعديلات Patches منها في إصدار Folsom. والفائدة هنا أن هذه التعديلات أصبحت جزءاً من المشروع، فلا تحتاج CERN أن تعيد تطبيقها بنفسها مع كل ترقية.
المصدر: Gavin McCance: تطوير إدارة الإعدادات في CERN، CHEP (14 أكتوبر 2013)، وعرض لندن (29 نوفمبر 2013).
من ثلاثة نماذج تجريبية Prototypes إلى خدمة إنتاج Production
أول عرض عن OpenStack داخل CERN كان في يناير 2011، أي بعد أشهر قليلة من ظهور المشروع نفسه. ولم ينتقل الفريق مباشرة إلى الإنتاج، وإنما بنى ثلاثة نماذج تجريبية متتالية، لكل منها هدف، كما رواها Belmiro Moreira في مدونة CERN التقنية:
| النموذج | إصدار OpenStack | ما الذي جربه |
|---|---|---|
| Guppy | Essex | أول تجربة على نظام Fedora 16 |
| Hamster | Folsom | نظام SLC6 وWindows، وتشغيل KVM وHyper-V معاً |
| Ibex | Folsom | نموذج كبير بأكثر من 600 سيرفر حوسبة Compute Node |
ولاحظ أن النموذج الثالث لم يكن صغيراً، فأكثر من 600 سيرفر حجم يكفي ليظهر فيه ما لا يظهر في معمل من خمسة أجهزة: مشكلات الشبكة، وبطء قاعدة البيانات، وضغط Load الطلبات على خدمات الإدارة. وهذا درس مهم لأي جهة: النموذج التجريبي الذي يقنعك يجب أن يكون قريباً من الحجم الحقيقي، وإلا فسوف تكتشف المشكلات في الإنتاج.
وفي يوليو 2013 بدأت الخدمة في الإنتاج على إصدار Grizzly، كما يقول Tim Bell في مقابلة مع مؤسسة OpenStack في 2020: «دخلنا الإنتاج في يوليو 2013». وبدأت بأربع خدمات فقط: Keystone للهوية، وNova للأجهزة الافتراضية، وGlance لقوالب الأنظمة Images، وHorizon للواجهة. وكانت السحابة موزعة من اليوم الأول على مركزي بيانات: مركز Meyrin الأصلي قرب جنيف، ومركز Wigner في بودابست، والمسافة بينهما تجعل زمن الاستجابة Latency نحو 24 ميلي ثانية.
والصورة التالية تبين أهم المحطات من 2011 إلى 2026:
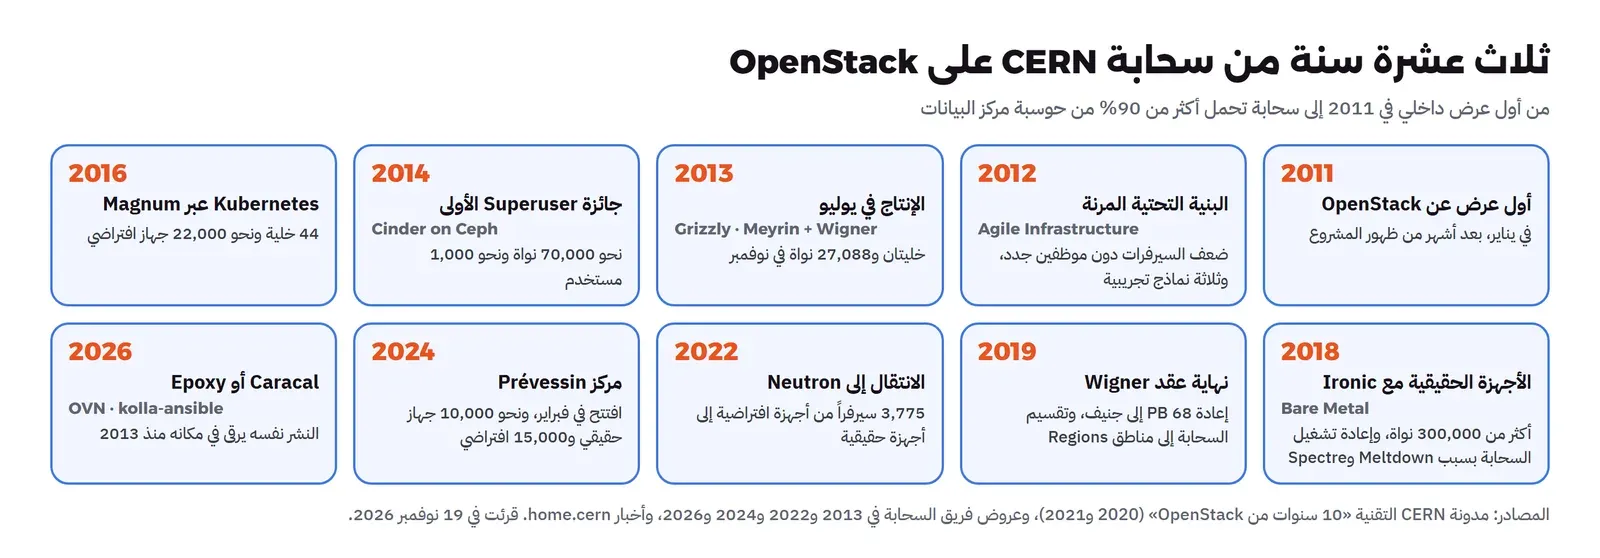
المصدر: 10 سنوات من OpenStack في CERN، الجزء الأول، والجزء الثاني (4 فبراير 2021)، ومقابلة Tim Bell (16 يوليو 2020).
الأرقام عبر السنين: كيف كبرت السحابة Cloud؟
الأرقام التالية من عروض فريق CERN ومدونته، وكل رقم بتاريخه. ولاحظ أن الأرقام لا تقاس دائماً بالطريقة نفسها، فبعضها يعد أنوية المعالج وبعضها يعد السيرفرات، ولذلك وضعنا كل رقم كما ورد في مصدره:
| التاريخ | ما قاله المصدر |
|---|---|
| نوفمبر 2013 | 946 سيرفراً و27,088 نواة و3,723 جهازاً افتراضياً في خليتين: Meyrin وWigner |
| مايو 2014 | 60,000 نواة، وأكثر من 5,500 جهاز افتراضي، لـ 370 مستخدماً و140 مشروعاً مشتركاً |
| نوفمبر 2014 | 70,000 نواة ونحو 1,000 مستخدم في سحابة واحدة |
| ديسمبر 2016 | 44 خلية، ونحو 22,000 جهاز افتراضي، ونحو 7,000 سيرفر حوسبة (193,000 نواة)، ونحو 2,400 مستخدم و2,800 مشروع |
| مايو 2018 | أكثر من 300,000 نواة على أكثر من 9,000 سيرفر، وأكثر من 4,000 مشروع، ونحو 90% من موارد CERN تقدم عبر OpenStack |
| يوليو 2020 | أكثر من 300,000 نواة، وأكثر من 500 عنقود Kubernetes، و5,000 جهاز حقيقي تديره السحابة |
| فبراير 2021 | أكثر من 8,000 سيرفر حوسبة، و75 خلية في 3 مناطق، ولا تزيد أي خلية على 200 سيرفر |
| يونيو 2024 | نحو 10,000 جهاز حقيقي ونحو 15,000 جهاز افتراضي |
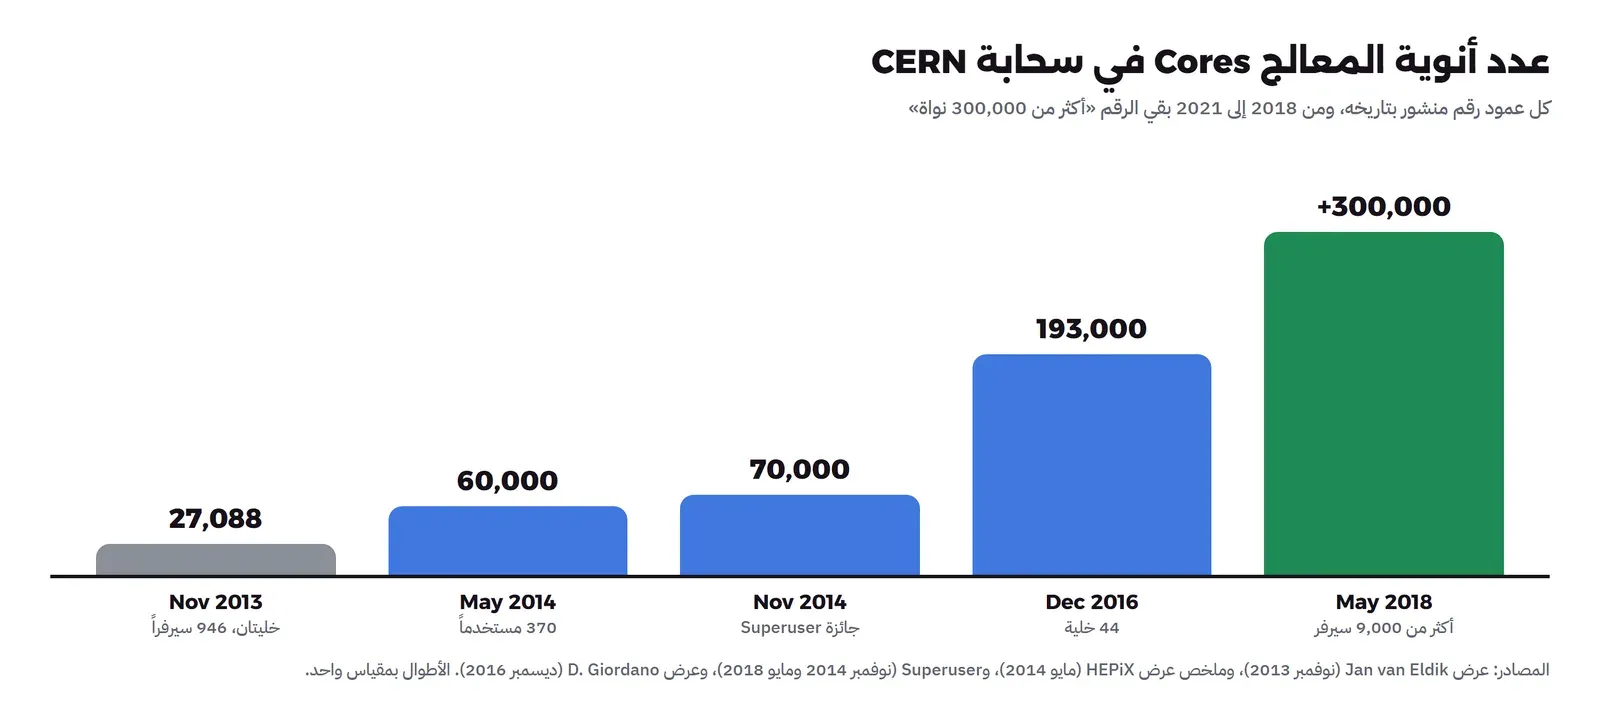
وفي نوفمبر 2013 كان الهدف المكتوب أن تصل السحابة إلى 15,000 سيرفر و100,000 جهاز افتراضي بنهاية 2015. ولم تصل إليه بهذا الشكل، ولكنها تجاوزته في أنوية المعالج بعد ذلك بقليل، فالرسم التالي يبين نمو الأنوية من نوفمبر 2013 إلى مايو 2018:
وقد يتساءل البعض: لماذا انخفض عدد الأجهزة الافتراضية من 22,000 في 2016 إلى نحو 15,000 في 2024، مع أن السحابة كبرت؟ والإجابة في قرار اتخذه الفريق في 2022، فقد نقل آلاف السيرفرات من أجهزة افتراضية إلى أجهزة حقيقية تديرها السحابة نفسها، كما سنشرح في قسم Ironic. ولذلك لا تقارن أرقام الأجهزة الافتراضية بعد 2021 بما قبلها، لأن ما يعد قد تغير.
وتقول صفحة مركز البيانات في موقع CERN اليوم إن المركز يضم 450,000 نواة معالج و10,000 سيرفر، وإن أكثر من 90% من الحوسبة فيه تعمل على سحابة OpenStack الخاصة.
المصدر: ملخص عرض Stefano Zilli في HEPiX (22 مايو 2014)، وSuperuser: جائزة Superuser (3 نوفمبر 2014)، وعرض D. Giordano (13 ديسمبر 2016)، وSuperuser عن عرض Arne Wiebalck (23 مايو 2018)، وصفحة مركز البيانات في CERN.
كيف كبرت السحابة دون أن تنهار؟ الخلايا Cells والمناطق Regions
في OpenStack تتكون خدمة Nova، المسؤولة عن الأجهزة الافتراضية، من خدمات إدارة مركزية وقاعدة بيانات Database وطابور رسائل Message Queue مثل RabbitMQ تتواصل عبره الخدمات مع السيرفرات. والطريقة البسيطة أن تضع كل السيرفرات خلف قاعدة بيانات واحدة وطابور رسائل واحد، وهذه الطريقة تعمل جيداً مع عشرات السيرفرات أو بضع مئات. ولكن عندما تصل إلى آلاف السيرفرات، يصبح طابور الرسائل نقطة فشل واحدة Single Point of Failure: إذا تعطل، تتوقف إدارة السحابة كلها.
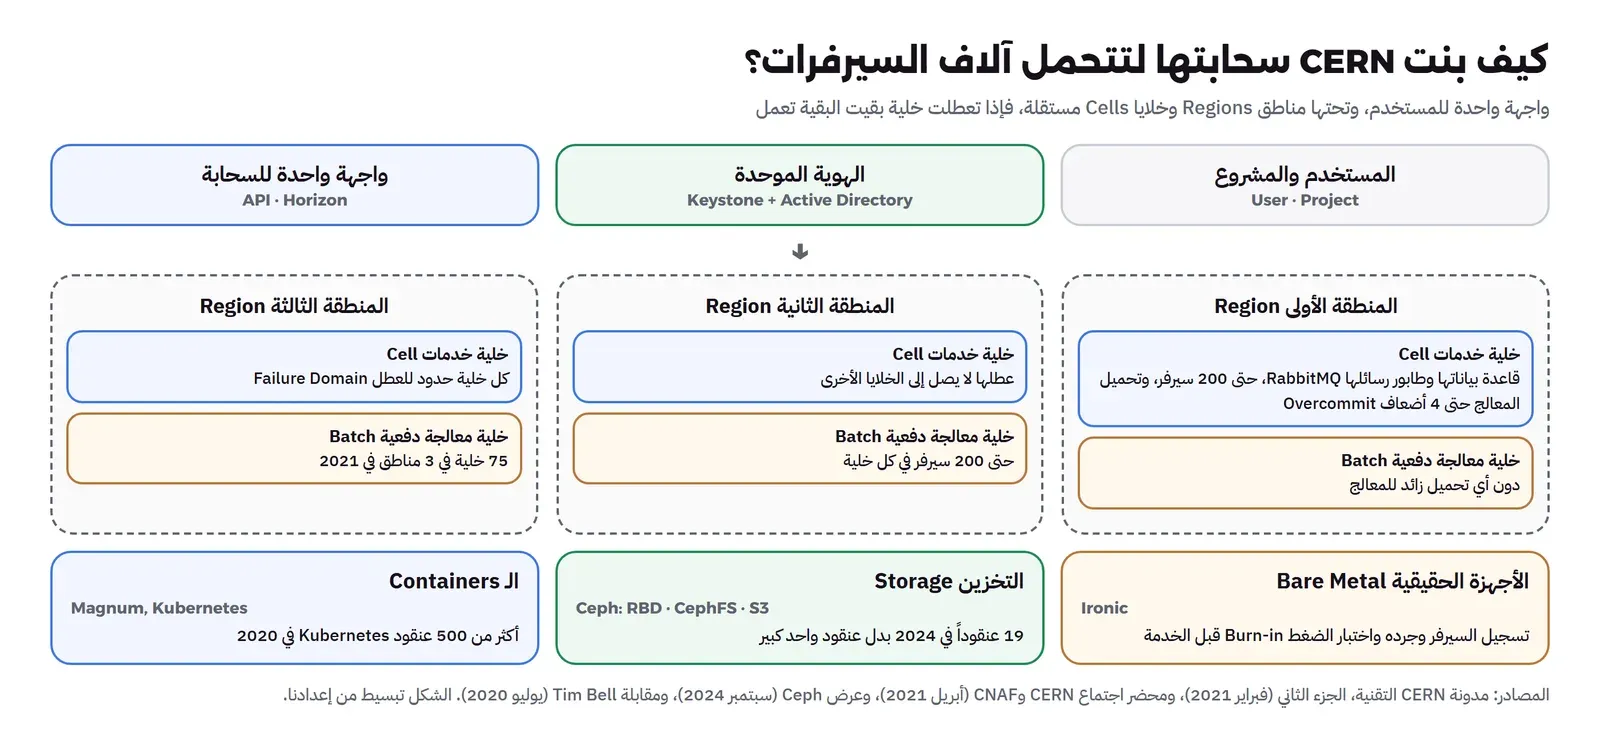
والحل الذي اعتمدته CERN من اليوم الأول هو الخلايا Cells. والخلية مجموعة من السيرفرات لها قاعدة بياناتها وطابور رسائلها الخاص، وفوقها طبقة واحدة يرى منها المستخدم السحابة كلها كأنها سحابة واحدة. فإذا تعطل طابور الرسائل في خلية، تتأثر سيرفرات هذه الخلية فقط، وتبقى بقية السحابة تعمل. وبدأت السحابة بخليتين في 2013، ثم وصلت إلى 44 خلية في 2016، ثم إلى 75 خلية في 3 مناطق في 2021، والقاعدة التي وضعها الفريق أن لا تزيد أي خلية على 200 سيرفر.
ولم تكن الخلايا للحجم فقط. ففي محضر اجتماع بين CERN ومركز CNAF الإيطالي في أبريل 2021 يذكر الفريق أنه يستخدم الخلايا أيضاً لفصل الاستخدامات المختلفة، ولتكون حدوداً للأعطال Failure Domains. فمثلاً خلايا الخدمات العادية تسمح بتحميل المعالج حتى 4 أضعاف Overcommit، لأن أغلب الأجهزة الافتراضية لا تستخدم معالجها كاملاً في الوقت نفسه، أما خلايا المعالجة الدفعية التي تحلل بيانات المصادم فلا تسمح بأي تحميل زائد، لأن كل جهاز فيها يستخدم معالجه كاملاً طوال الوقت.
وفي 2019 أضاف الفريق مستوى أعلى: قسم السحابة إلى مناطق Regions، والسبب كما ورد في المدونة هو تقليل خطر طابور الرسائل مرة أخرى، لأن بعض الخدمات كانت ما زالت مشتركة بين كل الخلايا. والصورة التالية تبين هذا البناء:
والفكرة نفسها طبقها فريق التخزين على Ceph، ففي عرض سبتمبر 2024 تجد عبارة «لا تضع كل البيض في سلة واحدة»، وكان لدى CERN وقتها 19 عنقود Ceph في الإنتاج بدل عنقود واحد كبير، وخمسة عناقيد إضافية في مركز البيانات الجديد. وتقول المدونة التقنية عن الخلايا الكبيرة في البدايات إنها كانت «بيضاً كثيراً في السلة نفسها».
المصدر: 10 سنوات من OpenStack في CERN، الجزء الثاني، ومحضر اجتماع CERN وCNAF (14 أبريل 2021)، وEnrico Bocchi: Ceph في CERN (27 سبتمبر 2024).
الترقية Upgrade دون إيقاف الأجهزة: مكون بعد مكون
من أكثر ما يخيف أي فريق يفكر في OpenStack هو الترقية Upgrade، لأن المشروع يصدر إصداراً جديداً كل ستة أشهر، والسحابة تتكون من خدمات كثيرة تعتمد على بعضها. والطريقة البسيطة أن توقف السحابة كلها في عطلة نهاية أسبوع وترقي كل شيء معاً، وهذه الطريقة تعني توقفاً طويلاً، وإذا فشل شيء فلا تعرف أي خدمة هي السبب.
واختارت CERN طريقاً آخر من البداية: ترقية مكون Component بعد مكون، وبين كل مكون والذي يليه أسابيع. ففي ترقية Icehouse في 2014 رقى الفريق أول المكونات في أغسطس، ثم Nova وHorizon في أكتوبر، وتوقفت واجهة البرمجة API نحو 6 ساعات، ويقول الفريق في مدونته: «كل الأجهزة الافتراضية استمرت في العمل خلال هذه المدة دون مشكلات». أي أن من توقف هو إدارة السحابة، أما الخدمات التي تعمل عليها فلم تشعر بشيء.
وهذا فرق مهم يجب أن تفهمه: في السحابة الخاصة هناك مستويان، مستوى الإدارة Control Plane الذي تنشئ منه الأجهزة وتحذفها، ومستوى العمل Data Plane حيث تعمل الأجهزة نفسها. وتوقف المستوى الأول ساعات مزعج للمطورين، ولكنه لا يوقف خدمة المواطن أو العميل. أما توقف المستوى الثاني فهو العطل الحقيقي.
ولم تكن كل الترقيات سهلة. ففي 2023 و2024 رقى الفريق كل مكونات مركز Meyrin إلى إصدار Yoga، ووصف ذلك في عرض يونيو 2024 بأنه «أول انتقال كبير» مع «توقف طويل للخدمة» في Nova وNeutron وPlacement، والسبب أن السحابة تأخرت عن إصدارات المشروع الأصلي، فأصبح على الفريق أن يتجاوز عدة إصدارات دفعة واحدة. ولذلك كان من أهداف الفريق المكتوبة في العرض نفسه: «تقليص الفجوة مع إصدارات OpenStack الأصلية».
وفي الفترة نفسها نقل الفريق نحو 15,000 جهاز افتراضي وهي تعمل Live Migration مرتين، لترقية نظام تشغيل السيرفرات من الإصدار 7 إلى 8 ثم إلى 9، وانخفضت المدة من 6 أشهر في الترقية الأولى إلى 10 أسابيع في الثانية، لأن الفريق أتمت Automated ما تعلمه في المرة الأولى. وفي عرض يوليو 2026 تقول CERN إنها تعمل على إصدار Caracal أو Epoxy، وإن «نشر Meyrin يرقى في مكانه منذ يوليو 2013»، أي أنها لم تبن السحابة من جديد مرة واحدة في ثلاث عشرة سنة.
المصدر: مدونة فريق السحابة: سحابتنا على Icehouse (6 نوفمبر 2014)، وJosé Castro León: كيف تبني سحابة أفضل وأكبر (6 يونيو 2024)، وLuis Fernández Álvarez: البنية السحابية في CERN (يوليو 2026).
الأجهزة الحقيقية Bare Metal مع Ironic: متى لا تحتاج المحاكاة الافتراضية؟
المحاكاة الافتراضية لها ثمن، فجزء من قدرة السيرفر يذهب إلى طبقة المحاكاة Hypervisor نفسها، وكل جهاز افتراضي يحتاج عنوان IP وصيانة لنظامه. وعندما يكون السيرفر كله مخصصاً لمهمة واحدة طوال الوقت، مثل تحليل بيانات المصادم، فهذا الثمن لا يقابله أي فائدة.
ولذلك أضافت CERN في 2018 خدمة Ironic، وهي المكون في OpenStack الذي يدير السيرفرات الحقيقية كما يدير الأجهزة الافتراضية: يطلب المستخدم سيرفراً من الواجهة نفسها، فيحصل على جهاز حقيقي كامل. وفي 2020 أدخل الفريق أكثر من 1,000 سيرفر قائم إلى Ironic دون إعادة تثبيتها. ثم في 2022 جاء القرار الأكبر: أعاد الفريق بناء 3,775 سيرفراً كانت تستضيف أجهزة افتراضية للمعالجة الدفعية، وجعلها أجهزة حقيقية تديرها Ironic. وسمى الفريق ذلك في عرضه «مراجعة ضريبة المحاكاة الافتراضية» Virtualisation Tax، وكانت النتيجة 16,000 جهاز افتراضي أقل، وتوفير أكثر من 10,000 عنوان IPv4.
واستخدمت CERN Ironic أيضاً لإدارة دورة حياة السيرفر كاملة، من وصوله إلى خروجه. فالسيرفر الجديد يسجل نفسه تلقائياً، ويجرد، ثم يمر باختبار ضغط Burn-in وقياس أداء قبل أن يدخل الخدمة، وأصبح هذا الاختبار هو الطريقة المعتمدة لكل شحنة أجهزة جديدة. وفي عرض يونيو 2024 تجد العبارة: «إدارة أسطول الأجهزة الحقيقية: 10,000 جهاز من التوظيف إلى التقاعد».
ولماذا يهمك هذا؟ لأن CERN مؤسسة عامة تشتري الأجهزة بمناقصات Public Procurement، وفي عرض 2013 يذكر الفريق أن المدة من تحديد الحاجة إلى استلام الأجهزة وقبولها تزيد على 280 يوماً، وتصل إلى 380 يوماً في أسوأ الحالات. وكل جهة حكومية تعرف هذه المدد. فإذا كانت أجهزتك تصل بعد سنة من طلبها، فأنت تحتاج إلى نظام يدخلها الخدمة في ساعات بعد وصولها، وليس في أسابيع.
المصدر: Jayaditya Gupta: تحديث تشغيل سحابة CERN، HEPiX (28 أبريل 2022)، وDomingo Rivera Barros: تحديث البنية السحابية (2 نوفمبر 2022)، والجزء الثاني من مدونة CERN.
التخزين على Ceph: من تجربة 300 TB إلى عشرات الـ PB
السحابة تحتاج إلى تخزين للأقراص التي يضيفها المستخدم إلى أجهزته Block Storage، وللملفات المشتركة File Storage، ولقوالب الأنظمة، ولتخزين الكائنات Object Storage بأسلوب S3. واختارت CERN لكل ذلك Ceph، وهو نظام تخزين موزع مفتوح المصدر يوزع البيانات على سيرفرات كثيرة ويتحمل تعطل بعضها. وقد شرحنا فكرته في Ceph للمبتدئين.
وبحسب عرض فريق التخزين في سبتمبر 2024 فقد بدأت التجربة في 2013 بنموذج من 300 TB، ثم توسع التخزين في 2016 من 3 PB إلى 6 PB دون توقف الخدمة، وفي 2024 كان لدى CERN 19 عنقوداً في الإنتاج، وإذا جمعت السعات الخام Raw Capacity المذكورة في العرض فهي نحو 73 PB. وكل عنقود يخدم استخداماً محدداً: أقراص Cinder وقوالب Glance عبر RBD، والملفات المشتركة عبر CephFS وخدمة Manila، وتخزين الكائنات عبر RadosGW. ويقدم الفريق للمستخدم أنواعاً من الأقراص بحسب الأداء، تبدأ من النوع العادي بسرعة 80 MB في الثانية و100 عملية في الثانية IOPS، وتنتهي بنوع على أقراص Flash بالكامل.
ولاحظ أن بيانات المصادم نفسها، أي الـ Exabyte الذي ذكرناه في البداية، ليست على Ceph، وإنما على نظام آخر بنته CERN اسمه EOS وعلى الأشرطة. أي أن CERN لم تحاول أن تجعل أداة واحدة تحل كل شيء، فاختارت Ceph لتخزين السحابة، وأبقت نظاماً متخصصاً لبيانات التجارب.
المصدر: Enrico Bocchi: Ceph في CERN (27 سبتمبر 2024)، وCERN: Exabyte من الأقراص.
مركز بيانات في بلد آخر، ثم العودة: قصة Wigner
في 8 مايو 2012 أعلنت CERN عقداً مع مركز Wigner للأبحاث في بودابست لاستضافة جزء من حوسبتها، يمتد في البداية حتى نهاية 2015 مع إمكانية التمديد أربع سنوات. وفي 13 يونيو 2013 افتتح المركز، وأضاف حتى 2.5 MW من الطاقة إلى 3.5 MW كانت في جنيف، ونحو 500 سيرفر و20,000 نواة و5.5 PB في البداية، ويربطه بجنيف خط شبكة بسرعة 200 Gbit في الثانية. وكانت السحابة الجديدة موزعة على المركزين من أول يوم.
ثم انتهى العقد في 2019، وتقول CERN في عرض 2024: «استضافة خارجية: 2.5 MW من 2013 إلى 2019». وكان على الفريق أن يعيد كل شيء إلى جنيف. وفي عرض قدمه Oliver Keeble عن إيقاف Wigner تجد المهمة بوضوح: إعادة كل البيانات وأغلب القدرة قبل نهاية 2019، أي 68 PB من البيانات و90 PB من السعة. وحتى يكتمل مركز البيانات الجديد، شغلت CERN مراكز بيانات مؤقتة في حاويات Container Data Centres بقدرة 0.5 MW من 2019 إلى 2024.
وفي 23 فبراير 2024 افتتحت CERN مركز بيانات Prévessin، بمساحة تزيد على 6,000 متر مربع، وبنته في أقل من سنتين، بقدرة تبدأ من 4 MW ويمكن أن تصل إلى 12 MW على ثلاثة طوابق، وبهدف كفاءة طاقة PUE قدره 1.1، مع استخدام الحرارة الناتجة لتدفئة مباني الموقع. وفي يوليو 2026 كان في Prévessin خلية واحدة بنحو 3,940 جهازاً.
المصدر: CERN: عقد Wigner (8 مايو 2012)، وافتتاح امتداد بودابست (13 يونيو 2013)، وOliver Keeble: إيقاف مركز Wigner (2020)، وCERN: مركز بيانات جديد (23 فبراير 2024).
Kubernetes فوق OpenStack: السحابة تخدم الـ Containers أيضاً
عندما انتشرت الـ Containers وأصبح Kubernetes هو الطريقة المعتادة لتشغيلها، لم تبن CERN منصة منفصلة، وإنما أضافت خدمة Magnum في OpenStack، وهي الخدمة التي تنشئ عنقود Kubernetes كاملاً بطلب من المستخدم. ودخلت Magnum الإنتاج في الربع الأخير من 2016، كما قال Spyros Trigazis من فريق CERN في مقابلة مع Superuser في فبراير 2017، وفي يوليو 2020 قال Tim Bell إن في السحابة أكثر من 500 عنقود Kubernetes.
والفائدة هنا أن الفريق لم يحتج إلى نظام هوية جديد أو نظام تخزين جديد أو نظام فوترة جديد، فالعنقود ينشأ في مشروع المستخدم نفسه، ويأخذ أقراصه من Ceph، ويدخل إليه المستخدم بالهوية نفسها. وإذا كنت تتساءل هل تحتاج Kubernetes أصلاً، فقد ناقشنا ذلك في هل تحتاج Kubernetes فعلاً؟
المصدر: Superuser: مقابلة Spyros Trigazis (9 فبراير 2017)، ومقابلة Tim Bell (16 يوليو 2020).
الحيوانات الأليفة والقطيع Pets vs Cattle: كيف شرحت CERN الفكرة لمستخدميها
أصعب جزء في أي سحابة ليس التقنية، وإنما أن يغير المستخدمون طريقة تفكيرهم. فمدير النظام الذي تعود أن يكون له سيرفر باسم يعرفه، يصلحه بيده كلما تعطل، سوف يجد صعوبة في فكرة أن الجهاز يمكن أن يحذف ويستبدل في أي لحظة. ولشرح ذلك استخدمت CERN في عرض نوفمبر 2013 تشبيهاً انتشر في عالم السحابة: الحيوانات الأليفة والقطيع Pets vs Cattle.
- الحيوان الأليف Pet: له اسم مثل pussinboots.cern.ch، وعندما يمرض تعالجه حتى يتعافى.
- القطيع Cattle: له رقم مثل vm00042.cern.ch، وعندما يمرض تأخذ غيره.
ولاحظ أن CERN لم تقل إن كل الأنظمة يجب أن تكون قطيعاً، فالعرض نفسه يقول إن التطبيقات الجديدة يجب أن تبنى بطريقة القطيع، ولكن الحيوانات الأليفة ما زالت ضرورية، بشرط أن تدار إعداداتها بأداة مثل Puppet حتى يمكن إعادة بنائها. وهذا توازن عملي تحتاجه أي جهة حكومية فيها أنظمة قديمة لا يمكن إعادة كتابتها: انقلها كما هي، وأدر إعداداتها بأداة، وابن الجديد بطريقة القطيع. والتشبيه نفسه ليس من CERN، فقد نشره قبلها آخرون في عالم السحابة، ولكن CERN كانت من أشهر من استخدمه.
ويعترف الفريق في عرض 2024 بأن «تقبل المستخدمين كان صعباً» وأن «البداية لم تكن سهلة إطلاقاً». وهذا اعتراف مهم ممن نجح، لأنه يعني أن الصعوبة طبيعية، وأنها ليست علامة على أن المشروع يفشل.
المصدر: عرض لندن (29 نوفمبر 2013)، وعرض Arne Wiebalck (6 يونيو 2024).
ما الذي لم يسر كما يجب؟ الأعطال Incidents والصعوبات
من يقرأ قصص النجاح فقط يظن أن كل شيء كان سهلاً، لذلك جمعنا هنا ما ذكره فريق CERN نفسه من صعوبات:
- Meltdown وSpectre في 2018: اضطر الفريق إلى إعادة تشغيل السحابة كلها لتطبيق إصلاحات المعالج، وأوقف ميزة تعدد الخيوط SMT. وفي عرض 2026 يقول الفريق إن «وتيرة الثغرات CVE الأخيرة تحتاج إلى أتمتة أكثر تقدماً لإعادة تشغيل السحابة».
- شبكة لم يكن يمكن لمسها: في البداية استخدمت السحابة نموذج الشبكة القديم nova-network، لأن «تغيير الشبكة لم يكن خياراً»، كما تقول المدونة. وفي 2022 نقل الفريق نحو 4,000 جهاز افتراضي إلى Neutron، مع توقف ساعة أو ساعتين لكل جهاز.
- التوفر العالي الذي يفشل: يقول Belmiro Moreira: «عندما يفشل حل التوفر العالي، لا يكون استعادة الخدمة سهلاً دائماً»، ويضيف أن الطريقة البسيطة سمحت لهم بتشغيل بنية كبيرة بعدد قليل جداً من الأعطال.
- خدمة غامضة تحذف الأجهزة: في عرض 2018 حكى Arne Wiebalck عن خدمة كانت تقتل أجهزة افتراضية، وقال: «استغرقنا وقتاً طويلاً لنعرف القاتل».
- الانتقال إلى Red Hat ثم الخروج منه: في 2026 ينقل الفريق طريقة النشر إلى kolla-ansible، لأن Red Hat توقفت عن إنتاج حزم RPM التي كانت السحابة تعتمد عليها. أي أن الاعتماد على مورد واحد ظهر حتى داخل عالم المصادر المفتوحة.
- الأمن: عندما بنى الفريق السحابة في Prévessin أضاف مجموعات الأمان Security Groups، وكتب في عرضه أن ذلك «ينهي الشعار القديم: كل شيء يتحدث مع كل شيء».
المصدر: مدونة CERN، الجزء الثاني، وSuperuser (23 مايو 2018)، وعرض يوليو 2026.
المساهمة في المشروع الأصلي Upstream: لماذا تعطي CERN ما تبنيه؟
في 3 نوفمبر 2014 حصلت CERN على أول جائزة Superuser تمنحها مؤسسة OpenStack في قمة باريس، وكان المرشحون الآخرون Comcast وTime Warner Cable وMercadoLibre. وفي يوليو 2020 قال Tim Bell إن فريق CERN قدم نحو 1,000 مساهمة Commit من 34 مساهماً خلال ثماني سنوات، وتولى أعضاء منه أدواراً في المشروع: مراجعين أساسيين Core Contributors، وقادة مشاريع، وأعضاء في اللجنة التقنية ومجلس الإدارة. وكل الكود الذي يكتبه الفريق منشور في مستودع البنية السحابية في CERN.
وقد يتساءل البعض: لماذا تصرف مؤسسة بحثية وقت مهندسيها على مشروع يستفيد منه منافسون وشركات تجارية؟ والإجابة في عبارات الفريق نفسه:
- «المساهمة لبناء المصداقية هي الطريق الوحيد المستدام». (Arne Wiebalck، 2024)
- «رأينا كيف يعمل ذلك، وكيف لا يعمل عندما لا تشارك». (Arne Wiebalck، 2024)
- «مشكلاتنا غالباً تحل قبل أن نطرحها». (Jan van Eldik، 2013)
- «الاستثناءات مكلفة». (عرض 2024)
والعبارة الأخيرة هي أساس الفكرة: كل تعديل تحتفظ به لنفسك ولا تدخله في المشروع الأصلي، سوف تعيد تطبيقه مع كل ترقية، وسوف يتعارض مع التغييرات الجديدة، وسوف يعرفه موظف واحد فقط. وقد ذكر الفريق في 2012 مشكلة أنه كان «أحياناً متقدماً على المشروع الأصلي»، أي أنه بنى أشياء قبل أن يبنيها المشروع، ثم اضطر إلى تركها عندما بنى المشروع طريقته. وقد شرحنا لماذا تساهم المؤسسات الكبيرة في المصادر المفتوحة في لماذا تساهم الشركات الكبيرة في المصادر المفتوحة؟، وكيف تدير جهتك مساهماتها في حوكمة المشاريع مفتوحة المصدر.
المصدر: Superuser: جائزة Superuser (3 نوفمبر 2014)، ومقابلة Tim Bell (16 يوليو 2020)، وعرض 2024.
السيادة والمصادر المفتوحة: ما الذي تقوله CERN فعلاً؟
في عرض 2024 ذكر Arne Wiebalck لماذا بنيت السحابة على برمجيات حرة ومفتوحة المصدر FOSS: لأن تعديلها ممكن فتعطي مرونة، ولأن «إعادة العطاء» لها أثر في المجتمع، ولأنها تساعد في تطوير مهارات الموظفين الذين يعودون إلى دولهم الأعضاء، ثم أضاف بين قوسين: «وتساعد في بعض أسئلة حوكمة البيانات Data Governance». ولاحظ أن السيادة هنا سبب ثانوي بين قوسين، أما الأسباب الرئيسية فهي المرونة والمهارات.
وفي 12 يونيو 2019 نشرت CERN مقالاً عن مشروع سمته MAlt، أي بدائل Microsoft، بعد أن ألغت Microsoft الوضع الأكاديمي الذي كانت CERN تحصل به على تراخيص مخفضة، فأصبح العقد الجديد يرفع تكلفة التراخيص «أكثر من عشرة أضعاف». وكان هدف المشروع كما كتبته CERN: «أن نعود إلى السيطرة باستخدام برمجيات مفتوحة»، ومن مبادئه «تجنب الارتباط بمورد واحد Vendor Lock-in لتقليل المخاطر والاعتماد» و«إبقاء أيدينا على البيانات».
ولكن الصورة الكاملة أكثر تواضعاً، وهي مهمة لمن يخطط. ففي 17 يناير 2022 أعلنت CERN انتهاء المشروع بعد ثلاث سنوات، ووصفته بأنه ساعد في «ترشيد استخدام التراخيص وتقليل الهدر»، ولم يذكر الإعلان انتقالات مكتملة. وفي تقرير CERN في مؤتمر HEPiX في أكتوبر 2023 تجد أن البريد انتقل إلى Exchange Online وانتهى ذلك في نهاية يونيو 2023. أي أن CERN نفسها، التي تشغل واحدة من أكبر السحابات الخاصة في العالم، بقيت على خدمة سحابية تجارية لبريدها.
وهذا ليس تناقضاً، وإنما قرار بحسب الحالة: السحابة التي تحمل عمل CERN الأساسي مبنية على أدوات تملكها، أما البريد فقرار آخر بحسابات أخرى. وفي 9 نوفمبر 2023 أطلقت CERN مكتب برنامج المصادر المفتوحة Open Source Program Office واختصاراً OSPO، وقالت إن «المصادر المفتوحة ركيزة أساسية للعلم المفتوح». والدرس لأي جهة: السيادة لا تعني أن تنقل كل شيء إلى أدوات مفتوحة، وإنما أن تعرف أين يجب أن تبقى السيطرة لك، وأن تبني هناك. وقد شرحنا كيف تقرر ذلك في الاستضافة الذاتية: متى تكون قراراً استراتيجياً.
المصدر: CERN: الانتقال إلى تقنيات مفتوحة المصدر (12 يونيو 2019)، وCERN: انتهاء مشروع MALT (17 يناير 2022)، وتقرير CERN في HEPiX (أكتوبر 2023)، وCERN: مكتب برنامج المصادر المفتوحة (9 نوفمبر 2023).
وهل تستخدم CERN السحابة العامة؟
نعم، ولكن مكملة وليست بديلة. ففي عرض 2024 يذكر الفريق أربع حالات تستخدم فيها CERN السحابة العامة: الخدمات أو الأجهزة التي لا تملكها CERN، مثل الحوسبة الكمية Quantum Computing، وتجربة التقنيات الجديدة قبل شرائها، وأوقات الذروة Peak Demand عندما يزيد الطلب على ما تملكه، واستمرارية الأعمال والتعافي من الكوارث Business Continuity and Disaster Recovery. وهذا هو النموذج الهجين Hybrid بمعناه العملي: الأساس عندك، والسحابة العامة لما لا يستحق أن تبنيه.
المصدر: عرض Arne Wiebalck (6 يونيو 2024).
الدروس المستفادة Lessons Learned: ما الذي تأخذه وما الذي تتركه
الجدول التالي يجمع الدروس الرئيسية، وما تعنيه لجهة حكومية أو شركة كبيرة تفكر في سحابة خاصة:
| ما فعلته CERN | ما يعنيه لجهتك |
|---|---|
| «لسنا حالة خاصة»: أدوات معيارية يعرفها السوق | اختر أدوات يمكنك أن توظف من يعرفها، ولا تبن أداة داخلية إلا لما لا يوجد |
| ثلاثة نماذج تجريبية، آخرها بأكثر من 600 سيرفر | اجعل التجربة قريبة من الحجم الحقيقي قبل قرار الإنتاج |
| خلايا لا تزيد على 200 سيرفر | قسم السحابة إلى وحدات مستقلة حتى يبقى العطل محدوداً |
| ترقية مكون بعد مكون، والأجهزة تعمل | افصل توقف الإدارة عن توقف الخدمة، وخطط للترقية كل إصدار |
| التأخر عن الإصدارات انتهى بترقية صعبة | لا تتأخر عن المشروع الأصلي أكثر من إصدارين أو ثلاثة |
| Ironic للأجهزة الحقيقية وإدارة دورة حياتها | لا تجعل كل شيء افتراضياً إذا كان السيرفر كله لمهمة واحدة |
| إعادة 68 PB من Wigner | اكتب خطة الخروج يوم توقع عقد الاستضافة |
| المساهمة في المشروع الأصلي | كل تعديل خاص تكلفة دائمة، فأدخله في المشروع أو اتركه |
| البريد على Exchange Online | السيادة قرار لكل خدمة، وليست شعاراً لكل شيء |
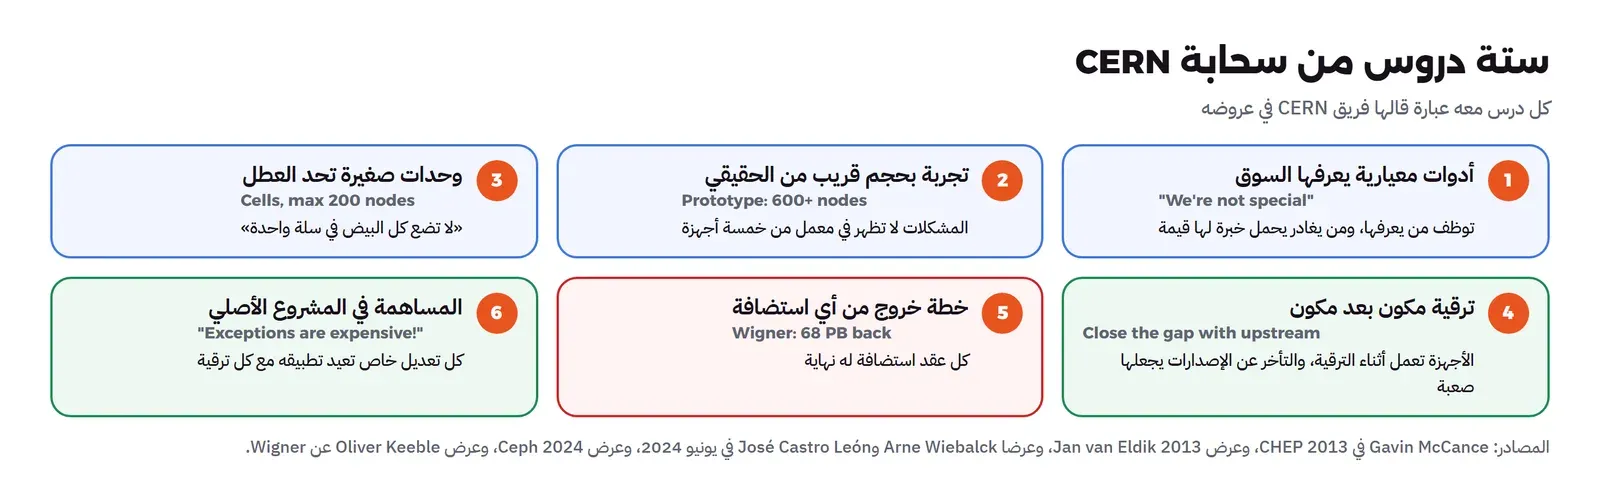
والصورة التالية تلخص هذه الدروس في شكل واحد:
ما الذي لا ينطبق عليك من تجربة CERN؟
من الخطأ أن تأخذ تجربة CERN كما هي، والسبب أن ظروفها مختلفة في ثلاثة أمور:
- الحجم: سحابة بآلاف السيرفرات تبرر فريقاً متخصصاً لكل مكون. أما جهة تملك عشرين سيرفراً، فقد يكفيها عنقود Proxmox كما شرحنا في عنقود Proxmox VE من ثلاث عقد، وOpenStack لها في الغالب تعقيد لا تحتاجه.
- نوع العمل: أغلب حوسبة CERN معالجة دفعية لبيانات علمية، وهذا العمل يتحمل أن يتوقف جهاز ويعاد تشغيل المهمة على غيره. أما الأنظمة الحكومية التي يستخدمها المواطن فتحتاج توفراً عالياً لكل طلب، وهذا يغير التصميم.
- الفريق: لم نجد رقماً رسمياً لعدد فريق السحابة في CERN، والرقم المنشور هو 34 مساهماً في الكود خلال ثماني سنوات. ولكن واضح من العروض أن الفريق يضم مهندسين متخصصين في كل مكون، وأن CERN تستثمر في المهارات منذ 2011. فإذا لم يكن عندك فريق يمكنه أن يقرأ كود OpenStack ويصلح فيه، فأنت تحتاج إلى شريك يدعمك، وهذا يغير حساب التكلفة.
وفي المقابل، هناك ما ينطبق على كل جهة مهما كان حجمها: الأدوات المعيارية، والتجربة قبل الإنتاج، وتقسيم الأعطال، وخطة الخروج، وعدم التأخر في الترقيات. وإذا كنت تقارن بين أدوات السحابة الخاصة، فسوف نقارن OpenStack وCloudStack وOpenNebula وProxmox في مرحلة السحابة الخاصة.
 دليلالسحابة الخاصة Private Cloud: متى تبنيها وماذا تحتاجمتى تحتاج مؤسستك سحابة خاصة بدل عنقود أجهزة افتراضية، وما الذي تجهزه من فريق وعتاد وعمليات وميزانية قبل أن تبدأ.
 دليلOpenStack من الداخل: Nova وNeutron وCinder وKeystoneماذا تفعل كل خدمة في OpenStack، وكيف يمر طلب إنشاء جهاز افتراضي بين Keystone وNova وPlacement وNeutron وCinder، مع مخرجات حقيقية من سحابة 2026.2.
 دليلOpenStack أم CloudStack أم OpenNebula أم Proxmox؟قرار السحابة الخاصة مبني على فريقك وحجمك وحاجتك إلى تعدد المستأجرين، مع معايير المقارنة وأسعار الدعم المنشورة وشجرة قرار ومثال لتكلفة سنة.
أخطاء شائعة عند الاستشهاد بتجربة CERN
- «CERN تركت Microsoft»: غير صحيح. مشروع MAlt انتهى بترشيد التراخيص، والبريد انتقل إلى Exchange Online في 2023.
- «OpenStack سهلة لأن CERN نجحت»: فريق CERN نفسه يقول إن منحنى التعلم حاد والاستثمار كبير، وإن البداية لم تكن سهلة.
- نقل الأرقام دون تاريخ: رقم 300,000 نواة من 2018 إلى 2021، ورقم 10,000 جهاز حقيقي من 2024، وكل رقم يقاس بطريقة مختلفة.
- نسخ التصميم كما هو: سياسة تحميل المعالج حتى 4 أضعاف تناسب خدمات CERN العادية، ولا تعني أنها تناسب نظاماً حكومياً حساساً.
- نسيان أن CERN بنت كل شيء حول OpenStack: Puppet وForeman وCeph والمراقبة والهوية. والسحابة بدون هذه الأدوات لا تعمل بهذا الحجم.
- نسبة السحابة كلها إلى السيادة: الأسباب التي ذكرها الفريق أولاً هي الحجم والموظفون والمرونة، والسيادة ذكرت بين قوسين.
قائمة تحقق Checklist قبل أن تبني سحابة خاصة على طريقة CERN
- كتبت المشكلة بأرقام: كم سيرفراً اليوم، وكم بعد ثلاث سنوات، وكم موظفاً يديرها.
- اخترت أدوات معيارية لكل طبقة: الإعداد، والسحابة، والتخزين، والمراقبة، والهوية.
- خططت لتجربة بحجم قريب من الحقيقي قبل قرار الإنتاج.
- حددت حجم الوحدة المستقلة (الخلية أو العنقود) وأقصى عدد سيرفرات فيها.
- وضعت جدولاً للترقية مع كل إصدار، وحددت أقصى تأخر تقبله عن المشروع الأصلي.
- فصلت في خطتك توقف الإدارة عن توقف الخدمات.
- كتبت خطة خروج لكل استضافة خارجية أو مورد دعم.
- حددت ما تبنيه بنفسك وما تتركه للسحابة العامة أو لخدمة تجارية.
- قررت سياسة المساهمة في المشاريع المفتوحة التي تعتمد عليها.
- جهزت خطة لتدريب المستخدمين، لأن التقبل أصعب من التقنية.
الخلاصة
- بدأت CERN سحابتها لأن السيرفرات ستتضاعف والموظفين لن يزيدوا، وليس لأنها تريد تقنية جديدة.
- القرار الأهم كان «لسنا حالة خاصة»: أدوات معيارية مفتوحة المصدر يعرفها السوق.
- الخدمة في الإنتاج منذ يوليو 2013، وكبرت من نحو 27,000 نواة إلى أكثر من 300,000 نواة في 2018، وتحمل اليوم أكثر من 90% من حوسبة مركز البيانات.
- الخلايا الصغيرة، والترقية مكوناً بعد مكون، وIronic للأجهزة الحقيقية، وCeph للتخزين، هي ما جعل الحجم ممكناً.
- عودة 68 PB من Wigner تبين قيمة أن تملك أدواتك وخطة خروجك.
- السيادة عند CERN قرار لكل خدمة، فالسحابة مفتوحة والبريد على خدمة تجارية.
- المساهمة في المشروع الأصلي ليست كرماً، وإنما الطريقة الوحيدة لتبقى السحابة قابلة للترقية.
وفي المقال القادم بإذن الله ننتقل إلى الخطة العملية: كيف تنقل أنظمة جهة حكومية إلى السحابة، من تصنيف البيانات إلى اختيار المزود. وأقرب المقالات إلى هذا الموضوع:
 دليلنقل أنظمة جهة حكومية إلى السحابة: خطة خطوة بخطوةإحدى عشرة خطوة لنقل أنظمة جهة حكومية إلى السحابة، من تصنيف البيانات واختيار المزود إلى الدفعات والتقارير، مع مثال وجداول قرار.
 دليلحكومات بنت سحابتها على المصادر المفتوحةماذا بنت فرنسا وألمانيا وهولندا والاتحاد الأوروبي فعلاً من سحابة وقواعد ومعايير مفتوحة، بالأرقام من الوثائق الرسمية.
 دليلالسحابة السيادية Sovereign Cloud: ما الذي يجعلها سيادية؟لماذا لا يكفي أن يكون السيرفر في بلدك، وكيف تقيس سيادة أي سحابة بأربعة أبعاد وأسئلة محددة قبل أن تختار المزود.
 دليلCeph للمبتدئين: تخزين موزع يتحمل تعطل السيرفراتكيف يوزع Ceph البيانات على عدة سيرفرات ويعيد نسخها وحده عندما يتعطل قرص، ومتى يكون أكبر من حاجتك.
 دليلعنقود Proxmox VE من ثلاث عقد: Quorum مع التوفر العالي HAبنينا عنقود Proxmox VE من ثلاث عقد، وقسنا النقل الحي والتوفر العالي بالثواني، ثم قطعنا الشبكة عن عقدة لنرى كيف يمنع النصاب الـ Split-brain.
 دليللماذا تساهم الشركات الكبيرة في المصادر المفتوحة، ولماذا نغيب نحن عنها؟موظفو Intel وGoogle وRed Hat يكتبون جزءاً كبيراً من نواة Linux وKubernetes، ولذلك أسباب اقتصادية مكتوبة. أعرض الأدلة والأسباب وأرقام منطقتنا، ثم رأيي فيما يكلفنا غيابنا وما تستطيع شركتك أن تبدأ به هذا الربع.
سجل التحديثات
- 2026-11-19: كتابة المقال من عروض فريق السحابة في CERN ومدونته التقنية وصفحات home.cern، ومراجعة كل المصادر في 19 نوفمبر 2026.