إذا كنت قد أنشأت أجهزة افتراضية Virtual Machines من قبل، على سيرفر KVM بأوامر virsh كما في KVM على سيرفر Linux مع libvirt، أو من واجهة Proxmox VE في عنقود من ثلاث عقد، فأنت تعرف أن الجهاز الافتراضي في النهاية عملية QEMU على سيرفر Linux، وقرص في مكان ما، وبطاقة شبكة متصلة بجسر Bridge. ثم تفتح توثيق OpenStack لأول مرة فتجد عشرات المشاريع بأسماء لا تشرح نفسها: Nova وNeutron وCinder وKeystone وGlance وPlacement، وتجد أن تثبيته الصغير يشغل أكثر من عشرين خدمة systemd على سيرفر واحد، فتسأل السؤال الطبيعي: لماذا كل هذا لكي أشغل جهازاً افتراضياً كنت أشغله بأمر واحد؟
والإجابة أن OpenStack لا يحاول أن يشغل جهازاً افتراضياً، فهذا يفعله KVM وlibvirt تحته كما في أي منصة أخرى، وإنما يحاول أن يبني سحابة Cloud: أن يطلب مئات المستخدمين من فرق مختلفة الأجهزة والشبكات والأقراص بأنفسهم، عبر واجهة برمجية API، كل منهم داخل مشروعه Project وحصته Quota، دون أن يرى أحدهم أجهزة الآخر، ودون أن يفتح أحد تذكرة Ticket لفريق البنية التحتية. وهذا يحتاج نظام هوية Identity، وجدولة Scheduling توزع الأجهزة على السيرفرات، وشبكات يبنيها المستخدم بنفسه، وأقراصاً تعيش بعد حذف الجهاز، وكل منها خدمة مستقلة. وإذا فهمت ما تفعله كل خدمة، وكيف تتكلم الخدمات مع بعضها، فسوف تقرأ أي سجل خطأ Error Log في OpenStack وأنت تعرف أين تبحث، وهذا هو الفرق بين من يشغل OpenStack ومن يخاف منه.
وفي دراسة حالة CERN رأينا سحابة OpenStack بأكثر من 300,000 نواة، وكيف قسمها فريقها إلى خلايا Cells وكيف رقاها مكوناً بعد مكون، ولن نعيد القصة هنا. وفي هذا المقال سوف ننزل طبقة: ماذا يوجد داخل كل مكون، وماذا يحدث بالضبط عندما تطلب جهازاً، مع مخرجات حقيقية من تثبيت DevStack بالإصدار 2026.2 على سيرفر واحد.
وسوف نناقش في هذا المقال ما يلي:
- الصورة الكاملة: عقد الإدارة Controller Nodes وعقد الحوسبة Compute Nodes، والقطع المشتركة التي تعتمد عليها كل الخدمات: قاعدة البيانات Database وطابور الرسائل Message Queue وmemcached.
- Keystone: المجالات Domains والمشاريع Projects والأدوار Roles، وتوكن Fernet، والكتالوج Service Catalog الذي يدل الكلاينت على كل خدمة.
- Nova من الداخل: nova-api وscheduler وconductor وcompute، والخلايا Cells v2، وخدمة Placement، والأنواع Flavors.
- مسار الطلب
openstack server createخطوة خطوة، وأين تبحث عندما يفشل. - Glance للقوالب Images، وNeutron للشبكات مع ML2 وOVN، والـ Router والعنوان العائم Floating IP ومجموعات الأمان Security Groups.
- Cinder للأقراص: الأنواع Volume Types والـ Backends، والفرق بين LVM مع iSCSI وCeph RBD.
- بقية الخدمات باختصار، ودورة الإصدار كل ستة أشهر مع SLURP، وأدوات النشر Deployment Tools التي تصلح للإنتاج Production والتي لا تصلح.
وهذا المقال من مرحلة السحابة الخاصة مفتوحة المصدر Private Cloud في مسار الحوسبة السحابية وبدائلها. والمواضيع في هذه المرحلة:
- السحابة الخاصة Private Cloud: متى تبنيها وماذا تحتاج قبلها
- OpenStack من الداخل: Nova وNeutron وCinder وKeystone (الموضوع الحالي)
- سحابة OpenStack صغيرة بيدك: من التثبيت إلى أول جهاز افتراضي
- Apache CloudStack وOpenNebula: بدائل أخف من OpenStack
- Harvester وعنقود Proxmox: الحوسبة المتقاربة HCI بأدوات مفتوحة
- OpenStack أم CloudStack أم OpenNebula أم Proxmox؟ قرار مبني على الفريق والحجم
 دليلالسحابة الخاصة Private Cloud: متى تبنيها وماذا تحتاجمتى تحتاج مؤسستك سحابة خاصة بدل عنقود أجهزة افتراضية، وما الذي تجهزه من فريق وعتاد وعمليات وميزانية قبل أن تبدأ.
 دليلسحابة OpenStack صغيرة بيدك: من التثبيت إلى أول جهازبنينا OpenStack 2026.2 بـ DevStack في جهاز افتراضي واحد، ثم أنشأنا مشروعاً وشبكة وجهازاً بعنوان عائم وقرصاً، ومعها المشكلات الحقيقية التي ظهرت وما حدث بعد إعادة التشغيل.
باختصار In Short
لماذا OpenStack مجموعة خدمات وليس برنامجاً واحداً؟
في Proxmox VE أو VMware vCenter تثبت منتجاً واحداً، فيه واجهة وقاعدة إعداد وأدوات للشبكة والتخزين، وكلها تتطور معاً بيد فريق واحد. أما OpenStack فبدأ من فكرة أخرى: أن تكون كل وظيفة في السحابة مشروعاً مستقلاً له فريقه وواجهته البرمجية API وقاعدة بياناته، وأن يتفق الجميع على طريقة واحدة للتواصل والمصادقة Authentication. لذلك تجد في قائمة مكونات OpenStack عشرات المشاريع، وأغلب السحب الحقيقية تستخدم سبعة أو ثمانية منها فقط.
وهذا التصميم له فائدة واضحة وثمن واضح. فالفائدة أنك تستطيع أن تستبدل جزءاً دون الآخر: أن تضع Ceph تحت Cinder بدل LVM، أو أن تربط Keystone بخدمة LDAP عندك، أو أن تشغل Nova دون Swift، وأن توزع كل خدمة على عدد السيرفرات الذي تحتاجه. والثمن أن عليك أن تفهم كيف ترتبط هذه الخدمات، لأن العطل في خدمة واحدة يظهر غالباً في خدمة أخرى: إذا تعطل Keystone فسوف ترى الخطأ في Nova على شكل 401 Unauthorized، وإذا تأخر RabbitMQ فسوف يبقى الجهاز في حالة BUILD دون رسالة واضحة. لذلك نبدأ بالصورة الكاملة قبل أي مكون.
الصورة الكاملة: عقد الإدارة Controller وعقد الحوسبة Compute
في أي سحابة OpenStack نوعان من السيرفرات. الأول عقد الإدارة Controller Nodes، وفيها مستوى الإدارة Control Plane: الواجهات البرمجية، والجدولة Scheduling، وقواعد البيانات، وطابور الرسائل. وهذه العقد لا تشغل أجهزة المستخدمين، وإنما تقرر أين تعمل وتسجل حالتها. والثاني عقد الحوسبة Compute Nodes، وفيها مستوى البيانات Data Plane: خدمة nova-compute مع libvirt وQEMU/KVM التي تشغل الأجهزة الافتراضية فعلاً، ومعها جزء الشبكة الذي يربط الأجهزة ببعضها. وقد تضاف عقد للتخزين وعقد للشبكة حسب التصميم. والصورة التالية تبين ذلك:
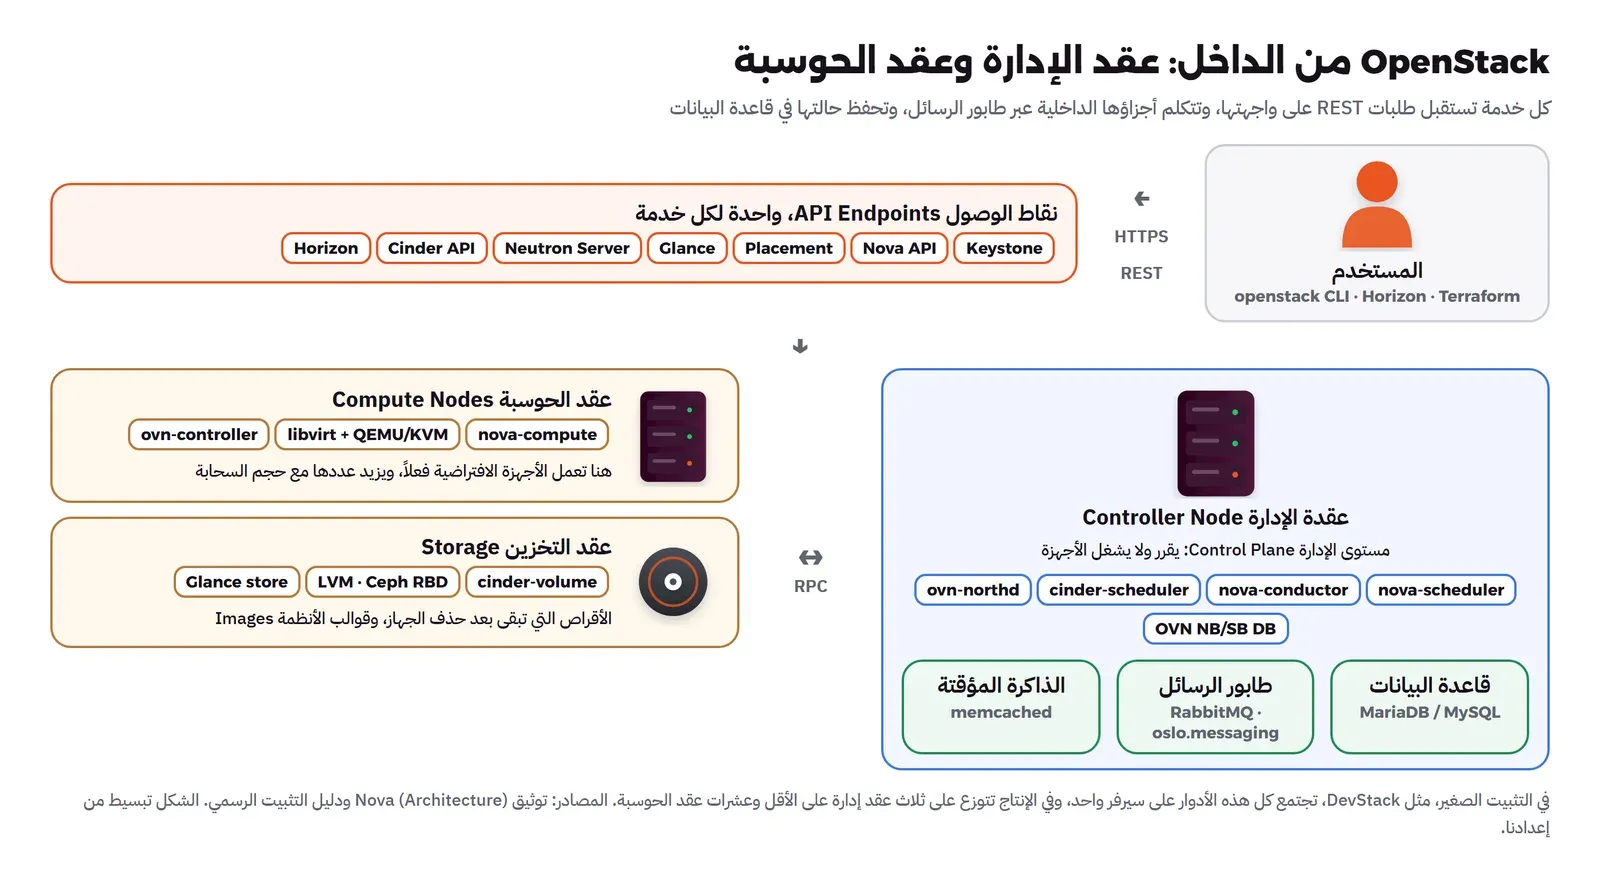
ويشرح توثيق بنية Nova القاعدة التي تنطبق على أغلب الخدمات: الواجهة التي يراها المستخدم REST API، أما الأجزاء الداخلية فتتواصل برسائل RPC عبر مكتبة oslo.messaging فوق طابور رسائل، وكل جزء يمكن تشغيل أكثر من نسخة منه على أكثر من سيرفر، إلا nova-compute التي تعمل نسخة واحدة منها على كل سيرفر حوسبة لأنها تدير ذلك السيرفر بالذات. وهذا يعني أن عقد الإدارة يمكن أن تكون ثلاثاً خلف موزع ضغط Load Balancer، وأن تضيف عقد حوسبة متى احتجت دون أن تغير شيئاً في الإدارة.
قاعدة البيانات Database: أين تعيش حالة السحابة؟
كل خدمة رئيسية لها قاعدة بيانات SQL خاصة بها، غالباً على MariaDB أو MySQL: قاعدة لـ Keystone فيها المستخدمون والمشاريع والأدوار، وقواعد لـ Nova فيها الأجهزة وحالاتها، وقاعدة لـ Neutron فيها الشبكات والمنافذ Ports، وقاعدة لـ Cinder فيها الأقراص، وهكذا. والمهم هنا أن عقد الحوسبة لا تتصل بقاعدة Nova مباشرة، فيقول توثيق Nova إن الخدمات على عقدة الحوسبة ترسل طلبات قاعدة البيانات عبر RPC إلى خدمة مركزية اسمها conductor، والسبب أمني وعملي معاً: فالسيرفر الذي يشغل أجهزة المستخدمين هو الأكثر عرضة للاختراق، فلا تعطه كلمة مرور قاعدة البيانات، والسبب العملي أن الترقية Upgrade أسهل، لأن عقدة حوسبة بإصدار أقدم تستطيع أن تتكلم مع conductor بإصدار أحدث عبر طبقة كائنات Objects مرقمة الإصدار.
ولذلك فقاعدة البيانات هي أثمن شيء في السحابة. فإذا خسرت قاعدة Nova فالأجهزة تبقى تعمل على السيرفرات، ولكن السحابة لم تعد تعرف عنها شيئاً: لمن هذا الجهاز، وما قرصه، وما عنوانه. لذلك تجد في كل تصميم إنتاجي عنقود قاعدة بيانات بثلاث عقد، مثل Galera، ونسخاً احتياطية Backups يومية تختبر استعادتها.
طابور الرسائل RabbitMQ: كيف تتكلم الأجزاء؟
عندما يقرر nova-scheduler أن جهازاً سوف يعمل على السيرفر compute-07، فهو لا يتصل بذلك السيرفر بـ HTTP، وإنما يضع رسالة في طابور RabbitMQ، وخدمة nova-compute على compute-07 تستمع لطابورها وتأخذ الرسالة. ويقول دليل التثبيت الرسمي إن OpenStack يستخدم طابور الرسائل لتنسيق العمليات ومعلومات الحالة بين الخدمات، وإن أغلب التوزيعات تستخدم RabbitMQ. وإذا كنت تريد أن تفهم الطوابير نفسها فقد شرحناها في RabbitMQ: طوابير موثوقة لتطبيقاتك.
وهناك نوعان من الرسائل يجب أن تفرق بينهما: الاستدعاء Call، وفيه ينتظر المرسل الرد، مثل conductor عندما يسأل compute عن شيء، والإرسال Cast، وفيه يرسل ولا ينتظر، مثل أمر بناء الجهاز. ولهذا السبب يكون أكثر عطل مربك في OpenStack هو طابور الرسائل البطيء: فالاستدعاءات تنتظر حتى تنتهي مهلتها، فترى في السجلات MessagingTimeout، والأجهزة تبقى عالقة في حالة وسطى. وقد رأينا في دراسة CERN أن فريقها قسم السحابة إلى خلايا ومناطق Regions أساساً لتقليل خطر طابور رسائل واحد كبير.
memcached ومكتبات oslo: القطع الصغيرة التي تعتمد عليها الخدمات
القطعة الثالثة memcached، وهي ذاكرة مؤقتة Cache بسيطة تستخدمها الخدمات لتحفظ نتيجة التحقق من التوكن Token، فلا تسأل Keystone عن كل طلب، ويستخدمها Horizon لجلسات المستخدمين Sessions. أما مكتبات oslo فهي الكود المشترك بين كل المشاريع: oslo.config لقراءة ملفات الإعداد بنفس الصيغة، وoslo.messaging للرسائل، وoslo.db لقاعدة البيانات، وoslo.policy للصلاحيات Permissions، وoslo.log للسجلات. وهذا سبب أن ملفات الإعداد مثل /etc/nova/nova.conf و/etc/neutron/neutron.conf تتشابه في أقسامها: [DEFAULT] و[database] و[keystone_authtoken] و[oslo_messaging_rabbit]، فإذا فهمت ملفاً واحداً فهمت البقية.
ولكي ترى هذه الصورة على سيرفر حقيقي، فهذه خدمات systemd في تثبيت DevStack على سيرفر واحد، حيث تجتمع عقدة الإدارة وعقدة الحوسبة والتخزين في نفس الجهاز:
systemctl list-units 'devstack@*' --no-pager --plain --no-legend[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]
[email protected] loaded active running Devstack [email protected]في المخرج أعلاه لاحظ التالي:
- الحروف الأولى اسم المشروع:
c-لـ Cinder، وg-لـ Glance، وn-لـ Nova، وq-لـ Neutron، وهذا الحرف من اسمها القديم Quantum. فخدمات Cinder ثلاث: الواجهةc-api، والجدولةc-sch، والأقراصc-vol. - Nova وحدها سبع خدمات: الواجهة
n-api، وواجهة البيانات الوصفية Metadata للأجهزةn-api-meta، والجدولةn-sch، ومنسقانn-super-condوn-cond-cell1، والحوسبةn-cpu، وشاشة المتصفحn-novnc-cell1. وسوف نرى بعد قليل لماذا يوجد منسقان. - Neutron مقسمة حسب الوظيفة:
neutron-apiللطلبات، وneutron-rpc-serverللرسائل، وعمال Workers دوريون، وعامل صيانة لـ OVN يصحح أي اختلاف بين قاعدة Neutron وقاعدة OVN. - ما لا تراه هنا: MySQL وRabbitMQ وmemcached وApache وOVN نفسه تعمل كخدمات النظام العادية، وليست تحت
devstack@، وهذا يذكرك بأنها قطع مشتركة وليست جزءاً من أي مشروع. أماetcdفتستخدمه Cinder هنا للتنسيق Coordination بين نسخها.
Keystone: من أنت، وماذا يحق لك، وأين الخدمات؟
كل طلب في OpenStack يبدأ من Keystone، وهو خدمة الهوية Identity Service. ووظيفته ثلاثة أشياء: يتحقق من هويتك (المصادقة Authentication)، ويعطيك توكناً Token يثبت هذه الهوية لبقية الخدمات مع الأدوار التي لك، ويعطيك الكتالوج Service Catalog، وهو قائمة الخدمات الموجودة في هذه السحابة وعنوان كل منها. والصورة التالية تبين المسار كاملاً:
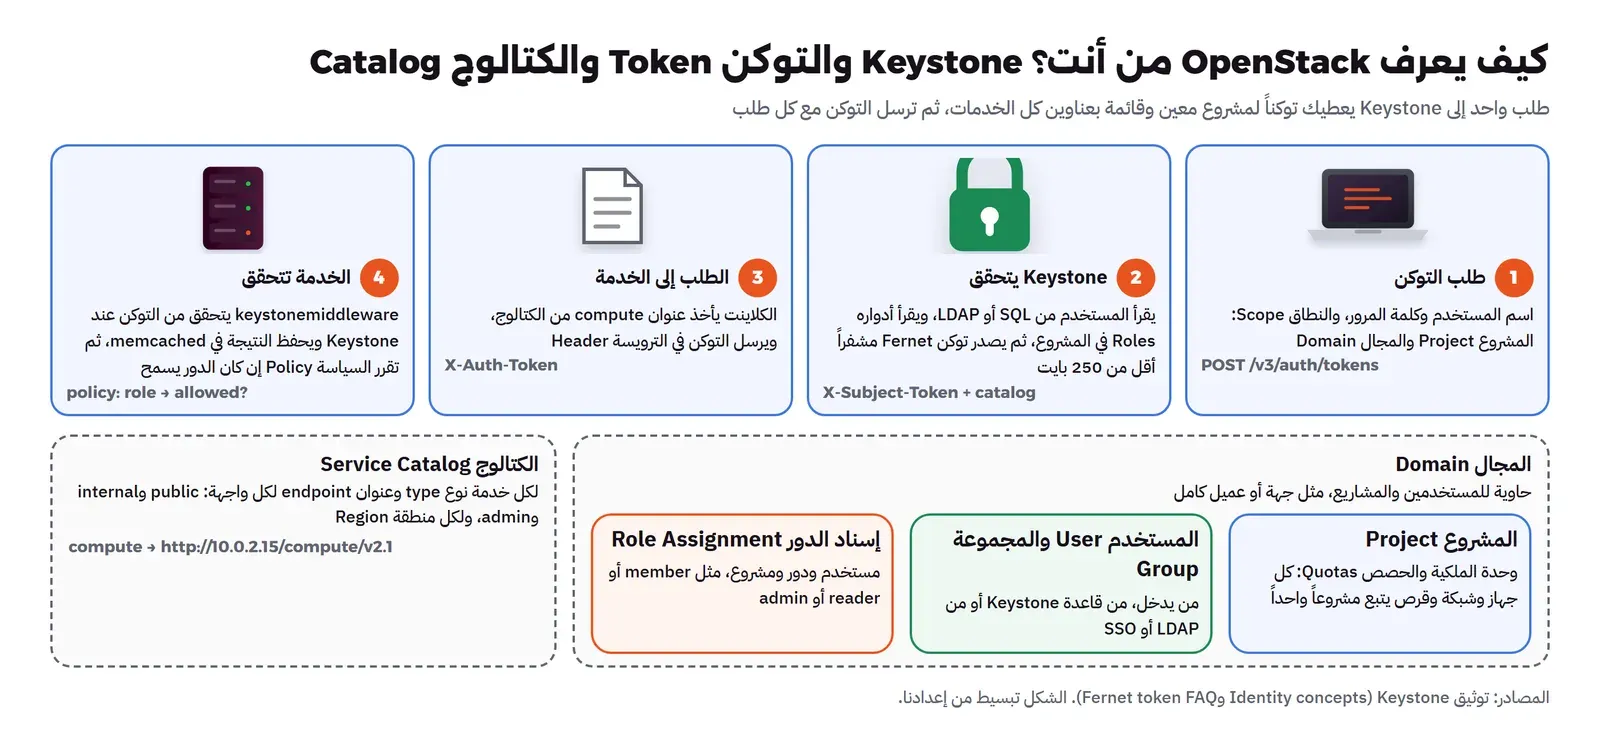
المجال Domain والمشروع Project والدور Role
يقوم نموذج الهوية في Keystone على أربع كلمات يجب أن تحفظها، كما يشرحها توثيق مفاهيم الهوية:
- المستخدم User والمجموعة Group: من يدخل إلى السحابة، شخصاً كان أو خدمة. ويمكن أن يأتي المستخدمون من قاعدة Keystone نفسها أو من LDAP أو Active Directory أو من الدخول الموحد SSO عبر بروتوكول مثل OpenID Connect.
- المشروع Project: وحدة الملكية في السحابة، وكان اسمه قديماً المستأجر Tenant. فكل جهاز وشبكة وقرص يتبع مشروعاً واحداً، والحصص Quotas تحسب لكل مشروع، والمستخدم في مشروع لا يرى موارد مشروع آخر.
- المجال Domain: حاوية أكبر تجمع مشاريع ومستخدمين، فتعطي كل جهة أو كل عميل مجالاً، ولكل مجال مديروه، وقد يأتي مستخدمو كل مجال من خدمة LDAP مختلفة.
- الدور Role وإسناده Role Assignment: الدور اسم مثل
readerأوmemberأوadmin، ولا يعني شيئاً وحده، وإنما يكتسب معناه عندما تسنده لمستخدم في مشروع، فتقول: هذا المستخدمmemberفي المشروع finance. وما يسمح به كل دور تحدده ملفات السياسة Policy في كل خدمة، وليس Keystone.
ولاحظ النقطة الأخيرة جيداً، لأنها مصدر خطأ شائع. فـ Keystone يقول فقط: هذا التوكن لمستخدم له دور member في المشروع finance، أما قرار إن كان member يستطيع أن يحذف شبكة أو ينشئ Router، فتأخذه Neutron نفسها من سياستها. لذلك إذا أنشأت دوراً جديداً اسمه network-admin في Keystone ولم تذكره في سياسة Neutron، فلن يتغير شيء.
التوكن Token: لماذا Fernet؟
التوكن الذي يصدره Keystone اليوم من نوع Fernet. ويقول توثيق Fernet إنه توكن حامل Bearer Token، أي أن من يحمله يستخدمه، فيه قدر محدود من بيانات الهوية والصلاحيات، مشفر بمفاتيح تشفير متماثلة Symmetric Keys اسمها مفاتيح Fernet، وحجمه أقل من 250 بايت. والفرق الكبير عن التوكنات القديمة من نوع UUID أن Fernet لا يحفظ في قاعدة البيانات إطلاقاً، فكل سيرفر Keystone يملك نفس المفاتيح يستطيع أن يفك أي توكن ويتحقق منه، دون أن تنتفخ قاعدة البيانات بملايين التوكنات المنتهية كما كانت تفعل في الإصدارات القديمة.
ولكن هذا يعني أن مفاتيح Fernet في المجلد /etc/keystone/fernet-keys/ يجب أن تكون نفسها على كل سيرفرات Keystone، وأن تدور Rotate بانتظام. ويشرح التوثيق أن في المستودع ثلاثة أنواع من المفاتيح: مفتاح أساسي Primary واحد يشفر ويفك، ومفاتيح ثانوية Secondary تفك فقط ما شفر قبل التدوير، ومفتاح مرحلي Staged سوف يصبح الأساسي في التدوير التالي. فإذا دورت المفاتيح على سيرفر واحد ونسيت أن تنسخها إلى البقية، فسوف تفشل نصف الطلبات بـ 401 حسب السيرفر الذي يصله الطلب، وهذا من أكثر الأعطال إرباكاً لمن يرى السحابة أول مرة.
ولنر توكناً حقيقياً. في سحابة DevStack بالإصدار 2026.2 حملنا متغيرات المدير بالملف openrc ثم طلبنا توكناً:
source ~/devstack/openrc admin admin
openstack token issue
والمخرج سوف يكون كما يلي (قصرنا التوكن هنا، وطوله الكامل 183 حرفاً):
+------------+----------------------------------------------------------------+
| Field      | Value                                                          |
+------------+----------------------------------------------------------------+
| expires    | 2026-11-19T18:11:35+0000                                       |
| id         | gAAAAABq_y3Hw72u92qNxnv9qv81EZ8W8fL9RAEHXz1sCo9xJLcBUYPm...    |
| project_id | 955bd2889d274af0b597aff520b00900                               |
| user_id    | 82a2ddfc71994af6b30f5dfee5d28dd8                               |
+------------+----------------------------------------------------------------+
في المخرج أعلاه لاحظ التالي:
- expires: طلبنا التوكن في الساعة 17:11 بتوقيت UTC، فينتهي بعد ساعة بالضبط، وهي المدة الافتراضية للتوكن في Keystone. وبعدها تطلب الأداة توكناً جديداً تلقائياً، أما السكربت الذي يحفظ التوكن ويستخدمه طويلاً فسوف يبدأ برؤية
401بعد ساعة. - id: يبدأ بـ
gAAAAA، وهذه بداية كل رسالة Fernet، وطوله 183 حرفاً، أي أقل من حد 250 بايت الذي يذكره التوثيق. ولاحظ أنه لا يحتوي شيئاً تقرؤه بعينك، فهو مشفر، ولا يفكه إلا Keystone بمفاتيحه. - project_id: التوكن محدد بنطاق Scope مشروع واحد هو admin. فإذا أردت أن تعمل في مشروع آخر فأنت تحتاج توكناً آخر لذلك المشروع، وهذا ما يجعل العزل بين المشاريع يبدأ من التوكن نفسه.
ثم سألنا عن المجالات والأدوار الموجودة في هذا التثبيت:
openstack domain list
openstack role list
+---------+---------+---------+--------------------+
| ID | Name | Enabled | Description |
+---------+---------+---------+--------------------+
| default | Default | True | The default domain |
+---------+---------+---------+--------------------+
+----------------------------------+---------------+
| ID | Name |
+----------------------------------+---------------+
| 113b04741a3d420a88ecadfa1c9c5f41 | manager |
| 530f173084b643ad986c50f84ab2aa90 | anotherrole |
| 53e60f20ea444a49ae21ca92df36e237 | admin |
| 5fa4d6e74223495f9c5abb2a203cd4a6 | ResellerAdmin |
| 6b5749a69a67444a8f70a9b1d1ab7e0a | member |
| 8a8d823fd7514cf487627dd216d3b90d | service |
| ef84a7317ab241e18dca512a7bb8eaaa | reader |
+----------------------------------+---------------+وفي المخرج أعلاه لاحظ أن هناك مجالاً واحداً اسمه Default، وكل المشاريع والمستخدمين فيه، وهذا يكفي لسحابة مؤسسة واحدة. أما الأدوار فأهمها reader للقراءة فقط، وmember للعمل العادي داخل المشروع، وmanager لمدير المشروع الذي يدير بعض الأمور داخل مشروعه دون أن يكون مدير السحابة، وadmin لمدير السحابة كلها، وservice للحسابات التي تستخدمها الخدمات نفسها حين تتكلم مع بعضها. أما anotherrole وResellerAdmin فيضيفهما DevStack لاختبارات المشروع، ولا تحتاجهما في سحابتك.
وأين مفاتيح Fernet التي تشفر هذا التوكن؟ في المجلد الذي ذكرناه، وإعداد Keystone يقول صراحة إن مزود التوكن هو Fernet:
sudo ls -la /etc/keystone/fernet-keys/
grep -A1 '^\[token\]' /etc/keystone/keystone.conf
drwx------ 2 stack stack 4096 Nov 19 16:10 .
drwxr-xr-x 4 stack root 4096 Nov 19 16:10 ..
-rw------- 1 stack stack 44 Nov 19 16:10 0
-rw------- 1 stack stack 44 Nov 19 16:10 1
[token]
provider = fernetفي المخرج أعلاه لاحظ أن هناك ملفين فقط، وهذا هو المستودع بعد الإنشاء مباشرة قبل أي تدوير: الملف 0 هو دائماً المفتاح المرحلي Staged، وصاحب أكبر رقم، هنا 1، هو المفتاح الأساسي Primary الذي يشفر التوكنات الجديدة. وكل ملف 44 بايت، أي مفتاح بترميز Base64، والصلاحية -rw------- تعني أن المستخدم الذي يشغل Keystone وحده يقرؤه، فلا تقم بتغيير هذه الصلاحية أو نسخ المفاتيح إلى مكان يقرؤه غيره، والسبب أن من يملك هذه الملفات يستطيع أن يصنع توكناً لأي مستخدم في السحابة.
الكتالوج Service Catalog: كيف يعرف الكلاينت عنوان كل خدمة؟
عندما تكتب openstack server list، فالأداة لا تعرف عنوان Nova مسبقاً، وإنما تعرف عنوان Keystone فقط من المتغير OS_AUTH_URL، ثم تأخذ عنوان Nova من الكتالوج الذي جاء مع التوكن. وفي الكتالوج لكل خدمة نوع Type، مثل compute وnetwork وvolumev3، ولكل نوع نقطة وصول Endpoint أو أكثر، ولكل نقطة واجهة Interface من ثلاث: public للمستخدمين، وinternal للخدمات فيما بينها، وadmin للإدارة، ولكل منها منطقة Region. وهذا ما يجعل السحابة الواحدة تتوسع إلى أكثر من منطقة، فالكلاينت يختار المنطقة ويأخذ عناوينها من نفس الكتالوج.
والآن نرى الكتالوج نفسه في نفس السحابة، بعد أن أكمل DevStack تسجيل كل الخدمات:
openstack catalog list+-------------+----------------+------------------------------------------------------------------------+
| Name | Type | Endpoints |
+-------------+----------------+------------------------------------------------------------------------+
| placement | placement | RegionOne |
| | | public: http://10.0.2.15/placement |
| | | |
| nova | compute | RegionOne |
| | | public: http://10.0.2.15/compute/v2.1 |
| | | |
| keystone | identity | RegionOne |
| | | public: http://10.0.2.15/identity |
| | | |
| glance | image | RegionOne |
| | | public: http://10.0.2.15/image |
| | | |
| neutron | network | RegionOne |
| | | public: http://10.0.2.15/networking |
| | | |
| nova_legacy | compute_legacy | RegionOne |
| | | public: http://10.0.2.15/compute/v2/955bd2889d274af0b597aff520b00900 |
| | | |
| cinder | block-storage | RegionOne |
| | | public: http://10.0.2.15/volume/v3 |
| | | |
+-------------+----------------+------------------------------------------------------------------------+في المخرج أعلاه لاحظ التالي:
- كل الخدمات على عنوان واحد: DevStack يضع كل الخدمات خلف Apache على المنفذ 80، وكل خدمة في مسار، مثل
/identityو/compute/v2.1و/networking. أما في الإنتاج فالمعتاد أن تكون كل خدمة خلف موزع الضغط على منفذها أو اسمها، مثلhttps://compute.cloud.example. - واجهة واحدة لكل خدمة: DevStack يسجل واجهة
publicفقط، وفي سحابة إنتاج تسجل غالباًinternalأيضاً على شبكة الإدارة، فتتكلم الخدمات فيما بينها دون أن تخرج حركتها إلى الشبكة العامة. - المنطقة RegionOne: هذا هو الاسم الافتراضي للمنطقة. فإذا بنيت لاحقاً سحابة ثانية في مركز بيانات آخر بنفس Keystone، فسوف تظهر نقاطها هنا تحت اسم منطقة أخرى.
- Placement في الكتالوج: لاحظ أن Placement خدمة مستقلة لها نوعها
placementوعنوانها، ولا يستخدمها المستخدم مباشرة، وإنما تستخدمها Nova وNeutron وCinder، وسوف نرى ما فيها بعد قليل. - أنواع الخدمات: الكلاينت يبحث بالنوع وليس بالاسم، فأداة
openstackتبحث عنcomputeلأوامر الأجهزة، وعنnetworkلأوامر الشبكات. أماcompute_legacyفواجهة Nova القديمة v2، وفي عنوانها رقم المشروع، وتبقيها DevStack للتوافق مع أدوات قديمة.
Nova: من يقرر أين يعمل الجهاز الافتراضي؟
Nova هي خدمة الحوسبة Compute Service، وهي أقدم مشاريع OpenStack وأكبرها. ووظيفتها أن تدير دورة حياة الأجهزة الافتراضية: الإنشاء والإيقاف والتشغيل وتغيير الحجم Resize والنقل Migration والحذف. ولكنها لا تشغل الأجهزة بنفسها، وإنما تطلب ذلك من برنامج المحاكاة Hypervisor عبر برنامج تشغيل Driver، وأشهرها برنامج libvirt الذي يدير QEMU/KVM، وهو نفس ما شرحناه في ما هي المحاكاة الافتراضية Virtualization. وتتكون Nova من عدة خدمات، لكل منها وظيفة واحدة:
- nova-api: تستقبل طلبات REST من المستخدمين، وتتحقق من التوكن والسياسة والحصة، وتكتب الطلب في قاعدة البيانات، ثم ترسله عبر الطابور. وهي لا تنتظر حتى يعمل الجهاز، فترد عليك فوراً بحالة BUILD.
- nova-scheduler: الجدولة Scheduler، تختار السيرفر الذي يعمل عليه الجهاز، بمساعدة Placement كما سوف نرى.
- nova-conductor: المنسق، يقوم بالعمليات الطويلة التي تتطلب أكثر من خطوة، مثل البناء والنقل، ويكتب في قاعدة البيانات نيابة عن عقد الحوسبة.
- nova-compute: تعمل على كل سيرفر حوسبة، وتنفذ الأوامر الفعلية: تنزل الـ Image، وتطلب المنفذ من Neutron، وتصل القرص من Cinder، وتكتب ملف XML للجهاز وتطلب من libvirt تشغيله.
- nova-novncproxy: يعطيك شاشة الجهاز Console في المتصفح عبر VNC، وهذا مهم عندما لا يصل الجهاز إلى الشبكة ولا تستطيع الدخول عبر SSH.
وهذه الخدمات تسجل نفسها في قاعدة Nova وترسل نبضة Heartbeat دورية، فتعرف السحابة من منها حي. والأمر التالي يبين ذلك، ومعه قائمة برامج المحاكاة:
openstack compute service list
openstack hypervisor list
+--------------------------------------+----------------+--------+----------+---------+-------+----------------------------+
| ID | Binary | Host | Zone | Status | State | Updated At |
+--------------------------------------+----------------+--------+----------+---------+-------+----------------------------+
| cac1f53c-2e9e-419f-bd5a-9c04540b88d4 | nova-scheduler | ostack | internal | enabled | up | 2026-11-19T17:12:01.000000 |
| aec4e3ed-e94f-47bd-841e-639fb1877bc3 | nova-conductor | ostack | internal | enabled | up | 2026-11-19T17:10:16.000000 |
| 3d285bf5-859d-4764-b849-e1ac1c3450e1 | nova-conductor | ostack | internal | enabled | up | 2026-11-19T17:12:02.000000 |
| 10e9de26-7c10-43e3-ad3e-5eb4cd6fa1fb | nova-compute | ostack | nova | enabled | up | 2026-11-19T17:10:25.000000 |
+--------------------------------------+----------------+--------+----------+---------+-------+----------------------------+
+--------------------------------------+---------------------+-----------------+-----------+-------+
| ID | Hypervisor Hostname | Hypervisor Type | Host IP | State |
+--------------------------------------+---------------------+-----------------+-----------+-------+
| 6399697d-0e9b-40e8-8214-f385635c8c83 | ostack | QEMU | 10.0.2.15 | up |
+--------------------------------------+---------------------+-----------------+-----------+-------+في المخرج أعلاه لاحظ التالي:
- Status وState عمودان مختلفان: Status قرار المدير، فإذا كتبت
openstack compute service set --disableقبل صيانة سيرفر أصبحdisabledفلا تختاره الجدولة لأجهزة جديدة، أما State فحالة الخدمة الفعلية من النبضة، فإذا توقفت النبضة أصبحdown. فالسيرفر الذي State عندهdownوStatusenabledهو أول ما تبحث عنه عندما تفشل الأجهزة الجديدة. - Zone: خدمات الإدارة في المنطقة الداخلية
internal، أماnova-computeففي منطقة التوفرnova، وهي الافتراضية، وفي سحابة حقيقية قد تقسم السيرفرات إلى مناطق حسب الغرفة أو مصدر الكهرباء. - Hypervisor Type يقول QEMU: وهذا لا يعني أن الجهاز يعمل بالمحاكاة البطيئة، فبرنامج libvirt يسمي نوعه QEMU في الحالتين، والذي يحدد التسريع هو الإعداد
virt_type = kvmفي ملف/etc/nova/nova-cpu.conf، وهو مضبوط علىkvmفي هذا التثبيت. - معرف السيرفر يتكرر: المعرف
6399697d…هو نفسه معرف مزود الموارد في Placement كما سوف نرى، فكل سيرفر حوسبة يسجل نفسه في Placement بنفس المعرف.
الخلايا Cells v2: لماذا توجد cell0 حتى في سحابة صغيرة؟
كل تثبيت Nova اليوم يستخدم الخلايا Cells v2، حتى لو كان سيرفراً واحداً. ويشرح توثيق تخطيط الخلايا الفكرة: هناك قاعدة بيانات عامة واحدة اسمها قاعدة API، فيها ما يخص السحابة كلها مثل الأنواع Flavors وطلبات البناء وخريطة الخلايا، ثم لكل خلية قاعدة بياناتها وطابور رسائلها الخاص، وعقد الحوسبة تتبع خلية واحدة. وفوق الخلايا كلها منسق أعلى اسمه super conductor، وهو الذي يعرف كل الخلايا ويقرر في أيها يبنى الجهاز.
وهناك خلية خاصة اسمها cell0 لا تحتوي أي سيرفر حوسبة. فإذا طلبت جهازاً ولم تجد الجدولة أي سيرفر مناسب، فسجل الجهاز يكتب في cell0 بحالة ERROR، لأنه لم ينتم إلى أي خلية حقيقية. لذلك عندما ترى جهازاً في ERROR مع رسالة No valid host was found، فهو في cell0، وسبب المشكلة في الجدولة، وليس في أي سيرفر حوسبة. والسحابة التي فيها cell0 وcell1 فقط اسمها في التوثيق «سحابة بخلية واحدة» Single-cell Deployment، وهذا هو تثبيت أغلب المؤسسات، أما الخلايا المتعددة فللسحب الكبيرة جداً كما في CERN.
والأمر التالي يعرض الخلايا في تثبيت DevStack، وقد أخفى الأمر كلمات المرور بنفسه:
nova-manage cell_v2 list_cells+-------+--------------------------------------+-----------------------------------------------------+------------------------------------------------------+
| Name | UUID | Transport URL | Database Connection |
+-------+--------------------------------------+-----------------------------------------------------+------------------------------------------------------+
| cell0 | 00000000-0000-0000-0000-000000000000 | none:/ | mysql+pymysql://root:****@127.0.0.1/nova_cell0?... |
| cell1 | d1c246ab-2a5b-4144-bd6a-b440c2451c43 | rabbit://stackrabbit:****@10.0.2.15:5672/nova_cell1 | mysql+pymysql://root:****@127.0.0.1/nova_cell1?... |
+-------+--------------------------------------+-----------------------------------------------------+------------------------------------------------------+في المخرج أعلاه لاحظ التالي:
- cell0 دون طابور: عنوان الطابور
none:/، لأنه لا يوجد فيها سيرفر حوسبة تراسله، وإنما قاعدة بياناتnova_cell0فقط تحفظ الأجهزة التي فشلت جدولتها، ومعرفها كله أصفار. - cell1 لها طابورها وقاعدتها: المضيف الافتراضي Virtual Host في RabbitMQ اسمه
/nova_cell1، وقاعدتهاnova_cell1، فرسائل هذه الخلية لا تختلط برسائل غيرها حتى لو كانت على نفس سيرفر RabbitMQ. - لماذا منسقان؟ هذا يفسر ما رأيناه في قائمة الخدمات. فـ
n-super-condيقرأ ملف/etc/nova/nova.confالذي يتصل بقاعدةnova_apiوبالطابور العام، أماn-cond-cell1فيقرأ ملف/etc/nova/nova_cell1.confالذي يتصل بقاعدةnova_cell1والطابور/nova_cell1. ولو أضفت خلية ثانية لأضفت لها منسقاً ثالثاً وطابوراً وقاعدة، دون أن تمس الخلية الأولى.
Placement: من يعرف الموارد الحرة؟
كانت Nova في الماضي تحسب الموارد الحرة بنفسها، ثم انفصل هذا الجزء إلى مشروع مستقل اسمه Placement، وهو اليوم خدمة REST لها قاعدة بياناتها. والفكرة فيه بسيطة وقوية: كل شيء يملك موارد هو مزود موارد Resource Provider، مثل سيرفر حوسبة، أو مجمع Pool تخزين مشترك، أو بطاقة شبكة. ولكل مزود مخزون Inventory من أصناف موارد Resource Classes، مثل VCPU وMEMORY_MB وDISK_GB، ولكل صنف إجمالي ومحجوز ونسبة تحميل زائد Allocation Ratio. وعندما يعمل جهاز على سيرفر تسجل له حصة Allocation من موارد ذلك السيرفر. وهناك أيضاً السمات Traits، مثل وجود معالج يدعم تعليمات معينة أو قرص SSD، فتطلب الأنواع Flavors سمة معينة فلا يختار إلا السيرفر الذي يملكها.
ولنر مخزون السيرفر الوحيد في تثبيت DevStack، والسيرفر جهاز افتراضي فيه 4 معالجات ونحو 10 GB من الذاكرة:
openstack resource provider list
openstack resource provider inventory list 6399697d-0e9b-40e8-8214-f385635c8c83
+--------------------------------------+--------+------------+--------------------------------------+----------------------+
| uuid | name | generation | root_provider_uuid | parent_provider_uuid |
+--------------------------------------+--------+------------+--------------------------------------+----------------------+
| 6399697d-0e9b-40e8-8214-f385635c8c83 | ostack | 2 | 6399697d-0e9b-40e8-8214-f385635c8c83 | None |
+--------------------------------------+--------+------------+--------------------------------------+----------------------+
+----------------+------------------+----------+----------+----------+-----------+-------+------+
| resource_class | allocation_ratio | min_unit | max_unit | reserved | step_size | total | used |
+----------------+------------------+----------+----------+----------+-----------+-------+------+
| VCPU | 4.0 | 1 | 4 | 0 | 1 | 4 | 0 |
| MEMORY_MB | 1.0 | 1 | 9945 | 512 | 1 | 9945 | 0 |
| DISK_GB | 1.0 | 1 | 37 | 0 | 1 | 37 | 0 |
+----------------+------------------+----------+----------+----------+-----------+-------+------+في المخرج أعلاه لاحظ التالي:
- VCPU مع allocation_ratio 4.0: السيرفر فيه 4 معالجات حقيقية، ولكن Placement تقبل أن تحجز عليه حتى (4 - 0) × 4.0 = 16 معالجاً افتراضياً، وهذا هو التحميل الزائد Overcommit، والسبب أن أغلب الأجهزة لا تستخدم معالجها كاملاً في نفس الوقت. ولاحظ أن
max_unitيساوي 4، أي أن جهازاً واحداً لا يأخذ أكثر من 4 معالجات مهما كان المخزون. - MEMORY_MB مع allocation_ratio 1.0: الذاكرة لا تحمل فوق طاقتها افتراضياً، والسبب أن الذاكرة إذا نفدت فعلاً فإن Linux يقتل أحد الأجهزة بالـ OOM Killer، وهذا أسوأ بكثير من بطء المعالج. و
reservedبقيمة 512 تعني أن 512 MB محجوزة لنظام السيرفر نفسه وخدماته، فالمتاح للأجهزة 9945 - 512 = 9433 MB. - DISK_GB: 37 GB هي مساحة القرص المحلي الذي تحفظ فيه الأقراص المؤقتة Ephemeral، وليس فيها أقراص Cinder، لأن تلك في نظام تخزين آخر.
- generation: رقم يزيد مع كل تغيير في المخزون أو الحصص، وتستخدمه Placement لكي لا يحجز طلبان نفس الموارد في نفس اللحظة: إذا تغير الرقم بين القراءة والكتابة يرفض الطلب الثاني ويعيد المحاولة.
وهذه الأرقام هي ما تعدله عندما تخطط السعة. فإذا كانت أجهزة مؤسستك قواعد بيانات تستخدم معالجها بكثافة، فخفض cpu_allocation_ratio إلى 1.0 أو 2.0، أما أجهزة التطوير الخاملة أغلب الوقت فتتحمل نسبة أعلى. ولا تقم برفع نسبة الذاكرة فوق 1.0 إلا وأنت تعرف ما تفعل، والسبب ما ذكرناه عن OOM Killer.
الأنواع Flavors: حجم الجهاز الافتراضي
الـ Flavor هو قالب الحجم: عدد المعالجات الافتراضية vCPU، والذاكرة RAM، وحجم القرص الأساسي، وقرص مؤقت Ephemeral اختياري، ومعه خصائص إضافية Extra Specs تطلب سمات من Placement أو تضبط سلوك الجهاز، مثل ربط المعالجات CPU Pinning أو الصفحات الكبيرة Huge Pages. ويشرح توثيق الأنواع هذه الخصائص. والقاعدة العملية أن تبقي عدد الأنواع صغيراً وواضحاً، مثل small وmedium وlarge، لأن كل نوع جديد يجعل تخطيط السعة Capacity Planning أصعب، والمستخدمون يختارون دائماً الأكبر إذا لم تكن هناك حصة تمنعهم.
وهذه الأنواع التي ينشئها DevStack افتراضياً:
openstack flavor list+----+-----------+-------+------+-----------+-------+-----------+
| ID | Name | RAM | Disk | Ephemeral | VCPUs | Is Public |
+----+-----------+-------+------+-----------+-------+-----------+
| 1 | m1.tiny | 512 | 1 | 0 | 1 | True |
| 2 | m1.small | 2048 | 20 | 0 | 1 | True |
| 3 | m1.medium | 4096 | 40 | 0 | 2 | True |
| 4 | m1.large | 8192 | 80 | 0 | 4 | True |
| 5 | m1.xlarge | 16384 | 160 | 0 | 8 | True |
| c1 | cirros256 | 256 | 1 | 0 | 1 | True |
| d1 | ds512M | 512 | 5 | 0 | 1 | True |
| d2 | ds1G | 1024 | 10 | 0 | 1 | True |
| d3 | ds2G | 2048 | 10 | 0 | 2 | True |
| d4 | ds4G | 4096 | 20 | 0 | 4 | True |
+----+-----------+-------+------+-----------+-------+-----------+ولاحظ هنا أن m1.xlarge يطلب 8 معالجات، والسيرفر الوحيد عنده max_unit بقيمة 4 في Placement، فأي جهاز بهذا النوع لن يجد مرشحاً، وسوف يذهب إلى cell0 بحالة ERROR، وكذلك m1.medium الذي يطلب قرصاً بحجم 40 GB والمتاح 37 GB فقط. فالنوع الموجود في القائمة لا يعني أن السحابة تستطيع تشغيله، والجدولة هي التي تقرر ذلك عند الطلب.
ماذا يحدث عندما تطلب جهازاً؟ مسار openstack server create
الآن نجمع ما سبق في طلب واحد. عندما تكتب openstack server create --flavor m1.small --image cirros --network private web-1، فإن الطلب يمر بعشر خطوات تقريباً، وكل خطوة في خدمة مختلفة، كما في الصورة التالية:
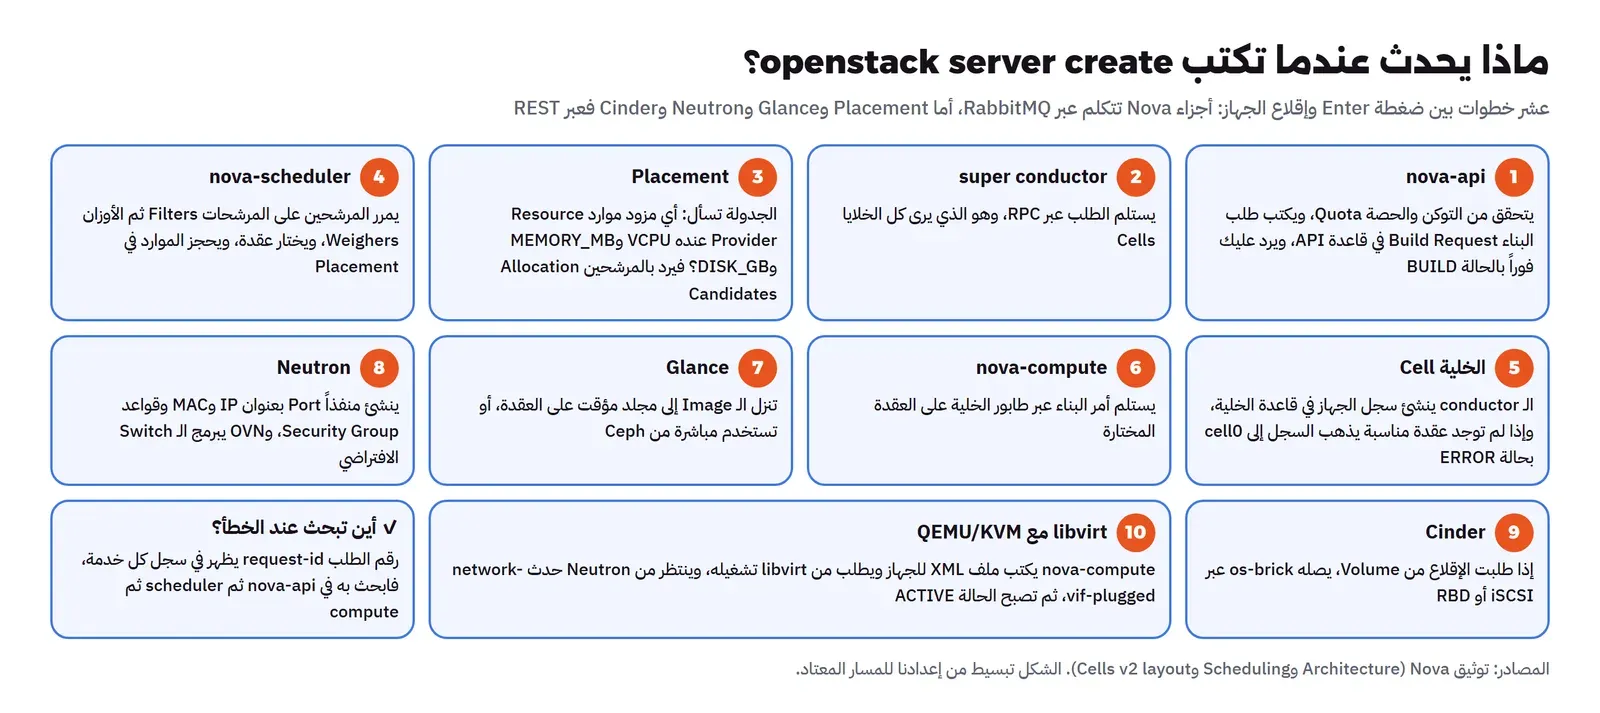
وفيما يلي الخطوات بتفصيل أكثر، مع ما يمكن أن يفشل في كل منها:
- nova-api: يتحقق من التوكن عبر Keystone، ومن أن السياسة تسمح لدورك بإنشاء جهاز، ومن أن الحصة في مشروعك تتسع لجهاز جديد بهذا الحجم. فإذا تجاوزت الحصة فالخطأ يأتيك فوراً برقم 403 قبل أن يبدأ أي شيء. ثم يكتب طلب البناء ويرد عليك، ولهذا يرجع الأمر بسرعة حتى لو استغرق الجهاز دقيقة ليعمل.
- super conductor: يأخذ الطلب من الطابور، ويطلب من الجدولة أن تختار سيرفراً.
- Placement: الجدولة تسأل Placement سؤالاً واحداً: أعطني المزودين الذين لديهم هذه الكمية من VCPU والذاكرة والقرص، وهذه السمات. فيرد بقائمة المرشحين Allocation Candidates. وهذه الخطوة تخرج آلاف السيرفرات من الحساب في استعلام قاعدة بيانات واحد بدل أن تفحص الجدولة كل سيرفر.
- nova-scheduler: يمرر المرشحين على المرشحات Filters، مثل منطقة التوفر Availability Zone وقواعد التفريق Anti-affinity التي تمنع جهازين من مجموعة واحدة أن يعملا على نفس السيرفر، ثم يرتبهم بالأوزان Weighers، مثل تفضيل السيرفر الذي فيه ذاكرة حرة أكثر، كما يشرح توثيق الجدولة. ثم يحجز الموارد في Placement حتى لا يأخذها طلب آخر في نفس اللحظة.
- الخلية: الـ conductor ينشئ سجل الجهاز في قاعدة الخلية التي فيها السيرفر المختار. وإذا لم يبق أي مرشح، فهنا يكتب الجهاز في cell0 بحالة ERROR مع
No valid host was found. - nova-compute: على السيرفر المختار، يستلم أمر البناء من طابور الخلية، ويبدأ العمل الفعلي.
- Glance: ينزل الـ Image إلى ذاكرة مؤقتة على السيرفر إذا لم تكن عنده من قبل، ولهذا يكون أول جهاز من Image كبيرة على سيرفر جديد أبطأ من الذي بعده. أما مع Ceph تحت Glance وNova معاً، فلا تنزل الـ Image، وإنما ينشئ Ceph نسخة Clone منها في ثوان.
- Neutron: يطلب nova-compute منفذاً Port في الشبكة المطلوبة، فيعطيه Neutron عنوان IP وعنوان MAC، ويطبق عليه قواعد مجموعة الأمان، ويبرمج OVN الـ Switch الافتراضي على السيرفر.
- Cinder: إذا طلبت أن يقلع الجهاز من قرص Volume، يطلب nova-compute من Cinder إنشاء القرص وبيانات الاتصال به، ثم تصل مكتبة os-brick إليه.
- libvirt: يكتب nova-compute ملف XML للجهاز ويطلب من libvirt تشغيله، ثم ينتظر من Neutron حدثاً اسمه
network-vif-pluggedيقول إن الشبكة جاهزة، وعندها فقط تصبح الحالة ACTIVE. وإذا لم يصل الحدث خلال المهلة، يفشل البناء برسالة عن انتهاء مهلةvif_plugging_timeout، وهذا غالباً عطل في جزء الشبكة على ذلك السيرفر.
والدرس العملي من هذا المسار أن رسالة الخطأ التي تراها في openstack server show قد تكون عامة، ولكن كل خدمة تكتب في سجلها رقم الطلب req-…، فخذ الرقم من سجل nova-api وابحث به في سجل الجدولة ثم في سجل nova-compute على السيرفر المختار، فتعرف الخطوة التي توقف عندها الطلب. وإذا كانت خدماتك تعمل تحت systemd كما في DevStack، فقد شرحنا البحث في السجلات بـ journalctl في الخدمات والسجلات مع systemd.
ولنر هذا المسار في سجلات حقيقية. في نفس سحابة DevStack أنشأ المستخدم fin-admin في مشروع اسمه finance جهازاً اسمه fin-vm1 من CirrOS، وكان رقم طلبه req-5c60cb8c-8a82-4133-b6e7-602cbe55b412. فبحثنا بهذا الرقم في سجل كل خدمة من خدمات Nova:
R=req-5c60cb8c-8a82-4133-b6e7-602cbe55b412
for u in n-api n-sch n-super-cond n-cpu; do
  sudo journalctl -u devstack@$u --no-pager -o short-iso | grep "$R"
done
والمخرج طويل، وفيما يلي أهم سطوره بالترتيب الزمني، بعد أن اختصرنا بداية كل سطر إلى الوقت واسم الخدمة، وقصرنا الأرقام الطويلة ونهايات الأسطر بعلامة …:
17:23:31 n-api   DEBUG nova.api.openstack.wsgi [req-5c60cb8c… finance fin-admin] Action: 'create', calling method: …
17:23:34 n-api   DEBUG nova.network.neutron [req-5c60cb8c… finance fin-admin] validate_networks() for [('b2bd22f0-3eb4-4…
17:23:45 n-api   DEBUG nova.quota [req-5c60cb8c… finance fin-admin] Getting quotas for project a31973590480418c8500a1a9a39c9289…
17:23:47 n-api   INFO  nova.api.openstack.requestlog [req-5c60cb8c… finance fin-admin] 10.0.2.15 "POST /compute/v2.1/servers" status: 202 …
17:23:49 n-sch   DEBUG nova.scheduler.manager [req-5c60cb8c… finance fin-admin] Starting to schedule for instances: ['10ac0183-a…
17:23:49 n-sch   DEBUG nova.scheduler.request_filter [req-5c60cb8c… finance fin-admin] Added required trait OWNER_NOVA to root p…
17:23:53 n-sch   DEBUG nova.filters [req-5c60cb8c… finance fin-admin] Starting with 1 host(s)
17:23:53 n-sch   DEBUG nova.filters [req-5c60cb8c… finance fin-admin] Filter ComputeFilter returned 1 host(s)
17:23:53 n-sch   DEBUG nova.filters [req-5c60cb8c… finance fin-admin] Filter ServerGroupAntiAffinityFilter returned 1 host(s)
17:23:53 n-sch   DEBUG nova.scheduler.manager [req-5c60cb8c… finance fin-admin] Filtered [(ostack, ostack) ram: 9433MB disk: 30720MB io_ops: 0 instances: 0, allocation_candidates: 1]
17:23:53 n-sch   DEBUG nova.scheduler.manager [req-5c60cb8c… finance fin-admin] Weighed [WeighedHost [host: (ostack, ostack) … weight: 0.0]]
17:23:53 n-sch   DEBUG nova.scheduler.utils [req-5c60cb8c… finance fin-admin] Attempting to claim resources in the placement API for instance 10ac0183-…
17:23:57 n-super-cond DEBUG nova.conductor.manager [req-5c60cb8c… finance fin-admin] Took 8.70 seconds to select destinations for 1 i…
17:24:10 n-cpu   INFO  nova.compute.claims [req-5c60cb8c… finance fin-admin] [instance: 10ac0183-…] Claim successful on node ostack
17:24:30 n-cpu   INFO  nova.virt.libvirt.driver [req-5c60cb8c… finance fin-admin] [instance: 10ac0183-…] Creating image(s)
17:25:06 n-cpu   DEBUG nova.compute.manager [req-5c60cb8c… finance fin-admin] [instance: 10ac0183-…] Preparing to wait for external event network-vif-plug…
17:25:15 n-cpu   INFO  os_vif [req-5c60cb8c… finance fin-admin] Successfully plugged vif VIFOpenVSwitch(active=False,address=fa:16:3e:22:3b:35,bridge_name='br-in…
17:25:17 n-cpu   DEBUG nova.compute.manager [req-5f819870… req-09f6a4d8… service nova] [instance: 10ac0183-…] Processing event netwo…
17:25:57 n-cpu   INFO  nova.compute.manager [req-5c60cb8c… finance fin-admin] [instance: 10ac0183-…] Took 87.17 seconds to spawn the in…
17:26:03 n-cpu   INFO  nova.compute.manager [req-5c60cb8c… finance fin-admin] [instance: 10ac0183-…] Took 114.32 seconds to build insta…
في المخرج أعلاه لاحظ التالي، وقارنه بخطوات الشكل:
- كل سطر يحمل الرقم والمشروع والمستخدم:
finance fin-adminبعد رقم الطلب في كل خدمة، فتعرف من طلب ماذا دون أن تبحث في Keystone. - nova-api (17:23:31 إلى 17:23:47): تحقق من الشبكة عند Neutron، ثم قرأ حصص المشروع، ثم رد بالحالة
202، أي «قبلت الطلب وسوف أنفذه»، وليس «انتهيت». ولهذا رجع الأمر إلى المستخدم قبل أن يعمل الجهاز بدقيقتين. - nova-scheduler (17:23:49 إلى 17:23:53): أضاف سمة
OWNER_NOVAإلى طلب Placement، ثم بدأ بمرشح واحد هو السيرفر الوحيد، ومرره على المرشحات Filters واحداً بعد الآخر، وكل منها أعاد سيرفراً واحداً، ثم الأوزان بوزن0.0لأنه لا يوجد من يقارن به، ثم حجز الموارد في Placement. ولاحظ أن الذاكرة المتاحة9433MBهي بالضبط 9945 ناقص 512 المحجوزة التي رأيناها في مخزون Placement. - super conductor (17:23:57): سجل أن اختيار الوجهة أخذ 8.70 ثانية، وفي سحابة صحية على عتاد حقيقي تتوقع هنا أجزاء من الثانية، فإذا رأيت ثوان كثيرة فابحث في سرعة Placement وقاعدة البيانات وطابور الرسائل.
- nova-compute (17:24:10 إلى 17:26:03): حجز الموارد محلياً Claim، ثم أنشأ القرص من الـ Image، ثم ربط المنفذ بالجسر
br-intفي Open vSwitch، ثم انتظر حدثnetwork-vif-plugged، ووصله الحدث من Neutron بطلب جديد برقم آخر من المستخدمservice nova، وهذا هو الحساب الذي تتكلم به الخدمات مع بعضها كما رأينا في الأدوار. - الوقت الكلي: 87.17 ثانية للتشغيل و114.32 ثانية للبناء كله. وفي سحابة إنتاج على عتاد حقيقي يقاس هذا بثوان، فإذا رأيت أرقاماً كهذه في الإنتاج فابحث في الخطوة التي أخذت أطول وقت بين سطرين متتاليين.
Glance: أين تعيش قوالب الأنظمة Images؟
Glance هي خدمة القوالب Image Service، وفيها كل Image يمكن أن تقلع منها الأجهزة: Ubuntu وDebian وWindows وقوالب المؤسسة الخاصة. والـ Image في Glance له بيانات وصفية Metadata، مثل الصيغة Disk Format (qcow2 أو raw أو vmdk وغيرها)، والحد الأدنى للذاكرة والقرص، والظهور Visibility: عامة public لكل المشاريع، أو خاصة private لمشروع واحد، أو مشتركة shared مع مشاريع محددة، أو community يراها من يبحث عنها. أما الملف نفسه فيحفظه Glance في مخزن Store، ويشرح توثيق إعداد Glance المخازن المدعومة: نظام ملفات محلي أو مشترك، أو Ceph RBD، أو Swift، أو تخزين S3، أو Cinder نفسه.
واختيار المخزن ليس تفصيلاً، والسبب أنه يحدد سرعة إنشاء الأجهزة. فمع مخزن ملفات محلي ينسخ كل سيرفر حوسبة الـ Image عبر الشبكة عند أول استخدام، ومع Ceph تحت Glance وNova وCinder معاً تصبح الـ Image والقرص في نفس العنقود، فينشأ القرص بنسخ عند الكتابة Copy-on-Write دون نقل أي بيانات. ولاحظ أيضاً أن صيغة raw هي المناسبة مع Ceph، لأن Ceph لا يستطيع أن ينسخ Image بصيغة qcow2 نسخاً سريعاً، فيحولها أولاً، وهذا يضيع الفائدة. وقد شرحنا Ceph نفسه في Ceph للمبتدئين.
وفي تثبيت DevStack تجد Image واحدة يرفعها تلقائياً، وهي CirrOS، نظام صغير جداً مصمم لاختبار السحب:
openstack image list+--------------------------------------+--------------------------+--------+
| ID | Name | Status |
+--------------------------------------+--------------------------+--------+
| 6ee2c5c2-f1be-430c-9651-16597a5e0dcf | cirros-0.6.3-x86_64-disk | active |
+--------------------------------------+--------------------------+--------+والحالة active تعني أن الملف رفع كاملاً وتحقق Glance من بصمته Checksum، فتستطيع الأجهزة أن تقلع منه. أما إذا رأيت queued فالسجل موجود والملف لم يرفع بعد، وإذا رأيت importing فالرفع ما زال يعمل. وفي سحابة حقيقية لن تستخدم CirrOS، وإنما Images رسمية من التوزيعات Cloud Images، مثل Ubuntu وDebian، وفيها cloud-init الذي يقرأ المفتاح وإعداد الشبكة عند الإقلاع الأول.
Neutron: شبكات يبنيها المستخدم بنفسه
في Proxmox VE أو VMware يبني فريق الشبكات الـ VLANs والجسور Bridges، ثم يختار المدير الشبكة لكل جهاز من قائمة، كما في الشبكات في Proxmox. أما في OpenStack فالمستخدم في مشروعه يبني شبكته الخاصة بأمر واحد، ويقسمها إلى شبكات فرعية Subnets، ويضع لها Router يخرجها إلى الإنترنت، دون أن يطلب شيئاً من أحد. وهذا ما تفعله Neutron، خدمة الشبكات Networking Service. وتعمل بمفاهيم قليلة، كما في مقدمة الشبكات في توثيق Neutron:
- الشبكة Network: شبكة طبقة ثانية Layer 2 معزولة، مثل Switch افتراضي خاص بالمشروع.
- الشبكة الفرعية Subnet: نطاق العناوين داخل الشبكة، مثل
10.0.0.0/24، مع البوابة Gateway وخادم DHCP وخوادم DNS. - المنفذ Port: نقطة اتصال بالشبكة، لها عنوان MAC وعنوان IP، وكل بطاقة شبكة لجهاز افتراضي منفذ، وكذلك واجهة الـ Router.
- الـ Router: يربط شبكات المشروع ببعضها وبالشبكة الخارجية، ويعمل ترجمة العناوين NAT.
- العنوان العائم Floating IP: عنوان من الشبكة الخارجية تربطه بمنفذ جهاز واحد، فيصل إليه الناس من الخارج، وتستطيع أن تنقله إلى جهاز آخر متى شئت.
- مجموعة الأمان Security Group: قواعد جدار ناري Firewall تطبق على كل منفذ، تحدد ما يسمح بدخوله وخروجه.
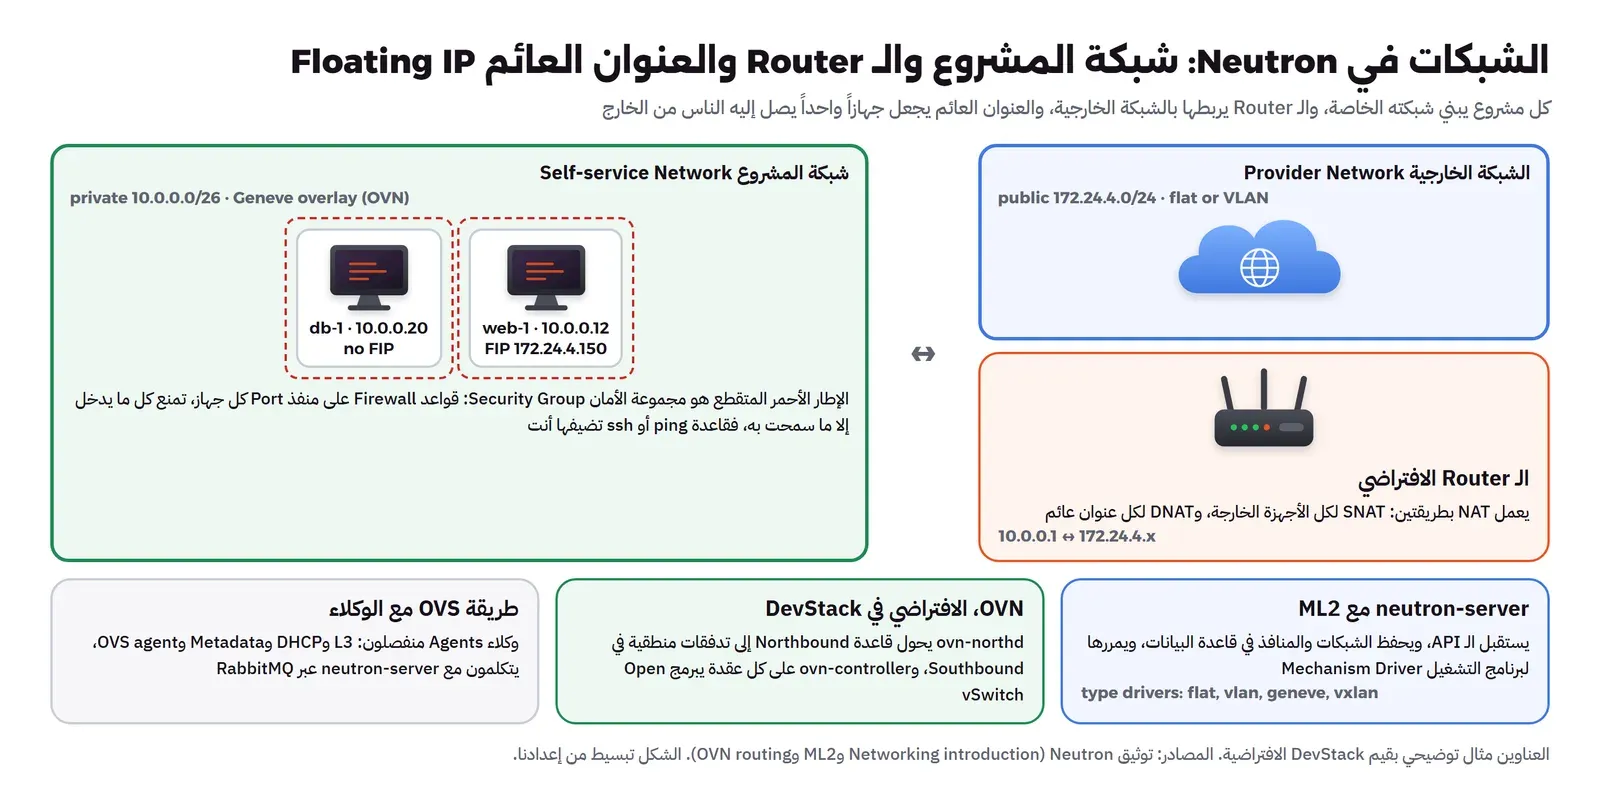
شبكات المزود Provider وشبكات المشروع Self-service
هناك نوعان من الشبكات يجب أن تفرق بينهما من البداية. الأول شبكة المزود Provider Network، وهي شبكة حقيقية في مركز البيانات، مثل VLAN رقم 120 على الـ Switches، ينشئها المدير ويربطها بها الأجهزة مباشرة، فيأخذ الجهاز عنواناً من شبكة المؤسسة كأنه سيرفر عادي. والثاني شبكة المشروع Self-service Network، وهي شبكة افتراضية تماماً، ينشئها المستخدم، وتنتقل حزمها بين السيرفرات داخل نفق Overlay، مثل Geneve أو VXLAN، فلا يحتاج فريق الشبكات أن ينشئ VLAN لكل مشروع. والمشاريع المختلفة تستطيع أن تستخدم نفس نطاق العناوين 10.0.0.0/24 دون تعارض، لأن كل شبكة معزولة في نفقها.
وفي أغلب السحب تجد الاثنين معاً: شبكة مزود واحدة خارجية External Network يخرج إليها كل Router، ومنها تأتي العناوين العائمة، وشبكات مشاريع كثيرة خلف هذه الـ Routers. والـ Router هنا يعمل NAT بطريقتين: ترجمة المصدر SNAT للأجهزة التي تخرج إلى الإنترنت بعنوان الـ Router، وترجمة الوجهة DNAT لكل عنوان عائم، فالطلب الذي يصل إلى 172.24.4.150 يترجم إلى 10.0.0.12 داخل المشروع.
ML2 مع OVN: من يبرمج الشبكة فعلاً؟
Neutron نفسها لا تنقل أي حزمة، وإنما تحفظ ما تريده في قاعدة البيانات، ثم تطلب من برنامج تشغيل Mechanism Driver أن ينفذه. وإطار برامج التشغيل اسمه ML2، أي Modular Layer 2، ويشرح توثيق ML2 أنه يفصل بين نوع الشبكة Type Driver، مثل flat وvlan وgeneve وvxlan، وطريقة تنفيذها Mechanism Driver. وأهم طريقتين اليوم:
- OVN: وهو المستخدم افتراضياً في DevStack، وفيه تكتب Neutron ما تريده في قاعدة اسمها Northbound، ثم تحوله خدمة
ovn-northdإلى تدفقات منطقية Logical Flows في قاعدة Southbound، وعلى كل سيرفر خدمةovn-controllerتقرأ ما يخصها وتبرمج Open vSwitch المحلي. والـ DHCP والـ Routers ومجموعات الأمان كلها تنفذ داخل Open vSwitch نفسه، دون وكلاء إضافيين. ويشرح توثيق التوجيه في OVN أن الحركة بين شبكات المشروع تمر مباشرة بين سيرفرات الحوسبة، وأن العناوين العائمة يمكن أن تكون موزعة Distributed، فتخرج حركة الجهاز من سيرفره مباشرة، أما SNAT فيمر بسيرفر بوابة Gateway Chassis. - Open vSwitch مع الوكلاء Agents: الطريقة الأقدم، وفيها وكيل لكل وظيفة:
neutron-openvswitch-agentعلى كل سيرفر، وneutron-l3-agentللـ Routers، وneutron-dhcp-agent، وneutron-metadata-agent، وكلها تتكلم مع neutron-server عبر RabbitMQ. وما زالت تعمل في سحب كثيرة، ولكن السحابة الجديدة تبدأ غالباً بـ OVN، لأن طبقاتها أقل.
ولنر ذلك في تثبيت DevStack، فهذا إعداد ML2 ثم الوكلاء والشبكات:
grep -E '^(type_drivers|mechanism_drivers)' /etc/neutron/plugins/ml2/ml2_conf.ini
openstack network agent list
openstack network list
type_drivers = local,flat,vlan,geneve
mechanism_drivers = ovn
+--------------------------------------+------------------------------+--------+-------------------+-------+-------+-------------------+
| ID | Agent Type | Host | Availability Zone | Alive | State | Binary |
+--------------------------------------+------------------------------+--------+-------------------+-------+-------+-------------------+
| 31a7e17b-1153-5823-ba36-8096c76a8bd5 | OVN Neutron agent | ostack | | :-) | UP | neutron-ovn-agent |
| bc5866c1-0308-41fa-9c75-3cdda6b94a4e | OVN Controller Gateway agent | ostack | | :-) | UP | ovn-controller |
+--------------------------------------+------------------------------+--------+-------------------+-------+-------+-------------------+
+--------------------------------------+---------+----------------------------------------------------------------------------+
| ID | Name | Subnets |
+--------------------------------------+---------+----------------------------------------------------------------------------+
| 6252b988-8085-48df-bfae-9d80a9375f71 | public | 1a1981b9-8db1-47e8-850c-b6cb591dcf86, 2d5fec4e-bc80-4d67-b145-360a027f06e1 |
| 71629965-1755-4278-82eb-7e4124ed4c91 | private | c8e729fd-5f0a-4727-8c08-ed737f276af2, f93990a2-ff07-4adf-91ae-97fbae1fe542 |
+--------------------------------------+---------+----------------------------------------------------------------------------+في المخرج أعلاه لاحظ التالي:
- mechanism_drivers = ovn: برنامج التشغيل الوحيد هو OVN، وأنواع الشبكات المسموحة
flatوvlanلشبكات المزود، وgeneveلشبكات المشاريع، وlocalللاختبار فقط. - وكيلان فقط: لا يوجد
neutron-l3-agentولاneutron-dhcp-agent، لأن OVN ينفذ الـ Routers والـ DHCP بنفسه. والوكيلOVN Controller Gateway agentهوovn-controllerعلى هذا السيرفر، وكلمة Gateway تعني أنه أيضاً سيرفر بوابة تمر به حركة SNAT إلى الشبكة الخارجية. أماneutron-ovn-agentفيقدم خدمة البيانات الوصفية Metadata للأجهزة. - Alive بوجه مبتسم:
:-)تعني أن الوكيل أرسل نبضته في الوقت، وXXXتعني أنه صامت. وهذه أول قائمة تنظر إليها عندما لا يأخذ جهاز عنوانه. - شبكتان جاهزتان: DevStack ينشئ
publicوهي شبكة المزود الخارجية، وprivateوهي شبكة مشروع demo، ولكل منهما شبكتان فرعيتان، واحدة IPv4 وواحدة IPv6.
مجموعات الأمان Security Groups: لماذا لا يرد الجهاز على ping؟
كل مشروع جديد يأتي معه مجموعة أمان اسمها default، وقواعدها الافتراضية تسمح بكل خروج، وتسمح بالدخول فقط من الأجهزة التي في نفس المجموعة. أي أن أي اتصال من خارج المجموعة، حتى ping من الـ Router أو SSH من جهازك، ممنوع حتى تضيف قاعدة له. وهذا أول ما يواجهه من يجرب OpenStack: ينشئ جهازاً، ويربط به عنواناً عائماً، ثم لا يرد الجهاز، فيظن أن الشبكة معطلة، والحقيقة أن الجدار الناري يعمل كما صمم تماماً. والحل أن تضيف قاعدة صريحة، مثل السماح بـ ICMP وبالمنفذ 22 من عنوان مكتبك فقط، ولا تقم بفتح المنفذ 22 لكل الإنترنت 0.0.0.0/0، والسبب أن البوتات تفحص كل عنوان عام خلال دقائق من ظهوره.
Cinder: أقراص تعيش بعد حذف الجهاز
الجهاز الافتراضي في OpenStack يقلع عادة من قرص مؤقت Ephemeral Disk، يعيش على سيرفر الحوسبة ويحذف مع الجهاز. وهذا مناسب لطريقة القطيع Cattle التي شرحناها في دراسة CERN، أي الأجهزة التي تبنيها من جديد ولا تصلحها. أما البيانات التي يجب أن تبقى، مثل ملفات قاعدة بيانات، فمكانها قرص من Cinder، خدمة التخزين الكتلي Block Storage Service. وقرص Cinder اسمه Volume، يعيش مستقلاً عن أي جهاز: تنشئه، وتربطه بجهاز Attach، فيظهر داخله قرصاً جديداً مثل /dev/vdb، ثم تفصله Detach وتربطه بجهاز آخر، وتأخذ منه Snapshot أو نسخة احتياطية Backup. والصورة التالية تبين أجزاءه:
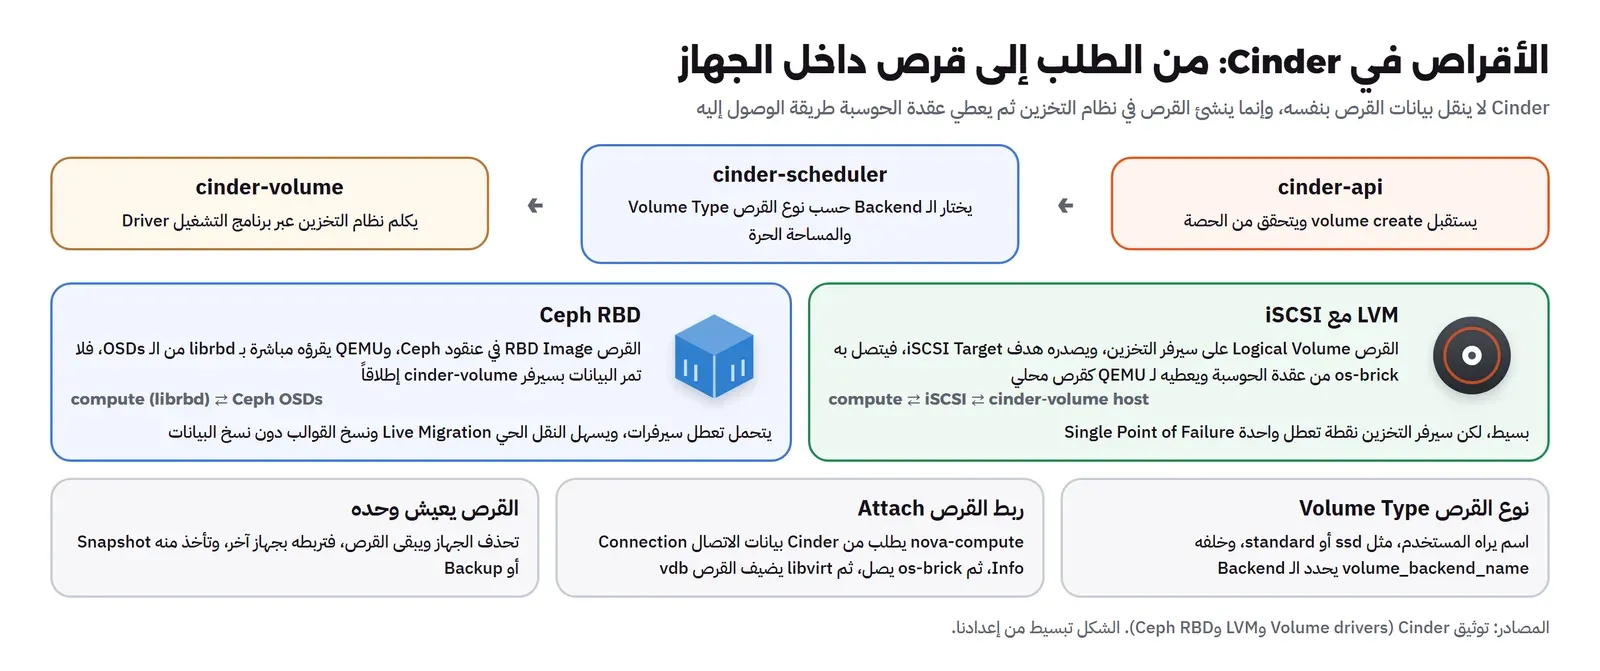
وتتكون Cinder من أربع خدمات: cinder-api للطلبات، وcinder-scheduler الذي يختار نظام التخزين المناسب لكل قرص جديد، وcinder-volume الذي يكلم نظام التخزين عبر برنامج تشغيل Driver، وcinder-backup اختيارياً لنسخ الأقراص إلى مكان آخر. وفي قائمة برامج التشغيل عشرات الأنظمة: LVM على Linux، وCeph RBD، وNFS، وأجهزة تخزين تجارية من NetApp وDell وPure Storage وغيرها.
وفي تثبيت DevStack الـ Backend هو LVM، والأمر التالي يبين خدمات Cinder ثم مجموعة الأقراص التي تحفظ فيها:
openstack volume service list
sudo vgs; sudo lvs
+------------------+--------------------+------+---------+-------+----------------------------+---------+---------------+
| Binary | Host | Zone | Status | State | Updated At | Cluster | Backend State |
+------------------+--------------------+------+---------+-------+----------------------------+---------+---------------+
| cinder-scheduler | ostack | nova | enabled | up | 2026-11-19T17:11:36.000000 | None | None |
| cinder-volume | ostack@lvmdriver-1 | nova | enabled | up | 2026-11-19T17:11:12.000000 | None | None |
+------------------+--------------------+------+---------+-------+----------------------------+---------+---------------+
VG #PV #LV #SN Attr VSize VFree
stack-volumes-lvmdriver-1 1 1 0 wz--n- <8.00g 388.00m
LV VG Attr LSize Pool Origin Data% Meta%
stack-volumes-lvmdriver-1-pool stack-volumes-lvmdriver-1 twi-a-tz-- 7.60g 0.00 10.74في المخرج أعلاه لاحظ التالي:
- Host يحمل اسم الـ Backend:
ostack@lvmdriver-1يعني خدمة cinder-volume على السيرفر ostack للـ Backend المسمى lvmdriver-1. فإذا أضفت Ceph في نفس السيرفر ظهر سطر ثان مثلostack@ceph، والجدولة تختار بينهما حسب نوع القرص. - مجموعة أقراص بحجم 8 GB: DevStack ينشئ ملفاً على القرص ويجعله مجموعة أقراص LVM، وداخلها مجمع رفيع Thin Pool بحجم 7.60 GB، والحرف
tفي أولtwi-a-tz--يعني Thin Pool. فكل قرص Cinder جديد يكون Logical Volume رفيعاً داخل هذا المجمع، لا يأخذ مساحة إلا بقدر ما يكتب فيه. - Data% بقيمة 0.00: لا يوجد أي قرص بعد، فالمجمع فارغ. وهذا الرقم هو ما يجب أن تراقبه في LVM الرفيع، لأن المجمع إذا امتلأ توقفت الكتابة في كل الأقراص التي فيه معاً.
LVM مع iSCSI أم Ceph RBD؟ الفرق في طريق البيانات
الفرق بين الـ Backends ليس في سطر الإعداد، وإنما في طريق البيانات من الجهاز إلى القرص:
- LVM مع iSCSI: حسب توثيق برنامج LVM، ينشئ cinder-volume القرص كـ Logical Volume في مجموعة أقراص Volume Group على سيرفره، ثم يصدره عبر هدف iSCSI Target. وعند الربط تتصل مكتبة os-brick على سيرفر الحوسبة بهذا الهدف، فيظهر عندها قرص محلي، تعطيه لـ QEMU. وهذه الطريقة بسيطة ولا تحتاج عتاداً خاصاً، ولكن كل بيانات الأقراص تمر بسيرفر واحد، فيصبح نقطة تعطل واحدة Single Point of Failure، فإذا توقف توقفت كل الأقراص عليه، لذلك تناسب المختبر Lab والسحب الصغيرة أكثر من الإنتاج الحساس.
- Ceph RBD: حسب توثيق برنامج Ceph RBD، القرص RBD Image في عنقود Ceph، وcinder-volume ينشئه فقط، أما القراءة والكتابة فيقوم بها QEMU مباشرة عبر مكتبة librbd من كل خوادم التخزين OSDs في نفس الوقت. فلا يوجد سيرفر وسيط، والعنقود يتحمل تعطل سيرفرات كاملة، والنقل الحي للجهاز سهل لأن قرصه متاح من كل سيرفر حوسبة. ولهذا السبب أصبح Ceph الشريك المعتاد لـ OpenStack في الإنتاج، ولكنه عنقود تخزين كامل يحتاج من يفهمه.
أما نوع القرص Volume Type فهو الاسم الذي يراه المستخدم، مثل ssd وstandard، وخلفه في الإعداد قيمة volume_backend_name تحدد الـ Backend. فإذا كان عندك Ceph على أقراص NVMe وNFS على أقراص بطيئة، تعطي كل منهما نوعاً، والمستخدم يختار، والحصص تحسب لكل نوع على حدة. ولا تقم بترك نوع افتراضي واحد للجميع في سحابة فيها أكثر من نظام تخزين، والسبب أن المستخدمين سوف يضعون كل شيء على الأسرع إذا لم تفرق الحصص بينهما.
Horizon وبقية الخدمات: ما الذي تحتاجه فعلاً؟
Horizon هي لوحة التحكم Dashboard في المتصفح، مبنية على Django، ولا تملك أي منطق خاص بها، فكل زر فيها طلب API إلى الخدمات نفسها، كما يشرح توثيق Horizon. وهذا يعني أن كل ما تفعله فيها تستطيع أن تفعله بـ openstack CLI أو بـ Terraform أو OpenTofu، وهذا ما يفعله أغلب المستخدمين المتقدمين بعد أسابيع. وإذا كنت تقارن بين Terraform وOpenTofu فقد شرحنا الفرق في Terraform أم OpenTofu.
وفوق الخدمات الأساسية مشاريع اختيارية كثيرة، والأشهر منها:
- Swift: تخزين الكائنات Object Storage، مثل S3، لملفات كثيرة تصل إليها عبر HTTP. وكثير من السحب تستخدم Ceph RGW بدله.
- Ironic: إدارة السيرفرات الحقيقية Bare Metal كأنها أجهزة افتراضية، وقد رأينا في دراسة CERN كيف أدارت به دورة حياة آلاف السيرفرات.
- Magnum: عناقيد Kubernetes داخل مشاريع المستخدمين.
- Octavia: موزع الضغط كخدمة Load Balancer as a Service، يشغل موزعاً لكل طلب.
- Heat: قوالب تنسيق Orchestration تنشئ مجموعة موارد مرتبطة بملف واحد، وكثير من الفرق تستخدم Terraform بدلاً منه.
- Designate وBarbican: الأول لخدمة DNS، والثاني لحفظ الأسرار Secrets ومفاتيح التشفير.
والقاعدة هنا أن تبدأ بالأساسيات فقط: Keystone وNova وPlacement وGlance وNeutron وCinder وHorizon. وكل خدمة تضيفها بعد ذلك تحتاج من يرقيها ويراقبها ويفهم أعطالها، فأضفها عندما يطلبها مستخدمون حقيقيون، وليس لأنها موجودة في القائمة.
دورة الإصدار Release Cycle: كل ستة أشهر، وSLURP كل سنة
يصدر OpenStack إصداراً جديداً كل ستة أشهر تقريباً، كما في صفحة الإصدارات الرسمية. وكان لكل إصدار اسم بحرف أبجدي، ثم أضيف إليه منذ 2023 رقم بالسنة: 2023.1 Antelope، ثم 2023.2 Bobcat، وهكذا حتى الإصدار الحالي 2026.2 Hibiscus الذي صدر في 30 سبتمبر 2026، والإصدار القادم 2027.1 Indri المتوقع في 24 مارس 2027، حسب الصفحة في 19 نوفمبر 2026.
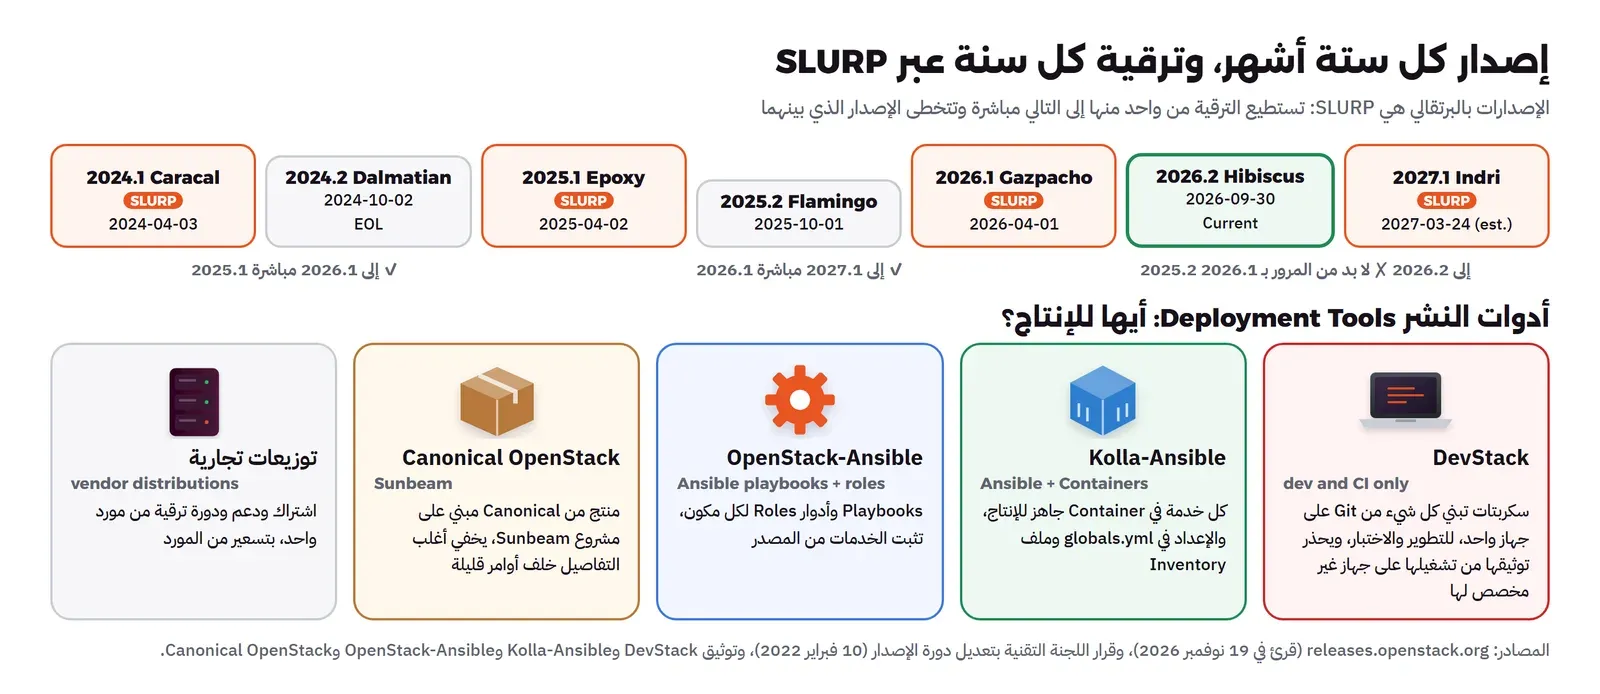
والإصدار كل ستة أشهر يعني أن من يرقي مع كل إصدار يرقي سحابته مرتين في السنة، وهذا عبء ثقيل على أي فريق، لأن الترقية تمس كل الخدمات وقواعد بياناتها. لذلك قررت اللجنة التقنية للمشروع في قرار تعديل دورة الإصدار في 10 فبراير 2022 أن يكون إصدار من كل اثنين من نوع SLURP، أي Skip Level Upgrade Release Process. ويقول القرار إن الترقية مدعومة ومختبرة بين كل إصدارين SLURP متتاليين، إضافة إلى الترقية بين أي إصدارين متجاورين، فمن يريد أن يرقي مرة في السنة ينتقل من SLURP إلى الذي بعده مباشرة، ويتخطى الإصدار الذي بينهما. أما الإصدار الذي ليس SLURP فطريق الترقية منه إلى الإصدار التالي فقط.
وهذا قرار يجب أن تأخذه عند بداية السحابة: هل تلحق كل إصدار، أم تبقى على إصدارات SLURP؟ فإذا اخترت SLURP، فلا تقم بتثبيت إصدار ليس SLURP في الإنتاج، والسبب أنك سوف تضطر إلى ترقيتين متتاليتين لتعود إلى المسار السنوي. ولاحظ في الجدول أيضاً أن كل إصدار يمر بثلاث حالات: مدعوم Maintained، ثم غير مدعوم Unmaintained تبقى فيه الفروع مفتوحة دون التزام من الفرق، ثم نهاية الحياة End of Life. فالإصدار 2024.2 Dalmatian وصل إلى نهاية حياته في 29 أبريل 2026، أي بعد نحو سنة ونصف من صدوره.
أدوات النشر Deployment Tools: DevStack ليس للإنتاج
لا يوجد برنامج تثبيت واحد لـ OpenStack، وإنما أدوات نشر تختلف في طريقتها، وهذه أشهرها:
- DevStack: مجموعة سكربتات يصفها توثيقها بأنها تبني بيئة OpenStack كاملة من آخر نسخ الكود في Git، وتستخدم بيئة تطوير وأساساً لاختبارات المشروع نفسه. ويحذر التوثيق من أنها تغير النظام تغييرات كبيرة، فلا تشغلها إلا على سيرفر أو جهاز افتراضي مخصص لها. وهي ممتازة لتفهم كيف تعمل الخدمات، ولكنها لا تعرف الترقية، ولا التوفر العالي High Availability، ولا إعادة التشغيل الآمنة بعد عطل، لذلك لا تقم ببناء أي شيء عليه بيانات حقيقية فوق DevStack.
- Kolla-Ansible: مشروع من OpenStack نفسه، مهمته كما في توثيقه أن يوفر Containers جاهزة للإنتاج وأدوات نشر لتشغيل سحب OpenStack. فكل خدمة في Container، والإعداد في ملف
globals.ymlوملف Inventory بأسماء السيرفرات، وAnsible يبني كل شيء ويرقيه. وهي الأداة التي تنتقل إليها CERN في 2026 كما ذكرنا في دراستها. وإذا كنت جديداً على Ansible فابدأ بـ Ansible للمبتدئين. - OpenStack-Ansible: يوفر Playbooks وأدواراً Roles لنشر كل مكون وإعداده، وهو مناسب لمن يريد تحكماً تفصيلياً بكل خدمة.
- Canonical OpenStack: منتج من Canonical مبني على مشروع Sunbeam، الذي يهدف كما يقول توثيقه إلى تخفيض عتبة الدخول لمن لا خبرة له بـ OpenStack، ويشغل الخدمات فوق Kubernetes ويديرها بأوامر قليلة.
- التوزيعات التجارية: شركات تبيع OpenStack مجمعاً مع الدعم ودورة ترقية واضحة، وتختلف شروطها وأسعارها، فاقرأها من صفحة كل مورد، ومقارنتها موضوع المقال الأخير في هذه المرحلة.
وفي المقال التالي في هذه المرحلة نبني سحابة صغيرة بـ DevStack خطوة بخطوة، والسبب أنه أسرع طريق لترى كل ما في هذا المقال يعمل أمامك على سيرفر واحد، مع أن الإنتاج يبنى بأداة أخرى.
أخطاء شائعة Common Mistakes
- البدء بكل المشاريع: تثبيت Swift وHeat وMagnum وOctavia من اليوم الأول، ثم ترقية عشر خدمات لا يستخدمها أحد. ابدأ بالأساسيات، وأضف الخدمة عندما يطلبها مستخدم.
- عقدة إدارة واحدة في الإنتاج: إذا توقفت توقفت السحابة كلها عن الاستجابة، مع أن الأجهزة تبقى تعمل. الإنتاج يحتاج ثلاث عقد إدارة على الأقل، مع عنقود قاعدة بيانات وعنقود RabbitMQ، كما شرحنا في مفاهيم التوفر العالي.
- إهمال RabbitMQ: أغلب الأعطال الغامضة، مثل الجهاز العالق في BUILD و
MessagingTimeout، سببها طابور الرسائل. راقب طوابيره وعدد الرسائل غير المستهلكة كما تراقب قاعدة البيانات. - مفاتيح Fernet غير متزامنة: تدوير المفاتيح على سيرفر واحد ونسيان البقية يعطي
401متقطعاً لا يفهمه أحد. - إنشاء دور جديد دون سياسة: الدور في Keystone لا يمنح شيئاً حتى تذكره سياسة الخدمة.
- ظن أن الشبكة معطلة: الجهاز لا يرد على ping لأن مجموعة الأمان
defaultتمنع الدخول، وليس لأن Neutron معطلة. - LVM مع iSCSI في الإنتاج الحساس: سيرفر cinder-volume يصبح نقطة تعطل واحدة لكل الأقراص.
- Images بصيغة qcow2 فوق Ceph: تفقد النسخ السريع، فيصبح إنشاء كل جهاز نسخاً كاملاً.
- تثبيت إصدار ليس SLURP ثم الرغبة في الترقية السنوية: تحتاج ترقيتين بدل واحدة لتعود إلى المسار.
- DevStack في الإنتاج: لا يعرف الترقية ولا التوفر العالي، وقد لا يعود كما كان بعد إعادة تشغيل السيرفر.
قائمة تحقق Checklist قبل أن تصمم سحابة OpenStack
- تعرف ما تفعله كل خدمة أساسية، وأين سجلها، ورقم الطلب الذي يربطها بالبقية.
- حددت عدد عقد الإدارة، وطريقة التوفر العالي لقاعدة البيانات وRabbitMQ وmemcached.
- قررت مصدر المستخدمين في Keystone: قاعدته أم LDAP أم SSO، وكيف تقسم الجهات إلى مجالات ومشاريع.
- كتبت سياسة الأدوار: من reader ومن member ومن admin، وما المسموح لكل دور في كل خدمة.
- صممت الشبكات: الشبكة الخارجية، ونوع شبكات المشاريع Geneve أو VLAN، وOVN أم OVS مع الوكلاء، ونطاق العناوين العائمة.
- اخترت الـ Backend لـ Cinder وGlance، وإذا كان Ceph فصيغة الـ Images
raw. - عرفت عدداً صغيراً من الأنواع Flavors والحصص الافتراضية لكل مشروع.
- اخترت أداة نشر للإنتاج، وقررت المسار: كل إصدار أم SLURP فقط، وتاريخ الترقية القادمة.
- جربت كل هذا على مختبر قبل الإنتاج، ورأيت بعينك طلب
server createيمر بالخدمات.
الخلاصة Summary
وصلنا لنهاية الموضوع، وأهم ما فيه:
- OpenStack مجموعة خدمات مستقلة، لكل منها REST API وقاعدة بيانات، وتتكلم أجزاؤها الداخلية برسائل RPC عبر RabbitMQ، وتحفظ نتائج التحقق من التوكن في memcached.
- عقد الإدارة تقرر وتسجل، وعقد الحوسبة تشغل الأجهزة بـ libvirt وQEMU/KVM، ولا تتصل بقاعدة البيانات إلا عبر conductor.
- Keystone يعطيك توكن Fernet صغيراً لا يحفظ في قاعدة البيانات، ومعه كتالوج بعناوين كل الخدمات، والأدوار تأخذ معناها من سياسة كل خدمة.
- Nova تختار السيرفر بمساعدة Placement الذي يعرف مخزون كل مزود موارد وحصصه، والجهاز الذي لم يجد سيرفراً يذهب إلى cell0.
- Neutron تبني شبكات المشاريع فوق OVN، والـ Router يعمل SNAT وDNAT، والعنوان العائم يفتح جهازاً واحداً، ومجموعة الأمان
defaultتمنع الدخول حتى تسمح به. - Cinder تنشئ الأقراص وتعطي عقدة الحوسبة طريقة الوصول، وفي LVM تمر البيانات بسيرفر واحد، وفي Ceph يقرأ QEMU مباشرة من العنقود.
- إصدار كل ستة أشهر، والحالي 2026.2 Hibiscus، وإصدارات SLURP تسمح بترقية واحدة في السنة، والإنتاج يبنى بأداة مثل Kolla-Ansible وليس بـ DevStack.
وفي المقال التالي بإذن الله نبني سحابة OpenStack صغيرة بأيدينا، وننشئ فيها مشروعاً وشبكة وRouter وجهازاً بعنوان عائم وقرصاً، ونرى كل خطوة من هذا المقال في السجلات. والمقالات القريبة من هذا الموضوع:
دليلسحابة OpenStack صغيرة بيدك: من التثبيت إلى أول جهازبنينا OpenStack 2026.2 بـ DevStack في جهاز افتراضي واحد، ثم أنشأنا مشروعاً وشبكة وجهازاً بعنوان عائم وقرصاً، ومعها المشكلات الحقيقية التي ظهرت وما حدث بعد إعادة التشغيل. دليلسحابة CERN على OpenStack: دروس من آلاف الخوادمكيف بنت CERN سحابة خاصة على OpenStack تحمل أكثر من 90% من حوسبتها منذ 2013، وما الذي تتعلمه جهتك من أرقامها وأخطائها.
 دليلApache CloudStack وOpenNebula: بدائل أخف من OpenStackكيف يعمل CloudStack وOpenNebula من الداخل، ومختبر حقيقي على OpenNebula 7.4 بحصص وجدولة، ومتى تختار كلاً منهما بدل OpenStack.
 دليلOpenStack أم CloudStack أم OpenNebula أم Proxmox؟قرار السحابة الخاصة مبني على فريقك وحجمك وحاجتك إلى تعدد المستأجرين، مع معايير المقارنة وأسعار الدعم المنشورة وشجرة قرار ومثال لتكلفة سنة.
سجل التحديثات Changelog
- 2026-11-19: كتابة المقال من التوثيق الرسمي لـ Nova وKeystone وNeutron وCinder وGlance وPlacement وصفحة الإصدارات وقرار SLURP، مع مخرجات حقيقية من تثبيت DevStack بالإصدار 2026.2 Hibiscus على Ubuntu 24.04.