

أغلب التطبيقات تحتاج طابوراً Queue قبل أن تحتاج وسيطاً كاملاً مثل RabbitMQ أو Kafka: إرسال بريد بعد التسجيل، أو تصغير صورة بعد رفعها، أو تقرير يأخذ دقيقة. وفي كثير من هذه التطبيقات يوجد Redis أو بديله المفتوح Valkey أصلاً للتخزين المؤقت Cache والجلسات، فيأتي السؤال الطبيعي: لماذا لا نضع المهام فيه أيضاً؟ والإجابة أن هذا ممكن وشائع جداً، فمكتبات مثل BullMQ وSidekiq وCelery تعمل فوقه، لكن الطابور فوق Redis له طرق محددة يضيع فيها العمل دون أي خطأ يظهر لك، وهذا ما سوف نكسره في هذا المقال واحداً واحداً.
وقد شرحنا في دليل Redis وValkey التثبيت والحفظ على القرص وسياسات الإخراج Eviction والرخصة، وشرحنا في مقال الطابور للمبتدئين معنى التأكيد Ack وإعادة المحاولة وال Dead Letter Queue، فلن نعيد ذلك هنا، وسوف نناقش في هذا المقال ما يلي:
- متى يكفيك طابور فوق Redis أو Valkey، ومتى تحتاج وسيطاً منفصلاً.
- الطابور فوق القائمة List: الأمر
BRPOPولماذا يضيع العمل معه، ثمBLMOVEمع قائمة للمهام الجارية ومهمة تعيد ما علق. - الطابور فوق التدفق Stream مع مجموعة مستهلكين Consumer Group: قائمة الرسائل المعلقة PEL، و
XACK، وXAUTOCLAIM، وعداد المحاولات. - الثغرات التي تفقد فيها المهام: القص Trimming، وامتلاء الذاكرة، والحفظ على القرص، والنسخ غير المتزامن.
- المكتبات الجاهزة BullMQ وCelery وSidekiq وRQ باختصار، وما الذي تحله كل منها.
- تجربة عملية على Redis 8.10.2 وValkey 9.1.2 جنباً إلى جنب، مع كل حالة فشل.
متى يكفيك Redis طابوراً؟
يكفيك طابور فوق Redis أو Valkey في الحالات التالية:
- مهام خلفية لتطبيق واحد: بريد، وإشعارات، وتصغير صور، وتقارير، بحجم من عشرات إلى آلاف المهام في الدقيقة.
- Redis موجود ومراقب: لا تريد نظاماً جديداً تشغله وتحدثه وتراقبه.
- مكتبة لغتك مبنية عليه: مثل BullMQ في Node.js، وSidekiq في Ruby، وCelery وRQ في Python، فتحصل على إعادة المحاولة والتأخير والجدولة جاهزة.
ولا يكفيك في الحالات التالية:
- مهمة لا يجوز أن تضيع أبداً، مثل خصم مبلغ أو إصدار فاتورة رسمية: هنا ضع المهمة في قاعدة البيانات نفسها مع البيانات، كما في نمط Outbox أو الطابور في PostgreSQL، والسبب أن Redis يحفظ في الذاكرة أولاً كما سوف ترى.
- عدة أنظمة تقرأ الأحداث نفسها وتعيد قراءتها بعد شهور: هذا عمل سجل أحداث مثل Kafka، فالتدفق في Redis يعيش في الذاكرة ويقص ليبقى صغيراً.
- توجيه معقد وأولويات وطوابير كثيرة لفرق مختلفة: هنا RabbitMQ أنسب، وقد قارنا الوسطاء في مقال RabbitMQ أم Kafka أم NATS؟.
الطابور فوق القائمة List
الحل البسيط الذي يكتبه كل مطور أول مرة: المنتج يضيف المهمة بالأمر LPUSH إلى أول القائمة، والعامل Worker ينتظرها بالأمر BRPOP من آخرها، فيحصل على طابور بترتيب الوصول FIFO دون أي سؤال دوري، لأن BRPOP يبقى منتظراً حتى تصل مهمة. والمشكلة أن BRPOP يحذف المهمة من Redis لحظة أخذها، فإذا توقف العامل بعد ذلك بسبب خطأ أو إعادة نشر Deploy أو نفاد الذاكرة فالمهمة ضاعت، ولا يوجد أي مكان في Redis يذكر أنها كانت موجودة. وهذه ليست حالة نظرية، فتوثيق Sidekiq عن الموثوقية يقول صراحة إن Sidekiq يستخدم BRPOP، وإن المهمة تضيع إلى الأبد إذا توقف أثناء تنفيذها، وإن الحل في النسخة التجارية Sidekiq Pro عبر ما يسميه super_fetch.
والحل المعروف الذي يذكره توثيق الأمر LMOVE تحت اسم Reliable Queue أن ينقل العامل المهمة في خطوة واحدة من قائمة الانتظار إلى قائمة ثانية للمهام الجارية، بالأمر BLMOVE المتاح منذ Redis 6.2، فلا توجد لحظة تكون فيها المهمة خارج Redis، ثم يحذفها العامل من القائمة الثانية بالأمر LREM بعد أن ينتهي. والصورة التالية تبين الطريقتين:
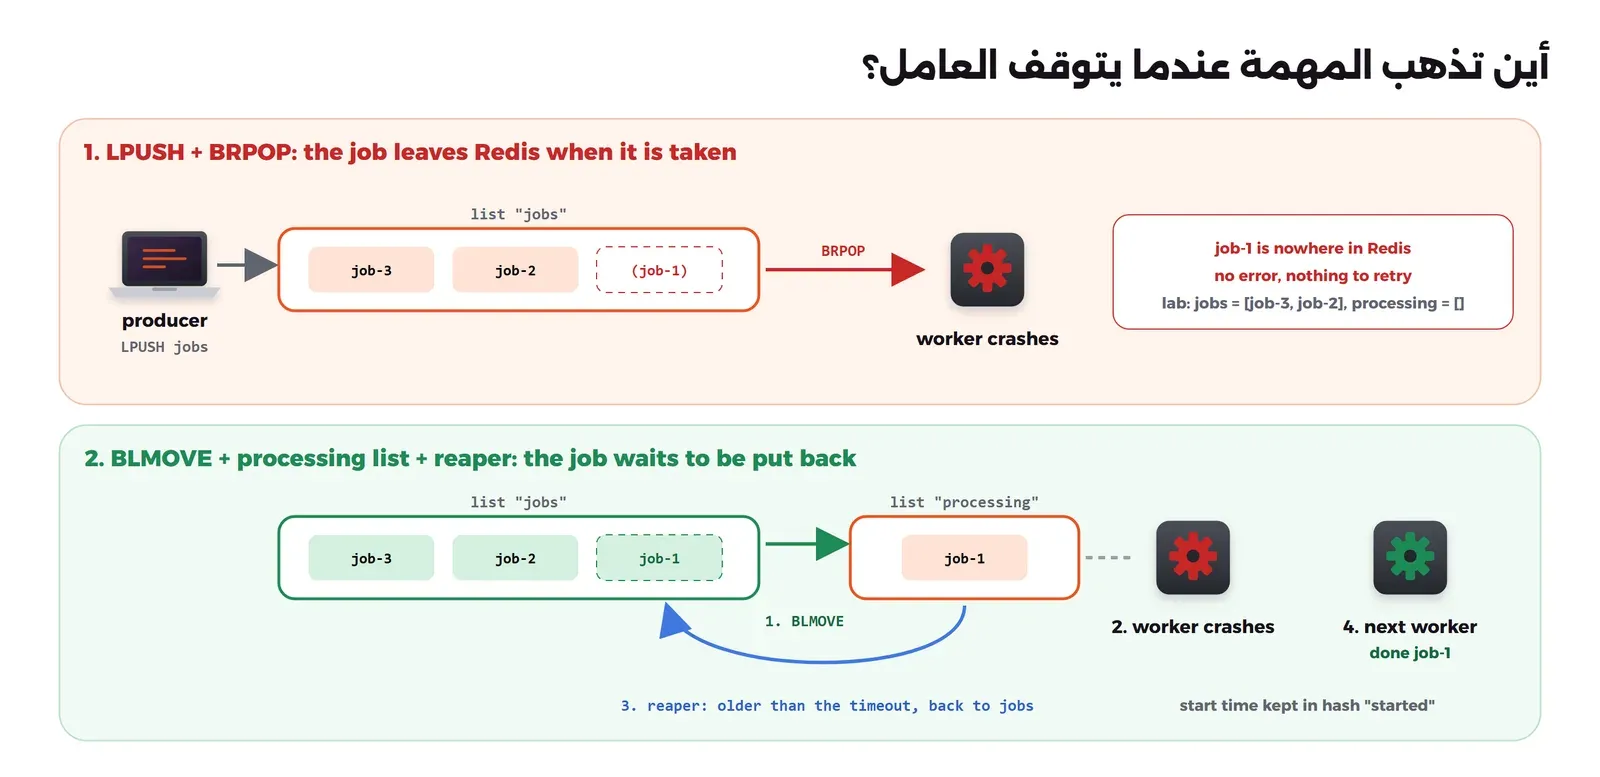
لكن قائمة المهام الجارية وحدها لا تكفي، فمن الذي يعيد المهمة إذا توقف العامل؟ يجب أن تكتب أنت مهمة دورية Reaper تمر على القائمة وتعيد كل مهمة مضى عليها وقت أطول من أطول مهمة طبيعية، وهنا تظهر نقطتان يجب أن تنتبه لهما:
- القائمة لا تحفظ وقت البدء، لذلك تحفظه أنت في مفتاح آخر، وبين
BLMOVEوحفظ الوقت لحظة صغيرة قد يتوقف فيها العامل، فاجعل ال Reaper يعيد كل مهمة لا يجد لها وقتاً، كما في التجربة. - إذا كان العامل بطيئاً وليس متوقفاً، فسوف يعيد ال Reaper مهمته ويأخذها عامل آخر، فتنفذ مرتين. لذلك اجعل المهلة أطول بوضوح من أطول مهمة، واجعل تنفيذ المهمة آمناً عند التكرار كما شرحنا في مقال Idempotency.
الطابور فوق التدفق Stream مع مجموعة مستهلكين
التدفق Stream في Redis سجل تضاف إليه الرسائل بالأمر XADD، ولكل رسالة معرف ID بالوقت، والفرق الكبير عن القائمة أن القراءة عبر مجموعة مستهلكين Consumer Group تعطيك ما بنيته بنفسك في القائمة، لكن داخل Redis:
- التوزيع: كل عامل يقرأ بالأمر
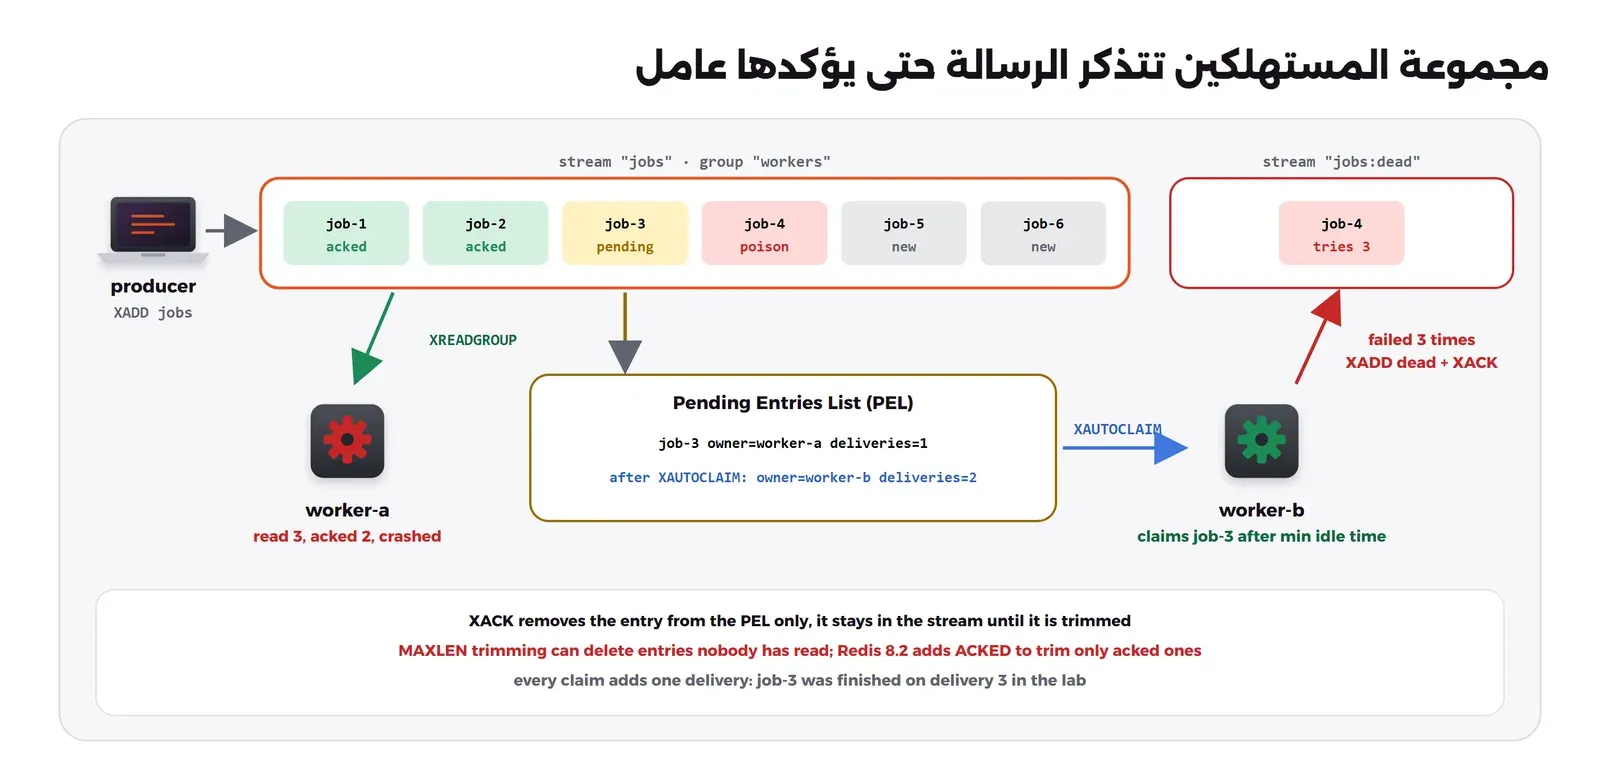
XREADGROUPباسمه، فيأخذ رسائل لم تأخذها العمال الأخرى في المجموعة نفسها. - قائمة الرسائل المعلقة Pending Entries List: واختصاراً PEL، فكل رسالة سلمت ولم تؤكد تبقى فيها مع اسم العامل الذي أخذها ووقت التسليم وعدد مرات التسليم، والأمر
XPENDINGيعرضها. - التأكيد: الأمر
XACKيخرج الرسالة من ال PEL بعد أن ينتهي العامل، ولاحظ أنه لا يحذفها من التدفق نفسه. - الاستلام من عامل متوقف: الأمر
XAUTOCLAIMالمتاح منذ Redis 6.2 ينقل إلى عامل آخر الرسائل التي بقيت معلقة أطول من مدة تحددها، ويزيد عداد التسليم، فتعرف منه الرسالة التي تفشل كل مرة Poison Message.
والصورة التالية تبين مسار الرسالة في المجموعة:
لكن التدفق لا يعطيك كل شيء، فلا يوجد فيه Dead Letter Queue جاهز، ولا إعادة محاولة بعد تأخير، ولا مهلة تعيد الرسالة وحدها، فكل ذلك تكتبه في العامل: تسأل عن الرسائل المعلقة بانتظام، وتقرأ عداد التسليم، وتنقل الرسالة التي تجاوزت حداً إلى تدفق آخر. وهذا بالضبط ما يفعله streams.py في التجربة.
أين تضيع المهام في Redis؟
حتى مع BLMOVE أو مجموعات المستهلكين، هناك أربعة أماكن تضيع فيها المهام بسبب طبيعة Redis نفسه، وكل منها سوف نراه في التجربة:
- القص Trimming: التدفق يكبر في الذاكرة، فيستخدم الناس
XADD ... MAXLENليبقى صغيراً، والقص التقليدي يحذف أقدم الرسائل سواء قرئت أم لا، فإذا توقف العمال ساعة وجاءت رسائل كثيرة حذفت مهام لم يرها أحد. وأضاف Redis 8.2 الخيارACKEDالذي يقص فقط ما أكدته كل المجموعات، بحسب توثيق XADD. - امتلاء الذاكرة: إذا كانت سياسة الإخراج
allkeys-lruوهي الشائعة لل Cache، فإن Redis يحذف مفاتيح كاملة عند الامتلاء، والطابور مفتاح واحد، فقد يختفي بكل مهامه دفعة واحدة. لذلك يقول دليل الإنتاج في BullMQ إنnoevictionهو الإعداد الوحيد الذي يضمن عمل الطوابير بشكل صحيح. - الحفظ على القرص: الإعداد الافتراضي يحفظ لقطة RDB كل فترة، فكل ما أضيف بعد آخر لقطة يضيع إذا توقف السيرفر فجأة، و AOF مع
everysecيقلل ذلك إلى ثانية تقريباً، وقد شرحنا الفرق في قسم الحفظ على القرص. - النسخ غير المتزامن: بحسب توثيق النسخ يستخدم Redis النسخ غير المتزامن افتراضياً، فالسيرفر الرئيسي يؤكد الكتابة قبل أن تصل إلى النسخة، وإذا سقط وأصبحت النسخة رئيسية Failover ضاعت آخر المهام التي أكدها. والأمر
WAITيقلل ذلك لكنه لا يجعل Redis نظاماً بضمانات قوية.
المكتبات الجاهزة فوق Redis
في أغلب المشاريع لن تكتب الطابور بنفسك، وإنما تستخدم مكتبة للغتك، وما سبق يساعدك أن تفهم ما تفعله المكتبة وما لا تفعله:
| المكتبة | اللغة والرخصة | كيف تتعامل مع العامل المتوقف |
|---|---|---|
| BullMQ | لغة Node.js، برخصة MIT | بحسب توثيق المهام المتوقفة يضع العامل قفلاً على المهمة ويجدده بانتظام، فإذا لم يجدده تعتبر المهمة متوقفة Stalled وتعاد إلى الانتظار، أو تفشل بعد عدد أقصى من التوقفات |
| Celery | لغة Python، برخصة BSD | مع Redis وسيطاً تعاد المهمة إذا لم تؤكد خلال مهلة الرؤية Visibility Timeout، وهي ساعة افتراضياً بحسب توثيق Celery مع Redis، والتوثيق نفسه يحذر من أن المهام المؤجلة ETA الأطول من هذه المهلة تنفذ مرة بعد مرة |
| Sidekiq | لغة Ruby، برخصة LGPLv3 للنسخة المفتوحة | النسخة المفتوحة تأخذ بالأمر BRPOP فتضيع المهمة الجارية إذا توقف، والاستعادة في النسخة التجارية Pro |
| RQ | لغة Python، برخصة BSD | مكتبة بسيطة تسجل المهام الجارية في سجلات Registries، وتنظف المهام التي انتهت مهلتها |
والإصدارات الأحدث في أكتوبر 2026 بحسب مستودعاتها: BullMQ 6.3.13، وCelery 5.6.3، وSidekiq 8.1.7، وRQ 2.12. ولاحظ أن كل المكتبات تعتمد على أن Redis نفسه لا يحذف مفاتيحها، فإعداد الذاكرة والحفظ مسؤوليتك أنت وليس مسؤولية المكتبة.
تجربة عملية: كل حالة فشل على Redis وValkey
سوف نشغل Redis 8.10.2 وValkey 9.1.2 جنباً إلى جنب بنفس الإعداد: حد ذاكرة 64 ميجابايت، والسياسة noeviction، وAOF مع everysec، ومعهما Container فيه Python 3.13.16 ومكتبة redis-py 6.4.0 لتشغيل السكربتات على الاثنين، على Docker Engine 29.8.0.
ملفات التجربة
أنشئ مجلداً فيه الملف compose.yaml:
name: lab-q2-redisq

services:
  redis:
    image: redis:8.10.2
    container_name: lab-q2-redis
    command: ["redis-server", "--maxmemory", "64mb", "--maxmemory-policy", "noeviction", "--appendonly", "yes", "--appendfsync", "everysec"]
    volumes: ["redis:/data"]

  valkey:
    image: valkey/valkey:9.1.2
    container_name: lab-q2-valkey
    command: ["valkey-server", "--maxmemory", "64mb", "--maxmemory-policy", "noeviction", "--appendonly", "yes", "--appendfsync", "everysec"]
    volumes: ["valkey:/data"]

  app:
    build: .
    image: lab-q2-rq-app:1
    container_name: lab-q2-rq-app
    command: ["sleep", "infinity"]
    volumes: ["./:/lab:ro"]

volumes:
  redis:
valkey:وDockerfile:
FROM python:3.13.16-slim
RUN pip install --no-cache-dir redis==6.4.0
WORKDIR /lab
ENV PYTHONUNBUFFERED=1
ثم أربعة سكربتات، وكل منها يأخذ اسم السيرفر redis أو valkey أولاً:
lists.py: الطابور فوق القائمة، مع BRPOP وBLMOVE وال Reaper
# A job queue on a Redis/Valkey list (ArabRoot lab).  python lists.py <host> <command> [args]
#   push N | brpop-crash | blmove-crash | work | reaper SECONDS | state
import os, sys, time, redis

r = redis.Redis(host=sys.argv[1], decode_responses=True)
cmd, args = sys.argv[2], sys.argv[3:]

if cmd == 'push':
    r.delete('jobs', 'processing', 'started')
    for i in range(1, int(args[0]) + 1):
        r.lpush('jobs', f'job-{i}')
    print('queued:', r.llen('jobs'))

elif cmd == 'brpop-crash':                     # take a job the simple way, then die before finishing it
    _, job = r.brpop('jobs')
    print('worker took', job, 'and crashed'); os._exit(1)

elif cmd == 'blmove-crash':                    # take a job and keep a copy in "processing" in the same step
    job = r.blmove('jobs', 'processing', 0, 'RIGHT', 'LEFT')
    r.hset('started', job, int(time.time()))
    print('worker took', job, 'into processing and crashed'); os._exit(1)

elif cmd == 'work':                            # the reliable loop: move, do the work, then remove from processing
    while (job := r.blmove('jobs', 'processing', 1, 'RIGHT', 'LEFT')):
        r.hset('started', job, int(time.time()))
        # ... the real work happens here ...
        with r.pipeline() as p:
            p.lrem('processing', 1, job).hdel('started', job).execute()
        print('done', job)

elif cmd == 'reaper':                          # put back jobs that stayed in processing too long
    limit = int(args[0]); now = int(time.time())
    for job in r.lrange('processing', 0, -1):
        age = now - int(r.hget('started', job) or 0)
        if age >= limit:
            with r.pipeline() as p:            # MULTI/EXEC: remove and requeue together
                p.lrem('processing', 1, job).rpush('jobs', job).hdel('started', job).execute()
            print(f'reaper: {job} was in processing for {age}s, back to the queue')

elif cmd == 'state':
print('jobs:', r.lrange('jobs', 0, -1), '| processing:', r.lrange('processing', 0, -1))streams.py: الطابور فوق التدفق مع مجموعة مستهلكين
# A job queue on a Redis/Valkey stream with a consumer group (ArabRoot lab).
#   python streams.py <host> setup | push N [MAXLEN] | push-acked N MAXLEN | crash NAME COUNT | pending | claim NAME IDLE_MS | work NAME
import os, sys, time, redis

r = redis.Redis(host=sys.argv[1], decode_responses=True)
cmd, args = sys.argv[2], sys.argv[3:]
S, G, DEAD, MAX_TRIES = 'jobs', 'workers', 'jobs:dead', 3

if cmd == 'setup':
    r.delete(S, DEAD)
    r.xgroup_create(S, G, id='$', mkstream=True)
    print('group', G, 'created on', S)

elif cmd == 'push':
    n, maxlen = int(args[0]), (int(args[1]) if len(args) > 1 else None)
    for i in range(1, n + 1):
        body = 'poison' if i == 4 else 'ok'                    # job 4 always fails
        r.xadd(S, {'job': f'job-{i}', 'body': body}, maxlen=maxlen, approximate=False)
    print('XLEN', r.xlen(S))

elif cmd == 'push-acked':                                      # Redis 8.2+: trim only entries every group has acked
    for i in range(1, int(args[0]) + 1):
        r.execute_command('XADD', S, 'MAXLEN', '=', args[1], 'ACKED', '*', 'job', f'job-{i}', 'body', 'ok')
    print('XLEN', r.xlen(S))

elif cmd == 'crash':                                           # read COUNT jobs, ack all but the last, then die
    name, count = args[0], int(args[1])
    msgs = r.xreadgroup(G, name, {S: '>'}, count=count)[0][1]
    for mid, f in msgs[:-1]:
        r.xack(S, G, mid)
    print(f'{name} read {[f["job"] for _, f in msgs]}, acked all but {msgs[-1][1]["job"]}, then crashed'); os._exit(1)

elif cmd == 'pending':
    s = r.xpending(S, G)
    print('pending:', s['pending'], 'consumers:', s['consumers'])
    for p in r.xpending_range(S, G, '-', '+', 10):
        print(f'  {p["message_id"]} owner={p["consumer"]} idle={p["time_since_delivered"]}ms deliveries={p["times_delivered"]}')

elif cmd == 'claim':
    name, idle = args[0], int(args[1])
    nxt, claimed, deleted = r.xautoclaim(S, G, name, min_idle_time=idle, start_id='0-0', count=100)
    print(f'{name} claimed {[f["job"] for _, f in claimed if f]} deleted_ids={deleted}')

elif cmd == 'work':                                            # claim stale jobs first, then read new ones
    name = args[0]
    while True:
        _, claimed, _ = r.xautoclaim(S, G, name, min_idle_time=1000, start_id='0-0', count=10)
        msgs = claimed or (r.xreadgroup(G, name, {S: '>'}, count=10, block=2000) or [[None, []]])[0][1]
        if not msgs:
            break
        for mid, f in msgs:
            tries = r.xpending_range(S, G, mid, mid, 1)[0]['times_delivered']
            if f['body'] == 'poison':
                if tries >= MAX_TRIES:
                    with r.pipeline() as p:                    # park it and ack it together
                        p.xadd(DEAD, {**f, 'tries': tries, 'from': mid}).xack(S, G, mid).execute()
                    print(f'{name}: {f["job"]} failed {tries} times, moved to {DEAD}')
                else:
                    print(f'{name}: {f["job"]} failed (delivery {tries}), left pending for a retry')
                continue
            r.xack(S, G, mid)
            print(f'{name}: done {f["job"]} (delivery {tries})')
        time.sleep(1.1)
print('pending left:', r.xpending(S, G)['pending'], '| dead:', r.xlen(DEAD))memory.py: المهام عندما تمتلئ الذاكرة
# What happens to queued jobs when memory fills up (ArabRoot lab).  python memory.py <host> <policy>
import sys, redis
r = redis.Redis(host=sys.argv[1], decode_responses=True)
policy = sys.argv[2]
r.flushall()
r.config_set('maxmemory', '16mb'); r.config_set('maxmemory-policy', policy)
before = int(r.info('stats')['evicted_keys'])
for i in range(2000):                                   # 2000 jobs waiting in a list and in a stream
    r.rpush('jobs:list', f'job-{i}')
    r.xadd('jobs:stream', {'job': f'job-{i}'})
errors, written = None, 0
for i in range(40000):                                  # then the app uses the same server as a cache: 40 MB of 1 KB keys
    try:
        r.set(f'cache:{i}', 'x' * 1024, ex=3600); written += 1
    except redis.ResponseError as e:
        errors = str(e); break
info = r.info()
print(f'{policy}: cache keys written={written} evicted={int(info["evicted_keys"]) - before} used={info["used_memory_human"]}')
print(f'  jobs:list length={r.llen("jobs:list")}  jobs:stream length={r.xlen("jobs:stream")}')
if errors:
print(' error:', errors)persist.py: المهام بعد توقف السيرفر فجأة
# Push jobs, then the caller kills the server with SIGKILL and counts again (ArabRoot lab).
#   python persist.py <host> push N | count
import sys, redis
r = redis.Redis(host=sys.argv[1], decode_responses=True)
if sys.argv[2] == 'push':
    r.delete('jobs')
    with r.pipeline(transaction=False) as p:
        for i in range(int(sys.argv[3])): p.rpush('jobs', f'job-{i}')
        p.execute()
    print('appendonly =', r.config_get('appendonly')['appendonly'], '| save =', r.config_get('save')['save'], '| queued:', r.llen('jobs'))
else:
    print('after restart, jobs:', r.llen('jobs'))
والتشغيل:
docker compose up -d --build
X="docker exec lab-q2-rq-app python"
العامل يتوقف بعد BRPOP
نضع ثلاث مهام، ثم يأخذ عامل واحدة بالأمر BRPOP ويتوقف قبل أن ينتهي:
$X lists.py redis push 3
$X lists.py redis brpop-crash
$X lists.py redis state
والمخرج سوف يكون كما يلي، وهو نفسه على Valkey:
queued: 3
worker took job-1 and crashed
jobs: ['job-3', 'job-2'] | processing: []
لاحظ أن job-1 لم يعد له أي أثر في Redis، فلا يوجد شيء يعيده ولا شيء يخبرك أنه ضاع، والعميل الذي ينتظر بريد التفعيل لن يصله شيء.
مع BLMOVE والمهمة الدورية Reaper
نكرر التجربة، لكن العامل هذه المرة ينقل المهمة إلى processing بالأمر BLMOVE، ثم ننتظر ثلاث ثوان ونشغل ال Reaper بمهلة ثانيتين، ثم عاملاً طبيعياً:
$X lists.py redis push 3
$X lists.py redis blmove-crash
$X lists.py redis state
sleep 3
$X lists.py redis reaper 2
$X lists.py redis state
$X lists.py redis work
والمخرج سوف يكون كما يلي:
queued: 3
worker took job-1 into processing and crashed
jobs: ['job-3', 'job-2'] | processing: ['job-1']
reaper: job-1 was in processing for 5s, back to the queue
jobs: ['job-3', 'job-2', 'job-1'] | processing: []
done job-1
done job-2
done job-3
في المخرج أعلاه لاحظ التالي:
- بعد توقف العامل بقيت
job-1فيprocessing، فلم تضع. - ال Reaper أعادها إلى آخر القائمة من الجهة التي يأخذ منها العمال، فنفذت أولاً، لأنها كانت أول مهمة وصلت.
- لاحظ أن مهلة الثانيتين هنا للتجربة فقط، ولو كانت مهمة حقيقية تأخذ عشر ثوان لأعادها ال Reaper وهي تعمل، ونفذت مرتين.
التدفق: عامل يتوقف، وآخر يستلم، ورسالة تفشل دائماً
ننشئ المجموعة workers، ونضيف ست مهام (الرابعة منها تفشل دائماً)، ثم يقرأ worker-a ثلاثاً ويؤكد اثنتين ويتوقف، ثم يحاول worker-b الاستلام مرتين، مرة بمهلة دقيقة ومرة بمهلة ثانية:
$X streams.py redis setup
$X streams.py redis push 6
$X streams.py redis crash worker-a 3
$X streams.py redis pending
$X streams.py redis claim worker-b 60000
sleep 2
$X streams.py redis claim worker-b 1000
$X streams.py redis pending
$X streams.py redis work worker-b
والمخرج سوف يكون كما يلي:
group workers created on jobs
XLEN 6
worker-a read ['job-1', 'job-2', 'job-3'], acked all but job-3, then crashed
pending: 1 consumers: [{'name': 'worker-a', 'pending': 1}]
  1791818294638-0 owner=worker-a idle=520ms deliveries=1
worker-b claimed [] deleted_ids=[]
worker-b claimed ['job-3'] deleted_ids=[]
pending: 1 consumers: [{'name': 'worker-b', 'pending': 1}]
  1791818294638-0 owner=worker-b idle=710ms deliveries=2
worker-b: done job-3 (delivery 3)
worker-b: job-4 failed (delivery 1), left pending for a retry
worker-b: done job-5 (delivery 1)
worker-b: done job-6 (delivery 1)
worker-b: job-4 failed (delivery 2), left pending for a retry
worker-b: job-4 failed 3 times, moved to jobs:dead
pending left: 0 | dead: 1
في المخرج أعلاه لاحظ التالي:
- بعد توقف
worker-aبقيتjob-3في ال PEL باسمه، وهذا ما لا تعطيه القائمة دون كود إضافي. - محاولة الاستلام الأولى بمهلة دقيقة لم تأخذ شيئاً، لأن الرسالة لم تبق معلقة دقيقة بعد، وهذه المهلة هي ما يحمي العامل البطيء من أن تؤخذ رسالته وهو يعمل عليها.
job-3نفذت في التسليم الثالث، لأننا استلمناها يدوياً مرة، ثم استلمتها حلقة العامل مرة أخرى بعد أن بقيت معلقة أكثر من ثانية. أي أن كل استلام يزيد العداد، والرسالة نفسها قد تصل إلى عاملين، فاجعل المهمة آمنة عند التكرار.job-4فشلت ثلاث مرات فنقلها العامل إلىjobs:deadوأكدها في معاملة واحدة، وهذا هو ال Dead Letter Queue الذي تبنيه بنفسك في Redis.
والنتيجة على Valkey 9.1.2 كانت نفسها سطراً بسطر، عدا معرفات الرسائل والأزمنة.
نكسرها: القص يحذف مهام لم يقرأها أحد
الآن نعيد البداية نفسها، ثم يضيف المنتج ألف مهمة مع MAXLEN يساوي 100 بينما العمال متوقفون:
for h in redis valkey; do
  $X streams.py $h setup; $X streams.py $h push 6; $X streams.py $h crash worker-a 3
  $X streams.py $h push 1000 100
  docker exec lab-q2-$h ${h}-cli XINFO GROUPS jobs
  sleep 2; $X streams.py $h claim worker-b 1000
done
والمخرج بعد حذف أسطر البداية المكررة وضم أسطر XINFO في سطر واحد سوف يكون كما يلي، الأول من Redis والثاني من Valkey:
XLEN 100
name workers consumers 1 pending 1 last-delivered-id 1791818336480-2 entries-read 3 lag 100
worker-b claimed [] deleted_ids=['1791818336480-2']

XLEN 100
name workers consumers 1 pending 1 last-delivered-id 1791818343259-0 entries-read 3 lag 1003
worker-b claimed [] deleted_ids=['1791818343259-0']
في المخرج أعلاه لاحظ التالي:
- بقيت 100 رسالة فقط من 1006، أي أن 903 مهمة حذفت قبل أن يقرأها أي عامل، دون أي خطأ عند المنتج.
- الرسالة المعلقة
job-3حذفت من التدفق أيضاً، فلم يجدXAUTOCLAIMشيئاً يستلمه، وأعاد معرفها في قائمة المعرفات المحذوفة، وهو سلوك موثق في توثيق XAUTOCLAIM منذ Redis 7.0، فإذا لم تسجل هذه القائمة في العامل فلن تعرف أن مهمة ضاعت. - عداد التأخر
lagمختلف بين الاثنين: Redis يقول 100، أي ما بقي ليقرأ، وValkey يقول 1003، أي ما أضيف بعد آخر قراءة، فلا تبن تنبيهاً على هذا الرقم قبل أن تختبره على السيرفر الذي تستخدمه.
والحل في Redis 8.2 وما بعده هو الخيار ACKED، فنكرر التجربة بالسكربت push-acked:
for h in redis valkey; do
  $X streams.py $h setup; $X streams.py $h push 6; $X streams.py $h crash worker-a 3
  $X streams.py $h push-acked 1000 100
  sleep 2; $X streams.py $h claim worker-b 1000
done
والمخرج بعد حذف أسطر البداية المكررة سوف يكون كما يلي:
XLEN 1004
worker-b claimed ['job-3'] deleted_ids=[]

redis.exceptions.ResponseError: Invalid stream ID specified as stream command argument
worker-b claimed ['job-3'] deleted_ids=[]
الجزء الأول من Redis والثاني من Valkey. مع ACKED حذف Redis فقط الرسالتين اللتين أكدتهما المجموعة، وبقيت كل المهام الأخرى رغم أن الحد 100، فالحد هنا يصبح هدفاً وليس قاعدة صارمة، فراقب طول التدفق. أما Valkey 9.1.2 فلا يعرف هذا الخيار، وهذا من الفروق التي بدأت تظهر بين المشروعين بعد انفصالهما، وقد ذكرنا غيرها في قسم هل Valkey بديل مباشر؟.
نكسرها: سياسة الإخراج تحذف الطابور كله
الآن نضع ألفي مهمة في قائمة وألفي مهمة في تدفق، ثم يستخدم التطبيق السيرفر نفسه Cache ويكتب 40 ميجابايت في سيرفر حده 16 ميجابايت، بثلاث سياسات:
for h in redis valkey; do for p in noeviction allkeys-lru volatile-lru; do $X memory.py $h $p; done; doneوالمخرج على Redis سوف يكون كما يلي:
noeviction: cache keys written=10824 evicted=0 used=16.00M
  jobs:list length=2000  jobs:stream length=2000
  error: command not allowed when used memory > 'maxmemory'.
allkeys-lru: cache keys written=40000 evicted=29189 used=16.00M
  jobs:list length=0  jobs:stream length=0
volatile-lru: cache keys written=40000 evicted=29233 used=16.00M
  jobs:list length=2000  jobs:stream length=2000
وعلى Valkey كانت النتيجة بنفس الشكل: مع allkeys-lru اختفت كل المهام في القائمة والتدفق، ومع noeviction توقفت الكتابة بعد 11,199 مفتاحاً وبقيت المهام. وفي المخرج أعلاه لاحظ التالي:
- مع
allkeys-lruحذف Redis المفتاحينjobs:listوjobs:streamكاملين بكل ما فيهما من مهام، أي 4000 مهمة، دون أي خطأ عند المنتج أو العامل، والسبب أن الإخراج يحذف مفاتيح كاملة وليس عناصر داخل المفتاح. - مع
noevictionبقيت المهام، لكن كتابة ال Cache فشلت بخطأ، فالتطبيق كله يتأثر عندما يمتلئ السيرفر. - مع
volatile-lruحذف Redis مفاتيح ال Cache فقط لأن لها TTL، وبقيت المهام لأنها بلا TTL، وهذا ينجح فقط إذا كان كل مفتاح Cache له TTL دائماً.
والقاعدة العملية: لا تضع الطابور وال Cache في سيرفر واحد بسياسة allkeys-*، والأفضل أن يكون للطابور سيرفر أو قاعدة منفصلة بالسياسة noeviction مع تنبيه على الذاكرة قبل أن تمتلئ.
نكسرها: السيرفر يتوقف فجأة
أخيراً نضيف 5000 مهمة، مرة دون AOF ومرة معه، ثم نوقف السيرفر بالإشارة SIGKILL كأن الكهرباء انقطعت:
for aof in no yes; do
  docker exec lab-q2-redis redis-cli CONFIG SET appendonly $aof
  $X persist.py redis push 5000; sleep 2
  docker kill lab-q2-redis; docker start lab-q2-redis; sleep 3
  $X persist.py redis count
done
والمخرج سوف يكون كما يلي، وهو نفسه على Valkey:
appendonly = no | save = 3600 1 300 100 60 10000 | queued: 5000
after restart, jobs: 0
appendonly = yes | save = 3600 1 300 100 60 10000 | queued: 5000
after restart, jobs: 5000
دون AOF ضاعت المهام الخمسة آلاف كلها، لأن قاعدة اللقطات الافتراضية save لم تصل بعد إلى أي شرط من شروطها (10000 تغيير في 60 ثانية، أو 100 في 300 ثانية، أو تغيير واحد في ساعة). ومع AOF وeverysec بقيت كلها، لأننا انتظرنا ثانيتين قبل الإيقاف، ولو أوقفناه فوراً لضاعت آخر ثانية تقريباً. فإذا كان Redis يحمل مهامك فAOF ليس اختيارياً.
حذف المختبر
docker compose down -v
docker image rm lab-q2-rq-app:1
أخطاء شائعة
- الطابور بالأمر BRPOP لمهام مهمة: المهمة تخرج من Redis لحظة أخذها، فإذا توقف العامل ضاعت دون أثر.
- الطابور وال Cache في سيرفر واحد مع
allkeys-lru: عند الامتلاء يحذف الطابور كله، كما رأيت في التجربة. - القص بالخيار MAXLEN مع عمال متوقفين: يحذف مهاماً لم تقرأ، واستخدم
ACKEDفي Redis 8.2 وما بعده، أو راقب التأخر وكبر الحد. - تجاهل المعرفات المحذوفة في رد XAUTOCLAIM: هي الدليل الوحيد على أن مهمة معلقة ضاعت.
- مهلة استلام أقصر من أطول مهمة: تنفذ المهمة نفسها مرتين على عاملين، وفي Celery تنفذ المهمة المؤجلة مرة بعد مرة إذا تجاوز تأجيلها مهلة الرؤية.
- Redis دون AOF يحمل مهاماً: كل ما بعد آخر لقطة يضيع عند أي توقف مفاجئ.
- الاعتماد على النسخة وقت Failover: النسخ غير متزامن، فآخر المهام قد لا تكون وصلت إليها.
الخلاصة
وصلنا لنهاية الموضوع، وأهم ما فيه:
- طابور فوق Redis أو Valkey مناسب للمهام الخلفية في تطبيق واحد عندما يكون Redis موجوداً أصلاً، وليس للمهام التي لا يجوز أن تضيع أبداً.
- القائمة مع
BRPOPتضيع المهمة إذا توقف العامل، ومعBLMOVEوقائمة للمهام الجارية ومهمة Reaper تبقى، لكنك تكتب الاستعادة بنفسك. - التدفق مع مجموعة مستهلكين يعطيك ال PEL وعداد التسليم و
XAUTOCLAIM، وال Dead Letter Queue وإعادة المحاولة تكتبها في العامل. - في تجربتنا ضاعت المهام في أربع حالات: القص حذف 903 مهمة لم تقرأ، و
allkeys-lruحذف 4000 مهمة دفعة واحدة، والتوقف المفاجئ دون AOF حذف 5000، والعامل المتوقف بعدBRPOPأضاع مهمته. - Redis 8.2 أضاف
ACKEDللقص الآمن، وValkey 9.1.2 لا يدعمه، فاختبر كل أمر على السيرفر الذي تستخدمه. - المكتبات مثل BullMQ وCelery وSidekiq وRQ تحل الاستعادة بطرق مختلفة، لكنها كلها تعتمد على أن Redis نفسه لا يحذف بياناتها.
 دليلRedis وبديله المفتوح Valkey: التخزين المؤقت والجلساتكيف تستخدم Redis للجلسات والعدادات دون أن تمتلئ الذاكرة، وماذا تعني رخصته الجديدة، ومتى يكفيك Valkey بدلاً منه.
 دليلالطابور Queue للمبتدئين: لماذا تحتاجه وكيف يعمللماذا تضع العمل البطيء في طابور بدل أن ينتظره المستخدم، وكيف تضمن ألا تضيع الرسالة إذا توقف ال Worker فجأة.
 دليلRabbitMQ أم Kafka أم NATS؟ كيف تختار وسيط الرسائلكيف تختار بين RabbitMQ وKafka وNATS بحسب نموذج كل منها وضماناته وتكلفة تشغيله، مع قياس على جهاز واحد.
 دليلPostgreSQL لكل شيء: متى يكفيك ومتى تحتاج غيره؟كم عملاً يستطيع PostgreSQL واحد أن يقوم به في شركتك الناشئة قبل أن تحتاج Redis أو Elasticsearch، وما الإشارة التي تقول لك إن الوقت قد حان.
سجل التحديثات
- أكتوبر 2026: كتابة المقال، وتنفيذ التجربة على Redis 8.10.2 وValkey 9.1.2 مع Python 3.13.16 ومكتبة redis-py 6.4.0 في Docker.


